计算机体系结构量化研究(第 7 版)
计算机体系结构量化研究(第 7 版)
Computer Architecture: A Quantitative Approach, Seventh Edition
作者:John L. Hennessy、David A. Patterson、Christos Kozyrakis。
收录正文第 1–7 章及附录 A–K、M。
附录:
1 定量设计与分析基础
一台 iPod,一部电话,一个移动互联网通信设备……这不是三台彼此独立的设备!我们把它叫作 iPhone!今天,Apple 将重新发明手机。它就在这里。
——Steve Jobs,2007 年 1 月 9 日
新的信息通信技术,尤其是高速互联网,正在改变企业的经营方式、变革公共服务的提供方式,并让更多人能够参与创新。高速互联网连接数每增加 10%,经济增长就会提高 1.3%。
——世界银行,2009 年 7 月 28 日
原章 DOI:10.1016/B978-0-443-15406-5.00001-8。原章版权标记:© 2026 Elsevier Inc.,保留所有权利,包括文本与数据挖掘、AI 训练及类似技术的相关权利。
1.1 引言
自第一台通用电子计算机诞生以来,在大约 75 年的时间里,计算机技术取得了令人难以置信的进步。如今,800 美元就能买到一部手机,其性能足以媲美 2000 年耗资逾 1 亿美元购置的世界最快计算机。这种飞速进步既源于制造计算机的技术不断发展,也源于计算机设计上的创新。
从历史上看,技术进步的步伐一直相当稳定,而计算机体系结构改进带来的进步却远没有那么均匀。在电子计算机问世后的最初 25 年里,这两股力量都作出了重要贡献,使性能每年提高约 25%。20 世纪 70 年代末,微处理器开始出现。微处理器能够充分受益于集成电路技术的发展,使性能的年增长率进一步提高到约 35%。
这一增长速度,加上微处理器批量生产带来的成本优势,使计算机产业中采用微处理器的比例不断上升。此外,计算机市场上的两项重大变化,使新的体系结构比以往更容易取得商业成功。第一,汇编语言编程几乎退出了主流,因而对目标代码兼容性的需求随之降低。第二,UNIX 及其仿制系统 Linux 等标准化、不依赖特定厂商的操作系统出现,降低了推出新体系结构的成本和风险。
这些变化使人们得以在 20 世纪 80 年代初成功开发出一批指令更简单的新体系结构,即精简指令集计算机(Reduced Instruction Set Computer,RISC)体系结构。基于 RISC 的计算机将设计者的注意力引向两项关键的性能技术:一是挖掘指令级并行性(instruction-level parallelism,ILP),最初通过流水线,后来通过多指令发射来实现;二是使用缓存,最初采用简单形式,后来逐步采用更精巧的组成方式与优化技术。
RISC 计算机抬高了性能门槛,迫使既有体系结构要么跟上,要么退出。Digital Equipment 的 Vax 未能跟上,最终被 RISC 体系结构取代。Intel 则迎难而上,主要做法是在内部把 80x86 指令转换为类似 RISC 的指令,从而得以采用许多最早由 RISC 设计开创的创新。到 20 世纪 90 年代末,随着晶体管数量激增,转换较为复杂的 80x86 体系结构所需的硬件开销变得微不足道。而在手机等低端应用中,80x86 指令转换在功耗和硅片面积上带来的额外成本,则推动了 RISC 体系结构 ARM 成为主流。
图 1.1 表明,体系结构与组成方面的改进相结合,使性能连续 17 年保持了超过 50% 的年增长率,这在计算机产业中前所未有。
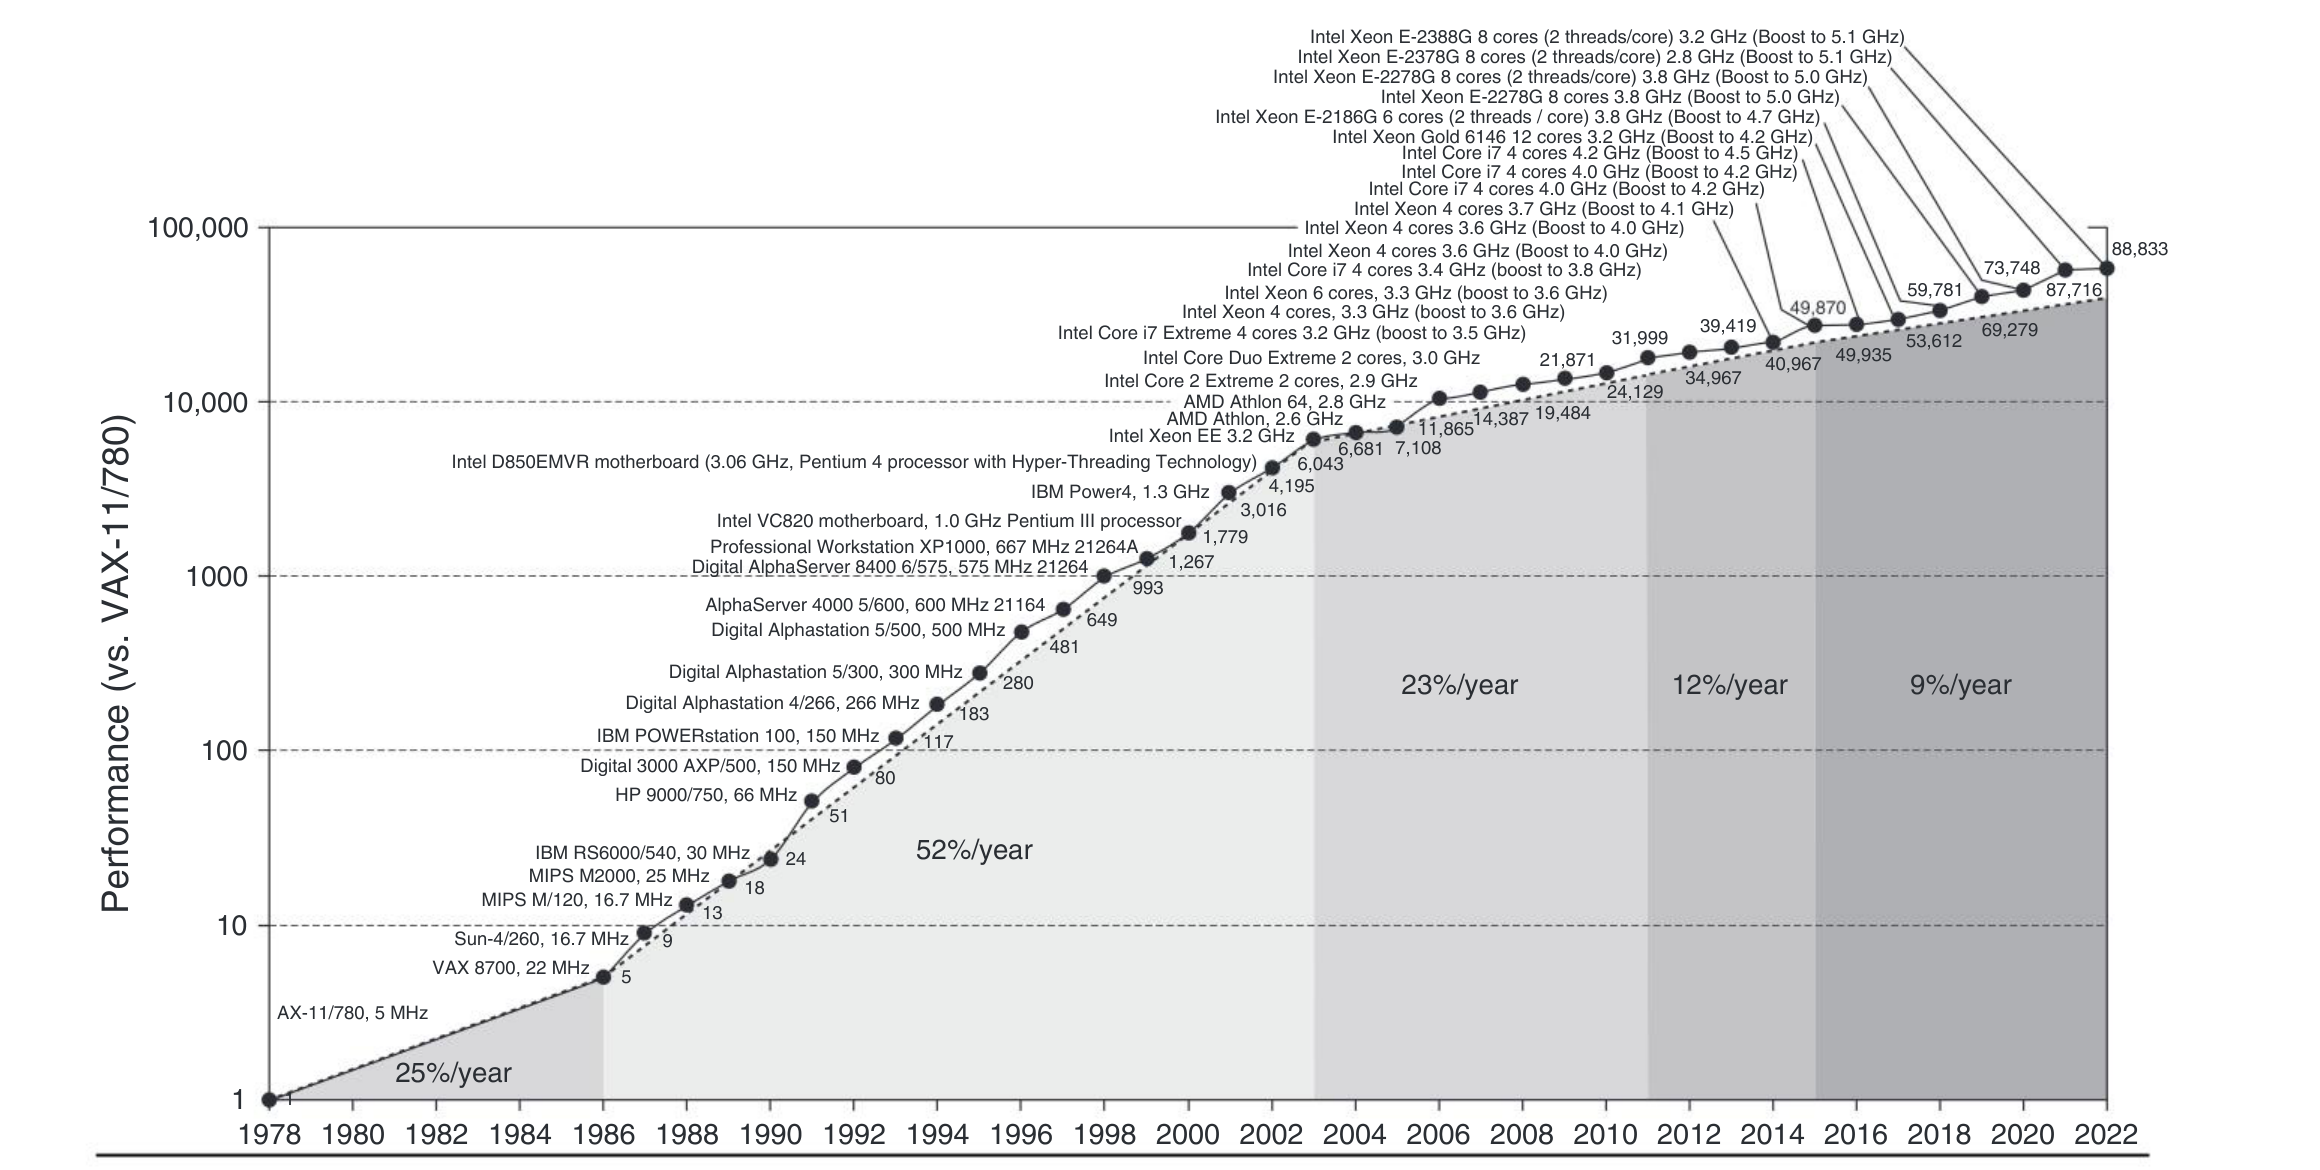
本图以 VAX-11/780 为基准,绘出了由 SPEC 整数基准测试的 base 配置测得的程序性能(原文指向 1.8 节1)。20 世纪 80 年代中期以前,处理器性能的增长主要由技术进步驱动,平均每年约 25%,即每 3.5 年翻一番。从 1986 年开始,年增长率提高到约 52%,即每 2 年翻一番。这既得益于 RISC 体系结构所代表的更先进的体系结构与组成思想,也得益于转向使用微处理器作为 CPU 的基本构件。到 2003 年,这种增长使实际性能达到持续按 25% 年增长率发展时所能达到性能的 25 倍。如果假设半导体技术改进本身每年能带来 35% 的增长,那么实际性能仍是这一水平的 7.5 倍。
2003 年,Dennard 缩放规律失效带来的功耗限制,以及可利用的指令级并行性的限制,使单处理器性能的年增长率降至 23%,并一直持续到 2011 年,相当于每 3.5 年翻一番。这些结果仅涉及单芯片系统,通常每片至多 8 个核心,每个核心支持 1 或 2 个硬件线程。自 2007 年起,最快的 SPECintbase 测试成绩都启用了自动并行化,因此更难据此衡量单处理器的速度。2011–2015 年,年增长率不足 12%,即每 6 年翻一番;部分原因在于 Amdahl 定律对并行加速的限制。2015 年以来,随着 Moore 定律放缓,年增长率降至 9%,即每 8 年翻一番。面向浮点运算的性能也呈现出同样的趋势,但在图中的各个阴影区间,年增长率通常要高出 1–2 个百分点。1989–2017 年间,SPEC 先后发布了六个版本,因此跨时期的性能是通过换算系数估算的;这些系数根据同时具有前后两代 SPEC 评分的计算机计算而得。
图内用语:Performance (vs. VAX-11/780) 为“相对于 VAX-11/780 的性能”,year 为“年”,cores 为“核心”,threads/core 为“每核心线程数”,Boost to 为“最高加速频率”。处理器型号与频率保留原文。
20 世纪这种惊人的增长速度带来了四方面影响。首先,它显著提升了计算机用户能够获得的计算能力。对于许多应用,性能最高的微处理器已经超过了不到 20 年前的超级计算机。
其次,性价比的大幅提高催生了新的计算机类别。随着微处理器的普及,个人计算机和工作站在 20 世纪 80 年代出现。过去 15 年又见证了智能手机和平板电脑的兴起,许多人已经用它们代替 PC,作为主要的计算平台。这些移动客户端设备越来越多地通过互联网访问容纳 50,000 台服务器的数据中心,而这些数据中心正被当作一台庞大的计算机来设计。带有无线连接的嵌入式计算机统称为物联网(Internet of Things,IoT)设备,如今每年的出货量已超过 100 亿台,预计还将大幅增长。
第三,Moore 定律所预示的半导体制造工艺进步,使基于微处理器的计算机在整个计算机设计领域占据了主导地位。传统上采用现成逻辑器件或门阵列构建的小型机,被采用微处理器构建的服务器取代。如今,即便是大型机和高性能超级计算机,也都是由微处理器组成的系统。
上述硬件创新带来了一场计算机设计的复兴,既强调体系结构创新,也强调充分利用技术进步。增长不断累积,到 2003 年,高性能微处理器的速度已经是单靠技术进步——包括电路设计的改进——所能达到水平的 7.5 倍;两者的年复合增长率分别为 52% 和 35%。
这场硬件复兴带来的第四项影响落在了软件开发上。自 1978 年以来约 90,000 倍的性能提升(见图 1.1),使现代程序员能够以一部分性能换取开发效率。与 C 和 C++ 这类注重性能的语言相比,如今更多程序采用 Java 这样的托管编程语言编写。此外,开发效率更高的 JavaScript、Python 等脚本语言,以及 AngularJS、Django 等编程框架,也越来越受欢迎。为了保持开发效率,同时尽量缩小性能差距,配备即时编译器和采用基于执行轨迹编译的解释器,正在取代过去传统的编译器与链接器。软件的交付方式也在变化:通过互联网使用的软件即服务(Software as a Service,SaaS),正在取代需要安装并运行在本地计算机上的盒装软件。
应用本身的性质同样在变化。语音、声音、图像和视频日益重要,而可预测的响应时间对用户体验也至关重要。Google Translate 就是一个令人振奋的例子。使用这款应用时,你可以举起手机,把摄像头对准一个物体;图像会通过无线互联网发送到仓库级计算机(warehouse-scale computer,WSC),由后者识别照片中的文字,并将其译成你的母语。你也可以对着它说话,让它用另一种语言输出语音翻译。它支持 133 种语言的文本翻译、37 种语言的照片翻译,以及对话模式下 32 种语言的语音翻译。
遗憾的是,图 1.1 同样表明,通用处理器快速提升的这场历时 17 年的硬件复兴已经结束。根本原因在于,半导体工艺中延续了数十年的两个特征,如今都不再成立。
1974 年,Robert Dennard 注意到,即使随着晶体管尺寸缩小而增加晶体管数量,给定面积硅片上的功率密度仍可保持不变。更令人惊叹的是,晶体管能够在运行得更快的同时消耗更少的功率。这种 Dennard 缩放规律在 2004 年前后失效了,因为电流与电压已经无法在保持集成电路可信赖性的同时继续下降。
这一变化迫使微处理器产业采用多个高效处理器或核心,来代替单个效率较低的处理器。事实上,Intel 在 2004 年取消了高性能单处理器项目,转而与其他厂商一道宣布,今后提升性能的途径是让每个芯片包含多个处理器,而不是一味加快单个处理器。这一里程碑标志着历史性的转变:从单纯依靠本书前三版重点讨论的 ILP,转向第四版着重介绍、第五版进一步扩充的数据级并行性(data-level parallelism,DLP)和线程级并行性(thread-level parallelism,TLP)。第五版还加入了 WSC 和请求级并行性(request-level parallelism,RLP),本版又扩展了这部分内容。编译器与硬件能够相互配合,在程序员不必关注的情况下隐式挖掘 ILP;相比之下,DLP、TLP 和 RLP 都是显式并行,需要重构应用,才能利用这种并行性。有时这很容易,但在许多情况下,它给程序员带来了重大的新负担。
Amdahl 定律(1.10 节)规定了每个芯片上能够有效利用的核心数量的实际上限。如果一项任务有 10% 必须串行执行,那么无论在芯片上放置多少核心,并行带来的最大加速比都只有 10。
最近发生变化的第二项观察是 Moore 定律。1965 年,Gordon Moore 作出了著名的预测:每个芯片上的晶体管数量每年翻一番;1975 年,他将这一周期修正为每 2 年。这个预测成立了约 50 年,如今却不再适用。例如,在本书 2010 年的版本中,Intel 最新的微处理器含有 1,170,000,000 个晶体管。如果 Moore 定律继续成立,那么我们本可预期 2022 年的微处理器含有 105,900,000,000 个晶体管。然而,Apple M2 微处理器只有 20,000,000,000 个晶体管,与 Moore 定律的预测相差约 5 倍。2
以下因素共同作用:
- Moore 定律放缓,Dennard 缩放规律失效,晶体管自身的改进幅度不再显著;
- 微处理器的功耗预算没有增加;
- 单个高功耗处理器被多个节能处理器取代;
- Amdahl 定律限制了多处理器能够带来的加速。
这些因素使处理器性能的提高速度放缓:如今每 8 年才翻一番,不再像 1986–2003 年那样每 1.5 年翻一番(见图 1.1)。3
要显著改善能耗、性能和成本这三者的综合表现,剩下的唯一途径就是专用化。未来的微处理器将包含若干领域专用核心,每种核心只擅长某一类计算,但在这类计算上的表现会远胜于通用核心。第 7 章介绍领域专用体系结构。2023 年 ChatGPT 的发布,极大地加速了专门面向 AI 领域的加速器部署,覆盖了从 IoT 设备到 WSC 的各类系统。
本书关注同步数字计算机,过去 75 年来,正是它们推动了计算机产业的发展。随着改进速度开始放缓,一些研究者正在探索尚未产生显著商业影响的替代方案,例如模拟计算、生物计算、量子计算、神经形态计算以及异步计算。由于这些不同设计何时能够、乃至究竟能否在经济上变得可行,仍不明确,我们的主题依然是同步数字硬件。
本书讨论过去一个世纪里促成惊人增长速度的体系结构思想及相应的编译器改进,也讨论这一局面发生剧变的原因,以及面向 21 世纪的体系结构、编译器和解释器所面临的挑战与初见前景的探索。贯穿全书的核心,是计算机设计与分析的定量方法:以对程序的实证观察、实验和仿真作为工具。本书体现的正是这种计算机设计风格与方法。本章的任务,是为后续章节和附录奠定定量分析的基础。
我们撰写本书,不仅是为了说明这种设计方法,也希望激励你为这一进步作出贡献。我们相信,正如这种方法过去适用于隐式并行的计算机,它也将适用于未来的计算机。
1.2 计算机的类别
上述变化为新世纪的一场重大转变奠定了基础:我们看待计算、计算应用以及计算机市场的方式都在改变。自个人计算机诞生以来,计算机的形态与使用方式还从未发生过如此显著的变化。使用方式的变化形成了五种差异很大的计算市场,每一种都有各自的应用、需求和计算技术。图 1.2 概括了这些主流计算环境及其重要特征。
| 特征 | 物联网/嵌入式计算机 | 个人移动设备(PMD) | 桌面计算机 | 服务器 | 集群/仓库级计算机 |
|---|---|---|---|---|---|
| 系统价格 | 10–100,000 美元 | 100–1,000 美元 | 300–2,500 美元 | 5,000–10,000,000 美元 | 100,000–200,000,000 美元 |
| 微处理器价格 | 0.01–100 美元 | 10–100 美元 | 50–500 美元 | 200–2,000 美元 | 50–250 美元 |
| 系统设计的关键问题 | 价格、能耗、特定应用的性能 | 价格、能耗、媒体处理性能、响应能力 | 性价比、能耗、图形性能 | 吞吐量、可用性、可扩展性、能耗 | 性价比、吞吐量、功耗随负载成比例变化的能力(energy proportionality) |
2021 年的销售量约为:20 亿台 PMD(其中 90% 为手机)、3.57 亿台 PC(其中 80% 为笔记本电脑)以及 1,300 万台服务器。嵌入式处理器的总销量约为 300 亿颗。2021 年,基于 ARM 技术的芯片出货量合计为 230 亿颗。请注意,服务器和嵌入式系统的价格跨度都很大,嵌入式设备可以从 U 盘一直到网络路由器。服务器价格跨度大的原因,是高端事务处理需要超大规模的多处理器系统。
物联网/嵌入式计算机
嵌入式计算机广泛存在于日常设备中:微波炉、洗衣机、大多数打印机、网络交换机,以及所有汽车。物联网(Internet of Things,IoT)指连接到互联网的嵌入式计算机,连接方式通常是无线的。配上传感器和执行器之后,IoT 设备能够收集有用的数据,并与物理世界交互,由此形成各种“智能”应用,例如智能手表、智能恒温器、智能音箱、智能汽车、智能家居、智能电网和智慧城市。
嵌入式计算机的处理能力与成本跨度最大,既包括价格可能低至 1 美分的 8 位至 32 位处理器,也包括用于汽车和网络交换机、价格达到 100 美元的高端 64 位处理器。尽管嵌入式计算市场的计算能力范围极广,价格始终是这一领域计算机设计中的关键因素。当然,性能要求也确实存在,但首要目标往往是以最低价格满足性能需求,而不是以更高价格换取更高性能。对 2025 年 IoT 设备出货量的预测在 300 亿至 400 亿台之间。
本书的大部分内容都适用于嵌入式处理器的设计、使用与性能分析,无论它们是现成的微处理器,还是将与其他专用硬件组合起来的微处理器核心。
遗憾的是,其他类别计算机赖以进行定量设计与评估的数据,向嵌入式计算领域的延伸还处于初期阶段,例如 1.9 节将介绍 EEMBC 所面临的挑战。因此,目前我们在这一领域还只能进行定性描述,这与本书其余部分的风格并不十分契合。为此,嵌入式计算的内容主要集中在附录 E。我们认为,单列附录既能使正文的论述更加连贯,又能让读者了解不同需求如何影响嵌入式计算。
个人移动设备
我们用个人移动设备(personal mobile device,PMD)统称一类带有多媒体用户界面的无线设备,例如智能手机、功能手机、平板电脑、智能手表等。2021 年,PMD 的年收入规模最大,约为 5,000 亿美元。由于整个产品的零售价只有几百美元,成本是首要关注点。重视能效通常是因为设备依靠电池供电;不过,采用更便宜封装的需求——例如用塑料而非陶瓷封装——以及不使用散热风扇,也会限制整机功耗。1.5 节将更详细地讨论能耗与功率。PMD 上的应用通常以 Web 为基础,并以媒体处理为中心,前文提到的 Google Translate 就是一个例子。能耗与尺寸的要求使这些设备采用闪存(Flash memory,见第 2 章),而不是磁盘作为存储介质。
PMD 中的处理器常被视为嵌入式计算机,但我们将 PMD 单列为一类,因为它们是可以运行外部开发软件的平台,并且具有许多桌面计算机的特征。其他嵌入式设备在硬件和软件的复杂程度上都更受限制。我们以能否运行第三方软件,作为非嵌入式计算机与嵌入式计算机之间的分界。
响应能力与可预测性是媒体应用的关键特征。实时性能要求意味着,应用的某个部分具有不可超越的最长执行时间。例如,在 PMD 上播放视频时,每一帧的处理时间是有限的,因为处理器很快就必须接收并处理下一帧。某些应用的要求更为细致:不仅限制某项任务的平均执行时间,也限制超过某个最长时间阈值的次数。这类要求有时称为软实时(soft real-time),允许偶尔错过某个事件的时限,只要错过的次数不要太多。实时性能的要求往往高度依赖具体应用。
许多 PMD 应用的另一些关键需求,是尽量减少存储器容量,以及高效利用能量。电池供电和散热共同推动了能效要求。存储器可能占系统成本的相当大一部分,因此在这类系统中,优化存储器容量十分重要。数据规模由应用本身决定,所以对存储器容量的重视,进一步转化为对代码体积的重视。
桌面计算
2021 年,按销售额衡量,桌面计算市场的规模约为智能手机市场的一半。桌面计算覆盖了从售价不足 300 美元的低端上网本,到售价可能达到 2,500 美元、配置丰富的高端工作站。自 2008 年起,每年生产的桌面类计算机中,一半以上都是使用电池的笔记本电脑。2021 年,笔记本电脑占桌面类计算机销量的四分之三。
在如此广泛的价格与能力范围内,桌面市场通常以优化性价比为目标。性能——主要指计算性能和图形性能——与系统价格的结合,是这一市场的客户最在意的因素,因此也是设计者最在意的因素。正因为如此,最新、性能最高的微处理器,以及经过成本优化的微处理器,往往最先出现在桌面系统中。影响计算机成本的因素将在 1.6 节讨论。
桌面计算的应用类型与基准测试通常也相对明确,不过,以 Web 为中心的交互式应用日益普及,正在给性能评估带来新的挑战。
服务器
20 世纪 80 年代,随着计算转向桌面,服务器的作用不断扩大,为用户提供规模更大、更可靠的文件与计算服务。这类服务器如今已经取代传统大型机,成为大规模企业计算的支柱。
对于服务器,重要的特征有所不同。首先,可用性至关重要,1.7 节将对此展开讨论。想一想为银行自动取款机或航空订票系统提供服务的服务器:这些服务器必须每周 7 天、每天 24 小时运行,这些服务器系统的失效远比一台桌面计算机的失效严重。图 1.3 估算了服务器应用因停机造成的收入损失。
第二个关键特征是可扩展性。随着服务需求增加,或功能要求扩大,服务器系统往往需要随之增长。因此,能够扩展服务器的计算能力、内存、存储容量和 I/O 带宽至关重要。
第三,服务器的成本目标是总拥有成本(total cost of ownership,TCO),而不只是购置价格。TCO 等于购置价格加上计算机整个使用期内的运行成本,后者包括电力、冷却、维护和占地空间的成本。关注 TCO 的原因包括:
- 服务器的使用寿命比桌面计算机长得多,通常为 5–8 年;
- 服务器消耗的电力远多于 PC;
- 服务器处理器的购置价格可能只占 TCO 的四分之一。
最后,服务器设计注重高效的吞吐能力。关键在于服务器的整体性能,例如每分钟处理的事务数,或每秒提供的网页数。单个请求的响应速度依然重要,但对于多数服务器,主要衡量指标是由单位时间处理请求的数量决定的整体效率和成本效益。1.9 节将再次讨论如何评估不同计算环境的性能。
| 应用 | 每小时停机成本(美元) | 停机占比 1% 时的年损失(87.6 小时/年,美元) | 停机占比 0.5% 时的年损失(43.8 小时/年,美元) | 停机占比 0.1% 时的年损失(8.8 小时/年,美元) |
|---|---|---|---|---|
| 证券经纪服务 | 4,000,000 | 350,400,000 | 175,200,000 | 35,000,000 |
| 能源 | 1,750,000 | 153,300,000 | 76,700,000 | 15,300,000 |
| 电信 | 1,250,000 | 109,500,000 | 54,800,000 | 11,000,000 |
| 制造业 | 1,000,000 | 87,600,000 | 43,800,000 | 8,800,000 |
| 零售 | 650,000 | 56,900,000 | 28,500,000 | 5,700,000 |
| 医疗保健 | 400,000 | 35,000,000 | 17,500,000 | 3,500,000 |
| 媒体 | 50,000 | 4,400,000 | 2,200,000 | 400,000 |
通过分析停机成本,也就是立即损失的收入,可以估算系统不可用带来的损失,数值按最接近的 100,000 美元取整。这里假设三种不同的可用性水平,并假定停机时间均匀分布。数据引自 Landstrom(2014),由 Contingency Planning Research 收集并分析。
集群/仓库级计算机
搜索、社交网络、视频观看与分享、多人游戏、在线购物等应用中 SaaS 的增长,推动了一类称为集群(cluster)的计算机发展。集群通常由价格较低的服务器通过局域网连接而成,对外作为一台更大的计算机工作。每个节点运行自己的操作系统,节点间通过网络协议通信。WSC 是规模最大的集群,其设计目标是让数万台服务器能够协同成为一个整体。第 6 章将介绍这类规模极大的计算机。
由于规模庞大,性价比与功耗对 WSC 至关重要。如第 6 章所述,数据中心的大部分成本与其中计算机的供电和冷却有关。由于计算机和网络设备通常每隔几年就要更换,一座 WSC 的这些设备每年摊销的成本约为 5,000 万美元。当采购如此庞大的计算能力时,必须精打细算:性价比提高 10%,就意味着每座 WSC 每年节省 500 万美元,即 5,000 万美元的 10%。而像 Amazon 这样的公司,可能拥有超过 100 座 WSC!
WSC 与服务器有一个共同点:可用性都至关重要。例如,Amazon.com 在 2023 年的销售额为 5,750 亿美元。一年约有 8,760 小时,因此平均每小时收入约为 6,600 万美元。圣诞购物高峰时段一小时内可能损失的收入,还会高出许多倍。如第 6 章所述,WSC 与服务器的不同之处在于,WSC 采用冗余、廉价的组件作为基本构件,并依靠软件层检测和隔离在这种计算规模下必然大量发生的故障,从而提供应用所需的可用性。还要注意,WSC 的可扩展性由连接各台计算机的局域网来实现,而不像服务器那样由集成的计算机硬件实现。
超级计算机与 WSC 也有相似之处:它们同样昂贵,造价高达数亿美元。不过,超级计算机侧重浮点性能,运行的是通信密集的大型批处理程序,一次可能持续数周。它们通常采用高带宽、低延迟的互连网络。相比之下,WSC 更注重交互式应用、大规模存储、标准局域网、可信赖性以及高互联网带宽。
并行性的类别与并行体系结构
在所有四类计算机1中,多个层次上的并行性如今都成为计算机设计的驱动力,而能耗与成本是主要约束。应用中基本存在两种并行性:
- 数据级并行性(DLP):有许多数据项可以同时处理。
- 任务级并行性(task-level parallelism,TLP):工作被组织为可以独立、并且大体上并行执行的任务。2
相应地,计算机硬件可以通过四种主要方式利用应用中的这两种并行性:
- 指令级并行性(ILP):在编译器的帮助下,利用流水线等方法挖掘较小规模的 DLP,并利用推测执行等方法挖掘中等规模的 DLP。
- 向量体系结构、图形处理器(GPU)和多媒体指令集:把一条指令并行地应用于一组数据,从而利用 DLP。
- 线程级并行性(TLP):在允许并行线程相互交互的紧耦合硬件模型中,利用 DLP 或任务级并行性。
- 请求级并行性(RLP):利用程序员或操作系统所指定的、相互之间基本解耦的任务之间的并行性。
Flynn(1966)研究 20 世纪 60 年代的并行计算工作时,提出了一种简单分类,其缩写至今仍在使用。这些类别针对 DLP 和 TLP。Flynn 考察多处理器中约束最强的部件上,指令流以及指令所需数据流的并行性,将所有计算机分为以下四类:
- 单指令流、单数据流(single instruction stream, single data stream,SISD)。这一类就是单处理器。程序员把它看作标准的顺序计算机,但它也可以利用 ILP。第 3 章将介绍采用超标量和推测执行等 ILP 技术的 SISD 体系结构。
- 单指令流、多数据流(single instruction stream, multiple data streams,SIMD)。多个处理器对不同数据流执行同一条指令。SIMD 计算机通过对多个数据项并行执行相同操作来利用 DLP。在早期 SIMD 计算机中,每个处理器都有自己的数据存储器,因此称为“多数据流”;但整个系统只有一个指令存储器和一个控制处理器,由后者取出并分发指令。较新的 SIMD 计算机则从一个共享存储器中一次取出多个数据项。第 4 章将讨论 DLP,以及利用它的三种不同体系结构:向量体系结构、标准指令集的多媒体扩展和 GPU。
- 多指令流、单数据流(multiple instruction streams, single data stream,MISD)。迄今尚未出现这种类型的成功商用多处理器,但它使这一简单分类完整起来。
- 多指令流、多数据流(multiple instruction streams, multiple data streams,MIMD)。每个处理器取出自己的指令,并操作自己的数据,主要利用 TLP。总体而言,MIMD 比 SIMD 更灵活,适用范围也更广,但其固有成本高于 SIMD。例如,MIMD 计算机也能利用 DLP,但开销很可能高于 SIMD 计算机。这意味着并行任务的粒度必须足够大,才能高效地利用并行性。第 5 章将讨论紧耦合的 MIMD 体系结构,它们通过让多个相互协作的线程并行运行来利用 TLP。第 6 章将讨论松耦合的 MIMD 体系结构,具体包括集群和仓库级计算机,它们利用 RLP,让许多独立任务自然地并行推进,而基本不需要通信或同步。
这种分类只是一个粗略模型,因为许多并行处理器实际上是 SISD、SIMD 与 MIMD 的混合体。尽管如此,它仍然有助于为本书将要介绍的计算机建立一个设计空间的基本框架。
1.3 计算机体系结构的含义
计算机设计者面临的任务十分复杂:先确定一台新计算机应当重视哪些属性,再设计一台在成本、功耗与可用性约束之内,尽可能提高性能与能效的计算机。这项任务涉及许多方面,包括指令集设计、功能组成、逻辑设计和实现。实现可能涵盖集成电路设计、封装、供电与冷却。要优化设计,就必须熟悉极为广泛的技术,从编译器、操作系统,一直到逻辑设计和封装。
几十年前,“计算机体系结构”通常仅指指令集设计,计算机设计的其他方面则被称为“实现”。这种说法往往暗含一种判断:实现乏味,或者缺乏挑战。我们认为,这种看法是不对的。体系结构设计者或计算机设计者的工作远不止指令集设计,项目其他方面的技术障碍,很可能比指令集设计本身更具挑战性。在介绍计算机体系结构设计者面临的更广泛挑战之前,我们先简要回顾指令集体系结构。
指令集体系结构:对计算机体系结构的狭义理解
本书用指令集体系结构(instruction set architecture,ISA)一词,指程序员实际可见的指令集。ISA 是最重要的计算机接口,因为它界定了软件与硬件之间的边界。下面的简要回顾将以 80x86、ARMv8 和 RISC-V 为例,说明 ISA 的七个维度。最普及的 RISC 处理器来自 ARM(Advanced RISC Machine)。2023 年,出货的 300 亿颗芯片采用了 ARM 处理器,数量超过采用 80x86 处理器的芯片出货量的 100 倍;80x86 通常简称 x86。附录 A 和附录 K 将进一步介绍这三种 ISA。
RISC-V(读作“RISC Five”)是一种现代 RISC 指令集,2010 年诞生于加利福尼亚大学伯克利分校,后来应产业界的请求,免费开放供各方采用。除了完整的软件栈——编译器、操作系统与模拟器——之外,还有多种可以自由获取的 RISC-V 实现,能够用于定制芯片或现场可编程门阵列(FPGA)。RISC-V 的开发比最早的 RISC 指令集晚了 30 年,因此既继承了前辈的优秀思想,例如大量寄存器、易于流水线化的指令和精简的操作集合,又避开了它们的疏漏或失误。它是前文所述 RISC 体系结构中一个自由、开放且设计优雅的例子,这也解释了为什么已有 200 多家公司加入 RISC-V International 基金会,其中包括 Alibaba、AMD、Google、Intel、MIPS、Nokia、NVIDIA、Qualcomm、Samsung、Seagate、Siemens、Sony 和 Western Digital。2024 年,RISC-V 片上系统(见 1.6 节)的出货量达到 20 亿颗,预计到 2031 年将增至每年 300 亿颗。本书以 RISC-V 的整数核心 ISA 作为讲解实例。
ISA 的类别
如今,几乎所有 ISA 都属于通用寄存器体系结构,操作数要么位于寄存器中,要么位于存储器中。x86 有 16 个通用寄存器,以及 16 个可以存放浮点数据的寄存器;RISC-V 则有 32 个通用寄存器和 32 个浮点寄存器(见图 1.4)。这一类 ISA 有两种常见形式:一种是 x86 这样的寄存器—存储器 ISA,许多指令在执行时都可以访问存储器;另一种是 ARMv8 和 RISC-V 这样的 load-store ISA,只能用加载(load)或存储(store)指令访问存储器。自 1985 年以来发布的所有 ISA 都采用 load-store 形式。
| 寄存器 | 名称 | 用途 | 保存方 |
|---|---|---|---|
x0 | zero | 常量 0 | 不适用 |
x1 | ra | 返回地址 | 调用方 |
x2 | sp | 栈指针 | 被调用方 |
x3 | gp | 全局指针 | — |
x4 | tp | 线程指针 | — |
x5–x7 | t0–t2 | 临时寄存器 | 调用方 |
x8 | s0/fp | 保存寄存器/栈帧指针 | 被调用方 |
x9 | s1 | 保存寄存器 | 被调用方 |
x10–x11 | a0–a1 | 函数参数/返回值 | 调用方 |
x12–x17 | a2–a7 | 函数参数 | 调用方 |
x18–x27 | s2–s11 | 保存寄存器 | 被调用方 |
x28–x31 | t3–t6 | 临时寄存器 | 调用方 |
f0–f7 | ft0–ft7 | 浮点临时寄存器 | 调用方 |
f8–f9 | fs0–fs1 | 浮点保存寄存器 | 被调用方 |
f10–f11 | fa0–fa1 | 浮点函数参数/返回值 | 调用方 |
f12–f17 | fa2–fa7 | 浮点函数参数 | 调用方 |
f18–f27 | fs2–fs11 | 浮点保存寄存器 | 被调用方 |
f28–f31 | ft8–ft11 | 浮点临时寄存器 | 调用方 |
除 32 个通用寄存器(x0–x31)外,RISC-V 还有 32 个浮点寄存器(f0–f31),每个可容纳一个 32 位单精度数或一个 64 位双精度数。在过程调用前后必须保持原值的寄存器,标记为由被调用方(Callee)保存。
1. 存储器寻址
几乎所有桌面计算机和服务器,包括 x86、ARMv8 和 RISC-V,都按字节寻址来访问存储器操作数。ARMv8 等体系结构要求对象必须对齐。对于一个大小为 字节、字节地址为 的对象,若 ,则访问是对齐的,参见原书 A-8 页的图 A.5。80x86 和 RISC-V 不强制要求对齐,但操作数对齐时,访问通常更快。
2. 寻址方式
寻址方式不仅指定寄存器和常量操作数,也指定存储器中对象的地址。RISC-V 的寻址方式有寄存器寻址、立即数寻址(用于常量)和位移寻址。位移寻址将一个常量偏移量加到寄存器内容上,形成存储器地址。x86 除支持这三种方式外,还支持位移寻址的三种变体:不使用寄存器的绝对寻址、使用两个寄存器的带位移基址加变址寻址,以及使用两个寄存器且将其中一个乘以操作数字节大小的带位移基址加比例变址寻址。去掉位移字段后,它还支持与后三种相对应的形式,即寄存器间接寻址、变址寻址,以及基址加比例变址寻址。ARMv8 除了支持 RISC-V 的三种寻址方式,还支持 PC 相对寻址、两个寄存器之和,以及两个寄存器中一个按操作数字节大小缩放后再求和的方式。它还支持自动递增和自动递减寻址,用计算出的地址替换参与地址计算的某个寄存器的内容。
3. 操作数的类型与大小
与多数 ISA 一样,x86、ARMv8 和 RISC-V 支持的操作数大小包括:8 位(ASCII 字符)、16 位(Unicode 字符或半字)、32 位(整数或字)、64 位(双字或长整数),以及 IEEE 754 的 32 位单精度和 64 位双精度浮点数。x86 还支持 80 位浮点数,即扩展双精度。随着近来 AI 热潮兴起,新一代处理器已经将 16 位半精度乃至更短的浮点格式纳入可选功能,参见第 7 章。
4. 操作
操作大致可分为数据传送、算术与逻辑、控制(下面介绍)以及浮点运算。RISC-V 是一种简单、易于流水线化的 ISA,也是当今 RISC 体系结构的代表。图 1.5 概括了 RISC-V 的整数 ISA,图 1.6 列出其浮点 ISA。x86 的操作集合则丰富和庞大得多,参见附录 K。
| 指令类型/操作码 | 指令含义 |
|---|---|
| 数据传送 | 在寄存器与存储器之间,或在整数寄存器与浮点/特殊寄存器之间传送数据;存储器寻址方式只有“12 位位移量+通用寄存器(GPR)的内容”。 |
lb, lbu, sb | 加载字节、加载无符号字节、存储字节,数据传入或传出整数寄存器。 |
lh, lhu, sh | 加载半字、加载无符号半字、存储半字,数据传入或传出整数寄存器。 |
lw, lwu, sw | 加载字、加载无符号字、存储字,数据传入或传出整数寄存器。 |
ld, sd | 加载双字、存储双字,数据传入或传出整数寄存器。 |
flw, fld, fsw, fsd | 加载单精度浮点数、加载双精度浮点数、存储单精度浮点数、存储双精度浮点数。 |
fmv._.x, fmv.x._ | 在整数寄存器与浮点寄存器之间复制数据;_ 取 S 时为单精度,取 D 时为双精度。 |
csrrw, csrrwi, csrrs, csrrsi, csrrc, csrrci | 读计数器并写状态寄存器;计数器包括时钟周期、时间和已完成指令提交的数量(instructions retired)。 |
| 算术/逻辑 | 对 GPR 中的整数或逻辑数据进行操作。 |
add, addi, addw, addiw | 加法;立即数加法(立即数均为 12 位);只对 32 位执行加法并将结果符号扩展到 64 位;只对 32 位执行立即数加法。 |
sub, subw | 减法;只对 32 位执行减法。 |
mul, mulw, mulh, mulhsu, mulhu | 乘法;只对 32 位执行乘法;取乘积的高半部分;有符号数乘无符号数并取高半部分;无符号乘法并取高半部分。 |
div, divu, rem, remu | 除法、无符号除法、求余、无符号求余。 |
divw, divuw, remw, remuw | 除法和求余,含义同上,但只使用低 32 位,并对 32 位结果进行符号扩展。 |
and, andi | 按位与、立即数按位与。 |
or, ori, xor, xori | 按位或、立即数按位或、按位异或、立即数按位异或。 |
lui | 加载高位立即数:将立即数加载到寄存器的第 31–12 位,然后进行符号扩展。 |
auipc | 将立即数放在第 31–12 位、低位补零后与 PC 相加;与 JALR 配合,可将控制转移到任意 32 位地址。 |
sll, slli, srl, srli, sra, srai | 移位:逻辑左移、逻辑右移、算术右移;均有移位量来自寄存器和来自立即数的形式。 |
sllw, slliw, srlw, srliw, sraw, sraiw | 移位,含义同上,但只移动低 32 位,并对 32 位结果进行符号扩展。 |
slt, slti, sltu, sltiu | 小于时置位、与立即数比较后小于时置位;分别提供有符号与无符号形式。 |
| 控制 | 条件分支与跳转;采用 PC 相对寻址或通过寄存器寻址。 |
beq, bne, blt, bge, bltu, bgeu | 根据 GPR 相等、不等、小于、大于等于的比较结果进行分支,提供有符号与无符号形式。 |
jal, jalr | 跳转并链接:保存 PC+4;目标为 PC 相对地址(JAL)或由寄存器给出(JALR)。若指定 x0 为目的寄存器,则执行普通跳转。 |
ecall | 向支持程序运行的执行环境发出请求,该环境通常是操作系统。 |
ebreak | 供调试器使用,将控制转移回调试环境。 |
fence, fence.i | 同步线程,以保证存储器访问的顺序;在写入指令存储器时,同步指令与数据。 |
RISC-V 包含基本指令集(原图写作 R64I),并提供可选扩展:乘除法(RVM)、单精度浮点(RVF)以及双精度浮点(RVD)。本图包括 RVM,下一图给出 RVF 与 RVD。附录 A 详细介绍 RISC-V。1
| 指令类型/操作码 | 指令含义 |
|---|---|
| 浮点 | 对双精度(DP)与单精度(SP)格式执行浮点操作。 |
fadd.d, fadd.s | 双精度、单精度加法。 |
fsub.d, fsub.s | 双精度、单精度减法。 |
fmul.d, fmul.s | 双精度、单精度浮点乘法。 |
fmadd.d, fmadd.s, fnmadd.d, fnmadd.s | 双精度、单精度乘加;双精度、单精度负乘加。 |
fmsub.d, fmsub.s, fnmsub.d, fnmsub.s | 双精度、单精度乘减;双精度、单精度负乘减。 |
fdiv.d, fdiv.s | 双精度、单精度浮点除法。 |
fsqrt.d, fsqrt.s | 双精度、单精度浮点平方根。 |
fmax.d, fmax.s, fmin.d, fmin.s | 双精度、单精度浮点最大值与最小值。 |
fcvt._._, fcvt._._u, fcvt._u._ | 转换指令:FCVT.x.y 将类型 x 转换为类型 y;x 和 y 可为 L(64 位整数)、W(32 位整数)、D(双精度)或 S(单精度)。整数可为无符号类型(U)。2 |
feq._, flt._, fle._ | 比较浮点寄存器中的浮点数,并将布尔结果写入整数寄存器;_ 取 S 时为单精度,取 D 时为双精度。 |
fclass.d, fclass.s | 向整数寄存器写入一个 10 位掩码,用以指示浮点数的类别,如负无穷、正无穷、负零、正零、NaN 等。 |
fsgnj._, fsgnjn._, fsgnjx._ | 只改变符号位的符号注入指令:复制另一个源操作数的符号位、取另一个源操作数符号位的反值,或取两个符号位的异或。 |
RISC-V 包含基本指令集(原图写作 R64I),并提供单精度浮点(RVF)和双精度浮点(RVD)可选扩展。DP 表示双精度,SP 表示单精度。
5. 控制流指令
几乎所有 ISA,包括这里的三种,都支持条件分支、无条件跳转、过程调用和返回。三者都采用 PC 相对寻址,将地址字段与 PC 相加来确定分支地址。不过,它们之间也有一些细微区别。RISC-V 的条件分支指令(原文写作 BE、BNE 等3)检查寄存器内容,而 x86 和 ARMv8 的分支指令检查算术或逻辑操作在执行时附带设置的条件码位。ARMv8 和 RISC-V 的过程调用将返回地址放入寄存器,而 x86 的调用指令 CALLF 则将返回地址压入存储器中的栈。
ISA 的编码
指令编码有两种基本选择:定长与变长。ARMv8 和 RISC-V 的指令长度均为 32 位,这简化了指令译码。图 1.7 给出了 RISC-V 的指令格式。x86 采用变长编码,长度为 1–18 字节。 变长指令所占空间可以小于定长指令,因此,同一程序编译为 x86 代码时,通常比编译为 RISC-V 代码更小。请注意,前面介绍的各种选择都会影响指令的二进制编码方式。例如,寄存器数量与寻址方式数量都会显著影响指令长度,因为寄存器字段与寻址方式字段可能在一条指令中出现多次。后来,ARMv7 和 RISC-V 分别提供了 Thumb-2 和 RV64IC 扩展,通过混合使用 16 位和 32 位指令来缩小程序体积。ARMv8 仍只使用 32 位指令。这些 RISC 体系结构紧凑版本的代码体积,比 x86 还小,参见附录 K。
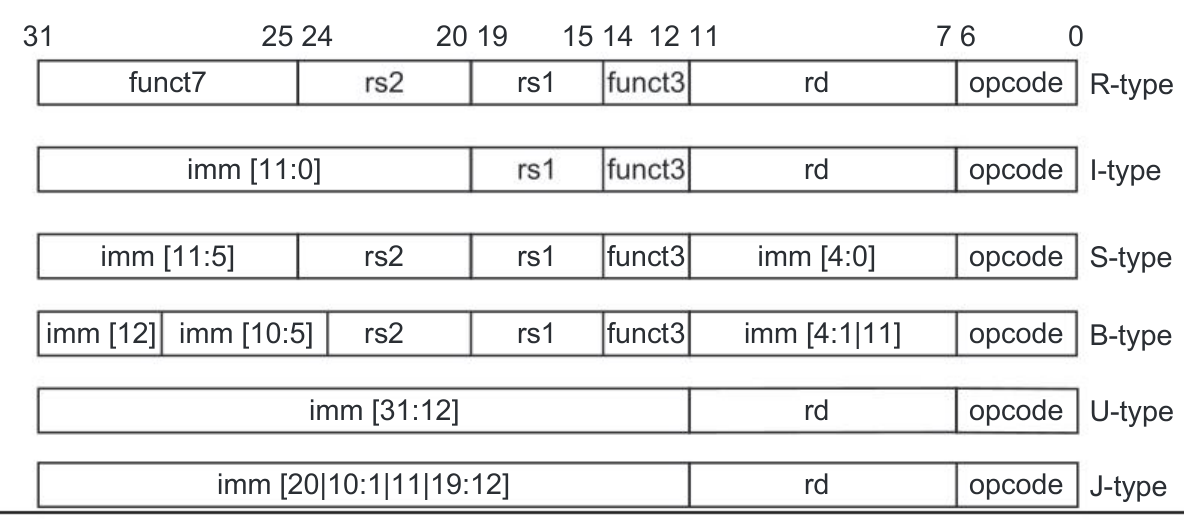
所有指令均为 32 位。R 格式用于整数寄存器之间的操作,例如 ADD、SUB 等;I 格式用于加载和立即数操作,例如 LD、ADDI;B 格式用于分支,J 格式用于跳转并链接;S 格式用于存储。为存储指令单独设置一种格式,使三个寄存器字段(rd、rs1、rs2)在各格式中的位置始终保持一致。U 格式用于宽立即数指令 LUI 和 AUIPC。
图内用语:opcode 为操作码,rd 为目的寄存器字段,rs1、rs2 为源寄存器字段,funct3、funct7 为功能字段,imm 为立即数字段;R-type 等分别表示 R 型等指令格式。位号与字段名称按原图保留。
当今指令集之间的差异已经不大,而应用领域却各有特点,因此,计算机体系结构设计者在 ISA 设计之外面临的其他挑战尤其突出。正因如此,从本书第四版开始,除这段简要回顾外,指令集的大部分内容都安排在附录中,参见附录 A 和附录 K。
完整意义上的计算机体系结构:围绕目标与功能需求设计组成和硬件
计算机实现包含两个部分:组成(organization)和硬件(hardware)。组成指计算机设计的较高层次方面,例如存储系统、存储互连,以及内部处理器或 CPU 的设计。CPU 即中央处理单元,负责实现算术、逻辑、分支和数据传送。微体系结构(microarchitecture)一词也常被用来代替“组成”。例如,AMD EPYC 和 Intel Xeon 都实现 x86 指令集,ISA 相同,但采用了不同的组成:它们的流水线与缓存组织差异很大。
随着每个微处理器中开始包含多个处理器,人们也开始用“核心”(core)来称呼处理器。“多核”(multicore)逐渐流行起来,取代了“包含多个处理器的微处理器”这种冗长表述。中央处理单元或 CPU 通常指微处理器中的某一个核心,因为 PMD、PC 和服务器中的微处理器如今几乎都是多核的。
硬件指计算机的具体实现细节,包括详细的逻辑设计和封装技术。一个计算机产品系列中,常常有一些计算机采用相同的 ISA 和非常相似的组成,却在硬件实现细节上有所不同。例如,Intel Core i7(见第 3 章)与 Intel Xeon E7(见第 5 章)几乎相同,但提供了不同的时钟频率与存储系统,使 Xeon E7 更适合服务器。
本书中的“体系结构”涵盖计算机设计的全部三个方面:ISA、组成(或微体系结构),以及硬件。
计算机体系结构设计者必须设计出既满足功能需求,又达到价格、功耗、性能和可用性目标的计算机。图 1.8 概括了设计新计算机时需要考虑的需求。很多时候,设计者还必须先确定功能需求究竟是什么,这本身就是一项重要工作。这些需求可能是市场推动下的具体功能。应用软件通过决定计算机将被如何使用,通常会影响某些功能需求的选择。如果某一种 ISA 已经拥有大量软件,设计者就可能决定让新计算机采用现有指令集。如果某类应用拥有庞大的市场,设计者也可能将有助于计算机在该市场上竞争的要求纳入设计。后续章节将深入考察其中的许多需求与特性。
| 功能需求 | 典型的必要功能或支持特性 |
|---|---|
| 应用领域 | 计算机的目标用途。 |
| 物联网/嵌入式计算 | 往往需要为图形、视频或其他特定应用扩展提供专门支持;可能需要限制与控制功耗;存在实时约束(第 2、3、5、7 章;附录 A、E)。 |
| 个人移动设备 | 满足多种任务的实时性能要求,包括图形、视频和音频的交互性能;重视能效(第 2–5、7 章;附录 A)。 |
| 通用桌面计算机 | 为多种任务提供均衡性能,包括图形、视频和音频的交互性能(第 2–5 章;附录 A)。 |
| 服务器 | 支持数据库与事务处理;增强可靠性与可用性;支持可扩展性与安全性(第 2、5、7 章;附录 A、D、F)。 |
| 集群/仓库级计算机 | 面向大量独立任务的吞吐性能;存储器纠错;energy proportionality,即功耗随负载成比例变化的能力;安全性(第 2、6、7 章;附录 F)。 |
| 软件兼容层次 | 决定计算机可以利用多少已有软件。 |
| 编程语言层面的兼容 | 给予设计者最大的灵活性;需要新的编译器(第 3、5、7 章;附录 A)。 |
| 目标代码或二进制兼容 | 指令集体系结构已完全确定,灵活性很小,但无需再投入软件开发或程序移植(附录 A)。 |
| 操作系统需求 | 支持所选操作系统所必需的功能(第 2 章;附录 B)。 |
| 地址空间大小 | 非常重要的特征,可能限制应用范围(第 2 章)。 |
| 存储管理 | 现代操作系统所必需,可采用分页或分段(第 2 章)。 |
| 保护 | 不同操作系统和应用具有不同需求:分页与分段、虚拟机(第 2 章)。 |
| 标准 | 市场可能要求遵循特定标准。 |
| 浮点 | 格式与算术运算:IEEE 754 标准(附录 J),以及用于图形、信号处理或 AI 的专门算术运算。 |
| I/O 接口 | 用于 I/O 设备:Serial ATA、Serial Attached SCSI、PCI Express(附录 D、F)。 |
| 操作系统 | UNIX、Windows、Linux、iOS、Android。 |
| 网络 | 支持不同网络:Ethernet、InfiniBand(附录 F)。 |
| 编程语言 | 语言(ANSI C、C++、Java、Fortran)会影响指令集(附录 A)。 |
左栏描述需求类别,右栏给出具体实例,并列出讨论相应问题的章节与附录。
设计者还必须留意技术与计算机使用方式的重要趋势,因为这些趋势不仅影响未来的成本,也影响一种体系结构的生命力。
1.4 技术发展趋势
一种 ISA 要获得长久成功,就必须在设计时考虑如何适应计算机技术的快速变化。毕竟,成功的新 ISA 可能沿用数十年:例如,IBM 大型机的核心体系结构已经使用了 60 年。体系结构设计者必须为技术变化预作规划,以延长成功计算机设计的生命期。
要规划计算机的演进,设计者就必须了解实现技术的迅速变化。以下五类发展迅猛的技术,对现代计算机的实现至关重要:
集成电路逻辑技术。 历史上,晶体管密度每年增长约 35%,略多于四年就能增至四倍。裸片面积的增长较慢,也较难预测,年增幅为 10%–20%。两者结合,使芯片上晶体管数量的传统年增长率达到约 40%–55%,即每 18–24 个月翻一番。如前所述,这一趋势称为 Moore 定律。器件速度的提升较慢,我们将在后面讨论。令人震惊的是,Moore 定律正在放缓。每个芯片上的器件数量仍在增加,但增长速度正在下降。与 Moore 定律盛行的年代不同,我们预计,每出现一代新工艺,晶体管数量翻番所需的时间都会进一步延长,见 1.12 节的图 1.24。
半导体 DRAM(动态随机存取存储器)。 这项技术是主存的基础,第 2 章将详细讨论。过去,DRAM 容量每三年增至四倍,如今增长速度已大幅下降。8 Gbit DRAM 于 2014 年开始出货,16 Gbit DRAM 却直到 2019 年才出货。下一步是在 2023 年推出 24 Gbit 产品,这是 DRAM 容量首次不再是 2 的幂。再下一目标是 32 Gbit DRAM。这意味着,DRAM 容量从 8 Gbit 增至 32 Gbit、达到原来的四倍,至少需要十年。未来的增长还面临重大挑战(Kim, 2005)。第 2 章提到了几种试图取代 DRAM 的技术,但现在越来越清楚的是,DRAM 不大可能被替代。
半导体 Flash(电可擦除可编程只读存储器)。 这种非易失性半导体存储器是个人移动设备(PMD)的标准存储装置;随着应用迅速普及,其容量也在快速增长。在服务器市场,2024 年基于 Flash 的固态硬盘(SSD)已占磁盘销售的一半以上。近年来,单个 Flash 芯片的容量每年增长约 50%–60%,大约每三年翻一番。1 目前,Flash 每比特的成本约为 DRAM 的 1/8–1/10。第 2 章将介绍 Flash。未来的容量增长仍将沿第三维度展开:在晶圆加工过程中增加更多层,同时缩小存储单元的尺寸。
磁盘技术。 1990 年以前,磁盘存储密度每年提高约 30%,三年翻一番;此后年增幅提高到 60%,并于 1996 年达到 100%。
2004–2011 年间,年增幅下降到约 40%,即每两年翻一番。过去十年,磁盘的进步速度已放缓至每年不到 5%,翻番需要 15–20 年。增加磁盘容量的一种办法是在面密度不变的情况下增加盘片,但厚度为 1 英寸的 3.5 英寸规格硬盘中,已经装有十张盘片。如今,硬盘每比特的成本约为 Flash 的 1/3–1/5,为 DRAM 的 1/100–1/200。未来可能需要增加封装厚度来容纳更多盘片,这又可能减少单位体积内能够容纳的硬盘数量。这项技术是服务器和仓库级存储的核心;附录 D 将详细讨论其发展趋势。
网络技术。 网络性能既取决于交换设备的性能,也取决于传输系统的性能。附录 F 将讨论网络的发展趋势。
这些技术共同塑造了计算机设计。随着速度和技术的改进,一个设计的生命期可能达到 3–7 年。工程师往往面向下一代技术开展设计,因为他们知道,等产品开始大批量出货时,再下一代技术可能已经具有更好的性价比,或者具备性能优势。
技术通常在持续进步,但当它跨越某个门槛、使一种新能力成为可能时,其影响可能表现为离散的跃升。例如,20 世纪 80 年代初,MOS 技术已能在单个芯片上容纳 25,000–50,000 个晶体管,于是单芯片 32 位微处理器成为可能。到 80 年代末,一级缓存可以集成到芯片上;此后的进步又使二级乃至三级缓存得以集成。消除了处理器内部以及处理器与各级缓存之间的跨芯片传输,就可能显著改善性价比和能效。技术发展到一定程度之前,这种设计根本无法实现。这样的技术门槛并不罕见,而且会对各种设计决策产生重大影响。
性能趋势:带宽的进步快于延迟
如 1.8 节将要讨论的,带宽或吞吐量是单位时间内完成的工作总量,例如磁盘传输的 MB/s;延迟或响应时间则是一个事件从开始到完成所需的时间,例如一次磁盘访问的毫秒数。2 图 1.9 绘出了微处理器、内存、网络和磁盘各个技术里程碑相对于起点的带宽与延迟改善倍数。图 1.10 对这些实例与里程碑给出了更详细的说明。
性能是微处理器和网络最主要的差异化因素,因此它们的进步最大:带宽提高了 45,000–80,000 倍,延迟改善了 50–90 倍。对于内存和磁盘,容量通常比性能更重要,因此容量的增长更大;不过,它们 450–4000 倍的带宽提升,仍然远大于 5–9 倍的延迟改善。
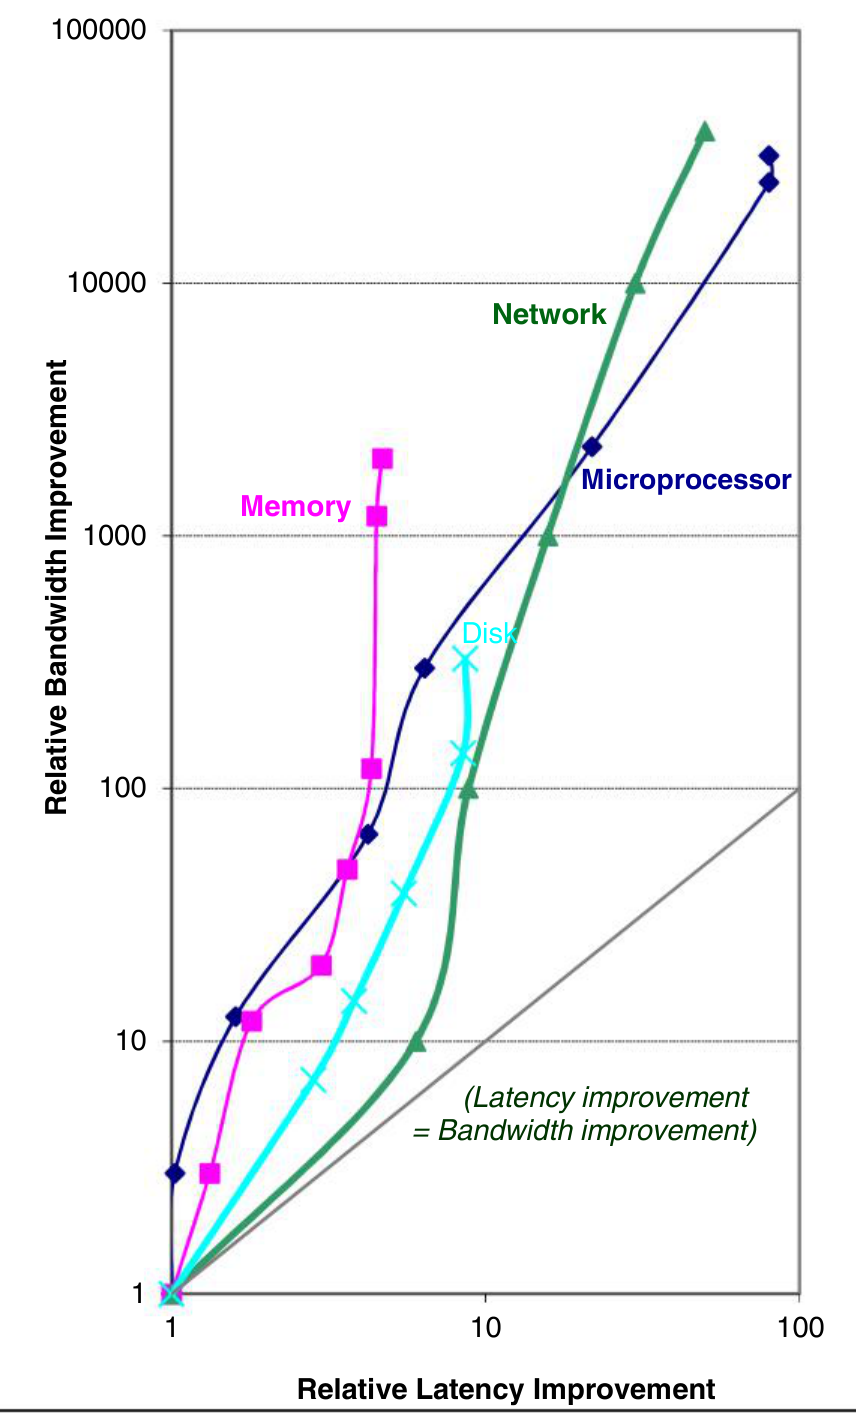
图 1.9(续)。 延迟改善了 5–64 倍,带宽则提高了约 450–80,000 倍。自上一版以来的五年中,各项技术的带宽增幅为 14%–100%,延迟却没有改善。事实上,磁盘和微处理器的延迟还增大了。对磁盘来说,2016 年那款容量为 0.6 TB、转速为 15,000 RPM 的硬盘仍然可以买到,不过我们认为,选用容量为 20 TB、转速为 7200 RPM 的硬盘更有意义,尽管它的延迟更长。2021 年 SPEC2017 性能最高的微处理器,标准时钟频率只有 2.8 GHz,低于 2016 年微处理器的 4.0 GHz,但其 Turbo 频率为 5.1 GHz,高于后者的 4.2 GHz。较低的标准时钟频率意味着更长的延迟。还应注意,图中采用的网络标准预计要到 2026 年才能完成,因此网络部分的结果略显乐观。根据 Patterson, D., 2004. “Latency lags bandwidth.” Commun. ACM 47 (10), 71–75 更新。
图内术语:Relative Bandwidth Improvement=相对带宽改善倍数;Relative Latency Improvement=相对延迟改善倍数;Microprocessor=微处理器;Memory=内存;Network=网络;Disk=磁盘。灰色对角线表示“延迟改善倍数=带宽改善倍数”。
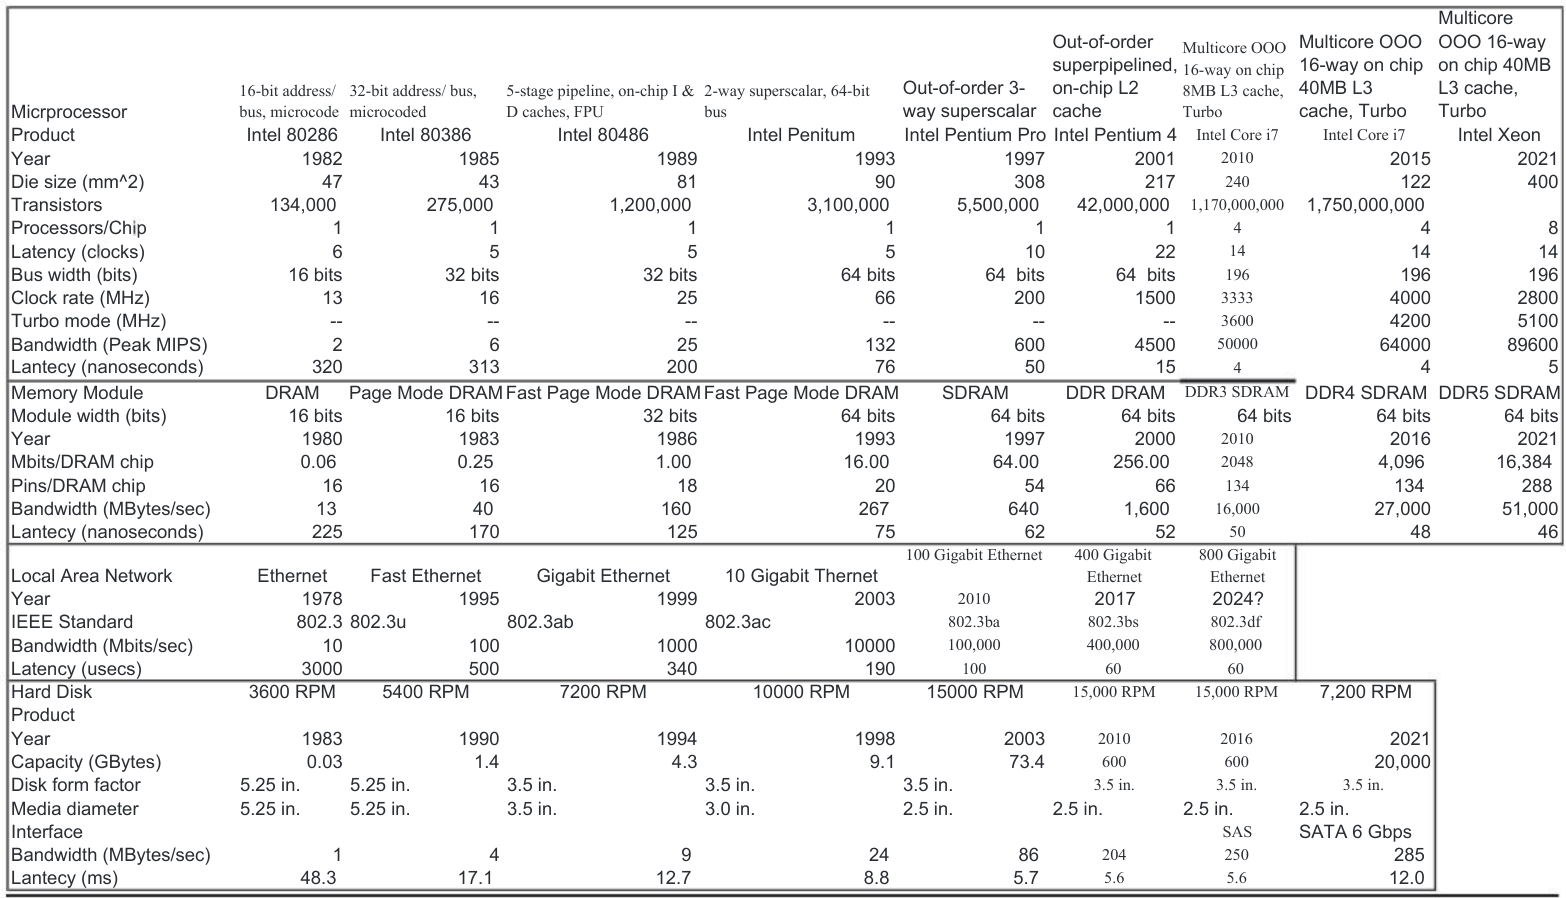
图 1.10(续)。 微处理器的里程碑覆盖了数代 IA-32 处理器:从采用 16 位总线、微码实现的 80286,发展到采用 64 位总线、多核、乱序执行、超流水线以及三级片上缓存的 Xeon。内存模块从 16 位宽的普通 DRAM,发展到 64 位宽的第五代双倍数据率同步 DRAM。以太网从 10 Mbit/s,发展到约 2026 年的 800 Gbit/s。磁盘的里程碑以转速为依据:到 2016 年,转速从 3600 RPM 提高到 15,000 RPM,2021 年又回到 7200 RPM。各例中的带宽均为最佳情况带宽,延迟则是假定不存在争用时执行一次简单操作所需的时间。根据 Patterson, D., 2004. “Latency lags bandwidth.” Commun. ACM 47 (10), 71–75 更新。
图中的四组数据如下。原表的空白单元格仍留空;“—”对应原表的双连字符。
图 1.10:微处理器
| 指标 | Intel 80286 | Intel 80386 | Intel 80486 | Intel Pentium | Intel Pentium Pro | Intel Pentium 4 | Intel Core i7 | Intel Core i7 | Intel Xeon |
|---|---|---|---|---|---|---|---|---|---|
| 特征 | 16 位地址/总线,微码 | 32 位地址/总线,微码 | 5 级流水线,片上指令/数据缓存,FPU | 双发射超标量,64 位总线 | 乱序三发射超标量 | 乱序超流水线,片上 L2 缓存 | 多核乱序,片上 16 路,8 MB L3 缓存,Turbo | 多核乱序,片上 16 路,40 MB L3 缓存,Turbo | 多核乱序,片上 16 路,40 MB L3 缓存,Turbo |
| 年份 | 1982 | 1985 | 1989 | 1993 | 1997 | 2001 | 2010 | 2015 | 2021 |
| 裸片面积(mm²) | 47 | 43 | 81 | 90 | 308 | 217 | 240 | 122 | 400 |
| 晶体管数 | 134,000 | 275,000 | 1,200,000 | 3,100,000 | 5,500,000 | 42,000,000 | 1,170,000,000 | 1,750,000,000 | |
| 每芯片处理器数 | 1 | 1 | 1 | 1 | 1 | 1 | 4 | 4 | 8 |
| 延迟(时钟周期) | 6 | 5 | 5 | 5 | 10 | 22 | 14 | 14 | 14 |
| 总线宽度(bit) | 16 | 32 | 32 | 64 | 64 | 64 | 196 | 196 | 196 |
| 时钟频率(MHz) | 13 | 16 | 25 | 66 | 200 | 1500 | 3333 | 4000 | 2800 |
| Turbo 频率(MHz) | — | — | — | — | — | — | 3600 | 4200 | 5100 |
| 带宽(峰值 MIPS) | 2 | 6 | 25 | 132 | 600 | 4500 | 50,000 | 64,000 | 89,600 |
| 延迟(ns) | 320 | 313 | 200 | 76 | 50 | 15 | 4 | 4 | 5 |
图 1.10:内存模块
| 指标 | DRAM | Page Mode DRAM | Fast Page Mode DRAM | Fast Page Mode DRAM | SDRAM | DDR DRAM | DDR3 SDRAM | DDR4 SDRAM | DDR5 SDRAM |
|---|---|---|---|---|---|---|---|---|---|
| 模块宽度(bit) | 16 | 16 | 32 | 64 | 64 | 64 | 64 | 64 | 64 |
| 年份 | 1980 | 1983 | 1986 | 1993 | 1997 | 2000 | 2010 | 2016 | 2021 |
| 每颗 DRAM 容量(Mbit) | 0.06 | 0.25 | 1.00 | 16.00 | 64.00 | 256.00 | 2048 | 4096 | 16,384 |
| 每颗 DRAM 引脚数 | 16 | 16 | 18 | 20 | 54 | 66 | 134 | 134 | 288 |
| 带宽(MB/s) | 13 | 40 | 160 | 267 | 640 | 1600 | 16,000 | 27,000 | 51,000 |
| 延迟(ns) | 225 | 170 | 125 | 75 | 62 | 52 | 50 | 48 | 46 |
Page Mode DRAM 为页模式 DRAM,Fast Page Mode DRAM 为快速页模式 DRAM。
图 1.10:局域网
| 指标 | Ethernet | Fast Ethernet | Gigabit Ethernet | 10 Gigabit Ethernet | 100 Gigabit Ethernet | 400 Gigabit Ethernet | 800 Gigabit Ethernet |
|---|---|---|---|---|---|---|---|
| 年份 | 1978 | 1995 | 1999 | 2003 | 2010 | 2017 | 2024? |
| IEEE 标准 | 802.3 | 802.3u | 802.3ab | 802.3ac | 802.3ba | 802.3bs | 802.3df |
| 带宽(Mbit/s) | 10 | 100 | 1000 | 10,000 | 100,000 | 400,000 | 800,000 |
| 延迟(μs) | 3000 | 500 | 340 | 190 | 100 | 60 | 60 |
Ethernet=以太网;Fast Ethernet=快速以太网;Gigabit Ethernet=千兆以太网,其余名称分别表示 10、100、400 和 800 Gbit/s 以太网。
图 1.10:硬盘
| 指标 | 3600 RPM | 5400 RPM | 7200 RPM | 10,000 RPM | 15,000 RPM | 15,000 RPM | 15,000 RPM | 7200 RPM |
|---|---|---|---|---|---|---|---|---|
| 产品 | ||||||||
| 年份 | 1983 | 1990 | 1994 | 1998 | 2003 | 2010 | 2016 | 2021 |
| 容量(GB) | 0.03 | 1.4 | 4.3 | 9.1 | 73.4 | 600 | 600 | 20,000 |
| 硬盘规格 | 5.25 英寸 | 5.25 英寸 | 3.5 英寸 | 3.5 英寸 | 3.5 英寸 | 3.5 英寸 | 3.5 英寸 | 3.5 英寸 |
| 盘片直径 | 5.25 英寸 | 5.25 英寸 | 3.5 英寸 | 3.0 英寸 | 2.5 英寸 | 2.5 英寸 | 2.5 英寸 | 2.5 英寸 |
| 接口 | SAS | SATA 6 Gbit/s | ||||||
| 带宽(MB/s) | 1 | 4 | 9 | 24 | 86 | 204 | 250 | 285 |
| 延迟(ms) | 48.3 | 17.1 | 12.7 | 8.8 | 5.7 | 5.6 | 5.6 | 12.0 |
译注(图 1.10): 原表中三列总线宽度均印为 196 bit,800 Gbit/s 以太网年份印为“2024?”,而图注与图 1.9 说明写“约 2026 年”;此处照录,没有自行统一。正文中的改善倍数与图注也不完全一致。
显然,在这些技术领域中,带宽的进步一直快于延迟,而且这种趋势很可能继续。计算机设计者应据此作出规划。
晶体管性能与连线的缩放
集成电路工艺通常以特征尺寸来描述,即晶体管或连线在 x 或 y 方向上的最小尺寸。特征尺寸从 1971 年的 10 μm,缩小到了 2022 年的 0.007 μm。事实上,我们已经换用了新的单位,因此 2022 年的量产工艺称为“7 nm”,而 3 nm 芯片也正在推进。Intel 宣布了 1.8 nm 芯片的计划,并将其重新命名为 18 Å(埃),为进一步缩小几何尺寸作铺垫。
每平方毫米硅片上能够容纳的晶体管数量,取决于一个晶体管的表面积。因此,随着特征尺寸线性缩小,晶体管密度按平方关系增加。
晶体管性能的提升却更复杂。特征尺寸缩小时,器件在水平方向的面积按平方关系缩小,在垂直方向上也会缩小。垂直尺寸的缩小要求降低工作电压,以保证晶体管正常工作并维持可靠性。这些缩放因素共同作用,使晶体管性能与工艺特征尺寸之间形成复杂关系。过去,作为一阶近似,可以认为晶体管性能会随特征尺寸的缩小而线性提高。
晶体管数量按平方关系增加,性能却只线性提高:这既是计算机体系结构设计者面临的挑战,也是他们施展才华的机会!在微处理器发展的早期,密度更快增长所带来的空间,被用于迅速从 4 位扩展到 8 位、16 位、32 位和 64 位。近些年来,密度提升则使一个芯片内集成多个处理器、更宽的 SIMD 单元,以及第 2–5 章介绍的推测执行与缓存创新成为可能。
晶体管的性能通常会随特征尺寸缩小而改善,集成电路中的连线却并非如此。具体而言,连线的信号延迟与其电阻和电容的乘积成正比。特征尺寸缩小时,连线当然会变短,但单位长度的电阻和电容特性会变差。这里的关系很复杂,因为电阻和电容都取决于工艺细节、连线的几何形状、连线负载,甚至与其他结构的相邻关系。工艺偶尔也会取得改进,例如引入铜互连,从而使连线延迟获得一次性改善。
不过,总体而言,相比晶体管性能,连线延迟随工艺缩放而改善的程度很有限,给设计者带来了额外挑战。除了功耗限制之外,连线延迟已经成为大规模集成电路的主要设计障碍,而且往往比晶体管的开关延迟更关键。信号在线路上传播的延迟占据了越来越大的时钟周期份额;但如今,功耗的影响甚至超过了连线延迟。
1.5 集成电路的功耗与能耗趋势
今天,对几乎所有类别的计算机而言,能耗都是设计者面临的最大挑战。首先,电力必须送入芯片并分配到各处;现代微处理器仅电源和接地就要占用数百个引脚和多层互连。其次,消耗的电能会转化为热量,必须将这些热量导出。
从系统角度看功率与能耗
系统体系结构设计者或用户,应如何看待性能、功率和能耗?从系统设计者的角度来看,主要有三个问题需要考虑。
第一,处理器可能需要的最大功率是多少?满足这一需求,可能是确保处理器正确运行的重要条件。例如,如果处理器试图从供电系统汲取超过其供给能力的功率,即所需电流超过系统能够提供的电流,通常就会引起电压下降,进而导致器件工作异常。现代处理器的功耗变化范围很大,峰值电流也很高;因此,它们提供了 voltage indexing 方法,使处理器能够降低运行速度,并在更大的余量内调节电压。显然,这会降低性能。
第二,处理器的持续功耗是多少?这一指标通常称为热设计功耗(thermal design power,TDP),因为它决定了散热要求。TDP 既不是峰值功耗——峰值往往可达到它的 1.5 倍——也不是某次计算实际消耗的平均功率;后者很可能更低。系统的电源通常按超过 TDP 的容量配置,散热系统的设计能力一般应达到或超过 TDP。如果散热不足,处理器的结温可能超过上限,导致器件失效,甚至造成永久性损坏。由于最高功耗以及由此产生的热量和温升,可能超过 TDP 所规定的长期平均水平,现代处理器提供了两种辅助热管理机制。首先,当温度接近结温上限时,电路会降低时钟频率,以降低功耗;如果这一措施无效,第二级热过载保护就会触发,关闭芯片电源。
设计者和用户应考虑的第三个因素是能耗与能效。回想一下,功率就是单位时间内的能量:1 W=每秒 1 J。比较处理器时,应当采用能耗还是功率?一般来说,能耗始终是更合适的指标,因为它与某项具体任务以及完成任务所需的时间相关。具体而言,完成一项工作负载的能耗,等于平均功率乘以该工作负载的执行时间。
因此,要判断两个处理器中哪一个完成某项任务的效率更高,就需要比较执行该任务的能耗,而不是功率。例如,处理器 A 的平均功耗可能比处理器 B 高 20%,但如果 A 只需 B 所用时间的 70% 就能完成任务,它的能耗便是 B 的 ,显然更好。
有人可能认为,在大型服务器或云环境中,工作负载通常可以假定为无穷无尽,所以只考虑平均功率就足够了;这种看法会产生误导。如果云中的处理器全是 B 而不是 A,那么在消耗相同能量的情况下,它完成的工作会更少。用能耗比较不同方案,就能避免这一陷阱。只要工作负载固定,无论是仓库规模的云,还是一部智能手机,比较能耗都是比较计算机方案的正确方法。
这是因为,云的电费和智能手机的续航时间,都由消耗的能量决定。
那么,功耗何时是有用的度量?它最主要的合理用途是作为约束:例如,一颗采用风冷的芯片可能被限制在 300 W 以内。在工作负载固定时,功耗也可以作为指标,但这不过是“每项任务的能耗”这一真正指标的另一种表现形式。
微处理器内部的能耗与功耗
对于 CMOS 芯片,传统上最主要的能量消耗来自晶体管开关,也称为动态能耗(dynamic energy)。每个晶体管所需的能量,与它所驱动的电容负载以及电压平方的乘积成正比:
这里,Energy 为能量,Capacitive load 为电容负载,Voltage 为电压。上式表示一次 或 逻辑转换脉冲的能量。一次单独转换,即 或 ,其能量为:
每个晶体管所需的功率,就是单次转换能量与转换频率的乘积。原书此处列出的公式为:
译注: 原页确实将上式印成了能量关系,并未出现前一句所说的“功率”与“转换频率”。由功率=单次转换能量×每秒转换次数,可直接得到相应关系 。上式不是完整的动态功率公式。前两式使用的是比例符号,未写出完整脉冲与单次转换之间的常数因子。
对于固定任务,降低时钟频率可以降低功率,但不能降低能耗。
显然,降低电压能够大幅降低动态功耗和能耗,因此,二十年间电压从 5 V 降到了略低于 1 V。电容负载取决于输出端连接的晶体管数量,以及所用工艺;工艺决定了连线和晶体管的电容。
例:降低电压与频率
问题。 当今一些微处理器采用可调电压设计,电压降低 15% 时,频率也可能降低 15%。这对动态能耗和动态功耗会有什么影响?
解答。 电容保持不变,因此,能耗的变化由电压平方之比决定:
也就是动态能耗降至原来的约 72%。计算功率时,还要乘上转换频率之比:
因此,动态功耗降至原来的约 61%。
工艺从一代演进到下一代时,参与开关的晶体管数量和开关频率的增加,超过了负载电容与电压降低所带来的收益,导致总体功耗和能耗上升。最早的微处理器功耗不到 1 W,最早的 32 位微处理器,例如 Intel 80386,功耗约为 2 W,而一颗 2.4 GHz 的 Intel Xeon Platinum 8380 消耗 270 W。这些热量必须从边长约 2.5 cm 的芯片上散出,因此我们已经接近风冷所能达到的极限,并且在这个位置停留了将近十年。Intel 和 NVIDIA 最近公布的芯片中,有些 TDP 接近 1000 W,需要液冷。
根据前面的公式,如果不能降低电压,也不能增加每颗芯片的功率,那么时钟频率的增长理应放缓。图 1.11 表明,自 2003 年以来,事实正是如此;即使是图 1.1 中每年性能最高的微处理器,也不例外。注意,时钟频率趋平的这一时期,正好对应图 1.1 中性能提升较慢的阶段。
配电、散热和防止局部热点,已经成为日益艰巨的挑战。如今,限制晶体管使用的主要因素是能耗;过去则是硅片面积。因此,尽管时钟频率停滞、供电电压不再下降,现代微处理器仍采用多种技术来努力提高能效:
把“无事可做”这件事做好。 现在,大多数微处理器都会关闭非活动模块的时钟,以节省能量、降低动态功耗。例如,没有浮点指令执行时,就关闭浮点单元的时钟;某些核心空闲时,就停止这些核心的时钟。
动态电压频率调节(DVFS)。 第二种技术直接来自前面的公式。PMD、笔记本电脑,甚至服务器,都有活动较少的时段,不必始终运行在最高时钟频率和电压下。现代微处理器通常提供几个可选的时钟频率和电压工作点,以降低功率和能耗。图 1.12 绘出了工作负载下降时,服务器在 2.4、1.8 和 1 GHz 三种时钟频率下通过 DVFS 所能获得的功耗节省。每降低一级,整个服务器的功耗约可节省 10%–15%。
面向常见情况设计。 PMD 和笔记本电脑经常处于空闲状态,因此,内存和存储设备提供低功耗模式来节省能量。例如,DRAM 提供一系列功耗逐级降低的模式,以延长 PMD 和笔记本电脑的电池续航;磁盘方面也曾有人提出,让磁盘在不使用时进入降低转速的模式,以节省功耗。
然而,处于这些模式时,DRAM 和磁盘都无法被访问;不论访问频率多低,要读写都必须先恢复到完全活动状态。如前所述,PC 微处理器则是按高工作温度下的重负载使用来设计的,并依赖片上温度传感器判断何时应自动减少活动,以防过热。这种“紧急降速”机制,使制造商能够按更常见的情况进行设计;如果用户确实运行了远比通常情况耗电的程序,再由这一安全机制提供保护。
超频。 Intel 从 2008 年开始提供 Turbo 模式:芯片判断短时间内以更高时钟频率运行是安全的,就提高频率,可能只加速少数几个核心,直到温度开始上升。例如,2.8 GHz 的 Xeon E-2378G 可以短时间运行在 5.1 GHz,见图 1.11。
事实上,图 1.1 中自 2008 年起每年性能最高的微处理器,都提供临时超频功能。到 2016 年为止,超频频率通常比标称值高约 10%;此后,Turbo 频率则高出 30%–80%。对于单线程代码,这些微处理器可以只保留一个核心工作、关闭其他核心,并让该核心运行得更快。注意,虽然操作系统能够关闭 Turbo 模式,但开启后,并不会在实际进入加速状态时通知程序员;因此,他们可能惊讶地发现,程序性能竟会随室温而变化!
异构核心。 手机早已同时采用速度快、功耗高的核心,以及速度较慢、能效更高的核心。例如,Apple iPhone 14 Pro 智能手机的芯片有两个高性能核心和四个高能效核心。目标是在维持用户所期望响应能力的前提下,用能效最高的处理器运行应用,以节省能量。智能手机甚至还配备了面向狭窄领域的专用处理器,以进一步提高这些任务的能效。
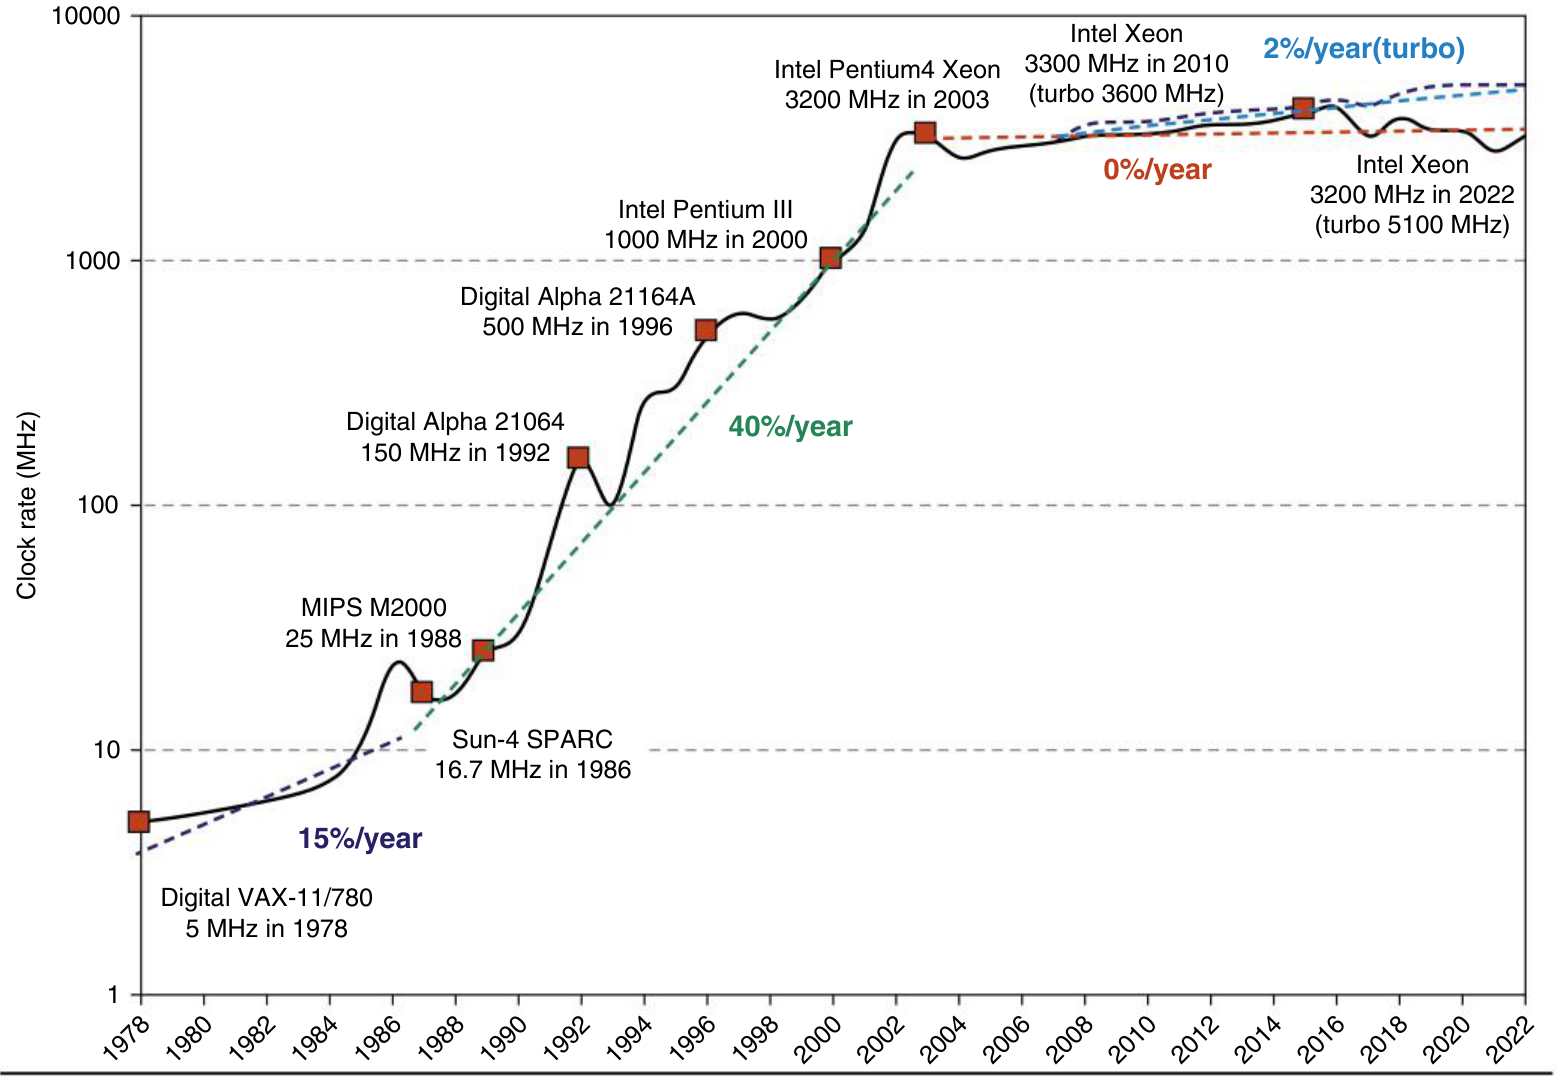
图 1.11(续)。 1978–1986 年,时钟频率每年提高不到 15%,性能则每年提高 22%。在 1986–2003 年这个性能年增 52% 的“复兴时期”,时钟频率以每年近 40% 的速度猛增。此后,时钟频率几乎停滞。自 2008 年起,Intel 提供 Turbo 模式,使芯片能够暂时以更高频率运行,直到温度过高。即便是 Turbo 频率,2011–2022 年的年增幅也只有约 2%。
图内术语:Clock rate=时钟频率;year=年;turbo=Turbo 模式。图中的产品名称保留英文,年份与 MHz 数值均为原书数据。
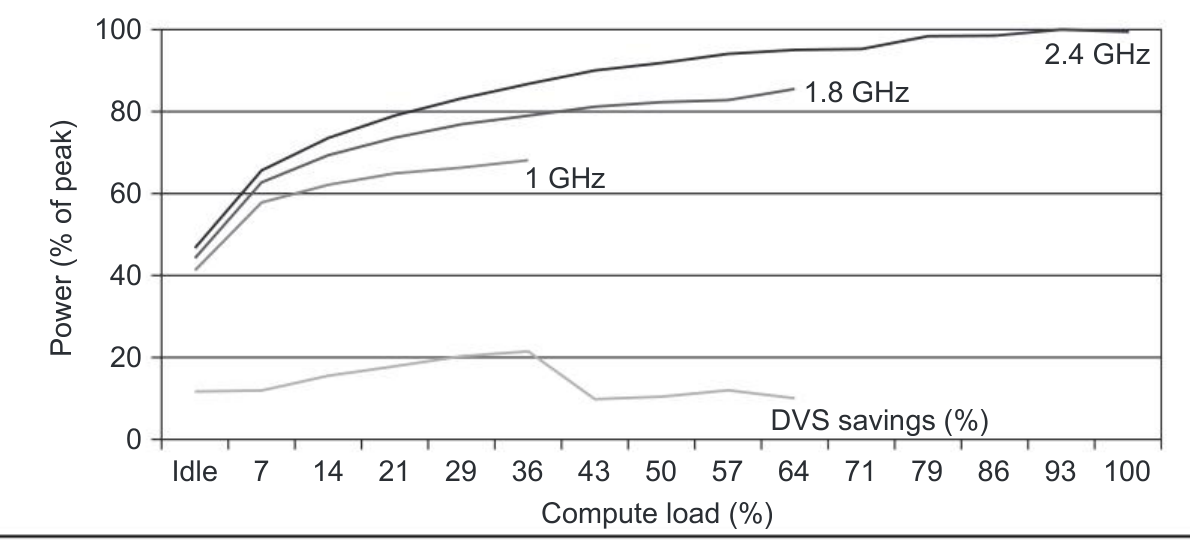
图 1.12(续)。 在 1.8 GHz 下,服务器最多只能处理约三分之二的工作负载,才能不违反服务水平要求;在 1 GHz 下,则只能安全地处理三分之一。引自 Barroso、Hölzle 和 Ranganathan(2019)的图 5.11。
图内术语:Power (% of peak)=功耗占峰值的百分比;Compute load (%)=计算负载百分比;Idle=空闲;DVS savings (%)=动态电压调节带来的节省百分比。
虽然传统上认为动态功耗是 CMOS 功耗的主要来源,静态功耗如今也成为一个重要问题,因为即使晶体管处于关闭状态,仍会有漏电流流过。原书此处列出的公式为:
译注: 原页在静态功耗段落中再次印出了动态能量公式。根据电功率定义,这里应讨论 ,其中 为漏电流。上面的原式仅为忠实呈现源文,不能用来计算静态功耗。
也就是说,静态功耗与器件数量成正比。
因此,即使晶体管闲置,增加晶体管数量也会增加功耗;晶体管尺寸更小的处理器,漏电流还会增大。于是,超低功耗系统甚至会切断非活动模块的供电,即采用电源门控(power gating),以控制漏电造成的损耗。
2011 年,设计目标是将漏电功耗控制在总功耗的 25%;高性能设计的漏电功耗有时远高于这一目标,可达到总功耗的 50%。部分原因是它们拥有大型 SRAM 缓存,而 SRAM 必须持续供电,才能保持所存储的值——SRAM 中的 S 就是 static。要阻止漏电,唯一的办法是关闭芯片部分区域的电源。
最后,处理器仅占整个系统能耗的一部分。因此,采用速度更快、处理器自身能效较低的方案,使系统其余部分更早进入休眠状态,有时反而是合理的。这一策略称为 race-to-halt。
功率和能耗的重要性,促使人们更严格地审视创新方案的效率。如今,主要评价指标是每焦耳完成的任务数,或每瓦性能;过去则关注每平方毫米硅片所提供的性能。这种新指标会影响利用并行性的方式,第 4 章和第 5 章将进一步说明。
能耗限制带来的计算机体系结构转变
随着晶体管技术的进步放缓,体系结构设计者必须从其他方面寻找提高能效的办法。事实上,在给定的能耗预算下,如今很容易设计出这样一种微处理器:它包含的晶体管太多,无法全部同时开启。这种现象称为 dark silicon(暗硅),因为在热约束下,芯片中很大一部分在任何时刻都不能被使用,只能保持“黑暗”。这一认识促使设计者重新审视处理器设计的基本原则,以寻求更高的单位能耗性能。
图 1.13 列出了现代计算机基本构件的能耗,其中一些比值大得令人惊讶。例如,一次 32 位浮点加法消耗的能量,是一次 8 位整数加法的 50 倍。
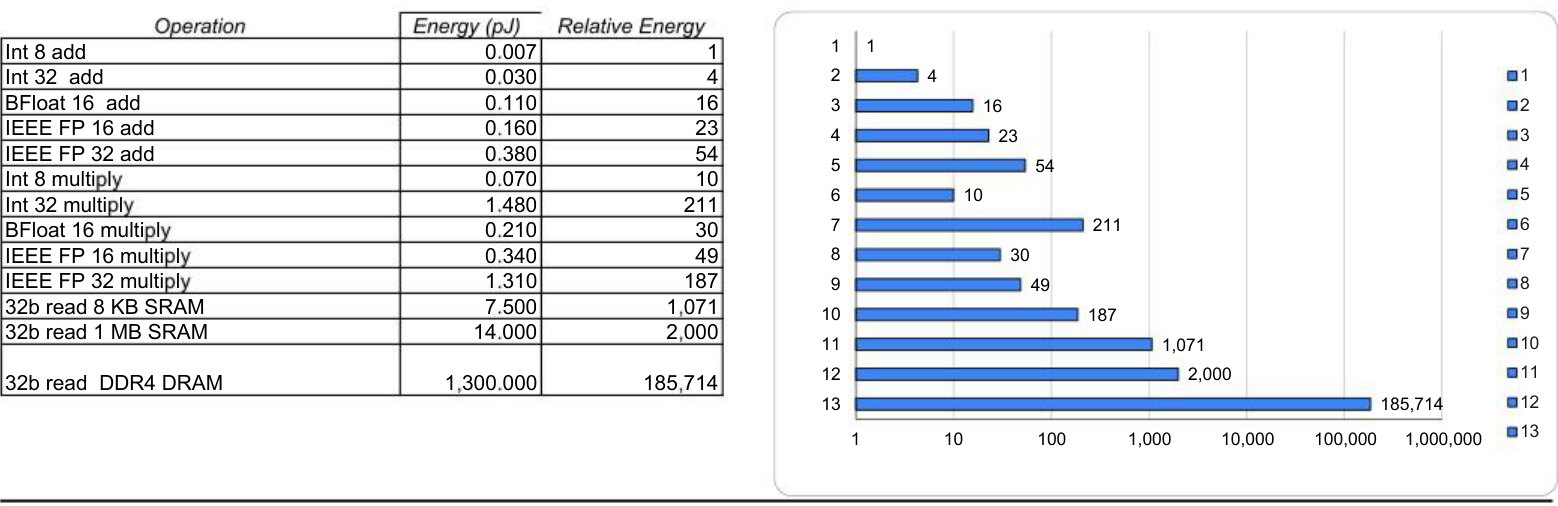
图内术语:Operation=操作;Energy (pJ)=能量(pJ);Relative Energy=相对能耗。右图编号与下表第一列一一对应,以 8 位整数加法为基准。
| 编号 | 操作 | 能量(pJ) | 相对能耗 |
|---|---|---|---|
| 1 | 8 位整数加法 | 0.007 | 1 |
| 2 | 32 位整数加法 | 0.030 | 4 |
| 3 | BFloat16 加法 | 0.110 | 16 |
| 4 | IEEE FP16 加法 | 0.160 | 23 |
| 5 | IEEE FP32 加法 | 0.380 | 54 |
| 6 | 8 位整数乘法 | 0.070 | 10 |
| 7 | 32 位整数乘法 | 1.480 | 211 |
| 8 | BFloat16 乘法 | 0.210 | 30 |
| 9 | IEEE FP16 乘法 | 0.340 | 49 |
| 10 | IEEE FP32 乘法 | 1.310 | 187 |
| 11 | 从 8 KB SRAM 读取 32 bit | 7.500 | 1071 |
| 12 | 从 1 MB SRAM 读取 32 bit | 14.000 | 2000 |
| 13 | 从 DDR4 DRAM 读取 32 bit | 1300.000 | 185,714 |
不过,最大的差异来自内存:一次 32 位 DRAM 访问的能耗,几乎是一次 8 位加法的 200,000 倍。小型 SRAM 的能效是 DRAM 的 175 倍,这表明,谨慎使用缓存和内存缓冲区至关重要。
“尽量降低每项任务的能耗”这一新设计原则,结合图 1.13 所示的相对能耗,启发了计算机体系结构的一条新方向,第 7 章将加以介绍。领域专用处理器通过减少宽位浮点运算,并配置专用存储器以减少 DRAM 访问,来节省能量;再把节省下来的能量用于支持比传统处理器多 10–1000 个、位宽较窄的算术单元。尽管这种处理器只能完成有限的一组任务,但在这些任务上,它们的速度和能效都远高于通用处理器。
正如医院既有全科医生,也有专科医生一样,在这个重视能耗的世界里,计算机已经成为两类核心的组合:一类是可以承担任何任务的通用核心,另一类是能把少数几件事做得极好、而且效率更高的专用核心。
计算机能耗对全球气候变化的影响
全球气候变化是当今社会面临的一项巨大挑战。计算的快速增长,也理所当然地引发了人们对其碳足迹的担忧。
排放可以分为:
- 运行排放(operational):来自硬件运行所消耗的能量;对服务器而言,也包括数据中心的额外开销。
- 隐含排放(embodied):还计入相关各个组成部分在制造过程中产生的碳排放,从芯片制造一直到数据中心建筑施工。
隐含排放成本更难计算,因为必须逐层追溯至最初的制造来源,核算各阶段排放,再把中间各环节直至最终产品的排放累加起来。
运行能耗为:
对数据中心而言,还有一个反映能量送达内部计算机时效率的因素,称为电能使用效率(Power Usage Effectiveness,PUE),第 6 章将加以介绍。
能耗以千瓦时(kWh)计量,排放以千克二氧化碳当量(CO₂e)计量;CO₂e 也把甲烷等温室气体计算在内。排放量的计算公式为:
能耗相对容易计算,但最后一项很难确定:根据主要能源来源的不同,各地之间可能相差 5–10 倍(Patterson et al., 2022)。煤炭是最不清洁的能源,天然气较清洁,但仍含碳;太阳能、风能、核能和水电则是无碳能源的例子。以 Google 的能源来源为例,2020 年,其新加坡数据中心所用能源中只有 4% 是无碳能源,而芬兰数据中心的比例达到 94%。即使在同一国家,差异也可能很大:在美国,内华达州数据中心的这一比例为 19%,爱荷华州则达到 93%。Google 之所以能够达到如此高的比例,是通过签约采购可再生能源,降低本地电网供电所对应的碳排放。以爱荷华州为例,那里昼夜都有充足的风能。
计算机体系结构设计者可以通过提高所设计计算机的运行能效,并学习如何降低其制造过程中的隐含碳足迹,帮助减少信息技术的碳足迹。
1.6 成本趋势
虽然某些计算机设计,特别是超级计算机,对成本的重视程度相对较低,但成本敏感型设计的重要性却在不断上升。事实上,过去四十年,利用技术进步降低成本、同时提高性能,一直是计算机产业的一条主线。
教科书常常忽略“性价比”中的成本这一半:一方面,成本不断变化,会使书中的内容过时;另一方面,成本问题相当复杂,而且各个细分市场的情况不同。然而,要在成本敏感的设计中明智地决定是否加入某项新功能,体系结构设计者就必须理解成本及其影响因素。试想一下,建筑师如果对钢梁和混凝土的价格一无所知,要怎样设计摩天大楼?
本节讨论影响计算机成本的主要因素,以及这些因素如何随时间变化。
时间、产量与商品化的影响
即使基本实现技术没有显著进步,制造出来的计算机部件,其成本也会随时间降低。推动这一变化的基本原理是学习曲线(learning curve):制造成本会随时间下降。衡量学习曲线的最佳方式,是观察**良率(yield)**的变化。
良率指制成器件中通过测试的比例。无论是芯片、电路板还是系统,良率翻一番,成本就能减半。
要预测产品整个生命期内的成本,就必须理解学习曲线如何提高良率。一个例子是,长期以来,DRAM 每 GB 的价格一直在下降。除了供不应求或供过于求的时期,DRAM 的定价通常与成本密切相关,因此两者走势基本一致。
微处理器的价格也会随时间下降,但它们不像 DRAM 那么标准化,所以价格与成本的关系更复杂。竞争激烈时,价格往往紧随成本变化,不过微处理器厂商大概很少会亏本销售。
产量是决定成本的第二个关键因素。增加产量会从几个方面影响成本。首先,它缩短了走过学习曲线所需的时间,而这一过程在一定程度上与制造的系统或芯片数量有关。其次,提高产量能够提升采购和制造效率,从而降低成本。作为经验法则,一些设计者估计,产量每翻一番,成本就会降低约 10%。此外,产量增加还减少了每台计算机需要分摊的开发费用,使成本与售价能够更加接近,同时仍有利润可赚。
**标准化商品(commodities)**是由多家厂商大量销售、彼此基本相同的产品。食品杂货店货架上的产品几乎都属于这一类,标准 DRAM、Flash、显示器和键盘也是如此。过去四十年,个人计算机产业中的很大一部分已经成为标准化商品业务,专注于制造通常运行 Microsoft Windows 的台式机和笔记本电脑。
由于许多厂商销售的产品几乎完全相同,这类市场的竞争非常激烈。竞争当然会压缩成本与售价之间的差距,但它也会降低成本。原因在于,标准化商品市场既有足够的规模,也有清晰的产品定义,使多家供应商能够竞争生产同一类产品所需的部件。部件供应商之间的竞争,加上它们能够实现的规模效益,共同降低了整体产品成本。这种竞争使计算机产业的低端市场能够提供优于其他细分市场的价格性能比,也推动了低端市场更快增长,只是利润极为有限——这与其他标准化商品行业一样。
集成电路的成本
一本计算机体系结构书,为什么要专门讨论集成电路成本?在竞争日趋激烈的计算机市场中,磁盘、Flash、DRAM 等标准部件在任何系统成本中都占据了相当比例;而在不同计算机之间存在差异的那部分成本里,集成电路所占的比重正在上升,尤其是在产量大、对成本敏感的细分市场。
事实上,由于 PMD 依赖片上系统(system on a chip,SoC),集成电路成本占据了 PMD 成本的很大一部分。因此,要理解当今计算机的成本,设计者就必须理解芯片的成本。
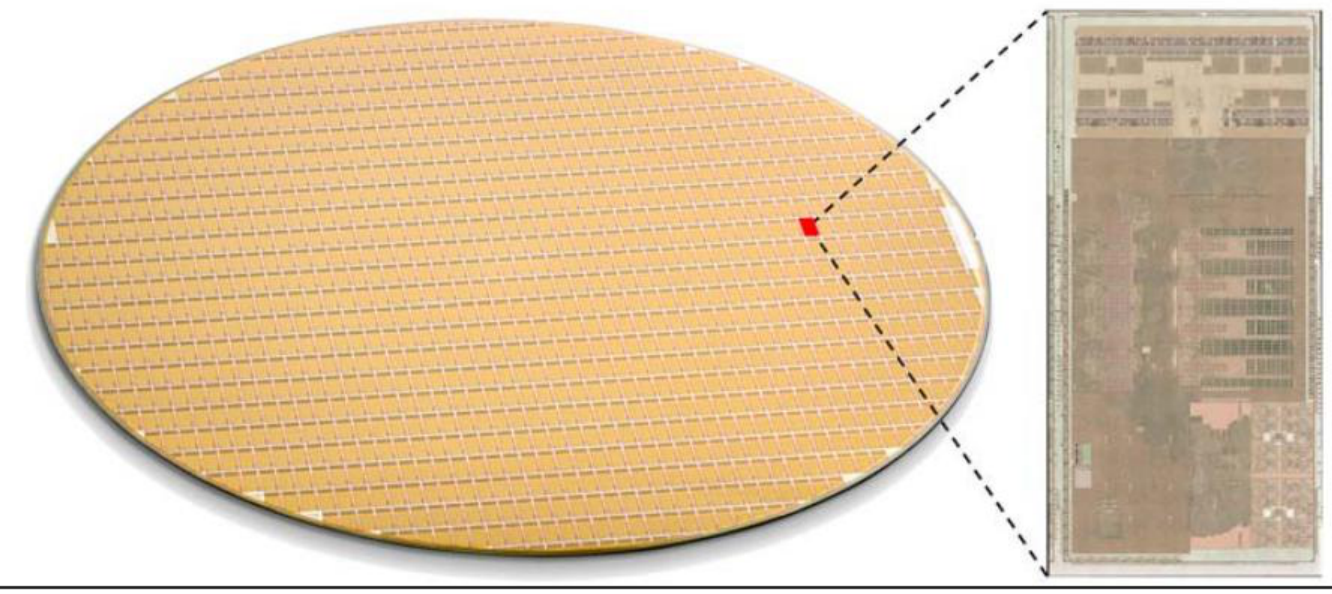
虽然集成电路成本已经呈指数级下降,但硅器件制造的基本过程没有改变:晶圆(wafer)仍然需要测试、切割成裸片(die),再进行封装,见图 1.14–1.16。因此,封装后集成电路的成本为:
本节重点讨论裸片成本,在末尾简要总结测试与封装方面的关键问题。
要预测每片晶圆能够得到多少颗合格芯片,首先要知道一片晶圆能容纳多少颗裸片,然后再预测其中能够正常工作的比例。这样就很容易估算成本:
这个芯片成本公式的第一项,最值得关注的特点是它对裸片尺寸十分敏感,下面就来说明。
每片晶圆的裸片数,大致等于晶圆面积除以裸片面积。更准确的估计为:
第一项是晶圆面积 与裸片面积之比。第二项修正了“方块装进圆盘”的问题,也就是圆形晶圆边缘的矩形裸片无法完整容纳的情况。用晶圆周长 除以正方形裸片的对角线长度,就近似得到沿边缘分布的裸片数量。
例:每片晶圆的裸片数
问题。 对于直径为 300 mm(30 cm)的晶圆,分别求边长为 1.5 cm 和 1.0 cm 的裸片,每片晶圆可以容纳多少颗。
解答。 当裸片面积为 2.25 cm² 时:
大裸片的面积是小裸片的 2.25 倍,因此每片晶圆能容纳的小裸片数大约也是大裸片数的 2.25 倍,实际比值为 :
然而,上式给出的只是每片晶圆能够容纳的最大裸片数。关键问题是:其中合格裸片的比例,也就是裸片良率,是多少?一个简单的集成电路良率模型,假定缺陷在晶圆上随机分布,且良率与制造工艺的复杂程度成反比,可得到:
这个 Bose–Einstein 公式是根据多条生产线的良率建立的经验模型(Sydow, 2006),至今仍然适用。晶圆良率反映整片晶圆报废的情况;这种晶圆上的各个裸片都不必再测试。为简化讨论,我们假定晶圆良率为 100%。单位面积缺陷数用来衡量随机制造缺陷。
2022 年,7 nm 和 5 nm 工艺的典型数值都是每平方英寸 0.075 个缺陷,换算为公制约为每平方厘米 0.012 个缺陷。最后,参数 称为工艺复杂度因子,用于衡量制造难度。2022 年的 7 nm 工艺中,;5 nm 工艺中,。
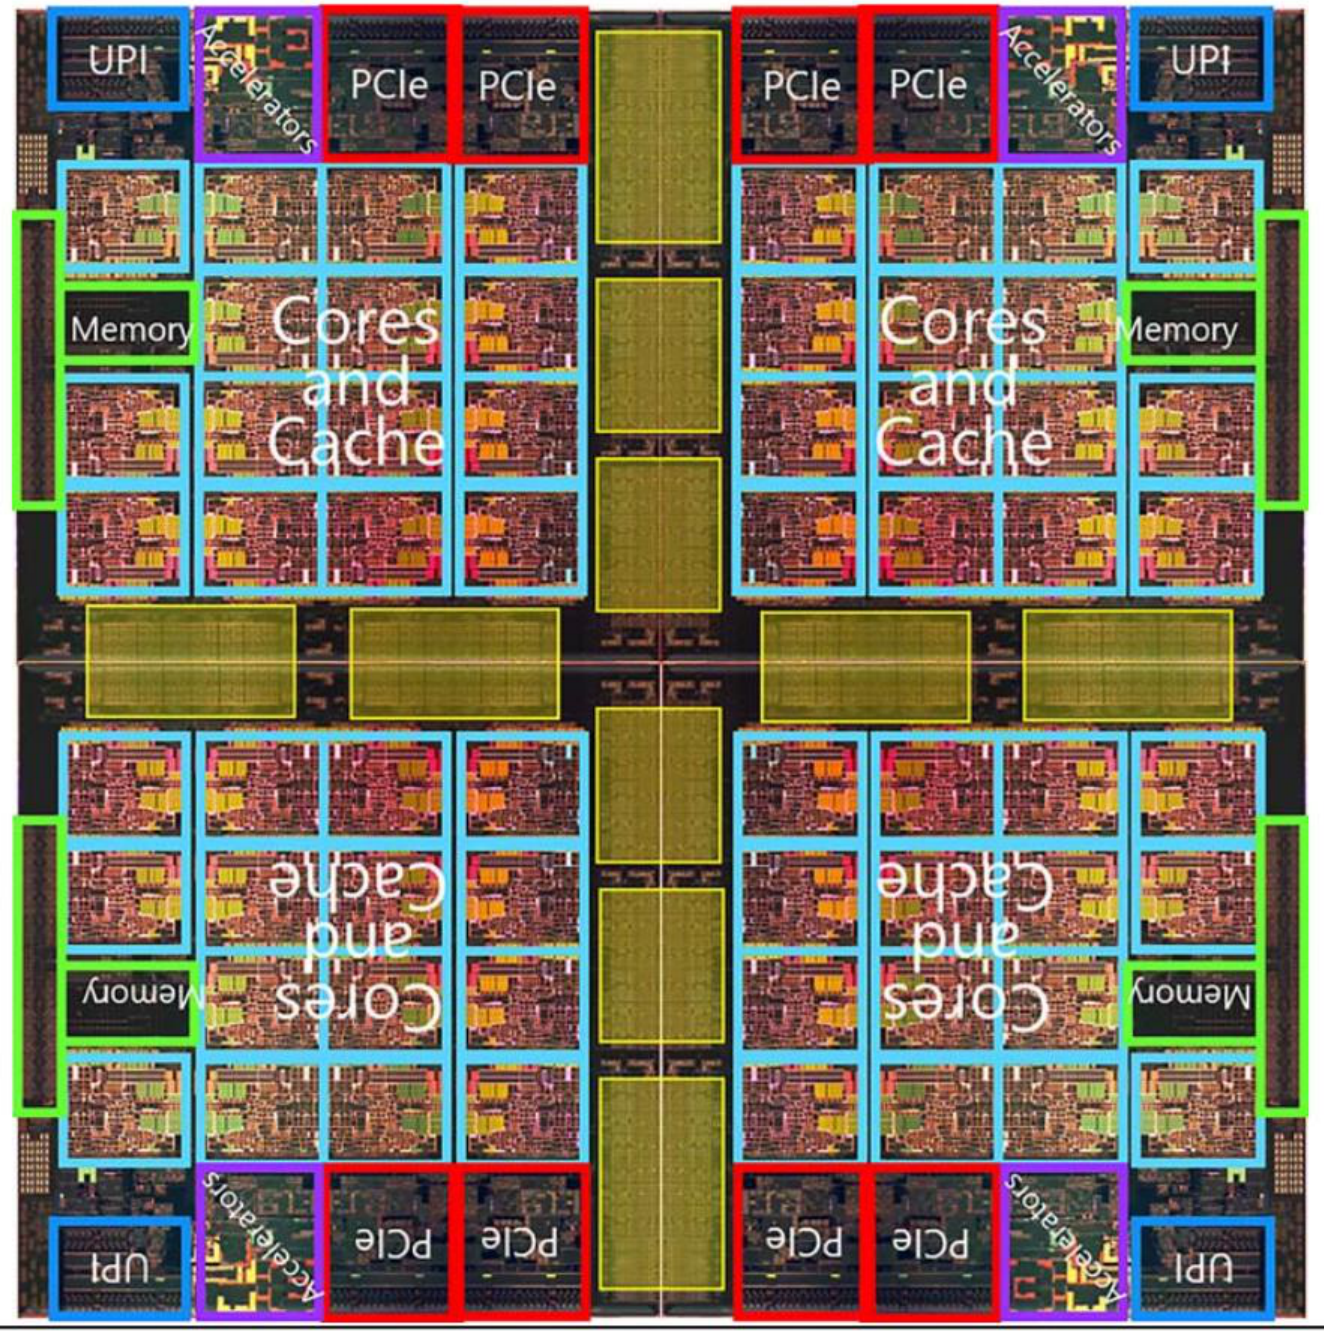
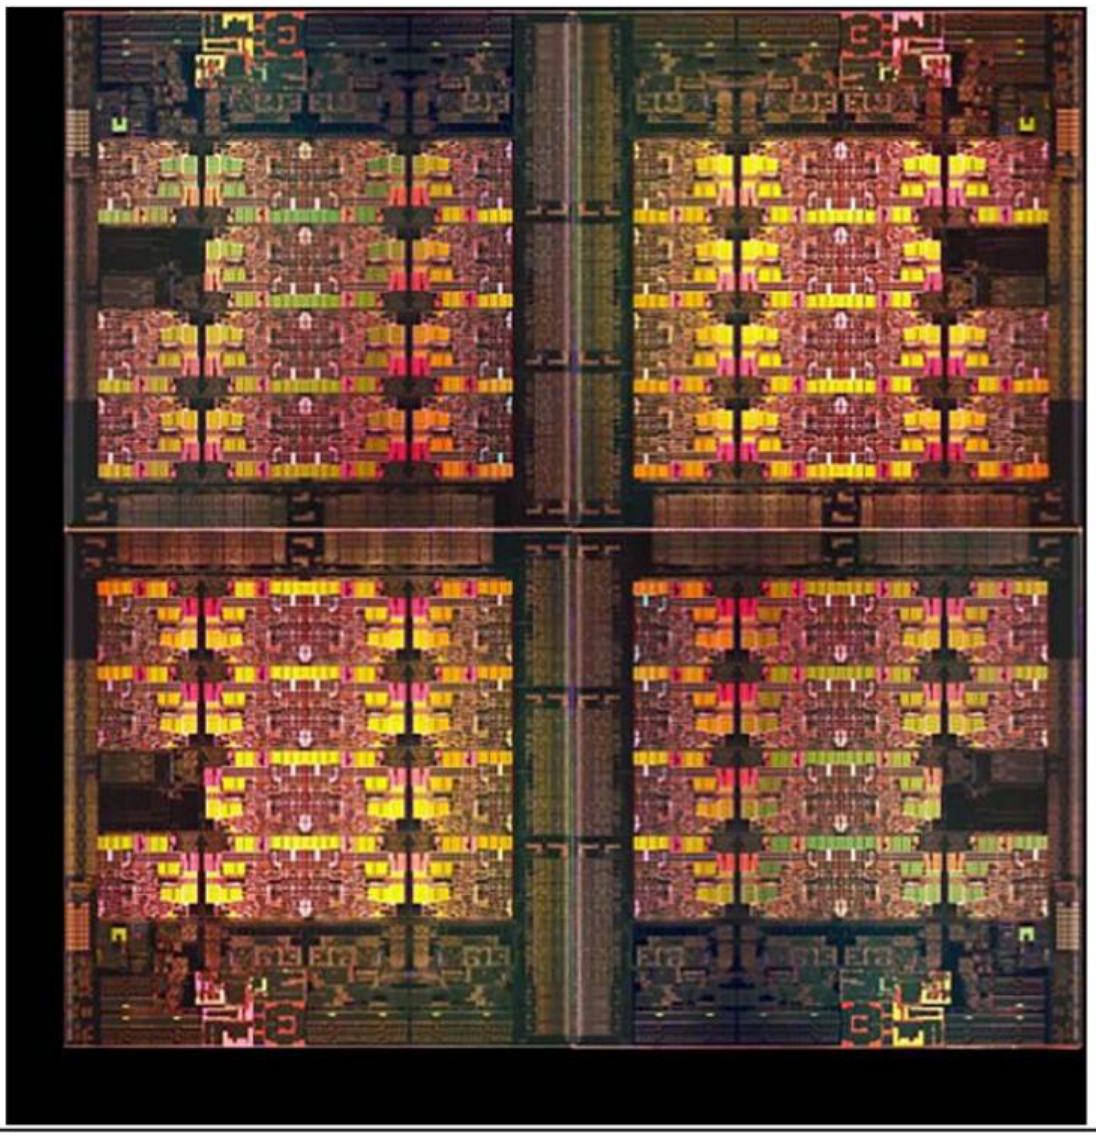
图 1.15(续)。 UPI(Ultra Path Interconnect)是 Intel 在处理器插槽之间使用的点对点互连。PCIe(Peripheral Component Interconnect Express)是连接 GPU、网络接口和存储设备的标准高速串行扩展总线。Memory 区域是 DDR5 DRAM 的内存控制器。Accelerators 区域包含对 Advance Matrix Extension(AMX)和 Advance Vector Extension(AVX)的硬件支持,还包含用于加速密码运算及数据压缩/解压缩的引擎 QuickAssist Technology,以及名副其实的 Data Streaming Accelerator(DSA,数据流加速器)。Sapphire Rapids 还有与高带宽内存共同封装的版本;HBM 接口也位于 Accelerator 区域。
图内其余术语:Cores and Cache=核心与缓存;Memory=内存控制器区域;Accelerators=加速器。
例:裸片良率
问题。 假定缺陷密度为每 cm² 0.012 个、,求边长分别为 1.5 cm 和 1.0 cm 的裸片的良率。
解答。 两种裸片的总面积分别为 2.25 cm² 和 1.00 cm²。对于较大的裸片,原书给出的良率计算为:
对于较小的裸片,原书给出的计算为:
最终关心的是每片晶圆上的合格裸片数。大裸片只有 40% 合格,小裸片则约有三分之二合格。小裸片的面积略小于大裸片的一半,每片晶圆的合格裸片数却大约是其四倍。
译注: 两式左端在原页中都写作 Die yield,但右端乘以了每片晶圆裸片数,因此实际计算的是“合格裸片数”,不是良率。原书算术结果也与其参数不完全一致:按原式重算,两种良率分别约为 0.3936 和 0.6587,合格裸片数分别约为 106.27 和 421.56,而非 109 和 427。
许多微处理器的裸片面积在 1.00–2.25 cm² 之间,但低端嵌入式 32 位处理器有时只有 0.05 cm²;用于廉价 IoT 设备嵌入式控制的处理器,往往还不到 0.01 cm²;高端服务器和 GPU 芯片则可达到 8 cm²。芯片能够重复制作的最大尺寸称为 reticle limit,即光刻设备在一次掩模曝光步骤中能够覆盖的面积,约为 8.5 cm²。
DRAM 和 SRAM 等标准化商品面临巨大价格压力,设计者因此引入冗余来提高良率。多年来,DRAM 普遍加入一些冗余存储单元,以容忍一定数量的缺陷。对于微处理器内部用作缓存的大型 SRAM 阵列,设计者也采用了类似技术。出于同样原因,GPU 在约 100 个片上处理器中会配置 4 个冗余处理器。显然,冗余单元可以显著提高良率。
2022 年,一片直径为 300 mm(12 英寸)的晶圆,采用 7 nm 工艺加工的成本约为 10,000 美元,采用 5 nm 工艺则约为 16,000 美元。假定加工后晶圆的成本为 16,000 美元,1.00 cm² 裸片的成本约为 35 美元,而 2.25 cm² 裸片的成本约为 135 美元。1
对于芯片成本,计算机设计者应记住什么?制造工艺决定晶圆成本、晶圆良率和单位面积缺陷数,因此设计者能控制的是裸片面积和冗余。原文接着指出:实际上,由于单位面积的缺陷数很小,每片晶圆的合格裸片数,以及由此得到的每颗裸片成本,大致随裸片面积的平方增长。2 设计者通过决定哪些功能放到裸片上、哪些不放,以及 I/O 引脚的数量,影响裸片尺寸,进而影响成本。从环境角度看,一片晶圆所对应的隐含碳成本,不取决于它最终产出多少颗合格裸片;因此,提高每片晶圆的合格裸片产出,是降低每颗裸片隐含碳成本的一种好办法。3
在得到可以装进计算机的部件之前,裸片必须先接受测试,以区分合格与不合格产品,再进行封装,并在封装后再次测试。这些测试显著增加了从流片到获得可用芯片的时间,也增加了芯片制造成本。
前面的分析主要讨论制造一颗可用裸片的可变成本,这适用于大批量集成电路。不过,对于低产量产品——少于一百万颗——有一项极其重要的固定成本,会显著影响集成电路的成本,那就是一整套掩模的成本。集成电路工艺的每个步骤都需要单独的掩模。因此,对于金属层数多达十层的现代高密度制造工艺,7 nm 的掩模成本约为 1000 万美元,5 nm 则约为 2000 万美元。
图 1.17 展示了商用芯片开发总成本的组成,以及这些成本在近期工艺节点上显著上升的情况。这些费用统称为非重复性工程费用(nonrecurring engineering,NRE),也就是新产品开发的一次性成本。
好消息是,半导体公司提供 shuttle runs,可以大幅降低微型测试芯片的成本。它们把许多个小设计放进同一个裸片,以分摊掩模费用;之后再切分成更小的部分,交给各个项目。因此,在 2022 年,TSMC 以 12,000 美元的价格,就能提供 80–100 颗未经测试、采用 28 nm 工艺、尺寸为 1 mm × 1 mm 的裸片。这些裸片虽然很小,却能为体系结构设计者提供数百万个晶体管的试验空间。例如,这样一颗裸片能够容纳数个 RISC-V 处理器。
shuttle runs 有利于原型制作和调试,但无法解决几万到几十万颗产品的小批量生产问题。由于掩模成本可能继续上涨,一种新的方法正逐渐受到重视,下面就来讨论。
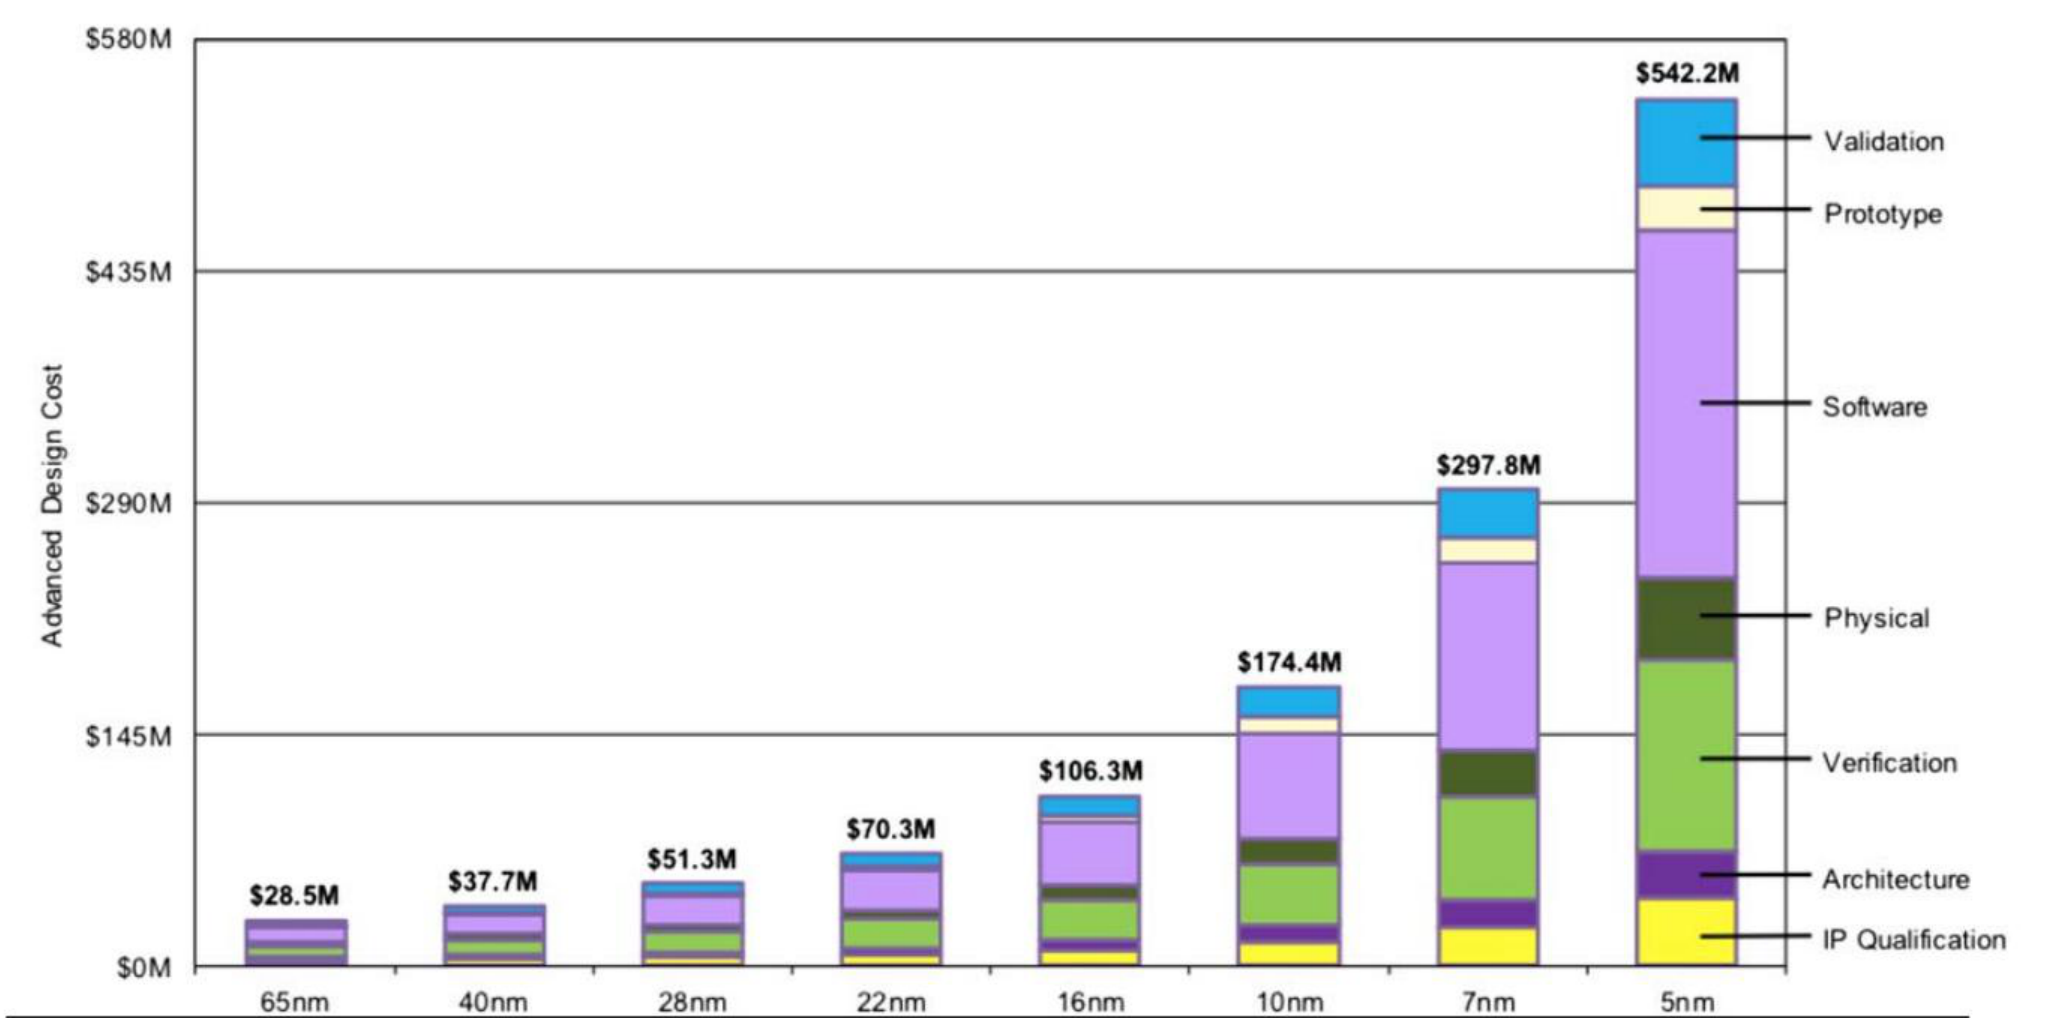
图 1.17(续)。 从图例下方向上看,各项含义如下:IP Qualification 是验证芯片所获授权 IP 模块的费用;Architecture 是芯片的逻辑设计;Verification 是检查芯片是否符合设计规格;Physical 是芯片版图的物理设计;Software 是该设计特有的底层软件,包括驱动程序、固件和诊断程序,这些软件必须为该芯片移植或重新优化;Prototype 包括评估芯片所需的电路板和软件;Validation 的层次高于 Verification,它检查软硬件系统是否满足用户最终应用的实际需求。掩模成本包含在物理设计中。5 nm 节点的数据是预测值,其他节点则依据实际经验。图源:Joel Hruska,2018 年 6 月 22 日,“As Chip Design Costs Skyrocket, 3nm Process Node Is in Jeopardy”。
图内纵轴 Advanced Design Cost 为先进芯片设计成本,M 表示百万美元。总额如下;各色分项未给出精确数字,不能从柱形高度补造数据。
| 工艺节点(nm) | NRE 总费用(百万美元) |
|---|---|
| 65 | 28.5 |
| 40 | 37.7 |
| 28 | 51.3 |
| 22 | 70.3 |
| 16 | 106.3 |
| 10 | 174.4 |
| 7 | 297.8 |
| 5 | 542.2(预测) |
Chiplet
本书前几版记录了向更小几何尺寸发展所需的费用。在第 6 版中,我们列出的 28 nm 工艺、300 mm 晶圆加工成本为 4000–5000 美元,与第 5 版所列 90 nm 晶圆的价格相近。
如今,5 nm 晶圆的成本为 16,000 美元,约为原来的四倍。第 6 版中,28 nm 工艺的掩模费用为 150 万美元,同样与第 5 版中 90 nm 工艺的费用相近;到了 5 nm,费用升至 2000 万美元,约增长到原来的 13 倍。AMD 发现,从 45 nm 到 5 nm,一颗面积为 250 mm² 的合格裸片,其成本升至原来的五倍(Naffziger, 2021)。
不断上涨的掩模成本,对高产量芯片,例如产量超过一千万颗的产品,影响相对较小;但对产量低于一百万颗的芯片,则形成了显著的成本下限。如第 7 章将要讨论的,通用处理器无法像专用处理器那样显著提高性价比,于是产业开始制造种类更多、各自产量较低的芯片,而不是把产量集中到少数几种芯片上。体系结构走向专用化的趋势,与半导体经济性更偏好超大规模生产的趋势发生了冲突。
此外,虽然最新、也更昂贵的工艺仍能改善逻辑门,芯片中的其他部件却未能同步进步,见图 1.13。单位连线长度的能耗改善得慢得多,SRAM 密度的增长也比过去缓慢。比较 65 nm 和 3 nm 工艺,图 1.18 表明,每 mm² 的 SRAM 容量约只有理想缩放所预期密度的 1/20;较早的工艺世代曾经能够达到那种理想缩放。模拟电路的缩放也在放缓,这意味着 7 nm 之后,I/O 的进步会很缓慢。
由于技术发展趋势与体系结构发展趋势方向相反,一种解决办法就是 chiplet,即用于组成同一封装系统的小型裸片。多个较小的裸片,其中一些可以采用较老、成本更低的工艺节点,被集成到一个封装中,取代 Moore 定律所展现的传统路径:不断制造更大的单一裸片。
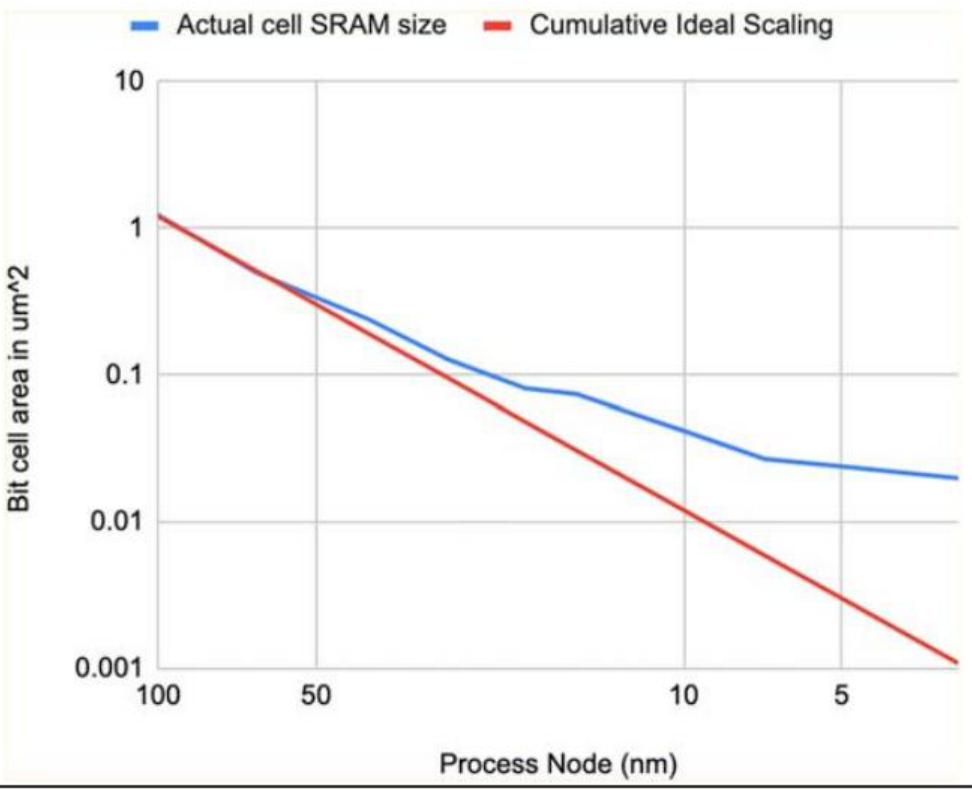
图内术语:Actual cell SRAM size=实际 SRAM 单元尺寸;Cumulative Ideal Scaling=累积理想缩放;Bit cell area in μm²=位单元面积(μm²);Process Node (nm)=工艺节点(nm)。
这种新型封装方案也带来了新的挑战:
- 芯片设计更复杂,因为必须把一个完整的逻辑设计划分成多个较小的独立部分。
- 需要新的 chiplet 间通信通路。与片上通信相比,这些通路更长,功耗或延迟更高,带宽也更低。
- 某些功能在单个大裸片中只需实现一次,拆成 chiplet 后则可能要在每个 chiplet 上重复实现。
尽管如此,相比单个大芯片的设计,合理选择 chiplet 仍然能够降低成本,并增加有效硅片总面积。
例如,最初的 AMD EPYC CPU 使用四个 14 nm chiplet(Naffziger, 2021)。AMD 估算,如果采用 14 nm 工艺制造一颗完整的 32 核芯片,需要 777 mm²。采用 chiplet 后,每个面积为 213 mm²,四个总共需要 mm²,比前者多约 10%。但将良率考虑在内,AMD 预计,采用 chiplet 可以获得约 1.7 倍的成本优势。此外,chiplet 还让 AMD 能够利用同一种设计,同时提供 16 核和 32 核产品。
对于第二代 EPYC Rome CPU,AMD 发现 I/O 在 7 nm 工艺下改善不大,因此,更合理的做法是把这些功能集中到一个采用较便宜工艺制造的 I/O chiplet 中:12 nm 工艺、面积 416 mm²;与此同时,采用 7 nm 工艺的 8 核 chiplet 可以缩小到 74 mm²。chiplet 再次使 AMD 能够基于一种设计,提供 16、24、48 和 64 核等多种产品。在与单片定制设计的比较中,AMD 估计,16–48 核设计的成本会高出约 1.8–2 倍;但 64 核设计根本无法制造,因为它的面积将超过 1000 mm²,越过掩模的 reticle limit。4 chiplet 之间的通信,确实比同一个大芯片内部通信更耗电;不过,这只占整个系统功耗的一小部分,可以纳入系统设计的统筹考虑。
AMD、Intel、NVIDIA 以及许多其他公司,已经在使用为特定产品设计的专用 chiplet。除了这些定制产品,如果 chiplet 能够标准化、在多条产品线之间复用,整个行业就有望受益:产量能够提高,每颗产品分摊的掩模成本也会降低。熟悉芯片历史的人会知道,Texas Instruments 的 TTL Data Book 及其 74xx 系列芯片,就是成功建立通用构件标准的例子;它们出现在 20 世纪 70 年代 Moore 定律的小规模集成阶段。今天,有许多工作正在尝试启动一个通用 chiplet 产业。一旦成功,定制硬件设计的成本和开发时间就可能大幅下降。不过,到目前为止,这更多还是一个理论上很有吸引力的可能性,尚不能说很有把握会实现。
为避免在系统讨论中混淆芯片与 chiplet,后续章节将用 **socket(插槽)**指代一个 CPU,无论它是单个大芯片,还是由多个 chiplet 组成的封装。
成本与价格
随着计算机走向商品化,产品制造成本与售价之间的差额不断缩小。这部分差额需要支付公司的研发(R&D)、市场推广、销售、制造设备维护、房屋租赁、融资成本、税前利润和税款。许多工程师会惊讶地发现,多数公司的研发开支只占收入的 4%–12%:标准化 PC 业务约为 4%,高端服务器业务约为 12%,而所有工程工作都要由这笔研发预算来承担。
制造成本与运行成本
在本书前四版中,“成本”指制造计算机的成本,“价格”指购买计算机的价格。仓库级计算机(WSC)出现后,一个系统内包含数万台服务器,除了购买费用,运行计算机的费用也变得非常可观。经济学把这两类费用分别称为资本性支出(CAPEX)和运营支出(OPEX)。
如第 6 章所示,如果假定 IT 设备的使用寿命较短,只有 3–4 年,那么服务器和网络设备摊销后的购置价格,约占 WSC 每月运行总成本的一半。总拥有成本(TCO)就是 CAPEX 加上 3–4 倍的 OPEX。5 每月运营成本中,约 40% 用于电力,以及配电、IT 设备散热基础设施的摊销;尽管这些基础设施的摊销年限已经长达 10–15 年。因此,要降低 WSC 的运营成本,计算机体系结构设计者必须高效利用能源。还要注意,随着 Moore 定律放缓,一些公司已经开始把 IT 设备的使用寿命延长到 6–8 年。
译注: 此处 35 美元和 135 美元均照录原文。即使用上一例原书给出的 427 和 109 颗合格裸片,16,000 美元分别相除也约为 37.47 和 146.79 美元;按上一例公式重新计算,则约为 37.95 和 150.56 美元。因此,不能把原文报价与前述参数视为完全一致的计算结果。 ↩︎
译注: 原文确实把“每片晶圆的合格裸片数”和“每颗裸片成本”一起说成随面积平方增长。按本节给出的公式,面积增大时,前者减少,后者增加;两者不能同向增长。这里明确保留并指出源文的问题。 ↩︎
译注: 原页在此印为“the number of ideas on a wafer”。根据同段上下文,应指晶圆上的 dies(裸片);译文按此语境译出,并在这里注明原文拼写问题。 ↩︎
译注: 原文写“Compared to single custom designs”,随后说成本“1.8× to 2× higher”,比较方向表述不清,与本段强调 chiplet 成本优势的上下文也有歧义。 ↩︎
译注: 原文紧接“每月成本”后写“TCO is then CAPEX plus 3–4 times OPEX”,没有在该句交代 OPEX 的时间口径。3–4 年寿命下使用这一关系,需要将 OPEX 理解为年度运营支出;不能把前面的月度 OPEX 直接乘以 3–4。 ↩︎
1.7 可信赖性
历史上,集成电路一直是计算机中最可靠的部件之一。它们的引脚可能容易受损,通信通道也可能发生故障,但芯片内部的失效率很低。对于特征尺寸为 5 nm 及以下的工艺,这一传统认识正在改变:瞬态故障与永久性故障都越来越常见,体系结构设计者必须在系统设计中应对这些挑战。存储系统长期以来就需要处理瞬态错误,例如某个比特发生翻转,以及永久性错误,例如存储单元损坏;如今,芯片内部的逻辑电路也开始出现问题。
事实上,研究人员发现,每一千台服务器中,会有少数几个被他们称为 mercurial cores 的核心(Dixit, 2021; Hochschild, 2021; Trippel, 2022)。这些核心在执行某些指令时会反复出错,只有把指令的实际结果与预期结果进行比较,才能发现问题。这类**静默数据错误(silent data errors)**或 silent corrupt execution errors 具有以下特点:
- 检出的频率远高于程序员的预期;
- 并非只是在硬件错误的背景发生率上增加了一点;
- 出现在功能逻辑中,而不是那些较容易用错误检测码发现问题的存储结构中;
- 可能在硬件安装很久之后才出现;
- 通常只影响特定核心,而不是整个多核芯片;
- 可能因多种原因突然且不可预测地出现,例如一次很小的软件改动,使原本很少使用的指令被更频繁地执行。
研究人员建议采用软件缓解措施来应对静默错误,同时要求硬件制造商构建更稳健的硬件,或许可以借鉴大型机采用的错误检查技术。还有研究者建议,通过加强扫描测试和系统级测试,改进制造后的测试。
本节简要介绍可信赖性方面的问题;相关术语的正式定义和解决方法,留待附录 D 的 D.3 节讨论。
计算机是在不同抽象层次上设计和构建的。我们可以沿着一台计算机逐层向下展开:在上一层看似一个部件的东西,在下一层就成为完整的子系统,如此递归,最终抵达单个晶体管。有些故障影响广泛,例如断电,但许多故障可以局限在一个模块的某个部件中。因此,某一层次上整个模块的彻底失效,在更高层模块看来,可能只是一处部件错误。理解这一差别,有助于寻找构建可信赖计算机的方法。
一个难题是:如何判定系统正在正常运行?随着互联网服务普及,这一理论问题变成了现实问题。基础设施提供商开始提供服务水平协议(SLA)或服务水平目标(SLO),承诺网络或供电服务的可信赖程度。例如,如果某个月有若干小时未满足协议约定,就向客户支付赔偿。因此,可以用 SLA 来判定系统究竟处于正常服务状态,还是停机状态。
相对于一份 SLA,系统会在两种服务状态之间交替:
- 服务正常(service accomplishment):按约定提供服务。
- 服务中断(service interruption):提供的服务不符合 SLA。
两种状态之间的转换,分别由**失效(failure)和恢复(restoration)**引起:前者使系统从状态 1 进入状态 2,后者则从状态 2 返回状态 1。对这些转换进行量化,可以得到可信赖性的两项主要度量:
- **模块可靠性(module reliability)**衡量从某个参考起始时刻起,服务连续正常提供的情况;等价地,也可以考察直到发生失效所经历的时间。因此,**平均失效前时间(mean time to failure,MTTF)是可靠性的一项度量。服务中断时间用平均修复时间(mean time to repair,MTTR)**衡量。**平均失效间隔时间(mean time between failures,MTBF)**则是 MTTF 与 MTTR 之和。
MTBF 的倒数就是失效率。**年失效率(annual failure rate,AFR)**与以小时为单位的 MTBF 之间,关系如下:
如果 MTBF 很大,或者等价地说 AFR 很小,则可以近似为:
原文接着指出,AFR 通常用每十亿小时运行中的失效次数来报告,即 FIT(failures in time)。1 因此,1,000,000 小时这样很大的 MTTF,大约对应 ,即 1000 FIT。如果一组模块的寿命都服从指数分布,也就是说,模块已使用多久并不影响其失效概率,那么,这组模块的总体失效率就是各模块失效率之和。
- **模块可用性(module availability)**衡量系统在服务正常与服务中断两种状态交替过程中,能够正常提供服务的程度。对于可修复的非冗余系统,模块可用性为:
注意,现在“可靠性”和“可用性”都是能够量化的指标,而不是“可信赖性”的同义词。根据这些定义,只要对部件可靠性作出一些假设,并假定各次失效相互独立,就能定量估算系统可靠性。
例:磁盘子系统的 MTTF
问题。 假设一个磁盘子系统包含下列部件,其 MTTF 分别如下:
- 10 块磁盘,每块的额定 MTTF 为 1,000,000 小时;
- 1 个 ATA 控制器,MTTF 为 500,000 小时;
- 1 个电源,MTTF 为 200,000 小时;
- 1 个风扇,MTTF 为 200,000 小时;
- 1 根 ATA 电缆,MTTF 为 1,000,000 小时。
采用寿命服从指数分布、各部件失效相互独立这两个简化假设,计算整个系统的 MTTF。
解答。 各部件失效率之和为:
也就是 23,000 FIT。系统的 MTTF 就是失效率的倒数:
即略少于五年。
应对失效的主要方法是冗余,可以是时间上的冗余,也可以是资源上的冗余。时间冗余是重复执行操作,观察是否仍会出错;资源冗余则是准备其他部件,在某个部件失效时接替它。一旦部件被更换,系统得到完全修复,就假定它的可信赖性恢复到如同新系统一样。下面用一个例子量化冗余的收益。
例:冗余电源的可靠性
问题。 磁盘子系统经常采用冗余电源来提高可信赖性。使用上一例的部件与 MTTF 数值,计算冗余电源的可靠性。假设一个电源就足以让磁盘子系统运行,现在再增加一个冗余电源。
解答。 我们需要一个公式,来表示系统在容忍一次失效后仍可提供服务时,能够获得怎样的可靠性。为简化计算,假设各部件的寿命服从指数分布,且失效相互独立。冗余电源组的 MTTF,等于其中一个电源首次失效前的平均时间,除以第一个电源被更换之前,另一个电源也失效的概率。因此,如果修复之前发生第二次失效的概率很小,这对电源的 MTTF 就会很大。
由于有两个电源,且失效相互独立,直到其中一个失效的平均时间为 。第二个电源在此期间也失效的概率,可以较好地近似为 MTTR 除以另一个电源的平均失效前时间。因此,一对冗余电源的 MTTF 可以合理地近似为:
采用前面的 MTTF 数值,并假设人工发现电源失效并将其更换,平均需要 24 小时,那么,这对容错电源的可靠性为:
因此,这对电源的可靠性约为单个电源的 4150 倍。
译注: 原文确实将 AFR 与 FIT 连在一起表述,但二者并非同一指标:上面的 AFR 是一年内失效的比例或概率,没有“每十亿小时”的量纲;FIT 则表示每十亿器件小时的失效次数。 ↩︎
1.8 安全性
操作系统以及其他具有特权访问能力的系统软件,例如虚拟机,存在大量软件漏洞,它们一直是攻击者入侵计算机系统的主要途径。然而,2015 年,Google 展示了一种用户程序:它利用 DDR3 DRAM 芯片中的弱点,能够突破虚拟内存保护(Seaborn, 2015)。由于 DRAM 内部采用二维结构,而 DDR3 DRAM 的存储单元又非常小,研究人员发现,反复写入 DDR3 DRAM 的某一行,对它进行“锤击”,可能会在相邻行引发扰动错误,使受害行中的比特翻转。后续工作表明,同时攻击附近的两行,效果更强。
**Row hammer(行锤)**攻击针对的是物理内存,因此,破坏某些数据远比精确击中虚拟内存中的特定目标容易。锤击的确切结果无法预测,但多次尝试可能导致灾难性后果。攻击者可以巧妙地利用 row hammer 改变页表项中的保护位,从而让程序获得对操作系统原本试图保护的内存区域的访问权限。后来的微处理器和 DRAM 加入了检测 row hammer 攻击的机制,以阻止这类攻击。第 2 章将讨论在 DRAM 和操作系统两个层面防范定向 row hammer 攻击的技术。
这一攻击震惊了许多安全研究人员;在此之前,他们认为硬件不会受到安全问题的影响。虽然可以说 row hammer 本质上是可信赖性问题,因为内存中保存了错误的信息,但它只是一个新攻击方向的开端:攻击者开始把硬件弱点作为目标。
至少从 20 世纪 70 年代起,人们就已经知道**时序通道(timing channel)**是一种安全弱点,但大多数体系结构设计者错误地认为,它在实践中无关紧要。早期攻击要么利用操作系统缺陷,要么要求攻击者能够实际接触目标设备,要么只能以极低的带宽泄漏信息。然而,时序这样的实现属性,同样可能影响功能行为。
2018 年曝光的 Spectre 鲜明地展示了这一问题:它利用微体系结构中的推测执行,从用户级沙箱、内核或 hypervisor 中泄漏私密信息,让用户态攻击代码获得这些信息(Kocher, 2019)。
Spectre 利用了三种微体系结构技术:
- 指令推测执行。 处理器核心试图越过分支进行推测,以并发执行数十条指令。推测正确时,就提交对 ISA 可见状态的修改;推测错误时,则撤销这些修改。Spectre 反其道而行:它故意让处理器推测执行一些指令,即使知道这些指令对 ISA 可见状态的修改最终会被撤销。其隐蔽目的,是在微体系结构中留下“面包屑”般的线索,暴露程序员原以为隐藏起来的秘密。
- 缓存。 缓存对 ISA 不可见。特别是,按照传统的计算机体系结构认识,组相联缓存中哪个块是最近最少使用的,并不影响程序正确执行,因此,发生错误推测时不必恢复这一状态。Spectre 利用这一出人意料的弱点,留下并随后寻找能够泄漏秘密的“面包屑”。它由此把缓存内容用作传递秘密数据值的“侧信道(side channel)”。
- 硬件多线程。 如果攻击程序能与目标程序紧邻运行,就更容易察觉这种细微的时序变化。在硬件多线程中,一个程序的指令可以与其他程序的指令交错执行,见第 3 章;这使攻击更容易实现。硬件攻击令人担忧,以至于云服务商如今提供了选项,让用户的服务器不与其他客户的程序共享。例如,AWS 提供 Dedicated Instances,价格比传统共享实例高约 5%。
自 Spectre 公布以来,许多其他攻击又陆续出现,利用了类似的微体系结构弱点。
第 2 章和第 3 章将更深入地讨论安全性,说明如何通过针对存储层次结构和处理器的时序攻击泄漏信息。
介绍了安全性,并对计算机技术的成本、功耗和可信赖性进行了量化之后,我们已经可以进一步量化性能。
1.9 性能的测量、报告与汇总
当我们说一台计算机比另一台更快时,究竟指什么?手机用户可能认为,程序运行所需的时间越短,计算机就越快;而 Amazon.com 的管理员可能认为,每小时完成的事务越多,计算机就越快。手机用户希望缩短响应时间(response time),即从一项活动开始到结束所经历的时间,也称执行时间。云数据中心的运营者则希望提高吞吐量(throughput),即给定时间内完成的工作总量。
比较不同设计方案时,我们经常需要说明两台计算机的性能关系,设它们分别为 X 和 Y。本书中,“X 比 Y 快”是指:对于给定任务,X 的响应时间或执行时间比 Y 短。
具体而言,“X 的速度是 Y 的 倍”表示:
由于执行时间是性能的倒数,下面的关系成立:
“X 的吞吐量是 Y 的 1.3 倍”则表示:在单位时间内,计算机 X 完成的任务数是 Y 的 1.3 倍。
遗憾的是,比较计算机性能时,人们采用的指标并不总是时间。我们的立场是:真实程序的执行时间,是唯一始终一致而可靠的性能度量。无论是提出其他指标来代替时间,还是用其他测量对象来代替真实程序,最终都曾导致误导性的宣传,甚至导致计算机设计上的错误。
即使是执行时间,也会因为计入的内容不同而有不同的定义。最直观的定义称为墙钟时间(wall-clock time)、响应时间或经过时间(elapsed time):它是完成一项任务所经历的全部延迟,包括存储设备访问、内存访问、I/O 活动、操作系统开销等一切时间。在多道程序环境下,处理器等待 I/O 时会转而执行另一个程序,因此未必会使某一个程序的经过时间最短。为了描述这种情况,我们需要另一个术语。CPU 时间专门区分了这一点:它是处理器实际进行计算的时间,不包括等待 I/O 或运行其他程序的时间。(显然,用户感受到的响应时间是程序的经过时间,而不是 CPU 时间。)
经常运行同一组程序的用户,是评估新计算机的理想人选。他们只需比较自身工作负载的执行时间,就能评价新系统。这里的工作负载,是指用户在计算机上运行的程序和操作系统命令的组合。不过,很少有人拥有这样的便利条件。大多数人不得不依靠其他方法,往往还要依靠其他评估者,来评价计算机,并寄望于这些方法能够预测自己使用新机器时的性能。一种方法是运行基准测试程序:许多公司用这类程序来确定其计算机的相对性能。
基准测试
测量性能时,最好的基准测试是真实应用,例如 1.1 节提到的 Google Translate。尝试用远比真实应用简单的程序来衡量性能,曾引发种种问题。
这类程序包括:
- 核心片段(kernels):真实应用中小而关键的部分。
- 玩具程序(toy programs):来自编程入门作业、从头到尾大约只有 100 行的程序,例如 Quicksort。
- 合成基准测试(synthetic benchmarks):为模仿真实应用的特征与行为而人为构造的程序,例如 Dhrystone。
如今,这三种做法都已失去公信力,通常是因为编译器开发者与体系结构设计者可以联手优化这些替代程序,使计算机在它们上面显得比运行真实应用时更快。令本书作者遗憾的是,Dhrystone 这个合成程序,至今仍是嵌入式处理器领域最常被引用的基准测试之一!我们曾以为,所有计算机体系结构设计者都已经承认,用合成基准测试表征性能是一种站不住脚的做法,因此在本书第 4 版中删掉了对这一谬误的讨论。
另一个问题是基准测试的运行条件。过去,提升基准测试性能的一种办法,是使用专门针对该测试的编译器选项。这些选项往往会触发某些变换,而这些变换对许多程序来说并不合法,或者会降低其他程序的性能。为限制这种做法、提高结果的意义,基准测试制定者通常要求:对于同一种语言(例如 C++ 或 C)编写的全部程序,厂商必须使用同一个编译器和同一组编译选项。其目的,是尽量降低“benchmarketing”的影响,即围绕基准成绩进行营销式优化(见 1.11 节)。1
除了编译器选项,还要决定是否允许修改源代码。对此有三种不同做法:
- 不允许对源代码作任何修改。
- 允许修改源代码,但实际上几乎不可能这样做。例如,数据库基准测试依赖标准数据库程序,其代码规模达数千万行。数据库公司极不可能仅为提升某一台计算机的性能而修改这些程序。
- 允许修改源代码,只要修改后的版本产生相同的结果。
基准测试设计者在决定是否允许修改源代码时,面临的关键问题是:这些修改是否符合实际使用方式,能否为用户提供有价值的信息;还是仅仅削弱了基准测试预测真实性能的准确性。第 7 章将看到,领域专用体系结构的设计者在为定义明确的任务开发处理器时,通常采用第三种做法。
为了避免把过多希望寄托在单一测试上,人们常把多个基准应用组合成基准测试套件(benchmark suite),用来衡量处理器运行不同应用时的性能。
当然,套件的质量取决于组成它的各项基准测试。不过,套件的一个重要优点是:其他基准测试的存在,能够减轻某一个测试的缺陷所造成的影响。基准测试套件的目标,是刻画两台计算机真实的相对性能,尤其是客户可能运行、却不在套件中的那些程序的相对性能。
建立标准化基准应用套件的尝试中,最成功的组织之一是 SPEC(Standard Performance Evaluation Corporation)。它源于 20 世纪 80 年代末为工作站和服务器提供更好基准测试的努力。当时,越来越流行的 Dhrystone 基准测试准确性欠佳,这也是促成 SPEC 的原因之一。计算机行业不断发展,对基准测试套件的需求也随之变化;如今 SPEC 已提供覆盖多种应用类别的测试。全部 SPEC 基准测试套件及其报告结果,都可以在 SPEC 网站 找到。
虽然下面许多小节主要讨论 SPEC 基准测试,但针对运行 Windows 的 PC,也开发了不少其他基准测试,例如 Geekbench。
一个值得警惕的例子是 Electronic Design News Embedded Microprocessor Benchmark Consortium 的基准测试,简称 EEMBC,发音与“embassy”相同。这套测试包含 41 个核心片段,用于预测不同嵌入式应用的性能,包括汽车与工业、消费类产品、网络、办公自动化和电信应用。EEMBC 同时报告未经修改的性能和“full fury”性能;后者几乎允许采取任何手段。部分因为这些测试使用小型核心片段,又部分因为其结果报告方式,EEMBC 的成绩并未被广泛引用。正因为它没有取得成功,那个它原本打算取代的 Dhrystone,遗憾地仍被沿用。EEMBC 于 2009 年推出 CoreMark:这是一个由四个核心片段组成的单一合成程序,如今它被引用的频率已经与 Dhrystone 相当。近期的 Embench 项目(Patterson et al., 2025)受到 SPEC 启发,旨在为嵌入式计算提供免费、开放的基准测试套件,取代 Dhrystone 和 CoreMark,成为标准的嵌入式基准测试(见 Embench 网站)。
桌面基准测试
桌面基准测试大致分为两类:处理器密集型和图形密集型,尽管许多图形基准测试也会给处理器带来繁重负载。SPEC 最初建立的是一套关注处理器性能的测试,起初称为 SPEC89。经过 SPEC92、SPEC95、SPEC2000 和 SPEC2006,它发展到了第六代 SPEC CPU2017。SPEC CPU2017 包含 10 个整数基准测试(CPU2017 Integer Speed)和 17 个浮点基准测试(CPU2017 Floating Point Speed)。2 图 1.19 描述了这一代 SPEC CPU 基准测试及其沿革。
对于前面讨论的编译器选项问题,SPEC 的解决方法是同时提供 base 和 peak 两种结果。base 要求同一种语言的所有基准程序使用相同的编译器选项,peak 则允许程序员为每项基准测试选择尽可能好的选项。
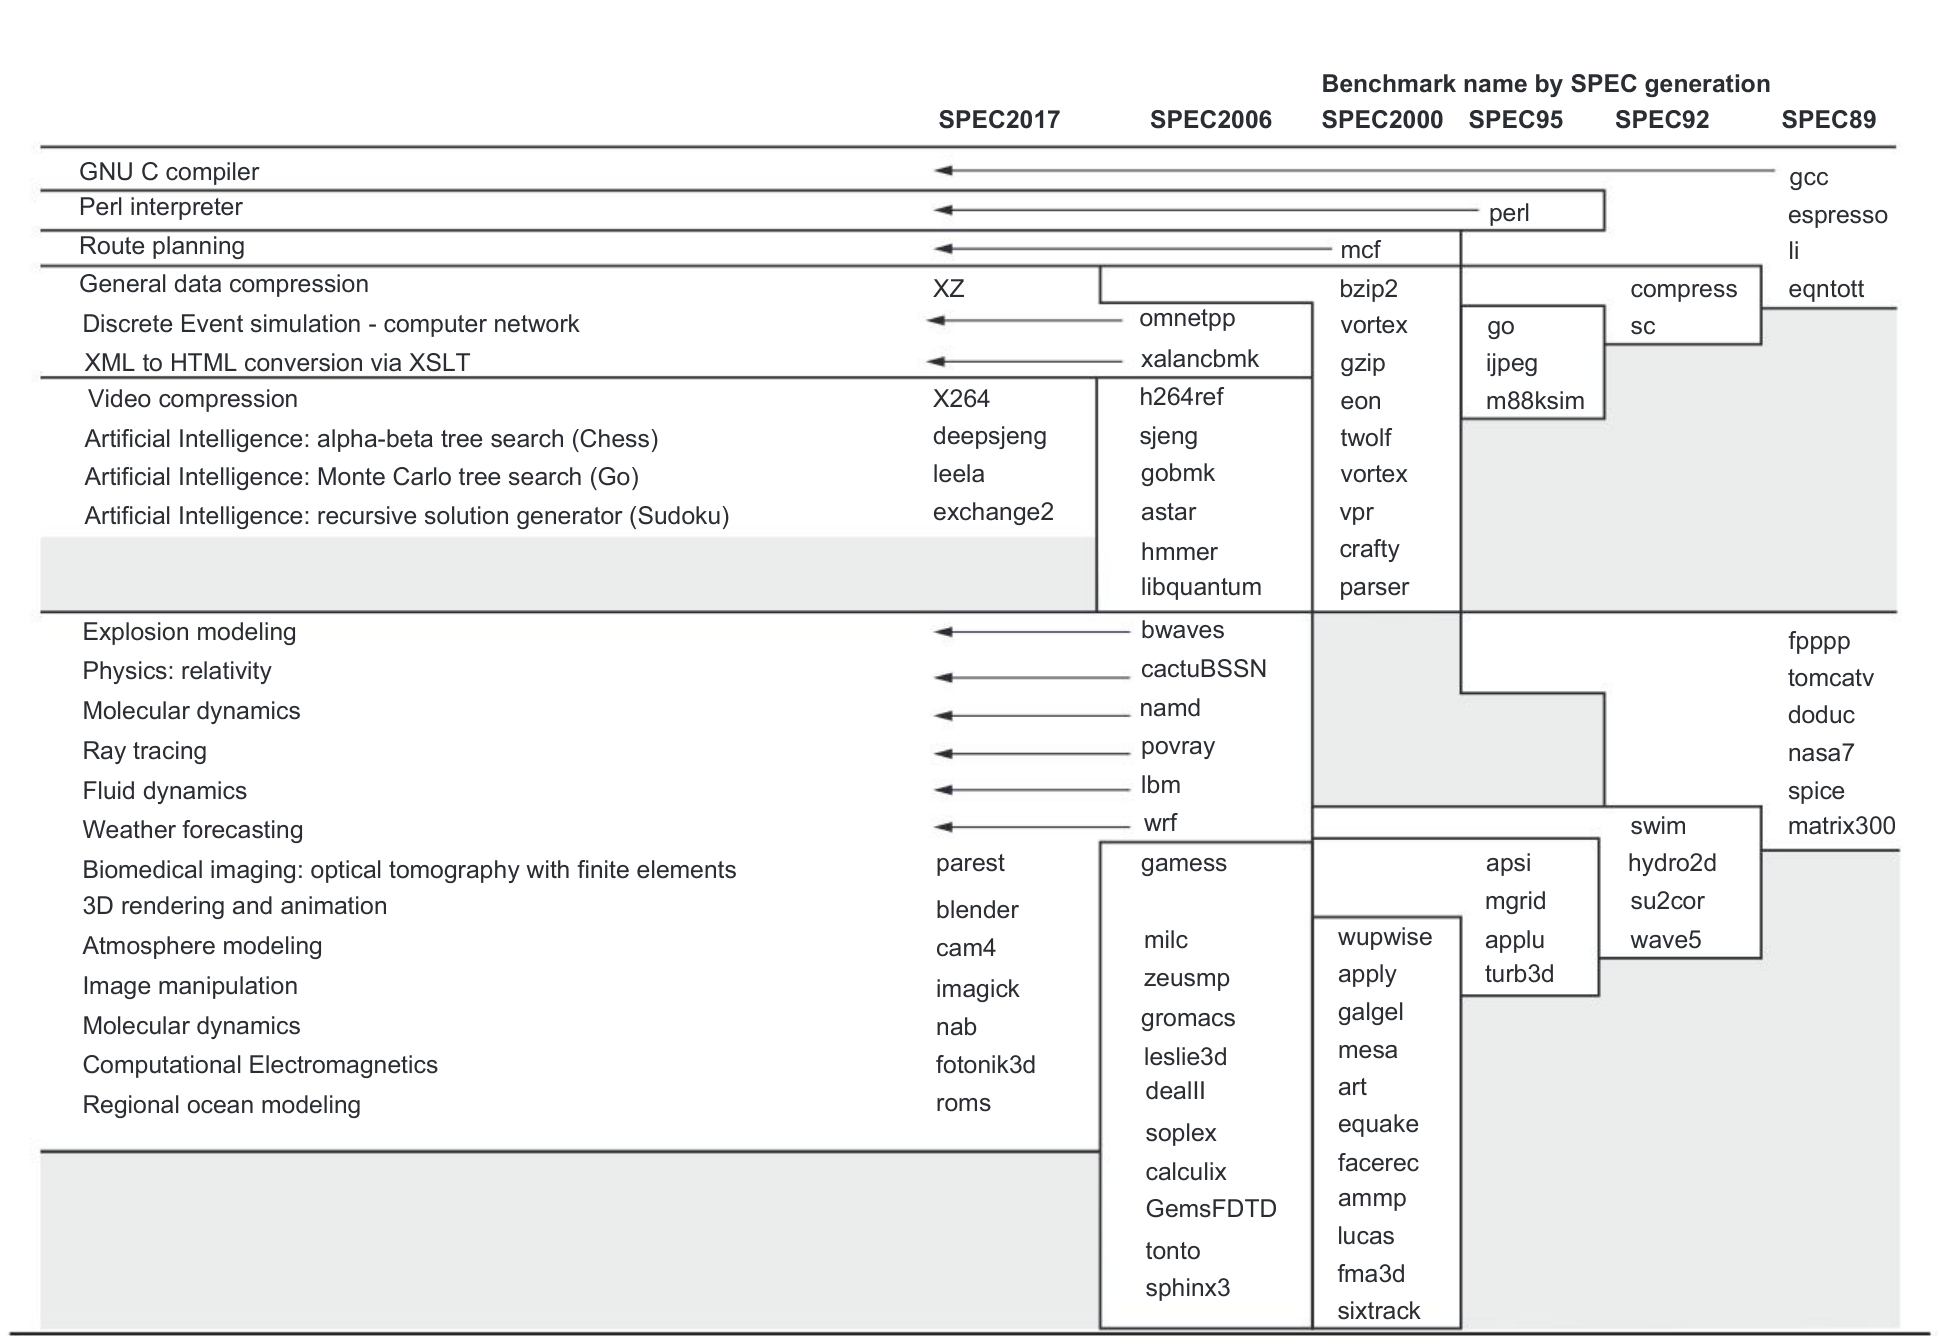
图 1.19 SPEC2017 程序及 SPEC 基准测试随时间的演变。分界线上方为整数程序,下方为浮点程序。SPEC2017 的 10 个整数程序中,5 个用 C 编写,4 个用 C++ 编写,1 个用 Fortran 编写。浮点程序中,3 个用 Fortran 编写,2 个用 C++ 编写,2 个用 C 编写,6 个混合使用 C、C++ 和 Fortran。图中列出了 1989、1992、1995、2000、2006 和 2017 年各版中的全部 82 个程序,其中 gcc 资历最老。只有 3 个整数程序和 3 个浮点程序历经了三代或更多代。虽然少数程序会从一代保留到下一代,但程序版本会变化,输入或测试规模也往往会扩大,以延长运行时间,避免测量受到扰动,或避免执行时间被 CPU 时间以外的某个因素主导。左侧的基准用途说明仅适用于 SPEC2017,并不适用于早期版本。不同代 SPEC 中处于同一行的程序通常没有关系;例如,fpppp 并不像 bwaves 那样是计算流体动力学(CFD)程序。
图内“Benchmark name by SPEC generation”意为“各代 SPEC 的基准程序名称”;程序名保留原标识符。图左侧用途说明译如下:
| SPEC2017 程序 | 用途 |
|---|---|
| gcc | GNU C 编译器 |
| perlbench | Perl 解释器 |
| mcf | 路径规划 |
| XZ | 通用数据压缩 |
| omnetpp | 计算机网络的离散事件仿真 |
| xalancbmk | 通过 XSLT 将 XML 转换为 HTML |
| X264 | 视频压缩 |
| deepsjeng | 人工智能:alpha-beta 树搜索(国际象棋) |
| leela | 人工智能:Monte Carlo 树搜索(围棋) |
| exchange2 | 人工智能:递归解生成器(数独) |
| bwaves | 爆炸建模 |
| cactuBSSN | 物理:相对论 |
| namd | 分子动力学 |
| povray | 光线追踪 |
| lbm | 流体动力学 |
| wrf | 天气预报 |
| parest | 生物医学成像:基于有限元的光学层析成像 |
| blender | 三维渲染与动画 |
| cam4 | 大气建模 |
| imagick | 图像处理 |
| nab | 分子动力学 |
| fotonik3d | 计算电磁学 |
| roms | 区域海洋建模 |
SPEC 基准测试采用真实程序,并作适当修改,以提高可移植性、尽量降低 I/O 对性能的影响。整数测试涵盖 C 编译器的一部分、围棋程序以及视频压缩等任务;浮点测试包括分子动力学、图像处理和天气预报。SPEC CPU 套件适合测试桌面系统和服务器的处理器性能。本书后面会多次使用这些程序的数据。不过,这些程序与现代编程语言及运行环境、与 1.1 节介绍的 Google Translate 应用,都相距甚远。其中三分之一的程序至少有一部分是用 Fortran 编写的!它们甚至采用静态链接,而大多数真实程序采用动态链接。遗憾的是,SPEC2017 中的应用或许确实是真实程序,却难以令人振奋。SPECINT2017 和 SPECFP2017 能否反映 21 世纪计算领域令人激动的发展,并不清楚。
1.11 节将介绍 SPEC CPU 套件开发过程中出现的问题,以及维持一套有用、具有预测能力的基准测试套件所面临的挑战。1
SPEC CPU2017 面向处理器性能,但 SPEC 还提供许多其他基准测试。图 1.20 列出了 2023 年仍在使用的 17 项 SPEC 基准测试。3
服务器基准测试
正如服务器具有多种功能,服务器基准测试也有多种类型。最简单的一种,或许是面向处理器吞吐量的测试。SPEC CPU2017 利用 SPEC CPU 程序构造了一种简单的吞吐量测试:同时运行每个 SPEC CPU 程序的多个副本,通常副本数与处理器数相同,再将 CPU 时间转换为处理速率,分别称为 SPEC CPU2017 Integer Rates 和 CPU2017 Floating Point Rates,以此衡量多处理器的处理速率。如果某次测量运行了 8 个副本,而用时只有参考机器的一半,那么该项测试的 SPECrate 就是 16。这类测试衡量的是 1.2 节所说的请求级并行性(RLP)。为了衡量线程级并行性(TLP),SPEC 还提供了它所称的高性能计算基准测试,围绕 OpenMP、MPI(Message Passing Interface,消息传递接口),以及 GPU 等加速器展开(见图 1.20)。
除 SPECrate 外,多数服务器应用和基准测试都有大量 I/O 活动,来源是存储访问或网络通信。这包括文件服务器、Web 服务器,以及数据库与事务处理(TP)系统的测试。SPEC 提供文件服务器基准测试 SPECstorage,也提供 Java 服务器基准测试。(附录 D 详细讨论若干文件与 I/O 系统基准测试。)SPEC VIRT_SC 2013 和 SPECvirt Datacenter 2021 评估虚拟化数据中心服务器的端到端性能。SPEC 还有一个衡量功耗的测试,将在 1.11 节讨论。
事务处理基准测试衡量系统处理事务的能力;这些事务由数据库访问和更新组成。航空订票系统和银行 ATM 系统是典型而简单的事务处理实例;更复杂的系统还涉及复杂数据库与决策。
| 类别 | 名称 | 衡量的性能 |
|---|---|---|
| 云 | Cloud_IaaS 2018 | 云端 NoSQL 数据库事务,以及使用 map/reduce 的 K-Means 聚类 |
| CPU | CPU2017 | 计算密集型整数与浮点工作负载 |
| 图形与工作站性能 | SPECviewperf® 2020 | 运行 OpenGL 和 Direct X 的系统的三维图形性能 |
| 图形与工作站性能 | SPECworkstation 3.1 | Windows 工作站运行专业应用时的性能 |
| 图形与工作站性能 | SPECapcSM for Maya® 2017 | 运行专有应用 Autodesk 3ds Max 2017 时的三维图形性能 |
| 图形与工作站性能 | SPECapcSM for PTC Creo 3.0 | 运行专有应用 PTC Creo 3.0 时的三维图形性能 |
| 图形与工作站性能 | SPECapcSM for Siemens NX 9.0 and 10.0 | 运行专有应用 Siemens NX 9.0 或 10.0 时的三维图形性能 |
| 图形与工作站性能 | SPECapcSM for SolidWorks 2021 | 运行专有 CAD/CAM 应用 SolidWorks 2021 的系统的三维图形性能 |
| 高性能计算 | SPEC ACCEL | 加速器与主机 CPU 运行使用 OpenCL 和 OpenACC 的并行应用时的性能 |
| 高性能计算 | SPEChpc 2021 | 四组规模递增的 HPC 应用或小型应用套件,覆盖单节点至数百节点 |
| 高性能计算 | SPEC MPI 2007 | 集群和对称多处理器(SMP)上运行的 MPI 并行、浮点、计算密集型程序 |
| 高性能计算 | SPEC OMP 2012 | 采用 OpenMP 的并行应用 |
| Java 客户端/服务器 | SPECjbb2015 | Java 服务器 |
| Java 客户端/服务器 | SPECjEnterprise 2018 Web Profile | Java EE Web Profile V7 或更高版本的应用服务器、数据库及其支撑基础设施 |
| Java 客户端/服务器 | SPECJEnterprise 2010 | Java EE Web Profile V5 或更高版本的应用服务器、数据库及其支撑基础设施 |
| Java 客户端/服务器 | SPECjvm 2008 | Java 运行时环境中的真实应用,以及侧重 Java 核心功能的基准测试 |
| 功耗 | SPECpower_ssj2008 | 运行 SPECjbb2015 的主流服务器级计算机的功耗。其他一些 SPEC 套件也测量功耗:ACCEL、CPU 2017、OMP、2012 和 VIRT_SC 2013 |
| 存储 | SPECstorage Solution 2020 | 文件服务器的吞吐量与响应时间 |
| 虚拟化 | SPEC VIRT_SC 2013 | 用于虚拟化服务器整合的数据中心服务器 |
| 虚拟化 | SPECvirt Datacenter 2021 | 数据中心多主机虚拟化环境的第三代基准测试 |
图 1.20 截至 2022 年仍在使用的 SPEC 基准测试。3
20 世纪 80 年代中期,一批关注此问题的工程师成立了独立于厂商的 Transaction Processing Council(TPC),试图为事务处理建立真实而公平的基准测试。其测试说明见 TPC 网站。
第一个 TPC 基准测试 TPC-A 于 1985 年发布,后来被多种不同的测试取代和增强。TPC-C 最初建立于 1992 年,模拟复杂的查询环境。TPC-H 模拟临时性的决策支持:查询彼此独立,无法利用对过去查询的了解来优化未来查询。TPC-DI 则面向数据集成(DI)这一新任务,它也称 ETL,即 Extract、Transform、Load(提取、转换、加载),是数据仓库的重要组成部分。TPC-DS 是决策支持基准测试。TPC-E 是一种在线事务处理(OLTP)工作负载,模拟证券经纪公司的客户账户。
面对传统关系数据库与“NoSQL”存储方案之间的争论,TPCx-HS 衡量的是使用 Hadoop 文件系统、运行 MapReduce 程序的系统;TPC-DS 则衡量使用关系数据库或 Hadoop 系统的决策支持系统。TPC-VMS 和 TPCx-V 衡量虚拟化系统的数据库性能;TPC-Energy 为现有全部 TPC 测试增加能耗指标。近年来,TPC 还把测试扩展到了物联网与人工智能领域。
所有 TPC 基准测试都用每秒事务数衡量性能。此外,它们还规定响应时间要求,因此只有满足响应时间限制时,测得的吞吐量才有效。为了模拟真实系统,更高的事务处理速率也要对应更大的系统规模,包括更多用户和更大的事务数据库。最后,还必须报告测试系统的成本,以便准确比较性价比。TPC 修改了其定价政策,让全部 TPC 测试遵循统一规范,并允许核实 TPC 公布的价格。
报告性能结果
报告性能测量结果时,首要原则应当是可复现性:列出另一位实验者重现结果所需的一切信息。SPEC 报告要求详细说明计算机和编译器选项,并同时公开基线结果与优化结果。除了硬件、软件以及基线调优参数的描述外,SPEC 报告还包括实际执行时间,同时以表格和图形呈现。TPC 报告更加完整,因为它还必须包含基准测试审计结果和成本信息。由于厂商既竞争性能,也竞争性价比,这些报告是了解计算系统真实成本的极佳资料。
汇总性能结果
在实际计算机设计中,必须使用一组被认为与目标有关的基准测试,对大量设计选择的相对收益进行定量评估。同样,消费者选择计算机时,也可能依赖基准测试的性能测量结果;理想情况下,这些测试应当类似于用户自己的应用。在这两种情形中,拥有一整套基准测试的测量结果都很有帮助:既可以使重要应用的性能与套件中的某一个或若干测试相对应,也可以了解性能的变化范围。最理想的情况是,这套测试能够构成应用空间中一个具有统计有效性的样本。不过,这需要的测试数量远多于通常的套件,还需要随机抽样,而几乎没有基准测试套件这样做。
一旦选定通过基准测试套件来衡量性能,我们就希望用一个数概括整套测试的结果。一种简单办法,是比较套件内各程序执行时间的算术平均值。另一种办法,是为每项基准测试赋予权重,再用加权算术平均值概括性能。选择权重的一种思路,是使所有程序在某台参考计算机上的加权执行时间相等;但这样会使结果偏向该参考计算机的性能特征。
我们也可以不选择权重,而是把执行时间相对于参考计算机进行归一化:用参考计算机的执行时间除以被评估计算机的执行时间,得到一个与性能成正比的比值。SPEC 采用这一方法,并将所得比值称为 SPECRatio。它有一项非常有用的性质,恰好契合本书衡量计算机性能的方法:比较性能之比。例如,假设某项基准测试上,计算机 A 的 SPECRatio 是 B 的 1.25 倍,那么:
注意,参考计算机的执行时间被约掉了。因此,像本书一贯采用的那样通过比值进行比较时,参考计算机的选择与结果无关。图 1.21 给出了一个例子。
由于 SPECRatio 是比值,而不是绝对执行时间,必须使用几何平均值来计算平均值。(SPECRatio 没有单位,因此对 SPECRatio 作算术比较没有意义。)4 其计算公式如下。
| 基准程序 | Sun UltraSPARC-IV+ 时间(秒) | AMD EPYC 7763 时间(秒) | AMD SPEC CPU2017 Ratio | Intel Xeon Platinum 8380 时间(秒) | Intel SPEC CPU2017 Ratio | AMD/Intel 时间之比 | Intel/AMD SPEC 比值之比 |
|---|---|---|---|---|---|---|---|
| perlbench | 1,774 | 257 | 6.90 | 253 | 7.01 | 1.02 | 1.02 |
| gcc | 3,976 | 310 | 12.83 | 371 | 10.72 | 0.84 | 0.84 |
| mcf | 4,721 | 236 | 20.00 | 240 | 19.67 | 0.98 | 0.98 |
| omnetpp | 1,630 | 199 | 8.19 | 138 | 11.81 | 1.44 | 1.44 |
| xalancbmk | 1,417 | 103 | 13.76 | 108 | 13.12 | 0.95 | 0.95 |
| x264 | 1,763 | 107 | 16.48 | 105 | 16.79 | 1.02 | 1.02 |
| deepsjeng | 1,432 | 231 | 6.20 | 248 | 5.77 | 0.93 | 0.93 |
| leela | 1,703 | 310 | 5.49 | 362 | 4.70 | 0.86 | 0.86 |
| exchange2 | 2,939 | 131 | 22.44 | 156 | 18.84 | 0.84 | 0.84 |
| xz | 6,182 | 253 | 24.43 | 255 | 24.24 | 0.99 | 0.99 |
| 几何平均值 | — | — | 11.99 | — | 11.69 | 0.98 | 0.98 |
图 1.21 SPEC CPU2017 参考计算机 Sun UltraSPARC-IV+ 的 Integer Speed 执行时间(秒),以及 AMD EPYC 7763 和 Intel Xeon Platinum 8380 的执行时间与 SPECRatio。最后两列分别给出执行时间之比与 SPEC 比值之比。该图表明,比较相对性能时,参考计算机无关紧要:执行时间之比与 SPEC 比值之比相同;几何平均值之比 ,也等于各项比值的几何平均值 0.98。5
对于 SPEC, 就是程序 的 SPECRatio。使用几何平均值可以保证两项重要性质:
- 比值的几何平均值,等于几何平均值之比。
- 几何平均值之比,等于性能比值的几何平均值;这意味着参考计算机的选择无关紧要。
因此,使用几何平均值有充分理由,尤其是在通过性能比值进行比较时。
例:几何平均值与参考计算机
证明:几何平均值之比等于性能比值的几何平均值,而且 SPECRatio 所采用的参考计算机不影响结果。
解: 假设有两台计算机 A 和 B,并分别测得一组 SPECRatio。
也就是说,A 与 B 的 SPECRatio 几何平均值之比,等于套件内全部基准测试上 A 相对 B 的性能比值的几何平均值。图 1.21 用 SPEC2017 的实例验证了这一点。
译注:原文两处均指向 1.11 节;本版实际集中讨论 benchmarketing 与基准测试失效问题的是 1.12 节。 ↩︎ ↩︎
译注:正文写“17 个浮点基准测试”,图 1.19 的语言分类则合计为 13 个,图中 SPEC2017 浮点项也列出 13 个。这里分别保留原文数字,未把其中一处静默改成另一处。 ↩︎
译注:原文正文写“2023 年、17 项”,图题写“截至 2022 年”,实际表格列出 20 项。表中 Maya 名称对应 Autodesk 3ds Max 描述,功耗行把“OMP, 2012”分开列出,也均按原表保留。 ↩︎ ↩︎
译注:“无单位,所以不能作算术比较”是原文的论断;无量纲本身并不排除算术运算。本节真正证明的是,几何平均值具备所需的比值关系,使相对比较不依赖参考计算机的选择。 ↩︎
译注:原表的“AMD/Intel times”列头另标有“seconds”,但这一列实际是执行时间之比,秒在相除时已约掉,因此译表按无量纲比值呈现;原列头的单位问题在此保留记录。 ↩︎
1.10 计算机设计的定量原则
前面已经讨论了如何定义、测量和汇总性能、成本、可信赖性、能耗与功耗。现在可以进一步探讨那些有助于计算机设计与分析的指导原则。本节将介绍一些重要的设计认识,以及两个用于评估不同方案的公式。
利用并行性
利用并行性是提高性能最重要的手段之一。本书每一章都有通过利用并行性来提升性能的例子。这里先简要介绍三个方面,后续章节再展开讨论。
第一个例子是系统级并行。为提高典型服务器基准测试的吞吐量,例如 SPECStorage 或 TPC-C,可以使用多个处理器和多个存储设备。处理请求的工作负载可以分散到这些处理器与存储设备上,从而提高吞吐量。能够扩充内存、增加处理器和存储设备数量的能力称为可扩展性(scalability),是服务器的一项重要优势。把数据分散存放在多个存储设备上,以便并行读写,是在利用数据级并行性(DLP)。SPECstorage 还依靠请求级并行性(RLP)使用多个处理器,而 TPC-C 则利用线程级并行性(TLP)加快数据库查询。
在更细致的数字电路设计层面,也可以利用并行性。例如,存储系统使用多个存储体(bank),允许同时访问不同存储体,以提高内存带宽。算术逻辑单元中的超前进位(carry-lookahead)利用并行性,将求和所需时间对操作数位数的依赖,从线性关系降为对数关系。这些也是 DLP 的例子。
利用流水线
在单个处理器内部,利用指令之间的并行性,是实现高性能的关键。最简单的办法之一就是流水线(pipelining)。(附录 C 对流水线作了更详细的介绍,第 3 章也将重点讨论。)流水线的基本思想,是让不同指令的执行过程相互重叠,从而缩短完成一段指令序列所需的总时间。其关键认识在于:并非每条指令都依赖紧邻它之前的那条指令,因此可能让这些指令全部或部分地并行执行。流水线是最广为人知的指令级并行性(ILP)实例。
利用预测
俗话说,有时先做再请求原谅,胜过事先请求许可;下一种机会就是预测。如果预测相当准确,而预测失败后的恢复机制又不太昂贵,那么在某些情况下,与其等到完全确定,不如先作猜测并开始工作,平均而言反而更快。预测用于存储层次结构(见第 2 章),在现代流水线处理器中更得到广泛应用(见第 3 章);但它也可能引发安全问题(见 1.8 节)。
利用局部性原理
对程序特性的观察,带来了一些重要的基本认识。我们经常利用的最重要的程序特性,就是局部性原理:程序往往会再次使用最近用过的数据和指令。一个广为流传的经验法则是,程序 90% 的执行时间花在仅仅 10% 的代码上。局部性的一个含义是:根据程序最近的访问行为,可以相当准确地预测它接下来将使用哪些指令和数据。局部性也适用于数据访问,只是不像代码访问那样明显。
人们观察到两种不同的局部性。时间局部性是指,最近访问过的项很可能很快再次被访问。空间局部性是指,地址彼此接近的项,其访问时间也往往彼此接近。第 2 章将介绍这些原理的应用。
通过冗余实现可信赖性
计算机不仅要快,还必须值得信赖。任何物理器件都有可能失效,因此我们通过加入冗余部件来提高系统的可信赖性:发生失效时,冗余部件可以接管工作,也可以帮助检测失效,前面介绍的冗余电源就是一个例子。内存和存储设备长期以来一直依赖冗余来保证可信赖性,而静默数据损坏问题(1.7 节)表明,这些技术对计算机的其他部件也将变得重要。
优先优化常见情况
计算机设计中最重要、应用最广泛的原则,也许就是优先优化常见情况:在作设计取舍时,优先照顾经常出现的情况,而不是罕见情况。这个原则适用于资源分配,因为一种情况出现得越频繁,改进它带来的影响就越大。
这一原则不仅适用于资源分配和性能,也适用于能耗。处理器的取指与译码单元,使用频率可能远高于乘法器,因此应当优先优化前者。可信赖性同样如此。如果数据库服务器每个处理器对应 50 个存储设备,那么系统的可信赖性很可能主要由存储设备决定。
此外,常见情况往往也比罕见情况更简单,处理起来更快。例如,处理器执行两个数的加法时,可以预期溢出很少发生,因此优化更常见的无溢出情况就能提高性能。这样做可能让溢出发生时的处理变慢,但只要溢出确实罕见,优化正常情况仍能提高整体性能。
本书将反复展示这一原则。在应用这个简单原则时,需要确定什么情况最常见,以及加快这种情况究竟能带来多大性能提升。
一个称为 Amdahl 定律的基本规律,可以将这一原则量化。
Amdahl 定律
改进计算机某一部分后能够获得多大的性能收益,可以用 Amdahl 定律计算。该定律指出:采用更快执行方式所能获得的性能提升,受限于这种更快方式可以发挥作用的时间比例。
Amdahl 定律定义了采用某项功能后可以获得的加速比(speedup)。加速比是什么?假设我们对计算机作出一项改进,使用该改进时性能就会提高。加速比定义为:
也可以写成:
加速比告诉我们:与原计算机相比,任务在采用改进后的计算机上能运行得多快。
Amdahl 定律提供了一种快速计算改进收益的方法。所得加速比取决于两个因素:
- 原计算机的计算时间中,能够利用改进的部分所占的比例。 例如,一个程序总共执行 100 秒,其中有 40 秒可以利用改进,那么这个比例就是 。我们将它称为 ,其值总是小于或等于 1。
- 改进后的执行方式本身带来的加速比。 也就是假设整个程序都能使用这种方式,它会运行得多快。这个值等于原方式所需时间除以改进方式所需时间。例如,程序的某个部分原来耗时 40 秒,改进后耗时 4 秒,那么加速比就是 。我们将它称为 ,其值总是大于 1。
在原计算机中采用改进后的执行方式,总执行时间等于未改进部分的时间,加上使用改进部分的时间:
整体加速比就是改进前后执行时间之比:
例:加快 Web 服务器的处理器
假设要改进一台提供 Web 服务的处理器。新处理器执行该 Web 服务应用中的计算部分时,速度是旧处理器的 10 倍。原处理器有 40% 的时间在计算,60% 的时间在等待 I/O。采用这项改进后,整体加速比是多少?
解:
Amdahl 定律体现了收益递减规律:只改进计算过程的一部分时,随着该部分不断被加速,整体加速比所获得的增量会越来越小。它的一个重要推论是:如果改进只能用于任务的一部分,那么任务的加速比不可能超过“1 减去该部分所占比例”的倒数。
使用 Amdahl 定律时,一个常见错误是混淆“原时间中能够利用改进的比例”与“改进后这部分占总时间的比例”。如果测量的不是计算过程中原本可以利用改进的时间,而是改进已经生效后的时间,结果就会出错!
Amdahl 定律可以指导我们判断某项改进会带来多大性能提升,以及如何分配资源来提高性价比。显然,应当按照时间消耗的比例投入资源。它特别适合比较两种方案的整体系统性能,也可以比较两种处理器设计方案,下面就是一个例子。
例:只加快平方根,还是加快全部浮点运算
图形处理器经常需要进行开平方运算。浮点平方根(FSQRT)的不同实现,性能差异很大,在面向图形的处理器之间尤其如此。假设一个关键图形基准测试有 20% 的执行时间用于 FSQRT。一种方案是改进 FSQRT 硬件,使这项操作的速度达到原来的 10 倍。
另一种方案是把图形处理器中所有浮点(FP)指令的速度提高到原来的 1.6 倍。假设浮点指令占应用执行时间的一半。设计团队认为,使全部浮点指令加速到 1.6 倍,与实现快速平方根所需的投入相同。请比较这两种方案。
解: 可以比较两种方案的加速比:
由于全部浮点运算出现得更频繁,整体加快浮点运算的方案略胜一筹。
Amdahl 定律的用途不限于性能。现在重新考虑 1.7 节的可靠性例题:通过冗余,把电源的平均失效前时间(MTTF)从 200,000 小时提高到 830,000,000 小时,即提高到原来的 4,150 倍。
例:冗余电源对系统可靠性的影响
磁盘子系统失效率的计算如下:
因此,可以改进的部分占失效率的比例,是系统总失效率每百万小时 23 次中的 5 次,即 0.22。
解: 可靠性的改善倍数为:
尽管一个模块的可靠性提高到了惊人的 4,150 倍,从整个系统看,收益虽然可以测出,却并不大。
在前面的例子中,我们需要知道新的、改进后的版本所占用的比例。1 直接测量这些时间往往比较困难。下面将介绍另一种比较方法,它所用的公式把 CPU 执行时间分解为三个独立因素。
只要知道某个方案如何影响这三个因素,就能确定它的整体性能。此外,在硬件真正完成设计之前,通常就可以构建模拟器来测量这些因素。
处理器性能公式
基本上,所有计算机都使用以固定速率运行的时钟。这些离散的时间事件称为时钟周期,英文中会使用 clock period、clock、cycle 或 clock cycle 等说法。设计者既可以用持续时间表示一个时钟周期,例如 1 ns,也可以用频率表示,例如 1 GHz。于是,程序的 CPU 时间可以写为:
或者:
除了执行程序所需的时钟周期数,还可以统计执行的指令数量,称为指令路径长度(instruction path length)或指令数(instruction count,IC)。知道总时钟周期数与 IC,就可以计算平均每条指令的时钟周期数(CPI)。本章采用 CPI,一是因为它便于使用,二是因为本章讨论的是简单处理器。设计者有时也使用每时钟周期指令数(instructions per clock,IPC),它是 CPI 的倒数。
CPI 的计算方式是:
这一处理器评价指标,有助于理解不同风格的指令集与实现方式,后面四章将大量使用它。
将上式中的指令数移项,可以得到总时钟周期数为 。因此,执行时间公式可以写成:
把这一公式展开为计量单位,就能看清各部分如何对应:
这个公式表明,处理器性能取决于三个因素:时钟周期时间(或时钟频率)、CPI 和 IC。
而且,CPU 时间对这三个因素的依赖程度相同;例如,其中任一项改善 10%,CPU 时间也会相应改善 10%。2
遗憾的是,很难只改变其中一个参数而完全不影响其他参数,因为改变各项指标所依赖的基础技术彼此相关:
- 时钟周期时间:硬件技术与组成。
- CPI:组成与指令集体系结构(ISA)。
- 指令数:ISA 与编译器技术。
幸运的是,许多潜在的性能优化技术主要改善其中一个因素,而对另外两个因素的影响较小,或者可以预测。
设计处理器时,有时把总 CPU 时钟周期数写成下式会很有帮助:
其中, 表示指令 在程序中执行的次数, 表示该指令每次执行平均需要的时钟周期数。因此,CPU 时间可写为:
总体 CPI 则是:
后一种计算方法使用每类指令各自的 ,以及该指令在程序中出现的比例,即 。 必须包含流水线影响、缓存未命中以及存储系统的其他低效因素,因此应通过测量获得,而不能只根据参考手册末尾的一张表来计算。
再看前面的性能例题,这次改用各类指令出现频率及其 CPI 的测量值。在实践中,这些数据通过模拟或硬件测量机制获得。
例:用处理器性能公式比较浮点优化
假设得到以下测量值:
| 测量项 | 数值 |
|---|---|
| 浮点运算出现频率 | 25% |
| 浮点运算平均 CPI | 4.0 |
| 其他指令平均 CPI | 1.33 |
| FSQRT 出现频率 | 2% |
| FSQRT 的 CPI | 20 |
有两种设计方案:把 FSQRT 的 CPI 降到 2,或者把所有浮点运算的平均 CPI 降到 2.5。请使用处理器性能公式比较两者。
解: 首先注意,只有 CPI 发生变化,时钟频率与指令数保持不变。先计算未采用任何改进时的原始 CPI:
从原始 CPI 中减去节省的周期数,即可得到改进 FSQRT 后的 CPI:
全部浮点指令得到改进后的 CPI,可以用同样方法计算,也可以分别计算浮点与非浮点指令的贡献后相加。采用后一种方法:
由于整体浮点优化方案的 CPI 略低,所以它的性能也略好。具体而言,该方案的加速比为:
令人欣慰的是,这与前面使用 Amdahl 定律得到的加速比相同。3
处理器性能公式中的各个因素,往往可以分别测量。
能够进行这种独立测量,是前例中采用处理器性能公式而不是 Amdahl 定律的一项重要优势。尤其是,某一组指令究竟占用了多大比例的执行时间,可能很难直接测量。在实践中,多半还是要对这组指令逐项计算 IC 与 CPI 的乘积,再求和。由于起点通常就是各项 IC 与 CPI 的测量结果,处理器性能公式格外有用。
要把这个公式作为设计工具,就必须能够测量各个因素。对已有处理器,执行时间容易通过测量获得,其默认时钟频率也已知。难点在于如何得到 IC 或 CPI。多数处理器都提供指令执行次数与时钟周期数的计数器。定期观察这些计数器,还可以把执行时间和指令数归到不同代码段上,帮助程序员理解与优化应用性能。设计者或程序员往往希望了解比硬件计数器所能提供的更细致的信息,例如,CPI 为什么是这个数值。这时,就需要使用类似于设计新处理器时所采用的模拟技术。
动态电压频率调节(DVFS)和超频等有助于能效的技术(见 1.5 节),会让这个公式更难使用,因为测量程序运行时,时钟频率可能在变化。一个简单办法是关闭这些功能,以保证结果可复现。幸运的是,性能与能效往往高度相关:程序运行时间越短,通常越节能。因此,在研究性能时,暂不考虑 DVFS 或超频对结果的影响,可能是可行的。
译注:这里原文确写“the fraction consumed by the new and improved version”。但 Amdahl 定律中的 必须取改进前的时间比例;前文已明确警告不能使用改进后的占比。此处措辞与其定义不一致。 ↩︎
译注:原文以“改善 10%”概括。严格说,当指令数、CPI 或时钟周期时间单独减少 10% 时,CPU 时间也减少 10%;若时钟频率增加 10%,时间则变为原来的 ,不能把这两种百分比混同。 ↩︎
译注:原式保留了舍入后的数值与等号。直接代入已显示的 1.33,原始 CPI 为 1.9975,全部浮点优化后的 CPI 为 1.6225;书中的 2.0 和 1.625 对应把非浮点 CPI 视为约 的处理。平方根公式下标原写 FPSQR,与正文 FSQRT 不一致。 ↩︎
1.11 综合实例:性能、价格与功耗
每章接近结尾处的“综合实例”(Putting It All Together),都会用真实案例运用该章介绍的原则。本节通过 SPECpower 和 SPEC CPU 基准测试,考察小型服务器的性能及单位功耗性能。
图 1.22 列出了我们评估的两台多处理器服务器及其价格。为使价格比较公平,两台都选用 Dell PowerEdge 服务器。第一台是 PowerEdge R650,采用 Intel Xeon Platinum 8380 微处理器,时钟频率为 2.30 GHz,Turbo 模式下为 3.4 GHz。与第 2–5 章讨论的微处理器不同,这款 Intel 芯片有 40 个核心和 256 MB 的 L3 缓存。我们选择双插槽系统,因此共有 80 个核心,并配置 256 GB、3200 MHz 的 DDR4 DRAM。第二台是 PowerEdge R7525,采用 AMD EPYC 7763 微处理器,时钟频率为 2.45 GHz,Turbo 模式下为 3.5 GHz。它具有相同的插槽数,以及相同容量和类型的 DRAM。AMD 微处理器采用 chiplet,因此每个插槽可有 64 个核心,整机共 128 个核心,L3 缓存为 256 MB。在 SPECpower 测试中,两台机器都运行 Oracle Java HotSpot 18.9 版 Java 虚拟机(JVM)。
操作系统都采用 SUSE Linux Enterprise Server 5.3 版。Dell 对 64 核 AMD 微处理器的报价,约为 40 核 Intel 微处理器的两倍,因此 R7525 的价格约为 R650 的 1.4 倍。
| 项目 | Dell PowerEdge R650 | 价格 | 占总价 | Dell PowerEdge R7525 | 价格 | 占总价 | R7525/R650 |
|---|---|---|---|---|---|---|---|
| 基础服务器 | Dell PowerEdge R650 | $5,049 | 21% | Dell PowerEdge R7525 | $3,989 | 11% | 0.79 |
| 电源 | 850 W | — | 750 W | — | 0.88 | ||
| 以太网 | 1 Gb/s | — | 1 Gb/s | — | 1.00 | ||
| 处理器 | Intel Xeon Platinum 8380 | $10,726 | 44% | AMD EPYC 7763 | $22,455 | 64% | 2.09 |
| 时钟频率 | 2.30 GHz | — | 2.45 GHz | — | 1.07 | ||
| Turbo 频率 | 3.4 GHz | — | 3.5 GHz | — | 1.03 | ||
| 插槽数 | 2 | — | 2 | — | 1.00 | ||
| 每插槽核心数 | 40 | — | 64 | — | 1.60 | ||
| DRAM | 256 | $8,277 | 34% | 256 | $8,277 | 23% | 1.00 |
| 磁盘 | 480 GB SSD | $509 | 2% | 480 GB SSD | $509 | 1% | 1.00 |
| SUES Linux OS | $3,619 | 15% | $3,715 | 11% | 1.03 | ||
| 总计 | $24,561 | 100% | $35,230 | 100% | 1.43 | ||
| CPU2017 Integer Speed | 11.7 | 12.0 | 1.03 | ||||
| CPU2017 Floating Point Speed | 228 | 248 | 1.09 | ||||
| CPU2017 Integer Rates | 533 | 822 | 1.54 | ||||
| CPU2017 Floating Point Rates | 449 | 634 | 1.41 | ||||
| SPECpower 最大 ssj_ops | 7,923,820 | 12,339,147 | 1.56 |
图 1.22 被测的两台 Dell PowerEdge 服务器、截至 2022 年 6 月的价格,以及性能。我们通过减去第二颗处理器的成本来计算处理器成本。因此,服务器基础成本也作了调整,扣除了默认处理器和内存的估算成本。第 5 章将介绍这些多插槽系统的互连方式。由于 Dell 没有提交这两款服务器的 SPECpower 结果,我们采用了 Fujitsu(Intel 平台)与 Lenovo(AMD 平台)服务器的 SPECpower 成绩;这些服务器使用相同的微处理器、存储系统和时钟频率。1
请注意,受基准测试的导向影响(见 1.9 节),这些服务器的配置并不寻常。相对于计算能力,图 1.22 中的系统内存很少,而且只配了一块容量仅为 480 GB 的固态盘。如果不需要相应增加内存和存储,增加核心的成本就并不高!
SPECpower 没有采用 SPEC CPU 中静态链接的 C 程序,而是使用用 Java 编写的、更现代的软件栈。它基于 SPECjbb,代表业务应用的服务器端,以每秒事务数衡量性能;该指标称为 ssj_ops,即每秒服务器端 Java 操作数(server-side Java operations per second)。与 SPEC CPU 类似,它会考验服务器处理器;此外还会考验缓存、存储系统,甚至多处理器互连系统。它也会考验 JVM,包括 JIT 即时编译器与垃圾收集器,以及底层操作系统的一部分。
图 1.22 的最后五行给出了 SPEC CPU 和 SPECpower 的性能结果。面向延迟的 CPU2017 Integer Speed 和 Floating Point Speed 成绩相近:AMD 系统分别是 Intel 系统的 1.03 倍和 1.09 倍。
而面向吞吐量的 SPEC CPU2017 Integer Rates、Floating Point Rates 和最大 SPECpower ssj_ops,分别约为 1.4 倍、1.5 倍和 1.6 倍,接近核心数约 1.6 倍的比例。2
虽然大多数基准测试和大多数计算机体系结构设计者,只关注系统在峰值负载下的性能,但计算机很少始终满负载运行。第 6 章图 6.35 给出了 Google 对数万台服务器持续 6 个月的利用率测量结果:平均利用率达到 100% 的服务器不到 1%,多数服务器的平均利用率在 10% 到 50% 之间。因此,SPECpower 从峰值负载开始,以 10% 为间隔逐步降低目标工作负载,一直降到 0%,并记录各档功耗。0% 负载称为 Active Idle,即系统仍处于运行状态的空闲。
图 1.23 展示了目标负载从 100% 变化到 0% 时,每瓦 ssj_ops(SSJ 操作数/秒)与平均功耗的变化。在每档目标工作负载下,采用 AMD 处理器的 R7525 都具有最低的功耗和最高的每瓦 ssj_ops。由于瓦特等于焦耳/秒,这个指标正比于每焦耳完成的 SSJ 操作数:
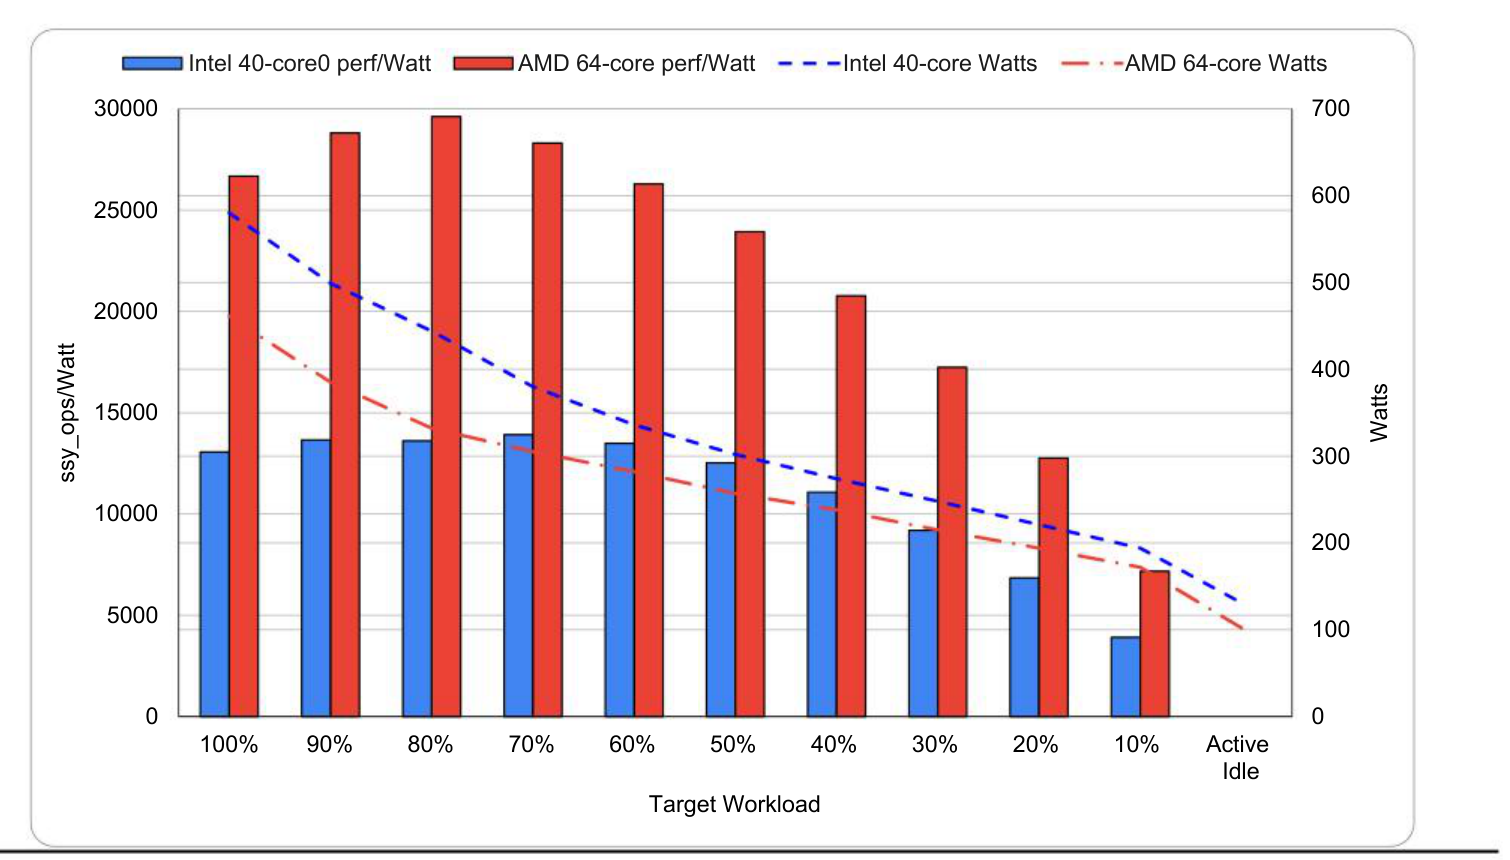
图 1.23 图 1.20 中两台服务器的单位功耗性能。3 左轴为 ssj_ops/watt,对应柱形;右轴为瓦特数,对应折线。横轴表示目标工作负载,从 100% 变化到 Active Idle。
图内标注:Target Workload 为目标工作负载,Watts 为功率(瓦特),perf/Watt 为每瓦性能;蓝色柱和蓝色虚线分别表示 Intel 40 核平台的每瓦性能与功率,红色柱和红色点划线分别表示 AMD 64 核平台的对应值。原图左轴写作“ssy_ops/Watt”、图例中写作“40-core0”,均为图中原有写法;上下文所指指标是 ssj_ops/watt。
为得到一个能够比较系统能效的汇总数值,SPECpower 采用:
采用 Intel 处理器的 R650,总体 ssj_ops/watt 为 11,533;R7525 则为 23,036。也就是说,价格约为 1.4 倍,单位功耗性能则达到两倍。
译注:表格数字与文字均按原页录入。DRAM 行原表只写“256”,正文说明单位为 GB;“SUES”也是原表拼写,正文为 SUSE。两个“总计”均等于基础服务器、处理器、DRAM 与磁盘价格之和,未包含表中另外列出的操作系统费用;因此各行占比相加会超过 100%。原书没有解释这一口径差异,不能把该总价视为上述所有收费项目的合计。 ↩︎
译注:此句依次给出约 1.4、1.5、1.6;但图 1.22 中 Integer Rates 与 Floating Point Rates 的比值分别为 1.54 和 1.41,前两个近似值在正文中似乎对调了。 ↩︎
译注:原图注确写“Figure 1.20”,但两台服务器的配置与性能表实际是图 1.22。 ↩︎
1.12 谬误与陷阱
本书每章都有“谬误与陷阱”这一节,目的是解释一些广泛流传、却应当避免的错误认识。我们把这类误解称为谬误(fallacies),讨论时会尽量给出反例。我们还会介绍陷阱(pitfalls),即很容易犯的错误。陷阱往往源于把仅在特定条件下成立的原则过度推广。本节旨在帮助你在设计计算机时避免这些错误。本章涉及的主题中,不乏错误认识和容易重蹈的覆辙。
陷阱:所有指数增长规律都会放缓
最先失效的是 Dennard 缩放规律。Dennard 在 1974 年观察到,电压和电流应当与晶体管的线性尺寸成正比。由于动态功耗与 成正比,这意味着随着 CMOS 工艺缩小,电路可以在保持功耗不变的同时,使用更多晶体管并运行于更高频率。30 年后,Dennard 缩放规律失效了:阈值电压和漏电流为每个晶体管的功耗设定了一个无法随尺寸继续缩减的下限。因此,现代芯片受到功率约束,频率提升也基本停滞,利用更高晶体管密度的代价越来越高。
接下来放缓的是硬盘。虽然磁盘领域没有一条对应的定律,但在过去 30 年里,决定磁盘容量的最大面密度曾以每年 30% 到 100% 的速度提高。过去十年中,这一增速却不足每年 5%。单盘容量的增长,主要依靠增加一块硬盘中的盘片数量。
再接下来,是久负盛名的 Moore 定律。每颗芯片的晶体管数每隔 1 到 2 年翻一番,已经不是近年的现实。例如,2014 年推出的 DRAM 芯片包含 80 亿个晶体管,直到 2019 年,包含 160 亿个晶体管的 DRAM 芯片才实现量产;按照 Moore 定律,那时本应至少达到 640 亿个晶体管。
图 1.24 展示了 Intel 自 1999 年以来对新工艺节点的估计。从 180 nm 到 22 nm,节点演进一直保持两年一代;到 14 nm 时延长为三年,下一个节点所需时间更长。
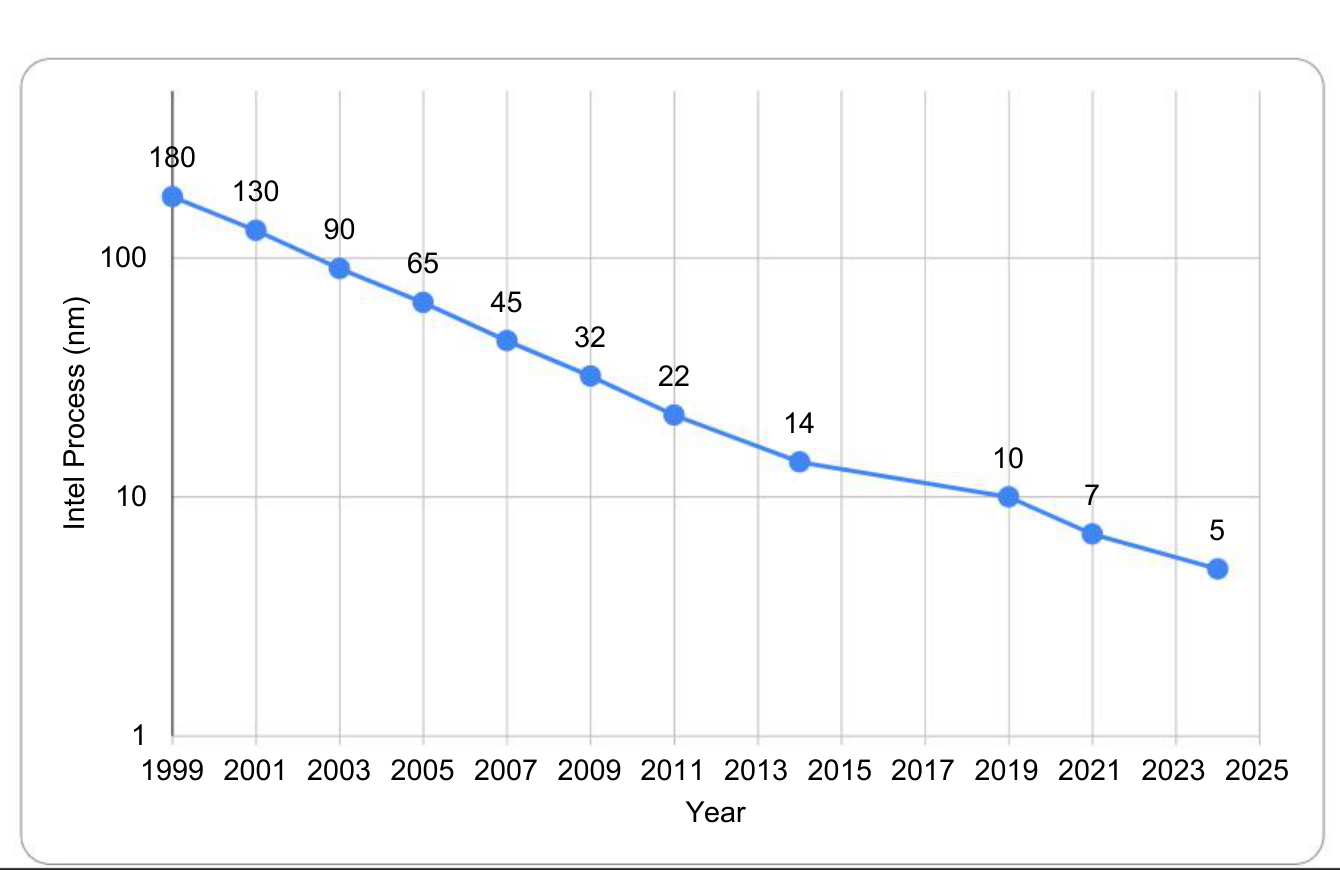
图 1.24 Moore 定律的放缓。图中给出了 Intel 新半导体工艺出现的时间,工艺节点以 nm 表示,纵轴采用对数刻度。注意,自 2011 年以来,新工艺节点之间的间隔由此前约两年延长为约三至五年。来源:WikiChip 的 Intel 工艺资料。
图内标注:Intel Process (nm) 为 Intel 工艺节点(nm),Year 为年份。
图 1.25 展示了微处理器与 DRAM 的带宽增长随时间的变化,这两者都受到 Dennard 缩放规律和 Moore 定律失效的影响;图中还列出了网络与磁盘的变化。曲线逐渐弯折,清楚地反映出技术进步正在放缓。自 1980 年前后以来,微处理器和网络的带宽改善幅度,是内存带宽改善幅度的十倍以上;而内存的改善幅度,又接近磁盘带宽改善幅度的十倍。
陷阱:工艺线宽已不再对应晶体管的实测宽度
直到 2005 年前后,以纳米表示的工艺数字仍对应芯片内部一个真实的物理尺寸。后来,传统平面晶体管在 20 nm 下表现不佳,因此转向在相同几何尺度下采用 FinFET 晶体管。为了表示这种新的 FinFET 晶体管更好,出于营销考虑,人们把它重新标成“16 nm 工艺”,尽管它仍处在相同的工艺尺度。一旦节点数字不再对应某个测量值,命名也就失去了约束。TSMC 7 nm 工艺的金属线间距为 40 nm,而 Intel 10 nm 工艺为 36 nm,因此 Intel 的 10 nm 可能做出比 TSMC 7 nm 更小的芯片。既然这些数字如今已经成为营销名称,就很难预测所谓“5 nm”及更小节点究竟能带来什么收益;而且,仍在制造最先进逻辑芯片的三家公司——Intel、Samsung 和 TSMC——采用的命名也可能不一致。
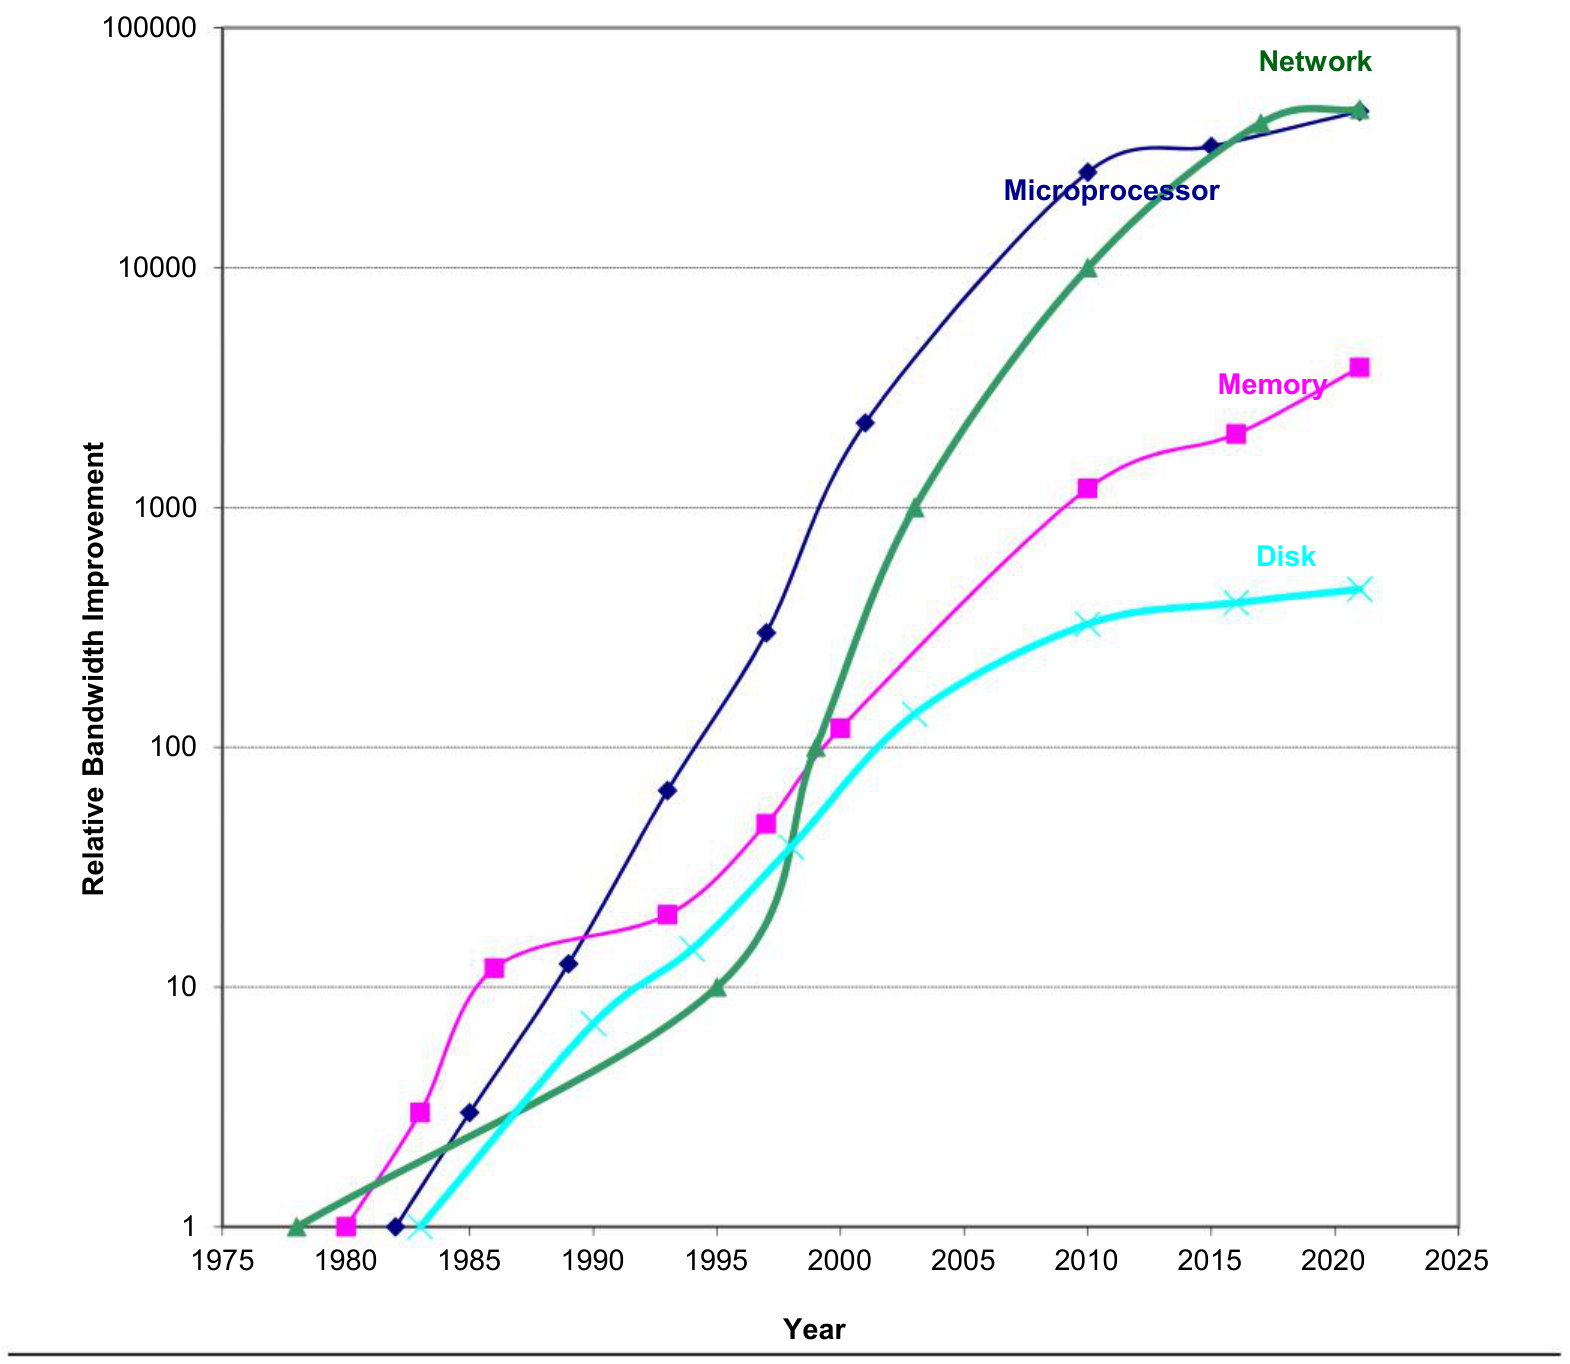
图 1.25 微处理器、网络、内存与磁盘的相对带宽随时间的变化,数据来自图 1.10。注意,在 2021 年,网络和微处理器与内存之间的带宽改善幅度相差约十倍,而内存与磁盘之间又相差近十倍。
图内标注:Relative Bandwidth Improvement 为相对带宽改善倍数,Year 为年份;Microprocessor、Memory、Network 和 Disk 分别为微处理器、内存、网络和磁盘。
谬误:多处理器是万能解药
2005 年前后转向在单颗芯片上放置多个处理器,并不是因为出现了某种突破,使并行编程骤然简单起来,或使多核计算机容易构建。发生这种转变,是因为指令级并行性的限制和功耗墙让人别无选择。一颗芯片上有多个处理器,并不保证功耗更低;设计一颗功耗更高的多核芯片,完全办得到。其潜力只在于:可以用多个较低频、较高效的核心,取代一个高频却低效的核心,从而继续提升性能。
第 4、5 章将看到,提高性能如今已经成了程序员的责任。程序员靠在 La-Z-Boy 躺椅上,什么也不做,只等硬件设计者让程序越来越快的时代,已经正式结束了。如果希望程序每一代都运行得更快,程序员就必须让程序具有更多并行性。
广为流传的那个版本的 Moore 定律——每一代技术都会带来更高性能——如今已有一部分要靠程序员来实现。
陷阱:栽在令人心碎的 Amdahl 定律上
几乎每位实际从事计算机设计的体系结构工程师都知道 Amdahl 定律。即便如此,我们差不多都曾在没有先测量某项功能的原有使用比例时,就花费巨大精力去优化它。直到整体加速效果令人失望,才想起本来应当先测量,再投入那么多精力改进!
陷阱:单点失效
1.10 节使用 Amdahl 定律进行的可靠性改善计算表明,系统的可信赖性受制于最薄弱的一环。 即使像前面的例子那样,把电源做得再可靠,单个风扇仍会限制磁盘子系统的可靠性。由 Amdahl 定律得出的这一认识,形成了容错系统的一条经验准则:应确保每个部件都有冗余,使任何单个部件的失效都不至于使整个系统停机。第 6 章将说明,软件层如何避免仓库级计算机(WSC)内部的单点失效。
谬误:提高性能的硬件改进也会提高能效,最差也不会增加能耗
Esmaeilzadeh et al.(2011)在一颗 2.67 GHz Intel Core i7 上,仅使用一个核心运行 SPEC2006,并启用 Turbo 模式(见 1.5 节)。时钟频率提高到 2.94 GHz,即原来的 1.10 倍后,性能提高到 1.07 倍,但 i7 消耗的焦耳数达到原来的 1.37 倍,瓦时数更达到 1.47 倍!1 也许正是这种低能效,使工程师在运行图 1.23 中两台服务器的 SPECpower 测试时关闭了 Turbo 模式。
谬误:基准测试永远有效
有许多因素影响基准测试预测真实性能的能力,其中一些会随时间变化。一个重要因素,是测试能否抵御“benchmark engineering”或“benchmarketing”——为了基准成绩而进行的专门优化。一旦某项基准测试标准化并广受采用,就会产生巨大压力,促使人们通过有针对性的优化,或对运行规则作激进解读,来提升成绩。
短小的核心片段,或执行时间集中在少量代码上的程序,尤其容易受到这种影响。
例如,尽管初衷很好,最初的 SPEC89 套件中还是包含了一个名为 matrix300 的小型核心片段,它由八种不同的 矩阵乘法组成。其中 99% 的执行时间花在同一行代码上(见 SPEC, 1989)。IBM 编译器对这个内层循环进行优化后,性能相对于前一版编译器提高到了九倍!它使用的是一种很好的技术,称为分块(blocking),第 2、4 章会讨论。但这项测试测到的是编译器调优效果,当然不能很好地反映整体性能,也不能代表这项优化通常能带来的收益。
如果忽视历史,就可能重蹈覆辙。SPEC Cint2006 整整十年没有更新,给了编译器开发者充足时间,针对这套测试不断打磨优化器。在一款 Intel 微处理器上,除了 libquantum,其他 SPEC Cint2006 测试的比值都落在 22 到 78 之间;libquantum 却快了 7,300 倍!这一“奇迹”来自 Intel 编译器的优化:它自动将代码并行化到所有核心上,还利用位打包(bit packing)来优化内存,把多个取值范围较窄的整数紧密打包,以节省内存空间,进而节省内存带宽。
为了说明基准测试的寿命之短,图 1.19 列出了历代 SPEC 中全部 82 个程序的状况;gcc 是 SPEC89 中唯一留存下来的程序。 令人吃惊的是,SPEC2000 及更早版本中的程序,约有 70% 在下一版中就被移除了。
谬误:磁盘的标称 MTTF 为 1,200,000 小时,接近 140 年,所以磁盘几乎不会失效
磁盘厂商当下的营销方式可能误导用户。如此高的 MTTF 是怎样算出来的?在早期测试中,厂商会把数千块磁盘放在一个房间里,运行几个月,然后统计失效数量。MTTF 等于这些磁盘累计工作小时数,除以失效磁盘数。
问题之一是,这个数值远远超过一块磁盘的使用寿命,而磁盘寿命通常按 5 年、即 43,800 小时估计。为使如此大的 MTTF 有所解释,厂商认为其模型对应如下使用方式:用户买入一块磁盘,此后每隔 5 年,也就是磁盘的计划使用寿命,就换一块。其含义是,如果许多客户以及他们的曾孙后代在今后一个世纪里一直这样做,那么平均更换 27 次、也就是约 140 年后,才会遇到一次失效。
更有用的指标是失效磁盘所占的比例,或年失效率(见 1.7 节)。假设有 1,000 块 MTTF 为 1,000,000 小时的磁盘,每天使用 24 小时。如果把失效磁盘换成可靠性特征相同的新盘,那么一年 8,760 小时内,失效磁盘的数量为:
换句话说,每年约有 0.9% 的磁盘失效,或在 5 年寿命中累计约 4.5%。2
而且,这些很高的标称数字,还假定温度和振动处于限定范围内。一旦超出范围,就不能再作同样保证。对真实使用环境中的磁盘进行的一项调查(Gray and van Ingen, 2005)发现,每年有 3% 到 7% 的磁盘失效,对应的 MTTF 约为 125,000–300,000 小时。一项规模更大的研究发现,磁盘年失效率为 2% 到 10%(Pinheiro et al., 2007)。因此,实际环境中的 MTTF,约比厂商标称值差 2 到 10 倍。
谬误:峰值性能能够反映实测性能
关于峰值性能,唯一普遍成立的定义是:“计算机保证不会超过的性能水平。”图 1.26 展示了四个程序在四种多处理器系统上的实测性能占峰值性能的比例,范围从 5% 到 58%。由于差距很大,而且会因基准程序不同而显著变化,峰值性能通常无助于预测实际性能。
陷阱:检测故障可能降低可用性
这个看似矛盾的陷阱,是因为计算机硬件中有相当多的状态,并非始终对正确运行至关重要。例如,分支预测器发生错误并不致命,可能只是性能受损。
在积极挖掘 ILP 的处理器中,并非所有操作都是程序正确执行所必需的。Mukherjee et al.(2003)发现,对于 SPEC2000 基准测试,可能处在关键路径上的操作不到 30%。
程序也存在同样现象。如果一个寄存器中的值已经“死亡”(dead),也就是程序会在下一次读取之前先写入新值,那么这个寄存器中的错误就无关紧要。如果在这样的寄存器中发现瞬态故障,就让程序崩溃,只会无谓地降低可用性。
Oracle 旗下 Sun Microsystems 部门曾在 2000 年遭遇这一问题:Sun E3000 到 Sun E10000 系统的 L2 缓存有奇偶校验,却没有纠错功能。构建缓存所用的 SRAM 存在间歇性故障,奇偶校验能够发现它们。如果缓存中的数据未被修改,处理器只需重新从缓存中读取数据。3 但设计者没有用纠错码(ECC)保护缓存,因此遇到脏数据错误时,操作系统别无选择,只能报告错误并使程序崩溃。现场工程师检查时,超过 90% 的案例都查不出问题。
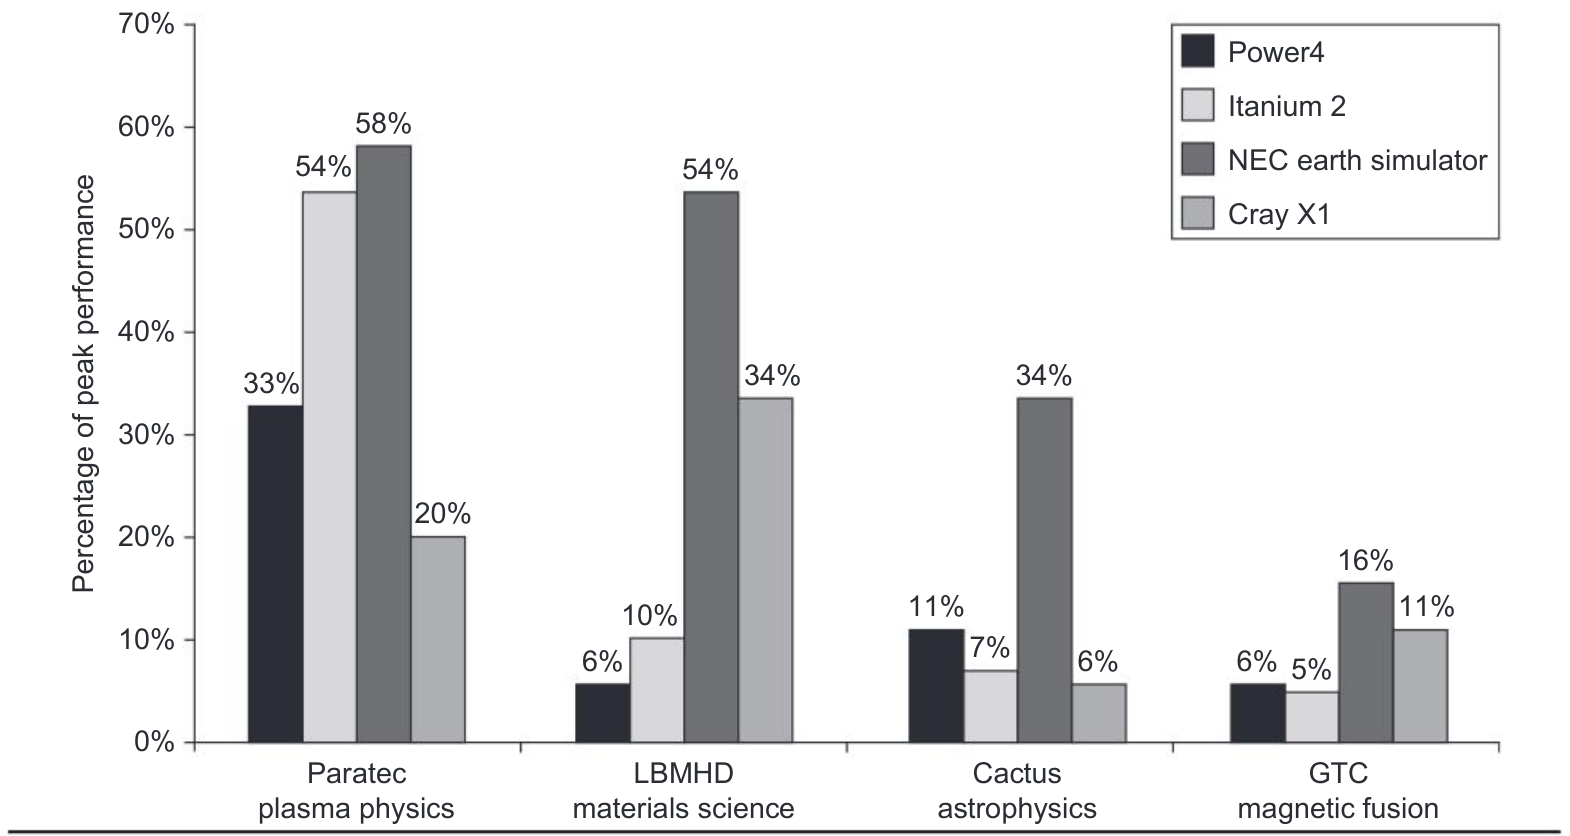
图 1.26 四个程序在四种多处理器系统上、规模扩展到 64 个处理器时,实测性能占峰值性能的比例。Earth Simulator 与 X1 是向量处理器(见第 4 章及附录 G)。它们不仅实现了更高的峰值性能比例,而且峰值性能本身最高,时钟频率却最低。除 Paratec 外,Power4 与 Itanium 2 系统的实测性能约为各自峰值的 5% 到 10%。4
图内标注:Percentage of peak performance 为占峰值性能的百分比。四个程序依次为 Paratec(等离子体物理)、LBMHD(材料科学)、Cactus(天体物理)和 GTC(磁约束聚变)。每组柱从左到右分别是 Power4、Itanium 2、NEC Earth Simulator、Cray X1。
原图来源:Oliker, L., Canning, A., Carter, J., Shalf, J., Ethier, S., 2004. Scientific computations on modern parallel vector systems. In Proceedings of the ACM/IEEE Conference on Supercomputing, November 6–12, 2004, Pittsburgh, PA, p. 10.
为降低这类错误的发生频率,Sun 修改了 Solaris 操作系统,安排一个进程主动把脏数据写回内存,以“清洗”(scrub)缓存。由于处理器芯片没有足够的引脚来增加 ECC,对脏数据而言,唯一可行的硬件方案是复制外部缓存,并用未发生奇偶校验错误的副本纠正错误。
陷阱就在于:检测到了故障,却没有提供纠正机制。这些工程师此后大概不会再设计外部缓存不带 ECC 的计算机了。
陷阱:高估计算技术对碳排放的影响
全球气候变化如此重要,考虑信息技术在其中的作用,当然不可或缺。但我们必须把数字算对,才能确保处理的是最重要的问题,也才能维护建议的可信度。讽刺的是,错误的计算有时反而更有新闻价值,从而吸引大量注意。即便后续发表的材料予以纠正,也往往得不到同样关注,那些错误的“似是而非的事实”便会在互联网上自行流传。
“Brandolini 定律”以幽默的方式概括了这种讽刺:驳斥错误信息所需的精力,是制造错误信息所需精力的十倍。
Koomey 和 Masanet 总结了估算排放时常见的四种错误(Koomey and Masanet, 2021):
- 忽视、误解,或错误描述关键参数随时间的变化。
- 认为计算活动的短期变化,必然立即引起用电量的同比例变化。
- 信息技术发展极快,哪怕预测未来几年也高度不确定,却仍试图作长期预测。
- 仅凭信息技术生态中某一部分的趋势,就得出适用于整体的结论。
以下三个例子说明了这些陷阱:
- 2010 到 2018 年间,云数据中心的工作负载增长到了原来的 26 倍,估算用电量增长到了 5 倍。有人据此预测云计算会带来严重后果。但尽管云发展迅速,全球所有数据中心的实际能耗增长却不到 10%。两种观察之所以可以同时成立,是因为在这段时期,大量计算从效率相对较低的本地数据中心,转移到了效率高得多的云数据中心(Masanet et al., 2020)。这一错误估计,正是犯了上面的第四种错误。
- 报纸曾声称:“观看 30 分钟 Netflix 产生的排放[1.6 kg CO₂e],相当于驾车近 4 英里。”更准确的估计是 36 克 CO₂e,约为前者的四十五分之一(Kamiya, 2020)。这一高估,主要源于第一种错误:忽视关键参数的变化。
- 报纸曾报道:“训练一个深度神经网络模型的排放,是一辆汽车全生命周期排放的五倍[284,019 kg]。”实际数字只有 2.4 kg CO₂e,约为前者的十二万分之一(Patterson et al., 2022)。第 7 章的“谬误与陷阱”会解释这一错误高估是如何产生的,主要原因仍是上述四种错误中的第一种。
1.13 结束语
本章介绍了一系列概念,并建立了一个定量分析框架,后续各章将在此基础上继续展开。从上一版开始,能效便始终与性能相伴,成为贯穿全书的主题。
第 2 章从至关重要的存储系统设计入手。我们将考察多种技术如何协同工作,使存储空间看起来无限大,同时又尽可能快。
对于缓存相关经验和背景不足的读者,附录 B 提供了入门材料。正如后续章节所展示的那样,软硬件协作已经成为高性能存储系统的关键,就像它对高性能流水线同样关键一样。
第 3 章讨论指令级并行性(ILP),其中流水线是最简单、最常见的形式。利用 ILP,是构建高速单处理器最重要的技术之一。第 3 章首先充分讨论基本概念,为理解这两章中将要考察的众多思想做好准备。1 这一章选用的实例横跨近 50 年,从最早的超级计算机之一 IBM 360/91,一直到当今市场上最快的处理器。重点是以动态方式、也就是在运行时利用 ILP。它还讨论 ILP 思想的局限,并引入多线程;第 4、5 章将继续深入这一主题。对于流水线相关经验和背景不足的读者,附录 C 提供了入门材料。我们预计,这些内容对许多读者来说只是复习,包括读过我们入门教材 Computer Organization and Design: The Hardware/Software Interface 的读者。
第 4 章介绍利用数据级并行性(DLP)的三种方式。最经典、历史最悠久的方法是向量体系结构,因此我们从这里开始,奠定 SIMD 设计的基本原理。(附录 G 更深入地讨论向量体系结构。)随后介绍当今大多数桌面微处理器都具有的 SIMD 指令集扩展。第三部分深入解释现代 GPU 的工作方式。多数 GPU 介绍从程序员的角度出发,往往掩盖了计算机真正的工作机制。本节则从内部实现的角度解释 GPU,包括 GPU 术语与传统体系结构术语之间的对应关系。
第 5 章关注如何利用多个处理器,也就是多处理器系统,来获得更高性能。与利用并行性来重叠执行单条指令不同,多处理利用并行性,让多条指令流在不同处理器上同时执行。我们的重点是最主要的多处理器形式——共享内存多处理器。不过,也会介绍其他类型,并讨论任何多处理器都要面对的普遍问题。这里同样会考察多种技术,重点放在 20 世纪 80、90 年代首次提出的那些重要思想上。
第 6 章先介绍集群,再深入讨论支撑现代云计算时代的仓库级计算机(WSC)。WSC 的设计者,堪称 Seymour Cray 等超级计算机先驱在专业上的继承人:他们同样在设计规模极大的计算机。一个 WSC 包含数万台服务器,设备及容纳设备的建筑成本接近 2 亿美元。前面各章关注的性价比与能效,同样适用于 WSC;基于定量分析作决策的方法也依然适用。本章还介绍虚拟机,这是实现安全云计算的一项关键技术。
第 7 章介绍领域专用体系结构:在 Moore 定律和 Dennard 缩放规律失效的背景下,这是继续提高性能与能效的唯一出路。它给出构建有效的领域专用体系结构的指导原则,介绍令人振奋的深度神经网络领域,分析四个近期实例——它们采用截然不同的方式加速神经网络——并比较其性价比。本版完稿之际,人工智能热潮空前高涨,不禁让人思考:从现在到下一版问世,通用 CPU 与 AI 加速器,究竟哪一方会获得更多投入?
本书还附有大量在线材料,详情见前言。这样做既是为了降低成本,也为了向读者介绍各种高级主题。图 1.27 列出了全部附录。书中收录的附录 A 至 C,对许多读者来说将是一次复习。
附录 D 不再以处理器为中心,而是讨论存储系统的问题。我们同样采用定量方法,但以系统行为的观察为基础,并从端到端的角度分析性能。该附录探讨一个重要问题:如何主要利用成本较低的磁存储技术,高效地存储和检索数据。重点是考察磁盘存储系统在典型 I/O 密集型负载下的性能,例如本章提到的 OLTP 基准测试。我们还深入讨论基于 RAID 的系统中的高级问题;这类系统用冗余磁盘同时实现高性能与高可用性。最后,附录 D 介绍排队论,为权衡利用率与延迟提供依据。
附录 E 从嵌入式计算的角度,重新审视各章及前面几个附录中的思想。
附录 F 广泛探讨系统互连,包括让计算机彼此通信的广域网与系统区域网络。
| 附录 | 标题 |
|---|---|
| A | 指令集原理 |
| B | 存储层次结构回顾 |
| C | 流水线:基础与中级概念 |
| D | 存储系统 |
| E | 嵌入式系统 |
| F | 互连网络 |
| G | 深入探讨向量处理器 |
| H | VLIW 与 EPIC 的硬件和软件 |
| I | 大规模多处理器与科学应用 |
| J | 计算机算术 |
| K | 指令集体系结构概览 |
| L | 地址转换的高级概念 |
| M | 历史回顾与参考文献 |
图 1.27 附录目录。
附录 H 回顾超长指令字(VLIW)的硬件与软件。相比之下,自 Hewlett-Packard 与 Intel 的 EPIC 在 1997 年登场以来,VLIW 在通用计算中的受欢迎程度已经下降。最终,它在数字信号处理器和领域专用体系结构中找到了用武之地。
附录 I 介绍用于高性能计算的大规模多处理器。
附录 J 是唯一从第 1 版保留下来的附录,讨论计算机算术。
附录 K 概览多种指令体系结构,包括 x86、IBM 360、VAX,以及众多 RISC 体系结构,例如 ARM、MIPS、Power、RISC-V 和 SPARC。
附录 L 讨论内存管理的高级技术,重点是虚拟机支持,以及面向超大地址空间的地址转换设计。随着云端处理器的发展,这些体系结构改进正在变得更加重要。
接下来介绍附录 M。
译注:此处原文确写“both chapters”,但所在段落仅明确介绍第 3 章,另一章的指代不清。 ↩︎
1.14 历史回顾与参考文献
附录 M(可在线获取)从历史角度回顾本书各章介绍的关键思想。这些历史回顾使我们能够沿着一系列机器,追踪某个思想的发展,或介绍一些重要项目。如果你希望考察某个思想或处理器最初的发展过程,或者想继续深入阅读,每段历史介绍的末尾都列有参考文献。就本章而言,可以参阅 M.2 节“计算机的早期发展”(The Early Development of Computers),其中讨论了数字计算机的早期发展与性能测量方法。
阅读这些历史材料时,你很快会意识到:与许多其他工程领域相比,计算领域还很年轻,而年轻的一大好处就是,某些开创性思想的提出者仍然健在——只要去问他们,我们就能了解这段历史!
案例与习题
作者:Gregory D. Peterson。
译校说明:题号、方括号内的难度标记及尖括号内的章节引用均沿用原书。部分章节引用与本版正文位置不完全一致;例如题目中涉及 Amdahl 定律的若干引用仍写为〈1.9〉,本版相关内容实际在 1.10 节。
案例一:芯片制造的发展趋势
本案例涉及的概念:
- 制造成本
- 制造良率
- 利用冗余容忍缺陷
尽管半导体制造正逼近物理学的基本极限,各公司仍在持续建设制造设施,以跟上 Moore 定律的步伐。每座新晶圆厂的成本都达数百亿美元;要制造新一代计算机芯片,还需要一系列相关技术共同取得进展。这些挑战直接影响能否造出性能更高的芯片,以及芯片的价格。本案例将探讨芯片设计中的一些决策,分析它们如何影响性能、良率、冗余和成本。
习题 1.1
[10/10/10/10/10/10]〈1.6〉 图 1.28 给出了影响 GPU 和 CPU 芯片成本的一组假设数据。接下来的几道题将探讨不同设计决策对这些芯片的影响。
| 芯片 | 裸片面积(mm²) | 估计缺陷密度(每 cm²) | N | 工艺尺寸(nm) | 晶体管数(十亿) | 核心数或 SM 数 |
|---|---|---|---|---|---|---|
| GPU A | 800 | 0.011 | 36 | 4 | 80 | 132 |
| GPU B | 2 × 850 | 0.011 | 37 | 4 | 210 | 160 |
| CPU A | 270 | 0.011 | 36 | 4 | 16 | 8 |
| CPU B | 12 × 75(计算) 1 × 400(I/O) | 0.010 0.010 | 35 34 | 5 6 | 90 | 96 |
a. [10]〈1.6〉 对于一片合格晶圆,GPU A 芯片的良率是多少?
b. [10]〈1.6〉 对于一片合格晶圆,CPU A 芯片的良率是多少?
c. [10]〈1.6〉 GPU B 将两个大型 chiplet 集成为一个封装系统。对于一片合格晶圆,每个 GPU B chiplet 的良率是多少?
d. [10]〈1.6〉 CPU B 将多个不同的 chiplet 集成为一个封装系统。其中,12 个用于计算任务的 chiplet 采用较小的工艺尺寸制造,另有一个用于 I/O 任务的 chiplet 采用较大的工艺尺寸。假设晶圆合格,构成 CPU B 的计算 chiplet 与 I/O chiplet 的良率各是多少?
e. [10]〈1.6〉 假设 GPU B 不采用 chiplet,而是制造成一块更大的单片芯片。此时的良率与原方案相比如何?你还能想到哪些使用 chiplet 更有利的理由?
f. [10]〈1.6〉 假设 CPU B 不采用 chiplet,而是使用较小的工艺节点制造成一块更大的单片芯片,并假定在较小工艺节点下 I/O 功能仍占用相同面积。此时的良率与原方案相比如何?
习题 1.2
[20/20/20/25/25]〈1.6〉 考虑制造上述各类芯片的工厂。我们希望评估应为每类芯片分配多少产能。假设每颗无缺陷的 GPU A 芯片可获得 1000 美元利润,
每颗无缺陷的 CPU A 芯片可获得 100 美元利润。对每类芯片,都假设晶圆直径为 300 mm。
a. [20]〈1.6〉 每片用于制造 GPU A 芯片的晶圆可获得多少利润?
b. [20]〈1.6〉 每片用于制造 CPU A 芯片的晶圆可获得多少利润?
c. [20]〈1.6〉 如果每月需求最多为 5000 颗 GPU A 和 3000 颗 CPU A,而工厂每月能加工 90 片晶圆,应为两类芯片各分配多少片晶圆?
d. [25]〈1.6〉 假设每个无缺陷的 GPU B 产品可获得 2500 美元利润,且每个产品需要两个 chiplet。每片用于制造 GPU B chiplet 的晶圆可获得多少利润?
e. [25]〈1.6〉 假设每个无缺陷的 CPU B 产品可获得 75 美元利润,每个产品需要 12 个计算 chiplet 和一个 I/O chiplet。每片用于制造 CPU B 计算 chiplet 的晶圆,能支持销售多少个 CPU B 产品?每加工一片计算 chiplet 晶圆,需要配套加工多少片 I/O chiplet 晶圆?如果工厂能加工 30 片这类晶圆,应如何在计算 chiplet 与 I/O chiplet 之间分配,才能使利润最大?最大利润是多少?
习题 1.3
[20/5]〈1.6〉 对于良率较低的大型处理器芯片,与其丢弃功能不完整的芯片,不如降价出售,以提高经济效益。某些产品可以按照不同核心数出售多个版本,这些版本也称为库存单位(stock keeping unit,SKU)。例如,可以销售分别包含 8、4、2、1 个核心的 CPU A 芯片。如果全部八个核心均无缺陷,就作为 CPU A8 出售;如果四至七个核心无缺陷,就作为 CPU A4 出售;如果两至三个核心无缺陷,就作为 CPU A2 出售。
为简化计算,用面积为原 CPU A 芯片 1/8 的芯片良率,作为单个核心的良率。再将该良率视为单个核心无缺陷的独立概率。每种配置的良率,则按相应数量核心无缺陷的概率计算。
a. [20]〈1.6〉 单个核心无缺陷的良率,以及 CPU A4、CPU A2 和 CPU A1 的良率各是多少?
b. [5]〈1.6〉 根据(a)的结果,你认为哪些芯片值得封装并出售?说明理由。
习题 1.4
[20/5/25]〈1.6〉 现在考虑用冗余提高 GPU 良率的类似方法。假设 GPU B 由两个 chiplet 构成,每个 chiplet 包含 85 个对称多处理器(原文为 symmetric multiprocessors,SM),相当于 GPU 中的核心。进一步假设,要交付一个包含 160 个 SM 的产品,需要两个可用的 GPU chiplet;每个 chiplet 最多可以有五个 SM 存在缺陷。
与习题 1.3 对 CPU A 的处理相同,以面积为原 GPU B chiplet 的 1/85 的 chiplet 良率,作为单个 SM 的良率。
同样,将该良率视为单个 SM 无缺陷的独立概率。再以至少 80 个 SM 无缺陷的概率,计算整个 chiplet 的良率。
译注:本题原文将 SM 展开为 symmetric multiprocessors;GPU 语境下通常所指的名称为 Streaming Multiprocessor。
a. [20]〈1.6〉 单个 SM 无缺陷的良率,以及每个 GPU B chiplet 的良率各是多少?
b. [5]〈1.6〉 根据(a)的结果,每片用于制造 GPU B chiplet 的晶圆能获得多少利润?与习题 1.2(d)的结果相比如何?
c. [25]〈1.6〉 对 GPU A 也可以作类似分析:假设每块裸片有 144 个 SM,而只要至少 132 个 SM 正常工作,芯片就可以出售。这样的冗余会如何影响每片晶圆的利润?它又会如何改变习题 1.2(c)的答案?
案例二:可扩展计算机系统
本案例涉及的概念:
- Amdahl 定律
- 冗余
- 平均失效前时间(MTTF)
现代系统的规模从微型物联网设备延伸到数据中心和超级计算机。以下习题讨论影响这些系统的实际问题,包括成本、功率与能耗,以及性能随规模的扩展。
大型可扩展计算机系统通常通过提高作业吞吐量(同时处理许多作业)、降低延迟(尽快完成任务),或兼顾两者,来获得高性能。利用并行性是提高性能的重要方法,适用于各种规模:从增加处理器内部的核心数,到增加服务器或节点内的处理器数、插槽数,再到增加数据中心或超级计算机中的服务器数、节点数。
习题 1.5
[10/20/20/20/25]〈1.10〉 将应用程序并行化时,理想加速比应等于处理器数量。实际上,加速比受两方面限制:程序中可并行化部分的比例,以及通信成本等额外开销。Amdahl 定律考虑了前者,却没有考虑后者。
a. [10]〈1.10〉 如果应用程序中可并行化的比例分别为 [80%、90%、95%、99%],忽略通信成本时,使用 N 个处理器的加速比各是多少?
b. [20]〈1.10〉 如果每增加一个处理器,通信开销就增加原始执行时间的 [0.5%、1%、2%、5%],使用 32 个处理器的加速比各是多少?
c. [20]〈1.10〉 如果处理器数量每翻一倍,通信开销就增加原始执行时间的 [0.5%、1%、2%、5%],使用 32 个处理器的加速比各是多少?
d. [20]〈1.10〉 如果处理器数量每翻一倍,通信开销就增加原始执行时间的 [0.5%、1%、2%、5%],使用 N 个处理器的加速比各是多少?
e. [25]〈1.10〉 写出求解下列问题的一般方程:若应用程序原始执行时间中有 P% 可以并行化,而处理器数量每翻一倍,通信开销就增加原始执行时间的 [0.5%、1%、2%、5%],那么使用多少个处理器才能获得最大的加速比?
习题 1.6
[10/20/20/20]〈1.10〉 在习题 1.5 中,各种并行执行方案所处理的问题规模相同,这称为强扩展(strong scaling)。在弱扩展(weak scaling,有时也称为 Gustafson 定律)中,问题规模随处理器数量增加而增大。下面考虑一个采用弱扩展的应用程序的性能,即扩展加速比,同时考虑串行应用程序(基准)中被并行化部分的比例和通信成本。
a. [10]〈1.10〉 如果串行应用程序中可并行化的比例分别为 [80%、90%、95%、99%],忽略通信成本,并假定其余方面都能随处理器数量增加而理想扩展,使用 N 个处理器的扩展加速比各是多少?
b. [20]〈1.10〉 如果每增加一个处理器,通信开销就增加原始执行时间的 [0.5%、1%、2%、5%],使用 32 个处理器的扩展加速比各是多少?
c. [20]〈1.10〉 如果处理器数量每翻一倍,通信开销就增加原始执行时间的 [0.5%、1%、2%、5%],使用 32 个处理器的扩展加速比各是多少?
d. [20]〈1.10〉 如果处理器数量每翻一倍,通信开销就增加原始执行时间的 [0.5%、1%、2%、5%],使用 N 个处理器的扩展加速比各是多少?
习题 1.7
[讨论]〈1.9、1.10〉 世界上规模最大的超级计算机所参加的 Top 500 榜单(top500.org),使用稠密线性代数程序 High Performance LINPACK(HPL)作为基准测试,报告系统实际达到的每秒浮点运算次数(FLOPS)以及理论峰值 FLOPS。该榜单也使用稀疏线性代数程序 High Performance Conjugate Gradient(HPCG),同样报告实际达到的 FLOPS。根据 2024 年 6 月的榜单,排名靠前的计算机在 HPL 上平均达到了峰值 FLOPS 的约 70%,但在 HPCG 上还不到峰值的 2%。
a. 能否将 Top 500 的 HPL 或 HPCG 结果换算为加速比或扩展加速比?请说明理由。
b. 将这些 Top 500 结果与图 1.26 所示超级计算机运行科学计算程序时报告的结果进行比较。
c. 2024 年,一项研究在当时位列 Top 500 榜首的 Frontier 上开展机器学习训练,报告称实际达到了理论每秒运算次数的 32%–38%。1 研究还报告,训练程序的扩展加速比(弱扩展)接近 100%,加速比(强扩展)为 87%–89%。这些结果与(a)、(b)中的情况相比如何?
译注:(c)原文直接用百分数表述 speedup 与 scaled speedup,未在题干中说明这些百分数的归一化基准。
习题 1.8
[10/10/20/20]〈1.10〉 你需要为一个包含 64 个核心的新处理器优化混合应用的性能。处理器上将运行四个应用程序,但它们对资源的需求并不相同。假设系统和应用程序具有图 1.29 所列的特征。你可以针对图中彼此独立的 A–D 场景中的任意一个或全部场景求解。图中的资源占比表示:如果四个应用程序(1–4)全部串行运行,每个应用程序的执行时间在总执行时间中所占的比例。假设将程序的一部分按 X 倍并行化,这一部分的加速比就是 X。
| 场景 | 指标 | 应用程序 1 | 应用程序 2 | 应用程序 3 | 应用程序 4 |
|---|---|---|---|---|---|
| A | 所需资源占比(%) | 35 | 31 | 20 | 14 |
| A | 可并行化比例(%) | 50 | 80 | 60 | 90 |
| B | 所需资源占比(%) | 41 | 28 | 17 | 14 |
| B | 可并行化比例(%) | 90 | 60 | 80 | 50 |
| C | 所需资源占比(%) | 37.5 | 25 | 22 | 15.5 |
| C | 可并行化比例(%) | 80 | 90 | 50 | 60 |
| D | 所需资源占比(%) | 50 | 25 | 12.5 | 12.5 |
| D | 可并行化比例(%) | 60 | 50 | 90 | 80 |
a. [10]〈1.10〉 与串行运行相比,让应用程序 1 使用整个处理器运行,能获得多大加速比?
b. [10]〈1.10〉 与串行运行相比,让应用程序 4 使用整个处理器运行,能获得多大加速比?
c. [20]〈1.10〉 按照应用程序 1 所需资源的比例,将相同比例的核心静态分配给它。如果只有应用程序 1 并行运行,其余应用程序仍串行运行,总体加速比是多少?
d. [20]〈1.10〉 如果按照四个应用程序各自的资源需求比例,分别为它们静态分配一定数量的核心,并让它们全部并行运行,总体加速比是多少?
习题 1.9
[10/10/20/20]〈1.7〉 设计服务器时,可用性是最重要的考虑因素,紧随其后的是可扩展性和吞吐量。
a. [10]〈1.7〉 一个单处理器的 FIT 值为 100。该系统的平均失效前时间(MTTF)是多少?
b. [10]〈1.7〉 如果需要一天才能使系统恢复运行,其可用性是多少?
c. [20]〈1.7〉 假设政府为降低成本,计划用廉价计算机构建超级计算机,而不采用价格昂贵、可靠性高的计算机。包含 1000 个处理器的系统,其 MTTF 是多少?假设其中一个处理器失效,整个系统就会失效。
d. [20]〈1.7〉 最大的超级计算机可以包含 10,000 个甚至更多节点,每个节点又有多个处理器或加速器。如果系统共有 50,000 个处理器,且可靠性特征与上述相同,其 MTTF 是多少?在这种情况下,在发生一次失效之前,我预计能够完成的作业,其最长运行时间是多少?
习题 1.10
[20/20/20]〈1.2、1.7〉 在云服务提供商使用的这类服务器集群中,单个设备失效不会使整个系统崩溃,而是减少系统在任一时刻能够响应的请求数。
a. [20]〈1.7〉 如果一家公司有 10,000 台计算机,每台计算机的 MTTF 为 35 天,只有在 1/3 的计算机失效时才发生灾难性的系统失效,那么系统的 MTTF 是多少?
b. [20]〈1.2、1.7〉 假设停机每小时造成 100,000 美元损失,系统崩溃后需要一天才能恢复运行。每年因停机造成的损失是多少?
c. [20]〈1.2、1.7〉 假设停机每小时造成 100,000 美元损失,系统崩溃后需要一天才能恢复运行。如果每台计算机额外投入 1000 美元,就能使 MTTF 翻倍,这是否是一个好的商业决策?假设计算机的使用寿命为三年。
案例三:计算机系统的能耗与功率
本案例涉及的概念:
- 动态能耗
- 功耗
现代系统的功耗取决于多种因素,包括芯片的时钟频率、效率和电压。以下习题探讨不同设计决策及使用场景对功率和能耗的影响。
习题 1.11
[10/10/10/10]〈1.5、1.9〉 手机承担的任务差异很大,包括播放流媒体音乐或视频、阅读电子邮件,以及日益增多的图像识别、语音识别等机器学习任务。用户要求手机具备较长的电池续航时间,因此降低功率和能耗至关重要。
本题考虑一个不符合现实的场景:手机没有专用处理单元,只配备一个四核通用处理单元。每个核心满负荷运行时消耗 0.5 W 功率。对于要完成的任务,这个四核处理器的速度是所需速度的八倍。
a. [10]〈1.5〉 与满功率运行相比,需要多少动态能量和动态功率?先假设四核处理器只运行 1/8 的时间,其余时间空闲,即在 7/8 的时间内关闭时钟,并假定这段时间内没有漏电。比较总动态能耗,以及核心运行期间的动态功率。
b. [10]〈1.5〉 如果采用频率和电压调节,需要多少动态能量和动态功率?假设在整个期间内,频率和电压都降至原来的 1/8。
c. [10]〈1.5、1.9〉 现在假设电压不能降到原电压的 50% 以下。这个电压称为电压下限(voltage floor);低于该电压,状态就会丢失。因此,频率可以继续下降,电压却不能继续下降。在这种情况下,动态能耗和动态功率分别能节省多少?
d. [10]〈1.5〉 采用 dark silicon(暗硅)方案时,会消耗多少能量?这种方案为每项主要任务设置专用 ASIC 硬件,并在不使用时通过电源门控将其关闭。芯片只保留一个通用核心,其余面积都用于专用单元。对于电子邮件这类任务,通用核心运行 25% 的时间,在其余 75% 的时间内通过电源门控完全关闭。在这 75% 的时间内,一个能耗仅为通用核心 20% 的专用 ASIC 单元运行,完成语音识别等任务。
习题 1.12
[10/10/10]〈1.5〉 如习题 1.11 所述,手机会运行各种各样的应用程序。这里沿用之前的假设:每个核心的功率为 0.5 W。
a. [10]〈1.5〉 假设 80% 的代码可以并行化。要使单个核心达到四路并行代码的执行速度,其频率和电压需要提高多少?
b. [10]〈1.5〉 在(a)中采用频率和电压调节,能够减少多少动态能耗?
译注:(a)原文要求提高单核的频率与电压,(b)仍使用“减少动态能耗”(reduction in dynamic energy)的问法。题干并不保证计算所得一定是节能。
c. [10]〈1.5〉 采用 dark silicon 方案时,会消耗多少能量?这种方案对所有硬件单元使用电源门控,使其可以完全关闭,且不产生漏电。系统提供专用 ASIC,以通用处理器 20% 的功率完成相同的计算。假设每个核心都支持电源门控,图像识别这类任务需要两个 ASIC 和两个核心。与使用四个核心并行运行的基准方案相比,需要多少动态能量?
习题 1.13
[10/10/10/10/10/20]〈1.5、1.9〉 通用处理器针对通用计算进行优化,因此能在大量应用程序上表现良好。不过,一旦把应用领域适当缩小,经过优化的功能单元或专用处理器就可以更加高效。借助 ASIC 或 GPU 等专用硬件,许多机器语言操作能够并发执行。本题从性能和散热两方面,探讨通用处理器与 GPU 之间的权衡。如果不能有效地将热量从计算机中排出,风扇吹回计算机的就会是热风,而不是冷风。
注意:两种方案的区别不只在处理器,片上存储器和 DRAM 也会产生影响。因此,这里的统计数据针对系统,而不是芯片。
| 系统 | 热设计功耗(TDP) | 空闲功率 | 繁忙时功率 |
|---|---|---|---|
| 基于 CPU | 504 W | 159 W | 455 W |
| 基于 GPU | 1838 W | 357 W | 991 W |
| 系统 | 吞吐量 A | 吞吐量 B | 吞吐量 C | A:最大 IPS 的百分比 | B:最大 IPS 的百分比 | C:最大 IPS 的百分比 |
|---|---|---|---|---|---|---|
| 基于 CPU | 5482 | 13,194 | 12,000 | 42% | 100% | 90% |
| 基于 GPU | 13,461 | 36,465 | 15,000 | 37% | 100% | 40% |
译注:图 1.31 的原表没有注明吞吐量的单位,译表不作补充。
a. [10]〈1.9〉 如果一个数据中心使用 CPU 时,有 70% 的时间运行工作负载 A,30% 的时间运行工作负载 B,那么 GPU 系统相对于 CPU 系统的加速比是多少?
b. [10]〈1.9〉 如果一个数据中心使用 CPU 时,有 70% 的时间运行工作负载 A,30% 的时间运行工作负载 B,那么三个系统各自能达到最大 IPS 的百分之多少?
c. [15]〈1.5、1.9〉 在(b)的基础上,假设当 IPS 从最大值的 0% 增加到 100% 时,功率从空闲功率线性增加到繁忙时功率。CPU 系统与 GPU 系统的每瓦性能相比如何?
d. [10]〈1.9〉 如果另一个数据中心有 40% 的时间运行工作负载 A,10% 的时间运行工作负载 B,50% 的时间运行工作负载 C,那么 GPU 系统相对于通用处理器系统的加速比是多少?
e. [10]〈1.5〉 假设一个机架冷却门售价 4000 美元,能够排出 14 kW 的热量。热量只是排到了机房内,要将其排出机房还需额外投入。按照图 1.30 和图 1.31 中的 TDP,一个冷却门能为多少台基于 CPU 或基于 GPU 的服务器散热?
f. [20]〈1.5〉 典型服务器集群每平方英尺最多能够散去 200 W 热量。已知一个服务器机架占用 11 平方英尺,包括前后预留空间,那么(e)中的服务器在一个机架内最多能放多少台?需要多少个冷却门?
译注:原文(b)写“三个系统”,但图 1.30、1.31 只列出 CPU、GPU 两类系统;(e)引用两幅图的 TDP,但 TDP 只列于图 1.30。题首第三项难度标记为 [10],而(c)标为 [15]。以上均保留原书差异。
习题
习题 1.14
[15/10]〈1.9〉 假设我们对一台计算机作了改进,使某种执行模式的速度提高到原来的十倍。测量启用改进模式之后的执行时间,发现其中有 50% 的时间使用了这种改进模式。注意,Amdahl 定律所需的是:在改进前的原始执行时间中,能够使用改进模式的那一部分所占的比例。因此,不能直接将测得的 50% 代入 Amdahl 定律计算加速比。
a. [15]〈1.9〉 这种快速模式带来的总体加速比是多少?
b. [10]〈1.9〉 原始执行时间中有百分之多少被转换成了快速模式?
习题 1.15
[20/10/10/15]〈1.9〉 假设我们考虑改进一个基于 chiplet 的多核处理器,用一个加密硬件 chiplet 替换一个计算核心 chiplet。执行加密操作时,它的速度是正常执行模式的 20 倍。定义“加密占比”为:原始执行时间中用于加密操作的时间比例。
a. [20]〈1.9〉 绘制加速比随加密计算占比变化的曲线。纵轴标注“净加速比”,横轴标注“加密占比”。
b. [10]〈1.9〉 加密占比达到多少时,增加加密硬件能获得 2 倍加速比?
c. [10]〈1.9〉 如果获得了 2 倍加速比,在新的执行时间中,加密操作占多少比例?
d. [15]〈1.9〉 假设失去一个计算核心 chiplet 会使其他计算的性能下降 10%。加密单元的使用比例至少达到多少,才值得这样做?
习题 1.16
[20/20/15]〈1.9〉 对处理器的一部分进行优化时,常常会出现这样的情况:一种指令加快了,其他方面却变慢了。例如,加入一个复杂而快速的浮点单元会占用空间;为了容纳它,可能必须把其他单元移到离中央更远的位置,导致访问那个单元的延迟增加一个周期。基本的 Amdahl 定律方程并没有考虑这种权衡。
a. [20]〈1.9〉 如果新的快速浮点单元使浮点运算的平均速度变为原来的 2 倍,而浮点运算占程序原始执行时间的 20%,忽略对其他指令的影响,总体加速比是多少?
b. [20]〈1.9〉 现在假设加快浮点单元使数据缓存访问变慢,耗时增加到原来的 1.5 倍,即加速比为 2/3。数据缓存访问占执行时间的 10%。此时的总体加速比是多少?
c. [15]〈1.9〉 实现新的浮点运算之后,浮点运算占执行时间的百分之多少?数据缓存访问又占多少?
习题 1.17
[10/10/20/20]〈1.5〉 云计算提供商等机构的服务器集群,必须提供足以应对一天中请求率峰值的计算能力。假设这些服务器在大多数时间里只使用 60% 的容量。进一步假设功率不会随负载线性变化:服务器在 60% 容量下运行时,仍消耗最大功率的 90%。虽然可以关闭一部分服务器,但负载增加时,重启需要的时间太长。现在有人提出一种新系统,可以快速重启,不过处于这种“最低维持运行”状态时,仍需消耗最大功率的 20%。
a. [10]〈1.5〉 关闭 40% 的服务器,能节省多少功率?
b. [10]〈1.5〉 让 40% 的服务器进入“最低维持运行”状态,能节省多少功率?
c. [20]〈1.5〉 将电压降低 20%、频率降低 20%,能节省多少功率?
d. [20]〈1.5〉 让 20% 的服务器进入“最低维持运行”状态,再关闭 20% 的服务器,能节省多少功率?
习题 1.18
[10/10/10/10/5]〈1.5〉 对于必须在规定截止时间前完成任务的实时系统,更早完成计算并没有额外收益。考虑一个物联网系统,即使在最坏情况下,执行所需代码的速度仍是必要速度的两倍。
a. [10]〈1.5〉 如果按当前速度执行,并在计算完成后关闭系统,能节省多少能量?
b. [10]〈1.5〉 如果把电压和频率都降为原来的一半,能节省多少能量?
c. [10]〈1.5〉 考虑另一个物联网系统:核心数多 50%,功率高 30%。如果按当前速度执行,并在计算完成后关闭系统,其能耗与(a)相比如何?
d. [10]〈1.5〉 仍考虑这个核心数多 50%、功率高 30% 的物联网系统。如果将电压和频率都降为原来的三分之一,其能耗与(c)相比如何?
e. [5]〈1.5〉 是否值得使用核心数更多的这个物联网系统?为什么?
习题 1.19
[10/15/15/10/10]〈1.4、1.5〉 体系结构设计者面临的一个挑战是:今天完成的设计,要经过数年的实现、验证与测试才能上市。这意味着设计者必须提前数年预测技术的发展状况,而这种预测有时很难做。
a. [10]〈1.4〉 按照 Moore 定律在历史上体现出的器件缩放趋势,2030 年一颗芯片上的晶体管数应该是 2020 年的多少倍?
b. [15]〈1.5〉 性能提升曾经与这一趋势相吻合。如果性能继续按 20 世纪 90 年代的速度增长,那么到 2030 年,芯片的性能大约应是 VAX-11/780 的多少倍?
c. [15]〈1.5〉 如果按 2010 年代末至 2020 年代初的增长速度计算,对 2030 年性能的较新预测是多少?
d. [10]〈1.4〉 什么因素限制了时钟频率的增长?体系结构设计者现在怎样利用额外的晶体管来提高性能?
e. [10]〈1.4〉 DRAM 容量的增长也放缓了。曾经连续 20 年,DRAM 容量每年提高 60%。如果 8 Gb DRAM 于 2014 年首次出现,而 16 Gb DRAM 到 2019 年才出现,那么这一阶段 DRAM 容量的年增长率是多少?
习题 1.20
[10/5/10/5/10]〈1.2〉 本题通过考察图 1.22 中两种相近的服务器配置,探讨计算机系统的总拥有成本(TCO)。
a. [10]〈1.2〉 假设两台服务器的工作负载都由 70% 的整数运算和 30% 的浮点运算组成。根据图 1.22 中各服务器的 SPEC 整数与浮点吞吐率,哪一台性能更好?
b. [5]〈1.2〉 根据(a)的结果,两台服务器在该工作负载下的性价比如何?
c. [10]〈1.2〉 假设两台服务器都在 60% 的时间里处于繁忙状态,其余时间空闲。繁忙时消耗电源额定功率上限的 90%,空闲时仅消耗上限的 30%。每台服务器一年的能耗是多少?
d. [5]〈1.2〉 假设连续使用 1 W 功率一年的费用为 1 美元。根据(c)的结果,每台服务器每年的用电费用是多少?
e. [10]〈1.2〉 假设服务器使用寿命为五年,把购置成本与每年用电费用都考虑在内,每年的成本各是多少?如果使用寿命改为六年或七年,结果会怎样变化?每台服务器整个使用寿命内的总成本是多少?
译注:原文(c)将一年内的消耗称为 power,此处按量纲译为“能耗”;(d)的条件是每瓦持续使用一年的费用,不是每瓦时的电价。
原书脚注:见 https://arxiv.org/pdf/2312.12705.pdf 。 ↩︎
参考文献
- Barroso, L., Hölzle, U., Ranganathan, P., 2019. The Datacenter as a Computer: Designing Warehouse-Scale Machines. Springer Nature.
- Jouppi, N., Kurian, G., Li, S., Ma, P., Nagarajan, R., Nai, L., Patil, N., Subramanian, S., Swing, A., Towles, B. Young, C., Patterson, D. “TPU v4: An optically reconfigurable supercomputer for machine learning with hardware support for embeddings.” In Proceedings of the 50th Annual International Symposium on Computer Architecture. June 2023.
- Norrie, T., Patil, N., Yoon, D.H., Kurian, G., Li, S., Laudon, J., Young, C., Jouppi, N., Patterson, D., 2021. The design process for Google’s training chips: TPU v2 and TPU v3. IEEE Micro 41 (2), 56–63.
- Patterson, D., Gonzalez, J., Holzle, U., Le, Q., Liang, C., Munguia, L.-M., Rothchild, D., So, D., Texier, M., Dean, J., 2022. The carbon footprint of machine learning training will plateau, then shrink. Computer 55 (7), 18–28.
- Patterson, D., Bennett, J., Bennett, M., Chelin, H., Harris, D., Hellar, J., Jones, W., Moron, K., Savani, P., Shepherd, R., Simar, R., Suskind, Z., Wallentowitz, S., 2025. Emebnch IOT 2.0 and DSP 1.0: Modern Embedded Computing Benchmarks. IEEE Computer. In press.
2 存储层次结构设计
理想情况下,人们希望存储容量可以无限大,使任何一个……字都能立即取得……我们……不得不考虑构建一种存储层次结构:其中每一级的容量都比前一级更大,但访问速度更慢。
——A. W. Burks、H. H. Goldstine 与 J. von Neumann,Preliminary Discussion of the Logical Design of an Electronic Computing Instrument(1946)
原章 DOI:10.1016/B978-0-443-15406-5.00002-X。原章版权标记:© 2026 Elsevier Inc.,保留所有权利,包括文本与数据挖掘、AI 训练及类似技术的相关权利。
2.1 引言
计算机先驱们正确地预见到,程序员会希望拥有无限多的高速存储器。满足这一愿望的一种经济办法,就是利用局部性以及不同存储技术在性价比上的权衡,构建存储层次结构。第 1 章介绍的局部性原理指出,大多数程序并不会均匀地访问所有代码或数据。局部性既体现在时间上,即时间局部性,也体现在空间上,即空间局部性。再结合这样一条准则——在实现技术和功率预算既定时,规模更小的硬件可以做得更快——便形成了由不同速度、不同容量的存储器组成的层次结构。图 2.1 展示了几种多级存储层次结构,以及典型的容量和访问速度。随着 Flash 和下一代存储技术在每比特成本上不断缩小与磁盘的差距,这些技术很可能会越来越多地取代磁盘,成为辅助存储。图 2.1 表明,它们已经用于许多个人计算机,并越来越多地用于服务器,因为它们在性能、功耗和密度方面具有显著优势。
高速存储器更昂贵,因此,存储层次结构分成若干级:每一级都比离处理器更远的下一级容量更小、速度更快、每字节价格更高。目标是让整个存储系统的每字节成本接近最便宜的一级,而速度接近最快的一级。在大多数情况下,但并非所有情况下,下一级所含的数据是相邻上一级数据的超集。这称为包含性(inclusion property)。对于缓存,这一性质通常由主存维持;对于虚拟内存,则通常由磁盘或 Flash 等辅助存储维持。
随着处理器性能提高,存储层次结构的重要性也在增加。图 2.2 将单核性能的变化与主存访问时间的历史改进情况进行了比较。处理器曲线表示单个核心平均每秒发出的内存请求数的增长,也就是两次访存间隔的倒数;存储器曲线表示每秒 DRAM 访问次数的增长,也就是 DRAM 访问延迟的倒数,假设只有一颗 DRAM 和一个存储体。实际情况更加复杂:处理器请求速率并不均匀,处理器往往包含多个核心,而存储系统通常有多个 DRAM 存储体和通道。尽管访问时间的差距多年来大幅扩大,但单个处理器的性能已难以显著提高,因此,处理器与 DRAM 之间差距扩大的速度也有所放缓。
高端处理器具有多个核心,其带宽需求因而高于单核。虽然近年来单核带宽的增长放慢,但随着核心数增加,CPU 的内存需求与 DRAM 带宽之间的差距仍在扩大。Intel Core i9 12900 这样的现代高端桌面处理器,每个核心在每个时钟周期内可以产生四次数据访存。
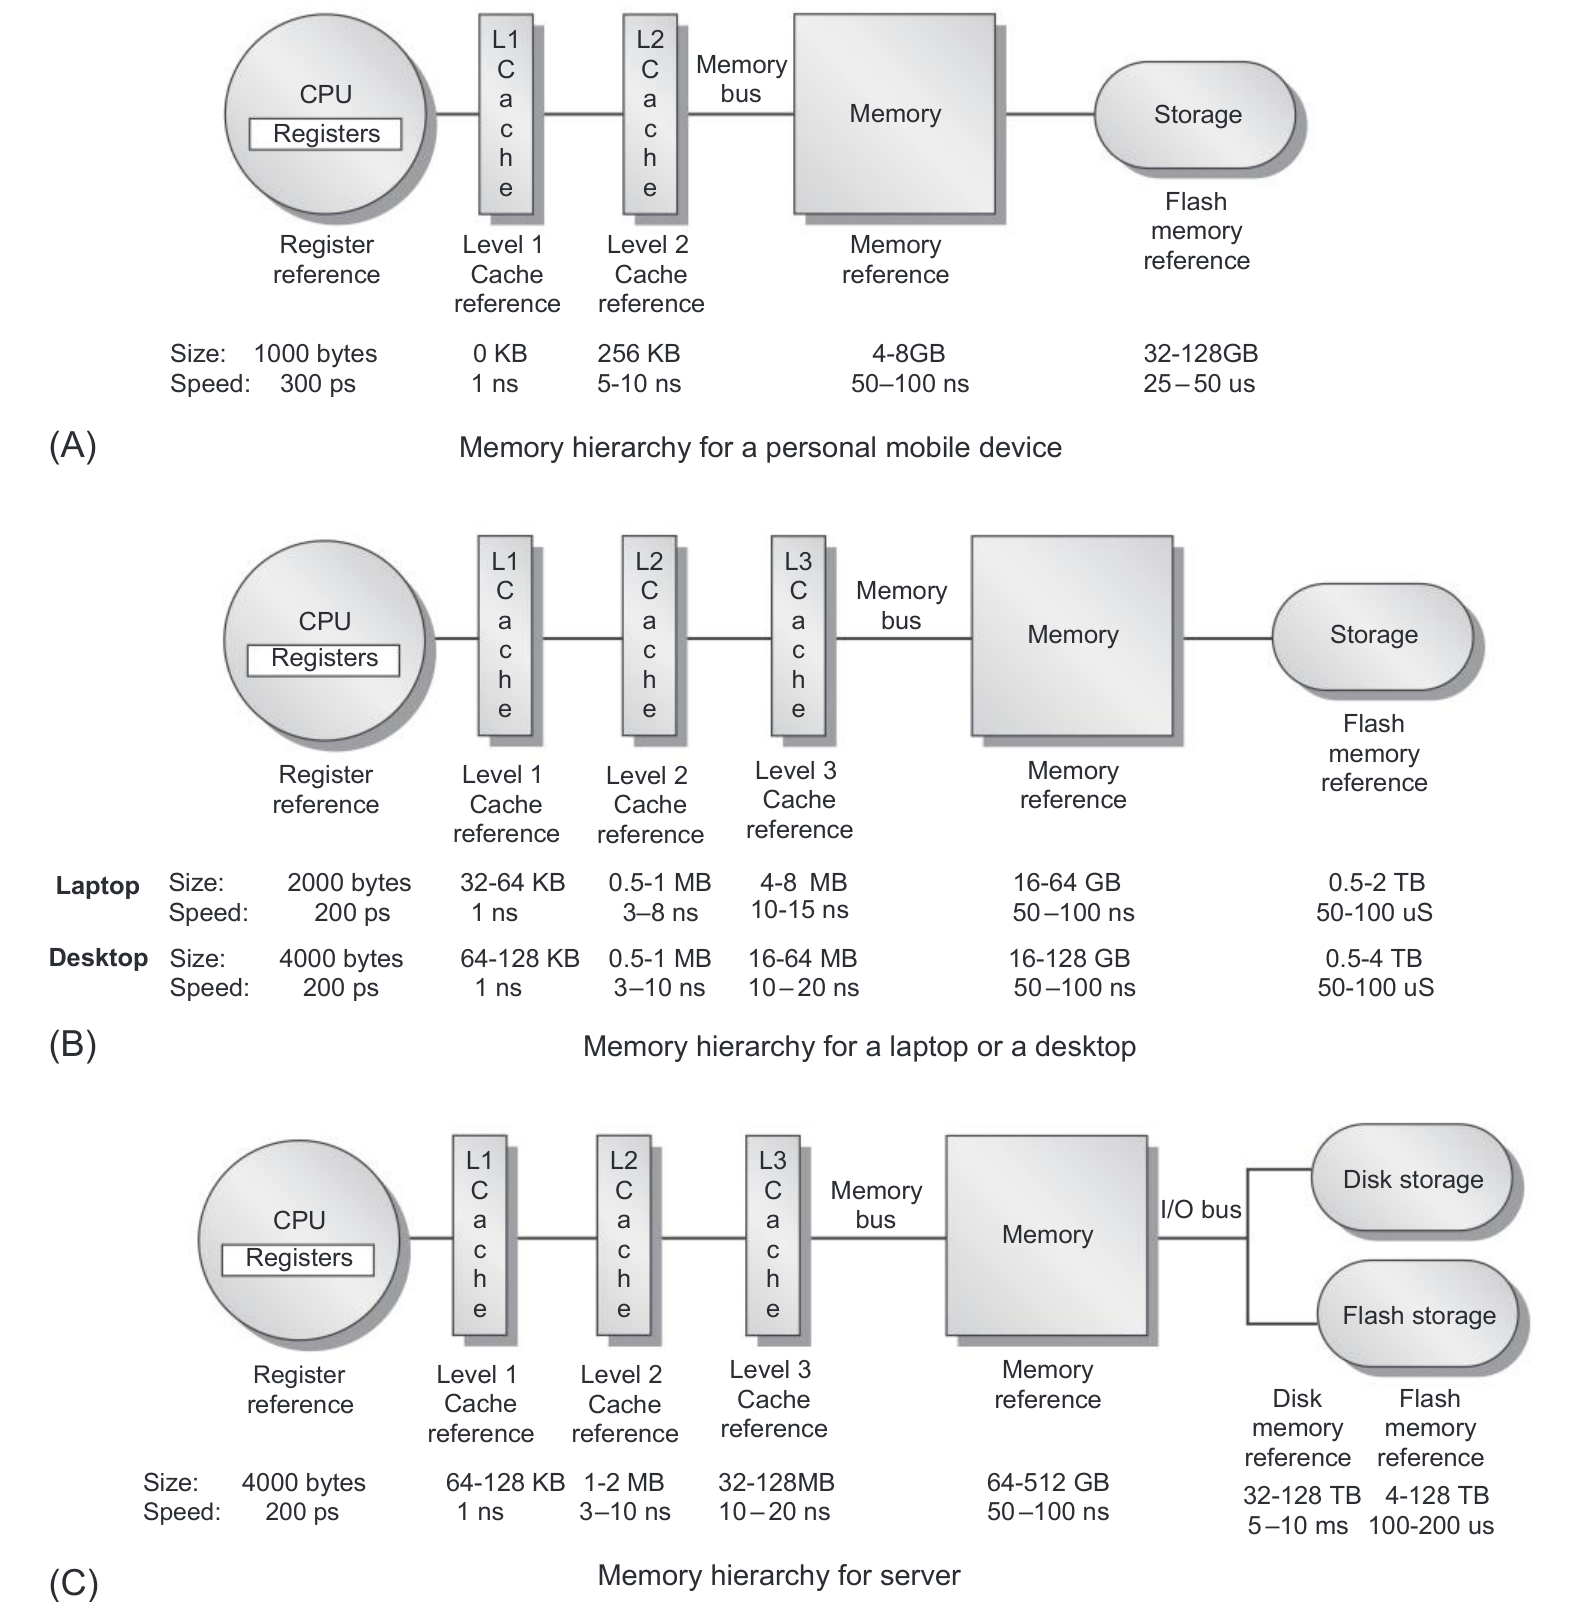
图 2.1(续)。 离处理器越远,下一级存储器就越慢、容量越大。注意,对于磁盘,时间单位从皮秒变为毫秒,相差 倍;容量单位从数千字节变为数十 TB,相差 倍。如果把仓库级计算机也纳入,而不仅仅考虑服务器,容量尺度还会增加三到六个数量级。PMD 完全采用由 Flash 构成的固态硬盘(SSD),笔记本和台式机也大量使用 SSD。许多台式机的主要存储系统是 SSD,而扩容和备份主要使用硬盘(HDD)。同样,许多服务器混合使用 SSD 与 HDD。HDD 正越来越多地主要用于备份和归档。
图内术语:Registers=寄存器;L1/L2/L3 Cache=一级/二级/三级缓存;Memory=主存;Storage=存储设备;Memory bus=内存总线;I/O bus=I/O 总线;Disk storage=磁盘存储;Flash storage=Flash 存储;reference=访问;Size=容量;Speed=访问时间;Laptop=笔记本;Desktop=台式机。ps、ns、μs、ms 分别为皮秒、纳秒、微秒和毫秒。图中各级容量及时间照录原图。
译注(图 2.1): PMD 的 L1 容量在原页中确实印为“0 KB”。
对于八个核心、平均时钟频率为 3 GHz 的 i9,数据访存峰值可达每秒 1920 亿次,每次 128 bit;此外,取指需求峰值约为每秒 480 亿次,每次同样为 128 bit。总需求带宽峰值达到惊人的 3840 GiB/s!1 实现如此高的带宽,靠的是缓存的多端口设计和流水线化;采用三级缓存,其中每个核心私有前两级,共享 L3;以及在第一级分别设置指令缓存和数据缓存。相比之下,采用两个内存通道的单总线 DDR5 主存,其峰值带宽仅为需求带宽的 2%,即 56 GiB/s。HBM 的访问时间更短、带宽更高,见 2.2 节和 2.3 节。
传统上,存储层次结构设计者主要优化平均访存时间,它由缓存访问时间、未命中率和未命中开销决定。近来,功耗也成为主要考虑因素。高端微处理器可能拥有 60 MiB 甚至更多的片上缓存,多芯片插槽中的缓存容量则可能达到 1 GiB。大型二级或三级缓存在不工作时会因漏电消耗相当多的功率,称为静态功耗;执行读写时还会消耗工作功率,称为动态功耗,见 2.3 节。PMD 处理器面临的问题更加突出,因为其中 CPU 的设计不那么激进,功率预算可能只有前者的 1/20–1/50。
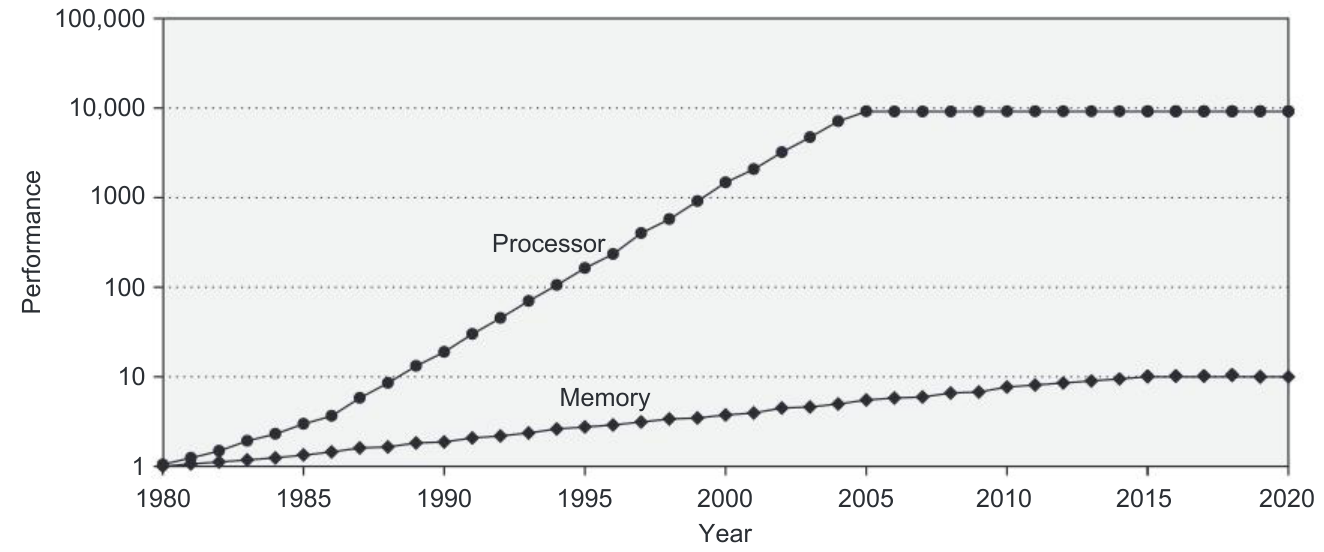
图 2.2(续)。 2017 年年中,AMD、Intel 和 NVIDIA 都宣布了采用不同版本 HBM(高带宽内存)技术的芯片组,图中未包含该技术。要表现处理器与 DRAM 性能差距的规模,纵轴必须使用对数坐标。存储器的基准是 1980 年的 64 KiB DRAM;到 2015 年为止,按延迟衡量的性能每年提高到前一年的 1.07 倍,见图 2.4,过去五年则基本没有改善。 处理器曲线假设:1986 年以前,每年提高到前一年的 1.25 倍;此后到 2000 年,每年为 1.52 倍;2000–2005 年为 1.20 倍;2005–2015 年,按每核心计的处理器性能只有小幅改善。可以看到,2010 年以前,DRAM 访问时间的改进缓慢但持续;2010 年以后,与早期相比,访问时间的改进幅度减小了,不过带宽仍在持续提高。更多信息见第 1 章图 1.1。
图内术语:Performance=性能;Processor=处理器;Memory=存储器;Year=年份。
在这些情况下,缓存可能占总功耗的 25%–50%。因此,设计者必须同时权衡性能与功耗,本章也将同时讨论这两个方面。
存储层次结构基础:简要回顾
处理器与存储器之间的性能差距不断扩大,重要性日益提高,存储层次结构的基础知识因而已经进入计算机体系结构的本科课程,甚至进入操作系统和编译原理课程。因此,我们先简要回顾缓存及其工作方式;本章的大部分内容则介绍更先进的创新技术,以应对处理器与存储器之间的性能差距。
当缓存中找不到某个字时,必须从层次结构的下一级——可能是另一层缓存,也可能是主存——取回这个字并放入缓存,然后才能继续执行。为了提高效率,一次搬移多个字,组成一个块(block),也称行(line);而且,由于空间局部性,这些字很可能很快就会用到。每个缓存块都包含一个标签(tag),用于指明它对应哪个内存地址。
一项关键设计决策是:块或行可以放在缓存的什么位置。最常用的方案是组相联(set associative),其中,一个组由缓存中的若干块组成。先把块映射到一个组,再将它放在该组中的任意位置。查找时,先根据块地址找到对应的组,再搜索这个组,通常是并行搜索,以找到所需的块。组由数据地址按下式选择:
如果一组有 个块,这种放置方式就称为 路组相联。相联度的两个极端各有专名。**直接映射缓存(direct-mapped cache)**每组只有一个块,因此一个块总是放在同一个位置;**全相联缓存(fully associative cache)**只有一个组,因此一个块可以放在任何位置。
只读数据很容易缓存,因为缓存与内存中的副本完全相同。写操作则更复杂,例如,如何保持两个副本一致?主要有两种策略。直写(write-through)缓存既更新缓存中的数据项,也将写操作传递下去,更新主存。写回(write-back)缓存只更新缓存中的副本;当其中的块即将被替换时,再将其复制回内存。两种策略都可以使用写缓冲区(write buffer):数据一旦进入缓冲区,缓存即可继续工作,无须等待写入内存的全部延迟。如果写缓冲区中已有其他修改过的块,就可以检查地址,判断新数据的地址是否与某个有效条目的地址匹配;若匹配,就将新数据并入该条目。这种优化称为写合并(write merging),Intel Core i7 等许多处理器都采用它。它对直写缓存更有帮助,因为写回缓存通常一次写回整个块。注意,I/O 设备寄存器往往也映射到物理地址空间。
这些 I/O 地址不能允许写合并,因为彼此独立的 I/O 寄存器不一定像内存中的字数组那样工作。例如,每个 I/O 寄存器可能都要求单独提供地址和数据字,而不能使用一个地址写入多个字。通常通过给页面设置属性,要求缓存采用不进行合并的直写方式,以满足这些带有副作用的访问要求。
衡量不同缓存组织收益的一项指标是未命中率(miss rate),即缓存访问中未命中的比例,也就是未命中次数除以访问总次数。
为了深入理解高未命中率的原因,进而改进缓存设计,三个 C 模型将未命中分成三类:
- 强制性未命中(compulsory miss):第一次访问某个块时,它不可能已经位于缓存中,因而必须把它取入缓存。即使缓存容量无限大,这类未命中仍然会发生。
- 容量未命中(capacity miss):如果缓存容纳不下程序执行期间所需的全部块,就会因块被丢弃后又重新取入,而在强制性未命中之外产生容量未命中。
- 冲突未命中(conflict miss):如果块放置策略不是全相联,就可能有多个块映射到同一组。在对这些块的访问交错发生时,某个块可能被丢弃后又重新取入,从而在强制性和容量未命中之外产生冲突未命中。
第 24 页的图 B.8 按三个 C 给出了各类缓存未命中的相对频率。2 如附录 B 所述,三个 C 模型是概念模型,它揭示的规律通常成立,但并不是解释每一次具体访问行为的决定性模型。
第 3 章和第 5 章将说明,多线程和多核给缓存增加了复杂性:它们既可能增加容量未命中,也带来第四个 C,即一致性未命中(coherency miss)。在多处理器中,为使多个缓存保持一致,缓存的刷新操作会引发这类未命中。第 5 章将讨论这些问题。
不过,未命中率可能由于多种原因产生误导。因此,一些设计者更愿意衡量每条指令的未命中次数,而不是每次访存的未命中次数,也就是未命中率。两者的关系为:
这项指标常写成每 1000 条指令的未命中次数,以便用整数而不是分数表示。
两种指标都没有计入一次未命中的代价。更好的指标是平均访存时间:
其中,命中时间是在缓存中命中所需的时间;未命中开销是从内存取回并替换缓存块所需的时间,即一次未命中的代价。平均访存时间仍然是间接性能指标;它虽优于未命中率,却不能取代执行时间。第 3 章将介绍,采用推测执行的处理器可以在未命中期间执行其他指令,从而降低实际承担的未命中开销。多线程也能让处理器容忍未命中,而不必被迫闲置,第 3 章会介绍这一技术。我们很快就会看到,要利用这些容忍延迟的技术,缓存就必须能够在处理尚未完成的未命中时,继续为其他请求提供服务。
如果这些内容对你而言是新的,或上述回顾过于简略,请参阅附录 B。它更详细地介绍了同样的基础知识,还给出了真实计算机中的缓存实例及其效果的定量评估。
附录 B 的 B.3 节介绍了六项基本缓存优化,这里简要回顾。附录还用定量实例说明了收益;这里也简要讨论这些取舍对功耗的影响。
增大块以降低未命中率。 最简单的办法是利用空间局部性,增加块大小。较大的块可以减少强制性未命中,但也会增加未命中开销。由于标签数量减少,静态功耗可能略有降低。较大的块也可能增加容量或冲突未命中,尤其是小缓存。选择合适的块大小需要复杂的权衡,取决于缓存容量和未命中开销。
增大缓存以降低未命中率。 减少容量未命中最直接的办法,就是增加缓存容量。缺点是命中时间可能变长,成本和功耗也更高。较大的缓存会同时增加静态和动态功耗。
提高相联度以降低未命中率。 提高相联度显然可以减少冲突未命中,但可能以更长的命中时间为代价。稍后还会看到,相联度也可能增加功耗。
采用多级缓存以降低未命中开销。 一项困难的选择是:让缓存命中足够快,以跟上处理器的高时钟频率,还是让缓存足够大,以缩小处理器访问与主存访问之间的差距?在原有缓存和内存之间再加一级缓存,可以简化这一选择。一级缓存可以足够小,以适应较短的时钟周期;二级或三级缓存则可以足够大,截获许多本来会访问主存的请求。二级缓存更重视减少未命中,因此通常采用更大的块、更大的容量和更高的相联度。多级缓存也比一个合并成整体的大缓存更节能。若 L1、L2 分别表示一级和二级缓存,则平均访存时间可改写为:
如今,从低端 PMD 到高端服务器多核处理器,所有处理器都采用多级缓存,通常有两级或三级。不同层级的设计取舍可能不同,因为需要优化的可能是命中时间,也可能是未命中时间。例如,L1 命中时间至关重要,但**末级缓存(last-level cache,LLC)**的命中时间略有增加,性能通常不那么敏感;LLC 一般是 L2 或 L3。而且,LLC 的未命中开销通常大于 L1。因此,在 L1 中代价过高的优化,在 LLC 中可能是合理的。
让读未命中优先于写,以降低未命中开销。 写缓冲区很适合实现这一优化。不过,它也会引起数据冒险:读未命中所需地址的最新值可能仍在写缓冲区中,即通过内存形成了写后读(RAW)冒险。一种解决办法是在读未命中时检查写缓冲区;如果没有冲突,而且存储系统可用,就让读请求先于写请求发出,以减少未命中开销。大多数处理器都让读优先于写。这一选择对功耗影响很小。
在缓存索引过程中避免地址转换,以缩短命中时间。 缓存必须处理从处理器虚拟地址到访存物理地址的转换;虚拟内存见 2.4 节和 B.4 节。一种常用优化是利用页内偏移来索引缓存,因为这部分在虚拟地址和物理地址中完全相同,详见附录 B 第 B.36 页。这种**虚拟索引、物理标签(virtual index/physical tag)方法会使系统更复杂,并且/或者限制 L1 缓存的容量与结构;但将转换后备缓冲区(translation lookaside buffer,TLB)**访问移出关键路径,收益超过了这些缺点。提高 L1 相联度也能避免这一问题,因为这样会减少缓存索引所需的位数。近期的 Intel 和 ARM 处理器采用了这种办法。
注意,以上六项优化都有潜在缺点,可能使平均访存时间反而增加。
本章其余部分假定读者已熟悉上述内容以及附录 B 的细节。在“融会贯通”一节中,我们将考察两种微处理器的存储层次结构:一种是用于高端台式机或小型服务器的 Intel Core i9 12900,另一种是用于 PMD 的 Arm Cortex-53,它是若干平板电脑和智能手机所用处理器的基础。3 在每一类中,处理器的预定用途不同,具体设计方法也有明显差异。
虽然 i9 比 Intel 面向移动设备的处理器拥有更多核心、更大缓存,但它们的体系结构相近。面向小型服务器的 i9 系列,以及面向较大型服务器的 Intel Xeon,通常会运行许多并发进程,而且往往服务于不同用户。因此,内存带宽变得更重要,这些处理器会提供更大的缓存和更积极的存储系统设计来提高带宽。
相比之下,PMD 只服务一个用户,操作系统通常较小,多任务较少,即同时运行的应用较少,应用也更简单。PMD 必须同时考虑性能与能耗,因为能耗决定续航时间。在深入讨论更先进的缓存组织与优化之前,需要先了解各种存储技术及其演进方式。
2.2 存储技术与优化
……真正让计算机站稳脚跟的一项发展,是可靠存储器的发明,也就是磁芯存储器。……它成本合理,工作可靠;正因为可靠,才得以逐步扩大容量。(第 209 页)
——Maurice Wilkes,Memoirs of a Computer Pioneer(1985)
本节介绍存储层次结构采用的技术,特别是用于构建缓存和主存的技术,包括 SRAM(静态随机存取存储器,用于缓存)、DRAM(动态随机存取存储器,用于主存)以及 Flash(用于非易失性存储)。最后一种技术用于替代硬盘,不过它基于半导体技术,因而也适合在本节介绍。
缓存未命中时,需要尽快从主存搬移数据,这要求内存具有很高的带宽,原文称高带宽内存(HBM)。可以把组成主存的许多 DRAM 芯片组织成多个存储体(bank)和 rank,或者加宽内存总线,也可以同时采用这两种方法来实现这一带宽。rank 是共同响应同一内存命令的一组 DRAM 芯片。
为了让存储系统跟上现代处理器的带宽需求,创新开始进入 DRAM 芯片内部。本节将介绍芯片内部的存储技术;在讨论各种技术与方案之前,先说明一些术语。**访问时间(access time)**是从发出读请求到所需的字到达之间的时间。注意,Flash 和 DRAM 都支持突发传输,传完整个块所需的时间可能比取得块的第一部分更长。
自 1975 年以来,几乎所有计算机都采用 DRAM 作为主存、SRAM 作为缓存,并把一至三级缓存与 CPU 集成在同一处理器芯片上。如今,所有 PMD 和笔记本,以及大多数台式机,都使用 Flash 而非磁盘;许多服务器则结合使用两者。
SRAM 技术
SRAM 的首字母 S 表示 static,即“静态”。DRAM 电路的动态特性要求读出数据后再将其写回,但只有下一次请求需要访问同一个存储体时,才会看到这一延迟。
SRAM 通常每比特使用六个晶体管,避免读取时扰动所存信息。在待机模式下,SRAM 只需很小的功率就能保持电荷。
早期,大多数桌面和服务器系统都使用独立 SRAM 芯片作为一级、二级或三级缓存。如今,这三级缓存都已集成到处理器芯片上。高端服务器采用 chiplet 时,可以有多达 60 个核心和 100 MiB 以上的缓存;采用堆叠裸片时,则可以超过 100 个核心,缓存达到 1 GB 以上。这类系统通常为每颗处理器芯片配置 256–512 GiB DRAM。大型片上三级缓存的访问时间通常是二级缓存的四至八倍;即便如此,L3 访问时间通常仍不超过 DRAM 的五分之一。
片上缓存 SRAM 的组织宽度通常与缓存块大小一致,标签与各块并列存放,因此可以在一个周期内读出或写入整个块。未命中后把取回的数据写入缓存,或将必须逐出的块写回时,这一能力尤其有用。如果不计组相联缓存的命中检测与选择,缓存访问时间与其中的块数成正比;能耗则同时取决于比特总数和块数:前者影响漏电引起的静态功耗,后者影响访问时的动态功耗。为提高带宽、改善访问时间并降低功耗,许多多级缓存采用分存储体组织,2.3 节将讨论这一主题。
DRAM 技术
早期 DRAM 容量不断增大时,封装必须引出全部必要的地址线,其成本成了问题。解决办法是复用地址线,将地址引脚数减半。图 2.3 给出了 DRAM 的基本组织。先在**行地址选通信号(row access strobe,RAS)期间发送一半地址,再在列地址选通信号(column access strobe,CAS)**期间发送另一半。这些名称来自芯片的内部组织:存储器组成一个矩形阵列,用行和列寻址。
DRAM 的另一个要求来自首字母 D 所表示的 dynamic,即“动态”。为了让每颗芯片容纳更多比特,原文描述为:DRAM 每比特只使用一个晶体管,它实际上起着电容器的作用。1 这带来两方面影响。首先,检测电荷的感测线必须先预充电,把电平设在逻辑 0 和 1 的“中间”,从而让单元中少量的电荷足以使感测放大器判定 0 或 1。读取时,一行数据被放入行缓冲区(row buffer),CAS 信号再选择其中一部分,从 DRAM 读出。由于读出一行会破坏其中的信息,当不再需要该行时,必须将它写回。写回可与其他操作重叠,但在早期 DRAM 中,这意味着再次读取新行之前所需的周期时间,会大于读出一行并访问其中一部分所需的时间。
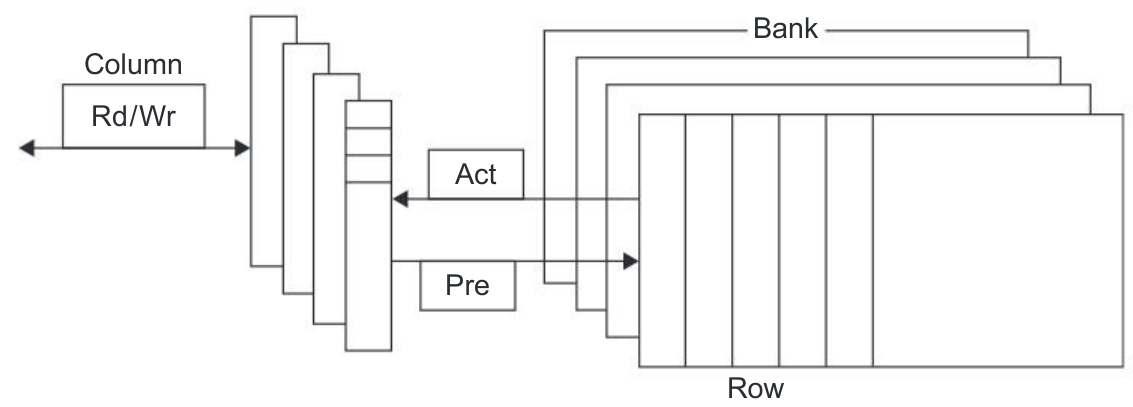
图 2.3(续)。 每个存储体由一系列行组成。发送 Act(Activate,激活)命令,会打开一个存储体及其中一行,并将该行装入行缓冲区。随后,可以连续提供列地址,按 DRAM 的接口宽度传输数据,DDR4 通常为 4、8 或 16 bit;也可以指定块传输及起始地址。Precharge(Pre,预充电)命令关闭该存储体和行,为下一次访问做好准备。每条命令以及块传输都与时钟同步,参见下面关于 SDRAM 的讨论。根据最初的信号名称,行信号和列信号有时仍分别称为 RAS 和 CAS。
图内术语:Bank=存储体;Row=行;Column=列;Rd/Wr=读/写;Act=激活;Pre=预充电。
此外,在没有读写操作的情况下,单元中的电荷会逐渐泄漏。为避免信息丢失,必须定期**刷新(refresh)**每个比特。幸运的是,只需读出一行再写回,就能同时刷新该行的全部比特。因此,存储系统中的每颗 DRAM 都必须在一定时间窗口内,例如 64 ms,访问每一行。DRAM 控制器和芯片内部都含有定期刷新的硬件。
这一要求意味着,存储系统有时会因向所有芯片发送刷新信号而暂时不可用。一次行刷新需要行激活和预充电,同时把该行写回;因为不必选择列,所需时间大约是取得一个数据项的 2/3,而 DRAM 的每一行都要执行一次。DRAM 的存储阵列在概念上是正方形,因此刷新步骤数通常是 DRAM 容量的平方根。设计者力求将刷新时间控制在总时间的 5% 以下。到目前为止,我们把主存描述得像瑞士列车一样,总能准时交付数据。实际上,SDRAM 的控制器通常位于处理器芯片上,会尽量避免打开新行,并尽可能采用块传输,以优化访问;刷新又增加了一个不可预测的因素。
Amdahl 提出过一条经验法则:内存容量应随处理器速度线性增长,才能维持系统平衡。因此,1000 MIPS 的处理器应配备 1000 MiB 内存。处理器设计者依靠 DRAM 来满足这一需求。过去,他们预期容量每三年增至四倍,或每年增长 55%。不幸的是,DRAM 性能增长慢得多,主要因为行访问时间的缩短幅度较小;它取决于功率限制、单个存储单元的储电能力,以及由此决定的单元大小等因素。深入讨论这些性能趋势之前,需要先介绍 20 世纪 90 年代中期以来 DRAM 的主要变化。
改善 DRAM 芯片内部的性能:SDRAM
很早的 DRAM 就有缓冲区,允许对同一行进行多次列访问,而不必重新访问行;不过,它们采用异步接口,因此每次列访问和传输,都要承担与控制器同步的开销。20 世纪 90 年代中期,设计者在 DRAM 接口中增加时钟信号,使重复传输免于这一开销,由此形成了同步 DRAM(synchronous DRAM,SDRAM)。除减少开销外,SDRAM 还能增加突发传输模式,无须指定新的列地址,就能连续传输多次。例如,把 DRAM 设为突发模式后,无须发送任何新地址,即可连续进行八次或更多的 16 bit 传输。突发传输的引入,使随机访问流与连续数据块访问之间的带宽出现显著差距。
随着 DRAM 密度增加,为取得更高带宽,DRAM 的接口也变得更宽。最初采用 4 bit 传输模式;到 2024 年,DDR DRAM 提供 4、8、16 或 32 bit 总线。21 世纪初又引入了双倍数据率(double data rate,DDR),使 DRAM 能在内存时钟的上升沿和下降沿都传输数据,从而将峰值数据率翻倍。
最后,SDRAM 引入多个存储体,以便管理功耗、改善访问时间,并允许对不同存储体进行交错和重叠访问。不同存储体的访问可以彼此重叠,每个存储体都有独立行缓冲区,因此不同存储体可以同时打开多行。把一颗 DRAM 划分为多个存储体,相当于在地址中新增一部分;此时地址由存储体号、行地址和列地址组成。当地址指定某个存储体中的新行时,必须打开这一行,产生额外延迟。现代内存控制接口完全负责存储体和行缓冲区的管理;如果后续访问指定了已经打开的行,就只需发送列地址,快速完成访问。
开始新访问时,DRAM 控制器先发送存储体号和行号;SDRAM 中称为 Activate,过去称为 RAS,即行选择。该命令打开一行,并将整行读入缓冲区。随后发送列地址,SDRAM 就根据请求类型,传输一个数据项,或执行突发传输。在访问新行之前,必须对存储体预充电。如果下一行仍在同一个存储体中,预充电延迟就会显现;如果位于另一个存储体,则关闭原行及预充电可以与新行的访问重叠。SDRAM 中,每一种命令周期都占整数个时钟周期。
1980–1995 年,DRAM 按 Moore 定律缩放,容量每 18 个月翻一番,即每三年增至四倍。20 世纪 90 年代中期至 2010 年,容量增长放慢,约每 26 个月翻番。再下一次翻番用了六年,即 2010–2016 年,而随后一次直到 2024 年年底才实现!图 2.4 给出了几代 DDR SDRAM 的容量与访问时间。从 DDR1 到 DDR3,访问时间约缩短至原来的三分之一,改善速度约合每年 7%。DDR4 和 DDR5 相比 DDR3 改善了功耗与带宽,但访问延迟相近。
DDR 是一系列标准,如图 2.4 所示。DDR2 将电压从 DDR1 的 2.5 V 降至 1.8 V,以降低功耗,同时提供 266、333 和 400 MHz 的更高时钟频率。DDR3 将电压降至 1.5 V,最高时钟频率为 800 MHz。DDR4 原预计 2014 年推出,实际于 2016 年年初大批量出货;它将电压降至 1.2 V,预计最高时钟频率为 1600 MHz。DDR5 使用 1.1 V 电压,直到 2022 年才达到量产规模;DDR6 看来要到 2025 年才会出现。
随着 DDR 引入,由于访问时间难以改善,存储器设计者越来越关注带宽。更宽的 DRAM、突发传输和 DDR 都推动了内存带宽的快速增长。DRAM 通常以小型电路板的形式出售,称为双列直插式内存模块(dual inline memory module,DIMM),包含 4–16 颗 DRAM 芯片。在桌面和服务器系统中,通常组织为 8 字节宽,另加 ECC。容易令人混淆的是,DDR SDRAM 组成 DIMM 后,名称按 DIMM 峰值带宽标注。例如,PC3200 的名称来自 字节,即 3200 MiB/s,其中装有 DDR SDRAM 芯片。2 芯片本身又按每秒比特数而不是时钟频率命名,使混淆进一步加重;因此,200 MHz 的 DDR 芯片称为 DDR400。图 2.5 展示了 I/O 时钟频率、每颗芯片每秒传输次数、芯片带宽、芯片名称、DIMM 带宽和 DIMM 名称之间的关系。
| 量产年份 | 芯片容量 | DRAM 类型 | 无须预充电:RAS 时间(ns) | 无须预充电:CAS 时间(ns) | 无须预充电:总时间(ns) | 需要预充电:总时间(ns) |
|---|---|---|---|---|---|---|
| 2000 | 256 Mbit | DDR1 | 21 | 21 | 42 | 63 |
| 2002 | 512 Mbit | DDR1 | 15 | 15 | 30 | 45 |
| 2004 | 1 Gbit | DDR2 | 15 | 15 | 30 | 45 |
| 2006 | 2 Gbit | DDR2 | 10 | 10 | 20 | 30 |
| 2010 | 4 Gbit | DDR3 | 13 | 13 | 26 | 39 |
| 2016 | 8 Gbit | DDR4 | 13 | 13 | 26 | 39 |
| 2021 | 8 Gbit | DDR5 | 13 | 13 | 26 | 39 |
图 2.4(续)。 访问时间针对随机地址处的一个字,假定必须打开新行。如果该行位于另一个存储体,假定该存储体已预充电;如果行尚未打开,则需要预充电,访问时间更长。随着存储体数量增加,隐藏预充电时间的能力也增强了。DDR4 原预计 2014 年推出,但直到 2016 年年初才开始量产。DDR5 最初容量与 DDR4 相同,但到 2024 年,每芯片密度已达到后者的四倍。
| 标准 | I/O 时钟频率(MHz) | 每秒百万次传输 | DRAM 名称 | 每 DIMM 带宽(MiB/s) | DIMM 名称 |
|---|---|---|---|---|---|
| DDR1 | 133 | 266 | DDR266 | 2128 | PC2100 |
| DDR1 | 150 | 300 | DDR300 | 2400 | PC2400 |
| DDR1 | 200 | 400 | DDR400 | 3200 | PC3200 |
| DDR2 | 266 | 533 | DDR2-533 | 4264 | PC4300 |
| DDR2 | 333 | 667 | DDR2-667 | 5336 | PC5300 |
| DDR2 | 400 | 800 | DDR2-800 | 6400 | PC6400 |
| DDR3 | 533 | 1066 | DDR3-1066 | 8528 | PC8500 |
| DDR3 | 666 | 1333 | DDR3-1333 | 10,664 | PC10700 |
| DDR3 | 800 | 1600 | DDR3-1600 | 12,800 | PC12800 |
| DDR4 | 1333 | 2666 | DDR4-2666 | 21,300 | PC21300 |
| DDR5 | 2400 | 4800 | DD5-4800 | 38,400 | PC38400 |
图 2.5(续)。 注意各列的数值关系:第三列为第二列的两倍;第四列把第三列的数字用于 DRAM 芯片名称;第五列为第三列的八倍,DIMM 名称则采用该数字的舍入值。DDR5 在 2022 年首次得到较大规模的应用。
译注(图 2.5): 原表最后一行的 DRAM 名称确实为“DD5-4800”,不是文本提取漏字;此处照录。21,300 等数值和 MiB/s 单位也按原表保留。
降低 SDRAM 功耗
动态存储芯片的功耗包括读写时的动态功耗,以及静态或待机功耗,两者都取决于工作电压。DDR5 SDRAM 的工作电压降到 1.1 V,较 DDR4 略有改善,较 DDR3 则约降低 25%。增加存储体也降低了功耗,因为一次只需读取一个存储体中的一行。
此外,所有近代 SDRAM 都支持低功耗模式(power-down mode),通过通知 DRAM 忽略时钟进入该模式。除内部自动刷新之外,SDRAM 的其他功能都被禁用;若不保留刷新,低功耗状态一旦持续超过刷新间隔,内存内容就会丢失。图 2.6 展示了 2 GB DDR3 SDRAM 在三种状态下的功耗。从低功耗模式恢复的确切延迟因芯片而异,典型值为 200 个 SDRAM 时钟周期。另有面向便携设备的低功耗 DDR,即 LPDDR1–5。它们供电电压更低、时钟更快,但每个通道允许连接的芯片更少,且芯片直接连接 CPU,而不是放在 DIMM 上。
图形数据 RAM,即 GDRAM(GDDR1–6),基于 SDRAM,但接口更宽、时钟更快,因此带宽为其 2–5 倍。较高时钟频率限制了每个通道可连接的 GDRAM 数量,并要求像 LPDDR 一样直接连接。到 2024 年,GDRAM 正被采用 HBM 的新设计取代,下一部分将介绍 HBM。
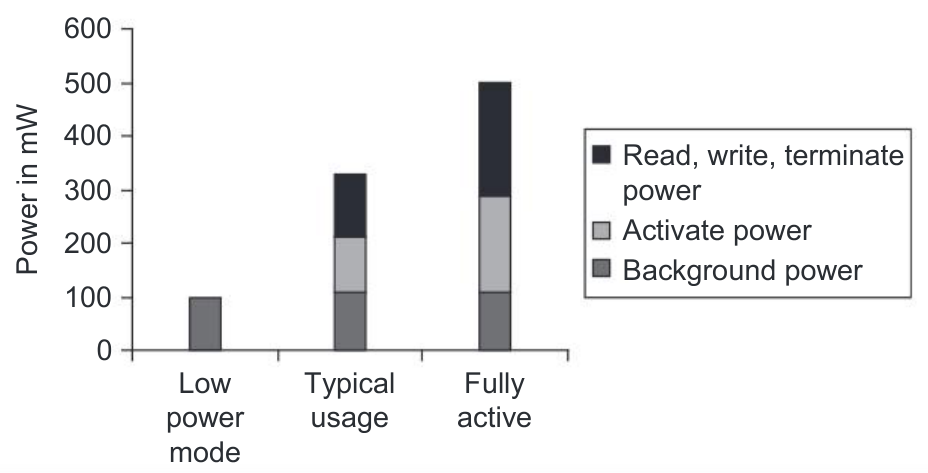
图 2.6(续)。 典型模式中,DRAM 有 30% 的时间执行读操作,15% 执行写操作;读写都假设采用八次传输组成的突发。数据基于 Micron 的 1.5 V、2 GB DDR3-1066。DDR4 和 DDR5 也能按类似比例节省功耗,而且由于工作电压较低,功耗还降低了 30%–40%。近期 DDR5 DRAM 可以在 DIMM 层面管理功耗,并提供更深的关闭模式,以进一步节能。
图内术语:Power in mW=功耗,单位 mW;Low power mode=低功耗模式;Typical usage=典型使用;Fully active=完全活动;Background power=背景功耗;Activate power=激活功耗;Read, write, terminate power=读、写及终端匹配功耗。
这些改进降低了 DRAM 功耗,但无论访问时间还是功耗,片外访问的代价仍占主导。例如,图 2.1 中,片外 DRAM 的访问时间是小型 L1 的 50–100 倍,是大型 L3 的 5–10 倍。能耗的比例也类似:片外 DRAM 访问约为小型 L1 的 100 倍、大型 L3 的 10–20 倍。片外访问较长的延迟和较高的能耗,共同推动了大型 LLC 的使用,以及改善其性能的各种技术。
封装创新:堆叠或嵌入式 DRAM、SRAM
DRAM 最近的一项创新来自封装,而非电路:把多颗 DRAM 堆叠起来,与处理器放在同一封装中。“嵌入式 DRAM”一词也可指把 DRAM 直接放到处理器芯片上的设计。将二者共同封装,缩短了 DRAM 与处理器之间的传输延迟,因而降低访问延迟;还可以采用更多、更快的连接,提高带宽。这种技术称为高带宽内存(high bandwidth memory,HBM)。
主要做法是通过带有互连的基板,即中介层(interposer),将 DRAM 堆叠在 CPU 旁边,并装入同一封装。假定 CPU 有多个内存通道,可以在四边各放一组,共四组,每组最多堆叠八颗 DRAM。采用专用 SDRAM 和四组堆叠,这样一个封装可包含 32 GiB 内存,数据传输率可达 4 TB/s。
因为芯片必须专为堆叠制造,早期用途大多集中于高端服务器、GPU 和领域专用体系结构(DSA)。图 2.7 展示了中介层方案,以及将芯片直接堆叠在处理器之上的另一种结构。图中的 3D 结构面临散热和电气噪声方面的挑战;到目前为止,垂直堆叠的唯一用途,是将用作 L3 的 SRAM 放在处理器之上。
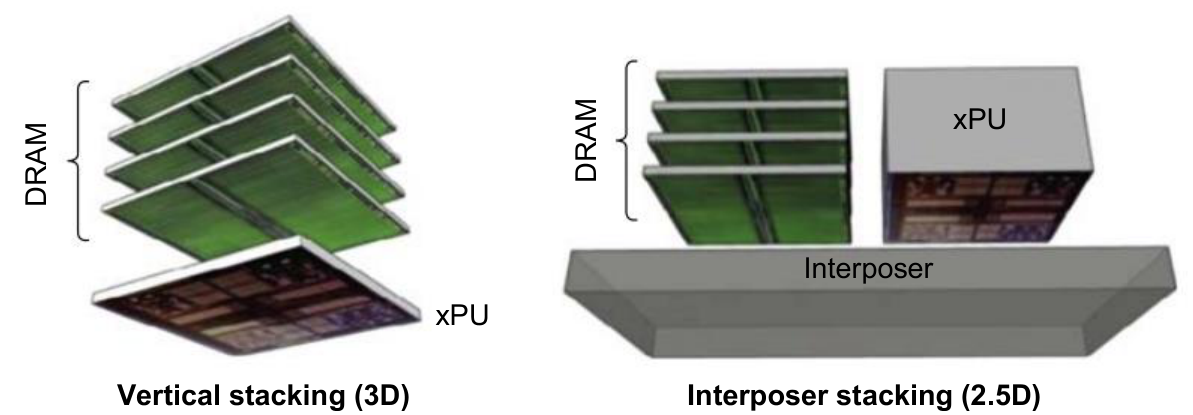
图 2.7(续)。 2.5D 形式已经广泛采用,可容纳最多四组堆叠,每组八颗 DRAM。AMD Genoa 芯片组目前采用 3D 堆叠,在每个裸片上堆叠一颗 SRAM,使一个 96 核 chiplet 上可以支持最多 1 GB 的 L3 缓存。3
图内术语:Vertical stacking (3D)=垂直堆叠(3D);Interposer stacking (2.5D)=中介层堆叠(2.5D);Interposer=中介层;xPU 为原图对处理器的泛称。
对于一些应用,封装内部可能容纳足够的 DRAM,满足全部需求。例如,一种作为专用集群节点的 NVIDIA GPU 正在采用 HBM 开发,而对于高端应用,HBM 很可能成为 GDDR5 的后继技术。有时可以直接将 HBM 用作主存,尽管成本限制和散热问题目前仍使它不适合某些嵌入式应用。下一节将讨论将 HBM 用作额外一级缓存,或额外主存单元的可能性。
Flash 存储器
Flash 是 EEPROM(电可擦除可编程只读存储器)的一种,通常只读,但可以擦除。另一项关键性质是,无须供电也能保持内容。这里着重介绍 NAND Flash:其密度高于 NOR Flash,更适合大容量非易失性存储;缺点是访问按顺序进行,写入也较慢,下面将说明。
Flash 在 PMD 和大多数台式机中作为辅助存储使用,与磁盘在服务器中的作用相同。此外,多数 PMD 的 DRAM 容量有限,因此 Flash 也可能充当存储层次中的一级;它承担这一角色的程度,远高于主存容量可能大 10–100 倍的台式机或服务器。
Flash 的体系结构和性质与标准 DRAM 大不相同,最重要的区别如下。
- Flash 按顺序读取,且一次读取整页;页大小可能为 512 字节、2 KiB 或 4 KiB。NAND Flash 访问随机地址的首字节时延迟较长,约 25 μs,但可以约 40 MiB/s 的速度提供页内其余数据。相比之下,DDR5 SDRAM 取得首字节约需 40 ns,随后可按 5 GiB/s 传输该行剩余数据。传输 2 KiB 时,NAND Flash 约需 75 μs,而 DDR SDRAM 不到 450 ns,即 Flash 的传输耗时超过 DDR SDRAM 的 150 倍。不过,读取 2 KiB 数据时,Flash 的速度仍是磁盘的 300–500 倍。由此可见,Flash 不适合取代 DRAM 作为主存,但由于每比特成本已经接近磁盘,尤其在较小容量下,已在许多系统中取代磁盘。
- Flash 必须先擦除才能覆写,flash 这个名称就来自这种“闪速”擦除过程;而且擦除以块为单位,不能单独擦除一个字节或字。因此,写入时必须凑齐整个块,或全部提供新数据,或把待写数据与块内其余内容合并。Flash 的写入速度约为 SDRAM 的 1/1500,但约为磁盘的 8–15 倍。
- Flash 是非易失性的,即断电仍能保存内容;不执行读写时,功耗显著较低,在待机模式下不到一半,完全不活动时可降为零。
- Flash 中任一块的写入次数有限,通常至少为 100,000 次。通过把写入均匀分布到整个存储器的各个块,系统可以尽量延长寿命。这种技术称为磨损均衡,原文称 write leveling,由 Flash 控制器负责。
- 高密度 NAND Flash 比 SDRAM 便宜,但比磁盘贵:Flash 约为每 GiB 0.12–0.20 美元,SDRAM 为每 GiB 5–10 美元,磁盘为每 GiB 0.02–0.05 美元。过去五年,Flash 成本下降的速度几乎是磁盘的两倍。
与 DRAM 类似,Flash 芯片也包含冗余块,使存在少量缺陷的芯片仍能使用;块重映射由芯片内部处理。Flash 控制器负责页面传输、页面缓存和磨损均衡。
高密度 Flash 的快速进步,对低功耗 PMD 和笔记本的发展至关重要;它也显著改变了台式机和大型服务器,前者越来越多地使用 SSD,后者则往往结合磁盘与 Flash 存储。
相变存储技术
**相变存储器(phase-change memory,PCM)**几十年来一直是活跃的研究领域。它通常利用微小的加热元件,使块体衬底在晶态与非晶态之间转换;这两种状态的电阻特性不同。衬底上覆盖着二维网络,每个比特对应其中一个交叉点。读取时检测某个 x 点和 y 点之间的电阻,因而原文也称其为 memristor(忆阻器);写入时施加电流,改变材料的相态。由于不需要晶体管等有源器件,理论上应能比 NAND Flash 获得更低成本和更高密度。
2017 年,Micron 和 Intel 开始交付基于这一技术的 Xpoint 存储芯片。相比 Flash,PCM 有两个主要优势:随机写性能更好,因为不需要擦除步骤;写入寿命也可能更长。读取延迟则略好于 Flash。由于“谬误与陷阱”一节将讨论的原因,PCM 未能形成发展势头,至少目前已经基本被搁置。
提高存储系统的可信赖性
大型缓存和主存显著增加了制造阶段以及运行期间发生错误的可能性。由于电路本身改变而产生、并且可以重复出现的错误,称为硬错误(hard error)或永久性故障(permanent fault)。它们既可能在制造阶段出现,也可能因运行期间的电路变化而产生,例如 Flash 单元在大量写入后失效。所有 DRAM、Flash 以及大多数 SRAM 在制造时都配有备用行,通过编程,用备用行替换缺陷行,便可容忍少量制造缺陷。运行期间只改变单元内容、没有改变电路本身的错误,则称为软错误(soft error)或瞬态故障(transient fault)。如果没有某种错误检测手段,它们就会成为第 1 章讨论的静默数据错误。
这类动态错误可以用奇偶校验位检测,也可以用**纠错码(error-correcting code,ECC)**检测并纠正。指令缓存只读,因此奇偶校验便足够;大型数据缓存和主存则使用 ECC,同时提供检测和纠错能力。奇偶校验只需增加一个比特,就能检测一串比特中的单比特错误。原文指出,多比特错误会逃过奇偶校验,成为静默错误,因此每个校验位所保护的比特数必须受到限制。4 典型比例为每 8 个数据比特配 1 个校验位。每 64 个数据比特增加 8 个冗余比特的 ECC,可以检测双比特错误并纠正单比特错误。ECC 在 DDR5 中成为标准配置。
在超大规模系统中,多比特错误乃至整颗存储芯片失效的概率都不可忽视。IBM 为此引入 Chipkill,IBM 服务器和 Google 集群等许多超大规模系统都采用了它;Intel 将自己的版本称为 SDDC。其思路与磁盘 RAID 类似:分散存放数据和 ECC 信息,即使一整颗芯片失效,也能利用其余芯片重构丢失的数据。
按 IBM 的一项分析,假设一台服务器有 10,000 个处理器,每个处理器配备 4 GiB 内存,则三年运行期间不可恢复错误的发生情况如下:
- **仅用奇偶校验:**约 90,000 次,平均每 17 分钟出现一次不可恢复或未检出的失效。
- **仅用 ECC:**约 3500 次,平均每 7.5 小时出现一次未检出或不可恢复的失效。
- **采用 Chipkill:**平均每两个月出现一次未检出或不可恢复的失效。
还可以换个角度:要达到上述 Chipkill 系统同样的错误率,最多能够保护多少台各有 4 GiB 内存的服务器?对于奇偶校验,即使只有一个处理器的服务器,其不可恢复错误率也高于由 10,000 台服务器组成、受 Chipkill 保护的系统。对于 ECC,由 17 台服务器组成的系统,其失效率约等于由 10,000 台服务器组成的 Chipkill 系统。5 因此,对于含 50,000–100,000 台服务器的仓库级计算机,Chipkill 是必需的,见第 6 章 6.8 节。
译注: 原文将单个晶体管描述为“实际上充当电容器”,此处按原文呈现。常见 DRAM 单元由访问晶体管和储存电荷的电容组成,不宜把这一简化表述理解为两者在结构上是同一个器件。 ↩︎
译注: 原文及图 2.5 使用 MiB/s;按 MHz 的十进制定义, 字节/秒为 3200 MB/s,而非 3200 MiB/s。 ↩︎
译注: 图 2.7 原注确实写“on a 96-core chiplet”。 ↩︎
译注: 原文将多比特错误概括为无法被奇偶校验检测。更准确地说,同一校验范围内,偶数个比特翻转会保持奇偶性而漏检;奇数个比特翻转仍可检测。 ↩︎
译注: 原文先讨论 10,000 个处理器的服务器,随后改用 10,000 台服务器进行比较,并给出 17 台 ECC 服务器。该换算口径未说明;仅按前文三年 3500 次与每两个月一次线性换算,也不能得到 17。 ↩︎
2.3 存储层次结构的十项高级性能优化
前面的平均访存时间公式,给出了缓存优化的三个指标:命中时间、未命中率和未命中开销。考虑到近期发展趋势,再加上缓存带宽与功耗。按照这些指标,可以把本节研究的十项高级存储系统优化分为五类:
- 缩短命中时间并降低功耗。 小缓存可以同时缩短命中时间、降低功耗,但代价是命中率下降。多个存储体也能缩短命中时间、降低功耗,尤其适用于较大的 L2、L3 缓存。
- 提高缓存带宽。 包括流水线化 L1、多存储体缓存和非阻塞缓存。它们对功耗的影响各不相同。如果存储系统能支持多个尚未完成的未命中,它们还可能降低未命中开销。
- 降低未命中开销。 包括关键字优先和写缓冲区合并,对功耗影响很小。采用多个存储体和 HBM,也可以缩短从内存访问一个块的延迟,从而降低未命中开销;无论访问单个块,还是并行访问多个块,都能受益。
- 降低未命中率。 包括编译器优化与相联度调整。显然,编译时取得的改进也有助于降低功耗。组相联会略微增加命中时间,但能降低未命中率;优化组相联缓存的替换策略,也可能减少未命中。
- 通过并行性降低未命中开销或未命中率。 包括硬件预取和编译器预取。它们通常会增加功耗,主要原因是预取的数据有一部分最终没有使用。
总体而言,随着我们依次讨论这些优化,硬件复杂度会逐渐增加。其中若干优化还需要先进的编译器技术,一项则依赖 HBM。最后将用图 2.17 汇总这十项技术的实现复杂度与性能收益。 有些技术较为直接,介绍会简短一些;另一些则需要更详细的说明。
第一项优化:采用虚拟索引和组相联的流水线化 L1 缓存
将 L1 流水线化,可以在延迟略有增加的代价下提高时钟频率。例如,20 世纪 90 年代中期,Intel Pentium 的指令缓存访问需要一个时钟周期;从 90 年代中期到 2000 年的 Pentium Pro 至 Pentium III,需要两个周期;2000 年面世的 Pentium 4,以及当前的 Intel i7 和 i9,则需要四个周期。指令缓存流水线化,实际上增加了流水线级数,使分支预测错误的代价更高。类似地,数据缓存流水线化,会增加从发出加载指令到使用数据之间的周期数,见第 3 章。如今,所有处理器都对 L1 进行了某种程度的流水线化,最简单的做法也是分开访问与命中检测;许多高速处理器的缓存流水线则有三级以上。
缓存流水线化后,组相联更容易实现,几乎不增加命中时间,甚至没有额外代价,因此可以提高 L1 命中率。较高相联度还可以避免虚拟索引缓存中的别名问题。
典型的缓存访问流水线可以把访问与命中检测分成四步:
- 译码地址,得到用于选择缓存字线的地址。
- 访问指令缓存或数据缓存的 SRAM。
- 将组内各条目的标签与 TLB 给出的物理标签比较,判断命中或未命中;命中时确定组内的对应条目。
- 通过多路选择器选出正确的缓存块,将所需的字与块内被访问的部分对齐,并传给 CPU。
在制造芯片之前,可以用 CAD 工具评估命中时间和功耗。CACTI 能估计 CMOS 微处理器中不同缓存结构的访问时间与能耗,其结果与更详细的 CAD 工具相比,误差在 10% 以内。给定最小特征尺寸后,CACTI 根据缓存容量、相联度、读写端口数量及其他更复杂的参数估算命中时间。图 2.8 给出了改变容量和相联度的估算结果。当然,这些估计既依赖工艺,也依赖缓存规模,因此必须使 CACTI 与所用工艺仔细匹配;图 2.8 展示的是某一工艺下的相对取舍。
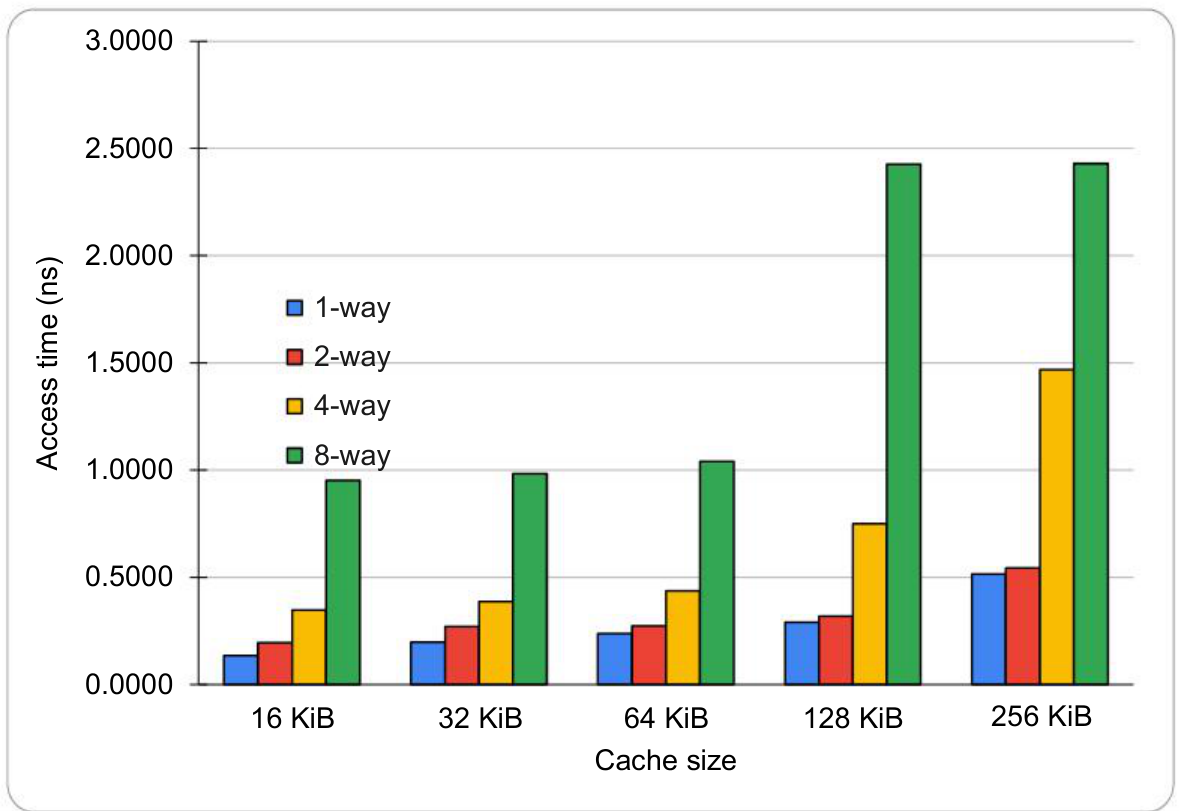
图 2.8(续)。 数据来自一个新的 CACTI 模型,模拟采用 14 nm、0.8 V 工艺、基于 FIN-FET 的 SRAM,详见 Ravipati et al.(2022)。假定单存储体、64 字节块。缓存布局假设,以及互连延迟与标签检查、多路选择代价之间的复杂取舍,使估算访问时间较高,八路组相联尤其如此;互连延迟也会随路数变化。用于连接缓存块的 H 树布局,可能进一步提高高相联度的估算访问时间,因为需要连接到 H 树的块更多。
图内术语:Access time (ns)=访问时间(ns);Cache size=缓存容量;1-way/2-way/4-way/8-way=一路/两路/四路/八路。
例:相联度与平均访存时间
问题。 利用附录 B 的图 B.8 和图 2.8,判断 32 KiB 四路组相联 L1 的访存时间,是否短于同容量的两路组相联 L1。假设访问 L2 的未命中开销,是较快 L1 访问时间的 15 倍;忽略 L2 之后的未命中。哪一种平均访存时间更短?
解答。 令两路组相联缓存的访问时间为 1,则原书给出的两路缓存计算为:
四路缓存的访问时间是两路的 1.4 倍。原书将未命中开销对应的时间写为 ,为简单起见取 10,于是:
显然,更高的相联度看起来不划算;不过,现代处理器的缓存访问通常是流水线化的,因此对时钟周期的确切影响很难判断,较高的相联度可能并不影响周期时间。如果还存在其他缓存优化,这一权衡会更加复杂。
译注: 应为 1.57,而非 1.38; 约为 10.714,而非 10.1。此外,第二式把以两路命中时间计的 1.4,与按另一时间单位缩放的未命中开销相加,单位不统一。若统一采用两路命中时间为单位,并沿用题设 15 的实际未命中开销,四路结果为 。
选择缓存容量和相联度时,还要考虑能耗,如图 2.9 所示。从两路增加到四路,能耗会变为原来的 1.1–1.7 倍,具体取决于缓存容量。
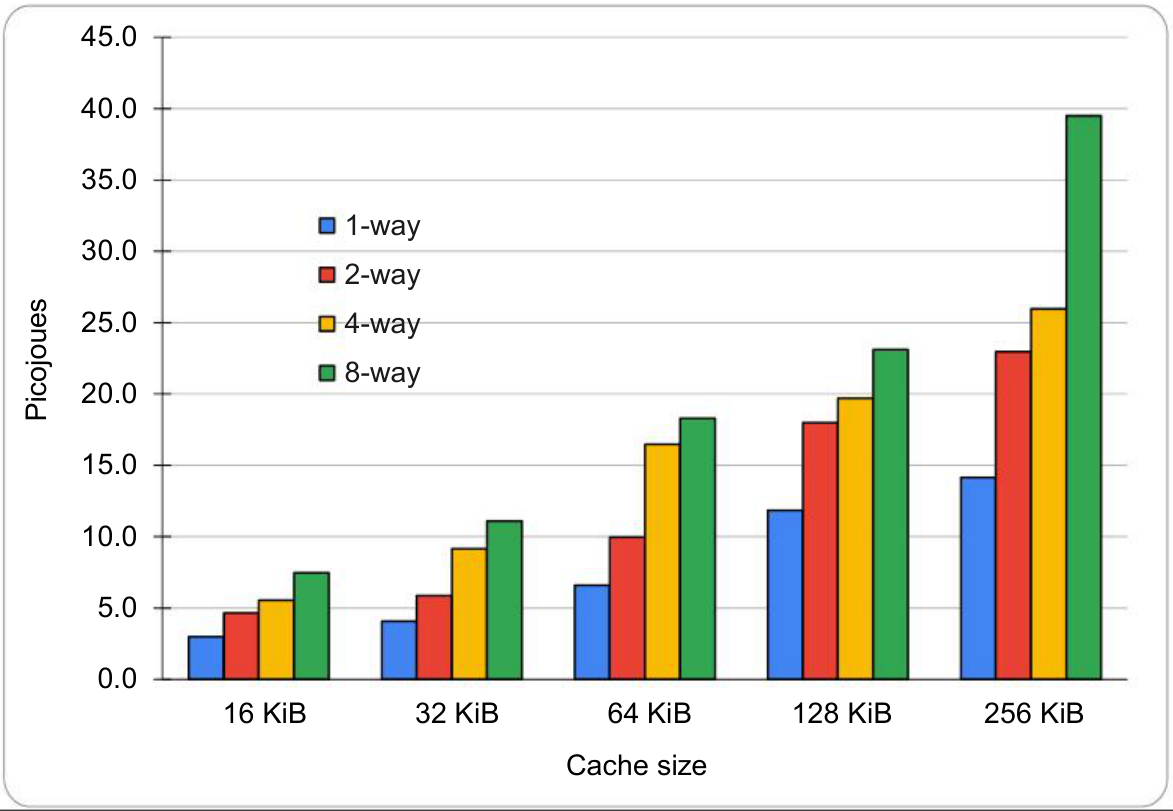
图 2.9(续)。 与前图一样,采用相同工艺参数的 CACTI 建模,见 Ravipati et al.(2022)。八路组相联的代价很大,因为必须并行读出八个标签及其对应数据。类似前图,用于布局缓存块的 H 树,可能增加高相联度所需能量的估计值。
图内术语:Picojoules=皮焦耳(原图拼为 Picojoues);Cache size=缓存容量;各路数含义同图 2.8。
能耗日益重要,设计者开始着力减少缓存访问所需能量。除相联度外,另一项关键因素是缓存中的块数,因为它决定了被访问的“行”数。保持总容量不变而增大块,可以减少行数,但可能增加未命中率,尤其是较小的 L1。
**路预测(way prediction)**试图在利用相联度的同时,保持直接映射缓存的命中速度。缓存保留额外比特,预测下一次访问的路,即组内的块。这样就能提前设置多路选择器,选出所需块,并在同一周期内并行读取数据和进行一次标签比较。若未命中,下一周期再检查其余块是否匹配。模拟表明,两路组相联的预测准确率超过 90%,四路组相联超过 80%;指令缓存通常比数据缓存预测得更准。对两路组相联缓存而言,只要路预测能让命中至少快 10%,就能缩短平均访存时间,而达到这一点很可能并不困难。路预测最早用于 20 世纪 90 年代中期的 MIPS R10000,后来广泛用于两路组相联处理器,也用于若干采用四路组相联的 ARM 处理器。对极高速处理器,可能难以实现只停顿一个周期的机制,而这恰恰是控制预测错误代价的关键。
另一种取得部分组相联优势的方法是牺牲缓存(victim cache),即用一个小缓存保存最近逐出的少数缓存行。Jouppi(1990)表明,八个条目的小型牺牲缓存,可以显著降低小型直接映射 L1 的未命中率。如今 L1、L2 更大,提高 L1 相联度并采用预取,效果已超过牺牲缓存。后面将看到,一些近期处理器实际上将 LLC 用作牺牲缓存。
第二项优化:采用多个存储体和端口,提高 L1 数据缓存带宽
处理器每周期能执行的指令数不断增加,设计者也必须增加数据缓存每周期能够接收的加载和存储操作数。早期多发射处理器每周期可以执行一次加载和一次存储;近期处理器则能执行两次加载和两次存储。这要求数据缓存每周期接收四次访问!如 2.5 节所述,指令缓存则利用空间局部性和分支预测,通过前瞻和预取跟上取指需求。
给寄存器堆增加多个读写端口是合理的,但在更大的缓存存储阵列中代价更高。因此,多数设计者选择多个存储体,可能再配上数量有限的多端口。
分存储体最初用于改善主存性能,如今既用于 DRAM 芯片内部,也用于缓存。Intel Core i7 的 L1 数据缓存有四个存储体,以支持每周期最多两次访存;i9 则采用双端口和八个存储体,以应对每周期四次访存的峰值。
显然,访问能够自然分散到不同存储体时,效果最好,因此地址到存储体的映射会影响存储系统行为。一种简单而有效的办法是将连续块地址依次分配到各存储体,称为顺序交错(sequential interleaving)。例如,有四个存储体时,块地址模 4 为 0 的块全部属于存储体 0,模 4 为 1 的属于存储体 1,依此类推。图 2.10 展示了这种组织。
| 存储体 0 的块地址 | 存储体 1 的块地址 | 存储体 2 的块地址 | 存储体 3 的块地址 |
|---|---|---|---|
| 0 | 1 | 2 | 3 |
| 4 | 5 | 6 | 7 |
| 8 | 9 | 10 | 11 |
| 12 | 13 | 14 | 15 |
起初你可能认为,即使分了存储体,数据缓存访问仍会发生大量冲突;但有几个因素会减少冲突。首先,其他流水线停顿和缓存未命中会干扰执行,处理器很少能够持续每周期四次访存。其次,即使四次访问同时到达,数据局部性也使其中两次或更多很可能访问同一个块,从而合并为一次缓存访问。
例:存储体冲突概率
问题。 假设有八个存储体和四次访问,访问同一块的请求数分别为一个、两个或三个,求发生冲突的概率。
解答。 如果四次访问分别指向不同的块,那么八个存储体中不发生冲突的概率,就是第 2、3、4 次访问都不落入先前请求已使用存储体的概率:
如果其中两次访问指向同一块,另外两次各自指向不同的块,则这一概率为:
原文接着指出,如果只有两个存储体被访问,冲突概率降至 12.5%(7/8)。存储体发生冲突时,其中一个请求延后处理,其余请求继续执行。
译注: 前两式给出的是“无冲突”概率,41% 和 66% 为舍入值。最后一句原文确实把冲突概率 12.5% 括注为 7/8;其中 7/8=87.5% 是无冲突概率,冲突概率应为 1/8。
当然,任何一个没有四次访存同时就绪的周期,冲突概率也会降低。双端口同样可以在不必处理冲突的情况下增加带宽。四个存储体均采用双端口时,冲突概率会低很多,因为同一存储体至少收到三个请求才会冲突。
双端口总会增加访问时间,而多个存储体的影响还取决于相联度和缓存容量等因素。提高 L1 带宽的这些方案,在访问时间上有何差异?图 2.11 展示了 CACTI 对 1、2、4 个存储体,分别配备 1、2、4 个端口时的估算。
图内术语:Access time (ns)=访问时间(ns);Number of Banks=存储体数量;Single ported=单端口;Dual ported=双端口;Quad ported=四端口。
例:比较多存储体和多端口
问题。 为简单起见,假设只要发生冲突,就让缓存访问增加 1 ns,即使有四次冲突也一样。使用图 2.11 的数据,假定四次访问同时到达,以下哪种设计的访问时间最短?
- 四个单端口存储体;
- 两个双端口存储体,每个存储体都有双端口;
- 四端口。
解答。 先考虑单端口,冲突概率为:
对于双端口,原文给出的冲突概率为 37.5%,并指出,有兴趣的读者可以检查全部 16 种请求组合,其中只有 6 种会有三个请求命中同一个存储体。因此:
最后,四端口方案只有一个存储体,访问时间为 1.5 ns。按照这些参数及冲突代价,两个双端口存储体的方案最佳。
译注: 双端口段给出的数值为 37.5%、6/16 和 0.875 ns。若四个独立请求等概率映射到两个存储体,发生冲突的是分布为 3+1、1+3、4+0、0+4 的 10 种组合,概率为 62.5%;6/16 则是 2+2、没有冲突的情况。按题设计算,双端口平均时间应为 1.125 ns。单端口式的准确概率为 90.625%,原文作近似。修正概率后,双端口、双存储体仍是三者中较快的方案。
第三项优化:用更好的替换策略降低未命中率
直接映射缓存的替换策略很简单,因为每个块只能去一个位置。相联度提高后,未命中时必须决定替换组内哪个条目。选择得当可以降低未命中率,尤其是相联度较高时,因为可选的块更多。不过,这需要为每个缓存块维护额外状态。L1 的访问占用率很高,很难承担这样的工作,因此常采用随机替换或简单近似。L2、L3 访问占用率较低,未命中开销较高,因此优化替换策略更有意义。
事实上,确实存在最优策略,称为 Belady 的 MIN 策略:替换下一次使用时间最遥远的块。遗憾的是,正如 Yogi Barra 曾说过的:“预测很难,尤其是预测未来。”尽管如此,MIN 既为替换策略设计提供了思考方式,也提供了衡量实际算法的基准。另一种常被提出的方案是 LRU(Least Recently Used,最近最少使用),替换上一次使用时间最久远的块。精确 LRU 很难实现,因为必须维护组内所有块的先后次序。
因此,实际采用更新更简单的伪 LRU或近似 LRU。一种简单方案是 NRU(Not Recently Used,最近未使用):组内每个条目保留一位,表示该块最近未被使用;每次访问相应条目时,就把这一位清零。未命中时,从 NRU 位为 1 的块中选一个替换;随后除新换入的块外,将所有 NRU 位设为 1。
如果组内多个块的 NRU 位为 1,原文解释为这些块要么全都在近期被访问过,要么全都未被近期访问过,就在组内随机选一个替换。NRU 很容易实现,因为请求匹配到组之后,只需写入一位。它曾用于若干早期 Intel 处理器的 L2 和 LLC,也常用于 L1。
另一种低成本 LRU 近似,是把 NRU 推广为每块多个比特组成的计数器,试图预测哪个块将在最遥远的未来才被再次使用。例如,每块使用一个 2 bit 饱和计数器,原文称为 recently referenced prediction counter。缓存命中时,将该块计数器置零;未命中时,如果有块的计数器值为 3,就替换该块,并把计数器设为 2。数值 2 表示该块可能很快再次使用,也可能不会。如果没有计数器为 3,就把组内所有计数器递增,直到至少一个达到 3,再替换那个块。这一方案的关键,是区分只使用一次的流式访问与反复使用同一块的访问。
Jaleel et al.(2010)模拟了多种引用预测替换策略,包括 NRU、LRU 和上述 2 bit 方案。对于 2 MB、16 路 L2,大致相当于 Intel i7 单个核心的配置,NRU 性能比 LRU 低约 1%,而 2 bit 预测方案高约 5%。在四核、8 MB LLC 的多程序环境中,2 bit 方案的改善为 7%;原因可能是多程序活动使 LLC 中一次性访问更多,而 2 bit 方案比 1 bit 方案更善于处理这种流式访问。还可以推广到 bit 计数器;随着 增加,原文指出,该方案会接近真正的 LRU。像 2 bit 方案那样对计数器赋予不同权重,可以优先保留那些在一次未命中之后至少又命中过一次的块,因为它们较不可能是只访问一次的流式数据。
还有许多更复杂的替换策略,试图比基于 LRU 的方法作出更好的选择,本质上是在模拟工作集行为,类似操作系统对虚拟内存的处理。一些研究取得了显著改善;如果能以足够低的开销实现,并继续优于这些加权近似 LRU 策略,它们可能成为未来 LLC 的候选方案。
第四项优化:采用多存储体 L2、L3,降低功耗与延迟并增加带宽
L1 数据缓存使用多个存储体,主要是为了增加加载/存储带宽;它们也能为非阻塞未命中提供更高的回填带宽,稍后将介绍这一优化。在更大的 L2、L3 中,多个存储体可以像 DRAM 那样降低功耗、缩短延迟,并增加响应非阻塞 L1 或 L2 未命中的带宽。Intel Core i9 的 L2 有八个存储体。
Arm Cortex 处理器则使用过 1–4 个存储体的 L2。Intel 多核处理器将 LLC 分布在各核心之间,因此存储体数量随核心数增加。
第五项优化:用非阻塞缓存提高缓存带宽
对于允许乱序执行的流水线计算机,第 3 章将介绍,数据缓存未命中时,处理器不一定必须停顿。例如,在等待缺失数据返回期间,处理器仍可以从指令缓存继续取指。非阻塞缓存(nonblocking cache),也称 lockup-free cache,允许数据缓存在一次未命中尚未完成时继续服务命中请求,从而扩大这一办法的收益。这种 hit under miss 优化,使处理器在未命中期间仍能做有用的工作,而不必完全停顿,因此降低了实际未命中开销。更精细也更复杂的办法,是让多个未命中相互重叠,进一步降低开销,称为 hit under multiple miss 或 miss under miss。后者只有在存储系统能服务多个未命中时才有益。近期 Intel、AMD 等高性能处理器通常同时支持二者;许多低端处理器则只在 L2 提供有限的非阻塞支持。
Farkas 和 Jouppi(1994)为考察非阻塞缓存降低未命中开销的效果,假设 8 KiB 缓存、14 周期未命中开销,这与 20 世纪 90 年代初相符。他们发现,允许一次未命中期间继续处理命中,可以使 SPECINT92 的实际未命中开销下降 20%,SPECFP92 下降 30%。Li et al.(2011)更新了这项研究,采用多级缓存、更符合当时情况的未命中开销,以及规模更大、要求更高的 SPECCPU2006。研究模型基于 Intel i7 的一个核心,峰值每周期可以产生两次数据访存。图 2.12 显示了原文所称“在一次未命中期间允许 1、2 和 64 次命中”时,数据缓存访问延迟的下降,图注给出了更多存储系统细节。1 与早期研究相比,缓存变大并新增 L3,减少了收益:SPECINT2006 平均延迟下降约 9%,SPECFP2006 约 12.5%。
非阻塞缓存未命中并不一定使处理器停顿,因此,很难单独判断某次未命中的影响,也很难计算平均访存时间。实际未命中开销不是各次未命中时间之和,而是处理器停顿期间不能与其他工作重叠的时间。收益取决于多个未命中存在时的开销、访存模式,以及处理器在未命中尚未完成时能执行多少条指令。
一般来说,乱序处理器能隐藏 L1 数据缓存未命中、但 L2 命中时的大部分开销;对于更低层级的缓存未命中,则很难隐藏其大部分开销。
决定支持多少个尚未完成的未命中,要考虑多项因素:
- 未命中访问流的时间和空间局部性,它们决定一次未命中是否会向更低一级缓存或内存发起新访问;
- 响应请求的缓存或内存的带宽;
- 如果处理器在未命中时间最长的末级缓存允许更多未完成请求,则更高层级至少也必须支持同样多,因为未命中从最高一级缓存开始;
- 存储系统的延迟。
图 2.12(续)。 模拟的数据存储系统基于 Intel i7:32 KiB L1,访问延迟四周期;与指令共享的 256 KiB L2,延迟十周期;2 MiB L3,延迟 36 周期。三级均为八路组相联,块大小 64 字节。按原图注,允许一次命中,使整数程序未命中开销降低 9%、浮点程序降低 12.5%;允许第二次,则分别改善至 10% 和 16%;允许 64 次,额外收益很小。
图内术语:Cache access latency=缓存访问延迟;Hit-under-1-miss、Hit-under-2-misses、Hit-under-64-misses 分别表示存在 1、2、64 个未完成未命中时仍可继续命中。程序名称保持原标识符。
译注: 原图注把右侧 SPECFP 数量写为 9,但图中右侧实际列出 14 个名称。正文和图注的“命中次数”说法,也与图例按“未完成未命中数”区分三种方案的表达不一致。
以下简化例子说明关键思想。
例:需要支持多少个未完成未命中
问题。 主存访问时间为 36 ns,存储系统持续传输率可达 16 GiB/s,块大小为 64 字节。假设请求流足以维持峰值带宽,且访问从不冲突,需要支持的最大未完成未命中数是多少?如果某次访问与前四次之一发生冲突的概率为 50%,且必须等到前一个访问完成后才能执行,估算最大未完成请求数。为简单起见,忽略两次未命中之间的时间。
解答。 第一种情况下,假设能保持峰值带宽,原书将每秒可支持的访问数写为:
每次访问耗时 36 ns,因此可支持:
如果冲突概率大于零,就需要更多未完成请求,因为冲突请求暂时无法开始处理;存储系统需要的是更多独立请求,而不是更少!近似地,可以假定一半访存暂时不必发到内存,因此必须支持两倍的未完成请求,即 18 个。
译注: 原页的第一式确实将指数 9 放在整个括号之外。其给出的 2.5 亿次/秒,对应的是 ,并非 。题设写 GiB/s,计算却采用十进制的 字节;若严格按 GiB 换算,乘以 36 ns 后约为 9.664 个。
Li、Chen、Brockman 和 Jouppi 的研究发现,整数程序在原文所称“一次”情况下,CPI 下降约 7%,64 次时约下降 12.7%;浮点程序分别下降 12.7% 和 17.8%。这些下降幅度与图 2.12 的数据缓存访问延迟变化很接近。
非阻塞缓存的实现
非阻塞缓存虽然能提高性能,却不易实现。首先面临两类挑战:仲裁命中与未命中的竞争,以及跟踪尚未完成的未命中,以确定加载或存储何时可以继续。
先看第一个问题。阻塞缓存未命中会使处理器停顿,未命中处理完成前,不再出现新的缓存访问;非阻塞缓存中,命中却可能与从下一层返回的未命中数据相冲突。几乎所有近期处理器都允许多个未完成未命中,因此不同未命中的返回也可能冲突。必须解决这些冲突,通常先让命中优先于未命中,再为彼此冲突的未命中确定处理次序。
第二个问题来自对多个未完成未命中的跟踪。阻塞缓存最多只有一个未完成请求,所以始终知道返回的是哪一个;非阻塞缓存很少如此。乍看之下,似乎可以假设按序返回,用简单队列把返回数据与等待最久的请求匹配。但 L1 未命中可能在 L2 命中,也可能在 L2 未命中;若 L2 也非阻塞,返回 L1 的顺序就不一定与原来的发出顺序相同。具有非均匀缓存访问时间,即 NUCA,的多核及其他多处理器系统,也会带来这一复杂性。
未命中数据返回时,处理器必须知道是哪条加载或存储指令引起的,才能让它继续;还必须知道数据应放到缓存哪里,以及该块标签的值。近期处理器通常把这些信息保存在一组**未命中状态处理寄存器(Miss Status Handling Registers,MSHR)**中。如果允许 个未完成未命中,就设置 个 MSHR。
每个 MSHR 记录数据应放入缓存的位置、相应标签位的值,以及引发未命中的加载或存储指令信息;下一章会介绍如何跟踪这些指令。因此,未命中时先分配一个 MSHR,填入相关信息,并用它的索引给内存请求加上标识。存储系统返回数据时携带该标识,缓存据此将数据和标签写入正确的块,并“通知”引发未命中的指令:数据已就绪,可以继续执行。非阻塞缓存显然需要额外逻辑,因而有能耗代价;但很难准确评估,因为它也可能缩短停顿和执行时间,从而降低能耗。
除了上述问题,多处理器存储系统无论位于单芯片还是多芯片,还必须解决与缓存一致性和存储一致性有关的复杂实现问题。而且,缓存未命中不再是原子操作:请求与响应分开,多个请求之间可以交错,因此也可能出现死锁。第 5 章将再次讨论,在线附录 I 的 I.7 节会作更详细的介绍。
第六项优化:关键字优先与提前重启,降低未命中开销
这项技术基于一个观察:处理器通常一次只需要块内的一个字。策略就是“不必耐心等完”:不等整个块装入,就发送所需字并恢复处理器执行。具体有两种方法:
- 关键字优先(critical word first):先向内存请求缺失的那个字,一到达就送给处理器;处理器继续执行,同时填充块内其余字。
- 提前重启(early restart):按正常次序取字,但所需字一到达,就送给处理器,让它继续执行。
一般只有缓存块较大时收益才明显。注意,在填充块内其余部分的同时,缓存通常仍会服务对其他块的访问。
不过,空间局部性使下一次访问很可能指向同一块的其余部分。与非阻塞缓存一样,未命中开销并不好算。关键字优先方案中,如果又出现第二次请求,其实际开销就是从请求发出到第二部分数据到达之间、无法与其他工作重叠的时间。两项技术的收益取决于块大小,以及再次访问尚未取回部分的可能性。
例如,在采用这两项技术的 i7 6700 上运行 SPECint2006 时,对仍有未完成未命中的块,平均会产生不止一次访问:平均 1.23 次,范围为 0.5–3.0。2.6 节将更详细地研究先进存储层次结构的性能。
第七项优化:通过编译器优化降低未命中率
到目前为止,所讨论的技术都需要改变硬件。下面的方法却无须改变硬件,就能降低未命中率。
这种“魔法”来自软件优化——硬件设计者最喜欢的解决办法!处理器与主存之间日益扩大的性能差距,促使编译器开发者仔细研究存储层次结构,寻找编译时优化的机会。研究同样分为改善指令未命中与改善数据未命中两类。下面介绍的优化,许多现代编译器都已采用。
循环交换
有些程序的嵌套循环按非连续顺序访存。只需交换循环嵌套次序,就能按数据存放顺序访问。假设数组无法完全放入缓存,这种方法通过改善空间局部性来减少未命中:在一个缓存块被丢弃前,尽可能多地使用其中的数据。例如,二维数组 x 的大小为 [5000,100],使 x[i,j] 与 x[i,j+1] 相邻存放;因为数组按行排列,这称为行优先(row major)。以下前后两段代码展示了如何优化访问:
原代码按 100 个字的步长跳跃访问;修改后则先访问完一个缓存块内的全部字,再转向下一个块。它在不改变执行指令数的情况下改善了缓存性能。
分块
**分块(blocking)**通过改善时间局部性减少未命中。这里仍涉及多个数组,其中有的按行访问,有的按列访问;每次循环迭代都会同时使用行和列,因此无论将数组按行优先还是列优先存放,都不能解决问题。这种相互正交的访问方式意味着,即便做过循环交换,仍有很大优化空间。
分块算法不处理完整行或完整列,而是处理子矩阵,即二维块,目的是在缓存中的数据被替换前尽可能多地使用它们。以下矩阵乘法代码说明了优化动机:
最内侧的两个循环会读遍 z 的全部 个元素,反复读取 y 同一行的 N 个元素,并写入 x 一行中的 N 个元素。图 2.13 展示了三个数组的访问状态:深色表示近期访问,浅色表示较早访问,白色表示尚未访问。
容量未命中的数量显然取决于 N 和缓存容量。如果能容纳全部三个 矩阵,只要没有缓存冲突,就没有问题。如果能容纳一个 矩阵和长度为 N 的一行,那么至少 y 的第 i 行与整个 z 可以保留在缓存中。容量再小一些,原文指出 x 与 z 都可能发生未命中。最坏情况下, 次运算需要访问 个内存字。
为保证正在访问的元素能放入缓存,将代码改为对 子矩阵计算。最内侧两个循环不再跨越 x 和 z 的完整长度,而以 B 为范围分段处理。B 称为分块因子(blocking factor)。假设 x 已初始化为零:
图 2.13(续)。 颜色深浅表示距访问发生的时间:白色表示尚未访问,浅色表示较早访问,深色表示较近访问。反复读取 y 和 z 的元素,用于计算 x 的新元素。图中沿相应行或列标出用于访问数组的变量 i、j、k。
图 2.14 展示了分块后的访问。只考虑容量未命中,访问内存字的总数为 ,相当于将访问量约降至原来的 。因此,分块结合利用了空间和时间局部性:y 受益于空间局部性,z 受益于时间局部性。这里采用正方形块 ,也可以用矩形块;如果矩阵不是正方形,这样做就是必要的。
我们关注的是减少缓存未命中,但分块还可以帮助寄存器分配。选择足够小的块,使其能够放入寄存器,即可尽量减少程序的加载和存储操作。
第 4 章 4.8 节将说明,对于以矩阵为主要数据结构的应用,要在采用缓存的处理器上取得良好性能,缓存分块不可或缺。
第八项优化:用硬件预取指令和数据,降低未命中开销或未命中率
非阻塞缓存使程序执行与内存访问重叠,从而有效降低未命中开销。另一种办法是在处理器提出请求前,提前**预取(prefetch)**所需内容。指令和数据都可以预取,既可以直接送入缓存,也可以送入一个访问速度快于主存的外部缓冲区。
指令预取常由缓存之外的硬件完成。通常,处理器在发生未命中时取回两个块:所请求的块及其后紧邻的块。所请求的块返回后放入指令缓存,预取的块则放入指令流缓冲区(instruction stream buffer)。如果请求的块已经在指令流缓冲区中,就取消原来的缓存请求,从流缓冲区读出该块,并发出下一次预取请求。
数据访问也可以采用类似方法(Jouppi,1990)。Palacharla 和 Kessler(1994)研究了一组科学计算程序,考察了能够处理指令或数据的多个流缓冲区。他们发现,对于配备两个 64 KiB 四路组相联缓存、分别存放指令和数据的处理器,8 个流缓冲区能够捕获全部未命中的 50%~70%。
Intel Core i7 和 i9 都支持向 L1 和 L2 进行硬件预取,最常见的预取操作是访问下一条缓存行。如果应用的 L1 和 L2 未命中率很低,预取就难以带来很大改善。即便 L1 或 L2 未命中率较高,也必须谨慎使用预取,因为“错误”的预取可能替换掉有用的缓存块,并且会消耗缓存或内存带宽。Xeon Skylake-SP 的硬件预取与 Sapphire Rapids 非常相似,包含 4 种数据预取器:L1 数据缓存单元预取器(Data cache unit prefetcher,DCUI)、L1 数据缓存指令指针步长预取器(Data cache instruction pointer stride prefetcher,DCUP)、L2 数据缓存空间预取器(Data cache spatial prefetcher,L2A)和 L2 数据缓存流预取器(Data cache streamer,L2P)。在 SPECCPU2017 中内存访问较密集的基准测试里,L2P 最为重要,贡献了 CPI 改善的 70%。注意,L2 预取器可以从 L3 或内存取数据,并将结果直接放入 L2;如果数据来自内存,则不会同时放入 L3。
图 2.15 给出了多核 Xeon 处理器 Skylake-SP 开启硬件预取后,一部分 SPECCPU2017 程序的总体性能改善,以 CPI 的下降衡量。不同程序的结果差异很大:有两个基准测试的性能略有下降,5 个的改善约为 10% 或更少,还有两个的性能提高到原来的两倍以上。图中还给出了 L3 的 MPKI(Misses Per K Instructions,每千条指令的未命中次数)下降情况,它与 CPI 的下降高度相关。
预取不计入未命中次数。因此,当 L2P 向 L2 缓存预取时,既可以消除原本会在 L3 命中的 L2 未命中,也可以消除原本会在 L3 未命中的 L2 未命中。由于 L3 未命中的耗时大约是 L2 未命中的 4 倍,大部分性能改善来自 L3 未命中的减少,如图 2.15 所示。
如果取消预取,被消除的 L3 未命中中会有许多、甚至全部重新出现。不过,预取机制并不完美,也可能引起额外的未命中。比较开启和关闭预取时 L3 所请求的数据流量,就能看出这一点。开启预取后,L3 缓存请求的数据量比关闭时增加了 19%。在少数情形下,例如 bwaves 和 lbm,预取器似乎非常准确,L3 流量的增幅不足 1%。预取效果良好时,对功耗的影响可以忽略,甚至略有益处;如果预取数据没有被使用,或有用的数据被挤出缓存,预取就会显著增加功耗。
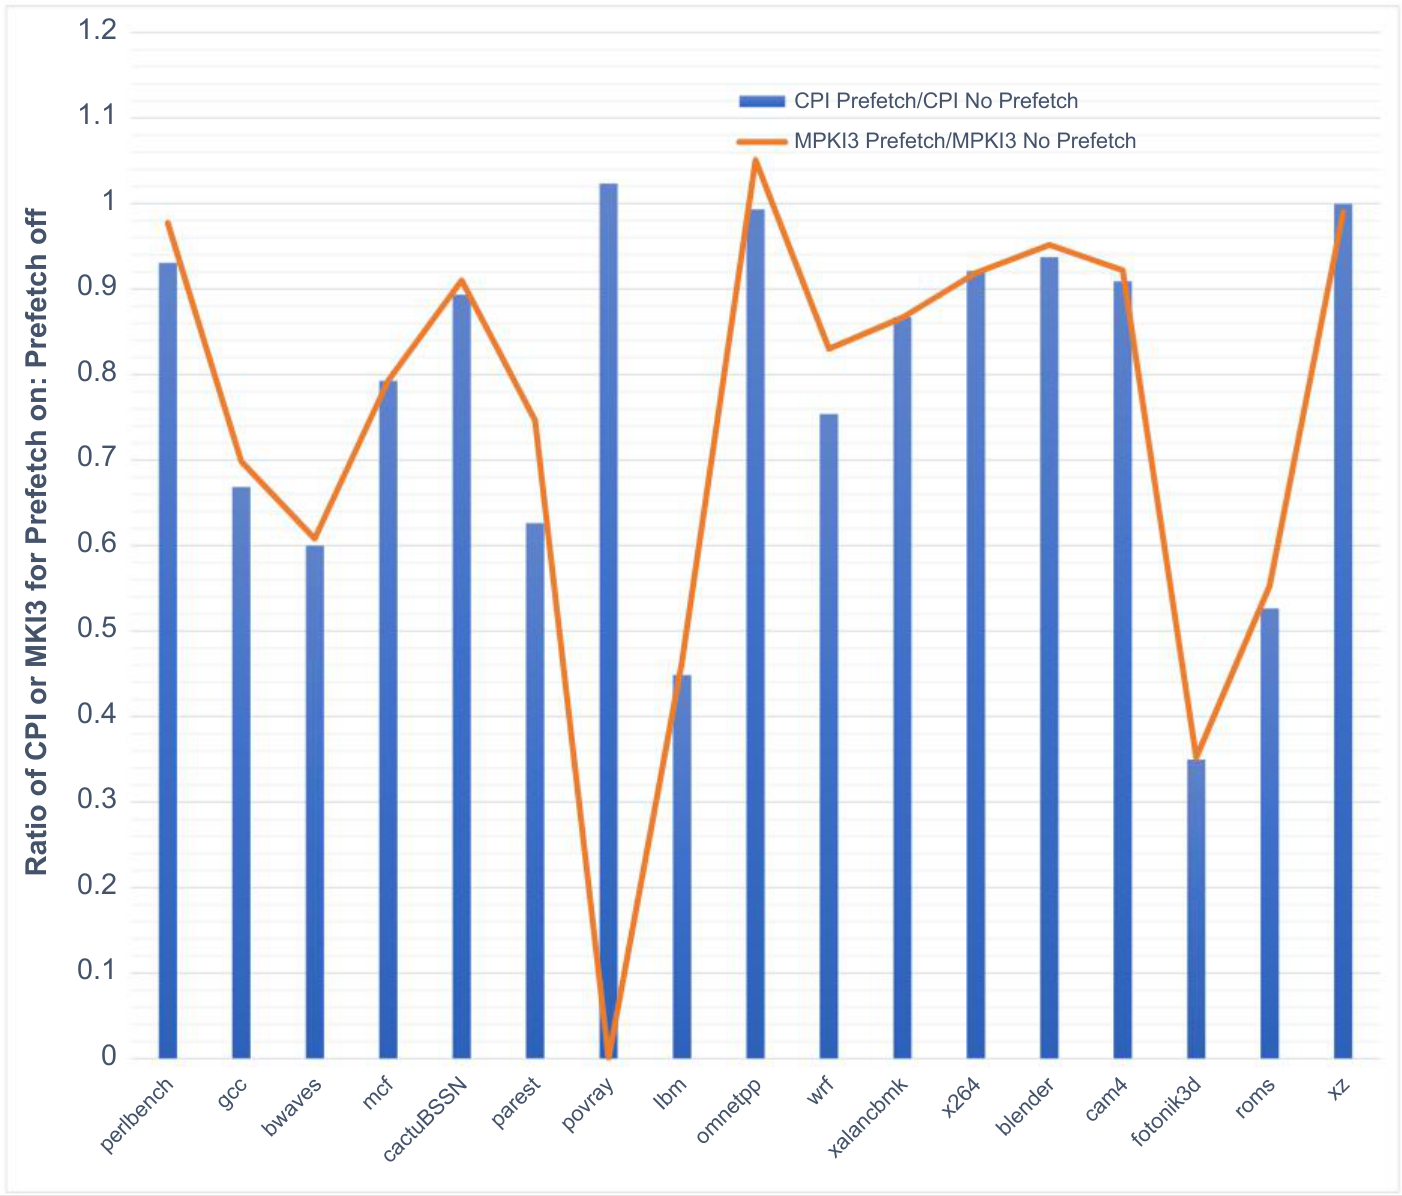
图 2.15(续)。 如果某个基准测试有多个输入,采集的数据来自其中内存访问最密集的输入。除 povray 外,CPI 的改善与 MKPI3 的下降非常接近;povray 的 MKPI3 接近 0,因此它的全部收益来自将数据从 L3 预取到 L2。L2P 不仅总体效果最好,而且在改善最大的 7 个基准测试中,贡献了 90% 的收益。数据来自 Navarro-Torres 等人(2019)。图中蓝色柱与橙色折线分别表示“开启预取时的 CPI / 关闭预取时的 CPI”和“开启预取时的 MPKI3 / 关闭预取时的 MPKI3”;纵轴为相应比值。
译注: 原图图例使用 MPKI3,图注却写作 MKPI3,纵轴还写作 MKI3,均指 L3 的每千条指令未命中次数。图注说有 15 个基准测试,图中实际列出了 17 个名称。
第九项优化:由编译器控制预取,降低未命中开销或未命中率
硬件预取之外的另一种办法,是由编译器插入预取指令,在处理器需要数据之前发出请求。预取分为两类:
- 寄存器预取(register prefetch):将值加载到寄存器中。
- 缓存预取(cache prefetch):只将数据加载到缓存中,不加载到寄存器中。
两者都可以采用会引发异常或不会引发异常的形式(faulting 或 nonfaulting);也就是说,地址出现虚拟地址错误或违反保护规则时,可以引发异常,也可以不引发异常。不会引发异常的预取如果遇到原本应产生异常的情形,就退化为空操作,这正是我们所希望的行为。
最有效的预取对程序在“语义上不可见”:不改变寄存器和内存的内容,也不会引起虚拟内存异常。今天的大多数处理器都提供不会引发异常的缓存预取。本节假定采用这种预取,也称为 nonbinding prefetch。
只有处理器在预取数据时能够继续执行,预取才有意义;也就是说,缓存不能停顿,而应在等待预取数据返回时继续提供指令和数据。正如你可能已经想到的,这类计算机的数据缓存通常是非阻塞的。
与硬件控制的预取一样,目标是使程序执行与数据预取重叠。循环很适合做预取优化,因此是重点。如果未命中开销较小,编译器只需将循环展开一两次,再将预取与执行调度在一起。如果未命中开销较大,就采用软件流水线(见附录 H),或者将循环展开多次,为未来的迭代预取数据。
不过,发射预取指令本身会带来指令开销,因此编译器必须确保这些开销不超过收益。通过把注意力集中于很可能发生缓存未命中的访问,程序既可以避免不必要的预取,又能显著改善平均内存访问时间。
例题:识别并预取可能未命中的数据
对于以下代码,判断哪些访问可能引发数据缓存未命中,然后插入预取指令以减少未命中,最后计算所执行的预取指令数及预取所避免的未命中次数。假设有一个容量为 8 KiB、块大小为 16 字节的直接映射数据缓存,采用写回和写分配策略。a 和 b 是双精度浮点数组,每个元素占 8 字节;a 有 3 行、100 列,b 有 101 行、3 列。程序开始时,两数组都不在缓存中。
解答。 编译器首先确定哪些访问可能引起缓存未命中,否则就会浪费时间,为本来能够命中的数据发射预取指令。a 的元素按照它们在内存中的存放顺序写入,因此 a 能受益于空间局部性:j 为偶数时未命中,为奇数时命中。a 有 3 行、100 列,因此这些访问将产生 次未命中。
b 的访问顺序与存放顺序不同,因此不能受益于空间局部性。不过,b 可以在两个层面受益于时间局部性:每次 i 的迭代都会访问相同元素,而每次 j 的迭代又会使用上一次迭代用过的 b 值。忽略可能发生的冲突未命中,b 的未命中发生于 i=0 时的 b[j + 1][0] 访问,以及 j=0 时对 b[j][0] 的第一次访问。i=0 时 j 从 0 变化到 99,因此 b 的访问产生 次未命中。
这样,循环对 a 产生约 150 次数据缓存未命中,对 b 产生 101 次,共 251 次。
为简化优化,我们不考虑预取循环最开始访问的元素。这些元素可能已经在缓存中;否则,就为 a 或 b 的前几个元素付出未命中开销。我们也不考虑抑制循环末尾越过 a 末端(a[i][100] 至 a[i][106])以及 b 末端(b[101][0] 至 b[107][0])的预取。如果预取可能引发异常,就不能如此处理。假设未命中开销很大,至少需要提前 7 次迭代开始预取;换句话说,假定预取直到第 8 次迭代才开始带来收益。下面列出加入预取后的代码,原书以加下划线的方式标示修改。
修改后的代码预取了 a[i][7] 至 a[i][99],以及 b[7][0] 至 b[100][0],将未获预取覆盖的未命中减少为:
- 第一个循环中,元素
b[0][0]、b[1][0]、……、b[6][0]产生 7 次未命中。 - 第一个循环中,元素
a[0][0]、a[0][1]、……、a[0][6]产生 4 次()未命中;空间局部性使每个 16 字节缓存块只发生一次未命中。 - 第二个循环中,元素
a[1][0]、a[1][1]、……、a[1][6]产生 4 次()未命中。 - 第二个循环中,元素
a[2][0]、a[2][1]、……、a[2][6]产生 4 次()未命中。
合计为 19 次未获预取覆盖的未命中。避免 232 次缓存未命中的代价是执行 400 条预取指令,这很可能是值得的。
例题:计算预取节省的时间
计算前例节省的时间。忽略指令缓存未命中,并假定数据缓存没有冲突未命中或容量未命中。假定预取可以彼此重叠,也可以与缓存未命中重叠,因而能够以最大内存带宽传输数据。忽略缓存未命中时,各循环的关键执行时间如下:原循环每次迭代用 7 个时钟周期,第一个预取循环每次用 9 个时钟周期,第二个预取循环每次用 8 个时钟周期,其中包含外层 for 循环的开销。一次未命中用 100 个时钟周期。
解答。 原来的双重循环共执行 次乘法。每次迭代用 7 个时钟周期,因此不计缓存未命中时为 个时钟周期。缓存未命中再增加 个时钟周期,总计 27,200 个时钟周期。
第一个预取循环迭代 100 次,每次 9 个时钟周期,共 900 个时钟周期;再加上缓存未命中的 个时钟周期,总计 2000 个时钟周期。第二个循环执行 次,每次 8 个时钟周期,共 1600 个时钟周期;加上缓存未命中的 个时钟周期,总计 2400 个时钟周期。
由前例可知,两个循环总共执行 个时钟周期,期间执行 400 条预取指令。如果预取能够与其余执行过程完全重叠,那么预取版本的加速比就是 ,约为 6.2。
虽然数组优化容易理解,现代程序却更常使用指针。Luk 和 Mowry(1999)证明,编译器预取有时也可以扩展到指针。在 10 个使用递归数据结构的程序中,访问节点时预取所有指针,使其中一半程序的性能提高了 4%~31%;其余程序的性能变化则仍在原性能的 2% 以内。关键既在于预取的数据是否已经位于缓存中,也在于预取是否足够早,能够使数据在需要时及时到达。
许多处理器支持缓存预取指令;高端处理器,例如 Intel Core i7 和 i9,通常还会在硬件中进行某种形式的自动预取。
第十项优化:用多条内存总线和多个内存模块提高带宽
桌面高性能处理器,例如 Intel i9 和 AMD Ryzen,服务器处理器,例如 Intel Xeon 和 IBM Power 系列,以及面向图形或深度学习的领域专用处理器,往往利用多个内存通道来增加可用内存带宽。多个通道允许独立访问,因此还能避免一次访问阻塞另一次访问,有效降低未命中开销。
有了多条内存总线,就可以考虑设计两种总线结构不同的内存通道,将 SDRAM 和 HBM 组合使用。这种搭配可以利用 HBM 的速度和带宽优势——HBM 的信号传输约定不同于普通 SDRAM——同时又不必将内存总容量限制在少数几个 HBM 堆叠所能提供的规模。以这种方式使用不同类型的内存,会形成 NUMA(原文展开为 NonUniform Memory Architecture,非均匀内存体系结构);要利用这一能力,就需要将关键数据放入更快的 HBM 内存。对于领域专用处理器,这通常由软件控制,并且往往需要领域专用语言来指导软件分配数据,以及在不同内存之间搬移数据(见第 7 章)。
除了显式管理 NUMA,也可以将 HBM 用作缓存;最新的 Intel 和 AMD 处理器也支持这种方式。
HBM 缓存实际上相当于新增的 L4 或末级缓存(LLC),其容量可以达到最大片上 L3 缓存的 10 倍或更多。不过,如此大的 DRAM 缓存带来一个问题:标签放在哪里?答案取决于标签数量。假设块大小为 64 字节,那么 1 GiB 的 L4 缓存需要 96 MiB 标签——大致相当于一个大型多核处理器全部缓存所使用的 SRAM 容量!增大块可以减少标签数量,但过大的块也可能提高未命中率,尤其是冲突未命中和一致性未命中(原文为 consistency misses)。
如果把 LLC 的标签放在 HBM 中,而不是片上,就可以采用更小的块和更多的标签。乍看之下,这似乎行不通,因为每次访问 L4 都需要两次 DRAM 访问:一次读标签,一次读数据。Loh 和 Hill(2011)提出了一个巧妙方案,本书称为 L-H 方案:将标签与数据放在 HBM SDRAM 的同一行中。虽然打开一行,以及随后关闭它,要花费较长时间,但访问该行另一部分的 CAS 延迟,约为访问新行耗时的三分之一。因此,可以先访问块的标签部分;若命中,再通过一次列访问选出正确的字。
Qureshi 和 Loh(2012)提出了一种称为 Alloy Cache 的改进,以缩短命中时间。它将标签和数据组合在一起,并采用直接映射结构。这样就可以直接索引 HBM 缓存,以突发传输同时读出标签和数据,将 LLC 的访问时间缩短为一个 HBM 周期。
与 L-H 方案相比,Alloy Cache 的命中时间缩短至不足一半,代价是未命中率增加到原来的 1.1~1.2 倍。
遗憾的是,两种方案在未命中时都需要两次完整的 DRAM 访问:先读出标签,再访问速度更慢的主存。图 2.16 给出了按 SPECRate 方式运行 10 个内存密集型 SPECCPU2006 基准测试时获得的加速比。Alloy Cache 增加了一个小型未命中预测器,尝试在预测会未命中时跳过最初的 HBM 访问。有了这一改进,Alloy Cache 的性能超过了 L-H 方案,甚至超过了并不实际可行的 SRAM 标签方案:预测器访问速度快,预测效果又好,因此能够更快判断未命中,降低未命中开销。Alloy Cache 的性能接近 Ideal 情形,也就是未命中预测完全准确、命中时间最短的 LLC。
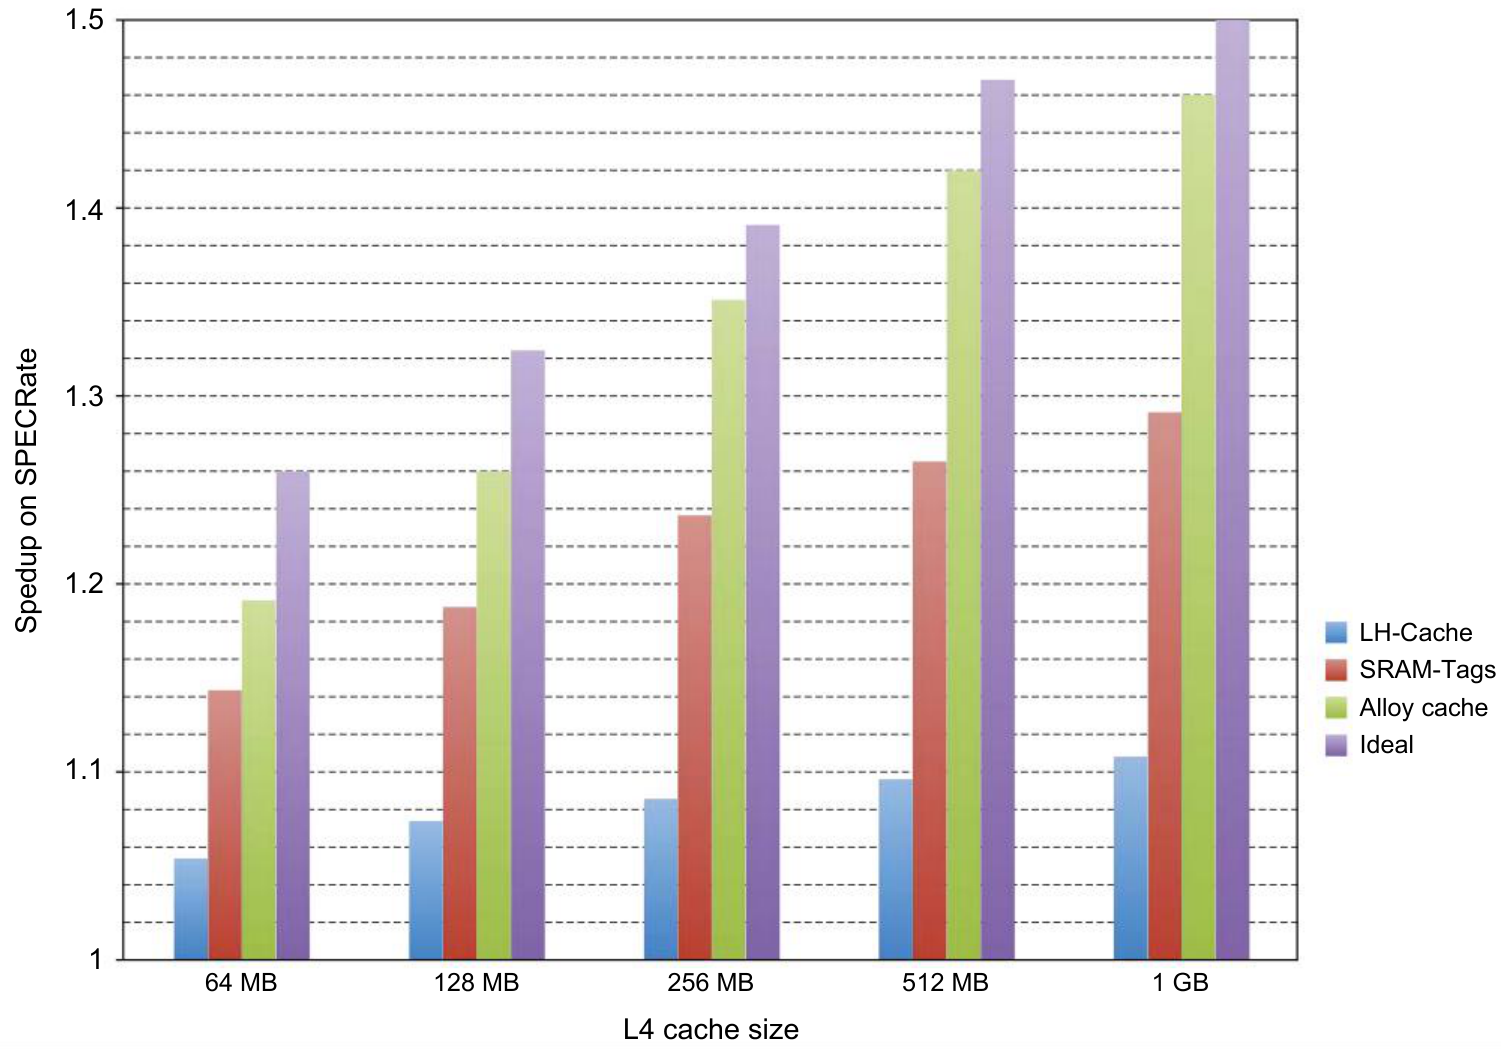
图 2.16(续)。 加速比为 1 表示 L4 LLC 未带来改善;如果 L4 完美无缺且访问不耗时,则能够达到加速比 2。测试使用内存访问最密集的 10 个 SPECCPI2006 基准测试,每个运行 8 次,并采用相应的未命中预测机制。Ideal 假定 LLC 只需访问和传输所请求的 64 字节块,且 LLC 的预测完全准确,即所有未命中都能以零成本预先获知。图中横轴为 L4 缓存容量,纵轴为 SPECRate 加速比;LH-Cache、SRAM-Tags、Alloy cache、Ideal 分别对应上述四种方案。
译注: 图 2.16 的原图注写作 SPECCPI2006,而前面的正文写作 SPECCPU2006。
HBM 很可能广泛用于多种不同配置:既可以作为某些高性能专用系统的全部内存,也可以作为多内存总线设计中的一部分内存,还可以充当 LLC 缓存。
存储层次结构优化小结
改善命中时间、带宽、未命中开销和未命中率的技术,通常也会影响平均内存访问时间公式中的其他部分,以及存储层次结构的复杂程度。图 2.17 汇总了这些技术,并估计了它们对复杂度的影响。
| 技术 | 命中时间 | 带宽 | 未命中开销 | 未命中率 | 功耗 | 硬件成本/复杂度 | 说明 |
|---|---|---|---|---|---|---|---|
| 小而简单的缓存 | + | − | + | 0 | 很简单;广泛使用 | ||
| 路预测缓存 | + | + | 1 | Pentium 4 使用 | |||
| 流水线化与多存储体缓存 | − | + | 1 | 广泛使用 | |||
| 非阻塞缓存 | + | + | 3 | 广泛使用 | |||
| 关键字优先与提前重启 | + | 2 | 广泛使用 | ||||
| 合并写缓冲区 | + | 1 | 在直写缓存中广泛使用 | ||||
| 降低缓存未命中的编译器技术 | + | 0 | 软件实现有挑战,但许多编译器能处理常见线性代数计算 | ||||
| 硬件预取指令和数据 | + | + | − | 指令:2;数据:3 | 大多数处理器提供预取指令;现代高端处理器还在硬件中自动预取 | ||
| 编译器控制的预取 | + | + | 3 | 需要非阻塞缓存;可能增加指令开销;许多 CPU 使用 | |||
| 用 HBM 增加一级缓存 | +/− | − | + | + | 3 | 依赖新的封装技术;效果高度依赖命中率的改善 |
图 2.17(续)。 一种技术通常只改善一个因素;但如果足够早地预取,就能减少未命中,否则也可以降低未命中开销。+表示改善该因素,−表示使该因素变差,空白表示没有影响。复杂度是主观评价,0 表示最容易,3 表示较有挑战。
表中的+表示该技术改善相应因素,−表示使相应因素变差,空白表示没有影响。一般来说,没有哪一种技术能改善一个以上的类别。
译注: 原文正文与图注在此使用“1、2、64 次命中”的说法,但图例为 Hit-under-1-miss、Hit-under-2-misses、Hit-under-64-misses。数字在图例中修饰未完成未命中数量,详见图后说明。 ↩︎
2.4 虚拟内存与保护
附录 B 的 B.4 节介绍了虚拟内存的关键概念。回顾一下,虚拟内存允许将物理内存视为辅助存储器的缓存;辅助存储器可以是硬盘,也可以是固态存储。虚拟内存在这两级存储之间搬移页面,就像缓存在不同层级之间搬移块一样。同样,TLB 充当页表的缓存,从而不必每次地址转换都访问内存。虚拟内存还能隔离共享同一物理内存、但拥有不同虚拟地址空间的进程。继续阅读之前,请确保已经理解虚拟内存的这两项功能。
本节进一步关注共享同一处理器的进程之间的保护与隐私问题。安全和隐私是 2025 年信息技术领域最棘手的两项挑战。电子窃密事件频频见诸报道,其中经常涉及信用卡号码清单;人们普遍认为,还有更多事件没有公开。当然,这类问题源于程序错误,使网络攻击者能够访问本不应访问的数据。程序错误不可避免,而在今天复杂的软件系统中,它们出现得相当频繁。因此,研究人员和从业者都在寻找更好的方法,使计算系统更加安全。尽管信息保护并不局限于硬件,在我们看来,真正的安全和隐私很可能既需要系统软件创新,也需要计算机体系结构创新。
本节首先回顾体系结构如何借助虚拟内存实现进程之间的相互保护,然后介绍侧信道攻击如何使信息跨越保护边界泄露。
通过虚拟内存实施保护
以页面为单位的虚拟内存,以及缓存页表项的 TLB,是进程相互保护的主要机制。附录 B 的 B.4 和 B.5 节回顾了虚拟内存,其中详细介绍了 80x86 如何通过分段和分页实现保护。本节只作简要回顾;如果你觉得过于简略,请参阅附录 B 中上述两节。
多道程序设计使多个并发运行的程序共享一台计算机,由此产生了程序之间相互保护、共享资源的需求,以及进程(process)这一概念。打个比方,进程就是程序赖以呼吸的空气和生存的空间:它包含一个正在运行的程序,以及让程序能够继续运行所需的全部状态。在任意时刻,都必须能够从一个进程切换到另一个进程。这称为进程切换(process switch)或上下文切换(context switch)。
操作系统与体系结构共同配合,让进程共享硬件而不相互干扰。为此,体系结构必须在运行用户进程时限制其可访问的内容,同时允许操作系统进程访问更多内容。体系结构至少必须做到以下几点:
- 提供至少两种模式,用于表明当前运行的是用户进程还是操作系统进程。后者有时也称为内核进程(kernel process)或管理进程(supervisor process)。
- 使处理器的一部分状态对用户进程可用,但不允许用户进程写入。这些状态包括用户/管理模式位、异常使能/禁止位,以及内存保护信息。不能让用户写入这些状态,因为如果用户能够自行取得管理权限、禁止异常或改变内存保护,操作系统就无法控制用户进程。
- 提供让处理器从用户模式进入管理模式、以及反向返回的机制。前者通常通过**系统调用(system call)**完成:一条特殊指令把控制权转移到管理程序代码空间中的指定位置,保存系统调用处的 PC,并使处理器进入管理模式。返回用户模式则类似于子程序返回,同时恢复先前的用户/管理模式。
- 提供限制内存访问的机制,以保护进程的内存状态,而不必在每次上下文切换时将进程换出到磁盘。
附录 A 介绍了若干内存保护方案,但迄今最常见的方案,是为每个虚拟内存页面添加保护限制。1 典型大小为 4 KiB、16 KiB 或更大的固定大小页面,经由页表从虚拟地址空间映射到物理地址空间。保护限制包含在每个**页表项(page table entry,PTE)**中,可以规定用户进程是否有权读取该页、写入该页,以及是否可以执行该页中的代码。此外,如果某页不在进程的页表中,进程既不能读它,也不能写它。由于只有操作系统能够更新页表,分页机制提供了完整的访问保护。
分页虚拟内存意味着,从逻辑上说,每次内存访问至少都要花费两倍时间:一次访问取得物理地址,第二次访问取得数据。这个代价实在太高。解决办法仍然依靠局部性原理:如果访问具有局部性,相应的地址转换也必然具有局部性。将地址转换保存在专用缓存中后,一次内存访问就很少需要再访问一次内存来完成地址转换。这种专门的地址转换缓存,传统上称为地址转换后备缓冲区(translation lookaside buffer,TLB)。
TLB 表项类似缓存表项:标签存放虚拟地址的一部分,数据部分存放物理页地址、保护字段、有效位,通常还包括使用位和脏位。操作系统若要修改这些位,先修改页表中的值,再使相应 TLB 表项失效。
当该表项从页表重新装入时,TLB 就取得这些位的准确副本。处理 TLB 未命中的办法,是从页表读取地址信息。随着地址空间不断扩大,页表结构变得更加复杂,处理器引入了专用硬件来处理 TLB 未命中。其方式类似缓存未命中处理,但更加复杂。附录 L 讨论更高级的地址转换技术。
假定计算机忠实遵守页面的访问限制,并正确地将虚拟地址映射到物理地址,似乎事情就解决了。然而,报纸头条却告诉我们并非如此。
问题没有解决,是因为我们不仅依赖硬件正确,还依赖操作系统正确。今天的操作系统由数千万行代码组成。缺陷通常以每千行代码的数量来衡量,因此投入使用的操作系统中存在数千个缺陷。操作系统缺陷形成的漏洞经常被人利用。不过,下一小节将说明,即便存储系统在功能上正确实现了隔离,仍然可能泄露受保护的信息。第 6 章将介绍虚拟机和 enclave 等技术,使程序即便面对有意作恶的操作系统,也能保护高度敏感的数据。遗憾的是,下面介绍的侧信道攻击有时还能绕过这些更强的保护机制。
针对存储系统的侧信道攻击
存储侧信道攻击的共同做法,是扰动存储系统中的某种状态,再利用处理器提供的计时器或性能计数器监测性能,观察扰动的效果。攻击之所以奏效,是因为多个独立进程共享了某些不属于指令集状态的硬件,例如缓存;这些硬件因而没有受到虚拟内存和操作系统通常用于隔离进程的那些机制的保护。
考虑下面这段简单代码:
假设要利用侧信道攻击窥探这段代码,判断 x 是否小于或等于 0。过程分为三步:
- 准备缓存(prime):窥探者将自己的信息写入那些将缓存 if-then-else 两条分支代码的缓存行。
- 让受害者的代码运行一次,这会使 then 分支或 else 分支的代码发生一次未命中。
- 探测缓存(probe):通过访问 P 和 Q,测量访问是命中还是未命中。可以使用精确计时器,也可以使用记录缓存未命中次数的性能计数器。如果 x≤0,就知道原来对应 P 的缓存行已被替换;窥探者再次访问这些缓存行时,就会发生未命中。知道哪些缓存行命中、哪些未命中,就能推断受害者走了哪条执行路径,从而泄露 x 的值的信息。
这个简单例子用不同代码路径区分了我们想知道的关键事实,即 x≤0 是否成立;但从程序行为中推断数据值或执行路径的方法还有很多。为了详细了解另一个进程的内存内容,窥探者可能要重复执行许多次 prime–probe 序列,不过这些操作能够很快完成。此类攻击的关键是:即使虚拟内存系统禁止窥探者直接访问受害者的地址空间,二者仍然共享缓存。
要使 prime–probe 攻击奏效,需要知道受害者代码在内存中的位置,还需要确保受害者代码在准备与探测步骤之间运行,中间没有其他操作。只要执行了其他代码,缓存就可能被扰动,从而大幅削弱攻击效果。窥探者与受害者之间的切换本身需要开销,也就是一次进程切换,因此也可能扰动缓存、降低攻击效果。如果二者在同一多核处理器的不同核上运行,并共享 LLC,攻击就会更容易实施,也更有效。下一章还会说明,多线程会进一步增强此类攻击,因为它让窥探者与受害者更加紧密地共享硬件资源。
这类侧信道攻击有若干缓解办法,可以显著降低信息泄露给窥探者的概率。只要共享任何资源,就几乎不可能阻止所有侧信道攻击;但可以大幅降低泄露速率,使窥探受害者在实际中变得不可行。以下措施能显著提高实施侧信道攻击的难度:
- 随机分配页面。 让攻击者难以判断某段代码会出现在缓存的什么位置。这对采用物理地址的缓存有效,对采用虚拟地址的缓存则无效。遗憾的是,某些操作系统代码可能固定在特定物理地址。另一种做法是,在使用高度敏感的信息之前,先将其复制到随机位置。关键在于切断缓存行为与已知代码或数据之间的联系。
- 扰乱计时。 含有高度敏感信息的关键代码段,可以在执行期间插入短暂的随机延迟。20 世纪 70 年代,人们就曾用类似办法防御最早的一批侧信道密码攻击。
- 在上下文切换时清空缓存,消除隐含的共享。 遗憾的是,这一办法必须覆盖 LLC,代价相当高。
- 划分资源。 如果共享发生在 LLC,可以将其划分为多个区域,分别提供给同时活动的进程。这可能带来显著的性能代价,尤其是对于内存占用较大的应用。大多数面向服务器环境的处理器支持缓存划分。
下一章将说明,引入推测执行和多线程会极大地提高侧信道攻击的带宽,可能达到原来的 100 倍,因此必须采用硬件或软件对策。
译注: 此处原文写“附录 A”,本节前文关于虚拟内存及保护机制的引用则指向附录 B 的 B.4 和 B.5 节。 ↩︎
2.5 贯穿各层的问题:存储层次结构设计
本节讨论五个在其他章节中涉及、又对存储层次结构至关重要的主题。
独立的取指单元
许多乱序执行处理器,甚至一些只是流水线较深的处理器,都会用单独的取指单元将取指,有时还包括初步译码,与后续执行过程解耦(见第 3 章)。取指单元通常从指令缓存取回整个块,再将其译码为单条指令。这种方法对于可变长度指令尤其有用;对于每个时钟周期能够发射不止一条指令的处理器,则是必需的。
由于访问指令缓存时以块为单位,其未命中率就不再适合与每条指令都访问一次指令缓存的处理器直接比较。此外,取指单元可能向 L1 预取块。正如前文所见,预取可能增加未命中次数,却实际降低了总的未命中开销。许多处理器还支持数据预取,同样可能一方面提高数据缓存未命中率,另一方面降低数据缓存的总未命中开销。
专用指令缓存
提供足够的指令带宽,是超标量处理器面临的最大挑战之一。对于将指令转换为微操作的设计,例如最新的 Arm 和 i7 处理器,可以用一个小型缓存保存近期已转换的指令,从而降低指令带宽需求和分支预测错误的开销。下一章将更深入地讨论这项技术。
推测执行与内存访问
高级流水线的一项主要技术是推测执行(speculation):处理器尚不知道一条指令是否确实需要执行,就先尝试执行它。
这类技术依赖分支预测;如果预测错误,就必须从流水线中清除推测执行的指令。支持推测执行的存储系统面临两个不同问题:保护和性能。推测执行可能产生一些最终不会被使用的内存访问,因为相应指令来自错误的推测。如果执行这些访问,就可能引发保护异常。显然,只有指令确实需要执行时,这类异常才应生效。下一章将介绍如何处理这种“推测产生的异常”。
推测执行处理器可能访问指令缓存和数据缓存,随后却不使用访问结果,因此推测执行可能提高缓存未命中率。但与预取一样,它也可能降低总的缓存未命中开销。使用推测执行后,即使指令集体系结构(ISA)和缓存结构完全相同,将其未命中率与没有推测执行的处理器比较,也会产生误导。最后,推测执行还是能够显著提高侧信道攻击泄露速率的一项能力。
缓存数据的一致性
数据可能同时存在于内存和缓存中。只要处理器是唯一读写数据的部件,而且缓存位于处理器与内存之间,处理器读到旧副本或过期副本的风险就很小。我们将看到,多个处理器以及 I/O 设备都可能使数据副本不一致,导致读到错误副本。
多处理器与 I/O 面临缓存一致性问题的频率不同。对于 I/O,出现多个数据副本是少见情形,应尽量避免;但在多个处理器上运行的程序,却希望在多个缓存中拥有同一数据的副本。多处理器程序的性能取决于系统共享数据时的性能。共享数据的一致性和性能,是第 5 章的重要主题。
I/O 缓存一致性的问题是:计算机中的 I/O 应该发生在什么位置,是 I/O 设备与缓存之间,还是 I/O 设备与主存之间?如果输入将数据写入缓存,输出从缓存读取数据,那么 I/O 和处理器看到的就是同一份数据。困难在于,这种做法会干扰处理器,并可能让处理器为 I/O 而停顿。此外,输入的新数据可能短期内不会被访问,却将原有信息挤出缓存,造成缓存干扰。
带缓存的计算机,其 I/O 系统的目标是在避免过期数据问题的同时,尽量减少干扰。因此,许多系统倾向于让 I/O 直接访问主存,把主存作为 I/O 缓冲区。如果采用直写缓存,主存中的信息副本就是最新的,输出也就没有过期数据问题。这一优点正是处理器曾采用直写的原因。不过,今天直写通常只见于一级数据缓存,其后还有采用写回的 L2 缓存。
写缓冲区和写合并给内存映射 I/O 带来了额外复杂性。例如,I/O 寄存器地址不能允许写合并,因为彼此独立的 I/O 寄存器不一定像内存中的字数组那样工作。它们可能要求为每个 I/O 寄存器分别提供一个地址和一个数据字,而不能用一个地址发起多字写入。通常的处理办法,是将这些页面标记为要求缓存采用不可合并的直写方式。
I/O 输入还需要额外注意。软件解决办法是保证输入缓冲区中的任何块都不在缓存中。可以把缓冲区所在的页面标记为不可缓存,让操作系统始终向这类页面输入数据;也可以由操作系统在输入发生前,从缓存中清除缓冲区对应的地址。硬件解决办法是在输入时检查 I/O 地址是否位于缓存中;若匹配,就使相应缓存项失效,避免使用过期数据。对于采用写回缓存的输出,这些办法同样适用。为了在数据中心实现高性能,可能还需要其他办法,将 I/O 融入存储层次结构。第 6 章将探讨这一主题。
通过虚拟机实施保护
**虚拟机(virtual machine,VM)**与虚拟内存有关,而且几乎同样古老。它最初出现于 20 世纪 60 年代末,多年来一直是大型机计算的重要组成部分。虚拟机让共享一台计算机的程序运行各自独立的操作系统版本,从而提供更高层次的程序间保护。虚拟机是当今大型数据中心的关键技术,第 6 章将详细介绍。
虚拟机往往引入影子页表,这会增加 TLB 未命中的代价,因为查找正确地址映射需要经过更复杂的过程。如附录 L 所述,设计者可以加入专用硬件,处理 TLB 未命中时这些更复杂的步骤。
2.6 融会贯通:ARM Cortex-A53 与 Intel Core i9 12900 的存储层次结构
本节介绍 ARM Cortex-A53(以下简称 A53)和 Intel Core i9 12900(以下简称 i9)的存储层次结构,并通过一组单线程基准测试,展示各组成部分的性能。先考察存储系统较简单的 Cortex-A53,再更详细地分析 i9,逐步追踪一次内存访问。本节假定读者熟悉采用虚拟地址索引的两级缓存层次结构。附录 B 详细解释了这种存储系统的基本组成;如果对此还不熟悉,强烈建议先回顾附录 B 的 Opteron 示例。
理解了 Opteron 的组成之后,下面对结构相似的 A53 系统的简要说明就容易掌握了。
ARM Cortex-A53
Cortex-A53 是一种可配置的核,支持同时包含 32 位和 64 位模式的 ARMv8A ISA。它以 IP(intellectual property,知识产权)核的形式交付。在嵌入式系统、PMD 及相关市场中,IP 核是主要的技术交付形式;数十亿颗 ARM、MIPS 和 RISC-V 处理器就是基于这些 IP 核制造的。注意,IP 核与 Intel i7 或 AMD Athlon 多核处理器中的“核”不是同一概念。IP 核本身也可以是多核结构,它的设计目标是与其他逻辑集成,包括专用处理器(如视频编码器或解码器)、I/O 接口和内存接口,然后制造出针对特定应用优化的处理器;从这个意义上说,它是芯片的核心。例如,Cortex-A53 IP 核用于多种平板电脑和智能手机,其设计高度重视能效,这是电池供电 PMD 的关键指标。A53 核非常普及,可以在一个芯片上配置多个核,用于高端 PMD;这里的讨论聚焦于单核。
IP 核通常分为两种。**硬核(hard core)**针对某个半导体厂商优化,是一个通过外部接口与其他部分连接的黑盒;这些接口仍位于芯片内部。硬核通常只允许参数化配置核外的逻辑,例如 L2 缓存容量,IP 核本身不能修改。**软核(soft core)**通常以使用标准逻辑单元库的形式交付,可以面向不同半导体厂商进行编译,也可以修改。不过,现代 IP 核十分复杂,大幅修改仍然很困难。通常,硬核具有更高的性能和更小的裸片面积,而软核能够移植到其他厂商的工艺,并且更容易修改。
Cortex-A53 每个时钟周期可以发射两条指令,时钟频率最高为 1.3 GHz。它支持两级 TLB 和两级缓存;图 2.18 汇总了存储层次结构。发生未命中时,先返回关键字;其余未命中处理尚未结束,处理器便可以继续执行。系统最多支持 4 个存储体。当数据缓存容量为 32 KiB、页大小为 4 KiB 时,每个物理页可能映射到两个不同的缓存地址,因为缓存索引占 7 位,块内偏移占 6 位,两者之和比页内偏移多 1 位。附录 B 的 B.3 节介绍了如何在未命中时通过硬件检测避免这类别名。图 2.19 展示 32 位虚拟地址如何索引 TLB 和缓存,正文假定一级缓存为 32 KiB、二级缓存为 1 MiB、页大小为 16 KiB。
| 结构 | 容量 | 组成 | 典型未命中开销(时钟周期) |
|---|---|---|---|
| 指令 MicroTLB | 10 项 | 全相联 | 2 |
| 数据 MicroTLB | 10 项 | 全相联 | 2 |
| L2 统一 TLB | 512 项 | 四路组相联 | 20 |
| L1 指令缓存 | 8~64 KiB | 两路组相联;64 字节块 | 13 |
| L1 数据缓存 | 8~64 KiB | 两路组相联;64 字节块 | 13 |
| L2 统一缓存 | 128 KiB~2 MiB | 16 路组相联;LRU | 124 |
图 2.18(续)。 页映射缓存(page map cache)记录一组虚拟页对应的物理页位置,以降低 L2 TLB 未命中开销。L1 缓存采用虚拟地址索引、物理地址标签;L1 数据缓存和 L2 均采用写回策略,默认在写入时分配。所有缓存的替换策略都是近似 LRU。如果 MicroTLB 和 L1 同时未命中,到 L2 的未命中开销会更高。L2 到主存的总线宽度为 64~128 位,较窄的总线带来的未命中开销更大。
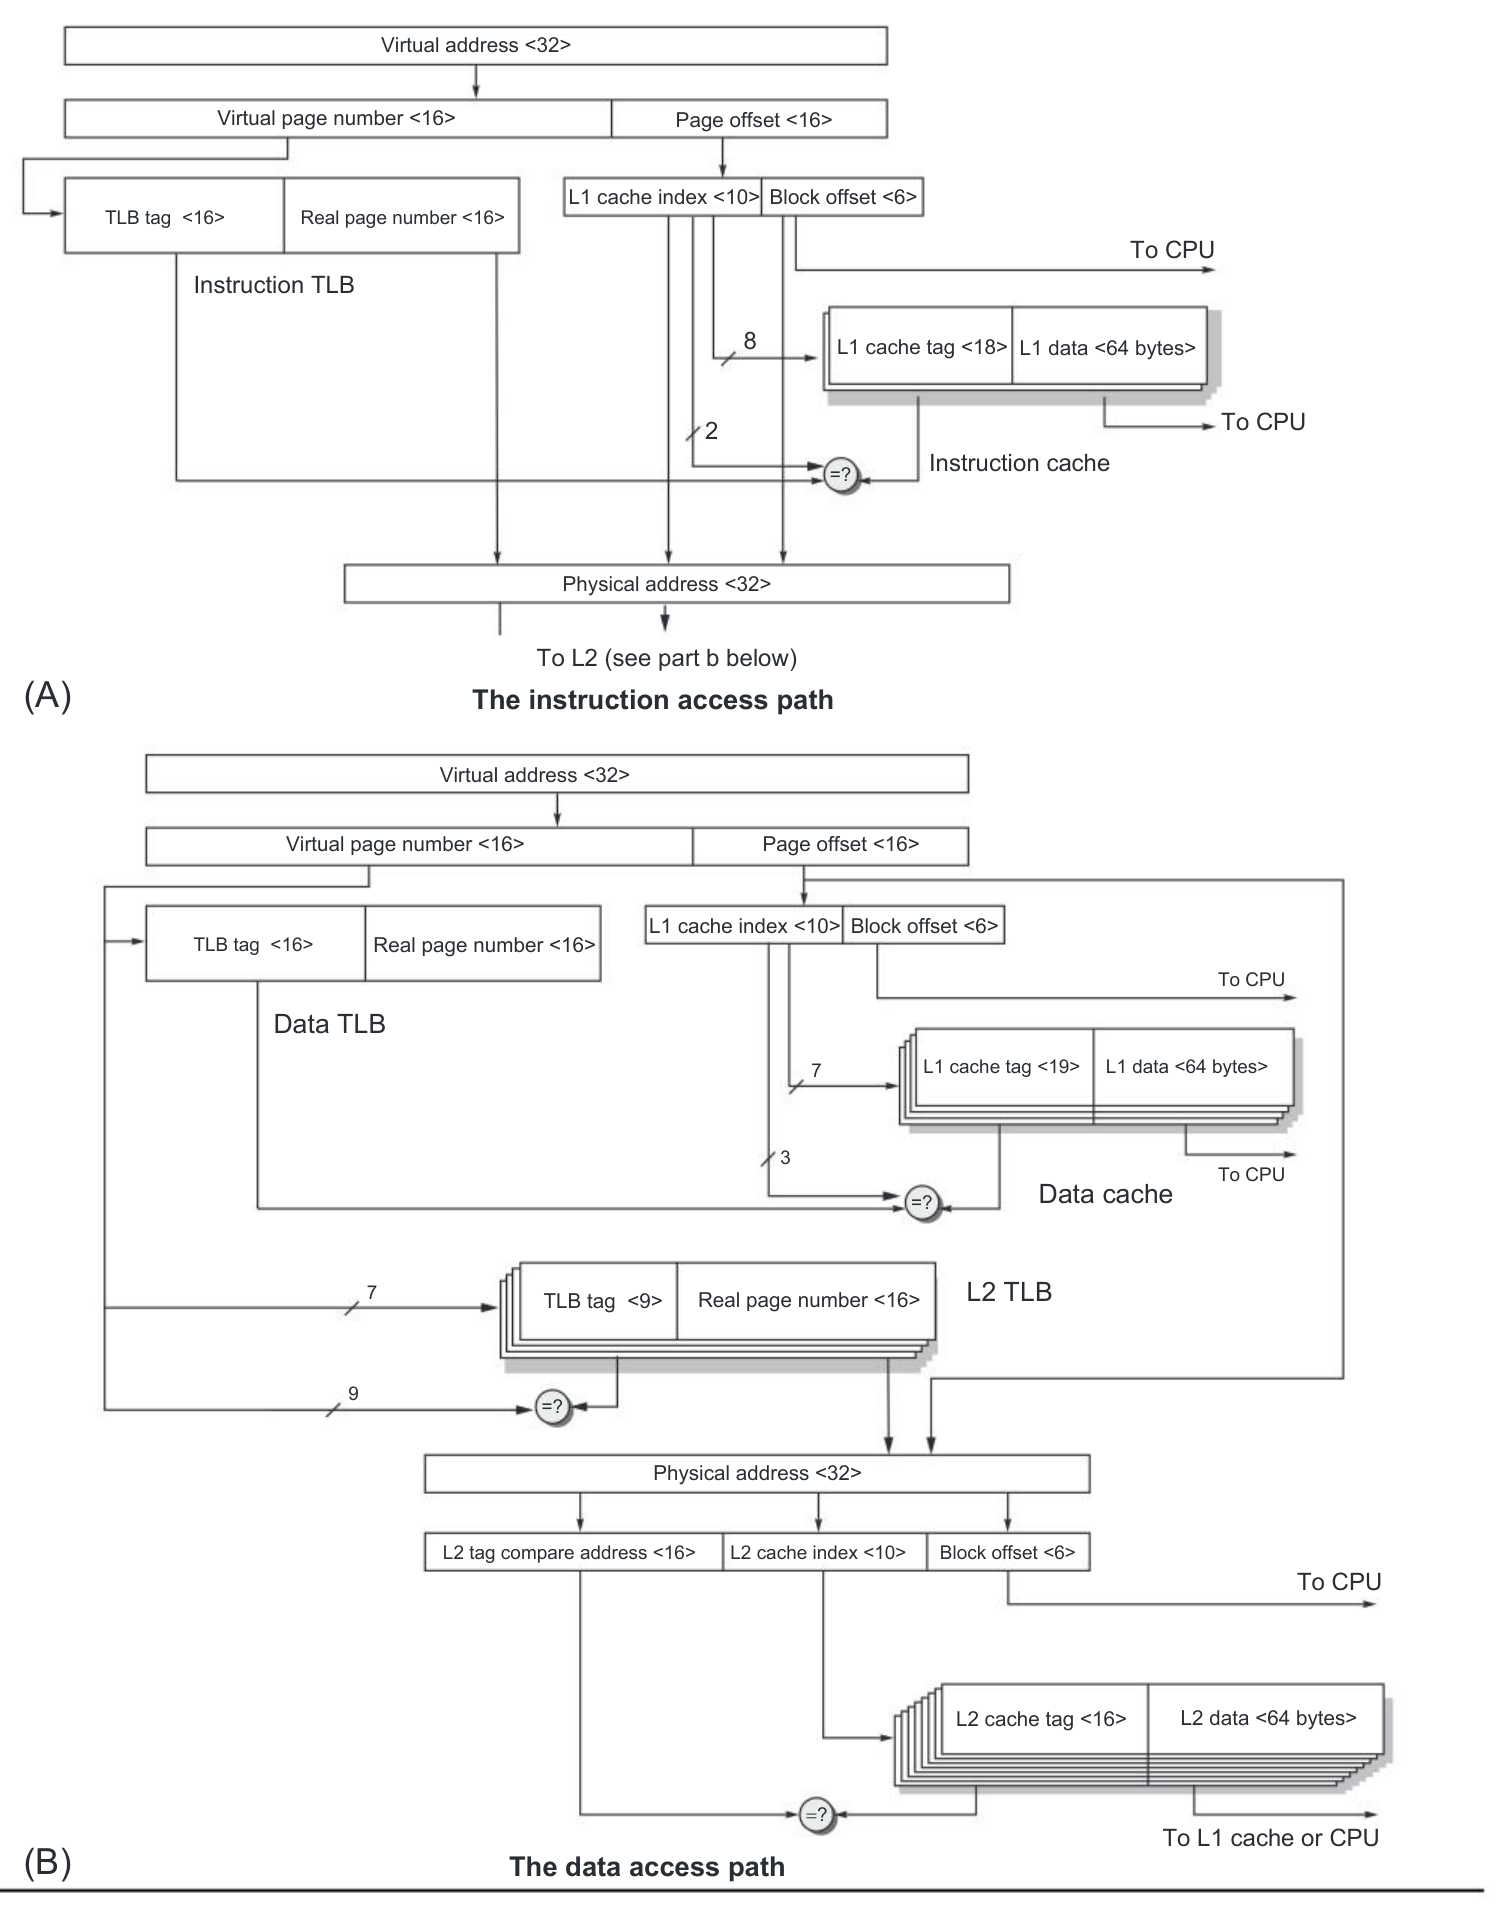
图 2.19(续)。 上半部分 A 为指令访问,下半部分 B 为数据访问,包括 L2。指令 TLB 和数据 TLB 都是全相联结构,各有 10 项;本图示例使用 64 KiB 页面。L1 指令缓存为两路组相联,块大小 64 字节,容量 32 KiB;L1 数据缓存容量 32 KiB,四路组相联,块大小 64 字节。L2 TLB 有 512 项,四路组相联。L2 缓存为 16 路组相联,块大小 64 字节,容量范围原图注写作 128 cKiB~2 MiB;图中画出的是 1 MiB L2。图中省略了缓存和 TLB 的有效位及保护位。
图内术语对照:Virtual address=虚拟地址;Physical address=物理地址;Virtual page number=虚拟页号;Real page number=物理页号;Page offset=页内偏移;Block offset=块内偏移;cache index=缓存索引;cache tag=缓存标签;L2 tag compare address=用于 L2 标签比较的地址;Instruction/Data TLB=指令/数据 TLB;Instruction/Data cache=指令/数据缓存;To CPU=送往 CPU;To L2=送往 L2;To L1 cache or CPU=送往 L1 缓存或 CPU。尖括号中的数字表示位数,标有 bytes 的数据字段表示字节数;“=?”为相等比较。
译注: 原正文写页大小为 16 KiB,图 2.19 的图注和图内 16 位页内偏移对应的却是 64 KiB。图 2.18 把 L1 数据缓存列为两路组相联,图 2.19 则写四路;图中 7 位索引与 6 位块内偏移,也与 32 KiB、四路组相联数据缓存相符。原图注中的“cKiB”并非常规容量单位。
Cortex-A53 存储层次结构的性能
原文对 Cortex-A8 的存储层次结构进行测量,配置为 32 KiB 一级缓存和 1 MiB L2 缓存,运行 SPECInt2006 基准测试。1
这些 SPECInt2006 程序的指令缓存未命中率很低,即使只看 L1 也是如此:大多数接近零,全部低于 1%。这可能是因为 SPECCPU 程序偏重计算,而两路组相联缓存又消除了大多数冲突未命中。
图 2.20 给出了数据缓存结果,其 L1 和 L2 未命中率都不可忽视。L1 未命中率从 0.5% 到 37.3%,相差约 75 倍,中位数为 2.4%。L2 全局未命中率从 0.05% 到 9.0%,相差 180 倍,中位数为 0.3%。素有“缓存克星”之称的 MCF 达到了上限,并显著影响均值。请记住,L2 全局未命中率远低于 L2 局部未命中率;例如,单独考察 L2 时,未命中率的中位数为 15.1%,而全局未命中率的中位数只有 0.3%。
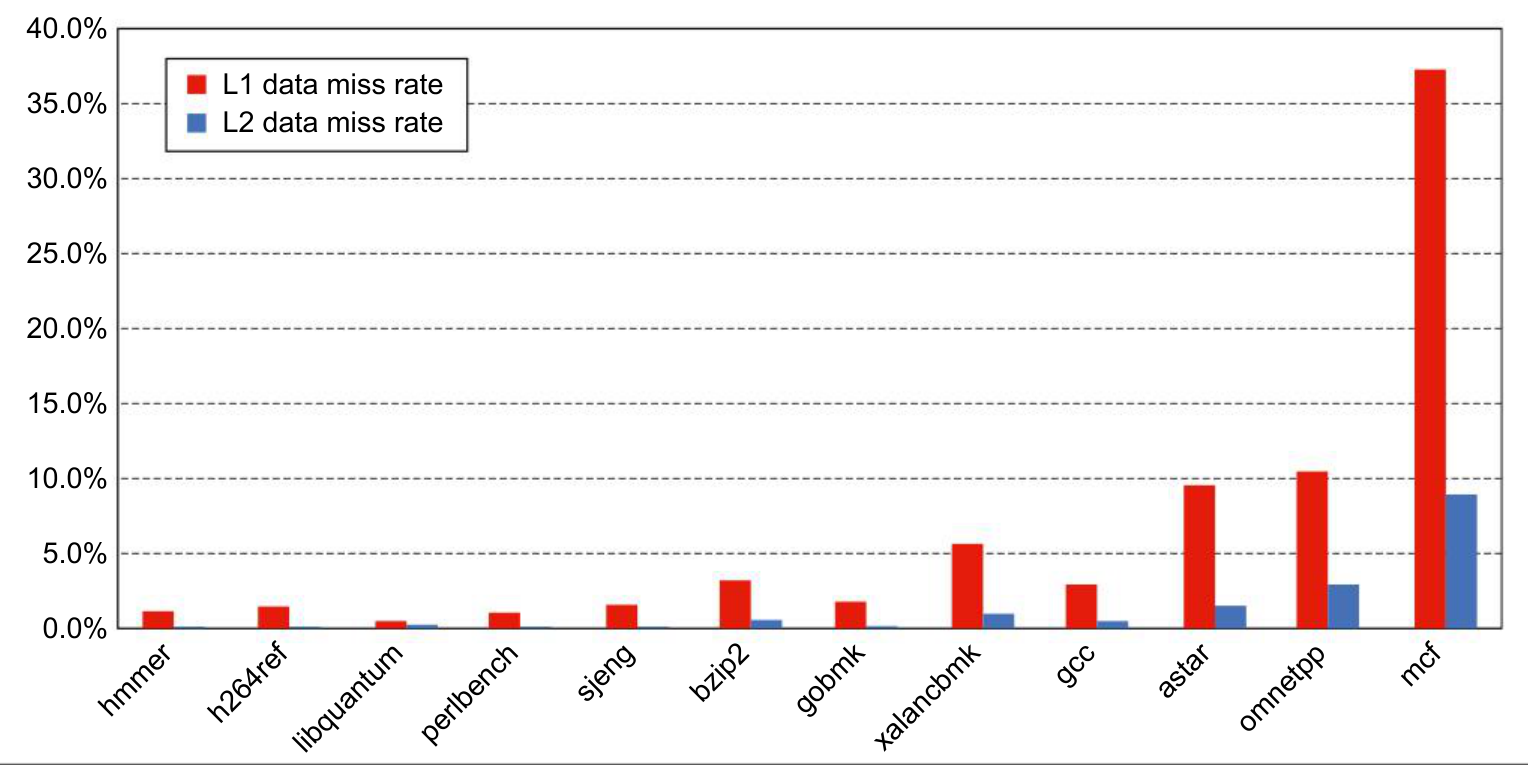
图 2.20(续)。 内存占用较大的应用,往往在 L1 和 L2 中都有较高的未命中率。注意,L2 的指标是以全部访问为分母的全局未命中率,包括在 L1 命中的访问。MCF 素有“缓存克星”之称。红柱表示 L1 数据未命中率,蓝柱表示 L2 数据全局未命中率。
使用这些未命中开销
采用图 2.18 中的未命中开销,可以得到图 2.21 所示的每次数据访问平均开销。虽然 L1 的未命中率约为 L2 的 7 倍,但 L2 的未命中开销是 L1 的 9.5 倍,因此对于给存储系统带来较大压力的基准测试,L2 未命中的影响略占上风。下一章将考察缓存未命中对总体 CPI 的影响。
图 2.21(续)。 尽管 L1 未命中率明显较高,但 L2 未命中开销超过 L1 的 5 倍,因此 L2 未命中仍可能产生显著影响。纵轴为每次数据访问的未命中开销;蓝色为 L1 数据平均内存开销,红色为 L2 数据平均内存开销。
Intel Core i9
i9 支持 x86-64 ISA,也就是 80x86 体系结构的 64 位扩展。采用 Alder Lake 微体系结构的 i9 12900 属于 big.little 设计,组合了两类核:8 个性能核(P-core)和 8 个能效核(E-core)。P 核时钟频率更高,并支持多线程(见第 3 章)。本章从单个 P 核的角度,讨论存储系统的设计与性能。
i9 的流水线和多线程性能将在第 3 章探讨,多处理器性能将在第 5 章考察。
i9 的每个核采用多发射、动态调度的 16 级流水线,每个时钟周期最多执行 4 条 80x86 指令;第 3 章将详细介绍。在 2024 年,最快的 i9 在 Turbo Boost 模式下,单个 P 核的时钟频率达到 5.1 GHz。当然,i9 不能让多个 P 核同时在 Turbo Boost 模式下工作而不发生过热。
i9 支持两个内存通道,每个通道连接各自的一组 DIMM,并可采用 DDR4 或 DDR5 并行传输。使用 DDR5-4800 时,最大内存带宽为 77 GB/s。
i9 使用 48 位虚拟地址和 36 位物理地址,原文据此给出的最大物理内存为 36 GiB。2 内存管理采用两级 TLB,见附录 B 的 B.4 节;图 2.22 汇总了相关参数。
| 特性 | 指令 TLB | 数据 DLB(原表列名) | 二级 TLB |
|---|---|---|---|
| 表项数 | 256 项,4 KiB 页面;32 项,2/4 MiB 页面 | 96 项,4 KiB 页面;32 项,2/4 MiB 页面;8 项,1 GiB 页面 | 2048 项,用于 4 KiB、2 MiB 和 1 GiB 页面 |
| 相联度 | 8 路 | 6 路、4 路、8 路 | 16 路 |
| 替换策略 | 伪 LRU | 伪 LRU | 伪 LRU |
| 访问延迟 | 1 个周期 | 1 个周期 | 8 个周期 |
| 未命中 | 8 个周期 | 8 个周期 | 访问页表需数十至数百个周期 |
图 2.22(续)。 一级 TLB 支持标准 4 KiB 页大小,并为其他页大小设置独立 TLB。数据 TLB 还包含分别用于加载和存储的小型 TLB。i9 可以用硬件页表遍历器并行处理 4 个 L2 TLB 未命中。关于多级 TLB、多种页大小支持以及硬件 TLB 未命中处理器的进一步讨论,请参阅在线附录 L。
译注: 原表将数据 TLB 列名拼为 Data DLB;表内参数及图注仍在讨论数据 TLB。
图 2.23 汇总了 i9 的三级缓存层次结构。一级缓存采用虚拟地址索引和物理地址标签,见附录 B 的 B.3 节;L2 和 L3 采用物理地址索引。与早期 Skylake 微体系结构相比,最新的高端处理器选择显著增大 L2,达到原来的 2~4 倍,而 L3 容量的增幅较小。这样一来,全部 L2 的总容量与 L3 总容量更为接近,因此设计者决定让 L3 采用**非包含式(noninclusive)**结构。某些版本的 i9 将支持采用 HBM 封装的四级缓存。
| 特性 | L1 指令缓存 | L1 数据缓存 | L2 | L2(原表末列) |
|---|---|---|---|---|
| 容量 | 32 KiB | 48 KiB;双端口;8 个存储体 | 每核 1.25 MiB | 所有核共享 30 MiB;非包含式 |
| 相联度 | 8 路 | 6 路 | 10 路 | 15 路 |
| 访问延迟 | 4 个周期 | 5 个周期 | 15 个周期 | 50 个周期 |
| 替换策略 | 伪 LRU | 伪 LRU | 加权 n 位 LRU | 加权 n 位 LRU |
图 2.23(续)。 三级缓存都采用写回和 64 字节块。L1 和 L2 为每核私有,L3 则由芯片上的各核共享。L3 在物理上分布为靠近各核的多个存储体,以简单的散列函数将地址分配到 L3 存储体。三级缓存都是非阻塞的,允许多个未完成写请求。L1 使用合并写缓冲区;如果写入时相应缓存行不在 L1,就将数据暂存其中,即 L1 写未命中不会分配缓存行。L3 是非包含式的,这使全部 L2 与 L3 合起来能够容纳的数据量超过 L3 容量;包含式 L3 则做不到这一点。非包含性对缓存一致性的影响将在第 5 章讨论。替换策略采用伪 LRU 与近似 LRU 的变体:L1 使用单个位,即一种 NRU 形式;L2 和 L3 使用多位方案。
译注: 原表最后两列均写作 L2;根据本表图注以及紧邻正文,最后一列实际讨论 L3。译表保留原列名,并明确指出这一差异。
图 2.24 标出了访问存储层次结构的各个步骤,假定页大小为 4 KiB。首先,将 PC 送到指令缓存。指令缓存索引的计算为:
因此需要 6 位索引。指令地址中的页号部分为 位,送到指令 TLB(步骤 1);与此同时,虚拟地址的 12 位页内偏移送到指令缓存(步骤 2)。注意,八路组相联的指令缓存恰好需要 12 位缓存地址:6 位索引,加上 64 字节块所需的 6 位块内偏移,因此不可能出现别名。
早期 i7 的指令缓存采用四路组相联,一个虚拟地址所对应的块可能出现在缓存中的两个位置,因为相应物理地址在这一位上可能为 0,也可能为 1。对于指令,这并不构成问题:即使同一条指令出现在缓存的两个位置,两个版本也必然相同。如果允许数据以这种方式重复存在,也就是出现别名,那么修改页映射时就必须检查缓存;不过,页映射修改并不频繁。只需采用一种很简单的**页着色(page coloring)**办法,见附录 B 的 B.3 节,就能消除这类别名的可能性:把偶数页号的虚拟页映射到偶数页号的物理页,奇数页同理。这样,虚拟页号与物理页号的最低位始终一致,便不会产生别名。
图 2.24(续)。 图中只画出读取操作,以及用于 4 KiB 页面的一级 TLB。写入过程类似,但由于 L1 缓存不采用写分配,写未命中只需将数据放入写缓冲区。系统包含多个数据 TLB,指令和数据 TLB 还都支持大页面。
图内术语对照:Virtual page number/Data virtual page number=虚拟页号/数据虚拟页号;Page offset=页内偏移;Physical address=物理地址;Tag=标签;Index=索引;Block offset=块内偏移;Prot=保护字段;V=有效位;D=脏位;PTEs=页表项;mux=多路选择器;Instruction=指令;Data/Data in=数据/写入数据;I/D CACHE=指令/数据缓存;I/D TLB=指令/数据 TLB;MAIN MEMORY=主存;Memory Interface=内存接口;blocks per set=每组的块数;banks=存储体。圆圈中的数字对应正文的访问步骤,尖括号中的数字表示位数。
译注: 本图多处标注与相邻正文及图 2.23 的参数不一致。例如,L2 在图内使用 16∶1 选择器、10 位索引,并标有“4 个存储体中 4K 个块”,而正文使用 10 路、11 位索引和 1.25 MiB;L3 图内写“16 个存储体中 128K 个块”,使用 16∶1 选择器和 13 位索引,而正文采用 8 个存储体、15 路、12 位索引、30 MiB。图内还有标签位宽和数据缓存块数的不一致。这些原图参数按原样保留,不能将图与正文视作一套完全一致的实现参数。
访问指令 TLB,寻找与地址匹配的有效 PTE(步骤 3 和 4)。TLB 除了转换地址,还检查 PTE 的保护要求,判断本次访问是否因违反访问权限而应引发异常。
指令 TLB 未命中时,先访问 L2 TLB,也称 STLB。它包含 2048 个用于 4 KiB 页面的 PTE,采用 16 路组相联结构。从 L2 TLB 装入 L1 TLB 需要 8 个时钟周期,加上最初访问 L1 TLB 的一个周期,共形成 9 个周期的未命中开销。如果 L2 TLB 也未命中,则由硬件算法遍历页表,更新 TLB 表项。在线附录 L 的 L.5 和 L.6 节介绍了页表遍历器与页结构缓存。
最坏情况下,页面不在内存中,需要操作系统从辅助存储器读入。处理一次缺页期间,处理器原本能够执行数百万条指令,因此只要有其他进程等待运行,操作系统就会换入另一个进程。如果没有 TLB 异常,则继续访问指令缓存。
地址的索引字段送往指令缓存全部 8 个存储体(步骤 5)。指令缓存标签为 位,即物理地址减去 6 位索引和 6 位块内偏移。原文随后将“四个标签和有效位”与指令 TLB 提供的物理页框进行比较(步骤 6)。i9 每次取指需要 32 字节,因此再从 6 位块内偏移中取 1 位,选择所需的 32 字节。原文据此写道:“6+1,也就是 87 位”,用于选择并向处理器发送 32 字节指令。3 L1 缓存采用流水线结构,命中延迟为 4 个时钟周期(步骤 7);未命中则访问二级缓存。
前文提到,指令缓存采用虚拟地址寻址和物理地址标签。二级缓存采用物理地址寻址,因此将 TLB 输出的物理页地址与页内偏移组合,构成访问 L2 的地址。L2 索引为:
因此,30 位块地址,即 36 位物理地址减去 6 位块内偏移,分为 19 位标签和 11 位索引(步骤 8)。索引和标签再次送到该核的 L2 缓存(步骤 9),并行进行比较。如果某一项匹配且有效(步骤 10),经过最初 15 个周期的延迟后,按每时钟周期 8 字节的速率,顺序返回整个块。
如果 L2 未命中,就访问 L3。对于包含 8 个 P 核和 8 个 E 核的 i9-12900,L3 总容量为 30 MiB,分成 8 个存储体。通过散列减少冲突,从散列结果中取 3 位选择存储体,而且只访问该存储体。每个存储体内的索引大小为:
12 位索引(步骤 11)送往选中 L3 存储体的全部 15 路(步骤 12)。L3 标签为 位,与 TLB 给出的物理地址进行比较(步骤 13)。如果命中,经过最初 50 个周期的延迟后,按每周期 16 字节的速率返回整个块,并将其同时放入 L1 和 L2。如果 L3 未命中,就发起内存访问。
i9 有两个独立内存通道;Xeon 服务器处理器则更多。这些通道可以连接 HBM 内存或标准 DIMM。由主存处理的未命中,其总延迟约等于判断 L3 未命中所需的 50 个处理器周期,加上取得关键指令的 DRAM 延迟。对于单存储体 DDR5-4800 SDRAM 和 4.0 GHz CPU,首批 16 字节的 DRAM 延迟约为 40 ns,即 160 个时钟周期,总未命中开销约为 200 个时钟周期。内存控制器以每个 I/O 总线时钟周期 32 字节的速率,填充 64 字节缓存块的其余部分,这还需 2.5 ns,即 10 个时钟周期。发生未命中时,所缺的块写入 L2 和 L1,不插入 L3;请记住,LLC 是非包含式的。
LLC 的主要作用是保存从 L2 淘汰的块。忽略多个核之间的共享,L2 和 L3 将保存不同的块,因此它们能缓存的数据总量等于两者容量之和,而不只是 L3 的容量。L2 和 L3 都采用写回,所以任何一次未命中都可能分别触发旧块向 L3 或内存写回。i9 配备合并写缓冲区,在下一级缓存未用于读取时,写回脏缓存行。未命中时还会检查写缓冲区;如果所需缓存行就在缓冲区内,便直接从中满足此次未命中。
现在假设指令是存储而不是加载。存储发射时,同样先查找数据缓存。未命中会使块进入写缓冲区,因为 L1 在写未命中时不分配块。命中时,也不会立即更新 L1 或 L2,而要等到确定这条存储指令不再具有推测性之后才更新。在此期间,存储操作保留在加载—存储队列中;这个队列属于处理器的乱序控制机制。
i9 还支持从存储层次结构的下一级向 L1 和 L2 预取。它的预取器与前文考察过性能的 i7 预取器相似。
i9 存储系统的性能
我们使用 SPECINT2017 基准测试,即 SPECINTRate,评价 i9 缓存结构的性能。i9 流水线使用独立取指单元、推测执行、指令预取和数据预取,结构复杂,因而难以与更简单处理器的缓存性能直接比较。如前所述,使用预取的处理器可以独立于程序实际执行的内存访问,另外产生缓存访问。由实际指令访问或数据访问所触发的缓存访问,有时称为按需访问(demand access),以区别于预取访问。按需访问既可能来自推测取指,也可能来自推测数据访问。
其中一些访问随后会被取消;第 3 章详细介绍推测执行与指令完成确认(instruction graduation)。推测执行处理器产生的未命中次数,至少与顺序执行、非推测处理器一样多,通常还会更多。由于这些复杂因素,单谈未命中率的意义已经不大。我们改用如今常见的每千条指令未命中次数(misses per kilo instructions,MPKI):分子为未命中次数,分母为已提交指令数,再按每千条指令计量。不同层级都可以给出 MPKI,因此有 MPKID1,即一级数据缓存指标,以及原文所写的 MKPI2 和 MKPI3,分别表示 L2 和 L3 的未命中次数。4
按需未命中之外,指令和数据预取也会产生实际发生的未命中。如果预取器非常有效,取消预取便会产生其他未命中。发出预取并出现一次“预取未命中”,只要能避免稍后发生的按需未命中,就可能让处理器运行得更快。i9 P 核的预取器是 Skylake 预取器的扩展;前文硬件预取一节中讨论过其性能。
i9 的取指单元尝试每周期取回 32 字节,因此每周期会取多条指令,这使指令缓存未命中率的比较更复杂。实际上,访问会读出整个 64 字节缓存行,随后的 32 字节取指不需要再次访问缓存,所以只按 64 字节块统计未命中。对于 SPECintRate 程序,32 KiB、八路组相联的指令缓存能实现非常低的指令未命中率。为简便起见,如果将未命中率定义为 64 字节块的未命中次数除以完成的指令数,那么除了 XALANCBMK,所有基准测试都低于 1%。由于一个 64 字节块通常包含 16~20 条指令,按每条指令衡量的有效未命中率还会低得多,具体取决于指令流的空间局部性。
图 2.25 展示了 SPECCPUINT2017 基准测试的 L1 数据缓存、L2 和 L3 的 MPKI。注意,有 4 个基准测试的 L1 数据缓存未命中相当多,每千条指令超过 20 次;前面已提到,Skylake 的 L1 预取器效果并不突出。同样这 4 个基准测试,即使使用容量达 1.25 MiB 的大 L2,L2 未命中仍达到每千条指令 10 次或更多。
图 2.25(续)。 L2 和 L3 也处理 L1 指令缓存未命中,但只有很少一部分会越过 L2。预取已开启,正如前文所示,它显著减少了原本会由 L2 引起的 L3 按需未命中。图中纵轴为每千条指令的未命中次数;MPKID1、MPKI2、MPKI3 分别对应 L1 数据缓存、L2 和 L3。
图 2.25 没有反映未命中的潜在影响。当然,在采用非阻塞缓存和乱序执行的处理器中,要准确测量这一影响几乎不可能:相互重叠的未命中代价较低,而处理器尤其可能在较短的 L1 未命中期间继续忙于其他工作。为了粗略估计 L1、L2 和 L3 未命中的潜在影响,图 2.26 将各级 MPKI 乘以一次未命中访问下一级所需的平均延迟。这并非对实际代价的测量,而是用来提示不同层级未命中的潜在重要程度。
MCF 是众所周知的“缓存克星”,其 L3 未命中很显著。对于其他内存密集型基准测试,L1、L2 和 L3 未命中的影响相对均衡。回想前文对 i7 预取的讨论,一些 SPEC 浮点基准测试的缓存未命中率同样很高。
下一章将考察 i9 的 CPI 与缓存未命中的关系,以及其他流水线因素的影响。
图 2.26(续)。 权重使用平均未命中开销,既忽略争用,也忽略未命中与指令执行重叠的可能性。纵轴为按未命中代价加权后的 MPKI,三组柱分别对应 L1D、L2 和 L3。
2.7 谬误与陷阱
存储层次结构在计算机体系结构的各个领域中,最天然地适合定量研究,似乎应该较少受到谬误与陷阱的影响。然而,本节受限的并不是无话可说,而是篇幅不足!
谬误:根据一个程序预测另一个程序的缓存性能
图 2.27 展示了 SPEC2000 基准测试套件中 3 个程序的指令和数据未命中率随缓存容量的变化。对于 4096 KiB 缓存,不同程序每千条指令的数据未命中次数分别为 9、2 或 90;对于 4 KiB 缓存,每千条指令的指令未命中次数分别为 55、19 或 0.0004。
数据库等商业程序即使使用较大的二级缓存,未命中率仍会很高,而 SPECCPU 程序通常不是这样。显然,将一个程序的缓存性能推而广之,用来判断另一个程序,并不明智。正如原文引用的图 2.23 所提醒的那样,差异可能非常大;甚至对整数密集型与浮点密集型程序相对未命中率的预测也可能出错,mcf 与 sphnix3 就提醒了我们这一点。1
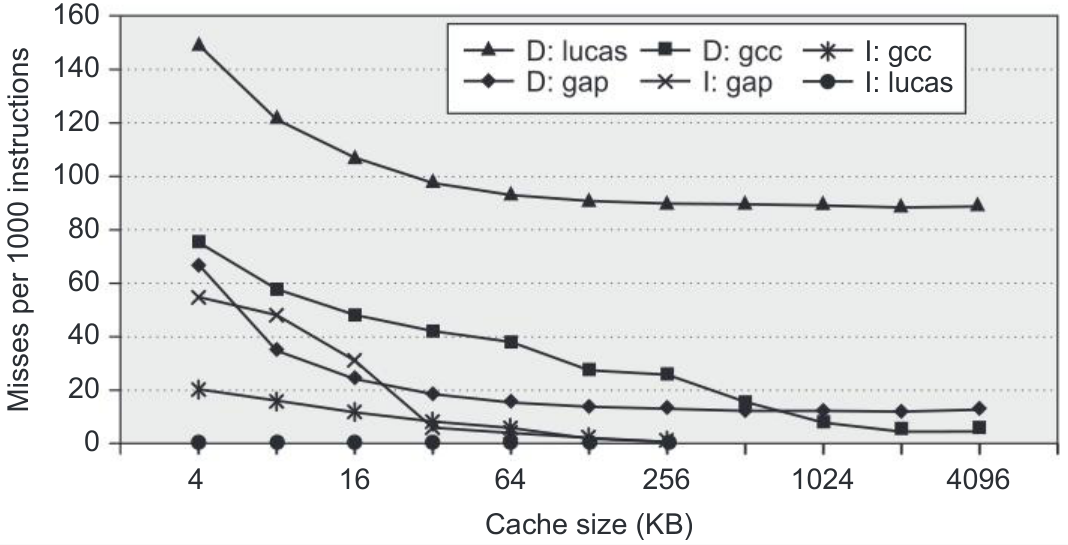
图 2.27(续)。 gcc 的指令未命中次数是 lucas 的 30,000~40,000 倍;反过来,lucas 的数据未命中次数是 gcc 的 2~60 倍。gap、gcc 和 lucas 都来自 SPEC2000 基准测试套件。图例中 I 表示指令未命中,D 表示数据未命中;纵轴为每 1000 条指令的未命中次数,横轴为缓存容量,原图横轴单位标作 KB。
陷阱:模拟足够多的指令,才能准确测量存储层次结构的性能
这里实际有三个陷阱。其一,试图用很短的访存轨迹预测大缓存的性能。其二,程序的局部性行为并非在整个执行过程中始终不变。其三,局部性还可能随输入而改变。
图 2.28 展示了同一个 SPEC2000 程序在 5 种输入下,每千条指令的累计平均指令未命中次数。对于这些输入,前 19 亿条指令的平均未命中率,与后续执行期间的平均未命中率相差很大。
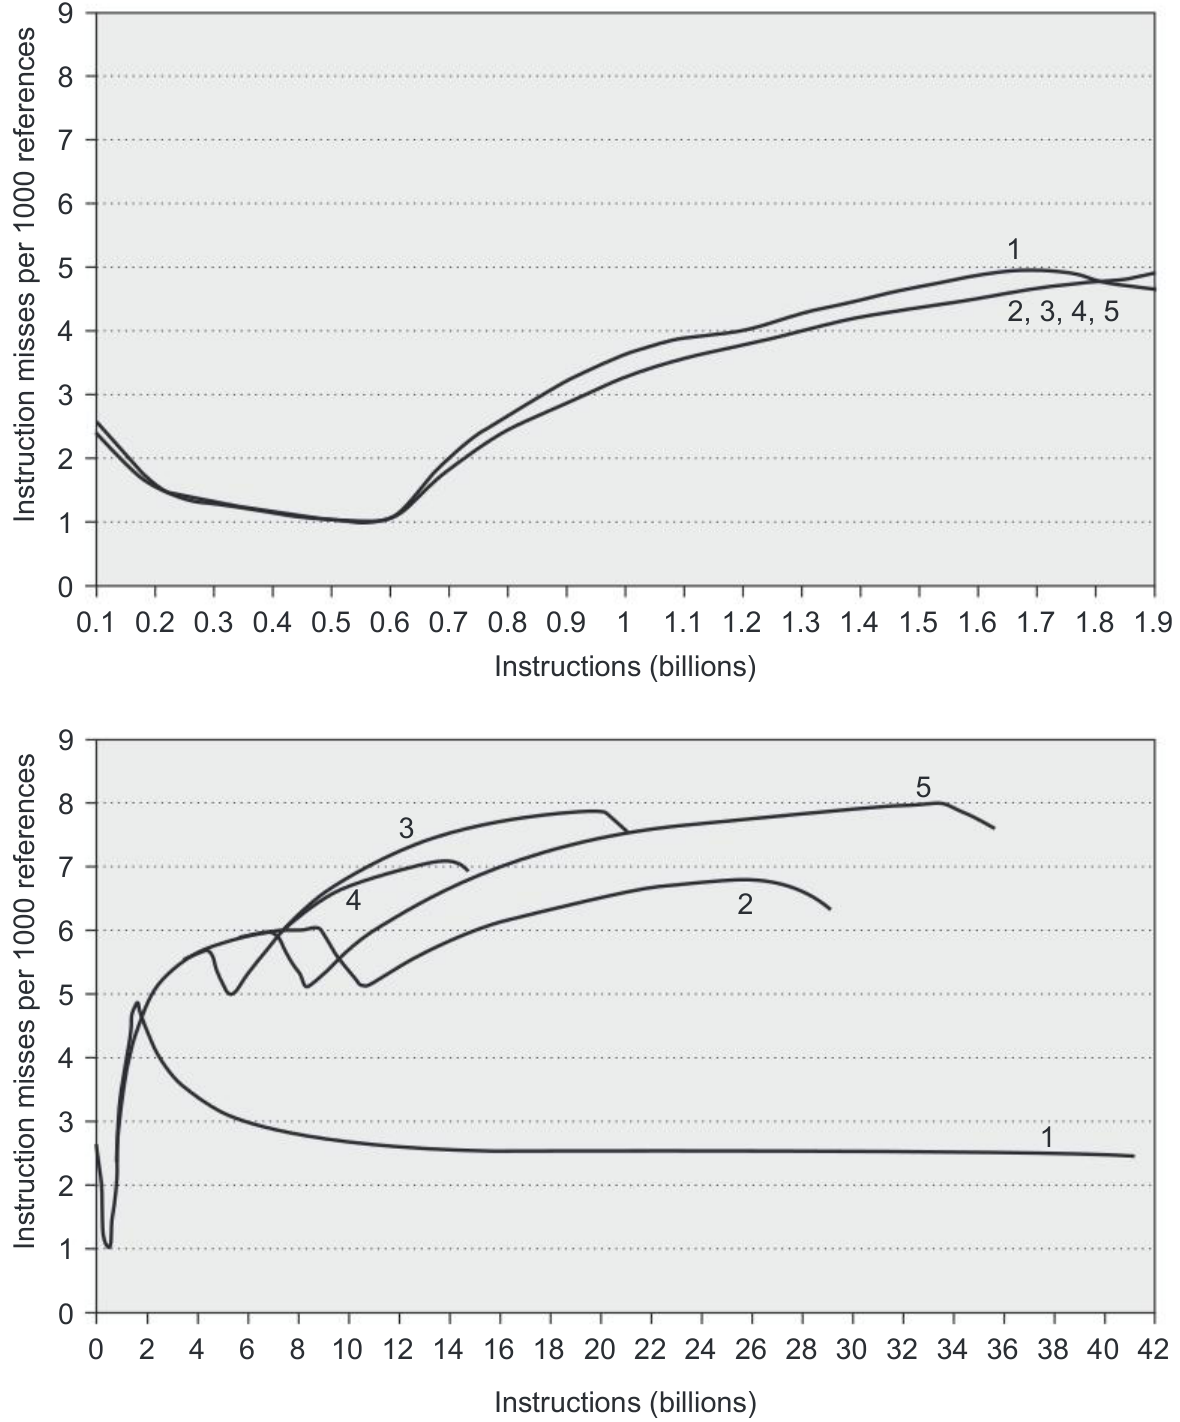
图 2.28(续)。 在前 19 亿条指令中,未命中次数的变化较小,5 种输入之间的差别也不大。运行至程序结束后,才能看出未命中次数如何随运行过程变化,又如何依赖输入。上图给出前 19 亿条指令的累计平均值:5 种输入都从每 1000 次访问约 2.5 次未命中开始,到约 4.7 次结束。下图展示运行至结束的累计平均值,所需指令数随输入不同,在 160 亿到 410 亿之间。前 19 亿条指令之后,每 1000 次访问的未命中次数随输入不同,在 2.4 到 7.9 之间变化。模拟对象是 Alpha 处理器,指令和数据分别使用 64 KiB、两路组相联、LRU 替换的 L1 缓存,另有一个统一的 1 MiB 直接映射 L2 缓存。图中 1~5 标识五种输入,横轴单位为十亿条指令,纵轴为每 1000 次访问的指令未命中次数。
陷阱:带缓存的系统未能提供足够高的内存带宽
缓存有助于降低平均内存访问延迟,但对于必须访问主存的应用,却不一定能提供较高内存带宽。体系结构设计者必须为这类应用在缓存之后配置高带宽内存(HBM)。第 4 章和第 5 章将再次讨论这一陷阱。
陷阱:引入一种“介于”两种现有技术之间,却在速度或价格上没有明确优势的存储技术
人们曾尝试引入新的存储技术,要么取代现有技术,要么填补两种现有技术之间的空白,例如 DRAM 与磁盘之间。多数尝试都失败了,因为新技术没有提供显著而持久的优势。有时,新技术每位成本更低,却慢得多;有时速度更快,却更昂贵。相变存储器,即 Micron 和 Intel 所称的 Xpoint,似乎是最近遇到这一陷阱的技术;更早还有电荷耦合器件、磁泡存储器和光盘等许多例子。
相比之下,Flash 是唯一取得重大成功的例子。Flash 获胜的原因在于:它不易失,速度又远快于磁盘,尤其是在读取方面;而且随着时间推移,每位成本的差距也大幅缩小。到 2022 年,除了大规模归档存储,Flash 已在很大程度上取代硬盘。
译注: 此处原文引用图 2.23,但该图是 i9 缓存参数表,并非程序间未命中率比较图;基准测试名称也确实拼作 sphnix3。 ↩︎
2.8 结束语:展望未来
过去三十年间,曾有人多次预言,计算机性能的提升即将停滞。每一次这样的预测都错了。它们之所以错,是因为依赖了未曾明说、后来又被事实推翻的假设。例如,由于未能预见从分立元件到集成电路的转变,有人曾预测,光速的限制会使计算机速度的上限比今天慢几个数量级。我们对存储墙的预测很可能也会出错,但它提醒我们,必须开始跳出既有框架思考。
——Wm. A. Wulf 和 Sally A. McKee,Hitting the Memory Wall: Implications of the Obvious,University of Virginia 计算机科学系,1994 年 12 月。这篇论文提出了 memory wall(存储墙)一词。1
使用存储层次结构的构想,可以追溯到 20 世纪 40 年代末至 50 年代初通用数字计算机诞生之时。虚拟内存在 60 年代初用于研究型计算机,70 年代进入 IBM 大型机。缓存也在大致同一时期出现。此后,这些基本概念不断扩展和完善,以缩小主存与处理器之间的访问时间差距,但基本思想始终未变。近年来,多种因素汇聚,使得过去 25 年一直由先进存储层次结构克服的存储墙,再次成为性能提升的重要限制。
一个正在显著改变存储层次结构设计的趋势,是 DRAM 密度提升和访问时间改善的持续放缓。过去 15 年都能观察到这两个趋势,最近 5 年尤其明显。虽然 DRAM 带宽有所增加,访问时间的缩短却缓慢得多,从 DDR4 到 DDR5 甚至没有改善。Dennard 缩放规律失效与 Moore 定律放缓都促成了这一局面。DRAM 使用的沟槽电容设计也限制了其缩放能力。堆叠内存等封装技术,很可能成为改善 DRAM 访问带宽和延迟的主要来源。最近,采用新半导体工艺时,SRAM 的性能改善也不如逻辑电路明显。
因此,我们看到多种因素会阻碍存储层次结构性能的提高:
- DRAM 延迟没有改善,密度提升幅度减小。
- SRAM 访问时间的改善幅度减小,每位功耗也几乎没有改善。
- 增大 LLC 容量或增加缓存级数,所得收益逐渐递减。
- 越来越多的应用以流式方式处理极大的数据集,时间和空间局部性较低,包括图形和深度神经网络;见第 4 章和第 7 章。
这些因素共同增强了存储墙的影响,而此前我们已经将它挡在门外 25 年。正如第 4 章和第 7 章将展示的,对某些应用而言,最佳办法可能是采用不同的存储组成;Cray 早在 50 年前设计的一台超级计算机中,就实践了这一认识!
不论 DRAM 和 SRAM 如何发展,Flash 都在发挥越来越大的作用。Flash 已主导 PMD 存储 15 年,并在近 10 年前成为笔记本电脑的标准配置。过去几年,多数台式机出厂时也已将 Flash 作为主要辅助存储器。Flash 相对 DRAM 的潜在优势,特别是不必为每一位配置控制写入的晶体管,也恰恰是其弱点:Flash 必须采用成批擦除再写入的周期,而这一过程慢得多。因此,虽然 Flash 已成为增长最快的辅助存储形式,DDR DRAM 仍然主导主存。
尽管以相变材料制造存储器的构想已存在一段时间,它却一直未能成为磁盘或 Flash 的有力竞争者。这项技术似乎比 Flash 有若干优势,包括消除缓慢的先擦除后写入周期,以及更长的使用寿命;但迄今尚未取得显著的商业成功。
多年来,人们不断预言存储墙即将到来,见前面的引语及论文,认为它将严重限制处理器性能。幸运的是,缓存扩展到更多层级,从 2 级发展到 4 级,更复杂的回填和预取机制,编译器与程序员对局部性重要性的更深认识,以及 DRAM 带宽的巨大提升——自 20 世纪 90 年代中期以来超过 200 倍——共同帮助我们抵御了存储墙。
近年来,L1 容量受到访问时间约束,而访问时间又受时钟周期限制;L2 和 L3 容量则受到能耗方面的限制。这些因素带来了新的挑战。i7 与 i9 处理器核在大约十二年间的演进正说明了这一点:L1 指令缓存容量没有变化,数据缓存也只增长了 50%!更积极地使用预取,正是为了弥补 L2 和 L3 无法继续增大的限制。
除了依靠多级缓存,还可以引入支持多个未完成未命中的乱序流水线,利用已有的指令级并行性,隐藏带缓存系统中尚未消除的内存延迟。引入多线程和更多线程级并行性,又将这一思路推进了一步:并行性更大,隐藏延迟的机会也更多。很可能,利用指令级与线程级并行性,会成为隐藏现代多级缓存系统各种内存延迟的更重要手段。
一个不时被重新提出的构想,是使用由程序员控制的 scratchpad,即软件显式管理的高速暂存存储器,或其他对软件可见的高速存储器。我们将看到,GPU 和领域专用体系结构会采用这类存储,见第 7 章。它们一直没有成为通用处理器的主流,原因有几方面。首先,引入行为不同的地址空间会打破原来的内存模型。其次,与编译器或程序员实施的缓存优化,例如预取,不同,使用 scratchpad 的存储变换必须完整处理从主存地址空间到 scratchpad 地址空间的重新映射。这使变换更难实施,也限制了适用范围。
GPU(见第 4 章)和领域专用体系结构(见第 7 章)大量使用本地 scratchpad,目前管理它们的负担仍落在程序员和编译器身上。对于能够利用这种存储的领域专用软件系统,性能收益非常显著。HBM 技术是图形及类似系统的主要工作内存。领域专用体系结构在克服 Dennard 缩放规律失效和 Moore 定律放缓带来的限制方面,已变得更加重要,见第 7 章;这也让 scratchpad 和类似向量的寄存器组越来越普遍。
Dennard 缩放规律失效同时影响 DRAM 和处理器技术。由于 DRAM 的独特结构,其受到的影响稍大一些;但无论逻辑还是存储,都受到功率上限和 Moore 定律放缓的制约。要延续过去 50 年间的性能提升,关键在于计算机体系结构与相关软件的共同创新,同时提高性能和效率。
译注: 引文原文将“即将”写作 eminent,并附有作者保留原误的
[sic]标记;按语义应为 imminent。中文译文按“即将”表达,特在此保留原书的用词提示。 ↩︎
2.9 历史回顾与参考文献
在线提供的 M.3 节回顾了缓存、虚拟内存和虚拟机的历史。IBM 在这三者的发展历程中都发挥了重要作用。该节还列出了供进一步阅读的参考文献。
案例与习题
作者:Rajeev Balasubramonian、Norman P. Jouppi、Naveen Muralimanohar 和 Sheng Li。
案例一:用高级技术优化缓存性能
本案例涉及的概念:
- 非阻塞缓存
- 面向缓存的编译器优化
- 软件和硬件预取
- 计算缓存性能对更复杂处理器的影响
矩阵转置就是交换矩阵的行与列。下面这段简单的 C 循环展示了转置操作:
习题 2.1
[10/15/15/12/20]〈2.3〉 假设输入和输出矩阵都按行优先顺序存放,即同一行中相邻的元素占据连续的内存地址。现在要在一个处理器上执行 256×256 双精度矩阵转置。该处理器的 L1 数据缓存容量为 16 KB,采用全相联结构,因此不必考虑缓存冲突;替换策略为最近最少使用(LRU),块大小为 64 字节。请记住,一个双精度值占 8 字节。
假设 L1 未命中或预取需要 16 个周期,并且总会在 L2 命中;L2 每 2 个处理器周期能够处理一个请求。若数据位于 L1 中,前述内层循环每次迭代需要 4 个周期。缓存对写未命中采用写分配和写时取入(fetch-on-write)策略。再作一个不现实的假设:写回脏缓存块需要 0 个周期。
上述简单实现对输出矩阵的访问顺序并不理想;但是,应用循环交换优化,又会使输入矩阵的访问顺序不理想。因此,仅靠循环交换不足以改善性能,必须采用分块。
a. [10]〈2.3〉 要从分块执行中获益,缓存至少需要多大?
b. [15]〈2.3〉 在上述最小容量缓存中,分块版本与未分块版本的未命中次数相比如何?
c. [15]〈2.3〉 编写矩阵转置代码,以 B 为块大小参数,使用 B×B 的块。
d. [12]〈2.3〉 要使性能不受两个数组在内存中所处位置的影响,L1 至少需要多高的相联度?
e. [20]〈2.3〉 在计算机上试运行分块和未分块的 256×256 矩阵转置。根据你对该计算机存储系统的了解,实际结果与预期有多接近?如有可能,解释其中差异。
习题 2.2
[10]〈2.3〉 假设你正在为前述未分块矩阵转置代码设计硬件预取器。最简单的硬件预取器只在发生未命中之后预取顺序相邻的缓存块。更复杂的“非单位步长”硬件预取器能够分析未命中访问流,检测非单位步长并据此预取。
相比之下,软件预取判断非单位步长,与判断单位步长同样容易。例如,可以使用 __builtin_prefetch() 函数在 C 代码中插入软件预取。假设预取直接写入缓存,而且不存在“污染”,即不会覆盖那些必须比预取数据更早使用的数据。采用非单位步长预取器时,为获得最佳性能,在内层循环的稳定执行阶段,任一时刻必须有多少个尚未完成的预取?
习题 2.3
[15/20]〈2.3〉 使用软件预取时,既要让预取足够及时,赶得上数据使用,又要尽量减少未完成的预取数量,以免超出微体系结构的能力,并尽量减少缓存污染。不同处理器具有不同的能力和限制,使这个问题更加复杂。
a. [15]〈2.3〉 编写一个带软件预取的分块矩阵转置版本。
b. [20]〈2.3〉 估计并比较分块与未分块矩阵转置在使用和不使用软件预取时的性能。
案例二:融会贯通——高度并行的存储系统
本案例涉及的概念:
- 贯穿各层的问题:存储层次结构设计
- 现代处理器中的存储层次结构参数
图 2.29 的程序可用来评价存储系统的行为。关键在于准确计时,再让程序以不同步长访问内存,从而触及存储层次结构的不同层级。图中给出了 C 代码。
第一部分是一个过程,利用标准工具准确测量用户 CPU 时间;在某些系统上,可能需要修改此过程。第二部分是一组嵌套循环,以不同步长和缓存容量读写内存。为了准确测量缓存时间,代码会反复执行多次。第三部分仅测量嵌套循环的开销,以便从总测量时间中扣除,得到访问本身的耗时。结果按 .csv 文件格式输出,方便导入电子表格。
根据待回答的问题以及被测系统的内存容量,可能需要调整 CACHE_MAX。以单用户模式运行,或者至少在没有其他活动应用的情况下运行,结果会更加稳定。注意,这段代码在现代计算机上可能需要数分钟才能完成。图 2.29 的代码源于 University of California, Berkeley 的 Andrea Dusseau 编写的程序,并以 Saavedra-Barrera(1992)中的详细说明为基础。
图 2.29 用于评价存储系统的 C 程序
图 2.29(续)。
译注: 代码按原书保留,仅翻译注释并整理缩进。正文说测量“用户 CPU 时间”,但
get_seconds()实际调用的是time();正文提到的CACHE_MAX在代码中名为ARRAY_MAX。此外,label()的形参类型为int,原书输出格式却使用%ld,两者类型不匹配。原文并未针对这些差异给出修订版本;这里不静默修改程序。
这段程序后来经过修改,以修复在较新计算机上遇到的一些问题。兼容 Linux 和 Microsoft Visual C++ 的版本,可在原书提供的代码页面找到。
前面的程序假定程序地址与物理地址保持对应关系;对于少数采用虚拟地址缓存的计算机,这一假定成立。通常,重启之后不久,虚拟地址往往还与物理地址保持这种对应关系,因此可能需要重启计算机,才能在结果中得到平滑的曲线。
回答以下问题时,假设存储层次结构所有组成部分的容量都是 2 的幂。假设页面大小远大于二级缓存块大小,如果存在二级缓存的话;并且二级缓存块大小不小于一级缓存块大小。
习题 2.4
[12/12/12/10/12]〈2.6〉 图 2.30 绘出了程序的一组示例输出;原文称横轴列出被访问数组的大小。根据图中的程序结果,回答以下问题。
a. [12]〈2.6〉 二级缓存的总容量和块大小分别是多少?
b. [12]〈2.6〉 二级缓存的未命中开销是多少?
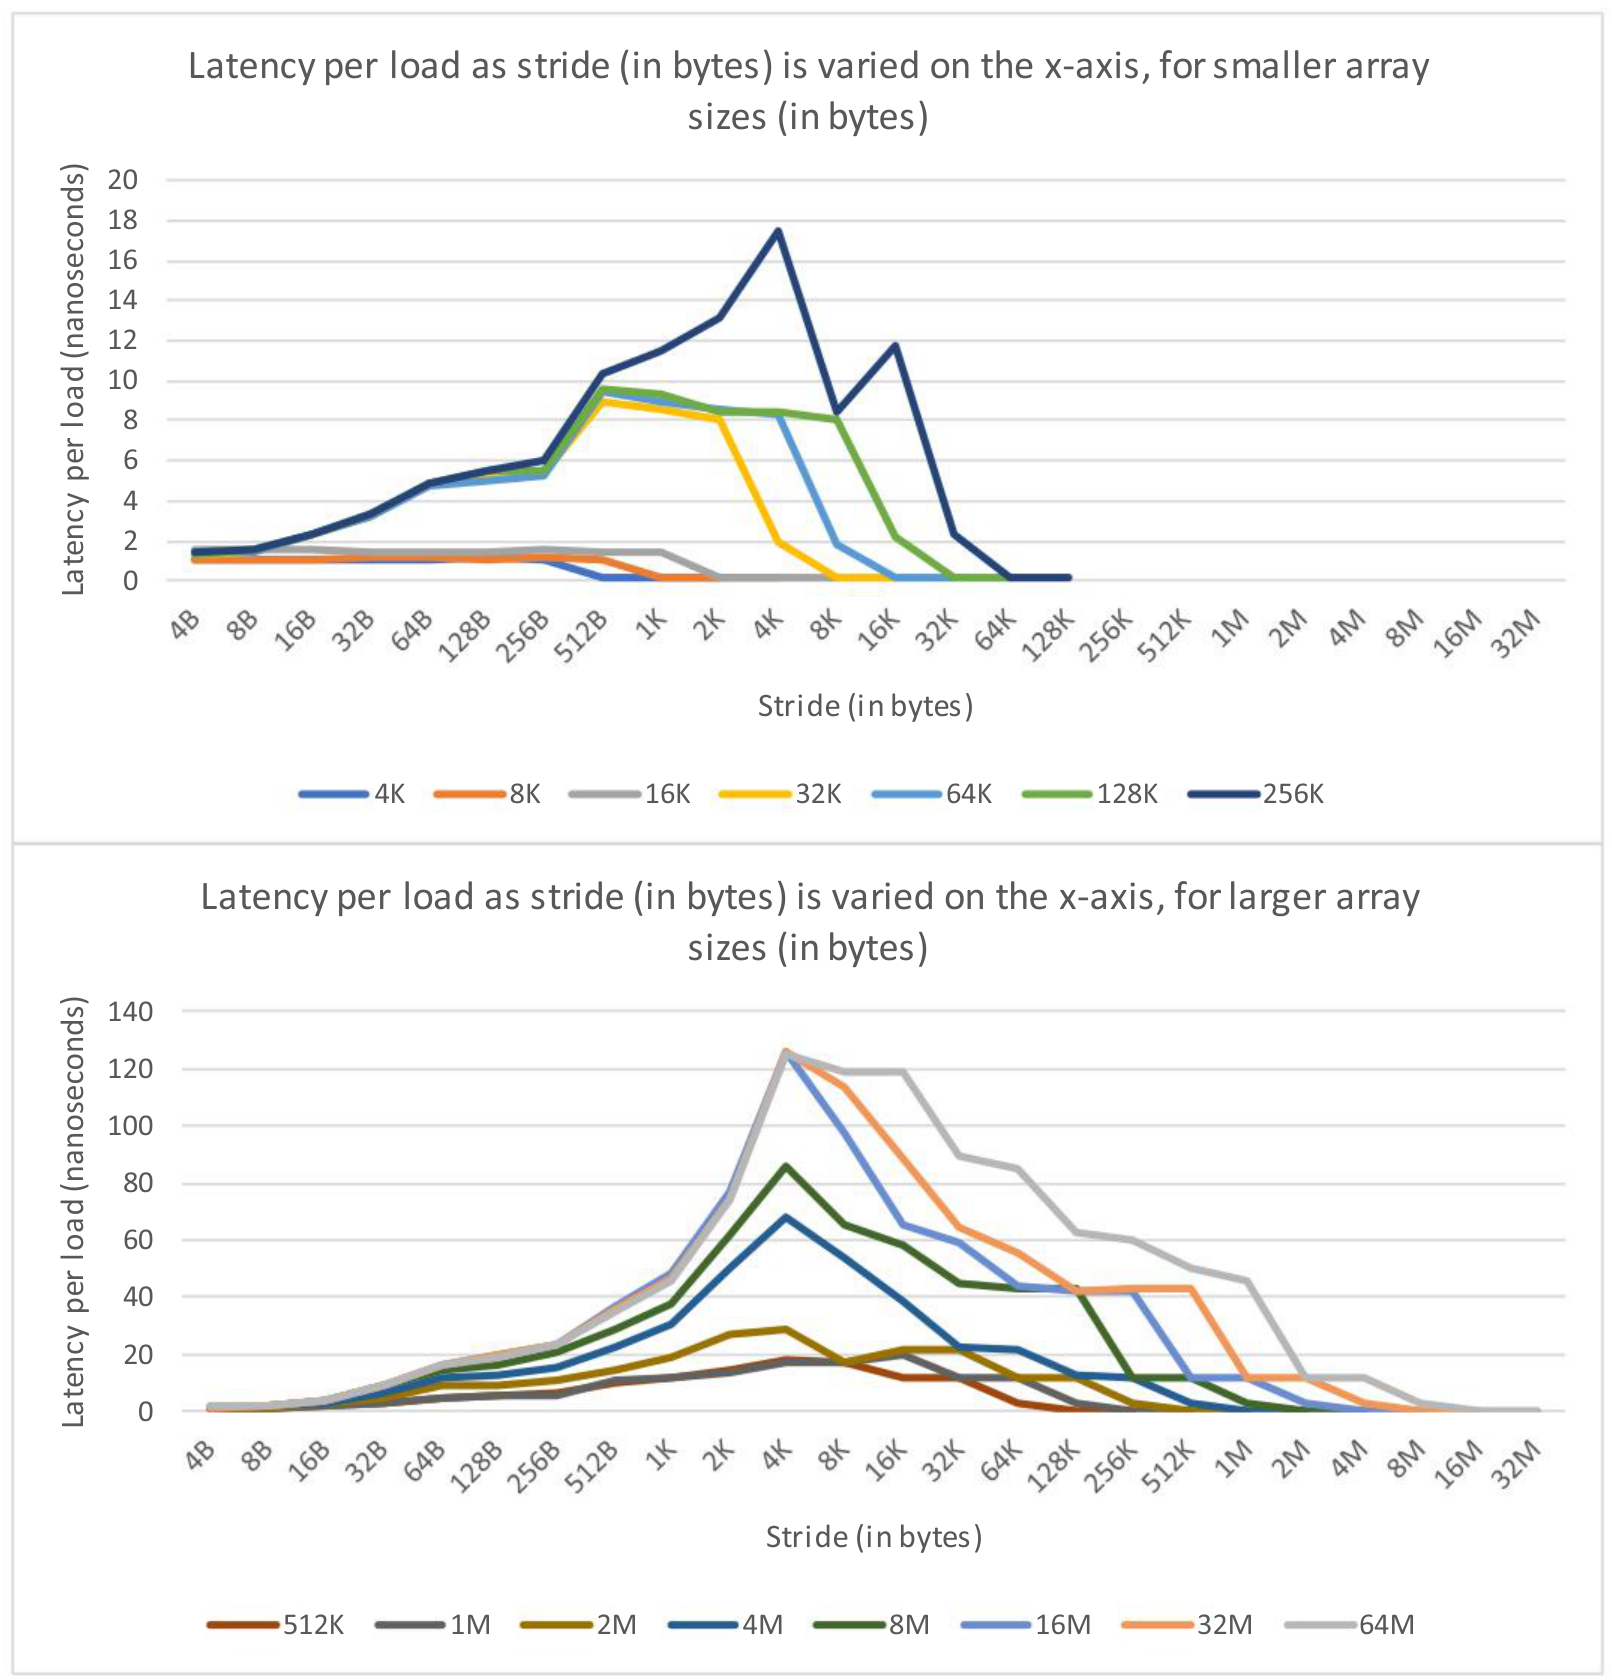
图内文字对照:上图是较小数组、下图是较大数组在不同步长下的单次加载延迟;横轴 Stride (in bytes)=步长,单位为字节;纵轴 Latency per load (nanoseconds)=每次加载的延迟,单位为纳秒。图例中的数值表示数组大小,单位为字节;上图为 4K、8K、16K、32K、64K、128K、256K,下图为 512K、1M、2M、4M、8M、16M、32M、64M。
译注: 题干写横轴为数组大小,但原图横轴明确标为访问步长,数组大小由不同曲线的图例区分。原图按原样保留。
c. [12]〈2.6〉 二级缓存的相联度是多少?
d. [10]〈2.6〉 主存容量是多少?
e. [12]〈2.6〉 若页大小为 4 KB,换页时间是多少?
习题 2.5
[12/15/15/20]〈2.6〉 如有必要,修改图 2.29 的代码,测量下列系统特性。绘制实验结果,以耗时为纵轴、内存访问步长为横轴;两个坐标轴都采用对数刻度,并为每种缓存容量绘制一条曲线。
a. [12]〈2.6〉 系统页大小是多少?
b. [15]〈2.6〉 TLB 有多少个表项?
c. [15]〈2.6〉 TLB 的未命中开销是多少?
d. [20]〈2.6〉 TLB 的相联度是多少?
习题 2.6
[20/20]〈2.6〉 在多处理器存储系统中,单个处理器可能无法使存储层次结构的较低层级达到饱和,但多个处理器协同工作应当能够做到。修改图 2.29 的代码,同时运行多个副本。你能否确定:
a. [20]〈2.6〉 计算机系统中有多少个实际处理器,又有多少个系统所见的处理器只是额外的多线程执行上下文?
b. [20]〈2.6〉 系统有多少个内存控制器?
习题 2.7
[20]〈2.6〉 能否想出一种通过程序测试指令缓存某些特性的方法?提示: 一段代码经编译后,可能产生大量不容易从源代码看出的指令。尽量使用 ISA 中长度已知的简单算术指令。
案例三:研究不同存储系统组成的影响
本案例涉及的概念:
- DDR3/DDR4 存储系统
- rank、存储体和行缓冲区对性能与功耗的影响
- DRAM 时序参数
- DRAM 调度策略
处理器芯片通常支持若干 DDR3 或 DDR4 内存通道。本案例只考察一个通道,探索改变若干参数如何影响其性能与功耗。回顾一下,一个通道可以连接一个或多个 DIMM,每个 DIMM 支持一个或多个 rank。rank 是协同工作的一组 DRAM 芯片,共同处理内存控制器发出的一条命令。
例如,一个 rank 可以由 16 颗 DRAM 芯片组成,每颗芯片在通道时钟的每个边沿处理 4 位输入或输出。这种芯片称为 x4(by four)芯片。一个 rank 也可以由 8 颗 x8 芯片或 4 颗 x16 芯片组成。注意,每种组合都能处理 64 位内存通道上传送的数据。rank 内部又分为 8 个(DDR3)或 16 个(DDR4)存储体。每个存储体都有一个行缓冲区,用来保存最近从该存储体读出的行。下面给出从一个存储体读取数据时,典型的内存命令序列。
(i) 内存控制器发出 **Precharge(预充电)**命令,使存储体准备好访问新行。经过 时间,预充电完成。
(ii) 然后发出 **Activate(激活)**命令,从存储体中读出所需行。经过 时间,激活完成,该行可视为已进入行缓冲区。
(iii) 接下来可以发出列读命令(column-read),即 CAS,将行缓冲区的指定部分送到内存通道。经过 CL 时间,突发数据的首个 64 位被送上内存通道。一次突发通常包含 8 次 64 位传输,在 4 个内存时钟周期的上升沿和下降沿完成;这段时间称为传输时间。
(iv) 如果接下来要访问该存储体中另一行的数据,也就是行缓冲区未命中,内存控制器就重复步骤 (i)~(iii)。这里暂且假定,CL 时间一过,就能发出步骤 (i) 的 Precharge 命令;有些情形还需要额外延迟,这里忽略。如果访问的是同一行中的另一个数据块,也就是行缓冲区命中,则只需再发出一个 CAS 命令。连续两个 CAS 命令至少必须相隔 4 个周期,确保第一次数据传输结束后,第二次才开始。
注意,内存控制器可以在相邻周期向不同存储体发命令,从而并行执行许多内存读写,不必闲等某个存储体的 、 和 CL 结束。以下各题假设 ,内存通道频率为 1 GHz,即传输时间为 4 ns。
习题 2.8
[10]〈2.2〉 行缓冲区未命中时,内存控制器经历的读取延迟是多少?
习题 2.9
[10]〈2.2〉 行缓冲区命中时,内存控制器经历的延迟是多少?
习题 2.10
[10]〈2.2〉 如果内存通道只支持一个存储体,而且内存访问主要表现为行缓冲区未命中,内存通道的利用率是多少?
习题 2.11
[15]〈2.2〉 假设行缓冲区未命中率为 100%,为了实现 100% 的内存通道利用率,通道至少需要支持多少个存储体?
习题 2.12
[10]〈2.2〉 假设行缓冲区未命中率为 50%,为了实现 100% 的内存通道利用率,通道至少需要支持多少个存储体?
习题 2.13
[15]〈2.2〉 假设正在执行一个含 4 个线程的应用,各线程都没有空间局部性,即行缓冲区未命中率为 100%。每隔 200 ns,4 个线程会同时各向内存控制器队列插入一个读操作。如果内存通道只支持一个存储体,平均内存访问延迟是多少?如果支持 4 个存储体,又是多少?
习题 2.14
[10]〈2.2〉 从以上问题中,你认识到了增加存储体数量有哪些收益和不利之处?
习题 2.15
[20]〈2.2〉 现在转而考察内存功耗。从原书提供的Micron 功耗计算器页面下载一份计算器。
该页面提供面向不同 DDR 技术的电子表格,这里只分析 DDR3。表格预先配置了 Micron 制造的多种 DRAM 芯片,可估计其功耗。在“DDR3 Config”工作表中,选择一颗 x8 DDR3 2 Gb DRAM 芯片,速度等级为 -093,预充电退出模式为 Fast。然后到“System Config”工作表,将工作负载设置为:页命中率,即行缓冲区命中率,50%;读数据总线利用率 45%;写数据总线利用率 25%;其他参数保持默认。
点击“Summary”工作表,查看这些芯片参数与工作负载条件下,单颗 DRAM 芯片的功耗构成。Micron 会随技术进展定期更新这些表格。2024 年夏季的版本显示,DRAM 芯片消耗 229 mW,其中 Activate 操作 45 mW、CAS 操作 145 mW、背景功耗 39 mW。
接着再次点击“System Config”,修改读写流量与行缓冲区命中率,观察功耗构成如何变化。例如,若通道利用率为 35%,其中读取占 25%、写入占 10%,功耗会下降多少?若将行缓冲区命中率提高到 80%,又会下降多少?
习题 2.16
[20]〈2.2〉 默认配置中,一个 rank 由 8 颗 x8、2 Gb DRAM 芯片组成。也可以使用 16 颗 x4 芯片,或 4 颗 x16 芯片。单颗 DRAM 的容量也可以选择 1 Gb、2 Gb 或 4 Gb。这些选项都在 Micron 功耗计算器的“DDR3 Config”工作表中。列出各种 rank 组成方式的总功耗。对于给定容量的 rank,哪种组成方式最省电?
习题 2.17
[20]〈2.2〉 考虑 DDR 存储系统中的两种内存控制器。正如前文所述,一种采用开页策略(open-page policy),另一种采用关页策略(close-page policy)。
采用开页策略时,如果某个存储体没有待处理请求,就保持行缓冲区打开,期待未来发生行缓冲区命中。采用关页策略时,如果没有待处理请求,就发出预充电命令,使存储体准备好未来访问另一行;这样做是预期空间局部性有限。两种策略在有待处理请求时,都优先选择行缓冲区命中的请求;如果没有能命中的请求,就按先来先服务顺序处理。
下表列出发往一个存储体的一串块读取请求,以所访问的 DRAM 行(X、Y、Z)以及进入内存控制器队列的周期表示。请写出内存控制器发出每条命令的周期。假设 Precharge、Activate 和 Column-Read 都需要 10 个周期。第一个请求在第 20 周期到达时,存储体已经完成预充电。
| 内存事务 | 入队周期 | 开页策略下的命令序列 | 关页策略下的命令序列 |
|---|---|---|---|
| 读 X | 20 | ||
| 读 X | 35 | ||
| 读 X | 90 | ||
| 读 Y | 95 | ||
| 读 X | 100 | ||
| 读 X | 160 |
习题
若干习题需要使用缓存模拟器。功能最强、公开可用的模拟器是 CACTI 7.0,但它使用较旧的 32 nm 工艺。这不会从根本上影响习题,尽管结果不会与更新的 SRAM 和 DRAM 工艺相符。原书提供了 CACTI 7.0 的 GitHub 地址。如果希望使用更新的 14 nm 工艺探索这些问题,可以尝试 FT-CACTI,它将 CACTI 7.0 的模型更新到较新的工艺。原书还提供了 FT-CACTI 的 GitHub 地址。1
习题 2.18
[12/12/15]〈2.3〉 以下问题使用 CACTI 7.0 或 FT-CACTI,研究小而简单的缓存所带来的影响。
a. [12]〈2.3〉 比较容量为 64 KB、块大小为 64 字节、只有一个存储体的缓存的访问时间。两路和四路组相联缓存的访问时间,相对于直接映射结构分别是多少?
b. [12]〈2.3〉 比较采用 64 字节块、单存储体、四路组相联缓存的访问时间。相对于 16 KB 缓存,32 KB 和 64 KB 缓存的访问时间分别是多少?
c. [15]〈2.3〉 对于 64 KB 缓存,在 1~8 路中找出平均内存访问时间最短的相联度。已知某工作负载套件的每条指令未命中次数如下:直接映射为 0.00664,两路组相联为 0.00366,四路组相联为 0.000987,八路组相联为 0.000266。总体而言,每条指令有 0.3 次数据访问。假定所有模型的缓存未命中都需要 10 ns。将命中时间换算为周期数时,采用 CACTI 输出的周期时间;它对应缓存流水线中不出现气泡时能够达到的最高工作频率。
习题 2.19
[15]〈2.3〉 你受命为一种新微处理器研究多存储体 L1 数据缓存与流水线化 L1 数据缓存的相对性能。假设缓存为 64 KB、两路组相联,块大小为 64 字节。流水线化版本需要 4 个流水级,才能完成访问、命中检测和组选择。多存储体版本由两个 32 KB、两路组相联存储体组成。使用 CACTI 或 FT-CACTI,假定采用其所支持的最佳条件。比较流水线化设计与多存储体设计的面积,以及每次访问所需的总动态读取能耗。指出哪种面积更小、哪种功耗更高,并解释可能的原因。
译注: 本题原文的 “assume the best supported” 未进一步说明“最佳”所指的具体参数或配置。
习题 2.20
[12/15]〈2.3〉 考虑在 L2 缓存未命中时采用关键字优先和提前重启。假设 L2 容量为 2 MB,块大小为 64 字节,回填通路宽 16 字节。每 4 个处理器周期可以向 L2 写入 16 字节;从内存控制器收到首个 16 字节块需要 120 个周期,随后主存每再传来一个 16 字节块需要 16 个周期。数据可以通过旁路直接送入 L2 的读端口。忽略将未命中请求传给 L2,以及将所请求数据传给 L1 的周期数。
a. [12]〈2.3〉 采用和不采用关键字优先与提前重启时,处理一次 L2 缓存未命中各需多少个周期?
b. [15]〈2.3〉 你认为关键字优先和提前重启,对 L1 还是 L2 更重要?哪些因素会影响两者的相对重要性?
习题 2.21
[12/12]〈2.3〉 你正在直写 L1 缓存与写回 L2 缓存之间设计一个写缓冲区。L2 写数据总线宽 16 B,每 4 个处理器周期能够对一个独立缓存地址执行一次写入。
a. [12]〈2.3〉 每个写缓冲区表项应当有多少字节宽?
b. [15]〈2.3〉 假设通过执行 64 位存储指令将内存清零,其他所有指令都可以与存储指令并行发射,而且相应块已在 L2 中。在稳定执行阶段,采用合并写缓冲区,相比不合并的写缓冲区,预期能获得多大加速比?
c. [15]〈2.3〉 对于采用阻塞缓存和非阻塞缓存的系统,可能发生的 L1 未命中,会怎样影响所需写缓冲区表项的数量?
译注: 本题题头的难度标记原为
[12/12],但实际有 a、b、c 三个小问,分别标为[12]、[15]、[15]。
习题 2.22
[20]〈2.1,2.2,2.3〉 缓存起到过滤器的作用。例如,一个程序每执行 1000 条指令,平均可能有 20 次内存访问的局部性过低,以至于无法由 2 MB 缓存满足。这时称该 2 MB 缓存的 MPKI,即每千条指令未命中次数,为 20;无论它前面有哪些更小的缓存,这个数值大体都成立。
假设缓存容量/延迟/MPKI 分别为:32 KB/1/100、128 KB/2/80、512 KB/4/50、2 MB/8/40,以及 8 MB/16/10。假设访问片外内存系统平均需要 200 个周期。对下面各缓存配置,计算访问缓存层次结构所花的平均时间。对于层级过浅或过深的缓存结构,你观察到了哪些不利之处?
a. 32 KB L1;8 MB L2;片外内存。
b. 32 KB L1;512 KB L2;8 MB L3;片外内存。
c. 32 KB L1;128 KB L2;2 MB L3;8 MB L4;片外内存。
习题 2.23
[15]〈2.1,2.2,2.3〉 考虑一个由程序 A 和 B 共享的 16 MB、16 路组相联 L3 缓存。缓存中有一种机制,监测每个程序的缓存未命中率,并为每个程序分配 1~15 路,以减少总的缓存未命中次数。假设为程序 A 分配 1 MB 时,MPKI 为 100;每增加 1 MB,MPKI 减少 1。为程序 B 分配 1 MB 时,MPKI 为 50;每增加 1 MB,MPKI 减少 2。应如何向 A 和 B 分配缓存路数,才能获得最佳效果?
习题 2.24
[20]〈2.1,2.6〉 你正在设计一台 PMD,并针对低能耗进行优化。处理器核连同一个 16 KB 的 L1 数据缓存,只要没有休眠,就消耗 1 W。对于给定任务,如果 L1 命中率达到 100%,处理器核的平均 CPI 为 1,即 1000 个周期执行 1000 条指令。每增加一个用于访问 L2 或更低层级的周期,处理器核便增加一个停顿周期。根据以下规格,哪一种 L2 容量能让该 PMD,包括处理器核、L1、L2 和内存,在执行这个任务时消耗最少能量?
a. 处理器核频率为 1 GHz,L1 的 MPKI 为 100。
b. 256 KB L2 的延迟为 10 个周期,MPKI 为 20,背景功耗为 0.2 W,每次 L2 访问消耗 0.5 nJ。
c. 1 MB L2 的延迟为 20 个周期,MPKI 为 10,背景功耗为 0.8 W,每次 L2 访问消耗 0.7 nJ。
d. 内存系统的平均延迟为 100 个周期,背景功耗为 0.5 W,每次内存访问消耗 35 nJ。
习题 2.25
[20]〈2.2〉 遵循 DDR 标准的存储系统,在内存时钟的每个边沿传输 64 位数据。为了容忍每次传输中的单个位损坏,无论它来自随机软错误,还是某个 DRAM 引脚或连线的硬错误,可靠存储系统会为每次 64 位数据传输附加 8 位编码。通常采用 Hamming 码,实现单错纠正、双错检测(SECDED)。
但是,有些硬件基础设施需要更高的可靠性。例如,它们可能要求即使整颗 DRAM 芯片及其全部输出位都失效,仍能保证纠错,这种能力称为 Chipkill。你能否设计一个简单的存储系统,在一颗 DRAM 芯片失效时仍能提供正确数据?提供这种更高可靠性有哪些代价?你或许不是编码理论专家,但很可能熟悉 RAID 存储实现中采用的奇偶校验和循环冗余校验(CRC)。
习题 2.26
[20]〈2.4〉 本章以共享缓存访问和 prime–probe 为主要例子介绍了侧信道。请列举存储层次结构中的其他几种侧信道,说明攻击者可能如何利用它们,以及处理器体系结构设计者可以如何防御这些攻击。
习题 2.27
[20]〈2.3〉 考虑以下三种四路组相联 L2 缓存设计。
(i) 并行访问标签和数据: 标签查找耗时 4 个周期、能耗 20 pJ,与耗时 20 个周期、能耗 1000 pJ 的数据阵列访问并行进行。
(ii) 串行访问标签和数据: 先进行耗时 4 个周期、能耗 20 pJ 的标签查找,再访问单独一路的数据阵列,后者耗时 20 个周期、能耗 250 pJ。
(iii) 带路预测的标签和数据访问: 先访问路预测器,耗时 1 个周期、能耗 5 pJ;随后并行访问预测路的标签和数据,分别耗时 4 和 20 个周期,能耗分别为 5 pJ 和 250 pJ。如果路预测错误,再并行访问其余三路的标签和数据,标签与数据查找分别耗时 4 和 20 个周期,能耗分别为 15 pJ 和 750 pJ。
假设路预测准确率为 80%,分别按性能和能耗对这三种设计排序。
习题 2.28
[20]〈2.3〉 本章介绍了使用大容量 L4 DRAM 缓存的可能性,并最终讨论了 Alloy Cache 设计。为了减轻 DRAM 访问的高代价,Alloy Cache 采用直接映射结构。通常认为,直接映射缓存可能具有较高的冲突未命中率。你认为这会成为 Alloy Cache 的问题吗?如果会,可以如何缓解?进一步讨论在 Alloy Cache 中使用较大数据块的利弊。例如,采用 4 KB 数据块会有哪些影响?
习题 2.29
[20]〈2.3〉 考虑一种基准 Alloy Cache 设计:访问标签需要 30 个周期,之后再花 4 个周期接收数据。如果标签访问发现未命中,就发起一次平均耗时 100 个周期的内存访问。由于确认 Alloy Cache 未命中耗时很长,设计中引入一个耗时 1 个周期的命中/未命中预测器,与 Alloy Cache 访问并行工作。若预测命中,操作序列与基准设计完全一样;若预测未命中,就在查找 Alloy Cache 的同时发起内存访问。
计算这两种设计从 Alloy Cache 开始、包括后续层级在内的平均访问延迟。假设预测器的表现如下,所有百分比都以全部访问为分母:(i) 对 80% 的访问正确预测为命中;(ii) 对 5% 的访问正确预测为未命中;(iii) 对 5% 的访问错误地预测为命中;(iv) 对 10% 的访问错误地预测为未命中。
习题 2.30
[10/10]〈2.1,2.2,2.3〉 一个组中的各路,可以看作按优先级从高到低排列的列表。每次访问该组,都可以重新排列列表,改变块的优先级。从这一角度看,缓存管理策略可分解为三个子策略:插入(Insertion)、提升(Promotion)和淘汰选择(Victim Selection)。插入规定新取回的块放在优先级列表的什么位置;提升规定每次访问某块,即缓存命中时,如何调整它在列表中的位置;淘汰选择规定发生未命中时,移除列表中的哪一项,为新块腾出空间。
a. 能否用插入、提升和淘汰选择三个子策略描述 LRU 缓存策略?
b. 能否提出其他具有竞争力、值得进一步探索的插入与提升策略?
习题 2.31
[15]〈2.1,2.3〉 处理器运行多个程序时,末级缓存通常由所有程序共享。这会引起相互干扰:一个程序的行为与缓存占用,会影响其他程序可用的缓存。
首先,这带来了服务质量(QoS)问题:干扰使程序获得的资源更少、性能更低,无法达到例如云服务运营者所承诺的水平。其次,这还涉及隐私:程序可以利用侧信道攻击,根据自己受到的干扰,推断其他程序的内存访问模式。可以为末级缓存增加哪些策略,使一个程序的行为不受其他共享缓存程序的影响?
习题 2.32
[15]〈2.3〉 容量达数 MB 的大 L3 缓存,可能需要数十个周期才能访问,因为信号必须经过很长的连线。例如,访问一个 16 MB L3 可能需要 20 个周期。可以不把整个 16 MB 缓存组织成每次访问都耗时 20 个周期的结构,而将它组织为由较小缓存存储体构成的阵列。有些存储体离处理器核较近,有些则较远。
这形成了非均匀缓存访问(NonUniform Cache Access,NUCA):其中 2 MB 可能只需 8 个周期,再往外的 2 MB 需要 10 个周期,依此类推,直到最后 2 MB 需要 22 个周期。你可以引入哪些新策略,使 NUCA 缓存的性能达到最大?
习题 2.33
[10/10/10]〈2.2〉 考虑一台桌面系统,其处理器连接到容量为 2 GB、带纠错码(ECC)的 DRAM。假设只有一个 72 位宽的内存通道,其中 64 位用于数据、8 位用于 ECC。
a. [10]〈2.2〉 如果采用 1 Gb DRAM 芯片,DIMM 上需要多少颗 DRAM?如果 DIMM 的每个数据引脚只连接一颗 DRAM,那么每颗 DRAM 必须有多少个数据 I/O?
b. [10]〈2.2〉 为支持 32 B 的 L2 缓存块,需要多大的突发长度?
c. [10]〈2.2〉 从已激活页面读取数据时,不计 ECC 开销,计算 DDR2-667 和 DDR2-533 DIMM 的峰值带宽。
习题 2.34
[20]〈2.3〉 在末级缓存中准确跟踪 LRU 信息,主要面临哪些挑战?
习题 2.35
[20]〈2.3〉 晶体管在电源和地之间会持续存在一定漏电流。处理器内部的能耗分为两类:晶体管切换时产生电流所消耗的动态能耗,以及每个晶体管在每个周期都存在漏电流所产生的漏电能耗。动态能耗取决于切换活动,漏电能耗则取决于晶体管数量。现代微处理器超过一半的面积由缓存占据,因此缓存是总漏电能耗的主要来源。
一种降低漏电能耗的办法,是通过电源门控切断晶体管供电,使其不再漏电。但有一个问题:如果切断缓存块中晶体管的供电,该块中保存的数据就会丢失。注意,假如某缓存块每周期消耗 X 单位的漏电能量,那么从内存取回该块就需要消耗 1000X 单位的动态能量。请利用上述技术,为末级缓存设计一种机制,在尽量少影响性能的同时,显著降低系统总能耗。
习题 2.36
[12]〈2.2〉 你正在配置一台服务器,它使用 16 核、3 GHz 的片上多处理器(CMP)。假设 L2 未命中回填不会被延迟,处理器执行某工作负载时的总体 CPI 为 2.0。L2 缓存行大小为 32 字节,系统使用 DDR4-2666 DIMM。若带宽需求有时达到平均值的两倍,应提供多少个独立内存通道,才能使系统不受内存带宽限制?该工作负载平均每 1000 条指令发生 6.67 次 L2 未命中。
习题 2.37
[15]〈2.2〉 考虑一个有 4 个内存通道的处理器。连续的内存块应放在同一存储体中,还是应分散到不同通道上的不同存储体?
习题 2.38
[15]〈2.2〉 计算机空闲时,可以让它待机,此时 DRAM 仍保持活动;也可以让它休眠。假设休眠只需将 DRAM 的内容复制到 Flash 等非易失介质。若向 Flash 读取或写入一个 64 字节缓存行需要 2.56 J,而 DRAM 对应操作需要 0.5 nJ,DRAM 的空闲功耗为 1.6 W,对应 8 GB 容量,那么系统至少空闲多久,休眠才有利?假设主存容量为 8 GB。
译注: 原页所印 Flash 能耗确为
2.56 J,并非文本提取丢失前缀后的结果。这个数值与题中 DRAM 的 0.5 nJ 相差极大。
习题 2.39
[15]〈2.2,2.7〉 正如 2.7 节所讨论的,Intel i7 处理器有一个积极的预取器。设计一个极其积极的预取器,可能带来哪些不利影响?2
3 指令级并行性及其开发
“谁是第一?”
“America。”
“谁是第二?”
“先生,没有第二。”
这是两位观众在 1851 年帆船赛上的一段对话;该赛事后来被称为“America’s Cup”。这段对话启发 John Cocke 将 IBM 的一款研究处理器命名为“America”。它是第一款超标量处理器,也是 PowerPC 的前身。
“因此,IA-64 把赌注押在了这样一种未来上:功耗不会成为关键限制,大量资源……也不会损害时钟速度、路径长度或 CPI 等因素。我的态度显然是怀疑的……”
——Marty Hopkins(2000),IBM Fellow、早期 RISC 先驱。他在 2000 年如此评论 Intel 与 HP 联合开发的新款 Intel Itanium。Itanium 采用静态 ILP 方法(见附录 H),Intel 为此投入巨资,但它在 Intel 微处理器销售额中的占比从未超过 0.5%。
原章 DOI:10.1016/B978-0-443-15406-5.00003-1。原章版权:Copyright © 2026 Elsevier Inc. 保留所有权利,包括文本与数据挖掘、AI 训练及类似技术相关权利。
3.1 引言
大约从 1985 年起,所有处理器都采用流水线,使指令的执行相互重叠,从而提高性能。指令之间这种潜在的重叠称为指令级并行性(instruction-level parallelism,ILP),因为这些指令可以并行求值。本章与附录 H 将讨论一系列技术:通过开发指令之间更多的并行性,扩展基本的流水线思想。
本章内容比附录 C 的基本流水线知识深入得多。如果你对附录 C 的概念还不够熟悉,建议先复习该附录,再进入本章。
本章首先考察数据冒险和控制冒险施加的限制,然后讨论如何增强编译器与处理器开发并行性的能力。前两节将介绍大量概念,本章后续内容以及下一章都建立在这些概念之上。
开发 ILP 大体有两种可以分开讨论的方法:(1)依靠硬件动态发现和开发并行性;(2)依靠软件技术,在编译时静态找出并行性。本章介绍这两种方法的核心概念,因为为其中一种方法开发的许多技术,也已用于主要依赖另一种方法的设计。采用动态硬件方法的处理器,包括近期所有 Intel、AMD 处理器以及许多 Arm 处理器,如今已主导桌面和服务器市场。同样的方法也已普遍用于平板电脑及大多数智能手机中的处理器。在物联网领域,功耗与成本约束比性能目标更重要,因此设计者开发的 ILP 程度较低。从 20 世纪 80 年代开始,人们曾多次尝试更激进的编译器方法,最近的一次是 1999 年推出的 Intel Itanium 系列。尽管投入了巨大的努力,这些方法只在领域专用体系结构,或具有大量数据级并行性、结构良好的科学应用中取得了成功(见第 7 章)。
本章还讨论 ILP 方法的局限,因为正是这些局限直接促成了向多核处理器的转变。在权衡 ILP 与线程级并行性(TLP)的使用时,理解这些局限仍然很重要。
本节讨论程序与处理器中哪些特征会限制可开发的指令间并行性,以及程序结构与硬件结构之间的关键映射关系。理解这种映射,才能判断某种程序属性是否真的会限制性能,以及会在什么情况下构成限制。
流水线处理器的 CPI(每条指令的时钟周期数),等于基础 CPI 与各种停顿的贡献之和:
理想流水线 CPI 衡量一种实现所能达到的最高性能。降低等号右侧的任意一项,就能降低流水线的总体 CPI;换一种说法,就是提高 IPC(每个时钟周期执行的指令数)。利用上式,可以按照某项技术降低总体 CPI 中的哪一部分,对各种技术加以描述。图 3.1 列出了本章与附录 H 将研究的技术,以及附录 C 入门内容涵盖的主题。本章将看到,我们用来降低理想流水线 CPI 的技术,也会使冒险处理变得更加重要。
| 技术 | 所减少或改善的部分 | 小节 |
|---|---|---|
| 转发与旁路 | 数据冒险停顿 | C.2 |
| 简单分支调度与预测 | 控制冒险停顿 | C.2 |
| 基本编译器流水线调度 | 数据冒险停顿 | C.2、3.2 |
| 基本动态调度 | 真依赖引起的数据冒险停顿 | C.7 |
| 循环展开 | 控制冒险停顿 | 3.2 |
| 每周期发射多条指令 | 理想 CPI | 3.3、3.8 |
| 深流水线 | 更高的时钟频率 | 3.3 |
| 高级分支预测 | 控制冒险停顿 | 3.4 |
| 寄存器重命名 | 输出依赖(WAW)与反依赖(WAR)引起的数据冒险停顿 | 3.5 |
| 结合推测执行的动态调度 | 数据冒险停顿 | 3.6 |
| 动态内存消歧 | 内存访问指令引起的数据冒险停顿 | 3.7 |
| 编译器依赖分析、软件流水线、踪迹调度(trace scheduling) | 理想 CPI、数据冒险停顿 | H.2、H.3 |
| 对编译器推测执行的硬件支持 | 理想 CPI、数据冒险停顿、控制冒险停顿 | H.4、H.5 |
| 同时多线程(SMT) | 停顿造成的空闲周期 | 3.11 |
图 3.1 附录 C、第 3 章与附录 H 研究的主要技术,以及各项技术影响的 CPI 公式分量。
什么是指令级并行性?
本章的所有技术都开发指令之间的并行性。一个基本块(basic block)内部可用的并行性很少。基本块是一段顺序代码,分支只能从入口进入,并且只能从出口离开。典型 RISC 程序中,动态执行的指令里,分支所占比例通常为 15%~25%,这意味着两个分支之间会执行 3~6 条指令。由于这些指令很可能相互依赖,基本块内部能够实现的重叠程度,往往还小于基本块的平均大小。要显著提高性能,就必须跨越多个基本块开发 ILP。
提高 ILP 最简单、也最常用的方法,是开发循环各次迭代之间的并行性。这种并行性通常称为循环级并行性。
下面是一个简单例子:循环将两个各含 1000 个元素的数组相加,而且完全可以并行执行。
虽然每次循环迭代内部几乎没有指令重叠的机会,但任意一次迭代都可以与其他任何迭代重叠。本章将介绍多种将这种循环级并行性转化为 ILP 的技术。其基本方法是展开循环:可以由编译器静态展开(下一节讨论),也可以由硬件动态展开(3.3~3.8 节讨论)。
开发循环级并行性的另一种重要方法,是在向量处理器与图形处理单元(GPU)中使用 SIMD;第 4 章将介绍这两类处理器。SIMD 指令通过并行处理少量到中等数量的数据项(通常为 2~16 个),开发数据级并行性。向量指令则同时利用并行执行单元与深流水线,并行处理大量数据项,从而开发数据级并行性。例如,上述代码用最简单的方式实现时,每次迭代需要 7 条指令:两次加载、一次加法、一次存储、两次地址更新和一次分支,总计 7000 条指令。在某种每条指令处理 4 个数据项的 SIMD 体系结构上,所需指令数可能只有四分之一。在某些向量处理器上,这段代码可能只需 4 条指令:两条向量指令从内存加载向量 x 与 y,一条向量指令将它们相加,另一条向量指令将结果向量写回。当然,这些指令会以流水线方式执行,延迟也相对较长,但这些延迟可以相互重叠。
数据依赖与冒险
要确定程序有多少并行性,以及如何开发这些并行性,关键在于判断一条指令如何依赖另一条指令。具体而言,要开发 ILP,就必须确定哪些指令可以并行执行。若两条指令相互独立,那么只要流水线有足够资源、不存在结构冒险,它们就能在任意深度的流水线中同时执行,而不引起停顿。若两条指令存在依赖,它们就不能并行,而必须按顺序执行,不过通常仍可以部分重叠。两种情况下,关键都是确定一条指令是否依赖另一条指令。
数据依赖
依赖分为三类:数据依赖(也称真数据依赖)、名依赖与控制依赖。若满足以下任一条件,指令 就对前面的指令 存在数据依赖:
- 指令 产生一个可能被指令 使用的结果。
- 指令 对指令 存在数据依赖,而指令 对指令 存在数据依赖。
第二个条件只是说,如果指令 经由第一类依赖组成的链条,间接依赖指令 ,两者也存在数据依赖。这条依赖链可以长到贯穿整个程序。注意,单条指令内部的依赖,例如 add x1,x1,x1,不计作这里所说的依赖。
例如,考虑下面的 RISC-V 代码。它把寄存器 f2 中的标量加到内存中的一个向量上;该向量从地址 0(x1) 开始,最后一个元素位于地址 0(x2)。
该指令序列中的数据依赖既涉及浮点(FP)数据:
也涉及整数数据:
上面两个存在依赖的序列中,箭头都表明每条指令依赖前一条指令。此处及后续例子的箭头表示,为正确执行而必须保留的顺序:箭尾所在指令必须先于箭头指向的指令。
若两条指令存在数据依赖,就必须按顺序执行,不能同时执行或完全重叠。依赖意味着,两条指令之间存在由一个或多个数据冒险组成的链条。(附录 C 对数据冒险作了简要说明,稍后我们会给出精确定义。)若同时执行这两条指令,具有流水线互锁的处理器就会检测到冒险并停顿,前提是流水线深度大于两条指令之间以周期数计的距离;这会减少甚至完全消除重叠。对于没有互锁、依靠编译器调度的处理器,编译器不能把有依赖的指令调度成完全重叠,否则程序就无法正确执行。指令序列中的数据依赖,反映了生成这些指令的源代码中存在的数据依赖。原始数据依赖的作用必须得到保留。
依赖是程序的属性。 某种依赖是否真的会使处理器检测到冒险,以及冒险是否真的会导致停顿,则是流水线组成的属性。理解这种区别,是理解如何开发 ILP 的关键。
数据依赖传达三方面信息:(1)存在冒险的可能性;(2)计算结果必须遵循的顺序;(3)可开发并行性的上限。本章末尾的一个陷阱条目将讨论这些限制,附录 H 会作更详细的探讨。
由于数据依赖会限制可开发的 ILP,本章的一项重点就是如何克服这些限制。可以采用两种方式:(1)保留依赖,但避免冒险;(2)通过变换代码消除依赖。在不改变依赖的前提下避免冒险,主要依靠代码调度;编译器和硬件都可以进行这种调度。
数据值既可以通过寄存器,也可以通过内存位置,在指令之间传递。当数据流经寄存器时,检测依赖比较直接,因为寄存器名称固定在指令编码中;不过,中间若夹有分支,问题就会更复杂,而且为确保正确性,编译器或硬件必须采取保守做法。当加载指令使用了先前存储指令产生的数据值时,就会形成经由内存位置传递的依赖。这类依赖更难检测,因为两个看起来不同的地址,可能指向同一个位置。例如,100(x4) 与 20(x6) 可能是同一个内存地址。此外,同一条加载或存储指令每次执行时,其有效地址可能不同;因此,100(x6) 与 20(x4) 有时相同、有时不同,这进一步增加了依赖检测的难度。
本章将研究用于检测涉及内存位置的数据依赖的硬件,但也会看到这些技术本身的局限。编译器对这类依赖的检测技术,对于发现循环级并行性至关重要。
名依赖
第二类依赖是名依赖(name dependence)。当两条指令使用同一个寄存器或内存位置,也就是同一个“名称”,但与该名称有关的数据并未在它们之间传递时,就存在名依赖。设指令 在程序顺序中先于指令 ,两者之间可能存在两种名依赖:
- 若指令 写入的寄存器或内存位置被指令 读取, 与 之间就存在反依赖(antidependence)。必须保留原始顺序,确保 读到正确的值。在前面的例子中,
fsd与addi之间存在关于寄存器x1的反依赖。
- 若指令 与指令 写入同一个寄存器或内存位置,就存在输出依赖(output dependence)。必须保留它们之间的顺序,确保最后写入的值来自指令 。
反依赖和输出依赖都属于名依赖,而不是真数据依赖,因为这两条指令之间并没有传递任何值。既然名依赖不是真依赖,只要改变指令所使用的名称,即寄存器编号或内存位置,使它们不再冲突,相关指令就可以同时执行或重新排序。对寄存器操作数进行这种重命名比较容易,这称为寄存器重命名。寄存器重命名既可以由编译器静态完成,也可以由硬件动态完成。
数据冒险
在讨论分支引起的依赖之前,先看看依赖与流水线数据冒险之间的关系。如果两条指令存在名依赖或数据依赖,并且它们的执行重叠到足以改变相关寄存器操作数或内存位置的访问顺序,就会发生冒险。由于存在依赖,我们必须保留所谓的程序顺序:即按照原始源程序,一次执行一条指令时所遵循的顺序。软件与硬件技术的共同目标,是仅在程序顺序会影响程序结果时才保留它,从而开发并行性。检测并避免冒险,可以确保保留必要的程序顺序。
根据指令中读、写访问的顺序,数据冒险可分为三类。按照惯例,冒险以流水线必须保留的程序顺序来命名。考虑两条指令 与 ,其中 在程序顺序中先于 。可能的数据冒险如下:
- RAW(read after write,写后读): 试图在前面的指令 写入源操作数之前读取它,因此错误地读到了旧值。这是最常见的冒险,对应真数据依赖。必须保留程序顺序,确保 得到 产生的值。
- WAW(write after write,写后写): 试图在 写入某个操作数之前写入它。最终写入操作按错误的顺序完成,使目标寄存器或内存位置中留下的是 写入的值,而非 写入的值。这种冒险对应输出依赖。只有在多个流水级都可能执行写入,或者允许指令在前面的指令停顿时继续推进的流水线中,才会发生 WAW 冒险。
- WAR(write after read,读后写): 试图在 读取某个目标位置之前写入它,因此 错误地读到了新值。这种冒险源于反依赖。多数静态发射流水线中,即使是更深的流水线或浮点流水线,也不会发生 WAR 冒险,因为所有读取都在较早阶段完成(附录 C 的流水线中为 ID),所有写入都在较晚阶段完成(附录 C 中为 WB)。若某些指令在流水线前部写入结果,而另一些指令在后部才读取源操作数,就可能发生 WAR 冒险;指令重新排序时也可能发生,本章将讨论这种情况。
注意,RAR(read after read,读后读)并不是冒险。
控制依赖
最后一类依赖是控制依赖。控制依赖确定指令 相对于某条分支指令的顺序,使 按正确的程序顺序执行,而且只在应该执行时才执行。除程序第一个基本块中的指令外,每条指令都对一组分支存在控制依赖;一般来说,要保留正确的程序顺序,就必须保留这些控制依赖。最简单的控制依赖例子之一,是 if 语句中 then 部分的语句对分支的依赖。例如:
S1 对 p1 存在控制依赖,S2 对 p2 存在控制依赖,但不依赖 p1。一般而言,控制依赖施加两项约束:
- 对某条分支存在控制依赖的指令,不能移到该分支之前,使其执行不再受该分支控制。例如,不能把
if语句then部分的一条指令移到if语句之前。 - 对某条分支不存在控制依赖的指令,不能移到该分支之后,使其执行受到该分支控制。例如,不能把
if之前的一条语句移入then部分。
严格保持程序顺序的处理器,也会保持控制依赖。不过,只要不影响程序的正确性,我们可能愿意执行本不该执行的指令,从而违反控制依赖。
因此,必须保留的关键属性并不是控制依赖本身。真正决定程序正确性的两项属性,是异常行为与数据流;通常,通过保持数据依赖与控制依赖,就能保留这两项属性。
保持异常行为,意味着无论如何改变指令执行顺序,都不能改变程序触发异常的方式。这个要求常被放宽为:指令执行顺序的改变,不得使程序产生新的异常。下面的简单例子说明,保持控制依赖与数据依赖如何避免这类问题。
容易看出,若不保持涉及 x2 的数据依赖,就会改变程序结果。较不明显的是,如果忽略控制依赖,把加载指令移到分支之前,加载指令就可能引发内存保护异常。注意,没有数据依赖阻止我们交换 beq 与 ld,限制只来自控制依赖。要在保留数据依赖的同时重新安排这两条指令,我们希望能够在分支跳转时直接忽略这个异常。3.3 节将介绍一种称为推测执行(speculation)的硬件技术,它使我们能够克服控制依赖造成的限制,包括这里的异常问题。附录 H 则介绍支持推测执行的软件技术。
保持数据依赖与控制依赖所保留的第二项属性是数据流。数据流是数据值在产生结果的指令与使用结果的指令之间的实际流动。分支使数据流具有动态性,因为某条指令的数据来源可能位于多个位置。换言之,仅仅保持数据依赖并不够,因为一条指令可能对不止一条先前指令存在数据依赖。究竟由哪条先前指令向它提供数据值,取决于程序顺序;保持控制依赖,就能确保这一顺序。
例如,考虑以下代码片段:
这里,or 使用的 x1 值取决于分支是否跳转。仅有数据依赖不足以保证正确性。or 对 add 和 sub 都存在数据依赖,但只保持这种先后顺序,还不足以保证正确执行。
指令实际执行时还必须保留数据流:若分支不跳转,or 应使用 sub 计算的 x1 值;若分支跳转,则应使用 add 计算的 x1 值。保持 or 对分支的控制依赖,就能防止数据流发生不合法的改变。同理,不能把 sub 移到分支之前。3.3 节将看到,帮助处理异常问题的推测执行,也能在保留数据流的同时减轻控制依赖的影响。
有时,我们能够确定,违反控制依赖既不会影响异常行为,也不会影响数据流。考虑下面的代码:
假设我们知道,在标记为 skip 的指令之后,sub 的目标寄存器 x4 不会再被使用。(某个值是否会被后续指令使用,这种属性称为活跃性,liveness。)若 x4 不再被使用,那么在分支之前改变它的值,就不会影响数据流,因为在 skip 之后的代码区域里,x4 是死的(dead),而不是活跃的(live)。因此,如果 x4 是死的,而且现有的 sub 指令不会产生异常——处理器处理后会继续恢复同一进程执行的异常除外——就可以把 sub 移到分支之前,因为这一改动不会影响数据流。
如果分支跳转,sub 虽然会执行,却不会起作用;但它也不会影响程序结果。这种代码调度也是推测执行的一种,通常称为软件推测执行,因为编译器是在对分支结果下注;这里押的是分支通常不跳转。附录 H 讨论更激进的编译器推测执行机制。通常,上下文足以说明“推测执行”是由硬件还是软件实现;若不够清楚,我们会明确写出“硬件推测执行”或“软件推测执行”。
通过检测控制冒险并引入控制停顿,可以保持控制依赖。多种软件与硬件技术能够消除或减少控制停顿,我们将分别在 3.2 节和 3.4 节讨论。
3.2 显露 ILP 的基本编译器技术
本节考察如何利用简单的编译器技术,增强处理器开发 ILP 的能力。这些技术对于采用静态发射或静态调度的处理器至关重要。
掌握这些编译器技术后,我们将在后文研究采用静态发射的处理器的设计与性能。附录 H 将研究更复杂的编译器方案及配套硬件,以便处理器开发更多 ILP。
基本流水线调度与循环展开
要让流水线保持满载,必须找出可以在流水线中重叠执行的独立指令序列,开发指令之间的并行性。为避免流水线停顿,一条有依赖的指令与产生其源数据的指令之间,必须间隔相当于源指令流水线延迟的时钟周期数。编译器能否进行这种调度,既取决于程序中可用的 ILP,也取决于流水线中各功能单元的延迟。除非明确另作说明,本章均采用图 3.2 的浮点单元延迟。我们假设使用标准的五级整数流水线,因此分支有 1 个时钟周期的延迟。我们还假设各功能单元完全流水线化,或者复制了与流水线深度相同的份数,使任意类型的操作都能在每个时钟周期发射,不存在结构冒险。
| 产生结果的指令 | 使用结果的指令 | 延迟(时钟周期) |
|---|---|---|
| 浮点 ALU 操作 | 另一条浮点 ALU 操作 | 3 |
| 浮点 ALU 操作 | 双精度存储 | 2 |
| 双精度加载 | 浮点 ALU 操作 | 1 |
| 双精度加载 | 双精度存储 | 0 |
图 3.2 本章采用的浮点操作延迟。最后一列是为避免停顿,两条指令之间需要插入的时钟周期数。这些数值与浮点单元的平均延迟相近。浮点加载到存储的延迟为 0,因为加载结果可以经旁路直接提供给存储,无需使存储停顿。我们继续假设整数加载的延迟为 1,整数 ALU 操作的延迟为 0,后者也包括从 ALU 操作到分支的情况。
本节考察编译器如何通过变换循环,增加可用的 ILP。这个例子既展示一种重要技术,也引出附录 H 中更强大的程序变换。我们使用下面这段代码,把一个标量加到一个双精度(64 位)浮点向量的所有元素上:
每次迭代的循环体彼此独立,因此这个循环可以并行执行。附录 H 将形式化地说明这一概念,并介绍如何在编译时判断循环迭代是否独立。这里先分析这个循环的性能,看看对于具有给定延迟的 RISC-V 流水线,怎样利用并行性提高性能。
第一步是将上述代码转换为 RISC-V 汇编语言。在下面的代码中,寄存器 x1 初始化为数组中地址最高的元素的地址,f2 保存标量值 。寄存器 x2 的初值满足:x2+8 是最后一个待处理数组元素的地址。
直接转换得到、尚未针对流水线调度的 RISC-V 代码如下:
先看看把该循环调度到延迟如图 3.2 所示的简单 RISC-V 流水线上时,运行效果如何。
例题 展示该循环在 RISC-V 流水线上未调度与调度后的执行情况,包括所有停顿或空闲时钟周期。调度时应考虑浮点操作的延迟。
解答 未进行任何调度时,循环按下表执行,每个数组元素需要 9 个周期。1
| 指令或停顿 | 发射时钟周期 |
|---|---|
Loop: fld f0,0(x1) | 1 |
| 停顿 | 2 |
fadd.d f4,f0,f2 | 3 |
| 停顿 | 4 |
| 停顿 | 5 |
fsd f4,0(x1) | 6 |
addi x1,x1,-8 | 7 |
bne x1,x2,Loop | 8 |
经过调度,可以只保留两次停顿,将时间缩短为 7 个周期:
fadd.d 之后的停顿,是为了等待 fsd 使用它的结果;调整 addi 的位置,则避免了 fld 之后的停顿。
在上例中,每 7 个时钟周期完成一次迭代,并写回一个数组元素,但真正操作数组元素的工作只占其中 3 个周期,即加载、加法与存储。其余 4 个周期是循环开销——addi 和 bne——以及两次停顿。要消除这 4 个周期,就需要相对于开销指令,增加实际操作的数量。
相对于分支与开销指令,增加实际指令数量的一种简单办法是循环展开。展开只是将循环体复制多次,并调整循环终止代码。
循环展开也能改善调度。它降低分支出现的频率,使来自多次迭代的指令可以一起调度。这样,通过交错安排展开后的各次迭代指令,就能消除数据使用停顿。如果展开时仅仅复制指令,重复使用同一组寄存器可能妨碍有效调度。因此,我们希望每次迭代使用不同的寄存器,这会增加所需的寄存器数量。
例题 将该循环展开为包含 4 份循环体的形式。假设 x1−x2,即数组大小,初始为 32 的倍数,意味着循环迭代次数为 4 的倍数。消除明显冗余的计算,不重复使用任何寄存器。
解答 合并 addi 指令,并删去展开时复制出的多余 bne 后,结果如下。注意,现在 x2 的初值应满足:x2+32 是最后 4 个元素的起始地址。
译注:上面的第 3 份循环体在原页中确实使用
f0,与题目“不重复使用寄存器”的要求不符;下一例调度后的对应位置使用f10。
我们消除了 3 条分支和 3 次对 x1 的递减。加载与存储指令中的地址作了补偿,因而可以合并修改 x1 的 addi 指令。这种优化看似简单,实际上需要符号代换与化简。符号代换和化简会重组表达式,使常数可以合并,例如把 改写为 ,再化简为 。附录 H 将介绍更一般的此类优化,用来消除存在依赖的计算。循环展开通常在编译过程的早期进行,使冗余计算显露出来,再由优化器消除。
若不进行调度,展开后的循环中,每条浮点加载或运算后面都紧接着一条依赖它的操作,因此都会引起停顿。这个展开后的循环需要 26 个时钟周期:每条 fld 停顿 1 个周期,每条 fadd.d 停顿 2 个周期,再加上 14 个指令发射周期;平均每个元素 6.5 个时钟周期。但经过调度,性能还能显著提高。
真实程序中,通常无法事先知道循环次数的上界。假设它为 ,我们希望展开循环,生成 份循环体。这时不生成单个展开循环,而是生成两个连续的循环。第一个执行 次,循环体与原循环相同。第二个以展开后的循环体为主体,外层循环迭代 次。(第 4 章会看到,这与向量处理器编译器中称为 strip mining 的技术相似。)当 很大时,大部分执行时间会花在展开后的循环体中。
上例通过展开消除开销指令,提高了循环性能,但也明显增大了代码。若针对前述流水线进行调度,展开后的循环性能如何?
例题 按图 3.2 的流水线延迟,对上例的展开循环进行调度,给出结果。
解答
译注:原页中最后两条存储的偏移确为正的
16、8,而addi x1,x1,-32位于它们之后。按所示顺序,这两个地址与对应加载的-16、-24不一致,不能保持原循环的数据写回位置。若将指针递减移到这两条存储之前,或在现有位置使用-16、-24,才能恢复对应地址;此处不替换原代码。
展开循环的总执行时间已降至 14 个时钟周期,即每个元素 3.5 个周期;相比之下,完全未展开、未调度时,每个元素为 8 个周期,已展开但未调度时则为 6.5 个周期。1
调度对展开循环带来的收益,比对原始循环更大。原因是循环展开显露出更多独立指令,可以通过调度最大限度地减少停顿;上述代码已经没有停顿。以这种方式调度循环,必须先认识到加载与存储彼此独立,可以交换顺序。
循环展开与调度小结
本章与附录 H 将介绍多种硬件与软件技术,利用 ILP 充分发挥处理器功能单元的潜力。多数技术的关键,是知道何时可以改变指令顺序,以及如何改变。在上面的例子中,我们进行了多次这样的改动;在人看来,这些改动显然是允许的。但实际系统必须由编译器或硬件,以系统化的方式完成这一过程。要得到最终的展开代码,需要作出以下判断与变换:
- 确认除循环维护代码之外,各次循环迭代彼此独立,从而判断循环展开能够带来收益。
- 使用不同寄存器,避免不同计算使用同一寄存器而产生不必要的约束,例如名依赖。
- 消除多余的测试与分支指令,调整循环终止和迭代代码。
- 观察到不同迭代中的加载和存储相互独立,从而确定展开后的加载与存储可以交换顺序。这种变换需要分析内存地址,确认它们没有指向同一地址。
- 调度代码,并保留一切为获得与原代码相同结果所必需的依赖。
所有这些变换共同的基础,是理解一条指令如何依赖另一条指令,以及在这些依赖之下,可以怎样修改或重新排列指令。
循环展开的收益受三种因素限制:(1)每进一步展开一次,能够摊薄的开销越来越少;(2)代码大小限制;(3)寄存器压力。先考虑循环开销。将循环展开 4 次后,指令之间已有足够的并行性,可以调度得完全没有停顿。实际上,14 个时钟周期中只有 2 个属于循环开销:维护下标值的 addi,以及结束循环的 bne。如果展开 8 次,开销就从每个元素 1/2 个周期降至 1/4 个周期。
第二项限制是展开导致代码增大。对于较大的循环,这可能成为问题,尤其是因此提高指令缓存未命中率时。
另一个常常比代码大小更重要的因素,是激进展开和调度可能造成寄存器不足。这种在大段代码中进行指令调度所产生的次生影响,称为寄存器压力。为了增加 ILP 而调度代码,会使活跃值的数量增加,这正是寄存器压力的来源。经过激进的指令调度后,可能无法为所有活跃值分配寄存器。变换后的代码在理论上更快,却可能因为寄存器短缺而失去部分乃至全部优势。不进行展开时,分支会充分限制激进调度,因此寄存器压力很少成为问题。但将展开与激进调度结合起来,就可能出现这一问题。对于多发射处理器,这一点尤其棘手,因为它们需要显露出更多可以重叠执行的独立指令序列。总体而言,复杂高层变换的潜在收益在生成详细代码之前很难测量,而这类变换的使用已使现代编译器的复杂度显著增加。
循环展开是增大可有效调度的直线代码片段的一种简单而实用的方法。它适用于多种处理器,从我们目前讨论的简单流水线,到本章后面将研究的多发射超标量处理器与 VLIW 处理器。
3.3 现代超标量处理器中的关键 ILP 概念
超标量处理器的理想 CPI 小于 1,通过硬件技术发现并开发 ILP。即使程序只经过适度优化,它们也能提供很高的性能,因此已成为服务器、桌面计算机、笔记本电脑和手机领域的主流选择。不过,它们的局限与设计复杂度,也促使芯片厂商将超标量思想与侧重数据级并行性的技术(见第 4 章的 SIMD)以及 TLP 技术(见第 5 章的多核)相结合。
采用 x86、Arm、RISC-V 等主流指令集体系结构(ISA)的处理器,必须忠实实现这些 ISA 的顺序语义。程序执行在功能上必须等价于在一个简单处理器上运行:该处理器按原始程序顺序执行指令,指令之间没有重叠。功能等价既涉及寄存器与内存位置中产生的值、引发的异常,也涉及这些值与异常变为可见的顺序。稍后将看到,许多超标量处理器虽然按照数据依赖决定的顺序执行指令,而非按照原始程序顺序执行,仍然能够保持功能等价。这类设计称为乱序(out-of-order,OOO)超标量处理器。由于多数现代超标量处理器都采用 OOO 流水线,许多人认为“超标量”与“乱序超标量”是同义词。本章后面也将介绍按程序规定顺序执行指令的低功耗、顺序超标量设计。
冗余代码消除、强度削弱和寄存器分配等基本编译器优化,对超标量处理器与标量处理器同样有益。不过,超标量处理器较少依赖循环展开等高级编译器技术,因为它们具有相应的硬件机制,能够在几十到几百条指令的窗口内实施类似优化。即使现有二进制程序没有为新处理器的流水线重新编译、重新优化,新一代超标量处理器也能使其获得性能提升。这个优点是超标量体系结构取得商业成功的关键因素之一。
更深的流水线与多发射
与前面讨论的简单流水线相比,超标量处理器通过改善 CPU 执行时间公式中的两个因素来提高性能。该公式为 :
- 更深的流水线:附录 C 的简单处理器采用五级流水线。超标量处理器采用更深的流水线,当代设计通常为 10~20 级。流水线更深,便可以缩短时钟周期;目前时钟频率为 1~5 GHz。两个整数操作数相加之类的简单操作仍只占一个流水级,而乘法、浮点操作、指令或数据缓存访问等较长延迟的操作,会占用多个流水级,通常为 2~4 级。不过,多数流水线大约有一半流水级,用于实现发现 ILP 并进行动态调度所需的复杂控制逻辑。
- 多发射或宽发射:附录 C 的简单处理器每个时钟周期启动一条指令,因此最佳流水线 CPI 为 1。超标量处理器试图在每个周期启动多条指令,当代设计为每周期 2~16 条。每周期启动 4 条指令的处理器,最佳 CPI 为 1/4,或者说最佳 IPC 为 4。这类处理器包含多个加法器、乘法器等功能单元,以并行执行指令。
例如,假设一个超标量处理器的发射宽度为 4 条指令,流水线深度为 15 级。它能够重叠执行 60 条指令,需要很高的 ILP 才能相对于简单流水线显著提高性能。
接下来先回顾 3.1 节提出的 ILP 挑战如何塑造了超标量处理器的设计,再在后续各节详细解释每项技术。
控制依赖 → 分支预测与推测执行
典型程序每 4~7 条指令就有一条分支。由此产生的控制依赖,严重限制了可开发的 ILP。
考虑 3.1 节中给数组元素加上一个标量的循环:
该循环单次迭代内部几乎没有并行性可供开发。要使不同迭代中的独立指令重叠执行,就必须迅速确定循环末尾 bne 的结果。本章后面将看到,15 级流水线的分支延迟通常为 5~10 个周期。控制循环结束的分支经常跳转,所以对于宽度为 4 条指令的流水线,每个分支延迟周期都意味着错失执行 4 条指令的机会,多发射与更深流水线带来的大部分性能收益因此被抵消。
编译器进行循环展开能够减少分支出现的频率,从而缓解这一问题。不过,合适的展开程度取决于处理器设计。宽度为 2、深度为 7 级的处理器,可能在循环展开 4 次后就表现良好;宽度为 4、深度为 15 级的处理器,却可能需要展开至 16 次,才能显露出足够的并行性。许多程序以二进制形式分发,很难针对每一种处理器流水线重新编译和优化。此外,循环展开对于条件语句(if-then-else)的分支并无帮助,而这类分支在循环内部也可能很常见。
超标量处理器利用动态分支预测与推测执行,减轻控制依赖的影响。其硬件结构保存最近分支执行的历史,据此预测分支是否跳转(方向预测),以及分支跳转后的下一条指令是什么(目标预测)。对于上面的简单循环,只需几次迭代和简单的历史记录结构,就足以高度确信该分支几乎总会跳转,而且其目标在整个程序执行过程中保持不变。面对包含数千条分支的程序,就需要更大、更复杂的预测结构来保存历史,并捕捉嵌套循环、直接或间接函数调用以及条件语句中可预测的行为模式;即使这些模式在执行过程中变化,也要能够捕捉。此外,深流水线与宽发射还要求处理器同时处理多条已预测、但仍在途的分支。
分支预测与取指令并行进行。每个时钟周期,硬件都必须确定下一周期访问指令时使用的程序计数器(PC)。第一次预测只能以当前 PC 为输入,此时甚至还不知道它是否指向分支,更不知道分支类型。因此,处理器通常采用多级方案,随着指令译码过程中逐步获得更多信息,不断修正预测。
在一条已预测分支之后取到的指令,会以推测方式执行,直到该分支本身执行、验证方向与目标预测为止。如果其中任一预测有误,就用恢复机制撤销错误预测分支之后推测取入并执行的所有指令。恢复完成后,从正确的 PC 继续执行。
超标量处理器要获得良好性能,分支预测就必须高度准确。假设我们的四发射处理器具有 10 周期分支延迟,对上面含 5 条指令的循环,预测准确率为 95%。每发生一次错误预测,处理器就会连续 10 个周期取入错误指令;对于四发射设计,这相当于损失执行 40 条指令的机会。要使 40 条指令在宽发射、深流水线中,以其他依赖允许的最快速度执行,处理器必须连续正确预测 7 条分支,其概率为 。连续执行 200 条指令而不发生错误预测的概率为 。即使忽略其他所有性能挑战,95% 的预测准确率仍会限制任意超标量处理器的持续性能,并限制流水线可采用的宽度与深度。
名依赖 → 寄存器重命名
分支预测使硬件能够进行循环展开,超标量处理器因而可以重叠执行多次迭代中的指令。对于我们的循环,关键是使不同迭代的加载指令 fld 重叠执行,因为这些指令有相当大的延迟,尤其是在部分加载发生 L1 缓存未命中时。然而,所有加载指令之间,都存在关于寄存器 f0 的名依赖(WAW)。图 3.3 展示了两次迭代之间的全部名依赖,即 WAW 与 WAR;它们使跨迭代的有效指令重叠无法实现。
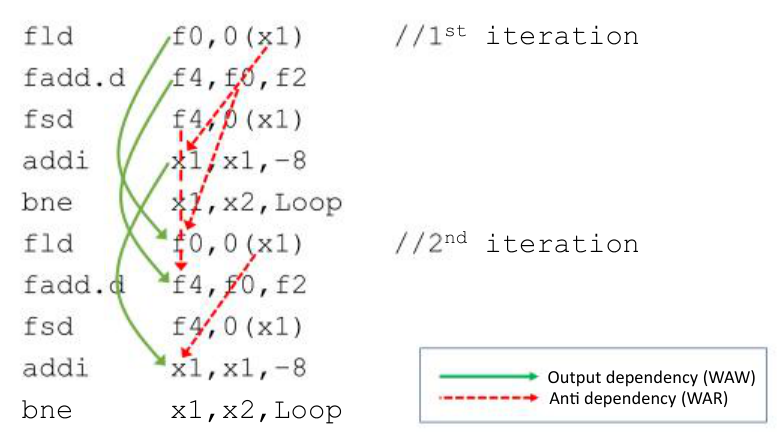
图 3.3 展开循环的两次迭代中,指令之间的全部名依赖。名依赖可以是输出依赖(WAW),也可以是反依赖(WAR)。图中 1st iteration、2nd iteration 分别表示第 1 次和第 2 次迭代;绿色实线为输出依赖,红色虚线为反依赖;指令与寄存器标识符保持原样。
如 3.2 节所示,编译器将循环展开 4 次时,会为每次迭代使用不同的一组整数寄存器,以消除名依赖。1 寄存器重命名试图用硬件完成同样的工作,但有两项主要区别。第一,硬件不能假定 ISA 定义的其他寄存器可供使用。尽管我们的示例代码只用了 f0、f2、f4 和 f6,其他所有浮点与整数寄存器都可能保存了程序前后部分需要使用的数据。第二,我们可能需要比 ISA 定义的数量更多的寄存器。
为了适应宽而深的流水线,将循环展开 10 次就需要 40 个浮点寄存器,每次迭代 4 个,超过了 RISC-V 定义的 32 个。1
硬件寄存器重命名通过实现数百个对软件透明的物理寄存器来应对这些挑战,并动态分配它们以消除名依赖。硬件维护指令引用的体系结构寄存器与实际实现的物理寄存器之间的映射。指令发射时,利用这一映射确定哪些物理寄存器保存输入操作数,并更新映射,指出哪个物理寄存器将保存输出操作数。如 3.4 节所讨论,其中一个难点是确定物理寄存器中的值何时不再需要,从而使该寄存器能被后续指令复用。2
数据依赖 → 利用动态调度实现乱序执行
分支预测对控制依赖进行推测,寄存器重命名消除经由寄存器的名依赖;在此基础上,超标量处理器通过动态调度,按数据依赖决定的顺序执行已取入的指令,这也称为数据流顺序。硬件实现两项功能。第一,跟踪所有待执行指令的输入操作数(物理寄存器)是否可用。当所有输入操作数都可用时,该指令就已就绪,可以执行。在我们的循环中,当 f4 与 x1 的值可用时,fsd 就已就绪。第二,根据指令年龄、指令关键程度等标准,从就绪指令中选择一部分,交给可用的功能单元执行。
动态调度会使指令乱序执行。在示例循环中,第一次迭代的加载 fld 可能发生缓存未命中,依赖它的加法 fadd.d 与存储 fsd 可能几十个周期都无法就绪。不过,addi 对该加载没有数据依赖,所以可以执行;这又使第二次迭代的加载能够执行。如果第二次加载缓存命中,那么第二次迭代的所有浮点指令,很可能比第一次迭代的对应指令更早完成。
动态调度受到操作数跟踪硬件容量的限制,这些结构通常能跟踪几十到一百条指令。当指令执行延迟可以静态确定时,编译器的静态调度效果很好;动态调度则能应对可变的执行延迟。这一点对于从多级缓存读取数据的加载指令尤其重要,因为它们的延迟可能从 2 个周期到 100 个周期不等。硬件会动态绕过缓存未命中的加载进行调度,执行后面任何独立的指令。这项优化是现代超标量处理器的一项关键性能优势。
内存依赖 → 推测性内存消歧
动态调度还必须遵守经由内存位置形成的依赖。考虑示例循环的以下版本:目标数组与输入数组不同,而且遍历两个数组的顺序也不同。
高性能的关键是尽早执行不同迭代的加载,因为其他浮点指令都对加载存在数据依赖,而加载访问缓存时可能具有很高的延迟。若硬件要把第 次迭代的加载调度到第 次迭代的存储之前,就必须先检查它们是否访问不同的内存地址。这种检查不一定能静态完成,因为 x1 与 x3 的值可能在编译时未知,编译器无法确定输入和输出数组是互不相交,还是有重叠。此外,存储的内存地址也不一定立即可用。只有影响 x3 值的所有先前指令都执行完,并且存储指令被分配给地址生成单元、算出有效地址 x3+40 后,才能进行检查。这种约束可能推迟下一条加载的执行,限制硬件可开发的 ILP。即使加载与存储的有效地址已知,硬件也可能无法安全地改变它们的顺序,因为这可能违反多处理器系统的存储一致性约束(见第 5 章)。
超标量处理器用推测性内存消歧(speculative memory disambiguation)应对内存依赖的不确定性。正如跟踪分支历史可以围绕控制依赖进行推测,硬件也会跟踪加载与存储指令的近期历史,学习哪些加载很可能依赖尚未算出地址的较早存储。对于不太可能存在依赖的加载,硬件会推测性地将其重排到较早的存储之前。当所有较早存储的地址都已确定,硬件就能验证这次重排是否正确。如果不正确,就必须重新执行加载及所有依赖它的指令,从错误推测中恢复。
推测恢复与精确异常 → 重排序缓冲区
超标量处理器上的程序执行,在功能上必须等价于一个指令之间完全不重叠的简单处理器。简单处理器只有在指令的全部依赖都已解决后才执行该指令,因此不需要预测分支结果,也不需要预测加载、存储指令的顺序。要保持功能等价,超标量处理器需要一种恢复机制,撤销分支错误预测,或加载与存储之间的依赖错误预测之后,错误执行的全部指令。该机制必须确保,错误执行的指令既不影响程序的数据流,即不更新寄存器或内存值,也不影响控制流,即不更新 PC。
这种等价要求也涵盖程序执行中触发的任何异常,例如加载指令的缺页异常,或浮点指令的算术溢出。在简单处理器中,异常发生并将控制权交给操作系统时,出错指令之前的所有指令均已完成,而出错指令之后的所有指令,都没有修改处理器状态(寄存器或内存位置),也没有触发异常。这一属性称为精确异常。超标量处理器一律预测指令不会引发异常,这通常是非常准确的预测。不过,在处理器确认某条可能引发异常的指令实际上不会引发异常之前,该指令之后的所有指令都必须视为推测执行的指令。
高级超标量处理器有两项属性,使精确异常更难实现。第一,它们会重排指令。在示例循环的第一次迭代中,存储指令触发缺页异常时,后续迭代中的若干加载和浮点指令可能已经执行,甚至可能各自触发了异常。第二,它们既对控制依赖,也对内存依赖进行推测。如果分支预测有误,在发现错误并恢复之前,部分已错误地全部或部分执行的指令,可能引发异常。如果推测性内存消歧有误,部分加载可能返回错误数据,进一步导致错误计算与错误异常。
超标量处理器使用重排序缓冲区(reorder buffer,ROB)从错误推测中恢复。ROB 是一种先进先出(FIFO)结构,临时保存指令结果,并且只允许这些结果按原始程序顺序,对程序的数据流和控制流产生永久影响。指令按照程序顺序获得 ROB 条目。指令乱序完成执行时,更新自身 ROB 条目,标记执行中检测到的潜在异常。每个时钟周期,硬件检查 ROB 中最老的指令,等待它们执行完成后,才允许结果永久影响寄存器和内存位置:丢弃物理寄存器中的较旧值,允许存储覆盖内存位置,并释放 ROB 条目。如果最老的指令是一条分支,而此前流水线对它的结果预测错误,就通过释放其后所有指令的 ROB 条目及其他临时缓冲区,例如为结果分配的物理寄存器,来撤销这些后续指令。撤销所有这些指令,能确保错误的分支推测不影响程序的数据流与控制流。随后从分支执行时算出的正确目标地址恢复执行。如果最老的指令是一条被错误重排到较早存储之前的加载,则撤销该加载本身及其后的所有指令,并从该加载指令的地址恢复执行。这种顺序确保内存依赖的错误推测不会影响程序的数据流与控制流。
ROB 提供的推测恢复也支持精确异常。如果 ROB 中最老的指令被标记为会产生缺页、算术溢出等异常,就撤销它本身以及后面的全部指令,再从操作系统相应异常处理程序的 PC 开始执行。硬件还会更新寄存器,帮助操作系统识别引发异常的指令与异常类型。只有当指令到达 ROB 头部时,才向操作系统报告异常,因此无论错误推测还是指令重排,都不会影响异常的报告顺序。
超标量处理器概览
图 3.4 概括了现代超标量处理器如何将多发射、深流水线与推测及动态调度技术结合起来。这样的处理器在整个流水线中,可以同时保有几十到几百条尚未完成的指令,包括多条已预测的分支,以及多条发生缓存未命中的加载、存储指令。处理器流水线由三部分组成,每部分都以流水线方式每周期处理多条指令。
处理器前端每周期取入并译码多条指令。它按顺序、以推测方式工作:利用分支预测确定每周期的 PC,但不重排指令。每条指令译码后,对寄存器操作数重命名,为结果分配一个 ROB 条目,再将指令发射到动态调度硬件结构中。如果没有空闲物理寄存器、ROB 条目或调度条目,前端就停止取入新指令,直到资源可用。我们用指令束(instruction bundle)表示同一个时钟周期内并行发射的一组指令。在多数超标量处理器中,同一指令束中的指令也会并行取入和译码。
执行引擎利用动态调度,以数据依赖所允许的速度,每周期推测性地、乱序处理多条指令。当一条指令的所有输入操作数都就绪,且有适当的功能单元可用时,就将它派发(dispatch)去执行。执行完成后,包括异常在内的指令结果会暂存在 ROB 条目中。硬件同时通知调度逻辑,因为部分依赖该指令的指令此时可能已经就绪。注意,同一指令束中的指令,很可能在不同的周期派发,也在不同的周期完成。硬件会重新排序并重叠执行来自多个指令束的指令。
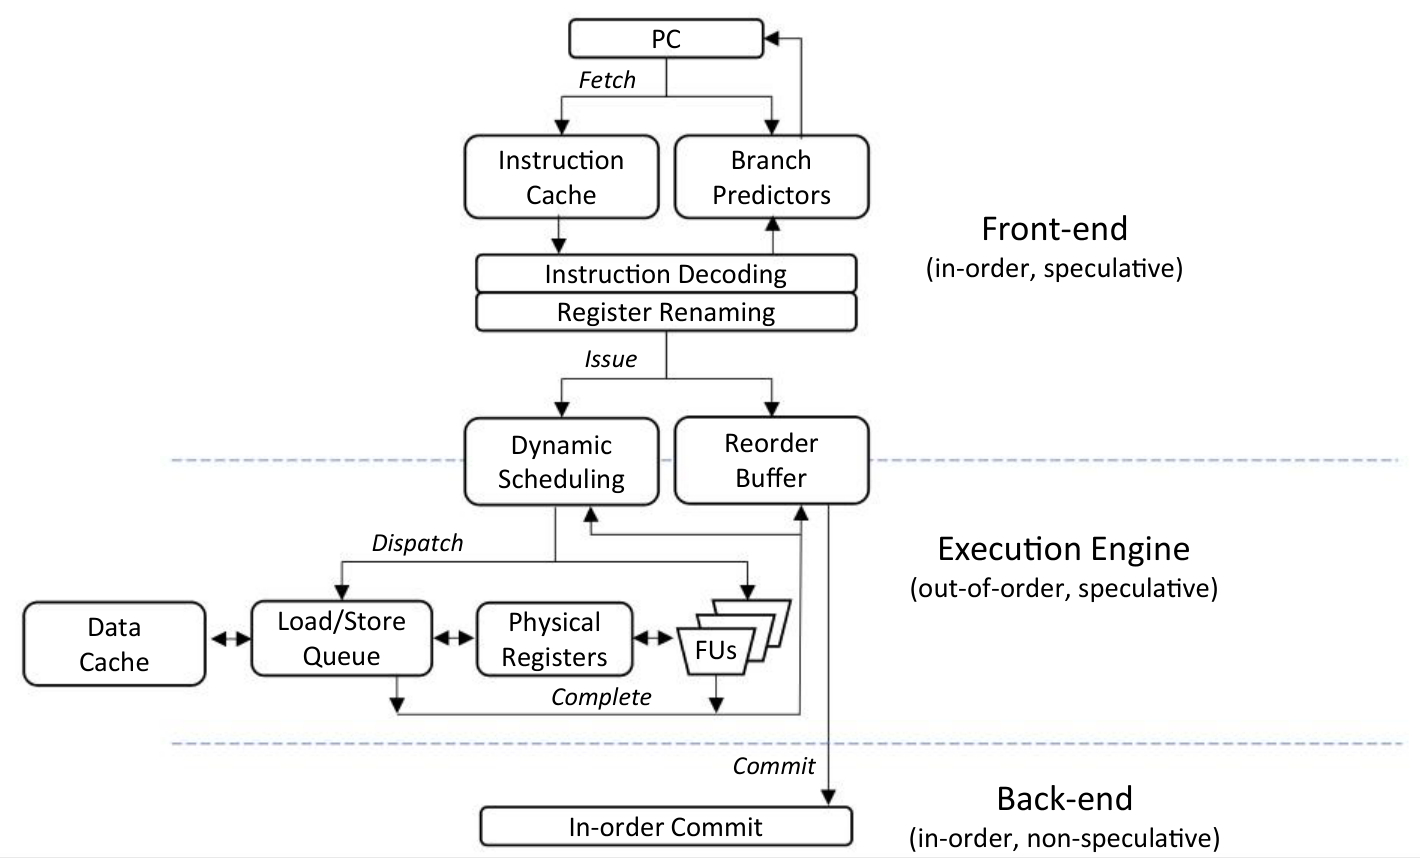
图 3.4 现代超标量乱序处理器流水线的高层概览。前端、执行引擎和后端都每周期处理多条指令。图中的若干硬件模块,例如缓存或某些功能单元,可能占据多个流水级。
图中文字对照:PC 为程序计数器;Instruction Cache 为指令缓存;Branch Predictors 为分支预测器;Instruction Decoding 为指令译码;Register Renaming 为寄存器重命名;Dynamic Scheduling 为动态调度;Reorder Buffer 为重排序缓冲区;Physical Registers 为物理寄存器;FUs 为功能单元;Load/Store Queue 为加载/存储队列;Data Cache 为数据缓存;In-order Commit 为顺序提交。Front-end 为前端(顺序、推测);Execution Engine 为执行引擎(乱序、推测);Back-end 为后端(顺序、非推测)。处理步骤 Fetch、Issue、Dispatch、Complete、Commit 依次为取指、发射、派发、完成、提交。
处理器后端利用 ROB,按程序顺序更新处理器状态、寄存器和内存位置,并从错误推测或异常中恢复。只有当指令成为 ROB 中最老的指令后,它才能提交(commit,也称退役,retirement),结果才会对体系结构可见。如果最老的指令引发异常或错误预测,就利用 ROB 撤销出错指令之后的指令:释放它们分配的物理寄存器和 ROB 条目,再从正确 PC 恢复执行。被撤销的指令中,有些可能已经执行完成,另一些则可能还在等待操作数。
了解现代乱序处理器的整体工作方式后,后续各节将深入考察其流水线中关键硬件结构的实现。3.8 节还会进一步讨论:每个流水级都要每周期处理多条指令,同时不违反任何依赖,这是复杂度的主要来源之一。
3.4 利用高级分支预测降低分支代价
程序必须通过频繁出现的分支来维持控制依赖,因此分支预测对于开发 ILP 至关重要。附录 C 讨论了简单的分支预测器:它们或者依赖编译时信息,或者仅根据一条分支自身已观察到的动态行为进行预测。随着流水线加深、每周期发射数增加,在途指令越来越多,更准确的分支预测也越来越重要。本节研究提高动态预测准确率的硬件技术,既包括方向预测(跳转或不跳转),也包括目标预测。本节大量使用 C.2 节介绍的简单 2 位预测器,因此读者必须先理解其工作原理,再继续阅读。
相关分支预测器
附录 C 的 2 位预测方案,只使用某一条分支的近期行为来预测它的未来行为。如果除了目标分支自身之外,还考察其他分支的近期行为,可能进一步提高准确率。考虑早期 SPEC 基准测试套件中 eqntott 的一小段代码,该程序的分支预测表现特别差:
假设 aa 和 bb 分别分配到 x1 和 x2,通常会生成以下 RISC-V 代码:
将这些分支分别标为 b1、b2 和 b3。关键观察在于:b3 的行为与 b1、b2 的行为相关。显然,如果 b1 和 b2 都不跳转,即两个条件都为真,aa 与 bb 都被赋值为 0,那么 b3 就会跳转,因为 aa 与 bb 显然相等。仅根据一条分支自身的行为来预测其结果,永远无法捕捉这种关系。
利用其他分支行为进行预测的预测器,称为相关预测器(correlating predictor)或两级预测器(two-level predictor)。现有相关预测器加入最近几条分支的行为信息,决定如何预测某条给定分支。例如, 预测器根据上一条分支的行为,从两个 2 位分支预测器中选择一个,预测当前分支。一般而言, 预测器根据最近 条分支的行为,从 个分支预测器中选择一个,每个预测器都是针对单条分支的 位预测器。
这种相关预测器的吸引力在于:只增加很少的硬件,就能取得比普通 2 位方案更高的预测准确率。
硬件之所以简单,来自一个简单观察:最近 条分支的全局历史可以保存在一个 位移位寄存器中,每一位记录相应分支是跳转(T)还是不跳转(NT)。将分支指令地址(PC)的低位与这 位全局历史拼接,就能索引分支预测缓冲区。例如,一个共有 64 个条目的 缓冲区,可以把分支字地址的低 4 位,与表示最近两条已执行分支行为的 2 位全局历史组合,形成 6 位索引,访问 64 个计数器。通过拼接或简单散列函数组合局部与全局信息,便能用结果索引预测表,而且预测速度与标准 2 位预测器一样快,稍后就会看到。
相关分支预测器比标准 2 位方案好多少?为了公平比较,必须让两者使用相同数量的状态位。 预测器的位数为:
没有全局历史的 2 位预测器,就是 预测器。
例题 有 4K 个条目的 分支预测器占多少位?使用相同位数的 预测器包含多少条目?
解答 4K 条目预测器包含:
若 预测器的预测缓冲区共占 8K 位,由分支选择的条目有多少?已知:
因此,由分支选择的预测条目数为 1K。
图 3.5 比较了前述 4K 条目的 预测器与 1K 条目的 预测器的错误预测率。可以看到,这种相关预测器不仅胜过状态位总数相同的简单 2 位预测器,而且常常胜过条目数量不受限制的 2 位预测器。
最著名的相关预测器,也许是 McFarling 的 gshare。gshare 将分支地址与最近条件分支的结果进行异或(XOR),形成索引;这实际上相当于对分支地址与分支历史作散列,再用散列结果索引由 2 位计数器组成的预测数组,如图 3.6。作为一种简单预测器,gshare 的效果相当好,经常成为比较更复杂预测器时的基线。将局部分支信息与全局分支历史结合的预测器,也称为 alloyed predictor 或混合预测器(hybrid predictor)。
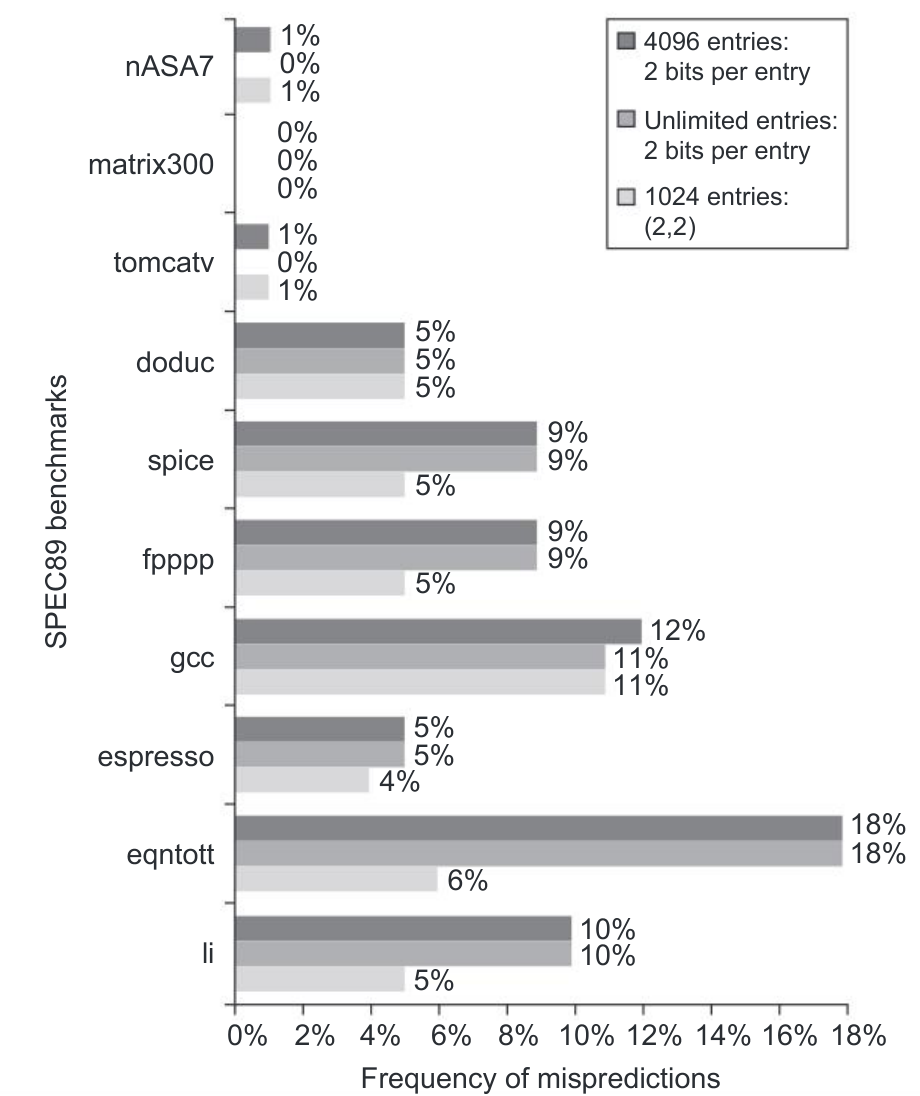
图 3.5 2 位预测器的比较。首先是一个 4096 位的非相关预测器,其次是条目数无限的非相关 2 位预测器,最后是具有 2 位全局历史、共 1024 个条目的 2 位预测器。1 虽然数据来自较老版本的 SPEC,但较新的 SPEC 基准也会表现出类似的准确率差异。
图中纵轴为 SPEC89 基准程序,名称保留英文;横轴为错误预测频率。三组柱依次表示:4096 个条目、每条目 2 位;无限条目、每条目 2 位;1024 个条目的 预测器。
竞争预测器:自适应地组合局部与全局预测器
相关分支预测的主要动机,是标准 2 位预测器只使用局部信息,因此在某些重要分支上预测不佳;加入全局历史可以弥补这个不足。竞争预测器(tournament predictor)更进一步,使用多个预测器,通常是一个全局预测器和一个局部预测器,并通过选择器在两者之间选择,如图 3.7。全局预测器用最近的分支历史进行索引,局部预测器用分支地址进行索引。竞争预测器是混合预测器或 alloyed predictor 的另一种形式。
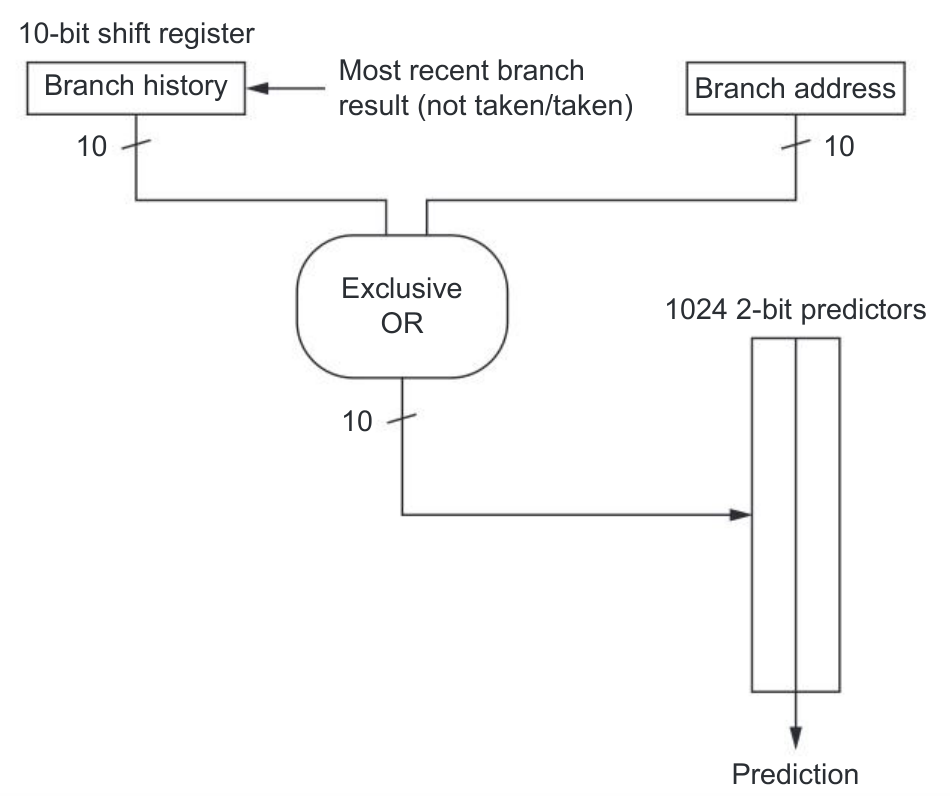
图 3.6 一个含 1024 个条目的 gshare 预测器,每个条目都是标准的 2 位预测器。图中 Branch history 为分支历史,保存在 10 位移位寄存器(10-bit shift register)中;Most recent branch result (not taken/taken) 为最近分支的结果(不跳转/跳转);Branch address 为分支地址;Exclusive OR 为异或;1024 2-bit predictors 为 1024 个 2 位预测器;Prediction 为预测结果。各条标为 10 的连线表示 10 位。
竞争预测器在中等规模(8K~32K 位)时能够取得更高准确率,也能有效利用规模很大的预测状态。现有竞争预测器为每条分支使用一个 2 位饱和计数器,根据近期哪一种预测器更有效——局部、全局,甚至随时间变化的混合——在两个预测器之间进行选择。与简单的 2 位预测器一样,饱和计数器需要两次错误预测,才会改变首选预测器。
竞争预测器的优势,是能为特定分支选择合适的预测器;这一点对于整数基准尤为关键。典型竞争预测器在 SPEC 整数基准中,有接近 40% 的时间选择全局预测器;在 SPEC 浮点基准中,这一比例则不足 15%。除率先采用这种技术的 Alpha 处理器外,多款 AMD 处理器也曾采用竞争式预测器。
图 3.8 使用 SPEC89,比照三种预测器在不同位数下的表现:局部 2 位预测器、相关预测器和竞争预测器。局部预测器最先达到极限;相关预测器明显改善;竞争预测器则略胜一筹。对于更新版本的 SPEC,结果也会类似,只是要到稍大的预测器规模才达到渐近行为。
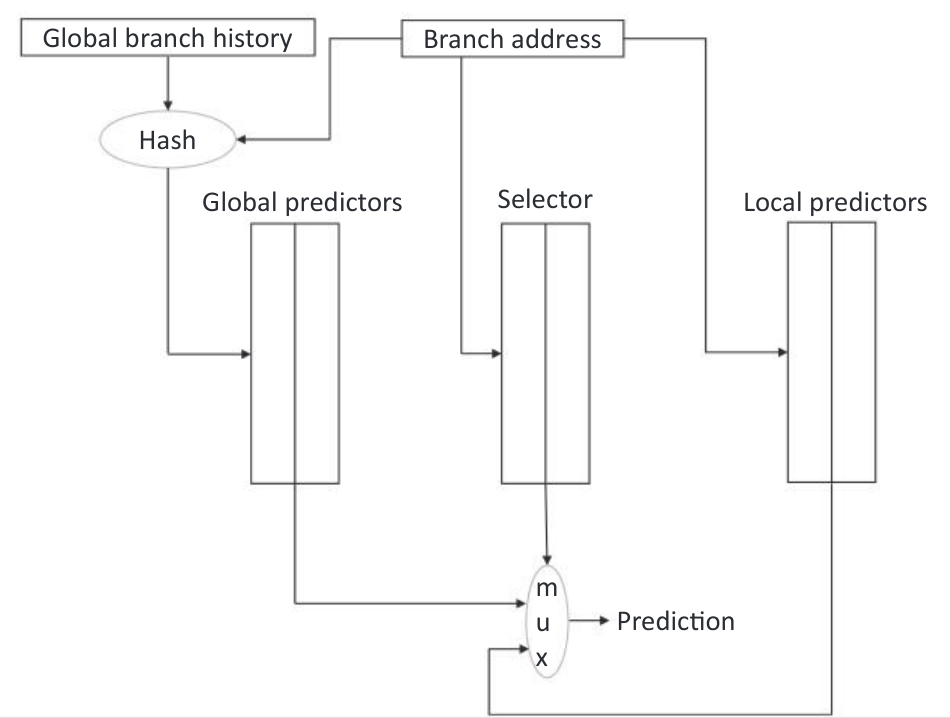
图 3.7 竞争预测器使用分支地址索引一组 2 位选择计数器,在局部与全局预测器之间选择。本图中,选择器表的索引就是当前分支地址。另外两张表也都是 2 位预测器,分别由全局历史和分支地址索引。选择器的行为类似 2 位预测器:当连续出现两次错误预测时,改变相应分支地址的首选预测器。用于索引选择器表和局部预测表的分支地址位数,与用于索引全局预测表的全局分支历史长度相同。注意,错误预测的处理有些复杂,因为既要修改选择器表,又要修改全局或局部预测器。
图中 Global branch history 为全局分支历史;Branch address 为分支地址;Hash 为散列;Global predictors 为全局预测器;Selector 为选择器;Local predictors 为局部预测器;mux 为多路选择器;Prediction 为预测结果。
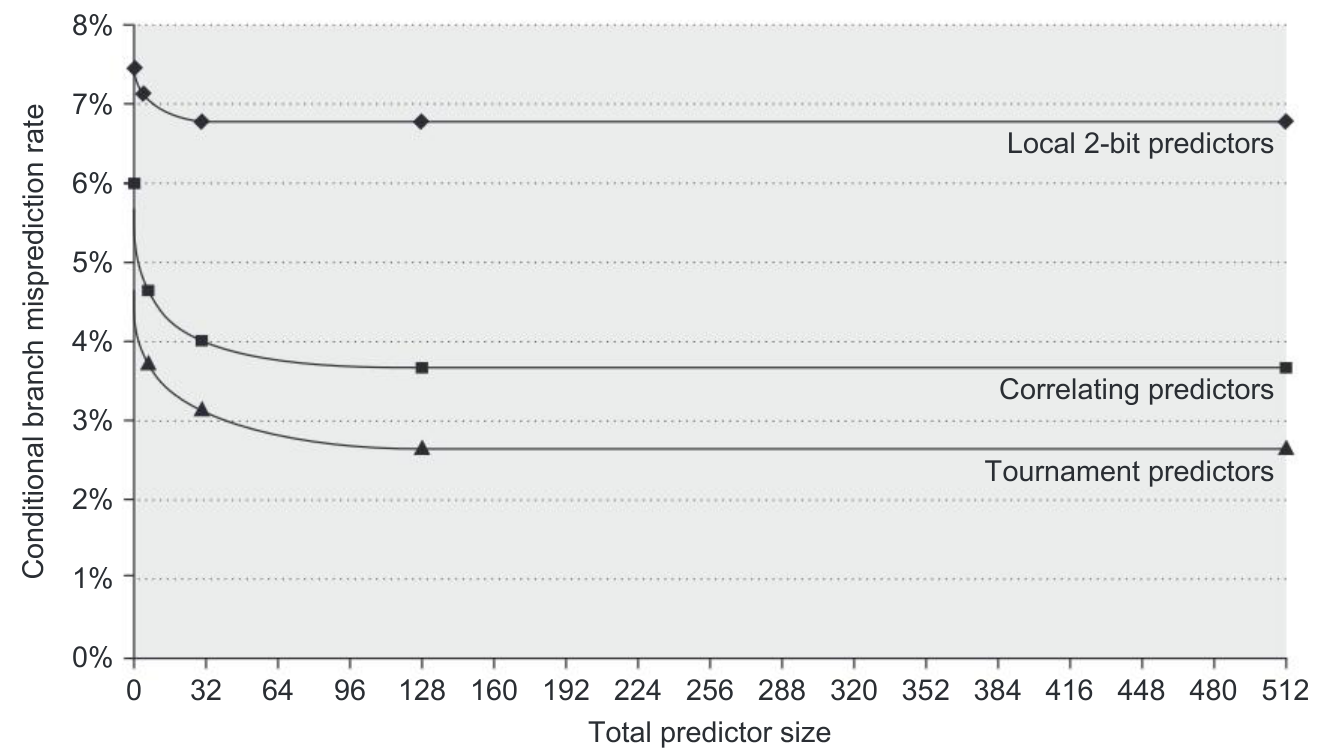
图 3.8 SPEC89 上三种预测器的错误预测率与预测器大小(千位)的关系。三种预测器分别是:局部 2 位预测器;在图中每个容量点,都对全局与局部信息的使用方式作最优组织的相关预测器;竞争预测器。虽然数据来自较老版本的 SPEC,但更新的 SPEC 基准表现出类似行为,只是可能要到稍大的预测器规模才收敛至渐近极限。横轴 Total predictor size 为预测器总大小;纵轴 Conditional branch misprediction rate 为条件分支错误预测率。三条曲线自上而下分别为局部 2 位、相关、竞争预测器。
图 3.8 所评估的局部预测器,本身也是两级预测器。第一级是局部历史表,包含 1024 个 10 位条目;每个条目对应最近 10 次分支结果。如果分支连续跳转 10 次或以上,局部历史表的相应条目便全为 1;如果跳转与不跳转交替出现,历史条目就是交替的 0 和 1。这 10 位历史使预测器能够发现并预测长度不超过 10 次分支的模式。局部历史表选中的条目,再用于索引一个包含 1K 个 3 位饱和计数器的表,由其提供局部预测。这个组合总共使用 29K 位,能够实现很高的分支预测准确率,同时比准确率相同的单级表占用更少的位。2 两级局部预测器对迭代次数较少的循环尤其有效。对于一个迭代 3 次的循环,局部历史可以识别连续三次跳转(TTT)的情况,并训练一个 2 位或 3 位饱和计数器,预测下一次分支不跳转。因此,经常执行、迭代次数较少的循环,可以达到 100% 的预测准确率。
带标签的混合预测器
维护局部和全局历史的预测器,其主要不足在于难以确定合适的历史长度。历史太短,就可能无法捕捉某些重复模式。例如,4 位局部历史无法准确捕捉一个迭代 5 次的循环。历史太长,则需要更长的训练时间才能准确捕捉模式,因为会用到饱和计数器表中的更多条目。例如,如果对上面的 eqntott 代码使用 3 位全局历史,就需要训练两个饱和计数器,才能正确预测 B1、B2、B3 之间的相关关系;这两个计数器分别对应全局历史 NNN 和 TNN。准确捕捉一种模式所需的计数器越多,就越容易遇到别名冲突(aliasing):散列碰撞导致多条分支使用同一个计数器跟踪历史。如果共享计数器的分支结果相反,而且经常交错执行,别名冲突就会造成破坏性干扰。
截至 2022 年,表现最好的分支预测方案通过组合多个预测器来应对这些不足,并跟踪某个预测是否可能属于当前分支。其中一类重要预测器,大体基于一种名为 PPM(prediction by partial matching,部分匹配预测)的统计压缩算法。PPM(见 Jiménez and Lin, 2001)与分支预测算法一样,试图根据历史预测未来行为。我们称这类分支预测器为带标签的混合预测器(tagged hybrid predictor,见 Seznec and Michaud, 2006);它使用一系列全局预测器,以不同长度的历史进行索引。
例如,图 3.9 中一个由五个组件构成的带标签混合预测器,包含五张预测表:。其中,访问 时,对 PC 与最近 条分支的历史进行散列;历史保存在移位寄存器 中,与 gshare 相同。用不同长度的历史分别索引独立预测器,是第一个关键区别。第二个关键区别,是在 至 中使用标签,减少别名冲突。标签可以很短,因为不要求百分之百匹配:4~8 位的小标签,看来就已能获得大部分收益。只有标签与分支地址及全局历史的散列结果匹配时,才使用 的预测。注意,与缓存不同,分支预测器的标签只用来降低别名冲突的概率,并不用于保证正确性。短标签仍有小概率发生别名冲突,但这只影响预测准确率,不影响正确性。 中每个预测器都可以采用标准 2 位计数器。实际中,需要三次错误预测才改变预测结果的 3 位计数器,比 2 位计数器略好。
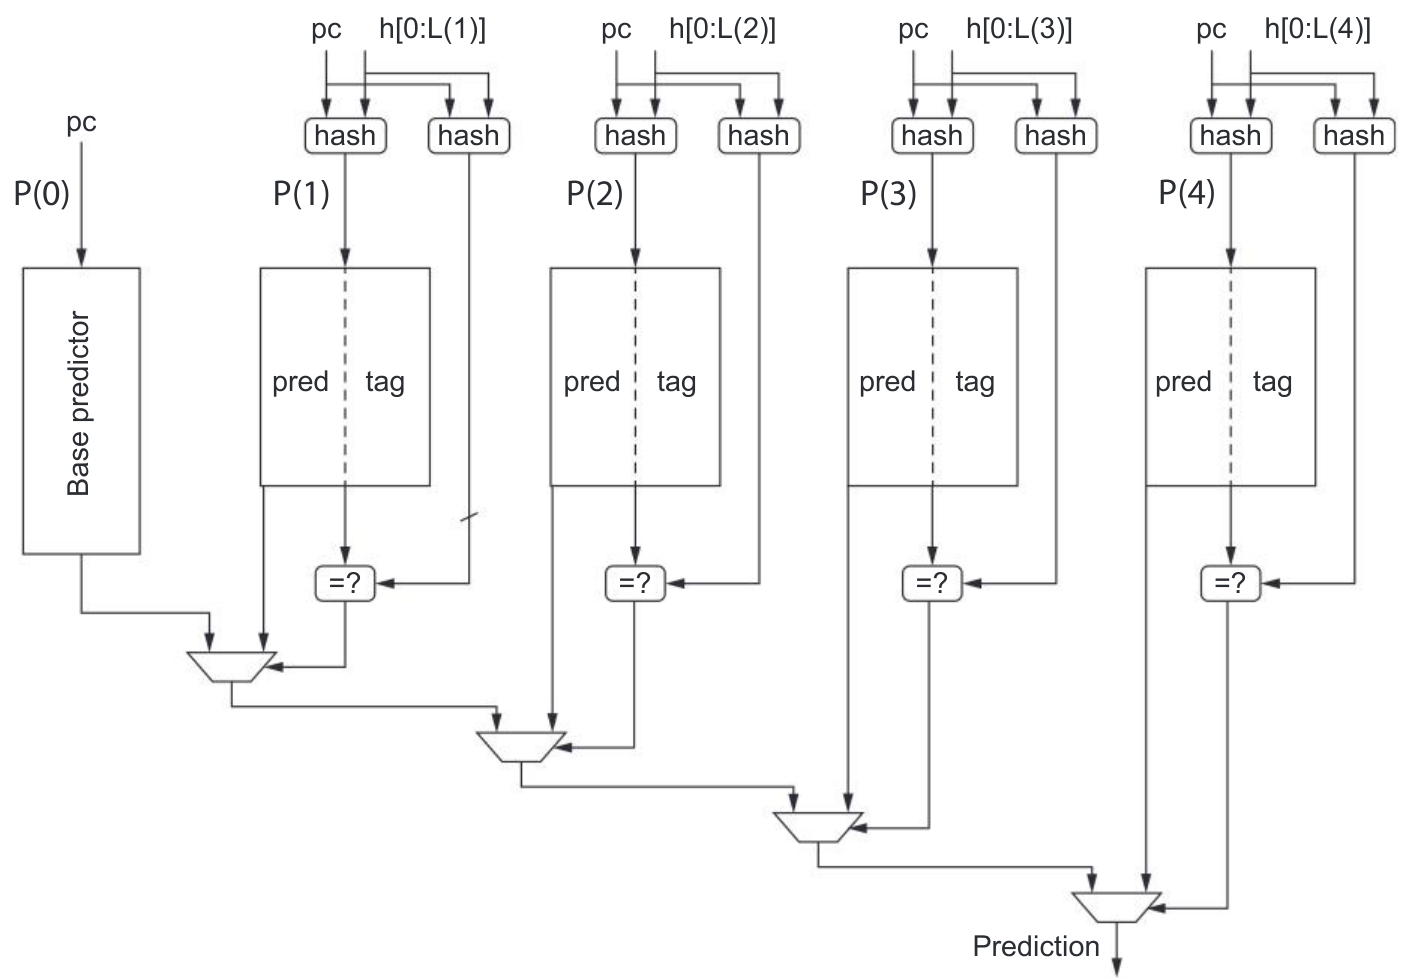
图 3.9 含五个组件的带标签混合预测器,具有五张独立的预测表。索引由分支地址与长度为 0~4 的近期分支历史片段散列而成,图中历史记作 h。散列可以像 gshare 一样简单,采用异或即可。每个预测器是 2 位预测器,也可能是 3 位预测器。标签通常为 4~8 位。最终选择标签匹配、且所用历史最长的那个预测。图中 Base predictor 为基础预测器;pc 为程序计数器;hash 为散列;pred 为预测值;tag 为标签;=? 表示是否相等的比较;Prediction 为最终预测;h[0:L(i)] 表示第 组使用的历史片段。3
对给定分支,选择使用最长历史、同时标签匹配的预测器。 没有标签,因此总会匹配;如果 至 均不匹配,它就提供默认预测。这种带标签混合方案还在每个按历史索引的预测条目中加入一个 2 位的 use 字段。该字段指示这个预测最近是否被使用,因而是否可能更准确;可以定期重置所有条目的 use 字段,清理陈旧预测。实现此类预测器还有许多细节,尤其是错误预测的处理。寻找最优预测器的搜索空间也很大,因为预测器数量、索引所用的具体历史,以及每个预测器的大小,都可以变化。
带标签混合预测器,有时称为 TAGE(TAgged GEometic)预测器,以及更早的基于 PPM 的预测器,曾赢得近期国际分支预测竞赛。它们使用中等容量的存储(32~64 KiB),就能胜过 gshare 与竞争预测器;而且这类预测器似乎还能够有效利用更大的预测缓存,进一步提高准确率。
大容量预测器的另一个问题是如何初始化。可以随机初始化,但随后需要相当长的执行时间,才能让预测器充满有用的预测。有些预测器,包括许多较新的设计,带有有效位,指示条目是否已被设置,还是仍处于“未使用”状态。对于未使用条目,可以用某种方法初始化,而不是使用随机预测。例如,某些指令集提供一个位,指示相应分支预期会跳转还是不跳转。在动态分支预测出现之前,这些提示位就是预测本身;在近期处理器中,它们可用来设置初始预测。也可以根据分支方向设置:向前跳转的分支初始化为不跳转,向后跳转的分支很可能是循环分支,初始化为跳转。对于运行时间较短的程序以及预测器较大的处理器,初始设置会对预测性能产生可以测量的影响。
图 3.10 显示,带标签混合预测器明显胜过 gshare,尤其是在 SPECint 和服务器应用等较难预测的程序上。图中用每千条指令的错误预测次数衡量性能。假设分支频率为 20%~25%,对于多媒体基准,gshare 每条分支的错误预测率为 2.7%~3.4%,带标签混合预测器为 1.8%~2.2%,即错误预测约减少三分之一。与 gshare 相比,带标签混合预测器实现更复杂,而且需要检查多个标签、选择预测结果,速度可能略慢。不过,对于流水线很深、分支错误预测代价很高的处理器,准确率提高的收益超过了这些不利影响。因此,许多高端处理器设计者选择在最新实现中加入带标签混合预测器。
此外,采用多级和多流水级设计,也为绕开分支预测器在速度、大小与复杂度之间的取舍提供了途径。
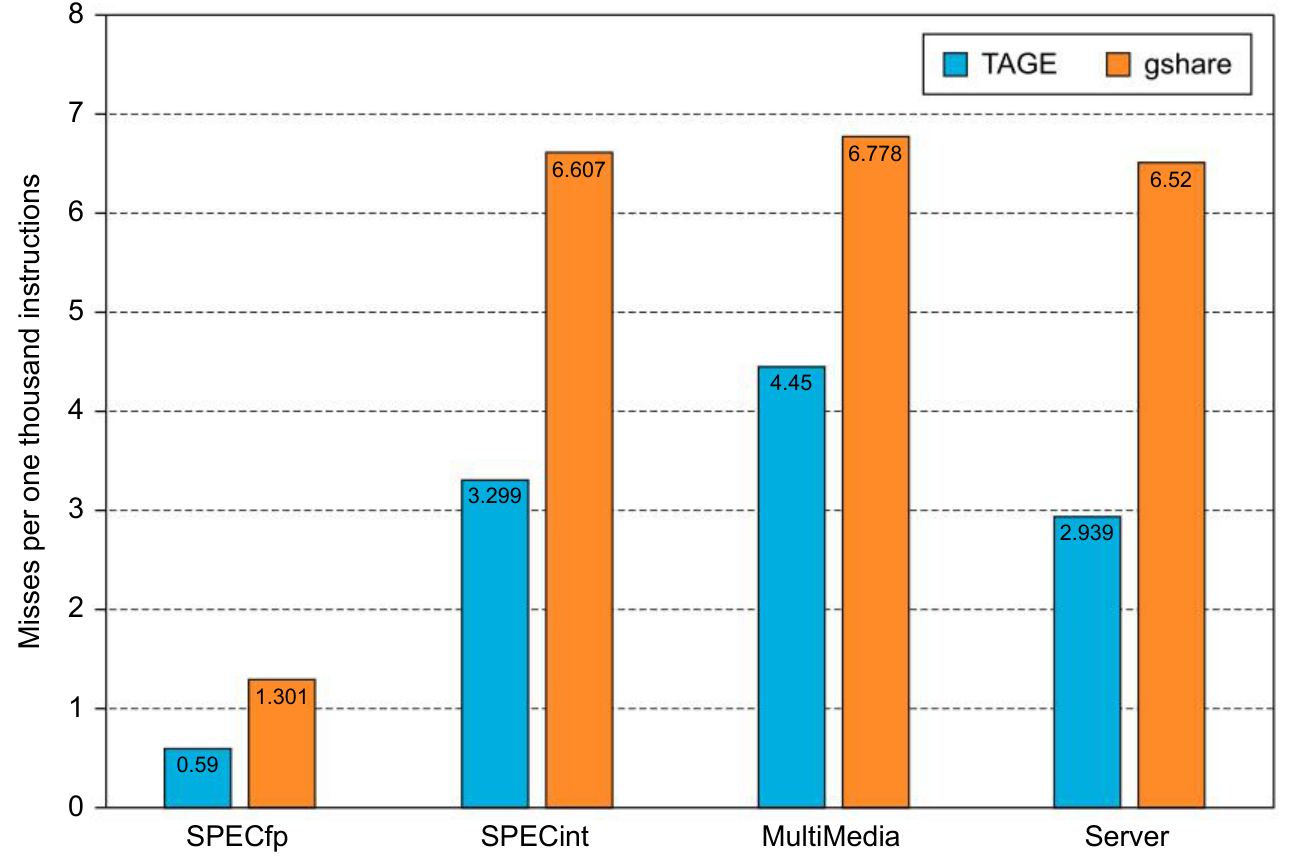
图 3.10 带标签混合预测器与 gshare 的错误预测率比较,以每执行 1000 条指令发生的错误预测次数衡量。两者使用的总位数相同,但带标签混合预测器将部分存储用于标签,gshare 则没有标签。基准包括 SPECfp、SPECint 的执行轨迹,以及一系列多媒体和服务器基准;后两类更接近 SPECint 的行为。蓝色为 TAGE,橙色为 gshare;纵轴为每千条指令的错误预测次数,横轴 MultiMedia 与 Server 分别为多媒体与服务器应用。
Intel 处理器分支预测器的演变
深流水线与每周期多发射相结合,使超标量处理器同时拥有许多在途指令;近期设计中可达数百条。因此,分支预测十分关键,也是 Intel 不断改进的领域。或许正因为它对性能如此重要,Intel 一向严格保密其分支预测器的细节。即使对于 2008 年推出的 Core i7 920 这样的老处理器,公开的信息也很有限。这里简要介绍已知情况,并比较采用 Nehalem 微体系结构的 Core i7 920,与 2016 年发布、采用 Skylake 微体系结构的 Intel Core i7 6700 中的预测器性能。
Core i7 920 使用两级预测器。第一级较小,目的是满足每个时钟周期预测一条分支的时间约束;第二级较大,作为后备。每一级都组合三种预测器:(1)附录 C 介绍的简单 2 位预测器,前面的竞争预测器也使用了它;(2)刚刚介绍过的全局历史预测器;(3)循环退出预测器。对于检测为循环分支的分支,循环退出预测器使用计数器,准确预测它会跳转多少次,也就是循环迭代次数。与竞争预测器一样,它跟踪三种预测的准确性,为每条分支选择最佳预测。除了这个多级主预测器,还用独立单元预测间接分支的目标地址,用栈预测返回地址。
关于 Core i7 6700 预测器的已知信息更少,但有充分理由相信 Intel 使用了带标签混合预测器。其优点之一,是同时具备早期 i7 中三个第二级预测器的功能。采用不同历史长度的带标签混合预测器,涵盖了循环退出预测器、局部历史预测器和全局历史预测器的功能。返回地址仍由单独的预测器处理。
与其他场合一样,推测执行使预测器评估面临一些困难:一次错误预测,很容易导致另一条分支被取入,并再次预测错误。为简化分析,我们考察错误预测次数占成功完成的分支数的比例;成功完成的分支,是那些并非由错误推测产生的分支。图 3.11 给出了这些数据。
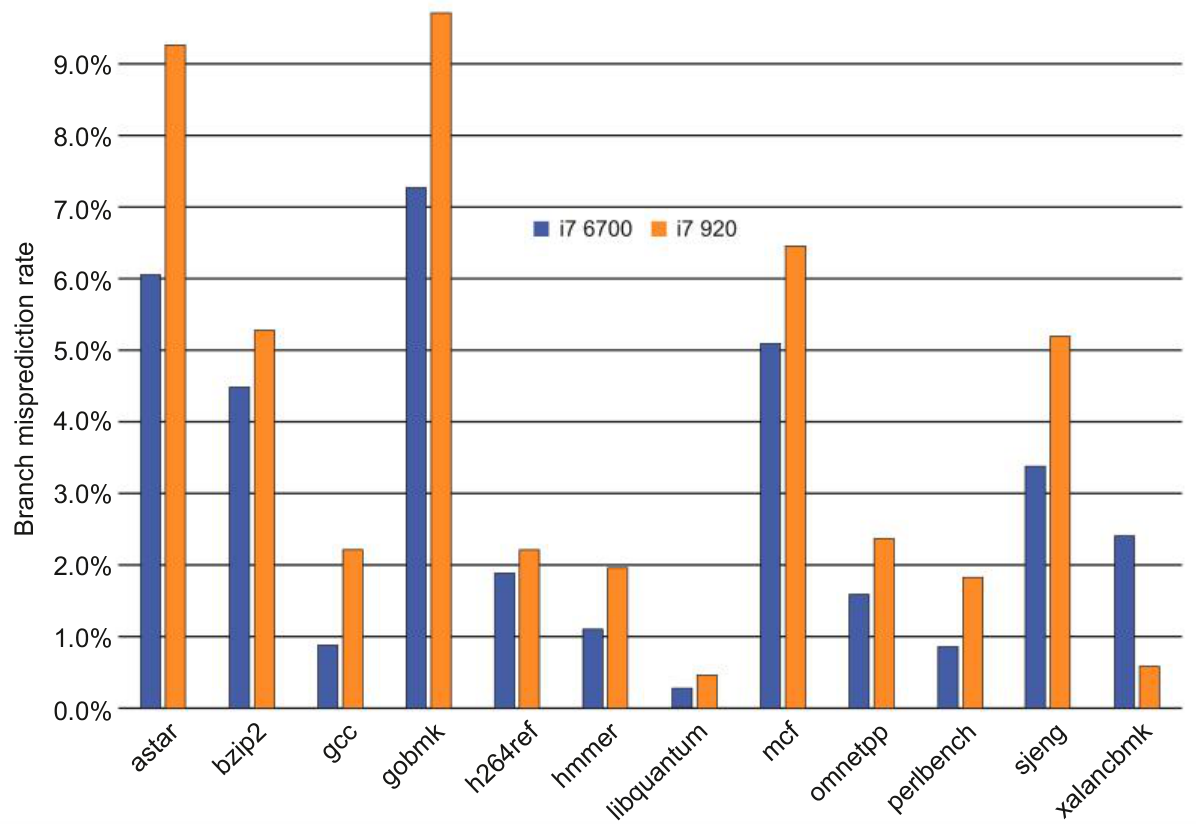
图 3.11 Intel Core i7 920 与 6700 上整数 SPEC CPU2006 基准的错误预测率。错误预测率按“已完成且预测错误的分支数/全部已完成分支数”计算。这可能在一定程度上低估错误预测率,因为如果一次分支错误预测又导致另一条本不该执行的分支被错误预测,这里只计为一次错误预测。平均而言,i7 920 的分支错误预测频率是 i7 6700 的 1.3 倍。纵轴为分支错误预测率;横轴为原始基准程序名;蓝色代表 i7 6700,橙色代表 i7 920。
这些数据对应 SPEC CPUint2006 基准。它们比 SPEC89 或 SPEC2000 大得多,因此即使采用更强大的预测器组合,错误预测率仍高于图 3.8。分支错误预测会导致无效推测执行,因此造成工作浪费,本章后面会进一步讨论。
分支目标缓冲区
到目前为止,所介绍的分支预测器能推测当前取指 PC 是否指向一条会跳转或不会跳转的分支。如果尚未译码的指令是一条预测为跳转的分支,还必须预测分支目标地址,才能重定向取指,并实现零分支代价。这通过分支目标缓冲区(branch-target buffer,BTB)或分支目标缓存完成。它是一种缓存,保存预测的分支后下一条指令地址。图 3.12 展示了一个 BTB。每个条目包含预测目标,以及一个标签,保存该条目对应分支的 PC。标签使处理器在 BTB 冲突时,避免误用另一条分支的目标地址,否则会降低性能。BTB 条目还包含有效位、分支类型,以及用于实现替换策略的若干位。
图 3.12 分支目标缓冲区。将正在取入的指令的 PC,与第一列保存的一组指令地址比较;这些地址是已知分支的地址。如果 PC 与某个条目匹配,那么正在取入的指令就是一条跳转分支,第二个字段“预测 PC”保存分支之后下一 PC 的预测值,立即从这个地址开始取指。第三个字段是可选的,可以用于保存额外的预测状态位。
图中文字:PC of instruction to fetch 为待取指令的 PC;Look up 为查找;Predicted PC 为预测 PC;Number of entries in branch-target buffer 为分支目标缓冲区的条目数。比较结果为否时:预测该指令不是一条跳转分支,按正常方式继续;为是时:该指令是一条跳转分支,将预测 PC 作为下一 PC。
访问 BTB 与访问分支预测器并行进行。若预测分支不跳转,就忽略 BTB 查找结果。若预测跳转,且 BTB 条目标签与所取指令的 PC 匹配,即 BTB 命中,就在后续周期使用预测 PC。若预测跳转,但 BTB 未命中,处理器就必须暂停取指,直到当前指令被取入、译码并计算出目标地址。频繁执行且跳转的分支目标会被放入 BTB,替换近期没有使用,或如今经常不跳转的分支目标。BTB 只需保存预测为跳转的分支,因为不跳转的分支只需取顺序的下一条指令,就像它不是分支一样。
图 3.13 使用分支目标缓冲区处理一条指令所涉及的步骤。图中的 IF、ID、EX 分别表示取指、译码、执行阶段。
图内流程完整译文如下:IF 阶段将 PC 发送到存储器和分支目标缓冲区,然后判断“是否在分支目标缓冲区中找到条目”。若否,ID 阶段判断“该指令是否为跳转分支”;若不是,则正常执行指令;若是,则在 EX 阶段把分支指令地址与下一 PC 写入分支目标缓冲区。若 IF 阶段找到了条目,ID 阶段发出预测 PC,并判断“分支是否跳转”;若否,则为错误预测,撤销已取指令,从另一目标重新取指,并从目标缓冲区删除该条目;若是,则分支预测正确,无停顿地继续执行。Yes、No 分别为是、否。
BTB 对跳转分支的命中率对性能至关重要,可以借助类似第 2 章缓存优化的方法提高。采用相联 BTB,可以减少冲突未命中;采用多级 BTB 结构,可以缓解命中时间与容量未命中之间的权衡。对于从取指到算出有效目标需要 5~10 个周期的处理器流水线,多级 BTB 尤其有用。
图 3.13 展示简单五级流水线使用 BTB 的步骤。可以看到,对一条实际跳转的分支,如果方向预测正确,而且在缓冲区中找到分支目标条目,就没有分支延迟;否则,至少有两个时钟周期的代价。
要评估 BTB 的效果,首先必须确定所有可能情形的代价。图 3.14 列出简单五级流水线的这些信息。
| 指令是否在缓冲区中 | 预测 | 实际分支行为 | 代价(周期) |
|---|---|---|---|
| 是 | 跳转 | 跳转 | 0 |
| 是 | 跳转 | 不跳转 | 2 |
| 否 | 跳转 | 2 | |
| 否 | 不跳转 | 0 |
图 3.14 假设缓冲区只保存跳转分支,表中列出分支是否在缓冲区内、实际是否跳转的所有可能组合及其代价。如果预测完全正确,且在目标缓冲区中找到分支,则没有分支代价。如果预测不正确,需要 1 个时钟周期用正确信息更新缓冲区,这期间无法取指;若需要重新取入该分支之后的正确指令,则再花 1 个周期。如果未找到分支而实际跳转,则有 2 个周期的代价,期间更新缓冲区。
例题 使用图 3.14 中各类错误预测的代价周期数,计算分支目标缓冲区的总分支代价。假设:
- 对缓冲区中的指令,预测准确率为 90%。
- 对预测跳转的分支,缓冲区命中率为 90%。
解答 考察两种事件的概率:预测跳转而实际不跳转;实际跳转但在缓冲区中未找到。两者代价均为 2 个周期。
随着流水线加长、分支延迟增大,动态分支预测带来的改善也会增加;更好的预测器还能进一步扩大性能优势。现代高性能处理器的分支错误预测延迟约为 15 个时钟周期,准确预测显然至关重要!
BTB 的一种变体,是保存一条或多条目标指令,以替代预测目标地址,或者两者同时保存。这有两个潜在优点。第一,允许 BTB 的访问时间长于连续两次取指之间的间隔,从而可能采用更大或多级的 BTB。第二,缓存实际目标指令,可以实施称为分支折叠(branch folding)的优化。分支折叠可使无条件分支只需 0 个周期,有时条件分支也能达到 0 周期。稍后会看到,Cortex A-53 使用单条目的分支目标缓存,保存预测目标处的指令。
考虑一个保存预测路径指令的 BTB,当前用一条无条件分支的地址访问它。无条件分支唯一的作用是改变 PC。因此,当 BTB 命中,且指示该分支为无条件分支时,流水线可以直接用 BTB 中的指令,替换指令缓存返回的那条无条件分支。如果处理器每周期发射多条指令,缓冲区也必须提供多条指令,才能获得最大收益。有些情况下,还可能消除条件分支的代价。
专用分支预测器:预测过程返回、间接跳转与循环分支
通过推测执行增加并行机会时,会遇到预测间接跳转的挑战,即跳转目标地址在运行时变化。高级语言程序会为间接过程调用,例如 C++ 虚函数调用、select 或 case 语句,以及 FORTRAN 的计算转移 goto,生成此类跳转。不过,许多间接跳转只是过程返回。例如,在 SPEC95 基准中,过程返回平均占所有分支的 15% 以上,并占间接跳转的绝大多数。对于 C++ 和 Java 等面向对象语言,过程返回更加频繁,因此优先研究过程返回是合理的。
虽然 BTB 可以预测过程返回,但如果一个过程从多个调用点被调用,而且同一调用点的调用在时间上并不集中,这种方法的准确率可能很低。例如,在 SPEC CPU95 中,一个激进的分支预测器对这类返回分支的准确率不足 60%。为解决这一问题,大多数处理器使用一个按栈方式工作的、小型返回地址缓冲区。这种返回地址栈(return address stack,RAS)缓存最近的返回地址:调用时压入返回地址,返回时弹出一个地址。如果该缓存足够大,即容量达到最大调用深度,就能完美预测返回。图 3.15 给出了若干 SPEC CPU95 基准在返回缓冲区包含 0~16 个条目时的表现。近期所有高性能超标量处理器都实现了 RAS。
图 3.15 按栈方式工作的返回地址缓冲区,在若干 SPEC CPU95 基准上的预测准确率。准确率指正确预测的返回地址所占比例。4 0 条目表示使用标准分支预测。除少数例外,调用深度通常不大,因此中等容量的缓冲区就能取得良好效果。数据来自 Skadron et al.(1999),使用修复机制,防止缓存的返回地址遭到破坏。图中纵轴 Misprediction frequency 实际为错误预测频率;横轴 Return address buffer entries 为返回地址缓冲区条目数;Go、m88ksim、cc1、Compress、Xlisp、Ijpeg、Perl、Vortex 为原基准程序名。
各种函数调用与控制转移也会产生间接跳转。预测这类分支的目标,不像过程返回那么简单。有些处理器为所有间接跳转增加专用预测器,另一些则依赖分支目标缓冲区。
gshare 之类的简单预测器,对许多条件分支预测得很好,但并没有针对循环分支、特别是长时间运行的循环作专门设计。如前所述,Intel Core i7 920(Skylake 微体系结构)使用了专用循环分支预测器。5 随着带标签混合预测器出现,而它们对循环分支也同样擅长预测,一些近期设计者选择把资源投入更大的带标签混合预测器,而不再设置独立的循环分支预测器。
集成取指单元
为满足多发射处理器的需求,近年来许多设计者将集成取指单元实现为独立、自主工作的单元,为流水线其余部分提供指令;这种组织通常称为解耦前端(decoupled front-end)。这实际上承认了:面对多发射的复杂性,已不能再把取指看作简单的单个流水级。因此,近期设计采用集成取指单元,将以下功能结合起来:
- 集成分支预测:分支预测器成为取指单元的一部分,持续预测分支,驱动取指流水线。分支预测器与 BTB 处理每个取指指令束中的多条分支。
- 指令预取:为了每周期提供多条指令,取指单元很可能需要提前获取指令。该单元自主管理指令预取,并将其与分支预测结合;有关预取技术,见第 2 章。
- 指令存储访问与缓冲:每周期取多条指令会遇到各种复杂问题,例如可能需要访问多个缓存行。取指单元封装这些复杂性,尝试通过预取隐藏跨缓存块的代价。它还提供缓冲,实质上作为按需供应单元,在发射级需要时,提供所需数量的指令。
如今几乎所有高端处理器都采用独立取指单元,并通过保存待处理指令的缓冲区,与流水线其余部分连接。
译注:原图注明确写作“4096 bits”,但图例和前文均为“4096 entries”,每条目 2 位,即 8192 位。 ↩︎
译注:原文写“总共 29K 位”。按本段明确列出的 1024×10 位历史表与 1024×3 位计数器表,相加为 13K 位;原文未说明其余 16K 位的来源。 ↩︎
译注:原正文称第 个预测器使用最近 条分支,图注称历史长度为 0~4,而图中标的是 至 。这些是源文自身的不同表述;图与文字均保留,未将图中 擅自改为 。原文 TAGE 展开词拼作“TAgged GEometic”,此处亦保留。 ↩︎
译注:原图注称“预测准确率”,但纵轴明确为“错误预测频率”,两者互为补数。读图时应以纵轴所示错误预测率理解数值。 ↩︎
译注:本处原文确写 Core i7 920(Skylake);但本节前文将 i7 920 归为 Nehalem、i7 6700 归为 Skylake。 ↩︎
3.5 利用寄存器重命名克服名依赖
寄存器重命名使超标量处理器能够利用大量物理寄存器,消除名依赖带来的 WAR 和 WAW 冒险风险。我们先通过一种可能的实现,详细考察重命名如何工作,再讨论其他实现方案的取舍。为简化说明,这里讨论整数寄存器重命名所需的硬件;浮点寄存器也使用类似结构。
图 3.16 展示采用统一寄存器堆(unified register file,URF)进行寄存器重命名所需的硬件结构。该寄存器堆实现大量物理寄存器,图中为 p0~p127,既保存 32 个体系结构可见寄存器的值,也保存尚未提交指令的临时值。两个硬件结构负责管理这些物理寄存器。重命名映射表标明:指令作为输入操作数指定的体系结构寄存器,当前对应哪一个物理寄存器编号,即 。当指令在处理器前端发射时,读取并更新这张表。因此,表中的映射具有推测性,因为其中一些指令以后可能因错误推测或异常而被撤销。体系结构映射表则根据已经提交的指令,记录每个体系结构寄存器对应的物理寄存器编号。体系结构映射表在流水线后端更新,用于异常与错误预测恢复。
图 3.16 采用统一寄存器堆(URF)的寄存器重命名硬件结构。每个 URF 条目的三个元数据位,分别表示物理寄存器是否空闲(F)、是否处于体系结构状态(A)、是否就绪(R)。如图所示,p0~p3 处于体系结构状态。p40 与 p42 分别处于已占用但未就绪、已占用且就绪状态,它们的值由尚未完成提交的指令产生。p41 空闲。1
图中文字:Renaming Map 为重命名映射表;Architectural Map 为体系结构映射表;Physical Register # 为物理寄存器编号;Unified Register File 为统一寄存器堆;Register Value 为寄存器值。图中箭头保留原映射关系,十六进制值为原示例数据。
图 3.17 描述物理寄存器可能处于的四种状态:空闲、已占用但未就绪、已占用且就绪、体系结构状态。空闲表示该物理寄存器未被使用,可以分配给新指令。两种已占用状态表示它已被一条尚未完成提交的指令分配。未就绪表示该指令尚未执行完成,后续依赖指令还不能使用这个值;就绪表示产生该值的指令已执行完成,但尚未提交,因此寄存器值已经可用。体系结构状态表示它保存的是一条已执行完成并已提交指令的结果;体系结构映射表的一个条目会指向它。体系结构寄存器总是就绪的。复位时,前 32 个物理寄存器处于体系结构状态,其余为空闲。图 3.16 用三个元数据位(Free、Architectural、Ready)编码每个物理寄存器的状态,编码如下:空闲 ;已占用但未就绪 ;已占用且就绪 ;体系结构状态 。
重命名的大部分工作在指令译码之后的发射阶段完成。不过,随着指令经过各执行阶段,物理寄存器也会发生状态转换。
- 发射(顺序):指令发射时,在重命名映射表中查找输入操作数。表给出当前保存该指令所读体系结构寄存器最新值的物理寄存器地址。物理寄存器编号及其状态,随后送往动态调度硬件(见 3.5 节)。2 同时,指令为输出寄存器 的新值分配一个新的物理寄存器 ,将重命名映射表中的 条目更新为 ,并把新分配物理寄存器设为已占用但未就绪。注意,存储、分支等指令不产生新的寄存器值,所以不分配物理寄存器。
- 派发(乱序):当保存指令输入操作数的所有物理寄存器,都处于体系结构状态或已占用且就绪状态时,该指令就绪,可以派发执行。3.5 节将介绍跟踪输入操作数状态的调度硬件。2 指令输出所用物理寄存器 的状态保持不变,仍为已占用但未就绪。
- 完成(乱序):功能单元完成指令执行后,将新值存入已分配的物理寄存器 ,把其状态改为已占用且就绪。依赖该指令的其他指令现在可以使用此值。
图 3.17 物理寄存器的生命周期。除一个转换外,所有状态转换都由分配该寄存器的指令在执行过程中触发。从体系结构状态转为空闲状态,则发生于一条后续指令提交时;这条后续指令为同一个体系结构寄存器使用了另一个物理寄存器。
图中四个状态分别是 Architectural(A,体系结构状态)、Free(F,空闲)、Used & Not Ready(UN,已占用但未就绪)、Used & Ready(UR,已占用且就绪)。复位时,p0~p31 进入 A,p32~p127 进入 F。为正在重命名的指令输出分配寄存器时,F→UN;指令执行完成时,UN→UR;指令提交时,UR→A;覆盖它的后续指令提交时,A→F;指令因错误推测或异常而撤销时,UN 或 UR→F。
- 提交(顺序):指令到达 ROB 头部,而且没有产生异常或错误预测时,就把结果提交到体系结构状态。物理寄存器 转为体系结构状态,同时更新体系结构映射表中 的条目。如果此前为 ,则改为 ,并将 设为空闲。由于覆盖它的指令刚刚提交, 中的值不可能再被需要。
- 恢复(顺序):如果 ROB 中最老的指令关联异常或错误预测,就必须撤销所有尚未提交的指令,恢复精确的体系结构状态,如同从未部分处理过这些指令。对重命名状态而言,只需两个快速步骤:首先,将所有处于两种已占用状态的物理寄存器标为空闲;其次,丢弃重命名映射表的当前状态,通过一次批量复制,将其初始化为体系结构映射表的状态。
超标量处理器在单个时钟周期内,对一个指令束中的所有指令重命名,因此重命名逻辑很复杂。第一项要求是映射表必须具有多个端口。如果处理器每周期派发 条指令,重命名映射表就必须支持 个读端口,查询全部输入操作数的当前映射,还需要 个写端口,更新全部输出操作数的映射。如果处理器每周期提交 条指令,体系结构映射表就需要 个写端口完成相应更新。物理寄存器的三个元数据位也必须支持每周期多次访问。由于它们以位掩码实现,为并行更新提供多个端口的成本较低。
每周期对多条指令重命名的第二项要求,是重命名逻辑必须检测并遵守指令束内部的数据依赖。如果依赖不在指令束内部,就利用重命名映射表,确定保存或将要保存所需结果的物理寄存器。如果一条指令依赖同一指令束中较早的指令,就应把较早指令所分配的物理寄存器作为输入操作数。通过下面这个给整数数组所有元素加 1 的循环,来看一个例子:
图 3.18 展示处理器如何以每周期 5 条指令的速度,对该循环两次迭代中的指令重命名。每个指令束含 5 条指令。第一个周期为结果分配三个物理寄存器:ld 用 p51 重命名 x2,第一条 addi 用 p52 重命名 x2,第二条 addi 用 p53 重命名 x1。周期结束时,映射表中 x2 的映射来自两条写入指令中较新的那一条,即 p52。指令束内部还存在三处数据依赖。第一处是 ld 产生 x2,后续 addi 使用它。addi 会忽略重命名表为 x2 返回的 p40,改用 ld 同时分配的 p51。重命名逻辑以类似方式,处理 sd 与 addi 之间关于 x2 的真依赖,以及 bne 与 addi 之间关于 x1 的真依赖。第二个周期,它同样处理第二次迭代的指令束,为这些指令产生的新值分配新的物理寄存器 p61、p62、p63。
图 3.18 以每周期 5 条指令的速度,对循环的两次迭代进行寄存器重命名。为简洁起见,图中只显示映射表的三个相关条目,以及每个条目所指物理寄存器的就绪位。一个指令束中的 5 条指令并行重命名,但必须遵守束内数据依赖。例如,bne 对前面的 addi 存在关于 x1 的数据依赖。重命名级输出交给动态调度使用;为辅助调度,已就绪的物理寄存器以下标 R 标记。3
图中文字:Clock Cycle i/i+1 为时钟周期 /;Fetched instructions 为已取指令;Renamed instructions 为重命名后的指令;Mapping Table 为映射表;Physical Reg # 为物理寄存器编号;Ready 为就绪位。第一个周期映射从 x1→p21、x2→p40、x3→p2(均就绪),变为 x1→p53、x2→p52(未就绪)、x3→p2(就绪);第二个周期进一步变为 x1→p63、x2→p62(未就绪)、x3→p2(就绪)。
另一项复杂性来自判断何时能安全地释放物理寄存器。一个用于体系结构寄存器 的物理寄存器 ,只有在后续覆盖指令为 分配了新的物理寄存器,而且所有仍等待调度的指令都不再需要读取 后,才能释放。此外,还必须确保在覆盖指令提交之前,没有指令会引发异常。因此,多数处理器选择延后到覆盖指令提交时才释放物理寄存器,以更长的占用时间换取实现简单。
寄存器重命名的其他实现
寄存器重命名还可以采用多种其他实现。
不设体系结构映射表。 使用 URF 时,可以只保留重命名映射表。发生错误预测或异常后,按以下方法恢复精确寄存器状态:派发时,每条指令在用新分配的物理寄存器编号 覆盖目标映射之前,先读取并在 ROB 中记录旧映射 。如果指令提交,就丢弃旧映射;如果发生异常或错误预测,就从较新指令向较老指令反向遍历 ROB,将每个条目中的旧映射依次恢复到重命名映射表。缺点是恢复延迟与 ROB 大小成正比。
分离物理寄存器与体系结构寄存器。 不采用具有 128 个物理位置的 URF,而是实现两个寄存器堆:一个体系结构寄存器堆 ARF,含 32 个条目 x0~x31;另一个重命名寄存器堆 RRF,保存临时重命名寄存器。指令派发时分配 RRF 寄存器,完成时更新其值;提交时,将新输出值从 RRF 的物理寄存器复制到 ARF 的体系结构寄存器,并更新重命名表以反映这一变化。异常或错误预测恢复很快,只需将所有 RRF 寄存器标为空闲,并重新初始化重命名映射表,使其指向 ARF。实际上,还可以把 ARF 与重命名映射表合并为一个 32 条目的结构:每个 ARF 条目包含指向 RRF 的指针,指明最新一条尚未提交、将覆盖该体系结构寄存器的指令所分配的物理寄存器。不再需要单独的体系结构映射表。
把重命名寄存器放入 ROB。 如果按上述方式分离体系结构寄存器与重命名寄存器,就可以把重命名寄存器集成进 ROB。每个 ROB 条目提供保存一个寄存器值的空间,将指令输出缓冲到提交时;提交时再从 ROB 复制到 ARF。若发生异常或错误预测,这个临时缓冲区与 ROB 条目一并释放。缺点是,它会让本来就具有多个端口的 ROB 更复杂。
把重命名表放入 ROB。 某些设计更进一步,把映射表也集成进 ROB。派发时,新指令必须在 ROB 中搜索:对于自己要读取的每个体系结构寄存器,找出最新的一条可能写入它的指令。如果找到匹配的 ROB 条目,那么当值就绪时,就由该条目向新指令提供输入值;否则,从体系结构寄存器堆读取。这种方式消除了读取输入操作数的两步过程,即先访问重命名映射表,再访问寄存器堆。但它要求 ROB 每周期针对多条指令、多个输入操作数进行相联搜索。搜索还必须优先选择较新的指令,也就是距离 ROB 头部最远的指令。
3.6 利用动态调度克服数据冒险
动态调度使超标量处理器能够在指令的数据依赖一旦解除后立即执行它,不受程序顺序限制,从而开发 ILP。当存在缓存未命中或其他长延迟操作时,动态调度也不可或缺,否则这些操作会造成长时间的流水线停顿。本书前几版首先介绍 Tomasulo 动态执行算法:它开发于 1967 年,实现在 IBM 360/91 大型机的浮点单元中。本版则直接介绍现代动态调度实现,它们建立在分支预测、推测执行与寄存器重命名之上。
动态调度的基本思想
动态调度包含两个步骤。首先,硬件必须跟踪每条待执行指令的数据依赖状态,确定它何时就绪,这称为指令唤醒(instruction wakeup)。其次,硬件必须从就绪指令中选择一部分,启动其执行,这称为指令派发(instruction dispatch)。尽管指令会乱序派发和执行,ROB 仍能保证从错误推测中恢复,并在指令产生异常时恢复精确状态。
指令唤醒与派发,可以由集中式硬件调度器,也称统一调度器,实现;也可以采用一组分布式的小型调度结构。近期 Intel 处理器,例如 Skylake 和 Golden Cove,对整数与浮点指令采用集中式方案;近期 AMD 处理器,例如 Milan 和 Genoa,则采用分布式方案。我们先介绍集中式调度器,再讨论分布式设计的取舍。在研究文献中,集中式调度器有时也称指令窗口、指令缓冲区或指令队列,尽管它并不按先进先出的方式工作。
图 3.19 上半部分给出集中式调度器各条目的字段,下半部分给出整体结构。每个条目都有 busy 字段,表示是否被一条尚未调度的指令占用。接下来的三个字段,在指令开始执行时使用:操作码、目标物理寄存器、待更新的 ROB 条目。之后,条目跟踪两个输入寄存器 和 的状态:执行该指令是否需要它们(Vj、Vk),将提供值的物理寄存器编号(Regj、Regk),以及值是否就绪(Rj、Rk)。最后一个字段指示整条指令是否就绪;当全部有效输入寄存器都就绪时,设置该字段。如果输入物理寄存器在发射时已就绪,或者功能单元通知调度器,写入它的指令已经完成,那么该输入就已就绪。功能单元通过广播总线,每周期通知调度器已完成指令所写入的物理寄存器。
每个调度器条目都带有比较器,持续把两个输入物理寄存器编号 Regj、Regk,与功能单元刚刚更新的物理寄存器编号比较。一旦匹配,就把相应的一个或两个寄存器标为就绪,即设置 Rj 和/或 Rk 为真。
图 3.19 集中式指令调度器的条目格式(上)与结构(下)。图中 Busy 为占用位,Op 为操作码,Dst Reg 为目标寄存器,ROB entry 为 ROB 条目,input register j/k 为输入寄存器 ,Ready 为就绪位。Allocator 为分配器,Scheduler 为调度器,FU availability 为功能单元可用情况,Completion notifications from FUs 为来自功能单元的完成通知。V、Reg、R 各字段含义见正文。
图 3.20 展示 ROB 的组成。每个条目跟踪一条指令:执行是否完成(Ready),是否产生寄存器输出(DestV),写入的体系结构寄存器与物理寄存器编号(Dst AReg、PReg),指令地址(PC),以及指令是否引起错误预测或异常的编码信息,包括错误预测或异常的类型。ROB 使用头、尾指针,按循环缓冲区管理。
图 3.21 是处理器执行引擎与后端的框图,包括指令窗口和 ROB。实线表示数据值或地址的传递,虚线表示指令、控制信号和通知的传递。图中也给出了加载/存储单元的基本结构,3.7 节将予以讨论。
下面回顾指令重命名之后的执行步骤。
1. 发射(顺序):所有指令都分配一个 ROB 条目。算术、逻辑与分支操作还分配调度器条目。加载、存储操作送入加载/存储队列,进行内存地址消歧与调度(见 3.7 节)。如果 ROB、硬件调度器或加载/存储队列已满,就使前端停顿,直到有空位。
| Ready:就绪 | Dst V:目标有效 | Dst AReg:目标体系结构寄存器 | Dst PReg:目标物理寄存器 | PC | 异常/错误预测信息 | 指针 |
|---|---|---|---|---|---|---|
| 0 | 0 | – | – | 0xff…204 | ROB 尾 | |
| 0 | 1 | x2 | p21 | 0xff…200 | ||
| 1 | 1 | x5 | p52 | 0xff…012 | ||
| 1 | 1 | x5 | p51 | 0xff…008 | ||
| 0 | 1 | x4 | p41 | 0xff…004 | ROB 头 |
图 3.20 重排序缓冲区(ROB)的结构。头、尾指针将条目作为循环缓冲区管理。表中未列出的上下方空行,表示原图中的空闲条目;Ready 列接收来自功能单元的完成信号,异常/错误预测信息列接收来自功能单元的异常与错误预测信号。
图 3.21 动态调度超标量处理器执行引擎与后端的基本结构,其中 ROB 用于推测恢复。指令由前端发射到 ROB 和指令调度器。调度器跟踪输入操作数的就绪状态,判断每条指令的数据冒险何时解除,再将其发送到功能单元(加、减、乘、除等),或内存单元(加载、存储)。指令执行完成时,更新其物理寄存器的值,并通知指令调度器,使依赖指令就绪,同时通知 ROB。
图中文字:Instruction Issue 为指令发射;Instruction Scheduler 为指令调度器;Instruction Dispatch 为指令派发;Reorder Buffer 为重排序缓冲区;Load/Store Queue 为加载/存储队列;Registers 为寄存器;FUs 为功能单元;Address Unit 为地址单元;Store Buffer 为存储缓冲区;Store Commit 为存储提交;Memory Unit 为内存单元;Data Cache 为数据缓存;Load/Store 为加载/存储;Load data/Store data 为加载数据/存储数据;Completion Notifications 为完成通知。实线 Data & addresses 为数据与地址,虚线 Instructions & notifications 为指令与通知。
2. 派发(乱序):每个周期,调度器从就绪指令中选择一部分执行。选择电路考虑可用功能单元的数量和类型,以及就绪指令的类型和年龄。由于指令必须按顺序提交,优先调度最老的就绪指令更好。被选中的指令从指令窗口移除,送到匹配的功能单元。对于流水线化的功能单元,每周期可发出一条指令。
3. 完成(乱序):功能单元先从 URF 读取输入数据,再执行送来的指令。算术操作完成后,将结果写回目标物理寄存器,同时向 ROB 和调度器发出完成通知。ROB 用通知把相应指令标为就绪,并记录可能检测到的异常或错误预测。调度器得到目标物理寄存器已就绪的通知后,进行指令唤醒:每个条目将目标寄存器编号与自己的输入寄存器编号比较,确定其中一个或两个输入是否刚刚就绪。如果某条目的两个输入寄存器现在都已就绪,该指令也就就绪,可以参与调度。
4. 提交或恢复(顺序):当指令到达 ROB 头部,且已经执行完成、没有产生异常时,可以提交。此外,分支指令不能预测错误,加载指令也不能在内存消歧中涉及错误推测。对于多数指令,提交就是更新目标寄存器的体系结构映射,并将指令从 ROB 移除。存储提交也类似,但还要通知存储缓冲区,现在可以安全地更新内存。如果导致错误推测的分支或加载,或产生异常的指令到达 ROB 头部,就清空 ROB 及整个处理器流水线,再从正确 PC 重新执行:正确的分支目标、加载指令地址,或异常处理程序的 PC。
上述四个步骤,每个都每周期处理多条指令。例如,一条流水线可以设计成每周期发射 4 条、派发 6 条、提交 4 条指令。派发宽度大于发射与提交宽度,是常见做法。只要功能单元足够,这就能在关键依赖解除后快速处理指令。例如,一条同时发生 L1 和 L2 缓存未命中的加载,可能使许多依赖指令在调度器中等待;当加载完成时,更宽的派发能力可以迅速处理这些积压指令。
动态调度示例
例题 假设一个动态调度超标量处理器有三个功能单元,分别执行浮点加载/存储、浮点加/减、浮点乘/除。功能单元延迟如图 3.2 所示:加法 2 周期,乘法 6 周期,除法 12 周期。1 下面是重命名后的代码,注释中给出原始代码;pf6 表示浮点物理寄存器,p2 表示整数物理寄存器。当 fmul.d 即将提交时,指令窗口、ROB 与浮点物理寄存器分别处于什么状态?
解答 图 3.22 给出 ROB、调度器和浮点物理寄存器的状态。注意,虽然 fsub.d 已执行完成,但必须等 fmul.d 提交后才能提交。fadd.d 可以先于 fdiv.d 执行并完成,因为 f6 已被重命名,避免了 WAR 冒险。浮点乘/除单元刚刚变为空闲,因此 fdiv.d 将在下一周期开始执行。
这个例子展示了采用动态调度与 ROB 的超标量处理器的关键特征:最早尚未完成的指令 fmul.d 之后,没有任何指令可以提交。因此,可以保持精确异常模型。
例如,如果 fmul.d 引发浮点异常,只需等它到达 ROB 头部,再触发异常,并清除 ROB 中其他尚未提交的指令。由于指令按顺序提交,异常便是精确的。相反,如果指令一完成就提交结果,那么 fsub.d 和 fadd.d 都可能在 fmul.d 触发异常之前完成;它们的目标寄存器 f8 和 f6 会被覆盖,这时中断就是不精确的。
重排序缓冲区:
| 条目 | 占用 | 指令 | 状态 | 就绪 | 目标 |
|---|---|---|---|---|---|
| 1 | 否 | fld pf6,0(p2) | 已提交 | 是 | pf6 (f6) |
| 2 | 否 | fld pf2,0(p3) | 已提交 | 是 | pf2 (f2) |
| 3 | 是 | fmul.d pf0,pf2,pf4 | 已完成 | 是 | pf0 (f0) |
| 4 | 是 | fsub.d pf8,pf2,pf6 | 已完成 | 是 | pf8 (f8) |
| 5 | 是 | fdiv.d pf10,pf0,pf6 | 已派发 | 否 | pf0 (f10) |
| 6 | 是 | fadd.d pf16,pf8,pf2 | 已完成 | 是 | pf16 (f6) |
指令调度器:
| 条目 | 占用 | Op | Dst | ROB | Vj | Regj | Rj | Vj(原表第二组) | Regj(原表第二组) | Rj(原表第二组) | 就绪 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 否 | fld | pf6 | 1 | – | – | – | – | – | – | 否 |
| 2 | 否 | fld | pf2 | 2 | – | – | – | – | – | – | 否 |
| 3 | 否 | fmul.d | pf0 | 3 | – | – | – | – | – | – | 否 |
| 4 | 否 | fsub.d | pf8 | 4 | – | – | – | – | – | – | 否 |
| 5 | 是 | fdiv.d | Pf0 | 5 | 是 | pf0 | 是 | 是 | Pf6 | 否 | 是 |
| 6 | 否 | fadd.d | pf16 | 6 | – | – | – | – | – | – | 否 |
浮点重命名寄存器:
| 寄存器 | 状态 | 值 |
|---|---|---|
pf0 | 已占用/就绪 | Mem[p3]+X |
pf2 | 体系结构状态 | Mem[p3] |
pf4 | 体系结构状态 | X |
pf6 | 体系结构状态 | Mem[p2] |
pf8 | 已占用/就绪 | Mem[p3]-Mem[p2] |
pf10 | 已占用/未就绪 | Y |
pf12 | 已占用/就绪 | 2*Mem[p3]-Mem[p2] |
图 3.22 当 fmul.d 即将提交时,只有两条 fld 已提交,虽然其他若干指令已经执行完成。fmul.d 位于 ROB 头部,两条 fld 仅为帮助理解而保留在图中。fsub.d 和 fadd.d 必须等 fmul.d 提交后才能提交,但其结果已经可用,其他指令可以把它们作为源操作数。fdiv.d 使用 fmul.d 刚刚算出的 pf0 值,现在已就绪,可以派发到执行单元;调度器即将选择它执行。ROB 中的状态、占用和指令字段仅为说明而显示。图中未画出加载/存储队列条目,但这些条目保持有序。2
有些用户和体系结构设计者认为,高性能处理器可以接受不精确的浮点异常,因为程序很可能就此终止;附录 J 进一步讨论这个问题。其他异常,例如缺页,如果不精确就难以处理得多,因为异常处理完成后,程序必须能够透明地恢复执行。
使用 ROB 实现指令顺序提交,除了提供精确异常,也能支持推测执行,如下例所示。
例题 考虑下列循环:
假设已经预测分支跳转,并已将循环中的全部指令派发了两次。再假设第一次迭代的 fld 与 fmul.d已提交,其余指令都已派发并完成执行。通常,存储会在 ROB 中等待有效地址操作数(本例为 x1)和待存数据(本例为 f4)计算完成。由于这里只考虑浮点流水线,假设存储指令发射时,其有效地址已经算出。此时重排序缓冲区与物理寄存器的状态如何?
解答 图 3.23 给出了重排序缓冲区,以及整数和浮点物理寄存器的状态。
重排序缓冲区:
| 条目 | 占用 | 指令 | 状态 | 就绪 | 目标 |
|---|---|---|---|---|---|
| 1 | 否 | fld f0,0(x1) | 已提交 | 是 | pf10 (f0) |
| 2 | 否 | fmul.d f4,f0,f2 | 已提交 | 是 | pf14 (f4) |
| 3 | 是 | fsd f4,0(x1) | 已完成 | 是 | – |
| 4 | 是 | addi x1,x1,-8 | 已完成 | 是 | p11 (x1) |
| 5 | 是 | bne x1,x2,Loop | 已完成 | 是 | – |
| 6 | 是 | fld f0,0(x1) | 已完成 | 是 | pf20 (f0) |
| 7 | 是 | fmul.d f4,f0,f2 | 已完成 | 是 | pf24 (f4) |
| 8 | 是 | fsd f4,0(x1) | 已完成 | 是 | – |
| 9 | 是 | addi x1,x1,-8 | 已完成 | 是 | p21 (x1) |
| 10 | 是 | bne x1,x2,Loop | 已完成 | 是 | – |
浮点物理寄存器:
| 寄存器 | 状态 | 值 |
|---|---|---|
pf0 | 空闲 | X |
pf2 | 体系结构状态 | Y |
pf4 | 空闲 | Z |
pf10 | 已占用/就绪 | Mem[A] |
pf14 | 已占用/就绪 | Mem[A]+Y |
pf20 | 已占用/就绪 | Mem[A-8] |
pf24 | 已占用/就绪 | Mem[A-8]+Y |
整数物理寄存器:
| 寄存器 | 状态 | 值 |
|---|---|---|
p1 | 体系结构状态 | A |
p2 | 体系结构状态 | B |
p11 | 已占用/就绪 | A-8 |
p21 | 已占用/就绪 | A-16 |
图 3.23 只有 fld 与 fmul.d 已提交,其他指令虽然都完成执行,却尚未提交。因此没有占用的指令调度器条目,图中也未显示它们。其余指令将尽快提交。前两个重排序缓冲区条目已经为空,此处仍列出,以保持示例完整。3
由于待存值尚未写入内存,而且旧寄存器值会在物理寄存器中保留到指令提交,处理器在发现分支预测错误时,可以撤销推测行为。假设图 3.23 的 bne 第一次实际上不跳转。该分支之前的指令到达 ROB 头部时照常提交;分支到达头部时,清空 ROB,从体系结构映射表恢复重命名映射表,再从正确分支目标开始取指。
许多采用推测执行的处理器,一旦发现分支预测错误,就尽早恢复。这需要清除该分支之后所有指令的 ROB 条目,同时允许 ROB 中分支之前的指令继续执行。在从正确后继指令重新启动之前,恢复正确的重命名状态要更困难。
通常的做法是在分支发射时,为整个重命名映射表保存一个检查点。如果后来发现分支预测错误,就恢复相应检查点。用于保存重命名状态检查点的硬件数量,限制了流水线中可以同时存在的待决分支数。在推测执行处理器中,一次错误预测通常影响很大,因此性能对分支预测更敏感。分支处理的各个方面——预测准确率、错误预测检测延迟、恢复时间——都变得更重要。
异常处理会推迟到指令准备提交时才真正触发。如果指令执行时产生异常,就在 ROB 中记录它。如果后来发现,比这条指令更老的某条分支预测错误,那么清空 ROB 时,该异常会与指令一起被丢弃。如果指令到达 ROB 头部,就知道它已不再是推测执行,确实应该触发异常。也可以尝试在异常一出现、且所有更早的分支均已确定后,立即处理异常;但与分支错误预测相比,这样处理异常更具挑战,而且异常发生频率较低,因此也没那么关键。
动态调度的细节
图 3.24 给出指令执行的各步骤、进入步骤必须满足的条件,以及所采取的动作。图中采用直到提交时才处理分支错误预测的方案。存储只有到达 ROB 头部才更新内存,确保只有在指令不再具有推测性之后,才改变内存。图 3.24 对存储作了一项重要简化,实际实现不必如此:它要求存储在两个输入寄存器值都就绪之后才计算地址。实际上,待存储的值只需要在存储即将提交、更新内存之前可用即可。
图 3.24 某些步骤的速度,对乱序处理器性能至关重要。例如,两条简单算术指令存在数据依赖,一条加法后面跟着一条减法。在附录 C 的简单五级流水线中,利用转发逻辑,它们可以在相邻周期执行,没有任何停顿。而在本节介绍的超标量处理器中,加法执行完成后,减法执行之前必须经过以下步骤:(1)更新减法的调度器条目,标明它已经就绪,即唤醒;(2)调度器选择减法执行,即发射;(3)从 URF 读取减法的输入寄存器值。如果每步都占一个完整周期,这两条指令的执行就会相隔三个周期,意味着必须有更多 ILP 才能使功能单元保持忙碌。许多处理器先把唤醒与调度合并到同一周期,以降低依赖指令间的执行延迟。因为完成通知可以在周期较早阶段发出,与加法执行并行进行,所以能够这样做。
这种技术可以推广到任何固定延迟指令:提前发出完成通知,抵消依赖指令唤醒与调度的延迟。此外,可以在派发时读取已经就绪的物理寄存器,并将其值保存在指令调度器中,从而避免以后从 URF 读取输入的额外延迟。加法结果可以通过额外的转发路径,在功能单元之间直接传递。这些优化虽然可行,能够缩短流水线并降低 CPI,却也增加了复杂度,使其与处理器时钟周期时间之间形成取舍。
图 3.24 的表格以下按“条件表+对应动作”重排,代码标识符与源文伪代码保持一致。4
| 当前步骤 | 等待条件 | 对应动作 |
|---|---|---|
| 所有指令的发射 | ROB 条目 b 可用,并且:加载/存储的 LSQ 条目 ls 可用,或其他指令的 SCHED 条目 w 可用 | A |
| 非加载/存储指令的发射 | B | |
| 加载指令的发射 | C | |
| 存储指令的发射 | D | |
| 指令派发 | SCHED[w].Ready | 选择指令,送往功能单元 |
| 非加载/存储指令的执行 | 指令已派发 | E |
| 加载/存储第 1 步 | LSQ[ls].Ready,且是最老的加载/存储指令 | F |
| 加载第 2 步 | 所有较早存储均访问不同地址 | G |
| 存储第 2 步 | 存储已提交 | H |
| 通知指令完成 | 执行结束 | I |
| 提交 | 指令位于 ROB 头部(条目 h),且 ROB[h].Ready=Yes | J |
A.所有指令的发射
B.非加载/存储指令的发射
C.加载指令的发射
D.存储指令的发射
E.非加载/存储指令的执行
F.加载/存储第 1 步
G.加载第 2 步
H.存储第 2 步
I.通知指令完成
J.提交
上段保留原伪代码关键词:clear 为清空,reset 为重置,fetch branch dest 为从分支目标取指,raise exception 为触发异常,notify LSQ 为通知加载/存储队列。原页在 ArchMap[a]=p;} 后结束,没有给出最外层 else 的闭合大括号;此处不补造。
图 3.24 指令执行的步骤及每一步的要求。对于正在发射的指令,rd 为目标寄存器,rs 与 rt 为源寄存器,w 为分配的指令调度器条目,b 为分配的 ROB 条目,h 为 ROB 头部条目。SCHED 是指令调度器数据结构,ROB 是重排序缓冲区数据结构,URF 是统一寄存器堆数据结构,LSQ 是加载/存储单元数据结构。RenamingMap 与 ArchMap 分别是重命名映射表与体系结构映射表。
减轻集中式指令调度器日益增长的复杂度,一种常见方法是采用分布式方案。一个极端设计是:为每个功能单元配一个仅有 4~10 个条目的调度器。发射时,每条指令分配到特定功能单元的调度器,由其跟踪指令何时就绪。这类分布式调度器通常称为保留站(reservation station)。对于唤醒和派发,一个 10 条目的小保留站,比一个超过 100 条目的集中式调度器简单、快速得多。例如,从 10 条指令中选择最老的就绪指令,比从 100 条中选择更快;每周期为本地功能单元选择 1 条指令,也比集中式调度器选择 4~8 条更容易。在大型调度器中,判断指令年龄最简单的方式,是依据条目位置。这要求部分指令派发后,压紧其余条目,使较老指令位于底部,留给新发射指令的空条目位于顶部。小型保留站则可以直接比较编码指令年龄的标签,而不依赖位置;即使采用压紧,处理 10 个条目也比 100 个容易。分布式保留站的缺点是条目利用率可能不均。如果程序的指令组合偏离设计者确定各结构大小时假定的常见组合,一个功能单元的保留站可能已满,另一个却为空。保留站满会使指令发射停顿。集中式调度器则能把任意条目用于发往任意功能单元的指令。
近期 AMD 处理器采用混合设计。例如,Milan 流水线的分布式设计具有 4 个整数调度器与 2 个浮点调度器。每个整数调度器可容纳任意整数指令、向任意整数功能单元派发;浮点调度器对浮点指令与功能单元也一样。因此,它们避免了为每个功能单元单独设置保留站造成的利用不足。六个分布式调度结构中的每一个,都比集中式调度器小,每周期需要派发的指令也更少。额外的复杂性在于,4 个整数调度器与 2 个浮点调度器必须分别协调,避免向同一个功能单元派发指令。由于可压紧保留站的大小与时钟频率之间存在取舍,一些近期处理器采用带年龄矩阵(age matrix)的非压紧保留站。年龄矩阵不提供完整的指令全序,但对于 路调度器,保证可以派发最老指令,以及其他任意 条指令。
译注:原文将本例延迟称为“图 3.2 所示”,但图 3.2 没有列出乘法 6 周期、除法 12 周期,且其中的延迟定义是两条指令之间需插入的周期数。本例按其明确给出的 2、6、12 保留,不把引用视为一致的延迟定义。 ↩︎
译注:原表存在多处不一致:(1)除法目标写
pf0 (f10),与代码pf10、原指令目标f0相反;调度器 Dst 也写Pf0。(2)除法在 ROB 中写“已派发”,但仍占用调度器,图注称即将派发;第二个输入Pf6的就绪位为“否”,整条指令却为“是”,而寄存器表的pf6已处于体系结构状态。(3)浮点寄存器最后一列写pf12,代码与 ROB 则为pf16。(4)pf0的乘法结果写成Mem[p3]+X,而非由所示乘法得到的积。(5)调度器第二组输入表头重复Vj/Regj/Rj,没有写成 k。这些冲突不能作为正确的调度规则。 ↩︎译注:原表把已提交指令对应的
pf10、pf14仍标为“已占用/就绪”,与 3.5 节规定的体系结构状态不符;fmul.d的两个结果写为Mem[A]+Y、Mem[A-8]+Y,使用的是加号。原值保留,不据此替换成推断的乘法结果。 ↩︎译注:原表伪代码存在标识符与逻辑不一致。包括:加载/存储行混用
ls与w,仍写SCHED[w].ROB;Readuy拼写;完成通知中ROB.Exception缺条目索引、SCHED[w]=Ready/LSQ[ls]=Ready未指明字段;加载就绪检查使用 Rj 而前面为地址输入设置 Rk;存储写内存读取 Regk,但前面把待存值放在 Regj;提交部分分支嵌套与最外层大括号不完整。译校只标明可从本表直接发现的不一致,不代作者设计另一套算法。 ↩︎
3.7 利用动态消歧克服内存依赖
上一节着重讨论存在寄存器数据依赖时的动态调度。现在考察经由内存的数据依赖,也就是加载与存储通过内存位置产生的依赖。这类依赖的检测与管理要困难得多。输入、输出寄存器名称完整编码在指令中,可以在流水线较早阶段检查依赖;内存地址却不是如此。加载和存储必须经过地址生成单元处理后,才能确定有效内存地址。此外,如果与较早的算术或加载指令之间存在寄存器依赖,而那些指令还在修改指针值,地址计算也可能停顿。
一种简单但缓慢的办法,是按程序顺序执行所有加载和存储。最老的内存访问指令先等待寄存器数据依赖解除,再计算地址,将其发送给缓存层次结构。遗憾的是,这会严重损害多发射处理器的性能,因为在存储提交之前,不能允许它覆盖缓存中的数据。即使用了分支预测和寄存器重命名,后续循环迭代的加载,也无法在当前迭代的存储提交之前访问数据缓存。采用这种方法,就无法跨循环迭代开发 ILP。
图 3.21 暗示了一种性能更好的方法,称为加载旁路(load bypassing)。一旦数据依赖允许,加载与存储便计算有效地址,但存储在提交前不送往缓存层次结构。加载则可以绕过较早的存储,前提是没有数据依赖:所有较早存储都已算出有效地址,而且都不同于该加载的有效地址。加载旁路要求存储缓冲区条目具有比较器,以便快速比较加载地址与所有待处理存储的地址。即使较早的存储还未提交,这项优化也能让后续迭代的加载提前访问缓存,隐藏未命中的延迟,并解除后续算术指令对加载的依赖。
另一项优化是存储转发(store forwarding)。如果地址比较表明加载依赖某条较早的存储,就允许加载直接从该存储的输入物理寄存器获取数据,无需访问存储层次结构。与多于两条指令之间的寄存器依赖类似,加载必须从它所依赖的、最新的那条存储获取数据。存储转发对 x86 处理器十分重要。体系结构寄存器数量少,只有 8 个整数寄存器,迫使编译器经常把变量从寄存器溢出到内存,几条指令后又重新加载。因此,超标量 x86 处理器常常重叠执行多对溢出(存储)与恢复(加载)指令。存储转发加速这些依赖加载,也加速其后的依赖指令。
推测性内存消歧
只有当所有地址都已知、可以检查依赖时,才允许加载绕过较早存储,这一要求仍然严重限制性能。
因此出现了推测性内存消歧:允许加载绕过尚未算出内存地址的较早存储,推测两者没有依赖。当缺失的存储地址变为可用时,再实际检查依赖。如果推测有误,就必须重新执行加载,以及所有已经使用其结果的依赖指令。由于在复杂流水线中选择性重执行很困难,常用恢复机制与分支错误预测或异常类似,清空加载指令之后的整个流水线。
多项研究定量表明,简单地一律推测不存在内存依赖,可能还不如完全不推测(Moshovos et al., 1997;Chrysos and Emer, 1998)。因此,近期所有乱序处理器都实现了有选择的推测性内存消歧。与分支预测学习模式类似,处理器学习哪些加载很可能依赖待处理存储。如果较早存储还没有算出地址,就不允许这些加载提前执行。当没有其他信息时,处理器可以先简单地推测不存在内存依赖,从而学习循环中加载和存储的模式。如果后来发现内存依赖,就把涉及该依赖的加载与存储的 PC 保存到硬件结构中。该加载再次执行时,查询这些结构,辅助判断它是否可能依赖某条尚未算出地址的待处理存储。
下面详细介绍 Chrysos 与 Emer 于 1998 年提出的 store sets(存储集合)方案,作为有选择的推测性内存消歧的一个设计例子。该方案侧重记录最近参与过内存依赖错误推测的加载与存储,能够简洁表示一条加载可能依赖一组存储,或一组加载可能依赖一条存储。图 3.25 给出所需的两个硬件结构。存储集合 ID 表(store set ID table,SSIT)跟踪最近参与内存依赖错误推测的加载、存储所属的存储集合 ID。SSIT 用加载与存储 PC 的若干位索引,初始时全部条目无效。集合 ID 是一个短整数,例如 0~63。最近取入存储表(last fetched store table,LFST)跟踪每个集合中最近取入的存储指令地址,即 PC。
硬件发现一次内存依赖错误推测时,分配一个存储集合标识符,将它写入相关加载与存储的 SSIT 条目。如果其中一条已经属于某个集合,即 SSIT 有效,就沿用它现有的集合 ID;如果两条分别属于不同集合,就合并这两个集合。存储派发时,查找自身的 SSIT 条目;若有效,就把自己的指令地址 PC 记入该集合的 LFST 条目。存储算出地址后,重置该 LFST 条目。加载算出地址、准备派发到存储层次结构时,检查这两个结构。如果它的 SSIT 有效,而且相应LFST 条目指向一条尚未算出地址的待处理存储,就不允许加载继续。其他情况下,即 SSIT 条目无效,或有效 SSIT 条目指向空的 LFST 条目,都允许加载推测性地先于尚无地址的较早存储发出。SSIT 无效,说明该加载近期没有参与依赖错误推测;SSIT 有效而 LFST 为空,则说明这条加载可能依赖的所有存储,都已经算出地址。
图 3.25 store sets 方案用于有选择的推测性内存消歧所需的硬件(Chrysos and Emer, 1998)。原论文建议 SSIT 包含 1K~4K 个条目,LFST 包含 64~128 个条目。根据处理器其余部分的实现方式,LFST 条目可以保存最近取入存储的指令地址 PC、ROB 条目编号,或加载/存储队列条目编号。
图中文字对照:Load/store PC 为加载/存储指令的 PC;Store Set ID Table 为存储集合 ID 表;Last Fetched Store Table 为最近取入存储表;V 为有效位;Store set ID 为存储集合 ID;Store PC 为存储指令 PC。示例中 SSIT 条目 3 有效、集合 ID 为 2,指向 LFST 条目 2,其有效位为 1,存储 PC 为 0x00800012。原图还列出调度器条目与结构:Busy 为占用,Op 为操作码,Dst Reg 为目标寄存器,ROB entry 为 ROB 条目,input register j/k 为输入寄存器 j/k,Ready 为就绪,Allocator 为分配器,Scheduler 为调度器,FU availability 为功能单元可用情况,CDB tags 为公共数据总线标签。
存储集合方案逐步捕捉那些曾导致依赖错误推测的加载、存储指令集合。它的准确率受若干因素限制。第一,不同加载和存储可能映射到同一个 SSIT 条目,造成不必要的集合合并。第二,如果某对加载/存储很少发生依赖错误推测,不在这些结构中跟踪它们,可能反而性能更好。最后,存储集合只能随时间增长,使处理器对加载旁路越来越保守。
一种简单的应对方法,是每隔几百万条指令就重置这两个结构,让硬件重新发现推测时最关键、最应保留的依赖。
第 5 章讨论存储一致性时会看到,多处理器系统给加载与存储施加更多顺序约束,即使内存地址已经确定也如此。有些情况下,连加载之间的重排都会出错。推测性内存消歧使处理器在这些约束之下仍能保持高性能。硬件可以学习哪些重排会违反存储一致性,只有在不太可能违反时,才通过重排内存访问来提高性能。
推测性内存消歧是值预测(value prediction)的一种简单、受限形式。值预测试图预测一条指令将产生的值。如果足够准确,它就可能消除数据流限制,实现更高的 ILP。过去 20 年,虽然许多研究者发表了数十篇有关值预测的论文,但迄今其效果还没有吸引力到足以促成商用处理器采用通用值预测。
3.8 现代超标量处理器的高级问题
每周期多发射的挑战
在动态调度处理器中,每周期发射多条指令很复杂,原因很简单:同一指令束中的指令可能相互依赖。我们介绍的指令执行各步骤,特别是发射、派发和提交,都必须考虑并行处理的指令之间的依赖。3.5 节讨论了每周期对多条指令重命名的复杂性;这里进一步说明其对流水线其他部分的影响。
超标量处理器曾采用两种不同方法来处理每周期多条指令。一种是在半个时钟周期内完成相应步骤,从而在一个周期内按顺序处理两条指令。遗憾的是,它不容易扩展到每周期 4 条或更多指令。关键在于,不能简单地通过增加流水级来消除这个问题。例如,如果发射过程占多个周期,仍必须及时更新重命名表,让下一周期发射的依赖指令能够使用更新后的信息。另一种方法是构造必要的逻辑,一次处理两条或更多指令,包括它们之间所有可能的依赖。现代超标量处理器在其深流水线的关键级采用这种方法。
发射步骤是宽发射处理器最基本的瓶颈之一。要正确发射一个含 条指令的指令束,必须:
- 分配并更新 个 ROB 条目;不足 个时,只发射一部分,即束内最老的那些指令。
- 在指令调度器与加载/存储队列中分配并更新 个条目;不足时,同样只发射束内最老的部分指令。
- 分配并更新至多 个物理寄存器;不足时,只发射束内最老的部分指令。
- 正确重命名束内 条指令的全部输入操作数,考虑束内指令之间的数据依赖与名依赖(见 3.5 节)。
依赖组合的数量随指令束大小的平方增长,因此发射很可能成为时钟频率瓶颈,这也是很少有处理器尝试超过每周期 8 条的原因。3.5 节的图 3.18 展示了每周期重命名多条指令的复杂性,也清楚说明了为什么过去 20 年,大批量生产的处理器发射率只从 3~4 条提高到 4~8 条。
每周期派发多条指令较简单,因为到了这一阶段,数据依赖和名依赖已解决,多数情况下可以分别处理各条指令。半导体缩放也让大量功能单元变得容易实现,可在每周期处理就绪指令,因此有些处理器的派发宽度超过发射宽度。这有助于快速处理缓存未命中的加载完成后突然就绪的一批指令。同样,只要提交逻辑保证:第一条报告异常或错误预测的指令之后,所有指令都被撤销,那么每周期从 ROB 提交多条指令也并不特别复杂。
下面用一个例子,从性能角度说明这些概念如何结合。
例题 在支持推测执行的双发射、动态调度处理器上,执行下列循环,对整数数组的每个元素加 1:
假设有独立的整数功能单元,分别用于有效地址计算、ALU 运算、分支条件求值。为该循环前三次迭代建立执行时间表。假设每周期最多可以提交任意类型的两条指令。
解答 图 3.26 给出支持推测执行的双发射动态调度处理器的性能。在这个例子中,循环末尾分支可能成为 ILP 的关键限制,因此推测执行的帮助非常明显。通过预测分支,后续指令可以在较早分支确定之前执行,但不能提交,因而加快执行。例如,第二次加载可以在较早的分支之前完成执行。1 如果不采用推测执行,分支结果的确定会成为关键性能瓶颈。
| 迭代 | 指令 | 发射周期 | 派发周期 | 完成周期 | 提交周期 | 说明 |
|---|---|---|---|---|---|---|
| 1 | ld p2,0(p1) | 1 | 2 | 4 | 5 | 第一条指令 |
| 1 | addi p22,p2,1 | 1 | 4 | 5 | 6 | 等待 ld |
| 1 | sd p22,0(p1) | 2 | 5 | 6 | 等待 addi | |
| 1 | addi p21,p1,8 | 2 | 2 | 3 | 7 | 按顺序提交 |
| 1 | bne p21,p3 Loop | 3 | 3 | 4 | 7 | 等待 addi |
| 2 | ld p32,0(p21) | 4 | 5 | 7 | 8 | 没有执行延迟 |
| 2 | addi p42,p32,1 | 4 | 7 | 8 | 9 | 等待 ld |
| 2 | sd p42,0(p21) | 5 | 8 | 9 | 等待 addi | |
| 2 | addi p31,p21,8 | 5 | 6 | 7 | 10 | 按顺序提交 |
| 2 | bne p31,p3 Loop | 6 | 7 | 8 | 10 | 等待 addi |
| 3 | ld p52,0(p31) | 7 | 8 | 10 | 11 | 最早可能时间 |
| 3 | addi p62,p52,1 | 7 | 10 | 11 | 12 | 等待 ld |
| 3 | sd p62,0(p31) | 8 | 11 | 12 | 等待 addi | |
| 3 | addi p41,p31,8 | 8 | 9 | 10 | 13 | 提前执行 |
| 3 | bne p41,p3 Loop | 9 | 10 | 11 | 13 | 等待 addi |
图 3.26 支持推测执行的双发射流水线中,各指令派发、发射、执行完成和提交的时间。注意,由于预测分支跳转,bne 后的 ld 可以提前开始执行。假设加载需要 1 周期生成地址、1 周期访问缓存,且全部命中;存储可以按需缓冲;一条指令所依赖的较早指令完成执行的同一周期,就可以调度它执行。表中存储的完成周期按原表留空。
推测应做到什么程度
推测执行的一项重要优势,是能提前发现缓存未命中等原本会使流水线停顿的事件。但这项潜在优势也伴随着显著的潜在代价。推测并非免费:它需要时间与能量,从错误推测中恢复还会进一步降低性能。此外,要支持足够高的指令执行速率,从推测中获益,处理器还需要额外资源,占用芯片面积并消耗功率。最后,如果推测引发缓存或地址转换后备缓冲区(TLB)未命中之类的特殊事件,而没有推测本来不会发生该事件,就更可能造成显著性能损失。
为保留大部分收益,同时尽量降低不利影响,许多支持推测执行的流水线,只允许在推测状态下处理代价低的特殊事件,例如缓存未命中。如果发生 TLB 未命中等高代价事件,就等引发事件的指令不再具有推测性后才处理。虽然这可能略微降低某些程序的性能,却能避免其他程序出现重大损失,尤其是特殊事件频繁、分支预测又不够出色的程序。
20 世纪 90 年代,推测执行的潜在弊端还不那么明显。随着处理器越来越激进地采用推测,实际代价逐渐显现,更宽发射与推测执行的局限也变得清楚。稍后将再次讨论这一问题。
跨越多个分支进行推测
本章讨论的宽发射、深流水线处理器,可以重叠执行几十条指令。这意味着任意时刻都可能有多个尚未确定的推测分支。另外三个特征进一步增加了这种可能性:(1)许多程序的分支频率很高;(2)某些代码段中的分支集中出现;(3)功能单元确定分支结果所需的延迟很长。数据库程序及其他结构较不规则的整数计算,经常表现出前两项特征,使跨多个分支的推测尤其重要。同样,功能单元延迟较长时,跨多个分支推测也更重要,因为它有助于避免长流水线引起的停顿。
跨多个分支推测的主要难点,是确定何时更新分支预测状态,包括历史寄存器、预测计数器和目标预测结构。如果只有一条尚未确定的推测分支,可以等它的结果明确后再更新状态。注意,无论预测正确还是错误,都需要更新预测器状态。存在多个推测分支时,就面临取舍:等一条分支确定后再更新预测表,预测随后的几条分支时就无法利用这条分支的历史;一旦预测跳转或不跳转就立即更新,状态又可能包含不准确的信息。若干处理器选择提前更新,如果实际结果与预测方向相反,就修正部分或全部预测结构中的这些更新。例如,有些处理器维护两个 RAS:一个在取入函数调用指令时推测性更新,另一个只在调用指令不再具有推测性时更新。
到目前为止,所有处理器每周期都只预测一条分支。使用单个 PC 从缓存取一个指令束,并索引预测结构,确定下一 PC。如果束内存在跳转分支,预测结构跟踪其中第一条跳转分支的信息。每周期跨越多条实际跳转的分支进行预测,会显著增加复杂度与功耗,性能收益很难抵消这些成本。比较容易取得收益的情况,是循环体很小的循环;可以用循环缓存有效捕捉它们,而这已经是许多现代处理器的常见功能。
推测执行与能效挑战
推测执行如何影响能效?乍看之下,可能认为它总会降低能效,因为推测一旦错误,就会从两方面额外耗能:
- 推测执行了结果不需要的指令,为处理器制造额外工作,浪费能量。
- 撤销推测、恢复处理器状态,以便从正确地址继续执行,又会消耗没有推测时本来不需要的额外能量。
推测执行确实会提高功耗,因为它引入了分支预测器、重命名表、指令窗口、ROB 等新的硬件结构来管理指令执行。这些大型结构持续使用,增加动态和静态功耗。但是,如果执行时间缩短的比例超过平均功耗提高的比例,总能耗仍可能下降。
因此,要理解推测执行对能效的影响,就必须考察它多频繁地造成无用工作。如果执行了大量不需要的指令,推测就不太可能带来幅度相当的运行时间改善。图 3.27 展示使用复杂分支预测器时,部分 SPEC2000 基准中因错误推测而执行的指令比例。科学计算代码的这一比例很小,整数代码却很大,平均约为 30%。因此,推测执行对整数应用很可能并不节能,而 Dennard 缩放规律失效,也使不完美推测的问题更加突出。设计者可以避免推测、减少错误推测,或者探索新方法,例如只对已知高度可预测的分支进行推测。
超标量处理器受到哪些限制
本章讨论的硬件技术,对于开发 ILP 特别有效。如今几乎所有中高性能处理器,都建立在宽发射、深流水线、分支预测、寄存器重命名和动态调度之上。不过,过去十年,超标量处理器的性能改进速度已经放缓。超标量特性持续渐进改进,但若干关键特征,例如发射宽度、流水线深度,甚至时钟频率,已多年基本不变。这表明超标量处理器的有效性存在限制。
图 3.27 因错误推测而执行的指令比例,整数程序(前五个)通常远高于浮点程序(后五个)。纵轴 Misspeculation 为错误推测比例;横轴依次为 164.gzip、175.vpr、176.gcc、181.mcf、186.crafty、168.wupwise、171.swim、172.mgrid、173.applu、177.mesa。
我们已经讨论了两个关键限制。第一,发射很宽,每周期 4 条或以上,同时流水线很深的处理器,设计复杂而且耗电。有些阶段的复杂度随发射宽度平方增长。为缓解这一问题,处理器厂商正将超标量技术与向量、多核技术结合,分别开发数据级和线程级并行性,以争取更大性能收益。这两类并行性比 ILP 更规则,或者粒度更粗,所需支持硬件也较简单,第 4、5 章将进一步讨论。第二,超标量处理器性能受分支预测准确率限制。即使只有几个百分点的错误预测率,也足以使更宽、更深的流水线失去效果。
第三项限制来自必须由片外缓存和主存服务的缓存未命中。Karkhanis 与 Smith 较早分析了这种可能持续数百周期的长时间未命中的影响(Karkhanis and Smith, 2002)。有趣的是,等待长时间未命中时,停在指令窗口中的依赖指令并非主要问题。现代处理器的大指令窗口能容纳这几十条依赖指令,不妨碍独立指令就绪后发出。
相反,ROB 堵塞是一个重要问题,因为在未命中尚未完成期间,任何更年轻的指令都不能提交。这促使研究者探索利用检查点技术,构造拥有数千 ROB 条目的超标量处理器,但目前还未商用。最后,长时间未命中返回的数据,经常被数据依赖的分支使用,使分支预测不准确。
译注:原题代码末尾为
bne x2,x3,Loop,而图 3.26 的重命名分支使用p21/p31/p41,对应的是更新后的指针x1,不是数组值x2。此外,原解答称第二次加载可先于较早分支完成,但表中第二次加载完成周期为 7,第一次分支完成周期为 4。原代码、文字与时间表均保留,不能据此声称它们已相互一致。 ↩︎
3.9 利用多发射与静态调度开发 ILP
前面各节介绍了多发射处理器利用硬件开发 ILP 的技术。尽管编译程序时假设指令顺序执行,一次一条、互不重叠,硬件仍利用分支预测、寄存器重命名和动态调度来发现并开发 ILP。相比之下,VLIW 处理器每次发射固定数量的指令,它们被组织成一条大指令,或一个固定的指令包,并在指令中明确标出并行性。VLIW 天生由编译器静态调度。Intel 和 HP 创建附录 H 所述的 IA-64 体系结构时,还为这种体系结构风格引入了 EPIC 名称,即 explicitly parallel instruction computer,显式并行指令计算机。
基本 VLIW 方法
VLIW 使用多个独立功能单元。它不试图分别向这些单元发射多条独立指令,而是把多个操作打包成一条很长的指令,或者要求发射包内的指令满足相同约束。两种方式没有本质区别,因此下面沿用最初的 VLIW 方法,假设多个操作放在同一条指令中。
VLIW 的优势随最大发射率增加而扩大,因此我们重点考察更宽的发射。事实上,对于简单双发射处理器,超标量方式的额外开销可能很小。许多设计者也会认为四发射处理器的开销仍可控制,但如本章前面所示,开销增长是限制进一步加宽发射的主要因素。
考虑一个 VLIW 处理器,每条指令包含五个操作:一个整数操作,也可以是分支;两个浮点操作;两次内存访问。指令为每个功能单元保留一组字段,每个单元可能需要 16~24 位,总指令长度为 80~120 位。相比之下,Intel Itanium 1 和 2 每个指令包包含六个操作,即可以同时发射两个各含三条指令的指令束,详见附录 H。
为了使功能单元保持忙碌,代码序列必须有足够并行性,填满可用操作槽。通过循环展开,并在扩大的单个循环体内调度代码,就能发现这种并行性。如果展开产生直线代码,可以采用只处理单个基本块的局部调度技术。如果要跨越分支调度,才能发现并开发并行性,就必须使用复杂得多的全局调度算法。全局调度不仅结构更复杂,还要处理复杂得多的优化取舍,因为跨分支移动代码代价很高。
附录 H 将介绍踪迹调度(trace scheduling),这是一种专为 VLIW 开发的全局调度技术;还会介绍特殊硬件支持,用来消除部分条件分支,扩展局部调度的适用范围,并提高全局调度的性能。
目前,我们先依靠循环展开,生成较长的直线代码,再用局部调度组成 VLIW 指令,重点考察这类处理器的执行效果。
例题 假设一个 VLIW 每周期可发射两次内存访问、两个浮点操作,以及一个整数操作或分支。为它给出循环 的展开版本,RISC-V 代码见 3.2 节。充分展开,以消除所有停顿。1
解答 图 3.28 给出代码。循环展开为七份循环体,消除了所有停顿,即完全空闲的发射周期。展开并调度后的循环需要 9 个周期,因此每 9 周期产生 7 个结果,平均每个结果 1.29 周期,几乎是 3.2 节采用展开、调度代码的双发射超标量处理器的两倍速度。1
原始 VLIW 模型在技术和实际使用层面都遇到问题,影响了效率。技术问题主要是代码增大,以及同步锁步运行的限制。两个因素共同导致 VLIW 代码显著增大。第一,要在直线代码片段中产生足够操作,就需要像前面的例子那样大量展开循环,从而扩大代码。第二,只要指令没填满,未使用功能单元对应的编码位就被浪费。附录 H 将讨论软件流水线等软件调度方法,在不显著扩大代码的情况下,获得循环展开的收益。
为抑制代码增大,有时会采用巧妙编码。例如,只设置一个较大的立即数字段,供任意功能单元使用。另一种方法是在主存中压缩指令,读入缓存或译码时再展开。附录 H将介绍其他技术,并记录 IA-64 中明显的代码膨胀。
| 内存访问 1 | 内存访问 2 | 浮点操作 1 | 浮点操作 2 | 整数操作/分支 |
|---|---|---|---|---|
fld f0,0(x1) | fld f6,-8(x1) | |||
fld f10,-16(x1) | fld f14,-24(x1) | |||
fld f18,-32(x1) | fld f22,-40(x1) | fadd.d f4,f0,f2 | fadd.d f8,f6,f2 | |
fld f26,-48(x1) | fadd.d f12,f0,f2 | fadd.d f16,f14,f2 | ||
fadd.d f20,f18,f2 | fadd.d f24,f22,f2 | |||
fsd f4,0(x1) | fsd f8,-8(x1) | fadd.d f28,f26,f24 | ||
fsd f12,-16(x1) | fsd f16,-24(x1) | addi x1,x1,-56 | ||
fsd f20,24(x1) | fsd f24,16(x1) | |||
fsd f28,8(x1) | bne x1,x2,Loop |
图 3.28 构成内层循环、替代原展开序列的 VLIW 指令。假设分支预测正确,该代码需要 9 个周期。9 周期发射 23 个操作,即每周期 2.5 个。效率,即包含实际操作的可用槽位比例,约为 60%。2 要达到这一发射率,需要比 RISC-V 通常在该循环中使用的更多寄存器。上述 VLIW 代码至少需要 8 个浮点寄存器;相应的基础 RISC-V 代码最少可用 2 个浮点寄存器,展开、调度后可能需要 5 个。
早期 VLIW 以锁步方式运行,完全没有冒险检测硬件。这种结构要求任意功能单元流水线停顿时,整个处理器都必须停顿,因为所有功能单元必须同步。编译器也许能对延迟确定的功能单元进行调度,以避免停顿,但很难预测哪些数据访问会因缓存而停顿,并据此调度。因此,缓存必须是阻塞式的,一旦阻塞就使所有功能单元停顿。随着发射率与内存访问数量增加,这种同步限制变得不可接受。较新的处理器让功能单元更加独立:由编译器避免发射时的冒险,而指令发射后,通过硬件检查允许不同步执行。
对于通用 VLIW 或需要运行第三方软件的 VLIW,二进制代码兼容性也是重大实际问题。在严格 VLIW 方案中,代码序列不仅依赖指令集定义,还依赖具体流水线结构,包括功能单元和延迟。因此,功能单元数量与延迟不同,就需要不同代码版本。这使跨代实现,或不同发射宽度实现之间的迁移,比超标量设计更困难。当然,要充分利用新超标量设计的性能,也可能需要重新编译;不过,能够直接运行旧二进制文件,仍是超标量方案的一项实际优势。在第 7 章介绍的领域专用体系结构中,这个问题不严重,因为应用就是针对特定体系结构配置编写的。
以 IA-64 为主要代表的 EPIC,为早期通用 VLIW 设计的许多问题提供了解决办法,包括支持更激进软件推测的扩展,以及在保留二进制兼容性的同时,克服代码依赖具体硬件的限制。
多发射的整体认识
图 3.29 总结多发射的基本方法、区别性特征,以及采用各方案的处理器。静态调度超标量处理器每周期发射的指令数虽可变,而非固定,但在概念上其实更接近 VLIW,因为两者都依靠编译器为处理器调度代码。随着发射宽度增加,静态调度超标量的优势递减,因此主要用于较窄发射,通常仅为双发射。若干低功耗处理器,例如本章后面介绍的 Arm A53,就是双发射、静态调度超标量处理器。超过这个宽度,大多数设计者会选择 VLIW,或动态调度并支持推测的超标量方案。
EPIC 体系结构在 2020 年取消之后,动态、推测超标量处理器成为服务器、桌面、笔记本乃至手机系统的主流。因此,“超标量处理器”通常就是指动态调度、支持推测执行的设计。有些芯片采用称为 big.LITTLE 的组合,同时包含动态调度与静态调度超标量处理器,交由软件根据使用场景,选择哪种处理器以优化性能或降低功耗。VLIW 在信号处理应用中仍然流行;第 7 章讨论领域专用加速器时,还会再次遇到它们。
所有多发射处理器的主要挑战,都是开发大量 ILP。如果并行性来自对浮点程序中简单循环的展开,那么原循环很可能也能在下一章介绍的向量处理器上高效运行。对这类应用,多发射处理器是否优于向量处理器并不明确:成本相近,而向量处理器通常同样快,甚至更快。多发射处理器的潜在优势,是能从结构较不规则的代码中提取一定并行性,并容易对各种形式的数据使用缓存。因此,多发射已成为开发 ILP 的主要方法,向量则主要成为这类处理器的扩展。
| 通用名称 | 发射组织 | 冒险检测 | 调度 | 区别性特征 | 示例 |
|---|---|---|---|---|---|
| 静态超标量 | 动态 | 硬件 | 静态 | 顺序执行 | 主要在嵌入式领域:MIPS、ARM,包括 Cortex-A53 |
| 动态超标量 | 动态 | 硬件 | 动态 | 部分乱序执行,但不推测 | 目前没有 |
| 超标量(动态并推测) | 动态 | 硬件 | 带推测的动态调度 | 带推测的乱序执行 | Intel Xeon 和 Core、AMD EPYC 和 Ryzen、ARM Neoverse 及许多 Cortex-A、Apple M1 |
| VLIW/LIW | 静态 | 主要依靠软件 | 静态 | 所有冒险由编译器确定并指示,通常为隐式指示 | 多见于信号处理,如 TI C6x |
| EPIC | 主要为静态 | 主要依靠软件 | 主要为静态 | 所有冒险由编译器确定并显式指示 | Intel Itanium |
图 3.29 多发射处理器使用的五种主要方法,以及区分它们的主要特征。本章侧重依赖硬件的技术,它们都是某种形式的超标量;附录 H 侧重编译器方法。IA-64 所体现的 EPIC 扩展了早期 VLIW 的许多概念,融合了静态与动态方法。
3.10 贯穿各层的问题
硬件推测与软件推测
本章高度依赖硬件的推测方法,与附录 H 的软件方法,为开发 ILP 提供了不同选择。它们的部分取舍与局限如下:
- 要广泛推测,就必须能够对内存访问消歧。对于包含指针的整数程序,在编译时很难做到。硬件方案利用前面介绍的技术,在运行时动态消除内存地址歧义,允许加载在运行时越过存储。支持围绕内存访问进行推测,也有助于克服编译器过度保守的问题;但如果不进行选择性推测,恢复机制的开销可能淹没收益。
- 当控制流难以预测,而且硬件分支预测优于编译时的软件分支预测时,硬件推测效果更好。许多整数程序符合这些条件:动态预测器的错误预测率通常不到静态预测器的一半。由于预测错误时,推测指令可能拖慢计算,这个差异十分重要。因此,即使静态调度处理器,通常也具有动态分支预测器。
- 硬件推测即使对推测指令,也能维持完全精确的异常模型。近期软件方案也增加了特殊支持,以实现这一点。
- 硬件推测不需要补偿或记账代码,而激进的软件推测机制需要这些代码。
- 编译器能够看到代码序列中更远的部分,可能因此比纯硬件方法获得更好的调度结果。
- 动态调度结合硬件推测时,为了在同一体系结构的不同实现上取得良好性能,不需要使用不同代码序列。这个优点最难量化,但长期看可能最重要。有趣的是,它也是 IBM 360/91 的设计动机之一。另一方面,IA-64 等较新的显式并行体系结构,也加入了灵活机制,减轻代码序列对具体硬件的固有依赖。
硬件支持推测的主要缺点,是复杂度与额外硬件资源。评价这项成本时,必须同时考虑软件方法的编译器复杂度,以及依赖这种编译器后,处理器可以简化多少、这些简化有多大价值。
有些设计者尝试结合动态与编译器方法,兼取两者之长。但组合也可能产生有趣而隐蔽的相互作用。例如,将条件移动与寄存器重命名结合,会出现一个微妙的副作用:一条被取消的条件移动,仍必须向目标寄存器复制一个值,因为该目标已在流水线较早阶段被重命名。
这些细微交互使设计与验证更复杂,也可能降低性能。
Intel Itanium 是有史以来以软件支持 ILP 和推测为基础、设计目标最为雄心勃勃的计算机。它未实现设计者的期待,尤其是在通用、非科学计算代码上。面对第 244 页描述的困难,设计者开发 ILP 的目标有所收敛,大多数体系结构最终选择硬件机制,每周期发射 3~4 条指令。
推测执行与存储系统
支持推测执行或条件指令的处理器,天然可能产生一些无效地址,而没有推测执行时本不会出现这些地址。
对这些地址触发保护异常,在功能上是不正确的,也很可能抵消推测执行的收益。如 3.5、3.6 节所述,超标量处理器把异常推迟到指令准备提交时,也就是不再具有推测性时才触发。但 3.12 节将看到,即使只是执行了后来会被撤销的无效地址加载,也可能成为严重安全漏洞的根源。
同理,也不能让这些指令因缓存未命中而使缓存停顿,因为不必要的停顿同样可能淹没推测收益。因此,这类处理器必须配备非阻塞缓存。实际上,访问 DRAM 的未命中代价非常大,所以只有当下一级是片上缓存(L2 或 L3)时,才处理推测产生的未命中。
第 84 页的图 2.5 显示,对于某些行为规律的科学计算程序,编译器能够保持多次未完成的 L2 未命中,从而有效降低 L2 未命中代价。要使这种方法奏效,缓存后方的存储系统也必须在同时进行的内存访问数量上,配合编译器的目标。
译注:原文引用“第 84 页的图 2.5”,但本版图 2.5 列出的是 DDR DRAM 与 DIMM 的时钟频率、带宽和命名,不能据此核验本段关于科学计算程序未命中的论述。原引用予以保留,不推断作者本来意指哪个图表。
3.11 多线程:利用线程级并行性提高单核吞吐量
本节介绍的多线程,确实是一个贯穿各层的问题:它既与流水线和超标量有关,也与 GPU(第 4 章)及多处理器(第 5 章)有关。软件线程与进程相似,都有自身状态和当前 PC;但线程通常共享同一进程的地址空间,因此,一个线程能够方便地访问同一进程中其他线程的数据。多线程是一项硬件技术,让同一进程内的多个线程,或多个进程,共享处理器流水线,而不必由操作系统在其间执行进程切换。在线程之间快速切换,或让不同线程的指令重叠执行,使多线程能够隐藏流水线延迟和内存延迟。
下一章将看到,多线程如何在 GPU 中带来同样的好处。最后,第 5 章将讨论多线程与多处理的结合。这些主题紧密交织,因为多线程是向硬件提供更多并行性的主要技术之一。严格来说,多线程利用的是线程级或进程级并行性,因而应属于第 5 章的主题;但考虑到它在提高流水线利用率和 GPU 中的重要作用,我们在这里先介绍其概念。
利用 ILP 提高性能的一大优点,是对程序员基本透明;但前面已经看到,在某些应用中,ILP 相当有限,或很难开发。尤其是在合理的指令发射速率下,访问内存或片外缓存的缓存未命中,几乎不可能靠现有的 ILP 隐藏。当然,处理器因等待缓存未命中而停顿时,功能单元的利用率会急剧下降。
用更多 ILP 掩盖长时间内存停顿,效果有限且成本显著,因此,自然会想到:能否利用应用中的其他并行性隐藏内存延迟?例如,在线事务处理系统中,请求带来的多次查询和更新之间,天然存在并行性。许多科学计算应用也有天然并行性,因为它们经常模拟自然界三维、并行的结构;可以利用独立线程开发这种结构中的并行性。甚至在采用现代 Windows 操作系统的桌面应用环境中,通常也有多个应用同时处于活动状态,成为进程级并行性的来源。
多线程允许多个线程以重叠的方式,共享一个处理器的功能单元。相较之下,开发线程级并行性(TLP)更一般的方法是使用多处理器:多个独立线程同时运行,在多条处理器流水线上并行执行。但多线程并不像多处理器那样复制整个处理器;它让一组线程共享处理器核心的大部分资源,仅复制寄存器和 PC 等私有状态。第 5 章将看到,许多较新的处理器,既在单颗芯片上集成多个处理器核心,也在每个核心内支持多线程。
复制处理器核心中每个线程的状态,意味着为每个线程建立独立的寄存器堆和 PC。内存本身可以通过已有的、支持多道程序的虚拟内存机制共享。此外,硬件必须能够较快地切换到另一个线程;尤其是,线程切换应当远比操作系统的进程切换高效。后者通常需要数百至数千个处理器周期;即便用户态协作式线程库中的线程切换,也需要数十至数百个时钟周期。
硬件多线程主要有三种方法:细粒度、粗粒度和同时多线程。细粒度多线程在每个时钟周期切换活动线程,使多个线程的指令交错分布在流水线各级中执行。这种交错通常采用轮转方式,跳过当时因停顿而不活动的线程。细粒度多线程的一项主要优点,是能够隐藏长、短停顿引起的吞吐量损失:一个线程停顿时,即使只停顿几个周期,也可以执行其他线程的指令。其主要缺点是减慢单个线程的执行,因为一个已就绪、原本可以不停顿执行的线程,会被其他线程的指令延后。它以单线程性能的损失——用延迟衡量——换取整体多线程吞吐量的提高。处理器也必须精心设计:由于不同线程的指令可能在流水线中重叠,所有进行转发或停顿控制的逻辑,除寄存器编号外,还必须考虑线程标识符。
细粒度多线程最早商用于 Denelcor HEP 和 Tera MTA 超级计算机。SPARC T1 至 T5 处理器(最初由 Sun 制造,后来由 Oracle 制造,现在由 Fujitsu 制造)采用细粒度多线程。这些处理器面向事务处理、Web 服务等多线程工作负载。T1 每个处理器支持 8 个核心,每核 4 个线程;T5 支持 16 个核心,每核 128 个线程。后续版本(T2–T5)还支持 4~8 个处理器插槽。下一章介绍的 NVIDIA GPU,也使用细粒度多线程。
译注:上述产品归属与线程数均按原书保留。“T5 每核 128 个线程”是原页文字,并非提取时把“每处理器”误读成“每核”;此处数值口径存疑,不能据此作为产品规格依据。
粗粒度多线程是作为细粒度多线程的替代方案提出的。它仅在代价高昂的停顿发生时切换线程,例如需要访问片外内存或缓存的缓存未命中。由于只有当前线程遭遇高代价停顿时,才发射其他线程的指令,因此,粗粒度多线程不再要求线程切换几乎零成本,也远不容易拖慢某个线程的执行。它还简化了处理器设计,因为任一时刻,流水线只执行一个线程的指令。其他活动线程的指令可以预取,但直到出现高代价停顿时才执行。
不过,粗粒度多线程有一个主要缺点:弥补吞吐量损失的能力有限,尤其难以弥补较短停顿造成的损失。这个限制来自粗粒度多线程的流水线启动成本。由于处理器只从单个线程发射指令,发生停顿时,在新线程开始执行之前,流水线中会出现气泡。由于这一启动开销,粗粒度多线程更适合降低代价极高的停顿:相对于停顿时间,重新填充流水线的时间可以忽略。若干研究项目探索过粗粒度多线程,但当前没有主要处理器采用这项技术。
最常见的多线程实现称为同时多线程(simultaneous multithreading,SMT)。SMT 是细粒度多线程的一种变体:在多发射、动态调度处理器上实现细粒度多线程,自然就会得到 SMT。与其他形式的多线程一样,SMT 利用 TLP 隐藏处理器中的长延迟事件,从而提高功能单元利用率。SMT 的关键认识是:寄存器重命名和动态调度,使来自独立线程的多条指令可以执行,而无需另外处理这些指令之间的依赖;依赖的解决可以交给动态调度机制。实际上,SMT 把多个线程的 ILP 交织起来,尽可能充分地利用流水线。
图 3.30 从概念上比较了以下四种处理器配置利用超标量资源的能力:
- 不支持多线程的超标量处理器。
- 支持粗粒度多线程的超标量处理器。
- 支持细粒度多线程的超标量处理器。
- 支持 SMT 的超标量处理器。
图 3.30 四种方法如何使用超标量处理器功能单元的执行槽位。横向表示每个时钟周期的指令执行能力;纵向表示连续的时钟周期。空白方格表示该周期对应的执行槽位未被使用。不同深浅的灰色与黑色,在多线程处理器中代表四个不同线程;对于不支持多线程的超标量处理器,黑色也表示已占用的发射槽位。Sun T1、T2(又称 Niagara)是细粒度多线程处理器,Intel Core i7 和 IBM Power10 则采用 SMT。T2 与 Power10 有 8 个线程,Intel i7 有 2 个线程。在所有现有 SMT 中,每次只从一个线程发射指令。SMT 的不同之处,是后续决定执行哪条指令的过程与发射解耦,因此,同一周期可以执行来自若干不同指令的操作。
图中文字:Execution slots=执行槽位;Time=时间;Superscalar=超标量;Coarse MT=粗粒度多线程;Fine MT=细粒度多线程;SMT=同时多线程。
在不支持多线程的超标量处理器中,ILP 不足限制了发射槽位的利用,其中包括缺少能够隐藏内存延迟的 ILP。由于 L2、L3 缓存未命中的延迟较长,处理器流水线经常有很大一部分处于空闲状态。
在粗粒度多线程超标量处理器中,切换到另一个线程,让它使用处理器资源,可以部分隐藏长停顿。这种切换减少了完全空闲的时钟周期数。但粗粒度多线程只在停顿时切换线程,而新线程有一段启动时间,因此,仍然很可能留下若干完全空闲的周期。
对于细粒度多线程,线程交错能够消除整行都空着的槽位。又因为每个周期都更换发射指令的线程,所以能够隐藏较长延迟的操作。由于指令发射与执行相连,一个线程只能发射已经就绪的那些指令。发射宽度较窄时,这不是问题——一个周期的槽位要么被占用,要么未被占用。因此,细粒度多线程非常适合单发射处理器,而 SMT 在这种处理器上没有意义。实际上,Sun T2 每周期发射两条指令,但它们来自不同线程。这使它不必实现复杂的动态调度,而是依靠更多线程来隐藏延迟。
如果在支持推测的超标量处理器上实现细粒度多线程,结果就是 SMT。现有大多数 SMT 实现中,所有发射的指令都来自同一个线程;但不同线程的指令可以在同一周期开始执行,由动态调度硬件判断哪些指令已经就绪。每个周期,指令调度器从所有线程中选取就绪指令执行。图 3.30 大幅简化了这些处理器的实际运行方式,但仍说明了多线程总体上的潜在性能优势,以及 SMT 对较宽发射、动态调度处理器的潜在优势。
SMT 利用了这样一个事实:动态调度处理器已经具备支持多线程所需的许多硬件机制,包括大量虚拟寄存器。在超标量处理器上增加每线程独立的重命名表、保存独立 PC,并支持来自多个线程的指令提交,即可构建多线程。
SMT 处理器的一项关键设计决策,是如何在线程间分配 ROB、指令调度器、BTB 表项等流水线资源。一种方法是静态划分各线程的资源,以限制单线程性能和整体硬件利用率为代价,取得性能的一致性与公平性。另一种方法是依据各运行线程的 ILP,按需动态共享表项,取舍方向恰好相反。SMT 处理器会在不同流水线模块中分别采用这两种方法。某些模块,例如 RAS,通常直接复制:它们本来就很小,而共享可能对性能产生较大影响。
每个时钟周期,SMT 处理器的前端都必须决定为哪个线程取指。一种尤其有效的做法,是优先为流水线其余部分中待完成指令最少的线程取指。这兼顾了性能与公平性:如果某线程在一段时间内表现出较高 ILP,指令能够不停顿地快速执行、提交,就会优先为它取指。但同一策略也照顾了较慢的线程:连续几个周期为快速线程取指后,较慢线程的待完成指令数会下降,取指优先级便会上升。
同时多线程在超标量处理器上的效果
一个关键问题是:实现 SMT 能够取得多少性能收益?2000~2001 年研究这个问题时,研究者假定,未来 5 年内动态超标量处理器会显著加宽:每周期支持 6~8 条指令发射,采用推测式动态调度,支持大量并发加载和存储、大型一级缓存,以及 4~8 个上下文,且能同时从多个上下文发射和退役(retirement)指令。
因此,模拟研究中多道程序工作负载取得两倍乃至更高性能收益的结果,并不符合实际。实践中,现有 x86 和 Arm 的 SMT 实现仅提供两个上下文,每次只从其中一个取指、发射,每周期最多发射 4 条指令。因此,SMT 的收益也更有限。只有 IBM Power 处理器实现了 4~8 个 SMT 线程。
Esmaeilzadeh 等(2011)进行了一组广泛而深入的测量,考察在单个 i7 920 核心上运行一组多线程应用时,SMT 带来的性能与能耗收益。Intel i7 920 每核支持两个 SMT 线程,较新的 i7 6700 也是如此。i7 920 与 6700 之间的变化相对较小,不太可能显著改变本节展示的结果。
使用的基准测试包括一组并行科学计算应用,以及来自 DaCapo 和 SPEC Java 套件的一组多线程 Java 程序,概况见图 3.31。图 3.32 给出了这些基准测试在 i7 920 的一个核心上,开启与关闭 SMT 时的性能比和能效比。(图中绘制的是能耗比的倒数,即能效比,使其与加速比一样,数值越大越好。)
尽管有两个基准测试的收益很小,Java 基准测试加速比的调和平均值仍为 1.28。这两个基准测试——pjbb2005 和 tradebeans——虽然是多线程的,但并行性有限。将它们纳入,是因为它们代表了可能在 SMT 处理器上运行的一类典型多线程基准测试:人们希望从中取得一些性能收益,而实际也确实取得了有限收益。PARSEC 基准测试的加速比略优于完整的 Java 基准测试集,调和平均值为 1.31。如果排除 tradebeans 和pjbb2005,Java 工作负载的加速比实际上会达到 1.39,明显优于 PARSEC 基准测试。(采用调和平均值汇总结果的含义,见图 3.32 图注。)
| 基准测试 | 说明 |
|---|---|
| blackscholes | 用 Black–Scholes 偏微分方程为期权组合定价 |
| bodytrack | 跟踪未使用标记点的人体 |
| canneal | 用考虑缓存的模拟退火算法,最小化芯片布线成本 |
| facesim | 模拟人脸运动,用于可视化 |
| ferret | 搜索与查询图像相似的一组图像的搜索引擎 |
| fluidanimate | 用 SPH 算法模拟流体运动的物理过程,用于动画 |
| raytrace | 用物理模拟进行可视化 |
| streamcluster | 近似求解数据点的最优聚类 |
| swaptions | 用 Heath–Jarrow–Morton 框架为互换期权组合定价 |
| vips | 对图像应用一系列变换 |
| x264 | MPG-4 AVC/H.264 视频编码器 |
| eclipse | 集成开发环境 |
| lusearch | 文本搜索工具 |
| sunflow | 照片级真实感渲染系统 |
| tomcat | Tomcat servlet 容器 |
| tradebeans | Tradebeans Daytrader 基准测试 |
| xalan | 用于转换 XML 文档的 XSLT 处理器 |
| pjbb2005 | SPEC JBB2005 的一个版本,固定问题规模,而非固定运行时间 |
图 3.31 本节用于研究多线程、第 5 章用于研究 i7 多处理的并行基准测试。表的上半部分是 Bienia 等(2008)收集的 PARSEC 基准测试,旨在代表适合多核处理器的计算密集型并行应用。下半部分由 DaCapo 中的多线程 Java 基准测试(见 Blackburn 等,2006)和 SPEC 的 pjbb2005 组成。这些基准测试都具有一定并行性;DaCapo 和 SPEC Java 工作负载中的其他 Java 基准测试,虽然使用多个线程,却几乎没有或完全没有真正的并行性,因此未用于这里。有关这些基准测试的特性及其与本节、第 5 章测量之间关系的更多信息,见 Esmaeilzadeh 等(2011)。
译注:表中 x264 的“MPG-4”沿用原书拼写。
能耗由加速比和功耗增长共同决定。对于 Java 基准测试,平均而言,SMT 的能效与不使用 SMT 相同,平均值为 1.0;但这是被两个表现不佳的基准测试拉低的。如果排除 pjbb2005 和 tradebeans,Java 基准测试的平均能效为 1.06,几乎与 PARSEC 基准测试一样好。在 PARSEC 基准测试中,SMT 降低的能耗为 。这种在提高性能的同时降低能耗的改进,非常难得。当然,两种情况下都承担了 SMT 所对应的静态功耗,因此,结果可能略微高估了能耗收益。
这些结果清楚地表明,在采用激进推测的处理器中,SMT 能够以较高能效提升性能。2011 年,在“更多、较简单的核心”与“较少、更复杂的核心”之间,取舍已经转向更多核心:每核通常是每周期发射 3~4 条指令的超标量处理器,以 SMT 支持 2~4 个线程。实际上,Esmaeilzadeh 等(2011)表明,在 Intel i5(与 i7 类似,但缓存更小、时钟频率更低)和 Intel Atom(最初面向上网本和 PMD 市场设计的 80×86 处理器,现在主要面向低端 PC)上,SMT 带来的能耗改善更大。
图 3.32 在 i7 处理器的一个核心上使用多线程,Java 基准测试的平均加速比为 1.28,PARSEC 基准测试为 1.31。这里采用不加权的调和平均值,隐含的工作负载是:在单线程基准配置下,每个基准测试的总执行时间相同。两类基准测试的平均能效分别为 0.99 和 1.07,也采用调和平均值。能效大于 1.0,表示该功能带来的执行时间降幅超过了平均功耗增幅。两个 Java 基准测试几乎没有加速,因此能效显著恶化。所有测试均关闭 Turbo Boost。数据由 Esmaeilzadeh 等(2011)使用 Oracle(Sun)HotSpot build 16.3-b01 Java 1.6.0 虚拟机和 gcc v4.4.1 原生编译器收集、分析。
图中文字:纵轴 i7 SMT performance and energy efficiency ratio=i7 SMT 性能比与能效比;Speedup=加速比;Energy efficiency=能效。横轴保留各基准测试名称。
译注:正文能效平均值写作 1.0,并以 1.08 计算 PARSEC 节能幅度;图注则分别写作 0.99 和 1.07。两处均忠实保留;,正文 7% 为取整值。
3.12 微体系结构侧信道攻击
本章介绍的推测执行和多线程技术,使宽发射处理器能够在广泛的工作负载上取得良好性能。但这些技术也引入了一类新的安全漏洞,称为微体系结构侧信道攻击,或瞬态执行攻击(transient execution attacks)。从 Meltdown[Lipp 等,2018]和 Spectre[Kocher 等,2019]攻击问世以来,新的侧信道攻击类型及变体不断出现。它们利用超标量处理器的性能机制,访问并泄露秘密数据。
微体系结构侧信道攻击,与第 2 章介绍的 prime-probe 攻击相似。特别令人担忧的是,这类攻击允许窥探者控制 prime 与 probe 两个阶段之间执行的指令序列。下面将解释,推测如何让这些指令绕过软件边界检查、虚拟内存保护、虚拟机隔离以及可信执行的硬件隔离等安全机制,直接访问秘密数据。因此,它们能够快速、准确地在缓存中留下标记,供探测阶段观察。更糟的是,SMT 处理器允许窥探进程与受害进程共享处理器流水线。这带来两个问题。第一,窥探者可以利用一级缓存、BTB 等多种缓存结构,建立高带宽侧信道。第二,由于窥探者与受害者并行运行,窥探者能够在正常执行活动(例如缓存重新填充)覆盖泄露的信息之前,迅速探测侧信道。推测与 SMT 相结合,使侧信道攻击在准确性和有效带宽方面,有可能超过此前所有已知攻击。大量服务运行在公有云框架等共享基础设施上,而这些设施采用超标量与 SMT 处理器,因此,微体系结构侧信道攻击可能带来严重的安全影响。
下面用一段概括最初 Meltdown 攻击的伪代码,说明推测如何协助侧信道攻击[Lipp 等,2018]。在共享核心上运行这段代码的窥探者,有可能观察到操作系统内核所使用的任意内存地址的值。
译注:原书分配及后文说明使用
user_memory,最后一条伪代码却使用user_array。注释的位置也沿用原页,不据此将代码视为完整可执行实现。
窥探者首先准备系统:(1)分配数组 user_memory;(2)确保其所有元素都不在处理器一级缓存中。接着,(3)发射一条会产生异常的指令,例如算术异常(除以零),或由加载指令触发的内存保护错误。如果处理器一次只执行一条指令,那么后续步骤(4~6)都不会执行。但支持推测的处理器会继续执行后面的代码,直到产生异常的指令到达 ROB 队首。因此,在异常被触发、步骤 4~6 的指令结果被丢弃之前,后续所有指令很可能已经完整或部分执行。
下一条指令(4)访问一处本不应有权访问的内核内存位置,例如,给窥探者地址空间中的指针加上或减去一个较大的偏移量。指令(5)依据读出的内核内存值的最低有效位,生成索引值 0 或 256;指令(6)用这个索引读取 user_memory 数组中的一个元素。异常到达 ROB 队首时,指令(4~6)会被撤销,但指令(6)对处理器一级缓存产生的影响仍然保留:数组 user_memory 的一部分已经进入缓存。窥探者可以在异常恢复后,或者在同一 SMT 处理器的另一个并行线程中,通过测量访问 user_memory 各元素的耗时来探测缓存。如果元素 0 的加载很快,说明缓存命中,也就说明该内核内存位置的最低有效位为 0;如果元素 256 的加载很快,则最低有效位为 1。窥探者可以重复这些步骤,绕过虚拟内存保护,逐步读取大片内核内存及其中的全部秘密。Meltdown 论文详细解释了各个步骤,并展示了 x86 指令集上的实现[Lipp 等,2018]。
大多数微体系结构侧信道攻击的结构都与 Meltdown 相似。在准备与探测之间,窥探者利用推测执行一些访问、泄露秘密数据的指令,但不让它们提交。秘密数据用于改变某个硬件性能机制的状态,随后再探测该机制,以推断秘密数据的若干位。近期提出的攻击使用了超标量处理器中广泛的性能机制(缓存、BTB 等)或推测事件(延迟异常报告、分支预测、内存消歧)。在包括 Spectre 在内的许多攻击中,窥探者通过现有软件接口调用操作系统或受害进程,并精心选择输入,使受害者自身的代码以推测方式访问、泄露秘密数据。受害进程处理这个调用时,窥探进程利用同一核心上的 SMT 线程探测泄露的数据。关于微体系结构侧信道攻击的详细回顾与分类,可参阅 Guangyuan Hu 等的综述[Hu 等,2021]。
在不损失性能的前提下,很难防御微体系结构侧信道攻击。第一种防御方式,是重新编译并修改可能操作秘密数据的代码。编译器可以加入 fence 指令,在某个条件确定之前,禁止推测执行。另一种做法是,在利用推测的指令与可能泄露秘密数据的加载之间,引入依赖;这称为推测加载加固(speculative load hardening)。这类防御的缺点在于依赖重新编译,而重新编译并非总是可行;另外,决定对潜在易受攻击代码多广泛地应用这些防御时,必须在性能与安全之间取舍。第二种方式,是限制对可用于传递秘密的共享硬件结构的访问。有些情况下会关闭 SMT 多线程,防止窥探进程轻易观察同一 SMT 处理器上与受害进程共享的各种结构。
通过缓存分区技术隔离不同进程使用的缓存空间,也能降低某些攻击的有效性。最后,还有若干方案提出修改处理器流水线,在推测期间限制访问或推迟使用潜在敏感数据,或者撤销错误推测指令对硬件性能机制的影响。Guangyuan Hu 等的综述也回顾了微体系结构侧信道攻击防御的主要类别[Hu 等,2021]。截至本书写作时,还没有一组防御措施能够保证应对所有可能的攻击。
微体系结构侧信道攻击使人们意识到:现有 ISA 对正确行为的规定,并不足以支持对安全攻击的推理。ISA 以独立于时序的方式,定义可编程处理器的功能行为。因此,完全可能构建出正确实现 ISA、却容易受到安全攻击的超标量处理器。当前的推测式超标量处理器正存在这一弱点。本领域还缺少相应的抽象与工具,用于建模并形式化分析硬件实现的时序行为,如何与安全和隐私意义上的正确执行相互作用。截至本书写作时,已有若干研究工作在应对这一挑战。
3.13 融会贯通:Arm Cortex-A53 与 Intel Golden Cove 处理器
本节考察两种多发射处理器的设计。首先讨论 Arm Cortex-A53 核心。手机和平板电脑的芯片常常集成若干高性能核心(big)与高能效核心(little),A53 经常充当其中的高能效核心。接着讨论 Intel Golden Cove 核心,它是 Alder Lake 客户端 CPU 系列和 Sapphire Rapids 服务器 CPU 系列中的高性能核心(p-core)。
Arm Cortex-A53
A53 是双发射、静态调度、动态发射的超标量处理器,每周期可以发射两条指令。图 3.33 展示了基本流水线结构。对于非分支的整数指令,流水线有 8 级:F1、F2、D1、D2、D3/ISS、EX1、EX2 和 WB,含义见图注。这是一条顺序流水线,因此,只有当一条指令的结果可用、且前面的指令也已经开始执行时,才能发射该指令执行。如果接下来的两条指令存在依赖,它们都可以进入相应的执行流水线,但到达流水线起点时,会串行执行。基于记分牌的发射逻辑确认第一条指令的结果可用后,第二条指令才能发射。
译注:原文在发射条件处写的是 “its results are available”(该指令的结果可用),与后文根据前一条指令结果判断就绪的说明并不严密一致。
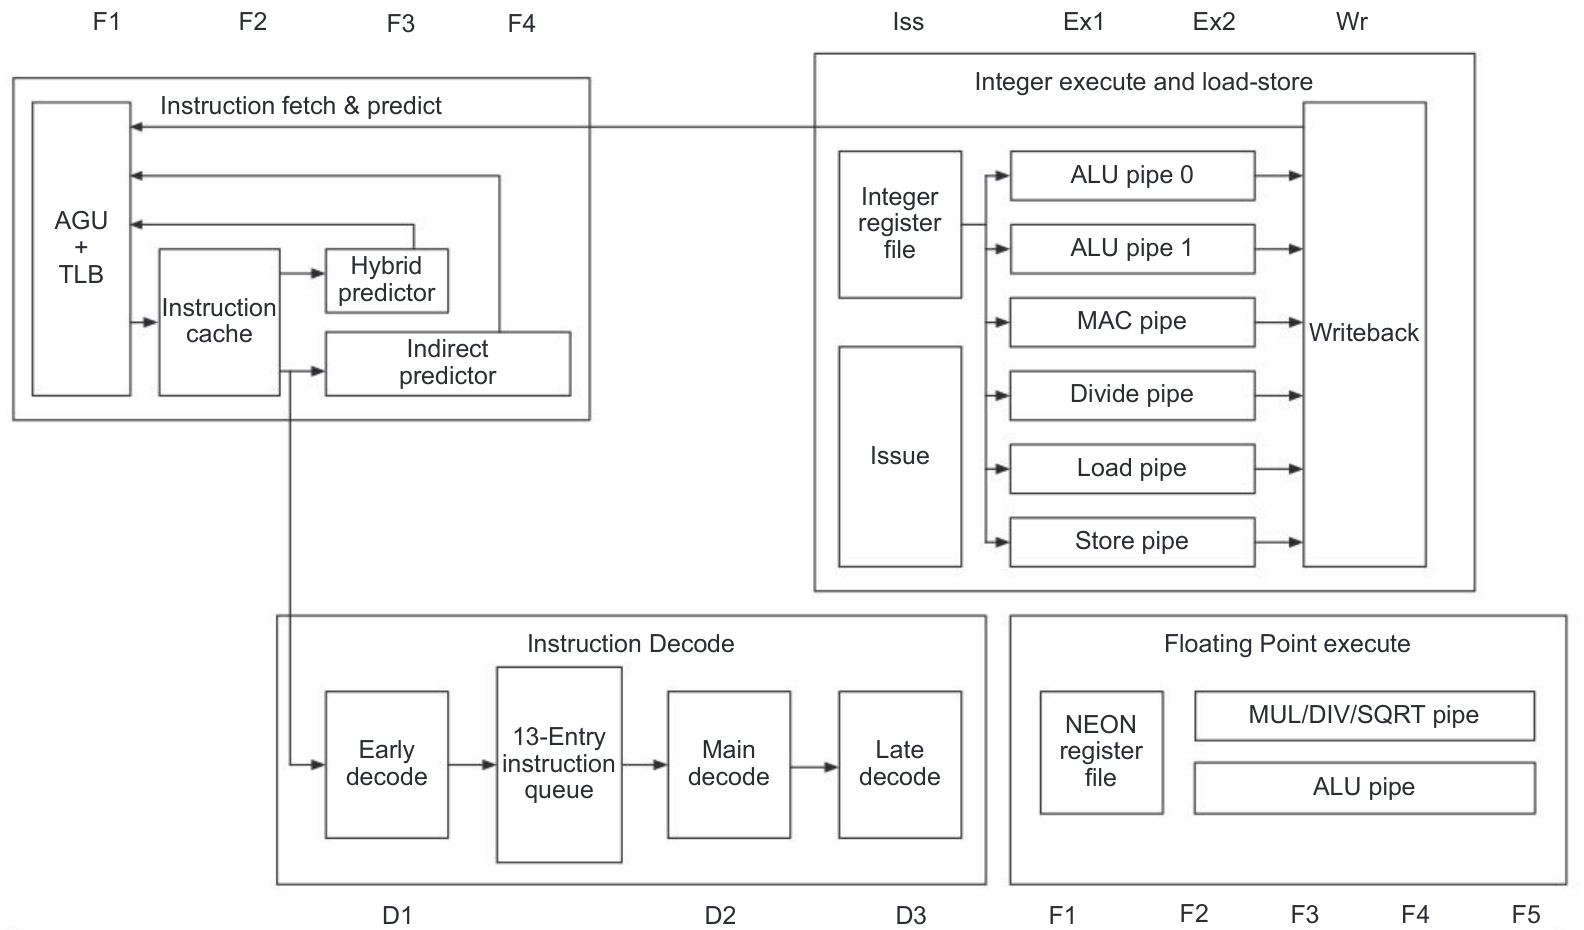
图 3.33 A53 整数流水线的基本结构为 8 级:F1、F2 取指;D1、D2 完成基本译码;D3 进一步译码某些较复杂的指令,并与执行流水线的第一级 ISS 重叠。ISS 之后,Ex1、EX2 和 WB 完成整数流水线。根据分支类型,使用四种不同的预测器。浮点执行流水线深度为 5 个周期,加上取指和译码所需的 5 个周期,共 10 级。
图中文字对照:
| 原文 | 中文 |
|---|---|
| Instruction fetch & predict | 取指与预测 |
| AGU + TLB | 地址生成单元与 TLB |
| Instruction cache | 指令缓存 |
| Hybrid predictor / Indirect predictor | 混合预测器 / 间接分支预测器 |
| Instruction Decode | 指令译码 |
| Early decode / Main decode / Late decode | 早期译码 / 主译码 / 后期译码 |
| 13-Entry instruction queue | 13 项指令队列 |
| Integer execute and load-store | 整数执行与加载、存储 |
| Integer register file / Issue / Writeback | 整数寄存器堆 / 发射 / 写回 |
| ALU pipe 0 / ALU pipe 1 | ALU 流水线 0 / ALU 流水线 1 |
| MAC pipe / Divide pipe | 乘加流水线 / 除法流水线 |
| Load pipe / Store pipe | 加载流水线 / 存储流水线 |
| Floating Point execute | 浮点执行 |
| NEON register file | NEON 寄存器堆 |
| MUL/DIV/SQRT pipe / ALU pipe | 乘法、除法、平方根流水线 / ALU 流水线 |
取指的四个周期包含一个地址生成单元,它通过递增上一个 PC,或使用以下四种预测器之一,产生下一个 PC:
- 单项分支目标缓存,包含两次指令缓存取指的内容,即假定预测正确时,分支之后的两条指令。第一个取指周期检查这个目标缓存;若命中,便由它提供接下来的两条指令。命中且预测正确时,分支执行没有延迟周期。
- 3072 项混合预测器,用于所有未在分支目标缓存中命中的指令,在 F3 工作。由该预测器处理的分支有 2 个周期延迟。
- 256 项间接分支预测器,在 F4 工作;预测正确时,由它预测的分支有 3 个周期延迟。
- 深度为 8 的返回栈,在 F4 工作,产生 3 个周期延迟。
译注:图注按 F1、F2 两级取指说明“8 级”整数流水线,原图与后文则明确列出 F1~F4 四个取指周期;原书两种描述均予保留。
分支在 ALU 流水线 0 中判定,因此错误预测的代价为 8 个周期。图 3.34 给出了 SPECint2006 的错误预测率。被浪费的工作量,既取决于错误预测率,也取决于沿错误分支路径执行期间维持的发射速率。如图 3.35 所示,浪费的工作量总体上随错误预测率变化,但可能更大,偶尔也可能更小。
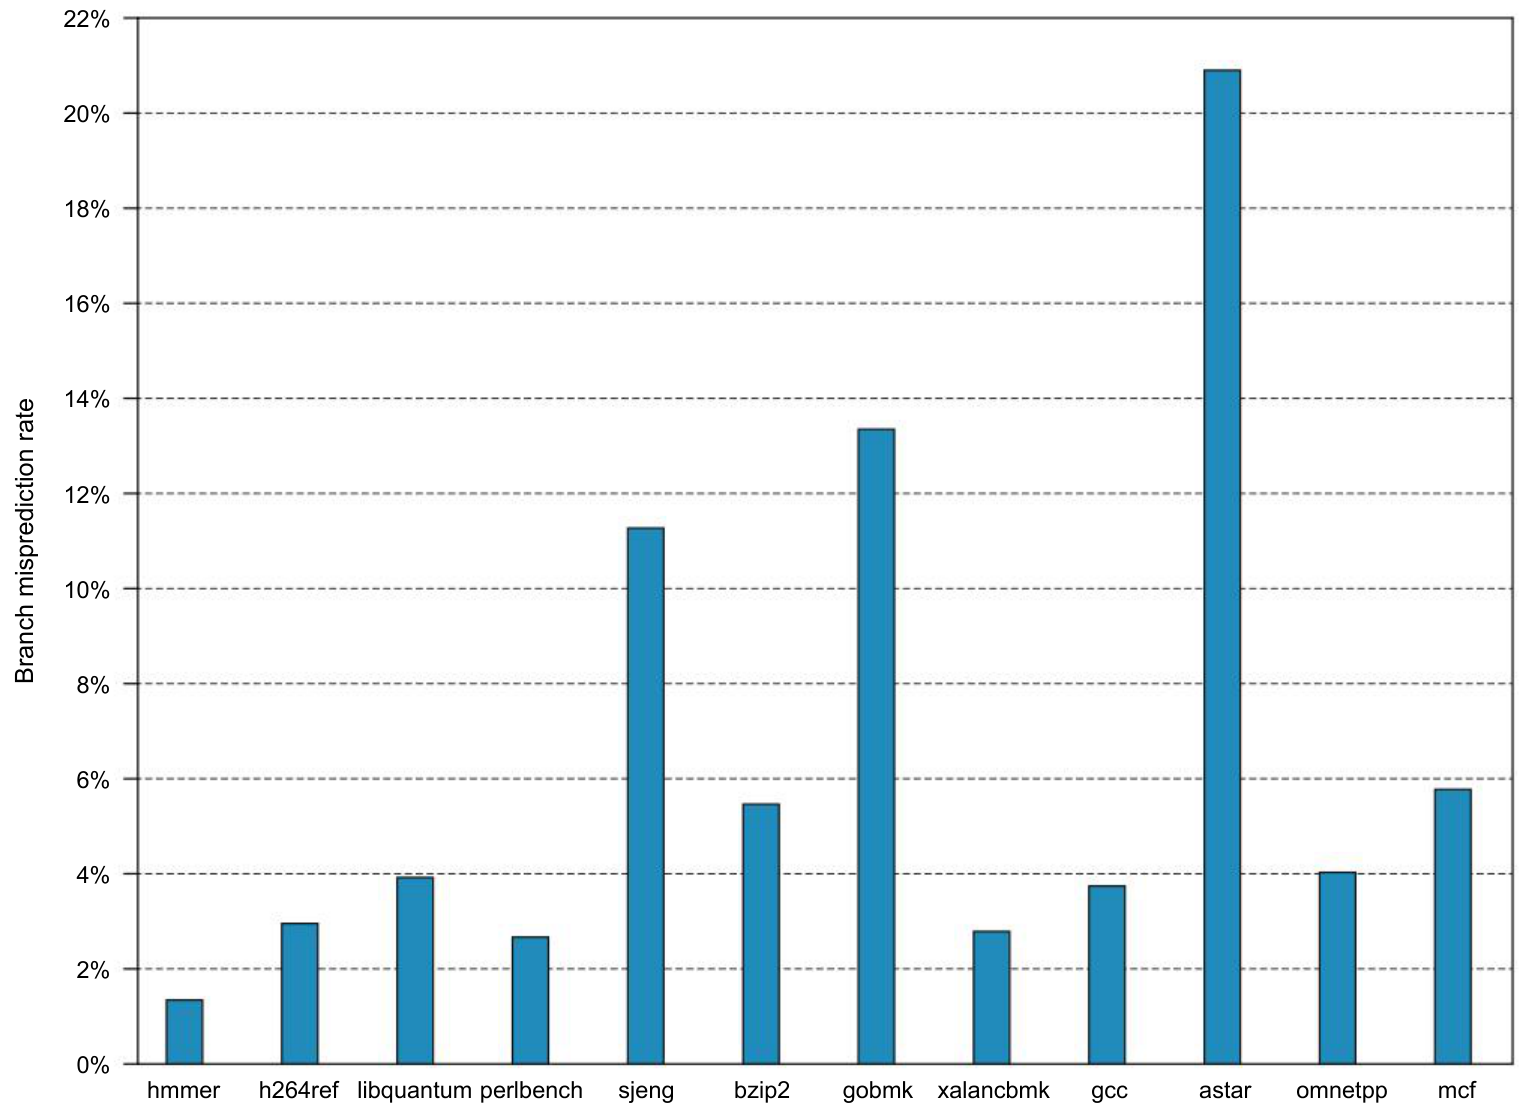
图 3.34 A53 分支预测器在 SPECint2006 上的错误预测率。纵轴 Branch misprediction rate=分支错误预测率,范围 0%~22%;横轴为各基准测试名称。
A53 流水线的性能
由于采用双发射结构,A53 的理想 CPI 为 0.5。流水线停顿有三个来源:
- 功能冒险:选中同时发射的两条相邻指令,需要使用同一条功能流水线。由于 A53 是静态调度处理器,编译器应尽量避免这种冲突。如果这样的指令连续出现,它们会在执行流水线起点串行化,只有第一条指令开始执行。
- 数据冒险:在流水线较早阶段检测到,可能使两条指令都停顿,也可能仅使一对指令中的第二条停顿。如果第一条不能发射,第二条必然停顿。同样,编译器应尽可能避免这类停顿。
- 控制冒险:只在分支预测错误时出现。
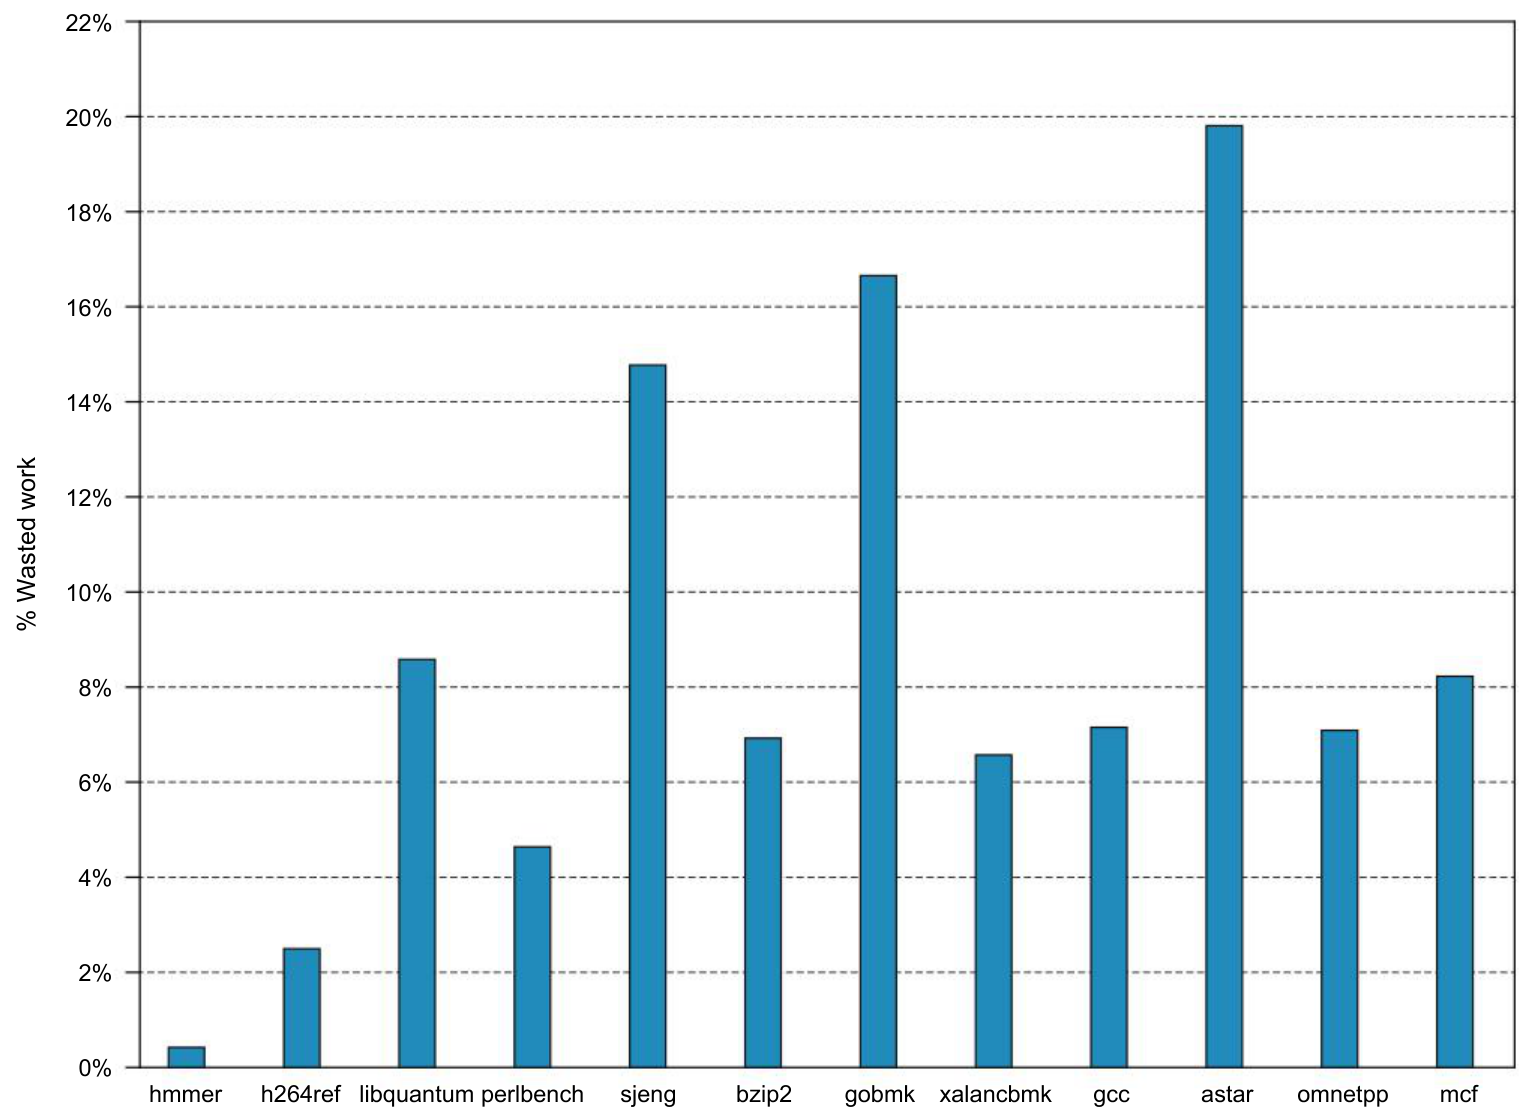
图 3.35 A53 因分支预测错误而浪费的工作。A53 是顺序执行处理器,因此,浪费的工作量取决于多种因素,包括数据依赖和缓存未命中;两者都会引起停顿。纵轴 % Wasted work=浪费的工作占比,范围 0%~22%;横轴为各基准测试名称。
TLB 未命中和缓存未命中也会造成停顿。在指令一侧,TLB 或缓存未命中会推迟指令队列的填充,很可能导致流水线下游停顿。当然,这取决于未命中类型:如果是 L1 未命中,且当时指令队列已满,延迟可能大部分被隐藏;如果是 L2 未命中,耗时就长得多。在数据一侧,缓存或 TLB 未命中会使流水线停顿,因为引起未命中的加载或存储无法继续向流水线后方推进,所有后续指令也就停顿。图 3.36 展示了 CPI 及各类因素贡献的估计值。
A53 采用较浅的流水线和相当积极的分支预测器,使流水线损失保持较小,并能以适中的功耗达到较高时钟频率。与 i7 相比,四核 A53 处理器的功耗约为其 1/200!总体上,A53 是非常成功的低功耗超标量处理器,经常与更高性能的 Arm 核心组成 big.LITTLE 配置。
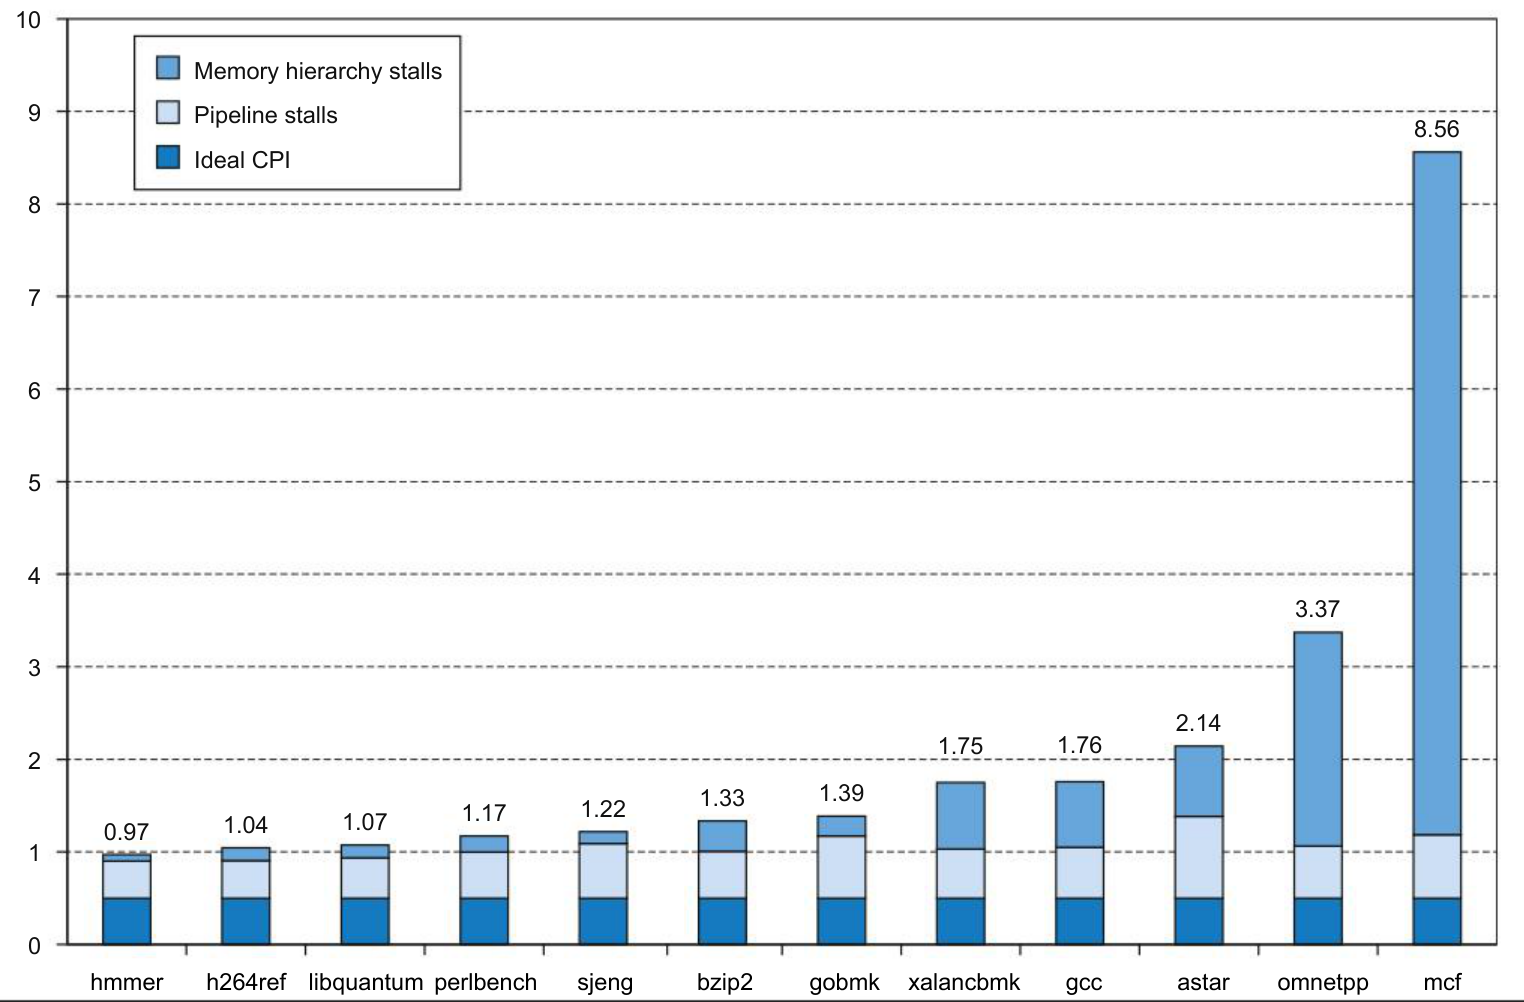
图 3.36 Arm A53 的 CPI 组成估计表明,流水线停顿相当显著,但在性能最差的程序中,缓存未命中的影响更大。估计方法是:用 L1、L2 未命中率及其代价,计算它们造成的每条指令停顿周期数,再从详细模拟器测得的 CPI 中减去这些部分,得到流水线停顿。流水线停顿包含上述三种冒险。
图中文字:Memory hierarchy stalls=存储层次结构停顿;Pipeline stalls=流水线停顿;Ideal CPI=理想 CPI。各程序总 CPI 依次为:hmmer 0.97、h264ref 1.04、libquantum 1.07、perlbench 1.17、sjeng 1.22、bzip2 1.33、gobmk 1.39、xalancbmk 1.75、gcc 1.76、astar 2.14、omnetpp 3.37、mcf 8.56。
Intel Golden Cove
Golden Cove 是一种采用激进乱序执行(OOO)与推测的微体系结构,旨在提高核心从单线程中开发指令级并行性的能力(Rotem 等,2022)。Golden Cove 核心还支持两个线程的 SMT 执行,Intel 自 2008 年以来的所有高端微体系结构均如此。Golden Cove 于 2021 年发布,是 Sunny Cove 微体系结构的后继。图 3.37 展示了其流水线的整体结构,以及许多关键结构的容量。
取指。 x86 指令长度从 1~15 字节不等,因此其指令供给尤其复杂。Golden Cove 前端每周期从指令缓存取 32 字节,用 6 个译码器把 x86 指令转换为类似 RISC 的微操作,再放入 144 项微操作队列。这种将 x86 指令集转换为更易流水化的简单操作的方法,于 1997 年在 Pentium Pro 中引入,之后一直沿用。对于语义更复杂的 x86 指令,微码引擎负责产生微操作序列:每周期最多生成 4 个微操作,持续工作直到所需序列全部生成。
前端包含微操作缓存,可保存 4K 个已译码微操作,每周期最多向微操作队列提供 8 个微操作。借助它,可以不使用指令缓存和译码器而供应指令。此外,循环流检测器(loop stream detector,LSD)跟踪能够容纳在微操作队列中的循环。LSD 允许微操作队列不断向后端供应指令,直到最终出现分支预测错误、终止循环流。单线程模式下,LSD 允许前端其他部分休眠,节省功耗。SMT 模式下,如果一个线程使用 LSD,就可以将更多前端资源用于加快另一个线程的指令供给。
为了更好地支持代码规模较大的工作负载,Golden Cove 的指令 TLB 是 Sunny Cove 的两倍:针对 4 KB 页面有 256 项,针对 2 MB/4 MB 页面有 32 项。代码预取也有所改进。虽然分支预测器的组织方式保密,但已知若干结构扩大了容量。二级分支目标缓冲区有 12K 项,而 Ice Lake 为 5K 项。
乱序执行引擎。 Golden Cove 用一个大型的 512 项 ROB 支持乱序执行。每周期最多重命名 6 个微操作,并将其发射到协调各功能单元执行的调度器。硬件能识别某些可优化的 x86 指令惯用模式。例如,将寄存器清零、或在寄存器之间移动值的指令,不必调度到功能单元上执行。
算术微操作调度器有 97 项,同时服务整数与浮点操作。利用其 5 个端口,每周期最多向整数功能单元发射 5 个已就绪微操作,并可向浮点及向量功能单元发射最多 3 个微操作。Golden Cove 实现了若干面向数据中心和 HPC 工作负载的 x86 ISA 扩展,包括 512 SIMD 指令(AVX-512),支持机器学习工作负载使用的 Brain Floating-point(BF16)格式、8 位整数(INT8)等数据类型。第 7 章将讨论较窄数据类型对机器学习的意义。Golden Cove 是首个实现面向机器学习工作负载的高级矩阵扩展(advanced matrix extensions,AMX)的 Intel 微体系结构。
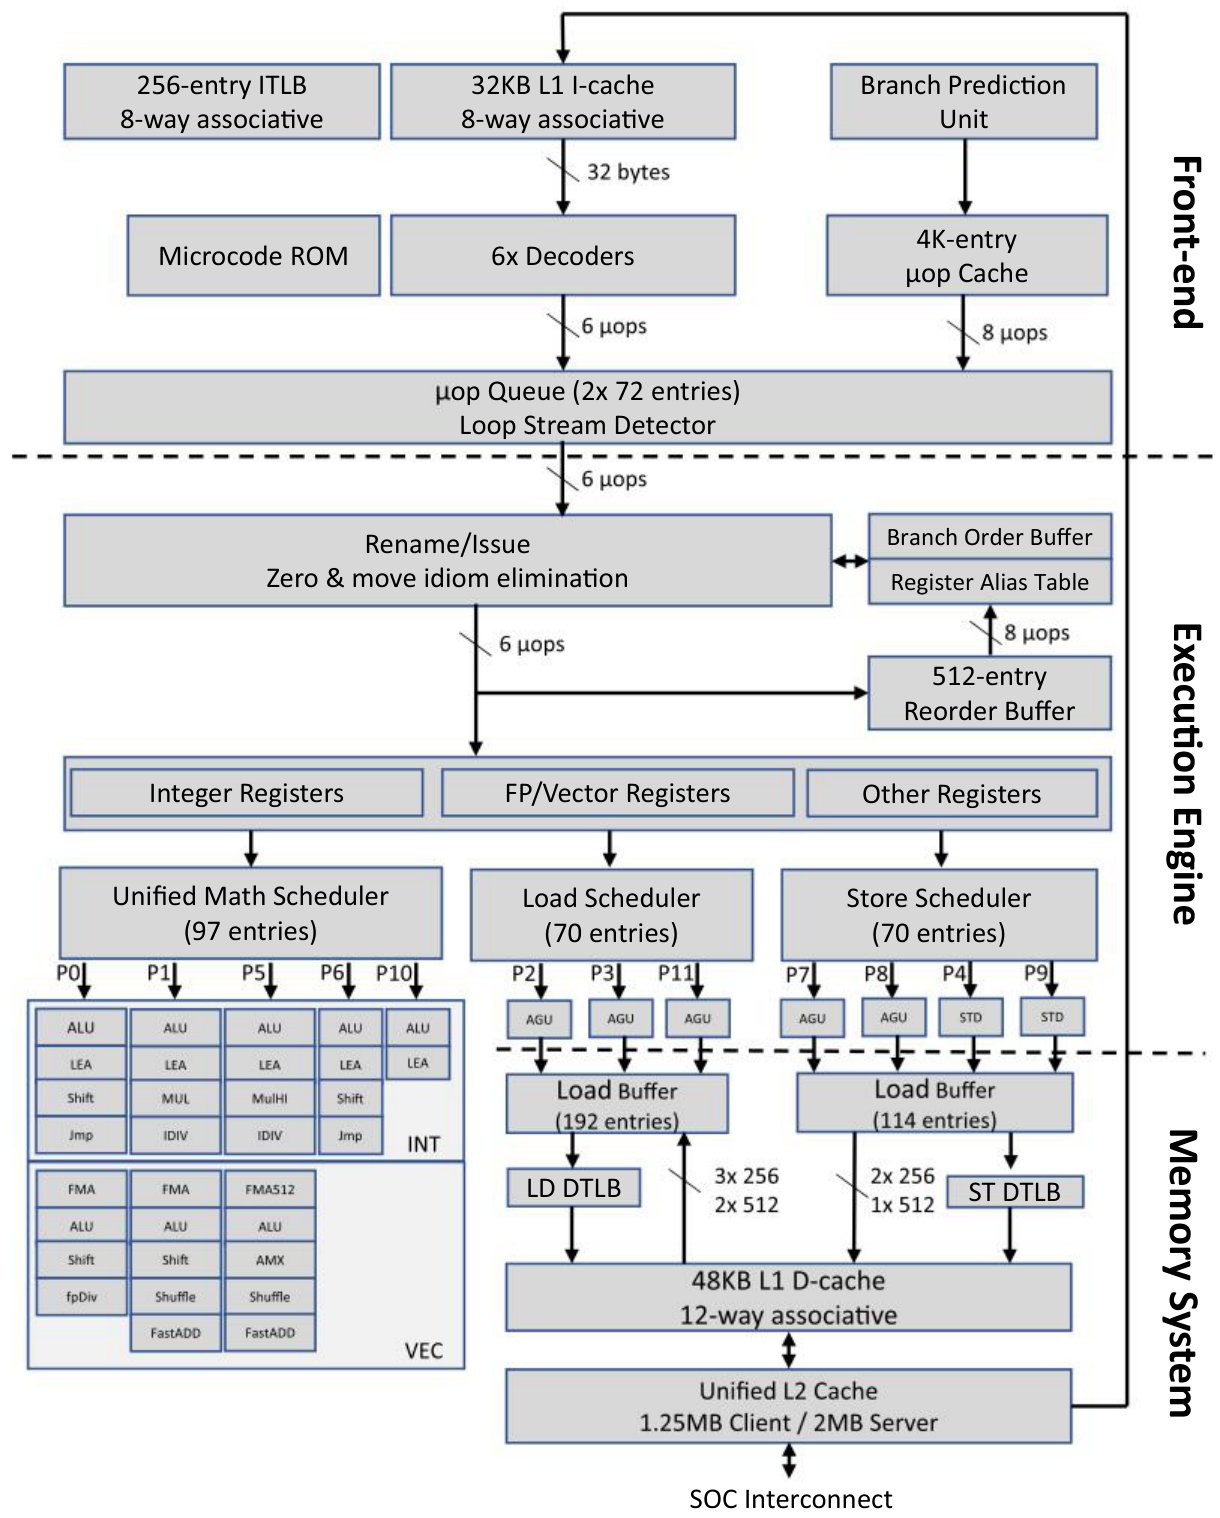
图 3.37 Intel Gold Cove 微体系结构框图。乱序核心每周期最多发射 6 个微操作,派发 12 个微操作,退役 8 个微操作。
图中文字对照:
| 原文 | 中文 |
|---|---|
| Front-end / Execution Engine / Memory System | 前端 / 执行引擎 / 存储系统 |
| 256-entry ITLB, 8-way associative | 256 项指令 TLB,8 路组相联 |
| 32KB L1 I-cache, 8-way associative | 32 KB L1 指令缓存,8 路组相联 |
| Branch Prediction Unit | 分支预测单元 |
| Microcode ROM / 6x Decoders | 微码 ROM / 6 个译码器 |
| 4K-entry μop Cache | 4K 项微操作缓存 |
| μop Queue (2x 72 entries) / Loop Stream Detector | 微操作队列(2×72 项)/ 循环流检测器 |
| Rename/Issue / Zero & move idiom elimination | 重命名、发射 / 消除清零与移动惯用操作 |
| Branch Order Buffer / Register Alias Table | 分支顺序缓冲区 / 寄存器别名表 |
| 512-entry Reorder Buffer | 512 项重排序缓冲区 |
| Integer Registers / FP/Vector Registers / Other Registers | 整数寄存器 / 浮点、向量寄存器 / 其他寄存器 |
| Unified Math Scheduler (97 entries) | 统一算术调度器(97 项) |
| Load Scheduler (70 entries) / Store Scheduler (70 entries) | 加载调度器(70 项)/ 存储调度器(70 项) |
| Load Buffer (192 entries) / Load Buffer (114 entries) | 加载缓冲区(192 项)/ 加载缓冲区(114 项,原图如此) |
| LD DTLB / ST DTLB | 加载数据 TLB / 存储数据 TLB |
| 48KB L1 D-cache, 12-way associative | 48 KB L1 数据缓存,12 路组相联 |
| Unified L2 Cache, 1.25MB Client / 2MB Server | 统一 L2 缓存,客户端 1.25 MB / 服务器 2 MB |
| SOC Interconnect | SoC 互连 |
| P0~P11 | 端口编号 |
| AGU / STD | 地址生成单元 / 存储数据单元 |
| INT / VEC | 整数 / 向量 |
| ALU / LEA | 算术逻辑单元 / 有效地址计算 |
| Shift / Jmp | 移位 / 跳转 |
| MUL / MulHI / IDIV | 乘法 / 取高位乘法 / 整数除法 |
| FMA / FMA512 / AMX | 融合乘加 / 512 位融合乘加 / 高级矩阵扩展 |
| fpDiv / Shuffle / FastADD | 浮点除法 / 重排 / 快速加法 |
| bytes / μops / entries | 字节 / 微操作 / 项 |
图中数据通路旁的 3×256、2×512、2×256、1×512,以及各端口与功能单元的对应关系,均保留原图。
译注:原图注写作 “Gold Cove”,正文为 “Golden Cove”;图中的存储调度器为 70 项,下一页正文为 38 项;存储一侧 114 项缓冲区也误标为 Load Buffer,正文则称 store buffer。以上均保留原页内容并分别说明。正文 “512 SIMD instructions” 未写位数单位,译文亦未擅补。
AMX 定义了一个新的二维寄存器堆,共 8 个寄存器;每个寄存器是由 16 行、每行 64 字节组成的数组。它还定义了一组矩阵乘法指令,可按不同二维形状操作这些寄存器,最高每周期执行 2K 次 Int8 运算。70 项加载调度器每周期可向 3 个地址生成单元供给操作。38 项存储调度器每周期可向 2 个地址生成单元和 2 个存储数据单元供给操作。
Golden Cove 通过 128 项分支顺序缓冲区,从分支预测错误中恢复(Boggs 等,2004)。遇到可能预测错误的条件分支与间接分支指令时,该缓冲区为寄存器重命名状态保存快照。一旦检测到错误预测,就丢弃所有更年轻的指令,恢复该分支之前的最后一份快照,然后从正确目标恢复取指。在错误预测恢复期间,更早的指令继续执行,无需等待错误预测指令到达 ROB 队首,也无需清空整条流水线。
存储子系统。 Golden Cove 每周期最多处理 3 次 32 字节加载,或 2 次 64 字节加载;同时最多处理 2 次 64 字节存储。流水线包含 192 项加载缓冲区和 114 项存储缓冲区,通过推测式内存消歧,发掘加载与存储之间的并行性。Golden Cove 支持存储转发,包括加载开头的一部分字节由存储转发、其余字节从数据缓存读取的情况。
48 KB L1 数据缓存采用 12 路组相联,命中时,从加载到使用结果的延迟为 5 个周期。填充缓冲区最多跟踪 16 次未完成的 L1 缓存未命中。L2 缓存容量为 1.25 MB(客户端芯片)或 2 MB(服务器芯片),延迟为 15 个周期,每周期可提供 64 字节数据。Golden Cove 改进了 L1 与 L2 的预取器。L2 缓存包括基于模式的多路径预取器,采用基于反馈的自适应预取限流。L2 缓存可同时保留 48 个未完成的未命中或预取请求。
加载操作的地址转换使用一个 TLB:针对 4 KB 页面有 96 项、6 路组相联;针对 2 MB/4 MB 页面有 32 项、4 路组相联;针对 1 GB 页面有 8 项。存储操作使用一个支持所有页面大小的 16 项 TLB。所有一级指令与数据 TLB 的后方,都有一个 2K 项二级 TLB(STLB)。STLB 未命中送往页面未命中处理器(page miss handler,PMH),它最多可以并行执行 4 次页表遍历。
与前代 Intel 微体系结构的比较。 图 3.38 将 Golden Cove 的关键特性,与 Skylake(2015)及 Sunny Cove(2019)比较。Golden Cove 的 ILP 能力显著提高:译码、发射、派发、退役各阶段,每周期都能处理更多指令;与前代相比,所有关键缓冲结构也都更大。同时,Golden Cove 核心还能达到较高频率,已公布的客户端与服务器产品最高频率分别为 5.5 GHz 和 4.2 GHz。
| 特性 | Skylake(2015) | Sunny Cove(2019) | Golden Cove(201,原文年份) |
|---|---|---|---|
| 微操作队列(每 SMT 线程) | 64 | 70 | 72 |
| 微操作缓存容量 | 1,500 | 2,304 | 4,096 |
| 保留站(整数+浮点) | 97 | 97 | 80 |
| 整数寄存器 | 180 | 280 | 280 |
| 浮点寄存器 | 168 | 224 | 332 |
| 未完成加载缓冲区 | 72 | 128 | 192 |
| 未完成存储缓冲区 | 56 | 72 | 114 |
| 重排序缓冲区 | 256 | 352 | 512 |
| 每周期取指字节数 | 16 | 16 | 32 |
| 指令译码器数量 | 1 个复杂+5 个简单 | 4 | 6 |
| 每周期发射指令数 | 4 | 5 | 6 |
| 通往功能单元的调度器端口数 | 8 | 10 | 12 |
| 每周期退役指令数 | 4 | 4 | 8 |
图 3.38 Intel 三代乱序微体系结构的特性。为了开发更多 ILP,关键流水线阶段(译码、发射、派发、退役)的宽度,以及关键缓冲区、队列、寄存器堆的容量,多年来持续增大。各种缓冲区的容量选择有时看似随意,实际上很可能以大量模拟为依据。
译注:原表 Golden Cove 年份为“201”,本节正文为 2021;原表整数与浮点保留站为 80 项,而前文及图 3.37 的统一算术调度器为 97 项。表中数据忠实保留,不将两种口径擅自统一。
Golden Cove 核心的性能
图 3.39 展示了 Golden Cove 核心以单线程模式运行 10 个 SPECPUint2017 基准测试的性能特征。CPI 在 0.32~0.89 之间,也就是说,核心平均每周期执行 1.11~3.14 条指令。CPI 与错误预测率、缓存未命中率、TLB 未命中率有较强相关性。例如,mcf 实现了网络单纯形法,用来解决公共交通车辆调度等最小费用流问题。该方法用寻找环、修改生成树等可快速完成的网络操作,替代一般单纯形算法中的线性代数。因此,这个基准测试包含依赖数据的分支,以及不可预测的指针访问,导致较高的分支错误预测率,以及存储层次结构各级较高的缓存未命中率。仅仅分支错误预测率高,就足以使核心缺少有用指令可执行;leela 就是如此,它是一个采用 Monte Carlo 局面估计的围棋引擎。对于用于垃圾邮件过滤的 Perl 脚本 perlbench、H.264/MPEG-4 AVC 视频编码程序 x264,以及生成数独题目的递归程序 exchange2 等基准测试,Golden Cove 的预测器与缓存表现良好,使后端能够开发大量 ILP。
图 3.40 展示了以双线程模式运行这 10 个 SPECCPUint2017 基准测试的性能收益。与单线程相比,Golden Cove 核心运行两个 SMT 线程时,吞吐量提高 5%~46%。对于单线程性能较低的基准测试,SMT 收益通常较大,例如 mcf 为 46%,leela 为 45%。这些基准测试未充分利用核心资源,使第二个 SMT线程仍能以相当可观的吞吐量执行。当双插槽系统中的全部 112 个核心都以双线程模式运行时,SMT 收益为 5%~37%。例如,访存密集的 mcf,仅一个核心活动时 SMT 收益为 46%,所有核心活动时则降至 27%,因为每个插槽中的 112 个线程会争用共享 L3 缓存与主存系统资源。总体而言,对 SPECPUint2017 rate 的几何平均值,SMT 的收益在单核时为 27%,双插槽系统时为 16%。虽然更宽的乱序流水线对各种单线程工作负载的收益并不相同,但 SMT 带来的显著吞吐量提升,证明了这种设计的价值。
| 指标 | perlbench_r | gcc_r | mcf_r | omnetpp_r | xalancbmk_r | x264_r | deepsjeng_r | leela_r | exchange2_r | xz_r |
|---|---|---|---|---|---|---|---|---|---|---|
| SpecRate | 6.68 | 7.84 | 7.12 | 6.31 | 7.9 | 16.43 | 5.5 | 4.97 | 17.53 | 3.92 |
| CPI | 0.328 | 0.577 | 0.899 | 0.717 | 0.505 | 0.321 | 0.512 | 0.666 | 0.318 | 0.730 |
| L1 数据缓存未命中率 | 1.33% | 7.81% | 14.85% | 8.90% | 14.20% | 2.05% | 1.29% | 1.21% | 0.03% | 5.02% |
| L2 未命中率 | 14.29% | 39.58% | 32.13% | 46.19% | 24.50% | 11.44% | 15.45% | 20.65% | 40.63% | 23.51% |
| L3 未命中率 | 8.89% | 23.67% | 59.06% | 23.01% | 2.05% | 31.62% | 66.67% | 1.43% | 0.00% | 24.03% |
| L1D MPKI | 3.88 | 22.08 | 38.25 | 29.33 | 38.2 | 4.33 | 3.04 | 3.19 | 0.1 | 12.51 |
| L2 MPKI | 1.35 | 11.83 | 12.36 | 13.95 | 9.77 | 1.36 | 1.38 | 0.7 | 0.13 | 3.08 |
| L3 MPKI | 0.12 | 2.8 | 7.3 | 3.21 | 0.2 | 0.43 | 0.92 | 0.01 | 0 | 0.74 |
| 数据 TLB MPKI | 0.1 | 0.45 | 1.56 | 3.36 | 0.11 | 0.04 | 0.23 | 0.01 | 0 | 1.43 |
| 分支错误预测率 | 0.49% | 1.30% | 8.77% | 2.06% | 0.28% | 1.46% | 4.04% | 9.44% | 1.81% | 3.95% |
图 3.39 Golden Cove 核心单线程运行 SPECCPUint2017 基准测试的关键性能特征。测量平台是双插槽 Sapphire Rapids 系统,每插槽 56 个核心、8 条 DDR5-4800 通道。基准测试二进制程序由 Intel ICC 18 编译,采用 AVX2 指令。MPKI 表示每 1000 条指令的未命中次数。
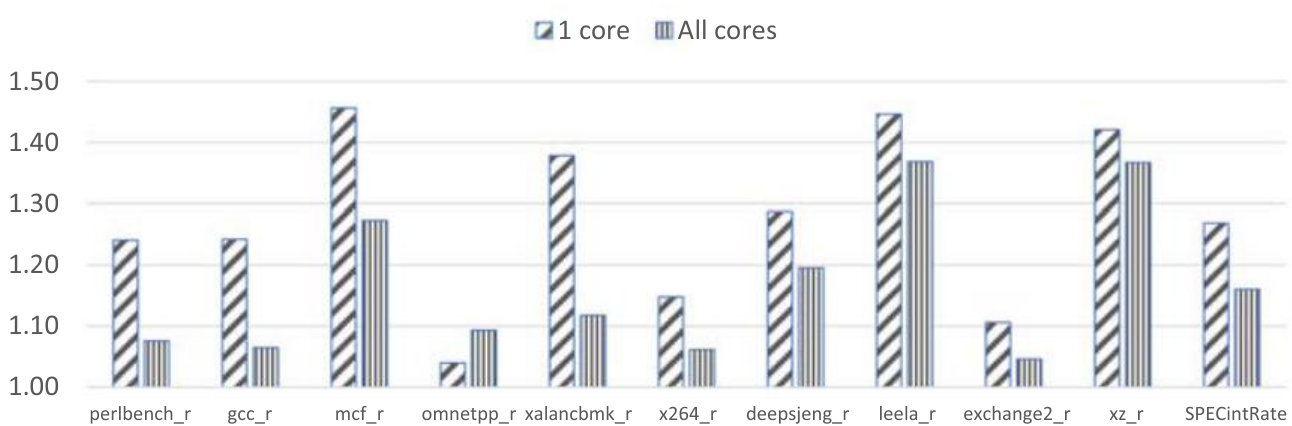
图 3.40 Sapphire Rapids 系统运行 SPECCPUint2017 基准测试时,每核使用两个 SMT 线程的性能收益。测试配置与图 3.39 相同。图中分别给出仅使用一个核心(最多两个 SMT 线程),以及使用双插槽系统全部 112 个核心(最多 224 个 SMT 线程)时的收益。图例 1 core=一个核心;All cores=所有核心;纵轴为相对性能,横轴保留基准测试及 SPECintRate 名称。
图 3.41 给出了双插槽系统全部 112 个核心都运行 SMT 时,每核的性能特征。图 3.38 与图 3.40 之间,分支错误预测率、L1 和 L2 未命中率的差异,来自核心资源竞争。
L3 未命中率的差异,则来自两个插槽上所有线程之间的资源竞争。例如,gcc 的每 1000 条指令 L3 缓存未命中次数(MPKI),从一个线程时的 2.8(图 3.38),增加到 224 个线程时的 20.2(图 3.40)。这一增长凸显了缓存与存储系统设计的重要性,尤其是对同时执行数百个线程的多核芯片。还要注意,开启 SMT 后,每线程 CPI 会增加。例如,从图 3.38 到图 3.40,perlbench 的 CPI 从 0.328 增加至 0.590。但此时有两个线程以这个速率执行指令,因此,核心整体的有效吞吐量增益为:
即提高 11.1%。
| 指标 | perlbench_r | gcc_r | mcf_r | omnetpp_r | xalancbmk_r | x264_r | deepsjeng_r | leela_r | exchange2_r | xz_r |
|---|---|---|---|---|---|---|---|---|---|---|
| CPI(每线程) | 0.590 | 1.260 | 1.420 | 1.950 | 0.958 | 0.556 | 0.794 | 0.934 | 0.552 | 1.150 |
| L1 数据缓存未命中率 | 1.85% | 9.10% | 18.98% | 10.43% | 17.03% | 2.96% | 2.68% | 1.92% | 0.00% | 7.37% |
| L2 未命中率 | 11.32% | 42.70% | 25.63% | 43.99% | 19.01% | 6.63% | 12.17% | 10.36% | 0.00% | 23.12% |
| L3 未命中率 | 82.96% | 65.62% | 78.92% | 80.76% | 63.95% | 77.78% | 81.21% | 35.19% | 0.00% | 71.43% |
| L1D MPKI | 5.53 | 26.74 | 48.47 | 35.1 | 47.14 | 6.32 | 6.39 | 5.16 | 0.01 | 17.82 |
| L2 MPKI | 1.35 | 15.27 | 12.43 | 15.85 | 9.32 | 0.9 | 1.49 | 0.54 | 0 | 4.13 |
| L3 MPKI | 1.12 | 10.02 | 9.81 | 12.8 | 5.96 | 0.7 | 1.21 | 0.19 | 0 | 2.95 |
| 数据 TLB MPKI | 0.15 | 0.6 | 1.32 | 4.53 | 0.11 | 0.01 | 0.24 | 0 | 0 | 1.78 |
| 分支错误预测率 | 0.63% | 1.11% | 9.04% | 1.97% | 0.29% | 1.38% | 4.22% | 9.86% | 1.91% | 4.03% |
图 3.41 共 112 核的双插槽系统以双线程模式运行 SPECCPUint2017 基准测试时,单个 Golden Cove 核心的关键性能特征。测试配置与图 3.39 相同。这里给出每个 SMT 线程的 CPI;MPKI 表示每 1000 条指令的未命中次数。
译注:最后两段把单线程与双线程性能表引用为图 3.38、3.40,实际对应图 3.39、3.41。正文
gcc的双线程 L3 MPKI 为 20.2,而图 3.41 为 10.02。按给出的 CPI 复算,,正文 1.111 与 11.1% 沿用原文;这只是算术核查,不消除表格与图表测量口径上的差异。
3.14 谬误与陷阱
本节几个谬误主要围绕这样的问题:很难预测性能和能效,也很难从时钟频率或 CPI 等单一指标外推性能。我们还将说明,不同体系结构方案面对不同基准测试,可能表现出截然不同的行为。
谬误:只要工艺不变,就很容易预测同一指令集体系结构两个不同版本的性能与能效
2008 年,Intel 为低端上网本和个人移动设备(PMD)市场推出了 Atom 230 处理器,同时实现 x86 体系结构的 64 位和 32 位版本。Atom 是静态调度、双发射超标量处理器,其微体系结构与 Arm A8 非常相似;A8 是 A53 的单核前代。2008 年,Intel 还推出了基于乱序 Nehalem 微体系结构的 Core i7 920。有意思的是,Atom 230 和 Core i7 920 都采用 Intel 的同一 45 nm 工艺制造。图 3.42 概述了 Intel Core i7 920、Arm Cortex-A8 和 Intel Atom 230。这些共同点提供了一个难得的机会:在底层制造工艺不变的情况下,直接比较同一指令集的两种截然不同的微体系结构。在比较之前,还需要进一步介绍 Atom 230。
| 类别 | 具体特性 | Intel i7 920:四核,每核有浮点单元 | ARM A8:单核,无浮点单元 | Intel Atom 230:单核,有浮点单元 |
|---|---|---|---|---|
| 芯片物理特性 | 时钟频率 | 2.66 GHz | 1 GHz | 1.66 GHz |
| 芯片物理特性 | 热设计功耗 | 130 W | 2 W | 4 W |
| 芯片物理特性 | 封装 | 1366 引脚 BGA | 522 引脚 BGA | 437 引脚 BGA |
| 存储系统 | TLB | 两级;均为 4 路组相联;128 项指令 / 64 项数据;L2 512 项 | 一级,全相联;32 项指令 / 32 项数据 | 两级;均为 4 路组相联;16 项指令 / 16 项数据;L2 64 项 |
| 存储系统 | 缓存 | 三级;L1 32 KiB / 32 KiB;L2 256 KiB;L3 2~8 MiB | 两级;L1 16/16 或 32/32 KiB;L2 128 KiB~1 MiB | 两级;L1 32/24 KiB;L2 512 KiB |
| 存储系统 | 峰值内存带宽 | 17 GB/s | 12 GB/s | 8 GB/s |
| 流水线结构 | 峰值发射速率 | 每周期 4 次操作,支持融合 | 每周期 2 次操作 | 每周期 2 次操作 |
| 流水线结构 | 流水线调度 | 推测、乱序 | 顺序、动态发射 | 顺序、动态发射 |
| 流水线结构 | 分支预测 | 两级 | 两级;512 项 BTB;4K 全局历史;8 项返回栈 | 两级 |
图 3.42 四核 Intel i7 920、一个典型 Arm A8 处理器芯片实例(256 MiB L2、32 KiB L1,无浮点单元),以及 Intel Atom 230 的概况,清楚展示了两类设计理念的区别:一类面向 PMD(Arm)或上网本(Atom),另一类面向服务器和高端桌面机。注意,i7 有四个核心,每个核心的性能都高于单核 A8 或 Atom。所有这些处理器均采用可比较的 45 nm 工艺实现。
译注:原图注写作“256 MiB L2”,而表中 A8 的 L2 范围为 128 KiB~1 MiB;原页单位如此,未默改为 KiB。
Atom 使用标准方法实现 x86 体系结构:把 x86 指令转换为类似 RISC 的微操作,正如自 20 世纪 90 年代中期以来每一种 x86 实现所做的那样。Atom 的微操作稍强一些,允许将算术操作与加载或存储配对;后来的乱序微体系结构通过宏融合(macrofusion)加入了这种能力。这项优化意味着,对于典型指令组合,平均只有 4% 的指令需要不止一个微操作。随后,微操作在深度为 16 的流水线中执行;与 Arm A8 一样,它能够每周期顺序发射两条指令。Atom 有两个整数 ALU,为浮点加法和其他浮点操作设置独立流水线,还有两条内存操作流水线,因此支持比 Arm A8 更一般的双操作执行,但仍受顺序发射能力限制。
Atom 230 有 32 KiB 指令缓存和 24 KiB 数据缓存,它们共同使用同一裸片上的 512 KiB L2。(Atom 230 也支持两个线程的多线程执行,但这里仅比较单线程。)
我们可能预期,采用相同工艺和相同指令集的 Core i7 与 Atom 230,在相对性能和能耗方面表现得可预测,也就是说,功耗与性能近似线性变化。我们用三组基准测试检验这个假设。第一组是来自 DaCapo 与 SPEC JVM98 的 Java 单线程基准测试,相关基准与测量的讨论见 Esmaeilzadeh 等(2011)。第二、第三组来自 SPEC CPU2006,分别是整数和浮点基准测试。
图 3.43 表明,i7 的性能明显高于 Atom。在所有基准测试中,i7 的性能都至少是 Atom 的 4 倍;其中两个 SPECFP 基准测试超过 10 倍,一个 SPECINT 基准测试超过 8 倍!两者时钟频率之比为 1.6,因此,大部分优势来自 i7 920 低得多的 CPI:Java、SPECINT、SPECFP 基准测试的 CPI 比值分别为 2.8、3.1、4.3。
但 i7 920 的平均功耗略低于 43 W,Atom 的平均功耗为 4.2 W,仅约十分之一!结合性能与功耗来看,Atom 的能效通常超过 i7 的 1.5 倍,而且经常达到 2 倍!对采用相同底层工艺的这两个处理器的比较,清楚表明:采用动态调度和推测的激进超标量处理器,其性能优势伴随着显著的能效劣势。
谬误:CPI 更低的处理器总是更快
谬误:时钟频率更高的处理器总是更快
关键在于,决定性能的是 CPI 与时钟频率的乘积。通过加深处理器流水线取得较高频率时,还必须维持较低 CPI,才能充分发挥更快时钟的好处。同样,一个时钟频率较高、CPI 较低的简单处理器,也可能更慢。
译注:上述两句忠实保留原书措辞,但原文“CPI 与时钟频率的乘积”有误。正确关系为 ,或等价地乘以时钟周期时间。相同指令数下,性能取决于时钟频率与 CPI 的比值;最后一句也不能仅凭同时“频率高、CPI 低”得出更慢的结论。
前一个谬误已经说明,即使 ISA 相同,面向不同环境设计的处理器,性能与能效也可能相差很大。实际上,即便同一家公司的一组处理器都面向高端应用,性能也可能存在很大差异。图 3.44 给出了 Intel 两种不同 x86 实现,以及同样由 Intel 设计的一个 Itanium 实现的整数、浮点性能。
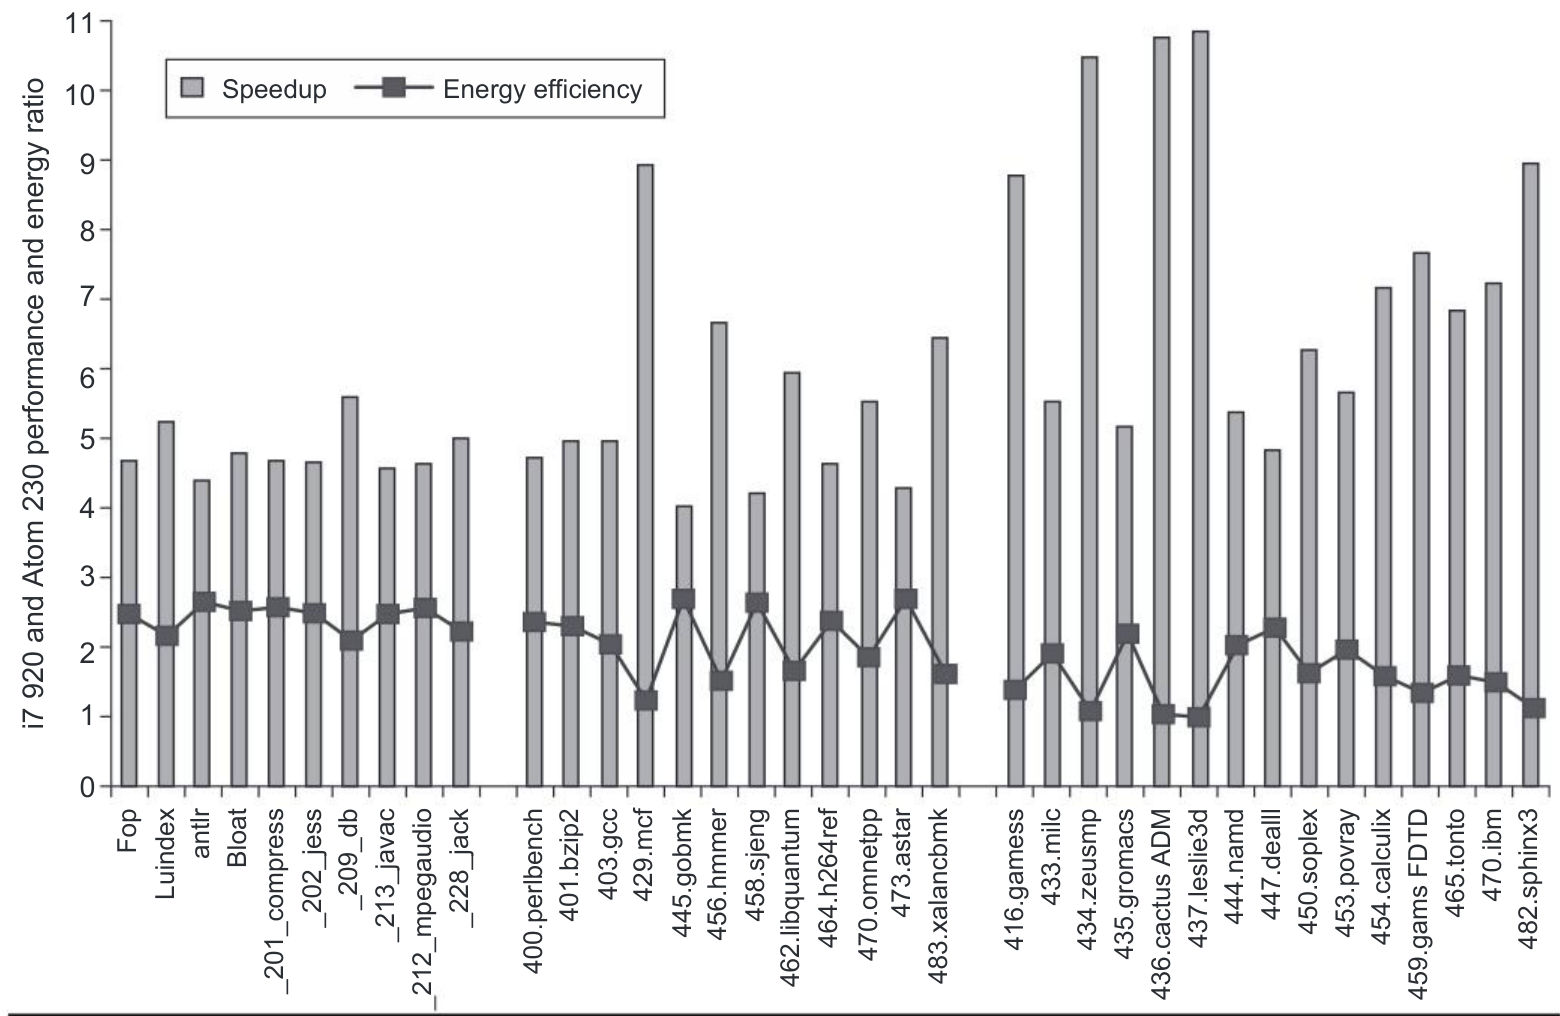
图 3.43 一组单线程基准测试上的相对性能与能效表明,i7 920 的性能为 Atom 230 的 4 倍至 10 倍以上,但平均功耗效率却只有约一半!柱状条表示 i7 相对 Atom 的性能,即执行时间(i7)/执行时间(Atom)。折线表示能耗(Atom)/能耗(i7)。i7 的能效从未优于 Atom,不过在四个基准测试上基本相当,其中三个是浮点基准测试。数据由 Esmaeilzadeh 等(2011)收集。SPEC 基准测试由标准 Intel 编译器优化编译,Java 基准测试使用 Sun(Oracle)Hotspot Java VM。i7 仅有一个核心处于活动状态,其余核心处于深度节能模式。i7 使用 Turbo Boost,扩大了性能优势,但相对能效略有下降。
图中文字:Speedup=加速比;Energy efficiency=能效;纵轴 i7 920 and Atom 230 performance and energy ratio=i7 920 与 Atom 230 的性能比和能耗比。横轴保留原基准测试名称。
译注:原图注的性能比公式分子、分母,与“i7 快 4~10 倍以上”及柱状图大于 1 的方向相反;加速比应为 Atom 执行时间 / i7 执行时间。折线多数大于 1,而正文说 Atom 更节能,因此图注的 Energy (Atom)/Energy (i7) 方向也与图形及文字结论不符。图注同时混用了 power efficiency 与 energy efficiency;译文区分其原措辞,未将原图数值或公式静默反转。
| 处理器 | 实现工艺 | 时钟频率 | 功率 | SPECCInt2006 base | SPECCFP2006 baseline |
|---|---|---|---|---|---|
| Intel Pentium 4 670 | 90 nm | 3.8 GHz | 115 W | 11.5 | 12.2 |
| Intel Itanium 2 | 90 nm | 1.66 GHz | 104 W;仅一个核心活动时约 70 W | 14.5 | 17.3 |
| Intel i7 920 | 45 nm | 3.3 GHz | 总计 130 W;仅一个核心活动时约 80 W | 35.5 | 38.4 |
图 3.44 三种 Intel 处理器之间存在很大差异。虽然 Itanium 有两个核心、i7 有四个核心,但基准测试只使用一个核心。功率列给出热设计功耗,并估计了多核处理器仅一个核心活动时的功耗。
Pentium 4 是 Intel 迄今流水化最激进的处理器,流水线超过 20 级,有 7 个功能单元,缓存微操作而非 x86 指令。相对于如此激进的实现,其性能却不理想,清楚表明开发更多 ILP 的尝试失败了——在途指令很容易就达到 50 条。Pentium 的功耗与 i7 相近,但晶体管数量更少,因为其一级缓存只有 i7 的一半,二级缓存仅 2 MiB,也没有三级缓存。
Intel Itanium 属于 VLIW 风格的体系结构。虽然相对于动态调度超标量处理器,它有望降低复杂度,却从未达到能够与主流 x86 处理器竞争的时钟频率,尽管其整体 CPI 看起来与 i7 接近。考察这些结果时,需要注意它们采用不同的实现工艺:对相同流水化程度的处理器而言,i7 在晶体管速度、因而在时钟频率方面占有优势。即便如此,Pentium 与 i7 超过 3 倍的性能差异,仍然令人惊讶。下一项陷阱解释了其中相当一部分优势来自何处。
陷阱:有时更大、更笨的办法反而更好
21 世纪初,很多注意力都放在构建激进处理器以开发 ILP 上,包括采用当时微处理器中最深流水线的 Pentium 4,以及具有当时最高每周期峰值发射速率的 Intel Itanium。人们很快发现,开发 ILP 的主要限制,往往是存储系统。对于一级缓存未命中造成的 10~15 个周期代价,推测式乱序流水线能够较好地隐藏其中相当一部分;但对于末级缓存未命中、需要访问主存的情况,代价可能达到 50~100 个周期,流水线几乎无能为力。
结果是,尽管晶体管数量庞大、技术极其复杂精巧,这些设计的指令吞吐量始终远未接近峰值。另一项变化进一步说明了这一陷阱:设计者不再试图用 ILP 隐藏更多内存延迟,而是直接把晶体管用于构建大得多的缓存。Itanium 2 和 i7 都采用三级缓存,而 Pentium 4 只有两级;前两者的三级缓存分别为 9 MiB、8 MiB,Pentium 4 的二级缓存则为 2 MiB。不言而喻,构建更大的缓存,远比设计 Pentium 4 超过 20 级的流水线容易;根据图 3.44 的数据,效果似乎也更好。
陷阱:有时更聪明的办法又胜过更大、更笨的办法
过去十年中,分支预测领域出现了一个颇令人意外的结果:带标签的混合预测器表明,使用相同位数时,更复杂的预测器可以胜过简单的 gshare 预测器,见图 3.10。
之所以令人惊讶,一个原因是,带标签的预测器实际保存的预测更少,因为它还要消耗位数存储标签;gshare 则只需一个大型预测数组。即便如此,避免将某个分支的预测误用于另一个分支,带来的优势似乎足以证明:与其把所有位数都分给预测值,不如划出一部分给标签。
陷阱:相信只要技术合适,就有大量 ILP 可供开发
大规模开发 ILP 的尝试因多种原因失败,其中最重要的一条,是一些设计者起初并不接受的事实:即使采用推测,也很难在常规结构的程序中找到大量 ILP。David Wall 在 1993 年进行了一项著名研究(见 Wall,1993),分析了多种理想化条件下可用的 ILP。本节概述其中一种处理器配置的结果,其能力约为 2023 年最先进处理器的 4~8 倍。Wall 的研究广泛记录了多种不同方法;对开发 ILP 的挑战感兴趣的读者,应阅读完整研究。
这里考虑的激进处理器具有以下特征:
- 每周期最多发射、派发 64 条指令,没有发射限制。这是 2023 年最宽处理器 IBM Power10 总发射宽度的 8 倍,每周期允许的加载与存储数量最多可达其 32 倍!如前所述,大发射速率带来严重的复杂度与功耗问题。
- 1K 项竞争预测器,以及 16 项函数返回预测器。这个预测器与 2016 年最好的预测器相当,并非主要瓶颈。错误预测在一个周期内处理,但会限制推测能力。
- 动态完成完美的内存引用消歧。这一目标很有雄心,但对于较小的窗口,也许可以实现。
- 寄存器重命名,额外提供 64 个整数寄存器和 64 个浮点寄存器,略少于 2011 年最激进的处理器。由于研究假定所有指令延迟都只有一个周期,而 Golden Cove 一类处理器的普通指令需要 1~4 个周期、复杂指令最高 15 个周期,因此,其有效重命名寄存器数量约为这些处理器的 5 倍。
图 3.45 展示了该配置在不同窗口大小下的结果。该配置比现有实现更复杂、成本更高,尤其体现在指令发射数量上。不过,它为未来实现可能取得的效果提供了有用的上限。这些图中的数据还因另一个原因显得十分乐观:64 条指令之间没有任何发射限制,例如,它们可以全是内存引用。即使在不久的将来,也不会有人考虑在处理器中提供这种能力。
此外,解释这些结果时还应记住:研究没有考虑缓存未命中,也没有考虑不等于一个周期的操作延迟,而这两者都具有显著影响。
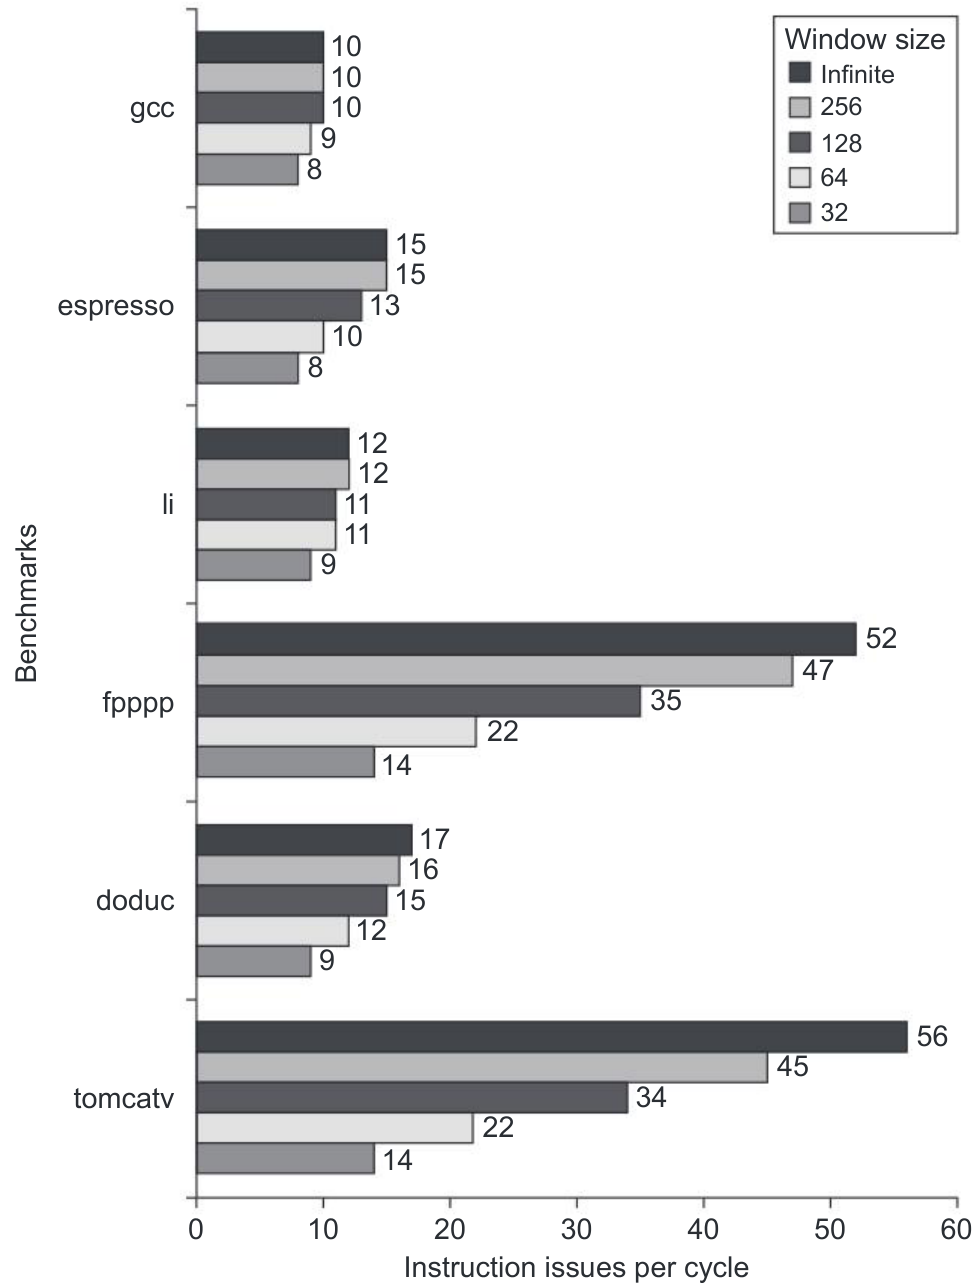
图 3.45 对若干整数与浮点程序,每周期最多发射 64 条任意指令时,可用并行性与窗口大小的关系。虽然重命名寄存器数量少于窗口大小,但所有操作的延迟都为一个周期,且重命名寄存器数量等于发射宽度,因此处理器能够开发整个窗口内的并行性。
图中文字:Window size=窗口大小;Infinite=无限;Benchmarks=基准测试;Instruction issues per cycle=每周期发射指令数。原图标出的全部数值如下,按窗口大小排列:
| 程序 | 无限 | 256 | 128 | 64 | 32 |
|---|---|---|---|---|---|
| gcc | 10 | 10 | 10 | 9 | 8 |
| espresso | 15 | 15 | 13 | 10 | 8 |
| li | 12 | 12 | 11 | 11 | 9 |
| fpppp | 52 | 47 | 35 | 22 | 14 |
| doduc | 17 | 16 | 15 | 12 | 9 |
| tomcatv | 56 | 45 | 34 | 22 | 14 |
图 3.45 中最引人注目的观察,是在上述现实处理器约束下,窗口大小对整数程序的影响不如对浮点程序那么大。这体现了两类程序的关键区别:两个浮点程序具有循环级并行性,因此能够开发更多 ILP;对于整数程序,分支预测、寄存器重命名,以及本来就较少的并行性等其他因素,都是重要限制。这一观察十分关键,因为过去十年中大多数市场增长领域——事务处理、Web 服务器等——依赖的是整数性能,而非浮点性能。
有些人当初不相信 Wall 的研究。但十年之后,现实已经清楚:大量硬件资源只换来有限的性能提高,而错误推测又带来严重能耗问题,两者共同迫使设计方向改变。结语将回到这个话题。
译注:第 1 项把 Power10 的“总发射宽度”按 8 条计算,而图 3.46 将其总宽度列为 16,图注又区分了单线程最多 8 条与总体 16 条。上述研究年份、预测器比较年份及“一周期延迟”等模型假设,也均按原书保留,不作为当代产品测量结果。
3.15 结束语
2000 年伊始,对开发 ILP 的关注达到顶峰。新世纪的前五年,人们逐渐看清:ILP 方法很可能已经见顶,需要寻找新方法。到 2005 年,Intel 和其他所有主要处理器厂商,都调整了方向,把重点转向多核。更高性能将通过 TLP 而非 ILP 实现,高效使用处理器的责任也将大幅从硬件转移到软件与程序员身上。这是自 25 多年前流水线和 ILP 早期发展以来,处理器体系结构最重大的变化。如今,除最深度嵌入式的应用领域外,已经很难找到单核芯片。
同一时期,设计者开始探索利用更多数据级并行性,作为提高性能的另一条途径。SIMD 扩展让桌面和服务器微处理器在图形及类似功能上取得适度性能提升。更重要的是,GPU 积极采用 SIMD,在具有大量 DLP 的应用中取得显著性能优势。对于科学计算应用,这些方法提供了一种可行选择,替代多核所利用的更通用、但效率较低的 TLP。第 4 章将探讨 DLP 应用的这些发展。2015 年前后又发生了一次重大技术转向:设计者开始探索领域专用体系结构,以牺牲部分可编程性,换取机器学习计算等关键应用在性能与功耗效率方面的大幅提升。第 7 章重点讨论领域专用硬件的构建。
许多研究者预言,ILP 的使用会大幅收缩,未来属于双发射超标量处理器和更多核心。然而,略高的发射速率本身有优势,推测式动态调度又能够应对一级缓存未命中等不可预测事件,因此,即使在数据中心等具有充足 TLP 的应用领域,多核设计的主要构件——处理器核心——仍在缓慢而稳定地改善 ILP。SMT 的加入,以及它在性能与能效方面的有效性,进一步巩固了推测式乱序执行的地位。尽管超标量设计的改进速度确实放缓,Intel、AMD、Arm、Apple 和 IBM 等厂商,仍持续、适时地推出改进。实际上,即使在嵌入式市场,最新处理器也已经引入动态调度、推测和更宽的发射。2023 年性能最好的乱序核心之一,是 Apple Avalanche,应用于智能手机的 A15 芯片和笔记本电脑的 M2 芯片。
ILP 的改进速度不太可能显著加快。从硅面积利用率和功耗效率来看,它实在过于低效。不过,ILP 缓慢改进的趋势很可能继续。单线程性能对若干工作负载的重要性,以及 ILP 技术广泛的适用性,仍然是重要考量。此外,在同一芯片中结合高性能核心与高能效核心,或结合可编程核心与定制加速器,可以平衡效率方面的顾虑,从而支持不断改进的乱序核心投入使用。请看图 3.46,其中列出 IBM Power 系列的七代处理器。Power 面向银行系统、客户关系管理等企业应用的高性能需求,通常属于领先的 ILP 设计。二十年来,Power 对 ILP 的支持持续改善,但晶体管数量增长的绝大部分——从 Power4 到 Power10 超过 100 倍——用于扩大片上缓存容量和增加每个裸片的核心数量。单线程每周期最多发射指令数,从 Power4 的 5 条增加到 Power10 的 8 条。Power10 SMT8 核心组织为两个执行域,每个域服务 8 个线程,并提供足以每周期发射 8 条指令的资源。同时,SMT 支持从无,发展到每个处理器 8 个线程。多代高性能 Intel 微体系结构也呈现类似趋势:新增硅面积中的很大一部分,用于支持更多核心、更宽 SIMD 单元和更大缓存。接下来的两章,重点讨论利用数据级与线程级并行性的方法。
| 特性 | Power4 | Power5 | Power6 | Power7 | Power8 | Power9 | Power10 |
|---|---|---|---|---|---|---|---|
| 推出年份 | 2001 | 2004 | 2007 | 2010 | 2014 | 2017 | 2021 |
| 峰值时钟频率(GHz) | 1.3 | 1.9 | 5.0 | 4.14 | 4.35 | 4.0 | 4.15 |
| 晶体管数量(百万) | 174 | 276 | 790 | 1,200 | 4,200 | 8,000 | 18,000 |
| 每周期发射数 | 5 | 5 | 7 | 6 | 8 | 18 | 16 |
| 每核功能单元数 | 8 | 8 | 9 | 12 | 16 | 38 | 42 |
| 每核 SMT 线程数 | 0 | 2 | 2 | 4 | 8 | 8 | 8 |
| 每芯片核心数 | 2 | 2 | 2 | 8 | 12 | 12 | 16 |
| 片上缓存总量(MiB) | 1.5 | 2 | 8 | 35 | 103.0 | 128 | 163 |
图 3.46 七代 IBM Power 处理器的特性。除了采用静态、顺序执行的 Power6,其余都是动态调度超标量处理器。Power7 和 Power8 的 L3 缓存采用嵌入式 DRAM。前文已简要介绍 Power9,它进一步扩大缓存,并支持片外 HBM。Power10 SMT8 核心包含两个执行资源域,每个域提供最多服务四个硬件线程的资源。因此,总发射宽度为每周期 16 条指令,而单线程每周期最多发射 8 条指令。
译注:正文称 Power10 每个执行域服务 8 个线程,图注则为每域最多 4 个;正文还使用“每处理器 8 个线程”,表格口径为“每核”。三处均忠实保留,不将其混为同一资源范围。表中 Power9 发射数 18 也是原页数值。
3.16 历史回顾与参考文献
在线提供的 M.5 节,讨论流水线与 ILP 的发展历程。我们给出了大量参考文献,供进一步阅读、探索这些主题。M.5 节同时涵盖第 3 章与附录 H。
案例研究:动态调度
案例与习题作者:Jason D. Bakos。
本案例研究考察以下简单循环在运行时的行为:
这个循环执行一次 Newton–Raphson 迭代,以求出 的根。假定:
- 保存在寄存器 f0 中。
- 常数 2.0 保存在寄存器 f8 中。
- 迭代次数保存在 x1 中。
- 输入数组的基地址保存在寄存器 x2 中。
习题 3.1
[15] 〈3.3, 3.6〉 在单发射、顺序执行 CPU 上执行这个循环体,需要多少个周期?假定:
- 加载延迟为 4 个周期,即产生结果与使用结果的指令之间,至少需要插入 3 个周期。
- 浮点指令延迟为 5 个周期。
- 整数指令延迟为 2 个周期。
- 分支在 4 个周期内确定结果。
- 存储的有效延迟为 0 个周期。
- 依赖指令可以在最后一条为其产生输入的指令完成的同一周期发射,并且转发总线数量无限。
- 最后完成提交的那条指令所在的周期,视为循环完成的周期。
请填写类似下表的表格来解答:
| 编号 | 指令 | 依赖于 | 使用该结果的指令 | 就绪周期 | 派发周期 | 完成周期 | 提交 / 分支确定周期 |
|---|---|---|---|---|---|---|---|
| 0 | fld f2,0(x2) | ||||||
| 1 | fmul.d f4,f2,f2 | ||||||
| 9 | bne x1,zero,loop |
习题 3.2
[5] 〈3.3, 3.6〉 在你对 3.1 的解答中,CPU 发射了指令的周期占总周期的百分之几?
习题 3.3
[15] 〈3.3, 3.6〉 假定 CPU 可以乱序发射、乱序提交指令,但每周期只能派发一条指令,也只能提交一条指令。
如果同一周期有不止一条指令准备好派发或提交,取指最晚的那条必须停顿。暂时假设寄存器自动重命名,以避免 WAR 和 WAW 名依赖引起的不一致。后面的问题将考察这是否必要。
执行该循环体需要多少个周期?请使用与 3.1 类似的表格。
习题 3.4
[5] 〈3.3, 3.6〉 在你对 3.3 的解答中,CPU 发射了指令的周期占总周期的百分之几?
习题 3.5
[15] 〈3.4, 3.6〉 现在假定可以对分支进行推测,分支预测器的准确率为 100%。在分支之后取到的指令,可以在分支结果确定之前派发,但必须等到分支结果确定之后才能提交。
执行两次迭代时,平均每次迭代需要多少个周期?请使用与 3.1 类似的指令调度表解答。
习题 3.6
[5] 〈3.4, 3.6〉 在你对 3.5 的解答中,CPU 派发了指令的周期占总周期的百分之几?
习题 3.7
[15] 〈3.5〉 假定每条指令的目标寄存器,从该指令提交的周期开始,到最后一条依赖于它的指令派发为止,都视为“存活”(live)。
对于你在 3.5 中得到的调度,找出寄存器 x1、x2、f2、f4、f6 的存活周期区间。
习题 3.8
[10] 〈3.5〉 你在 3.7 中得到的寄存器生存期,是否说明代码存在某些名依赖(WAR、WAW),会在当前动态指令顺序下引起问题?为什么?
习题 3.9
[15] 〈3.3, 3.6〉 现在假定目标体系结构支持双发射、双提交,并具有无限大的指令窗口,可以从中选取指令调度。执行两次迭代时,平均每次迭代需要多少个周期?
习题 3.10
[5] 〈3.6〉 在你对 3.9 的解答中,发射槽位的利用率是多少?
习题 3.11
[5] 〈3.6〉 3.9 的性能结果是否符合你的预期?为什么?
习题
作者:Jason D. Bakos。
习题 3.12
[25] 〈3.11〉 本题探讨三种采用不同多线程(MT)方式的处理器之间的性能取舍。它们都是超标量处理器,采用顺序流水线,所有加载与分支之后都必须固定停顿 3 个周期,且具有相同的 L1 缓存。同一线程在同一周期发射的指令,按程序顺序读取,彼此不能存在任何数据依赖或控制依赖。
应用是一个列表搜索程序,在 x16 与 x17 指定的地址范围内扫描内存区域,寻找保存在 x9 中的特定值。将搜索空间均分为四个大小相等、各自连续的块,每块分配一个搜索线程,从而并行化为四个线程。每个线程的大部分运行时间都花在以下展开后的循环体中:
假定:
- 用屏障保证所有线程同时开始。
- 第一次 L1 缓存未命中发生在循环完成两次迭代之后。
- 所有 BEQAL 分支都不跳转。
- BLT 总是跳转。
- 三种处理器都按轮转方式调度线程。
- 处理器 A 是超标量同时多线程体系结构,每周期最多发射来自两个线程的合计两条指令。
- 处理器 B 是细粒度多线程体系结构,每周期最多从单个线程发射四条指令,遇到任何流水线停顿就切换线程。
- 处理器 C 是粗粒度多线程体系结构,每周期最多从单个线程发射八条指令,在 L1 缓存未命中时切换线程。
求各处理器完成循环前两次迭代所需的周期数。
译注:原题假设中的“BEQAL”与代码的
beq不一致,daddiu及#64写法也是原页内容,均未改写为另一套指令。本题对细粒度切换时机的定义也按题设保留。
习题 3.13
[25/25/25] 〈3.1, 3.2, 3.9〉 本题考察软件技术如何从常见向量循环中开发指令级并行性(ILP)。以下循环称为 DAXPY 循环,即双精度 ,是 Gauss 消元中的核心操作。代码对长度为 100 的向量执行 DAXPY:。初始时,R1 设为数组 X 的基地址,R2 设为 Y 的基地址:
译注:正文使用 R1、R2,代码使用 x1、x2;第一条指令写入 x4,原注释却写“x1 = 上界”。均按原书保留。
假定功能单元延迟如下表。采用一个周期的延迟分支,在 ID 阶段确定分支结果。所有结果都支持完全旁路。
| 产生结果的指令 | 使用结果的指令 | 延迟(时钟周期) |
|---|---|---|
| 浮点乘法 | 浮点 ALU 操作 | 6 |
| 浮点加法 | 浮点 ALU 操作 | 4 |
| 浮点乘法 | 浮点存储 | 5 |
| 浮点加法 | 浮点存储 | 4 |
| 整数操作及所有加载 | 任意 | 2 |
a. [25]〈3.1〉 假定单发射流水线。给出未经编译器调度的循环,以及由编译器针对浮点操作延迟和分支延迟进行调度后的循环,标出所有停顿或空闲时钟周期。未经调度和调度后,结果向量 Y 的每个元素分别需要多少执行周期?如果只依靠处理器硬件,时钟需要快多少,才能达到调度编译器带来的性能提升?忽略提高时钟速度对存储系统性能可能产生的影响。
b. [25]〈3.2〉 假定单发射流水线。充分展开循环并合并循环开销指令,使其能够在没有任何停顿的情况下调度。必须展开多少次?给出指令调度。每个结果元素的执行时间是多少?
c. [25]〈3.9〉 假定 VLIW 处理器的每条指令包含五个操作,如图 3.28 所示。比较两种循环展开程度:先将循环展开 6 次,以开发 ILP,合并循环开销指令,调度到没有任何停顿,即没有发射周期完全空闲;然后重复这一过程,但改为展开 10 次。忽略分支延迟槽。给出两种调度。每种调度下,结果向量每个元素的执行时间是多少?操作槽位的利用率各是多少?两种调度的代码大小相差多少?各自总共需要多少寄存器?
习题 3.14
[20/20] 〈3.3, 3.6〉 本题考察动态调度处理器运行习题 3.13 中循环时的表现。功能单元如下表:
| 功能单元类型 | EX 周期数 | 功能单元数量 | 保留站数量 |
|---|---|---|---|
| 整数 | 1 | 1 | 5 |
| 浮点加法器 | 10 | 1 | 3 |
| 浮点乘法器 | 15 | 1 | 2 |
假定:
- 功能单元没有流水化。
- 功能单元之间没有转发,结果在指令完成时传递。
- 执行阶段 EX 同时完成加载、存储的有效地址计算与内存访问,因此流水线为 IF/ID/DIS/EX/WB。
- 加载需要一个时钟周期。
- 派发阶段 DIS 和结果写回阶段 WB,各需要一个时钟周期。
- 有五个加载缓冲槽位和五个存储缓冲槽位。
- 非零分支指令 BNEZ 需要一个时钟周期。
a. [20]〈3.3, 3.6〉 使用单发射流水线,流水线延迟取上表数值。对于循环的三次迭代,给出每条指令的停顿周期数,以及开始执行、即进入第一个 EX 周期的时钟周期。每次循环迭代需要多少个周期?请用包含以下各列的表格回答:
- 迭代:循环迭代编号。
- 指令。
- 派发:指令派发的周期。
- 执行:指令执行的周期。
- 内存访问:访问内存的周期。
- 完成:结果可供其他指令使用的周期。
- 说明:描述该指令正在等待的事件。
表格应展示三次循环迭代。可以忽略第一条指令。
b. [20]〈3.3, 3.6〉 重做 a,但改为双发射处理器,并假定浮点单元(FPU)完全流水化。
习题 3.15
[10] 〈3.6〉 假定动态调度处理器每周期只能向等待中的指令广播、即转发一个功能单元的结果。使用上一题 3.14 的硬件配置和延迟,找出一个不超过 10 条指令的代码序列,使处理器必须因这一限制产生的结构冒险而停顿。指出停顿发生在序列中的什么位置。
习题 3.16
[20] 〈3.4〉 一个 相关分支预测器,用最近执行的 个分支的行为,从 个预测器中选择一个;每个预测器都是 位预测器。两级局部预测器的工作方式相似,但只跟踪各个分支自身的历史行为,用来预测其未来行为。
这类预测器存在设计取舍:相关预测器只需要很少的存储空间保存历史,因此可以为大量独立分支维护 2 位预测器,降低不同分支指令复用同一预测器的概率;局部预测器则需要更多空间保存历史,因此只能跟踪相对较少的分支指令。
本题比较一个可跟踪四个分支的 相关预测器,需要 16 位,与一个使用相同存储空间、可跟踪两个分支的 局部预测器。对于下面给出的分支结果序列,列出每次预测、所用表项、预测结果导致的所有表项更新,以及每个预测器最终的错误预测率。假定截至此时,所有分支都已跳转。按以下状态初始化预测器。
相关预测器
| 表项 | 分支 | 上次结果 | 预测 |
|---|---|---|---|
| 0 | 0 | T | T,已有一次错误预测 |
| 1 | 0 | NT | NT |
| 2 | 1 | T | NT |
| 3 | 1 | NT | T |
| 4 | 2 | T | T |
| 5 | 2 | NT | T |
| 6 | 3 | T | NT,已有一次错误预测 |
| 7 | 3 | NT | NT |
局部预测器
| 表项 | 分支 | 最近两次结果(右侧为最近一次) | 预测 |
|---|---|---|---|
| 0 | 0 | T,T | T,已有一次错误预测 |
| 1 | 0 | T,NT | NT |
| 2 | 0 | NT,T | NT |
| 3 | 0 | NT | T |
| 4 | 1 | T,T | T |
| 5 | 1 | T,NT | T,已有一次错误预测 |
| 6 | 1 | NT,T | NT |
| 7 | 1 | NT,NT | NT |
译注:T 表示跳转,NT 表示不跳转。原题将局部预测器写为 ,但表中记录最近两次结果;表项 3 又只写一个 NT,均为原页内容。题设“16 位”与是否计入历史位的口径也未进一步说明,译文不补造假设。
| 分支 PC(字地址) | 结果 |
|---|---|
| 454 | T |
| 543 | NT |
| 777 | NT |
| 543 | NT |
| 777 | NT |
| 454 | T |
| 777 | NT |
| 454 | T |
| 543 | T |
习题 3.17
[10] 〈3.4〉 假定有一个深流水线处理器,只为条件分支实现分支目标缓冲区。错误预测代价始终为 4 个周期,缓冲区未命中代价始终为 3 个周期。假定命中率 90%、预测准确率 90%、分支频率 15%。与分支代价固定为两个周期的处理器相比,采用分支目标缓冲区的处理器快多少?假定不含分支停顿的基础 CPI 为 1。
习题 3.18
[10/5] 〈3.4〉 考虑一个分支目标缓冲区:正确预测条件分支、错误预测、缓冲区未命中的代价,分别为 0、2、2 个时钟周期。考虑一种区分条件与无条件分支的设计:对条件分支保存目标地址,对无条件分支保存目标指令。
a. [10]〈3.9〉 在缓冲区中找到一个无条件分支时,其代价是多少个时钟周期?
b. [10]〈3.9〉 求对无条件分支采用分支折叠(branch folding)带来的改进。假定命中率 90%,无条件分支频率 5%,缓冲区未命中代价为两个周期。这项增强带来多少性能改善?命中率至少需要多高,才能获得性能收益?
译注:题首难度标注为 [10/5],b 小问却标为 [10];子问指向 3.9,而题首指向 3.4。编号及难度均照原书保留。
习题 3.19
[10] 〈3.2, 3.7〉 考虑以下代码,它计算稀疏矩阵 A 与稠密向量 x 的乘积。稀疏矩阵采用压缩稀疏行(Compressed Sparse Row,CSR)格式:所有非零元素按行优先顺序保存在连续内存块中,第 个非零元素保存在 val[i],对应列保存在 col[i],其所在行为 ,满足 。也就是说,ptr 数组保存各行第一个元素的索引。
a. [5]〈3.7〉 哪些加载指令可能需要推测式内存消歧?是否可能通过内存存在 RAW 依赖?
b. [5]〈3.2〉 你预计分支预测器对第 10 条指令中的分支,预测效果如何?
译注:原代码的行尾注释写
i!=ptr[i],输出指针递增注释写&x[row];lw后的索引步长为 8,且使用fmac.d、fli、b等写法。
习题 3.20
[10] 〈3.2, 3.5〉 考虑以下代码,它用 Horner 法,对保存在寄存器 f6、f8 中的两个输入值计算多项式。
将循环展开为原来的两倍,并给浮点寄存器使用其他名称进行重命名,避免名依赖引起的性能损失。然后给出最终的寄存器映射。
译注:乘法注释中的
x1、x2,以及第二个乘法仍写temp而后续使用temp2,均为原书注释;指令本身的输入是 f6、f8。
习题 3.21
[5] 〈3.7〉 对于以下代码片段,分别求两种 CPU 执行它所需的周期数:一种不支持加载旁路与推测式内存消歧,另一种同时支持这两项功能。假定存储与加载指令之间没有依赖。
假定使用单发射乱序流水线,包含一个延迟为 3 个周期的整数单元,以及一个延迟为 4 个周期的加载 / 存储单元。指令可以在最后一条产生其依赖结果的指令完成的同一周期发射。请说明你所做的其他假设。
补充参考文献
- Boggs, D., Weiss, S., Kyker, A., 2004. Branch Reorder Buffer. US Patent 6,799,268.
- Hu, G., He, Z., Lee, R.B., 2021. SoK: hardware defenses against speculative execution attacks. In: Proceedings of the 2021 International Symposium on Secure and Private Execution Environment Design (SEED), pp. 108–120. doi:10.1109/SEED51797.2021.00023.
- Kocher, P., Horn, J., Fogh, A., Genkin, D., Gruss, D., Haas, W., et al., 2019. Spectre attacks: exploiting speculative execution. In: The Proceedings of the 40th IEEE Symposium on Security and Privacy.
- Lipp, M., Schwarz, M., Gruss, D., Prescher, T., Haas, W., Fogh, A., et al., 2018. Meltdown: reading kernel memory from user space. In: Proceedings of the 27th USENIX Security Symposium.
- Moshovos, A., Breach, S.E., Vijaykumar, T.N., Sohi, G.S., 1997. Dynamic speculation and synchronization of data dependences. In: Proceedings of the 24th Annual International Symposium on Computer Architecture (ISCA’97). Association for Computing Machinery, New York, NY, USA, pp. 181–193. doi:10.1145/264107.264189.
- Rotem, E., et al., 2022. Intel Alder Lake CPU Architectures. in IEEE Micro 42 (3), 13–19. doi:10.1109/MM.2022.3164338.
4 向量、SIMD 与 GPU 体系结构中的数据级并行性
我们把这些算法称为数据并行算法,因为它们的并行性来自对大批数据同时进行操作,而不是来自多条控制线程。
——W. Daniel Hillis 与 Guy L. Steele, “Data parallel algorithms,” Commun. ACM(1986)
如果要犁一块地,你宁愿用两头健壮的牛,还是 1024 只鸡?
——超级计算机之父 Seymour Cray (主张采用两个强大的向量处理器,而不是大量简单处理器)
原章 DOI:10.1016/B978-0-443-15406-5.00004-3。原章版权标记:© 2026 Elsevier Inc.,保留所有权利,包括文本与数据挖掘、AI 训练及类似技术的相关权利。
4.1 引言
对于第 1 章介绍的单指令多数据(SIMD)体系结构,一直存在一个问题:究竟有多广泛的应用具有显著的数据级并行性(DLP)?SIMD 分类提出近 60 年后(Flynn, 1966),答案已经不仅包括科学计算中面向矩阵的计算,还包括面向媒体的图像、声音处理,以及第 7 章将介绍的机器学习算法。请注意,这些都是线性代数的不同应用形式。多指令多数据(MIMD)体系结构每执行一次数据操作,都需要取一条指令;SIMD 的一条指令却可以启动许多数据操作,因此有望获得更高能效。这两点使 SIMD 对个人移动设备和服务器都很有吸引力。最后,SIMD 相对于 MIMD 最大的优点也许是:程序员仍可按顺序执行的方式思考,同时通过并行的数据操作获得加速。
本章介绍 SIMD 的三种形式:向量体系结构、多媒体 SIMD 指令集扩展,以及图形处理单元(GPU)。1
第一种形式比另外两种早了 30 多年,它把流水线执行扩展到大量数据操作。这种向量体系结构比其他 SIMD 形式更容易理解,也更容易成为编译的目标,但直到最近,人们还认为它对微处理器而言过于昂贵。其中一部分成本来自晶体管,另一部分则来自提供充足动态随机访问存储器(DRAM)带宽的成本;相比之下,传统微处理器普遍依赖缓存来满足存储性能需求。
第二种形式沿用了 SIMD 这个名称,基本含义是同时并行执行数据操作,如今大多数支持多媒体应用的指令集体系结构都具备这种能力。对于 x86 体系结构,SIMD 指令扩展始于 1996 年的 MMX(多媒体扩展),随后十年间又推出了多个 SSE(流式 SIMD 扩展)版本,并一直发展到今天的 AVX(高级向量扩展)和 AMX(高级矩阵扩展)。要让 x86 计算机达到最高计算速率,往往需要使用这些 SIMD 指令,浮点程序尤其如此。
第三种 SIMD 形式来自图形加速器领域,其潜在性能高于当今传统的多核计算机。GPU 与向量体系结构具有一些共同特征,同时也有自身的鲜明特点;这在一定程度上源于它们发展所在的生态环境。
在这种环境中,除了 GPU 及其图形存储器之外,还有系统处理器与系统内存。为体现这些区别,GPU 领域将这种体系结构称为异构(heterogeneous)体系结构。除了图形,GPU 也在推动机器学习的发展。第 7 章将介绍 GPU 的这一用途。
对于具有大量数据并行性的问题,这三种 SIMD 形式都具有一个共同优势:与经典的 MIMD 并行编程相比,它们对程序员更友好。
本章旨在帮助体系结构设计者理解:为什么向量比多媒体 SIMD 更通用,以及向量与 GPU 体系结构有哪些相似和不同之处。向量体系结构是多媒体 SIMD 指令的超集,而且提供了更好的编译模型;GPU 与向量体系结构也有不少相似之处。因此,我们先介绍向量体系结构,为后面两节奠定基础。下一节概述向量体系结构,附录 G 则会更深入地讨论这一主题。
原书注:本章以本书第 5 版中 Krste Asanovic 撰写的附录 F“Vector Processors”和附录 G“Hardware and Software for VLIW and EPIC”为基础,也采用了 Computer Organization and Design 第 5 版中 John Nickolls 与 David Kirk 撰写的附录 A“Graphics and Computing GPUs”的材料;还在较小程度上参考了 Joe Gebis 与 David Patterson 的“Embracing and Extending 20th-Century Instruction Set Architectures”(IEEE Computer,2007 年 4 月),以及 David Patterson 与 Andrew Waterman 的“SIMD Considered Harmful”(2017 年 9 月)。 ↩︎
4.2 向量体系结构
执行可向量化应用最高效的方式,就是使用向量处理器。
——Jim Smith,ISCA,1994 年
向量体系结构先把分散在内存中的数据元素收集到大型、顺序组织的寄存器堆中,在这些寄存器上执行操作,再把结果分散写回内存。一条指令可以对独立的数据元素执行几十次寄存器到寄存器的操作。
这些大型寄存器堆起着由编译器控制的缓冲区的作用,既能隐藏内存延迟,又能有效利用内存带宽。所有向量加载和存储操作都采用深流水线,因此每个向量只需支付一次较长的内存延迟,而不必让每个元素分别承担这一延迟。例如,加载一个含 32 个元素的向量时,较长的内存延迟可以分摊到这 32 个元素上。向量程序力求使存储系统持续保持忙碌。
随着功耗限制的重要性日益增加,向量体系结构能够在不承担乱序超标量处理器的能耗与设计复杂度的情况下提供良好性能,这使它更具吸引力。向量指令能够提高简单顺序标量处理器的性能,而不显著增加能耗需求和设计复杂度。许多在复杂乱序设计上运行良好的程序,如果直接用向量指令表达其中的数据级并行性,执行效率会更高(Kozyrakis and Patterson, 2002)。
RV64V 扩展
我们先介绍一个简单的向量处理器,如图 4.1 所示。它大体借鉴了近 50 年前的早期超级计算机之一 Cray-1,但指令集采用 RISC-V 的向量扩展 RVV。我们称它为 RV64V:RV64 表示 64 位 RISC-V 基础指令集,V 表示向量扩展。下面使用 RV64V 的一个简化子集来说明向量处理器的工作原理。
RV64V 的主要组成部分如下。
- 向量寄存器。 RV64V 有 32 个向量寄存器,每个保存一个向量。向量寄存器堆必须有足够多的端口,才能向所有向量功能单元提供数据。
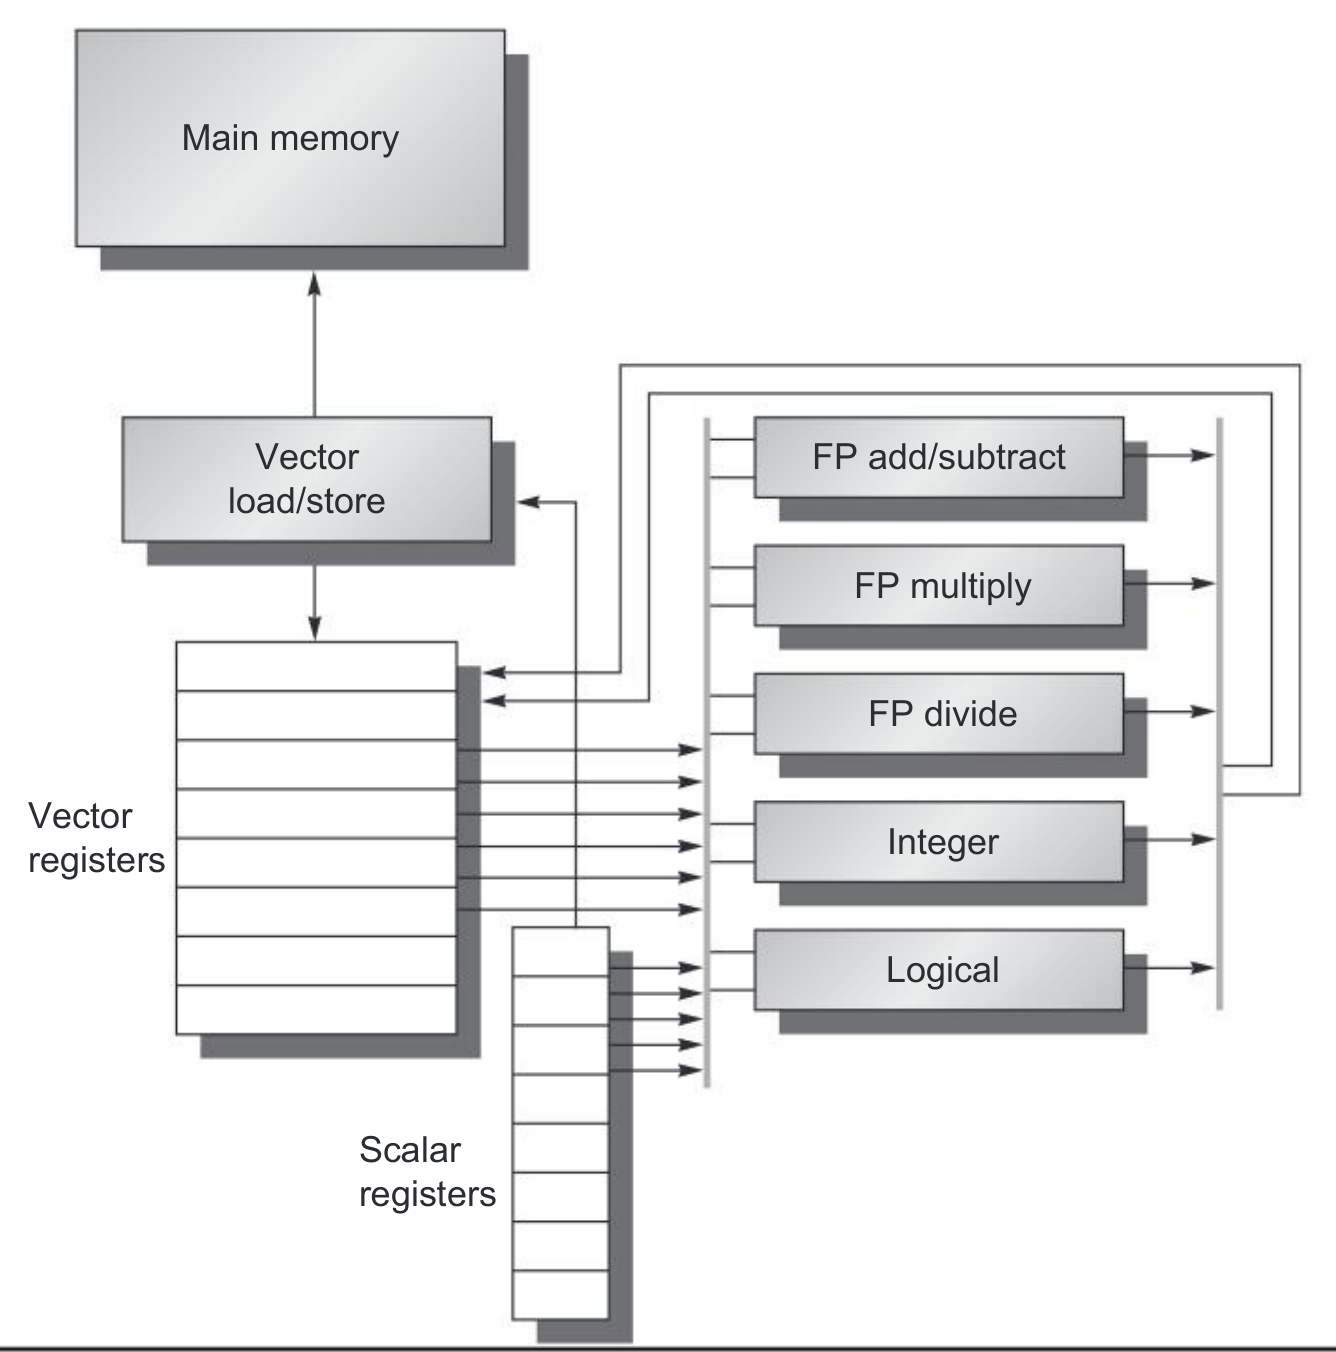
图内术语:Main memory=主存;Vector registers=向量寄存器;Scalar registers=标量寄存器;FP add/subtract=浮点加/减;FP multiply=浮点乘;FP divide=浮点除;Integer=整数;Logical=逻辑;Vector load/store=向量加载/存储。
这些端口使针对不同向量寄存器的操作能够高度重叠。向量寄存器堆至少需要 16 个读端口和 8 个写端口,并通过一对交叉开关将这些端口连接到各功能单元的输入和输出。增加寄存器堆带宽的一种方法,是采用多个存储体;对于较长的向量,这种方法很有效。
- 向量功能单元。 每个单元都采用完整的流水线,每个时钟周期可以开始一次新操作。控制逻辑需要检测功能单元的结构冒险,以及寄存器访问的数据冒险。图 4.1 包含 5 个功能单元。为简化讨论,本节主要考虑浮点功能单元。
- 向量加载/存储单元。 向量存储单元负责向量在内存与寄存器之间的传送。在最初的延迟之后,这个单元可以每个时钟周期加载或存储一个字。通常,标量加载和存储也由它完成。
- 标量寄存器。 与 RV64G 相同,RV64V 有 31 个通用寄存器和 32 个浮点寄存器。它们可以向向量功能单元提供数据,也可以提供传送给向量加载/存储单元的地址。功能单元在读入标量操作数时,会将其锁存到输入端。
- 最大向量长度。 与下一节介绍的 SIMD 扩展不同,每条向量指令处理的元素个数并不由操作码指定。最大向量长度 VLMAX 取决于具体实现,因此不同实现可以在采用同一指令集的同时,支持不同的最大向量长度。
图 4.2 列出了 RV64V 向量指令。指令的输入可以来自向量寄存器,也可以来自标量整数寄存器 xi 或标量浮点寄存器 fi。后缀 .vv 表示两个向量操作数;.vx 表示一个向量和一个标量整数寄存器;.vi 表示一个向量和一个立即数;.vf 表示一个向量和一个标量浮点寄存器。汇编器通常能根据操作数推断后缀。在指令发射时,标量操作数会被复制到相应的功能单元。
| 助记符 | 名称 | 说明 |
|---|---|---|
vadd | 整数加 | 将 V[rs1] 与 V[rs2] 的对应元素相加,结果写入 V[rd] |
vsub | 整数减 | 从 V[rs1] 的各元素中减去 V[rs2] 的对应元素,结果写入 V[rd] |
vmul | 整数乘 | 将 V[rs1] 与 V[rs2] 的对应元素相乘,结果写入 V[rd] |
vdiv | 整数除 | 用 V[rs2] 的各元素除 V[rs1] 的对应元素,结果写入 V[rd] |
vmacc | 整数乘加 | 将 V[rs1] 与 V[rs2] 的对应元素相乘,再将结果加到 V[rd] 的对应元素上 |
vfadd | 浮点加 | 将 V[rs1] 与 V[rs2] 的对应浮点元素相加,结果写入 V[rd] |
vfsub | 浮点减 | 从 V[rs1] 的各浮点元素中减去 V[rs2] 的对应元素,结果写入 V[rd] |
vfmul | 浮点乘 | 将 V[rs1] 与 V[rs2] 的对应浮点元素相乘,结果写入 V[rd] |
vfdiv | 浮点除 | 用 V[rs2] 的各浮点元素除 V[rs1] 的对应元素,结果写入 V[rd] |
vfmacc | 浮点乘加 | 将 V[rs1] 与 V[rs2] 的对应浮点元素相乘,再将结果加到 V[rd] 的对应元素上 |
vxor | 按位异或 | 对 V[rs1] 与 V[rs2] 的对应元素求异或,结果写入 V[rd] |
vor | 按位或 | 对 V[rs1] 与 V[rs2] 的对应元素求或,结果写入 V[rd] |
vand | 按位与 | 对 V[rs1] 与 V[rs2] 的对应元素求与,结果写入 V[rd] |
vsll | 逻辑左移 | 将 V[rs1] 的各元素左移,位数由 V[rs2] 的对应元素给出,结果写入 V[rd] |
vsrl | 逻辑右移 | 将 V[rs1] 的各元素逻辑右移,位数由 V[rs2] 的对应元素给出,结果写入 V[rd] |
vsra | 算术右移 | 将 V[rs1] 的各元素右移并扩展符号位,位数由 V[rs2] 的对应元素给出,结果写入 V[rd] |
vpeq | 判等 | V[rs1] 与 V[rs2] 的对应元素相等时,将 V[0] 的对应 1 位元素置 1,否则置 0 |
vpne | 判不等 | V[rs1] 与 V[rs2] 的对应元素不相等时,将 V[0] 的对应 1 位元素置 1,否则置 0 |
vmxor | 掩码异或 | 对 V[rs1] 与 V[rs2] 各元素最低有效位组成的 1 位元素求异或,结果写入 V[0] |
vmor | 掩码或 | 对 V[rs1] 与 V[rs2] 各元素最低有效位组成的 1 位元素求或,结果写入 V[0] |
vpmand | 掩码与 | 对 V[rs1] 与 V[rs2] 各元素最低有效位组成的 1 位元素求与,结果写入 V[0] |
vlei | 连续加载 | 从 R[rs1] 指定的起始地址加载向量到 V[rd];元素宽度 i 可为 8、16、32 或 64 位,元素个数由 vl 指定 |
vlsei | 步长加载 | 从 R[rs1] 指定的起始地址加载向量到 V[rd];步长为 R[rs2],即各元素地址为 R[rs1] + j × R[rs2],其中 j = 0、1、…… |
vloxei | 索引加载(聚集) | 将地址 R[rs2] + V[rs2] 中的元素加载到 V[rs1];V[rs2] 提供索引 |
vsei | 连续存储 | 将 V[rd] 存入以 R[rs1] 为起始地址的内存 |
vssei | 步长存储 | 将 V[rd] 存入内存,元素地址为 R[rs1] + j × R[rs2] |
vsoxei | 索引存储(散布) | 将 V[rs1] 的各元素存入地址 R[rs2] + V[rs2] |
setvl | 设置向量长度 | 设置元素宽度和寄存器数量(记录在 vtype 中);将 vl 和目的寄存器设为最大向量长度 mvl 与源寄存器值中的较小者 |
译注: 本表按原书保留指令名称和寄存器表达式。原书表内的
setvl与后文代码中的vsetvl、图注的vctype与正文的vtype、图注的.vs/.sv与正文的.vx/.vf并不一致;vpmand也按表中原样保留。这些是原书对 RV64V 的简化描述,不能直接作为可汇编的现行 RVV 指令规范。
传统向量体系结构在处理窄数据类型时效率不高,而这些类型在实际应用中很常见。同样大小的寄存器既可以保存 32 个 64 位元素,也可以保存 128 个 16 位元素或 256 个 8 位元素。让硬件支持不同数据宽度,对媒体和科学应用都很有价值。
注意,图 4.2 中的 RV64V 指令省略了数据宽度!RV64V 的一项创新,是把数据宽度与每个向量寄存器关联,而不是像通常那样由指令提供。程序在执行向量指令前对所用寄存器进行配置,其中状态寄存器的标准元素宽度(standard element width,SEW)字段指明元素的位数。
例如,SEW 为 64 就表示 64 位元素。图 4.3 列出了支持的宽度。
| 数据类型 | 支持的宽度 |
|---|---|
| 整数 | 8、16、32、64 位 |
| 浮点数 | 16、32、64 位 |
采用动态寄存器类型(dynamic register typing)的一个原因是:传统向量体系结构需要许多指令才能支持如此多的数据宽度。考虑图 4.3 中的各种宽度,如果没有动态寄存器类型,图 4.2 的指令表就会长得多!类型只需设置一次,不必在每条指令中重复指定。
动态指定类型还允许将向量寄存器重新分组。例如,假设整个寄存器堆有 1024 字节,而计算只需要 4 个由 64 位浮点数组成的向量;便可以将其配置为 4 个各有 256 字节的向量寄存器,每个保存 32 个元素。将长度乘数 LMUL 设为 8,就把每 8 个寄存器组合为一个寄存器组,使有效寄存器数变为 4 个。
向量体系结构受到的一项批评是,更多的状态会拖慢上下文切换。在这里的 RV64V 实现中,状态从 字节增加到 字节,扩大为原来的 3 倍。为了降低切换上下文的代价,处理器记录软件自上次上下文切换以来是否写过向量寄存器。
动态指定寄存器类型的第三个好处是,不同宽度操作数之间的转换,可以根据寄存器配置,作为算术指令的一部分隐式完成,而不必增加显式转换指令。下一节将给出这一优点的例子。
vle 和 vse 分别加载和存储整个向量,其操作数包括一个向量寄存器和一个保存基地址的 RV64G 寄存器。实际向量长度由 vl 给出,不一定等于 VLMAX;vtype 记录向量配置。谓词 pi 则用于对含 IF 语句的代码实施掩码控制。
向量指令可以采用多种实现方式,包括同时处理多个元素。较慢但较宽的功能单元可以降低功耗。由于各元素的操作彼此独立,增加功能单元数量不需要像超标量处理器那样,进行代价高昂的依赖检查。
向量处理器如何工作:一个例子
观察 RV64V 的向量循环,是理解向量处理器最好的方式。考虑本节贯穿使用的典型运算 ,其中 X 和 Y 是最初驻留在内存中的向量,a 是标量。单精度形式称为 SAXPY,即单精度 加 Y;双精度形式称为 DAXPY。这是 Linpack 基准的内层循环(Dongarra et al., 2003)。Linpack 是一组线性代数例程,而 Linpack 基准由执行高斯消元的例程组成。
先假定向量寄存器可保存 32 个元素,正好等于这次运算的向量长度;后面会放宽这一假设。
例题
假定 X 和 Y 各含 32 个元素,x5 和 x6 分别保存它们的起始地址。写出在 RV64G 和 RV64V 上执行上述计算的代码。
解答
RV64G 代码如下:
RV64V 代码则为:
译注: 原页的标量代码到最后一条
addi即结束,末行注释也不完整,没有列出循环分支。上面的向量代码实际列出 7 条指令,下一页正文却称为 8 条。
在向量代码中,汇编器会把 vfmul 翻译为 vfmul.vf,因为其中一个操作数是标量浮点寄存器;vfadd 则成为 vfadd.vv,因为两个操作数都是向量。开头的配置指令将寄存器堆设置为 4 个元素宽度为 64 位的向量寄存器。
与标量代码动态执行的 258 条指令相比,向量代码只需执行 8 条指令。向量指令每次处理 32 个元素,而且消除了标量循环中占近一半的循环控制开销。
当编译器能产生向量指令,而且程序的大部分时间都用于执行这些向量指令时,就称该程序已经向量化;能够这样转换的程序称为可向量化程序。循环迭代之间的数据依赖(称为循环携带依赖,loop-carried dependence)可能阻止向量化,4.5 节将进一步讨论这一问题。
另一个重要差别是流水线互锁的频率。在标量 RV64G 代码中,fadd 必须等待 fmul,fsd 又必须等待 fadd。向量处理器只需在第一个元素到达之前停顿,之后的元素就可以连续流过流水线。这种逐元素转发称为向量链接(chaining)。因此,标量代码因这些依赖产生的停顿可能是向量代码的 32 倍。通过附录 H 介绍的软件流水线、循环展开或乱序执行,可以减少标量代码的停顿,但不能消除两种代码对指令带宽需求的巨大差别。
向量执行时间
向量指令序列的执行时间取决于三个因素:向量操作的长度、指令之间的结构冒险,以及数据依赖。功能单元接受新操作数并产生新结果的速率称为启动速率(initiation rate)。知道向量长度和启动速率,就可以估计向量指令的执行时间。
现代向量处理器通常有多个通道,每个时钟周期可以产生两个或更多结果;有些功能单元则并未完全流水线化。先考虑简单的 RV64V:它只有一个通道,每个时钟周期处理一个元素。因此,一条向量指令所需的时钟周期数大致等于向量长度。
为了简化对指令序列的分析,可以把那些有可能一起执行的向量指令组成一个编队(convoy)。同一编队内的指令不能发生结构冒险,否则就必须串行执行。在前面的例子中,加载与乘法指令可以放进同一个编队。我们通过统计编队数来估计性能,并暂时假定:一个编队执行完毕后,才开始执行其他标量指令或向量指令。
存在写后读依赖的指令仍可通过链接放进同一个编队。一个元素一旦产生,就可以直接转发给需要它的功能单元,而不用等到整个向量寄存器写完。这样,同一个时钟周期就可以读写同一向量寄存器中的不同元素。早期向量处理器的链接存在时序限制,类似标量流水线中的转发限制;现代处理器通常支持灵活链接,只要没有结构冒险,就可以把任意活动的向量操作链接起来。本章始终假定支持灵活链接。
我们用 chime 作为编队执行的时间单位。含 m 个编队的序列需要 m 个 chime;对于向量长度为 n、每个时钟周期处理一个元素的简单实现,执行时间约为 个时钟周期。
chime 模型忽略了依赖具体处理器的若干开销,因此对于某些向量长度,它只是粗略估计;向量越长,估计通常越准确。使用 chime 而不直接使用“每个结果的时钟周期数”,正是为了明确表示我们忽略了这些开销。
例如,实际处理器通常每个时钟周期只能发射一条指令,这会使 chime 模型低估执行时间。只要向量长度远大于编队中的指令数,仍可近似认为一个编队占用一个 chime。
例题
考虑下列向量指令序列。假定每种功能单元各有一个,忽略指令发射开销,给出编队划分、chime 数和每次浮点操作所需的时钟周期数。
解答
第一条加载可以与乘法链接。第二条加载与第一条加载存在结构冒险,因此必须开始一个新编队;加法可以与第二条加载链接。存储又与第二条加载存在结构冒险,因此需要第三个编队:
| 编队 | 指令 |
|---|---|
| 1 | vle64、vfmul |
| 2 | vle64、vfadd |
| 3 | vse64 |
因此,共需 3 个 chime。每个结果需要两次浮点运算,所以平均每次浮点运算需要 1.5 个时钟周期。现实中,第一条加载和乘法通常需要两个时钟周期才能发射,而不是一个周期。若向量长度为 32,估计总时间为 个时钟周期,这一点发射开销相对较小。
比指令发射开销更重要的是启动时间,即填满流水线所需的延迟。为便于举例,我们采用 Cray-1 的流水线深度;现代处理器的流水线通常更深,尤其是加载流水线。假定所有功能单元都完全流水线化:浮点加法启动时间为 6 个时钟周期,乘法为 7 个时钟周期,除法为 20 个时钟周期,向量加载为 12 个时钟周期。
掌握这些向量基础之后,接下来几个小节将介绍若干优化:它们或是提高性能,或是扩大能够在向量体系结构上良好运行的程序范围。具体来说,要回答以下问题:
- 向量处理器怎样以高于每个时钟周期一个元素的速度执行单个向量?每周期处理多个元素可以提高性能。
- 当向量长度不等于最大向量长度(mvl)时,怎样处理?多数应用中的向量长度与体系结构的向量长度不同,因此必须为这一常见情况提供高效方案。
- 待向量化的代码中含有 IF 语句时怎么办?如果能高效处理条件语句,就能向量化更多代码。
- 向量处理器对存储系统有何要求?缺少足够的存储器带宽,向量执行可能徒劳无功。
- 怎样处理多维矩阵?这种数据结构很常见,必须能对它向量化,向量体系结构才具有广泛适用性。
- 怎样处理稀疏矩阵?这种常见的数据结构也必须能够向量化。
- 怎样为向量计算机编程?如果体系结构创新与编程语言及其编译器不相适应,就可能无法得到广泛使用。
本节其余部分和附录 G 将回答这些问题。
多个通道:每个时钟周期处理多个元素
向量体系结构的一项关键优势是:一条简短的指令就能指定几十个相互独立的操作,所需的指令位数却与标量指令相同。向量指令的语义允许以深流水线、并行功能单元阵列,或者两者的组合来实现这些操作。图 4.4 以向量加法说明了并行执行方式。
RV64V 的向量算术运算具有一个简单性质:向量的第 N 个元素只与其他向量的第 N 个元素进行运算。这使多通道向量单元的实现大为简化。
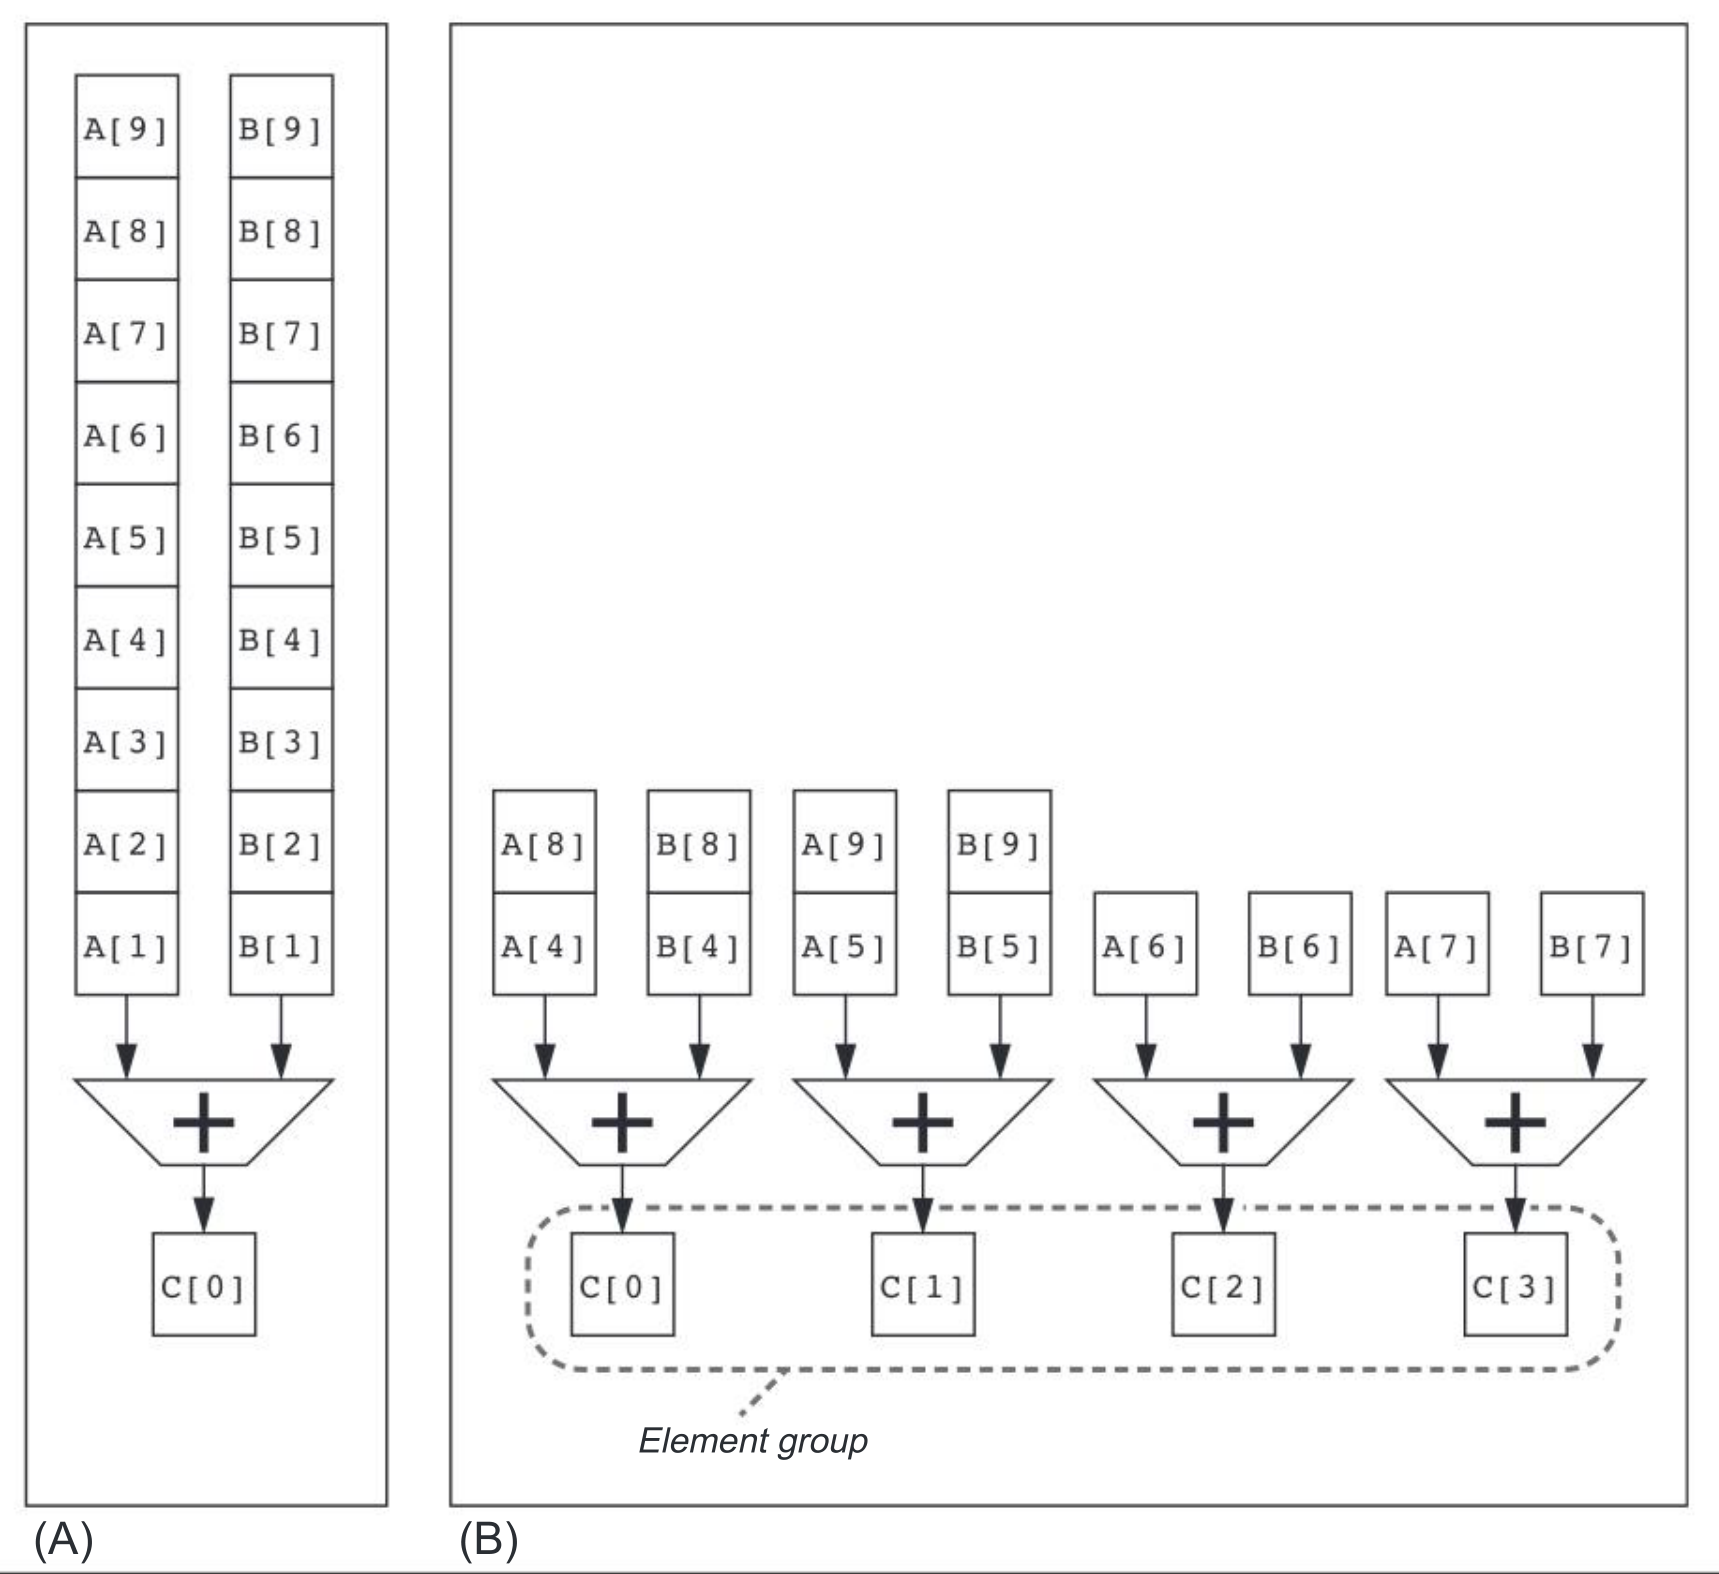
图内标记 A、B、C 表示向量;Element group=元素组;加号表示加法功能单元。
就像增加公路车道可以提高车流量一样,增加向量通道(lane)可以提高峰值性能。图 4.5 给出了一个四通道向量单元。对长度为 32 的向量,每个 chime 只需 8 个时钟周期。要充分利用多通道,向量必须足够长;否则,硬件消耗指令的速度会很快,需要更多指令级并行性和足够的指令带宽来供给它。
每个通道包含向量寄存器堆的一部分,以及每种向量功能单元的一条流水线。每个时钟周期,各通道共同处理一个元素组。例如,通道 0 保存所有向量寄存器的第 0 个元素,因此这些元素的源和目的位置都在本通道内。
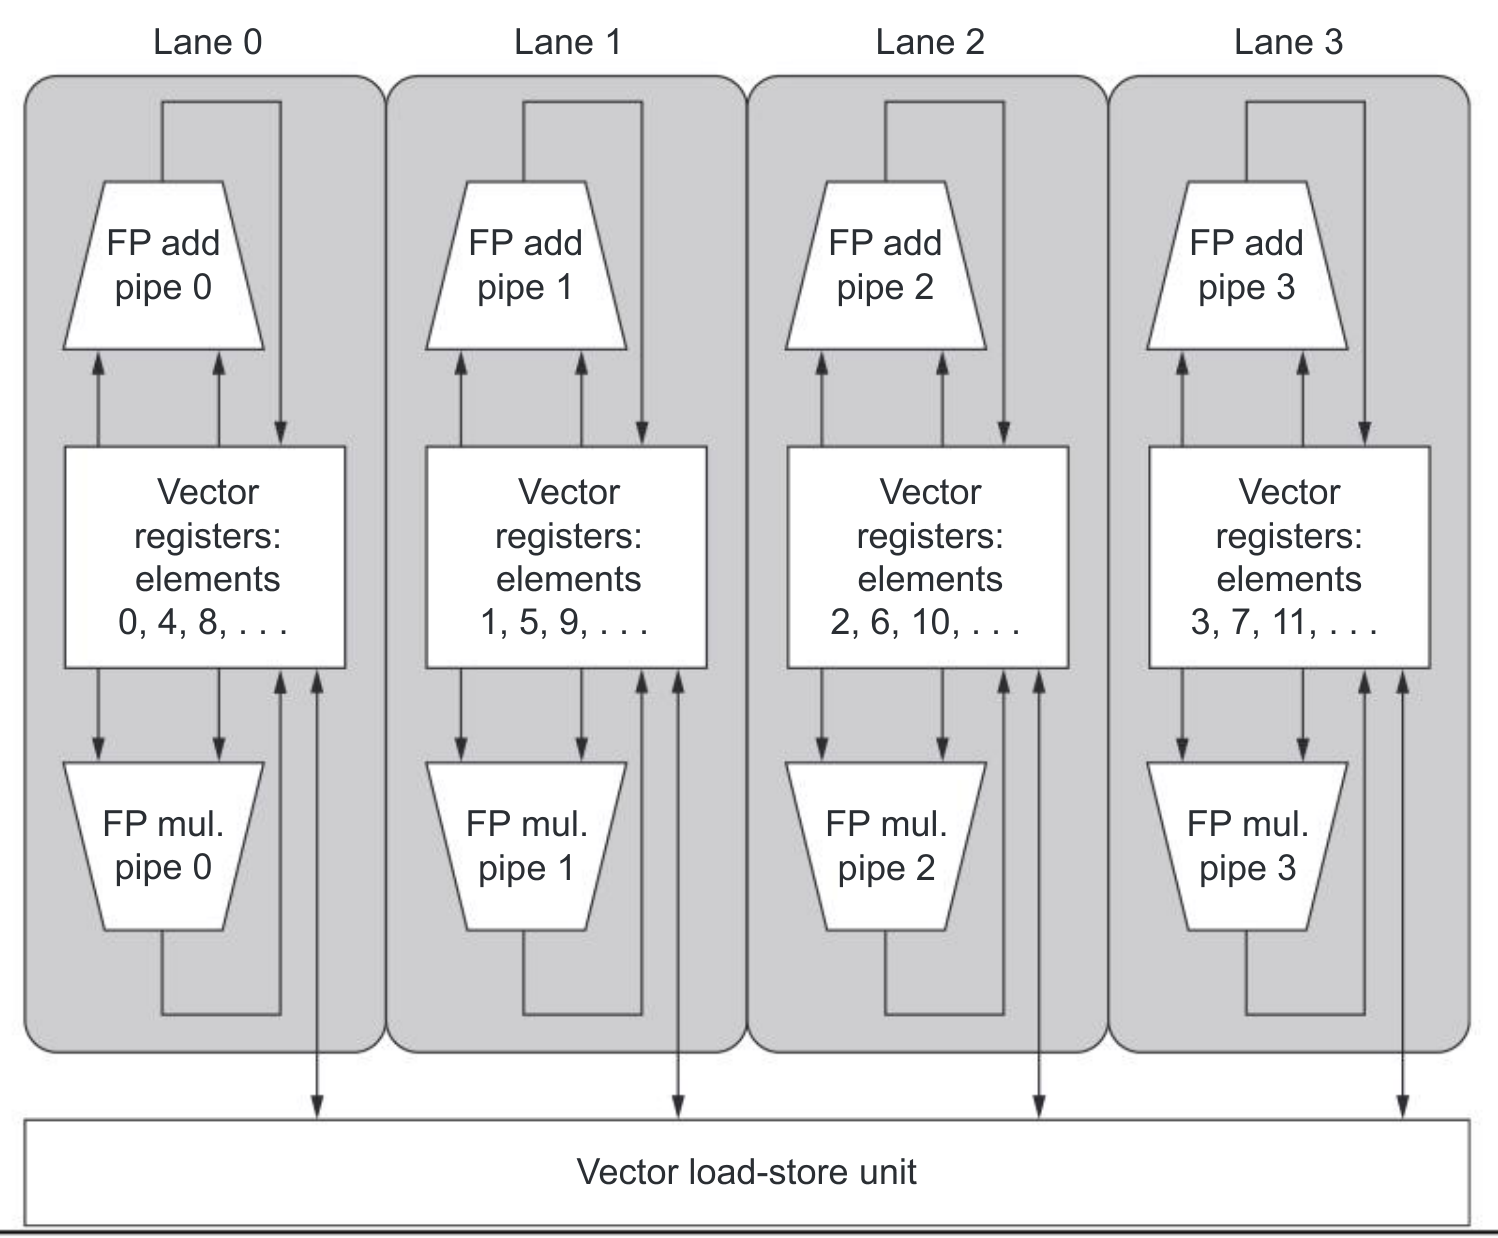
图内术语:Lane=通道;FP add pipe=浮点加法流水线;FP multiply pipe=浮点乘法流水线;Vector register elements=向量寄存器元素;Vector load-store unit=向量加载/存储单元。
避免通道之间的通信,可以减少连线和寄存器端口需求。这解释了向量处理器为何能达到每个时钟周期 64 次操作:例如,16 个通道每个周期分别完成两次算术操作和两次加载/存储操作。
增加通道只需增加少量控制逻辑,而且无须修改已有机器码。设计者可以据此权衡面积、频率、电压和能耗。例如,将时钟频率减半、通道数加倍,可以保持峰值性能不变。
向量长度寄存器:处理长度不等于 32 的循环
前面假定向量长度恰好等于最大向量长度 32,但实际程序很少如此。向量长度在编译时可能未知,也可能在同一段程序的不同次执行中变化:
所有向量操作的大小都取决于 n,而 n 可能到运行时才知道。它还可能是包含上述循环的过程的一个参数,因此会在执行过程中改变。
向量长度寄存器 vl 控制所有向量操作,包括内存操作。它的值不得超过最大向量长度;最大长度保存在 VLMAX 寄存器中。这样,新一代实现就可以增加向量长度而无须增加指令集。相比之下,SIMD 扩展往往需要扩充指令集,才能利用更宽的硬件。
当 n 大于最大向量长度时,可以采用 strip mining,即把长向量循环分段处理,如图 4.6 所示。循环先后处理多个最大长度的向量,并额外处理一个不足最大长度的余数段。RISC-V 无须为余数单独编写一个循环:setvl 将 vl 和另一个目的寄存器同时设为 VLMAX 与 n 中的较小者。
如果需要执行的迭代数大于 n,就尽可能快地一次处理 VLMAX 个元素,将 vl 设为 VLMAX。如果 n 小于 VLMAX,最后一次只处理剩余的 n 个元素,将 VLMAX 设为 n。setvl 写入另一个标量寄存器的结果,可以用于循环的辅助管理操作。
译注: 原文确写“迭代数大于 n”和“将 VLMAX 设为 n”,与前文
vl = min(VLMAX,n)的定义不一致。按这一定义,前一条件应比较 VLMAX,最后不足一个完整向量时应将vl设为 n。
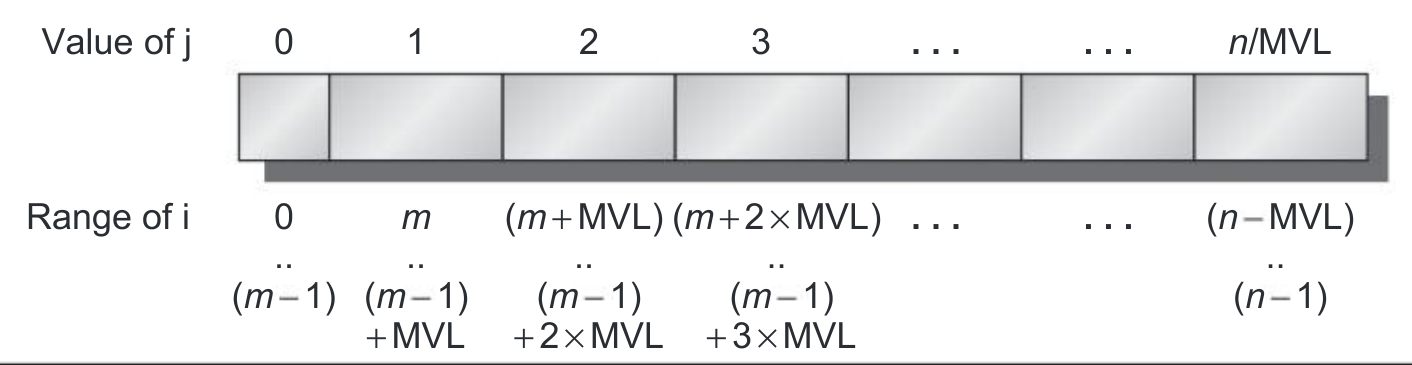
图内的 j 是分段循环索引,i 是原循环索引;MVL/VLMAX 表示最大向量长度。
向量掩码寄存器:处理 IF 语句
根据 Amdahl 定律,如果程序只有一小部分能向量化,或可向量化比例只是中等,整体加速比就会非常有限。向量化程度较低的两个主要原因,是循环内的条件语句(IF 语句)以及稀疏矩阵。IF 语句给循环引入控制依赖,因此,仅用目前介绍的技术,不能让这种循环以向量方式运行。同样,现有功能也无法高效实现稀疏矩阵。本小节先讨论条件执行,稀疏矩阵留待后文。
考虑下面的循环:
由于循环体有条件地执行,这个循环通常不能向量化。不过,如果只对满足 X[i] 非零的迭代执行循环体,就可以把减法向量化。实现这一能力的常见扩展,是向量掩码控制。
向量掩码是一个布尔向量,决定相应元素的操作是否执行,类似第 3 章的标量谓词执行。掩码元素为 1 时执行相应操作;为 0 时,目的寄存器中的对应元素保持不变。RVV 使用 v0 作为掩码,而不使用单独的掩码寄存器;v0 每个元素的最低有效位(位 63)用于控制相应操作。
假定 X 和 Y 的起始地址分别在 x5 和 x6 中,前面的循环可以写为:
译注: 原文写作“least-significant bit (bit 63)”,代码注释也使用
v0<63>。对通常从 0 开始编号的 64 位值,最低有效位应为位 0,因此这里的文字与位号存在矛盾。本文不将该示意描述视为现行 RVV 掩码布局的规范。
将条件分支转换为直线式条件执行代码的编译技术,称为 IF 转换(IF-conversion)。
使用向量掩码寄存器仍有开销。在标量体系结构中,条件执行指令即使条件不成立,也仍需要执行时间。不过,去掉分支及相关控制依赖后,即使有时做了无用功,条件执行指令仍可能更快。同样,采用向量掩码的向量指令,即使某些元素的掩码为零,也仍需同样的执行时间。尽管掩码中可能有大量零,使用向量掩码控制仍可能明显快于标量方式。
4.4 节将说明,向量处理器与 GPU 的一个差别,是处理条件语句的方式。向量处理器把谓词寄存器纳入体系结构状态,依靠编译器显式操作掩码寄存器。GPU 则用硬件操作软件不可见的内部掩码寄存器,达到相同效果。两者都有相同的代价:无论对应掩码位为 0 还是 1,硬件都花时间执行该向量元素,因此使用掩码会降低有效的 FLOP/s。
存储体:为向量存储系统提供带宽
向量加载/存储单元的行为远比算术功能单元复杂。加载的启动时间,是把第一个字从内存送入寄存器所需的时间。如果之后的向量元素能够无停顿地供应,向量启动速率就等于取出或存入新字的速率。与较简单的功能单元不同,这个速率未必能达到每时钟周期一个元素,因为存储体造成的停顿可能降低有效吞吐量。
现代向量处理器的内存启动延迟通常超过 100 个时钟周期,远高于算术单元。前面为 RV64V 使用的 12 个周期来自 Cray-1。较新的向量处理器采用缓存来降低这一延迟。
为了每个时钟周期提供一个字,存储系统通常由多个存储体组成。大量存储体还有助于同时处理按行和按列访问的数组。需要的并不只是简单的交错存储,而是具有独立地址控制的存储体,原因有三点:
- 许多向量处理器每个时钟周期需要执行多次加载或存储;而单个存储体的周期可能相当于多个处理器时钟周期,因此需要独立的地址和控制。
- 向量处理器需要支持非顺序访问,这要求各存储体能独立寻址。
- 多处理器共享同一个存储系统时,各处理器会产生独立的访问流。
例题
Cray T90 的最大配置 Cray T932 有 32 个处理器,每个处理器每个时钟周期可以产生 4 次加载和 2 次存储。处理器时钟周期为 2.167 ns,存储系统所用 SRAM 的周期为 15 ns。要让全部处理器都以完整的存储器带宽运行,至少需要多少个存储体?
解答
每个周期的最大访存次数是 。每个 SRAM 存储体会忙碌 个处理器时钟周期,向上取整为 7。因此,至少需要 个存储体!
Cray T932 实际上只有 1024 个存储体,因此早期型号不能同时向所有处理器持续提供满带宽。后来的内存升级用流水线化的同步 SRAM 代替了 15 ns 的异步 SRAM,将存储周期缩短了一半以上,从而提供了足够的带宽。
从更高层次看,向量加载/存储单元与标量处理器中的预取单元具有相似作用:它们都试图通过向处理器持续提供数据流来满足带宽需求。
步长:在向量体系结构中处理多维数组
一个向量中相邻的元素,在内存中的位置未必连续。考虑下面这段直接实现矩阵乘法的 C 代码:
我们可以把 B 的每一行与 D 的每一列相乘的操作向量化,并对以 k 为索引的内层循环实施 strip mining。
为此,必须考虑怎样寻址 B 中相邻的元素和 D 中相邻的元素。为数组分配内存时,需要将其线性化,按行优先顺序(如 C)或列优先顺序(如 Fortran)布局。这意味着行元素或列元素必有一类在内存中不连续。例如,上面的 C 代码采用行优先顺序,内层循环相邻两次迭代访问的 D 元素间隔为一行的大小乘以 8(每个元素的字节数),共 800 字节。第 2 章说明了分块技术如何改善基于缓存的系统的局部性;对于没有缓存的向量处理器,则需要另一种技术来获取在内存中不连续的向量元素。
要收集到同一个向量寄存器中的相邻元素之间的距离,称为步长(stride)。在这个例子中,矩阵 D 的步长为 100 个双字(800 字节),矩阵 B 的步长为 1 个双字(8 字节)。如果采用 Fortran 的列优先顺序,两者的步长就会互换:D 中相邻元素的步长为 1,即 1 个双字(8 字节)。
B 的步长则为 100,即 100 个双字(800 字节)。因此,如果不重排循环,编译器就无法同时消除 B 和 D 中相邻访问元素之间的较大间隔。
向量一旦加载到向量寄存器中,其元素在逻辑上就连续了。因此,只需提供支持步长的向量加载和存储操作,向量处理器就能处理大于 1 的非单位步长。能够访问不连续的内存位置,并将它们整理成稠密结构,是向量体系结构的重要优势之一。
缓存天然适合单位步长的数据访问。对于按单位步长访问的大型科学数据集,增加缓存块大小可以降低未命中率;但对于非单位步长访问,增加块大小甚至可能产生负面效果。分块技术能够解决其中一些问题(见第 2 章),但对某些问题,高效访问不连续数据仍是向量处理器的优势,4.7 节将给出实例。
RV64V 按字节寻址,因此本例的步长为 800。这个值必须动态计算,因为编译时可能不知道矩阵大小;而且与向量长度一样,同一语句在不同次执行时,矩阵大小也可能改变。向量步长和起始地址都可以放在通用寄存器中,随后用 vlse(带步长的向量加载)把向量读入寄存器。存储非单位步长的向量时,则使用 vsse(带步长的向量存储)。
支持大于 1 的步长会使存储系统复杂化。引入非单位步长后,就可能频繁访问同一个存储体。多个访问争用同一存储体时,会发生存储体冲突,使某个访问停顿。原书给出的冲突条件是:
译注: 原式分母写的是“Least common multiple”,即最小公倍数。若连续元素地址按模 B 映射到 B 个存储体,步长 S 以元素为单位,则再次访问同一存储体的间隔为 ,不是 。因此,在每周期启动一次访问、忙碌时间以周期计的假设下,相应冲突条件应为 。例如 B = 8、S = 1 时,回到同一存储体应间隔 8 次访问,而原式给出 1;原式不能据以判断冲突。
例题
假设有 8 个存储体,存储体忙碌时间为 6 个时钟周期,总内存延迟为 12 个周期。加载一个含 64 个元素的向量,步长为 1 时需要多久?步长为 32 呢?
解答
因为存储体数大于存储体忙碌时间,步长为 1 时,加载需要 个时钟周期,即平均每个元素 1.2 个周期。最坏的步长是存储体数量的整数倍,步长为 32、存储体数为 8 就属于这种情况。除第一次以外,每次访问都会与前一次访问冲突,必须等待 6 个周期的存储体忙碌时间。总时间为 个时钟周期,即每个元素 6.1 个周期,慢了约 5 倍!
聚集与散布:在向量体系结构中处理稀疏矩阵
前面提到,稀疏矩阵十分常见,因此需要让使用稀疏矩阵的程序也能以向量方式执行。稀疏矩阵中的向量元素通常以某种紧凑形式保存,再通过间接寻址访问。考虑一个简化的稀疏结构,代码可能如下:
这段代码对数组 A 和 C 执行稀疏向量求和,使用索引向量 K 和 M 指定 A、C 中的非零元素。A 和 C 的非零元素个数必须相同,都是 n 个,所以 K 和 M 的大小也相同。
支持稀疏矩阵的主要机制是使用索引向量的聚集/散布操作。这些操作用于在稀疏矩阵的压缩表示(不包含零)与普通表示(包含零)之间转换。聚集操作接受一个索引向量,将基地址与索引向量中的偏移量相加,以这些地址取出元素,形成向量寄存器中的一个稠密向量。完成对稠密向量的操作之后,散布存储使用同一个索引向量,将稀疏向量按展开形式写回内存。支持这种操作的硬件称为聚集/散布硬件,几乎所有现代向量处理器都具有它。RV64V 对应的指令是 vloxe(索引向量加载或聚集)和 vsoxe(索引向量存储或散布)。例如,若 x5、x6、x7 和 x28 保存上述各向量的起始地址,内层循环可以写成:
译注: 原页先把 M 加载到
v16,随后访问 C[M[]] 的指令却使用v2。上面的代码保留原书;按其前后数据流,此处索引寄存器应与保存 M 的寄存器一致。
这种技术允许含稀疏矩阵的代码以向量方式执行。简单的向量化编译器无法自动向量化上述源代码,因为它不知道 K 中的元素是否互不相同,也就不知道迭代之间是否没有依赖。此时需要程序员给出指示,告诉编译器以向量方式执行这个循环是安全的。
虽然索引加载和存储(聚集和散布)能够流水线化,但其速度通常明显低于非索引加载或存储,因为在指令开始时还不知道要访问哪些存储体。
此外,为支持聚集和散布,寄存器堆还必须提供向量单元各通道之间的通信。
聚集或散布的每个元素都有独立地址,因此不能成组处理,而且存储系统的许多位置都可能发生冲突。即使系统采用缓存,每次独立访问仍会产生显著延迟。不过,正如 4.7 节将展示的,针对这种情况专门设计并投入更多硬件资源,比起对这些不可预测的访问放任不管,可以获得更好的存储系统性能。
4.4 节将说明,从没有专门指令把地址限制为连续这一意义上看,GPU 的所有加载都是聚集,所有存储都是散布。为把可能很慢的聚集/散布转换为效率更高的单位步长访存,GPU 硬件会在执行时尝试识别连续地址。
向量体系结构的编程
向量体系结构的一个优势,是编译器能够在编译时告诉程序员某段代码能否向量化,并且常常提示不能向量化的原因。这种直观的执行模型使其他领域的专家也能学会:通过修改代码,或在可以假定操作互相独立时向编译器提供提示,来改进性能;聚集/散布数据传输就是一例。编译器和程序员互相提示如何提高性能,正是这种对话简化了向量计算机的编程。
今天,决定程序能否成功以向量方式运行的主要因素,是程序本身的结构:循环是否有真数据依赖(见 4.5 节)?能否通过重构消除这些依赖?这既受所选算法影响,也在一定程度上受编码方式影响。
为了解科学计算程序能够达到怎样的向量化程度,我们考察 Perfect Club 基准的结果。图 4.7 显示了两个代码版本在 Cray Y-MP 上执行时,以向量方式完成的操作比例。第一个版本仅由编译器优化原始代码,第二个版本则大量使用 Cray Research 程序员团队提供的提示。多项向量处理器应用性能研究表明,不同程序的编译器向量化程度差异很大。
对于编译器自身难以充分向量化的程序,加入大量提示的版本显著提高了向量化程度。所有程序现在都超过 50%,中位数由约 70% 提高到约 90%。
| 基准测试 | 仅编译器优化时,以向量方式执行的操作比例 | 程序员辅助后,以向量方式执行的操作比例 | 提示优化带来的加速比 |
|---|---|---|---|
| BDNA | 96.1% | 97.2% | 1.52 |
| MG3D | 95.1% | 94.5% | 1.00 |
| FLO52 | 91.5% | 88.7% | N/A |
| ARC3D | 91.1% | 92.0% | 1.01 |
| SPEC77 | 90.3% | 90.4% | 1.07 |
| MDG | 87.7% | 94.2% | 1.49 |
| TRFD | 69.8% | 73.7% | 1.67 |
| DYFESM | 68.8% | 65.6% | N/A |
| ADM | 42.9% | 59.6% | 3.60 |
| OCEAN | 42.8% | 91.2% | 3.92 |
| TRACK | 14.4% | 54.6% | 2.52 |
| SPICE | 11.5% | 79.9% | 4.06 |
| QCD | 4.2% | 75.1% | 2.15 |
4.3 面向多媒体的 SIMD 指令集扩展
SIMD 多媒体扩展源自一个简单的观察:许多媒体应用处理的数据类型,比 32 位处理器所针对的类型更窄。图形系统通常用 8 位分别表示三原色中的每一种,再用 8 位表示透明度;音频采样则视应用而定,通常用 8 位或 16 位表示。以一个 256 位加法器为例,只要将其进位链分段,处理器就能同时对由 32 个 8 位操作数、16 个 16 位操作数、8 个 32 位操作数或 4 个 64 位操作数组成的短向量执行运算。这种分段加法器增加的成本很小。图 4.8 概括了典型的多媒体 SIMD 指令。与向量指令一样,SIMD 指令对一组向量数据执行相同的操作。但向量计算机通常具有大型寄存器堆,例如 RISC-V RV64V 的 32 个向量寄存器,每个可以保存 32 个 64 位元素;SIMD 指令通常指定较少的操作数,因此使用的寄存器堆也小得多。
向量体系结构提供了简洁的指令集,适合作为向量化编译器的目标。相比之下,SIMD 扩展有三项主要缺失:没有向量长度寄存器,没有步长访问或聚集/散布数据传送指令,也没有掩码寄存器。
| 指令类别 | 操作数 |
|---|---|
| 无符号加/减 | 32 个 8 位、16 个 16 位、8 个 32 位或 4 个 64 位 |
| 最大值/最小值 | 32 个 8 位、16 个 16 位、8 个 32 位或 4 个 64 位 |
| 平均值 | 32 个 8 位、16 个 16 位、8 个 32 位或 4 个 64 位 |
| 右移/左移 | 32 个 8 位、16 个 16 位、8 个 32 位或 4 个 64 位 |
| 浮点运算 | 16 个 16 位、8 个 32 位、4 个 64 位或 2 个 128 位 |
- 多媒体 SIMD 扩展把数据操作数的个数固定在操作码中,结果是 x86 体系结构的 MMX、SSE、AVX 和 AMX 扩展增加了数百条指令。向量体系结构则用向量长度寄存器指定当前操作的操作数个数。这种可变长度的向量寄存器,很容易适应那些向量长度自然小于体系结构所支持最大长度的程序。此外,向量体系结构具有隐含的最大向量长度,配合向量长度寄存器,可以避免使用大量操作码。
- 直到最近,多媒体 SIMD 才开始提供向量体系结构中较复杂的寻址方式,即步长访问和聚集/散布访问。这些功能能够扩大向量化编译器可成功处理的程序范围(见 4.7 节)。
- 多媒体 SIMD 通常也不像向量体系结构那样提供掩码寄存器,以支持各元素的条件执行,不过这种情况正在改变。
这些缺失让编译器生成 SIMD 代码更困难,也增加了使用 SIMD 汇编语言编程的难度。
在 x86 体系结构中,1996 年加入的 MMX 指令复用了 64 位浮点寄存器,因此基本指令能够同时执行 8 个 8 位操作或 4 个 16 位操作。随后又加入了并行的 MAX、MIN 操作,各种掩码与条件指令,数字信号处理器中常见的操作,以及一些被认为有助于重要媒体库的专用指令。注意,MMX 访问内存时复用了浮点数据传送指令。
其后继者是 1999 年的流式 SIMD 扩展 SSE。它增加了 16 个独立的 128 位寄存器(XMM 寄存器),使一条指令能够同时执行 16 个 8 位操作、8 个 16 位操作或 4 个 32 位操作。
它还支持并行的单精度浮点运算。因为 SSE 使用独立寄存器,也需要独立的数据传送指令。Intel 很快又通过 2001 年的 SSE2、2004 年的 SSE3 和 2007 年的 SSE4 加入双精度 SIMD 浮点数据类型。只要程序员把操作数相邻放置,能够同时执行 4 次单精度或 2 次双精度浮点运算的指令,就能提高 x86 计算机的峰值浮点性能。每一代还会增加一些专用指令,用于加速当时被认为重要的特定多媒体功能。
2010 年加入的高级向量扩展 AVX,将寄存器宽度再次翻倍到 256 位(YMM 寄存器),从而将所有较窄数据类型的并行操作数目翻倍。图 4.9 列出了适用于双精度浮点计算的 AVX 指令。2013 年的 AVX2 增加了 30 条新指令,例如聚集指令 VGATHER 和向量移位指令 VPSLL、VPSRL、VPSRA。2017 年的 AVX-512 再次将宽度翻倍至 512 位(ZMM 寄存器),将寄存器数量也翻倍至 32 个,并加入约 250 条新指令,其中包括散布指令 VPSCATTER 和掩码寄存器 OPMASK。AVX 还为未来版本将寄存器扩展到 1024 位做了准备。
最新的扩展是高级矩阵扩展 AMX,它出现在 2022 年推出的微处理器中,目标是支持机器学习所依赖的矩阵乘法(见第 7 章)。AMX 增加了 8 个称为 tile 的二维向量寄存器。每个 tile 为 :16 行,每行 256 位宽。因此,AMX 增加的总状态为 字节。Tile Matrix Multiply(TMUL)单元可以执行矩阵乘法。
| AVX 指令 | 说明 |
|---|---|
VADDPD | 对 4 个打包的双精度操作数执行加法 |
VSUBPD | 对 4 个打包的双精度操作数执行减法 |
VMULPD | 对 4 个打包的双精度操作数执行乘法 |
VDIVPD | 对 4 个打包的双精度操作数执行除法 |
VFMADDPD | 对 4 个打包的双精度操作数执行乘加 |
VFMSUBPD | 对 4 个打包的双精度操作数执行乘减 |
VCMPxx | 对 4 个打包的双精度操作数执行 EQ、NEQ、LT、LE、GT、GE 等比较 |
VMOVAPD | 传送对齐的 4 个打包双精度操作数 |
VBROADCASTSD | 将一个双精度操作数广播到一个 256 位寄存器中的 4 个位置 |
矩阵元素可以是 8 位整数,也可以是采用 BF16 格式的 16 位浮点数(见第 7 章)。因此,一个 256 位的行可以保存 32 个 int8 数据或 16 个 BF16 数据。
总体来说,这些扩展的目标一直是加速精心编写的库,而不是让编译器自动生成它们(见附录 H)。不过,较新的 x86 编译器正在尝试生成这种代码,尤其是针对浮点密集型应用。由于操作码决定 SIMD 寄存器的宽度,每当宽度翻倍,SIMD 指令的数量也必须随之翻倍。
既然存在这些不足,为什么多媒体 SIMD 扩展仍如此流行?首先,在标准算术单元上增加最初的 SIMD 支持成本很低,实现也容易。其次,与向量体系结构相比,它增加的处理器状态很少,而状态大小始终关系到上下文切换时间。第三,向量体系结构需要很高的内存带宽,而许多计算机不具备这一条件。第四,SIMD 无须处理这样一种虚拟内存问题:一条指令产生 32 次访存,其中任何一次都可能发生缺页异常。最初的 SIMD 扩展为每组在内存中对齐的 SIMD 操作数分别传送数据,所以这些传送不会跨越页边界。SIMD 的短而定长的“向量”还有一个优点:很容易加入支持新媒体标准的指令,例如置换指令,或消费的操作数个数少于、或多于向量所产生个数的指令。最后,人们还曾担心向量体系结构能否与缓存良好配合。较新的向量体系结构已经解决了这些问题。不过,支配全局的因素是向后二进制兼容性的极端重要性:一旦体系结构走上 SIMD 这条路,就很难再离开。
例题
为了了解多媒体指令的形式,假设为 RISC-V 增加一个 256 位 SIMD 多媒体扩展,暂称为 RVP,P 代表 packed(打包)。本例只考虑浮点运算,用后缀 4D 表示同时处理 4 个双精度操作数。与向量体系结构一样,可以把 SIMD 处理器看作具有多个通道,这里有 4 个。RV64P 将 F 寄存器扩展到完整宽度,即 256 位。下面给出 DAXPY 循环的 RISC-V SIMD 代码;原书以下划线标出为支持 SIMD 而修改的部分。假设 X 和 Y 的起始地址分别在 x5 和 x6 中。
解答
RISC-V SIMD 代码如下:
译注: 原代码的
addi x28,x5,将#256排到了注释区域;两次加载与存储之间只有结果注释,没有印出计算乘积与和的指令。原书声称使用下划线标示改动,但相应指令文本并不完整。
改动包括:
- 将每条 RISC-V 双精度指令替换成相应的 4D 指令;
- 将索引增量从 8 改为 32;
- 增加
splat指令,在f0的 256 位中产生 a 的 4 个副本。
RISC-V SIMD 虽然没有像 RV64V 那样把动态指令带宽需求降为原来的 1/32,但也实现了接近 4 倍的减少:执行 67 条指令,而 RV64G 需要 258 条。这段代码预先知道元素个数;实际中,个数通常在运行时才确定,因此还需要额外的 strip mining 循环,处理元素个数不是 4 的整数倍的情况。
多媒体 SIMD 体系结构的编程
由于多媒体 SIMD 扩展具有较强的专用性,使用这些指令最容易的方法一直是调用库或直接编写汇编语言。
较新的扩展变得更规则,为编译器提供了更合理的目标。借用向量化编译器的技术,编译器已经开始自动生成 SIMD 指令。例如,当今先进的编译器可以生成 SIMD 浮点指令,大幅提高科学计算代码的性能。不过,程序员必须确保内存中的所有数据都按代码运行时 SIMD 单元的宽度对齐,否则编译器可能对本来能够向量化的代码生成标量指令。
Roofline 可视化性能模型
比较不同 SIMD 体系结构潜在浮点性能的一种直观方法,是 Roofline 模型(Williams et al., 2009)。图中的水平线与斜线构成类似屋顶的形状,既是这个简单模型名称的由来,也说明了它的用途(见图 4.11)。它在二维图中将浮点性能、内存性能和算术强度联系起来。算术强度是每访问一字节内存所执行的浮点运算次数,计算方法是用程序的浮点运算总次数,除以执行过程中与主存之间传送的数据总字节数。图 4.10 展示了几个示例计算内核的相对算术强度。
峰值浮点性能可以根据硬件规格得到。本案例中的许多内核无法完全放入片上缓存,因此峰值内存性能由缓存之后的存储系统决定。这里需要的是处理器实际能够获得的峰值内存带宽。
它并非仅仅是 DRAM 引脚处的带宽,例如图 4.30 中的带宽。测量实际交付的峰值内存性能的一种方法,是运行 Stream 基准测试。
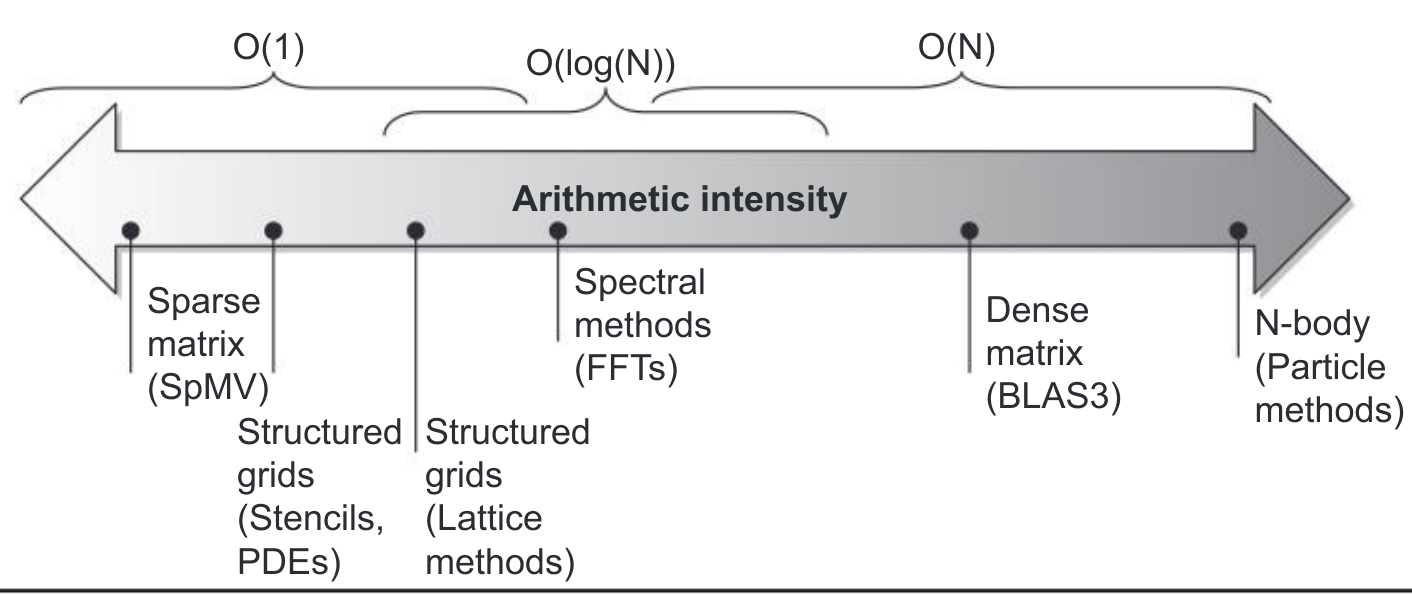
图内术语:Arithmetic intensity=算术强度;Sparse matrix (SpMV)=稀疏矩阵(稀疏矩阵向量乘);Structured grids (Stencils, PDEs)=结构化网格(Stencil 计算、偏微分方程);Structured grids (Lattice methods)=结构化网格(格点方法);Spectral methods (FFTs)=谱方法(快速 Fourier 变换);Dense matrix (BLAS3)=稠密矩阵(三级 BLAS);N-body (Particle methods)=N 体问题(粒子方法)。
图 4.11 左侧给出 NEC SX-9 向量处理器的 Roofline 模型,右侧给出 Intel Core i7 920 多核处理器的模型。纵轴是可达到的浮点性能,范围从 2 到 256 GFLOP/s;两图横轴都是算术强度,范围从每访问一个 DRAM 字节执行 1/8 次浮点运算,到执行 16 次浮点运算。注意,两轴均采用对数刻度,而且对一台计算机只需建立一次 Roofline 图。
对于某个计算内核,可以根据其算术强度确定横轴上的一个点。经过这个点画一条竖线,内核在该计算机上的性能必定位于这条线上。再画一条水平线表示计算机的峰值浮点性能。实际浮点性能显然不可能高于这条线,因为这是硬件的限制。
怎样表示峰值内存性能呢?横轴单位是 FLOP/byte,纵轴单位是 FLOP/second,所以 bytes/second 在这张图中对应一条 45 度斜线。
因此,在 Roofline 模型中可以画出第三条线,表示在给定算术强度下,计算机的存储系统能够支持的最大浮点性能。图 4.11 中的这些限制可以写成:
如果这个推导太快,不妨换一种方式。假设要画一条曲线 ,表示充分利用内存带宽时的性能上限。
曲线上的每个点 都对应一个计算速率(纵轴)和一个内存带宽。这个带宽是隐含的,因为横轴 FLOP/byte 表达了计算量与完成这些计算所需内存数据量之间的关系。具体来说,图上给定点 的内存带宽为 :纵轴是 FLOP/second,横轴是 FLOP/byte,两者相除得到 bytes/second,恰好是内存带宽单位。将式子重写为 ,再令 m 为系统固定的峰值内存带宽,就得到了一条斜率为 m 的直线。
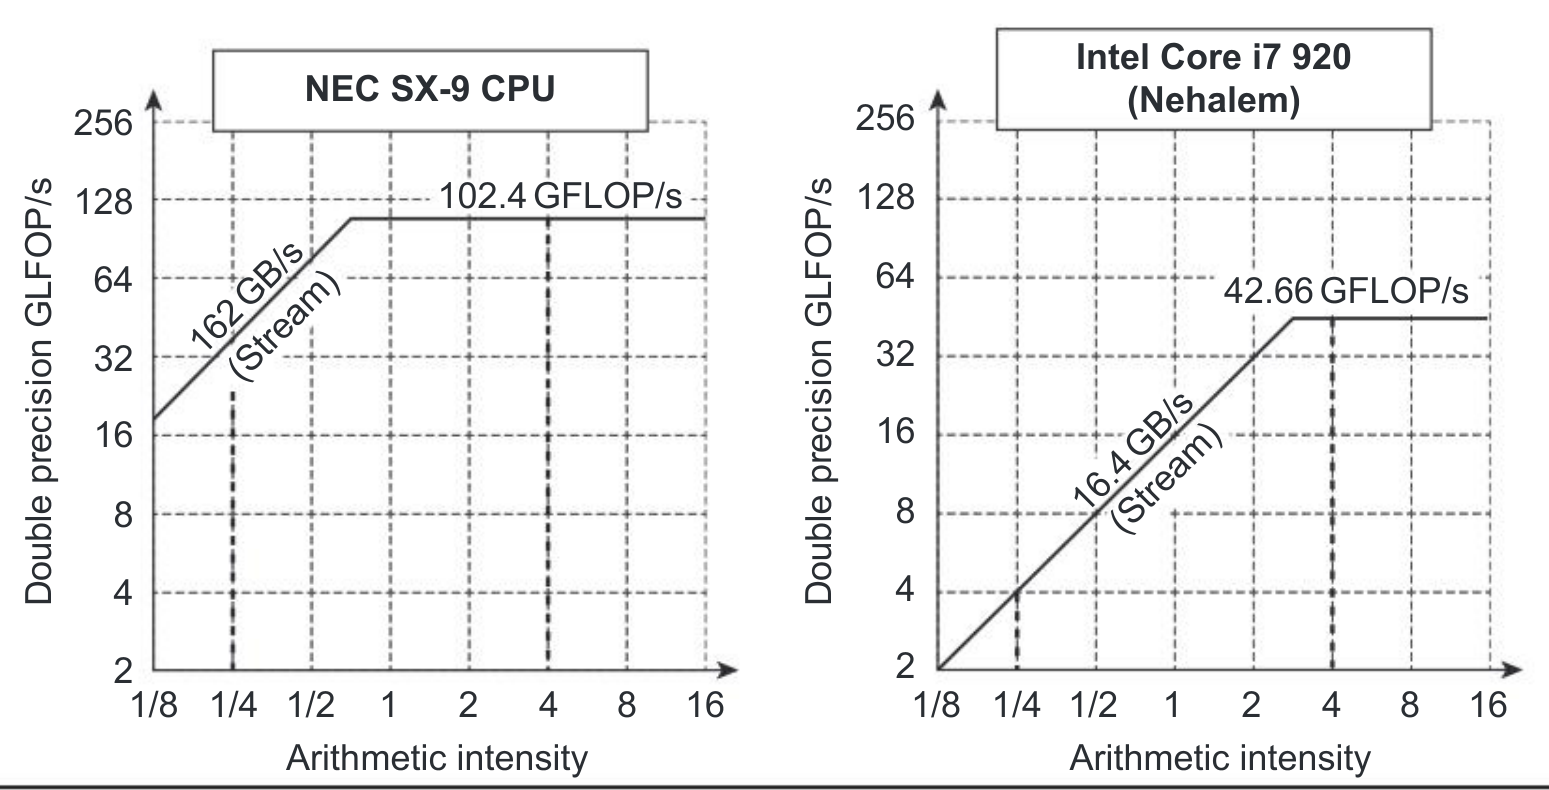
图内术语:Arithmetic intensity=算术强度;Double precision GFLOP/s=双精度浮点性能,单位 GFLOP/s;Stream 为测量内存带宽的基准测试。
译注: 图注在比较 2.4 倍加速比时,将 SX-9 的单位印为“102.4 FLOP/s”,漏了 G;同一图注前文、曲线标记和数值比较均表明应为 102.4 GFLOP/s。图注保留原文,并在此指出。
“屋顶线”根据内核的算术强度给出性能上限。如果把算术强度看成一根向上顶到屋顶的杆子,它或者碰到平坦部分,表示性能受计算能力限制;或者碰到倾斜部分,表示性能最终受内存带宽限制。图 4.11 中算术强度为 4 的右侧竖直虚线是前一种情况。
算术强度为 1/4 的左侧竖直虚线则是后一种情况。一台计算机的 Roofline 模型一旦建立,就可以重复使用,因为它不会随计算内核改变。
斜线与水平线交汇的“屋脊点”还能揭示计算机的一个重要特征。如果它远在右侧,只有算术强度很高的内核才能达到最大性能;如果它靠近左侧,几乎任何内核都有可能达到最大性能。我们将看到,与其他 SIMD 处理器相比,这款向量处理器的内存带宽高得多,屋脊点也明显更靠左。
图 4.11 表明,SX-9 的峰值计算性能是 Core i7 的 2.4 倍,但内存性能是其 10 倍。对于算术强度为 0.25 的程序,SX-9 快约 10 倍,即 40.5 对 4.1 GFLOP/s。较高的内存带宽将屋脊点从 Core i7 的 2.6 降到 SX-9 的 0.6,意味着更多程序可以在向量处理器上达到峰值计算性能。
向量体系结构与多媒体 SIMD 计算机的异同
前面提到,SIMD 的一个优点是最初的数据并行支持非常简单,成本也低。体系结构设计者把已有寄存器和 ALU 分成多个 8 位、16 位或 32 位部分,再并行计算。操作码指定数据宽度与运算,数据传送就是对单个寄存器进行加载和存储。
为了通过更多的数据并行性进一步加速 SIMD,设计者随后将寄存器宽度翻倍,以同时处理更多分段。由于指令集通常坚持向后二进制兼容,而且数据宽度由操作码指定,扩展 SIMD 寄存器也就扩展了 SIMD 指令集。此后每一次寄存器宽度和指令数量翻倍,都会推动 ISA 不断膨胀,成本则由处理器设计者、编译器作者和汇编语言程序员承担。自 1978 年以来,x86 指令集从 80 条增长到约 1400 条,主要推动力就是 SIMD。
向量计算机从主存中聚集对象,放入长而顺序组织的向量寄存器;流水线执行单元在这些寄存器上高效计算,再将结果散布回主存。加载或存储的操作数可以连续排列,也可以按非单位步长排列,甚至随机分布(聚集/散布);但在向量寄存器内部,它们是连续的。简单的向量处理器可能每次只执行一个元素的操作,但各元素操作在定义上相互独立,因此理论上可以同时计算所有元素。
当今向量处理器通常每个时钟周期处理 2、4 或 8 个字元素。当向量长度不是每周期处理元素数的整数倍时,硬件会处理边界情况。与 SIMD 一样,向量也支持不同的数据宽度:每个寄存器能够保存 N 个 64 位元素的处理器,也能处理 2N 个 32 位、4N 个 16 位或 8N 个 8 位元素。
图 4.12 汇总了 x86 AVX2 与 RV32V 上 DAXPY 程序的指令数量(Patterson and Waterman, 2017)。与辅助代码(bookkeeping code)相比,SIMD 计算代码显得很少:x86 AVX2 代码中约三分之二到四分之三属于 SIMD 开销。辅助代码包括复制标量 a 以供 SIMD 执行使用,处理 n 不是 SIMD 寄存器宽度整数倍时的 strip mining 代码,以及 n 为 0 时跳过主循环的代码。RV32V 不需要这些辅助管理操作,因此显著减少了静态指令数。与 SIMD 不同,它有向量长度寄存器 vl,使向量指令能够适应任意 n;还有 vsetvl 指令,自动处理 n 不是向量通道数整数倍以及 n 为 0 的情况。
不过,SIMD 与向量处理的最大差别并非静态代码大小。SIMD 程序执行的指令数是 RV32V 的 10~20 倍,因为每次 SIMD 循环只处理 2 或 4 个元素,而向量循环处理 64 个元素。额外的取指与译码意味着完成同一任务需要更多能量。
与标量版 DAXPY 相比,尽管主循环大小不变,SIMD 版本按指令条数和字节数衡量的代码大小都大约翻倍。根据 SIMD 寄存器宽度,动态执行指令数降为原来的 1/2 或 1/4。RV32V 向量版本的静态代码大小却只增加到原来的 1.2 倍,动态指令数则降为原来的 1/43。
| ISA | IA-32 AVX2 | RV32V |
|---|---|---|
| 静态指令数 | 29 | 13 |
| 主循环中的指令数 | 6 | 10 |
| 辅助指令数 | 23 | 3 |
| 每次主循环产生的结果数 | 4 | 64 |
| 动态指令数(n = 1000) | 1517 | 163 |
动态指令数虽然相差很大,却未必是 SIMD 与向量之间最重要的差别。更重要的可能是 ISA 和辅助代码的急剧膨胀。像 x86 这样坚持向后二进制兼容和渐进式指令集设计的 ISA,每次改变 SIMD 宽度,都必须复制此前针对较窄 SIMD 寄存器定义的全部指令。
多代 SIMD ISA 已经产生了数百条 x86 指令,未来还会增加数百条。汇编程序员需要承担很大的认知负担:vfmadd213pd 到底是什么意思,应该什么时候使用?这也意味着第三方应用必须重新编码,才能使用新指令;在很多情况下,这并不是轻而易举的工作。
相比之下,RV64V 代码不受向量寄存器存储空间大小的影响。即使向量存储空间扩大,RV64V 代码也无须改变,甚至不必重新编译。因为最大向量长度 VLMAX 由处理器提供,所以处理器设计者将向量存储空间翻倍或减半,都不影响代码。
SIMD ISA 规定了硬件的组织方式,因此增加数据级并行性就需要修改指令集和编译器。向量 ISA 则允许处理器设计者根据应用选择数据并行资源,而不影响程序员或编译器。在将体系结构与实现分离这一设计原则上,向量体系结构做得好得多。
4.4 图形处理单元
只需几百美元,人们就能购买一块含有数千个并行浮点单元的 GPU 芯片,将它插入桌面 PC。这样的价格和便利性使高性能计算走向更多用户。当这种潜力与让 GPU 更易编程的语言结合后,人们对 GPU 计算的兴趣迅速增长。
今天,人们谈论使用 GPU 计算时,可能指的是:
- 用 GPU 生成图形;
- 用 GPU 进行科学计算或多媒体计算;
- 用 GPU 进行机器学习计算。
在图形生成领域,GPU 毫无疑问占据优势。许多科学计算和多媒体应用的程序员,则在考虑究竟使用 GPU 还是 CPU。例如,截至 2022 年,全球前 500 台超级计算机中有 30% 依赖 GPU 完成大部分计算。对第 7 章所讨论的机器学习感兴趣的程序员,更倾向于使用 GPU。
沿着计算机体系结构的发展谱系追溯,GPU 和 CPU 并没有共同祖先,也不存在一个可以同时解释两者的“缺失环节”。4.10 节将说明,GPU 的主要祖先是图形加速器,因为擅长图形处理正是 GPU 存在的理由。尽管 GPU 正在进入主流计算领域,它们仍不能放弃继续在图形处理方面保持优势的责任。因此,从以下角度理解 GPU 设计可能更合适:既然已经为高效图形处理投入了这些硬件,还能增加什么,使更广泛的应用从中获得性能收益?
本节着重讨论如何用 GPU 进行计算。如果想了解 GPU 计算与传统图形加速任务如何结合,可参见 John Nickolls 和 David Kirk 撰写的“Graphics and Computing GPUs”,即本书同一作者所著 Computer Organization and Design 第 6 版的附录 C。
GPU 的术语和某些硬件特性与向量及 SIMD 体系结构很不相同,因此,我们先介绍一个简化的 GPU 编程模型,再说明其体系结构。
GPU 编程
CUDA 为表达算法中的并行性提供了一个优雅的解决方案——并非适用于所有算法,但它所适用的范围已经足够重要。它似乎契合了我们的思考和编码方式,使任务级以外的并行性也能得到更容易、更自然的表达。
——Vincent Natol,“Kudos for CUDA”,HPC Wire,2010 年
GPU 程序员面临的挑战不仅是让 GPU 获得良好性能,还要协调系统处理器与 GPU 上的计算调度,以及系统内存与 GPU 内存之间的数据传送。此外,正如本节后面将看到的,GPU 几乎拥有编程环境能够利用的所有并行形式:多线程、MIMD、SIMD,甚至指令级并行性。
NVIDIA 决定开发一种类似 C 的语言和编程环境,同时应对异构计算与多种并行形式带来的挑战,提高 GPU 程序员的生产率。这个系统称为 CUDA,即 Compute Unified Device Architecture。CUDA 为系统处理器(host,主机)生成 C/C++ 代码,为 GPU(device,设备,也是 CUDA 中 D 的含义)提供一种 C 和 C++ 方言。NVIDIA 用 CUDA 线程作为统一各种并行形式的概念。以这种最底层的并行性作为编程原语,编译器和硬件就能把数千个 CUDA 线程组合起来,利用 GPU 内部的多线程、MIMD、SIMD 和指令级并行性。因此,NVIDIA 将 CUDA 编程模型归类为单指令多线程(SIMT)。后面将解释为何要把这些线程组织成组,称为线程块(Thread Block)。执行整个线程块的硬件,在本节称为多线程 SIMD 处理器。
介绍 CUDA 程序示例之前,只需了解以下几个细节:
- 为区分 GPU(设备)函数与系统处理器(主机)函数,CUDA 对前者使用
__device__或__global__,对后者使用__host__。 - 使用
__device__声明的 CUDA 变量分配在 GPU 内存中(见后文),所有多线程 SIMD 处理器都能访问。 - 在 GPU 上运行的函数采用扩展调用语法
name<<<dimGrid, dimBlock>>>(参数列表)。其中,dimGrid指定代码的维度,以线程块为单位;dimBlock指定一个块的维度,以线程为单位。 - 除了块标识符
blockIdx和块内线程标识符threadIdx,CUDA 还提供表示每块线程数的blockDim,其值来自调用中的dimBlock参数。
先看 4.2 节 DAXPY 循环的普通 C 代码:
CUDA 版本如下。我们启动 n 个线程,每个向量元素对应一个;在多线程 SIMD 处理器上,每个线程块有 256 个 CUDA 线程。GPU 函数先根据块 ID、每块线程数和线程 ID,计算相应元素索引 i;只要索引仍在数组范围内,即 i < n,就执行乘法和加法。
比较 C 和 CUDA 代码,可以看到数据并行 CUDA 程序的一种常见并行化模式。C 版本的各次循环迭代彼此独立,因此可以直接把循环转换成并行代码,让每次迭代成为一个独立线程。前面提到过,4.5 节还将详细说明:向量化编译器同样依赖于循环迭代之间不存在依赖,这类依赖称为循环携带依赖(loop-carried dependence)。CUDA 程序员通过指定网格维度和每个 SIMD 处理器的线程数,显式确定并行性。因为每个元素只分配给一个线程,所以将结果写回内存时不需要在线程之间同步。
并行执行和线程管理由 GPU 硬件处理,而不是由应用程序或操作系统完成。为了简化硬件调度,CUDA 要求线程块能够独立执行,而且可以按任意顺序执行。不同线程块不能直接通信,不过可以通过全局内存中的原子操作进行协调。
我们很快会看到,许多 GPU 硬件概念在 CUDA 中并不明显。追求性能的程序员编写 CUDA 时必须考虑 GPU 硬件。尽管 CUDA 编程模型看起来像 MIMD,高效 GPU 代码仍要求程序员按 SIMD 操作来思考。这可能影响编程生产率,但多数程序员本来就是为了性能而选择 GPU。出于后面将说明的原因,他们知道,要让多线程 SIMD 处理器发挥最佳性能,就应使每组 32 个线程在控制流上保持一致;还需要为每个处理器创建更多线程,以隐藏 DRAM 延迟。为了获得预期的内存性能,数据地址也需要集中在一个或少数几个内存块中。
与许多并行系统一样,CUDA 通过提供内建函数(intrinsics),让程序员显式控制硬件,在生产率与性能之间折中。一方面希望提高生产率,另一方面又希望程序员能够表达硬件所能完成的一切,这种矛盾经常出现在并行计算中。CUDA 将如何在这场经典的生产率与性能之争中演进,以及它是否会流行到其他 GPU、甚至其他体系结构中,都是值得关注的问题。
NVIDIA GPU 的计算结构
前面提到的特殊发展背景,解释了 GPU 为什么形成了独立于 CPU 的体系结构风格和术语。理解 GPU 的一个障碍就是术语,其中有些名称甚至会造成误导。克服这一障碍比想象中困难得多,本章多次重写的经历就说明了这一点。
为了兼顾理解 GPU 体系结构和学习这些采用非传统定义的术语,我们在软件部分使用 CUDA 术语,在硬件部分则先采用描述性更强的名称,有时借用 OpenCL 的术语。解释完体系结构后,再将这些名称对应到 NVIDIA GPU 的正式术语。
图 4.13 从左到右列出本节的描述性名称、主流计算中最接近的术语、供感兴趣的读者参考的 NVIDIA GPU 正式术语,以及简短说明。本节其余部分采用其中的描述性名称来解释 GPU 微体系结构。
我们选择 NVIDIA 系统作为例子,因为它们具有 GPU 体系结构的代表性。具体来说,我们沿用前面 CUDA 并行编程语言的术语,并以 NVIDIA Pascal GPU 为例(见 4.7 节)。后续 NVIDIA GPU 的基本微体系结构相同,通常增加了 Pascal 某些部件的副本。
与向量体系结构一样,NVIDIA GPU 只有在数据级并行问题上才能表现良好。两者都有聚集/散布数据传送和掩码寄存器,而 NVIDIA GPU 的寄存器甚至更多。有时,向量处理器由软件实现的功能,NVIDIA GPU 会用硬件实现。这是因为向量处理器有一个可以执行软件功能的标量处理器。与大多数向量体系结构不同,NVIDIA GPU 还依赖单个多线程 SIMD 处理器内部的多线程来隐藏内存延迟(见第 2、3 章)。不过,无论向量体系结构还是 GPU,高效代码都要求程序员以成组的 SIMD 操作为单位思考。
网格(Grid)是在 NVIDIA GPU 上运行、由一组线程块构成的代码。图 4.13 将网格类比为一个向量化循环,将线程块类比为经过 strip mining 后、能够完成一段完整计算的循环体。举个具体例子,假设要计算两个各含 8192 个元素的向量的逐元素乘积:A = B * C。本节会反复使用这个例子。图 4.14 展示了它与前两个 GPU 概念的关系。处理全部 8192 个元素乘法的 GPU 代码称为网格,类似一个向量化循环。为分解成更易管理的规模,网格由多个线程块组成,每块最多处理 512 个元素,类似向量化循环的循环体。注意,GPU SIMD 指令每次处理 32 个元素。对于长度为 8192 的向量,本例共有 个线程块。网格和线程块是由 GPU 硬件实现的编程抽象,帮助程序员组织 CUDA 代码。线程块可类比为向量长度为 32 的、经过 strip mining 的向量循环。
线程块由线程块调度器分配给执行其代码的处理器,也就是本节所称的多线程 SIMD 处理器。
| 类别 | 本节的描述性名称 | GPU 之外最接近的传统术语 | CUDA/NVIDIA 正式术语 | 简要说明 |
|---|---|---|---|---|
| 程序抽象 | 可向量化循环 | 可向量化循环 | Grid | 在 GPU 上执行,由一个或多个可并行执行的线程块(向量化循环体)组成 |
| 程序抽象 | 向量化循环体 | 经过 strip mining 的向量化循环体 | Thread Block | 在一个多线程 SIMD 处理器上执行的向量化循环,由一个或多个 SIMD 指令线程组成;它们可通过局部存储器通信 |
| 程序抽象 | SIMD 通道操作序列 | 标量循环的一次迭代 | CUDA Thread | SIMD 指令线程的一个纵向切片,对应由一个 SIMD 通道执行的一个元素;是否保存结果取决于掩码和谓词寄存器 |
| 机器对象 | SIMD 指令线程 | 向量指令线程 | Warp | 只包含 SIMD 指令的传统线程,在一个多线程 SIMD 处理器上执行;是否保存结果由逐元素掩码决定 |
| 机器对象 | SIMD 指令 | 向量指令 | PTX Instruction | 跨多个 SIMD 通道执行的一条 SIMD 指令 |
| 处理硬件 | 多线程 SIMD 处理器 | (多线程)向量处理器 | Streaming Multiprocessor | 执行 SIMD 指令线程,独立于其他 SIMD 处理器 |
| 处理硬件 | 线程块调度器 | 标量处理器 | Giga Thread Engine | 将多个线程块(向量化循环体)分配给多线程 SIMD 处理器 |
| 处理硬件 | SIMD 线程调度器 | 多线程 CPU 的线程调度器 | Warp Scheduler | 调度和发射已就绪的 SIMD 指令线程的硬件单元;包含记分牌以跟踪 SIMD 线程的执行 |
| 处理硬件 | SIMD 通道 | 向量通道 | Thread Processor | 对单个元素执行 SIMD 指令线程中的操作;是否保存结果取决于掩码 |
| 存储硬件 | GPU 内存 | 主存 | Global Memory | GPU 中所有多线程 SIMD 处理器都可访问的 DRAM |
| 存储硬件 | 私有内存 | 栈或操作系统的线程局部存储 | Local Memory | 每个 SIMD 通道私有的一部分 DRAM |
| 存储硬件 | 局部存储器 | 局部存储器 | Shared Memory | 一个多线程 SIMD 处理器内部的快速本地 SRAM,其他 SIMD 处理器无法访问 |
| 存储硬件 | SIMD 通道寄存器 | 向量通道寄存器 | Thread Processor Registers | 单个 SIMD 通道中的寄存器,在整个线程块(向量化循环体)中分配 |
译注: 本表实际有 13 个术语,原图注的“11 个”不符。图注的图号与页码也沿用了其他版本:本版向量术语对照见图 4.24,厂商和 OpenCL 术语对照见图 4.27、图 4.28。为避免混淆,下文“局部存储器”专指本节的 Local Memory,即 NVIDIA 所称 Shared Memory;NVIDIA 的 Local Memory 则对应本节“私有内存”。
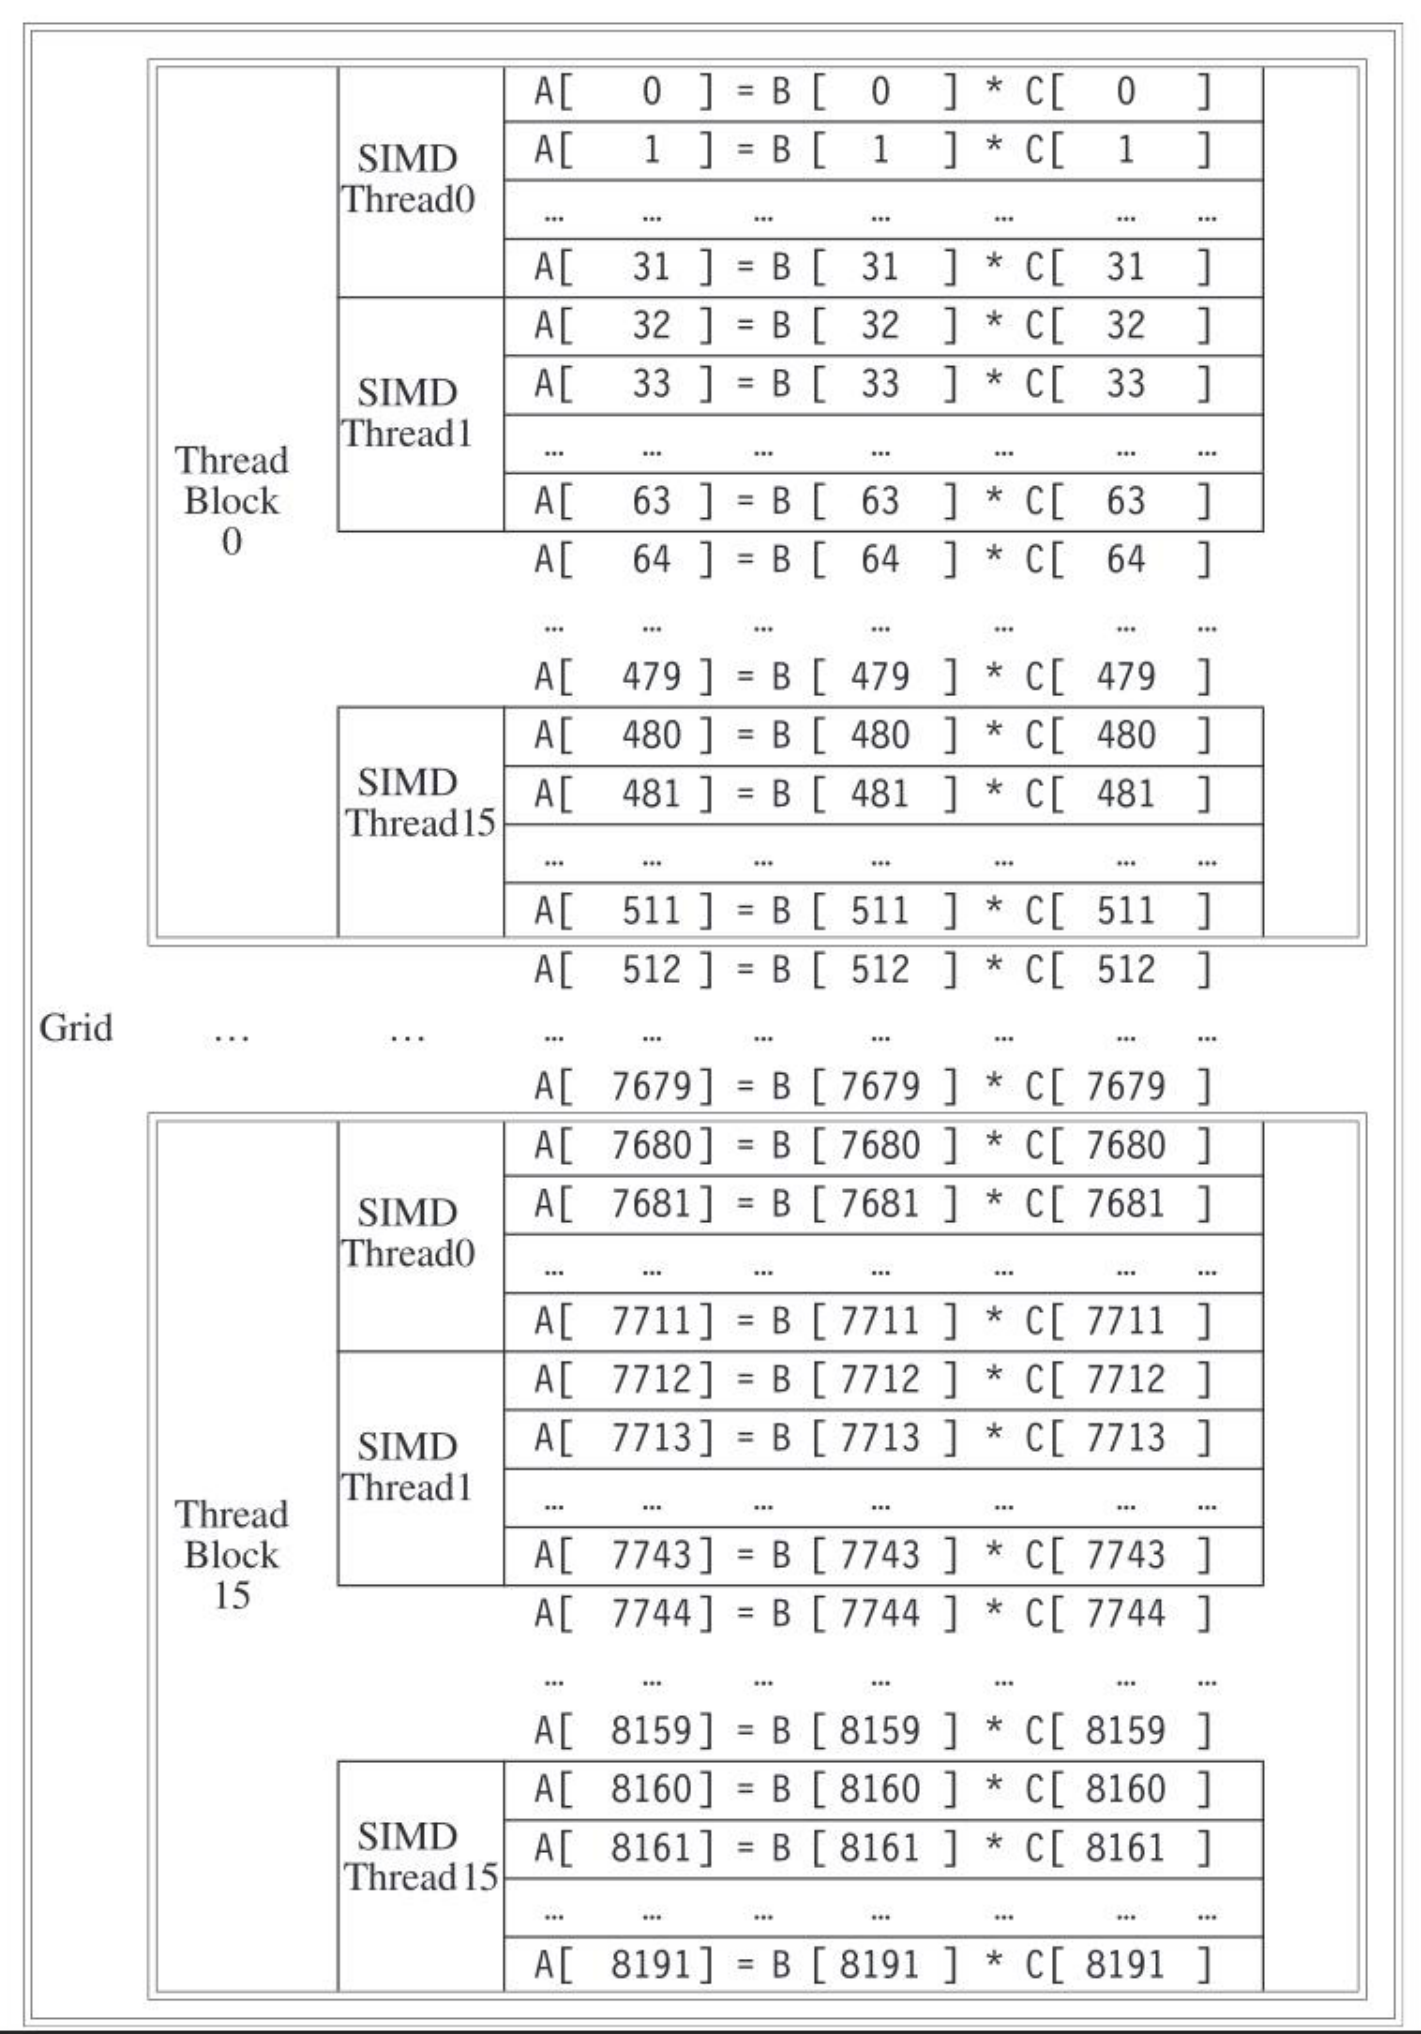
图内术语:Grid=网格;Thread Block=线程块;SIMD Thread=SIMD 指令线程。A、B、C 的数组下标展示各层负责的元素范围。
程序员告诉由硬件实现的线程块调度器,需要运行多少个线程块。在本例中,调度器将 16 个线程块分派给多线程 SIMD 处理器,以计算循环中的全部 8192 个元素。
图 4.15 给出了多线程 SIMD 处理器的简化框图。它类似向量处理器,但采用许多并行功能单元,而不像向量处理器那样采用少数深流水线单元。在图 4.14 的编程示例中,每个多线程 SIMD 处理器分配到 512 个向量元素。SIMD 处理器是完整的处理器,拥有独立的程序计数器 PC,并使用线程编程(见第 3 章)。
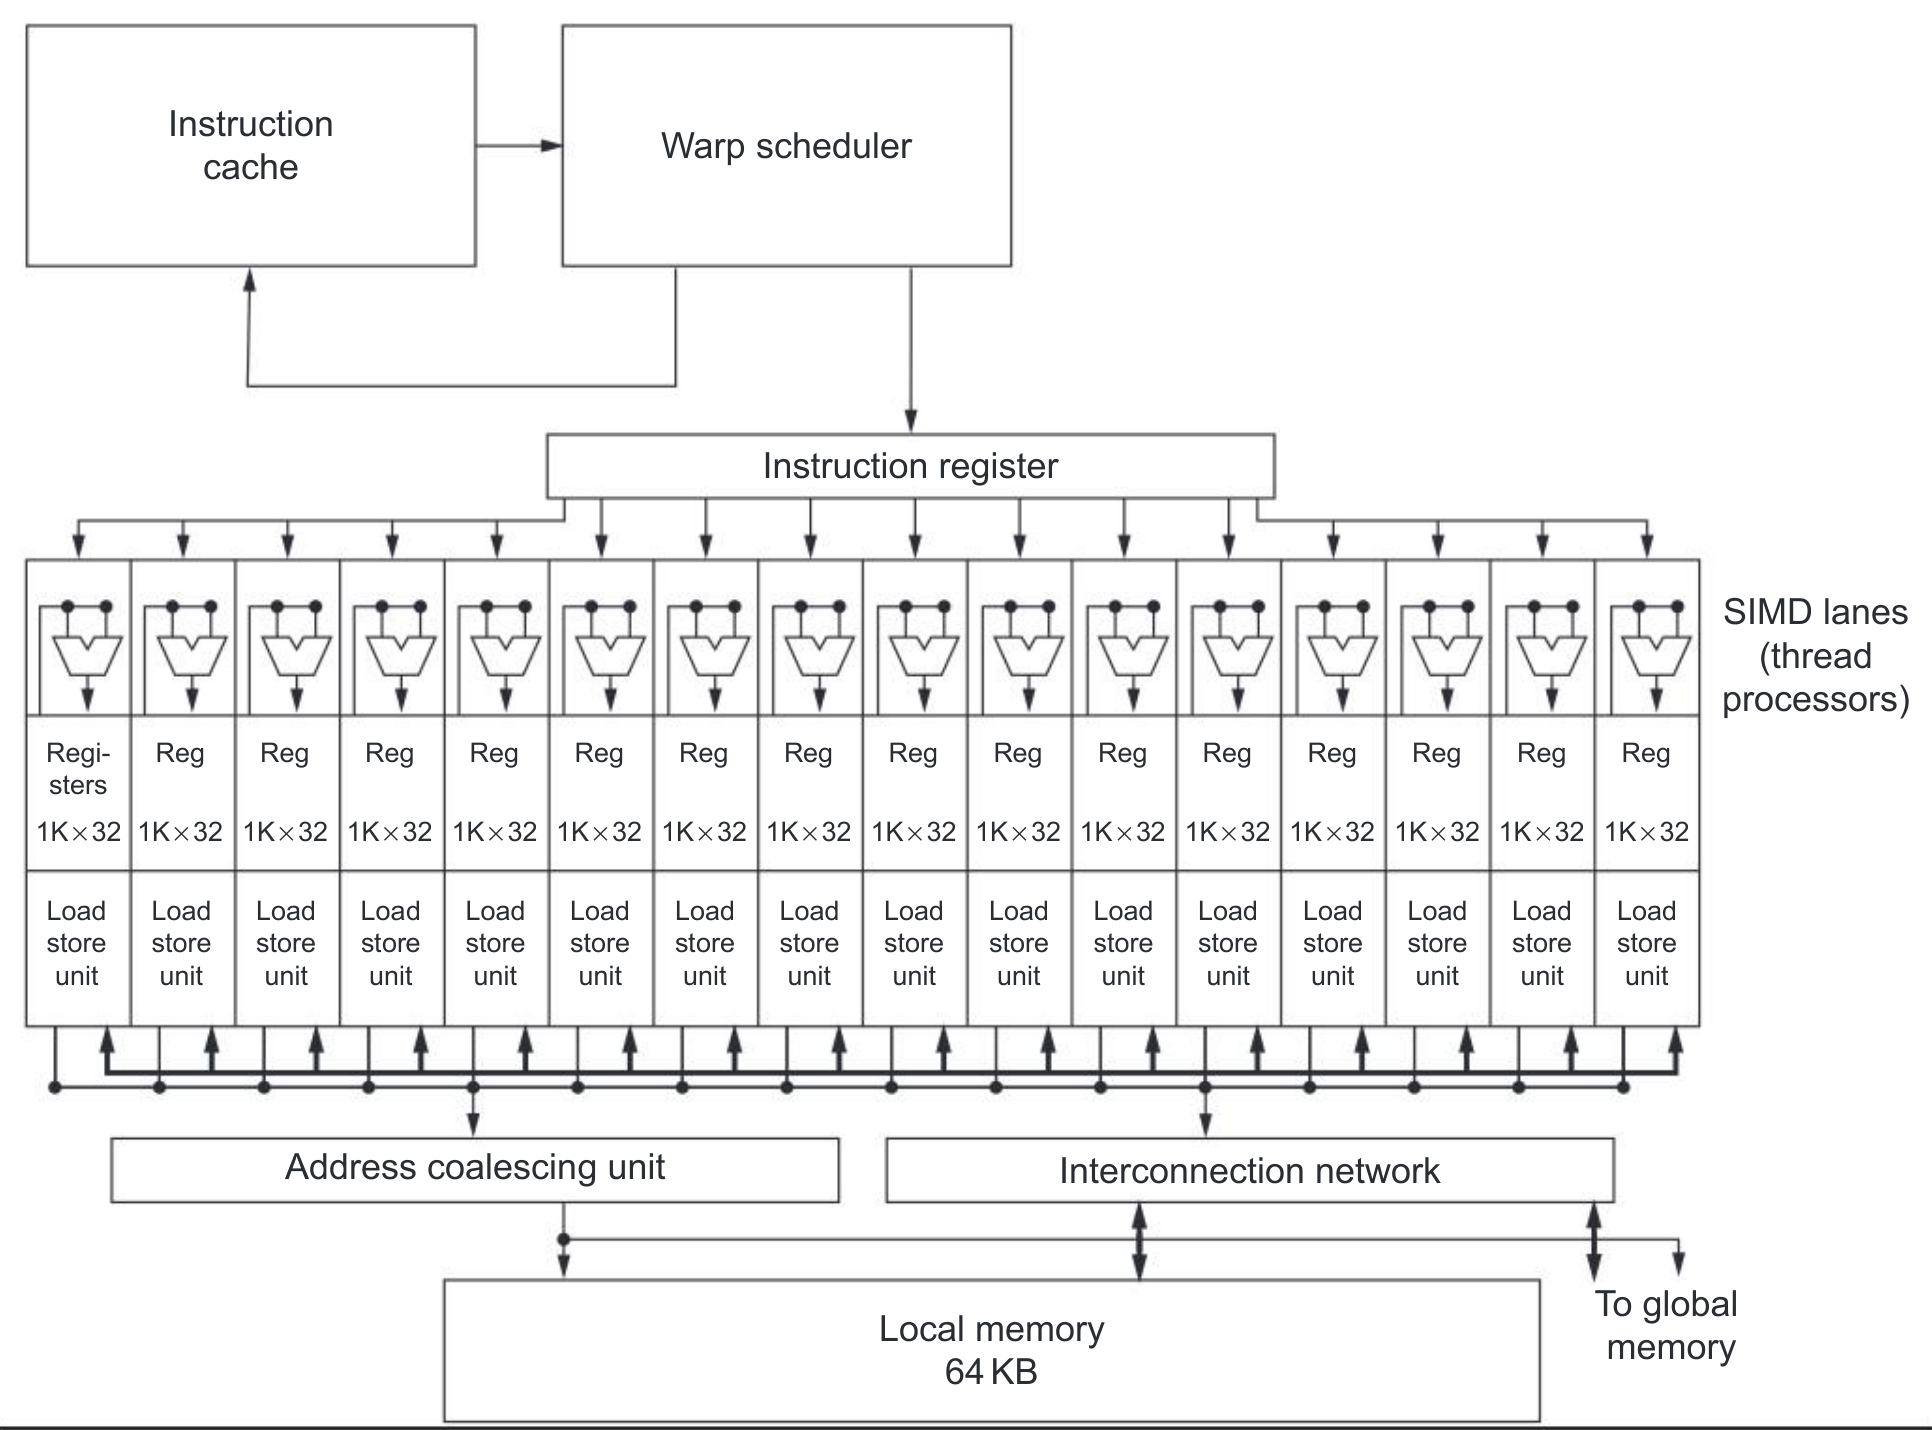
图内术语:Instruction cache=指令缓存;Warp scheduler=Warp 调度器,即本节的 SIMD 线程调度器;Instruction register=指令寄存器;Registers/Reg=寄存器;Load store unit=加载/存储单元;Address coalescing unit=地址合并单元;Interconnection network=互连网络;Local memory=局部存储器;To global memory=通向全局内存;SIMD lanes (thread processors)=SIMD 通道(线程处理器)。
GPU 硬件包含一组多线程 SIMD 处理器,它们执行由线程块(相当于向量化循环体)组成的网格。也就是说,GPU 是由多线程 SIMD 处理器构成的多处理器。一块 GPU 可以有一个到几十个多线程 SIMD 处理器。例如,Pascal P100 有 56 个,Hopper H100 有 132 个,而较小的芯片可能只有一两个。线程块调度器将线程块分配给多线程 SIMD 处理器,使具有不同处理器数量的 GPU 型号能够透明扩展。图 4.16 展示了 Pascal 体系结构 P100 实现的芯片布局。
图内主要标记:PCI Express 3.0 Host Interface=PCI Express 3.0 主机接口;GigaThread Engine=线程块调度引擎;L2 Cache=L2 缓存;High-Speed Hub=高速枢纽;NVLink=NVLink 互连。
再深入一层,硬件所创建、管理、调度和执行的机器对象是SIMD 指令线程:它是只包含 SIMD 指令的传统线程。这些线程各有自己的 PC,在多线程 SIMD 处理器上运行。SIMD 线程调度器知道哪些线程已就绪,并将它们送到分派单元,在处理器上执行。因此,GPU 有两级硬件调度器:
- 线程块调度器:将线程块(向量化循环体)分配给多线程 SIMD 处理器。
- SIMD 处理器内部的 SIMD 线程调度器:决定各 SIMD 指令线程何时在该处理器内运行。
这些线程中的 SIMD 指令宽度为 32,因此本例每个 SIMD 指令线程计算 32 个元素。每个线程块包含 个 SIMD 线程,见图 4.14。
因为线程由 SIMD 指令组成,SIMD 处理器必须有并行功能单元来执行这些操作。我们将它们称为 SIMD 通道,它们与 4.2 节的向量通道十分相似。
对于 Pascal GPU,每个 32 元素宽的 SIMD 指令线程映射到 16 个物理 SIMD 通道,因此线程内每条 SIMD 指令需要 2 个时钟周期完成。一个 SIMD 指令线程中的各元素锁步执行,仅在开始时进行调度。继续采用向量处理器的类比,可以说它有 16 个通道、向量长度为 32,一个 chime 为 2 个时钟周期。正是这种“宽而浅”的特点,使我们采用 SIMD 处理器这一更准确的类比,而不是向量处理器。
GPU 的 SIMD 处理器所具有的通道数,可以是从较小数值到线程块线程数之间的任意值,正如向量处理器的通道数可以在 1 与最大向量长度之间变化。例如,不同 GPU 世代中,每个 SIMD 处理器的通道数曾在 8 到 32 之间变化。
根据定义,SIMD 指令线程相互独立,所以 SIMD 线程调度器可以选取任何已就绪的线程,而不必始终沿着某个线程的指令序列执行下一条指令。调度器包含一个记分牌(见第 3 章),跟踪最多 64 个执行时间各异的 SIMD 指令线程,判断哪条 SIMD 指令已准备好执行。缓存和 TLB 的命中、未命中会改变内存指令的延迟,因此需要记分牌判断这些指令何时完成。图 4.17 展示了调度器随时间以不同顺序选择 SIMD 指令线程的过程。GPU 设计者的假设是:GPU 应用拥有足够多的 SIMD 指令线程,使多线程既能隐藏 DRAM 延迟,又能提高多线程 SIMD 处理器的利用率。
继续看向量乘法:每个多线程 SIMD 处理器必须将两个向量的各 32 个元素从内存加载到寄存器,通过读写寄存器执行乘法,再将乘积从寄存器写回内存。为了保存这些元素,Pascal GPU 的一个 SIMD 处理器依据型号具有多达 32,768~65,536 个 32 位寄存器,图 4.15 中每个通道有 1024 个。与向量处理器一样,这些寄存器在逻辑上分布到各向量通道中,这里则称 SIMD 通道。
每个 SIMD 线程最多使用 256 个寄存器,因此可以把一个 SIMD 线程看作最多拥有 256 个向量寄存器,每个包含 32 个 32 位元素。
双精度浮点操作数使用两个相邻的 32 位寄存器,因此也可以将其看作:每个 SIMD 线程有 128 个向量寄存器,每个包含 32 个 64 位元素。
图内术语:SIMD thread scheduler=SIMD 线程调度器;Time=时间;SIMD thread 8 instruction 11=SIMD 线程 8 的第 11 条指令,其余标记依此类推。
寄存器使用量与最大线程数之间存在权衡:每个线程使用的寄存器越少,能够容纳的线程就越多;使用的寄存器越多,线程数就越少。也就是说,并非所有 SIMD 线程都需要最大数量的寄存器。Pascal 设计者认为,若为所有线程都配备最大数量的寄存器,就会有大量宝贵的硅面积闲置。
为了支持许多 SIMD 指令线程,每个线程在创建时,都会动态获得所在 SIMD 处理器的一组物理寄存器;线程退出时再释放。例如,一个线程块可以包含 16 个 SIMD 线程、每个线程使用 36 个寄存器,同时另一个线程块包含 32 个 SIMD 线程、每个线程使用 20 个寄存器。后续线程块可能按任意顺序到来,因此寄存器必须按需分配。这种变化可能产生碎片,使一些寄存器无法利用;但实际上,对于给定的可向量化循环(网格),大多数线程块使用相同数量的寄存器。硬件必须知道每个线程块的寄存器在大型寄存器堆中的位置,并按线程块记录这些信息。因为某个线程块的指定寄存器可能位于寄存器堆中的任何位置,这种灵活性需要硬件中的路由、仲裁和分存储体机制。
注意,一个 CUDA 线程只是 SIMD 指令线程的一个纵向切片,对应一个 SIMD 通道执行的一个元素。CUDA 线程与 POSIX 线程很不相同,不能从 CUDA 线程任意发起系统调用。
现在可以看看 GPU 指令的形式了。
NVIDIA GPU 指令集体系结构
与大多数系统处理器不同,NVIDIA 编译器的目标指令集是硬件指令集的一种抽象。PTX(Parallel Thread Execution)向编译器提供稳定的指令集,并支持不同 GPU 世代之间的兼容;真正的硬件指令集则对程序员隐藏。PTX 指令描述单个 CUDA 线程上的操作,通常与硬件指令一一对应,但一条 PTX 指令也可能展开为多条机器指令,反之亦然。PTX 使用数量不限、只写一次的寄存器,编译器必须执行寄存器分配,把 PTX 寄存器映射到实际设备中数量有限、可反复读写的硬件寄存器。随后运行的优化器可以进一步减少寄存器使用量,同时消除死代码、合并指令,并计算分支可能发生分歧及分歧路径可能重新汇合的位置。
PTX 与 x86 微体系结构有一些相似之处:两者都转换为内部形式,x86 的内部形式是微指令。但区别在于,x86 在程序执行期间由硬件完成转换,GPU 则在加载时由软件完成。
PTX 指令格式为:
其中 d 是目的操作数,a、b、c 是源操作数,分号右侧为注释。操作类型 opcode.type 可以使用下列类型说明符:
| 类型 | .type 说明符 |
|---|---|
| 无类型的 8、16、32、64 位位串 | .b8、.b16、.b32、.b64 |
| 8、16、32、64 位无符号整数 | .u8、.u16、.u32、.u64 |
| 8、16、32、64 位有符号整数 | .s8、.s16、.s32、.s64 |
| 16、32、64 位浮点数 | .f16、.f32、.f64 |
源操作数可以是 32 位或 64 位寄存器,也可以是常量。除存储指令以外,目的操作数均为寄存器。
图 4.18 列出了基本 PTX 指令集。所有指令都可以由 1 位谓词寄存器控制,谓词寄存器可以用设置谓词指令 setp 赋值。控制流指令包括函数调用 call 与返回 return、线程退出 exit、分支 branch,以及线程块内部线程的屏障同步 bar.sync。在分支指令前加上谓词,就得到条件分支。编译器或 PTX 程序员将虚拟寄存器声明为 32 位或 64 位、有类型或无类型的值。例如,R0、R1 等用于 32 位值,RD0、RD1 等用于 64 位值。PTX 的虚拟寄存器到物理寄存器的映射发生在加载时。
下面的 PTX 指令序列对应前面 DAXPY 循环的一次迭代(原文引用第 292 页):
如前所示,CUDA 程序员为每次循环迭代分配一个 CUDA 线程;CUDA 为每个线程块提供唯一的 blockIdx,为块内每个 CUDA 线程提供唯一的 threadIdx。这样便创建了 8192 个 CUDA 线程,并用唯一编号寻址数组中的每个元素,不需要递增或分支代码。前 3 条 PTX 指令在 R8 中计算该元素唯一的字节偏移,再与数组基地址相加。后续指令加载两个双精度浮点操作数,执行乘法、加法并存储结果。对应 CUDA 语句 if (i < n) 的 PTX 代码稍后介绍。
这个例子表明,通用 GPU(GPGPU)程序员首先尝试创建尽可能多的线程,然后针对已知的低效来源进一步优化,例如未合并的内存访问。NVIDIA 提供的一些 CUDA 示例,也从简单但不一定高效的内核出发,逐步改进成更高效的代码,归约运算就是一例。
与向量体系结构不同,GPU 没有分别用于连续、步长和聚集/散布传送的不同指令。所有数据传送都是聚集/散布!为了恢复连续(单位步长)传送的效率,GPU 使用专门的地址合并硬件,识别一个 SIMD 指令线程中的各通道是否共同发出了连续地址。运行时硬件随后通知内存接口单元,请求一次传送 32 个连续字的块传送。
| 类别 | 指令 | 示例 | 含义 | 说明 |
|---|---|---|---|---|
| 算术 | add.type | add.f32 d,a,b | d = a + b | |
| 算术 | sub.type | sub.f32 d,a,b | d = a - b | |
| 算术 | mul.type | mul.f32 d,a,b | d = a * b | |
| 算术 | mad.type | mad.f32 d,a,b,c | d = a * b + c | 乘加 |
| 算术 | div.type | div.f32 d,a,b | d = a / b | 多条微指令 |
| 算术 | rem.type | rem.u32 d,a,b | d = a % b | 整数余数 |
| 算术 | abs.type | abs.f32 d,a | d 为 a 的绝对值 | |
| 算术 | neg.type | neg.f32 d,a | d = 0 - a | |
| 算术 | min.type | min.f32 d,a,b | d = (a < b) ? a : b | 浮点形式选择非 NaN 值 |
| 算术 | max.type | max.f32 d,a,b | d = (a > b) ? a : b | 浮点形式选择非 NaN 值 |
| 算术 | setp.cmp.type | setp.lt.f32 p,a,b | p = (a < b) | 比较并设置谓词 |
| 算术 | mov.type | mov.b32 d,a | d = a | 传送 |
| 算术 | selp.type | selp.f32 d,a,b,p | d = p ? a : b | 按谓词选择 |
| 算术 | cvt.dtype.atype | cvt.f32.s32 d,a | d = convert(a) | 将 atype 转为 dtype |
| 特殊函数 | rcp.type | rcp.f32 d,a | d = 1/a | 倒数 |
| 特殊函数 | sqrt.type | sqrt.f32 d,a | d = sqrt(a) | 平方根 |
| 特殊函数 | rsqrt.type | rsqrt.f32 d,a | d = 1/sqrt(a) | 平方根的倒数 |
| 特殊函数 | sin.type | sin.f32 d,a | d = sin(a) | 正弦 |
| 特殊函数 | cos.type | cos.f32 d,a | d = cos(a) | 余弦 |
| 特殊函数 | lg2.type | lg2.f32 d,a | d = log(a)/log(2) | 以 2 为底的对数 |
| 特殊函数 | ex2.type | ex2.f32 d,a | d = 2 ** a | 以 2 为底的指数 |
| 逻辑 | and.type | and.b32 d,a,b | d = a & b | |
| 逻辑 | or.type | or.b32 d,a,b | d = a | b | |
| 逻辑 | xor.type | xor.b32 d,a,b | d = a ^ b | |
| 逻辑 | not.type | not.b32 d,a,b | d = ~a | 按位取反 |
| 逻辑 | cnot.type | cnot.b32 d,a,b | d = (a == 0) ? 1 : 0 | C 的逻辑非 |
| 逻辑 | shl.type | shl.b32 d,a,b | d = a << b | 左移 |
| 逻辑 | shr.type | shr.s32 d,a,b | d = a >> b | 右移 |
| 内存访问 | ld.space.type | ld.global.b32 d,[a+off] | d = *(a+off) | 从指定内存空间加载 |
| 内存访问 | st.space.type | st.shared.b32 [d+off],a | *(d+off) = a | 存入指定内存空间 |
| 内存访问 | tex.nd.dtyp.btype | tex.2d.v4.f32.f32 d,a,b | d = tex2d(a,b) | 纹理查找 |
| 内存访问 | atom.spc.op.type | atom.global.add.u32 d,[a],b;atom.global.cas.b32 d,[a],b,c | 原子执行 d = *a; *a = op(*a,b); | 原子读—修改—写 |
| 控制流 | branch | @p bra target | if (p) goto target | 条件分支 |
| 控制流 | call | call (ret),func,(params) | ret = func(params) | 调用函数 |
| 控制流 | ret | ret | return | 从函数调用返回 |
| 控制流 | bar.sync | bar.sync d | 等待线程 | 屏障同步 |
| 控制流 | exit | exit | exit | 终止线程执行 |
图 4.18 的修饰符:
- 算术
.type:.s32、.u32、.f32、.s64、.u64、.f64。 - 数值比较
.cmp:eq、ne、lt、le、gt、ge;无序比较:equ、neu、ltu、leu、gtu、geu、num、nan。 - 特殊函数
.type:.f32,部分支持.f64。 - 逻辑
.type:.pred、.b32、.b64。 - 内存空间
.space:.global、.shared、.local、.const;内存类型.type:.b8、.u8、.s8、.b16、.b32、.b64。 - 原子
.op:and、or、xor、add、min、max、exch、cas;.spc:.global;.type:.b32。
为了获得地址合并带来的重要性能收益,GPU 程序员必须确保相邻 CUDA 线程同时访问邻近地址,使这些访问能够合并到一个或少数几个内存块或缓存块中;我们的例子就满足这一条件。
GPU 中的条件分支
与单位步长传送一样,向量体系结构和 GPU 处理 IF 语句的方式也很相似:前者主要用软件配合有限硬件支持来实现,后者则使用更多硬件。除显式谓词寄存器外,GPU 分支硬件还利用内部掩码、分支同步栈和指令标记,管理分支何时分成多条执行路径,以及这些路径何时重新汇合。
在 PTX 汇编层面,一个 CUDA 线程的控制流由分支、调用、返回、退出指令,以及每条指令逐线程通道的谓词控制来描述;程序员通过每个线程通道的 1 位谓词寄存器指定谓词。PTX 汇编器分析分支图,将其优化为最快的 GPU 硬件指令序列。每个线程都可以自行决定分支走向,无须保持锁步。
在 GPU 硬件指令层面,控制流包括分支、跳转、索引跳转、调用、索引调用、返回、退出,以及管理分支同步栈的特殊指令。一些早期 GPU 为每个 SIMD 线程提供一个栈;栈项包含标识 token、目标指令地址和目标线程活动掩码。GPU 有特殊指令向某个 SIMD 线程的栈压入栈项,也有特殊指令与指令标记,弹出栈项或将栈展开到指定位置,再使用目标活动掩码跳转到目标地址。GPU 硬件指令也具有逐通道的谓词控制(启用/禁用),由每通道的 1 位谓词寄存器指定。Volta GPU 及其后继产品取消了这个栈,并允许 Warp 分拆。
对于使用 PTX 分支指令编写的简单最外层 IF-THEN-ELSE,PTX 汇编器通常会将其优化为完全由谓词控制的 GPU 指令,不产生 GPU 分支指令。较复杂的控制流则经常混用谓词执行、GPU 分支以及特殊指令和标记。当部分通道跳转到目标地址、其他通道顺序执行时,分支同步栈会压入一个栈项;NVIDIA 称之为分支分歧(diverge)。当 SIMD 通道执行同步标记、路径汇合(converge)时,也会使用这种组合:弹出栈项,采用其中的活动掩码,跳转到栈项指定的地址。
PTX 汇编器会识别循环分支,生成跳回循环顶部的 GPU 分支指令,同时生成特殊栈指令,以处理某些通道提前退出循环的情况;
当所有通道都完成循环时,再使 SIMD 通道汇合。GPU 的索引跳转和索引调用指令也会压栈,使所有通道完成 switch 语句或函数调用后,SIMD 线程能够汇合。
GPU 的设置谓词指令——图 4.18 中的 setp——计算 IF 语句的条件,PTX 分支指令依赖该谓词。若 PTX 汇编器生成不含 GPU 分支的谓词指令,就使用逐通道谓词寄存器,针对每条指令启用或禁用各 SIMD 通道。IF 的 THEN 部分中的 SIMD 指令,会向所有 SIMD 通道广播操作;谓词为 1 的通道执行操作并保存结果,其余通道不执行,也不保存结果。ELSE 部分使用相对于 THEN 部分取反的谓词,于是原先空闲的通道执行并保存结果,原先活动的通道则空闲。ELSE 结束后,指令不再受该谓词控制,原来的计算继续。因此,对于长度相同的两条路径,IF-THEN-ELSE 的效率只有 50% 或更低。
IF 语句可以嵌套,这正是使用栈的原因。对于复杂控制流,PTX 汇编器通常生成谓词指令、GPU 分支和特殊同步指令的混合序列。深层嵌套可能使执行嵌套条件语句时的大多数通道闲置:等长路径的两层 IF 嵌套效率为 25%,三层为 12.5%,以此类推。向量处理器中类似的情况是只有少数掩码位为 1;处理嵌套 IF 时,由于需要组合各层条件来设置向量掩码寄存器,正会出现这种情况。
进一步看,PTX 汇编器会在合适的条件分支指令上设置“分支同步”标记,把当前活动掩码压入各 SIMD 线程内部的栈。如果条件分支发生分歧,一些通道跳转、另一些顺序执行,就压入栈项,并根据条件设置当前内部活动掩码。在 ELSE 部分之前,一个分支同步标记弹出分歧分支栈项,并翻转掩码位。若存在嵌套 IF-ELSE,掩码调整会比简单取反稍复杂。IF 语句结束时,PTX 汇编器再加入一个分支同步标记,弹出之前的活动掩码,恢复为当前活动掩码。
如果所有掩码位都是 1,THEN 末尾的分支就会跳过 ELSE 部分。所有掩码位都是 0 时,也有类似优化:条件分支会跳过 THEN 指令。并行 IF 语句和 PTX 分支经常使用所有通道一致认可的分支条件,即所有通道都沿同一路径前进;此时 SIMD 线程不会分歧为不同的逐通道控制流。PTX 汇编器会优化这类分支,跳过没有任何通道需要执行的指令块。
例如,条件式错误检查必须执行测试,却很少进入错误处理路径,这时上述优化就很有用。
下面的条件语句类似 4.2 节中的例子:
假设 R8 已保存按元素大小缩放后的线程 ID,这个 IF 语句可以编译成下列 PTX 指令。*Push、*Comp 和 *Pop 表示 PTX 汇编器插入的分支同步标记,分别压入旧掩码、对当前掩码取反,以及弹栈恢复旧掩码。
译注: 原页的比较指令确为
setp.neq.s32 P1, RD0, #0,但前一条指令加载的是.f64数据,目的也是 64 位RD0。类型与前后浮点数据流不一致,neq也不同于图 4.18 所列的ne。
再次强调,SIMD 处理器通常会执行 IF-THEN-ELSE 中的所有指令,只是在 THEN 部分启用某些通道,在 ELSE 部分启用其他通道。前面提到,各通道对谓词分支达成一致的情况出乎意料地常见,例如按所有通道都相同的参数值分支,使活动掩码全为 0 或全为 1。此时,分支会跳过 THEN 或 ELSE 指令。
这种灵活性让每个元素看起来都有自己的程序计数器。然而,在最慢的情况下,每 2 个时钟周期只有一个 SIMD 通道能够保存结果,其余通道全部闲置。向量体系结构中对应的最慢情况,就是只有一个掩码位置 1。这种灵活性可能使不熟悉 GPU 的程序员写出性能很差的代码,但在程序开发初期也有帮助。必须记住:一个时钟周期内,SIMD 通道只能执行 PTX 指令指定的操作,或保持闲置;两个 SIMD 通道不能同时执行不同指令。后面将把这种做法与向量方法比较。
这种灵活性也解释了为什么把 SIMD 指令线程中的每个元素称为 CUDA 线程:它给人以独立执行的错觉。初学者可能认为,这种线程抽象意味着 GPU 能更从容地处理条件分支——一些线程走一条路,其余走另一条路;只要不急着得到结果,看起来确实如此。
每个 CUDA 线程要么与线程块中的其他线程执行相同指令,要么闲置。这种同步使带条件分支的循环更容易处理,因为掩码可以关闭 SIMD 通道,并自动检测循环结束。
译注: 上句原文使用“Thread Block”。但本节前文明确说明,一个线程块可包含多个独立调度的 SIMD 指令线程;此处锁步执行与掩码的范围应是同一 SIMD 指令线程(Warp),不是整个线程块。
实际性能有时会暴露这种简单抽象的局限。让 SIMD 通道以高度独立的 MIMD 方式工作,就像在物理内存很小的计算机上编写大量使用虚拟地址空间的程序:两者都正确,却很可能慢到令程序员难以接受。
条件执行体现了两类体系结构的分工差异:GPU 在运行时用硬件完成向量体系结构在编译时完成的工作。向量编译器执行两次 IF 转换,生成四种不同的掩码。基本执行过程与 GPU 相同,只是向量方式还要执行一些额外指令。向量体系结构与标量处理器集成,因此当掩码为 0 的情况占主导时,可以避免浪费这些执行时间。何时改用标量更有利取决于标量处理器与向量处理器的相对速度,分界可能在掩码中少于 20% 的位为 1 时。GPU 可以在运行时进行一项向量体系结构无法在编译时完成的优化:掩码全为 0 或全为 1 时,跳过 THEN 或 ELSE 部分。
因此,GPU 执行条件语句的效率最终取决于分支分歧的频率。例如,一个特征值计算程序有很深的条件嵌套,但实测发现,约 82% 的发射周期中,32 个掩码位有 29~32 个为 1,所以 GPU 的执行效率比直觉预期更高。
同一机制还处理向量循环的 strip mining,即元素个数与硬件宽度不完全匹配的情况。本节开头的示例使用 IF 语句,检查当前 SIMD 通道对应的元素编号(前例中保存在 R8)是否小于界限,即 i < n,并据此设置掩码。关键区别是:向量编译器设置掩码寄存器并生成不同循环,n 层嵌套最多需要 种;GPU 则由硬件跟踪掩码与嵌套。两种方法的运行时间相近。
NVIDIA GPU 的存储结构
图 4.19 展示了 NVIDIA GPU 的存储结构。多线程 SIMD 处理器的每个 SIMD 通道,都获得一块私有的片外 DRAM 区域,本节称为私有内存。它用于栈帧、寄存器溢出,以及放不进寄存器的私有变量。不同 SIMD 通道不共享私有内存。GPU 用 L1 和 L2 缓存缓存这些数据,以辅助寄存器溢出并加快函数调用。
每个多线程 SIMD 处理器内部的片上存储器,本节称为局部存储器。它是一块小型 scratchpad 存储器,延迟低,约几十个时钟周期;带宽高,可达每周期 128 字节。程序员可以把需要重用的数据放在这里,供同一线程或同一线程块中的其他线程使用。局部存储器容量有限,通常为 48 KiB;它不会在同一处理器先后执行的线程块之间保留状态。它由单个多线程 SIMD 处理器内的各通道共享,但不在不同 SIMD 处理器之间共享,因此本节称之为“局部”。创建线程块时,处理器动态分配一部分局部存储器;线程块内所有线程退出后,再释放这部分空间。这部分存储器为该线程块私有。
最后,整个 GPU 和所有线程块共享的片外 DRAM 区域,本节称为 GPU 内存。前面的向量乘法示例只使用 GPU 内存。
图内术语:CUDA thread=CUDA 线程;Per-CUDA thread private memory=每个 CUDA 线程的私有内存;Thread block=线程块;Per-block local memory=每个线程块的局部存储器;Grid=网格;Inter-grid synchronization=网格间同步;GPU memory=GPU 内存;Sequence=执行顺序。
称为主机的系统处理器可以读写 GPU 内存。局部存储器只属于各多线程 SIMD 处理器,主机无法访问;主机也无法访问私有内存。
GPU 传统上不依赖大型缓存容纳应用的整个工作集,而是使用较小的流式缓存。由于工作集可能达到数百兆字节,它依靠大量 SIMD 指令线程的多线程执行来隐藏 DRAM 长延迟。既然用多线程隐藏延迟,系统处理器中用于大型 L2、L3 缓存的芯片面积,就可以在 GPU 中用于计算资源和保存大量线程状态的寄存器。相比之下,向量加载和存储只支付一次延迟,然后将其余访问流水线化,把延迟分摊到许多元素上。
虽然用大量线程隐藏内存延迟是 GPU 最初的设计理念,但较新的 GPU 和向量处理器都使用缓存降低延迟。这可以用排队论中的 Little 定律解释:延迟越长,一次访存期间需要运行的线程越多,所需寄存器也越多。因此,GPU 增加缓存,是为了降低平均延迟,减轻潜在的寄存器数量不足。GPU 缓存设计时假定的命中率远低于 CPU 缓存,因为 GPU 经常处理从高带宽内存连续流入的数据。
前面说过,为提高内存带宽、降低开销,当同一个 SIMD 线程中并行线程的地址位于同一块内时,PTX 数据传送指令与内存控制器配合,把各请求合并成一个内存块请求。这给 GPU 程序施加了一些约束,类似系统处理器程序为了触发硬件预取而遵循的规则(见第 2 章)。GPU 内存控制器还会暂存请求,将指向同一个已打开 DRAM 页的请求一起发送,以提高带宽,见 4.6 节。第 2 章对 DRAM 的介绍足以帮助理解按相关地址分组的潜在收益。
较新 GPU 体系结构中的创新
真实 GPU 的多线程 SIMD 处理器比图 4.15 的简化版本复杂一些。为提高硬件利用率,每个 SIMD 处理器有两个 SIMD 线程调度器,每个带多个指令分派单元;有些 GPU 的调度器更多。双调度器选出两个 SIMD 指令线程,从各线程发射一条指令,送往两组各 16 个 SIMD 通道、16 个加载/存储单元,或 8 个特殊函数单元。多个执行单元使每个时钟周期都能调度两个 SIMD 指令线程,最多有 64 个通道活动。因为线程相互独立,不需要检查指令流之间的数据依赖。这类似一个通道数加倍、可以从两个独立线程发射向量指令的多线程向量处理器。
图 4.20 展示双调度器的指令发射,图 4.21 给出 Pascal GP100 GPU 的多线程 SIMD 处理器框图。
图内术语:SIMD thread scheduler=SIMD 线程调度器;Instruction dispatch unit=指令分派单元;Time=时间;SIMD thread N instruction M=SIMD 线程 N 的第 M 条指令。
译注: 本版单调度器的指令调度示意实际为图 4.17,图 4.16 是 P100 全芯片框图。原图注的图号未默改。
图 4.22 表明,每代新 GPU 通常都会增加一些提高性能或方便编程的特性。以 Pascal GPU 为例,主要有四项创新:
- 快速的单精度、双精度和半精度浮点运算。 Pascal GP100 对 IEEE 浮点标准的三种精度都提供很高性能:单精度峰值为 10 TFLOP/s;双精度约为其一半,即 5 TFLOP/s;半精度以二元素向量表示时,约为其两倍,即 20 TFLOP/s。原子内存操作包含这三种精度的浮点加法。Pascal GP100 是首款具有如此高半精度性能的 GPU。
- 高带宽内存。 Pascal GP100 采用堆叠式高带宽内存 HBM2。它有 4096 条数据线,运行在 0.7 GHz,提供 732 GB/s 的峰值带宽,比前代 GPU 快一倍以上。后续 GPU 使用更新、更快的 HBM。
- 高速芯片间互连。 GPU 是协处理器,当一个 CPU 配合多个 GPU 使用时,PCI 总线可能成为通信瓶颈。Pascal GP100 引入 NVLink 通信通道,每个方向最多支持 20 GB/s 数据传送。
每个 GP100 有 4 条 NVLink 通道,每芯片的双向总峰值带宽为 160 GB/s。面向多 GPU 应用的系统可配置 2、4 或 8 个 GPU;每个 GPU 都能对通过 NVLink 连接的其他 GPU 执行加载、存储和原子操作。某些情况下,NVLink 还能与 CPU 通信,例如 IBM Power9 及后续 CPU 支持 CPU—GPU 通信。在这类芯片中,NVLink 为相连的全部 GPU 和 CPU 提供一致的内存视图,并且可以在缓存之间直接通信,而不必经由内存到内存的传送。
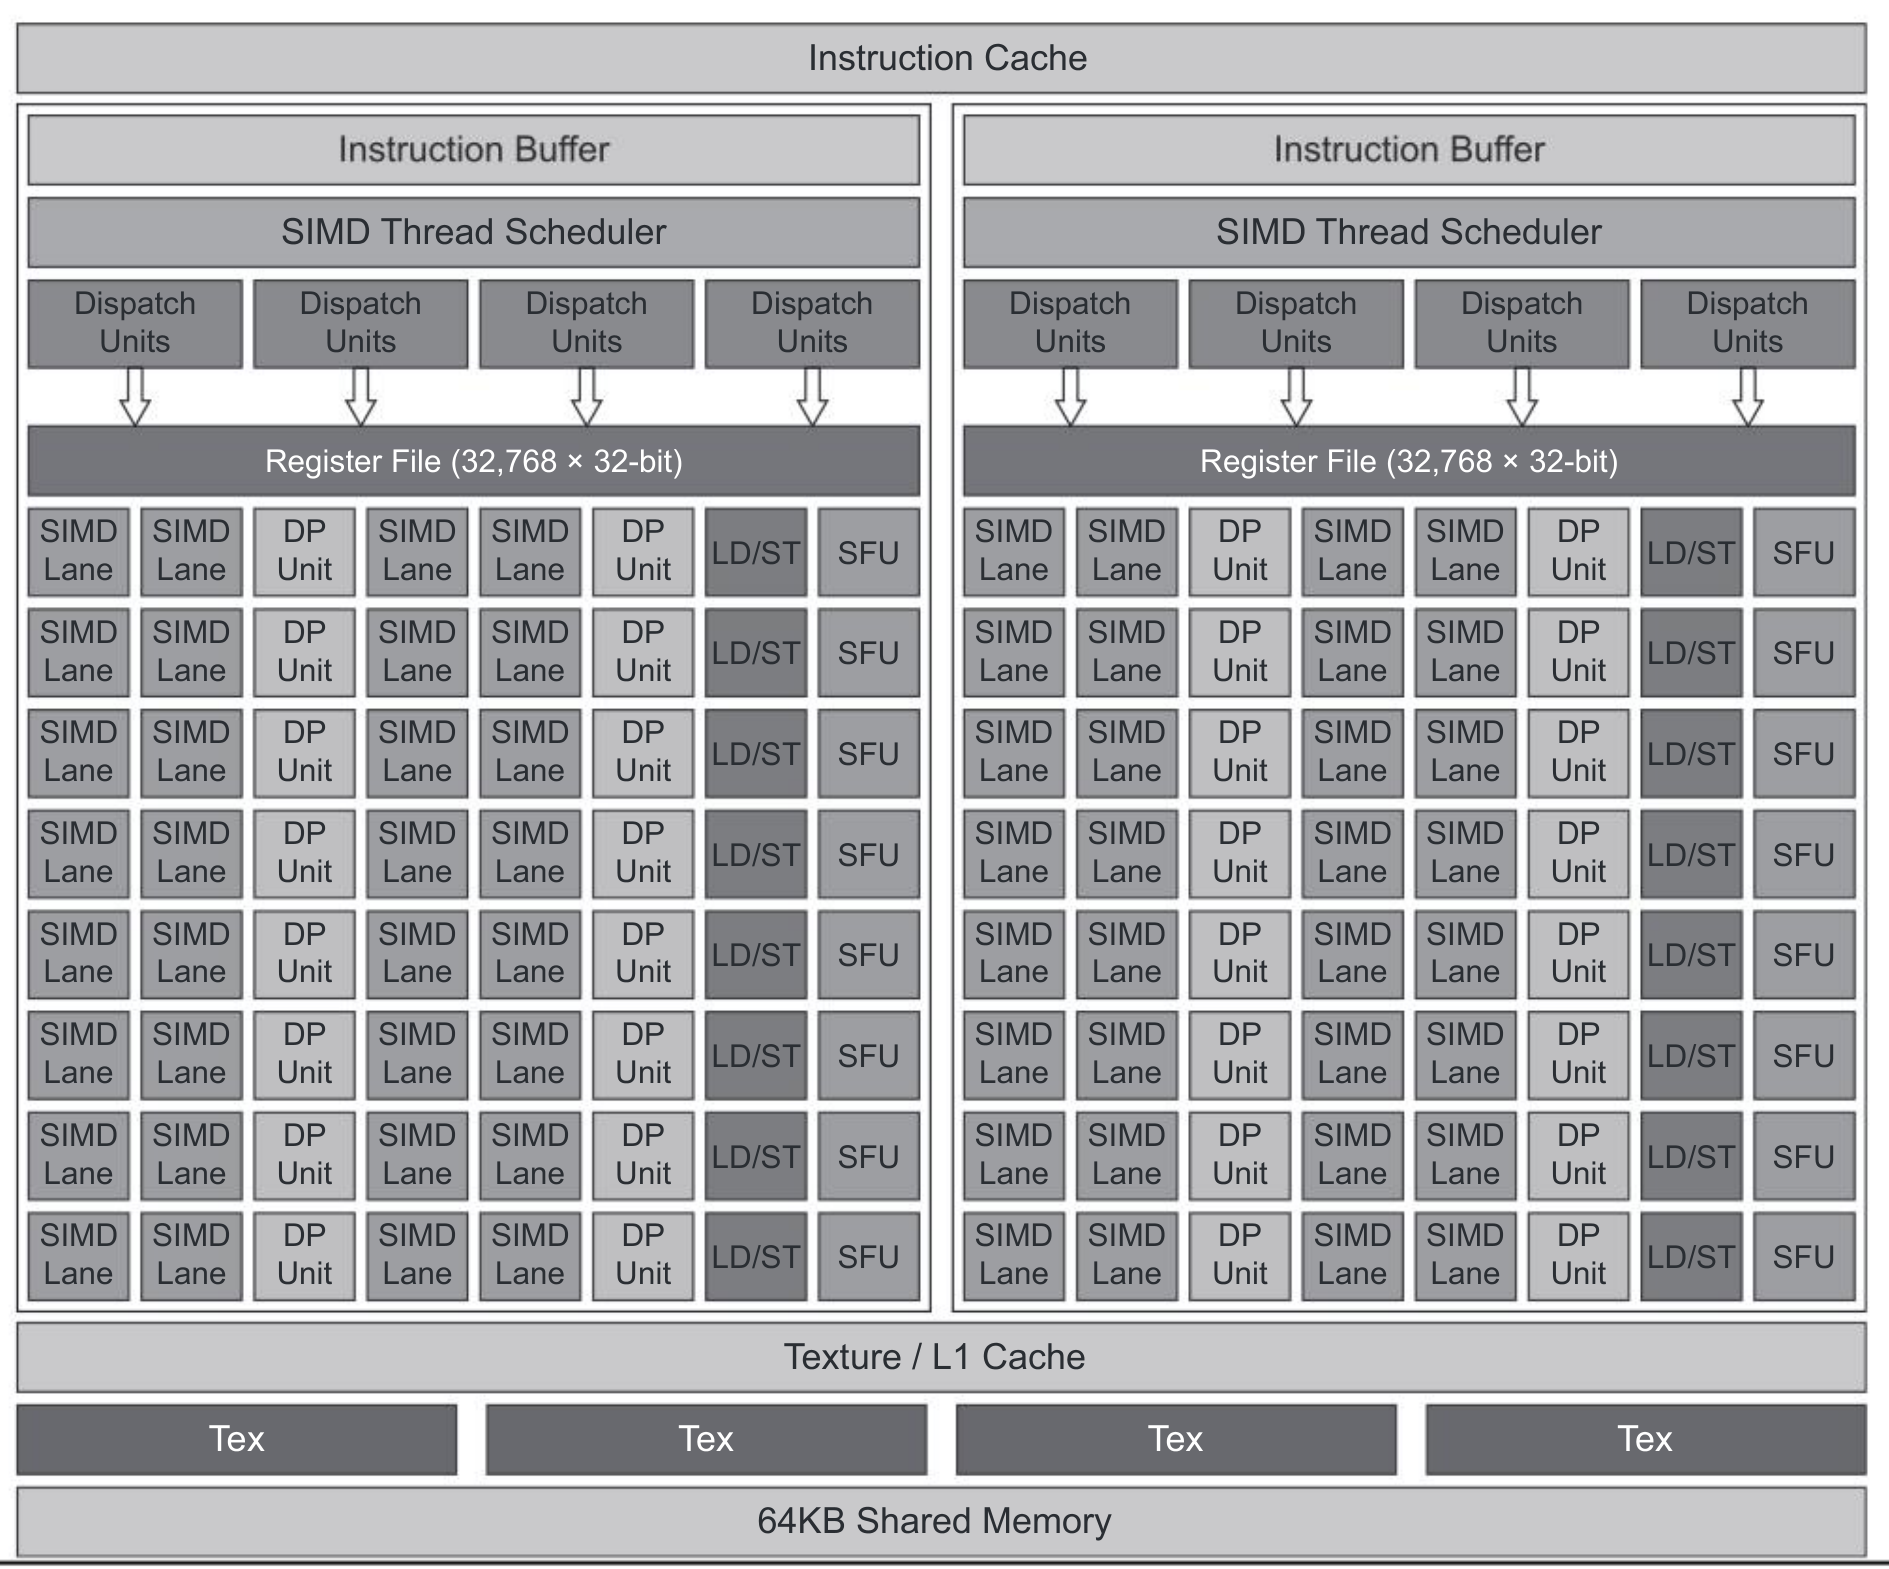
图内术语:Instruction Cache=指令缓存;Instruction Buffer=指令缓冲区;SIMD Thread Scheduler=SIMD 线程调度器;Dispatch Units=分派单元;Register File=寄存器堆;SIMD Lane=SIMD 通道;DP Unit=双精度单元;Texture / L1 Cache=纹理/L1 缓存;Tex=纹理单元;Shared Memory=共享存储器,即本节所称局部存储器。
- 统一虚拟内存和分页支持。 Pascal GP100 在统一虚拟地址空间内增加了缺页处理能力,使同一系统中所有 GPU 和 CPU 能以同一个虚拟地址表示同一数据结构。线程访问远端地址时,一个内存页会传到本地 GPU,供后续使用。统一内存以按需分页替代 CPU 与 GPU 或不同 GPU 之间的显式内存复制,简化编程模型;它也允许分配远超 GPU 实际容量的内存,以处理内存需求很大的问题。与任何虚拟内存系统一样,仍须避免过度页面迁移。
| GPU 型号 | P100 | V100 | A100 | H100 |
|---|---|---|---|---|
| 发布年份 | 2016 | 2017 | 2020 | 2022 |
| SM 数量 | 56 | 80 | 108 | 132 |
| 基准时钟频率(GHz) | 1.19 | 1.12 | 1.10 | 1.13 |
| Turbo 模式时钟频率(GHz) | 1.48 | 1.53 | 1.41 | 1.98 |
| 裸片面积(mm²) | 610 | 815 | 826 | 814 |
| 工艺(TSMC) | 16 nm | 12 nm FinFET+ | 7 nm N7 | 4N |
| 功率(W) | 300 | 300 | 400 | 700 |
| 晶体管数量(十亿) | 15.3 | 21.1 | 54.2 | 80 |
| 内存带宽(GB/s) | 732 | 900 | 2000 | 3350 |
| L2 缓存大小(MB) | 4 | 6 | 40 | 50 |
| 单精度 SIMD 宽度 | 8 | 32 | 32 | 32 |
| 双精度 SIMD 宽度 | 4 | 32 | 32 | 32 |
| 峰值单精度性能(GFLOP/s) | 10,608 | 15,700 | 19,500 | 66,900 |
| 峰值双精度性能(GFLOP/s) | 5,304 | 7,800 | 9,700 | 33,500 |
| 面向机器学习的峰值 16 位性能(GFLOP/s) | N.A. | 125,000 | 312,000 | 989,000 |
| 面向机器学习的峰值 8 位性能(GFLOP/s) | N.A. | N.A. | N.A. | 1,979,000 |
图 4.22 列出四代 GPU 的关键参数,图 4.23 则以 Pascal P100 为基准展示其变化。变化最大的是 L2 缓存容量,其次是单、双精度峰值浮点性能和晶体管数量。A100 的浮点性能增幅相对于晶体管数量增幅较小,因为它主要着眼于提高机器学习性能,见图 4.22 最后两行及第 7 章。H100 浮点性能的大幅提升,部分来自接近翻倍的功率和 4 nm 工艺。
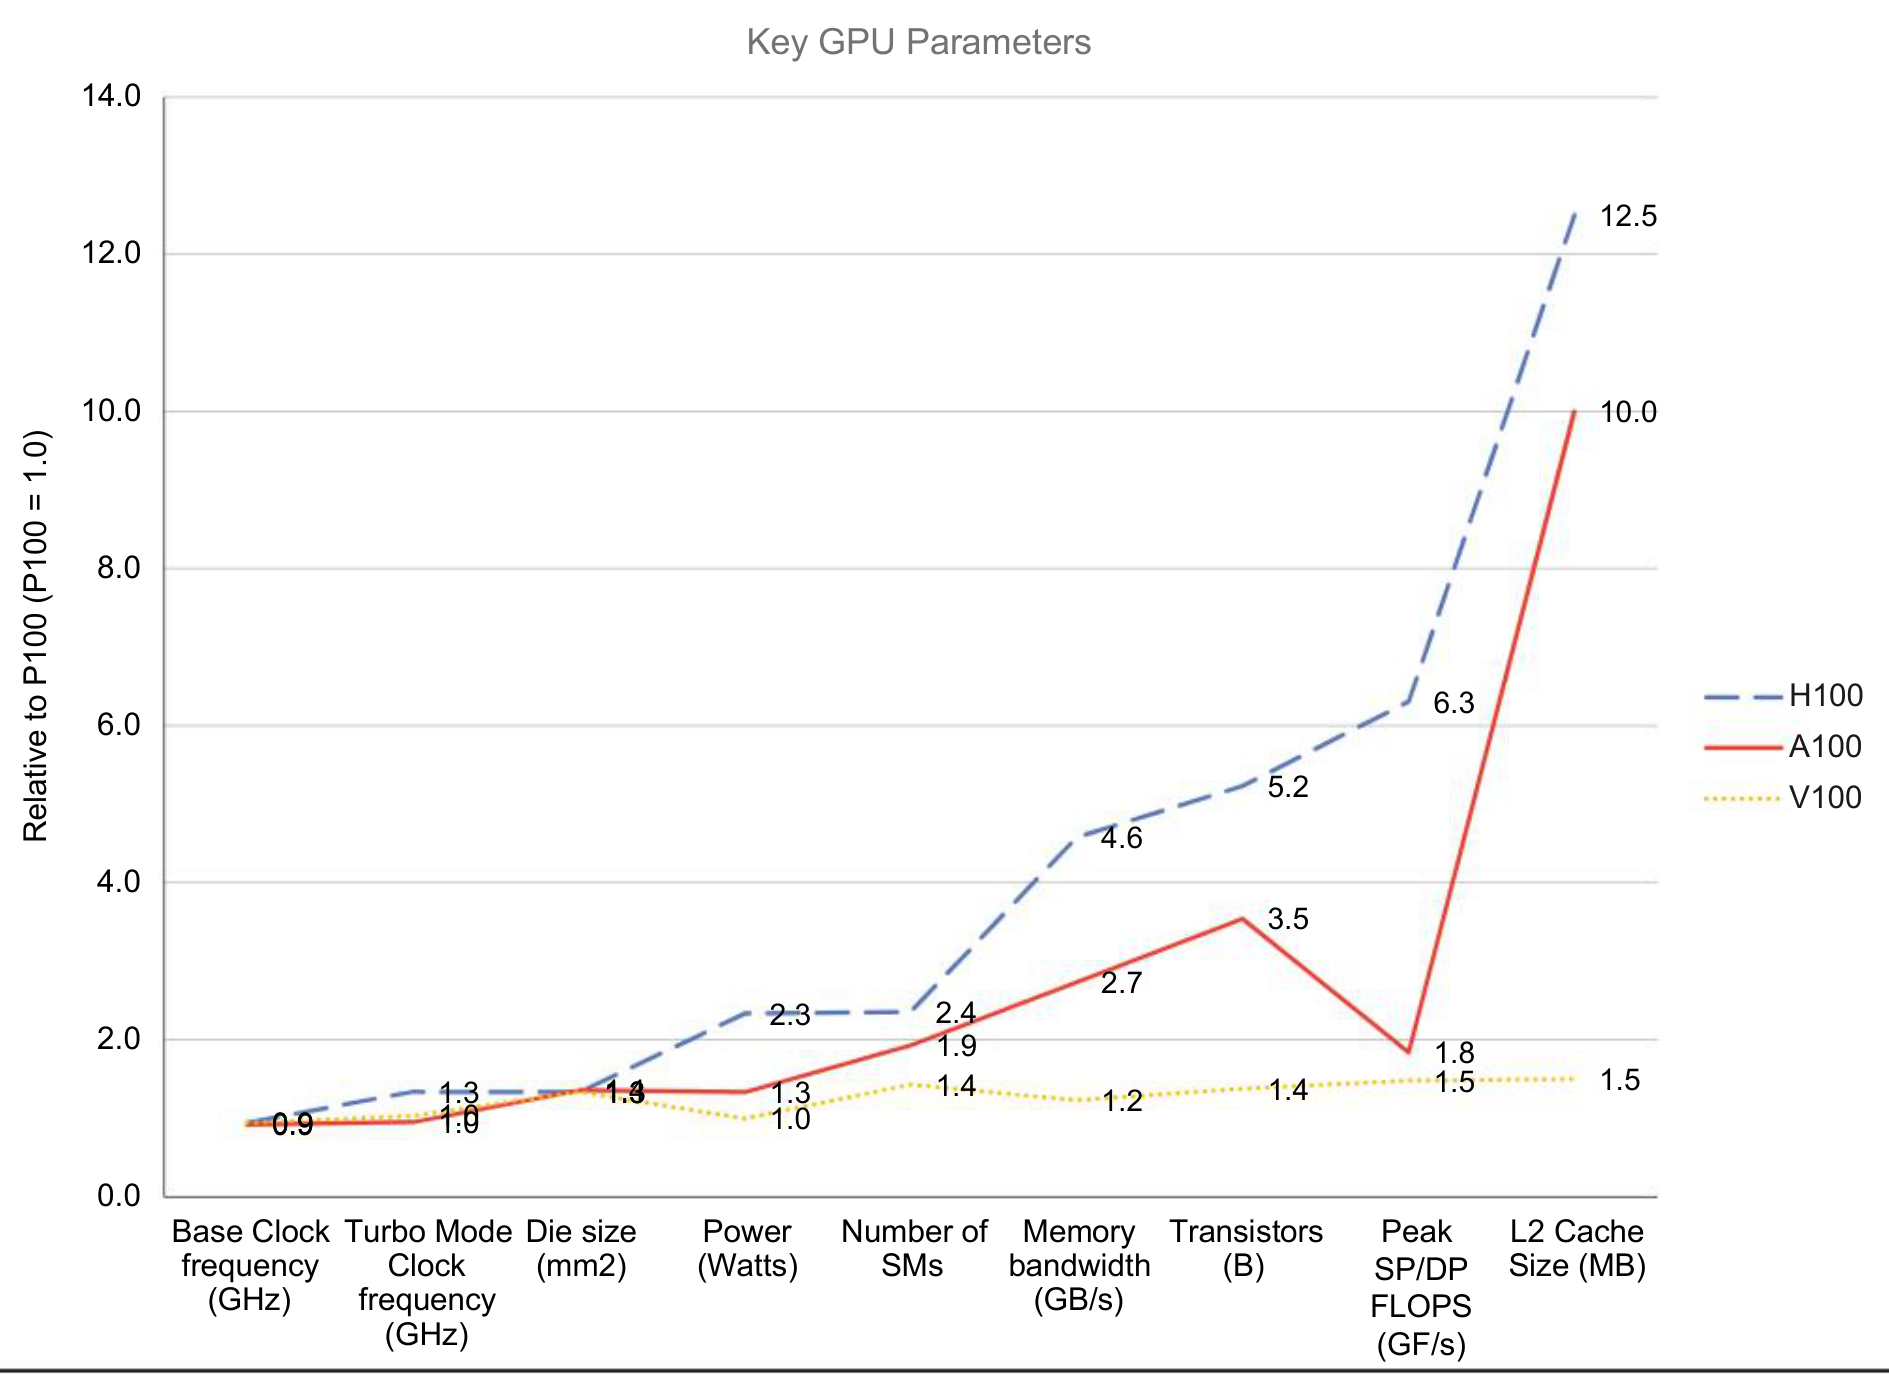
图中纵轴以 P100 = 1.0 归一化;横轴依次为基准时钟频率、Turbo 模式时钟频率、裸片面积、功率、SM 数量、内存带宽、晶体管数量、单/双精度峰值浮点性能、L2 缓存容量;三条线分别表示 H100、A100 和 V100。单位与数值见图 4.22。
向量体系结构与 GPU 的异同
正如我们看到的,向量体系结构与 GPU 确实有很多相似之处。这些相似性加上 GPU 特殊的术语,使部分体系结构研究者对 GPU 究竟有多新颖产生困惑。了解两者的内部组织后,就能够理解它们的共同点和差别。两者都为数据级并行程序而设计,却走了不同道路,因此值得深入比较,以更好地理解 DLP 硬件需要什么。图 4.24 先列出向量术语,再给出 GPU 中最接近的对应概念。
SIMD 处理器类似向量处理器。GPU 中的多个 SIMD 处理器像独立的 MIMD 核一样工作,就像许多向量计算机包含多个向量处理器。从这个角度看,NVIDIA H100 是一台具有硬件多线程支持的 132 核机器,每个核有 64 个通道。
| 类别 | 向量术语 | 最接近的 CUDA/NVIDIA GPU 术语 | 说明 |
|---|---|---|---|
| 程序抽象 | 向量化循环 | Grid | 概念相似,但 GPU 的名称描述性较弱 |
| 程序抽象 | chime | — | Pascal 一条向量指令(PTX 指令)只需 2 周期,因此 GPU 的 chime 很短。Pascal 有两个支持常用浮点指令的执行单元,可交替使用,实际发射速率为每周期一条指令 |
| 机器对象 | 向量指令 | PTX Instruction | SIMD 线程的一条 PTX 指令广播到全部 SIMD 通道,类似向量指令 |
| 机器对象 | 聚集/散布 | 全局加载/存储(ld.global/st.global) | 所有 GPU 加载和存储都是聚集/散布,每个通道提供独立地址;若地址允许,由合并单元实现单位步长性能 |
| 机器对象 | 掩码寄存器 | 谓词寄存器与内部掩码寄存器 | 向量掩码是显式体系结构状态,GPU 掩码则位于硬件内部;GPU 条件执行硬件在谓词之外增加了动态管理掩码的机制 |
| 处理与存储硬件 | 向量处理器 | 多线程 SIMD 处理器 | 两者相似,但 SIMD 处理器通常通道较多,每通道只需少数周期即可完成向量;向量体系结构通道较少,完成向量需要较多周期。前者还支持多线程,后者通常不支持 |
| 处理与存储硬件 | 控制处理器 | 线程块调度器 | 最接近的是把线程块分配给多线程 SIMD 处理器的调度器。但 GPU 没有标量—向量操作,也没有单位步长或带步长的数据传送指令,而向量控制处理器经常提供这些功能 |
| 处理与存储硬件 | 标量处理器 | 系统处理器 | 缺少共享内存且通过 PCI 总线通信需要数千周期,使 GPU 配套的系统处理器很少承担向量体系结构中标量处理器所承担的任务 |
| 处理与存储硬件 | 向量通道 | SIMD 通道 | 很相似,本质上都是带寄存器的功能单元 |
| 处理与存储硬件 | 向量寄存器 | SIMD 通道寄存器 | 多线程 SIMD 处理器执行一个 SIMD 指令线程时,全部 16 个通道中同名的寄存器相当于一个向量寄存器。每线程寄存器数量可变,Pascal 最多为 256,因此最多相当于 256 个向量寄存器 |
| 处理与存储硬件 | 主存 | GPU 内存 | 前者是向量系统内存,后者是 GPU 内存 |
最大的差异在于多线程:它是 GPU 的基础,而大多数向量处理器没有这一机制。
再看寄存器。本节实现中的 RV64V 寄存器堆保存完整向量,即连续的一组元素;GPU 中的一个向量则分散在所有 SIMD 通道的寄存器中。RV64V 处理器有 32 个向量寄存器,每个可能保存 32 个元素,总共 1024 个。GPU 的一个 SIMD 指令线程最多有 256 个寄存器,每个含 32 个元素,共 8192 个。这些额外寄存器用于支持多线程。
图 4.25 左侧是向量处理器执行单元,右侧是 GPU 的多线程 SIMD 处理器。为了讲解,我们假定二者都只有 4 个通道。图中,四个 SIMD 通道协同工作,很像四通道向量单元;整个 SIMD 处理器也很像一个向量处理器。
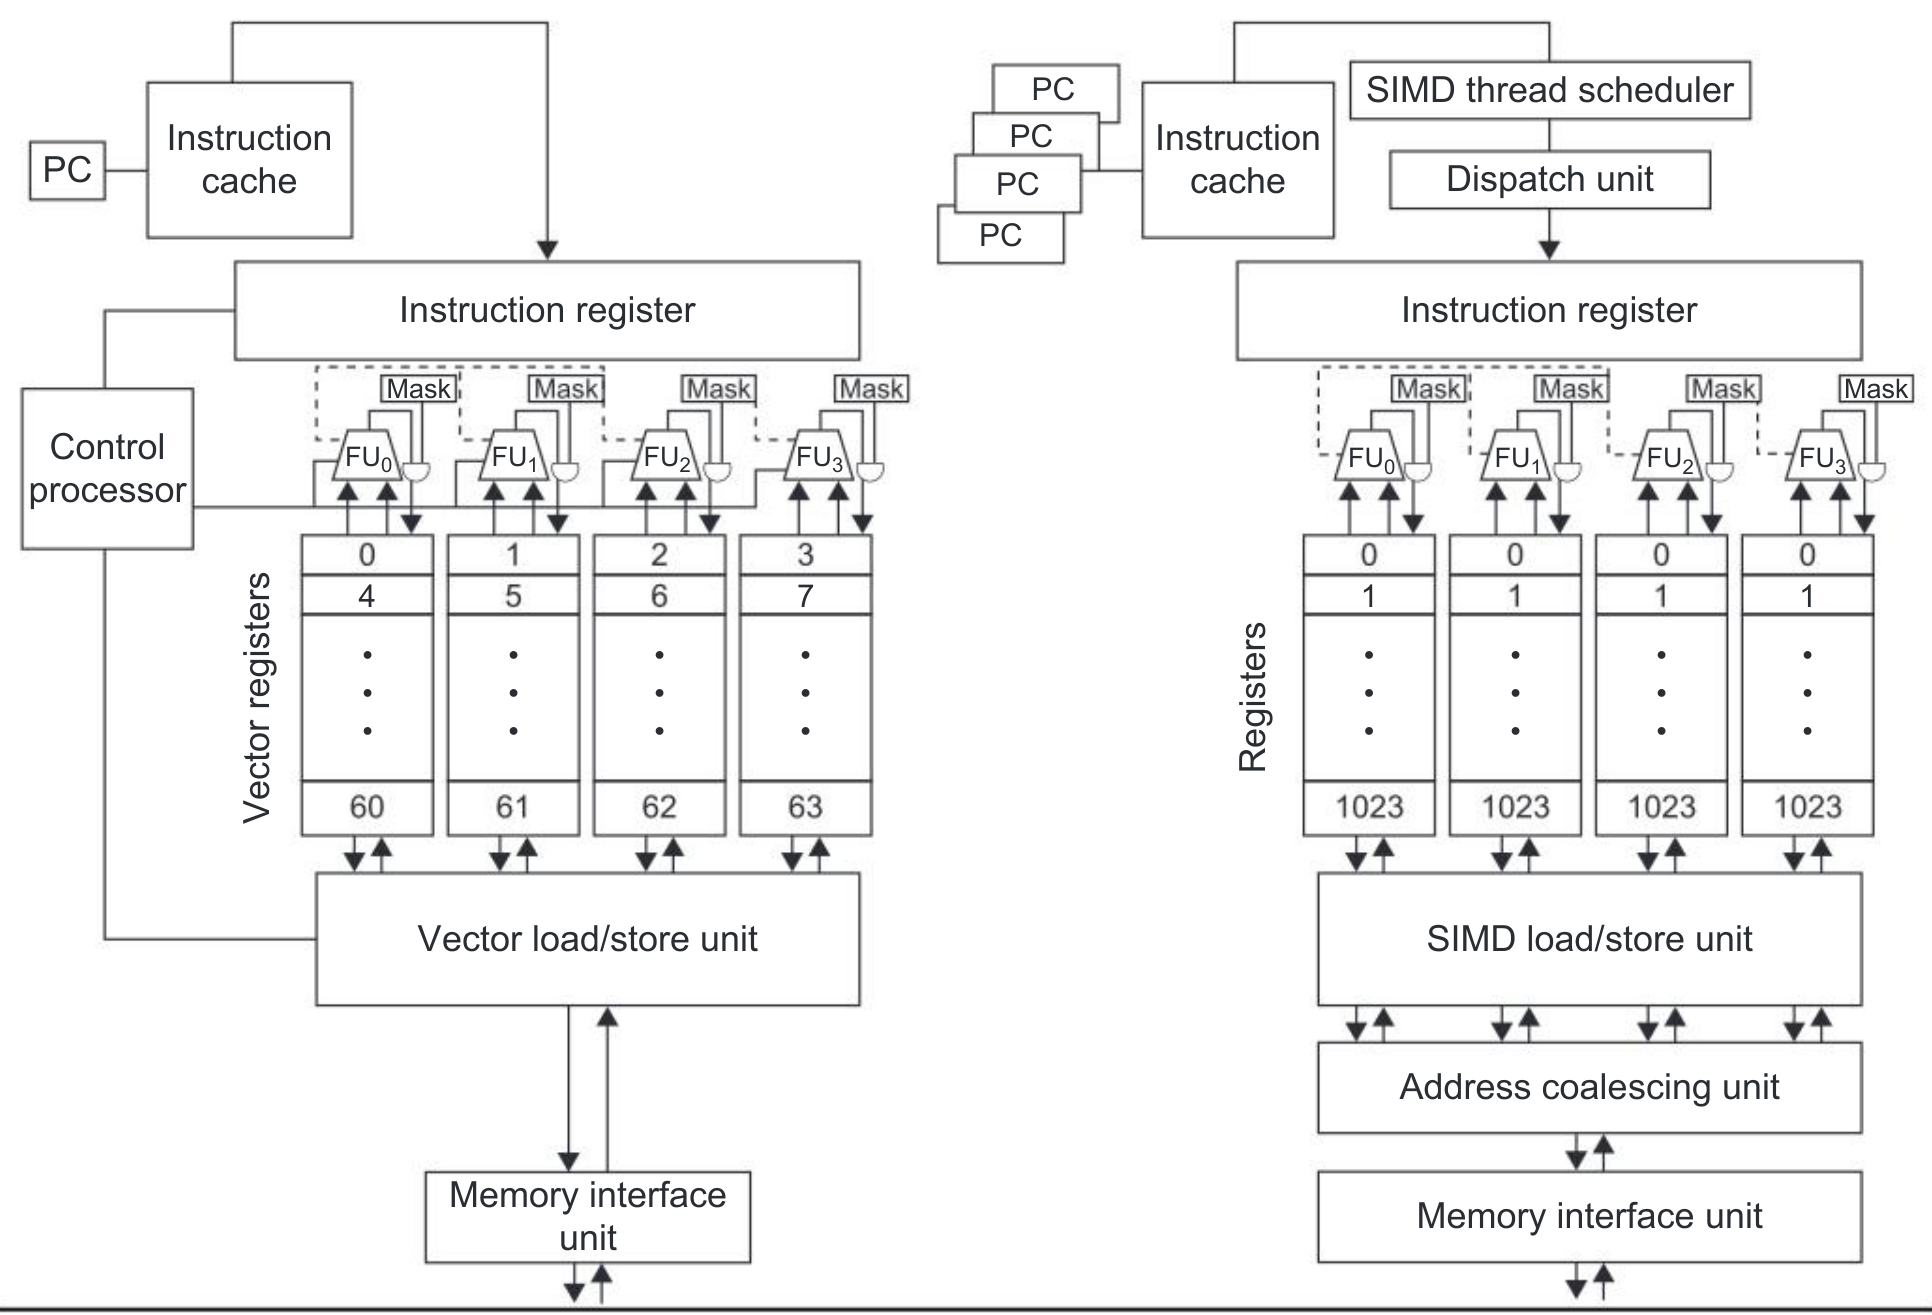
图内术语:PC=程序计数器;Mask=掩码;FU=功能单元;Instruction cache/register=指令缓存/寄存器;Control processor=控制处理器;Vector registers=向量寄存器;Vector/SIMD load/store unit=向量/SIMD 加载存储单元;Memory interface unit=内存接口单元;SIMD thread scheduler=SIMD 线程调度器;Dispatch unit=分派单元;Address coalescing unit=地址合并单元。
实际上 GPU 的通道更多,因此它的“chime”更短。向量处理器可能有 2~8 个通道、向量长度为 32,对应 4~16 个时钟周期的 chime;多线程 SIMD 处理器可能有 8 或 16 个通道,SIMD 线程宽度为 32 个元素,因此 chime 只有 4 或 2 个周期。这正是我们使用“SIMD 处理器”这一描述性名称的原因:它比传统向量处理器更接近 SIMD 设计。
GPU 中与向量化循环最接近的是网格;与向量指令最接近的是 PTX 指令,因为 SIMD 线程会将一条 PTX 指令广播到所有通道。
对于内存访问,GPU 的所有加载都是聚集,所有存储都是散布。如果 CUDA 线程同时访问的邻近地址落在同一缓存块或内存块内,GPU 的地址合并单元就能提供高带宽。向量体系结构显式提供单位步长加载/存储,而 GPU 编程中的单位步长是隐含的;这解释了为什么 CUDA 虽然看起来像 MIMD,高效 GPU 代码仍要求程序员按 SIMD 操作来思考。CUDA 线程可以生成自己的地址,包括步长和聚集/散布地址,因此两种体系结构都有地址向量。
两者隐藏内存延迟的方法很不相同。向量体系结构用深流水线访问,把延迟分摊到全部向量元素上,每次向量加载只支付一次延迟。因此,向量加载和存储类似内存与向量寄存器之间的块传送。GPU 则用多线程隐藏延迟。有些研究者正尝试为向量体系结构加入多线程,以兼得两者的优点。
对于条件分支,两者都使用掩码寄存器。两条条件路径即使不保存结果,也会占用时间或空间。区别是向量编译器在软件中显式管理掩码,而 GPU 硬件与汇编器通过分支同步标记和内部栈,隐式保存、取反、恢复掩码。
向量计算机的控制处理器在向量指令执行中作用重要。它向全部向量通道广播操作,并为向量—标量操作广播标量寄存器值;还会隐式进行 GPU 中需要显式执行的计算,例如为单位步长和非单位步长访存自动递增地址。GPU 没有这样的控制处理器,最接近的是把线程块分配给多线程 SIMD 处理器的线程块调度器。许多 DLP 应用的地址天然相邻,但 GPU 仍需要运行时硬件先生成地址,再检查它们是否相邻,这很可能不如使用控制处理器节能,尤其是常见的单位步长访问。
向量计算机的标量处理器执行向量程序中的标量指令,即那些放在向量单元上执行会太慢的操作。与 GPU 配套的系统处理器最接近这一角色,但分离的地址空间和 PCIe 传送,使二者配合需要数千个周期的开销。向量计算机中的标量处理器做浮点计算可能慢于向量处理器,却不会慢到系统处理器与 GPU 多线程 SIMD 处理器之间那样的程度,尤其把通信开销算进去后。
因此,GPU 中每个“向量单元”都必须执行一些在向量计算机中本应交给标量处理器的工作。与其在系统处理器上计算再传回结果,不如用谓词寄存器和内部掩码关闭除一个以外的所有通道,让单个通道完成标量任务,反而可能更快。向量计算机中相对简单的标量处理器,很可能比这种 GPU 方案更快、更节能。如果未来系统处理器与 GPU 结合得更紧密,例如 NVIDIA Grace 处理器,那么系统处理器能否像向量和多媒体 SIMD 体系结构中的标量处理器那样工作,将是一个值得关注的问题。
多媒体 SIMD 计算机与 GPU 的异同
从高层看,带有多媒体 SIMD 扩展的多核计算机与 GPU 确实具有相似之处。图 4.26 汇总了它们的异同。
| 特性 | 带 SIMD 的多核计算机 | GPU |
|---|---|---|
| SIMD 处理器数量 | 4~8 | 8~32 |
| 每处理器的 SIMD 通道数 | 2~4 | 最多 64 |
| 硬件多线程支持的 SIMD 线程数 | 2~4 | 最多 64 |
| 典型单精度/双精度性能比 | 2:1 | 2:1 |
| 最大缓存容量 | 40 MB | 4 MB |
| 内存地址宽度 | 64 位 | 64 位 |
| 主存容量 | 最多 1024 GB | 最多 24 GB |
| 页级内存保护 | 支持 | 支持 |
| 按需分页 | 支持 | 支持 |
| 标量处理器与 SIMD 处理器集成 | 是 | 否 |
| 缓存一致性 | 支持 | 部分系统支持 |
译注: 本表的规模与容量数据不应视为前面图 4.22 中各代 GPU 的统一上限;例如本章已列出 H100 的 132 个 SM 和 50 MB L2 缓存。
两者都是多处理器,各处理器都使用多个 SIMD 通道,只是 GPU 的处理器和通道多得多。两者都用硬件多线程提高利用率,只是 GPU 支持的线程多得多。两者的单精度与双精度峰值浮点性能比大致都是 2:1。两者都使用缓存,但 GPU 使用较小的流式缓存,多核计算机则使用大型多级缓存,试图完整容纳工作集。两者都使用 64 位地址空间,但 GPU 的物理主存小得多。两者都支持页级内存保护和按需分页,因此能够寻址远超板载容量的内存。
除了处理器数、通道数、硬件线程数和缓存容量的巨大数量差异,还存在许多体系结构差异。传统计算机中的标量处理器与多媒体 SIMD 指令紧密集成;GPU 则隔着 I/O 总线,甚至拥有独立主存。GPU 内的多个 SIMD 处理器使用同一地址空间;在 CPU 厂商支持下,例如 IBM Power9,一些系统还可以提供全部内存的一致视图。与 GPU 不同,多媒体 SIMD 历来缺少聚集/散布访存支持,4.7 节将说明这是一项重要缺失。
向量体系结构编程的一项关键方法,是阅读编译器关于哪些循环已向量化的报告,并据此修改代码。GPU 编译器几乎不说明代码将以多高效率执行;程序员必须借助性能分析工具,例如 NVIDIA Parallel Nsight,获得动态执行行为的反馈,再判断怎样改进代码。
CUDA/SIMT 比一些人预想的更成功,是因为它以合适的方式在程序员与系统之间分配了开发并行性的工作:把容易但繁琐的优化留给系统,让程序员专注于寻找足够外层循环并行性这个困难问题。这种分工甚至可能促使程序员寻找全新的算法。
CUDA/SIMT 刚出现时,许多体系结构设计者持怀疑态度,因为他们假定程序或算法相对固定,任务是针对这个固定输入优化其余系统。从这个角度看,大量开发者似乎不太可能投入时间重写大批代码,因此 GPU 计算会一直停留在小众领域。过于关注为既有平台编写的标准基准测试,也让体系结构设计者难以想象:新的、具有重大经济价值的应用,会从头开始主要面向不同于 CPU 的新体系结构编写。
GPU 的幸运之处在于,机器学习应用并不建立在数千名程序员编写数百万行代码之上,因此更容易从头编写新应用。它的智能来自一个相对较小的程序从数据中学习,而不是把智能编码成庞大程序。在标准 Python 框架 JAX、PyTorch、TensorFlow 中编写的小型内核,可以通过数千块 GPU 分析海量数据、训练数周,产生有价值的深度神经网络。
小结
揭开术语的面纱后,可以看到 GPU 本质上是多线程 SIMD 处理器的集合,只是比传统多核计算机拥有更多处理器、每处理器更多通道,以及更多多线程硬件。例如,Hopper H100 GPU 有 132 个 SIMD 处理器,每个有 64 个通道,并支持 64 个 SIMD 线程。Pascal 通过从两个 SIMD 线程向两组通道发射指令来利用指令级并行性。GPU 的缓存也较少,Hopper 的 L2 为 50 MiB;通过远端标量处理器或远端 GPU 的配合,还能维持缓存一致性。
CUDA 编程模型用一个抽象——CUDA 线程——包装了所有这些并行形式。程序员可以认为自己在为数千个线程编程,实际上,每组 32 个线程在许多 SIMD 处理器的通道上执行。追求良好性能的程序员需要记住:这些线程按块组织,每次执行 32 个;要获得良好的存储系统性能,访问地址应彼此相邻。
本节虽然采用 CUDA 和 NVIDIA GPU,但 OpenCL 以及其他厂商的 GPU 中也能找到相同思想。
现在理解了 GPU 的工作方式,就可以揭示正式术语了。图 4.27 和图 4.28 将本节的描述性名称与定义,对应到 CUDA/NVIDIA 和 AMD 的正式术语,并列出 OpenCL 名称。我们认为,GPU 学习曲线陡峭,部分原因就在于把 SIMD 处理器称为 streaming multiprocessor,把 SIMD 通道称为 thread processor,把局部存储器称为 shared memory,尤其是这块局部存储器根本不在不同 SIMD 处理器之间共享!希望这种虽稍绕路、但分两步解释的方法,能帮助读者更快理解。
| 类别 | 本书的描述性名称 | CUDA/NVIDIA 正式术语 | 简要说明及 AMD/OpenCL 名称 | CUDA/NVIDIA 正式定义 |
|---|---|---|---|---|
| 程序抽象 | 可向量化循环 | Grid | 在 GPU 上执行的可向量化循环,由一个或多个可并行执行的线程块(向量化循环体)组成。OpenCL 称 index range,AMD 称 NDRange | 线程块组成的数组,可以并发、顺序或混合执行 |
| 程序抽象 | 向量化循环体 | Thread Block | 在多线程 SIMD 处理器上执行的向量化循环,由一个或多个 SIMD 指令线程组成,线程间通过局部存储器通信。AMD 和 OpenCL 称 work group | 并发执行的 CUDA 线程数组,可通过共享内存和屏障同步合作、通信;线程块在网格内有一个线程块 ID |
| 程序抽象 | SIMD 通道操作序列 | CUDA Thread | SIMD 指令线程的纵向切片,对应一个通道执行的一个元素,是否保存结果取决于掩码。AMD 和 OpenCL 称 work item | 执行顺序程序的轻量级线程,可与同一线程块中的其他 CUDA 线程合作;在块内具有线程 ID |
| 机器对象 | SIMD 指令线程 | Warp | 仅含 SIMD 指令的传统线程,在多线程 SIMD 处理器上运行,是否保存结果由逐元素掩码决定。AMD 称 wavefront | 一组并行 CUDA 线程(例如 32 个),在多线程 SIMT/SIMD 处理器中共同执行同一条指令 |
| 机器对象 | SIMD 指令 | PTX instruction | 跨多个 SIMD 通道执行的一条 SIMD 指令。AMD 称 AMDIL 或 FSAIL 指令 | 指定由一个 CUDA 线程执行的指令 |
| 类别 | 本书的描述性名称 | CUDA/NVIDIA 正式术语 | 简要说明及 AMD/OpenCL 名称 | CUDA/NVIDIA 正式定义 |
|---|---|---|---|---|
| 处理硬件 | 多线程 SIMD 处理器 | Streaming multiprocessor | 执行 SIMD 指令线程,独立于其他 SIMD 处理器。AMD 和 OpenCL 称 compute unit;但 CUDA 程序员为一个通道编程,而不是为多个通道组成的“向量”编程 | SM 是执行 CUDA 线程 Warp 的多线程 SIMT/SIMD 处理器;SIMT 程序指定单个 CUDA 线程的执行,而不是多个 SIMD 通道构成的向量 |
| 处理硬件 | 线程块调度器 | Giga Thread Engine | 将多个向量化循环体分配给多线程 SIMD 处理器。AMD 称 Ultra-Threaded Dispatch Engine | 当资源可用时,将网格中的线程块分派并调度到 SM |
| 处理硬件 | SIMD 线程调度器 | Warp scheduler | 调度和发射已就绪的 SIMD 指令线程,含记分牌以跟踪执行。AMD 称 Work Group Scheduler | SM 中的 Warp 调度器在 Warp 的下一条指令就绪时调度其执行 |
| 处理硬件 | SIMD 通道 | Thread processor | 对单个元素执行 SIMD 指令线程中的操作,是否保存结果由掩码决定。OpenCL 称 processing element;AMD 也称 SIMD Lane | SM 中的数据通路和寄存器堆部分,执行一个 Warp 的一个或多个通道的操作 |
| 存储硬件 | GPU 内存 | Global memory | GPU 中所有多线程 SIMD 处理器可访问的 DRAM。OpenCL 称 global memory | 任意网格、任意线程块的所有 CUDA 线程均可访问;实现为一块 DRAM 区域,可以被缓存 |
| 存储硬件 | 私有内存 | Local memory | 每个 SIMD 通道私有的一部分 DRAM。AMD 和 OpenCL 都称 private memory | CUDA 线程私有的线程局部内存,实现为可缓存的 DRAM 区域 |
| 存储硬件 | 局部存储器 | Shared memory | 一个多线程 SIMD 处理器内部的快速 SRAM,其他处理器不可访问。OpenCL 称 local memory,AMD 称 group memory | 组成同一线程块的 CUDA 线程共享、而对该块私有的快速 SRAM,用于在线程块的屏障同步点进行线程间通信 |
| 存储硬件 | SIMD 通道寄存器 | Registers | 单个 SIMD 通道内的寄存器,在向量化循环体中分配。AMD 也称 registers | CUDA 线程的私有寄存器;每个线程处理器中的多线程寄存器堆,为若干 Warp 的特定通道提供寄存器 |
4.5 检测与增强循环级并行性
程序中的循环,是本章和第 5 章讨论的许多并行形式的源泉。本节介绍用于发现程序中可供向量和 SIMD 体系结构利用的并行性的编译技术,以及支持这些技术的硬件。前面已经说明,GPU 将这项优化交给程序员,而不是 CUDA 编译器。我们将精确定义:
什么情况下循环是并行的或可向量化的,依赖如何阻止循环并行,以及怎样消除某些依赖。发现和调整循环级并行性,对利用 DLP、TLP,以及附录 H 中更积极的静态 ILP 方法(例如 VLIW)都至关重要。
循环级并行性通常在源代码层面或接近源代码的层面分析,而多数 ILP 分析发生在编译器生成指令之后。循环级分析需要判断不同迭代之间的操作数有哪些依赖。这里暂时只考虑数据依赖:某个操作数先被写入,随后又被读取。名称依赖也存在,可以用第 3 章的重命名技术消除。
循环级并行性分析重点判断:后续迭代的数据访问是否依赖前面迭代产生的值,这种依赖称为循环携带依赖。第 2、3 章中的多数例子没有循环携带依赖,因此具有循环级并行性。先看下面的源代码:
两次使用 x[i] 之间存在依赖,但它局限于单次迭代,不是循环携带依赖。不同迭代中连续使用 i 之间确实存在循环携带依赖,不过 i 是归纳变量(induction variable),这种依赖容易识别和消除。原书第 2 章 2.2 节曾在循环展开中展示如何消除归纳变量依赖,本节稍后还会介绍其他例子。
寻找循环级并行性需要识别循环、数组引用和归纳变量计算等结构,因此与机器码层面相比,编译器更容易在源代码或接近源代码的层面分析。下面看一个更复杂的例子。
例题
考虑下面的循环:
假设 A、B、C 是彼此不同、互不重叠的数组。实际上,数组有时可能相同或重叠;而且它们可能作为参数传给包含本循环的过程,所以判断数组是否相同或重叠,往往需要复杂的过程间程序分析。循环中的 S1、S2 之间有哪些数据依赖?
解答
- 存在两类依赖。第一类是 S1 使用较早一次迭代中 S1 计算的值:迭代 i 计算
A[i+1],迭代 i+1 读取它。S2 对B[i]、B[i+1]也有同样的关系。 - 第二类是 S2 使用同一次迭代中 S1 计算的
A[i+1]。
这两类依赖不同,影响也不同。为看清差别,假设一次只存在其中一类。S1 依赖之前迭代中的 S1,所以它是循环携带依赖,迫使相邻迭代串行执行。
译注: 原代码 S1 的注释终止符缺少斜线;它不影响作者讨论的数据依赖,但使代码不能直接作为完整 C 程序编译。
第二类依赖,即 S2 依赖 S1,只在一次迭代内部发生,并非循环携带。因此,如果只有这一依赖,只要每次迭代内的两个语句保持顺序,多次迭代就能并行执行。原书 2.2 节中用展开暴露并行性的例子曾出现这类依赖。这样的迭代内部依赖很常见,使用链接的向量指令序列恰好就具有这种依赖。
也可能存在不妨碍并行化的循环携带依赖,下面就是一例。
例题
S1 和 S2 之间有哪些依赖?这个循环是否并行?如果不是,说明怎样使它并行。
解答
S1 使用前一次迭代中 S2 赋的值,因此 S2 到 S1 存在循环携带依赖。尽管如此,这个循环仍能并行化。与前例不同,这个依赖关系没有环:两个语句都不依赖自身,而且虽然 S1 依赖 S2,S2 却不依赖 S1。如果一个循环可以写成依赖关系无环的形式,就可以并行化,因为无环意味着依赖关系只规定了语句之间的偏序。
原循环虽然没有依赖环,仍需变换以符合这一偏序、暴露并行性。两个观察至关重要:
- 不存在从 S1 到 S2 的依赖。否则就会形成环,循环不能并行。正因为没有这一依赖,交换两个语句不会影响 S2 的执行。
- 第一次迭代时,S2 依赖循环开始前计算好的
B[0]。
由此可以将原循环替换为:
译注: 第 2 点原文确为“S2 depends on … B[0]”。按题中代码,读取
B[0]的是 S1,S2 读取的是 C、D。
两个语句之间的依赖已不再由循环携带,因此只要保持每次迭代内的语句顺序,各次迭代就可以重叠执行。
分析应从找出所有循环携带依赖开始。这样的依赖信息是不精确的:它说明依赖可能存在。考虑:
这里第二次引用 A 不必翻译成加载指令,因为前一语句已经计算并保存了该值。第二次引用可以直接使用计算 A 时的寄存器。执行这项优化,必须知道两次引用总是指向同一内存地址,且中间没有访问并改动同一位置。通常,数据依赖分析只说明一次引用可能依赖另一次引用;要证明二者必定指向完全相同的地址,需要更复杂的分析。本例两次引用位于同一基本块,所以简单分析就足够。
译注: 原页上述两条赋值语句均未印出分号,代码按原样保留。
循环携带依赖经常以递推(recurrence)形式出现:某变量的值基于前一次或更早一次迭代中的值定义,通常依赖紧邻的前一次迭代,例如:
识别递推重要,有两个原因:一些体系结构,尤其是向量计算机,提供执行递推的特殊支持;在 ILP 场景中,也仍可能利用相当数量的并行性。
寻找依赖
发现程序依赖,对于判断哪些循环可能并行,以及消除名称依赖都很重要。依赖分析的复杂性还来自 C、C++ 的数组和指针,以及 Fortran 的引用传参。标量变量引用显式给出名称,通常比较容易分析;指针和引用参数导致的别名,会给这种分析带来一些复杂性和不确定性。
编译器一般怎样检测依赖?几乎所有依赖分析算法都假定数组下标为仿射形式。简单地说,如果一维数组下标能写成 ,其中 a、b 是常量,i 是循环索引变量,它就是仿射的。多维数组只有在各维下标都为仿射形式时,才满足这一条件。稀疏数组访问通常形如 x[y[i]],是非仿射访问的主要例子之一。
因此,判断循环中对同一数组的两次引用是否依赖,等价于判断两个仿射函数在循环界限内的不同索引处能否取相同值。例如,循环以 为下标存储,以 为下标加载,i 从 m 到 n。若以下两个条件成立,就存在依赖:
- 存在两个循环索引 j、k,都在循环范围内,即 、。
- 循环先写入下标 的元素,随后又通过下标 读取同一元素,即 。
一般而言,编译时无法总是判断依赖是否存在。例如,a、b、c、d 的值可能未知,甚至来自其他数组,于是无法确定依赖。另一些情况下,依赖在编译时可判定,但测试代价很高,例如访问取决于多层嵌套循环的迭代索引。不过,许多程序主要使用简单下标,a、b、c、d 都是常量,这时可以设计成本合理的编译时测试。
一个简单且足以证明不存在依赖的测试,是最大公约数 GCD 测试。它基于这样的事实:若存在循环携带依赖, 必须整除 。所谓整数 x 整除整数 y,是指 y/x 得到整数商且没有余数。
例题
用 GCD 测试判断下面的循环是否存在依赖:
解答
,因此 ,而 。2 不能整除 −3,所以不可能存在依赖。
GCD 测试能够充分保证依赖不存在;但即使满足其整除条件,也未必真的存在依赖,例如该测试没有考虑循环边界。
一般情况下,判断依赖是否真正存在是 NP 完全问题。不过,在实践中,许多常见情况可以低成本地精确分析。近年来,按通用性和成本逐层提高的一组精确测试,已经显示出准确而高效的效果。“精确”测试指能准确判定依赖是否存在;虽然一般情况是 NP 完全的,受限情形下仍有成本低得多的精确测试。
编译器除了检测依赖,还希望对依赖分类,以识别名称依赖,并在编译时通过重命名与复制消除。
例题
下面的循环包含多种依赖。找出所有真依赖、输出依赖和反依赖,并通过重命名消除输出依赖和反依赖。
解答
- 四条语句之间,由
Y[i]产生从 S1 到 S3、从 S1 到 S4 的真依赖。它们不是循环携带依赖,因此不妨碍循环并行,但要求 S3、S4 等待 S1 完成。 - 由
X[i]产生从 S1 到 S2 的反依赖。 - 由
Y[i]产生从 S3 到 S4 的反依赖。 - 由
Y[i]产生从 S1 到 S4 的输出依赖。
下列版本消除了这些假依赖:
循环后,变量 X 已重命名为 X1。编译器可在后续代码中直接用 X1 替换 X,因此这里不需要真正的复制操作,通过名称替换或寄存器分配即可完成;其他情况下,重命名仍可能需要复制。
译注: 原页重命名后代码的
for头缺少右括号,按原样保留。补上该右括号才是完整 C 语法;这不改变示例的依赖分析。
依赖分析既是利用并行性的关键技术,也是第 2 章分块等程序变换的基础。有效地为向量计算机、SIMD 计算机或多处理器编译程序,都高度依赖它。其主要局限是适用范围有限:通常只分析同一循环嵌套内、使用仿射下标函数的引用。因此,很多情形下,面向数组的依赖分析无法回答所需问题。例如,用指针而非数组下标访问时,分析会困难得多;这也是许多面向并行计算机的科学应用仍偏好 Fortran 而不是 C/C++ 的原因之一。跨过程调用分析引用也极为困难。因此,分析顺序语言代码固然重要,我们仍需要 OpenMP、CUDA 等显式编写并行循环的方法。
消除有依赖的计算
前面说过,递推是有依赖计算的重要形式,点积就是典型例子:
循环在变量 sum 上有循环携带依赖,所以不能并行。但可以把它变换为两个循环,一个完全并行,另一个部分并行。先执行完全并行的部分:
sum 从标量扩展成向量,这种变换称为标量扩展(scalar expansion),它使新循环完全并行。不过,随后还必须执行归约步骤,把向量各元素相加:
这个循环虽然不并行,却具有称为归约的特殊结构。归约在线性代数中很常见,也是第 6 章仓库级计算机所使用的主要并行原语 MapReduce 的关键部分。一般而言,任何函数都可以作为归约运算符,常见例子包括 max 和 min。
向量和 SIMD 体系结构有时用专门硬件处理归约,使其比标量方式快得多。
这些加速器采用的技术类似多处理器环境中的做法。一般变换适用于任意处理器数量;为简单起见,假设有 10 个处理器。求和归约的第一步中,每个处理器执行如下代码,p 为 0~9 的处理器编号:
10 个处理器各自累加 1000 个元素,这些工作完全并行;随后,一个简单的标量循环再把最后 10 个部分和相加。向量处理器和 SIMD 处理器采用类似方法。
需要注意,上述变换依赖加法结合律。无限范围、无限精度的算术满足结合律,计算机算术却未必满足:整数运算的范围有限,浮点运算的范围和精度都有限。因此,这些重组技术偶尔可能产生错误行为,尽管这种情况较少见。出于这一原因,多数编译器要求显式启用依赖结合律的优化。
译注: 本节引用“第 2 章 2.2 节”;但在本版中,循环展开的相应讨论属于第 3 章,而第 2 章讨论存储层次结构。
4.6 贯穿各层的问题
能耗与 DLP:低频而宽,还是高频而窄
数据级并行体系结构的一项根本功耗优势,可以从第 1 章的能量公式看出。假设具有充足的 DLP,将时钟频率减半、执行资源加倍,可以保持性能不变:向量计算机将通道数加倍,多媒体 SIMD 使用更宽的寄存器和 ALU,GPU 则增加 SIMD 通道。如果降低频率时还能降低电压,就能在维持相同峰值性能的同时,降低计算的能耗和功率。因此,相比依赖高时钟频率获得性能的系统处理器,GPU 通常频率较低,见 4.7 节。
与乱序处理器相比,DLP 处理器可以用更简单的控制逻辑在每个周期启动大量操作。例如,向量处理器所有通道的控制完全相同,不需要决定多指令发射的逻辑,也不需要推测执行逻辑。它们取指和译码的指令数量也少得多。向量体系结构还便于关闭未使用的芯片部分:每条向量指令发射时,就显式说明了随后若干周期所需的全部资源。
分存储体内存与高带宽内存
4.2 节指出,为支持单位步长、非单位步长和聚集/散布访问,向量体系结构需要很高的内存带宽。
为达到最高内存性能,AMD 和 NVIDIA 的高端 GPU 使用堆叠 DRAM,Intel 的 Xeon Phi 也采用它。这种内存也称高带宽内存 HBM,包括 HBM2、HBM3、HBM4:内存芯片层层堆叠,堆叠体与处理芯片相邻,置于同一插座内。极宽的总线,通常有 4096~5120 条数据线,提供高带宽;内存芯片与处理器芯片位于同一封装内,还能降低延迟和功耗。堆叠 DRAM 的容量通常为 8~32 GB。
计算任务和图形加速任务都可能产生大量内存需求,使存储系统面对许多互不相关的请求。这种分散性会损害性能。GPU 内存控制器为不同存储体维护独立的请求队列,等待积累足够多的请求后,再打开一行并一次性传送所有所需数据。这种等待提高了带宽,却增加了延迟;控制器必须确保没有处理单元因等待数据而饥饿,否则相邻处理器也可能闲置。4.7 节将说明,聚集/散布和考虑存储体组织的访问技术,相对于传统的基于缓存的体系结构,可以显著提高性能。
步长访问与 TLB 未命中
步长访问的一个问题,是它与向量体系结构或 GPU 中虚拟内存地址转换后备缓冲器 TLB 的相互作用;GPU 也用 TLB 完成内存映射。根据 TLB 的组织和内存中数组的大小,甚至可能每访问一个数组元素就发生一次 TLB 未命中!缓存也可能出现同类冲突,不过其性能影响可能较小。
4.7 融会贯通:嵌入式与服务器 GPU、Tesla 与 Core i7
图形应用十分普及,因此,移动客户端、笔记本电脑、高性能台式机和传统服务器中如今都能看到 GPU。图 4.29 列出了面向平板电脑和笔记本客户端的 Intel Xe GPU 片上系统,以及面向服务器的 NVIDIA Hopper GPU 的主要特征。
Iris Xe ICX 是 Intel GPU 微体系结构家族中的低功耗成员。它的基本构件是执行单元(Execution Unit,EU),即一个支持七路多线程的 SIMD 处理器。每个线程有 128 个寄存器,每个寄存器宽 32 字节。主要计算单元是一个八路 SIMD 单元,用于浮点和整数计算;辅助单元是一个两路 SIMD 单元,用于扩展数学运算。
每个 EU 每个时钟周期能够执行 16 次 16 位浮点运算,或 8 次 32 位浮点运算。图 4.29 所列实例有 96 个 EU、12 MB L3 缓存,每个时钟周期可以向 DRAM 传输 128 字节数据。
NVIDIA Hopper H100 的睿频时钟频率为 2.0 GHz,包含 132 个 SIMD 处理器。通往 HBM3 存储器的数据通路宽 5120 位,在 2.62 GHz 时钟的上升沿和下降沿都传输数据,因此,峰值存储器带宽为 3330 GB/s。
H100 裸片的各项物理指标都相当惊人:它包含 800 亿个晶体管,采用 TSMC 4 nm 工艺,裸片面积为 814 mm²,典型功率为 700 W。
| 特征 | Intel Xe GPU(Core i7-1195G7 中) | NVIDIA Hopper H100 |
|---|---|---|
| 推出年份 | 2021 | 2022 |
| 核心数 | 96 | 132 |
| 基础时钟频率(GHz) | 0.30 | 1.13 |
| 睿频时钟频率(GHz) | 1.40 | 1.98 |
| 裸片面积(mm²) | N.A. | 814 |
| 制造工艺 | Intel 10 nm SF | TSMC 4N |
| 功率(W) | 最高 28(包括 CPU、缓存等) | 700 |
| 晶体管数(十亿) | N.A. | 80 |
| 存储器技术 | LPDDR4x-4267 | HBM3 |
| 存储器容量(GB) | 32 | 80 |
| 存储器带宽(GB/s) | 68 | 3350 |
| 片上存储容量(MB) | 12 | 50 |
| 单精度 SIMD 宽度 | 8 | 32 |
| 双精度 SIMD 宽度 | N.A. | 32 |
| 单精度峰值(GFLOP/s) | N.A. | 66,900 |
| 双精度峰值(GFLOP/s) | N.A. | 33,500 |
| 机器学习 16 位峰值(GFLOP/s) | 4300 | 989,000 |
译注: 正文把 H100 的峰值带宽写为 3330 GB/s,图 4.29 写为 3350 GB/s。按正文给出的位宽和频率计算, GB/s。
GPU 与带有多媒体 SIMD 的 MIMD 的比较
一组 Intel 研究人员发表了一篇论文(Lee 等,2010),比较了带有多媒体 SIMD 扩展的四核 Intel i7 与 Tesla GTX 280。虽然这项研究没有采用 CPU 和 GPU 的最新版本,但它解释了性能差异背后的原因,因此是对这两种风格最深入的比较。此外,这两类体系结构的当前版本,与研究中的版本仍有许多相似之处。
图 4.30 列出了两个系统的特征。这两款产品都是在 2009 年秋季购买的。Core i7 采用 Intel 的 45 nm 半导体工艺,GPU 采用 TSMC 的 65 nm 工艺。如果由中立方,或由两个利益相关方共同进行比较,也许会更加公平;不过,本节的目的并非判定一种产品比另一种快多少,而是理解这两种截然不同的体系结构风格中,各项特征的相对价值。
| 特征 | Intel Core i7-960 | NVIDIA GTX 280 | GTX 280 / Core i7 |
|---|---|---|---|
| 处理单元数(核或 SM) | 4 | 30 | 7.5 |
| 时钟频率(GHz) | 3.2 | 1.3 | 0.41 |
| 裸片面积 | 263 | 576 | 2.2 |
| 制造工艺 | Intel 45 nm | TSMC 65 nm | 1.6 |
| 芯片功率(不是模块功率) | 130 | 130 | 1.0 |
| 晶体管数 | 7 亿 | 14 亿 | 2.0 |
| 存储器带宽(GB/s) | 32 | 141 | 4.4 |
| 单精度 SIMD 宽度 | 4 | 8 | 2.0 |
| 双精度 SIMD 宽度 | 2 | 1 | 0.5 |
| 单精度标量峰值(GFLOP/s) | 26 | 117 | 4.6 |
| 单精度 SIMD 峰值(GFLOP/s) | 102 | 311–933 | 3.0–9.1 |
| 单精度:一次加法或乘法 | N.A. | (311) | (3.0) |
| 单精度:一次融合乘加 | N.A. | 622 | 6.1 |
| 单精度:双发射融合乘加与乘法(罕见情况) | N.A. | 933 | 9.1 |
| 双精度 SIMD 峰值(GFLOP/s) | 51 | 78 | 1.5 |
译注: 原表制造工艺的比值写为 1.6,按表内数字 。图注所指“图 4.28”是术语比较表,不含带宽数据,显然是交叉引用错误;本节随后图 4.31 才列出实测 Roofline 带宽。以上均保留原值并注明。
图 4.31 中 Core i7 920 与 GTX 280 的 Roofline 曲线显示了这两台计算机的差异。920 的时钟频率低于 960(2.66 GHz 对 3.2 GHz),系统的其余部分相同。
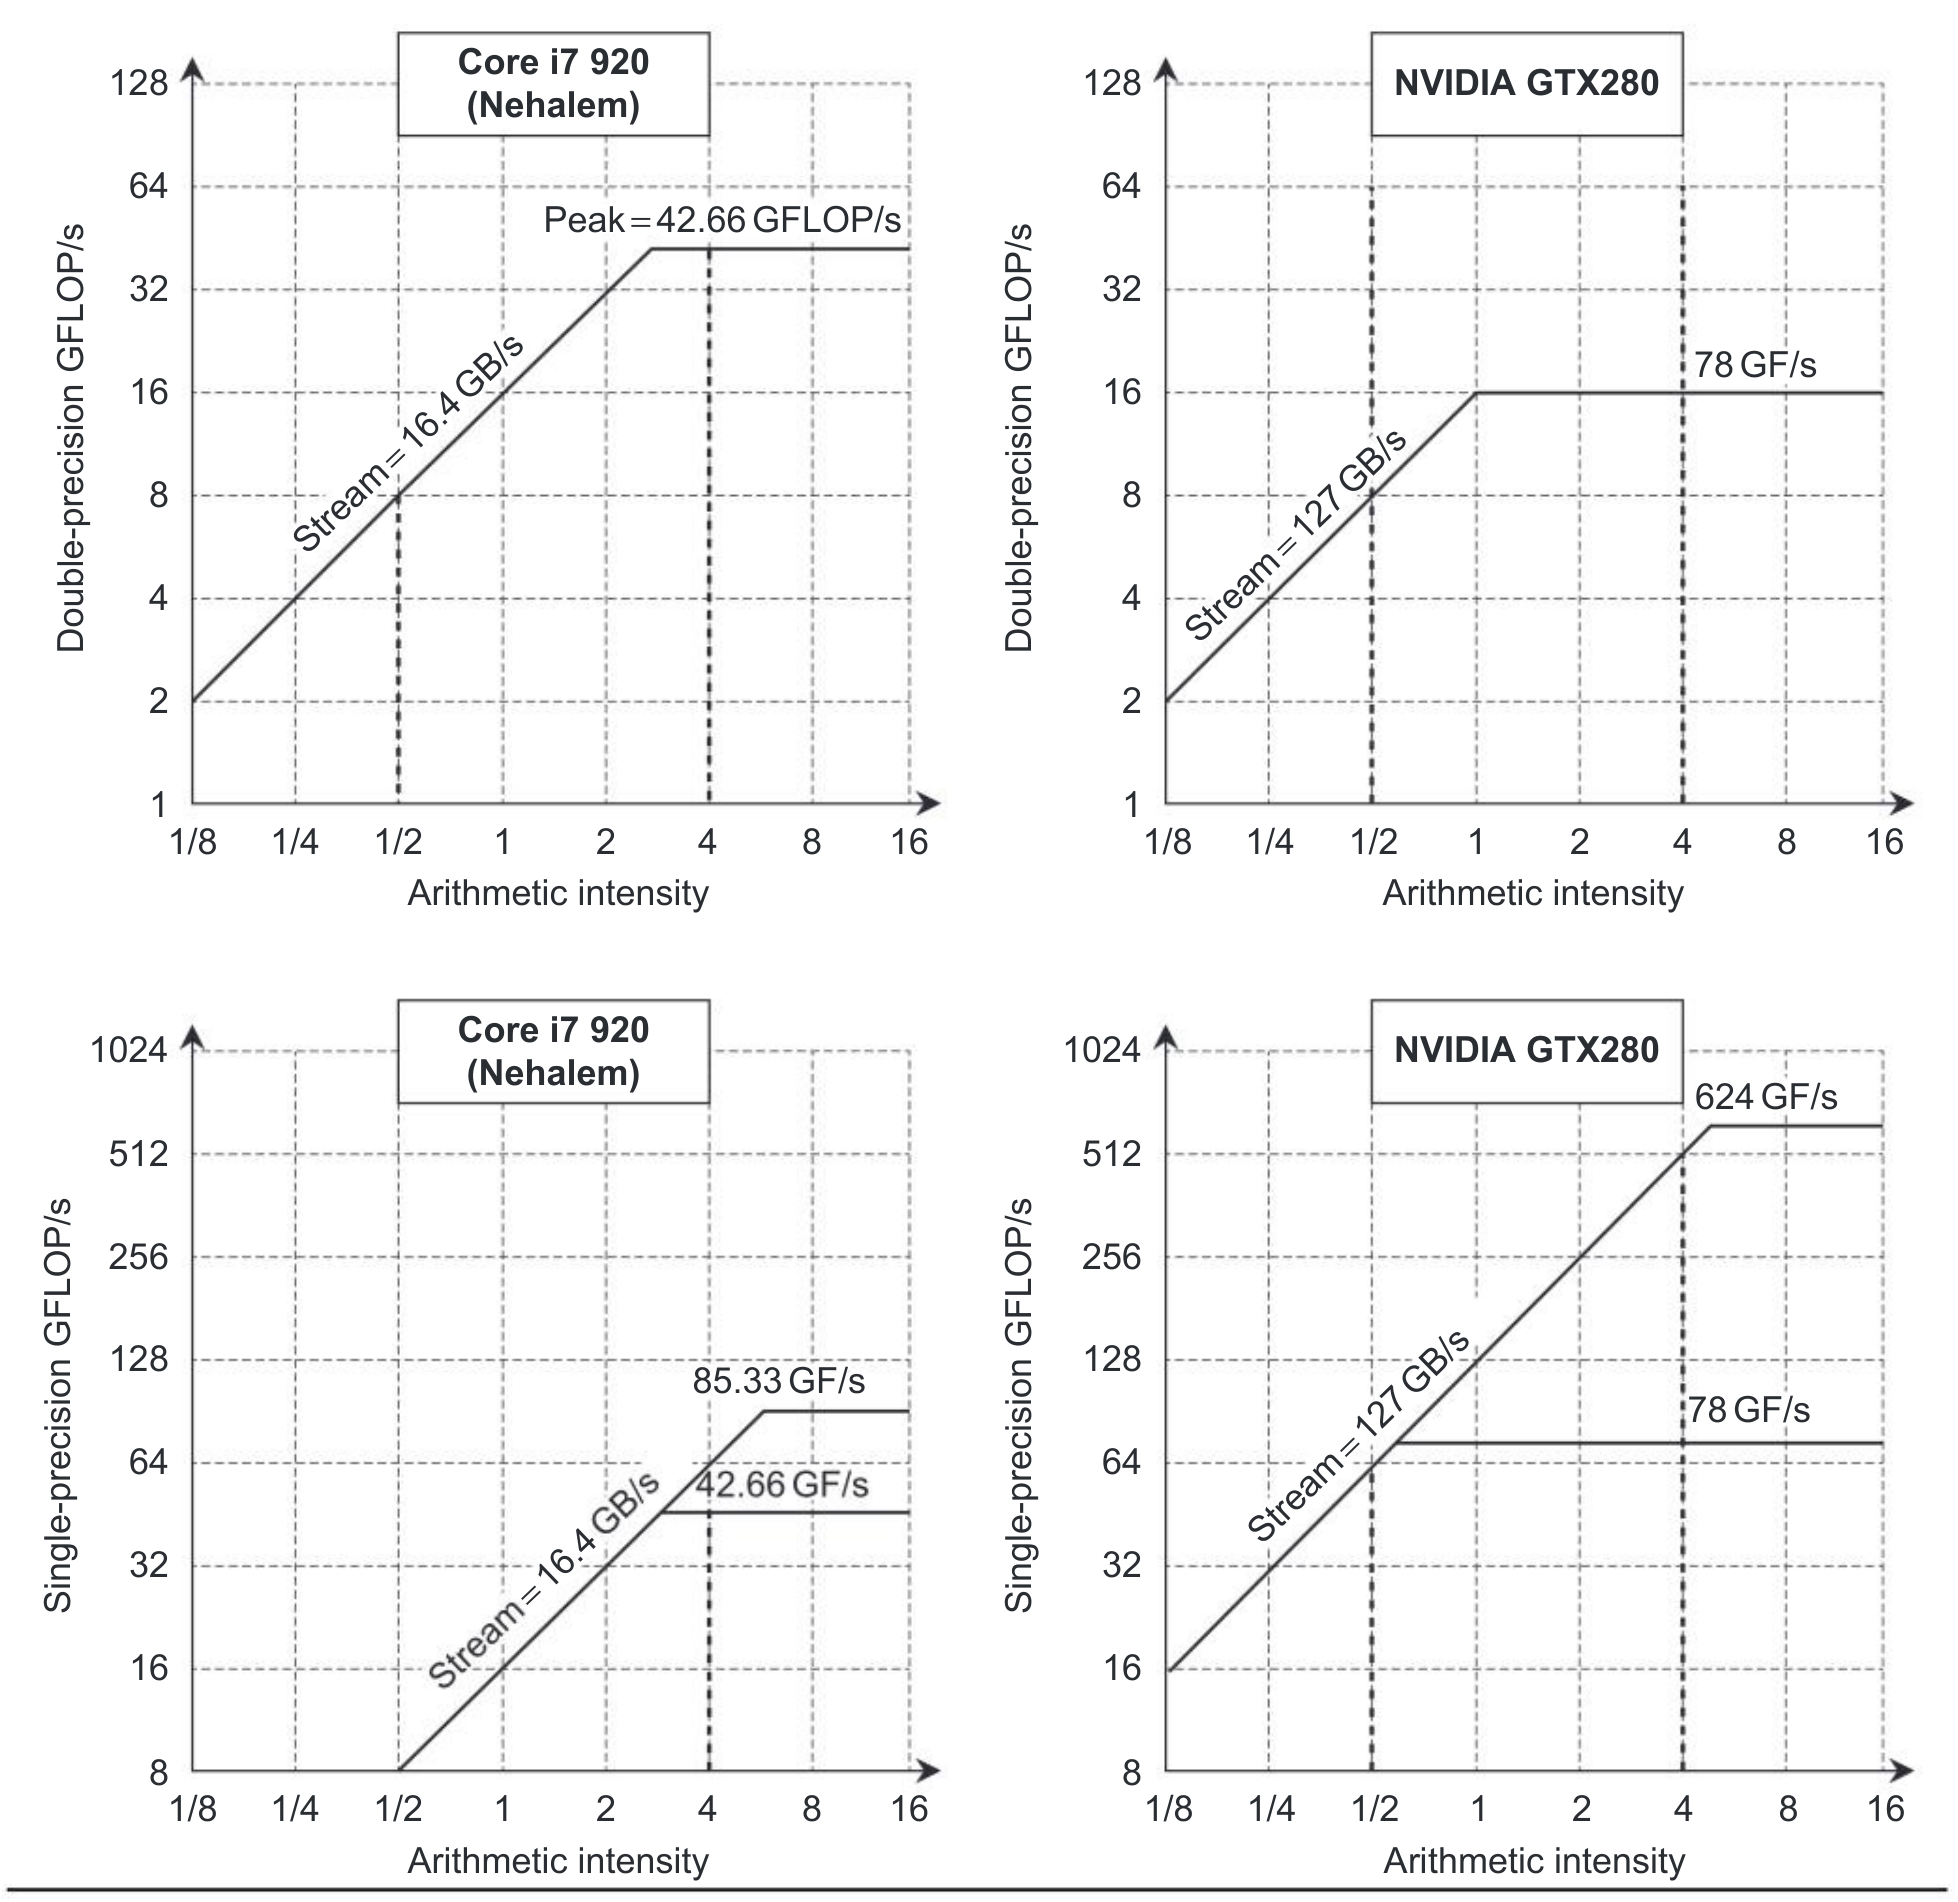
图内标记:Arithmetic intensity=算术强度;Double-precision/Single-precision GFLOP/s=双精度/单精度 GFLOP/s;Peak=峰值;Stream=STREAM 所测存储器带宽。
译注: 原图及图注有三处不一致。右上图的水平线标为 78 GFLOP/s,却画在纵轴约 16 的位置。图注末尾的“双精度 512 GFLOP/s”应与单精度曲线对应,因为同一图已给出双精度峰值 78 GFLOP/s。算术强度为 4 时,单精度性能仍受带宽限制:按图中数据,Core i7 为 GFLOP/s,GTX 280 为 GFLOP/s;因此,“仅受计算能力限制”不能同时适用于图注所列的全部情况。
GTX 280 不仅具有高得多的存储器带宽和双精度浮点性能,其双精度曲线的转折点也明显更靠左。前面提到,Roofline 曲线的转折点越靠左,就越容易达到计算性能峰值。GTX 280 的双精度转折点为 0.6,Core i7 为 2.6。单精度情况下,转折点向右移动了很多;由于单精度性能上限高得多,要达到这一上限也困难得多。注意,内核的算术强度根据访问主存的字节数计算,而不是访问缓存的字节数。因此,如果大部分访问确实命中缓存,缓存就可能改变一个内核在某台计算机上的算术强度。Roofline 曲线有助于解释本案例中的相对性能。还要注意,两种体系结构给出的带宽都针对单位步长访问;后面会看到,对于不能合并的实际聚集/散布地址,GTX 280 和 Core i7 都会更慢。
研究人员表示,他们先分析了当时新提出的四套基准测试的计算与存储访问特征,再“制定出能够体现这些特征的一组吞吐计算内核”。图 4.32 描述了这 14 个内核,图 4.33 给出了性能结果,数值越大表示速度越快。
GTX 280 的原始规格与 Core i7 相比,从慢 2.5 倍(时钟频率)到快 7.5 倍(每芯片核心数)不等;实际性能则从慢 2.0 倍(Solv)到快 15.2 倍(GJK)不等。Intel 研究人员分析了这些差异的原因:
- 存储器带宽。 GPU 的存储器带宽是 Core i7 的 4.4 倍,这有助于解释 LBM 和 SAXPY 分别快 5.0 倍与 5.3 倍的原因:两者的工作集都达数百 MB,无法装入 Core i7 的缓存。(为了密集地访问存储器,SAXPY 没有采用缓存分块。)因此,Roofline 曲线的斜率解释了它们的性能。SpMV 的工作集也很大,但只快 1.9 倍,因为 GTX 280 的双精度浮点性能仅为 Core i7 的 1.5 倍。
- 计算吞吐能力。 其余内核中有五个受计算能力限制:SGEMM、Conv、FFT、MC 和 Bilat。GTX 分别快 3.9、2.8、3.0、1.8 和 5.7 倍。前三个使用单精度浮点运算,而 GTX 280 的单精度性能快 3–6 倍。(图 4.30 所示比 Core i7 快 9 倍的情况,仅发生在 GTX 280 每个周期都能发射一次融合乘加和一次乘法这一极特殊的条件下。)MC 使用双精度运算,所以只快 1.8 倍,因为双精度性能仅快 1.5 倍。Bilat 使用超越函数,GTX 280 直接提供硬件支持(见图 4.18)。Core i7 有三分之二的时间花在计算超越函数上,因此 GTX 280 快 5.7 倍。
最后这一观察说明了对工作负载中常见运算提供硬件支持的价值:包括双精度浮点运算,甚至可能包括超越函数。
- 缓存的收益。 光线投射(RC)在 GTX 上只快 1.6 倍,因为 Core i7 的缓存与缓存分块使它避免像 GPU 上那样受存储器带宽限制。缓存分块也有助于 Search。如果索引树足够小,能装入缓存,Core i7 的速度就是其两倍。较大的索引树则会使程序受存储器带宽限制。
| 内核(简称) | 应用领域 | SIMD 并行性的特点 | 线程级并行性的划分 | 性能特点 |
|---|---|---|---|---|
| SGEMM(SGEMM) | 线性代数 | 规则 | 跨二维分块 | 分块后受计算能力限制 |
| Monte Carlo(MC) | 计算金融 | 规则 | 跨路径 | 受计算能力限制 |
| 卷积(Convolution,Conv) | 图像分析 | 规则 | 跨像素 | 受计算能力限制;小滤波器时受带宽限制 |
| FFT(FFT) | 信号处理 | 规则 | 跨较小的 FFT | 依规模而定,受计算能力或带宽限制 |
| SAXPY(SAXPY) | 点积 | 规则 | 跨向量 | 大向量时受带宽限制 |
| LBM(LBM) | Time migration | 规则 | 跨单元 | 受带宽限制 |
| 约束求解器(Constraint solver,Solv) | 刚体物理 | 聚集/散布 | 跨约束 | 受同步限制 |
| SpMV(SpMV) | 稀疏求解器 | 聚集 | 跨非零元素 | 典型的大矩阵受带宽限制 |
| GJK(GJK) | 碰撞检测 | 聚集/散布 | 跨对象 | 受计算能力限制 |
| 排序(Sort) | 数据库 | 聚集/散布 | 跨元素 | 受计算能力限制 |
| 光线投射(Ray casting,RC) | 体绘制 | 聚集 | 跨射线 | 第一级工作集为 4–8 MB;最后一级超过 500 MB |
| 搜索(Search) | 数据库 | 聚集/散布 | 跨查询 | 小树时受计算能力限制;大树底部受带宽限制 |
| 直方图(Histogram,Hist) | 图像分析 | 需要冲突检测 | 跨像素 | 受归约/同步限制 |
| Bilateral(Bilat) | 图像分析 | 规则 | 跨像素 | 受计算能力限制 |
译注: 原表把 SAXPY 的应用写为“Dot product(点积)”,这里按原表保留。SAXPY 本身计算的是标量乘向量再加另一向量,并非点积。LBM 的应用栏“Time migration”也按原表保留,不根据缩写另行推定其应用。
总的来说,GTX 280 上的 Search 快 1.8 倍。缓存分块也有助于 Sort。虽然大多数程序员不会在 SIMD 处理器上运行 Sort,但可以用名为 split 的 1 位排序原语来实现它。不过,split 算法执行的指令远多于标量排序。因此,GTX 280 的速度仅为 Core i7 的 0.8 倍。缓存也有助于 Core i7 上的其他内核,因为缓存分块能让 SGEMM、FFT 和 SpMV 转为受计算能力限制。这再次说明了第 2 章所述缓存分块优化的重要性。
- 聚集/散布。 如果数据分散在主存各处,多媒体 SIMD 扩展几乎帮不上忙;只有数据按 16 字节边界对齐时,才能获得最佳性能。因此,GJK 在 Core i7 上从 SIMD 获得的收益很小。如前所述,GPU 提供了向量体系结构具有、但 SIMD 扩展缺失的聚集/散布寻址。地址合并单元也发挥了作用:它把对同一 DRAM 行的访问合并起来,减少聚集和散布的次数。存储器控制器还会把访问同一 DRAM 页的请求放到一批中。这些机制相结合,使 GTX 280 上的 GJK 比 Core i7 快了惊人的 15.2 倍,超过图 4.30 中任何单一物理参数的比值。这进一步说明了聚集/散布对向量和 GPU 体系结构的重要性,而 SIMD 扩展恰恰缺少它。
| 内核 | 单位 | Core i7-960 | GTX 280 | GTX 280 / Core i7 |
|---|---|---|---|---|
| SGEMM | GFLOP/s | 94 | 364 | 3.9 |
| MC | 十亿路径/s | 0.8 | 1.4 | 1.8 |
| Conv | 百万像素/s | 1250 | 3500 | 2.8 |
| FFT | GFLOP/s | 71.4 | 213 | 3.0 |
| SAXPY | GB/s | 16.8 | 88.8 | 5.3 |
| LBM | 百万次查找/s | 85 | 426 | 5.0 |
| Solv | 帧/s | 103 | 52 | 0.5 |
| SpMV | GFLOP/s | 4.9 | 9.1 | 1.9 |
| GJK | 帧/s | 67 | 1020 | 15.2 |
| Sort | 百万元素/s | 250 | 198 | 0.8 |
| RC | 帧/s | 5 | 8.1 | 1.6 |
| Search | 百万次查询/s | 50 | 90 | 1.8 |
| Hist | 百万像素/s | 1517 | 2583 | 1.7 |
| Bilat | 百万像素/s | 83 | 475 | 5.7 |
- 同步。 Hist 的同步性能受原子更新限制。即使 Core i7 提供硬件取值并递增指令,原子更新仍占其总运行时间的 28%。因此,原文称“Hist 只比 GTX 280 快 1.7 倍”。Solv 对一批互相独立的约束进行少量计算,然后执行屏障同步。Core i7 受益于原子指令,以及一个即使此前对存储层次结构的访问尚未全部完成、也能保证结果正确的存储一致性模型。GTX 280 缺少这样的存储一致性模型,其版本需要由系统处理器启动某些批次,结果 GTX 280 的速度只有 Core i7 的一半。这说明,对某些数据并行问题,同步性能可能十分重要。
译注: “Hist 只比 GTX 280 快 1.7 倍”是原文的比较方向。根据上一页图 4.33,Hist 在 GTX 280 上为 2583 百万像素/s,在 Core i7 上为 1517 百万像素/s,实际是 GTX 280 约快 1.7 倍。
值得玩味的是,向量体系结构比 SIMD 指令早了几十年,其聚集/散布支持却对这些 SIMD 扩展的实际效果如此重要;在这项比较之前就有人作出了这一判断(Gebis 与 Patterson,2007)。Intel 研究人员指出,如果 Core i7 能提供更高效的聚集/散布支持,14 个内核中有 6 个就能更好地利用 SIMD。
这项比较还缺少一项重要信息:在两个系统上获得这些结果,各自需要付出多少努力。理想情况下,今后的比较应公开两边使用的代码,让其他人能在不同硬件平台上复现实验,并可能进一步改进结果。
比较的更新
此后的几年中,Core i7 与 Tesla GTX 280 的后继产品针对其弱点作出了改进。Intel 的 ACV2 增加了聚集指令,AVX/512 增加了散布指令,两者都出现在 Intel Skylake 系列中。NVIDIA Pascal 的双精度浮点性能达到单精度的一半,而非八分之一,还提供了快速原子操作和缓存。
译注: 原文写作“ACV2”和“AVX/512”。结合本章 4.3 节的扩展名称,分别应为 AVX2 和 AVX-512。
图 4.34 列出了这两款后继产品的特征。图 4.35 使用原论文 14 个基准中的 3 个比较性能——我们只找到了这 3 个的源代码。图 4.36 给出了两个新的 Roofline 模型。新 GPU 芯片比其前代快 15–50 倍,新 CPU 芯片比其前代快 50 倍,而新 GPU 比新 CPU 快 2–5 倍。
从历史来看,GPU 上 SGEMM 相对 CPU 的 3.9 倍加速,以及 CUDA 的可用性,对 Intel 和 NVIDIA 后来的发展都至关重要。SGEMM 是 Single precision GEneral Matrix Multiply(单精度通用矩阵乘法)的缩写,而矩阵乘法正是深度神经网络的核心计算。Alex Krizhevsky 是多伦多大学的博士生,曾选修一门使用 GPU 进行计算的研究生课程。2012 年,他在 GPU 上训练了名为 AlexNet 的神经网络,并将其提交给计算机视觉领域的 ImageNet 竞赛。AlexNet 不仅获得第一名,还大幅降低了视觉识别错误率。2012 年,AlexNet 是唯一参赛的 DNN;仅仅两年之后,全部参赛方案都依赖 DNN。这个结果推动 GPU 成为 DNN 的首选计算引擎,DNN 的重要性此后也迅速上升。
2012 年,Intel 的市值是 NVIDIA 的 10 多倍。在我们于 2024 年修订本章时,DNN 的日益普及使双方地位反转:NVIDIA 的市值已超过 Intel 的 30 倍。注意,2012 年 NVIDIA 并没有一个以 DNN 为目标的宏大计划。它通过 CUDA 尽可能向更多程序员开放 GPU 的潜力,让任何人都能围绕任何课题探索,使一个杀手级应用自行出现,由此获得了成功。
| 特征 | Intel Xeon Platinum 8180 | NVIDIA P100 | P100 / Xeon |
|---|---|---|---|
| 处理单元数(核或 SM) | 28 | 56 | 2.0 |
| 时钟频率(GHz) | 2.5 | 1.3 | 0.52 |
| 裸片面积 | N.A. | 610 mm² | — |
| 制造工艺 | Intel 14 nm | TSMC 16 nm | 1.1 |
| 芯片功率(不是模块功率) | 80 W | 300 W | 3.8 |
| 晶体管数 | N.A. | 153 亿 | — |
| 存储器带宽(GB/s) | 199 | 732 | 3.7 |
| 单精度 SIMD 宽度 | 16 | 8 | 0.5 |
| 双精度 SIMD 宽度 | 8 | 4 | 0.5 |
| 单精度 SIMD 峰值(GFLOP/s) | 4480 | 10,608 | 2.4 |
| 双精度 SIMD 峰值(GFLOP/s) | 2240 | 5304 | 2.4 |
译注: 图 4.34 再次把带宽比较指向不含带宽数据的图 4.28,属于与图 4.30 同样的交叉引用疑误。
| 内核 | 单位 | Xeon 8180 | P100 | P100 / Xeon | 原平台 GTX 280 / Core i7-960 |
|---|---|---|---|---|---|
| SGEMM | GFLOP/s | 3494 | 6827 | 2.0 | 3.9 |
| DGEMM | GFLOP/s | 1693 | 3490 | 2.1 | — |
| FFT-S | GFLOP/s | 410 | 1820 | 4.4 | 3.0 |
| FFT-D | GFLOP/s | 190 | 811 | 4.2 | — |
| SAXPY | GB/s | 207 | 544 | 2.6 | 5.3 |
| DAXPY | GB/s | 212 | 556 | 2.6 | — |
译注: 图 4.35 图注所指的“图 4.30”是硬件参数表;此前以 SAXPY 测量带宽的基准结果实际位于图 4.33。
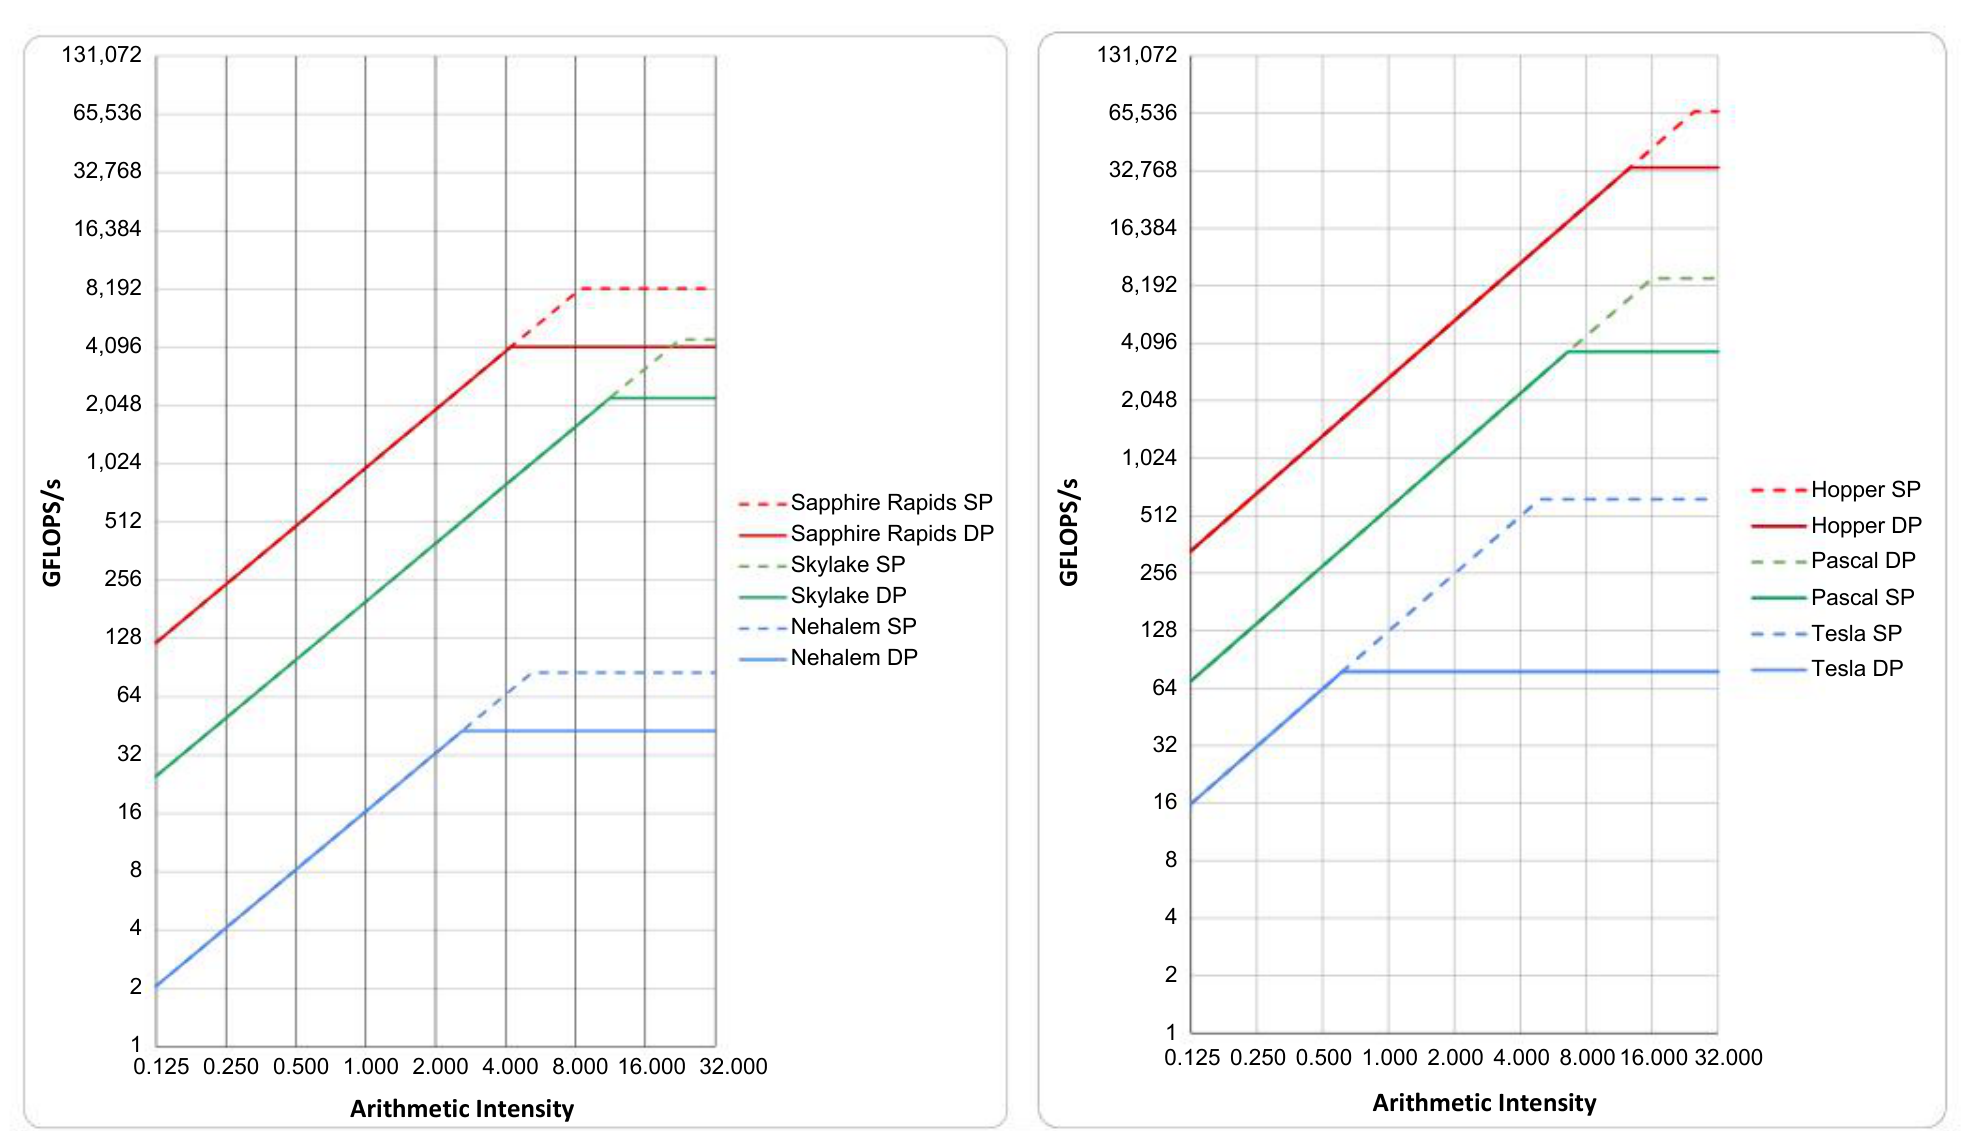
图内标记:Arithmetic Intensity=算术强度;SP=单精度;DP=双精度;纵轴 GFLOPS/s 按原图保留;Sapphire Rapids、Skylake、Nehalem、Hopper、Pascal、Tesla 均为产品或微体系结构名称。
译注: 原图右侧图例把 Pascal 较高的曲线标为 DP、较低的曲线标为 SP,与本图图注和前文 P100 的单、双精度峰值关系相反。
本节图 4.30、4.32、4.33 的完整出处:Lee, W.V., et al., 2010. Debunking the 100× GPU vs. CPU myth: an evaluation of throughput computing on CPU and GPU. In: Proc. 37th Annual Int’l. Symposium on Computer Architecture (ISCA), June 19–23, 2010, Saint-Malo, France.
4.8 谬误与陷阱
从程序员的角度看,DLP 是仅次于 ILP 的最容易利用的并行性;从体系结构设计者的角度看,它也可能是最简单的一类。不过,其中仍有许多谬误与陷阱。
谬误:GPU 作为协处理器,处于不利地位
主存与 GPU 存储器相分离固然有缺点,但与 CPU 保持一定距离也有优势。
例如,PTX 的存在,部分原因就在于 GPU 具有 I/O 设备的性质。编译器与硬件之间的这一间接层,让 GPU 体系结构设计者拥有远大于系统处理器设计者的灵活性。我们往往很难事先知道,一项体系结构创新能否获得编译器和程序库的良好支持,以及它对应用是否重要。有时,一种新机制可能只在一两代产品中有用,随后便随着 IT 世界的变化而不再重要。PTX 允许 GPU 设计者探索性地尝试创新,并在效果不佳或重要性下降时,在后续几代中将其移除,从而鼓励了实验。对于系统处理器,纳入新特性所需的论据自然要充分得多,因而能进行的实验也少得多:发布二进制机器码,通常就意味着这一体系结构今后的所有代际都必须支持这些新特性。
PTX 的价值已有实例证明:不同代的体系结构曾彻底改变硬件指令集,从类似 x86 的面向存储器的形式,改为类似 RISC-V 的面向寄存器的形式,并把地址宽度加倍至 64 位,却没有破坏 NVIDIA 的软件栈。
陷阱:只关注向量体系结构的峰值性能,忽略启动开销
早期存储器—存储器型向量处理器,例如 TI ASC 和 CDC STAR-100,启动时间很长。对于某些向量问题,向量长度必须超过 100,向量代码才会比标量代码快!由 STAR-100 派生的 CYBER 205,执行 DAXPY 的启动开销为 158 个时钟周期,使向量与标量性能持平所需的向量长度明显增加。如果 Cray-1 与 CYBER 205 的时钟频率相同,那么在向量长度超过 64 以前,Cray-1 都更快。实际上,Cray-1 的时钟频率也更高,尽管 205 推出的时间更晚,因此两者性能交叉时的向量长度超过了 100。
陷阱:提升向量性能,却没有相应提升标量性能
这种不平衡是许多早期向量处理器的问题,也是 Cray 计算机的设计者 Seymour Cray 改写既有规则的领域。许多早期向量处理器的标量单元相当慢,启动开销也很大。即使在今天,向量性能较低、但标量性能较好的处理器,也可能胜过峰值向量性能更高的处理器。良好的标量性能能够压低各种开销,例如 strip mining,并减轻 Amdahl 定律的影响。
一个很好的例子是,比较一台高速标量处理器和一台标量性能较低的向量处理器。Livermore Fortran 内核包含 24 个科学计算内核,各自的可向量化程度不同。图 4.37 给出了两个不同处理器在这套基准上的性能。尽管向量处理器的峰值性能更高,但以调和平均值衡量时,较低的标量性能使它慢于高速标量处理器。
今天,这种危险的另一种表现,是只提高向量性能——例如增加通道数——却不提高标量性能。这种短视也会把计算机引向不平衡的设计。
下一个谬误与此密切相关。
| 处理器 | 所有循环中的最低速率(MFLOPS) | 所有循环中的最高速率(MFLOPS) | 全部 24 个循环的调和平均值(MFLOPS) |
|---|---|---|---|
| MIPS M/120-5 | 0.80 | 3.89 | 1.85 |
| Stardent-1500 | 0.41 | 10.08 | 1.72 |
谬误:不提供足够的存储器带宽,也能获得良好的向量性能
从 DAXPY 循环与 Roofline 模型中可以看到,存储器带宽对所有 SIMD 体系结构都十分重要。DAXPY 每次浮点运算需要 1.5 次存储器访问,这也是许多科学计算程序的典型比例。即使浮点运算完全不花时间,Cray-1 也无法提高所用向量指令序列的性能,因为它受存储器限制。当编译器通过分块改变计算,使数据能够保留在向量寄存器中时,Cray-1 的 Linpack 性能出现了飞跃。这种方法降低了每 FLOP 对应的存储器访问次数,使性能提高到接近原来的两倍!对于原先需要更高带宽的循环,此时 Cray-1 的存储器带宽便足够了。
谬误:GPU 的存储器性能不足时,只要增加线程就行
GPU 使用大量 CUDA 线程来隐藏访问主存的延迟。如果各 CUDA 线程的存储器访问十分分散,或彼此缺少关联,存储器系统响应每个独立请求的速度就会越来越慢。最终,即使线程很多,也无法掩盖这些延迟。因此,要让“增加 CUDA 线程”的策略奏效,不仅需要大量 CUDA 线程,这些线程的存储器访问还必须具有良好的局部性。
4.9 结束语
各种流行应用凸显了音频、视频和游戏在个人移动设备上的重要地位,数据级并行性(DLP)对这些设备也因而变得日益重要。再加上 DLP 的编程模型比任务级并行性更容易使用,并且可能拥有更好的能效,就不难理解为什么 DLP 在这十年中迎来了复兴。
我们正在看到,系统处理器越来越多地具备 GPU 的特征,反之亦然。传统处理器与 GPU 之间最大的性能差异之一,来自聚集/散布寻址。传统向量体系结构已经展示了如何为 SIMD 指令加入这种寻址方式;我们预计,随着时间推移,SIMD 扩展还会吸收更多来自成熟向量体系结构的思想。
正如 4.4 节开头所说,GPU 面临的问题并不只是“哪一种体系结构最好”,而是:既然已经为高效处理图形投入了硬件,应该如何增强它,使其支持更通用的计算?虽然向量体系结构在理论分析中有许多优势,但它能否像 GPU 一样,成为图形处理的良好基础,仍有待证明。RISC-V 选择了向量体系结构而非 SIMD。如同过去的体系结构之争,市场将帮助判定这两种数据并行体系结构的优势和弱点究竟有多重要。到目前为止,DNN 越来越普及,且依赖 NVIDIA GPU 与 CUDA 进行训练——第 7 章将介绍这一点——已使 DLP 的天平向 GPU 倾斜。
4.10 历史回顾与参考文献
在线提供的 M.6 节讨论了 ILLIAC IV——早期 SIMD 体系结构的代表——以及 Cray-1——向量体系结构的代表。我们还考察了多媒体 SIMD 扩展与 GPU 的历史。
案例与习题
作者:Jason D. Bakos。
案例:低算术强度机器学习任务中的 GPU 与向量处理器
本案例涉及的概念:
- 算术强度与性能瓶颈
- GPU(SIMT)编程模型与并行性
- 向量处理器编程模型与并行性
考虑一个执行神经网络批量归一化(batch normalization)层和整流线性单元(ReLU)层的内核。把这两层合在一起,对应的 C 代码如下。
假设所有变量均为 float16 类型。
习题 4.1
[5]〈4.3〉 从输入和输出数组每访问一个字节,需要执行多少次算术运算?
习题 4.2
[15]〈4.4〉 用 PTX 实现这个循环体。假设 in 和 out 数组存放在全局内存中,mean、stddev、scale 和 offset 数组存放在共享内存中。
习题 4.3
[5]〈4.4〉 假设在你的 GPU 上,加载指令的延迟为 10 个周期,其他所有浮点指令的延迟均为 4 个周期。GPU 核心上必须执行多少个 Warp,才能隐藏所有指令延迟,也就是让核心始终保持 100% 利用率?假设核心的寄存器数量无限,存储器系统的带宽也无限。若每个 Warp 有 32 个线程,对应的线程总数是多少?
习题 4.4
[4]〈4.4〉 假设代码结构如下,并且在一个 Warp 内,、、。codeblock1 的延迟为 100 个周期,codeblock2 为 200 个周期,codeblock3 为 300 个周期。预期执行时间是多少?
译注: 原题代码含
codeblock4,但题干没有给出其延迟,也没有说明各线程条件之间的相关性。
习题 4.5
[15]〈4.2〉 用 RV64V 汇编实现 a 部分的代码。假设该体系结构支持 16 位浮点数,寄存器初值如下:
x1:in数组的基地址x2:mean数组的基地址x3:stddev数组的基地址x4:scale数组的基地址x5:offset数组的基地址x6:out数组的基地址x7:n_channels
你可能需要下面这条未列入图 4.2 的 RV64V 指令:
习题 4.6
[10]〈4.2〉 假设有两个加载/存储单元和五个向量浮点单元。重新安排 e 部分的代码,把指令组织成编队。
习题 4.7
[5]〈4.2〉 向量长度为 32 时,f 部分的向量指令序列需要多少个 chime?每 FLOP 的周期数是多少?
译注: 原题 4.5、4.6、4.7 分别引用“a 部分”“e 部分”“f 部分”,但本版将前面的题目排为独立编号 4.1–4.7,没有这些字母小问。结合连续题干,它们分别承接案例代码、习题 4.5 与习题 4.6。
习题 4.8
[10/20/20/15/15]〈4.2〉 考虑下面的代码,它将两个包含单精度复数的向量相乘:
习题 4.9
假设处理器工作频率为 700 MHz,最大向量长度为 64。加载/存储单元的启动开销为 15 个周期,乘法单元为 8 个周期,加/减法单元为 5 个周期。
a. [10]〈4.3〉 这个内核的算术强度是多少?说明理由。
b. [20]〈4.2〉 使用 strip mining,将这个循环转换为 RV64V 汇编代码。
c. [20]〈4.2〉 假设支持链接,并且只有一条存储器流水线,需要多少个 chime?包括启动开销在内,每个复数结果需要多少个时钟周期?
d. [15]〈4.2〉 如果向量指令序列采用链接,包括开销在内,每个复数结果需要多少个时钟周期?
e. [15]〈4.2〉 现在假设处理器有三条存储器流水线,并支持链接。如果循环中的访问没有存储体冲突,每个结果需要多少个时钟周期?
译注: 原页将复数乘法代码标为习题 4.8,将后续假设和 a–e 小问标为 4.9。c、d 两问原文都写了链接条件,条件存在重复,未擅自把其中一问改成“不支持链接”。
习题 4.10
[30]〈4.2、4.3、4.4〉 本题比较向量处理器,与一个由标量处理器和 GPU 协处理器组成的混合系统的性能。在混合系统中,主机处理器的标量性能优于 GPU,所以所有标量代码均在主机处理器上执行,所有向量代码均在 GPU 上执行。我们把第一个系统称为向量计算机,第二个系统称为混合计算机。
假设目标应用包含一个向量内核,其算术强度为每访问一个 DRAM 字节执行 0.5 FLOP。不过,应用还有一个标量部分,必须在内核执行之前和之后分别准备输入向量与输出向量。对于一个样本数据集,标量代码部分在向量处理器,以及混合系统的主机处理器上,都需要 400 ms 执行时间。内核读取的输入向量共包含 200 MB 数据,输出数据为 100 MB。向量处理器的峰值存储器带宽为 30 GB/s,GPU 的峰值存储器带宽为 150 GB/s。混合系统还有额外开销:在调用内核前后,需要在主机内存与 GPU 本地内存之间传送所有输入向量。混合系统的直接存储器访问(DMA)带宽为 10 GB/s,平均延迟为 10 ms。假设向量处理器和 GPU 的性能都受存储器带宽限制。计算这两台计算机执行该应用所需的时间。
译注: 原题在“内核调用前后”都写“所有输入向量”,并未在此处区分输入传入与输出传回;这里忠实保留。此处 GPU local memory 指与主机内存相对的 GPU 本地内存,不等同于前文 NVIDIA 为每线程私有地址空间使用的 Local Memory 名称。
习题 4.11
[15/25/25]〈4.4、4.5〉 4.5 节讨论了归约操作,即通过反复应用某个运算,把一个向量缩减为一个标量。归约是循环递推的一种特殊形式。例如:
向量化编译器可以应用一种名为**标量扩展(scalar expansion)**的变换,把 dot 扩展为向量,并拆分循环,使乘法能够用向量运算完成,而归约保留为单独的标量运算:
如 4.5 节所述,如果允许浮点加法满足结合律,就可以用多种技术并行执行归约。
重写这个循环,使其符合这些准则,并消除取模运算符。假设每个 Warp 有 32 个线程;只要同一 Warp 中两个或更多线程所访问下标除以 32 的余数相同,就会发生存储体冲突。
a. [15]〈4.4、4.5〉 一种方法称为递推倍增(recurrence doubling),它依次对越来越短的向量进行相加,例如先把两个 32 元素向量相加,再把两个 16 元素向量相加,依此类推。写出以这种方式执行第二个循环的 C 代码。
b. [25]〈4.4、4.5〉 在某些向量处理器中,向量寄存器内的单个元素可以寻址。因此,一个向量运算的两个操作数可以来自同一向量寄存器的不同部分。利用这种灵活性,还可以采用另一种名为**部分和(partial sums)**的归约方案:将向量归约为 个和,其中 是向量功能单元的总延迟,包括操作数读写的时间。
假设 RV64 向量寄存器可以按元素寻址,例如,可以用操作数 V1(16) 启动向量运算,表示输入操作数从第 16 个元素开始。另假设加法的总延迟为 8 个周期,包括读取操作数和写入结果的时间。写出一个 RV64V 代码序列,将 V1 的内容归约为 8 个部分和。
c. [25]〈4.4、4.5〉 在 GPU 上执行归约时,为输入向量的每个元素关联一个线程。首先,每个线程把相应的值写入共享内存。然后,每个线程进入一个循环,将输入值两两相加。每次迭代后,元素数量减半,活跃线程数也随之减半。为了尽可能提高归约性能,整个循环过程中应尽量增加所有线程都活跃的 Warp 数量。换句话说,活跃线程应当连续。此外,每个线程对共享数组的索引方式还应避免共享内存中的存储体冲突。下面的循环只违反第一条准则,并使用了对 GPU 而言代价很高的取模运算符。
译注: 原书把 c 小问所称的“下面的循环”,以及要求改写该循环的段落,排在 a 小问之前。原页循环更新式写作
s * = 2,其中空格拆开了复合赋值运算符;可编译的 C/CUDA 写法应为s *= 2。
习题 4.12
[10/10/10/10]〈4.3〉 下面的内核实现了时域有限差分(finite-difference time-domain,FDTD)方法的一部分,用于计算三维空间中的 Maxwell 方程。这是 SPEC06fp 某个基准的一部分:
假设 dH1、dH2、Hy、Hz、dy、dz、Ca、Cb 和 Ex 都是单精度浮点数组,IDx 是 unsigned int 数组。
a. [10]〈4.3〉 这个内核的算术强度是多少?
b. [10]〈4.3〉 这个内核适合向量执行或 SIMD 执行吗?为什么?
c. [10]〈4.3〉 假设在存储器带宽为 30 GB/s 的处理器上执行这个内核。它受存储器限制,还是受计算能力限制?
d. [10]〈4.3〉 假设该处理器的峰值计算吞吐量为 85 GFLOP/s,建立它的 Roofline 模型。
译注: 原题把
dH1、dH2列为数组,但代码中按没有下标的标量使用。
习题 4.13
[10/15]〈4.4〉 假设某 GPU 体系结构包含 10 个 SIMD 处理器。每条 SIMD 指令的宽度为 32,每个 SIMD 处理器包含 8 条用于单精度算术与加载/存储指令的通道,即每条没有发生分歧的 SIMD 指令每 4 个周期能够产生 32 个结果。假设某内核中的分歧分支使平均只有 80% 的线程处于活跃状态。执行的全部 SIMD 指令中,70% 是单精度算术指令,20% 是加载/存储指令。由于部分存储器延迟未能被隐藏,假设平均 SIMD 指令发射率为 0.85。GPU 的时钟频率为 1.5 GHz。
习题 4.14
下面各项改进带来的吞吐量加速比分别是多少?
a. [10]〈4.4〉 计算上述内核在该 GPU 上的吞吐量,单位为 GFLOP/s。
b. [15]〈4.4〉 假设有以下选择:
- 把单精度通道数增加到 16。
- 把 SIMD 处理器数增加到 15。假设这项改动不影响任何其他性能指标,且代码能够扩展到新增的处理器。
- 增加一个缓存,将存储器延迟有效降低 40%,使指令发射率提高到 0.95。
译注: 原页将体系结构假设排为习题 4.13,将问题和 a、b 小问排为 4.14;此处沿用原编号,不把它们合并或重新编号。
习题 4.15
[10/15/15]〈4.5〉 本题考察几个循环,并分析其并行化潜力。
a. [10]〈4.5〉 下面的循环有循环携带依赖吗?
b. [15]〈4.5〉 找出下面循环中的所有真依赖、输出依赖和反依赖。通过重命名消除输出依赖和反依赖。
c. [15]〈4.5〉 考虑下面的循环:
S1 与 S2 之间有依赖吗?这个循环是并行的吗?如果不是,说明如何使其并行。
习题 4.16
[10]〈4.4〉 列出并描述至少四个影响 GPU 内核性能的因素。换句话说,由内核代码引起的哪些运行时行为,会使内核执行过程中的资源利用率下降?
习题 4.17
[10]〈4.4〉 假设有一个 GPU,具有如下特征:
- 时钟频率为 1.5 GHz。
- 包含 16 个 SIMD 处理器,每个处理器包含 16 个单精度浮点单元。
- 片外存储器带宽为 100 GB/s。
假设所有存储器延迟都能被隐藏,不考虑存储器带宽时,该 GPU 的单精度浮点峰值吞吐量是多少 GFLOP/s?考虑存储器带宽限制后,能否持续保持这一吞吐量?
习题 4.18
[60]〈4.4〉 在这个编程练习中,你将编写一个包含大量数据级并行性、同时也包含条件执行行为的 CUDA 内核,并分析其行为。使用 NVIDIA CUDA Toolkit,以及不列颠哥伦比亚大学的 GPU-SIM(原书链接:gpgpu-sim.org)或 CUDA Profiler,编写并编译一个 CUDA 内核:在 的棋盘上执行 Conway 生命游戏的 100 次迭代,并将棋盘的最终状态返回主机。假设棋盘由主机初始化。为每个细胞分配一个线程。确保每次游戏迭代后都加入屏障。使用以下游戏规则:
- 任何活细胞,如果活邻居少于两个,就死亡。
- 任何活细胞,如果有两个或三个活邻居,就存活到下一代。
- 任何活细胞,如果活邻居多于三个,就死亡。
- 任何死细胞,如果恰好有三个活邻居,就变成活细胞。
完成内核后,回答以下问题:
a. [60]〈4.4〉 使用 -ptx 选项编译代码,检查内核的 PTX 表示。该内核的 PTX 实现包含多少条 PTX 指令?内核中的条件执行部分包含分支指令,还是仅包含谓词化的非分支指令?
b. [60]〈4.4〉 在模拟器中执行代码后,动态指令数是多少?达到的每周期指令数(IPC)或指令发射率是多少?动态指令中,控制指令、算术逻辑单元(ALU)指令和存储器指令分别占多少?是否存在共享内存存储体冲突?有效片外存储器带宽是多少?
c. [60]〈4.4〉 实现内核的改进版本,使片外存储器访问能够合并,并观察运行性能的变化。
第 4 章参考文献
- David Patterson and Andrew Waterman, 2017. SIMD Instructions Considered Harmful. Computer Architecture Today Blog.
5 线程级并行性
对传统组成方式的转变始于 20 世纪 60 年代中期。当时,在提高计算机运行速度的努力中,收益递减规律开始显现……电子电路的运行速度最终受制于光速……而许多电路已经工作在纳秒量级。
——W. Jack Bouknight et al.,The ILLIAC IV System(1972)
我们今后的所有产品开发都将投向多核设计。我们相信,这是整个行业的一个关键转折点。
——Intel 总裁 Paul Otellini,2005 年 Intel Developer Forum,谈 Intel 未来的发展方向
自 2004 年以来,处理器设计者通过增加核心数来利用 Moore 定律的缩放效应,而不再专注于单核性能。转向多核在一定程度上是对 Dennard 缩放规律失效的回应;然而,正如单核扩展已经受到限制一样,这一失效也可能很快限制多核的扩展。
——Hadi Esmaeilzadeh et al.,Power Limitations and Dark Silicon Challenge the Future of Multicore(2012)
原章 DOI:10.1016/B978-0-443-15406-5.00005-5。原章版权标记:© 2026 Elsevier Inc.,保留所有权利,包括文本与数据挖掘、AI 训练及类似技术的相关权利。
5.1 引言
正如本章开篇的引语所示,多年来,一些研究者始终认为单处理器体系结构的发展已接近尽头。显然,其中某些判断为时过早。事实上,在 1986–2003 年间,受微处理器推动,单处理器性能的增长速度达到了自 20 世纪 50 年代末、60 年代初第一批晶体管计算机问世以来的最高水平。
尽管如此,多处理器在整个 20 世纪 90 年代仍日益重要。设计者希望构建性能超越单个微处理器的服务器和超级计算机,同时利用通用商品微处理器在性价比上的巨大优势。如第 1 章和第 3 章所述,开发指令级并行性(ILP)的收益递减,使单处理器性能增长放缓;与此同时,功耗问题日益受到关注。这两方面共同开启了计算机体系结构的新时代:从低端到高端,多处理器都发挥着重要作用。第二段引语正好捕捉到了这一明确的转折点。
多处理日益重要,反映了以下几个主要因素:
- 2000–2005 年间,设计者试图发现并开发更多 ILP,却遇到了硅面积和能量利用效率显著下降的问题。这种做法效率不高,因为功耗与硅面积成本的增长超过了性能增长。除了 ILP,我们所知的、能够让性能提升超过基本技术在开关速度方面所允许提升幅度的可扩展通用方法,只有多处理,包括 SIMD 和 MIMD 两类方法。
- 随着云计算和软件即服务日益重要,人们对高端服务器的兴趣不断增加。
- 互联网上海量数据的可获得性,推动了数据密集型应用的增长。
- 人们认识到,提高桌面性能已不那么重要;图形和 AI 加速器除外,它们使用其他形式的并行性。这或许是因为现有性能已能满足需求,也可能是因为计算和数据高度密集的应用正在云端执行。
- 人们更加了解如何有效使用多处理器,尤其是在具有大量固有并行性的服务器环境中。这些并行性可能来自大型数据集,通常表现为数据并行;来自科学与工程代码中的“自然世界”并行;或者来自大量独立请求之间的并行,即请求级并行性。
- 通过复制现有设计而不是进行全新设计,可以更充分地利用设计投入;所有多处理器设计都能获得这种好处。
- 设计包含不同类型核心的多核处理器,即 big/little,使系统可以使用高性能且功耗较高的核心,也可以使用效率更高的低功耗核心,并能纳入领域专用加速器。
- 将互连和共享内存的缓存一致性支持集成到各个芯片中,从而支持构建由多个多核处理器组成的系统。
第三段引语提醒我们,多核在扩展性能方面能提供的空间可能有限。Amdahl 定律的影响与 Dennard 缩放规律失效相结合,意味着多核的前景可能受到限制,至少在提高单个应用性能这一用途上如此。异构处理器和领域专用处理器或许提供了其他出路。本章后面将再次讨论这一主题。
本章重点研究**线程级并行性(thread-level parallelism,TLP)**的开发。TLP 意味着存在多个程序计数器,因此主要通过 MIMD(Multiple Instruction, Multiple Data,多指令流多数据流)处理器来利用。虽然 MIMD 已存在数十年,但 TLP 在从嵌入式应用到高端服务器的整个计算领域占据核心地位,主要还是过去 30 年的产物。同样,将 TLP 广泛用于各类通用应用,而不仅是事务处理或科学应用,也是较近才发生的事情。
本章关注多处理器(multiprocessor)。我们将其定义为由紧密耦合的处理器组成的计算机:处理器的协调和使用通常由一个操作系统控制,操作系统也可能有副本;处理器通过共享地址空间共享内存。这类系统通过两种不同的软件模型开发 TLP。第一种是执行一组紧密耦合、协作完成同一任务的线程,通常称为并行处理(parallel processing)。第二种是执行多个相对独立的进程,这些进程可能来自一个或多个用户;这属于请求级并行性,但规模远小于下一章讨论的情形。请求级并行性可以由一个运行于多个处理器上的应用来开发,例如响应查询的数据库,也可以由多个彼此独立运行的应用来开发,后者通常称为多道程序设计(multiprogramming)。
本章考察的多处理器,通常从单插槽 8 核处理器到包含数十个、有时数百个核心的系统不等,核心之间主要通过共享内存通信与协调。虽然通过内存共享意味着拥有共享地址空间,但不一定意味着只有一个物理存储器。这类多处理器既包括在单个芯片中包含多个核心的系统,即多核处理器(multicore),也包括由多个芯片构成的计算机,其中每个芯片通常又是一个多核处理器。
除了真正的多处理器,我们还将回到多线程这一主题。多线程是一种让多个线程在单个多发射处理器上交错执行的技术。许多多核处理器也提供多线程支持。
下一章将讨论数据中心。数据中心通常由数量极大的处理器构成,少则数千,多则数十万,通过网络技术连接;所用网络技术不一定与连接互联网的技术相同。这些大型系统服务于云计算,主要并行执行海量独立任务。本章讨论的多核与多处理器,是这些更大规模系统的构件。此外,搜索和某些机器学习算法等容易并行化的计算密集型任务,也会使用集群。当集群增长到数万台服务器乃至更大规模时,又称为仓库级计算机。Alibaba、Amazon、Google、Microsoft 和 Facebook 都构建并使用仓库级计算机。这类系统有时也称为多计算机(multicomputer),尤其是在科学计算领域。
许多其他著作,例如 Culler et al.(1999),对这些系统有详细介绍。多处理领域范围广阔且持续变化——刚提到的 Culler 等人的书超过 1000 页,而且只讨论多处理!因此,我们选择将注意力集中在计算领域中我们认为最重要、最具通用性的部分。附录 I 讨论构建更大规模计算机时出现的一些问题,以及它们在计算密集型科学应用中的使用。
我们将重点考察约含 8–1024 个处理器核心的多处理器。这些核心可能分布在 1–64 个独立芯片上,也可能封装在一个插槽中的模块里,每个模块包含多个 CPU 以及内存。无论按出货量还是销售金额衡量,这类设计都占据绝对主导地位。在大规模多处理器中,互连网络是设计的关键组成部分;附录 F 专门讨论这一主题。
多处理器体系结构:问题与方法
为了利用一个包含 个处理器的 MIMD 多处理器,通常必须至少有 个可执行线程或进程。如今大多数高端多核芯片都有多线程能力,此时所需数量还要高 2–8 倍。单个进程中的独立线程通常由程序员识别,或者由操作系统根据多个独立请求创建。另一种极端情况是,线程可能只包含循环的几十次迭代,由并行编译器利用循环中的数据并行性生成。分配给一个线程的计算量称为粒度(grain size),它对如何高效开发 TLP 十分重要。不过,TLP 与 ILP 的关键定性区别在于:TLP 由软件系统或程序员在较高层次识别,线程则由数千至数十亿条可并行执行的指令构成。
线程也能用于开发数据级并行性,但其开销通常高于 SIMD 处理器,例如向量单元或 GPU,见第 4 章。这些开销意味着,粒度必须足够大,才能高效利用并行性。例如,向量处理器或 GPU 也许能高效地并行执行短向量上的运算,但如果把这份并行工作分散给许多线程,粒度可能太小,以致 MIMD 中的开销高得无法接受。
传统上,共享内存多处理器分为两类,区别在于处理器数量,而数量又决定了存储器组成和互连策略。我们按照存储器组成来称呼这些多处理器,因为多少处理器算少、多少算多,会随时间不断变化。
早期多处理器通常使用单一共享存储器,并通过总线连接处理器与存储器。这类系统称为 UMA(Uniform Memory Access,均匀内存访问)多处理器,因为所有处理器访问内存所需时间相同。一些早期多核处理器也采用 UMA。公共总线简化了设计,但随着核心数与各核心性能同时增长,总线也成为瓶颈。因此,大多数多核处理器转向图 5.1 所示的结构,使用共享的末级缓存(Last Level Cache,LLC),通常将其分散布置。互连网络让核心能够访问内存接口,也允许 LLC 之间通信;后文将看到,为维持一致的内存视图,必须进行这种通信。一些设计让一小组处理器共享一个 LLC 分片。
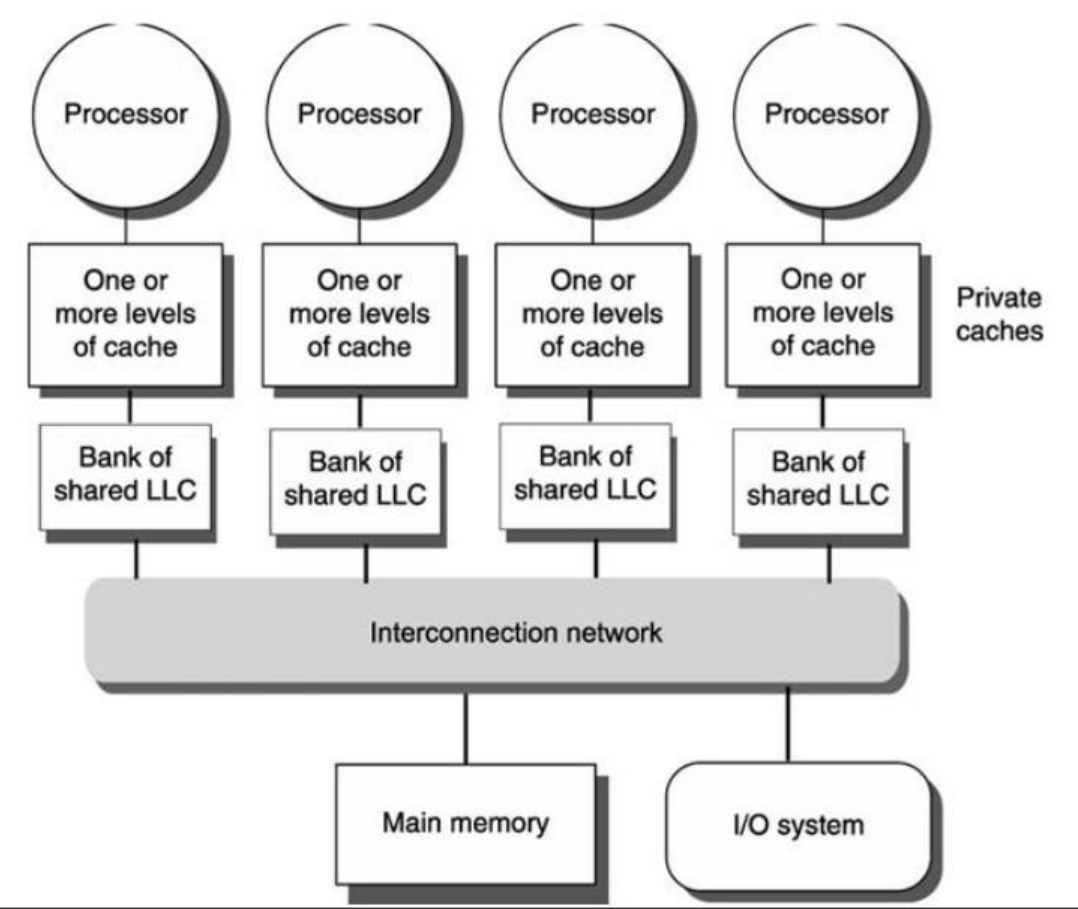
图 5.1(续)。 在多数现代多核处理器中,L3 分成多个存储体,每个存储体与一个或两个多核处理器相关联,原文用词为 multicores。早期多处理器中的总线被互连网络取代。对于较大的多核系统,这通常是多级间接网络,到达某些多核处理器需要经过多跳。内存通常也通过同一互连网络访问,I/O 设备同样如此。注意,即使设计采用 UMA,也可能采用 NUCA(NonUniform Cache Access,非均匀缓存访问),因为到达 LLC 不同共享存储体的时间并不相同。
图内术语:Processor=处理器;One or more levels of cache=一级或多级缓存;Private caches=私有缓存;Bank of shared LLC=共享 LLC 的存储体;Interconnection network=互连网络;Main memory=主存;I/O system=I/O 系统。
由多个多核处理器组成的系统,可以同时使用多个存储器,并通过互连网络连接各多核处理器,如图 5.2 所示。这种体系结构称为分布式共享内存(distributed shared memory,DSM),表现出**非均匀内存访问(Nonuniform Memory Access,NUMA)**特征:访问延迟取决于发起访问的核心与保存数据的物理存储器之间的关系。虽然内存在物理上是分布式的,但处理器共享一个地址空间,可以访问全部内存,这正是“分布式共享内存”这一名称的含义。需要通信的进程和线程,请求操作系统将各自虚拟地址空间的一部分映射到物理地址空间中的某个共享区域。随后由存储系统确保各处理器能够正确访问和共享内存;本章将深入研究这一主题。
相比之下,下一章介绍的集群与仓库级计算机,更像是由网络连接起来的独立计算机;每台计算机可能又由基于多核的多处理器组成。如果没有运行在两台计算机上的软件协议协助,一台计算机无法访问另一台计算机的内存。这类设计通过消息传递协议在计算机之间通信数据。
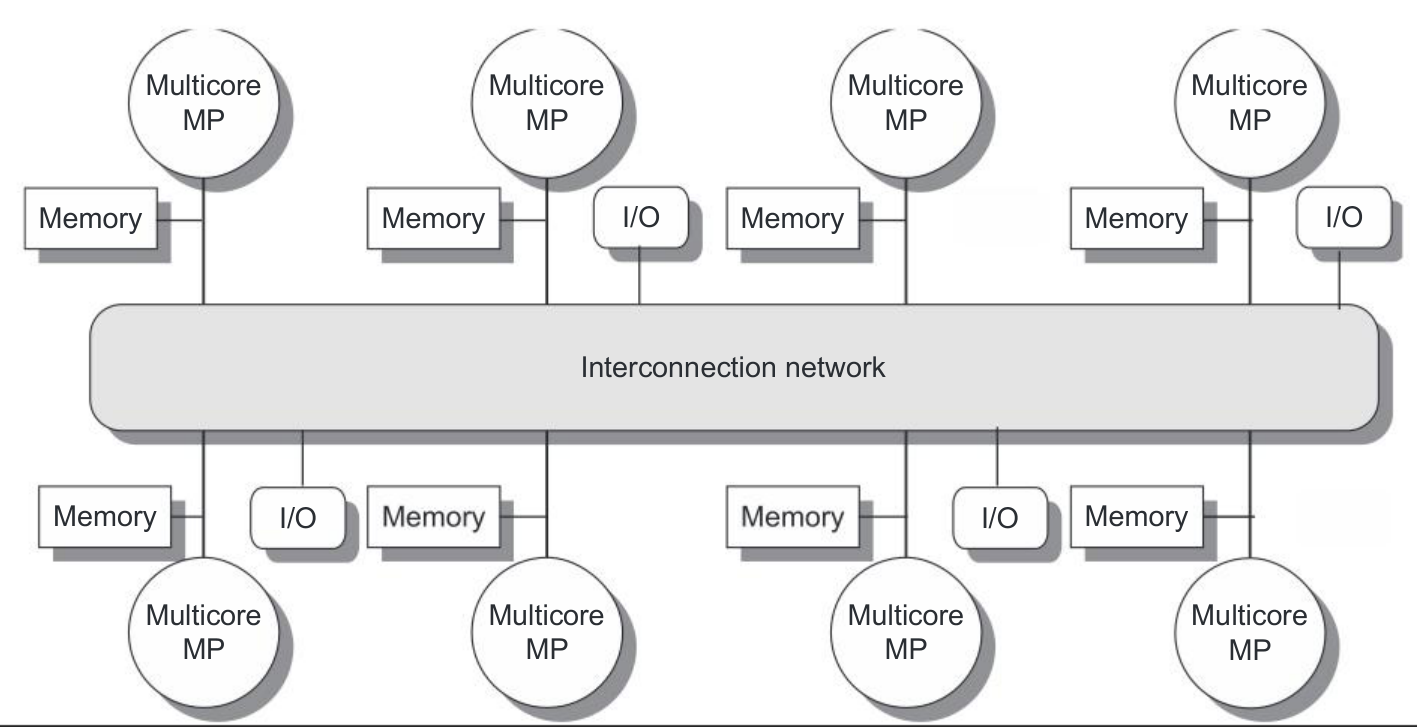
图 5.2(续)。 每个处理器核心共享全部内存,但访问连接在本核心所在芯片上的本地内存,要比访问远程内存快得多。这些设计中有许多也采用 NUCA。
图内术语:Multicore MP=多核多处理器;Memory=内存;Interconnection network=互连网络;I/O=输入/输出。
并行处理的挑战
多处理器的应用范围很广,既可以运行几乎不通信的独立任务,也可以运行必须由线程相互通信才能完成任务的并行程序。对于彼此依赖、相互作用的线程,并行处理有两大障碍,都可以用 Amdahl 定律解释。要克服这些障碍,通常需要综合考虑算法的选择和实现、底层编程语言与系统、操作系统及其支持功能,以及体系结构与硬件实现。很多情况下,其中某一项是关键瓶颈;但当处理器数量扩展到较大规模,例如 32 个或更多时,往往需要关注软硬件的所有方面。
第一道障碍是程序中可用并行性有限;第二道障碍来自相对较高的通信成本。可用并行性的限制,使任何并行处理器都难以获得良好的加速比,下面第一个例题说明了这一点。
例题:串行部分允许占多大比例
假设希望用 100 个处理器获得 80 的加速比。原计算中允许有多大比例是串行的?
解答。 回顾第 1 章,Amdahl 定律为:
为简化本例,假定程序只有两种运行模式:一种是充分使用全部处理器的并行模式,即增强模式;另一种是只使用一个处理器的串行模式。这样,增强模式的加速比就是处理器数量,而增强部分的比例就是在并行模式下执行的时间比例。代入上式:
化简得:
因此,要用 100 个处理器取得 80 的加速比,原计算中只有 0.25% 可以是串行的!当然,要取得线性加速,即用 个处理器获得 的加速比,通常要求整个程序都可以并行执行,没有串行部分。实践中,程序并非只在完全并行或串行这两种模式下运行;即使处于并行模式,也往往没有使用全部处理器。Amdahl 定律也可用于分析加速程度不同的应用,如下例所示。
例题:使用不同数量处理器的执行阶段
假设一个应用运行在包含 100 个处理器的多处理器上,可以使用 1、50 或 100 个处理器。假定 95% 的时间可以使用全部 100 个处理器,那么,为了得到 80 的加速比,剩余 5% 的执行时间中,有多少必须使用 50 个处理器?
解答。 使用包含更多项的 Amdahl 定律:
代入,原书写为:
化简:
如果应用中 95% 的部分能完美使用 100 个处理器,要得到 80 的加速比,原书表述为:“剩余时间中的 4.8% 必须使用 50 个处理器,而只有 0.2% 可以串行执行!”1
并行处理的第二项主要挑战,是远程访问的高延迟。在现有共享内存多处理器中,不同核心之间的数据通信可能花费 50–100 个以上时钟周期;不同芯片上核心之间的通信,则可能从 500 个时钟周期到 1000 个甚至更多,大规模多处理器尤为如此。具体时间取决于通信机制、互连网络类型和多处理器规模。长通信延迟的影响显然十分显著。下面看一个简单例子。
例题:远程通信对 CPI 的影响
假设一个应用运行在 32 处理器的多处理器上,处理一次远程内存访问需要 200 ns。对该应用,假定除通信访问以外,所有访问都命中本地存储层次;这显然是乐观假设。处理器会在远程请求上停顿,时钟频率为 4 GHz。如果基本 CPI 为 0.5,即假定所有访问都命中缓存,那么,与 0.2% 的指令涉及远程通信访问相比,完全没有通信的多处理器会快多少?
解答。 先计算每条指令的时钟周期数更简单。当 0.2% 的访问为远程访问时,有效 CPI 为:
远程请求开销为:
因此,原书计算 CPI 为:
原书据此得出:全部访问都在本地完成的多处理器快 倍!2 实际上,性能分析复杂得多,因为一部分不涉及通信的访问也会在本地层次中未命中,而且远程访问时间并不是单一常数。例如,大量访问争用全局互连,会使延迟增加,远程访问的开销因而更高;另一方面,如果内存采用分布式组织,而访问恰好指向本地内存,时间也可能更短。
这个问题也可以用 Amdahl 定律分析,留给读者作为练习。
并行性不足和远程通信延迟过长,是使用多处理器时最大的两项性能挑战。应用并行性不足,主要必须依靠软件解决:开发并行性能更好的新算法,并由软件系统尽量增加充分利用全部处理器的执行时间。远程高延迟的影响,则可以由体系结构和程序员共同缓解。例如,可以通过缓存共享数据等硬件机制,或者重新组织数据、让更多访问在本地完成等软件机制,降低远程访问频率。也可以用第 3 章讨论的多线程,或第 2 章详细讨论的预取,来容忍延迟。
本章的大部分内容关注如何减轻远程通信高延迟的影响。例如,5.2–5.4 节讨论如何利用缓存降低远程访问频率,同时维持一致的内存视图。5.5 节讨论同步:同步本质上涉及处理器间通信,并可能限制并行性,因此是一个重要的潜在瓶颈。5.6 节介绍延迟隐藏技术与共享内存的存储一致性模型。附录 I 则主要研究规模更大的多处理器,以及它们在科学计算中的应用。
5.2 多处理器缓存一致性
两个处理器分别通过各自的缓存观察内存,因此,对同一内存位置,它们最终可能看到不同的值,如图 5.3 所示。这一困难通常称为缓存一致性问题(cache coherence problem)。注意,一致性问题之所以存在,是因为系统既有主要由主存定义的全局状态,又有由各处理器核心的私有缓存定义的局部状态。因此,即使多核系统中某些缓存级别,例如 LLC,是共享的,而另一些级别,例如 L1 和 L2,是私有的,一致性问题仍然存在,仍必须解决。
| 时间 | 事件 | 处理器 A 的缓存内容 | 处理器 B 的缓存内容 | 内存位置 X 的内容 |
|---|---|---|---|---|
| 0 | 1 | |||
| 1 | 处理器 A 读 X | 1 | 1 | |
| 2 | 处理器 B 读 X | 1 | 1 | 1 |
| 3 | 处理器 A 向 X 存入 0 | 0 | 1 | 0 |
图 5.3(续)。 最初假定两个缓存都不包含该变量,X 的值为 1。还假定采用直写缓存;写回缓存会带来额外但类似的复杂性。A 写入 X 后,A 的缓存与内存都包含新值,但 B 的缓存没有更新。如果 B 读取 X,得到的仍然是 1!
非正式地说,如果对一个数据项的任何读取都返回该数据项最近写入的值,那么存储系统就是一致的。这个定义虽然直观,却含糊且过于简单;实际情况复杂得多。它包含存储系统行为的两个不同方面,而这两个方面对编写正确的共享内存程序都至关重要。第一个方面称为缓存一致性(coherence),规定一次读操作可以返回哪些值。第二个方面称为存储一致性(consistency),规定写入的值何时会被一次读操作返回。先来看 coherence。
一个存储系统满足以下三个性质时,就具有缓存一致性:
- 单处理器读一致性。 处理器 P 向位置 X 写入后,再由 P 读取 X;如果 P 的这次写与读之间没有其他处理器写 X,那么读取必须返回 P 写入的值。
- 多处理器读一致性。 一个处理器向位置 X 写入后,另一个处理器再读取 X;如果两次操作在时间上相隔足够远,而且其间没有其他对 X 的写入,那么读取返回该写入值。
- 多处理器写串行化。 对同一位置的写操作必须串行化:任意两个处理器对同一位置的两次写入,在所有处理器看来顺序相同。例如,如果先后向某个位置写入 y 和 z,任何处理器都不可能先读到 z,随后又读到 y。
单处理器读一致性保持了程序顺序;即使在单处理器中,我们也要求这一性质成立。多处理器读一致性定义了“一致的内存视图”的含义:如果一个处理器能够不断读到旧值,我们显然会说内存是不一致的。
多处理器写串行化的必要性更为微妙,但同样重要。假设不对写操作串行化,处理器 P1 先写位置 X,随后 P2 也写位置 X。写串行化保证每个处理器最终都能看到 P2 的写入。如果不串行化,某些处理器可能先看到 P2 的写入,随后才看到 P1 的写入,并无限期地保留 P1 写入的值。避免这类困难最简单的办法,就是保证所有处理器都以相同顺序看到对同一位置的全部写操作;这一性质称为写串行化(write serialization)。
虽然上述三个性质足以确保 coherence,但一个写入值何时可见,也同样重要。原因在于,我们不可能要求对 X 的一次读取,立即看到另一个处理器刚写入 X 的值。例如,一个处理器写 X 后极短时间内,另一个处理器就读 X,此时可能无法保证读取返回新写入的数据,因为新数据甚至还没有离开发起写入的处理器。写入值究竟必须在何时对读取者可见,由**存储一致性模型(memory consistency model)**定义,5.6 节将讨论这一主题。
Coherence 与 consistency 相辅相成:前者定义对同一个内存位置的读写行为;后者定义读写操作与对其他内存位置的访问之间的关系。暂且作两个假设。第一,只有所有处理器都看到了某次写入的效果,该写操作才算完成,才允许下一次写操作发生。第二,处理器不改变任意写操作相对于其他任何内存访问的顺序。
这两个条件意味着:如果一个处理器先写 A,再写 B,那么任何看到了 B 新值的处理器,也必须看到 A 的新值。这些限制允许处理器重排读操作,却要求处理器按照程序顺序完成写操作。在到达 5.6 节之前,我们一直采用这一假设;届时会准确分析它的含义,并讨论其他选择。
保证一致性的基本方案
多处理器与 I/O 的一致性问题,虽然起因相似,却具有不同特点,适用的解决办法也因此不同。I/O 中出现多个数据副本的情况较少,且应尽量避免;而在多个处理器上运行的程序,通常会在若干缓存中保留同一数据的副本。在具有一致性的多处理器中,缓存既支持共享数据项的迁移,也支持其复制。
一致性缓存支持迁移(migration):数据项可以透明地移入本地缓存,并在那里使用。这样既降低了访问远程分配的共享数据项的延迟,也减少了对共享内存带宽的需求。迁移还能降低能耗,因为访问本地缓存比访问片外内存节能得多。
缓存会在本地保存数据项的一个副本,因此,一致性缓存也为同时被读取的共享数据提供复制(replication)。复制既减少访问延迟,也减轻对同一共享数据项的读取争用。支持迁移和复制,对共享数据访问的性能至关重要,同时也节省能量。因此,多处理器不会仅靠软件避免这个问题,而是引入维护缓存一致性的协议,在硬件中解决它。
保证一致性:失效与更新
有两种方法可以满足一致性要求。一种方法是在写入某个数据项之前,确保处理器对该数据项具有独占访问权。这种协议称为写失效协议(write invalidate protocol),因为它会在写入前使其他副本失效。这是迄今最常见的协议。独占访问保证写入发生时,不存在其他可读或可写的副本:该数据项在其他缓存中的副本全部失效。
图 5.4 展示了采用写回缓存的失效协议如何工作。考虑一次写入之后,另一个处理器又进行读取,就可以看出该协议如何保证一致性:由于写入要求独占访问权,读取处理器保留的任何副本都必须失效。因此,当持有旧副本的缓存再次读取该数据时,会发生缓存未命中,被迫获取一个新副本。对于写操作,我们也要求写入处理器具有独占访问权,从而防止其他处理器同时写入。
| 处理器操作 | 总线操作 | 处理器 A 的缓存内容 | 处理器 B 的缓存内容 | 内存位置 X 的内容 |
|---|---|---|---|---|
| 0 | ||||
| 处理器 A 读 X | X 缓存未命中 | 0 | 0 | |
| 处理器 B 读 X | X 缓存未命中 | 0 | 0 | 0 |
| 处理器 A 向 X 写入 1 | 使 X 失效 | 1 | 0 | |
| 处理器 B 读 X | X 缓存未命中 | 1 | 1 | 1 |
图 5.4(续)。 假定最初两个缓存都没有 X,内存中 X 的值为 0。表中处理器与内存的内容,是处理器操作和总线操作都完成后的值。空白表示没有操作,或没有缓存副本。B 第二次未命中时,处理器 A 返回该值,并取消来自内存的响应。此外,B 的缓存内容和内存中 X 的内容都得到更新。在块转为共享状态时更新内存,可以简化协议;也可以跟踪所有权,只有块被替换时才要求写回。后者需要增加一个状态位来表示块的所有权。所有权位表明,一个块可以被共享读取,但只有拥有它的处理器才能写入;该处理器在修改或替换这个块时,负责更新其他处理器和内存。如果多核处理器使用共享缓存,例如 L3,那么所有内存访问都经过共享缓存;L3 扮演本例中内存的角色,而需要维护一致性的,是各核心的私有 L1、L2 缓存。正是这一认识,使一些设计者选择在多核处理器内部使用目录协议。要使这种办法工作,L3 缓存必须具有包含性。回顾第 2 章:如果更高一级缓存中的任何位置,本例为 L1 和 L2,也都存在于 L3,那么缓存就具有包含性。5.7 节将再次讨论包含性。
如果两个处理器同时尝试写同一数据,其中一个会赢得竞争,如何决定胜者稍后介绍,并使另一个处理器的副本失效。后者若要完成写入,就必须取得新的数据副本,而该副本已经包含更新后的值。因此,这种协议实现了写串行化。
另一种办法是在写入一个数据项时,更新它在全部缓存中的副本。这称为写更新协议(write update protocol)或写广播协议(write broadcast protocol)。写更新协议必须广播对共享缓存行的所有写入,因此消耗的带宽大得多。正因如此,近期所有多处理器都默认采用写失效协议;本章其余部分只讨论失效协议。
缓存一致性协议
实现缓存一致性协议的关键,是跟踪所有共享数据块的状态。缓存块的状态通过与块关联的状态位保存,类似于单处理器缓存中的有效位和脏位。目前有两类协议,使用不同的方法跟踪共享状态:
- 基于目录(directory based)。 某个物理内存块的共享状态,集中保存在一个称为目录的位置。目录通常位于共享 LLC,或位于该块所在内存对应的内存接口。为了可扩展性,包含多个芯片的多数多处理器使用多个分布式目录,通常每个芯片一个。许多多核处理器将目录信息与 LLC 关联;由于 LLC 分散为多个存储体,单个多核处理器内部的目录也是分布式的!分布式目录比单一目录复杂,5.4 节将讨论这类设计。
- 监听(snooping)。 共享状态不集中保存在一个目录中,而由每个持有某物理内存块副本的缓存跟踪该块的共享状态。因为这些信息仅保存在本地,每次一致性事务都必须向所有缓存广播。若使用总线等广播介质,每个缓存控制器就监视,也就是“监听”该介质,判断自己是否持有被请求块的副本。
监听协议曾广泛用于这样一类多处理器:它由单核微处理器和缓存构成,通过总线连接到一个共享内存。如今,大多数多核设计采用混合协议:用监听维持各个非共享缓存,即 L1 和 L2,的一致性;在 LLC 或内存接口处使用目录方案,决定必须监听哪些处理器,才能确保一致性。一些多核处理器的组织次序相反:在通过广播介质连接的 2–4 个插槽之间采用监听,而由目录指出各插槽内部需要监听哪些核心。5.4 节末尾将再次讨论混合方案。
5.3 通过监听维护缓存一致性
如前所述,监听既可以用来维护单个处理器及其私有缓存的一致性,也可以用来维护通过广播介质连接的一小组处理器的一致性。下面假定这一广播介质是总线。我们以多个处理器连接在同一总线上的情况来说明协议;但对于单个处理器及其缓存,基本监听操作完全相同。
总线的关键优势在于,它具有广播能力,因此很容易完成一致性协议中的两项关键操作:使副本失效,以及找到共享数据项的最新值。例如,要使某个块失效,处理器只需取得总线访问权,在总线上广播需要失效的地址。所有处理器持续监听总线,观察地址,并检查该地址对应的数据项是否在自己的缓存中;如果在,就使缓存中对应的项失效。
写入一个共享块时,写入处理器必须取得总线访问权,广播失效请求。如果两个处理器同时尝试写共享块,它们广播失效操作的尝试,会在总线仲裁时被串行化。先取得总线访问权的处理器,会使它所写入块的所有其他副本失效。如果两个处理器尝试写的是同一个块,总线所施加的串行化也就使两次写入串行化。这一方案的一个含义是:对共享数据项的写入,在获得总线访问权之前不能完成。稍后讨论实现细节时,我们还会回到这一问题。所有一致性方案都必须用某种办法,将对同一缓存块的访问串行化:可以串行化对通信介质的访问,也可以串行化对其他共享结构的访问,例如下一节介绍的目录。
除了使被写入块的现存副本失效,缓存未命中时还必须找到数据项。在直写缓存中,很容易找到数据的最新值,因为所有写入数据都会送往内存,因而始终可以从内存取得最新值。写缓冲区会增加一些复杂性,必须将其有效地视为额外的缓存项。
对于写回缓存,寻找最新值更困难,因为数据项的最新值可能位于某个私有缓存,而非共享缓存或内存中。幸运的是,写回缓存可以对缓存未命中和写操作采用同一种监听方案:每个处理器监听放到共享总线上的每个地址。如果某处理器发现自己持有所请求缓存块的脏副本,就响应读请求,提供该块,并中止对内存或 LLC 的访问。额外复杂性来自必须从另一个处理器的私有 L1 或 L2 缓存取得块;这通常比从 LLC 取得它更慢。写回缓存对内存带宽的要求较低,因此能支持更多、更快的处理器。于是,所有多核处理器的 L2 和 L3 都采用写回缓存,下面也以写回缓存来考察一致性的实现。
正常的缓存标签就能用于监听,每个块的有效位则使失效操作易于实现。读未命中也很好处理,无论它由失效还是其他事件引起,都只需依赖监听能力。对于写操作,我们希望知道是否有其他缓存持有该块副本:如果没有其他副本,写回缓存就不必把写操作放到总线上。省去这一总线操作,既缩短写入时间,也降低带宽需求。
为了跟踪一个缓存块是否共享,可以像有效位和脏位一样,为每个块再增加一个状态位。加入表示共享与否的位后,就可以判断一次写入是否必须生成失效请求。写入处于共享状态的块时,缓存会在总线上发出失效请求,并将该块标记为独占。此后,这个核心不再为该块发送失效请求。持有某缓存块唯一副本的核心,称为该块的拥有者(owner)。
失效请求发送后,拥有者缓存中的块从共享状态转为非共享,即独占状态。如果之后其他处理器请求这个块,状态必须重新变为共享。由于监听缓存也能看到所有未命中,因此它知道其他处理器何时请求了这个独占块,也就知道何时应将状态改为共享。
每次总线事务都必须检查缓存地址标签,这可能干扰处理器自身的缓存访问。一种减少干扰的办法是复制标签,让监听访问检查标签副本。如果 LLC 具有包含性,即 L1 或 L2 中的所有项都存在于 LLC,就可以用 LLC 判断是否需要监听。这样,具有包含性的 LLC 能区分哪些未命中可以直接访问内存,哪些需要发起监听。许多近期多核处理器要求 L2 具有包含性,但 LLC 不必如此;这种情况下,可以监听 L2,只有 L2 命中时才监听 L1。L2 还可能分成多个存储体以提高带宽,从而降低争用。
一个协议示例
监听一致性协议通常在每个核心中加入有限状态控制器来实现。控制器响应核心内处理器和总线或其他广播介质的请求,改变选中缓存块的状态,并利用总线访问数据或使其失效。从逻辑上,可以认为每个块都关联一个独立控制器;也就是说,对不同块的监听操作或缓存请求可以独立进行。实际实现中,一个控制器允许针对不同块的多个操作交错执行:即使一次只能进行一个缓存访问或一次总线访问,也可以在一个操作尚未完成时启动另一个操作。在具有非阻塞缓存的处理器中,这些事务能够重叠。可以利用未命中状态处理寄存器(MSHR)确定完成某个事务需要更新哪个缓存块。还要记住,虽然下文称之为总线,但任何支持向所有一致性控制器及其私有缓存广播的互连网络,都能用来实现监听。同一协议也可以维护各个核心的一致性,并与目录机制连接,以获得更好的可扩展性。
我们考虑的简单协议具有三个状态:无效(Invalid)、共享(Shared)和已修改(Modified)。共享状态表示私有缓存中的块可能被共享;已修改状态表示该块已在私有缓存中更新。注意,已修改状态意味着该块为独占。
图 5.5 列出了核心产生的请求,位于表格上方约三分之二,以及来自总线的请求,位于下方约三分之一。对这一基本协议最常见的扩展,是增加一个独占状态,表示块尚未修改,且仅保存在一个私有缓存中。本节后文将讨论这一扩展及其他扩展。
| 请求 | 来源 | 被寻址缓存块的状态 | 缓存操作类型 | 功能与说明 |
|---|---|---|---|---|
| 读命中 | 处理器 | 共享或独占 | 普通命中 | 读取本地缓存中的数据。 |
| 读未命中 | 处理器 | 无效 | 普通未命中 | 在总线上发出读未命中。 |
| 读未命中 | 处理器 | 共享 | 替换 | 地址冲突未命中:在总线上发出读未命中。 |
| 读未命中 | 处理器 | 独占 | 替换 | 地址冲突未命中:写回缓存块,然后在总线上发出读未命中。 |
| 写命中 | 处理器 | 独占 | 普通命中 | 写入本地缓存中的数据。 |
| 写命中 | 处理器 | 共享 | 一致性 | 在总线上发出失效请求。这类操作常称为升级未命中(upgrade miss)或所有权未命中(ownership miss),因为它不获取数据,只改变状态。 |
| 写未命中 | 处理器 | 无效 | 普通未命中 | 在总线上发出写未命中。 |
| 写未命中 | 处理器 | 共享 | 替换 | 地址冲突未命中:在总线上发出写未命中。 |
| 写未命中 | 处理器 | 独占 | 替换 | 地址冲突未命中:写回缓存块,然后在总线上发出写未命中。 |
| 读未命中 | 总线 | 共享 | 无操作 | 允许共享缓存或内存为读未命中提供服务。 |
| 读未命中 | 总线 | 独占 | 一致性 | 尝试读取共享数据:将缓存块放到总线上,写回该块,并将其状态改为共享。 |
| 失效 | 总线 | 共享 | 一致性 | 尝试写入共享块:使该块失效。 |
| 写未命中 | 总线 | 共享 | 一致性 | 尝试写入共享块:使该缓存块失效。 |
| 写未命中 | 总线 | 独占 | 一致性 | 尝试写入在别处被独占的块:写回该缓存块,并将它在本地缓存中的状态改为无效。 |
图 5.5(续)。 第四列将缓存操作分为普通命中或未命中,与单处理器缓存中相同;替换,即单处理器缓存的替换未命中;以及为维护缓存一致性所需的一致性操作。普通操作或替换操作也可能触发一致性操作,取决于该块在其他缓存中的状态。对于从总线上监听到的读未命中、写未命中或失效请求,只有在读写地址与本地缓存中的某个有效块匹配时,才需要采取动作。
总线上出现失效或写未命中请求时,所有在私有缓存中持有该块副本的核心,都使其失效。对于写回缓存中的写未命中,如果某个私有缓存独占该块,它还必须写回该块;否则,可以从共享缓存或内存读取数据。
图 5.6 是对私有写回缓存的单个块采用写失效协议时的有限状态转换图。为简明起见,将协议的三个状态画了两遍:左边表示处理器请求引起的转换,对应图 5.5 上部;右边表示总线请求引起的转换,对应图 5.5 下部。粗体表示总线动作,以区别于状态转换的触发条件。每个节点表示处理器或总线请求所选定的私有缓存块的状态。
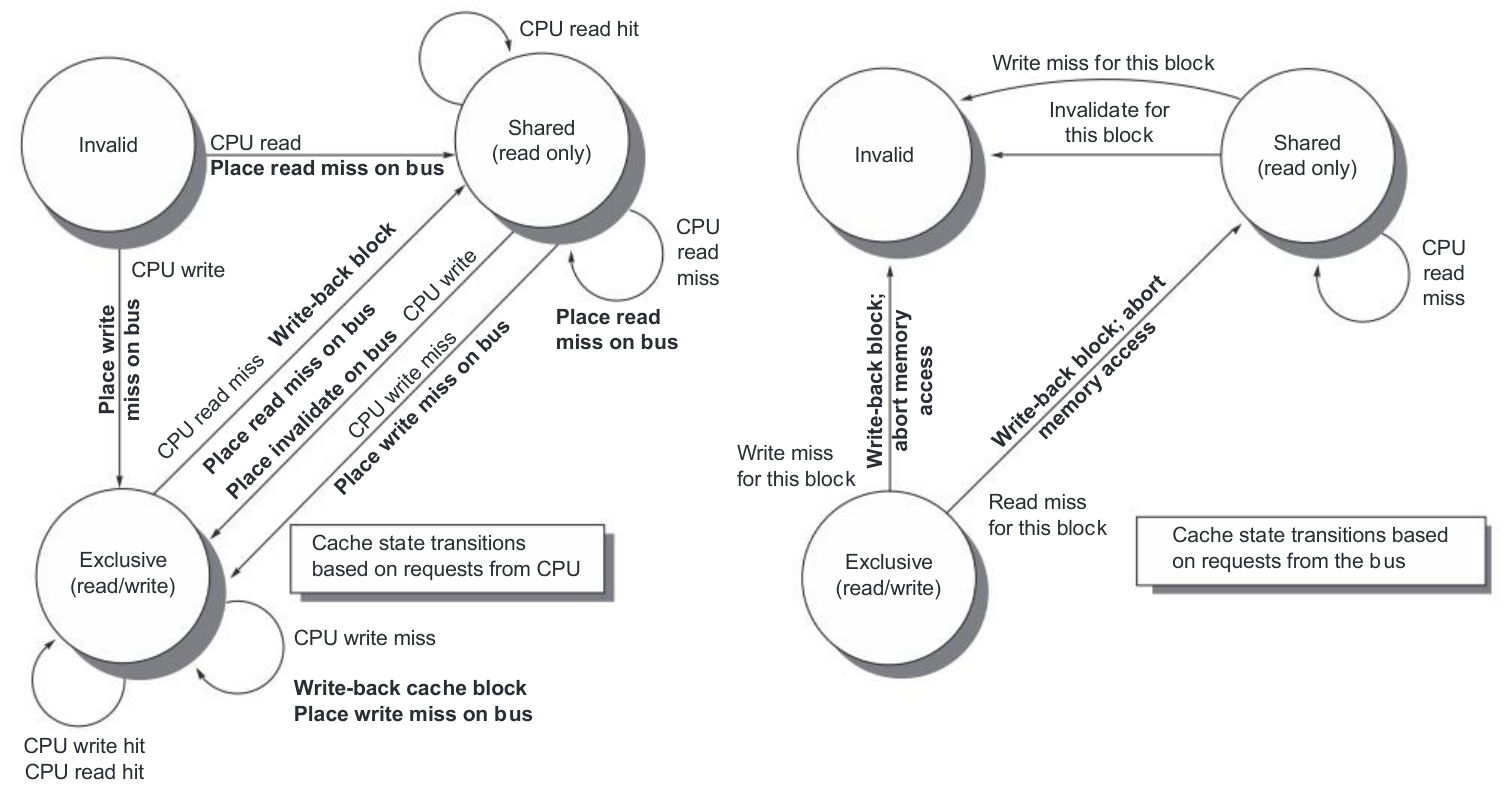
图 5.6(续)。 圆圈表示缓存状态;状态名下方括号中的内容,表示本地处理器在不改变状态的情况下允许执行的访问。转换弧上用普通字体标出触发状态变化的事件,用粗体标出状态转换所产生的总线动作。触发事件针对私有缓存中的一个块,而不是缓存中的某个固定地址。因此,对处于共享状态的缓存块发生读未命中,是访问另一个地址而在该缓存块处未命中。图左边表示与此缓存关联的处理器引起的转换,右边表示总线操作引起的转换。在独占或共享状态下发生读未命中,以及在独占状态下发生写未命中,都意味着处理器请求的地址与本地缓存块中保存的地址不匹配。这是普通的缓存替换未命中。尝试写入共享状态的块,会发出失效请求。每当总线事务发生,所有包含该事务所指缓存块的私有缓存,都执行右半图规定的动作。协议假定:如果一个块在所有本地缓存中都为干净状态,读未命中由内存或共享缓存提供数据。实际实现会合并这两套状态图。实践中,失效协议有许多细微变种,包括增加未修改的独占状态,以及决定未命中时由处理器还是内存提供数据。在多核芯片中,具有包含性的共享 LLC 相当于内存;这里的总线,是连接各核心私有缓存与共享缓存的总线,而共享缓存再与内存相连。
图内术语:Invalid=无效;Shared (read only)=共享(只读);Exclusive (read/write)=独占(可读写);CPU read/write hit/miss=CPU 读/写命中或未命中;Place read/write miss on bus=在总线上发出读/写未命中;Place invalidate on bus=在总线上发出失效请求;Write-back block=写回块;abort memory access=中止内存访问;for this block=针对该块。
这套缓存协议中的所有状态,在单处理器缓存中也都需要,分别对应无效、有效且干净,以及脏状态。图 5.6 左半部分大多数弧所表示的状态变化,在单处理器写回缓存中同样需要;例外是对共享块写命中时发出的失效请求。右半部分的状态变化则完全是为了一致性,单处理器缓存控制器中不会出现。
如前所述,每个缓存只有一个有限状态机,触发事件来自相连的处理器或总线。图 5.7 将图 5.6 左右两部分的转换合并,形成单个缓存块的完整状态图。
要理解协议为何有效,只需注意:任何有效缓存块,要么在一个或多个私有缓存中处于共享状态,要么恰好在一个缓存中处于独占状态。转入独占状态是处理器写该块的前提;任何这类转换,都要求在总线上发出失效或写未命中,从而使其他所有本地缓存中的该块无效。此外,如果其他某个本地缓存原本独占该块,它会写回该块,提供包含所需地址的数据。最后,如果总线上发生对独占块的读未命中,持有独占副本的本地缓存就转为共享状态。
图 5.7 中的灰色动作处理总线上的读写未命中,实际上就是协议的监听部分。此协议与大多数其他协议还保持另一性质:任何处于共享状态的内存块,在共享 LLC 或内存中的副本始终是最新的。这个性质简化了实现。
虽然这个简单缓存协议是正确的,但它省略了若干会让实现棘手得多的复杂情况。其中最重要的是,协议假定操作具有原子性:执行某个操作时,不会有另一个操作插入其中。然而,这一假设并不自然成立,因为许多操作需要多个时钟周期。例如,上述协议假定检测写未命中、取得总线和收到响应是一个原子动作,但实际实现做不到这一点。事实上,甚至读未命中也可能不是原子的:在多核处理器 L2 中检测到未命中后,核心必须仲裁,争取连接共享 L3 或内存的总线访问权。稍后会讨论如何克服这一困难。
图内各状态与动作的中文含义见图 5.6;Write-back data=写回数据。本图的 Exclusive 表示前文三状态协议中的已修改、独占状态,与下面 MESI 新增的干净独占状态需结合上下文区分。
基本一致性协议的扩展
刚介绍的协议是一个简单的三状态协议,通常用各状态名称的首字母称为 MSI(Modified、Shared、Invalid,即已修改、共享、无效)协议。基本协议有许多扩展,通过增加状态和事务来优化某些行为,从而可能提高性能。最常见的两种扩展如下。
- MESI:在基本 MSI 中增加 Exclusive 状态,形成已修改、独占、共享、无效四个状态。独占状态表示该块只在一个缓存中存在,而且是干净的。处于 E 状态的块可以直接写入,不必发出任何失效请求,因此优化了同一缓存先读后写某块的情况。写入后,块从 Exclusive 转为 Modified。如果其他处理器对 E 状态的块发生读未命中,就必须转为 S 状态,以维持一致性。由于后续访问都受到监听,能够持续维护这一状态的准确性。可以方便地加入这一新状态:用编码一致性状态的位表示独占,用脏位表示该块已经修改。CXL 标准采用 MESI;CXL 是支持处理器与加速器之间一致性内存的互连标准。Intel i7 和 i9 使用 MESI 的变种 MESIF,增加 Forward 状态,用来指定哪个共享处理器响应未命中并提供数据,目的是提高分布式内存组织中的性能。
- MOESI:在 MESI 中增加 Owned 状态,表示该缓存拥有此块,而内存副本已过期。在 MSI 和 MESI 中,尝试共享一个处于 Modified 状态的块时,原缓存与新加入共享的缓存都转为 Shared,并且必须将该块写回内存。在 MOESI 中,原缓存可以从 Modified 转为 Owned,而不写回内存。其他新共享该块的缓存保持 Shared;只有原缓存具有的 O 状态,表明主存副本已过期,且指定缓存是拥有者。因为内存不是最新的,拥有者必须在未命中时提供该块的值,并在替换该块时写回内存。AMD Opteron 系列采用 MOESI。较新的 AMD 处理器采用基于 MOESI 的协议,同时加入前述 F 状态及 D(Dirty)状态。D 是 Owned 的一种变体,也表示内存中的副本已过期。
对称共享内存多处理器与监听协议的限制
随着多处理器中的处理器数量增加,或各处理器的内存需求增长,系统中的任何集中式资源都可能成为瓶颈。对于多核处理器,仅有几个核心时,单一共享总线就会成为瓶颈。因此,多核设计转向带宽更高的互连方案,并采用多个独立存储器,以支持更多核心。5.8 节考察的多核芯片采用三种不同方法:
- IBM Power 10 单芯片最多有 15 核,采用 16 个并行环,连接分布式 L3 缓存以及最多 16 个独立内存通道。
- Xeon Platinum 系列既有最多 40 核的单芯片形式,也有原书称为 chiplet 的形式,其中包含四颗处理器芯片以及 HBM 内存或缓存。它用多个环连接芯片上最多 40 个核心、分布式 60 MiB LLC,以及最多八个内存通道,具体取决于配置。原书称,最新 Xeon 服务器 Sapphire rapids 已宣布采用 56 核、每个 chiplet 四颗芯片,总计 224 核。1
- AMD EPYC 基于 chiplet 设计,每个 chiplet 有 8 核,每个插槽最多 4 个 chiplet,最多两个插槽,共 64 核。每个 chiplet 内共享 LLC,并有自己的内存通道。Infinity Path 用于连接 chiplet 内部及 chiplet 之间的核心。下一代将支持最多 12 个 chiplet,总计 96 核。
除了缓存未命中和一致性流量造成的共享互连争用,缓存的监听带宽也可能成为问题,因为每个缓存可能都要检查每一次未命中。因此,增加互连带宽可能只是把争用转移到了缓存。下面的例题说明这个问题。
例题:监听带宽的限制
考虑一个 16 处理器的多核系统,每个处理器都有自己的 L1 和 L2,L2 通过共享总线进行监听。假定每个 L2 请求平均占用 15 个周期,无论它是由一致性未命中还是其他未命中引起。时钟频率为 4.0 GHz,CPI 为 0.5,加载/存储指令占 40%。如果要求一致性流量消耗不超过 L2 带宽的 50%,那么每个处理器允许的最大一致性未命中率(CMR)是多少?
解答。 先写出可使用缓存周期数的方程,其中 CMR 为一致性未命中率:
因此,CMR 必须不超过 0.26%。下一节与附录 I 中,我们将看到一些 CMR 超过 1% 的应用。反过来,如果假定 CMR 可以达到 1%,那么只能支持 4 个处理器。显然,即使小型多核处理器,也需要扩展监听带宽的方法。2
增加监听带宽有几种技术:
- 复制标签。这使缓存层的有效监听带宽翻倍,但对于很大的缓存,代价也很高;如果标签副本表明监听命中,仍需访问主标签。若 L2 分成多个存储体,也能有效提高监听带宽,许多近期设计都采用这种办法。
- 如果多核处理器的 LLC 是共享且具有包含性的,就可以先监听 LLC,只有 LLC 命中时才查询 L2;否则,可以确定数据不在私有缓存中。将 LLC 分成多个存储体,也能提高其带宽。IBM Power 10 使用这一方法,它产生 NUCA 设计,但能使 LLC 的监听带宽有效地按存储体数量扩展。如果监听在 LLC 命中,仍必须向所有 L2 广播,各 L2 再监听自己的内容。注意,这一方法要求 LLC 具有包含性。后面将看到,Power 10 采用继承自早期 Power 处理器的复杂一致性方案,力图尽量减少广播监听。
目录方案提供了另一种扩展一致性带宽的方法:避免监听与广播。由于它不依靠共享广播机制串行化操作,因此必须通过请求—响应机制,知道一致性操作何时完成。5.4 节将介绍目录方案。
AMD Opteron 位于监听协议与目录协议之间的另一个中间位置。内存直接连接到每个多核插槽,最多可连接四个插槽。由于本地内存略快,系统为 NUMA。Opteron 使用点对点链路向最多三颗其他芯片广播,以实现一致性协议。处理器间链路不共享,因此,处理器只有收到显式确认,才知道失效操作已完成。于是,它像监听协议一样广播以寻找可能共享的副本,又像目录协议一样用确认来确定操作顺序。由于 Opteron 实现中的本地内存仅略快于远程内存,一些软件把 Opteron 多处理器当作均匀内存访问系统。
实现监听缓存一致性
魔鬼藏在细节里。
——经典谚语
1990 年编写本书第一版时,最后一个“融会贯通”实例是一个采用监听一致性的 30 处理器单总线多处理器。它的总线带宽略高于 50 MiB/s,而这点带宽在 2023 年甚至不足以支持 Intel i9 的一个核心!1995 年编写第二版时,采用不止一条总线的首批缓存一致性多处理器刚刚出现,我们于是增加了一个附录,描述多总线系统中监听的实现。
到 2024 年,每个核心数超过四个的多核系统,都在封装内部采用片上间接互连,即既不是总线,也不是交叉开关;这种间接网络还会进一步扩展,以连接多颗芯片,构成缓存一致性多处理器。因此,即使在单芯片内部,设计者也必须面对这样的挑战:没有总线来简化事件串行化时,如何实现监听或目录方案。
实现前面的一致性协议,需要满足两个性质:
- 原子性。 一致性事件,例如取得独占访问权,虽然要经过多个时钟周期,却必须表现为原子操作。如果其他插入其间的事件不能改变其结果,该事件就表现为原子的。
- 可串行化。 一致性事件必须表现为按某个串行顺序发生,而且所有处理器看到的顺序相同。
如果其中任何性质不成立,两个处理器就可能看到不同的数据值,说明系统不具有一致性。
可串行化比较容易实现。一致性协议必须保证,对某个地址的全部访问都经过一个公共点;它可以是总线、共享 LLC,或某个内存模块。这个公共点强制可能冲突的访问确定先后次序,从而保证它们串行化。协议还应在代表 CPU 发起新事务前,先处理来自总线或其他通信网络的所有待处理请求。
实际实现监听一致性协议时,更大的困难是:在任何近期多处理器中,写未命中和升级未命中都不天然具有原子性。检测写未命中或升级未命中、与其他处理器和内存通信、为写未命中取得最新值并确保所有失效请求得到处理,最后更新缓存,这些步骤不可能像一个时钟周期内的动作一样完成。
在单总线多核系统中,可以先仲裁取得通往共享缓存或内存的总线,再改变缓存状态,并一直持有总线,直到所有动作完成,从而使这些步骤实际表现为原子操作。处理器如何知道所有失效动作已经完成?早期设计用一条状态线表示:所有必要的失效请求都已收到,正在处理。收到这一信号后,产生未命中的处理器就可以释放总线,因为它知道,在下一次未命中相关操作发生前,所需动作都会完成。在这些步骤期间独占总线,便使各步骤整体具有原子性。
注意,没有共享总线就无法这样做;而且,这种方法与非阻塞缓存不兼容!
替代办法是:处理器在处理读未命中或写未命中,包括升级未命中,的过程中,必须能够接收传入事务,使缓存块失效,并重新发起读写请求。
理解并实现这一协议的最简单方法,是加入额外的瞬态(transient state)。对于核心中需要通信的每个事务,在其内部加入这些额外的“隐藏”状态。它们之所以是瞬态,是因为等待的是存储系统中某个动作完成,而不是等待核心发起新的请求。在瞬态中,如果收到系统发来的、由其他核心生成的写未命中或失效请求,就将缓存块状态改为无效,核心重新尝试访问;此时访问必然未命中。用表格更容易理解这些隐藏状态的作用,如图 5.8 所示。通过重新启动被另一操作打断的动作,这些瞬态有效地使协议动作具有原子性。
| 缓存状态 | 核心动作 | 等待事项 | 成功后的状态 |
|---|---|---|---|
| 无效 | 读未命中 | 未命中请求返回 | 共享 |
| 无效 | 写未命中 | 未命中请求返回 | 独占 |
| 共享 | 读未命中 | 未命中请求返回 | 共享 |
| 共享 | 写命中 | 失效完成 | 独占 |
| 共享 | 写未命中 | 未命中请求返回 | 独占 |
| 独占 | 读未命中 | 未命中请求返回 | 共享 |
| 独占 | 写未命中 | 未命中请求返回 | 独占 |
图 5.8(续)。 这些状态是瞬态:“等待事项”列所列事务完成后,便像基本一致性协议一样转入成功状态。但是,如果待处理事务完成前,收到对同一块的写未命中或失效请求,就将该块改为无效,并从这一状态重新启动事务。由于块已无效,此时只能发生读未命中或写未命中。注意,图 5.6 和图 5.7 中的写回也必须执行。先完成写回较简单;如果将写回暂存于缓冲区,传入事务也必须监听缓冲区内容。
共享内存多处理器的性能
在采用监听一致性协议的多核系统中,多种现象共同决定性能。尤其是,整体缓存性能既取决于单处理器缓存未命中流量,也取决于一致性事务引起的流量;后者导致失效及后续缓存未命中。改变处理器数量、缓存容量和块大小,会以不同方式影响未命中率的这两个组成部分,系统的整体行为则由两种效应共同决定。
附录 B 将单处理器未命中率分为 3C:容量、强制性和冲突未命中,以帮助理解应用行为和缓存设计的改进空间。类似地,处理器间通信引起的未命中,常称为一致性未命中(coherence miss),也可以分为两个来源。
第一个来源是真共享未命中(true sharing miss),它由通过缓存一致性机制传递数据而产生。在失效协议中,处理器第一次写某个共享缓存块时,会发出失效请求,以取得该块的所有权。此外,另一个处理器尝试读取该缓存块中已修改的字时,也会未命中,继而传输该块。这两种未命中都归为真共享未命中,因为它们直接来自处理器之间的数据共享。
第二种效应称为伪共享(false sharing),来自采用每块只有一个有效位的失效一致性算法。如果因为写入了块中的某个字,使整块失效,并导致后续访问未命中,但这个被写入的字并不是随后读取的字,就可能出现伪共享。如果收到失效请求的处理器使用了被写入的字,那么属于真共享访问,无论块大小如何,都将未命中。反之,如果写入和读取的是同一缓存块中的不同字,失效没有传递任何新值,只造成一次额外缓存未命中,那么就是伪共享未命中。此时被共享的是块,块内并没有某个字真正共享;如果块大小只有一个字,这种未命中就不会发生。下面的例题说明这些共享模式。
例题:区分真共享与伪共享
假定 z1 和 z2 两个字位于同一个缓存块中,该块在 P1 和 P2 的缓存中都处于共享状态。对于以下事件序列,判断每次访问是真共享未命中、伪共享未命中还是命中。若块大小为一个字时仍会发生的未命中,就定义为真共享未命中。
| 时间 | P1 | P2 |
|---|---|---|
| 1 | 写 z1 | |
| 2 | 读 z2 | |
| 3 | 写 z1 | |
| 4 | 写 z2 | |
| 5 | 读 z2 |
解答。 按时间步分类如下:
- 真共享未命中,因为 z1 在 P2 中处于共享状态,必须使 P2 中的 z1 失效。
- 伪共享未命中,因为 P1 写 z1 时使 z2 一同失效,但 P2 并不使用 z1 的这个值。
- 伪共享未命中,因为 P2 的读取使包含 z1 的块被标记为共享,但 P2 并没有读取 z1。P2 读取后,包含 z1 的块处于共享状态;必须通过一次写未命中取得独占访问权。在某些协议中,这由升级请求处理:发出总线失效请求,但不传输缓存块。
- 伪共享未命中,原因与第 3 步相同。
- 真共享未命中,因为读取的值是由 P2 写入的。
虽然我们将在商业负载中看到真共享和伪共享未命中的影响,但在紧密耦合、共享大量用户数据的应用中,一致性未命中的作用更为显著。附录 I 研究并行科学负载的性能时,将详细考察这些影响。
小规模多处理器上的商业负载
本节研究一个四处理器共享内存多处理器运行在线事务处理负载时的存储系统行为。该研究于 1998 年在四处理器 Alpha 系统上进行,但对这类负载的多处理器性能而言,它仍是最全面、最有启发性的研究。我们重点理解多处理器的缓存活动,尤其是 L3,因为那里大量流量与一致性有关。
结果来自 AlphaServer 4100 的实测,或以 AlphaServer 4100 为模型的可配置模拟器,见 Barroso et al.(1998)。AlphaServer 4100 的每个处理器都是 Alpha 21164,每时钟最多发射四条指令,运行频率为 300 MHz。虽然它的频率远低于近期设计的处理器,但由四发射处理器和三级缓存层次组成的基本结构,与多核 Intel i7、i9 及其他处理器十分相似,如图 5.9 所示,只是缓存比新多核系统的小。我们不纠缠于具体性能,而是考察每处理器 L3 容量从 2 MiB 到 8 MiB 时的模拟行为。
虽然原研究考察了三种负载,我们只关注以 TPC-B 为模型的在线事务处理(OLTP)负载,底层数据库为 Oracle 7.3.2。TPC-B 的内存行为与较新的 TPC-C 类似,后者见第 1 章。负载由一组产生请求的客户进程,以及一组处理请求的服务器进程组成。服务器进程占用 85% 的用户态时间,其余属于客户进程。通过精心调优并保持足够多的请求,可用忙碌的处理器隐藏 I/O 延迟;不过,服务器进程通常执行约 25,000 条指令后就会因 I/O 阻塞。总体上,71% 的执行时间处于用户态,18% 用于操作系统,11% 为空闲,主要在等待 I/O。在所研究的商业应用中,OLTP 对存储系统的压力最大,即使使用大得多的 L3 进行评估,也存在明显挑战。例如,AlphaServer 中的处理器约有 90% 的周期处于停顿状态;由 L3 未命中造成的内存访问占近一半停顿时间,L2 未命中占 25%。
先考察改变 L3 容量的影响。在这些研究中,每处理器 L3 从 1 MiB 变化到 8 MiB。当每处理器为 2 MiB 时,L3 总量与 Intel i7 6700 相同。但是 i7 的缓存是共享的,既有优势也有劣势。共享的 8 MiB 缓存不太可能胜过总量为 16 MiB 的独立 L3 缓存。
| 缓存级别 | 特性 | Alpha 21164 | Intel i7 |
|---|---|---|---|
| L1 | 容量 | 8 KB 指令/8 KB 数据 | 32 KB 指令/32 KB 数据 |
| L1 | 相联度 | 直接映射 | 指令 8 路/数据 8 路 |
| L1 | 块大小 | 32 B | 64 B |
| L1 | 未命中开销 | 7 | 10 |
| L2 | 容量 | 96 KB | 256 KB |
| L2 | 相联度 | 3 路 | 8 路 |
| L2 | 块大小 | 32 B | 64 B |
| L2 | 未命中开销 | 21 | 35 |
| L3 | 容量 | 2 MiB(共 8 MiB,不共享) | 每核心 2 MiB(共 8 MiB,共享) |
| L3 | 相联度 | 直接映射 | 16 路 |
| L3 | 块大小 | 64 B | 64 B |
| L3 | 未命中开销 | 80 | 约 100 |
图 5.9(续)。 虽然 i7 的容量更大、相联度更高,但未命中开销也更高,因此行为可能差别不大。两种系统从私有缓存取得数据时,都有很高的开销,为 125 个周期或更多。一个关键区别是:i7 的 L3 是共享的,Alpha 服务器则有四个独立、不共享的 L3。
图 5.10 给出了增大缓存容量的影响。缓存采用两路组相联,以减少大量冲突未命中。随着 L3 增大,L3 未命中减少,执行时间得到改善。令人意外的是,几乎全部收益都出现在从 1 MiB 增加到 2 MiB 的过程中,即四个处理器的总缓存从 4 MiB 增加到 8 MiB。再往上增加,额外收益很少,尽管在 2 MiB 和 4 MiB 时,缓存未命中仍造成明显性能损失。这是为什么?
图 5.10(续)。 缓存增大时,空闲时间也增长,抵消了一部分性能收益。这是因为存储系统停顿减少后,需要更多服务器进程来掩盖 I/O 延迟。可以重新调优负载,改善计算与通信之间的平衡,抑制空闲时间的增长。PAL 代码是一组在特权模式下执行的专用操作系统级指令序列,例如 TLB 未命中处理程序。
图内术语:Normalized execution time=归一化执行时间;L3 cache size (MB)=L3 缓存容量(MB,图中单位);Idle=空闲;PAL code=PAL 代码;Memory access=内存访问;L2/L3 cache access=L2/L3 缓存访问;Instruction execution=指令执行。
为了更好地回答这个问题,必须确定哪些因素构成 L3 未命中率,以及它们怎样随 L3 增长而变化。图 5.11 显示五类来源对每条指令内存访问周期数的贡献。L3 为 1 MiB 时,最大的两项是指令未命中和容量/冲突未命中。L3 增大后,这两项降为次要因素。遗憾的是,强制性、伪共享和真共享未命中不受 L3 增大的影响。因此,在 4 MiB 和 8 MiB 时,真共享未命中成为主要部分;它们没有改变,所以 L3 超过 2 MiB 后继续增大,总未命中率只能有限下降。
增大缓存消除了大多数单处理器未命中,却没有改变多处理器未命中。那么,增加处理器数量,对不同类型未命中又有什么影响?
图内术语:Memory cycles per instruction=每条指令的内存访问周期数;Cache size (MB)=缓存容量(MB,图中单位);Instruction=指令未命中;Capacity/conflict=容量/冲突未命中;Compulsory=强制性未命中;False sharing=伪共享未命中;True sharing=真共享未命中。以下图 5.12、5.13 沿用同一分类。
图 5.12 显示这一数据,基准配置是每处理器 2 MiB、两路组相联 L3,与 i7 的每处理器有效缓存容量相同,但相联度更低。正如所料,真共享未命中率增加,而单处理器未命中并未减少来抵消它,因此每条指令的总内存访问周期数上升。
最后考察增大块是否有利于这一负载。更大的块应当降低指令未命中和冷未命中率;在一定限度内,也应减少容量/冲突未命中,还可能降低真共享未命中率。图 5.13 展示块从 32 字节增到 256 字节时,每千条指令的未命中数。这一变化影响了未命中率的四个组成部分:
- 真共享未命中率降至原来的一半以下,说明真共享模式具有一定局部性。
- 强制性未命中率显著下降,符合预期。
- 冲突/容量未命中小幅减少,块大小增为八倍时,仅降至原来的 ,说明在 L3 大于 2 MiB 后发生的单处理器未命中,空间局部性不强。
- 伪共享未命中率虽然绝对值很小,却几乎翻倍。
图中横轴 Processor count 为处理器数量;纵轴及分类含义见图 5.11。
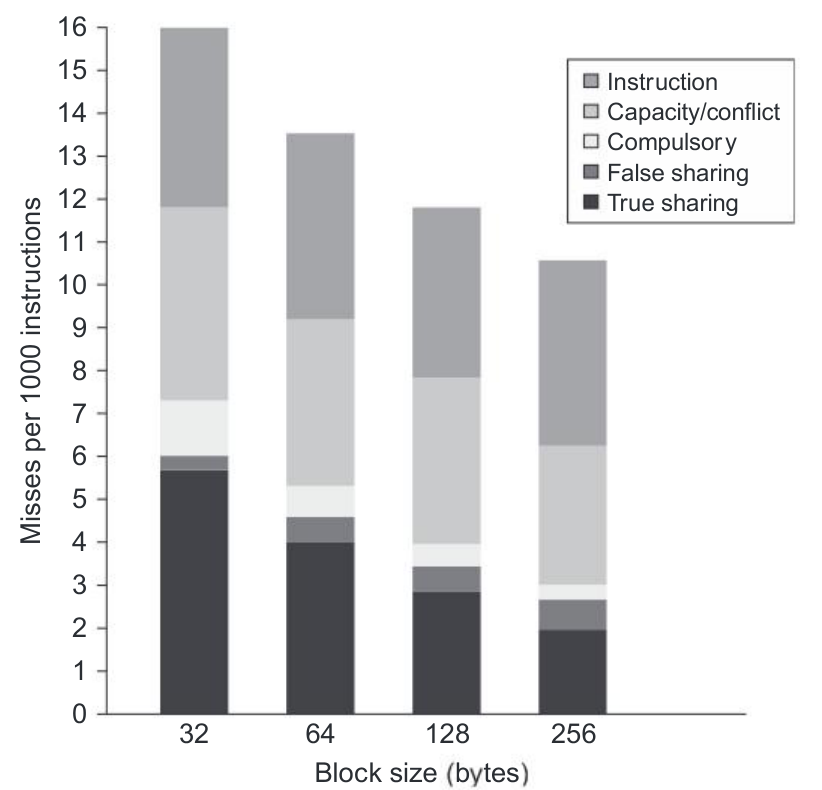
图中纵轴 Misses per 1000 instructions 为每千条指令的未命中数;横轴 Block size (bytes) 为块大小,单位为字节;分类见图 5.11。
指令未命中率没有明显变化,令人吃惊。如果一个纯指令缓存呈现这种行为,我们会认为其空间局部性很差。但对于混合存放指令和数据的 L2、L3,指令与数据冲突等其他因素,也可能导致大块时仍有较高的指令未命中率。其他研究同样发现,大型数据库与 OLTP 负载的指令流空间局部性较低,因为其中有大量短基本块和专用代码序列。根据这些数据,若想让采用较大块的 L3 达到 32 字节块 L3 的性能,允许的未命中开销可以表示为 32 字节块未命中开销的倍数:
| 块大小 | 相对于 32 字节块未命中开销的倍数 |
|---|---|
| 64 字节 | 1.19 |
| 128 字节 | 1.36 |
| 256 字节 | 1.52 |
现代 DDR SDRAM 的块访问速度很快,因此这些数值是可以达到的,尤其是 64 字节,即 i7/i9 的块大小,以及 128 字节。当然,还必须考虑到内存流量增加,以及与其他核心争用内存的影响。后一种效应很容易抵消提高单处理器性能带来的收益。5.4 节将考察规模更大、基于 NUMA 的多处理器在一种高度可扩展但耦合松散的负载下的性能特征。
5.4 通过目录维护缓存一致性
如 5.3 节所示,监听协议在每次缓存未命中时,都必须与所有缓存通信,包括对可能共享的数据进行写入。没有集中式数据结构来跟踪缓存状态,是监听方案成本低的根本优势,却也是它在可扩展性方面的致命弱点。
可以通过分布内存来增加内存带宽和互连带宽,如图 5.2 所示。 这样便立即将本地内存流量与远程内存流量分开,降低存储系统与互连网络的带宽需求。但是,如果仍要求一致性协议在每次缓存未命中时广播,那么分布内存的收益也很有限。
如前所述,监听一致性协议的另一种选择是目录协议(directory protocol)。目录保存每个可能被缓存的块的状态,包括哪些缓存或缓存集合可能持有副本,以及该块是否已修改。
对于具有包含性共享 LLC 的单个多核处理器,很容易在 LLC 实现目录:只需为每个 LLC 块保存一个长度等于核心数的位向量。由于所有 L2 块必然都在 LLC 中,该向量便可指明哪些私有 L2 可能持有该块,只向这些缓存发送失效请求即可。对于 LLC 具有包含性的单个多核处理器,这一方案工作得很好,Intel i7 就采用了它。假如 LLC 不具有包含性,仍可以在 LLC 保存目录信息:或者维护独立目录结构,如 Intel Xeon;或者复制 L2 标签,如 AMD EPYC。单一目录也简化了事件排序,而这是实现各种存储一致性模型所必需的,见 5.6 节。 有了单一目录,只需暂缓后续请求,直到确认当前请求完成,例如失效请求,或获取远程缓存数据的请求。随着核心数增加,这种阻塞办法效率低下;有多个目录时则无法工作。
因此,目录也必须像内存一样分布,而不能只有一个。但是,分布方式必须让一致性协议知道,任意已缓存内存块的目录信息位于哪里。显而易见的办法是让目录随内存一起分布:不同一致性请求可以到达不同目录,正如不同内存请求可以到达不同存储器。
分布式目录保留了这样一个特征:某块的共享状态始终位于一个确定、已知的位置。结合目录中保存的“其他哪些节点可能缓存该块”的信息,一致性协议便可以避免广播。图 5.14 显示在每个节点加入目录之后的分布式内存多处理器。
最简单的目录实现,为每个内存块关联一个目录项。所需信息量与“内存块数量 × 节点数量”成正比;内存块大小与 L2 或 LLC 块相同,而节点可以是单个多核处理器,也可以是内部通过监听实现一致性的一小组处理器。对于处理器数量少于几百的多处理器,每个处理器本身也可能是多核,这一开销不是问题,因为采用合理块大小时,目录开销可以接受。更大规模的多处理器则需要让目录结构有效扩展的方法,不过只有超级计算机规模的系统才需要担心这一点。
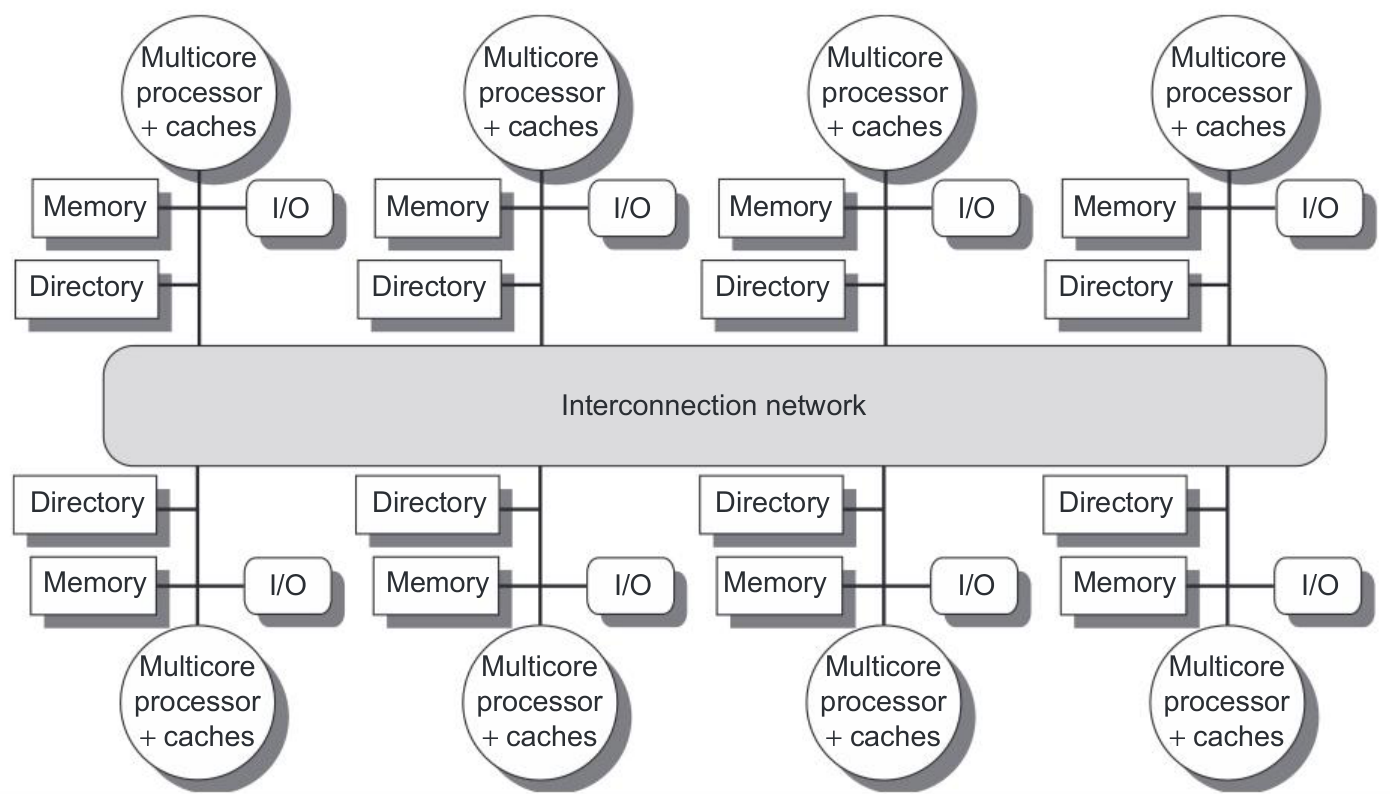
图 5.14(续)。 图中一个节点是一颗多核芯片,其所关联内存的目录信息可以位于片上,也可以位于片外。每个目录负责跟踪哪些缓存共享了本节点所辖内存地址。一致性机制既维护目录信息,也处理多核节点内部所需的一致性动作。
图内术语:Multicore processor + caches=多核处理器及缓存;Memory=内存;Directory=目录;Interconnection network=互连网络;I/O=输入/输出。
目录式缓存一致性协议的基础
与监听协议一样,目录协议必须实现两项主要操作:处理读未命中,以及处理对共享、干净缓存块的写入。对当前已共享块的写未命中,只是这两者的简单组合。为实现这些操作,目录必须跟踪各缓存块的状态。在一个简单协议中,可以有如下状态:
- 共享(Shared):一个或多个节点缓存了该块,内存中的值为最新,持有副本的全部缓存中的值也为最新。
- 未缓存(Uncached):没有节点持有该缓存块的副本。
- 已修改(Modified):恰有一个节点持有该块副本,而且已经写入,因此内存副本过期。这个处理器称为块的拥有者。
除了跟踪每个可能共享的内存块的状态,还必须跟踪哪些节点持有副本,因为写入时必须使它们失效。最简单的办法,是为每个可能被缓存的内存块保存位向量。块为共享状态时,各位指示对应核心或核心组是否持有副本;块为独占状态时,该位向量也能用来跟踪拥有者。为提高效率,各缓存自身还会跟踪其缓存块状态。
各缓存的状态机,其状态及转换与监听缓存相同,只是转换时的动作略有区别。使副本失效,以及找到数据项独占副本的过程不同,因为两者都需要请求节点与目录通信,再由目录与一个或多个远程节点通信。在监听协议中,这两步通过向所有节点广播合并完成。目录式系统则使用请求核心、目录控制器和响应核心之间的点对点消息,不向所有节点广播。
在查看状态图之前,先列出核心与目录之间为处理未命中、维护一致性可能传送的消息,有助于理解协议。图 5.15 给出了节点间的消息类型。**本地节点(local node)**是请求发起的节点。**归属节点(home node)**是某地址的内存位置和目录项所在的节点。物理地址空间静态分布,因此,给定物理地址,其内存与目录位于哪个节点是已知的。例如,地址高位可表示节点号,低位表示该节点内存中的偏移。本地节点也可能就是归属节点。即使二者相同,也必须访问目录,因为第三个节点,即远程节点,仍可能持有副本。
**远程节点(remote node)**是持有该缓存块副本的节点;它可能独占该块,此时是唯一副本,也可能共享该块。远程节点可能与本地节点或归属节点相同。这时基本协议不变,只是处理器间消息可以改为处理器内部消息。
本节采用简单的存储一致性模型。为尽量减少消息类型和协议复杂性,假定消息按发送顺序接收并处理。5.8 节考察的多处理器和多核系统满足这一假设,但极大规模的多处理器可能不满足。不严格遵守此顺序时,会增加复杂性,5.6 节讨论存储一致性模型时会涉及其中一部分。本节利用这一假设,确保节点发出的失效请求在传送新消息之前得到处理,正如讨论监听协议实现时的假设一样。
与监听协议一样,这里省略了一些实现一致性所必需的细节。其中大多数问题,同样可以通过增加瞬态来处理非原子动作。
| 消息类型 | 来源 | 目的地 | 消息内容 | 功能 |
|---|---|---|---|---|
| 读未命中 | 本地缓存 | 归属目录 | P,A | 节点 P 在地址 A 读未命中:请求数据,并让 P 成为读共享者。 |
| 写未命中 | 本地缓存 | 归属目录 | P,A | 节点 P 在地址 A 写未命中:请求数据,并让 P 成为独占拥有者。 |
| 失效 | 本地缓存 | 归属目录 | A | 请求向所有缓存了地址 A 所在块的远程缓存发送失效消息。 |
| 失效 | 归属目录 | 远程缓存 | A | 使地址 A 的共享数据副本失效。 |
| 获取(Fetch) | 归属目录 | 远程缓存 | A | 取得地址 A 所在块并发往归属目录;将远程缓存中 A 的状态改为共享。 |
| 获取并失效(Fetch/invalidate) | 归属目录 | 远程缓存 | A | 取得地址 A 所在块并发往归属目录;使缓存中的该块失效。 |
| 数据值应答 | 归属目录 | 本地缓存 | D | 从归属内存返回数据值。 |
| 数据写回 | 远程缓存 | 归属目录 | A,D | 写回地址 A 的数据值。 |
| 确认 | 归属目录 | 本地缓存 | A | 表示针对地址 A 请求的全部失效操作均已完成。目录逐一跟踪收到的确认,待所有共享副本失效后发送该消息。 |
| 确认 | 远程缓存 | 归属目录 | P,A | 表示处理器 P 已完成地址 A 的失效操作。目录逐一跟踪这些确认,然后向发起请求的本地缓存发送确认。 |
图 5.15(续)。 前三种是本地节点发往归属节点的请求。第四至第六种是归属节点为了满足读写未命中请求而发往远程节点的消息。数据值应答把值从归属节点传回请求节点。数据写回有两个原因:缓存中的块被替换,必须写回归属内存;或者响应归属节点发来的获取或获取并失效消息。每当块转为共享状态就写回数据,可以减少协议所需的状态,因为所有脏块都必须独占,而所有共享块在归属内存中始终都有可用副本。最后两行是确认,用于跟踪远程缓存何时完成失效,以及本地缓存完成写入所需的全部失效何时完成。失效操作本来不要求响应,但存储一致性模型要求我们知道何时可以继续写入,所以必须加入确认消息。
一个关键增补就是图 5.15 中的确认消息。因为我们不能直接知道所有必要的失效何时完成,所以,对于不返回任何数据的失效请求,必须让接收方发回确认,才能知道该操作已经完成。而且,只有确认全部失效都完成后,才能允许写入继续。5.6 节讨论存储一致性时,将说明这一限制的必要性;附录 I 也将进一步讨论。
一个目录协议示例
目录协议中,缓存块的基本状态与监听协议完全一样,目录状态也与前面类似。因此,可以先看单个缓存块的简单状态转换图,再考察内存中各块所对应目录项的状态图。和监听一样,这些状态图不表示协议的全部细节。实际控制器高度依赖多处理器的许多细节,例如消息交付特性、缓冲结构等。本节介绍基本状态图,实现中的棘手问题留到附录 I。
图 5.16 显示单个缓存响应的协议动作。记号沿用上一节:节点外部的请求为灰色,动作以粗体表示。单个缓存的状态变化由读未命中、写未命中、失效和数据获取请求触发。缓存自身也会产生发往归属目录的读未命中、写未命中和失效消息。读写未命中需要数据值应答,必须等应答到达后才能改变状态;因此,与监听一样,这些事务需要瞬态。目录还必须跟踪失效操作,以确定何时全部完成。
图 5.16 中缓存块状态图的工作方式与监听基本相同:状态一致,触发事件也几乎一样。在监听方案中通过总线或其他网络广播的写未命中,改由目录控制器选择性发送数据获取和失效操作。与监听协议一样,任何缓存块在被写入时必须处于独占状态,任何共享块在内存中都必须为最新。在许多多核处理器中,最外层缓存由核心共享,例如 Intel i7 和 i9、AMD Opteron 和 EPYC,以及 IBM Power 系列的 L3;这一层的硬件通过内部目录或监听,维持同一芯片各核心私有缓存的一致性。这种设计允许目录信息保存在 LLC。扩展到多个插槽后,LLC 不再共享,需要进一步扩展,稍后讨论。
目录协议的另一半由目录实现。一条发往目录的消息会引起两类动作:更新目录状态,以及发送额外消息来满足请求。目录表示一个块的三个标准状态;但与监听不同,它表示某内存块的全部缓存副本的状态,而不是单个缓存块的状态。
内存块可能没有被任何节点缓存,可能由多个节点缓存且可读,即共享,也可能恰好由一个节点独占缓存且可写。除了状态,目录还必须跟踪持有副本的节点集合,这里用 Sharers 集合表示。节点少于 64 个时,通常用位向量保存它;每个节点可能包含 4–8 个处理器,因此处理器数可以是节点数的 4–8 倍。目录请求需要更新 Sharers,并读取它以执行失效操作。
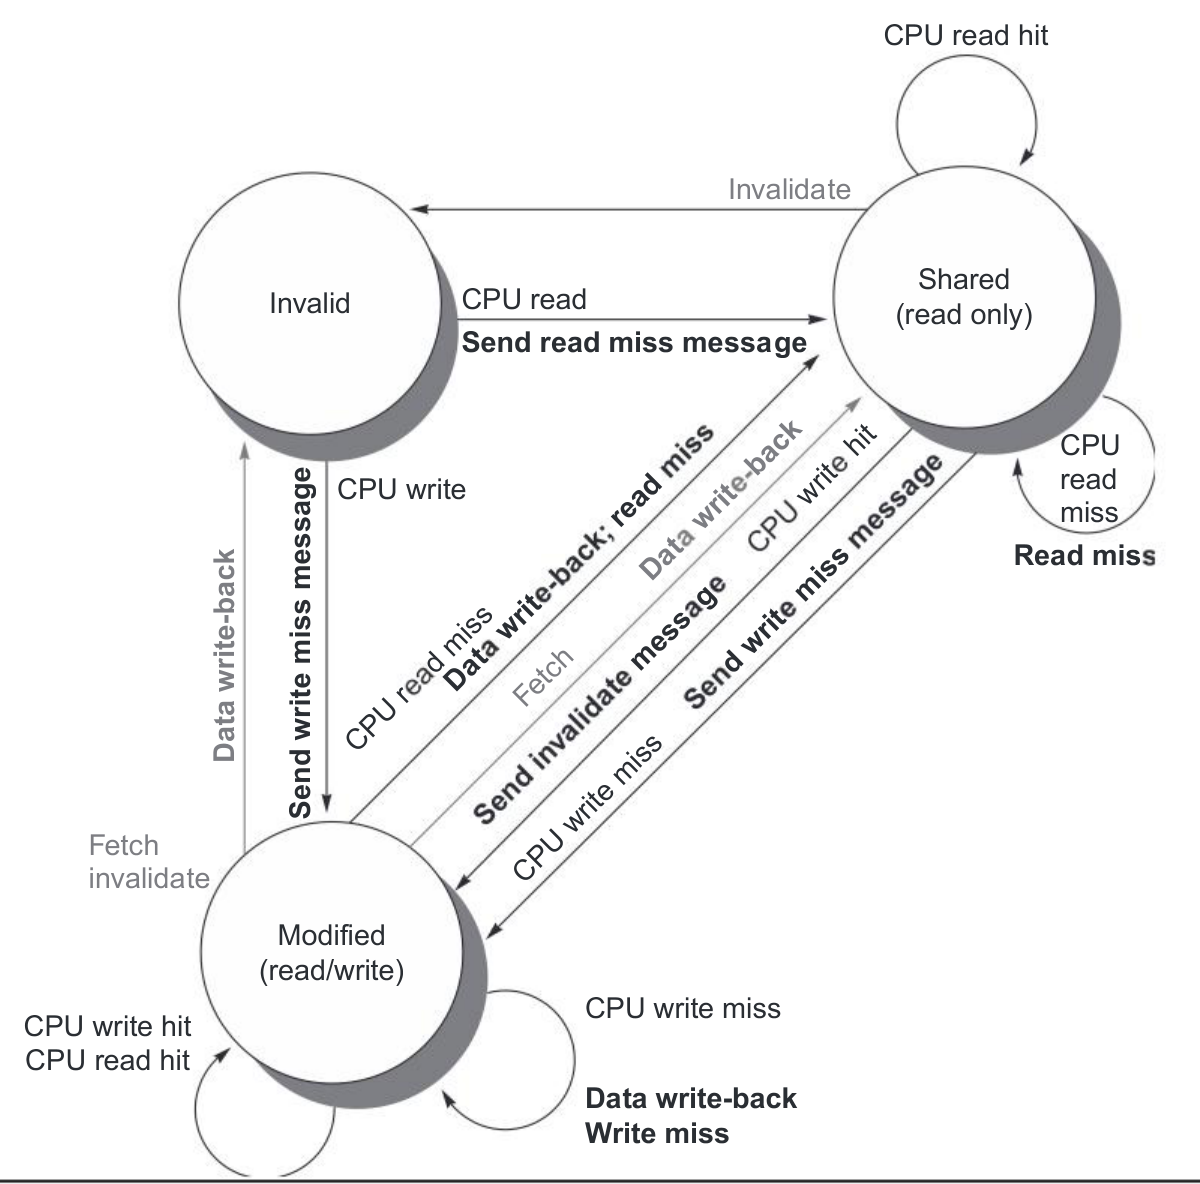
图 5.16(续)。 状态与监听情况一致,事务也很相似,只是用显式失效和写回请求代替了原先在总线上广播的写未命中。与监听控制器一样,假定尝试写共享缓存块被视为未命中。实际实现可以把它视为所有权请求或升级请求,无须重新获取缓存块就交付所有权。
图内术语:Invalid=无效;Shared (read only)=共享(只读);Modified (read/write)=已修改(可读写);CPU read/write hit/miss=CPU 读/写命中或未命中;Send read/write miss message=发送读/写未命中消息;Send invalidate message=发送失效消息;Fetch=获取;Fetch invalidate=获取并失效;Data write-back=数据写回。
图 5.17 显示目录对收到消息所采取的动作。目录接收三种请求:读未命中、写未命中和数据写回。响应消息以粗体表示,对 Sharers 的更新以粗斜体表示。因为所有触发消息都来自外部,所有动作都画成灰色。这个简化协议假定某些动作是原子的,例如请求一个值并发送给另一个节点。真实实现不能依靠这一假设,需要像监听方案一样增加瞬态。
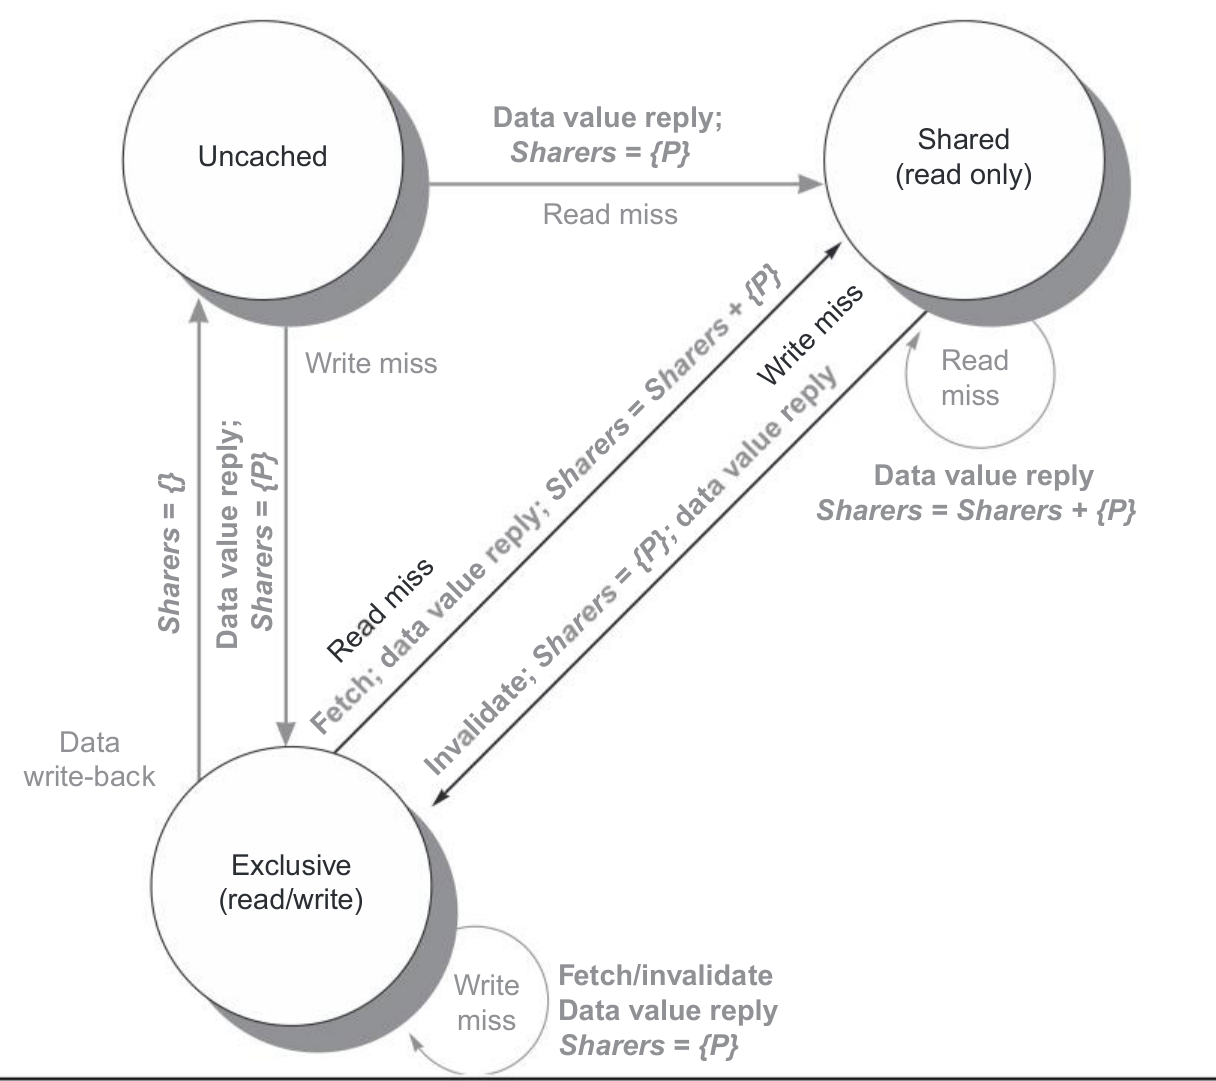
图 5.17(续)。 与监听一致性一样,目录只有确认全部失效请求都已被接收,才能响应写未命中。目录方案通过收到失效请求的缓存向目录发送确认来跟踪这一进程。
图内术语:Uncached=未缓存;Shared (read only)=共享(只读);Exclusive (read/write)=独占(可读写);Read/Write miss=读/写未命中;Data value reply=数据值应答;Data write-back=数据写回;Fetch/invalidate=获取并失效;Invalidate=失效。Sharers 为共享者集合,{P} 表示仅含节点 P,{} 表示空集,Sharers + {P} 表示把 P 加入集合。
为理解目录操作,下面按状态分别考察请求和动作。块为未缓存时,内存副本就是当前值,因此只可能收到以下请求:
- 读未命中。 从内存向请求节点发送数据,将其设为唯一共享节点,块转为共享状态。
- 写未命中。 将值发送给请求节点,让它成为共享集合中的节点。块转为独占,表示唯一有效副本已被缓存;Sharers 指明拥有者。
块为共享时,内存中的值是最新的,也可能发生这两类请求:
- 读未命中。 从内存发送所需数据,并将请求节点加入共享集合。
- 写未命中。 向请求节点发送值。向 Sharers 中所有节点发送失效消息,并将 Sharers 设为只包含请求节点。目录知道所有失效已完成后,块转为独占。
块为独占时,当前值位于 Sharers 指定节点,即拥有者,的缓存中。此时可能收到三种目录请求:
- 读未命中。 向拥有者发送数据获取消息,使其缓存中的块转为共享,并把数据发给目录。目录将数据写入内存,再发回请求处理器。把请求节点加入 Sharers;原拥有者仍保留可读副本,因此仍在集合中。
- 数据写回。 拥有者正在替换块,所以必须写回。写回使内存副本成为最新,归属目录实际上成为拥有者。该块转为未缓存,Sharers 为空。
- 写未命中。 该块将有新的拥有者。向旧拥有者发送消息,让它使缓存块失效,并将值发给目录;目录再转发给请求节点,后者成为新拥有者。Sharers 改为新拥有者,块仍处于独占状态。
实际多处理器的目录协议还有额外优化。例如,在本协议中,对独占块发生读写未命中时,块先发往归属目录,在那里写入归属内存,再转发给最初的请求节点。许多商用多处理器协议直接将数据从拥有者发往请求节点,同时仍写回归属节点。这些优化增加了需处理的消息类型,也增加了复杂性。此外,监听协议中的同类扩展也可用于目录协议,原书举例为“加入 O 和 I 状态”。1
实现目录方案,需要解决大多数与监听协议相同的挑战。但是,如果不限制 CPU 数量,还会出现额外问题,见附录 I。
在多核处理器中实现目录一致性
所有多芯片多处理器都选择将监听与某种目录结合,以便在较多处理器下维持一致性。事实上,随着单芯片核心数增长,许多设计即使在单芯片内部也采用混合方案,将目录信息与共享 LLC 的分片关联。如果 LLC 具有包含性,可以把目录信息与各 LLC 块的标签关联。目录可以指出哪些 L2 持有共享数据;如果多个 L2 通过某个共享结构连接,例如 Power 处理器的环形总线,则只需指出需要监听哪一组处理器。也可以只让 LLC 包含所有共享缓存行,而不要求包含其他行;或者建立目录,指出需要监听哪些 L2 或 L2 集群。AMD EPYC 通过复制 L2 标签建立目录。
一旦超出共享 LLC 的范围,就需要为某块的目录信息安排一个唯一关联点。这类系统中的内存也是分布式的,因此最容易将目录放在内存接口处。假定一致性在 LLC 层实现,目录只需跟踪哪些核心的 LLC 可能持有某共享块。这样,每个内存块的目录信息很少,只需 1–16 bit。也可以按缓存方式保存这些数据,而不为每个内存块都保留。采用目录缓存就意味着必须处理目录未命中;最简单的处理办法是假定该块可能存在于各处,向每个集群发送失效请求。
多数设计要么只采用目录,要么在目录之下对部分核心监听,但两者角色也可以反过来。芯片数较少时,可以监听 LLC 层保存的目录。LLC 目录命中后,再向持有副本的 L2 发出显式失效请求。EPYC 采用这一方式,因为它最多有两个插槽、两个 LLC。
NUMA 多处理器运行 WWW 搜索应用的性能
截至 2022 年,所有较新的多核处理器都是 NUMA,其中许多还因 LLC 分布式布置而采用 NUCA;当然,核心越多,非均匀性就越明显。更大规模的这类系统主要用于服务器,通常提供交互式服务,因此既要求高吞吐量,也要求快速响应,而且通常还有服务质量要求。
为考察性能与系统权衡,我们选择一个基于交互式搜索中最耗时部分的负载。负载与本节数据的详细介绍见 Ayers et al.(2018)。这部分计算主要发生在搜索树的根部,检查网页索引中的独立分片,称为 shard;这些索引通过离线批处理构建。搜索过程的其他几个部分与之类似,但耗时较少。
与 SPECint 等其他负载相比,搜索负载的 L2 指令未命中率更高;其整体 CPI 与 LLC 未命中率则介于访存最密集的基准测试,例如 mcf,与更典型的 SPECint 程序之间。该负载具有很高并行性:在 72 核 Intel Xeon E7 系统上,相对于 8 核系统获得线性加速。这是因为它由请求级并行性构成,见第 6 章,进程间通信极少,因此由共享数据读写产生的一致性流量也很少。
数据采集所用 Intel Xeon E788xx 的特征如下:
| 特性 | 数值 |
|---|---|
| 每芯片核心数 | 18 |
| 总核心数,两颗芯片 | 36 |
| 每核心 SMT 线程数 | 2 |
| 缓存块大小 | 64 B |
| 每核心 L1I | 32 KiB,4 路 |
| 每核心 L1D | 32 KiB,8 路 |
| 每核心 L2 | 256 KiB,8 路 |
| 每插槽共享 L3 | 45 MiB,16 路 |
虽然一致性流量很少,这个搜索应用对存储系统的压力仍然很大。图 5.18 给出 L1、L2、L3 的 MPKI,并将平均未命中开销与 MPKI 相乘,估计未命中成本。这会高估实际停顿时间,因为处理器能隐藏一部分未命中时间。L3 未命中的重要性,使 CPI 与 L3 未命中率高度相关;第 2 章考察硬件预取时也观察到了这一点。还要记住,L3 未命中要访问片外 DRAM,其能耗也是 L3 命中的十倍或更多。
由于采用组相联缓存,冲突未命中很少:改用全相联缓存、消除全部冲突未命中,只能使两个 L1 的未命中率下降 7%,L2 和 L3 则下降不足 1%。这个应用长期运行,因此强制性未命中很少;一致性未命中也很少,所以容量未命中占主导。考虑到 WWW 搜索引擎的数据规模,这并不令人意外。
使用较大的 L3 是减少容量未命中的一种方法。如果空间局部性高,增大块也能降低容量未命中率。图 5.19 给出此负载下,改变各级缓存块大小的影响。记住,由于共享很少,通常会随着大块伪共享增加的一致性未命中,在这里影响很小。
图 5.18(续)。 相比 L3 的 240 周期未命中开销,处理器更容易隐藏 L1、L2 分别为 12、56 周期的开销。因此,相对于图中 L3 的估算,L1、L2 的实际未命中成本会更低。估计假定发往 L3 和内存的未命中中,有 2/3 命中本地 L3 存储体或本地内存,不包括一致性事务成本。
图内术语:MPKI=每千条指令的未命中数;Estimated Miss Cost (clock cycles)=估算未命中成本(时钟周期);Miss cost=未命中成本。
图中纵轴为 MPKI;图例 32、64、128、256、512、1024 表示块大小,单位为字节;L1I 和 L1D 分别为 L1 指令缓存和数据缓存。
正如预料,增大块对 L1 指令缓存未命中的影响最大,但较大的 L3 也有显著收益。L1 数据缓存最敏感:最初未命中率下降约 25%,但块继续变大后,未命中率又上升。
当然,增大块虽然通常能降低未命中率,却会增加流向下一层的流量。因此,性能能否改善,取决于更多内存流量造成的潜在争用、更高的单次未命中成本,以及对功耗的潜在影响。单次未命中成本又取决于存储系统是否优先返回关键字,让访存操作先继续执行;功耗则主要取决于未命中次数,而不是块大小。
图 5.20 展示较大块相对于 32 B 块的内存流量。即使只考虑这一个基准测试,选择最佳块大小也很复杂。例如,增大 L1I 块似乎合理,因为改为 64 B 后未命中率大幅下降,而流量只略增。由于包含性使 L1D 与 L2 采用不同块大小变得棘手,把 L2 块增至 64 B,会使流向 L2 的流量变为 1.5 倍,L2 到 L3 的流量变为 1.3 倍。是否划算,取决于在更广泛的基准测试上分析整个系统的行为。假定不要求包含性,增大 L3 块似乎更有吸引力。不过,还必须考虑怎样跟踪 L2 的一致性信息。尽管如此,流量只增至 1.2 倍,未命中率却降至原来的 ,仍然很有吸引力。
图内术语:Traffic relative to system with 32B block=相对于采用 32 B 块的系统的流量;图例 64、128、256、512、1024 为块大小,单位为字节。
对于数据共享更密集的应用,增大块很可能产生更多一致性未命中,进一步削弱 L1D、L2 使用大块的优势。科学应用中未命中的分析见附录 I。
译注: 此处写为“加入 O 和 I 状态”;但 I(Invalid)在前述基本 MSI 协议中已经存在。此处不猜测作者原拟写的是哪一扩展状态,保留字面表述。 ↩︎
5.5 同步:基础
同步机制通常由用户级软件例程构建,并依靠硬件提供的同步指令。对于较小的多处理器或争用较低的情形,关键硬件能力是一条不可中断的指令,或一组指令序列,能够以原子方式读取并修改某个值。软件同步机制再利用这一能力建立。本节重点介绍加锁与解锁同步操作的实现。它们既能直接构建互斥,也可实现更复杂的同步机制。
争用较高时,同步会成为性能瓶颈:争用带来额外延迟,而更大规模多处理器本身的延迟也可能更高。附录 I 讨论如何把本节的基本同步机制扩展到更多处理器。
基本硬件原语
在多处理器中实现同步,需要一组能原子地读取并修改内存位置的硬件原语。没有这一能力,构建基本同步原语的成本会过高,并随处理器数量增加而增长。
基本硬件原语有几种不同形式,都能以原子方式读取并修改一个位置,并提供某种办法,判断读与写是否原子地执行。这些原语是各种用户级同步操作的构件,例如锁和屏障。体系结构设计者通常不期待用户直接使用基本硬件原语,而是希望系统程序员用它们建立同步库;这一过程往往复杂而棘手。先来看一种原语,以及如何用它构建基本同步操作。
一种典型操作是原子交换(atomic exchange),交换一个寄存器中的值与内存中的值。假设要构建简单的锁,用 0 表示空闲,1 表示不可用。处理器尝试加锁时,将寄存器中的 1 与锁对应的内存位置交换。如果已有其他处理器取得访问权,交换返回 1;否则返回 0。后一种情况下,锁的值也被改成 1,阻止其他竞争的交换操作再得到 0。
例如,两个处理器同时尝试交换时,必定恰有一个先执行,返回 0;第二个执行交换时便返回 1,竞争由此分出结果。用 exchange 或 swap 原语实现同步,关键在于操作具有原子性:交换不可分割,两个同时发生的交换由写串行化机制确定顺序。采用这种方式设置同步变量的两个处理器,不可能都认定自己同时成功设置了变量。
还有一些其他原子原语可用于同步。它们的共同关键性质,是读取并更新内存值,而且我们能够知道这两项操作是否原子地执行。许多较早的多处理器提供 test-and-set(测试并置位):测试一个值,如果满足测试条件,就设置它。例如,可以定义为测试值是否为 0,然后置为 1,使用方法类似原子交换。另一个原语是 fetch-and-increment(取值并递增):返回某内存位置的值,同时原子地将它加一。用 0 表示同步变量尚未被占用,就可以像使用交换一样使用这一原语。取值并递增还有其他用途,稍后会看到。
单条原子内存操作的实现存在挑战,因为它要求在一条不可中断的指令中完成一次内存读和一次内存写。这使一致性实现复杂化:硬件既不能让其他操作插入读写之间,又不能造成死锁。
另一种办法是使用一对指令,由第二条返回一个值,据此判断这一对指令是否表现得像原子操作。如果任意处理器执行的所有其他操作,看起来都发生在这一对指令之前或之后,那么这对指令就有效地具有原子性。因此,原子性成立时,其他处理器不能在二者之间改变该值。MIPS 和 RISC-V 采用这种方式。
RISC-V 的这对指令包括特殊的加载 load reserved,也称 load linked 或 load locked,以及特殊的存储 store conditional。Load reserved 将 rs1 指定内存地址的内容加载到 rd,并对该地址建立保留(reservation)。Store conditional 将 rs2 中的值存入 rs1 指定地址。如果对同一内存位置的写入破坏了加载建立的保留,条件存储失败,并向 rd 写入非零值;成功则写入 0。如果处理器在这两条指令之间发生上下文切换,条件存储总是失败。
这两条指令按次序使用。由于保留加载返回初始值,条件存储仅在成功时返回 0,下面的序列可将 x4 中的值与 x1 指定的内存位置原子交换:
序列结束时,x4 的内容与 x1 指定内存位置的内容已经原子交换。只要某处理器在 lr 与 sc 之间介入并修改内存值,sc 就向 x5 返回非零值,令代码重试。
保留加载/条件存储机制的一个优点,是可以构建其他同步原语。例如,下面是原子取值并递增:
这些指令通常通过一个寄存器跟踪 lr 指定的地址,常称为保留寄存器(reserved register)。发生中断,或者与该寄存器地址匹配的缓存块失效,例如由于另一个 sc,就清除这一寄存器;原文在此也称它为 link register。sc 只需检查自己的地址是否与保留寄存器匹配。匹配就成功,否则失败。由于对保留地址的其他存储尝试或任何异常,都可能导致条件存储失败,因此必须谨慎选择插在两条指令之间的指令。原书要求只允许寄存器—寄存器指令,以免出现处理器始终无法完成 sc 的死锁情形。此外,两条指令之间的指令数量应尽量少,以降低无关事件或竞争处理器使条件存储频繁失败的概率。1
利用一致性实现锁
有了原子操作,就可以利用多处理器的一致性机制实现自旋锁(spin lock):处理器不断尝试取得锁,在循环中“自旋”,直至成功。程序员预计锁只持有很短时间,并希望锁可用时加锁延迟很低,便会采用自旋锁。因为它会占住处理器,在循环中等待锁释放,所以并不适用于所有场合。
最简单的实现,是把锁变量保存在内存中;没有缓存一致性时会采用这一方法。处理器不断用原子交换等操作尝试加锁,并检查交换返回的值是否表示锁空闲。释放锁只需向锁写入 0。下面为 x1 中保存地址的自旋锁加锁,EXCH 是前述原子交换序列的宏。
如果多处理器支持缓存一致性,就可以缓存锁,并由一致性机制维护锁值。这样有两个优势。第一,自旋,也就是在紧循环中测试并尝试取得锁,可以在本地缓存副本上进行,而无须每次尝试都访问全局内存。第二,锁访问往往具有局部性:上一次使用锁的处理器,很快又会使用它。此时锁值可能仍在该处理器的缓存中,显著缩短加锁时间。
要获得第一项优势,即在本地副本上自旋而不必每次尝试都生成内存请求,需要改变上述简单过程。前面的循环每次交换都要求写入。如果多个处理器竞争锁,它们都会产生写操作,而且大多数会写未命中,因为每个处理器都试图取得锁变量的独占状态。
因此,应修改自旋过程,先持续读取锁的本地副本,直到看到锁可用,再用交换操作尝试取得锁。处理器不停读取和测试,直到值表明锁已释放。接着,它与所有同样处于“自旋等待”的进程竞争,看谁先锁住变量。所有进程都使用交换指令,读取旧值并写入 1。唯一胜者得到 0,其他竞争者得到胜者写入的 1。失败者还会继续把变量设置为已加锁值,但这没有关系。胜者执行锁后的代码,完成后向锁写入 0 以释放锁,下一轮竞争随即开始。代码如下,记住 0 表示未加锁,1 表示已加锁:
来看看这种方案怎样使用缓存一致性机制。图 5.21 列出多个进程用原子交换竞争锁时,处理器与总线或目录的操作。持锁处理器向锁写入 0 后,其他所有缓存副本失效,必须取回新值来更新自己的副本。其中一个缓存先取得未加锁值 0,再执行交换。等其他处理器的缓存未命中得到满足时,发现变量已加锁,只能继续测试和自旋。
| 步骤 | P0 | P1 | P2 | 步骤结束时锁变量的缓存一致性状态 | 总线/目录操作 |
|---|---|---|---|---|---|
| 1 | 持有锁 | 开始自旋,测试 lock=0 | 开始自旋,测试 lock=0 | 共享 | 以任意次序满足 P1、P2 的缓存未命中;锁变量转为共享。 |
| 2 | 将 lock 置为 0 | 收到失效请求 | 收到失效请求 | 独占(P0) | P0 发出锁变量的写失效。 |
| 3 | 缓存未命中 | 缓存未命中 | 共享 | 总线/目录处理 P2 的未命中;P0 写回;状态为共享。 | |
| 4 | 总线/目录忙,等待 | lock=0 测试成功 | 共享 | P2 的缓存未命中得到满足。 | |
| 5 | lock=0 | 执行交换,缓存未命中 | 共享 | P1 的缓存未命中得到满足。 | |
| 6 | 执行交换,缓存未命中 | 完成交换:返回 0,并置 lock=1 | 独占(P2) | 总线/目录处理 P2 的未命中;生成失效请求;锁变量为独占。 | |
| 7 | 交换完成,返回 1,并置 lock=1 | 进入临界区 | 独占(P1) | 总线/目录处理 P1 的未命中;发送失效请求,使 P2 写回。 | |
| 8 | 自旋,测试 lock=0 | 无。 |
图 5.21(续)。 P0 起初持有锁,第 1 步时锁值为 1,即已加锁;在第 1 步开始前,锁变量由 P0 独占。P0 退出并释放锁,第 2 步。P1、P2 竞争,看看谁在交换时读到未加锁值,第 3–5 步。P2 获胜并进入临界区,第 6、7 步;P1 尝试失败,开始自旋等待,第 7、8 步。真实系统中,这些事件耗时远超过八个时钟节拍,因为获取总线及响应未命中需要更长时间。到第 8 步后,这一过程可以重复,最终由 P2 再次取得独占访问权,将锁置为 0。
这个例子还说明保留加载/条件存储的另一个优势:读和写显式分离。保留加载不必产生总线流量,因此可以使用下面这个简单序列,达到优化后交换版本的同样效果。x1 保存锁地址,lr 代替 LD,sc 代替 EXCH。
第一个分支构成自旋循环;第二个分支处理两个处理器同时看到锁可用时的竞争。
译注: 本节代码保留原书的指令名、寄存器名、操作数顺序及立即数记法,仅翻译注释,未改写为某个汇编器的可执行语法。原文交替使用 reserved register 与 link register 指称跟踪保留地址的寄存器,译文明确保留这一用词关系。 ↩︎
5.6 存储一致性模型简介
缓存一致性保证多个处理器看到一致的内存视图,却没有回答这个视图必须“一致到什么程度”。所谓“一致到什么程度”,实质上是问:另一个处理器更新的值,某处理器必须在什么时候看到?处理器通过共享变量通信,变量既用于保存数据,也用于同步,因此问题可归结为:一个处理器必须以什么顺序观察另一个处理器的数据写入?而观察另一个处理器写入的唯一办法是读取,所以问题又转化为:不同处理器对不同内存位置的读写之间,必须强制保证哪些性质?
这个问题表面简单,实际上非常复杂。下面把进程 P1、P2 的两段代码并排写出:
假定进程运行在不同处理器上,A 和 B 最初都被两个处理器缓存,初值为 0。如果写入总是立即生效,并立即被其他处理器看到,那么标为 L1、L2 的两个 IF 条件不可能同时为真,因为到达 IF 就意味着 A 或 B 已被赋值为 1。但如果写失效延迟,而处理器在延迟期间仍可继续执行,那么 P1 和 P2 读取前,可能都还没有分别看到 B 和 A 的失效请求。问题是:是否应允许这种行为?如果允许,应当满足什么条件?
最直接的存储一致性模型称为顺序一致性(sequential consistency)。它要求任何一次执行的结果,都等同于这样一种执行:每个处理器的内存访问保持原有顺序,而不同处理器之间的访问以任意方式交错。顺序一致性排除了上述例子中不直观的结果,因为在开始 IF 之前,相应赋值必须已经完成。
实现顺序一致性最简单的办法,是要求处理器延迟完成某次内存访问,直到该访问导致的所有失效动作都完成。等价的办法是,在前一次访存完成前,延迟下一次访存。要记住,存储一致性涉及不同变量之间的操作:这里要求排序的两个访问指向不同内存位置。在本例中,必须等先前的写入,即 B=1 或 A=1,完成后,才读取 A 或 B,即判断 A==0 或 B==0。因此,在顺序一致性下,不能简单地把写入放进写缓冲区,然后继续读取。
顺序一致性提供了简单的编程范式,却限制了潜在性能,尤其是在处理器众多或互连延迟较大的多处理器中。下面的例题说明这一点。
例题:等待失效完成的代价
某处理器写未命中时,需要 60 个周期取得所有权,取得后再用 40 个周期发出失效请求;失效请求发出后,还需要 80 个周期完成并收到确认。如果另有四个处理器共享该缓存块,在顺序一致性下,一次写未命中会使写入处理器停顿多久?假定失效必须得到显式确认,一致性控制器才知道它已经完成。如果写未命中取得所有权后,无须等待失效就能继续执行,写入又要多久?
解答。 等待失效时,每次写入需要取得所有权的时间,加上完成失效的时间,总计:
相比之下,取得所有权只需 60 个周期。如果采用适当的写缓冲实现,甚至可以在所有权建立之前继续执行。
为了改善性能,研究者和体系结构设计者探索了两条路线。第一条保留顺序一致性,但采用更积极的实现,用延迟隐藏技术减少开销,5.7 节将讨论。第二条采用限制更少的存储一致性模型,使硬件能够更快。这类模型会影响程序员对多处理器的理解,因此在讨论之前,先看看程序员期待什么。
程序员的视角
顺序一致性虽有性能劣势,却在程序员看来具有简单的优点。挑战在于设计一种易于解释、同时允许高性能实现的编程模型。
一种允许更高效实现的模型,是假定程序已经正确同步。如果对共享数据的全部访问都由同步操作确定次序,程序就是已同步的(synchronized)。所谓一次数据访问由同步操作排序,是指:在每种可能的执行中,某处理器对变量的写入,与另一处理器对该变量的读或写之间,都隔着一对同步操作;写入处理器在写后执行其中一个,访问处理器在访问前执行另一个。如果变量可能在没有同步排序的情况下更新,就称为数据竞争(data race),因为结果取决于处理器的相对速度。与硬件设计中的竞争一样,其结果不可预测。因此,已同步程序也称为无数据竞争(data-race-free)程序。
举个简单例子,两个处理器读取并更新同一个变量。每个处理器都用加锁和解锁包围读与更新,既保证更新互斥,也保证读取一致。显然,现在每次写入与另一处理器的读取之间,都隔着两个同步操作:写后的解锁,以及读前的加锁。如果两个处理器都写变量,其间没有读取,两次写入也同样必须由同步操作隔开。
人们普遍认为,多数程序都是已同步的。主要原因在于,如果访问不同步,程序行为很可能无法预测:执行速度决定哪一个处理器赢得数据竞争,进而影响程序结果。即使采用顺序一致性,要推理这类程序也很困难。
程序员可以尝试自行构建同步机制来保证顺序,但这极其棘手,容易造成错误,而且体系结构未必支持;这意味着它可能无法在未来几代多处理器上工作。因此,几乎所有程序员都会选择使用正确的同步库,并让库针对多处理器及同步原语类型优化。
最后,标准同步原语保证:即使体系结构实现的模型比顺序一致性更宽松,已同步程序的行为仍如同硬件实现了顺序一致性。
宽松一致性模型:基础与释放一致性
宽松一致性模型的核心思想,是允许读写乱序完成,同时用同步操作强制必要的次序,使已同步程序表现得如同处理器具有顺序一致性。不同宽松模型,按它们放松了哪些读写顺序来分类。用形式为 的规则描述顺序,意思是操作 X 必须先完成,才执行 Y。顺序一致性要求保持全部四种可能顺序:
宽松模型则由放松其中哪些顺序来定义:
- 只放松 ,得到全存储序(total store ordering,TSO),原书也称处理器一致性(processor consistency)。因为它保持写操作之间的顺序,许多在顺序一致性下运行的程序,不增加同步也能在此模型下运行。
- 同时放松 和 ,得到部分存储序(partial store order,PSO)。
- 放松全部四种顺序,会产生多种模型,包括 PowerPC 使用的弱序(weak ordering),以及原书所述 RISC-V 使用的释放一致性(release consistency)。
放松这些顺序可带来显著性能优势,这也是原书所述 RISC-V、ARMv8,以及 C++ 和 C 语言标准选择释放一致性的原因。
释放一致性区分两种同步操作:一种取得共享变量的访问权,记为 ;另一种释放对象,允许其他处理器取得访问权,记为 。它基于这样的观察:在已同步程序中,acquire 操作必须先于共享数据的使用;release 操作必须晚于共享数据的全部更新,并先于下一次 acquire。于是可以略微放松顺序:位于 acquire 之前的读或写,不必在 acquire 之前完成;位于 release 之后的读或写,也不必等待 release。因此,只保留涉及 、 的那些顺序,如图 5.22 所示。图 5.23 的例子表明,在五个模型中,它施加的顺序限制最少。
释放一致性是一种限制很少、又易于检查的模型,并确保已同步程序呈现顺序一致的执行。多数同步操作要么是 acquire,要么是 release:前者通常读取同步变量并原子更新,后者通常只写入。但是屏障等操作兼具二者作用,其排序效果与弱序相同。虽然同步操作总会保证先前写入完成,有时仍希望在没有明确同步操作时,保证写入完成。此时使用显式指令,RISC-V 中称为 FENCE,以保证该线程之前的全部指令完成,包括所有内存写入以及相关失效动作完成。
| 模型 | 采用它的系统 | 普通访问的顺序 | 同步访问的顺序 |
|---|---|---|---|
| 顺序一致性 | 多数机器将其作为可选模式 | ||
| 全存储序或处理器一致性 | IBM S/370、DEC VAX、SPARC | ||
| 部分存储序 | SPARC | ||
| 弱序 | PowerPC | ||
| 释放一致性 | MIPS、RISC-V、Armv8、C 和 C++ 规范 | ; |
图 5.22(续)。 从限制最强的顺序一致性到限制最少的释放一致性,实现的灵活性逐步增加。较弱的模型依赖同步操作建立的屏障,而不要求每次内存操作都隐含一个屏障。定义释放一致性需要区分 acquire 和 release,分别记为 、。如果对表中每个 S 都统一展开这两种记号,则包含一个 S 的顺序会变为两条,例如 变为 和 ;每条 则展开为右下单元格末尾的四种顺序。
图 5.23(续)。 可以由传递性推导的顺序没有画出,例如顺序一致性中对 C 的写入先于 S 的释放,以及弱序或释放一致性中 acquire 先于 release。
图中从左到右为顺序一致性、TSO(全存储序或处理器一致性)、PSO(部分存储序)、弱序、释放一致性。= A 表示读取 A,B = 表示写入 B,其余类似;acquire(S) 为获取同步对象 S,release(S) 为释放 S。
如前所述,在没有广播介质的较大多处理器中,需要跟踪失效操作,才能知道它们何时完成。关于宽松模型的复杂性、实现问题与性能潜力,我们强烈推荐 Adve 和 Gharachorloo(1996)的出色教程。
5.7 贯穿各层的问题
多处理器重新定义了许多系统特征,例如性能评价、内存延迟,以及可扩展性的重要程度,因此引出了横跨软硬件的有趣设计问题。本节先介绍几个与存储一致性有关的例子,再考察多处理结合多线程后带来的性能收益。
编译器优化与一致性模型
定义存储一致性模型的另一个原因,是明确编译器对共享数据可以合法执行哪些优化。在显式并行程序中,除非同步点定义清楚,而且程序已同步,否则编译器不能交换对两个不同共享数据项的读与写,因为这可能改变程序语义。这种限制甚至阻止一些较简单的优化,例如将共享数据分配到寄存器,因为这一过程通常会交换读写顺序。在隐式并行化的程序中,例如用 High Performance Fortran(HPF)编写的程序,程序必须已同步,而且同步点已知,因此不存在这一问题。
编译器优化共享变量访存的技术究竟能取得多大成功,仍是开放问题。优化技术的现状,以及共享数据常通过指针或数组索引访问的事实,限制了此类优化的应用。如果这项技术成熟,并带来明显性能优势,编译器作者就会希望利用更宽松的编程模型。这种可能性,以及尽量为未来保留灵活性的愿望,使 RISC-V 设计者经过长期争论,最终选择释放一致性。
用推测隐藏严格一致性模型中的延迟
第 3 章已经说明,推测可以隐藏内存延迟。它也可隐藏严格一致性模型引起的延迟,从而获得宽松存储模型的大部分收益。核心思想是利用动态调度重排内存访问,使它们可能乱序执行。
乱序访存可能违反顺序一致性,影响程序执行。推测处理器的延迟提交机制可以避免这一后果。假定一致性协议基于失效:如果某次访存在提交前收到针对其地址的失效请求,处理器就利用推测恢复撤销相关计算,从该访存重新开始。当然,还必须保证这不会给利用推测实施侧信道攻击创造新的机会,见第 3 章。
如果重排后的访存顺序可能产生与顺序一致性不同的结果,处理器就重新执行。关键在于,处理器只需保证结果与全部访问按序完成时相同;检测何时结果可能不同,就能做到这一点。这种办法有吸引力,因为推测重启很少发生:只有未同步访问实际造成竞争时才会触发,见 Gharachorloo et al.(1992)。
Hill(1998)主张,将顺序一致性或处理器一致性与推测执行结合,作为首选模型。他的论证有三点。第一,对这两种模型采用积极实现,可以获得更宽松模型的大多数优势。第二,这几乎不增加推测处理器的实现成本。第三,程序员仍可用较简单的顺序一致性或处理器一致性模型推理。MIPS R10000 团队在 20 世纪 90 年代中期就认识到了这一点,并利用 R10000 的乱序能力,支持这种积极的顺序一致性实现。
包含性及其实现
所有多处理器都使用多级缓存层次,以降低全局互连需求和缓存未命中延迟。如果缓存还具备多级包含性,即每一级都是离处理器更远一级的子集,那么可以利用这种层次,减少监听与处理器访存争用缓存时产生的一致性流量和处理器流量冲突。许多具有多级缓存的多处理器强制保持包含性,不过近来有若干系统选择不强制保持。
乍看之下,维持多级包含性似乎很简单。以两级为例:L1 未命中,要么命中 L2,要么也在 L2 未命中,随后将数据同时装入 L1、L2。类似地,在 L2 命中的失效请求都必须发往 L1,若 L1 有该块,就使它失效。
问题出在 L1 与 L2 块大小不同时。选择不同块大小完全合理,因为 L2 大得多,未命中开销中的延迟部分也长得多,因此希望采用更大的块。这时,“自动”维持包含性会怎样?L2 的一个块对应多个 L1 块,L2 未命中所替换的数据也相当于多个 L1 块。例如,L2 块是 L1 的四倍时,L2 一次未命中会替换相当于四个 L1 块的数据。来看具体例子。
例题:不同块大小如何破坏包含性
假定 L2 块大小是 L1 的四倍。说明一个同时在 L1、L2 引起替换的未命中,如何破坏包含性。
解答。 假定 L1、L2 都直接映射,L1 块为 字节,L2 块为 字节。L1 中有两个块,起始地址为 和 ,且 ,所以 x 也是某个 L2 块的起始地址。这个 L2 块包含 L1 的 、、、 四块。现在处理器访问块 y,它在两级缓存中都映射到包含 x 的块,因此未命中。L2 取得 字节,替换原先包含 、、、 的块;L1 则只取 字节,替换包含 x 的块。L1 中仍有 ,L2 却没有,因此包含性不再成立。
块大小不同时,要维护包含性,必须在低一级发生替换时探查更高各级,确保低级中被替换的任何字,都在高级缓存中失效。各级相联度不同也会造成类似问题。Baer 和 Wang(1988)详细描述了包含性的优势与挑战。到 2017 年,多数设计者选择实现包含性,常采用各级统一块大小的办法。近期 Intel 处理器,包括 i9 和高端 Xeon,以及 AMD EPYC,不强制 L3 包含性,但对 L1、L2 仍要求包含性。这让 L2、L3 可以保存不同数据,提高 L3 的有效利用率;按每核心计算,L3 只比 L2 略大。
多线程给多处理器带来的性能收益
本节简要考察在两个多核处理器上采用多线程的效果:Intel Xeon E7 8800 与 Power8。使用 5.4 节末讨论的高度并行网页搜索基准测试。SMT 的收益取决于处理器数量、支持的线程数以及 ILP 流水线。两种处理器最相关的特征如下:
| 特性 | Intel Xeon E7 | IBM Power8 |
|---|---|---|
| 核心数 | 18 | 12 |
| 每核心 SMT 线程数 | 2 | 8 |
| 每时钟发射数 | 4 | 8 |
| 功能单元数 | 8 | 16 |
回顾前文,网页搜索具有大量请求级并行性,进程间通信很少,因此 Xeon E7 从 8 核扩展到 72 核时获得线性加速。图 5.24 给出增加线程数后,相对于单线程版本的加速比。支持八线程的 Power8 总收益更大,不过这也可能与其更高发射率和更多功能单元密切相关。
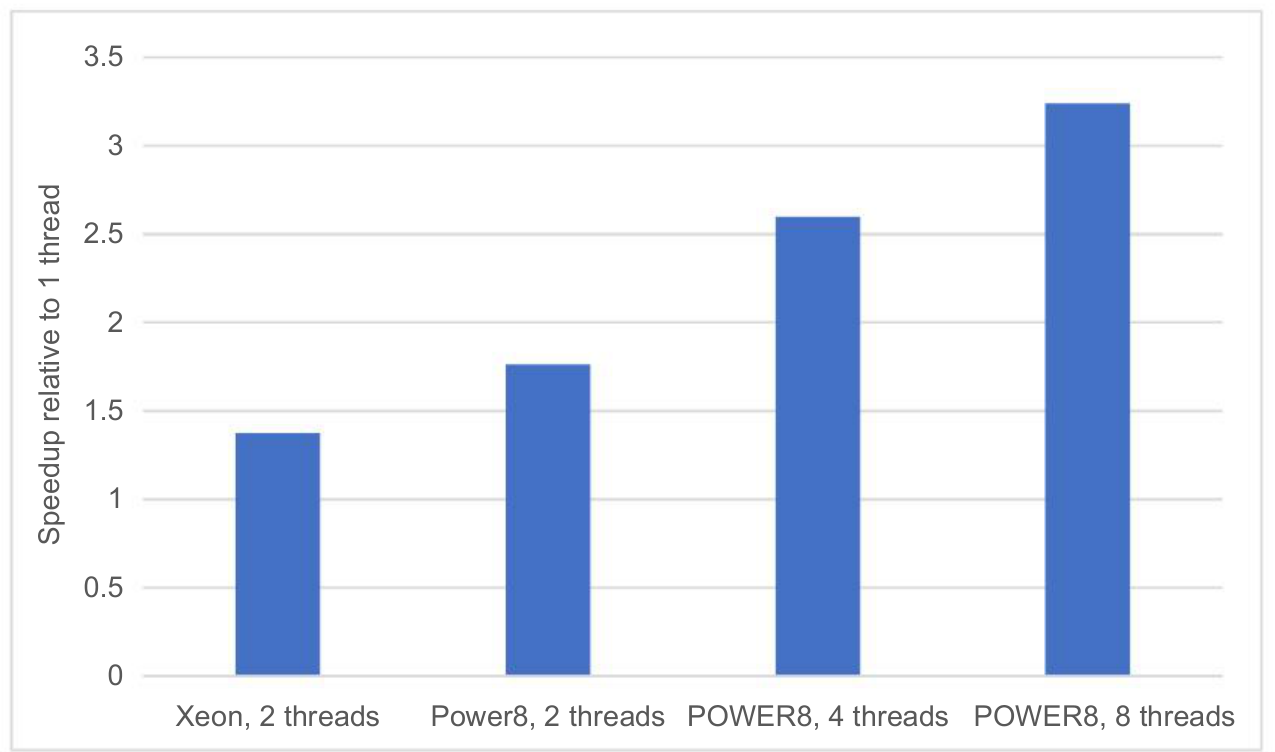
图 5.24(续)。 Power8 是这里唯一在 SMT 核心中提供超过两个线程的处理器。对于这一高度并行应用,Power8 的宽发射和大量功能单元带来了显著性能优势。
图中纵轴为相对于一个线程的加速比;横轴依次为 Xeon 两线程,Power8 两线程、四线程和八线程。
5.8 融会贯通:多核处理器及其性能
大约 15 年来,多核一直是提高性能的主要方向。不过,不同实现差别很大,对更大规模多芯片多处理器的支持也各不相同。
本节考察三种多核设计、它们对更大规模多处理器的支持,以及其中一些系统在性能和能效方面的可扩展性。
三种多核服务器处理器
图 5.25 列出三种面向服务器的多核处理器的主要特征,这些处理器用于 2019–2022 年间上市的系统。
| 特征 | IBM Power10 | Intel Xeon Platinum | AMD EPYC |
|---|---|---|---|
| 每芯片核心数;多芯片模块(MCM) | 每芯片 4–15 核;每插槽 8–30 核 | 每芯片 4–60 核;每插槽 8–120 核 | 每芯片 8 核;每插槽 64 核 |
| 多线程 | SMT | SMT | SMT |
| 每核心线程数 | 8 | 2 | 2 |
| 时钟频率 | 4.15 GHz | 2.2–3.6 GHz | 3.5 GHz |
| L1 指令缓存 | 每核心 96 KiB | 每核心 32 KiB | 每核心 32 KiB |
| L1 数据缓存 | 每核心 64 KiB | 每核心 32 KiB | 每核心 32 KiB |
| L2 缓存 | 每核心 2 MiB | 每核心 1 MiB | 每核心 512 KiB |
| L3 缓存 | 每核心 8 MiB;共享,访问非均匀 | 22–77 MiB,每核心 1.375 MiB;核心数较多的配置共享 | 每核心 4 MiB,采用堆叠存储器时可达每核心 12 MiB;共享 |
| 包含性 | L2 具有包含性 | L2 具有包含性 | L3 对共享块具有包含性 |
| 多核缓存一致性协议 | 扩展 MESI,带行为和局部性提示,共 13 个状态 | MESIF:扩展 MESI,允许直接传送干净块 | MDOEFSI:扩展 MOESI,增加 dirty 和 forward 状态 |
| 多芯片缓存一致性实现 | 混合方式,以监听为主,辅以有限目录 | 混合方式,监听加 L3 目录 | 混合方式,监听加位于 L3 的目录,目录保存 L2 标签副本 |
| 多处理器互连支持 | 最多 16 芯片,任意处理器间 1 或 2 跳 | 最多 8 芯片,直接通过 UPI 互连 | Infinity Fabric 连接每插槽的 4 个 chiplet,最多 2 插槽 |
| 处理器芯片数范围 | 1–16 | 2–8 | 1–2 |
| 核心数范围 | 4–240 | 8–480 | 8–128 |
图 5.25(续)。 表中列出各处理器家族的处理器数量、时钟频率和缓存容量范围。这些处理器都采用 NUCA 与 NUMA 结构。L3 访问时间分别针对本地分片和远程分片,内存访问时间分别针对本地内存和远程内存;所有访问时间均为平均值。最后一行列出已公布性能数据,例如 SPECintRate 数据的系统配置范围,包括处理器芯片数和总核心数。注意,虽然已有 56 核 Intel Xeon,采用最新微体系结构的处理器最多为 40 核。大多数系统提供 chiplet 形式;IBM 和 Intel 设计还支持包含多个 chiplet 的更大型多处理器。
译注: 原图注提到访问时间,但本页表格没有相应数据行;图注的 Xeon 核心数与表内范围也不完全一致。此处分别保留,不补入原书未提供的数据。协议缩写 MDOEFSI 按原表保留。
Intel Xeon Platinum 采用类似 Skylake 微体系结构的核心,但时钟频率比桌面处理器略低,原因是功耗限制;它配备更大的 L3 缓存,也有多得多的核心。Power10 是 IBM Power 系列最新一代,核心更多,缓存更大。本例中,AMD EPYC Milan 系列每个 chiplet 有 8 核,每插槽有 4 个 chiplet。由于这些处理器用于多核、多处理器服务器,它们按家族提供多种配置,在处理器数量、缓存容量等方面有所不同,如图所示。
这三种系统体现了连接片上核心,以及连接多个处理器芯片或 chiplet 的多种技术。图 5.26 展示 Power10 与 Xeon Platinum 的芯片组成。Power10 每个核心直接连接一个 8 MiB 的 L3 存储体;其他存储体通过互连网络访问,网络有 8 条独立总线。
图 5.26B 展示核心数较多时 Xeon Platinum 处理器芯片的组成,图中为 24 核。两组环形互连各自连接一组核心,每个核心都有相应的 L3 分片,以及负责部分地址空间的一致性逻辑。任意核心经过一个或两个环,都能访问其他缓存存储体或核心。Xeon Platinum 提供 3 条 UPI 互连链路,用于连接多颗 Xeon。
AMD EPYC Milan 的单芯片版本最简单,因为每个 chiplet 只有八核。八个核心与八存储体 L3 通过宽度为 32 字节的双向环连接。同一插槽中的其他 chiplet 通过 Infinity Path 连接,它将插槽内八颗多核芯片全连接。这三种多核都属于 NUCA,因为访问 L3 所需时间取决于访问哪个存储体。
由这些多核芯片组成的多处理器采用多种互连策略,如图 5.27 所示。Power10 设计支持连接 16 颗 Power10 芯片,总共 240 核。组内连接把 4 颗处理器芯片构成全连接模块;组间链路把每颗处理器芯片连接到其他各模块中的 3 颗芯片。多颗 Xeon 通过 UPI 互连。在八插槽多处理器中,采用最新公布的 Xeon 时可有 448 核;每颗处理器的 3 条 UPI 链路连接 3 个邻居。图 5.27 展示八颗 Xeon 的一种连接方式:与 Power10 一样,任意两颗处理器相距一跳或两跳。有少数公司制造了规模更大的 Xeon 多处理器,通过接入 UPI 网络并扩展网络及一致性机制,支持更多处理器。EPYC 通过 Infinity Path 连接一个插槽中的八个 chiplet。如图 5.27 所示,同一插槽内的 chiplet 全连接。两个插槽可利用未使用的 Infinity Path 连接相连,使任意两个 chiplet 相距一跳或两跳。
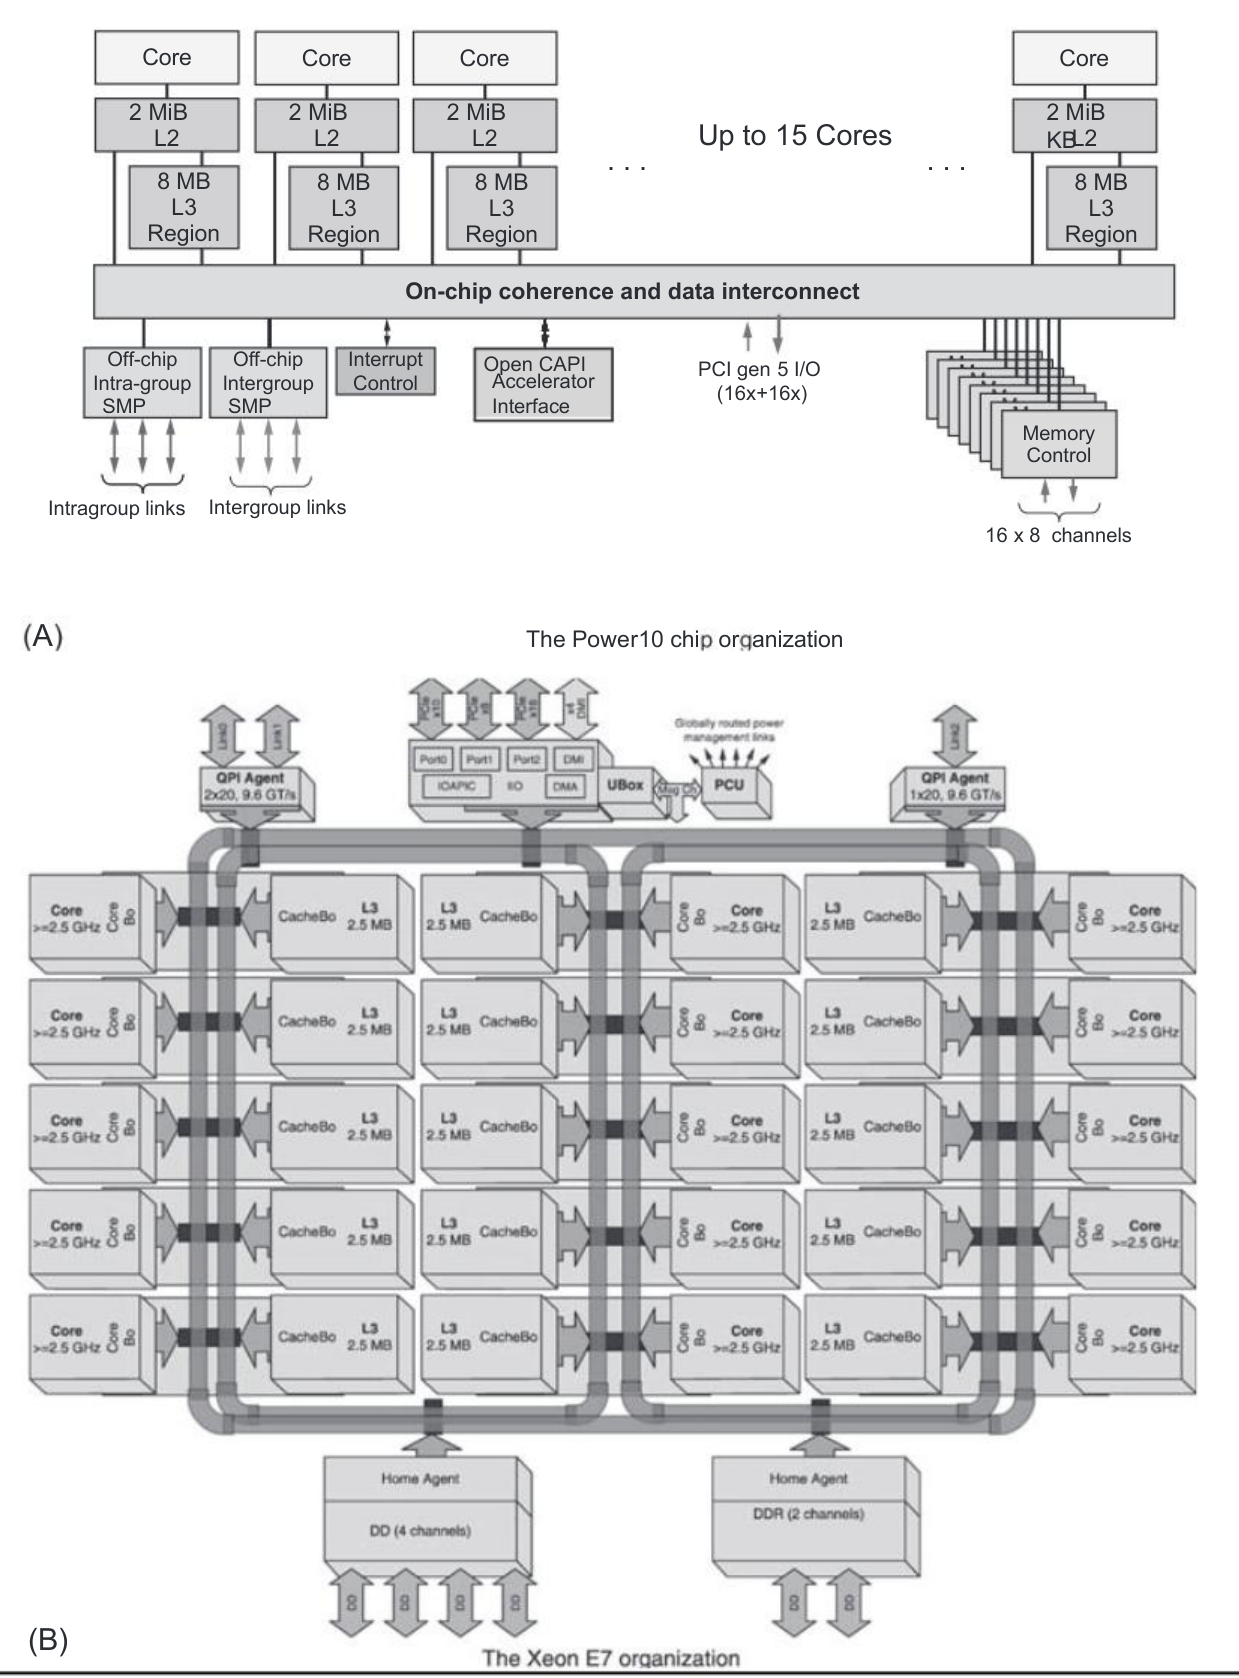
图中文字:Core 为核心,Region 为分区;On-chip coherence and data interconnect 为片上一致性与数据互连;Off-chip Intra-group / Intergroup SMP 为片外组内/组间 SMP;Interrupt Control 为中断控制;OpenCAPI Accelerator Interface 为 OpenCAPI 加速器接口;Memory Control 为存储器控制;Intragroup / Intergroup links 为组内/组间链路。图 A 标有最多 15 核、每核心 2 MiB L2 和 8 MB L3 分区、16 × 8 个存储通道,以及 PCI 第 5 代 I/O(16x + 16x)。图 B 中 Home Agent 为归属代理,QPI Agent 为 QPI 代理,Globally routed power management lines 为全局布线的电源管理信号线;Port、Link、channels 分别为端口、链路、通道。其余接口、缩写和速率保留原标记。图 B 的原始分辨率较低,放大后部分细小标签仍较模糊。
译注: 本节正文称 Xeon Platinum,并称图中为 24 核;图注实际写 Xeon E7,图 B 可见 15 个核心方框(3 列,每列 5 个)。图内 MB、MiB 及接口名称均按原图保留,不能据此将图 B 当作前述 Platinum 配置的精确示意图。
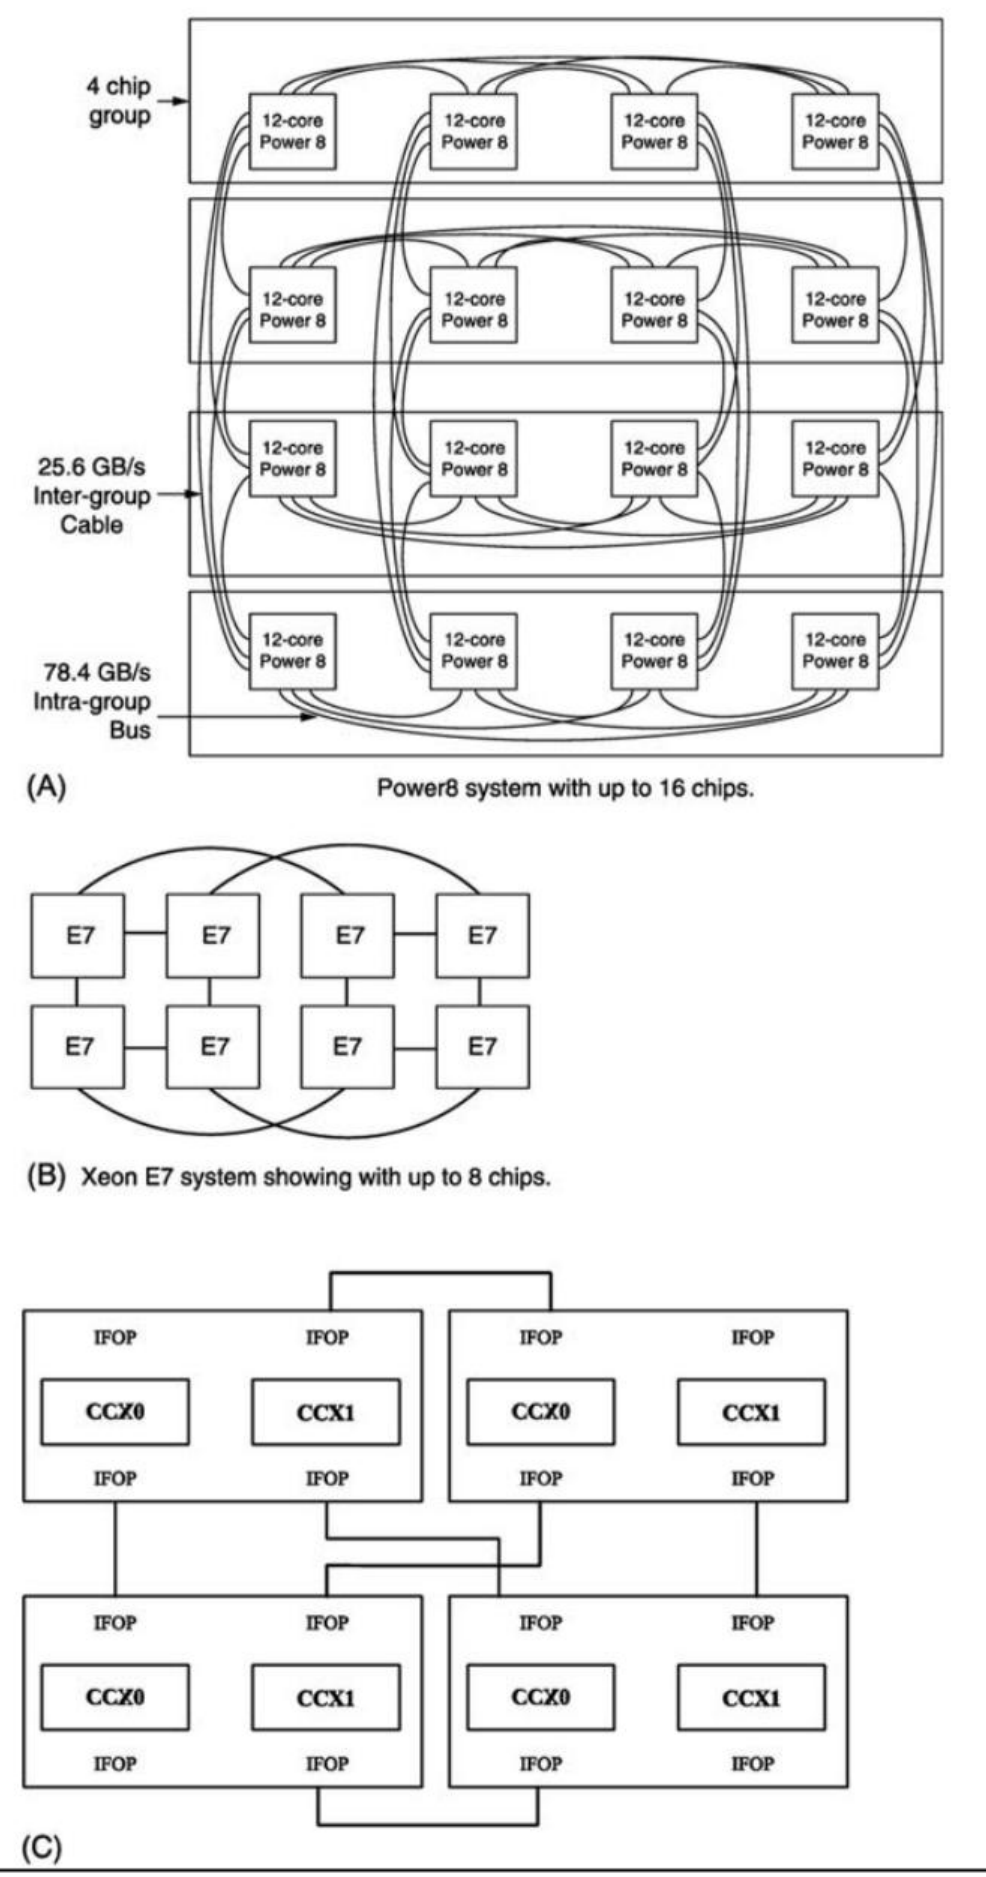
图 5.27(续)。 三种设计都将四颗芯片全连接,一跳即可到达;访问另一组四颗芯片还需一跳,因此任意两颗多核芯片相距一跳或两跳。访问远程多核芯片的缓存,无论取回数据还是使数据失效,都要先经过芯片间互连的一跳或两跳,再经过芯片内部互连;若取回数据,还需类似的返回路径。图中 AMD EPYC 为全连接的四芯片、32 核结构,每个 CCX 有四核;它是每插槽 64 核、最多两插槽系统的构建单元。Infinity Path(IFOP)链路将四颗多核芯片全连接;未使用的 IFOP 链路各可连接另一个 32 核模块。
图中文字:4-chip group 为四芯片组;Intra-group Bus 为组内总线,78.4 GB/s;Inter-group Cable 为组间电缆,25.6 GB/s;上部标题为“最多 16 芯片的 Power8 系统”,中部标题为“最多 8 芯片的 Xeon E7 系统”。CCX、IFOP 为原图标识符。
译注: 本图图注使用 Power10、Xeon Platinum,图内则明确标为 Power8、12-core Power8 和 Xeon E7,存在版本标注不一致。EPYC 的 chiplet 数量在本节表格、正文与图注中也有不同配置表述;原文分别保留。
多核多处理器运行多道程序工作负载时的性能
先用 SPECintRate 比较三种多核处理器的性能可扩展性,最大配置采用提交给 SPEC 的最大单系统配置,核心数为 128–220。图 5.28 相对于最小的 15 核或 16 核配置绘制性能,并假定该配置分别实现理想的 15 倍或 16 倍加速。这幅图没有比较不同处理器之间的性能。例如,16 核 AMD EPYC 的性能是 Intel Xeon 的 1.14 倍。图 5.28 只展示各处理器家族增加核心后,性能如何扩展。
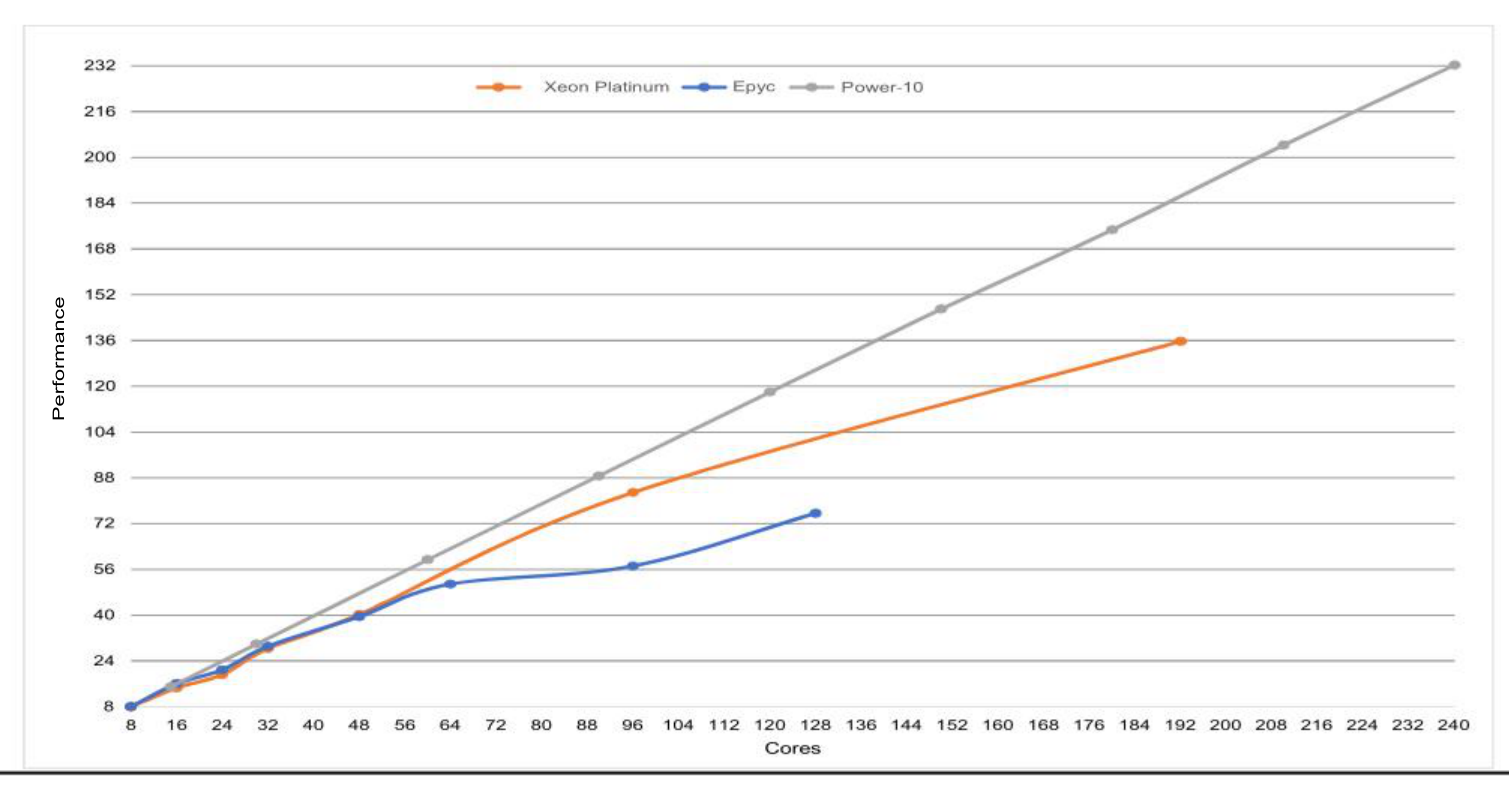
图 5.28(续)。 Intel、AMD 的性能相对于 16 核配置绘制,IBM 则相对于 15 核配置,并假定最小配置已经获得理想加速比。图中显示某种多处理器增加核心后的扩展情况,没有提供不同处理器之间的性能比较。注意,即使假定 16 核处理器实现理想加速,当核心数较多时,AMD 和 Intel 的实际加速比也只有理想值的约 50%–60%。IBM 的扩展情况好得多:在 220 核时,相对于 15 核版本达到 97% 的效率。由于扩展更好、每核心性能也略高,210 核 Power10 的吞吐量是 240 核 Xeon Platinum 的 1.3 倍,每核心性能约高 50%;我们估计,其中 70%–80% 的优势来自更高的核心性能,20%–30% 来自扩展到更多核心时的更好表现。由于已公布数据的可得性及核心配置不同,Intel、AMD 的测量结果可能取自略有不同的处理器配置。横轴为核心数,纵轴为性能。
随着核心数增加,AMD 和 Intel 系统的加速效果都减弱。例如,240 核 Xeon 系统相对于 16 核系统的加速比为 157.8,而非 240。
相对于八核结果,这意味着约 70% 的效率;当然,八核系统相对于单核也不太可能实现理想加速。AMD EPYC 在核心较少时更快,但到 64 核时遇到性能限制。这些限制既可能来自系统问题,也可能来自体系结构。在 128 核时,EPYC 相对于 16 核版本的效率约为 66%。按相对于最小配置的加速比衡量,IBM Power10 的可扩展性最好,220 核时效率为 97%。SPECintRate 不大受缓存一致性问题影响,因此内存和互连带宽很可能起到重要作用。
译注: 原书在本段及图 5.28 中混用了若干核心数与归一化基准。例如正文先以 16 核为基准,随即又称与八核比较;图中 Power10 曲线终点约为 240 核,而图注与正文讨论 220 核。原文个别位置将 Xeon 拼为 Xenon,此处产品名统一为 Xeon。
Xeon Platinum 在两种不同工作负载下的可扩展性
接下来简要考察 Xeon Platinum 多处理器运行科学并行计算工作负载,以及基于 Java 服务器的工作负载时的可扩展性;后一种测试同时测量性能和功率。
SPEComp2012 包含 14 个采用 OpenMP 共享内存并行标准编写的科学与工程程序。程序用 Fortran、C 和 C++ 编写,覆盖流体动力学、分子建模及图像处理等领域。不同于 SPECintRate,这些程序的进程会经常通过共享地址空间通信。与前一组结果一样,图 5.29 假定最小的 28 核配置实现线性加速。到 72 核为止,相对于 28 核系统,较小配置可以实现线性加速;92–108 核时效率降至约 90%,随后在 172–220 核时降至约 50%。
最后用 SPECpower2008 比较 Xeon 系统的性能与能效。SPECpower 模拟运行多个 Java 流的服务器,会执行 Java 虚拟机、垃圾回收和即时(JIT)编译器。工作负载随系统规模扩展,模拟实际服务器。测试报告 10%–100% 负载下的性能与功率。100% 表示系统在满足服务质量保证的前提下能处理的最大负载,并随计算机能力调整,即更大的配置运行更大的工作负载。图 5.30 展示 28–224 核在最大负载下的吞吐量增长及能效,后者为性能除以平均功率。对于这种高度并行、随规模扩展的基准测试,Xeon Platinum 从 28 核扩展到 224 核,基本实现理想加速。初看图表,也许会以为 224 核时能效急剧下降;请仔细观察坐标并阅读图注。
SPECpower 还测量从空闲到 100% 负载的平均功耗,以衡量能效。图 5.31 给出 224 核 Xeon Platinum 的结果。注意,在 50% 负载下,系统平均功耗为满载时的 60%,因此相对能效约为 85%。
图中横轴为核心数,纵轴为相对于 28 核性能的加速比,按正文所述把 28 核配置标为 28。
观察 SPECpower 时,要记住它由许多独立任务组成,而且任务数随处理器规模增加。因此,与并行任务交互更多,或工作负载不随规模增加的情况相比,它获得的性能提升要好得多。例如 SPECintRate 虽然也主要由独立任务组成,扩展效果仍只有理想值的 60%–70%;SPECOMP 扩展到大量核心时,效率约为 50%。附录 I 更详细地讨论扩展及其对应用和性能的影响。
图 5.30(续)。 吞吐量取最大工作负载下的 ss_jops,使用左侧纵轴。相对于 28 核版本,56、112、224、448 核版本的吞吐量效率为 99%–100%。折线表示能效,单位见右侧纵轴。整个核心数范围内,能效变化只有几个百分点。灰色:性能/平均功率。横轴为核心数,橙色柱为性能。
译注: 正文讨论到 224 核,图及图注还包含 448 核。图注所称能效仅变化“几个百分点”也应结合右轴实际范围阅读:右轴从 起,并非从零开始。
图 5.31(续)。 柱形图按左轴绘出性能/功率;折线按右轴绘出相对于满载系统的效率,即性能/功率的相对值。负载不超过峰值 30% 时,能效不到满载系统的 65%;负载达到峰值 70% 或更高时,能效至少为满载系统的 97%。横轴为负载。
5.9 谬误与陷阱
以我们目前对并行计算的理解来看,仍有许多潜在陷阱,有的将由谨慎的设计者发现,有的则会让不幸的设计者付出代价。多年来围绕多处理器的大量炒作,也产生了许多常见谬误。这里选取其中一部分。
陷阱:用线性加速比而非执行时间衡量多处理器性能
图 5.28、5.29 这类绘制性能与处理器数量关系的曲线,会依次出现线性加速、平台期和下降,长期以来人们用它们判断并行处理器是否成功。加速比虽然反映并行程序的一个方面,却不是性能的直接度量。首先要看所扩展处理器本身的能力:一个能够线性扩展到 100 颗 Intel Atom——用于上网本的低端处理器——的程序,仍可能比运行在八核 Xeon 上的版本慢。对于浮点密集型程序尤其要小心:没有硬件辅助的处理单元可能扩展得很好,整体性能却很差。同样,像 SPECpower 这样的基准测试,包含大量独立并行任务,并随多处理器规模扩大问题规模,也能达到很高的效率。
只有比较各计算机上的最佳算法时,执行时间的比较才公平。在两台计算机上运行完全相同的代码,看起来公平,实际上未必如此:并行程序在单处理器上可能比串行版本更慢。开发并行程序有时会带来算法改进,因此,把原先已知最好的串行程序与并行代码比较,虽然看似公平,比较的却不是等价算法。为体现这种区别,有时使用“相对加速比”(relative speedup,同一程序)和“真实加速比”(true speedup,最佳程序)两个术语。
若结果显示超线性性能,即程序在 个处理器上运行,比等价单处理器快 倍以上,可能说明比较不公平;不过,确实也有“真实”的超线性加速。例如,一些科学应用在处理器数量小幅增加时,从 2 或 4 个增加到 8 或 16 个,经常出现超线性加速。这往往是因为,关键数据结构放不进 2 或 4 个处理器的缓存总容量,却能放进 8 或 16 个处理器的缓存总容量。
总的来说,用加速比比较性能,最好也只能说需要十分谨慎,最坏则会误导。正如上一节所见,两个不同多处理器的加速比并不一定能说明它们的相对性能。即使是在同一多处理器上比较两种算法,也需要谨慎:必须采用真实加速比,而非相对加速比,才能得到有效比较。
陷阱:认为 Amdahl 定律不适用于并行计算机
1987 年,一位研究机构负责人宣称,某种 MIMD 多处理器已经打破 Amdahl 定律,见 1.9 节。但这绝不意味着该定律对并行计算机失效:程序中未获改进的部分仍会限制性能。要理解当时媒体报道的依据,不妨看看 Amdahl(1967)的原话:
此时可以得出一个相当明显的结论:除非串行处理速度也取得几乎同等幅度的进展,否则为实现高并行处理速度付出的努力将是徒劳的。〔第 483 页〕
对这一定律的一种解释是:每个程序都有必须串行执行的部分,所以具有经济价值的处理器数量存在上限,例如 100 个。在 1000 个处理器上实现线性加速,推翻的是对 Amdahl 定律的这种解释。
所谓“克服” Amdahl 定律,其依据是采用扩展加速比,也称弱扩展(weak scaling)。研究者将基准测试的数据集扩大到原来的 1000 倍,再比较扩大规模后的基准测试在单处理器与并行系统上的执行时间。对于这一特定算法,串行部分为常量,与输入规模无关,其余部分完全并行,因此能在 1000 个处理器上获得线性加速。由于运行时间的增长快于线性,扩大规模后的程序即使用 1000 个处理器,实际运行时间仍更长。
假定输入规模随之扩大的加速比,不等于真实加速比;把它当成真实加速比报告,会产生误导。并行基准测试经常运行在规模不同的多处理器上,所以必须说明允许怎样扩展应用,以及如何扩展。简单地让数据规模与处理器数量成比例,通常并不合适;但当处理器数量增加很多时,仍假定问题规模固定,即强扩展(strong scaling),往往也不合适,因为用户拥有大得多的多处理器后,很可能会选择运行规模更大或细节更丰富的应用。附录 I 进一步讨论这一重要问题。
陷阱:认为只有线性加速才能让多处理器具有成本效益
人们普遍认可,并行计算的主要优势之一,是比最快的单处理器更早得到结果。然而,许多人也认为,除非实现完美的线性加速,否则并行处理器的成本效益无法与单处理器相比。
其论点是:多处理器成本与处理器数量呈线性关系,所以只要加速比低于线性,性能/成本比就会下降,并行处理器就不如单处理器合算。
这一论点的问题在于,成本不仅取决于处理器数量,还取决于内存、I/O 和系统开销,例如机箱、电源、互连等。在每颗芯片含多个处理器的多核时代,这种说法更站不住脚。
Wood 和 Hill(1995)指出了将内存计入系统成本的影响。我们用较新的 TPC-C 和 SPECrate 数据举例;使用并行科学应用工作负载也可以论证同一点,而且结论很可能更有力。
图 5.32 给出 IBM eServer p5 多处理器配置 4–64 个处理器时,TPC-C、SPECintRate 与 SPECfpRate 的加速比。只有 TPC-C 超过线性加速。SPECintRate 和 SPECfpRate 的加速比低于线性,但成本增长也低于线性,因为与 TPC-C 不同,它们所需主存和磁盘的增长均低于线性。
图中横轴为处理器数量,纵轴为加速比;三条测量曲线依次为 TPM、SPECintRate、SPECfpRate 的加速比。
如图 5.33 所示,更多处理器可能比四处理器配置更具成本效益。比较两台计算机的性价比时,必须准确估计系统总成本及可达到的性能。对于许多内存需求较大的应用,这样的比较会显著增加多处理器的吸引力。
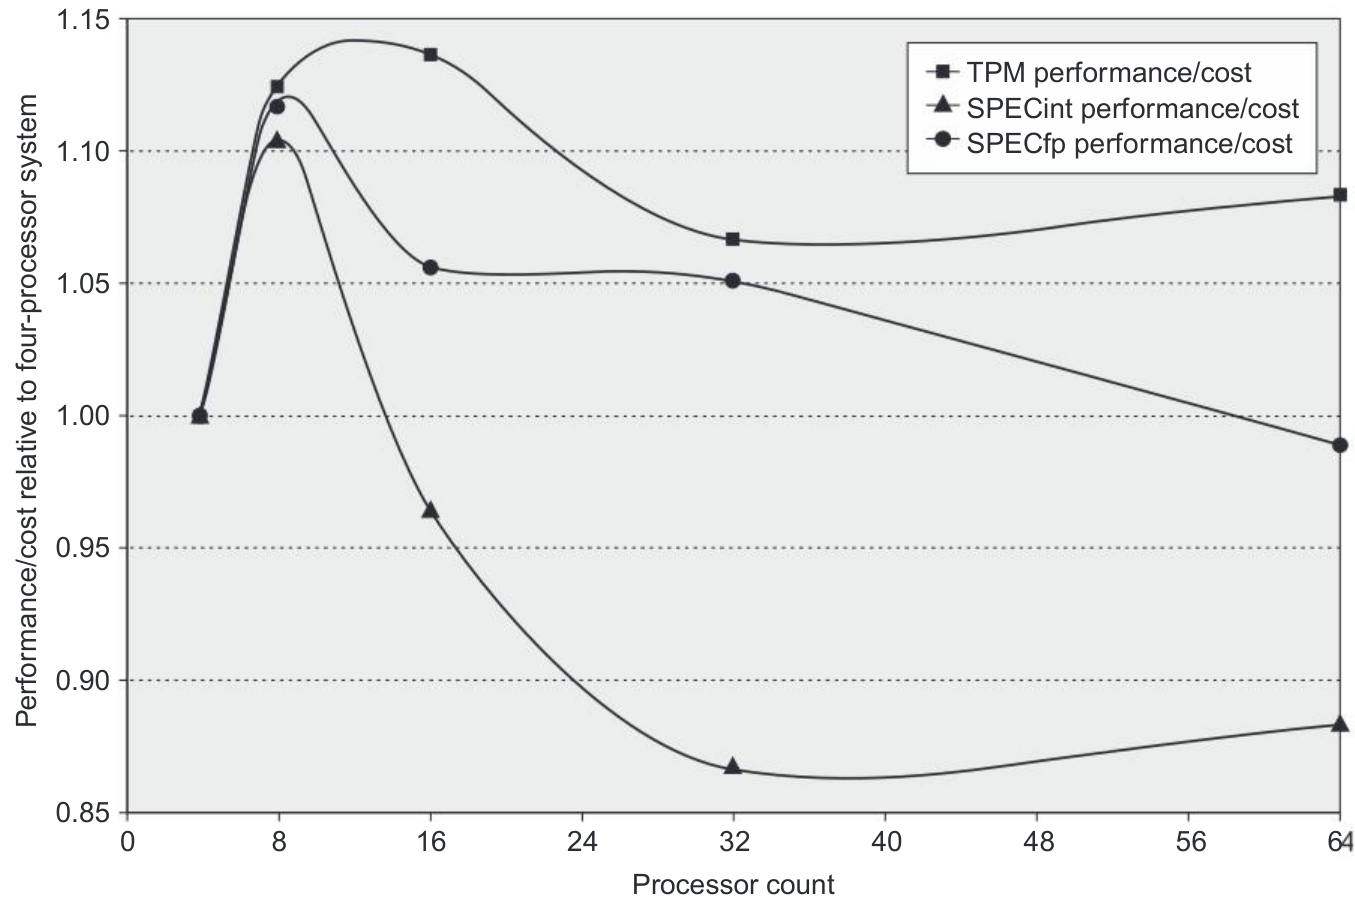
图 5.33(续)。 大于 1.0 的测量值表示该配置比四处理器系统更具成本效益。八处理器配置对三种基准测试均有优势;16 和 32 处理器配置则有两种基准测试显示性价比优势。TPC-C 使用正式测试的配置,所以磁盘和内存几乎与处理器数量线性增长,64 处理器系统的成本约为 32 处理器系统的两倍。相比之下,SPECrate 的磁盘和内存增长较慢,虽然仍快于 64 处理器时获得最佳 SPECrate 所必需的增长。具体而言,磁盘从四处理器版本的一块,增加到 64 处理器版本的四块,共 140 GB;内存从四处理器系统的 8 GiB 增加到 64 处理器系统的 20 GiB。横轴为处理器数量,纵轴为相对于四处理器系统的性能/成本;三条曲线分别为 TPM、SPECint、SPECfp 的性能/成本。
陷阱:没有开发能利用多处理器体系结构、或针对它优化的软件
多处理器软件长期落后于单处理器软件的发展,可能是因为问题难得多。可以选择的例子很多,这里举一个,说明问题有多微妙。
常见问题出现在将单处理器软件改用于多处理器环境时。例如,2000 年 SGI 的操作系统最初用一把锁保护整个页表数据结构,因为设计者假定页面分配并不频繁。在单处理器上,这不会造成性能问题;在多处理器上,却可能成为某些程序的主要瓶颈。
考虑一个使用大量页面、并在启动时初始化这些页面的程序;UNIX 对静态分配的页面就会这样做。假定程序已经并行化,由多个进程分配页面。页面分配要使用页表,而页表每次使用时都会加锁,因此即使操作系统内核支持多个线程,只要各进程同时尝试分配页面——初始化时完全可能如此——也会被串行化。
页表操作串行化消除了初始化阶段的并行性,显著影响整体并行性能。即使采用多道程序,这个瓶颈仍存在。例如,把并行程序拆成彼此独立的进程,每个处理器运行一个,进程间完全不共享数据。有位用户确实这样做过,因为他合理地怀疑,性能问题来自应用中意外的数据共享或相互干扰。不幸的是,那把锁仍使所有进程串行化,所以多道程序的性能也很差。
这一陷阱说明,软件在多处理器上运行时,会出现微妙却严重影响性能的问题。与许多关键软件组件一样,操作系统的算法和数据结构也必须放在多处理器环境中重新考虑。把锁的保护范围缩小到页表的较小部分,就能有效消除这一问题。存储结构中也存在类似问题,即使实际上没有共享数据,也会增加一致性流量。
当多核成为从桌面到服务器的主流方向后,并行软件投入不足的问题逐渐显现。由于此前缺少足够关注,软件系统很可能还要经过多年,才能充分利用不断增加的核心数。
5.10 多核扩展的未来
40 多年来,研究者与设计者一直预言,单处理器将走向终结,多处理器将占据主导地位。直到本世纪初,这种预测还不断被事实否定。第 3 章已经说明,试图发现和利用更多 ILP,在硅面积和功耗方面的效率代价已高到难以承受。当然,多核并不能神奇地解决功耗问题,因为它显然既增加晶体管总数,也增加正在切换的活跃晶体管数量,而这两者正是功耗的主要来源。
本节将看到,能耗问题已经在限制多核扩展,今后的限制很可能也比此前设想的更严重。
ILP 扩展失效,既因为可用 ILP 有限,也因为利用这些 ILP 的效率有限。类似地,两种因素共同决定,单靠增加核心来提高性能,不太可能普遍成功,至少作为加快单个程序的方法如此。一方面是 Amdahl 定律所揭示的并行性利用效率问题,另一方面是决定多核处理器能耗需求的 Dennard 缩放规律失效。
为理解这些因素,我们采用一个简单的工艺缩放模型,依据 Esmaeilzadeh et al.(2012)广泛而详尽的分析。先回顾 CMOS 的能耗和功率。第 1 章给出晶体管切换所需能量:
CMOS 缩放主要受热功率限制,热功率由静态漏电功率和通常占主导的动态功率组成。功率为:
为理解能量和功率缩放的影响,将较早的 Xeon E5,即 2014/2015 年的 22 nm 工艺,与 2021 年 Xeon Platinum 的 10 nm 工艺比较。图 5.34 根据工艺预测,列出其对能量、功率缩放的影响。注意,功率缩放比大于 1.0,意味着新器件消耗更多功率;这里为原来的 1.79 倍。
| 比较项目 | 缩放比 |
|---|---|
| 器件数量缩放,每个晶体管面积变为四分之一 | 4 |
| 频率缩放,依据器件速度预测 | 1.75 |
| 预测的电压缩放 | 0.81 |
| 预测的电容缩放 | 0.39 |
| 每个切换晶体管的能量缩放, | 0.26 |
| 假定切换晶体管比例相同,且芯片达到完整频率缩放时的功率缩放 | 1.79 |
图 5.34(续)。 特征数据来自 International Technology Roadmap for Semiconductors,它多年来为后续半导体工艺指明方向。由于继续缩放面临挑战,新工艺的不确定性增加,这一路线图在 2015 年版后停止。比较展示六年间 Dennard 缩放放缓,以及 Moore 定律放缓的影响;若按 Moore 定律原来的速度,11 nm 本应在 2018/2019 年实现。
译注: 正文使用 10 nm,图注使用 11 nm。表中的 ,再乘器件数与频率缩放比,约为 ,表内数量关系一致。
来看这对较新的 Intel Xeon Platinum 8380 意味着什么。它有 40 核,接近 100 亿晶体管,包括 60 MiB 缓存;运行频率为 2.3 GHz,额定热功率为 270 W,裸片面积为 600 mm²。功耗已经限制时钟频率:八核 Xeon Gold 运行在 3.2 GHz,功耗 140 W。比较 2017–2022 年的 Xeon 版本可见,如果不增加核心数,时钟频率可提高约 50%;若增加核心数,时钟频率基本不变。功耗是关键限制。此外,还可能受到 Amdahl 定律的影响,如下例所示。
例题:功率约束与 Amdahl 定律
假定未来一代处理器有 96 核,但平均只能让 54 核工作。90% 的时间可以利用全部可用核心,9% 的时间可以利用 50 核,1% 的时间必须严格串行。可以期望多大的加速比?假定闲置核心可以关闭且不耗电,不同核心使用数量在时间上的分布使我们只需考虑平均功耗。与一个 99% 的时间都能利用全部处理器的 24 处理器版本相比,该多核的加速比如何?
解答。 在能利用超过 54 核的那 90% 时间内,可用核心数求解如下:
于是加速比为:
再计算 24 个处理器的加速比:
同时考虑功率约束和 Amdahl 定律,96 处理器版本相对于 24 处理器版本的加速不到两倍。实际上,提高时钟频率所带来的加速,几乎能赶上处理器数量增加到四倍的收益。本章结语还将讨论这些问题。
译注: 本例沿用原书的平均使用数模型与取整结果;由 得 。Amdahl 公式中的 Fraction 是按串行执行工作量划分的比例,不能一般地与并行执行后各阶段所占时间比例互换。原例直接用同一组百分比计算平均功耗和加速比,读者使用这一简化模型时应注意这一假设边界。
多核的未来在于异构
单纯扩展多核很可能撞上刚才讨论的功率墙。多核的未来将朝更异构的系统发展。对于个人移动设备和桌面系统,很可能采用片上系统(SoC)设计,包含多个通用核心及领域专用加速器。Apple M1、M2 就是很好的例子,下面将简要考察 M1。
数据中心使用的大型多核系统,越来越多地采用基于领域专用体系结构的片外加速器。以更节能的方式实现计算最密集的部分,例如神经网络训练或推理,就能更有效地利用多核内部的通用处理器。数据中心多核是否也会纳入不同类型的通用核心,目前尚无定论,但功耗限制可能推动它们向这个方向发展。
Apple M1:异构的 SoC 多核
2020 年末推出的 M1 包含:
- 通用 ARM 核心,其中四个是高性能、也更耗电的核心,四个是能效核心。
- 八核 GPU,图形任务性能可达 2.6 teraops。
- 16 核神经网络引擎,机器学习推理任务相对于通用核心可加速 10–15 倍,同时功耗更低。
- 信号处理引擎,负责图像处理以及媒体编码、解码。
- 加密引擎,用于支持安全隔区(security enclaves)。
对许多应用,M1 以更低功耗提供更高性能。Apple M1 发布约一年后,Intel 推出多种新处理器,也具备其中一些能力,尤其是同时采用性能核心与能效核心。Apple 没有公布两类核心的相对性能和功率数据;对 Intel i9 系列中采用性能核心和能效核心的设计进行测量,可见在不使用 SMT 时,性能核心的性能约为能效核心的 1.5 倍;只有性能核心支持 SMT。对于能利用 SMT 的并行工作负载,性能核心的性能为能效核心的 1.8–2.0 倍。性能核心的功耗为能效核心的 1.3–1.7 倍,具体取决于是否使用 SMT。
5.11 结束语
上一节已经说明,多核不能神奇地解决功耗问题:它显然既增加晶体管总数,也增加正在切换的活跃晶体管数量,而这两者正是功耗的主要来源。Dennard 缩放放缓只会使问题更严重。
不过,多核确实改变了局面。本章结果表明,允许闲置核心进入节能模式,并纳入具有不同性能/功率特征的核心,可以提高能效。例如,关闭 Intel Xeon 或 i9 的部分核心,能够让其他核心以 Turbo 模式运行,从而在“较少处理器、较高频率”和“较多处理器、较低频率”之间权衡。同样,让 M1 的能效核心处理要求较低的任务,可以减少功耗、延长电池续航。SoC 还可以包含专用处理器或加速器,以比通用核心更高的性能、更低的功耗执行关键功能。
多核也改变了让处理器保持忙碌的责任分配:它更多依靠线程级和请求级并行性,需要应用与程序员识别;此前的 ILP 则主要由硬件负责。多道程序及能够避开 Amdahl 定律限制的高度并行工作负载,更容易受益。同样,GPU、深度学习处理器等领域专用加速器,见第 7 章,既能暴露更多并行性,也能采用更高效的组成方式,例如用 SIMD 代替 MIMD、用程序控制的存储器代替缓存,以克服瓶颈。
在 2012 年版中,我们提出是否值得考虑异构处理器的问题。当时尚无这类多核交付或发布,异构多处理器也只在专用计算机或嵌入式系统中取得有限成功。将第 4、7 章讨论的领域专用处理器与通用处理器结合,或许是兼顾更高性能、更高能效,并保留通用处理器一定灵活性的最佳方向。
5.12 历史回顾与参考文献
在线附录 M.7 节回顾多处理器与并行处理的历史,按时期和体系结构组织内容,讨论早期实验性多处理器以及并行处理领域的一些重要争论,也涉及近期进展,并提供进一步阅读的参考文献。
案例研究与习题
作者:Amr Zaky。
案例研究 1:单芯片多核多处理器
本案例阐释以下概念:
- 监听一致性协议的状态转换与操作。
- 监听一致性协议的性能。
- 监听一致性协议的实现优化。
- 同步及其对缓存一致性支持的利用。
事务记法
本案例采用如下记法:
Pi, r/w, Mj 表示处理器核心 i 读/写内存块 j。例如,P2, r, M3 表示处理器核心 2 读取内存块 3。
缓存配置与策略
案例中的 L1、L2 都采用直接映射、写回、写分配策略。假定 L2 包含与之相连的各 L1 缓存。所有 L1 和 L2 缓存的缓存行大小相同,且等于一个内存块的大小。
一致性协议
采用 5.3 节中的写失效监听协议,状态为 M、S、I。
内存分布与寻址
习题 5.1
[20]〈5.3〉 图 5.35 是一个四处理器 SMP。每个处理器核心有私有 L1,所有核心共享 L2;缓存配置和策略见案例引言。
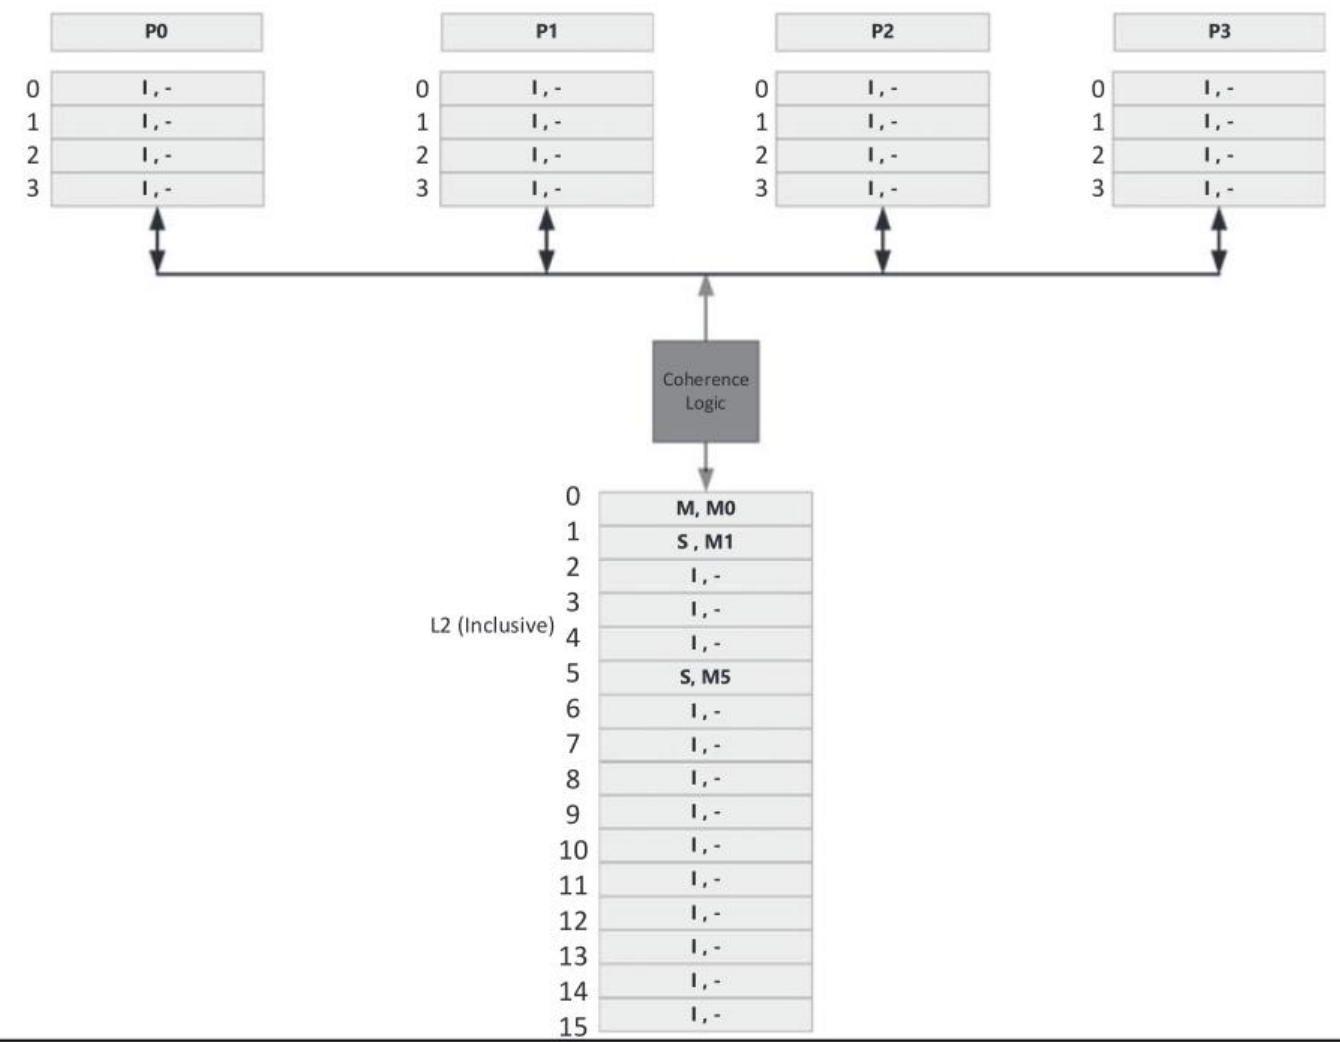
图中 Coherence Logic 为一致性逻辑,L2(Inclusive)为具有包含性的 L2。P0–P3 的四个 L1 表项均为 I;L2 有 16 项,其中 0 项为 M、M0,1 项为 S、M1,5 项为 S、M5,其余为 I。
L2 缓存行的初始状态和数据见图。L2 块表项中的 Mi 表示该项缓存了内存块 i。
- 对下面依次发生的内存读写,描述缓存行状态的变化,以及缓存和监听逻辑采取的操作。序列中 x || y 表示操作 x 之后执行操作 y;Mi 表示物理内存块 i。
习题 5.2
[30]〈5.3〉 图 5.36 给出所用监听协议的一种实现中,各操作的延迟,单位为处理器周期。
| 访问 | 处理器周期 | 用途 |
|---|---|---|
| L1 标签访问 | 1 | L1 读/写命中;未命中的第一个周期;来自一致性逻辑的监听查询 |
| L1 数据访问 | 1 | L1 读,与标签访问并行;L1 写 |
| L2 标签访问 | 6 | L1 未命中 |
| L2 数据访问 | 12 | L1 写回、L1 重填 |
| 一致性逻辑访问 | 1 | L1 未命中;L1 升级未命中,即失效操作;L1 对一致性逻辑的响应 |
图 5.36 附注。 标签访问与读数据访问并行进行;读未命中时,丢弃读出的数据。写操作则必须等标签访问确认写命中后,才能访问数据阵列,因此写命中需要两个周期。这里假定时钟周期过短,无法在一个周期内先后完成标签访问和数据访问。
示例。 若某内存块在 P2 的 L1 中处于已修改状态,P1 对它写未命中的延迟如图 5.37 所示。
| 步骤 | 延迟 |
|---|---|
| P1 标签访问 | 1 周期 |
| P1 未命中,发出失效请求 | 1 周期 |
| 一致性监听查询 P2 及所有核心的标签 | 1 周期 |
| P2 写回 L2 | 12 周期 |
| L2 重填 P1 | 12 周期 |
| 合计 | 27 周期 |
假定总线上的处理器能在一个周期内报告它们相对于待失效缓存行的状态:L1 命中共享行、L1 命中已修改行,或 L1 未命中。
- 计算习题 5.1 的读写序列总共需要多少延迟周期。
习题 5.3
[10/10]〈5.3〉 假定一个缓存行恰好容纳数组 A 的一个元素,且数组 A 完全位于 L2 中,但不在 P0 的 L1 中。
- 上述 for 循环每次迭代的两次内存访问需要多少周期?
- 如果协议由 MSI 改为 MESI,这些内存访问需要多少周期?
习题 5.4
[15]〈5.3〉 为进一步研究 MSI、MESI 的性能,解释为什么使用 MSI 时,下列两个循环的数据访问需要不同的周期数,而使用 MESI 时,周期数应不会有明显差异。假定 A[i] 最初不在 L1 中,但整个数组 A 都在 L2 中。
习题 5.5
[15/15]〈5.3〉 考虑以下内存读写序列:
假定访问的内存块都不在 L1 中,但全部在 L2 中。
- 计算上述读写序列的总延迟周期数。
- 如果处理器核心可以直接向另一核心提供数据,而不必等待 L2 提供,计算总延迟周期数。假定一个处理器的 L1 向另一个 L1 传送数据需要 4 周期。
现在采用图 5.38 中另一种 L2 结构。每两个核心共享一个私有 L2,该 L2 包含与之连接的核心的 L1。还假定 LLC 包含两个 L2。L1 缓存行未命中由 L2 提供服务,除非 L2 也未命中;此时从 LLC 取得该行,而 LLC 可能还要从内存获取。从 LLC 取回的缓存行先写入 L2,再传给请求它的 L1。如果存在一致性逻辑,这一过程通常需要执行一致性操作;如果其他缓存,包括 L1、L2 或 LLC,已有该行,还可能需要改变其状态。
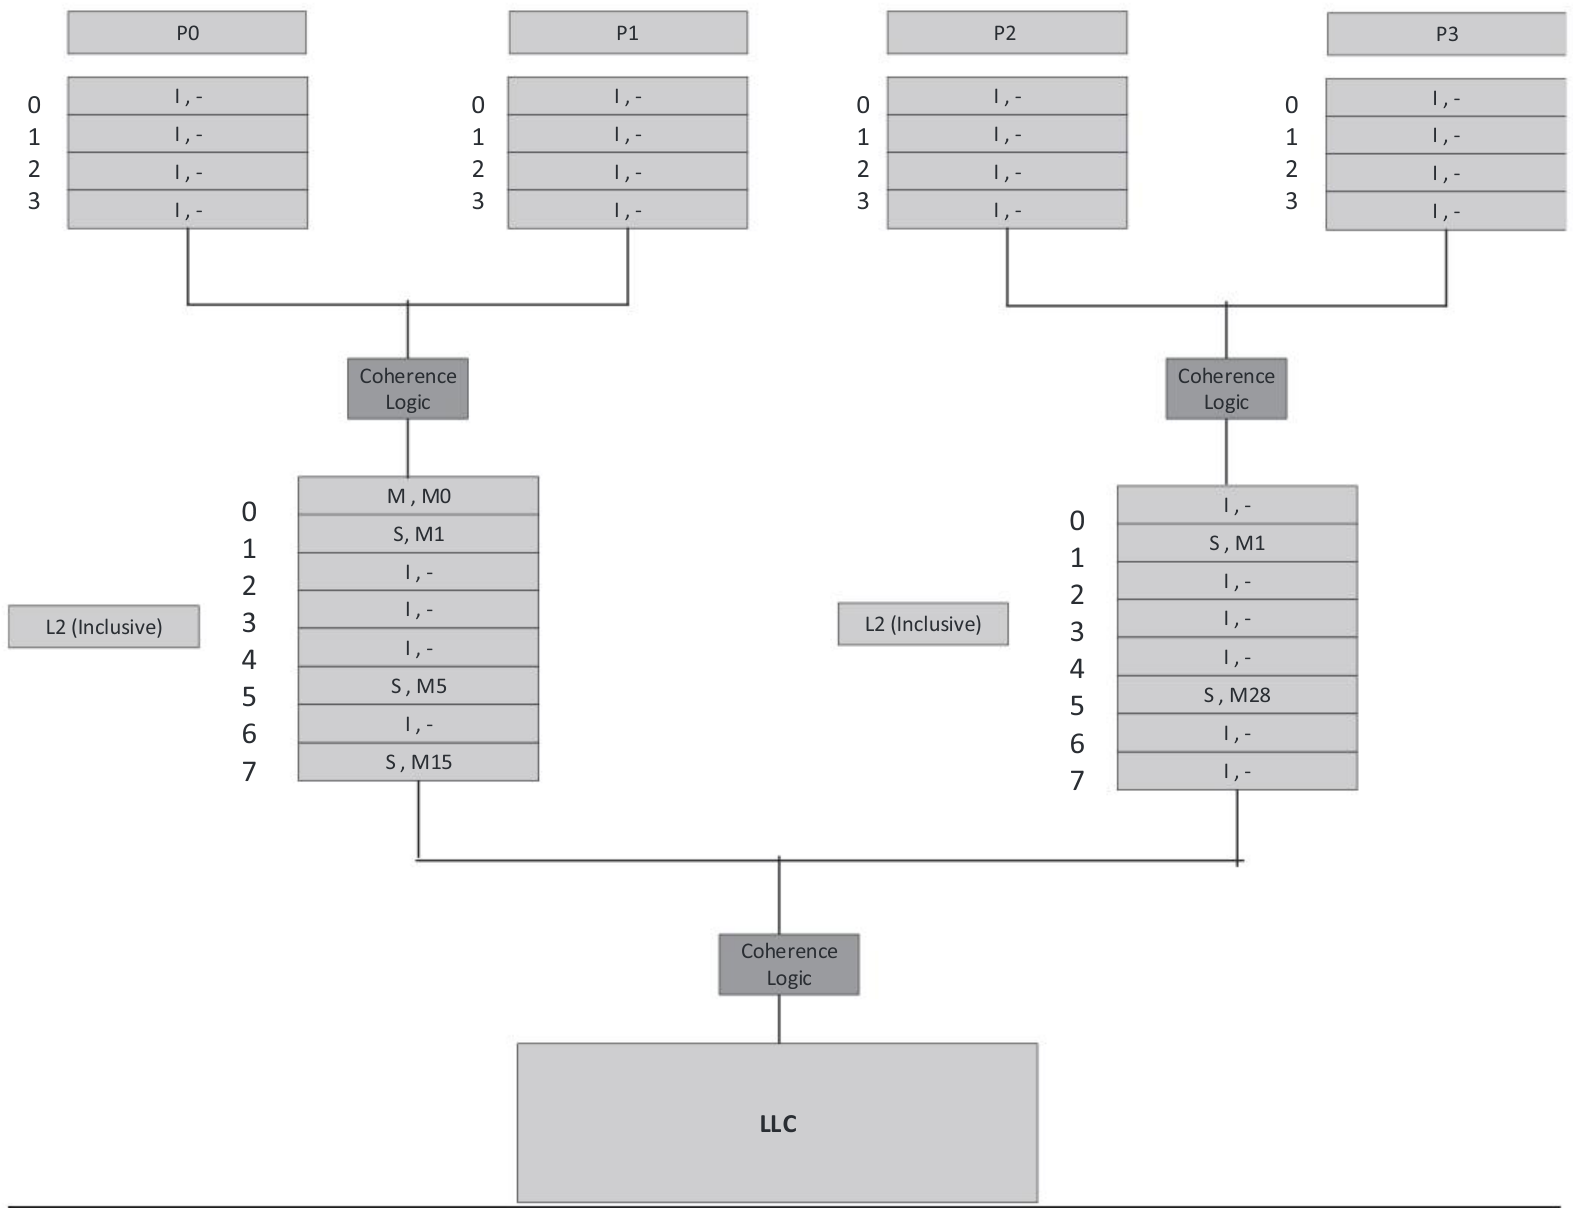
图中 Coherence Logic 为一致性逻辑,L2(Inclusive)为具有包含性的 L2,LLC 为末级缓存。四个 L1 最初均为 I。左侧 L2 的 0、1、5、7 项分别为 M、M0;S、M1;S、M5;S、M15,其余为 I。右侧 L2 的 1、5 项分别为 S、M1 和 S、M28,其余为 I;状态与块号按原图保留。
习题 5.6
[20]〈5.3〉 讨论新配置的监听协议实现。例如,对内存块 M38 的访问在 L1、L2 都未命中后,P0 的 L1 和 P0/P1 的 L2 将处于什么状态?我们也许会想完全省去 L1 一致性逻辑,即 L1 与 L2 之间的逻辑,只使用 L2 与 LLC 之间的一致性逻辑;但实现 L1/L2 一致性逻辑可以创造一些性能优化机会。请举例说明。
习题 5.7
[10]〈5.3〉 解释为什么在 L2 中采用 MESI,同时在 L1 中采用 write-once 协议,可以减少这一配置的一致性流量。write-once 策略在首次写某缓存行时按直写缓存工作,后续写则按写回缓存工作。
习题 5.8
[20]〈5.3〉 假定采用 MSI,计算以下访存序列的读写总延迟周期数。
习题 5.9
[20]〈5.5〉 下面给出 5.5 节讨论的两种自旋锁循环实现。
实现一:
实现二,按原页排列:
- 当 P0、P1 竞争 P2 持有的锁时,分别给出两种实现中自旋锁循环的时序。
译注: 原页第二段确有连续两条相同的 bnez,且 EXCH 之后没有分支;这里未擅自移动指令。请结合 5.5 节的 test-and-test-and-set 循环理解其意图,原题代码本身存在排列疑点。
案例研究 2:简单的目录一致性
本案例阐释以下概念:
- 目录一致性协议的状态转换。
- 一致性协议的性能。
- 一致性协议的优化。
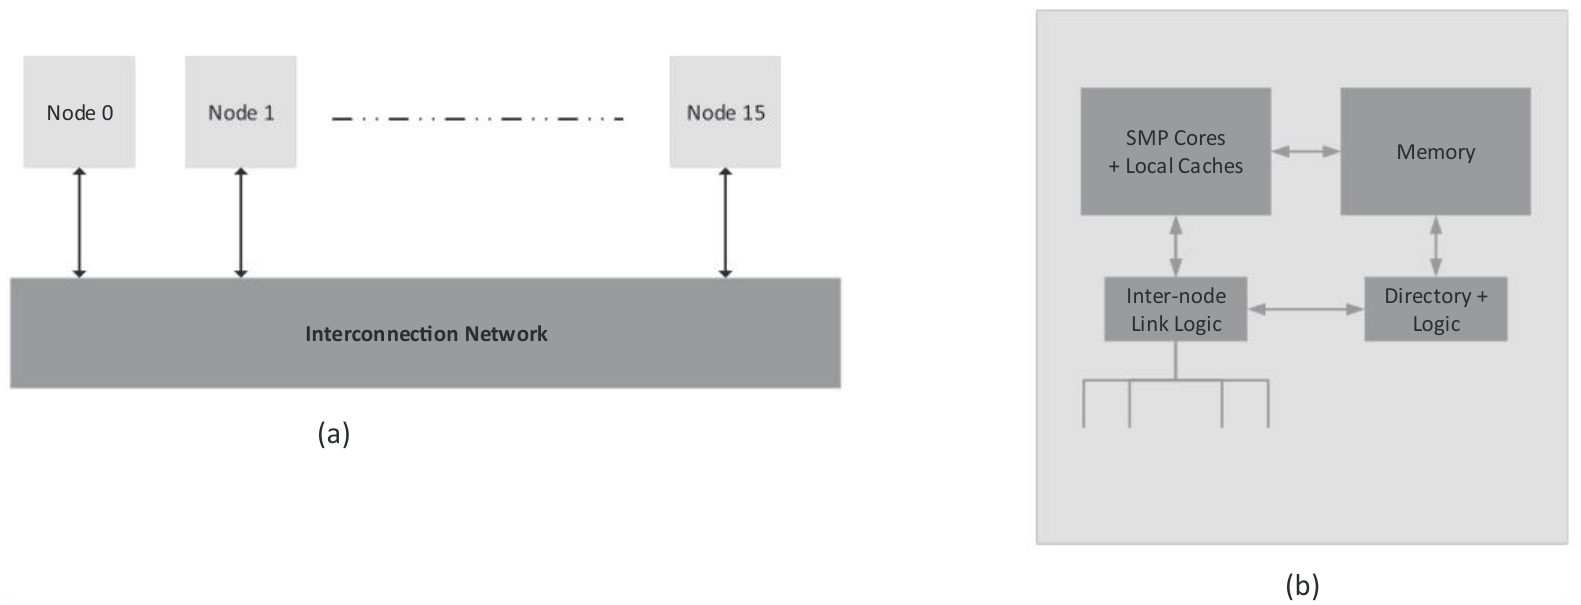
图 5.39(续)。 考虑图(a)中的分布式共享内存系统:16 个处理器核心节点连接到互连网络 IN。图(b)给出节点内部结构,允许每个节点含多个以 SMP 方式连接的核心;开始时可以先假定每节点只有一个核心。如果有多个核心,则可假定它们通过监听维护彼此间的一致性。Node 为节点,Interconnection Network 为互连网络,SMP Cores + Local Caches 为 SMP 核心及本地缓存,Memory 为内存,Inter-node Link Logic 为节点间链路逻辑,Directory + Logic 为目录及其逻辑。
一致性协议
采用 5.4 节中的目录式写失效协议,状态为 M、S、I。
内存分布与寻址
内存均匀分布在各节点上。内存块地址的最高 4 位表示该内存所在的节点编号。除非题目另有说明,否则不指定内存块大小及分布式内存中的块数。
事务记法
本案例采用以下记法:
Ni, r/w, M(m, n) 表示处理器节点 i 读/写位于节点 m 的内存块 n。例如,N2, r, M(3,7) 表示节点 2 读取节点 3 的内存块 7。
缓存配置与策略
案例中的 L1、L2 等缓存都采用直接映射、写回、写分配策略。假定每级缓存包含更靠近处理器的各级缓存。所有缓存的缓存行大小相同,且等于一个内存块的大小。
习题 5.10
[20]〈5.4〉 假定所有缓存块最初均无效。对以下依次发生的访存,描述缓存行状态变化、目录控制器采取的操作,以及交换的一致性消息。x || y 表示操作 x 之后执行操作 y。
习题 5.11
[5/10]〈5.4〉 假定每节点分配 1 GiB 分布式内存,内存块为 128 字节。
a. 描述一种直接的节点目录数据结构布局,计算实现它所需的总位数,并计算目录容量占内存容量的百分比。
b. 使用 a 中的布局,画出节点 1 的目录内容。提醒:所有目标为 M(1, *) 的访问都会访问节点 1 的目录。
习题 5.12
[5/5/5]〈5.4〉 为缩小目录,可以采用下面一种或两种结构调整:
- 让每个目录项记录比一个块更大的内存区域的一致性状态,从而减少目录项数。
- 让目录项记录一组节点而非单个节点的内存使用情况,从而缩小每个目录项。
a. 若每项记录 4 KiB 内存的使用情况,每节点分配 1 GiB 分布式内存,目录有多少项?
b. 若将 16 节点分为四组、每组四节点,目录项记录一组节点而非单个节点对内存块的所有权,一个目录项有多大?
c. 同时采用上述两种优化,目录有多大?
习题 5.13
[15/5]〈5.4〉 考虑案例习题 5.11 的直接目录实现,画出执行 MSI 所需的一组一致性消息。应提供足够细节,明确地址、源/目标节点、数据和命令。
a. 画出各类消息的字段,按位计算每类消息的大小。
b. 重做 a;必要时增加填充位,使消息长度为整数字节。
习题 5.14
[10/10/10/10/5]〈5.4〉 习题 5.12 的目录容量优化,会以执行目录一致性协议所需消息数增加为代价。用下面的访存序列比较不同优化下交换的消息数。
a. 未优化目录容量,即采用 5.11 的实现时,描述采取的操作和交换的一致性消息。
b. 采用 5.12a 的修改,每个目录项管理 4 KiB 内存块时,描述采取的操作和交换的一致性消息。
c. 采用 5.12b 的修改时,描述采取的操作和交换的一致性消息。四组分别为 G0:N0、N1、N2、N3;G1:N4、N5、N6、N7;G2:N8、N9、N10、N11;G3:N12、N13、N14、N15。
d. 同时采用 5.12a、b 时,描述采取的操作和交换的一致性消息。分组仍为 G0:N0、N1、N2、N3;G1:N4、N5、N6、N7;G2:N8、N9、N10、N11;G3:N12、N13、N14、N15。
e. 填写下表,对不同的一致性组节点数和每项管理的内存块大小,给出每节点目录位数,以及完成上述事务序列所交换的消息数。
| 每个一致性组的节点数 | 每项管理的内存块大小 | 每节点目录大小,位 | 上述事务序列交换的消息数 |
|---|---|---|---|
| 1 | 128 字节 | ||
| 1 | 4 KiB | ||
| 4 | 128 字节 | ||
| 4 | 4 KiB |
习题 5.15
[10]〈5.4〉 把 5.12c 的优化推到逻辑上的极端,可以完全省去节点目录,不再记录哪个节点使用哪个内存块。假定保留一部分目录逻辑,这种组成会需要大量一致性消息。即使消息开销如此之高,保留目录逻辑是否仍有价值?提示:假定任意节点 i 发往节点 j 的消息在互连网络中遵循确定路径,且按序处理;节点 i 和 j 都需要读或写节点 k 中的同一内存块。
案例研究 3:存储一致性
本案例阐释以下概念:
- 顺序一致性(SC)模型允许的程序行为。
- SC 模型允许的硬件优化。
- 用同步原语使一种一致性模型模拟约束更严格的模型。
习题 5.16
[10/5/5/]〈5.6〉 下列代码是两个处理器上运行的两个进程所使用的 Peterson 互斥算法。该算法旨在说明,不借助硬件同步原语也可以保证互斥。
初始条件:enter0, enter1 = false,即 P0、P1 最初都不希望进入临界区。
a. 证明,当两个进程都想进入临界区,且处理器遵循顺序一致性模型时,每次只能有一个进程进入临界区。
b. 给出一种符合 SC 的 P0、P1 读写顺序,使 P0 先于 P1 进入临界区。
c. 给出一种符合 SC 的 P0、P1 读写顺序,使 P1 先于 P0 进入临界区。
习题 5.17
[10]〈5.6〉 说明处理器实现释放一致性(RC)模型时,Peterson 算法不保证正确。给出一种符合 RC 的操作顺序,使进程 P1、P2 同时进入临界区。
译注: 原题写 P1、P2,前题代码中的两个进程则为 P0、P1;进程名不一致,按原题保留。
习题 5.18
[5/5/5]〈5.6〉 假定 a、b 初值均为 0。
a. 使用 SC 时,这两个进程可能打印哪些输出?
b. 将代码原样放在采用 RC 的系统上执行,两个进程可能永远无法越过 while 循环。解释原因。
c. 给出一种编译器代码重排,使 SC 系统上也可能出现 b 所述的效果。
译注: 原页没有标出 while 的空循环体或终止分号,print 的缩进也与 while 接近。
习题 5.19
[10]〈5.6〉 在 5.18 中,如果 P0 在 P1 将 b 置为 1 之前,就把 b 预取到自己的缓存,在 SC 系统上会产生意外结果吗?假定存在缓存一致性机制。
习题 5.20
[10/10]〈5.6〉 为习题 5.15 的互斥代码加入同步原语,使它在实现 RC 的系统上正确工作。
译注: 原题引用 5.15,但该题讨论目录;本页互斥代码实际属于 5.16。
习题 5.21
[20/20/20]〈5.6〉 顺序一致性要求所有读写看起来按某个全序执行。因此,在某些情况下,处理器提交读或写指令前必须停顿。考虑:
其中 write A 缓存未命中,read B 缓存命中。在 SC 下,处理器必须让 read B 等待,直到能给 write A 确定顺序并执行它。简单的 SC 实现会让处理器停顿,直到缓存收到数据、可以执行写。
较弱的一致性模型放宽读写顺序约束,减少必须停顿的情况。Total Store Order(TSO)要求所有写看起来按某个全序发生,但允许一个处理器的读越过它自己的写。因此可以采用写缓冲区,保存已经提交、但尚未与其他处理器的写确定相对顺序的写操作。TSO 下的读可以越过写缓冲区,也可能从缓冲区旁路获得数据;SC 不允许这样做。
假定每周期可执行一个内存操作;缓存命中,或可由写缓冲区满足的操作,不产生停顿。未命中带来 100 周期内存延迟。分别在 SC、TSO 下,计算每个操作前有多少停顿周期。写缓冲区最多容纳一次写。访存使用 5.1 中的记法。
a. [20]〈5.6〉
b. [20]〈5.6〉
c. [20]〈5.6〉
习题
习题 5.22
[15/20/10]〈5.1〉 本题研究互连网络拓扑对运行在 64 处理器分布式内存多处理器上的程序 CPI 的影响。处理器时钟频率为 2.0 GHz;应用的所有访问都在缓存中命中时,基础 CPI 为 0.75。假定 0.2% 的指令涉及远程通信访问。一次远程通信访问的代价为 ns,其中 h 是访问远程处理器内存并返回时经过的网络跳数。所有通信链路均为双向。
a. [15]〈5.1〉 64 个处理器分别排列成环、 网格及超立方体时,计算最坏情况下的远程通信代价。提示:含 个节点的超立方体,其最长通信路径有 n 条链路。
b. [20]〈5.1〉 将不含远程通信时的基础 CPI,与 a 中三种拓扑各自达到的 CPI 比较。
译注: 原题难度标记含三个数,但原页实际只有 a、b 两问。
习题 5.23
[15]〈5.2〉 如何修改图 5.6 的基本监听协议,使之适用于直写缓存?与写回缓存相比,直写缓存不再需要哪项主要硬件功能?
习题 5.24
[20/20]〈5.2〉 回答以下问题。
a. [20]〈5.2〉 为图 5.6 的基本监听缓存一致性协议增加干净独占状态,按图中的有限状态机格式绘出协议。
b. [20]〈5.2〉 在 a 的协议中增加 owned 状态,仍用图 5.6 的有限状态机格式描述。
习题 5.25
[15]〈5.2〉 一种解决伪共享的建议是为每个字增加有效位。这样,协议可以仅使一个字失效,不必移除整个块;一个处理器可在缓存中保留块的一部分,另一个处理器则写块的另一部分。这会给图 5.6 的基本监听缓存一致性协议增加哪些复杂性?请考虑所有可能的协议操作。
习题 5.26
[15/20]〈5.3〉 本题研究:设计共享内存多处理器系统时,处理器采用更积极的 ILP 技术会带来什么影响。考虑除处理器外完全相同的两个系统。A 的处理器采用简单的单发射、顺序执行流水线;B 采用四发射、乱序执行及 64 项重排序缓冲区。
a. [15]〈5.3〉 按图 5.11 的划分,把执行时间分为指令执行、缓存访问、内存访问及其他停顿。你预期 A、B 的这些部分各有何不同?
b. [10]〈5.3〉 根据 5.3 节对 OLTP 行为的讨论,OLTP 与其他基准测试之间哪项重要差别,限制了它从更积极的处理器设计中获得的收益?
习题 5.27
[15]〈5.3〉 如何修改应用代码以避免伪共享?哪些工作可由编译器完成,哪些可能需要程序员指示?
习题 5.28
[15]〈5.3〉 某应用统计一个词在大量文档中出现的次数。大量处理器分工搜索不同文档,生成一个巨大的数组 word_count;元素为 32 位整数,每个元素记录该词在一篇文档中的出现次数。第二阶段将计算移到一台四处理器小型 SMP 服务器,每个处理器对约四分之一的元素求和,最后由一个处理器计算总和。
a. 假定每个处理器都有一个 32 字节 L1 数据缓存,指出上述代码存在的缓存行共享,是真共享还是伪共享。
b. 重写代码,减少访问 word_count 元素时的未命中次数。
c. 指出一种手工修改代码的方法,消除所有伪共享。
译注: 原题写的是“32-byte L1 data cache”,未明确说 32 字节是缓存总容量还是缓存行大小;译文不擅自补上“行”。最后一行代码的终止分号也依原页未补。
习题 5.29
[15]〈5.4〉 假定采用目录一致性协议。目录当前记录处理器 P1 以 exclusive 模式持有某块数据;若此时又收到 P1 对同一缓存块的请求,可能意味着什么?目录控制器应如何处理?这类情况称为竞争条件(race conditions),也是一致性协议难以设计和验证的原因。
习题 5.30
[20]〈5.4〉 目录控制器可能向已被本地缓存控制器替换的缓存行发送失效消息。为避免这些消息并保持目录一致,可以使用替换提示(replacement hints),通知控制器某块已经被替换。修改 5.4 节的目录一致性协议,使其采用这类提示。
习题 5.31
[20/15/20/15]〈5.4〉 采用完整位向量直接实现目录的缺点之一,是目录信息总量按“处理器数 × 内存块数”增长。如果内存容量与处理器数量线性增长,目录总容量就按处理器数的平方增长。实践中,目录对每个内存块只需要 1 位,而一个块通常为 32–128 字节,所以处理器数量较少或中等时问题不严重。例如,块大小为 128 字节、处理器数为 P,目录存储量相对于主存为 ;P = 128 时,开销为 12.5%。注意到需要保留的信息量只须与各处理器的缓存容量成比例,就可以避免这一问题。下面研究几种方案。
译注: 此处原文“每个内存块只需要 1 位”,结合紧接着的公式,应按每个处理器、每个内存块一个共享位理解;不是整个系统每个块总共一位。
a. [20]〈5.4〉 一种可扩展目录协议把多处理器组织为逻辑层次结构,处理器位于叶节点,目录位于各子树根部。每个子树的目录记录哪些后代缓存了哪些内存块,还记录归属于该子树、但缓存在子树外部的内存块。假定各目录全相联,计算目录记录处理器信息所需的存储量。答案应同时包含各层节点数和总节点数。
b. [15]〈5.4〉 另一种缩小目录的方法,是任一时刻只允许目录所管理的有限个内存块被共享。将目录实现为四路组相联缓存,保存完整位向量。目录缓存未命中时,选出一个目录项并使其失效。描述这种组成如何工作,详细说明块被读、写、替换及写回内存时会发生什么。修改图 5.20 的协议,体现这种目录组成所需的新状态转换。1
c. [20]〈5.4〉 不减少目录项数,也可以采用非稠密位向量。例如,把每个目录项设为 9 位。若块在归属节点之外仅被一个节点缓存,该字段保存节点编号;若被多个外部节点缓存,该字段就是位向量,每一位代表八个处理器的一组,组内至少有一个缓存该块。针对由八个八处理器组组成的 64 处理器 DSM 系统,说明这种方案如何工作。
d. [15] 缩小目录的一种极端方法,是实现“空”目录:每个处理器的目录都不存储任何内存状态,只接收请求并适当地转发。在 DSM 系统中,与完全没有目录相比,保留这种目录有何好处?
习题 5.32
[10]〈5.5〉 使用 load linked/store conditional 指令对,实现经典的 compare-and-swap 指令。
习题 5.33
[15]〈5.5〉 常见性能优化是在同步变量周围填充空间,让同一缓存行内没有其他有用数据。构造一个例子,说明这种优化在某些情况下极其有效。假定采用监听式写失效协议。
习题 5.34
[30]〈5.5〉 在多核处理器中实现 load linked/store conditional 的一种方法,是限制它们采用不经过缓存的内存操作。一个监视单元截获任意核心发往内存的所有读写,跟踪 load linked 的来源,以及它与对应 store conditional 之间是否插入其他存储。监视单元能阻止任何失败的 store conditional 写入数据,并通过互连信号通知处理器该存储失败。
为支持四核 SMP 的存储系统设计这种监视单元。注意,读写请求的数据长度通常可以不同,为 4、8、16 或 32 字节。任意内存位置都可能是 load linked/store conditional 的目标;监视器应假定,对任意位置的这类访问都可能与同一位置的普通访问交错。监视器复杂度应与内存容量无关。
习题 5.35
[25]〈5.5〉 证明:在 L1 更靠近处理器的两级缓存层次中,如果 L2 的相联度至少与 L1 一样高,两级都采用 LRU 替换且块大小相同,则不需要额外操作就能维持包含性。
译注: 原题的结论还涉及 L2 是否得知 L1 命中并同步更新替换次序等条件;题面没有说明。
讨论
[Discussion]〈5〉 为详细评价多处理器性能,系统设计者使用三类工具之一:分析模型、轨迹驱动模拟和执行驱动模拟。分析模型用数学表达式描述程序行为。轨迹驱动模拟先在真实机器上运行应用,生成通常由内存操作组成的轨迹,再将轨迹送入缓存模拟器或具有简单处理器模型的模拟器重放,以预测参数变化后的性能。执行驱动模拟器则模拟整个执行过程,为处理器状态等维护等价结构。
a. 这些方法在精度与速度之间有何权衡?
b. CPU 轨迹若采集不慎,可能带入采集系统自身的特征。以分支预测和自旋等待同步为例讨论这一问题。提示:纯 CPU 轨迹方法只有轨迹,无法取得程序本身。
习题 5.36
[40]〈5.7,5.9〉 多处理器和集群通常随处理器数量增加而提高性能,理想情况是 n 个处理器获得 n 倍加速。本题这个有意偏置的基准测试,目标是构造一个处理器越多、性能反而越差的程序。例如,在多处理器或集群上,一个处理器运行最快;两个更慢,四个比两个更慢,以此类推。对于这两种组成方式,各有哪些关键性能特征会产生与线性加速相反的效果?
译注:原题引用图 5.20,但本版图 5.20 展示不同块大小的访存流量,并非目录协议状态图;本章目录项状态转换图为图 5.17。 ↩︎
6 面向效用计算的仓库级体系结构
数据中心就是计算机。
——Luiz André Barroso,Google(2007)
一百年前,企业不再使用蒸汽机和发电机自行发电,而是接入新建成的电网。电力公司供应的廉价电能,改变的不只是企业的运作方式;它引发了一连串经济与社会变革,造就了现代世界。今天,一场相似的革命正在发生。大型信息处理工厂接入互联网这张全球计算网络,开始向我们的家庭与企业输送数据和软件代码。这一次,成为公共服务的是计算。
——Nicholas Carr,The Big Switch: Rewiring the World, from Edison to Google(2008)
原章 DOI:10.1016/B978-0-443-15406-5.00006-7。原章版权标记:© 2026 Elsevier Inc.,保留所有权利,包括文本与数据挖掘、AI 训练及类似技术的相关权利。
编号说明: 本版原书把“谬误与陷阱”和“结束语”都标为 6.9,随后“历史回顾与参考文献”标为 6.10。可按标题和导航顺序区分这两节。
6.1 引言
谁都能造出一个快 CPU,诀窍在于造出一个快系统。
——Seymour Cray,被誉为超级计算机之父
仓库级计算机(warehouse-scale computer,WSC)是数十亿人每天使用的互联网服务的基础:搜索、社交网络、在线地图、视频流、网上购物、在线游戏、软件即服务,等等。智能手机成为随处可用、始终在线的瘦客户端设备,使我们必须建立可扩展、可靠且具有成本效益的 WSC,作为这些极受欢迎的互联网服务的后端平台。这也催生了云计算:以公共服务的方式提供计算硬件、软件,乃至数据,任何持有信用卡的人都可以使用。
WSC 看起来或许只是大型集群,但我们将看到,其体系结构和运作方式大有不同。要以合理成本和良好性能达到每座 WSC 超过 50,000 台服务器的规模,就必须协同设计它的各个方面,包括硬件、软件、网络,甚至容纳 WSC 的建筑物中的配电与冷却基础设施。在这个前沿领域,WSC 是超级计算机的现代继承者,Seymour Cray 因而也成了今天 WSC 体系结构设计者的先驱。Cray 的超级计算机同样采用纵向协同设计,支持科学家与工程师在其他地方无法完成的高性能计算(HPC)。不过,Cray 的计算机价格极高,只有少数公司负担得起。今天的 WSC 如同一台巨大的机器,造价达数亿美元,却能以令人惊讶的成本效益,为广泛用户支持多种计算。因此,可以说,WSC 在当今社会所起的作用,比过去 Cray 超级计算机的作用更为重要。
WSC 设计者与服务器设计者有许多共同目标和要求:
性价比。 每美元能够完成多少工作至关重要,部分原因在于规模:将一组 WSC 的成本降低几个百分点,就可能节省数千万美元。
能效。 除了离开 WSC 的光子之外,它们基本上是封闭系统,几乎所有消耗的能量最终都变成必须排出的热量。因此,峰值功率和实际功耗决定了配电与冷却系统的成本,也决定了一座 WSC 能够容纳的硬件数量,进而决定其峰值性能和用户容量。建设 WSC 的大部分基础设施成本都花在供电与冷却上。此外,能效也是履行环境责任的重要部分。
通过冗余实现可信赖性。 互联网服务长期运行且全天候使用,这意味着 WSC 中的硬件与软件必须共同提供至少 99.99% 的可用性,也就是“四个九”;每年的服务中断时间必须少于 1 小时。冗余是 WSC 和服务器实现可信赖性的关键。服务器设计者常常增加硬件并承担更高成本,以达到高可用性;WSC 设计者则依靠大量具有成本效益的服务器,通过网络连接,由软件管理冗余。除了 WSC 内部的局部冗余,组织还需要多座互为冗余的 WSC,以掩盖可能导致整座 WSC 失效的事件。事实上,虽然每项云服务都需要至少 99.99% 的可用性,但 Amazon、Google、Microsoft 这样的互联网公司,整体的可信赖性还必须更高。如果其中一家公司每年完全离线 1 小时,也就是整体可用性只有 99.99%,就会成为头版新闻。多座 WSC 还有一个好处:降低广泛部署的服务的访问延迟。
网络 I/O。 服务器设计者必须提供良好的外部网络连接,WSC 设计者也一样。后者还面临另一项挑战:提供高带宽、且往往经过定制的内部网络,用来在一座 WSC 内实现分布式可靠服务,并保持多座 WSC 之间的数据一致性。
当然,也有一些 WSC 特性不同于服务器体系结构:
- 种类繁多的工作负载。 通过云计算,WSC 承载各种类型和规模的工作负载。其中有些是单节点数据库、科学计算等传统服务器应用;但 WSC 也承载规模最大的分布式工作负载,包括社交网络与搜索这样的交互式服务、视频流平台,以及计算这些服务所需元数据的大规模并行批处理程序。机器学习(ML)计算在 WSC 计算周期中所占的比例持续提高,既包括在线服务的推理负载,也包括批处理的训练负载。
- 充足的并行性。 服务器设计者会担心:目标市场中的应用是否有足够并发性,值得配置这么多并行硬件?为利用这种并行性所需的通信硬件是否过于昂贵?WSC 设计者没有这样的顾虑。首先,随着更多用户和工作负载迁移到云平台,进程级并行性十分充足。其次,批处理应用通常需要对大量不同数据集进行独立处理,因此能够利用数据级并行性。这与第 4 章介绍的数据级并行性相似,但这次针对的是存储设备上的海量数据集,而不是内存中较小的数据集,因此可以用多台机器以分布式方式加以利用。最后,交互式互联网服务面向成千上万乃至数百万彼此独立的用户。不同用户的读写很少相互依赖,因此交互式服务可以利用请求级并行性:大量独立请求并行推进,几乎不需要通信或同步。
- 运行成本不可忽视。 服务器设计者通常忽略服务器的运行成本,认为它与购买成本相比微不足道。WSC 规模巨大,寿命也更长,建筑物以及电气与冷却基础设施通常按 10–20 年摊销。因此,运行成本很快就会累积起来:在 10 年期间,能耗、配电和冷却可能占 WSC 成本的 30% 以上。
- 选址很重要。 建设 WSC 的第一步是建一座仓库。问题在于建在哪里。房地产经纪人强调地段,但 WSC 的选址意味着:能获得低价电力,有水或温度适宜的空气用于冷却,靠近互联网骨干光纤,附近有人能够到 WSC 工作,而且地震、洪水、飓风等自然灾害风险较低。更直接的考虑是土地成本,以及是否有足够空间供 WSC 扩建。对于拥有许多 WSC 的公司,还要考虑在地理上靠近现有或未来互联网用户群,以降低访问互联网服务的延迟。其他因素包括税收、不动产成本、社会因素(人们有时希望设施设在本国)、数据主权(某些司法辖区要求数据本地托管)、网络的成本与可靠性、电力的成本与来源(例如水电还是煤电)、天气(越凉爽越便宜),以及整体互联网连通性。
- 在各种利用率下都高效计算。 服务器设计者通常在成本预算内追求峰值性能,关心功率主要是为了不超过机箱的散热能力。6.7 节将说明,由于多种原因,WSC 服务器很少满负载运行。高利用率很难实现,因为它可能增加外部用户感受到的延迟,或加剧共享 WSC 计算、存储和网络组件的工作负载之间的干扰。既然运行成本不可忽略,WSC 服务器就必须在低、中、高各种利用率下都高效计算。
- 规模,以及规模带来的机遇和问题。 极端规模的计算机往往极其昂贵,因为它们需要定制硬件,而数量又少,定制成本难以有效摊销。不过,一次购买数千台服务器,就能获得可观的批量折扣。WSC 的内部规模如此之大,即使 WSC 本身数量不多,也能产生规模经济。这种规模经济催生了商业云计算:WSC 较低的单位成本,使公司能够以低于外部用户自行部署的成本出租服务器,同时仍然获利。100,000 台服务器的另一面则是失效。图 6.1 列出了一个只有 2400 台服务器的小型集群发生的中断与异常。即使一台服务器的平均失效前时间(MTTF)长达惊人的 25 年(200,000 小时),WSC 设计者也需要按每天五台服务器失效来设计。图 6.1 给出的硬盘年失效率为 2%–10%。
译注: 如果按同段的 100,000 台、独立且均匀失效的口径估算,每天预期失效数为 ,与原文的五台不同;原文未说明这里是否另用了较小的服务器规模。
| 第一年大致发生次数 | 原因 | 后果 |
|---|---|---|
| 1 或 2 | 公共电网故障 | 整座 WSC 失去市电;若 UPS 与发电机工作正常,WSC 不会停机。发电机约有 99% 的时间能够正常工作 |
| 4 | 集群升级 | 为升级基础设施而计划停机,常见原因是不断变化的网络需求,例如重新布线、升级交换机固件等。每发生一次非计划停机,约有九次计划内的集群停机 |
| 以下五类合计数千次 | 硬盘失效 | 硬盘年失效率为 2%–10%(Pinheiro 等,2007) |
| 同上 | 磁盘变慢 | 仍能运行,但速度降至正常的 1/10–1/20 |
| 同上 | 内存故障 | 每年发生一次不可纠正的 DRAM 错误(Schroeder 等,2009) |
| 同上 | 机器配置错误 | 配置问题导致约 30% 的服务中断(Barroso 与 Hölzle,2009) |
| 同上 | 不稳定的机器 | 1% 的服务器每周重启不止一次(Barroso 与 Hölzle,2009) |
| 5000 | 单台服务器崩溃 | 机器重启通常耗时约 5 分钟,原因可能是软件或硬件问题 |
假设每台服务器有两块硬盘,年失效率为 4%,那么对于 100,000 台服务器,WSC 设计者应预期平均每小时就有一块硬盘失效。不过,如图 6.1 所示,软件失效远多于硬件失效。因此,系统设计必须能够承受软件缺陷导致的服务器崩溃,这甚至比磁盘失效还频繁。在拥有数万台服务器的大型设施中,WSC 运维人员会非常熟练地更换硬盘,所以磁盘失效对 WSC 造成的成本远低于小型数据中心。DRAM 也是如此。如果能买到价格更低、可靠性再差一些的组件,WSC 甚至可能合理地使用它们。
例题
计算运行在图 6.1 所示 2400 台服务器上的一个服务的可用性。与真实 WSC 中的服务不同,本例的服务不能容忍硬件或软件失效。假设重启软件需要 5 分钟,修复硬件需要 1 小时。
解答
可以计算各类组件失效导致的停机时间,来估计服务可用性。保守地取图 6.1 每一类的最低次数,并把其中 1000 次停机平均分给四类组件。我们忽略速度变慢的磁盘——它们是这 1000 次停机中的第五类——因为它们损害性能,却不影响可用性。也忽略公共电网故障,因为不间断电源(UPS)系统掩盖了其中 99% 的故障。
一年有 小时,因此可用性为:
如果不使用软件冗余来掩盖这些大量中断,这 2400 台服务器上的服务平均每周就会停机一天,一个“九”也达不到,远低于 WSC 追求的 99.99% 可用性。
计算机集群是 WSC 的前身。集群由独立计算机构成,用局域网(LAN)和交换机连接。20 世纪 90 年代末,集群先在科学计算中流行起来,随后进入互联网服务领域,因为对于不需要密集通信的工作负载,它们比共享内存多处理器更具成本效益。共享内存多处理器则是第 5 章介绍的多核计算机的前身。因此,一种看法是,WSC 不过是由数百台服务器组成的集群,顺理成章地演进为数万台服务器。
不过,传统集群的运营者一般从组织的多个部门收集机器和第三方软件,集中运行。他们主要关注把众多服务整合到较少机器上,并将服务相互隔离,以保护敏感信息。因此,为了服务组织内部不同客户,容纳这些集群的设施往往具有很强的硬件和软件异构性。WSC 设计者则会定制第三方软件,或开发自己的软件,硬件也同质得多。总体而言,WSC 的目标是让仓库中的软硬件像一台计算机那样工作,通常运行多种应用。传统集群的最大成本往往是维护人员;设计良好的 WSC 中,服务器硬件是最大成本,人员成本则从最高项降到最低项。集群通常也没有 WSC 的规模,因此无法获得前面所说的规模经济。
WSC 在规模和成本上也类似高性能计算系统:有些 HPC 系统拥有一百万个处理器,造价数亿美元。HPC 系统历来采用同质体系结构,其处理器更强,节点间网络延迟也远低于 WSC,因为 HPC 应用的相互依赖更强,通信更频繁。HPC 系统针对少数长期运行的任务进行优化,让服务器保持满负载,甚至一次持续数周。WSC 则旨在支持各种工作负载,包括许多负载变化的交互式服务。WSC 的服务器利用率在 10%–80% 之间,每天都会随时间变化。WSC 的硬件异构性更高,因为它们逐步填充硬件,并引入多代设备,以更好地服务不同工作负载。分布式存储是 WSC 体系结构的重要组成部分,因为 WSC 工作负载比科学计算更加密集地使用存储与 I/O。HPC 系统常用的检查点和恢复等容错技术,对许多 WSC 工作负载并不实用。不过,近来 WSC 引入机器学习领域专用加速器(DSA),以及支持在数百到数千个加速器之间执行长时间训练任务的网络,使 WSC 与 HPC 体系结构日益接近。较新 WSC 的很大一部分,就是为容纳机器学习超级计算机而设计的。
6.2 云计算:效用计算的回归
如果我所倡导的这种计算机成为未来的计算机,那么,计算或许有一天也能像电话系统一样,组织成一项公共服务……计算服务可能成为一个重要新产业的基础。
——John McCarthy,MIT 百年校庆(1961)
效用计算(utility computing,即按使用量付费的计算服务)可以追溯到 20 世纪 60、70 年代的商业分时系统,甚至批处理系统。当时,企业只需支付终端与电话线路的费用,再按实际使用的计算量付费。分时计算时代结束以后,人们多次尝试提供这种按使用量付费的服务,却往往以失败告终。推动云计算——效用计算在现代的成功形式——的变化,是互联网服务自 2000 年代以来的极度普及。人们主要通过广泛使用的瘦客户端访问商业、娱乐或教育在线服务:在个人计算机上使用浏览器应用,在智能手机上使用提供交互界面的应用。互联网服务的应用逻辑和数据管理运行在后端服务器上;这些服务器必须具有高可用性、足够快的速度和可扩展性,才能满足服务不断变化的要求。云计算让各种类型、各种规模的互联网服务提供商,都能为其服务后端租用当时所需的资源。云提供商在多个地理区域维护多座 WSC,为客户提供支持。
云计算为用户带来显著优势:
- 进入门槛低。 任何持有信用卡的人,都能启动一个有几个核心的小型虚拟机,在几秒钟内开始使用,每小时只需几美分,而且不必作出长期承诺。相比之下,视已有条件而定,为自有后端采购计算、存储和网络设备可能需要数周,花费数千美元,还需要签订场地与运维支持的长期合同。
- 按使用量付费,随规模调整。 云用户可以迅速增加或减少所用虚拟机的数量,改变其类型,以紧密适应服务的负载与性质。在大多数云模式中,用户按所用资源付费,计费粒度可细至秒。相比之下,随着负载变化,自有后端总会面临配置过大(过于昂贵)或配置过小(资源不足)的问题。按使用量付费对初创企业尤其重要,因为它们的产品可能一夜之间走红。能够使用更多资源,为不断扩大的客户群提供良好服务质量,而无需巨额前期 IT 支出,会从根本上改变其商业模式。
- 运维成本低。 场地租金、保险和运维人员工资等运行成本,是自有基础设施总成本的重要组成部分。即使只有 10 台服务器,服务提供商仍须雇用一位在安全、网络、软件配置和可靠性方面具有充分专业知识的计算机管理员,才能运营服务。云计算显著降低了运维成本。云提供商负责基础网络、安全与可靠性等许多运维工作;成本由数千个用户与数千台服务器共同分摊,并通过本章后面将讨论的自动化与协同设计进一步降低。
- 可靠性与安全性更好。 除了成本较低,大多数云用户还享有显著改善的可靠性与安全性。小型服务供应商不具备、或者负担不起可靠且安全地运营自有基础设施所需的专业能力。云提供商具备这些能力,提供的安全与可靠性功能,有些内置于基础服务中,例如自动恢复并重启失效的 VM;另一些按使用量付费,例如为灾难恢复进行自动复制。不过,云基础设施的共享性质也带来了新的安全挑战,云提供商必须加以应对。
- 使用最新技术。 云提供商有动力迅速采购并部署最新的硬件或软件技术,以提高效率,或取得相对于竞争对手的优势。由于规模大,云提供商往往能优先获得最新芯片等新技术。它们也会自行开发一些最新的软硬件技术。即使只运行几个虚拟机,云用户也能受益于这些新技术。
云提供商能够获利,原因如下:
- 规模经济。 AWS、Microsoft Azure、Google Cloud Platform、Alibaba Cloud 和 Tencent Cloud 等大型云提供商,在所有地点合计运营着数百万台服务器,因此可以从多个方面受益于规模经济。例如,购买芯片等组件时,可以获得可观的批量折扣。对于优化供应链、新型自动化工具、适合自身场景的定制芯片、新型分布式系统,或能长期降低资本支出与运行支出的 WSC 协同设计,其研发成本也很容易摊销。
- 协同设计带来的效率。 正如本章将看到的,WSC 的各个方面,包括芯片、系统、软件、冷却和供电,都经过协同设计,从而显著改善各种效率指标,例如降低功耗或云管理开销。
- 通过复用提高利用率。 云提供商将多个用户和工作负载复用到基础设施上,取得远高于任一用户单独使用时所能达到的利用率。这使其能更好地摊销占总成本主要部分的资本支出,例如计算、存储和网络硬件的购置成本。本章后面将讨论在 WSC 中复用工作负载所面临的一些挑战,以及云提供商开发的一些解决方案。
- 更高层次的服务。 云平台最初出租的是服务器的一部分或多台服务器所提供的原始计算能力。随着时间推移,云提供商开始提供众多更高层次的服务,例如数据库即服务、ML 即服务,以及跨地理区域分布的内容分发网络(CDN)。这些高层服务的价格明显高于其消耗的原始计算周期成本,因为它们减少了客户必须自行部署和运维的软件数量。
云提供商运营 IT 基础设施的成本,远低于客户自行运营的成本,因此既能为客户节省开支,也能取得可观利润。Hamilton(2010)援引一项 2006 年的研究,将 WSC 与只有 1000 台服务器的传统 IT 数据中心比较,报告了以下优势:
- 存储成本降至原来的约 。 当时,WSC 磁盘存储每 GB 每年的成本为 $4.6,传统数据中心为 $26。
- 管理成本降至原来的约 。 WSC 中每位管理员管理超过 1000 台服务器,传统数据中心只有 140 台。
- 网络成本降至原来的约 。 当时,WSC 的互联网带宽成本为每 Mbit/s 每月 $13,传统数据中心为 $95。不难理解,订购 1000 Mbit/s 的带宽,比订购 10 Mbit/s 更容易谈到低得多的每 Mbit/s 价格。
云计算让所有人都能享受到 WSC 的优势。它使成本具有可组合性,并在不增加用户额外成本的情况下,营造出能够无限扩展的效果:使用 1000 台服务器 1 小时,费用不会高于使用 1 台服务器 1000 小时。确保有足够的服务器、存储和互联网带宽来满足需求,是云提供商的责任。前述优化后的供应链能够把新计算机的交付时间缩短到一周,对于在不使提供商破产的前提下提供这种效果,大有帮助。风险转移、成本可组合性、按使用量计价,以及更好的可靠性与安全性,共同构成了强有力的理由,使不同规模的企业选择云计算,而非自有的本地部署系统。
如今,云计算已取得极大成功,而且越来越普及。据估计,2021 年全球最终用户在公有云上的支出超过 4000 亿美元(Gartner,2022)。预计未来几年增长率将接近 20%,因此到 2025 年,云服务支出预计将超过传统 IT 支出。换句话说,云计算已经是,而且很可能继续是,推动计算机体系结构发展的主要力量。
云计算模式
图 6.2 展示了云计算服务的三种主要模式。这些模式的区别在于:哪些基础设施组件由云提供商管理,哪些仍由云用户管理。
图内术语:Traditional IT=传统 IT;Data=数据;Application Logic=应用逻辑;Runtime=运行时;Middleware=中间件;Operating System=操作系统;Virtualization=虚拟化;Storage=存储;Compute=计算;Networking=网络;Cloud service=云服务;Managed by user=用户管理;Managed by cloud provider=云提供商管理。PaaS/FaaS 中运行时层的斜纹表示这一层的管理责任因具体服务而异。
- 基础设施即服务(Infrastructure as a Service,IaaS)。 云提供商向用户提供虚拟化的计算、存储和网络资源。这些资源的规模可灵活调整,例如虚拟机可以有 1–256 个核心、0.5–1024 GB 内存;它们在功能上等价于物理硬件资源,但实际是利用 6.3 节将讨论的虚拟化技术,划分物理硬件来实现的。用户在这套虚拟硬件之上启动自己选择的软件栈,包括操作系统、一个或多个中间件与运行时框架,以及一个或多个应用。计算资源按规模和使用时间计费;存储资源按容量和预配置的吞吐量计费。网络带宽通常与计算资源规模相关:更大的虚拟机配置更多网络带宽。
- 平台即服务(Platform as a Service,PaaS)。 云提供商管理操作系统、中间件的所有方面,而且通常还管理运行用户代码的运行时框架。例如,AWS 的 Elastic MapReduce 服务管理 Hadoop 集群,用户可在其上编写分布式分析作业。AWS 的 Elastic Kubernetes Service 管理运行 Kubernetes 编排框架的集群,让用户运行容器化应用。PaaS 的计价方式与 IaaS 相似,按虚拟机的使用时间和规模计费,再加上管理额外软件组件的溢价。
- 函数即服务(Function as a Service,FaaS)。 这一模式通常称为无服务器计算(Serverless Computing)。它与 PaaS 相似,云提供商管理操作系统和应用运行时,例如容器执行框架或托管语言的运行时系统。在 PaaS 中,用户代码作为长期运行的服务执行,能够接收并处理多个外部请求;在 FaaS 中,用户代码在短生命周期的函数中执行,函数因单个外部事件或一小批事件而启动。FaaS 让用户能够迅速把云资源使用规模从零扩大到数千个实例,从而随着应用负载变化优化成本与性能。因此,对于负载变化很大的应用,例如物联网(IoT)应用与交互式分析负载,FaaS 尤其有吸引力。
- 软件即服务(Software as a Service,SaaS)。 提供商提供一个完整应用,用户通过客户端设备访问。提供商管理应用的各个方面,包括核心逻辑和所处理的用户数据。许多云客户利用 IaaS 与 PaaS 资源运行应用,再以 SaaS 的形式提供给消费者或企业客户。云提供商自身也提供一些 SaaS 服务,例如电子邮件和基于云的办公套件。价格依据用户数量、数据量,以及其他与具体应用有关的功能和指标确定。
IaaS 是最早的云模式,后来逐渐增加了许多简化虚拟机管理的功能。例如,提供商会整理维护流行操作系统稳定版本的镜像,以减轻操作系统安装与更新的负担;用户可以在虚拟机上自动启动这些镜像。云提供商的基础设施会跟踪机器级或应用级指标,据此自动增加(向外扩展,scale out)或减少(向内收缩,scale in)分布式应用所用的虚拟机数量。用户可以配置可靠性选项,例如定期保存虚拟机状态快照,以及采用主备或双活复制来进行故障恢复。最后,为提高容错能力,用户可以将虚拟机配置为分散在不同机架、独立集群或多个地理区域。这些功能也适用于 PaaS 模式。
云安全是重要问题,因为在所有这些模式中,物理机器都可能由多个用户共享。云安全的基石是硬件辅助虚拟化技术,它为并发运行的虚拟机提供内存隔离(见 6.3 节)。网络虚拟化也得到网络接口芯片的硬件支持(见 6.5 节),使云提供商和用户能够有选择地开放 WSC 内部或经互联网建立的网络连接。存储服务提供静态数据加密和传输中数据加密。在最新硬件支持的实例上,内存中的数据也会加密。云提供商监控其管理的软件,并在必要时更新软件以修复安全漏洞。最后,云提供商还提供身份管理服务,让企业客户能够对其员工或客户进行身份验证与授权,实现访问控制。
不过,有些使用场景对云环境中多租户带来的安全风险尤其敏感,例如处理金融或医疗数据的应用。微体系结构侧信道攻击可能绕过内存隔离机制,这类攻击的发现也引发了新的安全忧虑。云提供商目前提供两种缓解方案。第一种是利用 Intel SGX 和 Arm TrustZone 等硬件 enclave,提供可信执行环境(TEE)。硬件 enclave 对部分内存加密,并保护允许处理加密数据的函数的进入与退出过程。其本质是再增加一层保护:即使攻击者绕过了操作系统与虚拟化所提供的内存隔离机制,或者云提供商中不守规矩的员工能够探测共享机器的内存总线,也仍有这一层防护。enclave 越来越多地被用于实现 TEE 和更高层次的机密计算框架。这项技术正快速演进,以满足新需求、降低开销、扩大适用范围,并回应微体系结构攻击也可能绕过 enclave 保护的担忧。
第二种方案是裸金属云模式,让用户直接访问云 WSC 中的一整台物理机器。这台机器不与其他用户共享,也不运行虚拟化软件栈。云提供商只管理网络,以保护裸金属机器免受其他云用户的侵害,同时保护其他用户不受这台机器的侵害。网络隔离通常由网络交换机实现,或者在裸金属机器与数据中心网络之间串接额外设备(bump-in-the-wire)。裸金属模式也让专业用户能够进一步细致调整机器上软件栈的各个方面,而不用担心虚拟化开销。
无论云客户使用 PaaS 容器、FaaS 函数,还是在 IaaS 虚拟机或裸金属机器上运行自己选择的软件栈,都可以读写云提供商管理的分布式存储服务中的数据。这些服务采用各种接口——块、文件系统或键值存储——针对不同速度进行优化并定价,例如基于 Flash、基于磁盘,或者面向归档优化的服务。计算与存储分离是云计算的一项基本理念。它让云用户能够方便地扩展计算资源,在可用的云模式之间灵活切换,并改变应用的组织方式;与此同时,数据接口保持稳定,并在逻辑上与计算分开。
进一步了解 IaaS 云服务
IaaS 是其他所有云模式与服务的基础。它依靠虚拟化技术划分一台物理机器,并在其上运行多个虚拟机实例。云提供商从不同配置的物理机器出发,创建种类与规模繁多的 IaaS 实例。图 6.3 列出了 AWS EC2 服务中若干实例类型的主要特征;这一 IaaS 服务于 2006 年首次推出。EC2 的实例类型与规模组合超过 600 种,图中展示其中 19 种,涵盖文中所称的四类实例:面向多种负载的通用实例;面向游戏、媒体转码等计算密集型负载的计算优化实例;面向高性能数据库的内存优化实例;面向分布式文件系统和 MapReduce 等负载的存储优化实例;以及提供 GPU、FPGA 和 ML 加速器等设备的加速计算实例。通过选择合适的实例系列、类型与规模,用户能够使虚拟基础设施的性能和成本恰好适应应用需求。
译注: 原文称“四类”(four families),随后列举且图 6.3 展示的是五类。
IaaS 实例可按四种方式购买:
- 按需实例。 用户可启动实例,并按使用秒数付费。
- 预留实例与节省计划。 相比按需实例,这些方式有显著折扣,但要求对单个实例或一组实例作出长期使用承诺。
- Spot 实例。 用户可以很低的折扣价租用当前尚未分配的计算能力。不过,如果其他类型的实例需要这些资源,Spot 实例可能被抢占。
- 专属宿主机与专属实例。 这些选项使用户能够确保自己的实例运行在不与其他用户共享的硬件上。
用户可以为长期运行的工作负载选择预留实例,为不规律的负载选择按需或 Spot 实例。
| 类别 | 实例 | vCPU 数 | 内存(GiB) | 存储(GB) | 网络(Gbps) | EBS(Gbps) | 加速器 | 每小时费用 |
|---|---|---|---|---|---|---|---|---|
| 通用 | t4g.nano | 2 | 0.5 | 仅 EBS | ≤5 | ≤2.1 | — | $0.0042 |
| 通用 | t4g.large | 2 | 8 | 仅 EBS | ≤5 | ≤2.7 | — | $0.0672 |
| 通用 | m6i.8xlarge | 32 | 128 | 仅 EBS | 12.5 | 10 | — | $1.5360 |
| 通用 | m6id.8xlarge | 32 | 128 | 1 × 1900 NVMe SSD | 12.5 | 10 | — | $1.8984 |
| 通用 | m6id.32xlarge | 128 | 512 | 4 × 1900 NVMe SSD | 50 | 50 | — | $7.5936 |
| 通用 | m6id.metal | 128 | 512 | 4 × 1900 NVMe SSD | 50 | 40 | — | $7.5936 |
| 计算优化 | c6in.8xlarge | 32 | 64 | 仅 EBS | 50 | 20 | — | $1.8144 |
| 计算优化 | c6in.32xlarge | 128 | 256 | 仅 EBS | 200 | 80 | — | $7.2576 |
| 内存优化 | r6i.large | 2 | 16 | 仅 EBS | ≤12.5 | ≤10 | — | $0.1260 |
| 内存优化 | r6i.32xlarge | 128 | 1024 | 仅 EBS | 50 | 40 | — | $8.0640 |
| 内存优化 | r6i.metal | 128 | 1024 | 仅 EBS | 50 | 40 | — | $8.0640 |
| 存储优化 | h1.16xlarge | 64 | 256 | 8 × 2000 HDD | 25 | — | — | $3.7440 |
| 存储优化 | im4gn.large | 2 | 8 | 1 × 937 Nitro SSD | ≤25 | ≤9.5 | — | $0.1819 |
| 存储优化 | im4gn.16xlarge | 64 | 256 | 4 × 7500 Nitro SSD | 100 | 38 | — | $5.8206 |
| 加速计算 | p4de.24xlarge | 96 | 1152 | 8 × 1000 NVMe SSD | 400 | 19 | 8 × A100 GPU;320 GB HBM2;600 GB/s NVSwitch | $40.9657 |
| 加速计算 | trn1.32xlarge | 128 | 512 | 4 × 2000 NVMe SSD | 8 × 100 | 80 | 16 × Trainium 芯片;512 GB HBM2 | $21.5000 |
| 加速计算 | inf1.xlarge | 4 | 8 | 仅 EBS | ≤25 | ≤4.75 | 1 × Inferentia 芯片 | $0.0280 |
| 加速计算 | inf1.24xlarge | 16 | 96 | 仅 EBS | 25 | 4.75 | 16 × Inferentia 芯片,具有直接互连 | $4.7210 |
| 加速计算 | f1.16xlarge | 64 | 976 | 4 × 940 NVMe SSD | 25 | 14 | 8 × Xilinx VU9p FPGA | $13.2000 |
AWS 提供多种与 EC2 实例解耦的持久化存储选项。AWS S3 是一个简单的对象存储,为 WSC 内部及互联网范围内的各种负载实现具有最终一致性的分布式存储。它提供多个数据层级:面向活跃访问数据的 standard,面向低频访问数据的 infrequent,面向可能需要快速恢复的备份数据的 glacier,以及面向数字保存数据的 glacier deep archive。每个层级都代表存储系统在性能与成本权衡中的一个不同设计点。AWS Elastic Block Storage(EBS)以固态硬盘(SSD 层级)或机械硬盘(HDD 层级)实现高性能分布式块存储。AWS Elastic File Storage(EFS)支持类似 NFS 的完整文件系统语义,完全由 AWS 管理,其存储容量具有弹性,会随着文件的创建或删除自动增减。最后,AWS FSx 是一个 HPC 文件系统,支持 Lustre、ZFS、ONTAP 与 Windows File Server 的文件系统接口。持久化存储按容量、预配置吞吐量与突发吞吐量计费。
云计算指标与 WSC 体系结构的驱动因素
在 6.7 节分析 WSC 效率之前,值得先了解几个直接影响 WSC 优化方式的云计算关键业务指标。
只要提供商能够持续以低于客户愿付价格的成本建设并运营共享基础设施,效用计算就是可行的业务。这使总拥有成本(TCO)成为 WSC 的首要指标。TCO 既包括购买建筑物与服务器等一次性的资本支出,也包括电费、员工工资等经常性运行支出。其次,共享基础设施的收入与高利用率直接相关。因此,WSC 的硬件与软件必须能够缓解把工作负载密集安排在共享服务器上所带来的问题,例如安全隔离和性能隔离问题。
体系结构还需要足够灵活,以便迅速部署新的软硬件组件。例如,一种新的 ML 加速器芯片,可能使客户工作负载的性价比达到原来的 10 倍。若能在芯片发布后的数周内、而非数月之后,将它集成到云基础设施中,就能显著影响云提供商的利润与客户的收益。客户也期望云服务具有很高的可靠性与可用性。这一要求推动了云体系结构的若干关键设计:分布于多个地理地点;每个地点有多座相互独立的 WSC;每座 WSC 内采用分布式体系结构;计算与存储分离。它还意味着,云硬件与软件偶尔进行的维护,对云用户而言应基本透明。有些客户工作负载是分布式应用,可以应对偶发的实例失效;但也有很多是依赖单台机器高可靠性的传统企业应用。云提供商追求软件的无中断升级(hitless upgrade),使客户实例在提供商更新管理 WSC 中虚拟机、交换机或存储的软件时,仍能持续运行。
本节主要讨论托管客户工作负载的公有云平台,例如 Amazon、Microsoft、Google、Alibaba、Oracle 和 Tencent 所运营的平台。也有少数计算需求庞大的公司,建设并运营私有云,为自身工作负载与互联网服务提供支持。例如,Google 在 2000 年代率先开发了许多 WSC 软硬件技术,以支持运行网页搜索、在线地图、YouTube 和广告投放等大规模工作负载的私有云。Meta 也运营着一个大型私有云,支撑 Facebook 和 Instagram 等社交网络服务。对全部工作负载实行严格控制,可以让公司简化云平台的某些方面。例如,如果所有工作负载都按分布式方式设计,支持单台服务器无中断升级的重要性就会降低。进程级和容器级隔离已足以满足安全要求,从而不再需要虚拟机。类似地,如果所有程序都使用同一个远程过程调用(RPC)库,就可以在这个库中实现原本需要网络虚拟化才能提供的安全功能。不过,私有云与公有云的 WSC 已足够相似,尤其在硬件体系结构方面,因此本章后续不再区分二者。
6.3 虚拟化的硬件支持
虚拟机被视为真实机器的一个高效、隔离的副本。我们通过虚拟机监控器(VMM)这一概念来解释这些含义。VMM 有三个基本特征。第一,VMM 为程序提供的环境与原机器基本相同;第二,程序在这一环境中运行时,最坏也只会有轻微的速度下降;最后,VMM 完全控制系统资源。
——Gerald Popek 与 Robert Goldberg,“Formal requirements for virtualizable third generation architectures”,Communications of the ACM(1974 年 7 月)
虚拟化技术最早开发于 20 世纪 60 年代末,此后一直是大型机计算的重要组成部分。虽然在 80、90 年代的单用户计算机和服务器领域大体受到忽视,虚拟化却在 2000 年代重新流行起来。最初的成功在于,让开发者能够在单台机器上运行多个操作系统,例如多个不同版本的 Windows,从而在不同场景下测试应用代码,而无需购买多台物理机器。很快,重点转向企业机房中的机器整合,目的或是提高利用率,或是让旧软件栈运行在其并不直接支持的新硬件上。这些企业使用场景启发了 WSC 规模效用计算的复兴,而虚拟化正是实现云计算的核心技术。
虚拟化通过增加硬件层或软件层,为被虚拟化的底层资源创建一个或多个虚拟副本。从一台物理机器出发,虚拟化能够创建多个虚拟机(VM),其呈现的指令集与底层硬件相同。这类 VM 称为**(操作)系统虚拟机**,IBM VM/370、VMware ESX Server 和 Xen 都是例子。如果对“机器”采用不同定义,还可以构建其他类型的 VM。例如,Java VM 和 JavaScript 引擎等基于语言的虚拟机,把用户级应用二进制接口(ABI)定义为机器。我们只讨论系统 VM:它使用户感觉自己独占整台计算机,可以运行包括操作系统在内的自有软件栈。一台计算机运行多个 VM,可以支持多种不同的操作系统。没有虚拟化时,一个操作系统拥有全部硬件资源;有了虚拟化,多个操作系统共同分享这些资源。
管理 VM 的软件层称为虚拟机监控器(virtual machine monitor,VMM),也称 hypervisor。被虚拟化的底层硬件平台,即物理机器,称为宿主机(host),其资源由多个客户虚拟机(guest VM)共享。hypervisor 类似于操作系统的底层部分,负责管理物理资源到虚拟资源的映射。它结合三项关键技术来管理资源:分时、分区和模拟。例如,CPU 核心可以由多个 VM 分时使用,类似操作系统让多个进程分时使用一个核心。对于多核芯片,还可以把核心划分给不同 VM。物理内存也进行分区,使每个 VM 在任一时刻只能访问其中的一部分页面。I/O 硬件则经常采用模拟:VM 的 I/O 调用经过 hypervisor,由后者访问 I/O 设备,再将结果返回 VM。hypervisor 中负责核心隔离的部分大约只需 10,000 行代码。它比传统操作系统小得多,因为不包含图形与用户界面、高层 API 和库等上层功能。后文将说明,如今所有主流指令集体系结构(ISA)都为 hypervisor 提供了大量硬件支持。而且,云提供商正逐步把 hypervisor 软件卸载到 SmartNIC 等专用硬件,为客户 VM 腾出宿主 CPU 核心的计算周期。
虚拟化提供的一些功能,从根本上改变了效用计算:
- 聚合。 虚拟化让具有不同软件栈的多个 VM 共享一台宿主机。因此,云提供商可以部署 TCO 最优的物理机器——通常是具有许多核心的大型服务器——再在每台机器上聚合多个大小不同的客户 VM。
- 更好的容错、恢复与维护。 虚拟化用运行在云服务器上的 VM,替代客户自有的物理机器。VM 把机器及其软件栈的全部状态封装为一组比特;这些比特可以操作,也可以迁移。例如,云提供商可以定期把 VM 状态保存到持久化存储,提供用于故障恢复的 VM 快照;还可以把状态从一台宿主机复制到另一台,即 VM 实时迁移,以便对原宿主机进行无中断维护,或支持主备容错。
- 更好的调度。 客户 VM 可以在宿主机之间迁移,因此云提供商能够不时尝试把运行中的 VM 集中到数量较少、利用率较高的宿主机上。腾出的宿主机可以进入低功耗状态以节能,也可以留给那些独占宿主机或使用相邻宿主机时效果最佳的大型工作负载。云提供商还可以通过迁移 VM,更好地均衡 WSC 网络与存储系统的负载,或将受到性能干扰的 VM 分开。
- 软件灵活性与隔离。 VM 提供的抽象能够运行完整软件栈,包括 DOS 等旧操作系统,或定制操作系统。典型部署可能有一些 VM 运行遗留操作系统,许多 VM 运行当前稳定版本,还有少量 VM 测试下一版本。所有这些软件栈可以共存,而不会使 WSC 运维复杂化。一个 VM 的崩溃、软件缺陷或安全事件,与同一宿主机上其他 VM 相隔离。
什么样的体系结构能够虚拟化?
hypervisor 在虚拟化底层硬件时,必须满足三个条件:安全性、等价性和效率。安全性要求 hypervisor 与客户 VM 隔离,客户 VM 彼此也隔离。客户 VM 不应能直接改变物理资源分配。等价性要求,运行在客户 VM 上的软件,其行为应与直接运行在原生硬件上完全相同。任何计算的输出及其副作用都应一致;例外是性能依赖或资源可用性差异引起的不同,例如分配给各 VM 的物理内存数量不同。效率则要求,客户 VM 上的软件性能应尽可能接近原生硬件。固定硬件资源被多个 VM 共享或分割时受到的限制,以及资源复用或模拟的开销,都可能降低性能。
先来看硬件如何支持安全性与等价性。为了虚拟化处理器,hypervisor 必须控制几乎所有方面——特权状态访问、地址转换、I/O、异常和中断——即使正在运行的客户 VM 暂时使用这些资源来执行操作系统代码或用户代码。例如,发生定时器中断时,hypervisor 必须挂起当前客户 VM,保存其状态,处理中断,决定接下来运行哪个 VM,再加载其状态。依赖定时器中断的客户 VM,会获得 hypervisor 提供的可编程虚拟定时器和模拟的定时器中断。为了掌握控制权,hypervisor 的特权级必须高于任何 VM 内的用户代码与操作系统代码,并能截获客户 VM 对核心、内存或中断等物理硬件资源的操作。
1974 年,Gerald Popek 和 Robert Goldberg 形式化地定义了 ISA 及其各种实现能够被虚拟化的要求(Popek 与 Goldberg,1974)。他们著名的定理指出,满足以下条件便可构建 hypervisor:
- ISA 至少定义两种处理器模式:系统模式和用户模式;
- 能够观察或更新系统状态的敏感指令集合,是只能在系统模式下使用的特权指令集合的子集。
系统状态包括反映或管理处理器状态、中断、虚拟内存(MMU)、安全性和资源分配等功能的全部配置寄存器与内存结构。如果所有能够观察或更新这类状态的指令,在用户模式执行时都会产生异常,使处理器进入系统模式,那么独自在系统模式运行的 hypervisor 就完全控制了系统。如果客户 VM 中的代码,例如操作系统,尝试执行任何敏感指令,hypervisor 都有机会介入,并按需管理或虚拟化物理资源。
20 世纪 90 年代末,虚拟化重新开始流行时,x86 ISA 并不满足 Popek 和 Goldberg 定理的要求。具体而言,有 17 条指令是敏感指令,却不是特权指令(Robin 与 Irvine,2000)。例如,push 指令允许在 ring 1 或 ring 3——x86 中供用户代码使用的两种模式——运行的客户操作系统,观察 %cs 寄存器的值;该寄存器除了其他信息,还描述当前处理器模式。因此,客户操作系统可以发现自己并没有运行在内核模式,即 x86 ring 0。尽管如此,早期 hypervisor 仍通过两种方法实现了 x86 虚拟化。VMware Workstation 依靠动态二进制翻译(DBT),运行操作系统未经修改的客户 VM。hypervisor 为 VM 加载代码页时,会扫描有问题的指令,并将其替换为等价、安全且性能良好的代码序列(Bugnion 等,2012)。Xen Hypervisor 则采用半虚拟化(paravirtualization):修改客户操作系统,消除有问题的指令,并使其高效地与底层 hypervisor 交互(Barham 等,2003)。虽然下面讨论的硬件支持使 x86 体系结构符合了 Popek 和 Goldberg 定理,DBT 与半虚拟化仍可用于解决虚拟化环境中的性能问题。
体系结构对虚拟化的支持
体系结构增加虚拟化支持,有三个动因。首先,体系结构设计者希望确保所有敏感指令都是特权指令,消除 hypervisor 对 DBT 和半虚拟化的需要。其次,在只有用户与系统两种模式的系统中,hypervisor 必须运行在系统模式。这会造成所谓的模式压缩(在 x86 中称为环压缩,ring compression):客户操作系统和应用不得不共享用户模式,从而削弱二者之间的隔离。最后,模式压缩还会降低性能,因为未经修改的操作系统倾向于频繁通过敏感指令访问系统状态,导致客户 VM 与 hypervisor 之间过多地切换。如今,所有主要指令集都提供虚拟化的体系结构支持。下面简要介绍 x86 的做法,并指出 Arm 和 RISC-V 的主要差异。
x86 ISA 的 VT-x 扩展为 hypervisor 定义了新的 root 模式,与现有的 x86 模式正交,从而解决这些问题,如图 6.4 所示。客户 VM 在 nonroot 模式运行,其中操作系统使用 ring 0,即 x86 系统模式;用户应用使用 ring 3,即 x86 用户模式。新增的正交模式消除了模式压缩,同时不改变现有操作系统所看到的硬件。VT-x 还把虚拟机的全部状态封装在物理内存中的一个结构里,称为虚拟机控制结构(virtual machine control structure,VMCS)。VMCS 包含 nonroot、ring 0 模式下操作系统可用的全部配置寄存器。它使 hypervisor 能够操作 VM 状态——保存、恢复、读取和写入——并调度 VM 执行,方式类似于操作系统管理用户进程及其状态。
hypervisor 准备启动或恢复 VMCS 描述的虚拟机时,使用 vmlaunch 或 vmresume 指令。这些指令以原子方式把 VMCS 的内容从内存复制到处理器寄存器,再把处理器切换到 nonroot 模式。VM 开始执行,按需在其操作系统(ring 0)与应用(ring 3)之间切换。大多数情况下,操作系统可以通过 x86 特权指令读写自身的配置寄存器,而不把控制权交给 hypervisor。发生以下 vmexit 事件时,处理器会切换到 root 模式,并调用 hypervisor:
- VM 代码尝试访问 root 模式的敏感状态,例如读取 CPU 的型号专用寄存器,或执行 root 模式特权指令,例如
vmlaunch; - 处理器收到外部中断,或者收到 VM 无法处理的中断,例如复位条件;
- VM 使用
vmcall指令调用 hypervisor。
图内术语:Guest OS=客户操作系统;Guest apps=客户应用;Host apps=宿主应用;Hypervisor or host OS=hypervisor 或宿主操作系统;VMentry=进入 VM;VMexit=退出 VM。
vmcall 指令相当于用户进程用来调用操作系统的 syscall 指令。
VT-x 扩展满足 Popek 和 Goldberg 定理的安全性与等价性要求,虽然实现方式并非直接对应。所有能够观察或修改 root 模式状态的指令,都是 root 模式特权指令,会引发 vmexit。不过,许多操作 nonroot 模式敏感状态的指令能够执行,而不会引发 vmexit,因为硬件保证它们只操作该 VM 独有的状态副本。这样可以减少 hypervisor 与客户 VM 之间的切换,提高性能。
与 VT-x 类似,RISC-V ISA 的 H 扩展为 hypervisor 定义了 H 模式,它与 S(系统)和 U(用户)模式正交。Arm ISA 通过新增的 EL2 执行模式支持虚拟化;其特权严格高于 Arm 的用户模式 EL0 和系统模式 EL1,但并不与二者正交。Arm 还有 TrustZone 安全扩展定义的 EL3 模式。EL3 与其他所有模式正交,允许安全监控器将系统资源划分给可信与非可信执行环境。TrustZone 系统的可信一侧,可以用于实现纯软件的可信平台模块(TPM)。
内存虚拟化
内存的虚拟化方式,对 hypervisor 和虚拟机的安全性与性能至关重要。在讨论其实现之前,先定义几个术语,以区分并理解第 2 章所述虚拟内存与 VM 内存虚拟化之间的相互作用。系统中实际存在的半导体内存,通常由 DRAM 芯片组成,称为宿主物理内存(host physical memory,HPM)。hypervisor 将 HPM 的不同部分分配给不同 VM,并确保除非明确许可,VM 不能读写其他 VM 的内存。每个 VM 中的客户操作系统管理客户物理内存(guest physical memory,GPM)。GPM 是线性地址空间;客户操作系统无法知道 hypervisor 如何利用 HPM 的部分区域来支撑 GPM。GPM 中不常用的部分,也可能通过分页暂时存放到辅助存储。最后,VM 中每个进程都有自己的客户虚拟内存(guest virtual memory,GVM)地址空间,由客户操作系统管理,并在 GPM 之上实现。因此,虚拟化系统只有一个 HPM 地址空间;每个 VM 有一个 GPM;每个 VM 内的每个客户进程各有一个 GVM。
ISA 尚未支持虚拟化时,hypervisor 通过影子页表为未经修改的客户系统管理内存。进程的页表由客户操作系统管理,将 GVM 映射到 GPM。hypervisor 截获操作系统的所有内存管理操作,例如 MMU 与 TLB 管理指令,并构建将 GVM 映射到 HPM 的影子页表。影子页表用于重新填充 TLB,在程序执行时,为加载与存储指令访问的 GVM 地址提供转换。管理影子页表时,hypervisor 决定每个 VM 能使用多少内存,以及某个 GVM 页面由 HPM 页面还是辅助存储提供后备空间。影子页表依靠 DBT 或半虚拟化截获操作系统的全部内存管理事件,并减少调用 hypervisor 的次数。影子分页很可能是 hypervisor 中最复杂的组成部分。
x86 的 VT-x 扩展为扩展页表(extended page table,EPT)定义了硬件支持,从而不再需要软件影子页表。扩展后的 MMU 与 TLB 指令和逻辑,既能识别操作系统管理的 GVM→GPM 页表,也能识别 hypervisor 管理的 GPM→HPM 页表。执行加载或存储指令时,硬件利用 TLB 快速将 GVM 地址转换为 HPM 地址。若 TLB 未命中,硬件页表遍历器会使用 GVM/GPM 与 GPM/HPM 两套页表,找出正确转换并重新填充 TLB,通常无需调用客户操作系统或 hypervisor。GVM/GPM 转换中发生缺页时,调用客户操作系统;GPM/HPM 转换中发生缺页时,则调用 hypervisor。
EPT 的页表遍历很复杂,因为两套页表都是多级结构,而且 GPM 地址必须先转换为 HPM 地址才能使用。图 6.5 展示了 x86 中转换 64 位地址所需的步骤。无论系统是否虚拟化,只要 TLB 命中,地址转换就能迅速完成,不需要任何内存访问。非虚拟化系统发生 TLB 未命中时,硬件遍历器从基址寄存器 CR3 指向的地址开始,进行四级页表查找;它以虚拟地址的不同部分为索引,依次访问 PML4、PDPT、PD 和 PT。转换成本为 4 次内存访问,每查一级访问一次。虚拟化系统则需要 24 次内存访问。CR3 的值,以及 PML4、PDPT、PD、PT 四级查找的结果,都是 GPM 地址,必须再通过 hypervisor 维护的 GPM→HPM 页表转换,而这套页表也有四级。因此,还需 次额外查找,总计 24 次内存访问。启用虚拟化后,页表遍历成本增加到 6 倍,使维持高 TLB 命中率更为重要,也推动了更大页面的使用,以扩大 TLB 覆盖范围、减少页表遍历步骤。附录 L 深入讨论多级页表、多种页面大小和页表缓存等地址转换关键优化。
Arm 与 RISC-V 对内存虚拟化提供的支持,与 x86 EPT 类似。
例题
假设一个非虚拟化 x86 系统运行典型负载时,基准平均访存时间(AMAT)为 2.2 个周期,计入了指令和数据缓存未命中,以及 L1 TLB 未命中的影响,但不包括 L2 TLB 未命中。假设 L2 TLB 未命中率为 0.2%,每次页表内存访问耗时 50 个周期,来自大致等比例的 L2、L3 与主存访问。系统总 AMAT 是多少?如果启用虚拟化,要保持 AMAT 不变,L2 TLB 未命中率应降低到多少?如果只能把 L2 TLB 未命中率优化到 0.005%,那么为了与非虚拟化系统保持相同 AMAT,虚拟化四级页表遍历的目标延迟应是多少?
图内术语:Guest virtual address=客户虚拟地址;Host physical address=宿主物理地址;Physical page number=物理页号;offset=页内偏移;index=索引;guest page table=客户页表;host page table=宿主页表;main memory access=主存访问。PML4、PDPT、PD、PT 为四级页表结构名称,保留原标识。
译注(图 6.5): 原图图例将蓝色标为客户页表、浅橙色标为宿主页表,但图中蓝色的每一行以 EPTP 为起点,承担 GPM→HPM 转换;浅橙色竖列以 CR3 为起点,承担 GVM→GPM 转换。图例颜色说明与图中转换路径相反。原图未改动,阅读时应以地址转换方向及 CR3/EPTP 起点为准。
解答
非虚拟化系统的总 AMAT 包括基准 AMAT 与 L2 TLB 未命中的影响,其中每次页表遍历需要 4 次内存访问:
可见,由于页表遍历成本很高,即使 L2 TLB 未命中率很低,也会显著影响性能。正如第 2 章所述,硬件页表遍历器可以同时处理多个尚未完成的 TLB 未命中,从而减轻部分开销。
对于虚拟化系统,如图 6.5 所示,页表成本提高到 6 倍。要得到相同的 2.6 个周期 AMAT,L2 TLB 未命中率必须降至 。
可以通过增大 L2 TLB 来降低 TLB 未命中率,并采用更大的页面,减轻虚拟化对 AMAT 的影响。例如,Intel 和 AMD 都支持 2 MiB 页面。如果 L2 TLB 未命中率降低到 0.05%,使 AMAT 达到 2.6 的页表遍历时间为:
译注: 题干给出 0.005%,解答却使用 0.05%,二者相差 10 倍。依原解公式,0.05% 对应每次页表内存访问 33.33 个周期、24 次访问合计约 800 个周期。若采用题干的 0.005%,则相应数值为每次约 333.33 个周期、合计约 8000 个周期。题干问“页表遍历”目标延迟,而原解最终列出的是单次页表内存访问成本,二者也应区分。
降低页表访问成本的一种方法,是增加专用 MMU 缓存来保存页表项。MMU 缓存不按顺序地址保存数据,而是保存多级页表项,使一次访问能够返回多个相互关联的页表项。详见附录 L。
I/O 虚拟化
虚拟化存储、网络等 I/O 系统的基本办法,是让 hypervisor 截获 VM 与 I/O 硬件之间的全部交互。为此,可以在执行程序控制 I/O(PIO)指令、对内存映射 I/O(MMIO)地址执行加载或存储,以及发生 I/O 中断时触发 vmexit。也可以通过 DBT 或半虚拟化引入 vmcall,将 I/O 请求交给 hypervisor。让 hypervisor 介入全部 I/O 操作有多种优势。第一,它可以在客户操作系统假定的 I/O 接口与实际硬件接口之间进行转换。这让旧 VM 能借助模拟的 I/O 设备运行,也让未经修改的 VM 受益于旧设备驱动程序无法配置或利用的新硬件功能。第二,hypervisor 能观察并控制全部 I/O 操作的状态和进度,因此可以把 VM 从一台物理机器迁移到另一台,而无需重启 VM。它可以令全部 I/O 操作进入静止状态,暂停 VM,把描述其状态的全部比特迁移到另一台机器——包括寄存器、内存,以及 hypervisor 跟踪的状态——再恢复执行。前文已讨论,这种实时迁移为云计算带来重要收益。最后,这种介入使 hypervisor 能制定策略,管理多个 VM 如何安全地共享 I/O 设备能力,例如限制每个 VM 能产生的网络带宽。
然而,介入会增加延迟和吞吐量开销。对于依赖 SSD 或高速网络接口(NIC)的 I/O 密集型应用,这种开销可能很大。例如,200 Gbps NIC 每秒最多可以传送 4 亿个以太网分组,逐个介入分组处理的代价相当高。这推动了 I/O 虚拟化的体系结构支持,让 VM 能直接且安全地访问 I/O 设备。以发送网络分组为例,理想过程如下:首先,客户操作系统或用户进程直接使用 MMIO 指令设置 I/O 设备;接着,设备的 DMA 引擎直接从 VM 内存复制待发送数据,无需 hypervisor 协助;分组发送完成后,I/O 设备直接向客户 VM 递送中断,也无需 hypervisor 协助。
第一步所需的支持已经讨论过:EPT 可以把 I/O 设备的 HPM 地址映射到客户系统的 GPM 或 GVM 地址空间。下面通过 x86 的 VT-d(IOMMU)扩展,讨论后两步,即 DMA 与中断虚拟化。Arm 与 RISC-V 定义了类似机制。还有一个额外要求:允许多个 VM 直接且安全地访问同一 I/O 设备。6.5 节将讨论基于 PCIe 的 I/O 设备所用的 SRIOV 方案。
VT-d 定义的 IOMMU 单元包含两个组件:DMA 重映射(DMAR)与中断重映射(IR)。DMAR 允许 VM 内的软件使用 GPM 或 GVM 地址,设置 I/O 设备的 DMA 引擎。DMA 引擎发起内存读写访问时,根据设备标识查找上下文标识符。对于通过 PCIe 接口连接的设备,设备标识包括总线号(8 位)、设备号(5 位)和功能号(3 位)。上下文标识符包含指向地址转换所需页表的指针,例如用于 GPM→HPM 转换的页表。利用这些页表,地址转换按常规方式进行。IOMMU 内含 TLB,缓存近期使用过的转换以加速处理。事实上,早期 IOMMU 没有硬件页表遍历器,TLB 未命中时会调用 hypervisor,把 DMA 引擎使用的地址转换为 HPM 地址,并更新 TLB 供后续使用。IOMMU 的 TLB 设计颇具挑战:既要通过足够容量维持低未命中率,也要有足够吞吐量支持一个或多个高性能 I/O 设备,例如一个 200 Gbps 设备在每个方向上,都可能为每秒最多 4 亿个分组生成 DMA 访问。
IR 的工作方式如下。为了产生消息信号中断,I/O 设备向系统中某个核心的高级可编程中断控制器(APIC)发送消息。在 VT-d 下,每个 VM 都关联一个虚拟 APIC,它是由相应 VMCS 标识的内存结构。设备产生中断时,IR 根据 I/O 设备标识符查找接收中断的 VM(VMCS)信息,以及如何改写中断消息。随后更新相应 VMCS 中的虚拟 APIC,记录待处理的中断。虚拟 APIC 还会通知当前运行该 VM 的核心,让它考虑递送中断。物理 APIC 根据核心状态和 VM 状态,决定中断能否立即触发,还是需要等待。例如,客户操作系统可能正在处理更高优先级的中断,必须先完成它,再触发其他中断。中断触发时,直接调用客户操作系统中对应中断向量的处理程序,无需 hypervisor 介入。这种无需退出 VM、向运行中 VM 递送中断的方式,称为 posted interrupts。它也可用于两个 VM 之间,或同一 VM 中两个进程之间的进程间中断(原文称 interprocess interrupts,IPI)。
hypervisor 实例:Xen 项目
Xen hypervisor 是 2003 年首次推出的开源项目,也是 AWS 最初采用的 hypervisor。它属于裸金属或 1 型 hypervisor,即机器启动时最先运行的软件就是 hypervisor。相比之下,VMware Workstation 等2 型 hypervisor先启动一个基础操作系统;hypervisor 本身是用户级进程,依靠宿主操作系统的服务,在同一硬件上运行其他 VM。
Xen 引入半虚拟化,解决 VT-x 和 VT-d 扩展出现之前,x86 虚拟化面临的安全与性能问题(Barham 等,2003)。Xen 开发者修改了 Linux 约 3000 行代码,约占 x86 专用代码的 1%。这些修改消除了敏感但非特权指令的使用,并替换了在虚拟化下效率极差的代码。例如,为避免清空与影子页表关联的 TLB,Xen 将自身映射到每个 VM 地址空间最高的 64 MiB。Xen 允许客户操作系统分配页面,只检查其是否违反保护限制。为了使客户操作系统免受 VM 内用户程序的侵害,最初的 Xen 利用了 x86 提供的三个保护级:Xen hypervisor 运行于最高特权级 0,客户操作系统运行于次一级 1,应用运行于最低级 3。大多数 x86 操作系统只使用特权级 0 和 3。这些修改均不影响 VM 工作负载所依赖的 Linux ABI。自 2011 年起,Linux 已直接支持 Xen 半虚拟化。
Xen 将 VM 称为 domain(域)。一个初始的特权域 Dom0 最先启动,并管理称为客户域的普通 VM。Dom0 包含硬件 I/O 设备驱动,即后端驱动。客户域使用虚拟磁盘和虚拟网络设备的前端驱动,通过调用 Dom0 完成 I/O 请求。还可以利用驱动域分离 Dom0 的部分功能;驱动域是不具有特权的 VM,负责某个具体 I/O 设备及其后端驱动。驱动域既避免 Dom0 成为系统瓶颈,也提高其可靠性:驱动程序崩溃不会影响 Dom0 的运行。
这些年来,Xen 不断演进,开始利用体系结构对虚拟化的支持。从 2006 年起,Xen 利用 VT-x 支持 Microsoft Windows 等未经修改的客户操作系统。后来又利用 VT-d 改进 I/O 性能与安全性。例如,驱动域利用 IOMMU,保护其他域不受后端驱动缺陷和漏洞利用的影响。Xen 支持轻量级 VM,混合使用硬件辅助虚拟化与半虚拟化,提高 VM 性能并减小内存占用。VM 越小,云 WSC 中一台服务器的内存就能容纳越多计算需求较低的 VM。
机密计算与安全 enclave
公有云系统广泛采用之后,金融或医疗等关键应用的数据安全问题受到关注。攻击者可以利用应用、客户操作系统或 hypervisor 本身的缺陷,绕过进程之间的硬件辅助内存隔离(虚拟内存),或 VM 之间的隔离(EPT)。云计算扩大了攻击面:云基础设施对外开放,攻击者可能运行在同一 WSC,甚至同一台机器上,即 VM 共置。许多云工作负载实现互联网服务,因此恶意用户可以与其交互,寻找代码注入或其他安全漏洞利用机会。最后,一些云用户可能并不完全信任云提供商,原因或是存在不守规矩员工的可能性,或是用户与提供商的某项产品存在直接竞争。
这些挑战推动了机密计算平台的发展:即使在公有云上运行、实现互联网服务,平台仍对数据的机密性与完整性提供有力保证。这类平台可利用同态加密、多方计算和零知识证明等新兴密码技术构建。但这些技术的计算开销仍然很大,因此 CPU 厂商引入了可信执行的硬件支持,例如 Intel 软件防护扩展(SGX)。更细粒度保护这一课题已有几十年历史,但过去因开销高,而且更高效、侵入性更低的其他方案已足够可用,商业进展一直有限。网络攻击的增加,以及在线机密信息数量的增长,使人们重新审视改善这类细粒度安全性的技术。
SGX 及其他 ISA 中的类似扩展,允许用户程序创建安全 enclave。放入 enclave 的代码与数据始终使用用户代码提供的密钥加密;只有在 CPU 芯片内部使用时才解密。程序通过狭窄的接口调用 enclave 内的函数,使用特殊指令将处理器切换到安全 enclave 模式。enclave 不处理中断、缺页或任何 vmexit 事件。发生这类事件时,处理器先把程序状态保存到加密内存,用合成值覆写寄存器,退出安全模式,再调用预先指定的中断处理程序。SGX 还有一项值得注意的功能:enclave 用代码与数据初始化时,会生成其状态的密码学散列值,外部证明服务可以检查这个值,以确认代码和数据此前均未遭修改。
enclave 使某些函数能够在只信任 CPU 厂商的条件下进行机密执行。由于 enclave 始终加密,常规 hypervisor 或操作系统的虚拟内存及 I/O 操作可以访问它,例如移动页面,但无法提取任何明文信息。要让 enclave 正常工作,函数所需的全部代码与数据都必须位于其中。与 Intel SGX 类似,IBM 和 AMD 的近期处理器也支持主存的即时加密。
6.4 仓库级计算机的计算机体系结构
一座 WSC 由 50,000–100,000 台计算服务器和存储模块组成,通过分层网络相互连接。计算、存储与网络设备安装在机架中,机架还容纳交流转直流电源转换器、备用电池等供电设备。图 6.6 是 Google 的 WSC 机架实例。
图内术语:Network switches=网络交换机;Power conversion=电源转换;Configurable payload bay=可配置设备安装区;Battery backup=备用电池。
机架尺寸差异很大。传统机架宽 19 英寸、深 48 英寸;一些近期设计则更浅、更宽,以便在每个水平托盘中容纳多台服务器。机架通常高 70–84 英寸,以机架单位(rack unit)表示, 英寸 cm。每个机架可容纳的服务器数量,还受到可用功率(例如每架 10–30 kW)、冷却与气流条件,以及机架连接到网络的可用带宽限制。机架在仓库建筑中成排布置,如图 6.7 所示。图 6.8 展示了一处包含多栋仓库规模建筑的 WSC 设施,建筑中容纳机架,以及运行这些机架所必需的电气与冷却设备。
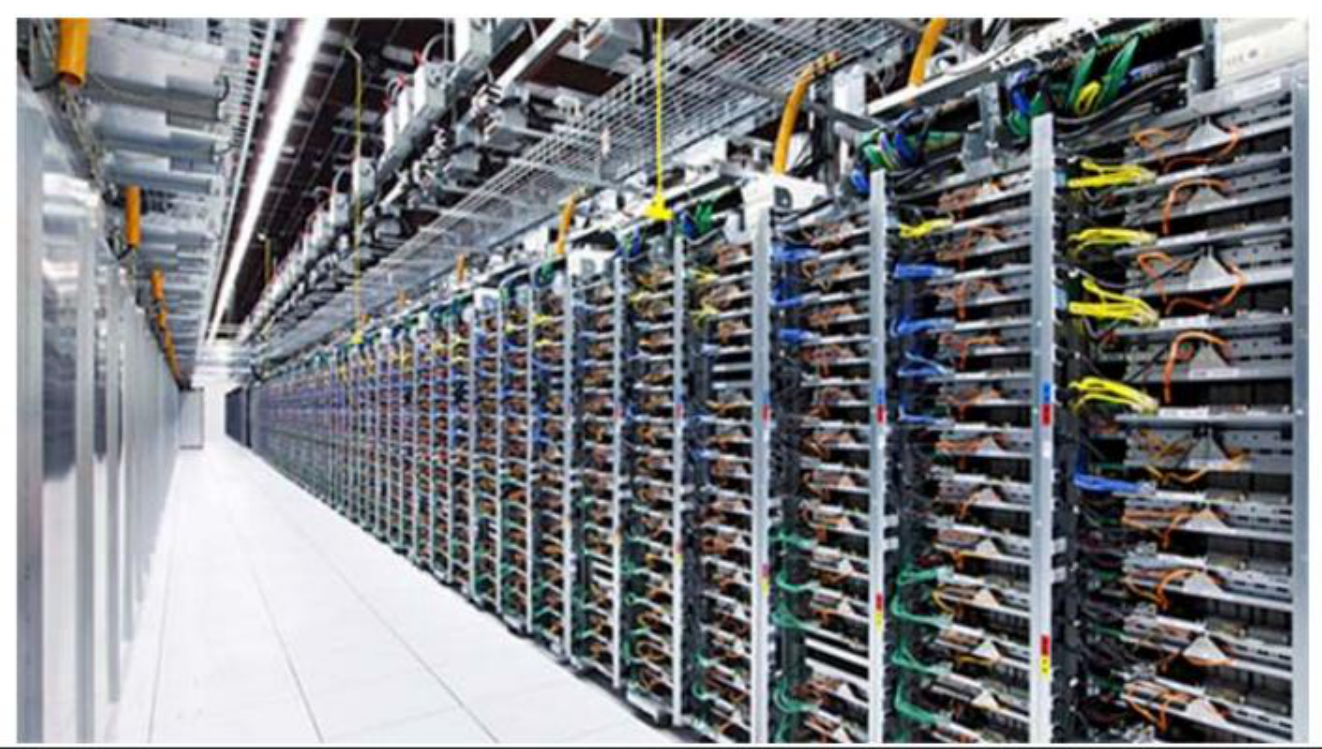
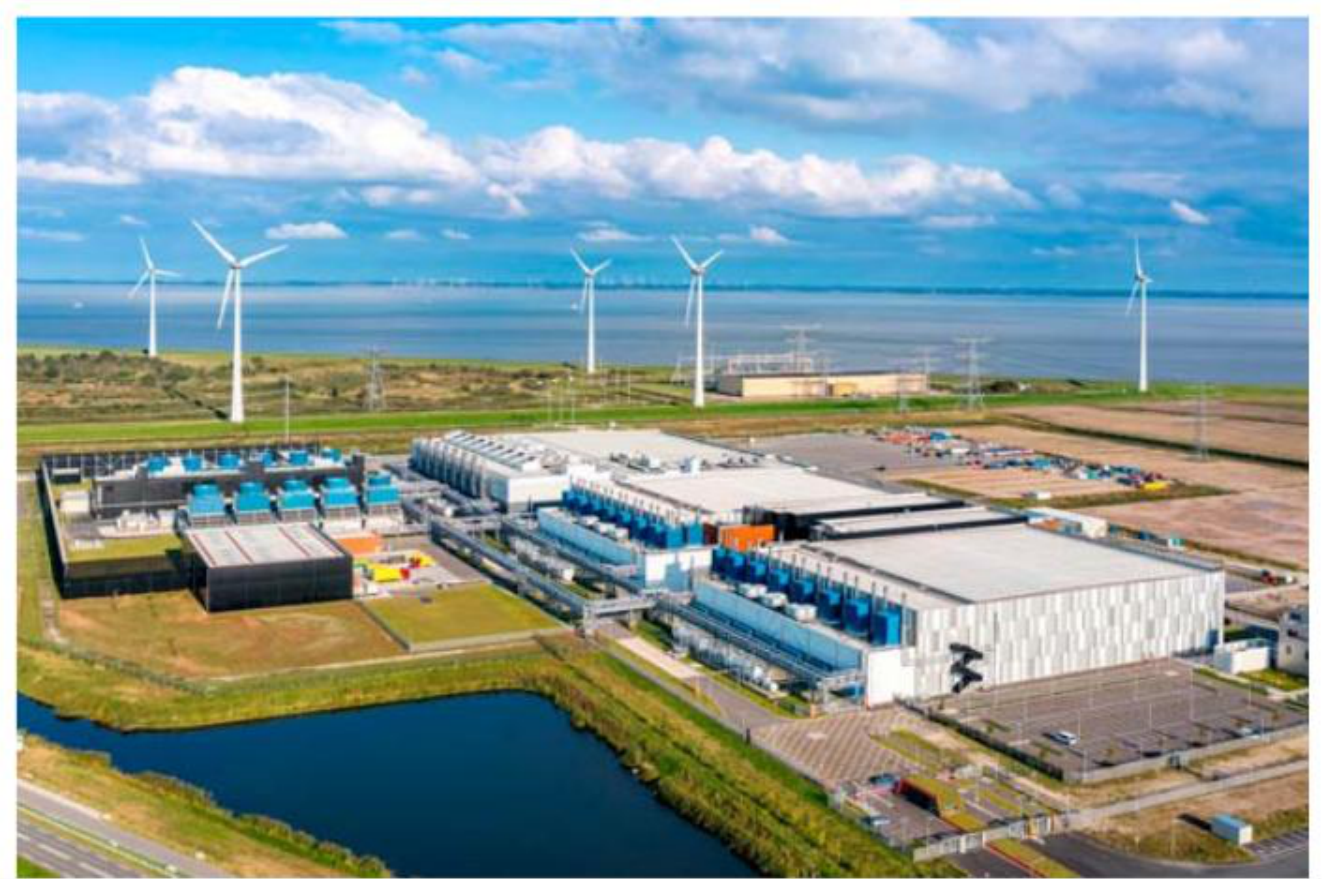
本节介绍 WSC 的计算、存储与网络组件,并重点介绍 Open Compute Project(OCP) 中的几个实例。OCP 维护 Meta、Google、Microsoft 和 Alibaba 等 WSC 运营商设计的硬件组件的详细规范。6.6 节将讨论供电与冷却设备:它们对 WSC 运行至关重要,而且与电子组件协同设计。
WSC 的计算系统
与传统企业数据中心相比,WSC 相对同构,但仍然包含多种服务器配置。采用异构配置的主要动机,是让硬件能力和成本更好地适应关键 WSC 工作负载的特征。图 6.9 总结了 Meta 在 2017 年的 WSC 中使用的七种服务器,以及各配置对应的负载。只要满足整体供电与冷却限制,一个机架既可以只安装一种服务器,也可以安装多种。因此,一些机架可能不会装满。在仓库整个寿命期内,硬件逐步安装和更换,所以 WSC 同时存在多代服务器与机架类型。
| 项目 | I 型 | III 型 | IV 型 | V 型 | VI 型 | VII 型 | VIII 型 |
|---|---|---|---|---|---|---|---|
| 使用场景 | Web 服务 | 数据库 | 数据分析 | 照片 | 多种服务 | 冷存储 | 分离式 Flash |
| CPU | 4 × Xeon D | 2 × Xeon E5 | 2 × Xeon E5 | 2 × Xeon E5 | 2 × Xeon E5 | 2 × Xeon E5 | 2 × Xeon E5 |
| 内存 | 32 GB | 256 GB | 128 GB | 32 GB | 256 GB | 256 GB | 32 GB |
| 存储 | 1 × 500 GB SATA | 2 × 3.2 TB PCIe Flash | 15 × 5 TB PCIe Flash | 30 × 4 TB SAS HDD | 1 × 1.8 TB PCIe Flash | 240 × 4 TB SATA HDD | 15 × 5 TB SATA/PCIe Flash |
图 6.9 来源:OCP Summit 2017: Facebook news recap。类型编号按原表保留,原表没有 II 型。
图 6.10 展示一台 1 RU 双插槽服务器。这是 WSC 的常见配置,因为它可以配置适当的计算与内存容量,处理广泛的应用。机箱金属件、主板、风扇、NIC 等固定成本分摊到两个 CPU 插槽,因此这种配置具有成本效益,即使服务器被划分为多个小 VM,也能很好地工作。还有一些设计进一步改善了成本与模块化程度。图 6.11 展示 Meta Yosemite 多节点服务器设计。其 4U 机箱包含三个 sled(可抽取的托架),每个可容纳 1–4 个不同配置的服务器刀片。基本配置的每个 sled 包含四台单插槽服务器,顶部另有一块小板,安装四个刀片共享的基板管理控制器(BMC)与 NIC。
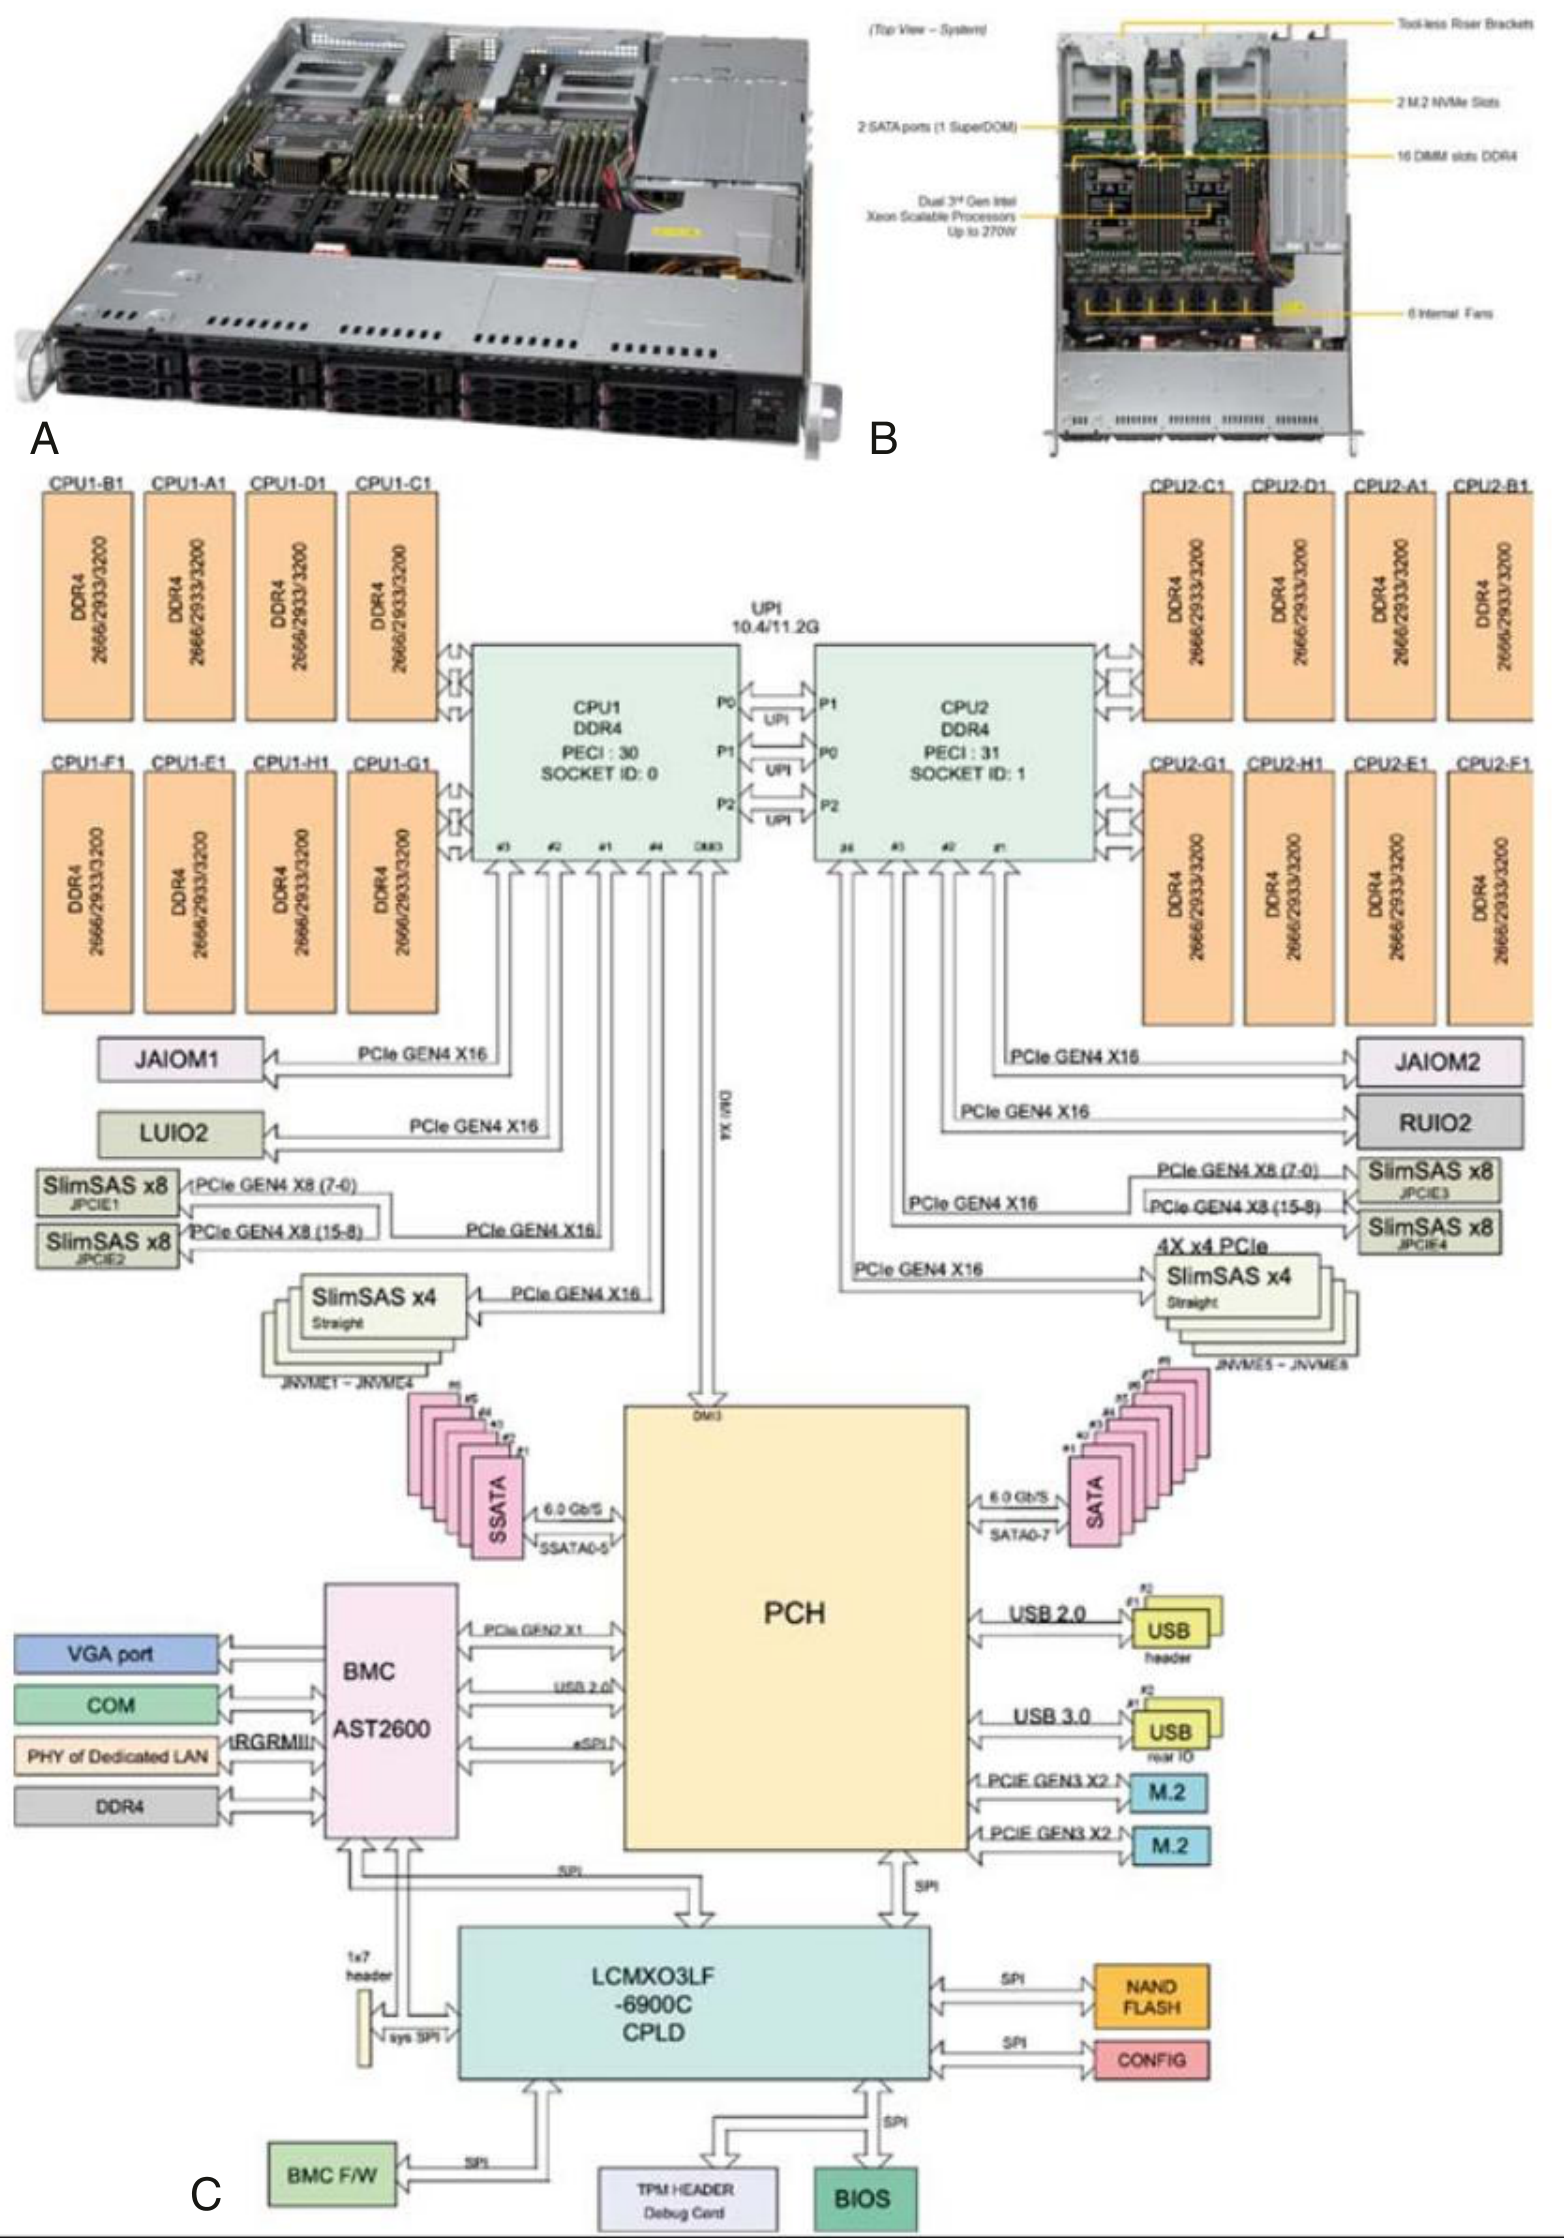
详细规范:SuperMicro SYS-120C-TN10R。图内术语:Top View—System=系统俯视图;Tool-less Riser Brackets=免工具转接卡支架;2 SATA ports (1 SuperDOM)=两个 SATA 端口(其中一个为 SuperDOM);2 M.2 NVMe Slots=两个 M.2 NVMe 插槽;16 DIMM slots DDR4=16 个 DDR4 DIMM 插槽;Dual 3rd Gen Intel Xeon Scalable Processors / Up to 270W=双路第三代 Intel Xeon 可扩展处理器,功耗最高 270 W;6 Internal Fans=六个内部风扇;Socket ID=插槽标识;Straight=直式;VGA port=VGA 端口;COM=串行端口;header=插针座;rear I/O=后部 I/O;PHY of Dedicated LAN=专用局域网接口的物理层;NAND FLASH=NAND 闪存;BMC F/W=BMC 固件;CONFIG=配置;TPM HEADER=TPM 插针座;Debug Card=调试卡。CPU、DDR4、UPI、PCIe、SATA、USB、BMC、PCH、CPLD、TPM、BIOS 及端口标识均保留原文。
译注: 原图注尺寸的最后一项也标为 D,和前一项重复。
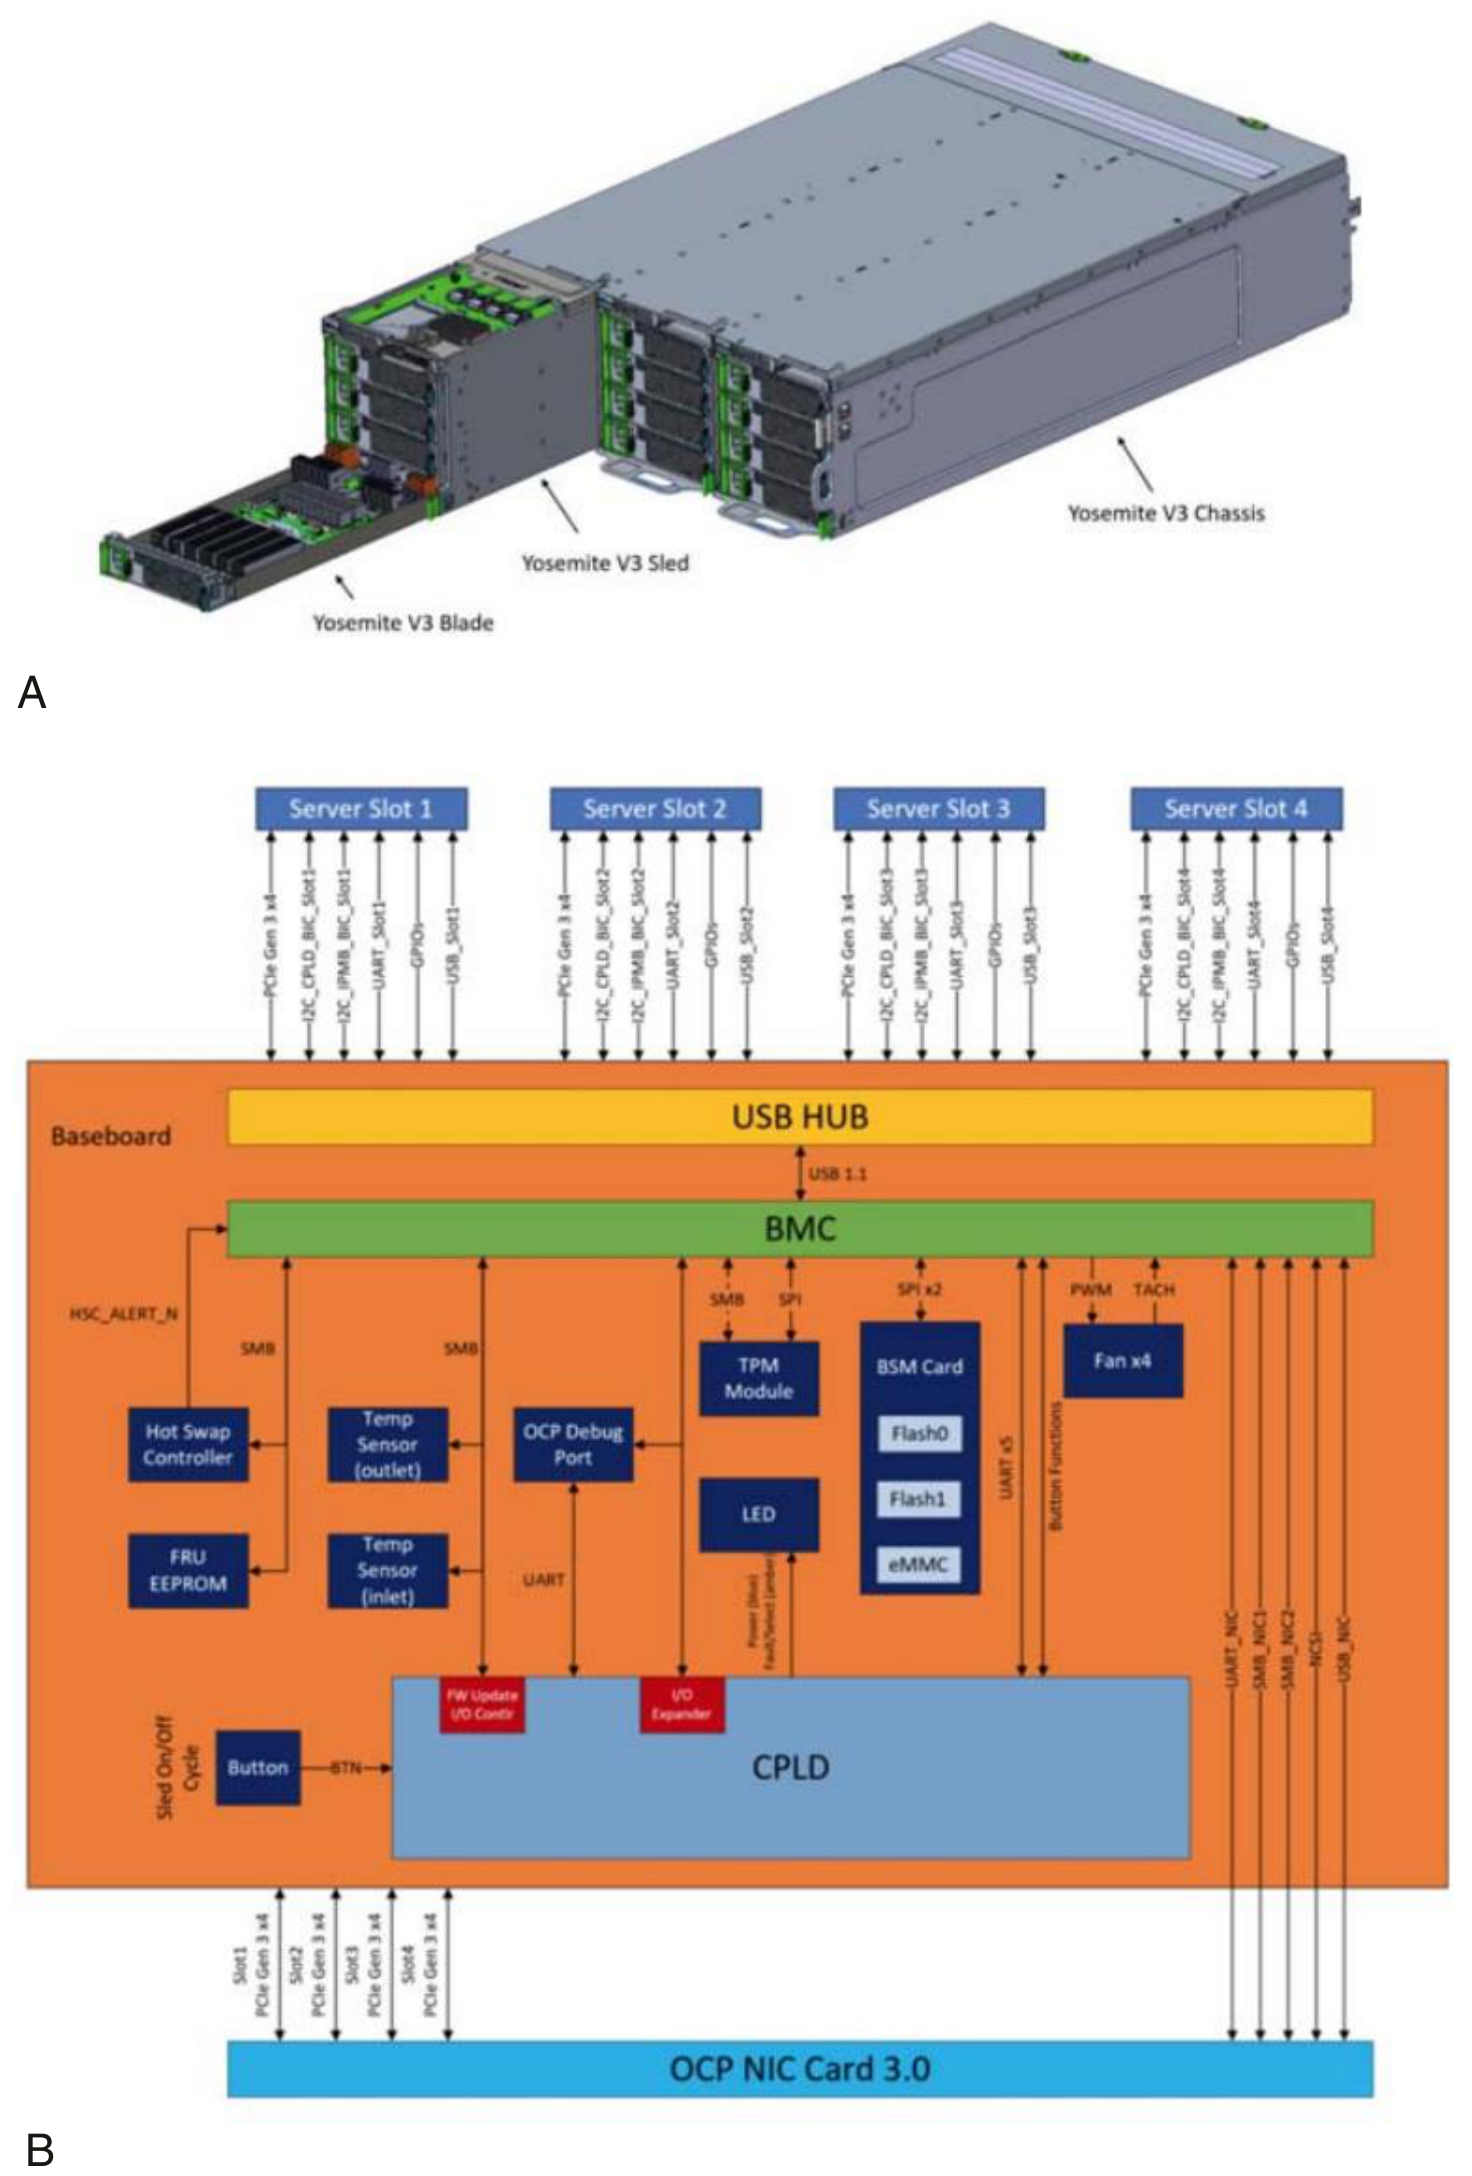
详细规范:OCP Yosemite v3 Platform Design Specification。图内术语:Chassis=机箱;Sled=可抽取托架;Blade=刀片;Server Slot=服务器插槽;Baseboard=基板;USB HUB=USB 集线器;Hot Swap Controller=热插拔控制器;Temp Sensor (outlet/inlet)=出口/入口温度传感器;OCP Debug Port=OCP 调试端口;TPM Module=TPM 模块;Fan=风扇;Button=按钮;Sled On/Off Cycle=sled 上电/断电循环;FW Update I/O Config=固件更新 I/O 配置;I/O Expander=I/O 扩展器;OCP NIC Card=OCP 网卡。BMC、BSM、CPLD、FRU EEPROM、LED、eMMC 及总线标识保留原文。
译注: 正文将 Yosemite 机箱写为 4U,图 6.11 图注则写为 3RU。
BMC 管理安全启动、风扇、稳压器及各种系统传感器。NIC 内含一个四路 PCIe 交换机,为每台服务器提供物理上独立的 NIC 资源接口。对于会话级并行性充足、内存需求较小的负载,例如前端 Web 服务器、横向扩展的微服务,以及中小型 VM,这种配置具有成本效益。这些负载使用两台单插槽服务器,能获得与一台双插槽服务器相同的吞吐量,因此没有必要使用双插槽服务器所需的更昂贵 CPU 芯片。Yosemite 设计让多台单 CPU 服务器分摊 BMC 与 NIC 的成本。Yosemite sled 也能容纳其他刀片配置,包括共享存储或共享领域专用加速器(DSA)的刀片。
ML 推理或视频转码芯片等小型 DSA,可以作为 PCIe 或 M.2 外设板卡,安装在上述服务器中。然而,大语言模型(LLM)等大型 ML 模型的训练与服务,在重要性、规模和计算强度方面不断增长,促成了 DSA 专用服务器的部署。这些服务器容纳 4–16 个高端 DSA 芯片,每个芯片功耗可达 800 W 或更高。每台服务器连接三种网络:第一,连接分布式存储和公共互联网的普通数据中心网络;第二,直接连接服务器内部 DSA 的高带宽网络;第三,独立的服务器间互连,支持跨多台服务器的分布式训练与推理。这些服务器是第 7 章讨论的 DSA 超级计算机的基本构件。
图 6.12 展示用于 GPU ML 训练的 NVIDIA DGX H100 服务器。这台 3U 服务器包含八个 H100 Tensor Core GPU;每个 GPU 配备 80 GB HBM,FP8 运算能力最高为 8 PFLOPS,BF16 或 FP16 运算能力为 2 PFLOPS。八个 GPU 通过四个交换芯片,利用 NVLink 互连直接通信,每 GPU 峰值带宽为 900 GB/s,即 18 条链路、每条 50 GB/s。四个交换机还向外提供 72 条链路,用于构建更大系统。通过增加一层 NVLink 交换机,DGX pod 系统最多可连接 32 台 DGX 服务器,即 256 个 GPU。更大系统采用 InfiniBand 网络连接 DGX pod,每 GPU 配备一个 400 Gbps CX7 NIC。两个 x86 CPU 管理这些 GPU,另外最多配备 2 TB 内存,并通过独立 NIC 连接普通 WSC 网络。单台 DGX 服务器功耗最高为 10 kW。类似的 GPU 服务器在公有云和私有 WSC 中都很常见。第 7 章将从端到端的角度考察 DSA 系统设计。
除 DSA 广泛采用之外,WSC 计算系统还有两个重要趋势。在 x86 垄断二十年之后,所有主要云提供商如今都提供使用 Arm CPU 的服务器。AWS 和 Alibaba 已开发出自己的 Arm CPU 芯片,利用其庞大采购量,并创造针对自身 WSC 环境进一步优化的机会。与十年前的预期不同,这些 Arm CPU 配备强大的乱序执行核心,能够与 x86 对手竞争,参见 6.9 节的陷阱讨论。
图内术语:CX7 HCA/NIC w/ PCIe Switch=带 PCIe 交换机的 CX7 主机通道适配器/网卡;4 NVLinks、5 NVLinks=四条、五条 NVLink 链路;1 400Gb=一条 400 Gb 链路;OSFP、NVSwitch、H100 保留产品或接口名称。
主存系统也正在发生重大变化。随着半导体缩放继续,CPU 芯片核心数量迅速增加。CPU 厂商还将多个 chiplet 共同封装,形成具有 64 个或更多核心的大型 CPU 插槽,每插槽功耗最高 400 W,需要很大的内存带宽。目前,CPU 集成内存控制器,通过 DDR 通道直接与 DRAM 模块通信。由于难以在 DRAM 工艺中设计更快的收发器,每个 DDR 引脚的速率限制在 3.2–8.4 Gb/s。相比之下,制造 CPU 的逻辑工艺可实现每引脚 64 Gb/s(PCIe)或 100 Gb/s(Ethernet)的收发器。新出现的趋势,是将部分或全部 DRAM 控制器移到独立的缓冲芯片中——这与 2000 年代中期以前的做法相似——并以 PCIe 级速率的链路连接 CPU 和缓冲芯片。缓冲芯片连接大量 DDR 通道,实现高容量、高带宽的内存系统。与 GPU 和其他 DSA 类似,CPU 封装也可能集成一定数量的堆叠式 HBM DRAM。Compute Express Link(CXL)联盟 推动的片外内存控制器趋势,还为内存系统设计创造了其他机会。CXL 缓冲芯片简化了新型非易失性存储技术的部署,也让少数服务器能够共享 DRAM 容量(Li 等,2023),类似 Yosemite sled 中四台服务器共享 NIC。基于交换的 CXL 网络可以进一步支持更大规模的内存分离。
WSC 的存储系统
许多 WSC 服务器包含本地存储,例如 1–8 块 HDD 或 Flash SSD。某些企业负载预期运行在具有本地设备的服务器上,或需要高于 WSC 网络能为单台服务器提供的存储吞吐量,因此必须使用本地存储。例如,八块基于 NVMe 的 SSD 可提供 400 Gbps 峰值读带宽。使用本地存储的 VM 必须认识到:磁盘或服务器失效时,数据会丢失。如果本地存储保存的并非临时数据,VM 软件就有责任保障持久性,例如将数据复制到多个实例。本地存储数据使用客户提供的密钥加密,以免物理硬件先后供不同 VM 使用时泄露数据。
大多数 WSC 负载把持久数据存储在分布式存储系统中。云提供商提供各种采用块、文件或对象接口的存储框架,后端使用 HDD 或 SSD,对应不同性能与价位。分布式存储系统有若干优势。计算硬件与持久化存储在物理上分离,简化了管理。VM 可以迁移,也可以在失效后重启,但仍通过网络连接同一存储卷或文件系统。保障持久性、进行故障和灾难恢复,以及扩展所分配存储容量与吞吐量的责任,都转移给了云提供商。
实现分布式存储的硬件组件,是称为 JBOD(just a bunch of disks)的磁盘阵列。图 6.13 展示 Meta Grand Canyon JBOD 阵列,在 4U 机箱内容纳 72 块 HDD。
详细规范:Grand Canyon Storage System Specification。图内术语:Case=机壳;Drawer=抽屉;HDDs=机械硬盘;Drive Plane Board=驱动器背板;Memory=内存;Boot SSD=启动 SSD;Storage Controller Card (normal)=存储控制器卡(常规);SAS Expander=SAS 扩展器;Drive power control + Sensors/Monitoring=驱动器电源控制及传感器/监控;Fan=风扇。Barton Springs、UIC、BSM、BMC、TPM、SAS IOC、NIC 及总线规格保留原标识。
若每块 HDD 为 16 TB,这就是 PB 级存储设备。图 6.14 展示 Meta Lightning JBOF 阵列,它包含两个独立的 Flash 托盘。每个托盘有 15 个槽位,每槽可容纳两个 M.2 形态(2.5 英寸)的 SSD,或一个 U.2 形态(3.5 英寸)的 SSD。JBOD 与 JBOF 阵列包含供电、信号完整性、遥测和管理所需的设备,也支持热插拔。不过,阵列内部并不实现复制或 RAID 编码等可靠性机制。
详细规范:Facebook Lightning Hardware Specification。图内术语:Host=宿主机;USB Cable=USB 电缆;USB Hub=USB 集线器;PCIe Re-timer=PCIe 重定时器;I2C Mux=I2C 多路复用器;Mini-SAS HD Cable=Mini-SAS HD 电缆;PCIe Expansion Board=PCIe 扩展板;PCIe Switch=PCIe 交换机;Upstream/Downstream=上行/下行;PCIe Drive Plane Board=PCIe 驱动器背板。
译注: 原文将 M.2、U.2 分别与“2.5 英寸”“3.5 英寸”并列。这两种接口/外形规范与上述尺寸并非固定对应关系。
这些阵列通过 PCIe 电缆连接机架中位于它们上方或下方的服务器,这些服务器通常称为头节点。服务器上运行的 WSC 存储软件实现分布式存储功能,包括跨机架、跨排、跨集群的复制或纠删码,使数据能够在 WSC 中各种失效情况下恢复:磁盘失效、机箱失效、服务器软硬件失效、机架失效或网络失效。只要副本或编码块分布在整个 WSC,无论是磁盘失效,还是服务 JBOD 阵列的网络链路失效,分布式存储软件都能以相同方式恢复数据。用统一机制处理多种失效情况,还能减少所需副本或编码块的总数。
WSC 体系结构设计者可以调整存储阵列的部署,为从热数据高速存储到低成本归档存储的不同场景进行优化。首先,可以部署针对吞吐量或容量优化的不同 HDD 与 SSD。其次,可以调整头节点数量、阵列与头节点之间的连接带宽,以及分配给 WSC 网络连接的带宽。例如,一个 Lightning JBOF 托盘既可由单个头节点通过一条 x8 PCIe 连接提供服务,也可由四个节点通过四条 PCIe 连接提供服务。最后,可以调整容错机制,在速度与存储开销之间权衡。三副本方案能容忍两块磁盘失效,恢复即时,但存储开销为 200%。相比之下,Reed–Solomon 码能够降低容错开销,却会引入恢复延迟。例如,RS(9,6) 码为每组六个数据块增加三个块,存储开销为 50%,恢复任一失效块时需要读取六个块。RS(14,10) 码的开销为 40%,但恢复任一失效块需要读取十个块。
WSC 的网络系统
随着 WSC 节点数量增加,以及每个节点计算或存储能力提高,WSC 网络流量迅速增长。图 6.15 显示,Google WSC 服务器之间的网络流量在短短十年间增长到 235 倍。显然,若不精心设计,WSC 网络很容易成为性能或成本瓶颈。
理想的 WSC 网络是一台完美的交叉开关,能够以全对分带宽连接 50,000–100,000 个节点:所有两两配对的节点都可以同时以各自 NIC 的全速通信,例如 100 Gbps。WSC 网络还必须具有韧性:即使大型系统中偶尔有网络链路或交换机失效,服务器仍应能高速通信。遗憾的是,这种理想交换机不切实际,因为对于 个端口或节点,其成本按 增长。到 2010 年代初,人们已经清楚,任何企业网络方案都无法满足 WSC 的规模与成本要求。因此,云提供商开发出新一类 WSC 网络,将超级计算的思想——拓扑结构——与商用网络的思想——交换芯片和传输协议——结合起来。
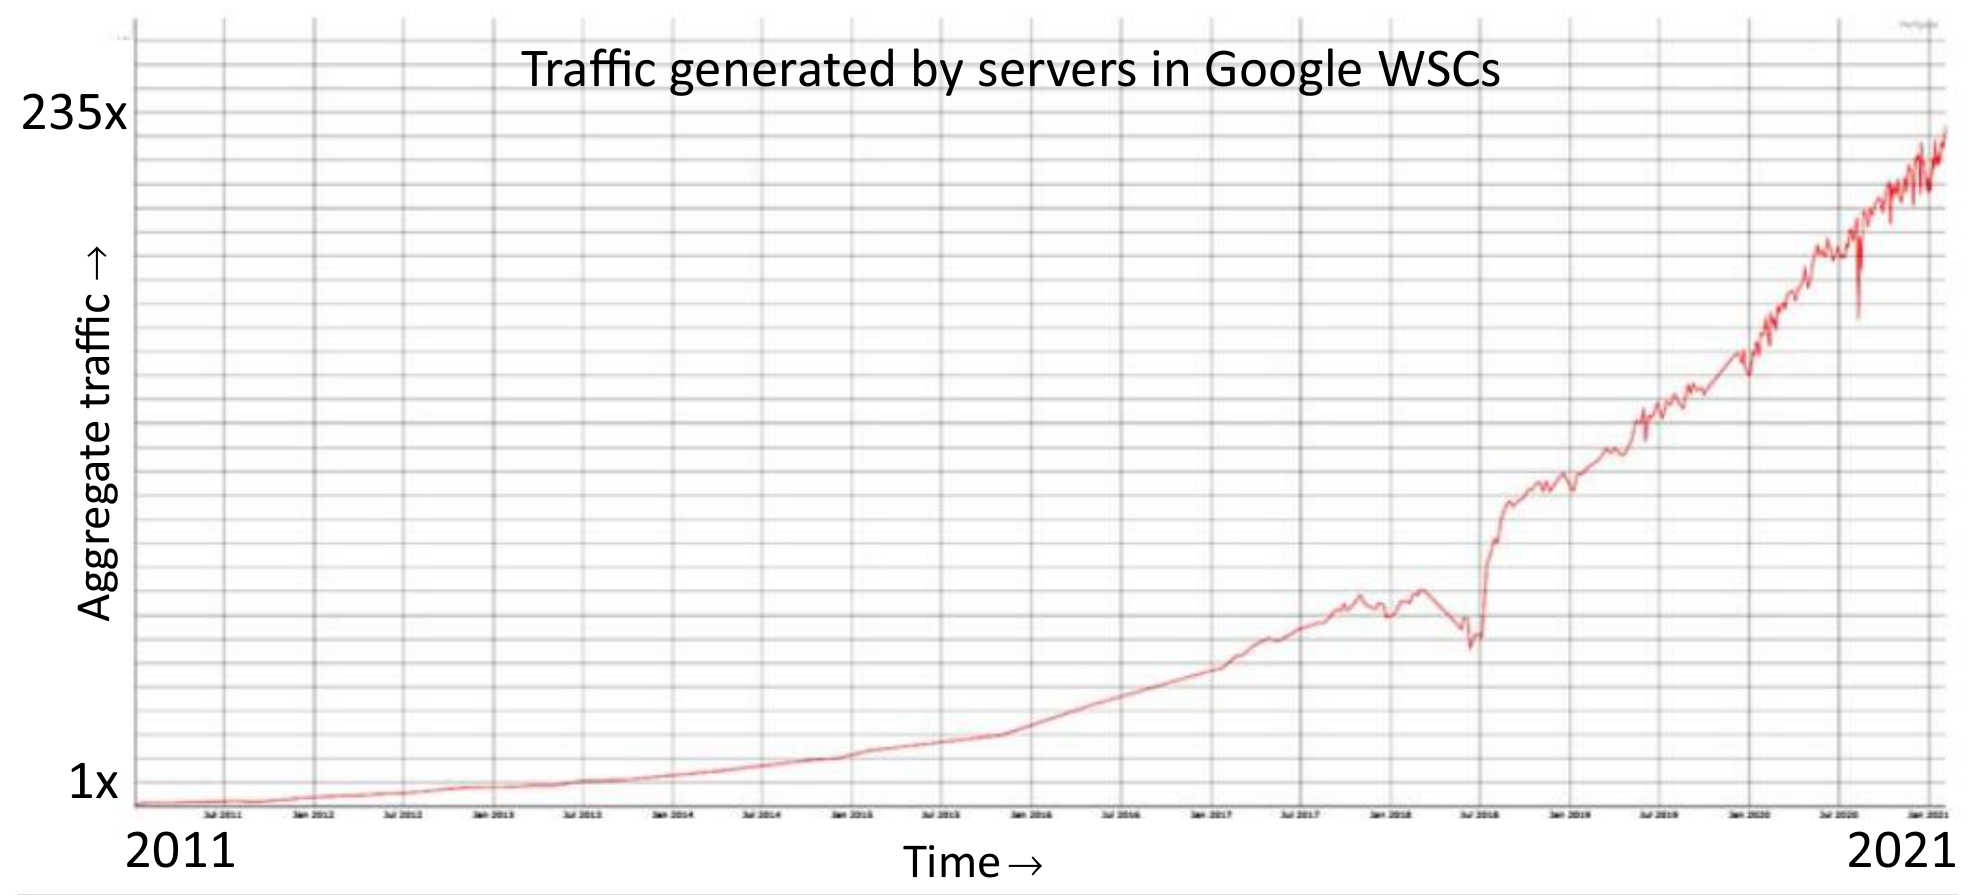
图内术语:Traffic generated by servers in Google WSCs=Google WSC 服务器产生的流量;Aggregate traffic=总流量;Time=时间;1× 与 235× 为相对起点的倍数。
现代 WSC 网络采用多级拓扑,例如 Clos 拓扑。这种拓扑最初为电路交换电话网而发明,以形式化研究其性质的电信专家命名(Clos,1953)。多级交换机使其能以显著更低的成本,逼近大型交叉开关的连通能力。图 6.16 展示 WSC 中 Clos 网络的一般结构。第一级是每个机架上的机架顶部交换机(top-of-the-rack,TOR),也称 L1 交换机。TOR 以向下的链路连接服务器,以向上的链路连接一组叶交换机(leaf,L2)。每个叶交换机连接全部脊交换机(spine,L3)。通过增加叶交换机组,这种模块化拓扑可以扩展到数万个节点;也可以遵循叶到脊的连接模式,增加更多层级。附录 L 深入讨论互连网络,包括拓扑和交换机微体系结构。
Clos 拓扑具有成本效益,因为三个层级的交换系统都由同一种商用交换芯片构建。图 6.17 展示 Google Jupiter 互连所用的交换机;这是 Google 第五代定制 WSC 网络,于 2012 年首次部署(Singh 等,2015)。TOR、叶和脊交换机都由一块或多块板卡实现,每块板卡包含四个 16 端口交叉开关芯片。达到最大规模时,Jupiter 的对分带宽高达每秒 1.3 Pbit( bit)。请注意,整个互联网的对分带宽可能只有 0.2 Pbit/s;原因之一是 Jupiter 专为高对分带宽而建,互联网则不是。图 6.18 回顾了 Google 五代定制 WSC 网络中,各级交换机的演变。
图内术语:Spine Block=脊交换模块;Leaf Block=叶交换模块;Server racks with ToR switches=带 TOR 交换机的服务器机架。
Clos 拓扑通常不提供全对分带宽。在上述 Jupiter 配置中,每个 TOR 交换机的下行与上行带宽比为 3∶1,称为 3∶1 超额订阅比(oversubscription ratio)。任意两台服务器都能以链路最高速率 40 Gbps 通信;但若一个机架内的全部服务器同时向其他机架发送数据,每台服务器的有效带宽就只有最高速率的三分之一。WSC 中不同通信路径相互重叠,叶与脊交换机的拥塞也会限制有效带宽。WSC 运营商采用多种技术减轻超额订阅与拥塞:把不太可能同时向网络核心全速发送的负载放在同一机架;尽量把分布式工作负载的进程调度到相邻位置,使大部分流量只经过一个 TOR 或一个叶交换机。遗憾的是,容错要求又倾向于把这些进程均匀分散到整个 WSC,以确保任一链路或机架失效对可用性的影响尽量小。运营商还会随机选择连接通过多路径 Clos 网络的路径,尽量均匀地分散流量,避免网络核心拥塞。
图 6.17 的 Clos 实现天然具有容错能力。任意两个 TOR 都能通过叶模块和脊模块中的多条路径通信。叶或脊模块中任何单条链路、单个芯片的失效,都不能使 TOR 断网。一些云部署在机架中放置一对冗余的 TOR 交换机,使不具备容错能力的应用免受 TOR 失效或维护的影响。
图内术语:Merchant silicon=商用交换芯片;Middle block(MB)=中间交换模块;Spine block=脊交换模块;Aggregation block=汇聚模块;up/down=上行/下行。图中速率与端口标记保持原样。
译注: 图中 middle block 下行标为“256 × 10G”,下方汇聚连接又标有“2 × 10G”;图注与随后例题则按 64 条 40 Gbps 下行、成对 40 Gbps 连接计算。正文说明了 40 Gbps 链路可以拆分为四条 10 Gbps 链路,但图示与例题并非完全相同的端口配置,阅读时应分别对应。
使用更新的商用交换芯片,可以设计类似的 Clos 拓扑。例如,Broadcom 于 2022 年发布的 Tomahawk 5,可以充当连接 800 Gbps 链路的 64 端口交叉开关、连接 400 Gbps 链路的 128 端口交叉开关,或连接 200 Gbps 链路的 256 端口交叉开关。这些选项为芯片使用方式带来额外灵活性。设计者可在拓扑核心采用更高速率,而在机架内部采用每链路 200 Gbps,以最大化系统中可连接的服务器端口数。
例题
利用图 6.17 中的构件,Jupiter 拓扑最多能支持多少台服务器?假设每台服务器通过一条 40 Gbps 链路连接 TOR,TOR 层的超额订阅比为 3∶1。还假设每个 TOR 到每个 middle box、每个汇聚模块到每个脊模块,都使用一对冗余的 40 Gbps 链路。如果 TOR 层的超额订阅比为 1∶1,容量又是多少?
解答
先回顾图 6.17 中的构件:
- 脊模块(L3)向汇聚模块提供 128 条 40 Gbps 下行链路。每个汇聚模块通过一对冗余链路连接每个脊模块,因此系统最多有 个汇聚模块。
- TOR(L1)具有 64 个 40 Gbps 端口。3∶1 超额订阅配置使用 48 条下行链路连接服务器,16 条上行链路连接汇聚模块。这 16 条上行链路足以按每处一对冗余链路,连接汇聚模块中的八个 middle box。
- 在汇聚模块(L2)层,每个 middle box 有 64 条连接 TOR 的下行链路,因此每个 middle box 可连接 32 个 TOR。
系统最大服务器数量为:
实际服务器数量会更少,因为某些汇聚模块用于连接其他 WSC 集群和公共互联网。不过,也可将每条 40 Gbps 链路拆分为四条 10 Gbps 链路,以较低的单服务器带宽支持更多服务器。
超额订阅比为 1∶1 时,每个 TOR 有 32 条上行和 32 条下行链路。假定汇聚模块设计不变,每个汇聚模块现在可容纳 16 个 TOR,每个 TOR 用四条链路连接每个 middle box。系统最大服务器数量为:
要容纳更多服务器,就必须使用更多汇聚模块和更大的脊模块。虽然机架内大量服务器高速发送时,超额订阅可能造成拥塞,但对于连接给定数量的服务器,它能够大幅降低 WSC 网络成本。
| 数据中心网络代际 | 首次部署 | 商用交换芯片 | TOR 配置 | 边缘汇聚模块 | 脊模块 | 网络内部速率 | 主机速率 | 对分带宽 |
|---|---|---|---|---|---|---|---|---|
| Four-Post CRs | 2004 | 厂商设备 | 48 × 1 Gbps | — | — | 10 Gbps | 1 Gbps | 2 Tbps |
| Firehose 1.0 | 2005 | 8 × 10 Gbps;TOR 为 4 × 10 Gbps | 上行 2 × 10 Gbps;下行 24 × 1 Gbps | 2 × 32 × 10 Gbps | 32 × 10 Gbps | 10 Gbps | 1 Gbps | 10 Tbps |
| Firehose 1.1 | 2006 | 8 × 10 Gbps | 上行 4 × 10 Gbps;下行 48 × 1 Gbps | 64 × 10 Gbps | 32 × 10 Gbps | 10 Gbps | 1 Gbps | 10 Tbps |
| Watchtower | 2008 | 16 × 10 Gbps | 上行 4 × 10 Gbps;下行 48 × 1 Gbps | 4 × 128 × 10 Gbps | 128 × 10 Gbps | 10 Gbps | n × 1 Gbps | 82 Tbps |
| Saturn | 2009 | 24 × 10 Gbps | 24 × 10 Gbps | 4 × 288 × 10 Gbps | 288 × 10 Gbps | 10 Gbps | n × 10 Gbps | 207 Tbps |
| Jupiter | 2012 | 16 × 40 Gbps | 16 × 40 Gbps | 8 × 128 × 40 Gbps | 128 × 40 Gbps | 10/40 Gbps | n × 10 Gbps / n × 40 Gbps | 1300 Tbps |
WSC 网络包含大量链路,因此电缆成本与布线复杂性是重要考虑因素。目前,服务器与 TOR 之间通常采用成束铜缆。例如,一条 200 Gbps 链路可能由四根各 50 Gbps 的电缆,或两根各 100 Gbps 的电缆组成。在 1–3 m 的短距离、100–400 Gbps 的链路速率下,铜缆实用且具有成本效益。L1、L2、L3 交换机之间的链路长得多,达到几十至几百米,且速率更高,因此优先采用光缆。光缆往往预先捆扎成束,以降低 WSC 部署复杂性。随着配备 GPU 或其他 DSA 的服务器需要越来越高的带宽,服务器到 TOR 的铜缆连接越来越难实现。我们或许很快就会看到以下技术在数据中心广泛部署:含中继器的有源铜缆,用于扩大铜缆的传输距离和带宽;或与计算芯片共同封装的光收发器,用于降低服务器到 TOR 连接的光收发器成本与功耗。
为 WSC 安装 100,000 台服务器,需要数月乃至数年;装满之后,还会逐步用最新硬件升级。叶交换机可以按需添加和更换,不影响网络其他部分;脊交换机则带来困难的权衡。如果随着 WSC 装机逐步增加脊交换机,每次添加都须大量调整叶与脊之间的布线,造成长时间的性能下降。如果一开始就安装全部脊交换机,则可预先铺好未来叶交换机所需的线路;但这也意味着脊交换机采用数据中心中最老的技术。若 Clos 网络最初使用 100 Gbps 链路,将部分叶交换机升级为 200 Gbps,并不会提高带宽,除非脊交换机也升级。这一矛盾促使 WSC 运营商在叶与脊之间加入一层光电路交换机(optical circuit switch,OCS)。OCS 是微机电系统(MEMS),可在毫秒内重新编程,改变输入光纤与输出光纤的连接。它只反射光,不作分组级决策,因此与链路速率无关。图 6.19 展示 Google 如何使用 OCS 层,支持 Jupiter 网络中叶模块和脊模块的逐步部署,让每个阶段都能针对现有叶交换机构建尽可能好的拓扑(Poutievski 等,2022)。随着交换机逐步增加,所有布线也都可以增量完成。
Google 工程师又将这一想法推进一步,用 OCS 完全替代脊交换机。叶交换机只连接 OCS,OCS 之间也有直接连接。图 6.20 展示 Google 如何编程设置 OCS 内部连接,配置叶交换机之间所需的拓扑与连接速率(Poutievski 等,2022)。请注意,一对采用 200 Gbps 链路的新叶交换机,现在能直接以全速通信,即使它们与所有其他旧叶交换机通信时仍须降至 100 Gbps。之所以能做到这一点,是因为 OCS 与脊交换机不同,它只反射光,与速率无关。
图内术语:Spine Blocks=脊模块;Aggregation Blocks=汇聚模块;Machine Racks=机器机架;DCNI (OCS)=由 OCS 实现的 DCNI 光交换层。
图内术语:DCNI (4× failure domains)=DCNI(四个故障域);block-to-block=模块间;100/200 Gbps block-to-block logical links=100/200 Gbps 模块间逻辑链路;512×100 Gbps、256×100 Gbps、512×200 Gbps block=具有相应链路数量与速率的模块。图下注明:这些逻辑链路对应的底层物理链路,分条带分布在 DCNI 层的全部 OCS 上。A–D 与六幅需求矩阵的数值保持原图。
从整体看,Clos 拓扑的脊层提供一种机制,将流量分散并均衡到接收节点所在叶模块的全部链路。这种分散方式能很好地处理许多流量模式,甚至最坏的全对全置换模式,但代价是脊交换机需要大量光收发器。Google 工程师发现,其网络流量模式相对可预测,远没有达到脊层所针对的最坏置换模式。OCS 层使他们不必一味分散流量,而可以进行拓扑工程:根据每天的应用流量模式,编程设置叶交换机之间所需的连接关系与带宽数量。
WSC 网络还需要相应的控制平面系统,处理全部网络设备的配置、路由、管理与实时控制。互联网依赖分布式、相互独立的管理;WSC 控制平面则利用逻辑上集中的网络状态视图,在性能、可扩展性、安全性与活性方面进行优化,超越一次只考虑一条网络连接所能达到的水平(Ferguson 等,2021)。控制平面的决策,由网络各层级每个交换设备所关联的 CPU 控制器执行。WSC 网络也推动了通信应用所使用的传输协议快速演进。由于 WSC 网络是同构且集中控制的系统,可以从交换机取得拥塞与遥测信息,或准确测量往返时间,以构建更好的拥塞控制算法。也可以部署远程直接内存访问(RDMA)协议,获得低延迟、低开销通信。
程序员眼中的 WSC
WSC 体系结构影响各种类型的工作负载。即使只使用一个 VM 的负载,也需要理解访问远程服务器存储的影响。分布式或云原生负载,则必须针对 WSC 中大量机器与网络的性能和可靠性特征进行优化。
程序员需要理解 WSC 的存储层次结构。图 6.21 列出其延迟、带宽与容量,图 6.22 用图形展示同一数据。两图基于以下假设:
- 服务器的两个插槽合计有 16 个内存通道,安装 32 GB DDR4-3200 内存模块。总内存容量为 512 GB,访问延迟为 100 ns,全部通道的峰值带宽为 409.6 GB/s。
- 服务器包含一个 3.84 TB NVMe Flash 驱动器,最大读带宽为 6.9 GB/s,无负载读延迟为 100 μs;另有一块 20 TB 硬盘,平均访问时间为 5 ms,持续传输速率为 300 MB/s。两个 CPU 插槽共享一个 100 Gbps 以太网 NIC。
- 本例中,每个机架包含 48 台服务器。NIC、交换机与网络软件使 DRAM 和 Flash 的访问时间增加 100 μs,磁盘访问时间增加 500 μs。100 Gbps NIC 将远程接收带宽限制为12.5 GB/s,但数据可以由机架中的多个设备共同提供。机架总存储容量约为 24.5 TB DRAM、184.3 TB Flash 和 960 TB 磁盘。
- 一排有 30 个机架,因此整个阵列的存储容量提高到 30 倍:735 TB DRAM、5.5 PB Flash 和 29.8 PB 磁盘。多级网络设备及可能的拥塞,使阵列范围内 DRAM 的延迟增加 200 μs,Flash 增加 300 μs,磁盘增加 1 ms。超额订阅使每台服务器远程访问 DRAM、阵列 Flash 或阵列磁盘时可用的带宽,限制为 20 Gbps,即 2.5 GB/s。
| 指标 | 本地 | 机架 | WSC 一排机架 |
|---|---|---|---|
| DRAM 延迟(μs) | 0.1 | 100.0 | 200.0 |
| Flash 延迟(μs) | 100.0 | 200.0 | 300.0 |
| 磁盘延迟(μs) | 5000.0 | 5500.0 | 6000.0 |
| DRAM 带宽(MB/s) | 409600 | 12500 | 2500 |
| Flash 带宽(MB/s) | 6900 | 12500 | 2500 |
| 磁盘带宽(MB/s) | 300 | 12500 | 2500 |
| DRAM 容量(GB) | 512 | 24500 | 735000 |
| Flash 容量(GB) | 3840 | 184320 | 5500000 |
| 磁盘容量(GB) | 20000 | 960000 | 29800000 |
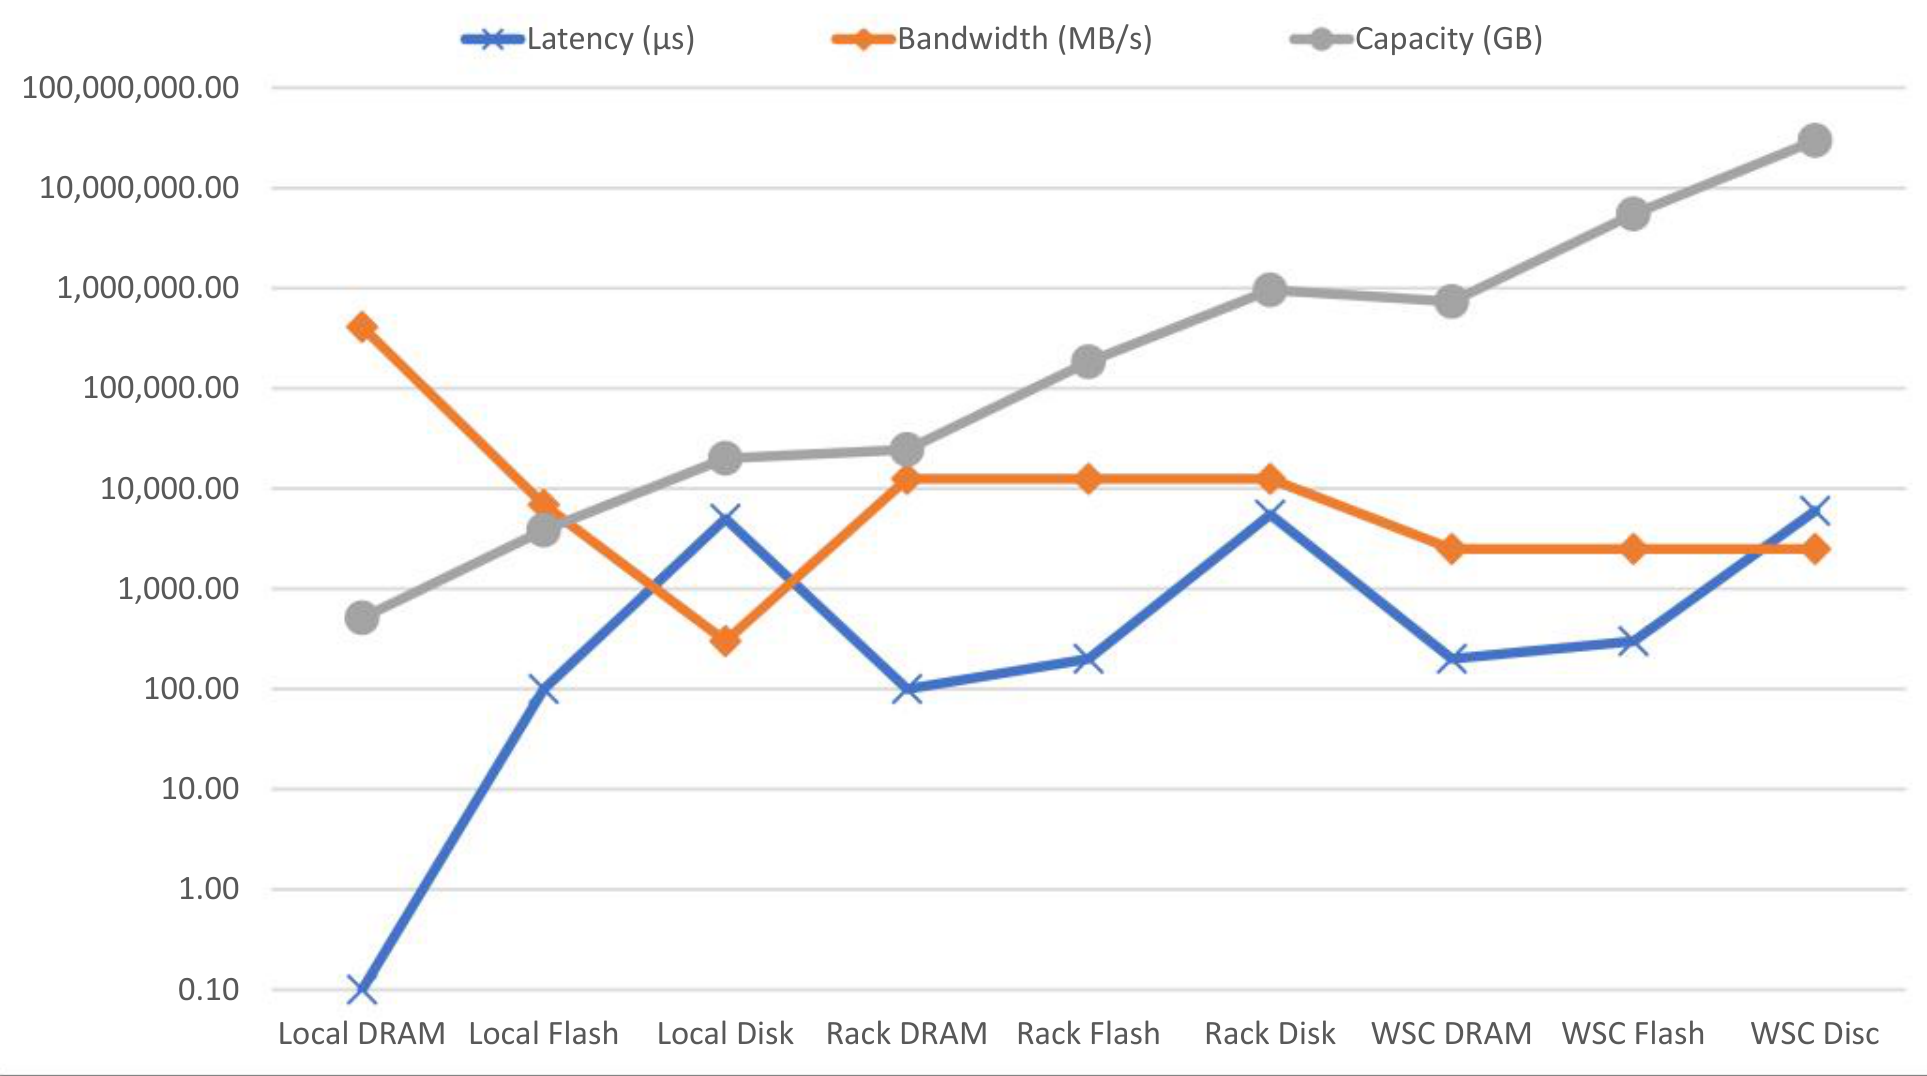
图内术语:Latency=延迟(μs);Bandwidth=带宽(MB/s);Capacity=容量(GB);Local=本地;Rack=机架范围;WSC=本例中一排机架的范围;DRAM、Flash、Disk/Disc 分别为 DRAM、Flash 与磁盘。纵轴使用对数刻度。
译注: 图 6.21 与正文均将一排机架的磁盘容量列为 29.8 PB;按同处给出的每架 960 TB、30 架计算,应为 28.8 PB,原值保留。正文还把阵列 DRAM 与 Flash 的延迟写成“增加 200 μs、300 μs”,而表中这两个数是远程访问的总延迟;表中的 Flash 总延迟 300 μs 对应在本地 100 μs 基础上增加 200 μs。原述与表值均保留,后续例题按表中总延迟计算。
图 6.21 和图 6.22 表明,对于机械硬盘和 Flash 设备,从本地访问改为远程访问,总延迟不会显著增加,因为设备本身的延迟远大于新增的网络延迟。如果数据来自多个远程磁盘,远程磁盘带宽会显著高于本地磁盘带宽。Flash 带宽在机架内部较高,跨一排机架时较低。这些观察推动了 WSC 中计算与存储的分离,为可扩展性和可靠性带来很大益处。许多分布式应用发起无状态计算任务,将其调度到 WSC 各处,并依赖分布式远程存储保存输入和输出。计算很容易扩展;分布式存储则通过将数据分片或分区到多个存储节点,达到所需的容量、带宽与可靠性。计算和存储都可以独立扩展,并利用大型 WSC 的并行性。
相比之下,两图显示,无论在同一机架还是同一排内,网络开销都会显著增加远程 DRAM 的访问延迟。尽管如此,远程 DRAM 与远程 Flash 的访问速度,仍比本地磁盘快十倍以上。网络使机架范围内 DRAM、Flash、磁盘之间的带宽差异消失,也使阵列范围内这三者之间的带宽差异消失。基于这些观察,许多 WSC 应用使用基于 DRAM 或 Flash 的分布式键值存储(KVS),快速访问海量数据。例如,Facebook 社交网络使用基于 DRAM 的 Memcache KVS,以交互式延迟提供服务;原文将服务规模写为“每天每用户数亿”(Nishtala 等,2013)。
译注: 原句写作“serve hundreds of millions per user each day”,没有明确说明“数亿”所计数的对象,且“per user”使量词关系可疑。
本地 DRAM 到远程 DRAM 的延迟骤增,推动了新 WSC 技术的部署。RDMA 网络技术消除了网络软件的开销和不可预测性。大多数网络开销,来自超额订阅引起的网络拥塞,或网络软件延迟;交换机本身每跳的直通延迟只有 200–500 ns。利用 NIC 硬件实现的 InfiniBand、RoCE 等网络协议,RDMA 可将远程内存访问延迟降至几微秒。新兴的 CXL 交换网络,也有望实现 WSC 内部的快速内存共享,即内存分离。
例题
假设 90% 的访问位于本地服务器,9% 位于服务器之外但在同一机架内,1% 位于机架之外但在同一排内,平均内存访问延迟是多少?
解答
AMAT 为:
与 100% 本地访问相比,约慢 100 倍。显然,服务器内部的访问局部性对 WSC 性能至关重要。
例题
在同一服务器内的磁盘之间、同一机架不同服务器的磁盘之间,以及同一排不同机架的服务器磁盘之间,传输 1000 MB 数据各需要多长时间?在这三种情况下,改为 DRAM 之间传输 1000 MB,速度能快多少?
解答
磁盘之间传输 1000 MB 需要:
在机架内及一排机架内传输时,带宽瓶颈是磁盘,而非网络。
内存到内存的块传输需要:
译注: 第一行保留原式; 实际约为 ,并非原书的 。按相同带宽口径计算,服务器内 DRAM 传输约需 2.44 ms。
因此,对于单台服务器之外的大块传输,数据位于内存还是磁盘并不重要。在网络限制下,关键在于采用多大的并行度,才能充分利用网络。对于大块传输,多个远程磁盘可以与远程内存竞争。
6.5 高性能 I/O 设备的体系结构
下面进一步考察 NIC 与 Flash 存储设备的体系结构。二者分别是 WSC 网络和存储的关键 I/O 组件。用于提高其带宽、降低延迟的许多软硬件优化,也适用于连接 CPU 宿主机,或直接连接 DSA 的其他 I/O 设备。
网络接口
图 6.23 展示一个简单网络接口(NIC)的框图,它有两个以太网端口,每个端口速率为 100 Gbps。每个端口都配有一个以太网介质访问控制(MAC)模块,以及一组发送/接收队列。MAC 模块用硬件实现网络栈的物理层——编码与信号传输——以及数据链路层——底层比特发送与接收。其余各层均可由宿主机软件实现,包括互联网通信常用的 IP 与 TCP 协议。下文将说明,现代 NIC 为其中一些软件任务提供完整或部分加速器。软件通过以太网设备驱动与 NIC 交互。发送和接收队列分别在两个方向上,将 MAC 层与软件栈解耦。每个队列至少需要存放两个以太网分组,每个分组最长可达 9000 字节。实际 NIC 的片上缓冲区更大。
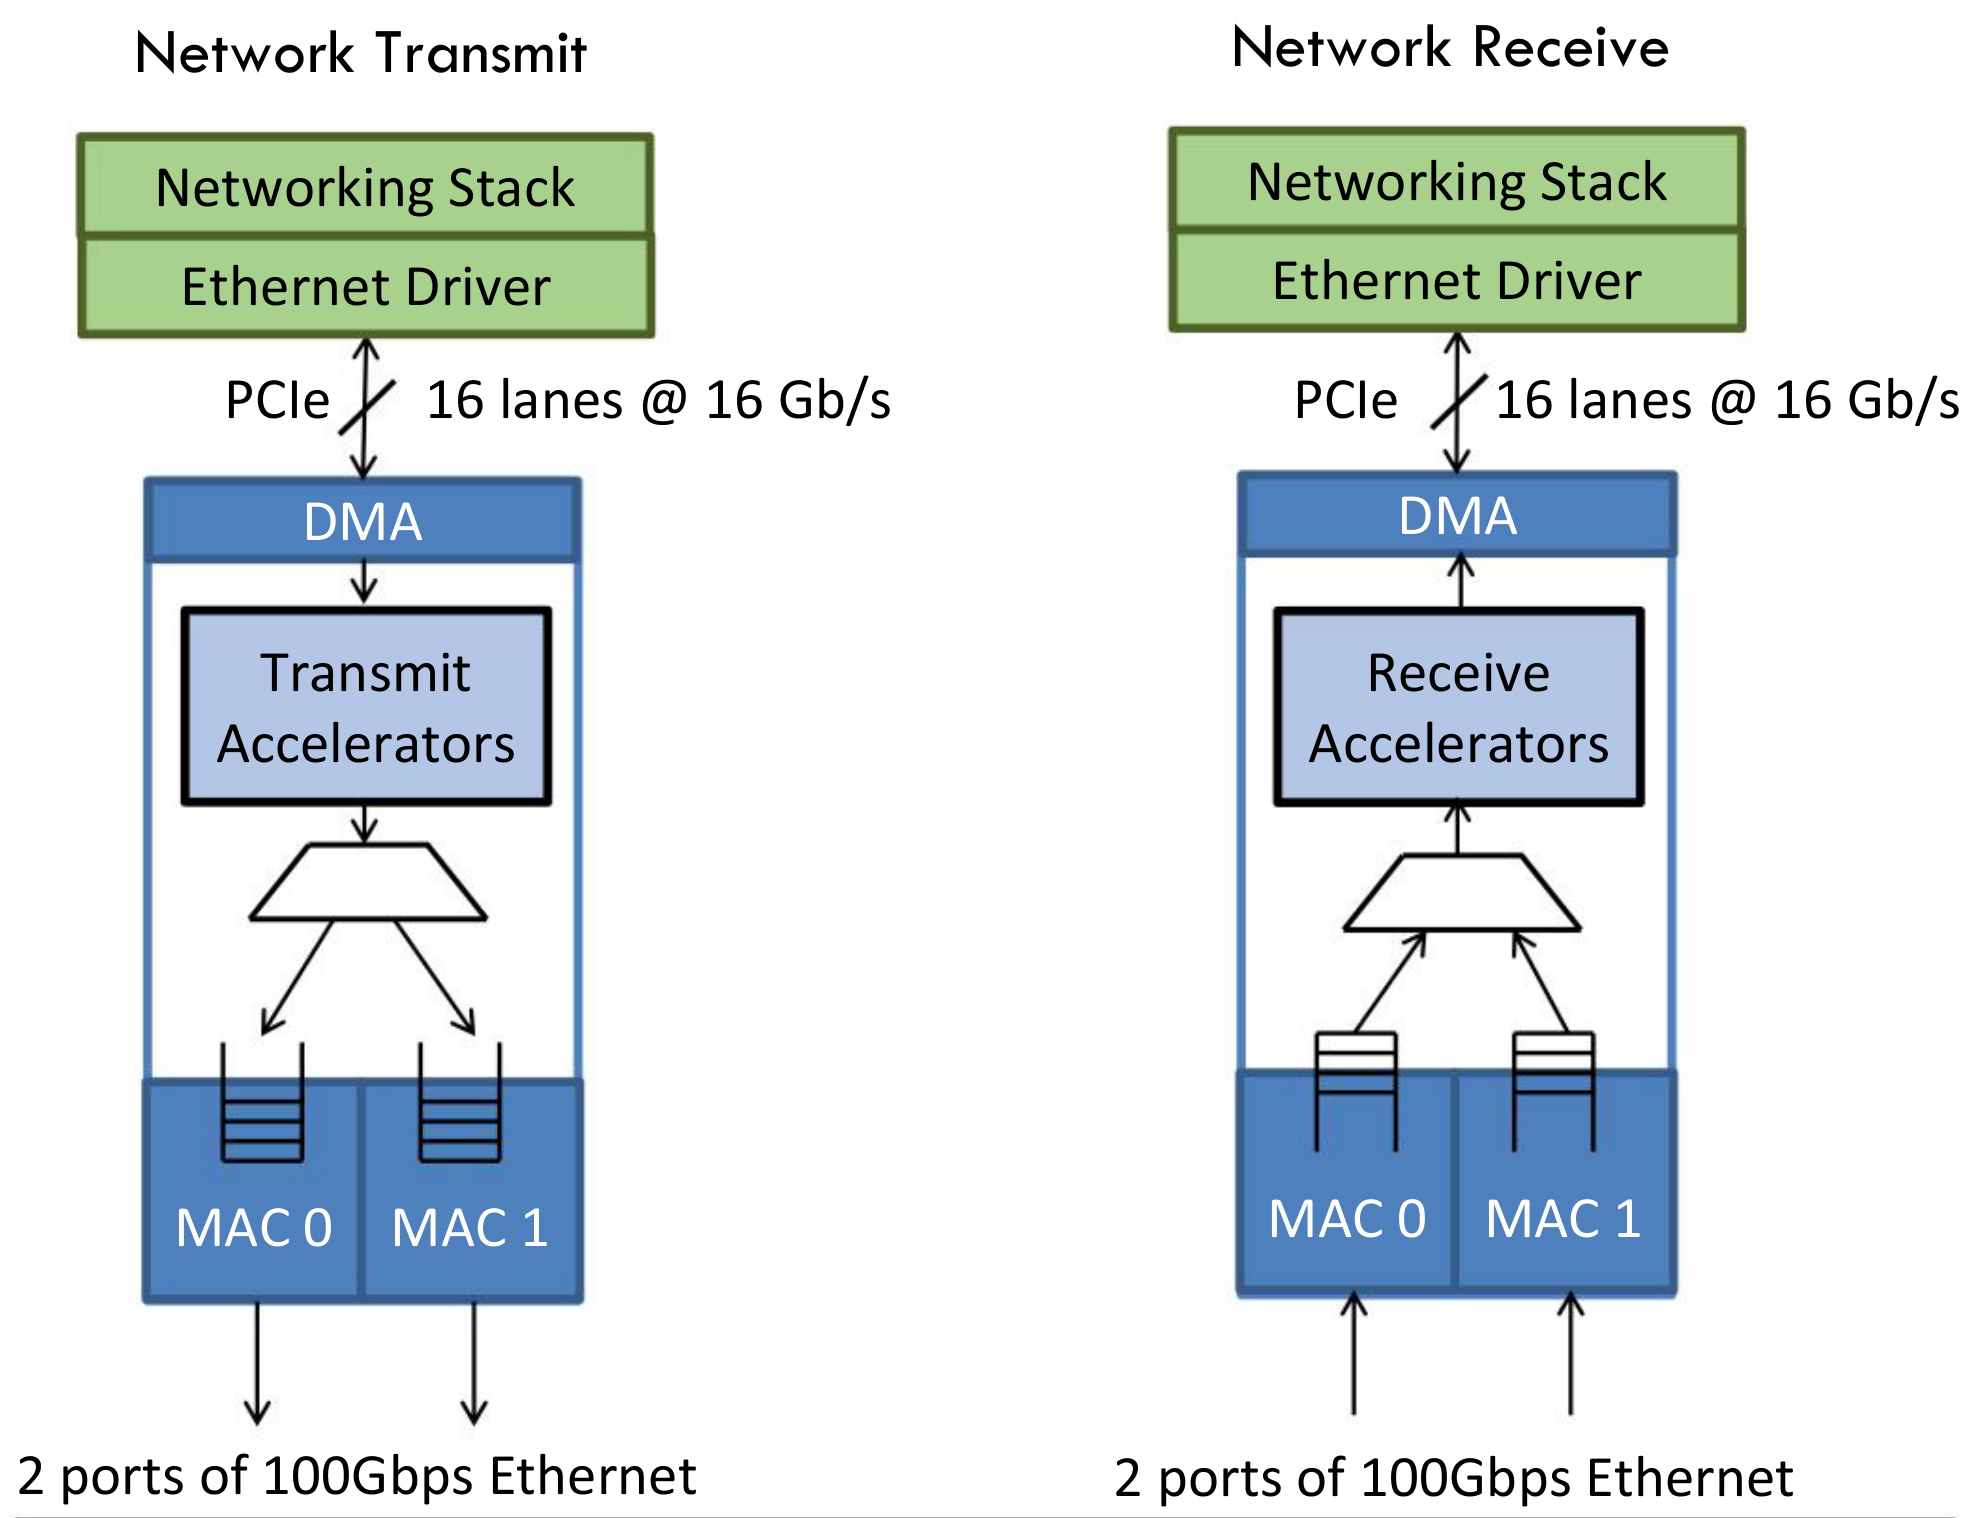
图内术语:Network Transmit/Receive=网络发送/接收;Networking Stack=网络协议栈;Ethernet Driver=以太网驱动;Transmit/Receive Accelerators=发送/接收加速器;16 lanes @ 16 Gb/s=16 条通道,每条 16 Gb/s;2 ports of 100 Gbps Ethernet=两个 100 Gbps 以太网端口;DMA=直接内存访问;MAC 0、MAC 1 为两个端口的 MAC 模块。
通过网络发送一个分组,要经过以下步骤。用户级软件在内存缓冲区中准备待发送数据,通过 write() 或 send() 等系统调用,沿预先建立的连接——例如 TCP/IP socket——发送。操作系统很可能先把数据复制到自身的内存缓冲区,再执行 TCP、IP 等一系列网络协议。每种协议都添加首部和尾部信息,例如源地址、目的地址、序号与纠错信息。分组准备好之后,操作系统设备驱动通过两个 FIFO 数据结构与 NIC 通信:发送队列(SQ)和完成队列(CQ)。它们都位于宿主机内存中,采用带首尾指针的环形缓冲区。操作系统驱动将描述符写入 SQ,其中包括分组的内存地址和目标以太网端口,然后递增 SQ 尾指针。接着,驱动写入映射到宿主物理地址空间的 NIC 寄存器,完成敲门铃(ringing a doorbell)操作,通知 NIC。NIC 随即访问 SQ 中第一个分组描述符,递增首指针,并设置 DMA 引擎,将分组从宿主内存复制到选定以太网端口的发送缓冲区。以太网 MAC 从缓冲区取出数据,以和上游以太网交换机协商好的速率发送,例如 100 Gbps。发送完成后,NIC 把分组描述符写入 CQ,递增 CQ 尾指针,并向宿主操作系统产生中断。处理中断时,操作系统可能释放该分组的内存缓冲区。对于 TCP 等协议,操作系统可能等到接收方确认收到数据后,才释放缓冲区。如果发送失败,可能重新发送分组。
通过网络接收分组,则经过以下步骤。NIC 与操作系统驱动通过一对 FIFO 数据结构通信:接收队列(RQ)和完成队列(CQ)。两者同样是宿主内存中带首尾指针的环形缓冲区。操作系统定期把为接收分组而分配的内存缓冲区地址填入 RQ。分组到达时,NIC 从 RQ 读取一个缓冲区地址,递增 RQ 首指针,再设置 DMA 引擎,将分组从 NIC 接收队列复制到操作系统缓冲区。DMA 传输完成后,NIC 释放其接收队列中的空间,将分组描述符写入 CQ,更新 CQ 尾指针,最后向宿主操作系统产生中断。操作系统随后通过 IP、TCP 等一系列协议处理分组,用错误检测码确认正确接收,并移除全部首部和尾部。接着,它把数据复制到监听该连接的应用的用户级缓冲区。最后,操作系统释放或回收自己的分组缓冲区,并可能生成确认消息,通知发送方分组是否无误收到。
上述简化的收发过程存在多处低效,会造成网络带宽低、延迟高。第一个问题是网络协议处理占用大量 CPU。NIC 通过所谓的无状态卸载(stateless offload)部分缓解这一问题,即用硬件加速器执行网络协议任务。最常见的卸载,是在发送时为 Ethernet、IP、TCP、UDP 等常用协议生成检错码,在接收时检查。NIC 在收发分组的过程中即时生成或检查检错码,并将结果告知宿主操作系统。NIC 还支持大段卸载(large segment offload):发送端逻辑把大消息拆分为网络支持的小分组;接收端则把小分组重新组装成大消息,即使分组乱序到达也能处理。因此,发送或接收 1 MB 数据块只需执行一次网络协议,而不是 次。大段卸载需要 NIC 配备更大的缓冲区,而且实现复杂,因为以太网分组经过 WSC 网络时可能重排,偶尔也会丢失。
第二个问题是中断处理开销。100 Gbps NIC 若接收最小的 64 B 以太网分组,每秒可能产生 2 亿次中断。为了避免 CPU 不堪重负,NIC 实现中断调节(interrupt moderation),限制中断频率,每次中断可表示多个分组到达。NIC 还包含中断导向逻辑,选择由哪个 CPU 核心接收中断。一种简单选择,是把所有分组的中断发给同一核心,使其用于网络处理的指令和数据缓存保持预热。在高网络速率下,这个核心会成为瓶颈,因此 NIC 也可以对每个分组的连接信息散列,把中断分散到多个核心,这称为接收端扩展(receive side scaling)。散列保证同一连接的全部中断交给同一核心,从而尽量减少同步开销。还应注意,操作系统完成网络处理后,可能需要再发一次中断,调度等待该分组的应用进程。因此,有些 NIC 会跟踪每条活跃连接最近在哪个核心发起发送系统调用;同一连接的分组到达时,就中断该核心。如果这个核心仍在运行建立连接的应用,就无需额外中断。操作系统与应用也可以通过轮询 NIC 的入站分组,完全避免中断。有些操作系统采用混合方案:NIC 中断使其开始执行网络子系统代码之后,会暂时保持轮询模式,以摊销中断成本。
第三个问题涉及内存与缓存开销。收发分组需要在 NIC、操作系统缓冲区和应用缓冲区之间多次复制。未经优化的系统消耗的内存带宽,会达到网络带宽的 5–8 倍。第一项优化是数据直接 I/O(DDIO):将收到的分组直接放入 CPU 的末级缓存。若分组很快得到处理,DDIO 能加速网络处理,并减少内存带宽消耗;否则,分组逐步被逐出到主存。第二项优化是首部分离(header splitting):将分组元数据与分组数据放在不同缓冲区。操作系统通常只处理首部,应用自己处理数据,因此分离能改善网络处理的局部性。首部分离也是零复制网络所必需的:载荷从 NIC 直接复制到应用缓冲区,省去经操作系统缓冲区进行的冗余复制。零复制要求接收应用预先提交可接收入站数据的缓冲区地址。分组重排和丢失会使零复制复杂化。
WSC 使用的大多数 NIC 是以太网设备,实现了上述若干优化。近几年,NIC 又出现两个趋势。第一,多个针对 ML 优化的集群采用 InfiniBand(IB)或融合以太网上的 RDMA(RoCE)网络设备。RoCE 在以太网之上实现 InfiniBand 协议。IB 与 RoCE 把全部网络协议处理卸载到 NIC,并对 CPU 或 GPU 内存中的应用缓冲区实现零复制网络。第二,开始部署 SmartNIC,在网卡上集成可编程核心,卸载广泛任务,包括网络协议处理、远程存储协议处理和各种 hypervisor 任务。公有云平台所用 NIC 还包含网络虚拟化硬件模块,即可编程逻辑:添加或移除支持私有虚拟网络所需的多层首部,并在共享 WSC 中执行安全规则(Firestone 等,2018)。
NVMe Flash 驱动器
Nonvolatile Memory Express(NVMe)驱动器广泛用于 WSC,构建针对高吞吐量与低延迟优化的存储系统。对于以每存储比特成本低为优化目标的系统,机械硬盘仍很常见。
图 6.24 展示 NVMe 驱动器的组成。关键组件是由垂直堆叠 Flash 存储芯片形成的封装,原文称每堆栈超过 100 个芯片,整体表现为一个高密度芯片。多个此类封装组织为通道,以提供并行性。每条通道一次只能支持一个访问,但设备控制器可以让不同通道的访问重叠。封装的访问粒度是 1–8 KB 的页,并包含一些用于纠错编码的备用存储空间。读一页需要几十微秒;写一页则更慢,也更复杂。页被组织为块,每块 64–256 页。首先用擦除操作重置块内容,需要数毫秒;随后可以按 0、1、2……的顺序逐页写入,每次写页需要一两毫秒。写入速度较低,源于 Flash 单元的性质——用浮栅上的电荷记录状态——以及为提高容量而广泛采用多级单元(MLC),还有 Flash 单元阵列的 NAND 组织方式。最后,Flash 块的耐久性有限。每块可擦除 100,000–1,000,000 次,之后便不能再正常存储数据。
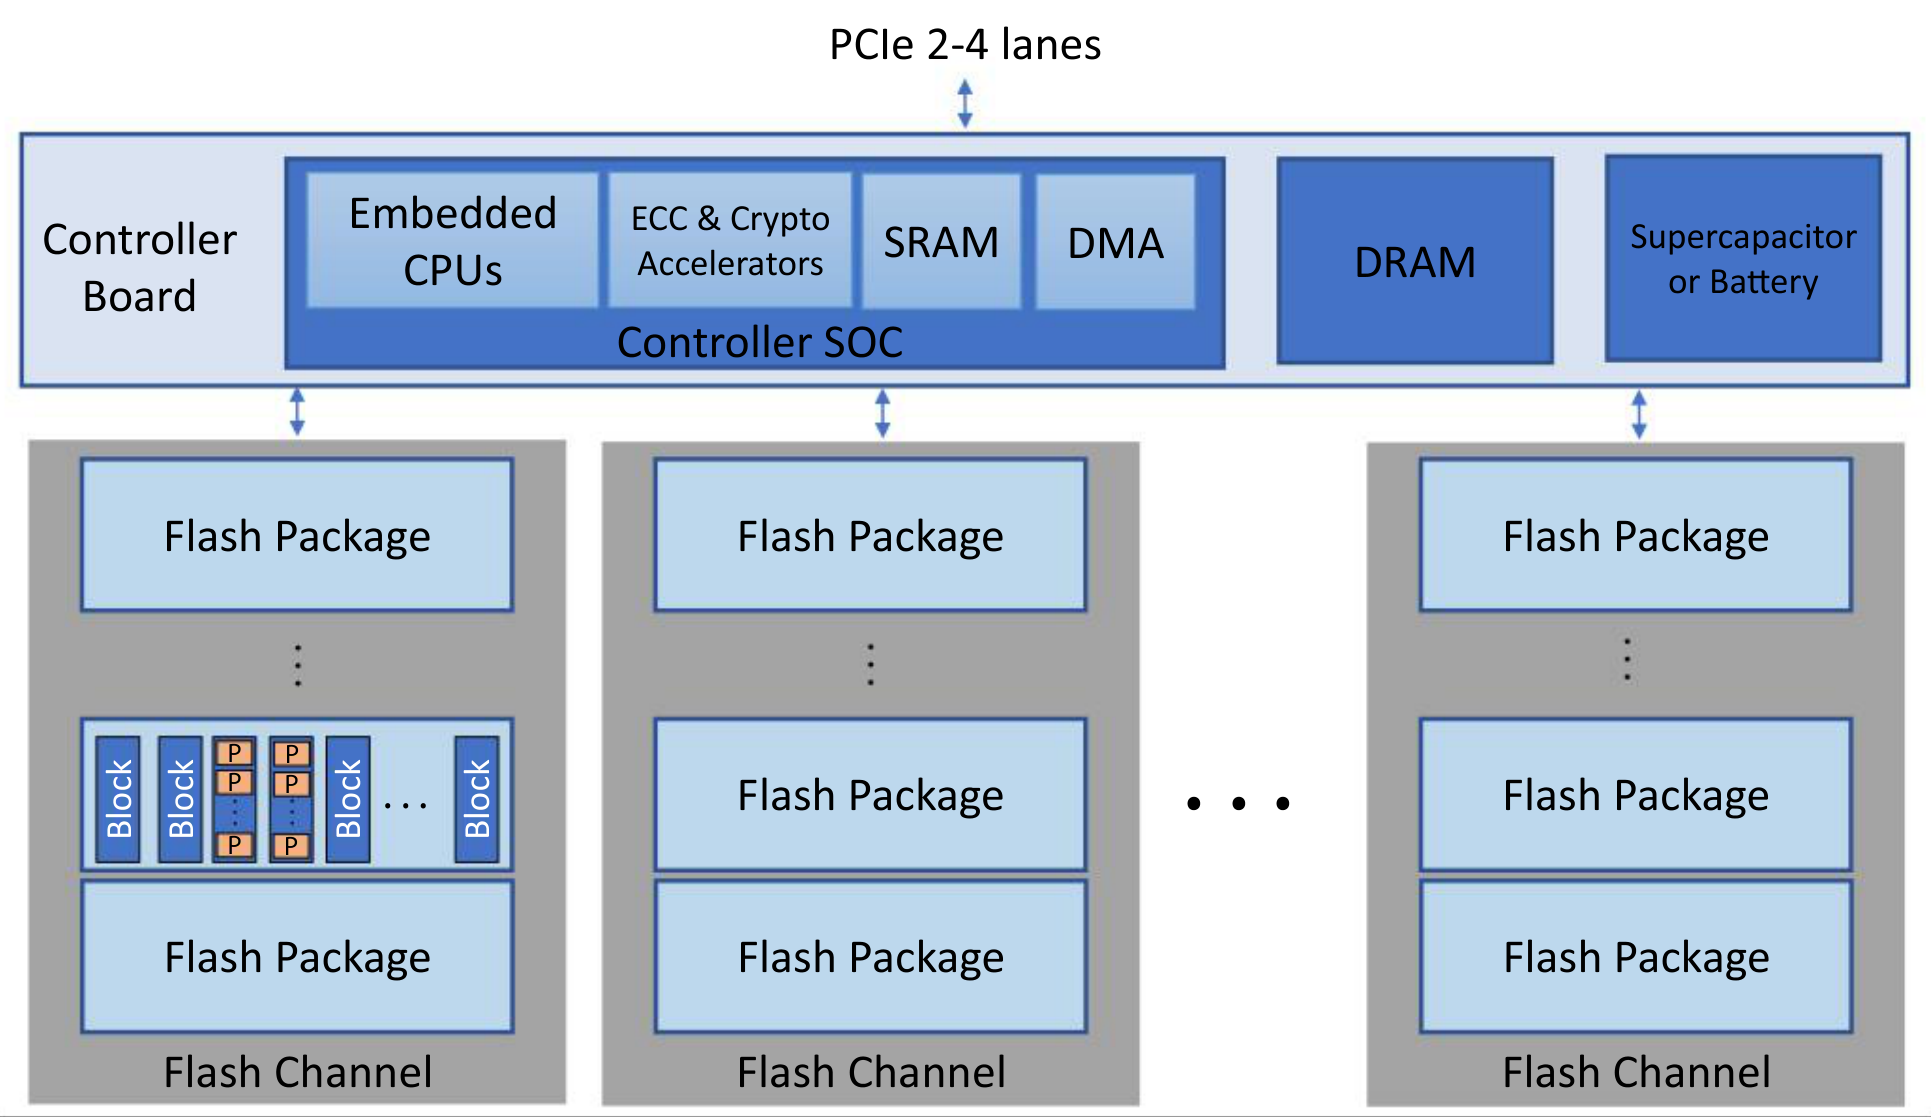
图内术语:Controller Board=控制器板;Controller SoC=控制器片上系统;Embedded CPUs=嵌入式 CPU;ECC & Crypto Accelerators=纠错码与密码加速器;Supercapacitor or Battery=超级电容或电池;Flash Channel=Flash 通道;Flash Package=Flash 封装;Block=块;P=页;PCIe 2–4 lanes=2–4 条 PCIe 通道。
这些设备特征使操作系统难以直接使用 Flash。因此,NVMe 控制器实现 Flash 转换层(FTL),将块存储读写访问转换为 Flash 的读、擦除与写操作,并把写入引起的磨损均匀分摊到全部可用块。图 6.25 展示 FTL 维护的关键数据结构。第一种是映射表,将宿主操作系统可见的逻辑块地址(LBA),映射到包含通道、封装、块和页编号的 Flash 设备地址。每次读取都查此表,确定要访问的物理页。第二种结构跟踪设备中每个块的状态,包括健康状况、是否已擦除,以及保存的有效页数。最后,还有指向当前写入点的指针,标识当前接收写入的块及块中下一个可用页。写逻辑块时,控制器在当前写入点写入新数据,更新映射表,记录逻辑块与物理页的新对应关系;最后,更新此前保存该逻辑块数据的 Flash 块的信息,将其有效页数减一。控制器选择擦除次数较少的 Flash 块作为下一个写入点,以均衡磨损。
| 数据结构 | 记录(LBA 或块号) | 物理页地址〈通道,封装,块,页〉 | 已擦除 | 擦除次数 | 有效页数 | 坏块标志 |
|---|---|---|---|---|---|---|
| 块映射表 | LBA 0 | 〈2,4,59,3〉 | — | — | — | — |
| 块映射表 | LBA 1 | 〈2,5,12,8〉 | — | — | — | — |
| 块映射表 | … | … | — | — | — | — |
| 块映射表 | LBA 8k | 〈4,0,33,129〉 | — | — | — | — |
| 块信息表 | 块 0 | — | False | 15 | 15 | False |
| 块信息表 | 块 1 | — | True | 33 | 0 | False |
| 块信息表 | … | — | … | … | … | … |
| 块信息表 | 块 2 | — | False | 1 | 4 | False |
| 写入点 | 写入点 | 〈3,1,12,24〉 | — | — | — | — |
NVMe 控制器在后台定期扫描块信息表,决定是否对有效页数较少的块进行垃圾回收。被回收块的所有有效页都复制到写入点,空块则安排擦除。这种紧凑整理对于利用全部可用容量至关重要,但会产生写放大问题:增加磨损,并延迟那些被额外写入阻塞的读取。针对不同访问模式与目标,垃圾回收和写入点选择存在多种权衡与算法。FTL 通常作为固件,运行在 NVMe 设备的一个或多个嵌入式核心上。图 6.25 的数据结构保存在 Flash 板上的 DRAM 中,并定期保存到 Flash,以保证非易失性。NVMe 设备通常配有超级电容,断电时控制器可以迅速把全部数据结构写入 Flash。FTL 还负责待处理访问的调度,以及利用 DRAM 缓存经常访问的数据。
NVMe 设备与宿主 CPU 软件之间的接口,类似于 NIC 的接口。它通过 PCIe 实现,采用命令队列与完成队列组成的队列对。发给 NVMe 的读写命令延迟不定,可能乱序完成。命令可能先排队,再由控制器调度。有些读命令很快完成,另一些则可能因对应 Flash 块、封装或通道存在待完成写入或垃圾回收任务,而延迟数毫秒。典型 NVMe 设备容量为 0.5–10 TB,无负载读延迟为 50–100 μs,吞吐量为每秒 1,000,000–2,000,000 次操作,功耗为 5–15 W。作为比较,典型硬盘容量为 1–25 TB,无负载读延迟为 5000–10,000 μs,吞吐量为每秒 100–200 次操作,功耗为 5–10 W。
I/O 设备虚拟化
如 6.3 节所述,可通过半虚拟化,或在加载/存储访问内存映射 I/O 地址时陷入 hypervisor,让它截获客户 VM 的全部 I/O 请求,以实现设备虚拟化。如今,NIC 和 NVMe 驱动器等高性能设备的设计,允许客户 VM 无需 hypervisor 协助便直接访问 I/O。
设备一侧的关键技术是 PCIe 接口虚拟化。按照 PCIe 标准的单根 I/O 虚拟化(SR-IOV)扩展,I/O 设备实现多个接口功能。唯一的物理功能(PF)包含管理设备全部功能所需的寄存器。非虚拟化系统中,唯一的操作系统运行设备驱动,使用 PF 完成 I/O;虚拟化系统中,hypervisor 使用 PF,并把设备实现的众多虚拟功能(VF)接口之一,映射到每个客户 VM 的客户物理地址空间,供其操作系统使用。每个 VF 都包含设备基本操作所需的全部寄存器:NIC 的分组收发,或 NVMe 驱动器的块读写。VF 不暴露管理功能,例如启用或禁用 VF、配置各 VF 可访问的存储块范围,或设置各 VF 可用的网络带宽比例。
宿主机一侧,支持 VM 直接访问 I/O 设备的关键技术是 6.3 节讨论的 IOMMU。hypervisor 配置 IOMMU,使其转换 I/O 设备各 PF/VF 使用的 DMA 地址,并正确重映射中断,从而让客户 VM 直接访问 VF。在每个 PF/VF 内,I/O 设备通常支持多个网络或存储访问队列对。这些队列对可以进一步分离和隔离客户 VM 内不同应用的 I/O 请求。例如,网络设备为每个应用使用独立队列对,可让操作系统控制各应用的带宽使用量,也可能把入站数据直接递送到应用的虚拟地址空间。
6.6 WSC 的配电与冷却
最先进 WSC 的关键负载功率可超过 100 MW,大致相当于美国 75,000 户住宅的用电功率。因此,理解如何向 WSC 供电,以及如何把热量排出设施,十分重要。事实证明,优化供电与冷却系统,并将其与 WSC 软硬件协同设计,是 WSC 尽管规模庞大,却仍具有成本效益的重要因素。
衡量 WSC 供电与冷却基础设施效率,有一个简单却有力的指标,称为电能使用效率(PUE,原文此处展开为 power utilization effectiveness):
IT 设备功率,是容纳计算、存储与网络设备的机架所消耗的功率。设施总功率还包括供电与冷却开销:供电过程中的电压转换带来损耗,冷却则消耗空调等设备的功率。PUE 大于或等于 1;数值越大,WSC 供电与冷却的效率越低。
Uptime Institute 已连续十五年跟踪大型设施的平均 PUE(Uptime Institute,2022)。2007 年平均 PUE 为 2.5,这意味着每向 IT 设备提供 1 W,供电与冷却还需要额外消耗 1.5 W,其中冷却占这部分开销的三分之二或更多。高开销带来三方面问题。第一,它提高 WSC 运行成本,特别是电费;配电与冷却基础设施还占 WSC 建设成本的大部分。第二,在设施总可用功率一定时,这些开销限制 WSC 的规模和可容纳的 IT 设备数量。第三,浪费能源不利于环境,尤其当发电能源并非可再生能源时,参见下一章 7.8 节。到 2021 年,报告中的平均 PUE 已降至 1.57。最大的 WSC 效率明显更高。图 6.26 显示 Google WSC 的平均 PUE,自 2020 年以来约为 1.10。
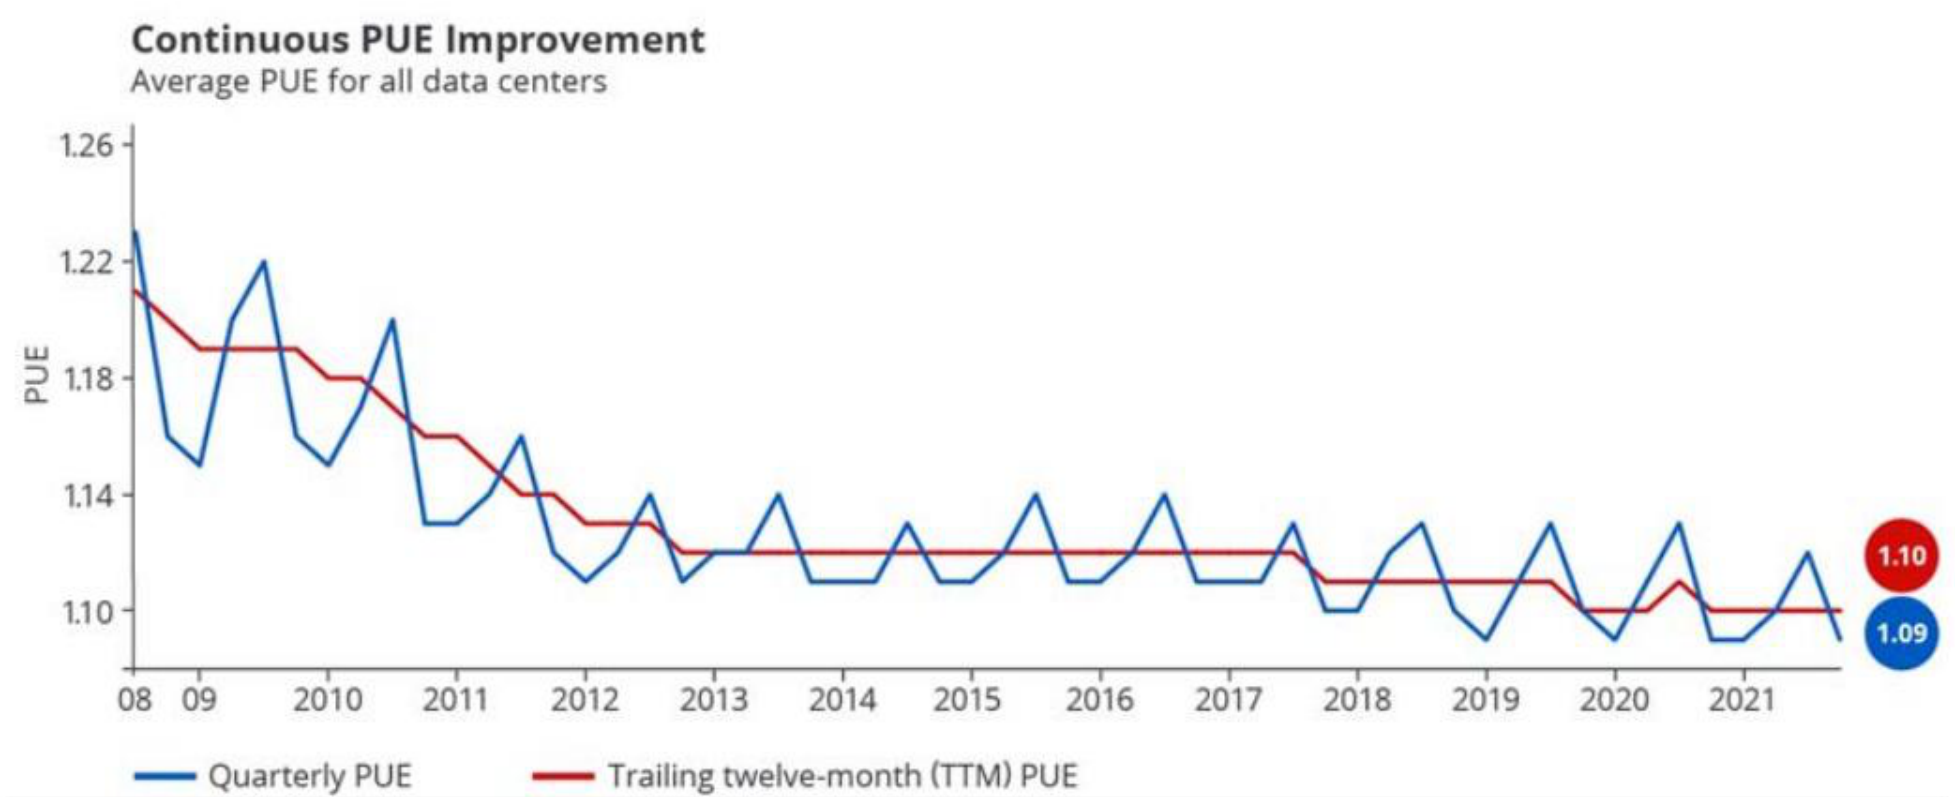
来源:Google Data Centers: Efficiency。图内术语:Continuous PUE Improvement=PUE 持续改善;Average PUE for all data centers=全部数据中心平均 PUE;Quarterly PUE=季度 PUE;Trailing twelve-month (TTM) PUE=过去十二个月 PUE。图中红线末值为 1.10,蓝线末值为 1.09,数据时间范围保持原图。
本节余下部分讨论,供电和冷却如何逐步优化,使额外开销降至 10%。PUE 并非常数:每座 WSC 周围的环境条件全年都在变化,影响冷却系统效率,因此其 PUE 也随之变化。
WSC 的供电
图 6.27 展示一个 WSC 供电基础设施实例,以及从公共电网线路到服务器之间的多次转换。为提供冗余,通常有两个外部电源,通过 115 kV 交流高压线路供电。电网变电站将电压降至 10–50 kV 交流,用于园区内部配电。接着,多个单元变电站将电压降至 400–500 V 交流,并接入某种不间断电源(UPS),确保外部供电中断时,WSC 的一部分仍能运行。UPS 系统通常包含一组柴油发电机,在外部断电后的 10–15 秒内提供电力;还包含某种电气、机械或化学储能,覆盖发电机启动所需的时间。UPS 还会平滑供电,消除尖峰与电压暂降。
来源:James Hamilton 的报告。图内术语与数值:High voltage utility distribution=高压公共电网配电;Substation=变电站,效率 99.7%;UPS: Rotary or Battery=旋转式或电池式 UPS,效率 94%;Transformers=变压器,两级各为 98% 效率;PDUs=配电单元;IT load—servers, storage, network=IT 负载——服务器、存储、网络;开关设备与导体损耗约 1%。图中路线标有 115 kV、13.2 kV、480 V、208 V;2.5 MW 发电机约消耗 180 加仑/小时。图注说明 UPS 与发电机也常接在 480 V 层级,服务器内部另有两级电源转换。总体效率为 ,即配电损耗约 11%。
每个单元变电站向多个配电单元(PDU)供电,由 PDU 降至 IT 硬件接受的 110 V 交流(北美)或 220 V 交流(欧洲)。每个 PDU 可支持 100–200 kW 功耗,包含多个断路器,每个约支持 6 kW,使单台服务器短路的影响范围较小。发电机与 UPS 以 或 冗余方式部署,其连接方式保证即使一个发电机或 UPS 因故障或维护离线,全部 PDU 仍能工作。
上述每次电压转换都会引入损耗。UPS 往往是最大问题,效率为 94%–97%,即损耗 3%–6%,因为为了连接电池等储能设备,需要经过交流转直流、再由直流转交流的双重转换。传统设计的总损耗可高达 11%,即效率只有 89%。遗憾的是,IT 设备内部还有更多损耗,PUE 并未计入。典型服务器的电源将 110 V 或 220 V 交流转换为 12 V 直流,再由稳压器降至半导体芯片所需电压,例如 CPU 可能需要 1.1 V 直流。服务器内部总损耗同样可达 10%。因此,有人建议在 PUE 之外,再使用服务器级电能使用效率 sPUE。
限制供电损耗的关键,是减少电压转换次数。一项重要改进,是采用分布式 UPS 功能,省去接在变电站层级的集中式 UPS 所需的双重转换。常见设计是在每个机架中加入电池阵列,作为架内全部设备的本地 UPS。这种安排效率达到 99%,而且增加了容错能力:单个电池失效时,阵列仍可运行。改用直流配电,还可以进一步改善效率。例如,变电站输出 380 V 直流,机架级电源降至 12–48 V,再分配给 IT 设备。机架内部直流配电,也免去了机架级 UPS 电池阵列所需的双重转换。
WSC 的冷却
WSC 设备产生大量热量,通过多层封闭式与开放式冷却回路,最终转移到设施之外。图 6.28 展示完整冷却回路,包括传统的架空地板冷却设计,以及 IT 机房之外所需的换热器、冷却塔等系统。机房空调(CRAC)冷却服务器机房空气。冷空气通过混凝土地板与钢结构支撑的架空地板砖之间的区域分配,再经冷通道中的穿孔地板砖释放。相邻排机架中的服务器朝向相反,使热排风交替朝不同方向吹出,形成冷热通道相间的布局。服务器风扇帮助冷空气流经芯片和散热器,将热量带到热通道。热空气向上升起,流向 CRAC 进风口,在那里利用冷冻水再次冷却,类似冰箱通过向箱外释放热量来制冷。液体吸热时蒸发;反过来,放热时凝结。空调在低压下将液体泵入盘管,使其蒸发吸热,再送往外部冷凝器释放热量。因此,在 CRAC 中,风扇推动热空气流经充满冷水的盘管,水泵再把变热的水送到冷水机组降温。
来源:James Hamilton 的报告。图内术语:Cooling tower=冷却塔;CWS pump=冷却水系统水泵;Heat exchanger (Water-side economizer)=换热器(水侧自然冷却装置);Primary pump=一次泵;A/C condenser/compressor/evaporator=空调冷凝器/压缩机/蒸发器;Computer room air handler=机房空气处理机;Air impeller=送风叶轮;Fans=风扇;Cold/Hot=冷/热;Leakage=泄漏;Diluted hot/cold mix=混合后的冷热空气;Server fans 6 to 9 W each=每个服务器风扇 6–9 W。图中注明:8 MW 设施的排污与蒸发损失约为每天 200,000 加仑。
这种基于 CRAC 的设计效率很低,是早期数据中心高 PUE(大于 2.5)的主要原因。过去十五年,一系列措施大幅降低了 WSC 冷却开销,使其降至 10%–20%。最简单却重要的方法之一,是让 IT 设备在更高温度下工作,减少空气所需的降温幅度。WSC 将冷通道温度从传统 IT 设施的低于 68°F(20°C),提高到 80°F(27°C)。虽然 IT 设备还能在更高温度下运行,但这可能影响错误发生频率及设备整体寿命。另一项简单优化,是物理隔离冷热通道,避免机架顶部冷热空气混合造成损失。图 6.29 展示 Google WSC 中隔离的热通道。接着,WSC 设计者对气流进行整体优化。传统数据中心中,每台服务器依靠内部风扇,确保有足够冷空气流过发热芯片,维持温度。这些机械风扇是服务器最脆弱的组件之一:例如,风扇的平均失效间隔时间(MTBF)为 150,000 小时,磁盘则为 1,200,000 小时。风扇自身还消耗可观功率,每个 6–9 W。例如,Google 将服务器风扇设计为与机房内数十个巨型风扇协同工作,保证整个机房的气流(图 6.30)。这种分工使小型服务器风扇尽量少耗电,同时仍能在最差功率与环境条件下发挥最大性能。大型风扇以气压作为控制变量,通过调整转速,维持冷热通道间所需的最小压差。
接下来的一组优化,针对空调冷水机组对机械制冷的需求。基本思想是利用 WSC 附近的低温空气或水,获得近乎免费的冷却。空气侧自然冷却(air-economization)使用大型风扇,将室外冷空气送入设施;空气先经过滤以避免污染,热空气则排到建筑之外。水侧自然冷却(water-economization)利用数据中心附近湖泊、河流或海洋中的冷水,以 WSC 空气冷却水回路与外部冷水源之间的换热系统,替代冷水机组(图 6.31)。空气侧与水侧自然冷却可以完全替代机械制冷,或者使冷水机组一年中只在少数炎热天气启用。因此,PUE 可能随时间变化,如图 6.26 所示。
随着时间推移,处理芯片功耗持续增加,最新 CPU 已达 400 W,GPU 达 800 W。装有这类设备的机架难以用空气冷却,促使液冷得到更广泛采用。第 7 章将介绍直接对处理芯片采用闭式液冷回路的 ML 加速器实例。WSC 运营商也在研究将 IT 设备浸没在特殊冷却液中,以改善散热,支持更快运行、更高时钟频率,或每芯片更多并行处理单元(Jalili 等,2021)。
6.7 仓库级计算的成本与效率
了解了 WSC 的体系结构,包括其机械组件之后,现在可以讨论其成本,以及为何这些设施虽然昂贵,却仍被认为具有成本效益。
WSC 的成本
如引言所述,WSC 设计者既关心建设成本,也关心运行成本。会计上将后者称为运营支出(OPEX),前者称为资本支出(CAPEX)。
为了把能源成本放到总体背景下考察,Hamilton(2010)通过案例研究估算一座 WSC 的成本。他确定,一座 8 MW 设施的 CAPEX 为 8800 万美元;约 46,000 台服务器及相应网络设备,再为 WSC 增加 7900 万美元 CAPEX。图 6.32 列出了这一案例的其他假设。
Hamilton 的研究折合每瓦的建筑、供电和冷却成本为 $11。Barroso 等(2018)报告的多个案例与之相符,每瓦成本为 $9–$13。
按照资本成本换算,可以将 CAPEX 转换为 OPEX,假定借款成本为 5%;这是美国会计规则中的一种标准惯例。也就是说,可以在设备有效寿命内,把 CAPEX 按固定金额逐月摊销。图 6.33 列出 Hamilton 案例每月 OPEX 的构成。请注意,各类资产的摊销年限差别很大:设施为 10 年,网络设备为 4 年,服务器为 3 年。因此,WSC 设施使用十年,但服务器每三年更换,网络设备每四年更换。通过摊销 CAPEX,Hamilton 得出每月 OPEX,其中也计入为建设 WSC 借款所需的资金成本,即年利率 5%。每月 OPEX 为 380 万美元,约占 CAPEX 的 2%,或每年占 24%。
这一数据还可以推导一条方便的经验准则,在考虑能耗、选择组件时作为参考。将供电与冷却基础设施摊销计入后,WSC 中每瓦每年的全部成本为:
| 项目 | 假设或成本 |
|---|---|
| 设施规模(关键负载,W) | 8,000,000 |
| 平均功率使用比例 | 80% |
| PUE | 1.45 |
| 电价(美元/kWh) | $0.07 |
| 供电与冷却基础设施占设施总成本比例 | 82% |
| 设施 CAPEX,不含 IT 设备 | $88,000,000 |
| 服务器数量 | 45,978 |
| 每台服务器成本 | $1450 |
| 服务器 CAPEX | $66,700,000 |
| 机架交换机数量 | 1150 |
| 每台机架交换机成本 | $4800 |
| 阵列交换机数量 | 22 |
| 每台阵列交换机成本 | $300,000 |
| 第 3 层交换机数量 | 2 |
| 每台第 3 层交换机成本 | $500,000 |
| 边界路由器数量 | 2 |
| 每台边界路由器成本 | $144,800 |
| 网络设备 CAPEX | $12,810,000 |
| WSC 总 CAPEX | $167,510,000 |
| 服务器摊销年限 | 3 年 |
| 网络设备摊销年限 | 4 年 |
| 设施摊销年限 | 10 年 |
| 年资金成本 | 5% |
来源:Hamilton, J., 2010. Cloud computing economies of scale. AWS Workshop on Genomics and Cloud Computing,2010 年 6 月 8 日,Seattle, WA。报告原址。
译注: 图 6.32 原图注引用“图 6.14”,但该图是 Lightning JBOF;包含人员成本的实际是图 6.33。上方保留原引用并在此指出。
成本大约为每瓦每年 $2。从短期经济角度看,为节能而降低成本,所增加的支出不应超过每节约一瓦每年 $2,见 6.9 节。从长期环境角度看,更高的节能支出也可能合理,见 7.8 节。
图 6.33 中,超过三分之一的 OPEX 与电力有关;随着时间推移,这部分成本呈上升趋势,而服务器成本呈下降趋势。网络设备也很重要,占总 OPEX 的 8%,相当于服务器 CAPEX 的 19%。网络设备成本下降没有服务器那么快,可能是因为更高网络带宽的需求持续增长。机架之上的网络层级中的交换机尤其如此,它们占网络成本的大部分。安保与设施管理人员成本仅占 OPEX 的 2%。用图 6.33 的 OPEX 除以服务器数量与每月小时数,得到每台服务器每小时成本约为 $0.11。
| 支出类别及占比 | 项目 | 月成本 | 占月成本比例 |
|---|---|---|---|
| 摊销后的 CAPEX(85%) | 服务器 | $2,000,000 | 53% |
| 同上 | 网络设备 | $290,000 | 8% |
| 同上 | 供电与冷却基础设施 | $765,000 | 20% |
| 同上 | 其他基础设施 | $170,000 | 4% |
| OPEX(15%) | 每月电力消耗 | $475,000 | 13% |
| 同上 | 每月人员工资与福利 | $85,000 | 2% |
| 合计 | 总 OPEX | $3,800,000 | 100% |
Barroso 等(2018)按每瓦每月成本评估 CAPEX 和 OPEX。一座 12 MW 的 WSC 若按十二年折旧,折旧成本为每瓦每月 $0.08。他们假定企业通过年利率 8% 的贷款取得建设资金;企业贷款利率通常在 7%–12%。利息再增加 $0.05,使合计成本达到每瓦每月 $0.13。他们以类似方法计入服务器成本。一台 500 W、价格 $4000 的服务器,相当于每瓦 $8;按四年折旧,为每瓦每月 $0.17。服务器贷款的 8% 利息再增加 $0.02。网络成本估计为每瓦每月 $0.03。他们报告,多 MW 级 WSC 的典型 OPEX 为每瓦每月 $0.02–$0.08,全部合计为每瓦每月 $0.37–$0.43。对于 8 MW WSC,扣除电费后的月成本约为 300 万–350 万美元。若从 Hamilton 的计算中减去每月电费,其月成本估计为 330 万美元。虽然采用的成本预测方法不同,二者结果却相当一致。
例题
美国各地区电价不同,从每 kWh $0.03 到 $0.15 不等。这两个极端电价对服务器每小时成本有何影响?
解答
将关键负载 8 MW 乘以图 6.32 中的平均 PUE(原文指“第二行”),计算平均功率使用量:
于是,图 6.33 中原为 $475,000 的每月电费,在每 kWh $0.03 时降至 $205,000,在每 kWh $0.15 时升至 $1,015,000。电费变化使每台服务器每小时成本由 $0.11,分别变为 $0.10 和 $0.13。
译注: 图 6.32 第二行是 80% 的平均功率使用比例,PUE 1.45 实际位于第三行;原解算式同时使用了二者。
例题
如果把所有摊销年限统一设为五年,每月成本会怎样变化?每台服务器每小时成本会怎样变化?
解答
原始电子表格可在线获取。把摊销年限改成五年后,图 6.33 的前四行变为:
| 项目 | 月成本 | 占比 |
|---|---|---|
| 服务器 | $1,260,000 | 37% |
| 网络设备 | $242,000 | 7% |
| 供电与冷却基础设施 | $1,115,000 | 33% |
| 其他基础设施 | $245,000 | 7% |
总月 OPEX 为 $3,422,000。如果所有设备每五年更换,每台服务器每小时成本为 $0.103;与图 6.33 相比,摊销成本中更多部分转移到设施,服务器所占部分相应减少。
每台服务器每小时约 $0.10 的成本,可能远低于许多企业自行拥有和运营较小传统数据中心的成本。WSC 的成本优势促使大型互联网企业像供电一样,把计算作为公共服务提供,用户只需为实际使用量付费。
这些年来,WSC 规模显著扩大,大型设施如今功耗超过 100 MW。上述 TCO 计算方法与结论仍然适用。现代 WSC 的建设成本为每瓦 $7–$10。图 6.34 的案例研究显示,装满设备的 WSC,其 TCO 以资本支出为主,尤其是计算、网络与存储设备成本(60%–65%),以及设施成本(10%);电力和 PUE 开销则低得多,分别约为 5% 和 3%。
通过电力配置提高效率
即使按每瓦 $7 计,一座 100 MW WSC 的建设成本也达 7 亿美元。提高成本效益的第一种方法,是容纳尽可能多的服务器,以摊销这笔成本。令人意外的是,扣除配电与冷却开销后,WSC 究竟能支持多少服务器,并不显而易见。服务器厂商标出的铭牌额定功率总是保守值:它表示所有组件同时达到最大功耗时,服务器可能消耗的最大功率。因此,第一步是在准备部署到 WSC 的各种负载下测量单台服务器,从功耗压力极端的 power-virus 基准测试,到更真实的工作负载。网络设备通常约占功耗的 5%,开始时可忽略。这些测量给出服务器实际峰值功率的估计,通常比铭牌功率低 60%,使 WSC 能部署的服务器数量大幅增加。
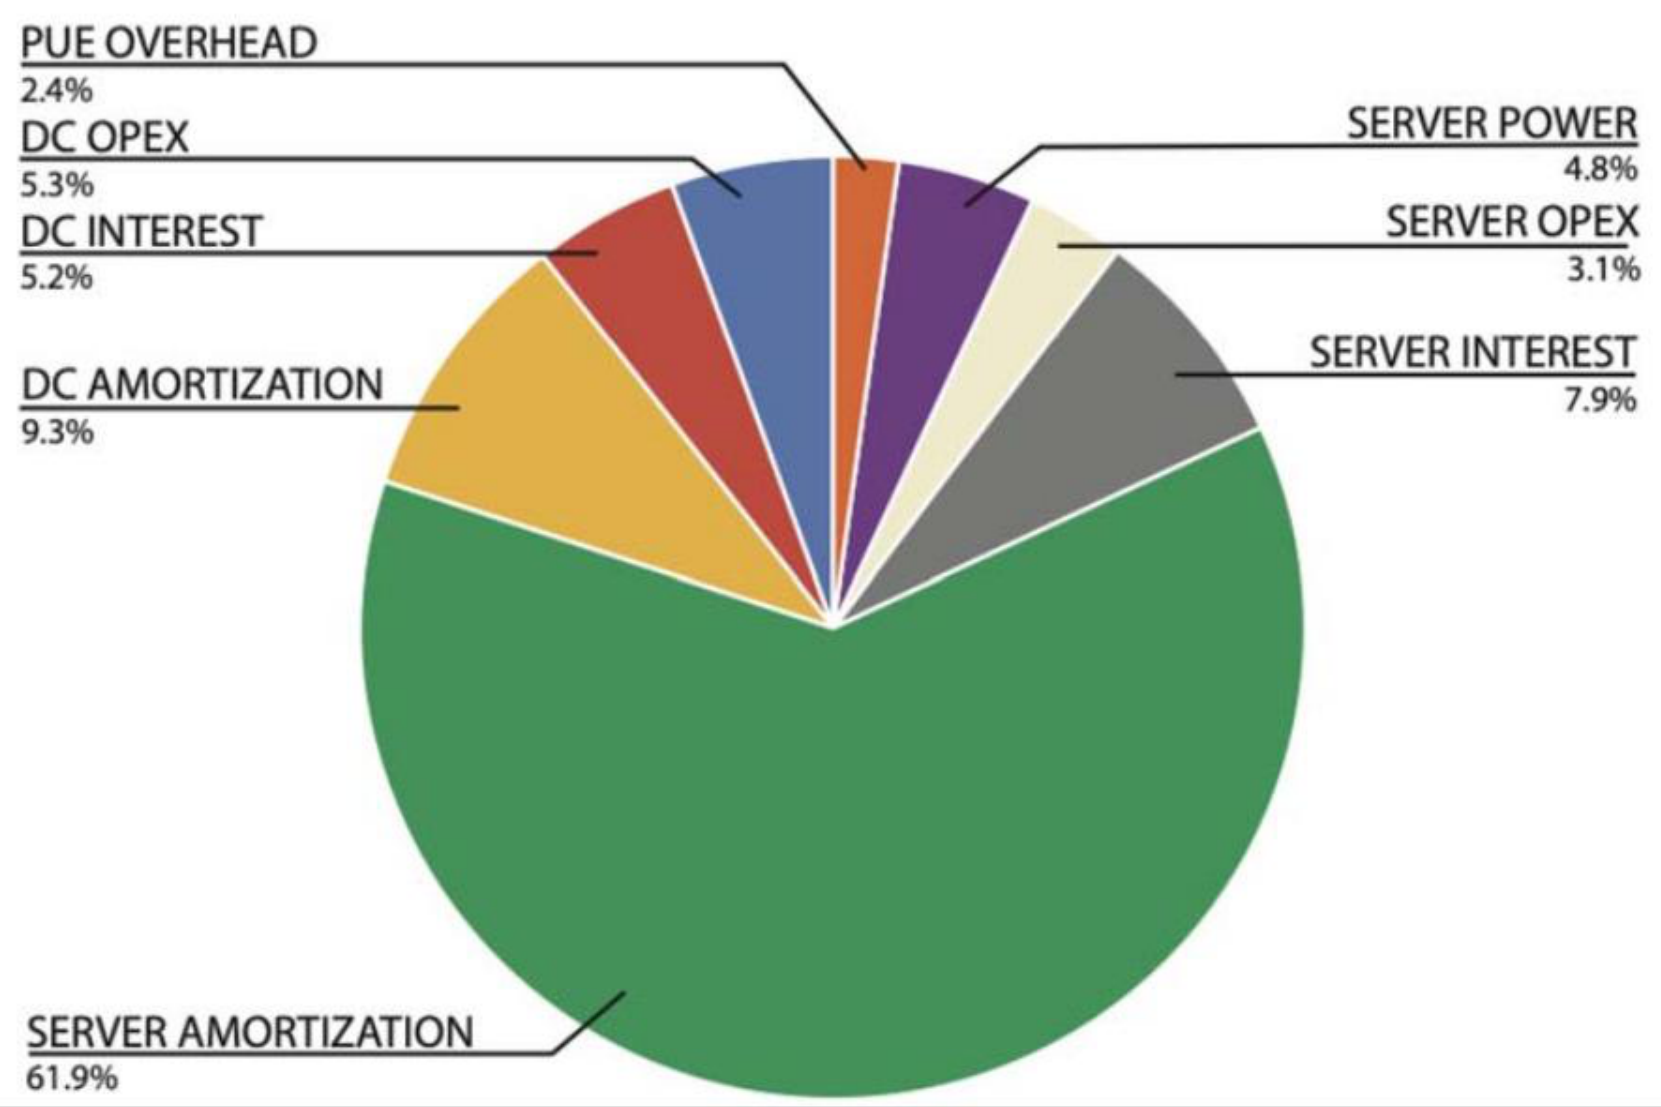
图内各项:服务器摊销(Server amortization)61.9%;服务器利息(Server interest)7.9%;服务器 OPEX 3.1%;服务器电力(Server power)4.8%;PUE 额外开销 2.4%;数据中心 OPEX 5.3%;数据中心利息(DC interest)5.2%;数据中心摊销(DC amortization)9.3%。
Fan 等(2007)表明,按服务器实际峰值功率配置仍然过于保守。他们发现,数千台服务器在理论最坏情况下可能达到的功耗,与实际会达到的功耗之间存在显著差距,因为没有真实负载会让数千台服务器同时保持峰值。以单台服务器实测峰值为基础,他们发现服务器数量可以安全地超额配置最多 40%。这种电力超额配置在 WSC 中已很常见,但需要全面的监测框架,检测同一机架、同一 PDU 之后,或整个 WSC 的服务器是否出现相关的功耗峰值。可使用以下技术缓解暂时超出机架、PDU 或 WSC 供电能力的问题:
- a. 降低部分服务器的时钟频率,从而降低功耗;
- b. 暂时从每个机架的电池中取得额外电力;
- c. 暂停低优先级任务,或将其从运行调度中撤下;
- d. 在机架、PDU 或 WSC 之间迁移任务,均衡电力需求,避免相关的功耗尖峰。
只要这些手段很少使用,对工作负载性能和电池寿命的影响就很小。
充分利用 WSC 中每一瓦可用功率,也是为 ML 等关键工作负载开发 DSA 的重要原因。第 7 章将说明,DSA 的每瓦性能比通用 CPU 高两个数量级。DSA 显著减少了为满足工作负载性能需求而新建 WSC 的必要性。这些节省很容易抵消大型定制 ASIC 的软硬件开发成本;2022 年,这类成本为 5000 万–1 亿美元。
通过提高利用率提高效率
由于服务器 CAPEX 主导 TCO,让服务器在大多数时间得到利用,对总体效率十分重要。WSC 面向公众提供效用计算,即云计算,也可面向一家大公司的工作负载提供私有云。在同一服务器池上复用用户和工作负载,不同负载需求的高峰与低谷相互平均,因而提高利用率。尽管如此,让 WSC 长期接近满负载运行仍然困难。图 6.35 展示 Google 两个集群在三个月期间的平均利用率分布。集群(a)用于混合负载,包括多种面向用户的服务。这些服务具有昼夜周期:工作时间或重要事件期间活跃度高,夜间或假日活跃度低,因此利用率在 10%–50% 之间变化。集群(b)用于大型持续批处理负载,长时间内需求变化小,因此利用率在 50%–85% 之间变化。
用户负载变化是许多 WSC 利用率中等或偏低的主要原因,但不是唯一原因。开发者也很难准确决定应用所需资源,以及实例的数量与类型。他们倾向于过度配置资源,以绕过 WSC 硬件异构导致的性能变化,以及共同调度的负载偶尔产生的干扰(Delimitrou 与 Kozyrakis,2014)。例如,占用 CPU 大部分核心的负载,更不容易受到同机内存密集型负载引发的缓存未命中影响。多数开发者对性能问题的可见性与理解有限,因此,大幅增加预留资源对他们而言是一种实用办法。
多年来,人们开发了多种提高利用率的技术,包括根据实际需求自动确定和伸缩云工作负载资源的工具,即适量配置(right sizing)与自动伸缩(autoscaling);预测或跟踪负载间干扰,并调整分配以减轻干扰的调度器,即干扰感知调度;以及允许低优先级任务,例如运行批量分析的可抢占 Spot 实例,安全使用已预留但暂时空闲资源的调度器,即 resource harvesting。设计空间很大,启发式方法难以安全高效地探索,因此经常采用 ML 与在线学习技术。硬件层面则越来越重视共同调度负载之间的性能隔离,使用缓存与内存带宽分区(Lo 等,2016),以及网络、存储系统的服务质量(QoS)技术。
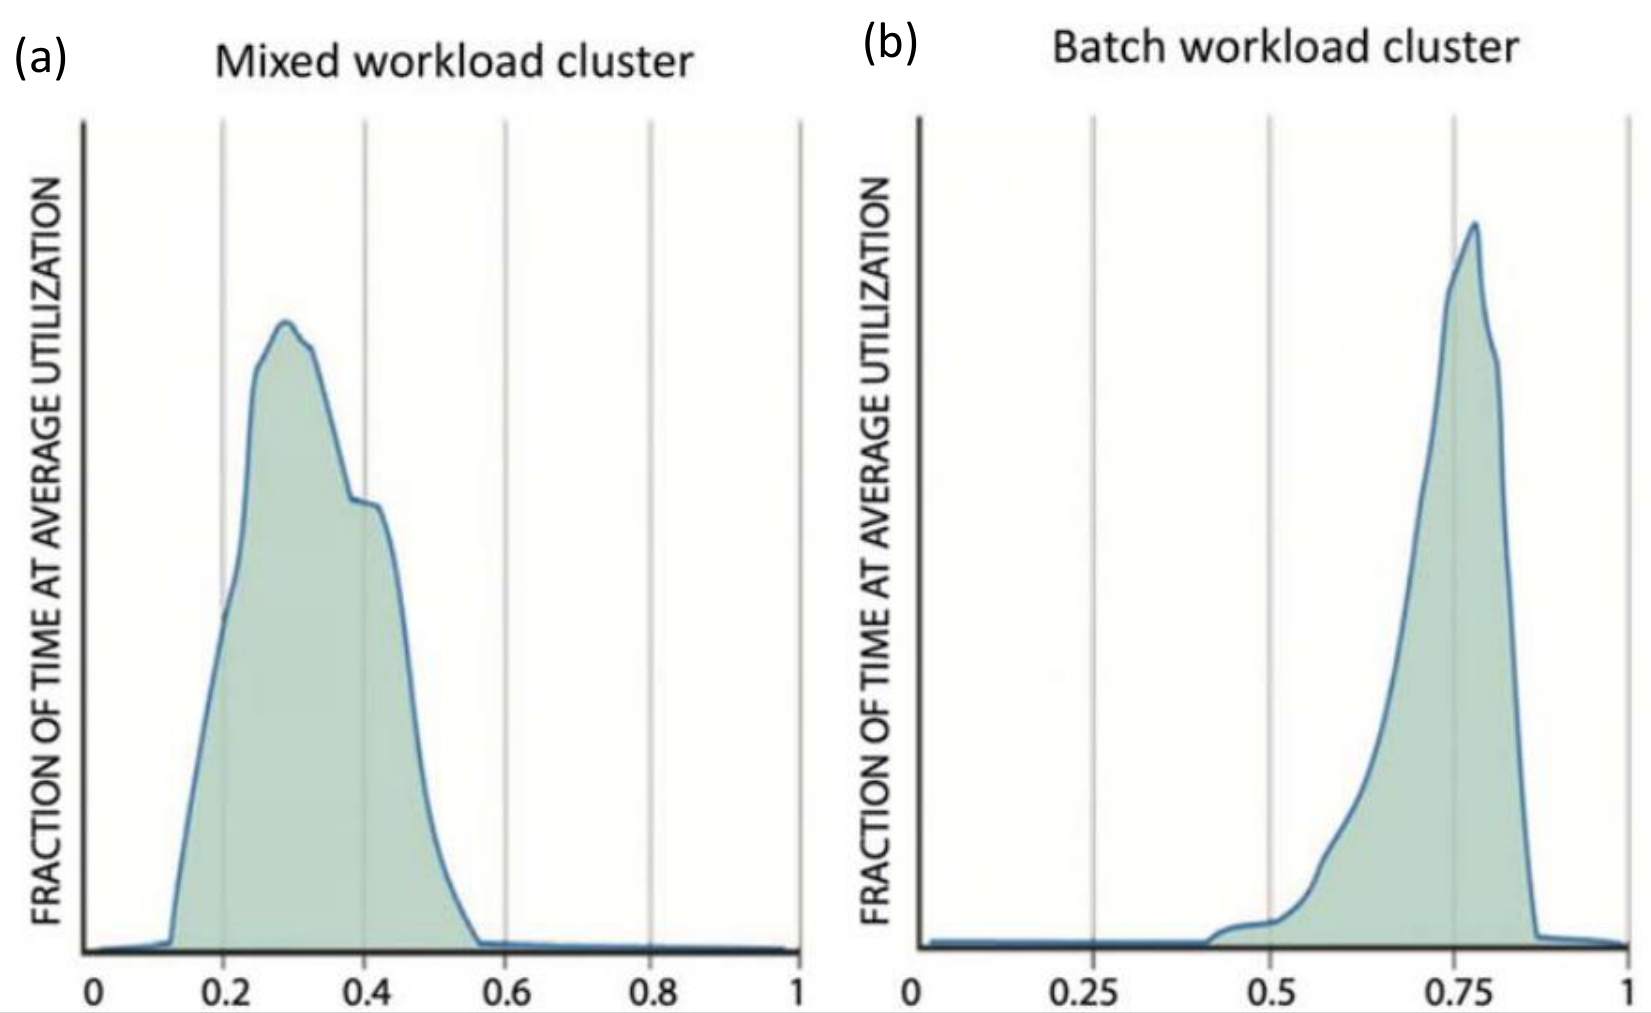
图内术语:Mixed workload cluster=混合负载集群;Batch workload cluster=批处理负载集群;Fraction of time at average utilization=处于相应平均利用率的时间比例;横轴为平均 CPU 利用率。
通过提高性能提高效率
既然每美元性能是最终指标,仍需要测量性能。分布式工作负载性能受到许多因素影响,包括随着数据距离增加而出现的带宽下降与延迟上升。在 WSC 中,服务器内部 DRAM 带宽是机架内部的 40 倍,机架内部又是整个 WSC 范围的 4–10 倍,见图 6.21。因此,在 WSC 中放置数据与程序时,还要考虑这一类局部性。
互联网服务开发者也关心延迟,因为用户能够感受到它。用户满意度与工作效率和服务响应时间密切相关。分时计算时代的多项研究指出,用户工作效率与一次交互所需时间成反比;交互时间通常分为人工输入时间、系统响应时间,以及用户看到响应后、进行下一次输入前的思考时间(Doherty 与 Thadhani,1982)。实验显示,系统响应时间减少 30%,交互时间却减少了 70%(Brady,1986)。这个看似不合理的结果,可以从人的行为解释:响应更快时,人们不易分心,能保持顺畅投入的状态,因此思考时间也更短。
图 6.36 展示 Bing 搜索引擎一项较近期实验的结果:研究者在搜索服务器中插入 50–2000 ms 延迟(Schurman 与 Brutlag,2009)。与先前研究的预期一致,到下一次点击的等待时间增量约为服务器延迟的两倍,例如服务器延迟 200 ms,会使到下一次点击的时间增加 500 ms。收入随延迟增大近似线性下降,用户满意度也如此。Google 搜索引擎的另一项研究发现,这些影响在为期四周的实验结束后仍长期存在。五周以后,在经历过 200 ms 延迟的用户中,每日搜索者数量仍减少 0.1%;经历过 400 ms 延迟的用户,搜索次数减少 0.2%。考虑到搜索业务的收入规模,即使这么小的变化也令人不安。实际上,结果负面到研究者提前终止了实验。
| 服务器延迟(ms) | 到下一次点击的时间增加量(ms) | 每用户查询量 | 每用户任意点击量 | 用户满意度 | 每用户收入 |
|---|---|---|---|---|---|
| 50 | — | — | — | — | — |
| 200 | 500 | — | −0.3% | −0.4% | — |
| 500 | 1200 | — | −1.0% | −0.9% | −1.2% |
| 1000 | 1900 | −0.7% | −1.9% | −1.6% | −2.8% |
| 2000 | 3100 | −1.8% | −4.4% | −3.8% | −4.3% |
正因为如此重视互联网服务中所有用户的满意度,性能目标通常要求高比例请求低于某个延迟阈值,而不只是规定平均延迟。这种阈值目标称为服务级目标(SLO)。例如,某个 SLO 可以要求 99% 的请求低于 100 ms。因此,Amazon Dynamo 键值存储系统的设计者决定:为了让建立在 Dynamo 之上的服务提供良好延迟,存储系统必须在 99.9% 的情况下达到其延迟目标(DeCandia 等,2007)。例如,Dynamo 的一次改进,对第 99.9 百分位延迟的改善远大于对平均情况的改善,体现了它的优先考虑。
Dean 与 Barroso(2013)提出 tail tolerant 一词,描述为满足这类目标而设计的系统:
正如容错计算旨在用较不可靠的部件构建可靠的整体,大型在线服务也需要用较不可预测的部件,构建响应时间可预测的整体。
不可预测性的来源包括:缓存、网络等共享资源争用,排队,Turbo 模式等优化和 DVFS 等节能技术造成的微处理器性能变化,软件垃圾回收,以及许多其他因素。Google 认为,与其试图消除 WSC 中这种变化,不如开发能够容忍尾部延迟的技术,掩盖或绕过暂时的延迟尖峰。例如,细粒度负载均衡可以在服务器之间迅速移动少量工作,减少排队延迟。
通过能耗与工作量成比例提高效率
如 6.6 节所述,PUE 虽然衡量 WSC 能效,却不反映 IT 设备内部发生的事情。另一种电力低效来自服务器内部电源,它把输入的较高交流或直流电压,转换为芯片和磁盘使用的低电压。2007 年,许多电源效率只有 60%–80%,因此服务器内部的损耗,甚至高于从公共电网高压线路,经多次转换到服务器低压供电的全部损耗。原因之一是电源额定功率经常超过主板实际需要。而且,这类电源通常在负载不超过 25% 时效率最差;图 6.35 表明,许多 WSC 服务器恰好工作在这个区间。计算机主板上的稳压模块(VRM)效率也可能较低。
Barroso 与 Hölzle(2007)认为,整台服务器应以 energy proportionality 为目标,即能耗与完成的工作量成比例。十五年后,我们已接近,却仍未达到这一理想。例如,第 1 章中 SPECpower 评价最高的服务器,空闲时仍消耗满负载功率的约 20%,负载只有 20% 时却消耗近 50%。相较 2007 年,这已是巨大进步:当时计算机空闲时使用满负载功率的 60%,20% 负载时使用 70%;但仍有改善空间。
传统系统软件的设计,只要可能提高性能,就会利用所有可用资源,而不考虑能耗影响。例如,操作系统会把全部内存用于程序数据或文件缓存,即使其中很多数据很可能永远不会被使用。近来,WSC 软件设计者开始针对能源使用及其与工作量的比例关系进行优化。例如,Lo 等(2014)设计了一个动态控制器,通过细粒度功率管理,让一组服务器刚好满足在线服务的 SLO 要求。这样改善了能耗与工作量的比例关系:服务器在 10%–60% 利用率下运行时,可节省 20%–30% 的能耗。
6.8 融会贯通:AWS 云中的定制芯片
Amazon Web Services(AWS)于 2006 年推出,是第一家提供 IaaS 云实例的厂商。截至 2023 年初,AWS 是最大的公有云提供商,提供超过 200 项云服务,按当时收入速度折算的年收入为 800 亿美元。AWS 在全球拥有云基础设施,已启用 30 个地理区域和 410 个接入点,包括边缘站点与缓存。在这 30 个区域中,AWS 运营 96 个可用区;每个可用区由一座或多座独立 WSC 组成,各自位于独立设施中,具有冗余供电、网络与连接。
AWS 一直为其云基础设施开发软硬件技术,总体目标是降低 TCO,并改善客户工作负载的性能与成本。除 6.7 节的效率优化之外,近期 AWS 云系统的发展还针对以下目标:
- 消除虚拟化开销。 这既降低基础设施成本,也让客户能将全部可用计算周期用于应用,还显著减少能源使用,以及运行阶段和制造建设阶段的碳排放。
- 减少新技术部署与维护的时间和成本。 新 CPU、加速器、新 DRAM 或 Flash 芯片等技术,为云运营商与客户带来显著的成本和性能改善。为取得最大收益,需要把部署时间从数月缩短到数周,并使客户工作负载感知的维护停机时间实际上降为零。
- 提高可用性与可靠性。 云设施正在成为像电力和电信系统一样的关键公共服务,因此不能轻易停摆。
- 扩大使用场景与目标市场。 例如,AWS 设计了 Outpost 机架,让一组 AWS 计算和存储单元能够安全地放在客户或第三方场地,支持因延迟、安全或监管原因而要求本地部署或边缘部署的应用。
过去十年,定制芯片在 AWS 基础设施中扮演着越来越重要的角色。2015 年,AWS 收购无晶圆厂半导体公司 Annapurna Labs,此后该公司开发了一系列针对云计算基础设施优化的芯片与系统。AWS 的使用规模足以支持自行开发芯片,与在 WSC 中使用商用芯片相比,获得以下收益:
- 纵向创新。 在横向分工的 IT 生态中,芯片、硬件和软件厂商各自在交付边界内优化。自行设计芯片后,AWS 可以纵向创新,例如增加能在系统级或 WSC 级节省成本的芯片功能。
- 专门化。 AWS 芯片设计优先实现能在其使用场景中带来显著端到端收益的功能。商用芯片则必须针对多个潜在客户的场景优化;长长的功能清单导致设计折中,也增加设计时间、芯片面积与功耗。
- 开发速度。 软件团队通常在新商用芯片部署之后,才开始相应开发。控制芯片与软件设计周期后,AWS 可以并行开发两者,确保硬件一部署,软件就已准备好,从每代芯片取得最大价值。
- 安全性。 定制芯片让 AWS 从整体设计整个系统,缩小攻击面。AWS 使用自有芯片提供硬件信任根,对芯片上运行的固件进行形式化验证,并把服务器内部交互限制在一组范围很窄的安全 API 中。
- 更低成本。 商用芯片售价比成本高 20%–100%。以 AWS 的规模,省去芯片厂商利润空间能带来大量节省,足以支撑自研芯片的成本。
到 2023 年初,AWS 已在 WSC 中部署以下定制芯片:
- Nitro: 一系列芯片,用于卸载并加速 hypervisor 与 I/O 任务,例如 VM 网络、VM 存储和 RDMA。
- Nitro Security: 部署在 AWS 主板上的小型芯片,支持主动监控硬件接口的安全性,并进行安全固件升级。
- Graviton: 面向云工作负载、兼顾性能、功耗与成本效率的 CPU 系列。
- Trainium 与 Inferentia: 用于 ML 训练和推理的 DSA 系列。第 7 章讨论 ML DSA 芯片的体系结构。
Nitro 系统
hypervisor 介入每次 I/O 操作,是云工作负载性能开销的重要来源。例如,在网络方面,它必须实现虚拟私有网络(VPC)所需的封装与解封装,执行安全规则和速率限制,并实现路由。现代 I/O 设备速度很高,例如 200 Gbps 以太网 NIC 和 5 Gbps NVMe 驱动器;现代服务器又可承载大量客户 VM,因此 hypervisor 任务可能占据宿主 CPU 的多个核心。如果专门为 hypervisor 预留这些核心,宿主机有效容量就显著降低;如果不预留,随着整体 I/O 流量变化,客户工作负载可能经历显著的性能抖动。最后,在与客户 VM 相同的 CPU 上运行复杂 hypervisor,也带来安全风险。
Nitro 项目的目标,是把几乎全部 hypervisor 任务卸载到 AWS 定制芯片,将所有 CPU 周期留给 VM 工作负载。AWS 自 2013 年起逐步实现这一目标。到 2017 年,原先基于 Xen 的 hypervisor 被极简的 Nitro hypervisor 替代。这个基于 KVM 的 hypervisor,只在 VM 启动或调整规模时,通过配置 VT-x、VT-d 等 CPU 功能,分配核心、内存与中断。如果 CPU 支持 posted interrupts,其他所有事件,包括频繁的 I/O 流量,都无需 hypervisor 介入。Nitro hypervisor 的功能范围有限,使其 CPU 开销可以忽略,也缩小了与 VM 的接口,提高安全性。
其余 hypervisor 任务由基于 AWS 定制芯片的一系列 Nitro 卡实现:
- Elastic Network Adapter(ENA)控制器。 这是 PCIe 以太网 NIC,通过 SR-IOV 让客户 VM 直接访问 ENA 虚拟功能。ENA 接口采用 6.5 节介绍的提交队列和完成队列。NIC 实现 VPC 数据平面任务,包括封装/解封装、安全规则、速率限制、路由、时间同步和流量加密。
- Elastic Fabric Adapter(EFA)控制器。 这是针对数据密集型 ML 与 HPC 应用优化的 PCIe NIC。与 RoCE 和 IB NIC 类似,EFA 在 NIC 中实现完整网络传输协议,支持绕过操作系统。AWS SRD 协议提供可靠数据报服务,利用 WSC 网络的多路径特征实现高吞吐量与低延迟(Shalev 等,2020)。应用通过 OFI Libfabric 或 NVIDIA Collective Communications Library(NCCL)等常用通信框架使用 EFA。NIC 为 GPU 和其他 DSA 支持零复制网络,也支持全部基础 VPC 数据平面任务。
- Elastic Block Storage(EBS)控制器。 PCIe EBS 控制器向客户 VM 暴露一组 NVMe 虚拟功能,使其经网络访问块存储卷。因此,VM 可以动态增删卷、调整卷大小,也可以暂停一段时间,或迁移到新机器后重新连接持久化 EBS 卷。控制器实现经网络访问远程存储所需的全部系统软件,包括零复制、数据完整性检查、屏障与快照,以及加密存储卷所需的密码算法。
- 实例存储控制器。 这块 PCIe 卡向客户 VM 暴露一组 NVMe 虚拟功能,使其访问本地 Flash 和硬盘。控制器实现透明加密;VM 终止时销毁密钥,使磁盘上的临时数据无法再访问。它为共享磁盘提供限速,实现完整性检查、快照与驱动器监控。对于 Flash 存储,它还实现 FTL 逻辑,即 Nitro-SSD。
- Nitro Controller 卡。 通过被动 API 端点与 EC2 控制平面交互,并协调其他全部 Nitro 卡及 Nitro hypervisor,实现资源分配和实例生命周期管理。
迄今,AWS 已实现五代 Nitro 卡芯片。全部芯片都包含 Arm 核心,使功能可以不断演进。每代有多种板卡,有时还采用多个芯片版本,支持特定用途。通常每种有独立产品型号(SKU),例如 EFA 网络专用 SKU、EBS 专用 SKU、面向大批量服务器配置、把所有功能集成在一个芯片中的主流“一体化”SKU,以及不含 Nitro 功能的简单 NIC SKU。Nitro 卡支持无中断升级:更新卡上固件时,不必停止宿主 CPU 上运行的 VM。
图 6.37 展示 Nitro 卡与 hypervisor 如何协作启动 VM 实例。收到客户请求后,EC2 控制平面寻找能够承载请求的服务器。首先,控制平面向该服务器的 Nitro Controller 发送启动命令(步骤 1)。接着,Nitro Controller 为 VM 分配特定核心与内存区域(步骤 2),要求 hypervisor 按这一分配配置 CPU(步骤 3)。随后,它映射包含 VM 启动镜像的 EBS 卷(步骤 4),通过 NVMe 接口将其提供给宿主机(步骤 5);并设置该 VM 关联的其他 EFA、ENA、EBS 与本地实例存储设备(步骤 6)。最后,将实例置为可运行状态,使其能够启动(步骤 7)。VM 开始运行后,只有核心、内存或设备分配变化,或 VM 自身调用 hypervisor 时,hypervisor 才执行。由于它基本不再介入运行路径,VM 实例与裸金属实例的性能几乎相同,如图 6.38 所示。
Nitro 系统加快了新技术部署。几乎全部虚拟化任务都由 Nitro 卡实现,因此部署新 CPU、DSA、存储系统,或支持新操作系统,无需投入大量精力移植或扩展 hypervisor。让服务器以裸金属配置运行,等价于启动 VM 而不在宿主 CPU 上运行 hypervisor。实例和服务器的管理都通过 Nitro 卡统一完成。
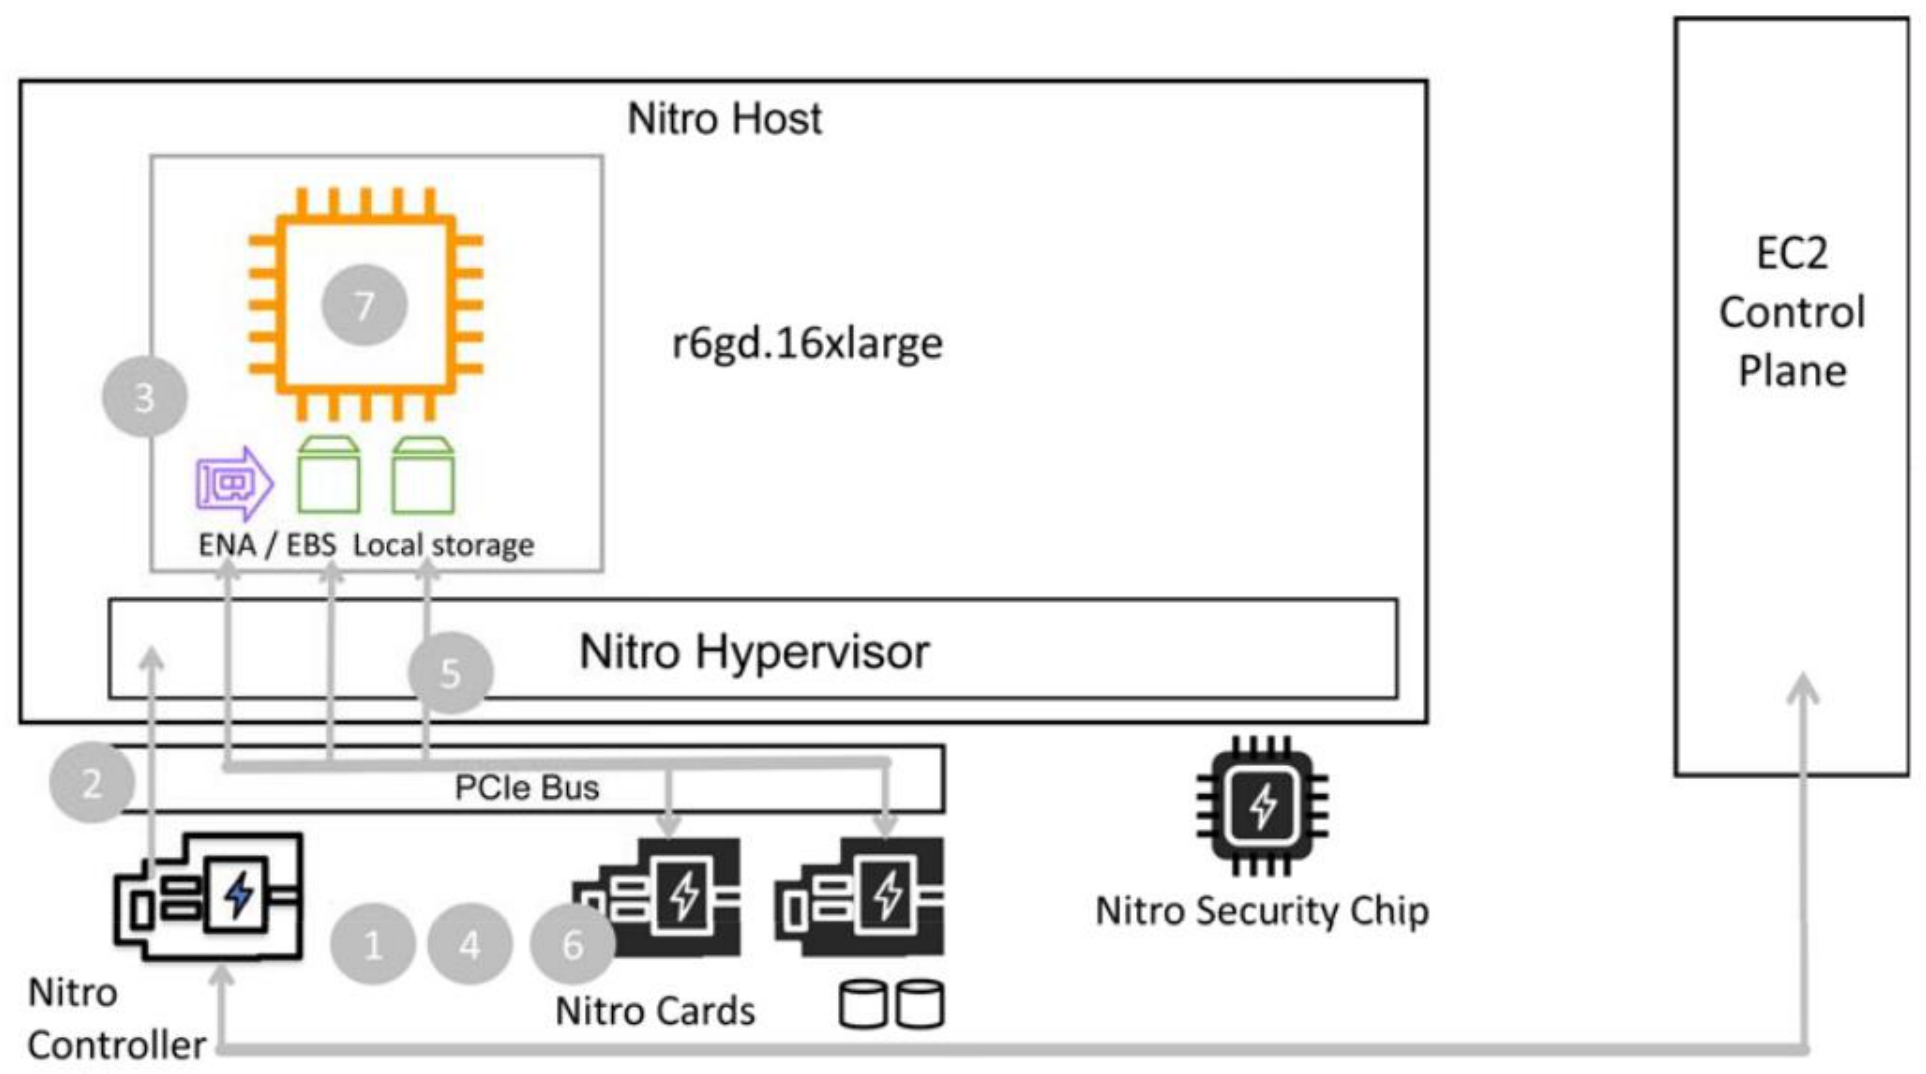
图内术语:Nitro Host=Nitro 宿主机;EC2 Control Plane=EC2 控制平面;Local storage=本地存储;Nitro Hypervisor=Nitro 虚拟机监控器;PCIe Bus=PCIe 总线;Nitro Controller=Nitro 控制器;Nitro Cards=Nitro 卡;Nitro Security Chip=Nitro 安全芯片。步骤 1–7 对应正文。
工作负载细节:Bare metal performance with the AWS Nitro System。图内标题 Metal vs Nitro Hypervisor (16 instances)=裸金属与 Nitro hypervisor 对比(16 个实例);Normalized Performance=归一化性能;Workload=工作负载。以裸金属为 1.000,VM 在 OpenFOAM、GROMACS、WRF、HPL 上分别为 0.995、0.995、0.994、0.992。
译注: 原图注将 EFA 带宽写为“100 GBps”,大写 B 表示字节。
Nitro 系统出现之前,AWS 大约提供 70 种 EC2 实例。到 2023 年初,已超过 600 种,涵盖多种 CPU(Intel 和 AMD x86、AWS 和 Apple Arm)、加速器(GPU、ML DSA、视频 DSA、FPGA)、存储与网络选项,以及操作系统(Linux、Windows、Unix、macOS)。
Nitro 的安全机制
Nitro Security 是一块放在服务器主板上的小芯片,通过 SPI 或 I2C 总线等接口,监控对本地非易失性存储设备的全部操作,检测异常,并负责提供与验证主板固件。在基于 x86 的宿主机中,它还位于 BMC 与 CPU 之间。这块芯片有两个重要作用。第一,禁止 CPU 上运行的任何软件更新包括 BMC 固件在内的所有固件;固件更新通过 Nitro Controller 提供,主板上不保存固件。这样消除了针对 SPI Flash 等存储设备的零日攻击和供应链攻击。第二,协助 Nitro Controller 完成安全启动与证明过程。
启动开始时,Security 芯片让服务器 CPU 与 BMC 保持复位,直到 Nitro Controller 完成自身安全启动与服务器身份验证。Nitro Controller 使用抗篡改的可信平台模块(TPM),通过密码学度量并验证自身启动 ROM 的完整性和有效性。TPM 保存用于对已知良好度量值进行数字签名的密钥。如果启动 ROM 有效,Nitro Controller 就继续度量和验证后续启动阶段使用的固件,以及服务器运行期间使用的软件镜像,从而扩展信任链。如果检测到无效固件,立即将服务器撤出服务,在问题解决前不运行客户负载。AWS 已形式化验证 Nitro 系统早期启动代码的内存安全属性(Cook 等,2021)。Nitro 完成安全启动后,下载并验证服务器主板固件;此时,Security 芯片才允许 CPU 与 BMC 启动。
Nitro 的安全启动保护裸金属服务器,因为 CPU 上的操作系统无法修改服务器的 BIOS、BMC 或其他固件。它也阻止因失误或恶意而部署未经正确签名、未经正式生产部署流程发布的固件。最后,它使 Nitro 系统能够部署到 AWS 设施之外,例如 Outpost 机架和边缘场景。AWS 可以远程证明 Nitro 服务器正在运行获准的固件与软件镜像组合,然后才允许它们运行客户负载,并连接 AWS 数据中心中的服务。
除安全启动之外,Nitro 的另一项重要安全特性,是让 AWS 员工无需直接访问用户数据,就能进行云管理。
本地存储与主存使用 VM 专属密钥加密,VM 终止时销毁密钥。持久化存储卷可以使用客户提供的密钥加密。AWS 数据中心之间的全部网络流量,在物理层透明加密;对大多数 EC2 实例类型,VPC 内全部流量在 Nitro 卡中透明加密。所有 AWS 管理 API 都经过加密、身份验证与授权,并记录日志。
Graviton CPU 芯片
AWS 开发基于 Arm 的 Graviton CPU,目标是为 EC2 实例提供尽可能好的性价比,并构建能效更高的服务器。2018 年,Graviton1 成为首个在大型云提供商中支撑 IaaS 实例的 Arm CPU,证明 Arm 软硬件生态可以大规模支持云应用。
图 6.39 列出三代 Graviton 的关键特征。利用第 3、4 章讨论的乱序执行与 SIMD 技术,每核心性能持续提高。
| 特征 | Graviton 1 | Graviton 2 | Graviton 3(E) |
|---|---|---|---|
| 发布年份 | 2018 | 2019 | 2021 |
| 制造工艺 | 16 nm | 7 nm | 7 nm |
| 晶体管数(十亿) | 5 | 30 | 55 |
| 指令集 | ARMv8.0a | ARMv8.2a + fp16、rcpc、dotprod、crypto | ARMv8.4 + sve、rng、bf16、int8、crypto |
| 时钟频率 | 2.3 GHz | 2.5 GHz | 2.6 GHz |
| 核心数 | 16 | 64 | 64 |
| 核心类型 | Cortex-A72 | Neoverse-N1 | Neoverse-V1 |
| 取指/译码/发射宽度 | 3 / 3 / 5 | 4–8 / 4 / 8 | 8 / 5–8 / 15 |
| 功能单元数:整数、FP/SIMD、LD/ST、BR | 3 / 2 / 2 / 1 | 3 / 2 / 2 / 1 | 4 / 4 / 5 / 2 |
| SIMD 功能单元 | 2 × 128 位(Neon) | 2 × 128 位(Neon) | 4 × 128 位(Neon);2 × 256(SVE) |
| ROB 大小 | 128 | 128 | 256 |
| 每核 L1I/L1D/L2 | 48 KB / 32 KB / — | 64 KB / 64 KB / 1 MB | 64 KB / 64 KB / 1 MB |
| LLC 大小 | 8 MB | 32 MB | 32 MB |
| DRAM 类型 | DDR4-2633 | DDR4-3200 | DDR5-4800 |
| DRAM 控制器数 | 2 | 8 | 8 |
| DRAM 带宽 | 40 GB/s | 200 GB/s | 300 GB/s |
| DRAM 加密 | 否 | 是 | 是 |
| PCIe 代际 | Gen4 | Gen4 | Gen5 |
| PCIe 通道数 | 32 | 48 | 64 |
Graviton2 核心约为 Graviton1 的两倍快;Graviton3 又将整数和浮点性能分别提高 30% 和 60%。多年来,每芯片内存带宽从 50 GB/s 提高到 300 GB/s,以支撑更高单核性能和四倍的核心数量。
图 6.40 展示 Graviton3 的体系结构。封装由七个 chiplet 组成。主 chiplet 包含 64 个核心及其缓存,以对分带宽 2 TB/s 的网状互连连接。左右各两个 chiplet 包含内存控制器与卸载功能,底部两个 chiplet 则包含 PCIe 接口和其他 I/O 功能。Graviton3 的多个方面针对云部署优化。第一,采用不支持 SMT 的核心,避免共享 SMT 核心的两个线程相互干扰,提高 L1 缓存、分支预测器与 TLB 的效率。第二,不支持双插槽服务器配置。这限制了单个 VM 能使用的核心数,却不再要求软件栈进行 NUMA 优化,并降低成本与功耗。类似 6.3 节讨论的 Meta Yosemite 服务器,Graviton3 机箱内包含三台单插槽服务器,共享 Nitro 卡、BMC 和电源,以摊销系统级成本。第三,采用 DDR5-4800 内存。内存带宽提高 50%,使较小的 L3 缓存成为可能;云实例使用大量核心时,这对性能尤其重要。最后,Graviton3 实现多种安全功能,包括始终启用的主存加密、Arm 指针认证扩展,以及为 Arm TRNG 指令提供的真随机数发生器。它也支持 posted interrupts,使 I/O 中断无需 hypervisor 介入即可直接递送给客户 VM。
译注: 正文称内存带宽从 50 GB/s 提高,图 6.39 的 Graviton1 却列为 40 GB/s,两者均保留。原文把 Meta Yosemite 的介绍指向 6.3 节,实际位于 6.4 节。图 6.39 和后面的图 6.41 均将 Graviton3 工艺写为 7 nm;本文忠实保留这一原书规格及其论述,未将它改写成其他版本的数据。
图内 DDR5、PCIe 为内存和 I/O 接口标识;中央 C 表示核心。
AWS 虽然自行生产 CPU,仍部署 x86 CPU 和 Apple CPU。它服务数百万客户,各自的软件兼容性限制与性能需求不同。某种 CPU 可能最适合代码占用大、随机访存多的负载,另一种则可能最适合 I/O 密集型负载。AWS 提供 CPU 体系结构、时钟频率、网络和存储配置不同的广泛实例,让客户为自己的负载选择最佳方案。在确定自有 CPU 规模时,AWS 追求性价比。有些 CPU 只要约一半核心满载,就会达到热设计功耗(TDP)限制;云厂商不得不让其余核心空闲,承担更高成本,或让所有核心以较低时钟频率、或启用节流机制运行,接受较低性能。AWS 考察整个服务器群负载分布第 50、90、99 百分位的 CPU 功耗及每瓦性能,偏好在第 50 和 90 百分位下,按性能归一化后功耗更低的设计。Graviton CPU 以能耗随工作量成比例为设计目标,50% 负载时消耗约 50% TDP。AWS 还通过协同优化 CPU、网络与存储追求端到端效率。应用在每个实例上达到尽可能好的性能,同样负载就需要更少实例,从而为客户节省费用、为云提供商降低 TCO,并减少运行排放和制造建设阶段的碳排放。
面向云计算的 CPU 效率
为了理解云计算选择 CPU 时的权衡,下面考察 2022 年第四季度可用的六种 AWS 计算实例,在 SPEC CPU2017 基准测试套件上的性能估计。图 6.41 列出实例配置及所用 CPU。所有实例都占用一整台物理服务器,可能是单插槽或双插槽。六种 CPU 代表 Intel、AMD、AWS 各两代产品,在乱序核心数量、存储层次结构与功耗方面差异显著。
图 6.42 展示每个实例只使用一个虚拟核心(vCPU)时的 SPEC CPU2017 性能估计。对支持 SMT 的 CPU 微体系结构,原文列举 AMD Milan 和两代 Intel CPU,这相当于测量一个核心以单线程模式运行时的性能。符合预期的是,采用 Intel、AMD、AWS 2021 年芯片的 m6i、m6a、c7g,分别优于同一厂商 2019 年芯片对应的 c5、c5a、c6g。各 CPU 厂商都逐步改善处理器的 ILP 能力,采用更长的向量指令,有时还提高时钟频率。使用 Intel Ice Lake 的 m6i 在整数负载上表现最好,使用 AMD Milan 的 m6a 在浮点负载上表现最好。不过,对于具体基准测试,最优核心可能差异很大。三种 2021 年核心各有一项比其他两者高出 25% 以上:Intel Ice Lake 对应 520.omnetpp,AMD Milan 对应原文所写的 519.lbr,AWS Graviton3 对应 549.fotonik3d。这种差异说明云平台提供 CPU 选择的优势。客户可以在不同实例上测试自己的具体负载,选择硬件特性与负载最匹配的一种。
| 项目 | c5.metal | c5a.24xlarge | c6g.metal | m6i.32xlarge | m6a.48xlarge | c7g.16xlarge |
|---|---|---|---|---|---|---|
| 实例信息 | ||||||
| CPU 插槽数 | 2 | 1 | 1 | 2 | 2 | 1 |
| 每实例总核心数 | 48 | 48 | 64 | 64 | 96 | 64 |
| 每实例总 vCPU 数 | 96 | 96 | 64 | 128 | 192 | 64 |
| CPU 芯片信息 | ||||||
| CPU 芯片 | Intel Xeon 8275L | AMD EPYC 7R32 | AWS Graviton2 | Intel Xeon 8375C | AMD EPYC 7R13 | AWS Graviton3 |
| 体系结构 | Cascade Lake | Rome | Graviton2 | Ice Lake | Milan | Graviton3 |
| 推出年份 | 2019 | 2019 | 2019 | 2021 | 2021 | 2021 |
| 工艺 | 14 nm | 7 nm | 7 nm | 10 nm | 7 nm | 7 nm |
| 每芯片核心数 | 24 | 48 | 64 | 32 | 48 | 64 |
| 每核 SMT 线程数 | 2 | 2 | 1 | 2 | 2 | 1 |
| 全核 Turbo 频率(GHz) | 3.00 | 2.80 | 2.50 | 3.50 | 2.90 | 2.60 |
| 最高单核 Turbo 频率(GHz) | 3.90 | 3.30 | 2.50 | 3.50 | 3.60 | 2.60 |
| L3 缓存大小(MB) | 36 | 192 | 32 | 54 | 256 | 32 |
| 每插槽 DRAM 通道数 | 6 | 8 | 8 | 8 | 8 | 8 |
| DRAM 类型 | DDR4-2933 | DDR4-3200 | DDR4-3200 | DDR4-3200 | DDR4-3200 | DDR5-4800 |
| 每插槽 DRAM 带宽(GB/s) | 141 | 205 | 205 | 205 | 205 | 300 |
| 每插槽估计功耗(W) | 240 | 280 | 130 | 280 | 300 | 170 |
图 6.43 展示每种实例使用全部可用 vCPU 时的 SPEC CPU2017 性能估计。对于所有整数基准测试,m6a 实例吞吐量最高,因为它支持最多的并发 vCPU:96 个 AMD Milan 核心,每核两个线程,共 192 个 vCPU。
| 类别 | 基准测试 | c5.metal | c5a.24xlarge | c6g.metal | m6i.32xlarge | m6a.48xlarge | c7g.16xlarge |
|---|---|---|---|---|---|---|---|
| 整数 | 500.perlbench_r | 5.88 | 4.27 | 3.68 | 6.55 | 5.02 | 5.09 |
| 整数 | 502.gcc_r | 6.79 | 6.01 | 4.58 | 7.68 | 7.07 | 7.27 |
| 整数 | 505.mcf_r | 5.63 | 5.55 | 4.95 | 5.90 | 6.70 | 7.15 |
| 整数 | 520.omnetpp_r | 5.95 | 3.49 | 3.81 | 6.76 | 5.07 | 5.37 |
| 整数 | 523.xalancbmk_r | 6.54 | 6.04 | 4.40 | 6.76 | 8.30 | 6.64 |
| 整数 | 525.x264_r | 9.49 | 9.14 | 7.35 | 10.39 | 10.85 | 11.76 |
| 整数 | 531.deepsjeng_r | 4.27 | 4.07 | 3.92 | 4.33 | 5.10 | 4.80 |
| 整数 | 541.leela_r | 4.00 | 3.56 | 3.54 | 4.13 | 4.32 | 4.23 |
| 整数 | 548.exchange2_r | 11.2 | 10.15 | 8.05 | 11.90 | 11.83 | 11.58 |
| 整数 | 557.xz_r | 3.65 | 2.88 | 2.58 | 3.78 | 3.67 | 3.25 |
| 浮点 | 503.bwaves_r | 36.49 | 61.14 | 35.68 | 45.33 | 74.52 | 74.39 |
| 浮点 | 507.cactuBSSN_r | 5.44 | 6.31 | 4.75 | 6.24 | 7.68 | 8.78 |
| 浮点 | 508.namd_r | 3.91 | 4.03 | 3.30 | 4.38 | 4.74 | 4.98 |
| 浮点 | 510.parest_r | 6.44 | 7.43 | 5.64 | 6.68 | 8.86 | 8.71 |
| 浮点 | 511.povray_r | 6.53 | 5.73 | 4.46 | 7.50 | 6.98 | 6.41 |
| 浮点 | 519.lbm_r | 3.93 | 6.21 | 3.62 | 4.71 | 7.55 | 6.00 |
| 浮点 | 521.wrf_r | 9.05 | 9.92 | 6.42 | 9.95 | 12.2 | 9.65 |
| 浮点 | 526.blender_r | 5.76 | 5.49 | 4.41 | 6.71 | 6.83 | 6.36 |
| 浮点 | 527.cam4_r | 7.41 | 8.25 | 5.12 | 8.33 | 9.85 | 8.16 |
| 浮点 | 538.imagick_r | 7.20 | 6.94 | 5.68 | 7.86 | 8.46 | 9.60 |
| 浮点 | 544.nab_r | 6.20 | 5.97 | 4.51 | 6.96 | 7.75 | 6.47 |
| 浮点 | 549.fotonik3d_r | 10.22 | 16.27 | 10.28 | 12.31 | 18.09 | 24.46 |
| 浮点 | 554.roms_r | 6.43 | 9.42 | 4.78 | 7.30 | 10.83 | 8.02 |
| 汇总 | 整数几何平均值 | 5.98 | 5.09 | 4.44 | 6.39 | 6.33 | 6.21 |
| 汇总 | 浮点几何平均值 | 7.22 | 8.48 | 5.84 | 8.23 | 10.22 | 9.69 |
译注: 正文写作“519.lbr”,表中实际为“519.lbm_r”;上方保留完整表名,正文原写法也已明示。图 6.41 表明 AMD Rome 同样有每核两个线程,原文前段列举支持 SMT 的 CPU 时没有把它列入。
| 类别 | 基准测试 | c5.metal | c5a.24xlarge | c6g.metal | m6i.32xlarge | m6a.48xlarge | c7g.16xlarge |
|---|---|---|---|---|---|---|---|
| 整数 | 500.perlbench_r | 230 | 226 | 198 | 333 | 478 | 272 |
| 整数 | 502.gcc_r | 233 | 199 | 127 | 330 | 436 | 166 |
| 整数 | 505.mcf_r | 151 | 124 | 106 | 236 | 261 | 204 |
| 整数 | 520.omnetpp_r | 146 | 126 | 104 | 200 | 249 | 124 |
| 整数 | 523.xalancbmk_r | 227 | 224 | 177 | 327 | 540 | 259 |
| 整数 | 525.x264_r | 442 | 487 | 440 | 625 | 1041 | 722 |
| 整数 | 531.deepsjeng_r | 226 | 255 | 237 | 315 | 572 | 299 |
| 整数 | 541.leela_r | 232 | 259 | 222 | 337 | 570 | 270 |
| 整数 | 548.exchange2_r | 511 | 593 | 502 | 828 | 1214 | 738 |
| 整数 | 557.xz_r | 166 | 164 | 119 | 223 | 346 | 140 |
| 浮点 | 503.bwaves_r | 486 | 285.92 | 360 | 716 | 597 | 630 |
| 浮点 | 507.cactuBSSN_r | 213 | 183.81 | 171 | 305 | 384 | 332 |
| 浮点 | 508.namd_r | 190 | 224.05 | 204 | 276 | 462 | 315 |
| 浮点 | 510.parest_r | 127 | 91.15 | 98 | 200 | 264 | 183 |
| 浮点 | 511.povray_r | 258 | 313.94 | 276 | 401 | 641 | 407 |
| 浮点 | 519.lbm_r | 54 | 32.55 | 36 | 75 | 71 | 63 |
| 浮点 | 521.wrf_r | 223 | 157.71 | 163 | 344 | 327 | 268 |
| 浮点 | 526.blender_r | 265 | 285.33 | 239 | 392 | 632 | 331 |
| 浮点 | 527.cam4_r | 296 | 271.04 | 227 | 410 | 661 | 368 |
| 浮点 | 538.imagick_r | 321 | 416.57 | 341 | 441 | 892 | 611 |
| 浮点 | 544.nab_r | 349 | 376.27 | 279 | 526 | 820 | 409 |
| 浮点 | 549.fotonik3d_r | 143 | 95.36 | 107 | 209 | 195 | 183 |
| 浮点 | 554.roms_r | 96 | 69.3 | 58 | 150 | 138 | 118 |
| 汇总 | 整数几何平均值 | 236 | 234 | 192 | 340 | 503 | 266 |
| 汇总 | 浮点几何平均值 | 202 | 174 | 164 | 298 | 380 | 276 |
对于浮点基准测试,m6i 在 64 个 Intel Ice Lake 核心上运行 128 个 vCPU,在约三分之一的测试中可与 m6a 竞争。这说明线程数量并不是高吞吐量计算唯一应考虑的因素;缓存、片上互连和功率管理等系统体系结构问题同样重要。
单台机器的绝对性能,并非云提供商或客户重视的唯一效率指标。云提供商很可能优化每瓦性能,以便在 WSC 有限功率预算内服务尽可能多的客户。云客户则很可能考虑性价比,寻找以最低成本达到某种性能水平的方法;也可能考虑每 vCPU 性能,因为 vCPU 是云实例的伸缩单位。图 6.44 比较 m6i、m6a、c7g 在 SPEC CPU2017 整数与浮点测试中的这些指标。基于 Graviton3 的 c7g,在其专门优化的每瓦性能与性价比两项指标上,具有显著的 2–3 倍优势。这对使用数十至数千个实例的横向扩展负载非常重要,无论它们是客户应用,还是数据库即服务、分析即服务等云服务。
图内指标:SPECint、SPECfp=整数、浮点性能;/vCPU=每虚拟 CPU 性能;/W=每瓦性能;/$=每美元性能。三组柱分别为 m6i(Intel Ice Lake)、m6a(AMD Milan)、c7g(AWS Graviton3)。
这也表明,云提供商即使以现有硬件 IP 为起点——本例为商用 Arm 核心——自行构建 CPU 芯片仍能获得显著的端到端收益。
6.9 谬误与陷阱
WSC 虽然只有 25 年历史,Google 等公司的 WSC 体系结构设计者已经发现许多谬误与陷阱,而且往往付出了代价才获得这些认识。正如引言所说,WSC 体系结构设计者就是今天的 Seymour Cray。
谬误:云计算提供商在亏钱
AWS 刚宣布时,关于云计算的一个常见疑问是:按当时那样低的价格,能否盈利?AWS 后来发展得如此庞大,必须在 Amazon 季度财报中单独列报。令一些人意外的是,AWS 已被证明是公司最赚钱的部分。2021 年,AWS 营收为 620 亿美元,营业利润为 185 亿美元;Amazon 其他全部业务营收为 4070 亿美元,营业利润却只有 65 亿美元。2016 年,AWS 营收为 122 亿美元,营业利润率为 25%,而 Amazon 零售业务的营业利润率低于 3%。AWS 一直贡献着 Amazon 约四分之三的利润。
陷阱:关注平均性能,而不是第 99 百分位性能
正如 Dean 和 Barroso(2013)指出的,WSC 服务开发者更关心分布尾部,而不是均值。如果某些客户获得的性能很差,这种体验可能把他们赶到竞争对手那里,而且再也不会回来。
陷阱:为了提高 WSC 性价比,采用性能过弱的处理器
Amdahl 定律仍然适用于 WSC。每个请求总有一些串行工作;如果它们在慢服务器上执行,请求延迟就可能增加(Hölzle,2010;Lim 等,2008)。如果串行工作使延迟增加,使用弱处理器的成本就必须包括优化代码、使延迟恢复到较低水平所需的软件开发成本。大量慢服务器带来的更多线程,也可能更难调度和均衡负载;线程性能的波动因此会导致更长的延迟。当必须等待最慢任务时,一次糟糕调度出现的概率即使只有千分之一,对 10 个任务可能无关紧要,对 1000 个任务却会成为问题。
十年前,有人预计定制 CPU 会采用比最新乱序核心更简单、但数量更多的核心。这个预期没有实现。云提供商继续部署配备最新乱序核心的最新 x86 芯片。一些提供商使用乱序 Arm 核心构建定制 CPU,在单线程性能上与 x86 乱序核心竞争,AWS Graviton CPU 就是一例。对于迁移到云上的单机负载,乱序核心是显而易见的选择。即使分布式负载拥有充足的请求级并行性,乱序核心也能让开发者无需花费大量精力优化代码,就获得良好的吞吐量和延迟。尽管存在效率问题,改进速度也不快,乱序核心对 WSC 系统仍然十分重要。有趣的是,高端乱序核心如今又普遍出现在智能手机中,与简单核心组成 big-little 配置。
大量较小服务器还可能导致利用率降低,因为需要调度的对象越少,显然越容易安排。最后,即便某些并行算法,在问题划分过细时,效率也会降低。Google 的经验法则是采用服务器级计算机中的低端型号(Barroso 和 Hölzle,2009)。
一个具体例子来自 Reddi 等(2010):他们比较了运行 Bing 搜索引擎的嵌入式微处理器 Atom 与服务器微处理器 Nehalem Xeon。结果发现,Atom 的查询延迟约为 Xeon 的三倍;Xeon 也更稳健。随着负载增加,Xeon 的服务质量缓慢、小幅下降;Atom 在试图承受额外负载时,很快就无法满足服务质量目标。虽然 Atom 的能效更高,但响应时间会影响收入,收入损失很可能远高于节能带来的成本节省。无法满足响应时间目标的高能效设计,很难获得部署;下一章 7.9 节还会看到这一陷阱的另一个实例。
这种行为会直接转化为搜索质量差异。鉴于延迟对用户的重要性,正如原文所引图 6.37 所示,只要查询延迟尚未超过截止时间,Bing 搜索引擎就会采用多种策略改善搜索结果。较大的 Xeon 节点延迟较低,因此有更多时间改进结果。于是,即使 Atom 几乎没有负载,也有 1% 的查询答案比 Xeon 差;正常负载下,这个比例为 2%。Kanev 等(2015)给出了更新、但结论一致的结果。
译注: 此处原文引用图 6.37,但图 6.37 是 Nitro 虚拟机启动过程。关于服务延迟影响的相邻图表是图 6.36,原书交叉引用疑有误。
陷阱:不同公司的 PUE 测量口径不一致
Google 的 PUE 测量从电力到达变电站之前开始。有些公司从 WSC 入口测量,跳过了降压环节,而这部分损耗可达 6%。如果 WSC 利用室外空气辅助冷却,季节不同,结果也会不同。最后,有些公司报告的是 WSC 设计目标,而不是建成系统的实测值。最保守、也最好的 PUE 测量方法,是从公用电网供电入口开始测量,并报告过去 12 个月的滚动平均值。
谬误:WSC 设施的资本成本高于其中服务器的资本成本
匆匆看一眼图 6.33,或许会得出这个结论,却忽略了整个 WSC 各部分不同的摊销年限。设施可使用长达 20 年,服务器则每三四年就要重新购置。按图 6.33 分别采用 10 年和 3 年摊销期,十年内设施资本支出为 7200 万美元,服务器则为 万美元,即 2.21 亿美元。因此,十年内 WSC 服务器的资本成本约为设施的三倍。原文所引图 3.34 的 TCO 分解也印证了这一点。
译注: 原文此处写“图 3.34”,相应 TCO 分解图实际是本章图 6.34。金额和倍数保留原文口径。
陷阱:试图依靠停止工作的低功耗模式,而不是仍可工作的低功耗模式来节电
图 6.35 表明,通用集群中服务器的平均利用率可能在 10%–50% 之间。考虑到 6.7 节讨论的 WSC 运营成本问题,人们可能认为低功耗模式会大有帮助。
第 1 章指出,DRAM 或磁盘进入不工作的低功耗模式时无法访问,因此无论读写速率多低,都必须先恢复到完全工作模式。问题在于,恢复所需的时间与能量,降低了这类低功耗模式的吸引力。图 6.35 显示,几乎所有服务器的平均利用率都至少为 10%;因此,可以预期长时间的低活动水平,却不能预期长时间完全不活动(Lo 等,2014)。
相比之下,处理器在低功耗模式下仍可运行,只是速率低于正常水平,因此仍可工作的低功耗模式更容易使用。处理器恢复到完全工作模式的时间也以微秒计,因而这类模式还缓解了低功耗模式引起的延迟顾虑。
译注: 原句将运行速率写作“at a small multiple of the regular rate”,未给出具体倍率。“低于正常水平”是根据本段对低功耗模式的讨论作出的语境解释,不能据此确定具体降频比例。
谬误:DRAM 的可信赖性已经提高,WSC 系统软件也能容错,因此不必额外花钱采用 ECC 内存
ECC 为每 64 位 DRAM 增加 8 位,因此取消纠错码(ECC),理论上可以节省九分之一的 DRAM 成本。尤其是曾有 DRAM 测量报告称,每兆位的失效率只有 1000–5000 FIT,FIT 表示每十亿运行小时的失效次数(Tezzaron Semiconductor,2004)。
Schroeder 等(2009)研究了 Google 大多数 WSC 中受 ECC 保护的 DRAM,测量持续 2.5 年,覆盖的服务器无疑有数十万台。研究发现,FIT 比已发表数据高 15–25 倍,即每兆位 25,000–70,000 次失效。超过 8% 的 DIMM 受到失效影响;每个 DIMM 平均每年发生 4000 次可纠正错误和 0.2 次不可纠正错误。按服务器统计,每年约三分之一的服务器经历 DRAM 错误,平均每年发生 22,000 次可纠正错误和 1 次不可纠正错误。原文接着说:也就是说,对三分之一的服务器而言,每 2.5 小时就会纠正一次内存错误。注意,这些系统采用的是更强大的 Chipkill 编码,而不是较简单的 SECDED 编码。如果采用后者,不可纠正错误率将高出 4–10 倍。
如果 WSC 只有奇偶校验保护,服务器每遇到一次内存奇偶校验错误都必须重启。假如重启耗时 5 分钟,那么三分之一的机器将把 20% 的时间花在重启上!这种行为会使这套昂贵设施的性能下降约 6%。此外,这些系统还会遭遇大量不可纠正错误,而操作人员甚至不会收到发生错误的通知。
译注: 原文“平均每年 22,000 次可纠正错误”与“每 2.5 小时一次”不一致。按一年 8760 小时计算,前者对应约每 0.40 小时一次;若每次重启 5 分钟,则约占 21% 的时间,与后文的 20% 接近。
Google 早年使用的 DRAM 甚至没有奇偶校验保护。2000 年,在下一版搜索索引发布前的测试中,系统开始针对测试查询推荐随机文档(Barroso 和 Hölzle,2009)。原因是某些 DRAM 出现固定为零的故障,破坏了新索引。Google 因此增加了一致性检查,以便将来检测这类错误。随着 WSC 规模扩大、ECC DIMM 价格更容易负担,ECC 成为 Google WSC 的标准配置。ECC 还有一个额外好处:维修时更容易找到损坏的 DIMM。
这些数据有助于解释第 4 章的 Fermi GPU 为什么为内存增加 ECC,而其前代产品甚至没有奇偶校验保护。这些 FIT 数据也让人怀疑:仅因 Intel Atom 处理器能效较高,就尝试把它用于 WSC 是否合适,因为其芯片组并不支持 ECC DRAM。
陷阱:无法像处理纳秒或毫秒延迟那样,有效处理微秒延迟
Barroso 等(2017)指出,现代计算机系统让程序员容易缓解纳秒级和毫秒级延迟,例如数十纳秒的缓存与 DRAM 访问,以及数毫秒的磁盘访问,却明显缺少对微秒级事件的支持。存储层次结构向程序员提供同步接口,硬件承担大量工作,使访问表现出正确的存储一致性与缓存一致性(第 2 章)。操作系统为磁盘读取提供类似的同步接口:大量操作系统代码确保等待磁盘时能安全切换到其他进程,数据准备好后再返回原进程。对于 Flash 等存储技术或 200 Gbit/s 以太网等高速网络接口带来的微秒级延迟,我们需要新的应对机制。
谬误:在活动较少时关闭硬件,能提高 WSC 性价比
图 6.33 表明,配电与冷却基础设施的摊销成本,比整个月的电费还高 50%。因此,把负载集中起来、关闭空闲机器,固然能省一些钱;但即使节省一半电力,每月运营费用也只降低 7%。还有实际问题需要解决:WSC 广泛部署的监控基础设施,依赖于向设备发出探测并检查响应。能耗与工作量成比例、以及仍可工作的低功耗模式,还有一个优点:
它们与 WSC 监控基础设施兼容,而这种基础设施使一名操作人员能够负责超过 1000 台服务器。还应注意,预防性维护正是空闲时间执行的重要任务之一。
WSC 的通常做法是在活动较少时运行其他有价值的任务,收回配电与冷却方面的投资。典型例子是为搜索创建索引的 MapReduce 批处理作业。AWS 的竞价机制也是从低利用率中获取价值的一例。如果用户能够灵活选择任务运行时间,允许 AWS 通过竞价实例更灵活地安排任务,例如放在 WSC 原本利用率较低的时段,计算费用最高可降至原来的四分之一。
谬误:Flash 设备只有存储频繁访问的温数据才划算
Flash 的每位成本比硬盘高一个数量级。不过,对某些冷数据存储系统,Flash 也可能具有成本效益。以社交网络发布照片的存储系统为例,多数旧照片很少被访问;但用户一旦请求查看旧照片,仍期待交互式响应。使用硬盘的冷存储系统,为满足 SLO 的延迟要求,就必须让磁盘保持旋转,每块磁盘约消耗 5 W。基于 Flash 的冷存储系统在空闲时效率更高,因为它没有运动部件,而且半导体芯片可以更快退出低功耗模式。节省的能源成本可能抵消 Flash 设备增加的购置成本。
译注: 原句印为“can exist low power modes faster”,其中 exist 与句法和上下文不符;这里按 exit(退出)理解。正文的其他数据保留原样。
6.9 结束语
继承了建造世界最大计算机的使命,WSC 的计算机体系结构设计者,正在设计未来信息技术的重要组成部分:它们支撑云计算,以及我们通过手机访问的全部在线服务。我们认为,WSC 正在改变系统设计的目标与原则,正如移动客户端和 IoT 的需求正在改变微处理器设计的目标与原则一样。两者也都在深刻改变软硬件产业。每美元性能与每焦耳性能,既推动移动客户端硬件,也推动 WSC 硬件的发展;并行性与领域专用加速器,是实现这两组目标的关键。在这个令人期待的未来世界的两个方面,体系结构设计者都发挥着至关重要的作用。
展望未来,WSC 既有令人振奋的机会,也面临重大挑战。随着更多负载迁移到云端,对 WSC 技术的投资持续增加,包括面向各类 WSC 任务的定制芯片和软件栈。运用机器学习技术设计、优化和管理 WSC 软硬件,已经展现出有希望的早期成果。另一方面,半导体技术的挑战依然存在。虽然晶体管特征尺寸仍在缩小,但半导体制造的复杂度和成本很高;由于 Dennard 缩放规律失效,能耗收益正在减少,见第 1 章。内存与铜互连的缩放也面临类似技术挑战。同时,WSC 体系结构设计者已经消除了系统栈中许多容易解决的低效因素。因此,这一领域很可能需要在构成 WSC 的芯片体系结构,以及与之协同设计的软件栈中,寻找新一轮创新。下一章讨论的 DSA,以及 chiplet、3D 集成、协同设计的光互连,都是有望为 WSC 带来持续改进的硬件发展方向。最后,WSC 的巨大能源需求,使降低、并尽可能抵消这些系统的环境影响成为必要。第 7 章将回顾先进 WSC 的运营商如何把计算调度到能源十分清洁的地区,使二氧化碳排放降至原来的五分之一到十分之一。不过,即便 WSC 面临这些环境挑战,把计算从客户端设备迁移到 WSC,仍能更充分地利用生产过程污染较大的硅芯片。手机等客户端设备中,硅芯片的利用率之低是众所周知的。
6.10 历史回顾与参考文献
在线附录 M.8 节介绍了集群的发展;集群是 WSC 和效用计算的基础。希望进一步了解的读者,可以从 Barroso 等(2018)、James Hamilton 的博客,以及他在每年 Amazon re:Invent 大会上的演讲入手。
案例研究:总拥有成本与资源分配
案例研究与习题作者:Parthasarathy Ranganathan。
案例研究 1:总拥有成本如何影响仓库级计算机的设计决策
本案例说明的概念:
- 总拥有成本(TCO)
- 服务器成本和功耗对整个 WSC 的影响
- 低功耗服务器的优点与缺点
习题 6.1
总拥有成本是衡量仓库级计算机(WSC)有效性的重要指标。TCO 包括 6.7 节介绍的资本支出(CAPEX)和运营支出(OPEX),反映整个数据中心达到某一性能水平的拥有成本。在比较不同服务器、网络和存储体系结构时,TCO 往往是数据中心所有者判断何种方案最佳的首要指标;不过, TCO 是一项考虑许多不同因素的多维计算。本案例旨在深入考察 WSC,了解不同体系结构如何影响 TCO,以及 TCO 如何影响运营商的决策。本案例使用图 6.32、图 6.33 与 6.7 节中的数据,并假设所描述的 WSC 达到运营商要求的性能水平。TCO 常用于比较在多个维度上不同的服务器方案。本案例中的习题,考察 WSC 中如何进行这类比较,以及作出决策时的复杂性。
[5/5/10]〈6.7〉 本章讨论了通过数据级并行性,使 WSC 在大型问题上取得高性能的方法。可以设想,使用高端服务器还可进一步提高性能。不过,更高性能的服务器,其价格往往会非线性增长。
a. [5]〈6.7〉 假设新服务器在相同利用率下快 10%,但贵 20%,WSC 的 CAPEX 是多少?
b. [5]〈6.7〉 如果这些服务器的功耗还增加 15%,WSC 的 OPEX 是多少?
c. [10]〈6.7〉 考虑上述速度提升与功耗增加,新服务器的成本必须是多少,才能与原集群相当?提示:根据这一 TCO 模型,你可能需要调整设施的关键负载。
习题 6.2
[5/10]〈6.7,6.9〉 为降低 OPEX,一个有吸引力的方案是使用低功耗服务器,减少运行服务器所需的总电量。不过,与高端服务器类似,高端部件的低功耗版本也存在非线性权衡。
a. [5]〈6.7,6.9〉 如果低功耗服务器在性能相同时功耗低 15%,价格却高 20%,这是划算的权衡吗?
b. [10]〈6.7,6.9〉 服务器价格降到多少时,才能与原集群相当?如果电价翻倍呢?
习题 6.3
[5/10/15]〈6.7〉 支持不同运行模式的服务器,可以让集群动态采用不同配置,以匹配工作负载的使用情况。给定低功耗服务器的功耗/性能模式见图 6.45。
a. [5]〈6.7〉 如果运营商决定让全部服务器以中等性能运行来节省电费,需要多少台服务器才能达到相同的性能水平?
b. [10]〈6.7〉 这种配置的 CAPEX 和 OPEX 是多少?
c. [15]〈6.7〉 如果另一种选择是购买便宜 20%、速度慢 、功耗低 的服务器,求使其 TCO 与基准服务器相当的性能—功耗曲线。
| 模式 | 性能 | 功耗 |
|---|---|---|
| 高 | 100% | 100% |
| 中 | 75% | 60% |
| 低 | 59% | 38% |
习题 6.4
[讨论]〈6.7〉 假设服务器运行恒定工作负载,讨论习题 6.3 中两种方案的权衡与收益。
习题 6.5
[讨论]〈6.1,6.7〉 与高性能计算(HPC)集群不同,WSC 的工作负载通常在一天中有显著波动。这次假设工作负载随时间变化,讨论习题 6.3 中两种方案的权衡与收益。
习题 6.6
[讨论]〈6.7〉 目前给出的 TCO 模型抽象掉了大量底层细节。讨论这些抽象对模型整体精度的影响。在什么情况下可以放心采用这些抽象?什么情况下加入更多细节,会得到显著不同的答案?
案例研究 2:WSC 中的资源分配与 TCO
本案例说明的概念:
- WSC 内的服务器与电力配置
- 工作负载随时间的变化
- 波动对 TCO 的影响
习题 6.7
部署高效 WSC 的一些关键挑战,是适当配置资源,并充分利用其容量。WSC 的规模,以及运行负载可能出现的变化,使这个问题十分复杂。本案例的习题说明,不同资源使用方式如何影响 TCO。根据需要使用图 6.32 和图 6.33 的数据。
[5/5/10]〈6.7〉 配置 WSC 的一项挑战,是在给定设施规模下,确定适当的电力负载。如本章所述,铭牌功率通常是很少达到的峰值。
a. [5]〈6.7〉 如果服务器铭牌功率为 200 W、成本为 $3000,估算每台服务器的 TCO 如何变化。
b. [5]〈6.7〉 再考虑功率更高、价格更低的服务器:功率为 300 W,成本为 $2000。
c. [10]〈6.7〉 如果服务器实际平均功耗只有铭牌功率的 70%,每台服务器的 TCO 如何变化?
习题 6.8
[15/10]〈6.7〉 TCO 模型的一项假设,是设施的关键负载固定,服务器数量与该负载相匹配。实际情况中,服务器功耗随负载变化,设施在不同时刻实际使用的关键功率也会变化。运营商必须根据关键电力资源,以及对数据中心部件耗电量的估计,进行初始配置。
a. [15]〈6.7〉 扩展 TCO 模型:最初按铭牌功率为 300 W 的服务器配置 WSC,但还要计算实际每月使用的关键功率和 TCO。假设服务器平均利用率为 40%,因此只消耗 225 W。有多少容量未被利用?
b. [10]〈6.7〉 对铭牌功率为 500 W、平均利用率为 20%、实际只消耗 300 W 的服务器,重复上述计算。
习题 6.9
[10]〈6.2,6.7〉 如 6.7 节所述,WSC 常以交互方式服务终端用户。交互式使用通常导致负载随一天中的时段变化,峰值与特定时段相关。例如,Netflix 租赁业务在晚间 8–10 点出现峰值;这些时段效应的总体影响相当显著。比较两种数据中心的每服务器 TCO:一种容量按凌晨 4 点的利用率配置,另一种按晚上 9 点配置。
习题 6.10
[讨论/15]〈6.2,6.7〉 讨论一些方案,以便在非高峰时段更好地利用多余服务器,或者节省成本。考虑到 WSC 的交互特征,大幅降低功耗面临哪些挑战?
习题 6.11
[讨论/25]〈6.7,6.9〉 提出一种通过降低服务器功耗来改善 TCO 的可行方法。评估你的方案有哪些挑战?估算它能带来的 TCO 改善,并说明优点与缺点。
习题
作者:Parthasarathy Ranganathan。
习题 6.12
[10/10/10]〈6.1〉 WSC 得以实现的一个重要条件,是充足的请求级并行性,这与指令级或线程级并行性不同。本题探讨不同并行性对计算机体系结构和系统设计的影响。
a. [10]〈6.1〉 讨论一些场景:其中提高指令级或线程级并行性,能获得比请求级并行性更大的收益。
b. [10]〈6.1〉 增加请求级并行性,对软件设计有什么影响?
c. [10]〈6.1〉 增加请求级并行性可能有哪些缺点?
习题 6.13
[讨论/15/15]〈6.3,6.4〉 当云计算服务提供商收到由多个虚拟机(VM)组成的作业,例如 MapReduce 作业时,有许多调度选择。可以轮转调度 VM,使其分散到所有可用处理器和服务器上;也可以集中安排,尽量少用处理器。例如,提交一个包含 24 个 VM 的作业,而云中有 30 个处理器,每个最多运行 3 个 VM,轮转调度会使用 24 个处理器,集中调度则使用 8 个。调度器还可以在不同范围内寻找可用核心:CPU 插槽、服务器、机架,或者机架阵列。
a. [讨论]〈6.4〉 假设提交的作业都是计算密集型负载,但内存带宽需求可能不同。就供电与冷却成本、性能和可靠性而言,轮转调度与集中调度各有哪些利弊?
b. [15]〈6.4〉 假设提交的作业都是 I/O 密集型负载,在不同调度范围内,轮转调度与集中调度各有哪些利弊?
c. [15]〈6.4〉 假设提交的作业都是网络密集型负载,在不同调度范围内,轮转调度与集中调度各有哪些利弊?
习题 6.14
[15/15/10/10]〈6.4〉 MapReduce 等分布式计算框架让没有数据依赖的任务在多个节点上运行,通常使用商用硬件,从而实现大量并行性;不过,并行程度也有限制。例如,为提供冗余,MapReduce 会把数据块写到多个节点,消耗磁盘带宽,也可能消耗网络带宽。假设数据集总大小为 300 GB,网络带宽为 1 Gb/s,map 处理速率为 10 s/GB,reduce 处理速率为 20 s/GB。再假设 30% 的数据必须从远程节点读取,每个输出文件还要写入其他两个节点以提供冗余。其他参数使用图 6.21。
a. [15]〈6.4〉 假设所有节点位于同一机架。使用 5 个、10 个、100 个、1000 个节点时,预期运行时间各是多少?讨论每种节点规模下的瓶颈。
b. [15]〈6.4〉 假设每机架有 40 个节点,任一远程读写等概率地访问任何节点。使用 100 个、1000 个节点时,预期运行时间各是多少?
c. [10]〈6.4〉 一个重要考虑是尽可能减少数据移动。从本地访问变为机架内访问,再变为阵列内访问,会显著变慢,因此必须充分优化软件,最大限度利用局部性。假设每机架有 40 个节点,MapReduce 作业使用 1000 个节点。若远程访问有 20%、50%、80% 发生在同一机架内,运行时间分别是多少?
译注: 原题总难度标记有四项,但原页实际仅列 a–c 三个小问。
习题 6.15
[20/20/10/20/20/20]〈6.1,6.4〉 WSC 程序员常通过数据复制,在软件层面应对失效。例如,Hadoop 分布式文件系统(HDFS)采用三副本:一个本地副本、一个同机架内的远程副本,以及一个其他机架上的远程副本。不过,值得考察在什么情况下确实需要这样的复制。
a. [20]〈6.1〉 假设 Hadoop 集群较小,不超过 10 个节点,数据集不超过 10 TB。使用图 6.1 的失效频率数据,一个 10 节点 Hadoop 集群在采用单副本、双副本和三副本时,可用性分别如何?
b. [20]〈6.1〉 假设采用图 6.1 的失效数据,Hadoop 集群有 1000 个节点。在单副本、双副本和三副本情况下,其可用性分别如何?对于大规模系统中复制的收益,你能得出什么推论?
c. [10]〈6.1,6.4〉 复制的相对开销,随每个本地计算小时写入的数据量变化。一个 1000 节点 Hadoop 作业对 1 PB 数据排序,并把用于数据 shuffle 的中间结果写入 HDFS。计算额外的 I/O 流量,以及机架内和跨机架的网络流量。
d. [20]〈6.1,6.4〉 使用图 6.21,计算双副本和三副本的时间开销。再用图 6.1 的失效率,比较不复制、双副本和三副本情况下的预期执行时间。
e. [20]〈6.1,6.4〉 现在考虑一个复制日志的数据库系统,假设每笔事务平均访问硬盘一次,并产生 1 KB 日志。计算双副本和三副本的时间开销。如果事务在内存中执行,只需 10 μs,又如何?
f. [20]〈6.1,6.4〉 再考虑另一个数据库系统:为通过两阶段提交实现 ACID 一致性,需要两次网络往返。维护一致性以及副本的时间开销是多少?
习题 6.16
[15/15/20/讨论]〈6.1,6.9〉 请求级并行性使许多机器能够并行处理同一问题,从而提高整体性能;但一个挑战是如何避免把问题划分得过细。从服务级别协议(SLA)角度看,进一步划分、采用更小的问题规模,可能使满足目标 SLA 需要更多努力。假设 SLA 要求 95% 的查询在 0.5 秒内响应,且采用类似 MapReduce 的并行体系结构,可以启动多个冗余作业来得到同样的结果。以下各问采用图 6.46 的查询响应时间曲线。曲线给出基准服务器,以及采用较慢处理器型号的“小型”服务器,在不同每秒查询数下的响应延迟。
a. [15]〈6.1,6.9〉 假设查询响应时间曲线如图 6.46,WSC 每秒接收 30,000 次查询,需要多少台服务器才能满足 SLA?根据这一响应时间概率曲线,需要多少台“小型”服务器才能满足 SLA?只考虑服务器成本,为满足目标 SLA 并具有成本优势,“小型”服务器必须比普通服务器便宜多少?
图内术语:Latency (s)=延迟(秒);Queries per second, for one server=单台服务器每秒查询数;Baseline=基准服务器;Small=小型服务器。
b. [15]〈6.1,6.9〉 “小型”服务器往往也因部件较便宜而可靠性较低。采用图 6.1 的数据,假设由不稳定机器和损坏内存引起的事件增加 30%。现在需要多少台“小型”服务器?它们必须比标准服务器便宜多少?
c. [20]〈6.1,6.9〉 现在假设是批处理环境。“小型”服务器整体性能为普通服务器的 30%。仍采用习题 6.15(b) 的可靠性数据,要提供与 2400 个标准服务器节点组成的阵列相同的预期吞吐量,需要多少个“小型”节点?假设性能随节点规模完美线性增长,每节点平均任务时长为 10 分钟。如果扩展效率为 85% 呢?60% 呢?
d. [讨论]〈6.1,6.9〉 扩展关系通常不是线性的,而是对数关系。一种自然反应可能是购买每节点计算能力更强的大型节点,以尽量减小阵列规模。讨论这种体系结构的一些权衡。
习题 6.17
[10/10/15/讨论]〈6.4,6.9〉 考虑把非易失性 Flash 加入存储层次结构,可以采用固态硬盘(SSD),或者通过 PCI Express 连接的卡。典型 SSD 带宽为 250 MB/s,延迟为 75 μs;PCIe 卡带宽为 600 MB/s,延迟为 35 μs。
a. [10] 在图 6.22 的本地服务器存储层次结构中加入这些点。假设它们在不同层次中访问时,其性能缩放系数与 DRAM 相同,那么经机架网络访问这些 Flash 设备时,表现如何?经阵列网络访问时呢?
b. [10] 讨论一些能够利用这一新增存储层次的软件优化。
c. [15] 如“谬误与陷阱”(6.9 节)所述,用 SSD 替换全部磁盘不一定划算。考虑一个使用 WSC 提供云服务的运营商,讨论哪些场景下使用 SSD 或其他 Flash 存储是合理的。
d. [讨论] 讨论存储层次结构中是否还可以容纳其他层次,例如更慢的内存(如分离式内存),或更慢的 Flash(采用更注重成本的技术)。
习题 6.18
[20/20/讨论]〈6.4〉存储层次结构。 一些 WSC 设计大量使用缓存来降低延迟;针对不同访问模式与需求,可以选择多种缓存方案。
a. [20] 考虑从 Web 提供富媒体流的设计选择,例如 Netflix 或 YouTube。首先需要估计视频数量、每个视频的编码格式数量,以及并发观看人数。假设一个流媒体提供商有 12,000 部可在线播放的作品,每部至少有四种编码格式,码率分别为 500、1000、1600、2200 kbps。再假设全站有 100,000 名并发观众,视频平均时长为 75 分钟,同时考虑 30 分钟节目与 2 小时视频。估算总存储容量、I/O 与网络带宽,以及视频流相关的计算需求。
b. [20] 对每位用户、每部视频以及全部视频整体而言,访问模式和引用局部性分别有什么特点?提示:随机还是顺序访问,时间局部性与空间局部性好还是差,工作集相对较小还是较大。
c. [讨论] 使用 DRAM、SSD 与硬盘,可以形成哪些影片存储方案?比较它们的性能与 TCO。习题 6.17(d) 中的其他存储技术是否有用?
习题 6.19
[20/讨论/讨论/讨论]〈6.4〉 考虑一个拥有 1 亿活跃用户的社交网站,用户用文字与图片发布自身动态,也浏览和互动其社交网络中的动态。为降低延迟,Facebook 等许多网站在后端存储/数据库层之前使用 memcached 缓存层。假设任一时刻,普通用户正在浏览兆字节量级的内容;任一天,普通用户上传的内容也为兆字节量级。
a. [20] 上述社交网站需要多少 DRAM 来容纳工作集?如果每台服务器有 96 GB DRAM,估计生成一个用户主页需要多少次本地内存访问与远程内存访问。
b. [讨论] 考虑两种候选 memcached 服务器设计:一种使用针对性能优化、耗能较高的核心,另一种使用较小、能效较高的核心,例如原文所举 Intel 和 AMD 发布的 E-core 与 P-core。memcached 需要大容量物理内存,却只有较低 CPU 利用率;这两种设计各有什么利弊?
c. [讨论] 当前内存模块与处理器紧密耦合,若要支持大容量内存,通常就必须增加 CPU 插槽数。列出其他能够提供大容量物理内存、又不必同比增加服务器插槽数量的设计,并比较它们的性能、功耗、成本与可靠性。
d. [讨论] 同一用户的信息,可以同时存在于 memcached 和存储服务器中;这些服务器又可以采用不同物理布局。讨论以下 WSC 布局的利弊:(1)把 memcached 放在同一台存储服务器上;(2)memcached 与存储服务器分属同一机架内的不同节点;(3)memcached 服务器集中在一组机架,存储服务器集中在另一组机架。
习题 6.20
[5/5/10/10/讨论/讨论/讨论]〈6.2,6.4,6.7〉数据中心网络。 MapReduce 等分布式框架与仓库级计算机结合,能有力地处理大规模数据。本题假设使用 4000 台服务器和 48,000 块硬盘,在 6 小时内对 1 PB 记录完成排序。
a. [5] 从图 6.21 及相关正文推导磁盘带宽。将数据读入主存、再把排序结果写回,需要多少秒?
b. [5] 假设每台服务器有两块 1 Gb/s 以太网 NIC,WSC 交换网络的超额订阅比为 4。在 4000 台服务器之间 shuffle 整个数据集,需要多少秒?
c. [10] 假设网络传输是 PB 级排序的性能瓶颈,能否估算 Google 数据中心采用的超额订阅比?
d. [10] 现在考察无超额订阅的 10 Gb/s 以太网的收益,例如采用 48 端口 10 Gb/s 以太网交换机,2010 年 Indy 排序基准测试冠军 TritonSort 就使用了这种配置。shuffle 1 PB 数据需要多久?
e. [讨论] 比较两种方法:(1)采用较高网络超额订阅比的大规模横向扩展系统;(2)采用高带宽网络的较小规模系统。各自可能的瓶颈是什么?在可扩展性与 TCO 方面,各有什么优缺点?
f. [讨论] 排序与许多重要科学计算负载都属于通信密集型,但许多其他负载并非如此。列举三个不能从高速网络获益的负载。对这两类负载,你会推荐哪些 EC2 实例?
g. [讨论] 查看 Sort Benchmark 中的各种基准测试,以及各类测试最近的优胜者。这些结果与 (e) 的讨论有什么对应关系?最近的 CloudSort 冠军使用的云实例,与 (f) 中的答案相比如何?
习题 6.21
[10/25/讨论]〈6.4,6.7〉 WSC 规模庞大,因此必须根据预期运行的负载,适当分配网络资源。不同分配方案会显著影响性能和总拥有成本。
a. [10] 使用图 6.32 电子表格中的数据,每台接入层交换机的超额订阅比是多少?如果减半,TCO 有何变化?如果加倍呢?
b. [25] 对受网络限制的负载,降低超额订阅比可能提高性能。假设一个计算作业使用 120 台服务器,读取 5 TB 数据。读取数据、中间数据和输出数据的比例,与图 6.47 中 2009 年 9 月相同;存储层次结构的带宽采用图 6.21。读取数据时,50% 来自远程磁盘;其中 80% 来自机架内,20% 来自阵列内。中间数据与输出数据有 30% 使用远程磁盘;其中 90% 位于机架内,10% 位于阵列内。将超额订阅比减半,整体性能会改善多少?如果超额订阅比加倍,性能又如何?计算各情况下的 TCO。
| 月份 | MapReduce 作业数 | 平均完成时间(s) | 每作业平均服务器数 | 每服务器平均核心数 | CPU 核心年 | 输入数据(PB) | 中间数据(PB) | 输出数据(PB) |
|---|---|---|---|---|---|---|---|---|
| 2016 年 9 月 | 95,775,891 | 331 | 130 | 2.4 | 311,691 | 11,553 | 4095 | 6982 |
| 2015 年 9 月 | 115,375,750 | 231 | 120 | 2.7 | 272,322 | 8307 | 3980 | 5801 |
| 2014 年 9 月 | 55,913,646 | 412 | 142 | 1.9 | 200,778 | 5989 | 2530 | 3951 |
| 2013 年 9 月 | 28,328,775 | 469 | 137 | 1.4 | 81,992 | 2579 | 1193 | 1684 |
| 2012 年 9 月 | 15,662,118 | 480 | 142 | 1.8 | 60,987 | 2171 | 818 | 874 |
| 2011 年 9 月 | 7,961,481 | 499 | 147 | 2.2 | 40,993 | 1162 | 276 | 333 |
| 2010 年 9 月 | 5,207,069 | 714 | 164 | 1.6 | 30,262 | 573 | 139 | 37 |
| 2009 年 9 月 | 4,114,919 | 515 | 156 | 3.2 | 33,582 | 548 | 118 | 99 |
| 2007 年 9 月 | 2,217,000 | 395 | 394 | 1.0 | 11,081 | 394 | 34 | 14 |
| 2006 年 3 月 | 171,000 | 874 | 268 | 1.6 | 2002 | 51 | 7 | 3 |
| 2004 年 8 月 | 29,000 | 634 | 157 | 1.9 | 217 | 3.2 | 0.7 | 0.2 |
c. [讨论] 你认为新兴技术趋势将怎样影响未来 WSC 的设计?例如,每个系统的核心越来越多,包括使用 chiplet;光互连带来更高带宽与更高能效。
习题 6.22
[5/15/15/20/25/讨论/讨论]〈6.2〉发挥云的能力。 假设你是 Alexa.com 排名靠前网站的运维与基础设施经理,正在考虑使用 Amazon Web Services(AWS)。决定是否迁移到 AWS 时,需要考虑哪些因素?可以使用什么服务和实例类型,能节省多少费用?你可以用 Alexa 和网站流量信息,例如 Wikipedia 的页面访问统计,估计热门网站的流量;也可以采用网上的具体案例,例如每日 280 万次页面浏览的 Drupal 单服务器案例。
这组幻灯片描述了一个 Alexa 排名第 3400、每日页面浏览量 280 万的网站,只使用一台服务器。服务器配有两颗四核 2.5 GHz Xeon、8 GB DRAM,以及三块构成 RAID1 的 15,000 RPM SAS 硬盘,每月成本约 $400。网站大量使用缓存,CPU 利用率在 50%–250% 之间,约相当于 0.5–2.5 个核心繁忙。
a. [5] 查看可用的 EC2 实例类型,哪些能够达到或超过当前服务器配置?
b. [15] 查看 EC2 价格信息,选择在 AWS 托管此网站最具成本效益的 EC2 实例,允许组合使用。每月 EC2 成本是多少?
c. [15] 再把 IP 地址和网络流量成本纳入计算,假设网站每天经互联网传入、传出 100 GB 数据。现在网站每月成本是多少?
d. [20] 原题所述 AWS 还向新客户免费提供一年微型实例,并对跨 AWS 的传入和传出流量各提供 15 GB 配额。根据你对所在部门 Web 服务器峰值与平均流量的估计,能否免费把它托管在 AWS?
e. [25] 如果 Netflix.com 这样大得多的网站,把流媒体与编码基础设施迁往 AWS,根据其服务特征,它可以使用哪些 AWS 服务,各自用于什么目的?
f. [讨论] 查看 Google、Microsoft、Alibaba 等其他云提供商的类似产品。(a)–(e) 的答案会怎样变化?
g. [讨论] “无服务器计算”(serverless computing)让你不必考虑具体服务器,就能构建和运行更高层次的应用与服务。例如 AWS Lambda、Google Cloud Functions、Microsoft Azure Functions 等。继续以网站运维与基础设施经理的身份考虑:什么时候会采用无服务器计算?
习题 6.23
[讨论/讨论/20/20/讨论]〈6.7,6.9〉 图 6.36 展示用户感知的响应时间如何影响收入,说明了为什么必须在保持低延迟的同时获得高吞吐量。
a. [讨论] 以 Web 搜索为例,有哪些可能降低查询延迟的方法?
b. [讨论] 为了解时间花在哪里,可以收集哪些监控统计?你准备如何实现这种监控工具?
c. [20] 假设每次查询的磁盘访问次数服从均值为 2、标准差为 3 的正态分布。要满足 95% 查询延迟不超过 0.1 s 的 SLA,磁盘访问延迟需要达到什么水平?
d. [20] 内存缓存可以减少访问硬盘等长延迟事件的发生频率。假设稳态命中率为 40%,命中延迟为 0.05 s,未命中延迟为 0.2 s,缓存能否帮助满足 95% 查询延迟不超过 0.1 s 的 SLA?
e. [讨论] 缓存内容何时会过时,甚至变得不一致?这种情况可能多久发生一次?如何检测并使这些内容失效?
习题 6.24
[15/15/20/讨论]〈6.6,6.7〉 典型电源单元(PSU)的效率随负载变化。例如,原题把第一档写为效率约“80%—40% load”,例子是一台 100 W PSU 输出 40 W;负载在 20%–40% 之间时,效率为 75%;负载低于 20% 时,效率为 65%。
译注: 原页确实印为“80%—40% load”,效率 80% 与负载 40% 之间缺少明确关系词,也没有清楚界定第一档负载范围。
a. [15] 假设一台服务器的实际功率与 CPU 利用率成正比,利用率曲线如图 6.48。PSU 平均效率是多少?
b. [15] 假设服务器的 PSU 采用 冗余,即 PSU 数量加倍,以保证一台 PSU 失效时仍能稳定供电。PSU 平均效率是多少?
c. [20] 刀片服务器厂商使用共享 PSU 池,既提供冗余,也能动态调整启用的 PSU 数量,使其匹配服务器实际功耗。假设一个刀片机箱共有 16 台服务器,最多使用 6 台 PSU。服务器利用率曲线相同,这种情况下机箱的 PSU 平均效率是多少?
d. [讨论] 结合图 6.32 和图 6.33 中更广泛的 TCO 讨论,考虑不同效率数值的影响:不同设计怎样影响总体 TCO?据此,你会如何优化未来仓库级计算机的设计?
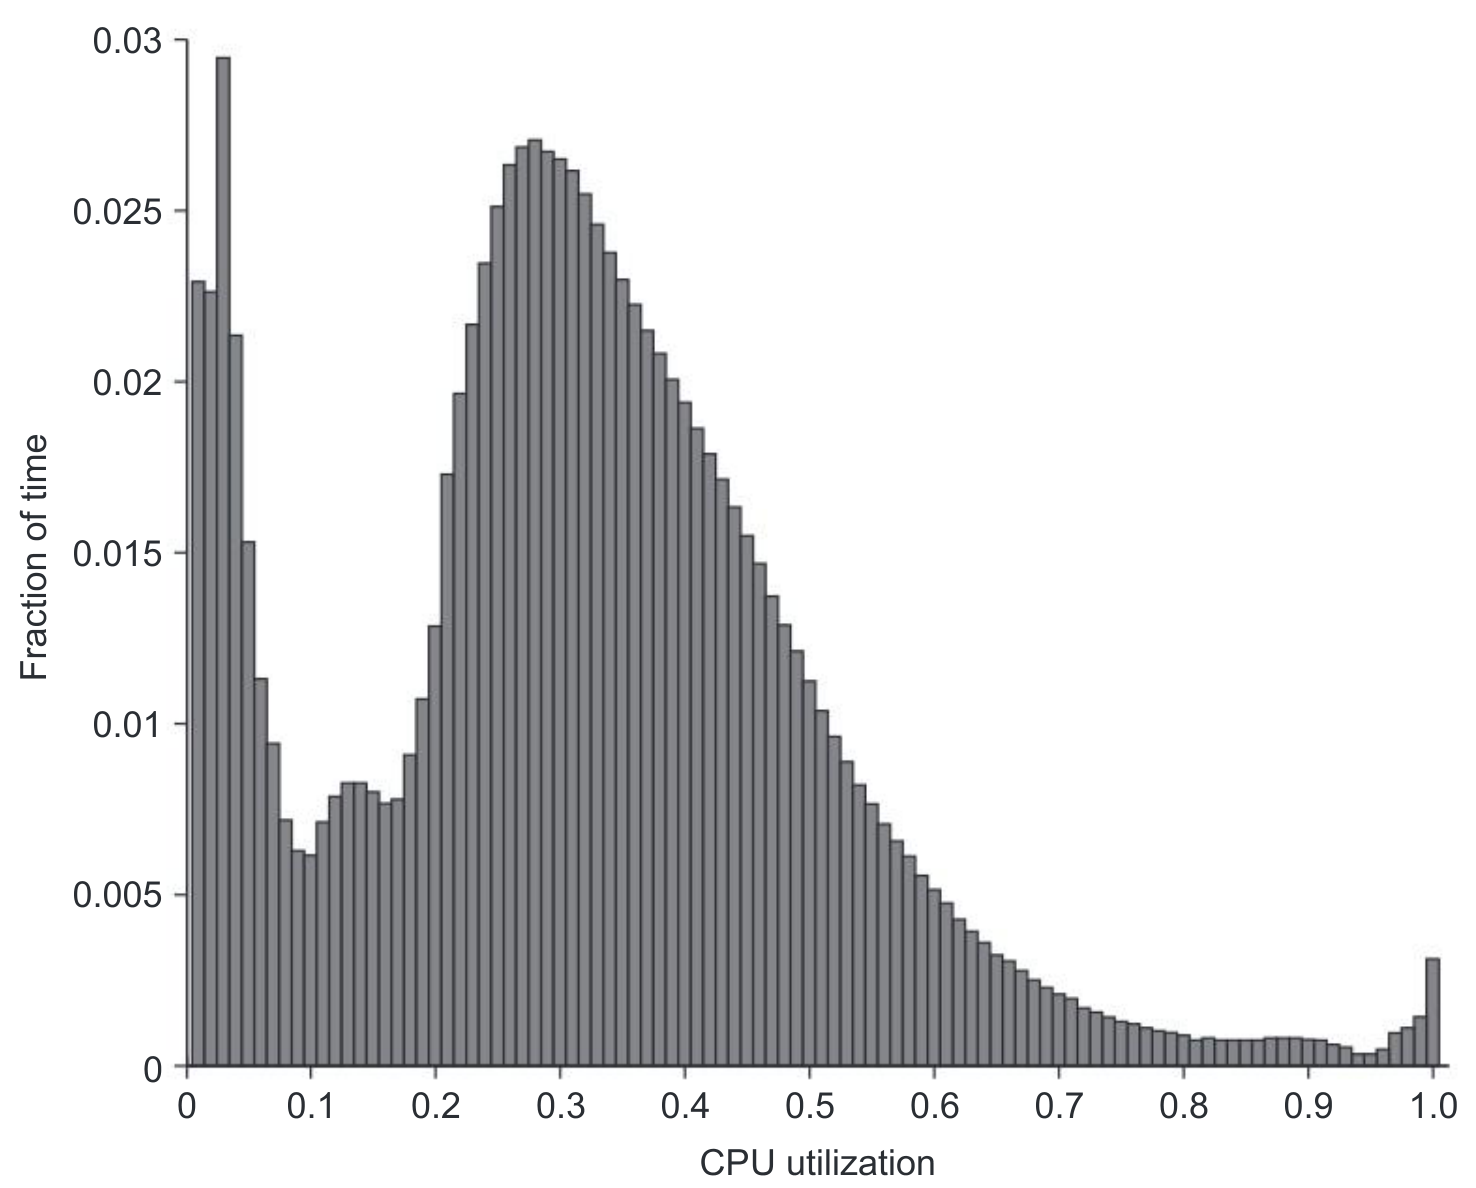
图内术语:Fraction of time=时间占比;CPU utilization=CPU 利用率。
习题 6.25
[5/讨论/10/15/讨论/讨论/讨论]〈6.6,6.9〉 Power stranding 指数据中心已经配置、却未使用的电力容量。考察图 6.49 中不同机器分组的数据(Fan、Weber 和 Barroso,2007)。注意,该论文所称的 cluster(集群),相当于本章所称的 array(阵列)。
a. [5] (1)机架级、(2)配电单元级、(3)阵列(集群)级,各有多少闲置电力容量?机器分组越大,电力容量的超额订阅呈现什么趋势?
b. [讨论] 你认为不同机器分组之间闲置电力容量的差异,是什么原因造成的?
c. [10] 考虑一个阵列级机器集合,全部机器实际总功率从不超过总配置功率的 72%;这有时也称为“总和的峰值”与“峰值的总和”之比。使用案例研究中的成本模型,比较按峰值容量配置与按实际使用配置的数据中心,计算可节省的成本。
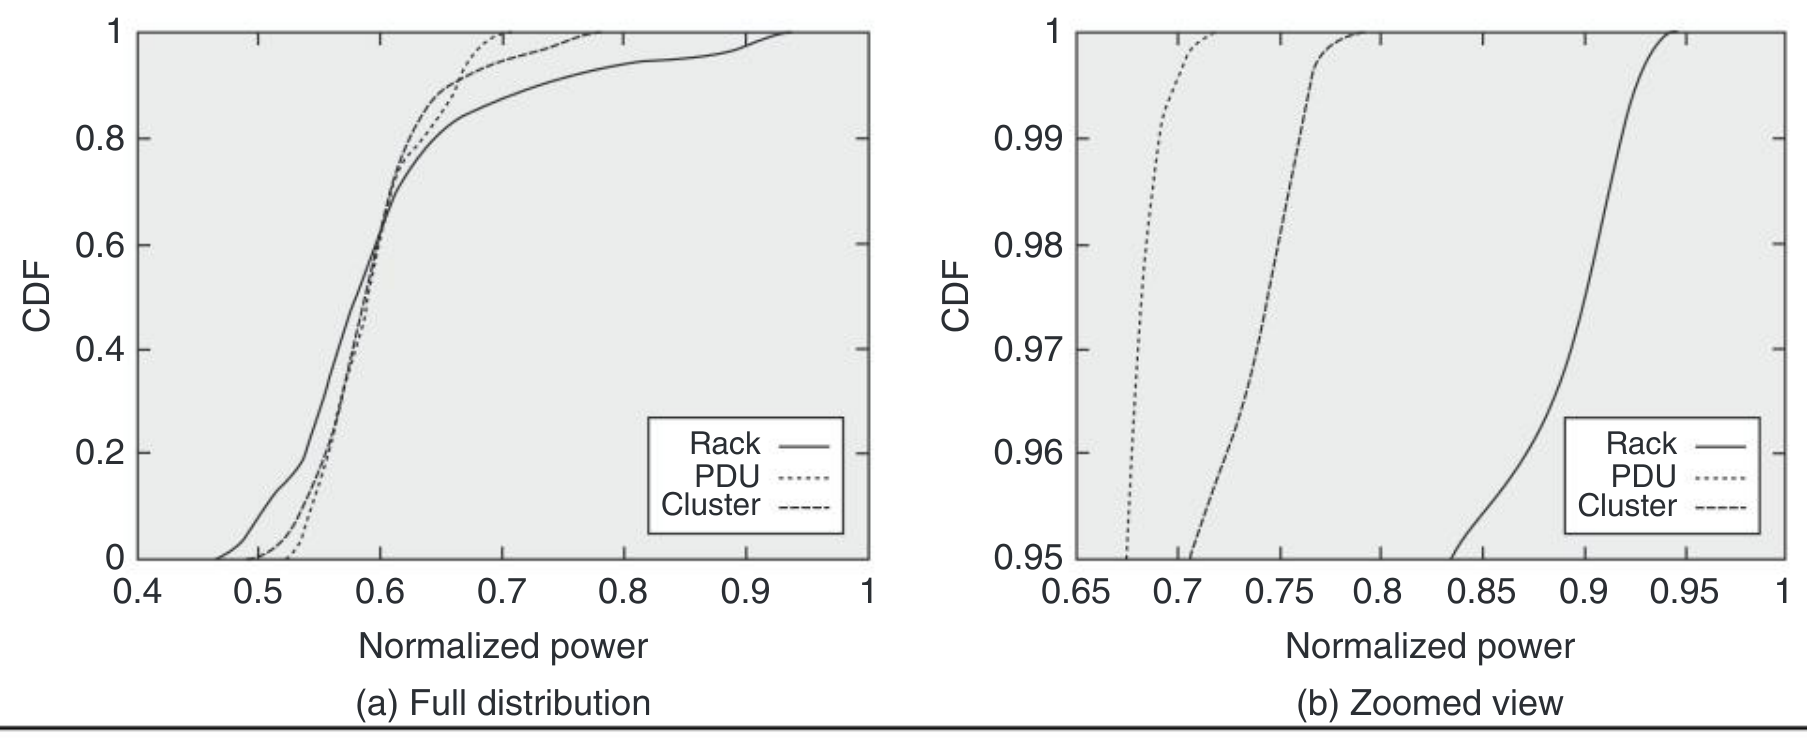
图内术语:Normalized power=归一化功率;Rack=机架;PDU=配电单元;Cluster=集群,对应本章的阵列;(a) Full distribution=完整分布;(b) Zoomed view=局部放大。
d. [15] 假设数据中心设计者决定在阵列级增加服务器,利用闲置电力容量。采用 (a) 的示例配置与假设,在总供电配置不变的情况下,WSC 可以增加多少台服务器?
e. [讨论] 要使 (d) 的优化在实际部署中可行,需要什么条件?提示:考虑极少数情况下,阵列中所有服务器同时达到峰值功率时,应如何限制功率。
f. [讨论] 可以设想两类功率上限管理策略(Ranganathan 等,2006):(1)事先制定功率预算的预先控制策略——“不要假定可以多用电,用之前先申请!”;(2)一旦违反预算再限制功率的响应式策略——“只要还没被告知不行,就按需要用电!”讨论两者的权衡,以及分别适合什么情况。
g. [讨论] 如果系统的能耗变得更接近与工作量成比例,总闲置电力容量会发生什么变化?
习题 6.26
[5/20/讨论]〈6.6,6.7〉 6.6 节讨论了每机架配置电池、作为本地 UPS 的方法。可以进一步把电池配置到每台服务器。下面考察这种设计的影响。
a. [5] 假设用电池作为服务器级微型 UPS,效率为 99.99%,从而不再需要效率只有 92% 的设施级 UPS。假设变电站开关效率为 99.7%,PDU、降压级与其他断路器的效率分别为 98%、98%、99%。计算每服务器电池备份方案带来的总体供电基础设施效率改善。
b. [20] 假设 UPS 成本为 IT 设备成本的 10%。使用案例研究成本模型的其他假设,求电池成本的盈亏平衡点,以单台服务器成本的比例表示:电池低于什么成本时,电池方案的 TCO 优于设施级 UPS?
c. [讨论] 两种方法还有哪些权衡?特别是,你认为两种设计的可管理性与失效模型会如何变化?
习题 6.27
[5/5/讨论]〈6.6,6.7〉 本题考虑 WSC 总运行功率的一个简化方程,如下:
译注: 题目缺少此处所述的方程。
a. [5] 假设一个 8 MW 数据中心的电力使用率为 80%,电价为每千瓦时 $0.10,冷却低效乘数为 0.8。比较两种优化的成本节省:(1)冷却效率提高 20%;(2)IT 设备能效提高 20%。
b. [5] IT 设备能效需要提高百分之多少,才能达到冷却效率提高 20% 的成本节省?
c. [讨论] 对于服务器能效优化与冷却能效优化的相对重要性,你能得出什么结论?
习题 6.28
[5/5/讨论]〈6.6,6.7〉 如本章所述,WSC 的冷却设备本身也可能消耗大量能量。主动管理温度可以降低冷却成本。已有一种优化方案是感知温度的负载放置:识别给定机房的冷却分布,把较热系统放到较冷位置,从而降低 WSC 整体冷却需求。
a. [5] 计算机房空调(CRAC)的性能系数(COP)衡量其效率,定义为移除的热量 与移除这些热量所需功 之比。CRAC 送入静压空间的空气温度越高,COP 越大。如果回风温度为 20°C,以 COP 1.9 移除 10 kW 热量,CRAC 消耗多少能量?如果同样体积的空气以 25°C 回流,冷却时 COP 为 3.1,现在 CRAC 消耗多少能量?
b. [5] 假设一种工作负载分配算法能把较热负载恰当地映射到较冷位置,让 CRAC 像上一问那样在较高温度下运行,提高冷却效率。上述两种情况之间节省多少功率?
c. [讨论] 鉴于 WSC 的规模,电源管理可能是复杂而多方面的问题。能效优化可以在硬件或软件中实现,可以针对 IT 设备或冷却设备,在系统级或集群级实施,等等。设计 WSC 整体能效方案时,必须考虑这些交互。设有一种整合算法,观察服务器利用率,把不同类别负载集中在同一服务器上以提高利用率;如果系统的能耗与工作量不成比例,这可能让服务器运行在能效更高的状态。这种优化与同时尝试使用不同电源状态的另一算法,会怎样相互影响?可参考 ACPI(Advanced Configuration Power Interface)中的例子。你还能想到哪些 WSC 中多种优化可能冲突的例子?你会怎样解决?
习题 6.29
[5/10/15/20]〈6.7〉 能耗与工作量成比例(energy proportionality,有时也称 energy scale-down),是指系统空闲时不耗电,更重要的是,功耗随活动水平和完成的工作量按比例逐渐增加。本题考察不同模型对能耗的影响。除非另有说明,以下默认使用图 6.50 的数据。
a. [5] 分析这种比例关系的一种简单方法,是假设活动水平与功率呈线性关系。仅使用图 6.50 的峰值功率和空闲功率数据,通过线性插值,绘制能效随利用率变化的趋势;能效以每瓦性能表示。如果空闲功率,即 0% 活动水平时的功率,只有图 6.50 假定值的一半,会怎样?如果空闲功率为零呢?
| 负载 | 性能 | 功率(W) | SPEC 权重 | 加权性能 | 加权功率(W) | 图 6.3 的权重(原表头) | 加权性能 | 加权功率(W) |
|---|---|---|---|---|---|---|---|---|
| 100% | 2,889,020 | 662 | 9.09% | 262,638 | 60 | 0.80% | 22,206 | 5 |
| 90% | 2,611,130 | 617 | 9.09% | 237,375 | 56 | 1.20% | 31,756 | 8 |
| 80% | 2,319,900 | 576 | 9.09% | 210,900 | 52 | 1.50% | 35,889 | 9 |
| 70% | 2,031,260 | 533 | 9.09% | 184,660 | 48 | 2.10% | 42,491 | 11 |
| 60% | 1,740,980 | 490 | 9.09% | 158,271 | 45 | 5.10% | 88,082 | 25 |
| 50% | 1,448,810 | 451 | 9.09% | 131,710 | 41 | 11.50% | 166,335 | 52 |
| 40% | 1,159,760 | 416 | 9.09% | 105,433 | 38 | 19.10% | 221,165 | 79 |
| 30% | 869,077 | 382 | 9.09% | 79,007 | 35 | 24.60% | 213,929 | 94 |
| 20% | 581,126 | 351 | 9.09% | 52,830 | 32 | 15.30% | 88,769 | 54 |
| 10% | 290,762 | 308 | 9.09% | 26,433 | 28 | 8.00% | 23,198 | 25 |
| 0% | 0 | 181 | 9.09% | 0 | 16 | 10.90% | 0 | 20 |
| 合计 | 15,941,825 | 4967 | 1,449,257 | 452 | 933,820 | 380 | ||
| ssj_ops/W | 3210 | ssj_ops/W | 2454 |
译注: 原表第七列表头写“Figure 6.3 weightings”,但图注说明权重来自图 6.48;这里同时保留表头与图注,并标出差异。加权结果也按原表保留,不用已舍入的权重重新覆盖原值。
b. [10] 绘制能效随活动水平变化的趋势,但功率变化采用图 6.50 第三列的数据。再假设仅空闲功率降至图 6.50 数值的一半,绘制能效曲线。将这些曲线与上一问的线性模型比较。对只关注空闲功率的做法,你能得出什么结论?
c. [15] 假设系统利用率组合如图 6.50 第七列。为简化起见,在 1000 台服务器中采用离散分布:109 台利用率为 0%,80 台为 10%,以此类推。使用 (a) 和 (b) 的假设,分别计算该负载组合的总性能与总能耗。
d. [20] 可以设计一种系统,在 0%–50% 负载区间中,功率与负载呈次线性关系。其能效曲线会在较低利用率时达到峰值,代价是在较高利用率时表现较差。重新设计图 6.50 第三列,使其展现这种能效曲线。假设利用率组合如图 6.50 第七列;为简化起见,在 1000 台服务器中采用离散分布,109 台利用率为 0%,80 台为 10%,以此类推。计算该负载组合的总性能与总能耗。
习题 6.30
[15/20/20]〈6.7〉 本题说明能耗与工作量比例模型,同服务器整合、高能效服务器设计等优化之间的交互。考虑图 6.51 和图 6.52 的场景。
a. [15] 考虑图 6.51 中两种服务器的功率分布:方案 A 是图 6.50 的服务器,方案 B 的能耗与工作量比例关系较差,但能效比 A 更高。采用图 6.50 第七列的利用率组合。为简化起见,在 1000 台服务器中采用离散分布:109 台利用率为 0%,80 台为 10%,以此类推,如图 6.52 第一行。性能变化采用图 6.50 第二列。比较两类服务器在该负载组合下的总性能与总能耗。
| 活动水平(%) | 0 | 10 | 20 | 30 | 40 | 50 | 60 | 70 | 80 | 90 | 100 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 方案 A 功率(W) | 181 | 308 | 351 | 382 | 416 | 451 | 490 | 533 | 576 | 617 | 662 |
| 方案 B 功率(W) | 250 | 275 | 325 | 340 | 395 | 405 | 415 | 425 | 440 | 445 | 450 |
b. [20] 考虑一个包含 1000 台服务器的集群,数据与图 6.50 类似,并汇总在图 6.51 和图 6.52 的第一行。在这些假设下,该负载组合的总性能与总能耗是多少?现在假设能够整合负载,得到方案 C 的分布,即图 6.52 第二行。此时总性能与总能耗是多少?与一个空闲功率为 0 W、峰值功率为 662 W、采用线性能耗与工作量比例模型的系统相比,总能耗如何?
c. [20] 使用服务器 B 的功率模型重复 (b),并与 (a) 的结果比较。
习题 6.31
[10/讨论]〈6.7〉系统级能耗与工作量比例关系的趋势。 考虑服务器功耗的以下两种分解:
- CPU 50%;内存 23%;磁盘 11%;网络/其他 16%。
- CPU 33%;内存 30%;磁盘 10%;网络/其他 27%。
a. [10] 假设 CPU 功率动态范围为 3.0 倍,即 CPU 空闲功耗为峰值的三分之一。内存、磁盘、网络/其他类别的动态范围分别为 2.0、1.3、1.2 倍。两种情况下整个系统的总动态范围分别是多少?
b. [讨论] 从 (a) 的结果中可以学到什么?如何在系统级改善能耗与工作量的比例关系?提示:系统级目标不能只靠 CPU 优化实现,而需要改善全部部件。
习题 6.32
[30]〈6.7〉 Pitt Turner IV 等(2008)对数据中心 Tier 等级分类作了很好的概述。Tier 等级定义场地基础设施的性能。为简化起见,只考虑图 6.53 中的关键差异,改编自 Pitt Turner IV 等(2008)。以案例研究中的 TCO 模型为框架,比较所列不同等级的成本影响。
习题 6.33
[讨论]〈6.7〉 根据图 6.36 与图 6.32,定性讨论停机造成的收入损失,与维持正常运行所需成本之间的权衡。
| 活动水平(%) | 0 | 10 | 20 | 30 | 40 | 50 | 60 | 70 | 80 | 90 | 100 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 方案 A、B 的服务器数 | 109 | 80 | 153 | 246 | 191 | 115 | 51 | 21 | 15 | 12 | 8 |
| 方案 C 的服务器数 | 504 | 6 | 8 | 11 | 26 | 57 | 95 | 123 | 76 | 40 | 54 |
| 等级 | 基础设施特征 | 可用性 |
|---|---|---|
| Tier 1 | 供电与冷却均为单一路径,无冗余部件 | 99.0% |
| Tier 2 | 冗余:两条供电与冷却分配路径 | 99.7% |
| Tier 3 | 冗余:三条供电与冷却分配路径,即使维护时也保持运行 | 99.98% |
| Tier 4 | 两条同时工作的供电与冷却分配路径,每条路径中均有冗余部件,可容忍任一单设备失效而不影响负载 | 99.995% |
习题 6.34
[15/讨论]〈6.6〉 最近一些研究定义了 TPUE,意为“真实 PUE”(true PUE)或“总体 PUE”(total PUE),定义为 。6.6 节将 PUE 定义为设施总功率与 IT 设备总功率之比。SPUE,即服务器 PUE,是一个类似 PUE、但用于计算设备的新指标,定义为服务器总输入功率与有效功率之比。有效功率指直接参与计算的电子部件所消耗的功率,包括主板、磁盘、CPU、DRAM、I/O 卡等。换言之,SPUE 衡量服务器内部电源、电压调节器和风扇带来的低效。
a. [15] 考虑提高计算机房空调(CRAC)送风温度的设计。CRAC 效率近似是温度的二次函数,因此这种设计能改善总体 PUE,假设改善 7%,基准 PUE 为 1.7。然而,服务器处温度提高,触发板载风扇控制器让风扇以更高速度运行。风扇功率是转速的三次函数,因此转速提高使 SPUE 恶化。假设采用如下风扇功率模型:其中 为归一化风扇转速,等于以 rpm 表示的风扇转速除以 18,000,基准服务器功率为 350 W。计算风扇转速(1)从 10,000 提高到 12,500 rpm,(2)从 10,000 提高到 18,000 rpm 时的 SPUE。比较两种情况下的 PUE 与 TPUE。为简化起见,在 SPUE 模型中忽略供电损耗。
译注: 原页“Assume a fan power model:”之后直接接“where ns…”,没有给出风扇功率模型公式。归一化转速定义和 350 W 参数确实存在。
b. [讨论] (a) 说明,PUE 虽然能很好地衡量设施开销,却不反映 IT 设备自身的低效。你能否指出另一种设计,其 TPUE 改善可能小于传统 PUE 的改善?提示:参见习题 6.26。
习题 6.35
[讨论/30/讨论]〈6.7〉 两个基准测试为评估服务器能效提供了良好起点:SPECpower_ssj2008 基准测试,见 SPECpower_ssj2008,以及 JouleSort 指标,见 Sort Benchmark。
a. [讨论] 查阅两种基准测试的说明。它们有哪些相似和不同之处?为了更好地服务于提高 WSC 能效的目标,你会如何改进它们?
b. [30] JouleSort 测量执行一次外部排序的系统总能耗,并试图建立一个能够比较嵌入式设备到超级计算机的指标。到 Sort Benchmark 查阅 JouleSort 说明。下载公开可用的排序算法实现,在笔记本、PC、手机等不同类别机器上,或者在不同配置下运行。从这些设置的 JouleSort 评分中,可以学到什么?
c. [讨论] 考虑上述实验中 JouleSort 评分最好的系统。你会如何改善能效?例如,尝试重写排序代码来提高评分。在云中运行排序,会怎样影响能效?
习题 6.36
[10/10/15/讨论]〈6.1,6.4〉 图 6.1 列出了服务器阵列中的中断事件。面对 WSC 的庞大规模,必须平衡集群设计与软件体系结构,以合理成本达到所需正常运行时间。本题考察仅靠硬件实现可用性的影响。
a. [10] 假设运营商希望只通过改进服务器硬件达到 95% 可用性,每类事件的次数需要减少多少?暂时假设单台服务器崩溃完全由冗余机器处理。
b. [10] 如果单台服务器崩溃只有 50% 的情况由冗余处理,(a) 的答案如何变化?如果只有 20% 呢?如果完全不由冗余处理呢?
c. [15] 讨论软件冗余对实现高可用性的重要性。如果 WSC 运营商考虑购买更便宜、但可靠性低 10% 的机器,会对软件体系结构有什么影响?软件冗余有哪些相关挑战?
d. [讨论] 讨论最终一致性对仓库级计算机扩展能力的重要性。
习题 6.37
[15]〈6.1,6.9〉 查阅普通 DDR4 DRAM 与支持纠错码(ECC)的 DDR4 DRAM 当前价格。为了获得 ECC 提供的更高可靠性,每位价格增加多少?仅使用 DRAM 价格与 6.9 节的数据,比较采用非 ECC 和 ECC DRAM 的 WSC,每美元可获得多少正常运行时间。
习题 6.38
[5/讨论/讨论]〈6.1,6.9〉WSC 的可靠性与可管理性问题。
a. [5] 考虑一个服务器集群,每台成本为 $2000。假设年失效率为 5%,每次维修平均需要 1 小时,更换部件每次花费系统成本的 10%。若维修技术人员每小时费用为 $100,每台服务器每年的维护成本是多少?
b. [讨论] 比较这一管理模型与传统企业数据中心模型的差异。后者有大量中小型应用,每个应用运行在自己的专用硬件基础设施上。
c. [讨论] 讨论仓库级计算机采用异构机器的权衡。
习题 6.39
[5/5/10/讨论]〈6.1,6.7〉 假设你创建了一项 Web 服务,99% 的时间运行良好,在 100 ms 内响应;1% 的时间出现性能问题,例如 CPU 进入低功耗状态,导致响应耗时 1000 ms。
a. [5] 服务越来越受欢迎,现在有 100 台服务器,而且处理用户请求的计算必须访问全部服务器。在这 100 台服务器上,一次查询出现慢响应的概率是多少?
b. [5] 要让集群延迟 SLA 仅有不超过 10% 的时间出现不良延迟,单服务器延迟 SLA 需要从“两个 9”(99%)提高到几个 9?
c. [10] 如果有 2000 台服务器,(a) 与 (b) 的答案如何变化?
d. [讨论] 6.7 节(原书所引第 531 页)讨论了能够容忍尾部延迟的设计。你的 Web 服务需要进行哪些设计优化?提示:参阅 Dean 和 Barroso(2013)的论文 The Tail at Scale。
习题 6.40
[讨论/讨论/5/5/5]〈6.3,6.2〉 现代虚拟化平台与 hypervisor 支持在线迁移,即在物理宿主机之间移动整个 VM。在线迁移为云提供商与客户带来许多收益,包括无中断系统维护,以及更有效地把负载安排到物理宿主机、改善 TCO。假设有机器 A、B,各有 12 个核心和 256 GB DRAM。最初,A 运行两个 VM:VM0 使用 6 个核心和 24 GB DRAM;VM1 使用 4 个核心和 48 GB DRAM。B 运行 VM2,使用 4 个核心和 128 GB DRAM。现在用户关闭 VM1。根据此前对该客户 VM 的经验,预计 VM0、VM2 在可预见的将来会持续运行。假设有一个简单 VM 迁移系统:(1)暂停 VM;(2)经网络传输 CPU/内存状态;(3)恢复 VM。假设迁移时间主要由内存内容的传输决定。
a. [讨论] 迁移 VM 时,除 CPU/内存状态外,还必须考虑哪些资源?如果目标是尽量缩短迁移时间,你预计应该如何管理这些资源?
b. [讨论] 假设要把 VM0 与 VM2 整合到同一物理宿主机。可以考察哪些指标,决定迁移哪一个 VM?
c. [5] 使用上述简单迁移系统,假设向 VM 客户承诺了“六个 9”的正常运行时间。如果每天最多迁移一次 VM,而且这是唯一可能导致停机的因素,迁移过程最多可以耗时多久?
d. [5] 假设系统决定把 VM2 迁到机器 A。仍假设每天迁移一次,A、B 之间至少需要多少带宽,才能在不违反正常运行时间保证的前提下完成迁移?
e. [5] 如果网络带宽为 200 Gb/s,在不违反“五个 9”的正常运行时间保证的情况下,每天最多可以迁移 VM0 多少次?
习题 6.41
[讨论]〈6.3,6.2〉 除进程隔离、虚拟机、物理隔离等机制外,容器化也是一种常用隔离机制。
a. [讨论] 查阅常用容器管理工具。隔离是否被宣传为它们的主要用途?
b. [讨论] 比较容器化与上述其他隔离机制的异同,从性能开销、隔离能力、硬件要求等多个方面讨论。
c. [讨论] 哪些类型的 WSC 运营商可能依赖各种隔离方式?为每种隔离技术给出一个 WSC 应用实例。
d. [讨论] 隔离机制从来都不是完美的。查找并解释这些机制在生产系统中被突破的若干实例。
习题 6.42
[30/10]〈6.5〉 今天的 WSC 提供大量成本/性能特征不同的 I/O 机制与加速器。云用户也能选择这些不同资源,价格公布在云提供商网站上。
a. [30] 绘制不同云提供商提供下列资源的每小时、每 GB、每 Gb/s 等成本。尝试比较不同类型实例,分离出每种资源的成本。
- i. 网络:不同带宽。
- ii. DRAM:不同容量与标准。
- iii. NVMe Flash:不同 IOPS、带宽。
- iv. 磁盘:不同 IOPS、带宽。
- v. GPU:不同 OPs/s。
- vi. FPGA。
- vii. ML 加速器:不同 OPs/s。
b. [10] 收集类似设备的零售价格。如果云提供商按这些价格购买设备,需要出租多久才能收回成本?
习题 6.43
[讨论/5/5/5/讨论]〈6.8〉 FPGA 可以在数小时内,而非数月或数年,部署新的专用硬件设计;但与 ASIC 相比,功耗与性能需要付出代价。本题考察在 FPGA 与 ASIC 上部署专用硬件的权衡。假设你是云运营商,可以购买以下一种加速器部署到服务器群:(1)FlexAcc,基于 FPGA,可快速修改与重新编程,始终保持相对 32 核 CPU 软件实现的 16 倍加速;(2)FastAcc,基于 ASIC,无法修改,但速度为 32 核 CPU 软件实现的 1024 倍,功耗为 FlexAcc 的八分之一、CPU 的三十二分之一。假设 FlexAcc 与 FastAcc 的购置价格相同。
a. [讨论] 哪些应用领域或程序库可能更适合 FlexAcc 这种形式?哪些更适合 FastAcc?
b. [5] 假设每次软件发布新版本,FastAcc 的有效性能减半,功耗不变。经过多少次软件发布后,FlexAcc 与 FastAcc 的瞬时每瓦性能相同?
c. [5] 假设一颗 32 核 CPU 成本为 $2048,电价为 $0.125/kWh。CPU 与 FastAcc 都部署两年,期间没有新软件版本。要与 CPU 的成本持平,FastAcc 最高购置价格是多少?
d. [5] 对 FlexAcc 重复 (c)。
e. [讨论] (a)–(d) 隐含假定 ASIC 加速器完全无法随软件演进,但实际并非如此。有哪些可编程 ASIC 的例子?它们如何保持灵活性?
习题 6.44
[讨论/讨论/240/5/5/5]〈6.8〉复现面向 WSC 的开源定制芯片。 Karandikar 等发布了一个开源 Protocol Buffers 硬件加速器设计。Protocol Buffers 是一种序列化框架,常用于仓库级计算机中的服务间通信与持久化存储。
a. [讨论] 设计这一加速器的动机是什么?查找一些参考资料,讨论不同云提供商、不同时间点上,序列化/反序列化占用的 CPU 比例。
b. [讨论] 这种加速器应如何集成到系统中,例如靠近核心、经 CXL 或 PCIe 接入?从性能和集成成本两个角度讨论权衡。
c. [240] 按 Karandikar 等论文的 artifact 附录,在 Protocol Buffers 加速器的开源实现上,运行源自 Google 服务器群的 Protocol Buffers 基准测试。需要能够访问 AWS。
d. [5] 该论文不仅提出新的 WSC 硬件,还利用 WSC 专门化完成评估:通过云 FPGA 与 FireSim 实现快速硬件模拟。比较按需付费使用所需 FPGA(EC2 F1),与直接购买一块 FPGA(Xilinx Alveo U250)的成本。
e. [5] 如果购买 FPGA,需要运行多少次基准测试才能收回成本?若再计入承载 FPGA 的服务器成本呢?
f. [5] 重做前面的计算,假设购买足够多的 FPGA,即八块,以匹配 artifact 所设置的、在云端多块 FPGA 上运行的并行度。
参考文献
Barroso, L.A., Holzle, U., Ranganathan, P., 2018. The Datacenter as a Computer: Designing Warehouse-Scale Machines, third ed. Morgan & Claypool Publishers.
Bugnion, E., Devine, S., Rosenblum, M., Sugerman, J., Wang, E.Y., November 2012. Bringing Virtualization to the x86 Architecture with the Original Vmware Workstation. 30 ACM Transactions of Computing Systems, p. 4. DOI: 10.1145/2382553.2382554.
Cook, B., Khazem, K., Kroening, D., Tasiran, S., Tautschnig, M., Tuttle, M.R., 2021. Model checking boot code from AWS data centers. Form. Methods Syst. Des. 57 (1), 34–52. DOI: 10.1007/s10703-020-00344-2.
Delimitrou, C., Kozyrakis, C., 2014. Quasar: resource-efficient and QoS-aware cluster management. In: Proceedings of the 19th international conference on Architectural support for programming languages and operating systems (ASPLOS ’14). Association for Computing Machinery, New York, NY, USA, pp. 127–144. DOI: 10.1145/2541940.2541941.
Ferguson, A.D., Gribble, S.D., Hong, C.-Y., Edwin Killian, C., Mohsin, W., Mühe, H., Ong, J., Poutievski, L., Singh, A., Vicisano, L., Alimi, R., Chen, S.S., Conley, M., Mandal, S., Nagaraj, K., Bollineni, K.N., Sabaa, A., Zhang, S., Zhu, M., Amin, V., April 12–14, 2021. Orion: Google’s Software-Defined Networking Control Plane. In: Proceedings fo the 18th USENIX Symposium on Networked Systems Design and Implementation.
Firestone, D., Putnam, A., Mundkur, S., Chiou, D., Dabagh, A., Andrewartha, M., Angepat, H., Bhanu, V., Caulfield, A., Chung, E., Chandrappa, H.K., Chaturmohta, S., Humphrey, M., Lavier, J., Lam, N., Liu, F., Ovtcharov, K., Padhye, J., Popuri, G., Raindel, S., Sapre, T., Shaw, M., Gabriel, S., Sivakumar, M., Srivastava, N., Verma, A., Zuhair, Q., Deepak, B., Doug, B., Vaid, K., Maltz, D.A., Greenberg, A., 2018. Azure accelerated networking: SmartNICs in the public cloud. In: Proceedings of the 15th USENIX Conference on Networked Systems Design and Implementation (NSDI’18). USENIX Association, USA, pp. 51–64.
Forecast: Public Cloud Services, Worldwide, 2020–2026, 3Q22 Update. Gartner 原书链接.
Jalili, M., Manousakis, I., Goiri, Í., Misra, P.A., Raniwala, A., Alissa, H., Ramakrishnan, B., Tuma, P., Belady, C., Fontoura, M., Bianchini, R., 2021. Cost-efficient overclocking in immersion-cooled datacenters. In: Proceedings of the 48th Annual International Symposium on Computer Architecture (ISCA ’21). IEEE Press, pp. 623–636. DOI: 10.1109/ISCA52012.2021.00055.
Karandikar, S., Leary, C., Kennelly, C., Zhao, J., Parimi, D., Nikolic, B., Asanovic, K., Ranganathan, P., 2021. A Hardware Accelerator for Protocol Buffers. In: MwICRO-54: 54th Annual IEEE/ACM International Symposium on Microarchitecture. MICRO ’21). DOI: 10.1145/3466752.3480051.
Li, H., Berger, D.S., Novakovic, S., Hsu, L., Ernst, D., Zardoshti, P., Shah, M., Rajadnya, S., Lee, S., Agarwal, I., Hill, M.D., Fontoura, M., Bianchini, R., March 2023. Pond: CXL-Based
Memory Pooling Systems for Cloud Platforms. In: Proceedings of the 28th ACM International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS). Vancouver, BC Canada.
Lo, D., Cheng, L., Govindaraju, R., Ranganathan, P., Christos, K., 2016. Improving Resource Efficiency at Scale with Heracles. ACM Trans. Comput. Syst. 34 (2), 33. DOI: 10.1145/2882783. Article 6.
Nishtala, R., Fugal, H., Grimm, S., Kwiatkowski, M., Lee, H., Li, H.C., McElroy, R., Paleczny, M., Peek, D., Paul, S., Stafford, D., Tung, T., Venkataramani, V., 2013. Scaling Memcache at Facebook. In: Proceedings of the 10th USENIX conference on Networked Systems Design and Implementation (nsdi’13). USENIX Association, USA, pp. 385–398.
Popek, G.J., Goldberg, R.P., July 1974. Formal requirements for virtualizable third generation architectures. Communications of the ACM 17 (7), 412–421. DOI: 10.1145/361011.361073.
Poutievski, L., Mashayekhi, O., Ong, J., Singh, A., Tariq, M., Wang, R., Zhang, J., Beauregard, V., Conner, P., Gribble, S., Kapoor, R., Kratzer, S., Li, N., Liu, H., Nagaraj, K., Ornstein, J., Sawhney, S., Urata, R., Vicisano, L., Yasumura, K., Zhang, S., Zhou, J., Amin, V., 2022. Jupiter evolving: transforming google’s datacenter network via optical circuit switches and software-defined networking. In: Proceedings of the ACM SIGCOMM 2022 Conference (SIGCOMM ’22). Association for Computing Machinery, New York, NY, USA, pp. 66–85. DOI: 10.1145/3544216.3544265.
Shalev, L., Ayoub, H., Bshara, N., Sabbag, E., Nov.–Dec. 2020. A Cloud-Optimized Transport Protocol for Elastic and Scalable HPC. IEEE Micro vol. 40 (6), 67–73. DOI: 10.1109/MM.2020.3016891.
Turner IV, Pitt, W., Seader, J.H k, Brill, K.G., 2008. Tier classifications define site infrastructure performance. White Paper, The Uptime Institute.
Uptime Institute Global Data Center Survey Results 2022. Uptime Institute 原书链接.
7 领域专用体系结构
Moore 定律不可能永远延续……再过 10–20 年,我们就会触及一个根本性的极限。
——Gordon Moore,Intel 联合创始人,2005 年
原章 DOI:10.1016/B978-0-443-15406-5.00007-9。原章版权标记:© 2026 Elsevier Inc.,保留所有权利,包括文本与数据挖掘、AI 训练及类似技术的相关权利。
7.1 引言
Gordon Moore 不仅在 1965 年预言了每芯片晶体管数量惊人的增长;本章开篇的引语还表明,他也预见了约 50 年后这种增长将接近停滞。第 1 章图 1.24 提供了一个例证:就连他创办的公司——几十年来一直以 Moore 定律指导资本投入并引以为豪的公司——也在放缓新半导体工艺的开发速度。
在半导体高速发展的年代,体系结构设计者借助 Moore 定律,不断创造新的机制,把日益充裕的晶体管资源转化为更高的性能。20 世纪 80 年代,一个五级流水线、32 位的 RISC 处理器,最少只需约 25,000 个晶体管;此后,可用资源增加到了当时的 1,000,000 倍,从而支持了前面各章介绍的种种功能,让通用处理器上的通用程序运行得更快:
- 一级、二级、三级乃至四级缓存;
- 512 位 SIMD 浮点运算单元;
- 15 级以上的流水线;
- 分支预测;
- 乱序执行;
- 推测性预取;
- 多线程;
- 每插槽包含数百个处理器的多处理器系统。
这些复杂的体系结构,面向的是以 C、C++ 等高效语言编写、规模达到数百万行的程序。设计者把这些程序视为黑盒,通常既不了解程序内部的结构,甚至也不了解程序究竟要完成什么任务。SPEC2017 中的基准程序,就只是用来测量性能和加速执行的对象。自 20 世纪 80 年代的 RISC 革命以来,处于软硬件交界处的一直是编译器开发者;然而,他们对应用的高层行为也只有有限的了解。这正是编译器甚至无法跨越 C、C++ 与 GPU 体系结构之间语义鸿沟的原因。
如第 1 章所述,Dennard 缩放规律早于 Moore 定律走到了尽头。因此,如今更多晶体管发生开关动作,就意味着更高的功耗。能耗预算没有增加,而我们已经用多个高效核心取代了单个低效处理器。因此,对于通用体系结构,已经没有其他重大的体系结构创新,能够继续大幅提高性价比和能效。由于电迁移以及芯片的机械、热约束等因素,能耗预算受到限制;要获得更高的性能,即每秒执行更多次运算,就必须降低每次运算的能量消耗。
图 7.1 从另一个角度展示了第 1 章提到的存储访问与逻辑运算的相对能量代价,这一次把它们表示为执行一条算术指令所需的开销。
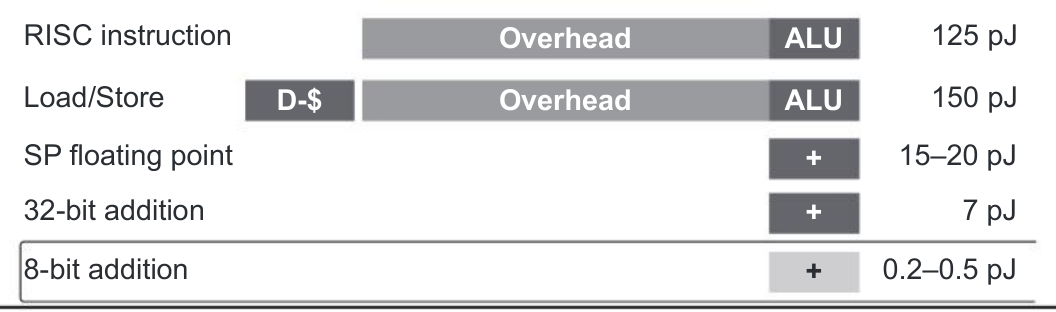
图中 RISC instruction 表示 RISC 指令,总能量为 125 pJ;Load/Store 表示加载/存储,总能量为 150 pJ;Overhead 为附加开销,D-$ 为数据缓存,ALU 为算术逻辑单元。单精度浮点运算(SP floating point)需要 15–20 pJ,32 位加法需要 7 pJ,8 位加法需要 0.2–0.5 pJ。
考虑到这些开销,对现有核心做些小幅调整,也许只能带来 5%–10% 的改进。如果希望在保留可编程性的同时获得大幅提升,就需要把每条指令执行的算术运算数量,从一次提高到数百次。要达到这样的效率,计算机体系结构必须发生根本变化:从通用核心转向领域专用体系结构(domain-specific architectures,DSA)。
因此,正如 21 世纪初从单处理器转向多处理器是形势所迫一样,如今设计者投入 DSA,也是因为传统道路已难以为继。新的常态是:一台计算机既包含运行操作系统等传统大型程序的标准处理器,也包含领域专用处理器。后者只完成很窄的一类任务,却能把它们做得极好。这样的计算机,将比过去同构的多核芯片具有更强的异构性。事实上,智能手机 SOC 已经采用了异构设计,用加速器提高信号处理、图形生成、图像转换等任务的能效。
这一论点的部分依据是:过去几十年中,那些借 Moore 定律发展起来的体系结构创新,例如缓存、乱序执行等,并不一定适合某些领域,尤其不一定有利于节能。它们占用的资源可以重新分配,让芯片更适合目标领域。例如,缓存非常适合通用体系结构,却未必适合 DSA。对存储访问模式容易预测的应用,或者视频这类数据规模巨大、复用却很少的应用,多级缓存往往配置过度:缓存囤积了可能不会再次使用的数据,白白消耗面积和能量。因此,DSA 有望同时提高硅资源的利用效率和能效,而后者通常是今天更重要的属性。
设计者大概不会为 SPEC2017 基准测试中的编译器这类大型 C++ 程序创建 DSA。领域专用算法几乎总是大型系统中规模较小、计算密集的核心部分,例如物体识别或语音理解。DSA 应当针对这部分计算,而不应打算运行整个程序。此外,修改基准测试代码不再意味着违反规则;对于 DSA 来说,这完全可以是合理的加速来源,部分原因正是待加速的代码规模较小。因此,想在 DSA 上作出有价值贡献的设计者,必须走出原有视野,学习应用领域及其算法。
除了拓宽专业知识,领域专用体系结构设计者还面临另一个挑战:找到需求规模足够大的目标领域,使得在 SOC 上分配专用硅面积、乃至单独定制一颗芯片值得投入。定制芯片及其配套软件的非重复性工程费用(NRE),要由制造的芯片数量分摊。因此,如果只需要 10,000 颗芯片,这种方案通常难以在经济上成立(见第 1 章图 1.17)。
服务较小规模应用的一种办法,是使用现场可编程门阵列(Field Programmable Gate Array,FPGA)等可重配置芯片。它们的 NRE 低于定制芯片,而且多个不同应用可能复用同一套可重配置硬件,分摊其成本。不过,这类硬件的效率远低于定制芯片,所以 FPGA 带来的收益也较为有限。
DSA 的另一项挑战是软件移植。C++ 语言及其编译器这类熟悉的编程环境,很少是使用 DSA 的合适途径。
本章接下来先给出 DSA 设计的五条指导原则,再介绍作为示例领域的深度神经网络(DNN)。我们选择 DNN,是因为在过去十年里,它们正在改变计算领域的许多方面。与某些硬件所针对的任务不同,DNN 适用于广泛的问题,因此,一种面向 DNN 的体系结构可以复用于语音、视觉、语言、翻译、搜索排序等许多领域。
随后,我们介绍六种 DSA:五种用于数据中心、加速 DNN 的定制芯片,以及一种用于个人移动设备(PMD)、加速 DNN 的 DSA。接着用 DNN 基准测试考察这些 DSA 的性价比,最后讨论计算机体系结构领域正在发生的复兴。
7.2 DSA 的设计原则
下面五条原则,大体上指导了 7.4–7.7 节将介绍的六种 DSA 的设计。它们不仅提高了面积效率和能效,还带来两个有价值的额外效果。首先,它们使设计更简单,从而降低 DSA 的 NRE(见 7.11 节中的相关谬误讨论)。1 其次,在 DSA 常见的面向用户的应用中,遵循这些原则的加速器,比传统处理器那些性能随时间变化的优化机制,更容易满足第 99 百分位响应时间的截止要求;7.10 节将讨论这一点。图 7.2 概括了六种 DSA 如何遵循这些原则。
1. 使用专用存储器,尽量缩短数据移动距离
通用微处理器中的多级缓存,要消耗大量面积和能量,力求为程序找到最佳的数据移动方式。例如,一个两路组相联缓存的能耗,是等效的软件控制 scratchpad 存储器的 2.5 倍。2 从定义上说,DSA 的编译器开发者和程序员了解目标领域,因此无需硬件代他们尝试安排数据移动。相反,应通过由软件控制、针对领域内特定功能专门设计的存储器来减少数据移动。
2. 把省去高级微体系结构优化所节约的资源,投入更多算术单元或更大的存储器
如 7.1 节所述,设计者曾把 Moore 定律带来的充裕资源,用于 CPU 和 GPU 上资源开销很大的优化:乱序执行、多线程、多处理、预取、地址合并等。对于范围更窄的专用领域,我们对实际运行的程序有更深入的了解,因此,把这些资源用于更多处理单元或更大的片上存储器,往往更为划算。
3. 采用与目标领域相匹配、最容易使用的并行形式
DSA 的目标领域几乎总是具有内在并行性。关键的设计决策是:如何利用这种并行性,又如何把它暴露给软件。应围绕目标领域自然的并行粒度设计 DSA,并在编程模型中以简单方式提供这种并行性。例如,对数据级并行性而言,如果 SIMD 能满足领域需求,那么,对程序员和编译器开发者来说,它肯定比 MIMD 更容易使用。
同样,如果超长指令字(Very Long Instruction Word,VLIW)能够表达该领域的指令级并行性,那么,与推测性乱序执行相比,这种设计可以更小,也更节能。此外,VLIW 和 SIMD 都能提高每次指令访问所对应的计算量。
4. 把数据宽度和类型缩减到领域所需的最简单形式
后文将看到,许多领域的应用通常受存储系统限制。因此,使用更窄的数据类型,可以提高有效存储带宽和片上存储器的利用率。更窄、更简单的数据类型,还能使相同芯片面积容纳更多算术单元,并降低算术运算的能耗。
5. 使用领域专用编程语言为 DSA 编写程序
如 7.1 节所述,DSA 的一个经典难题,是让应用能在新体系结构上运行。一个由来已久的谬误是:假定新计算机足够有吸引力,程序员就会专门为它重写代码。幸运的是,早在设计者被迫转向 DSA 之前,领域专用编程语言和库就已经逐渐普及。例如,DNN 领域的 JAX、PyTorch、TensorFlow(Paszke et al., 2019;Abadi et al., 2016),以及数据库系统使用的 SQL。这些工具大大提高了把应用移植到 DSA 上的可行性。如前所述,在一些领域中,只有应用里规模很小、计算密集的部分需要运行在 DSA 上,这也简化了移植工作。
| 原则 | Google TPUv4 lite | Google TPUv4 | NVIDIA A100 | NVIDIA T4 | Graphcore IPU Bow | Samsung NPUv2 |
|---|---|---|---|---|---|---|
| 目标领域 | DNN 推理 | DNN 训练与推理 | DNN 训练与推理 | DNN 推理 | DNN 训练与推理 | DNN 推理 |
| 设计目标 | 数据中心 ASIC | 数据中心 ASIC | 数据中心 ASIC | 数据中心 ASIC | 数据中心 ASIC | PMD SOC |
| 1. 专用存储器 | 16 MiB VMEM,128 MiB CMEM | 32 MiB VMEM,128 MiB CMEM | 27 MiB 多线程寄存器堆,40 MiB L2 缓存 | 10 MiB 多线程寄存器堆,18 MiB L2 缓存 | 897 MiB 处理器内存储器 | 2 MiB 紧耦合存储器 |
| 2. 更多算术单元 | 65,536 个乘加单元 | 131,072 个乘加单元 | 110,592 个乘加单元 | 20,480 个乘加单元 | 94,208 个乘加单元 | 8192 个乘加单元 |
| 3. 容易使用的并行形式 | 单线程、VLIW、SIMD、顺序执行 | 单线程、VLIW、SIMD、顺序执行 | 多线程、SIMD | 多线程、SIMD | 多线程、SIMD | 单线程、SIMD |
| 4. 更小的数据宽度 | 8 位整数、bf16 | 8 位整数、bf16 | 1 位、4 位、8 位整数,fp16、bf16、tf32 | 4 位、8 位整数,fp16 | fp16 | 4 位、8 位、16 位整数,fp16 |
| 5. 领域专用语言 | JAX、PyTorch、TensorFlow | JAX、PyTorch、TensorFlow | JAX、PyTorch、TensorFlow | JAX、PyTorch、TensorFlow | JAX、PyTorch、TensorFlow | TensorFlow、TensorFlow Lite |
任何能够训练的芯片,也都能够执行推理。与各自的训练版本相比,Google 和 NVIDIA 都通过减少核心数量、降低外部存储器成本,来降低推理产品的成本。
DSA 带来了许多新术语,主要来自新的应用领域,也有一些来自传统处理器中没有出现过的新体系结构机制。与第 4 章的做法一样,图 7.3 列出新缩写、术语及简短解释,便于读者查阅。
| 类别 | 术语 | 缩写 | 简要解释 |
|---|---|---|---|
| 通用 | 领域专用体系结构(Domain-specific architectures) | DSA | 为特定领域设计的专用处理器;领域之外的处理工作依靠其他处理器完成。 |
| 通用 | IP 模块(Intellectual property block) | IP | 可以集成到 SOC 中的可复用设计模块。由此形成了一个市场:一些组织提供 IP 模块,另一些组织将这些模块组合成 SOC。 |
| 通用 | 片上系统(System on a chip) | SOC | 把一台计算机的全部组成部分集成到一颗芯片中;常见于 PMD。 |
| 深度神经网络 | 激活值(Activation) | — | 人工神经元被“激活”的结果,即非线性函数的输出。 |
| 深度神经网络 | 批(Batch) | — | 一起处理的一组数据集,以降低读取权重的成本。 |
| 深度神经网络 | 卷积神经网络(Convolutional neural network) | CNN | 对前一层输出中空间相邻的区域进行加权和非线性运算的 DNN。 |
| 深度神经网络 | 深度神经网络(Deep neural network) | DNN | 由多层人工神经元组成的网络;神经元对前一层输出与权重的乘积应用非线性函数。 |
| 深度神经网络 | 推理(Inference) | — | DNN 的生产使用阶段,也称 serving。 |
| 深度神经网络 | 多层感知机(MultiLayer perceptron) | MLP | 对前一层所有输出进行加权和非线性运算的 DNN;这样的层称为全连接层。 |
| 深度神经网络 | 整流线性单元(Rectified linear unit) | ReLU | 执行 的非线性函数;其他常用非线性函数包括 sigmoid 和双曲正切函数(tanh)。 |
| 深度神经网络 | 循环神经网络(Recurrent neural network) | RNN | 输入同时来自前一层和先前状态的 DNN。 |
| 深度神经网络 | 训练(Training) | — | DNN 的开发阶段,也称学习(learning)。 |
| 深度神经网络 | Transformer | — | 利用注意力机制为输入序列中各位置提供上下文的 DNN。与 RNN 一样,它常用于自然语言翻译和文本摘要;但与 RNN 不同,它一次处理整个输入,而非依次处理。因此,各项运算能够并行进行,使其可以处理大得多的数据。 |
| 深度神经网络 | 权重(Weights) | — | 训练过程中学得、随后应用于输入的数值,也称参数(parameters)。 |
| 深度神经网络 | 大语言模型(Large Language Model) | LLM | 原表也称其为 Frontier models;基于 Transformer 模型的解码阶段,通常拥有数十亿到数万亿个参数。 |
许多领域已经有了 DSA,例如面向图形的 GPU;还有一些领域值得继续探索,包括数据分析、图像处理、安全和隐私。不过,本章贯穿始终的示例是人工智能。
7.3 示例领域:深度神经网络
人工智能(AI)不仅是计算领域的下一波浪潮,也是人类历史上的下一个重大转折点……这场智能革命将由数据、神经网络和算力驱动。Intel 致力于发展 AI,因此……我们已经引入了一系列先进手段,以推动 AI 的发展与广泛应用。
——Brian Krzanich,Intel CEO,2016 年
自世纪之交以来,人工智能(AI)强势回归。研究重心不再是用一大套逻辑规则来构建智能,而是转向从样本数据中进行机器学习(machine learning,ML),以此实现人工智能。事实表明,编程让计算机具有智能,比编程让计算机学会如何变得智能更难。不过,学习所需的数据量也远远超出了最初的估计。本世纪的仓库级计算机(WSC)从互联网上数十亿用户及其智能手机中收集并存储 PB 级信息,提供了充足的数据。
我们同样低估了从海量数据中学习所需的计算量。不过,WSC 的数千台服务器中配备了 GPU;它们具有出色的单精度浮点性价比,提供了所需的算力。
机器学习中的深度神经网络(DNN),是过去十年 AI 和 ML 领域最引人注目的方向。DNN 带来的突破包括:在语言翻译方面,一次跨越所取得的进展,超过了此前十年的全部积累(Tung, 2016;Lewis-Kraus, 2016);在图像识别竞赛中,采用 DNN 后,错误率仅用五年就从 26% 降到了 3.5%(Krizhevsky et al., 2012;Szegedy et al., 2015;He et al., 2016);2016 年,DNN 使计算机程序首次战胜了人类围棋冠军(Silver et al., 2016)。2022 年,一个 DNN 根据一维氨基酸序列,预测了全部 2 亿种已知蛋白质的三维结构,解决了困扰生物学家数十年的问题。《Science》杂志把这一成果评为年度最大突破(Jumper et al., 2021),相关研究者又在 2024 年获得了诺贝尔奖。几乎每个月都会出现重要的 DNN 新成果,因此有人把这个时代称为“深度学习的黄金十年”(Dean, 2022)。这些应用虽然许多运行在云端,但也推动了第 1 章所述的智能手机 Google Translate 等应用。
希望在本节之外进一步学习 DNN 的读者,可以下载并动手尝试 JAX 和 PyTorch 教程;如果暂时不打算动手,也可以阅读免费的在线 DNN 教材(Nielsen, 2016)。Google 的 ML/AI 速成课程也很出色!
DNN 中的神经元
DNN 的灵感来自大脑中的神经元。神经网络使用的人工神经元,计算过程其实很简单:把一组权重或参数与相应数据值相乘,求和,再经过一个非线性函数得到输出。后文将看到,每个人工神经元都有很大的扇入和扇出。对图像处理 DNN,输入数据就是照片的像素,像素值分别与权重相乘。人们尝试过许多非线性函数,目前常用的一种却非常简单:
当 为负数时返回 0,为正数或零时返回原值。这个简单函数有一个较长的名字:整流线性单元(rectified linear unit,ReLU)。非线性函数的输出称为激活值(activation),也就是人工神经元被“激活”后得到的输出。
一组人工神经元可以分别处理输入的不同部分;这一组的输出,又成为下一层人工神经元的输入。输入层和输出层之间的层称为隐藏层。在图像处理中,可以把不同层理解为寻找不同层次的特征:从边缘、角等低层特征,逐渐走向眼睛、耳朵等高层特征。如果应用要判断图像中是否有狗,最后一层的输出可以是一个介于 0 和 1 之间的概率,也可以是一组对应不同犬种的概率。
“深度”神经网络的名称,来自网络的层数。早期缺少数据和算力,多数神经网络都比较浅,可能只有两个隐藏层。到 2024 年,一些 DNN 已有数十层,使用数千亿个权重。图 7.4 列出了一些 DNN 的层数、参数数量和训练时间。
| DNN 模型(类型与层数) | 参数数量 | 数据集规模与类型 | 训练平台与时间 |
|---|---|---|---|
| BERT-large:24 层 Transformer 编码器(Devlin et al., 2018) | 340 M | BookCorpus,8 亿个词;英文 Wikipedia,25 亿个词 | 64 个 TPU v2 × 4 天,约 1500 TPU v2 小时 |
| Stable Diffusion v2 Base:带 UNet、交叉注意力和 OpenCLIP-ViT/H 文本编码器的潜在扩散模型(Rombach et al., 2022) | UNet 为 860 M,文本编码器为 123 M | 经过筛选的 LAION-5B,58.5 亿个图文对 | 256 个 A100 GPU × 33 天,约 200,000 A100 小时 |
| Switch-Transformer Base:12 层、采用混合专家的 Transformer 编码器—解码器(Fedus et al., 2022) | 8000 M | Colossal Clean Crawled Corpus,3560 亿个 token | 16 个 TPU v3 × 2.5–3 天,约 70 TPU v3 小时 |
| GPT-3:96 层 Transformer 解码器(Brown et al., 2020) | 175,000 M | Common Crawl:4100 亿个 token;WebText2:190 亿;Books1:120 亿;Books2:550 亿;Wikipedia:30 亿 | 估计为 1024 个 A100 GPU × 34 天,约 840,000 A100 小时 |
表中 M 表示百万。为减少基准测试的工作量,MLPerf Training 3.1 对部分相同规模的模型采用了小得多的数据集。例如,Stable Diffusion v2 使用的图文对只有 4 亿个,而不是图中的约 59 亿个;在 8 个较新的 H100 GPU 上训练不到一小时,总计约 6 H100 小时,而表中的生产训练需要约 200,000 A100 小时。即使基于 H100 的系统性能是基于 A100 系统的 3.3 倍,Stable Diffusion 的生产训练所需时间仍约为 MLPerf 训练的 10,000 倍。1
训练与推理
以上讨论的是已经投入生产使用的 DNN。开发 DNN 时,首先要确定神经网络架构:选择层的数量和类型、每层的维度以及数据宽度。专家可能设计新的网络架构,但多数实践者会从已有的众多设计中选择,例如图 7.4 中那些已经在相似问题上取得良好效果的模型。
选定网络架构后,下一步是学习神经网络图中每条边对应的权重。权重决定模型的行为。根据所选架构不同,一个模型可能包含数千到数千亿个权重。
训练,就是调整这些权重,使 DNN 逼近训练数据所描述的复杂函数,例如从图片映射到图片中的物体;这一过程代价高昂。
开发阶段通常称为训练或学习,生产使用阶段则有多种称呼:推理(inference)、serving、预测(prediction)、评分(scoring)或 implementation。用教育作比喻,训练就像进入大学学习某个专业,serving 则像毕业后运用所学完成工作。
多数 DNN 采用监督学习:它们获得一个训练集,数据经过预处理,带有正确标签。在 ImageNet DNN 竞赛中(Russakovsky et al., 2015),训练集包含 120 万张照片,每张照片都标记为 1000 个类别之一。有些类别划分得相当细,例如特定品种的狗和猫。比赛使用另外一组保密的 50,000 张照片进行评测,错误率最低的 DNN 获胜。
设置权重是一个迭代过程:利用训练集,沿神经网络反向进行计算,这称为反向传播(backpropagation)。例如,训练集中一张图片的犬种已经知道;先查看 DNN 对这张图片给出的结果,再调整权重,使答案更准确。令人惊讶的是,训练开始时,权重应初始化为随机值;随后不断迭代,直到对模型在训练集上达到的准确率感到满意为止。
从数学角度看,学习的目标是:在多层神经网络架构上,找到把输入映射为正确输出的函数。backpropagation 即“误差的反向传播”。它计算所有权重的梯度,交给优化算法;优化算法再通过更新权重来尽量减小误差。DNN 中最常用的优化算法是随机梯度下降。它根据反向传播得到的梯度,按比例调整权重,使下降尽可能快。希望深入了解的读者可参阅 Nielsen(2016)。
训练可能需要数千颗芯片连续计算数周甚至数月。推理阶段处理一个数据样本,往往用时不到 100 ms,所需时间约为训练的一百万分之一。虽然训练远比一次推理耗时,但推理的总计算时间,还要乘上 DNN 的用户数量及其调用频率。
训练完成后,你会部署 DNN,希望训练集能够代表真实世界,也希望它足够受欢迎,让用户使用它花费的总时间,远远超过你开发它所投入的时间!
有些任务没有训练数据集,例如预测现实世界中某个事件的未来走向。这里不展开讨论,但强化学习(reinforcement learning,RL)是处理这类学习问题的一种常用算法。它不是从训练集中学习,而是对现实世界采取行动,再根据行动使情况变好还是变坏,从奖励函数中获得反馈信号。
很难想象还有哪个领域变化得更快。2024 年最常见的四类 DNN 是:多层感知机(MLP)、卷积神经网络(CNN)、循环神经网络(RNN)和 Transformer 模型。它们都是依靠训练集进行监督学习的例子。为了展示模型变化有多快,图 7.5 给出了仅六年间 Google 生产环境 DNN 工作负载的显著变化。
| DNN 模型 | TPU v1,2016 年 7 月,推理 | TPU v3,2019 年 4 月,训练与推理 | TPU v4 lite,2020 年 2 月,推理 | TPU v4,2022 年 10 月,训练 |
|---|---|---|---|---|
| MLP/DLRM | 61% | 27% | 25% | 24% |
| RNN | 29% | 21% | 29% | 2% |
| CNN | 5% | 24% | 18% | 12% |
| Transformer | — | 21% | 28% | 57% |
| 其中:BERT | (28%) | (26%) | ||
| 其中:大语言模型 | (31%) |
介绍 Transformer 的论文发表于 2017 年,两年后,它已占工作负载的 21%。BERT 发表于 2018 年;启发大型 Transformer 模型研究的 GPT-3 论文发表于 2020 年。到 2022 年,这类模型已占 TPU v4 工作负载的近 60%。
多层感知机
MLP 是最早出现的 DNN。每一层都对上一层全部输出的加权和应用一组非线性函数 :
加权求和由输出向量与权重矩阵相乘实现,见图 7.6。这样的层称为全连接层,因为每个输出神经元的结果,都依赖于上一层的所有输入神经元。
对于每一类 DNN,都可以计算每层的神经元数量、运算次数和权重数量。MLP 最简单,因为它只是把输入向量与权重数组作向量—矩阵乘法。以下给出推理所用的参数及计算公式;我们把乘法和加法各计为一次运算:
- :输出向量的维度,即神经元数量;
- :输入向量的维度;
- 权重数量:;
- 运算次数:;
- 每个权重对应的运算次数:2。
最后一项,就是第 4 章 Roofline 模型中讨论的算术强度(operational intensity)。这里使用“每个权重对应的运算次数”,因为权重可能多达数十亿个,通常无法全部放入芯片。例如,某个 MLP 的一层具有 、,则该层有 2048 个神经元、8,388,608 个权重,需要 16,777,216 次运算,算术强度为 2。根据 Roofline 模型,算术强度越低,越难实现高性能。
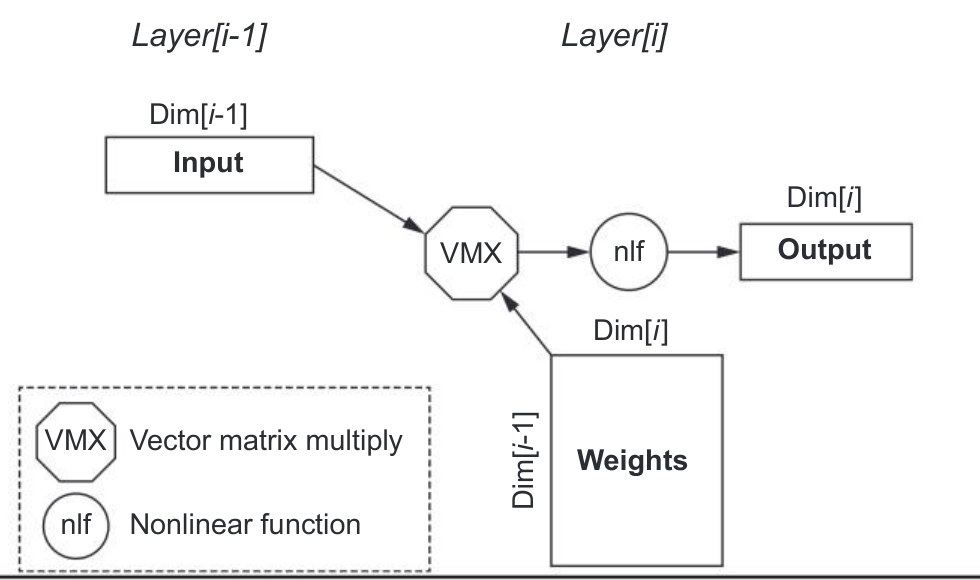
ReLU 是 MLP 常用的非线性函数。输入层与输出层的维度往往不同。这样的层称为全连接层,因为它依赖上一层的全部输入,即使其中许多输入为零。一项研究发现,44% 的输入为零;这可能部分源于 ReLU 会把负数变成零。图中 Input、Weights、Output 分别为输入、权重、输出;VMX 表示向量—矩阵乘法,nlf 表示非线性函数,Dim 为维度。
卷积神经网络
CNN 广泛用于计算机视觉。图像具有二维结构,因此,要寻找图像内部的关系,自然应从相邻像素入手。CNN 使用前一层输出中空间相邻区域经过非线性函数得到的结果作为输入,再乘以权重;同一组权重会被多次复用。
CNN 的基本思想是:每一层都提高对图像的抽象程度。例如,第一层可能只识别水平线和垂直线;第二层把它们组合起来,识别角;下一层可能识别矩形和圆。再下一层就能利用这些输入,检测狗的某些部位,如眼睛或耳朵。更高的层则尝试识别不同犬种的特征。
每个神经网络层都会生成一组二维特征图(feature map);特征图中的每个单元,都试图识别输入中相应区域的某种特征。
图 7.7 展示了起始步骤:对输入图像进行 的 stencil 计算,生成第一张特征图的各个元素。stencil 计算按照固定模式使用相邻单元,更新数组中的全部元素。输出特征图的数量,取决于试图从图像中捕捉多少种特征,以及应用 stencil 时使用的步长。2
图中,每组四个输入像素都与同样的四个权重相乘,生成输出特征图的单元。所示输入像素组之间的步长为 2,也可以采用其他步长。联系 MLP 来看,每次 卷积,都可以看作一个很小的全连接运算,用来生成输出特征图上的一个点。原图注接着指出,图 7.7 展示了多个特征图如何把这些点扩展为第三个维度上的向量。3 图中 Input image 为输入图像,Output feature map 为输出特征图;Weights、VMX、nlf 的含义与图 7.6 相同。
实际过程更复杂,因为图像通常不是单一、平面的二维层。彩色图像一般有红、绿、蓝三个通道。例如,一个 stencil 要访问 12 个元素:红色通道的 个像素、绿色通道的 个像素,以及蓝色通道的 个像素。在这种情况下,对图像的三个输入通道应用 stencil,每张输出特征图都需要 12 个权重。
图 7.8 给出了第一层之后的一般情形:输入和输出都可以包含任意数量的特征图。计算时,对全部输入特征图应用一个三维 stencil,并配上一组权重,生成一张输出特征图。
从数学角度看,如果输入和输出的特征图数量都为 1、步长也为 1,那么二维 CNN 的单个层,与二维离散卷积进行的是相同计算。
三维 stencil 覆盖输入特征图,用于生成一张输出特征图。每张输出特征图都有自己独有的一组权重,向量—矩阵乘法会针对每张图分别进行。虚线表示之后生成的输出特征图。如图所示,输入和输出特征图的尺寸与数量往往不同。与 MLP 一样,CNN 也常用 ReLU 作为非线性函数。图中 NumFM 表示特征图数量,DimFM 表示特征图的边长,DimSten 表示 stencil 的边长。
从图 7.8 可以看出,CNN 比 MLP 更复杂。以下给出有关参数,以及权重数量、运算次数的计算公式:
- :正方形输入特征图的边长;
- :正方形输出特征图的边长;
- :正方形 stencil 的边长;
- :输入特征图数量;
- :输出特征图数量;
- 神经元数量:;
- 每张输出特征图的权重数量:;
- 每层权重总数:;
- 每张输出特征图的运算次数:。
- 每层总运算次数:
- 每个权重对应的运算次数:。
某个 CNN 的一层可能具有以下参数:、、、(输入特征图数量),以及 (输出特征图数量)。这一层有 25,088 个神经元和 73,728 个权重,需要 28,901,376 次运算,算术强度为 392。这个例子说明,相比 MLP 中的全连接层,CNN 层通常具有更少的权重和更高的算术强度。
循环神经网络
第三类 DNN 是 RNN,它曾广泛用于语音识别和语言翻译。RNN 在 DNN 模型中加入状态,使其能够记住信息,从而显式建模具有先后顺序的输入。这就像硬件中组合逻辑与状态机的区别。例如,模型可能获知了某个人的性别;在之后翻译词语时,就需要传递并记住这条信息。RNN 的每一层,都会对上一层的输入和前一时刻的状态进行一组加权求和。不同时间步之间会复用权重。
长短期记忆(long short-term memory,LSTM)模型是一种 RNN,它缓解了早期 RNN 无法记住重要长期信息的问题。LSTM 曾一度非常流行,但如今已在很大程度上被 Transformer 取代。
Transformer 神经网络
Transformer 模型大约与本书上一版同时问世,如今已经成为极其流行且重要的一类 DNN。Transformer 依靠自注意力(self-attention),对输入数据中的不同部分赋予不同权重。它与 RNN 一样,常用于自然语言翻译和文本摘要;但与 RNN 顺序处理输入不同,它会一次性处理整个输入。因此,各项运算可以并行进行,处理输入的速度也更快,使 Transformer 能够处理规模大得多的数据集。
Transformer 依靠注意力机制,为输入序列中的各个位置提供上下文。注意力层在输入序列的任意位置,都可以访问此前的全部状态。介绍 Transformer 的论文,标题正是《Attention Is All You Need》(Vaswani,2017)。图 7.9 和图 7.10 展示了 Transformer 模型的体系结构。
注意力机制基于一张键值表。键和对应值的宽度为特征数量,长度为输入 token 数量。注意力计算会多次遍历这张表。Softmax 把 DNN 的输出归一化为预测输出类别的概率分布。原图注称,它把输入映射为 −1 至 +1 之间、总和为 1 的值。4 缩放点积会增强输入中的某些部分,同时削弱其他部分,例如调整长期因素相对于短期因素的影响。图中 Query、Key、Value 分别为查询、键、值,NumFeatures 为特征数量,NumInputTokens 为输入 token 数量,Scaled Dot Product 为缩放点积。
多头注意力(Multihead Attention)并行运行多份图 7.9 中的注意力机制,把得到的输出拼接起来,再变换为预期维度,随后送入 MLP。图中 Inputs 为输入,Input Embeddings 为输入嵌入,Add & Normalize 为相加与归一化,Encoder Output 为编码器输出,Output Probabilities 为输出概率。
一种流行的 Transformer 变体是 BERT(Bidirectional Encoder Representations from Transformers),它在原始 Transformer 的基础上进行了改进,提供两种模型,使用 BookCorpus 和英文 Wikipedia 进行面向自然语言处理的预训练(Devlin 等,2018)。另一种流行模型是 GPT-3(Generative Pretrained Transformer 3),它通过预测下一个 token 来训练,这称为生成式预训练。GPT-3 以规模庞大著称,拥有 1750 亿个参数,而其前身 GPT-2 有 15 亿个参数。GPT-3 催生了一类统称为大语言模型(large language model,LLM)或 Frontier Models 的模型。自 2021 年起,探索 LLM 的潜力就受到机器学习界——包括产业界——的高度关注。如今,在自然语言处理领域,Transformer 已在很大程度上取代 RNN(见图 7.5)。
批处理
DNN 可能拥有大量权重。一种性能优化方法是:从存储器取出权重之后,让一组输入复用这些权重,从而提高有效算术强度。例如,一个图像处理 DNN 可以一次处理 32 张图像,使读取权重的有效开销降至原来的 1/32。这样的输入集合称为批(batch)或小批量(minibatch)。批处理不仅能提高推理性能;要获得良好的训练效果,反向传播也需要使用一批样本,而不是每次只使用一个样本。
对于图 7.6 中的 MLP,一个批可以看作一系列输入行向量,也可以看作一个行数等于批大小的矩阵。将它们作为矩阵计算,比把各个向量作为独立输入依次计算更高效。
量化
与许多其他应用相比,DNN 对数值精度的要求较低。例如,它不需要高性能计算通常采用的双精度浮点运算。2024 年,许多 DNN 加速器支持 8 位或 16 位浮点数据;新近的 DNN DSA 还提供 6 位乃至 4 位浮点数据。DNN 也不需要完全达到 IEEE 754 浮点标准的精度要求;该标准的目标是把误差限制在浮点有效数最低位单位的二分之一以内。
为了利用数值精度上的灵活性,开发者经常在推理阶段使用定点运算代替浮点运算;训练通常仍采用浮点运算。这种从浮点数到整数的转换称为量化(quantization),经过转换的应用则称为已量化(quantized)的应用(Vanhoucke 等,2011)。定点数据可以是 1、2、4、8 或 16 位;标准的乘加运算通常使用乘法位宽的两倍进行累加。这种转换一般发生在训练完成之后,可能使 DNN 的准确率下降几个百分点(Bhattacharya 和 Lane,2016)。
位宽更窄的数据有利于 DNN:它们既能提高算术强度,也能减少权重所占的存储容量;后文将看到,这一容量往往受到限制。
DNN 小结
即使只是以上简要介绍,也足以说明:面向 DNN 的 DSA 至少需要高效执行以下矩阵相关运算——向量—矩阵乘法、矩阵—矩阵乘法和 stencil 计算。它们还需要支持非线性函数,至少包括 ReLU、Sigmoid 和 tanh。这些要求并不多,却仍然留下了极为广阔的设计空间,后续各节将对此展开讨论。
译注:图 7.4 的两处训练时间换算与其列出的设备数量和天数不一致。64 个 TPU v2 连续运行 4 天为 6144 个设备小时,而非约 1500;16 个 TPU v3 运行 2.5–3 天为 960–1152 个设备小时,而非约 70。原表未说明是否采用了其他计量口径。 ↩︎
译注:原文将步长也列为输出特征图“数量”的影响因素。按本节随后给出的参数区分,步长直接影响的是每张输出特征图的空间尺寸;特征图数量与所采用的滤波器数量对应。 ↩︎
译注:原图注确实写作图 7.7;从图示内容看,这里所指的多个特征图构成第三个维度的情况,应参见图 7.8。 ↩︎
译注:原图注写作 −1 至 +1。Softmax 的定义为 ,对于有限实数输入,其各输出均为正数且总和为 1,因此应处于 0 与 1 之间,不会为负数。 ↩︎
7.4 Google 的 Tensor Processing Unit v4 与 v4 lite:数据中心 DNN 加速器
早在 2006 年,Google 工程师就开始讨论在数据中心部署 GPU、FPGA 或定制 ASIC。他们当时的结论是:能够在专用硬件上运行的应用为数不多,利用大型数据中心的富余容量,几乎就能免费完成这些工作,而要比“免费”更划算并不容易。2013 年,讨论发生了转折。当时的预测显示,如果每人每天使用基于语音识别 DNN 的语音搜索 3 分钟,Google 就需要把数据中心规模扩大一倍,才能满足计算需求。若依靠传统 CPU 实现这一目标,既耗时又昂贵。
Google 随即启动了一个高优先级项目,力求快速开发出用于推理的定制 ASIC,同时购买现成的 GPU 用于训练。项目的目标是把性价比提高到 GPU 的 10 倍。Tensor Processing Unit(TPU)v1 实现了这一目标:其每瓦性能达到同时代 CPU 的 80 倍、GPU 的 30 倍。随着机器学习日益重要,CPU 和 GPU 也加入了针对机器学习的专门优化,因此,它们与 DNN DSA 的差距如今已有所缩小。
第一代 TPU 采用面向推理的单核设计,第二代和第三代则采用同时面向训练与推理的双核设计。它们通过面向 DNN 的 JAX、PyTorch 和 TensorFlow 框架编程,并使用定制的 XLA 编译器。
开发第四代 TPU 时,1 Google 意识到:只要采用相同的核心,就可以从同一个设计派生出两款芯片——一款使用单核进行推理,类似 TPU v1;另一款使用双核进行训练,类似 TPU v2 和 TPU v3。图 7.11 列出了本节介绍的两款 TPU 的特性。同一个团队基于统一的代码库开发了这两款芯片。
| 特性 | Google TPU v4 lite | Google TPU v4 |
|---|---|---|
| 投入生产部署的年份 | 2020 | 2020 |
| 峰值性能 | 138 TFLOPS(bf16 或 8 位整数) | 275 TFLOPS(bf16 或 int8) |
| DNN 目标任务 | 仅推理 | 训练或推理 |
| 时钟频率 | 1050 MHz | 1050 MHz |
| 工艺节点、裸片面积 | 7 nm,<400 mm² | 7 nm,<700 mm² |
| 晶体管数量 | 160 亿 | 220 亿 |
| 每台 CPU 主机连接的芯片数 | 8 | 4 |
| 热设计功耗 | 175 W | 未提供 |
| 空闲功耗;最小/平均/最大功耗 | 55 W;未提供 | 90 W;121/170/192 W |
| 芯片间互连 | 2 条,每条 50 GB/s | 6 条,每条 50 GB/s |
| 最大配置规模 | 8 颗芯片 | 4096 颗芯片 |
| 提供云服务的平台 | ||
| 处理器类型 | 单指令、二维数据 | 单指令、二维数据 |
| 每核运算单元数 | 65,536(bf16) | 65,536(bf16) |
| 每芯片核心数 | 1 | 2 |
| 每核线程数 | 1 | 1 |
| 片上存储容量 | 144 MiB | 160 MiB |
| DRAM 容量、带宽 | 8 GiB,614 GB/s | 32 GiB,1200 GB/s |
我们先介绍面向推理的 TPU v4 lite,再说明 TPU v4 为支持训练所作的改动。
TPU v4 lite 的体系结构
图 7.12 是 TPU v4 lite 的框图,其中包括 uncore,即芯片上 TensorCore 之外的全部部分。TPU v4 也采用与推理芯片相同、但规模有所扩大的 uncore。设计的中心是一个向量单元,以及 16 MB 的向量存储器。向量单元执行 DNN 的激活函数。Google 从 TPU v2 开始引入自行设计的“brain float 16”(Bfloat16)浮点格式,因为它比 IEEE 754 fp16 更适合 DNN。与 fp16 不同,bf16 的指数位数与 IEEE 754 fp32 相同,但尾数位数更少,而 DNN 对尾数位数的要求较低。
向量单元连接四个矩阵乘法单元(matrix multiply unit,MXU)。每个 MXU 每个时钟周期执行 的矩阵乘法计算:可以使用 bf16 并以 IEEE 754 fp32 累加,也可以使用 8 位整数并以 32 位累加。每个 MXU 有 16,384 个乘加单元,使 TPU v4 lite 的峰值性能达到 138 TFLOPS。跨通道单元(Cross Lane Unit,XLU)负责在 VPU 的各个通道之间执行 矩阵转置、归约和排列操作。
MXU 采用脉动执行(systolic execution),通过减少对向量存储器的读写来节约能耗(Kung 和 Leiserson,1980;Ramacher 等,1991)。脉动阵列是一组按二维方式排列的运算单元;每个单元独立计算部分结果,其输入来自相对于该单元处于上游的其他运算单元。
阵列依靠不同方向的数据按固定时间间隔到达各个单元,并在单元内组合运算。数据以不断前进的波前形式流经阵列,类似心脏推动血液流经人体循环系统,因此得名“脉动”。
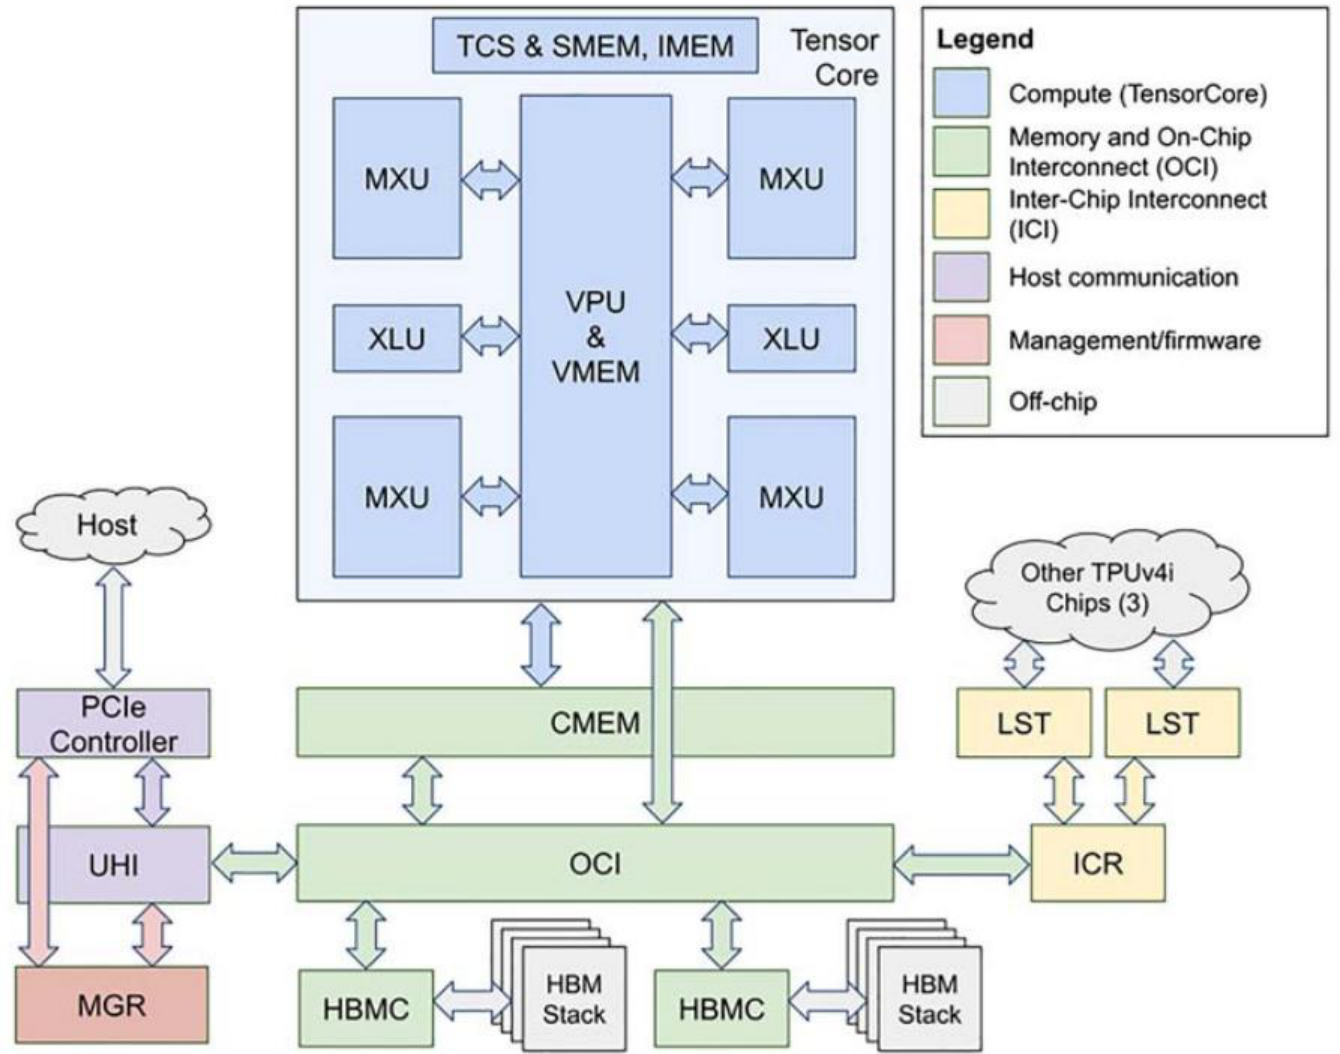
体系结构中的存储器包括公共存储器(Common Memory,CMEM)、向量存储器(Vector Memory,VMEM)、标量存储器(Scalar Memory,SMEM)、指令存储器(Instruction Memory,IMEM)以及高带宽存储器(High Bandwidth Memory,HBM)。HBM 是采用独立封装的标准 DRAM 产品,许多 DNN DSA 都依赖它。数据通路包括矩阵乘法单元 MXU、向量处理单元 VPU、跨通道单元 XLU 和 TensorCore 定序器(TensorCore Sequencer,TCS)。uncore 是图中上方中央大型阴影框之外的全部部分,包括片上互连(On-Chip Interconnect,OCI)、芯片间互连路由器(ICI Router,ICR)、ICI 链路栈(Link Stack,LST)、HBM 控制器(HBMC)、统一主机接口(Unified Host Interface,UHI)和芯片管理器(Chip Manager,MGR)。图例还区分了计算、存储器与片上互连、芯片间互连、主机通信、管理/固件以及片外部分;HBM Stack 表示 HBM 堆叠,Host 表示主机,PCIe Controller 表示 PCIe 控制器;Other TPUv4i Chips (3) 表示另外 3 颗 TPUv4i 芯片。
图 7.13 展示了脉动阵列的工作过程。图中底部的六个圆表示乘加单元,预先装入了权重 。输入数据 在时间上错开,从阵列上方进入。图中按页面由上向下展示的十个步骤,代表十个时钟周期。阵列向下传递输入,向右传递乘积和部分和。当数据走完整个脉动阵列时,所需的乘积之和就会输出。注意,在脉动阵列中,输入数据只需从存储器读取一次,输出数据也只需写回存储器一次。
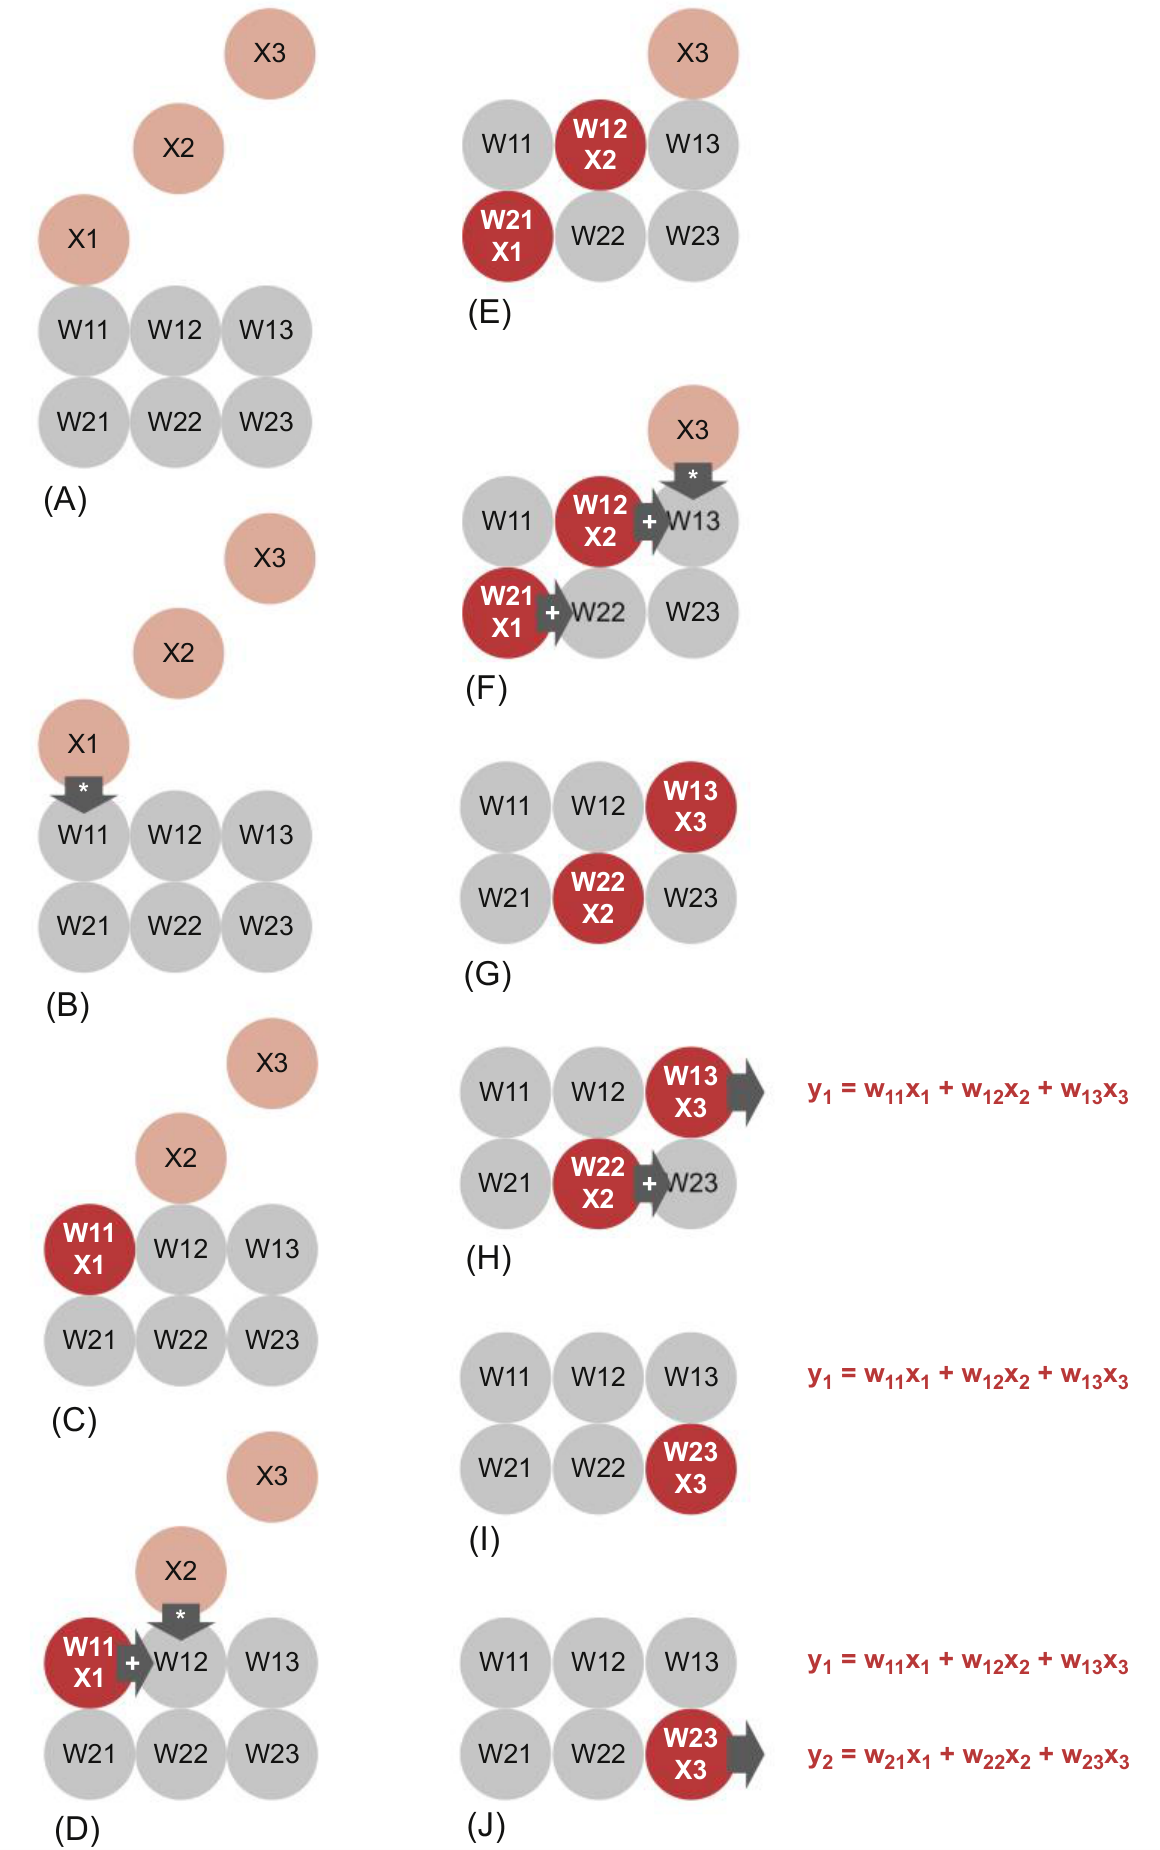
本例中,六个权重已经位于乘加单元内,TPU 通常也是如此。三个输入在时间上错开,以实现预期的数据配合;本图中它们从上方进入,而在 TPU 中,数据实际上从左侧进入。阵列把数据向下传递给下一个单元,把计算结果向右传递给下一个单元;过程结束后,在右侧得到乘积之和:,。绘图由 Yaz Sato 提供。
TPU 中的脉动阵列相当于旋转了上述布置。原文以图 7.13 为参照,说明权重从顶部装入,输入数据从左侧流入阵列。2 一次含 128 个元素的乘加操作,会以对角波前的形式通过矩阵。权重预先装入,并随波前推进,与新数据块的首批数据一同生效。控制与数据都经过流水化,使其表现得像是一次读入了 128 个输入;经过一段输入延迟后,它们更新 128 个累加器存储器中各自的一个位置。从正确性角度看,软件无需知道矩阵单元内部采用脉动阵列;但为了获得良好性能,软件必须考虑该单元的延迟。
图 7.14 展示了 TPU v4 lite 裸片的平面布局。该芯片采用 7 nm 工艺,时钟频率为 1.05 GHz。虽然确切的裸片面积并未公开,但它小于 400 mm²。
图 7.14 中最大的模块是 CMEM,占芯片面积的 28%。DNN 所需的一些大型数据结构无法装入 16 MB 向量存储器,因此 TPU v4 在存储层次中增加了一个 128 MB 存储器,减少对速度最慢、能效最低的主存——HBM——的访问次数。
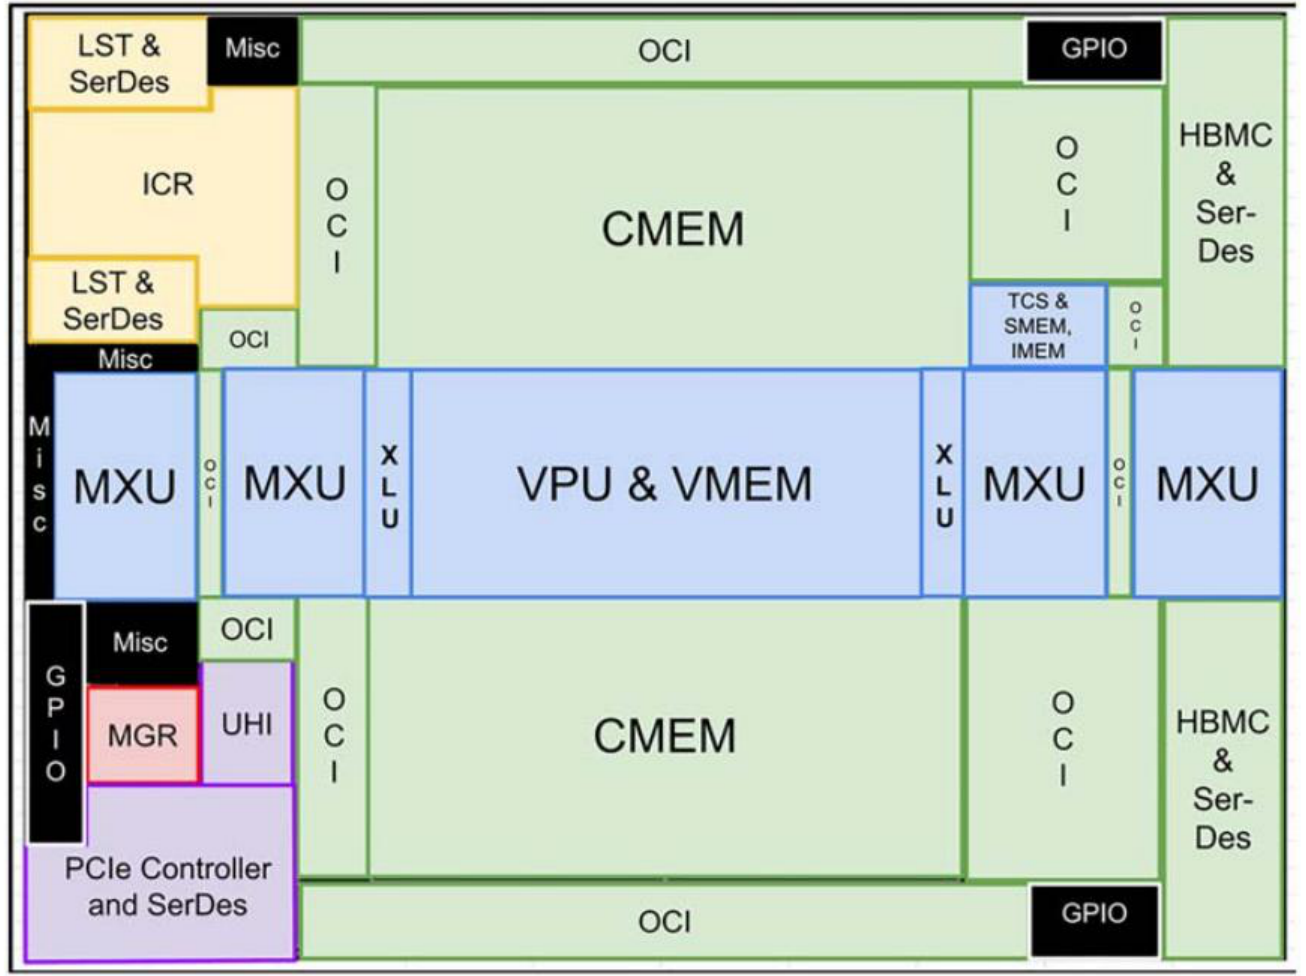
原图注称,配色与图 7.11 一致。3 裸片面积小于 400 mm²,CMEM 占面积的 28%。在各模块紧邻排列的布局中,OCI 模块被拉长以填满空隙,因为裸片的尺寸及整体布局主要取决于 TensorCore、CMEM 和 SerDes 的位置。TensorCore 和 CMEM 的模块布局源自 TPU v4。图中 SerDes 表示串行器/解串器,GPIO 为通用输入输出,Misc 为其他模块;其余缩写见图 7.12。
TPU v4 lite 的指令集体系结构
Google 工程师没有要求 TPU v4 与 TPU v2、TPU v3 的 VLIW 指令集保持二进制兼容,而是选择编译器兼容,原因有以下几点:
- VLIW 最初的立足点就是:随着硬件资源增加,通过重新编译应用,让编译器控制新增的指令级并行性;二进制兼容反而会限制这一点。
- 一些 Google 工程师曾开发过 Itanium 编译器,了解二进制兼容对 VLIW 编译器和硬件的弊端。
- XLA 编译器除 TensorFlow 外,还接受 JAX 和 PyTorch,因此 TPU 可以依赖一个编译器,而无需提供供多种编译器使用的接口。
- TPU 软件以源代码形式维护和分发,而不是二进制形式。
TPU v4 指令集使用约 400 位的 VLIW 指令束,取代 TPU v2 和 TPU v3 的 322 位指令束;新增位用于控制额外特性,例如更多的 MXU。
XLA 生成与机器无关的高层操作(high-level operation,HLO),以及与机器相关的低层操作(low-level operation,LLO)。HLO 层的优化适用于所有平台。如果新一代 TPU 所需的编译器改动仅限于 LLO,例如使用更宽的 VLIW,那么 HLO 优化就不受影响。
XLA 编译器显式控制各类并行性:
- 指令级并行。 XLA 使用循环展开、指令调度和软件流水等标准编译技术,使所有计算单元保持忙碌。
- 数据级并行。 对于二维向量寄存器和计算单元,数据在计算单元及存储器中的布局对性能至关重要,其重要性可能超过向量处理器或 SIMD 处理器。对 MXU 而言,两个二维输入相互作用,生成一个二维输出。每个操作数都有自己的存储布局,需要转换为二维寄存器中的布局,再在精确的时刻送入 MXU,以满足脉动阵列的时序要求。
- 存储级并行。 TPU v4 lite 没有缓存,因此存储层次各级之间的全部数据传输,都由编译器调度。芯片 uncore 各处分布着张量 DMA 引擎,以减轻互连延迟和导线缩放困难带来的影响。
这些张量 DMA 引擎作为协处理器,完整译码并执行 TensorCore DMA 指令。TPU v4 lite 的四维 DMA 为本地(片上)、远程(芯片间)以及主机(主机到芯片、芯片到主机)传输提供统一的 DMA 体系结构,使应用更容易从单颗芯片扩展到整个 pod。
- 线程级并行。 XLA 把 TensorFlow 程序中的并行工作映射到超级计算机中的数千颗芯片上,目标是在从 4 颗到 4096 颗芯片的系统上无缝运行。
TPU v4 相比 TPU v4 lite 的变化
如前所述,芯片本身最大的变化是:TPU v4 有两个 TensorCore(TC),而不是一个,因此峰值性能翻倍,达到 275 TFLOPS。两个核心共享 CMEM,因此它称为“公共存储器”。
从系统角度看,两款 TPU 的差异很大。TPU v4 lite 针对推理优化,每台 CPU 主机配置 8 颗 TPU v4 lite。训练对主机计算能力的要求更高,因此每台 CPU 主机只配置 4 颗 TPU v4。TPU v4 的目标是互连成为 Google 称作 pod 的超级计算机,因此它有 6 条芯片间互连(Inter-Chip Interconnect,ICI)链路,而 TPU v4 lite 只有 2 条。相比之下,TPU v3 有 4 条 ICI 链路。增加链路后,TPU v4 可以采用二分带宽更高的网络拓扑,即三维环面。TPU v3 的 pod 最多容纳 1024 颗芯片,TPU v4 则可达 4096 颗。因此,一个 pod 的 bf16 峰值性能超过 1 EFLOPS。TOP500 榜单对单台 HPC 超级计算机进行排名;Google 则在云中部署了数十个这样的 pod。
TPU v4 为训练带来的最后一项主要改进,是把片外 HBM 容量从 TPU v4 lite 的 8 GiB 增加至 32 GiB。
小结:TPU v4 如何遵循设计准则
下面考察 TPU v4 和 TPU v4 lite 如何遵循 7.2 节的准则。
- 使用专用存储器,尽量缩短数据移动的距离。 TPU v4 提供两级由程序控制的片上 SRAM,其能效是片外 HBM 的 20 倍。
- 把取消先进微体系结构优化所节省的资源,投入更多运算单元或更大的存储器。 TPU v4 提供 160 MiB 软件控制的 scratchpad 存储器,包括 128 MiB CMEM 和两个 16 MiB VMEM,以及 131,072 个 16 位/32 位 ALU;ALU 数量比同时代服务器 CPU 高一个数量级。TPU v4 lite 的 ALU 数量减半,而片上存储容量几乎相同,包括 128 MiB CMEM 和一个 16 MiB VMEM。
- 采用与应用领域匹配的最简单并行形式。 TPU 的每个 TC 都有四个 MXU,以二维 SIMD 并行提供性能,内部则采用脉动结构进行流水化。除利用数据级并行外,它还在每个插槽中提供两个 TC,并使每台超级计算机最多容纳 4096 颗芯片。约 400 位的 VLIW 指令则用于利用指令级并行。同时代 CPU 依赖多处理、乱序执行、多线程和一维 SIMD。
- 把数据大小与类型缩减到该领域所需的最简形式。 TPU 主要计算 16 位浮点数据,以 32 位浮点数累加,同时支持 8 位整数。主要收益是:较窄的数据减少了对存储带宽和容量的需求。CPU 还支持 64 位整数,以及 32 位、64 位浮点数。
- 采用领域专用编程语言,把代码移植到 DSA。 TPU 使用 JAX、PyTorch 和 TensorFlow 编程框架;CPU 则必须运行几乎所有编程语言。
7.5 NVIDIA A100 与 T4 GPU:数据中心的图形和 DNN 加速器
如第 4 章所示,NVIDIA GPU 从根本上说是一种多处理器体系结构,其中的处理器称为流式多处理器(Streaming Multiprocessor,SM)。对于同一代产品,GPU 通过改变 SM 的数量,在成本与性能之间形成不同配置;SM 数量从数十个到一百多个不等。GPU 还利用多处理器结构设置冗余 SM,以提高芯片良率。
GPU 的存储层次同时具有缓存和 scratchpad 存储器,但隐藏存储延迟主要依靠大量线程,以及在线程之间快速切换。支持快速上下文切换的主要硬件,是容量很大的寄存器堆。GPU 体系结构鼓励 CUDA 程序员暴露大量线程,以便一些线程等待存储器时,始终有其他线程可以执行。GPU 每次把 32 个线程组成一个 warp;某个 warp 等待 HBM 中的操作数时,就切换到另一个 warp。只有 warp 的访存得到合并(coalesced),即加载或存储访问连续的存储位置,GPU 才能充分利用存储带宽。
GPU 最初是为图形处理设计的。这类工作采用数据密集型算法,数值计算量大,存储访问模式规则。DNN 具有相似特点,因此十年前 GPU 就已成为机器学习的热门平台。
随着在 GPU 上运行机器学习越来越普遍,近几代 GPU 除了进行同时有利于图形与机器学习的体系结构增强,还加入了专门服务于 DNN 的特性。前一类改进包括,新型服务器级 GPU:
- 提高主存带宽和容量;
- 增大缓存容量;
- 增加每个插槽中的 SM 数量;
- 提高 Turbo 加速频率。
NVIDIA A100 Tensor Core 体系结构
第 4 章的 4.4 节介绍过,NVIDIA GPU 采用分块式体系结构,每个块称为 SM。第 4 章使用了更具描述性的名称:多线程 SIMD 处理器。随着 GPU 世代更替,SM 数量不断增加,从 Pascal 的 56 个增长到 Hopper 的 132 个(见图 4.21)。与 Google TPU v3 同时代的 Volta(Jouppi,2020),是首款直接支持机器学习的 NVIDIA GPU。NVIDIA 报告称,取决于矩阵大小,这种支持使 GPU 的机器学习峰值性能提高至原来的 6–9 倍。
CUDA 的矩阵乘法操作为 ,其中 、、、 都可以是更大矩阵的分块(Raihan,2019)。每次分块运算由 三个维度描述:
- 的维度为 ;
- 的维度为 ;
- 和 的维度为 。
这正是矩阵乘法所要求的维度关系。Volta 增加了四条 TC PTX 指令来支持这些操作:LoadA、LoadB、MultiplyAddA 和 StoreD。每条指令都根据数据类型、形状、步长、数据布局和同步方式,提供多种选项。
为了把计算映射到 SM 的多线程结构,每个分块还会进一步划分为 fragment,分别映射到各线程的寄存器中。例如,对于一个 分块,由 32 个线程组成的 warp 可以把每线程 个元素的 fragment,映射到 8 个独立的通用寄存器中。NVIDIA 尚未公布 fragment 到寄存器的具体映射方式。对细节感兴趣的读者可以参阅 Raihan(2019):该研究通过逆向分析发现,矩阵 在一个 warp 内的数据分布,与矩阵 、 不同。
每个 Volta SM 包含四个子核,其结构见图 7.15;每个子核又包含两个 Tensor Core(TC)(Choquette,2018)。Google 也把 TPU 中的处理器称为 TensorCore,这只是名称上的巧合。Volta 有 80 个 SM,因此共有 个 TC。
NVIDIA Ampere 每个子核只有一个 TC,因此总数为 个。Hopper 则恢复为每个子核两个 TC。
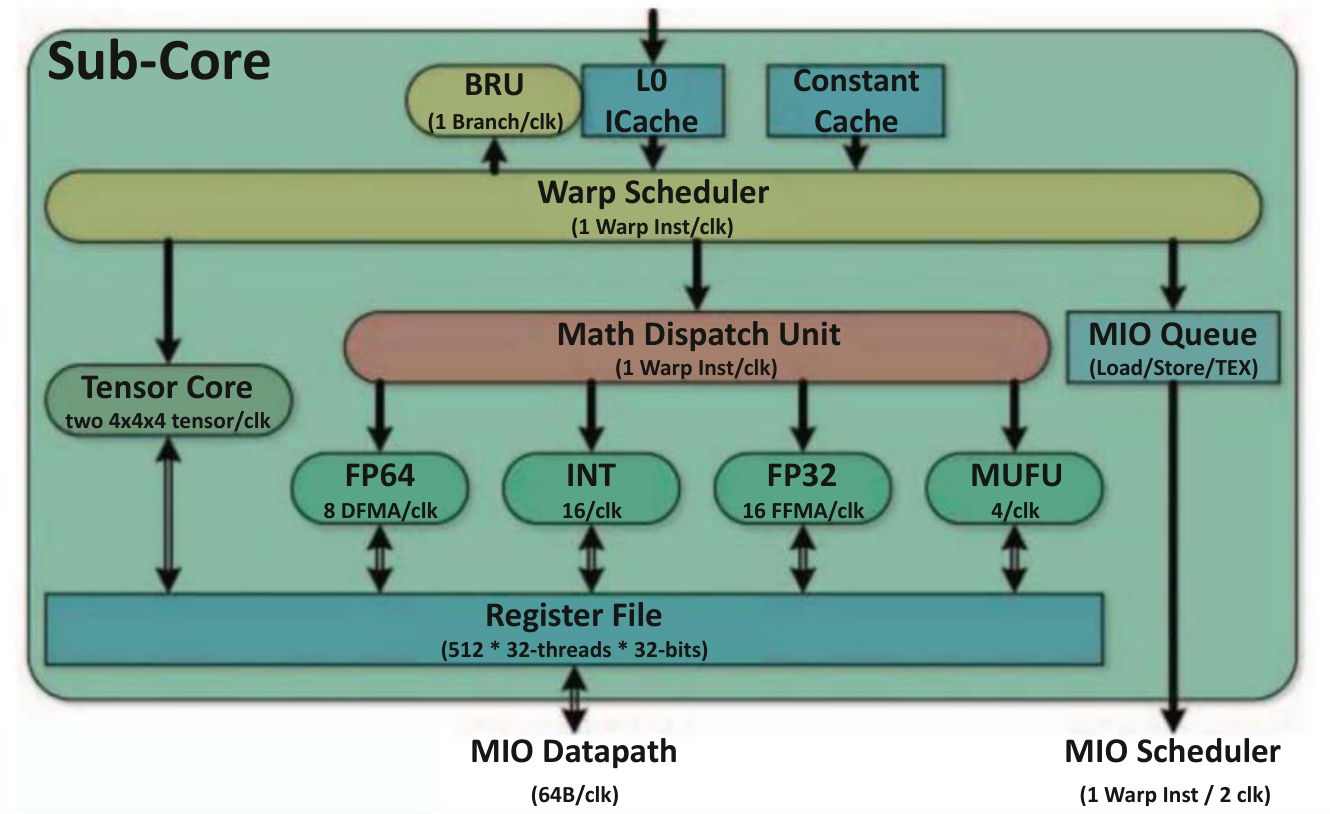
转载自 Choquette、Giroux 和 Foley(2018),《Volta: Performance and Programmability》,IEEE Micro,38(2):42–52,图 3。图中 Warp Scheduler 为 warp 调度器,Math Dispatch Unit 为算术派发单元,Register File 为寄存器堆,Constant Cache 为常量缓存,L0 ICache 为 L0 指令缓存,BRU 为分支单元;MIO Queue、Datapath、Scheduler 分别为 MIO 队列、数据通路和调度器。图中 Load/Store/TEX 表示加载、存储和纹理操作,INT 为整数单元,FP32/FP64 为相应精度的浮点单元;MUFU 保留原缩写。BRU 每周期处理 1 条分支;warp 调度器和算术派发单元每周期各处理 1 条 warp 指令;Tensor Core 每周期处理两个 4×4×4 张量运算;FP64 为 8 DFMA/周期,FP32 为 16 FFMA/周期,INT 为 16/周期,MUFU 为 4/周期;MIO 数据通路为 64 B/周期,MIO 调度器每 2 周期处理 1 条 warp 指令。寄存器堆容量表示为 。
每个 TC 执行矩阵乘法。 一个 TC 每个时钟周期处理 1024 位数据,可处理从 1 位整数到 16 位浮点数的操作数:1024 个 1 位整数、256 个 4 位整数、128 个 8 位整数,或 64 个 16 位浮点数。图 7.15 中的 warp 调度器向 TC 发送乘加操作;TC 从寄存器堆取出操作数,完成 矩阵乘法,再把结果写回寄存器堆。每个 TC 每个周期完成一次这样的矩阵乘加,原文计为 64 次浮点运算。1
NVIDIA 没有公布 TC 的框图。Raihan(2019)通过运行微基准,尝试揭示其底层微体系结构;图 7.16 给出了他们推测的 Volta TC 微体系结构。
TPU 的矩阵乘法硬件依赖脉动阵列。Volta 只计算 矩阵,而不是 ,因此不需要脉动阵列。Volta 的乘加硬件采用组合逻辑,依靠良好的电路设计、逻辑设计、流水化和物理设计,在一个时钟周期内完成全部 64 次浮点运算。
Volta TC 可以执行 fp16 运算,或 fp16 与 fp32 的混合精度运算。图 7.17 展示了后续 GPU 如何改变 TC 支持的数据类型。Ampere 中的 tf32 是 TensorFloat-32 的缩写:其指数位数与 fp32 相同,都是 8 位;尾数位数与 fp16 相同,都是 10 位。
这种 19 位格式在存储器中需要占用 32 位。当 bf16 的 7 位尾数或 fp16 的 5 位指数不足以满足需求时,tf32 可以提供比 fp32 更高的计算效率。Hopper 的 fp8 浮点格式有两种:符号位、4 位指数、3 位尾数;或者符号位、5 位指数、2 位尾数。设计上的预期是,训练的前向传播需要更高精度,因此需要更多尾数位;反向传播则需要更大的数值范围,因此需要更多指数位。
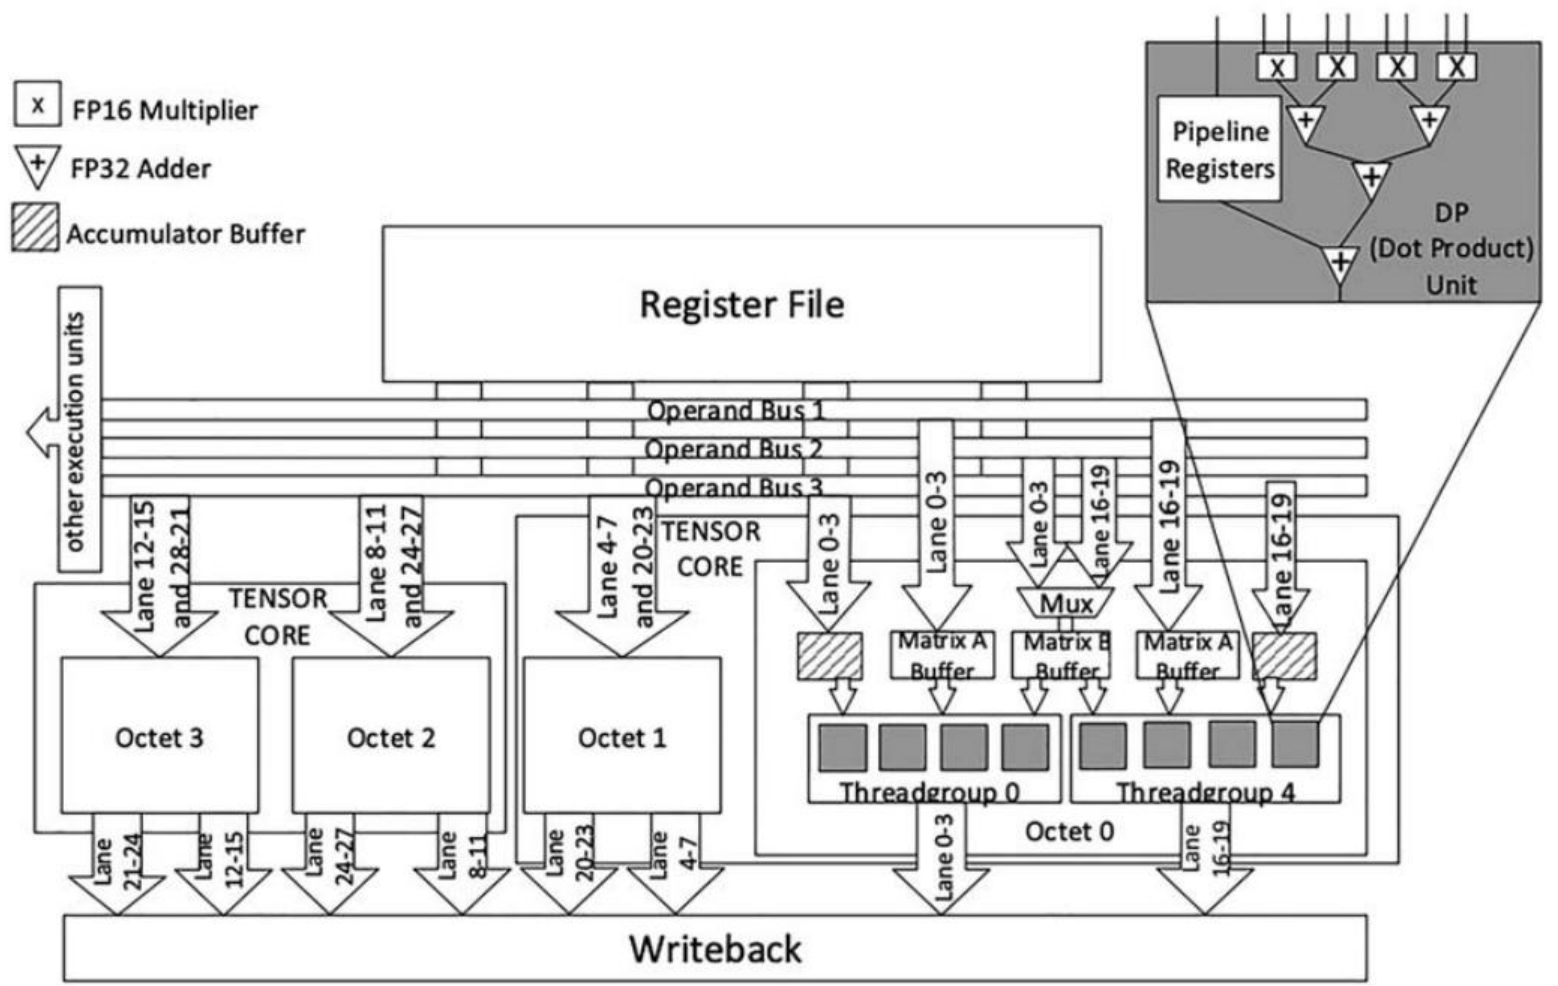
threadgroup 是 warp 内四个连续线程组成的组。octet 由两个 threadgroup 构成,用于计算结果中 的子分块。每个 Volta warp 有四个 octet。转载自 Raihan、Goli 和 Aamodt(2019),《Modeling Deep Learning Accelerator Enabled GPUs》,2019 IEEE International Symposium on Performance Analysis of Systems and Software (ISPASS),79–92 页,图 13。图中 FP16 Multiplier 为 fp16 乘法器,FP32 Adder 为 fp32 加法器,Accumulator Buffer 为累加器缓冲区,Pipeline Registers 为流水线寄存器,DP 为点积单元,Operand Bus 为操作数总线,Matrix A/B Buffer 为矩阵 A/B 缓冲区,Writeback 为写回,Lane 为通道,Other Execution Units 为其他执行单元;Register File 为寄存器堆,Mux 为多路选择器。
| GPU 世代 | 整数类型 | 浮点类型 |
|---|---|---|
| Volta | n.a. | fp16、fp32 |
| Turing | Int8 | fp16 |
| Ampere | Int1、Int4、Int8 | fp16、fp32、bf16、tf32、fp64 |
| Hopper | Int8 | fp16、fp32、bf16、tf32、fp64、fp8 |
| Blackwell | Int8 | fp16、fp32、bf16、tf32、fp64、fp8、fp6、fp4 |
Blackwell 的 fp4 格式只有 2 位指数和 1 位尾数;令人惊讶的是,它仍然是一种浮点格式,只是总共只有 16 个可能的取值。
A100 的每个 SM 有 4 个 TC,每个 TC 每周期处理 4096 位数据。Ampere 还引入了对细粒度结构化稀疏性的支持:对于连续四个数值组成的数据块,只要其中任意两个为零,就可以使用这一机制。A100 增加了一条执行 2:4 稀疏矩阵乘法的 PTX 指令。
TC 只对两个非零值执行运算,因此能在一半时间内完成相同计算。当数据符合这种模式时,这项优化使峰值性能翻倍。DNN 的适应性相当强,机器学习框架可以尝试让训练后的部分数据满足 2:4 稀疏模式。NVIDIA 展示的一个例子中,性能提升为 1.10–1.18 倍,具体取决于批大小。
除了增加 fp8(见图 7.17),Hopper 还加入了专门针对 Transformer DNN 的硬件,足见这类模型的重要性。Transformer Engine 监测各 TC 输出值的统计特征,自动为 Transformer DNN 的每一层选择 fp8 或 fp16 数据类型;只要可行,就使用 fp8 提高性能。硬件在执行过程中完成 fp8 与 fp16 之间的缩放转换,程序员无需自行管理。Transformer Engine 的目标,是让 DNN 中每一层都采用满足自身需求的最小数据范围。
Hopper 取消了 A100 的 Int1 和 Int4 数据类型(见图 7.17),可能是因为体系结构设计者认为它们已不再必要。机器学习变化迅速,即使从 DNN DSA 开始设计到正式部署只有三年,也很难预判届时哪些数据类型会重要。
图 7.18 列出了 NVIDIA A100 和 T4 GPU 的主要特性。与上一节 TPU v4 lite 和 TPU v4 的比较类似,面向推理时,NVIDIA 每台 CPU 主机配置 8 块 T4,而每台主机配置 4 块 A100。同样,在系统层面,A100 可以扩展到 4096 颗芯片,T4 则只能扩展到 8 颗。A100 使用 12 条 NVLink,无缝扩展为称作 DGX 的 8 插槽系统;再通过集群网络交换机和链路,连接 512 台 DGX,组成总计 4096 颗芯片的系统。
图 7.19 和图 7.20 展示了两款 GPU 的芯片布局。A100 与 T4 在尺寸、功耗和主存方面有显著差异。T4 的裸片面积约为 A100 的三分之二,但 SM 数量仅约为其 40%,因为 T4 使用更大的工艺节点,即 12 nm,而 A100 为 7 nm。值得注意的是,T4 的热设计功耗约为 A100 的四分之一,分别为 70 W 和 300 W,而基础时钟频率约为 A100 的 1/1.3,分别为 585 MHz 和 765 MHz。在最高 Turbo 加速模式下,关系反而倒转:T4 的频率约为 A100 的 1.1 倍,分别为 1590 MHz 和 1410 MHz。
另一个主要差异是,T4 采用图形 DRAM(GDDR6),A100 采用高带宽存储器(HBM2E)。容量比例同样约为 40%,分别为 16 GiB 和 40 GiB;带宽差距却接近 5 倍,分别为 320 GB/s 和 1555 GB/s。
| 特性 | NVIDIA A100 | NVIDIA T4 | Graphcore MK2 IPU |
|---|---|---|---|
| 投入生产部署的年份 | 2020 | 2018 | 2021 |
| 峰值性能(原表单位:TFLOPS) | 312(bf16),624(int8) | 65(IEEE fp16)/130(8 位整数) | 250(bf16) |
| DNN 目标任务 | 训练或推理 | 仅推理 | 训练或推理 |
| 时钟频率 | 765 MHz / Turbo 1410 MHz | 585 MHz / Turbo 1590 MHz | 1850 MHz |
| 工艺节点、裸片面积 | 7 nm,826 mm² | 12 nm,545 mm² | 7 nm,832 mm² |
| 晶体管数量 | 540 亿 | 140 亿 | 590 亿 |
| 每台 CPU 主机连接的芯片数 | 4 | 8 | 4 |
| 热设计功耗 | 300 W | 70 W | 300 W |
| 芯片间互连 | 12 条链路,每条 25 GB/s | — | 3 条链路,每条 64 GB/s |
| 最大配置规模 | 4096 颗芯片 | 8 颗芯片 | 256 颗芯片 |
| 提供云服务的平台 | AWS、Azure、Google | AWS、Azure、Google | AWS、Azure、Google |
| 处理器类型 | 单指令多线程 | 单指令多线程 | 多线程、单指令多数据 |
| 每处理器运算单元数 | 1024(fp16) | 512(fp16) | 64(fp16) |
| 每芯片处理器数 | 108 | 40 | 1472 |
| 每核线程数 | 32 | 32 | 6 |
| 片上存储容量 | 40 MiB | 18 MiB | 897 MiB |
| DRAM 类型 | HBM2E | GDDR6 | 无 |
| DRAM 容量、带宽 | 40 GiB,1555 GB/s | 16 GiB,320 GB/s | 0 |
译注:原表的峰值性能行统一标为 TFLOPS,表中沿用该原始表头。整数运算吞吐量应使用 TOPS,而不是表示浮点吞吐量的 TFLOPS;这里将单位疑点单独说明,未改动原表数值。
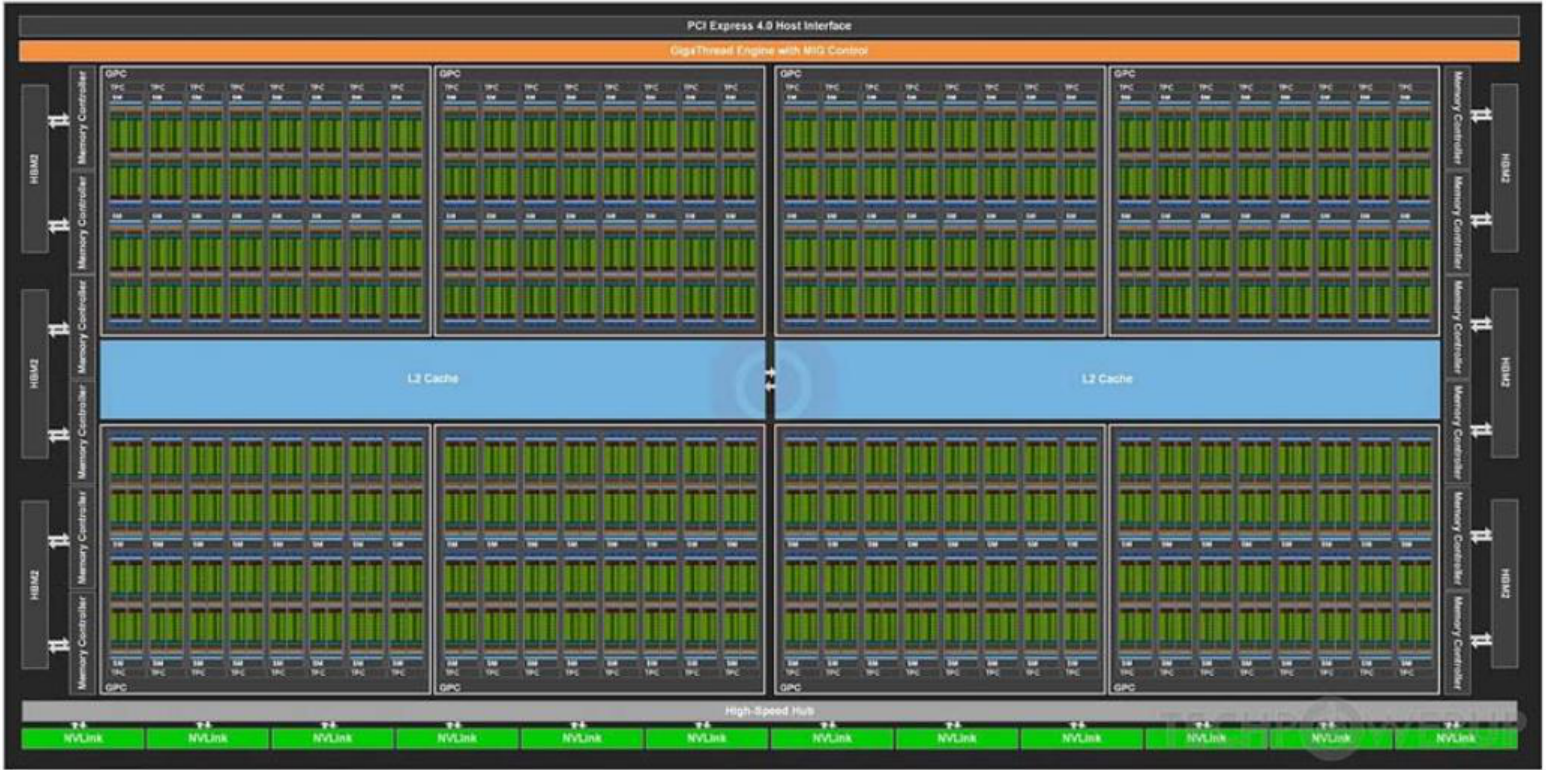
图中绘有 128 个 SMP,NVIDIA 仅启用其中 108 个。L2 缓存容量为 40 MB。A100 可以将 DRAM 数据压缩后放入缓存,以加速非结构化稀疏数据及其他可压缩的数据模式。其宣称的效果是:DRAM 读写带宽最多达到 4 倍,L2 读取带宽最多达到 4 倍,L2 缓存的有效容量最多达到 2 倍。图中 PCI Express 4.0 Host Interface 为 PCI Express 4.0 主机接口,GigaThread Engine with MIG Control 为带 MIG 控制的 GigaThread 引擎,Memory Controller 为存储控制器,L2 Cache 为 L2 缓存,High-Speed Hub 为高速集线器;GPC、TPC、SM、HBM2 和 NVLink 保留原缩写与产品名称。
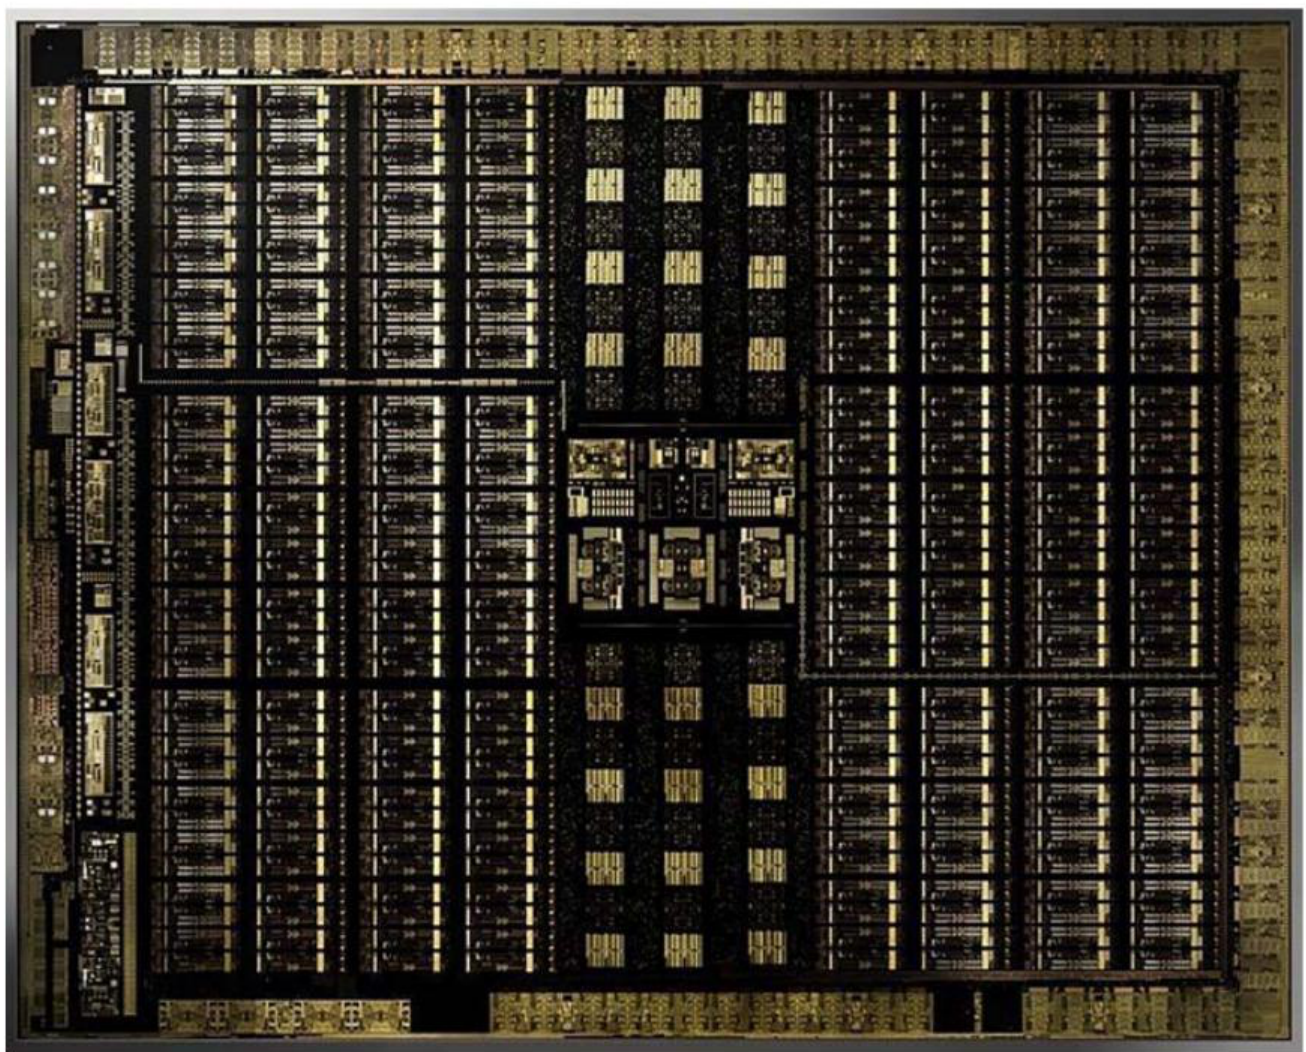
最后一个差异是主存纠错码(ECC)的处理方式。与服务器 CPU 一样,A100 使用更宽的 HBM,使 ECC 校验或存储能够与数据访问同时进行:72 位中,64 位为数据,8 位为 ECC。T4 的 GDDR 存储器宽度为 64 位,因此启用 ECC 时,存储控制器会把 ECC 位存放到 DRAM 芯片的其他位置。前一种方式称为 sideband ECC,后一种称为 in-band ECC。因此,T4 客户可以选择是否启用 ECC。Google 数据中心要求主存启用 ECC,这使 T4 的性能平均下降约 5%(见 7.10 节)。
小结:A100 与 T4 如何遵循设计准则
下面考察 TPU v4 如何遵循 7.2 节的准则。2
- 使用专用存储器,尽量缩短数据移动的距离。 GPU 使用很大的寄存器堆支持大规模多线程:A100 为 27 MiB,T4 为 10 MiB。这些寄存器的总容量,与其 L2 缓存的 40 MiB 和 18 MiB 相当。
GPU 用作图形 DSA 时,多线程很有帮助;但它对机器学习究竟有多大帮助,目前还不清楚。 2. 把取消先进微体系结构优化所节省的资源,投入更多运算单元或更大的存储器。 A100 有 110,592 个 16 位/32 位 ALU,T4 有 20,480 个,同样远多于同时代 CPU。 3. 采用与应用领域匹配的最简单并行形式。 GPU 依赖多处理、多线程和二维 SIMD,不过其乘法单元比 TPU 的小。 4. 把数据大小与类型缩减到该领域所需的最简形式。 为了让程序员选择最合适的位宽,GPU 提供最广泛的数据类型:4 位和 8 位整数,以及 IEEE 16 位、32 位浮点数;A100 还增加了 1 位、16 位整数,以及 bf16、tf32、fp64 浮点格式。 5. 采用领域专用编程语言,把代码移植到 DSA。 GPU 使用面向机器学习的 JAX、PyTorch、TensorFlow 框架,以及 CUDA 和 OpenCL 编程。图形处理则使用 DirectX、Metal、OpenGL 等库。
7.6 Graphcore IPU Bow:面向训练的数据中心加速器
图 7.18 列出了 Graphcore 智能处理单元(Intelligence Processing Unit,IPU)的主要特征,图 7.21 则是其裸片照片。IPU 是单芯片上的大规模并行处理器,第二代 IPU Bow 包含 1472 个 IPU 核心,每核每个时钟周期可完成 64 次 16 位浮点运算。与 GPU 一样,IPU 使用冗余核心提高这颗 832 mm² 大型芯片的良率,每 24 个核心中有一个冗余核心。IPU 使用 Graphcore 自行设计的 32 位标量指令。与 CPU 和 GPU 一样,它包含硬件多线程支持,每核直接支持 6 个线程。因此,和 GPU 编程一样,IPU 也鼓励程序员使用大量线程,保证有足够工作维持较高的利用率。
芯片中央的交换单元(Exchange Unit)负责各个 tile 之间的通信。与 TPU v4 和 A100 一样,IPU 提供片上链路,使多颗 IPU 可以互连成更大的系统。虽然理论上限是 64,000 颗 IPU,但提交 MLPerf 基准测试结果的最大系统包含 256 颗芯片(见 7.10 节)。每颗芯片上的交换单元与 IPU 链路配合,让程序员可以无缝地向任意芯片上的任意 tile 发送消息。全到全通信的测量结果表明,无论芯片内部还是芯片之间,其有效带宽都很高。
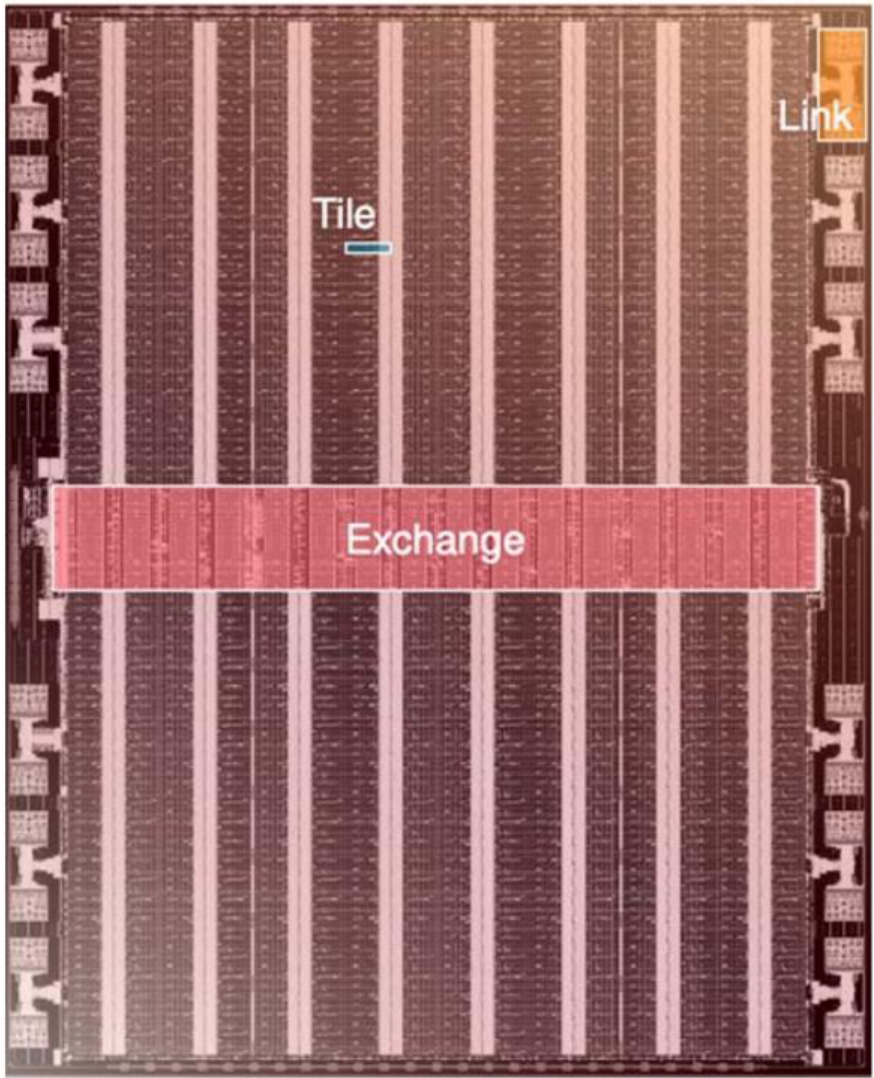
芯片采用 7 nm 工艺,裸片面积为 832 mm²。原图注写道,它包含 1492 个 tile,每个 tile 都有一个 IPU 核心和 624 KiB SRAM,总计每颗裸片 897 MiB。1 交换单元负责 tile 之间的全部通信。每颗裸片有 3 条 IPU 链路,可构建大规模系统;截至原书所述时期,经过基准测试的最大系统有 256 颗芯片。tile 中的存储器约占裸片面积的一半,tile 逻辑约占四分之一,交换单元约占十分之一,其余为 uncore。原图署名来源为《Sparsity-Aware and Re-configurable NPU》。图中 Tile、Exchange、Link 分别表示计算块、交换单元和链路。
为了简化设计和编程,IPU 的并行计算采用Bulk Synchronous Parallel(BSP)模型。BSP 把并行计算划分为一系列较大的步骤,以降低问题的复杂度。每一步先进行计算,再进行通信,最后执行屏障同步;因此,所有线程都必须完成同步,程序才能进入下一步。
IPU 最不同寻常的特征,是它的存储系统。每个 IPU Bow tile 有 624 KiB SRAM,1472 个核心合计每颗芯片拥有高达 897 MiB SRAM。这是第一代 IPU 的 3 倍,接近 TPU v4 片上 SRAM 的 6 倍,也是 A100 L2 缓存的 22 倍。另一个同样大胆的选择是:IPU 不连接 DRAM。
如果应用需要的存储容量超过 IPU 所能容纳的范围,就必须经过网关,访问与主机 ARM CPU 相连的 DDR4 DRAM。IPU 体系结构设计者押注的是:片上 SRAM 足以满足大多数 DNN 的需要(原文参见 7.11 节)。2
小结:IPU Bow 如何遵循设计准则
IPU Bow 对 7.2 节准则的遵循情况如下。
- 使用专用存储器,尽量缩短数据移动的距离。 IPU Bow 每核配置 624 KiB 存储器,尽量把数据留在本地。原书此处把每芯片总容量写为 897 GiB。3 唯一的 DRAM 位于 CPU 主机上,其带宽远低于前面几种 DSA 的 DRAM。
- 把取消先进微体系结构优化所节省的资源,投入更多运算单元或更大的存储器。 IPU Bow 有 94,208 个 16 位 ALU,同样远远超过同时代 CPU。
- 采用与应用领域匹配的最简单并行形式。 IPU 依赖多处理、多线程和一维 SIMD。
- 把数据大小与类型缩减到该领域所需的最简形式。 与其他 DSA 不同,IPU Bow 只支持 fp16 和 fp32。
- 采用领域专用编程语言,把代码移植到 DSA。 与 TPU 和 GPU 一样,IPU 使用 JAX、PyTorch 和 TensorFlow 编程框架。
7.7 Samsung 神经处理单元(NPU):智能手机推理加速器
智能手机中的 DSA 被设计为片上系统(SOC)的一部分。图 7.22 以与图 7.11、图 7.18 中数据中心加速器相对应的指标,列出了 Samsung 神经处理单元(Neural Processing Unit,NPU v1)的特性;图 7.23 则展示了裸片照片。与数据中心推理 DSA 相比,它的能耗和裸片面积预算低两个数量级。
每个 NPUv1 包含三个核心,核心框图见图 7.24。每核包含两个 NPU 引擎,共享一个称为紧耦合存储器(Tightly Coupled Memory,TCM)的 1 MiB scratchpad。NPU 引擎的中心是张量单元,其中有四个 乘加阵列,与 TPU v4 lite 的四个 MXU 类似。它们可能也采用脉动阵列结构,主要处理 8 位整数;也可以处理 16 位整数,但每次运算需要多个时钟周期。
| 特性 | Samsung NPUv1 | Samsung NPUv2 | Intel Core i7-11375H |
|---|---|---|---|
| 投入生产部署的年份 | 2021 | 2022 | 2021 |
| 峰值性能(原表单位:TOPS/sec,8 位整数) | 14.6(8 位) | 39.3(4 位),19.7(8 位),9.8(fp16) | 1.3(8 位),0.6(fp16) |
| DNN 目标任务 | 仅推理 | 仅推理 | 通用 |
| 基础时钟频率(MHz) | 332 | 332 | 3300 |
| Turbo 时钟频率(MHz) | 1196 | 1196 | 5000 |
| AVX/SIMD 时钟频率(MHz) | N.A. | N.A. | 原表留空 |
| 工艺节点、裸片面积 | 5 nm,5.4 mm² | 4 nm,4.7 mm² | 10 nm,122 mm² |
| 晶体管数量 | N.A. | N.A. | N.A. |
| 热设计功耗 | 0.6 V 时 0.33 W;0.9 V 时 0.79 W | 0.55 V 时 0.38–5.1 W | 28–35 W |
| 处理器类型 | 单指令、二维数据 | 单指令、二维数据 | 多线程 SIMD |
| 每核运算单元数 | 2048(8 位) | 4096(8 位) | 64(8 位) |
| 每芯片核心数 | 3 | 2 | 4 |
| 每核线程数 | 1 | 1 | 2 |
| 片上存储容量 | 3 MiB | 2 MiB | 17 MiB |
| DRAM 类型 | N.A. | N.A. | DDR4、LPDDR4 |
| DRAM 容量、带宽 | N.A. | N.A. | 64 GiB,26–34 GB/s |
这些处理器将在 7.9 节中比较。原图注明来源为《Architecture for Samsung Flagship Mobile SoC》。N.A. 沿用原表,表示未提供或不适用。
译注:原表将峰值性能统一标为“TOPS/sec(8 位整数)”,但各列也列出了 4 位整数及 fp16 数据;此外,TOPS 本身已表示每秒万亿次运算,再附加 /sec 重复计入了时间单位。表中保留原始表头和数值;若按运算类型区分,整数吞吐量应以 TOPS 表示,浮点吞吐量应以 TFLOPS 表示。
NPUv1 采用 5 nm 工艺,裸片面积为 5.4 mm²,包含三个核心。NPUv2 采用 4 nm 工艺,裸片面积为 4.7 mm²,包含两个核心。两个版本中,每核都包含 1 MiB SRAM。两张裸片照片保持实际的相对尺寸。来源:2021 ACM/IEEE 48th Annual International Symposium on Computer Architecture (ISCA)。图中 NPU Core 为 NPU 核心,NPU Control Unit / controller 为 NPU 控制单元/控制器。
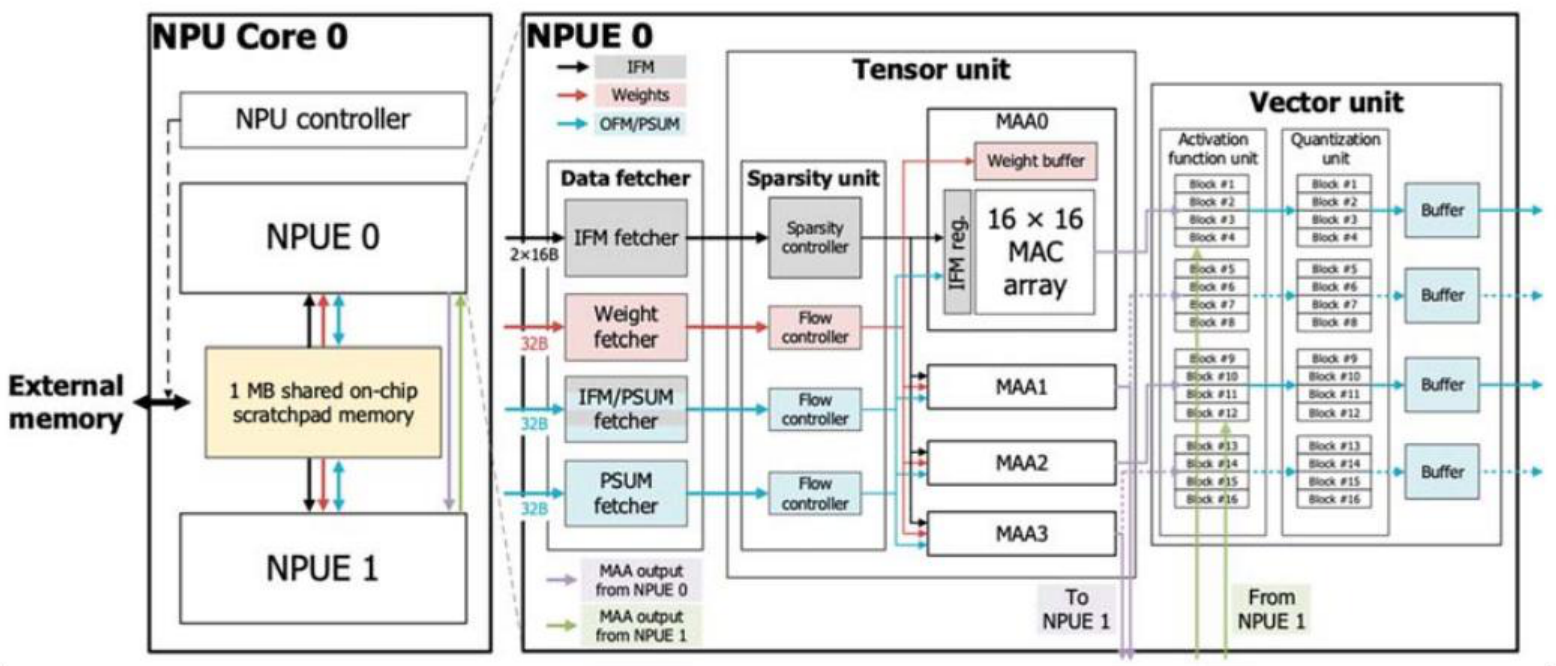
来源:《A Multi-Mode 8K-MAC HW-Utilization-Aware Neural Processing Unit with a Unified Multi-Precision Datapath in 4nm Flagship Mobile SoC》。图中 External Memory 为外部存储器,shared on-chip scratchpad memory 为共享片上 scratchpad 存储器;Data Fetcher、Tensor Unit、Vector Unit 分别为数据读取单元、张量单元和向量单元;Sparsity Unit / Controller 为稀疏处理单元/控制器,Flow Controller 为流控制器,Activation Function Unit 为激活函数单元,Quantization Unit 为量化单元,Weight Buffer 为权重缓冲区,IFM reg. 为输入特征图寄存器。NPUE 表示 NPU 引擎,MAC array 为乘加阵列,IFM/OFM 分别为输入/输出特征图,PSUM 为部分和,Buffer 为缓冲区,Block 为模块;MAA output from NPUE 0/1 表示来自 NPU 引擎 0/1 的 MAA 输出,To/From NPUE 1 表示送往/来自 NPU 引擎 1。图内 scratchpad 标为 1 MB,正文按原书写作 1 MiB。
数据读取单元把数据从 TCM 传送到其右侧的张量单元。它包含分别读取输入特征图(IFU)、权重(WFU)和部分和(PSUM)的子单元;还有一个 IFM/PSUM 单元,可根据计算需要读取特征图或部分和。所有读取子单元都可以同时工作,通过各自独立的 256 位通路访问 TCM。
NPUv1 最有新意的特性,可能是利用输入矩阵的稀疏性来降低能耗、提高性能。图 7.24 中,张量单元左侧的稀疏处理单元跳过输入中的零值,生成稠密矩阵,然后送入四个 MAC 单元。张量单元旁边是向量单元;与 TPU v4 lite 的向量单元一样,它对 MAC 单元的输出执行非线性激活操作。
NPUv1 问世一年后,Samsung 公布了下一代 NPU(见图 7.22 和图 7.23)。NPUv2 与 NPUv1 的总体思路相近,时钟频率相同,每核 TCM 容量也相同,主要差异如下:
- NPUv2 每核只有一个 NPU 引擎,而不是两个。
- NPUv2 的每个张量单元除了支持 8 位整数,还支持 16 位浮点数和 4 位整数。
- NPUv2 的每个张量单元支持 4096 个 8 位 MAC,使每核 MAC 数量翻倍。
- 为减轻核心面积增大的影响,每个 NPUv2 包含两个核心,而不是三个。
- NPUv2 有多种工作模式。例如,面向语音唤醒等始终开启的功能时,可以优先降低功耗,只使用一个核心,让其他单元休眠。与标准模式相比,低功耗模式可节省 89% 的功耗。在低延迟模式下,两个核心都以高时钟频率运行 DNN,尽快完成模型处理;此时功耗可能显著高于 NPUv1。
- NPUv2 还具有聚集单元,可以访问另一个核心的 TCM。与软件方案相比,该单元显著减少了低延迟模式下的冗余数据传输和总延迟。
- NPUv2 采用 4 nm 工艺,而不是 5 nm,裸片面积减小了 15%。
小结:Samsung NPU 如何遵循设计准则
NPU 对 7.2 节准则的遵循情况如下。
- 使用专用存储器,尽量缩短数据移动的距离。 NPU 每核有 1 MiB scratchpad 存储器,占核心面积的 51%。
- 把取消先进微体系结构优化所节省的资源,投入更多运算单元或更大的存储器。 NPUv1 有 6144 个 8 位 MAC,NPUv2 有 8192 个。
- 采用与应用领域匹配的最简单并行形式。 NPU 依赖多处理和二维 SIMD。
- 把数据大小与类型缩减到该领域所需的最简形式。 NPUv1 只支持 8 位、16 位整数,NPUv2 增加了 4 位整数和 16 位浮点数。
- 采用领域专用编程语言,把代码移植到 DSA。 NPU 使用 TensorFlow 和 TensorFlow Lite 编程框架。
7.8 贯穿各层的问题
异构性与片上系统
把 DSA 纳入系统的简单方法,是通过 I/O 总线连接;本章的数据中心加速器都采用这种方式。为了避免通过缓慢的 I/O 总线读取存储器操作数,这些加速器配置了本地 DRAM。
Amdahl 定律提醒我们:主机存储器与加速器存储器之间传送数据的频繁程度,可能限制加速器的性能。把主机 CPU 和加速器集成到同一个片上系统(system on a chip,SOC)中,必然有利于某些应用。
可以用于这类集成的设计称为 IP 模块(IP block),IP 是 Intellectual Property(知识产权)的缩写;不过,“可移植设计模块”可能更能说明它的用途。IP 模块通常使用 Verilog 或 VHDL 等硬件描述语言定义,以便集成进 SOC。IP 模块促成了一个市场:许多公司开发 IP 模块,其他公司购买这些模块,为自己的应用构建 SOC,而无需自行设计每一个部分。后文图 7.32 绘出了 Apple 多代个人移动设备 SOC 中 IP 模块的数量,展示了它们的重要性:仅四年间,数量就增长到原来的三倍。另一个迹象是,Apple SOC 中 CPU 和 GPU 只占三分之一面积,其余都由 IP 模块占据(Shao 和 Brooks,2015)。
设计 SOC 很像城市规划:相互独立的团队都在争取有限资源,而找到适当的折中并不容易。CPU、GPU、缓存、视频编码器等都可以调整设计,用更多或更少的面积和能耗,换取更高或更低的性能。SOC 用于平板电脑还是物联网设备,其资源预算也会不同。因此,IP 模块必须能够在面积、能耗和性能方面灵活伸缩。对于新的 IP 模块,提供资源占用较小的版本尤其重要,因为它可能尚未在 SOC 生态中站稳脚跟;初始资源需求较为适度,会更容易被采用。
集成的吸引力是否会使大多数数据中心处理器来自传统 CPU 公司,并把 IP 加速器集成进 CPU 裸片?还是系统公司会继续通过 I/O 总线部署加速器,延续 2017–2024 年的主流方式?这将是值得观察的问题。
机器学习训练的能耗与碳排放
对全球气候变化的关注,理所当然地促使人们研究机器学习对环境的影响。图 7.25 展示了遵循最佳实践如何使能耗最多降至原来的百分之一、排放最多降至千分之一(Patterson,2022)。示例的起点是著名的 2017 年 Transformer 模型,在普通数据中心使用 GPU 训练。图中展示了在 2019 年、继而在 2021 年应用最佳实践所带来的节省。借鉴缓存“3C”的记忆法,我们把机器学习能效的四项要素称为 4M。
- Model——模型。 第一个 M 指 DNN 模型,示例从 Transformer 开始。最佳实践是选择能够同样出色地解决相同问题的、最新且最高效的模型。
2019 年,Google 研究人员通过神经架构搜索(Neural Architecture Search,NAS),发现了 Evolved Transformer:在质量相同的情况下,它的速度达到 Transformer 的 1.3 倍(So,2019)。2021 年,同一批研究人员再次使用 NAS,发现了 Primer:它的速度达到 Transformer 的 4.2 倍、Evolved Transformer 的 3.2 倍,质量同样不变(So,2021)。注意,NAS 并不频繁进行:针对一个问题领域和体系结构搜索空间进行一次,而不是每次训练模型都进行。搜索结果通常公开发表,模型也会开源,让所有机器学习从业者受益。之后反复使用 NAS 找到的更高效模型,所节省的能耗和排放足以抵偿搜索本身的成本。 2. Machine——机器。 选择训练该模型时效率最高的硬件。以 2017 年 P100 GPU 的性能为基准,2019 年 TPU v2 的性能为其 5.7 倍,2021 年 TPU v4 的性能为其 14 倍,即 TPU v2 的 2.6 倍。结合第一个 M,与在 P100 上运行 Transformer 相比,2019 年的能耗和排放降至原来的 1/7.4,2021 年降至 1/57。 3. Mechanization——数据中心设施(PUE)。 Google 云数据中心的 PUE 约为 1.1,而平均数据中心约为 1.6,前者的 PUE 约为后者的 1/1.4。1 结合前两个 M,与在平均 PUE 数据中心的 P100 上运行 Transformer 相比,2019 年的能耗和排放降至原来的 1/10.7,2021 年降至 1/83。
图中蓝线表示 2019 年的改善,紫线表示 2021 年的改善;纵轴为相对于 2017 年基准的改善倍数,采用对数刻度。横轴依次加入 Model、Machine、Mechanization、Map 四项因素。2019 年标注值依次为 1.3、7.4、10.7、65.1;2021 年依次为 4、57、83、747。
- Map——地理位置。 第 1 章已提到,数据中心的位置会显著影响能源供应的清洁程度,差异可达 5–10 倍。以平均能源供应的每千瓦时排放量为基准,2019 年 Google 艾奥瓦州数据中心的排放量为其 1/6;2021 年俄克拉何马州数据中心为其 1/9,即 2019 年艾奥瓦州的 1/1.5。结合前三个 M,与在平均 PUE、平均能源清洁程度的数据中心中用 P100 训练 Transformer 相比,2019 年的排放降至原来的 1/65,2021 年降至 1/747。
遵循 4M 最佳实践,最有希望让我们以可持续的方式兑现机器学习的巨大潜力。
开放的指令集
DSA 设计者面临的一项挑战,是如何与 CPU 协作,运行应用的其余部分。如果二者位于同一个 SOC 中,那么选择哪种 CPU 指令集就是一个重大决定,因为直到不久之前,几乎每种指令集都属于某一家独立公司。过去,开发 SOC 的实际第一步往往是与某家公司签约,锁定指令集。
另一条路是自行设计定制 RISC 处理器,再为它移植编译器和库。IP 核授权的费用与麻烦,使 SOC 中出现了数量惊人的自制简单 RISC 处理器。一位 AMD 工程师估计,一颗现代微处理器内部可能有 12 种指令集!
RISC-V 提供了第三条路:一种切实可用、免费且开放的指令集,并预留了充足的操作码空间,用于增加领域专用协处理器指令,使前述 CPU 与 DSA 的紧密集成成为可能。为支持 DSA,RISC-V 预留了四个用于自定义指令的操作码,每个都可以通过 10 位功能码扩展,因此足以容纳数千条这样的指令。SOC 设计者现在可以选择一种拥有大量配套软件的标准指令集,而无需先签订合同。
他们仍然必须在设计早期选定指令集,但无需选定一家公司并与之签约。他们可以自行设计 RISC-V 核心,可以向销售 RISC-V IP 模块的多家公司之一购买,也可以下载他人开发的免费开源 RISC-V IP 模块。最后一种方式类似开源软件:志愿者维护浏览器、编译器、操作系统等,供用户免费下载使用。
开放指令集还带来额外好处:它改善了提供 RISC-V 技术的小公司的商业前景,因为客户不再需要担心某家拥有独有指令集的公司能否长期存续。
RISC-V 对 DSA 的另一项吸引力是:在 DSA 中,指令集的重要性不如通用处理器中那么高。如果 DSA 通过图结构或并行模式等高层抽象来编程,像 JAX、PyTorch 和 TensorFlow 那样,那么需要在指令集层面处理的工作就更少。原文将其中的图结构写作“data acyclic graphs(DAGs)”。2 此外,当性价比和能源成本方面的进步主要来自增加 DSA 时,二进制兼容性可能不再像过去那样重要。
截至本书写作时,RISC-V 很可能已成为 ARM 和 x86 之后第三重要的指令集。开放的 RISC-V 指令集前景可期。(我们真希望能窥见未来,看看从现在到本书下一版出版时,RISC-V 会发展成什么样!)
7.9 融会贯通:比较 DNN 加速器
下面以 DNN 领域为例,比较本章各加速器的性价比。1 我们先详细比较 TPU v4 lite 与 T4 的推理基准测试表现,再比较 TPU v4、A100 和 IPU Bow 的训练性能。最后,简要评估智能手机中的 Samsung NPU,并将其与笔记本电脑使用的 x86 CPU 比较。
推理:TPU v4 lite 与 T4
图 7.26 展示了在 Google 数据中心运行时,TPU v4 lite 相对于 T4 的性能。三项推理基准来自 MLPerf,每项都有两种成绩。server 版本在几十到几百毫秒的延迟上限约束下,以每秒查询数衡量性能;offline 版本同样使用每秒查询数,但没有延迟上限。
对于 server 基准,TPU v4 lite 的速度为 T4 的 1.3 倍;对于 offline 基准,为 1.6 倍。
图 7.27 展示了已报告的 MLPerf 性能,与 Google 数据中心实测结果之间的差异。T4 的 Turbo 加速频率是基础频率的 2.6 倍;温度上升时,时钟可能降频,因此散热系统对 T4 性能至关重要。T4 与 TPU v4 lite 都采用风冷。MLPerf Inference 要求每次测试至少持续 1 分钟,这与芯片及散热器充分升温所需的时间相近。Google 的实验发现,以最低频率空闲运行的 T4 温度为 35°C;以最高 1.6 GHz 运行 MLPerf 后,30 秒内就升至 75°C。此后温度保持在 75°C,而时钟频率在 0.9–1.3 GHz 之间变化。考虑到 Google 数据中心的环境,以及其强制要求的 ECC——MLPerf Inference 当时允许选择是否启用 ECC——图 7.27 给出了启用 ECC 并持续运行 10 分钟时的影响。
T4 的性能比其报告的 MLPerf Inference 成绩低 19%–26%。相比之下,TPU v4i 起始温度约为 37°C,10 分钟后只上升约 5°C。Google 有意在数据中心中为 TPU v4i 配备充足的供电和散热能力,以维持稳定的延迟,并提供额外存储空间用于 ECC,使 ECC 可以始终开启且不损失性能。此处的 TPU v4i 即本节所述 TPU v4 lite。
T4 对 ResNet 和 SSD 使用 int8,对 NMT 使用 fp16。MLPerf Inference 0.7 不包含 NMT,因此 NMT 使用 0.5 版结果,ResNet 和 SSD 使用 0.7 版结果。图中从左至右分别为 ResNet server 1.6、ResNet offline 1.8、SSD server 0.7、SSD offline 1.1、NMT server 2.0、NMT offline 2.1,以及 server 和 offline 的几何平均值 1.3、1.6;基准 T4 的性能为 1。
T4 的 100% 基准是 NVIDIA 报告的 MLPerf 成绩;TPU v4i 的 100% 基准是在 Google 数据中心中运行、未经认证的 MLPerf 成绩。1 分钟测试开始前,T4 处于空闲状态,然后在最高频率下,分别关闭和开启 ECC,运行 MLPerf 1 分钟。T4 使用会占用存储带宽的 inline ECC。10 分钟测试前,机器不处于空闲状态。TPU v4i 的速度不随 ECC 开关状态或运行时长改变。图例依次为:T4 运行 1 分钟、ECC 关闭;T4 运行 1 分钟、ECC 开启;T4 运行 10 分钟、ECC 关闭;T4 运行 10 分钟、ECC 开启;TPU v4i 运行 10 分钟、ECC 开启。Serv、Offl、Geo Mean 分别表示 server、offline 和几何平均值。
训练:TPU v4、A100 与 IPU Bow
图 7.28 和图 7.29 展示了三种训练系统随规模扩展,在 ResNet-50 和 BERT 两项 MLPerf 基准上的性能。厂商可以自行选择要报告训练结果的系统规模,因此,能够进行哪些比较,受三家公司选择的限制。
图中的点为已报告结果,连线表示对中间规模系统性能的推算。TPU v4 少于 2048 颗芯片的结果来自 MLPerf Training 1.0,其余所有系统的数据点来自 MLPerf Training 2.0。两个坐标轴均为对数刻度。横轴为参与基准测试的系统芯片数量,纵轴为相对于 8 路 A100 的性能;黄色为 TPU v4,蓝色为 A100,红色为 MK2 IPU。图例中的 exact 表示报告的数据点,interpolated 表示插值连线。2
图中的点为已报告结果,连线表示对中间规模系统性能的推算。TPU v4 少于 2048 颗芯片的结果来自 MLPerf Training 1.0,其余所有系统的数据点来自 MLPerf Training 2.0。两个坐标轴均为对数刻度,轴和图例的含义与图 7.28 相同。
本节希望比较规模相同或成本相同的系统。图中的大标记代表已报告结果,点之间的连线则是推算值。TPU v4 和 A100 的 MLPerf 结果都扩展到了远大于 IPU 的系统规模:前两者为 4096 颗芯片,IPU 为 256 颗。对 ResNet-50,TPU v4 快于 A100,A100 又快于 IPU;对 BERT,TPU v4 略快于 A100,而 A100 显著快于 IPU。
推理:Samsung NPUv1、NPUv2 与 Intel Core i7 加 Iris Xe GPU
MLPerf 还提供一组面向移动设备的推理基准。为降低计算需求,移动基准使用的权重通常更少,质量目标也低于数据中心基准。图 7.30 展示了两个 MLPerf 类别的结果:NPUv1 和 NPUv2 属于手机类别,Intel Core i7 属于笔记本电脑类别。
这种比较并非完全同类,因为笔记本电脑的功耗和裸片面积预算更高,时钟频率也快得多,差异达到 5–25 倍(见图 7.22)。即便如此,面向特定领域的 NPU 加速器仍分别达到 CPU 的 1.2 倍和 3.4 倍性能。3 一个原因是它们会跳过稀疏矩阵中的零值,平均获得 1.4 的加速比。
NPUv1 结果来自 MLPerf 1.0,Core i7 来自 MLPerf 1.1,NPUv2 来自 MLPerf 2.0。图中蓝色为 NPUv1,橙色为 NPUv2,Core i7 的性能归一化为 1。各项性能分别为:MobileNetEdge 1.5/3.7,MobileDET_SSD 1.5/4.5,Deeplabv3+–MobileNetv2 1.7/3.6,MobileBERT 0.6/0.8,几何平均值 1.2/2.6。
注意,与另外三项基准相比,MobileBERT 在 NPU 上表现较弱,因为它要求使用 fp16 计算。NPUv1 不支持 fp16,因此这项测试实际运行在同一 SOC 中的 DSP 上。NPUv2 可以直接运行该测试,但它相对 i7 的 fp16 性能优势,远小于整数数据类型的情况。
7.10 谬误与陷阱
在面向 DNN 的商用 DSA 发展的第一个十年里,谬误与陷阱随处可见。
陷阱:与常规软件不同,DNN 可能迅速变化
图 7.5 展示了 Google 生产环境中 DNN 推理模型组合在四年间的变化。第一篇 BERT 论文发表于 2018 年,两年后,它已占工作负载的四分之一以上。不仅如此,即使模型类型不变,其规模也在持续快速增长。四年间,推理应用的存储占用和计算需求平均每年增长到原来的 1.5 倍。
训练方面的增长更快。2024 年,人们对拥有数千亿乃至数万亿参数的大语言模型充满期待。GPT-3 论文发表两年后,LLM 已占 TPU v4 工作负载的四分之一。
DSA 体系结构设计者的挑战是:通过专用化提高 DNN 性能,同时保持足够的灵活性,既支持现有模型快速增长,也能容纳不断出现的新 DNN。
谬误:对于 DNN 硬件,每秒推理次数(IPS)是公平的综合性能指标
IPS 不适合作为 DNN 推理硬件的单一、总体性能指标,因为它本质上与应用中一次典型推理的复杂度成反比,而复杂度取决于 DNN 层的数量、大小和类型等因素。例如,TPU v1 运行四层 MLP1 时达到 360,000 IPS,运行 89 层 CNN1 时却只有 4700 IPS;同一个 TPU 的 IPS 相差 75 倍!因此,把 IPS 作为唯一的速度指标,比用 MIPS 或 FLOPS 衡量传统处理器还容易误导,应当更坚决地摒弃。
与本书上一版出版时不同,如今已有机器学习工作负载的行业标准基准 MLPerf。再以 IPS 或每秒峰值运算次数这样的间接指标宣称性能,已经没有理由。本章选择介绍哪些 DSA 时,就以 MLPerf 结果作为参考;本章所有 DSA 都有 MLPerf 成绩。
陷阱:新 DSA 的编译器需要很长时间才能成熟
传统编程语言的开源编译器,让评估新型常规 CPU 变得相当容易;但对于 DNN DSA,情况并非如此。Google、NVIDIA 等公司的团队,为 JAX、PyTorch 和 TensorFlow 开发了各自的新型编译器和库。2017 年以来,虽然许多初创公司都在开发新的 DNN DSA,但其中大多数至今还没有提交过一次 MLPerf 结果。原因可能是:它们的软件栈还未能展现出体系结构设计者预期的性能。
谬误:推理要求低延迟,所以批大小必须为 1
图 7.31 列出了 MLPerf 基准和生产应用的延迟约束,以及它们在 TPU v4 lite 上使用的批大小。延迟约束以 99% 的查询必须满足的时间上限表示,这是合理的做法。即使某些批大小达到数百,TPU v4 lite 仍能满足延迟约束。还需注意量级差异:对 CPU 来说,微秒级延迟有时就会造成性能问题,而推理延迟通常以毫秒计。
| 类型 | DNN | 延迟约束 | 批大小 |
|---|---|---|---|
| MLPerf | ResNet50 | 15 ms | 16 |
| MLPerf | SSD | 100 ms | 4 |
| MLPerf | GNMT | 250 ms | 16 |
| 生产应用 | MLP0 | 7 ms | 512 |
| 生产应用 | MLP1 | 20 ms | 128 |
| 生产应用 | CNN0 | 1 ms | 16 |
| 生产应用 | CNN1 | 32 ms | 16 |
| 生产应用 | RNN0 | 60 ms | 8 |
| 生产应用 | RNN1 | 10 ms | 32 |
| 生产应用 | BERT0 | 5 ms | 128 |
| 生产应用 | BERT1 | 10 ms | 64 |
陷阱:不支持多租户
与 CPU 一样,推理 DSA 也应支持多租户。如果一个应用使用许多模型,让这些模型共享硬件,可以降低成本和延迟。例如,翻译 DNN 需要支持许多语言对,语音 DNN 则必须处理多种方言。另一个原因只是良好的软件工程实践:例如,先让少量客户试用新特性,或逐步部署新版本,以降低软件更新出现问题的风险。Google 八种生产推理工作负载中,有六种需要多租户。
其中三个应用的最大存储占用达到 1300–3000 MB,远远超过 2024 年单个插槽中 SRAM 能容纳的范围。如前所述,DNN 规模预计还会继续增长,而未来工艺中 SRAM 的改进速度较慢(见第 1 章图 1.18)。对于部署在云中的设备,多租户带来的一个结果是:enclave 等安全特性正在成为保护客户数据的必要条件。例如,NVIDIA 的 A100 和 H100 GPU 支持 enclave。
陷阱:设计 DSA 时不了解体系结构历史
在通用计算中未能成功的思想,可能恰好适合 DSA,因此熟悉历史的体系结构设计者可能具有竞争优势。DNN 加速器的两项重要特征,都可追溯到 20 世纪 80 年代:脉动阵列(Kung 和 Leiserson,1980),以及超长指令字(Very Long Instruction Word,VLIW)(Fisher,1983)。前者降低了 TPU 中大型 MXU 的面积和功耗,后者简化了指令级并行的利用。我们建议读者认真发掘本书每章末尾“历史回顾”中的内容,寻找能够改进自己所设计 DSA 的宝贵思想。
谬误:DNN 训练期间没有 I/O
Facebook 开发了一条数据存储与集成流水线,为由数万个 GPU 组成的机器学习集群提供数据(Zhao,2022)。深度学习推荐模型(DLRM)在 Facebook 广泛使用,消耗了大部分机器学习训练周期。数据存储和集成需求增长迅速:2020–2022 年间,存储容量增长到原来的 2 倍,在线数据摄取带宽增长到 4 倍。Facebook 三个集群的 DLRM 能耗平均分布为:存储占 28%,预处理占 22%,训练占 50%。
谬误:训练一个 DNN 模型的排放,相当于五辆汽车的全生命周期排放
这个标题于 2019 年出现在 MIT Review 和 New Scientist 中,此后又出现在多篇研究论文里。这一说法针对的是 Evolved Transformer 的训练,原文指向 7.9 节和图 7.25。1 其源头是一篇论文(Strubell,2019):作者试图估算发现 Evolved Transformer 的 NAS 所产生的碳排放,而原始论文(So,2019)并未报告这个数据。由于无法获取进行 NAS 的 Google 所对应的 4M 数据,研究者改用 GPU,并采用数据中心 PUE 与能源清洁程度的平均值。这种可以理解的替代方式,使排放估算值达到 Google 实际使用 TPU v2 和自身数据中心进行 NAS 时排放量的约 5 倍。
NAS 的计算成本也存在误解。Evolved Transformer 的 NAS 先使用较小的代理任务搜索最佳模型,以节约时间、资金和能源,再把找到的模型扩展到完整规模。然而,外部研究者假定搜索一直使用完整规模的任务。
这使 NAS 的计算量估计达到实际值的 18.7 倍。原文给出的总体高估倍数为 88,并在括号中列出 。2 遗憾的是,MIT Review 和 New Scientist 的记者,以及后来许多引用该论文的作者,又把 Evolved Transformer NAS 的一次性成本,与每次训练产生、相对很小的成本混为一谈,进一步放大了错误。
发现 Evolved Transformer 的 NAS 所产生的排放,是训练一次该模型的 1300 倍。因此,Evolved Transformer 的实际训练排放,约为所宣称的“五辆汽车全生命周期排放”的 1/120,000,原文列式为 :实际为 2.4 kg,而不是 284,019 kg。若再考虑在 Google 俄克拉何马州数据中心使用 TPU v4 训练 Primer 带来的进一步改进(见图 7.25),训练一个与 Transformer 效果相当的模型,排放降至 0.2 kg,即约为五辆汽车全生命周期排放的 1/1,400,000。
7.11 结束语
传统目标是改进通用计算机,让所有程序受益;近年来,方向开始转向使用 DSA 加速一部分程序。本章介绍了这种转变中的若干商业实例。至少在过去十年间,体系结构研究人员不断发表针对通用处理器的创新,基于有限基准的模拟,宣称获得 10% 或更低的性能提升;与此同时,公司现在报告的 DSA 硬件产品加速比却达到 3–10,乃至更高。它们不仅提供了令人瞩目的加速,也显著降低了机器学习的能耗和排放影响。
我们认为,这说明该领域正在经历变革,而以下两个因素正带来体系结构创新的复兴:
- Dennard 缩放与 Moore 定律相继走向历史性的终点,这意味着,要继续改善成本、能耗和性能,就必须依靠计算机体系结构创新;
- DSA 巨大的潜在收益,以及它与领域专用编程语言之间的协同作用。
尤其是在本书第七版写作之际,人们对人工智能潜力的热情,已经使数据中心投资的重点,从 CPU 服务器转向 AI DSA。
我们相信,许多体系结构研究人员将设计出新的 DSA,把标准提高到超越本章实例的水平。我们迫不及待地想看到:到本书下一版出版时,计算机体系结构的世界会是什么模样!
来源:Shao, Yakun Sophia 和 David Brooks,Research Infrastructures for Hardware Accelerators,Springer Nature,2022。图中横轴依次为 A4(2010)、A5(2011)、A6(2012)、A7(2013)和 A8(2014),纵轴为专用 IP 模块数量。相关讨论见 7.8 节。
7.12 历史回顾与参考文献
在线提供的 M.9 节介绍了 DSA 的发展历程。
案例研究与习题
案例与习题由 Cliff Young 编写。
案例研究 1:矩阵乘法
本案例阐明的概念:矩阵乘法运算的结构。
矩阵乘法也许是你在高中代数中接触过的内容,它是当今深度学习革命中最基本的计算密集型运算。与标量乘法一样,矩阵乘法有两个输入、一个输出,但三个操作数都是二维矩阵。描述矩阵形状时,通常先给行数,再给列数;例如, 矩阵有 3 行、5 列,共 15 个元素。
矩阵相乘时,形状必须匹配。按照 FORTRAN 的惯例,我们通常把矩阵乘法写作 ,其中 为结果矩阵,、 为输入矩阵。 是 矩阵,、 分别为 和 矩阵。关键在于:只需三个标量 、、,就能确定矩阵乘法的全部几何关系。 与 的行数同为 , 与 的列数同为 ,而 的列数必须等于 的行数。
这些字母可能让人难以理清。我们可以把矩阵乘法看作一个长方体,三个面分别对应矩阵 、、(图 7.33)。三个标量决定长方体的三条边长,而矩阵乘法的计算量对应长方体的体积。设想把每个输入矩阵的值,沿垂直于其所在面的方向广播到长方体内部;来自 和 的两个值相遇之处,就计算它们的乘积。如何得到输出 呢?对于输出中的每个位置,把垂直于 所在面的直线上所有乘积相加,就得到 中该位置的值。
下面给出一个很简单的矩阵乘法程序,通常也称为 GEMM,即 GEneral Matrix Multiplication。GEMM 是基本线性代数子程序库(Basic Linear Algebra Subroutines,BLAS,读作“blahs”)的一部分;BLAS 是线性代数的标准库。
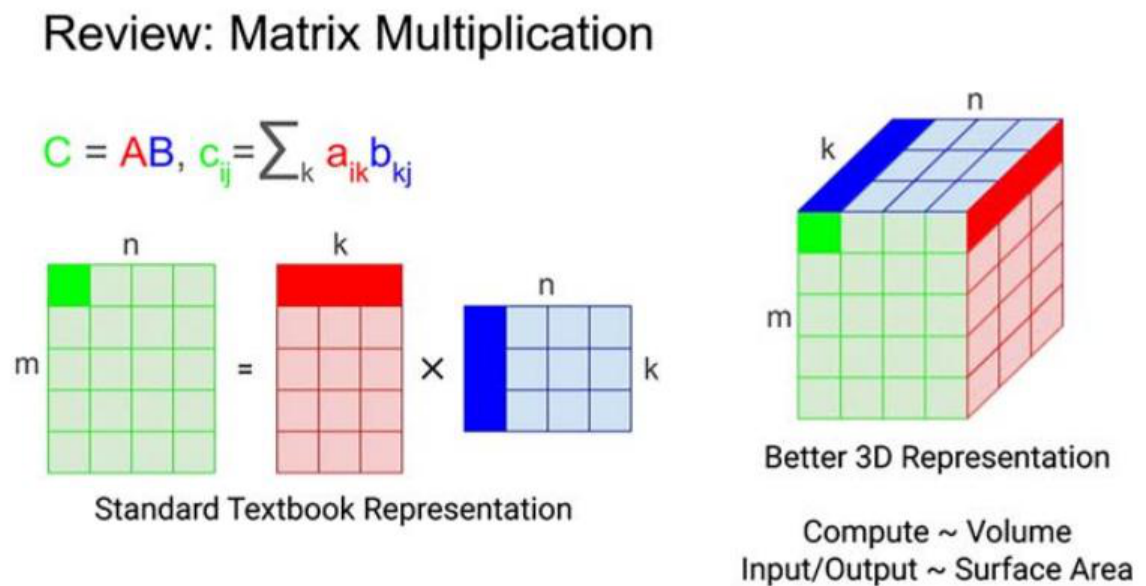
图中左侧为常见教科书中的表示,右侧为更直观的三维表示;Compute ~ Volume 表示计算量对应体积,Input/Output ~ Surface Area 表示输入输出量对应表面积。
译注:代码按原书保留。结果矩阵的声明写为 c[M][K],与正文给出的 形状不符;参数中的数组引用写法也不是可直接编译的标准 C++。本案例代码用于说明计算结构,不能不加修改就当作完整程序运行。
习题 7.1
[10/20/10/10/20] ⟨7.3,7.4⟩
a. [10] 假设 、、 相等。这个算法的渐近时间复杂度是多少?如果不熟悉大 O 记号,请用 、、 写出加法和乘法次数的公式。参数所占空间的渐近复杂度是多少?当 、、 变大时,这对矩阵乘法的算术强度意味着什么?
b. [20] 假设 、、,即三个维度两两互素。写出三个矩阵 、、 中各存储位置的访问顺序。可以先写二维下标,再转换为存储地址或相对于各矩阵起点的偏移量。哪些矩阵的元素按顺序访问?哪些不是?假设采用按行优先的 C 语言存储布局。
c. [10] 假设通过交换行列构造新矩阵 ,即 的转置,其形状改为 B[N][K]。此时最内层循环语句为:
现在哪些矩阵的元素按顺序访问?
矩阵乘法最内层循环中的语句:
称为乘加操作(multiply-accumulate,MAC)。可以将它写成一个简短的子程序:
高性能计算的惯例是把一个 MAC 计为两次运算,显然分别对应乘法与加法;即使 ISA 将 MAC 定义为单个操作码,也仍如此。例如,IBM POWER 就采用这种指令,需要三个源操作数。矩阵乘法可以改写为使用 MAC 的版本:
d. [10] 对于 、、 的情况,这个程序执行多少次 MAC?共多少次运算?
e. [20] 假设有一个硬件单元,每周期可以完成两个 矩阵的乘法。若它运行在 1 GHz,每秒执行多少次 MAC?相当于每秒多少次运算?
分解
为了引出矩阵乘法的下一种表达方式,先把 GEMM_MAC 改写为接受转置后的 :所有值保持不变,只交换行列。 是 矩阵,其转置 是 矩阵。
译注:原书这一代码块缺少函数末尾的右花括号;此处按原样保留。
这种转置还带来一个好处: 和 在存储器中的最内层维度,也就是变化最快的维度,现在都对应 。
点积或内积
考虑点积操作。dot 接收两个向量,把对应元素逐一相乘,再把乘积相加,返回总和。
习题 7.2
[25/25/25] ⟨7.3,7.4⟩
a. [25] 改写 GEMM_MAC_BT,在嵌套循环中用点积替代 MAC。总共会调用多少次 dot?
b. [25] 假设不是使用接受 len 参数的软件 dot,而是使用一个要求长度固定的硬件版本,例如长度固定为 2。把代码改写为使用这样的 dot2。它会被调用多少次?如果 不是偶数,应如何处理?
SAXPY
另一种略有不同的分解方式使用 SAXPY,即 Single-precision Alpha times X Plus Y(单精度的 )。SAXPY 接收一个输入向量和一个标量,用标量缩放输入向量的每个元素,再把所得乘积加到输出向量的对应位置。
c. [25] 改写 GEMM,在嵌套循环中用 saxpy 替代 MAC。
外积
两个向量的外积是一个矩阵,包含这两个向量中所有可能元素配对的乘积。与 GEMM 一样,通常把结果矩阵同时用作输入和输出,将外积加到传入的矩阵上。还需注意,这个程序使用了一点 C 语言下标技巧:把 result 作为原始指针传入,然后手动计算它的下标。
译注:原页确实在 result[i * len_y + j] 后附有 [29][30][31],与 float *result 的类型不相容,疑为排版混入的标记。
习题 7.3
[25/25] ⟨7.3,7.4⟩
a. [25] 改写 GEMM,在嵌套循环中用 outer_product 替代 MAC。示例中具体的下标写法并不重要,可以自行修改 outer_product,让它适合所选择的接口。
b. [25] 重画图 7.33,展示如何把长方体分解为点积、SAXPY 和外积操作。可以把长方体中的小块略微分开,以显示三种运算各自的分组方式。
案例研究 2:神经网络层
本案例阐明的概念:深度神经网络的结构。
图 7.34 转载自经典 AlexNet 论文的图 2(Krizhevsky,2012)。这篇论文发表于 2012 年,却已经包含了现代神经网络设计中几乎所有仍然重要的组成部分。
来源:Krizhevsky、Sutskever 和 Hinton,《ImageNet Classification with Deep Convolutional Neural Networks》,Advances in Neural Information Processing Systems 25(2012)。图中展示了“两个 GPU 的职责划分。一个 GPU 运行图中上半部分的各层部分,另一个运行下半部分。GPU 仅在某些层交换数据。网络输入为 150,528 维,其余各层的神经元数量依次为 253,440—186,624—64,896—64,896—43,264—4096—4096—1000。”图中 Stride of 4 为步长 4,Max pooling 为最大池化,dense 表示全连接。
这张图需要一些解释。为便于阅读,我们把它逐项拆开,仅讨论基本内容。
- 图左侧和中间的长方体,以及右侧的矩形,表示激活值,也称特征图。有些具有三维结构,例如 AlexNet 的输入是 的 RGB 图像,颜色维度为 3;有些只有一维结构,例如右侧五个矩形是长度为 2048 或 1000 的一维向量。最后一个含 1000 个值的激活向量,是 AlexNet 的“输出分类器”,列出输入图像属于 ILSVRC 比赛中各个类别的概率。
- 图中没有显式绘出 AlexNet 的层和权重。它们位于相邻的激活表示之间,其形状可由激活的形状推导,稍后会说明。
- 前五层位于各长方体之间,是卷积层。输出长方体中的每一点,都依赖于一个感受野,即大长方体内部画出的小长方体。每组卷积输入或输出下方的数字——3、48、128、192、192、128——表示该层的深度或特征深度。输入激活的深度对应 RGB;后续层中,更多的深度则表示更抽象的概念。长方体还标出了空间尺寸:输入为 ,第一层后迅速降至 ,第二层后为 ,第三和第四层后为 。1
- 前几层通过两种机制缩小空间尺寸,其含义类似图像分辨率。第一种是使用步长:每隔 4 个像素评估一次感受野,而不是对每个像素位置都评估。
第二种是最大池化:对空间上 的一组激活值,返回其中的最大值。
- 最后三层是全连接层,本质上是矩阵—向量乘法。第六层把 展平成一维向量,两个 GPU 各有一组 21,632 个激活值,总计 43,264 个;然后通过矩阵乘法将其投影到 4096 个激活值。第七层将 4096 个激活值映射为 4096 个;分类器层再从 4096 个降至最终的 1000 个输出类别。
- 在分类器层,Softmax 函数把含 1000 个激活值的向量转换为 1000 个概率。Softmax 是向量函数,原书给出的公式为:
其中,输入向量的 个元素为 ,输出向量的 个元素为 。2 不必被公式吓到:各输出共用同一个分母,它是一个缩放因子,保证输出向量中各值之和为 1。
- 图中还展示了跨两个 GPU 的并行化,两者之间只有有限通信。后面还会讨论并行化。
习题 7.4
[10/20/15//25/25/25/25] ⟨7.3,7.4⟩
a. [10] 每个卷积层有多少权重?生成一个输出激活值需要使用多少权重?
b. [20] 根据图注给出的总数,推导各卷积层的神经元(激活值)数量,例如第一个卷积层输出为 253,440 个,依此类推。
c. [15] AlexNet 的第六、七、八层,开始时数据分布在两个 GPU 上。为完成这些计算,每个 GPU 需要向另一个发送多少数据?这些层在每个 GPU 上驻留多少权重?处理一张图像时,这些层执行多少次运算?
d. [25] 深度学习实践中一个令人遗憾的现实是:我们学过的简洁卷积公式,实际使用时不一定完全吻合。缩小空间尺寸的层就能体现这一点,包括卷积核步长和最大池化。我们可能预期,长度为 的滤波器对长度为 的输入做卷积,会产生 个输出;但某些神经网络层的规格似乎会产生更多输出。通常的解决办法是在输入中加入一定量的零填充(zero padding),增大有效尺寸,以达到预期输出尺寸。对于图中使用步长和最大池化的层,何时需要在 X 或 Y 方向填充,才能使尺寸计算吻合?注意,最大池化也可能需要设置步长。
e. [25] Softmax 看起来可能很复杂,但用几个小例子试一试,就能形成直觉。Softmax 的输入称为 logits。请计算以下向量的 Softmax:
- 四个值均为 2.0 的向量;
- 向量
[1,2,3,4]; - 长度为四的 one-hot 向量;
- 包含两个较大值和两个较小值的四维向量。
随后尝试缩放整个向量、给所有元素加上同一个值,以及改变向量中各元素的相对大小。从定性角度看,Softmax 对输入有什么影响?输出向量的大部分数值总量会集中在哪里?
f. [25] 使用均匀分布、高斯分布和指数分布,生成一些随机的 1000 维向量,再计算它们的 Softmax。绘制输出的累积分布函数(CDF)。需要多少个输入项,才能分别占据 CDF 的 50%、95% 和 99%?
g. [25] Softmax 可能出现数值不稳定,因为它使用的指数函数增长很快,相对不大的输入就可能产生超出浮点表示范围的值。如何改写 Softmax,以消除这种数值不稳定?
AlexNet 缺少的一项重要组成部分是注意力层。介绍 Transformer 体系结构的论文《Attention Is All You Need》(原文此处写作 Vishwani,2017)就突出了它的重要性。3 注意力的代数形式为:
图 7.35 用图形展示了注意力。这个表达仍然有些简略,下面进一步解释。
- 三个输入 、、,分别表示 Query(查询)、Key(键)和 Value(值)。这些名称提示我们,注意力的工作方式类似内容寻址存储器(CAM)。4 这种硬件结构保存键值对,接收查询,而不是普通存储器中的地址;如果某个键与查询相等,就返回对应的值。但与 CAM 布尔式的精确比较和选择不同,注意力的选择更为柔和,因此学习时反向传播能够通过它进行。
- 先把 看作向量,而不是矩阵。深度学习中一个令人困惑的现象是:激活向量未必具有容易被人理解的“含义”;研究者用较为专业的说法,称它位于潜在空间(latent space)。图中底部表示 的 MatMul,暂时可看作矩阵—向量乘法,其中 为矩阵, 为向量。
现在把 看作一组向量,每个向量都表示与查询向量处于同一潜在空间的一个键。于是, 可以理解为计算 与各个键向量的点积。这里的点积就像比较函数:两个向量方向大致相同时,点积较大;方向正交时,点积为零。因此,第一个 MatMul 只是把查询向量 与各键比较,计算 与每个键的相似程度。
- Scale(缩放)和可选的 Mask(掩码)都是逐元素操作,这里略过。
- Softmax 如前所述,把 产生的 logits 转换为概率分布,从而确定应给每个键值对分配多大权重。
- 最后一次矩阵乘法 ,按 Softmax 选出的权重缩放各个值向量。如果 Softmax 的结果是 one-hot,就像内容寻址存储器报告“这里命中了”;如果结果包含多个非零值,就会把那些键最接近查询的值,按照接近程度混合起来。因此,第二个 MatMul 返回的是由查询决定的、各个值的加权组合。
- 最后,取消最初“ 是一个向量”的简化假设,把它看作一组查询。我们并行处理整组查询,注意力模块针对每个查询,分别返回一个混合后的值向量。
转载自 Vaswani、Shazeer、Parmar、Uszkoreit、Jones、Gomez、Kaiser 和 Polosukhin,《Attention Is All You Need》,Advances in Neural Information Processing Systems 30(2017),图 2 的一部分。图中 Scaled Dot-Product Attention 为缩放点积注意力,MatMul 为矩阵乘法,Mask (opt.) 表示可选掩码。
习题 7.5
[25/15/15] ⟨7.3,7.4⟩
a. [25] 探索点积如何起到比较函数的作用。为保持简单,仍使用四维向量。标准正交基向量集合 {[1,0,0,0], [0,1,0,0], [0,0,1,0], [0,0,0,1]} 中,任意两个不同向量的点积显然都为零。但神经网络产生的向量很少这样规整,因为它们是通过随机过程学习得到的。随机选取一个四维向量,然后构造一个包含它的正交基。四个向量不必为单位长度,但必须两两点积为零。
b. [15] 如果一个键向量等于另一个的两倍,会怎样?它们与查询的点积之比是多少?
c. [15] 同样,如果一个键向量是另一个的相反数,会怎样?点积之比是多少?经过 Softmax 后,那个负的点积会怎样?
案例研究 3:数值表示
本案例阐明的概念:数值表示和浮点运算。
矩阵乘法是当今神经网络中的关键大规模运算,而降低精度则是使每秒万亿、千万亿次运算在芯片面积和功耗上变得可承受的重要因素。AlexNet 使用 32 位浮点值编写,并在 GPU 上运行;TPUv1 的高运算吞吐量,部分来自使用 8 位定点运算。为了简化练习,我们只讨论 4 位数值表示,这样就能列举每种格式的全部可表示值。
整数
无符号整数是由 位组成的位串,每一位的权值是相应的 2 的幂。把四个位从最高有效位到最低有效位依次记作 、、、,则四位无符号整数的值为:
这四位可以表示 0 到 15 的整数。
为了表示有符号整数,二进制补码格式把最高有效位的权值从 8 改为 −8:
因此,四位可以表示 −8 到 7 的整数。最高有效位也称为符号位。
第三种较少使用的格式称为 Excess-k。它的二进制表达与无符号格式相似,但增加了一个偏置项 ,改变各位所代表数值的解释:
偏置不一定由硬件表示,也可能完全由软件通过改变数值解释来管理。无符号整数相当于 excess-0 值。5
更少见的一种整数格式是符号—数值表示(sign-magnitude),第一位表示符号,其余位按通常方式表示数值:
四位符号—数值表示有一个有趣特点:零有两种表示,实质上是正零和负零。这给比较带来麻烦,因为两种零的位模式不同,但比较时应该相等。
习题 7.6
[5/10/10/10/20] ⟨7.4,7.5⟩
a. [5] 列举全部四位整数值,包括无符号和有符号表示。可以列成表格;使用二进制形式会很有帮助。
b. [10] 符号—数值表示取相反数很容易,只需翻转符号位。对于有符号补码值, 与 之间是否存在通用模式或公式?忽略 −8,因为它的相反数 8 无法用四位有符号数表示。
c. [10] 对每一种格式,两个四位数相加,需要多少位才能表示其和?
d. [10] 两个四位无符号数相乘,需要多少位才能精确表示无符号乘积?
e. [20] 假设要构建一个接受两个四位输入的乘法器,输入可能都无符号、都有符号,或一个有符号而另一个无符号。要保证这三种情况下输出正确,分别需要做什么?
浮点数
如果还记得高中化学中的科学计数法,你会记得它把阿伏伽德罗常数——一摩尔中的原子或分子数量——写成类似 的形式。计算机中的浮点表示本质上做的是同样的事,只是不使用十进制来表示有效数字和指数,而是使用能以位表示的整数。
浮点数包含三个部分:
- 一个符号位,与整数的符号—数值表示相同;
- 零个或多个小数位,对应阿伏伽德罗常数中的“.02”。它们表示基数点右侧的值:这里是二进制小数点,科学计数法中则是十进制小数点。把小数位作为整体来看,它很像一个无符号整数。那么,6.02 中的 6 去哪里了?这恰恰是浮点格式高效表示实数的关键,下面会继续解释;
- 零个或多个指数位,主要以 Excess-k 格式表示以 2 为底的指数;此外,可能有一些特殊取值,用于处理格式中的边界情况。
对于所谓的规格化浮点数(normal),数值由下式给出:
符号项决定整个表达式为正还是为负。注意,中间项在小数位之前有一个“隐含的首位 1”。因此,中间项所表示的值位于数轴上的半开区间 :这种小数位格式永远不会表示 2.0,但如果小数位足够多,就能非常接近它。原文以 IEEE 双精度格式的 53 位为例。6 隐含首位 1 与指数项相结合,赋予浮点格式巨大的动态范围:指数每增加一级,它在实数轴上覆盖的区间跨度就是前一级的两倍。
你可能会问:浮点格式如何表示零?这就需要一个特殊指数编码,通常是指数位全零。对于这个特殊编码,使用修改后的公式:
其中,minexp 是最小规格化浮点数的指数值。除此之外,唯一变化是:隐含首位 1 变为隐含首位 0。当小数部分不为零时,这种格式中的值称为非规格化数(subnormal 或 denormal)。
它们在浮点数的数值稳定性和误差分析中起着关键作用。
习题 7.7
[20/20/20/5/10] ⟨7.4,7.5⟩
a. [20] 一种四位格式有 1 个符号位、1 个小数位和 2 个指数位。列出全部 16 种四位编码在实数轴上对应的值。假设指数采用 excess-(−2):指数编码 0 表示非规格化范围,1 表示指数 −1,2 表示指数 0,3 表示指数 1。
b. [20] 把这 16 个值画在实数轴上。由于对称,只画正半轴或负半轴也可以。非规格化数在数轴上起什么作用?
c. [20] 对于 1 个符号位、没有小数位、3 个指数位的格式,画出所有可表示值。这些值如何分布?对于这种格式,你会如何实现乘法?
d. [5] 对于 1 个符号位、3 个小数位、没有指数位的格式,画出所有可表示值。这种格式看起来像什么?
e. [10] 如果格式包含 1 个符号位、2 个小数位和 1 个指数位,又会怎样?这个单独的指数位起什么作用?这种格式与上一种有什么不同?
案例研究 4:计算、供数与规模
本案例阐明的概念:
- 简单神经网络模型的存储容量与计算速率,即“speeds and feeds”;
- 构建面向 DNN 的 DSA。
若以每个字所蕴含的系统设计智慧衡量,Jon Bentley 的《The Back of the Envelope》(Bentley,1999)或许是最出色的文章之一。Bentley 在文中介绍了一种计算机系统设计方法:借助纸笔——甚至旧信封的背面——和高中代数,快速判断某个设计是否合理,乃至是否可能。计算机体系结构设计者有时把这种分析称为 speeds and feeds,即把计算速度、数据供给速率和容量放在一起估算。本节给出若干这样的例子。
Google 的第一代 Tensor Processing Unit(TPU)包含一个 脉动阵列矩阵乘法器,峰值性能达到每秒 92 万亿次运算。这个数字在当时令人惊叹,是同时代双芯片 K80 GPU 的 30 倍、超大规模数据中心 CPU 的 90 倍。在介绍 TPU 的论文中(Jouppi,2017),作者同时指出,TPU 的存储带宽是关键瓶颈:两个 DDR3 通道只能以约 30 GB/s 的速率加载单字节权重。
习题 7.8
[10/10/10/10] ⟨7.3,7.4,7.5⟩
a. [10] 假设脉动阵列中的每个单元每周期执行一次乘加,计为两次运算,计算 TPU 的运行时钟频率。
b. [10] TPU 加载一个 64 KiB 权重分块需要多久?
c. [10] 本题把算术强度(arithmetic intensity)定义为一个已加载值被复用的次数,通常表现为它参与多个不同的 ALU 运算。7 在稳态运行中,每个权重需要达到多大的算术强度,才能使 TPU 同时达到峰值存储带宽和峰值计算吞吐量?
后来的 TPUv4 lite 使用两个 HBM 堆叠,存储带宽达到 614 GB/s(Jouppi,2021)。它有四个 脉动阵列,但这里暂且忽略这一点,把计算资源看作一个整体的 脉动阵列。
d. [10] 对于每个权重占 2 字节的 bf16——TPUv1 每个权重仅占 1 字节——TPUv4 lite 加载“64 KiB 权重”需要多久?8 要同时达到计算与存储峰值,它需要多大的算术强度?
根据原书引用的 NVIDIA H100 规格页面,最快的 H100 GPU 版本采用 SXM 形态:fp64 峰值为 32 TFLOPS/second,fp32 为 367 TFLOPS,Tensor Core 的 bf16 为 1.979 TFLOPS,fp8 或 int8 模式为 3958 TFLOPS/second。9 据报告,H100 包含 132 个流式多处理器,时钟频率介于约 1 GHz 的基础频率和约 2 GHz 的加速频率之间。
另一个 DNN DSA 是 Cerebras WSE-2,它堪称工程奇迹:使用整片制造晶圆构建单个计算单元,面积约为 50 颗常规最大尺寸裸片的总和;常规裸片面积上限约为 800 mm²。片上规格同样引人注目:40 GB SRAM、20 PB/s 带宽,以及 20 kW 功耗。这些庞大的资源通过 12 条 100 Gb/s 以太网链路与外界连接。
习题 7.9
[10/10/10] ⟨7.3,7.4,7.5⟩
a. [10] 考虑 fp32 的峰值 TFLOPS,这个数值很可能是在 GPU 峰值频率下测得的。每个 SM、以及整颗 H100 芯片中,可能分别有多少 fp32 功能单元?
b. [10] H100 Tensor Core 的 bf16 每秒运算次数高出很多。据此,你认为 Tensor Core 功能单元与 SIMD 核心功能单元的数量之比是多少?
c. [10] GPT-3 有 1750 亿个参数,因此即使每个权重只占 1 字节,一个 GPT-3 实例仅权重就需要 175 GB。把这些参数从 WSE 之外的独立存储系统流式传送到晶圆上,需要多久?
习题
习题 7.10
[5/5/10/10/10/10/15] ⟨7.9⟩
2024 年,在云中租用一块 NVIDIA H100 GPU 的费用为每小时 2–4 美元。媒体报道的购买价格,即资本支出(CAPEX),约为 30,000 美元。运营支出(OPEX)的一部分是电费。H100 的 TDP 为 700 W;2023 年,美国各地零售电价约为每千瓦时 0.10–0.20 美元。
a. [5] 假设设备持续出租,H100 的年租金收入是多少?
b. [5] 如果购买价格是云厂商为 H100 支付的唯一成本,需要多久才能收回购置成本?
c. [10] 运行这样一台设备一年,最坏情况下电费是多少?
d. [10] 电费会怎样改变回收期?还有哪些因素可能影响 GPU 全生命周期的总拥有成本?
e. [10] 假设其他因素造成的运营支出与电费相等,此时回收期是多少?
f. [10] 假设 GPU 的有效使用寿命约为 8 年,云厂商可能获得多少利润?如果每逢新一代 GPU 推出,例如每两年,H100 租金大致减半,利润会如何变化?
g. [15] 到目前为止,我们忽略了影响 H100 租赁盈利能力的一些实际问题。收入方面,我们假定多年间硬件始终可以 100% 出租。更现实的利用比例可能是多少?如果 H100 用于推理而不是训练,这个比例可能如何变化?支出方面,我们省略了容纳 H100 的 CPU 主机的 CAPEX 和 OPEX、出租 H100 公司的人员成本,以及资金成本,也就是持有现金而不投资的机会成本。估算这些因素如何影响预期利润。如果调整后的利润估计在经济上不合理,可能有哪些合理解释?
习题 7.11
[10/10/10/10] ⟨7.2⟩
第一代 Anton 分子动力学超级计算机,通常模拟一个边长为 64 埃的水立方体。计算机本身可以近似为边长 1 米的立方体。单个模拟步骤对应 2.5 飞秒的模拟时间,实际耗时约 10 微秒。
分子动力学的物理模型假定,在每个“外层”时间步中,系统中的每个粒子都对其他每个粒子施加作用力,因此实质上要求整台计算机进行一次全局同步。
a. [10] 计算从模拟空间到现实硬件空间的空间放大倍数。
b. [10] 计算模拟时间相对于实际经过时间的减速倍数。
c. [10] 上述两个答案竟然非常接近。这只是巧合,还是有其他限制以某种方式约束了它们?提示:光速限制既适用于被模拟的化学系统,也适用于进行模拟的硬件。
d. [10] 在这些限制下,要用仓库级超级计算机以 Anton 的速率进行分子动力学模拟,需要满足什么条件?换句话说,对于边长为 或 米的机器,可能达到的最快模拟步耗时是多少?如果使用跨越全球的云服务进行模拟,又会怎样?
译注:原文这里明确写作 ,原图第二组特征图的上、下半部分也分别出现 22 与 27 的不一致标注。 ↩︎
译注:原公式的分子写作 ,分母使用 ,随后文字使用 作为输入符号;若统一采用输入向量 ,分子应写作 。 ↩︎
译注:原文此处作者拼作 Vishwani,而图 7.35 和参考文献均为 Vaswani。 ↩︎
译注:原文第一次将 CAM 展开为 context-addressable memory,后文则使用 content-addressable memory;这里按其键值匹配机制统一译为“内容寻址存储器”。 ↩︎
译注:本案例明确把 定义为加到编码值上的偏置,因此公式中为 ,后面的习题也采用 excess-(−2)。这与把 Excess-k 中的 k 定义为待减去偏置量的惯例不同,应以本题给出的定义为准。 ↩︎
译注:IEEE 双精度的 53 位有效精度包含隐含首位 1;显式存储的小数位为 52 位。原文在这里把 53 称为小数位数量,混用了两种计数。 ↩︎
译注:本题把算术强度描述为每个已加载值的复用次数;在 Roofline 模型中还常按每字节数据对应的运算次数计量。解题时应明确所采用的单位,以及一次乘加计为两次运算的口径。 ↩︎
译注:原题写作“64 KiB weights”,未明确在 bf16 情形中指 64 KiB 数据,还是 64 Ki 个权重。两种解释所需传输字节数不同,题目单位按原样保留。 ↩︎
译注:原页确实写作 fp32 为 367、bf16 为 1.979。后者与题目所说“Tensor Core 吞吐量高出很多”不一致,疑有数字或分隔符问题。原书还把 fp64 和 fp8/int8 项的单位写成 TFLOPS/second,而 TFLOPS 已含“每秒”的含义;int8 的整数运算吞吐量通常应以 TOPS 表示。 ↩︎
参考文献
- Bentley, J., 1999. The Back of the Envelope(信封背面的估算). IEEE Software 16(5), 121.
- Brown, T., Mann, B., Ryder, N., Subbiah, M., Kaplan, J.D., Dhariwal, P., et al., 2020. Language Models Are Few-Shot Learners(语言模型是少样本学习者). Advances in Neural Information Processing Systems 33, 1877–1901.
- Choquette, J., Giroux, O., Foley, D., 2018. Volta: Performance and Programmability(Volta:性能与可编程性). IEEE Micro 38(2), 42–52.
- Dean, J., 2022. A Golden Decade of Deep Learning: Computing Systems & Applications(深度学习的黄金十年:计算系统与应用). Daedalus 151(2), 58–74.
- Devlin, J., Chang, M.W., Lee, K., Toutanova, K., 2018. BERT: Pre-Training of Deep Bidirectional Transformers for Language Understanding(BERT:面向语言理解的深度双向 Transformer 预训练). Proceedings of the Annual Conference of the North American Chapter of the Association for Computational Linguistics: Human Language Technologies (NAACL-HLT), 4171–4186.
- Fedus, W., Zoph, B., Shazeer, N., 2022. Switch Transformers: Scaling to Trillion Parameter Models with Simple and Efficient Sparsity(Switch Transformer:通过简单高效的稀疏机制扩展至万亿参数模型). Journal of Machine Learning Research 23(120), 1–39.
- Jouppi, N.P., Young, C., Patil, N., Patterson, D., Agrawal, G., Bajwa, R., et al., 2017. In-Datacenter Performance Analysis of a Tensor Processing Unit(张量处理单元在数据中心中的性能分析). Proceedings of the 44th Annual International Symposium on Computer Architecture, 1–12.
- Jouppi, N.P., Yoon, D.H., Kurian, G., Li, S., Patil, N., Laudon, J., et al., 2020. A Domain-Specific Supercomputer for Training Deep Neural Networks(用于训练深度神经网络的领域专用超级计算机). Communications of the ACM 63(7), 67–78.
- Jouppi, N.P., Yoon, D.H., Ashcraft, M., Gottscho, M., Jablin, T.B., Kurian, G., et al., 2021. Ten Lessons from Three Generations Shaped Google’s TPU v4(三代产品的十项经验塑造了 Google TPU v4). 2021 ACM/IEEE 48th Annual International Symposium on Computer Architecture (ISCA), 1–14.
- Jouppi, N., Kurian, G., Li, S., Ma, P., Nagarajan, R., Nai, L., et al., 2023. TPU v4: An Optically Reconfigurable Supercomputer for Machine Learning with Hardware Support for Embeddings(TPU v4:提供嵌入硬件支持、可光学重配置的机器学习超级计算机). Proceedings of the 50th Annual International Symposium on Computer Architecture, 1–14.
- Jumper, J., Evans, R., Pritzel, A., Green, T., Figurnov, M., Ronneberger, O., et al., 2021. Highly Accurate Protein Structure Prediction with AlphaFold(使用 AlphaFold 高精度预测蛋白质结构). Nature 596(7873), 583–589.
- Krizhevsky, A., Sutskever, I., Hinton, G.E., 2012. ImageNet Classification with Deep Convolutional Neural Networks(使用深度卷积神经网络进行 ImageNet 分类). Advances in Neural Information Processing Systems 25.
- Paszke, A., Gross, S., Massa, F., Lerer, A., Bradbury, J., Chanan, G., et al., 2019. PyTorch: An Imperative Style, High-Performance Deep Learning Library(PyTorch:命令式风格的高性能深度学习库). Advances in Neural Information Processing Systems 32.
- Patterson, D., Gonzalez, J., Hölzle, U., Le, Q., Liang, C., Munguia, L.M., et al., 2022. The Carbon Footprint of Machine Learning Training Will Plateau, Then Shrink(机器学习训练的碳足迹将先趋于平稳,再逐步缩小). Computer 55(7), 18–28.
- Raihan, M.A., Goli, N., Aamodt, T.M., 2019. Modeling Deep Learning Accelerator Enabled GPUs(支持深度学习加速器的 GPU 建模). 2019 IEEE International Symposium on Performance Analysis of Systems and Software (ISPASS). IEEE, 79–92.
- Rombach, R., Blattmann, A., Lorenz, D., Esser, P., Ommer, B., 2022. High-Resolution Image Synthesis with Latent Diffusion Models(使用潜在扩散模型合成高分辨率图像). Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 10684–10695.
- So, D., Le, Q., Liang, C., 2019. The Evolved Transformer(进化得到的 Transformer). International Conference on Machine Learning, 5877–5886.
- So, D., Mańke, W., Liu, H., Dai, Z., Shazeer, N., Le, Q.V., 2021. Searching for Efficient Transformers for Language Modeling(搜索用于语言建模的高效 Transformer). Advances in Neural Information Processing Systems 34, 6010–6022.
- Strubell, E., Ganesh, A., McCallum, A., 2019. Energy and Policy Considerations for Deep Learning in NLP(自然语言处理深度学习的能源与政策考量). Annual Meeting of the Association for Computational Linguistics.
- Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A.N., et al., 2017. Attention Is All You Need(注意力机制即可满足所需). Advances in Neural Information Processing Systems 30.
- Zhao, M., Agarwal, N., Basant, A., Gedik, B., Pan, S., Ozdal, M., et al., 2022. Understanding Data Storage and Ingestion for Large-Scale Deep Recommendation Model Training: Industrial Product(理解大规模深度推荐模型训练的数据存储与摄取:工业产品). Proceedings of the 49th Annual International Symposium on Computer Architecture, 1042–1057.
A 指令集原理
| 指令 | 含义 |
|---|---|
A n | 将存储单元 n 中的数加到累加器中。 |
E n | 若累加器中的数大于或等于零,接下来执行存储单元 n 中的指令;否则顺序执行。 |
Z | 停机并敲响警铃。 |
——Wilkes 与 Renwick,选自 EDSAC 的 18 条机器指令列表(1949)
A.1 引言
本附录集中讨论指令集体系结构,也就是程序员或编译器作者能够看到的计算机部分。对本书读者而言,这些内容大多应当是复习;将其收录于此,是为了提供背景知识。
本附录介绍指令集设计者可选择的多种设计方案,重点讨论四个方面。首先,对指令集的不同方案进行分类,并定性评价各种方法的优缺点。其次,给出并分析一些基本不依赖特定指令集的测量结果。再次,讨论语言与编译器,以及它们对指令集体系结构的影响。最后,“融会贯通”一节展示这些思想如何体现在典型的 RISC 体系结构——RISC-V 指令集中。附录以指令集设计中的谬误与陷阱收尾。
为进一步说明这些原理,并与 RISC-V 对照,附录 K 还介绍四种其他通用 RISC 体系结构(MIPS、Power ISA、SPARC 和 Armv8)、四种嵌入式 RISC 处理器(ARM Thumb2、RISC-V Compressed、microMIPS),以及三种较早的体系结构(80x86、IBM 360/370 和 VAX)。1 在讨论体系结构分类之前,需要先说明指令集测量的一些问题。
本附录将考察多种体系结构测量结果。显然,结果取决于所测量的程序和使用的编译器。不能将这些结果视为绝对值;换用不同编译器或另一组程序,可能得到不同数据。我们认为,本附录中的测量能够合理地反映一类典型应用的情况。许多结果只使用少量基准程序,以便清楚展示数据和程序之间的差异。设计新计算机的体系结构时,应当在决策前分析规模大得多的程序集合。这里给出的通常是动态测量:某个事件的频率,按它在被测程序执行过程中实际发生的次数加权。
开始讨论一般原理之前,先回顾第 1 章的三类应用。桌面计算强调整数和浮点数据类型程序的性能,很少关注程序大小。例如,五代 SPEC 基准测试都从未报告代码大小。当今服务器主要用于数据库、文件服务、Web 应用,以及面向大量用户的一些分时应用。因此,浮点性能的重要性远低于整数和字符串性能;但几乎每一种服务器处理器仍然包含浮点指令。个人移动设备和嵌入式应用重视成本与能耗,因而代码大小非常重要:更少的存储器既更便宜,也更省电。为降低芯片成本,某些指令类别(例如浮点指令)可能是可选的;还可能采用专为节省存储空间而设计的压缩指令集版本。
尽管如此,这三类应用的指令集仍非常相似。事实上,与这里重点介绍的 RISC-V 类似的体系结构,已经成功用于桌面、服务器和嵌入式应用。
一种与 RISC 十分不同、却同样成功的体系结构是 80x86(见附录 K)。令人意外的是,它的成功未必否定 RISC 指令集的优点。与 PC 软件保持二进制兼容的商业重要性,加上Moore 定律提供的大量晶体管,促使 Intel 在外部支持 80x86 指令集,同时在内部采用 RISC 指令集。近期的 80x86 微处理器,包括过去十年制造的全部 Intel Core 微处理器,都通过硬件将 80x86 指令转换成类似 RISC 的指令,然后在芯片内部执行转换后的操作。这样既向程序员维持了 80x86 体系结构的表象,又允许计算机设计者实现具有高性能的 RISC 风格处理器。不过,80x86 这样的复杂指令集仍存在严重缺点;我们将在结束语中进一步讨论。
有了这些背景,下面开始探讨指令集体系结构的分类。
译注:原文称“四种”,但括号内实际只列出三个名称。 ↩︎
A.2 指令集体系结构的分类
处理器内部存储的类型是最基本的区别,因此本节集中讨论体系结构这一部分的不同选择。主要方案是栈、累加器或一组寄存器。操作数可以显式指定,也可以隐含指定:栈体系结构的操作数隐含在栈顶;累加器体系结构则隐含地以累加器作为一个操作数。通用寄存器体系结构只使用显式操作数,即寄存器或存储单元。图 A.1 给出这些体系结构的框图,图 A.2 展示代码序列 在这三类指令集中通常如何表示。根据体系结构类别和具体指令的选择,显式操作数可以直接从存储器访问,也可能需要先装入临时存储位置。
这些图说明,寄存器计算机实际上分为两类。一类允许任意指令在执行时访问存储器,称为寄存器—存储器体系结构;另一类只允许加载和存储指令访问存储器,称为加载—存储体系结构。第三类把所有操作数放在存储器中,称为存储器—存储器体系结构,但如今销售的计算机中已经没有这一类。有些指令集体系结构的寄存器多于单一累加器,但限制了这些专用寄存器的用途;这种体系结构有时称为扩展累加器计算机或专用寄存器计算机。
虽然早期计算机大多采用栈或累加器体系结构,但 1980 年之后设计的几乎所有新体系结构,都采用加载—存储寄存器体系结构。通用寄存器(general-purpose register,GPR)计算机兴起,主要有两个原因。第一,寄存器与处理器内其他存储形式一样,速度比存储器快。第二,对于编译器而言,寄存器比其他内部存储形式更容易高效利用。例如,在寄存器计算机上,计算表达式 时,可以按任意次序进行乘法;考虑到操作数的位置或流水线因素,这种自由可能提高效率(见第 3 章)。但在栈计算机中,由于操作数隐藏在栈内,硬件只能按一种次序计算表达式,而且可能需要多次装入同一个操作数。
图内术语:Processor=处理器;Memory=存储器;Stack=栈;Accumulator=累加器;Register-memory=寄存器—存储器;Register-register/load-store=寄存器—寄存器/加载—存储。
| 栈 | 累加器 | 寄存器(寄存器—存储器) | 寄存器(加载—存储) |
|---|---|---|---|
Push A | Load A | Load R1,A | Load R1,A |
Push B | Add B | Add R3,R1,B | Load R2,B |
Add | Store C | Store R3,C | Add R3,R1,R2 |
Pop C | Store R3,C |
更重要的是,寄存器可以保存变量。将变量分配到寄存器之后,存储器流量减少,程序执行加快(因为寄存器比存储器快),代码密度也提高(因为指定一个寄存器所需的位数比指定一个存储单元少)。
A.8 节将说明,编译器作者希望所有寄存器地位相同,且不保留作特定用途。较早的计算机把一些寄存器分配给专门用途,违背了这一期望,实质上减少了通用寄存器的数量。如果真正通用的寄存器太少,尝试将变量分配到寄存器就得不偿失;编译器反而会把所有尚未指定用途的寄存器都留给表达式求值。
多少寄存器才足够?答案当然取决于编译器的有效性。多数编译器会留出一些寄存器计算表达式,用一些寄存器传递参数,再将其余寄存器分配给变量。现代编译技术能够有效使用更多寄存器,促使较新的体系结构增加了寄存器数量。
GPR 体系结构可按两项主要指令集特征分类。这两项都与典型算术或逻辑指令(ALU 指令)的操作数有关。第一项是 ALU 指令采用两个还是三个操作数。三操作数格式包含一个结果操作数和两个源操作数;两操作数格式则让其中一个操作数同时充当源和结果。第二项是 ALU 指令中有多少个操作数可以是存储器地址。典型 ALU 指令支持的存储器操作数可以从零个到三个。图 A.3 列出这两个属性的组合及相应计算机实例。虽然共有七种可能组合,但其中三种足以对几乎所有现有计算机分类。如前所述,它们是加载—存储(也称寄存器—寄存器)、寄存器—存储器,以及存储器—存储器。
| 存储器地址数 | 允许的最大操作数总数 | 体系结构类型 | 实例 |
|---|---|---|---|
| 0 | 3 | 加载—存储 | ARM、MIPS、PowerPC、SPARC、RISC-V |
| 1 | 2 | 寄存器—存储器 | IBM 360/370、Intel 80x86、Motorola 68000、TI TMS320C54x |
| 2 | 2 | 存储器—存储器 | VAX(也有三操作数格式) |
| 3 | 3 | 存储器—存储器 | VAX(也有两操作数格式) |
图 A.4 给出各方案的优缺点。它们当然不是绝对结论,而是定性描述;实际影响取决于编译器与实现策略。即使 GPR 计算机提供存储器—存储器操作,编译器也完全可以忽略这些操作,将它当作加载—存储计算机使用。体系结构最普遍的影响之一,是改变指令编码以及完成一个任务所需的指令数。附录 C 和第 3 章将讨论这些体系结构方案如何影响具体实现方法。
| 类型 | 优点 | 缺点 |
|---|---|---|
| 寄存器—寄存器 (0, 3) | 指令编码简单、定长;代码生成模型简单;各指令执行所需时钟周期数相近(见附录 C)。 | 相比在指令中访问存储器的体系结构,指令数更多。指令数较多、指令密度较低,使程序更大,可能影响指令缓存。 |
| 寄存器—存储器 (1, 2) | 可以直接访问数据,无需先执行单独的加载指令;指令格式通常易于编码,代码密度较高。 | 操作数地位不对等,因为二元运算会破坏一个源操作数。每条指令都要编码寄存器号和存储器地址,可能限制寄存器数。每条指令的周期数随操作数位置而异。 |
| 存储器—存储器 (2, 2) 或 (3, 3) | 最紧凑;无需占用寄存器保存临时值。 | 指令大小差异很大,尤其是三操作数指令;每条指令完成的工作量也差异很大。存储器访问造成瓶颈。(如今已不使用。) |
小结:指令集体系结构的分类
本节及 A.3–A.8 各节末尾,将总结一种新指令集体系结构应当具备的特征,为 A.9 节介绍的 RISC-V 体系结构奠定基础。从本节可以明确看出,新设计应采用通用寄存器。结合图 A.4 与附录 C 对流水线的讨论,可以进一步预期,它应当是一种采用加载—存储方式的通用寄存器体系结构。
讨论了体系结构类别,接下来考察操作数寻址。
A.3 存储器寻址
无论采用加载—存储体系结构,还是允许任意操作数访问存储器,都必须规定如何解释存储器地址,以及如何指定这些地址。这里给出的测量大多不依赖具体计算机,但并非完全如此。有些测量会明显受到编译技术的影响。考虑到编译技术的关键作用,这些测量都使用优化编译器。
存储器地址的解释
应当如何解释一个存储器地址?换言之,给定地址和长度,会访问什么对象?本书讨论的所有指令集都按字节寻址,并提供字节(8 位)、半字(16 位)和字(32 位)访问。大多数计算机还提供双字(64 位)访问。
对于较大对象内部的字节次序,有两种约定。小端序(Little Endian)将地址为“x…x000”的字节放在双字的最低有效位置,也就是“小端”。从最高有效位置到最低有效位置,字节编号为:
大端序(Big Endian)将地址为“x…x000”的字节放在双字的最高有效位置,也就是“大端”。字节编号为:
在同一台计算机内部,字节序通常不易察觉;只有同时以不同粒度(例如既按字又按字节)访问同一存储位置的程序,才能看出差异。然而,在不同字节序的计算机之间交换数据时,它就成为问题。比较字符串时,小端序也与字的通常排列次序不一致;字符串在寄存器里会呈现为“SDRAWKCAB”,即 BACKWARDS 的倒序。
第二个存储器问题是,许多计算机要求大于一个字节的对象访问必须对齐。在字节地址 处访问大小为 字节的对象,若 ,就称该访问对齐。图 A.5 展示哪些地址上的访问是对齐或非对齐的。
为什么要在计算机中施加对齐限制?非对齐会增加硬件复杂性,因为存储器通常按字或双字的整数倍边界组织。因此,一次非对齐访存可能需要多次对齐访存才能完成。即使计算机允许非对齐访问,使用对齐访问的程序仍会执行得更快。
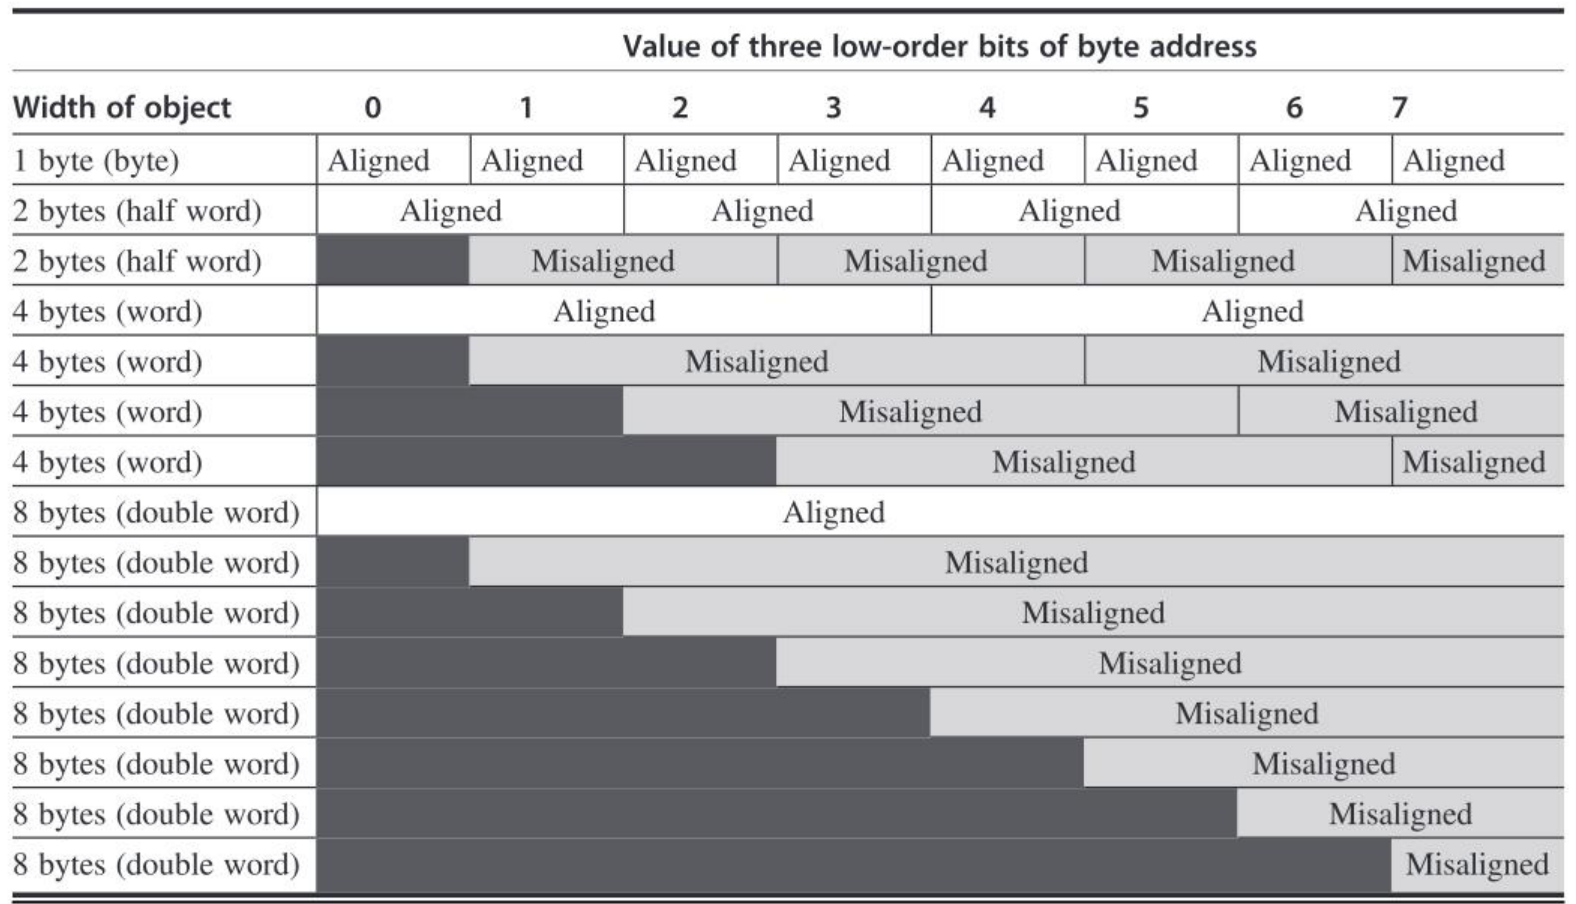
图内术语:Width of object=对象宽度;Value of three low-order bits of byte address=字节地址最低 3 位的值;Aligned=对齐;Misaligned=非对齐。byte、half word、word、double word 分别为字节、半字、字、双字。
即使数据已经对齐,支持字节、半字和字访问,也需要对齐网络,将它们在 64 位寄存器中对齐。例如,假定在图 A.5 中,从地址最低 3 位的值为 4 的位置读取一个字节,就需要右移 3 字节,将这个字节放到 64 位寄存器的适当位置。根据具体指令,计算机可能还需要对该数值进行符号扩展。存储操作比较容易:只需改变存储器中被寻址的那些字节。在某些计算机中,字节、半字或字操作不会影响寄存器的高位部分。本书讨论的计算机都允许按字节、半字和字访问存储器,但只有 IBM 360/370、Intel 80x86 和 VAX,支持对宽度小于整个寄存器的寄存器操作数执行 ALU 运算。
讨论了存储器地址的不同解释之后,接下来研究指令指定地址的方式,即寻址方式。
寻址方式
给定地址后,我们已经知道要访问存储器中的哪些字节。本小节考察体系结构如何指定待访问对象的地址。寻址方式不仅可以指定存储器位置,也可以指定常数和寄存器。使用存储器位置时,寻址方式所确定的实际地址称为有效地址。
图 A.6 列出近代计算机中出现过的全部数据寻址方式。立即数或字面量通常被视为存储器寻址方式,尽管所访问的值实际上位于指令流中;寄存器往往单独列出,因为它们通常没有存储器地址。我们将依赖程序计数器的方式单列,称为 PC 相对寻址。它主要用于在控制转移指令中指定代码地址,将在 A.6 节讨论。
| 寻址方式 | 指令示例 | 含义 | 用途 |
|---|---|---|---|
| 寄存器 | Add R4,R3 | Regs[R4] ← Regs[R4] + Regs[R3] | 值已经位于寄存器中。 |
| 立即数 | Add R4,3 | Regs[R4] ← Regs[R4] + 3 | 使用常数。 |
| 位移 | Add R4,100(R1) | Regs[R4] ← Regs[R4] + Mem[100 + Regs[R1]] | 访问局部变量;也可模拟寄存器间接寻址和直接寻址。 |
| 寄存器间接 | Add R4,(R1) | Regs[R4] ← Regs[R4] + Mem[Regs[R1]] | 通过指针或计算出的地址访问。 |
| 变址 | Add R3,(R1+R2) | Regs[R3] ← Regs[R3] + Mem[Regs[R1] + Regs[R2]] | 有时用于数组寻址:R1 为数组基址,R2 为索引偏移。 |
| 直接/绝对 | Add R1,(1001) | Regs[R1] ← Regs[R1] + Mem[1001] | 有时用于访问静态数据;地址常数可能需要较大范围。 |
| 存储器间接 | Add R1,@(R3) | Regs[R1] ← Regs[R1] + Mem[Mem[Regs[R3]]] | 若 R3 保存指针 p 的地址,则此方式得到 *p。 |
| 自动递增 | Add R1,(R2)+ | Regs[R1] ← Regs[R1] + Mem[Regs[R2]];Regs[R2] ← Regs[R2] + d | 在循环中遍历数组。R2 指向数组起点;每次访问后,按元素大小 d 递增 R2。 |
| 自动递减 | Add R1,-(R2) | Regs[R2] ← Regs[R2] - d;Regs[R1] ← Regs[R1] + Mem[Regs[R2]] | 用途与自动递增相同;自动递减/递增也可分别充当 push/pop,以实现栈。 |
| 比例变址(scaled) | Add R1,100(R2)[R3] | Regs[R1] ← Regs[R1] + Mem[100 + Regs[R2] + Regs[R3] * d] | 数组变址;有些计算机允许将其用于任何变址寻址方式。 |
图 A.6 使用寻址方式最常见的名称,尽管不同体系结构的名称可能不同。本图及全书采用 C 语言的一种扩展作为硬件描述记法。此图只有一个不属于 C 的特征:用左箭头 ← 表示赋值。我们还用数组 Mem 表示主存,用数组 Regs 表示寄存器。因此,Mem[Regs[R1]] 表示以寄存器 1(R1)内容为地址的存储单元中的内容。后面还将引入用于访问和传送不足一个字的数据的扩展。
寻址方式可以显著减少指令数,但也会增加计算机实现的复杂性,并可能提高实现这些方式的计算机的平均每条指令周期数(CPI)。因此,了解各种寻址方式的使用情况,对决定体系结构应包含哪些方式十分重要。
图 A.7 给出 VAX 体系结构上三个程序的寻址方式使用情况。本附录有少数测量采用较早的 VAX,因为它的寻址方式最丰富,对存储器寻址的限制也最少。例如,原书 A-9 页的图 A.6 展示了 VAX 支持的全部方式。不过,本附录大多数测量采用较新的寄存器—寄存器体系结构,以说明程序如何使用当代计算机的指令集。
图内术语:Memory indirect=存储器间接;Scaled=比例变址;Register indirect=寄存器间接;Immediate=立即数;Displacement=位移;Frequency of the addressing mode=寻址方式使用频率。各组三条柱依次为 TeX、spice、gcc。
如图 A.7 所示,位移寻址与立即数寻址占主导地位。下面考察这两种常用方式的一些性质。
位移寻址
采用位移寻址时,首要问题是实际使用的位移范围。了解各种位移长度的使用情况,才能决定支持哪些长度。位移字段的大小直接影响指令长度,因此这一选择很重要。图 A.8 展示在加载—存储体系结构上,使用我们的基准程序测量数据访问得到的结果。分支偏移将在 A.6 节讨论。数据访问模式与分支不同,将它们混合分析意义不大;不过在实际设计中,为简化实现,往往将立即数字段设为相同宽度。
图内术语:Percentage of displacement=位移占比;Number of bits of displacement=位移位数;Integer average=整数程序平均值;Floating-point average=浮点程序平均值。
立即数或字面量寻址
立即数可用于算术运算、比较(主要供分支使用),以及需要将常数放入寄存器的传送操作。最后一种情形包括代码中直接写出的常数(通常较小),以及地址常数(通常较大)。设计立即数支持时,需要知道所有操作是否都应支持立即数,还是只需部分操作支持。图 A.9 给出指令集中一般整数、浮点操作类别的立即数使用频率。
另一项重要测量是立即数的值域。与位移一样,立即数大小会影响指令长度。图 A.10 显示,小立即数使用最多;但也会用到大立即数,很可能主要用于地址计算。
图内术语:Loads=加载;ALU operations=ALU 操作;All instructions=全部指令;Floating-point average=浮点程序平均值,Integer average=整数程序平均值。三组数值依次为浮点/整数 22%/23%、19%/25%、16%/21%。
小结:存储器寻址
首先,由于使用广泛,一种新的体系结构至少应支持位移、立即数和寄存器间接寻址。图 A.7 表明,这三种方式占测量中全部寻址方式的 75%–99%。其次,位移寻址的地址字段至少应有 12–16 位,因为图 A.8 的图注表明,这些长度能覆盖 75%–99% 的位移。最后,立即数字段至少应有 8–16 位。这一说法未得到所引用图注的支持。
图内术语:Percentage of immediates=立即数占比;Number of bits needed for immediate=立即数所需位数;Floating-point average=浮点程序平均值;Integer average=整数程序平均值。
讨论了指令集类别并选定寄存器—寄存器体系结构,又给出数据寻址方式的建议之后,下一节将讨论数据的大小与含义。
A.4 操作数的类型与大小
操作数类型如何指定?最常用的方法,是通过操作码中的编码指出操作数类型。另一种方法是给数据附加由硬件解释的标记;标记说明类型,系统再据此选择操作。不过,带类型标记数据的计算机,如今只能在计算机博物馆中找到。
先看桌面与服务器体系结构。通常,操作数类型——整数、单精度浮点数、字符等——实际上也确定了它的大小。常见类型包括字符(8 位)、半字(16 位)、字(32 位)、单精度浮点数(也是 1 个字)和双精度浮点数(2 个字)。整数几乎一律采用二进制补码表示。字符通常采用 ASCII,但随着计算机的国际化,Java 使用的 16 位 Unicode 日渐普及。 直到 20 世纪 80 年代初,多数计算机厂商仍自行选择浮点表示格式;此后几乎全部计算机都遵循同一标准——IEEE 754。不过,近期某些专用处理器已经不再坚持这种精度水平。附录 J 将详细讨论 IEEE 浮点标准。
有些体系结构提供字符串操作,但通常较为有限,并将字符串中的每个字节视为一个字符。典型支持包括字符串比较与传送。
为支持商业应用,一些体系结构提供十进制格式,通常称为压缩十进制(packed decimal)或二进制编码十进制(binary-coded decimal,BCD):用 4 位编码 0–9,每字节压入两位十进制数字。数字字符串有时称为非压缩十进制;通常还提供称为压缩和展开(packing/unpacking)的操作,在两种表示之间转换。
使用十进制操作数的一个原因,是获得与十进制数精确一致的结果,因为有些十进制小数没有精确的二进制表示。例如, 是简单的十进制小数,却需要无限循环的二进制位表示:。因此,十进制下精确的计算,在二进制下可能只是近似值,这对金融交易可能构成问题。(更精确的算术讨论见附录 J。)
SPEC 基准测试使用字节或字符、半字(短整数)、字(整数和单精度浮点数)、双字(长整数)及浮点数据类型。图 A.11 给出这些程序访问存储器对象时,按对象大小统计的动态分布。不同类型的访问频率,有助于确定哪些类型最需要高效支持。计算机是否应采用 64 位访问通路,还是用两个周期访问一个双字就已足够?前面已经说明,字节访问需要对齐网络:直接支持字节操作到底有多重要?图 A.11 通过存储器引用考察了被访问的数据类型。
图内术语与数值:Byte=字节(8 位),Half word=半字(16 位),Word=字(32 位),Double word=双字(64 位)。依次按字节、半字、字、双字排列,浮点程序平均值为 1%、0%、29%、70%;整数程序平均值为 10%、5%、26%、59%。
某些体系结构允许按字节或半字访问寄存器中的对象,但这种访问很少。在这些程序的 VAX 测量中,它不超过寄存器引用的 12%,约占全部操作数访问的 6%。
A.5 指令集中的操作
多数指令集体系结构支持的操作,可以按图 A.12 分类。对各种体系结构都适用的一条经验法则是:执行最频繁的通常是指令集中的简单操作。例如,在流行的 Intel 80x86 上运行一组整数程序时,图 A.13 中的 10 条简单指令占全部执行指令的 96%。因此,实现这些指令时应确保它们足够快,因为它们就是最常见的情形。
如前所述,图 A.13 的指令存在于面向各种应用——桌面、服务器、嵌入式——的每一种计算机中。图 A.12 中各类操作的差异,主要取决于指令集包含哪些数据类型。
| 操作类型 | 示例 |
|---|---|
| 算术与逻辑 | 整数算术、逻辑操作:加、减、与、或、乘、除 |
| 数据传送 | 加载、存储;在支持存储器寻址的计算机上为 move 指令 |
| 控制 | 分支、跳转、过程调用与返回、陷阱 |
| 系统 | 操作系统调用、虚拟存储器管理指令 |
| 浮点 | 浮点加法、乘法、除法、比较 |
| 十进制 | 十进制加法、乘法、十进制数与字符转换 |
| 字符串 | 字符串传送、比较、搜索 |
| 图形 | 像素与顶点操作、压缩/解压缩操作 |
| 排名 | 80x86 指令 | 整数程序平均占比(占执行指令总数) |
|---|---|---|
| 1 | 加载(Load) | 22% |
| 2 | 条件分支(Conditional branch) | 20% |
| 3 | 比较(Compare) | 16% |
| 4 | 存储(Store) | 12% |
| 5 | 加法(Add) | 8% |
| 6 | 按位与(And) | 6% |
| 7 | 减法(Sub) | 5% |
| 8 | 寄存器间传送(Move register-register) | 4% |
| 9 | 调用(Call) | 1% |
| 10 | 返回(Return) | 1% |
| 总计 | 96% |
译注: 原表所列已舍入百分比相加为 95%,原表总计与图注均为 96%。
A.6 控制流指令
分支与跳转行为的测量,较少依赖其他测量及具体应用,因此下面考察控制流指令的使用情况;它们与前几节的操作没有多少共同之处。
对于改变控制流的指令,术语并不统一。20 世纪 50 年代通常称为 transfer;从 1960 年起开始使用 branch,后来又出现其他名称。本书将无条件改变控制流的操作称为跳转(jump),将有条件改变控制流的操作称为分支(branch)。
控制流改变可分为四类:
- 条件分支;
- 跳转;
- 过程调用;
- 过程返回。
我们希望了解这些事件的相对频率,因为各事件不同,可能采用不同指令,也可能表现出不同行为。图 A.14 给出加载—存储计算机运行我们的基准程序时,各类控制流指令的频率。
图内术语:Call/return=调用/返回;Jump=跳转;Conditional branch=条件分支;Frequency of branch instructions=分支指令频率。浮点/整数程序平均值依次为 8%/19%、10%/6%、82%/75%。
控制流指令的寻址方式
控制流指令必须指定目标地址。绝大多数情况下,目标在指令中显式指定;过程返回是主要例外,因为返回目标在编译时未知。最常见的指定方式,是给出一个与程序计数器(PC)相加的位移,这类指令称为 PC 相对控制流指令。PC 相对分支或跳转有优势:目标通常距离当前指令很近,用相对于当前 PC 的位置表示,需要的位数更少。此外,PC 相对寻址还能让代码的运行不依赖装入位置。这种位置无关性可省去程序链接时的一部分工作,对于执行期间动态链接的程序也很有用。
要实现编译时目标未知的返回或间接跳转,就需要 PC 相对寻址以外的方法。必须能够动态指定目标,使它在运行时改变。最简单的方法,是指定一个包含目标地址的寄存器;也可以允许跳转使用任意寻址方式提供目标地址。
这种寄存器间接跳转还支持四项重要功能:
- 多数编程语言中的
case或switch语句,在多个选项之间选择。 - C++、Java 等面向对象语言中的虚函数或方法,根据参数类型调用不同例程。
- C、C++ 等语言中的高阶函数或函数指针,允许将函数作为参数传递,带来某些类似面向对象编程的能力。
- 动态共享库:只有程序实际调用时,才在运行期间装入和链接库,而非在运行前静态装入和链接。
以上四种情况下,目标地址在编译时都未知,因此通常先从存储器装入寄存器,再执行寄存器间接跳转。
分支通常通过 PC 相对寻址指定目标,因此一个重要问题是:目标距离分支有多远?了解位移分布,有助于选择支持的分支偏移范围,从而影响指令长度与编码。图 A.15 给出以指令条数表示的 PC 相对分支位移分布。约 75% 的分支是前向分支。
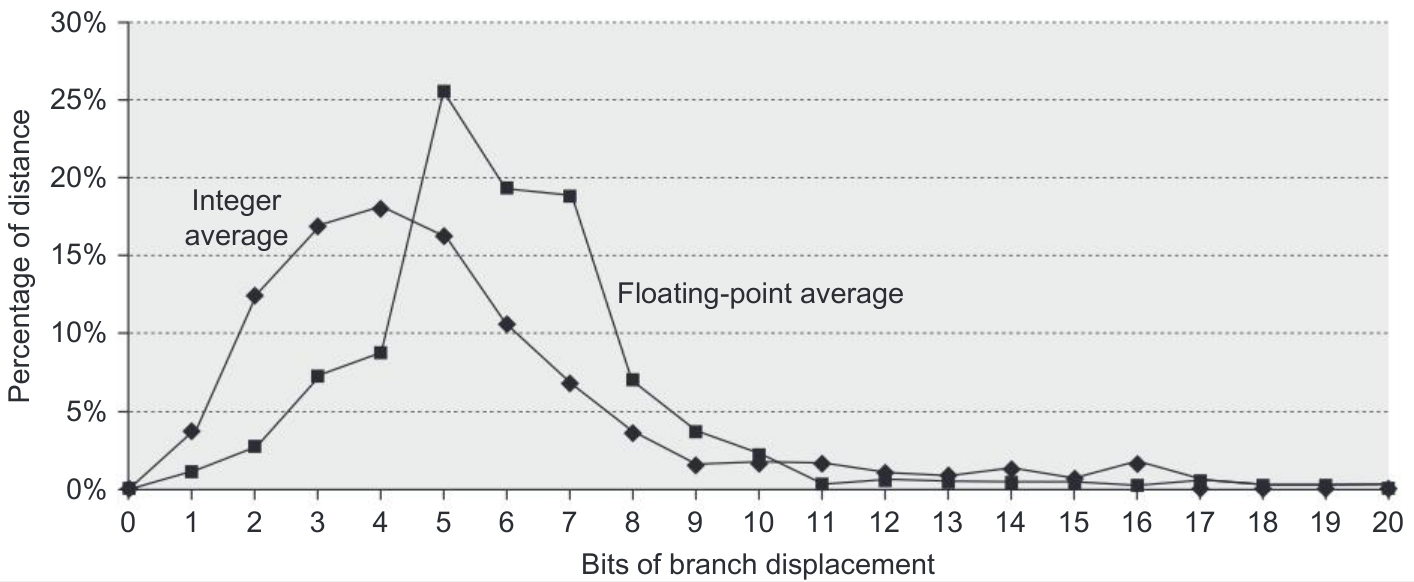
图内术语:Percentage of distance=各距离占比;Bits of branch displacement=分支位移位数;Integer average=整数程序平均值;Floating-point average=浮点程序平均值。
条件分支的选择
多数控制流改变属于分支,因此如何指定分支条件是一项重要决定。图 A.16 给出目前使用的三种主要方法及其优缺点。
| 名称 | 实例 | 条件测试方法 | 优点 | 缺点 |
|---|---|---|---|---|
| 条件码(CC) | 80x86、ARM、PowerPC、SPARC、SuperH | 测试 ALU 操作设置的专用位;是否设置也可能由程序控制。 | 有时可顺便得到条件,无需额外代价。 | 条件码构成额外状态;由于它在指令与分支之间传递信息,会限制指令重排。 |
| 条件寄存器/有限比较 | Alpha、MIPS | 用简单比较(相等或与零比较)的结果,测试任意寄存器。 | 简单。 | 比较能力有限,可能影响关键路径;一般条件可能需要额外比较。 |
| 比较并分支 | PA-RISC、VAX、RISC-V | 比较是分支的一部分,允许较通用的比较,如大于、小于。 | 一个分支只需一条指令,而非两条。 | 可能决定分支指令的关键路径。 |
分支一个很显著的特点,是大量比较都是简单测试,其中许多是与零比较。因此,一些体系结构将它们作为特殊情况处理,尤其是在采用比较并分支指令时。图 A.17 给出条件分支使用各种比较的频率。
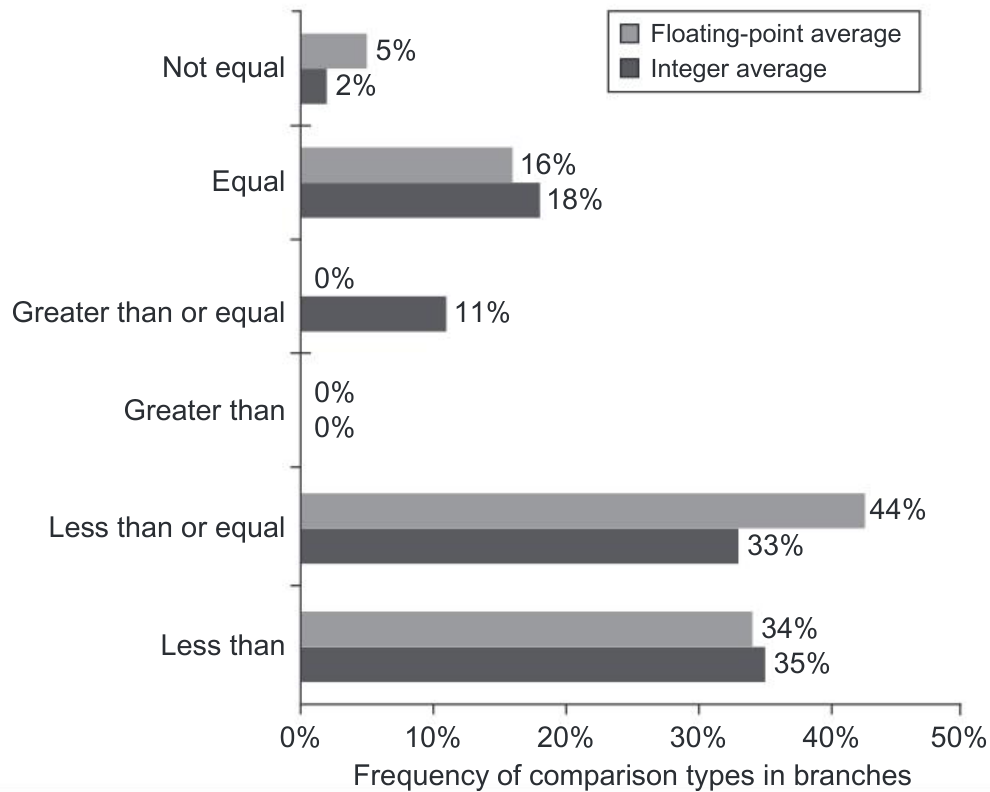
图内术语:Not equal=不等于;Equal=等于;Greater than or equal=大于或等于;Greater than=大于;Less than or equal=小于或等于;Less than=小于。依次对应的浮点/整数程序平均值为 5%/2%、16%/18%、0%/11%、0%/0%、44%/33%、34%/35%。横轴为分支中各比较类型的频率。
过程调用的选择
过程调用与返回包含控制转移,也可能保存部分状态;至少要将返回地址保存在某处,有时放在专用链接寄存器中,也可以直接使用 GPR。一些较早的体系结构提供一次保存许多寄存器的机制,而较新体系结构要求编译器为每一个需要保存、恢复的寄存器生成存储和加载指令。
保存寄存器有两种基本约定:在调用处保存,或在被调用过程内部保存。调用者保存(caller saving)要求调用过程保存调用后还要使用的寄存器,被调用过程无需顾虑它们;被调用者保存(callee saving)则相反,被调用过程保存自己准备使用的寄存器,使调用者不受约束。有时,由于两个过程访问全局可见变量的方式,必须采用调用者保存。例如,过程 P1 调用 P2,两个过程都会操作全局变量 x。若 P1 将 x 分配到寄存器,就必须在调用 P2 前,将 x 保存到 P2 知道的位置。独立编译的可能性,会增加编译器判断被调用过程是否可能访问这些寄存器变量的难度。假定 P2 本身不访问 x,但可能调用访问 x 的 P3,而 P2、P3 又是分别编译的。由于这些复杂性,多数编译器会保守地在调用者一侧保存任何可能在调用期间被访问的变量。
两种约定都可用时,有些程序采用被调用者保存更好,另一些采用调用者保存更好。因此,当今多数实际系统混合使用两种机制。应用二进制接口(ABI)规定这类约定,包括哪些寄存器由调用者保存、哪些由被调用者保存。本附录后面将考察,复杂的自动寄存器保存指令为什么可能不适合编译器的需要。
小结:控制流指令
控制流指令是执行最频繁的指令之一。条件分支虽有多种选择,但一种新体系结构的分支寻址,应当能够到达分支前后数百条指令范围内的目标。这意味着 PC 相对分支位移至少需要 8 位。跳转指令还应支持寄存器间接和 PC 相对寻址,以支持返回及当今系统的许多其他功能。
到这里,我们已经从汇编程序员或编译器作者的视角,完成了对指令体系结构的考察。倾向的方案是加载—存储体系结构,支持位移、立即数、寄存器间接寻址;数据包括 8、16、32、64 位整数,以及 32、64 位浮点数;指令包括简单操作、PC 相对条件分支、用于过程调用的跳转并链接指令,以及用于过程返回等用途的寄存器间接跳转。
接下来要选择如何表示这种体系结构,以便硬件高效执行。
A.7 指令集编码
前面各项选择显然会影响指令如何编码为处理器执行的二进制表示。表示方式不仅影响编译后的程序大小,也影响处理器实现:处理器必须对其译码,迅速找出操作及操作数。操作通常由一个称为操作码的字段指定。下面将看到,关键决定是如何将寻址方式与操作一起编码。
这一决定取决于寻址方式的种类,以及操作码与寻址方式之间的独立程度。某些较早的计算机有一至五个操作数,每个操作数又有十种寻址方式(见图 A.6)。面对如此多的组合,通常需要为每个操作数设置独立的地址说明符,说明如何访问它。另一个极端是加载—存储计算机,它们只有一个存储器操作数,而且只有一两种寻址方式;此时显然可将寻址方式直接编码在操作码中。
寄存器数量与寻址方式数量都会显著影响指令大小,因为寄存器字段和寻址方式字段可能在同一条指令中出现多次。实际上,对大多数指令而言,寻址方式与寄存器字段消耗的位数,远多于操作码。编码指令集时,设计者必须权衡几种互相竞争的要求:
- 希望拥有尽可能多的寄存器和寻址方式。
- 寄存器与寻址方式字段的大小,会影响平均指令大小,继而影响平均程序大小。
- 希望指令长度便于流水线实现处理。易于译码的指令有何价值,将在附录 C 与第 3 章讨论。至少,指令应为整数字节长度,而非任意位数。许多桌面与服务器设计者选择定长指令,以牺牲平均代码大小为代价,获得实现上的好处。
图 A.18 展示三种常见编码方案。第一种称为可变编码,因为几乎所有操作都可以使用全部寻址方式;当寻址方式和操作都很多时,它最合适。第二种称为固定编码,将操作与寻址方式合并到操作码中;它通常只有一种指令长度,适合操作和寻址方式都较少的情形。二者的权衡是程序大小与处理器译码难易程度。可变编码力求用尽可能少的位表示程序,但不同指令的长度与所完成工作量可能差异很大。
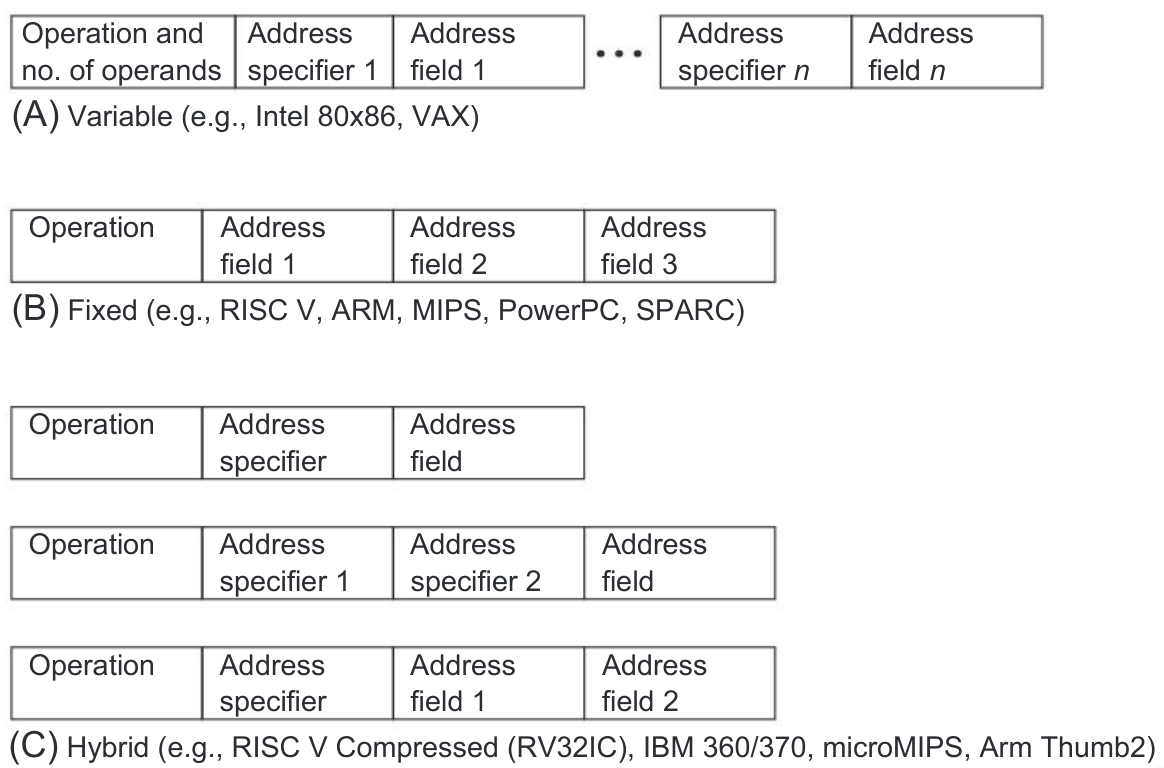
图内术语:Operation and no. of operands=操作及操作数数量;Operation=操作;Address specifier=地址说明符;Address field=地址字段。(A) 变长:Intel 80x86、VAX;(B) 定长:RISC-V、ARM、MIPS、PowerPC、SPARC;(C) 混合:RISC-V Compressed(RV32IC)、IBM 360/370、microMIPS、Arm Thumb2。
看一条 80x86 指令,就能说明可变编码:
add 表示两个操作数的 32 位整数加法,操作码占 1 字节。80x86 的地址说明符占 1 或 2 字节,指定源/目的寄存器 EAX,以及第二个操作数的寻址方式(此处为位移)和基址寄存器 EBX;这一组合用 1 字节即可指定。处于 32 位模式时(见附录 K),地址字段为 1 或 4 字节。由于 1000 大于 ,该指令总长为:
80x86 指令长度在 1–17 字节之间。80x86 程序通常比采用固定格式的 RISC 程序更小(见附录 K)。
在可变与固定这两个极端之间,很自然会想到第三种方案:减小可变体系结构中指令大小与工作量的差异,同时提供多种指令长度以减少代码大小。这就是混合方法,下面将给出实例。
减小 RISC 的代码大小
RISC 开始用于嵌入式应用后,32 位固定格式成为负担,因为这类应用重视成本,也就重视更小的代码。为此,几家厂商提供了新混合版本的 RISC 指令集,同时包含 16 位和 32 位指令。较窄指令支持更少的操作、较小的地址和立即数字段、较少的寄存器,并采用两地址格式,而非经典 RISC 的三地址格式。RISC-V 提供名为 RV32IC 的扩展,C 表示 compressed(压缩)。常见情形,例如较小的立即数,以及源、目的寄存器相同的常用 ALU 操作,都可以编码为 16 位格式。1 附录 K 还给出 ARM Thumb 和 microMIPS 两个实例,它们均声称代码大小最多可缩减 40%。
与这些指令集扩展不同,IBM 直接压缩标准指令集,并加入硬件,在指令缓存未命中、从存储器取指时解压。因此,指令缓存中仍保存完整的 32 位指令,主存、ROM 和磁盘上则保存压缩代码。RV32IC、microMIPS、Thumb2 等压缩格式的优点,是让指令缓存的有效容量仿佛增加约 25%;IBM CodePack 的优点则是编译器不必为不同指令集作修改,而且指令译码仍可保持简单。
CodePack 首先对任意 PowerPC 程序进行行程长度编码压缩,然后将得到的压缩表装入片上一个 2 KB 表中,因此每个程序都有自己的独特编码。压缩后,分支目标不再位于对齐的字边界;为处理这种情况,PowerPC 在存储器中建立哈希表,将压缩地址与未压缩地址相互映射。类似 TLB(见第 2 章),它缓存最近使用的映射,以减少访存次数。IBM 声称,整体性能代价为 10%,换来 35%–40% 的代码缩减。
小结:指令集编码
前几节关于指令集各组成部分的选择,决定设计者是否有条件在可变编码与固定编码之间作选择。若能够选择,重视代码大小甚于性能的设计者会选可变编码,重视性能甚于代码大小的设计者会选固定编码。RISC-V、MIPS 和 ARM 都有同时使用 16 位、32 位指令的扩展;代码大小受严格限制的应用,可以选择 16 位变体。附录 E 给出 13 个体现设计者选择结果的实例。2 附录 C 与第 3 章还将进一步讨论,指令的可变性如何影响处理器性能。
为 A.9 节介绍 RISC-V 指令集体系结构所需的铺垫已经接近完成。不过在此之前,简要考察编译技术及其对程序性质的影响,会很有帮助。
A.8 贯穿各层的问题:编译器的作用
如今,桌面和服务器应用几乎都使用高级语言编程。这意味着,执行的大多数指令来自编译器,指令集体系结构实质上已经成为编译器的目标。在较早时期,这些应用的体系结构决策,往往是为简化汇编编程或服务某个特定计算内核而作出的。编译器会显著影响计算机性能,因此,理解当今编译技术,对于设计并高效实现指令集至关重要。
过去人们曾试图将编译技术及其对硬件性能的影响,与体系结构及其性能隔离;这与当时试图将体系结构和实现分离的想法类似。对于当今桌面编译器和计算机,这种分离基本不可能。体系结构的选择,无论好坏,都会影响所能生成的代码质量,以及为它构建优秀编译器的复杂度。
本节主要从编译器的角度讨论指令集的重要目标。先回顾当今编译器的结构,再讨论编译技术如何影响体系结构决策,以及设计者如何让编译器更容易或更难生成好代码。最后考察编译器与多媒体操作;遗憾的是,它们是编译器作者与体系结构设计者合作不佳的一个例子。
近期编译器的结构
先考察当今优化编译器的样貌。图 A.19 展示近期编译器的结构。
编译器作者的首要目标是正确性:所有有效程序都必须正确编译。第二目标通常是生成代码的执行速度。随后才是编译速度、调试支持、不同语言之间的互操作性等其他目标。编译器的各遍(pass)通常将高层、较抽象的表示,逐步变换为更低层表示,最终到达指令集。这种结构有助于管理变换的复杂性,更容易编写没有错误的编译器。
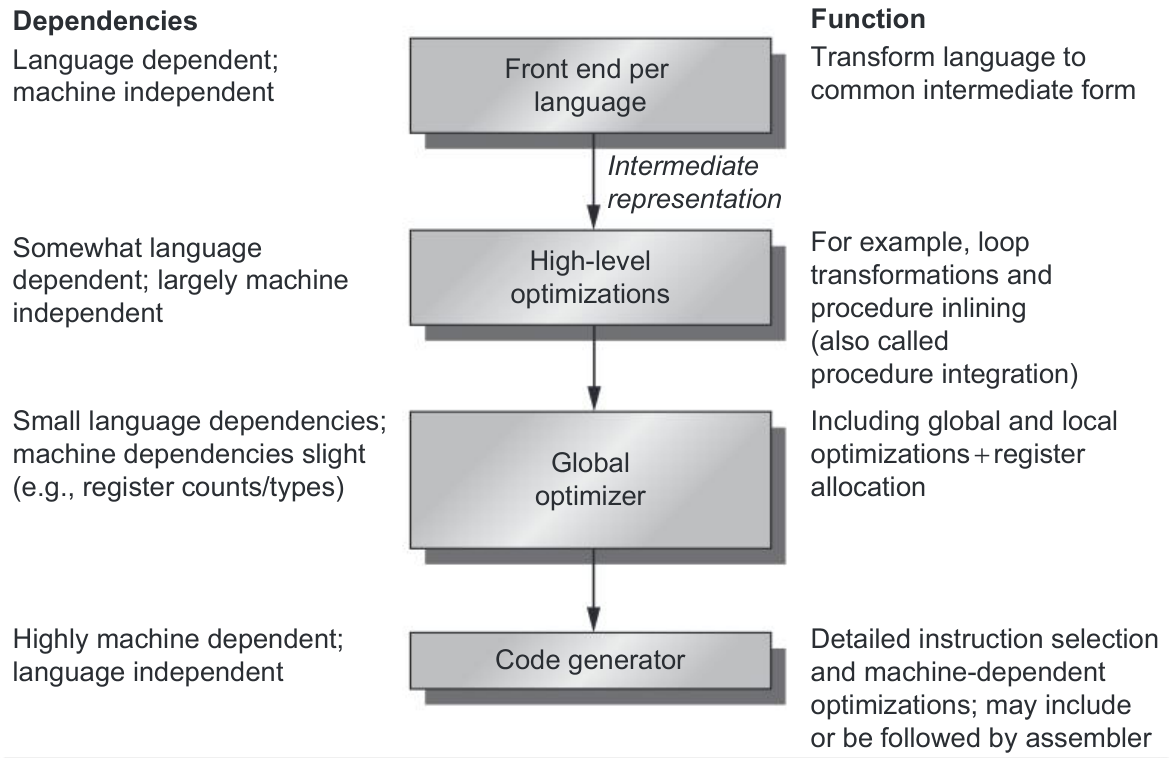
图中的处理顺序及说明如下,前端输出中间表示(Intermediate representation):
| 阶段 | 依赖关系 | 功能 |
|---|---|---|
| 每种语言的前端(Front end per language) | 依赖语言,与机器无关 | 将语言转换为通用中间形式 |
| 高层优化(High-level optimizations) | 部分依赖语言,基本与机器无关 | 例如循环变换与过程内联,也称过程集成(procedure integration) |
| 全局优化器(Global optimizer) | 对语言依赖很少,对机器依赖较小,例如寄存器数量与类型 | 全局及局部优化,加上寄存器分配 |
| 代码生成器(Code generator) | 高度依赖机器,与语言无关 | 具体指令选择与机器相关优化;可能包含汇编器,或随后运行汇编器 |
编写正确编译器的复杂度,是限制优化程度的一大因素。多遍结构虽能降低复杂性,却意味着某些变换必须先于另一些变换进行。图 A.19 表明,有些高层优化发生得很早,当时还不知道最终代码是什么样。作出这类变换后,编译器无法承受重新回顾全部步骤、甚至撤销变换的代价;无论编译时间还是复杂度,都难以接受这种反复。因此,编译器会假定后续阶段能够处理某些问题。例如,通常必须在知道被调用过程的精确大小之前,就决定将哪些调用展开为内联代码。这就是阶段顺序问题(phase-ordering problem)。
这种变换顺序如何与指令集体系结构相互影响?全局公共子表达式消除就是一个好例子。它找到两处计算同一值的表达式,将第一次计算结果保存在临时量中,随后使用这个临时值,省去第二次计算。
要使这种优化真正有价值,临时量必须分配到寄存器。否则,将其存入内存并随后重新加载的代价,可能抵消避免重复计算的收益。事实上,临时量未获分配寄存器时,这种优化有时反而使代码变慢。阶段顺序令问题更加复杂,因为寄存器分配通常在全局优化阶段接近结束、代码生成之前才进行。所以,执行这项优化时,优化器必须假定寄存器分配器会把临时量放入寄存器。
现代编译器的优化可以按变换方式分类:
- 高层优化:经常直接作用于源程序,输出再交给后续优化阶段。
- 局部优化:只在顺序执行的代码片段内部进行;编译领域称这种片段为基本块。
- 全局优化:将局部优化扩展到跨越分支的范围,并引入一组针对循环的变换。
- 寄存器分配:建立寄存器与操作数的对应关系。
- 处理器相关优化:利用特定体系结构知识进行优化。
寄存器分配
寄存器分配既能加快代码,也能使其他优化发挥作用,因此即使不是最重要的优化,也一定是最重要者之一。当今的分配算法基于图着色。基本思想是构造一张图,表示可能分配到寄存器的候选对象,再借助该图分配寄存器。粗略地说,就是使用有限种颜色,使依赖图中任意两个相邻节点都不同色;目标是将活跃变量全部分配到寄存器。一般图着色问题的耗时可能随图规模呈指数增长(NP 完全),但实践中有表现良好的启发式算法,能以接近线性的时间得到接近最优的分配。
当整数变量的全局分配至少有 16 个通用寄存器可用,最好更多,并且浮点数另有寄存器时,图着色的效果最好。寄存器太少时,启发式着色算法容易失败,图着色也就难以奏效。
优化对性能的影响
某些简单优化——局部优化和处理器相关优化——有时难以与代码生成器中的变换明确区分。图 A.20 给出典型优化的例子,最后一列表示这些变换应用于源程序的频率。
| 优化类别与名称 | 说明 | 占优化变换总次数的比例 |
|---|---|---|
| 高层优化 | 在源代码层次或接近该层次进行,与处理器无关 | |
| 过程集成 | 用过程体替换过程调用 | N.M. |
| 局部优化 | 在顺序代码内部进行 | |
| 公共子表达式消除 | 用一次计算代替两次相同计算 | 18% |
| 常量传播 | 若一个变量被赋予常量,则用该常量替换变量的各次出现 | 22% |
| 降低栈高度 | 重排表达式树,尽量减少表达式求值需要的资源 | N.M. |
| 全局优化 | 跨越分支进行 | |
| 全局公共子表达式消除 | 与局部版本相同,但允许跨越分支 | 13% |
| 复制传播 | 将被赋值为 X 的变量 A(即 A=X)的所有出现替换为 X | 11% |
| 代码移动 | 将每次迭代计算相同值的代码移出循环 | 16% |
| 归纳变量消除 | 简化或消除循环内部的数组寻址计算 | 2% |
| 处理器相关优化 | 依赖处理器知识 | |
| 强度削减 | 例如用加法和移位代替乘以常数 | N.M. |
| 流水线调度 | 重排指令,改善流水线性能 | N.M. |
| 分支偏移优化 | 选择能够到达目标的最短分支位移 | N.M. |
图 A.21 展示不同优化对两个程序执行指令数的影响。在这个例子中,优化后的程序比未优化程序少执行约 25%–90% 的指令。这说明,在提出新的指令集特性之前,必须先考察优化后的代码:设计者试图改进的指令,可能已经被编译器完全删除。
图内术语:Branches/calls=分支/调用;Floating-point ALU ops=浮点 ALU 操作;Loads-stores=加载/存储;Integer ALU ops=整数 ALU 操作。横轴为相对未优化版本的执行指令数百分比,纵轴为程序和编译优化等级。等级 0、1、2、3 下,mcf 为 100%、84%、76%、76%;lucas 为 100%、21%、12%、11%。
编译技术对体系结构决策的影响
编译器与高级语言的相互作用,会显著影响程序使用指令集的方式。有两个重要问题:变量如何分配和寻址?适当分配变量需要多少寄存器?回答这些问题,必须考察当今高级语言分配数据的三个独立区域:
- 栈用于分配局部变量,分别在过程调用和返回时增长、缩小。栈中对象以栈指针为基址寻址,主要是标量,即单个变量,而非数组。这里的栈用于保存活动记录,并不是用来求表达式值的栈,因此几乎不会逐值执行入栈、出栈。
- **全局数据区**用于分配静态声明的对象,如全局变量和常量;其中很大比例是数组或其他聚合数据结构。
- 堆用于分配不遵循栈式纪律的动态对象,通过指针访问,通常不是标量。
对栈分配对象,寄存器分配比对全局变量有效得多;对堆对象则基本无法进行,因为它们通过指针访问。某些全局变量和栈变量无法分配寄存器,是因为存在别名:可以通过多种途径引用变量地址,将其放进寄存器会破坏程序语义。对于当今编译技术,大多数堆变量实质上都有别名。
例如,下面的 & 返回变量地址,* 对指针解引用:
跨过对 *p 的赋值时,不能始终将 a 分配在寄存器中,否则生成的代码就不正确。别名会造成严重问题,因为确定指针可能指向哪些对象,往往很困难,甚至不可能。编译器必须保守;有些编译器只要发现某指针可能指向过程内某个局部变量,就不再将该过程中的任何局部变量分配到寄存器。
体系结构设计者如何帮助编译器作者
当今编译器的复杂性并不来自翻译 A=B+C 这样的简单语句。多数程序在局部都很简单,用简单翻译方法即可。复杂性来自程序规模大、全局交互复杂,也来自编译器的结构:它只能一步一步决定哪种代码序列最好。
编译器作者常遵循体系结构基本原则的一条推论:让常见情况执行得快,让少见情况执行正确。也就是说,如果知道哪些情况常见、哪些少见,并且两者的代码都容易生成,那么少见情况的代码质量可能并不特别重要,但正确性必须保证。
有些指令集特征能够帮助编译器作者。它们不是不可更改的硬性规则,而是帮助编写高效、正确编译器的指导原则。
- 保持规则性。 只要合理,指令集的三个主要组成部分——操作、数据类型、寻址方式——就应当正交。两个方面相互独立,就称它们正交。例如,对任意操作,只要能使用一种寻址方式,就能使用全部寻址方式,则操作与寻址方式正交。这种规则性可简化代码生成;当生成何种代码的决策分散在编译器两遍中时,尤其重要。一个反例是限制某类指令只能使用某些寄存器。面向专用寄存器体系结构的编译器常陷入困境:明明还有许多可用寄存器,却没有类型合适的寄存器。
- 提供基本操作,而不是完整解决方案。 与某个语言结构或计算内核函数“匹配”的专用功能,常常无法使用。对高级语言的支持尝试,可能只适用于一种语言,或者执行的工作多于、少于该语言正确高效实现所需。A.10 节给出一个失败实例。
- 简化不同方案之间的权衡。 编译器作者最困难的任务之一,是为每一段代码选择最佳指令序列。过去,指令数或总代码大小或许是好指标;但第 1 章已说明,如今已非如此。缓存与流水线使权衡变得很复杂。设计者若能帮助编译器作者理解不同代码序列的成本,就能改善代码质量。一个特别困难的例子是寄存器—存储器体系结构:变量被引用多少次之后,先把它加载进寄存器才更便宜?这一阈值很难计算,甚至同一体系结构的不同机型也可能不同。
- 提供能将编译时已知量绑定为常数的指令。 编译器作者不希望处理器在运行时解释一个编译时就已确定的值。反例是那些仍在运行时解释编译时固定值的指令。例如,VAX 过程调用指令
calls动态解释一个指明需保存哪些寄存器的掩码,而这个掩码在编译时就已固定(见 A.10 节)。
编译器对多媒体指令的支持与不足
遗憾的是,SIMD 指令设计者(见第 4 章 4.3 节)基本忽略了上述建议。这些指令往往提供完整解决方案而非基本操作,寄存器不足,数据类型也不适合既有编程语言。设计者希望用低成本方案帮助一部分用户,但通常只有少量底层图形库例程使用它们。
SIMD 指令实质上是一种优雅体系结构的简化版本,而后者拥有自己的编译技术。4.2 节说明,向量体系结构对数据向量执行操作;它最初为科学代码发明,但多媒体计算内核也常能向量化,只是向量往往较短。如 4.3 节所述,可以将 Intel MMX、SSE,PowerPC AltiVec,或 RISC-V P 扩展视作短向量计算机:MMX 的向量包含八个 8 位元素、四个 16 位元素或两个 32 位元素;AltiVec 的向量长度是其两倍。实现时,只需将较窄元素相邻地放在宽寄存器中。
这些微处理器将向量寄存器大小写入体系结构:MMX 各元素位数之和限制为 64 位,AltiVec 为 128 位。当 Intel 决定扩展到 128 位向量时,就增加了一整套新指令,称为流式 SIMD 扩展(SSE)。
向量计算机的主要优点之一,是一次加载多个元素,再将执行与数据传送重叠,从而隐藏访存延迟。向量寻址方式旨在汇集散布在存储器中的数据,紧凑排列以便高效处理,再将结果放回对应位置。
向量计算机包含带步长寻址和聚集/散布寻址(见 4.2 节),以扩大可向量化的程序范围。带步长寻址在每次访问之间跨过固定字数,因此顺序寻址常称为单位步长寻址。聚集与散布从另一个向量寄存器获取地址,可视为向量计算机的寄存器间接寻址。相较之下,这些短向量 SIMD 计算机只支持单位步长访问:一次访存从一个宽存储单元装入或存出全部元素。多媒体数据通常形成以存储器为起点和终点的数据流,因此,带步长与聚集/散布寻址对成功向量化至关重要(见 4.7 节)。
例题 比较向量计算机与 MMX,将每个像素由 3 字节表示的 RGB(红、绿、蓝)转换为 YUV(亮度、色度)。转换只需把三行 C 代码放进循环:
译注: 原页第二、三行若干项之间缺少运算符,U 行的 B 系数确为 4221。这段代码不能直接作为可编译的 C 示例使用。习题 A.8给出了带减号的数组版本,可对照阅读。
一台数据宽度为 64 位的向量计算机,可同时计算 8 个像素。支持带步长寻址的一种媒体向量计算机需要:
- 3 条向量加载,取入 RGB;
- 3 条向量乘法,处理 R;
- 6 条向量乘加,处理 G、B;
- 3 条向量移位,完成除以 32768;
- 2 条向量加法,加上 128;
- 3 条向量存储,写出 YUV。
总共 20 条指令,完成上面 C 代码中的 20 个操作,转换 8 个像素(Kozyrakis,2000)。由于一个向量可能包含 32 个 64 位元素,实际可一次转换 个像素。
相比之下,Intel 网站给出的库例程,对 8 个像素执行相同计算,需要 116 条 MMX 指令,加 6 条 80x86 指令(Intel,2001)。指令数约为六倍,是因为缺少带步长访存,必须用大量指令装入并展开 RGB 像素,再压紧并存储 YUV 像素。
向量短、长度受体系结构限制,寄存器少,再加上简单的访存方式,都使向量化编译技术更难发挥作用。因此,这些 SIMD 指令更常见于手写库,而非编译生成的代码。
小结:编译器的作用
本节给出几项建议。首先,新指令集体系结构至少应有 16 个通用寄存器,不包括独立的浮点寄存器,以简化基于图着色的寄存器分配。关于正交性的建议意味着,所有数据传送指令都应适用全部已支持的寻址方式。最后三条建议——提供基本操作而非完整方案、简化方案之间的权衡、不要在运行时绑定常数——都表明,宁可偏向简单。也就是说,设计指令集时应理解“少即是多”。遗憾的是,SIMD 扩展更像成功营销的例子,而非软硬件协同设计的杰出成果。
A.9 融会贯通:RISC-V 体系结构
本节介绍一种名为 RISC-V 的加载—存储体系结构。RISC-V 是免费许可的开放标准,与许多 RISC 体系结构相似,也建立在类似于前几节讨论的观察结果之上。(M.3 节将讨论这些体系结构如何兴起,以及流行的原因。)RISC-V 汲取了 RISC 体系结构 30 年的经验,清理了大多数出于短期考虑而加入或遗漏的设计,使其更容易实现,也更高效。RISC-V 提供 32 位和 64 位指令集,以及浮点等多种功能扩展;这些扩展均可添加到 32 位或 64 位基础指令集之上。我们讨论 64 位版本 RV64,它是 32 位版本 RV32 的超集。
回顾前面各节,对于桌面与服务器应用,我们期望指令集具备以下特点:
- A.2 节:采用通用寄存器和加载—存储体系结构。
- A.3 节:支持位移寻址(地址偏移量为 12–16 位)、立即数寻址(8–16 位)和寄存器间接寻址。
- A.4 节:支持 8、16、32、64 位整数和 64 位 IEEE 754 浮点数。
- A.5 节:支持加载、存储、加、减、寄存器间传送和移位这些简单指令,因为它们在执行的指令中占绝大多数。
- A.6 节:支持相等、不等和小于比较,以及分支(至少 8 位 PC 相对地址)、跳转、调用和返回。
- A.7 节:重视性能时采用定长指令编码,重视代码大小时采用变长编码。在某些缓存较小或只有一级缓存的低端嵌入式应用中,较大的代码可能显著影响性能。提供压缩指令集扩展的 ISA,为应对这种差异提供了办法。
- A.8 节:至少提供 16 个、最好 32 个通用寄存器;确保所有寻址方式都适用于所有数据传送指令;以精简的指令集为目标。该节没有讨论浮点程序,但它们通常使用独立的浮点寄存器。这样可以增加寄存器总数,而不增加指令格式或通用寄存器堆速度方面的困难。不过,这种折中并不满足正交性。
下面通过说明 RISC-V 如何遵循这些建议,介绍其体系结构。与先前的 RISC 一样,RISC-V 强调:
- 简单的加载—存储指令集。
- 有利于流水线效率的设计(见附录 C),包括固定的指令集编码。
- 作为编译器目标的高效率。
RISC-V 很适合作为研究体系结构的模型,不仅因为这类处理器广泛使用,也因为它容易理解。附录 C 和第 3 章还会使用这一体系结构;若干习题和编程项目也以它为基础。
RISC-V 指令集的组织
RISC-V 由三个支持 32 位或 64 位整数的基础指令集,以及可附加于某个基础指令集的多种可选扩展组成。这使 RISC-V 能覆盖广泛的应用:小到逻辑电路与存储器预算极其有限、成本可能不超过 1 美元的小型嵌入式处理器,大到完整支持浮点、向量及多处理器配置的高端处理器。图 A.22 汇总三个基础指令集、各扩展及其基本功能。本书的实例使用 RV64IMAFD,简称 RV64G。RV32G 是 64 位体系结构 RV64G 的 32 位子集。
| 基础指令集或扩展名称 | 功能 |
|---|---|
| RV32I | 32 位整数基础指令集,含 32 个寄存器。 |
| RV32E | 32 位整数基础指令集,但仅有 16 个寄存器,面向非常低端的嵌入式应用。 |
| RV64I | 64 位基础指令集;所有寄存器均为 64 位,并增加向寄存器加载和从寄存器存储 64 位数据的指令 LD、SD。 |
| M | 增加整数乘法和除法指令。 |
| A | 增加并发处理所需的原子指令;见第 5 章。 |
| F | 增加 IEEE 单精度(32 位)浮点支持,包括 32 个 32 位浮点寄存器,以及加载、存储和操作这些寄存器的指令。 |
| D | 将浮点支持扩展为 64 位双精度,使寄存器宽度变为 64 位,并增加相应的加载、存储和运算指令。 |
| Q | 进一步增加四倍精度浮点支持,即 128 位操作。 |
| L | 增加 IEEE 标准的 64 位和 128 位十进制浮点支持。 |
| C | 定义面向小存储器嵌入式应用的压缩指令集版本,为常见 RV32I 指令提供 16 位形式。 |
| V | 未来支持向量操作的扩展;见第 4 章。 |
| B | 未来支持位字段操作的扩展。 |
| T | 未来支持事务性存储器的扩展。 |
| P | 支持打包 SIMD 指令的扩展;见第 4 章。 |
| RV128I | 未来提供 128 位地址空间的基础指令集。 |
译注:本节保留原书对扩展名称与发展阶段的描述,其中“未来”等措辞反映原书文字,不能据此判断这些扩展今天的标准化状态。
RISC-V 的寄存器
RV64G 有 32 个 64 位通用寄存器(GPR),编号为 x0、x1、…、x31,也称整数寄存器。RV64G 所包含的浮点扩展 F、D 还提供 32 个浮点寄存器(FPR),编号为 f0、f1、…、f31,可保存 32 个单精度(32 位)或 32 个双精度(64 位)数。(保存一个单精度数时,FPR 的另一半不使用。)它同时提供单精度和双精度浮点操作。
x0 的值始终为 0。后面将看到,借助这个寄存器,简单指令集也能合成多种有用的操作。
少数特殊寄存器可以与通用寄存器相互传送数据。例如浮点状态寄存器,用于保存浮点运算结果的信息。此外,也有在 FPR 与 GPR 之间传送数据的指令。
RISC-V 的数据类型
整数数据类型包括 8 位字节、16 位半字、32 位字和 64 位双字;浮点类型包括 32 位单精度和 64 位双精度。之所以加入半字,是因为 C 等语言包含这种类型,而且操作系统等关注数据结构大小的程序经常使用它。如果 Unicode 得到广泛使用,半字也会更常用。
RV64G 的操作针对 64 位整数,以及 32 位或 64 位浮点数。字节、半字和字加载到通用寄存器时,通过补零或复制符号位填满 GPR 的 64 位;随后使用 64 位整数操作处理它们。
RISC-V 数据传送的寻址方式
数据寻址方式只有立即数和位移两种,字段均为 12 位。将 12 位位移字段置为 0,就能实现寄存器间接寻址;以寄存器 0 为基址寄存器,就能实现地址范围受 12 位字段限制的绝对寻址。充分利用零,便可让体系结构直接支持的两种方式产生四种实际效果。
RV64G 的存储器按字节寻址,地址宽度为 64 位,采用 Little Endian 字节编号。它是加载—存储体系结构,因此存储器与 GPR 或 FPR 之间的所有访问,都通过加载或存储完成。为支持前述类型,涉及 GPR 的访存宽度可以是字节、半字、字或双字;FPR 可以加载和存储单精度或双精度数。访存不一定要对齐,但未对齐访问可能极其缓慢。实际使用时,程序员和编译器选择未对齐访问是很不明智的。
RISC-V 指令格式
RISC-V 只有两种寻址方式,因此可以将其编码在操作码中。为便于流水线实现与译码,所有指令都是 32 位,主操作码占 7 位。图 A.23 给出四种主要指令类型的布局。格式既简单,又提供 12 位字段,用于位移寻址、立即数常量或 PC 相对分支地址。
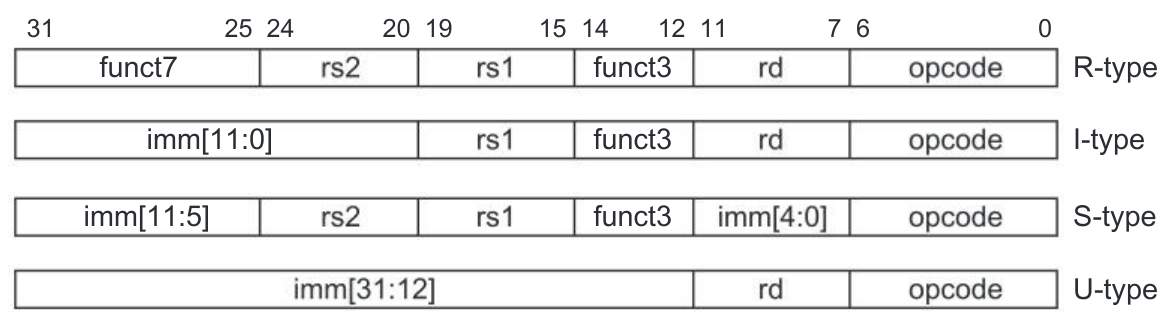
图内术语:R/I/S/U-type=R/I/S/U 型;opcode=操作码;rd=目的寄存器;rs1、rs2=第一、第二源寄存器;funct3、funct7=3 位、7 位功能字段;imm=立即数。图中保留原字段名和位编号。
图 A.24 说明各指令格式及字段用途。opcode 指定指令大类,如 ALU 指令、ALU 立即数、加载、存储、分支或跳转;funct 字段指定具体操作。例如 ALU 指令共用一个操作码,由 funct 决定加、减、与等操作。注意,一种格式可能编码多类指令:I 型同时用于 ALU 立即数指令与加载,S 型用于存储与条件分支。
| 指令格式 | 主要用途 | rd | rs1 | rs2 | 立即数 |
|---|---|---|---|---|---|
| R 型 | 寄存器—寄存器 ALU 指令 | 目的 | 第一源 | 第二源 | |
| I 型 | ALU 立即数;加载 | 目的 | 第一源;基址寄存器 | 数值;位移 | |
| S 型 | 存储;比较并分支 | 基址寄存器;第一源 | 待存储的数据源;第二源 | 位移;偏移量 | |
| U 型 | 跳转并链接;寄存器跳转并链接 | 保存返回 PC 的目的寄存器 | 寄存器跳转并链接的目标地址 | 跳转并链接的目标地址 |
RISC-V 的操作
RISC-V,更准确地说 RV64G,支持前面推荐的简单操作以及少量其他操作。指令分为四大类:加载与存储、ALU 操作、分支与跳转、浮点操作。
任意通用寄存器或浮点寄存器均可加载和存储,但加载到 x0 不产生效果。图 A.25 给出加载与存储指令实例。单精度浮点数占浮点寄存器的一半;单精度与双精度之间必须显式转换。浮点格式采用 IEEE 754(见附录 J)。图 A.28(原文标为 A-42 页)列出 RV64G 的全部指令。2
| 指令示例 | 指令名称 | 含义 |
|---|---|---|
ld x1,80(x2) | 加载双字 | |
lw x1,60(x2) | 加载字 | |
lwu x1,60(x2) | 无符号加载字 | |
lb x1,40(x3) | 加载字节 | |
lbu x1,40(x3) | 无符号加载字节 | |
lh x1,40(x3) | 加载半字 | |
flw f0,50(x3) | 加载单精度浮点数 | |
fld f0,50(x2) | 加载双精度浮点数 | |
sd x2,400(x3) | 存储双字 | |
sw x3,500(x4) | 存储字 | |
fsw f0,40(x3) | 存储单精度浮点数 | |
fsd f0,40(x3) | 存储双精度浮点数 | |
sh x3,502(x2) | 存储半字 | |
sb x2,41(x3) | 存储字节 |
为理解这些图表,需要对 A-9 页开始使用的类 C 描述语言再作几项扩充:
- 当传送数据的长度可能不明确时,在 后加下标。因此 表示传送一个 位量。 表示将 同时传送给 、。
- 下标也用于选择字段中的位。位编号从最高有效位的 0 开始,可以是单个位,例如 得到 x4 的符号位;也可以是范围,例如 得到 x3 的最低有效字节。
Mem是表示主存的数组变量,以字节地址为下标,可以传送任意字节数。- 上标表示重复某字段,例如 表示长度为 48 位的全零字段。
##表示连接两个字段,可以出现在数据传送的任一侧; 和 分别将第一个操作数左移或右移第二个操作数指定的位数。
例如,假定 x8、x10 为 32 位寄存器:
它表示:取出以寄存器 x8 的内容为地址的存储器字,将其符号扩展为 64 位,再存入 x10。3
所有 ALU 指令都是寄存器—寄存器指令。图 A.26 给出若干算术/逻辑指令实例,包括加、减、AND、OR、XOR 和移位等简单操作;这些指令还都提供使用 12 位符号扩展立即数的形式。LUI(load upper immediate,加载高位立即数)装入寄存器第 12–31 位,将立即数字段符号扩展到高 32 位,并将低 12 位清零。利用 LUI,可以用两条指令构造一个 32 位常量,也可以在数据传送时仅增加一条指令,就使用任意 32 位常量地址。
如前所述,x0 可以合成常用操作。加载常量只需使用以 x0 为源操作数的立即数加法;寄存器间传送只需使用一个源为 x0 的加法或按位或。(有时用助记符 li,即 load immediate,表示前者,用 mv 表示后者。)
| 指令示例 | 指令名称 | 含义 |
|---|---|---|
add x1,x2,x3 | 加法 | |
addi x1,x2,3 | 无符号立即数加法 | |
lui x1,42 | 加载高位立即数 | |
sll x1,x2,5 | 逻辑左移 | |
slt x1,x2,x3 | 小于则置位 | 若 ,则 ,否则 。 |
RISC-V 控制流指令
控制流由一组跳转和分支指令处理;图 A.27 给出典型实例。两条跳转指令——跳转并链接、寄存器跳转并链接——都是无条件转移,并始终将“链接地址”,即顺序上紧接跳转指令的下一条指令地址,存入 rd 字段指定的寄存器。不需要链接地址时,令 rd 为 x0,就得到通常的无条件跳转。两条指令的区别是:目标地址通过立即数字段加 PC 得到,还是通过立即数字段加寄存器内容得到。偏移量按半字单位解释,以兼容包含 16 位指令的压缩指令集 R64C。4
所有分支都有条件。条件由指令指定,允许各种算术比较:相等、大于、小于及其反条件。分支目标由 12 位有符号偏移量指定,先左移一位以得到 16 位对齐地址,再加上当前程序计数器。基于浮点寄存器内容的分支,先执行浮点比较,例如 feq.d 或 fle.d,按比较结果将整数寄存器置为 0 或 1;再执行以 x0 为一个操作数的 beq 或 bne。
细心的读者会发现,RV64G 中仅适用于 64 位的指令非常少,主要是 64 位加载与存储,以及不作符号扩展的 32、16、8 位加载形式(默认形式进行符号扩展)。为无需额外指令就能支持 32 位模运算,还有忽略 64 位寄存器高 32 位的指令变体,例如字加法、字减法 addw、subw。其余部分竟然都能直接适用。
| 指令示例 | 指令名称 | 含义 |
|---|---|---|
jal x1,offset | 跳转并链接 | |
jalr x1,x2,offset | 寄存器跳转并链接 | |
beq x3,x4,offset | 等于零则分支 | 若 ,则 。 |
bgt x3,x4,name | 不等于零则分支 | 若 ,则 。 |
RISC-V 浮点操作
浮点指令操作浮点寄存器,并指定单精度或双精度。操作包括加、减、乘、除、平方根,以及融合乘加和乘减。所有浮点指令都以字母 f 开头,后缀 d 表示双精度,s 表示单精度,例如 fadd.d、fadd.s、fmul.d、fmul.s、fmadd.d、fmadd.s。浮点比较按比较结果设置整数寄存器,与整数指令“小于则置位”和“大于则置位”类似。
除浮点加载与存储 flw、fsw、fld、fsd 外,还有不同浮点精度间的转换、整数寄存器与浮点寄存器间的数据传送 fmv,以及浮点数与整数之间的转换 fcvt;后者按需要将整数寄存器用作源或目的。
图 A.28 列出几乎全部 RV64G 指令,并概述其含义。
| 指令类型/操作码 | 指令含义 |
|---|---|
| 数据传送 | 在寄存器与存储器之间,或整数与浮点寄存器之间传送数据;唯一的存储器寻址方式是 12 位位移加 GPR 内容。 |
lb, lbu, sb | 加载字节、无符号加载字节、存储字节;与整数寄存器传送。 |
lh, lhu, sh | 加载半字、无符号加载半字、存储半字;与整数寄存器传送。 |
lw, lwu, sw | 加载字、存储字;与整数寄存器传送。 |
ld, sd | 加载双字、存储双字。 |
| 算术/逻辑 | 操作 GPR 中的数据;字形式忽略高 32 位。 |
add, addi, addw, addiw, sub, subi, subw, subiw | 加法与减法,同时提供字形式和立即数形式。 |
slt, sltu, slti, sltiu | 小于则置位,有符号、无符号以及立即数形式。 |
and, or, xor, andi, ori, xori | 与、或、异或,均有寄存器—寄存器和寄存器—立即数形式。 |
lui | 加载高位立即数:将立即数装入寄存器第 31…12 位,高 32 位设为 0。 |
auipc | 将立即数与 PC 的高 20 位相加后放入寄存器;用于构造到任意 32 位地址的分支。 |
sll, srl, sra, slli, srli, srai, sllw, slliw, srli, srliw, srai, sraiw | 移位:逻辑左移、逻辑右移和算术右移,均有立即数和字形式;字形式不改变高 32 位。 |
mul, mulw, mulh, mulhsu, mulhu, div, divw, divu, rem, remu, remw, remuw | 有符号和无符号整数乘法、除法及求余,支持用两条指令得到 64 位乘积;也有字形式。 |
| 控制 | 条件分支与跳转;采用 PC 相对寻址或寄存器寻址。 |
beq, bne, blt, bge, bltu, bgeu | 比较两个寄存器后分支:相等、不等、小于、大于或等于;有符号与无符号形式。 |
jal, jalr | 跳转并链接,地址相对于寄存器或 PC。 |
| 浮点 | 所有浮点操作均有双精度(.d)和单精度(.s)形式。 |
flw, fld, fsw, fsd | 加载、存储字(单精度)和双字(双精度)。 |
fadd, fsub, fmult, fiv, fsqrt, fmadd, fmsub, fnmadd, fnmsub, fmin, fmax, fsgn, fsgnj, fsjnx | 加、减、乘、除、平方根、乘加、乘减、负乘加、负乘减、最大值、最小值,以及替换符号位的指令。单精度操作码后加 .s,双精度后加 .d,例如 fadd.s、fadd.d。 |
feq, flt, fle | 比较两个浮点寄存器,将 0 或 1 的结果存入 GPR。 |
fmv.x.*, fmv.*.x | 在浮点寄存器与 GPR 之间传送;“*”为 s 或 d。 |
fcvt.*.l, fcvt.l.*, fcvt.*.lu, fcvt.lu.*, fcvt.*.w, fcvt.w.*, fcvt.*.wu, fcvt.wu.* | 在浮点寄存器与整数寄存器之间转换;“*”为 S 或 D,分别表示单精度、双精度。有符号、无符号,以及字、双字形式。 |
RISC-V 指令集的使用情况
为说明哪些指令经常使用,图 A.29 给出 SPECint2006 程序在 RV32G 上各指令和指令类别的出现频率。
| 程序 | 加载 | 存储 | 分支 | 跳转 | ALU 操作 |
|---|---|---|---|---|---|
| astar | 28% | 6% | 18% | 2% | 46% |
| bzip | 20% | 7% | 11% | 1% | 54% |
| gcc | 17% | 23% | 20% | 4% | 36% |
| gobmk | 21% | 12% | 14% | 2% | 50% |
| h264ref | 33% | 14% | 5% | 2% | 45% |
| hmmer | 28% | 9% | 17% | 0% | 46% |
| libquantum | 16% | 6% | 29% | 0% | 48% |
| mcf | 35% | 11% | 24% | 1% | 29% |
| omnetpp | 23% | 15% | 17% | 7% | 31% |
| perlbench | 25% | 14% | 15% | 7% | 39% |
| sjeng | 19% | 7% | 15% | 3% | 56% |
| xalancbmk | 30% | 8% | 27% | 3% | 31% |
译注:图 A.24 原表将两种跳转列于 U 型,并将寄存器跳转目标列入 rs1;原图注末句写作“S 和 J”。这些与图 A.23 的字段布局及本节随后描述并不一致。 译注:图 A.29 的 bzip 行按原表相加为 93%,与图注所称“除 omnetpp 外,其他指令均不到 1%”不一致;原图注也确实将加载与存储频率之比写为“1/5 到 3 倍”。 ↩︎
译注:图 A.28 实际位于原书 A-41 页;A-42 页为图 A.29。正文的“All”与图 A.28 的“绝大多数”表述也有差异。 ↩︎
译注:原文既假定 x8、x10 为“32 位寄存器”,又将 64 位结果写入 x10,且同一式中混用 x8 和 R8。 ↩︎
译注:压缩指令集名称在此原文写作 R64C。图 A.27 的
beq、bgt英文名称分别写成“Branch equal zero”“Branch not equal zero”,与右侧比较两个寄存器的含义不一致;示例中的name与语义栏offset也不一致。 ↩︎译注:图 A.26、A.28 的部分指令名、助记符和语义存在疑点,包括
addi的“unsigned”、sll的立即数示例、subi/subiw、重复出现的srli/srai、fmult/fiv/fsgn/fsjnx,以及 LUI 高 32 位“置零”与正文“符号扩展”的差异等。这些条目存在明显疑点,不宜把本表直接当作汇编编程规范。 ↩︎
A.10 谬误与陷阱
体系结构设计者曾反复被一些常见但错误的观念绊倒。本节考察其中几种。
陷阱:专门为高级语言结构设计“高级”指令集特性
试图把高级语言特性纳入指令集,曾促使设计者提供功能强大、灵活性很高的指令。然而,这些指令往往在常见情况下完成了多余的工作,或不能恰好满足某些语言的需要。许多尝试旨在消除 20 世纪 70 年代所谓的语义鸿沟(semantic gap)。其想法是补充指令集,让硬件达到语言层次,但新增内容可能造成 Wulf 等人(1981)所称的语义冲突(semantic clash):
……由于赋予指令过多的语义内容,计算机设计者反而使这条指令只能在有限的上下文中使用。(第 43 页)
更多时候,指令只是大材小用:对于最常见情况而言过于通用,执行了不必要的工作,因而变慢。VAX 的 CALLS 又是一个好例子。它采用被调用者保存策略,即由被调用者指定要保存哪些寄存器;但保存操作是在调用者中的调用指令里完成的。执行 CALLS 前,实参已压入栈中;它接着执行:
- 必要时对齐栈。
- 将实参数量压栈。
- 将过程调用掩码指定的寄存器压栈(见 A.8 节)。掩码保存在被调用过程的代码中,即使分别编译,被调用者也能指定调用者应保存哪些寄存器。
- 将返回地址压栈,再将栈顶和栈底指针压栈,以保存活动记录。
- 清除条件码,使陷阱使能处于已知状态。
- 将一个状态信息字和一个全零字压栈。
- 更新两个栈指针。
- 跳转到过程的第一条指令。
实际程序中的绝大多数调用不需要这样的开销。多数过程知道自己的实参数量;采用寄存器而非存储器中的栈传递参数,就能建立快得多的链接约定。而且,CALLS 强制使用两个寄存器来建立链接,许多语言却只需一个链接寄存器。许多支持过程调用和活动栈管理的尝试没有实用价值:有的与语言需求不符,有的太通用,使用代价过高。
VAX 设计者还提供了简单得多的 JSB 指令,它只将返回 PC 压栈并跳转到过程,因此快得多。然而,多数 VAX 编译器仍使用开销更大的 CALLS。将调用指令加入体系结构,是为了统一过程链接约定。其他计算机则通过编译器开发者之间的约定统一调用规范,无需承担复杂、极度通用的过程调用指令的开销。
谬误:存在一种“典型程序”
许多人希望相信,存在一个单一的“典型”程序,可以用来设计最优指令集。例如,第 1 章讨论过合成基准程序。本附录的数据清楚表明,不同程序使用指令集的方式可能差异很大。图 A.30 给出四个 SPEC2000 程序的数据传送宽度分布;仅凭这四个程序,就很难说什么才算典型。如果指令集支持某类专用应用,例如其他应用完全不使用的十进制指令,差异还会更大。
图内术语:Double word=双字(64 位);Word=字(32 位);Half word=半字(16 位);Byte=字节(8 位)。applu、equake、gzip、perl 为程序名;横轴为各宽度占数据访问的比例。
陷阱:通过指令集体系结构创新缩减代码,却不考虑编译器
图 A.31 比较四种 MIPS 编译器生成的相对代码大小。设计者努力将代码减小 30%–40%,而不同编译策略带来的变化可能远大于此。与性能优化一样,体系结构设计者应先以编译器能生成的最紧凑代码为起点,再提出节省空间的硬件创新。
| 编译器 | Apogee Software 4.1 | Green Hills Multi2000 2.0 | Algorithmics SDE4.0B | IDT/c 7.2.1 |
|---|---|---|---|---|
| 体系结构 | MIPS IV | MIPS IV | MIPS 32 | MIPS 32 |
| 处理器 | NEC VR5432 | NEC VR5000 | IDT 32334 | IDT 79RC32364 |
| 自相关计算内核 | 1.0 | 2.1 | 1.1 | 2.7 |
| 卷积编码器计算内核 | 1.0 | 1.9 | 1.2 | 2.4 |
| 定点位分配计算内核 | 1.0 | 2.0 | 1.2 | 2.3 |
| 定点复数 FFT 计算内核 | 1.0 | 1.1 | 2.7 | 1.8 |
| Viterbi GSM 解码器计算内核 | 1.0 | 1.7 | 0.8 | 1.1 |
| 五个计算内核的几何平均值 | 1.0 | 1.7 | 1.4 | 2.0 |
谬误:有缺陷的体系结构不可能成功
80x86 是一个鲜明的例子:它的指令集体系结构,大概只有创造者才会喜欢(见附录 K)。一代代 Intel 工程师试图弥补最初设计中不受欢迎的决定。例如,80x86 支持分段,其他体系结构却选择了分页;它对整数使用扩展累加器,其他处理器使用通用寄存器;它对浮点数据使用栈,而其他人早已放弃执行栈。
尽管存在这些重大问题,80x86 仍取得了巨大成功,原因有三。第一,最初的 IBM PC 选择它作为微处理器,使 80x86 的二进制兼容性极具价值。第二,Moore 定律提供了充足资源,使 80x86 微处理器能够将指令转换为内部 RISC 指令集,再执行类似 RISC 的指令。这种组合既能兼容宝贵的 PC 软件,又能取得与 RISC 处理器相当的性能。第三,PC 微处理器销量极大,Intel 很容易承担硬件转换所增加的设计成本。大批量生产还让厂商沿学习曲线不断进步,降低产品成本。
转换所需的更大的裸片面积和更高功耗,可能是嵌入式应用的负担,但在桌面市场具有极大的经济合理性。桌面市场的性价比优势也使它对服务器很有吸引力;它在服务器上的主要弱点原是 32 位地址,这已通过 64 位地址扩展解决。
谬误:能够设计出毫无缺陷的体系结构
任何体系结构设计,都要在特定软硬件技术背景下权衡取舍。技术随时间变化,当初可能正确的决定,后来会显得像错误。例如,1975 年 VAX 设计者过于重视代码大小效率,低估了五年后易于译码和流水线实现的重要性。RISC 阵营的例子是延迟分支(见附录 K):对于五级流水线,它能简单地处理流水线冒险;对于流水线更深、每周期发射多条指令的处理器,却成为难题。此外,几乎所有体系结构最终都会受到地址空间不足的限制。这也是 RISC-V 预先考虑 128 位地址可能性的原因之一,尽管数十年后才可能需要它。
一般来说,若想长期避免此类缺陷,就可能不得不牺牲短期效率。这很危险,因为一种新 ISA 在问世头几年必须努力争取生存。
A.11 结束语
最早的体系结构受当时硬件技术限制,指令集能力有限。硬件技术一旦允许,计算机体系结构设计者便开始寻找支持高级语言的方法。围绕如何高效支持程序,这一探索经历了三个不同的思想阶段。
20 世纪 60 年代,栈式体系结构流行起来。它被认为很适合高级语言;考虑到当时的编译技术,这一判断很可能是正确的。70 年代,设计者主要关心如何降低软件成本,办法主要是用硬件替代软件,或提供能简化软件设计工作的高级体系结构。这催生了高级语言计算机体系结构运动,也催生了 VAX 这样的强大体系结构:寻址方式众多、数据类型丰富,而且高度正交。到了 80 年代,编译技术更加成熟,处理器性能重新受到重视,设计又回到较简单的体系结构,主要是加载—存储型计算机。
20 世纪 90 年代,指令集体系结构出现以下变化:
- 地址宽度加倍。 大多数桌面和服务器处理器的指令集,从 32 位地址扩展到 64 位地址;寄存器宽度等也扩大为 64 位。附录 K 给出三个从 32 位走向 64 位的实例。
- 通过条件执行优化条件分支。 第 3 章将说明,条件分支会限制高性能计算机设计。因此,人们希望用有条件地完成操作来替代条件分支,例如多数指令集都增加了条件传送(见附录 H)。
- 通过预取优化缓存性能。 第 2 章说明,存储层次结构对性能日益重要:某些计算机一次缓存未命中消耗的指令时间,甚至相当于早期计算机一次缺页。为此,新增预取指令,试图通过提前取数隐藏未命中代价(见第 2 章)。
- 支持多媒体。 大多数桌面和嵌入式指令集都扩展了多媒体应用支持。
- **加快浮点运算。** 附录 J 介绍为提高浮点性能而新增的操作,例如将乘法和加法合并,以及成对单精度执行;原文称这些都是 RISC-V 的一部分。
1970–1985 年间,许多人认为计算机体系结构设计者的主要工作就是设计指令集。因此,那一时期的教科书强调指令集设计,正如 50、60 年代的体系结构教科书强调计算机算术一样。人们期望受过良好训练的设计者,对流行计算机的优点,尤其是缺点,持有鲜明见解。许多研究者与教材作者没有充分认识二进制兼容性对指令集创新的压制作用,给人一种许多体系结构设计者都有机会设计指令集的印象。
如今,计算机体系结构的定义已经扩展为整个计算机系统的设计与评价,既不只是定义指令集,也不只是设计处理器,因此有大量值得研究的课题。事实上,本附录内容曾是 1990 年本书第一版的核心,如今却主要作为参考资料放在附录中!
对指令集体系结构感兴趣的读者可以阅读附录 K。它介绍目前具有市场影响或具有历史意义的多种指令集,并将九种流行的加载—存储计算机与 RISC-V 比较。
A.12 历史回顾与参考文献
M.4 节(在线提供)讨论指令集的演变,并列出可供进一步阅读、探索相关主题的参考文献。
习题(Gregory D. Peterson 编写)
习题由 Gregory D. Peterson 编写。
习题 A.1
[10]〈A.9〉 利用图 A.29,计算某个嵌入式 RISC-V CPU 实现的有效 CPI。假设已经测得各类指令的平均 CPI 如下:
| 指令 | 时钟周期数 |
|---|---|
| 所有 ALU 操作 | 1.0 |
| 加载 | 5.0 |
| 存储 | 3.0 |
| 分支:跳转 | 5.0 |
| 分支:不跳转 | 3.0 |
| 跳转指令 | 3.0 |
将 astar 与 gcc 的指令频率取平均,得到所用的指令混合。
习题 A.2
[10]〈A.9〉 利用图 A.29 和上表,计算 RISC-V 的有效 CPI。将 bzip 与 hmmer 的指令频率取平均,得到指令混合。可以假设所有其他指令,即图 A.29 所列类别未涵盖的指令,每条需要 3.0 个时钟周期。
习题 A.3
[10]〈A.9〉 利用图 A.29,计算某个 RISC-V CPU 实现的有效 CPI。假设测得各类指令的平均 CPI 如下:
| 指令 | 时钟周期数 |
|---|---|
| 所有 ALU 操作 | 1.0 |
| 加载 | 3.5 |
| 存储 | 2.8 |
| 分支:跳转 | 4.0 |
| 分支:不跳转 | 2.0 |
| 跳转指令 | 2.4 |
将 gobmk 与 mcf 的指令频率取平均,得到指令混合。可以假设所有其他指令,即图 A.29 所列类别未涵盖的指令,每条需要 3.0 个时钟周期。
习题 A.4
[10]〈A.9〉 利用图 A.29 和上表,计算 RISC-V 的有效 CPI。将 perlbench 与 sjeng 的指令频率取平均,得到指令混合。
习题 A.5
[10]〈A.8〉 考虑下面由三条语句组成的高级语言代码:
使用复制传播技术(见图 A.20)变换代码,直到所有操作数都不是计算得到的值。指出哪些变换减少了一条语句的计算工作,哪些增加了计算工作。这说明,要满足人们对优化编译器的期望,会面临什么技术挑战?
习题 A.6
[30]〈A.8〉 编译器优化可以改善代码大小和/或性能。从 SPEC CPU2017 或 EEMBC 基准套件中选择一个或多个程序,使用 RISC-V 或你能使用的其他处理器,以及 GNU C 编译器,分别在不优化、-O1、-O2、-O3 条件下编译。比较生成程序的性能与大小,并与图 A.21 的结果比较。
习题 A.7
[20/20/20/25/10]〈A.2,A.9〉 考虑以下 C 代码:
假定 A、B 为 64 位整数数组,C、i 为 64 位整数。所有数据值及地址,除运算时外,均保存在存储器中;A、B、C、i 的地址分别为 1000、3000、5000、7000。寄存器中的值在循环的两次迭代之间丢失。所有地址和字均为 64 位。
a. [20]〈A.2,A.9〉 写出 RISC-V 代码。动态执行多少条指令?发生多少次存储器数据访问?代码占多少字节?
b. [20]〈A.2〉 写出 x86 代码。动态执行多少条指令?发生多少次存储器数据访问?代码占多少字节?
c. [20]〈A.2〉 写出栈式计算机的代码。所有运算都在栈顶进行;只有 push、pop 指令访问存储器,其余指令从栈中移除操作数,再将结果放回栈。实现只对栈顶两个表项采用硬连线栈,使处理器电路很小、成本很低;更深的栈位置保存在存储器中,对它们的访问需要访存。动态执行多少条指令?发生多少次存储器数据访问?
d. [25]〈A.2,A.9〉 不再处理上述代码,而是编写一个稠密单精度矩阵乘法例程,即 SGEMM。输入矩阵为 时,动态执行多少条指令?发生多少次存储器数据访问?
e. [10]〈A.2,A.9〉 矩阵规模增大时,动态指令数和存储器数据访问次数如何变化?
习题 A.8
[25/25]〈A.2,A.8,A.9〉 考虑以下 C 代码:
译注:本题 U、V 两行含有三个减号,A.8 节的对应例题缺少这些运算符,两处代码有所不同。
假定 R、G、B、Y、U、V 为 64 位整数数组。所有数据值及地址,除运算时外,均保存在存储器中;各数组的地址依次为 1000、2000、3000、4000、5000、6000。寄存器中的值在循环两次迭代之间丢失,所有地址和字均为 64 位。
a. [25]〈A.2,A.9〉 写出 RISC-V 代码。动态执行多少条指令?发生多少次存储器数据访问?代码占多少字节?
b. [25]〈A.2〉 写出 x86 代码。动态执行多少条指令?发生多少次存储器数据访问?代码占多少字节?与 A.8 节讨论的 MMX 多媒体指令实现和向量实现比较。
习题 A.9
[10/10/10/10]〈A.2,A.7〉 以下各问讨论 ISA 的指令编码。
a. [10]〈A.2,A.7〉 某处理器指令长 14 位,有 64 个通用寄存器,因此地址字段长 6 位。能否为以下指令提供编码:3 条二地址指令、63 条一地址指令、45 条零地址指令?
b. [10]〈A.2,A.7〉 指令长度和地址字段大小同上。能否编码 3 条二地址指令、65 条一地址指令、35 条零地址指令?说明理由。
c. [10]〈A.2,A.7〉 指令长度和地址字段大小同上。若已有 3 条二地址指令和 24 条零地址指令,最多还能编码多少条一地址指令?
d. [10]〈A.2,A.7〉 指令长度和地址字段大小同上。若已有 3 条二地址指令和 65 条零地址指令,最多还能编码多少条一地址指令?
习题 A.10
[10/15]〈A.2〉 假定整数值 A、B、C、D、E、F 保存在存储器中;指令操作码占 8 位,存储器地址占 64 位,寄存器地址占 6 位。
a. [10]〈A.2〉 对图 A.2 中每种指令集体系结构,计算 的代码中,每条指令包含多少个地址或名称?总代码大小是多少?
b. [15]〈A.2〉 图 A.2 中某些体系结构在计算时会破坏操作数。处理器内部存储中的数据值丢失,会影响性能。对每种体系结构,写出计算以下语句的代码序列:
标出执行期间被破坏的每个操作数,并标出仅用于弥补处理器内部数据丢失而加入的每条“额外开销”指令。对每段代码,给出总代码大小、进出存储器的指令与数据字节数、额外指令数和额外数据字节数。
习题 A.11
[15]〈A.2,A.7,A.9〉 RISC-V 设计提供 32 个通用寄存器与 32 个浮点寄存器。如果寄存器有好处,更多寄存器是否更好?当 ISA 设计者考虑是否增加、以及增加多少 RISC-V 寄存器时,应权衡哪些因素?尽量多地列出并讨论。
习题 A.12
[5]〈A.3〉 考虑具有以下成员的 C 结构体:
C 编译器必须按结构体定义中的顺序保留成员。32 位机器上 foo 的大小是多少?若允许任意调整成员顺序,最小需要多少空间?64 位机器上又如何?
习题 A.13
[30]〈A.7〉 许多计算机厂商现在提供工具或模拟器,允许测量用户程序的指令集使用情况。方法包括机器模拟、硬件支持的陷阱,以及在目标代码模块中插入软件计数器或使用内置硬件计数器的插桩技术。选择一种处理器及工具,对用户程序插桩。(开源 RISC-V 体系结构有一组相关工具;Performance API,即 PAPI 等工具可用于 x86。)测量一个 SPEC CPU2017 基准程序的指令混合,并与本附录给出的结果比较。
习题 A.14
[30]〈A.8〉 Intel i7 Kaby Lake 等较新的处理器支持 AVX2 向量/多媒体指令。编写单精度稠密矩阵乘法函数,使用不同编译器与优化选项编译。使用基本线性代数子程序库(BLAS)例程,例如 SGEMM 的线性代数代码,包含经过优化的稠密矩阵乘法版本。比较你的代码与 BLAS SGEMM 的代码大小及性能;再探索改用双精度和 DGEMM 后的变化。
习题 A.15
[30]〈A.8〉 在上一题为 i7 开发的 SGEMM 代码中使用 AVX2 intrinsics,以改善性能。尤其应尝试向量化代码,更充分利用 AVX 硬件。将代码大小和性能与原代码比较,再与 Intel Math Kernel Library(MKL)的 SGEMM 实现比较。
习题 A.16
[30]〈A.7,A.9〉 RISC-V 处理器是开源的,拥有丰富的实现、模拟器、编译器及其他工具。可在 riscv.org 查看工具概览,包括 RISC-V 处理器模拟器 spike。使用 spike 或另一种模拟器,测量若干 SPEC CPU2017 基准程序的指令混合。
习题 A.17
[35/35/35/35]〈A.2–A.8〉 gcc 支持大多数现代指令集体系结构,见 GNU GCC。为你能使用的若干体系结构,例如 x86、RISC-V、PowerPC、ARM,分别构建 gcc。
a. [35]〈A.2–A.8〉 编译一部分 SPEC CPU2017 整数基准程序,建立代码大小表。每个程序在哪种体系结构上最好?
b. [35]〈A.2–A.8〉 编译一部分 SPEC CPU2017 浮点基准程序,建立代码大小表。每个程序在哪种体系结构上最好?
c. [35]〈A.2–A.8〉 编译一部分 EEMBC AutoBench 基准程序,见 EEMBC,建立代码大小表。每个程序在哪种体系结构上最好?
d. [35]〈A.2–A.8〉 编译一部分 EEMBC FPBench 浮点基准程序,建立代码大小表。每个程序在哪种体系结构上最好?
习题 A.18
[40]〈A.2–A.8〉 能效对现代处理器,尤其嵌入式系统,已经非常重要。为你能使用的两种体系结构分别构建 gcc,例如 x86、RISC-V、PowerPC、Atom、ARM。(也可以探索比较 RISC-V 的不同版本。)编译一部分 EEMBC 基准程序,并使用 EnergyBench 测量执行期间的能耗。比较各处理器的代码大小、性能和能耗。每个程序在哪种处理器上最好?
习题 A.19
[20/15/15/20] 比较以下四种指令集体系结构的存储器使用效率:
- 累加器型:所有运算都在一个寄存器和一个存储器位置之间进行。
- 存储器—存储器型:指令中的所有地址都只引用存储器位置。
- 栈式:所有运算都在栈顶进行。只有 push、pop 访问存储器;其余指令从栈中取出操作数,并用结果替代。实现仅对栈顶两个表项采用硬连线栈,使处理器电路很小、成本很低;其余栈位置保存在存储器中,访问它们需要访存。
- 加载—存储型:所有运算都在寄存器中进行,寄存器间运算每条指令包含三个寄存器名。
为衡量存储器使用效率,对四种指令集均作如下假设:
- 指令长度均为整数字节。
- 操作码始终占 1 字节(8 位)。
- 访存采用直接寻址,即绝对寻址。
- 变量 A、B、C、D 最初都在存储器中。
a. [20]〈A.2,A.3〉 自行设计汇编助记符,可以参照并推广图 A.2。对每种体系结构,为下列高级语言代码写出最优的等价汇编代码:
b. [15]〈A.3〉 在 a 问代码中,标出每一次已经加载过的值又从存储器重新加载的情形。再标出每一次某条指令的结果作为另一条指令操作数传递的情形,并区分这些传递经由处理器内部存储还是存储器。
c. [15]〈A.7〉 假设代码来自小型嵌入式应用,使用 16 位存储器地址和数据操作数;加载—存储体系结构有 16 个通用寄存器。对每种体系结构回答:取入多少指令字节?进出存储器的数据有多少字节?按总访存流量(代码加数据)衡量,哪种体系结构效率最高?
d. [20]〈A.7〉 现改为采用 64 位存储器地址和数据操作数的处理器。对每种体系结构回答 c 问。按这些指标衡量,各体系结构的相对优劣发生了什么变化?
习题 A.20
[30]〈A.2,A.3〉 采用上述四种指令集体系结构,但假定支持的访存方式除直接寻址外还包括寄存器间接寻址。自行设计汇编助记符(可参照并推广图 A.2),分别为以下 C 代码写出最优的等价汇编代码:
假定 A、B 是 64 位整数数组,C、D、i 是 64 位整数。
习题 A.21
[20/20]〈A.3,A.6,A.9〉 可以从已编译应用中提取位移寻址或 PC 相对寻址所需的位移大小。对编译到 RISC-V 的一个或多个 SPEC CPU2017、EEMBC 基准程序使用反汇编器。
a. [20]〈A.3,A.9〉 记录每条使用位移寻址的指令的位移值,绘制直方图,并与图 A.8 比较。
b. [20]〈A.6,A.9〉 记录每条使用 PC 相对寻址的分支指令的偏移量,绘制直方图,并与图 A.15 比较。
习题 A.22
[15/15/10/10/10/10]〈A.3〉 将十六进制数 5249 5343 5643 5055 表示的值,存入一个对齐的 64 位双字中。
a. [15]〈A.3〉 按图 A.5 第一行的物理排列,用 Big Endian 字节序写出要保存的值。然后将每字节解释为 ASCII 字符,在字节下面写出对应字符,组成按 Big Endian 顺序存储的字符串。
b. [15]〈A.3〉 使用与 a 问相同的物理排列,以 Little Endian 字节序写出要保存的值,并在每字节下方写出对应 ASCII 字符。
c. [10]〈A.3〉 采用 Big Endian 字节序存储时,从给定 64 位双字中能读出的所有未对齐 2 字节字,其十六进制值分别是什么?
d. [10]〈A.3〉 采用 Big Endian 字节序存储时,从给定 64 位双字中能读出的所有未对齐 2 字节字,其十六进制值分别是什么?1
e. [10]〈A.3〉 采用 Little Endian 字节序存储时,从给定 64 位双字中能读出的所有未对齐 2 字节字,其十六进制值分别是什么?
f. [10]〈A.3〉 采用 Little Endian 字节序存储时,从给定 64 位双字中能读出的所有未对齐 4 字节字,其十六进制值分别是什么?
习题 A.23
[25,25]〈A.3,A.9〉 不同寻址方式的相对频率,会影响 ISA 选择支持哪些寻址方式。图 A.7 展示三个 VAX 应用的寻址方式相对频率。
a. [25]〈A.3〉 将一个或多个 SPEC CPU2017、EEMBC 基准程序编译到 x86。使用反汇编器考察指令及各种寻址方式的相对频率,并绘制直方图。结果与图 A.7 相比如何?
b. [25]〈A.3,A.9〉 将一个或多个 SPEC CPU2017、EEMBC 基准程序编译到 RISC-V。使用反汇编器考察指令及各种寻址方式的相对频率,并绘制直方图。结果与图 A.7 相比如何?
习题 A.24
[讨论]〈A.2–A.12〉 考虑桌面、服务器、云和嵌入式计算的典型应用。面向这些市场的计算机,其指令集体系结构设计分别会受到什么影响?
译注:原书 A.22 的 c、d 两问完全重复,均写作 Big Endian 和 2 字节。 ↩︎
B 存储层次结构回顾
Cache:藏匿或存放物品的安全之处。
——《韦氏新世界美国英语词典》,大学版第 2 版(1976)
B.1 引言
本附录简要复习存储层次结构,包括缓存与虚拟存储器的基本原理、性能公式和简单优化。本节先回顾以下 36 个术语:
| 英文术语 | 中文 |
|---|---|
| cache | 缓存 |
| fully associative | 全相联 |
| write allocate | 写分配 |
| virtual memory | 虚拟存储器 |
| dirty bit | 脏位 |
| unified cache | 统一缓存 |
| memory stall cycles | 存储器停顿周期数 |
| block offset | 块内偏移 |
| misses per instruction | 每条指令的未命中次数 |
| direct mapped | 直接映射 |
| write back | 写回 |
| block | 块 |
| valid bit | 有效位 |
| data cache | 数据缓存 |
| locality | 局部性 |
| block address | 块地址 |
| hit time | 命中时间 |
| address trace | 地址轨迹 |
| write through | 直写 |
| cache miss | 缓存未命中 |
| set | 组 |
| instruction cache | 指令缓存 |
| page fault | 缺页 |
| random replacement | 随机替换 |
| average memory access time | 平均存储器访问时间 |
| miss rate | 未命中率 |
| index field | 索引字段 |
| cache hit | 缓存命中 |
| n-way set associative | n 路组相联 |
| no-write allocate | 非写分配 |
| page | 页 |
| least recently used | 最近最少使用 |
| write buffer | 写缓冲区 |
| miss penalty | 未命中代价 |
| tag field | 标签字段 |
| write stall | 写停顿 |
如果觉得复习节奏太快,可以先阅读我们为经验较少的读者编写的《计算机组成与设计》第 7 章。
地址离开处理器后,遇到的存储层次结构最高层,也就是第一层,称为缓存。由于局部性原理适用于许多层次,利用局部性提高性能也已成为普遍做法,所以只要通过缓冲重用经常出现的内容,往往都称为缓存,例如文件缓存、名称缓存等。
处理器在缓存中找到所需数据项,称为缓存命中;找不到,则发生缓存未命中。此时,从主存取出包含目标字的一组固定大小的数据,称为块或行,放入缓存。时间局部性告诉我们,近期很可能再次需要这个字,因此把它放在访问快速的缓存中很有价值;空间局部性则意味着块中的其他数据也很可能很快用到。
处理一次缓存未命中所需的时间,同时取决于存储器延迟和带宽。延迟决定取回块中第一个字所需的时间,带宽决定取回其余部分的时间。缓存未命中由硬件处理,会让顺序执行处理器暂停,即停顿,直至数据可用。对于乱序执行,使用该结果的指令仍须等待,但其他指令可以在未命中期间继续执行。
类似地,程序引用的对象不必全部驻留主存。虚拟存储器允许一些对象驻留磁盘。地址空间通常划分为固定大小的块,称为页。任意时刻,每页位于主存或磁盘中。处理器引用的页面既不在缓存中,也不在主存中时,就发生缺页,整页从磁盘调入主存。 缺页耗时很长,因此由软件处理,而不是让处理器一直停顿;磁盘访问期间,处理器通常切换去执行其他任务。从较高层次看,缓存与主存之间对访问局部性的依赖,以及容量、单位位成本的相对关系,与主存和磁盘之间的关系很相似。
图 B.1 给出从高端桌面机到低端服务器,各存储层次的典型容量和访问时间范围。
| 层次 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| 名称 | 寄存器 | 缓存 | 主存 | 磁盘存储 |
| 典型容量 | <4 KiB | 32 KiB–8 MiB | <1 TB | >1 TB |
| 实现技术 | 多端口定制 CMOS 存储器 | 片上 CMOS SRAM | CMOS DRAM | 磁盘或 FLASH |
| 访问时间(ns) | 0.1–0.2 | 0.5–10 | 30–150 | 5,000,000 |
| 带宽(MiB/s) | 1,000,000–10,000,000 | 20,000–50,000 | 10,000–30,000 | 100–1000 |
| 管理者 | 编译器 | 硬件 | 操作系统 | 操作系统 |
| 后备层次 | 缓存 | 主存 | 磁盘或 FLASH | 其他磁盘及 DVD |
缓存性能回顾
由于局部性,以及小容量存储器速度更快,存储层次结构可以显著改善性能。一种评价缓存性能的方法,是扩展第 1 章的处理器执行时间公式,加入处理器等待访存而停顿的周期数,称为存储器停顿周期数。执行时间等于处理器周期数与存储器停顿周期数之和,再乘以时钟周期时间:
这里假设 CPU 时钟周期数包含处理缓存命中的时间,并假设缓存未命中期间处理器停顿。B.2 节将重新考察这一简化假设。
存储器停顿周期数取决于未命中次数,以及每次未命中的开销,即未命中代价:
最后一种形式的优点,是各项都容易测量。我们已知道如何测量指令数 IC;对于推测执行处理器,只统计提交的指令。每条指令的访存次数也可用同样方式测量:每条指令都需要一次取指,而是否还需要数据访问,也很容易判断。
注意,未命中代价按平均值计算,这里却把它当作常量使用。未命中发生时,缓存后面的存储器可能正忙于先前的请求或刷新;处理器、总线和存储器的时钟不同,在这些时钟域接口处所需周期数也会变化。因此,用一个数表示未命中代价是一种简化。
未命中率就是缓存访问中未命中的比例,即未命中次数除以访问次数。可以用缓存模拟器测量:输入指令和数据访问的地址轨迹,模拟缓存行为,判断各次访问是否命中,再报告命中与未命中的总数。如今,许多微处理器提供统计未命中次数和访存次数的硬件,使测量更简单、更快。
上式只是近似,因为读、写的未命中率和未命中代价往往不同。可以分别按每条指令的读写次数、以周期为单位的未命中代价,以及读写未命中率来表示:
通常,我们合并读写,并求其平均未命中率与平均未命中代价,从而将完整公式简化为:
未命中率是缓存设计最重要的指标之一,但后面将看到,它不是唯一指标。
例题:缓存未命中对执行时间的影响
某计算机在所有访存均命中缓存时,每条指令周期数 CPI 为 1.0。数据访问仅有加载和存储,共占指令的 50%。若未命中代价为 50 个时钟周期、未命中率为 1%,所有指令都命中缓存时,计算机会快多少?
解答。 先计算全部命中时的执行时间:
对于实际缓存,先计算存储器停顿周期数:
其中 表示每条指令有一次取指和 0.5 次数据访问。总执行时间为:
性能之比等于执行时间之比的倒数:
因此,没有缓存未命中的计算机,速度是原来的 1.75 倍。
有些设计者喜欢用每条指令未命中次数,而非每次存储器访问的未命中率来衡量。两者关系为:
已知每条指令的平均访存次数,就能利用这个公式,在未命中率与每条指令未命中次数之间转换。例如,将上一例按访存计算的未命中率转换为每条指令未命中次数:
顺便说,每条指令未命中次数常换算成每 1000 条指令未命中次数,以便用整数而非小数表示。上面的结果也可写为每 1000 条指令未命中 30 次。
这一指标的优点是与硬件实现无关。例如,推测执行处理器取入的指令数量约为实际提交数量的两倍;若按访存次数而非指令数计算未命中率,就可能人为压低结果。缺点是它与体系结构有关:80x86 与 RISC-V 每条指令的平均访存次数可能很不相同。因此,它最受研究同一计算机系列的设计者欢迎,不过 RISC 体系结构之间的相似性,仍使一种体系结构的结果对其他体系结构有所启发。
例题:两种未命中指标的等价性
为说明两种未命中率公式等价,重新计算前一例,这次假定每 1000 条指令未命中 30 次。用指令数表示存储器停顿时间。
解答。 重新计算停顿周期数:
得到与 B-5 页相同的结果,说明两种公式等价。1
存储层次结构的四个问题
继续介绍缓存,先回答存储层次结构第一层的四个共同问题:
- 一个块可以放到上层的什么位置?——块放置。
- 如果块在上层,如何找到它?——块识别。
- 发生未命中时,应替换哪个块?——块替换。
- 写操作如何处理?——写策略。
这些问题的答案,有助于理解不同存储层次的权衡;因此,每个实例都会围绕这四个问题展开。
问题 1:块可以放入缓存的什么位置?
图 B.2 表明,块放置位置的限制,将缓存组织分成三类。
图内术语:Fully associative=全相联;Direct mapped=直接映射;Set associative=组相联;Block no.=块编号;Block frame address=块框地址;Cache=缓存;Memory=存储器;Set=组。图中三项位置说明完整译于图注。
- 每个块在缓存中只有一个可放置位置,称为直接映射。映射通常是“块地址 mod 缓存块数”。
- 块可放在缓存任意位置,称为全相联。
- 块只可放在缓存中某组限定位置,称为组相联。组是缓存内的一组块;先将块映射到一个组,再放入该组任意位置。通常通过选择地址位来确定组,即“块地址 mod 缓存组数”。每组含 个块,就称为 路组相联。
从直接映射到全相联,实际上是一系列相联度。直接映射就是一路组相联;含 个块的全相联缓存,可以称为 m 路组相联。等价地,直接映射有 个组,全相联只有一个组。
原书所述的大多数处理器缓存采用直接映射、二路或四路组相联,原因稍后说明。
问题 2:如果块在缓存中,如何找到它?
每个缓存块框都有一个地址标签,记录块地址。对于可能包含目标数据的所有缓存块,检查其标签是否与处理器给出的块地址相符。由于速度至关重要,通常会并行比较所有可能的标签。
还必须判断缓存块是否包含有效信息。最常见做法是在标签旁增加有效位,说明该表项是否包含有效地址;有效位未置位,就不能认为地址匹配。
进入下一个问题之前,先看处理器地址与缓存的关系。图 B.3 展示地址如何划分:先分为块地址与块内偏移,块框地址又可分成标签字段和索引字段。
图内术语:Block address=块地址;Tag=标签;Index=索引;Block offset=块内偏移。
块内偏移选择块内所需数据,索引选择组,再比较标签以判断命中。虽然可以比较比标签更完整的地址,但没有必要:
- 不应比较偏移量,因为整个块要么存在,要么不存在;只要块存在,任何块内偏移都应匹配。
- 索引已经用来选择待检查的组,重复检查它没有意义。例如,存于组 0 的地址,其索引必为 0,否则不可能存入组 0;组 1 的索引必为 1,依此类推。缩短缓存标签存储的位宽,可以节省硬件和能耗。
缓存总容量不变时,提高相联度会增加每组块数,因而缩小索引、增大标签。也就是说,图 B.3 的标签与索引分界向右移动;最终到全相联时,索引字段消失。
问题 3:缓存未命中时替换哪个块?
未命中时,缓存控制器必须选择一个块,用所需数据替换它。直接映射的优点是简化硬件决策,实际上根本无须选择:只检查一个块框是否命中,也只能替换该块。全相联或组相联有多个候选块,主要采用三种策略:
- 随机替换:随机选择候选块,使分配均匀分布。有些系统生成伪随机块号,使行为可复现,这对硬件调试尤其有用。
- 最近最少使用(LRU):记录块的访问情况,降低淘汰即将再次使用的数据的概率。依据过去预测未来,替换最久未用的块。其依据是局部性的推论:如果最近使用过的块很可能再次使用,那么最久未用的块就是较好的淘汰候选。
- 先进先出(FIFO):由于精确确定 LRU 可能复杂,改为找出进入缓存时间最早的块,以近似 LRU。
随机替换易于硬件实现。需要跟踪的块越多,LRU 越昂贵,通常只能近似。一种常见的近似方案称为 pseudo-LRU(伪 LRU),为缓存每组维护一组位,每位对应一路;路是组相联缓存中的一个存储体,四路组相联就有四路。访问某组时,将包含目标块的那一路对应的位设为 1;如果该组所有位都为 1,就清零除最近设置那一位之外的全部位。需要替换块时,从标志位为 0 的路中选择;若候选不止一个,通常随机选择。这近似于 LRU,因为被替换的块,自上次组内所有块都被访问过之后,就没有再被访问。图 B.4 比较 LRU、随机、FIFO 的未命中情况。
| 容量 | 二路 LRU | 二路随机 | 二路 FIFO | 四路 LRU | 四路随机 | 四路 FIFO | 八路 LRU | 八路随机 | 八路 FIFO |
|---|---|---|---|---|---|---|---|---|---|
| 16 KiB | 114.1 | 117.3 | 115.5 | 111.7 | 115.1 | 113.3 | 109.0 | 111.8 | 110.4 |
| 64 KiB | 103.4 | 104.3 | 103.9 | 102.4 | 102.3 | 103.1 | 99.7 | 100.5 | 100.3 |
| 256 KiB | 92.2 | 92.1 | 92.5 | 92.1 | 92.1 | 92.5 | 92.1 | 92.1 | 92.5 |
问题 4:写操作如何处理?
处理器缓存访问以读为主:所有取指都是读,多数指令不写存储器。附录 A 的图 A.32、A.33 给出的 RISC-V 程序指令混合中,存储占 10%,加载占 26%。2 因此,写占总访存的 ,约 7%;占数据缓存访问的 ,约 28%。加速常见情况,就意味着优先优化读,尤其因为处理器传统上必须等待读完成,却不一定要等待写。尽管如此,Amdahl 定律(1.9 节)仍提醒我们,高性能设计不能忽视写速度。
幸运的是,常见情况也比较容易加速。读取和比较标签时,可以同时读取缓存块,因此只要块地址可用,读取就能开始。若命中,立即将目标部分送给处理器;若未命中,这次读取没有收益,但对桌面和服务器而言,除额外耗电外也没有损害,忽略读出的值即可。
写操作不能如此乐观。在标签检查确认命中之前,不能修改块。由于检查标签不能与写并行,写通常比读慢。另一个复杂因素是处理器还会指定写入大小,通常为 1–8 字节;只能修改块中的相应部分。读则可以放心地多读一些字节。
写策略通常是区分缓存设计的重要特征。写缓存有两种基本选择:
- 直写(write through):同时写缓存中的块和下一级存储器中的块。
- 写回(write back):只写缓存块;直到该块被替换时,才将修改后的内容写入主存。
为减少替换时的写回次数,通常加入脏位,记录块是脏的(在缓存中被修改)还是干净的(未被修改)。干净块无需在未命中替换时写回,因为下层已有相同副本。
写回和直写各有优点。写回以缓存速度完成写入,同一块被多次写,只需向下层写一次。部分写操作不必到达存储器,节省了带宽,因此写回对多处理器很有吸引力。它也减少其余存储层次及互连的使用,从而节省能耗,对嵌入式应用同样有吸引力。
直写比写回易于实现:缓存始终干净,读未命中不会像写回那样触发下层写入。它还保证下一级始终保存最新副本,简化数据一致性处理。数据一致性对多处理器和 I/O 很重要,原书在第 4 章与附录 D 讨论。多级缓存使上层采用直写更可行,因为写只需传播到下一级,不必一直到主存。
后面会看到,I/O 与多处理器提出的要求并不一致:一方面,希望处理器缓存采用写回来减少流量;另一方面,又希望采用直写,使缓存与下层存储保持一致。
直写期间,如果处理器必须等待写完成,就发生写停顿。常见优化是加入写缓冲区:数据进入缓冲区后,处理器即可继续执行,使执行与存储器更新重叠。不过稍后也会看到,即使有写缓冲区,仍可能发生写停顿。
写操作不需要先取得原数据,因此写未命中有两种选择:
- 写分配:写未命中时先分配并装入该块,再按写命中处理。这是自然的选择,写未命中的行为类似读未命中。
- **非写分配**:看似不寻常,但写未命中不改变缓存,只修改下一级存储器中的块。
因此,非写分配时,一个块要等程序尝试读取它,才会进入缓存;写分配则使只被写、不被读的块也进入缓存。
例题:写分配与非写分配
一个拥有大量表项的全相联写回缓存初始为空。依次发生以下五次访存,方括号内为地址:
分别采用非写分配和写分配时,命中、未命中各多少次?
解答。 非写分配时,地址 100 不在缓存中,写又不分配块,因此前两次写均未命中。地址 200 也不在缓存,所以读也未命中,但它把块装入缓存,随后对 200 的写命中。最后对 100 的写仍未命中。总计 4 次未命中、1 次命中。
写分配时,首次访问 100、200 未命中;之后二者均在缓存中,其余访问命中。总计 2 次未命中、3 次命中。
两种写未命中策略,都可以配合直写或写回。写回缓存通常采用写分配,希望后续对同一块的写能在缓存中完成。直写缓存通常采用非写分配,理由是后续写即使命中,仍必须传到下层,那么把块装入缓存又有何收益?
实例:Opteron 数据缓存
图 B.5 用 AMD Opteron 微处理器的数据缓存,使上述概念具体化。它保存 65,536 字节,即 64 KiB 数据;块大小为 64 字节,采用二路组相联、LRU 替换、写回,以及写未命中时写分配。
按图中四个带圈数字,跟踪一次命中。B.5 节将说明,Opteron 向缓存提供 48 位虚拟地址,同时将其转换为 40 位物理地址,用于标签比较。
Opteron 没有使用完整的 64 位虚拟地址,是因为设计者认为当时尚无人需要如此大的虚拟地址空间;较小宽度也简化映射。他们计划在后续微处理器中扩大虚拟地址。
送入缓存的物理地址分成 34 位块地址和 6 位块内偏移,因为 ,且 。块地址再分成地址标签和缓存索引;图中的步骤 1 就是这一划分。
缓存索引选择待比较的标签,以判断目标块是否在缓存中。索引宽度取决于缓存容量、块大小和相联度。Opteron 为二路组相联,其索引计算如下:
图内术语:Block address=块地址;Tag=标签(25 位);Index=索引(9 位);Block offset=块内偏移(6 位);Valid=有效位;Data=数据(64 位);512 blocks=512 块;CPU address=CPU 地址;Data in/out=输入/输出数据;2:1 mux=二选一多路选择器;Victim buffer=牺牲块缓冲区;Lower-level memory=下一级存储器。“=?” 表示相等比较。3
所以索引为 9 位,标签为 位。虽然这个索引足以选出正确的块,但 64 字节远超过处理器一次所需的数据。更合理的做法,是将缓存的数据部分组织成 8 字节宽,正好对应 64 位 Opteron 的自然字长。因此,除选择缓存块的 9 位外,还从块内偏移中取 3 位,选择正确的 8 字节。索引选择就是图中的步骤 2。
读出两个标签后,与处理器块地址中的标签部分比较,这是步骤 3。还必须检查有效位;若未置位,即使比较相等也不算命中。
假定一个标签匹配,最后用二选一多路选择器选出命中的一路,通知处理器接收正确数据。Opteron 用 2 个时钟周期完成这四步;因此,随后的 2 个周期内,若指令试图使用该加载结果,就需要等待。
与任何缓存一样,Opteron 的写处理比读复杂。待写字在缓存中时,前三步相同。由于 Opteron 乱序执行,只有指令已获准提交、标签比较又确认命中后,数据才能写入缓存。
目前讨论的是常见的命中情况。读未命中时,缓存通知处理器数据尚不可用,并从下一层读取 64 字节。块的前 8 字节延迟为 7 个时钟周期,余下部分每 8 字节需 2 个周期。由于是组相联缓存,还需选择替换块。Opteron 采用 LRU,选择最久未访问的块,所以每次访问都要更新 LRU 位。替换块需要更新数据、地址标签、有效位和 LRU 位。
由于采用写回,被替换的数据块可能已修改,不能直接丢弃。Opteron 每块维护 1 个脏位,记录它是否被写过。如果“牺牲块”已修改,就把其数据和地址送入牺牲块缓冲区;它类似其他计算机的写缓冲区,可容纳 8 个牺牲块。Opteron 在执行其他缓存操作的同时,将这些块写入下一级。缓冲区满时,缓存必须等待。
写未命中与读未命中非常相似,因为二者都会分配块。
数据缓存的工作方式已经清楚,但它不能满足处理器的全部存储需求:处理器还需要指令。虽然可以让一个缓存同时提供指令和数据,却可能形成瓶颈。例如,执行加载或存储时,流水线处理器会同时请求一个数据字和一个指令字;单个缓存就会产生结构冒险,引起停顿。简单办法是分开:一个缓存专供指令,另一个专供数据。包括 Opteron 在内,多数较新的处理器都采用分离缓存。因此,Opteron 除 64 KiB 数据缓存外,还有 64 KiB 指令缓存。
处理器知道自己发出的是指令地址还是数据地址,所以可以分别提供端口,使处理器与存储层次之间的带宽加倍。分离还允许独立优化容量、块大小和相联度,改善性能。与 Opteron 的指令、数据分离缓存相对,能够同时保存指令和数据的缓存称为统一缓存或混合缓存。
图 B.6 表明,指令缓存未命中率低于数据缓存。分离指令和数据,可以消除两者块之间的冲突,但也固定了分配给各类数据的缓存空间。哪种影响更重要?公平比较必须保持总容量相同:例如,16 KiB 指令缓存加 16 KiB 数据缓存,应与 32 KiB 统一缓存比较。计算分离缓存的平均未命中率,必须知道访问各缓存的比例。根据附录 A 的数据,指令访问比例为 ,约 74%;数据访问为 ,约 26%。缓存分离对性能的影响,不止未命中率的变化,后面会继续说明。
| 容量(KiB) | 指令缓存 | 数据缓存 | 统一缓存 |
|---|---|---|---|
| 8 | 8.16 | 44.0 | 63.0 |
| 16 | 3.82 | 40.9 | 51.0 |
| 32 | 1.36 | 38.4 | 43.3 |
| 64 | 0.61 | 36.9 | 39.4 |
| 128 | 0.30 | 35.3 | 36.2 |
| 256 | 0.02 | 32.6 | 32.9 |
B.2 缓存性能
指令数与硬件无关,因此很容易让人想用它评价处理器性能。这样的间接指标,已经误导过许多计算机设计者。评价存储层次结构时,也有类似诱惑:专注于未命中率,因为它同样与硬件速度无关。后面将看到,未命中率可能与指令数一样具有误导性。更好的指标是平均存储器访问时间:
命中时间是在缓存中命中所需的时间,另外两项已经介绍过。各项可用绝对时间,例如命中需 0.25–1.0 ns,也可用处理器等待存储器的周期数,例如未命中代价为 150–200 周期。要记住,平均存储器访问时间仍是间接指标:虽然比未命中率好,却不能替代执行时间。
这个公式可以帮助我们在分离缓存与统一缓存之间选择。
例题:分离缓存还是统一缓存?
16 KiB 指令缓存加 16 KiB 数据缓存,与 32 KiB 统一缓存相比,哪种未命中率更低?使用图 B.6 的数据,假设 36% 的指令是数据传送。命中需 1 周期,未命中代价为 100 周期。统一缓存若只有一个端口,无法同时满足两次请求,因此加载或存储命中还需额外 1 周期;用第 3 章的流水线术语说,这产生了结构冒险。两种方案的平均存储器访问时间各是多少?假设均为带写缓冲区的直写缓存,忽略写缓冲区引起的停顿。
解答。 先把每 1000 条指令未命中次数转换为未命中率。由前面的通式可得:
每条指令恰好需要一次取指,因此指令未命中率为:
36% 的指令是数据传送,因此数据未命中率为:
统一缓存要同时计入指令和数据访问:
前面指出,约 74% 的访存是取指。因此,分离缓存的总体未命中率为:
所以,32 KiB 统一缓存的有效未命中率略低于两个 16 KiB 缓存。
平均存储器访问时间可以按指令、数据访问分别计算:
于是两种组织分别为:
因此,本例的分离缓存每周期提供两个端口、避免结构冒险,尽管有效未命中率更高,平均访问时间却优于单端口统一缓存。1
平均存储器访问时间与处理器性能
一个自然问题是:缓存未命中所决定的平均存储器访问时间,能否预测处理器性能?
首先,还有其他停顿来源,例如 I/O 设备使用存储器造成的争用。由于存储层次造成的停顿通常占主导,设计者经常假定所有存储器停顿都来自缓存未命中。这里也采用这一简化,但计算最终性能时,应计入所有存储器停顿。
其次,答案取决于处理器。对于顺序执行处理器(见第 3 章),基本可以:未命中会使处理器停顿,停顿时间与平均访问时间密切相关。暂时采用这个假设,下一小节再回到乱序处理器。
如上一节所述,CPU 时间可建模为:
这里会产生一个问题:缓存命中的周期,应归入 CPU 执行周期,还是存储器停顿周期?两种约定都说得通,但通常采用前者。
现在可以考察缓存对性能的影响。
例题:缓存如何影响顺序执行处理器
假设未命中代价为 200 周期;忽略存储器停顿时,每条指令通常需 1.0 周期;平均未命中率为 2%,每条指令平均访问存储器 1.5 次,即每 1000 条指令平均未命中 30 次。计入缓存行为后,性能受到什么影响?分别用每条指令未命中次数和未命中率计算。
解答。
计入缓存未命中后:
改用未命中率计算:
有无缓存停顿,时钟周期时间和指令数都相同。因此 CPU 时间增至七倍,CPI 从“完美缓存”的 1.00 变为可能未命中时的 7.00。如果完全没有存储层次结构,CPI 还会增加到 ,执行时间超过有缓存系统的 40 倍!
这个例子表明,缓存行为对性能的影响巨大。对于低 CPI、高频率处理器,未命中还有双重影响:
- 越低,固定数量的未命中周期所占相对影响越大。
- CPI 中的未命中代价以处理器周期计量。即使两台计算机的存储层次完全相同,频率更高的处理器,一次未命中也要经历更多周期,CPI 中存储器部分因而更大。
因此,低 CPI、高频率处理器更加依赖缓存;评价其性能时忽略缓存,也更加危险。Amdahl 定律再次发挥作用!
尽管最小化平均存储器访问时间是合理目标,本附录也经常这样做,但最终目标始终是缩短处理器执行时间。下例说明二者可能不同。
例题:命中速度、相联度与 CPU 时间
两种缓存组织对处理器性能有何影响?假设完美缓存下 CPI 为 1.0,时钟周期时间为 0.35 ns,每条指令访问存储器 1.4 次。两种缓存均为 128 KiB、64 字节块;一种直接映射,另一种二路组相联。
图 B.5 表明,组相联需要多路选择器,根据标签匹配结果选择组内的块。缓存命中速度可能直接决定处理器速度,因此假设为容纳该选择器,组相联处理器的时钟周期需延长到原来的 1.35 倍。初步近似认为,两种缓存未命中代价均为 65 ns;实际通常会取整到整数周期。
先计算平均访问时间,再计算处理器性能。命中时间均为 1 周期;128 KiB 直接映射缓存的未命中率为 2.1%,相同容量二路组相联为 1.9%。
解答。
平均存储器访问时间以二路组相联更好。
处理器性能为:
将“未命中代价 × 时钟周期时间”替换为 65 ns:
相对性能为:
原书据此得出的结论是:与平均访问时间的比较不同,直接映射的平均性能略好。尽管二路组相联未命中较少,它却让所有指令的时钟周期都变长。由于 CPU 时间才是最终评价标准,而直接映射也更易实现,本例应选直接映射。2
未命中代价与乱序执行处理器
对于乱序处理器,应该怎样定义“未命中代价”?是访问存储器的完整未命中延迟,还是只有处理器必须停顿的那部分,即“暴露出来”、未能重叠的延迟?对于一直停顿到数据未命中完成的处理器,这个问题并不存在。
重新定义存储器停顿,将未命中代价改为不能重叠的延迟:
类似地,某些乱序处理器会延长命中时间,性能公式中的相应部分也可以按总命中延迟减去重叠命中延迟来划分。还可以进一步区分无争用延迟与资源争用造成的延迟,把乱序处理器中的存储器资源争用纳入公式。这里只关注未命中延迟。
现在必须确定:
- 存储器延迟的长度:乱序处理器中,访存操作从哪个时刻开始、到哪个时刻结束?
- 延迟重叠的长度:与处理器执行的重叠从何时开始?等价地说,什么时候认为访存操作使处理器停顿?
乱序处理器很复杂,因此没有唯一正确的定义。
由于流水线退役阶段只看到已提交操作,可以把“某周期退役的指令数少于理论最大值”定义为处理器停顿,并将停顿归因于第一条无法退役的指令。这一定义并非万无一失。例如,优化某类停顿,不一定总能缩短执行时间,因为原来被它遮蔽的另一类停顿,可能随之暴露。
延迟计时可以从访存指令进入指令窗口、生成地址,或实际发往存储系统时开始。只要始终一致,哪一种都可以。
例题:隐藏部分未命中延迟
重新考虑前例,不过时钟周期较长的处理器现在支持乱序执行,仍采用直接映射缓存。假定 65 ns 未命中代价的 30% 可以重叠,也就是平均 CPU 存储器停顿时间降为 45.5 ns。
解答。 乱序(OOO)计算机的平均存储器访问时间为:
其性能为:
因此,尽管时钟周期明显更长,直接映射缓存的未命中率也更高,只要能隐藏 30% 的未命中代价,乱序计算机仍可略快一些。3
总之,虽然为乱序处理器定义、测量存储器停顿的方法相当复杂,但必须注意这些问题,因为它们显著影响性能。复杂性在于,乱序处理器能容忍一部分缓存未命中延迟,而不损害性能。因此,评价存储层次的权衡时,设计者通常使用乱序处理器与存储器模拟器,确保降低平均存储延迟的优化,也确实改善程序性能。
图 B.7 汇总本附录的缓存公式,既总结本节,也便于查阅。
| 用途 | 公式 |
|---|---|
| 索引位数 | |
| 执行时间 | |
| 存储器停顿 | |
| 按指令数表示停顿 | |
| 两种未命中指标 | |
| 平均存储器访问时间 | |
| 执行时间与每条指令停顿 | |
| 执行时间与每条指令未命中 | |
| 执行时间与未命中率 | |
| 乱序执行中的停顿 | |
| 两级缓存平均访问时间 | |
| 两级缓存停顿 |
B.3 六种基本缓存优化
平均存储器访问时间公式,为介绍缓存性能优化提供了框架:
因此,将六种缓存优化分为三类:
- 降低未命中率:增大块、增大缓存容量、提高相联度。
- 降低未命中代价:采用多级缓存,让读优先于写。
- 缩短命中时间:索引缓存时避免地址转换。
本节末的图 B.18(原文指 B-40 页)汇总这六种方法的实现复杂度及性能收益。
改善缓存行为的传统方法,是降低未命中率。下面介绍三种技术。为理解未命中的原因,先将其划分为三个简单类别:
- 强制未命中(compulsory miss):第一次访问某块时,它不可能已在缓存中,必须先装入;也称冷启动未命中或首次访问未命中。
- 容量未命中(capacity miss):缓存无法同时容纳程序执行所需的全部块,某块被丢弃后又要重新取回,除强制未命中外便出现容量未命中。
- 冲突未命中(conflict miss):组相联或直接映射中,如果太多块映射到同一组,一些块会被丢弃后又重新取回;这是强制、容量之外的冲突未命中,也称 collision miss。在全相联缓存中命中、在 n 路组相联中却未命中的情况,可理解为某些热门组收到超过 n 个不同块的请求。
第 5 章还加入第四个 C,即 coherence miss:多处理器为保持多个缓存一致而清除缓存内容,导致的一致性未命中。本节暂不考虑。
图 B.8 按三个 C 列出未命中的相对频率。无限容量缓存仍会发生的,是强制未命中;全相联缓存发生的,是容量未命中;从全相联降为八路、四路等相联度后新增的,是冲突未命中。图 B.9 用图形表示相同数据:上图为绝对未命中率,下图为各类占全部未命中的百分比随容量的变化。
为显示相联度的收益,按每次降低相联度所增加的未命中,将冲突未命中再分为四部分:
- 八路:从没有冲突的全相联降至八路组相联,新增的冲突未命中。
- 四路:从八路降至四路新增的冲突未命中。
- 二路:从四路降至二路新增的冲突未命中。
- **一路**:从二路降至一路,即直接映射,新增的冲突未命中。
图中可见,SPEC2000 的强制未命中率很小;许多长时间运行的程序也是如此。
明确三个 C 后,设计者可以采取什么措施?概念上最容易解决的是冲突:全相联消除所有冲突未命中。但硬件昂贵,而且可能降低处理器时钟频率(见 B-29 页例题),使总体性能下降。
对于容量未命中,除增大缓存外,办法不多。如果上层容量远小于程序需求,大量时间花在两层之间搬移数据,就称存储层次发生抖动(thrashing)。由于替换过于频繁,计算机速度接近下层存储器,甚至因未命中额外开销而更慢。
另一个方向是增大块,以减少强制未命中;但稍后会看到,大块也可能增加其他未命中。
三个 C 有助于理解原因,却也有局限:它解释平均行为,不一定能解释某一次未命中。例如,改变容量不仅改变容量未命中,也改变冲突未命中,因为更大的缓存将访问分散到更多块中;同一次访问可能随容量变化,从容量未命中变为冲突未命中。类似地,Gupta 等人(2013)指出,改变块大小除了预期的强制未命中减少,有时也会减少容量未命中。
三个 C 还忽略替换策略,因为它难以建模,通常影响也较小。但特定情况下,替换策略可能产生反常行为,例如相联度提高,未命中率反而变差,与三个 C 模型矛盾。有人建议利用地址轨迹确定存储器中的最优放置,以避免三个 C 模型中的放置未命中;这里未采用这一建议。
遗憾的是,许多降低未命中率的技术,也会增加命中时间或未命中代价。必须将降低未命中率的愿望,与加速整个系统的目标平衡。第一个例子就说明这种整体视角的重要性。
| 缓存容量(KiB) | 相联度 | 总未命中率 | 强制未命中率 | 强制占比 | 容量未命中率 | 容量占比 | 冲突未命中率 | 冲突占比 |
|---|---|---|---|---|---|---|---|---|
| 4 | 一路 | 0.098 | 0.0001 | 0.1% | 0.070 | 72% | 0.027 | 28% |
| 4 | 二路 | 0.076 | 0.0001 | 0.1% | 0.070 | 93% | 0.005 | 7% |
| 4 | 四路 | 0.071 | 0.0001 | 0.1% | 0.070 | 99% | 0.001 | 1% |
| 4 | 八路 | 0.071 | 0.0001 | 0.1% | 0.070 | 100% | 0.000 | 0% |
| 8 | 一路 | 0.068 | 0.0001 | 0.1% | 0.044 | 65% | 0.024 | 35% |
| 8 | 二路 | 0.049 | 0.0001 | 0.1% | 0.044 | 90% | 0.005 | 10% |
| 8 | 四路 | 0.044 | 0.0001 | 0.1% | 0.044 | 99% | 0.000 | 1% |
| 8 | 八路 | 0.044 | 0.0001 | 0.1% | 0.044 | 100% | 0.000 | 0% |
| 16 | 一路 | 0.049 | 0.0001 | 0.1% | 0.040 | 82% | 0.009 | 17% |
| 16 | 二路 | 0.041 | 0.0001 | 0.2% | 0.040 | 98% | 0.001 | 2% |
| 16 | 四路 | 0.041 | 0.0001 | 0.2% | 0.040 | 99% | 0.000 | 0% |
| 16 | 八路 | 0.041 | 0.0001 | 0.2% | 0.040 | 100% | 0.000 | 0% |
| 32 | 一路 | 0.042 | 0.0001 | 0.2% | 0.037 | 89% | 0.005 | 11% |
| 32 | 二路 | 0.038 | 0.0001 | 0.2% | 0.037 | 99% | 0.000 | 0% |
| 32 | 四路 | 0.037 | 0.0001 | 0.2% | 0.037 | 100% | 0.000 | 0% |
| 32 | 八路 | 0.037 | 0.0001 | 0.2% | 0.037 | 100% | 0.000 | 0% |
| 64 | 一路 | 0.037 | 0.0001 | 0.2% | 0.028 | 77% | 0.008 | 23% |
| 64 | 二路 | 0.031 | 0.0001 | 0.2% | 0.028 | 91% | 0.003 | 9% |
| 64 | 四路 | 0.030 | 0.0001 | 0.2% | 0.028 | 95% | 0.001 | 4% |
| 64 | 八路 | 0.029 | 0.0001 | 0.2% | 0.028 | 97% | 0.001 | 2% |
| 128 | 一路 | 0.021 | 0.0001 | 0.3% | 0.019 | 91% | 0.002 | 8% |
| 128 | 二路 | 0.019 | 0.0001 | 0.3% | 0.019 | 100% | 0.000 | 0% |
| 128 | 四路 | 0.019 | 0.0001 | 0.3% | 0.019 | 100% | 0.000 | 0% |
| 128 | 八路 | 0.019 | 0.0001 | 0.3% | 0.019 | 100% | 0.000 | 0% |
| 256 | 一路 | 0.013 | 0.0001 | 0.5% | 0.012 | 94% | 0.001 | 6% |
| 256 | 二路 | 0.012 | 0.0001 | 0.5% | 0.012 | 99% | 0.000 | 0% |
| 256 | 四路 | 0.012 | 0.0001 | 0.5% | 0.012 | 99% | 0.000 | 0% |
| 256 | 八路 | 0.012 | 0.0001 | 0.5% | 0.012 | 99% | 0.000 | 0% |
| 512 | 一路 | 0.008 | 0.0001 | 0.8% | 0.005 | 66% | 0.003 | 33% |
| 512 | 二路 | 0.007 | 0.0001 | 0.9% | 0.005 | 71% | 0.002 | 28% |
| 512 | 四路 | 0.006 | 0.0001 | 1.1% | 0.005 | 91% | 0.000 | 8% |
| 512 | 八路 | 0.006 | 0.0001 | 1.1% | 0.005 | 95% | 0.000 | 4% |
图内术语:Miss rate per type=各类未命中率;Cache size=缓存容量(图中 KB);1/2/4/8-way=分别从二路降到一路、四路降到二路、八路降到四路、全相联降到八路而增加的冲突未命中;Capacity=容量;Compulsory=强制。下图纵轴表示占全部未命中的比例。
第一种优化:增大块以降低未命中率
最简单的办法是增大块。图 B.10 展示一组程序与多种缓存容量下,块大小与未命中率的权衡。大块减少强制未命中,因为局部性既包含时间局部性,也包含空间局部性,而大块利用了后者。
同时,大块也增加未命中代价。缓存中的块数因此减少,可能增加冲突未命中;缓存较小时,甚至增加容量未命中。显然,没有理由把块增大到未命中率反而上升。即使未命中率降低,如果平均访问时间增加,也没有收益:未命中代价的上升,可能超过未命中率下降所带来的好处。
图内术语:Miss rate=未命中率;Block size=块大小(字节);4K、16K、64K、256K 为缓存容量。原图注称“五种”,图和表实际列出四种容量、五种块大小,见本节译注:1
例题:按平均访问时间选择块大小
图 B.11 给出图 B.10 的实际未命中率。假设存储系统先花 80 周期开销,此后每 2 周期提供 16 字节。因此,16 字节需 82 周期,32 字节需 84 周期,依此类推。对图 B.11 的每种缓存容量,哪种块大小使平均访问时间最短?
解答。
假设命中时间恒为 1 周期,与块大小无关,则 4 KiB 缓存采用 16 字节块时:
256 KiB 缓存采用 256 字节块时:
图 B.12 列出两种极端之间所有块大小与缓存容量的平均访问时间。粗体为同一容量下最快的选择:4 KiB 缓存选 32 字节块,较大缓存选 64 字节块。这也是原书所述处理器缓存的常用块大小。
| 块大小(字节) | 4 KiB 缓存 | 16 KiB 缓存 | 64 KiB 缓存 | 256 KiB 缓存 |
|---|---|---|---|---|
| 16 | 8.57% | 3.94% | 2.04% | 1.09% |
| 32 | 7.24% | 2.87% | 1.35% | 0.70% |
| 64 | 7.00% | 2.64% | 1.06% | 0.51% |
| 128 | 7.78% | 2.77% | 1.02% | 0.49% |
| 256 | 9.51% | 3.29% | 1.15% | 0.49% |
| 块大小(字节) | 未命中代价(周期) | 4 KiB 缓存 | 16 KiB 缓存 | 64 KiB 缓存 | 256 KiB 缓存 |
|---|---|---|---|---|---|
| 16 | 82 | 8.027 | 4.231 | 2.673 | 1.894 |
| 32 | 84 | 7.082 | 3.411 | 2.134 | 1.588 |
| 64 | 88 | 7.160 | 3.323 | 1.933 | 1.449 |
| 128 | 96 | 8.469 | 3.659 | 1.979 | 1.470 |
| 256 | 112 | 11.651 | 4.685 | 2.288 | 1.549 |
与所有这些技术一样,设计者既要降低未命中率,也要降低未命中代价。块大小取决于下层存储器的延迟与带宽。高延迟、高带宽有利于大块,因为每次未命中可以多取许多字节,而代价只略增。反过来,低延迟、低带宽有利于小块,因为大块节省不了多少时间。例如,小块未命中代价的两倍,可能接近双倍大小块的代价。小块数量更多,也可能减少冲突。图 B.10 与图 B.12 正说明了:以最小未命中率选块大小,与以最小平均访问时间选择,并不相同。
看过增大块对强制、容量未命中的正反影响,下面考察提高容量和相联度的潜力。
第二种优化:增大缓存以降低未命中率
减少图 B.8、B.9 中容量未命中的直接办法,是增加缓存容量。明显缺点是命中时间可能更长,成本和功耗更高。这种技术在片外缓存中尤其常见。
第三种优化:提高相联度以降低未命中率
图 B.8、B.9 展示提高相联度如何改善未命中率,可得两条经验。第一,对于这些容量,从减少未命中的实用效果看,八路组相联几乎相当于全相联。比较图 B.8 的八路数据与容量未命中列即可看出差异,因为后者按全相联计算。
第二条称为 2∶1 缓存经验法则:容量为 N 的直接映射缓存,其未命中率约等于容量为 N/2 的二路组相联缓存。在前面三个 C 的图中,这适用于小于 128 KiB 的缓存。
与许多例子相同,改善平均访问时间的一个方面,往往损害另一个方面。大块降低未命中率,却提高未命中代价;高相联度可能增加命中时间。因此,短时钟周期推动简单的缓存设计,而越来越高的未命中代价又鼓励提高相联度。
例题:提高相联度是否值得?
假定提高相联度使时钟周期时间变化如下:
命中时间为 1 周期。直接映射时,未命中访问一个永不未命中的 L2 缓存(见下一小节),代价为 25 周期;未命中代价不必取整为整数周期。使用图 B.8 的未命中率,以下各关系分别在哪些缓存容量下成立?
这里 AMAT 表示平均存储器访问时间。
解答。 各相联度的平均访问时间为:
各方案的未命中实际耗时相同,因此保留 25 个基准周期。例如,4 KiB 直接映射缓存为:
512 KiB 八路组相联缓存为:
译注: 以上两式保留原书结果。若直接使用式中显示的三位小数未命中率,结果分别为 3.45 和 1.67,而非 3.44 和 1.66;原书未说明是否使用了未显示的更高精度数据。图 B.13 的数值也按原表保留。
| 缓存容量(KiB) | 一路 | 二路 | 四路 | 八路 |
|---|---|---|---|---|
| 4 | 3.44 | 3.25 | 3.22 | 3.28 |
| 8 | 2.69 | 2.58 | 2.55 | 2.62 |
| 16 | 2.23 | 2.40 | 2.46 | 2.53 |
| 32 | 2.06 | 2.30 | 2.37 | 2.45 |
| 64 | 1.92 | 2.14 | 2.18 | 2.25 |
| 128 | 1.52 | 1.84 | 1.92 | 2.00 |
| 256 | 1.32 | 1.66 | 1.74 | 1.82 |
| 512 | 1.20 | 1.55 | 1.59 | 1.66 |
利用这些公式与图 B.8 的数据,就得到图 B.13。缓存不超过 8 KiB、相联度提高到四路为止,例题中的相应不等式成立;从 16 KiB 开始,高相联度增加的命中时间,超过未命中减少所节省的时间。
本例没有计入较慢时钟对程序其余部分的影响,因此还低估了直接映射的优势。
第四种优化:采用多级缓存以降低未命中代价
降低未命中次数曾是缓存研究的传统重点,但性能公式表明,降低未命中代价可能同样有效。此外,第 80 页图 2.2 表明,处理器速度的提升比 DRAM 快,未命中相对代价随时间增加。
这一性能差距让设计者面临问题:应该加快缓存,跟上处理器速度,还是增大缓存,以弥合处理器与主存间越来越大的差距?
一个答案是两者都做。在原有缓存和主存之间增加一级缓存,就简化了选择。L1 可以小到足以匹配高速处理器的时钟周期,L2 则可大到截获许多原本必须访问主存的请求,降低有效未命中代价。
增加一级的概念很直接,却使性能分析复杂化;二级缓存的某些定义也并不直观。用 L1、L2 分别表示一级和二级缓存,则:
又有:
所以:
这里,二级未命中率是在一级过滤后剩余的请求中测量的。为避免歧义,采用两个术语:
- 局部未命中率:某级缓存未命中次数,除以访问该缓存的总次数。L1 为 ,L2 为 。
- 全局未命中率:某级缓存未命中次数,除以处理器发出的全部访存次数。L1 仍为 ,L2 则为 。
L2 的局部未命中率较高,因为 L1 已经截获了最容易命中的访问。因此,全局未命中率更有用:它说明处理器发出的访存中,有多大比例最终到达主存。
此时,每条指令未命中次数的指标很有优势:无需纠结局部、全局,只要在每条指令的存储器停顿中加入 L2 影响。
例题:两级缓存的未命中率与停顿
1000 次访存中,L1 未命中 40 次,L2 未命中 20 次。各类未命中率是多少?假设 L2 到主存的未命中代价为 200 周期,L2 命中为 10 周期,L1 命中为 1 周期,每条指令访问存储器 1.5 次。平均存储器访问时间和每条指令平均停顿周期数是多少?忽略写操作影响。
解答。 L1 局部、全局未命中率均为 ;L2 局部为 ,全局为 。因此:
将 1000 次访存除以每条指令 1.5 次访存,得到约 667 条指令。因此,换算为每 1000 条指令未命中次数,需要乘以 1.5:L1 为 次,L2 为 次。假定未命中在取指和数据访问间均匀分布:
从 AMAT 中减去 L1 命中时间,再乘以每条指令平均访存次数,同样得到:
因此,多级缓存计算中,采用每条指令未命中次数,通常比采用未命中率更不容易混淆。
上述公式合并读写,并假定 L1 采用写回。若 L1 采用直写,它会将所有写操作送到 L2,而不只是未命中;也可能采用写缓冲区。
图 B.14、B.15 展示一种设计中,未命中率与相对执行时间如何随 L2 容量变化,可得两点认识。第一,只要 L2 远大于 L1,全局未命中率就与同等容量单级缓存的未命中率非常接近,因此对一级缓存的直觉与知识仍适用。第二,局部未命中率不适合评价二级缓存,因为它取决于 L1 未命中率,仅改变 L1 就能使它变化。所以应使用全局未命中率。
图内术语:Local miss rate=局部未命中率;Global miss rate=全局未命中率;Single cache miss rate=单级缓存未命中率;Miss rate=未命中率;Cache size=缓存容量(图中 KB)。2
明确这些定义后,再考察 L2 参数。两级最重要的差别是:L1 速度会影响处理器时钟频率,而 L2 速度只影响 L1 的未命中代价。因此,某些不适合 L1 的方案,可以用于 L2。二级缓存设计主要回答两件事:能否降低 CPI 中与平均访问时间有关的部分?成本是多少?
首先决定 L2 容量。L1 中的所有内容很可能也在 L2,所以 L2 应大得多;若仅略大,局部未命中率会很高。这一观察促使人们设计非常大的 L2,容量相当于早期计算机的主存!
图内术语:Second-level cache size=L2 容量(KB);Relative execution time=相对执行时间;L2 hit=L2 命中,深色为 8 周期,浅色为 16 周期。
另一个问题是:组相联是否更适合 L2?
例题:L2 相联度对未命中代价的影响
已知:
- 直接映射 L2 命中时间为 10 周期。
- 二路组相联使命中时间增加 0.1 周期,变成 10.1 周期。
- 直接映射 L2 局部未命中率为 25%。
- 二路组相联 L2 局部未命中率为 20%。
- L2 未命中代价为 200 周期。
L2 相联度对未命中代价有何影响?
解答。 L2 直接映射时,L1 未命中代价为:
相联度只使命中增加 0.1 周期,因此新的 L1 未命中代价为:
实际 L2 几乎总与 L1 和处理器同步,因此命中时间必须是整数周期。若能略作优化,可缩短至 10 周期;否则向上取整至 11 周期。两种情况都优于直接映射:
因此,可以通过降低 L2 未命中率,来降低 L1 未命中代价。
还需考虑 L1 中的数据是否也在 L2。**多级包含(multilevel inclusion)**是存储层次的自然策略:L1 数据始终也在 L2。其优点是,仅检查 L2,就能判断 I/O 与缓存之间,或多处理器各缓存之间的一致性。
一个缺点是:测量可能表明,小 L1 适合小块,大 L2 适合大块。例如 Pentium 4 的 L1 块为 64 字节,L2 为 128 字节。仍可维持包含关系,但 L2 未命中时要额外工作:使 L1 中所有映射到被替换 L2 块的块失效,略微提高 L1 未命中率。为避免此问题,许多设计者让所有缓存层采用相同块大小。
但若成本只允许 L2 比 L1 略大,是否还应将很大一部分容量用于重复保存 L1?此时合理的反向策略是多级互斥(multilevel exclusion):L1 数据绝不同时存在于 L2。通常,L1 未命中时,在 L1、L2 之间交换块,而不是单纯用 L2 块替换 L1 块,从而避免浪费 L2 空间。例如 AMD Opteron 的两个 64 KiB L1 与 1 MiB L2,就遵循互斥属性。
这些问题说明,新手可能分别设计 L1 和 L2,但如果已有兼容的 L2,L1 设计会容易得多。例如,下一级若为采用多级包含关系的写回缓存,可吸收重复写入,那么 L1 采用直写的风险就小得多。
所有缓存设计的核心,都是在快速命中与减少未命中之间平衡。L2 命中次数远少于 L1,因此重点转向减少未命中;这推动更大容量,以及提高相联度、增大块等降低未命中率的技术。
第五种优化:读未命中优先于写,以降低未命中代价
这项优化在写完成之前,先服务读请求。先看写缓冲区带来的复杂性。
对于直写缓存,最重要的改进是设置适当大小的写缓冲区。但它可能保存读未命中所需位置的最新值,因此使访存复杂化。
例题:写缓冲区中的数据冒险
考虑以下代码:
假定缓存直接映射、直写,地址 512 与 1024 映射到同一缓存块;写缓冲区可容纳四个字,读未命中时不检查它。x2 的值是否总与 x3 相同?
解答。 按第 2 章术语,这是存储器中的写后读数据冒险。存储后,x3 的数据进入写缓冲区。随后加载使用相同缓存索引,因此未命中。第二次加载试图把地址 512 的值装入 x2,也未命中。如果缓冲区尚未完成向主存地址 512 的写入,就会从 512 读到旧的错误值,送入缓存,再送入 x2。没有适当措施,x3 就可能不等于 x2!3
最简单的解决办法,是让读未命中等到写缓冲区清空。另一种办法是检查缓冲区:如果没有冲突,且存储系统可用,就让读未命中继续。几乎所有桌面和服务器处理器都采用后一种,让读优先于写。
写回缓存也能减少处理器写操作的开销。假设读未命中将替换一个脏块,可以先把脏块复制到缓冲区,再读存储器,最后才写回,而不是先完成脏块写回再读。处理器很可能正在等待的读,就能更早结束。与前述情况类似,再发生读未命中时,要么等待缓冲区清空,要么检查缓冲区内各字地址是否冲突。
已有五种优化用来降低未命中率或未命中代价,现在考虑平均访问时间的最后一项:命中时间。它至关重要,因为可能影响处理器频率。许多处理器即使需要多个周期访问缓存,缓存访问时间仍限制其时钟频率。因此,快速命中的意义超出了平均访问时间公式:它能加快一切。
第六种优化:索引缓存时避免地址转换,以缩短命中时间
即使缓存很小、很简单,也必须处理从处理器虚拟地址到访存物理地址的转换。B.4 节将说明,处理器将主存视为存储层次的另一层,因此磁盘上的虚拟存储器地址必须映射到主存。
“加速常见情况”原则建议使用虚拟地址访问缓存,因为命中远比未命中常见。这称为虚拟缓存,与传统采用物理地址的物理缓存相对。但必须区分索引缓存和比较地址两个任务:索引用虚拟还是物理地址?标签比较又用哪一种?索引、标签都使用虚拟地址,可以把地址转换从命中路径中去掉。为什么不是所有缓存都这样设计?
第一是保护。页级保护通常在虚拟地址转换为物理地址时检查,而且无论如何都不能省略。一个办法是在未命中时从 TLB 复制保护信息,增加字段保存,并在每次虚拟缓存访问时检查。
第二,每次切换进程,同一虚拟地址就可能指向不同物理地址,需要清空缓存。图 B.16 展示它对未命中率的影响。一个办法是在缓存标签中加入进程标识符(PID)。由操作系统分配,只在 PID 被回收重用时才需清空;PID 可以区分缓存数据是否属于当前程序。图中也显示用 PID 避免清空所带来的改善。
第三,操作系统和用户程序可能使用两个不同虚拟地址访问同一个物理地址。这些地址称为同义地址或别名(synonyms/aliases),可能让虚拟缓存保存同一数据的两份副本;修改一份后,另一份就错误。物理缓存不会出现这一情况,因为访问首先转换到同一个物理缓存块。
图内术语:Miss rate=未命中率;Cache size=缓存容量;Uniprocess=无进程切换的基础部分;PIDs=使用 PID 后增加的部分;Purge=清空缓存再增加的部分。柱形为堆叠,不是三种方案各自独立的未命中率。
解决同义地址的硬件方案称为 antialiasing(消除别名),保证每个物理地址在缓存中只有唯一副本。例如,AMD Opteron 指令缓存为 64 KiB、二路组相联,页为 4 KiB;组索引中有三个虚拟地址位,因此硬件必须处理对应的别名。未命中时,它检查全部八个可能位置,原文写作“四组、每组两块”,确认没有块匹配即将取入数据的物理地址。如果找到,就使其失效,保证新数据装入后物理地址唯一。4
软件可以强制别名共享某些地址位,大大简化问题。例如 Sun Microsystems 的一个较早 UNIX 版本,要求所有别名的低 18 位相同,这种限制称为页着色(page coloring)。它实际上是把组相联映射用于虚拟存储器:4 KiB()页面映射到 64()组,使虚拟地址和物理地址低 18 位一致。于是,容量不超过 字节,即 256 KiB 的直接映射缓存,不会出现同一物理块的重复副本。从缓存角度看,软件保证虚拟页地址与物理页地址低几位相同,相当于扩大了页内偏移。
最后一个问题是 I/O。I/O 通常使用物理地址,要与虚拟缓存交互,就需反向映射为虚拟地址。附录 D 将进一步讨论 I/O 对缓存的影响。
一种兼取虚拟、物理缓存优点的方案,是用页内偏移的一部分——虚拟与物理地址中相同的部分——索引缓存。按索引读缓存的同时,转换地址的虚拟部分,并用物理地址比较标签。
这样,读取可立即开始,标签比较仍用物理地址。**虚拟索引、物理标签(VIPT)**的限制,是直接映射缓存不能大于页大小。例如,B-13 页图 B.5 的数据缓存有 9 位索引、6 位块内偏移;要完全采用这个技巧,页至少需 字节,即 32 KiB。否则,一部分索引必须从虚拟地址转换。图 B.17 展示采用这一技术的缓存、TLB 和虚拟存储器组织。
提高相联度,可以在保持索引位属于地址中无需转换部分的同时,支持更大缓存。回顾索引公式:
例如,相联度与容量同时加倍,索引宽度不变。IBM 3033 是极端例子:尽管研究表明超过八路后,未命中率收益很小,它仍采用十六路组相联。这样,即使 IBM 体系结构的页面只有 4 KiB,64 KiB 缓存仍能使用无需转换的物理索引。
图内全部字段如下,尖括号内为原图位宽:
| 原字段 | 中文及位宽 |
|---|---|
| Virtual address | 虚拟地址,64 位 |
| Virtual page number | 虚拟页号,50 位 |
| Page offset | 页内偏移,14 位 |
| TLB tag compare address | 与 TLB 标签比较的地址,43 位 |
| TLB index | TLB 索引,7 位 |
| TLB tag / TLB data | TLB 标签 43 位/数据 26 位 |
| L1 cache index / Block offset | L1 索引 8 位/块内偏移 6 位 |
| L1 tag compare address / L1 cache tag | L1 标签比较地址/缓存标签,均 26 位 |
| L1 data | L1 数据,512 位 |
| Physical address | 物理地址,40 位 |
| L2 tag compare address / L2 cache tag | L2 标签比较地址/缓存标签,均 21 位 |
| L2 cache index / Block offset | L2 索引 14 位/块内偏移 6 位 |
| L2 data | L2 数据,512 位 |
| To CPU | 送往 CPU |
| To L1 cache or CPU | 送往 L1 或 CPU |
| =? | 相等比较 |
基本缓存优化小结
本节改善未命中率、未命中代价和命中时间的技术,通常也影响平均访问时间公式的其他项,以及存储层次的复杂度。图 B.18 汇总这些技术,并估计复杂度。“+”表示改善,“−”表示损害,空白表示无影响。没有一种优化能同时改善超过一类指标。
| 技术 | 命中时间 | 未命中代价 | 未命中率 | 硬件复杂度 | 说明 |
|---|---|---|---|---|---|
| 增大块 | − | + | 0 | 很简单;Pentium 4 的 L2 使用 128 字节块。 | |
| 增大缓存容量 | − | + | 1 | 广泛使用,尤其是 L2。 | |
| 提高相联度 | − | + | 1 | 广泛使用。 | |
| 多级缓存 | + | 2 | 硬件昂贵;L1、L2 块大小不同时更复杂;广泛使用。 | ||
| 读优先于写 | + | 1 | 广泛使用。 | ||
| 索引缓存时避免地址转换 | + | 1 | 广泛使用。 |
译注:图 B.10、B.11、B.12 的原图注均称“五种不同容量”,实际图表列出 4、16、64、256 KiB 四种容量及五种块大小。图 B.18 的页码在本节开头原文写作 B-40,实际图表位于 B-41。 ↩︎
译注:图 B.14 原图注在同一段同时出现“32 KiB 一级缓存”与“两个各 64 KiB 一级缓存”。 ↩︎
译注:原代码注释首行使用 R3,解答最后一句印作“x3x1 would not be equal to x2”。依照题干所比较的寄存器及前述操作,译文解释为 x3 与 x2,并在此保留原稿异常文字。 ↩︎
译注:原文给出三个虚拟索引位,却称检查“四组、每组两块,共八个位置”;这些数量之间存在疑点。 ↩︎
译注:图 B.17 的 L2 标签 21 位、索引 14 位、块内偏移 6 位合计为 41 位,与图示 40 位物理地址不符;字段按原图保留,未静默改数。 ↩︎
B.4 虚拟存储器
……我们设计了一种系统,使磁芯存储器与磁鼓的组合在程序员看来如同单级存储器,所需的数据传送则自动完成。
——Kilburn 等(1962)
计算机在任一时刻都运行着多个进程,每个进程都有自己的地址空间。(下一节将介绍进程。)为每个进程都配置足以覆盖其整个地址空间的存储器,代价过高,何况许多进程只会使用其中很小的一部分。因此,必须让多个进程能够共享容量较小的物理存储器。
实现这一目标的一种方式是虚拟存储器(virtual memory):把物理存储器分成若干块,再分配给不同进程。这种方法必须内含保护机制,把进程的访问限制在属于它自己的块内。多数虚拟存储器形式还可以缩短程序启动时间,因为程序开始执行前,无须把全部代码和数据都放入物理存储器。
虚拟存储器提供的保护对于今天的计算机至关重要,但共享并不是当初发明虚拟存储器的原因。早先,当程序大到物理存储器容纳不下时,程序员必须设法让它能够运行。他们把程序分成若干部分,找出不会同时使用的部分,再在执行过程中由用户程序控制这些覆盖段(overlay)的装入和卸载。程序员既要保证程序访问的物理主存不超过计算机实际拥有的容量,还要保证正确的覆盖段在正确的时刻被装入。
不难想见,这种负担降低了程序员的生产效率。
虚拟存储器正是为了把程序员从这一负担中解放出来而发明的:它自动管理主存与辅助存储器构成的两级存储层次结构。图 B.19 展示了一个含四个页面的程序从虚拟存储器到物理存储器的映射。
图中文字:Virtual address=虚拟地址;Virtual memory=虚拟存储器;Physical address=物理地址;Physical main memory=物理主存;Disk=磁盘。虚拟页面 A、B、C 的起始地址分别为 0、4K、8K,映射到物理地址 16K、24K、4K;起始地址为 12K 的 D 页位于磁盘。
除了共享受保护的存储空间、自动管理存储层次结构之外,虚拟存储器还简化了程序的装入运行。这个机制称为重定位(relocation),它使同一个程序可以在物理存储器的任意位置运行。只需改变映射关系,图 B.19 的程序就可以放在物理存储器或磁盘上的任意位置。(在虚拟存储器普及之前,处理器会专门为此设置重定位寄存器。)除硬件方案外,也可以用软件在每次运行程序时修改程序中的全部地址。
第 1 章介绍的若干有关缓存的一般存储层次结构概念,同样适用于虚拟存储器,只是许多术语不同:块称为页(page)或段(segment),未命中称为缺页(page fault)或地址故障(address fault)。使用虚拟存储器时,处理器产生虚拟地址(virtual address),再由软硬件协同把它转换成访问主存所用的物理地址(physical address)。这一过程称为存储器映射(memory mapping)或地址转换(address translation)。目前,虚拟存储器管理的两级存储器是 DRAM 和磁盘。图 B.20 给出了虚拟存储器相关参数的典型范围。
| 参数 | 一级缓存 | 虚拟存储器 |
|---|---|---|
| 块(页)大小 | 16–128 字节 | 4096–65,536 字节 |
| 命中时间 | 1–3 个时钟周期 | 100–200 个时钟周期 |
| 未命中代价 | 8–200 个时钟周期 | 1,000,000–10,000,000 个时钟周期 |
| 其中:访问时间 | 6–160 个时钟周期 | 800,000–8,000,000 个时钟周期 |
| 其中:传送时间 | 2–40 个时钟周期 | 200,000–2,000,000 个时钟周期 |
| 未命中率 | 0.1%–10% | 0.00001%–0.001% |
| 地址映射 | 25–45 位物理地址映射到 14–20 位缓存地址 | 32–64 位虚拟地址映射到 25–45 位物理地址 |
除了图 B.20 的数量差异,缓存与虚拟存储器还存在以下区别:
- 缓存未命中时的替换主要由硬件控制,而虚拟存储器的替换主要由操作系统控制。未命中代价越高,作出正确选择就越重要,因此可以让操作系统介入,花一些时间决定替换什么。
- 处理器的地址位数决定虚拟存储器的大小;缓存的容量则与处理器的地址位数无关。
- 辅助存储器除了充当主存的下一级后备存储器,还用于存放文件系统。事实上,文件系统占用了辅助存储器的大部分空间,而这部分通常不在地址空间中。
虚拟存储器还涵盖若干相关技术。它可以分成两类:一类使用固定大小的块,称为页;另一类使用可变大小的块,称为段。页大小通常固定为 4096–8192 字节,而段大小可以变化。不同处理器支持的最大段大小从 字节到 字节不等;最小的段为 1 字节。图 B.21 展示了两种方式如何划分代码与数据。
选择分页还是分段虚拟存储器,也会影响处理器。分页地址是单个固定大小的地址,分为页号和页内偏移,与缓存地址类似。分段地址则不能只用一个这样的地址表示:段长可变,需要用一个字表示段号,另一个字表示段内偏移,共两个字。不分段的地址空间对编译器更简单。
操作系统教材已充分讨论过这两种方法的优缺点,图 B.22 汇总了主要观点。
图中文字:Code=代码;Data=数据;Paging=分页;Segmentation=分段。分页把代码和数据划为等长的块;分段则按可变长度划分。
| 比较项目 | 分页 | 分段 |
|---|---|---|
| 每个地址占用的字数 | 一个 | 两个(段号与偏移) |
| 对程序员是否可见 | 对应用程序员不可见 | 可能对应用程序员可见 |
| 替换一个块 | 简单,所有块大小相同 | 困难,必须找到连续、大小适合且未使用的主存区域 |
| 存储空间利用不充分的原因 | 内部碎片,即页内未使用部分 | 外部碎片,即主存中未使用的小片空间 |
| 磁盘传输是否高效 | 是,可调整页大小以平衡访问时间和传送时间 | 不一定;小段可能只传送几个字节 |
由于替换问题(图中第三行),今天很少有计算机采用纯分段。某些计算机采用称为段页式(paged segments)的混合方法,一个段由整数个页组成。这样简化了替换,因为一个段占用的存储空间不必连续,而且整个段也不必全部驻留主存。较新的一种混合方式是提供多种页大小,较大的页是最小页大小的 的幂倍。例如,IBM 405CR 嵌入式处理器允许单个页面为 1 KiB、4 KiB()、16 KiB()、64 KiB()、256 KiB()、1024 KiB()和 4096 KiB()。
再看存储层次结构的四个问题
现在,我们可以针对虚拟存储器回答存储层次结构的四个问题了。
问题 1:块可以放在主存的什么位置?
虚拟存储器未命中需要访问旋转磁介质设备,因此未命中代价相当高。在较低未命中率和较简单的放置算法之间,操作系统设计者通常选择前者,因为未命中代价实在太高。因此,操作系统允许把块放在主存的任意位置。按照 B-8 页图 B.2 的术语,这就是全相联。
问题 2:若块已在主存中,如何找到它?
分页与分段都依赖一个以页号或段号索引的数据结构,其中存放块的物理地址。分段时,把偏移与段的物理地址相加,就得到最终物理地址;分页时,则只需把偏移拼接到物理页地址之后(见图 B.23)。
这种包含物理页地址的数据结构通常称为页表(page table)。它以虚拟页号为索引,表项数量等于虚拟地址空间中的页数。假设虚拟地址为 32 位,页面为 4 KiB,每个页表项(page table entry,PTE)占 4 字节,则页表大小为:
为了减小这个数据结构,某些计算机会对虚拟地址应用散列函数,使表的长度只需等于主存中的物理页数,这可能远小于虚拟页数。这种结构称为反向页表(inverted page table)。沿用上述示例,若物理存储器为 512 MiB,反向页表只需 1 MiB();每个表项增加的 4 字节用于保存虚拟地址。HP/Intel IA-64 同时提供传统页表与反向页表,把采用何种机制的选择留给操作系统程序员。
图中文字:Virtual address=虚拟地址;Virtual page number=虚拟页号;Page offset=页内偏移;Page table=页表;Physical address=物理地址;Main memory=主存。
为减少地址转换时间,计算机会设置一个专门缓存地址转换结果的缓存,称为地址转换后备缓冲器(translation lookaside buffer,TLB),也简称 translation buffer;稍后将详细介绍。
问题 3:虚拟存储器未命中时应该替换哪个块?
如前所述,操作系统最重要的原则是尽量减少缺页。遵循这一原则,几乎所有操作系统都尝试替换最近最少使用(LRU)的块:如果过去可以预示未来,那么它最不可能很快再次被使用。
为了帮助操作系统近似实现 LRU,许多处理器提供使用位(use bit)或引用位(reference bit),逻辑上每次访问页面都会将它置位。(为减少工作量,实际上只在后面介绍的地址转换缓冲器未命中时才置位。)操作系统定期清除使用位,并在稍后记录这些位,从而确定某段时间内访问过哪些页面。通过这种跟踪方式,操作系统可以选出最近最少被引用的页面之一。
问题 4:写入时会发生什么?
主存的下一级是旋转磁盘,访问一次要耗费数百万个时钟周期。由于访问时间相差悬殊,还没有人构造过这样一种虚拟存储器操作系统:处理器每执行一次 store,就从主存直写到磁盘。(请不要把这句话理解为一个可以凭“率先实现”而出名的机会!)因此,写策略始终是写回。
由于不必要地访问下一级的代价极高,虚拟存储器系统通常设有脏位(dirty bit)。只有块在从磁盘读入后被修改过,才需要写回磁盘。
快速地址转换技术
页表通常大到必须放在主存中,有时页表自身还会被分页。分页意味着:从逻辑上说,每次访存至少要花两倍时间,一次访问取得物理地址,第二次访问取得数据。如第 2 章所述,可以利用局部性避免额外的访存。把地址转换结果保存在一个专门的缓存中,访存时就很少需要额外访问一次主存来转换地址。这个专用的地址转换缓存称为 TLB,也称 TB(translation buffer)。
TLB 表项与缓存表项相似:标签包含虚拟地址的一部分,数据部分包含物理页框号、保护字段、有效位,通常还有使用位和脏位。操作系统要修改页表项中的物理页框号或保护属性时,必须确保旧表项不在 TLB 中,否则系统就无法正确工作。
这里的脏位表示对应的页面已脏,并不是说 TLB 中的地址转换结果已脏,也不是说数据缓存中某个特定块已脏。操作系统通过修改页表中的值来复位这些位,然后使对应的 TLB 表项无效。之后从页表重新装入该表项时,TLB 就会得到这些位的准确副本。
图 B.24 展示了 Opteron 数据 TLB 的组织,并标出了地址转换的每一步。该 TLB 采用全相联放置,因此转换首先把虚拟地址送到全部标签(步骤 1、2)。当然,只有标签的有效位置位,才能构成匹配。同时,硬件根据 TLB 中的保护信息检查此次访存类型是否违规(也在步骤 2)。
与缓存中的道理相同,12 位页内偏移不必包含在 TLB 中。匹配的标签把相应的物理地址送过一个等效的 40 选 1 多路选择器(步骤 3)。然后,将页内偏移与物理页框拼接,形成完整的物理地址(步骤 4);其宽度为 40 位。
地址转换很容易处在决定处理器时钟周期的关键路径上,因此 Opteron 的 L1 缓存采用虚拟地址索引、物理地址标签。
图中文字:Virtual page number=虚拟页号(36 位);Page offset=页内偏移(12 位);V=有效位;R/W=读/写;U/S=用户/系统;D=脏位;A=已访问位;Tag=标签(36 位);Physical address=物理地址字段(28 位);40:1 mux=40 选 1 多路选择器;Low-order 12 bits of address=地址低 12 位;High-order 28 bits of address=地址高 28 位;40-bit physical address=40 位物理地址。尖括号中的数字表示字段位数。
选择页大小
最明显的体系结构参数是页大小。选择页大小,需要权衡支持大页与支持小页的各种因素。以下因素支持使用大页:
- 页表大小与页大小成反比,因此增大页面可以节省用于地址映射的存储器或其他资源。
- 如 B.3 节所述,较大的页可以使容量较大的缓存仍具有较短的命中时间。
- 在辅助存储器与主存之间传送较大的页,比传送较小的页更高效;这一传送也可能经过网络。
- TLB 表项数量有限,因此页越大,能够高效映射的存储空间越多,TLB 未命中也就越少。
最后一个原因促使近年的微处理器支持多种页大小。对某些程序来说,TLB 未命中对 CPI 的影响可以和缓存未命中同样显著。
采用较小页面的主要动机是节省存储空间。当连续的虚拟存储区域大小不是页大小的整数倍时,小页可以减少浪费。页内未使用的空间称为内部碎片(internal fragmentation)。若假设每个进程有三个主要的段——代码、堆和栈——则每个进程平均浪费的空间是页大小的 1.5 倍。对于拥有数百兆字节内存、页面为 4–8 KiB 的计算机来说,这点浪费可以忽略。不过,当页面非常大时(超过 32 KiB),主存、辅助存储器以及 I/O 带宽都可能被浪费。最后还要考虑进程启动时间:许多进程很小,大页会延长启动进程所需的时间。
虚拟存储器与缓存小结
虚拟存储器、TLB、一级缓存、二级缓存都在映射虚拟和物理地址空间的一部分,很容易弄混地址的哪些位应该送到哪里。图 B.25 用一个假想示例展示了从 64 位虚拟地址到 41 位物理地址、再到两级缓存的整个过程。L1 缓存的容量和页大小同为 8 KiB,因此它采用虚拟索引、物理标签。L2 缓存为 4 MiB;两级缓存的块大小均为 64 字节。
首先,在逻辑上把 64 位虚拟地址分成虚拟页号和页内偏移。前者送往 TLB 以转换为物理地址,后者的高位送往 L1 缓存作为索引。若 TLB 命中,就把物理页号送到 L1 缓存标签处进行匹配检查。若匹配,则 L1 缓存命中,再由块内偏移选出要送给处理器的字。
若 L1 缓存未命中,则使用物理地址尝试访问 L2 缓存。物理地址的中间部分用作 4 MiB L2 缓存的索引,把读出的 L2 缓存标签与物理地址的高位部分比较。若匹配,则 L2 缓存命中——
——数据送到处理器,再由块内偏移选出所需的字。若 L2 未命中,就用物理地址从主存取得该块。
图中文字:Virtual address=虚拟地址(64 位);Virtual page number=虚拟页号(51 位);Page offset=页内偏移(13 位);TLB tag compare address=TLB 标签比较地址(43 位);TLB index=TLB 索引(8 位);L1 cache index=L1 缓存索引(7 位);Block offset=块内偏移(6 位);TLB tag=TLB 标签(43 位);TLB data=TLB 数据(28 位);L1 tag compare address=L1 标签比较地址(28 位);L1 cache tag=L1 缓存标签(原图标为 43 位);L1 data=L1 数据(512 位);Physical address=物理地址(41 位);L2 tag compare address=L2 标签比较地址(19 位);L2 cache index=L2 缓存索引(16 位);L2 cache tag=L2 缓存标签(19 位);L2 data=L2 数据(512 位);To CPU=送往 CPU;To L1 cache or CPU=送往 L1 缓存或 CPU;“=?”表示相等比较。1
这个例子虽然简单,但与实际缓存的主要差异在于复制。首先,图中只有一个 L1 缓存;若有两个 L1 缓存,图的上半部分就要复制一份。这样通常也会有两个 TLB:一组缓存与 TLB 服务指令,由 PC 驱动;另一组服务数据,由有效地址驱动。
第二处简化是所有缓存和 TLB 都采用直接映射。若某一个采用 路组相联,就需要把标签存储器、比较器和数据存储器各复制 份,并以 多路选择器连接各数据存储器,选择命中的数据。当然,如果缓存总容量不变,那么根据 B-22 页图 B.7 中的公式,缓存索引也要减少 位。
译注:原图把 L1 缓存标签标为 43 位,但同图中的 L1 标签比较地址为 28 位;按 41 位物理地址减去 13 位页内偏移也应为 28 位。图中原始标注予以保留,并在此说明不一致。 ↩︎
B.5 保护与虚拟存储器实例
多道程序设计(multiprogramming)让多个并发运行的程序共享一台计算机,也给程序之间的保护与共享提出了新要求。这些要求与今天计算机中的虚拟存储器紧密相连,因此本节将一并讨论,并介绍两个虚拟存储器实例。
多道程序设计引出了进程(process)的概念。打个比方,进程是程序呼吸的空气和生存的空间:它包含正在运行的程序,以及继续运行所需的全部状态。分时(time-sharing)是多道程序设计的一种变体,让多个交互用户同时共享处理器和存储器,给每个用户一种独占计算机的感觉。因此,系统必须随时能够从一个进程切换到另一个进程。这种切换称为进程切换(process switch)或上下文切换(context switch)。
无论一个进程从头到尾连续执行,还是反复被中断并与其他进程交替执行,它都必须正确运行。维持进程正确行为的责任由计算机设计者与操作系统设计者共同承担:前者必须保证进程状态中属于处理器的部分能够保存和恢复;后者必须保证各进程的计算互不干扰。
要保护一个进程的状态不被另一个进程破坏,最稳妥的方式是把当前信息复制到磁盘。但是,这会让一次进程切换耗时数秒,对分时环境而言实在太慢。
操作系统通过划分主存,让多个进程的状态同时保留在内存中,从而解决这一问题。这样的划分意味着操作系统设计者需要计算机设计者提供保护支持,确保一个进程不能修改另一个进程的状态。除了保护,计算机还要允许进程间共享代码和数据,以实现进程通信,或通过减少相同信息的副本数来节省存储空间。
进程保护
让每个进程使用自己的页表,并使各页表指向不同的内存页,就能把进程相互隔离。显然,必须禁止用户程序修改自己的页表,否则保护机制就会被绕过。
保护可以进一步加强,程度取决于计算机设计者或购买者的担忧。向处理器的保护结构中加入保护环(ring),可以把存储访问保护从用户态、内核态这两级扩展到更多级。与绝密、机密、秘密、公开这样的军事密级系统相似,同心环式的安全级别允许最受信任的程序访问一切,次一级程序访问除最内层以外的所有内容,以此类推。“平民”程序最不受信任,因此访问范围也最有限。还可以限制哪些存储区域能够包含代码,即执行保护(execute protection),甚至限制各级之间的入口点。本节稍后将介绍使用保护环的 Intel 80x86 保护结构。在实践中,保护环是否优于简单的用户态和内核态系统,尚不明确。
当设计者的担忧升级为惶恐时,这些简单的保护环可能还不够。要限制程序在最受保护区域内享有的自由,就需要新的分类体系。这里不再用军事模型,而用钥匙和锁作比喻:程序没有钥匙,就不能“开锁”访问数据。要使这些钥匙——即 capability——发挥作用,硬件与操作系统必须能够明确地把它们从一个程序传给另一个程序,同时禁止程序自行伪造。如果要把检查钥匙的耗时控制得很低,就需要大量硬件支持。
多年来,80x86 体系结构尝试过其中若干方案。由于向后兼容一直是其指导原则之一,最新版本也包含了它在虚拟存储器方面的全部尝试。下面考察两种选择:先介绍较早的分段地址空间,再介绍较新的平坦 64 位地址空间。
分段虚拟存储器实例:Intel Pentium 的保护机制
一个人所设计的第二个系统,是最危险的系统。……一般的倾向是过度设计第二个系统,把设计第一个系统时谨慎搁置的各种想法和修饰全部加进去。
——F. P. Brooks, Jr.,《人月神话》(1975)
最初的 8086 用段来寻址,却没有提供虚拟存储器或保护支持。段有基址寄存器,但没有界限寄存器,也没有访问检查;装入段寄存器之前,对应的段必须已经在物理存储器中。Intel 在 8086 的后继处理器上明显加强了虚拟存储器和保护支持,并扩展了少数字段以支持更大的地址。这套保护方案相当复杂,许多细节经过精心设计,试图避免安全漏洞。我们将它称为 IA-32。接下来的几页只概述 Intel 的部分保护措施;如果你觉得读起来吃力,不妨想象一下实现它们有多困难!
第一项增强是把传统的两级保护模型加倍:IA-32 有四个保护级。最内层的 0 级对应传统内核态,最外层的 3 级权限最低。IA-32 为每个级别设置独立的栈,以防止级别之间出现安全漏洞。它还有类似传统页表的数据结构,其中包含段的物理地址,以及需要对转换后地址执行的一系列检查。
Intel 的设计者并未止步于此。IA-32 对地址空间进行划分,让操作系统与用户都能够访问整个空间。用户可以调用这个空间中的操作系统例程,甚至向其传递参数,同时仍保持完整的保护。安全地完成这种调用并非易事,因为操作系统栈与用户栈并不相同。
此外,IA-32 允许操作系统为传给被调用例程的参数维持相应的保护级别。它禁止用户进程请求操作系统间接访问用户自身无权访问的内容,从而封堵这种潜在的保护漏洞。(这样的安全漏洞称为特洛伊木马,Trojan horse。)
Intel 设计者遵循的原则是:在支持共享和保护的同时,尽量减少对操作系统的信任。举一个受保护共享的例子:工资程序既要签发支票,又要更新本年度累计工资与福利支付总额。因此,我们希望程序能够读取工资和本年度累计信息、修改累计信息,却不能修改工资本身。稍后将看到支持这种功能的机制。本小节的其余部分将考察 IA-32 保护的全貌及其动机。
加入界限检查与存储器映射
增强 Intel 处理器的第一步,是让分段寻址除了提供基址,还能够检查界限。IA-32 的段寄存器不再包含基址,而是包含指向一种虚拟存储器数据结构的索引;这种结构称为描述符表(descriptor table),承担传统页表的角色。IA-32 中相当于页表项的是段描述符(segment descriptor),其中包含一些与 PTE 类似的字段:
- 存在位(present bit):相当于 PTE 的有效位,表示这是一个有效的地址转换。
- 基址字段(base field):相当于页框地址,包含段内第一个字节的物理地址。
- 访问位(access bit):类似某些体系结构中的引用位或使用位,可辅助替换算法。
- 属性字段(attributes field):指定使用该段的操作所允许的类型和保护级别。
此外,还有分页系统中没有的界限字段(limit field),规定段内有效偏移的上界。图 B.26 展示了 IA-32 段描述符的几个实例。
除了这种分段寻址,IA-32 还提供可选的分页系统。32 位地址的高位部分选择段描述符,中间部分作为索引,访问该描述符选定的页表。下面讨论不依赖分页的保护系统。1
图中文字与字段:
| 图中项目 | 中文含义及原图标注 |
|---|---|
| Attributes、G/D、Base、Limit | 属性 8 位;G/D 等字段 4 位;基址 32 位;界限原图标为 24 位 |
| Code segment | 代码段:Present(存在)、DPL(描述符特权级)、11、Conforming(一致)、Readable(可读)、Accessed(已访问) |
| Data segment | 数据段:Present(存在)、DPL、10、Expand down(向下扩展)、Writable(可写)、Accessed(已访问) |
| 调用门的主字段 | Attributes(属性,8 位)、Word count(字计数,8 位)、Destination selector(目标选择子,16 位)、Destination offset(目标偏移,16 位) |
| Call gate | 调用门:Present(存在)、DPL、0、00100 |
加入共享与保护
为实现受保护的共享,地址空间的一半由所有进程共享,另一半由每个进程独占,分别称为全局地址空间(global address space)和局部地址空间(local address space)。两部分各有一个相应命名的描述符表:指向共享段的描述符放在全局描述符表中,私有段的描述符放在局部描述符表中。
程序把表内索引和一个表示选用哪张表的位装入 IA-32 段寄存器。系统依据描述符的属性检查操作;只要偏移小于界限字段,就把处理器给出的偏移与描述符中的基址相加,得到物理地址。每个段描述符还有一个独立的 2 位字段,规定该段的合法访问级别。只有程序试图使用描述符中保护级编号更小的段时,才会发生违规。
现在可以说明,如何让上述工资程序更新本年度累计信息,却不能修改工资。首先,向它提供一个指向相关信息、但可写位清零的描述符:它能读数据,却不能写。然后提供一个受信任的程序,它只负责写入本年度累计信息;为它配置一个可写位置位的描述符(图 B.26)。工资程序使用 Conforming 位置位的代码段描述符调用受信任的代码。按照这里的说明,被调用程序采用被调用代码的特权级,而非调用者的特权级。1 因此,工资程序能够读取工资,也能调用受信任程序更新本年度累计总额,却不能修改工资本身。若系统中存在特洛伊木马,要使其奏效,就必须把它放进那个唯一职责是更新累计信息的受信任程序中。这种保护方式的理由是:限制漏洞可能出现的范围,可以提高安全性。
加入从用户到操作系统的安全调用:门与参数保护级的继承
允许用户跳转到操作系统内部,是相当大胆的一步。那么,在不信任操作系统或其他任何代码的前提下,硬件设计者如何增加系统安全的把握?IA-32 的做法是限制用户进入代码的位置,安全地把参数放到正确的栈上,并确保用户参数不会获得被调用代码的保护级别。
为了限制进入其他代码的入口,IA-32 提供一种特殊的段描述符,称为调用门(call gate),由属性字段中的一个位识别。与其他描述符不同,调用门给出内存中某个对象的完整物理地址,忽略处理器提供的偏移。1 如前所述,它的目的在于防止用户任意跳入受保护或特权更高的代码段。在工资程序的例子中,这意味着工资程序只能从正确的边界进入受信任代码。
只有施加这种限制,一致代码段才能按预期工作。
如果调用者与被调用者“相互怀疑”,谁也不信任谁,该怎么办?答案在图 B.26 最下方描述符的字计数字段中。当调用指令使用调用门描述符时,硬件会按照描述符指定的字数,把内容从局部栈复制到该段保护级所对应的栈中。用户因此可以先把参数压入局部栈,再由硬件安全地转移到正确的栈上。通过调用门返回时,会从两个栈中弹出参数,并把返回值复制到适当的栈。请注意,这个模型与目前通过寄存器传参的做法不兼容。
这一方案仍然留下了潜在漏洞:操作系统可能使用用户作为参数传入的地址,却按操作系统的安全级别而非用户级别访问。IA-32 的解决办法是在每个处理器段寄存器中专设 2 位,表示请求特权级(requested protection level)。操作系统例程被调用时,可以执行一条指令,把所有地址参数中的这 2 位设为调用用户的保护级。这样,地址参数装入段寄存器时,请求特权级就会设为正确值。随后,IA-32 硬件用请求特权级防止不当访问:系统例程不能利用这些参数,访问特权高于所请求级别的段。
分页虚拟存储器实例:64 位 Opteron 存储管理
AMD 工程师发现,前面复杂的保护模型很少得到使用。实际普遍采用的是 80386 引入的平坦 32 位地址空间:把所有段寄存器的基址都设为 0。因此,AMD 在 64 位模式下取消了多段,假定段基址为 0,并忽略界限字段。原书在此列出的页大小是 4 KiB、2 MiB 和 4 MiB。2
AMD64 体系结构把 64 位虚拟地址映射为 52 位物理地址;具体实现也可以采用更少的位数,以简化硬件。例如,Opteron 使用 48 位虚拟地址和 40 位物理地址。AMD64 要求虚拟地址高 16 位只是低 48 位的符号扩展,并将这种形式称为 canonical form(规范形式)。
64 位地址空间所需的页表大小十分惊人,因此 AMD64 用多级层次页表映射地址空间,将页表规模控制在合理范围内。级数取决于虚拟地址空间的大小。图 B.27 展示了 Opteron 的 48 位虚拟地址如何经过四级转换。
图中文字:Page-map L4 base addr (CR3)=四级页映射表基址(CR3);Page-map L4 table=四级页映射表;Page-mp entry=页映射表项;Page-directory pointer table=页目录指针表;Page-dir-ptr entry=页目录指针表项;Page-directory table=页目录表;Page-dir entry=页目录项;Page table=页表;Page-table entry=页表项;Page offset=页内偏移;Physical address=物理地址;Physical page frame number=物理页框号;Main memory=主存。虚拟地址位 63–48 为全 0 或全 1 的符号扩展;47–39、38–30、29–21、20–12 分别索引四级页映射表、页目录指针表、页目录表、页表;11–0 是页内偏移。
各级页表的偏移来自四个 9 位字段。地址转换先把第一个偏移加到四级页映射表基址寄存器上,再从所得位置读取主存,取得下一级页表的基址。接着,把下一个地址偏移加到刚取得的基址上,再次访问主存,确定第三级页表的基址;随后继续以相同方式进行。最后一个地址字段加到最终的页表基址上,再按所得地址读取主存,才终于取得被引用页面的物理地址。把它与 12 位页内偏移拼接,就得到完整物理地址。注意,Opteron 体系结构中的一张页表可以放在一个 4 KiB 页面中。
Opteron 在各级页表中都使用 64 位表项。原书接着说明:前 12 位保留以供将来使用,接下来的 52 位包含物理页框号,最后 12 位提供保护与使用信息。3 各级字段略有不同,基本字段包括:
- 存在(Presence):表示页面在内存中。
- 读/写(Read/write):表示页面是只读还是可读写。
- 用户/管理(User/supervisor):表示用户是否能访问该页面,还是仅限较高的三个特权级访问。
- 脏(Dirty):表示页面是否已被修改。
- 已访问(Accessed):表示自上次清零以来,页面是否被读过或写过。
- 页大小(Page size):原书说明,表示最后一级对应 4 KiB 页还是 4 MiB 页;若为后者,Opteron 只需三级而非四级页表。2
- 禁止执行(No execute):80386 的保护机制中没有这个位;增设它是为了禁止在某些页面中执行代码。
- 页面级缓存禁用(Page level cache disable):表示页面是否可缓存。
- 页面级直写(Page level write through):表示数据缓存对该页面采用写回还是直写。
由于 Opteron 在 TLB 未命中时通常要经过四级表,因此有另外三个可能检查保护限制的位置。原书说明,Opteron 只遵循最底层 PTE 的保护信息,对其他级只检查有效位是否置位。2
表项长 8 字节,每张页表含 512 个表项,页面为 4 KiB,因此一张页表恰好占一页。四个级别字段各为 9 位,页内偏移为 12 位,所以还剩下 位,需要作符号扩展以满足规范地址的要求。
前面解释了合法地址的转换过程,那么,如何防止用户建立非法地址映射并借此捣乱?页表自身受到保护,不允许用户程序写入。因此,用户可以尝试任何虚拟地址,但操作系统通过控制页表项,就控制了实际能够访问的物理存储器。若要让进程共享内存,只需让各自地址空间中的页表项指向同一个物理页。
Opteron 使用四个 TLB 来减少地址转换时间:两个用于指令访问,两个用于数据访问。与多级缓存类似,它用容量更大的两个 L2 TLB 来减少 TLB 未命中,一个服务指令,另一个服务数据。图 B.28 介绍了这些 TLB 的参数。
小结:32 位 Intel Pentium 与 64 位 AMD Opteron 的保护机制
Opteron 的存储管理代表了当今多数桌面和服务器计算机的做法:依赖页面级地址转换和操作系统的正确运行,为共享同一台计算机的多个进程提供安全保障。虽然这里把两者作为不同方案介绍,Intel 实际上已经追随 AMD,接纳了 AMD64 体系结构。因此,AMD 和 Intel 都支持 80x86 的 64 位扩展;同时,为了兼容,也都支持复杂的分段保护方案。
| 参数 | 说明 |
|---|---|
| 块大小 | 1 个 PTE(8 字节) |
| L1 命中时间 | 1 个时钟周期 |
| L2 命中时间 | 7 个时钟周期 |
| L1 TLB 容量 | 指令与数据 TLB 相同:每个 40 个 PTE,其中 32 个用于 4 KiB 页,8 个用于 2 MiB 或 4 MiB 页 |
| L2 TLB 容量 | 指令与数据 TLB 相同:512 个 PTE,均用于 4 KiB 页 |
| 块替换 | LRU |
| 写策略 | 不适用 |
| L1 块放置 | 全相联 |
| L2 块放置 | 四路组相联 |
如果你觉得分段保护模型比 AMD64 模型更难实现,那是因为事实确实如此。工程师付出的努力尤其令人沮丧,因为很少有客户使用这套复杂的保护机制。此外,这个保护模型与类 UNIX 系统的简单分页保护不相匹配,意味着只有专门为这种计算机编写操作系统的人才会使用它,而这种情况尚未出现。
译注:图 B.26 的段描述符字段宽度原标为 8、4、32、24 位,合计 68 位,另一个调用门示意合计 48 位;这些是原书图文,不能把该示意直接当作准确的描述符二进制编码。原文关于“32 位地址高位选择段描述符”、Conforming 采用被调用者特权级,以及调用门为“完整物理地址”的表述也需结合具体模式的处理器体系结构手册核查。 ↩︎ ↩︎ ↩︎
译注:原文在介绍 64 位模式时也引用了其他模式的分页参数。实际编程或硬件实现须区分运行模式,并核对相应处理器手册。 ↩︎ ↩︎ ↩︎
译注:原书这里明确给出“64 位表项”,随后却列出 位,算术上不一致。译文忠实记录这处源文错误,未把字段宽度猜改成某个值。 ↩︎
B.6 谬误与陷阱
即便只是回顾存储层次结构,也有谬误与陷阱!
陷阱:地址空间过小
DEC 与卡内基梅隆大学合作设计新一代 PDP-11 计算机家族后,仅仅五年,人们就发现这个设计存在致命缺陷。相比之下,IBM 在 PDP-11 之前六年发布的一种体系结构,只经过小幅修改,25 年后仍然兴盛。而曾因包含多余功能而受到批评的 DEC VAX,在 PDP-11 停产后仍卖出了数百万台。这是为什么?
PDP-11 的致命缺陷是地址只有 16 位,而 IBM 360 的地址为 24–31 位,VAX 为 32 位。地址位数限制了程序长度,因为程序及其所需数据的大小必须小于 。地址位数之所以难以改变,是因为它决定了所有可能保存地址的部件的最小宽度:PC、寄存器、存储字,以及有效地址运算的宽度。如果一开始就没有扩展地址的计划,后来成功修改地址位数的机会微乎其微,通常也就意味着这个计算机家族走到了尽头。
Bell 与 Strecker(1976)这样说:
在计算机设计中,只有一种错误很难挽回:没有为存储器寻址和存储管理提供足够的地址位。PDP-11 延续了几乎所有已知计算机从未中断的这一传统。[第 2 页]
一些曾经成功的计算机最终因地址位不足而“饿死”,包括 PDP-8、PDP-10、PDP-11、Intel 8080、Intel 8086、Intel 80186、Intel 80286、Motorola 6800、AMI 6502、Zilog Z80、CRAY-1 和 CRAY X-MP;这还只是部分名单。
历史悠久的 80x86 系列的特别之处,在于它成功扩展过两次:先是在 1985 年随 Intel 80386 扩展到 32 位,较近的一次则是随 AMD Opteron 扩展到 64 位。
陷阱:忽视操作系统对存储层次结构性能的影响
图 B.29 给出了三个大型工作负载中由操作系统引起的存储停顿时间。约 25% 的停顿时间或者直接用于操作系统的未命中,或者源于操作系统的干扰使应用程序发生未命中。
| 工作负载 | 未命中发生在应用中的比例 | 未命中发生在 OS 中的比例 | 应用固有未命中所占时间 | OS 与应用冲突所占时间 | OS 指令未命中所占时间 | 迁移引起的数据未命中所占时间 | 块操作中的数据未命中所占时间 | 其他 OS 未命中所占时间 | OS 未命中及与应用冲突的总时间比例 |
|---|---|---|---|---|---|---|---|---|---|
| Pmake | 47% | 53% | 14.1% | 4.8% | 10.9% | 1.0% | 6.2% | 2.9% | 25.8% |
| Multipgm | 53% | 47% | 21.6% | 3.4% | 9.2% | 4.2% | 4.7% | 3.4% | 24.9% |
| Oracle | 73% | 27% | 25.7% | 10.2% | 10.6% | 2.6% | 0.6% | 2.8% | 26.8% |
表中“应用固有未命中”和“OS 与应用冲突”两列属于应用未命中导致的时间;“OS 指令未命中”“迁移引起的数据未命中”“块操作中的数据未命中”“其他 OS 未命中”四列属于直接由 OS 未命中导致的时间。数据来源:Torrellas, J., Gupta, A., Hennessy, J., 1992. Characterizing the caching and synchronization performance of a multiprocessor operating system(多处理器操作系统缓存与同步性能的特征分析). Proceedings of the Fifth International Conference on Architectural Support for Programming Languages and Operating Systems (ASPLOS),1992 年 10 月 12–15 日,波士顿(SIGPLAN Notices 27:9,9 月),162–174 页。
陷阱:指望操作系统随着时间推移改变页大小
Alpha 的体系结构设计者制定了一套周密计划,希望随着时间推移增大页大小,从而扩展体系结构,甚至将这一计划体现在虚拟地址大小的设计中。然而,当后续 Alpha 真要增大页面时,操作系统设计者却不愿配合。最终,只好修改虚拟存储器系统,在保持 8 KiB 页面不变的情况下扩展地址空间。
其他计算机的设计者观察到很高的 TLB 未命中率,于是在 TLB 中增加了对多种更大页面的支持。他们希望操作系统程序员把对象分配到合理范围内最大的页中,以节约 TLB 表项。经过十年的尝试,多数操作系统仍只在少数专门挑选的功能中使用这些 superpage:映射显示内存或其他 I/O 设备,或者让数据库代码使用非常大的页。
B.7 结语
要构造一个跟得上日益加快的处理器的存储系统,困难可想而知:主存所用的基本器件,与最廉价计算机里的并无不同。帮助我们的正是局部性原理;它的有效性,已经在现今计算机从磁盘到 TLB 的存储层次结构的每一级上得到证明。
然而,存储器的相对访问延迟不断增大,到 2016 年已需数百个时钟周期。这意味着,程序员和编译器编写者若希望程序具有良好性能,就必须了解缓存和 TLB 的参数。
B.8 历史回顾与参考文献
M.3 节(在线提供)考察了缓存、虚拟存储器与虚拟机的发展历史。(该历史回顾涵盖本附录和第 3 章。)IBM 在这三者的发展史上都占据重要地位。该节还提供了进一步阅读的参考文献。
补充参考文献:
- Gupta, S., Xiang, P., Yang, Y., Zhou, H. Locality principle revisited: a probability-based quantitative approach(重访局部性原理:一种基于概率的量化方法). Journal of Parallel and Distributed Computing 73 (7), 1011–1027。原书此条未列出版年份。
习题(Amr Zaky 编写)
习题 B.1
[10/10/10/15]〈B.1〉 为了体会局部性原理对于论证使用缓存的合理性有多重要,你在一台具有 L1 数据缓存和主存的计算机上做实验,只考察数据访问。
各种访问的延迟以 CPU 周期计,分别为:缓存命中 1 个周期;缓存未命中 110 个周期;禁用缓存后访问主存 105 个周期。
a. [10]〈B.1〉 运行一个总体未命中率为 3% 的程序时,平均访存时间是多少个 CPU 周期?
b. [10]〈B.1〉 接下来,运行一个专门生成完全随机数据地址、毫无局部性的程序。为此,使用大小为 1 GB 的数组,整个数组都能放进主存。程序不断访问数组中的随机元素,用均匀随机数发生器生成元素下标。若数据缓存为 64 KB,平均访存时间是多少?
c. [10]〈B.1〉 把 b 问的结果与禁用缓存时的主存访问时间比较,对于局部性原理在论证使用缓存的合理性中所起的作用,你能得出什么结论?
d. [15]〈B.1〉 你观察到,缓存命中带来 104 个周期的收益(1 个周期对 105 个周期),但未命中会损失 5 个周期(110 个周期对 105 个周期)。一般地,用 表示收益(gain), 表示损失(loss)。用 和 求出未命中率的临界上限,超过它之后,使用缓存反而不利。
习题 B.2
[15/15]〈B.1〉 假设缓存容量为 512 字节,块大小为 64 字节,主存容量为 2 KB。可以把主存看作由 64 字节块组成的数组:M0、M1、……、M31。图 B.30 列出采用直接映射时,各缓存块可能容纳的主存块。
a. [15]〈B.1〉 若缓存改为全相联,给出相应表格。
b. [15]〈B.1〉 若缓存改为四路组相联,重做 a 问。
| 缓存块 | 组 | 路 | 可能存放的主存块 |
|---|---|---|---|
| 0 | 0 | 0 | M0、M8、M16、M24 |
| 1 | 1 | 0 | M1、M9、M17、M25 |
| 2 | 2 | 0 | M2、M10、M18、M26 |
| 3 | 3 | 0 | …… |
| 4 | 4 | 0 | …… |
| 5 | 5 | 0 | …… |
| 6 | 6 | 0 | …… |
| 7 | 7 | 0 | M7、M15、M23、M31 |
习题 B.3
[10/10/10/10/15/10/15/20]〈B.1〉 降低功耗的需求经常会影响缓存的组织方式。本题假设缓存在物理上分为数据阵列、标签阵列和替换阵列,分别存放数据、标签以及替换策略所需的信息。每种阵列又在物理上分成多个可单独访问的子阵列,每路一个。例如,一个采用最近最少使用(LRU)替换的四路组相联缓存,有四个数据子阵列、四个标签子阵列和四个替换子阵列。采用 LRU 时,每次访问都要访问一次替换子阵列;采用先进先出(FIFO)时,每次未命中才访问一次;采用随机替换时则不需要访问。某个具体缓存的各阵列访问功耗权重如图 B.31。1
| 阵列或操作 | 功耗权重(每访问一路) |
|---|---|
| 数据阵列 | 20 单位 |
| 标签阵列 | 5 单位 |
| 其他信息阵列(Miscellaneous array) | 1 单位 |
| 主存访问 | 200 单位 |
估算以下各配置下存储系统(缓存+主存)的功耗,单位为上述功耗单位。假设缓存为四路组相联,分别给出采用 LRU、FIFO 和随机替换策略时的答案。
a. [10]〈B.1〉 缓存读命中,所有阵列同时读取。
b. [10]〈B.1〉 缓存读未命中时,重做 a 问。
c. [10]〈B.1〉 假设缓存访问分成两个周期,重做 a 问。第一周期访问所有标签子阵列,第二周期只访问标签匹配的那个数据子阵列。
d. [10]〈B.1〉 缓存读未命中时,重做 c 问;第二周期不访问数据阵列。
e. [15]〈B.1〉 增加预测将要访问哪一路的逻辑,重做 c 问。第一周期只访问预测路的标签子阵列。路命中,即预测路中的地址匹配,意味着缓存命中;路未命中则需要在第二周期检查全部标签子阵列。若路命中,第二周期只访问一个数据子阵列,即标签匹配的那一路。假设路预测器命中。
f. [10]〈B.1〉 假设路预测器未命中,即选错了路,重做 e 问。预测失败会增加一个额外周期,在此期间访问全部标签子阵列。假设路预测器未命中之后,缓存读命中。
g. [15]〈B.1〉 假设缓存读未命中,重做 f 问。
h. [20]〈B.1〉 运用 e、f、g 问的结果,处理一般情况:工作负载的路预测器未命中率为 5%,缓存未命中率为 3%。考虑不同的替换策略。
习题 B.4
[10/10/15/15/15/20]〈B.1〉 用一个具体例子比较直写和写回缓存对写带宽的需求。假设缓存为 64 KB,行大小为 32 字节,写未命中时分配一行。若配置为写回缓存,则在需要替换脏行时写回整行。缓存通过一条 64 位宽、即 8 字节宽的总线连接下一级存储器。通过这条总线写入 字节需要的 CPU 周期数为:
其中括号表示向上取整。例如,写入 8 字节需要 个周期;用同一公式计算,写入 12 字节需要 15 个周期。
参考下面的 C 代码片段回答问题:
a. [10]〈B.1〉 对于直写缓存,j 循环的全部迭代合计要花多少 CPU 周期把写数据传送到主存?
b. [10]〈B.1〉 若配置为写回缓存,写回一个缓存行需要多少 CPU 周期?
c. [15]〈B.1〉 把 PORTION 改为 8,重做 a 问。
d. [15]〈B.1〉 在替换一个缓存行之前,至少对该行内数组元素更新多少次,写回缓存才更有优势?
e. [15]〈B.1〉 设想一种情形:缓存行内所有字都会被写入(不一定使用上述代码),但直写缓存所需的总 CPU 周期数反而少于写回缓存。2
习题 B.5
[10/10/10/10/]〈B.2〉 你正围绕一个顺序执行处理器构建系统。其频率为 1.1 GHz,不计访存时 CPI 为 1.35。
只有 load 和 store 指令会从存储器读写数据,分别占全部指令的 20% 和 10%。系统有分离的 L1 缓存,命中不引入额外代价。指令缓存和数据缓存都采用直接映射,各为 32 KB。指令缓存的未命中率为 2%,块大小为 32 字节;数据缓存采用直写,未命中率为 5%,块大小为 16 字节。数据缓存配有写缓冲,能消除 95% 写操作的停顿。
统一 L2 缓存容量为 512 KB,采用写回,块大小为 64 字节,访问时间为 15 ns。它通过 128 位数据总线连接 L1 缓存,总线运行在 266 MHz,每个总线周期传送一个 128 位字。系统发往 L2 缓存的全部访存请求中,有 80% 无须访问主存就能完成。此外,被替换的块有 50% 是脏块。主存宽 128 位,访问延迟为 60 ns;经过这段延迟之后,可以通过 128 位宽、133 MHz 的主存总线,以每周期一个总线字的速率,传送任意数量的总线字。
a. [10]〈B.2〉 指令访问的平均访存时间是多少?
b. [10]〈B.2〉 数据读的平均访存时间是多少?
c. [10]〈B.2〉 数据写的平均访存时间是多少?
d. [10]〈B.2〉 计入访存后,总体 CPI 是多少?
习题 B.6
[10/15/15]〈B.2〉 把未命中率(每次访问的未命中数)转换为每条指令的未命中数,依赖两个因素:每条取入指令对应的访存次数,以及取入指令中实际提交的比例。
a. [10]〈B.2〉 B-5 页中每条指令未命中数的公式,首先用未命中率、访存次数和指令数三个因素表示。每个因素都对应实际发生的事件。若改写为“未命中率乘以每条指令访存次数”,有什么不同?
b. [15]〈B.2〉 推测执行处理器会取入一些最终不提交的指令。B-5 页公式中的每条指令未命中数,针对的是执行路径上的指令,也就是完成程序实际必须执行的指令。把该公式改写成只使用未命中率、每条取入指令的访存次数,以及取入指令中最终提交的比例。为什么使用这些因素,而不用 B-5 页公式里的因素?
c. [15]〈B.2〉 “每条取入指令的访存次数”这个因素的值,未必等于某条特定指令实际发生的访存次数;因此,b 问的转换可能给出不正确的数值。重新改写 b 问的公式,修正这一缺陷。
习题 B.7
[20]〈B.1,B.3〉 在直写 L1 缓存后面接写回 L2 缓存、而非直接接主存的系统中,合并写缓冲可以简化。解释如何实现这种简化。是否存在某些情形,采用完整的写缓冲而非你提出的简化版本会更有帮助?
习题 B.8
[5/5/5]〈B.3〉 考察以下计算:
数组 、、、 各有 512 个 4 字节整数元素,内存布局如下。
| 内存字节地址范围 | 内容 |
|---|---|
| 0–2047 | 数组 |
| 2048–4095 | 数组 |
| 4096–6143 | 数组 |
| 6144–8191 | 数组 |
上述计算通过迭代 512 次的 for 循环完成。假设缓存为 32 Kbyte、四路组相联,访问时间为一个周期,未命中代价为每次访问 100 个 CPU 周期,写回的代价也为 100 个 CPU 周期。缓存在写命中时采用写回,在写未命中时采用写分配。
a. [5]〈B.3〉 若三个 load 和一个 store 全都在数据缓存中未命中,一次迭代需要多少周期?
b. [5]〈B.3〉 若缓存行为 16 字节,每次迭代平均需要多少周期?提示:空间局部性!
c. [5]〈B.3〉 若缓存行为 64 字节,每次迭代平均需要多少周期?
d. 若缓存改为直接映射,且容量缩小到 2048 字节,每次迭代平均需要多少周期?3
习题 B.9
[20]〈B.3〉 在其他参数不变时,提高缓存的相联度,从统计上说能够降低未命中率。但在某些特殊情况下,对特定工作负载提高相联度反而会增大未命中率。
比较容量相同的直接映射缓存与两路组相联缓存,假设组相联缓存采用 LRU 替换。为简化问题,块大小为一个字。构造一个字访问轨迹,使两路组相联缓存的未命中次数更多。
提示:把访问轨迹限定在两路组相联缓存的同一组内,并让同一轨迹在直接映射缓存中只涉及两个块位置。
习题 B.10
[10/10/15]〈B.3〉 考虑由 L1、L2 数据缓存组成的两级存储层次结构。假设两级缓存在写命中时都采用写回策略,且块大小相同。列出响应以下事件时采取的操作。
a. [10]〈B.3〉 缓存构成包含式层次时,发生 L1 缓存未命中。
b. [10]〈B.3〉 缓存构成互斥式层次时,发生 L1 缓存未命中。
c. [15]〈B.3〉 在 a、b 两问中,分别考虑被逐出的行是干净行和脏行的情况。
习题 B.11
[15/20]〈B.2,B.3〉 不让某些指令进入缓存,可以减少冲突未命中。
a. [15]〈B.3〉 画出一个程序的层次结构,使其中部分程序最好不要进入指令缓存。提示:考虑某些代码块处在比其他块更深的嵌套循环中的程序。
b. [20]〈B.2,B.3〉 提出软件或硬件技术,强制把某些块排除在指令缓存之外。
习题 B.12
[5/15]〈B.3〉 较大的缓存虽然未命中率较低,但命中时间往往更长。假设直接映射的 8 KB 缓存命中时间为 0.22 ns,未命中率为 ;四路组相联的 64 KB 缓存命中时间为 0.52 ns,未命中率为 。
a. [5]〈B.3〉 若未命中代价为 100 ns,在什么条件下使用较小的缓存能降低总体访存时间?
b. [15]〈B.3〉 分别假设未命中代价为 10 和 1000 个周期,重做 a 问。总结什么时候采用较小的缓存可能更有利。4
习题 B.13
[15]〈B.4〉 程序运行在一台具有四表项、全相联微型 TLB 的计算机上(图 B.33)。
| 虚拟页号 VP# | 物理页号 PP# | 表项有效位 |
|---|---|---|
| 5 | 30 | 1 |
| 7 | 1 | 0 |
| 10 | 10 | 1 |
| 15 | 25 | 1 |
以下给出程序访问的虚拟页号轨迹。对每次访问,指出 TLB 命中还是未命中;若需要访问页表,再指出页面命中还是缺页。如果未访问页表,在页表列填写 X(图 B.34、图 B.35)。
| 虚拟页索引 | 物理页号 | 存在(Y=是,N=否) |
|---|---|---|
| 0 | 3 | Y |
| 1 | 7 | N |
| 2 | 6 | N |
| 3 | 5 | Y |
| 4 | 14 | Y |
| 5 | 30 | Y |
| 6 | 26 | Y |
| 7 | 11 | Y |
| 8 | 13 | N |
| 9 | 18 | N |
| 10 | 10 | Y |
| 11 | 56 | Y |
| 12 | 110 | Y |
| 13 | 33 | Y |
| 14 | 12 | N |
| 15 | 25 | Y |
| 访问的虚拟页 | TLB(命中或未命中) | 页表(命中或缺页) |
|---|---|---|
| 1 | ||
| 5 | ||
| 9 | ||
| 14 | ||
| 10 | ||
| 6 | ||
| 15 | ||
| 12 | ||
| 7 | ||
| 2 |
习题 B.14
[15/15/15/15/]〈B.4〉 有些存储系统用软件把 TLB 未命中作为异常处理,另一些系统则由硬件处理 TLB 未命中。
a. [15]〈B.4〉 两种 TLB 未命中处理方式之间有哪些权衡?
b. [15]〈B.4〉 软件处理 TLB 未命中是否总比硬件处理慢?解释原因。
c. [15]〈B.4〉 是否存在硬件难以处理、软件却能处理的页表结构?是否也存在软件难以处理、硬件却容易管理的页表结构?
d. [15]〈B.4〉 为什么浮点程序的 TLB 未命中率一般高于整数程序?
习题 B.15
[20/20]〈B.5〉 采用类似 Hewlett-Packard Precision Architecture(HP/PA)的保护方案,可以提供比 Intel Pentium 体系结构更灵活的保护。该方案中,每个页表项除了页面访问权限,还包含一个“保护 ID”(钥匙)。每次访存时,CPU 将页表项中的保护 ID,与四个保护 ID 寄存器中的值分别比较;访问这些寄存器要求 CPU 处于管理模式。如果没有匹配的保护 ID,或者此次访问不被允许,例如写入只读页,就产生异常。
a. [20]〈B.5〉 说明如何利用这个模型,方便地将操作系统构造为若干相对较小、彼此不能覆盖写入的代码块,即微内核。与操作系统内任何代码都能写任意内存位置的单体操作系统相比,这种操作系统可能有哪些优点?
b. [20]〈B.5〉 对系统作一个简单修改,就能让每个页表项拥有两个保护 ID:一个用于读访问,另一个用于写或执行访问;如果可写位和可执行位都未置位,后一个字段就不用。为读和写能力使用不同的保护 ID,可能有什么好处?提示:这是否更便于进程之间共享数据和代码?
C 流水线:基础与中级概念
这确实是个得抽上三斗烟才能解决的问题。
——Sir Arthur Conan Doyle,The Adventures of Sherlock Holmes
C.1 引言
本书的许多读者可能已经通过其他教材(例如我们编写的基础教材 Computer Organization and Design)或其他课程学习过流水线基础。第 3 章高度依赖这些知识,因此,继续阅读前,应确保自己已经熟悉本附录介绍的概念。阅读第 3 章时,也可以随时回到这里快速复习。
本附录首先介绍流水线基础,包括它对数据通路的影响、冒险,以及流水线性能。本节描述基本的五级 RISC 流水线,后续内容均以此为基础。C.2 节介绍冒险为何影响性能,以及如何处理冒险;C.3 节讨论简单五级流水线的实际实现,重点是控制和冒险处理。
C.4 节讨论流水线与指令集设计各方面的相互作用,其中包括异常以及异常与流水线的关系这一重要主题。如果读者还不熟悉精确与非精确中断,以及异常后的恢复,这些内容会很有帮助,因为它们是理解第 3 章更高级方法的关键。
C.5 节讨论如何扩展五级流水线,以处理执行时间较长的浮点指令。C.6 节通过深流水线处理器 MIPS R4000/4400 的案例,将这些概念联系起来,同时介绍它的八级整数流水线和浮点流水线。MIPS R4000 与单发射嵌入式处理器相似,例如 2010 年推出、曾用于多款智能手机和平板电脑的 ARM Cortex-A5。1
C.7 节引入动态调度,以及用记分牌(scoreboard)实现动态调度的方法。这一内容作为贯穿各层的问题介绍,因为它可以作为第 3 章核心概念的导论;第 3 章着重讨论动态调度方法。C.7 节也为理解第 3 章更复杂的 Tomasulo 算法提供了平缓的入门路径。虽然不先介绍记分牌也能讲解和理解 Tomasulo 算法,但记分牌方法更简单,也更容易掌握。
什么是流水线?
流水线是一种让多条指令重叠执行的实现技术;它利用执行一条指令所需的各项操作之间存在的并行性。如今,流水线是实现高速处理器的关键技术,甚至售价不足一美元的处理器也采用流水线。
流水线类似装配线。汽车装配线有许多工序,每道工序都完成汽车制造的一部分。各道工序并行工作,但处理的是不同的汽车。计算机流水线的每一步完成一条指令的一部分;与装配线一样,不同的步骤并行完成不同指令的不同部分。每一步称为一个流水级或流水段。各级首尾连接,构成流水线:指令从一端进入,逐级前进,再从另一端离开,就像装配线上的汽车。
汽车装配线的吞吐量以每小时生产的汽车数量定义,取决于成品汽车驶离装配线的频率。同样,指令流水线的吞吐量由指令离开流水线的频率决定。由于各级相互连接,就像装配线一样,所有流水级都必须同时做好前进一步的准备。指令沿流水线前进一级所需的时间,称为一个处理器周期。所有级同时推进,因此处理器周期的长度由最慢一级所需的时间决定,正如汽车装配线上最耗时的工序决定了车辆向前推进的间隔。在计算机中,处理器周期几乎总是一个时钟周期。
流水线设计者的目标,是使各级的处理时间均衡,就像装配线设计者努力均衡各道工序的耗时一样。如果各级完全均衡,那么在理想条件下,流水线处理器平均每条指令所需的时间为:
此时,流水线的加速比等于流水级数,就像具有 道工序的装配线,理想情况下可以将汽车产出速度提高到原来的 倍。不过,各级通常不能完全均衡,流水线本身也有额外开销。因此,流水线处理器平均每条指令的时间达不到理论最小值,但可以接近它。
流水线降低了每条指令的平均执行时间。如果原来的处理器执行每条指令需要多个时钟周期,那么流水线会降低 CPI。本附录主要采用这一观察角度。
流水线是一种开发顺序指令流中指令间并行性的实现技术。它有一个显著优势:与某些加速技术不同(见第 4 章),程序员看不到它的存在。
RISC-V 指令集基础
本书使用加载—存储体系结构 RISC-V 说明基本概念。书中介绍的几乎所有思想也适用于其他处理器,但复杂指令的实现可能复杂得多。本节使用 RISC-V 体系结构的核心部分;完整描述见第 1 章。虽然我们使用 RISC-V,但这些概念具有很强的共通性,同样适用于包括 ARM、MIPS 核心体系结构在内的各种 RISC。所有 RISC 体系结构都有几个关键特征:
- 所有数据运算都针对寄存器中的数据,并且通常修改整个寄存器;每个寄存器为 32 位或 64 位。
- 只有加载和存储操作影响存储器:前者把数据从存储器送入寄存器,后者把寄存器中的数据送入存储器。通常也提供加载或存储小于整个寄存器宽度的数据的操作,例如字节、16 位或 32 位。
- 指令格式数量很少,所有指令通常具有相同长度。在 RISC-V 中,寄存器说明符
rs1、rs2和rd总在固定位置,从而简化控制。
这些简单特征极大地简化了流水线实现,这正是这些指令集采用这种设计的原因。第 1 章完整介绍了 RISC-V ISA,这里假定读者已经读过该章。
RISC 指令集的一种简单实现
要理解 RISC 指令集的流水线实现,先要理解非流水线实现。本节给出一种简单方案,每条指令最多需要 5 个时钟周期。我们将把它扩展成流水线版本,大幅降低 CPI。这里的非流水线方案既不是最经济的,也不是性能最高的;选择它,是因为它能自然地过渡到流水线实现。实现指令集需要引入若干不属于体系结构状态的临时寄存器,本节引入它们是为了简化流水线。我们只关注 RISC 体系结构的一个整数子集,包含字加载/存储、分支和整数 ALU 操作。
这个 RISC 子集的每条指令都可以在最多 5 个时钟周期内完成。这 5 个周期如下。
- 取指周期(IF): 将程序计数器(PC)送至存储器,取出当前指令。PC 加 4,更新为下一条顺序指令的地址,因为每条指令长 4 字节。
指令译码/寄存器读取周期(ID): 对指令译码,从寄存器堆读出源寄存器说明符指定的寄存器。在读取寄存器时,检查它们是否相等,以备分支使用。对指令的偏移字段进行符号扩展,留待可能使用。将符号扩展后的偏移加到已递增的 PC 上,计算可能的分支目标地址。
译码与寄存器读取并行进行,因为 RISC 体系结构的寄存器说明符位置固定。这种技术称为固定字段译码。可能读出了实际上用不到的寄存器,这既无益于性能,也不会损害性能;不过,读取不需要的寄存器会浪费能量,因此重视功耗的设计可能避免这样做。对于加载和 ALU 立即数操作,立即数字段始终在相同位置,因此容易进行符号扩展。若要更完整地实现 RISC-V,就需要计算两个不同的符号扩展值,因为存储指令的立即数字段位于不同位置。
执行/有效地址计算周期(EX): ALU 对上一周期准备的操作数执行操作,具体功能取决于指令类型:
- 存储器访问: ALU 将基址寄存器与偏移相加,得到有效地址。
- 寄存器—寄存器 ALU 指令: ALU 按 ALU 操作码指定的运算,对从寄存器堆读出的值进行操作。
- 寄存器—立即数 ALU 指令: ALU 按 ALU 操作码指定的运算,对第一个读出的寄存器值和符号扩展后的立即数进行操作。
- 条件分支: 判断条件是否成立。
在加载—存储体系结构中,有效地址计算与执行可以合并在同一个周期,因为没有指令需要同时计算数据地址并对该数据进行运算。2
存储器访问周期(MEM): 对加载指令,存储器使用上一周期算出的有效地址读取数据;对存储指令,则以该有效地址,把从寄存器堆读出的第二个寄存器值写入存储器。
写回周期(WB): 对寄存器—寄存器 ALU 指令或加载指令,将结果写回寄存器堆。加载结果来自存储系统,ALU 指令结果来自 ALU。
在这一实现中,分支指令需要 3 个周期,存储指令需要 4 个周期,其余指令需要 5 个周期。假定分支频率为 12%、存储频率为 10%,这种典型指令分布对应的总体 CPI 为 4.66。不过,无论是追求最佳性能,还是在给定性能下尽量减少硬件,这个实现都不是最优的。改进这一设计留作练习,下面集中讨论如何把它流水线化。
RISC 处理器的经典五级流水线
只要每个时钟周期启动一条新指令,上一节的执行过程几乎不需要改变,就能实现流水线。这也说明了我们为什么选择这一设计。前面每个时钟周期现在成为一个流水级,也就是流水线中的一个周期,形成图 C.1 所示的执行模式;这也是绘制流水线的典型方式。虽然每条指令需要 5 个周期才能完成,但每个周期硬件都会启动一条新指令,并执行五条不同指令的某一部分。
| 指令/时钟周期 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| 指令 | IF | ID | EX | MEM | WB | ||||
| 指令 | IF | ID | EX | MEM | WB | ||||
| 指令 | IF | ID | EX | MEM | WB | ||||
| 指令 | IF | ID | EX | MEM | WB | ||||
| 指令 | IF | ID | EX | MEM | WB |
流水线真有这么简单吗?当然没有。本节和后续各节将解决流水线引入的问题,使这条 RISC 流水线真正可行。
首先,必须确定处理器每个周期发生什么,确保不会在同一周期让同一数据通路资源执行两种不同操作。例如,不能要求一个 ALU 同时计算有效地址并执行减法。因此,必须保证指令在流水线中重叠时不会引发这类冲突。幸运的是,RISC 指令集足够简单,资源使用情况较容易分析。图 C.2 以流水线形式画出简化的 RISC 数据通路。主要功能部件在不同周期使用,因此重叠执行多条指令时,冲突相对较少。这基于三个观察。
首先,指令存储器与数据存储器分离,通常由独立的指令缓存和数据缓存实现(见第 2 章)。如果只有一个存储器,取指与访问数据就会冲突;独立缓存消除了这一冲突。注意,若流水线处理器的时钟周期与非流水线版本相等,存储系统必须提供五倍带宽。这种需求增长,是提高性能的代价之一。
其次,寄存器堆在两个阶段使用:在 ID 读取,在 WB 写入。两种用途不同,所以图中把同一寄存器堆画在两个位置。因此,每个周期需要完成两次读取和一次写入。为处理对同一寄存器的读写,以及稍后就会说明的另一个原因,我们在周期前半段写入,后半段读取。
第三,图 C.2 没有处理 PC。要每个周期启动一条新指令,就必须每周期递增并保存 PC;这必须在 IF 阶段完成,以准备下一条指令。此外,还需要一个加法器,在 ID 阶段计算可能的分支目标地址。另一个问题是,我们需要在 ALU 阶段使用 ALU 判断分支条件。实际上,比较两个寄存器并不需要完整的 ALU,但所需功能已足以使这项工作必须放在这一流水级进行。
除了确保流水线中的不同指令不会同时争用硬件资源,还必须保证处于不同级的指令不会互相干扰。为此,在相邻流水级之间加入流水线寄存器:周期结束时,把某一级的全部结果保存到寄存器中,作为下一周期下一级的输入。图 C.3 给出了包含这些寄存器的流水线。
为简洁起见,许多图省略了流水线寄存器,但流水线正常工作必须有它们。即使是没有流水线的多周期数据通路,也需要类似寄存器,因为只有寄存器中的值能够跨时钟边界保留。在流水线处理器中,这些寄存器还承担一个关键作用:把中间结果从一级送往另一级,而源级和目的级不一定直接相邻。例如,存储指令要写入存储器的寄存器值在 ID 读出,到 MEM 才真正使用,因此必须经过两个流水线寄存器。ALU 指令在 EX 产生结果,到 WB 才真正写回,同样要经过两个流水线寄存器。为便于引用,我们按它们连接的两个流水级命名:IF/ID、ID/EX、EX/MEM 和 MEM/WB。
流水线的基本性能问题
流水线提高了处理器的指令吞吐量,即单位时间完成的指令数,却不缩短单条指令的执行时间。事实上,由于流水线控制开销,每条指令的执行时间通常还会略有增加。吞吐量提高意味着程序运行更快、总执行时间更短,尽管没有任何一条指令本身执行得更快。
单条指令执行时间不缩短这一事实,限制了实际可采用的流水线深度;下一节会看到这一点。除了流水线延迟的限制,还有各级不均衡与流水线额外开销的限制。各级不均衡会降低性能,因为时钟不能快于最慢一级所需的时间。
流水线开销来自流水线寄存器延迟和时钟偏斜。寄存器会给时钟周期增加建立时间与传播延迟:建立时间指触发写入的时钟信号到来前,寄存器输入必须保持稳定的时间。时钟偏斜是时钟到达任意两个寄存器的时刻之差的最大值,也限制了时钟周期的下限。一旦时钟周期已经缩短到时钟偏斜与锁存器开销之和,继续加深流水线便没有意义,因为周期内已没有时间用于有效工作。感兴趣的读者可参见 Kunkel and Smith(1986)。
例题 考虑上一节的非流水线处理器。假定时钟频率为 4 GHz(或周期为 0.5 ns),ALU 操作和分支需要 4 个周期,访存操作需要 5 个周期;三者相对频率分别为 40%、20% 和 40%。由于时钟偏斜和建立时间,流水线化会给周期增加 0.1 ns 开销。忽略延迟影响,指令执行速率可以获得多大加速比?
解答 非流水线处理器的平均指令执行时间为:
流水线实现的周期,必须等于最慢一级的时间加上开销,即 ;这也是平均指令执行时间。因此:
0.1 ns 的开销实际上限制了流水线的效果。如果开销不随时钟周期变化,Amdahl 定律告诉我们,它会限制加速比。
译注: 原页确实同时写“4 GHz”和“0.5 ns”,两者不对应;4 GHz 对应 0.25 ns。原解答始终按 0.5 ns 计算。
如果流水线中的每条整数指令都独立于其他指令,这条简单 RISC 流水线就能正常工作。实际指令可能相互依赖;这是下一节的主题。
C.2 流水线的主要障碍:流水线冒险
有些情形会阻止指令流中的下一条指令在指定周期执行,这些情形称为冒险(hazard)。冒险会使流水线达不到理想加速比。冒险分为三类:
- 结构冒险: 硬件无法同时支持重叠执行中所有可能的指令组合,从而产生资源冲突。在现代处理器中,结构冒险主要发生在使用频率较低的专用功能单元上,例如浮点除法及其他执行时间较长的复杂指令。只要程序员和编译器开发者了解这些指令的吞吐量较低,它们就不是影响性能的主要因素。我们不再深入讨论这种不常见的情形,而把重点放在另外两类更常见的冒险上。
- 数据冒险: 一条指令依赖前一条指令的结果,而流水线中的重叠执行使这种依赖暴露出来。
- 控制冒险: 对分支及其他改变 PC 的指令进行流水线处理所产生的冒险。
冒险可能迫使流水线停顿。避免冒险常常需要让部分指令继续推进,同时延迟其他指令。在本附录讨论的流水线中,一条指令停顿时,比它更晚发射、因而在流水线中行进得更少的所有指令也必须停顿;更早发射、因而行进得更远的指令则必须继续,否则冒险永远无法消除。因此,停顿期间不再取新指令。本节将用几个例子说明停顿如何工作;它并没有听起来那么复杂。
有停顿时的流水线性能
停顿会使流水线性能低于理想值。由上一节的公式出发,可以计算实际加速比:
这里 为时钟周期。可以把流水线理解为降低 CPI,也可以理解为缩短时钟周期。通常使用 CPI 比较流水线,因此先采用前一种观点。流水线处理器的理想 CPI 几乎总是 1,所以:
忽略流水线引入的周期开销,并假定各级完全均衡,两种处理器的周期便可以相同,于是:
一种重要而简单的情形,是所有指令所需周期数都相同,并且等于流水级数,即流水线深度。此时,非流水线 CPI 等于流水线深度,因此:
若没有停顿,就得到直观结论:流水线能使性能提高到原来的流水线深度倍。
数据冒险
流水线的一个主要作用,是通过重叠执行改变指令之间的相对时序。这种重叠引入数据冒险和控制冒险。当流水线改变操作数的读写顺序,使其不同于非流水线处理器按顺序执行指令时的顺序,就会发生数据冒险。假定程序顺序中指令 先于指令 ,两者都使用寄存器 ,则可能出现三类冒险:
- 写后读(RAW): 最常见的一类。指令 读取 早于指令 写入 。若不阻止它, 就会使用错误的 值。
- 读后写(WAR): 指令 读取 晚于指令 写入 ,于是 使用了错误的值。简单五级整数流水线不可能发生 WAR,但重排指令时会出现;从原书 C-65 页开始讨论动态调度流水线时将看到这种情况。
- 写后写(WAW): 指令 写入 晚于指令 写入 ,导致后续使用的 值错误。简单五级整数流水线也不会发生这种冒险,但指令重排或执行时间不同时会发生,后文将讨论。1
第 3 章将更详细地讨论数据依赖与冒险。现在只关注 RAW。考虑以下指令的流水线执行:
add 后面的所有指令都使用它的结果。如图 C.4 所示,add 在 WB 阶段写入 x1,但 sub 在 ID 阶段就读取它,因而发生 RAW 冒险。若不采取预防措施,sub 会读到并使用错误的值。事实上,这个值甚至是不确定的:虽然看起来可以认为它总是 add 之前某条指令写入 x1 的旧值,但事实并不总是如此。如果 add 与 sub 之间发生中断,add 的 WB 会完成,此时 x1 已经是 add 的结果。显然,这种不可预测的行为不能接受。
and 也可能产生 RAW 冒险。图 C.4 中 x1 的写入直到第 5 周期结束才完成,因此第 4 周期读取寄存器的 and 会取得错误结果。
xor 可以正确执行,因为它在第 6 周期读取寄存器,晚于写回。or 也不会发生冒险,因为寄存器堆在周期前半段写入、后半段读取。注意,xor 仍然依赖 add,只是不会再构成冒险;第 3 章将更深入地讨论这一点。下一小节介绍如何消除 sub 和 and 冒险导致的停顿。2
用转发尽量减少数据冒险停顿
图 C.4 的问题可以用一种简单硬件技术解决,称为转发(forwarding),也称旁路(bypassing),有时称 short-circuiting。关键在于:sub 真正需要结果的时刻,晚于 add 产生结果的时刻。如果直接把结果从 add 保存它的流水线寄存器,送到 sub 需要它的位置,就能避免停顿。其工作方式如下:
- 始终把 EX/MEM 与 MEM/WB 流水线寄存器中的 ALU 结果反馈到 ALU 输入。
- 若转发硬件发现,前一条 ALU 操作写入的寄存器,正是当前 ALU 操作的源寄存器之一,控制逻辑就选择转发结果作为 ALU 输入,而不使用从寄存器堆读出的值。
注意,采用转发后,如果 sub 停顿,add 就会先完成,旁路便不会启用。两条指令之间发生中断时,也是如此。
图 C.4 的例子表明,结果不仅可能来自紧前一条指令,也可能来自早两个周期启动的指令。图 C.5 加入了旁路,并突出显示寄存器读写的时序。这段代码可以无停顿执行。
转发还可以推广为:把结果直接传给需要它的功能单元,即从一个单元输出端的流水线寄存器传到另一个单元的输入,而不只是反馈给原来的单元。例如:
要避免这段代码停顿,需要把流水线寄存器中的 ALU 输出和存储器输出,分别转发给 ALU 与数据存储器输入。图 C.6 展示了全部转发路径。
必须停顿的数据冒险
可惜,旁路无法处理所有潜在的数据冒险。考虑以下指令:
图 C.7 展示了这段代码带旁路的数据通路。它与连续两条 ALU 指令不同:ld 到第 4 周期,即 MEM 周期结束,才取得数据,而 sub 在该周期开始时就需要数据。因此,使用加载结果造成的数据冒险,无法用简单硬件完全消除。图中所需的转发路径必须逆着时间工作,而计算机设计者还没有这种本领!可以把结果从流水线寄存器直接转发给 ALU,供比加载晚两个周期启动的 and 使用;or 也没有问题,它通过寄存器堆取得值。但对 sub 来说,转发结果来得太晚:需要时是在周期开始,结果却在周期结束才到达。
加载指令的延迟无法仅靠转发消除。需要增加称为流水线互锁(pipeline interlock)的硬件,以保证正确的执行模式。一般来说,互锁检测冒险,并使流水线停顿,直到冒险消失。在这里,它让需要使用数据的指令及其后的指令停顿,等待源指令产生数据。这会插入一个停顿,也称气泡,与处理结构冒险时相同。该指令的 CPI 增加量等于停顿长度;这里为一个周期。
图 C.8 用流水级名称展示停顿前后的时序。停顿使 sub 及其后指令都晚一个周期,因而给 and 的转发现在通过寄存器堆完成,or 则完全不再需要转发。插入气泡使整个序列的完成时间增加一个周期;第 4 周期没有新指令启动,第 6 周期没有指令完成。
| 情形/指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
无停顿:ld x1,0(x2) | IF | ID | EX | MEM | WB | ||||
sub x4,x1,x5 | IF | ID | EX | MEM | WB | ||||
and x6,x1,x7 | IF | ID | EX | MEM | WB | ||||
or x8,x1,x9 | IF | ID | EX | MEM | WB | ||||
有停顿:ld x1,0(x2) | IF | ID | EX | MEM | WB | ||||
sub x4,x1,x5 | IF | ID | 停顿 | EX | MEM | WB | |||
and x6,x1,x7 | IF | 停顿 | ID | EX | MEM | WB | |||
or x8,x1,x9 | 停顿 | IF | ID | EX | MEM | WB |
分支冒险
控制冒险对这条 RISC-V 流水线造成的性能损失,可能大于数据冒险。执行分支时,PC 可能改为当前值加 4 以外的其他值,也可能不改变顺序流。分支把 PC 改为目标地址,称为跳转(taken);顺序执行下一条指令,则称为不跳转(not taken 或 untaken)。若指令 是跳转分支,通常要在 ID 结束、地址计算与比较完成后,才能修改 PC。
图 C.9 所示的最简单处理方法,是在 ID 译码时发现分支后,重新取分支的后继指令。第一次 IF 实际上是停顿,因为它没有完成有效工作。若分支不跳转,已取出的指令本来就是正确的,这次重复 IF 就没有必要。稍后将利用这一点提出几种方案。
每次分支停顿一周期,随分支频率不同,会造成 10%~30% 的性能损失,下面研究如何减少这种损失。
降低流水线的分支代价
处理分支延迟所致停顿的方法很多。先讨论四种简单的编译时方案。它们都是静态方案:每条分支在整个执行期间采取的处理方式固定。软件可以利用对硬件方案和分支行为的了解,尽量减少分支代价。随后讨论按程序行为动态预测分支的硬件方案;第 3 章还会介绍更强大的动态分支预测技术。
最简单的方法,是冻结或冲刷流水线:保持或删除分支后的所有指令,直到知道分支目标。其主要吸引力在于软硬件都简单,前面的图 C.9 就采用这种方法。它的分支代价固定,软件无法降低。
| 情形/指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| 分支指令 | IF | ID | EX | MEM | WB | ||||
| 分支后继 | IF | IF | ID | EX | MEM | WB | |||
| 分支后继+1 | IF | ID | EX | MEM | |||||
| 分支后继+2 | IF | ID | EX |
性能更好、复杂度只略高的方案,是把每个分支都当作不跳转,硬件像没有分支一样继续运行。但在确定分支结果前,必须小心避免修改处理器状态。复杂性来自判断指令何时可能修改状态,以及如何撤销修改。
在简单五级流水线中,预测不跳转方案像对待普通指令一样,继续取分支后的指令;流水线看起来没有任何异常。如果实际跳转,就把已取指令转为空操作,并从目标地址重新取指。图 C.10 展示了两种情况。
另一种方案是把所有分支都预测为跳转。一旦译码并算出目标地址,就开始从目标取指、执行。当实际跳转时,这会节省一周期,因为 ID 结束就已知道目标地址,比 ALU 阶段确定分支条件早一周期。无论预测跳转还是不跳转,编译器都可以通过组织代码,让最常走的路径符合硬件选择,以改善性能。3
第四种方案称为延迟分支,曾广泛用于早期 RISC 处理器。延迟为一条指令时,执行顺序为:
| 情形/指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| 不跳转:分支 | IF | ID | EX | MEM | WB | ||||
| 指令 i+1 | IF | ID | EX | MEM | WB | ||||
| 指令 i+2 | IF | ID | EX | MEM | WB | ||||
| 指令 i+3 | IF | ID | EX | MEM | WB | ||||
| 指令 i+4 | IF | ID | EX | MEM | WB | ||||
| 跳转:分支 | IF | ID | EX | MEM | WB | ||||
| 指令 i+1 | IF | 空闲 | 空闲 | 空闲 | 空闲 | ||||
| 分支目标 | IF | ID | EX | MEM | WB | ||||
| 目标+1 | IF | ID | EX | MEM | WB | ||||
| 目标+2 | IF | ID | EX | MEM | WB |
顺序后继指令位于分支延迟槽中,无论分支是否跳转都要执行。图 C.11 给出了五级流水线的相应行为。虽然延迟可以超过一条指令,但实际采用延迟分支的处理器几乎都只有一个指令延迟;若流水线潜在分支代价更长,则使用其他技术。编译器的任务是让延迟槽中的后继指令既合法又有用。
在硬件预测过于昂贵的年代,延迟分支对短而简单的流水线很有用,但它会使采用动态分支预测的实现变得复杂。因此,RISC-V 合理地没有采用延迟分支。
各种分支方案的性能
各方案的实际性能如何?假定理想 CPI 为 1,计入分支代价后:
又因为:
所以:
无条件分支和条件分支都可以贡献分支频率与分支代价,但条件分支更常见,因此占主导。
| 情形/指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| 不跳转:分支 | IF | ID | EX | MEM | WB | ||||
| 延迟槽指令(i+1) | IF | ID | EX | MEM | WB | ||||
| 指令 i+2 | IF | ID | EX | MEM | WB | ||||
| 指令 i+3 | IF | ID | EX | MEM | WB | ||||
| 指令 i+4 | IF | ID | EX | MEM | WB | ||||
| 跳转:分支 | IF | ID | EX | MEM | WB | ||||
| 延迟槽指令(i+1) | IF | ID | EX | MEM | WB | ||||
| 分支目标 | IF | ID | EX | MEM | WB | ||||
| 目标+1 | IF | ID | EX | MEM | WB | ||||
| 目标+2 | IF | ID | EX | MEM | WB |
例题 对更深的流水线,例如 MIPS R4000 及后来的 RISC 处理器,在不存在条件比较寄存器停顿的前提下,至少经过三个流水级才能知道分支目标,再过一个周期才能确定分支条件。这种三级延迟下,三种最简单预测方案的分支代价如图 C.12 所示。假定下列频率,求分支对 CPI 的实际增加量:
| 分支类型 | 频率 |
|---|---|
| 无条件分支 | 4% |
| 条件分支,不跳转 | 6% |
| 条件分支,跳转 | 10% |
解答 将各类分支的相对频率乘以对应代价,就得到 CPI 增量,结果见图 C.13。
| 分支方案 | 无条件分支代价 | 条件分支不跳转代价 | 条件分支跳转代价 |
|---|---|---|---|
| 冲刷流水线 | 2 | 3 | 3 |
| 预测跳转 | 2 | 3 | 2 |
| 预测不跳转 | 2 | 0 | 3 |
| 分支方案/频率 | 无条件分支 | 不跳转的条件分支 | 跳转的条件分支 | 全部分支 |
|---|---|---|---|---|
| 事件频率 | 4% | 6% | 10% | 20% |
| 停顿流水线 | 0.08 | 0.18 | 0.30 | 0.56 |
| 预测跳转 | 0.08 | 0.18 | 0.20 | 0.46 |
| 预测不跳转 | 0.08 | 0.00 | 0.30 | 0.38 |
更长的延迟显著放大了方案之间的差异。如果基础 CPI 为 1,分支是唯一停顿来源,那么理想流水线的性能为采用停顿方案的 1.56 倍。在相同假设下,预测不跳转方案的性能为停顿方案的 1.13 倍。
用预测降低分支成本
流水线越深,分支的潜在代价越大,仅靠延迟分支之类的方法就不够了,必须采用更积极的预测。方案分两类:利用编译时信息的低成本静态方法,以及根据程序行为动态预测的方法。下面分别讨论。
静态分支预测
改善编译时预测的一个重要方法,是利用此前运行采集的性能剖析信息(profile)。它之所以有效,是因为分支行为常呈双峰分布:单条分支通常明显倾向于跳转或不跳转。图 C.14 展示了这种策略的效果。图中采集 profile 与评测使用相同输入;其他研究表明,即使改变输入、使用另一次运行的 profile,预测准确率也只发生很小变化。
任何分支预测方案的效果,都取决于准确率和条件分支频率;SPEC 的条件分支频率为 3%~24%。整数程序不仅失误率较高,分支频率通常也更高,这是静态预测的主要限制。下一小节介绍近年来大多数处理器使用的动态预测器。
动态分支预测与分支预测缓冲器
最简单的动态方案是分支预测缓冲器,也称分支历史表。它是由分支指令地址的低位索引的小型存储器,其中一位记录分支最近是否跳转。这种最简单的缓冲器没有标记,只有当分支延迟长于计算可能目标 PC 所需的时间时,才能帮助缩短分支延迟。
采用这种缓冲器时,我们实际上并不知道预测是否对应当前分支:该条目可能由另一条地址低位相同的分支写入。但这无关紧要。预测只是一个暂且当作正确的提示,硬件沿预测方向取指;如果错误,就翻转预测位并写回。
它实际上相当于一个每次访问都命中的缓存。其效果既取决于条目有多大概率确实对应当前分支,也取决于对应时的预测准确率。分析性能之前,先对预测方案做一个虽小却重要的改进。
简单的 1 位方案有一个缺点:即使某分支几乎总是跳转,一次不跳转也可能导致连续两次预测错误,而非一次,因为第一次失误会翻转预测位。
常用的改进是 2 位预测方案:必须连续失误两次,才改变预测方向。图 C.15 给出了相应有限状态机。
图 C.15(续) 2 位方案是更一般的预测缓冲器每项使用一个 位饱和计数器方案的特例。计数器取值范围为 到 ;值不小于最大值的一半时,预测跳转,否则预测不跳转。研究表明,2 位预测器与更一般的 位方案效果几乎相同,所以大多数系统使用 2 位预测器。
译注: 原图的两条跨状态转移为
10 → 00(不跳转)和01 → 11(跳转),并非每次严格加一或减一的相邻饱和计数器转移。
分支预测缓冲器可以实现为小型专用“缓存”,在 IF 阶段用指令地址访问;也可以把两位附在每个指令缓存块中,与指令一起取出。如果译码发现是分支,并预测跳转,那么目标 PC 一旦确定,就从目标取指;否则继续顺序取指和执行。图 C.15 表明,若预测错误,就改变预测位。
在真实应用上,每项两位的缓冲器能达到怎样的准确率?图 C.16 表明,4096 项缓冲器在 SPEC89 中的准确率从超过 99% 到 82% 不等,即失误率为 1%~18%。这样的 4K 项缓冲器在 2017 年已经算小,扩大容量还能略有改善。
随着我们尝试开发更多 ILP,预测准确率变得至关重要。图 C.16 表明,通常具有更高分支频率的整数程序,预测准确率反而低于循环密集的科学计算程序。有两条改进途径:增大缓冲器,以及提高每次预测所用方法的准确率。但图 C.17 表明,至少对 SPEC 这类基准,4K 项与无限容量缓冲器的表现已经相当接近,缓冲器命中率并非主要限制。正如前面所说,只增加每个预测器的位数而不改变结构,效果也很小。我们需要提高每个预测器本身的准确率,第 3 章将介绍这一方向。
C.3 如何实现流水线?
进一步讨论基本流水线之前,先复习 RISC-V 的一种简单非流水线实现。
RISC-V 的一种简单实现
本节沿用 C.1 节的方式,先介绍简单的非流水线实现,再介绍流水线实现;但这次具体针对 RISC-V 体系结构。
我们关注一个整数子集,包括字加载与存储、相等条件分支和整数 ALU 操作;后文再加入基本浮点操作。虽然只讨论子集,基本原理可以扩展到全部指令,例如加入存储需要额外处理立即数字段。起初对分支采用较保守的实现,本节末尾再说明更积极的实现。
每条 RISC-V 指令最多可在 5 个周期内完成:
1. 取指周期(IF)
操作: 输出 PC,从存储器取指,放入指令寄存器 IR;PC 加 4,得到下一条顺序指令的地址。IR 保存后续周期仍需使用的指令,NPC 则保存下一个顺序 PC。
2. 指令译码/寄存器读取周期(ID)
操作: 译码并访问寄存器堆,读取 rs1、rs2 指定的寄存器。通用寄存器的输出保存到临时寄存器 A、B,供后续周期使用。IR 的低 16 位也进行符号扩展,存入临时寄存器 Imm,供下一周期使用。1
由于这些字段在 RISC-V 指令中的位置固定,译码和读寄存器可并行进行。加载与 ALU 立即数指令的立即数字段位置相同,因此本周期也计算符号扩展后的立即数,以备下周期使用。存储指令的立即数字段分成两部分,需要单独进行符号扩展。
3. 执行/有效地址计算周期(EX)
ALU 对上一周期准备的操作数执行操作,按指令类型分为四种。
访存:
操作: ALU 将两个操作数相加,形成有效地址,结果保存到 ALUOutput。
寄存器—寄存器 ALU 指令:
操作: ALU 对 A、B 执行功能码指定的操作;功能码由 func3 和 func7 字段组合而成。结果保存到临时寄存器 ALUOutput。
寄存器—立即数 ALU 指令:
操作: ALU 对 A、Imm 执行操作码指定的运算,结果保存到 ALUOutput。
分支:
操作: Imm 中符号扩展后的立即数左移两位,形成字偏移,再与 NPC 相加,计算分支目标。由于这里只考虑相等条件分支,比较上一周期读出的 A 与 B,以确定是否跳转。
RISC-V 的加载—存储体系结构允许将有效地址计算与执行放在同一周期,因为没有指令需要同时计算数据地址、计算指令目标地址并对数据运算。这里未包含的其他整数指令是各种跳转,它们与分支类似。
4. 存储器访问/分支完成周期(MEM)
所有指令都更新 PC:PC ← NPC;。
访存:
操作: 按需访问存储器。加载把返回数据放入 LMD(load memory data,加载存储器数据)寄存器;存储把 B 写入存储器。两者均使用上一周期算出、保存在 ALUOutput 中的地址。
分支:
操作: 若分支跳转,用 ALUOutput 中的目标地址替换 PC。
5. 写回周期(WB)
寄存器—寄存器或寄存器—立即数 ALU 指令:
加载指令:
操作: 把来自存储系统(LMD)或 ALU(ALUOutput)的结果,写入 rd 指定的寄存器。
图 C.18 展示指令在数据通路中的流动。每个周期结束时,本周期算出且以后仍需使用的值——无论供当前指令还是下一条指令使用——都要写入存储部件。这些部件可以是内存、通用寄存器、PC 或临时寄存器,如 LMD、Imm、A、B、IR、NPC、ALUOutput、Cond。临时寄存器在同一条指令的不同周期之间保存值,其他存储部件则属于可见状态,在相继执行的指令之间保存值。
图内术语:Instruction fetch=取指;Instruction decode/register fetch=译码/读取寄存器;Execute/address calculation=执行/地址计算;Memory access=访存;Write-back=写回;Instruction/Data memory=指令/数据存储器;Registers=寄存器堆;Sign-extend=符号扩展;Mux=多路选择器;Add=加法器;Branch taken=分支跳转;ALU output=ALU 输出。A、B、IR、NPC、Imm、Cond、LMD 为正文定义的临时寄存器。
如今处理器都采用流水线,但这种多周期实现,大致反映了早期多数处理器的实现方式。按上述五周期结构,用简单有限状态机即可实现控制;更复杂的处理器可以采用微码控制。无论哪一种,指令执行步骤都决定控制结构。
这个多周期实现有些硬件冗余可以消除。例如,递增 PC 与计算有效地址/执行 ALU 操作各用了一个 ALU。它们不在同一周期使用,因此可以增加多路选择器,共享一个 ALU。类似地,指令和数据访问发生在不同周期,也可放入同一存储器。
这里不优化这种简单实现,而保留图 C.18 的设计,因为它更适合作为流水线实现的基础。
RISC-V 的基本流水线
与前面一样,每周期启动一条新指令,就能在几乎不改动的情况下,将图 C.18 流水线化。每个级在每个周期都活跃,所以一级内的全部操作必须在一周期内完成,各种操作的组合也必须能够同时发生。此外,级间传递的值必须保存到寄存器。图 C.19 在每对相邻级之间加入合适的寄存器,称为流水线寄存器或流水线锁存器,按所连接的级命名。图中特别清楚地展示了穿过这些寄存器的连接。
原先为单条指令在各周期间临时保存值的寄存器,现都归入流水线寄存器。IR 是 IF/ID 的一部分;用于提供寄存器名称的字段已单独标出。流水线寄存器既传数据也传控制。以后还需使用的值,必须存入这些寄存器,并逐级复制,直到不再需要。若仍使用原先非流水线数据通路的临时寄存器,值可能尚未用完就被覆盖。例如,加载或 ALU 操作写回时,目的寄存器字段来自 MEM/WB,而不是 IF/ID。我们要写的是当前加载或 ALU 指令指定的寄存器,而不是此刻正从 IF 进入 ID 的另一条指令指定的寄存器。目的字段因此逐级复制,直到 WB 使用。
任一时刻,一条指令只活跃于一个流水级,所以为它执行的操作都位于一对流水线寄存器之间。也可以按指令类型,逐级考察必须发生的操作,图 C.20 就采用这一视角。字段名称反映数据从一级流向下一级的过程。前两级的操作与当前指令类型无关;它们必须如此,因为到 ID 结束才完成译码。
IF 的活动取决于 EX/MEM 中的指令是否为跳转分支。如果是,IF 结束时把 EX/MEM 中的分支目标写入 PC;否则写入递增后的 PC。前面说过,分支的这一作用会引入复杂性,后续几节将处理它。源寄存器采用固定位置编码,是能够在 ID 读取寄存器的关键。
控制这条简单流水线,只需决定图 C.19 中四个多路选择器的设置。ALU 阶段的两个选择器根据 ID/EX 的 IR 字段所指示的指令类型设置:上方输入取决于是否为分支,下方输入取决于是否为寄存器—寄存器 ALU 操作。IF 中的选择器在递增 PC 与 EX/MEM.ALUOutput(分支目标)间选择,受 EX/MEM.cond 控制。第四个选择器按 WB 指令是加载还是 ALU 操作,选择写回值。
| 级 | 任意指令的操作 | ALU 指令 | 加载指令(原表栏名) | 分支指令 |
|---|---|---|---|---|
| IF | IF/ID.IR ← Mem[PC];IF/ID.NPC, PC ← (if ((EX/MEM.opcode == branch) & EX/MEM.cond) {EX/MEM.ALUOutput} else {PC+4}); | |||
| ID | ID/EX.A ← Regs[IF/ID.IR[rs1]];ID/EX.B ← Regs[IF/ID.IR[rs2]];ID/EX.NPC ← IF/ID.NPC;ID/EX.IR ← IF/ID.IR;ID/EX.Imm ← sign-extend(IF/ID.IR[immediate field]); | |||
| EX | EX/MEM.IR ← ID/EX.IR;EX/MEM.ALUOutput ← ID/EX.A func ID/EX.B;或 EX/MEM.ALUOutput ← ID/EX.A op ID/EX.Imm; | EX/MEM.IR ← ID/EX.IR;EX/MEM.ALUOutput ← ID/EX.A + ID/EX.Imm;EX/MEM.B ← ID/EX.B; | EX/MEM.ALUOutput ← ID/EX.NPC + (ID/EX.Imm << 2);EX/MEM.cond ← (ID/EX.A == ID/EX.B); | |
| MEM | MEM/WB.IR ← EX/MEM.IR;MEM/WB.ALUOutput ← EX/MEM.ALUOutput; | MEM/WB.IR ← EX/MEM.IR;MEM/WB.LMD ← Mem[EX/MEM.ALUOutput];或 Mem[EX/MEM.ALUOutput] ← EX/MEM.B; | ||
| WB | Regs[MEM/WB.IR[rd]] ← MEM/WB.ALUOutput; | 仅加载:Regs[MEM/WB.IR[rd]] ← MEM/WB.LMD; |
图 C.20(续) IF 除取指和计算新 PC 外,也把递增 PC 保存到 PC 和流水线寄存器 NPC,以便以后计算分支目标;与图 C.19 相同,IF 中 PC 有两个可能来源。ID 读取寄存器,对 IR 的 12 位立即数字段符号扩展,并传递 IR 与 NPC。EX 执行 ALU 运算或地址计算,传递 IR,以及存储指令所需的 B;若分支跳转,则置 cond=1。MEM 访问存储器、必要时写 PC,并传递最后一级需要的值。WB 用 ALU 输出或加载值更新寄存器。为简化表达,整个 IR 都逐级传递,尽管实际所需字段会越来越少。
译注: 原表“Load instruction”栏也包含存储操作;EX 栏第一行原印为
EX/MEM.IR to ID/EX.IR,这里按其他栏的同类赋值格式明确箭头。图注又写“MEM 阶段必要时写 PC”,与本节及图 C.19 把 PC 写入移至 IF 的说明不一致。
除四个已画出的选择器外,还需要一个图 C.19 未画出的选择器;从 ALU 指令的 WB 操作可看出原因。原文称目的寄存器字段随指令类型不同而处在两个位置:寄存器—寄存器 ALU 指令一类,ALU 立即数或加载另一类。所以,对写寄存器的指令,还需要从 MEM/WB 的 IR 中选择正确的目的字段。此处字段布局问题见前面的译注:
RISC-V 流水线的控制实现
让指令从 ID 进入 EX 的过程通常称为指令发射;完成这一步,就称已发射。对 RISC-V 整数流水线,所有数据冒险都能在 ID 检查;若有冒险,则在发射前停顿。也可以在 ID 确定所需转发,并设好控制。尽早检测互锁会简化硬件,因为除非整个处理器都停顿,否则不必暂停一条已经更新处理器状态的指令。
另一种方法是在使用操作数的周期开始时检测冒险或转发;本流水线对应 EX 和 MEM。为了展示两种方法的区别,下面在 ID 检测源指令为加载的 RAW 冒险,即加载互锁,而在 EX 决定 ALU 输入转发。图 C.21 列出必须处理的各种情况。
先实现加载互锁。如果存在加载引起的 RAW 冒险,那么需要加载结果的指令处于 ID 时,加载处于 EX。用一个小表就能列出全部危险情形,并直接转成硬件。图 C.22 在使用结果的指令处于 ID 时,检测全部加载互锁。
检测到冒险后,控制单元必须插入停顿,阻止 IF 和 ID 中的指令继续推进。所有控制信息都在流水线寄存器中;只要保留指令本身就足够,因为控制可由它导出。因而只需把 ID/EX 中的控制部分清零,使之成为空操作,例如不做任何事的 add x0,x0,x0。同时,让 IF/ID 的内容保持不变,保存被阻塞的指令。更复杂的冒险也可用相同思路:比较一组流水线寄存器来检测冒险,插入空操作以防错误执行。
转发逻辑的实现类似,但要考虑更多情形。关键是流水线寄存器同时含有待转发数据和源/目的寄存器字段。从逻辑上说,转发都是从 ALU 或数据存储器输出,送往 ALU 输入、数据存储器输入或零值检测单元。因此,比较 EX/MEM、MEM/WB 中 IR 的目的寄存器,与 ID/EX、EX/MEM 中 IR 的源寄存器,就能实现转发。
| 情形 | 代码示例(从上到下执行) | 处理 |
|---|---|---|
| 无依赖 | ld x1,45(x2)add x5,x6,x7sub x8,x6,x7or x9,x6,x7 | 后面紧接的三条指令都不依赖 x1,因此不可能有冒险。 |
| 依赖必须停顿 | ld x1,45(x2)add x5,x1,x7sub x8,x6,x7or x9,x6,x7 | 比较器发现 add 使用 x1,在 add 进入 EX 前将它及其后的 sub、or 停顿。 |
| 通过转发克服依赖 | ld x1,45(x2)add x5,x6,x7sub x8,x1,x7or x9,x6,x7 | 比较器发现 sub 使用 x1,把加载结果及时转发到 ALU,使 sub 能开始 EX。 |
| 有依赖,但访问次序正确 | ld x1,45(x2)add x5,x6,x7sub x8,x6,x7or x9,x1,x7 | 无需处理:加载在周期前半段写 x1,or 在 ID 后半段读 x1。 |
ID/EX 的操作码字段(原表记为 ID/EX.IR0..5) | IF/ID 的操作码字段(原表记为 IF/ID.IR0..6) | 匹配的操作数字段 |
|---|---|---|
| 加载 | 寄存器—寄存器 ALU、加载、存储、ALU 立即数或分支 | ID/EX.IR[rd] == IF/ID.IR[rs1] |
| 加载 | 寄存器—寄存器 ALU 或分支 | ID/EX.IR[rd] == IF/ID.IR[rs2] |
译注: 图 C.22 两列表头的操作码位范围分别为
0..5和0..6,原表即如此,这里不统一成同一范围。
图 C.23 列出转发目标为当前 EX 指令的 ALU 输入时,所需比较及可能的转发。
| 源指令所在流水线寄存器 | 源指令操作码 | 目的指令所在流水线寄存器 | 目的指令操作码 | 转发目标 | 比较条件:相等则转发 |
|---|---|---|---|---|---|
| EX/MEM | 寄存器—寄存器 ALU、ALU 立即数 | ID/EX | 寄存器—寄存器 ALU、ALU 立即数、加载、存储、分支 | 上方 ALU 输入 | EX/MEM.IR[rd] == ID/EX.IR[rs1] |
| EX/MEM | 寄存器—寄存器 ALU、ALU 立即数 | ID/EX | 寄存器—寄存器 ALU | 下方 ALU 输入 | EX/MEM.IR[rd] == ID/EX.IR[rs2] |
| MEM/WB | 寄存器—寄存器 ALU、ALU 立即数、加载 | ID/EX | 寄存器—寄存器 ALU、ALU 立即数、加载、存储、分支 | 上方 ALU 输入 | MEM/WB.IR[rd] == ID/EX.IR[rs1] |
| MEM/WB | 寄存器—寄存器 ALU、ALU 立即数、加载 | ID/EX | 寄存器—寄存器 ALU | 下方 ALU 输入 | MEM/WB.IR[rd] == ID/EX.IR[rs2] |
图 C.23(续) 原图注说,判断是否转发需要 10 次独立比较。EX 中目的指令的流水线寄存器是 ID/EX;源值来自 EX/MEM 或 MEM/WB 的 ALUOutput,或 MEM/WB 的 LMD。这里的逻辑尚未处理多条指令写同一寄存器的情况。例如:
必须保证 sub 使用 addi 而非 add 的结果。只需增加条件:对同一个输入,只有 EX/MEM 转发未启用时,才允许 MEM/WB 转发。addi 结果位于 EX/MEM,因此会优先于 MEM/WB 中的 add 结果被选择。
译注: 表内列出四行寄存器相等比较,但图注仍写“10 次独立比较”,未解释其计数口径。原图注把图 C.24 的页码写成 C.36,实际为 C-37。
除判断何时启用转发的比较器与组合逻辑外,还必须扩展 ALU 输入多路选择器,增加来自相关流水线寄存器的连接。图 C.24 展示了新增选择器和连接后的相关数据通路。
RISC-V 的冒险检测与转发硬件比较简单;扩展到浮点后,情况会复杂一些。在此之前,先处理分支。
在流水线中处理分支
RISC-V 的条件分支比较两个寄存器值,这里假定比较在 EX 中借助 ALU 完成。还要计算分支目标。分支条件判断与下一 PC 的确定决定分支代价,因此希望在 EX 结束前,算出两种可能 PC 并选出正确值。可以增加一个独立加法器,在 ID 计算目标。由于指令尚未完成译码,会把每条指令都暂当分支,计算可能目标。这可能比在 EX 同时算目标和判断条件更快,但会多用一点能量。
图 C.25 将加法器放在 ID、条件判断放在 EX,只对流水线结构做了小改动。这条流水线的分支代价为两个周期。某些早期 RISC,例如 MIPS,限制分支条件的形式,使比较可以在 ID 完成,将延迟降至一个周期。不过,若 ALU 指令写某寄存器,紧接着的分支就根据它判断,会发生数据冒险;若判断放在 EX,则没有这一问题。
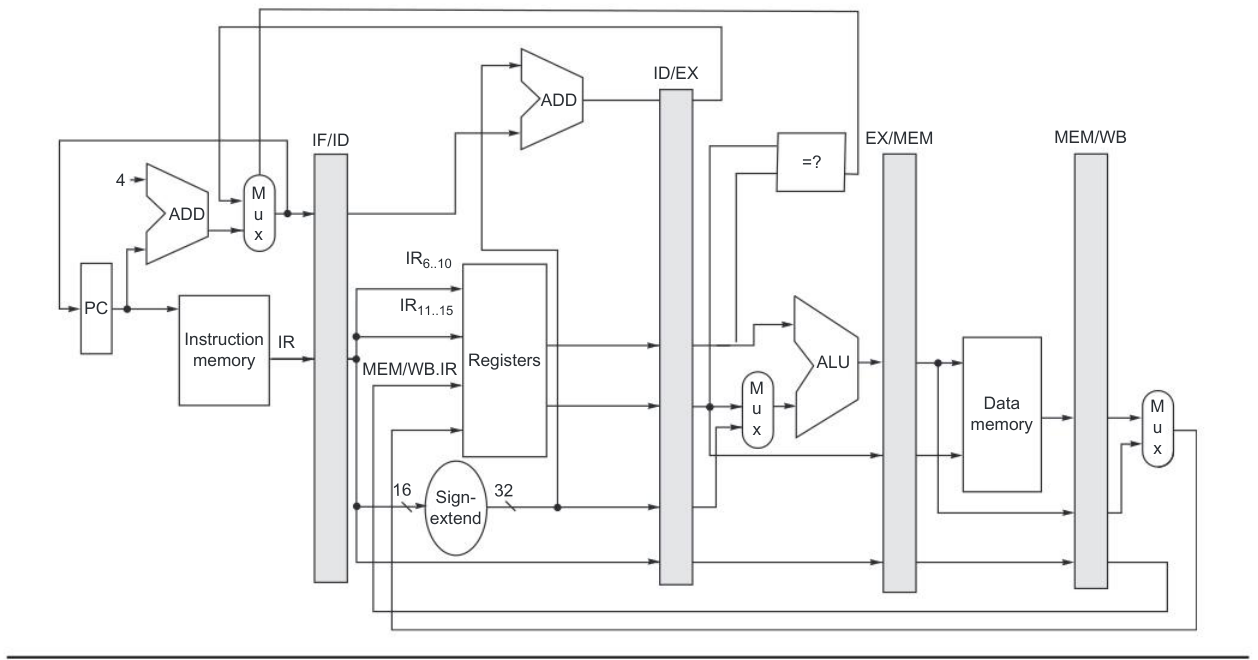
流水线越来越深,分支延迟随之增加,使动态预测成为必要。例如,把译码与读寄存器分成两个级,分支延迟很可能至少再增加一周期。若不处理,分支延迟就转化为实际代价。许多实现复杂指令集的旧处理器,其分支延迟为 4 周期或更多;大型深流水线处理器的分支代价常达 6 或 7 周期。设计激进的高端超标量处理器,例如第 3 章讨论的 Intel i7,甚至可能达到 10~15 周期。总的来说,流水线越深,以周期计的分支代价越大,准确预测就越关键。
译注: 本节原文混用了字段布局。此处写“低 16 位”,图 C.18、C.19 及 C.20 图注却写 12 位;分支伪代码采用
NPC + (Imm << 2);后文还说目的寄存器随指令类别处于两个位置,图 C.25 使用IR6..10、IR11..15。这些与本书第 1 章给出的 RISC-V 固定字段并不一致,疑有旧版示例遗留。原页存储赋值行的箭头未印出,此处根据紧随其后的文字说明补明写入方向。 ↩︎
C.4 流水线为何难以实现?
了解如何检测与解决冒险后,可以处理前面暂时避开的一些复杂问题。本节前半讨论异常情况:指令执行顺序以非预期方式改变;后半讨论不同指令集带来的挑战。
处理异常
流水线处理器更难处理异常,因为指令重叠执行,使得判断一条指令能否安全地修改处理器状态变得更困难。指令分成若干部分执行,经过几个周期才完成;与此同时,流水线中的其他指令可能触发异常,迫使处理器在某些指令完成前中止它们。在深入讨论问题与解法之前,需要了解可能发生的情况,以及体系结构对异常支持的要求。
异常类型与要求
不同处理器对正常指令顺序被改变的情况采用不同术语,如中断(interrupt)、故障(fault)、异常(exception),但用法不统一。本书用“异常”统称这些机制,包括:
- I/O 设备请求。
- 用户程序调用操作系统服务。
- 跟踪指令执行。
- 断点,即程序员请求的中断。
- 整数运算溢出。
- 浮点运算异常。
- 缺页,即页面不在主存。
- 未对齐的访存,如果体系结构要求对齐。
- 违反存储器保护。
- 使用未定义或尚未实现的指令。
- 硬件故障。
- 电源故障。
特指某一类时,使用更完整的名称,如 I/O 中断、浮点异常或缺页。
虽然统称异常,各类事件的重要特征决定了硬件应采取什么措施。异常要求可沿五个部分独立的维度分类:
- 同步或异步: 若每次使用相同数据和内存分配运行程序,事件总在相同位置发生,就是同步事件。除硬件故障外,异步事件来自处理器与存储器之外的设备。异步事件通常可等当前指令完成再处理,因此较容易处理。
- 用户请求或强制发生: 用户任务直接要求发生的,是用户请求事件。从某种意义上说,它们可预测,算不上真正的“意外”;之所以作为异常处理,是因为仍使用同一套保存和恢复状态的机制。触发此类事件的指令,其唯一功能就是产生异常,所以总能在该指令完成后处理。强制发生的异常由用户程序无法控制的硬件事件引起,因不可预测而较难实现。
- 用户可屏蔽或不可屏蔽: 用户任务能屏蔽或禁用的事件,称为用户可屏蔽。屏蔽位仅控制硬件是否响应异常。
- 指令内部或指令之间: 事件是在执行中途发生、阻止指令完成——无论这段执行多短——还是在指令之间被识别?指令内部异常通常是同步的,因为由指令触发。它们需要停止并重新启动指令,比指令间异常更难实现。指令内部的异步异常来自灾难性情况,如硬件故障,总会使程序终止。
- 恢复或终止: 若中断后程序总是停止,则为终止事件;若继续执行,则为恢复事件。终止异常较容易实现,因为处理器不必在处理后重新启动同一个程序。
图 C.26 按这五个维度对前面的例子分类。最难实现的,是发生在指令内部、又必须恢复执行的中断。处理它时,必须调用另一个程序,保存正在执行的程序状态、纠正异常原因、恢复状态,然后重试触发异常的指令。这一过程实际上必须对原程序不可见。若流水线允许处理器处理异常、保存状态并重新启动,同时不影响程序执行,就称该流水线或处理器可重新启动(restartable)。早期超级计算机与微处理器常缺少这一属性,但如今几乎所有处理器至少对整数流水线都提供它,因为实现虚拟内存需要这一能力(见第 2 章)。
| 异常类型 | 同步/异步 | 用户请求/强制发生 | 用户是否可屏蔽 | 指令内部/之间 | 恢复/终止 |
|---|---|---|---|---|---|
| I/O 设备请求 | 异步 | 强制发生 | 不可屏蔽 | 之间 | 恢复 |
| 调用操作系统 | 同步 | 用户请求 | 不可屏蔽 | 之间 | 恢复 |
| 跟踪指令执行 | 同步 | 用户请求 | 可屏蔽 | 之间 | 恢复 |
| 断点 | 同步 | 用户请求 | 可屏蔽 | 之间 | 恢复 |
| 整数运算溢出 | 同步 | 强制发生 | 可屏蔽 | 内部 | 恢复 |
| 浮点运算上溢或下溢 | 同步 | 强制发生 | 可屏蔽 | 内部 | 恢复 |
| 缺页 | 同步 | 强制发生 | 不可屏蔽 | 内部 | 恢复 |
| 未对齐访存 | 同步 | 强制发生 | 可屏蔽 | 内部 | 恢复 |
| 违反存储器保护 | 同步 | 强制发生 | 不可屏蔽 | 内部 | 恢复 |
| 使用未定义指令 | 同步 | 强制发生 | 不可屏蔽 | 内部 | 终止 |
| 硬件故障 | 异步 | 强制发生 | 不可屏蔽 | 内部 | 终止 |
| 电源故障 | 异步 | 强制发生 | 不可屏蔽 | 内部 | 终止 |
停止并重新开始执行
与非流水线实现一样,最难的异常具有两个特征:发生在指令内部,即对应 EX 或 MEM 的执行中途;并且必须允许重新启动。例如,这条 RISC-V 流水线中,取数据引起的虚拟内存缺页要到 MEM 才会发生。发现缺页时,已有几条其他指令正在执行。缺页必须可重启,并需要操作系统等另一执行实体介入。因此,要安全地停止流水线、保存状态,以便在正确状态下重启指令。
通常通过保存重启位置的 PC 实现重启。若重启指令不是分支,就正常取顺序后继并执行;若是分支,则重新判断条件,再从目标或顺序后继取指。异常发生后,流水线控制可按以下步骤安全保存状态:
- 在下一个 IF 强行注入一条陷阱指令。
- 在陷阱真正发生前,禁止故障指令及其后的所有指令写入状态。做法是从异常指令开始,将它及后继指令的流水线锁存器控制置零,但不影响先于它的指令。这样,不能在异常处理前完成的指令就不会改变状态。
- 操作系统异常处理程序得到控制后,立即保存故障指令的 PC,供以后返回使用。
异常处理结束后,用专门指令重新加载 PC 并启动指令流;RISC-V 使用异常返回指令。若流水线可以停止在这样一个边界:故障指令之前的指令全部完成,之后的指令都能从头执行,就称它提供精确异常。
理想情况下,故障指令尚未改变状态;某些异常要正确处理,也确实要求这一点。但对浮点异常等其他异常,某些处理器会在异常得到处理前写回故障指令的结果。此时,即使目的寄存器与某个源寄存器相同,硬件也必须能找回原源操作数。浮点操作可能执行许多周期,其他指令很可能已经改写这些源操作数;下一节将看到,浮点操作常乱序完成。为解决此问题,许多高性能处理器引入两种模式:精确异常模式,以及不保证精确异常的快速/性能模式。精确模式允许的浮点指令重叠较少,因此更慢。
许多系统要求精确异常;另一些系统则因为它能简化操作系统接口而认为它很有价值。最低限度,任何带请求分页或 IEEE 算术陷阱处理程序的处理器,都必须用硬件或适当软件支持提供精确异常。整数流水线较容易实现精确异常,虚拟内存需求也强烈推动了对访存精确异常的支持。实际中,这些原因使设计者与体系结构设计者总为整数流水线提供精确异常。本节介绍 RISC-V 整数流水线的实现,浮点的更复杂问题留到 C.5 节。
RISC-V 中的异常
图 C.27 列出各流水级可能产生的异常。由于同时执行多条指令,同一周期可能发生多个异常。例如:
| 指令/周期 | 1 | 2 | 3 | 4 | 5 | 6 |
|---|---|---|---|---|---|---|
ld | IF | ID | EX | MEM | WB | |
add | IF | ID | EX | MEM | WB |
当 ld 位于 MEM、add 位于 EX 时,可能同时发生数据缺页和算术异常。可以先只处理数据缺页,再重启执行。只要软件正确,第一次异常不会再发生,第二次会重新出现,并可单独处理。1
| 流水级 | 可能发生的异常 |
|---|---|
| IF | 取指缺页;未对齐访存;违反存储器保护 |
| ID | 未定义或非法操作码 |
| EX | 算术异常 |
| MEM | 取数据缺页;未对齐访存;违反存储器保护 |
| WB | 无 |
实际情况没有这个例子这么简单。异常可能乱序发生:后一条指令的异常,可能早于前一条指令的异常出现。仍考虑 ld 后跟 add:ld 在 MEM 发现数据缺页,add 在 IF 就可能发现取指缺页。虽然由后面的指令引起,取指缺页却会先出现。
既然要实现精确异常,就必须先处理 ld 的异常。将 ld 所在位置的指令称为 ,将 add 所在位置称为 。不能按异常实际出现的时间立即处理,否则就违反非流水线的顺序。硬件应把每条指令引起的所有异常,记录到与它关联的异常状态向量中,并随指令沿流水线传递。一旦设置异常标志,就关闭所有可能写入数据的控制信号,包括写寄存器和写内存。存储指令可在 MEM 产生异常,因此硬件必须能在它发生异常时阻止写入完成。
当指令进入 WB,或即将离开 MEM 时,检查异常状态向量。若有异常,就按非流水线处理器中应发生的时间顺序处理:先处理最早指令的异常,通常也先处理该指令最早流水级的异常。这样, 的全部异常都会先于 被处理。先前各级为 所做的某些操作可能无效,但由于寄存器与内存写入已禁用,状态不会改变。C.5 节将看到,为浮点操作维持这种精确模型难得多。
下一小节讨论拥有更强大、执行时间更长指令的处理器,其流水线异常处理会遇到什么问题。
指令集带来的复杂性
RISC-V 指令没有多于一个结果,我们的整数流水线也只在执行结束时写入该结果。当指令保证能够完成时,称其已提交(committed)。在这里,全部指令在 MEM 结束、WB 开始时提交,此前不更新状态,所以精确异常较容易实现。
有些处理器的指令在自身及前驱尚未保证完成前,就在执行中途改变状态。例如,原文指出 IA-32 的自增寻址方式会在执行中途更新寄存器。如果此时因异常中止,处理器状态已经改变。虽然知道哪条指令引起异常,若无额外硬件支持,指令只完成一半,异常仍是不精确的,之后很难重启指令流。也可以把状态更新推迟到提交,但这可能困难或昂贵,因为指令自身可能依赖更新后的状态;例如,一条 VAX 指令对同一寄存器多次自增。
因此,具有这类指令的处理器,多数能够撤销指令提交前的一切状态变化。异常发生时,利用这种能力把状态恢复到被中断指令开始之前。下一节将看到,更强的 RISC-V 浮点流水线也会引入类似问题;C.7 节的技术还会显著增加异常处理复杂性。
另一类相关问题,是指令执行过程中更新内存,例如 Intel 或 IBM 360 的字符串复制(见附录 K)。为了能够中断并重启,这些指令规定使用通用寄存器作为工作寄存器。于是,部分完成的指令状态始终保存在寄存器中:异常时保存,处理后恢复,指令就能继续。
某些零散的体系结构状态还可能制造额外冒险,或需要额外的保存/恢复硬件,条件码就是典型例子。许多处理器会在执行指令时隐式设置条件码。这样做有好处:条件判断与实际分支可以分离。但要在设置条件码和分支之间调度指令、填补流水线延迟,就变得困难,因为大多数指令都会设置条件码,不能放在这段间隔中。
此外,采用条件码的处理器必须确定分支条件何时最终有效,即找出分支之前最后一次设置条件码的时刻。大多数隐式设置条件码的处理器,会推迟分支条件判断,直到全部前驱都有机会写条件码。显式设置条件码的体系结构允许调度条件测试与分支之间的间隔,但控制仍须跟踪最后一条设置条件码的指令,以确定分支条件何时已知。实际上,必须把条件码当作一个操作数,检测它与分支之间的 RAW 冒险,正如 RISC-V 对寄存器所做的那样。
另一个棘手领域是多周期操作。设想要把如下 x86 指令序列流水线化:
这些指令本身都不特别长,x86 最长可达 15 字节,但执行周期数差异极大:从一周期到数百周期。数据存储器访问次数也从零到可能数百次不等。数据冒险非常复杂,既发生在指令之间,也发生在指令内部;movsb 的源、目的区域完全可能重叠。
让所有指令执行相同周期数的简单方案不可接受,因为会引入大量冒险与旁路条件,并形成极长的流水线。直接在 x86 指令层面流水线化很难,但人们找到了类似 VAX 所用的巧妙解法:对微指令执行进行流水线处理。微指令是用来组成更复杂指令的一系列简单指令。由于它们很简单,看起来很像 RISC-V,流水线控制容易得多。自 1995 年以来,所有 Intel IA-32 微处理器都采用把 IA-32 指令转换成微操作,再对微操作流水线化的策略。ARM 中某些较复杂指令也采用这种方法。
相比之下,加载—存储处理器的操作简单,工作量相近,更容易流水线化。认识到指令集设计与流水线之间的关系,就能设计出更适合高效流水线的体系结构。下一节将介绍 RISC-V 流水线如何处理执行时间长的浮点指令。
许多年来,人们认为指令集与实现之间关系不大,设计指令集时没有把实现问题作为重点。20 世纪 80 年代,人们逐渐认识到,指令集的复杂性会同时增加流水线实现难度并降低效率。90 年代,各家公司都转向更简单的指令集,以降低激进实现的复杂度。
译注: 本节沿用可产生整数算术异常的教学流水线例子。不能据此认为标准 RISC-V 的普通
add会因整数溢出自动陷阱。 ↩︎
C.5 扩展 RISC-V 整数流水线以处理多周期操作
现在来考察如何扩展 RISC-V 流水线,使其支持浮点运算。本节重点介绍基本方法和设计选择,最后给出 RISC-V 浮点流水线的若干性能测量结果。
要求所有 RISC-V 浮点操作都在一个、甚至两个时钟周期内完成,并不现实。这样做意味着必须接受很低的时钟频率,或者在浮点单元中使用极大量的逻辑电路,或者两者兼有。因此,我们允许浮点流水线中的操作具有更长的延迟。可以把浮点指令想象成沿用整数指令的流水线,但有两点重要改变。第一,EX 周期可以重复多次,直到操作完成;不同操作的重复次数可以不同。第二,可以设置多个浮点功能单元。如果待发射的指令会在所需功能单元上引起结构冒险,或者引起数据冒险,就必须停顿。
本节假定 RISC-V 实现有四个独立的功能单元:
- 主整数单元,处理加载、存储、整数 ALU 操作和分支。
- 浮点与整数乘法器。
- 浮点加法器,处理浮点加法、减法和转换。
- 浮点与整数除法器。
如果还假定这些功能单元的执行阶段不采用流水线,得到的结构如图 C.28。由于 EX 没有流水线化,使用同一功能单元的下一条指令必须等前一条离开 EX,才能发射。而且,如果一条指令不能进入 EX,其后面的整条流水线都要停顿。
实际电路中,中间结果大概不会像图 C.28 暗示的那样,在 EX 单元周围循环;EX 阶段只是需要多个时钟周期。我们可以推广图中的浮点流水线结构,使某些阶段流水线化,并允许多个操作同时进行。描述这种流水线时,既要定义功能单元的延迟,也要定义启动间隔(initiation interval,又称 repeat interval)。延迟仍按前文定义:产生结果的指令与使用该结果的指令之间,需要间隔的周期数。启动间隔则是连续发射两项同类操作之间,至少必须经过的周期数。以下采用图 C.29 所列的延迟和启动间隔。
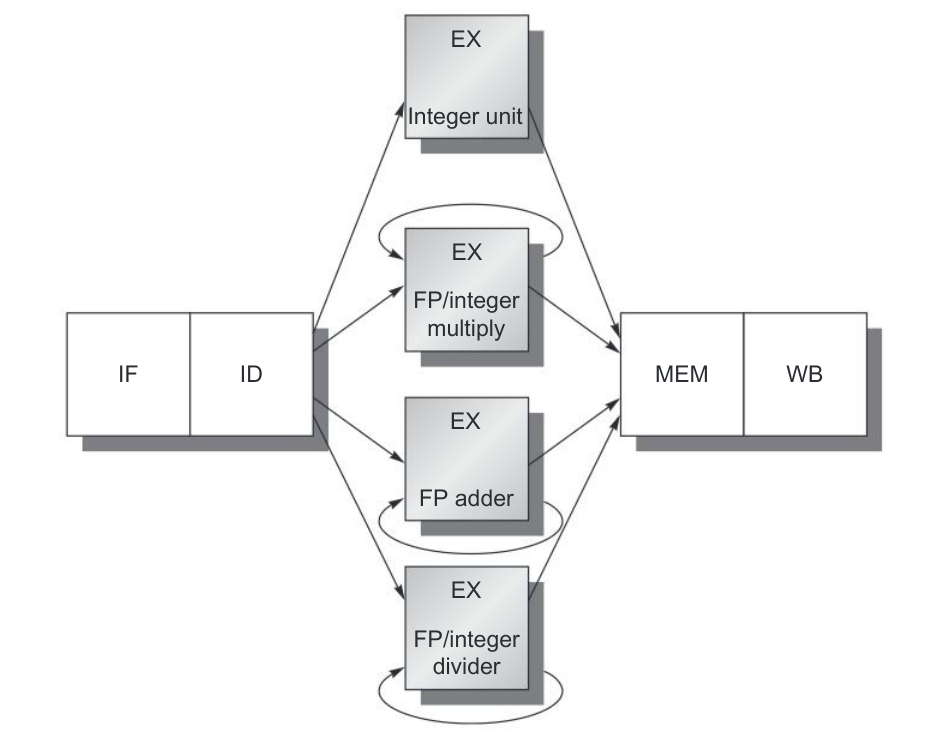
| 功能单元 | 延迟 | 启动间隔 |
|---|---|---|
| 整数 ALU | 0 | 1 |
| 数据存储器(整数和浮点加载) | 1 | 1 |
| 浮点加法器 | 3 | 1 |
| 浮点乘法器(也执行整数乘法) | 6 | 1 |
| 浮点除法器(也执行整数除法) | 24 | 25 |
按这个定义,整数 ALU 操作的延迟是 0,因为其结果可在下一周期使用;加载的延迟是 1,因为其结果必须间隔一周期后才能使用。多数操作在 EX 开始时取用操作数,因此,延迟通常等于从 EX 之后到结果产生位置之间的阶段数:例如,ALU 操作是零级,加载是一级。主要例外是存储:它晚一个周期才取用待写入存储器的值。因此,向存储指令提供待存储数据时,产生该数据的操作与存储指令之间所需的间隔少一个周期;基址寄存器则没有这种减免。流水线延迟实质上等于执行流水线深度减一;执行深度是从 EX 到产生结果的阶段所包含的阶段数。因此,上例中浮点加法有四级,浮点乘法有七级。为了提高时钟频率,设计者需要减少每级的逻辑层数,这使复杂操作所需的流水级数增加。
所以,提高时钟频率的代价是操作延迟增大。
图 C.29 的示例流水线允许同时有四项尚未完成的浮点加法、七项浮点/整数乘法,以及一项浮点除法。把图 C.28 扩展后,就得到图 C.30 的画法。图 C.30 通过增加由流水线寄存器隔开的阶段来实现相应的启动间隔。各功能单元彼此独立,因此采用不同的阶段名称。对于除法单元这样需要多个时钟周期的阶段,图中进一步分格,以表示其延迟。这些小格并非完整的流水级,所以其中只能有一项活动操作。也可以使用本附录前面常用的时序图来表示这一结构;图 C.31 给出了一组相互独立的浮点运算和浮点加载、存储操作。浮点操作的延迟更长,自然会提高 RAW 冒险及相应停顿的发生频率,本节稍后将讨论这一点。
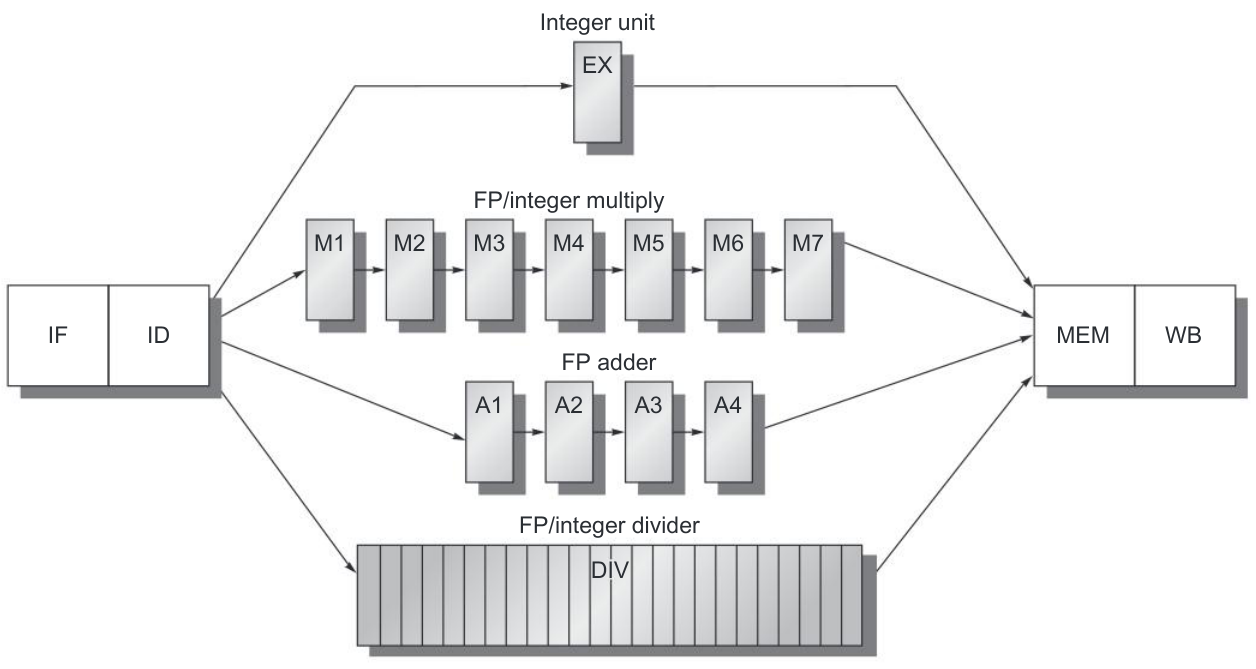
译注:图 C.29 将除法的延迟和启动间隔分别列为 24 和 25,而图 C.30 的原图注称除法需 24 周期完成。按本节的延迟定义,两处存在一周期的差别。
图 C.30 的结构需要增加流水线寄存器,例如 A1/A2、A2/A3 和 A3/A4,并修改相应连线。ID/EX 寄存器必须扩展,使 ID 能连接到 EX、DIV、M1 和 A1;可分别用 ID/EX、ID/DIV、ID/M1 或 ID/A1 表示其中连接到相应下一阶段的部分。
ID 与后续各阶段之间的流水线寄存器,在逻辑上可以视为相互独立,实际也可以实现为独立寄存器。每个流水级同时只容纳一项操作,因此控制信息可以与该级入口的寄存器关联。
| 指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|
fmul.d | IF | ID | M1 | M2 | M3 | M4 | M5 | M6 | M7 | MEM | WB |
fadd.d | IF | ID | A1 | A2 | A3 | A4 | MEM | WB | |||
fadd.d(原图如此) | IF | ID | EX | MEM | WB | ||||||
fsd | IF | ID | EX | MEM | WB |
延迟较长的流水线中的冒险与转发
对于图 C.30 这样的流水线,冒险检测与转发有几个不同于前面的方面:
- 除法单元没有完全流水线化,因此可能出现结构冒险,需要检测并暂停指令发射。
- 指令运行时间不同,同一周期要求进行的寄存器写入可能多于一次。
- 指令不再按顺序到达 WB,因此可能出现 WAW 冒险。不过,寄存器读取始终在 ID 中完成,所以不会出现 WAR 冒险。
- 指令完成顺序可能与发射顺序不同,从而给异常处理带来问题;下一小节将讨论。
- 操作延迟变长,RAW 冒险造成的停顿更频繁。
延迟变长导致的停顿增加,与整数流水线中的情况本质相同。在讨论浮点流水线带来的新问题及其解决方法之前,先看 RAW 冒险的潜在影响。图 C.32 给出一段典型浮点代码及其停顿。本节末尾还将考察这条浮点流水线在所选 SPEC 子集上的性能。
再看上述第 2、3 项与写操作有关的问题。若浮点寄存器堆只有一个写端口,一连串浮点运算,以及浮点加载与浮点运算的组合,都可能争用它。考虑图 C.33 的时序:在周期 11,三条指令同时到达 WB,都要写寄存器堆。
| 指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
fld f4,0(x2) | IF | ID | EX | MEM | WB | ||||||||||||
fmul.d f0,f4,f6 | IF | ID | 停顿 | M1 | M2 | M3 | M4 | M5 | M6 | M7 | MEM | WB | |||||
fadd.d f2,f0,f8 | IF | 停顿 | ID | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | A1 | A2 | A3 | A4 | MEM | WB | ||
fsd f2,0(x2) | IF | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | ID | EX | 停顿 | 停顿 | 停顿 | MEM |
| 指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|
fmul.d f0,f4,f6 | IF | ID | M1 | M2 | M3 | M4 | M5 | M6 | M7 | MEM | WB |
… | IF | ID | EX | MEM | WB | ||||||
… | IF | ID | EX | MEM | WB | ||||||
fadd.d f2,f4,f6 | IF | ID | A1 | A2 | A3 | A4 | MEM | WB | |||
… | IF | ID | EX | MEM | WB | ||||||
… | IF | ID | EX | MEM | WB | ||||||
fld f2,0(x2) | IF | ID | EX | MEM | WB |
只有一个写端口时,处理器必须让指令依次完成。这是一个结构冒险。增加写端口可以解决它,但这种做法未必合算,因为额外端口很少用得上:稳态所需的最大写端口数只是一个。因此,我们选择把写端口访问作为结构冒险来检测和约束。
实现这种互锁有两种方法。第一种是在 ID 中跟踪写端口的使用,像处理其他结构冒险一样,在发射前暂停指令。可以用一个移位寄存器,记录已发射指令将在何时使用寄存器堆。若 ID 中的指令与已发射指令需要在同一时间写寄存器堆,就让 ID 中的指令停顿一周期。
每个时钟周期,把这个预约寄存器移位一位。其优点是保留了“所有互锁检测和停顿插入都在 ID 中进行”的性质,代价是增加移位寄存器和写冲突检测逻辑。本节以下均采用这一方案。
另一种方案是在发生冲突的指令试图进入 MEM 或 WB 时才暂停它。延迟到这一位置检测,可以选择暂停冲突双方中的任一条。一个简单但有时并非最优的启发式规则是:优先让延迟最长的单元通过,因为它最可能已经因 RAW 冒险而使其他指令等待。这一方案的优点是到 MEM 或 WB 入口才需检测,冲突在那里很容易看出;缺点是停顿现在可能来自两个位置,使控制更加复杂。注意,在 MEM 之前停顿,会占住 EX、A4 或 M7,并可能让停顿向流水线上游传播;在 WB 前停顿,则会堵住 MEM。
另一个问题是 WAW 冒险。以图 C.33 为例,假如后面的加载指令提前一周期发射,并以 f2 为目的寄存器,它会比前面的浮点加法早一周期写入 f2,因而造成 WAW 冒险。这个冒险仅在前一条运算的结果从未被任何指令使用、随后就被覆盖时发生。如果在这两次写入之间有一条使用 f2 的指令,就必须因 RAW 冒险而停顿,后面的写入也无法在前一条运算完成前发射。可以说,在这条流水线上,WAW 冒险只会在执行了一条没有用处的指令时出现;但仍必须检测它,确保最终留在 f2 中的是程序顺序中后一条指令的结果。C.8 节将说明,合理代码中有时也会出现这种序列。
译注:原书这一段及下一段多处把本应区分的指令都排作
fadd.d,同时又明确提到“加载指令”,使描述自相矛盾。上、下两段依据图 C.33 的指令次序和时序,用“前面的浮点运算”与“后面的加载指令”区分其角色;此处并未把原书的排印混乱当作新的一种冒险。
处理 WAW 冒险有两种可能。第一,延迟加载指令的发射,直到前面的浮点加法进入 MEM。第二,检测到冒险后取消前一条浮点加法的结果,修改控制,使其不写回;这样后面的指令可以立即发射。由于此类冒险很少见,任选较易实现的一种即可。在两种方案中,都可在后面的指令处于 ID、准备发射时检测冒险;暂停后面的指令,或把前面的结果写入变为空操作,都不难。难处在于判断后面的指令可能先完成,这需要知道流水线长度和前一条指令的当前位置。幸而“两次写入之间没有读取”的序列极少出现,可以采用简单办法:只要 ID 中的指令要写的寄存器也是某条已发射指令的目的寄存器,就不让它进入 EX。C.7 节将介绍如何借助额外硬件消除这种停顿。现在先把浮点流水线的冒险检测和发射逻辑串起来。
检测冒险时,既要考虑浮点指令之间,也要考虑浮点与整数指令之间。除浮点加载、存储以及浮点—整数寄存器传送之外,浮点和整数寄存器互不相干。整数指令操作整数寄存器,浮点运算操作自己的寄存器。因此,检测两类指令之间的冒险,只需考虑浮点加载、存储和寄存器传送。这种控制简化是分开设置整数、浮点寄存器堆的另一项优点。主要优点是:不增大任一寄存器堆就能使寄存器总数翻倍,也不增加任一寄存器堆的端口数就能提高带宽。主要缺点除了需要额外的寄存器堆,还包括偶尔在两组寄存器间传送数据的少量开销。
假定流水线在 ID 中完成全部冒险检测,那么发射前须进行三项检查:
- 检查结构冒险。 等待所需功能单元空闲——本流水线只有除法需要这样检查——并确保需要写回时寄存器写端口可用。
- 检查 RAW 数据冒险。 等待源寄存器不再列为某个流水线寄存器中尚未完成的目的寄存器,除非结果能在本指令需要时及时提供。这里需要若干项检查,取决于产生数据的指令何时给出结果,以及使用数据的指令何时需要结果。例如,ID 中的浮点运算若以
f2为源寄存器,则 ID/A1、A1/A2、A2/A3 中都不能把f2列为目的寄存器,因为这些浮点加法在 ID 中的指令需要结果时尚未完成。ID/A1 是 ID 输出寄存器中送往 A1 的部分。除法的情况稍复杂:若希望把除法的最后几个周期也与后续指令重叠,就必须专门处理即将完成的除法。实际设计可能放弃这一优化,以简化发射条件。 - 检查 WAW 数据冒险。 检查 A1 到 A4、D、M1 到 M7 中是否有指令与本指令写同一目的寄存器;若有,就暂停 ID 中指令的发射。
多周期浮点操作使冒险检测更复杂,但概念仍与 RISC-V 整数流水线相同;转发逻辑也是如此。可以比较 EX/MEM、A4/MEM、M7/MEM、D/MEM、MEM/WB 中的目的寄存器,是否等于浮点指令的某个源寄存器;若相同,就使相应输入多路选择器选取转发的数据。习题将要求你具体写出 RAW、WAW 冒险检测及转发逻辑。
多周期浮点操作也给异常机制带来问题,下面接着讨论。
保持精确异常
长时间运行的指令还会造成另一个问题,可用下面的代码说明:
这段代码看似简单,没有依赖关系。但先发射的指令可能比后发射的更晚完成。在这里,fadd.d 和 fsub.d 都可能在 fdiv.d 之前完成。这称为乱序完成(out-of-order completion),在包含长时间操作的流水线中很常见,参见 C.7 节。
既然冒险检测会保证指令间依赖关系不被破坏,乱序完成为什么还是问题?假设 fadd.d 已完成、fdiv.d 尚未完成时,fsub.d 触发浮点算术异常。结果就是我们希望避免的非精确异常。看起来似乎可以像整数流水线那样,让浮点流水线排空,但异常可能出现在无法这样处理的位置。例如,若加法完成后,fdiv.d 才决定触发浮点算术异常,硬件层面就无法形成精确异常。实际上,fadd.d 已覆盖自己的一个操作数,即使有软件帮助,也不能恢复到 fdiv.d 之前的状态。
问题的根源是完成次序与发射次序不同。处理乱序完成有四种方法。
第一种是忽略这一问题,接受非精确异常。20 世纪 60 年代和 70 年代初采用过这种方式;原书回顾的此前十五年中,某些超级计算机仍这样做:禁止某些类别的异常,或由硬件在不停止流水线的情况下处理它们。对当代多数处理器,这种办法很难采用,因为虚拟内存和 IEEE 浮点标准等功能实际上要求软硬件配合提供精确异常。前面提过,一些处理器采用两种执行模式解决它:一种速度快但异常可能不精确;另一种较慢但精确。较慢的模式可以由模式开关实现,也可以插入显式检查浮点异常的指令。两种做法都会严格限制浮点流水线中允许的重叠和重排,使得实际上一次只有一条浮点指令在执行。DEC Alpha 21064、21164,IBM Power1、Power2,以及 MIPS R8000 都采用过这种方案。
第二种是先缓冲一项操作的结果,直到所有更早发射的操作都完成。有些处理器确实采用这种办法;但若各操作运行时间相差很大,需要缓冲的结果数也可能很大,代价便会增加。而且,为了在等待长指令期间继续发射,必须从结果队列提供旁路,这需要大量比较器和很大的多路选择器。
这一基本方法有两种可行变体。其一是 CYBER 180/990 使用的 history file,它保存寄存器的旧值。发生异常,且必须回退到某条已乱序完成的指令之前时,可以从 history file 恢复原值。VAX 等处理器也用相似技术处理自动递增、自动递减寻址。另一种是 Smith 和 Pleszkun 于 1988 年提出的 future file,它保存寄存器的新值;更早的指令全部完成后,再用它更新主寄存器堆。这样发生异常时,主寄存器堆就包含被中断状态的精确值。第 3 章还将介绍支持推测执行所需的另一种方法;所谓推测执行,是指在尚不知道先前分支结果时就执行后续指令。
第三种是允许异常在一定程度上不精确,但保存足够信息,让陷阱处理例程重新构造精确的异常次序。这意味着要知道流水线中有哪些操作,以及它们各自的 PC。处理异常后,由软件完成位于“最晚一条已完成指令”之前的所有未完成指令,然后重新开始。考虑以下最坏情况:
- 指令 1:一条长时间运行、最终导致执行中断的指令。
- 指令 2 到指令 :一系列尚未完成的指令。
- 指令 :一条已经完成的指令。
给定流水线中所有指令的 PC 以及异常返回 PC,软件就能找到指令 1 和指令 的状态。指令 已完成,因此应当从指令 重新开始。处理异常后,软件必须模拟指令 1 到指令 的执行,随后从异常返回,并在指令 处恢复。陷阱处理程序要正确执行这些指令,复杂度很高;这是该方案的主要困难。
对于类似 RISC-V 的简单流水线,可以做一项重要简化:若指令 2 到指令 都是整数指令,那么既然指令 已完成,指令 2 到指令 必然也已完成;因此,只需处理浮点操作。为使方案可实现,可以限制同时重叠执行的浮点指令数。例如,如果只允许两条指令重叠,就只需要软件完成触发中断的那一条。
当浮点流水线很深,或浮点功能单元较多时,这种限制可能降低潜在吞吐率。一些 SPARC 实现用这一方案来允许浮点操作与整数操作重叠。
第四种是混合方案:只有在能够确定所有更早的指令都将完成而不会引发异常时,才继续发射后续指令。这样一来,发生异常时,触发异常的指令之后没有指令已经完成,而之前的指令都能完成。为了维持精确异常,有时必须暂停处理器。浮点功能单元必须在 EX 早期判断是否可能发生异常,在这里的 RISC-V 流水线中是最初三个时钟周期之内,从而阻止后续指令完成。MIPS R2000/3000、R4000 和 Intel Pentium 采用这种办法;附录 J 还将进一步讨论。
简单 RISC-V 浮点流水线的性能
图 C.30 的流水线可能因除法单元而发生结构停顿,也可能因 RAW 冒险而停顿;WAW 冒险也存在,但实际很少发生。图 C.34 按各类浮点操作的每次执行,给出停顿周期数。例如,每个浮点基准程序的第一根柱表示每次浮点加、减或转换导致的结果等待周期数。正如预期,每项操作的停顿周期数大致随浮点操作延迟变化,为功能单元延迟的 46% 到 59%。
图 C.35 则给出五个 SPECfp 基准程序中整数和浮点停顿的完整分解。图中有四类:浮点结果停顿、浮点比较停顿、加载与分支延迟,以及浮点结构停顿。实际未计入分支延迟停顿;若分支延迟只有一周期,并采用一个哪怕不很强的分支预测器,这部分就很小。每条指令的总停顿周期数在 0.65 到 1.21 之间。
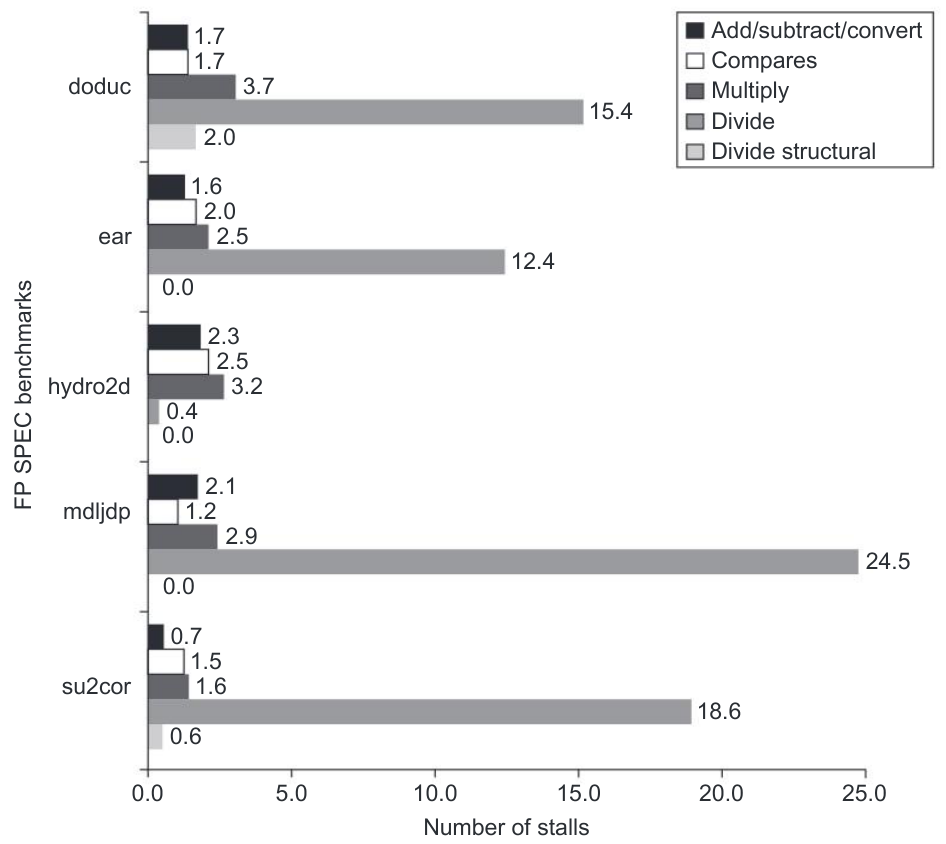
| 基准程序 | 加/减/转换 | 比较 | 乘法 | 除法 | 除法结构停顿 |
|---|---|---|---|---|---|
| doduc | 1.7 | 1.7 | 3.7 | 15.4 | 2.0 |
| ear | 1.6 | 2.0 | 2.5 | 12.4 | 0.0 |
| hydro2d | 2.3 | 2.5 | 3.2 | 0.4 | 0.0 |
| mdljdp | 2.1 | 1.2 | 2.9 | 24.5 | 0.0 |
| su2cor | 0.7 | 1.5 | 1.6 | 18.6 | 0.6 |
| 基准程序 | 浮点结果停顿 | 浮点比较停顿 | 分支/加载停顿(原图标签) | 浮点结构停顿 |
|---|---|---|---|---|
| doduc | 0.98 | 0.07 | 0.08 | 0.08 |
| ear | 0.52 | 0.09 | 0.07 | 0.00 |
| hydro2d | 0.54 | 0.22 | 0.04 | 0.00 |
| mdljdp | 0.88 | 0.10 | 0.03 | 0.00 |
| su2cor | 0.61 | 0.02 | 0.01 | 0.01 |
C.6 融会贯通:MIPS R4000 流水线
本节考察 MIPS R4000 处理器家族(包括 4400)的流水线结构与性能。MIPS 体系结构与 RISC-V 非常相似,只在少数指令上不同,例如 MIPS ISA 中的延迟分支。R4000 实现 MIPS64,但整数和浮点程序都采用比前述五级设计更深的流水线。它把五级整数流水线拆成八级,以获得更高的时钟频率。由于缓存访问的时间尤为关键,新增的阶段来自对存储器访问过程的拆分。这种较深的流水线有时称为超流水线(superpipelining)。
图 C.36 用抽象数据通路表示八级流水线结构,图 C.37 则表示连续指令在其中的重叠。虽然指令存储器和数据存储器访问都占多个周期,但它们完全流水线化,所以仍可每周期启动一条新指令。实际上,在缓存命中检测完成以前,流水线就已经使用了数据;第 3 章会更详细地讨论其实现。
各级的功能如下:
- IF: 取指的前半部分。此时实际完成 PC 选择,并启动指令缓存访问。
- IS: 取指的后半部分,完成指令缓存访问。
- RF: 指令译码、读取寄存器、检查冒险,以及检测指令缓存是否命中。
- EX: 执行,包括有效地址计算、ALU 操作,以及分支目标计算与条件判断。
- DF: 取数据,即数据缓存访问的前半部分。
- DS: 取数据的后半部分,完成数据缓存访问。
- TC: 检查标签,判断数据缓存访问是否命中。
- WB: 加载指令和寄存器—寄存器操作写回。
除了显著增加所需转发通路,这条延迟更长的流水线也增加了加载和分支的延迟。图 C.37 显示,加载延迟为两周期,因为数据在 DS 结束时可用。图 C.38 用简略时序表示了加载之后立即使用结果的情况,也说明:加载结果需要转发给比加载晚三或四周期的使用者。
图 C.39 中,分支条件在 EX 阶段判断,因此基本分支延迟为三周期。MIPS 体系结构有一个周期的延迟分支槽;R4000 对剩余两周期采用预测不跳转策略。如图 C.40,不跳转的分支只有一个周期的延迟槽;跳转的分支则在延迟槽之后还有两个空闲周期。指令集中提供了前面介绍的 branch-likely 指令,有助于填充分支延迟槽。流水线互锁既负责落实分支跳转时的两周期停顿代价,也负责因使用加载结果而引起的数据冒险停顿。
R4000 之后的所有 MIPS 处理器实现都使用了动态分支预测。
| 指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
ld x1,… | IF | IS | RF | EX | DF | DS | TC | WB | |
add x2,x1,… | IF | IS | RF | 停顿 | 停顿 | EX | DF | DS | |
sub x3,x1,… | IF | IS | 停顿 | 停顿 | RF | EX | DF | ||
or x4,x1,… | IF | 停顿 | 停顿 | IS | RF | EX |
较深流水线不仅增加加载和分支停顿,也增加 ALU 操作所需的转发层数。在五级 RISC-V 流水线中,两条寄存器—寄存器 ALU 指令之间可以从 ALU/MEM 或 MEM/WB 转发;在 R4000 中,ALU 旁路有四个可能的来源:EX/DF、DF/DS、DS/TC 和 TC/WB。
| 情形与指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| 跳转:分支指令 | IF | IS | RF | EX | DF | DS | TC | WB | |
| 延迟槽 | IF | IS | RF | EX | DF | DS | TC | WB | |
| 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | ||
| 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | |||
| 分支目标 | IF | IS | RF | EX | DF | ||||
| 不跳转:分支指令 | IF | IS | RF | EX | DF | DS | TC | WB | |
| 延迟槽 | IF | IS | RF | EX | DF | DS | TC | WB | |
| 分支后第 2 条指令 | IF | IS | RF | EX | DF | DS | TC | ||
| 分支后第 3 条指令 | IF | IS | RF | EX | DF | DS |
浮点流水线
R4000 的浮点部件包含浮点除法器、乘法器和加法器三个功能单元。乘法或除法的最后一步也会使用加法器逻辑。双精度浮点运算的时间从取负的两周期,到平方根的 112 周期不等;各单元的启动频率也不同。可以把浮点部件看作由图 C.41 所列的八种阶段组成;它们按不同次序组合,执行各种浮点操作。
每种阶段只有一份硬件,不同指令可能按不同次序使用某级零次或多次。图 C.42 给出最常见双精度浮点操作的延迟、启动间隔及所用阶段。
根据图 C.42,可以判断一串相互独立但类型不同的浮点操作能否无停顿地发射。如果时序会导致共享流水级冲突,就需要停顿。图 C.43–C.46 给出四种常见的双指令序列:乘法后接加法、加法后接乘法、除法后接加法,以及加法后接除法。各图列出第二条指令所有值得考察的起始位置,以及在该位置能够发射还是必须停顿。当然,也可能同时有三条活动指令,那样停顿的可能性更大,图也更复杂。
| 阶段 | 功能单元 | 说明 |
|---|---|---|
| A | 浮点加法器 | 尾数相加 |
| D | 浮点除法器 | 除法流水级 |
| E | 浮点乘法器 | 异常检测 |
| M | 浮点乘法器 | 乘法器第一阶段 |
| N | 浮点乘法器 | 乘法器第二阶段 |
| R | 浮点加法器 | 舍入 |
| S | 浮点加法器 | 操作数移位 |
| U | — | 拆解浮点数的编码 |
| 浮点指令 | 延迟 | 启动间隔 | 流水阶段(按使用次序) |
|---|---|---|---|
| 加法、减法 | 4 | 3 | U, S+A, A+R, R+S |
| 乘法 | 8 | 4 | U, E+M, M, M, M, N, N+A, R |
| 除法 | 36 | 35 | U, A, R, D²⁸, D+A, D+R, D+A, D+R, A, R |
| 平方根 | 112 | 111 | U, E, (A+R)¹⁰⁸, A, R |
| 取负 | 2 | 1 | U, S |
| 绝对值 | 2 | 1 | U, S |
| 浮点比较 | 3 | 2 | U, A, R |
| 操作 | 发射/停顿 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 乘法 | 发射 | U | E+M | M | M | M | N | N+A | R | |||||
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | |||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | |||||||||
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 加法 | 发射 | U | S+A | A+R | R+S |
| 操作 | 发射/停顿 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 乘法 | 发射 | U | E+M | M | M | M | N | N+A | R | |||||
| 乘法 | 发射 | U | M | M | M | M | N | N+A | R |
| 操作 | 发射/停顿 | 25 | 26 | 27 | 28 | 29 | 30 | 31 | 32 | 33 | 34 | 35 | 36 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 除法 | 周期 0 已发射… | D | D | D | D | D | D+A | D+R | D+A | D+R | A | R | |
| 加法 | 发射 | U | S+A | A+R | R+S | ||||||||
| 加法 | 发射 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 发射 | U | S+A | A+R | |||||||||
| 加法 | 发射 | U | S+A | ||||||||||
| 加法 | 发射 | U |
| 操作 | 发射/停顿 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 除法 | 停顿 | U | A | R | D | D | D | D | D | D | D | D | D | |
| 除法 | 发射 | U | A | R | D | D | D | D | D | D | D | D | ||
| 除法 | 发射 | U | A | R | D | D | D | D | D | D | D |
译注:图 C.44 最后一行在 U 后仅标 M,未标通常的 E+M,译表照录。图 C.45 原图注称周期 28 开始的加法要等到周期 36,但表内周期 34 和 35 的起始位置已标为可发射;两处不一致,均予保留。
R4000 流水线的性能
下面考察 SPEC92 基准在 R4000 流水线上运行时的停顿。流水线停顿或效率损失主要有四个来源:
- 加载停顿: 在加载之后一或两周期内使用结果而引起的延迟。
- 分支停顿: 每个跳转分支造成两周期停顿,再加上未填满或被取消的分支延迟槽。R4000 实现的 MIPS 指令集支持在编译时预测分支的指令;实际行为与预测不符时,取消延迟槽中的指令。这有助于填充分支延迟槽。
- 浮点结果停顿: 因浮点操作数的 RAW 冒险而停顿。
- 浮点结构停顿: 浮点流水线中的功能单元冲突限制了发射,从而造成延迟。
图 C.47 给出 10 个 SPEC92 基准在 R4000 流水线上的 CPI 分解,图 C.48 以表格给出同一组数据。
这两图显示了加深流水线的代价。R4000 的分支延迟远长于经典五级流水线,显著增加了分支耗费的周期;分支较频繁的整数程序尤为明显。这也是后来的中等深度到深流水线处理器几乎都使用动态分支预测器的原因;原书这里以 8–16 级作为典型深度。
浮点程序有一个有趣现象:浮点功能单元的延迟造成的结果停顿,多于结构冒险造成的停顿。后者既来自启动间隔限制,也来自不同浮点指令之间的功能单元冲突。因此,应先着力降低浮点操作延迟,再考虑进一步流水线化或复制功能单元。当然,降低延迟可能增加结构停顿,因为许多潜在结构停顿原先被数据冒险遮住了。
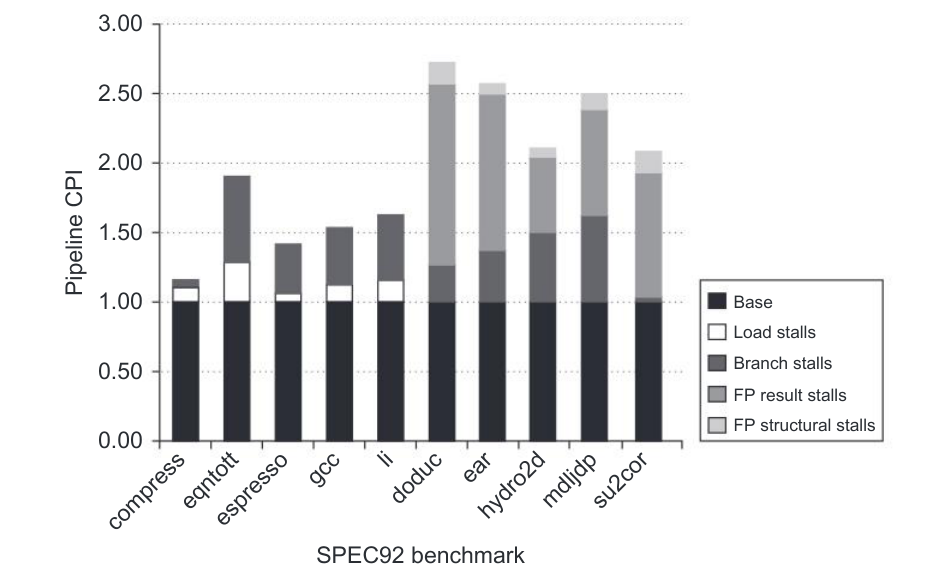
| 基准程序 | 流水线 CPI | 加载停顿 | 分支停顿 | 浮点结果停顿 | 浮点结构停顿 |
|---|---|---|---|---|---|
| Compress | 1.20 | 0.14 | 0.06 | 0.00 | 0.00 |
| Eqntott | 1.88 | 0.27 | 0.61 | 0.00 | 0.00 |
| Espresso | 1.42 | 0.07 | 0.35 | 0.00 | 0.00 |
| Gcc | 1.56 | 0.13 | 0.43 | 0.00 | 0.00 |
| Li | 1.64 | 0.18 | 0.46 | 0.00 | 0.00 |
| 整数平均值 | 1.54 | 0.16 | 0.38 | 0.00 | 0.00 |
| Doduc | 2.84 | 0.01 | 0.22 | 1.39 | 0.22 |
| Mdljdp2 | 2.66 | 0.01 | 0.31 | 1.20 | 0.15 |
| Ear | 2.17 | 0.00 | 0.46 | 0.59 | 0.12 |
| Hydro2d | 2.53 | 0.00 | 0.62 | 0.75 | 0.17 |
| Su2cor | 2.18 | 0.02 | 0.07 | 0.84 | 0.26 |
| 浮点平均值 | 2.48 | 0.01 | 0.33 | 0.95 | 0.18 |
| 总体平均值 | 2.00 | 0.10 | 0.36 | 0.46 | 0.09 |
C.7 贯穿各层的问题
RISC 指令集与流水线效率
前面讨论过,指令集简单有利于构建流水线。简单指令集还有另一项优点:更容易调度代码,使流水线高效执行。看一个简单例子:把存储器中的两个值相加,再将结果存回存储器。有些复杂指令集只需一条指令,另一些需要两三条;典型 RISC 体系结构则需要四条,即两次加载、一次加法和一次存储。在多数流水线中,若把它们直接排在一起执行,中间就会发生停顿。
RISC 把这些操作分成独立指令,因此编译器可以单独调度它们,使用前面介绍以及第 3 章将讨论的更强技术;硬件也可以动态调度,下面会简要介绍,第 3 章还会深入讨论。调度效率与实现简便这两方面的优势相当显著,因此近年的复杂指令集流水线实现,几乎都先将复杂指令转换成类似 RISC 的简单操作,再对这些操作调度并进行流水线处理。近年的 Intel 处理器全部采用这一方法,ARM 处理器也对某些较复杂的指令这样处理。
动态调度流水线
简单流水线取出一条指令后,只要它与流水线中的已有指令之间不存在无法通过旁路或转发掩盖的数据依赖,就会发射它。转发逻辑降低了流水线的有效延迟,使部分依赖关系不会变成冒险。如果冒险不可避免,检测硬件就从使用结果的指令开始暂停流水线;在依赖关系消除之前,不再取出或发射新指令。为了减少这种性能损失,编译器可以通过调度来避免冒险;这称为编译器调度,也称静态调度。
一些早期处理器采用另一种办法,称为动态调度:由硬件重新安排指令执行,以减少停顿。本节通过 CDC 6600 的记分牌(scoreboard)技术作一个较简单的介绍。有些读者会发现,先读这一部分,再学习第 3 章更复杂的 Tomasulo 算法及其推测执行扩展,会容易一些。
本附录此前介绍的所有技术都按序发射指令。这意味着,如果流水线中某条指令停顿,其后的指令就不能继续。两条指令间一旦出现冒险,流水线即会停顿,即使后面存在与它们独立、原本不必停顿的指令,也无法前进。
前述 RISC-V 流水线在 ID 中同时检查结构冒险和数据冒险;一条指令能够正确执行时,才从 ID 发射。为了让指令只要操作数就绪便开始执行,即便某条前序指令仍然停顿,就必须把发射过程拆成两部分:检查结构冒险,以及等待数据冒险消失。我们仍按序译码、按序发射,但希望指令的数据操作数一旦可用,就立即执行。因此,流水线将采用乱序执行,这也意味着可能乱序完成。为实现它,须将 ID 拆成两个阶段:
- 发射: 指令译码,检查结构冒险。
- 读操作数: 等待数据冒险消除,然后读取操作数。
与原 RISC-V 流水线一样,IF 在发射之前,EX 在读操作数之后。执行可能因操作类型不同而耗费多个周期,因此要区分开始执行和完成执行两个时刻;在这段时间内,指令处于执行中。这样就允许多条指令同时执行。除了这些流水线结构变化,我们还会改变功能单元的数量、操作延迟以及功能单元的流水线化程度,以更充分地研究这些高级技术。
用记分牌实现动态调度
动态调度流水线中的指令都按序通过发射阶段,但在第二阶段——读操作数——可能停顿或越过彼此,从而乱序进入执行。记分牌技术允许在资源足够、没有数据依赖约束时乱序执行指令;它因首先实现这种能力的 CDC 6600 记分牌而得名。
在讨论如何把记分牌用于 RISC-V 之前,需要注意:原先整数、浮点流水线中不会出现的 WAR 冒险,在乱序执行时可能发生。例如:
fadd.d 与 fsub.d 之间存在潜在 WAR 冒险。如果流水线先执行 fsub.d,再执行 fadd.d,就会产生错误结果。同样,也必须避免 WAW 冒险;例如,把 fsub.d 的目的寄存器改为 f10,就会出现这种冒险。记分牌通过暂停涉及冒险的后一条指令,来避免这两类问题。
记分牌的目标是尽可能早地执行指令,从而在没有结构冒险时维持每周期一条指令的执行速率。当下一条本该执行的指令停顿时,只要其他指令不依赖任何活动或停顿中的指令,就可以继续发射和执行。记分牌全面负责指令发射与执行,包括全部冒险检测。利用乱序执行,要求多条指令同时处于 EX;这可以靠多个功能单元、流水线化的功能单元,或二者结合来实现。从流水线控制角度看,这两种能力本质上等价,因此下面假定处理器有多个功能单元。
CDC 6600 有 16 个独立功能单元,包括四个浮点单元、五个访存单元,以及七个整数运算单元。对于 RISC-V,记分牌主要用于浮点部件才有意义,因为其他功能单元的延迟很小。假定有两个乘法器、一个加法器、一个除法器,以及一个负责全部访存、分支和整数运算的整数单元。虽然比 CDC 6600 简单,这个例子已足以展示原理,无需引入大量细节或很长的指令序列。RISC-V 与 CDC 6600 都采用加载—存储体系结构,所以两者的技术几乎相同。图 C.49 给出处理器结构。
每条指令都要经过记分牌,在其中建立数据依赖记录;这一过程对应指令发射,替代了 RISC-V 的部分 ID 工作。随后,记分牌决定指令何时可以读操作数并开始执行。若不能立即执行,它就监视硬件的每次状态变化,判断何时条件满足。记分牌也控制指令何时能够把结果写入目的寄存器。因此,所有冒险检测和消解都集中在记分牌中。图 C.49 展示其组织;理解它之前,先看流水线发射与执行部分的步骤。
每条指令执行经过四步。这里重点讨论浮点运算,因此不另设访存步骤。先非形式化地说明,再讨论记分牌如何维护决定步骤间推进时机的信息。这四步替代了标准 RISC-V 流水线的 ID、EX 和 WB。
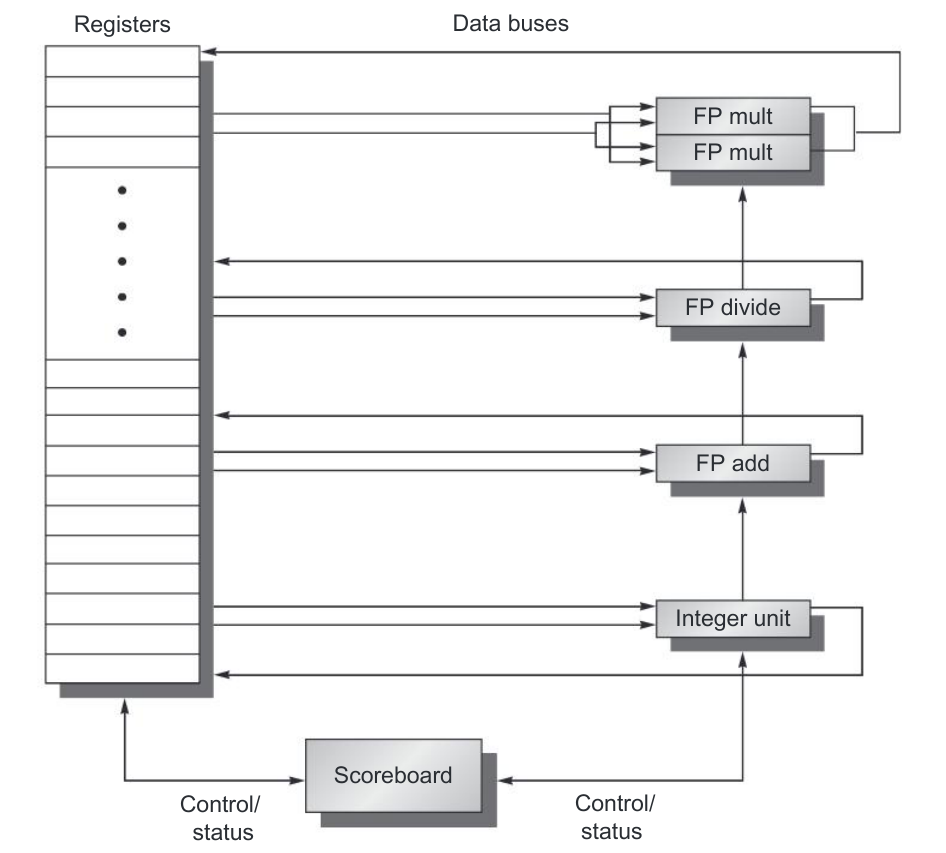
- 发射。 如果指令所需的功能单元空闲,并且没有其他活动指令具有相同目的寄存器,记分牌就把指令发射到功能单元,并更新内部数据结构。这替代 RISC-V ID 阶段的部分工作。确保没有其他活动功能单元要写同一目的寄存器,就能保证没有 WAW 冒险。若有结构或 WAW 冒险,就暂停发射;在消除之前,不再发射任何后续指令。发射停顿会使取指与发射之间的缓冲区逐渐填满。如果缓冲区只有一个条目,取指立即停顿;如果它是可容纳多条指令的队列,则队列满后才停顿。
- 读操作数。 记分牌监视源操作数是否可用。若没有更早发射且仍在活动的指令将写该源寄存器,该操作数便可用。全部源操作数就绪后,记分牌通知功能单元从寄存器读取并开始执行。RAW 冒险在此动态消解,指令可以乱序进入执行。此步骤与发射一起,完成简单 RISC-V 流水线中 ID 的功能。
- 执行。 功能单元收到操作数后开始执行;结果准备好时,通知记分牌执行已完成。这替代原流水线的 EX;浮点执行可能持续多个周期。
- 写结果。 记分牌获知功能单元已完成执行后,检查 WAR 冒险,并在必要时暂停这条准备完成的指令。
WAR 冒险的例子,就是前面同时使用 f8 的 fadd.d 与 fsub.d:
fadd.d 的源操作数 f8,与 fsub.d 的目的寄存器相同;但 fadd.d 还依赖更早的指令。记分牌会让 fsub.d 停在写结果阶段,直到 fadd.d 读完操作数。一般而言,只要同时满足以下条件,就不能让一条已执行完毕的指令写结果:
- 有一条按发射顺序更早的指令尚未读取操作数;
- 该指令的某个源寄存器,恰好等于这条准备写回的指令的目的寄存器。
若没有这种 WAR 冒险,或冒险已经消除,记分牌便通知功能单元把结果存入目的寄存器。这替代了简单 RISC-V 流水线的 WB。
乍看之下,记分牌似乎很难区分 RAW 与 WAR 冒险。
这套记分牌只在两个操作数都已出现在寄存器堆中时才读取它们,因此没有利用转发。这一损失并不一定像最初想象的那么大。不同于前面的简单流水线,只要没有 WAR 冒险,指令一执行完就会立即写寄存器堆,不必等一个静态安排、可能还隔着数周期的写回时隙。这缩短了流水线延迟,也降低了转发的收益。
不过,由于写结果与读操作数不能重叠,仍会多出一周期延迟;若想消除它,还需额外缓冲。
记分牌根据自己的数据结构,与功能单元通信,控制指令从一步前进到下一步。还有一个小问题:连向寄存器堆的源操作数总线和结果总线数量有限,这构成结构冒险。记分牌必须确保,同时允许进入第 2 步和第 4 步的功能单元数不超过可用总线数。这里不再展开,只说明 CDC 6600 的解决办法:把 16 个功能单元分成四组,为每组提供一套称为 data trunks 的总线;每个时钟周期,同组只能有一个单元读取操作数或写回结果。
C.8 谬误与陷阱
陷阱:意料之外的执行序列,可能导致意料之外的冒险
乍看之下,WAW 冒险似乎不应出现:编译器不会生成两次写同一寄存器、而中间完全没有读取的代码。但意料之外的执行序列仍可能产生它。例如,一条运行时间很长的浮点除法触发陷阱;如果陷阱处理例程很早就写入与除法相同的目的寄存器,并且写入发生在除法完成之前,就可能出现 WAW 冒险。硬件或软件必须防止这种情况。
陷阱:过度流水线化会影响设计的其他方面,使整体性价比反而下降
最好的例子来自 VAX 的两种实现:8600 和 8700。8600 最初上市时,时钟周期为 80 ns,随后重新设计的 8650 把周期缩短为 55 ns。8700 的流水线简单得多,在微指令层面工作,处理器更小,时钟周期也更短,只有 45 ns。最终,8650 的 CPI 约有 20% 优势,而 8700 的时钟频率约高 20%。因此,8700 用少得多的硬件达到了相同性能。
陷阱:用未经优化的代码评估动态或静态调度
未经优化的代码包含可由优化器消除的冗余加载、存储及其他操作,比经过优化的紧凑代码容易调度得多。不论是利用延迟分支调度控制延迟,还是调度 RAW 冒险引起的延迟,都是如此。例如,在流水线与 C.1 节几乎相同的 R3000 上运行 gcc,比较“未优化但已调度”与“已优化且已调度”的代码,后者的空闲时钟周期频率增加了 18%。
当然,优化后的程序快得多,因为它的指令更少。公平评估编译时调度器或运行时动态调度,必须使用优化后的代码;真实系统的良好性能不仅来自调度,也来自其他优化。
C.9 结束语
20 世纪 80 年代初,流水线主要还是超级计算机和售价数百万美元的大型机所采用的技术。到 80 年代中期,第一批流水线微处理器出现,推动了计算领域的转变:微处理器在性能上超越小型机,最终开始挑战并胜过大型机。90 年代初,高端嵌入式微处理器也采用了流水线,而桌面处理器则走向第 3 章介绍的复杂动态调度与多发射方法。
本书 1990 年首次出版时,本附录的内容对研究生而言尚属较为深入的知识;如今,它已成为本科基础内容,甚至用于售价不到 1 美元的处理器!
C.10 历史回顾与参考文献
在线提供的 M.5 节讨论了流水线和指令级并行的发展,范围涵盖本附录与第 3 章的内容。那里列有大量参考文献,供读者进一步阅读和探索这些主题。
习题(Diana Franklin 修订)
习题 C.1
[15/15/15/15/25/10/15]〈A.2〉 使用下面的代码片段:
假定 x3 的初值等于 x2+396。
译注:题首的章节引用
A.2、sd x1,0,(x2)中多出的逗号,以及 64 位加载、存储配合步长 4 的组合,均为原题所写,未在译文中静默改动。
a. [15]〈C.2〉 数据冒险源于代码中的数据依赖。依赖关系是否构成冒险,取决于机器实现,例如流水线级数。列出上述代码中的所有数据依赖,记录寄存器、产生数据的指令和使用数据的指令。例如,ld 与 addi 之间存在关于 x1 的数据依赖。
b. [15]〈C.2〉 给出该序列在五级 RISC 流水线上的时序。假定没有任何转发或旁路硬件,但同一周期内的寄存器写入与读取可以经寄存器堆实现“转发”,如图 C.5 中 add 与 or 的关系。使用类似图 C.8 的时序表。假定通过清空流水线处理分支,所有存储器访问都需一周期。整个循环执行需要多少周期?
c. [15]〈C.2〉 给出该序列在具有完整转发与旁路硬件的五级 RISC 流水线上的时序,使用类似图 C.8 的表。假定预测分支不跳转,所有存储器访问都需一周期。整个循环执行需要多少周期?
d. [15]〈C.2〉 给出该序列在图 C.6 所示、具有完整转发与旁路硬件的五级 RISC 流水线上的时序,使用类似图 C.8 的表。假定预测分支跳转,所有存储器访问都需一周期。整个循环执行需要多少周期?
e. [25]〈C.2〉 高性能处理器的流水线很深,可以超过 15 级。设想一条十级流水线,将原五级流水线的每一级拆成两级。唯一需要注意的是:转发从一对阶段的末端,送到需要该数据的另一对阶段的开头。例如,从第二个执行阶段的输出转发到第一个执行阶段的输入,仍会造成一周期延迟。给出该序列在具有完整转发与旁路硬件的十级 RISC 流水线上的时序,使用类似图 C.8 的表,但各级标作 IF1、IF2、ID1 等。假定预测分支跳转,所有存储器访问都需一周期。整个循环执行需要多少周期?
f. [10]〈C.2〉 假定五级流水线中最慢的阶段需要 0.8 ns,流水线寄存器延迟为 0.1 ns。五级流水线的时钟周期是多少?如果十级流水线将每一级的逻辑均分为两半,它的时钟周期是多少?
g. [15]〈C.2〉 利用 (d)、(e) 的答案,求五级与十级流水线执行该循环时的 CPI。只从第一条指令到达写回阶段时开始计数,直到循环结束;不计第一条指令启动流水线的时间。再利用 (f) 求得的时钟周期,计算两台机器的平均指令执行时间。
习题 C.2
[15/15]〈C.2〉 假定分支频率如下,前两项按全部指令计:
| 类型 | 频率 |
|---|---|
| 条件分支 | 15% |
| 跳转与调用 | 1% |
| 条件分支中实际跳转的比例 | 60% |
a. [15]〈C.2〉 考察四级流水线:无条件分支在第二周期末确定,条件分支在第三周期末确定。假定只有第一级总能在不知道分支是否跳转的情况下完成,忽略其他停顿。如果完全没有分支冒险,机器的性能会提高到原来的多少倍?
b. [15]〈C.2〉 现在考虑高性能处理器的十五级流水线:无条件分支在第五周期末确定,条件分支在第十周期末确定。仍假定只有第一级总能独立于分支是否跳转而完成,并忽略其他停顿。如果完全没有分支冒险,性能会提高到原来的多少倍?
习题 C.3
[5/15/10/10]〈C.2〉 从一台单周期实现的计算机出发,按功能拆分阶段时,各阶段所需时间并不完全相同。原机器的时钟周期为 7 ns;拆分后的测量值为:IF 1 ns、ID 1.5 ns、EX 1 ns、MEM 2 ns、WB 1.5 ns。流水线寄存器延迟为 0.1 ns。
a. [5]〈C.2〉 五级流水线机器的时钟周期是多少?
b. [15]〈C.2〉 如果每四条指令发生一次停顿,新机器的 CPI 是多少?
c. [10]〈C.2〉 流水线机器相对于单周期机器的加速比是多少?
d. [10]〈C.2〉 如果流水线有无限多个阶段,相对于单周期机器的加速比是多少?
习题 C.4
[15]〈C.1、C.2〉 经典五级 RISC 流水线的一种精简硬件实现,可以使用 EX 阶段硬件完成分支比较,并且直到分支指令到达 MEM 的那个周期,才把目标 PC 送到 IF。在 ID 中解析分支能够减少控制冒险停顿,但某一方面的改进可能损害其他情况下的性能。写出一小段代码,说明即使具有数据转发,在 ID 中计算分支仍会造成数据冒险。
习题 C.5
[12/13/20/20/15/15]〈C.2、C.3〉 本题考察寄存器—存储器体系结构的流水线。该体系结构有寄存器—寄存器和寄存器—存储器两种格式,存储器寻址方式只有一种:偏移量加基址寄存器。ALU 操作格式如下:
或
ALUop 可以是加、减、AND、OR、加载(忽略 Rsrc1)或存储;Rsrc、Rdest 是寄存器,MEM 是基址寄存器与偏移量的组合。分支对两个寄存器进行完整比较,并采用 PC 相对寻址。假定机器每周期启动一条新指令,其流水线与 VAX 8700 微流水线相似(Clark,1987):
| 指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | IF | RF | ALU1 | MEM | ALU2 | WB | |||||
| 2 | IF | RF | ALU1 | MEM | ALU2 | WB | |||||
| 3 | IF | RF | ALU1 | MEM | ALU2 | WB | |||||
| 4 | IF | RF | ALU1 | MEM | ALU2 | WB | |||||
| 5 | IF | RF | ALU1 | MEM | ALU2 | WB | |||||
| 6 | IF | RF | ALU1 | MEM | ALU2 | WB |
第一个 ALU 阶段用于访存和分支的有效地址计算;第二个用于运算和分支比较。RF 同时完成译码与寄存器读取。假定同一时钟周期内对同一寄存器的读写,可以把写入数据转发给读取方。
a. [12]〈C.2〉 求所需加法器总数,包括任何加法器或递增器。给出指令与流水级的组合以证明答案;只需给出一种使加法器需求达到最大的组合。
b. [13]〈C.2〉 求所需寄存器读、写端口和存储器读、写端口数。给出指令与流水级的组合,并标明各条指令所需读、写端口数,以证明答案正确。
c. [20]〈C.3〉 找出 ALU 所需的全部数据转发。假定 ALU1 与 ALU2 使用不同的 ALU,补齐为避免或减少停顿所需的 ALU 间转发。用图 C.23 的表格格式,但忽略最后两列,描述参与转发的两条指令之间的关系。注意考虑中间隔有另一条指令的情况,例如:
d. [20]〈C.3〉 当源单元或目的单元不是 ALU 时,列出避免或减少停顿所需的全部转发。仍采用图 C.23 的格式,忽略最后两列。不要漏掉传向访存操作及由访存操作传出的转发。
e. [15]〈C.3〉 列出所有剩余冒险,其中至少一个源或目的单元不是 ALU。使用类似图 C.25 的表,但把最后一列改为冒险持续长度。
f. [15]〈C.2〉 用例子列出全部控制冒险,并说明停顿长度。采用类似图 C.11 的格式,为每个例子加上标签。
习题 C.6
[12/13/13/15/15]〈C.1、C.2、C.3〉 现在为经典五级 RISC 流水线加入寄存器—存储器 ALU 操作。为抵消复杂度增加,将所有存储器寻址限制为寄存器间接寻址:地址就是某个寄存器的值,不允许再加偏移或位移。例如,add x4,x5,(x1) 将 x5 的内容与地址等于 x1 的存储单元内容相加,并把结果放入 x4。寄存器—寄存器 ALU 操作不变。以下问题均针对整数 RISC 流水线。
a. [12]〈C.1〉 重新排列传统五个阶段,使之支持仅通过寄存器间接寻址实现的寄存器—存储器操作,写出阶段次序。
b. [13]〈C.2、C.3〉 说明重排后需要哪些新的转发路径,并给出每条路径的源、目的和所传输的信息。
c. [13]〈C.2、C.3〉 阶段重排后,这种寻址方式产生哪些新的数据冒险?为每种新冒险给出一段指令序列。
d. [15]〈C.3〉 对于同一程序,支持寄存器—存储器 ALU 操作的流水线,可能通过哪些方式改变相对于原流水线的指令数?逐项列出,并各给一对具体序列:一段用于原流水线,一段用于重排后的流水线。
e. [15]〈C.3〉 假定所有指令在每个阶段都耗费一周期。对于同一程序,这种寄存器—存储器 RISC-V 相对于原流水线,可能通过哪些方式产生不同的 CPI?全部列出。
习题 C.7
[10/10]〈C.3〉 本题研究加深流水线影响性能的两个方面:时钟周期缩短,以及数据、控制冒险停顿增加。原机器采用五级流水线,时钟周期 1 ns;第二台机器采用十二级流水线,时钟周期 0.6 ns。五级流水线每五条指令因数据冒险发生一次停顿,十二级流水线每八条发生三次。此外,分支占指令的 20%,两台机器的分支误预测率均为 5%。
a. [10]〈C.3〉 仅考虑数据冒险,十二级流水线相对于五级的加速比是多少?
b. [10]〈C.3〉 若第一台机器的分支误预测代价为两周期,第二台为五周期,计入误预测停顿后,两台机器各自的 CPI 是多少?
习题 C.8
[15]〈C.5〉 构造类似图 C.21 的表,用于检查图 C.30 的 RISC-V 浮点流水线中的 WAW 停顿。不考虑浮点除法。
习题 C.9
[20/22/22]〈C.4、C.6〉 本题考察一个常见向量循环在静态和动态调度的 RISC-V 流水线上的运行。它就是附录 G 详细讨论的 DAXPY 循环,也是高斯消元的核心操作。对于长度为 100 的向量,循环实现 。原题给出的代码如下,并称其为 MIPS 代码:
译注:原题混用了 MIPS 名称与 RISC-V 风格记号;
fsd的操作数次序也与前文fsd f2,0(x2)不同。题首分值为[20/22/22],各小题实际均标[20],也照录。
对 (a)–(c),假定整数操作(包括加载)在一周期内发射并完成,其结果具有完整旁路。浮点运算只采用图 C.29 中的延迟值,但假定浮点单元完全流水线化。对于记分牌,假定等待另一个功能单元结果的指令,可在结果写入的同一周期通过读操作数阶段;另外,一条指令完成 WB 的同一周期,也允许正在等待该功能单元的另一条活动指令发射。
a. [20]〈C.5〉 使用 C.5 节的 RISC-V 流水线,延迟取图 C.29 的值,但浮点单元完全流水线化,启动间隔为 1。绘制类似图 C.32 的时序图,显示每条指令的执行。每次循环迭代,从第一条指令进入 WB 到最后一条进入 WB,需要多少时钟周期?
b. [20]〈C.8〉 静态重排指令,使该循环的停顿最少;必要时重命名寄存器。其余假定同 (a)。绘制类似图 C.32 的时序图。每次迭代从第一条指令进入 WB 到最后一条进入 WB,需要多少周期?
c. [20]〈C.8〉 使用上面的原始代码,考虑通过动态调度的一种形式——记分牌——执行。绘制类似图 C.32 的图,显示指令经过 IF、IS(发射)、RO(读操作数)、EX(执行)、WR(写结果)的时序。每次迭代从第一条指令进入 WB 到最后一条进入 WB,需要多少周期?题目最后的 WB 与本小题列出的 WR 对应。
习题 C.10
[25]〈C.8〉 记分牌必须能够区分 RAW 与 WAR 冒险,这一点至关重要:WAR 冒险要求暂停写入指令,直到读取操作数的指令开始执行;RAW 冒险则相反,要求延迟读取指令,直到写入指令完成。例如:
fsub.d 依赖 fmul.d,构成 RAW 冒险,所以必须允许 fmul.d 先于 fsub.d 完成。如果不能区分 RAW 与 WAR,而让 fmul.d 等待 fsub.d,处理器就会死锁。这一序列中,fadd.d 与 fsub.d 之间又有 WAR 冒险,因此在 fsub.d 开始执行之前,不能允许 fadd.d 完成。难点在于区分 fmul.d 与 fsub.d 之间的 RAW,以及 fsub.d 与 fadd.d 之间的 WAR。
为了理解为什么这个三指令场景很重要,请逐步跟踪每条指令的发射、读操作数、执行和写结果。假定除执行外,记分牌每步都耗费一周期;fmul.d 执行需三周期,fsub.d 和 fadd.d 各需一周期。处理器有两个乘法功能单元、两个加法功能单元。按如下方法给出跟踪结果:
- 建立表格,列名为“指令、发射、读操作数、执行、写结果、说明”。第一列按程序顺序列指令,行间多留空间,较大的单元格便于填写分析结果。在
fmul.d行的“发射”列填 1,表示它在周期 1 完成发射。继续填写各阶段,直到记分牌第一次让某条指令停顿的周期。
- 对停顿指令,在相应列写“在时钟周期 X 等待”,X 为当前周期号,表示记分牌通过暂停该阶段来处理 RAW 或 WAR 冒险。在“说明”列写明冒险类型,以及哪条相关指令造成等待。
- 在“等待”单元格中补上“于时钟周期 Y 完成”,填完余下表格,直到所有指令完成。对发生过停顿的指令,在“说明”中解释等待为何在那个时刻结束,以及如何避免死锁。提示:思考如何防止 WAW 冒险,以及这对活动指令序列意味着什么。比较三条指令的完成次序与程序次序。
习题 C.11
[10/10/10]〈C.5〉 编写若干短代码片段,说明使用不同延迟的功能单元会遇到的问题。每种情况都绘制类似图 C.32 的时序图,展示相应概念,并清楚指出问题。
a. [10]〈C.5〉 使用不同于图 C.32 的代码,说明只有一份 MEM 和 WB 阶段硬件时产生的结构冒险。
b. [10]〈C.5〉 给出一个必须停顿的 WAW 冒险例子。
译注:原题题首列出三项分值
[10/10/10],但原书附录 C 的最后一页只列出 (a)、(b) 两问;下一页已进入附录 D。题内章节引用中,C.8 被用于记分牌相关题目,虽然正文记分牌实际在 C.7;这些引用保留原题写法。
D 存储系统
我认为硅谷这个名字起错了。回顾过去十年产品出货带来的收入,磁盘比硅带来的收入还多。这个地方应该改叫氧化铁谷。
——Al Hoagland,磁盘先驱(1982)
将带宽与存储结合……便能迅速、可靠地访问不断增多的磁盘以及 Internet……资料库中持续扩展的海量内容……各种存储阵列的容量,正在以远超计算机性能进步的速度飞涨。
——George Gilder,〈终点将近〉(“The End Is Drawing Nigh”),Forbes ASAP(2000 年 4 月 4 日)
D.1 引言
搜索引擎、拍卖等 Internet 服务的普及,提高了 I/O 对计算机的重要性:谁都不想要一台无法访问 Internet 的桌面计算机。时代名称的变化也反映了这一点。20 世纪 60 至 80 年代被称为“计算革命”,1990 年以来则被称为“信息时代”;关注的重点从纯粹的计算能力转向信息技术进步。Internet 服务依赖海量存储与网络,前者是本附录的重点,后者是附录 F 的重点。
重心从计算转向信息通信与存储,意味着除了性价比,还必须重视可靠性和可扩展性。程序崩溃让人沮丧,数据丢失却可能令人抓狂;因此,对存储系统可信赖性的要求通常高于计算机其他部分。可信赖性是存储的根基,存储也有自身丰富的性能理论——排队论,用来权衡吞吐量与响应时间。对于处理器,决定哪些特性得到利用的软件是编译器;在存储领域,操作系统接替了这一角色。
因此,存储形成了不同于处理器的多面文化,但依然属于体系结构。我们先探讨磁盘技术的进步,因为在这里讨论的时期,它是桌面计算机和服务器的主导存储设备。假定读者已经熟悉存储设备基础,其中一部分已在第 1 章介绍。
D.2 磁盘存储进阶
磁盘行业历来着力提高容量。容量进步通常用面密度的提高来表示,单位是每平方英寸的位数:
到约 1988 年为止,面密度每年提高 29%,即每三年翻倍。此后到约 1996 年,年增长率增至 60%,每三年提高到四倍,与 DRAM 的传统增长率相当。从 1997 年到约 2003 年,年增长率升至 100%,每年翻倍。当促成这轮复兴的创新潜力基本释放之后,近年的增长率回落至约 30%。2011 年,商用产品的最高密度为每平方英寸 4000 亿位。每 GB 成本下降的速度至少与面密度增长一样快,其中小直径磁盘的贡献更大。1983 至 2011 年间,每 GB 成本改善了近 100 万倍。
磁盘在辅助存储领域的主导地位曾多次受到挑战。图 D.1 展示了一个原因:磁盘与 DRAM 之间著名的访问时间鸿沟。DRAM 延迟约为磁盘的十万分之一,但代价是每 GB 成本为磁盘的 30–150 倍。
带宽差距更复杂。例如,2011 年一种高速磁盘容量为 600 GB,介质传输速率为 200 MB/s,售价约 $400。同年一个售价约 $200、容量为 4 GB 的 DRAM 模块能以 16,000 MB/s 传输(见第 2 章),带宽约为该磁盘的 80 倍。但按每 GB 容量计算,DRAM 的带宽高 6000 倍;按每美元计算,则高 160 倍。
**译注:**原页确写 6000 倍;按同段给出的带宽和容量,,应为 12,000 倍。80 倍的总带宽比和 160 倍的每美元带宽比则与所列条件一致。
许多人曾试图发明一种比 DRAM 便宜、比磁盘快的技术来填补鸿沟,但迄今均未成功。挑战者始终未能在恰当时机推出产品。等新产品上市时,DRAM 与磁盘已如前述预测那样取得进展,成本随之下降,挑战者的产品立刻就过时了。
最接近成功的挑战者是闪存。这种半导体存储器与磁盘一样非易失,带宽也相近,但延迟低 100–1000 倍。2011 年,闪存每 GB 价格为 DRAM 的 1/15–1/20。它在手机中很流行,因为可以采用小得多的容量,而且比磁盘节能,尽管每 GB 成本比磁盘高 15–25 倍。与磁盘和 DRAM 不同,闪存位会磨损,典型写入次数上限约为 100 万次,因此当时在桌面计算机和服务器中尚不普及。
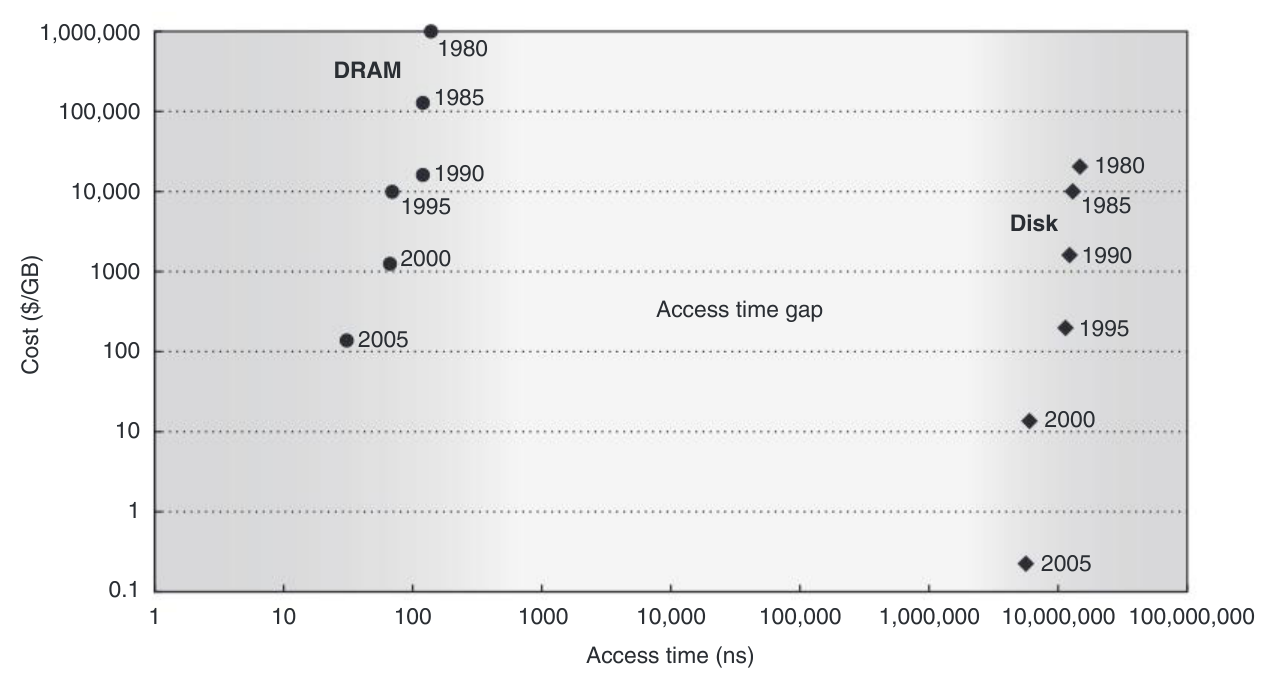
磁盘在可预见的未来仍有生命力,但传统的扇区—磁道—柱面模型已不再适用。该模型假定相邻块位于同一磁道;同一柱面的块因无需寻道而访问更快;某些磁道彼此比另一些更近。
首先,磁盘内加入微处理器后,开始提供 ATA、SCSI 等更高层的智能接口。为加快顺序传输,这些接口把磁盘组织得更像磁带,而不是随机访问设备。逻辑块沿单个盘面按蛇形次序排列,尽可能连续覆盖以相同位密度记录的所有扇区。(磁盘会改变记录密度,因为外磁道的数据块旋转得快得多,电子电路难以跟上;降低线密度可简化任务。)因此,顺序块可能处于不同磁道。后文图 D.22将说明,处理现代磁盘时假定传统扇区—磁道模型是一个谬误。
其次,微处理器进入磁盘不久,磁盘就加入缓冲区,在计算机准备接收之前暂存数据;后来又加入缓存,以免再次执行读访问。此外,还出现了命令队列,允许磁盘在保持正确行为的前提下决定命令执行顺序,尽可能提高性能。图 D.2 表明,队列深度达到 50 时,较好的调度可使随机 I/O 的每秒操作数翻倍。虽然实际系统不太可能在队列中积压 256 个命令,但这能使每秒 I/O 数达到原来的三倍。有了缓冲、缓存与乱序访问,要准确建模真实磁盘性能,就远比扇区—磁道—柱面模型复杂。
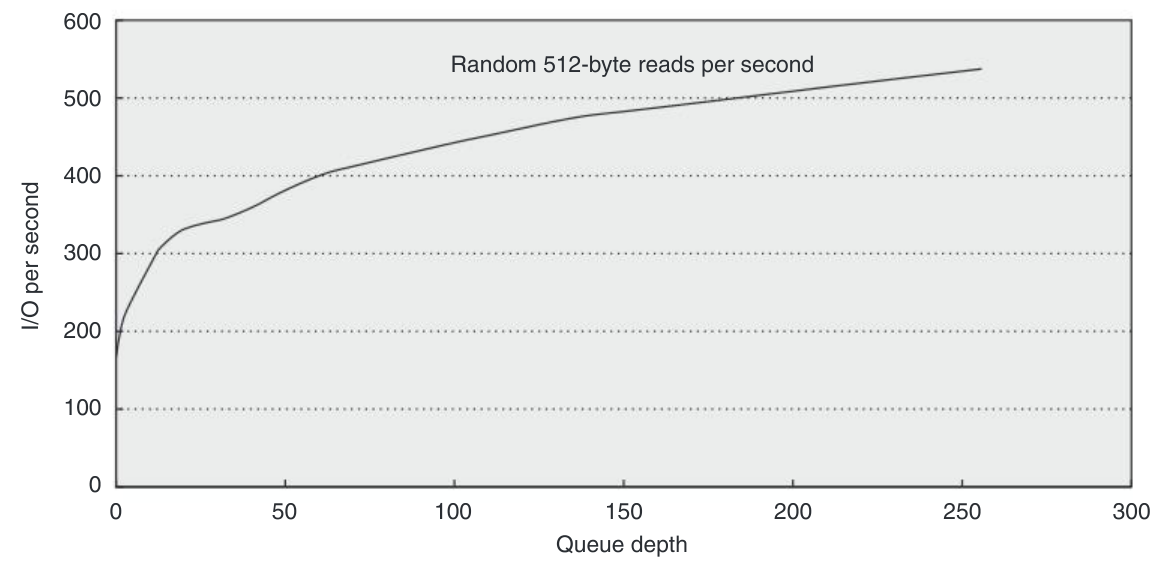
最后,盘片数从过去的 12 张减少为如今的 4 张,甚至 1 张。因此,单个柱面容纳的数据占比大幅减少,柱面也不再像过去那样重要。
磁盘功耗
与处理器一样,磁盘功耗也日益受到重视。2011 年典型 ATA 磁盘在空闲、读写、寻道时的功耗可能分别为 9 W、11 W、13 W。旋转更小的质量效率更高,因此小直径磁盘可以节能。下式说明转速与盘片大小对电机功耗的重要影响[Gurumurthi 等 2005]:
因此,更小的盘片、更低转速、更少盘片,都有助于降低电机功耗;而电机占了磁盘功耗的大部分。
图 D.3 列出 2011 年两种 3.5 英寸磁盘的规格。串行 ATA(SATA)追求大容量与低廉的每 GB 成本,因此 2000 GB 磁盘每 GB 不到 $0.05。它们采用外形尺寸允许的最宽盘片,装四到五张;转速为 5900 RPM,寻道也相对慢,以支持更高面密度并降低功耗。相应的 Serial Attach SCSI(SAS)磁盘追求性能,转速达 15,000 RPM,寻道快得多。为了高速旋转,它使用较低面密度;为了省电,盘片明显窄于外形尺寸。这些因素使 SAS 容量降到 600 GB。
SATA 每 GB 成本约有五倍优势;反过来,SAS 在每单位 IOPS 或每单位 MB/s 的成本上约有五倍优势。尽管盘片更小且数量少得多,SAS 因转速与寻道快得多,功耗仍是 SATA 的两倍。
| 接口 | 容量(GB) | 价格 | 盘片数 | RPM | 直径(英寸) | 平均寻道(ms) | 功耗(W) | I/O/s | 磁盘带宽(MB/s) | 缓冲带宽(MB/s) | 缓冲大小(MB) | MTTF(小时) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SATA | 2000 | $85 | 4 | 5900 | 3.7 | 16 | 12 | 47 | 45–95 | 300 | 32 | 0.6 M |
| SAS | 600 | $400 | 4 | 15,000 | 2.6 | 3–4 | 16 | 285 | 122–204 | 750 | 16 | 1.6 M |
**译注:**原图注确写“512 KB 扇区”。正文关于盘片数、功耗及成本倍数的描述,与表中四张/四张、12 W/16 W 和价格/容量数据并不一致。
磁盘阵列进阶
磁盘阵列同时改善存储系统的可信赖性与性能。一个理由是:采用更多磁盘、因而更多磁臂,可以比少量大磁盘提供更高的潜在吞吐量。把数据分散在多个磁盘上称为条带化(striping);当数据文件足够大时,它自动把访问分散到多个磁盘。(阵列提高吞吐量,但未必改善延迟。)如第 1 章所见,缺点是设备越多,可信赖性越低: 个设备的可靠性通常只有单设备的 。
**译注:**这里的 应理解为特定模型下的平均失效前时间(MTTF)之比:各设备寿命独立且服从相同指数分布,任何一个设备失效都会使系统失效。若“可靠性”指给定时间内无失效的概率,则系统可靠性为单设备可靠性的 次方,不能直接除以 。
若单盘可靠性相同,磁盘阵列发生故障的次数会多于少量大容量磁盘;但可通过添加冗余磁盘容错,提高可信赖性。一个磁盘失效后,丢失的信息由冗余信息重建。危险仅在于平均修复时间 MTTR 内又有磁盘失效。磁盘的平均失效前时间 MTTF 达数十年,而 MTTR 以小时计,所以冗余能使多磁盘系统测得的可靠性远高于单盘。
这种冗余磁盘阵列称为 RAID,最初是 redundant array of inexpensive disks(廉价磁盘冗余阵列)的缩写;有人更愿意用 independent(独立)解释 I。故障恢复能力,加上以 MB/s 或 I/O/s 衡量的高吞吐量,使 RAID 很有吸引力。再结合小直径磁盘体积小、功耗低的优势,RAID 现已主导大型存储系统。
图 D.4 概括了五种标准 RAID 级别,列出每级为八个用户数据磁盘配备的冗余/校验盘数量,以及优缺点。标准级别已有充分文献,因此这里仅作简要回顾,再深入讨论高级组织。
- **RAID 0:**没有冗余,有时也叫 JBOD,即 just a bunch of disks(只是一组磁盘),尽管数据可能跨磁盘条带化。通常列出这一级,是为了给其他级别的成本、性能、可信赖性提供比较基准。
- **RAID 1:**也叫镜像(mirroring)或影子复制(shadowing),每份数据保留两个副本。它最简单、出现最早,但成本也最高。有些控制器允许镜像盘独立处理读取,以优化读性能;代价可能是镜像写入完成得更慢。
- **RAID 2:**来自将内存式纠错码 ECC 应用于磁盘的思路。最初 RAID 论文发表时有这样的阵列产品,因而将它纳入;此后其他 RAID 组织更具吸引力,便没有了这类产品。
| RAID 级别 | 组织 | 可容忍失效数;八个数据盘的校验空间开销 | 优点 | 缺点 | 厂商/产品 |
|---|---|---|---|---|---|
| 0 | 无冗余条带化 | 0 个;0 个校验盘 | 无空间开销 | 无保护 | 广泛使用 |
| 1 | 镜像 | 1 个;8 个校验盘 | 无需奇偶校验计算;恢复快;小写入比更高 RAID 级别快;读取快 | 校验存储开销最高 | EMC、HP(Tandem)、IBM |
| 2 | 内存式 ECC | 1 个;4 个校验盘 | 不依赖失效磁盘自行诊断 | 约 Log 2 的校验存储开销 | 未使用 |
| 3 | 位交错奇偶校验 | 1 个;1 个校验盘 | 校验开销低;大读/写带宽高 | 不支持小规模随机读写 | Storage Concepts |
| 4 | 块交错奇偶校验 | 1 个;1 个校验盘 | 校验开销低;小读带宽更高 | 校验盘是小写入的瓶颈 | Network Appliance |
| 5 | 块交错分布式奇偶校验 | 1 个;1 个校验盘 | 校验开销低;小读写带宽更高 | 小写入需要 4 次磁盘访问 | 广泛使用 |
| 6 | 行—对角线奇偶校验、EVEN-ODD | 2 个;2 个校验盘 | 可抵御两盘失效 | 小写入需要 6 次磁盘访问;校验开销翻倍 | Network Appliance |
- **RAID 3:**高层磁盘接口知道磁盘健康状况,因此很容易确定哪块盘失效。设计者发现,只需额外一盘保存各数据盘信息的奇偶校验,就能恢复单盘失效。数据组成条带,每条带含 个数据块和一个校验块。失效时,只要从有效校验信息中“减去”完好数据块,剩下的就是缺失数据;无论坏的是数据盘还是校验盘,都适用。RAID 3 假定读写数据跨越所有磁盘,适合大量数据读写。
- **RAID 4:**许多应用以小访问为主。由于扇区自带错误检查,允许每盘独立读就能安全提高每秒读取次数。乍看之下,写入仍会很慢,因为必须读取所有磁盘以计算奇偶校验。另一种只涉及两个磁盘的方法能提高写入速率:先读即将覆盖的旧数据,在写新数据之前算出哪些位会改变;再读校验盘的旧校验值,根据变化更新校验,然后写回。这样的“小写入”仍比小读慢,需要四次磁盘访问,但比每次写入都读取所有盘更快。RAID 4 与 RAID 3 一样,校验盘开销低;除了小读写,它的大读写速度也能与 RAID 3 相同,但控制更复杂。
- **RAID 5:**RAID 4 的小写入有个性能缺陷:都要读写同一校验盘,造成瓶颈。RAID 5 把校验信息分散到阵列所有磁盘,消除这个瓶颈。各条带的校验块轮换所在磁盘,使校验均匀分布。控制器在写某个块时,须计算哪块盘存放相应校验,不过这可以很简单。RAID 5 与 RAID 3、4 一样,校验盘开销低;既有 RAID 3 的大读写能力,又有 RAID 4 的小读能力,小写带宽则比 RAID 4 更高。不过,它也需要经典 RAID 级别中最复杂的控制器。
简要回顾经典 RAID 之后,来看 RAID 问世后逐渐流行的两类组织。
RAID 10 与 01,即 1+0 与 0+1
RAID 文献并不总会讨论 RAID 1 的镜像如何与条带化结合。假设需要存放四个磁盘容量的数据,有八个物理盘可用。可以先把盘分成四对,每对组成 RAID 1,再跨四对条带化;也可以先分成两个四盘组,各组成 RAID 0,再向两个 RAID 0 组镜像写入。前者称为 RAID 1+0 或 RAID 10,即“条带化的镜像”;后者称为 RAID 0+1 或 RAID 01,即“镜像的条带”。
RAID 6:超越单盘失效
RAID 1–5 中基于奇偶校验的方案,能够抵御一个可自行识别的失效;但如果操作员在故障期间不慎更换了错误的磁盘,阵列就同时出现两个失效,造成数据丢失。另一个问题是磁盘带宽增长慢于容量,因此 RAID 中磁盘的 MTTR 越来越大,第二次失效的概率随之上升。例如,在没有干扰的情况下,顺序读完一个 500 GB SATA 磁盘可能要三小时。受损 RAID 往往还必须继续提供数据服务,重建可能被大幅拉长,进一步增加 MTTR。除了时间增长,重建时读取更多数据,也更容易遭遇不可纠正的介质错误,造成数据丢失。阵列盘数增加,以及采用比 SCSI 更慢、更大的 ATA 磁盘,也让人担忧同时发生多个失效。
因此,多年来人们越来越重视抵御不止一个失效。例如,Network Appliance(NetApp)最初构建 RAID 4 文件服务器。双盘失效逐渐威胁客户数据后,它提出更强健的行—对角线奇偶校验(row-diagonal parity),也称 RAID-DP[Corbett 等 2004]。与标准 RAID 一样,它逐条带计算奇偶校验并保存冗余信息。为保护双盘失效,每条带增加两个校验块。假设共有 个磁盘,其中 个存数据。图 D.5 采用 。
行校验盘与 RAID 4 相同,保存本条带其他四个数据块的偶校验。对角线校验盘的每个块保存同一对角线上各块的偶校验。注意,每条对角线都会漏掉一个磁盘,例如对角线 0 不覆盖磁盘 1。因此,只需 条对角线就能保护 个磁盘,图 D.5 的校验盘只存对角线 0–3。
假设图 D.5 中数据盘 1、3 同时失效,看看这个方案如何工作。第一行缺少这两个盘的数据块,无法按标准 RAID 用行校验恢复;但对角线 0 只缺磁盘 3 的一个块,所以能够恢复。这样,先用对角线校验恢复失效盘四块中的一块。每条对角线各漏掉不同磁盘,因而有两条只缺一个块。本例为对角线 0、2;接着从对角线 2 恢复失效磁盘 1 的块。恢复这些块之后,就能用标准 RAID 4 的条带 0、2 再恢复两块,进而恢复更多对角线。持续这一过程,直到两块失效磁盘全部重建。
IBM 研究者更早提出的 EVEN-ODD 与行—对角线校验相似,但正常运行和恢复的计算量稍大[Blaum 1995]。后来的论文展示了如何扩展 EVEN-ODD,以抵御三个失效[Blaum、Bruck 和 Vardy 1996;Blaum 等 2001]。
D.3 故障与失效的定义及真实案例
人们也许能接受计算机偶尔崩溃、所有程序必须重启,却坚持要求信息永不丢失。因此,存储的首要原则是:无论发生什么,都必须记住信息。
第 1 章介绍了可信赖性基础,本节进一步给出失效的标准定义与实例。
首先,要澄清术语混淆。fault、error、failure 常被混用,但在可信赖性文献中含义不同。例如,编程失误属于故障、错误还是失效?讨论设计时刻与程序运行时刻,结论是否不同?如果运行时未触发该失误,它还算故障/错误/失效吗?再如,α 粒子击中 DRAM 单元,但数值没改变,属于什么?如果数值改变了,但未访问该位呢?如果内存纠错后向 CPU 返回了正确值,又是否发生了故障/错误/失效?这些问题足以说明,必须有精确定义才能有效讨论。
为避免含混,本节采用 Laprie[1985]及 Gray 和 Siewiorek[1991]的术语,它们得到 IFIP 第 10.4 工作组与 IEEE Computer Society 容错技术委员会认可。把系统当作一个模块讨论,而术语可递归应用于子模块。先看可信赖性(dependability)的定义:
计算机系统的可信赖性,是其所提供服务具备的一种品质,使人有充分理由信赖该服务。系统提供的服务,是与其用户交互的其他系统所感知到的实际行为。每个模块也都有理想的规定行为;服务规范是对预期行为达成一致的描述。实际行为偏离规定行为时,就发生了系统失效(failure)。失效源于该模块的缺陷,即错误(error);错误的原因则是故障(fault)。
故障发生后产生潜在错误,错误被激活后成为有效错误;当错误真正影响所提供的服务时,便发生失效。从错误出现到因此发生失效之间的时间,称为错误潜伏期(error latency)。因此,错误是故障在系统内部的表现,失效则是错误在服务层面的表现。[第 3 页]
回到前面的例子。编程失误是故障,其后果是软件中的错误或潜在错误。激活后,它成为有效错误;当有效错误产生错误数据并影响所提供的服务时,就发生失效。
α 粒子击中 DRAM 可视为故障。如果改变内存内容,就产生错误;在读取受影响的内存字之前,错误一直潜伏。如果被激活的字错误影响服务,就发生失效。如果 ECC 纠正了错误,则不会失效。
操作员的失误是故障,由此改变的数据是错误;错误在激活前保持潜伏,后续过程相同。
概括起来,三者关系如下:
- 一个故障产生一个或多个潜在错误。
- 错误有三项性质:①潜在错误一旦激活,就成为有效错误;②错误可能在潜在与有效状态之间反复切换;③有效错误常从一个组件传播到另一个,形成新错误。因此,组件中的有效错误,或由其原有潜在错误激活而来,或由该组件内或其他地方的错误传播而来。
- 当错误影响所提供的服务时,组件发生失效。
- 这些性质可以递归应用于系统中的任何组件。
Gray 和 Siewiorek 按成因将故障分为四类:
- **硬件故障:**设备失效,例如 α 粒子击中存储单元。
- **设计故障:**软件设计中的故障较常见,硬件设计中的较少见。
- **操作故障:**运行、维护人员的失误。
- **环境故障:**火灾、洪水、地震、断电和蓄意破坏。
按持续时间,故障又分为瞬态、间歇性和永久性[Nelson 1990]。瞬态故障只存在有限时间,不会复发;间歇性故障使系统在有故障与无故障运行之间反复;永久性故障不会随时间自行消失。
明确区别之后,来看真实案例。实际错误率很少公开,一是学术界很少有足够多硬件可供测量;二是工业界研究人员通常不获准公开失效信息,以免公司在市场竞争中处于不利地位。下面是少数例外。
Berkeley 的 Tertiary Disk
加利福尼亚大学的 Tertiary Disk 项目于 2000 年为旧金山美术博物馆建立艺术图像服务器,数据库包含超过 70,000 件艺术品的高质量图像[Talagala 等 2000]。数据放在一个由 20 台 PC 组成、通过交换式以太网连接的集群上,共有 368 个磁盘,占据七个七英尺高的机架。
图 D.6 列出各组件的失效率。建设之前,设计者预计 SCSI 数据盘最不可靠,因为它们既是机械部件,数量又多;其次是数量较少的 IDE 磁盘,再次是电源和集成电路。他们认为电缆等无源器件几乎不会失效。
| 组件 | 系统内总数 | 失效总数 | 失效比例 |
|---|---|---|---|
| SCSI 控制器 | 44 | 1 | 2.3% |
| SCSI 电缆 | 39 | 1 | 2.6% |
| SCSI 磁盘 | 368 | 7 | 1.9% |
| IDE/ATA 磁盘 | 24 | 6 | 25.0% |
| 磁盘机箱——背板 | 46 | 13 | 28.3% |
| 磁盘机箱——电源 | 92 | 3 | 3.3% |
| 以太网控制器 | 20 | 1 | 5.0% |
| 以太网交换机 | 2 | 1 | 50.0% |
| 以太网电缆 | 42 | 1 | 2.3% |
| CPU/主板 | 20 | 0 | 0% |
图 D.6 打破了一些预想。设计者遵从厂商建议,让磁盘机箱减振并保持良好散热,数据盘因而非常可靠。相比之下,放置 IDE/ATA 磁盘的 PC 机箱没有同等环境控制。(这些磁盘不存数据,而是存放用于启动 PC 的应用与操作系统。)表中 SCSI 背板、SCSI 电缆及以太网电缆的可靠性,竟然并不比数据盘更高!
Tertiary Disk 是具有大量冗余组件的大系统,能够承受这些不同失效。组件连接与镜像放置经过安排,使任何单点失效都不能令某幅图像不可用。最初看似过度设计,后来证明至关重要。
这段经历也说明了瞬态故障与硬故障的差别。图 D.6 的几乎所有失效,最初都表现为瞬态故障。操作员需要判断组件表现是否差到必须替换,还是可以继续使用。团队实际上没有用“失效”一词,而借用了处理问题员工的说法,由操作员决定是否“解雇”问题组件。
Tandem
第二个案例来自工业界。Gray[1990]收集了 Tandem Computers 的故障资料;Tandem 是容错计算先驱之一,系统主要用于数据库。图 D.7 展示 1985–1989 年导致系统失效的故障,分别给出每系统绝对故障数和分类比例。数据表明,硬件与维护可靠性明显改善。1985 年的磁盘需要 Tandem 每年维护,后来改用无需计划维护的磁盘。系统中芯片、连接器数量减少,加上软件能够容忍硬件故障,到 1989 年硬件只占失效的 7%。而且,即便归因于硬件,真正原因也常是设备内嵌的软件,即固件。1989 年已报告停机的首要原因是软件,占 62%,其次是系统操作,占 15%。
这种统计的局限,是只反映被报告的问题。例如,断电引起的环境失效被视为本地问题,不会上报 Tandem。操作故障的数据很难收集,因为操作员要报告自己的失误,可能影响主管评价,进而影响工作稳定和加薪。Gray 认为环境与操作故障均存在漏报。他得出的结论是:要提高可用性,必须改进软件质量及软件容错,简化操作,并容忍操作故障。
关于操作员在可信赖性中作用的其他研究
Tertiary Disk 与 Tandem 都侧重存储。若想更准确衡量人在失效中的作用,需要考察存储以外的系统。Murphy 和 Gent[1995]试图改进操作故障数据:让系统在每次启动时自动询问操作员重启原因。他们把同一故障引起的连续崩溃归为操作故障,也计入直接导致崩溃的操作,例如错误参数、不当配置、不正确的应用安装。他们仍认为操作员错误存在漏报,但数据比 Gray 依赖操作员填表、再逐级上报管理部门的方法准确。VAX 系统中硬件/操作系统导致的失效,占比从 1985 年的 70% 降到 1993 年的 28%;同期操作员导致的失效从 15% 升到 52%。他们预计,系统管理将成为未来可信赖性的主要挑战。
最后一组数据来自政府。美国联邦通信委员会 FCC 要求,电话公司出现影响至少 30,000 人或持续 30 分钟的中断时,必须提交说明。详细报告由调查人员确定原因,而非设备操作员,因此没有前述自行报告的问题。Kuhn[1997]研究了 1992–1994 年的中断原因,Enriquez[2001]追踪了 2001 年上半年。虽然多年间网络过载引起的失效显著减少,但人为原因造成的用户中断分钟数占比,从约三分之一增至三分之二。
这些及其他案例说明,当时大型系统失效的首要原因,是操作员故障。芯片和连接器数量减少,降低了硬件故障;内存 ECC、RAID 等容错技术也改善了硬件可信赖性。至少有些操作系统会在加入新功能前考虑可靠性影响,所以到 2011 年,失效大多发生在其他环节。
虽然失效可能由操作员引发,但维护与升级流程如此容易出错,本身就暴露了系统技术水平的不足。多数存储厂商当时表示,客户在存储整个生命周期中的管理支出,远高于购买成本。因此,未来可信赖存储的挑战,是容忍操作员故障,或者通过简化管理工作来避免故障。注意,RAID 6 即使遇到操作员误换一块好盘,也能保持系统存续。
至此,我们介绍了存储的根基——可信赖性,给出了定义、案例和改进方法。下一站是性能。
D.4 I/O 性能、可靠性度量与基准测试
I/O 性能有些指标,在其他设计中找不到对应物。一项是多样性:哪些 I/O 设备能接入计算机?另一项是容量:能连接多少个 I/O 设备?
除了这些独有指标,传统的响应时间、吞吐量同样适用于 I/O。I/O 吞吐量有时称为 I/O 带宽,响应时间也称延迟。下面两图说明二者如何权衡。图 D.8 是简单的生产者—服务者模型:生产者创建任务并放入缓冲区,服务者从先进先出缓冲区取出任务并执行。
响应时间从任务进入缓冲区开始,到服务者完成任务为止。吞吐量是在一段时间内平均完成的任务数。要尽可能提高吞吐量,服务者就不能空闲,缓冲区也不能空;但响应时间包括缓冲区中的等待,所以空缓冲区有利于缩短响应时间。
另一项 I/O 性能指标是它对处理器执行的干扰。数据传输可能妨碍另一进程运行,处理中断也有开销。这里关心的是:一个进程会因另一个进程的 I/O 而多花多少时间?
吞吐量与响应时间
图 D.9 描绘典型 I/O 系统的吞吐量和响应时间。曲线拐弯区域意味着:略增吞吐量,响应时间就显著变长;反之,略微缩短响应时间,就会使吞吐量大幅下降。
体系结构设计者怎样平衡冲突?如果计算机需要与人交互,图 D.10 提供了答案。人与计算机的一次交互,即事务,可分为三部分:
- **输入时间:**用户输入命令的时间。
- **系统响应时间:**从用户提交命令到完整响应显示出来的时间。
- **思考时间:**从收到响应,到开始输入下一条命令的时间。
三者之和称为事务时间。多项研究报告,用户生产率与事务时间成反比。图 D.10 表明,系统响应缩短 0.7 秒,传统事务却节省 4.9 秒,即 34%;图形事务节省 2.0 秒,即 70%。看似不可思议,却符合人的特性:响应越快,思考所需时间越少。尽管该研究已有 20 年,处理器也快了 1000 倍,响应时间仍常远超一秒。例如,桌面 PC 启动应用时会有大量磁盘 I/O,点击网页链接时会有网络延迟。
为反映响应时间对生产率的重要性,I/O 基准也权衡吞吐量和响应时间。图 D.11 列出三种基准的响应时间边界:在 90% 响应时间低于限定值,或平均响应时间低于限定值的条件下,报告最大吞吐量。下面详述这些基准。
| I/O 基准 | 响应时间限制 | 吞吐量指标 |
|---|---|---|
| TPC-C:复杂查询 OLTP | 至少 90% 的事务满足限制;多数事务类型为 5 秒 | 每分钟新订单事务数 |
| TPC-W:事务型 Web 基准 | 至少 90% 的 Web 交互满足限制;多数交互类型为 3 秒 | 每秒 Web 交互数 |
| SPECsfs97 | 平均响应时间 ≤40 ms | 每秒 NFS 操作数 |
事务处理基准
事务处理(TP,在线事务处理则为 OLTP)主要关注 I/O 速率,即每秒磁盘访问次数,而非以每秒字节数衡量的数据速率。TP 通常涉及许多终端对大量共享信息的修改,并保证失效时行为仍正确。例如,顾客从 ATM 取款时银行计算机失效,事务系统必须保证:若钱已到手,账户就扣款;若钱没到手,账户保持不变。航空订票和银行都是传统用户。
如第 1 章所述,TP 社群的两打成员合力制定行业基准,为免触怒各自法律部门,匿名发表了报告[Anon. 等 1985]。这促成了 Transaction Processing Council(事务处理委员会,TPC),其成立后陆续制定了八项基准,概括于图 D.12。
以 TPC-C 为例。它用数据库模拟批发供应商的订单录入环境,包括订单录入与交付、付款记录、订单状态查询、仓库库存监控。它并发运行五种复杂度不同的事务,数据库有九张表,记录和客户规模可以扩展。指标为每分钟事务数 tpmC,以及包含硬件、软件、三年维护支持的系统价格。原书指向第 1 章第 42 页图 1.17,列举 TPC-C 性能及性价比最好的系统。
TPC 最先引入了以下不同寻常的特点,其中有些直到当时仍只有 TPC 采用:
- **结果包括价格。**提交结果必须列出硬件、软件和维护合同成本,因此既能比较性能,也能比较性价比。
- **数据集通常随吞吐量扩大。**基准力求模拟真实系统:需求增加时,存储数据量也一起增长。例如,让每分钟数千人只访问几百个银行账户,并不合理。
- **结果要审计。**提交前须经认证 TPC 审计员批准,以规则保证公平。结果可以受到质疑,争议提交 TPC 解决。
| 基准 | 数据大小(GB) | 性能指标 | 首次结果日期 |
|---|---|---|---|
| A:借记/贷记(已退役) | 0.1–10 | 每秒事务数 | 1990 年 7 月 |
| B:批量借记/贷记(已退役) | 0.1–10 | 每秒事务数 | 1991 年 7 月 |
| C:复杂查询 OLTP | 100–3000,最小为 0.07×TPM | 每分钟新订单事务数(TPM) | 1992 年 9 月 |
| D:决策支持(已退役) | 100、300、1000 | 每小时查询数 | 1995 年 12 月 |
| H:即席决策支持 | 100、300、1000 | 每小时查询数 | 1999 年 10 月 |
| R:业务报表决策支持(已退役) | 1000 | 每小时查询数 | 1999 年 8 月 |
| W:事务型 Web 基准 | 约 50、500 | 每秒 Web 交互数 | 2000 年 7 月 |
| App:应用服务器与 Web 服务基准 | 约 2500 | 每秒 Web 服务交互数(SIPS) | 2005 年 6 月 |
- **用吞吐量衡量性能,但约束响应时间。**例如 TPC-C 要求 90% 的新订单事务响应少于五秒。
- **由独立机构维护。**TPC 会费支持包含首席运营机构在内的管理体系,负责解决争议、邮寄投票批准基准变更、举行董事会会议等。
SPEC 系统级文件、邮件与 Web 服务器基准
SPEC 最著名的是处理器性能基准,但也开发了文件、邮件与 Web 服务器基准。
七家公司共同制定综合基准 SFS,评估运行 Sun Microsystems 网络文件服务 NFS 的系统。后来升级为 SFS 3.0,也称 SPEC SFS97_R1,支持 NFS 第 3 版、在 UDP 之外增加 TCP 传输,并采用更真实的操作组合。通过对 NFS 系统的测量,构成读、写和文件操作的综合混合。SFS 提供默认参数,以便比较。例如,一半写操作使用完整的 8 KB 块,另一半使用 1、2、4 KB 的部分块;读操作则为 85% 完整块、15% 部分块。
与 TPC-C 一样,SFS 按报告吞吐量扩大数据量:每增加 100 NFS 操作/s,容量必须增加 1 GB。它也限制平均响应时间,上限为 40 ms。图 D.13 给出两个 NetApp 系统的响应时间—吞吐量曲线。遗憾的是,SFS 不像 TPC 那样对不同价格配置作归一化。
SPECMail 用于评估 Internet 服务商的邮件服务器。SPECMail2001 基于 SMTP 和 POP3,在用户数从一万扩展到一百万时,测量吞吐量和响应时间。
SPECWeb 评估万维网服务器,衡量同时进行的用户会话数。SPECWeb2005 模拟 Web 服务商访问场景,由服务器托管多个组织的主页,包含三类负载:银行(HTTPS)、电子商务(HTTP 与 HTTPS)、支持(HTTP)。
可信赖性基准的例子
TPC-C 确实包含可信赖性要求:被测系统必须能应对单磁盘失效,所以实际提交者都在存储系统中采用某种 RAID。
更近一些的研究关注容错的实际效果。Brown 和 Patterson[2000]建议:向系统注入故障,观察服务质量指标随时间变化,以测量可用性。对于 Web 服务器,显然应测性能——每秒完成请求数,以及容错程度——存储子系统、网络连接拓扑等能容忍的故障数。
最初实验注入单个故障,例如磁盘扇区写错误,再通过服务质量记录系统行为。实验比较 Linux、Solaris、Windows 2000 Server 的软件 RAID;用 SPECWeb99 提供负载并测性能。为注入故障,将 RAID 卷中一块 SCSI 盘替换成模拟盘:一台运行相应软件的 PC,通过 SCSI 控制器在总线上表现为磁盘。模拟器支持注入多种瞬态故障,如可纠正读错误,以及永久故障,如写入时的介质失效。
图 D.14 展示各系统遇到不同故障的行为。上排左侧为 Linux,右侧为 Solaris。RAID 在重建完成前若再失去一盘,就可能丢数据,因此重建时间 MTTR 越长,可用性越低。但重建越快,从应用夺取的 I/O 资源越多,应用性能越差。策略必须在重建期间牺牲性能,与延长脆弱窗口、降低预测 MTTF 之间取舍。
**译注:**原图注把置信区间解释成单次性能观测值的概率区间,这并不严谨。通常的 99% 置信区间描述重复抽样构造的区间对待估参数的覆盖率,不能直接解释为未来观测值有 99% 概率落入该区间。
虽然这些系统除源代码外,都没有文档说明重建策略,仅一次故障注入就足以揭示差异。Linux 与 Solaris 在活动磁盘因故障停用后,会自动向热备盘重建 RAID 卷;Windows 虽支持重建,却必须手动启动。所以,没有人工介入时,Windows 在第一次失效后仍暴露于第二次失效,脆弱窗口扩大。不过,一旦得到指令,它修复得很快。
实验还揭示了自动备用盘使用、重建速率、瞬态错误等可用性策略,同样没有系统为这些策略提供文档。
对于瞬态故障,Linux 软件 RAID 与 Solaris、Windows 恰好相反。Linux 非常保守:第一次错误出现,就宁愿可控地停用磁盘,也不等着判断是否瞬态。Solaris 和 Windows 更宽容,忽略多数瞬态故障,预期它们不会复发。因此,后两者对瞬态故障的耐受力显著强于 Linux。它们仍会记录瞬态故障,确保即使不采取动作也有错误报告。面对永久故障,各系统表现相似。
D.5 排队论入门
设计处理器时,可以用第 1 章 CPI 公式作简单的粗算,也可以付出更大代价,进行完整模拟以提高准确性。I/O 系统同样可以用最好情况分析粗算;完整模拟能更准确预测性能,但工作量也大得多。
I/O 设计还可借助一种数学工具:它比最好情况分析稍费力,却准确得多;又比完整模拟省事得多。I/O 事件具有概率性,I/O 资源又是共享的,因此可以用一些简单定理计算整个系统的响应时间与吞吐量。这就是排队论(queuing theory)。该领域已有许多专著和课程,本节只作初步介绍;即便如此,也有助于设计更好的 I/O 系统。
先把 I/O 系统看成图 D.15 的黑箱。处理器发出 I/O 请求,请求到达设备;设备满足请求后,请求便“离开”。
通常关心系统长期运行的稳态,而非启动过程。如果要研究非稳态,虽然可以借助 Markov 链,但除少数情况外,所得方程只能通过模拟求解。本节旨在介绍比粗算稍难、比模拟简单的方法,因此不涉及这些分析;详情可参见附录 M 所列文献。
本节因此假定:系统处理多个相互独立的 I/O 请求,并处于平衡,输入率必须等于输出率;任务持续到来,其供应不依赖等待服务的时间。现实中许多系统,如 TPC-C,任务消费速率还由内存容量等其他特性决定。
由此得到 Little 定律,它关联系统平均任务数、新任务平均到达率与平均完成时间:
只要黑箱内部不创建或销毁任务,该定律适用于任何平衡系统。到达率与响应时间必须采用相同时间单位,单位不一致是常见错误来源。
试着推导它。观察系统 分钟,记录每个任务的服务经历并累加。期间完成 个任务,各任务在系统内停留时间之和为 。任务在时间上可能重叠,原文据此写出 。于是:
**译注:**任务时间“可能重叠”并不能保证累计时间总大于观察时间;若系统长时间空闲,上述不等式未必成立。这不影响后面由三个比值建立的 Little 定律关系;有限观察窗口还须妥善处理边界任务。
用代数分解第一式:
**译注:**原页两分式之间印为“∞”;根据两侧等式与紧接着的文字,该处应为乘号,以上明确按乘法排出。
代入三个定义并交换右侧两项顺序,便得到 Little 定律:系统平均任务数=到达率×平均响应时间。这个简单等式的作用远超直觉,后面会看到。
打开黑箱,就得到图 D.16。任务积压等待服务的区域称为队列或等待队列,执行请求的设备称为服务者(server)。直到本节最后两页之前,都先假设只有一个服务者。
结合 Little 定律与以下定义,可得到几个有用等式:
- :任务平均服务时间。平均服务率为其倒数 ,许多排队论教材用 表示。
- :任务在队列中的平均时间。
- :任务在系统中的平均时间,即响应时间,是前两者之和。
- 到达率:每秒平均到达任务数,通常用 表示。
- :平均正在接受服务的任务数。
- :平均队列长度。
- :系统平均任务数,是前两者之和。
这些定义澄清一个常见混淆:问的是开始服务前要排队多久,还是任务完成总共要多久?后者才是响应时间,两者关系为:
由 Little 定律,平均接受服务任务数是到达率乘以平均服务时间。原文接着说,服务者利用率是“平均接受服务任务数除以服务率”。单服务者的服务率是 ,随后给出的利用率(此时也等于每服务者平均任务数)公式为:
**译注:**上述引号内文字与量纲不一致。这里正确的比例是“到达率÷服务率”,即紧接着的公式;不是平均任务数除以服务率。
利用率必须在 0 与 1 之间,否则到达任务多于能够服务的任务,违背平衡假设。这其实也是 Little 定律的另一种写法。利用率也称流量强度(traffic intensity),通常记为 。
例题:单盘利用率
一个单磁盘 I/O 系统平均每秒收到 50 个请求,磁盘平均每个请求服务 10 ms,利用率是多少?
**解答。**将 10 ms 写成 0.01 s:
因此利用率为 0.5。
队列向服务者交付任务的规则称为排队规则(queue discipline)。最简单、最常见的是先进先出 FIFO。假设 FIFO,队列等待时间可表示为:
也就是排在前面的任务数乘平均服务时间,再加上到达时正在服务的任务还要占用多久。(到达过程还有一个限制,将在后文说明。)
最后一项不像初看那样简单。新任务可以在任何时刻到达,无法知道现有任务已服务多久。但虽然请求是随机事件,只要知道事件的分布,仍能预测性能。
随机变量的 Poisson 分布
要估计最后一项,先了解随机变量分布。若变量以给定概率取某个给定集合中的值,它就是随机变量:不能确知下一个值,却可能知道各个值的概率。
I/O 请求可用随机变量建模,因为操作系统通常在多个进程间切换,而进程各自产生独立请求。磁盘寻道与旋转延迟同样具有概率性,因此服务时间也用随机变量建模。
对离散取值,可用直方图刻画分布:把最小值到最大值分成称为桶的子区间,再用柱形表示每桶数量。它适合 I/O 请求数等离散量。对于等待时间等连续量,可以画覆盖全范围的曲线,或者用非常小的时间单位划出大量桶,以精确估计。例如,虽然磁盘服务时间连续,仍可每 10 μs 一个区间绘制直方图。
为求前式最后一项,必须刻画这个随机变量;平均时间和某种方差度量就够了。平均值采用加权算术平均时间。测得第 类任务出现 次,其频率为:
于是:
其中 为第 类任务时间, 为出现频率。为描述均值附近的变化,通常用标准差;这里使用标准差的平方,即方差,以便刻画概率分布:
计算方差时必须注意单位。100 ms 平方后是 10,000 平方毫秒,这个单位很不直观;无量纲度量更方便。因此使用变异系数的平方,记为 :
由此得到变异系数 :
为了预测性能,需要数学上易于处理的随机事件分布。最常用的是指数分布,其 。
这里用一个常数刻画围绕平均值的变化。原文称, 不随时间变化,反映了事件历史不影响当前事件发生概率的性质。这种“健忘”称为无记忆性(memoryless),是这些模型用于预测的重要假设。否则,就必须考虑请求相互之间的精确到达时刻,数学处理会复杂得多。
原文将最广泛使用的一种“指数分布”称为 Poisson 分布,以数学家 Siméon Poisson 命名。它描述给定时间区间内的随机事件,有若干便利的数学性质,其概率质量函数为:
若到达间隔服从指数分布,且采用前述到达率作为事件速率,则到达计数形成 Poisson 过程;时间区间 内的到达数服从参数 的 Poisson 分布。如前文所述,前面的等待时间关系还要求到达过程为 Poisson 过程(原文此处把该关系称为 的等式)。
译注:Poisson 分布是离散计数分布,并非指数分布;Poisson 过程的到达间隔才服从指数分布。 恒定也不足以推出无记忆性。下面 描述的是服务时间分布,指数服务时间满足 ,不能把这个结论直接套给 Poisson 计数。
现在可回答新任务还需等待正在服务的任务多久,即平均剩余服务时间;仍假设 Poisson 到达:
虽然不推导,可用直觉理解:若服务时间并不随机,全部等于平均值,标准差为零,,平均剩余时间正好是平均服务时间的一半。如果服务时间随机,原文称“且为 Poisson”,则 ,剩余时间等于加权平均服务时间;此处应按前述译注理解为指数服务时间。
例题:推导平均排队时间
利用上面的定义和公式,以平均服务时间和利用率表示平均排队时间。
**解答。**新任务前面的 个任务都必须先完成,每个平均耗时 。若服务者正忙,还要等待平均剩余服务时间;忙碌概率就是利用率 。因此:
代入剩余时间公式,以及由 Little 定律得到的 :
本节采用指数服务时间,因此 :
整理末项,用 代换:
移项、化简:
黑箱内部组件同样处于平衡,所以也可应用 Little 定律:
代入排队时间公式:
因为 ,所以:
这样就建立了队列任务数与利用率的关系。
例题:平均排队请求数
对于前面例题中利用率为 0.5 的系统,队列平均有多少 I/O 请求?
解答。
平均有 0.5 个请求排队。
这些等式来自应用数学中的排队论,用于预测此类随机变量的行为。真实系统过于复杂,难以精确分析,所以排队论最适合只需近似答案的情况。
排队论严格区分过去事件与未来事件:过去可用简单算术汇总测量,未来则须用更复杂数学预测。计算机系统常用过去预测未来,例如第 2 章的最近最少使用替换策略;因此测量与预测分布的区别常被淡化。我们先以测量验证分布类型,再依赖该分布推断。
回顾模型假设:
- 系统处于平衡。
- 连续请求之间的时间,即到达间隔,服从指数分布。
- 请求源数量无限。这是无限总体模型;若到达率随系统内已有任务数变化,则使用有限总体模型。
- 服务者完成上一任务后,能立即开始下一任务。
- 队列长度无限,采用 FIFO,因此排在前面的任务都必须完成。
- 只有一个服务者。
这样的队列称为 M/M/1:
- 第一个 M:请求到达间隔服从指数分布,。M 来自定义和分析无记忆过程的数学家 A. A. Markov。
- 第二个 M:服务时间服从指数分布,,同样代表 Markov。
- 1:单服务者。
M/M/1 简单而广泛使用。排队示例常假设指数分布,有一个充分理由、一个尚可理由、一个不佳理由。充分理由是原文所说的许多任意分布叠加后表现为指数分布;计算机行为常由多个组件交互形成,因此指数到达间隔往往适合建模。尚可的理由是:变异程度不明确时,选择中等变异的 ,比假定几乎无变异 或很大变异的大 更稳妥。不佳的理由则只是数学简单。
译注:“任意分布叠加成为指数分布”不能按字面作为一般定理;常见近似指许多相互独立、各自相对稀疏的到达流汇合,可近似为 Poisson 到达,其间隔近似指数分布。
下面实际运用排队论。
例题:旧磁盘的响应时间
处理器每秒发送 40 个磁盘 I/O,请求满足指数分布假设,旧磁盘平均服务时间为 20 ms。求:①平均利用率;②平均排队时间;③包含排队与服务的平均响应时间。
**解答。**每秒平均到达 40 个任务,服务时间 20 ms=0.02 s,所以:
服务时间服从指数分布,可使用简式:
平均有 80% 的时间花在排队上!
例题:换用更快磁盘
换新磁盘,服务时间降到 10 ms,重新计算。
解答。
平均响应时间为 10+6.7=16.7 ms。服务速度只提高两倍,响应却快了六倍。
多服务者模型
到目前为止,假设服务者只有一个,例如一块磁盘。实际系统常有多盘,可采用图 D.17 的多个服务者,这在排队论中称 M/M/m。
用 表示服务者数,对应公式如下。前两个很简单:
排队时间为:
它与 M/M/1 公式相似,但将单服务者利用率换为“新任务必须排队、不能立即服务”的概率,并将等待时间除以服务者数。
遗憾的是,多服务者时排队概率复杂得多。首先,系统没有任务的概率是:
随后,原书将“任务数至少等于服务者数”的概率印为:
**译注:**原页分子漏了括号和对 的相应乘方。与前式和下一页数值代入一致的关系应为:
当 时,概率退化为利用率,便回到 M/M/1 公式。来看例题。
例题:增加第二块慢磁盘
不换快盘,而增加另一块慢盘并复制数据,让任何一盘都能服务读取。假设全部请求都是读,使用 M/M/m 重新回答前面的问题。
**解答。**两盘平均利用率为:
先计算零任务概率(原文此处写“队列中无任务”,但公式 指整个系统无任务):
再计算必须排队的概率。原书第一行沿用分子 的排印错误,但下一行实际按 计算;以下显式按正确括号保持其数值推导:
最后,排队时间为:
平均响应时间为 20+3.8=23.8 ms。对这个工作负载,两盘将排队等待时间缩短到单慢盘的 1/21,比单快盘也缩短 1.75 倍。不过,单快盘系统的平均服务时间——原文如此称呼此处的响应时间——仍比双慢盘快 1.4 倍,因为单盘服务本身快两倍。
若能把 M/M/m 推广到多队列、多服务者,就更接近现实。可惜这些模型难以求解和使用,本节不再展开。
D.6 贯穿各层的问题
点到点链路和交换机取代总线
随着 Moore 定律不断降低组件成本,点到点链路与交换机越来越普及。处理器、磁盘、LAN 速度提高,I/O 带宽需求随之上升;总线成本优势又在缩小,因此桌面计算机和服务器中的总线已时日无多。这一趋势在本书上一版时始于高性能计算机,到 2011 年已遍及存储领域。图 D.18 列出旧的总线标准及替代方案。
新一代接口的位数与带宽按单方向计算,双向合计则翻倍。新设计使用的导线少得多,因此常通过提供多倍导线数与带宽的版本来扩展吞吐量。
| 标准 | 宽度(位) | 长度(m) | 时钟频率 | MB/s | 最大 I/O 设备数 |
|---|---|---|---|---|---|
| 并行 ATA | 8 | 0.5 | 133 MHz | 133 | 2 |
| Serial ATA | 2 | 2 | 3 GHz | 300 | ? |
| SCSI | 16 | 12 | 80 MHz | 320 | 15 |
| Serial Attach SCSI | 1 | 10 | (DDR) | 375 | 16,256 |
| PCI | 32/64 | 0.5 | 33/66 MHz | 533 | ? |
| PCI Express | 2 | 0.5 | 3 GHz | 250 | ? |
块服务器与 filer
到目前为止,我们基本没有讨论操作系统在存储中的作用。就像编译器决定如何使用指令集,操作系统决定硬件提供的哪些 I/O 技术真正得到利用。它通常在磁盘块之上提供文件抽象。逻辑单元、逻辑卷、物理卷,是 Microsoft 与 UNIX 系统中描述磁盘块子集合的相关术语。
逻辑单元是磁盘阵列向外提供的存储元素,通常由阵列的一部分磁盘构成;服务器将其看作一个虚拟“磁盘”。在 RAID 阵列中,逻辑单元被配置成某种 RAID 布局,例如 RAID 5。物理卷是文件系统访问逻辑单元时使用的设备文件。逻辑卷又提供一层虚拟化,让文件系统可以把物理卷拆成多个部分,或跨多个物理卷条带化。逻辑单元是阵列对操作系统呈现虚拟盘的抽象;物理卷、逻辑卷则是操作系统把这些虚拟盘划分成更小、独立文件系统的抽象。
介绍了块集合的术语之后,需要问:文件这一抽象应在哪里维持——服务器中,还是存储区域网络另一端?
传统答案是服务器。服务器按块访问存储并维护元数据。多数文件系统使用文件缓存,因此服务器还必须保持文件访问的一致性。磁盘既可能直接连接,即位于服务器内部并接到 I/O 总线,也可能经存储区域网络连接;两者都是服务器向存储子系统传送数据块。
另一种答案是磁盘子系统自身维护文件抽象,服务器用文件系统协议与之通信。例如 UNIX 的网络文件系统(Network File System,NFS),以及 Windows 的通用 Internet 文件系统(Common Internet File System,CIFS)。这类设备称为网络附加存储(NAS),因为这样提供文件服务的存储,再直接附着于服务器就没有意义。不过名称有些不准确:FC-AL 一类存储区域网络,也可用于连接块服务器。只提供文件服务和文件存储的 NAS 设备,通常称为 filer。Network Appliance 是最早生产 filer 的公司之一。
把存储放上网络的驱动力,是让多台计算机更容易共享信息,让操作员更容易维护共享系统。
异步 I/O 与操作系统
磁盘花在机械延迟上的时间,通常远多于传输数据。因此,提高 I/O 性能的自然途径是并行化,让多个磁盘同时为一个程序访问数据。
直观的做法是请求数据,随即尝试使用它。操作系统切换到其他进程,数据到达后再切回请求者。这称为同步 I/O:进程等待数据从磁盘读出。
另一种方式是请求发出后进程继续运行,直到试图读取请求的数据时才阻塞。这样的异步 I/O允许进程不断发请求,使多个 I/O 同时进行。其思想与乱序 CPU 中的缓存相同:通过多个未完成事件提高带宽。
D.7 I/O 系统的设计与评估——Internet Archive 集群
I/O 系统设计的艺术,在于满足成本、可信赖性与设备种类目标,同时避免性能和可信赖性瓶颈。避免瓶颈,意味着主存与 I/O 设备之间的组件必须平衡;因为整条链的性能与可信赖性,以及相应的性价比或成本—可信赖性,只能与最薄弱环节一样好。设计者还须规划扩展,让客户按应用调整 I/O。但设备数量与类型的扩展也有代价:更长总线和网络、更大电源、更大机箱。
设计时应比较不同连接方式和各类设备数量,分析性能、成本、容量与可用性。可按以下步骤进行,各步答案可能由市场要求决定,也可能由成本、性能和可用性目标决定。
- 列出要接入的设备类型,或系统支持的标准总线与网络。
- 列出各设备物理要求,包括大小、功耗、连接器、总线插槽、扩展机箱等。
- 列出各设备成本,包含其所需控制器的成本分摊。
- 列出各设备可靠性。
- 记录各设备对处理器资源的需求:发起 I/O、支持设备运行(如处理中断)、完成 I/O 的指令周期;等待 I/O 使用完内存、总线、缓存所造成的停顿;从 I/O 活动恢复所花的周期,例如刷新缓存。
- 列出各设备对内存和 I/O 总线的需求。即使处理器不用内存,主存与 I/O 连接带宽也有限。
- 评估不同组织方式的性能与可用性。负担得起时,尽量避免单点失效。性能须靠模拟才能适当评估,也可用排队论估算。若假定设备独立失效且寿命呈指数分布,可计算可靠性;再估计设备 MTTF,并考虑失效到修复的时间,得到可用性。
最后根据成本、性能、可用性目标选择最佳组织。
性价比目标会影响 I/O 方案与物理设计。性能用 MB/s 还是 I/O/s 衡量,取决于应用需求。追求高性能时,限制应只来自设备速度、数量,以及内存、处理器速度;追求低成本时,成本应主要花在 I/O 设备本身。可用性目标部分取决于中断给组织造成的损失。
与其只做纸上设计,不如评估一个真实系统。
Internet Archive 集群
我们估算 Internet Archive 一个大型、以存储为主的集群的成本、性能与可用性。该项目始于 1996 年,旨在保存不断变化的互联网历史。通过 Wayback Machine,可以“穿越时间”,查看某个 URL 的网站过去是什么样。原书所述时期,已有超过 1 PB( 字节)数据,每月新增 20 TB(1 TB= 字节),因此可扩展存储是必要条件。同一批硬件还每隔几个月爬取网络,获取互联网快照。
LAN 连接的计算机集群已成为经济实惠、适合某些应用的计算引擎。集群也在 Google 等 Internet 服务中扮演重要角色,这类场景与本例一样,更重存储而非计算。
Internet Archive 多年来采用过多种硬件,当时正在迁移到新集群,以提高电力与机房面积利用效率。基本单元是 Capricorn Technologies 的 1U 存储节点 PetaBox GB2000。2006 年配置为四个 500 GB 并行 ATA(PATA)磁盘、512 MB DDR266 DRAM、一个 10/100/1000 以太网接口,以及执行 80x86 指令集的 VIA 1 GHz C3 处理器。典型节点功耗约 80 W。
图 D.19 是标准 VME 机架中的集群。每架装 40 个 GB2000,总原始容量 80 TB;40 节点通过一个 48 端口 10/100 或 10/100/1000 交换机连接,整架功耗约 3 kW。计算设施通常限制每架 10 kW,因此远低于上限。
1 PB 需要约 12 个这样的机架,由更高层交换机连接各架交换机的千兆上行链路。
估计性能、可信赖性和成本
为说明评估方法,对组件成本、性能、可靠性作若干估计。成本与性能假设如下:
- VIA 处理器、512 MB DDR266、ATA 控制器、电源、风扇、机箱合计 $500。
- 四个 7200 RPM PATA 磁盘,每盘 500 GB,平均寻道 8.5 ms,介质传输 50 MB/s,价格 $375;PATA 链路速率 133 MB/s。
- 48 端口 10/100/1000 交换机及一架所需全部电缆,共 $3000。
- VIA 处理器性能为 1000 MIPS。
- ATA 控制器每个磁盘 I/O 增加 0.1 ms 开销。
- 操作系统每次磁盘 I/O 执行 50,000 条 CPU 指令。
- 网络协议栈在集群与外界间传输一个数据块,执行 100,000 条 CPU 指令。
- Wayback 历史查询平均 I/O 为 16 KB;采集新快照时为 50 KB。
例题:每单位 IOPS 的成本
评估 80 TB 机架每单位每秒 I/O 次数(IOPS)的成本。假定每次 I/O 都有平均寻道和平均旋转延迟;负载均匀分散到所有盘;所有设备可用到 100% 容量,即仅受最弱环节限制,而且该环节可达 100% 利用率。对两种平均 I/O 大小分别计算。
**解答。**I/O 性能由最弱环节限制,因此逐项计算链上最大性能。
先看一个 GB2000 的 CPU、主存与总线。CPU 上限取决于速度,以及磁盘 I/O 和网络发送的指令数:
主存上限由内存带宽与传输大小决定:
PATA 链路受带宽与 I/O 大小限制:
机器有两条总线,原文给出合计上限:16 KB 时 18,600 IOPS,50 KB 时 5400 IOPS。
**译注:**原页确为 18,600,但按前面约 8300 的两倍应为约 16,600;精确用十进制单位算为 16,625。保留原值并指出算术不一致,不影响后文“磁盘为瓶颈”的结论。
再看 ATA 控制器。经 PATA 传输一个块所需时间为:
加 0.1 ms 控制器开销,每次 I/O 约为 0.2–0.5 ms,因此每控制器最大速率:
下一环是磁盘。平均 I/O 时间为寻道、半周旋转与数据传输之和:
因此,在采用平均寻道的前提下,每盘最大速率分别为:
四盘合计 292–308 IOPS。最后是连接外界的网络,按千兆链路计算:
显然,GB2000 的瓶颈在磁盘。整架 16 KB 时 IOPS,50 KB 时 IOPS。交换机若不能分别支持 Gbit/s,以及 Gbit/s,就会成为瓶颈。假定 48 端口交换机多出的八个千兆端口连接外界,就能承载架内 160 盘的全部 IOPS。
按这些假设,整架成本为:
原文指出磁盘本身占成本近 60%;每 TB 约 $1000,比 2001 年上一版中的存储集群好约 10–15 倍;每单位 IOPS 成本约 $7。
**译注:**按给出的价格,磁盘总价为 $60,000,占 $84,500 的约 71%,与“近 60%”不一致;额外 $1500 在此前成本假设中未单独解释。
计算 TB-80 集群的 MTTF
Google 等 Internet 服务依赖应用层多个数据副本保证可信赖性,常把副本放在不同地理位置,同时防范环境与硬件故障。Internet Archive 在每个站点有两份数据,站点位于旧金山、阿姆斯特丹、埃及亚历山大。每站的音乐、书籍、电影、视频等高价值内容保留双份,历史网页爬取数据保留单份。为降低成本,80 TB 机架内不设置冗余。
例题:机架失效前平均时间
不用厂商标称的 600,000 小时 MTTF,而采用近期磁盘调查[Gray 和 van Ingen 2005]。如第 1 章所述,ATA 每年约有 3%–7% 失效,MTTF 约 125,000–300,000 小时。仍假定寿命呈指数分布,并作如下假设:
| 组件 | MTTF(小时) |
|---|---|
| CPU/内存/机箱 | 1,000,000 |
| PATA 磁盘 | 125,000 |
| PATA 控制器 | 500,000 |
| 以太网交换机 | 500,000 |
| 电源 | 200,000 |
| 风扇 | 200,000 |
| PATA 电缆 | 1,000,000 |
**解答。**各组件失效率相加:
系统 MTTF 是失效率的倒数:
在这些组件 MTTF 假设下,平均约每三周,机架内就有某个部件失效;约 70% 是磁盘,约 20% 是风扇或电源。
D.8 融会贯通:NetApp FAS6000 Filer
Network Appliance 于 1992 年进入存储市场,目标是提供易于操作的文件服务器,运行原文所称的 NSF,采用自家的日志结构文件系统与 RAID 4 阵列。后来增加 Windows CIFS 支持,并采用行—对角线校验,即 RAID-DP/RAID 6(见 D.2 节)。为支持希望避开文件系统开销、直接访问原始块的数据库等应用,NetApp filer 也能通过标准 Fibre Channel 接口提供数据块。它还支持 iSCSI,让 SCSI 命令经过 TCP/IP 传输,因而可用以太网等标准网络设备连接服务器与存储,并跨越更远距离。
**译注:**原文两处写作 NSF,按上下文应指 NFS;下文谈以太网文件服务又写作 NTFS,而通常相应网络协议为 NFS。为避免混同协议与文件系统,保留原标识并标明疑点。
当时最新产品为 FAS6000,采用 AMD Opteron 多处理器,通过 HyperTransport 连接,运行 NetApp 软件栈,包括原文所列 NSF、CIFS、RAID-DP、SCSI 等。它有双处理器 FAS6030 与四处理器 FAS6070 两种。如第 5 章所述,Opteron 的 DRAM 分布于各处理器;每个连接 8 GB DDR2700,所以两款分别为 16 GB、32 GB。如原文所引第 4 章所述,DRAM 总线宽 128 位,另外有 SEC/DED 位。两种型号都将四条 HyperTransport 链路用于 I/O。
作为 filer,它需要大量 I/O 连接磁盘和服务器。集成 I/O 包括:
- 8 个 Fibre Channel(FC)控制器与端口;
- 6 条千兆以太网链路;
- 6 个 x8(2 GB/s)PCI Express 插槽;
- 3 个 133 MHz、64 位 PCI-X 插槽;
- IDE、USB、32 位 PCI 等标准 I/O。
每个 FC 控制器可接六个磁盘架,每架十四个 3.5 英寸 FC 磁盘,所以集成 I/O 最多连接 盘。扩展槽可加 FC 控制器,扩至 1008 盘,或者减少每个 FC 网络的盘数以降低争用。每盘 500 GB,假定 RAID RDP 组含十四个数据盘、两个校验盘,则 672 盘的可用数据容量为 294 TB,1008 盘为 441 TB。
也可经 Fibre Channel—SATA 桥接控制器连接 SATA 盘;顾名思义,该控制器允许 FC 与 SATA 通信。
六条千兆以太网连接服务器。运行原文所称的 NTFS 或 CIFS 时,FAS6000 表现为文件服务器;运行 iSCSI 时,则表现为块服务器。
为提高可信赖性,可将两个 filer 配对,其中一个失效时由另一个接管。集群故障转移要求双方经 FC 互连都能访问两台 filer 的全部磁盘。这条互连还允许双方在对方 NVRAM 中保存日志副本,并保持时钟同步。系统持续监控健康,自动故障转移。正常 filer 保持自身网络身份和主要功能,同时接管失效 filer 的网络身份,通过虚拟 filer 处理它的所有数据请求,直到管理员恢复原有服务状态。
D.9 谬误与陷阱
谬误:组件会迅速失效并停止工作
不少容错文献采用简化假设:组件一直完美运行,直到潜在错误激活,随后发生失效并停止工作。
Tertiary Disk 的经历恰好相反。许多组件在彻底失效很久之前就开始表现异常,通常须由操作员判断是否宣布它已失效。组件一般会继续违反服务约定,直到被操作员“终止”。
图 D.20 展示四个最终被停用的磁盘,在更换前多久开始异常。
| 失效磁盘的系统日志消息 | 日志条数 | 持续时间(小时) |
|---|---|---|
硬件失效:现场可更换单元的外围设备写故障。原文 Hardware Failure (Peripheral device write fault [for] Field Replaceable Unit) | 1763 | 186 |
未就绪:诊断失败,ASCQ 为现场可更换单元的组件 ID。原文 Not Ready (Diagnostic failure: ASCQ = Component ID [of] Field Replaceable Unit) | 1460 | 90 |
已恢复错误:现场可更换单元超过失效预测阈值。原文 Recovered Error (Failure Prediction Threshold Exceeded [for] Field Replaceable Unit) | 1313 | 5 |
已恢复错误:现场可更换单元超过失效预测阈值。原文 Recovered Error (Failure Prediction Threshold Exceeded [for] Field Replaceable Unit) | 431 | 17 |
谬误:计算机系统确如广告所言,达到 99.999% 的“五个九”可用性
服务器公司的市场部门开始夸耀硬件可用性,宣称图 D.21 中 99.999% 的等级,即“五个九”;甚至操作系统公司的市场部门也试图让人有这种印象。
| 每年不可用时间(分钟) | 可用性 | 可用性等级(九的个数) |
|---|---|---|
| 50,000 | 90% | 1 |
| 5000 | 99% | 2 |
| 500 | 99.9% | 3 |
| 50 | 99.99% | 4 |
| 5 | 99.999% | 5 |
| 0.5 | 99.9999% | 6 |
| 0.05 | 99.99999% | 7 |
每年只中断五分钟当然令人印象深刻,但考虑调查中的实际失效数据,很难相信。例如 HP 声称,HP-9000 硬件与 HP-UX 能在“某些预先定义、预先测试的客户环境中”保证 99.999% 可用性[Hewlett-Packard 1998]。保证不包括操作员、应用和环境故障,而这些很可能已是主要故障类别;也不包括计划停机。系统未达承诺时,厂商承担什么经济处罚,同样不清楚。
Microsoft 也开展“五个九”营销。2001 年 1 月,www.microsoft.com 停机 22 小时;要把该网站可用性提高到 99.999%,此后 250 年都必须没有停机。
与宣传暗示不同,管理良好的服务器通常达到 99%–99.9% 可用性。
陷阱:功能实现在哪一层,会影响可靠性
理论上,把 RAID 放进软件没有问题;实践中,让它可靠运行却很难。
软件文化通常依赖连续版本与补丁,最终逐步达到正确;软件也难与其他层隔离。例如,正常运行往往依赖恰当的操作系统版本和补丁。因此,许多客户因软件 RAID 的缺陷或环境不兼容而丢失数据。
硬件当然也会有缺陷,但硬件文化通常更重视初始发布前的正确性测试;硬件也更可能独立于操作系统版本。
谬误:操作系统最适合调度磁盘访问
ATA、SCSI 等高层接口向主机操作系统提供逻辑块地址。基于这种抽象,OS 最多只能尝试按逻辑地址递增排序。只有磁盘知道逻辑地址如何映射到扇区、磁道与盘面的物理几何,因而能降低旋转和寻道延迟。
例如有以下四次读取[Anderson 2003]:
| 操作 | 起始 LBA | 长度 |
|---|---|---|
| 读 | 724 | 8 |
| 读 | 100 | 16 |
| 读 | 9987 | 1 |
| 读 | 26 | 128 |
主机可能按逻辑块顺序重排:
| 操作 | 起始 LBA | 长度 |
|---|---|---|
| 读 | 26 | 128 |
| 读 | 100 | 16 |
| 读 | 724 | 8 |
| 读 | 9987 | 1 |
取决于数据实际位置,重排反而会恶化性能,如图 D.22。磁盘自行调度只需转 3/4 周,OS 调度却要三周。
谬误:系统中磁盘的平均寻道时间,等于跨越三分之一柱面数的寻道时间
这一误解把厂商销售磁盘时的指标与预期实际性能混为一谈,还错误地假定寻道时间与距离成正比。“三分之一距离”的经验规则,是在磁道很多、排除当前磁道的条件下,从一个随机位置到另一个随机位置的平均距离。过去厂商公布这一距离的寻道时间,便于一致比较;现在则计时全部寻道,再除以次数,计算“平均值”。若错误地认为寻道时间线性依赖距离,可用厂商公布的最短与“平均”时间作如下常见估计:
这个谬误有两层。首先,寻道时间并不与距离线性相关。磁臂必须克服惯性加速,达到最大移动速度,在接近目标时减速,再等待振动停止,即稳定时间。有时还须暂停以控制振动。对于超过 200 个柱面的磁盘,Chen 和 Lee[1995]采用模型:
针对每种盘选择 ,使公式吻合距离为 1、最大距离、最大距离三分之一时的标称时间。图 D.23 比较该式与错误的线性公式;平方根项体现了加减速。
第二,规格中的平均值只有在磁盘活动没有局部性时才适用。幸运的是,磁盘访问既有时间局部性,也有空间局部性(见附录 B 第 B-2 页)。图 D.24 是 UNIX 分时与业务处理两种负载的寻道距离样本。注意两者都有很高比例访问同一柱面,即图中距离 0。可见这个谬误极具误导性。
图内参数公式转写如下,其中 表示柱面数:
D.10 结束语
存储是我们往往视为理所当然的技术之一。然而,若真正审视今天的局面,存储才是王者。甚至可以说,已经商品化的服务器,如今正在成为存储设备的外围设备。IBM 的一些预测进一步说明了这一点:它预计未来两年,存储销售额将超过服务器销售额。
——Michael Vizard,Infoworld 主编(2001 年 8 月 11 日)
随着价值日益显现,存储系统已成为创新与投资的重点。
存储系统当时的挑战是可信赖性与可维护性。用户不但要求数据永不丢失,即可靠性;应用也越来越要求随时能够访问数据,即可用性。尽管软硬件可靠性与容错有所改善,维护困难仍同时影响成本与可用性。一个广被引用的数字是:每花 $1 购买存储,客户就要花 $6–$8 运行它。如果通过搜索服务那样的系统高层多副本来保障可信赖性,超大系统就可能对存储组件的性价比十分敏感。
因此,存储可信赖性与可维护性的挑战,已成为 I/O 的主导问题。
D.11 历史回顾与参考文献
M.9 节(在线提供)介绍存储设备与技术的发展,包括磁盘的发明者、RAID 背后的故事,以及操作系统和数据库的历史,并列有进一步阅读的参考文献。
附录 D 案例研究与习题
作者:Andrea C. Arpaci-Dusseau 与 Remzi H. Arpaci-Dusseau。
案例研究 1:剖析单个磁盘
本案例涉及:性能特征、微基准测试。
存储系统内部通常隐藏在一个简单接口之后:线性块数组。所有存储系统采用公共接口有许多好处:操作系统无需修改便能使用任何存储系统,后者则可以在接口背后自由创新。例如,单盘可按最佳性能的方式,将内部〈扇区、磁道、盘面〉几何映射到线性数组;多盘 RAID 也可把任意数量磁盘的块映射成同样的数组。但固定接口也有缺点,尤其是操作系统不知道底层精确块布局时,无法进行某些性能、可靠性、安全性优化。
本案例探索如何用软件揭示块接口背后的结构。基本思想是给系统做“指纹识别”:运行定义明确的负载,测量不同请求耗时,就能推断出数量惊人的底层细节。
Berkeley 的 Nisha Talagala 等提出 Skippy,用于识别单盘参数。关键是连续寻址到地址差线性增加的扇区,即差值依次增加 1、2、3……,以分离旋转影响。算法在盘上跳跃,每次写入前把跳跃距离增加一个扇区,输出每次写入的距离与时间。使用原始设备接口,避开文件系统优化。SECTOR_SIZE 等于磁盘一次能读取的最小数据量,例如 512 字节。详见 Talagala 和 Patterson[1999]。
把写入耗时画成寻道距离的函数,可推断最小传输时间(无寻道、无旋转延迟)、磁头切换时间、柱面切换时间、旋转延迟和磁头数。典型图形有四条斜率相同、截距不同的线。最高与最低两条对应不同旋转延迟,但没有柱面或磁头切换开销;两者之差揭示旋转延迟。次低线对应磁头切换加上逐渐增加的旋转延迟;第三条线对应柱面切换加旋转延迟。
习题 D.1
[10/10/10/10/10]〈D.2〉图 D.25 是在模拟磁盘 Disk Alpha 上运行 Skippy 的结果。
a. [10]〈D.2〉最小传输时间是多少?
b. [10]〈D.2〉旋转延迟是多少?
c. [10]〈D.2〉磁头切换时间是多少?
d. [10]〈D.2〉柱面切换时间是多少?
e. [10]〈D.2〉磁头数量是多少?
习题 D.2
[25]〈D.2〉近似画出在 Disk Beta 上运行 Skippy 的图形。该盘参数:最小传输时间 2.0 ms,旋转延迟 6.0 ms,磁头切换 1.0 ms,柱面切换 1.5 ms,四个磁头,每磁道 100 个扇区。
习题 D.3
[10/10/10/10/10/10/10]〈D.2〉在自行选择的磁盘上实现并运行 Skippy。
a. [10]〈D.2〉画出结果,并报告厂商与型号。
b. [10]〈D.2〉最小传输时间是多少?
c. [10]〈D.2〉旋转延迟是多少?
d. [10]〈D.2〉磁头切换时间是多少?
e. [10]〈D.2〉柱面切换时间是多少?
f. [10]〈D.2〉磁头数量是多少?
g. [10]〈D.2〉真实磁盘的结果与模拟磁盘相比,是否存在定性差异?
案例研究 2:剖析磁盘阵列
本案例涉及:性能特征、微基准测试。
Wisconsin 大学 Timothy Denehy 等的 Shear 算法[Denehy 等 2004]用于识别 RAID 参数。基本思路是生成请求负载并计时,观察哪些请求组合更慢,从而推断哪些块位于同一磁盘。
这里定义几个 RAID 属性。数据以 block(块) 为单位分配;块是文件系统向存储系统读写的最小单位,因此文件系统和识别软件知道其大小。chunk 是单盘内连续分配的一组块。stripe(条带) 是跨越 个数据盘、每盘一个 chunk 的集合。pattern(重复模式) 是最短的数据块序列,使模式中偏移 始终位于同一个磁盘 。
习题 D.4
[20/20]〈D.2〉下面代码识别 pattern 大小,使用原始设备以避开文件系统优化。所有 Shear 算法的关键是随机请求,避免触发 RAID 或单盘预取、缓存。基本做法是在 RAID 内以固定间隔 访问 个随机块,测量每一间隔对应的完成时间。下面保留原代码结构,非 C 语句按伪代码翻译。
把 个请求的测量时间画成 的函数,会看到所有请求落在同一盘时最慢;因此,最高耗时对应的 就是 RAID 的 pattern 大小。
a. [20]〈D.2〉图 D.26 是未知 RAID 的测量结果。其 pattern 多大?0.4、0.8、1.6 秒各对应什么?如果是 RAID 0,有多少盘?chunk 多大?
b. [20]〈D.2〉画出以下系统运行该段 Shear 代码的结果:,磁盘随机读 5 ms,RAID 0,四盘,chunk 为 8 KB。
习题 D.5
[20/20]〈D.2〉下面代码识别 chunk 大小。随机选择 个 pattern,但始终从受控偏移 、 读取。
将时间画成 的函数,requestA、requestB 落在不同盘时耗时最低;因此,低耗时对应的 是 RAID 不同盘的 chunk 边界。
a. [20]〈D.2〉图 D.27 是未知 RAID 的结果。chunk 多大?0.75、1.5 秒在该系统中分别对应什么?
b. [20]〈D.2〉画出以下系统的结果:,随机读 5 ms,RAID 0,八盘,chunk 为 12 KB。
习题 D.6
[10/10/10/10]〈D.2〉最后,用下面代码确定 chunk 如何分布到磁盘。随机选择 个 pattern,穷举模式内 chunk 的所有两两组合,并一起读取。
运行后,把测量时间表示为 的函数。最简单的画法,是以二者为坐标建立二维表,用灰度表示时间:深色较快、浅色较慢。因此,浅色意味着两个偏移落在同一盘。
图 D.28 对应一个已知 pattern 为 384 KB、chunk 为 32 KB 的系统。
a. [20]〈D.2〉一个 pattern 有多少 chunk?
b. [20]〈D.2〉哪些 chunk 看起来位于同一盘?
c. [20]〈D.2〉系统看起来有多少盘?
d. [20]〈D.2〉画出块跨盘分配的可能布局。
**译注:**本题总标题的难度为四个 10,四个小问却各标 20。
习题 D.7
[20]〈D.2〉画出图 D.29 系统运行布局算法后的图形。系统有四盘,每个 chunk 为四个 4 KB 块,即 16 KB,采用 RAID 5 Left-Asymmetric(左非对称)布局。
案例研究 3:RAID 重建
本案例涉及:RAID 系统、RAID 重建、平均失效前时间 MTTF、平均数据丢失前时间 MTDL、performability、双重失效。
RAID 保证单盘失效不丢数据,关键职责之一就是恢复失效盘的数据,这称为重建。本案例分别考虑可容忍单盘失效的 RAID,以及可容忍双盘失效的 RAID-DP。
重建通常有两种方式。离线重建把全部资源用于恢复,不服务应用请求;在线重建边恢复边处理请求,通常将恢复带宽限制在总带宽的一部分。
重建方式影响可靠性和 performability。RAID 5 若在第一盘恢复前又坏第二盘,就丢数据,所以重建时间 MTTR 越长,可靠性或 MTDL 越低。Performability 试图结合性能和可用性,定义为某状态下的性能乘以该状态概率。阵列状态可以是无故障正常运行、单盘失效重建、多盘失效停机。
本组习题假定 RAID 有六盘和足够热备盘;每盘采用原书称为图 D.3 中的 37 GB SCSI 磁盘,峰值顺序读 142 MB/s、写 85 MB/s。连接到总传输能力 320 MB/s 的 Ultra320 SCSI 总线。磁盘独立失效,忽略其他故障;XOR 与内存复制开销忽略。在线重建最多使用 RAID 总计 10 MB/s 带宽。
**译注:**本版图 D.3 列的是 600 GB SAS,并无这里所称的 37 GB SCSI。题内给出的容量、读写速率和总线参数原样保留;若需要未给出的旧磁盘参数,例如 MTTF,不能把该交叉引用当作已补齐条件。
习题 D.8
[10]〈D.2〉六盘 RAID 4,画出块跨盘分布的简单示意图。
习题 D.9
[10]〈D.2,D.4〉单盘失效时 RAID 4 开始重建。预计经过多久需要重建一次?
习题 D.10
[10/10/10]〈D.2,D.4〉假定重建在时刻 开始。
a. [10]〈D.2,D.4〉重建需要哪些读写操作?
b. [10]〈D.2,D.4〉离线重建何时完成?
c. [10]〈D.2,D.4〉在线重建何时完成?
习题 D.11
[10/10/10/10]〈D.2,D.4〉研究 MTDL。RAID 4 只有在第一失效盘修复前发生第二盘失效,才丢数据。
a. [10]〈D.2,D.4〉离线重建期间再次失效的概率是多少?
b. [10]〈D.2,D.4〉根据这一概率,离线重建的 MTDL 是多少?
c. [10]〈D.2,D.4〉在线重建期间再次失效的概率是多少?
d. [10]〈D.2,D.4〉根据这一概率,在线重建的 MTDL 是多少?
习题 D.12
[10]〈D.2,D.4〉RAID 4 离线重建的 performability 是多少?以 IOPS 衡量,假设负载为均匀分布到阵列磁盘的随机只读请求。
习题 D.13
[10]〈D.2,D.4〉在线重建的 performability 是多少?假定在线修复期间 IOPS 降至峰值的 70%。在线和离线哪种更好?
习题 D.14
[10]〈D.2,D.4〉RAID 6 容忍最多两个同时失效。假定六盘 RAID-DP 基于 RAID 4,,如图 D.5。若数据盘 0、3 失效,如何重建?列出计算前四条带缺失块的步骤。
案例研究 4:预测 RAID 性能
本案例涉及:RAID 级别、排队论、工作负载影响、磁盘布局影响。
本案例用简单排队论预测 I/O 性能,考察配置与负载如何影响服务时间、利用率、平均响应时间。
配置对性能影响很大。不同 RAID 级别可用不同队列模型表示。例如, 盘 RAID 0,若请求适当分散,可建模为 个独立 M/M/1。RAID 1 则依赖负载:读可发给任一镜像,写须送达两盘,因此双盘只读用 M/M/2,只写用 M/M/1。 盘 RAID 4 也依赖负载:读到特定数据盘,写都须更新校验盘,后者成为瓶颈。所以只读时可建模为 个独立系统,只写时为一个 M/M/1。
块布局也很重要。40 GB 单盘若随机访问整个 40 GB,布局影响不大;若只访问一半,即 20 GB,就可把数据紧凑放在连续的 20 GB 磁道,而非均匀铺满 40 GB,以缩短寻道。
本题故意采用简化模型:小随机请求的平均定位与传输时间,是寻道距离的线性函数。40 GB 磁盘服务时间为 5 ms×空间利用率。全盘使用时是 5 ms,只用前 20 GB 则为 2.5 ms。
整个案例中,处理器每秒发出 167 个小随机请求,满足指数分布假设;请求等于块大小,为 8 KB;每盘 40 GB。无论配置如何,工作负载共访问 40 GB 数据,应尽可能高效地在各盘分配。
习题 D.15
[10/10/10/10/10]〈D.5〉先假定只有一个 40 GB 磁盘。
a. [10]〈D.5〉平均服务时间是多少?
b. [10]〈D.5〉平均利用率是多少?
c. [10]〈D.5〉每请求平均等待磁盘多久?
d. [10]〈D.5〉平均排队请求数是多少?
e. [10]〈D.5〉平均响应时间是多少?
习题 D.16
[10/10/10/10/10/10]〈D.2,D.5〉改用两块 40 GB 盘组成 RAID 0,按 8 KB 块均匀条带化,无冗余。
a. [10]〈D.2,D.5〉40 GB 如何跨盘分配?总计随机访问 40 GB 时,每请求的预期服务时间是多少?
b. [10]〈D.2,D.5〉如何用排队论建模?
c. [10]〈D.2,D.5〉每盘平均利用率是多少?
d. [10]〈D.2,D.5〉每请求平均等待多久?
e. [10]〈D.2,D.5〉每队列平均请求数是多少?
f. [10]〈D.2,D.5〉平均响应时间是多少?
习题 D.17
[20/20/20/20/20]〈D.2,D.5〉改为两块 40 GB 盘组成 RAID 1,将数据镜像;用排队论建模只读负载。
a. [20]〈D.2,D.5〉40 GB 如何分配?总计随机访问 40 GB 时,每请求的预期服务时间是多少?
b. [20]〈D.2,D.5〉如何建模?
c. [20]〈D.2,D.5〉每盘平均利用率是多少?
d. [20]〈D.2,D.5〉每请求平均等待多久?
e. [20]〈D.2,D.5〉平均响应时间是多少?
习题 D.18
[10/10]〈D.2,D.5〉将 RAID 1 的只读负载换成只写。
a. [10]〈D.2,D.5〉说明如何用排队论建模系统与负载。
b. [10]〈D.2,D.5〉平均利用率、等待时间、响应时间分别是多少?
案例研究 5:I/O 子系统设计
本案例涉及:RAID 系统、平均失效前时间 MTTF、性能与可靠性权衡。
在给定预算下设计 I/O 子系统,满足最低容量,优化性能、可靠性或两者。只要预算允许,磁盘和控制器数量不限。可用部件如下:
- 10,000 MIPS CPU,$1000,MTTF 为 1,000,000 小时。
- 1000 MB/s I/O 总线,可容纳 20 条 Ultra320 SCSI 总线及其控制器。
- Ultra320 SCSI 总线,每条 320 MB/s,最多 15 盘,也称 SCSI string;电缆 MTTF 为 1,000,000 小时。
- Ultra320 SCSI 控制器,50,000 IOPS,$250,MTTF 为 500,000 小时。
- 机箱 $2000,可为最多八盘供电、散热;机箱 MTTF 为 1,000,000 小时,风扇和电源各为 200,000 小时。
- 图 D.3 所述 SCSI 磁盘。
- 替换任何失效组件都需要 24 小时。
负载假设:操作系统每磁盘 I/O 执行 70,000 条 CPU 指令;有许多并发随机 I/O,平均大小 16 KB。所有方案都必须满足:预算 $28,000,容量至少 1 TB。
习题 D.19
[10]〈D.2〉先只优化容量与性能,不考虑可靠性,特别关注 IOPS。讨论什么 RAID 级别和块大小能获得最佳性能。
习题 D.20
[20/20/20/20]〈D.2,D.4,D.7〉在预算与容量约束下,怎样配置 SCSI 磁盘、控制器、机箱才能性能最佳?
a. [20]〈D.2,D.4,D.7〉预计能提供多少 IOPS?
b. [20]〈D.2,D.4,D.7〉系统成本是多少?
c. [20]〈D.2,D.4,D.7〉容量是多少?
d. [20]〈D.2,D.4,D.7〉MTTF 是多少?
习题 D.21
[10]〈D.2,D.4,D.7〉重设计为 RAID 10 或 RAID 01,以优化可靠性。不仅要容忍盘坏,还要容忍控制器、电缆、电源、风扇失效;具体而言,任一单组件失效,不能同时阻断一对副本的访问。画出 RAID 10、RAID 01 的跨盘块布局。此环境中哪种更合适?
习题 D.22
[20/20/20/20/20]〈D.2,D.4,D.7〉在容量和预算限制内,只优化 RAID 10 或 RAID 01 的可靠性。给出配置。
a. [20]〈D.2,D.4,D.7〉组件整体 MTTF 是多少?
b. [20]〈D.2,D.4,D.7〉系统 MTDL 是多少?
c. [20]〈D.2,D.4,D.7〉可用容量是多少?
d. [20]〈D.2,D.4,D.7〉系统成本是多少?
e. [20]〈D.2,D.4,D.7〉只写负载预计有多少 IOPS?
习题 D.23
[10]〈D.2,D.4,D.7〉若有同价但容量翻倍的磁盘,仍然只优化可靠性,会怎样改变配置?为什么?
案例研究 6:悄然损坏的位
本案例涉及:磁盘局部失效、失效分析、性能分析、奇偶校验保护、校验和。
你的任务是避免 bit rot,即文件中的位或块随时间损坏。归档场景尤其重要:数据写一次,可能多年后才访问;如果不额外保护,文件的位或块可能因介质错误、其他 I/O 故障而逐渐改变或不可访问。
应对 bit rot 需要两部分:检测与恢复。高效检测可为文件每块保存校验和。校验和函数输入一个可能很长的数据串,输出固定长度的校验串。利用的性质是:数据变了,计算出的校验和也极可能改变。
检测之后,恢复需要冗余。例如镜像保存多个块副本;奇偶校验保存额外信息,通常比镜像节省空间。本案例分析这些技术在不同场景中的有效性,并编写代码保护一组文件的数据完整性。
习题 D.24
[20/20/20]〈D.2〉D.24–D.27 使用简单奇偶校验:为文件系统每个文件计算一个校验块,并为文件的每个 4 KB 块使用原文所称的 20 字节 MD5 校验和。
**译注:**原页确为“20-byte MD5”,而 MD5 输出为 128 位,即 16 字节;后面的 D.27 也明确写 128 位。
先考察空间开销。Douceur 和 Bolosky[1999]发现,PC 文件大小分布如下:
| 文件大小 | ≤1 KB | 2 KB | 4 KB | 8 KB | 16 KB | 32 KB | 64 KB | 128 KB | 256 KB | 512 KB | ≥1 MB |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 比例 | 26.6% | 11.0% | 11.2% | 10.9% | 9.5% | 8.5% | 7.1% | 5.1% | 3.7% | 2.4% | 4.0% |
研究还发现文件系统通常约半满。假定有一个 37 GB 卷,约半满且符合该分布,回答:
a. [20]〈D.2〉用校验和检测单个错误,需要在盘上额外保存多少信息?分别给出字节数、占卷容量比例。
b. [20]〈D.2〉若既检测又纠正单个错误,额外信息是多少?同样给出字节数和容量比例。
c. [20]〈D.2〉根据这个分布,用来计算校验和的块过大、过小,还是恰好合适?
习题 D.25
[10/10]〈D.2,D.3〉数据保护的一大问题是错误检测。可采用惰性检测:等文件被访问才检查数据。问题是,不常访问的文件会慢慢损坏,等终于访问时,错误多到无法纠正。主动方法是 disk scrubbing:周期性扫描全部数据,主动发现错误。
a. [10]〈D.2,D.3〉假定位翻转独立,每 GB 数据每月发生一次。使用原文所称的“同一个半满的 20 GB 卷”,以及图 D.3 的 SCSI 盘,寻道 4 ms、传输约 100 MB/s,应多久扫描一次文件、检查并修复完整性?
b. [10]〈D.2,D.3〉位翻转速率达到多少时,不可能继续维持完整性?仍用 20 GB 卷和该 SCSI 盘。
**译注:**本题从前题 37 GB 改称“同一个 20 GB 卷”,且所引旧 SCSI 规格不完全对应本版图 D.3;各题明确给定的值分别保留。
习题 D.26
[10/10/10/10]〈D.2,D.4〉额外保护也有性能成本,下面研究这一方案的开销。
a. [10]〈D.2,D.4〉顺序写入一个 40 MB 文件,然后一次性写入实现保护方案所需的额外信息。方案产生多少写流量?给出总字节数及占总流量的比例。
b. [10]〈D.2,D.4〉改为像更新数据库表一样随机更新文件:连续执行 4 KB 随机写,每次都更新盘上保护信息。共写 10,000 次,方案产生多少 I/O 流量?给出总字节数及占总流量比例。
c. [10]〈D.2,D.4〉假定保护信息始终放在磁盘另一独立区域,远离被保护文件;每个文件 A 的所有校验和存在另一文件 Achecksums。每次读取都要检查校验和,因此会有开销。顺序读取 10,000 个 4 KB 块,平均寻道 4 ms,传输 100 MB/s(如图 D.3 的 SCSI 盘);读取文件及其校验和需要多久?增加校验和带来的时间代价是多少?
d. [10]〈D.2,D.4〉仍按 c 问分开放置保护信息,但改为从远大于 10,000 块的文件随机读取 10,000 个 4 KB 块,每次仍检查校验和。同样磁盘条件下,读取要多久?额外时间代价是多少?
习题 D.27
[40]〈D.2,D.3,D.4〉将理论付诸实践,开发用户级文件防损坏工具。编写一组简单工具,检测并修复数据完整性。第一个用于建立校验和与奇偶校验,命名为 build:
build 将文件 filename 所需校验和与冗余信息,存到同目录的 .filename.cp,以便查找。
第二个用于检查并尽可能修复损坏文件,命名为 repair:
它读取相应 .cp,验证保存的校验和是否与重新计算的一致。只有一个块不匹配时,用冗余重建正确数据并修复文件;若至少两个块损坏,只报告文件已无法修复。为测试系统,原书提供名为 corrupt 的破坏工具:
它只是用随机噪声填满指定块。校验和采用 MD5,对输入串输出 128 位“指纹”。原书给出一个简单实现地址:
奇偶校验通过 XOR 计算。C 中两个 BLOCKSIZE 块的计算如下:
案例研究 7:把数据排好序
本案例涉及:基准测试、性能分析、性价比分析、开销摊销、平衡系统。
数据库领域长期用基准比较系统。本题研究 Anon. 等[1985]引入的一项基准(见第 1 章):外排序,即磁盘到磁盘的排序。
它很有意思。首先,排序同时考验磁盘、内存、处理器。其次,要达到最高性能,需要深入了解 CPU 缓存、操作系统、I/O 子系统。最后,它又足够简单,学生也能实现,见后文。
视数据量而定,排序可以一趟或多趟完成。若内存能容纳全部数据,读入、排序、写回即可,称为“一趟排序”。内存不足则需多趟。有多种方法;简单做法是逐块排序输入并写回,留下“输入文件大小/内存大小”个有序临时文件,再归并为最终输出,即“两趟排序”。若第二趟还不能同时归并全部流,这种不常见情形还需更多趟。
本案例分析排序在不同场景的有效性和性价比,并自行实现外排序,在真实硬件上测量。
习题 D.28
[20/20/20]〈D.4〉先不限制花费,配置完成排序耗时最短的系统。要取得峰值带宽,所有数据路径都必须够快。
为简化,假定内存中键排序的时间与 CPU 速率及内存带宽线性相关:例如 1 MIPS、内存带宽 1 MB/s 的机器,排序 1 MB 记录需一秒。另假定 I/O 阶段经过仔细编写,能达到顺序带宽。内存装不下全部数据时,当然需要两趟。
I/O 可能有额外内存复制。例如 read() 先将磁盘数据读入系统缓冲,再复制到用户缓冲,因此 I/O 时内存带宽也会成为问题。
再假定读、排序、写完全不重叠:读盘时只读盘;排序时只用 CPU 与内存;写盘时只写盘。
任务是配置系统,以峰值性能排序 1 GB,即约一千万条 100 字节记录。按下表选择 CPU、内存、I/O 互连、磁盘。
| 部件 | 等级 | 性能/带宽 | 价格 |
|---|---|---|---|
| CPU | 慢 | 1 GIPS | $200 |
| CPU | 标准 | 2 GIPS | $1000 |
| CPU | 快 | 4 GIPS | $2000 |
| I/O 互连 | 慢 | 80 MB/s | $50 |
| I/O 互连 | 标准 | 160 MB/s | $100 |
| I/O 互连 | 快 | 320 MB/s | $400 |
| 内存 | 慢 | 512 MB/s | $100/GB |
| 内存 | 标准 | 1 GB/s | $200/GB |
| 内存 | 快 | 2 GB/s | $500/GB |
| 磁盘 | 慢 | 30 MB/s | $70 |
| 磁盘 | 标准 | 60 MB/s | $120 |
| 磁盘 | 快 | 110 MB/s | $300 |
注意:购买单处理器系统,最多两条 I/O 互连;内存容量与磁盘数自行决定,每互连的盘数视为无限。
a. [20]〈D.4〉总成本多少?按 CPU、内存容量、磁盘数、I/O 总线分别列出。
b. [20]〈D.4〉排序 1 GB 记录需要多久?分别列出磁盘读、磁盘写与排序时间。
c. [20]〈D.4〉瓶颈在哪里?
习题 D.29
[25/25/25]〈D.4〉再看性价比。买高性能机器容易,买高性价比机器难。
PennySort 比赛(research.microsoft.com/barc/SortBenchmark/)就是例子:用一美分尽可能多地排序记录。假定系统可用三年,即 94,608,000 秒,用这个时间除以机器总价(美分),得到一美分的时间预算。
本题略简化:预算不超过 $2000,能构建的最快排序机器是什么?使用 D.28 相同硬件表。(提示:可以编写小程序,枚举所有配置。)
a. [25]〈D.4〉总成本多少?按 CPU、内存容量、磁盘数、I/O 总线分别列出。
b. [25]〈D.4〉这一配置的读、写、排序时间各是多少?
c. [25]〈D.4〉瓶颈在哪里?
习题 D.30
[20/20/20]〈D.4,D.6〉良好磁盘性能常依赖开销摊销:既然必须付出某项开销,付出之后就尽量多做有用工作,以降低它的影响。这个思想广泛适用于计算机系统。磁盘中,每次传输前要寻道、旋转;传更多数据,就能摊薄昂贵的定位开销。
本题关注两趟排序的第二趟。假设开始时盘上有 个有序段(run),每段大小均能放进主存。从每段读取一个 chunk,归并为最终有序输出。每次读一个段都要寻道和旋转,因为上次很可能读的是另一段。
a. [20]〈D.4,D.6〉磁盘带宽 100 MB/s,平均寻道 7 ms,转速 10,000 RPM。每次从一个段读 1 MB,共 100 段,每段 1 GB;最终输出以 1 GB 大块写入。若 I/O 是主要且唯一成本,归并阶段多久完成?
b. [20]〈D.4,D.6〉将每次读取从 1 MB 改为 10 MB,第二趟总时间如何变化?
c. [20]〈D.4,D.6〉两种情况都以最大化磁盘效率为目标。效率定义为传输数据时间占全部磁盘访问时间的比例。各自效率是多少?
习题 D.31
[40]〈D.2,D.4,D.6〉自行编写外排序。原书提供数据生成工具 generate:
它创建名为 filename、大小为 size MB 的文件。原文称,文件由“100 字节的键,带有 10 字节的记录(需要排序的部分)”构成。
译注:原页把 key 与 record 的大小/名称倒置;结合 D.28、以及本题末尾“100 字节记录”,通常应理解为100 字节记录,其中 10 字节是排序键。
另有 check 检查输入是否有序:
基本一趟排序就是读取、排序、写出。不过有许多优化:重叠读取与排序,将键和记录其余部分分离以改善缓存、加快排序,重叠排序与写入,等等。
一个重要规则是数据最初必须在磁盘上,而不在文件系统缓存中。最容易保证的方法是卸载再重新挂载文件系统。
目标之一:打破 Datamation 排序纪录。原书所述纪录为一百万条 100 字节记录用时 0.44 秒,由 32 台机器集群取得。如果足够精心,配几块磁盘的单台 PC 也可能超过它。
E 嵌入式系统
作者:Thomas M. Conte,North Carolina State University(北卡罗来纳州立大学)
ENIAC 计算机装有 18000 只真空管,重达 30 吨;未来的计算机或许只需要 1000 只真空管,重量也许只有 1.5 吨。
——Popular Mechanics(《大众机械》),1949 年 3 月
E.1 引言
嵌入式计算机系统是内置于其他设备、其存在并不显而易见的计算机,是计算机市场中增长最快的部分。这些设备包括日常使用的机器(大多数微波炉、洗衣机、打印机、网络交换机和汽车都含有从简单到十分先进的嵌入式微处理器)、手持数字设备(例如 PDA、手机和音乐播放器),以及视频游戏机和数字机顶盒。虽然有些应用中的计算机可以编程,例如 PDA,但在许多嵌入式应用中,编程只发生在最初装入应用代码或之后升级该应用软件时。因此,应用程序会针对处理器和系统精心调优。这个过程有时会在关键循环中有限地使用汇编语言,不过,上市时间的压力和良好的软件工程实践会把这类汇编代码限制在整个应用的一小部分。
与桌面系统和服务器系统相比,嵌入式系统的处理能力和成本范围要宽得多:低端系统可能使用成本不足 1 美元的 8 位或 16 位处理器;另一些系统使用功能完整的 32 位微处理器,性能可达约 500 MIPS,价格约为 10 美元;高端嵌入式处理器的价格可达数百美元,每秒能够执行数十亿条指令。尽管嵌入式系统市场的计算能力跨度很大,价格仍是这一领域计算机设计的关键因素。当然,性能要求也始终存在,但首要目标往往是以最低价格满足性能需求,而不是以更高价格换取更高性能。
嵌入式系统处理信息的方式往往与通用处理器大不相同。这些应用通常受到截止期限约束,即所谓的实时约束。在这类应用中,某项计算必须在规定时间之前完成,否则系统就会失效;还有其他形式的实时约束,将在下一小节讨论。
嵌入式系统应用通常把信息当作信号来处理。日常所说的“信号”常常使人想到无线电传输,有些嵌入式系统确实如此,例如手机。但信号也可以是一幅图像、由一系列图像构成的视频、控制传感器的测量值,等等。信号处理需要特定的计算,许多嵌入式处理器都针对这些计算进行优化。下面将对此深入讨论。这类系统对基准测试的需求也相差很大,既要衡量运行小型、有限代码片段的能力,也要衡量运行数万至数十万行代码应用程序的性能。
许多嵌入式应用还有两个重要特点:需要尽量减少内存,以及需要尽量降低功耗。在许多应用中,内存可能占系统成本的相当大一部分,因此优化内存容量十分重要。有时,整个应用都必须放入处理器芯片上的内存;另一些情况下,则要求整个应用装入容量很小的片外内存。无论哪种情况,对内存容量的重视都会转化为对代码大小的重视,因为数据大小是由应用决定的。有些体系结构提供了专门缩减代码大小的指令集功能。更大的内存也意味着更高的功耗,而功耗优化对嵌入式应用往往至关重要。低功耗要求通常来自电池供电,但使用更便宜封装的需要(塑料封装相对于陶瓷封装),以及没有风扇散热,也会限制总功耗。本附录稍后将更详细地讨论功耗问题。
嵌入式系统的另一个重要趋势,是把处理器核与应用专用电路结合起来,形成所谓的“处理器核加 ASIC”(core plus ASIC)或“片上系统”(system on a chip,SOC);它们也可以看作专用多处理器,见 E.4 节。通常可以把定制硬件方案与运行在标准化嵌入式处理器核上的软件结合起来,满足应用的功能和性能要求;这种处理器核在设计时就考虑了与专用硬件的连接。实际的嵌入式问题通常采用以下三种方式之一解决:
- 设计者采用软硬件结合的方案,其中包含一些定制硬件,以及与定制硬件集成在一起的嵌入式处理器核;两者往往位于同一芯片上。
- 设计者编写定制软件,在现成的嵌入式处理器上运行。
- 设计者采用数字信号处理器,并为它编写定制软件。数字信号处理器是针对信号处理应用专门设计的处理器。下文将讨论它与通用嵌入式处理器的一些重要区别。
图 E.1 概括了三类计算环境及其重要特征。
译注: 图 E.1 中的三类是桌面系统、服务器和嵌入式系统,并非上面列举的三种嵌入式实现方式。
| 特征 | 桌面系统 | 服务器 | 嵌入式系统 |
|---|---|---|---|
| 系统价格 | $1000–$10000 | $10000–$10000000 | $10–$100000;高端包括网络路由器 |
| 微处理器模块价格 | $100–$1000 | 每处理器 $200–$2000 | 每处理器 $0.20–$200 |
| 每年销售的微处理器数量,2000 年估计值 | 150000000 | 4000000 | 300000000;仅计 32 位和 64 位处理器 |
| 系统设计的关键问题 | 性价比、图形性能 | 吞吐量、可用性、可扩展性 | 价格、功耗、特定应用的性能 |
图 E.1 三类计算环境及其系统特征概览。 注意服务器和嵌入式系统的价格范围都很宽。服务器的这一跨度来自高端事务处理和 Web 服务器应用对超大规模多处理器系统的需求。对于嵌入式系统,网络路由器是一种重要的高端应用,它可能包含多个处理器、大量内存和其他电子器件。如果把 8 位和 16 位微处理器也计算在内,2000 年销售的嵌入式处理器总数估计超过 10 亿。事实上,原书所述历来销量最大的微处理器,是 Intel 销售的一款 8 位微控制器!低端服务器市场很难与桌面市场分开,因为低端服务器,尤其是售价低于 5000 美元的服务器,与桌面 PC 基本没有区别。因此,PC 销量中可能有多达数百万台实际上用作服务器。
实时处理
嵌入式应用的性能要求往往就是实时要求。所谓实时性能要求,是指应用程序的某一部分具有不可超过的最大允许执行时间。例如,数字机顶盒处理每个视频帧的时间受到限制,因为处理器必须在下一帧到来之前接收并处理当前帧;这种系统通常称为硬实时系统。在有些应用中,要求更为复杂:既限制特定任务的平均执行时间,也限制执行时间超过某个上限的次数。这类方式通常称为软实时,适用于这样的情形:偶尔错过某个事件的时间约束是允许的,只要次数不太多。实时性能通常高度依赖具体应用,测量时一般使用取自应用本身或标准化基准测试的计算内核,见 E.3 节。
构建硬实时系统涉及三个关键因素。首先是某项任务必须以什么速率发生;与之相联系的,是达到这一实时速率所需的硬件和软件。很多在桌面系统中十分有利的结构,却给硬实时分析带来困难。例如,分支推测、缓存等都会给代码执行引入不确定性。同一段代码可能执行得非常高效,也可能非常低效,取决于硬件分支预测器和缓存是否“各尽其职”。工程师必须依据最坏情况执行时间(worst-case execution time,WCET)来分析代码。对于传统微处理器硬件,如果假设所有分支都预测错误,所有缓存访问都未命中,得到的 WCET 就会过于悲观。这样,为满足给定 WCET,系统设计者可能最终把系统设计得过于昂贵,而原本成本低得多的系统就已足够。
为了应对硬实时系统的挑战,同时仍然利用分支行为和访问局部性等熟知的体系结构特性,可以改变处理器的设计方式。以分支预测为例:众所周知,动态分支预测的准确率远高于加在分支指令中的静态“提示位”,但静态提示的行为更容易预测。同样,虽然缓存的性能优于由软件管理的片上内存,后者却能提供可预测的内存访问延迟。在一些嵌入式处理器中,可以通过缓存行锁定(line locking)把缓存转换成由软件管理的片上内存。采用这种方式时,可以把某个缓存行锁在缓存中,在解除锁定之前,该行都不能被替换。
E.2 信号处理与嵌入式应用:数字信号处理器
数字信号处理器(digital signal processor,DSP)是针对数字信号处理算法优化的专用处理器。这些算法中的大多数,从时域滤波(例如无限长冲激响应和有限长冲激响应滤波)、卷积,到各种变换(例如快速傅里叶变换、离散余弦变换),乃至前向纠错(forward error correction,FEC)编码,都以同一种运算为核心:乘累加。例如,离散傅里叶变换的形式为:
其中
离散余弦变换常被用来替代它,因为离散余弦变换不需要复数运算。这两种变换都以乘积求和为核心。为了加速这一运算,DSP 通常提供执行乘累加(multiply-accumulate,MAC)的专用硬件。指令 MAC A,B,C 的语义为 A = A + B * C。在某些情况下,这一运算的性能如此重要,以至于为应用选择 DSP 时,只依据它的 MAC 运算吞吐量作决定。
DSP 经常使用定点运算。如果把整数的小数点看作位于最低有效位的右侧,那么这里所说的定点数,其二进制小数点就在符号位的右侧。因此,这种定点数据表示的是介于 −1 和 +1 之间的小数。
例题
有以下三个简单的 16 位二进制位串:
如果将它们解释为二进制补码整数,分别代表什么值?如果解释为定点数呢?
解答
数的表示方法告诉我们,二进制小数点左边第 位的位权为 ,右边第 位的位权为 。先假设这三个二进制位串是整数。此时小数点位于最右侧,所以它们分别表示 、 和 ,即 16384、2048 和 18440。
定点表示把二进制小数点放在符号位右侧,因此三个二进制位串分别表示 、 和 。相应分数为 、 和 ,近似小数值分别为 0.50000、0.06250 和 0.56274。另一种求法是:对于 位二进制补码定点数,用其整数表示值除以 ,也会得到相同结果:
可以把定点运算看成一种低成本浮点运算。它不在每个字中保存指数,也没有自动对齐和规格化操作数的硬件,而是依靠 DSP 程序员把指数保存在单独的变量中,并将每次结果适当地左移或右移,使其与该指数变量保持一致。由于一个指数变量往往由一组定点变量共享,这种运算方式也称为块浮点(blocked floating point),即一块变量共用同一个指数。
为了支持这类手工安排的计算,DSP 通常提供一些较宽的寄存器,以防舍入误差;这与浮点单元内部使用额外保护位类似。图 E.2 概览了四代 DSP,列出了数据宽度和累加寄存器宽度。注意,DSP 体系结构设计者并不要求字长必须是 2 的幂。图 E.3 列出了 TI TMS320C55 DSP 的数据操作数大小。
| 代次 | 年份 | 代表性 DSP | 数据宽度 | 累加器宽度 |
|---|---|---|---|---|
| 1 | 1982 | TI TMS32010 | 16 位 | 32 位 |
| 2 | 1987 | Motorola DSP56001 | 24 位 | 56 位 |
| 3 | 1995 | Motorola DSP56301 | 24 位 | 56 位 |
| 4 | 1998 | TI TMS320C6201 | 16 位 | 40 位 |
图 E.2 四代 DSP 的数据宽度,以及用于减少舍入误差的寄存器宽度。
| 数据大小 | 运算中的内存操作数占比 | 数据传送中的内存操作数占比 |
|---|---|---|
| 16 位 | 89.3% | 89.0% |
| 32 位 | 10.7% | 11.0% |
图 E.3 TMS320C55 DSP 的数据操作数大小。 大约 90% 的操作数是 16 位。该 DSP 有两个 40 位累加器。与许多 DSP 一样,它没有浮点运算,所以这些数据都是定点整数。
除了 MAC 运算,DSP 往往还提供加速通信算法中某些部分的运算。一类重要算法围绕前向纠错码的编码与译码展开。这类编码在数字比特流中加入额外信息,以抵御传输错误。原书将码率为 的编码描述为:每 个信息位对应 个校验位。例如,码率为 1/2 的编码,每 2 位中包含 1 个信息位。这类码常称为网格码(trellis code),因为一种常见的编码流程图看起来像花园中的格架。Viterbi 提出了网格码的一种常用译码算法。该算法通过一系列比较和选择操作,恢复传输比特的真实值。因此,DSP 往往提供比较—选择运算,以支持 FEC 码的 Viterbi 译码。
译注: 原文确实将 写作“校验位”数,与紧接的 1/2 码率例子不一致。通常码率 表示每 个编码输出位包含 个信息位,即冗余位为 。
为了更好地说明 DSP,下面详细考察 Texas Instruments(德州仪器)的两类 DSP。TMS320C55 系列面向由电池供电的嵌入式应用。TMS VelociTI 320C6x 系列则是一组强大的八发射 VLIW 处理器,面向更广泛、对功耗可能不那么敏感的应用。
TI 320C55
TI 320C55 体系结构位于 DSP 产品范围的一端。C55 针对低功耗嵌入式应用进行优化,总体体系结构如图 E.4 所示。其核心是一个七级流水线 CPU,各级概述如下:
- 取指级:从内存读取程序数据,送入指令缓冲队列。
- 译码级:对指令译码,将任务派发给其他主要功能单元。
- 地址级:计算数据访问地址,以及程序执行不连续时的分支地址。
图 E.4 TMS320C55 DSP 的体系结构。 C55 是七级流水线处理器,具有一些独特的指令执行设施。(Texas Instruments 提供。)图中的 IU、PU、AU、DU 分别为指令缓冲单元、程序流单元、地址数据流单元和数据计算单元。数据读总线 BB、CB、DB 各为 16 位,对应的读地址总线 BAB、CAB、DAB 各为 24 位;数据写总线 EB、FB 各为 16 位,写地址总线 EAB、FAB 各为 24 位。程序地址总线 PAB 为 24 位,程序读总线 PB 为 32 位。
- 访问 1/访问 2 级:将数据读地址送往内存。
- 读级:通过 B、C、D 总线传送操作数数据。
- 执行级:在 A 单元和 D 单元执行运算,并通过 E、F 总线执行写操作。
C55 的流水线会检测流水线冒险,在出现读后写(WAR)和写后读(RAW)冒险时停顿。
C55 确实配有 24 KB 指令缓存,但可以配置以适应不同工作负载。它可以配置成两路组相联、直接映射,或称为“ramset”的模式。最后一种模式用于支持硬实时应用:在该模式下,缓存中的块不能被替换。
C55 还具备先进的电源管理功能。它通过软件可编程的“空闲域”(idle domain)实现动态电源管理。芯片上的电路块被划分到这些空闲域中,每个域都可以正常运行,也可以进入低功耗空闲状态。程序员可访问的空闲控制寄存器(Idle Control Register,ICR)决定下次执行 IDLE 指令时,哪些域将进入空闲状态。这六个域分别是 CPU、直接内存访问(DMA)、外设、时钟发生器、指令缓存,以及外部内存接口。某个域进入空闲状态后,该域的功能就不可用。不过,在外设域中,每个外设都有一个 Idle Enable 位,用来控制该外设是否响应空闲状态的变化。因此,可以分别配置每个外设,使其在外设域进入空闲状态时一同空闲,或继续保持活动。
作为 DSP,C55 的核心特征是其 MAC 单元。C55 有两个 MAC 单元,每个由一个 17 位乘 17 位的乘法器与一个 40 位专用加法器组成。每个 MAC 单元在一个周期内完成其工作;因此,在流水线充分运行时,C55 每周期可以执行两次 MAC。这种能力对于高效执行信号处理应用至关重要。C55 还有一个比较、选择和存储单元(compare, select, and store unit,CSSU),用于 Viterbi 译码器的加法/比较部分。
TI 320C6x
与 C55 DSP 系列形成鲜明对照的,是高端 Texas Instruments VelociTI 320C6x 处理器系列。C6x 更接近传统的超长指令字(VLIW)处理器,它力图利用许多信号处理算法中丰富的指令级并行性(ILP)。在嵌入式领域采用 VLIW 来开发 ILP 的厂商,并非只有 Texas Instruments;其他 VLIW DSP 厂商还包括 Ceva、StarCore、Philips/TriMedia 和 STMicroelectronics。为什么这些厂商倾向于 VLIW,而不是超标量?在嵌入式领域,代码兼容性没有那么突出,因此,可以针对最新一代处理器手工调优新应用,也可以重新编译。超标量在桌面领域表现出色的另一个原因,是编译器无法在编译时预测内存延迟。
而在嵌入式领域,内存延迟往往更容易预测。事实上,硬实时约束要求内存延迟能够静态预测。当然,在这种环境和约束下,超标量也能表现良好,但用于动态调度指令的额外硬件,既消耗宝贵的芯片面积,也增加功耗。因此,VLIW 自然成为高性能嵌入式处理器的一种选择。
C6x 系列不同成员采用不同的流水线深度。例如,C64x 的流水线有 11 级。最前面的 4 级执行取指,随后 2 级执行指令译码,最后 4 级执行指令。C64x 的总体体系结构如图 E.5 所示。
译注: 原文列出的 4+2+4 合计为 10 级,与同段“11 级”不一致。
C6x 系列的执行级分为两个部分:左侧或称“1”侧,右侧或称“2”侧。L1 和 L2 单元执行逻辑及算术运算;D 单元执行其中一部分逻辑和算术运算,还负责内存访问,即 load 和 store。两个 M 单元执行乘法及相关运算,例如移位。最后,S 单元执行比较、分支以及某些 SIMD 运算;下一小节将详细解释 SIMD。每一侧都有自己的寄存器堆,包含 32 个 32 位寄存器:1 侧为 A 寄存器堆,2 侧为 B 寄存器堆。一侧可以访问另一侧的寄存器,但代价是多花 1 个周期。例如,在 1 侧执行的指令可以访问 B5,不过因此会增加 1 个周期的执行时间。
图 E.5 TMS320C64x DSP 系列的体系结构。 C6x 是八发射的传统 VLIW 处理器。(Texas Instruments 提供。)上方为程序缓存/程序内存,地址宽度 32 位、数据宽度 256 位;下方为数据缓存/数据内存,地址宽度 32 位,数据可为 8、16、32 或 64 位。CPU 包含程序取指、指令派发、指令译码、数据通路 A/B 及各自的寄存器堆,还包括低功耗控制(Power down)、控制寄存器、控制逻辑、测试、仿真和中断支持;其他外设包括定时器、串行端口等。EDMA 和 EMIF 保留原图接口标识。
传统 VLIW 的代码大小表现很差,这与嵌入式系统的需求相悖。但 C6x 系列通过一种“压缩”指令的方法,使 VLIW 代码达到与等价 RISC(精简指令集计算机)代码相同的密度。为此,取指以图 E.6 所示的“指令包”为单位进行。每条指令都有一个 p 位,用来指定指令属于当前 VLIW 字还是下一个 VLIW 字,具体含义见图注。这样,VLIW 编码就不再需要用 NOP 填充。
图 E.6 TMS320C6x DSP 系列的指令包。 p 位决定下一条指令是否开始一个新的 VLIW 字。如果指令 的 p 位为 1,那么指令 与指令 并行执行,即在同一周期执行。如果指令 的 p 位为 0,那么指令 在指令 之后的周期执行。(Texas Instruments 提供。)图中 A–H 为八条 32 位指令,位号为 31 至 0。
软件流水线是 VLIW 实现高性能的重要技术,但它要求循环每次迭代的调度都与其他迭代相同。条件分支指令会破坏这一模式,因此 C6x 系列提供了通过谓词执行(predication)来有条件执行指令的方法。在谓词执行中,指令先完成其工作,但执行结束时会检查另一个寄存器,例如 A1。如果 A1 为零,指令就不写入结果;如果 A1 非零,指令正常完成。这样,就可以把简单的 if-then 和 if-then-else 结构转换为直线代码,以便进行软件流水线调度。
媒体扩展
在 DSP 与微控制器之间,还有一种折中方式:媒体扩展。这些扩展以相对较低的成本,向微控制器体系结构加入类似 DSP 的能力。由于媒体处理的效果由人的感官判断,多媒体运算的数据通常远窄于现代桌面和服务器处理器的 64 位数据字。例如,图形浮点运算通常使用单精度而非双精度,而且所需精度往往低于 IEEE 754 的要求。在处理 32 位、16 位甚至 8 位整数时,与其闲置 64 位算术逻辑单元(ALU)的能力,不如用多媒体指令同时操作多个较窄的数据项。因此,在 64 位 ALU 上对 16 位数据执行一次分段加法(partitioned add),就能在单个时钟周期内完成 4 次 16 位加法。额外的硬件成本只是阻断 ALU 四个 16 位分段之间的进位。这类指令例如可以用于像素的图形运算,通常称为单指令多数据(SIMD)指令或向量指令。
大多数图形多媒体应用使用 32 位浮点运算。一些计算机把单精度浮点运算的峰值性能提高一倍,方法是让一条指令同时启动两次 32 位运算,操作数并排放在一个双精度寄存器中。两个分段必须彼此隔离,避免一个半部的运算影响另一个半部。这种浮点运算称为成对单精度运算(paired single operation),例如可用于顶点的图形变换。这种性能翻倍通常通过将浮点单元数量加倍来实现,因此比仅仅阻断整数加法器中的进位更加昂贵。
图 E.7 概括了当时几种计算机中的 SIMD 多媒体指令。
| 指令类别 | Alpha MAX | HP PA-RISC MAX2 | Intel Pentium MMX | PowerPC AltiVec | SPARC VIS |
|---|---|---|---|---|---|
| 加/减 | — | 4H | 8B、4H、2W | 16B、8H、4W | 4H、2W |
| 饱和加/减 | — | 4H | 8B、4H | 16B、8H、4W | — |
| 乘法 | — | — | 4H | 16B、8H | — |
| 比较 | 8B(≥) | — | 8B、4H、2W(=、>) | 16B、8H、4W(=、>、≥、<、≤) | 4H、2W(=、≠、>、≤) |
| 右移/左移 | — | 4H | 4H、2W | 16B、8H、4W | — |
| 算术右移 | — | 4H | — | 16B、8H、4W | — |
| 乘加 | — | — | — | 8H | — |
| 移位并加法(饱和) | — | 4H | — | — | — |
| AND/OR/XOR | 8B、4H、2W | 8B、4H、2W | 8B、4H、2W | 16B、8H、4W | 8B、4H、2W |
| 绝对差 | 8B | — | — | 16B、8H、4W | 8B |
| 最大值/最小值 | 8B、4W | — | — | 16B、8H、4W | — |
| 打包(2n 位 → n 位) | 2W → 2B;4H → 4B | 2*4H → 8B | 4H → 4B;2W → 2H | 4W → 4B;8H → 8B | 2W → 2H;2W → 2B;4H → 4B |
| 解包/合并 | 2B → 2W;4B → 4H | — | 2B → 2W;4B → 4H | 4B → 4W;8B → 8H | 4B → 4H;2*4B → 8B |
| 置换/重排 | — | 4H | — | 16B、8H、4W | — |
图 E.7 桌面处理器的多媒体支持概览。 五种体系结构的支持方式多种多样,共同点很少。所有运算的宽度都是固定的,在 64 位或 128 位 ALU 上执行多个较窄的运算。B 表示字节(8 位),H 表示半字(16 位),W 表示字(32 位);因此,8B 表示一条指令操作 8 个字节。AltiVec 按 128 位 ALU 计,其余按 64 位计。打包和解包中的 2*2W 表示两个操作数,每个操作数含两个字。本表对完整多媒体体系结构作了简化,省略了很多细节。例如,HP MAX2 包含计算平均值的指令,SPARC VIS 包含将寄存器设置为常数的指令。本表也未列出 AltiVec、MAX 和 VIS 的内存对齐操作。表中“—”对应原表空白单元格。
DSP 也提供图 E.7 前三行中的运算,不过会稍微改变它们的语义。首先,由于 DSP 经常用于实时应用,算术溢出不能触发异常,否则可能错过一个事件;因此,无论输入是什么,运算结果都会被使用。为了适应这种不容延误的环境,DSP 体系结构使用饱和运算:如果结果太大而无法表示,就根据结果的符号,将其设置为相应方向上可表示的极限值。原文接着对比二进制补码运算:“可以把一个较小的正数加到一个较大的正数上。”
译注: 这一对比句没有给出相加之后的结果。从饱和运算的上下文看,这里应当讨论补码溢出时结果可能变成负数;此说明仅用于提示缺失的论意,不作为作者原文的补译。
E.3 嵌入式基准测试
就在原书写作前的几年前,嵌入式市场仍有许多厂商引用 Dhrystone 性能;而这一基准测试在 20 多年前就已受到批评,并被桌面系统弃用!如前所述,嵌入式应用的种类极为繁多,性能要求也各不相同,包括硬实时、软实时以及总体性价比,因此,使用单一的一套基准测试并不现实。实际中,许多嵌入式系统设计者会自行设计能反映其应用的基准测试,形式可能是计算内核,也可能是整个应用的独立运行版本。
对于可以用内核性能较好描述的嵌入式应用,当时最好的标准化基准测试似乎是一套新的测试集:EDN Embedded Microprocessor Benchmark Consortium,即 EEMBC,读音同英语 embassy。EEMBC 基准测试分为六类,在 EEMBC 的术语中称为“分委员会”(subcommittee):汽车/工业、消费电子、电信、数字娱乐、网络(当时为第二版),以及办公自动化(同样为第二版)。图 E.8 列出了这六个不同的应用类别,共包含 50 项基准测试。
虽然许多嵌入式应用对小型内核的性能很敏感,但也要记住,整个应用(可能有数千行代码)的总体性能往往同样重要。因此,对于许多嵌入式系统,EEMBC 基准测试只能用于部分地评估性能。
译注: 原书上一段最后一句将 EEMBC 误写为 EMBCC;根据本节上下文统一为 EEMBC。
| 基准测试类型(“分委员会”) | 内核数量 | 基准测试示例 |
|---|---|---|
| 汽车/工业 | 16 | 6 项微基准测试:算术运算、指针追踪、内存性能、矩阵运算、查表、位操作;5 项汽车控制基准测试;5 项滤波或 FFT 基准测试 |
| 消费电子 | 5 | 5 项多媒体基准测试:JPEG 压缩/解压缩、滤波,以及 RGB 转换 |
| 电信 | 5 | 滤波与 DSP 基准测试:自相关、FFT、译码器、编码器 |
| 数字娱乐 | 12 | MP3 译码;MPEG-2 和 MPEG-4 编码与译码,每项分别应用于五种不同数据集;MPEG 浮点编码;4 项常用密码标准和算法的基准测试,包括 AES、DES、RSA 以及用于数据解压缩的 Huffman 译码;增强型 JPEG 和色彩空间转换测试 |
| 网络第 2 版 | 6 | IP 数据包检查(取自 RFC1812 标准)、IP 重组、IP 网络地址转换(NAT)、路由查找、OSPF、服务质量(QOS),以及 TCP |
| 办公自动化第 2 版 | 6 | Ghostscript、文本解析、图像旋转、抖色、Bézier |
图 E.8 EEMBC 基准测试套件,包含六个类别中的 50 个内核。 关于基准测试的更多信息和成绩,见原书所列网站 www.eembc.org。
以功耗和效率为指标
在嵌入式市场,成本和功耗的重要性往往至少不亚于性能。除了处理器模块的成本——其中包括所有必需的接口芯片——内存往往是嵌入式系统中成本第二高的部分。与桌面系统或服务器不同,大多数嵌入式系统没有辅助存储;整个应用必须驻留在 Flash 或 DRAM 中。PDA 和手机等许多嵌入式系统同时受到成本和物理尺寸的约束,因此,应用所需内存容量非常关键。同样,功耗往往是选择处理器的决定性因素,对电池供电系统尤其如此。
EEMBC EnergyBench 提供处理器运行 EEMBC 性能基准测试时的能耗数据。通过 EEMBC 认证的 Energymark 分数是一项可选指标,设备厂商可以选择将其与经认证的设备性能分数一同提供,以说明处理器利用功率和能量的效率。EEMBC 统一采用 National Instruments 的 LabVIEW 图形化开发环境和数据采集硬件来实现 EnergyBench。
图 E.9 按典型工作功耗给出了相对每瓦性能。将它与图 E.10 所示未经功耗归一化的性能相比,会发现结果差别很大。NEC VR 4122 在每瓦性能上有明显优势,但其性能却是倒数第二!从功耗角度看,针对电池供电系统设计的 NEC VR 4122 是明显的赢家。IBM PowerPC 也展现了以高效用电达到高性能的能力,不过它的典型功耗为 6 W,可能不适合大多数电池供电设备。
图 E.9 五种嵌入式处理器的相对每瓦性能。 功率取处理器的典型工作功耗,不包含任何接口芯片。横轴依次为汽车、办公和电信测试;纵轴为相对每瓦性能。图例为 AMD ElanSC520、AMD K6-2E+、IBM PowerPC 750CX、NEC VR 5432 和 NEC VR 4122。
图 E.10 五种嵌入式处理器的性能。 性能以 AMD ElanSC520 为基准,表示为其性能的倍数。横轴依次为汽车、办公和电信测试;五种处理器与图 E.9 相同。
E.4 嵌入式多处理器
在原书描述的时期,多处理器已在服务器环境中十分常见,Sun、Compaq 和 Apple 等厂商也提供多种桌面多处理器系统。在嵌入式领域,一些专用设计已经采用定制多处理器,包括 Sony PlayStation 2,见 E.5 节。
许多专用嵌入式设计由一个通用可编程处理器或 DSP,加上处理面向流的 I/O 的专用有限状态机组成。从计算机图形和媒体处理到电信,这种专用多处理器已日益常见。在这类设计中,处理器间的交互有严格的规程,而且相对简单,主要由简单的通信通道组成。不过,由于设计的大部分已固化在硅片中,确保输入/输出处理器与通用处理器之间的通信协议正确,仍是一个重大挑战。
稍后,嵌入式领域开始出现由多个通用处理器组成的嵌入式多处理器。这类多处理器主要面向高端电信和网络市场,因为这些市场对可扩展性的要求非常高。一个例子是 empowerTel Networks 为 IP 语音系统设计的 MXP 处理器。
MXP 处理器包含四个主要组成部分:
- 串行语音流接口,包括处理抖动的支持。
- 快速数据包路由和信道查找支持。
- 完整的 Ethernet 接口,包括 MAC 层。
- 四个 MIPS32 R4000 级处理器,每个都有自己的缓存;总计 48 KB,即每处理器 12 KB。
MIPS 处理器运行负责维护 IP 语音信道的代码,包括保证服务质量、回声消除、简单压缩和数据包编码。由于目标是尽可能多地运行彼此独立的语音流,多处理器是一种理想方案。MIPS 核的尺寸很小,因此整颗芯片只使用 1350 万个晶体管。后续几代芯片预计将能处理更多语音信道,并执行更复杂的回声消除、语音活动检测和压缩。
多处理在嵌入式计算领域日益普及,主要有两个原因。首先,困扰桌面和服务器系统的二进制软件兼容性问题,在嵌入式领域没有那么突出。嵌入式应用的软件往往为特定应用从头编写,或经过大量修改;注意,这也是嵌入式指令级并行更青睐 VLIW 而非超标量的原因。其次,应用通常具有自然的并行性,在高端嵌入式领域尤其如此。机顶盒、网络交换机、手机(见 E.7 节)和游戏系统(见 E.5 节)等应用中,天然并行性的例子比比皆是。随着应用需求不断提高,使用线程级并行的障碍较低,加之对芯片成本、进而对硅片利用效率更为敏感,共同推动了嵌入式领域广泛采用多处理。
E.5 案例研究:Sony PlayStation 2 的 Emotion Engine
桌面计算机和服务器依靠存储层次结构,降低相对静态数据的平均访问时间;但有些嵌入式应用中的数据往往是连续的数据流。在这类应用中,空间局部性仍然存在,时间局部性却有限得多。
为了从桌面系统之外的角度考察存储性能,本节介绍 Sony PlayStation 2 核心的微处理器。我们将看到,电子游戏持续不断的图形和音频数据流,使它采用了不同的存储设计方法:利用许多专用、独立的内存来提供高带宽。
图 E.11 给出了 Sony PlayStation 2(PS2)的框图。作为游戏机,它具有视频、声音和 DVD 播放器接口并不奇怪。令人意外的是,它还配有 USB 和 IEEE 1394 两种标准计算机 I/O 总线、便携式 PC 常见的 PCMCIA 插槽,以及调制解调器。这些附加功能表明,Sony 对 PS2 的设想并不限于传统游戏。I/O 处理器(IOP)看起来只是管理 I/O 设备和游戏机,实际上它还包含一个 34 MHz MIPS 处理器,用作运行早期 Sony PlayStation 游戏的仿真计算机。
它还连接到标准 PC 声卡,为游戏提供声音。
图 E.11 Sony PlayStation 2 的框图。 10 个 DMA 通道协调芯片上各个小型内存之间的数据传送;处理完成的数据最终都送往图形接口,再由 Graphics Synthesizer 渲染。Graphics Synthesizer 利用片上 DRAM 容纳完整的帧缓冲区,并配合图形处理器,根据 Emotion Engine 提供的显示命令执行所需的渲染。嵌入式 DRAM 支持像素处理器与显示缓冲区之间的 1024 位传送。
超标量 CPU 是双发射的 64 位 MIPS III,带有两路组相联的 16 KB 指令缓存、两路组相联的 8 KB 数据缓存,以及 16 KB 暂存存储器(scratchpad memory)。它还扩展了用于多媒体应用的 128 位 SIMD 指令,见 E.2 节。向量单元 0 主要作为 CPU 的类似 DSP 的协处理器(见 E.2 节),可在 128 位寄存器上执行 SIMD 运算,其中每个数据字的宽度可为 8 位至 32 位。它有 4 KB 指令内存和 4 KB 数据内存。向量单元 1 的功能与 VPU0 类似,但通常独立于 CPU 运行,并含有 16 KB 指令内存和 16 KB 数据内存。
这三个单元都能通过 128 位系统总线通信;此外,CPU 与 VPU0 之间有一条 128 位专用通路,VPU1 与图形接口之间也有一条 128 位专用通路。虽然 VPU0 和 VPU1 的微体系结构相同,内存大小及其直接连接单元的差异,决定了它们在游戏中的不同职责。采用 0.25 微米线宽时,Emotion Engine 芯片使用 1350 万个晶体管,面积为 225 mm²;Graphics Synthesizer 的面积为 279 mm²。作为比较,采用 0.25 微米工艺的 Alpha 21264 微处理器面积约为 160 mm²,使用 1500 万个晶体管。(本图依据〈Sony’s Emotionally Charged Chip〉中的图 1,Microprocessor Report,13:5。)
图中 Emotion Engine 内包括 300 MHz、支持 128 位 SIMD 的超标量 CPU 核、VPU0、VPU1、图形接口、内存控制器、10 通道 DMA、IPU(MPEG 译码器)和 I/O 接口,共享 128 位/150 MHz 总线。主存为 32 MB DRDRAM。Graphics Synthesizer 包括 16 个并行像素处理器(150 MHz)及 4 MB 多端口嵌入式 DRAM 视频内存;输出格式列为 NTSC、PAL、DTV、VESA。其他图内标识包括本地总线、48 通道声音芯片、I/O 电路和兼容 PlayStation 的 34 MHz MIPS CPU,接口与连接宽度、频率均保留在图中。
因此,这一嵌入式应用的存储系统面临的一个挑战,是充当大量 I/O 设备的数据源或目的地。PS2 设计者采用两个通道上的两颗 PC800(400 MHz)DRDRAM 芯片应对这一挑战,提供 32 MB 存储容量和 3.2 GB/s 峰值内存带宽。
图中其余主要部分,基本上就是两颗大芯片:Graphics Synthesizer 和 Emotion Engine。
Graphics Synthesizer 从 Emotion Engine 接收渲染命令,这些命令通常称为显示列表(display list)。它们由一系列 32 位命令组成,告诉渲染器使用什么形状、放在哪里,以及填充什么颜色和纹理。
这颗芯片还拥有存储系统中带宽最高的部分。Graphics Synthesizer 采用嵌入式 DRAM,在片内容纳整个视频缓冲区,并提供 2048 位宽的接口,使像素填充不会成为瓶颈。这种嵌入式 DRAM 大幅降低了对 DRDRAM 带宽的需求,体现了嵌入式应用中的一种常见技术:为各个功能配置专用的独立内存,以较低成本提高整个系统的内存带宽。
剩下的那颗大芯片是 Emotion Engine。它接收 IOP 的输入,并生成电子游戏的显示列表,以实现实时三维视频变换。Emotion Engine 的设计受到一个重要观察的启发:一般而言,在赛车游戏中,前景对象不断变化,而背景对象对事件的反应变化较少,尽管背景可能占屏幕的大部分。这个观察促成了职责划分。
CPU 将 VPU0 作为紧密耦合的协处理器使用:每条 VPU0 指令都是标准 MIPS 协处理器指令,地址由 MIPS CPU 产生。VPU0 被称为向量处理器,但它与一些桌面处理器中用于多媒体的 128 位 SIMD 扩展相似,见 E.2 节。
相比之下,VPU1 自行提取指令和数据,与 CPU/VPU0 并行工作,更像传统的向量单元。在这种划分下,更灵活的 CPU/VPU0 处理前景动作,VPU1 处理背景。两者都把生成的显示列表送入图形接口,再传往 Graphics Synthesizer。
因此,Emotion Engine 的程序员可以从三套处理资源中选择,来实现自己的程序:包含浮点单元的传统 64 位 MIPS 体系结构、带多媒体指令扩展的 MIPS 体系结构(VPU0),以及独立的向量处理器(VPU1)。为了加速 MPEG 译码,还有一个协处理器——图像处理单元(Image Processing Unit,IPU),它可以独立于另外两套资源运行。
采用这种功能划分之后,问题就是如何连接这些单元,如何让数据在单元之间流动,以及如何提供所有单元所需的内存带宽。前面已经提到,Emotion Engine 的设计者选择了许多专用内存。CPU 除了 16 KB 指令缓存和 8 KB 数据缓存,还配有 16 KB 暂存存储器(SPRAM)。VPU0 有 4 KB 指令内存和 4 KB 数据内存;VPU1 有 16 KB 指令内存和 16 KB 数据内存。注意,后面这四个是内存,并不是其他位置某个更大内存的缓存。每个内存的访问延迟都只有 1 个时钟周期。VPU1 的内存比 VPU0 大,因为它生成显示列表的主要部分,而且基本独立工作。
程序员把所有这些内存组织成两组双缓冲区,一组接收输入的 DMA 数据,一组存放输出的 DMA 数据。随后,程序员使用不同处理器,将输入缓冲区中的数据变换到输出缓冲区。为了让数据在单元间持续流动,程序员接着设置 10 个 DMA 通道,并注意满足实现逼真动画所需的每秒 15 帧实时截止期限。
图 E.12 表明,这种组织支持两种主要运行模式。串行模式中,CPU/VPU0 先对送给 VPU1 的内容进行预处理,以暂存存储器为缓冲区,再由 VPU1 为图形接口生成显示列表。并行模式中,CPU/VPU0 和 VPU1 都生成显示列表。显示列表和 Graphics Synthesizer 具有多个上下文标识符,用来区分并行生成的显示列表,最终产生协调一致的图像。
Emotion Engine 的所有单元都由一条公共的 150 MHz、128 位宽总线连接。为提供更大的带宽,还有两条专用总线:CPU 与 VPU0 之间的 128 位通路,以及 VPU1 与图形接口之间的 128 位通路。程序员在设置 DMA 通道时,也要选择使用哪条总线。
图 E.12 使用 Emotion Engine 组织的两种模式。 原图注所说的第一种模式把工作分给两个单元,再由图形接口适当地合并显示列表;第二种模式把 CPU/VPU0 用作过滤器,决定将哪些内容送给 VPU1,再由后者生成全部显示列表。串行还是并行的数据流,由程序员选择。SPRAM 表示暂存存储器。图中 Main memory 为主存,Rendering engine 为渲染引擎。
译注: 图中的排列顺序为上方串行连接(Serial connection)、下方并行连接(Parallel connection);原图注“第一种”“第二种”的叙述顺序恰好相反,即先描述并行、后描述串行。
从总体上看,如果把这一问题交给面向服务器的设计者,设计结果可能是一条公共总线、许多本地缓存,以及保持数据一致的缓存一致性机制。而 PlayStation 2 遵循嵌入式设计传统,至少使用了九个不同的内存模块。为了让数据实时地从内存流向显示器,PS2 采用专用内存、专用总线和 DMA 通道。一致性由程序员负责;考虑到数据从主存到图形接口的连续流动以及实时要求,这种由程序员控制的一致性很适合该应用。
E.6 案例研究:Sanyo VPC-SX500 数码相机
数码相机是另一种非常熟悉的嵌入式系统。这里考察 Sanyo VPC-SX500。开机后,相机的微处理器首先对所有部件执行诊断,并把错误信息显示在相机背面的液晶显示屏(LCD)上。这款相机采用 1.8 英寸低温多晶硅薄膜晶体管(TFT)彩色 LCD。拍照时,摄影者先将快门按下一半,让微处理器测量光照。随后,微处理器保持快门打开,以获得所需的光量;电荷耦合器件(CCD)把光捕获成红、绿、蓝像素。CCD 是一块 1/2 英寸、1360 × 1024 像素的逐行扫描芯片。像素逐行读出,经过白平衡、颜色和混叠校正程序处理,再存入 4 MB 帧缓冲区。下一步是把图像压缩为 JPEG 等标准格式,并存入可移除的 Flash 存储器。摄影者选择压缩方式,在这款相机中称为精细(fine)或普通(normal),压缩比为 10 至 20 倍。512 MB Flash 存储器至少能保存 1200 张精细质量的压缩图像,或约 2000 张普通质量的压缩图像。随后,微处理器更新 LCD,显示剩余可拍摄照片数减少了一张。
前一段概括了数码相机的基本工作方式,但相机还包含许多其他功能:在彩色 LCD 上显示已拍摄的图像、通过睡眠模式节省电池电量、监控电池剩余能量、利用缓冲快速连续记录未压缩图像;这款相机还支持以 MPEG 格式录制视频,以及以 WAV 格式录音。
相机的电子大脑是一台嵌入式计算机,芯片上集成了多种专用功能 [Okada et al. 1999]。图 E.13 给出了一颗与该相机所用芯片相似的芯片框图。如 E.1 节所述,这类芯片称为片上系统(SOC),因为它基本把过去一块小型印刷电路板上的所有部件集成到单颗芯片中。与集成程度较低的方案相比,SOC 通常可以缩小尺寸并降低功耗。Sanyo 声称,其 SOC 使相机只需竞争对手相机一半数量的电池,而且外形更小。
为了提高性能,它配有两条总线。16 位总线连接许多较慢的 I/O 设备,包括 SmartMedia 接口、程序及数据内存和 DMA。32 位总线连接 SDRAM、信号处理器(连接 CCD)、Motion JPEG 编码器,以及 NTSC/PAL 编码器(连接 LCD)。注意,与桌面微处理器不同,这颗芯片必须集成种类繁多的 I/O 总线。32 位 RISC MPU 采用专有设计,运行频率为 28.8 MHz,与总线时钟频率相同。这颗芯片功耗为 700 mW,采用 0.35 微米工艺,在 10.5 × 10.5 mm 的裸片中集成了 180 万个晶体管。
图 E.13 Sanyo 数码相机中的片上系统(SOC)。 该框图来自 Okada 等人 [1999],对应正文所述相机中 SOC 的前代芯片。后继 SOC 名为 Super Advanced IC,采用三条总线而非两条,运行频率为 60 MHz,功耗为 800 mW;它采用 0.35 微米工艺,在 10.2 × 10.2 mm 的裸片中集成了 310 万个晶体管。注意,这个嵌入式系统的晶体管数,是 1990 年最先进高性能微处理器的两倍!图中的 SOC 最多处理 1024 × 768 像素,而后继芯片支持 1360 × 1024 像素。
图中的 32 位信号总线(Signal bus)连接 SDRAM 控制器、信号处理器、MJPEG 和 NTSC/PAL 编码器,并通过双通道视频 D/A 连接 LCD/TV。总线桥(Bus bridge)将其与 16 位 CPU 总线相连。CPU 总线一侧包括 RISC 核、SSFDC 控制器、DRAM 控制器、两个 UART、IrDA、PCMCIA 控制器、SIO/PIO/PWM、DMA 控制器,以及音频 D/A、A/D;外围设备包括 CCD、SDRAM、SmartMedia、存放程序的 Flash、DRAM、RS-232、IrDA 端口、PCMCIA 卡、麦克风、扬声器和其他设备。各接口缩写及数据位宽保留原图标识。
E.7 案例研究:手机内部
游戏机和数码相机都是熟悉的嵌入式系统,而在原书描述的时期,最为人熟悉的嵌入式系统是手机。1999 年,美国有 7600 万蜂窝通信用户,比前一年增长了 25%。全球年增长率则接近 35%,因为发展中国家发现,建设蜂窝基站比铺设铜线基础设施便宜得多。因此,在许多国家,使用中的手机数量超过了有线电话数量。
不难理解,蜂窝手机市场的年增长率达到 35%,1999 年全球售出约 2.8 亿部手机。作为比较,同年的个人计算机销量为 1.2 亿台。这些数字意味着,改进手机可以投入巨大的工程资源;按每立方英寸所包含的工程创新衡量,手机可能居于领先地位 [Grice and Kanellos 2000]。
在揭示手机的内部结构之前,先简要介绍无线技术。
无线网络背景
网络既可以用铜和玻璃构建,也可以借助空气形成无线网络。本小节的大部分内容依据 National Research Council(美国国家研究委员会)[1997] 的一份报告。
无线电波是由天线传播的电磁波。无线电波经过调制,也就是把声音信号叠加在较强的无线电波上,由后者携带声音信号,因此称其为载波信号。无线电波具有特定的波长或频率:可以用一个完整波形的长度来度量,也可以用每秒的波数来度量。长波的频率低,短波的频率高。FM 广播电台在 88 MHz 至 108 MHz 频段发射,采用频率调制(FM)承载声音信号。
通过调谐到不同频率,无线电接收机可以选取特定信号。除了 AM 和 FM 广播,还有其他频率专门留给民用波段无线电、电视、寻呼机、空中交通管制雷达、全球定位系统等使用。在美国,Federal Communications Commission(联邦通信委员会)决定由谁使用哪些频率,以及用于何种目的。
无线链路的误码率(bit error rate,BER)由接收信号功率、接收机硬件造成的干扰噪声、其他来源的干扰,以及信道特性共同决定。噪声通常与射频带宽成正比,一个关键指标是达到给定 BER 所需的信噪比(signal-to-noise ratio,SNR)。图 E.14 列出了无线通信面临的其他挑战。
| 挑战 | 说明 | 影响 |
|---|---|---|
| 路径损耗 | 原表定义为接收功率除以发射功率;无线电系统必须克服干扰噪声,以达到所需信噪比。原表称路径损耗随距离呈指数变化,距离超过 100 米时还取决于干扰。 | 发射功率 1 W、发射频率 1 GHz、数据率 1 Mbit/s、BER 为 时,无线电设备之间的距离,在自由空间中可达 728 米,在茂密丛林中则为 4 米。 |
| 阴影衰落 | 接收信号被物体、室外建筑物或室内墙壁阻挡;提高功率可以改善接收 SNR。它取决于物体数量及其介电特性。 | 如果发射机在移动,需要改变发射功率,以保证所在区域中的接收 SNR。 |
| 多径衰落 | 同一信号的多个副本在不同时刻到达并相互干扰;其程度由最早与最晚信号之间的时延相对于信号带宽的关系决定。 | 发射频率为 900 MHz 时,信号功率每隔 30 cm 就会变化。 |
| 干扰 | 频率复用、邻信道干扰和窄带干扰。 | 需要滤波器和扩频技术。 |
图 E.14 无线通信面临的挑战。
译注: 原表采用的“接收功率/发射功率”是传输增益方向的比值,与通常用“发射功率/接收功率”表示的损耗互为倒数;它所用的“随距离呈指数变化”(exponential)也不应与常见传播模型中的距离幂律混为一谈。下文沿用原书的这一措辞,未将其无标记地改写为另一种模型。
通常,选择无线通信,是因为通信设备需要移动,或者布线不方便。这意味着无线网络必须动态调整自身结构,因而路由更加困难。第二个挑战是无线信号没有屏蔽保护,容易相互干扰,设备移动时尤其如此。功率也是无线通信的一个挑战:一方面,这些设备往往由电池供电;另一方面,天线需要辐射能量进行通信,而其中只有很少一部分到达接收机。因此,无线通信的原始误码率通常比铜线高一千至一百万倍。
无线网络主要有两种体系结构:基站式体系结构和对等式体系结构。基站之间通过有线线路进行较远距离通信,移动设备只与本地的一座基站通信。
对等式体系结构允许移动设备相互通信,消息从一台设备逐跳传到下一台,直至到达目标设备。虽然对等方式更易于重新配置,但基站方式往往更可靠,因为设备与基站之间只有一跳。作为最普及的无线网络实例,蜂窝电话依赖带基站的无线电系统。
蜂窝系统利用原书所称的“指数路径损耗”,在空间上相隔较远的位置复用同一频率,从而大幅增加可服务的用户数量。蜂窝系统把城市划分成互不重叠的六边形小区;相邻小区使用不同频率,只有在小区相距足够远、相互干扰可以接受时,才复用同一频率。
在三个六边形小区的交点处设置一座带有发射机和天线的基站。基站连接到交换中心;当移动设备离开一个小区、进入另一个小区时,交换中心负责协调切换,同时负责通过有线线路接入和发起呼叫。典型小区的半径为 2 至 10 英里,具体取决于地形、人口等因素。
手机
图 E.15 展示了作为手机核心的无线电设备组成。无线电信号先由天线接收,经过放大、混频、滤波、解调,最后译码。天线是无线电波传播介质与发射机或接收机电子电路之间的接口。可以把天线设计成在某些方向上效果最好,使发射和接收都具有方向性。
调制将信息编码到信号的幅度、相位或频率中,以提高在受损信道条件下的稳健性。无线电发射机经过相同的处理步骤,只是顺序相反。
图 E.15 无线电接收机由天线、射频放大器、混频器、滤波器、解调器和译码器组成。 混频器接收两个输入信号,产生包含和频、差频成分的输出信号。滤波器选择一个更窄的频带,将其送到下一级。调制对信息编码,使其更稳健;译码则把信号还原为信息。根据应用不同,所有电子部件都可以采用模拟或数字实现。例如,原书所述汽车收音机全部采用模拟器件,而 PC 调制解调器除放大器外都采用数字器件。当时的蜂窝手机使用模拟硅芯片实现射频放大器和第一级混频器。图中从左至右依次为 Antenna、RF amp、Mixer、Filter、Demodulator、Decoder,对应上述处理顺序。
最初,所有器件都是模拟的;随着时间推移,大多数逐渐被数字器件取代,这要求把无线电信号从模拟形式转换成数字形式。为了灵活支持更多无线电频段,其中一些功能被数字信号处理器等可编程芯片上的软件程序取代。由于这类处理器通常用在移动设备中,设计者重视每焦耳的性能,以延长电池续航;重视每平方毫米硅片面积的性能,以缩小尺寸和降低成本;也重视每项任务所需的字节数,以减小内存容量。
图 E.16 给出了手机电子系统的通用框图,其中 DSP 执行信号处理,微控制器负责其余任务。手机本质上是充当无线电设备的移动计算机。它包含标准 I/O 设备——键盘和 LCD 显示屏——以及用于无线联网的麦克风、扬声器和天线。
图 E.16 手机框图。 DSP 执行图 E.15 中的信号处理步骤,微控制器控制用户界面、电池管理和呼叫建立。(依据 Groe and Larson [2000] 的图 1.3。)图中包括天线、射频接收机 Rx、射频发射机 Tx、DSP、微控制器、扬声器、麦克风、显示屏和键盘。
电池效率影响销量:既包括等待来电时的待机功耗,也包括能够通话的分钟数。
手机开机后的首要任务是寻找小区。它扫描整个频段以找到最强的信号;由于需要在行驶车辆中工作,这一扫描每隔 7 秒就会重复一次,信号强度下降时也会重复。随后,它选择一个未被使用的无线电信道。本地交换中心为手机注册,记录其电话号码和电子序列号,并分配一个语音信道用于通话。为了确认手机获得了正确的信道,基站在该信道上发送一个特殊音调,手机再把音调发回以作确认。如果 5 秒内没有听到监视音调,手机就会超时,并从头重新执行这一过程。随着信号强度减弱,原基站向手机即将进入的基站发出切换请求。
为了通过无线电进行双向通话,两个方向分别使用预留频段,形成一个频率对,或称信道。最初的蜂窝基站在 869.04 至 893.97 MHz 发射,称为前向通路;手机在 824.04 至 848.97 MHz 发射,称为反向通路。两者之间留有频率间隔,防止相互干扰。一个小区可能有 4 至 80 个信道。信道又分为用于呼叫建立的建立信道,以及承载数据或语音业务的语音信道。
通信采用数字方式,类似调制解调器,速率为 9600 bit/s。由于无线介质容易丢失信息,从行驶车辆中通信时尤其如此,手机会把每条消息发送五次。为了节省电池电量,最初的手机通常根据与基站的距离,采用 0.6 W 或 3.0 W 两种发射功率。这种相对较低的功率不仅允许使用更小的电池,从而缩小手机尺寸,还便于实现频率复用,而频率复用正是蜂窝电话的关键。
图 E.17 展示了一部 Nokia 数字手机的电路板,并标出了主要部件。注意,电路板上有两个处理器。一个 Z-80 微控制器负责控制电路板功能、处理键盘和显示屏 I/O,以及与基站协调。DSP 负责所有信号压缩和解压缩。此外,还有用于模数和数模转换、放大、电源管理以及射频接口的专用芯片。
图 E.17 Nokia 手机中的电路板。 (HowStuffWorks, Inc. 提供。)图中标出射频与电源电路(RF and power)、音频 D/A 与 A/D、电池、内存,以及微处理器与控制逻辑。
2001 年,一部手机大约有 10 块集成电路,除了标准 CMOS 器件,还包括采用砷化镓、硅锗等特殊工艺的器件。出于经济性和灵活性的考虑,芯片数量后来缩减到只有几块。不过,这些 SOC 内部仍包含独立的微控制器和 DSP,由代码实现刚才描述的许多功能。
手机标准及其演进
人们通过多种标准提高手机通信速度。码分多址(code division multiple access,CDMA)是一个常见例子。与最早的、称为高级移动电话服务(advanced mobile phone service,AMPS)的主要采用模拟技术的系统相比,CDMA 为一条通信通路使用更宽的射频频带。
较宽的频带更难被阻断,这种技术称为扩频(spread spectrum)。其他标准还有时分多址(time division multiple access,TDMA)和全球移动通信系统(global system for mobile communication,GSM)。这些第二代标准——CDMA、GSM 和 TDMA——主要采用数字技术。
CDMA 的主要区别是,所有通话者共享同一个信道,该信道以高得多的速率运行,再通过对每个通话作独特编码来区分它们。每路 CDMA 通话最初为 9600 bit/s,随后经过编码,以大小相等的消息在 1.25 Mbit/s 的速率下传输。它不像 AMPS 那样把每个信号发送五次,而是扩展每个比特;按原书的表述,使其占用“最小频率的 11 倍”,从而在有干扰的情况下仍能成功传输。基站接收这些消息,并将其分离成每路通话各自的 9600 bit/s 数据流。
译注: “1.25 Mbit/s”和“最小频率的 11 倍”均为原书原述。“每个比特被扩展”与“频率的 11 倍”的关系在原文中未作说明,不能据此直接推导扩频因子;此处不补造原书没有给出的编码过程或参数。
为了增强私密性,CDMA 使用从一组 64 个预定义码中选取的伪随机序列。为同步手机与基站,使二者选取共同的伪随机种子,CDMA 依赖全球定位系统的时钟;GPS 持续发送精确的时间信号。通过精心选择编码,共享业务对收听者来说就像随机噪声。因此,共享同一信道的用户越多,噪声越大,信噪比也就逐渐降低。于是,CDMA 系统的容量在一定程度上取决于人们的主观接受程度,即听者对背景噪声有多敏感。
此外,CDMA 使用语音压缩,并根据通话中实际语音活动的多少改变传输数据率。
这两种技术都能节省带宽,从而使每个小区容纳更多通话。CDMA 必须仔细控制功率,避免靠近基站的信号淹没来自远处的信号,目标是让所有信号到达基站时的强度大致相同。额外的好处是,CDMA 手机发射的功率更低;这既有助于延长电池续航,也能在用户靠近基站时提高容量。
因此,与 AMPS 相比,CDMA 可以把系统容量提高最多一个数量级,改善通话质量和电池续航,并增强用户的私密性。在经历相当大的商业纷争之后,出现了一个名为 International Mobile Telephony 2000(IMT-2000)的新第三代标准,主要基于两个相互竞争的 CDMA 版本和一个 TDMA 版本。原书当时预计,这个标准可能使手机在世界任何地方都能使用。
E.8 结束语
嵌入式系统是一大类范围极广的计算设备,本附录只展示了其中一些方面。例如,TI 320C55 DSP 是一款相对“类似 RISC”的处理器,为嵌入式应用设计,具有经过精细调整的功能。另一端的 TI 320C64x 则是一款性能很高的八发射 VLIW 处理器,用于要求十分苛刻的任务。有些处理器只能依靠电池供电,另一些则可以使用市电。它们的共同点,是需要为嵌入式应用执行某种程度的信号处理。媒体扩展试图把 DSP 功能与更通用的处理能力结合起来,使这些处理器能够用于信号处理应用。
我们考察了几个案例,包括 Sony PlayStation 2、数码相机和手机。PS2 执行精细的三维图形处理,手机则按照复杂的通信标准对信号编码和译码;但两者的系统体系结构都与通用桌面或服务器平台十分不同。一般而言,对通用应用看似实用的体系结构决策,例如多级缓存或乱序超标量执行,在嵌入式应用中往往没有那么合适。这是由芯片面积、成本、功耗和实时约束共同决定的。这些系统所提供的编程模型,也对程序员和编译器提出了更高的要求,需要它们承担更多开发并行性的工作。
F 互连网络
修订者:Timothy M. Pinkston,南加州大学;José Duato,瓦伦西亚理工大学与 Simula。
“媒介即讯息”,因为正是媒介塑造并控制着人类交往与行动的探索方式和形式。
——Marshall McLuhan,Understanding Media(1964)
电影、广播和电视的奇迹,都是单向传播的奇迹;而单向传播根本称不上交流。
——Milton Mayer,On the Remote Possibility of Communication(1967)
互连网络是并行体系结构的心脏。
——Chuan-Lin Wu 与 Tse-Yun Feng,Interconnection Networks for Parallel and Distributed Processing(1984)
的确,随着系统复杂度与集成度不断提高,许多设计者发现,路由分组比布设连线更有效率。
——Bill Dally,Principles and Practices of Interconnection Networks(2004)
F.1 引言
前面的章节和附录介绍了单台计算机的组成部件,却很少讨论这些部件之间如何互连,以及多台计算机系统如何连接在一起。近年来,计算机体系结构的这些方面变得越来越重要。本附录介绍怎样将单个设备连接成一个能够相互通信的设备群体。这里泛称的“设备”,可以是计算机中的一个部件或一组部件,也可以是一台计算机,乃至一个计算机系统。图 F.1 展示了组成这个群体的各个要素:由设备及其软硬件接口构成的端节点、将端节点连接到互连网络的链路,以及互连网络本身。互连网络也称网络、通信子网或通信子系统。将多个网络互连称为网际互连(internetworking),它依靠通信标准,在不同类型的网络之间转换信息,互联网便是一例。
计算机体系结构设计者应当重视互连网络,原因有多个。除了提供外部连接,网络还广泛用于单台计算机内部各层次部件的互连,甚至深入处理器微体系结构。大型机使用网络已有很长历史;如今,为支持更强的计算能力和更大的存储容量,通信带宽需求大幅增长,个人计算机中也可以看到这样的设计。交换网络正在取代总线,成为计算机之间、I/O 设备之间、电路板之间、芯片之间乃至芯片内部模块之间的常规通信方式。计算机体系结构设计者必须理解互连问题及其解决办法,才能更有效地设计和评估计算机系统。
图内术语:Device=设备;SW interface=软件接口;HW interface=硬件接口;End node=端节点;Link=链路;Interconnection network=互连网络。
互连网络覆盖的应用领域十分广泛,正如存储层次结构覆盖很宽的速度和容量范围一样。处理器芯片和系统内部的网络,往往与处理器和存储器具有许多共同特征:它们更多依靠高速硬件方案,较少依靠灵活的软件栈。跨系统实现的网络则通常与存储和 I/O 更相似,更多依靠操作系统和软件协议,而非高速硬件——不过,如今这些方向正在趋于融合。在所有这些领域,性能都包括延迟和有效带宽;除了仿真技术,排队论也是评估性能的重要分析工具。
这个主题非常庞大:图 F.1 的某些部分,本身就是整本书或整门大学课程讨论的内容。本附录旨在为计算机体系结构设计者概述网络问题及其解决方案。我们将对关键概念和思想作入门性解释,介绍互连网络技术与方法对体系结构的影响,并提供便于深入阅读的参考资料。本附录还用一套统一术语描述基本选择,为评估各种互连网络提供共同框架。我们将看到,许多类型的网络具有共同的优选方案,但另一些网络的最佳解决办法却很不相同。跨越不同网络应用领域时,这些差异尤其明显。
互连网络的应用领域
互连网络部署在计算机系统内部及系统之间的不同层次,以满足高性能计算、存储 I/O、集群/工作组/企业系统、网际互连等应用的运行需求。根据待连接设备的数量及其相互距离,可以将互连网络分为四大领域。
- 片上网络(on-chip network,OCN):也称 network-on-chip(NoC),用于连接芯片或多芯片模块内的微体系结构功能单元、寄存器堆、缓存、计算 tile、处理器核心及 IP 核。当前及近期的 OCN 可以连接几十到几百个此类设备,最大互连距离为厘米量级。高性能芯片中的大多数 OCN 都经过专门设计,以缓解工艺持续缩小、晶体管集成度提高所造成的横跨芯片的片内连线延迟问题;不过,一些专有设计正得到更广泛的应用,例如 IBM 的 CoreConnect、Arm 的 AMBA 和 Sonic 的 Smart Interconnect。目前 OCN 的实例包括:Intel Teraflops 处理器芯片中的网络 [Hoskote07],连接 80 个简单核心;Intel Single-Chip Cloud Computer(SCCC)中的网络 [Howard10],连接 48 个 IA-32 体系结构核心;以及 Tilera 的 TILE-Gx 系列处理器 [TILE-GX] 中的网络。后者在 2011 年第四季度采用 TSMC 的 40 nm 工艺连接 100 个处理核心,并计划在 2013 年采用 TSMC 的 28 nm 工艺连接 200 个核心,代号为“Stratton”。两款 Intel 原型的网络峰值带宽均为 256 GBps,TILE-Gx100 处理器则最高达到 200 Tbps。有关 OCN 的更多详细信息,见 Flich [2010]。
- 系统/存储区域网络(system/storage area network,SAN):用于多处理器和多计算机系统内部的处理器间互连、处理器与存储器之间的互连,也用于服务器与数据中心环境中存储和 I/O 部件的连接。通常可以连接数百个这样的设备;一些超级计算机的 SAN 则能互连数千个设备,例如 IBM Blue Gene/L 超级计算机。最大互连距离覆盖的范围相对较小,通常为几十米量级,但有些 SAN 可跨越数百米。例如,2000 年末推出的流行 SAN 标准 InfiniBand,可以在 300 m 距离上,以最高 120 Gbps 的速率支持系统和存储 I/O 互连。
- 局域网(local area network,LAN):用于连接分布在机房、建筑物或园区内的独立计算机系统。将 PC 连接成集群,就是一个典型例子。最初,LAN 最多只连接约一百个设备;借助网桥,如今可以连接数千个设备。最大互连距离通常覆盖几千米,但有些网络可跨越几十千米。例如,最流行且经久不衰的 LAN——以太网——有一种 10 Gbps 标准版本,可在 40 km 距离上保持最高性能。
- 广域网(wide area network,WAN):也称长途网络,连接分布在全球的计算机系统,因此需要网际互连支持。WAN 能在数千千米的距离尺度上连接数百万台计算机。异步传输模式(Asynchronous Transfer Mode,ATM)就是一个 WAN 实例。
图 F.2 按互连设备数量及距离尺度,大致展示了这些网络领域之间的关系。一些网络在一个或两个维度上存在重叠,由此产生产品竞争。有些网络方案已成为商业标准,另一些仍为专有方案。根据设计要求,不同互连网络领域的优选方案可能有显著差异,但各领域所面对的问题,以及解决这些问题所用的概念,却依然惊人地相似。不论面向哪个领域,都应避免使网络成为系统性能与成本效益的瓶颈。因此,计算机体系结构设计者的最终目标,是设计成本尽可能低的互连网络,使其能在尽可能短的时间内传送尽可能多的可用信息。
图内横轴为互连设备数量,纵轴为距离(m),均采用数量级刻度。
本附录的思路与组织
要理解互连网络,可以采用自顶向下的方法,逐步揭示设计网络涉及的概念与复杂性。我们首先把网络看成一个不透明的“黑盒”,假定它只是以理想方式完成若干必要功能;随后,系统地打开黑盒的各个层次,逐渐揭示更复杂的概念和网络的非理想行为。
F.2 节先讨论仅互连两个设备的情况。此时,可以把黑盒网络看作一个简单的专用链路网络,即在两个设备之间双向传输的导线或导线集合。F.3 节接着讨论互连两个以上设备的情况,此时黑盒网络可以看作连接这些设备的共享链路网络,或点到点交换网络。之后,我们继续剥开黑盒的其他层次,更详细地考察网络拓扑(F.4 节)、路由、仲裁与交换(F.5 节),以及交换机微体系结构(F.6 节)。F.7 节讨论商用网络中的实际问题,F.8 节通过实例说明各类网络的权衡。F.9 节简要讨论网际互连,F.10 节介绍互连网络中贯穿各层的其他问题。F.11 节列举互连网络中一些常见的谬误与陷阱,F.12 节给出结束语。最后,F.13 节简要介绍历史背景并推荐进一步阅读的资料。
F.2 互连两个设备
本节介绍理解两个联网设备之间如何通信所必需的基本概念,包括接收方可能尚未准备好处理发送方发来的数据,以及传输中可能发生错误等情况。为便于理解,此时可以将黑盒网络看作理想网络,其行为相当于两个设备之间的简单专用链路。图 F.3 展示了这种情况:单向连线从设备 A 通向设备 B,反方向也有一条;每个端节点都包含一个保存数据的缓冲区。不论网络多么复杂、是否采用专用链路,每个端节点设备都需要与网络连接,向网络注入信息并从网络接收信息。我们先介绍端节点为发起和完成通信所必须执行的基本功能,再讨论网络介质以及网络为实现通信所必须执行的基本功能。之后给出一个简单的性能模型,并通过若干例子说明关键网络参数的影响。
网络接口的功能:构造与处理消息
假设希望两个联网设备互相读取对方存储器中的一个字。发送或接收的信息单位称为消息(message)。为了取得所需数据,两个设备首先必须构造并发送一种消息,即包含该数据在另一设备中地址的请求。这个地址,即存储器或操作数的位置,使接收方能够确定到哪里寻找被请求的信息。处理请求后,每个设备再构造并发送另一种消息,即包含数据的应答。地址与数据信息通常称为消息的有效载荷(payload)。
除了有效载荷,每条消息还包含一些控制位,供网络投递消息以及接收方处理消息使用。最常见的控制位用于区分消息类型,例如请求、应答、请求确认和应答确认,以及使网络能够将信息正确传送到目的地。根据这些附加控制位相对于有效载荷的位置,它们编码在消息的首部和/或尾部中。图 F.4 给出了图 F.3 所示简单专用链路网络的一种消息格式。这个例子只有一个字的有效载荷,但某些互连网络中的一条消息可以包含数千个字。
图内字段:Destination port=目的端口;Message ID=消息 ID;Sequence number=序号;Data=数据;Checksum=校验和。Type=类型,其中 00 为请求、01 为应答、10 为请求确认、11 为应答确认;Header、Payload、Trailer 分别表示首部、有效载荷与尾部。
消息在通过网络传输之前,必须先构造出来;从网络收到消息之后,也必须进行处理。这些操作以及下文介绍的其他功能,由端节点中的网络接口负责,网络接口也称通道适配器。除了用于向网络发送消息、从网络接收消息的直接存储器访问(DMA)引擎与链路驱动器,还可以使用专用存储器或寄存器来缓冲收发消息。根据网络所属领域和设计要求,网络接口硬件可以仅由通信设备自身构成,如 OCN 和某些 SAN;也可以是一块独立接口卡,集成多个嵌入式处理器、多个 DMA 引擎以及数千兆字节 RAM,如许多 SAN 以及大多数 LAN 和 WAN。
除硬件外,网络接口也可包含软件或固件,以执行所需操作。即使是图 F.3 的简单例子,也可能调用消息传递软件,将请求和应答转换为带有适当首部的消息。这样,用户应用就不必关心消息的构造和处理,因为这些任务可以在较低层次自动完成。应用程序通常与操作系统或运行时系统协作,发送和接收消息。由于每个设备上的多个进程很可能共享网络,操作系统不能让发给一个进程的消息被另一个进程接收。因此,消息传递软件必须包含区分进程的保护机制。一种做法是在首部中增加发送进程与目标接收进程都知道的端口号。
除了构造和处理消息,端节点还必须完成其他功能,才能在设备之间建立通信。虽然硬件支持可以减少工作量,其中有些工作也可以用软件完成。例如,大多数网络都规定一次可以传输的信息上限,即最大传输单元,以便合理确定网络缓冲区的大小。超过最大传输单元的消息会被划分为较小的单位,称为分组(packet)或数据报(datagram),再通过网络传送。目的端节点在将数据交付应用之前,会把这些分组重新组装为消息。通过在分组首部中加入消息 ID 字段,可以区分属于同一条消息的分组与其他分组。如果分组乱序到达目的地,就在重组消息时重新排序;通常为此在分组首部设置另一个包含序号的字段。
端节点为发起并完成网络通信所遵循的一系列步骤,称为通信协议。发送和接收通常遵循彼此对称、顺序相反的步骤。通信协议由软件与硬件共同实现,以加快执行速度。例如,许多网络接口卡具有硬件定时器,以及将消息拆分为分组、重新组装消息、计算循环冗余校验(CRC)校验和、处理虚拟存储器地址等硬件支持。
一些网络接口还包含额外硬件,将协议处理从主机计算机卸载出去,例如 LAN 和 WAN 中使用的 TCP 卸载引擎。但对于 SAN 这类低延迟互连网络,即使使用消息传递接口(MPI)等较轻量的通信协议,这也可能仍然不够。通过绕过操作系统(OS),还能进一步提高通信性能。实现方法可以是直接在网络接口存储器中分配消息缓冲区,使应用直接读写这些缓冲区,从而避免额外的存储器到存储器复制。相应协议称为零复制协议或用户级通信协议。在初始化时调用 OS 分配缓冲区,并由硬件阻止未经授权的存储器访问,仍然能够保持保护机制。
一般而言,端节点通过网络发送消息时,需要执行以下部分或全部步骤:
- 应用执行系统调用,将待发送数据复制到操作系统或网络接口缓冲区;必要时将消息拆分成分组,并构造分组首部与尾部。
- 计算校验和,将其写入分组首部或尾部。
- 启动定时器,由网络接口硬件发送分组。
消息接收按相反顺序进行:
步骤 3: 网络接口硬件接收分组,放入自身缓冲区或操作系统缓冲区。
步骤 2: 对每个分组计算校验和。如果与发送方的校验和匹配,接收方就向分组发送方返回确认;否则丢弃该分组,并假定发送方会在相应定时器超时后重新发送。
步骤 1: 全部分组通过检查后,系统重新组装消息,将数据复制到用户地址空间,并通知相应应用。
发送方还必须对分组确认作出响应:
- 收到确认时,释放缓冲区中相应分组的副本。
- 如果尚未收到确认就发生超时,则重新发送分组,并重新启动定时器。
正如网络端节点通过协议支持通信一样,网络内部的物理层、数据链路层与网络层也使用协议,主要负责分组传输、流量控制、错误处理及下面介绍的其他功能。
网络的基本结构与功能:介质与物理形式、分组传输、流量控制和错误处理
分组在源端准备好发送之后,由网络接口中的专用硬件注入网络。硬件包含收发器电路,以驱动电气或光学的物理网络介质。介质类型与物理形式,主要取决于应在多大互连距离上维持某种信号速率,例如传输速度。在芯片或多芯片模块内的厘米或更短距离上,通常可以利用中上层铜金属互连,使每条线达到数 Gbps 的信号速率。印制在电路板、中板与背板上的十几层或更多层铜走线,可以在约 1 m 距离上支持 Gbps 级差分对信号速率。Category 5E 非屏蔽双绞铜线可在 100 m 距离上实现 0.25 Gbps 的传输速度;同轴铜缆可在千米距离上提供 10 Mbps。在这些导体线路中,通常可以在一定限度内,以缩短距离换取更高传输速度。光学介质则能在千米距离上实现更高速度:多模光纤可在几千米距离上支持 100 Mbps,更昂贵的单模光纤可在数千米距离上支持 Gbps 级传输。波分复用还能使光纤带宽提高数倍,倍数等于所用波长的数量。
驱动网络链路的硬件还可能包含编码器,将信号编码为适合给定传输距离的非二进制形式。编码技术可以采用多个电压电平、冗余、数据与控制的轮换(例如 4b5b 编码),以及/或者保证单位时间内的最少信号跳变次数,以便接收方恢复时钟。接收端对信号解码,并将分组存入对应缓冲区。所有这些操作都在网络物理层完成,其细节超出了本附录的范围;幸运的是,我们无需深入这些细节。从数据链路层及更高层看,物理层可以视为一条没有分级的长线性流水线,信号以波的形式在网络传输介质中传播。上述各项功能通常统称为分组传输。
除了传输分组,网络硬件和软件还在数据链路层与网络层协议中共同负责可靠投递。这包括两项责任:(1)防止发送方发送分组的速率超过接收方的处理速率;(2)确保分组在传输过程中既不损坏,也不丢失。第一项责任有两种实现方式:接收方缓冲区满时丢弃分组,之后通知发送方重传;或者在缓冲区满时通知发送方停止发送,待缓冲区有空间容纳更多分组时再恢复。后一种策略通常称为流量控制。
除了发送方与接收方之间简单的握手,还有几种常用且值得关注的流量控制技术。较流行的是 Xon/Xoff(也称 Stop & Go)和基于 credit 的流量控制。Xon/Xoff 在缓冲区占用率达到高水位时,通知发送方停止发送;降至低水位时,通知发送方恢复发送。两者之间保留一定滞回区间,以减少通知数量。这些“停止”和“继续”信号可以通过附加控制线发送,也可以编码在控制分组中。
基于 credit 的流量控制通常在发送方设置一个 credit 计数器,初始 credit 数等于接收方的缓冲区条目数。每发送一个分组,发送方就将计数器减一。接收方从缓冲区中取走一个分组后,以控制分组的形式返还一个 credit;发送方收到它后将计数器加一。这些方法本质上都是在接收方达到低水位,或发送方用完 credit 时,限制发送端注入分组,从而控制流入网络的分组数量。
译注: 上一段原文写作“接收方达到低水位”。结合前文 Xon/Xoff 的占用率定义,停止发送对应高占用率,低水位对应恢复发送。
Xon/Xoff 通常产生的控制流量远少于基于 credit 的流量控制,因为只有跨过高、低占用率水位时才发送通知。另一方面,基于 credit 的流量控制所需缓冲区不足 Xon/Xoff 的一半。Xon/Xoff 的缓冲区必须足够大,以保证“停止”信号到达发送方之前不会溢出;而基于 credit 的流量控制不会发生这种溢出,因为发送方会在 credit 耗尽时停止传输。对这两种方法而言,只有缓冲区大小与通信距离相适应,才能充分利用链路带宽。
下面用一个覆盖不同互连网络领域的简单例子,比较这两种流量控制技术的缓冲需求。
例题:流量控制所需的缓冲容量
假设一个专用链路网络连接两个设备,每条链路每个方向的原始数据带宽都是 8 Gbps。为了充分利用网络带宽,一个设备持续向另一个设备发送大小为 100 字节(包括首部)的分组。若只考虑链路传播延迟,在互连距离分别为 1 cm、1 m、100 m 和 10 km 时,基于 credit 的流量控制最少需要多少 credit 和缓冲空间?与 Xon/Xoff 相比,所需的最小缓冲空间有何差别?
解答 起初接收缓冲区为空,发送方的 credit 数等于缓冲区容量。每发送一个分组,发送方消耗一个 credit。为了使发送方能持续以网络速率发送分组,第一个返还的 credit 必须在 credit 耗尽之前到达发送方。收到第一个 credit 后,发送方会以发送分组的相同速率持续收到 credit。这里仅考虑链路上的传播延迟,不考虑其他延迟和开销,因此假定发送方和接收方的处理时间为零。从开始发送第一个分组,到第一个 credit 返回发送方,所需时间等于分组到接收方、再由 credit 返回发送方的往返传播延迟。该时间必须小于或等于分组发送时间与初始 credit 数的乘积:
光速约为 300,000 km/s。假定在导体中可以达到其 66%,则每个距离所需的最小 credit 数满足:
每个 credit 对应一个能容纳一个分组的缓冲条目。因此,在 1 cm 和 1 m 距离上,每个设备所需的最少 credit 数及缓冲空间均为 1 个分组;在 100 m 距离上为 10 个分组;在 10 km 距离上为 1000 个分组。
对于 Xon/Xoff,上述最小缓冲容量分别对应高水位到缓冲区顶部,以及低水位到缓冲区底部的空间。为了减少通知,还需要在高、低水位之间增加滞回区间。因此,Xon/Xoff 所需的最小缓冲空间是基于 credit 的流量控制的两倍以上。
实现流量控制的网络不需要丢弃分组,有时称为无损网络;会丢弃分组的网络则有时称为有损网络。这种分组处理方式上的单一差异,会强烈限制其他相关网络问题可采用的解决方案,包括分组路由、拥塞、死锁和可靠性;本附录后面将讨论这些问题。它对性能的影响也很大:丢弃的分组需要重传,因而占用更多链路带宽,并承受额外延迟。这些行为与性能差异,最终限制了某些方案适用的互连网络领域。例如,较短距离上传输分组的大多数网络,如 OCN 和 SAN,倾向于实现流量控制;较长距离上的网络,如 LAN 和 WAN,则倾向于允许丢弃分组。在较短距离上,流控信息传回发送方的延迟可以忽略,而在较长距离上则不能。通常运行的应用种类,也会影响有损或无损网络的选择。例如,丢弃 Web 浏览器等互联网客户端发出的分组,只影响对应用户观察到的延迟;但如果丢弃的是并行应用中某个进程发送的分组,而该分组延迟位于关键路径上,就可能显著延长整个应用的执行时间。
第二项责任,即确保分组在传输中既不损坏也不丢失,可以通过检测并恢复传输错误的机制实现。如图 F.4 所示,在分组格式中加入校验和或其他检错字段,便可使接收方检测错误。这些冗余信息在发送时计算,在接收时核验。分组通过检查后,接收方以控制分组的形式发送确认。注意,这种确认控制分组也可以同时携带流量控制信息,例如一个 credit 或停止信号,从而减少控制分组开销。前面已经说明,最常见的错误恢复方式,是用定时器记录每个分组的发送时间;如果确认到达之前定时器已经超时,就认定分组丢失或传输有误,并重新发送。
网络内部及端节点之间的通信协议,还必须处理分组传输、流量控制和可靠性之外的许多问题。例如,两个设备若来自不同制造商,可能采用不同的字内字节顺序,即大端或小端字节序;协议就必须在投递过程中将每个字的字节顺序反转。协议还必须防范一种情况:先前延迟的分组重新继续传输,从而产生重复分组。根据系统要求,协议可能需要使操作流水化,以提高性能。最后,在连接两个以上设备时,协议可能还要处理网络拥塞,避免性能下降;F.7 节将进一步介绍。
性能刻画:延迟与有效带宽
介绍了两个设备间收发消息的基本步骤之后,现在可以讨论性能了。先看传输单个分组的延迟,再看在分组粒度上将多个分组的网络传输流水化时,所能达到的有效带宽,也称吞吐量。
图 F.5 展示了单个分组延迟的基本组成部分。随着后面逐渐揭示网络“黑盒”的内部结构,一些延迟分量还会进一步细分。图中的时间参数适用于许多互连网络领域:芯片内部、电路板上的芯片之间、机箱中的电路板之间、计算机中的机箱之间、集群中的计算机之间、集群之间,等等。具体数值可能变化,但延迟的组成部分相同。
图内术语:Sender/Receiver=发送方/接收方;Sender overhead/Receiver overhead=发送开销/接收开销;Transmission time=传输时间,等于字节数除以带宽;Time of flight=飞行时间;Transport latency=传送延迟;Total latency=总延迟;Time=时间。
下面这些术语经常被宽泛使用,容易造成混淆,因此在这里给出较精确的定义。
- 带宽(bandwidth):严格地说,传输介质的带宽是一个频率范围;在这个范围内,该介质引入的单位长度衰减低于某个阈值。它必须与传输速度区分,后者是单位时间通过介质传输的信息量。例如,20 世纪 90 年代末,调制解调器通过编码更多电压电平,使每个信号周期承载更多位,在固定带宽下提高了传输速度;这里的固定带宽,是电话线路话音信道提供的 3 kHz 带宽。不过,为了与更广泛使用的含义一致,本附录用“带宽”表示信息能够传输的最高速率,其中的信息包括分组首部、有效载荷与尾部。单位通常为 bit/s,有时也使用 byte/s。带宽一词也用于表示介质,即网络链路的实测速率。聚合带宽是网络提供的总数据带宽;有效带宽或吞吐量,是聚合带宽中网络实际交付给应用的部分。
- 飞行时间(time of flight):分组的第一位到达接收方所需的时间,包括链路传播延迟,以及网络内其他硬件(如链路中继器和网络交换机)引起的延迟。其单位可以是 WAN 中的毫秒、LAN 中的微秒、SAN 中的纳秒,以及 OCN 中的皮秒。
- 传输时间(transmission time):分组通过网络所需的时间,不包括飞行时间。一种测量方法,是求分组第一位与最后一位到达接收方的时刻之差。按定义,传输时间等于分组大小除以网络链路的数据带宽。这里假定没有其他分组竞争带宽,即网络为零负载或无负载状态。
- 传送延迟(transport latency):飞行时间与传输时间之和,即分组停留在互连网络内的时间。换一种表述,就是从分组第一位注入网络,到最后一位到达接收方的时间;它不包括发送方准备分组的开销,以及接收方收到分组后进行处理的开销。
- 发送开销(sending overhead):端节点准备一个分组,以便注入网络所需的时间;这里指分组,而不是消息,包括硬件和软件两部分。在这整个时间内端节点都处于忙碌状态,所以称为开销。端节点一旦空闲,此后的延迟便计入传送延迟。假定开销由一个常数项,以及一个依赖分组大小的可变项组成。常数项包括存储器分配、分组首部准备、DMA 设备设置等;可变项主要来自缓冲区之间的复制,对极短分组通常可以忽略。
- 接收开销(receiving overhead):端节点处理到达分组所需的时间,也包括硬件和软件两部分。同样假定它由常数项和依赖分组大小的可变项构成。一般而言,接收开销大于发送开销。例如,接收方可能需要支付中断处理成本,也可能必须将分组重新排序并组装成消息。
一个分组的总延迟可以写成:
下面看看,从 OCN 到 SAN、LAN 再到 WAN,传送延迟的各分量以及发送和接收开销的重要性如何变化。
例题:不同网络领域中的总延迟
假定一个专用链路网络连接 OCN、SAN、LAN 或 WAN 中的两个设备,每条链路每个方向的数据带宽都是 8 Gbps,希望在设备间传送大小为 100 字节(包括首部)的分组。端节点的每分组发送开销为 ,接收开销为 ;其中 OCN、SAN、LAN、WAN 的 分别为 0 μs、0.3 μs、3 μs、30 μs,这些是相应网络类型的典型值。假定飞行时间仅包括链路传播延迟,不包括交换或其他延迟,请计算在互连距离分别为 0.5 cm、5 m、5000 m、5000 km 时,从一个设备向另一个设备发送分组的总延迟。
解答 利用上面的表达式,以及前一个例题给出的导体传播延迟计算方式,代入各网络参数即可求得总分组延迟。对于 OCN:
将所有项换算成纳秒,OCN 的总延迟为:
代入 SAN 的相应数值:
代入 LAN 的相应数值:
代入 WAN 的相应数值:
长距离情况下,飞行时间占总延迟的比例增大,且传输错误更容易发生;因此,WAN 和 LAN 采用更复杂、更耗时的通信协议,使发送与接收开销增大。标准化的需要也是原因之一。此外,从几十个、几百个、几千个到数万个设备,不同互连网络领域中典型应用对协议提出的要求,也会增加复杂性。后面讨论连接两个以上设备时,还会考察这一问题。
上述例子表明,对 WAN 和某些 LAN 而言,飞行时间中的传播延迟极大,其他延迟分量,包括发送与接收开销,实际上都可以忽略。但 SAN 和 OCN 并非如此:与开销和传输延迟相比,传播延迟很小。请记住,这个例子只考虑了信号在链路中的传播,忽略了交换机及网络中其他硬件造成的飞行时间。在不拥塞的 WAN 和 LAN 中,交换机延迟通常远小于端节点开销和链路传播延迟;但对多处理器 SAN 和多核 OCN 而言,不一定如此,后面将会看到这一点。
到目前为止,我们只考察了单个分组的传送,并计算其端到端总延迟。为了计算两个联网设备的有效带宽,需要考察它们之间连续传送的分组流。必须记住,对给定成本与功耗目标进行优化的网络,除了要尽量缩短分组延迟,还要在尽可能短的时间内传送尽可能多的可用信息;衡量这一点的指标就是网络交付的有效带宽。
对于不必等到应答就能发送下一分组的应用,发送方可以将后续分组的发送开销,与先前分组的传送延迟和接收开销重叠。这本质上是将网络上的分组传输流水化,也称链路流水化。幸运的是,正如本书前面各章所述,许多应用领域都允许多个应用,或同一应用的多个线程并发通信,例如 Web 服务器并发处理数千个客户端请求,或流媒体传送。因此,设备能够连续发送分组流,而不必等待确认或应答。此外,长消息在传送前通常会拆分成最大大小的分组,在这种情况下,也会连续向网络注入多个分组。若无法实现这种重叠,就必须等到前一分组被确认之后才能发送后一分组,性能会显著下降。
对流水化传送的分组进行确认也很直接:只需在源端保留所有已发送但尚未确认分组的副本,并跟踪返回确认与缓冲分组之间的对应关系。发送方收到相应确认后,便将分组从缓冲区移除。确认中包含该分组的消息 ID 和序号,就能建立这种对应关系。此外,每个缓冲分组必须关联一个独立定时器,以便超时后重传。
网络分组传送的流水化,与处理器内部计算的流水化有很多相似之处,但也存在差别,例如不需要任何级间锁存器。信息只是以连续信号波的形式在网络链路上传播。因此,可以将网络看成具有所需任意级数的逻辑流水线,使飞行时间不影响可实现的有效带宽。前一分组传输结束后,可以立即开始下一分组的传输,从而将当前分组的发送开销,与先前分组的传送延迟及接收延迟重叠。
如果发送开销小于传输时间,分组便能背靠背地连续传输;持续发送时,有效带宽趋近于原始链路带宽。反之,如果发送开销大于传输时间,注入点的有效带宽就会远低于原始链路带宽。对于每条持续向网络注入分组流的链路,其链路注入带宽 为:
还必须考虑接收方无法以分组到达速率消耗分组的情况。如果接收开销大于发送开销,接收方处理到达分组的速度不够快,就会出现这种现象。此时,网络每条接收链路的链路接收带宽 小于链路注入带宽,其表达式为:
两个设备通过专用链路通信时,一个设备发送的全部分组都由另一个设备接收。如果接收方无法足够快地处理分组,其缓冲区就会填满,流量控制将限制发送方的传输。由于这种情况来自网络外部的原因,这里不作进一步讨论。另外,如果接收开销大于发送开销,接收缓冲区同样会填满,流量控制也会限制发送方的传输。在这种情况下,从平均效果看,流量控制相当于用接收开销替代发送开销。
假定网络理想地表现为两条方向相反、以满链路带宽运行的专用链路,这与迄今为止对网络的黑盒认识一致,则有效带宽等于“注入带宽的两倍”和“接收带宽的两倍”中的较小者。乘以二,是因为两个设备各有一条注入链路。由此得到:
其中,。结合传输时间的表达式,可以看出:当传输时间大于开销时,网络交付的有效带宽就等于聚合网络带宽。因此,只要网络行为理想,即为基于 credit 和 Xon/Xoff 的流量控制提供足够的 credit 与缓冲区,就能充分利用网络,而与飞行时间以及分组传播距离无关。
这个分析假定发送方与接收方的网络接口一次只能处理一个分组。如果可以并行处理多个分组,例如 IBM Federation 网络接口的做法,那么这些分组的开销就能重叠,使有效带宽按重叠倍数提高,直到达到传输时间规定的上限。
下面利用前述表达式,考察分组大小、传输时间和开销对 OCN、SAN、LAN、WAN 中链路注入带宽、链路接收带宽及有效带宽的影响。
例题:分组大小与有效带宽
与上一例相同,假定专用链路网络连接 OCN、SAN、LAN 或 WAN 中的两个设备,每条链路每个方向的数据带宽为 8 Gbps。对于 4 字节(一个 32 位字)到 1500 字节(以太网最大传输单元)的分组,绘制各类网络中有效带宽随分组大小变化的曲线。端节点的每分组发送与接收开销仍分别为 和 ;OCN、SAN、LAN、WAN 的 分别为 0 μs、0.3 μs、3 μs 和 30 μs。什么因素限制了有效带宽?分组大小达到多少时,有效带宽与聚合网络带宽的差距不超过 10%?
解答 图 F.6 利用上述简单表达式和参数,绘出了四种网络领域中有效带宽随分组大小变化的曲线。对 OCN 而言,在所有分组大小下,传输时间都大于发送或接收开销,因而能够充分利用 16 Gbps 的聚合带宽,即将注入链路(或接收链路)带宽乘以二,以计入两个设备。
图内横轴为分组大小(bytes),纵轴为有效带宽(Gbit/s);四条曲线分别对应 OCN、SAN、LAN、WAN。
对 SAN 而言,当分组小于约 800 字节时,开销,具体说是接收开销,大于传输时间;因此,要利用至少 90% 的聚合带宽,分组必须达到 655 字节或更大。对于 LAN 和 WAN,在本例所有分组大小下,开销都远大于传输时间,因此大多数链路带宽未被利用。
译注: 原图、原解答中的约 800 字节和 655 字节按原书保留。若严格代入题干给定的 SAN 参数,接收开销为 ns,传输时间为 ns( 为分组字节数);两者相等时约为 421.1 字节,达到 90% 带宽所需约为 377.0 字节。因此,题干参数与图、解答的阈值并不一致,不应把原图阈值当作该组参数的精确计算结果。
这个例子说明,要使网络交付的有效带宽最大化,降低相对于分组传输时间的发送与接收开销十分重要。
上述分析表明,可以通过检查分组经过的路径、确定瓶颈位置,给有效带宽求出一个上界。我们可以将这个思路扩展到网络接口之外:把整个端到端网络看作一条管道,并找出其中最窄的部分。需要关注三处:全部网络注入链路的聚合及其网络注入带宽 ;全部网络接收链路的聚合及其网络接收带宽 ;以及全部网络链路的聚合及其网络带宽 。随着后面逐步揭示网络黑盒的内部结构,将给出这些带宽的表达式。
到目前为止,我们假定只互连两个设备时,黑盒网络表现理想,网络带宽等于聚合原始网络带宽。实际上,网络带宽可能远低于聚合带宽,下面各节将说明这一点。一般而言,网络端到端交付给应用的有效带宽,受上述三个潜在瓶颈区域中最小值的限制:
后面随着对互连网络了解加深,并考察互连两个以上设备的一般情况,还会进一步扩展这个表达式。
本附录的一些小节将介绍相应概念在高端商用产品中的具体实现。图 F.7 列出了几种商用计算机;它们都曾在其发展历程的某个时刻,成为同类中全球性能最高的系统之一。虽然这些系统能够互连两个以上设备,但同样实现了仅互连两个设备所必需的基本功能。本节讨论的问题不仅适用于这些系统中的 SAN,也适用于从 OCN 到 WAN 的其他互连领域。
| 公司 | 系统[网络名称] | 推出年份 | 最大计算节点数[每节点 CPU 数] | 最大配置占地 | 分组最大大小[首部](字节) | 每节点注入[接收]带宽(MB/s) | 最小发送/接收开销 | 最大铜缆长度;流控;检错 |
|---|---|---|---|---|---|---|---|---|
| Intel | ASCI Red Paragon | 2001 | 4510[×2] | 2500 ft² | 1984[4] | 400[400] | 数 μs | 握手;CRC+奇偶校验 |
| IBM | ASCI White SP Power3[Colony] | 2001 | 512[×16] | 10,000 ft² | 1024[6] | 500[500] | 约 3 μs | 25 m;基于 credit;CRC |
| Intel | Thunder Itanium2 Tiger4[QsNet II] | 2004 | 1024[×4] | 120 m² | 2048[14] | 928[928] | 0.240 μs | 13 m;基于 credit;链路与目的端 CRC |
| Cray | XT3[SeaStar] | 2004 | 30,508[×1] | 263.8 m² | 80[16] | 3200[3200] | 数 μs | 7 m;基于 credit;CRC |
| Cray | X1E | 2004 | 1024[×1] | 27 m² | 32[16] | 1600[1600] | 0(直接 LD、ST 访问) | 5 m;基于 credit;CRC |
| IBM | ASC Purple pSeries 575[Federation] | 2005 | >1280[×8] | 6720 ft² | 2048[7] | 2000[2000] | 约 1 μs,最多并行处理 4 个分组 | 25 m;基于 credit;CRC |
| IBM | Blue Gene/L eServer Sol.[Torus Net.] | 2005 | 65,536[×2] | 2500 ft²(每 1K 节点机架为 0.9 × 0.9 × 1.9 m³) | 256[8] | 612.5[1050] | 约 3 μs(2300 周期) | 8.6 m;基于 credit;CRC(首部/分组) |
F.3 连接两个以上设备
到目前为止,我们只考虑了两个设备通过黑盒网络通信的连接方式。但互连网络真正吸引人的地方,是能够将数百个、甚至数千个设备连接在一起;这一点也使其构建更加困难。为了连接两个以上设备,网络必须具备适当的结构和更多功能。本节继续采用黑盒方法,从概念层面介绍多设备互连所需的附加网络结构与功能。F.4–F.7 节将进一步讨论各项主题的细节。在适用之处,我们会将这些结构与功能,同上一节介绍的网络介质、流量控制及其他基础概念联系起来。本节还按照连接结构,将网络分为共享介质网络与交换介质网络两大类,并加以比较。最后扩展网络性能的表达式,再给出一个例子。
附加的网络结构与功能:拓扑、路由、仲裁和交换
互连两个以上设备的网络,需要通过某种机制,在分组源端与目的端之间建立物理连接,以传送分组并将其投递到正确目的地。这些机制有不同实现方式,不同互连网络领域之间也可能有很大差异。不过,不论属于哪个领域,所涉及的网络结构与功能类型基本相同。
多个设备通过网络互连时,往往不能用专用链路永久建立它们之间的连接。这样做要么限制过强,因为给定源端的所有分组都只能到达同一个目的端,而不能发往其他目的端;要么成本高得难以接受,因为每个源端到每个目的端都需要一条专用链路。下一节将进一步评估这一点。因此,网络通常让不同设备对共享路径;路径如何共享,由网络的连接结构决定,这种结构通常称为网络拓扑。拓扑回答的是一个重要问题:“分组有哪些可能的路径?”这些路径应使分组到达预定目的地。
凡是互连两个以上设备的网络,还需要一种将每个分组投递到正确目的地的机制。相应功能称为路由,可以定义为:计算从分组源端到其目的端的有效路径所需执行的一组操作。路由回答的是:“对分组而言,可能路径中的哪些路径是允许的,即有效的?”同样,目的是使分组到达预定目的地。根据网络的不同,这个功能可以在源端执行,计算整条路径;也可以在中间设备执行,动态计算部分路径;还可以在每个可能的目的设备执行,核实该设备是否就是分组的目标。通常需要扩展图 F.4 中的分组首部,以包含必要的路由信息。
一般而言,网络中的不同设备对会共享路径或路径的一部分,因此分组可能请求共享资源。多个分组同时请求同一资源时,需要用仲裁功能解决冲突。仲裁与流量控制共同回答:“路径何时可以供分组使用?”每次仲裁都会产生一个胜者,并可能有多个败者。败者未获准访问所请求的资源,通常需要缓冲。如前一节所述,可以实现流量控制,以防止缓冲区溢出。胜者获得的资源接通后,形成了可继续前进的路径,它便向目的端推进。这一功能称为交换。交换回答的是:“如何将路径分配给分组?”为了提高已有通信资源的利用率,大多数网络不会一次建立整条端到端路径,而是像 F.5 节将解释的那样,通常逐段建立。
无论网络拓扑采用何种形式,只要连接两个以上设备,除了上一节的基本功能,都必须实现路由、仲裁和交换这三项功能。不过,其复杂度与执行顺序取决于网络拓扑类别,下面将进一步讨论。一般而言,路由、仲裁和交换负责在拓扑提供的可能路径中,建立从源端到目的端的一条有效路径。路径建立后,再用前面介绍的分组传输功能可靠地发送分组,并在相应目的端接收。如果实现了流量控制,它会通过限制发送方来防止缓冲区溢出;流控可以在端到端层次、网络内部链路层次,或两个层次同时实现。
共享介质网络
连接多个设备最简单的方法,是让它们共享网络介质,如图 F.8(a) 的总线。这也是传统的设备互连方式。共享介质可以采用半双工:数据能够沿任一方向传输,但同一设备不能同时发送和接收;也可以采用全双工:数据可沿两个方向传输,同一设备可以同时收发。直到不久之前,多数系统的 I/O 设备通常还共享一条 I/O 总线,早期片上系统(SoC)设计也使用共享总线连接片上部件。最流行的局域网以太网,最初是一条由最多约一百台计算机共享的半双工总线,不过如今也有交换介质版本。
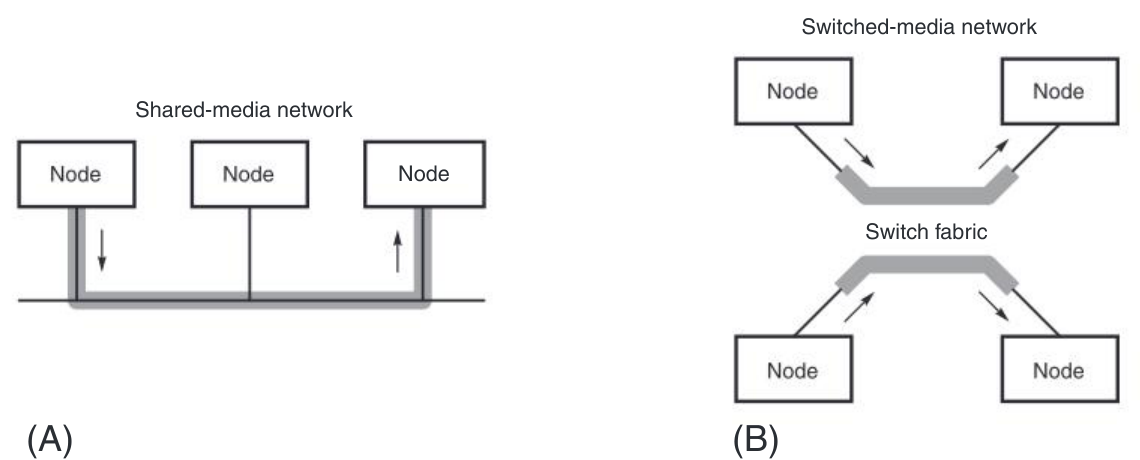
图内术语:Node=节点;Shared-media network=共享介质网络;Switched-media network=交换介质网络;Switch fabric=交换结构。
由于网络介质共享,必须有机制协调并仲裁介质的使用,保证同一时刻只发送一个分组。如果网络设备之间的物理距离很短,可以由中央仲裁器授予发送权限。此时,网络节点可以通过专用控制线连接仲裁器。但对节点很多、分布距离很大的网络,集中仲裁并不现实,因此也采用分布式仲裁;最初的共享介质以太网 LAN 就属于这种情况。
共享介质分布式仲裁的第一步,是“先观察,再行动”。节点首先检查网络,避免在已有分组传输时尝试发送。发送前先监听以避免冲突,称为载波侦听。互连空闲时,节点尝试发送。当然,事先观察并不保证成功,因为另一个节点也可能在同一时刻决定发送。两个节点同时发送,就会发生冲突。假定网络接口能够通过监听,判断线路上的其他数据是否干扰了自己的数据,从而检测到冲突。为发现冲突而进行的监听称为冲突检测,这是分布式仲裁的第二步。
问题还没有完全解决。如果检测到冲突后,网络中的每个节点都等待完全相同的时间,监听确认没有流量,然后再次发送,节点就可能继续同步,一再相互冲突。为避免重复碰撞,分组遭到破坏的每个节点在重发前,都要等待一个随机时间,也称退避。随机化打破了同步。如果继续发生冲突,则重传尝试之间的等待时间按指数增长,以免给网络造成过重负担。
虽然这种方式控制了共享介质上的拥塞,却不能保证公平:发生冲突的节点还在等待时,后来到达的节点可能已经成功发送。如果没有很多节点同时提出大量网络需求,这个简单方法效果很好。但在高利用率下,由于介质共享且缺乏公平保证,性能就会下降。另一种能支持公平性的共享介质分布式仲裁方法,是在节点之间传递令牌。获得令牌的节点得到使用网络的权利。如果令牌在节点间循环传递,仲裁过程就能保证一定程度的公平性。
仲裁结束、某个设备获准访问共享介质之后,交换功能十分直接:该设备只需将自身接入共享介质,就建立了通向每个可能目的端的路径。路由也非常简单,因为所有设备都连接到同一共享介质,都会看到每个分组;每个设备只需检查该分组是否发给自己即可。这种策略还有一个有利的副作用:设备只需发送一次,就能把分组发给共享介质上的所有设备。这种通信方式称为广播;与之相对,单播中的每个分组只发给一个设备。共享介质使向每个设备广播分组十分容易,也便于向一部分设备发送,即组播。
交换介质网络
另一种方式,并不让所有相连节点同时共享整个网络介质,而是在节点共享的若干互不相交部分之间进行切换。这些部分由无源点到点链路及相连的有源交换部件组成;交换部件动态地在不同源端—目的端设备对之间建立通信。这些无源和有源部件共同构成网络交换结构(network switch fabric),也称 network fabric,端节点连接在这个结构上。图 F.8(b) 给出了概念示意。
F.4–F.7 节将更详细地介绍交换结构,进一步揭示交换介质网络黑盒的各个层次。不过,仅从图 F.8(b) 的高层视图,就已经可以看出交换介质网络相对于共享介质网络的潜在带宽优势:其聚合带宽可以高出很多倍,从而有可能获得更高的有效带宽。共享介质在任何时刻最多允许一个节点发送分组,而交换介质网络可能允许全部相连节点同时发送。
与共享介质网络一样,交换介质网络也必须实现前面提到的路由、仲裁和交换三项附加功能。每个分组进入网络时,先进行路由,在拓扑提供的路径中选择通往目的端的一条。分组请求的路径,必须由某个集中式或分布式仲裁器授予;仲裁器解决同一路径资源上的并发请求冲突。请求的资源获准后,网络接通所需连接以建立路径,使分组能够向目的端转发;若未获准,分组通常需要缓冲。交换网络内部通常按路由、仲裁、交换的顺序执行;共享介质网络中的路由则通常最后执行。
共享介质网络与交换介质网络的比较
一般而言,共享介质网络的优势在于成本低;相应的代价是,聚合网络带宽完全不会随互连设备数增加而扩展。此外,还需要全局仲裁机制解决请求冲突,这可能引入另一种瓶颈,进一步限制可扩展性。每增加一个接入共享介质的设备,还会增大导体的寄生电容,从而增加飞行时间中的传播延迟,并可能延长时钟周期。此外,共享介质不断授予不同的请求设备,也使网络分组传输更难流水化。
交换介质网络的主要优势,是所实现的网络资源量随相连设备数量增加,从而提高聚合网络带宽。它允许多对节点同时通信,能够提供远高于共享介质网络的有效带宽;还可以将系统扩展到共享介质无法实现的大规模节点数。不过,如果网络资源按超线性速度增长,这个扩展优势也会成为缺点。若网络成本超线性增长,而有效带宽只随互连设备数次线性增长,那么对许多应用与互连领域而言,这就是低效率的设计。
性能刻画:延迟与有效带宽
上述路由、交换和仲裁功能,为分组传送延迟引入了额外分量,必须计入总分组延迟表达式。假定不存在网络资源竞争,例如网络无负载,则总分组延迟为:
其中,、、 分别是分组经历的总路由时间、总仲裁时间与总交换时间,可以通过测量得到,也可以根据更详细的分析计算得到。这些分量与网络链路上的总传播延迟 相加,构成分组的总飞行时间。
上式仅给出总分组延迟的下界,因为它没有计入资源竞争可能造成的额外延迟。网络负载很重时,多个分组可能同时请求相同网络资源,形成竞争并降低性能。仲裁失败的分组必须等待在缓冲区中,其等待时间作为竞争延迟增加到分组延迟中;上式没有包含这部分。当网络或其一部分趋于饱和时,竞争延迟可能比零负载、甚至轻负载条件下的整个分组延迟大几个数量级。遗憾的是,当网络负载超过中等水平时,用解析方法计算总分组延迟并不容易。在这种情况下,用详细网络模型的周期精确仿真来测量这些量,是估算分组延迟更好、更准确的方法。不过,上式仍可用于计算最佳情况下的延迟下界。
出于类似原因,有效带宽也不容易精确计算,但适当扩展上一节末尾的模型,可以估算最佳情况下的上界。需要做的是确定整个端到端网络管道最窄的部分,也就是求出互连设备的整个网络中的注入带宽 、接收带宽 和网络带宽 。
网络注入带宽可以直接用链路注入带宽 乘以网络注入链路总数。网络接收带宽也可由 类似求出,但还要乘以一个反映应用流量及其他特征的因子。连接两个以上设备时,在分析流控对接收链路带宽的影响时,不能再假定源端与目的端一一对应。例如,对于具有多对一流量特征的应用,来自不同注入链路的若干分组可能同时到达同一接收链路,导致接收链路竞争。
这种影响可以用平均接收因子 表示;它既可以测量,也可以通过详细分析计算,定义为到达接收链路的分组中能够被接受的平均比例或百分比。只有这些分组可以立即投递,因此网络接收带宽按这一因子缩减。这种下降源于应用行为,与网络内部特征无关。最后,网络带宽 则考虑包括竞争在内的内部网络特征。随着后面进一步揭示互连网络黑盒的内部结构,我们将逐步推导其计算表达式。
总体而言,网络端到端交付给应用的有效带宽,由这三部分中的最小者决定:
下面利用这些表达式,比较 OCN、SAN、LAN、WAN 四个互连领域中,共享介质网络与交换介质网络的延迟和有效带宽。
例题:网络规模扩大时的延迟与有效带宽
当互连节点数 从 4 扩大到 1024 时,绘制共享介质与交换介质 OCN、SAN、LAN、WAN 的总分组延迟与有效带宽。假定所有网络链路,包括节点处的注入与接收链路,数据带宽都为 8 Gbps,传送大小为 100 字节的单播分组。共享介质网络共享一条链路,交换介质网络的网络链路数至少等于节点数;两者都忽略内部竞争对延迟与带宽的影响。
端节点的每分组发送与接收开销分别为 和 ;OCN、SAN、LAN、WAN 的 分别为 0 μs、0.3 μs、3 μs、30 μs,互连距离依次为 0.5 cm、5 m、5000 m、5000 km。此外,假定总路由、仲裁与交换时间为常数或节点数的函数:共享介质网络中, ns、 ns、 ns;交换介质网络中, ns。最后,考虑应用流量与网络结构,假定共享介质网络的平均接收因子 ,交换介质网络的平均接收因子为多对数形式 。
解答 总分组延迟的所有分量都与上一节例题相同,只有飞行时间额外增加了路由、仲裁和交换延迟。共享介质网络增加的延迟总计为 ns;交换介质网络增加的延迟总计为 ns。图 F.9 只绘出 OCN 和 SAN 的延迟,因为这两类网络的结果更值得关注。
对 OCN 而言,当节点数量为中等到较大规模时,、、 的总和占据飞行时间的主要部分,并远大于其他每个延迟分量,共享介质网络尤其如此。由于两种网络的仲裁延迟不同,共享介质的延迟随节点数增加而增长得远比交换介质剧烈。对 SAN 而言,在大多数网络规模下,、、 都主导飞行时间;但只有当共享介质网络规模很大时,它们才大于其他每个延迟分量。在交换介质网络中,这些分量小于其他延迟分量,却不可忽略。对 LAN 和 WAN 而言,飞行时间由传播延迟主导;正如上一节计算所示,传播延迟又主导其他延迟分量。因此,无论共享介质还是交换介质,、、 都可忽略。
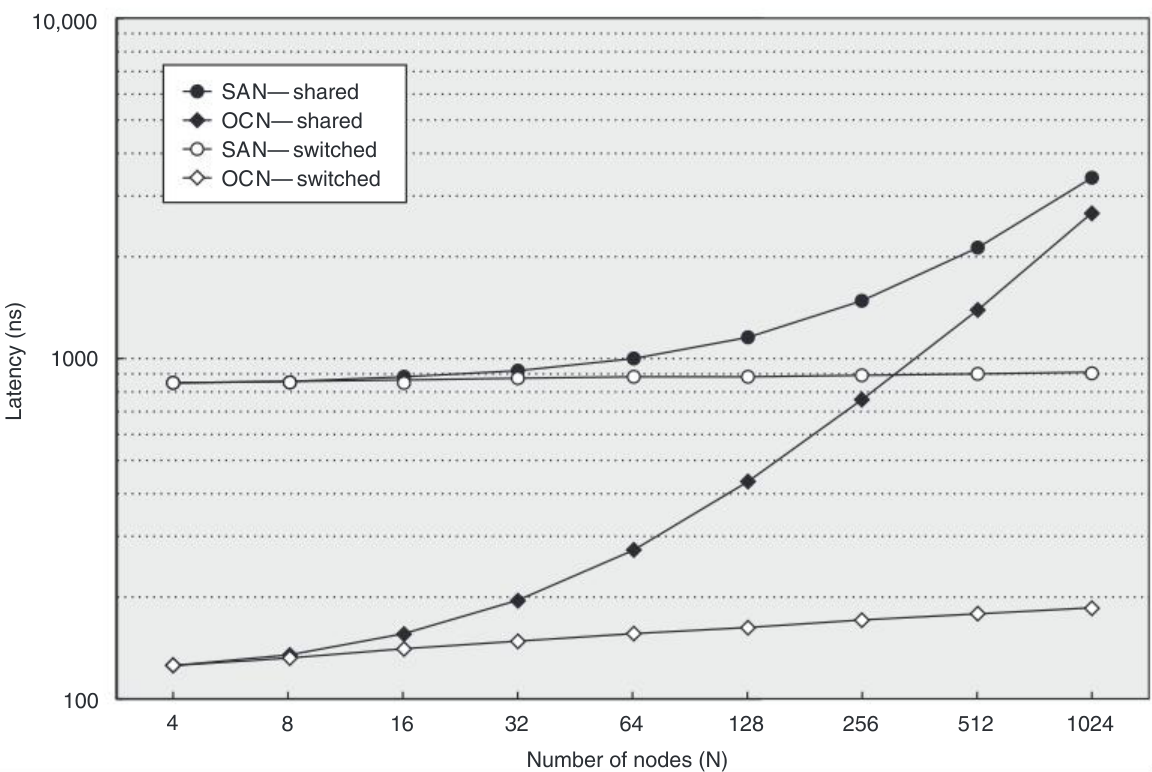
图内横轴为节点数 ,纵轴为延迟(ns);shared=共享介质,switched=交换介质。
图 F.10 给出了四个网络领域中有效带宽随互连节点数的变化。所有共享介质网络的有效带宽都不会随规模增长,因为所有接收链路在同一时刻最多接收一个单播分组;除 OCN 外,这一带宽还进一步受各网络接收开销的限制。所有交换介质网络的有效带宽都随节点数增加而提高,但会按平均接收因子缩减;除 OCN 外,接收开销还会进一步限制有效带宽。
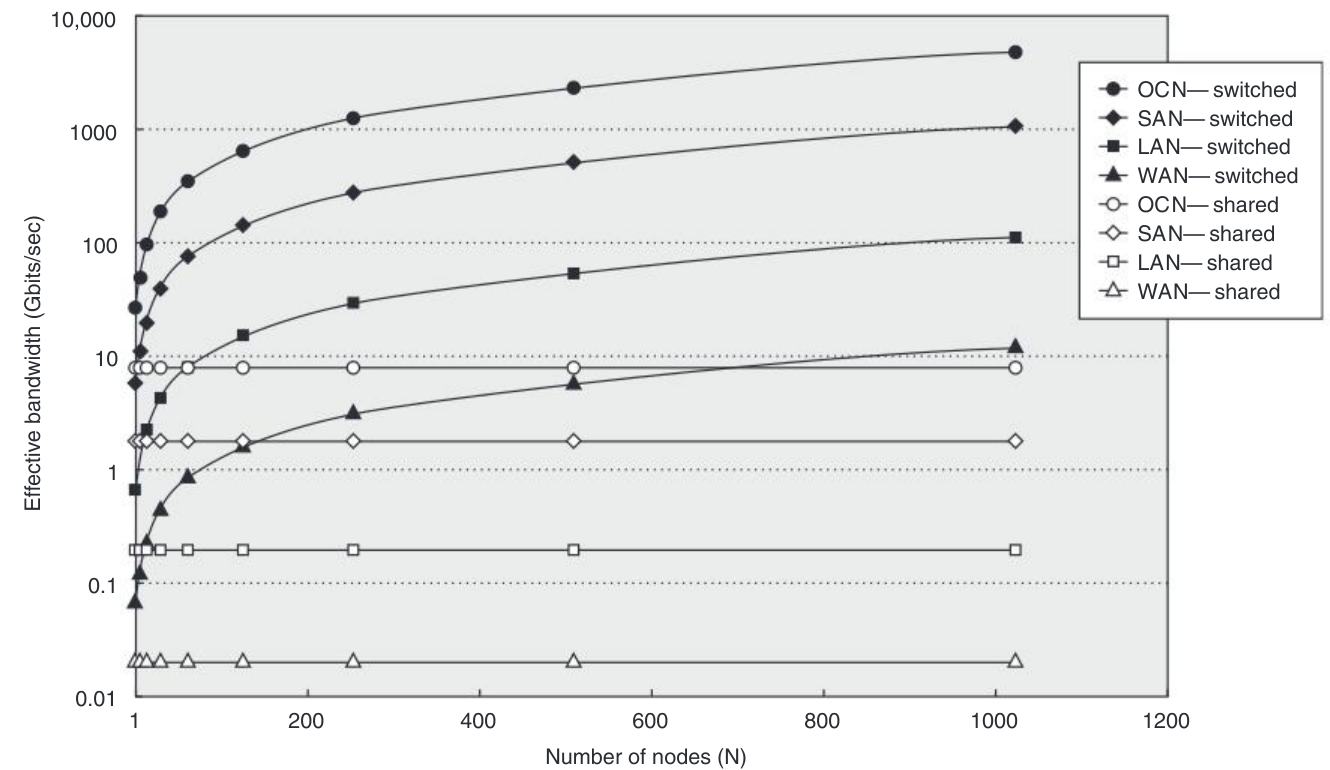
图内横轴为节点数 ,纵轴为有效带宽(Gbit/s);各条曲线分别表示 OCN、SAN、LAN、WAN 的交换介质与共享介质网络。
译注: 原图注称交换式 OCN 可达到聚合带宽,但题设给定的接收因子为 ,按本节公式,有效带宽还会受到这一因子的限制。例如 时,,有效带宽上限约为 Gbit/s,低于 Gbit/s 的聚合注入带宽,也与图中曲线相符。原图注的这句话与题设及曲线不一致。
既然优势如此明显,为什么以前没有一直采用交换网络?早期计算机慢得多,共享网络介质对性能影响不大。此外,早期 LAN 和 WAN 的交换机占据多块大型电路板,体积接近整台计算机。随着 Moore 定律推动技术发展,交换机尺寸显著缩小,系统对高性能通信的需求也大幅提高。交换网络使通信能够像处理器和主存一样,受益于硅技术的快速进步。电信公司的交换设备曾经有大型机那么大,如今却已有单芯片交换机,甚至整个片上交换网络。因此,当前技术与应用的发展趋势都倾向于交换网络。正如单芯片处理器使处理器在许多出人意料的场合取代逻辑电路一样,单芯片交换机和片上交换网络也正在多个应用领域中取代共享介质网络,即总线。例如,交换网络 PCI Express(PCIe)于 2005 年被引入,用于取代个人计算机主板上传统的 PCI-X 总线。
前一例还强调了优化 OCN 和 SAN 的路由、仲裁与交换功能的重要性。特别是在这两个领域,互连距离与开销通常小到足以使延迟和有效带宽对这些功能的实现质量更加敏感,网络规模越大越是如此。因此,这些领域通常主要采用更快的硬件方案。在 LAN 和 WAN 中,由于性能主要取决于其他因素,较慢但更灵活的软件实现就足够了。对于 OCN 和 SAN,交换介质网络的拓扑设计,也会显著影响实际性能能有多接近延迟下界和有效带宽上界。
接下来的三节将讨论交换网络中的这些重要问题,下一节首先介绍拓扑。
F.4 网络拓扑
当设备数量较少时,一个交换机就足以在交换介质网络中将它们连接起来。然而,交换机的端口数受现有超大规模集成电路(VLSI)技术、成本、功耗等因素限制。当所需网络端口数超过单个交换机支持的端口数时,就需要由互连交换机组成的交换结构。为了具备必要的完全可达性,即连通性,网络交换结构必须提供从任意端节点设备到其他任意设备的路径。无论是接入交换结构的连接,还是交换结构内部交换机之间的连接,都采用点到点链路,而非共享链路;也就是说,链路两端各只有一个交换机或一个端节点设备。由交换机、链路、端节点设备等全部部件构成的互连结构,称为网络拓扑。
文献中描述过的网络拓扑很难统计,但在商业系统中实际使用的,大约不超过十几种。20 世纪 70 年代至 80 年代初,研究者不断尝试提出新拓扑,以减少分组必须经过的交换机数量,即跳数。20 世纪 90 年代,随着流水化传输和交换技术的引入,跳数的重要性有所降低。不过,拓扑今天仍然重要,尤其对 OCN 和 SAN 而言,因为拓扑与其他影响性能的网络设计参数之间存在微妙联系;在端节点极多时,例如 Blue Gene/L 超级计算机的 64K 个节点,或延迟极其关键时,例如多核处理器芯片,这一点尤为突出。拓扑也极大地影响网络的实现成本。
并行超级计算机 SAN 的拓扑最引人注目,也最富想象力;为简化路由、封装和扩展,它们通常采用规则结构。LAN 和 WAN 的拓扑则往往更加随意或因地制宜,主要受长距离连接、跨不同通信子网连接等困难影响。基于交换机的 OCN 拓扑出现较晚,但正迅速普及。本节介绍商用产品中较流行的拓扑,并简要讨论其优点、缺点和约束。
集中式交换网络
如前所述,当交换机端口数不小于设备数时,单个交换机就能互连这些设备。这种简单网络通常称为交叉开关(crossbar)或交叉开关交换机。图 F.11(a) 表明,交叉开关内部交叉点开关的复杂度,随端口数按平方增长。因此,当设备规模超出实现技术所能支持的范围时,需要成本更低的方案。
解决交叉开关扩展问题的一种常见方法,是把一个大交叉开关拆成多级小交换机,再按一定方式互连,使任何源端只需通过交换结构一次,就能到达任何目的端。按这种方式组织的拓扑,通常称为多级互连网络(multistage interconnection network,MIN)或多级交换结构,其复杂度一般按 增长。MIN 最初于 20 世纪 50 年代为电话交换提出,后来用于构建并行超级计算机、对称多处理器、多计算机集群和 IP 路由器交换结构的通信骨干。
MIN 级间的互连模式是一种或多种置换,可以用一组数学函数表示,每级对应一个函数。图 F.11(b) 展示了著名的 Omega 拓扑:每级采用完美洗牌置换(perfect-shuffle permutation)作为互连模式,后接交换开关,形成每级的 perfect-shuffle exchange。在这个例子中,八个输入/输出端口通过三级 交换机互连。可以很容易看出,任意输入端口经过这三级一次,就能到达任意输出端口。一般而言,使用 交换机时,具有 个输入/输出端口的 MIN 至少需要 级,每级含 个交换机,总计 个交换机。
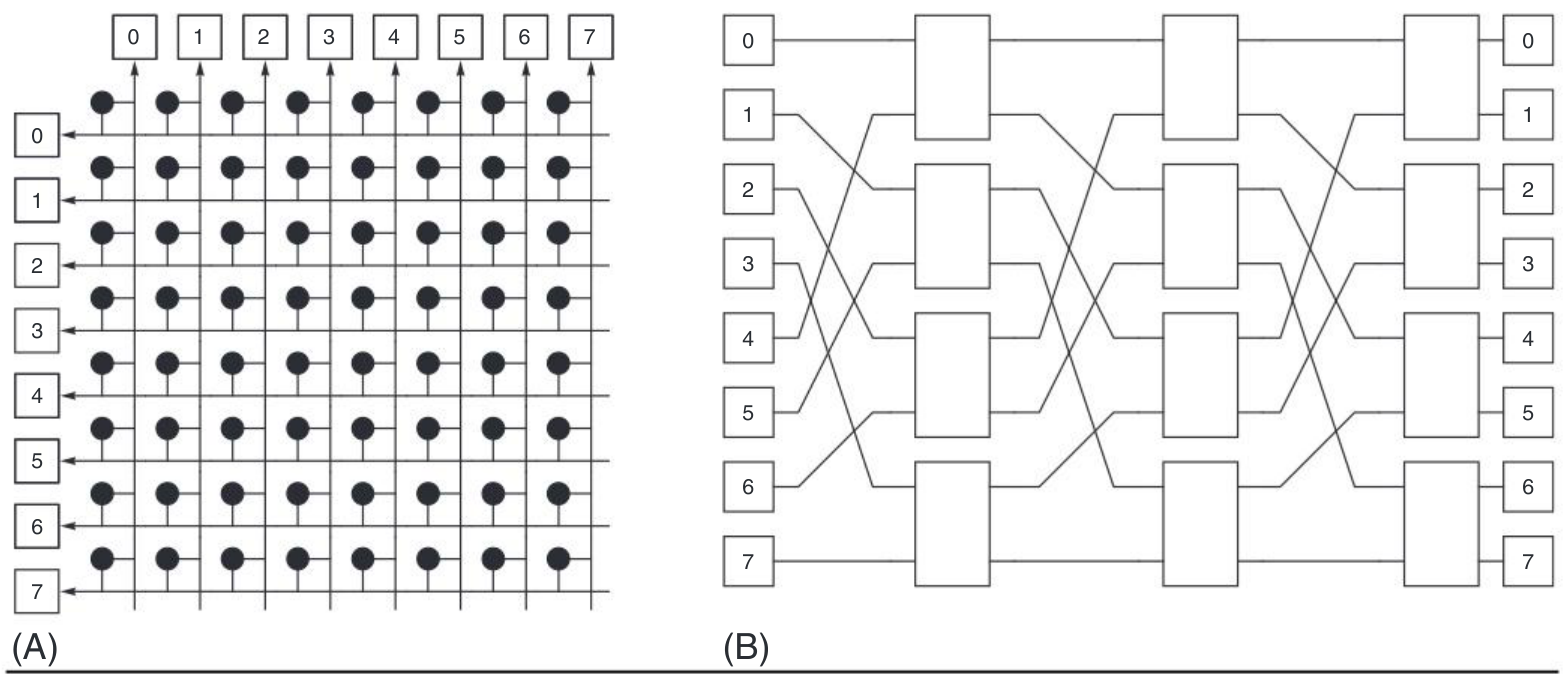
尽管具有内部结构,MIN 整体上仍可视为集中式交换结构,端节点设备连接在网络外围,因此称为集中式交换网络。换一个角度,MIN 通过一组交换机来互连节点,而其中一些交换机可能没有直接连接任何节点,因此它还有另一个常见名称:间接网络。
例题:交叉开关与 MIN 的成本
计算使用单个交叉开关互连 4096 个节点,相对于使用由 、 和 交换机构成的 MIN 的成本。分别比较单向链路与交换机的相对成本。对 交换机,假定交换机成本随输入端口数,或等价地输出端口数 ,按平方增长。
解答 使用单个交叉开关时,网络交换机成本与 成正比。单向链路成本为 8192,计入了端节点到交叉开关,以及交叉开关返回端节点的全部链路。使用 交换机构成 MIN 时,每个交换机成本与 成正比,但总共有 个交换机。此外,交换机输出方向共有 级单向链路,每级 条,再加上从端节点接入 MIN 的 条链路。因此,交叉开关相对于各 MIN 的成本为:
译注: 交换机成本前三项的 170、170、85 为原书给出的近似整数;对应比值分别约为 170.67、170.67、85.33。原式仍保留等号和原数值。
在所有情况下,单个交叉开关的交换机成本都远高于 MIN。使用尺寸最小、数量最多的交换机构成 MIN,可以获得最显著的成本下降;有趣的是, 与 交换机组成的 MIN,其相对交换机成本相同。交叉开关的链路成本低于 MIN,但差距在所有情况下都不到一个数量级。还必须记住,端节点链路与交换机间链路在长度和封装要求上不同,因此单位成本通常也不同。尽管链路成本较低,交叉开关的总体相对成本仍然较高。
MIN 降低交换机成本的代价是性能:网络链路上更容易发生竞争,从而降低性能。不同源端到不同目的端的路径同时共享一条或多条链路,就会出现分组在网络中阻塞的竞争。竞争程度取决于通信流量行为。例如,在图 F.11(b) 的 Omega 网络中,从端口 0 发往端口 1 的分组,会在第一级交换机处等待从端口 4 发往端口 0 的分组。在交叉开关中,到不同目的端的路径不共享链路,因此不会出现这种阻塞;所以交叉开关是无阻塞的。当然,如果两个节点同时发往同一个目的端,即使是交叉开关,也会在接收链路处发生阻塞。正如上一节末尾所述,性能分析中用平均接收因子 来计入这种影响。
为了减少 MIN 的阻塞,需要增加交换机数量,或使用更大的交换机,为每对源端与目的端提供替代路径。第一种常见方案,是至少再增加 级交换机,使其结构与原拓扑形成镜像。得到的网络具有可重排无阻塞性:它允许为新出现的源端—目的端设备对建立不冲突的路径。但跳数也大致增加一倍,而且可能需要通过某种集中控制,重新安排现有通信设备对的路径。
第二种方案不再增加交换级数,而是在前后两级交换机之间使用更大的中间级交换机;如有需要,中间级交换机本身也可用多级结构实现。中间级提供足够多的替代路径,使第一级与最后一级之间能够建立互不冲突的路径。最著名的例子是无阻塞的 Clos 网络。可以对三级 Clos 拓扑中的中间级交换机递归应用多路径性质,将所有交换机逐步缩小至 ,前提是第一和最后一级一开始也使用这种尺寸。最终得到具有 级的 Beneš 拓扑,它是可重排无阻塞的。图 F.12(a) 同时说明这两种拓扑:除第一和最后一级之外的全部交换机,共同递归地构成 Clos 网络的中间级交换机。
迄今讨论的 MIN 使用单向网络链路,但只需折叠 Clos、Beneš 等对称网络,就很容易得到双向形式。重叠的单向链路沿相反方向运行,构成双向链路;重叠的交换机则合并成一个端口数翻倍的交换机,即 交换机。图 F.12(b) 展示了这种折叠 Beneš 拓扑,但端节点连接在原网络最内侧的交换级。网络另一侧仍有空闲端口,可供以后扩展规模。这类网络称为双向多级互连网络。
这种网络具有许多有用性质,包括模块化,以及利用通信局部性的能力,使分组不必经过全部网络级。规则结构还降低了路由复杂度;多路径特性则有助于将流量更均匀地分散到网络资源上,并容忍故障。
另一种构造具有可重排无阻塞性质的双向 MIN 的方法,是形成一棵平衡树,端节点设备位于叶子,交换机位于树的内部顶点。每一层都必须提供足够链路,使总链路带宽在各层保持不变。此外,除根之外,每个顶点的交换机端口数通常按 增长,其中 是树层数。可以在每个顶点使用总计 个交换机实现,每个交换机有 个输入端口和 个输出端口,或者说 个双向端口,即 个输入/输出端口。这种拓扑称为胖树网络。
由于每个方向只使用 个双向端口中的一半,所以每级需要 个交换机,胖树总共需要 个交换机。根级不需要向上的链路,因此该级交换机数量可以减半,总交换机数减少 。图 F.12(b) 给出了采用 交换机的胖树;可以看到,它与折叠 Beneš 网络相同。
对多数采用 MIN 的商用系统而言,在很宽的规模范围内,胖树都是首选拓扑。多计算机集群中的大多数 SAN,以及许多最强大超级计算机中的 SAN,均基于胖树。Myrinet、Mellanox 和 Quadrics 提供的商用通信子系统也由胖树构建。
分布式交换网络
如上所述,交换介质网络为设计独立于通信设备的通信子系统,提供了十分灵活的框架。但某些情况下,将端节点设备与使其通信的网络资源更紧密地集成起来会更合适。与其把交换结构集中在外部子系统中,不如将交换机分布到各个端节点上;这些端节点于是成为网络节点,或简称节点,整个网络称为分布式交换网络。每个交换机直接连接一个或多个端节点设备,组成一个网络节点。这些节点直接与其他节点相连,不必间接通过某个外部交换机,因此这种网络也常称为直接网络。
分布式与集中式交换网络的拓扑形式很不相同:前者的端节点分布在整个交换结构区域,而不是仅连接在外围的一条或两条边上。这使系统中的交换机数量等于总节点数。一种很直接的连接方式,是为每个节点与其他任意节点之间都设置专用链路。这样的全连接拓扑提供最佳连通性,实际上就是完全连通,但成本高于交叉开关,下面的例子说明了这一点。
例题:全连接网络与交叉开关的成本
计算用全连接拓扑互连 个节点,相对于用交叉开关拓扑的成本。分别考虑单向链路与交换机的相对成本。假定 交换机成本随单向端口数按平方增长,而 交换机成本只按线性增长。
解答 交叉开关拓扑需要一个 交换机,所以交换机成本与 成正比。链路成本为 ,包括从端节点到集中式交叉开关的单向链路及反向链路。
在全连接拓扑中,每个节点采用两组 交换机,也可以将它们合并成一组,以直接与所有其他节点双向连接。因此, 个节点的总交换机成本与 成正比。每个节点的端设备与本地交换机之间,需要两条方向相反的单向链路;此外,本地交换机还需要 条单向链路,通向其他端节点上的交换机。总单向链路数因此为 。全连接拓扑相对于交叉开关的成本为:
随着互连设备数增加,全连接拓扑的交换机成本接近交叉开关的两倍;两者都很高,即按平方增长。此外,全连接拓扑的相对链路成本始终更高,且随节点数线性增长。再次提醒,端节点链路与交换机间链路在长度和封装方式上不同,直接网络尤其如此,因此对应成本通常也不同。尽管成本更高,全连接拓扑相对于交叉开关并无额外性能收益,因为二者都无阻塞。所以实践中通常使用交叉开关网络,而非全连接网络。
成本更低的一种替代方案,是按环形拓扑将节点依次直接连接,如图 F.13 所示。对于双向环,每个节点只使用一个 交换机和两条与相邻节点共享的双向网络链路,总计 个交换机、 条双向网络链路。这个线性成本没有计入节点内部所需的 条注入/接收双向链路。
与共享介质网络不同,环允许多次传输同时进行:第一个节点可以发给第二个,同时第二个发给第三个,依此类推。不过,逻辑上不相邻的节点对之间没有专用链路,分组到达目的地之前必须经过中间节点,传送延迟因此增加。在双向环中,分组可以沿任一方向传输,通常选择通向目的地的最短路径。此时平均需要经过 次网络交换机跳转;若再计入源节点的本地交换机,总交换机跳数还要加一。沿途也可能因为其他分组同时请求相同资源而阻塞。
全连接网络与环形网络,构成分布式交换拓扑的两个极端;对于给定的成本与性能要求,两者之间还有许多值得考虑的方案。一般而言,理想的交换介质拓扑,其成本应接近环形网络,而性能应接近全连接网络。图 F.14 展示了三种常见直接网络拓扑,广泛用于不同成本与性能定位的系统。它们都将节点沿多个维度排列,并按可用数学方式描述的规则模式互连。
在 mesh(网格)拓扑中,每个维度上的节点组成线性阵列;在 torus(环面)拓扑中,每个维度上的节点组成一个环。两者都支持与相邻节点直接通信,旨在相对于单一环形网络减少分组跳数;这是通过增加维度、提高连通性实现的,商用系统通常不超过三维。超立方体或 n-cube 则是 mesh 的特例,每个维度只连接两个节点,因此必须有足够维度来连接系统的全部 个节点,即 。超立方体的连通性优于 mesh 和 torus,代价是链路数和每节点端口数较多,导致更高的链路和交换机成本。
例题:torus 与胖树的成本
计算使用 torus 拓扑互连 个设备,相对于使用胖树拓扑的成本。分别考虑双向链路与交换机的相对成本,假定交换机成本随双向端口数按平方增长。给出交换机规模相近时的近似表达式。
解答 使用 交换机时,胖树需要 台交换机;这里假定最后一级即根节点,与其他各级的交换机数量相同。每台交换机有 个双向端口,即 个输入端口和 个输出端口;交换机成本随端口数按平方增长,所以网络交换机总成本与 成正比。链路成本为 ,因为 级中的每一级都需要 条双向链路,其中包括设备与胖树之间的链路。torus 的交换机数量与节点数相同,每台交换机有 个双向端口,其中包括连接通信设备的端口, 是维数。
因此,torus 的交换机总成本为 。每个节点需要 条双向链路,分别用于 个不同维度及其端节点设备连接。不过,各维度上的链路由两个节点共享,因此全部 个节点的双向链路总数为 。torus 相对于胖树的成本为:
当交换机规模相近时,,因而:
交换机端口数,也称交换机度数,较小时,torus 的成本较低,维数较低时尤其如此。对于较大的 ,这一特性特别有用。另一方面,如果使用较大的交换机,或者 torus 维数较多,那么胖树成本更低,也更可取。例如,互连 256 个节点、采用 交换机时,胖树的交换机与链路成本均为 torus 的四倍;它平均而言较少的网络争用,补偿了这部分额外成本。使用 交换机时,例如同样互连 256 个节点,胖树与 torus 的成本相当。交换机规模继续增大,torus 会因每个节点都包含交换机而比胖树更昂贵。让每台交换机连接多个端节点设备,可以摊薄这一成本,这种做法称为 bristling。
图 F.14 的拓扑有一个有趣的共同点:网络链路规则地分布在若干个正交维度上。实际上,它们都是更大一类直接网络拓扑 k-ary n-cube 的特例,其中 表示 个维度中的每一维所互连的节点数。这些拓扑的对称性和规则性简化了网络实现,即封装,以及分组路由:分组沿某一维移动时,不会改变其他维度上到达目的地还需经过的跳数。下一节将看到,简单的路由算法很容易利用这种拓扑性质。
与间接网络一样,直接网络中并发请求同一路径或其部分路径的分组,也可能相互阻塞;全连接网络是唯一的例外。间接网络可以通过增大交换机来减少级数和交换机跳数,同样,直接网络可以通过增大交换机度数、增加拓扑维数来减少跳数。
对于规模和交换机成本给定的系统,似乎总应尽量增加维数,但事实并非总是如此。大多数电子系统是在三维物理世界中,使用集成电路芯片、印制电路板、背板等平面二维封装技术构建的。三维以内的直接网络,无论系统规模如何,都能在三维空间中用相对较短的链路实现。维数更高时,导线或光纤会越来越长。链路长度随系统规模增加的现象也见于 MIN,包括胖树:它们要么所有级都需要较长链路,要么随着级数增多而需要越来越长的链路。F.2 节第一个例题已经表明,采用流量控制的缓冲区,其大小与链路长度成正比,因而需要更多芯片面积。这也是 2005 年计算节点数最多的超级计算机 IBM Blue Gene/L,采用三维 torus 进行处理器间通信的原因之一。胖树需要长得多的链路,会使 64K 节点系统更难实现。这突出表明,必须正确选择满足系统要求的网络拓扑。
除了链路长度,实现拓扑所带来的其他约束也会限制其扩展程度,包括可用引脚数和能够实现的二分带宽。引脚数是芯片、印制电路板以及背板或机箱连接器带宽的一项局部限制。在将处理器核与交换机集成于同一芯片或多芯片模块的直接网络中,引脚带宽既用于访问主存,也用于实现节点链路。有限的引脚数因此可能迫使设计减少交换机端口数,或者减少每条链路的位线数。在间接网络中,交换机与处理器核分开实现,大多数引脚因而可以专门用于通信。但交换机组合成板卡时,对于给定拓扑,板上交换结构所有输入、输出链路的总需求,不能超过板卡连接器的可用引脚数。
二分带宽是一项更全局的限制,反映给定实现或封装技术能够达到的互连密度和带宽。互连密度与时钟频率彼此相关:导线排列得越密,串扰与寄生电容越大,通常就必须降低时钟频率。例如,片上网络的线密度和频率受到可用金属层及其间距限制;印制电路板则受到铜线密度限制。网络拓扑要能够实现,就不能超出实现技术所能提供的二分带宽。迄今实现的大多数网络,受到的引脚限制比二分带宽限制更强,近年来转向刀片式系统后尤其如此。不过,二分带宽对性能仍有重大影响。
对于给定拓扑,计算二分带宽 的方法是:把网络分为大致相等的两部分,每部分含一半节点,再将穿过这条假想分界线的链路带宽相加。对于不对称拓扑,二分带宽取所有将网络等分的方案中带宽最小者。全连接网络的二分带宽与 条单向链路或 条双向链路成正比,其中 为节点数。总线的二分带宽,就是那一条共享半双工链路的带宽。其他拓扑的数值位于这两个极端之间。通常以网络注入和接收的二分带宽为参照:对于分别有 条注入、接收链路的网络,该值为 。凡能提供这一二分带宽的网络拓扑,都称为具有全二分带宽。
图 F.15 汇总了本节讨论的几种拓扑在互连 64 个节点时,需要的交换机与链路数、交换机规模、节点之间最大与平均交换机跳数,以及用链路数表示的二分带宽。
| 评价项目 | 总线 | 环 | 二维 mesh | 二维 torus | 超立方体 | 胖树 | 全连接 |
|---|---|---|---|---|---|---|---|
| 性能 | |||||||
| 二分带宽,按链路数计 | 1 | 2 | 8 | 16 | 32 | 32 | 1024 |
| 最大跳数(平均跳数) | 1(1) | 32(16) | 14(7) | 8(4) | 6(3) | 11(9) | 1(1) |
| 成本 | |||||||
| 每台交换机的输入/输出端口数 | 不适用 | 3 | 5 | 5 | 7 | 4 | 64 |
| 交换机数 | 不适用 | 64 | 64 | 64 | 64 | 192 | 64 |
| 网络链路数 | 1 | 64 | 112 | 128 | 192 | 320 | 2016 |
| 链路总数 | 1 | 128 | 176 | 192 | 256 | 384 | 2080 |
拓扑对网络性能的影响
交换网络拓扑要求分组经过一跳或多跳才能到达目的地,每一跳都是分组穿过一台交换机及其相应链路的过程。有意思的是,可以把每台交换机及其链路,建模为上一节所说的、连接两个以上设备的黑盒网络;这里的“设备”是指端节点或其他交换机。区别仅在于,穿过交换机时没有发送与接收开销,而路由、交换与仲裁延迟不再是累计值,而是各台交换机自身的延迟。
因此,若分组到达目的地平均需要经过 跳,则 ,其中 、、 分别为单台交换机的路由、仲裁和交换延迟。假设网络在每一跳都以分组为单位划分流水级,下一节将重新审视这一假设,那么传输延迟也会相应地随跳数倍增。再作一个简化假设:到第一台交换机或第一级交换机的全部注入链路,以及从各交换机引出的全部链路,包括接收链路,长度和延迟都大致相等。于是,网络中的总传播延迟 ,等于单条链路的传播延迟 乘以 ;这里在跳数之外加一,是为计入注入链路。由此,网络平均分组延迟在最佳情况下的下界,即无争用时的延迟为:
再次强调,前述表达式假定交换机能以分组为单位对分组传输进行流水化。
沿用前面的方法,找到端到端网络管道最窄的部分,就可以估计有效带宽在最佳情况下的上界。只考虑管道内部的网络部分,网络带宽由拓扑的阻塞特性决定。要实现无阻塞,就必须为每个源—目的节点对提供许多备选路径,这会使网络总带宽远高于网络注入或接收的总带宽,成本相当高。由于这种方案通常昂贵得难以接受,多数网络都允许不同程度的阻塞,从而降低拓扑所提供总带宽的利用率。原文接着指出:“这同样有代价,但并非性能方面的代价。”
译注:原文为 “This, too, is costly but not in terms of performance.”,其否定词与前文关于阻塞降低带宽利用率的论述不一致。
网络阻塞程度取决于拓扑和流量分布。假定拓扑的二分带宽 能够实现,通常确实如此,就可以用它作为衡量网络最大阻塞程度的一个固定指标。理想情况下,不论流量如何变化,网络都能达到全二分带宽,瓶颈于是转移到注入或接收链路。然而,目的地位于另一半网络的分组必然穿过二分链路,因此这些链路可能成为瓶颈,使网络带宽低于全二分带宽。幸运的是,并非所有流量都必须跨越网络二分面,因而拓扑提供的总带宽可以得到更充分利用。此外,二分链路更多的拓扑,到达目的地的备选路径也更多,通常阻塞更少,总带宽利用率因而更高。若只有一部分流量必须跨越二分面,用二分流量比例 表示,,那么二分面处的网络管道,实际等效地加宽为原来的 倍。这里假定流量分布使二分链路的平均负载,至少与其他网络链路一样高。这给出了可实现网络带宽 的上限:
相应地,考虑网络拓扑后,有效带宽表达式变为:
必须注意, 高度依赖应用程序产生的流量模式,需要通过测量或详细流量分析得到。
例题:NEWS 最近邻通信
科学计算程序中常见的一种通信模式,是二维数组的最近邻元素沿指定方向通信。有时称之为 NEWS 通信,即 north、east、west、south,分别代表北、东、西、南四个方向。将一个 数组的元素,一一映射到采用下列拓扑互连的 64 个端节点设备上:总线、环、二维 mesh、二维 torus、超立方体、全连接和胖树。假定分组可以使用拓扑提供的任意最短路径,在最佳情况下,每个节点分别向北侧与东侧邻居发送一条消息,需要多长时间?对应的有效带宽是多少?忽略没有北侧或东侧邻居的元素。为简化分析,假设所有网络中每跳的分组传送时间均为一个单位,即每跳的 、、、 与分组传输时间之和为 1;注入链路延迟也包含在这一单位时间内,发送和接收开销为零。
解答 这种通信模式总共需要发送 个分组,即向北和向东两个通信阶段各 56 个。分组经过的跳数取决于拓扑。源与目的之间是一对一通信,因此 。注入和接收带宽将有效带宽限制在最多 64 个带宽单位,尽管这种通信模式只需要 56 个带宽单位。该上限还可能受到可实现网络带宽的进一步限制,后者由二分带宽与跨越二分面的流量比例 决定,两者都依赖拓扑。各类情况如下。
- 总线。 数组元素如何映射到节点,对总线没有影响,因为所有节点间的距离都同为一跳。但这 112 次传输必须依次进行,总共需要 112 个时间单位。二分带宽为 1,,所以有效带宽仅为 1 个单位。
- 环。 假定数组第一行映射到节点 0–7,第二行映射到节点 8–15,依此类推。所有节点同时向东侧邻居发送,即由节点 发往节点 ,只需要一个时间单位。在这种映射下,每个节点与北侧邻居恰好相隔八跳,因此需要八个时间单位,所有节点也并行进行。通信总时间为九个时间单位。假定使用双向环,二分带宽为两条双向链路,小于全二分带宽的 32 条双向链路。向东通信时,最坏情况下也只有 56 个分组中的两个跨越二分面,因而二分链路不会成为瓶颈。向北通信时,56 个分组中有八个必须跨越这两条链路,故 ,网络带宽为 个单位。有效带宽同样被限制在 22.4 个单位,低于这种通信模式所需带宽的一半。
- 二维 mesh。 64 个节点排成八行八列,与 NEWS 通信完全匹配。所有节点先同时向北侧邻居发送,再同时向东侧邻居发送,总共只需两个时间单位。二分带宽为八条双向链路,虽低于全二分带宽,但最近邻通信模式与拓扑完美匹配,仍能达到最大有效带宽。向东通信时,最坏情况下有 56 个分组中的八个跨越二分面,没有超过二分带宽;向北通信没有分组跨越同一二分面。因此 ,网络带宽为 个单位。有效带宽由通信模式限制为 56 个单位,而不是受 mesh 网络限制。
- 二维 torus。 这种通信模式没有使用 torus 的回绕链路,所以映射及性能与 mesh 相同。
- 超立方体。 假定一行中的元素映射到构成整个超立方体的八个三维子立方体中的相同位置,使连续的行元素落在仅相隔一跳的节点上。北侧邻居同样可以映射到正交维度中相隔一跳的节点。因此这种通信模式只需两个时间单位。超立方体提供 32 条链路的全二分带宽,但 112 个分组中至多只有八个需要跨越二分面。所以有效带宽仅由通信模式限制为 56 个单位,不受超立方体网络限制。
- 全连接。 无论如何映射,节点间距离都同为一跳。如果注入和接收链路能同时发送、接收两个分组,那么向北和向东并行传输只需一个时间单位。实际并非如此,所以需要两个时间单位。有效带宽由通信模式限制为 56 个单位,1024 条二分链路中的大部分因此未能充分利用。
- 胖树。 假定采用与环相同的元素映射,交换机有八个双向端口。每个八节点组通过三级双向网络互连,共八组,因此同时向东侧邻居通信至多需要三跳,即三个时间单位。每个节点的北侧邻居位于相邻的八节点组,需要五跳,即五个时间单位。胖树上的总时间因此为八个单位。胖树提供全二分带宽,所以即使最坏情况下有一半流量跨越二分面,只要持续注入分组,仍能达到 56 个单位的有效带宽;这一限制来自通信模式,而非胖树网络。
不能从上述例题得出错误结论,以为 mesh 与 torus、超立方体、胖树等二分带宽更高的网络同样好。为简化分析,例题采用了若干有利于低二分带宽网络的假设。实际中,分组通常大于链路宽度,占用链路的时间远不止一个网络周期。许多通信模式也不能这样整齐地映射到二维 mesh,通常更具全局性且更不规则。这些因素共同增加了低二分带宽网络中分组阻塞的机会,导致延迟升高、有效带宽下降。
为了进一步将拓扑讨论与实际系统联系起来,图 F.16 列出了商用高性能计算机所用拓扑的若干属性。
| 公司 | 系统[网络]名称 | 最大节点数[× CPU 数] | 基本网络拓扑 | 节点注入[接收]带宽,MB/s | 每条链路每方向的数据位数 | 原始单方向网络链路带宽,MB/s | 原始网络二分带宽,双向,GB/s |
|---|---|---|---|---|---|---|---|
| Intel | ASCI Red Paragon | 4816[×2] | 二维 mesh,64×64 | 400[400] | 16 位 | 400 | 51.2 |
| IBM | ASCI White SP Power3[Colony] | 512[×16] | 使用 8 端口双向交换机的双向 MIN,通常为胖树或 Omega | 500[500] | 8 位,另加 1 个控制位 | 500 | 256 |
| Intel | Thunder Itanium2 Tiger4[QsNet II] | 1024[×4] | 使用 8 端口双向交换机的胖树 | 928[928] | 8 位,另加 2 个用于 4b/5b 编码的控制位 | 1333 | 1365 |
| Cray | XT3[SeaStar] | 30,508[×1] | 三维 torus,40×32×24 | 3200[3200] | 12 位 | 3800 | 5836.8 |
| Cray | X1E | 1024[×1] | 每台交换机连接 4 个端设备的二维 torus,约 23×11,带 express 链路 | 1600[1600] | 16 位 | 1600 | 51.2 |
| IBM | ASC Purple pSeries 575[Federation] | >1280[×8] | 使用 8 端口双向交换机的双向 MIN,通常为胖树或 Omega | 2000[2000] | 8 位,另加 2 个用于新型 5b/6b 编码方案的控制位 | 2000 | 2560 |
| IBM | Blue Gene/L eServer Sol.[Torus Net.] | 65,536[×2] | 三维 torus,32×32×64 | 612.5[1050] | 1 位,串行传输 | 175 | 358.4 |
F.5 网络路由、仲裁与交换
在交换介质网络中,无论采用何种拓扑,分组所经路径上的每台交换机都要执行路由、仲裁和交换。文献提出了许多实现这些功能的有趣技术。本节重点介绍商业系统针对较常见拓扑所采用的一组代表性方法,并说明其性能影响。
路由
路由算法规定每个分组允许使用哪条或哪些网络路径。理想情况下,算法为所有分组提供最短路径,同时将流量负载均匀分散到各条网络链路,以尽量减少争用。但为了保证无论流量行为如何,所有分组都能送达,拓扑提供的某些路径可能必须禁用。例如,如果允许分组从源节点出发后,无限制地经过非最短路径上的跳转,分组就可能永远到不了目的地,这种情况称为活锁。同样,如果一组分组沿某些路径,永远阻塞在网络中,只等待被同组其他分组占有的链路或相关缓冲区等资源,也会使分组无法送达,这称为死锁。死锁源于网络资源有限,因此网络流量越大、可用资源越少,死锁发生概率越高。要让网络正常工作,路由算法必须防止这种异常;它有多种形式,例如路由死锁、请求—应答即协议死锁,以及故障引起的重配置死锁等。同时,为使网络性能尽可能高,路由算法还必须高效:最佳情况下,应让分组能选择拓扑提供的所有路径。
防止活锁最简单的方法,是只允许源到目的节点之间的最短路径;也可以略放宽限制,只允许有限次非最短路径跳转。最严格的方式还有一个好处,即消耗的网络带宽最少,但若最短路径发生争用或故障,分组就不能改走其他非最短路径。
死锁更难防止。实践中常用两种策略:避免与恢复。在死锁避免中,路由算法只允许分组沿那些能使网络全局状态保持无死锁的路径传输。常见方法是在一组资源间建立次序;该资源集是支持网络完全可达性所需的最小集合。按某种全序或偏序向分组授予这些资源,就能防止这些资源形成循环依赖。这样,无论分组处于网络何处,都始终可以获得一条逃逸路径,避免进入死锁状态。在死锁恢复中,资源授予不以避免死锁为前提;由于死锁可能发生,系统采用某种机制检测其存在的可能性。一旦检测到,就从死锁资源集中移走一个或多个分组,可以丢弃分组以回退,也可以将分组转移到专门的死锁恢复资源上,使其继续前进。释放的资源随后分配给其他需要它们的分组,从而解除死锁。
先考察用于分布式交换网络的路由算法。图 F.17(a) 展示了二维 mesh 某区域中,众多可能的分组死锁配置之一。只允许分组使用按照某种全序依次穿过各维度的最短路径,就可以避免所有这类死锁及活锁。也就是说,只有分组到达目的地已不再需要使用此前各维度的任何链路,路由算法才允许它使用当前维度的链路。图 F.17(b) 给出了按 XY 维序穿过网络的例子。所有分组必须遵循相同的维度顺序,且只有在某一维度中不再需要链路时,才可离开该维度。这一著名算法称为维序路由(dimension-order routing,DOR),在超立方体中称为 e-cube 路由。许多采用分布式交换网络及片上网络的商业系统都使用它。由于它对给定源—目的节点对总是提供同一条路径,所以属于确定性路由算法。
在支持网络完全可达性所必需的某个最小资源集上,按维度顺序传输,可以避免 mesh 和超立方体中的死锁。但是,对于带有回绕链路的分布式交换拓扑,例如环和 torus,如果要将资源用到全部容量,还必须在各维度内部的某个最小资源集上建立全序。另一种办法,是要求各维度中始终保留一些空闲资源,即 bubble(空泡),使占用量低于全部容量,从而避免死锁。为保证完全可达性,可以复制物理链路,也可以复制每条链路对应的逻辑缓冲区,分别形成物理通道或虚拟通道,再在这些通道上排序。避免死锁不需要给全部网络资源排序,只需对支持完全可达性的某个最小资源集,即某个逃逸资源集排序。基于这一技术,即 Duato 协议,可以定义这样的路由算法:除了逃逸资源集以外,还允许给定源—目的节点对使用拓扑提供的备选路径。算法必须从允许的路径中选一条,最好选择最高效者。根据当前网络流量状态调整路径,可以更充分利用网络总带宽并减少争用。这种能力称为自适应路由,许多商业系统都采用它。
例题:维序路由消除了多少种转向
在 维 mesh 中,维序路由排除了多少种可能的维间转向?在维持连通且无死锁的前提下,实际最少需要排除多少种转向?以二维 mesh 说明。
解答 维序路由恰好排除一半可能的维间转向。很容易证明,从任意较低次序维度转到较高次序维度都是允许的,反向则不允许。例如,图 F.17 二维 mesh 的八种可能转向中,允许 、、、;正负号表示沿某维移动的方向。不允许的四种转向是 、、、。排除这些转向,既能防止任何形式的环形成,从而避免死锁,又能保持网络连通;代价是完全不能进行自适应路由。
Turn Model 路由算法证明,要防止环形成且保持连通,最少只需排除四分之一的可能转向,但必须选对转向集合。只有某些特定集合能同时满足两个要求。若选错了,即使排除四分之一的转向,其余允许转向的组合仍可能模拟已被排除的转向,从而形成环与死锁,或者使网络不连通。例如,对二维 mesh,只需排除两个最终朝西的转向,即 和 ,同时要求需要向西移动的分组一开始就先向西走,便能维持连通。二维 mesh 除了这种 west-first(向西优先)路由,还可以采用 negative-first(负方向优先)路由和 north-last(最后向北)路由。与 DOR 相比,这些算法多允许的四分之一转向,提供了部分路由自适应能力,所以它们属于自适应路由算法。
集中式交换网络也可通过限定资源使用的全序或偏序,定义无死锁路由算法。在胖树中,可以沿从输入叶级向上到根、再向下到输出叶级的路径,为资源建立全序。路由算法允许分组按递增偏序使用资源:先沿树向上,到达源和目的节点的某个最近公共祖先(least common ancestor,LCA),再沿树向下直到目的地。对于给定目的节点,存在多个最近公共祖先,所以向上阶段有多条备选路径,算法因此具有自适应性。不过,从一个最近公共祖先向下到目的地,胖树拓扑只提供一条确定路径。这种自路由性质也见于许多 MIN,很容易利用:只需对目的节点地址作移位,就能得到各级交换机应选的输出端口。
更一般地,无论直接或间接网络,都可以将一棵树映射到任意拓扑上,并通过赋予方向,允许使用同一树层级节点之间的链路:“up”表示朝根节点移动,“down”表示远离根节点移动。这样就能在任意拓扑上定义通用的 up/down 路由**,让分组沿零条或多条 up 链路,再沿零条或多条 down 链路到达目的地;路径选择也可以自适应。up/down 次序防止形成环,从而避免死锁。自配置交换 LAN Autonet 以及早期 Myrinet SAN 都使用过这种技术。
实际路由算法由两部分共同实现:源节点写入分组头的路由信息,以及交换机内的路由控制机制。对于源路由,完整路径由源节点预先计算,可能通过查表得到,并写入分组头。这通常包括预定源—目的路径上各台交换机应使用的一个或多个输出端口;分组经过交换机时,路由控制机制可逐步剥除这些信息。头部还可以增加一个位字段,说明是否允许自适应路由,即能否任选所列输出端口之一。对于分布式路由,路由信息通常就是目的地址。沿途各交换机的路由控制机制利用它,通过有限状态机计算或查阅本地路由表,即转发表,决定下一个输出端口。源路由相比分布式路由,简化了交换机内的路由控制机制,但每个分组头都需要更多路由位,增大了头部开销。
仲裁
仲裁算法决定分组何时可以使用它所请求的网络路径。理想情况下,仲裁器尽量将空闲网络资源与请求它们的分组匹配起来。在交换机层面,仲裁器尽量将空闲输出端口,与位于输入端口并请求相应输出端口的分组匹配。当无法同时满足所有请求时,交换机仲裁器应公平分配输出端口,解决冲突,防止分组因始终得不到请求资源而饥饿。如果采用 serve-longest-queue(优先服务最长队列,SLQ),短队列中的分组就可能饥饿。对同一优先级的分组,简单的轮询(round-robin,RR)或基于等待时间的策略,既足够公平,也容易实现。
仲裁可以分布进行,以避免集中式瓶颈。简单的方法有请求和授权两个阶段。假定每个输入端口都有队列存放到达的分组,每个输出端口都有采用轮询策略的本地仲裁器。图 F.18(a) 展示了四端口交换机的一组可能请求。在请求阶段,各输入端口队首分组,向它所需输出端口的仲裁器发送一个请求。各输出端口仲裁器独立仲裁所收到的请求,只选中一个。在授权阶段,每个仲裁器的一个请求者获得所请求的输出端口。如图所示,不同输入端口的两个分组若请求同一输出端口,就只有一个获得授权。因此,即使所有输入队列都有待发送分组,某些输出端口的带宽仍会闲置。
可以改进简单的两阶段方法,让每个输入端口同时提交多个请求;这些请求可能来自不同虚拟通道,也可能对应多个自适应路由选项,并发往不同输出端口仲裁器。每个输入端口提交多个请求,能提高匹配概率。此时仲裁需要三个阶段:请求、授权和确认。图 F.18(b) 中,每个输入端口的分组最多可以提交两个请求。请求阶段与两阶段仲裁相同:请求发往输出端口仲裁器,后者从收到的请求中选一个。授权阶段也相同:选中的请求获得授权。但一个输入端口可能提交多个请求,所以也可能收到多个授权,必须再用轮询等仲裁策略选一个,并在确认阶段通知相应输出端口仲裁器。
如图 F.18(b) 所示,一个输入端口虽然提交了多个请求,也可能一个授权都没得到,而某些被请求的端口仍空闲。因此,进行第二轮仲裁可以提高匹配概率。这一轮只提交尚未匹配的输入、输出端口之间的请求。允许每个输入端口提出多个请求的迭代仲裁器,可以提高交换机输出端口以及网络链路带宽的利用率,代价是仲裁器更复杂、仲裁延迟更大;如果仲裁位于关键路径上,还可能延长路由器时钟周期。
交换
交换技术规定如何在网络中建立连接。理想情况下,从时间与空间两方面考虑,网络资源之间的连接应恰在资源准备好、且确实需要使用之时才建立或“接通”,并且只维持实际需要的时间。这样,不同流量既能高效共享可用带宽,也能实现低延迟。在路由算法允许、仲裁算法授权的拓扑路径上,每一跳的连接可以采用三种基本方式建立:分组到达前,用电路交换建立;整个分组到达后,用存储转发分组交换建立;或者只接收部分分组后,用 cut-through 分组交换建立,接收单位不小于分组头。
电路交换预先建立电路,为整个源—目的路径上的分组传输分配网络带宽。可以在路径每一跳设置流水级,使分组沿电路流水传输,称为流水化电路交换。一个或多个分组只需进行一次路由、仲裁与交换,因此分组头不需要路由位,降低了延迟和开销。如果设备间持续在同一已建立电路上传输信息,这种方式可能很高效。但带宽从共享资源池中预先划走,无论源节点是否需要使用都已占定,因此电路交换也可能极不高效,严重浪费带宽。
更常见的情况是间歇发送分组;此时分组交换能让网络带宽得到更有效的共享和利用。它主要分为存储转发与 cut-through 两类,两者都能以分组大小或更小的信息单位复用链路带宽,让不同来源分组更好地共享带宽。不过,更细粒度的共享也增加了交换开销:每个分组都要进行路由、仲裁和交换,每个分组都需要路由位,采用流量控制时还需要流控位。
存储转发分组交换先在接收交换机完整存下分组,再按源—目的路径依次转发到下一跳。分组在每台交换机都完整存下后才继续发送,因此链路完全解耦,即使各链路带宽差异很大,也能充分利用各自带宽。这一点对 WAN 很重要,代价则是分组延迟。原文指出,总路由、仲裁与交换延迟随跳数成倍累积;F.4 节已经在该假设下分析过性能。
cut-through 分组交换在接收交换机暂存下分组头,或分组头之后等量的载荷时,就可以建立连接,让分组以流水方式“穿过”交换机;无须等到其余部分到达,便可接通已获授权的资源。原文将这描述为:路由、仲裁和交换延迟与跳数的关系由乘法变为加法,从而减少总分组延迟。cut-through 有两种形式,主要区别是流量控制所作用的信息单位大小,以及由此决定的交换机缓冲需求。虚拟 cut-through 交换按分组实施流量控制;虫孔交换则按流控单元,即 flit,实施流量控制。flit 小于最大分组,通常至少与分组头一样大。虫孔交换机只须能存储分组的一小部分,所以阻塞的分组可能横跨多台交换机。这会阻塞需要使用相同链路的其他分组,使网络过早饱和、有效带宽降低;除非在交换机内部使用某种集中缓冲区存放这些分组,这称为带缓冲的虫孔交换。现有工艺可以在芯片上实现较大缓冲区,所以虚拟 cut-through 更常见;但对于力求节省芯片资源的 OCN,虫孔交换仍可能更合适。
允许多个分组通过 flit 级时分复用,同时共享一条物理链路的带宽,可以缓解虫孔交换引起的过早饱和。这要求物理链路两端都配备一组虚拟通道,即前面提到的逻辑缓冲区,并将分组交换到这些通道中。此前已说明,虚拟通道可以将物理链路带宽与已缓冲分组解耦,以避免死锁。这里的复用则使某个分组即使与前方已阻塞分组共享部分链路,它的 flit 仍能获得带宽并继续前进。这又提高了网络带宽利用率,进而降低平均分组延迟。
对网络性能的影响
路由、仲裁与交换可以减少分组争用延迟,从而影响有负载网络的分组延迟。在没有争用的空载网络中,路由和仲裁算法除了决定这些功能在交换机中的实现延迟外,不会影响分组延迟;交换芯片从输入引脚到输出引脚的延迟,通常为几十纳秒。上一节给出的最佳情况分组延迟表达式,只有交换方式改变时才需要调整。前面假定采用存储转发,因此源节点和全部 跳都要付出整个分组的传输延迟。cut-through 则以分组头而非整个分组为粒度,在路径各条网络链路上流水传输,减少了这一延迟分量。分组延迟下界为:
译注:式中的 和 对应前文的单台交换机仲裁与交换延迟 、;Packet 与 Header 分别表示分组和分组头的大小。 原文此前关于“乘法变为加法”的措辞容易引起误解:对照 F.4 节的存储转发公式,改变的是分组传输项,由 变为 ;各交换机的路由、仲裁和交换延迟仍按跳数累加。
有效带宽取决于路由、仲裁与交换能让带宽得到多高效的利用。路由算法可将有负载网络中的流量分布得更均匀,提高拓扑总带宽,特别是二分链路带宽的利用率。仲裁算法可尽量增加接受分组的输出端口数,同样提高带宽利用率。交换技术则可提高分组间资源共享程度,进一步提高利用率。这些因素通过效率因子 ,,共同影响网络带宽:
除仿真外,很难用其他手段计算或量化 。不过,有了这个参数,就可用下式估计有效带宽的最佳情况上界,同时计入路由、仲裁和交换的影响:
也取决于网络对应用流量的适应程度。例如,如果源—目的节点对之间持续发送大量分组流,电路交换的 可能高于 cut-through;若分组间歇发送,情况则可能相反。
例题:确定性路由与自适应路由的性能
对一个互连 4096 个节点的三维 torus,绘制延迟和吞吐量随施加负载变化的曲线,比较确定性路由和自适应路由;同时比较其中最好与最差网络的效率。假定采用虚拟 cut-through、三阶段仲裁及虚拟通道,分别考察两个和四个虚拟通道的情况。假定其中一个虚拟通道按维序采用 bubble 流量控制,以避免死锁;其他虚拟通道则按维序使用,用于确定性路由,或者沿最短路径使用,用于自适应路由,方式与 IBM Blue Gene/L torus 网络相同。
解答 路由算法的行为取决于多个网络设计参数,参数间又有复杂依赖,因此很难解析计算其性能。设计人员通常使用周期精确仿真器评估。一种评估设计决策的方法,是在一系列网络负载下运行多组仿真,每次只修改一个感兴趣的设计参数,其他参数保持不变。这类评估经常使用合成流量,因为它能让网络稳定在某个工作点,便于细致分析行为。这里采用这一方法;也可以使用轨迹驱动或执行驱动仿真。
图 F.19 展示了典型的互连网络性能曲线。左图对两种路由算法及各自两个、四个虚拟通道的情况,画出平均分组延迟,以网络周期计,随施加负载即流量生成率的变化;右图同样画出吞吐量即流量交付率的变化。施加负载除以网络节点数进行归一化,单位为字节/周期/节点。仿真假定流量均匀分布,分组为 256 字节,flit 为 1 字节。每跳的路由、仲裁与交换延迟之和为一个网络周期,每条链路的飞行时间为十个周期。链路带宽为每周期 1 字节,因此结果不依赖网络时钟频率。
各条曲线具有相似形状,但数值不同。延迟曲线都从前述公式预测的空载延迟开始,然后随流量及资源争用增加而缓慢上升。施加负载更大时,延迟呈指数增长,网络接近饱和,无法吸收全部施加负载,导致分组在源节点排队等待注入。仿真中队列会随时间持续增长,延迟趋于无穷;实际中,队列达到容量上限后,会迫使应用停止生成更多分组,或者应用等待未完成分组的确认和响应,自行限制生成速率。不过,自适应路由为拥塞资源上的分组提供备选路径,所以延迟增长更慢。
同样的原因使自适应路由在虚拟通道数相同时,能达到比确定性路由更高的峰值吞吐量。未饱和时,吞吐量随施加负载近似线性增长;网络达到饱和后,交付流量的速率便跟不上生成速率。因此,饱和点表示最大可达即“峰值”吞吐量,不会高于前述有效带宽公式的预测值。饱和后,全网络发生大量队头阻塞,F.6 节将进一步说明,吞吐量往往下降,正如高峰时段车辆反而走得更慢。这一吞吐量区域很重要:它表明,如果没有有效采用 F.7 节将简述的拥塞管理技术,路由算法会造成多大的性能下降。本例中,以饱和后的持续吞吐量衡量,自适应路由的性能下降比确定性路由更大。
对于两种算法,四个虚拟通道比两个通道更能让分组越过前方阻塞分组,因而提高峰值吞吐量。四虚拟通道自适应路由的峰值吞吐量为 0.43 字节/周期/节点,接近效率为 100%,即 ,时的最大值 0.5。这里假定注入和接收带宽足够高,使网络二分面成为瓶颈。此时,网络带宽就是 100% 乘以二分带宽,再除以跨越二分面的流量比例 。二分面将 torus 分成大小相等的两半,对于均匀流量,只有一半注入流量的目的节点在另一半,所以 。4096 节点三维 torus 的二分带宽,为 条单向链路乘以每条链路每周期 1 字节的带宽。再像归一化网络带宽一样除以节点数,得到二分带宽 0.25 字节/周期/节点;除以 ,即得理想最大网络带宽 0.5 字节/周期/节点。
将测得的峰值吞吐量除以理想吞吐量,就能得到仿真网络的效率因子。完全自适应路由加四虚拟通道的效率为 ,确定性路由加两个虚拟通道则为 。二者相差 12 个百分点;如果进一步改进路由、仲裁、交换及虚拟通道设计,还可能获得另外 14 个百分点的效率提升。
为把这部分讨论放到实际系统中观察,图 F.20 列出商用高性能计算机 SAN 使用的技术。这些问题不仅适用于图中的 SAN,也适用于从 OCN 到 WAN 的其他互连领域。
| 公司 | 系统[网络] | 最大节点数[× CPU 数] | 基本拓扑 | 交换机排队/缓冲 | 路由算法 | 交换机仲裁 | 网络交换技术 |
|---|---|---|---|---|---|---|---|
| Intel | ASCI Red Paragon | 4510[×2] | 二维 mesh,64×64 | 输入缓冲,1 flit | 分布式维序路由 | 两阶段 RR,分布在交换机各处 | 虫孔交换,无虚拟通道 |
| IBM | ASCI White SP Power3[Colony] | 512[×16] | 8 端口双向交换机组成的双向 MIN,通常为胖树或 Omega | 输入和中央缓冲,输出排队,8 倍加速 | 基于源的 LCA 自适应最短路径路由,以及基于表的多播路由 | 两阶段 RR;集中式,同时在输出处为旁路路径设置分布式仲裁 | 带缓冲的虫孔交换,多播采用虚拟 cut-through;无虚拟通道 |
| Intel | Thunder Itanium2 Tiger4[QsNet II] | 1024[×4] | 8 端口双向交换机组成的胖树 | 输入缓冲 | 基于源的 LCA 自适应最短路径路由 | 两阶段 RR、优先级与 aging,分布在输出端口 | 虫孔交换,两个虚拟通道 |
| Cray | XT3[SeaStar] | 30,508[×1] | 三维 torus,40×32×24 | 输入缓冲,输出暂存 | 分布式、基于表的维序路由 | 两阶段 RR,分布在输出端口 | 虚拟 cut-through,四个虚拟通道 |
| Cray | X1E | 1024[×1] | 每交换机连接 4 个端设备的二维 torus,约 23×11,带 express 链路 | 输入缓冲,虚拟输出排队 | 分布式、基于表的维序路由 | 两阶段 wavefront,全局流水化仲裁器 | 虚拟 cut-through,四个虚拟通道 |
| IBM | ASC Purple pSeries 575[Federation] | >1280[×8] | 8 端口双向交换机组成的双向 MIN,通常为胖树或 Omega | 输入和中央缓冲,输出排队,8 倍加速 | 源路由与分布式、基于表的 LCA 自适应最短路径及多播路由 | 两阶段 RR;集中式,同时在输出处为旁路路径设置分布式仲裁 | 带缓冲的虫孔交换,多播采用虚拟 cut-through;八个虚拟通道 |
| IBM | Blue Gene/L eServer Solution[Torus Net.] | 65,536[×2] | 三维 torus,32×32×64 | 输入、输出缓冲 | 分布式自适应路由,带 bubble 逃逸虚拟通道 | 两阶段 SLQ,分布在输入、输出处 | 虚拟 cut-through,四个虚拟通道 |
F.6 交换机微体系结构
网络交换机实现交换介质网络的路由、仲裁与交换功能,也实现缓冲区管理机制;对于无损网络,还实现相应的流量控制。某些网络的交换机还承担部分网络管理功能,在启动或发生故障时探索、配置和重新配置网络拓扑。本节通过一种基本交换机微体系结构,以及适合前述不同路由、仲裁和交换技术的多种方案,揭示交换机的内部结构。
基本交换机微体系结构
交换机内部数据通路提供输入与输出端口之间的连接。虽然可以采用共享总线或多端口中央存储器,但当所需总带宽较高时,前者能力不足,后者则过于昂贵。多数高性能交换机采用内部交叉开关,实现无阻塞连接,允许多个输入—输出端口对并发连接。阻塞分组可由先进先出(FIFO)或循环队列缓冲;为获得较大容量和灵活性,可以在静态 RAM 中实现为动态可分配多队列(dynamically allocatable multi-queues,DAMQ)。这些队列可放在输入端口,形成输入缓冲交换机;放在输出端口,形成输出缓冲交换机;集中放在内部,形成中央缓冲交换机;或输入、输出两侧都设置,形成输入—输出缓冲交换机。图 F.21 为后一种结构的框图。
路由可以用路由控制单元中的有限状态机或转发表实现。使用有限状态机时,状态机处理分组头提供的路由信息,按路由算法确定可用输出端口;自适应路由可能给出多个端口。头部中的部分路由信息在使用后,通常由路由控制单元剥除或修改,以简化下一跳处理。使用转发表时,头部路由信息作为地址,访问包含路由算法所允许输出端口的表项。网络开始运行时,必须先把转发表加载到交换机中。还存在混合方案:将转发表缩减为一小组路由位,与一个小型逻辑模块结合。路由控制单元据这些位判断允许的路径,并决定分组应走的输出端口。其目标是构建灵活而紧凑的路由控制单元,避免大型转发表浪费面积和功耗,从而适用于 OCN。路由控制单元通常是集中资源,也可以在每个输入端口复制一份,避免形成瓶颈。每个分组只进行一次路由,而分组通常足够大,需要多个周期才能穿过交换机,因此集中路由控制单元很少成为瓶颈。图 F.21 假定使用集中式路由控制。
如上一节所述,当两个或更多分组同时请求同一输出端口时,需要仲裁。交换机仲裁可集中或分布实现:前者把全部请求和状态信息送到中央仲裁单元;后者将仲裁器分布在交换机各处,通常位于输入或输出端口。一个分组可能多次参与仲裁,每个输入端口还可能关联多个队列,使需处理的仲裁请求增加。因此,许多实现采用分层仲裁:先在各输入端口本地,从该端口对应的分组与队列中选出一个请求;再全局仲裁各输入端口仲裁器选出的请求。图 F.21 假定采用集中式仲裁单元。
图 F.21 基本结构的工作过程如下。分组开始到达输入端口时,链路控制器解码输入信号并生成位序列;如果外部链路宽度与内部数据通路不同,还可能反串行化数据,以适配内部宽度。它同时从分组头或链路控制信号中提取信息,确定分组应存入哪个队列。接收并缓冲分组的同时,或者根据交换技术在完整缓冲后,将头部送往路由单元。路由单元向仲裁单元提出一个或多个输出端口请求。如果端口空闲且有足够空间容纳整个分组或一个 flit,具体取决于交换方式,仲裁就可成功。若实现带虚拟通道的虫孔交换,每个 flit 的传输还可能需要额外仲裁和分配步骤。资源分配后,如果前面没有其他分组且链路空闲,分组便穿过内部交叉开关,进入相应输出缓冲区和链路。链路控制器实现的链路级流量控制,防止链路另一端相邻交换机的输入队列溢出。如果采用虚拟通道交换,多个分组可以按 flit 在链路上时分复用。各输入、输出端口独立工作,因此没有争用时,多个到达分组可以并发处理。
缓冲区组织
如前所述,队列可以位于输入侧、输出侧或两侧。输出缓冲交换机的优点是完全消除队头阻塞(head-of-line blocking,HOL)。当一个队列中缓冲了两个或多个分组,队首分组阻塞,从而挡住后面的分组,而后者若位于队首本来可以前进,这就称为队头阻塞。输出缓冲交换机不会发生这种情况,因为同一队列的所有分组状态相同,都需要同一输出端口。但所有输入端口可能同时收到发往同一输出端口的分组。由于输入侧没有缓冲区,输出缓冲区必须能同时存下全部这些到达分组。这要求内部交换速度加速 倍,即输出队列写入带宽为链路带宽的 倍, 为端口数。这往往太昂贵,因此无损网络很少单独采用这种方案。由于同时收到许多发往同一输出端口分组的概率通常较小,采用输出缓冲交换机的商用系统,往往只提供适度内部加速,罕见的缓冲区溢出则通过丢包处理。
输入缓冲交换机无须内部加速就能接收分组,但输入队列可能发生 HOL 阻塞,如图 F.22(a)。即使分组目的地均匀分布,输出端口利用率也可能因此低于 60%。图 F.22(b) 表明,虚拟通道,图中为两个,可以缓解但不能消除 HOL 阻塞。更有效的办法是将输入队列组织为图 F.22(c) 的虚拟输出队列(virtual output queues,VOQ):每个输入端口都设置与输出端口数相同的队列,分别缓冲发往不同输出端口的分组。这一技术广泛用于 ATM 交换机和 IP 路由器。主要缺点是成本与可扩展性:VOQ 数量随端口数按平方增长。而且,虽然它消除了单台交换机内部的 HOL 阻塞,却没有解决端到端网络层面的 HOL 阻塞。当然,也可以支持网络级 VOQ,即在每个交换机输入端口,设置与整个网络输出端口总数相同的队列,但这极其昂贵。另一种办法是只动态分配一部分队列,将发往拥塞目的地的分组单独存储或缓存。
输入—输出联合缓冲交换机,在输出侧有足够空间时尽量减少 HOL 阻塞,同时由于输入侧也有缓冲,尽量降低所需内部加速倍数。它还将内部交叉开关传输与外部链路传输解耦。这对于采用虚拟通道、在链路上按 flit 时分复用的 cut-through 实现尤其有用。许多商用设计都采用输入—输出缓冲交换机。
路由算法的实现
必须区分路由算法与其实现。算法描述分组穿过网络的转发规则,影响分组延迟和网络吞吐量;实现则影响分组到达节点后的处理延迟、所需芯片面积及路由计算功耗。研究者提出了多种预先计算路由,或隐藏路由计算延迟的方法。但在不明显削弱路由灵活性的前提下,减少面积和功耗,得到的关注少得多。这两方面如今都非常重要,OCN 尤其如此。许多现有设计通过采用相对简单的路由算法应对这些问题,但随着工艺继续缩放,制造缺陷、工艺波动等问题增加,未来很可能需要更复杂的算法,下面将作简述。
如前所述,按计算发生的位置,可区分源路由与分布式路由。源路由将实现复杂度移到端节点:路径需要存入表中,按目的端节点标识符选择分组路径。分布式路由则将复杂度移入交换机,在分组路径的每一跳都选择输出端口。分布式路由有两种基本实现。第一种,用逻辑模块为特定拓扑实现固定算法;最常见的是维序路由,按既定顺序消除各维度上的位移。另一种使用转发表,每个表项编码到某个目的地应使用的输出端口,所以最坏情况下,表项数须与目的节点数相同。
两者各有利弊。基于逻辑的路由计算延迟很短,面积通常很小,功耗低,但必须针对特定拓扑设计,因而受该拓扑限制。基于表的分布式路由相当灵活,能支持任意拓扑和路由算法,只需按所用算法填写适当表项;例如 up*/down* 算法可定义在任意不规则拓扑上。缺点是面积和功耗开销不可忽视,可扩展性也成问题:最坏情况下,一个具有 个端节点及交换机的系统,需要 张表,每表 项,成本按平方增长。
哪种方案更合适取决于网络领域。SAN 常见基于表的方案,InfiniBand 就是如此;OCN 等环境则因面积和功耗而尽量避免查表,适合采用基于逻辑的实现。这也构成 OCN 设计者面临的挑战:器件不断微缩,带来更多制造缺陷、更高的瞬态或永久故障率、明显工艺波动,即晶体管行为偏离设计规格,还需要不同的时钟和电压域,并面临严格的功率与能量预算。这些挑战都要求网络支持异构性。故障部件、关闭供电的交换机和链路,以及因性能波动不可接受而禁用的部件,会在网络中形成不同且可能不规则的区域。因此,同构设计可能最终形成异构系统。在这种背景下,高效实现足够灵活、能应对新挑战的路由算法非常重要。
一种著名方法是区间路由(interval routing)[Leeuwen 1987],为每个输出端口定义一段目的地址范围;它具有一定灵活性,又比传统查表方案紧凑得多。虽然灵活性仍不足,却提供了解决新挑战的线索。较新的 Logic-Based Distributed Routing(LBDR,基于逻辑的分布式路由),在逻辑实现的高效与表实现的灵活之间,提供了一种可行折中。它以规则二维 mesh 为参照,但允许制造缺陷、故障及其他异常改变拓扑,从中派生出不规则网络。故障、禁用或断电部件破坏规则性后,维序路由已不能使用。为支持此类拓扑,LBDR 在每台交换机定义一组配置位:四个连接位,每端口一个,指出与拓扑中相邻交换机的连接情况;例如可以用它们禁用通向故障部件的输出端口。此外还有八个路由位,每输出端口两个,规定可用路由选项。这些路由位根据待实现算法计算,在加电时设置。基本含义是:某路由位置位,就表示分组可以通过关联输出端口离开,并允许在下一台交换机进行某种转向。LBDR 在这方面类似区间路由,不过它定义的是几何区域,而非目的地址范围。图 F.23 给出在不规则拓扑上,用 LBDR 实现一种与拓扑无关的算法的例子,并列出计算出的配置位。
连接位与路由位配合一小组逻辑门,实现路由算法。LBDR 以初始拓扑,即二维 mesh 为参照,根据当前路由器坐标、目的路由器坐标和配置位作决定。图 F.24 展示所需逻辑,图 F.25 展示如何在各路由器中使用配置位,将分组从源送到目的地。可以看到,交换机 10 禁用了西向端口,以落实路由限制。
LBDR 提供了一种高效实现 OCN 路由的方法。最近,它已扩展为支持非最短路径、集合通信操作与流量隔离。所有这些改进都仅使用少量配置位,保持了紧凑而高效的实现。LBDR 及其扩展的详细介绍,以及当时 OCN 的研究进展,见 Flich[2010]。
交换机微体系结构的流水化
对交换机微体系结构进行流水化,可以提高性能。交换机流水处理分组,与向量处理器流水执行指令有相似之处。在向量流水线中,一条指令规定对流水处理的全部向量元素执行何种操作;类似地,交换机中的一个分组头,规定如何处理该分组在内部数据通路上传输的全部物理传输单元,即 phit,这些单元以流水方式处理。不同输入端口的分组彼此独立,还能并行处理,就像多个独立指令或指令线程可以并行执行一样。
分析交换机内部基本功能,并将其组织成多个阶段,就能实现流水化。图 F.26 是图 F.21 基本结构的一种五级流水组织,假定采用 cut-through,并用转发表实现路由。第一级接收分组头后,第二级利用目的地址等路由信息,查找转发表中允许的路由选项。与此同时,第一级继续接收分组的其他部分并存入输入队列。第三级进行仲裁,第四级配置交叉开关,将获准输出端口分配给分组;第五级将分组头存入输出缓冲区,准备沿外部链路发送。注意,第二和第三级只供分组头使用;一旦内部数据通路建立,载荷和尾部只使用数据流经的三个阶段。
虚拟通道交换机通常还需要一级进行虚拟通道分配,而且每个 flit 穿过交叉开关之前都需要仲裁。路由和仲裁算法若较复杂,这些操作还可能占用多个时钟周期。
其他交换机微体系结构改进
如前所述,有时会提高交换机内部速度,以提升输出端口利用率。通常通过提高时钟频率、增大内部数据通路宽度即 phit 大小,或两者结合来实现。另一种办法,是为每个输入端口的队列组到输出端口设置多条并行数据通路,例如增加交叉开关的输入端口数。如果每个输入端口实现多个物理队列,就可以为每个输入队列设置一个独立的交叉开关端口。例如 IBM Blue Gene/L 为每个交换机输入端口实现了两个交叉开关访问端口与两个读取端口。
输入、输出间并行数据通路的另一种实现方式,是把缓冲区移到交叉开关的交叉点。这通常称为带缓冲交叉开关(buffered crossbar switch)。它为每个输入端口到不同输出端口提供独立通路,使一个输入端口可以同时向 个不同输出端口发送最多 个分组。为各输入—输出端口对提供独立交叉点存储器,可消除单台交换机内的 HOL 阻塞;仲裁也比其他结构简单得多。每个输出端口只能从自身对应、与其他输出端口互不重叠的一组交叉点存储器接收分组,因此每个输出端口可以使用完全独立且十分简单的仲裁器。
如果不是成本太高,带缓冲交叉开关将是理想结构。交叉点存储器数量随端口数按平方增长,相比基本结构显著提高成本并降低可扩展性。此外,每个交叉点存储器都必须足够大,才能高效实现链路级流量控制。为降低成本,多数设计者选择输入缓冲或输入—输出联合缓冲,再辅以前述某些增强机制。
F.7 商用互连网络的实际问题
除了前面介绍的技术问题,各类互连网络还有一些重要的实际问题需要考虑。下面列举其中几项。
连接能力
通信设备的类型、数量及通信要求,会影响互连网络及其协议的复杂度。协议必须面向最大的网络规模,并处理系统范围内可能出现的异常事件。需要考虑的问题包括:网络接口的硬件与软件应有多轻量?应接到存储器网络还是 I/O 网络?是否应支持 缓存 一致性?如果每次网络事务都需要操作系统介入,发送与接收开销就会很大。如果网络接口连接到 I/O 网络,例如 PCI Express 或 HyperTransport,其注入与接收带宽便受到 I/O 网络带宽限制。Cray XT3 SeaStar、Intel Thunder Tiger 4 QsNet II 以及许多其他超级计算机、集群网络都是如此。为支持一致性,发送者可能每次发送前都要刷出 缓存,接收者每次接收前也可能需要刷出 缓存,以避免陈旧数据问题。这些操作进一步增加发送与接收开销,常使网络接口成为网络瓶颈。
计算机系统通常有多套互连,功能及成本—性能目标各不相同。例如,处理器—存储器互连通常比 I/O 互连带宽更高、延迟更低,也更可能支持 缓存 一致性,但较少遵循或成为标准。个人计算机通常有处理器—存储器互连,以及 PCI-X 2.0、PCIe 或HyperTransport 等 I/O 互连,后者连接快慢不同的设备,例如 USB 2.0、千兆以太网 LAN、FireWire 800。Blue Gene/L 超级计算机采用五套互连网络;其中只有一套是承担大部分处理器间应用流量的三维 torus。其余包括用于广播和多播的树形集合通信网络,用于合并结果及 散布(scatter)、聚集(gather) 的树形屏障网络,用于诊断、调试和初始化的控制网络,以及负责节点与磁盘间 I/O 的千兆以太网。
得克萨斯大学奥斯汀分校的 TRIPS EDGE 处理器具有八套专用片上网络,互连构成两个处理器核及片上 L2 缓存 的 106 个异构 tile。有的双向通道宽达 128 位,有的每方向宽达 168 位。它还有芯片间交换网络,在多处理器配置中互连多个芯片。片上网络中有两套交换网络:一套传送操作数,另一套用于片上存储器通信。其他网络本质上是用于状态和控制的扇出树或重新汇合的专用链路网络。互连占据相当大的芯片资源:七个金属层中有五个用于全局网络布线。
标准化:跨公司的互操作性
标准在计算机设计的许多方面都很有用,互连网络也不例外。成功的标准具有低成本和稳定性等优点。客户可以选择多家供应商,竞争使价格接近成本,也使互连方案的生存不再依赖某一家公司的稳定性。为标准互连设计的部件还可能拥有更大市场,较高销量可降低供应商成本,进一步让客户受益。最后,标准允许多家公司构建采用统一接口的产品,客户不必等某一家公司开发出与所有目标产品相连的接口。
标准的一个缺点是,委员会和各利益群体需要很长时间才能就定义达成一致;技术迅速变化时,这尤其成问题。另一个问题是什么时候标准化:设计者一方面希望在任何东西造出来之前已有标准,另一方面,先造出一些东西再标准化更好,可以避免把无用功能写进规范,或漏掉重要功能。如果过早标准化,往往完全由委员会设计,就像让法国所有厨师合做一道菜,很少能端出杰作。标准固定了接口,也可能抑制该层面的创新,至少在下一版标准出现前如此,而更新间隔可能数年甚至更久。越来越常见的做法,是公司组成联盟,共同定义并认可某种技术,使之成为“事实上的”行业标准;InfiniBand 就是这样。
LAN 和 WAN 使用标准,并能有效互操作。WAN 涉及多种公司,必须连接众多品牌的计算机,很难想象专有 WAN 会成功。以太网无处不在,说明标准在 LAN 和 WAN 中都受欢迎;多数客户不太可能把自己 LAN 的生存绑定在某一家公司的稳定性上。有些 SAN 已标准化,例如 Fibre Channel,但多数仍是专有网络。OCN 大多也采用专有设计,少数在片上系统(SoC)中获得广泛商用,例如 IBM CoreConnect 和 ARM AMBA。
拥塞管理
当过多分组试图使用同一链路或链路集合,所需带宽超过可用带宽时,就会发生拥塞。拥塞本身并不降低性能,拥塞链路只是运行在最大容量。性能下降发生在 HOL 阻塞存在时:发往非拥塞目的地的分组,被发往拥塞目的地的分组挡住,部分链路带宽浪费,网络吞吐量下降,原书指向 F.4 节末例题加以说明。拥塞控制是指当所有节点的总流量超过网络承受能力时,用于减少流量的机制。
电路交换网络的一个优点是,一旦建立电路,就保证有足够带宽交付沿该电路发送的全部信息。电路建立时预留互连带宽;网络满了,就不能再建立电路。其他交换技术通常不预留带宽,因此互连可能被过多分组堵塞。就像高峰时段通勤者遭遇堵车,分组拥堵会增加延迟,极端情况下甚至使每秒交付的分组更少。分组交换网络必须实现某种拥塞管理。机制可分两类:一类控制拥塞,另一类消除拥塞造成的性能下降。
互连网络有三种基本拥塞控制方案,各有缺点:丢包、流量控制,以及抑制分组(choke packet)。最简单的是 F.2 节简述过的丢包:分组到达交换机时,如果缓冲区没有空间,就将其丢弃。这依靠处理传输错误的高层软件重发丢失分组。已发送或重发的分组可能随后又被丢弃,造成大量带宽浪费,因此通常只用于互联网这样的有损网络。
第二种方案依靠前述流量控制。缓冲区满时,链路级流量控制反馈,阻止继续发送分组。这种反压反馈迅速向后传播,直到造成拥塞的源节点,迫使它们降低注入速率。主要缺点是,源节点得知拥塞时已经太晚,网络早已拥塞,而且该方案没有采取额外措施缓解拥塞。反压流量控制常用于无损网络,例如超级计算机及企业系统的 SAN。
更复杂的流控方式,是在发送与接收端节点之间直接实施,统称端到端流量控制。窗口机制是一种基于 credit的端到端流控,窗口必须足够大,才能让分组高效地在网络中流水传输。窗口限制未确认分组数,从而在拥塞发生时,限制各源节点对拥塞的贡献。TCP 使用滑动窗口。注意,端到端流控只描述互连网络中两个节点之间的交互,并不覆盖全部端节点之间的整个网络。因此,它有助于拥塞控制,但不是全局解决方案。
第三种方案使用抑制分组,出发点是只有网络存在拥塞时才限制流量注入。各交换机监测繁忙程度,超过阈值就进入警告状态。处于该状态的交换机,对收到的每个分组,向源节点回送包含原目的地的抑制分组,要求源节点按固定比例减少发往该目的地的流量。由于源节点可能已沿相同路径发送其他分组,它会等在途分组返回后,再响应抑制分组。该方案降低分组注入速率,直到流量减小,就像高速公路入口的调节信号灯控制车辆进入速率一样。反馈延迟短时很有效;若拥塞通知耗时较长,通常是因为飞行时间长,这种控制可能不稳定,反应过慢或使注入速率振荡,都会降低带宽利用率。
另一条思路不是控制拥塞,而是消除其负面后果,即如前所述,消除每台交换机的 HOL 阻塞。可以使用虚拟输出队列,但每个输入端口所需队列数须等于网络设备数,成本极高且完全不具备扩展性。幸运的是,只动态分配少量专设队列,单独存放经过某些网络热点区域的拥塞分组,就能取得良好效果,类似 缓存 只保存更频繁访问的内存位置。这称为区域显式拥塞通知(regional explicit congestion notification,RECN)。
容错
随着晶体管集成密度及系统设备数增加,系统发生故障的概率也提高。因此,可靠性与可用性已成为主要关注点,未来互连设备越来越多时还会更加重要。一个实际问题是:互连网络是否要求所有设备都正常,整个网络才能正常工作?软件故障通常远多于硬件故障,因此还必须考虑:单个设备的软件崩溃,会不会阻止其他设备通信?有些硬件设计者试图构建无故障网络,但实际问题只能是故障率多高,而不是能否彻底避免。通信子系统必须具备故障发生时的应对机制,因为故障终将发生。
互连网络的故障主要有瞬态和永久两类。瞬态故障通常由电磁干扰引起,可以用 F.2 节技术检测和纠正,往往只需链路级或端到端重传。永久故障则是某个部件不再按规格工作,常由过热、偏置过大、过度使用、老化等造成,不能仅靠高层软件协议重传恢复。网络中必须存在其他物理路径,并由路由算法提供以绕过故障;否则,网络就会受损,无法交付那些唯一可用路径经过故障资源的分组。
处理永久故障的技术主要有三类:资源备用、容错路由、网络重配置。资源备用将故障资源关闭或旁路,并接入备用资源替代。例如 ServerNet 有两套相同交换结构,任一时刻只使用一套;一套故障就切换到另一套。也可不接入备用资源,而在故障后降级运行。例如 IBM Blue Gene/L 能旁路故障网络资源,同时保留基本拓扑和路由算法。主要缺点是,为保留三维 torus 等基本拓扑,一处故障之后可能必须关闭大量正常资源,例如 midplane 节点板。
容错路由利用拓扑已有的多条路径,在故障下路由消息,无须备用资源。设计时为每种支持的故障组合确定备选路径,并纳入路由算法;检测到故障后使用适当路径。困难在于故障模式可能任意出现,必须保证采用备选路径后,算法仍然无死锁。直接网络的规则性可能被故障破坏,尤其难处理。Cray T3E 是在三维 torus 直接网络上成功采用该技术的例子。间接网络中也有许多实例,如 ASCI White 和 ASC Purple 的双向多级网络。它们提供端节点间多条最短路径,本身没有路由死锁问题,见 F.5 节;发生故障时,由源节点选择替代路径。
网络重配置更通用,可处理故障或其他原因造成的主动和被动拓扑变化。重配置时,先发现拓扑中无故障的部分,再计算新的路由表,并分发到相应交换机或端节点。根据路由方式,它需要可编程交换机、可编程网络接口,或两者;也可使用 up*/down* 之类通用算法,配置到故障后可能出现的所有拓扑上。这样,设计者无须事先为每种故障组合提供路径。可编程网络部件提供高度灵活性,代价是成本和延迟更高。用于集群和 SAN 的多数标准或专有互连,包括 Myrinet、Quadrics、InfiniBand、Advanced Switching 和 Fibre Channel,都带有按当前拓扑配置或重新配置路由的软件。
另一个实际问题与节点容错有关:网络即使能承受故障,在新增或移除节点时,能否继续运行?这通常称为热插拔。若不能,每次增删节点都将使网络停用,对 WAN、LAN 不现实,对多数 SAN 也无法接受。在线扩容需要热插拔,因此多数网络支持它。通常通过动态网络重配置实现,即不停止用户流量便重配置网络。困难在于,交换机或端节点路由表动态、异步更新期间,网络中可能同时存在多个甚至相互冲突的路由算法,必须仍保证无死锁。多数 WAN 通过必要时丢包解决,但无损网络中的动态重配置复杂得多。最近已有若干理论和实用技术,能高效应对这一问题。
例题:容错能力如何影响用户可用性
图 F.27 给出了一个局域网中 58 台桌面计算机,在略超过一年内的故障数量。假定一种 LAN 要求所有机器正常,网络才能发送数据:某节点崩溃后无法接收消息,待交付数据便会堵塞互连。另一种是传统 LAN,它能在节点故障时继续运行,只需丢弃发往拒绝接收消息节点的数据。假定你必须同时使用自己的工作站和 LAN 才能工作,相比传统 LAN,不容错 LAN 使你无法工作的概率高多少?假定每次崩溃的停机时间少于 30 分钟,使用图中的一小时时段数据计算。
| 每时段故障机器数 | 具有该故障机器数的一小时时段数 | 按一小时时段统计的故障总数 | 具有该故障机器数的一天时段数 | 按一天时段统计的故障总数 |
|---|---|---|---|---|
| 0 | 8605 | 0 | 184 | 0 |
| 1 | 264 | 264 | 105 | 105 |
| 2 | 50 | 100 | 35 | 70 |
| 3 | 25 | 75 | 11 | 33 |
| 4 | 10 | 40 | 6 | 24 |
| 5 | 7 | 35 | 9 | 45 |
| 6 | 3 | 18 | 6 | 36 |
| 7 | 1 | 7 | 4 | 28 |
| 8 | 1 | 8 | 4 | 32 |
| 9 | 2 | 18 | 2 | 18 |
| 10 | 2 | 20 | ||
| 11 | 1 | 11 | 2 | 22 |
| 12 | 1 | 12 | ||
| 17 | 1 | 17 | ||
| 20 | 1 | 20 | ||
| 21 | 1 | 21 | 1 | 21 |
| 31 | 1 | 31 | ||
| 38 | 1 | 38 | ||
| 58 | 1 | 58 | ||
| 合计 | 8974 | 654 | 373 | 573 |
解答 按图 F.27,不容错网络中无法工作的小时比例为:
传统网络中,只有自己的工作站崩溃时才不能工作。若故障均匀分布到各工作站,则比例为:
因此,按图 F.27 的故障统计,使用不容错 LAN 时,无法工作的概率超过传统 LAN 的 30 倍。换句话说,负责维护 LAN 的人,会接到多出约 30 倍的愤怒用户来电!
F.8 互连网络实例
为了进一步使前述概念具体化,本节从本附录讨论的四类互连领域中选取五个实例。OCN、LAN、WAN 各一个,SAN 两个,分别为系统区域网络和系统/存储区域网络。前两个是高性能系统的专有网络,后三个是商用系统广泛使用的网络标准。
片上网络:Intel Single-Chip Cloud Computer
随着晶体管集成度按 Moore 定律持续提高,处理器设计者迫切需要应对横跨芯片的片内连线延迟,以及深亚微米工艺缩放带来的其他问题。多核微体系结构因简单、模块化,并能开发超越单核激进流水化和多指令/多数据发射所能实现的并行性,而日益普及。不论处理器是单核还是多核,对片内通信带宽的要求都越来越高,更不用说片间带宽。这激发了人们对 OCN 的广泛兴趣,希望高效支持指令、寄存器操作数、内存与 I/O 数据在核内、核间以及片内、片外的通信。这里重点介绍 Intel Single-chip Cloud Computer(SCC) 原型中的片上网络。
SCC 是具有 48 个 Intel IA-32 核的芯片多处理器原型。图 F.28 显示,其核分布在 二维 mesh 上,网络连接 24 个 tile、四个片上存储器控制器、一个电压调节控制器(VRC)以及一个外部系统接口控制器(SIF)。每个 tile 内两个核连接一台路由器。四个存储器控制器位于 mesh 两侧边缘,每侧两个,VRC 和 SIF 位于底边。
每个存储器控制器可寻址两个 DDR3 DIMM,每个 DIMM 最多 8 GB,因此总容量最多 64 GB。VRC 允许任一核或系统接口调节六个预定义区域中任一区域的电压;原文将每区描述为两个双 tile 区。时钟还能以更细粒度调节,每个 tile 有自己的运行频率。关闭区域或降低其运行水平,可大幅节能。应用因此能完全控制各核的功耗状态,并可通过 API 设定各区电压与频率。SIF 用于从芯片外部与网络通信。
每个 tile 包含两个基于 P54C 的 IA 处理器核,各配有 16 KB L1 数据 缓存、16 KB 指令 缓存,以及 256 KB L2 缓存 和控制器;还包含五端口路由器、仅供测试的流量发生器、处理所有消息传递请求的 mesh 接口单元(MIU)、内存查找表(配有配置寄存器,用于将核的物理地址映射到系统的扩展内存映射)、消息传递缓冲区,以及用于时钟生成和跨异步边界同步的电路。
就 OCN 而言,MIU 负责核与网络之间的接口,包括大消息的分组化与重组、命令转换、地址解码与查找、链路级流控、credit 管理,以及按轮询进行仲裁。系统采用基于 credit的流控及虚拟 cut-through,因此长消息必须拆成分组。路由器按二维 mesh 连接,原文在此描述各路由器具有自己的电源和时钟源。路由器间链路为 16 字节数据加 2 字节边带,频率 2 GHz。包含链路穿越在内的空载延迟为四个周期。八个虚拟通道中,六个用于性能,两个用于处理协议级死锁。消息级仲裁采用 wrapped wave-front 仲裁器。路由为 XY 维序算法,每台路由器都预计算输出端口。
除了 tile 的电压、频率区域之外,由路由器和链路构成的网络自身只有一个独立区域。因此,全部网络部件使用相同电源、运行于相同速度;路由器与 tile 之间需要异步时钟域转换。
译注:原页先称路由器“each on its own power supply and clock source”,随后又明确称全部网络部件使用同一电源和速度。此处分别保留两个陈述,未擅自消除其表述差异。
SCC 的一个特色,是核间通信采用基于消息的协议,而不是硬件 缓存 一致存储器。每台路由器都有消息传递缓冲区,并提供 API 对 MPI 结构进行完全控制;缓存 一致性可以由软件实现。
相比 Teraflops 处理器,SCC 路由器对二维片上互连作了显著改进。它面向多处理器互连中更宽的数据通路,并针对该宽度进一步优化延迟、面积和功耗。目标频率从前代 Teraflops 的 5 GHz 降到 2 GHz,但互连体系结构性能更高。
| 机构与处理器[网络] | 年份 | 网络端口数[核/tile+其他端口] | 基本拓扑 | 每链路每方向数据位数 | 链路带宽[链路时钟] | 路由;仲裁;交换 | 芯片金属层数;流控;虚拟通道 |
|---|---|---|---|---|---|---|---|
| MIT Raw[General Dynamic Network] | 2002 | 16[16 个 tile] | 二维 mesh,4×4 | 32 位 | 0.9 GB/s[225 MHz,与处理器同频] | XY DOR,带请求—应答死锁恢复;RR;虫孔 | 6 层;基于 credit;无虚拟通道 |
| IBM Power5 | 2004 | 7[2 个 PE 核+5 个其他端口] | 交叉开关 | 取指 256 位;存储 64 位;装入 256 位 | [1.9 GHz,与处理器同频] | 最短路径;无阻塞;电路交换 | 7 层;握手;无虚拟通道 |
| U.T. Austin TRIP Edge[Operand Network] | 2005 | 25[25 个执行单元 tile] | 二维 mesh,5×5 | 110 位 | 5.86 GB/s[533 MHz,时钟按 80% 缩放] | YX DOR;分布式 RR;虫孔 | 7 层;on/off 流控;无虚拟通道 |
| U.T. Austin TRIP Edge[On-Chip Network] | 2005 | 40[16 个 L2 tile+24 个网络接口 tile] | 二维 mesh,10×4 | 128 位 | 6.8 GB/s[533 MHz,时钟按 80% 缩放] | YX DOR;分布式 RR;虚拟 cut-through(VCT) | 7 层;基于 credit;4 个虚拟通道 |
| Sony、IBM、Toshiba Cell BE[Element Interconnect Bus] | 2005 | 12[1 个 PPE、8 个 SPE+3 个内存及 I/O 接口端口] | 环,共 4 个,每方向 2 个 | 128 位数据,另加 16 位标签 | 25.6 GB/s[1.6 GHz,为处理器频率一半] | 最短路径;集中式树形 RR;流水化电路交换 | 8 层;基于 credit;无虚拟通道 |
| Sun UltraSPARC T1 | 2005 | 最多 13[8 个 PE 核+4 个 L2 存储体+1 个共享 I/O] | 交叉开关 | 8 个核与 4 个 L2 存储体 均为 128 位 | 19.2 GB/s[1.2 GHz,与处理器同频] | 最短路径;基于等待时间仲裁;VCT | 9 层;握手;无虚拟通道 |
系统区域网络:IBM Blue Gene/L 三维 torus
据 www.top500.org,IBM Blue Gene/L 是 2005 年全球规模最大、性能最高的计算机系统。它有 65,536 个双处理器计算节点、1024 个 I/O 节点,峰值性能 360 TFLOPS,占地约 2500 平方英尺。每节点两个处理器可都用于计算,并在 virtual mode 下各自处理通信协议;也可一个负责计算,另一个负责网络接口处理。分组从 32 字节到最大 256 字节不等,头部占 8 字节,包含路由、虚拟通道、链路级流控、大小等信息,以及保护头部的 1 字节 CRC。另有 3 字节用于分组级 CRC,1 字节作为有效指示。
主互连是专有的 三维 torus SAN,连接全部 64K 节点。每个节点交换机通过六条双向 350 MB/s 链路连接相邻节点;两个本地处理器的注入带宽为 612.5 MB/s,接收带宽为 1050 MB/s。网络接收带宽等于全部交换机端口的入站带宽,避免接收链路成为瓶颈;较高的接收带宽使目的节点可以同时吸收多个分组。
两个节点组成一块 计算卡;16 块计算卡加 2 块 I/O 卡组成 节点板;16 块节点板组成 midplane;两个 midplane 构成一个 1024 节点机架,物理尺寸为 米。链路最长 8.6 米,因此只需相对少量缓冲,就能高效实施链路级流控。为降低延迟,系统采用虚拟 cut-through,在输入、输出端口分布仲裁,并在前一台交换机用有限状态机预先计算当前交换机的路径,使部分路由延迟移出关键路径。为提高有效带宽,采用双读取端口的输入缓冲交换机、四虚拟通道虚拟 cut-through,以及基于 bubble 流控的完全自适应无死锁路由。
如此规模的网络,容错至关重要。链路采用相对较低的 700 MHz 时钟,与处理器同频,双沿传输,即每方向每条位串行链路支持 1.4 Gbit/s 或 175 MB/s,以降低故障率;但故障仍会发生。故障时,包含故障的 midplane 节点板被关闭并旁路,隔离故障,计算从最后一个检查点恢复。每个 midplane 配备独立的旁路交换板,作为 torus 节点板之外的附加部件。旁路板可配置为连接对应 midplane 节点板的链路,或连接下一旁路板,从而有效移除对应的一组节点板。虽有某些维度的处理节点数减少,机器仍保留其拓扑结构和路由算法。
屏障同步、广播/多播和归约等集合通信,在三维 torus 上效果不佳,因为它们可能用流量淹没网络。为此,系统另外使用两套每链路带宽更高的树形网络,高效实现集合与合并操作。除高效同步及广播/多播外,硬件还高效支持某些算术归约,例如对每节点提供的一个值求总和或最大值。除了 torus 和两套树网,Blue Gene/L 还实现用于 I/O 的千兆以太网,以及带宽更低的控制系统快速以太网,支持并行 I/O、配置、调试和维护。
系统/存储区域网络:InfiniBand
InfiniBand 是 InfiniBand Trade Association 成员公司联盟在 2000 年 10 月制定的行业事实网络标准。它既可作为处理器间通信的系统区域网络,也可作为服务器 I/O 的存储区域网络。它是基于交换机的互连,供应商与用户可灵活选择拓扑、路由及仲裁方法。它支持 300 米距离,每链路每方向 2–120 Gbit/s 数据速率;采用 cut-through、16 个虚拟通道与服务等级、基于 credit的链路级流控、加权轮询公平调度,以及可编程转发表。还包含通信子网管理、端到端路径建立、虚拟目的地命名等提高可靠性和可用性的功能。图 F.30 将其分组格式与 LAN、WAN 的另外两项标准并列;图 F.31 则与科研及商用高性能系统中广泛使用的两种专有 SAN 比较。
InfiniBand 提供两种基本用户级通信机制:发送/接收及远程 DMA(RDMA)。发送/接收要求接收者在发送者发数据前,显式提交接收缓冲区,即在通道适配器网络接口中分配空间。RDMA 则允许发送者直接将数据远程 DMA 到接收设备内存。例如,在连接 3.4 GHz Intel Xeon 主机的 Mellanox MHEA28-XT 通道适配器上测量,名义分组大小为 4 字节时,发送/接收机制的发送和接收开销分别为 0.946 μs、1.423 μs,RDMA 则分别为 0.910 μs、0.323 μs。
| 网络[供应商] | 2005 年前十名超级计算机集群中的应用 | 节点数 | 基本拓扑 | 原始双向链路带宽 | 路由算法 | 仲裁技术 | 交换技术;流控 |
|---|---|---|---|---|---|---|---|
| InfiniBand[Mellanox、Voltair] | SGI Altrix、Dell PowerEdge Thunderbird | 超过数百万,GUID 地址空间为 2¹²⁸,类似 IPv6 | 完全可配置,任意拓扑 | 4–240 Gbit/s | 任意,表驱动,通常为 up*/down* | 加权 RR 公平调度,两级优先级 | cut-through;16 个虚拟通道,其中 15 个传数据;基于 credit |
| Myrinet-2000[Myricom] | 西班牙 Barcelona Supercomputer Center | 8192 | 16 端口双向交换机组成的双向 MIN,Clos 网络 | 4 Gbit/s | 基于源的 dispersive 自适应最短路由 | RR | cut-through,无虚拟通道;Xon/Xoff |
| QsNet II[Quadrics] | Intel Thunder Itanium2 Tiger4 | 超过数万个 | 8 端口双向交换机组成的胖树 | 21.3 Gbit/s | 基于源的 LCA 自适应最短路径 | 两阶段 RR、优先级、aging,分布在输出端口 | 虫孔,两个虚拟通道;基于 credit |
F.2 节已经说明,分组大小对充分利用带宽十分重要。自然会问,消息本来的大小是什么样?图 F.32(a) 展示商用流体动力学仿真应用 Fluent 的消息大小,数据采自俄亥俄州立大学 Network-Based Computer Laboratory 的 InfiniBand 网络。一条曲线累计发送消息数,另一条累计数据字节数。这里的消息是 MPI 信息单位,网络传输时还会分成 InfiniBand 最大传输单位,即分组。最大消息超过 512 KB,但约 90% 小于 512 字节;2 KB 消息对应约 50% 的传输字节。NAS Parallel Benchmark 的 Integer Sort 内核也测得约 75% 的消息小于 512 字节,图未列出。许多应用发送的小消息远多于大消息,尤其因为请求和确认比数据响应、块写入更加频繁。
InfiniBand 允许将协议处理从主机卸载到网卡控制器,降低处理开销。图 F.32(b) 用广泛使用的 InfiniBand MPI 实现 MVAPICH,展示卸载及绕过操作系统的收益。图按两种模式、两种网络速度绘制有效带宽。IPoIB 模式由主机操作系统 IP 层处理 InfiniBand 通信,不绕过 OS;另一模式让 MVAPICH 直接运行在 Mellanox 原生接口 VAPI 上,将传输协议处理卸载到通道适配器硬件,绕过 OS。图包括 10 Gbit/s 单倍数据率(SDR)与 20 Gbit/s 双倍数据率(DDR)网络。结果清楚表明,协议卸载和 OS bypass 显著降低发送、接收开销,使有效带宽接近线速。
以太网:局域网
以太网作为 LAN 极其成功,从 1978 年提出、原文称当时几乎处处可见的 10 Mbit/s 标准,到较新的、预计会广泛采用的 10 Gbit/s 标准。多类计算机都将以太网作为标准通信接口。IEEE 802.3 以太网是按目的地址路由分组的分组交换网络。最早为同轴电缆设计,后来主要使用 Cat5e 铜缆,长距离和高带宽采用光纤。原文还提到其无线版本 802.11,以说明这一技术体系的普及。
在 20 年间,计算机相比 1978 年快了数千倍,共享介质以太网却保持不变。于是,在更快、更高带宽网络出现前,工程师不得不寻找过渡办法。一种办法是以多个以太网连接机器,再用互联设备连接这些以太网,需要时将流量从一个转到另一个。各以太网由此能并行工作,提高整个计算机集合的总互连带宽;这些设备实际上提供了类似前述点到点网络交换机的功能。
图 F.33 展示潜在并行性。根据转发方式及所连网络类型,这些设备名称不同:
- 网桥。 连接各 LAN,按分组地址将流量从一侧转到另一侧。工作于以太网协议层,通常比下面的路由器更简单、便宜。按下一节 OSI 模型,见图 F.36,它工作于第二层,即数据链路层。
- 路由器或网关。 将 LAN 接到 WAN,或连接不同 WAN,并处理不兼容的编址。通常比网桥慢,工作于 OSI 第三层即网络层。WAN 路由器将网络划为较小、分离的子网,简化管理并提高安全性。
另一类互联设备是集线器,但它仅把多个网段扩展成一个 LAN,任一时刻仍只有一条消息能传输,所以无助于性能。它工作于 OSI 第一层即物理层。由于这些设备并非最初以太网标准规划的一部分,后来补入的性质增加了 LAN 维护难度和成本。
截至 2011 年,以太网链路有 10、100、10,000、100,000 Mbit/s 等速率。10 和 100 Mbit/s 以太网允许多设备共享介质,1000 Mbit/s 及以上则依靠点到点链路和交换机。交换机通常采用某种存储转发。
原文从以太网最早实现谈起,指出其没有真正的流量控制。最初它用载波侦听和指数退避,见 F-23 页,仲裁共享介质。有些交换机尝试利用这一接口补入自己的流控版本;原文称流量控制不是以太网标准的一部分。
广域网:ATM
异步传输模式(Asynchronous Transfer Mode,ATM)是电信行业制定的广域网标准。20 世纪 90 年代,它曾尝试在 LAN 领域与以太网竞争,后来退回其 WAN 优势领域。
这一电信标准内建可扩展带宽,从 155 Mbit/s 起,以四倍递增至 620 Mbit/s、2480 Mbit/s,依此类推。作为 WAN,它采用单模或多模光纤。虽然也是交换介质,ATM 与前述实例不同,依赖虚连接通信;它用虚拟通道进行路由,在同一网络段复用不同连接,避免传统基于连接网络的低效。面向 WAN 也促使它采用存储转发。如图 F.30,它与其他协议不同,使用载荷 48 字节的小型固定分组;并采用基于 credit的流控,而 IP 路由器不实施这种流控。
虚连接和小分组的原因在于服务质量。电信行业关心语音流量,因此既重视带宽,也重视可预测性。建立虚连接比分组无连接网络的变化更小,并简化存储转发。固定小分组还更容易实现快速路由器和交换机。为此,ATM 甚至提出自己的协议栈,与 TCP/IP 竞争。令人意外的是,交换机虽简单,ATM 协议族却庞大复杂。最初的梦想是从 LAN 到 WAN 无缝衔接,摆脱当时各式路由器拼凑的局面;这个梦想后来已从鼓舞人心的愿景,变成令人怀念的往事。
F.9 网际互连
网际互连(internetworking)无疑是通信领域最重要的创新之一。它使独立且不兼容网络中的计算机,能够可靠、高效地通信。图 F.34 说明为何需要跨越不同网络:它展示从斯坦福大学向相距约 75 千米的加利福尼亚大学伯克利分校传送文件时,涉及的机器和网络。
网际互连的成本低得惊人。例如,发送电子邮件,远比从美国一海岸打电话到另一海岸、在答录机留言便宜;而它使用的长途通信线路与电话相同,这使成本改善更令人印象深刻。
实现网际互连的关键技术,是无需底层网络可靠、仍能提供可靠通信的软件标准。成功标准的根本原则是按层组织,各层负责整体通信任务的一部分。每台计算机、每个网络及交换机实现自己所属层的标准,并依赖其他部件履行责任。这些分层软件标准称为协议族或协议套件。它们让应用可用于任何互连,而无须应用程序员额外处理。图 F.35 概括了通信的层次模型。
最流行的网际互连标准是 TCP/IP,即传输控制协议/网际协议。这个协议族构成名称朴素的 Internet 的基础,将全世界数亿台计算机连接起来。由于广泛普及,即使在兼容网络之间本地通信,也会采用 TCP/IP。例如,网络文件系统 NFS 即使很可能只跨以太网这类同构 LAN 通信,也使用 IP。这里以 TCP/IP 为例,其他协议族思路类似;其历史见 F.13 节。
协议族的目标,是把责任按层次划分,每层向上层提供所需服务,从而简化标准。顶部为应用,底部为实际发送比特的物理通信介质。正如抽象数据类型屏蔽实现细节、简化程序员工作一样,分层策略使标准更容易理解。
早期各种网络协议工作造成术语混乱,因此开放系统互连(OSI)提出一种模型,推广了把网络描述为一系列层次的方式,见图 F.36。虽然并非所有协议都严格遵循这一分层,各层名称仍广为使用,所以经常会听到简单的第三层交换机与智能第七层交换机之类讨论。
| 层号 | 层名称 | 主要功能 | 协议示例 | 网络部件 |
|---|---|---|---|---|
| 7 | 应用层 | 用于专为网络运行而编写的应用 | FTP、DNS、NFS、HTTP | 网关、智能交换机 |
| 6 | 表示层 | 在应用格式与网络格式之间双向转换 | 网关 | |
| 5 | 会话层 | 建立、维持并结束跨网络会话 | 命名管道、RPC | 网关 |
| 4 | 传输层 | 在会话层之下提供附加连接 | TCP | 网关 |
| 3 | 网络层 | 将逻辑网络地址和名称转换为物理地址,例如计算机名到 MAC 地址 | IP | 路由器、ATM 交换机 |
| 2 | 数据链路层 | 把分组转换成原始比特,在接收端把比特转换回分组 | Ethernet | 网桥、网络接口卡 |
| 1 | 物理层 | 在物理线缆上传输原始位流 | IEEE 802 | 集线器 |
协议族的关键在于:通信在逻辑上发生于发送端与接收端的同一协议层,但由更低层服务实现。这种通信方式称为对等通信(peer-to-peer)。可以用一个比喻说明:战场上将军 A 要给将军 B 发消息,写好后装进写有 B 名字的信封,交给一位上校,命令其送达。上校再套一层信封,写上 B 部属中对应上校的名字,交给少校;少校照做后交给上尉,上尉交给中尉,中尉交给军士。军士取过信封,再套上写有 B 所属部队某军士名字的信封,交给一名列兵。列兵借来摩托车,将大信封交给对方军士。送达后,信件沿指挥链向上传递,每人拆开写有自己名字的外层信封,把内部信封交给上级。在 B 看来,消息就是另一位将军发来的。两位将军都不知道谁参与了传送,也不知道信件怎样从一个师送到另一个师。
协议族与这一比喻比想象中更相似,见图 F.37。低层协议在原消息前添加头部,还可能添加尾部。更低一层再加自己的头部;如果消息超过该层限制,还会拆成更小消息。沿用前述比喻,就是将军的长信装不进一个信封时,要拆开装进多个。拆分及添加头尾的过程不断继续,直到物理传输介质,再把消息送到目的地。接收端各层检查本层消息,剥去自己的头尾,将其交给更高一层并重新拼合。针对一条消息的这种嵌套称为协议栈,反映添加和移除头尾时后进先出的性质。
正如比喻所暗示的,分层可能给消息传递增加相当大延迟。显然,减少层数是降低延迟的一条途径;但必须记住,协议族规定的是标准,并不强制实现方法。正如指令集体系结构有许多实现方式,协议族也一样。
以 TCP/IP 协议栈为例,假定最底层是以太网,其上为 Internet Protocol,即 IP 层。IP 分组的正式名称是数据报(datagram)。IP 将数据报路由到目的机器,中途可能经过许多机器或交换机。它尽力交付,却不保证数据报能送达、内容无误或顺序正确。IP 之上的 TCP 层则保证可靠、按序交付,并防止数据报损坏。
按图 F.37,假定某应用经以太网给另一机器发送消息,先从 TCP 开始。一次最多可发送 64 KB;数据可能大得多,因此 TCP 必须将其拆成较小段,并在到达后按正确顺序重组。TCP 为每个数据报添加图 F.38 的 20 字节头部,再交给 IP。物理层上方的 IP 也添加 20 字节头部。IP 向以太网提交的数据,采用图 F.30 的分组格式发送。正如图 F.37,TCP 分组位于 IP 数据报的数据部分之内。
图 F.38 中,IP header、TCP header 分别为 IP、TCP 头部,IP data、TCP data 为相应数据;Type 为类型,Length 为长度,Identifier 为标识符,Fragment 为分片,Time 为生存时间,Protocol 为协议,Header checksum 为头部校验和,Source、Destination 为源与目的地,Sequence number 为序号,Piggyback acknowledgment 为捎带确认,Flags 为标志,Window 为窗口,Checksum 为校验和,Urgent pointer 为紧急指针。图内 TCP 数据大小按原书标为 0–65,516 字节。
图 F.38 图注(续) 一种优化是,TCP 可先发送一串数据报,再等待发送更多数据的许可。无须等许可就能发送的数据报数量称为窗口;窗口字段说明,在本数据报已确认字节之后,还可以发送多少字节。TCP 根据 IP 交付的成功情况调整窗口:越可靠、越快,窗口越大。数据到达并获确认时,窗口向前滑动,因此称为滑动窗口协议。
TCP 的捎带确认字段是另一种优化。有些应用沿同一连接双向发送数据,专发一个只含确认的数据报很浪费。该字段让携带数据的数据报,同时确认先前传输,即将确认“捎带”在数据上。
TCP 紧急指针给出数据报中某个重要字节的地址,例如中断字符。它使应用可以越过数据,避免用户必须等此前全部数据处理完,软件才看到要求停止的字符。IP 标识符与分片字段允许中间机器将原数据报拆成多个较小数据报;每片都携带原数据报唯一标识符,分片字段说明各片的位置。生存时间字段使数据报经过规定最多中间交换机后,无论身处何处都被丢弃。知道数据报若能到达、最多经过多少跳,有助于简化协议软件。协议字段指明哪个上层协议发送了此 IP 数据报,本例为 TCP。版本 V 与类型字段允许网络采用不同版本的 IP 软件。显式版本号使软件能逐机平稳升级,无须关闭整个网络。原书最后指出,互联网协议第六版 IPv6 已得到广泛使用。
F.10 互连网络中贯穿各层的问题
本节讨论其他章节涉及的五个主题。互连网络从根本上影响这些主题,而它们也反过来影响互连网络。
针对密度优化与针对 SPEC 优化的处理器
世界各地的人都在访问网站,服务器究竟放在哪里并不太重要。因此,许多服务器放在托管机房,按预留和使用的网络带宽、占用空间以及耗电量收费。过去,桌面微处理器通常在能散掉热量的前提下尽量追求速度,很少顾及封装及周边芯片尺寸。直到 2006 年,Intel 和 AMD 某些桌面微处理器功耗仍高达 130 瓦!机房占地效率也很少被重视。这些优先取舍使电力成为托管机房的主要成本,处理器密度受到功耗与散热能力限制,互连的功耗也包括在内。
随着便携计算机普及,2005 年笔记本销量首次超过台式机,其功耗和散热需求较低,因而有机会用这类技术实现密度高得多的计算。例如,2006 年 Intel Pentium M 的功耗为 25 瓦,但许多应用的性能已接近桌面微处理器。因此,每瓦性能或每立方英尺性能,可能取代每处理器性能,成为重要评价指标。关键是许多应用已经采用大型集群,所以用例如 256 个节能处理器替换 64 个高耗电处理器,可能既更便宜,又保持软件兼容。这使功耗与性能都高效的互连设计更加重要。
Google 集群就是从少量“更热”处理器转向大量“更凉”处理器的典型例子。每机架采用最多 80 个 1 GHz Intel Pentium III,而非高耗电的高端处理器。其他例子包括基于移动处理器、机架单元刀片宽 1 英寸高 7 英寸的刀片服务器。HP ProLiant BL10e G2 支持最多 20 个 1 GHz 超低电压 Pentium M,配 400 MHz 前端总线、1 MB L2 缓存 及最多 1 GB 内存。Fujitsu Primergy BX300 支持最多 20 个 1.4 或 1.6 GHz Pentium M,每处理器有 512 MB 内存,可扩至 4 GB。
智能交换机与智能接口卡
图 F.39 展示网络中智能放在哪里的权衡:一般是在更智能的网络接口与更智能的交换机之间选择。一方更智能,另一方通常就能更简单、更便宜。以太网接口便宜,因而成为多数桌面机和服务器的标准部件。对规模较小、不需要大型交换机复杂转发表与生成树协议的用户,也有低成本交换机可选。
Myrinet 采取相反思路。其交换机很简单,除流控和仲裁外,只提取分组头第一个字节,直接选择输出端口,不实现路由表。智能放在网络接口卡 NIC 中,NIC 负责高效通信支持,以及网络配置和重配置的分布式协议。
InfiniBand 采用混合方案:对磁盘等要求较低的设备,提供便宜而简单的目标通道适配器(TCA),希望它能直接集成进某些 I/O 设备;对主机则提供更昂贵、更强大的主机通道适配器(HCA)。交换机实现路由表。
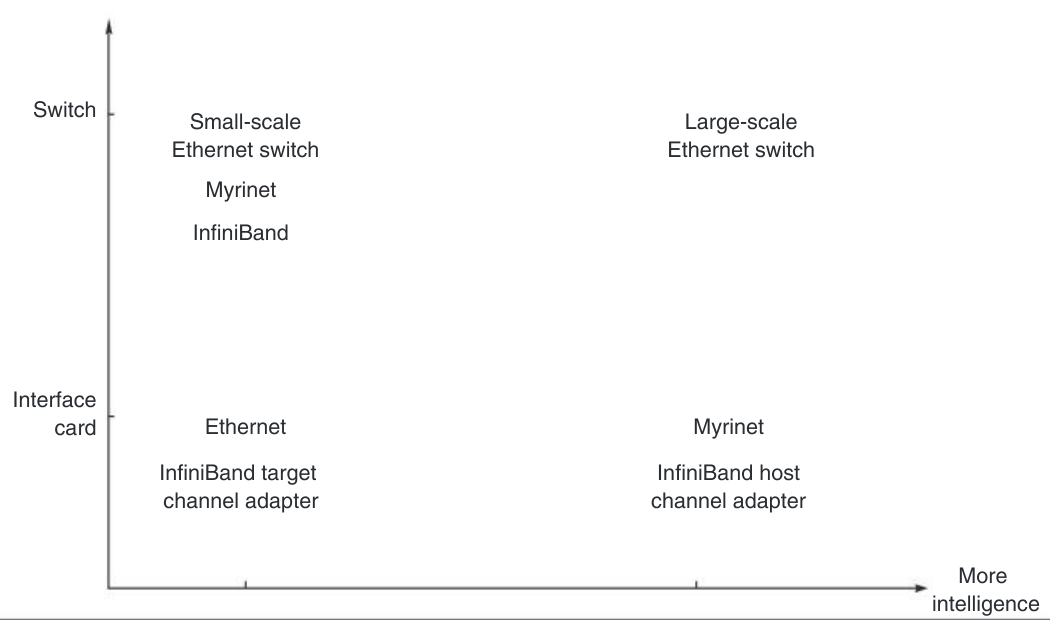
保护与用户访问网络
一项挑战是:在常见情况下不调用操作系统,同时保证安全通信。Cray Research T3D 超级计算机提供了有趣案例。它与较新的 Cray X1E 一样支持全局地址空间,load/store 可以跨网络访问内存;每次访问都经 TLB 检查,因此有保护保障。为了传送较大对象,硬件又增加块传输引擎(BLT)。但使用 BLT 前必须调用操作系统,检查整个访问范围,确认不会违反保护要求。
图 F.40 比较不同对象大小下的读写带宽。很大的读取,例如 512 KB,BLT 达到最高 140 MB/s;但 8 KB 及以下,简单 load 性能更高。写入时两者都达到 90 MB/s 峰值,可能是受内存总线限制。但 BLT 要到传输 2 MB 时才追上简单 store;更小传输用 store 更快。显然,若 BLT 在常见情况下能避免调用操作系统,就会更有用。
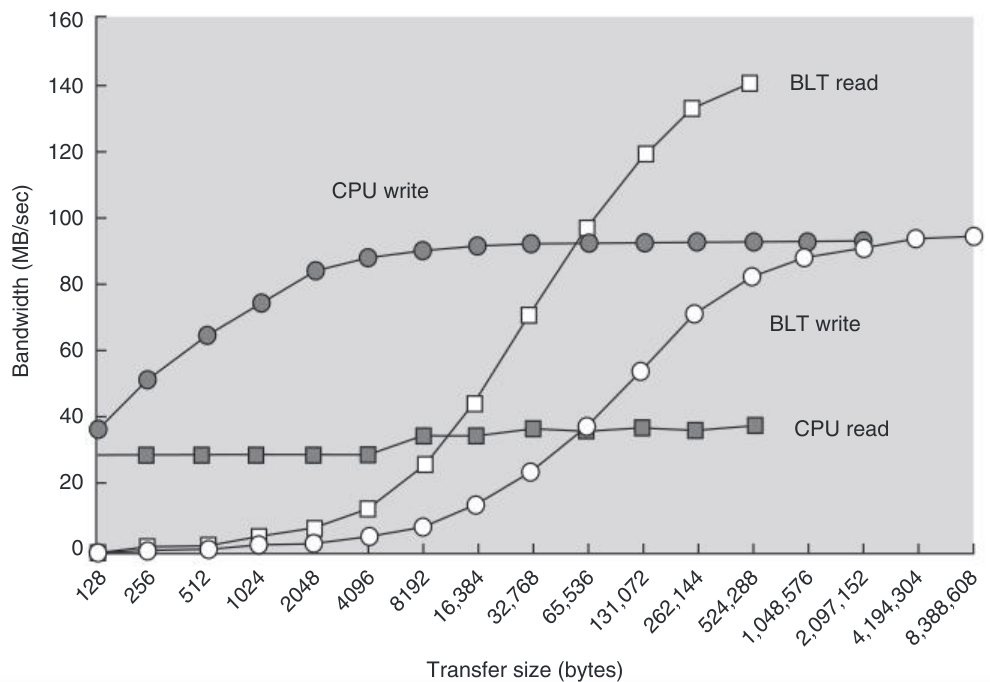
高效访问存储层次与高效访问网络
SPECint、SPECfp 等传统处理器评测,鼓励把存储层次与处理器紧密集成,因为存储层次的效率直接转化为处理器性能。因此,微处理器把多级 缓存 及写缓冲放到片上。然而,这些基准不奖励良好的互连接口,许多机器访问网络时都必须等整个存储层次走完:写操作缓慢穿过已满的写缓冲,读操作先经历一级、二级、甚至三级 缓存 未命中,才到达互连。因此,新系统访问互连的延迟可能比旧机器更高。
比较三款过去的机器:40 MHz SPARCstation-2、无外部 缓存 的 50 MHz SPARCstation-20、有外部 缓存 的 50 MHz SPARCstation-20。按 SPECint95,其性能依次提高;但访问 I/O 总线 S-bus 的时间也依次增至 200、500、1000 ns。SPARCstation-2 最快,因为内存和 I/O 共用一条总线,且只有一级 缓存。SPARCstation-20 访问必须先经过内存总线 M-bus,再到 I/O 总线,增加 300 ns;有二级 缓存 的机器在访问 I/O 总线前,还要再付出 500 ns。
面向计算优化的处理器与接收开销
如果没有卸载,接收消息往往涉及中断,必须清空并重新启动处理器流水线。前面已经提到,读取网络状态及从接口接收数据,通常只能以 缓存 未命中的速度完成。如果微处理器进一步提高超标量程度和时钟频率,每次接收消息所错过的指令发射机会,可能增加到不可接受的程度。
F.11 谬误与陷阱
互连网络领域流传着不少误解,也有许多容易忽略的风险。本节给出若干提醒,设计时应谨慎。
谬误:互连网络已经很快,无须改进
互连网络与存储器、I/O 子系统一样,为系统提供特定功能。设计目标应是让处理器尽可能快地执行指令,因此其带宽必须足够高,避免持续饱和而成为整体瓶颈。
20 世纪 80 年代引入虫孔交换后,用单芯片交换机构建大直径拓扑成为可能,网络带宽容量不再一定是限制因素。这却使人错误地认为互连无须继续改进。自那时以来,人们大量关注处理器性能,对互连的关注相对少得多。随着技术进步,互连在系统资源、成本、功耗,以及其他影响功能和性能的属性中所占比例越来越大。单纯把某些网络参数做得过大以提高带宽,已不再具备成本可行性。设计者必须将端到端互连与处理器、存储器和 I/O 子系统协同设计,满足整个系统的成本、功率、功能和性能目标。带片上网络的多核处理器就是显例。
谬误:二分带宽是网络的准确成本约束
二分带宽虽然很流行,却从未成为实际互连实现的主要约束,尽管未来可能如此。相比成本指标,它更适合做性能指标。芯片引脚数才是更实际的带宽约束。
陷阱:只用带宽,尤其二分带宽,衡量网络性能
网络总带宽或二分带宽很少是端到端真正的瓶颈。即使是,分组穿越二分面的效率几乎从不为 100%,即 ;网络端点接收效率也几乎不为 100%,即 。前者高度依赖路由、交换、仲裁等因素,两者又都高度依赖流量特征。忽略这些因素,只看原始带宽,会严重误判性能。例如,一个网络的总带宽或二分带宽完全可能更高,测量性能却更低。
TCP/IP 等复杂协议能够尽量提高交付带宽,这似乎使不少网络公司相信网络只有一个评价指标。对视频流这类收发双方少有交互的应用,也许如此;但许多应用是请求—响应型,每条大消息都伴随一条或多条小消息,NFS 就是一例。
图 F.41 比较 NFS 流量在共享 10 Mbit/s 以太网 LAN 与交换式 155 Mbit/s ATM LAN 上的表现。以太网驱动优化更好,因此载荷不超过 512 字节时,10 Mbit/s 以太网反而更快。表中分别给出发送全部 NFS 消息的开销、传输及总时间。ATM 峰值链路速度高约 15 倍,8 KB 消息的实测链路速度也近九倍,但较高开销抵消了带宽优势,发送 NFS 流量最终只快 1.2 倍。
| 大小,字节 | 消息数 | ATM 开销,秒 | 以太网开销,秒 | 数据字节数 | ATM 传输,秒 | 以太网传输,秒 | ATM 总时间,秒 | 以太网总时间,秒 |
|---|---|---|---|---|---|---|---|---|
| 32 | 771,060 | 532 | 389 | 33,817,052 | 4 | 48 | 536 | 436 |
| 64 | 56,923 | 39 | 29 | 4,101,088 | 0 | 5 | 40 | 34 |
| 96 | 4,082,014 | 2817 | 2057 | 428,346,316 | 46 | 475 | 2863 | 2532 |
| 128 | 5,574,092 | 3846 | 2809 | 779,600,736 | 83 | 822 | 3929 | 3631 |
| 160 | 328,439 | 227 | 166 | 54,860,484 | 6 | 56 | 232 | 222 |
| 192 | 16,313 | 11 | 8 | 3,316,416 | 0 | 3 | 12 | 12 |
| 224 | 4820 | 3 | 2 | 1,135,380 | 0 | 1 | 3 | 4 |
| 256 | 24,766 | 17 | 12 | 9,150,720 | 1 | 9 | 18 | 21 |
| 512 | 32,159 | 22 | 16 | 25,494,920 | 3 | 23 | 25 | 40 |
| 1024 | 69,834 | 48 | 35 | 70,578,564 | 8 | 72 | 56 | 108 |
| 1536 | 8842 | 6 | 4 | 15,762,180 | 2 | 14 | 8 | 19 |
| 2048 | 9170 | 6 | 5 | 20,621,760 | 2 | 19 | 8 | 23 |
| 2560 | 20,206 | 14 | 10 | 56,319,740 | 6 | 51 | 20 | 61 |
| 3072 | 13,549 | 9 | 7 | 43,184,992 | 4 | 39 | 14 | 46 |
| 3584 | 4200 | 3 | 2 | 16,152,228 | 2 | 14 | 5 | 17 |
| 4096 | 67,808 | 47 | 34 | 285,606,596 | 29 | 255 | 76 | 290 |
| 5120 | 6143 | 4 | 3 | 35,434,680 | 4 | 32 | 8 | 35 |
| 6144 | 5858 | 4 | 3 | 37,934,684 | 4 | 34 | 8 | 37 |
| 7168 | 4140 | 3 | 2 | 31,769,300 | 3 | 28 | 6 | 30 |
| 8192 | 287,577 | 198 | 145 | 2,390,688,480 | 245 | 2132 | 444 | 2277 |
| 合计 | 11,387,913 | 7858 | 5740 | 4,352,876,316 | 452 | 4132 | 8310 | 9872 |
**译注:**表内个别行显示的分项之和与显示的总时间不一致。
陷阱:接收链路带宽不足,使端节点更成为性能瓶颈
除非流量模式是一一置换,否则多数源同时注入流量时,一些目的地会同时收到多个分组,从而争用。如果不处理,争用可能演变为拥塞,并传播到整个网络。可通过分析流量模式、提供额外接收带宽应对,例如让接收带宽高于注入带宽。IBM Blue Gene/L 的片上交换机就采用 7 位注入链路、12 位接收链路,接收带宽等于交换机全部输入链路总带宽。
陷阱:使用高性能 NIC,却忘记 NIC 与主机处理器之间的 I/O 子系统
这与上一个问题有关。消息通常先在用户空间缓冲区中组成,再调用通信库发送函数;某些 SAN 和 OCN 也可能由实现一致性协议的 缓存 控制器组成消息。两种情况下,传输前都必须将消息复制到网络接口存储器。如果 I/O 带宽低于链路带宽,或引入较大开销,通信性能会明显受影响。例如,最早上市的万兆以太网卡使用 PCI-X 系统总线接口,其带宽显著低于 10 Gbit/s。
谬误:零复制协议无须在缓冲区之间复制消息或片段
传统计算机网络协议只允许通过特权模式系统调用访问通信设备。因此,发送消息时,通信例程需要将用户缓冲区内容复制到内核缓冲区。协议可能需要保留副本,以便出错重传,而系统调用一旦返回应用,应用就可能修改用户缓冲区。零复制协议的通信例程在用户空间执行,协议也简单得多,因此消除了这一缓冲区到缓冲区的复制。
不过,消息仍须从应用缓冲区复制到 NIC 存储器,网卡硬件才能从那里向网络发送。直接在 NIC 内存分配应用消息缓冲,可以消除这一复制,某些协议确实如此;但这在当时系统中未必方便,因为 NIC 内存通常通过 I/O 子系统访问,远慢于主存。一般更高效的办法,是在主存组成消息,再让 DMA 设备搬到 NIC 内存。
还有一份很少被计入的复制:从计算消息片段的地方,通常为 ALU,结果先在处理器寄存器中,复制到主存。20 世纪 80 年代的某些类脉动体系结构,如 iWarp,能把消息片段从处理器直接送入网络,真正消除全部消息复制。Cray X1E 共享内存多处理器超级计算机也采用这一方法。
接收端同样有类似问题。不过,这并不意味着零复制协议低效;它们代表当时系统使用的最高效实现类型。
陷阱:评估性能时忽略软件开销
要降低软件开销,必须得到操作系统和通信库配合。即使协议卸载,软件开销仍大于硬件开销,绝不能忽略。图 F.32 和 F.41 分别展示 SAN 与 WAN 标准的实例,超级计算机专有 SAN 也有类似情况。20 世纪 90 年代初,Connection Machine CM-5 发送消息的软件开销为 20 μs,硬件仅 0.5 μs。同一时期第一代 Intel Paragon 的硬件开销只有 0.2 μs,初版软件却有 250 μs;后续降至 25 μs,再降到几微秒,仍然主导硬件开销。IBM Blue Gene/L 的 MPI 发送/接收开销约为 3 μs,其中硬件最多只占三分之一。
这不过是 Amdahl 定律在网络中的体现:若软件开销没有同步降低,更快的网络硬件就难以发挥作用。如今 OS bypass、轻量协议和卸载已将软件开销通常降到几微秒甚至更少,但它仍是重要性能因素。
谬误:MIN 比直接网络更具成本效益
MIN 所用交换机通常明显少于待连接设备数。直接网络则往往在每节点内集成交换机,交换机数与节点数相同。但完全可以在一个节点放多个计算设备,例如片上有交换机的多核处理器,或让多个设备连接一台交换机,即 bristling。此时,直接网络的成本效益可以与 MIN 相当甚至更好。注意,MIN 每个节点还可能需要多块网络接口,才能匹配直接网络每节点多条链路的带宽。
谬误:低维直接网络比超立方体等高维网络性能更高
一些研究以二分带宽为主要物理约束,分析最优维数后得出这一结论。但多数研究没有考虑链路流水化,只考虑很短的链路,或忽略交换机体系结构约束。把二分带宽当作主要限制,也使结论失准。如今多数研究者和设计者,包括此前得出相反结论的一部分人,都认为高 radix,即高端口数,交换机比低 radix 更具成本效益。
谬误:虫孔交换比其他交换技术性能更好
虫孔交换与虚拟 cut-through 等流水交换技术的空载延迟相同。20 世纪 80 年代末虫孔交换机出现,恰逢网络带宽大幅增长,许多人便认为性能提升主要来自虫孔交换。实际上,主要收益来自链路带宽急剧提高;而链路带宽提高,是因为虫孔允许用片上缓冲存分组片段,不必使用节点主存或其他片外存储。后来更大的片上缓冲成为可能,虚拟 cut-through 在达到相同空载延迟的同时,提供高得多的吞吐量。但虫孔交换并未因此消失;在只能采用小缓冲的应用中,例如某些 OCN,它仍是首选。
谬误:少量虚拟通道总能让分组越过前方阻塞分组,从而提高吞吐量
一般而言,在虫孔交换机中采用少量虚拟通道是好主意,分组较可能越过前方阻塞分组,降低延迟、显著提高吞吐量。但虚拟 cut-through 的收益没那么大。它的缓冲区应足以容纳多个分组,因此每个虚拟通道都可能引入 HOL 阻塞,高负载下甚至降低性能。增加虚拟通道提高成本,却可能收效甚微,除非通道数与交换机端口数相同,并按目的地映射分组,即使用虚拟输出排队。
虚拟通道当然可以分离不同流量类别,在虚拟 cut-through 网络中很有价值。但按 flit 在物理链路上复用,会让不同虚拟通道的所有分组都受到延迟。若按整分组复用,平均延迟会明显更低;此时又必须限制分组大小,避免一个分组独占大部分链路带宽。
谬误:自适应路由导致乱序,目的端重新排序开销太大
自适应路由让分组根据流量选择不同路径,因此通常会导致乱序交付。但这不必然意味着目的端重排开销很大,以至自适应路由没有价值。例如,迄今最高效的一些算法在部分虚拟通道支持完全自适应路由,同时要求其他通道采用确定性路由避免死锁,IBM Blue Gene/L 就是这样。此时,每个分组都很容易在两者间选择:头部一个比特即可告知交换机,是可用全部虚拟通道,还是只用确定性通道。配合如下协议,就能消除目的端重排开销。
并行计算机和集群的多数通信协议,会按消息大小使用两种机制。短消息采用 eager 协议,直接发送,接收节点用预分配缓冲暂存。长消息采用 rendezvous 协议:先发送控制消息,请求目的端分配足以容纳整条消息的缓冲区;目的端确认分配后,发送者将消息拆成有大小上限的分组并传送。
若 eager 消息只用确定性路由,显然没有重排开销。长消息的分组则可自适应路由,每个分组都含消息内序号或距消息起点的偏移量,因此目的节点能直接放入消息缓冲中的正确位置,相比确定性路由没有额外复制或重排。唯一差别是完成条件:不再只检查消息最后一个分组是否到达,而要累计到达分组,计数与消息大小相符时通知接收完成。长消息即使不频繁,通常也占大部分带宽,所以多数分组都能从自适应路由获益,而无须增加重排开销。
谬误:自适应路由提供备选路径,因此本身总能提高容错能力
仅有自适应路由不足以容忍链路或交换机故障。还需要检测并通知故障的机制,路由逻辑才能排除故障路径、使用剩余路径。而且,同一故障在确定性路由下只影响一定数量的路径,自适应路由下却可能影响更多源—目的节点对。因此,某些自适应交换机在故障时会切换到确定性路由,由源节点选择备选路径。
例如 Cray T3E 用方向顺序路由容忍少量故障,按方向次序使用资源,如 、、、、、最后 ,避免形成环。同时,需要时很容易经非最短路径绕过故障部件;例如,即使分组稍后必须向 移动,也可先沿 走几跳。
陷阱:只在网络内部实现功能,而不做端到端实现
问题在于,把只能在最高层完成的功能放到较低层,便只能部分满足通信需求。Saltzer、Reed 和 Clark[1984,第 278 页]提出端到端论证:
只有了解通信系统两端的应用,并得到应用协助,才能完整、正确地规定所讨论的功能。因此,不可能仅把该功能作为通信系统自身的一项特性来完整提供。
他们举了 MIT 一个网络的例子:网络有多个网关,每个都为到下一网关的传输添加校验和。应用程序员误以为校验和保证了准确性,认为消息存于各网关内存期间也受保护。后来一个网关出现瞬态故障,每传输一百万字节就交换一对字节。久而久之,一套操作系统的源代码反复经过该网关,被逐渐破坏。唯一办法竟是将受损文件与纸质程序清单对照,手工修复!如果校验和由端系统应用计算和检查,就能保证安全。
不过,只要有端到端检查,链路级中间检查仍有价值。端到端检查只能发现两节点之间某处出错,不能定位;中间检查可以找出坏掉的部件。
第二个问题是性能。出错时由端点重传整个消息,虽足以保证正确性,但在中间位置只重传消息的一部分,往往比等待端点超时再全部重传快得多。
陷阱:不顾延迟、带宽或软件要求,所有网络一律使用 TCP/IP
早期工作站网络设计者认为,不管消息是发到房间另一头还是大洋彼岸,都采用同一协议栈很优雅,于是都必须付出 TCP/IP 开销。考虑到早期以太网硬件不可靠,这当时也许明智,却为后来的商用系统设下高软件开销门槛。如果消息只走几十米甚至更短,软件却浪费数百微秒,那么低延迟接口硬件和互连就很难获得投入动力。TCP/IP 还会占用大量处理器资源。一个粗略经验是,每 1 Mbit/s 带宽需要约 1 MHz 处理器速度,因此 1000 Mbit/s 链路可能使一颗 800–1000 MHz 处理器饱和。
反过来看,从软件角度 TCP/IP 最有吸引力,因为连接面最广,带来的机会最多。针对某种 LAN 或 SAN 优化的软件,适用范围有限。例如 Java 程序通信依赖 TCP/IP,若为另一协议优化,就必须编写连接 Java 与该协议的适配软件。
TCP/IP 支持者指出,协议本身理论上不必像当时实现那么沉重,但商用系统的进步有限。市场已有 TCP/IP 卸载引擎,希望既保持通用软件模型,又降低处理器占用和消息延迟。如果处理器性能继续远快于网络速度增长,或者多处理器变得普遍,软件 TCP/IP 对处理器占用和消息延迟的影响也可能减弱。
F.12 结语
互连网络设计是当今计算机体系结构发展中最令人振奋的领域之一。随着新多核范式出现,以及传统多处理器/集群系统和互联网进步,互连体系结构创新面临许多挑战与机会,覆盖计算机系统全部层面:片上核间、板上芯片间、系统中板卡间、机房计算机间,以及局域乃至全球通信。无论应用于何处,在既定成本和功率约束下,互连都应以尽可能短的时间传送尽可能多的信息,避免成为系统瓶颈。拓扑、路由、仲裁、交换和流量控制,是实现此类高性能设计的关键概念。
互连网络设计必须是端到端的:注入链路、接收链路、网络端点接口,与交换结构内部的拓扑、交换机和链路同样重要。端节点接口的带宽和开销往往才是瓶颈,许多人却误把互连网络仅理解为网络交换结构。这就像处理器设计者把计算机体系结构只理解为指令集体系结构,或只理解为微体系结构一样糟糕!端到端问题与流量特征,使互连设计具有挑战,并至今仍然重要。
例如,低端到端延迟的需求,正推动更靠近处理器和存储器控制器的高效接口发展。我们可能很快看到,用于多处理器系统的多数多核处理器,都将网络接口做到片上,并专门用某个或某些核执行通信任务。IBM Blue Gene/L 已经如此,每颗双核处理器芯片可用一个核承担该任务。
网络从最初朴素的共享介质走到今天,仍有很长路要走。它还在追赶:在片上、I/O 和局域网等许多领域,交换介质点到点网络只是近期才取代传统总线网络。性能远未触顶,因此我们期待 WAN、LAN、SAN,尤其 OCN,在不久的将来迅速进步。更高的互连性能,是本领域以信息和通信为中心的未来愿景的关键;这一发展已以多种方式惠及全世界数以百万计的人。正如本附录开头的引语所说,这场双向通信革命,处于人类交往与行动形式变化的核心。
致谢
我们衷心感谢以下各位,他们以不同方式为上一版附录作出贡献:Lei Chai、Scott Clark、José Flich、Jose Manuel Garcia、Paco Gilabert、Rama Govindaraju、Manish Gupta、Wai Hong Ho、Siao Jer、Steven Keckler、Dhabaleswar(D.K.)Panda、Fabrizio Petrini、Steve Scott、Jeonghee Shin、Craig Stunkel、Sayantan Sur、Michael B. Taylor,以及 Bilal Zafar。特别感谢 Jose Flich 为本版附录提供的新贡献。
F.13 历史回顾与参考文献
本附录认为,应用领域差异很大的互连网络,从处理器芯片内的片上网络,到连接全球计算机的广域网,都有许多共同关注点。因此,互连概念按统一框架介绍,不以应用划界。但它们的历史截然不同,对相似问题采用不同解决方案,就是证明。不同领域研究群体之间缺少充分交流,无疑也促成了实现方法的多样性。下面列举相关读物。涵盖 WAN 和 LAN 的优秀通论包括 Davie、Peterson 和 Clark[1999]以及 Kurose 和 Ross[2001];面向多处理器与集群 SAN 的优秀教材有 Duato、Yalamanchili 和 Ni[2003]及 Dally 和 Towles[2004]。Pinkston[2004]专门论述互连死锁处理的章节很有价值。Jantsch 和 Tenhunen[2003]编辑的多核处理器与 SoC 片上网络著作,也值得阅读。
广域网
广域网是最早的数据互连网络。Internet 的前身 ARPANET 于 1969 年连接美国各地获得政府高级研究计划局 ARPA 资助的计算机科学系。最初设想是底层提供可靠通信;实际底层故障经验,促成了能容忍失败的 TCP/IP,成为今天互联网的基础。Vint Cerf 与 Robert Kahn 因在 20 世纪 70 年代中期开发 TCP/IP,获得 ACM 软件奖。Kahn[1972]是介绍 ARPANET 思想的早期文献;Stevens[1994–1996]的经典著作适合进一步学习 TCP/IP。
1975 年 ARPANET 大约有 100 个网络,1983 年只有 200 个。1995 年 Internet 已覆盖全球 50,000 个网络,其中约一半在美国。此后很难再统计网络数量,但 IP 主机从 1995 到 2000 年增长 15 倍,2000 年底达到一亿台,此后增长更快。多数服务商动态分配 IP,许多 LAN 使用私有地址,多数网络又支持无线连接,使主机总数几乎无法计算。2005 年 7 月,Internet Systems Consortium(www.isc.org)估计互联网主机超过 3.5 亿台,预计年增长约 25%。虽然 ARPANET、NSFNET 等政府网络奠定了基础,商业部门后来接手,使互联网蓬勃发展。但重大创新仍可能更多来自政府资助研究,而非商业部门;美国国家科学基金会 GENI,即 Global Environment for Network Innovation,计划就是一例。
互联网最令人振奋的应用是万维网。1989 年,CERN 程序员 Tim Berners-Lee 为信息访问开发它。1992 年,伊利诺伊大学的年轻程序员 Marc Andreessen 开发图形界面 Mosaic,大受欢迎,后来成为 Netscape 创始人之一,推动商用浏览器普及。1995 年 5 月本书第二版出版时,网页超过 30,000 个,每两个月翻倍;写第三版时已超过 13 亿个。2005 年 12 月,Web 服务器接近 7500 万台,当年增长 30%。
ATM 曾试图成为统一、终极的通信标准,既支持数据,也支持数字语音即电话。从技术上,它结合了分组交换与电路交换的优点,还很好地支持服务质量(QoS)。Alles[1995]提供了良好综述。1995 年,人们毫不怀疑 ATM 代表该领域未来;十年后,高昂设备与培训成本几乎击垮 ATM,人们回归简单的 TCP/IP。LAN 领域输给以太网家族也是重大打击:ATM 传输前要建立连接,而以太网分组交换延迟明显更低。后来虽引入 ATM 无连接服务器补救,却昂贵且构成 LAN 的集中瓶颈。
WAN 如今依赖光纤。光纤技术进展如此迅速,带宽常未被充分利用。主要原因是波分复用(WDM)商业化,一根光纤能在不同波长同时传多条数据流,一代即三至五年内带宽提高三个数量级;Senior[1993]是光纤通信方面的良好教材。但 IP 路由器仍可能成为瓶颈。链路速率 10–40 Gbit/s、大型核心路由器有数千端口时,必须在几十纳秒内处理分组。最费时的是路由,IP 地址的定义与分配方式,使每个分组通常都要在树结构中复杂搜索。网络处理器因此成为实现路由和分组过滤的高性价比方案,通常类似 RISC,具有大量硬件线程,并使用 local store 而非 缓存。
局域网
ARPA 在 WAN 上的成功,直接促成最流行的 LAN。Xerox Palo Alto Research Center 的许多研究者,在大学时就受 ARPA 资助,了解网络价值。1974 年,该群体创造了今日桌面计算机先驱 Alto[Thacker 等 1982]和今天的 LAN 以太网[Metcalfe 和 Boggs 1976]。David Boggs、Butler Lampson、Ed McCreight、Bob Sprowl 和 Chuck Thacker 后来都成为计算机科学与工程名家,获得大量奖项。
最初以太网为 3 Mbit/s,对当时计算机仿佛是无限通信带宽,依靠有线电视行业的互连技术。专门微码使 Alto 经以太网的往返延迟达到 50 μs,至今仍不算差。Boggs 的业余无线电经验,促成无中央仲裁器的设计:使用前先侦听,冲突后改变退避时间。
DEC、Intel 与 Xerox 宣布 10 Mbit/s 以太网标准,是商业成功的关键。这一宣布绕过了漫长的 IEEE 标准化过程,IEEE 最终仍发布了 802.3 以太网标准。
数种试图替代以太网的方案都失败了。FDDI 委员会耗时过久才达成标准,接口昂贵,而且在交换机已开始便宜时仍用共享介质。ATM 则一方面 LAN 版标准化太慢,另一方面如前所述,无连接服务器延迟高、表现差,也错失机会。InfiniBand 因下述原因也受挫。以太网因此继续绝对主导 LAN,也凭高带宽低成本,在高性能计算市场与 SAN 有力竞争。其在高端系统中的主要缺点,是延迟相对高,多数接口卡不支持所需协议。
吸取以往失败经验,LAN 更新主要围绕以太网扩展,包括更低成本的非屏蔽双绞线(UTP)、交换互连、更高链路速率,以及无线等新领域。几乎所有新 PC 主板和笔记本都提供 100/1000 Mbit/s 快速/千兆以太网端口,多数笔记本还有 54 Mbit/s 无线以太网。将家电、机顶盒、台式机、笔记本连接到共享互联网出口的家庭有线或无线 LAN,也很常见。Spurgeon[2006]提供了优秀的在线以太网技术及历史综述。
系统区域网络
Clos[1953]为电话交换局提出了最早一批无阻塞多级互连之一。后来,SAN 的许多早期发明来自大规模并行处理器(MPP)。早期代表 Illiac IV 是 20 世纪 70 年代初的 SIMD 阵列,64 个处理单元在当时已属“大规模”,以基于二维 torus 的拓扑互连,支持邻居通信。Cosmic Cube 则用以太网接口芯片,在六维立方体中连接 64 个处理器;非相邻节点通过中间节点存储转发,逐步送到目的地。80 年代中期 Connection Machine 规模大得多,包含 64K 个 1 位处理单元,也用超立方体及存储转发。此后互连网络显著进步。
20 世纪 70 至 90 年代,大量研究首先优化拓扑,后来转向路由、交换、仲裁与流控。最初主要追求性能,少顾实现限制和贯穿各层的问题。许多奇特拓扑虽有有趣性质,却使路由复杂。超立方体从中脱颖而出,80 年代十分流行,但 90 年代以后几乎从 MPP 消失。Dally[1990]的性能模型促成这一变化:若实现受导线数限制,低维拓扑在相同导线预算下能用更宽链路,性能优于高维。许多设计者跟随这一趋势,假定设计受导线限制,尽管多数实现当时及现在实际上受引脚限制。90 年代后采用低维拓扑的超级计算机包括 Intel Paragon、Cray T3D、Cray T3E、HP AlphaServer、Intel ASCI Red、IBM Blue Gene/L。
另一些设计者则选择双向 MIN,令交换机数少于节点数。最流行的是 Leiserson[1985]最初提出的胖树,首次用于 Connection Machine CM-5,后来用于 IBM ASCI White 和 ASC Purple。若干基于 Transputer 的欧洲并行计算机也采用这种间接拓扑,Quadrics 继承了其中一些特征。Myrinet 也不断演进,Myrinet 2000 将胖树作为主要拓扑。实际上,当时多数SAN,包括 Myrinet、InfiniBand、Quadrics,以及计划中的 PCI Express Advanced Switching,都基于胖树。
拓扑虽然最显眼,其他功能也显著影响性能。Holt[1972]的奠基工作引起人们对计算机系统死锁性质的关注。Merlin 和 Schweitzer[1980]、Gunther[1981]提出早期存储转发无死锁技术。Kermani 和 Kleinrock[1979]首先提出虚拟 cut-through 流水交换,Dally 和 Seitz[1986]以虫孔加以改进,显著降低轻负载延迟及拓扑对消息延迟的影响。虫孔最初优于虚拟 cut-through,主要因为流控粒度小于分组,高带宽链路不再那么受交换机可用存储带宽限制。现在通常更偏好虚拟 cut-through,因为其 HOL 阻塞影响较小、吞吐量更高,而集成技术已允许每链路实现许多分组缓冲。
Tamir 和 Frazier[1992]以动态分配多队列概念,为 VOQ 奠定基础。同一时期 Dally[1992]提出虚拟通道,这对更高效的无死锁路由,以及减少拥塞、提高吞吐量的流控技术至关重要。Duato[1993]的新理论同样重要:只需一个“逃逸”虚拟通道,就能在避免死锁的同时实现完全自适应路由;此前,所需通道数随维数指数增长。Pinkston 和 Warnakulasuriya[1997]进一步表明,死锁实际可能极少发生,为恢复型路由提供支持。Scott 和 Goodman[1994]是最早分析流水化通道价值的研究者之一,使链路带宽不依赖飞行时间。这些创新广泛用于历代高性能互连。例如 IBM Blue Gene/L 使用虚拟 cut-through、每链路四虚拟通道、一个逃逸通道的完全自适应路由,以及流水化链路。
MPP 只占信息技术市场很小且仍缩小的一部分,逐渐让位于刀片服务器和集群。美国 ASC(Advanced Simulation and Computing)计划,原称 ASCI(Accelerated Strategic Computing Initiative),推动设计了一系列性能越来越强、造价 5000 万至 1 亿美元的独一无二 MPP。后来许多机器本质上是更低成本的 SMP 集群;Pfister[1998]与 Sterling[2001]给出两种集群视角。2005 年 TOP500 中近 75% 已是集群。不过,每一代 MPP 乃至集群,都因规模及其他扩展因素产生新问题,推动互连研究。例如,最简单的源路由难以扩展到大系统;胖树随着网络增大需要更长链路,这促使 Blue Gene/L 选择可用有界长度链路实现的三维 torus 与分布式路由。
存储区域网络
系统区域网络最初面向单机房或单楼层,距离几十至几百米,用于 MPP 和集群。后来 SAN 也被用作存储区域网络的缩写,即用网络技术连接存储设备与计算服务器。如今许多人说 SAN,指的就是存储网络。2006 年最广泛的例子是 Fibre Channel(FC),有仲裁环 FC-AL、交换式 FC-SW 等多种形式。不仅磁盘阵列通过 FC 连服务器,还有磁盘直接用 FC 链路接交换机,以享受交换网络更高带宽及互连能力。
2000 年 10 月,InfiniBand Trade Association 公布 1.0 规范[InfiniBand Trade Association 2001],由 Intel、HP、IBM、Sun 等推动,面向高性能计算,以点到点链路、交换机和自己的协议取代 PCI。其特征同时适合连接集群的系统区域网络,以及连接阵列和服务器的存储区域网络,因而也面临两面竞争。存储领域主要对手是迅速改进的以太网。IETF 提出 iSCSI,在 IP 网络传送 SCSI 命令[Satran 等 2001]。由于大量生产的以太网交换机和接口卡成本更低,千兆以太网主导中低端市场。InfiniBand 推出缓慢、份额小,还延迟了原生支持它的芯片组开发;NIC 仍须插入 PCI 或 PCI-X 总线,未兑现取代 PCI 的承诺。
最终取代 PCI 的是另一个 I/O 标准 PCI Express。与 InfiniBand 类似,它也是交换网络,但使用点到点串行链路。它保留 PCI 软件兼容性,大幅简化迁移;又受益于大规模生产,用于桌面机连接一块或多块高端显卡,深受玩家欢迎。如今每块 PC 主板都提供一个或多个 x16 PCI Express 接口。它绝对主导 I/O接口,但当时标准并不支持处理器间通信。
Advanced Switching Interconnect(ASI) 可能成为 PCI Express 的补充。它兼容 PCI Express,可直接连接当时主板,同时支持处理器间通信与 I/O。支持者相信它终会在数据中心以统一网络取代 SAN 和 LAN,但讽刺的是,人们也曾这样评价 InfiniBand。详细讨论见 Pinkston 等[2003]。此外,新的磁盘接口 Serial Advanced Technology Attachment(SATA),用串行信号取代并行 IDE,提高带宽。市场大多数磁盘采用它,但 Fibre Channel 仍很活跃;事实上,InfiniBand 在 SAN 的许多承诺,是 FC 先实现的,扩大了后者市场份额。
有人认为,以太网、PCI Express、SATA 分别占据 LAN、I/O 接口、磁盘接口的优势;其他存储网络竞争者的命运还取决于多种因素。计算机体系结构的妙处,是这种问题不会永远停留在重复论点、毫无定论的学术争论。竞争在市场上展开,资金雄厚而富有才华的团队全力塑造未来。技术不断变化,也会奖励敏锐或幸运的人;技术与贯彻执行的最佳组合,常决定商业成功。谁胜谁负,至少下一轮如何,时间会揭晓。
片上网络
与其他领域相比,OCN 还处于起步阶段。直到 20 世纪 90 年代末,连接片内 缓存、寄存器堆、ALU 等功能单元,通常仍用追求低延迟的专用链路,或追求简单的共享总线。后来单芯片互连设备数增加,片内长连线的长度与延迟增加、芯片功耗提高,必须更有组织地共享片上带宽,遂产生 network-on-chip 概念。Agarwal[Waingold 等 1997]与 Dally[Dally 1999;Dally 和 Towles 2001]最早认识到这一点。他们认为,路由分组的 OCN 可让许多通信流高效共享日益丰富的导线资源,并通过模块化缓解 Ho、Mai 和 Horowitz[2001]指出的横跨芯片的片内连线延迟问题,还能改善故障隔离与容错。Taylor 等[2005]随后描述设计挑战,并提出以五元组刻画 OCN 延迟的模型。Bertozzi 等[2005]提出包含完整综合流程的设计方法。此后大量研发投入,使 OCN 成为微体系结构热点。
千禧年以来,带 OCN 的多核与 tile 设计日益普及。Pinkston 和 Shin[2005]综述了早期系统。多数设计利用交换式 OCN 简化布线的优点:核或 tile 之间的路径能在设计早期精确定义和优化,改善功耗与性能。核或 tile 四边通常有数万条导线作为“引脚”,因此可用导线资源换取网络性能,采用很宽的通道并行发送数据,而不是在固定窄通道上串行化;宽度还可能按功率管理需求增减。
环、mesh 与交叉开关容易用平面芯片工艺实现,也容易定义路由,所以是早期交换式 OCN 的常见选择。未来一颗芯片可能通过三维集成连接几十至几百个异构核或 tile,这种趋势是否持续,值得关注。处理器微体系结构已因应用需求和工艺进步而大幅演变,我们也期待片上网络出现同样重大的体系结构改进。
附录 F 习题
带 ✪ 的习题,其解答向在 textbooks.elsevier.com 注册的教师提供。
习题 F.1
✪ [15]〈F.2,F.3〉对于较远距离,电子通信是否总比非电子方式快?比较两种发送 1000 GB 数据的方式所需的时间:使用 25 盘 8 mm 磁带并交给隔夜快递;通过 Internet 使用 FTP。作如下四项假设:
- 磁带在太平洋时间下午 4 点取走,次日东部时间上午 10 点(太平洋时间上午 7 点)送达 4200 km 外。
- 第一条网络路径中,最慢链路是传输速率为 45 Mbit/s 的 T3 线路。
- 第二条路径中,最慢链路是 100 Mbit/s 以太网。
- 你能使用两地之间最慢链路带宽的 50%。
这两条 Internet 路径上的全部字节,是否都能在隔夜快递员到达之前送达?
习题 F.2
✪ [10]〈F.2,F.3〉沿用习题 F.1 的假设,运送一个 1000 GB 包裹的隔夜快递,其带宽是多少?
习题 F.3
✪ [10]〈F.2,F.3〉沿用习题 F.1 的假设,要比隔夜快递更快,最慢链路至少需要多大带宽?哪些标准网络选项能达到这一速率?
习题 F.4
✪ [15]〈F.2,F.3〉最初的以太网标准规定速率为 10 Mbit/s,最大距离为 2.5 km。在这种以太网上,处于飞行途中的字节最多有多少?假设能够使用峰值带宽的 90%。
习题 F.5
✪ [15]〈F.2,F.3〉正如 F.2 节的延迟例题所示,WAN 的飞行时间很长,因此流控成为一个问题。以太网最初在 10 Mbit/s 速率下标准化时,没有包含流控。对于链路长 100 m 的 10 Gbit/s 以太网,假设能够使用峰值带宽的 90%,计算飞行中的字节数。这个答案对网络设计者意味着什么?
习题 F.6
✪ [15]〈F.2,F.3〉假设以太网上发送零长度数据分组的总开销为 100 μs,空载网络能够以标称峰值 1000 Mbit/s 的 90% 传输。本题假设以太网分组头和分组尾合计为 56 字节,并连续发送大小相同的分组。令有效载荷从 32 字节起,以 32 字节为增量变化,直到最大值 1500 字节;画出实际提供的用户数据带宽(Mbit/s)随有效载荷大小变化的曲线。
习题 F.7
✪ [10]〈F.2,F.3〉习题 F.6 表明,单个用户实际得到的带宽可能令人失望。沿用其假设,要达到峰值带宽的一半,最大有效载荷大小需要增加多少?
习题 F.8
✪ [10]〈F.2,F.3〉ATM 采用固定传输大小的原因之一是:短消息排在长消息后面时,节点可能必须等整次传输结束。对于时间敏感的应用,例如语音和视频,大传输单元造成的延迟可能超出应用容许范围。在空载互连中,若一个节点必须等待一个最大长度的以太网分组,最坏延迟是多少微秒?等待一次 ATM 传输又是多少?分组大小见图 F.30。本题假设能使用 622 Mbit/s ATM 网络和 1000 Mbit/s 以太网各自带宽的 100%。
习题 F.9
✪ [10]〈F.2,F.3〉习题 F.7 提示,为增加实际带宽,需要扩大最大有效载荷;习题 F.8 则提示,这会影响最坏延迟。如果按照习题 F.7 的答案增加最大有效载荷,对延迟会有什么影响?
习题 F.10
✪ [12/12/20]〈F.4〉图 F.11(原书标注第 F-31 页)中的 Omega 网络由三列交换机组成,每列四个,每个交换机有两个输入和两个输出。交换机可以设为直通(straight):上输入接上输出、下输入接下输出;也可以设为交换(exchange):上输入接下输出、下输入接上输出。对于每一列交换机,都把输入和输出从上到下编号为 0、1、…、7,与处理器编号对应。
a. [12]〈F.4〉当交换机设为交换状态且有一条消息通过时,该消息所用输入和输出的编号有什么关系?(提示:考虑对编号二进制表示中的位进行操作。)
b. [12]〈F.4〉对于相邻列中由链路连接的两个交换机,前一交换机的输出编号与所接后一交换机的输入编号是什么关系?
c. [20]〈F.4〉根据 a、b 两问的结果,设计并描述一种简单的 Omega 网络分布式控制路由方案。消息携带由发送处理器计算的路由标记(routing tag)。说明处理器如何计算标记,以及每个交换机如何检查标记中的一个位来决定自身状态。
习题 F.11
✪ [12/12/12/12/12/12]〈F.4〉证明,图 F.11(原书标注第 F-31 页)的八节点 Omega 网络能否实现以下置换,即通信模式:
a. [12]〈F.4〉位反转置换:二进制坐标为 的节点,与节点 通信。
b. [12]〈F.4〉完美洗牌置换(perfect shuffle):节点 与节点 通信,即循环左移一位。
c. [12]〈F.4〉位取反置换:节点 与节点 通信,即每一位都取反。
d. [12]〈F.4〉蝶形置换:节点 与节点 通信,即交换最高位和最低位。
e. [12]〈F.4〉矩阵转置置换:节点 与节点 通信,即把位置大致相隔半圈的位互换。
f. [12]〈F.4〉桶形移位置换(barrel-shift):节点 与节点 通信,其中 是节点总数,。
**译注:**e 问的下标含有 ;但本题指定八节点,地址长度为三位,原文没有说明奇数位长时如何划分两组位。原页 f 问确实写作“modulo ”,也只给出 。若意在表达全部 个节点上的循环移位置换,通常应模 ,且 。
习题 F.12
✪ [12]〈F.4〉使用 18 端口交叉开关设计一种网络拓扑,以最少交换机连接 64 个节点。每个交换机端口都支持到设备和来自设备的双向通信。
习题 F.13
✪ [15]〈F.4〉使用 18 端口交叉开关,为 64 个节点设计通过交换机的延迟最小的拓扑。假设每个交换机延迟为一个单位,导线延迟为零。
习题 F.14
✪ [15]〈F.4〉使用 18 端口交叉开关,为 64 个节点设计使各条链路所需带宽均衡的交换拓扑。假设通信流量均匀分布。
习题 F.15
✪ [15]〈F.4〉比较交叉开关、Omega 网络和胖树连接八个节点时的互连延迟。使用图 F.11(原书标注第 F-31 页)、F.12(第 F-33 页)和 F.14(第 F-37 页)。假设胖树全部由双输入、双输出交换机构成,使其硬件资源更便于与 Omega 网络比较。每个交换机带来一个单位的时间延迟。胖树随机选择路径,因此各例均须给出最好和最坏情况。从节点 0 向节点 6 发送消息需要多长时间?节点 1 与节点 7 通信需要多长时间?
习题 F.16
✪ [15]〈F.4〉仿照图 F.14(原书标注第 F-37 页)中的 4-cube,画出 6-cube 拓扑。若分组目的地均匀分布,分组所需的最大跳数和平均跳数分别是多少?
习题 F.17
✪ [15]〈F.4〉完成一张类似图 F.15(原书标注第 F-40 页)的表,列出各类网络拓扑的性能和成本;但不局限于 64 节点,而是考虑用 交换机连接 个节点的一般情形。
习题 F.18
✪ [20]〈F.4〉重做 F.4 节的“NEWS 最近邻通信”例题,但把 NEWS 通信换成习题 F.11 中的位取反通信模式。
习题 F.19
✪ [15]〈F.5〉给出互连网络发生死锁必须具备的四个具体条件。维序路由消除了哪些条件?采用“逃逸”路径的自适应路由消除了哪些?采用回退式或前进式死锁恢复的自适应路由又消除了哪些?解释答案。
习题 F.20
✪ [12/12/12/12]〈F.5〉下列路由算法通过禁止某些维度转弯来约束路由。分析它们是否同时满足连通性和无死锁性,从而证明能否用作二维 mesh 的逃逸路径,并解释答案。(提示:可以参考 Turn Model 算法;也可以画出一个 mesh 的有向通道依赖图,检查是否不存在环,以证明结论。)以下用 W、E、N、S 分别表示西、东、北、南。
a. [12]〈F.5〉允许的转弯为 W→N、E→N、S→W、S→E。
b. [12]〈F.5〉允许的转弯为 W→S、E→S、N→E、S→E。
c. [12]〈F.5〉允许的转弯为 W→S、E→S、N→W、S→E、W→N、S→W。
d. [12]〈F.5〉允许的转弯为 S→E、E→S、S→W、N→W、N→E、E→N。
习题 F.21
✪ [15]〈F.5〉假设一个 64 节点二维 mesh 的通信流量均匀分布,计算并比较维序路由与 up*/down* 路由的效率因子 的上界。对于 up*/down*,假设根节点位于最优位置,即靠近 mesh 中心的节点。(提示:需要根据路由算法,求出承担全局负载的网络二等分链路上的负载。)
习题 F.22
✪ [15]〈F.5〉沿用习题 F.21 的假设,求用 交换机构成的 64 节点胖树上,up*/down* 路由的效率因子。将结果与二维 mesh 上的 up*/down* 路由比较并解释。
习题 F.23
✪ [15]〈F.5〉假设向输出端口发出的请求、输出端口返回的许可都均匀分布,计算两阶段仲裁把交换机全部 个输入端口同时匹配到 个输出端口的概率。将它与三阶段仲裁的匹配概率比较:后者允许每个输入端口同时提出两个请求,同样假设请求与许可均匀随机分布。
习题 F.24
✪ [15]〈F.5〉F.5 节的公式展示了 cut-through 交换的价值。用于构建集群的以太网交换机往往不支持 cut-through。对于 64 节点集群,比较在 1000 Mbit/s 以太网上传送 1500 字节时,使用和不使用 cut-through 所需的时间。假设每个以太网交换机耗时 1.0 μs,消息经过七个中间交换机。
习题 F.25
✪ [15]〈F.5〉沿用习题 F.24 的假设,对于 32 字节,cut-through 与存储转发的差别是什么?
习题 F.26
✪ [15]〈F.5〉降低延迟的一种方法是使用更大的交换机。与习题 F.24 不同,假设连接集群中任意两个节点只需三个中间交换机,其余参数与 F.24 相同。对于 1500 字节,cut-through 与存储转发的差别是什么?对于 32 字节呢?
习题 F.27
✪ [20]〈F.5〉使用 FlexSim 1.2(http://ceng.usc.edu/smart/FlexSim/flexsim.html)或其他周期精确的网络模拟器,模拟 256 节点二维 torus。采用虫孔路由、32 flit 分组、均匀随机通信模式,以及四个虚拟通道。比较三种方案的性能:采用 DOR 的确定性路由;使用逃逸路径的自适应路由,即 Duato 协议;以及使用前进式死锁恢复的真正完全自适应路由,即 Disha。仿照图 F.19的例题,分别画出延迟随施加负载变化和吞吐量随施加负载变化的曲线。对每种算法再分别用两个、八个虚拟通道运行模拟并绘图。比较并解释结果,说明虚拟通道的数量以及各算法使用通道的方式,如何影响网络性能、为什么会有这种影响。(提示:采集结果之前,应先预热数千个网络周期,确保模拟达到稳态。)
习题 F.28
✪ [20]〈F.5〉重做习题 F.27,以位反转通信替代均匀随机通信。比较并解释结果,说明通信模式如何影响网络性能及其原因。
习题 F.29
✪ [40]〈F.5〉分别采用 16 flit 和 128 flit 分组,重做习题 F.27、F.28。比较并解释结果,说明分组大小与其他设计参数如何影响网络性能及其原因。
习题 F.30
[20]〈F.2,F.4,F.5,F.8〉图 F.7、F.16 和 F.20 按机型列出了本书第四版出版时,TOP500 中若干超级计算机的互连网络特性。用最新 TOP500 更新这些表格。与原图数据相比,系统及其网络发生了怎样的变化?再利用图 F.29、F.31,对微处理器中的 OCN 以及面向集群的 SAN 作类似比较。
习题 F.31
✪ [12/12/12/15/15/18]〈F.8〉使用 M/M/1 排队模型作答。某网桥的测量结果显示,分组以每秒 200 个的速率到达,网关转发每个分组约需 2 ms。
a. [12]〈F.8〉网关利用率是多少?
b. [12]〈F.8〉网关中的平均分组数是多少?
c. [12]〈F.8〉分组在网关中停留的平均时间是多少?
d. [15]〈F.8〉改变到达率,画出响应时间随利用率变化的曲线。
e. [15]〈F.8〉对于 M/M/1 队列,系统中至少有 个任务的概率为 。若 FIFO 能容纳 10 条消息,溢出概率是多少?
f. [18]〈F.8〉要使因 FIFO 溢出造成的丢包率低于百万分之一,网关的缓冲容量至少应为多大?
习题 F.32
✪ [20]〈F.8〉发送与接收时间不均衡,会导致网络性能问题。发送过快时,接收方来不及取出消息,网络发生积压,消息延迟上升。带宽匹配(bandwidth matching)提供了一种简单办法:降低发送方速率,使之与接收方性能匹配[Brewer 和 Kuszmaul 1994]。若两台机器通过 UDP 一类协议交换相同数量的消息,其中一台会领先,先发完自己的所有消息。接收方把这些消息全部存放好后,才发送自己的消息。估算这种情况与带宽匹配情况的性能。假设发送开销 200 μs,接收开销 300 μs,飞行时间 5 μs,延迟 10 μs,两台机器希望交换 100 条消息。
习题 F.33
[40]〈F.8〉按照带宽匹配的建议,放慢 UDP 发送代码,使之与接收代码匹配,比较采用与不采用带宽匹配时的 UDP 性能[Brewer 和 Kuszmaul 1994]。设计实验,测定性能变化幅度。当两个节点发送到同一目的地时,应该怎样改变发送速率?当一个发送方向两个目的地发送时呢?
习题 F.34
✪ [40]〈F.6,F.8〉如果能使用 SMP 和集群,编写程序,测量处理器之间的通信延迟与通信带宽,如图 F.32(原书标注第 F-80 页)所示。
习题 F.35
[20/20/20]〈F.9〉如果能使用 UNIX 系统,用 ping 探索 Internet。先阅读手册页,再不带选项标志运行 ping,确保能到达以下站点;它应报告 X is alive。根据所用系统,可能可以设置详细模式 -v 和路由追踪模式 -R,查看本机与目标机器之间的路径;也可能必须使用原书所称的 trace route 程序,此时请查阅其手册页。可以使用 UNIX 的 script 命令记录整个会话。
a. [20]〈F.9〉追踪到同一 LAN 中另一台机器的路由。延迟是多少?
b. [20]〈F.9〉追踪到校园内另一台不在同一 LAN 的机器的路由。延迟是多少?
c. [20]〈F.9〉追踪到校外另一台机器的路由。例如,如果你给朋友发电子邮件,可以试着追踪这条路由。看看能否查明沿途使用了哪些网络。延迟是多少?
习题 F.36
[15]〈F.9〉使用 FTP 从远程站点传输文件,再在同一 LAN 的本地站点间传输。两次传输的带宽有什么差异?在一天中的不同时刻或一周中的不同日期再试。瓶颈在 WAN 还是 LAN?
习题 F.37
✪ [10/10]〈F.9,F.11〉图 F.41(原书标注第 F-93 页)对不同 TCP/IP 消息大小,比较了高带宽、高开销网络与低带宽、低开销网络的延迟。
a. [10]〈F.9,F.11〉对于哪些消息大小,高带宽网络提供的实际带宽更高?
b. [10]〈F.9,F.11〉对于 a 问中的消息大小,每种网络的实际带宽分别是多少?
习题 F.38
✪ [15]〈F.9,F.11〉利用图 F.41(原书标注第 F-93 页)的统计数据,估算每种网络的每条消息开销。
习题 F.39
✪ [15]〈F.9,F.11〉习题 F.37 计算了开销和峰值带宽不同的两个网络,在不同消息大小下哪个更快。利用图 F.41(原书标注第 F-93 页)的统计数据,低开销、低带宽网络能够更快传输的消息占百分之多少?高开销、高带宽网络能够更快传输的数据占百分之多少?
习题 F.40
✪ [15]〈F.9,F.11〉衡量互连延迟与带宽的一项有趣指标,是达到峰值带宽一半所需的消息大小。这个半峰值点借用向量处理术语,有时称为 。利用图 F.41(原书标注第 F-93 页),估算使用 155 Mbit/s ATM 和 10 Mbit/s 以太网发送 TCP/IP 消息时的 。
习题 F.41
[讨论]〈F.10〉Google 集群曾由 1 机架单元(RU)的 PC 构成,每台有一个处理器、两个磁盘。如今有密度高得多的选择。若用现代方案替换这些 1 RU PC,能减少多少机房面积?访问 Compaq 或 Dell 网站,寻找密度最高的替代方案。估算这对设备成本、场地租金分别有什么影响?为达到良好的功耗/性能效率,互连网络设计会受到怎样的影响?
习题 F.42
[讨论]〈F.13〉编写本书第四版时,Ethernet、InfiniBand、Advanced Switching 在机房中的竞争会如何发展,还不清楚。各自有什么技术优势和经济优势?系统维护人员为什么会偏好其中某一种?如今每种网络的流行程度如何?与 Myrinet、Quadrics 等专有商用网络相比如何?
附录 F 参考文献
- Agarwal, A., 1991. 互连网络性能的极限(Limits on interconnection network performance). IEEE Trans. on Parallel and Distributed Systems 2 (4, April), 398–412.
- Alles, A., 1995. ATM 网际互连(ATM internetworking), May. www.cisco.com/warp/public/614/12.html.
- Anderson, T.E., Culler, D.E., Patterson, D., 1995. 论工作站网络 NOW(A case for NOW (networks of workstations)). IEEE Micro 15 (1, February), 54–64.
- Anjan, K.V., Pinkston, T.M., 1995. Disha:一种高效的完全自适应死锁恢复方案(An efficient, fully-adaptive deadlock recovery scheme: Disha). Proc. 22nd Annual Int’l. Symposium on Computer Architecture, June 22–24, 1995, Santa Margherita Ligure, Italy.
- Arpaci, R.H., Culler, D.E., Krishnamurthy, A., Steinberg, S.G., Yelick, K., 1995. Cray-T3D 的实测评估:编译器视角(Empirical evaluation of the Cray-T3D: A compiler perspective). Proc. 22nd Annual Int’l. Symposium on Computer Architecture, June 22–24, 1995, Santa Margherita Ligure, Italy.
- Bell, G., Gray, J., 2001. Cray、集群与计算中心(Crays, Clusters and Centers). Microsoft Corporation, Redmond, Wash. MSR-TR-2001-76.
- Benes, V.E., 1962. 可重排的三级连接网络(Rearrangeable three stage connecting networks). Bell Syst. Tech. J. 41, 1481–1492.
- Bertozzi, D., Jalabert, A., Murali, S., Tamhankar, R., Stergiou, S., Benini, L., De Micheli, G., 2005. 面向定制领域专用多处理器 SoC 的 NoC 综合流程(NoC synthesis flow for customized domain specific multiprocessor systems-on-chip). IEEE Trans. on Parallel and Distributed Systems 16 (2, February), 113–130.
- Bhuyan, L.N., Agrawal, D.P., 1984. 计算机网络的广义超立方体与 hyperbus 结构(Generalized hypercube and hyperbus structures for a computer network). IEEE Trans. on Computers 32 (4, April), 322–333.
- Brewer, E.A., Kuszmaul, B.C., 1994. 如何使 CM-5 数据网络获得良好性能(How to get good performance from the CM-5 data network). Proc. Eighth Int’l Parallel Processing Symposium, April 26–29, 1994, Cancun, Mexico.
- Clos, C., 1953. 无阻塞交换网络研究(A study of non-blocking switching networks). Bell Systems Technical Journal 32 (March), 406–424.
- Dally, W.J., 1990. k-ary n-cube 互连网络性能分析(Performance analysis of k-ary n-cube interconnection networks). IEEE Trans. on Computers 39 (6, June), 775–785.
- Dally, W.J., 1992. 虚拟通道流控(Virtual channel flow control). IEEE Trans. on Parallel and Distributed Systems 3 (2, March), 194–205.
- Dally, W.J., 1999. 受互连限制的 VLSI 体系结构(Interconnect limited VLSI architecture). Proc. of the Int’l. Interconnect Technology Conference, May 24–26, 1999, San Francisco, Calif.
- Dally, W.J., Seitz, C.I., 1986. Torus 路由芯片(The torus routing chip). Distributed Computing 1 (4), 187–196.
- Dally, W.J., Towles, B., 2001. 为分组寻路,而非为导线布线:片上互连网络(Route packets, not wires: On-chip interconnection networks). Proc. of the 38th Design Automation Conference, June 18–22, 2001, Las Vegas, Nev.
- Dally, W.J., Towles, B., 2004. 互连网络原理与实践(Principles and Practices of Interconnection Networks). Morgan Kaufmann Publishers, San Francisco.
- Davie, B.S., Peterson, L.L., Clark, D., 1999. 计算机网络:系统方法(Computer Networks: A Systems Approach), 第 2 版. Morgan Kaufmann Publishers, San Francisco.
- Duato, J., 1993. 虫孔网络无死锁自适应路由的新理论(A new theory of deadlock-free adaptive routing in wormhole networks). IEEE Trans. on Parallel and Distributed Systems 4 (12, December), 1320–1331.
- Duato, J., Pinkston, T.M., 2001. 使用混合资源集合的无死锁自适应路由一般理论(A general theory for deadlock-free adaptive routing using a mixed set of resources). IEEE Trans. on Parallel and Distributed Systems 12 (12, December), 1219–1235.
- Duato, J., Yalamanchili, S., Ni, L., 2003. 互连网络:工程方法(Interconnection Networks: An Engineering Approach). Morgan Kaufmann Publishers, San Francisco, 第 2 次印刷.
- Duato, J., Johnson, I., Flich, J., Naven, F., Garcia, P., Nachiondo, T., 2005. 面向无损多级互连网络的新型可扩展、高性价比拥塞管理策略(A new scalable and cost-effective congestion management strategy for lossless multistage interconnection networks). Proc. 11th Int’l. Symposium on High Performance Computer Architecture, February 12–16, 2005, San Francisco.
- Duato, J., Lysne, O., Pang, R., Pinkston, T.M., 2005. 第一部分:互连网络无死锁动态重配置理论(Part I: A theory for deadlock-free dynamic reconfiguration of interconnection networks). IEEE Trans. on Parallel and Distributed Systems 16 (5, May), 412–427.
- Flich, J., Bertozzi, D., 2010. 纳米尺度时代的片上网络体系结构设计(Designing Network-on-Chip Architectures in the Nanoscale Era). CRC Press, Boca Raton, FL.
- Glass, C.J., Ni, L.M., 1992. 用于自适应路由的 Turn Model(The Turn Model for adaptive routing). Proc. 19th Int’l. Symposium on Computer Architecture, May, Gold Coast, Australia.
- Gunther, K.D., 1981. 分组交换数据传输系统中的死锁预防(Prevention of deadlocks in packet-switched data transport systems). IEEE Trans. on Communications, COM-29:4 (April), 512–524.
- Ho, R., Mai, K.W., Horowitz, M.A., 2001. 导线的未来(The future of wires). Proc. of the IEEE 89:4 (April), 490–504.
- Holt, R.C., 1972. 计算机系统的若干死锁性质(Some deadlock properties of computer systems). ACM Computer Surveys 4 (3, September), 179–196.
- Hoskote, Y., Vangal, S., Singh, A., Borkar, N., Borkar, S., 2007. 用于 TFLOPS 处理器的 5 GHz mesh 互连(A 5-ghz mesh interconnect for a teraflops processor). IEEE Micro 27 (5), 51–61.
- Howard, J., Dighe, S., Hoskote, Y., Vangal, S., Finan, S., Ruhl, G., Jenkins, D., Wilson, H., Borka, N., Schrom, G., Pailet, F., Jain, S., Jacob, T., Yada, S., Marella, S., Salihundam, P., Erraguntla, V., Konow, M., Riepen, M., Droege, G., Lindemann, J., Gries, M., Apel, T., Henriss, K., Lund-Larsen, T., Steibl, S., Borkar, S., De, V., Van Der Wijngaart, R., Mattson, T., 2010. 采用 45 nm CMOS、支持 DVFS 的 48 核 IA-32 消息传递处理器(A 48-core IA-32 message-passing processor with DVFS in 45 nm CMOS). IEEE International Solid-State Circuits Conference Digest of Technical Papers, 58–59.
- InfiniBand Trade Association, 2001. InfiniBand 体系结构规范 1.0.a 版(InfiniBand Architecture Specifications Release 1.0.a). www.infinibandta.org.
- Jantsch, A., Tenhunen, H.(编), 2003. 片上网络(Networks on Chips). Kluwer Academic Publishers, The Netherlands.
- Kahn, R.E., 1972. 资源共享计算机通信网络(Resource-sharing computer communication networks). Proc. IEEE 60:11 (November), 1397–1407.
- Kermani, P., Kleinrock, L., 1979. 虚拟 cut-through:一种新的计算机通信交换技术(Virtual cut-through: A new computer communication switching technique). Computer Networks 3 (January), 267–286.
- Kurose, J.F., Ross, K.W., 2001. 计算机网络:以 Internet 为特色的自顶向下方法(Computer Networking: A Top-Down Approach Featuring the Internet). Addison-Wesley, Boston.
- Leiserson, C.E., 1985. 胖树:支持高硬件效率超级计算的通用网络(Fat trees: Universal networks for hardware-efficient supercomputing). IEEE Trans. on Computers, C-34:10 (October), 892–901.
- Merlin, P.M., Schweitzer, P.J., 1980. 存储转发网络中的死锁避免,第一部分:存储转发死锁(Deadlock avoidance in store-and-forward networks. I. Store-and-forward deadlock). IEEE Trans. on Communications, COM-28:3 (March), 345–354.
- Metcalfe, R.M., 1993. 计算机/网络接口设计:ARPANET 与以太网的经验(Computer/network interface design: Lessons from Arpanet and Ethernet). IEEE J. on Selected Areas in Communications 11 (2, February), 173–180.
- Metcalfe, R.M., Boggs, D.R., 1976. 以太网:本地计算机网络的分布式分组交换(Ethernet: Distributed packet switching for local computer networks). Comm. ACM 19 (7, July), 395–404.
- Partridge, C., 1994. 千兆网络(Gigabit Networking). Addison-Wesley, Reading, Mass.
- Peh, L.S., Dally, W.J., 2001. 流水化路由器的延迟模型与推测式体系结构(A delay model and speculative architecture for pipelined routers). Proc. 7th Int’l. Symposium on High Performance Computer Architecture, January 20–24, 2001, Monterrey, Mexico.
- Pfister, G.F., 1998. 探寻集群(In Search of Clusters), 第 2 版. Prentice Hall, Upper Saddle River, N.J.
- Pinkston, T.M., 2004. 互连网络中的死锁特征与处理(Deadlock characterization and resolution in interconnection networks). 载于 Zhu, M.C., Fanti, M.P.(编), Deadlock Resolution in Computer-Integrated Systems(计算机集成系统中的死锁处理). CRC Press, Boca Raton, Fl, 445–492.
- Pinkston, T.M., Shin, J., 2005. 走向片上网络化微系统的趋势(Trends toward on-chip networked microsystems). Int’l. J. of High Performance Computing and Networking 3 (1), 3–18.
- Pinkston, T.M., Warnakulasuriya, S., 1997. 论互连网络中的死锁(On deadlocks in interconnection networks). Proc. 24th Int’l. Symposium on Computer Architecture, June 2–4, 1997, Denver, Colo.
- Pinkston, T.M., Benner, A., Krause, M., Robinson, I., Sterling, T., 2003. InfiniBand:系统与局域网络未来的“事实”标准,还是仅为 PCI 总线的可扩展替代方案?(InfiniBand: The ‘de facto’ future standard for system and local area networks or just a scalable replacement for PCI buses?). Cluster Computing, 集群通信体系结构专刊,6:2 (April), 95–104.
- Puente, V., Beivide, R., Gregorio, J.A., Prellezo, J.M., Duato, J., Izu, C., 1999. 自适应 bubble 路由器:提高 torus 网络性能的一种设计(Adaptive bubble router: A design to improve performance in torus networks). Proc. 28th Int’l. Conference on Parallel Processing, September 21–24, 1999, Aizu-Wakamatsu, Japan.
- Rodrigo, S., Flich, J., Duato, J., Hummel, M., 2008. 面向 CMP 的高效单播与多播支持(Efficient unicast and multicast support for CMPs). Proc. 41st Annual IEEE/ACM International Symposium on Microarchitecture (MICRO-41), November 8–12, 2008, Lake Como, Italy, 364–375.
- Saltzer, J.H., Reed, D.P., Clark, D.D., 1984. 系统设计中的端到端论证(End-to-end arguments in system design). ACM Trans. on Computer Systems 2 (4, November), 277–288.
- Satran, J., Smith, D., Meth, K., Sapuntzakis, C., Wakeley, M., Von Stamwitz, P., Haagens, R., Zeidner, E., Dalle Ore, L., Klein, Y., 2001. iSCSI. IETF IPS 工作组,Internet 草案. www.ietf.org/internet-drafts/draft-ietf-ips-iscsi-07.txt.
- Scott, S.L., Goodman, J., 1994. 流水化通道对 k-ary n-cube 网络的影响(The impact of pipelined channels on k-ary n-cube networks). IEEE Trans. on Parallel and Distributed Systems 5 (1, January), 1–16.
- Senior, J.M., 1993. 光纤通信:原理与实践(Optical Fiber Commmunications: Principles and Practice), 第 2 版. Prentice Hall, Hertfordshire, U.K.
- Spurgeon, C., 2006. Charles Spurgeon 的以太网网站(Charles Spurgeon’s Ethernet Web Site). www.etherman-age.com/ethernet/ethernet.html.
- Sterling, T., 2001. Windows 上的 Beowulf PC 集群计算与 Linux 上的 Beowulf PC 集群计算(Beowulf PC Cluster Computing with Windows and Beowulf PC Cluster Computing with Linux). MIT Press, Cambridge, Mass.
- Stevens, W.R., 1994–1996. TCP/IP 详解(TCP/IP Illustrated),三卷. Addison-Wesley, Reading, Mass.
- Tamir, Y., Frazier, G., 1992. 用于 VLSI 通信交换机的动态分配多队列缓冲(Dynamically-allocated multi-queue buffers for VLSI communication switches). IEEE Trans. on Computers 41 (6, June), 725–734.
- Tanenbaum, A.S., 1988. 计算机网络(Computer Networks), 第 2 版. Prentice Hall, Englewood Cliffs, N.J.
- Taylor, M.B., Lee, W., Amarasinghe, S.P., Agarwal, A., 2005. 标量操作数网络(Scalar operand networks). IEEE Trans. on Parallel and Distributed Systems 16 (2, February), 145–162.
- Thacker, C.P., McCreight, E.M., Lampson, B.W., Sproull, R.F., Boggs, D.R., 1982. Alto:一种个人计算机(Alto: A personal computer). 载于 Siewiorek, D.P., Bell, C.G., Newell, A.(编), Computer Structures: Principles and Examples(计算机结构:原理与实例). McGraw-Hill, New York, 549–572.
- TILE-GX,http://www.tilera.com/sites/default/files/productbriefs/PB025_TILE-Gx_Processor_A_v3.pdf.
- Vaidya, A.S., Sivasubramaniam, A., Das, C.R., 1997. 虚拟通道与自适应路由的性能收益:应用驱动的研究(Performance benefits of virtual channels and adaptive routing: An application-driven study). Proc. 11th ACM Int’l Conference on Supercomputing, July 7–11, 1997, Vienna, Austria.
- Van Leeuwen, J., Tan, R.B., 1987. 区间路由(Interval Routing). The Computer Journal 30 (4), 298–307.
- von Eicken, T., Culler, D.E., Goldstein, S.C., Schauser, K.E., 1992. Active messages:集成通信与计算的一种机制(Active messages: A mechanism for integrated communication and computation). Proc. 19th Annual Int’l. Symposium on Computer Architecture, May 19–21, 1992, Gold Coast, Australia.
- Waingold, E., Taylor, M., Srikrishna, D., Sarkar, V., Lee, W., Lee, V., Kim, J., Frank, M., Finch, P., Barua, R., Babb, J., Amarasinghe, S., Agarwal, A., 1997. 向软件全面开放:Raw Machines(Baring it all to software: Raw Machines). IEEE Computer 30 (September), 86–93.
- Yang, Y., Mason, G., 1991. 无阻塞广播交换网络(Nonblocking broadcast switching networks). IEEE Trans. on Computers 40 (9, September), 1005–1015.
G 深入探讨向量处理器
修订:Krste Asanovic,Massachusetts Institute of Technology。
向量处理器当然不是我发明的。据我所知,目前已有三种,分别以 Illiac-IV、CDC Star 和 TI ASC 处理器为代表。这三种都是开创性的处理器……当先驱有一个问题:你总会犯错,而我从来、从来都不想当先驱。最好总是第二个上场,这样就能看看先驱们犯了哪些错误。
——Seymour Cray,1976 年在 Lawrence Livermore Laboratories 介绍 Cray-1 的公开演讲
G.1 引言
第 4 章介绍了向量体系结构,并在向量体系结构的背景下,说明了多媒体 SIMD 扩展与 GPU 的定位。
本附录更深入地讨论向量体系结构,包括更精确的性能模型,以及以往向量体系结构的具体设计。图 G.1 列出若干典型向量处理器的特征,包括寄存器的大小和数量、功能单元的数量和类型、加载—存储单元数,以及通道数。
| 处理器(年份) | 向量时钟频率(MHz) | 向量寄存器数 | 每寄存器元素数(64 位元素) | 向量运算单元 | 向量加载—存储单元 | 通道数 |
|---|---|---|---|---|---|---|
| Cray-1(1976) | 80 | 8 | 64 | 6 个:浮点加法、浮点乘法、浮点倒数、整数加法、逻辑、移位 | 1 | 1 |
| Cray X-MP(1983) Cray Y-MP(1988) | 118 166 | 8 | 64 | 8 个:浮点加法、浮点乘法、浮点倒数、整数加法、2 个逻辑单元、移位、置位计数/奇偶校验 | 2 个加载 1 个存储 | 1 |
| Cray-2(1985) | 244 | 8 | 64 | 5 个:浮点加法、浮点乘法、浮点倒数/平方根、整数加法/移位/置位计数、逻辑 | 1 | 1 |
| Fujitsu VP100/VP200(1982) | 133 | 8–256 | 32–1024 | 3 个:浮点或整数加法/逻辑、乘法、除法 | 2 | 1(VP100) 2(VP200) |
| Hitachi S810/S820(1983) | 71 | 32 | 256 | 4 个:浮点乘加、浮点乘法或除法后加减、2 个整数加法/逻辑单元 | 3 个加载 1 个存储 | 1(S810) 2(S820) |
| Convex C-1(1985) | 10 | 8 | 128 | 2 个:浮点或整数乘法/除法、加法/逻辑 | 1 | 1(64 位) 2(32 位) |
| NEC SX/2(1985) | 167 | 8+32 | 256 | 4 个:浮点乘法/除法、浮点加法、整数加法/逻辑、移位 | 1 | 4 |
| Cray C90(1991) Cray T90(1995) | 240 460 | 8 | 128 | 8 个:浮点加法、浮点乘法、浮点倒数、整数加法、2 个逻辑单元、移位、置位计数/奇偶校验 | 2 个加载 1 个存储 | 2 |
| NEC SX/5(1998) | 312 | 8+64 | 512 | 4 个:浮点或整数加法/移位、乘法、除法、逻辑 | 1 | 16 |
| Fujitsu VPP5000(1999) | 300 | 8–256 | 128–4096 | 3 个:浮点或整数乘法、加法/逻辑、除法 | 1 个加载 1 个存储 | 16 |
| Cray SV1(1998) SV1ex(2001) | 300 500 | 8 | 64(MSP) | 8 个:浮点加法、浮点乘法、浮点倒数、整数加法、2 个逻辑单元、移位、置位计数/奇偶校验 | 1 个加载—存储 1 个加载 | 2 8(MSP) |
| VMIPS(2001) | 500 | 8 | 64 | 5 个:浮点乘法、浮点除法、浮点加法、整数加法/移位、逻辑 | 1 个加载—存储 | 1 |
| NEC SX/6(2001) | 500 | 8+64 | 256 | 4 个:浮点或整数加法/移位、乘法、除法、逻辑 | 1 | 8 |
| NEC SX/8(2004) | 2000 | 8+64 | 256 | 4 个:浮点或整数加法/移位、乘法、除法、逻辑 | 1 | 4 |
| Cray X1(2002) Cray X1E(2005) | 800 1130 | 32 | 64 256(MSP) | 3 个:浮点或整数的加法/逻辑、乘法/移位、除法/平方根/逻辑 | 1 个加载 1 个存储 | 2 8(MSP) |
如果某台机器是多处理器系统,表中条目表示其中一个处理器的特征。若干机器的向量单元与标量单元时钟频率不同,表中给出向量单元的频率。Fujitsu 机器的向量寄存器可配置:8K 个 64 位条目可在寄存器数量与每寄存器大小之间进行反向调整。例如,VP200 可以配置为 8 个各含 1K 元素的寄存器,也可以配置为 256 个各含 32 元素的寄存器。NEC 机器有 8 个连接运算单元的前台向量寄存器,另外有 32–64 个后台向量寄存器,连接存储系统与前台向量寄存器。
表中的置位计数(population count)指统计二进制表示中值为 1 的位数。加法流水线执行加法和减法。Hitachi S810/S820 的乘法/除法—加法单元,先执行浮点乘法或除法,再执行加法或减法;乘加单元则先乘、后加或减。注意,大多数处理器使用向量浮点乘除单元执行向量整数乘除;其中一些处理器还让浮点标量运算和浮点向量运算共用功能单元。每个向量加载—存储单元,都表示能够与向量寄存器进行一次独立、可与其他传送重叠的输入或输出。
通道数就是每个功能单元内的并行流水线数,见 G.4 节。例如,NEC SX/5 的乘法功能单元每周期可完成 16 次乘法。若干机器可以把一条 64 位通道拆为两条 32 位通道,以提高只需较低精度的应用的性能。Cray SV1 和 Cray X1 可以将 4 个各有 2 条通道的 CPU 编组,共同作为一个有 8 条通道的大 CPU 工作;Cray 将其称为 Multi-Streaming Processor(MSP)。
G.2 深入分析向量性能
对于长向量,chime 近似已经相当准确。不过,还有一种开销,影响远比指令发射限制更大。
chime 模型忽略的最重要开销,是向量启动时间。启动时间来自向量操作的流水线延迟,主要取决于所用功能单元的流水线深度。它使一个编队的实际执行时间超过一个 chime。由于我们假设各编队在时间上不重叠,启动时间还会推迟后续编队的执行。当然,相邻编队中的指令,不是在某个功能单元上存在结构冲突,就是存在数据依赖,因此不重叠的假设是合理的。
完成一个编队的实际时间,由向量长度与启动时间之和决定。如果向量长度无限大,启动开销就能被摊薄;但向量长度有限,启动开销便会显现,下面的例子说明了这一点。
例题 假设功能单元的启动开销如图 G.2 所示。给出各编队可以开始执行的时间,以及总共需要的周期数。向量长度为 64 时,该时间与 chime 近似相比如何?
解答 图 G.3 按编队给出答案,假定向量长度为 。一个棘手的问题是:我们认为什么时刻才算整个向量指令序列完成?这决定了 SV 的启动时间是否可见。这里假设后续指令不能放入同一编队,而且前面已经假定编队之间不重叠。因此,总时间是最后一个编队中最后一条向量指令完成所需的时间。这是一种近似:最后一条向量指令的启动时间,在一些指令序列中可见,在另一些序列中则可能不可见。为简单起见,我们始终将它计入。
向量长度为 64 时,每个结果所需时间为 个时钟周期,而 chime 近似为 4 个时钟周期。计入启动开销后,执行时间是原来的 1.16 倍。
译注: 上式沿用原书的 4.65;精确计算为 4.65625,通常保留两位小数应为 4.66。这里不把原书截取的近似值静默改成另一数值。
| 单元 | 启动开销(周期) |
|---|---|
| 加载和存储单元 | 12 |
| 乘法单元 | 7 |
| 加法单元 | 6 |
| 编队 | 开始时间 | 第一个结果时间 | 最后一个结果时间 |
|---|---|---|---|
1. LV | 0 | 12 | |
2. MULVS.D LV | |||
3. ADDV.D | |||
4. SV |
为简单起见,我们通常使用 chime 近似估算运行时间;只有需要更精确的性能结果,或要说明某项改进的收益时,才计入启动时间。对长向量这一常见情形,启动开销的影响并不很大。本附录后面还会讨论降低启动开销的方法。
指令的启动时间来自执行该指令的功能单元的流水线深度。如果要保持每时钟周期产生一个结果的启动速率,则有:
例如,若一个操作需要 10 个时钟周期,那么要达到每周期启动一个操作的速率,就必须使用 10 级流水线。因此,流水线深度取决于操作的复杂度和处理器的时钟周期时间。功能单元的流水线深度差异很大,常见为 2–20 级;使用最频繁的单元通常为 4–8 个时钟周期。
对于 VMIPS,我们采用与 Cray-1 相同的流水线深度,尽管更现代的处理器往往具有更大的延迟,尤其是加载延迟。所有功能单元都采用完全流水化设计。按第 4 章的设定,浮点加法的流水线深度为 6 个时钟周期,浮点乘法为 7 个时钟周期。在 VMIPS 上,和大多数向量处理器一样,使用不同功能单元的独立向量操作可以在同一编队中发射。
除了启动开销,还要考虑执行 strip-mining 循环的开销。这种开销来自重新启动向量指令序列、设置向量长度寄存器(VLR);在编队与其他指令不重叠的假设下,它实际上增加了向量启动时间。如果一个编队的这项开销为 10 个周期,那么每 64 个元素的有效开销就增加 10 个周期,即每元素增加 0.15 个周期。
由一系列编队组成的 strip-mining 循环,其运行时间主要取决于两个因素:
- 循环中的编队数,它决定 chime 数。我们用 表示以 chime 为单位的执行时间。
- strip-mining 中每组编队的开销。它由对每个数据块执行 strip-mining 标量代码的开销 ,以及各编队的向量启动开销 组成。
第一次设置向量指令序列时,还可能有一项固定开销。近来的向量处理器已将它降得很低,因此这里忽略不计。
利用这些组成部分,可以表示一组向量指令处理长度为 的向量所需的总时间,记为 :
译注: 原式使用普通方括号。结合后面把 200 个元素分成 4 段的例题,这里的方括号表示所需分段次数,即对 向上取整;不是向下取整。
、 和 的取值,都取决于编译器和处理器。指令的寄存器分配与调度,既会影响哪些指令被放入一个编队,也会影响各编队的启动开销。
为简单起见,VMIPS 的 采用常数。根据对 Cray-1 向量执行的多种测量,取 。乍看之下,这个值似乎过小:每次循环都需要设置向量起始地址与步长、递增计数器,并执行循环分支。但实际上,这些标量指令可以与向量指令完全或部分重叠,从而尽量减少这些辅助操作占用的时间。当然, 取决于循环结构;不过,与向量代码对 和 的影响相比,这种依赖关系较弱。
| 操作 | 启动代价(周期) |
|---|---|
| 向量加法 | 6 |
| 向量乘法 | 7 |
| 向量除法 | 20 |
| 向量加载 | 12 |
例题 在 VMIPS 上执行向量操作 需要多长时间?其中 为标量,向量 、 的长度均为 200。
解答 假定 、 的地址最初分别位于 Ra、Rb 中, 位于 Fs 中;还要记住,MIPS 及 VMIPS 的 R0 始终为 0。由于 ,strip-mining 循环的第一次迭代处理 8 个元素,之后每次处理 64 个元素。每个向量下一段起始字节地址的增量,为本段向量长度的 8 倍。因此,第一段之后地址寄存器递增 ,后续各段之后递增 。向量共有 字节;将下一段地址与初始地址加 1600 比较,即可判断是否完成。实际代码如下:
循环中的三条向量指令存在依赖,必须放入三个编队,因此 。代入基本公式:
是以下三项之和:
- 向量加载的 12 个时钟周期启动时间;
- 乘法的 7 个时钟周期启动时间;
- 存储的 12 个时钟周期启动时间。
因此:
总执行时间为:
计入全部启动开销后,每元素执行时间为 个周期,而 chime 近似为 3 个周期。G.4 节将进一步允许不同编队重叠执行。
图 G.5 给出前例 在不同向量长度下的每元素开销与实际执行速率。按 chime 计数的模型,每元素需要 3 个时钟周期;两种开销在极限情况下还会为每元素增加 0.9 个时钟周期。
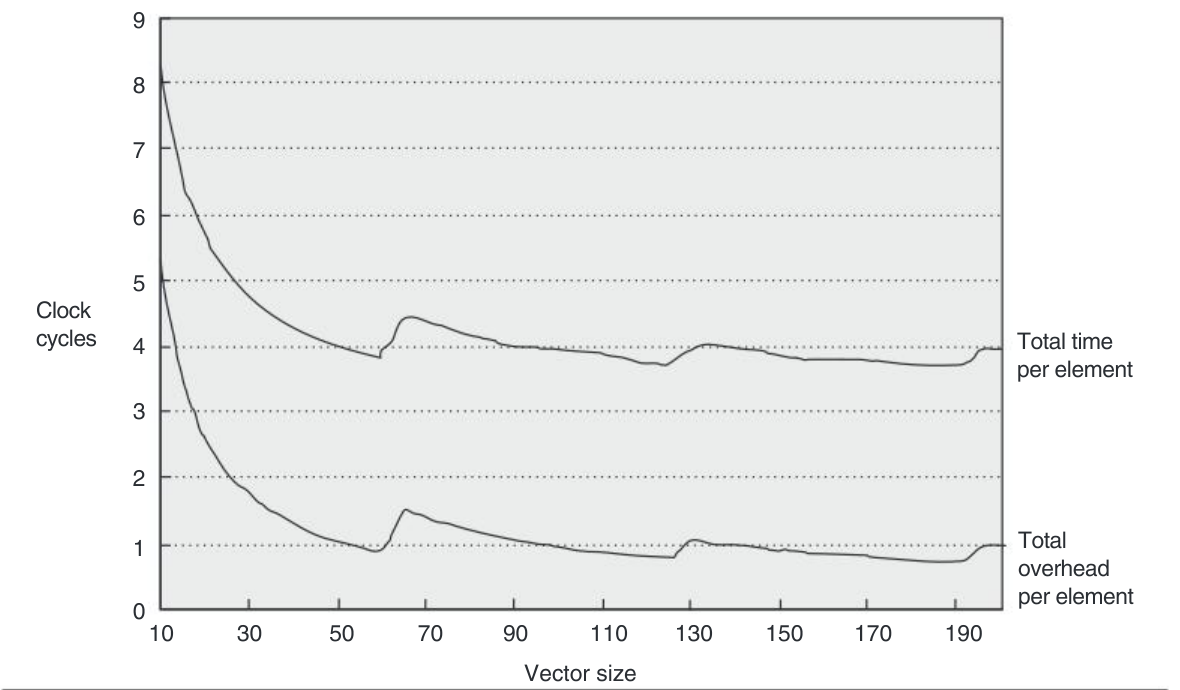
图内术语:Clock cycles=时钟周期;Vector size=向量长度;Total time per element=每元素总时间;Total overhead per element=每元素总开销。
译注: 图注原写“F-6 页”,对应例题实际位于本附录 G-6 页。正文“极限情况下增加 0.9 个周期”也与本节参数不一致:按 、、,长向量的每元素开销极限为 个周期。
指令启动的流水化与多通道
增加通道数可以提高峰值性能,却不会改变启动延迟。因此,让一条向量指令的启动与此前向量指令的收尾重叠,以减少启动开销,就变得十分关键。最简单的情况是两条指令访问不同的向量寄存器。例如:
一种实现方式是:第一条向量指令的最后一个元素进入浮点加法流水线后,紧接着让第二条指令的第一个元素进入。为降低控制逻辑复杂度,一些向量机要求两条派发到同一向量单元的指令之间,保留一段恢复时间,即空转时间(dead time)。图 G.6 用单条向量流水线的时序图,同时说明启动延迟与空转时间。
下面的例题说明空转时间对可达到的向量性能有何影响。
例题 Cray C90 有两条通道,但发往同一功能单元的任意两条向量指令之间,即使没有数据依赖,也必须有 4 个时钟周期的空转时间。最大向量长度为 128 个元素时,这会使可达到的峰值性能降低多少?如果通道数增至 16,又会降低多少?
解答 最大长度为 128 的向量分配到两条通道,需占用向量功能单元 64 个时钟周期。空转时间又增加 4 个周期的占用,使峰值性能降至无空转时间时的 。如果增至 16 条通道,最大长度的向量指令只需占用功能单元 个周期,空转时间使峰值性能降至无空转时间时的 。后一种情况下,向量单元的忙碌时间永远不可能超过总时间的三分之二!
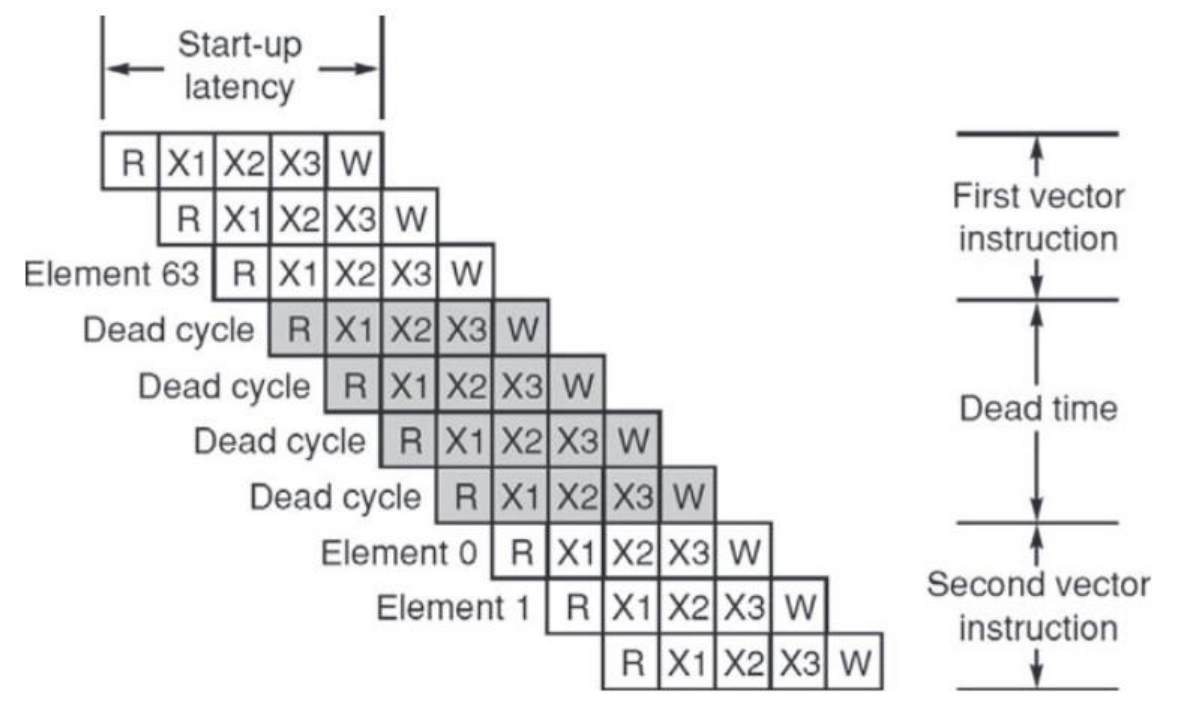
图内术语:Start-up latency=启动延迟;First/Second vector instruction=第一/第二条向量指令;Dead time/Dead cycle=空转时间/空转周期;Element=元素;R、X1–X3、W 分别表示读寄存器、三个执行级和写寄存器。
当多条指令可能读写同一个向量寄存器,或某些指令可能因不可预测的原因停顿——例如向量加载遇到存储体冲突——时,指令启动的流水化就更加复杂。但随着通道数与流水线延迟不断增加,允许指令启动完全流水化,也就愈加重要。
G.3 深入探讨向量存储系统
要维持每时钟周期取出或存入一个字的启动速率,存储系统就必须能够以这一速率提供或接收数据。正如第 4 章所述,通常的做法是将访问分散到多个独立存储体。大量存储体有助于处理按行或按列访问数据的向量加载、存储。
所需访问速率与存储体访问时间,决定了需要多少个存储体才能避免停顿。下面的例子说明这些时序在向量处理器中如何配合。
例题 假设从字节地址 136 开始读取一个含 64 个元素的向量,一次存储器访问耗时 6 个时钟周期。要支持每周期读取一个元素,需要多少个存储体?各存储体收到哪些地址?不同元素何时到达 CPU?
解答 每次访问耗时 6 个周期,因此至少需要 6 个存储体;不过,我们希望存储体数为 2 的幂,故选择 8 个。图 G.7 给出一个具有 8 个存储体、访问延迟为 6 个时钟周期的系统中,最初几组访问的时序。
| 周期编号 | 存储体 0 | 存储体 1 | 存储体 2 | 存储体 3 | 存储体 4 | 存储体 5 | 存储体 6 | 存储体 7 |
|---|---|---|---|---|---|---|---|---|
| 0 | 136 | |||||||
| 1 | 忙 | 144 | ||||||
| 2 | 忙 | 忙 | 152 | |||||
| 3 | 忙 | 忙 | 忙 | 160 | ||||
| 4 | 忙 | 忙 | 忙 | 忙 | 168 | |||
| 5 | 忙 | 忙 | 忙 | 忙 | 忙 | 176 | ||
| 6 | 忙 | 忙 | 忙 | 忙 | 忙 | 184 | ||
| 7 | 192 | 忙 | 忙 | 忙 | 忙 | 忙 | ||
| 8 | 忙 | 200 | 忙 | 忙 | 忙 | 忙 | ||
| 9 | 忙 | 忙 | 208 | 忙 | 忙 | 忙 | ||
| 10 | 忙 | 忙 | 忙 | 216 | 忙 | 忙 | ||
| 11 | 忙 | 忙 | 忙 | 忙 | 224 | 忙 | ||
| 12 | 忙 | 忙 | 忙 | 忙 | 忙 | 232 | ||
| 13 | 忙 | 忙 | 忙 | 忙 | 忙 | 240 | ||
| 14 | 忙 | 忙 | 忙 | 忙 | 忙 | 248 | ||
| 15 | 256 | 忙 | 忙 | 忙 | 忙 | 忙 | ||
| 16 | 忙 | 264 | 忙 | 忙 | 忙 | 忙 |
真实存储体的时序通常分为访问延迟和存储体周期时间(也称存储体忙时)两个部分。访问延迟,是地址到达存储体之后,直到存储体返回数据值的时间;忙时则是存储体被一个请求占用的时间。访问延迟会增加从存储器读取向量的启动开销。总存储器延迟还包括地址和数据在 CPU 与存储体之间穿过流水化互连网络的时间。存储体忙时决定存储系统的有效带宽,因为在该忙时结束之前,处理器不能向同一存储体发出第二个请求。
前例使用的简单非流水化 SRAM 存储体,访问延迟与忙时大致相同。对于流水化 SRAM 存储体,访问延迟大于忙时,因为每个元素的访问只占用存储体流水线的一个阶段。对于 DRAM 存储体,访问延迟通常短于忙时,因为 DRAM 在破坏性读取后,需要额外时间恢复读出的值。对于支持同时进行多次向量访问,或允许向量加载、存储采用非顺序访问的存储系统,存储体数应大于最低要求,否则就会发生存储体冲突。
如果步长与存储体数互质,并且存储体数量足以避免单位步长访问发生冲突,那么单条向量访存指令内部就不会发生存储体冲突。
在没有存储体冲突时,多字步长与单位步长的访问速率相同。如果存储体数超过避免步长为 1 时发生停顿所需的最低数量,就能降低某些其他步长下的停顿频率。例如,64 个存储体配合步长 32 时,每隔一次访问才停顿一次,而非每次访问都停顿。若原来步长为 8、存储体数为 16,则每隔一次访问停顿一次;改用 64 个存储体后,步长 8 每八次访问才停顿一次。多个存储器流水线和/或多个处理器共享同一存储系统时,也需要更多存储体来避免冲突。即使只有一条存储器流水线,前一条指令的最后几个元素与后一条指令的最初几个元素之间,也可能在单位步长访问中发生存储体冲突;增加存储体数可以降低此类指令间冲突的概率。2011 年,大多数向量超级计算机已将每个 CPU 的访问分散到数百个存储体。非单位步长访问仍可能出现存储体冲突,因此程序员通常尽量选择单位步长访问。
译注: 上段给出的停顿频率还取决于存储体忙时,原文没有为这些步长示例另行说明忙时条件。例如,若继续采用前例的 6 周期忙时,64 个存储体、步长 8 会循环访问 8 个不同存储体,单条连续访存序列不必每八次停顿一次。
现代超级计算机可能有数十个 CPU,每个 CPU 又有多条存储器流水线,连接到数千个存储体。为每一条流水线与每一个存储体分别提供专用通路并不现实,因此通常采用多级交换网络将两者连接起来。当不同向量访问争用同一网络通路时,交换网络可能发生拥塞,使存储系统出现额外停顿。
G.4 提高向量性能
本节将在第 4 章的基础上,更深入地介绍提高向量处理器性能的技术。
深入探讨向量链接
早期的向量链接实现类似转发,但这会限制链接中源指令和目的指令的执行时序。较新的实现采用灵活链接(flexible chaining):只要不产生结构冒险,一条向量指令基本上可以与任何其他正在执行的向量指令链接。灵活链接要求不同向量指令同时访问同一个向量寄存器。可以通过增加读写端口实现,也可以像存储系统那样,把向量寄存器堆组织为交错存储体。本附录余下部分都假定采用这种链接方式。
即使两个操作互相依赖,链接仍允许它们在向量的不同元素上并行推进。因此,可以将它们调度到同一编队,减少所需的 chime 数。对前述指令序列,即使操作之间有依赖,仍可达到每周期持续执行两次浮点运算的速率(忽略启动时间),也就是一个 chime!整个序列的运行时间变为:
图 G.8 给出向量长度为 64 时,这两条向量指令采用链接和不采用链接的时序。该编队只需一个 chime;但由于使用链接,实际编队执行时间中仍会显现启动开销。图中链接执行共需 77 个时钟周期,即每个结果 1.2 个周期。其间完成 128 次浮点运算,所以达到每时钟周期 1.7 次浮点运算。不采用链接时需要 141 个周期,即每时钟周期 0.9 次浮点运算。
图内术语:Unchained=不链接;Chained=链接;Total=总周期数。原图分别给出 141 与 77 个周期。
虽然链接能将两条有依赖的指令放入同一编队,减少执行时间中的 chime 部分,却不能消除启动开销。要准确估计运行时间,就必须同时计算编队内部和编队之间的启动时间。采用链接时,一个序列的 chime 数取决于处理器中不同向量功能单元的数量,以及应用对它们的需求。尤其要注意,任何编队都不能包含结构冒险。例如,在 VMIPS 这样只有一个向量加载—存储单元的处理器上,含两条向量访存指令的序列至少需要两个编队,也就是两个 chime。
链接如此重要,以至于每种现代向量处理器都支持灵活链接。
深入探讨稀疏矩阵
第 4 章介绍了让稀疏矩阵程序以向量方式执行的技术。先简要回顾一下:稀疏矩阵中的向量元素通常以某种紧凑形式保存,再通过间接寻址访问。对于一种简化的稀疏表示,代码可能如下:
这段代码对数组 A、C 执行稀疏向量求和,使用索引向量 K、M 指定 A、C 中的非零元素。A 和 C 必须有相同数量的非零元素,即各有 个。另一种常见的稀疏矩阵表示,用位向量标记哪些元素存在,再用一个稠密向量保存非零元素。同一程序中往往会同时使用两种表示。许多程序都会遇到稀疏矩阵;具体实现方式很多,取决于程序采用的数据结构。
简单的向量化编译器不能自动向量化上述代码,因为它不知道 K 中各元素的值互不相同,因而也不知道不存在依赖。程序员需要通过编译指示,告诉编译器可以按向量方式执行该循环。
更先进的向量化编译器,可以插入运行时数据依赖检查,不依赖程序员注释便自动完成向量化。检查采用高级加载地址表(ALAT)的向量化软件实现;ALAT 硬件是附录 H 所述 Itanium 处理器的一项机制。这里用软件哈希表替代相联 ALAT 硬件,检测同一次 strip-mining 迭代中的两个元素访问是否指向同一地址。若未发现依赖,该次迭代就可以按最大向量长度完成;若检测到依赖,则将向量长度调小,使所有依赖约束都不被违反,剩余元素留给下一次 strip-mining 迭代。这个方案确实会增加相当多的软件开销,但在通常没有依赖的情况下,这些额外操作大多也能向量化。因此,循环仍远快于标量代码,不过比程序员提供编译指示时慢得多。
许多较新的超级计算机都具有散布—聚集功能。这些操作实现更复杂,也更容易遇到存储体冲突,因此通常比固定步长访问慢;但它们仍远快于可能采用的另一种实现,即标量循环。矩阵的稀疏性特征若有变化,就必须重新计算索引向量。许多处理器提供快速计算索引向量的支持。VMIPS 的 CVI(create vector index,创建向量索引)指令,根据给定步长 生成索引向量,其元素为 。有些处理器提供生成压缩索引向量的指令,只生成对应于掩码寄存器中 1 所在位置的条目;另一些向量体系结构则提供压缩向量的方法。在 VMIPS 中,我们把 CVI 定义为始终依据向量掩码生成压缩索引向量。掩码全为 1 时,就生成普通索引向量。
索引加载—存储与 CVI 指令,还提供了另一种支持条件向量执行的方法。先回顾第 4 章的代码:
下面的向量指令序列使用 CVI 实现这个循环:
译注: 原书在这里给出的高级语言代码是 DAXPY:
Y(i)=a*X(i)+Y(i);紧接着的汇编却按A(i)≠0筛选元素,并计算A(i)=A(i)-B(i),两段代码并不对应。下文条件的比较符号在原页中排印异常;前面的SNEVS.D注释和后文“非零”共同表明其含义为A(i)≠0。
散布—聚集实现是否优于条件执行实现,取决于条件成立的频率与各操作的开销。忽略链接时,原版本的运行时间为 。第二个版本采用索引加载与存储,假设每周期处理一个元素,则运行时间为 ,其中 是条件成立的元素比例,即 A(i)≠0 的比例。假定 、 大致相当,或远小于 ,即可求出第二种方法何时更好:
希望 ,因此:
也就是说,非零元素不足四分之一时,第二种方法更快。许多情况下,实际执行条件内操作的频率远低于这个比例。如果索引向量可以重用,或者 if 内向量语句的数量增多,散布—聚集方法的优势还会显著扩大。
G.5 编译器向量化的效果
两个因素决定程序能在多大程度上以向量方式执行。第一个是程序自身的结构:循环是否存在真数据依赖?能否通过重构消除这些依赖?它取决于所选算法,也在一定程度上取决于代码的写法。第二个是编译器的能力。对于迭代之间完全不存在并行性的循环,没有编译器能够将其向量化;但在判断循环究竟能否向量化这方面,不同编译器的能力差异极大。向量化采用的技术,与第 3 章为发掘指令级并行性而讨论的技术相同;这里仅回顾这些技术的实际效果。
不同编译器的程序向量化效果差异很大。图 G.9 可以作为向量化编译器能力的一个概览:它用包含 100 个手写 FORTRAN 内核的测试集,展示不同处理器上的向量化程度。这些内核专门用于测试向量化能力,都能手工向量化;习题中还会出现其中一些循环。
| 处理器 | 编译器 | 完全向量化 | 部分向量化 | 未向量化 |
|---|---|---|---|---|
| CDC CYBER 205 | VAST-2 V2.21 | 62 | 5 | 33 |
| Convex C-series | FC5.0 | 69 | 5 | 26 |
| Cray X-MP | CFT77 V3.0 | 69 | 3 | 28 |
| Cray X-MP | CFT V1.15 | 50 | 1 | 49 |
| Cray-2 | CFT2 V3.1a | 27 | 1 | 72 |
| ETA-10 | FTN 77 V1.0 | 62 | 7 | 31 |
| Hitachi S810/820 | FORT77/HAP V20-2B | 67 | 4 | 29 |
| IBM 3090/VF | VS FORTRAN V2.4 | 52 | 4 | 44 |
| NEC SX/2 | FORTRAN77 / SX V.040 | 66 | 5 | 29 |
G.6 融会贯通:向量处理器的性能
本节考察向量处理器的性能指标,以及这些指标能够反映哪些处理器特征。要确定处理器执行一个向量问题的性能,必须同时考虑启动开销与持续执行速率。报告向量处理器执行某个循环的性能时,最简单、也最好的方法,是给出该向量循环的执行时间。不过,人们往往以 MFLOPS——每秒百万次浮点运算——而非执行时间来表示向量循环性能。我们用 表示处理长度为 的向量时达到的 MFLOPS。只要浮点运算次数的计算口径一致,用 (时间)或 (速率)衡量就是等价的。无论采用哪一种,都应计入开销。
本节从不同角度分析 VMIPS 执行 DAXPY 循环(见第 4 章)的性能。我们仍使用 G.2 节建立的公式计算向量循环执行时间,同时考察如何根据算出的时间,以不同方式衡量性能。本节对 采用常数,会引入少量误差,这里忽略不计。
向量性能的度量
向量长度对处理器性能影响很大,因此除了时间与 MFLOPS,还经常采用与长度有关的指标。这些指标在不同处理器之间往往相差很大,值得比较。不过请记住,比较两台处理器的相对速度时,最终关心的始终是时间。三个最重要的长度相关指标是:
- :无限长向量的 MFLOPS。它可以用于估计峰值性能,但实际问题的向量长度有限,所承受的开销代价更大。
- :达到 一半所需的向量长度。这是衡量开销影响的良好指标。
- :使向量方式快于标量方式所需的向量长度。它既反映开销,也反映标量与向量的相对速度。
下面看看 VMIPS 执行 DAXPY 问题时的这些指标。采用链接时,DAXPY 内循环可以组织为图 G.10 所示的编队,假定 Rx 和 Ry 保存起始地址。
| 访存指令 | 链接的运算指令 | 编队 |
|---|---|---|
LV V1,Rx | MULVS.D V2,V1,F0 | 编队 1:链接执行加载和乘法 |
LV V3,Ry | ADDV.D V4,V2,V3 | 编队 2:链接执行第二次加载和加法 |
SV Ry,V4 | 编队 3:存储结果 |
回顾包含 个元素的向量循环执行时间公式:
链接使循环能够在 3 个 chime 中完成;由于只有一条存储器流水线,不能再少,因此 。如果 足以完整反映性能,那么循环的浮点运算速率就应为时钟频率的 ,因为每次迭代执行两次浮点运算。仅根据 chime 数,不计 strip-mining 和启动开销时,500 MHz 的 VMIPS 可达到 333 MFLOPS。
有几种办法可以继续提高性能:增加向量加载—存储单元;允许编队重叠,以降低启动开销的影响;通过向量寄存器分配减少所需加载次数。本节考察前两项扩展。最后一项优化确实用于与 VMIPS 颇为接近的 Cray-1,使性能提高了 50%。减少加载次数需要过程间优化,习题 G.6 将讨论这种变换。分析前两项扩展之前,先来看看计入开销后的实际性能。
VMIPS 执行 DAXPY 的峰值性能
首先要确定真正的峰值性能 ,因为它必然不同于理想的 333 MFLOPS。暂时仍采用简化假设:只有前一编队中的全部指令完成,后一编队才能开始;后面再取消这一限制。在该假设下,向量序列的启动开销就是各条指令启动时间之和:
在性能公式中代入 、、、,并假设 不是 64 的整数倍,可得处理 个元素的时间:
实际持续执行时,每次迭代需要超过 4 个时钟周期,而不是忽略开销时理论上的 3 个 chime。差异主要来自每 64 个元素的启动开销:启动需要 49 个周期,循环控制开销则为 15 个周期。
对于 500 MHz 时钟,现在可以计算 :
分子与 无关,因此:
不计启动开销、仅由向量功能单元结构决定的峰值性能,是这个结果的 1.33 倍。实际上,这项基准测试中峰值性能与持续性能的差距还会更大!
VMIPS 在 Linpack 基准测试上的持续性能
Linpack 基准测试对一个 矩阵执行高斯消元。因此,向量长度从 99 逐渐减至 1;长度为 的向量会使用 次。所以,平均向量长度为:
现在可以用长度为 66 的向量,较准确地估计 DAXPY 的性能:
忽略启动开销的峰值数值,是按实际向量长度估计的持续性能的 1.64 倍。实际上,Linpack 还有相当一部分代码不能向量化。虽然在向量化之前,这部分代码占执行时间不到 20%,但以浮点运算速率计,它的性能不到向量代码的十分之一。因此,根据 Amdahl 定律,整体性能会明显低于只分析内循环得到的估计。
由于向量长度显著影响性能,比较向量机时常使用 和 。
例题 对 500 MHz 的 VMIPS,如果只考虑 DAXPY 内循环, 是多少?
解答 把 作为峰值速率,需要求出达到约 125 MFLOPS 的向量长度。假定测量处理 个元素,从 MFLOPS 公式出发:
化简,并假设 ,此时执行时间为 ,得到:
因此 :在 VMIPS 上,长度为 13 的向量就能使 DAXPY 循环达到约一半的峰值性能。
例题 使向量操作快于标量操作的向量长度 是多少?
解答 同样知道 。标量方式执行一次迭代的时间,可估为 个周期。其中 10 是循环控制开销的估计,比 strip-mining 循环的开销稍小。上一题已经得到,在 时,这个循环以向量方式运行需要 个时钟周期。因此:
对 DAXPY 循环,只要向量至少有两个元素,向量方式就快于标量方式。这个门槛低得令人意外。
增强版 VMIPS 的 DAXPY 性能
DAXPY 和许多向量问题一样,受存储器限制。因此,增加访存流水线可以提高性能。这正是 Cray X-MP 及其后继处理器与 Cray-1 的主要体系结构差异。Cray X-MP 有三条存储器流水线,而 Cray-1 只有一条;X-MP 的链接也更加灵活。这会怎样影响性能?
例题 如果为 VMIPS 再增加两条存储器流水线,DAXPY 的 会是多少?
解答 有三条存储器流水线时,所有指令都能放入同一编队,只需一个 chime。启动开销不变,因此:
三条存储器流水线将持续执行所需周期数从 326 降至 194,带来约 1.7 倍的加速。注意 Amdahl 定律的影响:按 chime 数衡量的理论峰值速率提高至原来的 3 倍,但整体持续性能只提高至原来的 1.7 倍。
另一项改进是允许不同编队重叠,并让标量循环控制操作与向量指令重叠。这要求在前一向量操作尚未完成时,后一操作就可以开始使用功能单元,因此指令发射逻辑会更加复杂。这种重叠可以消除第一个编队之外各编队单独产生的启动开销,并隐藏循环控制开销。
要尽可能隐藏 strip-mining 开销,就需要让不同分段的循环实例重叠,使同一编队的两个实例,以及可能存在的两组标量代码同时执行。这需要使用第 3 章所述避免 WAR 冒险的技术;不过,由于不允许对同一个向量元素进行重叠读写,因此可以避免复制。这项技术称为 tailgating,Cray-2 曾使用过它。另一种办法是像第 3 章那样,展开外层循环,用不同寄存器组创建多个向量指令序列实例,前提是寄存器足够多。
让编队和标量循环控制操作尽可能重叠后,每个向量序列只会显现一次启动与循环开销,不再取决于编队数或各编队的指令数。这样,采用向量寄存器的处理器既能在短向量上获得较低的启动开销,也能在很长的向量上达到较高峰值性能。
例题 若为 VMIPS 再增加两条存储器流水线,并允许 strip-mining 与启动开销完全重叠,DAXPY 的 和 分别是多少?
解答
由于开销只显现一次,。于是:
增加访存流水线、采用更灵活的发射逻辑,使峰值性能达到原来的 4 倍。不过,,所以对较短向量,持续性能约提高至原来的 倍。
本节考察了几种向量性能指标。只根据 ,就能计算理论峰值性能:
计入循环开销后,可以计算无限长向量的峰值性能 ,以及长度为 的向量的持续性能 :
还可以据此求出 和 ,从另一角度观察向量启动开销,以及向量方式与标量方式的速度比。采用多种向量处理器性能指标,有助于理解应用实际可能获得的性能范围。
G.7 现代向量超级计算机:Cray X1
Cray X1 于 2002 年推出,与 NEC SX/8 一起代表了当时现代向量超级计算机的先进水平。X1 的系统体系结构支持数千个强大的向量处理器共享同一个全局存储器空间。
图 G.11 展示了 Cray X1 独特的处理器体系结构。一个大型多流处理器(Multi-Streaming Processor,MSP)由四个单流处理器(Single-Streaming Processor,SSP)组合而成。每个 SSP 都是一颗单芯片向量处理器,包含一个标量单元、标量缓存和一个双通道向量单元。标量单元是一颗双发射、乱序执行的超标量处理器,具有 16 KB 指令缓存和 16 KB 标量直写数据缓存;两者均为两路组相联,缓存行大小为 32 字节。向量单元包含向量寄存器堆、三个算术单元和一个加载—存储单元。与超标量指令发射机制相比,向量功能单元更容易采用深流水线,因此向量单元的运行频率为 800 MHz,而标量部分为 400 MHz。每条向量通道每周期都能执行一次 64 位浮点加法和一次 64 位浮点乘法,使每个 MSP 的峰值性能达到 12.8 GFLOPS。
早期 Cray 的 ISA 可以追溯到 1976 年的 Cray-1,分别为地址、标量和向量提供八个寄存器。X1 的 ISA 则从头重新设计,吸收了近 30 年编译器与微体系结构研究的经验。它具有 64 个 64 位标量地址寄存器、64 个 64 位标量数据寄存器、32 个每元素 64 位的向量数据寄存器,以及八个每元素 1 位的向量掩码寄存器。寄存器数量大幅增加,使编译器能够将更多程序变量映射到寄存器中,减少访存流量;也有利于代码的静态调度,提高运行时指令执行的重叠程度。早期 Cray 使用紧凑的变长指令集,而 X1 的 ISA 采用定长指令,以简化超标量取指和译码。
图内术语:MSP=多流处理器;SSP=单流处理器;Superscalar unit=超标量单元;Vector unit=向量单元;Ecache=外部缓存,每片为 0.5 MB。
四颗 SSP 芯片与四颗缓存芯片一起封装在一个多芯片模块中;后者构成四个 SSP 共享的 2 MB 外部缓存(Ecache)。Ecache 为两路组相联,缓存行大小为 32 字节,采用写回策略。它可以缓存向量,从而减少具有时间局部性的代码所产生的访存流量。ISA 还提供不在缓存中分配空间的向量加载、存储指令变体,避免已知局部性很差的数据污染 Ecache。Ecache 的带宽足以在每个 800 MHz 时钟周期,为每条通道提供一个 64 位字,即每个 MSP 超过 50 GB/s。
X1 封装层次的下一级如图 G.12 所示:四个 MSP、16 颗存储器控制器芯片和 DRAM 放在同一块印制电路板上,构成一个 X1 节点。每颗存储器控制器芯片有八个独立的 Rambus DRAM 通道,每通道提供 1.6 GB/s 存储器带宽。节点共有 128 个存储器通道,主存总带宽超过 200 GB/s。
一个 X1 系统最多可包含 1024 个节点,即 4096 个 MSP 或 16,384 个 SSP;节点间通过带宽极高的全局网络连接。网络连接经由存储器控制器芯片实现,任一处理器都可以使用加载、存储指令直接访问系统内的全部存储器。与基于集群的系统所采用的消息传递协议相比,这提供了快得多的全局通信。在如此多的高带宽共享内存节点之间维护缓存一致性,是一项挑战。X1 的做法是限制每个 Ecache 只能缓存本地节点 DRAM 中的数据。存储器控制器采用目录方案,维护节点内四个 Ecache 之间的一致性。远程节点访问某个存储位置时,可以获得其最新值;远程存储操作则先使本地 Ecache 中的相应副本失效,再更新存储器。不过,远程节点不能缓存这些本地存储位置的数据。
图内术语:mem=存储器;IO=输入/输出;51 GFLOPS 表示每秒 510 亿次浮点运算,200 GB/sec 表示每秒 200 GB。P、S、M 沿用原图模块缩写;原图注没有分别展开其名称,此处不推造定义。
面对长延迟的缓存未命中和全局通信,向量加载、存储尤其有用,因为相对简单的向量硬件便能生成并跟踪大量尚未完成的访存请求。当时的超标量微处理器仅支持 8~16 个尚未完成的缓存未命中,而每个 MSP 处理器最多可以支持 2048 个未完成访存请求,即每个 SSP 512 个。为作弥补,超标量微处理器逐渐采用更大的缓存行——128 字节及以上——以便每次未命中都取回更多数据;但在对大型数据集进行非单位步长访问时,这会造成大量带宽浪费。X1 在各处都采用较短的 32 字节缓存行来减少浪费,并依靠支持大量相互独立的缓存未命中来维持存储器带宽。这样的延迟容忍能力,加上面向非单位步长访问的巨大存储器带宽,解释了为何某些代码在向量机上的执行速度远高于超标量微处理器。
多流处理器
Cray 首先在 SV1 中引入 Multi-Streaming 概念,随后在 X1 中作了大幅增强。MSP 内的四个 SSP 共享 Ecache,硬件支持这四个 SSP 之间的屏障同步。每个 X1 SSP 具有一个双通道向量单元和 32 个向量寄存器,每个寄存器容纳 64 个元素。对于如何使用一个 MSP 中的 SSP,编译器有多种选择。
最简单的方式,是把四个双通道 SSP 组合起来,模拟一个八通道向量处理器。X1 为节点内的 SSP 提供高效的屏障同步原语,编译器负责生成 MSP 代码。例如,对于一个遍历 1000 个元素、可以向量化的内循环,编译器将第 0~249 次迭代分配给 SSP0,第 250~499 次分配给 SSP1,第 500~749 次分配给 SSP2,第 750~999 次分配给 SSP3。各 SSP 可以独立处理自己的迭代,但进入下一组嵌套循环之前,必须与其他 SSP 同步。
如果内循环的迭代次数不多,八通道 MSP 的效率就会很低:每个 SSP 只能处理少量元素,启动时间和同步开销将主导执行时间。另一种用法是由编译器在外循环层面进行并行化,让各 SSP 处理不同的内循环。例如,下面的嵌套循环将矩阵的上三角部分乘以一个常数:
考虑 MAX_ROWS 和 MAX_COLS 均为 100 的情况。随着外循环迭代,内循环的向量长度从 100 逐步减至 1。即使第一次执行内循环,其长度也远低于八通道 MSP 的最大向量长度 256,因此代码效率较低。编译器也可以把整个内循环分配给单个 SSP。例如,SSP0 处理第 0、4、8 等行,SSP1 处理第 1、5、9 等行。这样,各 SSP 所看到的向量都会更长。这种方式实际上把标量开销也并行化了,利用了各 SSP 内独立的标量单元。
大多数应用代码采用 MSP,但如果向量并行性有限而线程级并行性丰富,也可以将代码编译为把所有 SSP 都用作独立处理器的形式。
Cray X1E
2004 年,Cray 宣布对最初的 X1 设计进行升级。X1E 采用较新的制造工艺,能在一颗芯片上放置两个 SSP,因而成为第一款多核向量微处理器。每个物理节点现在包含八个 MSP,但组织成两个各含四个 MSP 的逻辑节点,以保持与 X1 相同的编程模型。此外,标量和向量时钟频率分别从 400 MHz、800 MHz 提升到 565 MHz、1130 MHz,峰值性能提高至 18 GFLOPS。
G.8 结束语
20 世纪 80 年代和 90 年代,流水线标量处理器的性能迅速提升,使传统向量超级计算机与高速、流水线化的超标量 VLSI 微处理器之间的差距显著缩小。到 2011 年,花不到 1000 美元就可以买到一台笔记本电脑,其 CPU 时钟频率高于当时任何在售的向量超级计算机,后者中有些售价高达数千万美元。虽然向量超级计算机的时钟频率较低,但它们利用多通道支持更高程度的并行——日本的设计最多达到 16 条通道——而超标量微处理器的多发射能力相对有限。尽管如此,低成本微处理器与领先向量超级计算机 CPU 的峰值浮点性能差距,已缩小到两倍以内。当然,高时钟频率和高峰值性能未必能转化为应用的持续性能。主存带宽是向量超级计算机与超标量微处理器系统之间最关键的区别。
提供如此大的非单位步长存储器带宽,是向量超级计算机的主要成本之一。传统上,向量超级计算机使用 SRAM 作为主存,以减少所需的存储体数量,并降低向量启动代价。SRAM 的访问时间虽然只有 DRAM 的几分之一,但每位成本约为后者的 10 倍!为了降低主存成本、获得更大容量,现代向量超级计算机都已改用 DRAM,并利用同步 DRAM 等新型高带宽 DRAM 接口。
将 DRAM 用作主存——Seymour Cray 在 Cray-2 中率先采用这一做法——说明向量超级计算机如何利用通用商品技术来改善性价比。另一个例子是引入向量数据缓存。不过,缓存并不适用于所有向量代码,因此这些向量缓存必须能够在大量缓存未命中存在时,仍保持很高的主存带宽。例如,Cray X1 MSP 可以有 2048 个尚未完成的存储器加载;而微处理器中,每个 CPU 同时存在的缓存未命中数,典型上限为 8~16 个。
还有一个例子,是双极型 ECL 或砷化镓不再是超级计算机 CPU 逻辑的首选技术。桌面计算机的成功使 CMOS 技术获得巨额投入,因此,与这些较为特殊的技术相比,CMOS 现已提供具有竞争力的晶体管性能,同时具有高得多的晶体管密度和低得多的功耗。于是,领先的向量超级计算机都采用了与超标量微处理器相同的 CMOS 技术。向量超级计算机的时钟频率低于通用微处理器,主要是因为它们为了降低工程设计成本,采用标准单元 ASIC 技术开发,而非全定制电路设计。一款微处理器可以销售数千万颗,以庞大销量摊薄设计成本;一款向量超级计算机只要能卖出一百多台,就算成功了!
反过来,超标量微处理器也开始吸收早期向量计算机推广的一些技术,多媒体 SIMD 扩展就是一例。正如第 4 章所示,为提高 SIMD 性能而投入的硬件资源正在迅速增长,甚至可能超过对多处理器的投入。如果 GPU 中更宽的 SIMD 单元能够与标量核紧密集成,并支持 scatter-gather,那么我们或许会得出结论:向量体系结构赢得了这场体系结构之战!
G.9 历史回顾与参考文献
本节补充第 4 章历史回顾中未展开的一些细节和参考文献。
CDC STAR 处理器及其后继 CYBER 205 都是存储器—存储器型向量处理器。为了简化硬件,同时满足很高的带宽要求——每次浮点运算最多需要三次访存——这些处理器不能高效处理非单位步长访问。虽然多数循环采用单位步长,但非单位步长循环在这些处理器上的性能很差,因为必须在存储器之间移动数据,才能将不相邻的向量元素收集到一起,随后再分散回去;这些操作使用专门的 scatter-gather 指令。此外,处理器还为稀疏向量提供专门支持:用一个位向量标示零元素和非零元素的位置,并用一个稠密向量保存非零值。由于存储器延迟很长,这些较复杂的向量操作速度较慢;对于稀疏或非单位步长操作,采用标量方式往往更快。Schneck [1987] 介绍了从早期流水线处理器(例如 Stretch)到第一代向量处理器的发展,其中包括 205 和 Cray-1。Dongarra [1986] 也作了很好的综述,重点是较新的处理器。
20 世纪 80 年代还出现了规模较小的向量处理器,称为小型超级计算机(minisupercomputer)。它们的价格约为超级计算机的十分之一:50 万~100 万美元,而后者为 500 万~1000 万美元,因此很快流行起来。虽然许多公司进入了这一市场,但最成功的是 Convex 和 Alliant。Convex 最初推出单处理器 C-1 向量机,随后提供一系列小型多处理器系统,最后一款是 1994 年宣布的 C-4。这段时期 Convex 成功的关键,在于重视 Cray 软件兼容能力、编译器的有效性(见图 G.9),以及 UNIX 操作系统实现的质量。C-4 是 Convex 销售的最后一款向量机;此后,该公司转向使用 Hewlett-Packard 的 RISC 微处理器构建大型多处理器系统,并于 1995 年被 HP 收购。Alliant [1987] 更重视多处理器方面,构建了一台八处理器计算机,每个处理器都具有向量能力。Alliant 于 20 世纪 90 年代初停止运营。
20 世纪 80 年代初,CDC 分拆出一个名为 ETA 的团队,开发性能达 10 GFLOPS 的新型超级计算机 ETA-10。ETA 处理器于 80 年代末交付(见 Fazio [1987]),采用低温 CMOS,最多可配置 10 个处理器。每个处理器都沿用基于 CYBER 205 的存储器—存储器体系结构。虽然 ETA-10 的峰值性能极高,但标量速度并未达到相应水平。1989 年,作为第一家超级计算机厂商的 CDC 关闭了 ETA,并退出超级计算机设计业务。
1986 年,IBM 推出 System/370 向量体系结构(见 Moore 等人 [1987]),以及它的首个实现 3090 Vector Facility。这一体系结构在 System/370 的基础上增加了 171 条向量指令。3090/VF 集成在 3090 CPU 内。与当时多数向量处理器不同,3090/VF 的向量数据经过缓存。IBM 370 系列此后不断演进,后来称为 IBM zSeries。向量扩展已从该体系结构中移除,一部分操作码空间被重新用于实现 64 位地址扩展。
1989 年末,Cray Research 分为两家公司,双方都致力于开发可在 90 年代初推出的高端处理器。Seymour Cray 领导其中分拆出来的 Cray Computer Corporation,直到该公司于 1995 年倒闭。其首款处理器 Cray-3 原计划采用砷化镓实现,但公司未能开发出可靠且具有成本效益的实现技术。1993 年,一台 Cray-3 原型机交付美国国家大气研究中心(NCAR)作评估之用,但该设计没有找到付费客户。公司申请破产时,原计划成为首款 1 GHz 处理器的 Cray-4 原型机已接近完成。1996 年因车祸不幸去世前不久,Seymour Cray 又创办了 SRC Computers,开发高性能系统,不过这一次采用通用商品组件。2000 年,SRC 宣布推出 SRC-6 系统,结合了 512 颗 Intel 微处理器、50 亿门可重构逻辑,以及一个高性能的向量式存储器系统。
Cray Research 则专注于 C90。这款新的高端机器最多具有 16 个处理器,时钟频率为 240 MHz,于 1991 年交付。J90 是采用 CMOS 和 DRAM 主存的向量机,起价 25 万美元,但典型配置约为 100 万美元。原书记载,1995 年年中,Cray Research 被 Silicon Graphics 收购;1998 年,该公司推出 SV1 系统,将速度显著更高的 CMOS 处理器接入 J90 存储器系统,并为各 CPU 增加向量数据缓存,以帮助满足增长的存储器带宽需求。SV1 还引入了 MSP 概念:通过组合多个较慢的 CPU,获得具有竞争力的单 CPU 性能。2000 年,Silicon Graphics 将 Cray Research 出售给 Tera Computer,合并后的公司更名为 Cray Inc。
现代向量化编译器技术的基础,以及数据依赖这一概念,由伊利诺伊大学的 Kuck 及其同事 [1974] 建立。Banerjee [1979] 提出了以他命名的检验方法。Padua 和 Wolfe [1986] 对向量化编译器技术作了很好的概述。
Lubeck、Moore 和 Mendez [1985]、Bucher [1983] 以及 Jordan [1987],都开展过不同超级计算机的基准测试研究,并尝试理解性能差异。有若干面向科学计算的基准测试套件,经常用于超级计算机性能评测,其中包括 Linpack 和 Lawrence Livermore Laboratories FORTRAN kernels。伊利诺伊大学协调收集了一组超级计算机基准测试,称为 Perfect Club。1993 年,Perfect Club 并入 SPEC;后者于 1996 年发布面向高端科学计算的 SPEChpc96 基准测试套件。NASA Ames Research Center 开发的 NAS parallel benchmarks [Bailey 等人 1991],已成为广泛用于超级计算机评估的一组计算内核和应用程序。后来又出现了 HPC Challenge 基准测试套件:除浮点性能外,其中的若干计算内核还着重考察存储器和互连带宽 [Luszczek 等人 2005]。虽然标准超级计算机基准测试可以粗略衡量机器能力,但在采购大型超级计算机之前,通常仍会根据客户现场实际需要运行的应用组合,进行细致的性能评估。
习题
以下习题均假设 VMIPS 时钟频率为 500 MHz,且 。采用图 G.2 中的启动时间,并假设运行时间始终包含存储延迟。
习题 G.1
[10]〈G.1、G.2〉 编写一段达到处理器峰值 MFLOPS 的 VMIPS 向量指令序列,使用 G.2 节的功能单元和指令说明。假设时钟频率为 500 MHz,峰值 MFLOPS 是多少?
习题 G.2
[20/15/15]〈G.1–G.6〉 考虑下面这段在 500 MHz VMIPS 上执行的向量代码,向量长度固定为 64:
忽略所有 strip-mining 开销,但假设执行循环所需时间必须包含存储延迟。整个指令序列产生 64 个结果。
a. [20]〈G.1–G.4〉 假定不采用链接,且只有一条存储器流水线,需要多少个 chime?计入启动开销后,这段向量序列每个结果需要多少时钟周期?将两次存储合计为一个结果。
b. [15]〈G.1–G.4〉 如果采用链接,计入开销后,这段序列每个结果需要多少时钟周期?
c. [15]〈G.1–G.6〉 假设 VMIPS 有三条存储器流水线,并支持链接。如果上述循环的访存不存在存储体冲突,这段序列每个结果需要多少时钟周期?
习题 G.3
[20/20/15/15/20/20/20]〈G.2–G.6〉 考虑以下 FORTRAN 代码:
本题始终采用 G.6 节的方法估算性能,假设 VMIPS 的时钟频率为 500 MHz。
a. [20]〈G.2–G.6〉 为循环的内部部分编写最佳的 VMIPS 向量代码。假设 x 存放在 F0 中,A 和 B 的地址分别存放在 Ra、Rb 中。
b. [20]〈G.2–G.6〉 求循环在 VMIPS 上的总执行时间 。它的 MFLOPS 性能 是多少?
c. [15]〈G.2–G.6〉 求该循环的 。
d. [15]〈G.2–G.6〉 求该循环的 。
e. [20]〈G.2–G.6〉 求该循环的 。假设标量代码已经过流水线调度,每次访存需要六个周期,每次浮点运算需要三个周期;标量开销也为 。
f. [20]〈G.2–G.6〉 假设 VMIPS 有两条存储器流水线。编写能利用第二条存储器流水线的向量代码,并给出编队划分。
g. [20]〈G.2–G.6〉 计算两条存储器流水线的 VMIPS 所对应的 和 。
习题 G.4
[20/10]〈G.2〉 假设某个 VMIPS 版本有八个存储体,每个存储体宽一个双字,存储器访问时间为八个周期。
a. [20]〈G.2〉 如果以 20 个双字为步长,执行长度为 64 的向量加载,完成加载需要多少周期?
b. [10]〈G.2〉 对 64 个元素的加载,步长为 20 时所达到的存储器带宽,是步长为 1 时的百分之多少?
习题 G.5
[12/12]〈G.5–G.6〉 考虑以下循环:
a. [12]〈G.5–G.6〉 将它拆成两个循环:一个没有依赖,另一个存在依赖。以源到源变换的方式,用 FORTRAN 写出这两个循环。这种优化称为循环分裂(loop fission)。
b. [12]〈G.5–G.6〉 为没有依赖的循环编写 VMIPS 向量代码。
习题 G.6
[20/15/20/20]〈G.5–G.6〉 Cray-1 设计于 1976 年;1989 年,一款更好的编译器使它运行编译后 Linpack 的性能几乎翻倍。下面用一个简单例子探究这种提升如何发生。考虑一个类似 DAXPY 的循环,其中 k 是包含该循环的过程的参数:
a. [20]〈G.5–G.6〉 只针对内循环,直接用 VMIPS 向量指令写出相应代码序列。
b. [15]〈G.5–G.6〉 用 G.6 节的方法,求以时钟周期计的 ,估算代码在 VMIPS 上的性能。可以假定外循环每次迭代都会产生 的开销。什么因素限制了性能?
c. [20]〈G.5–G.6〉 改写 VMIPS 代码,减轻这一性能限制;用 VMIPS 向量指令给出新的内循环。提示:想一想什么决定了 ,能否改变它?求新序列的总执行时间。
d. [20]〈G.5–G.6〉 用 G.6 节的方法求 ,估算新版本的性能。
习题 G.7
[15/15/25]〈G.4〉 考虑以下代码:
假设 A 和 B 的地址分别存放在 Ra、Rb 中,F0 保存 0。
a. [15]〈G.4〉 利用向量掩码功能,为该循环编写 VMIPS 代码。
b. [15]〈G.4〉 利用 scatter-gather,为该循环编写 VMIPS 代码。
c. [25]〈G.4〉 假设除法延迟为 20 个周期,估算这两个向量循环的性能,即以时钟周期计的 。假设所有向量指令每周期产生一个结果,不受向量掩码寄存器设置的影响。假设 B 中 50% 的元素为 0。如果上述循环具有代表性,考虑硬件成本后,你会构建哪一种实现?
译注:原书循环上限为 64,c 小问却要求 ,两者不一致。原代码也未列出
end if,不在译文中补成可编译程序。
习题 G.8
[15/20/15/15]〈G.1–G.6〉 峰值性能与持续性能可能相差很大。对于一个问题,Hitachi S810 的峰值速度是 Cray X-MP 的两倍;但对于另一个更接近实际的问题,Cray X-MP 的速度却是 Hitachi 处理器的两倍。下面用两个版本的 VMIPS 及以下代码序列,分析这种现象的原因:
假设有一个 VMIPS 版本,称为 VMIPS-II,每种浮点功能单元均配有两套,且各单元之间完全支持链接。假设 VMIPS 和 VMIPS-II 都有两个加载—存储单元。由于增加了功能单元,操作到单元的分配也更加复杂,VMIPS-II 的全部开销—— 与 ——均加倍。
a. [15]〈G.1–G.6〉 求代码序列 1 在 VMIPS 上的时钟周期数。
b. [20]〈G.1–G.6〉 求代码序列 1 在 VMIPS-II 上的时钟周期数,并与 VMIPS 比较。
c. [15]〈G.1–G.6〉 求代码序列 2 在 VMIPS 上的时钟周期数。
d. [15]〈G.1–G.6〉 求代码序列 2 在 VMIPS-II 上的时钟周期数,并与 VMIPS 比较。
习题 G.9
[20]〈G.5〉 下面这段涉及二维数组的代码有些棘手。循环中是否存在依赖?能否将这些循环写成可并行执行的形式?如果可以,应如何改写?若能向量化,请改写源代码,使这一点清楚地体现出来。
习题 G.10
[12/15]〈G.5〉 考虑以下循环:
a. [12]〈G.5〉 说明这段代码中存在循环携带依赖。
b. [15]〈G.5〉 用 FORTRAN 改写代码,使其可以向量化为两个独立的向量指令序列。
习题 G.11
[15/25/25]〈G.5〉 如 G.5 节所述,有些循环结构不容易向量化。一种常见结构是归约(reduction):反复应用某个运算,将一个数组归并为一个值的循环。这是递推的一种特殊情况。点积是常见的例子:
该循环显然存在围绕 dot 的循环携带依赖,无法直接向量化。一个好的向量化编译器首先会拆分循环,将可以向量化的部分与递推部分分离,可能改写为:
变量 dot 被扩展为一个向量;这一变换称为标量扩展(scalar expansion)。可以完全依靠编译器来尝试向量化第二个循环,见 a 小问;也可以借助硬件支持,见 b 小问。利用向量技术进行归约时,有一个重要限制:这要求归约所用的运算满足结合律。然而,由于舍入和有限的数值范围,浮点运算并不严格满足结合律。因此,大多数编译器要求程序员明确指出,是否允许利用结合律来更高效地编译归约操作。
a. [15]〈G.5〉 编译含有递推的循环时,一种简单方案是依次对越来越短的向量相加:先对两个 32 元素向量相加,再对两个 16 元素向量相加,依此类推。这种技术称为 recursive doubling,比全部以标量方式运算更快。请给出用 recursive doubling 执行上述第二个循环的 FORTRAN 代码。
b. [25]〈G.5〉 在某些向量处理器中,向量寄存器可以按元素寻址,而且一次向量操作的两个操作数可以来自同一向量寄存器的不同部分。这允许采用另一种归约方案,称为部分和(partial sums)。其核心思想是将向量归约为 个和,其中 是通过向量功能单元的总延迟,包括操作数读写时间。假设 VMIPS 向量寄存器可以按元素寻址,例如可用 V1(16) 作为操作数发起向量操作,表示输入操作数从元素 16 开始。另假设加法总延迟(包括操作数读写)为八个周期。编写一段 VMIPS 代码,将 V1 的内容归约为八个部分和;一次向量操作即可完成。
c. [25]〈G.5〉 讨论加入 b 小问中的扩展,会如何影响一台具有多条通道的机器。
习题 G.12
[40]〈G.3–G.4〉 将 MIPS 模拟器扩展为 VMIPS 模拟器,并加入时钟周期计数功能。用 MIPS 和 VMIPS 汇编语言编写一些简短的基准测试程序,测量 VMIPS 上的加速比、向量化比例和功能单元使用情况。
习题 G.13
[50]〈G.5〉 修改 MIPS 编译器,加入依赖检查器。让它处理一些科学计算代码和循环,测量可以向量化的语句比例。
习题 G.14
[讨论] 一些向量处理器的支持者可能认为,向量处理器专注于提升峰值向量性能,为持续增强处理能力提供了最佳路径。另一些人则会认为,强调峰值性能的方向有误,因为越来越多程序的性能由非向量部分主导——还记得 Amdahl 定律吗?支持者会回应说,程序员应努力让程序能够向量化。你如何看待这一争论?
参考文献
- Alliant Computer Systems Corp, 1987. Alliant FX/Series: Product Summary(Alliant FX 系列:产品概要). Mass, Acton (June).
- Asanovic, K., 1998. Vector microprocessors(向量微处理器). Ph.D. thesis, Computer Science Division, University of California at Berkeley (May).
- Bailey, D.H., Barszcz, E., Barton, J.T., Browning, D.S., Carter, R.L., Dagum, L., Fatoohi, R.A., Frederickson, P.O., Lasinski, T.A., Schreiber, R.S., Simon, H.D., Venkatakrishnan, V., Weeratunga, S.K., 1991. The NAS parallel benchmarks(NAS 并行基准测试). Int’l. J. Supercomputing Applications 5, 63–73.
- Banerjee, U., 1979. Speedup of ordinary programs(普通程序的加速). Ph.D. thesis, Department of Computer Science, University of Illinois at Urbana-Champaign (October).
- Baskett, F., Keller, T.W., 1977. An Evaluation of the Cray-1 Processor(Cray-1 处理器评估). In: Kuck, D.J., Lawrie, D.H., Sameh, A.H. (Eds.), High Speed Computer and Algorithm Organization. Academic Press, San Diego, pp. 71–84.
- Brandt, M., Brooks, J., Cahir, M., Hewitt, T., Lopez-Pineda, E., Sandness, D., 2000. The Benchmarker’s Guide for Cray SV1 Systems(Cray SV1 系统基准测试指南). Cray Inc., Seattle, Wash.
- Bucher, I.Y., 1983. The computational speed of supercomputers(超级计算机的计算速度). In: Proc. ACM SIGMETRICS Conf. on Measurement and Modeling of Computer Systems, August 29–31, 1983, Minneapolis, Minn, pp. 151–165.
- Callahan, D., Dongarra, J., Levine, D., 1988. Vectorizing compilers: A test suite and results(向量化编译器:测试套件与结果). In: Supercomputing ’88: Proceedings of the 1988 ACM/IEEE Conference on Supercomputing, November 12–17, pp. 98–105. Orlando, FL.
- Chen, S., 1983. Large-scale and high-speed multiprocessor system for scientific applications(面向科学应用的大规模高速多处理器系统). In: Hwang, K. (Ed.), Superprocessors: Design and applications. Proc. NATO Advanced Research Workshop on High-Speed Computing, June 20–22, 1983, Julich, Kernforschungsanlage, Federal Republic of Germany, IEEE (August), 1984.
- Dongarra, J.J., 1986. A survey of high performance processors(高性能处理器综述). COMPCON, IEEE 8–11 (March).
- Dunnigan, T.H., Vetter, J.S., White III, J.B., Worley, P.H., 2005. Performance evaluation of the Cray X1 distributed shared-memory architecture(Cray X1 分布式共享存储体系结构的性能评估). IEEE Micro 25 (1 (January–February)), 30–40.
- Fazio, D., 1987. It’s really much more fun building a supercomputer than it is simply inventing one(真正造出一台超级计算机,比仅仅发明它有趣得多). COMPCON, IEEE 102–105 (February).
- Flynn, M.J., 1966. Very high-speed computing systems(超高速计算系统). In: Proc. IEEE 54:12 (December), pp. 1901–1909.
- Hintz, R.G., Tate, D.P., 1972. Control data STAR-100 processor design(Control Data STAR-100 处理器设计). COMPCON, IEEE 1–4 (September).
- Jordan, K.E., 1987. Performance comparison of large-scale scientific processors: Scalar mainframes, mainframes with vector facilities, and supercomputers(大型科学计算处理器的性能比较:标量大型机、配备向量部件的大型机与超级计算机). Computer 20 (3 (March)), 10–23.
- Kitagawa, K., Tagaya, S., Hagihara, Y., Kanoh, Y., 2003. A hardware overview of SX-6 and SX-7 supercomputer(SX-6 与 SX-7 超级计算机硬件概述). NEC Research & Development J 44 (1 (January)), 2–7.
- Kuck, D., Budnik, P.P., Chen, S.-C., Lawrie, D.H., Towle, R.A., Strebendt, R.E., Davis Jr., E.W., Han, J., Kraska, P.W., Muraoka, Y., 1974. Measurements of parallelism in ordinary FORTRAN programs(普通 FORTRAN 程序并行性的测量). Computer 7 (1 (January)), 37–46.
- Lincoln, N.R., 1982. Technology and design trade offs in the creation of a modern supercomputer(构建现代超级计算机时的技术与设计权衡). IEEE Trans. on Computers 363–376. C-31:5 (May).
- Lubeck, O., Moore, J., Mendez, R., 1985. A benchmark comparison of three supercomputers: Fujitsu VP-200, Hitachi S810/20, and Cray X-MP/2(三种超级计算机的基准测试比较:Fujitsu VP-200、Hitachi S810/20 与 Cray X-MP/2). Computer 18 (1 (January)), 10–29.
- Luszczek, P., Dongarra, J.J., Koester, D., Rabenseifner, R., Lucas, B., Kepner, J., McCalpin, J., Bailey, D., Takahashi, D., 2005. Introduction to the HPC challenge benchmark suite(HPC Challenge 基准测试套件简介). Lawrence Berkeley National Laboratory, Paper LBNL-57493 (April 25). 原书链接.
- Miranker, G.S., Rubenstein, J., Sanguinetti, J., 1988. Squeezing a Cray-class supercomputer into a single-user package(将 Cray 级超级计算机装进单用户系统). COMPCON, IEEE 452–456 (March).
- Miura, K., Uchida, K., 1983. FACOM vector processing system: VP100/200(FACOM 向量处理系统:VP100/200). In: Proc. NATO Advanced Research Workshop on High-Speed Computing. June 20–22, 1983, Julich, Kernforschungsanlage, Federal Republic of Germany; also in K. Hwang, ed., Superprocessors: Design and applications, IEEE (August), 1984, 59–73.
- Moore, B., Padegs, A., Smith, R., Bucholz, W., 1987. Concepts of the System/370 vector architecture(System/370 向量体系结构的概念). In: Proc. 14th Int’l. Symposium on Computer Architecture, June 3–6, 1987, Pittsburgh, Penn, pp. 282–292.
- Padua, D., Wolfe, M., 1986. Advanced compiler optimizations for supercomputers(面向超级计算机的高级编译优化). Comm. ACM 29 (12 (December)), 1184–1201.
- Russell, R.M., 1978. The Cray-1 processor system(Cray-1 处理器系统). Comm. of the ACM 21 (1 (January)), 63–72.
- Schneck, P.B., 1987. Superprocessor Architecture(超级处理器体系结构). Kluwer Academic Publishers, Norwell, Mass.
- Smith, B.J., 1981. Architecture and applications of the HEP multiprocessor system(HEP 多处理器系统的体系结构与应用). Real-Time Signal Processing IV 298, 241–248. August.
- Sporer, M., Moss, F.H., Mathais, C.J., 1988. An introduction to the architecture of the Stellar Graphics supercomputer(Stellar Graphics 超级计算机体系结构简介). COMPCON, IEEE 464 (March).
- Tanqueray, D., 2002. The Cray X1 and supercomputer road map(Cray X1 与超级计算机路线图). In: Proc. 13th Daresbury Machine Evaluation Workshop, December 11–12, Cheshire, England.
- Vajapeyam, S., 1991. Instruction-level characterization of the Cray Y-MP processor(Cray Y-MP 处理器的指令级特征分析). Ph.D. thesis, Computer Sciences Department, University of Wisconsin-Madison.
- Watanabe, T., 1987. Architecture and performance of the NEC supercomputer SX system(NEC SX 超级计算机系统的体系结构与性能). Parallel Computing 5, 247–255.
- Watson, W.J., 1972. The TI ASC—a highly modular and flexible super processor architecture(TI ASC:高度模块化且灵活的超级处理器体系结构). In: Proc. AFIPS Fall Joint Computer Conf, pp. 221–228.
H VLIW 与 EPIC 的硬件和软件
EPIC 方法以投入大量资源为基础:相比超标量处理器,它需要更多的加载—存储单元、计算单元和分支单元,也需要容量更大、延迟更低的缓存。因此,IA-64 的赌注在于:未来功耗不会成为关键限制;大量资源及其利用机制,也不会因对时钟速度、执行路径长度或 CPI 的不利影响而损害性能。
——M. Hopkins,关于 EPIC 方法与 IA-64 体系结构的评论(2000)
H.1 引言:静态开发指令级并行性
本附录讨论如何利用编译技术,增加程序中可开发的并行性,以及支持这些技术的硬件。下一节定义什么样的循环可以并行,依赖如何妨碍循环并行,以及如何消除某些依赖。再下一节讨论通过代码调度提高并行性。这两节是相关技术的入门。
我们不打算详述面向 ILP 的编译技术,因为那需要数百页,而不是这里分配的约 20 页。这里提供的是一般背景,使读者能基本理解现代计算机用来开发 ILP 的编译技术。
硬件支持可以大大提高这些编译技术的效果,H.4、H.5 节将讨论这种支持。IA-64 集中了静态开发并行性的编译与硬件思想,支持研究人员在十余年基于编译器的指令级并行研究中提出的许多概念。H.6 节介绍 Intel IA-64 体系结构及其第二代实现 Itanium 2,并分析性能。
静态方法所用的核心思想——寻找并行性、减少控制与数据依赖、采用推测执行——与第 3 章动态方法的思想相同。主要区别在于,本附录的方法由编译器在编译时应用,而不是由硬件在运行时应用。编译时技术主要有两项优点:不在运行时引入相应处理开销;能考虑比运行时方法通常所能覆盖的更大程序范围。下一节的例子就说明,编译器可以判断整个循环能够并行执行,而硬件不一定能发现这类并行性。
静态方法的主要缺点是只能利用编译时信息。没有运行时信息,就往往必须保守地假定最坏情况。
H.2 检测并增强循环级并行性
循环级并行性通常在源代码层面或接近源代码的层面分析;大部分 ILP 分析则在编译器已生成指令后进行。循环级分析需要确定:跨越同一循环的不同迭代时,操作数之间存在哪些依赖。
现在只考虑数据依赖,即某个操作数先被写入,随后又被读取。名称依赖也存在,可以用第 3 章讨论的重命名技术消除。
循环级并行性分析的重点是:后续迭代的数据访问,是否依赖更早迭代产生的数据值。这种依赖称为循环携带依赖(loop-carried dependence)。3.2 节的大多数例子没有这种依赖,因此具有循环级并行性。先看一个源代码层面的并行循环:
这里对 x[i] 的两次使用存在依赖,但都在同一次迭代内,因而不是循环携带的。不同迭代中对 i 的连续使用确实具有循环携带依赖,但它涉及归纳变量,容易识别和消除。3.2 节在展开循环时已展示如何消除归纳变量依赖,本节后面还有其他例子。
发现循环级并行性,需要识别循环、数组访问和归纳变量计算等结构。因此,相比机器代码层面,在源代码或接近源代码的层面进行分析,编译器会容易得多。下面看一个复杂些的例子。
例题
考虑如下循环:
假定 A、B、C 是不同且不重叠的数组。实际中,数组有时可能相同或重叠;如果它们作为参数传入包含该循环的过程,判断这一点通常需要复杂的过程间分析。循环中 S1、S2 之间存在哪些数据依赖?
解答
有两种不同的依赖:
- S1 使用 S1 在前一次迭代计算出的值:迭代
i计算A[i+1],迭代i+1读取它。S2 对B[i]、B[i+1]也有同样的关系。 - S2 使用同一次迭代中 S1 计算出的
A[i+1]。
这两种依赖不同,影响也不同。分别假定只存在其中一种,就能看出区别。
S1 依赖此前迭代的 S1,因此它是循环携带依赖,会迫使循环的连续迭代串行执行。
第二种依赖——S2 依赖 S1——发生在同一次迭代内,不由循环携带。如果只有这种依赖,只要保持每次迭代内两条语句的顺序,多次迭代就可以并行。3.2 节有这样的例子,循环展开能够暴露其并行性。
也可能存在不妨碍并行化的循环携带依赖,如下例所示。
例题
考虑如下循环:
S1、S2 之间有什么依赖?这个循环能否并行?如果目前不能,说明如何将其改写为并行循环。
解答
S1 使用前一次迭代中 S2 赋予的值,因此 S2 到 S1 有循环携带依赖。尽管如此,循环仍可并行化。与上例不同,这里的依赖不构成环:两条语句都不依赖自身,而且虽然 S1 依赖 S2,S2 却不依赖 S1。若循环能改写为依赖关系中没有环的形式,就可以并行;因为无环意味着依赖只对语句规定了一个偏序。
原循环的依赖关系并不成环,但仍须变换,使其符合这一偏序并暴露并行性。两个观察很关键:
- 不存在 S1 到 S2 的依赖,否则就形成依赖环,循环无法并行。既然没有这项依赖,交换两条语句不会影响 S2 的执行。
- 第一次迭代中,S1 依赖的是循环开始之前就已计算好的
B[1]。
因此可将原循环替换为:
两条语句之间的依赖不再由循环携带,因此只要保持每次迭代内的语句顺序,不同迭代就可以重叠。
分析首先要找出所有循环携带依赖。但这种依赖信息并不精确:它通常只告诉我们依赖可能存在。考虑:
第二次访问 A 不必翻译成加载指令,因为该值刚由前一条语句计算并存储。可以直接引用保存计算结果的寄存器。进行这种优化,必须知道两次访问始终指向同一地址,且中间没有对该位置的其他访问。普通数据依赖分析只说明一次访问可能依赖另一次;要证明两次访问必定是完全相同的地址,需要更复杂的分析。这里,两次访问位于同一基本块,简单版本的分析就足够了。
循环携带依赖常表现为递推(recurrence):
递推是指某个变量的定义依赖此前迭代中的变量值,通常就是上一次迭代,如上例。识别递推有两个重要原因:某些体系结构,特别是向量计算机,对递推执行有专门支持;某些递推也能提供相当数量的并行性。看下面的循环:
在迭代 i 中,循环访问元素 i-5,称其依赖距离为 5。许多有循环携带依赖的循环,其依赖距离为 1。距离越大,展开循环可获得的潜在并行性越多。展开第一个距离为 1 的循环,连续语句仍然相互依赖;单条机器指令之间虽还有一些并行性,但不多。展开距离为 5 的循环,则会得到五条互不依赖的语句,因此 ILP 多得多。虽然距离为 1 的情形很常见,较大距离也会出现,并可能提供足够并行性,使处理器持续忙碌。
寻找依赖
发现程序依赖,是做好三项工作的重要组成部分:有效调度代码、确定哪些循环具有并行性,以及消除名称依赖。困难来自 C、C++ 等语言中的数组和指针,以及 FORTRAN 的引用传参。标量变量显式引用名字,通常容易分析;但指针和引用参数引入的别名,会带来复杂性与不确定性。
编译器一般如何检测依赖?几乎所有依赖分析算法都假定数组下标是仿射的。最简单地说,如果一维数组下标可写为 ,其中 是常量、 是循环索引变量,就称其为仿射下标。多维数组如果每一维下标都是仿射的,整个下标也是仿射的。稀疏数组中常见的 x[y[i]] 是非仿射访问的主要例子之一。
因此,判断一个循环中对同一数组的两次访问是否依赖,等价于判断:在循环界限内,对不同索引取值,两个仿射函数能否相等。例如,设存储访问下标为 ,加载访问同一数组的下标为 ,循环索引 从 到 。若满足以下两个条件,就存在依赖:
- 存在两个都在循环范围内的迭代索引 ,即 、。
- 循环先写下标 的元素,随后按下标 读取同一元素,即 。
一般不能在编译时确定依赖是否存在。例如, 的值可能未知,甚至来自其他数组;这时无法作出判断。另一些情形虽可在编译时判定,检测代价却很高,例如访问取决于多重嵌套循环的迭代索引。不过,许多程序主要使用简单下标, 都是常量,这时可以设计开销合理的编译时依赖测试。
一种能充分证明依赖不存在的简单方法是最大公约数测试(GCD test)。它依据这样一个事实:若存在循环携带依赖, 必须整除 。所谓整数 整除整数 ,就是 的商为整数且无余数。
例题
用 GCD 测试判断下面的循环是否存在依赖:
解答
这里 ,所以 ,而 。2 不能整除 −3,因此不可能存在依赖。
GCD 测试可以充分保证不存在依赖;但满足整除条件,也不一定实际存在依赖。例如,该测试没有考虑循环边界。
一般而言,确定依赖是否实际存在是 NP 完全问题。不过,常见情形中有许多可以低成本地精确分析。采用一组适用范围和代价逐步增加的精确测试,已经证明既准确又高效。“精确”意味着测试能确切判断依赖是否存在;虽然一般情形为 NP 完全问题,对受限情形仍有便宜得多的精确测试。
除了发现依赖,编译器还希望对其分类,以识别名称依赖,并在编译时通过重命名和复制消除它们。
例题
下面的循环包含多种依赖。找出全部真依赖、输出依赖和反依赖,并通过重命名消除输出依赖与反依赖。
解答
四条语句之间有以下依赖:
- 因
Y[i],S1 到 S3、S1 到 S4 存在真依赖。它们不由循环携带,因此不妨碍循环并行,但要求 S3、S4 等待 S1 完成。 - 因
X[i],S1 到 S2 存在反依赖。 - 因
Y[i],S3 到 S4 存在反依赖。 - 因
Y[i],S1 到 S4 存在输出依赖。
下面的改写消除了这些伪依赖:
循环之后,变量 X 已重命名为 X1;后续代码中,编译器可以直接把 X 替换为 X1。这里不必真的复制数据,通过名字替换或寄存器分配即可实现重命名。但另一些情况下,重命名确实需要复制操作。
依赖分析是开发并行性的关键技术。在指令层面,它提供调度时交换访存操作、判断循环展开收益所需的信息;在循环层面,它是检测并行性的基本工具。有效地把程序编译到向量计算机或多处理器,都极为依赖它。
主要局限是,数组依赖分析只适用于受限情况:访问须在同一个循环嵌套中,并使用仿射下标。许多情形下,它无法告诉我们想知道的信息,例如:
- 通过指针而不是数组下标访问对象,下文还将讨论。
- 通过另一个数组间接索引;许多稀疏数组表示都如此。
- 某些输入值可能造成依赖,但实际运行中的输入从不取这些值,因此实际没有依赖。
- 优化不仅要知道依赖是否可能存在,还要知道某次读取究竟依赖这个变量的哪一次写入。
处理指针程序需要另一类分析,通常称为指向分析(points-to analysis),参见 Wilson 与 Lam[1995]。其核心问题是:两个指针能否指向同一地址?对于复杂的动态数据结构,这极难回答。例如,要判断程序某一点上的两个指针是否可能指向同一链表节点,一般不可判定,实际也很难分析。但可能回答一个较简单的问题:两个指针能否指向同一条链表的节点,即便节点本身不同?这种较受限的分析,对于调度通过指针完成的访存仍很有用。
指向分析的基本方法依赖三类信息:
- 类型信息: 限制指针可以指向什么。
- 对象分配或取地址时的信息: 同样用来限制指向范围。例如,
p始终指向某一源代码行分配的对象,而q从不指向该对象,那么二者不可能指向同一对象。 - 指针赋值信息: 例如,若
p可能被赋为q,那么p就可能指向q能指向的任何对象。
指针分析已在几类情形中成功应用,而且很有用:
- 用指针传递对象地址时,可以确定它可能引用的对象集合。一个重要用途是判断两个指针参数是否可能指向同一对象。
- 指针可能指向几种类型之一时,有时能在程序不同位置确定它所指数据对象的类型。
- 通常能够区分只可能指向局部对象的指针与可能指向全局对象的指针。
有两类限制影响大型程序的精确依赖分析。第一类来自算法适用范围。困难常常不是依赖分析本身不够精确,而是它不适用。例如,程序任意使用指针、对其进行算术运算时,指针依赖分析实际上就几乎无从进行。
第二类是必须跨越过程边界,才能取得准确行为信息。例如,一个过程接收两个指针参数,要判断它们的值是否可能相同,就需要跨过程分析。这称为过程间分析,远比单个过程内部的分析复杂。不同于单个循环嵌套内的数组下标分析,指向分析通常需要过程间分析。原因很简单:若分析某个程序片段时,不知道两个指针在入口处的任何信息,就只能保守假定最坏情况,即它们可能指向同一对象,但又不保证指向同一对象。这种不确定性很可能一路传播,使结果失去用途。
实际程序中,取得完全准确的过程间信息往往代价太高,因此编译器通常采用近似,所得信息又可能太不精确而无法利用。
Java 等强类型现代语言使依赖分析更容易;与此同时,大量使用过程和抽象数据类型组织程序,又增加了难度。不过,随着算法不断改进,以及指针依赖分析越来越重要,我们预期这一重要问题仍会持续取得进展。
消除相互依赖的计算
编译器可以降低相互依赖计算的影响,获得更多 ILP。关键技术是通过回代消除或减少依赖计算;这会增加并行性,有时也会增加计算量。它既可用于基本块内,也可用于循环,下面分别讨论。
在基本块内,可用表达式代数化简,以及消除值复制的复制传播(copy propagation),把以下序列:
简化成:
这里假定 R1 没有其他用途。3.2 节展开循环时合并多次数组索引递增,以及把递增操作移过访存操作,都是这种优化的例子。
上例实际消除了计算,但有时也会为了增加代码并行性而保留、甚至增加操作的数量。这类优化称为树高缩减(tree height reduction):表示计算的树变得更宽、更矮。考虑:
每条指令都依赖紧邻的前一条,至少需三个执行周期。利用结合律,可以改写为:
该序列只需两个执行周期。展开循环时,这类优化机会经常出现。
无限范围、无限精度的算术满足结合律,但计算机算术不一定满足:整数范围有限,浮点数则范围与精度都有限。因此,这种重组有时会导致错误行为,虽然并不常见。出于这一原因,多数编译器要求显式启用依赖结合律的优化。
循环展开后,代数优化对于降低递推依赖的影响很重要。递推表达式在某次迭代中的值,由依赖此前迭代的函数给出。展开含递推的循环后,有时能通过代数优化,使每次展开后的迭代只需计算一次递推。常见形式来自显式语句,例如:
假定把这个循环展开五次,五次迭代的 x 分别为 x1 到 x5,每组展开结束时可写为:
未经优化时,需要五次串行依赖的操作。但可改写为:
这样,最长依赖链只需三个操作。
递推也来自隐式计算,例如数组索引:每个下标都要转换为根据循环索引计算的地址。通过展开与代数优化,同样可以尽量减少这些相互依赖的计算。
译注:本节代码中原书缺失的语句分号,以及重命名例子
for首行缺失的右圆括号,已按完整语法补齐;变量、表达式和循环界限均未改变。
H.3 为并行性调度和组织代码
我们已经看到,循环展开通过生成更长的直线代码序列,有助于发现指令之间的并行性。为此,人们还发展了两项重要技术:软件流水线和踪迹调度。
软件流水线:符号化循环展开
软件流水线(software pipelining)重新组织循环,使新循环的每次迭代都由原循环不同迭代中的指令组成。查看 2.2 节例子中已经调度的展开循环代码,最容易理解这种方法。1 该例的调度器实际上交错排列了不同迭代的指令,从而把同一次迭代内部具有依赖关系的指令隔开。从不同迭代中选择指令,可以使相互依赖的计算之间隔着整个循环体,增加展开后循环在调度时不发生停顿的机会。
软件流水线无需真正展开循环,就能交错安排不同迭代的指令,如图 H.1 所示。这可以看作 Tomasulo 算法硬件机制的软件对应物。前例的软件流水线循环包含一条加载、一条加法和一条存储,分别取自不同迭代。进入循环前还需要一些启动代码,循环完成后也需要收尾代码;为简化讨论,暂时忽略它们。
例题 下面的循环将数组中每个元素加上 F2 的内容,数组起始地址在 R1 中。给出它的软件流水线版本,可以省略启动和收尾代码。
解答 软件流水线对循环进行符号化展开,再从每次迭代中选取指令。由于展开只是符号化的,循环开销指令 DADDUI 和 BNE 不必复制。下列展开后的循环体省去了这些开销指令,并标出各次迭代选中的指令:
图内术语:Iteration=迭代;Software-pipelined iteration=软件流水线中的一次迭代。
把来自不同迭代的选中指令与循环控制指令合在一起,得到:
忽略启动和收尾部分,假定将 DADDUI 调度到 ADD.D 之前,并调整 L.D 的偏移量、把它放入分支延迟槽,这个循环可以达到每 5 个时钟周期产生一个结果。加载与存储的偏移量相差 16,即两次迭代,因此主循环应少运行两次。注意,重复使用 F4、F0、R1 等寄存器,要求硬件避免循环中可能出现的读后写(WAR)冒险。在本例中,应该不会因数据依赖而停顿,因此该冒险不应构成问题。
查看展开版本,就能确定启动和收尾代码。启动时,要执行第 1、2 次迭代中主循环尚未执行的指令,即这两次迭代的 L.D,以及第 1 次迭代的 ADD.D。收尾时,要执行最后两次迭代中尚未执行的指令,包括最后一次迭代的 ADD.D 和最后两次迭代的 S.D。
软件流水线循环的寄存器管理可能很棘手。前例还不太难,因为一次迭代写入的寄存器,在下一次迭代就会读取。在其他情况下,可能需要增加从指令发射到结果被使用之间间隔的迭代数:循环体指令少而延迟大时,就有这种需要。这时必须将软件流水线与循环展开结合起来。
软件流水线可以视为符号化循环展开;事实上,一些软件流水线算法正是利用循环展开算法来确定如何安排流水线。相对于直接展开,软件流水线的主要优点是占用的代码空间更少。二者除了改善内层循环的调度,还分别减少不同类型的开销。循环展开减少分支和计数器更新所构成的循环开销;软件流水线则让循环未以峰值速度运行的阶段只在整个循环的开头和结尾各出现一次。若将一个执行 100 次迭代的循环固定展开 4 次,那么每次启动展开后的内层循环时都要支付启动开销,共支付 (100/4=25) 次。图 H.2 直观展示了这种行为。
两项技术针对的是不同开销,因此结合使用可能得到最佳性能。实践中,采用软件流水线的编译相当困难:许多循环必须经过大量变换才能流水化;流水线循环的开销与效率之间存在复杂权衡;寄存器管理又增加了一层复杂性。IA-64 为软件流水线加入了大量硬件支持,以帮助处理后两类问题。这些硬件可以提高软件流水线的应用效率,却不能省去复杂的编译器支持,也不能免除对循环最佳编译方式的艰难选择。
图内术语:Software pipelining=软件流水线;Loop unrolling=循环展开;Number of overlapped operations=重叠执行的操作数;Time=时间;Start-up code=启动代码;Wind-down code=收尾代码;Proportional to number of unrolls=与展开次数成正比;Overlap between unrolled iterations=展开迭代之间的重叠。
全局代码调度
3.2 节讨论了利用循环展开与代码调度提高 ILP。若循环体是直线代码,这些技术效果很好,因为展开后的循环看起来像一个基本块。同样,若循环体只有一个基本块,就比较容易找到可重复的调度,软件流水线也很有效。但若展开循环的循环体内部还存在控制流,调度就会复杂得多。一般来说,要有效调度这类循环体,必须把指令移过分支,这就是全局代码调度。
本节先讨论全局代码调度的难点和限制。H.4 节讨论消除内层循环内部控制流的硬件支持;这里还将介绍两项在无法消除控制流时可用的编译技术。
全局代码调度的目标,是在保持数据依赖和控制依赖的前提下,把含有内部控制结构的代码片段压缩成尽可能短的序列。数据依赖为操作规定了偏序;控制依赖则限制代码跨越某些指令的移动。数据依赖可通过循环展开来处理;对于存储器操作,还可借助依赖分析,判断两次访问是否指向同一地址。寻找最短代码序列,意味着尽量缩短关键路径,也就是最长的相互依赖指令序列。
循环展开可以减少循环分支造成的控制依赖;全局代码调度则通过代码移动,减弱非循环条件分支造成的控制依赖。代码移过分支,往往会改变其执行频率,因此,要有效利用全局代码移动,就需要估计不同路径的相对执行频率。全局代码移动不能保证代码一定更快,但只要频率信息准确,编译器就能判断这种移动是否可能提高速度。
许多内层循环包含条件语句,因此全局代码移动十分重要。图 H.3 给出一个典型片段,可将其视为展开循环的一次迭代;较常执行的控制流以阴影标出。
图内 T、F 分别表示条件为真、为假;X 是 else 分支中的代码。A(i)、B(i)、C(i) 表示相应数组元素。
要有效调度这段代码,可能需要把对 B、C 的赋值提前到检查 A 之前。这样的全局代码移动必须满足一组约束才合法。另外,移动 B 的代码具有推测性,而移动 C 的代码没有这种性质:只有原本会执行包含 B 的路径时,移动 B 才能加快计算。
要移动 B,必须确保数据流和异常行为都不改变。编译器通常不移动某些可能产生异常的指令,例如存储器访问,以此避免改变异常行为。H.5 节将说明,硬件支持如何增加推测性代码移动的机会,并消除控制依赖。即使增强了推测支持,能够探索更多机会,选择最佳编译方式仍很复杂。
编译器怎样才能确认移动 B、C 的赋值不会影响数据流?考察图 H.3 流程图的一种典型代码生成结果。假设 A、B、C 的地址分别在 R1、R2、R3 中:
先考虑把对 B 的赋值移到 BNEZ 之前。将 if 语句之前最后一条对 B 赋值的指令记为 (i)。若在代码段 X 中或 if 语句之后,B 在再次被赋值前就被引用,将这条引用指令记为 (j)。只要存在这样的 (j),移动 B 的赋值就会改变程序数据流:原先 (j) 依赖于 (i),移动后却会依赖提前执行的 B 赋值。可以设想更复杂的方法,在 B 的旧值仍被使用时也允许移动赋值,例如在 if 之前保存 B 的影子副本,并在 X 中使用该副本。通常会避免这种方法,因为实现复杂,而且一旦选中的踪迹不是最佳路径,额外指令就可能拖慢程序。
把 C 的赋值移到第一个分支之前,需要两步。首先,将赋值越过 else 部分的汇合点,移入 then 部分。这会让计算 C 的指令依赖于分支控制;若走较少执行的 else 路径,它们就不再执行。因此,在这个片段之后执行、且数据依赖于 C 赋值的指令,会受到影响。为了让这些指令得到正确值,必须在 else 路径上复制一份计算 C 并赋值的指令。第二步,如果移动不会影响流入分支条件的数据,就可以将 C 从 then 部分移过条件判断。C 一旦移到 if 检查之前,else 中的副本通常就成为冗余,可以删除。
由此可见,全局代码调度受到许多约束。这也是设计者提供硬件支持、简化此类代码移动的动机;H.4 和 H.5 节将详细讨论。
全局代码调度还要通过复杂权衡来决定是否移动代码。例如,假设能够将 B 的赋值移到条件分支之前,必要时在另一分支加入补偿代码,这样就一定更快吗?答案是:有可能!同样,将 C 复制到 if 的两个分支,最初只会使代码变大;只有编译器最终成功地把计算移过 if 检查,才可能受益。
在移动 B 的计算及赋值时,编译器必须考虑:
- then 和 else 分支的相对执行频率是多少?若 then 频繁得多,移动可能有益;否则移动的可能性较低,但并非绝无可能。
- 在分支之前执行 B 的计算与赋值,代价是多少?分支之前可能有空闲指令发射槽,可以容纳 B 的指令。从一阶近似看,B 的计算因此可能是“免费的”。
- 移动 B 会怎样改变 then 分支的执行时间?若 B 位于该分支关键路径的起点,收益可能很大。
- B 是否是最值得移到分支之前的片段?与移动 C 或 then 中其他语句相比如何?
- else 分支可能需要的补偿代码,代价是多少?这些代码能否得到有效调度,对执行时间又有何影响?
仅从这份不完整清单,就能看出全局代码调度极其复杂。权衡取决于许多因素,各项全局调度决策又高度相互依赖。甚至最初选择哪些指令作为全局移动候选,也很复杂。
为简化这一过程,人们发展了多种全局代码调度方法。下面简要介绍的两种方法遵循同一原则:让编译器集中处理一个直线代码片段,该片段代表估计最常执行的路径。通过循环展开生成直线代码,而难点当然在条件分支的处理。两种方法都选择并调度最常执行的路径,相当于把控制流“拉直”。
踪迹调度:聚焦关键路径
对于每周期发射许多指令的处理器,若条件执行或谓词执行(见 H.4 节)不适用或不受支持,而单靠循环展开又无法暴露足够的 ILP,踪迹调度就很有用。踪迹调度(trace scheduling)组织全局代码移动的过程,把潜在的代码移动代价转移到较少执行的路径上,从而简化调度。由于指定为低频的路径可能承担大量额外开销,这项技术最适合以下情况:性能剖析信息表明路径之间存在显著频率差异,而且这些信息能够较好地反映程序行为,不太依赖具体输入。当然,这也把它的有效应用限制在某些程序类别中。
踪迹调度分两步。第一步称为踪迹选择:寻找一个很可能执行的基本块序列,把其中的操作合并到更少的指令中;这一序列称为踪迹(trace)。循环分支的跳转概率很高,因此可用循环展开生成长踪迹。另外,静态分支预测也会为其他条件分支选择跳转或不跳转,于是多个基本块串接成直线序列。例如,若图 H.3 是内层循环,阴影路径比其他路径频繁得多,将循环展开四次后,主要踪迹就由阴影部分的四个副本组成,如图 H.4 所示。
选择踪迹后,第二步踪迹压缩(trace compaction)试图将它压缩成少量宽指令。踪迹压缩就是代码调度:尽可能把操作提前,并将其装入尽量少的宽指令或发射包中。
踪迹调度的优点是简化了全局代码移动的决策。它把分支视为进入或离开选定踪迹的跳转,并假定该踪迹是最可能的路径。将代码移过踪迹入口或出口时,通常需要在相应位置加入额外的维护代码。
图内术语:Trace entrance=踪迹入口;Trace exit=踪迹出口;T、F 表示条件为真、为假。
核心假设是:踪迹的执行概率远高于其他路径,因此维护代码的代价不必成为决定因素。只要指令能够移动,而且移动可以加快主要踪迹,就移动它。
踪迹调度已经成功应用于循环密集、性能剖析数据准确的科学代码。但对于行为不易刻画、循环不那么密集的程序,这种方法是否适合仍不清楚。在此类程序中,补偿代码的显著开销可能使踪迹调度失去吸引力;即使可用,编译器要有效使用它也会极其复杂。
超块
踪迹调度的主要缺点之一,是踪迹中间的入口与出口会造成严重复杂性:编译器必须生成并跟踪补偿代码,而且往往难以估计其代价。超块(superblock)的形成过程类似踪迹,但它是一种扩展基本块,只允许一个入口,可以有多个出口。
由于只有一个入口,超块压缩只需考虑跨越出口的代码移动,因此比踪迹压缩容易。在前例中,可以形成只有一个入口的超块,移动 C 便更简单。此外,若循环只有一个基于计数的出口,例如没有提前退出、仅通过终止条件退出的 for 循环,那么得到的超块也只有一个入口和一个出口,调度就更加容易。
怎样构造只有一个入口的超块?方法是使用尾部复制(tail duplication),为踪迹入口之后的部分创建一个独立代码块。在前例中,每次循环展开都会创建一个从超块通往残余循环的出口,残余循环负责余下的迭代。图 H.5 将图 H.3 的片段视为内层循环体,展开四次后给出超块结构。选择了未预测到的路径时,执行便退出超块,之后的迭代由残余循环处理。如果残余循环的预期执行频率仍很高,也可以为它创建超块。
相对于更一般的踪迹生成方法,超块减少了维护与调度的复杂性,但可能导致更大的代码膨胀。与踪迹调度一样,当其他技术(例如 if 转换)失效时,超块调度可能最适合。即便如此,代码复制代价的估计仍可能限制其用途,并且必然增加编译过程的复杂性。
循环展开、软件流水线、踪迹调度和超块调度,都试图增加每周期发射多条指令的处理器能够开发的 ILP。
图内术语:Superblock exit with n=对应 n 值的超块出口;Execute n times=执行 n 次;T、F 分别表示条件为真、为假。四个出口分别将 n 设为 4、3、2、1,交由右侧残余循环处理。
这些技术各自的有效性,以及它们与不同体系结构方法的适配性,是高速处理器研究者和设计者最积极探索的热点之一。
译注:本段原文写作 2.2 节;同节后文将循环展开及调度的相关讨论指向 3.2 节。 ↩︎
H.4 暴露并行性的硬件支持:谓词指令
如果编译时能够较准确地预测分支行为,循环展开、软件流水线和踪迹调度等技术就能增加可用并行性。如果分支行为不明确,仅靠编译器可能无法发现很多 ILP,控制依赖会严重限制可开发的并行性。为克服这些问题,体系结构设计者可以扩展指令集,加入条件指令或谓词指令。它们能够消除分支,将控制依赖转化为数据依赖,从而有望改善性能。这既适用于第 3 章侧重硬件的方法,也适用于本附录侧重软件的方法,因为两类方法都能借助谓词化消除分支。
条件指令的概念很简单:指令引用一个条件,执行时检查该条件。条件为真就正常执行;条件为假,程序继续执行,效果如同该指令是一条空操作。许多较新的体系结构包含某种条件指令。最常见的是条件传送(conditional move):仅当条件为真时,才把值从一个寄存器传送到另一个寄存器。在简单的代码序列中,这类指令能够完全消除分支。
例题 考虑以下代码:
假设 R1、R2、R3 分别保存 A、S、T,给出使用分支和使用条件传送的两种实现。
解答 直接采用分支的实现如下。注意,这里假定采用普通分支,而不是延迟分支。
若条件传送在第三个操作数等于零时才执行传送,则一条指令就够了:
条件指令将原先分支代码中的控制依赖转化为数据依赖。向量计算机也使用这种变换,称为 if 转换(if conversion)。在流水线处理器中,依赖必须解决的位置因此从流水线前部、原先处理分支的位置,后移到流水线末端、写寄存器的位置。
条件传送的一个明显用途是实现绝对值函数 A = abs(B),即 if (B<0) {A=-B;} else {A=B;}。该语句可以用两次条件传送实现,也可用一次无条件传送 A=B 加一次条件传送 A=-B 实现。
上述例子和绝对值函数的编译,都通过条件传送将控制依赖转化为数据依赖,消除分支,并可能改善流水线行为。发射率不断提高,设计者必须在两种选择之间取舍:每周期执行多个分支,或设法消除分支来避免这一要求。每周期处理多个分支十分复杂,因为其中一个分支必然控制依赖于另一个分支。准确预测两个分支的结果、更新预测表、执行正确序列,都很困难;因此,迄今大多数设计者都避免采用每周期执行多个分支的处理器。条件传送和谓词指令能够减轻分支压力。此外,条件传送常常可以消除难以预测的分支,进一步增大潜在收益。
条件传送是条件指令或谓词指令最简单的形式。它适合短序列,却有局限:如果分支保护的是大段代码,为消除分支可能必须引入许多条件传送,效率并不高。
为弥补这一不足,一些体系结构支持完全谓词化(full predication),由谓词控制所有指令的执行。谓词为假时,指令成为空操作。这样可以直接转换依赖于分支的大段代码。例如,循环中的 if-then-else 可以全部转为谓词执行:条件为真时只执行 then 部分,为假时只执行 else 部分。谓词化对全局代码调度尤其有价值,因为它可以消除使指令调度显著复杂化的非循环分支。
谓词指令也能让时间敏感的指令提前推测执行,即使将它直接移到保护分支之前可能引发异常。条件传送也能实现这一目的,但代价更高。
例题 下面是一段双发射超标量处理器的代码。每周期可以发射一条存储器访问和一条 ALU 操作,或者单独发射一条分支。
| 第一个指令槽 | 第二个指令槽 |
|---|---|
LW R1,40(R2) | ADD R3,R4,R5 |
ADD R6,R3,R7 | |
BEQZ R10,L | |
LW R8,0(R10) | |
LW R9,0(R8) |
第二周期的存储器操作槽被浪费了。如果分支不跳转,还会出现数据依赖停顿,因为分支之后第二条 LW 依赖前一条加载。请使用谓词化的 LW 改善这段代码。
解答 将谓词化的字加载称为 LWC,假设第三个操作数非零时才执行加载。紧跟分支的 LW 可以改为 LWC,并提前到第二次发射:
| 第一个指令槽 | 第二个指令槽 |
|---|---|
LW R1,40(R2) | ADD R3,R4,R5 |
LWC R8,0(R10),R10 | ADD R6,R3,R7 |
BEQZ R10,L | |
LW R9,0(R8) |
这样既省去一次指令发射位置,又减少最后一条指令的流水线停顿,执行时间可缩短数个周期。当然,如果编译器对分支的预测错误,这条谓词指令就不产生效果,也不会改善运行时间;因此,这种变换具有推测性。
如果分支后面的序列很短,就可以将整段代码转为谓词执行,并删除分支。
将整个代码段转换为谓词执行,或提前移动一条推测指令并使之谓词化,都会消除控制依赖。正确的代码生成与谓词指令的条件执行,共同保证原先由分支约束的数据流不变。为了保持异常行为,谓词为假时,谓词指令不能产生异常。这一点非常关键:在前例中,若 R10 为零,无条件执行 LW R8,0(R10) 很可能触发保护异常,而这种异常本不应发生。
当然,如果条件满足,即 R10 非零,LW 仍可能触发合法、可恢复的异常,例如缺页;当硬件知道控制条件为真时,就必须处理这种异常。
实现谓词指令的主要难点是决定何时撤销指令。可以在指令发射时撤销,也可以在流水线后部、提交结果或引发异常之前撤销。两种选择各有缺点。如果很早就撤销,控制条件也必须很早确定,否则会因数据冒险而停顿。那些依赖数据、较难预测的分支条件,恰恰是谓词化的候选,因此早期撤销可能增加流水线停顿。正因为这种潜在停顿,现有支持谓词执行或条件传送的设计都不在早期撤销,而是在流水线后部撤销。这意味着被撤销的指令仍会消耗功能单元资源,并可能损害性能。前递等其他流水线实现技术也会与谓词指令相互作用,进一步增加复杂性。
谓词指令或条件指令,对于实现简短的控制流分支、消除部分难预测分支、降低全局代码调度开销,都非常有用。然而,其用途受到几个因素限制:
- 被撤销的谓词指令仍消耗处理器资源。 条件为假的指令至少占用取指资源,在大多数处理器上还占用功能单元执行时间。因此,把指令移过分支并改为条件执行,如果该指令原本不会执行,就会拖慢程序。同理,将依赖控制的代码段谓词化并消除分支,如果该段原本不会执行,也可能使处理器变慢。一个重要例外是:该指令占用的周期原本就会空闲,前面的超标量例子正是如此。跨分支移动指令、或将代码转换为谓词执行,本质上都是对分支结果进行推测。条件指令让这件事更容易,却无法消除猜错时占用的执行时间。在用一条条件传送替换“分支加传送”的简单场景中,条件传送或谓词化几乎总是更好;当较长序列被改为条件执行时,收益就更有限。
- 谓词能够提早求值时最有用。 如果确定条件所需的数据依赖,使条件求值和谓词指令无法分开调度,条件指令就可能因为数据冒险而停顿。
分支预测与推测执行可以避免这种停顿,至少在预测准确时如此。
- 控制流比简单的二选一序列更复杂时,条件指令的使用可能受限。 例如,把指令移过多个分支,需要让它同时受这些分支条件控制;这要求指定两个条件,或者添加指令来计算控制谓词。缺乏这种能力时,if 转换的开销更大,优势也更小。
- 条件指令可能比无条件指令更慢。 代价可能表现为指令所需周期数增加,或整个处理器的时钟频率降低。如果条件指令更昂贵,就必须审慎使用。
因此,许多体系结构包含少数简单条件指令,最常见的是条件传送;只有少数体系结构为大部分指令提供条件版本。MIPS、Alpha、PowerPC、SPARC,以及以 Pentium 处理器定义的 Intel x86,都支持条件传送。IA-64 则支持所有指令的完全谓词化,H.6 节将介绍。
H.5 编译器推测的硬件支持
如第 3 章所述,许多程序的分支可以依据程序结构或性能剖析信息,在编译时准确预测。此时,编译器可能希望通过推测改善调度或提高发射率。谓词指令是一种推测手段,但更适用于通过 if 转换完全消除控制依赖的场景。很多时候,我们希望把推测指令不仅移到分支之前,还移到条件求值之前,而谓词化无法做到这一点。
要积极开展推测,需要三项能力:
- 编译器能找出可以推测性移动、又不影响程序数据流的指令,必要时结合寄存器重命名。
- 在确认异常确实应该发生之前,能够忽略推测指令的异常。
- 能够推测性交换可能存在地址冲突的加载与存储,或两条存储。
第一项是编译器能力,后两项需要硬件支持,下面逐一讨论。
保持异常行为的硬件支持
要积极推测,就必须能够移动任意类型的指令,同时保持其异常行为。关键观察是:如果推测路径预测错误,其结果不会用于最终计算,这些推测指令也就不应触发异常。
研究人员考察过四种方法,使更积极的推测不致引入错误的异常行为:
- 硬件与操作系统协作,忽略推测指令的异常。这能保持正确程序的异常行为,却不能保持错误程序的异常行为。有些程序可能无法接受,不过已有若干处理器把它作为由程序控制的“快速模式”。
- 使用永不触发异常的推测指令,并加入检查,判断异常何时应当发生。
- 推测指令导致异常时,在其写入的结果寄存器上附加称为 poison 位的状态位。普通指令试图使用这样的寄存器时,poison 位触发故障。
- 提供指令推测标记;硬件暂存其结果,直到能够确定该指令不再处于推测状态。
为解释这些方法,必须区分两种异常:一种表示程序错误,通常导致终止,例如存储器保护违规;另一种可以处理并恢复执行,例如缺页。对于推测指令,可恢复异常可以像普通指令一样接收和处理。如果该指令本不该执行,处理多余异常可能损害性能,却不会使执行结果出错。然而,其代价可能很高,因此一些处理器提供硬件支持来避免立即处理这些异常。支持硬件推测的处理器也是如此:可以在推测状态下处理某些异常,而将另一些推迟到确认指令不再是推测执行时处理。
表示程序错误的异常不应出现在正确程序中;除调试模式等情况外,发生这类异常的程序,其结果没有良好定义。如果推测指令引发这类异常,必须等到确认该指令不再处于推测状态,才能真正触发异常。
保持异常行为的最简单方法是:可恢复异常一旦发生,硬件和操作系统就处理它;对于会导致终止的异常,则只返回一个未定义值。如果触发终止类异常的指令并非推测指令,程序本身就是错误的。
注意,这时程序不会终止,而会继续运行,虽然几乎肯定产生错误结果。如果该指令是推测指令,程序仍可能正确,推测结果只是不被使用;因此返回未定义值不会造成伤害。无论推测多么积极,这种方法都不会使原本正确的程序失败。原先可能因异常终止的错误程序,则会得到错误结果。对某些程序而言这是可接受的,前提是编译器还能够生成不作推测、可以正常因异常终止的普通版本。
例题 考虑以下 if-then-else 语句,其中 A 位于 0(R3),B 位于 0(R2):
其代码片段为:
假设几乎总是执行 then 分支,使用编译器推测重新编译这段代码。R14 未被使用,可以分配。
解答 新代码如下:
整个 then 分支都被提前推测执行。临时寄存器避免了加载 B 时破坏 R1;若这次推测加载的结果不需要使用,R14 中的该结果就没有用处。整个片段执行后,A 的值位于 R14。else 分支也可以结合条件传送进行推测,但如果分支高度可预测而且代价低,这样可能更慢,因为会从执行一条分支变为始终执行两条额外指令。
这种方法并不需要知道某条指令是否是推测指令。标明这一点,主要有助于处理错误程序在普通指令上发生终止类异常的情况:如果该指令未标为推测,就可以终止程序。
在这种方法和下一种方法中,通常都需要重命名,以防推测指令破坏仍然存活的值。重命名一般只针对寄存器值;由于这一限制,不能破坏存储指令的目的位置,因此不能推测执行存储。寄存器数量有限,以及寄存器溢出到存储器的开销,会限制推测规模。当然,主要约束仍然是编译器预测错误时执行推测指令的代价。
第二种保持异常行为的方法,引入不产生终止类异常的推测版本指令,以及检查此类异常的指令。两者结合,能够精确保留异常行为。
例题 使用推测加载 sLD 和推测检查指令 SPECCK,改写前例,完全保持异常行为。假定 R14 可用。
解答 代码如下:
注意,推测检查要求保留一个代表 then 分支的基本块。如果只推测了 then 的一部分,这个基本块本来就必须存在。更重要的是,检查潜在异常需要额外代码。
第三种方法跟踪已发生的异常,却把终止类异常推迟到结果真正被使用时才触发。它保留异常的发生,但并非完全精确。方法很简单:为每个寄存器增加一个 poison 位,为每条指令增加一个表示是否推测执行的位。推测指令导致终止类异常时,置位目的寄存器的 poison 位;其他异常立即处理。若推测指令使用了 poison 位为 1 的寄存器,则把其目的寄存器的 poison 位也置为 1。若普通指令试图使用 poison 位为 1 的源寄存器,便触发故障。这样,原本会产生异常的程序仍会产生异常,只是触发点移到了非推测指令第一次使用该结果的位置。poison 位只附于寄存器值,不附于存储器值,因此存储从不推测执行,只要任一操作数带有 poison 标记,就触发陷阱。
例题 考虑原书 H-29 页的代码片段,说明使用推测指令和 poison 位时如何编译,并指出在何处识别推测性存储器访问的异常。假设 R14 可用。
解答 操作码前的 s 表示推测指令:
如果 sLD 引发终止类异常,就置位 R14 的 poison 位。随后非推测存储 SD 执行时,若该位为 1,就触发异常。1
还有一个必须解决的问题:上下文切换时,若 poison 位已置位,操作系统该如何保存用户寄存器?需要专用指令来保存和重置这些位的状态,才能避免此问题。
第四种方法依靠类似重排序缓冲区的硬件机制。编译器把指令标为推测,并指明它被提前移过了多少个分支,以及编译器为每个分支假设的方向——跳转或不跳转。后者实际上告诉硬件,指令原来位于哪个代码块。实践中,只允许跨越一个分支移动,就能得到大部分收益;因此,只需一位表示指令来自跳转路径还是不跳转路径。另一种办法是在推测指令的原位置留下哨兵(sentinel),通知硬件:此前的推测指令现在已不再具有推测性,可以提交结果。
所有指令发射时都进入重排序缓冲区,并强制按序提交,与硬件推测方法相同。不过,这里并没有实际的推测性分支预测或动态调度。缓冲区跟踪指令何时可以提交,并延迟推测指令的“写回”部分。只有该指令越过的分支也准备好提交,或到达对应哨兵时,推测指令才能提交。此时,硬件知道它是否本来就应该执行:如果应该执行且出现终止类异常,就应终止程序;如果本不该执行,就忽略异常。注意,寄存器重命名仍由编译器承担,以确保正确使用推测结果,并保证程序正确执行。
存储器访问推测的硬件支持
通常,只有编译器确信地址不会冲突时,才把加载移过存储。3.2 节的例子已经表明,这类变换对于缩短代码片段的关键路径十分重要。要让编译器在不能完全确认移动正确时也这样做,可以在体系结构中加入检查地址冲突的专用指令。它留在加载的原位置,起到守卫的作用,而加载被提前移过一条或多条存储。
推测加载执行时,硬件保存访问地址。如果在检查指令之前,后续存储修改了该位置,推测就失败;若该位置未被修改,推测便成功。失败有两种处理方式。如果只推测了加载,那么在检查指令处重做加载就够了;检查指令除存储器地址外,还可提供目的寄存器。如果依赖该加载的后续指令也被推测,就需要一段修复代码,从加载开始重新执行所有推测指令。此时,检查指令指定修复代码的地址。
本节介绍了多种硬件辅助机制。它们是有效支持第 3 章和本附录中侧重编译器的方法的关键。此外,其中若干机制也容易融入第 3 章侧重硬件的方法,带来进一步收益。
译注:原书此例的代码使用 sLD、SD,而注释和随后文字混用了 LW、SW。这里按实际代码指令称为“推测加载”和 SD,避免把字加载/存储与双字加载/存储混为一谈。 ↩︎
H.6 Intel IA-64 体系结构与 Itanium 处理器
本节概述 Intel IA-64 体系结构,以及它在 Itanium 处理器中的实现。原书将其视为最先进的 VLIW 风格处理器。
Intel IA-64 指令集体系结构
IA-64 是 RISC 风格的寄存器—寄存器指令集,但包含许多新颖特性,支持编译器开发 ILP。这里着重介绍 IA-64 ISA 的独特之处;其中多数已经在本附录讨论过,包括谓词化、由编译器检测并行性,以及存储器访问推测。
发布 IA-64 时,HP 和 Intel 引入 EPIC(Explicitly Parallel Instruction Computer,显式并行指令计算机)一词,以区别于早期 VLIW 和其他 RISC 体系结构。VLIW 与 EPIC 共享许多特性,但 EPIC 还加入了若干扩展,主要分为两类:
- 更灵活地表示指令间并行性,并提供更灵活的指令格式。 VLIW 依赖固定格式,要求一条宽指令内的所有操作都能并行执行,格式也非常僵硬。EPIC 则显式标示可能存在的指令依赖,并采用多种指令格式。与僵硬的 VLIW 方法相比,EPIC 能更灵活地表达并行性,也能减少不灵活指令格式通常带来的代码膨胀。
- 提供更全面的软件推测支持。 早期 VLIW 方案在这方面的支持很有限。
此外,IA-64 还包含寄存器窗口、可轮转的浮点寄存器(FPR)栈等多种提升性能的特性。
IA-64 寄存器模型
IA-64 的寄存器状态包括:
- 128 个 64 位通用寄存器;稍后会看到,它们实际为 65 位宽。
- 128 个 82 位浮点寄存器,比标准 80 位 IEEE 格式多两位指数。
- 64 个 1 位谓词寄存器。
- 8 个用于间接分支的 64 位分支寄存器。
- 用于系统控制、存储映射、性能计数器,以及与操作系统通信的其他寄存器。
整数寄存器采用寄存器栈机制来加速过程调用,类似 Berkeley RISC-I 中提出、后来用于 SPARC 的机制。0–31 号寄存器始终可访问,并以 0–31 编址;32–128 号寄存器用作寄存器栈,每个过程分配 0–96 个寄存器。1 硬件通过寄存器重命名,为被调用过程创建新的栈帧;一个称为当前帧指针(CFM)的特殊寄存器,指向该过程使用的寄存器集合。栈帧分为局部区和输出区:局部区存放局部数据,输出区向被调用过程传递值。alloc 指令指定这两个区域的大小。只有整数寄存器支持寄存器栈。
发生过程调用时,更新 CFM,使被调用过程的 R32 指向输出区的第一个寄存器。原文在此将输出区也称为“被调用过程”的输出区;随后说明,这样就能把调用者的参数传入被调用者可寻址的寄存器。2 被调用者执行 alloc,分配所需的局部寄存器和用于进一步调用其他过程、传递参数的输出寄存器。
局部寄存器包含调用者的输出寄存器。专用加载和存储指令负责保存及恢复寄存器栈;称为寄存器栈引擎的专用硬件处理栈溢出。
除整数寄存器外,还有浮点、谓词和分支寄存器。浮点寄存器保存浮点数据,分支寄存器保存间接分支的目标地址。谓词寄存器保存控制谓词指令执行的谓词;稍后详述这一机制。
整数和浮点寄存器都为 32–128 号寄存器支持轮转。1 寄存器轮转旨在简化软件流水线循环的寄存器分配,这是 H.3 节讨论过的难题。结合谓词化,还可以避免循环展开,以及独立的序言、尾声代码。这能减少软件流水线引起的代码膨胀,并使它适用于迭代次数较少的循环;在传统方法中,这类循环的额外开销往往抵消许多收益。
指令格式与显式并行支持
IA-64 的设计目标,是获得 VLIW 方法的主要优势——一条指令内操作的隐式并行性,以及操作字段的固定格式——同时保有比通常 VLIW 更大的灵活性。它依赖编译器检测 ILP,把指令调度到并行指令槽;同时增加格式灵活性,并允许编译器标明一条指令不能与其后继指令并行执行。
IA-64 用两个不同概念,兼顾隐式并行性与易于译码。把指令放入指令组(instruction group)来表达隐式并行;用包含三条指令的 bundle 实现多条指令的固定打包格式。先定义指令组。
指令组是一段连续指令序列,其中没有寄存器数据依赖,只有少数例外。只要硬件资源足够,而且保持经由存储器产生的依赖,组内所有指令都可以并行执行。组的长度没有固定限制,但编译器必须显式标出组间边界,即在属于不同组的两条指令之间插入 stop 标记。要解释 stop 如何表示,必须先说明指令怎样放进 bundle。
IA-64 将指令编码为 128 位 bundle。每个 bundle 包含一个 5 位模板字段和三条各 41 位的指令。严格说,这些 41 位单元不能单独算作指令,必须结合模板字段才能解释;有时称之为 syllable。为简便,这里仍称“指令”。为简化译码与发射,模板字段规定 bundle 中每条指令所需的执行单元类型。图 H.6 给出五种槽类型、可容纳的指令类别和例子。
| 执行单元槽 | 指令类型 | 指令说明 | 指令示例 |
|---|---|---|---|
| I-unit | A | 整数 ALU | 加、减、AND、OR、比较 |
| I-unit | I | 非 ALU 整数操作 | 整数和多媒体移位、位测试、传送 |
| M-unit | A | 整数 ALU | 加、减、AND、OR、比较 |
| M-unit | M | 存储器访问 | 整数/浮点寄存器的加载和存储 |
| F-unit | F | 浮点 | 浮点指令 |
| B-unit | B | 分支 | 条件分支、调用、循环分支 |
| L + X | L + X | 扩展 | 扩展立即数、stop 和空操作 |
每个 bundle 的 5 位模板字段,同时描述与该 bundle 关联的 stop,以及其中各条指令需要的执行单元类型。图 H.7 列出模板能编码的格式和 stop 位置。它只能表示所有可能的指令类型与 stop 组合中的一个子集。下面用例子说明。
例题 将数组递增循环 x[i] = x[i] + s 展开七次,并把指令放入 bundle。先忽略流水线延迟,以最小化 bundle 数量;再调度代码,以最小化停顿。假设每周期执行一个 bundle,任何停顿都使整个 bundle 停顿;采用图 3.2 的流水线延迟。为简便,使用 MIPS 助记符。
| 模板值 | 槽 0 | 槽 1 | 槽 2 | stop 位置 |
|---|---|---|---|---|
| 0 | M | I | I | 无 |
| 1 | M | I | I | 槽 2 后 |
| 2 | M | I | I | 槽 1 后 |
| 3 | M | I | I | 槽 1 后、槽 2 后 |
| 4 | M | L | X | 无 |
| 5 | M | L | X | 槽 2 后 |
| 8 | M | M | I | 无 |
| 9 | M | M | I | 槽 2 后 |
| 10 | M | M | I | 槽 0 后 |
| 11 | M | M | I | 槽 0 后、槽 2 后 |
| 12 | M | F | I | 无 |
| 13 | M | F | I | 槽 2 后 |
| 14 | M | M | F | 无 |
| 15 | M | M | F | 槽 2 后 |
| 16 | M | I | B | 无 |
| 17 | M | I | B | 槽 2 后 |
| 18 | M | B | B | 无 |
| 19 | M | B | B | 槽 2 后 |
| 22 | B | B | B | 无 |
| 23 | B | B | B | 槽 2 后 |
| 24 | M | M | B | 无 |
| 25 | M | M | B | 槽 2 后 |
| 28 | M | F | B | 无 |
| 29 | M | F | B | 槽 2 后 |
解答 两个版本见图 H.8。这里的延迟虽与 Itanium 不同,但最常见的 MMF bundle 在 Itanium 中必须独立发射,与本例假定一致。
(a) 使 bundle 数量最少。 每周期至多执行一个 bundle;“末尾 stop”表示槽 2 之后的组边界。
| bundle 模板 | 槽 0 | 槽 1 | 槽 2 | 末尾 stop | 执行周期 |
|---|---|---|---|---|---|
| 9: M M I | L.D F0,0(R1) | L.D F6,-8(R1) | 是 | 1 | |
| 14: M M F | L.D F10,-16(R1) | L.D F14,-24(R1) | ADD.D F4,F0,F2 | 否 | 3 |
| 15: M M F | L.D F18,-32(R1) | L.D F22,-40(R1) | ADD.D F8,F6,F2 | 是 | 4 |
| 15: M M F | L.D F26,-48(R1) | S.D F4,0(R1) | ADD.D F12,F10,F2 | 是 | 6 |
| 15: M M F | S.D F8,-8(R1) | S.D F12,-16(R1) | ADD.D F16,F14,F2 | 是 | 9 |
| 15: M M F | S.D F16,-24(R1) | ADD.D F20,F18,F2 | 是 | 12 | |
| 15: M M F | S.D F20,-32(R1) | ADD.D F24,F22,F2 | 是 | 15 | |
| 15: M M F | S.D F24,-40(R1) | ADD.D F28,F26,F2 | 是 | 18 | |
| 16: M I B | S.D F28,-48(R1) | DADDUI R1,R1,#-56 | BNE R1,R2,Loop | 否 | 21 |
(b) 假定每周期执行一个 bundle,使周期数最少。
| bundle 模板 | 槽 0 | 槽 1 | 槽 2 | 末尾 stop | 执行周期 |
|---|---|---|---|---|---|
| 8: M M I | L.D F0,0(R1) | L.D F6,-8(R1) | 否 | 1 | |
| 9: M M I | L.D F10,-16(R1) | L.D F14,-24(R1) | 是 | 2 | |
| 14: M M F | L.D F18,-32(R1) | L.D F22,-40(R1) | ADD.D F4,F0,F2 | 否 | 3 |
| 14: M M F | L.D F26,-48(R1) | ADD.D F8,F6,F2 | 否 | 4 | |
| 15: M M F | ADD.D F12,F10,F2 | 是 | 5 | ||
| 14: M M F | S.D F4,0(R1) | ADD.D F16,F14,F2 | 否 | 6 | |
| 14: M M F | S.D F8,-8(R1) | ADD.D F20,F18,F2 | 否 | 7 | |
| 15: M M F | S.D F12,-16(R1) | ADD.D F24,F22,F2 | 是 | 8 | |
| 14: M M F | S.D F16,-24(R1) | ADD.D F28,F26,F2 | 否 | 9 | |
| 9: M M I | S.D F20,-32(R1) | S.D F24,-40(R1) | 是 | 11 | |
| 16: M I B | S.D F28,-48(R1) | DADDUI R1,R1,#-56 | BNE R1,R2,Loop | 否 | 12 |
译注:图 H.8 图注把整数加法简称为 DADD,表中实际助记符是 DADDUI。
指令集基础
介绍推测专用支持之前,先简述主要指令编码,并概览五类主要指令 A、I、M、F、B。每条 IA-64 指令长 41 位,高 4 位与 bundle 中指定执行单元槽的位共同构成主操作码。也就是说,4 位操作码在不同执行槽类别中复用,可以把操作码理解为这 4 位加 M、F、I、B 或 L + X 标识。每条指令的低 6 位指定保护该指令的谓词寄存器,下一小节将讨论。
图 H.9 汇总除多媒体指令外的大多数主要格式,并列出各格式编码的指令示例。
| 指令类型 | 该类格式数 | 代表指令 | 额外操作码位 | GPR/FPR 数 | 立即数字段 | 其他/说明 |
|---|---|---|---|---|---|---|
| A | 8 | 加、减、AND、OR | 9 | 3 | 0 位 | |
| A | 左移并相加 | 7 | 3 | 0 位 | 2 位移位计数 | |
| A | ALU 立即数操作 | 9 | 2 | 8 位 | ||
| A | 立即数加法 | 3 | 2 | 14 位 | ||
| A | 立即数加法 | 0 | 2 | 22 位 | ||
| A | 比较 | 4 | 2 | 0 位 | 2 个谓词目的寄存器 | |
| A | 立即数比较 | 3 | 1 | 8 位 | 2 个谓词目的寄存器 | |
| I | 29 | 可变移位量的右移/左移 | 9 | 3 | 0 位 | 许多多媒体指令使用此格式 |
| I | 位测试 | 6 | 3 | 6 位字段指定符 | 2 个谓词目的寄存器 | |
| I | 传送到 BR | 6 | 1 | 9 位分支预测 | 分支寄存器指定符 | |
| M | 46 | 整数/浮点加载、存储及缓存行预取 | 10 | 2 | 0 位 | 推测/非推测 |
| M | 整数/浮点加载、存储、缓存行预取,并按立即数后递增 | 9 | 2 | 8 位 | 推测/非推测 | |
| M | 整数/浮点加载、预取,并按寄存器值后递增 | 10 | 3 | 推测/非推测 | ||
| M | 整数/浮点推测检查 | 3 | 1 | 两字段合计 21 位 | ||
| B | 9 | PC 相对分支、计数分支 | 7 | 0 | 21 位 | |
| B | PC 相对调用 | 4 | 0 | 21 位 | 1 个分支寄存器 | |
| F | 15 | 浮点算术 | 2 | 4 | ||
| F | 浮点比较 | 2 | 2 | 2 个 6 位谓词寄存器字段 | ||
| L + X | 4 | 长立即数传送 | 2 | 1 | 64 位 |
译注:表中保留源书的字段数和空白,包括“22 位立即数、2 个 GPR/FPR”一行;按前文通常的寄存器字段宽度直接相加会出现位数疑点,不能仅凭本表推导准确的机器码布局。
谓词化与推测支持
IA-64 提供全面的谓词化支持:几乎每条指令都可以带谓词。谓词寄存器的编号放在指令字段的低 6 位。由于支持范围很广,if 转换和代码移动的开销,比只支持有限条件指令时更低。完全谓词化带来的一个结果是:条件分支不过是一条带保护谓词的分支!
谓词寄存器通过比较或测试指令设置。比较指令指定十种比较测试之一,以及两个目的谓词寄存器。这两个寄存器可以分别写入比较结果(0 或 1)及其反值,也可以写入组合两个测试的某种逻辑函数,例如 AND,以及其反值。这种能力允许一条指令完成多个比较。
IA-64 分别支持两类推测:控制推测负责推迟推测指令的异常;存储器访问推测支持加载指令的推测执行。
推迟异常采用与 poison 位等价的机制。通用寄存器上的位称为 NaT(Not a Thing);多出的这一位使 GPR 实际宽度达到 65 位。浮点寄存器则使用特殊值 NaTVal(Not a Thing Value),以零有效数和超出 IEEE 范围的指数编码。只有推测加载会生成这些值,但所有不影响存储器的指令,都会把 NaT 或 NaTVal 传播到结果寄存器。加载有推测和非推测两种;后者只能立即触发异常,不能推迟。浮点异常不通过这套机制处理,而用浮点状态寄存器记录。
推迟的异常可以通过两种方式解决。第一,如果非推测指令,例如存储,将 NaT 或 NaTVal 作为源操作数,就立即触发不可恢复的异常。第二,可以用 chk.s 检测 NaT 或 NaTVal,并跳转到编译器安排的恢复例程,从推测操作中恢复。这种恢复方式对存储器访问推测更有意义。
如果带有 NaT 或 NaTVal 的内容不能存储,操作系统就无法保存处理器状态。因此,IA-64 提供特殊的寄存器保存与恢复指令:它们不会因 NaT 或 NaTVal 而引发异常,同时会保存和恢复 NaT 位。
IA-64 对存储器访问推测的支持,采用 advanced load,即提前加载:把加载推测性地移到它可能依赖的存储之前。用 ld.a 执行提前加载时,会在称为 ALAT 的特殊表中创建一项,同时记录加载的目的寄存器和访问地址。每条存储执行时,都对有效 ALAT 项进行相联查找;若发现相同地址,就将该项标为无效。
在任何非推测指令,例如存储,使用提前加载的结果或由该结果派生的值之前,必须显式检查。检查指定提前加载的目的寄存器。如果对应 ALAT 项仍有效,推测就合法,检查只需清除该项。若检查失败,则取决于检查形式:ld.c 直接在此处重新从存储器加载数据,适用于只提前加载本身的情况;另一种 chk.a 指定修复例程地址,用于重新执行加载,以及依赖加载值的其他推测代码。
Itanium 2 处理器
Itanium 2 是 IA-64 的第二代实现。第一代 Itanium 1 于 2001 年推出,时钟频率为 800 MHz。原书记载 Itanium 2 于 2003 年首次交付,2005 年最高频率达到 1.6 GHz。两者很相似,流水线结构有一些差异,存储层次结构的差异则更大。Itanium 2 的速度约为 Itanium 1 的四倍,来自频率翻倍、更积极的存储层次结构、增加功能单元以提高指令吞吐量、更完善的旁路、缩短流水线以减少部分停顿,以及更加成熟的编译器系统。
在两代 Itanium 之间大致相同的时间跨度里,Pentium 性能提高到原来的三倍多。相比已经成熟的 IA-32 实现,Itanium 的体系结构和软件系统都较新,因此更大的改进幅度是合理的。
Itanium 2 每周期可取指和发射两个 bundle,至多六条指令。它采用全片上的三级存储层次结构。第一级指令和数据缓存分离,各为 16 KB;浮点数据不放入一级缓存。第二、三级为统一缓存,容量分别为 256 KB 和 3–9 MB。
功能单元与指令发射
Itanium 2 有 11 个功能单元:两个 I-unit、四个 M-unit(两个加载、两个存储)、三个 B-unit、两个 F-unit。所有功能单元都采用流水线。图 H.10 给出典型指令的延迟。此外,结果从一个单元旁路到另一个单元,通常至少增加一个周期。
| 指令 | 延迟 |
|---|---|
| 整数加载 | 1 |
| 浮点加载 | 5–9 |
| 正确预测为跳转的分支 | 0–3 |
| 预测错误的分支 | 6 |
| 整数 ALU 操作 | 0 |
| 浮点算术 | 4 |
Itanium 2 每周期从两个 bundle 发射至多六条指令。最坏情况下,如果某个 bundle 在发射时被拆开,硬件可能只看到四条指令:第一个 bundle 剩一条,第二个有三条。指令依据 bundle 位分配到功能单元;这种分配不因其中出现空操作或谓词为假的指令而改变。此外,如果下一条待发射指令需要的单元已被占用,使发射受阻,相应 bundle 就会被拆开。即使只剩一条指令,拆开的 bundle 仍占据两个 bundle 槽中的一个。
Itanium 2 的八级流水线分为四个主要部分:
- 前端:IPG、Rotate。 每周期向预取缓冲区取至多 32 字节,即两个 bundle。缓冲区最多容纳八个 bundle,共 24 条指令。分支预测使用类似第 3 章所述的多级自适应预测器。
- 指令分发:EXP、REN。 将至多六条指令分发到 11 个功能单元,并实现寄存器轮转和寄存器栈所需的重命名。
- 操作数分发:REG。 访问寄存器堆、进行寄存器旁路、访问并更新寄存器记分牌,以及检查谓词依赖。记分牌判断各条指令何时能继续,使 bundle 中某一条指令因缓存未命中等不可预测事件而停顿时,不必让整个 bundle 停顿。图 H.8 已说明,除非精心调度,整包停顿会导致较差性能。
- 执行:EXE、DET、WRB。 通过 ALU 和加载—存储单元执行指令,检测异常并设置 NaT,退役指令并写回。
Itanium 1 和 Itanium 2 都具有许多通常与第 3 章动态调度流水线联系在一起的机制:动态分支预测、寄存器重命名、记分牌、执行前用于指令对齐和重命名等的多个流水级,以及执行后用于异常检测的多个流水级。虽然这些机制一般比先进动态调度超标量处理器中的对应机制简单,但总体看来,更依赖编译器技术的 Itanium,似乎与第 3 章那些动态调度处理器一样复杂!
既然主要依靠编译时技术寻找并行性,为何还要加入这些特性?原因主要有两个。第一,动态技术有时确实好得多,省去它们会严重损害性能;动态分支预测就是例子。
第二,高性能离不开缓存,而缓存不可避免地产生未命中。未命中难以预测,在当时处理器上耗时也很长。早期 VLIW 处理器发生缓存未命中时,整个处理器会冻结,保持编译器最初规定的同步并行关系。现代处理器的未命中代价可达数十到数百周期,这种方法完全不现实。允许部分指令继续而另一些停顿,就需要引入某种动态调度,这里采用记分牌。若停顿很长,反依赖还会阻碍等待期间的进展。
因此,Itanium 实现也引入寄存器重命名。
Itanium 2 的性能
图 H.11 比较 1.5 GHz Itanium 2 与 Pentium 4、AMD Athlon、IBM Power5 在五个 SPECint 和五个 SPECfp 基准上的性能。就完整 SPEC 浮点套件而言,Itanium 2 略慢于 Power5,比 AMD Athlon 或 Pentium 4 快约 35%。在 SPECint 上,Itanium 2 比 Power5 快 15%,而 AMD Athlon 和 Pentium 4 又都比 Itanium 2 快约 15%。Itanium 2 与 Power5 的功耗和裸片面积都大得多。事实上,Power5 包含两个处理器,普通 SPEC 测试时只启用其中一个,但其晶体管数仍不到 Itanium 的一半。如果移除 Power5 的一个处理器来缩小面积、晶体管数和功耗,那么 Itanium 将明显成为规模最大、功耗最高的处理器。
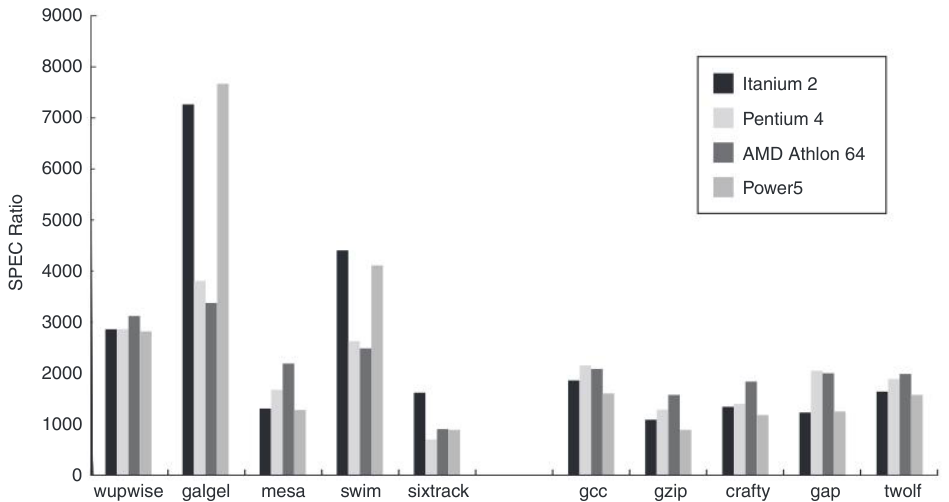
图内纵轴 SPEC Ratio 为 SPEC 性能比;横轴依次为 wupwise、galgel、mesa、swim、sixtrack、gcc、gzip、crafty、gap、twolf;图例保留处理器名称。
H.7 结束语
IA-64 最初由 Hewlett-Packard 与 Intel 联合设计。许多设计者既有早期 VLIW 处理器的实践经验,也受益于多年基于这些早期概念的研究。IA-64 的明确目标,是在硬件实现简单得多的前提下,取得不逊于、甚至优于硬件方法的 ILP。
设计者希望更简单的实现能够支持高得多的时钟频率。事实上,在发布 IA-64 和首款 Itanium 时,它们被描述为具有明显优势、将接替 RISC 方法的新方案。
遗憾的是,现实很不一样。IA-64 和 Itanium 实现看起来至少与采用动态推测的处理器同样复杂,两种方法都没有显著而稳定的性能优势。Itanium 也没有获得更高的能效,结果只有少数主要关心浮点性能的客户采用它。
Intel 原计划也让 IA-64 成为自己的新 64 位体系结构。但其平庸的整数性能,尤其是 Itanium 1 的表现,加上较大裸片面积,以及 AMD 推出 IA-32 的 64 位版本,共同迫使 Intel 扩展 IA-32 的地址空间。具有更大地址空间和强劲整数性能的 IA-32 处理器问世后,人们对 IA-64、Itanium 的兴趣进一步降低。原书所述时期的最新变化,是 Intel 用 IPF 取代 IA-64 这一名称:旧 x86 体系结构扩展到 64 位后,原来的名称已不那么贴切。
参考文献
- Wilson, R.P., Lam, M.S., 1995. Efficient context-sensitive pointer analysis for C programs(C 程序的高效上下文敏感指针分析). In: Proc. ACM SIGPLAN ’95 Conference on Programming Language Design and Implementation, June 18–21, 1995, La Jolla, Calif., pp. 1–12.
I 大规模多处理器与科学应用
Hennessy 和 Patterson 应该把 MPP 放到第 11 章。
——Jim Gray,Microsoft Research,2000 年被问及第三版应如何介绍大规模并行处理器(MPP)时
遗憾的是,对从事 MPP 业务的公司来说,第三版总共只有十章;MPP 市场也没有像撰写第一、第二版时所预期的那样发展。
版本说明: 本附录保留原书的历史叙述、机器参数与应用测量条件;其中“当时最新”等判断应结合文内年代阅读。
I.1 引言
大规模多处理器的主要用途是真正的并行程序设计。它不同于多道程序运行或面向事务的计算:后两者并行执行相互独立的任务,任务之间没有多少交互;在真正的并行计算中,一组任务协同执行同一个应用。并行计算的主要目标是科学与工程技术应用。相比之下,Web 服务器和多数事务处理应用等松耦合商业应用,任务之间很少通信。由于任务间通信稀少,松耦合集群通常就足以满足这些应用的要求,而且最具成本效益。
真正的并行计算涉及彼此协作的任务,因此,任务间通信的性质以及硬件如何支持通信,对应用性能有决定性影响。本附录下一节将讨论这些问题,以及不同通信模型的特点。
顺序程序的性能主要取决于缓存行为和指令级并行相关因素;并行程序还具有若干影响性能的重要特征,包括并行度、并行任务的大小、任务间通信的频率和性质,以及同步的频率和性质。这些方面既受应用本身性质的影响,也受编程风格的影响。I.3 节将介绍几种科学应用的重要特征,帮助读者认识这些问题。
正如第 5 章所见,同步对获得良好性能可能至关重要。在大规模多处理器中,可能需要同步的并行任务更多,因而同步引起的争用也严重得多。I.4 节讨论如何扩展第 5 章的同步机制。
I.5 节深入分析共享内存并行应用在中等规模共享内存多处理器上的性能。我们将看到,其行为和性能特征比小规模共享内存多处理器复杂得多。I.6 节讨论如何考察不同规模多处理器的并行性能这一普遍问题。I.7 节研究分布式共享内存缓存一致性的实现挑战;这是中等规模多处理器采用的关键体系结构方法。I.7、I.8 两节要求读者对互连网络有基本了解,阅读前至少应快速浏览附录 F。
I.8 节探讨 Blue Gene 的设计:在原文所述时期,它是最新、最令人振奋的大规模多处理器之一。Blue Gene 采用集群结构,但使用专为此用途设计的定制高密度节点;此前多数集群多处理器的节点体系结构,则类似于桌面计算机或较小规模多处理器的节点。定制节点显著降低了节点成本、物理尺寸和功耗。拥有 64K 个节点的 Blue Gene/L,在 2006 年按线性代数基准 Linpack 衡量,是世界上最快的计算机。
I.2 处理器间通信:性能的关键问题
处理器数量较多的多处理器中,处理器彼此相距更远,因此通信代价更高。此外,真正的并行应用要求应用内部的线程相互通信,其通信量通常大于松耦合的独立进程或独立事务集合;后两种情况正是许多商业服务器应用的典型特征。上述因素共同使高效的处理器间通信成为决定并行性能的最重要因素之一,在科学计算市场中尤其如此。
遗憾的是,要刻画应用的通信需求和体系结构的通信能力,十分复杂。本节考察决定通信性能的关键硬件特征,下一节再讨论应用行为及其通信需求。
任何硬件通信机制都有三个关键性能指标。
- 通信带宽。 理想情况下,通信带宽应受处理器、存储器和互连带宽的限制,而不应受通信机制某个环节的限制。互连网络决定系统的最大通信容量。单个节点的输入、输出带宽往往和系统总带宽同样重要,既受节点内部体系结构影响,也受通信机制影响。通信机制如何影响节点带宽?发生通信时,参与通信的节点中的资源会被占住,阻碍其他传入、传出通信。如果报文中的每个字都引入这种资源占用,它就对通信带宽设定了一个绝对上限,而且通常低于网络或存储系统所能提供的带宽。资源占用也可能包含按每次通信事件支付的部分,例如每个传入或传出的请求都会产生一次。在后一种情况下,资源占用限制的是通信事件速率,它对总体通信带宽的影响则取决于报文大小。
- 通信延迟。 理想情况下,延迟应尽可能低。如附录 F 所述,在没有争用时:
传播时间是固定的,传输时间由互连网络决定。收发报文的软、硬件开销则主要由通信机制及其实现决定。延迟为什么关键?它既影响性能,也影响多处理器编程的难易程度。若不能隐藏延迟,通信就会占住处理器资源,或迫使处理器等待,从而直接影响性能。
开销(overhead)与资源占用(occupancy)密切相关,因为许多形式的开销也会占住节点的一部分资源,带来资源占用代价,进而限制带宽。通信机制的关键特征可以直接影响这两者。例如,如何为远程通信的目的地址命名?如何实现保护?在共享地址空间中,命名和保护由处理器提供,额外开销很小。相反,如果每次通信都必须由操作系统提供这些机制,就会增加通信的开销和资源占用代价,进而降低带宽、增加延迟。
- 通信延迟隐藏能力。 通信机制在多大程度上能够让通信与计算重叠,或让不同通信重叠,从而隐藏延迟?虽然这一指标不像前两项那样容易测量,但它仍然很重要。可以在通信延迟相同、延迟隐藏支持不同的多处理器上测量运行时间,对其加以量化。隐藏延迟当然是个好主意,但也给软件系统、最终给程序员增加了负担;而且,能够隐藏多少延迟取决于应用。因此,通常最好仍尽可能降低延迟本身。
正如下节所示,这些性能指标都受应用所需通信的特征影响。被传送数据项的大小是最明显的一项:它不仅直接影响延迟和带宽,还影响不同延迟隐藏方法的有效性。同样,通信模式的规则程度影响命名和保护的成本,从而影响通信开销。一般来说,既能高效处理小规模也能处理大规模数据传送、既适应不规则也适应规则通信模式的机制,更灵活,也能在更广泛的应用中保持效率。当然,设计者考察任何通信机制时,都必须同时考虑成本与性能。
不同通信机制的优势
大规模多处理器传送数据的两种主要方式是消息传递和共享内存。这两类通信机制各有优势。共享内存通信的优点包括:
- 与集中式多处理器中广为理解的机制兼容;这类机器都采用共享内存通信。OpenMP 联盟(说明见 openmp.org)提出了共享内存多处理器的标准编程接口。消息传递也有标准,即 MPI(Message Passing Interface,消息传递接口),但原文所讨论的共享内存多处理器,以及面向吞吐量环境中的松耦合集群,并不采用这一标准。
- 当处理器间通信模式复杂,或在执行过程中动态变化时,更容易编程。同样的优势也简化了编译器设计。
- 可以用熟悉的共享内存模型开发应用,只把注意力集中在对性能至关重要的访问上。
- 传送小数据项时,通信开销更低,带宽利用更好。这源于通信的隐式性质,以及通过内存映射在硬件中实现保护,而不是通过 I/O 系统实现保护。
- 可以用硬件控制的缓存自动缓存全部共享和私有数据,从而降低远程通信频率。我们将看到,缓存同时降低共享数据访问的延迟和争用。这一优势也伴随一个缺点,下文会提到。
消息传递通信的主要优势包括:
- 硬件可以更简单,尤其是与能够一致地缓存远程数据、具有可扩展性的共享内存实现相比。
- 通信是显式的,因而更容易理解。在共享内存模型中,有时很难判断何时会发生通信、何时不会,以及通信的代价有多大。
- 显式通信将程序员的注意力引向并行计算中这个代价高昂的环节,有时能促使多处理器程序采用更好的结构。
- 同步自然地与消息发送联系在一起,减少了同步不正确引入错误的可能性。
- 更容易采用由发送方发起的通信,这在性能上可能有一定优势。
- 如果通信较少、结构较规则,就更容易用类似事务的结构提高容错能力。此外,节点耦合较松、通信显式,也使故障隔离更加容易。
- 规模最大的多处理器采用集群结构,而这种结构本质上基于消息传递。使用两套通信模型可能引入不必要的复杂性。
当然,无论硬件支持哪一种机制,都可以在其上用软件建立所需的通信模型。在共享内存之上支持消息传递要容易得多:消息本质上是将数据从一处存储器送到另一处,因此可以通过从地址空间的一部分复制到另一部分来实现。主要困难在于,报文可能未对齐且长度任意,而存储系统通常以对齐的缓存块为传送单位。软件可以付出较小的性能代价克服这些困难;如果增加少量硬件支持,则基本可以不付出性能代价。
在消息传递硬件上高效支持共享内存就困难得多。没有显式的共享内存硬件支持时,每次共享内存访问都需要操作系统介入,提供地址转换、内存保护,并将访存转换为消息的发送和接收。加载、存储通常只移动少量数据,而软件处理这些通信的开销很高,严重限制了软件共享内存能够提供可接受性能的应用范围。原书因此指出,在商业系统中,用消息传递来实现共享内存一直没有成为实用方案。
译注: 本节关于 MPI 使用范围及软件共享内存实用性的判断,保留原书所讨论系统和年代的语境,不应读作对所有实现的普遍限制。
I.3 科学应用的特征
可扩展共享内存多处理器的主要用途是真正的并行程序设计,而非多道程序运行或面向事务的计算。并行计算主要面向科学与工程技术应用。因此,要理解其设计问题,需要先了解这类应用的行为。本节对此作一个介绍。
科学应用的特征
本节的科学与工程并行工作负载由两个应用和两个计算内核组成。两个内核分别是快速傅里叶变换(FFT)和 LU 分解。之所以选择它们,是因为它们代表了广泛应用中常用的技术,而且其性能特征具有许多并行科学应用的典型特点。此外,这两个内核的代码较短,容易理解其行为,并直接追溯到具体的体系结构特征。和许多科学应用一样,这组工作负载基本没有 I/O。
本附录使用的两个应用是 Barnes 和 Ocean,代表了两种重要、但很不相同的并行计算类型。下面简要介绍各应用和内核,从并行度与通信两个方面刻画其基本行为。我们将说明如何为分布式共享内存多处理器分解问题;对于只使用一套集中式存储器的多处理器,下面某些数据分解并非必要。
FFT 内核
FFT 是采用谱方法的应用中的关键内核,涉及的领域从信号处理、流体流动到气候建模。本节研究的 FFT 应用,是复数 FFT 并行算法的一维版本。对 个数据点,其顺序执行时间为 。算法采用等于 的高基数,以尽量减少通信。本附录的测量采用含一百万个点的输入数据集。
算法有三个主要数据结构:待变换数据的输入数组、输出数组,以及预先计算、执行期间只读的单位根矩阵。所有数组均组织成方阵。算法有六个步骤:
- 转置数据矩阵。
- 对数据矩阵的每一行执行一维 FFT。
- 将单位根矩阵与数据矩阵相乘,结果写回数据矩阵。
- 转置数据矩阵。
- 对数据矩阵的每一行执行一维 FFT。
- 转置数据矩阵。
数据矩阵和单位根矩阵按连续的若干行划分给各处理器,使各处理器负责的部分位于其本地存储器。所有处理器都会频繁访问单位根矩阵的第一行,因此常在上述第一步复制这一行;这里也采用这种做法。数据转置保证了各 FFT 步骤有良好的局部性,否则这些步骤会访问非本地数据。
通信只发生在转置阶段,需要进行大量的全到全通信(all-to-all)。将分配给一个处理器的若干行中的连续列片段组成块,转置这些块,并将其放到目的矩阵中的正确位置。每个处理器在本地转置一个块,同时向系统中其他每个处理器各发送一个块。虽然转置中没有对单个字的重用,但缓存块较长时,仍值得将转置分块,以利用源矩阵中长缓存块所提供的空间局部性。
LU 内核
LU 对稠密矩阵作 LU 分解,代表了 QR 分解、Cholesky 分解和特征值方法等许多稠密线性代数计算。对一个 矩阵,运行时间为 ,并行度与 成正比。利用第 2 章介绍的技术对算法分块,可以高效执行稠密 LU 分解,获得很好的缓存行为,并减少通信。分块之后,主要计算是最内层循环中的稠密矩阵乘法。块应足够小,以保持较低的缓存未命中率;同时也应足够大,以减少在计算中并行度较低部分所花的时间。较小的块,例如 或 ,通常就能同时满足这两个条件。
减少处理器间通信有两个重要细节。首先,以二维平铺方式将矩阵块分配给处理器:对于由 个块组成的矩阵,每块为 ,将一个 网格反复铺在块矩阵上,直到全部块都分配给处理器。其次,稠密矩阵乘法由拥有目的块的处理器完成。采用这种分块与分配方案后,消元过程中的通信既规则又可预测。本附录的测量使用 输入矩阵和 的块。
在共享地址空间中编写二维矩阵的分块 LU 分解,一种自然方法是用二维数组表示矩阵。但由于块按平铺方式分配,而一个块在二维数组的地址空间中并不连续,因此很难把各块安置在拥有它们的处理器的本地存储器中。解决办法是使用四维数组,保证分配给同一处理器的块连续地存放在本地:前两维指定块在二维块网格中的编号,后两维指定块内元素。
译注: 上段网格大小为 ,其边长符号不能直接当成图 I.1 中表示处理器总数的 ,否则会把网格位置数与处理器数量混为一谈。
Barnes 应用
Barnes 实现了 Barnes–Hut n 体算法,用于求解星系演化中的一个问题。n 体算法模拟大量物体之间的相互作用力。在这里,物体代表恒星的集合,相互作用力是引力。完整计算全部物体两两之间的相互作用,计算量按 增长。为降低计算时间,n 体算法利用了力随距离衰减这一性质。例如,引力按 衰减,其中 为两物体间的距离。Barnes–Hut 算法把距离某个物体“足够远”的一组物体,近似为位于该组质心处的一个点,其质量等于整组物体的质量。如果目标物体与该组中任一物体都足够远,这种近似引入的误差就可以忽略。各集合按层次组织,可以用树表示。算法的运行时间为 ,并行度与 成正比。
Barnes–Hut 算法使用八叉树,每个节点最多有八个子节点,用来表示一部分空间中的八个立方体。每个节点代表以其为根的子树中的全部物体,我们把这一集合称为空间单元(cell)。由于空间密度不同,而叶节点代表单个物体,树的深度也不同。对每个物体,都遍历一次树,计算作用于该物体的合力。力的计算从树根开始:每访问一个节点,判断以该节点为根的子树所表示空间单元的质心,离当前物体是否“足够远”。如果足够远,就以位于该单元质心的一个点近似整棵子树,计算这个质心对该物体施加的力;否则,必须“打开”该单元,访问它的各棵子树。物体与单元的距离,以及允许的误差,共同决定哪些单元需要打开。计算力的阶段占据主要执行时间。本附录用 16K 个物体进行测量,判断单元是否需要打开的参数取实际常用范围的中间值。
Barnes–Hut 要获得高效并行性能并不容易。物体分布不均匀,而且随时间变化,因而难以在处理器间划分工作,并保持良好的引用局部性。两个性质对此有帮助:第一,系统演化缓慢;第二,引力随距离迅速衰减,所以每个单元很可能只需访问少数其他单元,其中大部分在上一时间步已经访问过。可以通过给每个处理器分配一棵子树来划分整棵树。计算子树中一个物体所受力时,许多访问仍然指向同一子树中的其他物体。由于各子树的工作量不同——空间中密集区域的单元需要访问更多单元——分配给处理器的子树大小,应依据某种工作量度量,例如需要访问多少其他单元,而不只是依据子树的节点数。对八叉树表示进行这种划分,可以兼顾负载平衡和引用局部性,同时保持较低的划分成本。不过,尽管局部性很好,最终的数据访问仍往往规模很小、结构不规则。因此,这种方案需要高效的共享内存通信实现。
Ocean 应用
Ocean 模拟涡流和边界流对大尺度海洋流动的影响。它用受限的红黑 Gauss–Seidel 多重网格技术,求解一组椭圆型偏微分方程。红黑 Gauss–Seidel 是一种迭代技术:给网格点着色,从而能够一致地依据相邻点的旧值更新各点。多重网格方法使用分层网格,通过迭代求解有限差分方程。层次中的每一层网格都比下一层点数更少,是对下一层网格的近似。较细的网格提高精度,从而提高收敛速率,但因数据点更多,也需要更多执行时间。下一次迭代应沿网格层次向上还是向下移动,取决于数据值的变化速率。每个时间步的误差估计用于决定继续留在当前网格、转向更粗网格,还是转向更细网格。当迭代在最细层次收敛时,就得到了一个解。对于 网格,每次迭代的工作量为 ,并行度也具有相同规模。
表示各层网格的数组根据具体问题动态分配并确定大小。整个海盆被划分为尽可能接近正方形的子网格,分配到各处理器本地存储器所对应的地址空间中;各处理器负责自己的子网格。本附录测量使用含 个网格点的输入。一次时间迭代分为五步。由于各步之间需要交换数据,所有处理器在每一步结束时同步,再进入下一步。当相邻子网格按最近邻方式访问彼此边界上的点时,就会发生通信。
并行程序的计算与通信
决定并行程序性能的一个关键特征,是计算量与通信量的比值。如果该比值很高,就意味着每传送一个数据项,应用会进行大量计算。如 I.2 节所述,通信是并行计算中代价高昂的部分,因此较高的计算/通信比十分有利。在并行处理环境中,我们关心的是:增加处理器数量、扩大问题规模,或同时改变二者时,这个比值如何变化。了解它随处理器数增长的变化,有助于判断应用能够获得多大加速。由于我们也常希望求解更大的问题,因此了解数据集大小对这一比值的影响同样关键。
要定量理解增加处理器后的计算/通信比,可以分别考察增加处理器或扩大问题规模时,计算量与通信量如何变化。图 I.1 表明,对这些应用,随着处理器数量增加,每个处理器的计算量按比例下降,而每个处理器的通信量下降得较慢。问题规模扩大时,计算量按算法的 复杂度增长。通信的变化更复杂,取决于算法细节;图 I.1 的说明概括了各应用的基本规律。
| 应用 | 计算量的变化 | 通信量的变化 | 计算/通信比的变化 |
|---|---|---|---|
| FFT | |||
| LU | |||
| Barnes | 约为 | 约为 | |
| Ocean |
计算量随 按 分析给出的速率增长,随 增加则线性下降。通信的变化更复杂。在 FFT 中,所有数据点都必须相互作用,所以通信量随 增加、随 减少。在 LU 和 Ocean 中,通信量与块的边界成正比,因此随数据集大小增长的速率,与包含 个点的正方形边长——即 ——成正比;同理,二者的通信量与 成反比。Barnes 最为复杂:由于物体间相互作用随距离衰减,需要通信的基本相互作用数量按 增长;为维护物体之间的关系,还需要一个 因子。处理器数增加时,通信量按 变化。
译注: 表中 LU 的计算量按原表保留为 。若这里的 按图注解释为矩阵元素总数,则完整稠密 LU 分解的计算量与前文的立方阶描述并不一致。原书没有在此交代额外归一化或单步计算假设,不据此改造原表。
整体计算/通信比由计算量与通信量各自的增长速率求得。通常,这个比值随数据集增大而缓慢上升,随处理器数增加而下降。这提醒我们:用更多处理器求解固定规模问题时,处理器间的通信增长,会带来越来越多的低效。它还说明,为使通信时间所占比例不变,增加处理器时,数据集需要以多快的速度增长。下面的例题展示这些取舍。
例题 假设已知 Ocean 在某台多处理器上使用四个处理器运行时,执行时间的 20% 用于等待通信。假定每次通信事件的代价与处理器数无关;一般情况下并非如此,因为通信代价会随处理器数增加。对同一规模的问题,预计在 32 处理器机器上能快多少?此时通信占执行时间的多少?若想保持通信时间占比不变,应将问题扩大多少?
原书解答 Ocean 的计算/通信比为 。因此,问题规模不变时,通信频率按 增长。原书据此认为通信时间增加到 倍,并用 Amdahl 定律的一种变形,同时计入计算时间减少和通信时间增加。设四个处理器的总执行时间为 ,则 32 个处理器的执行时间为:
于是加速比为:
通信时间占比从 20% 变成 。
为了使通信时间占比保持不变,计算/通信比必须保持不变,因此问题规模必须与处理器数以相同的速率增长。注意,此时问题规模已经改变,不能再公平地比较原问题与扩大后问题的加速比。I.6 节会再次讨论针对多处理器扩大应用规模这一关键问题。
译注: 上述解答与图 I.1 的“每处理器”通信量不一致。按表中 Ocean 的 以及题设通信单价不变的假定,固定问题由 4 扩到 32 个处理器时,每处理器通信时间应除以 ,不是乘以 。相应地,,加速比约 5.86,通信占比约 41.4%。原书把相对于计算的通信比例上升,直接用成了绝对通信时间上升。这里完整保留原解答,并明确区分这一按题设计算的校正;保持通信占比需将数据集扩大 8 倍的结论不受此处方向错误影响。
I.4 同步:向更大规模扩展
本节先讨论较大规模多处理器中的同步性能问题,再讨论解决办法。
同步性能的挑战
要理解第 5 章介绍的简单自旋锁为什么难以扩展,可以设想一台大型多处理器中,全部处理器都争用同一把锁。目录或总线成为所有处理器必须串行通过的点,导致大量争用和通信流量。下面的例题展示情况可能有多糟。
例题 一条总线上有 10 个处理器,每个处理器同时尝试给一个变量加锁。假设每个总线事务,不论读未命中还是写未命中,都持续 100 个时钟周期。可以忽略对已在缓存中的锁实际读写所需的时间,也可以忽略持锁时间——这两项影响都不大!假设时刻 0 锁释放时,所有处理器都在自旋。求全部 10 个处理器依次获得锁所需的总线事务数,以及处理这 10 个请求大约需要多久。总线完全公平:所有未完成请求都先于新请求得到服务;各处理器速度相同。
解答 当有 个进程争用锁时,它们依次执行下列动作,每个动作都产生一个总线事务:
- 次链接加载(load linked),用于访问锁。
- 次条件存储(store conditional),尝试获得锁。
- 1 次存储,释放锁。
因此, 个进程共需要 个总线事务。这里假定临界区执行时间可以忽略,因而锁会在其他条件存储失败的处理器再次尝试链接加载前释放。
对 个进程,总线操作总数为:
对 10 个进程,共有 120 个总线事务,需要 12,000 个时钟周期;原书接着写作“每次获取锁 120 个时钟周期”。
译注: 最后一个平均值有算术错误:,即每次获取锁平均 1200 个时钟周期,不是 120。
例题中的困难来自锁争用、锁访问的串行化,以及总线访问延迟。总线的公平性实际上还使情况更糟,因为它推迟了获得锁的处理器释放锁的时机;遗憾的是,无论采用何种总线仲裁,都存在某种最坏情况。自旋锁原本的两个主要优点——占用较少的总线或网络周期,以及同一处理器反复使用锁时性能良好——在这个例子中都消失了。下一部分将考虑其他实现;在此之前,先看看如何用自旋锁实现另一种常见的高层同步原语。
屏障同步
带有并行循环的程序中,另一种常见同步操作是屏障(barrier)。屏障迫使各进程等待,直到所有进程都到达屏障,才一起放行。典型实现可以使用两个自旋等待机制:一个锁保护到达计数器,另一个让各进程等待,直到最后一个进程到达。实现屏障时,通常让进程反复检查变量,直到满足条件;这里用 spin(condition) 表示这一操作。图 I.2 给出一种典型实现,假设 lock、unlock 提供基本自旋锁,total 是必须到达屏障的进程数。
实际中还有一个因素会使屏障实现更复杂。屏障经常用在循环内:从屏障中放行的进程执行一些工作,随后再次到达同一屏障。假设某个进程实际上一直没有离开屏障,仍停留在 spin 操作中;例如,操作系统可能暂时调度了另一个进程。此时,某个进程可能跑得很快,在最后一个进程离开前,就再次到达屏障。这个“快”进程重置 release 标志,将仍未离开的“慢”进程困在屏障内。于是,所有进程都会在下一轮屏障中无限等待:一个进程仍被困在上一轮,计数永远无法达到 total。
这里重要的是,应用程序员没有做错任何事;出错的是屏障实现者,他对执行进展作了不能成立的假设。一种显然的解决办法是,在进程退出屏障时也进行计数,就像进入时一样;上一轮所有进程都离开之前,不允许任何进程再次进入并重新初始化屏障。但这个额外步骤会显著增加屏障延迟和争用,而我们很快就会看到,二者原本已经很大。另一种办法是sense-reversing barrier,即通过翻转标志含义来复用的屏障。它为每个进程设置私有变量 local_sense,初值为 1。图 I.3 给出代码。这个版本可以安全复用,但下面的例题表明,其性能仍然可能很差。
译注: 原图 I.3 末尾额外印有一个右花括号,未给出对应的左花括号。
例题 总线上有 10 个处理器,同时尝试执行屏障。与前例一样,每个总线事务为 100 个时钟周期。忽略对缓存中锁的实际读写时间,也忽略屏障实现中其他非同步操作的时间。求全部 10 个处理器到达屏障、获得放行并退出屏障所需的总线事务数。总线完全公平,所有待处理请求均先于新请求得到服务;处理器速度相同。不必考虑进程退出屏障时的计数。整个过程需要多久?
解答 假设 lock 和 unlock 用链接加载与条件存储实现。图 I.4 列出一个处理器通过屏障时的总线事件序列,假设最先抢到总线的进程尚未持锁。最后到达屏障的进程略有不同,见图注。
对于第 个进程,总线事务数为 ;最后到达的进程少一次。因此,对 个进程,总线事务数为:
10 个进程需要 204 个总线周期,也就是 20,400 个时钟周期!该屏障操作花费的时间,接近 10 个处理器依次加锁、解锁所需时间的两倍。
| 事件 | 进程 的次数 | 对应源码行 | 说明 |
|---|---|---|---|
LL counterlock | lock(counterlock); | 所有进程尝试获取锁。 | |
| 条件存储 | lock(counterlock); | 所有进程尝试获取锁。 | |
LD count | 1 | count = count + 1; | 成功获得锁的进程。 |
| 链接加载 | lock(counterlock); | 未成功的进程再次尝试。 | |
SD count | 1 | count = count + 1; | 因获得独占访问权而未命中。 |
SD counterlock | 1 | unlock(counterlock); | 获取锁数据时发生未命中。 |
LD release | 2 | spin(release == local_sense); | 读取 release:首次读取时未命中,最终被写入后再未命中一次。 |
这些例子表明,多进程之间存在严重争用时,同步性能确实可能成为瓶颈。如果争用很少,同步操作也不频繁,我们主要关心同步原语的延迟,即单个进程完成一次同步需要多久。基本自旋锁需要两个总线周期:一个首次读取锁,一个写入锁。可以通过多种方法将它减少到一个周期,例如直接在交换操作上自旋。如果锁几乎总是空闲,这样可能更好;但如果锁不空闲,每次尝试都会产生总线周期,造成大量总线流量。实际中,自旋锁延迟也没有前例表现得那么差,因为对缓存中已有数据项的写未命中会作为权限升级处理,比真正的读未命中便宜。
这些例子中更严重的问题是,每个进程完成同步的尝试都被串行化。有争用时,这会大幅增加完成同步的时间。例如,若全部 10 次加锁、解锁仅受无争用延迟制约,那么原文指出,完成同步只需 1000 个周期,而不是 15,000 个周期。屏障的情况同样糟糕,有些方面甚至更差,因为它极有可能产生争用。总线互连加剧了这些问题,但目录式多处理器中串行化也可能同样严重,而且延迟很大。下一部分介绍一些适用于高争用或处理器数量较多情况的解决办法。
译注: 这里的 15,000 个周期与前例算出的 12,000 个周期不一致;1000 的比较值也未说明具体计入哪些加锁、解锁事务。保留原文比较,不将它与前例强行合并成同一次计算。
面向更大规模多处理器的同步机制
我们希望同步机制在无争用时延迟低,在争用严重时又能尽量减少串行化。先讨论软件如何改善高争用下锁和屏障的性能,再介绍两种能够在维持低延迟的同时减少串行化的基本硬件原语。
软件实现
前述自旋锁实现的主要困难,是许多进程同时自旋时,由争用造成的延迟。一种办法是在进程获取锁失败时,主动让它延迟一段时间。每次获取失败后按指数增加延迟,可取得最佳性能。图 I.5 展示带指数退避的自旋锁。指数退避是减少共享资源争用的常用技术,也适用于共享网络与总线访问,见 F.4–F.8 节。该实现不延迟最初的自旋循环,以便在争用较小时维持低延迟。因此,即使有许多进程等待,退避也不影响它们第一次尝试获取锁。也可以延迟首次尝试,但如果只有两个进程使用锁、其中一个首次检查时恰好发现锁被占用,这样反而会损害性能。
延迟可通过将 R3 值的一份副本逐次递减到 0 来实现。具体时间取决于多处理器,但初始时间单位应约等于执行临界区并释放锁所需的时间。PAUSE R3 应延迟 R3 个这样的时间单位。每次条件存储失败,R3 都乘以 2,让进程再次尝试前等待两倍的时间。争用处理器执行指令速率的微小差别,通常足以避免各进程持续碰撞。如果执行时间的自然扰动还不够,可以用一个较小随机值初始化 R3,增大连续退避时间的差异,降低连续碰撞的概率。
另一种技术是队列锁:把等待的处理器排成队列;每当一个处理器释放锁,就让队列中的下一个处理器尝试访问。这消除了释放锁时的争用。下一部分用硬件实现说明队列锁的工作原理;采用数组的软件实现,也能获得其中大部分收益。在介绍硬件原语之前,先看更好的屏障机制。
前述屏障在两个阶段都有争用:汇集阶段需要原子更新计数器,放行阶段则要求所有进程读取 release 标志。前者更严重,因为它要求对同步变量独占访问,产生更多串行化;后者相比之下只有读争用。可以用合并树(combining tree)减少争用:多个请求按树状结构在局部逐级合并。同样的合并树也可以用于放行,降低该阶段的争用。
这里的合并树屏障采用预先确定的多叉树结构,用 表示汇入数;实践中 效果不错。当第 个进程到达某节点时,向树的上一层发信号;当一个进程到达根时,放行全部等待进程。与前例一样,仍采用 sense-reversing 技术。图 I.6 的树形屏障用树汇集进程,并用一个信号解除屏障。一些 MPP,如 T3D、CM-5,还提供了屏障硬件支持;较新的机器则依赖软件库。
当第 个进程到达树中一个节点时,它继续进入父节点,递增父节点的计数;原图注接着说,父节点计数达到 时设置 release。每个节点的计数由最后到达的进程清零。与简单屏障一样,使用 sense-reversing 避免竞争。初始化树时,应将 tree[root].parent 设为 −1。
译注: 原图 I.6 是不完整的类 C 伪代码:
if (count == k)缺明确的闭合括号,barrier定义有两个参数而两处调用只传一个,数组声明也使用区间记号。这段伪代码不能直接用作可编译实现。图注关于父节点计数达到 k 即设置 release 的说法,应结合递归代码中仅在根节点放行来理解。
硬件原语
下面考察两个硬件同步原语。第一个处理锁,第二个可用于屏障,以及其他需要计数或分配不同索引的用户层操作。两种情况下都能建立这样的硬件原语:延迟基本与前述版本一致,但串行化大幅减少,因此在争用时具有更好的扩展性。
最初锁实现的主要问题,是产生了大量不必要的争用。例如,锁释放时,所有处理器都会产生读未命中和写未命中,尽管至多只有一个处理器能成功拿到未锁定状态的锁。前例的十次加锁/解锁中,每次都会发生这种情况。
可以通过显式地把锁从一个等待处理器交给下一个,改善这一点。每次释放锁时,不再让所有处理器竞逐,而是保留等待者列表,到谁的轮次就把锁明确交给谁。这就是队列锁。它可以用本节所述硬件实现,也可以用数组跟踪等待进程,以软件实现;两者基本思想相同。这里的硬件实现假定使用目录式多处理器,能够按地址访问各处理器的缓存。在总线式多处理器中,软件实现更合适:让每个处理器为锁使用不同地址,就能将锁从一个进程显式传给另一个。
队列锁如何工作?第一次访问锁变量未命中时,将未命中请求发给同步控制器;控制器可以集成到存储器控制器中,例如总线式系统,也可以集成到目录控制器。如果锁空闲,就直接将它返回给处理器。如果不可用,控制器就记录该节点的请求,例如在向量中置一位,然后向处理器返回表示“已锁定”的值,让它在该值上自旋。锁释放时,控制器从等待列表中选出一个处理器继续执行。随后可以更新该处理器缓存中的锁变量,也可以使其副本失效,让处理器再次未命中并取回可用的锁。
例题 使用通过更新锁副本来交接的队列锁,让 10 个处理器依次加锁、解锁,需要多少总线事务、多少时间?系统的其他假设与前面的锁例题相同。
解答 对 个处理器,每个处理器最初都尝试访问锁,产生一个总线事务;其中一个成功并释放锁,因此第一个处理器完成前共 个事务。后续每个处理器需要两个事务:一个接收锁,一个释放锁。因此总事务数为:
现在事务数与争用处理器数呈线性关系,而不像此前自旋锁那样呈二次关系。10 个处理器需要 29 个总线周期,也就是 2900 个时钟周期。
实现这种队列锁,有几个关键点。首先,要能区分对锁的首次访问,以便执行入队操作;也要区分释放锁,以便把锁交给其他处理器。等待进程队列可以用多种机制实现。对于目录式多处理器,该队列类似共享者集合,可以用相似硬件实现目录和队列锁操作。一个复杂之处在于,硬件必须能够收回这样的锁:请求锁的进程可能已经被上下文切换,甚至不会再次被调度到同一个处理器。
队列锁可以改善屏障的性能。也可以引入一种原语,缩短递增屏障计数器所需的时间,减少这个瓶颈处的串行化,预期取得与队列锁类似的性能。一种用于这一目的、也用于构造其他同步操作的原语是 fetch-and-increment,即原子地取出变量并将其值加一。返回值既可以是增加后的值,也可以是原先取出的值。与简单的 sense-reversing 屏障相比,利用该原语可以显著改善屏障实现。
例题 用 fetch-and-increment 编写屏障代码。在与前例相同的假设下,另假设一次返回递增后值的 fetch-and-increment 操作耗时 100 个时钟周期,求 10 个处理器通过屏障的时间,以及所需总线周期数。
解答 代码如图 I.7。对 个处理器,实现需要 次 fetch-and-increment、 次访问 count 的缓存未命中,以及 次放行操作的缓存未命中,共 个总线事务。10 个处理器需要 30 个总线事务,也就是 3000 个时钟周期。与队列锁一样,时间随处理器数线性增长。当然,fetch-and-increment 也可用于合并树屏障,减少各树节点处的串行化。
译注: 图 I.7 原代码没有保存原子操作的返回值,而是随后读取共享的 count;这与题设强调返回递增后值不一致,还可能让多个进程同时观察到 total 并竞争清零。实际实现需要用本次原子操作的返回值唯一确定最后到达者,并满足相应内存顺序要求。
如上所见,大规模多处理器中的同步问题可能相当尖锐。再把长内存访问延迟,以及计算中可能发生的负载不均衡考虑进来,就不难理解为什么高效利用大规模并行处理器如此具有挑战性。
I.5 科学应用在共享内存多处理器上的性能
本节讨论 I.3 节的科学应用在对称共享内存多处理器和分布式共享内存多处理器上的性能。
科学工作负载在对称共享内存多处理器上的性能
我们使用下列问题规模,评估四个科学应用在对称共享内存多处理器上的性能:
- Barnes–Hut: 16K 个物体,运行六个时间步;精度控制参数设为 1.0,这是典型且符合实际的取值。
- FFT: 一百万个复数数据点。
- LU: 矩阵,采用 的块。
- Ocean: 网格,使用典型误差容限。
考察处理器数、缓存容量和块大小变化时的未命中率,我们将总未命中率分为一致性未命中和普通单处理器未命中。后者包括容量未命中、冲突未命中和强制未命中。这里将其统称为容量未命中,因为容量是这些基准程序中的主要原因。测量中,即使没有其他处理器共享一个缓存块,任何将它从共享状态升级为独占状态所需的写未命中,也计为一致性未命中。这对应一种不区分私有块和共享块的协议。
图 I.8 显示固定问题规模、将处理器数量从 1 增加到 16 时,四个应用的数据未命中率。处理器增多使缓存总量增大,通常会降低容量未命中率;另一方面,更多处理器通常带来更多通信,使一致性未命中率上升。这两种效应的强弱因应用而异。
在 FFT 中,容量未命中率从接近 7% 降到略高于 5%,一致性未命中率则从约 1% 增至约 2.7%,因此总未命中率大致不变。Ocean 呈现多种因素的共同影响,其中一些与网格划分,以及网格边界如何映射到缓存块有关。典型二维网格程序中,通信引起的未命中与各网格分区的边界成正比,而容量未命中与网格面积成正比。因此,固定总问题规模、增加缓存总量,对容量未命中率的影响更大,至少在每个子网格都能装入单个处理器缓存之前如此。从一个处理器增加到两个时,未命中率显著跳升,原因在于多个网格映射到缓存的方式引起冲突。这种冲突存在于直接映射和两路组相联缓存中,相联度更高时逐渐消失。对基于数组、尤其是同时使用多个网格的应用,这类冲突并不少见。Barnes 和 LU 中,处理器数增加对未命中率影响不大,有时略升,有时略降。
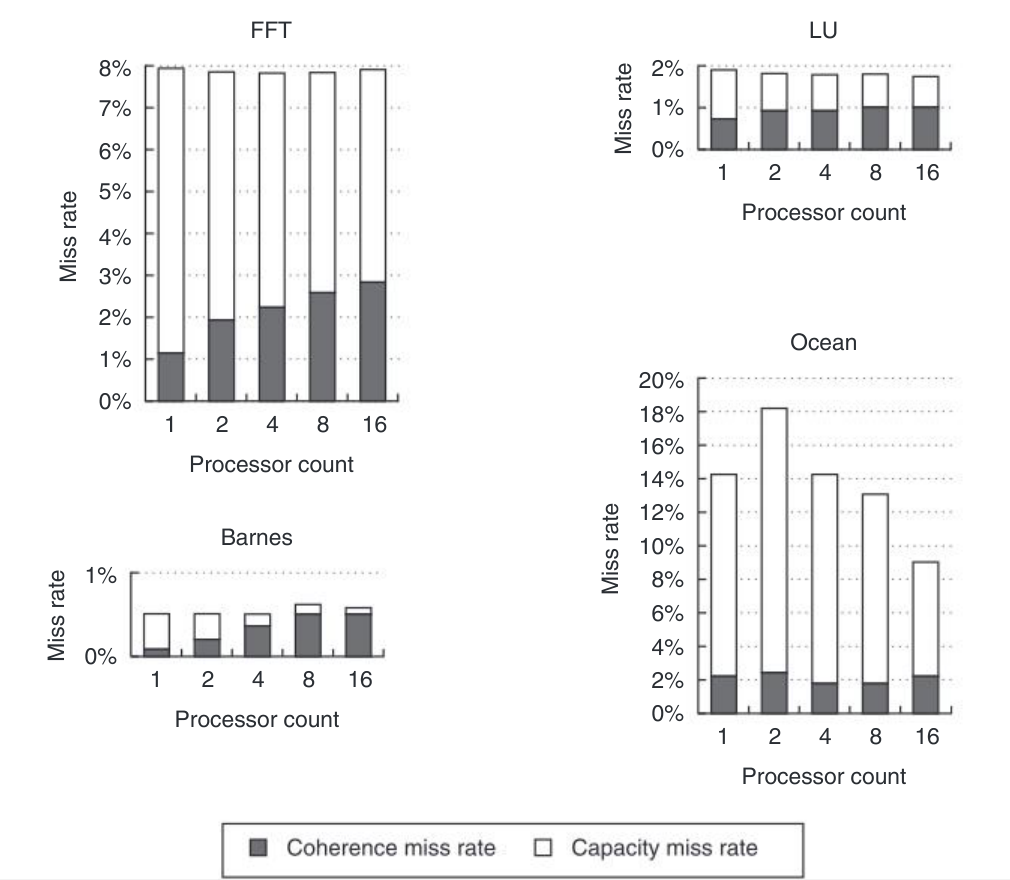
这些基准的强制未命中都很少,已计入容量未命中。大部分未命中来自对潜在共享数据的访问,但未命中率较高的 FFT 和 Ocean 中,容量未命中而非一致性未命中占主要部分。只要数据分配在用于共享数据的地址空间区域,就属于“潜在共享”。除 Ocean 外,这些数据都被大量共享;Ocean 虽然把整个网格视为潜在共享对象,实际共享的却只有子网格边界。固定问题规模下,处理器增加会改变边界,因而网格中实际共享的部分也随之变化。
Ocean 从一个处理器增加到两个时,容量未命中率的异常上升来自子网格访问冲突。除 Ocean 外,固定规模问题使用更多处理器时,一致性事务造成的缓存未命中比例都上升。Ocean 最初的一致性未命中会随处理器增加而下降,因为其中有大量对“潜在共享但实际未共享”数据取得写所有权的未命中;在约 16 个处理器时,子网格开始装入总缓存,这种效应减弱。单处理器数据也包括写升级未命中:在该协议中,数据即使实际未共享,只要处于共享状态也会发生这种未命中。所有运行都采用 64 KB、两路组相联、32 字节块的缓存。各图纵轴刻度不同,以便清楚展示各基准的行为。图中灰色为一致性未命中,白色为容量未命中;Miss rate 为未命中率,Processor count 为处理器数量。
增大缓存通常有利于性能,因为它减少了代价高昂的缓存未命中。图 I.9 展示固定 16 个处理器、增加缓存容量时,未命中率及其一致性、单处理器容量两部分如何变化。有两种效应可能使缓存增大后未命中率不下降,或下降得不如预期快:应用固有的通信,以及未命中率的平台区间。
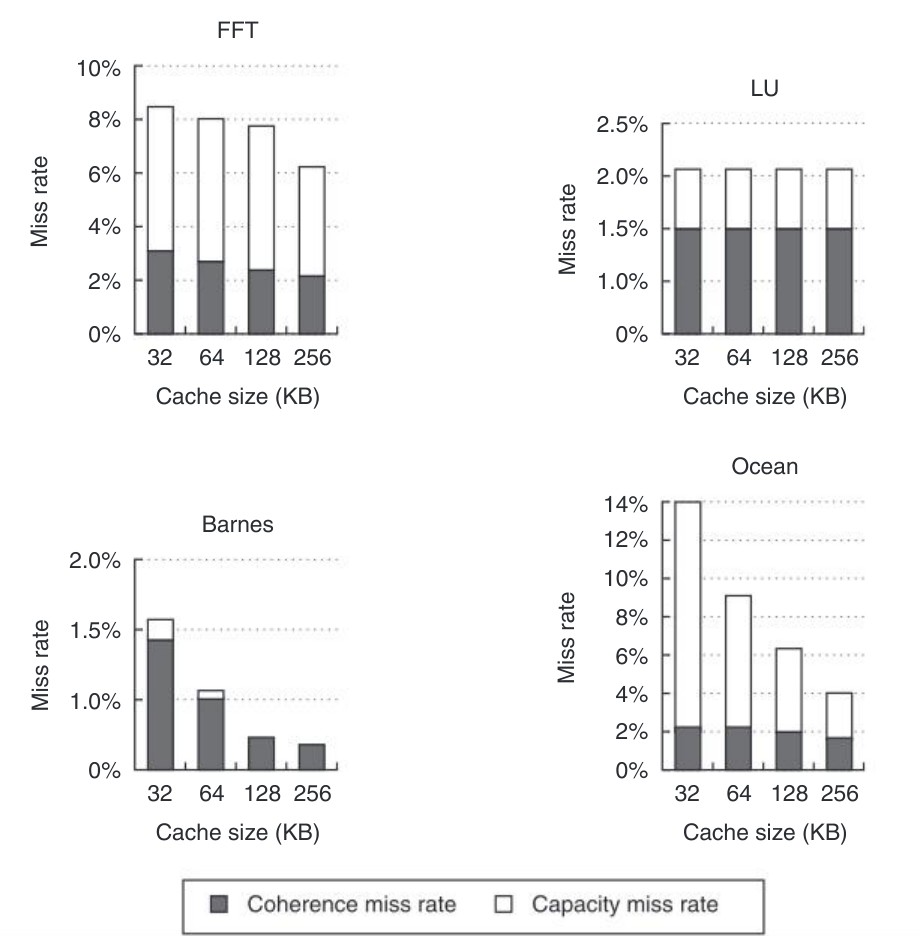
图中 Cache size 为缓存容量,单位 KB;灰色为一致性未命中率,白色为容量未命中率。
固有通信带来一定频率的一致性未命中,增加缓存容量不会显著影响它。因此,固定问题规模下不断增大缓存,最终会由一致性未命中率限制总体未命中率的进一步下降。Barnes 最明显:一致性未命中几乎成为全部未命中。
另一个次要效应,是容量未命中率会暂时停留在某个平台:此时部分数据已经驻留缓存,但数据集的另一重要部分仍放不进去,略微增大缓存也无济于事。LU 中,约 4 KB 的很小缓存就能容纳内层循环使用的两个 块;此后,下一次明显改善要等到两个矩阵都装入缓存,即缓存总量达到 4–8 MB 时。这有时称为工作集效应。FFT 在缓存容量为 32–128 KB 时也部分表现出这一效应,容量未命中率只降低 0.3 个百分点。超过这一范围后,一个主要数据结构开始驻留缓存,容量未命中率下降加快。这种平台区间常见于有规则地处理大型数组的程序。
增加块大小是改变缓存未命中率的另一种办法。在单处理器中,较大缓存往往适合较大块。但多处理器中还出现两个新效应:共享数据的空间局部性降低,以及伪共享可能使未命中率上升。若干研究表明,共享数据的空间局部性低于非共享数据。局部性较差意味着,在块中全部内容被访问之前,该块被替换的可能性更高,因此获取大块对共享数据的收益不如单处理器明显。同样,增大基本块大小,也会增加伪共享的潜在频率,使未命中率上升。
图 I.10 展示 16 个处理器、64 KB 缓存条件下,增加缓存块大小后的未命中率。最有意思的是 Barnes:未命中率先降后升,上升来自一致性未命中增加,很可能由伪共享引起。其他基准中,块越大,总未命中率越低。Ocean 和 LU 中,块大小增加对一致性未命中与容量未命中的影响大致相同。FFT 中,一致性未命中率实际下降得比容量未命中率更快,这是因为它的通信组织得非常高效。对于优化较少的程序,预计会有更多伪共享,共享数据空间局部性也更差,从而更接近 Barnes 的行为。
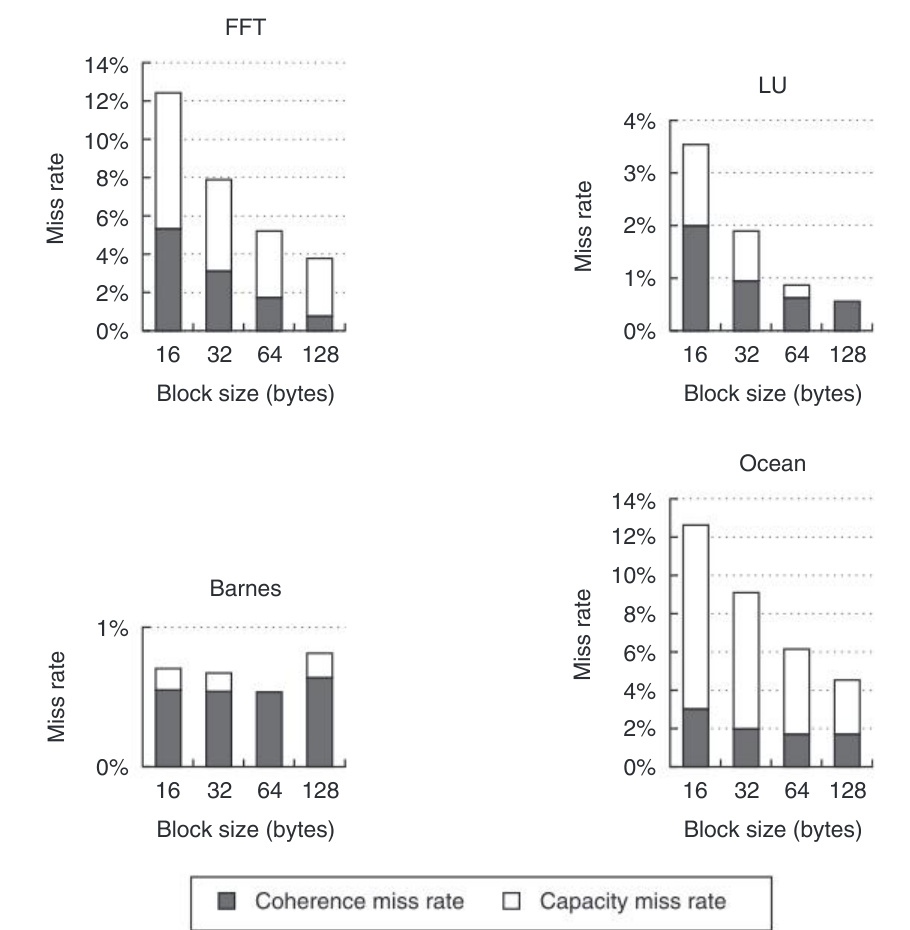
图中 Block size 为块大小,单位字节;灰色为一致性未命中率,白色为容量未命中率。图注概括总体趋势,Barnes 的例外见正文。
更长的块使未命中率下降,似乎意味着总应选择更长的块;然而,总线式多处理器的瓶颈往往是有限的存储器与总线带宽。块越大,每次未命中在总线上传输的字节数就越多。图 I.11 显示块增大后的总线流量增长;高未命中率程序、尤其 Ocean 最严重。流量增长会同时增加未命中代价和总线争用,实际可能使性能下降。
记住,这里的协议将所有权或升级未命中按普通未命中处理,略微增加了大缓存块的代价;在 Ocean 和 FFT 中,这一简化造成的流量都不到总流量的 10%。纵轴 Bytes per data reference 表示每次数据访问的字节数,横轴为块大小,单位字节。
科学工作负载在分布式存储器多处理器上的性能
目录式多处理器的性能也受许多与总线式多处理器相同的因素影响,例如缓存容量、处理器数和块大小;此外,还取决于未命中在存储层次结构中不同位置的分布。请求数据项的位置同时取决于最初的分配和共享模式。我们先看科学与工程工作负载的基本缓存性能,再分析不同未命中类型的影响。
由于这台多处理器规模更大、延迟也高于前面的监听式多处理器,我们从稍大的 128 KB 缓存和 64 字节块开始分析。
在分布式存储器体系结构中,内存请求在本地和远程之间的分布是性能关键,因为它既影响全局带宽消耗,也影响请求延迟。因此,本部分各图将缓存未命中分为本地和远程请求。阅读时应记住:这些应用的大部分远程未命中是一致性未命中,但容量未命中也可能发生在远程;对数据分布不佳的应用,这种远程容量未命中可能很多。
图 I.12 表明,在上述缓存容量下,处理器数变化对未命中率影响不大,Ocean 是例外:64 个处理器时其未命中率上升。这有两个原因:网格变小后,缓存映射冲突增加,使本地未命中上升;一致性未命中也增加,而它们都是远程未命中。
Ocean 的本地未命中率从 8 个处理器时的 5%,降到 32 个处理器时的 2%,再升到 64 个处理器时的 4%;主要由通信驱动的远程未命中率则从 1% 单调升至 2.5%。各图纵轴刻度不同,以呈现细节。所有运行均采用 128 KB、两路组相联、64 字节块的缓存。灰色为本地未命中,白色为远程未命中。
远程未命中包括所有需要与另一节点通信的未命中,无论是取数据还是发送失效请求。尤其是,本图及本部分其他数据把写升级未命中也计入远程未命中:数据在本地存储器中已经是最新的,但其他节点仍缓存着它,所以必须发送失效消息。这些失效确实产生远程流量,但是否延迟写入,取决于存储一致性模型。
图 I.13 展示固定 64 个处理器、64 字节块时,缓存增大对未命中率的影响。下降幅度大体符合预期,但由于一致性未命中很少降低或完全不降低,远程未命中的下降通常慢于本地未命中。到所示最大容量 512 KB 时,远程未命中率已不小于本地未命中率。更大的缓存会强化这一趋势。
原图注指出,在所有情况下,本地未命中率降幅都大于远程未命中率降幅。前文所述 FFT 的未命中率平台在缓存超过 128 KB 后结束。运行使用 64 个处理器和 64 字节缓存块。横轴为缓存容量,单位 KB;灰色为本地未命中,白色为远程未命中。
译注: 图注的“所有情况下”与图中 Barnes 的柱状数据并不完全一致:Barnes 的远程部分下降更明显。
图 I.14 考察改变块大小的影响。这些应用空间局部性良好,因此即使块已经很大,进一步增大仍能降低未命中率,只是最大块的性能收益较小。而且,大部分改善来自本地未命中的减少。
灰色为本地未命中,白色为远程未命中;横轴块大小以字节计。
图 I.15 没有直接画内存总流量,而是给出每次数据访问所需字节数随块大小的变化,并分解为本地与全局带宽需求。在总线系统中,把各处理器需求相加即可得到总线与存储器带宽总需求。对于可扩展互连,则可用图 I.15 的数据计算每节点所需全局带宽,并估计对分带宽,如下例所示。
横轴为块大小,单位字节;纵轴为每次数据访问的字节数。灰色 Local 表示本地部分,白色 Global 表示全局部分。原图 LU 并非单调上升,图注描述的是总体趋势。
例题 假设有 64 个处理器,频率为 1 GHz,每个处理器每时钟周期持续发出一次访存。块大小为 64 字节时,远程未命中率为 0.7%。求 FFT 的每节点带宽和估计的对分带宽。假设处理器不因远程访存请求而停顿,例如全部远程数据都已预取时可能如此。这些带宽需求与各种互连技术相比如何?
原书指出,FFT 采用全到全通信,因此对分带宽等于处理器数乘以每节点带宽,约为 。64 处理器的 SGI Origin 3000 的对分带宽约为 50 GB/s,当时没有标准网络技术能接近这一水平。
解答 每节点带宽就是每次访问传输的数据字节数乘以访问速率:
该速率略高于 Cray T3E 使用块预取时硬件可持续的传输速率,低于 SGI Origin 3000 每两个处理器 1.6 GB/s 的速率。FFT 的每节点需求超过当时最快标准网络可持续带宽的五倍。
译注: 原式中速率写成
1 GB/sec,量纲与“每秒十亿次访问”的题设不符;这里用显式的次数、字节单位表达同一计算,结果仍为 448 MB/s。原书的 28.7 GB/s 是把所有节点注入带宽直接相加的估计,没有另列跨越二分截面的流量比例或单向/双向口径,不能把该乘法当成对分带宽的一般定义。原文将对分带宽说明排在 Answer 标记之前。
前例考察带宽需求;并行程序的另一个关键问题是远程内存访问时间,也就是延迟。为理解这一点,考虑一个简单的目录式多处理器。图 I.16 给出模型参数:本地存储器访问的首字时间为 85 个处理器周期;本地存储器通路宽 16 字节,网络互连宽 4 字节。模型忽略争用;除采用全到全通信的 FFT 可能例外,这对所考察并行基准的影响应该不太严重。但其他工作负载中,争用可能显著影响性能。
| 特征 | ≤16 个处理器:处理器时钟周期 | 17–64 个处理器:处理器时钟周期 |
|---|---|---|
| 缓存命中 | 1 | 1 |
| 缓存未命中,由本地存储器提供 | 85 | 85 |
| 缓存未命中,由远程归属目录提供 | 125 | 150 |
| 缓存未命中,访问远程缓存数据(三跳未命中) | 140 | 170 |
最后一种情况称为三跳未命中,因为必须询问归属目录和远程缓存,代价更高。这个简单模型没有计入失效时间,但包含了互连时间随规模增加的部分因素。远程延迟以 SGI Origin 3000 为依据;原书将其称为 2001 年最快的可扩展互连系统,并假定处理器频率为 500 MHz。
图 I.17 在图 I.16 参数下,给出每次内存访问的平均周期代价;这里只计算各类访问本身的延迟。每根柱子分别列出缓存命中、本地未命中、远程未命中和三跳远程未命中的贡献。代价同时受未命中与升级的总频率,以及未命中在哪个位置得到服务的分布影响。除 Ocean 外,处理器数增加时远程访存代价相当稳定。Ocean 在 64 个处理器时未命中率的上升,已在图 I.12 中清楚显示;未命中率上升,自然应使访存耗时增加。
图中给出各基准在 8、16、32、64 个处理器上的访存代价,即第 2 章所称平均存储器访问时间;假设数据缓存为 512 KB、两路组相联、64 字节块。代价由四种访问组成,各类代价见图 I.16。Barnes 和 LU 未命中率低,所以总访问时间低。FFT 的较高代价由较高的本地未命中率(1%–4%)及明显的三跳未命中率(1%)决定。随着总缓存增加,本地未命中率从 4% 降至 1%,带来 FFT 的改善。Ocean 的访存代价变化最大,64 个处理器时总成本也最高,主要来自较高的本地未命中率,平均为 1.6%。从 8 增至 16 个处理器时,网格更容易装入各自缓存,访存代价下降;到 64 个处理器时,数据集太小,难以良好映射,本地未命中与一致性未命中都上升,如图 I.12 所示。
图中横轴为处理器数量,纵轴为每次访存平均周期数;图例依次为缓存命中、本地未命中、远程未命中、到远程缓存的三跳未命中。
图 I.17 展示的访存代价,是这些基准中主要的多处理器成本;但完整性能模型还应计入存储系统争用,以及同步延迟造成的损失。
I.6 用科学应用测量并行处理器性能
如何测量并行处理器的性能,一直是并行处理领域最有争议的问题之一。当然,最直接的回答是:按原样运行给定基准,并考察实际经过时间,也就是墙钟时间。
测量墙钟时间显然合理;对并行处理器,CPU 时间可能误导读者,因为处理器可能闲置,却不能供其他用途使用。
用户和设计者往往不仅关心固定处理器数量下的性能,还关心增加处理器后性能如何扩展。许多情况下,扩大应用或基准规模是合理的。如果预期用更多处理器求解更大问题,却让基准规模保持不变,那么有限并行度和通信增加的影响会使结果显得悲观。因此,常有必要同时测量固定规模问题和扩大规模问题随处理器增加获得的加速比,分别给出未扩展和扩展后的加速比曲线。如何测量单处理器算法也很重要,以免得到异常结果:在单处理器上仍用基准的并行版本,可能低估单处理器性能,从而夸大加速比。
一旦决定测量扩展加速比,接下来的问题就是如何扩展应用。假设已经确定,在 个处理器上运行规模为 的基准是合理的;那么,要改在 个处理器上运行,应怎样调整规模?有两种显然的方法:保持每个处理器使用的内存量不变;或者在假定理想加速的前提下,保持总执行时间不变。
第一种称为内存约束扩展(memory-constrained scaling),规定在 个处理器上运行规模为 的问题。第二种称为时间约束扩展(time-constrained scaling);由于要保持运行时间不变,必须知道运行时间与问题规模之间的关系。例如,若数据规模为 的应用在 个处理器上的运行时间与 成正比,那么按时间约束扩展,应选择在 个处理器上理想运行时间仍为 的问题。这个问题的规模为 。
例题 某问题规模为 时,执行时间与 成正比。在 10 个处理器上,实际运行时间为 1 小时。按时间约束和内存约束两种扩展模型,求在 100 个处理器上应运行的问题规模及有效运行时间。
解答 按时间约束扩展,理想运行时间仍为 1 小时,因此问题规模为 ,即原来的约 2.15 倍。按内存约束扩展,问题规模为 ,理想执行时间为原来的 倍,也就是 100 小时!多数用户不会愿意使用十倍的处理器,却运行一百倍长的时间,因此这一问题规模可能不现实。
除了扩展方法,还要考虑另一类问题:如果扩大问题规模会影响结果质量,程序应怎样扩展?通常,必须调整应用中的其他参数。一个简单例子是,求解微分方程所需的收敛时间。问题越大,收敛时间往往越长,例如较大问题通常需要更多迭代。因此,扩大问题规模后,总运行时间可能比基本算法复杂度所指示的增长更快。
例如,假设迭代次数按问题规模的对数增长。若基本算法运行时间与问题规模呈线性关系,实际运行时间便与 成正比。从在 10 个处理器上运行规模为 的问题出发,只考虑基本算法的扩展,会允许在 100 个处理器上运行规模为 的问题。原文接着认为,计入迭代次数增长后,应运行规模为 、满足 的问题,才能维持运行时间不变;据此得出规模为 ,而不是 。
译注: 原书的 以及 5.72 按原述保留;5.72 对应近似采用自然对数。但若严格沿用前句 ,从规模 扩至 ,等时条件应为 ,仍然依赖初始规模 。原书没有说明可消去这一依赖的额外归一化假设,不能将 5.72 作为任意初始规模都成立的扩展倍数。
实际中,为控制误差而扩展问题,需要深入了解应用,还可能涉及误差容限等其他因素;例如,误差容限影响 Barnes–Hut 中打开空间单元的判据。反过来,这些效应往往显著改变应用的通信特征、并行度,以及应选择的问题规模。
扩展加速比与未扩展加速比,即真正的同规模加速比,并不相同;混淆两者曾导致错误的性能主张。原文在这里仍引用 I.6 节的讨论。扩展加速比有重要作用,但前提是扩展方法合理,并且明确报告使用了扩大规模后的应用。Singh、Hennessy 和 Gupta[1993]对这些问题有详细论述。
I.7 缓存一致性的实现
本节研究实现缓存一致性的挑战,先讨论第 5 章只是略作提及的监听一致性协议。目录协议在监听协议之上又增加了一些复杂性,主要原因是没有广播,必须用其他机制解决竞争。此外,目录式多处理器的处理器数量更多,不能再假定缓冲空间无限,必须寻找避免死锁的新方法。先从监听协议谈起。
如第 5 章所述,不使用总线时,监听协议处理未命中的难点,在于如何让包含多个步骤的未命中处理过程表现为原子操作。升级未命中与写未命中需要相同的基本处理,也产生相同的实现难题;为简化讨论,这里集中分析升级未命中。处理步骤如下:
- 检测到未命中,构造发往其他缓存的失效消息。
- 获得广播通信链路的使用权后,发送消息。
- 所有失效请求处理完毕后,处理器更新缓存块状态,再执行引起升级未命中的写入。
这里有两个相关难题。第一,若 P1、P2 同时试图升级同一缓存块,如何解决竞争?第二,在第 3 步,处理器如何知道全部失效请求都已处理完毕,从而可以完成这一步?
判定竞争获胜者的办法,在于广播介质施加的顺序。通信介质必须把每次缓存未命中广播到所有节点。若 P1、P2 同时尝试广播,必须保证:或者 P1 的消息先到达 P2,或者 P2 的消息先到达 P1。以下条件可以保证这一性质:每个节点的全部传入、传出请求都必须通过同一个通道;网络只有在能够保证交付时才接受消息,亦即实际上采用电路交换,见附录 F。如果 P1、P2 同时发起失效广播,网络就只能接受其中一个,推迟另一个。这种排序保证 P1、P2 中有一个先完成第 2 步的通信。网络可以在接受消息且保证它成为下一次传输时显式发信号;也可以让处理器监听网络中的自身请求:一旦看见该请求,就知道在任何后续消息之前,它会完整传到全部处理器。
假设 P1 赢得发送失效消息的竞争;一旦知道自己获胜,就能继续第 3 步,完成未命中处理。但 P2 有潜在问题:它开始第 1 步时,相信块处于共享状态;而 P1 要在第 3 步继续,必须知道 P2 已处理失效请求,也就是 P2 的块必须已经变成无效!一种简单方法是让 P2 观察到 P1 的失效广播先于自己的广播,意识到自己输了。P2 随后使块失效,并发出写未命中来获取数据。P1 先看到自己的失效请求,再看到 P2 的请求,因此会先将块改为已修改状态并更新数据,这保证了执行进展,避免死锁。P1 随后看到对已修改块的失效请求时,就知道自己赢得过一场竞争;第 5 章的基本协议中不会出现这种情况。它可以直接忽略此失效请求,因为后面会有写未命中;也可以将块写回存储器,并把状态改为无效。
另一种办法是让传入请求优先于传出请求。因此,P2 在发送自身失效请求之前,必须先处理所有待处理的失效或写未命中。如果某个传入请求与待发消息指向同一块,处理器就必须准备好重启写操作,因为传入请求可能改变该块的状态。注意,由于传入失效优先于传出请求,P1 成功完成广播后,就知道失效会被处理。目录协议不采用广播,处理器无法由此知道失效何时到达;它需要显式确认,下一部分会讨论。实际上,在请求得到确认之前,处理器连自己是否赢得所有权竞争都无法确定。
读取也需要多个步骤,因为数据必须从存储器,或在写回缓存系统中从远程缓存取回;不过,读取没有引入写入之外根本不同的问题。
还有一些棘手的边界情况必须正确处理。例如,写回缓存发生读未命中时可能需要写回一个块;处理器可能优先处理读未命中,推迟写回。若此时出现针对待写回块的监听请求,处理器必须发现它并返回数据,否则可能死锁。类似地,处理器发出写未命中,准备让一个块成为独占状态,但在接收数据并更新块之前,其他处理器又对该块发出读未命中。此时,必须等写入处理器收到数据并完成更新后,才能处理那些读未命中。
另一项较难的问题是:在写回缓存系统中,读未命中或写未命中的数据可能来自存储器,也可能来自某个处理器缓存,但请求者事先不知道来源。多数总线系统使用一个全局信号,表示是否有处理器持有独占、因而也是最新的副本;若没有,才由存储器响应。对于流水化互连,可以要求各处理器在未命中广播后的固定周期数内报告是否持有独占副本,从而使用这种方案。
但现代多处理器基本无法给出监听请求处理时间的严格上限。因此,需要另一种机制判断存储器副本是否最新。一种方法是在存储器中增加一致性位,指示数据是否被某个远程缓存独占。这已经开始接近目录方法,下面就讨论其实现挑战。
DSM 多处理器中的缓存一致性实现
实现目录式缓存一致性协议,需要解决监听协议中所有由非原子操作造成的问题,却不能依赖广播。广播曾经强制竞争写入串行化,也保证了存储一致性模型所要求的顺序,见第 5 章。避免广播是目录系统的核心目标,因此必须用其他方法保证串行化。
对某内存块的独占访问请求很容易排序,因为它们到达该块唯一的目录时,就会被串行处理。只要目录控制器保证一个请求被完整处理后再开始下一个,写入就会串行化。
请求者事先不知道谁会赢,而且通信不是广播,所以目录处理完获胜者的请求后,必须通知它。这可以通过写未命中的数据响应完成,也可以用针对失效请求、显式授予所有权的确认消息完成。
竞争失败者怎么办?最简单的方法是返回否定确认,即 NAK,让请求节点重新发出请求。这相当于监听方案中广播网络发生冲突,需要其中一个发送节点重试。下一部分将说明,为什么与缓冲请求相比,NAK 是有吸引力的方案。
发送写未命中响应或所有权确认后,虽然已通知请求节点获得所有权,但仍不知道共享者集合中的各节点是否收到并处理了失效请求。所有存储一致性模型最终都会要求处理器知道这次写入的全部失效已完成,例如在下一次缓存未命中之前,或者在同步点。监听方案由广播网络本身提供这种保证。
目录方案如何知道失效已完成?唯一的办法,是让失效消息的接收节点,也就是共享者集合成员,显式确认目录发来的失效消息。确认应发给谁?有两种选择。第一种发给目录,由目录计数,全部确认收齐后,再向最初的请求者发送一条确认。第二种是在授予所有权时,目录告知请求者应收到多少条确认;各失效接收方直接向请求者确认,请求者身份由目录提供。多数现有实现采用后者,因为它降低了目录成为瓶颈的可能性。显式确认虽然增加了目录协议的复杂性,但这是避免监听广播这类串行化机制的代价;而这类机制本身正是扩展性的限制。
避免有限缓冲引起的死锁
目录式多处理器可能具有很大规模,因此实现中又多了一项复杂性。第 5 章假定网络总能接受一致性消息,而且请求最终会得到处理。在更大型多处理器中,无限缓冲的假设可能不合理。缓冲空间有限会怎样?主要影响是,缓存控制器或目录控制器可能无法完成消息发送,从而导致死锁。
潜在死锁来自以下三个性质,它们也是许多死锁场景的共同特征:
- 完成事务需要不止一种资源。 生成请求、生成回复与确认,以及接收回复,都需要消息缓冲区。
- 资源一直持有到非原子事务完成。 生成回复所用的缓冲区,在回复被接受之前不能释放,原因稍后说明。
- 资源获取不存在全局偏序。 节点可以自由产生请求和回复。
这些性质会导致死锁;要避免死锁,必须破坏其中至少一项。在事务未完成时释放资源很困难,因为必须完整撤销事务,不能把它留在半完成状态。因此,我们尝试解决对多种资源的需要。不能简单取消这种需要,但可以设法保证所需资源始终可用。
保证事务最终完成的一种办法,是始终预留足够缓冲区来接收消息。对小型多处理器,如果处理器在缓存未命中时阻塞,或只有少量尚未完成的未命中请求,这或许可行;但对目录协议未必实用,因为一次写入就可能产生大量失效消息。此外,预取和多个尚未完成的未命中请求等特性,还会进一步增加缓冲需求。多数系统采用另一种策略:只有在能够保证具备完成事务所需资源后,才真正启动事务。这一策略由四部分组成:
- 请求与回复使用分开的物理或虚拟网络。这里的“回复”,是控制器进行状态转换时必须等待的任何消息。这样,新请求就不会堵住那些能够释放缓冲区的回复。
- 每个预期会收到回复的请求,在生成时就分配接收回复的空间。如果没有空间,请求必须等待。这保证节点总能接收回复,让回复方释放缓冲区。
- 控制器可以对任何请求返回 NAK,但绝不能拒绝回复。这防止控制器在无法保证回复缓冲空间时启动事务。
- 收到 NAK 的请求直接重试。
要理解为什么这四项能避免死锁,必须保证所有回复都能被接受,而且每个请求最终都能获得服务。缓存或目录控制器总在发出请求之前分配回复缓冲区,所以回复返回时一定能接受。要说明每个请求最终都能得到服务,需要说明任一个请求都可以完成。每个请求都起源于缓存的读未命中或写未命中,因此只需说明二者最终可获服务。写未命中包含了读未命中的动作,下面只讨论写未命中。块未缓存是最简单的情况,而共享块情况包含了它,因此重点讨论共享和独占两种情况。
先看块处于共享状态时:
- CPU 尝试写入,产生发往目录的写未命中。为简化讨论,假设处理器已经停顿;即便继续发请求,在第一次请求完成之前,也不应再对同一缓存块发请求。不同块的请求可以独立处理。
- 写未命中被发送到该内存块的目录控制器。一个缓存控制器负责同一缓存块位置的所有请求,而不论其中当前存放的是哪一个内存块的数据;目录控制器则把不同块的请求视为独立事件,前提是有足够缓冲,并在代表该请求进一步发消息前就分配好。目录控制器的冲突只发生在两个请求针对同一块时。它必须等待第一个操作完成;第二个请求可以被 NAK,也可以被缓冲,但不能在第一个完成前获得服务。
- 假设该写未命中是目录控制器接下来处理的事件。控制器发出失效请求,缓存控制器总能在有限延迟后接受。一种可能是,缓存控制器对同一块也有尚未完成的未命中请求。这与监听方案中的竞争相对应;仍须强制缓存控制器接受并执行目录请求来打破竞争。根据具体时序,该缓存控制器要么稍后从目录取得缓存行,要么收到 NAK 并重新启动过程。
块处于独占状态时稍复杂。分析从写未命中到达目录控制器开始,有两种情况:
- 目录控制器向持有者发送取回/失效消息。消息到达时,块仍处于独占状态。缓存控制器将数据写回归属目录,并使本地状态无效。归属目录已预先分配缓冲区,所以一定能接收回复;随后把数据发给请求处理器,请求者同样一定能接收。更新缓存后,请求方缓存控制器通知处理器。
- 目录控制器向记录中的所有者发出取回/失效消息。但消息到达时,该缓存控制器已经因另一次读未命中或写未命中而替换了该块。此时,它已经把块以数据写回消息发往归属目录,并使本地数据不可用。这与取回/失效消息所要求的效果完全相同,因此协议在这种情况下也能正确工作。
上述分析说明:只要缓存和目录控制器能够接受那些没有其他未完成操作的块的请求、总能接受回复,并允许请求被 NAK 后重试,一致性机制就能正常工作。和监听协议一样,缓存控制器必须能打破竞争;这里始终让目录发来的指令优先。能够对请求返回 NAK,使有限缓冲实现得以避免死锁。
目录控制器的实现
缓存控制器仍需具备监听方案中的能力:在等待本地处理器请求的响应时,能处理其他独立块的请求。传入请求仍按顺序处理,每个请求处理完再开始下一个。如果短时间到达的请求太多,缓存控制器可以返回 NAK,因为目录稍后会重新生成请求。
目录也必须支持多个活动事务,独立处理不同块的请求。这与缓存控制器处理独立块的传入请求略有不同:目录在较早请求仍未完成时,就需要开始处理另一个请求。它不能总等一个请求完成后才处理下一个,否则可能死锁。因此目录控制器必须可重入:等待回复时可以挂起当前执行,接收另一项事务。必须这样做的地方,是响应读未命中或写未命中、等待所有者回复时。由此得到三点重要结论:
- 只有在远程取回,或取回/失效操作尚未完成时,才需要保存、恢复控制器状态。
- 对于会让未完成请求数超出上限的读、写未命中,可以直接 NAK,从而限制目录同时处理的事务数量。
- 如果所有者不经目录转送数据,而是直接向请求者转发,同时也把数据返回目录,就可以避免要求目录处理多个未完成请求。这一点与降低延迟一起,构成采用转发式协议的动机。不过,请求到达时间非常接近时,转发式协议也会引入其他复杂情况。
剩下的主要难点是处理 NAK。一种方案是让每个处理器跟踪自身未完成事务,从而在 NAK 到达时知道对应的请求;另一种是在 NAK 中附上原始请求,让接收控制器据此恢复。由于每个请求都已预留接收回复的槽位,而 NAK 也是回复,因此总能收到 NAK。实际上,这个回复槽位还可以保存请求信息,让处理器在被拒绝后重新发出请求。
实践中,要正确实现这些协议并避免死锁,必须十分谨慎。本节的核心思想——处理非原子性与有限缓冲——对保证实现正确至关重要。设计者发现,形式化和非形式化验证技术都有助于确认实现的正确性。
I.8 定制集群方案:Blue Gene/L
Blue Gene/L(BG/L)是一种可扩展的消息传递超级计算机。按每瓦计算能力衡量,其设计提供了前所未有的计算密度。由于注重能效,BG/L 的每立方英尺吞吐量也达到了当时无与伦比的水平。高计算密度、性价比高的节点,以及对可靠性、可用性和可维护性(RAS)的广泛支持,使 BG/L 能高效扩展到极大的处理器规模。
BG/L 采用分布式存储和消息传递,却与常见的集群计算机颇为不同。后者往往面向吞吐量,处理器、互连,有时连封装和系统组织都采用通用商品技术。BG/L 则使用专门定制的处理节点:其中包含两个处理器、缓存和互连逻辑;处理器源自嵌入式市场中低功耗、较低时钟频率的 PowerPC 440。加入 SDRAM 芯片后,就构成完整的计算节点;这些 SDRAM 是 BG/L 设计中唯一的通用商品半导体器件。
原书描述,BG/L 最多包含 64 K 个节点,组织成 32 个机架,每架在约 50 立方英尺的空间中容纳 1 K 个节点。每个机架包含两块双面板,每板 512 个节点。由于板内和机架内密度很高,85% 的互连都位于单个机架内部,大幅减少了机架间连接的复杂性与延迟。节点的低功耗和高密度又使机架十分紧凑,从而显著提高效率:机架内连接所需的互连网络逻辑,集成在构成每个节点的单颗计算芯片中。
译注: 原书同段的“64 K 个节点”与“32 架、每架 1 K 节点”不相符;后者合计为 32 K 节点。
附录 F 讨论了 BG/L 的主要互连网络,即三维 torus。它还有四种网络:连接指定 I/O 节点的千兆以太网、用于测试的 JTAG 网络、屏障网络,以及全局集体通信网络。屏障网络包含四条独立通道,可在所有处理器之间执行全局 OR 或全局 AND,延迟小于 1.5 μs。全局集体通信网络把所有处理器连接成树,用于全局操作;它直接支持多种整数归约,无须处理器介入,使大规模归约比典型超级计算机快 10–100 倍。该网络还能高效地广播单个值。集体通信网络与 torus 的支持逻辑,都集成在每个处理节点的核心芯片中。
Blue Gene/L 计算节点
每个 BG/L 节点由一颗处理芯片和若干 SDRAM 芯片组成。图 I.18 中的处理芯片包含以下部分:
- 两个 PowerPC 440 CPU。 原书将每个 CPU 描述为双发射超标量处理器,采用七级流水线,具备推测式乱序发射能力,时钟频率为适中而节能的 700 MHz。每个 CPU 有独立的 32 KB 指令缓存和 32 KB 数据缓存,采用非阻塞设计,最多支持四个尚未完成的未命中请求;缓存一致性必须由软件保证。每个 CPU 还包含一对浮点协处理器,每个协处理器都有自己的浮点寄存器组,每周期能发射一次乘加操作。它们支持专用 SIMD 指令集能力,其中包括利用寄存器对和 128 位操作数完成复数运算。
- 各自独立的全相联 L2 缓存。 每个 L2 容纳 2 KB 数据,块大小为 128 字节,实质上充当预取缓冲区。L2 控制器识别流式数据访问,也负责从 L3 或主存预取。其延迟很低,为 11 个周期;原书给出的带宽为每周期 5 字节,并称 L2 预取缓冲区能够向 L1 缓存提供 5.5 GB/s。
- 采用嵌入式 DRAM 实现的 4 MB L3 缓存。 每个 L2 缓冲区都通过总线连接 L3,总线从 L3 提供 11 GB/s 带宽。
- 支持 256–512 MB DDR DRAM 的存储器总线。 它向 L3 缓存提供 5.5 GB/s 的主存带宽。考虑到每个节点有两个处理器、每个处理器又有两个浮点单元,这个内存容量似乎偏小。按 Amdahl 的经验规则,即每 1 MIPS 配备 1 MB 内存,再假定性能达到峰值的 25%,每节点内存应约为现有容量的 2.7 倍。不过,对于浮点运算密集型应用,计算需求相对于内存容量通常呈超线性增长,所以每节点最高 512 MB 的配置可能是合理的。
- 五种互连网络的支持逻辑。
译注: 原书所列“每周期 5 字节”与 700 MHz、5.5 GB/s 并不一致:按前两项相乘为 3.5 GB/s。原图也标示 5.5 GB/s。CPU 发射方式等描述同样按本节原述保留。
图中两个 CPU 各有 32 KB/32 KB 的 L1 缓存和双发射浮点单元;L2 prefetch buffer 为 L2 预取缓冲区,Snoop 为监听通路。中间是带 ECC 纠错控制的嵌入式 DRAM 共享 L3 目录,右侧为可用作 L3 缓存或存储器的 4 MB 嵌入式 DRAM。连线标出 128、256、1024 位等宽度,以及 5.5、11、22 GB/s 的带宽。底部接口从左到右依次为千兆以太网、IEEE 1149.1 JTAG、torus、集体通信、全局中断/lockbox、带 ECC 的 DDR 控制器。原图将 torus 标为六条出链路和六条入链路、每条 1.4 GB/s;集体通信为三出三入、每条 2.8 GB/s;全局网络支持四个全局屏障或中断;DDR 为含 ECC 的 144 位宽、256/512 MB,带宽 5.5 GB/s。这些链路单位照原图保留。
BG/L 把 DRAM 以外的全部逻辑放入单颗芯片,提高密度、降低功耗与成本,使处理节点可以极其紧凑地排列。这种密度又使互连网络兼具低延迟、高带宽和较高性价比。两者结合,得到了一种能够经济有效地扩展的超级计算机:对于超大规模多处理器,与其他方案相比,每瓦 GFLOPS 提高了一个数量级,每美元 GFLOPS 也显著改善。
例如,具有 64 K 节点的 BG/L 峰值性能为 360 TFLOPS,功耗约 1.4 MW。若使用原书所称能效最高的高端浮点处理器 Power5+ 达到同样的 360 TFLOPS 峰值,约需 23,500 个处理器——其双处理器配置以 1.9 GHz 运行,每周期最多执行 8 次浮点运算。仅处理器本身,不包括外部缓存、DRAM 和互连,功耗就约为 2.9 MW,约是整套 BG/L 的两倍。同样,BG/L 节点芯片面积较小,外部只需 DRAM 芯片,因此与基于高端多处理器构建的节点相比,成本也显著降低。图 I.19 展示了 64 K 节点 BG/L 的照片。这个拥有 128 K 处理器的系统,总占地规模与早期 16 K 处理器的多处理器系统相当。
译注: 图 I.19 原图注写的是“64 K 处理器”,而同页正文写“64 K 节点、128 K 处理器”。两种口径有冲突。
I.9 结束语
在此前五到十年间,大规模多处理器的格局发生了剧烈变化。规模最大的多处理器都采用了某种形式的集群,但将它们统称为“集群”,会掩盖体系结构、实现方式、成本和性能上的重大差异。Bell 和 Gray[2002]讨论了这一趋势,认为集群将占主导地位。Dongarra 等[2005]也认为,对于最大的多处理器,某种形式的集群几乎不可避免;但他们提出了更细致的分类,以区分各种不同方案。
图 I.20 汇总了用于大规模多处理器的术语,着重从体系结构和实现角度定义这些名称。图 I.21 展示了各种体系结构方案之间的层次关系。虽然过去十五年间方案有所趋同,但以 Linpack 基准评测世界上最快 500 台计算机的 TOP500 榜单,仍包含通用商品集群、定制集群、对称多处理器(SMP)、分布式共享内存系统(DSM)和 constellation;其中既有标量处理器,也有向量处理器。
| 术语 | 特征 | 示例 |
|---|---|---|
| MPP | 最初指由大量小型处理器构成的一类体系结构;处理器通常为定制设计,体系结构通常采用 SIMD 方式。 | Connection Machines CM-2 |
| SMP(对称多处理器) | 共享内存多处理器,各处理器与内存之间的关系对称,也称 UMA(均匀存储器访问)。可扩展版本采用多级互连网络,典型配置上限为 64–128 个处理器。 | SUN Sunfire、NEC Earth Simulator |
| DSM(分布式共享内存) | 以分布方式支持可扩展共享内存的一类体系结构。既有支持缓存一致性的实现,也有不支持的实现;通常可容纳数百至数千个处理器。 | SGI Origin 和 Altix、Cray T3E、Cray X1、IBM p5 590/5 |
| 集群(cluster) | 使用消息传递的一类多处理器。各节点可采用通用商品或定制设计,互连也一样。 | 见通用商品集群与定制集群两行 |
| 通用商品集群(commodity cluster) | 节点完全采用通用商品,通常是无显示终端的工作站、主板或刀片服务器,通过 SAN 或 LAN 相连,通常经 I/O 总线访问网络。 | Beowulf 及其他自行组装的集群 |
| 定制集群(custom cluster) | 节点和互连均为定制设计,比通用商品集群集成得更紧密;也称分布式存储多处理器或消息传递多处理器。 | IBM Blue Gene、Cray XT3 |
| Constellation | 将规模较小的多处理器组成集群,构成大规模多处理器。所用小规模多处理器通常采用 DSM 或 SMP 体系结构,并有 32 个或更多处理器。 | 较大的 SGI Origin/Altix、ASC Purple |
表中的 IBM p5 590/5 产品名称按原表保留。Constellation 在这里是特定系统分类名,保留英文,以免另造中文名称造成歧义。
不过,从 TOP500 榜单中各类多处理器的分布,仍能看出一些正在形成的趋势:
- 集群占据系统总数的大多数。 开发工作量较小,显然是其日益普及的动力。高端多处理器市场还没有发展到足够大的规模,无法让全盘高度定制的设计成为主流选择。
- 多数集群采用通用商品。 它们往往由用户自行组装,而非由系统厂商设计成标准产品。
- 榜单前 25 名的类型更为多样。 尽管通用商品集群在总数上占主导地位,前 25 名却包括九个定制集群,主要是 Blue Gene 或 Cray XT3;两个 constellation;八个通用商品集群;两个 SMP,其中一个是节点采用向量处理器的 NEC Earth Simulator;以及四个 DSM 多处理器。
- 向量处理器几乎消失。 它们曾经占据榜单的主导地位。
- IBM Blue Gene 主导前十名。 这体现了其设计取舍的优势:采用部分通用商品处理器核心,定制许多其他功能,并兼顾性能、功耗和封装密度。
- 体系结构趋同更多源自市场作用。 增长不足、供应商有限等因素的推动,比对“最佳体系结构方案”形成明确共识更强。
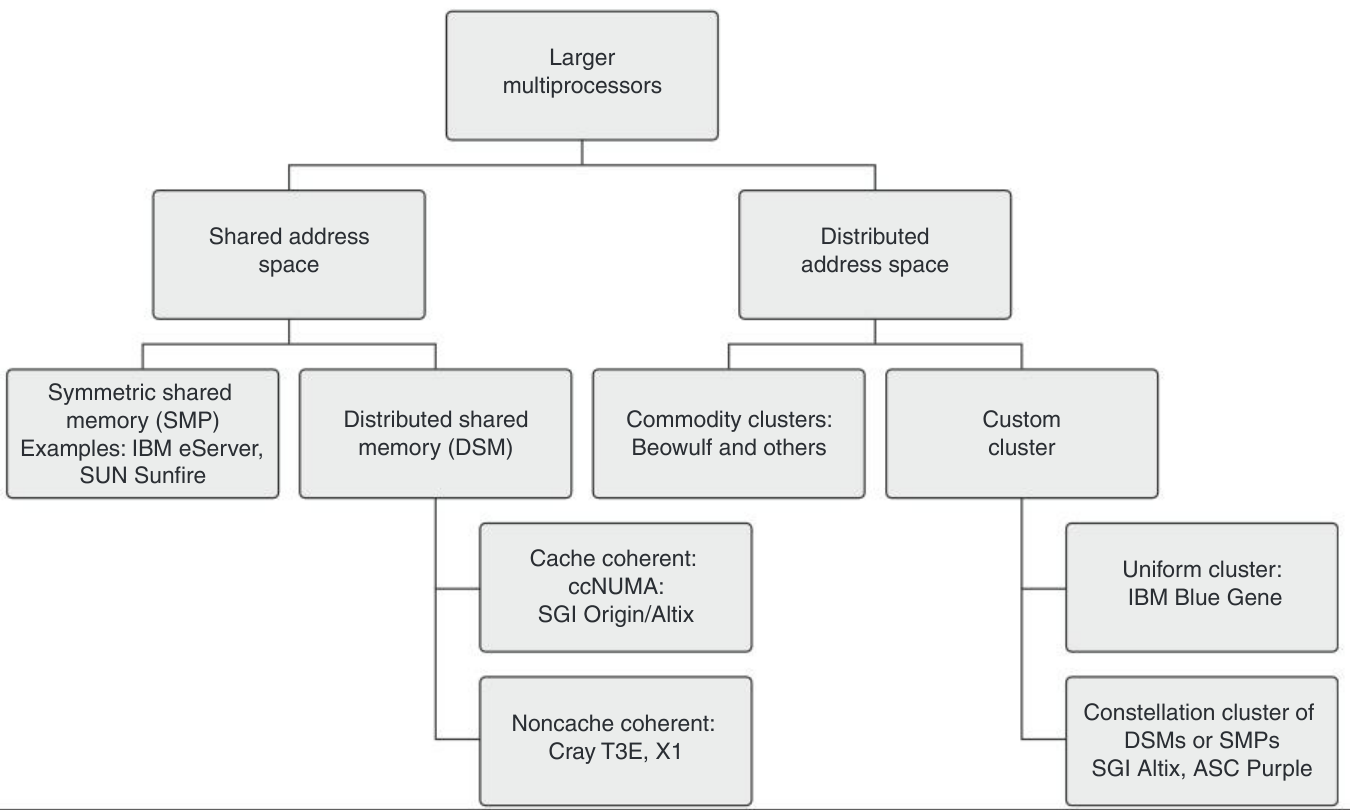
图中顶层按地址空间分为两支。共享地址空间下分为对称共享内存 SMP(IBM eServer、SUN Sunfire)和分布式共享内存 DSM;DSM 再区分为缓存一致的 ccNUMA(SGI Origin/Altix)与不支持缓存一致性的系统(Cray T3E、X1)。分布式地址空间下分为通用商品集群(Beowulf 等)和定制集群;定制集群再分为节点结构统一的集群(IBM Blue Gene),以及由 DSM 或 SMP 组成的 constellation 集群(SGI Altix、ASC Purple)。
软件——包括应用程序、编程语言和编程环境——仍是并行计算的重大挑战,就像三十年前设计 Illiac IV 等多处理器时一样。编程容易与并行性能高,仍难以兼得。在这个方面取得更大进展之前,要向单一编程模型及其底层体系结构方案收敛,进程仍会缓慢,或者由已获证实的体系结构优势以外的因素推动。别忘了,对于单处理器,我们实质上已经有一种编程模型和一种体系结构方案!
J 计算机算术
本附录作者:David Goldberg,Xerox Palo Alto Research Center。
快的总会取代慢的,哪怕快的算错了。
—— W. Kahan
J.1 引言
计算机算术有时被视为 CPU 设计中一个专门的分支,但它的重要性不容忽视。1994 年,Intel 的 Pentium 芯片被发现存在除法算法缺陷,这件事让 Intel 深切体会到这一点。这个浮点运算缺陷不仅招致大量负面报道,也给公司造成了巨额损失。Intel 为更换有缺陷的芯片,计提了 3 亿美元的损失。
本附录将研究一些基本的浮点算法,其中包括 Pentium 所采用的除法算法。虽然人们为浮点加速器提出过种类繁多的算法,实际实现通常仍建立在本附录介绍的少数基本算法之上,只是加以改进或变化。除选择加、减、乘、除算法外,计算机体系结构设计者还必须作出其他决定:应实现哪些精度?应如何处理异常?本附录将为这些以及其他决策提供必要的背景知识。
鉴于 IEEE 浮点标准(IEEE 754)正日益得到广泛采用,本附录的浮点讨论几乎完全围绕这一标准展开。浮点运算虽然需要处理指数并移动小数部分,但大部分时间花在用整数算法处理小数部分上;这并不意味着必须与执行整数指令的硬件共用电路。因此,在讨论浮点运算之后,我们还将进一步考察整数算法。
关于计算机算术的良好参考资料,按详尽程度由浅入深排列,包括 Patterson 与 Hennessy [2009] 第 3 章,Hamacher、Vranesic 与 Zaky [1984] 第 7 章,以及 Gosling [1980] 和 Scott [1985]。
J.2 整数算术的基本技术
学过计算机算术的读者会发现,本节的大部分内容属于复习。
行波进位加法
加法器通常由多个简单部件组合而成。半加器和全加器就是构造加法器的基本部件。半加器接收两个位 、,输出和位 与进位 。从数学上说,
其中 表示向下取整。写成逻辑方程,则为 、,其中 表示 , 表示 。半加器也称为 (2,2) 加法器,因为它有两个输入、两个输出。
全加器是 (3,2) 加法器,定义为 、,对应的逻辑方程为:
用小部件构造 位加法器时,主要问题是如何将进位从一个部件传到下一个部件。最直接的办法是采用行波进位加法器(ripple-carry adder):把 个全加器连接起来,如图 J.1 所示。本附录图中的最低有效位一律位于右侧。加法器的输入为 和 ;前者表示数值 。第 个加法器的输出 接入下一个、即第 个加法器的进位输入,最低位的进位输入 置为 0。既然最低位进位接 0,最低位加法器本可采用半加器。不过,后面会看到,把这个进位置为 1 对减法很有用。
电路产生输出所需的时间,通常与信号经过的最大逻辑级数成正比。不过,逻辑级数与实际延迟的准确关系高度依赖工艺,所以比较加法器时,我们只比较逻辑级数。行波进位加法器有多少级?由 、 算出 需要两级,再由 算出 又需要两级,依此类推直到 ,共需 级。整数运算的典型 值是 32,双精度浮点运算则是 53。行波进位加法器最慢,但也最便宜:只需 个简单单元,以简单而规则的方式连接。
与 J.8 节讨论的设计相比,行波进位加法器相当慢,为什么还要使用它?在 CMOS 等工艺中,虽然它的时间复杂度为 ,常数因子却很小。因此,短的行波进位加法器常被用作较大加法器的基本模块。
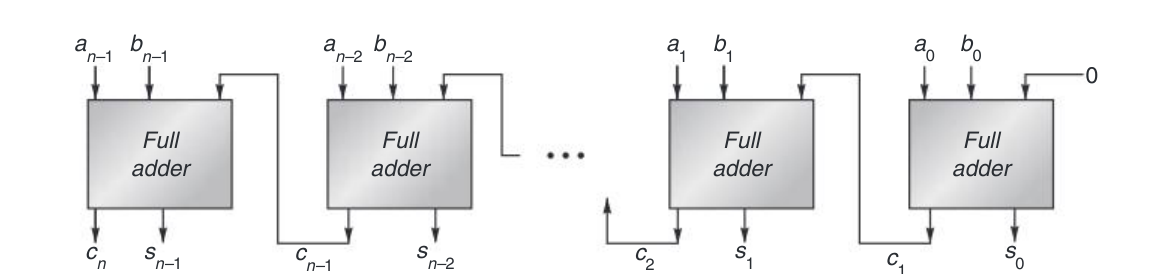
图中 Full adder 表示全加器; 为输入位, 为和位, 为进位。
基 2 乘法与除法
最简单的乘法器逐位计算两个无符号数的乘积,如图 J.2(a) 所示。待相乘的数 与 分别置于寄存器 A、B,寄存器 P 初值为 0。每一步乘法分为两部分。
乘法步骤
- 若 A 的最低有效位为 1,就把含有 的寄存器 B 加到 P;否则向 P 加上全 0。和写回 P。
- 将 P、A 组成的寄存器对右移一位。第 1 步的进位移入 P 的最高位,P 的最低位移入 A 的最高位,A 的最低位移出后弃去。
重复 次之后,乘积位于 (P,A) 中,A 保存低半部分。
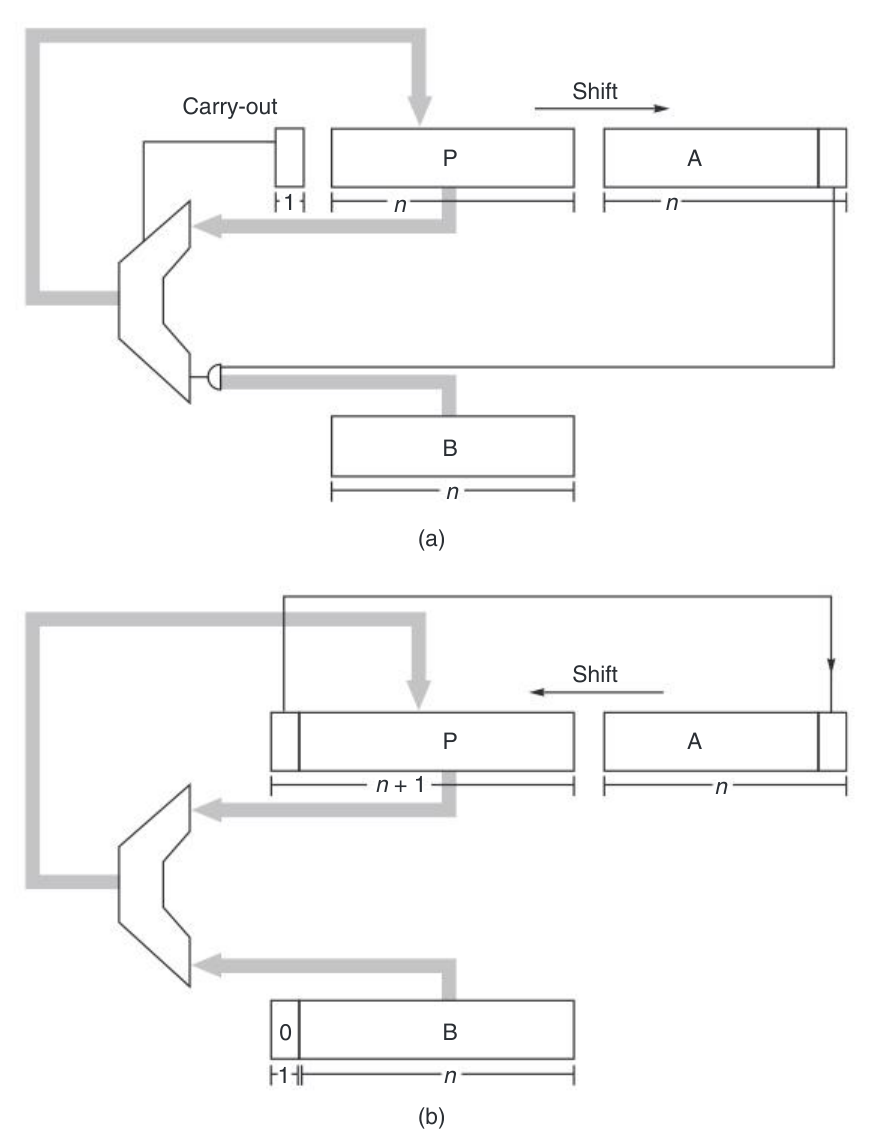
图中 Carry-out 为进位输出,Shift 为移位;乘法器的 P 和 A 各为 位,另有一位进位;除法器的 P 为 位,A 为 位,B 在最高端补 0。
除法器与乘法器很相似,也逐位产生商。要计算 ,仍把 放入 A、 放入 B,P 置 0。下面的算法称为恢复余数除法(restoring division),每一步包含:
- 将寄存器对 (P,A) 左移一位。
- 从 P 中减去 B。
- 如果结果为负,把 A 的最低位置 0;否则置 1。
- 如果结果为负,向 P 加回 B,以恢复原值。
重复 次后,A 中是商,P 中是余数。这正是纸笔长除法的二进制形式;图 J.3(a) 给出了一个例子。图 J.2(b) 是相应硬件框图。乘除法器可以共用同一套硬件,主要变化是移位必须能够向两个方向进行。
恢复操作也可以省去:当一次减法产生负数时,保留它,在下一步作相应补偿。这称为不恢复余数除法(nonrestoring division)。每一步如下:
- 若 P 为负:(i-a) 将 (P,A) 左移一位;(ii-a) 把 B 加到 P。
- 若 P 非负:(i-b) 将 (P,A) 左移一位;(ii-b) 从 P 中减去 B。
- (iii) 若 P 为负,将 A 的最低位置 0;否则置 1。
重复 次之后,A 保存商。若 P 非负,它就是余数;否则,还需要恢复一次,即加上 ,才得到余数。图 J.3(b) 给出了数值例子。步骤 (i-a) 与 (i-b) 相同,因此很容易想到先统一移位,再判断 P 的符号。但这样不行,因为移位可能使符号位丢失。
(a) 恢复余数除法: 除以 ,B 始终为 。
| P | A | 操作 |
|---|---|---|
00000 | 1110 | 初始值 |
00001 | 110 | 第 1 步 (i):移位 |
−00010 | 1100 | 第 1 步 (ii):减 00011;(iii):结果为负,商位置 0 |
00001 | 1100 | 第 1 步 (iv):恢复 |
00011 | 100 | 第 2 步 (i):移位 |
00000 | 1001 | 第 2 步 (ii):减 00011;(iii):结果非负,商位置 1 |
00001 | 001 | 第 3 步 (i):移位 |
−00010 | 0010 | 第 3 步 (ii):减 00011;(iii):结果为负,商位置 0 |
00001 | 0010 | 第 3 步 (iv):恢复 |
00010 | 010 | 第 4 步 (i):移位 |
−00001 | 0100 | 第 4 步 (ii):减 00011;(iii):结果为负,商位置 0 |
00010 | 0100 | 第 4 步 (iv):恢复;商为 ,余数为 |
(b) 不恢复余数除法:同样计算 ,B 始终为 。
| P | A | 操作 |
|---|---|---|
00000 | 1110 | 初始值 |
00001 | 110 | 第 1 步 (i-b):移位 |
11110 | 1100 | 第 1 步 (ii-b):减 ,即加其补码 11101;(iii):P 为负,商位置 0 |
11101 | 100 | 第 2 步 (i-a):移位 |
00000 | 1001 | 第 2 步 (ii-a):加 ,即 00011;(iii):P 非负,商位置 1 |
00001 | 001 | 第 3 步 (i-b):移位 |
11110 | 0010 | 第 3 步 (ii-b):减 ,即加 11101;(iii):P 为负,商位置 0 |
11100 | 010 | 第 4 步 (i-a):移位 |
11111 | 0100 | 第 4 步 (ii-a):加 ,即 00011;(iii):P 为负,商位置 0 |
00010 | 0100 | 余数为负,再加 00011,作最后一次恢复;商为 ,余数为 |
为什么不恢复余数法有效?令 表示第 步之后 (P,A) 的内容,暂不计放入 A 空闲低位中的商位。以上例为例,初始 ,第一次移位后得到 28。恢复余数法首先把 变成 ,再从高半部分减去 ,相当于计算 。若结果非负,两种算法没有区别。若结果为负,恢复余数法将它恢复为 ,下一步得到
不恢复余数法则保留负的结果,下一步先移位,再加上 ,得到
因此,在上述比较中,两种算法得到的 (P,A) 位模式相同。
我们一直假定 为无符号数,即 。乘法中 P 用 位就足够;除法中,P 需要 位来表示符号,加法器也要有 位。
恢复余数除法似乎要多做一次加法,为什么仍有人采用它?常见实现并不真的执行第 (iv) 步的加法,而是检查减法结果的符号,仅当结果非负时才把结果装入 P。还有一点:开始除法前,必须检查除数是否为 0。
有符号数
有符号数有四种常见表示:原码(sign magnitude)、补码(two’s complement)、反码(one’s complement)和移码(biased)。原码以最高位表示符号,其余 位表示绝对值。补码中,一个数与其相反数的编码之和为 。反码通过逐位取反得到负数,一个数与其相反数的编码之和为 。在这三种表示中,非负数都采用通常的二进制表示。移码则把每个数 编码为无符号数 ;只要 , 就可以为负。典型偏置值为 。
例如,用 4 位表示 :其相反数的原码为 ;补码为 ,因为 。
反码将 逐位取反,因此 为 。若移码的偏置为 ,则 表示为 , 表示为 。
补码是最广泛采用的整数表示,本节也采用它。它的一大优点是有符号加法非常简单:只需丢弃最高位的进位输出。例如,计算 ,将 与 相加得 ,恰为正确结果 3。补码数 的数值可写为
例如,4 位补码 表示 ,与上例一致。
当运算结果超出所用表示能够容纳的范围时,就发生溢出(overflow)。例如,4 位无符号数 与 相加得 17,其二进制表示 无法容纳于 4 位。无符号溢出很容易检测:最高有效位产生进位输出,当且仅当发生溢出。补码稍复杂:进入最高位的进位与从最高位产生、随后被丢弃的进位不同,当且仅当发生溢出。上面的 中,进入和离开最左位的进位都为 1,所以没有溢出。
对补码数求负,先逐位取反,再加 1。例如, 取反得 ,加 1 得 。所以,用加法器计算 ,只需输入 与 ( 的逐位反码),并把最低位进位置 1。这也解释了为什么图 J.1 最右侧使用全加器。
补码乘法不如加法简单。直观方法是先把两个操作数都变成非负数,执行无符号乘法,若原操作数异号,再把结果取负。这个方法容易理解,却需要额外时间和硬件。更好的方法是沿用图 J.2(a):把 装入 A、 装入 B。由于 B 始终保存 ,下文交替使用 B 和 。如果 B 可以为负而 A 非负,只需保证 P 右移时采用算术移位,即向最高位移入 P 的符号位,而不是加法进位,就能将无符号乘法改成补码乘法。此时, 位加法器相加的是范围为 到 的补码数。
再考虑 为负的情况。处理它的方法称为 Booth 重编码。这是计算机算术中的基本技术,J.9 节还会用到。前面的乘法算法从最低位到最高位检查 。若 ,步骤 (i) 依次加 B、加 B、加 B、加 0。Booth 重编码把 7 改写为 ,其中 表示 。于是可依次减 B、加 0、加 0、加 B。这个过程同时使用加减法,比无符号算法复杂,但在 为负时体现出优势。
例如,令 。先把 视为无符号数 12,再重编码为 。乘法仅迭代 次,最高位被忽略,最终减去 倍的乘数,恰得正确结果。因此,对 重编码后,无论正负都能使用相同算法。具体说,只要允许某些步骤从 P 减去 ,而不是仅加 或 0 即可。若 A 的初值为 ,第 步 A 的最低位为 ,乘法步骤 (i) 改为:
- 若 ,向 P 加 0。
- 若 ,向 P 加 B。
- 若 ,从 P 减 B。
- 若 ,向 P 加 0。
第一步 时,规定 。
例题 计算 乘以 时,寄存器对 (P,A) 的值依次是什么?
解答 见图 J.4。
以上四种情况可以统一表述为:第 步向 P 加 。于是,所有加法累积得到
结合式 J.2.3 与 ,右边正是补码意义下的 。
| P | A | 操作 |
|---|---|---|
0000 | 1010 | 将 装入 A, 装入 B |
0000 | 1010 | 第 1 步 (i):,按规则 I 加 0 |
0000 | 0101 | 第 1 步 (ii):移位 |
0101 | 0101 | 第 2 步 (i):,按规则 III 减 ,即加 |
0010 | 1010 | 第 2 步 (ii):移位 |
1101 | 1010 | 第 3 步 (i):,按规则 II 加 |
1110 | 1101 | 第 3 步 (ii):算术移位,最左位移入 1 |
0011 | 1101 | 第 4 步 (i):,按规则 III 减 ,即加 0101 |
0001 | 1110 | 第 4 步 (ii):移位;最终结果 |
实现 Booth 重编码规则最简单的方法,是把 A 向右扩展一位,用新的一位保存 。与先把所有负操作数取正的朴素方法相比,这种方法不需要额外步骤,也不必对负数单独处理,只略微增加控制逻辑。若乘法器与除法器共用,硬件本来就具备减 的能力。因此,补码乘法的一种简单实现就是:右移 P 时保留符号,保存 A 最近移出的一位,并据此决定向 P 加还是减 。
Booth 重编码通常是设计有符号乘法硬件的最佳方法。但若硬件未直接支持,在软件或微码中实现它常因条件判断和分支而过慢。如果硬件支持算术移位,能正确处理负的 ,则可以把 当作无符号数,用前面的算法执行前 步;若 ,此时 A 的最低位为 1,就从 P 减 ,否则不加也不减;最后再移位一次,总共移位 次。它实际上计算 ,依式 J.2.3 正是所求补码乘积。若不支持算术移位,先把操作数转为非负数可能更合适。
最后补充两点。测试有符号乘法例程时,一个很好的测试用例是 ,因为只有这种情况会产生 位的结果。与乘法不同,硬件除法通常先把操作数转为非负数,再执行无符号除法。
由于除法比乘法慢得多,而且出现频率更低,处理符号的额外时间对除法的影响相对较小。
系统层面的问题
设计指令集时,需要解决若干整数算术问题,这里讨论其中几项。
首先,如何处理整数溢出?有符号与无符号运算的溢出检测不同,使问题更复杂。对有符号运算,可以在溢出时置标志位、触发陷阱,或者不作处理;最后一种情况下,必须由软件检查溢出。对程序员最方便的方法,是设置一个使能位:使能时溢出触发陷阱,不使能时只置标志位;或者提供两种不同的加法指令。这样,无论是否需要陷阱,都只需一条指令。J.7 节还会看到,这与 IEEE 浮点标准处理浮点溢出的方式相似。图 J.5 总结了几种常见机器的处理方式。
| 机器 | 有符号溢出触发陷阱? | 无符号溢出触发陷阱? | 有符号溢出置标志位? | 无符号溢出置标志位? |
|---|---|---|---|---|
| VAX | 使能时触发 | 否 | 是;Add 设置 V 位 | 是;Add 设置 C 位 |
| IBM 370 | 使能时触发 | 否 | 是;Add 设置条件码 | 是;Logical add 设置条件码 |
| Intel 8086 | 否 | 否 | 是;Add 设置 V 位 | 是;Add 设置 C 位 |
| MIPS R3000 | 两种 add 指令,一种总触发,另一种从不触发 | 否 | 否;软件必须根据操作数和结果的符号判断 | 否;软件必须根据操作数和结果的符号判断 |
| SPARC | 否 | 否 | Addcc 设置 V 位,Add 不设置 | Addcc 设置 C 位,Add 不设置 |
译注:表中的 8086“V 位”为原书记法,保留其原有术语。
再看无符号加法。图 J.5 的体系结构都不在无符号溢出时触发陷阱,因为无符号算术主要用于地址运算。用加法实现无符号地址的减法很方便。例如, 时,可以向无符号地址 加 ,以减去 2。这会产生溢出,但我们不希望因此触发陷阱。
第二个问题涉及乘法。两个 位数相乘,应该返回 位结果,还是只返回低 位,并在完整结果容纳不下时报告溢出?支持 位结果的理由是,几乎所有高级语言都把乘法定义为同类型整数变量之间的运算,结果仍是该类型的整数变量。
因此,编译器不会生成利用双倍精度结果的代码。支持 位结果的理由则是,汇编语言例程可以利用它显著加速多精度整数乘法,约可快 3 倍。
第三个问题出现在希望每周期执行一条指令的机器中。通常难以让乘法或除法像加法、寄存器间移动一样快。可能的办法有三种:第一,提供单周期的 multiply-step 指令,例如执行 Booth 算法的一步;第二,在浮点单元中执行整数乘法,并将其纳入浮点指令集,DLX 就采用此法;第三,在 CPU 中设置自主运行的乘法单元,或者保证固定周期数后给出结果,由编译器安排等待,或者提供互锁。这些考虑也适用于除法。最初的 SPARC 提供 multiply-step,却没有 divide-step;MIPS R3000 则由自主单元执行乘除法。较新的 SPARC 体系结构加入了整数乘法指令。HP Precision Architecture 的设计者尤其深入地分析了乘除操作数的出现频率,并据此设计乘法和除法步骤,详见 Magenheimer 等 [1988]。
最后一个问题是负数的整数除法与余数。例如, 与 应是多少?计算 和 时,负的 足够常见,值得认真考虑;负的 则很少见。如果硬件提供相应指令,其语义应与高级语言一致。遗憾的是,各语言并不一致,见图 J.6。
| 语言 | 整数除法 | 余数 |
|---|---|---|
| FORTRAN | ||
| Pascal | ||
| Ada | ; | |
| C | 未定义 | −5 % 3 未定义 |
| Modula-3 |
译注:本表按原书所述历史语境保留,不能据此判断现行语言标准的语义;特别是 C 栏的“未定义”是原书措辞。
在这些定义中,有一种明显更优,即 。于是 ,。MOD 应满足 ,使 。所以 ,。这种定义有很多优点,其中包括:
- 对大小为 的散列表计算索引时,可以用 MOD N,并保证结果处于合法的 到 范围。
- 图形处理中,在不同坐标系之间转换时,0 附近不会出现“异常”。例如,将每英寸 100 点系统中的坐标 转为每英寸 70 点位图显示器上的坐标 ,公式 会把一到两个 坐标映射到每个 坐标。但若像 Pascal 那样把 DIV 定义为 向 0 舍入, 三个点都会映射到 0。
- 等价于与低 位为 1 的掩码作按位 AND; 等价于算术右移 位。
译注:这里“余数非负”的结论沿用本段正除数的情境;若除数为负,不能由上述恒等式推出余数非负。
还需提醒一个多精度加法陷阱。许多指令集提供一种加法变体,接收两个 位数和一个单比特的第三操作数,第三操作数就是上一次加法产生的进位。多精度数通常存储在数组中,因此必须能够递增数组指针,而不破坏进位位。
J.3 浮点数
很多应用需要表示非整数。方法不止一种:可以采用定点表示,用整数算术运算,只需把二进制小数点想象成位于最低有效位右侧以外的某个位置。两个这样的数相加可用整数加法,乘法则需要额外移位。也有人提出存储一个数的对数,以对数相加代替乘法,或者用整数对 表示分数 。然而,得到广泛采用的非整数表示只有浮点表示。它把计算机字分为指数和有效数(significand)两部分。例如,指数为 −3、有效数为 1.5,可以表示 。统一一种表示的好处很明显:数值分析人员可以建立高质量的软件库,计算机设计者可以发展高性能硬件实现技术,硬件厂商也可以构建标准化加速器。浮点表示已经占据主导地位,其他表示似乎不大可能再得到广泛采用。
浮点指令的语义不像指令集其他部分那样明确。过去,不同计算机系列的浮点行为差别很大,涉及指数与有效数的位数、指数范围、舍入方式,以及下溢和上溢等异常情况的处理。计算机体系结构教材曾经需要就这些细节逐项提供建议,幸运的是,如今已无此必要:业界正迅速趋同于 IEEE 754-1985 标准规定的格式,它同时也是国际标准 IEC 559。采用统一浮点形式的好处,与统一采用浮点而非其他非整数表示的好处类似。
IEEE 算术与此前许多算术系统的主要区别如下:
- 把恰好处于两个浮点数中间的结果舍入到最近浮点数时,选择末位为偶数的那个。
- 包含特殊值 NaN、 和 。
- 用非规格化数(denormal)表示小于 的计算结果。
- 默认舍入到最近值,但还提供另外三种舍入模式。
- 提供完善的异常处理机制。
第一点需要解释。两个浮点数运算的结果,通常不能由另一个浮点数精确表示。例如,在十进制、两位有效数字的系统中,,必须舍入到两位:应该是 3.0 还是 3.1?IEEE 标准把这种中点情况舍入到末位为偶数的数,因此 3.05 舍入为 3.0。标准共有四种舍入模式:默认的舍入到最近值,在中点时取偶数;另外三种分别向 0、向 、向 舍入。
其余区别将在后续各节展开。进一步阅读可参考 IEEE [1985]、Cody 等 [1984] 和 Goldberg [1991]。
特殊值与非规格化数
标准最醒目的特点,或许是在除以 0、对负数开平方等异常情况下,默认仍允许计算继续。例如,负数平方根的结果是 NaN(Not a Number,非数),它是一种不表示普通数值的位模式。设一个求零点程序接收函数 F,并在若干位置求值,以确定其零点。
如果程序不慎探测到 F 的定义域外,F 很可能引发异常。要处理这种情况,传统的求零点程序高度依赖语言和操作系统,因为它必须考虑操作系统如何响应异常,以及这种响应如何映射回程序设计语言。在 IEEE 算术中,很容易写出能处理这种情况、又可跨系统运行的求零点程序:每次计算 F 后检查返回值是否为 NaN;若是,就知道探测到了定义域外。
IEEE 算术规定,运算输入若为 NaN,输出也是 NaN,例如 。因此,编写能够接受 NaN 参数的浮点子程序,通常无需增加特殊检查。比如用
计算反余弦,只要 arctan 能正确处理 NaN,arccos 也会自动正确处理。因为若 为 NaN,那么 、、,以及 也都是 NaN,无需逐一检查。
译注:此处列举的商在原文中写成 ,与公式根号内的分子、分母次序相反;两者都会传播 NaN,所以不影响本段说明。
虽然 是 NaN, 却不是,而是另一个特殊值 。标准定义了正、负无穷的算术规则,例如 。上述反余弦公式也说明了它的作用:当 时,,因此自然可定义 。这样, 自动得到正确结果 。
最后一类特殊值是非规格化数。很多浮点系统中,若最小指数为 ,则小于 的数无法表示,运算产生这种结果时会直接置零。IEEE 标准则用小于 1 的有效数表示它们,称为渐进下溢(gradual underflow):数值降到 以下时,精度逐渐减少,直到所有有效位都被移出才变为 0。例如,在四位有效数字的十进制系统中,令 ,则 舍入为 ,损失一位精度; 舍入为 , 为 ,直到 才足够小而舍入为 0。
非规格化数保留了 这样的熟悉性质,使小数值运算更可预测。例如,仍用四位有效数字的十进制系统,若 、,则 。直接置零的系统会把它变成 0,于是 ,计算结果却是 。渐进下溢不会如此:这个差是可表示的非规格化数,所以减法结果精确。
浮点数的表示
IEEE 单精度用 32 位存储:1 位符号、8 位指数、23 位小数部分。指数是有符号数,采用 J.2 节介绍的移码表示,偏置为 127。偏置指数指第 1 至第 8 位的指数域中存储的无符号数;无偏置指数,或简称指数,指 2 的实际幂次。小数域表示小于 1 的数,而浮点数的有效数是 1 加上这部分。若偏置指数为 ,小数域为 ,则其数值大小为 。
例题 下列 32 位字表示什么单精度数?
解答 指数域作为无符号数为 129,因此实际指数是 。小数部分为 ,有效数为 1.25。符号位为 1,所以表示 。
不要把小数部分(本例为 .25)与有效数混淆;有效数是 1 加小数部分。 的首位 1 不出现在存储表示中,是隐含位。对 IEEE 格式数运算时,通常先把小数部分解包(unpack),也就是将隐含的 1 显式补出。
| 参数 | 单精度 | 扩展单精度 | 双精度 | 扩展双精度 |
|---|---|---|---|---|
| ,精度位数 | 24 | ≥32 | 53 | ≥64 |
| 127 | ≥1023 | 1023 | ≥16383 | |
| −126 | ≤−1022 | −1022 | ≤−16382 | |
| 指数偏置 | 127 | 1023 |
单精度指数范围为 −126 到 127,对应偏置指数 1 到 254。偏置指数 0 和 255 用于特殊值,如图 J.8。偏置指数为 255 时,小数域为 0 表示无穷,非零表示 NaN,因此 NaN 并不只有一种位模式。
| 指数 | 小数域 | 表示的值 |
|---|---|---|
| 任意 | ||
| NaN |
偏置指数与小数域都为 0 时,表示 0。由于普通数含有隐含首位 1,有效数总是不小于 1,因此必须另作约定来表示 0。非规格化数则用指数域为 0 的字表示 。
IEEE 标准与多数浮点格式采用偏置指数,主要因为这能使非负浮点数的编码顺序与整数顺序一致,从而可用整数比较器比较浮点数大小。另一个相关好处是,全 0 的字表示数值 0。缺点是指数相加稍显麻烦:必须从偏置指数之和中减去一次偏置。
J.4 浮点乘法
乘法是最简单的浮点运算,因此先讨论它。二进制浮点数表示为 。由
可知,浮点乘法包含几个部分。首先,用普通整数乘法相乘两个有效数。浮点数以符号与数值分离的形式存储,因此乘法器只需处理无符号数,尽管前面已经看到,Booth 重编码也能方便地处理有符号补码。其次,舍入结果:若有效数是无符号 位数,单精度例如 ,乘积最多有 位,必须舍入为 位。最后,计算新指数;由于指数带偏置,须从两个偏置指数之和中减去偏置。
例题 以下单精度数的乘法如何在二进制中进行?原页列式为:
解答 解包后,两个有效数均为 1.0,乘积也是 1.0,因此结果形式为:
指数由下式计算:
图 J.7 给出的偏置为 ,因此 −127 的补码为 。乘积的偏置指数为
这是十进制 134,对应实际指数 ,与预期一致。
译注:原页例题把两个 8 位指数的末位排进了后面的字段,显示成 7 位指数。按题中数值及解答,完整编码应分别为
1 10000010 000…与0 10000011 000…。
浮点乘法最值得关注的是舍入。图 J.9 展示几种情况;各进制的处理类似,因此采用更便于阅读的十进制。
| 情况 | 精确乘法 | 舍入判断 | 三位有效数字结果 |
|---|---|---|---|
| (a) | 第四位 ,进一 | 8.34 | |
| (b) | ,后面存在非零位,进一 | ||
| (c) | ,进一并产生进位 |
这里 ,所以最终保留最高的三位有效数字,第四位称为舍入位,记作 。若 ,直接保留前三位;若 ,如 (a),就在第三位加 1;若 ,如 (b),还要检查后面的数字,决定直接截断还是加 1。其实只需知道后面是否存在非零位,可以用 sticky 位记录。比较 (a)、(b) 可知,相对于乘积最低位,舍入位可能位于两个不同位置。(c) 说明,加 1 可能产生进位,此时有效数会先变为 10.0。
用图 J.2 的乘法器再加一个 sticky 位,就能直接实现舍入。设 A、B、P 都为 位。相乘得到 (P,A) 中的 位乘积。乘法过程中,前 次移入 A 的位都与 sticky 位作 OR。令 表示 sticky 位,(guard,保护位)为 A 的最高位, 为 A 的次高位,则有两种情况:
- P 的最高位为 0:将 P 左移一位,把 A 的 位移入;A 的其他位无需移动。
- P 的最高位为 1:令 、,并把指数加 1。
现在,若 ,P 就是正确舍入的乘积;若 ,应取 P+1,这里的加 1 指在 P 的最低位加 1;若 ,恰好落在中点,是否进一取决于 P 的最低位。
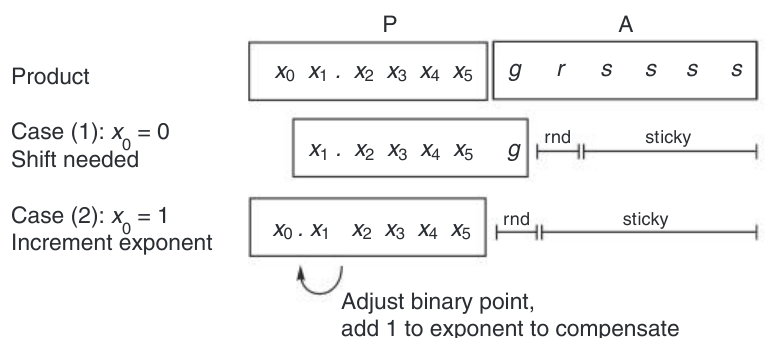
图中 Product 为乘积;Case (1): Shift needed 表示情况 (1) 需要移位;Case (2): Increment exponent 表示情况 (2) 指数加 1。调整二进制小数点位置时,须给指数加 1 来补偿。rnd 表示舍入位,sticky 表示黏滞信息。
把相同规则用于图 J.9(b) 的十进制例子:乘法后 P=126、A=501,。P 的最高位非零,属于情况 (2),令 ,得到 。这似乎可能是中点,但 表明实际略大于半个末位单位,所以向 P 加 1,得到正确舍入结果。
精确规则取决于舍入模式,见图 J.11。注意,P 非负,保存的是结果的绝对值。更高效的实现可参考 Santoro、Bewick 与 Horowitz [1989]。
| 舍入模式 | 结果非负时加 1 的条件 | 结果为负时加 1 的条件 |
|---|---|---|
| 向 | ||
| 向 | ||
| 向 0 | ||
| 舍入到最近值 |
例题 在二进制、 时,说明算法如何在四种舍入模式下计算 。
解答 ,。有效数的整数乘积为 ,所以 P=0110、A=0100,。P 的最高位为 0,按情况 (1) 左移,变为 1100。结果为负,依图 J.11:
| 模式 | 有效数各位 | 原因 |
|---|---|---|
| 向 | 为真,加 1 | |
| 向 | 不加 1 | |
| 向 0 | 不加 1 | |
| 最近值 | 与 均为假 |
指数为 ,所以除向 舍入得到 外,其余模式均得到 。
舍入结果大到无法表示时,就发生上溢。单精度中,结果指数不小于 128 就会如此。若 为偏置指数,则 ,因此 的范围为 到 ,即 −125 到 381。
原书指出,这个范围可用 9 位表示,因此一种检测办法是在 9 位加法器中计算指数,见习题 J.12。一定要在舍入之后检查上溢,图 J.9(c) 已说明舍入可能改变这一判断。
译注:9 位只有 512 种编码,而上述区间有 507 个值,但不能直接套用普通 9 位有符号补码范围 −256…255,或把负数当普通无符号数。这里的 9 位指数运算须配合适当编码与进位判别;原书把具体检测留给习题 J.12。
非规格化数
由于非规格化数的存在,下溢检查更复杂。单精度结果指数小于 −126,不一定就意味着下溢,因为结果仍可能是可表示的非规格化数。例如,。通常,乘积的无偏置指数低于 −126 时,必须右移乘积并递增指数,直到指数达到 −126。若整个有效数都被移出,就发生下溢。下溢的精确定义更微妙,见 J.7 节。
若一个乘法操作数是非规格化数,有效数带前导 0,乘积也会带前导 0。若乘积指数小于 −126,结果是非规格化数,仍按上法右移并递增指数。若指数大于 −126,结果可能成为规格化数;此时左移乘积并递减指数,直到规格化,或指数降至 −126。
非规格化数是浮点乘法实现中的一个主要障碍,因为它要求乘法器支持本来不需要的可变位数移位。因此,高性能浮点乘法器常常不直接处理非规格化数,而是触发陷阱交由软件处理。有些实际程序即便正常运行也会频繁下溢,它们在需要陷阱处理非规格化数的系统中会慢很多。
还没有讨论操作数为 0 的情况。可以在开始乘法前检查两个操作数,也可以在乘法后检查乘积。如果事后检查,要正确处理 :结果是 NaN,而不是 0。确认结果为 0 后,把偏置指数设为 0。不要忘记符号:即使结果为 0,乘积符号也是两个操作数符号的 XOR。
乘法的精度
整数乘法需要决定返回乘积的低位字还是完整乘积;浮点乘法也有类似问题:精确乘积应舍入到操作数精度,还是高一级精度?标准高级语言中,整数乘法没有可生成“单精度乘单精度得双精度”指令的结构。
浮点情况则不同。很多语言允许把两个单精度变量的乘积赋给双精度变量,数值算法也能利用这种运算。最著名的例子,是用迭代改进法求解线性方程组。
J.5 浮点加法
浮点运算通常接收两个 位精度的输入,返回 位结果。理想算法先精确执行运算,再按当前舍入模式舍入到 位。上一节的乘法正是如此。实现 IEEE 算术的硬件必须给出与理想算法相同的结果,却不一定真的执行理想算法;加法就有更好的方法。
先看 6 位二进制数 与 相加。对阶后为
用 6 位加法器、暂时丢弃第二加数的低位,得到
第一个被丢弃的位为 1,但仅凭它无法判断是否进一,还需检查余下的 0001。其实只要像乘法那样用 sticky 位记录其中是否有非零位即可。因此,两个 位数相加,用 位加法器已足够,只需另存第一个丢弃位(舍入位),以及其余丢弃位的 OR(sticky 位),再按图 J.11 判断。本例 sticky 为 1,需要进一,最终为 。
再看:
6 位加法器得到:
由于左侧产生进位,舍入位不再是第一个被丢弃的位,而变成和的最低位 1。丢弃的 01 作 OR 得 sticky=1。两者均为 1,所以和的高 6 位 应进一,结果为 。
再看减法:
最简单的计算方式是把 转成补码,使差变成和:
6 位加法器得到:
最高位抵消后,必须把第一个丢弃位,即保护位,补到结果的最低端,得到 ;第二个丢弃位则成为舍入位。这与乘法算法的情况 (1) 相似。舍入位为 1 还不足以作决定,剩余 0001 的 OR 给出 sticky=1,所以最终进一为 。可见,减法抵消最高位时,需要一个保护位。若最高两位都抵消,是否就需要两个保护位?不需要。如果 足够接近,以至于差的最高两位抵消,那么 会是精确的,根本不需要保护位。
加法比乘法复杂,是因为它可能因操作数符号而实际变成减法。加法可能在左侧产生进位;减法可能发生抵消;两者都会改变舍入位的位置。不过,无需先求精确和再舍入,只要用最高 位的和,以及舍入位、sticky 位,就能确定结果。
下面详细给出浮点加法算法。令两个加数为 ,指数和有效数分别为 。输入已经解包,因此 含显式首位。算法分八步:
- 若 ,交换操作数,使 。暂定结果指数为 。
- 若 异号,把 替换成其补码。
- 把 放入 位寄存器,右移 位;若上一步取过补码,高位移入 1。移出的位中,最高一位置入 ,次高位置入 ,其余位的 OR 置入 sticky。
- 把 与保存 的 位寄存器相加,得到初步有效数 。若两加数异号、S 最高位为 1、且没有进位输出,则 S 为负,需用其补码替换。这只可能发生在 时。
- 若两加数同号,且第 4 步有进位输出,则 S 右移一位,高位移入进位 1。否则,左移直到规格化;第一次左移时把 移入低位,之后移入 0。相应调整结果指数。
- 调整 。若第 5 步右移,令 为移位前 S 的最低位,;若不移位,令 、;若左移一次, 不变;若左移至少两次,令 。原书解释,最后一种情况仅发生于两加数异号且指数相同,此时第 4 步计算精确。
- 按图 J.11 舍入 S:对应条件成立时,在最低位加 1。若产生进位,则右移 S 并调整指数。这样得到最终有效数。
- 确定符号。若两加数同号,结果同号;若异号,结果取决于原来哪个为负、第 1 步是否交换,以及第 4 步是否对 S 取补码,见图 J.12。
译注:第 6 步的赋值应按调整前的 同时计算,不能先覆盖 再计算 。原书“左移至少两次只会发生于指数相同”过于严格:指数相差 1 也可能严重抵消,例如 ;该差同样精确,故置 的处理仍适用。
| 第 1 步交换? | 第 4 步取补码? | 原 符号 | 原 符号 | 结果符号 |
|---|---|---|---|---|
| 是 | 任意 | + | − | − |
| 是 | 任意 | − | + | + |
| 否 | 否 | + | − | + |
| 否 | 否 | − | + | − |
| 否 | 是 | + | − | − |
| 否 | 是 | − | + | + |
例题 用上述算法计算 。
解答 初始 。
- ,交换;,暂定指数为 0。
- 两操作数都为负,不对 取负。
- 交换后的 右移两位,得 。
- ,因此 S=.001,并有进位。
- 右移并补入进位,S=1.000,指数增为 1。
- 舍入位是原和的最低位,即 1;sticky 为 。
- 为真,按图 J.11 进一,得 S=1.001。
- 两加数均为负,结果为负。原页末式写作 。
译注:原页末式右侧漏了负号;与题目及本步文字一致的结果应为 。
例题 计算 。
解答 。
- 不交换,,暂定指数为 0。
- 异号,把 替换成补码 0.100。
- ,不移位,。
- 。异号、最高位为 1、无进位,因此对和取补码,得 S=0.010。
- 左移两位,S=1.000,指数减为 −2。
- 左移两次,。
- 舍入不需要加 1。
- 结果为 。查图 J.12:取过补码、未交换、原 为负,所以结果为正,即 。
加速加法
估算上述算法的时间:第 2 步可能需要一次加法,第 4 步需要一到两次,第 7 步可能再需一次。若 位加法耗时 T,单精度 、双精度 ,看起来至少需要 4T。但这过于悲观:第 4 步若需两次加法,两输入必然同指数、异号,差是精确的,第 7 步无需进一,所以最多三次加法。
同样,第 3、5 步似乎各需一次可变移位,但若 ,第 3 步最多右移一位,只有第 5 步需要可变移位;若 ,第 3 步需要可变移位,第 5 步却最多左移一位。因此最多只执行一次可变移位。即便如此,三次串行加法对 53 位双精度有效数来说仍很耗时。
加速方法之一是流水线,J.10 节会介绍商业芯片实例。另一种是并行进行两次加法,Intel 860 就采用了它 [Kohn and Fu 1989];下面说明它如何把延迟从 3T 降为 T。
分三种情况。首先,两操作数同号,需要合并第 4、7 步。第 4 步是否产生进位尚不确定,因此和的最高位位置未知;用两个加法器分别覆盖两种可能。第一个假定无进位,因而可事先算出 。若应进一,计算 ,其中加 1 的位置是 的最低位,可通过把普通加法器的最低进位输入置 1 实现;否则照常计算 。若 ,还需知道和的最低位,它也能很快预先算出。第二个加法器假定会进位,此时 和加 1 的位置不同,但也能事先算出。究竟是否有进位,要到加法完成后才知道;两个加法器并行运行,必有一个产生正确答案。
其次,两输入异号、同指数。此时和精确,无需舍入,但结果符号要等加法结束才知道。不要在第 2 步先取补码,因为那要一次加法;改为并行计算 与 。前者把对 取补码与求和合并,得到 ;后者得到 。
其中一个非负,就是最终结果的绝对值。这样,所有加法仍由两个并行加法器在一步完成。
最后,两输入异号、指数不同,情况更复杂。若 ,差的首位仅可能在两个位置之一,类似普通加法。若 ,可能发生抵消,首位几乎可以出现在任何位置;不过,只有差的首位与 首位同位置时才可能需要进一。因此,一个加法器假定需要进一,另一个假定不需要,即可合并第 4、7 步。但第 2 步的加法怎么办?
考虑第 4 步中两个操作数的对齐关系:
若标为 z 的位全为 0, 的高 位可用 算出;若至少一个 z 为 1,则用 。因此一次加法就能得到差,但仍需取得 补码对应的 ,供第 7 步舍入。
为此,将第 2、4 步合并:第 2 步不对 取补码;把加法器向右扩展两位,扩展的和记为 。在 右侧补两个 0 得 ,在 后附上初步的 得 。若第 3 步得到的初步 sticky 为 1,计算 ;若 sticky 为 0,则计算 。现在, 的最低两位就是正确的 ,sticky 已在第 3 步正确算出。再与第 4、7 步的合并方法结合,就能在一次加法时间 T 内得到结果。
还有一些细节,见 Santoro、Bewick 与 Horowitz [1989] 及习题 J.17。该论文虽针对乘法,但很多讨论同样适用于加法。习题 J.19 还给出了另一种符号—数值形式的加法方法。
非规格化数
与乘法不同,即使一个输入为非规格化数,以上加法算法也几乎不变。只需检测指数域是否为 0;若为 0,解包有效数时不补首位 1,并把内部偏置指数置为 1,算法其余部分照常运行。
处理非规格化输出时,第 5 步略作修改:左移 S,直到规格化,或指数达到 ,即偏置指数为 1。若指数为 ,且舍入后 S 的最高位为 1,结果仍是规格化数,按通常方式打包,省去首位 1。
若最高位为 0,则结果是非规格化数,存回格式时指数域应置 0。J.7 节将讨论检测下溢的精确规则。
译注:原文此处写“结果解包时”(unpacked),但语境是把内部结果编码回浮点格式,即打包;译文据此表述,并保留此说明。
上溢很容易检测:只有第 5 步右移时,偏置指数被增至单精度的 255、双精度的 2047,或者舍入后发生同样情况,才会出现上溢。
J.6 除法与余数
本节讨论浮点除法与余数。
迭代除法
前面介绍过整数除法。将它改成浮点算法,与把整数乘法改成浮点乘法类似。由
可知,只需用除法器计算 ,再乘以 。图 J.2(b) 中的操作数装入位置与整数除法略有不同: 装入 B, 装入 P,A 无需保存操作数。随后使用整数除法算法,仅省去最初的一次左移,结果形式为 。为舍入,再多算两个商位,分别作为保护位和舍入位,并用余数是否非零作为 sticky 位。保护位是必要的,因为第一个商位可能为 0;但分子分母均已规格化,商的最高两位不可能都为 0。这个算法每步产生一个商位。
另一种除法方法以二次而非线性速率收敛到商,J.10 节会介绍采用它的实际机器。下面先介绍两种主要迭代算法,再与直接除法算法比较。构造迭代算法的一般方法是 Newton 迭代,见图 J.13。先把问题变成求函数零点,再从某个零点估计出发,以该点的切线近似函数,用切线零点作为新估计。若 是估计值,切线方程为
其零点为
取 ,其零点为 ,所以 Newton 迭代给出从 求倒数的方法。因 ,式 J.6.1 化为
因此,可如下计算 :
- 缩放 ,使 ,查表取得 的近似值 。
- 迭代 ,直到 足够准确。
- 计算 ,并撤销第 1 步的缩放。
第 2 步需要多少次?精确到 位意味着相对误差的绝对值为 。简单代数计算表明,下一步的相对误差绝对值为 ,所以正确位数每步翻倍。Newton 迭代具有自校正性质: 出现误差并不致命,它只是被当作 的一个估计,下一步会改进它,正确位数大致翻倍。舍入会造成误差;更重要的是,初始几次迭代本来就不期待很多正确位,因此可降低乘法精度,加快运算而不损害最终准确性。习题 J.20 讨论另一种应用。
译注:原页把下一步相对误差写为正的 ,但没有绝对值。令 ,严格关系是 ;正确位数翻倍的结论针对误差绝对值。
第二种方法常称为 Goldschmidt 算法。计算 时,让分子分母同时乘以使 的数 。具体令 ,每步计算 、,则 始终不变。选择 使 ,便有 。
同样思想也能计算其他函数。例如,求 ,令 ,每步计算 、,则 。若选择 使 ,就有 。TI 8847 用这种技术求平方根。
回到除法。令 ,写 ,其中 。若取 ,则 ;再取 ,则 ,依此类推。因为 ,所以 。相应有
即
这个算法似乎有两个问题: 离 1 较远,即 离 0 较远时,收敛慢;另外它不自校正,因为商是若干独立因子的乘积,其中一个因子的误差不会自行纠正。解决前者,可先查得 的近似倒数 ,再对 运行算法;因为 ,收敛很快。
为应对后者,运算需多保留几位,以补偿舍入误差。不过,Goldschmidt 算法仍有较弱的自校正性质: 的精确值并不重要。前几次迭代无需 的完整精度,可以把 取为 的截断值,以加快迭代而不影响收敛速度。此时 不再恰为 ,式 J.6.3 不能直接使用,但很容易组织成不依赖 精确值的算法:
- 缩放 ,使 。
- 查表取得 的近似值 。
- 令 、。
- 重复下列循环,直到 足够接近 :
两种迭代方法彼此相关。将 Newton 迭代展开,直接用 表示各项,而不递归引用 ,可得(见习题 J.22):
它与式 J.6.3 很相似。事实上,将式 J.6.3 中的 替换成 ,并取 ,两式完全相同。因此,若以无限精度迭代,两种方法会产生完全相同的 序列。
迭代的优点是无需专用除法硬件,可借用乘法器,只需增加控制逻辑;而且每步使正确位数翻倍,普通除法则每步只增加固定数量的位。
迭代求倒数有两个缺点。首先,IEEE 要求除法正确舍入,迭代却只能保证接近正确舍入值。Newton 方法先算 再乘 ,还存在额外问题:倒数正确舍入,并不保证商正确舍入。例如,十进制 ,,则 应舍入为 .25;但 舍入为 .020,再乘 13 得 .26,末位相差 1。其次,迭代不给出余数;若借用浮点除法硬件做整数除法,这尤其麻烦,因为几乎所有高级语言都有余数运算。
传统经验认为,若想通过迭代得到正确舍入结果,应先将 算到略多于 位,再将 算到略多于 位,最后舍入到 位。但还有更快的方法,似乎最早实现于 TI 8847:仅增加约 6 位精度,算出初步商 ;再以同样额外 6 位精度比较 与 ,就能迅速决定 是否正确舍入,或者最低位应加 1、减 1。习题 J.21 进一步讨论。
选择算法时,还要考虑除法与乘法的相对速度。除法更复杂,通常更慢。常见经验目标是使除法速度达到乘法的约三分之一。支持这一目标的理由之一,是一些实际程序,例如部分版本的 spice,除法与乘法次数之比为 1:3。另一个“3”来自平方根迭代:每次一次除法的算法可以换成每次三次乘法,见习题 J.20。
浮点余数
对于非负整数,整数除法与余数满足
类似地,可定义浮点余数为 。怎样把 转为整数?IEEE 余数采用就近取偶规则:选择满足 的整数 ;若有两个,取偶数。然后定义 。与整数余数范围不同,浮点余数满足 。这是精确定义,却不适合直接执行,因为 可能极大;单精度中可达 。
译注:这里余数界采用正除数 ;对一般非零实数除数,应写为 。
若采用直接除法,求 REM 有自然办法:按计算 的过程进行。设 ,在图 J.2(b) 中将 装入 P, 装入 B。执行 次除法步骤后,P 保存 ,满足 。IEEE 余数绝对值不超过 ,所以结果是 或 。只需保存最后一个商位,以处理恰好位于中点的情况。
但指数差可能很大,而浮点单元通常限制一条指令的最长执行时间,因此往往不能直接实现 REM。J.10 节的芯片都没有 REM,不过可像 Intel 8087 系列那样提供 remainder-step 指令:接收 ,不断执行除法步骤,直到 P 中得到余数,或已执行 步; 是较小的常数,例如最高支持精度的除法步数。这样,软件可重复调用 REM-step,第一次用 作分子,之后改用上一次的部分余数。原书给出的调用次数是 。
译注:原页确实使用向下取整符号。但“每次至多 n 步、反复执行直到完成”通常还需计入不足 n 步的最后一次,不能把该式直接当作所有输入的精确调用次数。
REM 可用于三角函数。为简单起见,设十进制五位有效数字,计算 。若 ,可用 缩减参数,算 。但若 ,则 ,五位系统得到 63662;再乘 3.1416,精确积为 200000.5392,却舍入为 ,参数缩减竟得到 0,远非正确结果。问题是精度不足。
若有 REM,可算 ,但仍不准确,因为 3.1416 只是 的近似值;实际 。
传统上,计算大参数周期函数有两种做法:参数过大时报错,或者保存很多位 ,作精确参数缩减。REM 对这两者帮助都不大。某些数学库,例如 Berkeley UNIX 4.3bsd,使用第三种办法:把 舍入为最近浮点数,称为“机器 ”,记作 ,然后用 缩减参数。大 时它与 差别很大,因此这样计算并不能得到真实的 。不过,以这种方式计算各三角函数,可使 等熟悉恒等式在几个舍入误差范围内仍成立。因此,REM 配合机器 提供了一种简单办法:小参数时准确,大参数时仍可能有用。
参数缩减时,若 REM 还能返回 的低位,其中 ,就很方便。实际实现往往用小于 的量,例如 ,利用 、 等恒等式;这时需要 的低位来选择正确公式。
J.7 浮点算术的其他问题
结束浮点算术讨论之前,再介绍几个主题。
融合乘加
浮点单元最常见的用途可能是矩阵运算,而最频繁的矩阵运算是矩阵与矩阵或向量相乘,归根结底需要计算内积 ,也就是一连串乘加组合。
为此,IBM RS/6000 引入了用一条指令计算 的融合乘加(fused multiply-add)。虽然一条指令需要读取三个操作数,它仍有望提高内积性能。
融合乘加先精确计算 ,最后只舍入一次。少一次舍入确实能略微提高内积精度,但这不是主要动机。它有两个主要优势:一是舍入可能需要加法,实现代价高,只舍入一次就消去了一次加法。
二是它增加的准确性,可用于在硬件未直接提供时实现正确舍入的除法和平方根,也可构建高效的多精度浮点软件包。
用融合乘加实现正确舍入除法有很多细节,但基本思想简单。再看 J.6 节的 :两位精度下, 舍入为 , 舍入为 ,并非正确商。应用两次融合乘加即可调整:
普通两位运算中, 舍入为 13,因此 ,无法调整。但融合乘加给出 ,再得 ,正确舍入为 .25。细节见 Montoye、Hokenek 与 Runyon [1990]、Markstein [1990]。
精度
本附录讨论的标准规定四种精度:单精度、扩展单精度、双精度、扩展双精度,参数见图 J.7。实现不必全部提供,但鼓励支持“单精度与扩展单精度”,或“单精度、双精度与扩展双精度”两种组合之一。科学计算广泛使用双精度,实际几乎总会实现它。因此,设计者通常只需决定是否提供扩展双精度,以及提供多少位。
Motorola 68882 与 Intel 387 协处理器采用标准允许的最小扩展格式:80 位,其中有效数 64 位。但许多较新的高性能浮点芯片没有实现 80 位扩展精度,原因之一是它与 64 位总线、寄存器配合不便。SPARC V8、PA-RISC 等新体系结构规定 128 位扩展精度,或称四倍精度(quad),并形成 15 位指数、113 位有效数的事实约定。
虽然多数高级语言不允许直接使用扩展精度,它对数学软件作者很有价值。例如,编写计算平面向量 长度 的库函数,若 ,直接计算就会溢出。这意味着要么把函数允许的指数范围减半,要么使用缩放等更复杂的算法。
有扩展精度时,简单算法就能工作。向量长度本身不复杂,也不难设计避免溢出的算法;但更复杂的问题中,扩展精度可能决定能否采用简单快速的算法。二进制到十进制转换就是好例子。Coonen [1984] 清楚介绍了一种依赖扩展精度的高效算法,Goldberg [1991] 也作了简述。准确计算超越函数同样会因扩展精度而容易许多。
精度还有一个重要问题:两次舍入(double rounding)。假设十进制单精度为两位、扩展精度为三位,计算 。精确积为 1.254,先舍入到扩展精度得 1.25,再舍入到单精度得 1.2;但直接舍入到单精度应为 1.3。因此,两次舍入未必等于一次。
若硬件只做双精度,能否先算双精度再舍入为单精度来模拟单精度?上述例子似乎说不能,但两次舍入并不总有危险。下列结论成立,证明不容易,见习题 J.25:
译注:这里的习题编号沿用原文;本附录实际讨论两次舍入的是习题 J.24,习题 J.25 讨论浮点异常的快速检测。
若 x、y 的有效数为 p 位,将 x+y 精确计算后先舍入至 q 位,只要 ,再舍入至 p 位就不会改变本应得到的答案。这不只适用于加法,也适用于乘法、除法和平方根。
上面的十进制例子 ,不满足条件。IEEE 二进制中,双精度 、单精度 ,有 。因此,可先正确计算双精度结果,即精确运算后舍入到双精度,再舍入到单精度,以实现单精度运算。
译注:原页正文重复这个不等式时,关系符被排为异常字符;此处依据同页完整命题恢复为 。本段讨论须连同标准的舍入及指数范围条件理解;后文还会专门说明下溢时的两次舍入问题。
异常
IEEE 标准定义五类异常:下溢、上溢、除以零、不精确(inexact)和无效操作(invalid)。默认只置标志,计算继续。标志具有 sticky 性质,一旦置位,直到显式清除才复位。标准强烈建议为每类异常提供陷阱使能位。若已使能的异常发生,则调用用户陷阱处理程序,相关异常标志值未定义。J.3 节的 、 就是异常:默认前者置无效操作标志并返回 NaN,后者置除以零标志并返回无穷。
多数其他系统也有下溢、上溢与除以零异常。无效操作针对 、、 等无法自然赋予普通浮点值或 的运算。不精确异常是 IEEE 算术的特色:结果需要舍入或发生上溢时触发。由于除以零和上溢都可能返回无穷,必须查看异常标志才能区分。不精确异常出现得太频繁,几乎谈不上“异常”,因此为它使能陷阱往往严重影响性能。除下溢外,是否使能陷阱不会改变一个运算是否算异常,后面再谈下溢。
标准假定,陷阱发生后可以识别触发它的运算及操作数。流水线或多个算术单元的机器中,仅检查程序计数器可能不够,可能需要硬件支持以准确定位。
还有如下问题:
两条指令可能并行执行。若除法触发陷阱,它的操作数 r2 可能已经被加法覆盖,尤其因为加法通常比除法快得多。支持 IEEE 陷阱的系统必须设法保存原 r2,或者由硬件保存,或者由编译器避免这种情形。这并非浮点独有,例如:
等待内存时执行第二条指令很高效;但若访问 0(r2) 发生缺页,重启第一条指令所需的 r2 可能已经丢失。
MIPS R3010 的办法,是在指令周期早期识别可能异常的指令。例如,浮点加法只有当至少一个操作数指数为 时才可能上溢。这个早期检查是保守的,可能把实际不异常的操作也标出来;但只要这种误报稀少,性能就很好。被标记为可能异常的指令,由陷阱处理程序中的专门代码计算,避免破坏状态。记住,这些问题只在使能陷阱时存在;否则,正常执行中设置异常标志很直接。
下溢
前面多次提到,下溢检测比其他异常复杂。IEEE 标准规定,使能下溢陷阱时,若结果是非规格化数,就必须触发陷阱。
若未使能,则只有损失准确性、结果必须舍入时,才置下溢标志。理由是:若下溢并未损害准确性,就没必要报警;但若用户使能陷阱,可能是想模拟直接置零,因此结果一旦低于 就应通知。
所以,无陷阱时,只有结果既非规格化又不精确,才报告下溢。不过,“非规格化”与“不精确”都有不同解释。通常,不精确意味着真实结果不能准确表示、必须舍入。设二进制有效数为三位,采用舍入到最近值,计算
返回 ,发生了舍入,应报告不精确。但是否还要报告下溢?渐进下溢损失有效位,是由于指数范围受限。若指数范围无限,结果将是 ,与渐进下溢的结果完全相同;非规格化有效数位数较少,在本例并未造成额外差别。
标准说明文档 [Cody 等 1984] 鼓励以此为判据:只有实际结果与“相同小数位数、但指数范围足够大”的系统所得结果不同时,才置下溢标志。不过,这种实现较难,因此标准也允许只要结果非规格化且不同于无限精度结果,就置下溢标志。
对于“结果为非规格化”也有两种定义。原书例子是 乘以 ,原文把精确积写为 ,舍入后为规格化数 。若此时报告下溢,就是采用舍入前规则,因为舍入前非规格化;若不报告,就是采用舍入后规则。标准允许任选其一,但所有运算必须保持一致。
译注:原页本例的操作数与声称的乘积不一致。所列 实为 ,不是 。本段保留原例,并仅据其声称的 结果解释两种检测时机;不可把原列乘法当作正确演算。
以浮点加法说明这些规则:加减法结果若为非规格化数,它总是精确的,因此不必设置下溢标志。未使能陷阱时,没有异常;使能时,下溢标志值未定义,也无需设置。
最后还有一个细节。未使能陷阱时, 位数运算的下溢结果是精度不超过 位的非规格化数;使能时,传给处理程序的却是舍入至 位、指数回绕后的结果。
这就可能出现两次舍入问题。处理程序若想返回非规格化结果,不能只对收到的参数再舍入,否则可能出错。因此,至少还须传递一位额外信息,才有可能正确舍入。
J.8 加速整数加法
前一节表明,浮点运算需要很多步骤,但最终都归结为整数运算。因此,加速整数运算也能加速浮点运算。
整数加法最简单,也最重要。即使程序不显式计算数值,递增程序计数器和计算地址也需要加法。尽管加法简单,高速实现却没有唯一最佳方法。下面讨论三种实际采用的技术:先行进位、跳跃进位和选择进位。
先行进位
位加法器是组合电路,因此可以写成“积之和”的逻辑表达式,用两级逻辑计算。怎样得到这样的电路?由式 J.2.1,第 位的和为
既是第 位的进位输入,也是第 位的进位输出。问题在于, 是已知输入, 却未知。目标是把 写成 a、b 各位的函数。先把式 J.2.2 改写为
这里 g 代表 generate(生成):若 为真,就一定产生 。p 代表 propagate(传播):若 为真, 就传到 。把式 J.8.1 中的 用式 J.8.2 替换,再递归替换 ,得到
采用该式计算进位的加法器称为先行进位加法器(carry-lookahead adder,CLA)。先用一级逻辑生成 p、g,再用两级生成进位,最后两级生成和,共五级,比行波进位的 级快得多。
遗憾的是,从式 J.8.3 或图 J.14 可以看出, 位 CLA 的 OR 门和最右侧 AND 门都需要 的扇入, 还要驱动 个 AND 门。再加上不规则结构和很多长连线, 很大时,这种完全展开的先行进位电路并不实用。
不过,可以逐步生成 p、g,构造约 级逻辑、结构简单规则的加法器。我们已有
即第 0 位自己生成进位,或把输入进位传播出去,就会产生 。类似地,
表示最低两位组成的块会生成进位, 表示进位可穿过该块。更一般地,对满足 的 j,有
式 J.8.5 表示:第 i 到 k 位的整个块生成进位,当且仅当高半块 自己生成进位,或低半块 生成进位后穿过高半块。若定义 ,这些式子对 也成立。
例题 用 p、g 表示 。
解答 由式 J.8.6,
由式 J.8.5,
有了这些准备,就可设计实用 CLA。第一部分用式 J.8.5、J.8.6,从各位的 p、g 生成各种分组 P、G;第二部分用式 J.8.4 生成全部进位。第一部分见图 J.15:输入 从顶部进入类型 1 单元,变成 p、g。
类型 2 单元按二叉树连接,生成各组 P、G。第二部分见图 J.16:从树底输入 ,所有进位从树顶输出。每个单元需要一对 (P,G),图中把所需值写在单元内。对比图 J.15、J.16,单元一一对应,生成进位的单元所需的 P、G,恰好由对应的另一单元产生。把它们合并,就得到图 J.17。操作数从顶部向下传播,在底部与 结合,再向上传播生成进位。图 J.17 尚省略了一小块额外逻辑,用来计算整个加法器的进位输出 。
CLA 的信号约经过 级逻辑,行波进位则为 , 越大,速度优势越明显。行波进位有 n 个单元,CLA 约有 2n 个;但在这里的布局中,占用空间为 。少量面积投入,就能获得显著加速。
还可按工艺作调整。例如,把每个树节点的输入从两个增为三个,树高便从 降为 ;但单元更复杂、可能更慢,抵消树高收益。若工艺适合快速行波传播,混合设计可能更好,如图 J.19:顶层组内行波传播,B 方框与图 J.17 相同。若穿过四个加法器的行波延迟,小于穿过一层 B 单元的延迟,这种设计就更快。为清楚显示结构,图 J.19 画成 16 位,图 J.17 的 8 位加法器对应它的右半部分。
跳跃进位加法器
跳跃进位加法器(carry-skip adder)的速度和成本都介于行波进位与先行进位之间。它不简称 CSA,因为 CSA 已用于 carry-save adder。其思路来自 P、G 的方程,例如
P 比 G 简单得多,因此跳跃进位加法器只计算 P,见图 J.18。
进位在所有块内同时开始逐位传播。某块若自身生成进位,即使该块的输入进位尚未确定,输出进位也会为真。若每次加法开始时把各块输入进位置 0,就不会产生伪进位,因此可以把各块的进位输出当作 G 信号。最低块的进位一旦产生,不仅送往下一块,还与下一块的 P 通过 AND 门结合。如果两者都为真,进位就跳过第二块,直接进入第三块,依此类推。只有各块进位输入能在每次运算开始时方便清零,例如利用 CMOS 预充电,这种设计才实用。
分析速度时,假设穿过两级逻辑耗时一个单位,则进位穿过 k 位块耗时 k,跳过一个块耗时 1。最长路径从第 0 位生成进位开始:穿过首块用 k,跳过中间块用 ,穿过末块再用 k。20 位、每块 4 位时,共需 个时间单位。
还有更好的分组。若从低到高采用 2、5、6、5、2 位的五个块,时间降为 9。可见,把内部块做得较大有利于加速;变块宽的思想有时也适用于其他加法器。由于仍有大量行波传播,这种加法器最适合行波传播快的工艺。
选择进位加法器
选择进位加法器(carry-select adder)并行计算两次,一次假设输入进位为 0,一次假设为 1。真正的输入进位确定后,只需选择预先算好的正确结果。图 J.20 将 8 位分成两半,用低半部分进位选择高半部分和位。如果各块内部使用线性时间的行波进位,它以增加 50% 成本换取约两倍速度。但 要驱动很多多路选择器,在某些工艺中可能很慢。
还可从两块增至四块以继续加速,如图 J.21。若 k 位块相加需 k 个时间单位,而由两个进位输出产生多路选择控制需 1 个时间单位,那么最佳分组应沿高位方向逐块增加一位,如图所示。因此,与跳跃进位类似,最佳设计采用可变块宽。
| 加法器 | 渐近时间 | 渐近空间 |
|---|---|---|
| 行波进位 | ||
| 先行进位 CLA | ||
| 跳跃进位 | ||
| 选择进位 |
图 J.22 总结了本节。跳跃进位、选择进位的时间来自恰当的块宽选择;跳跃进位的推导见习题 J.26。不要把这些方法看成互斥选项,而应把它们看成构造加法器的模块。适用性高度依赖工艺:信号能驱动很多多路选择器时,选择进位很好;每次运算开始时能方便清零时,跳跃进位很有吸引力。
渐近性质有助于理解,却不宜过分依赖,因为它只在 n 极大时才占主导。加法器的 n 是精度位数,而双精度与 20 年前一样,仍约 53 位。计算机越快,计算过程往往越长、舍入误差更多,确实会要求更高精度,但这种增长随时间发生得很慢。
J.9 加速整数乘法与除法
J.2 节的乘除法算法较慢,每周期只产生一位,尽管这里的周期可能只是 CPU 指令周期的一部分。本节讨论提高乘除法性能的各种技术,包括 Pentium 芯片使用的除法算法。
跳过连续零位
跳过连续零位(shifting over zeros)如今用得不多,但很有启发性。它的特点是执行时间依赖操作数。它未能比逐位算法快很多,而且可变执行时间不利于流水线、与 CPU 同步和编译器优化,因此较少采用。乘法中的思路是增加逻辑,检测图 J.2(a) 中 A 的最低位是否为 0。
若为 0,就跳过加法,直接移位,这便是名称的由来。
除法呢?不恢复余数法每步都执行一次 ALU 加法或减法,似乎无从省略。但可以换个角度:计算 ,就是从 a 中减去若干倍 b,再记录减了多少次。每一步的余数都必须容纳于图 J.2(b) 的 P 中。如果余数是很小的正数,通常会减 b,但也可以仅移位,等下一步再减。只要余数足够小,最高位为 0,移位后仍容纳得下,就不会丢信息;不过,需要改变记录减法次数的方式。
这类方法通常称为 SRT 除法,以独立提出类似算法的 Sweeney、Robertson、Tocher 命名。主要额外复杂性在于:不像普通不恢复余数法,每步的商位不能立即由本步结束时 P 的符号确定。
具体算法如下。以 n 位 a 除以 n 位 b,将它们分别装入 A、B,P 初始为 0。
SRT 除法
- 若 B 的 n 位表示有 k 个前导 0,把所有寄存器左移 k 位。
- 对 ,依次执行:
- (a) 若 P 的最高三位相同,令 ,将 (P,A) 左移一位。
- (b) 若最高三位不全相同且 P 为负,令 ,也记作 ,将 (P,A) 左移一位,再加 B。
- (c) 其余情况,令 ,将 (P,A) 左移一位,再减 B。
- 若最终余数为负,加 B 修正余数,并把商减 1。最后,余数右移 k 位,撤销初始缩放。
译注:原算法第 3 步写“从 减 1”,但本节按生成顺序编号, 是首个商位。图 J.23、J.35 都明确对完整商减 1;正文据此说明,不把它误作从最高商位减 1。
图 J.23 给出例子。虽然讨论的是整数除法,为解释算法,可把二进制小数点想象在数值最高位之前,把 看成 。分子分母同时缩放,商不变。(P,A) 保存补码余数。例如 P=11110、A=0 时,余数为 。记余数值为 r,则 。
| P | A(含已生成的商数字) | 步骤 |
|---|---|---|
00000 | 1000 | 除以 ,B=0011 |
00010 | 0000 | 步骤 1:B 有两个前导 0,全部左移两位,B=1100 |
00100 | 0000 | 步骤 2.1:P 最高三位相同,情况 (a),,移位 |
01000 | 0001 | 步骤 2.2:最高位不全相同且 P 非负,情况 (c),,移位 |
11100 | 0001 | 减 B,即加 10100 |
11000 | 0010 | 步骤 2.3:最高三位相同,情况 (a),,移位 |
10000 | 步骤 2.4:最高位不全相同且 P 为负,情况 (b),,移位 | |
11100 | 加 B=01100 | |
01000 | 步骤 3:余数为负,加 01100 恢复,商减 1 | |
00010 | 0010 | 余数右移两位,得 ;商 |
算法先将 b 规格化到 。ALU 决策规则是:若 ,即 P 最高三位相同,只左移得到 2r;若 ,由于已排除前一条件,此时 ,左移后加 b,得 ;若 ,则从 2r 减 b。利用 ,容易验证余数始终满足 。普通不恢复余数法只有 ,P 需 n+1 位;SRT 的范围更紧,可省去 P、b 和加法器的最高一位,检测最高三位相同也随之变成检测最高两位。
实际实现还可在每次 ALU 操作后,把 P 一次左移到满足 或 。若移 k 位,就一次生成 k 个零商位。因此,SRT 有时也被描述为把余数保持在 的规格化形式。
SRT 的本步商位取决于本步选择的操作,而操作取决于上一步结果;不恢复余数法的本步商位,则取决于本步结果。因此,最终余数为负时,SRT 还要调整商,不恢复余数法不用。更关键的是,SRT 允许商数字为 。图 J.23 为了示意把商放在 A 的空闲低位,但一位不能容纳 −1、0、1 三种值,实际不能如此实现。最后还要通过完整加法器转成普通补码。一种常见方法是用两个寄存器分别累计正商位、负商位,最后相减。
由于同一个数可用 −1、0、1 数字写成多种形式,这称为冗余商表示。SRT 与普通不恢复余数法的区别可归纳为:
- ALU 决策:后者依据 P 的符号,SRT 依据 P 的最高两位。
- 最终商:后者由各步 P 的符号直接得到;SRT 有 1、0、−1 三种数字,需要完整 n 位加法器转换。
- 速度:操作数导致较多零商位时,SRT 更快。
这个简单 SRT 版本通常还不够快,不太实用;本节稍后会介绍实用变体。
用一个加法器加速乘法
跳零技术用得不多,下面介绍广泛采用的方法。乘法加速可分为使用一个加法器和使用多个加法器两类,先看前者。
由于进位传播,实际不能用两级逻辑完成普通加法。用图 J.17 的单元相加两个 64 位数,生成 P、G 要穿过七个单元,生成进位再穿过七个,至少 28 级逻辑。图 J.2 的简单乘法器每一步都要经过它。
保留进位加法器(carry-save adder,CSA)能显著减少每步工作量。它只是 n 个彼此独立的全加器,图 J.24 给出使用它的乘法器。每个“+”圆圈是单比特全加器,方框是寄存器的一位。每次加法产生和位、进位,分别存入 P 的两部分。各位独立,只需两级逻辑,远少于 28 级。
操作时,先将 P 的和位与进位全部清零,执行第一步 ALU 运算;若用 Booth 重编码,可能是减法。然后把 P 的最低和位移入 A,并移动 A。P 的高 n−1 位不必真的移位,因为下一周期它们的和位会送入低一位的加法器。
图中 Carry bits 为进位,Sum bits 为和位,Shift 为右移。因为各单元独立、不传播进位,每步加法都快得多。
CSA 有两个缺点。第一,保存进位需再增加一份 P 寄存器,硬件更多。第二,最后一步后,乘积的高位字仍需普通加法器把和与进位合并;可把 P 的输出送入本来执行加法指令的加法器。用两个寄存器表示 P,有多种可能组合,属于冗余表示,因此这种乘法也称冗余乘法。不是 CSA 的普通加法器称为进位传播加法器(carry-propagate adder,CPA),可采用行波、先行进位等方式。
不增加加法器的另一种办法,是每步查看 A 的低 k 位,而不只一位,称为高基数乘法。例如 k=2:低两位为 00 加 0,01 加 B,10 则把 b 左移一位再加;11 看似要计算 ,却可用高基数 Booth 重编码避免。把 A 看成四进制数:出现数字 3 时,改为 ,并给高一位加 1 补偿。它与普通 Booth 一样,对正负整数都有效。
图 J.25 给出基 4 Booth 的规则。第 i 步,A 的低两位为 ,再结合刚移出的 ,选择向 P 加多少倍 b。图 J.26 给出例子。这种方法也称 overlapping triplets(重叠三位组),因为每步查看三位,而普通 Booth 查看两位。
| A 的第 位 | A 的第 位 | 刚移出的第 位 | 加入的倍数 |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | +b |
| 0 | 1 | 0 | +b |
| 0 | 1 | 1 | +2b |
| 1 | 0 | 0 | −2b |
| 1 | 0 | 1 | −b |
| 1 | 1 | 0 | −b |
| 1 | 1 | 1 | 0 |
| P | A | L | 操作 |
|---|---|---|---|
00000 | 1001 | 0 | 乘 ,B=1011 |
11011 | 1001 | 0 | A 低位为 01,L=0,加 B,即加 11011 |
11110 | 1110 | 0 | 右移两位,左侧补 1 |
01000 | 1110 | 0 | A 低位为 10,L=0,加 −2b,即加 01010 |
00010 | 0011 | 1 | 右移两位;乘积 |
除控制逻辑更复杂外,重叠三位组还要求 P 多一位,以容纳 ±2b。也可以采用基 8 或更高基数,但此时需要 3B 这样的加数。基 8 乘法器通常在乘法开始时预先计算一次 3B,后续复用。
用多个加法器加速乘法
若面积允许设置多个加法器,还能继续加速。图 J.27 是两个 5 位数相乘的简单阵列乘法器,使用三个 CSA 和一个 CPA。(a) 是本节采用的框图形式,(b) 展示所有输入,(c) 展示加法器及其连接;(c) 的每一行对应 (a) 的一个方框。
图中 CSA 为保留进位加法器,Propagate adder 为进位传播加法器。为使相同位权处于同一列,图形被“扭转”了;实际版图更可能排成方形。
它的加法次数与图 J.24 相同,所以延迟与单个 CSA 的方案没有巨大差异;但阵列能够流水化,提高总吞吐率。阵列处理器有时采用如此细的流水线,J.10 节讨论的单芯片浮点加速器却都没有这样做。
流水线的一般讨论见附录 C,乘法器中的应用见 Kogge [1981]。
若芯片分给算术的面积容纳不下完整双精度阵列,可采用图 J.28 的两遍方案。第一遍“处理掉”B 的五位,结果反馈到阵列顶部,与接下来的三个部分积相加;第二遍结果再送入 CPA。但这样会失去流水化能力。
阵列与便宜得多的图 J.2、J.24 方案加法次数相同,为何仍流行?首先,阵列是组合电路,信号直接流过、无需逐级时钟锁存,延迟小于重复使用单个加法器。图 J.28 的两遍方案通常仍有时钟,但穿过 k 级阵列的周期,可以小于单级方案时钟的 k 倍。其次,阵列方便进一步加速。例如图 J.29 让两次加法并行,每条流仅穿过约一半的加法器,所以速度接近图 J.27 的两倍。这种奇偶阵列乘法器因结构规则,很适合 VLSI。
还可利用异步逻辑。图 J.2 需要时钟,原因之一是防止加法器输出尚未稳定,就反馈回输入。若图 J.28 的阵列足够长,信号从顶部到底部的时间不短于第一个加法器稳定所需时间,可能完全不用时钟。
Williams 等 [1987] 讨论过这种设计,不过针对的是除法器。
以上方法的乘法时间仍为 ,使用树可降为 。最简单的树先将 两两相加,使加数从 n 降为 n/2,再降为 n/4,约 log n 步后得到总和。但普通全加器是 (3,2) 器件,三个输入压成两个,不是两压一,不能直接套用二叉树。使用全加器的 Wallace 树见图 J.30。在用中规模集成器件构建算术单元的年代,它是高速乘法器的首选。VLSI 中却有版图问题:展开所有加法器和连线后,它不像图 J.27 那样规则。因此,VLSI 设计者常采用其他 log n 设计,例如下面的二叉树乘法器。
要在二叉树中相加,需有将两个数字合成一个和数字的 (2,1) 加法器。普通二进制受进位影响,做不到,但换一种表示就可能做到。
采用前面解释 Booth 时使用的带符号数字表示(signed-digit representation):每位可为 1、、0。代价有二:每个数字需两位二进制编码;相加规则较复杂,要检查 与 。虽然需要回看两位,但普通二进制的进位可能需要回看任意多位。
先按图 J.31 计算每位的和 、进位 ,再计算 。表的设计保证最终这一步不再生成进位。
| 当前数字之和 | 更低一位数字 x、y 的条件 | 输出 |
|---|---|---|
| 任意 | ||
| 任意 | ||
| 任意 | ||
| 任意 | ||
| 原页列为 的左侧条件组 | 且 | |
| 同上 | 其他 | |
| 原页列为 的右侧条件组 | 且 | 原页为 |
| 同上 | 其他 |
译注:两组条件式的输入都印成 ,且右组第一输出印成 。按数值恒等式及紧随其后的例题,左组输入应为 ,右组第一输出应为 。也就是:当前和为 +1 时,下位 x、y 均非负则取 ,否则取 ;当前和为 −1 时,下位均非负则取 ,否则取 。
例题 带符号数字 与 的和是什么?
解答 最低位 ,中间位 ,最高位 ,因此
这样就有了 (2,1) 加法器,可直接构成二叉树:第一步并行计算 、 等。
下一步再把这些结果两两相加,依此类推。最后仍需 CPA,把带符号数字转为补码,但所有 CSA 乘法器本来也需要这一步。
Wallace 树和带符号数字树的时间都是 log n。前者门数少、版图较难;后者规则,却需每位两比特和更复杂的加法逻辑。各种乘法技术也能组合,例如 Booth 重编码结合阵列:把图 J.27 中单个 换成两位一组的部分积,并用 Booth 避免计算 3b。
用一个加法器加速除法
一个加法器加速乘法的方法有 CSA 与高基数两种,但把它们用于不恢复余数除法有困难。如果图 J.2(b) 改为 CSA,P 就变成和、进位两个寄存器,如图 J.24。每周期末尚未求出两者之和,所以 P 的符号未知,而选择下一步 ALU 操作和商数字都需要它。
高基数也有商选择问题。纸笔除法需要猜商;二进制只有两个候选,可先猜再按 P 的符号修正。高基数有多个候选,似乎必须计算 b 的所有倍数,与 P 比较,选择会很复杂。
采用冗余商表示,就能同时解决这两类问题。允许 −1、0、1 后,往往有多个合法商数字。前面的 SRT 尽量选择 0,以省去 ALU 运算;保留进位除法则利用这种自由度:余数以和、进位分存,虽不知道精确值,仍可能选出合法商位。
图 J.32 横轴为第 i 步余数 ,三条线分别表示选择 后的 。只要 满足 ,就可以选该 q。右半图给出允许范围,可以相互重叠。
不必精确知道 r,只需知道它落在足够小的区间内,且整个区间包含于某一条允许范围即可。实现时,把保留进位表示的高几位送入 CPA 求出近似 r,再结合除数 b,通常查表选择 q。高基数除法也可这样做,无论是否使用 CSA,都能以 P 的高位索引商选择表。
设计高速 SRT 除法器的关键,是决定要检查 P、B 的多少位。例如,基 4、商数字为 −2、−1、0、1、2,使用 CPA,需要多少位?分两步考虑。普通基 2 不恢复余数法中, 保证 P 不溢出;但基 4 每步计算 ,若 接近 b,4r 就接近 4b,最大商数字 2 也无法把它拉回 ,余数可能无限增大。改为限制 ,就容易验证它始终有界。
确定范围后,可画图 J.33。例如 时可选 q=1,即 。假设检查 P 的最高 5 位,含符号,和 b 的最高 4 位,不含始终非负的符号。若 P 为 00011xxx…、b 为 1001xxx…,把小数点放在各数值字段左侧,则截断信息只能说明 r 处于 到 ,b 处于 到 。因此,r/b 可低至 ,要求 q=1;也可高至 ,要求 q=2。可见 5 位 P 与 4 位 b 不足以选择。
检查 P 的 6 位与 b 的 4 位就足够,可编写简单程序遍历验证,结果见图 J.34。
例题 用 8 位寄存器和基 4 SRT 算法计算 149/5。
解答 沿用前面的 SRT 算法,但把步骤 2 的商选择改为查图 J.34,详见图 J.35。
Pentium 采用与此类似的基 4 SRT 算法,但使用 CSA,习题 J.34(c)、J.35 进一步探讨。原文这里的习题编号与本附录的题目编排不完全一致:保留进位形式的 SRT 除法见习题 J.33(c),Pentium 缺陷见习题 J.34;J.35 则讨论高基数方法对余数分步指令的影响。尽管这里例子简单,所有 SRT 分析的步骤都相同:先确定 范围,再画 对 图,确定商选择范围,最后写程序检查需要多少位;有时也能解析求出位数。
实际实现还有许多细节。例如商表很规则,编码为 PLA 通常比 ROM 便宜。更多讨论见 Burgess 与 Williams [1995]。
| b 的高 4 位(十进制) | q=−2 时 P 范围 | q=−1 时 P 范围 | q=0 时 P 范围 | q=1 时 P 范围 | q=2 时 P 范围 |
|---|---|---|---|---|---|
| 8 | −12…−7 | −6…−3 | −2…1 | 2…5 | 6…11 |
| 9 | −14…−8 | −7…−3 | −3…2 | 2…6 | 7…13 |
| 10 | −15…−9 | −8…−3 | −3…2 | 2…7 | 8…14 |
| 11 | −16…−9 | −9…−3 | −3…2 | 2…8 | 8…15 |
| 12 | −18…−10 | −10…−4 | −4…3 | 3…9 | 9…17 |
| 13 | −19…−11 | −10…−4 | −4…3 | 3…9 | 10…18 |
| 14 | −20…−11 | −11…−4 | −4…3 | 3…10 | 10…19 |
| 15 | −22…−12 | −12…−4 | −5…4 | 3…11 | 11…21 |
| P | A 与商数字(示意) | 操作 |
|---|---|---|
000000000 | 10010101 | 149 除以 5,B=00000101 |
000010010 | 10100000 | 步骤 1:B 有 5 个前导 0,左移 5 位后 B=10100000,查 b=10 的分组 |
001001010 | 1000000 | 步骤 2.1:P 高六位为 2,左移两位;可选 q=0 或 1,取 |
100101010 | 000002 | 步骤 2.2:P 高六位为 9,左移两位, |
111101010 | 000002 | 减 2b,即加 011000000 |
110101000 | 00020 | 步骤 2.3:高位为 −3,左移两位;可选 0 或 −1,取 |
010100000 | 步骤 2.4:高位为 −11,左移两位, | |
111100000 | 加 2b=101000000 | |
010000000 | 步骤 3:余数为负,加 b=010100000 恢复,商减 1 |
J.10 融会贯通
本节比较 Weitek 3364、MIPS R3010 与 Texas Instruments 8847,见图 J.36、J.37。这是很合适的一组对象:三者都在单芯片上实现 IEEE 标准的加、减、乘、除,都于 1988 年推出。
它们的时钟周期都在 40 ns 左右,算法却很不相同。Weitek 设计详见 Birman 等 [1990],MIPS 的较简略介绍见 Rowen、Johnson 与 Ries [1988],TI 的细节见 Darley 等 [1989]。
三者都可以并行进行加法与乘法,都不实现扩展精度,也不提供 remainder-step。J.6 节指出,若有该指令,软件实现 IEEE 余数很方便。设计者可能认为,最有影响力的用户运行的是不能依赖扩展精度的可移植程序,因此不提供它;但扩展精度确实能使数学库更快、更简单。
| 特性 | MIPS R3010 | Weitek 3364 | TI 8847 |
|---|---|---|---|
| 时钟周期(ns) | 40 | 50 | 30 |
| 面积(mil²) | 114,857 | 147,600 | 156,180 |
| 晶体管数 | 75,000 | 165,000 | 180,000 |
| 引脚数 | 84 | 168 | 207 |
| 功耗(W) | 3.5 | 1.5 | 1.5 |
| 每次加法周期数 | 2 | 2 | 2 |
| 每次乘法周期数 | 5 | 2 | 3 |
| 每次除法周期数 | 19 | 17 | 11 |
| 每次平方根周期数 | — | 30 | 14 |
晶体管越多,通常所需周期越少。不过,比较每次运算的周期数要小心:MIPS 数字来自完整 R3000/R3010 系统;Weitek 与 TI 数字来自独立芯片,在完整系统中通常会更大。
TI 8847 图内标注如下:
| 原标注 | 中文 |
|---|---|
| Pads | 焊盘 |
| Input registers | 输入寄存器 |
| Operand select | 操作数选择 |
| C register | C 寄存器 |
| Divide/square root registers and multiplexers | 除法/平方根寄存器与多路选择器 |
| Signed digit multiplier | 带符号数字乘法器 |
| Divide/square root state machine | 除法/平方根状态机 |
| Seed programmable logic array | 初值可编程逻辑阵列 |
| Pre-alignment | 预对阶 |
| Timing | 时序 |
| Instruction decoder | 指令译码器 |
| ALU | 算术逻辑单元 |
| Pipeline register | 流水线寄存器 |
| Signed digit converter | 带符号数字转换器 |
| Product register | 乘积寄存器 |
| Status | 状态 |
| Normalizer | 规格化单元 |
| Rounder | 舍入单元 |
| Sum register | 和寄存器 |
MIPS R3010 图内标注如下:
| 原标注 | 中文 |
|---|---|
| Pads | 焊盘 |
| IEEE exception and status register | IEEE 异常与状态寄存器 |
| Conflict detect | 冲突检测 |
| Register timing and decode | 寄存器时序与译码 |
| Register file | 寄存器文件 |
| Forwarding control | 转发控制 |
| Operand forwarding and staging | 操作数转发与分级暂存 |
| External data bus | 外部数据总线 |
| Instruction decode | 指令译码 |
| 32b ↔ 64b alignment | 32 位与 64 位对齐 |
| Exponent datapath | 指数数据通路 |
| Add control | 加法控制 |
| Shifter | 移位器 |
| Sticky | sticky 位逻辑 |
| Pipeline control and interlock logic | 流水线控制与互锁逻辑 |
| IEEE rounding | IEEE 舍入 |
| Adder | 加法器 |
| Clocks | 时钟 |
| Divide control / Divider | 除法控制/除法器 |
| Phase locked loop | 锁相环 |
| I/O control | I/O 控制 |
| Multiply control / Multiplier | 乘法控制/乘法器 |
Weitek 图中 Pads 为焊盘,ALU 为算术逻辑单元,Reg. file 为寄存器文件,I/O muxes 为 I/O 多路选择器,Control 为控制,Divide/sqrt 为除法/平方根单元,Multiplier 为乘法器,Status reg. 为状态寄存器。
MIPS 的晶体管最少,也只有它既无流水化运算,也无硬件平方根。乘法与加法还不是完全独立的,因为共用最终舍入的 CPA 与舍入逻辑。
R3010 的加法混合使用行波、CLA 与选择进位:先按图 J.20 分成两半,各半内部采用图 J.19 那样的行波与 CLA 混合结构,再进一步改变块宽,而不是每块固定 4 位。乘法器介于图 J.2 与 J.27 之间:阵列恰好足够大,使输出无需时钟即可反馈;同时采用基 4 Booth 和图 J.29 的奇偶技术。它与 Weitek 一样,可以并行乘除,TI 则不行。除法采用商数字 −2、−1、0、1、2 的基 4 SRT,与 Taylor [1985] 的设计相似。双精度除法约比乘法慢四倍。
R3010 表明,采用 乘法器时,SRT 除法器可以足够快,维持合理的乘除速度比。
Weitek 3364 有独立加、乘、除单元,也采用基 4 SRT,但加法和乘法都流水化。加法三级为:(1) 比较指数,(2) 加法后移位或移位后加法,(3) 最终舍入。第 1、3 级各半周期,所以三级流水线总延迟仍为两周期。乘法采用图 J.28 式阵列,但使用基 8 Booth,需要预先算 3b。三级分别是:(1) 算 3b,(2) 通过阵列,(3) 最终进位传播加法与舍入。单精度通过阵列一次,双精度两次,总延迟也为两周期。
Weitek 的加法器是图 J.18 跳跃进位的变体。 是多个项的 AND,但它通过逐级传播计算,每一级做一次 AND。因此,块内进位向左传播时,下一块的 向右传播,块宽选择成两股信号同时到达。3364 还支持与除法共用硬件的平方根。其双精度乘、除周期比为 2:17,差距较大,是因为乘法用基 8、除法用基 4;R3010 的乘除则采用相同基数。
TI 8847 最突出的特点,是用 J.6 节的 Goldschmidt 迭代作除法。它使乘除周期比改善为 3:11,但两者无法并行。加法为两级流水线:第一级比较指数、移动小数部分并相加,第二级规格化和舍入。乘法使用带符号数字加法器的二叉树,分三级:第一遍穿过阵列,处理一半位;第二遍处理另一半;第三级把带符号数字转换为补码。只有一套阵列,因此每隔一个周期才能启动一次乘法。不过,放慢时钟后,可在一个周期内穿过阵列两遍,从而每周期启动一次乘法。8847 加法器采用选择进位而非 CLA。如 J.6 节所述,为确保除法正确舍入,TI 内部保留 60 位精度。
这三款芯片展示了相似约束下的不同取舍。最有趣的是算法多样性:加法各不相同,乘法也各不相同;Booth 重编码是三者共同采用的技术。
J.11 谬误与陷阱
谬误:实际浮点应用程序很少下溢
多数程序确实很少下溢,但有些实际程序会频繁下溢。求解一维波动方程的 SDRWAVE [Kahaner 1988] 就是例子,正常运行时也常发生下溢。某台机器的测量表明,若增加渐进下溢的硬件支持,SDRWAVE 的速度可提高约 50%。
谬误:整数与浮点数之间的转换很少见
在 spice 中,转换与除法一样频繁。认为转换稀少,导致 SPARC 第 8 版指令集出现了一个设计失误:没有提供从整数寄存器向浮点寄存器移动数据的指令。
陷阱:只提高浮点单元速度,不提高内存带宽
浮点单元的典型任务,是把两个向量相加产生第三个向量。若元素为双精度,每次浮点加法要传送三个 64 位数据,共 24 字节。若浮点单元还能并行执行乘法与加法,而多数单元都能如此,带宽需求会更大。
陷阱:−x 不等于 0−x
这个 IEEE 标准细节难倒过一些设计者。浮点数采用符号与数值分离表示,所以有 +0、−0 两个零。标准规定 ,而 。因此,当 x=0 时,−x 与 0−x 不同。
译注:原文这里按通常的舍入模式说明符号零差异;向 舍入时,精确抵消为零的符号另有规则,不能把这一等式无条件套用于所有舍入模式。
J.12 历史回顾与参考文献
最早的计算机使用定点而非浮点。Burks、Goldstine 与 von Neumann [1946] 在《电子计算装置逻辑设计的初步讨论》中写道:
“浮动”小数点系统似乎有两个主要目的,两者都源于一个事实:每台机器每字的数字位数,是由设计考虑确定的常数。第一个目的,是在和或积中尽可能保留更多有效数字;第二个目的,是减轻人工估算并在问题中插入“比例因子”的负担。
比例因子是乘法常数,用来让数值保持在机器可表示范围内。
当然,引入适当比例因子的安排会耗费人的时间,这是无法否认的。我们只是认为,与为机器准备一个有意义的问题所耗的总时间相比,这部分时间所占比例很小。我们觉得浮点的第一个好处多少有些虚幻:为了支持浮点,必须牺牲本可用来让每字保存更多数字的存储容量。因此,浮动二进制小数点的有限好处,能否抵偿存储容量损失,以及算术和控制电路复杂性的增加,在我们看来并不明确。
这让我们看到了早期设计者的立场:节省计算机时间和存储,比节省程序员时间更重要。
最早介绍 Wallace 树、Booth 重编码、SRT 除法、重叠三位组等技术的论文,收录于 Swartzlander [1990]。Anderson 等 [1967] 很好地介绍了早期 IBM 360/91,它使用流水化 Wallace 树、Booth 重编码和迭代除法。Freiman [1961] 分析逐位 SRT 的平均时间,是少数未收入该论文集、却很有价值的历史论文之一。
Mead 与 Conway [1980] 的经典教材认为 CLA 在 VLSI 中成本效益不佳,不鼓励采用。Brent 与 Kung [1982] 的重要论文帮助改变了这一看法。详细 CLA 版图见 Ngai 与 Irwin [1985] 或 Weste 与 Eshraghian [1993],更理论化的分析见 Leighton [1992]。Takagi、Yasuura 与 Yajima [1985] 详细介绍了带符号数字树乘法器。
IEEE 算术占主导之前,浮点格式很多,重要者包括 IBM 370、DEC VAX 和 Cray。VAX 最接近 IEEE:单精度 F 格式也有隐含位、8 位指数、23 位小数部分,但没有 sticky 位,中点总向上舍入而不是取偶。指数范围略有不同:,IEEE 为 −126;,IEEE 为 127。主要区别是缺少特殊值与渐进下溢。VAX 的保留操作数类似 signaling NaN,引用它就触发陷阱。最初双精度 D 格式也只有 8 位指数,对许多应用太少,所以后来增加 G 格式,与 IEEE 双精度一样有 11 位指数。VAX 还有 128 位 H 格式。
IBM 370 使用十六进制而非二进制,因此不能使用隐含首位。单精度含 7 位指数与 24 位小数,即 6 个十六进制数字。原书据此写出最大可表示数为
并与 IEEE 的 比较。十六进制规格化只要求首个十六进制数字非零,换成二进制后,最高三位仍可能为零,因此有效精度可能少于 24 位。采用较高基数,是为了减少浮点加法时的移位量;但在运算时间通常不依赖操作数的机器中,这一优势已不那么重要。
译注:上述“最大可表示数”公式为原页原式,只由指数域位数作了数量级比较,未计实际指数偏置、端点和有效数,不能当作两种格式的精确最大有限值;本附录图 J.7 给出的 IEEE 单精度最大无偏置指数为 127。
370 也没有舍入位与 sticky 位,效果上是截断而非舍入,许多计算结果会系统性偏小。它与 VAX、IEEE 还有一点不同:所有位模式都是合法数值。因此,库函数必须另行约定出错时返回什么。例如 IBM FORTRAN 库对 竟返回 2!
Cray 算术很有意思,因为它一切以最高浮点性能为目标。指数域 15 位,小数域 48 位。加法没有保护位,乘法比加法更不准确。若把乘法看成 p 个、每个 2p 位的数相加,Cray 会丢弃每个加数的低位,因此不容易分析准确误差。倒数用迭代计算,a/b 则以 a 乘 1/b;两种误差叠加,使除法的最后三位不可靠。至少,Cray 迫使数值分析人员始终保持警觉!
IEEE 标准化始于 1977 年,主要由 W. Kahan 推动,部分基础来自他在多伦多大学 IBM 7094 上的工作 [Kahan 1968]。过程漫长,渐进下溢争议最大。Cleve Moler 曾说,有人建议赴美游客千万别错过三个景点:拉斯维加斯、大峡谷,以及 IEEE 标准委员会会议。标准终于在 1985 年获批。
Intel 8087 是第一个重要商业 IEEE 实现,1981 年就已问世,早于标准定稿,因此保留了最终标准删除的特性,例如 projective bits。据 Kahan 说,扩展双精度的长度取决于 8087 能实现什么。IEEE 并非直接基于某个既有系统,但多数特性在其他系统出现过:CDC 6600 为 INDEFINITE、INFINITY 保留特殊位模式,非规格化数思想见 Goldberg [1967] 与 Kahan [1968]。Kahan 因其浮点贡献获得 1989 年图灵奖。
浮点很少成为大众媒体焦点,但 1994 年 11 月,报纸却充满了浮点除法的报道。
Intel 当时所有 Pentium 芯片的除法算法出现缺陷。发现者是 Virginia 州 Lynchburg College 的数学教授 Thomas Nicely,他在计算素数倒数时遇到了问题。消息首先刊登在 11 月 7 日的 Electronic Engineering Times 头版。
Intel 起初拒不正视,声称只影响理论数学家,并对媒体说:“这甚至算不上勘误……即使你是工程师,也不会遇到它。”压力增大后,Intel 于 11 月 30 日发布白皮书,解释为何认为缺陷不严重。理由之一是:随机选两个浮点数相除,商出错的概率约九十亿分之一。但 Intel 没有解释,为何认为普通客户会随机使用浮点数。
压力持续上升。一个尤其令人不满的事实是,Intel 在 Nicely 之前已知道问题,却决定不公开。最终,12 月 20 日,Intel 宣布无条件更换使用错误算法的 Pentium,并计提一笔当时未公布金额的费用,后来确定为 3 亿美元。
Pentium 采用 J.9 节介绍的简单 SRT 变体。错误出在把商选择表转换为 PLA 时:Intel 显然认为,几个商数字为 2 的表项永远不会被访问,于是据此优化,让这些位置输出 0。然而它们实际会被访问,导致错误。虽然 2048 项中只有 5 项错误,随机输入的错误商概率仍为九十亿分之一。习题 J.34 会进一步研究。
本附录完整书目见后面的“参考文献”页。
习题
习题 J.1
[12]〈J.2〉 用 n 位补码能够表示的最大、最小整数分别是什么?
习题 J.2
[20/25]〈J.2〉 J.2 节“有符号数”指出:最高位的输入进位与输出进位不同时,补码加法溢出。
a. [20]〈J.2〉 对输入、输出进位的四种组合,各给出一对整数实例,验证上述规则。
b. [25]〈J.2〉 解释为什么该规则总成立。
习题 J.3
[12]〈J.2〉 用 4 位二进制数和 Booth 重编码计算 。
习题 J.4
[15]〈J.2〉 式 J.2.1、J.2.2 用于两个 n 位数的加法。推导减法的类似方程,此时以借位代替进位。
习题 J.5
[25]〈J.2〉 若机器硬件不检测整数溢出,说明如何在软件中检测有符号加法的溢出。
习题 J.6
[15/15/20]〈J.3〉 将以下数分别表示成 IEEE 单精度与双精度浮点数。
a. [15]〈J.3〉 10。
b. [15]〈J.3〉 10.5。
c. [20]〈J.3〉 0.1。
习题 J.7
[12/12/12/12/12]〈J.3〉 对下列单精度浮点数,写出其二进制值、十进制值,以及 IEEE 编码。
a. [12]〈J.3〉 小于 1 的最大数。
b. [12]〈J.3〉 最大数。
c. [12]〈J.3〉 最小的正数(限规格化数)。
d. [12]〈J.3〉 最大非规格化数。
e. [12]〈J.3〉 最小正数。
习题 J.8
[15]〈J.3〉 把非规格化数也考虑在内时,非负浮点数的编码顺序仍与整数顺序相同吗?
习题 J.9
[20]〈J.3〉 编写程序,打印你所用计算机上表示浮点数的位模式。NaN 使用什么位模式?
习题 J.10
[15]〈J.4〉 取 ,展示二进制浮点乘法算法如何计算 。
习题 J.11
[12/10]〈J.4〉 考虑浮点乘法中的指数相加。
a. [12]〈J.4〉 实现指数加法的硬件是什么样的?
b. [10]〈J.4〉 若单精度偏置为 129 而非 127,实现指数加法会更容易还是更困难?
习题 J.12
[15/12]〈J.4〉 浮点乘法的上溢检测讨论指出,单精度可在 9 位加法器中相加指数,以检测指数溢出。
a. [15]〈J.4〉 给出检测上溢的精确规则。
b. [12]〈J.4〉 改用 10 位加法器,检测是否会更容易?
习题 J.13
[15/10]〈J.4〉 关于浮点乘法:
a. [15]〈J.4〉 构造两个单精度浮点数,使其乘积直到最终舍入时才发生上溢。
b. [10]〈J.4〉 是否有某种舍入模式,使这种现象不可能发生?
习题 J.14
[15]〈J.4〉 给出一个操作数为非规格化数、结果却为规格化数的乘法例子。最后需要移多少位?若输入均为双精度,最大可能移多少位?
习题 J.15
[15]〈J.5〉 用 J.5 节的浮点加法算法,以 4 位精度计算 。
习题 J.16
[10/15/20/20/20]〈J.5〉 某些情况下可以确定 a+b 能被浮点数精确表示,不需要舍入。
a. [10]〈J.5〉 若 a、b 同指数、异号,解释为什么 a+b 精确。J.5 节“加速加法”使用过这个性质。
b. [15]〈J.5〉 给出指数相差 1、符号相反、但 a+b 不精确的例子。
c. [20]〈J.5〉 若 ,计算 a−b 时 a 的最高两位抵消,解释为什么差精确。正文介绍抵消时提到过这个性质。
d. [20]〈J.5〉 若 ,且指数相差 1,证明除非 a−b 的最高位与 a 的最高位处于同一位置,否则差精确。这一点在“加速加法”中提到过。
e. [20]〈J.5〉 若 a−b 或 a+b 的结果是非规格化数,证明它精确。J.7 节“下溢”提到过这个性质。
习题 J.17
[15/20]〈J.5〉 使用并行加法器的快速浮点加法,取 。
a. [15]〈J.5〉 对 ,逐步执行快速加法算法。
b. [20]〈J.5〉 若舍入模式为向 ,上述例子中,假定会产生进位的加法器会遇到什么额外问题?提出解决办法。
习题 J.18
[12]〈J.4、J.5〉 如何用两个并行加法器,避免浮点乘法最后单独进行舍入进一的加法?
习题 J.19
[30/10]〈J.5〉 本题给出只用一个加法器、把浮点加法所需加法次数从三次减至两次的方法。
a. [30]〈J.5〉 令 A、B 为异号整数,a、b 为其绝对值。证明,对无符号数 a、b 执行以下步骤可得到 A+B。
- 对其中一个操作数逐位取反。
- 用循环进位(end-around carry)将取反后的操作数与另一个未取反的操作数相加。
- 若产生进位输出,结果采用未取反操作数的符号。
- 否则,对结果逐位取反,并采用被取反操作数的符号。
b. [10]〈J.5〉 利用上述结果,说明 J.5 节浮点加法算法的第 2、4 步如何只需一次加法完成。
习题 J.20
[20/15/20/15/20/15]〈J.6〉 迭代求平方根。
a. [20]〈J.6〉 用 Newton 方法推导平方根迭代算法,公式中会出现一次除法。
b. [15]〈J.6〉 你能想到的浮点数除以 2 的最快方法是什么?
c. [20]〈J.6〉 若除法慢,平方根迭代也会慢。对 应用 Newton 方法,推导不使用除法的算法。
d. [15]〈J.6〉 假定“除以 2:浮点加法:浮点乘法”的耗时比为 1:2:4。乘法与除法的耗时比满足什么条件时,(c) 的每次迭代比 (a) 更快?
e. [20]〈J.6〉 采用 (a) 的方法,要在三次迭代后达到双精度,初始估计需要多少个正确位?可忽略舍入误差。
f. [15]〈J.6〉 假定 spice 在 TI 8847 上运行时,16.7% 时间花在平方根例程中;这一比例曾在其他机器测得。利用图 J.36,假设迭代三次,如果改为用 (a) 的软件算法实现平方根,spice 会慢多少?
习题 J.21
[10/20/15/15/15]〈J.6〉 正确舍入的迭代除法。a、b 为 p 位有效数浮点数,双精度时 p=53。令精确商 ,且 。迭代结果 多保留几位,满足 。以下要求 ,即使 q 可以精确表示为浮点数,也必须严格小于。
a. [10]〈J.6〉 若 x 为浮点数,,紧随 x 的下一个可表示数是什么?
b. [20]〈J.6〉 说明如何由 计算具有 p+1 位精度、且满足 的 。
c. [15]〈J.6〉 假定舍入到最近值,证明正确舍入的商必为 、、 之一。
d. [15]〈J.6〉 根据 的最低位与 的符号,给出从 得到正确舍入商的规则。
e. [15]〈J.6〉 对另外三种舍入模式回答 (c)。
习题 J.22
[15]〈J.6〉 验证 J.6 节展开 Newton 迭代所得的公式。提示:若
则
译注:提示中的乘积上限 n 与左侧 ,和正文以 编号的展开式存在一位索引偏移。若沿用正文迭代编号, 的乘积上限应为 n−1。
习题 J.23
[15]〈J.7〉 两次舍入与一次舍入可能不同的例子使用了中点取偶规则。如果中点总向上舍入,两次舍入仍有危险吗?
习题 J.24
[10/10/20/20]〈J.7〉 J.7 节“精度”中斜体命题的某些情况不难证明。
a. [10]〈J.7〉 若先舍入到 q 位、再到 p 位,与直接舍入到 p 位不同,原二进制数必须具有什么形式?
b. [10]〈J.7〉 证明:p 位数相乘,若 ,先舍入到 q 位再到 p 位,等于直接舍入到 p 位。
c. [20]〈J.7〉 若 a、b 是同号 p 位数,证明当 时,a+b 先舍入到 q 位再到 p 位,等于直接舍入到 p 位。
d. [20]〈J.7〉 对异号的 a、b 证明 (c)。
习题 J.25
[讨论]〈J.7〉 MIPS 的异常处理方法需要快速检测两个浮点操作数是否可能导致异常,并尽量避免误报。你能提出实用的检测方法吗?其性能成本取决于浮点数的分布,这在 Knuth [1981] 和 Swartzlander [1990] 收录的 Hamming 论文中有讨论。
习题 J.26
[12/12/10]〈J.8〉 跳跃进位加法器。
a. [12]〈J.8〉 假定时间与逻辑级数成正比,n 位加法器分成固定 k 位块,一次加法需要多久?
b. [12]〈J.8〉 k 取什么值最快?
c. [10]〈J.8〉 解释为什么时间复杂度为 。
习题 J.27
[10/15/20]〈J.8〉 补全以下加法器框图的细节。
a. [10]〈J.8〉 用 AND、OR 门实现图 J.15 的“1”“2”方框。
b. [15]〈J.8〉 图 J.19 中,顶行加法单元需要向 C 单元传递哪些信号?写出 C 单元的逻辑方程。
c. [20]〈J.8〉 扩展图 J.17,使其产生最终进位 。
习题 J.28
[15]〈J.9〉 普通 Booth 重编码第 i 步采用的 b 的倍数为 。你能为基 4 Booth,即重叠三位组,找到类似公式吗?
习题 J.29
[20]〈J.9〉 按图 J.27 的方式展开图 J.29,画出各个加法器。
习题 J.30
[25]〈J.9〉 为基 8 Booth 重编码写出类似图 J.25 的表格。
习题 J.31
[18]〈J.9〉 假设带符号数字数值 、 按 J.9 节例题相加。用 写出和的第 i 位 的公式。
习题 J.32
[15]〈J.9〉 正文讨论了商数字为 −2、−1、0、1、2 的基 4 SRT 除法。如果还允许 ±3,应以什么关系代替 ?
习题 J.33
[25/20/30]〈J.9〉 关于图 J.34 的 SRT 商选择表:
a. [25]〈J.9〉 编写程序生成该表。
b. [20]〈J.9〉 该表关于 P 的正负具有一定对称性。能否利用它,只存正 P 的表项?
c. [30]〈J.9〉 若用 CSA 代替 CPA,商表输入由除数的 k 位和余数的 l 位组成;余数高位通过把和寄存器、进位寄存器的高 l 位相加得到。k、l 应是多少?编程生成相应商表。
习题 J.34
[12/12/12]〈J.9、J.12〉 最初生产的数百万片 Pentium 有时会给出错误除法结果。它使用与 J.9 节示例相似的基 4 SRT,但余数以保留进位形式存储,见 J.33(c)。Intel 表示缺陷来自商表的五个错误表项。
a. [12]〈J.9、J.12〉 错误表项本应给出 ±2,却给出 0。冗余表示似乎可能使算法在后续迭代中从错误商位“恢复”。证明 Pentium 缺陷无法如此恢复。
b. [12]〈J.9、J.12〉 浮点除法需对前面的整数 SRT 作两处修改:除数已规格化,不再需要步骤 1;初始余数可能不满足正确边界,Pentium 为 。证明省去步骤 2(a) 的第一次左移可以解决这个问题。
c. [12]〈J.9、J.12〉 若错误表项对应的余数可能出现在第一次除法步骤,随机测试很快就会发现缺陷。原文括注此时“余数就是除数”(divisor)。实际并未很快发现,这说明索引到错误表项的余数值有什么特征?
译注:括注使用了 divisor(除数),但本附录前面将被除数有效数装入初始 P,因而这里“除数”与初始化叙述不一致,可能是 dividend(被除数)的笔误。
习题 J.35
[12]〈J.6、J.9〉 remainder-step 的讨论假定采用逐位除法。若改用高基数除法,需要作哪些变化?
习题 J.36
[25]〈J.9〉 图 J.28 没有利用阵列可流水化的能力。能否设计一种把最底 CSA 的输出反馈到下部 CSA、而非最顶 CSA 的方案,使它比图 J.28 更快?
参考文献
Anderson, S.F., Earle, J.G., Goldschmidt, R.E., Powers, D.M., 1967. “The IBM System/360 Model 91: Floating-point execution unit”(IBM System/360 Model 91:浮点执行单元). IBM J. Research and Development 11, 34–53. 重印于 Swartzlander [1990]。本文很好地介绍了一种早期的高性能浮点单元,其乘法采用流水化的 Wallace 树,除法采用迭代算法。
Bell, C.G., Newell, A., 1971. Computer Structures: Readings and Examples(计算机结构:文选与实例). McGraw-Hill, New York.
Birman, M., Samuels, A., Chu, G., Chuk, T., Hu, L., McLeod, J., Barnes, J., 1990. “Developing the WRL3170/3171 SPARC floating-point coprocessors”(WRL3170/3171 SPARC 浮点协处理器的开发). IEEE Micro 10 (1), 55–64. 这些芯片采用与 Weitek 3364 相同的浮点核心;本文对该浮点设计作了相当详细的介绍。
Brent, R.P., Kung, H.T., 1982. “A regular layout for parallel adders”(并行加法器的规则布局). IEEE Trans. on Computers C-31, 260–264. 这篇论文推动了先行进位加法器(CLA)在 VLSI 中的广泛应用。
Burgess, N., Williams, T., 1995. “Choices of operand truncation in the SRT division algorithm”(SRT 除法算法中操作数截断的选择). IEEE Trans. on Computers 44, 7. 本文分析了 SRT 除法需要检查除数和余数的多少位。
Burks, A.W., Goldstine, H.H., von Neumann, J., 1946. “Preliminary discussion of the logical design of an electronic computing instrument”(电子计算装置逻辑设计的初步讨论). In: Aspray, W., Burks, A. (Eds.), Papers of John von Neumann. 致美国陆军军械部的报告,第 1 页;另有重印。MIT Press, Cambridge, Mass., pp. 97–146. Tomash Publishers, Los Angeles, 1987.
Cody, W.J., Coonen, J.T., Gay, D.M., Hanson, K., Hough, D., Kahan, W., Karpinski, R., Palmer, J., Ris, F.N., Stevenson, D., 1984. “A proposed radix- and word-length-independent standard for floating-point arithmetic”(一种与基数和字长无关的浮点算术标准提案). IEEE Micro 4 (4), 86–100. 本文包含比 IEEE 754 更一般的 854 标准草案。其重要之处在于附有对标准的评注,其中大部分同样适用于 754。
不过,应注意该草案与最终标准仍有一些差异。
Coonen, J., 1984. Contributions to a proposed standard for binary floating point arithmetic(对二进制浮点算术标准提案的贡献). 博士学位论文,University of California—Berkeley。这是唯一详细讨论如何利用舍入模式实现高效二进制与十进制转换的文献。
Darley, H.M., et al., 1989. “Floating point/integer processor with divide and square root functions”(具有除法和平方根功能的浮点/整数处理器). 美国专利 4,878,190,1989 年 10 月 31 日。就专利文献而言,相当易读。它从整体上介绍了 TI 8847 芯片,但没有给出除法算法的全部细节。
Demmel, J.W., Li, X., 1994. “Faster numerical algorithms via exception handling”(通过异常处理加速数值算法). IEEE Trans. on Computers 43 (8), 983–992. 本文很好地说明了 IEEE 浮点独有的特性如何提高一个重要软件库的性能。
Freiman, C.V., 1961. “Statistical analysis of certain binary division algorithms”(若干二进制除法算法的统计分析). Proc. IRE 49 (1), 91–103. 本文分析了采用跳过零移位的 SRT 除法算法的性能。
Goldberg, D., 1991. “What every computer scientist should know about floating-point arithmetic”(每位计算机科学家都应了解的浮点算术知识). Computing Surveys 23 (1), 5–48. 本文从软件角度深入讲解了 IEEE 标准。
Goldberg, I.B., 1967. “27 bits are not enough for 8-digit accuracy”(27 位不足以保证 8 位十进制数字的精度). Comm. ACM 10 (2), 105–106. 本文提出了使用隐含位和渐进下溢的方法。
Gosling, J.B., 1980. Design of Arithmetic Units for Digital Computers(数字计算机运算单元设计). Springer-Verlag, New York. 这是一本简明、写得很好的书,不过主要关注中规模集成电路(MSI)设计。
Hamacher, V.C., Vranesic, Z.G., Zaky, S.G., 1984. Computer Organization(计算机组成),第 2 版. McGraw-Hill, New York. 这是一本计算机体系结构入门书,其中介绍计算机算术的一章写得很好。
Hwang, K., 1979. Computer Arithmetic: Principles, Architecture, and Design(计算机算术:原理、体系结构与设计). Wiley, New York. 在有关计算机算术的书籍中,本书涉及的主题最为广泛。
IEEE, 1985. “IEEE standard for binary floating-point arithmetic”(IEEE 二进制浮点算术标准). SIGPLAN Notices 22 (2), 9–25. 这里重印了 IEEE 754 标准。
Kahan, W., 1968. “7094-II system support for numerical analysis”(7094-II 系统对数值分析的支持). SHARE Secretarial Distribution SSD-159. 该系统具有许多后来被纳入 IEEE 浮点标准的特性。
Kahaner, D.K., 1988. “Benchmarks for ‘real’ programs”(“实际”程序的基准测试). SIAM News,11 月。文中给出的基准程序实际上会导致大量下溢。
Knuth, D., 1981. The Art of Computer Programming(计算机程序设计艺术),第 2 版,第 II 卷. Addison-Wesley, Reading, Mass. 本书有一节介绍浮点数的分布。
Kogge, P., 1981. The Architecture of Pipelined Computers(流水线计算机的体系结构). McGraw-Hill, New York. 本书简要讨论了流水化乘法器。
Kohn, L., Fu, S.-W., 1989. “A 1,000,000 transistor microprocessor”(一个具有 100 万个晶体管的微处理器). In: IEEE Int’l. Solid-State Circuits Conf. Digest of Technical Papers, pp. 54–55. 有多篇文章介绍 i860,而这篇给出的浮点算法细节最多。
Koren, I., 1989. Computer Arithmetic Algorithms(计算机算术算法). Prentice Hall, Englewood Cliffs, N.J.
Leighton, F.T., 1992. Introduction to Parallel Algorithms and Architectures: Arrays, Trees, Hypercubes(并行算法与体系结构导论:阵列、树与超立方体). Morgan Kaufmann, San Francisco. 这是一本出色的书,重点在于算法的复杂度分析。第 1.2.1 节很好地讨论了在树结构上实现先行进位加法。
Magenheimer, D.J., Peters, L., Pettis, K.W., Zuras, D., 1988. “Integer multiplication and division on the HP Precision architecture”(HP Precision 体系结构上的整数乘法与除法). IEEE Trans. on Computers 37 (8), 980–990. 本文解释了 Precision 体系结构采用整数运算分步指令和除法分步指令的设计依据。
Markstein, P.W., 1990. “Computation of elementary functions on the IBM RISC System/6000 processor”(IBM RISC System/6000 处理器上的初等函数计算). IBM J. of Research and Development 34 (1), 111–119. 本文说明了如何使用融合乘加实现正确舍入的除法和平方根。
Mead, C., Conway, L., 1980. Introduction to VLSI Systems(VLSI 系统导论). Addison-Wesley, Reading, Mass.
Montoye, R.K., Hokenek, E., Runyon, S.L., 1990. “Design of the IBM RISC System/6000 floating-point execution”(IBM RISC System/6000 浮点执行单元的设计). IBM J. of Research and Development 34 (1), 59–70. 本文介绍了一种融合乘加的实现。
Ngai, T.-F., Irwin, M.J., 1985. “Regular, area-time efficient carry-lookahead adders”(布局规则、面积与时间效率高的先行进位加法器). In: Proc. Seventh IEEE Symposium on Computer Arithmetic, pp. 9–15. 本文介绍了类似图 J.17 的 CLA,其中位信息先向上传播,再向下返回。
Patterson, D.A., Hennessy, J.L., 2009. Computer Organization and Design: The Hardware/Software Interface(计算机组成与设计:硬件/软件接口),第 4 版. Morgan Kaufmann, San Francisco. 第 3 章以更平缓的方式介绍了本附录前三分之一的内容。
Peng, V., Samudrala, S., Gavrielov, M., 1987. “On the implementation of shifters, multipliers, and dividers in VLSI floating point units”(VLSI 浮点单元中移位器、乘法器和除法器的实现). In: Proc. Eighth IEEE Symposium on Computer Arithmetic, pp. 95–102. 这是一篇非常值得推荐的综述,介绍了 VLSI 设计中实际采用的多种技术。
Rowen, C., Johnson, M., Ries, P., 1988. “The MIPS R3010 floating-point coprocessor”(MIPS R3010 浮点协处理器). IEEE Micro, 53–62,6 月。
Santoro, M.R., Bewick, G., Horowitz, M.A., 1989. “Rounding algorithms for IEEE multipliers”(IEEE 乘法器的舍入算法). In: Proc. Ninth IEEE Symposium on Computer Arithmetic, pp. 176–183. 本文以通俗易读的方式讨论了如何高效实现浮点乘法的舍入。
Scott, N.R., 1985. Computer Number Systems and Arithmetic(计算机数制与算术). Prentice Hall, Englewood Cliffs, N.J.
Swartzlander, E. (Ed.), 1990. Computer Arithmetic(计算机算术). IEEE Computer Society Press, Los Alamitos, Calif. 这是一套两卷本的历史论文集。
Takagi, N., Yasuura, H., Yajima, S., 1985. “High-speed VLSI multiplication algorithm with a redundant binary addition tree”(采用冗余二进制加法树的高速 VLSI 乘法算法). IEEE Trans. on Computers C-34 (9), 789–796. 本文讨论了二叉树结构的带符号数字乘法器,TI 8847 所用设计以此为基础。
Taylor, G.S., 1981. “Compatible hardware for division and square root”(兼容除法与平方根运算的硬件). In: Proc. Fifth IEEE Symposium on Computer Arithmetic,1981 年 5 月 18–19 日,Ann Arbor, Mich., pp. 127–134. 本文很好地讨论了一种基 4 SRT 除法算法。
Taylor, G.S., 1985. “Radix 16 SRT dividers with overlapped quotient selection stages”(商选择级重叠的基 16 SRT 除法器). In: Proc. Seventh IEEE Symposium on Computer Arithmetic,1985 年 6 月 4–6 日,pp. 64–71, Urbana, Ill. 本文介绍了一种非常精巧的高基数除法算法。
Weste, N., Eshraghian, K., 1993. Principles of CMOS VLSI Design: A Systems Perspective(CMOS VLSI 设计原理:系统视角),第 2 版. Addison-Wesley, Reading, Mass. 该教材有一节介绍各种加法器的布局。
Williams, T.E., Horowitz, M., Alverson, R.L., Yang, T.S., 1987. “A self-timed chip for division”(一种自定时除法芯片). In: Advanced Research in VLSI, Proc. 1987 Stanford Conf., MIT Press, Cambridge, Mass. 本文介绍了一种除法器,目标是在不占用组合电路方案那么大面积的前提下,达到组合电路的速度。
K 指令集体系结构概览
RISC:1985 年以后发布的任何计算机。
——Steven Przybylski,Stanford MIPS 的设计者之一
K.1 引言
本附录介绍十种指令集体系结构。其中一些仍是信息技术产业的重要组成部分,另一些则已功成身退。保留它们,一部分原因是希望展示指令集体系结构的设计风尚如何随时间改变。
我们先介绍八种 RISC 体系结构,以 RISC-V 作为比较基准。每年出货的 ARM(含 Thumb-2)、MIPS(含 microMIPS)、Power 和 SPARC 计算机,价值数十亿美元。ARM 在个人移动设备(PMD,包括智能手机和平板电脑)和嵌入式市场都占据主导地位。
80x86 仍是按销售额计规模最大的 ISA,主导桌面和大部分服务器市场。它在嵌入式和 PMD 市场未能取得立足之地,也开始在服务器市场失去部分份额。它经历的扩展比本书其他任何 ISA 都多,而且近期没有停止扩展的计划。如今已经转向 64 位寻址,我们预计它还会长期存在,只是未来的作用可能小于过去 30 年。
VAX 代表另一类 ISA:强调代码大小,并提供较高级的机器语言,希望更贴合编程语言。设计者显然预期它会大量使用微码实现,这让单芯片和流水线实现更具挑战。它的继任者 Alpha 是一种类似 MIPS 和 RISC-V 的 RISC 体系结构,但生命周期较短。
IBM 360/370 则是一款为后续许多指令集树立标准的经典体系结构。1 设计者在 20 世纪 60 年代初作出的决定包括:
- 8 位字节。
- 按字节寻址。
- 32 位字。
- 32 位单精度和 64 位双精度浮点格式。
- 32 位通用寄存器,以及独立的 64 位浮点寄存器。
- 不同性价比的计算机系列之间保持二进制兼容。
- 将体系结构与实现分离。
如第 2 章所述,IBM 370 经扩展后支持虚拟化,因此其虚拟机开销在各 ISA 中最低。IBM 360/370 已扩展为 64 位版本,仍是 IBM 大型机业务的基础。
译注:原文此处写作“vulnerable IBM 360/370”,与随后赞述其经典地位的上下文不协调,疑为 venerable 的笔误;译文按“经典”表达该段明确含义。 ↩︎
K.2 桌面、服务器及嵌入式计算机的 RISC 体系结构概览
引言
本节介绍两组精简指令集计算机(RISC)体系结构。第一组面向桌面、服务器和个人移动设备(PMD):
- Advanced RISC Machines 的 ARMv8,即 64 位 ISA AArch64。
- MIPS64 第 6 版,即原书讨论的最新 64 位 ISA。
- Power 3.0,合并了早期 IBM Power 和 PowerPC 体系结构。
- RISC-V,具体采用 64 位扩展 RV64G。
- SPARCv9,即 64 位 ISA。
如图 K.1 所示,这些体系结构相当相似。
| 项目 | ARMv8 | MIPS64 R6 | Power v3.0 | RV64G | SPARCv9 |
|---|---|---|---|---|---|
| 基础 ISA 最初年代 | 1986 | 1986 | 1990 | 2016 | 1987 |
| 本版 ISA 年代 | 2011 | 2014 | 2013 | 2016 | 2008 |
| 指令长度(位) | 32 | 32 | 32 | 32 | 32 |
| 地址空间:大小、模型 | 64 位,平坦 | 64 位,平坦 | 64 位,平坦 | 64 位,平坦 | 64 位,平坦 |
| 数据对齐 | 优先对齐 | 优先对齐 | 可不对齐 | 优先对齐 | 对齐 |
| 数据寻址方式数 | 8,含比例变址及前/后递增 | 1,另有 1 种仅用于浮点 | 4 | 1 | 2 |
| 整数寄存器:数量、模型、宽度 | 31 个 64 位 GPR,加栈指针 | 31 个 64 位 GPR | 31 个 64 位 GPR | 31 个 64 位 GPR | 31 个 64 位 GPR |
| 独立浮点寄存器 | 32 × 32 位或 32 × 64 位 | 32 × 32 位或 32 × 64 位 | 32 × 32 位或 32 × 64 位 | 32 × 32 位或 32 × 64 位 | 32 × 32 位或 32 × 64 位 |
| 浮点格式 | IEEE 754 单/双精度 | IEEE 754 单/双精度 | IEEE 754 单/双精度 | IEEE 754 单/双精度 | IEEE 754 单/双精度 |
历史上还有两款重要 RISC 处理器,与上述体系结构近乎相同。Digital Equipment Corporation 在 1992–2004 年制造的 DEC Alpha,与 MIPS64 几乎一致。HP 约从 1986 年到 2005 年生产 PA-RISC,之后由 Itanium 取代。PA-RISC 与 Power ISA 最接近;后者来自 IBM Power,而 IBM Power 又继承自 IBM 801。
第二组是面向较低端应用的嵌入式 RISC:
- Advanced RISC Machines 的 Thumb-2:包含 16 位和 32 位指令的 32 位指令集,兼有 ARMv7、ARMv8 的特性。
- microMIPS64:包含 16 位指令的 MIPS64 版本。
- RISC-V 压缩扩展 RV64GC:在 RV64G 上增加一组 16 位指令。
RV64GC 和 microMIPS64 都有对应的 32 位版本,即 RV32GC、microMIPS32。
由于基础 32 位或 64 位桌面、服务器体系结构的比较会讨论各 ISA 的差异,这里对嵌入式体系结构主要关注 16 位指令。
| 项目 | microMIPS64 | RV64GC | Thumb-2 |
|---|---|---|---|
| 发布年份 | 2009 | 2016 | 2003 |
| 指令长度(位) | 16/32 | 16/32 | 16/32 |
| 地址空间:大小、模型 | 32/64 位,平坦 | 32/64 位,平坦 | 32 位,平坦 |
| 数据对齐 | 对齐 | 优先对齐 | 对齐 |
| 数据寻址方式数 | 2 | 1 | 6 |
| 整数寄存器:数量、模型、宽度 | 31 个 64 位 GPR | 31 个 64 位 GPR | 15 个 32 位 GPR |
| 大多数 16 位指令可访问的整数寄存器 | 8 个 GPR + SP + GP + RA;GPR 为 0、2–7、17,或 2–7、16、17 | 8 个 GPR + SP;GPR 为 8–15 | 8 个 GPR + SP,宽 32 位 |
图 K.2 表明,这些嵌入式体系结构也很相似。三者的 16 位指令都是 32 位指令的简化版本,通常只允许使用有限的寄存器。基本思想是用 16 位版本替换常见的 32 位指令,从而缩小代码。RV32GC 或 Thumb-2 加入 16 位指令后,代码大小约为仅使用对应 32 位 ISA——RV32G 或 ARMv7——时的 0.73 倍。
三者的重要区别在基础 32 位 ISA 的结构。RV64GC 的 32 位指令与 RV64G 完全相同,因为 RISC-V 从一开始就考虑了 16 位选项,分支和跳转目标按 16 位边界指定。microMIPS64 基于 MIPS64,只作一项改变:分支和跳转偏移量按 16 位而不是 32 位对齐解释。它还使用了 MIPS64 为用户自定义指令扩展保留的编码空间;这些扩展不属于基础 ISA。
Thumb-2 稍有不同。其 32 位指令大多是 ARMv7 的子集,但不包含一些在 ARMv8 中被删除的特性,例如大多数指令的条件执行,以及把 PC 当作 GPR 写入。Thumb-2 还包含数十条在 ARMv8 引入的指令,具体为位字段操作、额外系统指令和同步支持。因此,Thumb-2 的 32 位指令构成一个独特的 ISA。
较早的 MIPS16 和 Thumb 采用独立模式:通过过程调用,转入只使用 16 位指令的代码段。其 16 位指令集并不完整,只面向对代码大小敏感的用户程序。
这些说明还受到一个复杂因素影响:较早的 RISC 经多年不断扩展。因此,本节选择描述原书所述时期的最新版本:桌面、服务器和 PMD 使用 ARMv8/AArch64、MIPS64 R6、Power v3.0、RV64G、SPARC v9;嵌入式部分描述 microMIPS64、RV64GC 和 Thumb-2 的 16 位子集。
讨论寻址方式和指令格式后,按五步概览指令:
- 附录 A 描述的 RV64G 核心中已有的指令。
- RV64G 或 RV64GC 没有、但至少另外两种体系结构具有的指令,按功能组织,例如扩展整数算术。
- ARM、MIPS、Power 或 SPARC 独有的指令组,按功能组织。
- 桌面、服务器、PMD RISC 的多媒体扩展。
- 嵌入式 RISC 的数字信号处理扩展。
本节覆盖这些体系结构的大多数指令,但并非每一条;Power 和 ARM 尤其如此,因为其指令很多。
寻址方式与指令格式
图 K.3 给出桌面、服务器、PMD 体系结构的数据寻址方式。除 ARM 外,它们都有一个寄存器,在参与地址计算时始终取零;因此,位移寻址以寄存器 0 为基址,就能合成范围有限的绝对寻址。PowerPC 的该寄存器可以被 ALU 操作修改,但用于地址计算时仍按零处理。同样,将位移设为零,就能合成寄存器间接寻址。简化的寻址方式是 RISC 的特征之一。
| 寻址方式 | ARMv8 | MIPS64 R6 | Power v3.0 | RV64G | SPARCv9 |
|---|---|---|---|---|---|
| 寄存器 + 偏移量:位移/基址 | B,H,W,D | B,H,W,D | B,H,W,D | B,H,W,D | B,H,W,D |
| 寄存器 + 寄存器:变址 | B,H,W,D | B,H,W,D | B,H,W,D | ||
| 寄存器 + 按比例缩放的寄存器:比例变址 | B,H,W,D | W,D | |||
| 寄存器 + 寄存器 + 偏移量 | B,H,W,D | ||||
| 寄存器 + 偏移量,并将寄存器更新为有效地址:带更新的基址寻址 | B,H,W,D | B,H,W,D | |||
| 使用寄存器原值寻址,再将寄存器更新为寄存器 + 偏移量:带更新的寄存器寻址 | B,H,W,D | ||||
| 寄存器 + 寄存器,并将寄存器更新为有效地址:带更新的变址寻址 | B,H,W,D | B,H,W,D | |||
| PC 相对:PC + 位移 | W,D | W,D |
如图 K.4 所示,嵌入式体系结构限制了 16 位指令可访问的寄存器;大多数指令通常只能访问八个寄存器,少数特殊指令能访问其他寄存器。图 K.5 给出其 16 位指令模式的数据寻址方式。这些加载和存储版本既限制了地址计算可用的寄存器,也大幅缩短了位移立即数字段。
| 寄存器指定方式 | microMIPS64 | RV64GC | Thumb-2 |
|---|---|---|---|
| 3 位编码 | 2–7、16、17 | 8–15 | 0–7 |
| 栈指针寄存器 | 29 | 2 | 0(用于加载/存储时) |
| 全局指针寄存器 | 28 | ||
| 返回地址寄存器 | 31 | 1 | 14 |
| 使用特殊寄存器 | 栈指针或全局指针;5 位偏移量 | 栈指针;5 位偏移量 | 栈指针;8 位偏移量 |
| 寻址方式 | microMIPS64 | RV64GC | Thumb-2 |
|---|---|---|---|
| 寄存器 + 偏移量:位移/基址 | 4 位偏移量,八个寄存器之一 | 5 位偏移量,八个寄存器之一 | 5 位偏移量,八个寄存器之一 |
| PC 相对数据 | 仅字;8 位偏移量 | ||
| 使用特殊寄存器 | 栈指针或全局指针;5 位偏移量 | 栈指针;5 位偏移量 | 栈指针;8 位偏移量 |
译注:图 K.4 的 microMIPS64 全局指针为 28,图 K.5 图注却写 30;Thumb-2 栈指针在图 K.4 写作 0,图 K.5 图注写作 r31,又与图 K.2 所述寄存器规模不协调。这些都是原页可见的源书差异。
代码引用通常采用 PC 相对方式,同时支持寄存器间接跳转,用于过程返回、case 语句和经指针调用函数。桌面 RISC 的 PC 相对分支地址经常先左移两位再与 PC 相加,以扩大分支范围;这是因为指令均为 32 位,且必须在存储器中按 32 位字对齐。嵌入式体系结构和带压缩扩展的 RISC-V 包含 16 位指令,出于类似原因,PC 相对地址通常左移一位。
图 K.6 展示桌面、服务器、PMD RISC 最重要的指令格式。每种 ISA 使用四种主要格式,通常覆盖 90%–98% 的指令。寄存器—寄存器格式用于相应 ALU 指令;ALU 立即数格式用于带立即数的 ALU 指令,也用于加载与存储;分支格式用于条件分支;跳转/调用格式用于无条件分支和过程调用。
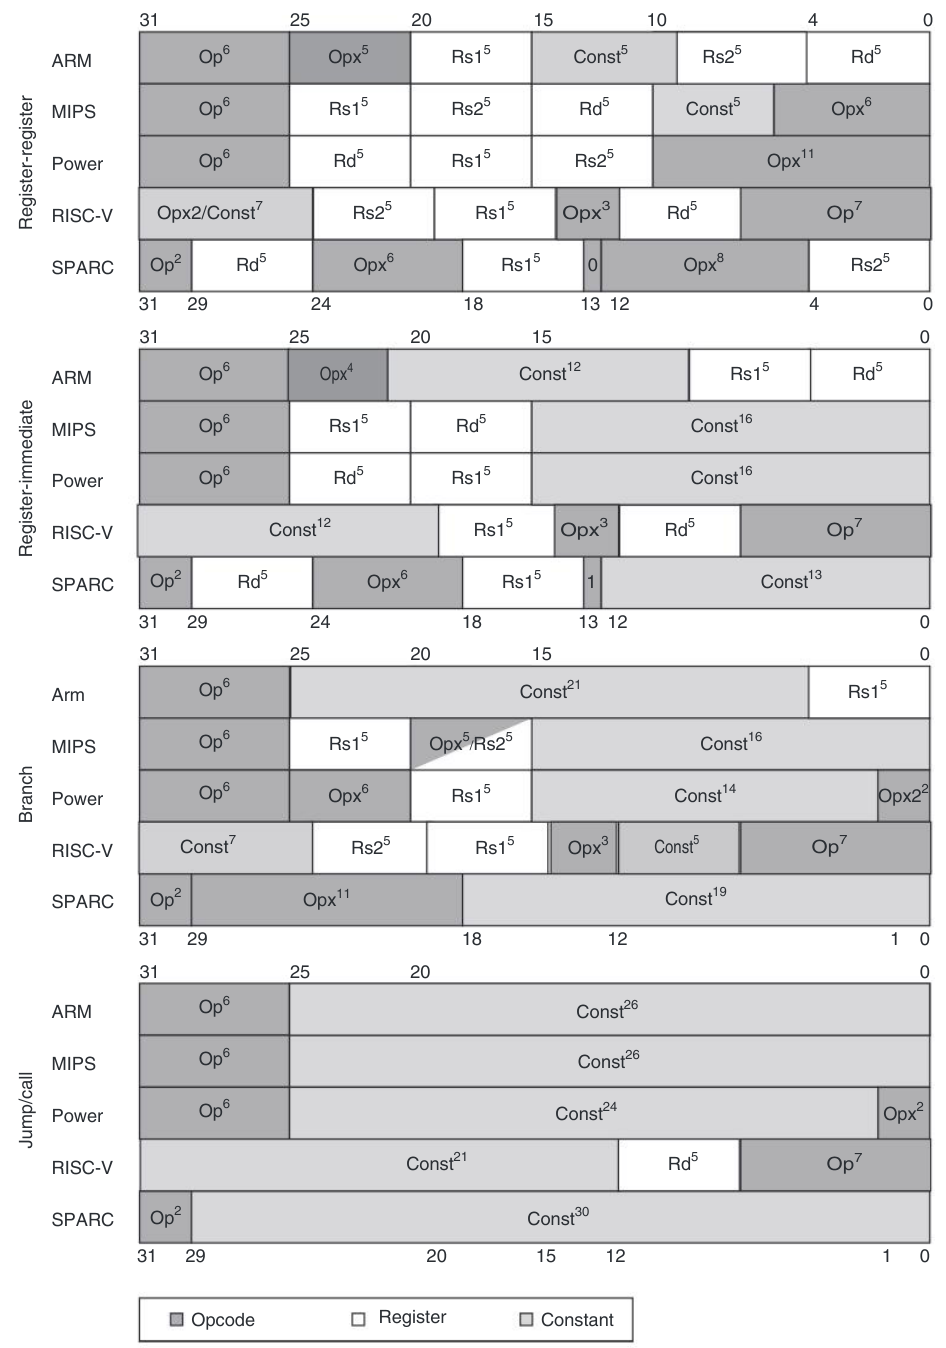
图内术语:Register-register=寄存器—寄存器;Register-immediate=寄存器—立即数;Branch=分支;Jump/call=跳转/调用;Opcode=操作码;Register=寄存器;Constant=常数。
译注:原图 RISC-V 跳转行的常数字段标为 21,加上 Rd 的 5 位和 Op 的 7 位会得出 33 位;原图保留这一标注。RISC-V 的分支、存储格式对立即数字段的解释也并非完全相同,下一图继续区分 SB 等变体。
图 K.6 省略了一些较少使用的格式,图 K.7 将其汇总。
| 体系结构 | 额外格式数 | 格式功能与用途 |
|---|---|---|
| ARMv8 | 至少 10 种,另有许多小变体;右列列出主要形式 | 带 13 位立即数字段的逻辑立即数操作 |
| ARMv8 | 常量移位量的移位,16 位操作码 | |
| ARMv8 | 16 位立即数格式 | |
| ARMv8 | 独占访问操作,三个寄存器字段 | |
| ARMv8 | 寄存器分支,较长操作码 | |
| ARMv8 | 带寻址方式位的加载/存储 | |
| MIPS64 | 1 | 一组 PC 相对加载/存储,使用寄存器—立即数格式,但立即数为 18 位,因为另一源操作数是 PC |
| Power | 9,不含小变体和向量扩展 | DQ 模式:使用 ALU 立即数形式,将位移的四位用于其他功能 |
| Power | DS 模式:使用 ALU 立即数形式,将位移的两位用于其他功能 | |
| Power | DX 格式:类似寄存器—立即数,以 PC 取代一个源寄存器 | |
| Power | MD、MDS 格式:类似寄存器—寄存器,用于移位和循环移位 | |
| Power | X、XS 及若干小变体:用于变址寻址、移位和多种扩展功能 | |
| Power | Z22、Z23 格式:操作浮点数 | |
| RV64 | 2 | SB 格式:分支格式的变体,对立即数作不同解释 |
| RV64 | UJ 格式:跳转/调用格式的变体,对立即数作不同解释 | |
| SPARC | 3 | 另一种条件分支格式,多三位位移,总共 22 位而不是 19 位,但没有预测提示 |
| SPARC | 22 位立即数格式,用于加载寄存器高半部 | |
| SPARC | 基于寄存器与零比较的条件分支格式 |
与基础 32 位体系结构不同,microMIPS64、RV64GC、Thumb-2 的 16 位扩展着重最小化代码。因此,虽然指令少得多,格式反而更多:microMIPS64、RV64GC 分别有八种和七种主要格式,Thumb-2 有十五种。图 K.8 显示,它们具有不同数量的寄存器操作数(0–3 个)、不同大小的立即数字段,甚至不同宽度的寄存器指定符。大多数指令只访问少量寄存器,较少的指令才可访问全部 32 个寄存器。
| 体系结构 | 操作码位数:主/扩展 | 寄存器指定符:个数 × 位宽 | 立即数字段位数 | 典型指令 |
|---|---|---|---|---|
| microMIPS64 | 6 | 无 | 10 | 跳转 |
| microMIPS64 | 6 | 1 × 5 | 5 | 寄存器—寄存器操作,32 个寄存器;以 SP 为基址的加载,目的寄存器不限 |
| microMIPS64 | 6 | 1 × 3 | 7 | 等于/不等于零的分支;以 GP 为基址的加载 |
| microMIPS64 | 6:4 | 2 × 3 | 寄存器—寄存器,rd/rs1 与 rs2;八个寄存器 | |
| microMIPS64 | 6:1 | 2 × 3 | 3 | 寄存器—寄存器立即数,rd/rs1 与 rs2;八个寄存器 |
| microMIPS64 | 6 | 2 × 3 | 4 | 加载和存储;八个寄存器 |
| microMIPS64 | 6:4 | 2 × 3 | 寄存器—寄存器,rd 与 rs1;八个寄存器 | |
| microMIPS64 | 6 | 2 × 5 | 寄存器—寄存器;32 个寄存器 | |
| RV64GC | 2:3 | 11 | 跳转 | |
| RV64GC | 2:3 | 1 × 3 | 7 | 分支 |
| RV64GC | 2:3 | 1 × 3 | 8 | 立即数操作,一个源寄存器 |
| RV64GC | 2:3 | 1 × 5 | 6 | 以 SP 为基址的存储 |
| RV64GC | 2:3 | 1 × 5 | 6 | ALU 立即数,以及以 SP 为基址的加载 |
| RV64GC | 2:4 | 2 × 5 | 寄存器—寄存器操作 | |
| RV64GC | 2:3 | 2 × 3 | 5 | 使用八个寄存器的加载和存储 |
| Thumb-2 | 3:2 | 2 × 3 | 5 | 移位、传送、字/字节加载和存储 |
| Thumb-2 | 3:2 | 1 × 3 | 8 | 立即数加、减、传送、比较 |
| Thumb-2 | 4:1 | 1 × 3 | 8 | 以 SP 为基址的加载/存储,对 SP 或 PC 做加法,多寄存器加载/存储 |
| Thumb-2 | 4:3 | 3 × 3 | 寄存器变址加载 | |
| Thumb-2 | 4:4 | 8 | 条件分支、系统指令 | |
| Thumb-2 | 4:12 | 杂项:22 条指令、12 种格式,包括比较零并分支、寄存器压栈/出栈、调整栈指针、字节反转、IF-THEN | ||
| Thumb-2 | 5 | 1 × 3 | 8 | PC 相对加载 |
| Thumb-2 | 5 | 11 | 无条件分支 | |
| Thumb-2 | 6:1 | 3 × 3 | 加/减 | |
| Thumb-2 | 6:3 | 1 × 4、1 × 3 | 特殊数据处理 | |
| Thumb-2 | 6:4 | 2 × 3 | 逻辑数据处理 | |
| Thumb-2 | 6:6 | 1 × 4 | 分支并切换指令集:ARM 与 Thumb |
指令
各体系结构的相似性,让我们能够同时介绍它们,先从与 RISC-V 64 位 ISA 等价的操作开始。
RV64G 核心指令
RV64G 几乎每条指令,都能在其他体系结构中找到对应操作,如图 K.9–K.19 所示;RISC-V 指令定义见 A.9 节。分为四类:数据传送(图 K.9)、算术和逻辑(图 K.10)、控制(图 K.11、K.12)、浮点(图 K.13)。
若一条 RV64G 核心指令在其他体系结构中需要短指令序列合成,图 K.9–K.13 用分号分隔该序列。为避免混淆,本附录总将目的寄存器写在最左边,不受各体系结构通常记法的影响。
| 数据传送指令 | ARMv8(R-I) | MIPS64(R-I) | Power(R-I、R-R) | RV64G(R-I) | SPARC(R-I、R-R) |
|---|---|---|---|---|---|
| 有/无符号字节加载 | LDR_B | LB_ | LBZ; EXTSB | LB_ | LD_B |
| 有/无符号半字加载 | LDR_H | LH_ | LHA/LHZ | LH_ | LD_H |
| 字加载 | LDRSW/LDR | LW_ | LW_ | LW_ | LD_W |
| 双字加载 | LDRX | LD | LD | LD | LDD |
| 单/双精度浮点寄存器加载 | LD_ | L_C1 | LF_ | FL_ | LD_F |
| 字节存储 | STB | SB | STB | SB | STB |
| 半字存储 | STW | SH | STH | STH | STH |
| 字存储 | STL | SW | STW | SW | ST |
| 双字存储 | STX | SD | SD | SD | STD |
| 单/双精度浮点存储 | ST_ | S_C1 | STF_ | FS_ | ST_F |
| 加载保留 | LDEXB, LDEXH, LDEXW, LDEXD | LL, LLD | lwarx, ldarx | LR | |
| 条件存储 | STEXB, STEXH, STEXW, STEXD | SC, SCD | stwcx, stdcx | SC | |
| 读/写特殊寄存器 | MF_, MT_ | MF, MT_ | M_SPR | csrr_, csrr_i | RD__, WR__ |
| 整数寄存器传送到浮点寄存器 | ITOFS | MFC1/DMFC1 | STW; LDFS | STW; FLDWX | ST; LDF |
| 浮点寄存器传送到整数寄存器 | FTTOIS | MTC1/DMTC1 | STFS; LW | FSTWX; LDW | STF; LD |
| 数据/指令流同步 | DSB, ISB | SYNC, SYNCI | SYNC, ISYNC | Fence, Fence.i | MEMBAR, FLUSH |
| 原子操作 | LDWAT, LDDAT, STWAT, STDAT | LLWP, LLDP, SCWP, SCDP | AMOSWAP.W/D, AMOADD.W/D, AMOAND.W/D, AMOXOR.W/D, AMOOR.W/D, AMOMIN_.W/D, AMOMAX_.W/D | CASA, SWAP, LDSTUB |
译注:图 K.9 的助记符按原表保留,包括 RV64G 栏的 STH、FLDWX、FSTWX、LDW,以及 MIPS 两行寄存器传送的名称与方向。这张跨体系结构概要表含版本混用和疑似笔误,不能将每个单元格直接作为可汇编代码。R-I、R-R 分别指寄存器—立即数和寄存器—寄存器格式。
比较与条件分支
每种体系结构都必须提供比较和条件分支。尽管它们有诸多相似之处,具体方法却各不相同。图 K.11 汇总控制指令,图 K.12 说明条件分支的处理。
SPARC 使用程序状态字中传统的四个条件码位:负、零、进位、溢出。任意算术或逻辑指令都可设置它们;与早期体系结构不同,每条指令是否设置条件码是可选的,显式选项可以减少流水线实现的问题。条件码既可作为操作的副作用设置,也可通过以 r0 为目的寄存器的减法来合成显式比较。条件分支检查条件码,判断各种无符号及有符号关系。浮点使用独立条件码编码 IEEE 754 条件,需要浮点比较指令。
SPARC 第 9 版从四方面扩展分支:为 64 位操作增加独立条件码;增加直接检查寄存器是否等于、不等于、小于、小于等于、大于等于或小于等于零的分支;增加三组浮点条件码;在分支指令中编码静态分支预测。1
Power 也采用四个条件码:小于、大于、等于和汇总溢出,但有八组副本。这使不同指令可使用不同条件码而不冲突,相当于多出八个 4 位寄存器。比较可以写入任意一组,条件分支也可读取任意一组。整数指令的选项位产生这样的效果:仿佛整数操作后面跟着一次与零比较,并设置第一组条件“寄存器”。
浮点指令也可选择设置第二组。PowerPC 允许对这八组条件码寄存器执行逻辑运算 CRAND、CROR、CRXOR、CRNAND、CRNOR、CREQV,让一个分支检测更复杂条件。Power 还包含分支计数寄存器,测试时自动递减,并可参与分支条件;另有专用指令用于读写条件寄存器。
RISC-V 与 MIPS 最相似。RISC-V 将完整的算术比较与分支结合;MIPS 也使用比较并分支,但比较限于相等以及与零比较。这种限制简化了分支判断,因为判断条件无需 ALU 操作,代价是有时必须先使用“小于则置位”指令 SLT、SLTI、SLTU、SLTIU:比较两个操作数,若前者小于后者,将目的寄存器置 1,否则置 0。更多细节见图 K.12。RISC-V 浮点比较将整数寄存器置为 0 或 1,再据此条件分支。MIPS 也使用独立浮点比较,把浮点寄存器置为 0 或 1,然后由浮点条件分支测试。
ARM 类似 SPARC,可选择设置传统四条件码。CMP 相减并据差设置条件码;CMN(compare negative)相加并据和设置条件码。TST 对两个操作数做 AND,设置除溢出以外的条件码;TEQ 用 XOR 设置前三个条件码。ARM 条件分支也根据条件码判断各类无符号及有符号关系。ARMv8 增加位测试指令,以及与零比较并分支。ARM 浮点比较设置整数条件码,由 B.cond 使用。
图 K.13 表明,五种体系结构的浮点支持也很相似。
| 算术/逻辑指令(各列均有 R-R、R-I 格式) | ARMv8 | MIPS64 | Power v3 | RISC-V | SPARC v9 |
|---|---|---|---|---|---|
| 字加法、立即数加法 | ADD, ADDI | ADDU, ADDUI | ADD, ADDI | ADDW, ADDWI | ADD |
| 双字加法 | ADDX | DADDU, DADDUI | ADD, ADDI | ADD, ADDI | ADD |
| 减法 | SUB, SUBI | SUBU, SUBI | SUBF | SUBW, SUBWI | SUB |
| 双字减法 | SUBX | DSUBU, DSUBUI | SUBF | SUB, SUBI | SUB |
| 乘法 | MUL, SMUL | MUL, MULU, DMUL, DMULU | MULLW, MULLI | MUL, MULU, MULW, MULWU | MULX |
| 除法 | MULX, SMULX | DIV, DIVU, DDIV, DDIVU | DIVW | DIV, DIVU, DIVW, DIVWU | DIVX |
| 余数 | MOD, MODU, DMOD, DMODU | MODSW, MODUW | REM, REMU, REMW, REMWU | ||
| AND | AND, ANDI | AND, ANDI | AND, ANDI | AND, ANDI | AND |
| OR | OR, ORI | OR, ORI | OR, ORI | OR, ORI | OR |
| XOR | XOR, XORI | XOR, XORI | XOR, XORI | XOR, XORI | XOR |
| 加载第 31–16 位 | MOV | LUI | ADDIS | ADDIS | SETHI (Bfmt.) |
| 加载 PC 高位 | ADR | ADDIUPC | ADDPCIS | AUIPC | |
| 逻辑左移:字/双字,立即数/可变移位量 | LSL | SLLV, SLL | RLWINM | SLL, SLLI, SLLW, SLLWI | SLL |
| 逻辑右移:字/双字,立即数/可变移位量 | RSL | SRLV, SRL | RLWINM 32-i | SRL, SRLI, SRLW, SRLWI | SRL |
| 算术右移:字/双字,立即数/可变移位量 | RSA | SRAV, SRA | SRAW | SRA, SRAI, SRAW, SRAWI | SRA |
| 比较 | CMP | SLT/U, SLTI/U | CMP(I)CLR | SLT/U, SLTI/U | SUBcc r0,... |
译注:图 K.10 原表存在多处助记符疑点,例如 ARM“除法”栏写 MULX, SMULX,RISC-V 栏写 ADDIS、SUBI、MULU 等,且部分 W/I 后缀顺序与附录 A 的写法不同。
| 控制指令 | ARMv8 | MIPS64 | PowerPC | RISC-V | SPARC v9 |
|---|---|---|---|---|---|
| 整数比较后分支 | B.cond, CBZ, CBNZ | BEQ, BNE, B_Z(<、>、≤、≥);或 S***; BEZ | BC | BEQ, BNE, BLT, BGE, BLTU, BGEU | BR_Z, BPcc(<、>、≤、≥、=、≠) |
| 浮点比较后分支 | B.cond | BC1T, BC1F | BC | BEZ, BNZ | FBPfcc(<、>、≤、≥、= 等) |
| 跳转、寄存器跳转 | B, BR | J, JR | B, BCLR, BCCTR | JAL, JALR,目的为 x0 | BA, JMPL r0,... |
| 调用、寄存器调用 | BL, BLR | JAL, JALR | BL, BLA, BCLRL, BCCTRL | JAL, JALR | CALL, JMPL |
| 陷阱 | SVC, HVC, SMC | BREAK | TW, TWI | ECALL | Ticc, SIR |
| 中断返回 | ERET | JR; ERET | RFI | EBREAK | DONE, RETRY, RETURN |
译注:原图把 EBREAK 放在 RISC-V“中断返回”行,存在明显功能分类疑点;保留原表,不应据此把断点指令用于中断返回。
| 条件分支特性 | ARMv8 | MIPS64 | PowerPC | RISC-V | SPARC v9 |
|---|---|---|---|---|---|
| 条件码位数:整数、浮点 | 16,即 8 加其反值 | 无 | 两者均 8 × 4 | 无 | 整数 2 × 4,浮点 4 × 2 |
| 基本比较指令数:整数、浮点 | 整数 1,浮点 1 | 整数 1,浮点 1 | 整数 4,浮点 2 | 整数 2,浮点 3 | 浮点 1 |
| 基本分支指令数:整数、浮点 | 1 | 整数 2,浮点 1 | 两者共 1 | 整数 4,也用于浮点结果 | 整数 3,浮点 1 |
| 寄存器与寄存器/常数比较并分支 | — | =、≠ | — | =、≠、≥、< | — |
| 寄存器与零比较并分支 | — | =、≠、<、≤、>、≥ | — | =、≠、<、≤、>、≥ | =、≠、<、≤、>、≥ |
译注:图 K.12 的 ARMv8 条件码数量写作“16(8 加反值)”,与正文所述四个条件码位不一致;其“与零比较并分支”行也与图 K.11 的 CBZ、CBNZ 不一致。原表数字与空缺均保留。
| 浮点指令(均为 R-R 格式) | ARMv8 | MIPS64 | PowerPC | RISC-V | SPARC v9 |
|---|---|---|---|---|---|
| 单/双精度加 | FADD | ADD.* | FADD* | FADD.* | FADD* |
| 单/双精度减 | FSUB | SUB.* | FSUB* | FSUB.* | FSUB* |
| 单/双精度乘 | FMUL | MUL.* | FMUL* | FMUL.* | FMUL* |
| 单/双精度除 | FDIV | DIV.* | FDIV* | FDIV.* | FDIV* |
| 单/双精度平方根 | FSQRT | SQRT.* | FSQRT* | FSQRT.* | FSQRT* |
| 单/双精度乘加、负乘加 | FMADD, FNMADD | MADD.*, NMAD.* | FMADD*, FNMADD* | FMADD.*, FNMADD.* | |
| 单/双精度乘减、负乘减 | FMSUB, FNMSUB | MSUB.*, NMSUB.* | FMSUB*, FNMSUB* | FMSUB.*, FNMSUB.* | |
| 将单/双精度符号或反符号复制到另一浮点寄存器 | FMOV, FNEG | FMOV.*, FNEG.* | FMOV*, FNEG* | FSGNJ.*, FSGNJN.* | FMOV*, FNEG* |
| 用符号位的 XOR 替换符号位,单/双精度 | FABS | FABS.* | FABS* | FSGNJX.* | FABS* |
| 单/双精度最大/最小 | FMAX, FMIN | MAX.*, MIN.* | FMAX.*, FMIN.* | ||
| 单/双精度浮点值分类 | CLASS.* | FCLASS.* | |||
| 比较 | FCMP | CMP.* | FCMP* | FCMP.* | FCMP* |
| 单/双精度浮点之间,或与有/无符号单字/双字整数之间的带舍入转换 | FCVT | CVT, CEIL, FLOOR | FCVT | F*TO* |
RV64GC 的核心 16 位指令
图 K.14–K.17 汇总 microMIPS64、RV64GC、Thumb-2 的数据传送、ALU 和控制指令。因为它们都基于完整体系结构的 32 位或 64 位版本,这里只关注 16 位指令实现的功能。浮点是可选项,因此不纳入这组比较。
| 数据传送指令 | microMIPS64:rs1;rs2/dst;偏移位数 | RV64GC:rs1;rs2/dst;偏移位数 | Thumb-2:rs1;rs2/dst;偏移位数 |
|---|---|---|---|
| 字加载 | 8;8;4 | 8;8;5 | 8;8;5 |
| 双字加载 | 8;8;5 | ||
| 以栈指针为基址的字加载 | 1;32;5 | 1;32;6 | 1;3;8 |
| 以栈指针为基址的双字加载 | 1;32;6 | ||
| 字存储 | 8;8;4 | 8;8;5 | 8;8;5 |
| 双字存储 | 8;8;5 | ||
| 以栈指针为基址的字存储 | 1;32;5 | 1;32;6 | 1;3;8 |
| 以栈指针为基址的双字存储 | 1;32;6 |
译注:Thumb-2 两处 1;3;8 均为原表数字,未将 3 擅改为其他寄存器数量。
| ALU 指令/功能 | microMIPS64 | RV64GC | Thumb-2 |
|---|---|---|---|
| 加载立即数 | 8;7 | 32;6 | 8;8 |
| 加载高位立即数 | 32;6 | ||
| 立即数加法 | 32;4 | 32;6 | 8;8;3 |
| 32 位字立即数加法并符号扩展 | 32;6 | ||
| 栈指针加立即数 | 1;9 | 1;6,增加立即数的 16 倍 | 1;7 |
| 栈指针加立即数,结果存入寄存器 | 1;8;6 | 1;8;6,增加立即数的 4 倍 | |
| 逻辑左/右移 | 8;8;3,末项为移位量 | 8;6,末项为移位量 | 8;8;5,末项为移位量 |
| 算术右移 | 8;6,末项为移位量 | 8;8;5,末项为移位量 | |
| AND 立即数 | 8;8;4 | 8;6 | 8;8 |
| 传送 | 32;32 | 32;32 | 16;16 |
| 加法 | 8;8;8 | 32;32 | 8;8;8 或 16;16 |
| AND、OR、XOR | 8;8 | 8;8 | 8;8 |
| 减法 | 8;8;8 | 8;8 | 8;8;8 |
| 32 位字加/减并符号扩展 | 8;8 |
| 控制操作 | microMIPS64 | RV64GC | Thumb-2 |
|---|---|---|---|
| 无条件分支 | 10 位偏移量 | 11 位偏移量 | 11 位偏移量 |
| 无条件分支并链接 | 11 位偏移量 | 11 位偏移量 | |
| 无条件寄存器分支,带/不带链接 | 任意 32 个寄存器之一 | 任意 32 个寄存器之一 | |
| 寄存器与零比较,等于/不等于时分支 | 八个寄存器;7 位偏移量 | 八个寄存器;8 位偏移量 | 无,但见图注 |
RV64G 之外的共同扩展
图 K.15–K.18 列出图 K.9–K.13 未包含的指令,仍按数据传送、ALU 和控制等类别组织。2 唯一显著的浮点扩展是倒数指令,MIPS64 和 Power 都支持。某条指令只有出现在不止一种标准体系结构中,才列入这些表。
回顾 K-6 页的图 K.3,各指令集支持的寻址方式比 RV64G 丰富。采用额外方式的加载和存储未列入图 K.17,但实际上也构成额外数据传送指令:ARM 有 64 条,Power3 有 12 条,MIPS64、SPARCv9 各有四条。
| 功能 | 定义 | ARMv8 | MIPS64 | PowerPC | SPARC v9 |
|---|---|---|---|---|---|
| 多寄存器加载/存储 | 加载或存储至少两个寄存器 | 加载寄存器对、存储寄存器对 | 多寄存器加载/存储,至多 31 个寄存器 | ||
| 缓存操作与预取 | 修改缓存行状态或预取 | Prefetch | CACHE、PREFETCH | Prefetch | Prefetch |
| 名称 | 定义 | ARMv8 | MIPS64 | PowerPC | SPARC v9 |
|---|---|---|---|---|---|
| 延迟分支 | 带/不带撤销的延迟分支 | BEQ, BNE, BGTZ, BLEZ, BCxEQZ, BCxNEZ | BPcc,A; FPBcc,A | ||
| 条件陷阱 | 条件为真时触发陷阱 | TEQ, TNE, TGE, TLT, TGEU, TLTU | TW, TD, TWI, TDI | Tcc |
现代处理器使用动态分支预测来加速分支,见 3.3 节。许多体系结构早期支持延迟分支,后续版本将其删除或基本淘汰,通常提供非延迟版本作为首选条件分支。
SPARC 的“撤销”分支优化了延迟分支:只有分支跳转时才执行延迟槽指令,否则撤销它。因此,可以安全地把分支目标指令复制进延迟槽,因为它只在跳转时执行。限制是目标不能又是一条分支,且编译时必须知道目标。SPARC 还提供非延迟跳转,因为设置 annul 位的无条件分支不执行下一条指令。
与完整 ISA 之间的差异相比,三种嵌入式 ISA 的 16 位子集,除了前面图中列出的立即数字段、SP 和其他寄存器使用等区别外,基本没有显著差异。
共同点已经介绍完,下面转向独有特性。先讲桌面/服务器 RISC,按描述独特特性所需篇幅由短到长排列,再讲嵌入式 RISC。
MIPS64 R6 独有的指令
MIPS 指令集经历六代。第 1–4 代主要增加指令;Release 6 删除许多旧指令,同时增加非延迟分支和非对齐数据访问支持。图 K.19 汇总其独有指令。
| 指令类别 | 指令名称 | 功能 |
|---|---|---|
| ALU | Byte align | 从一对寄存器提取由若干字节组成的字或双字,用于非对齐字节复制 |
| ALU | Align Immediate to PC | 将 PC 的高 16 位与左移 16 位的立即数相加,结果放入寄存器,用于形成 PC 相对地址 |
| ALU | Bit swap | 反转寄存器中每个字节内的位顺序 |
| ALU | No-op and link | 将 PC+8 写入寄存器 |
| ALU | Logical NOR | 对两个寄存器计算 NOR |
| 控制转移 | Branch and Link conditional | 寄存器与零比较,条件为真则分支;将返回地址放入链接寄存器 |
| 控制转移 | Jump indexed、Jump and link indexed | 偏移量与寄存器相加形成新 PC,可带或不带链接地址 |
SPARC v9 独有的指令
SPARC 有几项独特特性。下面先介绍其中的主要特性,再用一张表汇总这些特性及其他较小差异。
寄存器窗口
SPARC 最主要的独特特性是寄存器窗口(register windows),它通过优化过程调用来减少寄存器与存储器之间的数据传送。处理器有多组寄存器,每次过程调用分配一组新寄存器。这样做原本可能限制过程调用的深度,但把这些寄存器组作为循环缓冲区使用即可避免这一限制。成本与性能曲线的拐点似乎在 6–8 组;调用栈更深的程序需要把寄存器内容保存到存储器,并在需要时恢复。
SPARC 可以有 2–32 个窗口,全局变量、局部变量、传入参数和传出参数通常各用 8 个寄存器。
每个窗口有 16 个不与其他窗口共用的寄存器,因此 SPARC 实现的物理寄存器数最少可以是 40 个,最多可以是 520 个;迄今大多数实现有 128–136 个。SPARC 没有把窗口切换绑定到调用和返回指令,而是提供独立的 SAVE 与 RESTORE 指令。SAVE 通过指向下一组寄存器来“保存”调用者的窗口,同时执行一次加法。巧妙之处在于,加法的源寄存器来自调用者窗口,目的寄存器却属于被调用者窗口。SPARC 编译器通常用这条指令改变栈指针,为新栈帧中的局部变量分配空间。RESTORE 与 SAVE 相反:恢复调用者窗口,同时执行加法;源寄存器来自被调用者窗口,目的寄存器属于调用者窗口。这样便自动释放栈帧。编译器还可以用它生成被调用过程的最终返回值。
寄存器窗口的风险是,寄存器数量增加可能降低时钟频率。不过,早期实现并未出现这种情况。自 1987 年起,带寄存器窗口的 SPARC 体系结构和不带寄存器窗口的 MIPS R2000 体系结构,都采用过多种工艺实现。在若干代产品中,同等工艺的 SPARC 实现并未比 MIPS 的时钟频率低,这可能是因为这些实现中,缓存访问时间比寄存器访问时间更具决定性。多发射需要多得多的寄存器端口;加上寄存器重命名或重排序缓冲区之后,寄存器窗口的代价变得更大。寄存器窗口是最早的 Berkeley RISC 设计的特性,SPARC 正是受这些设计启发而采用它。在本书所述时期仍在使用的其他主要体系结构中,只有 Tensilica 也采用寄存器窗口;RISC-V ISA 没有纳入这一特性。
快速陷阱
SPARC v9 提供了加快陷阱处理的支持。它把单级陷阱扩展到至少四级,使寄存器窗口上溢和下溢的陷阱处理程序也能被中断。增加这些级别后,处理程序就不必在代码中显式检查缺页或栈指针未对齐的情况,因此可以执行得更快。体系结构增加两条指令来从这种多级处理程序返回:RETRY 会重新执行被中断的指令,DONE 则不会。为支持用户级陷阱,RETURN 指令可以在非特权模式下从陷阱返回。
对 LISP 和 Smalltalk 的支持
剩下最主要的算术特性是带标记的加法和减法。SPARC 的设计者花了相当多时间研究 LISP、Smalltalk 等语言,这影响了前面已经讨论的若干 SPARC 特性:寄存器窗口、条件陷阱指令、使用 32 位指令地址的调用,以及多字算术运算,参见 Taylor 等人 [1986] 和 Ungar 等人 [1984]。体系结构为带标记的数据类型提供少量支持,可以进行加法、减法,进而进行比较。最低两位用于标识操作数是否为整数,整数编码为 00。因此,只要任一操作数没有标为整数,或者结果过大,TADDcc 和 TSUBcc 就会设置溢出位。随后的条件分支或陷阱指令决定下一步怎么处理。如果操作数不是整数,软件就恢复操作数、检查其类型,并根据类型调用正确的运算。未对齐存储器访问陷阱也可以用于带标记数据,因为用标记错误的指针进行加载可能属于非法访问。图 K.20 展示这两种标记支持。
图中整数标记为 00,有效指针标记为 11;Word address 表示字地址。示例指令分别为 TADDcc r7, r5, r6 和 LD rD, r4, −3。
图 K.21 汇总上面介绍的额外指令及其他若干指令。
| 指令类别 | 指令名称 | 功能 |
|---|---|---|
| 数据传送 | SAVE, RESTORE | 保存或恢复寄存器窗口 |
| 数据传送 | Nonfaulting load | 加载指令的一种变体,地址异常不会引发故障,允许对加载进行推测执行 |
| ALU | Tagged add、Tagged subtract,带陷阱和不带陷阱两种形式 | 执行带标记加/减法,设置条件码,并可选择触发陷阱 |
| 控制转移 | Retry, Return, Done | 支持陷阱处理 |
| 浮点 | FMOVcc | 根据整数或浮点条件码,在浮点寄存器之间进行条件传送 |
ARM 独有的指令
较早的 ARM 体系结构版本 ARM v6 和 v7 具有许多不同寻常的特性,包括所有指令都能条件执行,以及把 PC 当作通用寄存器。这些特性在 ARMv8 中被移除,32 位和 64 位 ISA 都是如此。不过,至少从指令集规模来看,它仍保留了相当大的复杂性。如第 K-6 页的图 K.3 所示,ARM 的寻址方式最多,包含表中列出的全部方式。要记住,这些寻址方式使它比 RVG 多出数十条加载/存储指令,即使后面的表格没有逐一列出。第 K-8 页的图 K.6 还表明,ARMv8 的指令格式数量远远最多,既反映了指令种类的多样性,也反映了寻址方式的差异,其中某些寻址方式适用于一些加载/存储指令,却不适用于另一些。
大多数 ARMv8 ALU 指令允许在完成运算之前先对第二个操作数移位。这扩大了立即数的取值范围,但可移位的操作数不限于立即数。可选操作包括逻辑左移、逻辑右移、算术右移和循环右移。此外,与 Power3 一样,大多数 ALU 指令可以选择是否设置条件标志。图 K.22 列出了额外的指令,但没有枚举所有变体,例如选择设置条件标志的形式;详见图注。
尽管所有指令都能条件执行这一特性已被取消,ARMv8 除前面提到的条件传送和条件置位之外,仍提供多种条件指令。
| 指令类别 | 指令名称 | 功能 |
|---|---|---|
| 数据传送 | Load/Store Non-temporal pair | 加载/存储一对寄存器,并指示不要缓存这些数据;只支持基址加按比例缩放偏移量寻址 |
| ALU | Add Extended word/double word | 对第二个寄存器操作数左移并扩展后,把两个寄存器相加 |
| ALU | Add with shift;add immediate with shift | 先对第二个操作数移位,再相加 |
| ALU | Address of page | 根据 PC 计算页地址,类似 ADDUIPC;原书称其与 ARMv8 的 ADR 相同 |
| ALU | AND、OR、XOR、XOR NOT shifted register | 对一个寄存器和一个经过移位的寄存器进行逻辑运算 |
| ALU | Bit field clear shifted | 对操作数移位、取反,再与另一个操作数相与 |
| ALU | Conditional compare、immediate、negative、negative immediate | 条件为真时,把条件标志设置为比较结果;否则保持条件标志不变 |
| ALU | Conditional increment、invert、negate | 根据条件,将目的寄存器设为源寄存器加一、按位取反或取负的结果 |
| ALU | CRC | 计算 CRC 校验和,支持字节、字、半字和双字 |
| ALU | Multiply add、subtract | 整数乘加或乘减 |
| ALU | Multiply negate | 将两个整数的乘积取负,支持字和双字 |
| ALU | Move immediate or inverse | 用立即数替换寄存器中的 16 位,立即数可能先经过移位 |
| ALU | Reverse bit order | 反转寄存器中的位顺序 |
| ALU | Signed bit field move | 传送有符号位字段,向左作符号扩展,向右补零 |
| ALU | Unsigned divide、multiply、multiply negate、multiply-add、multiply-sub | 基本指令的无符号版本 |
| 控制转移 | CBNZ, CBZ | 与零比较并按不等/相等条件分支,同时指示这不是调用或返回 |
| 控制转移 | TBNZ, TBZ | 测试寄存器中的某一位不等于/等于零,并据此分支 |
译注:
Address of page一行把页地址计算与ADR混为一谈;条件比较一行“否则保持条件标志不变”的描述也不宜直接当作指令手册的精确定义。
Power3 独有的指令
Power3 源于 IBM 多代商用 RISC 计算机——IBM RT/PC、IBM Power1 和 IBM Power2——以及主要由 IBM、Motorola 开展的 PowerPC 开发工作。下面先介绍分支寄存器和循环分支支持,随后图 K.23 列出只有 Power3 提供的其他指令。
分支寄存器:链接寄存器与计数寄存器
Power3 不占用 32 个通用寄存器之一来保存过程调用的返回地址,而是把地址放入专用的链接寄存器。许多过程在返回前不会调用其他过程,因此并非总要把链接寄存器的值另存起来。把返回地址放在专用寄存器中还能加快返回跳转,因为硬件处理这种跳转时不必经过寄存器读取流水级。
类似地,Power3 还有一个计数寄存器,用于执行固定次数迭代的 for 循环。使用专用寄存器后,分支硬件可以快速判断基于计数寄存器的分支是否可能跳转,因为在执行周期的早期就能知道该寄存器的值。分支指令测试计数寄存器的值时,会自动将它减一。
计数寄存器和链接寄存器本来就位于控制分支的硬件附近;而分支预测的问题之一,是在流水线中尽早得到目标地址,见附录 C。因此,Power 的设计者决定让这两个寄存器再承担一种用途:任意一个都可保存条件分支的目标地址。于是,PowerPC 在基本条件分支之外增加了从这两个寄存器取目标地址的指令 BCLR 和 BCCTR。图 K.23 列出所增加的数十条指令;此外还应注意,它为十进制浮点数提供了丰富的功能。
| 指令类别 | 指令名称 | 功能 |
|---|---|---|
| 数据传送 | LHBRX, LWBRX, LDBRX | 加载半字/字/双字,同时反转字节顺序 |
| 数据传送 | SHBRX, SWBRX, SDBRX | 存储半字/字/双字,同时反转字节顺序 |
| 数据传送 | LDQ, STQ | 在存储器与一对寄存器之间加载/存储四字 |
| ALU | DRAN | 在寄存器中生成随机数 |
| ALU | CMPB | 比较寄存器中的各个字节,并逐字节设置另一个寄存器 |
| ALU | CMPRB | 将字节 与另外两个字节 、 比较,并设置条件,指示是否满足 |
| ALU | CRAND, CRNAND, CROR, CRNOR, CRXOR, CREQV, CORC, CRANDC | 对条件寄存器进行逻辑运算 |
| ALU | ZCMPEQB | 将字节 与另一个寄存器中的 8 个字节比较,并设置条件,指示 是否等于其中任意一个 |
| ALU | EXTSWSL | 对字作符号扩展并左移 |
| ALU | POPCNTB, POPCNTW, POPCNTD | 分别统计每个字节、每个字或一个双字中 1 的个数;字节/字的统计结果放入对应的另一字节/字 |
| ALU | PRTYD, PRTYW | 计算字或双字中各字节的奇偶校验 |
| ALU | BPERMD | 置换双字中的位,生成一个经置换的字节 |
| ALU | CDTBCD, CDCBCD, ADDGCS | 转换为/转换自二进制编码十进制数(BCD),或对两个 BCD 值进行运算 |
| 控制转移 | BA, BCA | 无条件或有条件地分支到绝对地址 |
| 控制转移 | BCCTR, BCCTRL | 有条件地分支到计数寄存器中的地址,不带/带链接 |
| 控制转移 | BCTSAR, BCTARL | 有条件地分支到分支目标地址寄存器中的地址,不带/带链接 |
| 控制转移 | CLRBHRB, MFBHRBE | 操作分支历史滚动缓冲区 |
| 浮点 | FRSQRTE | 估算平方根的倒数 |
| 浮点 | FTDIV, FTSQRT | 检查除零或对负数求平方根的情况 |
| 浮点 | FSEL | 将寄存器与零比较,从两个操作数中选择一个传送 |
| 浮点 | Decimal floating point operations | 一组共 48 条指令,支持十进制浮点运算 |
译注: 本表助记符依原页保留,包括
DRAN、CORC、ZCMPEQB、BCTSAR等可疑拼写。原表FTSQRT功能写作 “square of negative number”,结合该行的平方根指令名译为“对负数求平方根”;并未把这些源书拼写视为已校正的汇编语法。
桌面/服务器 RISC 的多媒体扩展指令
对多媒体和图形操作的支持经历了若干阶段,起点是 1996 年出现的 Intel MMX、MIPS MDMX 和 SPARC VIS。正如 4.3 节所述——这里假定读者已读过该节——这些扩展把一个寄存器视为多个相互独立的短整数,每个为 8 位或 16 位,并对寄存器内的全部元素并行执行算术和逻辑运算。这些最初的 SIMD 扩展有时称为打包 SIMD(packed SIMD)。2000 年以后,它们通过加宽寄存器、将这些寄存器部分或全部与通用寄存器或浮点寄存器分离,以及增加并行浮点运算支持,得到进一步发展。RISC-V 为这类打包 SIMD 指令预留了扩展,但设计者目前选择把重点放在真正的向量扩展上。向量扩展 RV64V 是一种向量体系结构;正如 4.3 节指出的,真正的向量指令集通用得多,通常能够用向量运算完成 SIMD 扩展所处理的操作。
图 K.24 展示 ARM、MIPS、Power 和 SPARC 的 SIMD 扩展的基本结构。注意这些 SIMD“向量寄存器”的组织方式不同:复用浮点寄存器、扩展浮点寄存器,或增加额外寄存器。其他重要区别还包括:是否同时支持浮点数和整数,是否支持 128 位整数,以及整数和逻辑运算是否允许把立即数字段用作操作数。SIMD 寄存器与存储器之间的数据传送使用标准加载和存储指令,同时增加特殊扩展来处理不足一个完整 SIMD 寄存器的数据。SPARC VIS 是最早用于图形的 ISA 扩展之一,能力要有限得多:算术运算只包含加、减、乘,没有浮点支持,针对位元素操作的指令也很有限。图 K.24 包含它,但后面不再详述。
| 项目 | ARMv8 | MIPS64 R6 | Power v3.0 | SPARC v9 |
|---|---|---|---|---|
| ISA 扩展名称 | Advanced SIMD | MIPS64 SIMD Architecture | Vector Facility | VIS |
| 当前版本年份 | 2011 | 2012 | 2015 | 1995 |
| 向量寄存器:数量 × 位数 | 32 × 128 | 32 × 128 | 32 × 128 | 32 × 64 |
| 复用 GP/FP 寄存器还是独立寄存器组 | 扩展 FP 寄存器,宽度加倍 | 扩展 FP 寄存器,宽度加倍 | 独立 | 与 FP 寄存器相同 |
| 整数位数 | 8、16、32、64 | 8、16、32、64 | 8、16、32、64、128 | 8、16、32 |
| 浮点位数 | 32、64 | 32、64 | 32 | |
| 整数与逻辑运算的立即数 | 算术 5 位;逻辑 8 位 |
图 K.25 展示这些 SIMD 扩展中的算术指令,只列出至少两种扩展都具有的指令。MIPS SIMD 还有许多其他指令,Power 3 的 Vector-Scalar Extension 也是如此,这里不作介绍。其中一种常见、但通用微处理器通常不具备的功能是饱和运算。饱和意味着,计算溢出时把结果设为最大正数或最小负数,而不像补码算术那样进行模运算。这类饱和运算常见于数字信号处理器,见下一小节,对于滤波程序很有用。另一种常见扩展是在单个寄存器内部累积数值的指令,点积以及最大值/最小值指令就是典型例子。
| 指令类别 | ARM Advanced SIMD | MIPS SIMD | Power Vector Facility |
|---|---|---|---|
| 加/减 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 饱和加/减 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 差的绝对值 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 相邻元素加/减,成对操作 | 16B、8H、4W | 16B、8H、4W | 16B、8H、4W、2D |
| 平均值 | 16B、8H、4W、2D | 16B、8H、4W、2D、Q | |
| 点积加、点积减 | 16B、8H、4W | 16B、8H、4W | 16B、8H、4W、2D |
| 有符号/无符号除法 | 16B、8H、4W | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 有符号/无符号乘法 | 16B、8H、4W | 16B、8H、4W | 16B、8H、4W、2D |
| 乘加、乘减 | 16B、8H、4W | 16B、8H、4W | 16B、8H、4W、2D |
| 有符号/无符号最大值 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 有符号/无符号最小值 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 有符号/无符号取模 | 16B、8H、4W、2D | 16B、8H、4W、2D、Q | |
| 相等比较 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 小于/小于等于比较,有符号/无符号 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
除算术指令外,最常见的增加内容是逻辑和按位操作,以及对 SIMD 寄存器内元素进行各种置换与打包的指令。图 K.26 汇总了这些扩展。最后,三种扩展都支持 SIMD 浮点操作,如图 K.27 所示。
| 指令类别 | ARM Advanced SIMD | MIPS SIMD | Power Vector Facility |
|---|---|---|---|
| 右移/左移,逻辑/算术 | 16B、8H、4W、2D | 16B、8H、4W、2D、Q | 16B、8H、4W、2D、Q |
| 统计前导零或尾随零 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| AND/OR/XOR | Q | Q | Q |
| 位插入与提取 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 统计 1 的个数 | 16B、8H、4W、2D | 16B、8H、4W、2D、Q | |
| 交织偶数/奇数、左侧/右侧元素 | 16B、8H、4W、2D | 6B、8H、4W、2D | |
| 打包偶数/奇数元素 | 16B、8H、4W、2D | 6B、8H、4W、2D | |
| Shuffle | 16B、8H、4W、2D | 16B、8H、4W、2D | |
| SPLAT | 16B、8H、4W、2D | 16B、8H、4W、2D |
译注: Power 列中两处
6B与同列其他行的16B不一致。
| 指令类别 | ARM Advanced SIMD | MIPS SIMD | Power Vector Facility |
|---|---|---|---|
| 浮点加、减、乘、除 | 4W、2D | 4W、2D | 4W、2D |
| 浮点乘加/乘减 | 4W、2D | 4W、2D | 4W、2D |
| 浮点最大值/最小值 | 4W、2D | 4W、2D | 4W、2D |
| 浮点平方根与平方根的倒数 | 4W、2D | 4W、2D | 4W、2D |
| 浮点比较 | 4W、2D | 4W、2D | 4W、2D |
| 浮点数与整数相互转换 | 4W、2D | 4W、2D | 4W、2D |
译注: 图 K.24 对 Power Vector Facility 只列 32 位浮点数,而本表又列出
2D。图 K.25–K.27 是原书的概括性比较,不宜当作完整的 ISA 支持清单。
嵌入式 RISC 的数字信号处理扩展指令
Thumb2 和 microMIPS32 都提供 DSP(数字信号处理)及多媒体操作指令。在 Thumb2 中,这些属于核心指令集;在 microMIPS32 中,它们属于 DSP 扩展。这些扩展编码为 32 位指令,其功能范围小于 MIPS64 或 ARMv8(AArch64)的 SIMD/向量扩展所提供的多媒体和图形支持。与后者那些更全面的扩展一样,Thumb2 和 microMIPS32 也采用打包 SIMD,但使用现有整数寄存器,仅作少量扩充来支持宽累加器,而且只操作整数数据。RISC-V 已规定,P 扩展将使用浮点寄存器支持打包整数 SIMD。
不过在本书出版时,该规范尚未完成。
DSP 操作经常包括线性代数函数和卷积等运算,其中间结果需要比输入更大的表示范围。Thumb2 用一组基于成对整数寄存器、产生 64 位结果的操作来处理这一问题。microMIPS32 DSP 有 4 个 64 位累加器寄存器,其中包括原本用于整数乘除的 Hi-Lo 寄存器。两种体系结构都对字节、半字和字提供并行算术,类似于 ARMv8 和 MIPS64 的多媒体扩展。此外,MIPS DSP 扩展还处理 DSP 运算大量使用的定点小数数据。这类数据有一个符号位,其余位表示小数部分。
其取值范围用十进制近似表示为 −1.0 到 0.9999。MIPS DSP 支持 Q15 和 Q31 两种定点小数格式,分别包含 1 个符号位以及 15 位或 31 位小数。
图 K.28 使用图 K.25 相同的记法列出共同操作。应记住,基本的 32 位指令集还提供其他功能,包括基本算术、逻辑和位操作。
| 功能 | Thumb-2 | microMIPS32 DSP |
|---|---|---|
| 加/减 | 4B、2H | 4B、2Q15 |
| 饱和加/减 | 4B、2H | 4B、2Q15、Q31 |
交换后加/减:交换 rt 中两个半字,对第一个半字作加法、第二个作减法;可选择饱和 | 2H | |
| 加法规约,即对各值求和 | 4B | |
| 绝对值 | 2Q15、Q31 | |
| 降低/提高数值精度 | 2B、Q15、2Q15、Q31 | |
| 左/右移,逻辑/算术,可选择饱和 | 4B、2H | |
| 乘法 | 2H | 2B、2H、2Q15 |
| 乘加/乘减,在 MIPS 中写入 GPR 或累加器 | 2H | 2Q15 |
| 复数乘法步骤:两次乘法加一次加/减法 | 2H | 2Q15 |
| 乘法并累加,通过加法或减法累积 | 2H | Q15、Q31 |
| 位复制 | B、H | |
比较 =、<、<=,设置条件字段 | 4B、2H | |
| Pick:根据条件位,从两个操作数中选择字节或半字 | 4B、2H | |
| Pack:从每个操作数中选择一个半字进行打包 | H | |
| Extract:提取 | Q63 | |
| 与累加器之间传送 | DW |
结束语
本节概述了 8 种 RISC 体系结构的寻址方式、指令格式和几乎全部指令。虽然后半部分着重讨论差异,但如果它们没有如此多的相似之处,就不可能在这么少的篇幅内介绍 8 种体系结构。事实上,我们估计,无论哪一种体系结构,所执行指令中超过 90% 都能在图 K.9–K.13 中找到。为了与这种一致性对照,图 K.29 用类似图 K.1 的格式,汇总了 20 世纪 70 年代的四种体系结构。
这些体系结构无法用同样的方式在一节中统一介绍,因此后面三节分别讨论 80x86、VAX 和 IBM 360/370。在计算史上,从来没有出现过像 20 世纪 80 年代 RISC 思想兴起后这样,对计算机体系结构达成如此广泛共识的时期。
| 项目 | IBM 360/370 | Intel 8086 | Motorola 68000 | DEC VAX |
|---|---|---|---|---|
| 发布年份 | 1964/1970 | 1978 | 1980 | 1977 |
| 指令长度,位 | 16、32、48 | 8、16、24、32、40、48 | 16、32、48、64、80 | 8、16、24、32、…、432 |
| 寻址:位数与模型 | 24 位,平坦/31 位,平坦 | 4+16 位,分段 | 24 位,平坦 | 32 位,平坦 |
| 数据须对齐? | 360 是,370 否 | 否 | 按 16 位边界对齐 | 否 |
| 数据寻址方式数 | 2/3 | 5 | 9 | =14 |
| 保护 | 页 | 无 | 可选 | 页 |
| 页大小 | 2 KB、4 KB | — | 0.25–32 KB | 0.5 KB |
| I/O | 专用操作码 | 专用操作码 | 存储器映射 | 存储器映射 |
| 整数寄存器:数量、模型、位数 | 16 个 GPR × 32 位 | 8 个专用数据寄存器 × 16 位 | 8 个数据寄存器及 8 个地址寄存器 × 32 位 | 15 个 GPR × 32 位 |
| 独立浮点寄存器 | 4 × 64 位 | 可选:8 × 80 位 | 可选:8 × 80 位 | 0 |
| 浮点格式 | IBM,十六进制浮点 | IEEE 754 单精度、双精度、扩展精度 | IEEE 754 单精度、双精度、扩展精度 | DEC |
K.3 Intel 80x86
引言
MIPS 出自一位体系结构设计者的构想。体系结构的各个部分配合得很协调,整体也能简明地描述出来。80x86 则不然:它是几个相互独立的团队在 20 多年里逐步演化的产物;在原有指令集上添加新特性,就像不断往已经塞满的旅行包里再塞衣服。下面是 80x86 的重要里程碑。
- 1978 年:Intel 发布 8086 体系结构。它是当时取得成功的 8 位微处理器 Intel 8080 的扩展,在汇编语言层面与其兼容。8086 是 16 位体系结构,内部寄存器均为 16 位。
8080 是直接明了的累加器机器,8086 则增加了一些寄存器。由于几乎每个寄存器都有专用用途,8086 介于累加器机器与通用寄存器机器之间,可以恰当地称为扩展累加器机器。
- 1980 年:Intel 发布 8087 浮点协处理器。它在 8086 基础上增加约 60 条浮点指令。设计者没有采用扩展累加器,而是选择栈与寄存器的混合形式,实质上是一种扩展栈体系结构:在完整的栈指令集之外,补充有限的一组寄存器—存储器指令。
- 1982 年:80286 扩展了 8086 体系结构,把地址空间扩大到 24 位,建立了精细复杂的存储器映射与保护模型,并增加少量指令,以补全指令集和操作保护模型。由于不加修改地运行 8086 程序十分重要,80286 提供实地址模式,使机器表现得就像一台 8086。
- 1985 年:80386 把 80286 体系结构扩展到 32 位。除了 32 位寄存器和 32 位地址空间之外,80386 还增加了新的寻址方式和操作,使它几乎成为通用寄存器机器。除分段寻址外,80386 还增加了分页支持,见第 2 章。与 80286 一样,80386 也有一种模式,可以不加修改地执行 8086 程序。
这段历史说明了兼容性这副“金手铐”对 80x86 的影响:每一步演进时,已有软件基础都太重要,不能冒险用大幅度体系结构变化去破坏它。幸运的是,后来的 80486(1989 年)、Pentium(原书列 1992 年)和 P6(1995 年)以提高性能为目标,对用户可见的指令集只增加了四条指令:三条用于辅助多处理器处理,另一条是条件传送指令。1
从 1997 年起,Intel 增加了数百条指令,在一个时钟周期内对多个较窄的数据类型进行操作,以支持多媒体,见附录 A。这些 SIMD 或向量指令主要用于手工编写的库或驱动程序,编译器很少生成它们。第一个扩展称为 MMX,于 1997 年出现。它包含 57 条指令,可在 64 位寄存器中打包和解包多个字节、16 位字或 32 位双字,并对这些窄数据项并行执行移位、逻辑和整数算术。它既支持饱和算术,也支持非饱和算术。MMX 使用构成浮点栈的那些寄存器,因此没有增加操作系统需要保存的新状态。
1999 年,Intel 在 Pentium III 中又增加 70 条指令,称为 SSE。主要变化是增加 8 个独立寄存器,把宽度加倍到 128 位,并增加单精度浮点数据类型,因此可以并行执行四个 32 位浮点操作。
为改善存储器性能,SSE 增加了缓存预取指令,以及绕过缓存、直接写入存储器的流式存储指令。
2001 年,Intel 又增加 144 条指令,称为 SSE2。新增数据类型是双精度浮点数,允许同时执行两个 64 位浮点操作。这 144 条指令几乎全部是已有 MMX 和 SSE 指令的变体,用于并行处理 64 位数据。这一变化不仅支持多媒体操作,还给编译器提供了独特栈体系结构之外的另一种浮点操作目标。编译器可以像在 RISC 机器上一样,把 8 个 SSE 寄存器当作浮点寄存器。Pentium 4 是第一款纳入 SSE2 指令的微处理器,这一变化提高了它的性能。发布时,1.5 GHz Pentium 4 的 SPECint2000(base)性能是 1 GHz Pentium III 的 1.24 倍,而 SPECfp2000(base)性能则达到 1.88 倍。
2003 年,这次由 Intel 之外的一家公司扩展 IA-32 体系结构。AMD 宣布一组体系结构扩展,把地址空间从 32 位扩展到 64 位。类似于 1985 年 80386 从 16 位到 32 位地址空间的过渡,AMD64 把所有寄存器加宽到 64 位;它还把寄存器数量增加到 16 个,并提供 16 个 128 位寄存器以支持 XMM——原书称其为 AMD 对 SSE2 的回应。其主要变化并非扩展指令集,而是增加一种称为长模式(long mode)的新模式,重新定义全部 IA-32 指令在 64 位地址下的执行方式。为了寻址更多寄存器,它为指令增加一个新前缀。AMD64 仍保留与标准 Intel 指令集向后兼容的 32 位模式,因此与 HP/Intel Itanium 相比,向 64 位寻址的过渡更加平滑。后来 Intel 效仿 AMD,作出几乎相同的改动,使大多数软件无需修改就能在 80x86 的两种 64 位地址版本上运行。
无论从设计美感上如何评价 80x86,都应记住,世界上这一体系结构家族的实例数量超过任何其他服务器或桌面处理器。不过,它曲折的身世确实造就了一种难以解释、也难以令人喜爱的体系结构。
下面先介绍寄存器和寻址方式,再讨论整数操作、浮点操作,最后分析指令编码。
80x86 寄存器与数据寻址方式
指令集的演化可以从 80x86 的寄存器中看出来,见图 K.30。原有寄存器用黑色表示,80386 的扩展用浅色表示,后续图也采用这一配色。80386 基本上把除段寄存器以外的全部 16 位寄存器扩展到 32 位,并在名称前加 E 表示 32 位版本。算术、逻辑和数据传送指令采用双操作数形式,允许图 K.31 所示的组合。
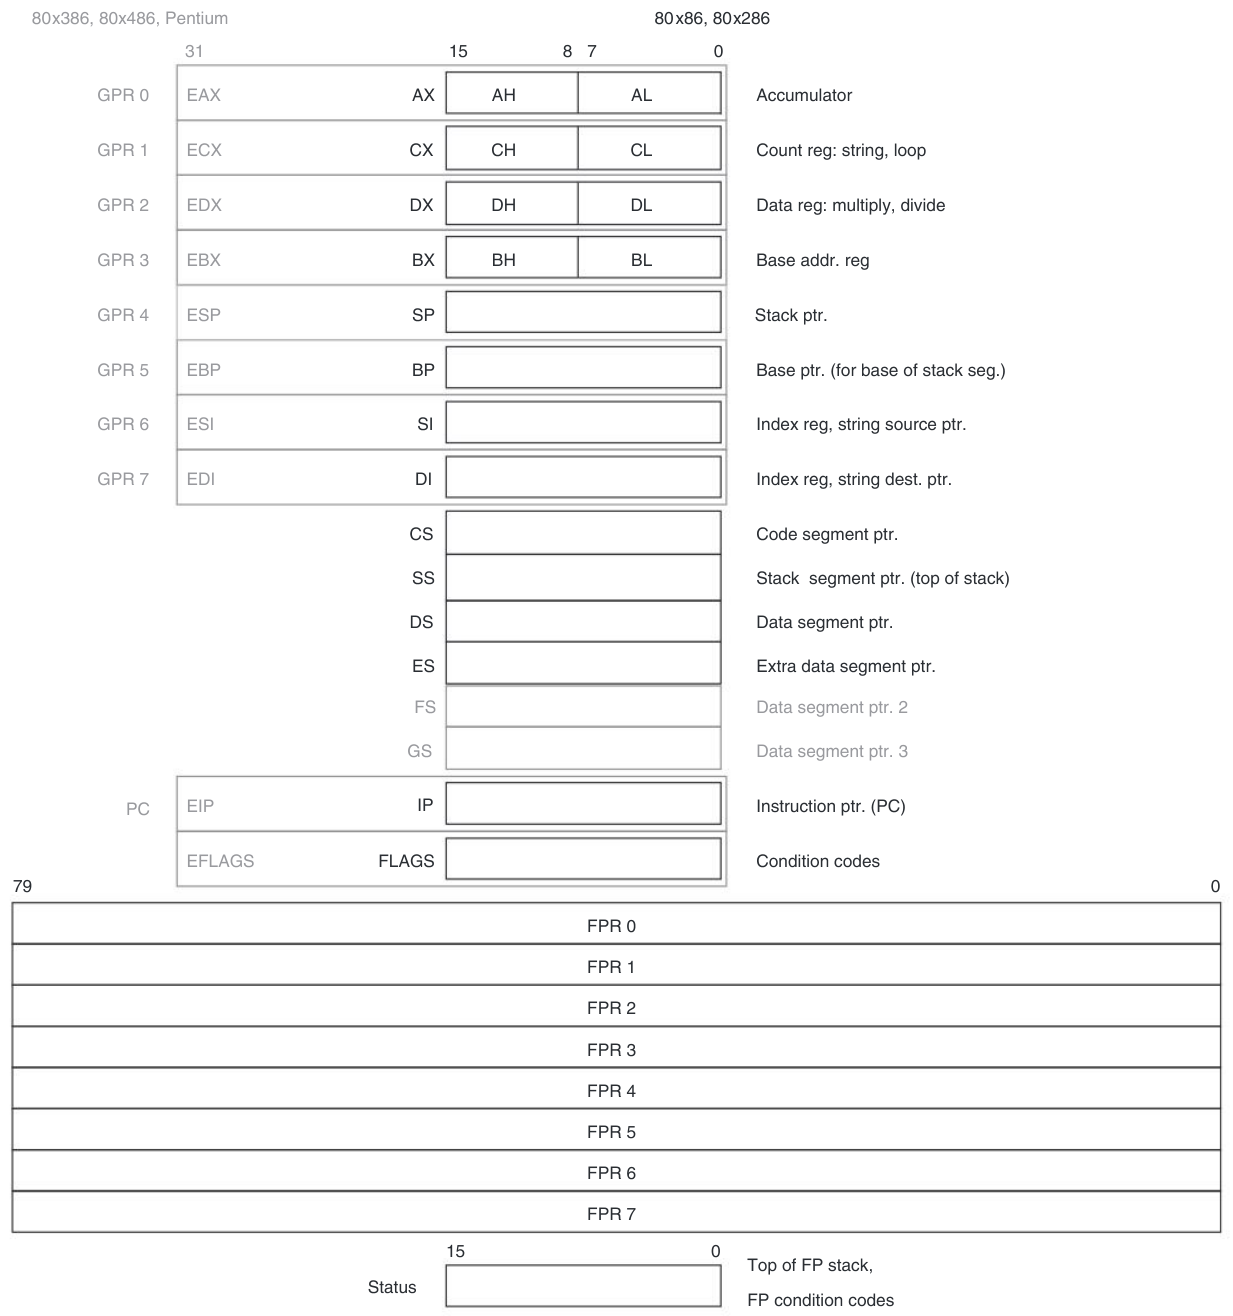
图中各寄存器用途为:EAX 累加器;EBX 基址寄存器;ECX 字符串/循环计数;EDX 乘除法数据寄存器;ESI 变址寄存器、字符串源指针;EDI 变址寄存器、字符串目的指针;EBP 基址指针,用于栈段基部;ESP 栈指针;EIP 指令指针,即 PC;EFLAGS 条件码。段寄存器 CS、SS、DS、ES、FS、GS 分别表示代码段、栈段、数据段、附加数据段及另两个数据段指针。浮点 Status 保存浮点栈顶位置和浮点条件码。
| 同时作源与目的的操作数类型 | 第二个源操作数类型 |
|---|---|
| 寄存器 | 寄存器 |
| 寄存器 | 立即数 |
| 寄存器 | 存储器 |
| 存储器 | 寄存器 |
| 存储器 | 立即数 |
解释寻址方式时,必须分清讨论的是 8086、80286 使用的 16 位模式,还是 80386 及后继处理器具有的 32 位模式。所支持的七种数据存储器寻址方式是:
- 绝对寻址。
- 寄存器间接寻址。
- 基址寻址。
- 变址寻址。
- 带位移量的基址变址寻址。
- 基址加比例变址寻址。
- 带位移量的基址加比例变址寻址。
在 32 位模式中,位移量可以是 8 位或 32 位;在 16 位模式中,可以是 8 位或 16 位。如果把地址长度的不同也分别算作一种寻址方式,总计有 11 种。
虽然存储器操作数可以使用任一种寻址方式,但每种方式可使用哪些寄存器受到限制。后面的“80x86 指令编码”小节列出全部限制;原书此处所引第 K-11 页与本附录实际位置不符。下面先说明基本的寄存器选项。
- 绝对寻址:根据模式使用 16 位或 32 位位移量。
- 寄存器间接寻址:16 位模式使用
BX、SI、DI;32 位模式使用EAX、ECX、EDX、EBX、ESI、EDI。 - 带 8 位或 16/32 位位移量的基址寻址:16 位模式使用
BP、BX、SI、DI;32 位模式使用EAX、ECX、EDX、EBX、ESI、EDI。位移量为 8 位,或者与地址模式同宽,即 16 位或 32 位。Intel 把这同一种寻址方式分成基址和变址两个名称,但两者实质相同,因此本书将其合并。本书所谓“变址寻址”另有所指,见下一项。 - 变址寻址:地址是两个寄存器之和,允许的组合为
BX+SI、BX+DI、BP+SI、BP+DI。
8086 将其称为基址变址寻址。32 位模式用另一种寻址方式达到相同效果。
带 8 位或 16 位位移量的基址变址寻址:地址是位移量与两个寄存器内容之和,寄存器限制与变址寻址相同。
基址加比例变址寻址:本方式及下一种方式在 80386 中加入,只能用于 32 位模式。地址计算为
Scale为 0、1、2 或 3;变址寄存器可以是除ESP之外的任意一个 32 位通用寄存器,基址寄存器可以是八个 32 位通用寄存器中的任何一个。带 8 位或 32 位位移量的基址加比例变址寻址:地址是位移量与上一种比例变址方式所算地址之和,寄存器限制相同。
80x86 采用小端(Little Endian)寻址。
理想情况下,80x86 逻辑地址与物理地址的讨论可留给第 2 章,但分段地址空间使我们无法略去这些信息。图 K.32 展示历代 80x86 机器的存储器映射选项;第 2 章更详细地讨论分段保护机制。
显然,无论使用哪种寻址方式,汇编程序员都必须说明某个地址应使用哪个段寄存器。为节省指令空间,处理器根据所用的地址寄存器自动选择段寄存器。规则很简单:指令引用 IP 使用代码段寄存器 CS;栈引用 BP 或 SP 使用栈段寄存器 SS;其他寄存器默认使用数据段寄存器 DS。下一小节说明如何覆盖这些默认选择。
图中 Real mode/Protected mode 为实模式/保护模式;Logical address、Linear address、Physical address 分别为逻辑地址、线性地址和物理地址;Segment 为段,Offset 为偏移量;Segmentation 和 Paging 分别为分段、分页。
80x86 整数操作
8086 支持 8 位字节和 16 位字(word)两种数据类型。数据类型的区分既适用于寄存器操作,也适用于存储器访问。80386 增加了 32 位地址与数据,后者称为双字(double word)。几乎每种操作都能处理 8 位数据以及另一种更长的数据;较长者由模式决定,为 16 位或 32 位。
显然,有些程序需要操作全部三种长度的数据。因此,80x86 的设计者提供了一种方便的方法,在不显著增加代码大小的情况下指定各个版本。他们认为,大多数程序会以 16 位或 32 位数据中的一种为主,所以可以设置一种默认的较长数据长度。代码段寄存器中的一个位决定该默认长度。若要覆盖默认值,就在指令前附加一个 8 位前缀,告诉机器这条指令使用另一种较长长度。
前缀办法借鉴自 8086;后者允许使用多个前缀改变指令行为。最初的三种前缀分别用于覆盖默认段寄存器、锁住总线以实现信号量操作(见第 5 章),以及重复执行后一条指令直到 CX 减至零。
最后一种前缀原本是为配合字节传送指令,以便传送可变数量的字节。80386 还增加了覆盖默认地址长度的前缀。
80x86 整数操作可分为四大类:
- 数据移动,包括传送、入栈和出栈。
- 算术与逻辑,包括逻辑运算、测试、移位,以及整数和十进制算术运算。
- 控制流,包括条件分支、无条件跳转、调用和返回。
- 字符串指令,包括字符串传送和比较。
图 K.33 给出若干典型 80x86 指令及其功能。
| 指令 | 功能 |
|---|---|
JE name | 若 equal(CC),则 IP ← name;原表给出范围 IP−128 ≤ name ≤ IP+128 |
JMP name | IP ← name |
CALLF name, seg | SP ← SP−2; M[SS:SP] ← IP+5; SP ← SP−2; M[SS:SP] ← CS; IP ← name; CS ← seg |
MOVW BX,[DI+45] | BX ←₁₆ M[DS:DI+45] |
PUSH SI | SP ← SP−2; M[SS:SP] ← SI |
POP DI | DI ← M[SS:SP]; SP ← SP+2 |
ADD AX,#6765 | AX ← AX+6765 |
SHL BX,1 | BX ← BX₁…₁₅ ## 0,将原字段与末尾零拼接 |
TEST DX,#42 | 按 DX & 42 的结果设置条件码标志 |
MOVSB | M[ES:DI] ←₈ M[DS:SI]; DI ← DI+1; SI ← SI+1 |
译注: 表中的
JE边界、CALLF入栈次序和MOVSB的递增方向均按原表保留,是原书的简化或可疑表述;不可据此代替对完整指令语义的核查。SR:X图注公式描述的是实模式地址形成。
数据传送、算术和逻辑指令总体上并无特别之处,只是算术与逻辑操作允许目的位置既可以是寄存器,也可以是存储器单元。
控制流指令必须能够寻址另一个段中的目标。因此,控制流指令分两种:段内转移为“近”(near),段间转移为“远”(far)。远跳转必须是无条件跳转;在 16 位模式中,操作码后跟两个 16 位量,一个作为指令指针,另一个装入 CS,成为新的代码段。在 32 位模式中,第一个字段扩展到 32 位,以匹配 32 位程序计数器 EIP。
调用和返回采用类似方式:远调用把返回指令指针与返回段压栈,然后同时装入指令指针和代码段;远返回则把二者从栈中弹出。程序员或编译器编写者必须确保同一过程始终使用相配的调用与返回类型:近返回不能与远调用配合,反之亦然。
字符串指令来自 80x86 的 8080 血统,在大多数程序中并不经常执行。
图 K.34 列出部分整数指令,许多指令同时具有字节和字两种形式。
| 类别 | 指令 | 含义 |
|---|---|---|
| 控制:条件与无条件分支 | JNZ, JZ | 条件成立时跳至 IP 加 8 位偏移量;JNE 是 JNZ 的别名,JE 是 JZ 的别名 |
| 控制 | JMP, JMPF | 无条件跳转;8 位或 16 位偏移量,有段内近跳转和段间远跳转版本 |
| 控制 | CALL, CALLF | 子程序调用;16 位偏移量,返回地址压栈,有近、远两种版本 |
| 控制 | RET, RETF | 从栈中弹出返回地址并跳转,有近、远两种版本 |
| 控制 | LOOP | 循环分支:CX 减一;若 CX ≠ 0,则跳至 IP 加 8 位位移量 |
| 数据传送:寄存器间或寄存器与存储器之间 | MOV | 在两个寄存器间,或寄存器与存储器间传送 |
| 数据传送 | PUSH | 将源操作数压栈 |
| 数据传送 | POP | 将栈顶操作数弹出到寄存器 |
| 数据传送 | LES | 从存储器装入 ES 和一个通用寄存器 |
| 算术/逻辑:使用数据寄存器与存储器 | ADD | 源操作数加到目的操作数,寄存器—存储器格式 |
| 算术/逻辑 | SUB | 从目的操作数中减去源操作数,寄存器—存储器格式 |
| 算术/逻辑 | CMP | 比较源与目的操作数,寄存器—存储器格式 |
| 算术/逻辑 | SHL | 左移 |
| 算术/逻辑 | SHR | 逻辑右移 |
| 算术/逻辑 | RCR | 通过进位位循环右移 |
| 算术/逻辑 | CBW | 把 AL 中的字节转换为 AX 中的字 |
| 算术/逻辑 | TEST | 源与目的操作数作逻辑 AND,并设置标志 |
| 算术/逻辑 | INC | 目的操作数加一,寄存器—存储器格式 |
| 算术/逻辑 | DEC | 目的操作数减一,寄存器—存储器格式 |
| 算术/逻辑 | OR | 逻辑 OR,寄存器—存储器格式 |
| 算术/逻辑 | XOR | 异或,寄存器—存储器格式 |
| 字符串:长度由重复前缀给出 | MOVS | 从源字符串复制到目的字符串,可以重复 |
| 字符串 | LODS | 将字符串的一个字节或字装入 A 寄存器 |
80x86 浮点操作
Intel 为浮点指令采用栈体系结构:加载把数压栈,运算从栈顶的两个元素中取得操作数,存储可以把元素弹出,正如附录 A 的栈机器示例所示。2
Intel 又补充了一些指令和寻址方式,使这种体系结构具备寄存器—存储器模型的部分优点。除从栈顶两个元素取得操作数之外,一个操作数也可以在存储器中,或位于栈顶以下七个寄存器之一。
不过,这种混合方式仍是一种受限的寄存器—存储器模型:加载总是把数据放到栈顶,并调整栈顶指针;存储则只能把栈顶内容写入存储器。3 Intel 用 ST 表示栈顶,用 ST(i) 表示栈顶以下第 个寄存器。
这一体系结构的新颖之处是,操作数在寄存器栈中的宽度大于它在存储器中的宽度,而且全部运算都按这种较宽的内部精度进行。加载时,数值自动转换为内部的 80 位格式;存储时,再转换回相应长度。存储器中的浮点数据可以是 32 位单精度或 64 位双精度,Intel 称之为 real。寄存器—存储器版本的指令先把存储器操作数转换为 Intel 80 位格式,再进行运算。整数加载和存储的数据传送指令还会自动在 16/32 位整数与实数之间转换。
80x86 浮点操作可分为四大类:
- 数据移动,包括加载、加载常量和存储。
- 算术,包括加、减、乘、除、平方根和绝对值。
- 比较,包括把结果传给整数 CPU 以便进行分支的指令。
- 超越函数指令,包括正弦、余弦、对数和求幂。
图 K.35 给出约 60 种浮点操作中的一部分。花括号 {} 表示基本操作的可选变体:{I} 表示有整数版本,{P} 表示运算后从栈中弹出一个操作数,{R} 表示交换该运算中操作数的次序。
| 数据传送 | 算术 | 比较 | 超越函数 |
|---|---|---|---|
F{I}LD mem/ST(i) | F{I}ADD{P} mem/ST(i) | F{I}COM{P}{P} | FPATAN |
F{I}ST{P} mem/ST(i) | F{I}SUB{R}{P} mem/ST(i) | F{I}UCOM{P}{P} | F2XM1 |
FLDPI | F{I}MUL{P} mem/ST(i) | FSTSW AX/mem | FCOS |
FLD1 | F{I}DIV{R}{P} mem/ST(i) | FPTAN | |
FLDZ | FSQRT | FPREM | |
FABS | FSIN | ||
FRNDINT | FYL2X |
并非所有组合都存在。因此,记法
代表 80x86 实际提供的以下指令:
整数减法指令没有弹栈或反向弹栈版本。
如果再计入操作数形式,组合会更多。忽略整数和弹栈变体,浮点加法有以下选项:
| 指令形式 | 操作数与结果 |
|---|---|
FADD | 两个操作数都在栈内,结果替换栈顶 |
FADD ST(i) | 一个源操作数为栈顶以下第 个寄存器,结果替换栈顶 |
FADD ST(i),ST | 一个源操作数为栈顶,结果替换栈顶以下第 个寄存器 |
FADD mem32 | 一个源操作数为存储器中的 32 位单元,结果替换栈顶 |
FADD mem64 | 一个源操作数为存储器中的 64 位单元,结果替换栈顶 |
如前所述,SSE2 提供了 IEEE 浮点寄存器模型。
80x86 指令编码
最棘手的部分留到最后:8086 的指令编码很复杂,有许多不同格式。没有操作数时,指令可以短至 1 字节;包含 16 位立即数并采用 16 位位移寻址时,可长至 6 字节。前缀还会使 8086 指令超出这些直观长度。
80386 的新增内容进一步扩大了指令长度,如图 K.36 所示。位移量和立即数字段都可以长达 32 位;还可能有两个新增前缀;操作码可长达 16 位;比例变址方式说明符再增加 8 位。原书据此称,80386 指令的最大可能长度为 17 字节。4
图中从上到下为:前缀 Prefixes,依次包括重复 Repeat、锁定 Lock、段覆盖 Seg. override、地址长度覆盖 Addr. override 和操作数长度覆盖 Size override;操作码 Opcode 与扩展 Opcode ext.;地址说明符 mod, reg, r/m 及 sc, index, base;位移量 Displacement;立即数 Immediate。Disp8 到 Disp32、Imm8 到 Imm32 分别表示这些字段的各个字节。
图 K.37 展示图 K.33 中若干示例指令的格式。操作码字节通常含有一位,用于指示操作数宽度是一个字节,还是由当前模式决定的较长长度,即 16 位或 32 位。某些指令的操作码还可以包含寻址方式和寄存器;许多形式为 register ← register op immediate 的指令就是如此。
其他指令使用一个 postbyte,即额外的操作码字节,图 K.36 中记为 mod, reg, r/m,其中包含寻址方式信息。
图中示例依次为:(a)JE PC + displacement;(b)远调用 CALLF,含偏移量 Offset 和段号 Segment number;(c)MOV BX,[DI+45];(d)PUSH SI;(e)ADD AX,#6765;(f)SHL BX,1;(g)TEST DX,#42。Condition 为条件,Displacement 为位移量,Constant/Immediate 为常量/立即数,Reg 为寄存器字段,r-m/r-r postbyte 为寄存器—存储器/寄存器—寄存器形式的 postbyte。
许多访问存储器的指令都使用这个 postbyte。基址加比例变址方式再使用第二个 postbyte,图 K.36 中记为 sc, index, base。
浮点指令编码在 8086 的 escape 操作码和 postbyte 地址说明符中。访问存储器的操作预留两位,决定操作数是 32/64 位实数,还是 16/32 位整数。在不访问存储器的版本中,同样两位用来决定运算后是否弹栈,以及结果写入栈顶还是栈顶以下的寄存器。
遗憾的是,在 80x86 中,寄存器限制无法与寻址方式的编码分开说明。因此,图 K.38 和 K.39 列出了 16 位、32 位模式下两个 postbyte 地址说明符的编码。
图 K.38 分为寄存器字段和地址字段两部分。以下按原表列出,包括原表自身的不一致。
reg | w=0 | w=1,16 位模式 | w=1,32 位模式 |
|---|---|---|---|
| 0 | AL | AX | EAX |
| 1 | CL | CX | ECX |
| 2 | DL | DX | EDX |
| 3 | BL | BX | EBX |
| 4 | AH | SP | ESP |
| 5 | CH | BP | EBP |
| 6 | DH | SI | ESI |
| 7 | BH | DI | EDI |
r/m | mod=0,16 位 | mod=0,32 位 | mod=1,16 位 | mod=1,32 位 | mod=2,16 位 | mod=2,32 位 | mod=3 |
|---|---|---|---|---|---|---|---|
| 0 | BX+SI | EAX | BX+SI+disp8 | EAX+disp8 | BX+SI+disp16 | EAX+disp32 | 同 reg 编码 |
| 1 | BX+DI | ECX | BX+DI+disp8 | ECX+disp8 | BX+DI+disp16 | ECX+disp32 | 同 reg 编码 |
| 2 | BP+SI | EDX | BP+SI+disp8 | EDX+disp8 | BP+SI+disp16 | EDX+disp32 | 同 reg 编码 |
| 3 | BP+SI | EBX | BP+SI+disp8 | EBX+disp8 | BP+SI+disp16 | EBX+disp32 | 同 reg 编码 |
| 4 | SI | (sib) | SI+disp16 | (sib)+disp8 | SI+disp8 | (sib)+disp32 | 同 reg 编码 |
| 5 | DI | disp32 | DI+disp8 | EBP+disp8 | DI+disp16 | EBP+disp32 | 同 reg 编码 |
| 6 | disp16 | ESI | BP+disp8 | ESI+disp8 | BP+disp16 | ESI+disp32 | 同 reg 编码 |
| 7 | BX | EDI | BX+disp8 | EDI+disp8 | BX+disp16 | EDI+disp32 | 同 reg 编码 |
译注: 原图的
r/m=3、16 位模式写成BP+SI,与前文列出的第四种组合BP+DI不一致;r/m=4的 16 位mod=1、mod=2两格,又分别写成SI+disp16、SI+disp8,与图注规则相反。
| 编码 | Index,变址寄存器 | Base,基址寄存器/值 |
|---|---|---|
| 0 | EAX | EAX |
| 1 | ECX | ECX |
| 2 | EDX | EDX |
| 3 | EBX | EBX |
| 4 | 无变址寄存器 | ESP |
| 5 | EBP | mod=0 时为 disp32;mod≠0 时为 EBP |
| 6 | ESI | ESI |
| 7 | EDI | EDI |
译注: 图注第二个 EBP 例子没有给出
Base字段,条件并不完整。保留原书条件,不能将其视为足以唯一确定地址方式的编码。
融会贯通:指令集使用情况的测量
本节给出 80x86 的详细测量,再与相同程序在 MIPS 上的测量比较。
为便于比较动态指令集测量结果,我们使用 SPEC92 的一个程序子集。80x86 数据于 1994 年取得,使用 Sun Solaris FORTRAN 和 C 编译器 V2.0,并在 32 位模式下执行。这些编译器的质量与 MIPS 所用编译器相当。
应记住,测量结果取决于所选基准程序与编译器技术。虽然我们认为本节测量能够较合理地反映这些体系结构的使用情况,其他程序的行为仍可能与这里任何一个基准不同,不同编译器也可能产生不同结果。实际研究指令集时,体系结构设计者应使用大得多的基准集合,尽量覆盖广泛的应用,并考虑操作系统及其对指令集的使用。这里测量的单用户基准,不一定具有与操作系统相同的行为。
我们先单独评价 80x86 的特性,再将指令数与 DLX 比较。5
80x86 操作数寻址测量
先看寻址方式。图 K.40 展示 80x86 操作数类型的分布。这里统计的是操作的“第二个”操作数,例如
只计为一个存储器操作数。若把第一个操作数的类型也计入,寄存器使用比例会增加到约 1.5 倍。
| 操作数类型 | 整数程序平均 | 浮点程序平均 |
|---|---|---|
| 寄存器 | 45% | 22% |
| 立即数 | 16% | 6% |
| 存储器 | 39% | 72% |
图 K.41 按各自寻址方式划分 80x86 的存储器操作数。最出人意料的可能是 80386 新增寻址方式很常用,即图中最后四行,约占全部存储器访问的一半。另一个意外是直接寻址也很常见。在大多数其他机器上,等价的直接寻址方式很少使用。可能因为 80x86 的分段地址空间使地址相对于段寄存器中的基址,直接寻址因此更有用。
| 寻址方式 | 整数程序平均 | 浮点程序平均 |
|---|---|---|
| 寄存器间接 | 13% | 3% |
| 基址 + 8 位位移量 | 31% | 15% |
| 基址 + 32 位位移量 | 9% | 25% |
| 变址 | 0% | 0% |
| 基址变址 + 8 位位移量 | 0% | 0% |
| 基址变址 + 32 位位移量 | 0% | 1% |
| 基址 + 比例变址 | 22% | 7% |
| 基址 + 比例变址 + 8 位位移量 | 0% | 8% |
| 基址 + 比例变址 + 32 位位移量 | 4% | 4% |
| 32 位直接寻址 | 20% | 37% |
这些寻址方式在很大程度上决定 Intel 指令的大小。图 K.42 展示指令长度分布。整数程序平均每条指令为 2.8 字节,标准差 1.5;浮点程序平均为 4.1 字节,标准差 1.9。长度差异部分来自寻址方式差异:整数程序更多采用较短的寄存器间接和 8 位位移量寻址。
浮点程序则更常使用 80386 新增、带较长的 32 位位移量的寻址方式。
图中长度 1–11 字节对应的浮点/整数平均百分比分别为:10/14、19/40、18/25、7/5、4/6、39/8、4/2、0/1、0/0、0/0、0/0。原图各项按所示精度取整,不重新归一化。
浮点指令兼具栈和寄存器两方面特征,实际如何使用呢?图 K.43 表明,至少本次测量所用的编译器很少遵循纯栈执行模型。原书建议参见 L.3 节了解这一现象的历史原因。6
最后,图 K.44 和 K.45 给出十个 SPEC92 程序的指令混合。
| 操作数形式 | doduc | ear | hydro2d | mdljdp2 | su2cor | 浮点平均 |
|---|---|---|---|---|---|---|
栈,第二操作数为 ST(1) | 1.1% | 0.0% | 0.0% | 0.2% | 0.6% | 0.4% |
寄存器,第二操作数为 ST(i), | 17.3% | 63.4% | 14.2% | 7.1% | 30.7% | 26.5% |
| 存储器 | 81.6% | 36.6% | 85.8% | 92.7% | 68.7% | 73.1% |
| 指令 | doduc | ear | hydro2d | mdljdp2 | su2cor | 浮点平均 |
|---|---|---|---|---|---|---|
| 加载 | 8.9% | 6.5% | 18.0% | 27.6% | 27.6% | 20% |
| 存储 | 12.4% | 3.1% | 11.5% | 7.8% | 7.8% | 8% |
| 加法 | 5.4% | 6.6% | 14.6% | 8.8% | 8.8% | 10% |
| 减法 | 1.0% | 2.4% | 3.3% | 2.4% | 2.4% | 3% |
| 乘法 | 0% | |||||
| 除法 | 0% | |||||
| 比较 | 1.8% | 5.1% | 0.8% | 1.0% | 1.0% | 2% |
| 寄存器间传送 | 3.2% | 0.1% | 1.8% | 2.3% | 2.3% | 2% |
| 加载立即数 | 0.4% | 1.5% | 0% | |||
| 条件分支 | 5.4% | 8.2% | 5.1% | 2.7% | 2.7% | 5% |
| 无条件分支 | 0.8% | 0.4% | 1.3% | 0.3% | 0.3% | 1% |
| 调用 | 0.5% | 1.6% | 0.1% | 0.1% | 0% | |
| 返回、间接跳转 | 0.5% | 1.6% | 0.1% | 0.1% | 0% | |
| 移位 | 1.1% | 4.5% | 2.5% | 2.5% | 2% | |
| AND | 0.8% | 0.8% | 0.7% | 1.3% | 1.3% | 1% |
| OR | 0.1% | 0.1% | 0.1% | 0% | ||
| 其他,XOR、NOT 等 | 0% | |||||
| 浮点加载 | 14.1% | 22.5% | 9.1% | 12.6% | 12.6% | 14% |
| 浮点存储 | 8.6% | 11.4% | 4.1% | 6.6% | 6.6% | 7% |
| 浮点加法 | 5.8% | 6.1% | 1.4% | 6.6% | 6.6% | 5% |
| 浮点减法 | 2.2% | 2.7% | 3.1% | 2.9% | 2.9% | 3% |
| 浮点乘法 | 8.9% | 8.0% | 4.1% | 12.0% | 12.0% | 9% |
| 浮点除法 | 2.1% | 0.8% | 0.2% | 0.2% | 0% | |
| 浮点比较 | 9.4% | 6.9% | 10.8% | 0.5% | 0.5% | 5% |
| 浮点寄存器间传送 | 2.5% | 0.8% | 0.3% | 0.8% | 0.8% | 1% |
| 其他浮点,绝对值、平方根等 | 3.9% | 3.8% | 4.1% | 0.8% | 0.8% | 2% |
| 指令 | compress | eqntott | espresso | gcc(cc1) | li | 整数平均 |
|---|---|---|---|---|---|---|
| 加载 | 20.8% | 18.5% | 21.9% | 24.9% | 23.3% | 22% |
| 存储 | 13.8% | 3.2% | 8.3% | 16.6% | 18.7% | 12% |
| 加法 | 10.3% | 8.8% | 8.15% | 7.6% | 6.1% | 8% |
| 减法 | 7.0% | 10.6% | 3.5% | 2.9% | 3.6% | 5% |
| 乘法 | 0.1% | 0% | ||||
| 除法 | 0% | |||||
| 比较 | 8.2% | 27.7% | 15.3% | 13.5% | 7.7% | 16% |
| 寄存器间传送 | 7.9% | 0.6% | 5.0% | 4.2% | 7.8% | 4% |
| 加载立即数 | 0.5% | 0.2% | 0.6% | 0.4% | 0% | |
| 条件分支 | 15.5% | 28.6% | 18.9% | 17.4% | 15.4% | 20% |
| 无条件分支 | 1.2% | 0.2% | 0.9% | 2.2% | 2.2% | 1% |
| 调用 | 0.5% | 0.4% | 0.7% | 1.5% | 3.2% | 1% |
| 返回、间接跳转 | 0.5% | 0.4% | 0.7% | 1.5% | 3.2% | 1% |
| 移位 | 3.8% | 2.5% | 1.7% | 1% | ||
| AND | 8.4% | 1.0% | 8.7% | 4.5% | 8.4% | 6% |
| OR | 0.6% | 2.7% | 0.4% | 0.4% | 1% | |
| 其他,XOR、NOT 等 | 0.9% | 2.2% | 0.1% | 1% | ||
| 浮点加载 | 0% | |||||
| 浮点存储 | 0% | |||||
| 浮点加法 | 0% | |||||
| 浮点减法 | 0% | |||||
| 浮点乘法 | 0% | |||||
| 浮点除法 | 0% | |||||
| 浮点比较 | 0% | |||||
| 浮点寄存器间传送 | 0% | |||||
| 其他浮点,绝对值、平方根等 | 0% |
译注: 两张指令混合表均保留原页空格、数值和平均值,不把空格擅自填成零。图 K.44 的
mdljdp2与su2cor两列逐项相同,且部分“平均”不等于所列五项的简单平均;图 K.45 的espresso加法项确为8.15%。
操作数量的比较测量
图 K.46 和 K.47 列出十个程序在 80x86 上执行的指令数,以及相对于 DLX 的执行指令数比值。小于 1.0 意味着 80x86 执行的指令更少。许多整数程序的指令数与 DLX 惊人地接近,因为人们原本会预期,DLX 这样的加载—存储体系结构所执行的指令数应多于 80x86 这样的寄存器—存储器体系结构。
浮点程序在 80x86 上的指令数总是更多,可能因为它没有普通的浮点寄存器模型,而采用栈体系结构。
另一个问题是 80x86 与 DLX 的总数据流量:80x86 可在运算中直接指定存储器操作数,DLX 则只能通过加载和存储访问存储器。图 K.46 和 K.47 也列出这十个程序的数据读、数据写及数据读—修改—写。下部各行给出每类访问相对于 DLX 的总次数比值,其中一次读—修改—写同时计为一次读和一次写。对于浮点程序,80x86 的数据访问次数约为 DLX 的 2–4 倍。
对于整数程序,约为 1.25 倍。最后,图 K.48 给出 80x86 和 DLX 各类别指令的比例。
| 测量项目 | compress | eqntott | espresso | gcc(cc1) | li | 整数平均 |
|---|---|---|---|---|---|---|
| 80x86 执行指令数,百万条 | 2226 | 1203 | 2216 | 3770 | 5020 | |
| 执行指令数/DLX | 0.61 | 1.74 | 0.85 | 0.96 | 0.98 | 1.03 |
| 80x86 数据读,百万次 | 589 | 229 | 622 | 1079 | 1459 | |
| 80x86 数据写,百万次 | 311 | 39 | 191 | 661 | 981 | |
| 80x86 数据读—修改—写,百万次 | 26 | 1 | 129 | 48 | 48 | |
| 80x86 数据读总数,百万次 | 615 | 230 | 751 | 1127 | 1507 | |
| 数据读/DLX | 0.85 | 1.09 | 1.38 | 1.25 | 0.94 | 1.10 |
| 80x86 数据写总数,百万次 | 338 | 40 | 319 | 709 | 1029 | |
| 数据写/DLX | 1.67 | 9.26 | 2.39 | 1.25 | 1.20 | 3.15 |
| 80x86 数据访问总数,百万次 | 953 | 269 | 1070 | 1836 | 2536 | |
| 数据访问/DLX | 1.03 | 1.25 | 1.58 | 1.25 | 1.03 | 1.23 |
| 测量项目 | doduc | ear | hydro2d | mdljdp2 | su2cor | 浮点平均 |
|---|---|---|---|---|---|---|
| 80x86 执行指令数,百万条 | 1223 | 15,220 | 13,342 | 6197 | 6197 | |
| 执行指令数/DLX | 1.19 | 1.19 | 2.53 | 2.09 | 1.62 | 1.73 |
| 80x86 数据读,百万次 | 515 | 6007 | 5501 | 3696 | 3643 | |
| 80x86 数据写,百万次 | 260 | 2205 | 2085 | 892 | 892 | |
| 80x86 数据读—修改—写,百万次 | 1 | 0 | 189 | 124 | 124 | |
| 80x86 数据读总数,百万次 | 517 | 6007 | 5690 | 3820 | 3767 | |
| 数据读/DLX | 2.04 | 2.36 | 4.48 | 4.77 | 3.91 | 3.51 |
| 80x86 数据写总数,百万次 | 261 | 2205 | 2274 | 1015 | 1015 | |
| 数据写/DLX | 3.68 | 33.25 | 38.74 | 16.74 | 9.35 | 20.35 |
| 80x86 数据访问总数,百万次 | 778 | 8212 | 7965 | 4835 | 4782 | |
| 数据访问/DLX | 2.40 | 3.14 | 5.99 | 5.73 | 4.47 | 4.35 |
译注: 原表以百万次显示并取整,部分合计与所列分项相加相差 1–2。正文的“2–4 倍”也是原文概括,与图 K.47 某些超过 4 的比值并不完全吻合。
| 类别 | 整数平均:x86 | 整数平均:DLX | 浮点平均:x86 | 浮点平均:DLX |
|---|---|---|---|---|
| 全部数据传送 | 34% | 36% | 28% | 2% |
| 全部整数算术 | 34% | 31% | 16% | 12% |
| 全部控制 | 24% | 20% | 6% | 10% |
| 全部逻辑 | 8% | 13% | 3% | 2% |
| 全部浮点数据传送 | 0% | 0% | 22% | 33% |
| 全部浮点算术 | 0% | 0% | 25% | 41% |
结束语
美在观者眼中。
——古老谚语
正如前面所见,Intel 的体系结构词典里找不到“正交”这个词。要完全弄清哪些寄存器、哪些寻址方式可用,必须查看所有寻址方式的编码,有时甚至还得查看指令编码。
有人认为,80x86 指令集的不优雅不可避免,是任何体系结构大获成功都必须付出的代价。我们不赞同这种看法。显然,任何成功的体系结构都无法抛弃以前实现中增加的特性;随着时间推移,有些特性也可能显得不再理想。但 80x86 的别扭从核心的 8086 指令集就已开始,8087、80286、80386 在体系结构上不一致的扩展又加重了它。
IBM 360/370 是一个反例,它比 80x86 古老得多,在大型机市场的统治地位也正如 80x86 在 PC 市场一样。毫无疑问,因为基础更好、扩展更一致,在首次实现 30 多年之后,这套指令集仍比 80x86 更合乎情理。
无论好坏,Intel 比竞争对手那些更优雅的体系结构早数年推出了 16 位微处理器,这一先发优势促使 IBM PC 选择了 8086 作为 CPU。7 它在风格上的不足由数量弥补;从合适的角度看,80x86 也很美。
80x86 的可取之处是,其体系结构组成部分并不太难实现。自 1978 年起,Intel 迅速提高整数程序性能,已经证明了这一点。对这种体系结构而言,实现很高的浮点性能是更大的挑战。
原文在这里写 Pentium 于 1992 年。 ↩︎
原文引用“第 A-4 页图 A.31”,图号与页码不相符;译文指向附录 A 的栈机器示例,并保留原始引用疑点。 ↩︎
原文在这里写“递增栈顶指针”(incrementing the top of stack pointer);译文用“调整”描述加载的栈行为,避免将抽象栈位置与物理寄存器索引的增减方向混同。此处原文没有说明物理寄存器的编号方向。 ↩︎
这里的 17 字节是原文把各字段最大长度相加所得的说法,不应直接理解为 x86 有效指令的体系结构长度上限。 ↩︎
本小节开头称比较对象为 MIPS,随后正文和图表均称 DLX。 ↩︎
附录 L 未收录。 ↩︎
原文写 IBM PC 选用 8086。它把体系结构家族与具体芯片的关系作了简化,不应据此判定原始 IBM PC 的具体 CPU 型号。 ↩︎
K.4 VAX 体系结构
VAX:产业史上最成功的小型机设计……VAX 很可能是 hacker 最喜爱的机器……
尤以规模庞大、方便汇编程序员使用的指令集著称;但在 RISC 革命之后,这一优势变成了负担。
——Eric Raymond,《The New Hacker’s Dictionary》,1991 年
引言
为加深读者对指令集体系结构的理解,我们选 VAX 作为复杂指令集计算机(CISC)的代表,因为它与 MIPS 截然不同,却仍容易理解。了解这两种差异如此显著的风格后,我们相信读者能够自行学习其他指令集。
设计 VAX 时,流行的思想是让指令集接近编程语言,从而简化编译器。例如,编程语言有循环,指令集就应有循环指令。VAX 体系结构设计者 William Strecker 曾在《VAX-11/780—A Virtual Address Extension to the PDP-11 Family》(AFIPS,National Computer Conference 会议录,1978 年)中说:
VAX-11 指令集的一个主要目标,是让编译器生成有效率的代码。四项决定帮助实现了这一目标:1)以非常规整、一致的方式处理运算符……2)避免加入编译器不大可能生成的指令……3)为常用运算符提供多种形式……4)用单条指令替代常见指令序列……例如过程调用、多路分支、循环控制和数组下标计算。
要记住,20 世纪 70 年代中期的 DRAM 容量不足本书所说“今天”DRAM 的千分之一,因此代码占用空间也至关重要。另一项流行思想便是尽量减小代码大小,而像 MIPS 这样的定长指令集并不强调这一点。例如,即使地址很小,MIPS 的地址字段也总是占 16 位;VAX 指令的字节数则可以变化,因此地址字段几乎不会浪费空间。
专门介绍 VAX 的书已有整部著作,本附录的这部分内容不可能穷尽一切。因此,下面只描述其中一些寻址方式和指令。为了展示 VAX 指令的实际使用,后面还给出两个 C 过程的 VAX 汇编代码。总体上,我们会将这些指令与读者已经熟悉的 MIPS 代码对照。
VAX 和 MIPS 的不同目标,导致了差别很大的体系结构。VAX 追求简单的编译器和高代码密度,因此采用强大的寻址方式、强大的指令和紧凑高效的指令编码。MIPS 的目标是通过流水线获得高性能、易于硬件实现,并与高度优化的编译器相配合。
这些目标促使 MIPS 采用简单指令、简单寻址方式、定长指令格式和较多寄存器。
VAX 操作数与寻址方式
VAX 是 32 位体系结构,地址和寄存器均为 32 位。但它还支持图 K.49 所示的许多其他数据长度与类型。遗憾的是,VAX 用“word”指 16 位量;而本书通常用“字”指 32 位量。图 K.49 给出 MIPS 与 VAX 数据类型名称的对应。阅读 VAX 指令时必须小心,因为指令采用的是 VAX 自己的数据类型名称。
| 位数 | 数据类型 | MIPS 名称 | VAX 名称 |
|---|---|---|---|
| 8 | 整数 | Byte,字节 | Byte,字节 |
| 16 | 整数 | Half word,半字 | Word,字 |
| 32 | 整数 | Word,字 | Long word,长字 |
| 32 | 浮点 | Single precision,单精度 | F_floating |
| 64 | 整数 | Double word,双字 | Quad word,四字 |
| 64 | 浮点 | Double precision,双精度 | D_floating 或 G_floating |
| 字符串 | Character,字符 | Character,字符 |
VAX 提供 16 个 32 位寄存器。VAX 汇编器用 r0、r1、……、r15 表示,我们也采用这种记法。不幸的是,其中四个实际上已经被指令集体系结构指定了用途。例如,r14 是栈指针 sp,r15 是程序计数器 pc。因此,r15 不能作通用寄存器,而使用 r14 也很困难,因为它会干扰操作栈的指令。另外两个专用寄存器是作为参数指针 ap 的 r12 和作为帧指针 fp 的 r13,后面会说明其用途。与 MIPS 一样,VAX 汇编器既接受寄存器编号,也接受寄存器名称。
VAX 的寻址方式包括附录 A 讨论的全部 MIPS 寻址方式:寄存器、位移量、立即数和 PC 相对寻址。而且,这些方式都既可用于跳转地址,也可用于数据地址。
但寻址方式还不止这些。为减小代码大小,VAX 的位移量寻址支持 8 位、16 位、32 位三种地址长度,分别称为字节位移量、字位移量和长字位移量寻址。因此,地址可以尽可能短,也能按需要足够长。大地址不必拆分,因而不需要 MIPS lui 那样的等价指令,见第 A-37 页图 A.24。1
这仍未囊括全部 VAX 寻址方式。几种方式还有 deferred 选项,意味着所寻址的对象只是实际对象的地址,必须再访问一次存储器才能取得操作数。其他机器通常称其为间接寻址。因此,还可以选择寄存器间接、自动递增间接,以及字节/字/长字位移量间接寻址。例如,按 VAX 汇编器记法,r1 表示操作数是寄存器 1,(r1) 表示操作数是 r1 所指的存储器单元。
还有一种变址寻址,它自动把变址操作数的值转换为相应的字节地址增量,再与地址的其余部分相加。对于一个 32 位字,在把下标加到基址前,需要先乘以 4。某些计算机把变址寻址称为比例寻址,它在地址计算过程中自动将 4 字节数据的下标乘以 4。
为处理如此丰富的寻址选择,VAX 把寻址方式的说明与操作本身的说明分离。操作码规定操作和操作数个数,每个操作数另有自己的寻址方式说明符。图 K.50 列出其名称、汇编语法、示例、含义与长度。
| 寻址方式 | 语法 | 示例 | 含义 | 地址说明符长度,字节 |
|---|---|---|---|---|
| 字面量 Literal | #value | #−1 | −1 | 1,原表称 6 位有符号值 |
| 立即数 | #value | #100 | 100 | 1 + 立即数长度 |
| 寄存器 | rn | r3 | r3 | 1 |
| 寄存器间接 | (rn) | (r3) | Memory[r3] | 1 |
| 字节/字/长字位移量 | displacement(rn) | 100(r3) | Memory[r3+100] | 1 + 位移量长度 |
| 字节/字/长字位移量间接 | @displacement(rn) | @100(r3) | Memory[Memory[r3+100]] | 1 + 位移量长度 |
| 变址,比例寻址 | base mode[rx] | (r3)[r4] | Memory[r3+r4×d],d 为数据字节数 | 1 + 基础寻址方式长度 |
| 自动递增 | (rn)+ | (r3)+ | Memory[r3]; r3=r3+d | 1 |
| 自动递减 | −(rn) | −(r3) | r3=r3−d; Memory[r3] | 1 |
| 自动递增间接 | @(rn)+ | @(r3)+ | Memory[Memory[r3]]; r3=r3+d | 1 |
译注: 原图把 Literal 标成“6 位有符号值”,并以
#−1为例;自动递增间接一行又用数据长度d表示地址寄存器的步长。这两处不应直接当作完整的 VAX 编码规则。
这种寻址风格意味着,操作本身不必知道操作数来自哪里:一条 VAX 加法指令的三个操作数可以全在寄存器、全在存储器,也可以任意混合。
例题
下面这条指令有多长?
addl3 表示有三个操作数的 32 位加法指令。假设 VAX 操作码长度为 1 字节。
解答
第一个操作数说明符 r1 指定寄存器寻址,占 1 字节。第二个 737(r2) 指定位移量寻址,分两部分:首字节指明字位移量寻址方式和基址寄存器 r2,随后是 2 字节位移量 737。第三个 (r3)[r4] 也有两部分:一个字节指定寄存器间接寻址 (r3),另一个字节指定变址寄存器及变址寻址 [r4]。因此总长度为
本示例把 VAX 的目的操作数放左边,源操作数放右边,与本书展示 MIPS 代码的方式相同。VAX 汇编器实际要求相反顺序;为减少混淆,本书在两种机器的示例中都将目的放在左侧。显然,左右安排是人为约定,唯一要求是保持一致。
补充说明
由于 PC 是 VAX 寻址方式可选择的 16 个寄存器之一,22 种寻址方式中的四种实际上由其他方式合成。分别选择 PC 作为寄存器时:立即数寻址实质是自动递增,PC 相对寻址实质是位移量寻址,绝对寻址实质是自动递增间接,相对间接寻址则是位移量间接。
VAX 指令编码
操作与寻址方式相互独立,因此 VAX 的指令编码与 MIPS 很不相同。
VAX 指令以一个字节的操作码开头,包含操作及操作数个数。操作数跟在操作码之后。每个操作数都以一个字节的地址说明符开头,说明其寻址方式。对于寄存器寻址这样的简单方式,这一个字节同时指定方式与寄存器号,见图 K.50 最右列。其他情况下,首字节之后还可能有多个字节,给出余下的地址信息。
以先前例题中的加法指令为例,看看它的编码:
假设指令从地址 201 开始。图 K.51 展示其编码。注意,操作数在存储器中的顺序与上面的汇编表示相反。执行 VAX 指令首先要取得源操作数,因此先存放源操作数很合理。对于 MIPS 这样的定长指令,顺序并不重要,因为在一个 32 位字中很容易找到源和目的操作数。
地址 201 的第一个字节是操作码。地址 202 的下一个字节是使用 r4 的变址方式说明符。与许多其他说明符一样,高 4 位给出方式,低 4 位给出该方式所用寄存器。由于 addl3 操作 4 字节数据,r4 将乘以 4,再加到随后指定的地址上;本例后续是使用 r3 的寄存器间接寻址。因此,202、203 两个字节共同定义汇编表示中的第三个操作数。
地址 204 的下一字节说明使用 r2 作基址的字位移量寻址。该说明符告诉 VAX,随后地址 205、206 的两个字节包含需要加到 r2 上的 16 位地址量。
最后一个字节给出目的操作数,选择使用 r1 的寄存器寻址。
| 字节地址 | 每个字节的内容 | 机器码,十六进制 |
|---|---|---|
| 201 | addl3 操作码 | c1 |
| 202 | [r4] 的变址方式说明符 | 44 |
| 203 | (r3) 的寄存器间接方式说明符 | 63 |
| 204 | 以 r2 为基址的字位移量说明符 | c2 |
| 205 | 16 位常数 737 的低字节 | e1 |
| 206 | 16 位常数 737 的高字节 | 02 |
| 207 | r1 的寄存器方式说明符 | 51 |
寻址方式如此多变,意味着同一种 VAX 操作可以具有许多长度;例如,整数加法可以是 3–19 字节。VAX 实现必须先译码第一个操作数,才能找到第二个,因此实现者很容易选择用一个时钟周期译码一个操作数。这样,即使采用简单地址,这种复杂的指令集也可能导致更高的每条指令时钟周期数。
VAX 操作
与其设计思想一致,VAX 不仅寻址方式很多,操作也很多。下面简要介绍一些,以展示这台机器的特点。
由于寻址方式很强,VAX 传送指令能够完成其他机器上的多种操作。它可在任意两个可寻址位置之间传送数据,因此加载、存储、寄存器间传送、存储器间传送都是其特例。把图 K.49 中类型的首字母 b、w、l、f、q、d、g、c 接在 mov 后面,就决定数据长度。有一种特殊的传送称为“传送地址”,传送操作数的 32 位地址,而不是数据,其名称为 mova。
MIPS 的算术操作在 VAX 中也有,但有两大差异。第一,数据类型直接附在名称后面。因而 addb、addw、addl 分别操作存储器或寄存器中的 8 位、16 位、32 位数据;MIPS 只有一种操作完整 32 位寄存器的 add。第二,为减小代码大小,加法指令会指明不同操作数的个数;MIPS 则始终指定三个,即使有一个是重复的。例如 MIPS 指令
和其他 MIPS 指令一样占 32 位;而 VAX 指令
将 r1 同时用作源与目的,只占 24 位:操作码 8 位,两个寄存器说明符各 8 位。
操作数量
现在可以说明 VAX 指令名的构成:
add 适用于 byte、word、long、float、double 数据类型,且各有两个或三个不同操作数的版本,因此 VAX 提供以下全部指令:
如果计入全部寻址方式,但不区分寄存器号和立即数数值,并仅考虑 byte、word、long 三种整数类型,VAX 的整数加法就有 30,000 多种版本;MIPS 只有四种!
VAX 指令数量大的另一个原因,是它提供了可以替代指令序列、或用更少字节表示单个操作的指令。下面给出四例,* 表示数据类型。
| VAX 操作 | 示例 | 含义 |
|---|---|---|
clr* | clrl r3 | r3=0 |
inc* | incl r3 | r3=r3+1 |
dec* | decl r3 | r3=r3−1 |
push* | pushl r3 | sp=sp−4; Memory[sp]=r3 |
最后一行的入栈指令,与对栈指针使用自动递减寻址的传送指令完全相同:
pushl 的优点是简短:由于 sp 隐含指定,它少占 1 字节。
分支、跳转和过程调用
VAX 分支指令与算术指令相关,因为分支依赖条件码。条件码是操作的副作用,表示结果为正、负、零,或是否溢出。大多数指令根据结果设置条件码;分支之类没有结果的指令则不设置。VAX 的条件码是 N(负)、Z(零)、V(溢出)和 C(进位)。另有比较指令 cmp*,专门为后续分支设置条件码。
VAX 分支指令覆盖所有条件。常用者有 beql(=)、bneq(≠)、blss(<)、bleq(≤)、bgtr(>)、bgeq(≥),功能与名称相符。无条件分支则根据 PC 相对偏移量长度命名:brb(branch byte)使用 8 位位移量,brw(branch word)使用 16 位位移量。
这里讨论的最后一大类是过程调用与返回。与 MIPS 不同,这些复杂指令可能需要数十个时钟周期。后面两个小节会展示其工作方式,但先要解释 calls、ret 操作的几个栈相关指针。栈指针 sp 与 MIPS 一样,指向栈顶;参数指针 ap 指向存储器中传给过程的实参或参数列表的起点;帧指针 fp 指向存储器中该过程局部变量区域,即栈帧的基部。VAX 调用和返回指令操作这些指针,使栈在跨过程调用时保持正确状态。
它们也为访问存储器操作数提供方便的基址寄存器。如后面将看到的,调用和返回还保存与恢复通用寄存器和程序计数器。图 K.52 再列出一些 VAX 指令。
| 指令类别 | 示例 | 含义 |
|---|---|---|
数据传送:字节、半字、字、双字;* 为类型 | mov* | 在两个操作数之间传送 |
| 数据传送 | movzb* | 字节零扩展为半字或字后传送 |
| 数据传送 | mova* | 传送操作数的 32 位地址,末尾表示数据类型 |
| 数据传送 | push* | 将操作数压栈 |
| 算术/逻辑:整数或逻辑字节、16 位半字、32 位字 | add*_ | 两操作数或三操作数加法 |
| 算术/逻辑 | cmp* | 比较并设置条件码 |
| 算术/逻辑 | tst* | 与零比较并设置条件码 |
| 算术/逻辑 | ash* | 算术移位 |
| 算术/逻辑 | clr* | 清零 |
| 算术/逻辑 | cvtb* | 将字节符号扩展到指定数据类型的长度 |
| 控制:条件与无条件分支 | beql, bneq | 相等时分支、不等时分支 |
| 控制 | bleq, bgeq | 小于等于时分支、大于等于时分支 |
| 控制 | brb, brw | 采用 8 位或 16 位地址量的无条件分支 |
| 控制 | jmp | 可用任意寻址方式指定目标的跳转 |
| 控制 | aobleq | 操作数加一;若结果 ≤ 第二操作数,则分支 |
| 控制 | case_ | 根据 case 选择值跳转 |
| 过程:调用/返回 | calls | 参数位于栈上的过程调用,见下文“更长的例子:sort” |
| 过程 | callg | 使用 FORTRAN 风格参数列表的过程调用 |
| 过程 | jsb | 跳至子程序并保存返回地址,类似 MIPS jal |
| 过程 | ret | 从过程调用返回 |
| 浮点:D、F、G、H 格式 | addd_ | D 格式双精度浮点加法 |
| 浮点 | subd_ | D 格式双精度浮点减法 |
| 浮点 | mulf_ | F 格式单精度浮点乘法 |
| 浮点 | polyf | 使用 F 格式系数表计算多项式 |
| 其他:特殊操作 | crc | 计算循环冗余校验 |
| 其他 | insque | 将队列项插入队列 |
融会贯通的例子:swap
为展示 VAX 汇编编程,我们翻译两个 C 过程 swap 和 sort。图 K.53 重列 swap 的 C 代码;下一小节讨论 sort。
我们按汇编编程的三个一般步骤描述 swap:
- 为程序变量分配寄存器。
- 生成过程主体代码。
- 在过程调用前后保持寄存器内容。
这些过程的 VAX 代码以 VMS C 编译器开启优化后生成的代码为基础。
| C 代码 |
|---|
swap(int v[], int k){int temp;temp = v[k];v[k] = v[k + 1];v[k + 1] = temp;} |
为 swap 分配寄存器
与 MIPS 不同,VAX 参数通常分配在存储器中,因此这一步更恰当地说应是“变量分配”。VAX 标准参数传递约定使用栈。两个参数 v[] 和 k 可通过参数指针 ap 访问:4(ap) 对应 v[],8(ap) 对应 k。要记住,按字节寻址时,相邻 4 字节字的地址相差 4。另一个变量只有 temp,把它分配给 r3。
swap 过程主体代码
swap 剩下的 C 代码为:
因为程序多次使用 v[] 和 k,为提高运行速度,VAX 编译器先把两个参数都移入寄存器:
这里遵循 VAX 用分号开始注释的约定。MIPS 的注释符号 #,在 VAX 汇编中表示常数操作数。
VAX 有变址寻址,可以直接使用下标 k,不必先换算成字节地址。因此代码很直接:
MIPS 的关键代码基本上是两次加载加两次存储;VAX 则是一次存储器到寄存器传送、一次存储器到存储器传送和一次寄存器到存储器传送。addl3 还体现了 VAX 寻址方式的灵活性:它把常数 1 加到存储器操作数上,再把结果放入寄存器。
至此,已经分配好存储位置,并写出执行过程操作的代码。剩下的只是跨越 swap 调用保持寄存器内容的代码。
在 swap 调用前后保持寄存器
VAX 提供一对保存、恢复寄存器的指令 calls 和 ret。本例展示它们的工作方式。
VAX C 编译器采用一种由被调用者决定保存内容的约定。检查上面代码可知,r0、r1、r2、r3 的值必须保存,才能稍后恢复。calls 预期在过程起始处看到一个 16 位掩码,用来决定保存哪些寄存器:若第 位为 1,就把寄存器 压栈。此外,calls 还把这个掩码压栈,使返回指令 ret 能恢复正确的寄存器。因此,保存动作由调用者执行的 calls 完成,而被调用者通过调用掩码决定保存哪些内容。
calls 的一个操作数给出传递的参数个数,以便调整栈相关的参数指针 ap、帧指针 fp 和栈指针 sp。当然,它还保存程序计数器,使过程能够返回。
因此,为 swap 保存这四个寄存器,只需在过程开始处增加掩码,让调用者的 calls 完成全部工作:
这条汇编伪指令要求汇编器放入一个 16 位常数,将适当的位设为 1,以保存 r0 到 r3。
返回指令撤销 calls 所做的工作。结束时,ret 根据当前帧指针设置栈指针,从而弹出 calls 压入的所有内容。在此过程中,它恢复 calls 保存的寄存器,包括掩码指定的寄存器以及旧的 fp、ap、pc。
为完成 swap,只需再加一条指令:
完整的 swap 过程
现在可以组合整个过程。图 K.54 标出每一段代码的用途,左列为 MIPS,右列为 VAX。
| 代码部分 | MIPS | VAX |
|---|---|---|
| 保存寄存器 | swap: addi $29,$29,-12sw $2,0($29)sw $15,4($29)sw $16,8($29) | swap: .word ^m<r0,r1,r2,r3> |
| 过程主体 | muli $2,$5,4add $2,$4,$2lw $15,0($2)lw $16,4($2)sw $16,0($2)sw $15,4($2) | movl r2,4(a)movl r1,8(a)movl r3,(r2)[r1]addl3 r0,#1,8(ap)movl (r2)[r1],(r2)[r0]movl (r2)[r0],r3 |
| 恢复寄存器 | lw $2,0($29)lw $15,4($29)lw $16,8($29)addi $29,$29,12 | |
| 过程返回 | jr $31 | ret |
译注: 原图前两条 VAX 传送写为
4(a)、8(a),而前文写为4(ap)、8(ap);图中保留原样,按上下文实际指参数指针ap。图内 MIPS 部分按可见指令计为 15 行,下一段原文却称 17 行;这里不擅自补两条指令。
这个例子展示了 VAX 比例变址寻址与复杂调用、返回指令在减少代码行数方面的优势。原文称,17 行 MIPS 汇编代码变成了 8 行 VAX 汇编代码。它也说明,在存储器中传递参数会增加存储器访问。
要记住,执行指令数不等于性能;后面的相关谬误会说明这一点。
VAX 软件约定把 r0、r1 视为不跨过程调用保存的临时寄存器;但原文接着说,VMS C 编译器“确实把”这两个寄存器纳入保存掩码。2 此外,编译器本应在 addl3 中使用 r1,而不是 8(ap)。这样的例子总会激起计算机体系结构设计者自己编写编译器的冲动!
更长的例子:sort
下面介绍较长的 sort 过程。图 K.55 是它的 C 版本。仍分几步讨论,最后与 MIPS 代码并排比较。
| C 代码 |
|---|
sort(int v[], int n){int i, j;for (i = 0; i < n; i = i + 1) {for (j = i - 1; j >= 0 && v[j] > v[j + 1]; j = j - 1) {swap(v,j);}}} |
译注: 保留原程序与“冒泡排序”这一原图称谓;从逐个插入并向前交换的循环结构看,它也容易被归为通过相邻交换实现的插入式排序。这里不改写算法以迁就名称。图 K.53、K.55 保留原书未显式声明返回类型的历史 C 写法。
为 sort 分配寄存器
参数 v、n 分别位于栈中的 4(ap)、8(ap)。两个局部变量分配给寄存器:i 用 r6,j 用 r4。由于代码频繁引用两个参数,VMS C 编译器在进入过程时把参数的地址复制到寄存器:
把操作数的值而非地址放入寄存器,似乎更有用;但这里我们仍服从 VMS C 编译器的决定。
显然,编译器不能确信 v 和 n 在存储器中不会重叠。
sort 过程主体代码
主体由两个嵌套 for 循环和一次带参数的 swap 调用组成。下面从外到内展开。
外层循环
首先翻译第一个 for:
C 的 for 语句有初始化、循环测试和迭代递增三部分。第一部分把 i 初始化为零,只需一条指令:
最后一部分给 i 加一,也只需一条:
若 i < n 为假就应退出,换言之,i >= n 时退出。测试需要两条指令:
cmpl 设置条件码,供条件分支 bgeq 使用。循环末尾只需跳回测试处:
因此,第一个 for 的框架是:
内层循环
第二个 for 为:
初始化同样只需一条指令:
j 减一也只需一条:
循环测试有两部分。只要任一条件不成立就退出,因此第一项失败,即 j < 0 时,必须直接离开循环:
注意,这里没有显式比较。这是条件码的一项好处:前一条指令的副作用已经设置条件。这个分支会跳过第二项条件测试。
若 v[j] > v[j+1] 为假,即 v[j] <= v[j+1],第二项测试也退出。先加载 v,并把 j+1 放入寄存器:
第一条指令用寄存器间接寻址取得 r5 指向的操作数。
变址寻址再次使我们能直接使用下标,无需换算成字节地址,所以测试 v[j] <= v[j+1] 的两条指令为:
循环末尾跳回完整测试的起点:
组合后,第二个 for 为:
译注:
bleq的比较条件为v[j] ≤ v[j+1]。
注意,循环顶部的 blss 测试的是根据 r4,即 j 的新值设置的条件码。这些条件码可能由进入循环之前的 subl3 设置,也可能由循环末尾的 decl 设置。
过程调用
下一步是内层 for 的主体:
调用 swap 很简单:
常数 2 表示压入栈中的参数个数。
传递参数
C 编译器通过栈传递变量,因此用下面两条指令向 swap 传参:
第一条使用寄存器间接寻址取得操作数。
译注: 这两条
pushl的先后顺序,与前面把4(ap)、8(ap)分别解释为v、k的参数布局存在顺序上的不一致。
在 sort 调用前后保持寄存器
剩下的代码是按被调用者保存约定保存、恢复寄存器。该过程使用 r2 到 r7,因此增加对应位置为 1 的掩码:
由于 ret 会撤销全部相关操作,只需把它接到过程末尾。
完整的 sort 过程
图 K.56 将全部部分组合起来。为便于阅读,仍按用途划分代码块,并将 MIPS 与 VAX 并列。这个例子中,11 行 C 语言 sort 变成 44 行 MIPS 汇编和 20 行 VAX 汇编。VAX 最大的优势是寄存器保存、恢复以及变址寻址。
| 代码部分 | MIPS | VAX |
|---|---|---|
| 保存寄存器 | sort: addi $29,$29,-36sw $15,0($29)sw $16,4($29)sw $17,8($29)sw $18,12($29)sw $19,16($29)sw $20,20($29)sw $24,24($29)sw $25,28($29)sw $31,32($29) | sort: .word ^m<r2,r3,r4,r5,r6,r7> |
| 主体:移动参数 | move $18,$4move $20,$5 | moval r7,8(ap)moval r5,4(ap) |
| 外层循环 | add $19,$0,$0for1tst: slt $8,$19,$20beq $8,$0,exit1 | clrl r6for1tst: cmpl r6,(r7)bgeq exit1 |
| 内层循环 | addi $17,$19,-1for2tst: slti $8,$17,0bne $8,$0,exit2muli $15,$17,4add $16,$18,$15lw $24,0($16)lw $25,4($16)slt $8,$25,$24beq $8,$0,exit2 | subl3 r4,r6,#1for2tst: blss exit2movl r3,(r5)addl3 r2,r4,#1cmpl (r3)[r4],(r3)[r2]bleq exit2 |
| 传参和调用 | move $4,$18move $5,$17jal swap | pushl (r5)pushl r4calls #2,swap |
| 内层循环末尾 | addi $17,$17,-1j for2tst | decl r4brb for2tst |
| 外层循环末尾 | exit2: addi $19,$19,1j for1tst | exit2: incl r6brb for1tst |
| 恢复寄存器 | exit1: lw $15,0($29)lw $16,4($29)lw $17,8($29)lw $18,12($29)lw $19,16($29)lw $20,20($29)lw $24,24($29)lw $25,28($29)lw $31,32($29)addi $29,$29,36 | |
| 过程返回 | jr $31 | exit1: ret |
谬误与陷阱
简化的能力,就是去除不必要之物,让必要之物得以表达。
——Hans Hoffman,《Search for the Real》,1967 年
谬误:可以设计出毫无缺陷的体系结构
所有体系结构设计都涉及在特定硬件与软件技术背景下作出取舍。这些技术很可能随时间改变,曾经正确的决定,后来也可能显得像错误。例如,1975 年的 VAX 设计者过分强调代码大小效率,却低估了十年后易于译码和流水线化的重要性。而且,几乎所有体系结构最终都会遭遇地址空间不足。不过,若要长期避免这些问题,往往就得牺牲体系结构的短期效率。
谬误:有缺陷的体系结构不可能成功
文献经常批评 IBM 360:分支不是 PC 相对的,位移量寻址的地址字段也太小。然而,这台机器取得了巨大成功,因为它正确解决了几个新问题。第一,它有很大的地址空间;第二,按字节寻址且善于处理字节;第三,它是一台通用寄存器机器;最后,它足够简单,能在很广的性能与成本范围内高效实现。
Intel 8086 是更鲜明的例子。按本段写作时的范围,8086 是仍广泛存在的体系结构中唯一不真正属于通用寄存器机器的一种。此外,分段地址空间给程序员和编译器编写者都造成了重大问题。尽管如此,由于被 IBM PC 选用,8086 体系结构获得了巨大成功。
谬误:执行指令更少的体系结构更快
VAX 设计者对 VAX 与 MIPS 作了量化比较,选用组织结构相近的 VAX 8700 和 MIPS M2000。图 K.57 展示执行指令数之比,以及按时钟周期衡量的性能之比。MIPS 执行的指令约为 VAX 的两倍,但 MIPS M2000 的性能却接近 VAX 8700 的三倍。
纵轴为 MIPS/VAX 比值,图例 Instructions executed 为执行指令数,Performance 为性能。横轴列出 spice、matrix、nasa7、fpppp、tomcatv、doduc、espresso、eqntott、li。原图横轴标题却误写为“位移量的位数(Number of bits of displacement)”,这里保留图像并指出其与所列程序名称不相符。
结束语
PDP-11 体系结构的虚拟地址扩展(Virtual Address eXtension)……提供约 4.3 GB 的虚拟地址空间;即使考虑存储器技术的迅速进步,这也应足以满足相当遥远的未来。
——William Strecker,《VAX-11/780—A Virtual Address Extension to the PDP-11 Family》,AFIPS,National Computer Conference 会议录,1978 年
我们已经看到,指令集既可在访问操作数的方式上差异巨大,也可在一条指令能够完成的操作上差异巨大。图 K.58 比较两个程序在这两种体系结构上的指令使用情况;即使体系结构很不相同,各类指令的使用行为也可能相似。
VAX 是其时代的产物,它强调代码密度、复杂操作与复杂寻址方式;这与本书这里强调的易于译码、简单操作、简单寻址方式和流水线性能相冲突。
VAX 累计售出超过 600,000 台,经历了非常成功的发展历程。1991 年,DEC 开始从 VAX 转向 Alpha。
| 程序 | 机器 | 分支 | 算术/逻辑 | 数据传送 | 浮点 | 合计 |
|---|---|---|---|---|---|---|
| gcc | VAX | 30% | 40% | 19% | 89% | |
| gcc | MIPS | 24% | 35% | 27% | 86% | |
| spice | VAX | 18% | 23% | 15% | 23% | 79% |
| spice | MIPS | 4% | 29% | 35% | 15% | 83% |
正交性是 VAX 体系结构的关键:操作码独立于寻址方式,寻址方式又独立于数据类型,甚至独立于不同操作数的个数。因此,一旦计入数据类型、操作数个数和寻址方式,几百种操作就扩展为数十万种指令。
习题(K.4)
习题 K.1
[3] <K.4> 下面的 VAX 指令把寄存器 r5 指向的存储器单元减一:
哪一条 MIPS 指令能完成相同操作?如果单条指令无法实现,请给出最短的 MIPS 指令序列。两种机器上相应指令的长度分别是多少?
习题 K.2
[5] <K.4> 要求与习题 K.1 相同,但改用以下 VAX 指令;它采用自动递增间接寻址,把一个存储器单元清零:
习题 K.3
[5] <K.4> 要求与习题 K.1 相同,但改用以下 VAX 指令;它给 r5 加一并将结果写回 r5,再与 r6 比较,若 r5 < r6 则分支到 L1:
其操作为 r5 = r5 + 1; if (r5 < r6) goto L1。原题用 # 引出这一说明;为避免与 VAX 的立即数符号混淆,这里将说明独立列出。
习题 K.4
[5] <K.4> 给出实现以下 C 语句的单条 VAX 指令,若不能用一条实现,则给出最短指令序列:
假设 a 对应寄存器 r3,b 对应 r4。
习题 K.5
[10] <K.4> 给出实现以下 C 语句的单条 VAX 指令,若不能用一条实现,则给出最短指令序列:
假设 c 对应寄存器 r3,i 对应 r4,x 是一个 32 位字数组,起始存储器地址为十进制 4,000,000。
K.5 面向大型机的 IBM 360/370 体系结构
引言
“计算机体系结构”一词由 IBM 于 1964 年为 IBM 360 创造。Amdahl、Blaauw 和 Brooks [1964] 用它指代程序员可见的指令集部分。他们认为,属于同一体系结构的计算机系列应能运行同样的软件。这在今天看似理所当然,当时却相当新颖。即使 IBM 已是产业领军企业,在 360 之前也拥有五种不同体系结构。因此,一家公司统一采用一种体系结构的想法十分大胆。360 的设计者希望通过定义共同体系结构,把 IBM 的六个不同部门整合起来。他们给出的定义是:
……机器语言程序员为了给一台计算机编写正确、与时序无关的程序而必须理解的计算机结构。
“机器语言程序员”意味着兼容性甚至在汇编语言层面也成立;“与时序无关”则允许不同的实现。
IBM 360 于 1964 年推出,包含六种型号,最高与最低性能之比为 25∶1。Amdahl、Blaauw 和 Brooks [1964] 讨论了 IBM 360 的体系结构,以及允许多个实现保持目标代码兼容的概念。按我们今天理解的含义,指令集体系结构这一观念是 360 最重要的贡献。它还引入了后来广泛采用的若干重要创新:
- 32 位体系结构。
- 采用 8 位字节、按字节寻址的存储器。
- 8、16、32、64 位数据长度。
- 32 位单精度和 64 位双精度浮点数据。
1971 年,IBM 开始交付第一批 System/370,即 155 和 165 型号,包含对 360 的若干重大扩展。Case 和 Padegs [1978] 对此进行了讨论,也回顾了 System/360 的早期历史。最重要的新增内容是虚拟存储器,不过带虚拟存储器的 370 直到 1972 年相应操作系统就绪才交付。到 1978 年,高端 370 的速度已是十年前交付的低端 360 的数百倍。1984 年,IBM 360 原有的 24 位寻址模型必须扩展,于是推出 370-XA(eXtended Architecture,扩展体系结构)。旧的 24 位程序可以不加修改地运行,但扩展到支持 31 位地址的 32 位寻址模型时,有些指令无法继续按原方式工作,因为它们不能生成 31 位地址。转换主要用汇编编写的操作系统,无疑是最大的任务。
关于 IBM 360 及其指令测量,已有多项研究。Shustek 的学位论文 [1978] 是最知名、最完整的 360/370 体系结构研究。他对指令集复杂性提出若干观察,直到数年后才受到充分重视。另一项重要研究是 Alexander 和 Wortman [1975] 的 Toronto 研究,在 IBM 360 上测量了 19 个 XPL 程序。
System/360 指令集
下面按指令类型和格式列出 360 指令集。System/370 另有 15 条用户指令。
整数/逻辑和浮点 R-R 指令
* 表示该指令为浮点指令,可替换为 D,即双精度,或 E,即单精度。
| 指令 | 说明 |
|---|---|
ALR | 寄存器逻辑加法 |
AR | 寄存器加法 |
A*R | 浮点加法 |
CLR | 寄存器逻辑比较 |
CR | 寄存器比较 |
C*R | 浮点比较 |
DR | 寄存器除法 |
D*R | 浮点除法 |
H*R | 浮点数减半 |
LCR | 寄存器取补后加载 |
LC*R | 取补后加载 |
LNR | 寄存器加载负值 |
LN*R | 加载负值 |
LPR | 寄存器加载正值 |
LP*R | 加载正值 |
LR | 加载寄存器 |
L*R | 加载浮点寄存器 |
LTR | 加载并测试寄存器 |
LT*R | 加载并测试浮点寄存器 |
MR | 寄存器乘法 |
M*R | 浮点乘法 |
NR | 寄存器 AND |
OR | 寄存器 OR |
SLR | 寄存器逻辑减法 |
SR | 寄存器减法 |
S*R | 浮点减法 |
XR | 寄存器异或 |
分支与状态设置 R-R 指令
这些 R-R 格式指令执行分支或设置某种系统状态。其中若干是特权指令,只能在管理模式(supervisor mode)下合法执行。
| 指令 | 说明 |
|---|---|
BALR | 分支并链接 |
BCTR | 按计数分支 |
BCR | 条件分支 |
ISK | 插入存储键(key) |
SPM | 设置程序掩码 |
SSK | 设置存储键 |
SVC | 管理程序调用 |
分支/逻辑和浮点指令:RX 格式
以下均为 RX 格式。符号 + 表示字操作,此时不添加字符,或者替换为 H 表示半字操作;例如 A+ 代表 A 和 AH 两个操作码。* 代表 D 或 E,即双精度或单精度浮点。
| 指令 | 说明 |
|---|---|
A+ | 加法 |
A* | 浮点加法 |
AL | 逻辑加法 |
C+ | 比较 |
C* | 浮点比较 |
CL | 逻辑比较 |
D | 除法 |
D* | 浮点除法 |
L+ | 加载 |
L* | 加载浮点寄存器 |
M+ | 乘法 |
M* | 浮点乘法 |
N | AND |
O | OR |
S+ | 减法 |
S* | 浮点减法 |
SL | 逻辑减法 |
ST+ | 存储 |
ST* | 存储浮点寄存器 |
X | 异或 |
分支与特殊加载、存储:RX 格式
| 指令 | 说明 |
|---|---|
BAL | 分支并链接 |
BC | 条件分支 |
BCT | 按计数分支 |
CVB | 转换为二进制 |
CVD | 转换为十进制 |
EX | 执行 |
IC | 插入字符 |
LA | 加载地址 |
STC | 存储字符 |
RS 和 SI 格式指令
以下是 RS 与 SI 格式指令。* 可以是 A,表示算术,或 L,表示逻辑。
| 指令 | 说明 |
|---|---|
BXH | 变址后若高于则分支 |
BXLE | 变址后若低于或等于则分支 |
CLI | 逻辑比较立即数 |
HIO | 停止 I/O |
LPSW | 加载程序状态字 PSW |
LM | 加载多个寄存器 |
MVI | 传送立即数 |
NI | 与立即数作 AND |
OI | 与立即数作 OR |
RDD | 直接读 |
SIO | 启动 I/O |
SL* | 算术/逻辑左移 |
SLD* | 双字算术/逻辑左移 |
SR* | 算术/逻辑右移 |
SRD* | 双字算术/逻辑右移 |
SSM | 设置系统掩码 |
STM | 存储多个寄存器 |
TCH | 测试通道 |
TIO | 测试 I/O |
TM | 按掩码测试 |
TS | 测试并置位 |
WRD | 直接写 |
XI | 与立即数作异或 |
SS 格式指令
这些是十进制或字符串指令。1
| 指令 | 说明 |
|---|---|
AP | 打包十进制加法 |
CLC | 字符逻辑比较 |
CP | 打包十进制比较 |
DP | 打包十进制除法 |
ED | 编辑 |
EDMK | 编辑并标记 |
MP | 打包十进制乘法 |
MVC | 传送字符 |
MVN | 传送数字部分 |
MVO | 带偏移量传送 |
MVZ | 传送区码(zone)部分 |
NC | 字符 AND |
OC | 字符 OR |
PACK | 打包,从字符转换为十进制 |
SP | 打包十进制减法 |
TR | 转换 |
TRT | 转换并测试 |
UNPK | 解包 |
XC | 字符异或 |
ZAP | 清零后作打包十进制加法 |
360 的详细测量
图 K.59 给出四个 IBM 360 程序的指令使用频率。
| 指令/类别 | PLIC | FORTGO | PLIGO | COBOLGO | 平均 |
|---|---|---|---|---|---|
| 控制 | 32% | 13% | 5% | 16% | 16% |
BC, BCR | 28% | 13% | 5% | 14% | 15% |
BAL, BALR | 3% | 2% | 1% | ||
| 算术/逻辑 | 29% | 35% | 29% | 9% | 26% |
A, AR | 3% | 17% | 21% | 10% | |
SR | 3% | 7% | 3% | ||
SLL | 6% | 3% | 2% | ||
LA | 8% | 1% | 1% | 2% | |
CLI | 7% | 2% | |||
NI | 7% | 2% | |||
C | 5% | 4% | 4% | 0% | 3% |
TM | 3% | 1% | 3% | 2% | |
MH | 2% | 1% | |||
| 数据传送 | 17% | 40% | 56% | 20% | 33% |
L, LR | 7% | 23% | 28% | 19% | 19% |
MVI | 2% | 16% | 1% | 5% | |
ST | 3% | 7% | 3% | ||
LD | 7% | 2% | 2% | ||
STD | 7% | 2% | 2% | ||
LPDR | 3% | 1% | |||
LH | 3% | 1% | |||
IC | 2% | 1% | |||
LTR | 1% | 0% | |||
| 浮点 | 7% | 2% | |||
AD | 3% | 1% | |||
MDR | 3% | 1% | |||
| 十进制、字符串 | 4% | 40% | 11% | ||
MVC | 4% | 7% | 3% | ||
AP | 11% | 3% | |||
ZAP | 9% | 2% | |||
CVD | 5% | 1% | |||
MP | 3% | 1% | |||
CLC | 3% | 1% | |||
CP | 2% | 1% | |||
ED | 1% | 0% | |||
| 合计 | 82% | 95% | 90% | 85% | 88% |
原文句子为 “These are add decimal or string instructions”,其中
add与后面的多种十进制操作不协调。译文按该表实际类别表述为“十进制或字符串指令”,并保留这一源书文字疑点。 ↩︎
K.6 历史回顾与参考文献
L.4 节(在线提供)讨论指令集的演化,并列出进一步阅读和探索相关主题的参考文献。
译注: 本节提到的附录 L 未收录。
致谢
感谢以下人士对本概览初稿提出意见:University of Manchester 的 Steven B. Furber 教授,Intel Corporation 的 Dileep Bhandarkar 博士,Silicon Graphics/MIPS 的 Earl Killian 博士,以及 Mitsubishi Electric Corporation 的 Hiokazu Takata 博士。
M 历史回顾与参考文献
如果……历史……能给我们什么启示,那就是:人类对知识与进步的追求坚定不移,任何阻力都无法使其退却。
——John F. Kennedy,莱斯大学演说,1962 年
忘记过去的人,注定重蹈覆辙。
——George Santayana,《理性生活》(The Life of Reason),1905 年,第 2 卷,第 3 章
译注: 本附录汇集不同时期撰写的历史回顾。“今天”“目前”等措辞应结合各段的历史背景理解。
M.1 引言
本附录介绍各章若干关键思想的历史背景。我们会沿着一系列机器追溯某种思想的发展,也会介绍一些重要项目。如果你希望研究某种思想或某台机器的最初发展过程,或者进一步阅读相关资料,可以查阅各节末尾列出的参考文献。
M.2 节从数字计算机的发明讲起,对应第 1 章。M.3 节讨论存储层次结构,对应第 2 章和附录 B。M.4 节讨论指令集体系结构,涵盖附录 A、J 和 K。M.5 节讨论流水线与指令级并行性,对应第 3 章及附录 C、H。M.6 节讨论向量、SIMD 与 GPU 体系结构中的数据级并行性,对应第 4 章。M.7 节讨论多处理器和并行程序设计,涵盖第 5 章及附录 F、G、I。M.8 节讨论集群的发展,涵盖第 6 章。最后,M.9 节讨论 I/O,对应附录 D。
原文编号说明: 本段原文将 I/O 历史回顾标为 M.9;本版实际节次为 M.10。M.9 为领域专用体系结构相关的历史回顾与参考文献。
M.2 计算机的早期发展(第 1 章)
本节回顾数字计算机的早期发展,以及性能度量方法的发展。
第一批通用电子计算机
宾夕法尼亚大学 Moore 学院的 J. Presper Eckert 和 John Mauchly 建造了世界上第一台能够完整运行的通用电子计算机。这台机器称为 ENIAC(Electronic Numerical Integrator and Calculator,电子数字积分计算机),由美国陆军资助,在第二次世界大战期间投入运行,但直到 1946 年才对外公布。ENIAC 用来计算火炮射表。它体积庞大:长 100 英尺、高 8½ 英尺、宽数英尺;20 个十位十进制数字寄存器,每个长 2 英尺。整机共有 18,000 只真空管。
它的体积比原文撰写时制造的普通计算机大三个数量级,速度却慢五个数量级以上,一次加法需要 200 微秒。ENIAC 支持条件跳转,而且可以编程,这使它与此前的计算器有了明确区别。编程需要手工连接电缆、设置开关,耗时从半小时到一整天不等。数据通过穿孔卡输入。ENIAC 的主要限制在于存储容量很小、编程又十分繁琐。
1944 年,John von Neumann 被吸引到 ENIAC 项目中。项目组希望改进程序输入方式,讨论了将程序作为数字存储的想法。von Neumann 帮助这些想法逐渐成形,并写了一份备忘录,提出一种称为 EDVAC(Electronic Discrete Variable Automatic Computer,电子离散变量自动计算机)的存储程序计算机。Herman Goldstine 将备忘录散发出去,并署上 von Neumann 的名字;Eckert 和 Mauchly 的名字却被遗漏了,这令两人十分不满。常用的“von Neumann 计算机”一词正是源于这份备忘录。一些早期计算机发明者认为,这一称呼给了归纳并写出这些思想的 von Neumann 过多荣誉,却低估了实际研制机器的工程师 Eckert 和 Mauchly。与大多数历史学家一样,本书作者——2000 年 IEEE von Neumann 奖章的获得者——认为,这三个人都在存储程序计算机的发展中发挥了关键作用。von Neumann 将这些思想写成文字、加以概括,并思考程序设计方面的问题,对将思想传播给更多人至关重要。
1946 年,剑桥大学的 Maurice Wilkes 访问 Moore 学院,参加了有关电子计算机进展的系列讲座的后半部分。回到剑桥后,Wilkes 决定启动一个项目,建造名为 EDSAC(Electronic Delay Storage Automatic Calculator,电子延迟存储自动计算机)的存储程序计算机。EDSAC 使用汞延迟线作为存储器,名称中的“延迟存储”由此而来。EDSAC 于 1949 年投入运行,是世界上第一台完整规模、能够实际运行的存储程序计算机[Wilkes、Wheeler 和 Gill,1951;Wilkes,1985、1995]。(曼彻斯特大学建造的小型原型机 Mark I 于 1948 年运行,也可以称为第一台能够运行的存储程序机器。)EDSAC 采用基于累加器的体系结构;这种指令集体系结构一直流行到 20 世纪 70 年代初。附录 A 开头简要介绍了 EDSAC 的指令集。
1947 年,Mauchly 还抽出时间参与创办了美国计算机协会(Association for Computing Machinery,ACM),并担任首任副主席和第二任主席。同年,Eckert 和 Mauchly 申请了电子计算机专利。Moore 学院院长要求将专利转交给大学,这可能促使两人下定决心离开。他们的离去使 EDVAC 项目受到重创,直到 1952 年才投入运行。
1946 年,Goldstine 离开 Moore 学院,加入位于普林斯顿的高等研究院,与 von Neumann 共事。他们和 Arthur Burks 根据 1944 年的备忘录发表了一份报告[Burks、Goldstine 和 von Neumann,1946]。这篇论文促成了 Julian Bigelow 在普林斯顿高等研究院建造的 IAS 机器。它共有 1024 个 40 位字,速度约为 ENIAC 的 10 倍。该小组思考了机器的用途,发表了一系列报告,并鼓励外界来访。这些报告和访问活动启发了许多新计算机的研制,其中包括 IBM 的第一台计算机 701,它以 IAS 机器为基础。以当时的条件来看,Burks、Goldstine 和 von Neumann 的论文令人惊叹。今天读来,你很难猜到这篇里程碑式的论文写于 50 多年前,因为现代计算机中的大多数体系结构概念都已在其中得到讨论,例如第 2 章开头的引文。
在 ENIAC 研制的同时,Harvard 的 Howard Aiken 正在设计一种名为 Mark-I 的机电式计算机。Mark-I 由一组 IBM 工程师建造。此后,他又研制了采用继电器的 Mark-II,以及采用真空管的 Mark-III 和 Mark-IV。Mark-III、Mark-IV 的建造晚于第一批存储程序机器。由于它们为指令和数据分别设置存储器,存储程序计算机的支持者认为这种设计是一种倒退。“Harvard 体系结构”一词就是为描述这种机器而创造的。虽然与最初的含义明显不同,今天这个术语也用于描述主存统一、但指令缓存和数据缓存分离的机器。
MIT 的 Whirlwind 项目[Redmond 和 Smith,1980]始于 1947 年,面向实时雷达信号处理。它带来了多项发明,其中最重要的创新是磁芯存储器:第一种可靠而廉价的存储技术。Whirlwind 的磁芯存储器能够容纳 2048 个 16 位字。此后,磁芯作为主要的主存技术使用了近 30 年。
重要的专用机器
第二次世界大战期间,英国和美国的主要计算研究工作都集中在用于破译密码的专用计算机上。英国的研究旨在解读德国 Enigma 密码机编码的消息。这项工作在 Bletchley Park 开展,催生了两台重要机器。第一台由 Alan Turing 构思,是一种称为 BOMB 的机电式机器[参见 Metropolis、Howlett 和 Rota,1980,收录的 Good 一文]。第二台由 Newman 和 Flowers 构思并设计,体积大得多,采用电子器件,称为 COLOSSUS[参见同书收录的 Randall 一文]。这些高度专用的密码分析机器能够读取加密消息,尤其是发给潜艇的消息,因此在战争中发挥了重要作用。Bletchley Park 的工作属于高度机密,事实上其中一部分在原文撰写时仍未解密,因此很难追溯其对 ENIAC、EDSAC 及其他计算机发展的直接影响;不过,它无疑通过推动技术进步、加深人们对相关问题的理解而产生了间接影响。
美国也进行了类似的专用密码分析计算机研究。这项工作的最直接继承者是 Engineering Research Associates(ERA)公司[参见 Metropolis、Howlett 和 Rota,1980,收录的 Thomash 一文]。ERA 成立于战后,试图将其中的关键思想商业化。它制造了几台机器,出售给秘密政府机构;后来被 Sperry-Rand 收购,而 Sperry-Rand 此前已收购 Eckert Mauchly Computer Corporation。
另一批值得肯定的早期机器,是 Konrad Zuse 于 20 世纪 30 年代末至 40 年代初在德国制造的一组专用机器[参见 Metropolis、Howlett 和 Rota,1980,收录的 Bauer 和 Zuse 的文章]。Zuse 不仅造出了能够运行的机器,还是第一个实现浮点运算的人;而 von Neumann 曾声称浮点运算没有必要!Zuse 的早期机器采用机械式存储装置,其体积小于当时其他机电式方案。他的最后一台机器也是机电式的,但因战争而未能完成。
John Atanasoff 是电子计算机发展的另一位重要早期贡献者。他在 20 世纪 40 年代初建造了一台小型电子计算机[Atanasoff,1940]。这台在 Iowa State University 设计的专用计算机称为 ABC(Atanasoff Berry Computer),始终未能完全投入运行。Mauchly 在建造 ENIAC 之前曾短暂拜访 Atanasoff,后者的一些思想,例如使用二进制表示,很可能影响了 Mauchly。Atanasoff 机器的存在、ENIAC 专利申请的延误——当时工作属于机密,战后才能申请专利——以及 von Neumann 的 EDVAC 论文已被散发,这些因素被用来推翻 Eckert–Mauchly 专利[Larson,1973]。尽管围绕 Atanasoff 作用的争论仍十分激烈,人们通常仍将建造第一台能够运行的通用电子计算机的功劳归于 Eckert 和 Mauchly[Stern,1980]。不过,Atanasoff 确实展示了后来计算机采用的几项重要创新。他的工作理应得到充分肯定;将世界上第一台专用电子计算机的功劳归于他,并认为他可能影响了 Eckert 和 Mauchly,也是公允的。
商业化的发展
1947 年 12 月,Eckert 和 Mauchly 成立了 Eckert-Mauchly Computer Corporation。他们的第一台机器 BINAC 为 Northrop 制造,于 1949 年 8 月展示。经历一些财务困难之后,公司被 Remington-Rand 收购;后者后来称为 Sperry-Rand。Sperry-Rand 将收购的 Eckert-Mauchly 公司、ERA 以及自身的制表机业务合并,成立了专门的计算机部门 UNIVAC。UNIVAC 于 1951 年 6 月交付第一台 UNIVAC I。UNIVAC I 售价为 250,000 美元,是第一款获得商业成功的计算机:总共制造了 48 套系统!这台早期机器以及许多其他引人入胜的计算机历史实物,可以在加利福尼亚州 Mountain View 的 Computer History Museum 看到。其他可参观早期计算系统的地方还包括慕尼黑的 Deutsches Museum、华盛顿特区的 Smithsonian Institution,以及众多网上虚拟博物馆。
IBM 此前从事穿孔卡和办公自动化业务,直到 1950 年才开始制造计算机。其第一台计算机 IBM 701 以 von Neumann 的 IAS 机器为基础,于 1952 年交付,最终售出 19 台[参见 Metropolis、Howlett 和 Rota,1980,收录的 Hurd 一文]。20 世纪 50 年代初,许多人对计算机的未来持悲观态度,认为这些“高度专用”机器的市场和发展机会相当有限。尽管如此,IBM 很快成为最成功的计算机公司。重视可靠性,以及以客户和市场为导向的策略,是它成功的关键。701 和 702 的成绩虽不算突出,后续于 1954 年和 1955 年交付的 650、704、705 却取得了显著成功,各型号销量在 132 至 1800 台之间。
计算机先驱们撰写了多本介绍早期计算历史的著作[Goldstine,1972;Wilkes,1985、1995]。Metropolis、Howlett 和 Rota[1980]编辑的文集则汇集了早期先驱的回忆。独立撰写的历史著作也很多,其中不少以相关人物为线索[Slater,1987];此外,还有专门研究计算历史的期刊 Annals of the History of Computing。
量化性能度量的发展:成功与失败
在计算技术的萌芽阶段,设计者就设定了性能目标:ENIAC 要比 Harvard Mark-I 快 1000 倍,IBM Stretch(7030)则要比当时最快的机器快 100 倍。不过,如何度量这些性能并不明确。回顾多年的发展,可以看到一个反复出现的现象:每一代计算机都会使上一代的性能评估技术过时。
最初的性能指标是执行单个操作,例如加法所需的时间。由于大多数指令的执行时间相同,一条指令的用时就能反映其他指令的情况。然而,随着一台机器中各种指令的执行时间差异增大,单一操作的时间不再适合用于比较。为考虑这些差异,人们测量计算机运行许多程序时各种指令出现的相对频率,据此计算指令混合。Gibson mix[Gibson,1970]是一种早期流行的指令混合。将每条指令的时间乘以它在混合中的权重,再求和,就能得到平均指令执行时间。如果以时钟周期计量,这就是每条指令的平均时钟周期数。由于当时指令集彼此相似,这种比较比加法时间更准确。从平均指令执行时间到 MIPS,只需再走一小步;正如前文所述,两者互为倒数。MIPS 的优点是非专业人士也容易理解。
随着 CPU 变得更加复杂,越来越依赖存储层次结构和流水线,每条指令不再具有一个固定的执行时间,也就无法仅根据指令混合和机器手册计算 MIPS。下一步是使用内核程序和合成程序进行基准测试。Curnow 和 Wichmann[1976]通过测量用 Algol 60 编写的科学程序,创建了 Whetstone 合成程序。该程序被转换成 FORTRAN 后,广泛用于描述科学程序的性能。McMahon[1986]与 Lawrence Livermore Laboratory 的研究人员开展了目标类似的工作,提出 Livermore FORTRAN Kernels,试图建立超级计算机的基准。不过,这些内核由真实程序中的循环组成。
人们逐渐认识到,不能用 MIPS 比较不同指令集的体系结构,于是提出了相对 MIPS 的概念。1977 年,VAX-11/780 即将发布时,DEC 运行了一些小型基准,这些基准也在 IBM 370/158 上运行。IBM 的市场部门将 370/158 称为 1 MIPS 计算机;由于这些程序在两台机器上运行速度相同,DEC 的市场部门也将 VAX-11/780 称为 1 MIPS 计算机。对于机器 ,基于某台参考机器定义的相对 MIPS 为:
VAX-11/780 广受欢迎,也因此成为常用的相对 MIPS 参考机器;特别是以 1 MIPS 的机器为基准,计算十分方便:如果某台机器在一个基准上比 VAX-11/780 快 5 倍,它的相对 MIPS 评分就是 5。这个 1 MIPS 的评分连续四年无人质疑,直到 DEC 的 Joel Emer 在分时负载下测量 VAX-11/780。他发现,VAX-11/780 的原生 MIPS 评分实际上为 0.5。后来,一些 VAX 在某些基准上达到 3 原生 MIPS,却被称为 6 MIPS 机器,因为它们比 VAX-11/780 快 6 倍。到 20 世纪 80 年代初,MIPS 一词几乎普遍用于指代相对 MIPS。
20 世纪 70 年代和 80 年代,超级计算机行业迅速发展,其特点是在浮点密集型程序上具有高性能。平均指令时间和 MIPS 显然不适合这一行业,于是产生了 MFLOPS,即每秒百万次浮点运算。它实际上度量的是某个基准执行时间的倒数。遗憾的是,客户很快就会忘记评分使用的具体程序,而市场部门也开始在超级计算机的性能竞争中宣称峰值 MFLOPS。
SPEC(System Performance and Evaluation Cooperative)成立于 20 世纪 80 年代末,试图改善基准测试的状况,为比较提供更可靠的依据。该组织最初关注 UNIX 市场中的工作站和服务器,在原文撰写时,这些仍是其基准的主要对象。首版 SPEC 基准现在称为 SPEC89,它采用更贴近实际的基准,使性能评估取得了显著进步。近二十年后,SPEC2006 仍在处理器基准测试中占据主导地位。
参考文献
Amdahl, G. M. [1967]. “Validity of the single processor approach to achieving large scale computing capabilities,” Proc. AFIPS Spring Joint Computer Conf., April 18–20, 1967, Atlantic City, N.J., 483–485.
Atanasoff, J. V. [1940]. “Computing machine for the solution of large systems of linear equations,” Internal Report, Iowa State University, Ames.
Azizi, O., Mahesri, A., Lee, B. C., Patel, S. J., & Horowitz, M. [2010]. Energy-performance tradeoffs in processor architecture and circuit design: a marginal cost analysis. Proc. International Symposium on Computer Architecture, 26-36.
Bell, C. G. [1984]. “The mini and micro industries,” IEEE Computer 17:10 (October), 14–30.
Bell, C. G., J. C. Mudge, and J. E. McNamara [1978]. A DEC View of Computer Engineering, Digital Press, Bedford, Mass.
Burks, A. W., H. H. Goldstine, and J. von Neumann [1946]. “Preliminary discussion of the logical design of an electronic computing instrument,” Report to the U.S. Army Ordnance Department, p. 1; also appears in Papers of John von Neumann, W. Aspray and A. Burks, eds., MIT Press, Cambridge, Mass., and Tomash Publishers, Los Angeles, Calif., 1987, 97–146.
Curnow, H. J., and B. A. Wichmann [1976]. “A synthetic benchmark,” The Computer J. 19:1, 43–49.
Dally, William J., “High Performance Hardware for Machine Learning,” Cadence Embedded Neural Network Summit, February 9, 2016. http://ip.cadence.com/uploads/presentations/1000AM_Dally_Cadence_ENN.pdf
Flemming, P. J., and J. J. Wallace [1986]. “How not to lie with statistics: The correct way to summarize benchmarks results,” Communications of the ACM 29:3 (March), 218–221.
Fuller, S. H., and W. E. Burr [1977]. “Measurement and evaluation of alternative computer architectures,” Computer 10:10 (October), 24–35.
Gibson, J. C. [1970]. “The Gibson mix,” Rep. TR. 00.2043, IBM Systems Development Division, Poughkeepsie, N.Y. (research done in 1959).
Goldstine, H. H. [1972]. The Computer: From Pascal to von Neumann, Princeton University Press, Princeton, N.J.
Gray, J., and C. van Ingen [2005]. Empirical Measurements of Disk Failure Rates and Error Rates, MSR-TR-2005-166, Microsoft Research, Redmond, Wash.
Jain, R. [1991]. The Art of Computer Systems Performance Analysis: Techniques for Experimental Design, Measurement, Simulation, and Modeling, Wiley, New York.
Kembel, R. [2000]. “Fibre Channel: A comprehensive introduction,” Internet Week (April).
Larson, E. R. [1973]. “Findings of fact, conclusions of law, and order for judgment,” File No. 4-67, Civ. 138, Honeywell v. Sperry-Rand and Illinois Scientific Development, U.S. District Court for the State of Minnesota, Fourth Division (October 19).
Lubeck, O., J. Moore, and R. Mendez [1985]. “A benchmark comparison of three supercomputers: Fujitsu VP-200, Hitachi S810/20, and Cray X-MP/2,” Computer 18:12 (December), 10–24.
Landstrom, B. [2014]. “The Cost Of Downtime,” http://www.interxion.com/blogs/2014/07/the-cost-of-downtime/
McMahon, F. M. [1986]. The Livermore FORTRAN Kernels: A Computer Test of Numerical Performance Range, Tech. Rep. UCRL-55745, Lawrence Livermore National Laboratory, University of California, Livermore.
Metropolis, N., J. Howlett, and G. C. Rota, eds. [1980]. A History of Computing in the Twentieth Century, Academic Press, New York.
Mukherjee S. S., C. Weaver, J. S. Emer, S. K. Reinhardt, and T. M. Austin [2003]. “Measuring architectural vulnerability factors,” IEEE Micro 23:6, 70–75.
Oliker, L., A. Canning, J. Carter, J. Shalf, and S. Ethier [2004]. “Scientific computations on modern parallel vector systems,” Proc. ACM/IEEE Conf. on Supercomputing, November 6–12, 2004, Pittsburgh, Penn., 10.
Patterson, D. [2004]. “Latency lags bandwidth,” Communications of the ACM 47: 10 (October), 71–75.
Redmond, K. C., and T. M. Smith [1980]. Project Whirlwind—The History of a Pioneer Computer, Digital Press, Boston.
Shurkin, J. [1984]. Engines of the Mind: A History of the Computer, W. W. Norton, New York.
Slater, R. [1987]. Portraits in Silicon, MIT Press, Cambridge, Mass.
Smith, J. E. [1988]. “Characterizing computer performance with a single number,” Communications of the ACM 31:10 (October), 1202–1206.
SPEC. [1989]. SPEC Benchmark Suite Release 1.0 (October 2).
SPEC. [1994]. SPEC Newsletter (June).
Stern, N. [1980]. “Who invented the first electronic digital computer?” Annals of the History of Computing 2:4 (October), 375–376.
Touma, W. R. [1993]. The Dynamics of the Computer Industry: Modeling the Supply of Workstations and Their Components, Kluwer Academic, Boston.
Weicker, R. P. [1984]. “Dhrystone: A synthetic systems programming benchmark,” Communications of the ACM 27:10 (October), 1013–1030.
Wilkes, M. V. [1985]. Memoirs of a Computer Pioneer, MIT Press, Cambridge, Mass.
Wilkes, M. V. [1995]. Computing Perspectives, Morgan Kaufmann, San Francisco.
Wilkes, M. V., D. J. Wheeler, and S. Gill [1951]. The Preparation of Programs for an Electronic Digital Computer, Addison-Wesley, Cambridge, Mass.
M.3 存储层次结构与保护机制的发展(第 2 章和附录 B)
计算技术的先驱们虽然已经认识到存储层次结构的必要性,并创造了这一术语,但自动管理两个存储层次的方案,最早由 Kilburn 等人[1962]提出,并在曼彻斯特大学的 Atlas 计算机上实现。这台计算机比 IBM 360 的发布早一年。IBM 原计划在下一代 System/370 中引入这一功能,但 1970 年的 TSS 操作系统未能胜任。370 系列于 1972 年宣布支持虚拟内存;translation lookaside buffer(TLB,快表)这个名称,也是为这台计算机创造的[Case 和 Padegs,1978]。在原文所述时期,只有少数超级计算机、嵌入式处理器和较老的个人计算机没有虚拟内存。
Atlas 和 IBM 360 都提供了页级保护,GE 645 则是第一个提供段页式管理的系统。更早的 Burroughs 计算机通过分段提供虚拟内存,类似于 Intel 8086 的分段地址方案。80286 是第一款具备附录 C 所述保护机制的 80x86 处理器,其设计受到 GE 645 上运行的 Multics 保护软件的启发。随着时间推移,计算机发展出更复杂的机制,其中最复杂的是 capability;它在 20 世纪 70 年代末至 80 年代初受到最广泛的关注[Fabry,1974;Wulf、Levin 和 Harbison,1981]。Wilkes[1982]是 capability 的早期研究者之一,他这样评价:
凡是参与过刚才所述这类系统[capability 系统]实现的人,或者尝试向别人解释它的人,大概都会觉得复杂性已经失控。尤其令人失望的是,capability 原本是可以自由传递的票据,这一诱人的想法已经不复存在……
与传统计算机系统相比,要提供一个保护域很小而且频繁变化的系统,必然要付出代价。这些代价将体现为额外的硬件、更慢的运行速度,以及更多的存储器占用。目前仍不能确定,采用 capability 方法能否将这些代价降低到合理的程度。[第 112 页]
原文撰写时,尽管人们对保护和安全越来越重视,操作系统界和计算机体系结构界对 capability 的兴趣却都已很少。
原文交叉引用说明: 上文原书写作“附录 C”;本版有关虚拟内存与保护机制的说明位于附录 B。此处保留原文编号并注明其差异。
Bell 和 Strecker[1976]在回顾 PDP-11 时指出,地址空间过小,是唯一难以补救的体系结构错误。设计 PDP-11 时,磁芯存储器的容量增长十分缓慢。此外,当时还有约 100 家小型机公司参与竞争;如果每个地址都必须经过 16 位数据通路两次,DEC 的产品就可能失去成本竞争力。因此,设计者决定只比 PDP-11 的前代产品增加 4 个地址位。
IBM 360 的设计者清楚地址长度的重要性,计划将体系结构扩展到 32 位地址。不过,IBM 360 实际只使用了 24 位,因为在 1964 年,较长地址会使低端 360 型号进一步变慢。遗憾的是,设计者没有向软件人员透露这一计划,程序员在高 8 个“未使用”的地址位中存放额外信息,挫败了扩展尝试。20 年后,Apple 在 Motorola 68000 的 24 位地址上犯了类似错误;当后来的 68000 使用完整的 32 位虚拟地址时,Macintosh 就需要一种程序来判定应用是否“32-bit clean”,即能否正确使用完整的 32 位地址。此后的计算机几乎都会检查未使用的位是否确实保持未使用状态;如果这些位的值不正确,就触发陷入。
正如正文所述,系统虚拟机是 IBM 在研究虚拟内存的过程中率先提出的。IBM 第一台支持虚拟内存的计算机,是 1967 年推出的 IBM 360/67。IBM 研究人员编写了 CP-67 程序,使一台机器呈现出多台独立 360 计算机的假象。随后,他们又编写了运行在这些虚拟机上的交互式单用户操作系统 CMS。CP-67 后来发展为 VM/370 产品;在原文撰写时,IBM 为其大型机销售 z/VM[Meyer 和 Seawright,1970;Van Vleck,2005]。
Atlas 论文发表几年后,Wilkes 发表了第一篇阐述缓存概念的论文[1965]:
本文讨论这样一种用法:以一套容量约为 32,000 字的高速磁芯存储器,辅助一套容量约为一百万字的低速磁芯存储器,使实际应用中的有效访问时间更接近高速存储器,而不是低速存储器。[第 270 页]
这篇仅有两页的论文描述了直接映射缓存。它虽然是第一篇讨论缓存的公开论文,但最早的实现可能是剑桥大学建造的一种直接映射指令缓存。该缓存采用隧道二极管存储器,这是当时最快的存储器。Wilkes 说,缓存存储器的想法是 G. Scarott 提出的。
这篇论文发表后,IBM 启动了一个项目,最终造出了第一台采用缓存的商用计算机 IBM 360/85[Liptay,1968]。Gibson[1967]描述了如何从存储器流量和未命中率两方面测量程序行为,并展示了不同程序的未命中率差异。他以 20 个程序为样本,每个程序都有 300 万次访存,还使用平均存储器访问时间比较有缓存和无缓存的系统。这一先例已有 40 多年的历史,但直到 20 世纪 90 年代初,许多人仍在使用未命中率进行比较。
Conti、Gibson 和 Pitkowsky[1968]介绍了 360/85 的实际性能。在论文中的 11 个程序里,360/91 仅有 3 个程序优于 360/85,尽管 360/85 的时钟周期更长(80 ns 对 60 ns)、存储器交叉访问的路数更少(4 路对 16 路)、主存也更慢(1.04 微秒对 0.75 微秒)。这篇论文也是第一篇使用 cache 一词的论文。
其他研究者很快扩充了缓存领域的文献。Strecker[1976]发表了第一篇比较不同缓存设计的论文,研究 PDP-11 的缓存。Smith[1982]随后发表了一篇全面的综述,使用了空间局部性和时间局部性这两个术语,成为许多计算机设计者的参考资料。虽然大多数研究依赖仿真,Clark[1983]却使用硬件监测器,连续数天记录 VAX-11/780 的缓存未命中。Clark 和 Emer[1985]后来又比较了地址转换的仿真结果和硬件测量结果。
Hill[1987]提出了附录 B 中用于解释缓存未命中的“三 C”分类。Jouppi[1998]回顾时说,Hill 的三 C 模型直接促成了他发明 victim cache:既利用较快的直接映射缓存,又避免冲突未命中的大部分代价。Sugumar 和 Abraham[1993]认为,三 C 模型中的基准缓存应该采用最优替换算法;这样既能消除基于最近最少使用(LRU)替换的未命中分类异常,也能将冲突未命中进一步划分为映射造成的未命中,以及非最优替换算法造成的未命中。
Kroft[1981]发表了最早讨论非阻塞缓存的论文之一。他后来解释说[Kroft,1998],自己是 Control Data Corporation 第一位设计带缓存计算机的人;在将旧概念用于新机制时,他想到可以让双端口缓存在发生一次未命中之后,继续处理其他访问。
Baer 和 Wang[1988]开展了最早的一批多级包含性研究。随后,Wang、Baer 和 Levy[1989]发表了多级缓存性能评估的早期论文。再后来,Jouppi 和 Wilton[1994]提出了片上多级缓存的多级排他性方案。
除 victim cache 外,Jouppi[1990]还研究了利用流缓冲区进行预取的方法。Farkas、Jouppi 和 Chow[1995]扩展了这项工作,使流缓冲区能在按序处理器中与非阻塞 load 和推测执行良好配合。后来 Farkas 等人[1997]又表明,乱序处理器虽然更能容忍不可预测的延迟,仍能从流缓冲区中获益。他们还进一步优化了流缓冲区的存储器带宽需求。
20 世纪 90 年代的编译器与操作系统的体系结构支持研讨会(ASPLOS)及国际计算机体系结构研讨会(ISCA)论文集,充满了关于缓存的论文。事实上,有些爱开玩笑的人声称,ISCA 真正的全称是 International Cache Architecture Symposium,即“国际缓存体系结构研讨会”。
第 2 章采用了 Cantin 和 Hill[2001]收集的 SPEC2000 基准测量结果。该章还使用了其他若干论文的数据,并在相应图注中注明出处:Agarwal 和 Pudar[1993];Barroso、Gharachorloo 和 Bugnion[1998];Farkas 和 Jouppi[1994];Jouppi[1990];Lam、Rothberg 和 Wolf[1991];Lebeck 和 Wood[1994];McCalpin[2005];Mowry、Lam 和 Gupta[1992];Torrellas、Gupta 和 Hennessy[1992]。
参考文献
Agarwal, A. [1987]. “Analysis of Cache Performance for Operating Systems and Multiprogramming,” Ph.D. thesis, Tech. Rep. No. CSL-TR-87-332, Stanford University, Palo Alto, Calif.
Agarwal, A., and S. D. Pudar [1993]. “Column-associative caches: A technique for reducing the miss rate of direct-mapped caches,” 20th Annual Int’l. Symposium on Computer Architecture (ISCA), May 16–19, 1993, San Diego, Calif. (Computer Architecture News 21:2 (May), 179–190).
Baer, J.-L., and W.-H. Wang [1988]. “On the inclusion property for multi-level cache hierarchies,” Proc. 15th Annual Int’l. Symposium on Computer Architecture (ISCA), May 30–June 2, 1988, Honolulu, Hawaii, 73–80.
Barham, P., B. Dragovic, K. Fraser, S. Hand, T. Harris, A. Ho, and R. Neugebauer [2003]. “Xen and the art of virtualization,” Proc. of the 19th ACM Symposium on Operating Systems Principles, October 19–22, 2003, Bolton Landing, N.Y.
Barroso, L. A., K. Gharachorloo, and E. Bugnion [1998]. “Memory system characterization of commercial workloads,” Proc. 25th Annual Int’l. Symposium on Computer Architecture (ISCA), July 3–14, 1998, Barcelona, Spain, 3–14.
Bell, C. G., and W. D. Strecker [1976]. “Computer structures: What have we learned from the PDP-11?” Proc. Third Annual Int’l. Symposium on Computer Architecture (ISCA), January 19–21, 1976, Tampa, Fla., 1–14.
Bhandarkar, D. P. [1995]. Alpha Architecture Implementations, Digital Press, Newton, Mass.
Borg, A., R. E. Kessler, and D. W. Wall [1990]. “Generation and analysis of very long address traces,” Proc. 17th Annual Int’l. Symposium on Computer Architecture (ISCA), May 28–31, 1990, Seattle, Wash., 270–279.
Cantin, J. F., and M. D. Hill [2001]. “Cache performance for selected SPEC CPU2000 benchmarks,” http://www.cs.wisc.edu/multifacet/misc/spec2000cache-data/.
Cantin, J., and M. Hill [2003]. “Cache performance for SPEC CPU2000 benchmarks, version 3.0,” http://www.cs.wisc.edu/multifacet/misc/spec2000cache-data/index.html.
Case, R. P., and A. Padegs [1978]. “The architecture of the IBM System/370,” Communications of the ACM 21:1, 73–96. Also appears in D. P. Siewiorek, C. G. Bell, and A. Newell, Computer Structures: Principles and Examples, McGraw-Hill, New York, 1982, 830–855.
Clark, B., T. Deshane, E. Dow, S. Evanchik, M. Finlayson, J. Herne, and J. Neefe Matthews [2004]. “Xen and the art of repeated research,” Proc. USENIX Annual Technical Conf., June 27–July 2, 2004, Boston, 1135–1144.
Clark, D. W. [1983]. “Cache performance of the VAX-11/780,” ACM Trans. on Computer Systems 1:1, 24–37.
Clark, D. W., and J. S. Emer [1985]. “Performance of the VAX-11/780 translation buffer: Simulation and measurement,” ACM Trans. on Computer Systems 3:1 (February), 31–62.
Compaq Computer Corporation. [1999]. Compiler Writer’s Guide for the Alpha 21264, Order Number EC-RJ66A-TE, June.
Conti, C., D. H. Gibson, and S. H. Pitkowsky [1968]. “Structural aspects of the System/360 Model 85. Part I. General organization,” IBM Systems J. 7:1, 2–14.
Crawford, J., and P. Gelsinger [1988]. Programming the 80386, Sybex, Alameda, Calif.
Cvetanovic, Z., and R. E. Kessler [2000]. “Performance analysis of the Alpha 21264-based Compaq ES40 system,” Proc. 27th Annual Int’l. Symposium on Computer Architecture (ISCA), June 10–14, 2000, Vancouver, Canada, 192–202.
Fabry, R. S. [1974]. “Capability based addressing,” Communications of the ACM 17:7 (July), 403–412.
Farkas, K. I., P. Chow, N. P. Jouppi, and Z. Vranesic [1997]. “Memory-system design considerations for dynamically-scheduled processors,” Proc. 24th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–4, 1997, Denver, Colo., 133–143.
Farkas, K. I., and N. P. Jouppi [1994]. “Complexity/performance trade-offs with non-blocking loads,” Proc. 21st Annual Int’l. Symposium on Computer Architecture (ISCA), April 18–21, 1994, Chicago.
Farkas, K. I., N. P. Jouppi, and P. Chow [1995]. “How useful are non-blocking loads, stream buffers and speculative execution in multiple issue processors?” Proc. First IEEE Symposium on High-Performance Computer Architecture, January 22–25, 1995, Raleigh, N.C., 78–89.
Gao, Q. S. [1993]. “The Chinese remainder theorem and the prime memory system,” 20th Annual Int’l. Symposium on Computer Architecture (ISCA), May 16–19, 1993, San Diego, Calif. (Computer Architecture News 21:2 (May), 337–340).
Gee, J. D., M. D. Hill, D. N. Pnevmatikatos, and A. J. Smith [1993]. “Cache performance of the SPEC92 benchmark suite,” IEEE Micro 13:4 (August), 17–27.
Gibson, D. H. [1967]. “Considerations in block-oriented systems design,” AFIPS Conf. Proc. 30, 75–80.
Handy, J. [1993]. The Cache Memory Book, Academic Press, Boston.
Heald, R., K. Aingaran, C. Amir, M. Ang, M. Boland, A. Das, P. Dixit, G. Gouldsberry, J. Hart, T. Horel, W.-J. Hsu, J. Kaku, C. Kim, S. Kim, F. Klass, H. Kwan, R. Lo, H. McIntyre, A. Mehta, D. Murata, S. Nguyen, Y.-P. Pai, S. Patel, K. Shin, K. Tam, S. Vishwanthaiah, J. Wu, G. Yee, and H. You [2000]. “Implementation of third-generation SPARC V9 64-b microprocessor,” ISSCC Digest of Technical Papers, 412–413 and slide supplement.
Hill, M. D. [1987]. “Aspects of Cache Memory and Instruction Buffer Performance,” Ph.D. thesis, Tech. Rep. UCB/CSD 87/381, Computer Science Division, University of California, Berkeley.
Hill, M. D. [1988]. “A case for direct mapped caches,” Computer 21:12 (December), 25–40.
Horel, T., and G. Lauterbach [1999]. “UltraSPARC-III: Designing third-generation 64-bit performance,” IEEE Micro 19:3 (May–June), 73–85.
Hughes, C. J., P. Kaul, S. V. Adve, R. Jain, C. Park, and J. Srinivasan [2001]. “Variability in the execution of multimedia applications and implications for architecture,” Proc. 28th Annual Int’l. Symposium on Computer Architecture (ISCA), June 30–July 4, 2001, Goteborg, Sweden, 254–265.
IEEE. [2005]. “Intel virtualization technology, computer,” IEEE Computer Society 38:5 (May), 48–56.
Jouppi, N. P. [1990]. “Improving direct-mapped cache performance by the addition of a small fully-associative cache and prefetch buffers,” Proc. 17th Annual Int’l. Symposium on Computer Architecture (ISCA), May 28–31, 1990, Seattle, Wash., 364–373.
Jouppi, N. P. [1998]. “Retrospective: Improving direct-mapped cache performance by the addition of a small fully-associative cache and prefetch buffers,” in G. S. Sohi, ed., 25 Years of the International Symposia on Computer Architecture (Selected Papers), ACM, New York, 71–73.
Jouppi, N. P., and S. J. E. Wilton [1994]. “Trade-offs in two-level on-chip caching,” Proc. 21st Annual Int’l. Symposium on Computer Architecture (ISCA), April 18–21, 1994, Chicago, 34–45.
Kessler, R. E. [1999]. “The Alpha 21264 microprocessor,” IEEE Micro 19:2 (March/April), 24–36.
Kilburn, T., D. B. G. Edwards, M. J. Lanigan, and F. H. Sumner [1962]. “One-level storage system,” IRE Trans. on Electronic Computers EC-11 (April) 223–235. Also appears in D. P. Siewiorek, C. G. Bell, and A. Newell, Computer Structures: Principles and Examples, McGraw-Hill, New York, 1982, 135–148.
Kroft, D. [1981]. “Lockup-free instruction fetch/prefetch cache organization,” Proc. Eighth Annual Int’l. Symposium on Computer Architecture (ISCA), May 12–14, 1981, Minneapolis, Minn., 81–87.
Kroft, D. [1998]. “Retrospective: Lockup-free instruction fetch/prefetch cache organization,” in G. S. Sohi, ed., 25 Years of the International Symposia on Computer Architecture (Selected Papers), ACM, New York, 20–21.
Kunimatsu, A., N. Ide, T. Sato, Y. Endo, H. Murakami, T. Kamei, M. Hirano, F. Ishihara, H. Tago, M. Oka, A. Ohba, T. Yutaka, T. Okada, and M. Suzuoki [2000]. “Vector unit architecture for emotion synthesis,” IEEE Micro 20:2 (March–April), 40–47.
Lam, M. S., E. E. Rothberg, and M. E. Wolf [1991]. “The cache performance and optimizations of blocked algorithms,” Proc. Fourth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 8–11, 1991, Santa Clara, Calif. (SIGPLAN Notices 26:4 (April), 63–74).
Lebeck, A. R., and D. A. Wood [1994]. “Cache profiling and the SPEC benchmarks: A case study,” Computer 27:10 (October), 15–26.
Liptay, J. S. [1968]. “Structural aspects of the System/360 Model 85. Part II. The cache,” IBM Systems J. 7:1, 15–21.
Luk, C.-K., and T. C Mowry [1999]. “Automatic compiler-inserted prefetching for pointer-based applications,” IEEE Trans. on Computers, 48:2 (February), 134–141.
McCalpin, J. D. [2005]. “STREAM: Sustainable Memory Bandwidth in High Performance Computers,” www.cs.virginia.edu/stream/.
McFarling, S. [1989]. “Program optimization for instruction caches,” Proc. Third Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 3–6, 1989, Boston, 183–191.
Menon, A., J. Renato Santos, Y. Turner, G. Janakiraman, and W. Zwaenepoel [2005]. “Diagnosing performance overheads in the xen virtual machine environment,” Proc. First ACM/USENIX Int’l. Conf. on Virtual Execution Environments, June 11–12, 2005, Chicago, 13–23.
Meyer, R. A., and L. H. Seawright [1970]. “A virtual machine time sharing system,” IBM Systems J. 9:3, 199–218.
Mowry, T. C., S. Lam, and A. Gupta [1992]. “Design and evaluation of a compiler algorithm for prefetching,” Proc. Fifth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 12–15, 1992, Boston (SIGPLAN Notices 27:9 (September), 62–73).
Oka, M., and M. Suzuoki [1999]. “Designing and programming the emotion engine,” IEEE Micro 19:6 (November–December), 20–28.
Pabst, T. [2000]. “Performance Showdown at 133 MHz FSB—The Best Platform for Coppermine,” www6.tomshardware.com/mainboard/00q1/000302/.
Palacharla, S., and R. E. Kessler [1994]. “Evaluating stream buffers as a secondary cache replacement,” Proc. 21st Annual Int’l. Symposium on Computer Architecture (ISCA), April 18–21, 1994, Chicago, 24–33.
Przybylski, S. A. [1990]. Cache Design: A Performance-Directed Approach, Morgan Kaufmann, San Francisco.
Przybylski, S. A., M. Horowitz, and J. L. Hennessy [1988]. “Performance tradeoffs in cache design,” Proc. 15th Annual Int’l. Symposium on Computer Architecture (ISCA), May 30–June 2, 1988, Honolulu, Hawaii, 290–298.
Reinman, G., and N. P. Jouppi. [1999]. “Extensions to CACTI.”
Robin, J., and C. Irvine [2000]. “Analysis of the Intel Pentium’s ability to support a secure virtual machine monitor,” Proc. USENIX Security Symposium, August 14–17, 2000, Denver, Colo.
Saavedra-Barrera, R. H. [1992]. “CPU Performance Evaluation and Execution Time Prediction Using Narrow Spectrum Benchmarking,” Ph.D. dissertation, University of California, Berkeley.
Samples, A. D., and P. N. Hilfinger [1988]. Code Reorganization for Instruction Caches, Tech. Rep. UCB/CSD 88/447, University of California, Berkeley.
Sites, R. L. (ed.) [1992]. Alpha Architecture Reference Manual, Digital Press, Burlington, Mass.
Skadron, K., and D. W. Clark [1997]. “Design issues and tradeoffs for write buffers,” Proc. Third Int’l. Symposium on High-Performance Computer Architecture, February 1–5, 1997, San Antonio, Tex., 144–155.
Smith, A. J. [1982]. “Cache memories,” Computing Surveys 14:3 (September), 473–530.
Smith, J. E., and J. R. Goodman [1983]. “A study of instruction cache organizations and replacement policies,” Proc. 10th Annual Int’l. Symposium on Computer Architecture (ISCA), June 5–7, 1982, Stockholm, Sweden, 132–137.
Stokes, J. [2000]. “Sound and Vision: A Technical Overview of the Emotion Engine,” http://arstechnica.com/hardware/reviews/2000/02/ee.ars.
Strecker, W. D. [1976]. “Cache memories for the PDP-11?” Proc. Third Annual Int’l. Symposium on Computer Architecture (ISCA), January 19–21, 1976, Tampa, Fla., 155–158.
Sugumar, R. A., and S. G. Abraham [1993]. “Efficient simulation of caches under optimal replacement with applications to miss characterization,” Proc. ACM SIGMETRICS Conf. on Measurement and Modeling of Computer Systems, May 17–21, 1993, Santa Clara, Calif., 24–35.
Tarjan, D., S. Thoziyoor, and N. Jouppi [2006]. CACTI 4.0. Technical Report HPL-2006-86, HP Laboratories.
Torrellas, J., A. Gupta, and J. Hennessy [1992]. “Characterizing the caching and synchronization performance of a multiprocessor operating system,” Proc. Fifth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 12–15, 1992, Boston (SIGPLAN Notices 27:9 (September), 162–174).
Van Vleck, T. [2005]. “The IBM 360/67 and CP/CMS,” http://www.multicians.org/thvv/360-67.html.
Wang, W.-H., J.-L. Baer, and H. M. Levy [1989]. “Organization and performance of a two-level virtual-real cache hierarchy,” Proc. 16th Annual Int’l. Symposium on Computer Architecture (ISCA), May 28–June 1, 1989, Jerusalem, 140–148.
Wilkes, M. [1965]. “Slave memories and dynamic storage allocation,” IEEE Trans. Electronic Computers EC-14:2 (April), 270–271.
Wilkes, M. V. [1982]. “Hardware support for memory protection: Capability implementations,” Proc. Symposium on Architectural Support for Programming Languages and Operating Systems (ASPLOS), March 1–3, 1982, Palo Alto, Calif., 107–116.
Wulf, W. A., R. Levin, and S. P. Harbison [1981]. Hydra/C.mmp: An Experimental Computer System, McGraw-Hill, New York.
M.4 指令集的演变(附录 A、J、K)
每当有人用面向栈或面向寄存器的指令集来开发未来的体系结构时,人们都应该扬起眉毛,表示惊讶。
——Meyers[1978,第 20 页]
最早的计算机,包括 UNIVAC I、EDSAC 和 IAS 计算机,都采用基于累加器的结构。在硬件资源极其有限的条件下,这类计算机结构简单,自然成为首选。第一台采用通用寄存器的计算机,是 Ferranti 公司于 1956 年建造的 Pegasus。Pegasus 有 8 个通用寄存器,其中 R0 恒为零;通过块传送,将磁鼓存储器中的数据装入这 8 个寄存器。
栈体系结构
1963 年,Burroughs 交付了 B5000。它也许是第一台认真考虑软件以及软硬件权衡的计算机。Barton 和 Burroughs 的设计者为 B5000 采用了栈体系结构[Barton,1961]。这种体系结构旨在支持 ALGOL 等高级语言,其操作系统 MCP 也用高级语言编写。B5000 还是美国制造商推出的第一台支持虚拟内存的计算机。1968 年推出的 B6500[Hauck 和 Dent,1968]增加了由硬件管理的活动记录。B5000 和 B6500 都将栈顶两个元素保留在处理器中,其余部分存放在内存中。栈体系结构具有良好的代码密度,却只提供两个高速存储位置。IBM 360 原始论文[Amdahl、Blaauw 和 Brooks,1964]及 PDP-11 原始论文[Bell 等人,1970]的作者都反对栈结构,主要理由有三点:
- 性能来自快速寄存器本身,而不是寄存器的使用方式。
- 栈结构的限制太多,需要大量交换和复制操作。
- 栈总有底部;当这部分放在较慢的内存中时,就会损失性能。
基于栈的硬件在 20 世纪 70 年代末失去青睐;除 Intel 80x86 的浮点体系结构外,它基本上消失了。例如,SPEC 报告列出的计算机中,除了 80x86,没有一种采用栈结构。
不过,20 世纪 90 年代 Java 虚拟机(JVM)的成功,又给栈体系结构注入了活力。JVM 是一种软件解释器,用于解释 Java 编译器生成的中间语言——Java 字节码[Lindholm 和 Yellin,1999]。解释器的目的是实现跨多种平台的软件兼容性,期望做到“一次编写,到处运行”。尽管解释执行使速度降低到约十分之一,有时兼容性仍比性能更重要,例如将 Java applet 下载到 Internet 浏览器时。
虽然有人提出用硬件直接执行 JVM 指令,例如 McGhan 和 O’Connor[1998]的方案,但截至原文撰写时,这些方案都没有产生显著的商业影响。人们转而寄望于 Java 即时编译器(JIT):它在程序运行时,将代码编译为执行该 Java 程序的计算机的原生指令集,从而克服解释执行的性能损失。Java 的流行还催生了直接编译为硬件原生指令集的编译器,绕过 Java 字节码这一抽象层。
“计算机体系结构”的定义
IBM 在 20 世纪 60 年代初创造了 computer architecture(计算机体系结构)一词。Amdahl、Blaauw 和 Brooks[1964]用它指代 IBM 360 指令集中程序员可见的部分。他们认为,具有相同体系结构的计算机系列应该能够运行同一套软件。今天看来,这似乎理所当然,但在当时却是相当新颖的想法。IBM 虽然已是行业领先者,在 360 之前却有五种不同的体系结构;因此,让一家公司统一采用一种体系结构,是一种激进的主张。360 的设计者希望,通过定义共同的体系结构,将 IBM 六个不同部门凝聚起来。他们对体系结构的定义是:
……机器语言程序员为了给某台计算机编写正确的、与时序无关的程序,所必须理解的计算机结构。
“机器语言程序员”意味着兼容性要一直保持到机器语言层面;“与时序无关”则允许采用不同的实现。该体系结构开辟了二进制兼容的道路,后来者纷纷沿用。
IBM 360 是第一种同时采用以 8 位字节为单位的字节寻址和通用寄存器、并获得大规模销售的计算机。360 还具有寄存器—内存指令,以及有限的内存—内存指令。附录 K 概述了这套指令集。
1964 年,Control Data 交付了第一台超级计算机 CDC 6600。正如 Thornton[1964]所述,他、Cray 和其他 6600 设计者是最早深入探索流水线技术的一批人。6600 是第一台通用 load-store 计算机。20 世纪 60 年代,6600 的设计者就认识到,为了高效实现流水线,必须简化体系结构。20 世纪 70 年代,微处理器和小型机设计者大多忽视了体系结构简洁性与实现之间的这种相互影响;到 80 年代,这一思想又重新受到重视。
高级语言计算机体系结构
20 世纪 60 年代末至 70 年代初,人们认识到软件成本的增长快于硬件成本。McKeeman[1967]指出,编译器和操作系统日益庞大、复杂,开发周期也越来越长。由于编译器不够成熟,加上计算机内存有限,当时大多数系统程序仍然用汇编语言编写。许多研究者提出,通过更强大、面向软件的体系结构来缓解软件危机。Tanenbaum[1978]研究了高级语言的特性;与其他研究者一样,他发现大多数程序其实很简单。他认为,体系结构设计应以此为出发点,针对程序大小和编译难度进行优化。为实现这些目标,Tanenbaum 提出一种栈计算机,采用按使用频率编码的指令格式。不过,正如我们已经看到的,程序大小并不能直接换算成性价比;在这项工作之后不久,栈计算机就逐渐退出了主流。
Strecker[1978]讨论了他和 DEC 的其他设计者如何通过 VAX 体系结构回应这些问题。VAX 的设计目标是简化高级语言的编译。编译器作者曾抱怨 PDP-11 缺乏完全的正交性;VAX 因而被设计成高度正交的体系结构,使一条高级语言语句可以映射为一条 VAX 指令。此外,VAX 的设计者还力图优化代码大小,因为编译后的程序常常超出现有内存容量。附录 K 概述了这套指令集。
VAX-11/780 是 VAX 系列公布的第一台计算机,也是历史上最成功、研究最充分的计算机之一。DEC 战略的基石,是用单一体系结构 VAX 运行单一操作系统 VMS。这项战略在十多年间取得了良好效果。大量报告 VAX 指令混合、实现测量结果和分析的论文,使它成为理想的案例研究对象[Clark 和 Levy,1982;Wiecek,1982]。Bhandarkar 和 Clark[1991]量化分析了 VAX 相对 RISC 计算机的劣势,从技术上解释了 VAX 的衰落。
在 VAX 设计的同时,研究界正在倡导一种更激进的方法,称为高级语言计算机体系结构(High-Level Language Computer Architecture,HLLCA)。这场运动试图把硬件“提升”到编程语言的层次,从而消除高级语言与计算机硬件之间的差距,即 Gagliardi[1973]所说的“语义鸿沟”。Meyers[1982]很好地总结了相关论点和高级语言计算机体系结构项目的历史。HLLCA 从未产生显著的商业影响。计算机内存容量的增长消除了高级语言带来的代码大小问题,也使操作系统能够用高级语言编写。更简单的体系结构与软件结合,以更低的成本和复杂性,提供了更高性能和更强的灵活性。
精简指令集计算机
20 世纪 80 年代初,计算机体系结构的发展方向开始转变,不再倾向于为语言提供高级硬件支持。Ditzel 和 Patterson[1980]分析了高级语言体系结构遇到的困难,认为出路在于更简单的体系结构。在另一篇论文中[Patterson 和 Ditzel,1980],两位作者首次讨论了精简指令集计算机(Reduced Instruction Set Computer,RISC)的思想,并提出支持简单体系结构的论据。VAX 的设计者 Clark 和 Strecker[1980]反驳了这一主张。
MIPS 这样的简单 load-store 计算机,通常称为 RISC 体系结构。RISC 的根源可以追溯到 6600 一类计算机:Thornton、Cray 等人认识到,要建造高速计算机,指令集的简洁性十分重要。Cray 在 CRAY-1 中延续了保持计算机简单的传统。商用 RISC 主要建立在三个研究项目的工作之上:Berkeley RISC 处理器、IBM 801,以及 Stanford MIPS 处理器。它们声称,相对于采用相同技术的其他计算机,可以获得 2 至 5 倍的性能优势,因此吸引了产业界的极大兴趣。
IBM 项目始于 1975 年,最早启动,却最晚公开。IBM 的计算机被设计为采用 ECL 的 24 位小型机;两个大学项目则都采用 MOS 技术,设计 32 位微处理器。John Cocke 被认为是 801 设计之父,并因这些贡献获得 Eckert–Mauchly 奖和图灵奖。Radin[1982]介绍了 801 体系结构的主要特点。801 是一个实验项目,从未以产品为目标;实际上,为控制成本和复杂性,这台计算机只采用了 24 位寄存器。
1980 年,Patterson 和 Berkeley 的同事启动了一个项目,为这一体系结构方法赋予了名称[Patterson 和 Ditzel,1980]。他们建造了 RISC-I 和 RISC-II 两台计算机。由于 IBM 的项目当时并不广为人知,也缺少公开讨论,Berkeley 团队在推广 RISC 方法方面的作用,对这项技术获得认可至关重要。他们还建造了最早支持混合格式 RISC 的指令缓存之一[Patterson 等人,1983]:内存中可以存放 16 位或 32 位指令,而缓存中统一为 32 位。Berkeley 团队后来又建造了面向 Smalltalk 的 RISC 计算机[Ungar 等人,1984],以及面向 LISP 的 RISC 计算机[Taylor 等人,1986]。
1981 年,Hennessy 和 Stanford 的同事发表了 Stanford MIPS 计算机的说明。高效的流水线和编译器辅助的流水线调度,都是最初 MIPS 设计的重要方面。MIPS 是 Microprocessor without Interlocked Pipeline Stages 的缩写,即“没有互锁流水级的微处理器”;这一名称反映出,它不使用使流水线停顿的硬件,而由编译器处理依赖。
这些早期 RISC 计算机——801、RISC-II 和 MIPS——具有许多共同点。两个大学项目都希望设计一种简单计算机,能够在大学的条件下用 VLSI 实现。三台计算机都采用简单的 load-store 体系结构和固定格式的 32 位指令,并强调高效流水线。Patterson[1985]介绍了这三台计算机,以及后来成为 RISC 特征的基本设计原则。Hennessy[1984]从另一个角度讨论了同样的思想,并介绍了 VLSI 处理器设计中的其他问题。
1985 年,Hennessy 发表论文解释 RISC 的性能优势,将其根源归于大幅降低的 CPI:RISC 处理器的 CPI 小于 2,而 VAX-11/780 超过 10;不过,这些数据并非来自完全相同的工作负载。Emer 和 Clark[1984]描述 VAX-11/780 性能的论文,对帮助 RISC 研究者理解其机器性能优势的来源起到了重要作用。
大学项目在 1983—1984 年间结束后,这项技术被产业界广泛接纳。许多早期计算机,即 1986 年之前制造的计算机的厂商,都宣称自己的产品是 RISC。不过,这些说法往往更多出于营销愿望,而非工程事实。
1986 年,计算机产业开始发布基于这三个 RISC 研究项目所探索技术的处理器。Moussouris 等人[1986]介绍了 MIPS R2000 整数处理器,Kane[1986]的书则完整描述了这一体系结构。Hewlett-Packard 将原有的小型机产品线转向 RISC;Lee[1989]介绍了 HP Precision Architecture。IBM 从未将 801 直接转化为产品,而是将其中的思想用于一种新的低端体系结构,集成到 IBM RT-PC 中;Waters[1986]编辑的论文集介绍了这项工作。1990 年,IBM 发布新的 RISC 体系结构 RS 6000,这是第一种超标量 RISC 处理器。1987 年,Sun Microsystems 开始交付基于 SPARC 体系结构的计算机;SPARC 源于 Berkeley RISC-II 处理器,由 Garner 等人[1988]介绍。PowerPC 则汇合了 Apple、IBM 和 Motorola 三方的力量。附录 K 概述了几种 RISC 体系结构。
为帮助解决 RISC 与传统设计之间的争论,VAX 处理器设计者后来选择组织结构相近的实现,对 VAX 与 RISC 处理器进行了量化比较:VAX 8700 和 MIPS M2000。VAX 与 MIPS 的不同目标导致了截然不同的体系结构。VAX 追求简单的编译器和较高的代码密度,因而采用功能强大的寻址方式和指令、高效的指令编码,以及较少的寄存器。MIPS 则追求通过流水线获得高性能、易于硬件实现,并适合高度优化的编译器;这些目标使它采用简单指令、简单寻址方式、定长指令格式和大量寄存器。
图 M.1 给出了执行指令数之比、CPI 之比,以及按时钟周期衡量的性能之比。由于两种实现的组织结构相近,比较中假定时钟周期相同。MIPS 执行的指令约为 VAX 的两倍,但 VAX 的 CPI 约为 MIPS 的六倍。因此,MIPS M2000 的性能接近 VAX 8700 的三倍。而且,构建 MIPS 处理器所需的硬件远少于 VAX 处理器。正是这种性价比差距,使原先制造 VAX 的公司推出基于 MIPS 的产品,随后完全放弃 VAX,转向与 MIPS 相当相似的 Alpha。Bell 和 Strecker[1998]总结了公司内部的这场争论。曾经是世界第二大计算机公司、也是小型机行业最成功企业的 DEC,在原文撰写时只剩下并入 HP 和 Intel 的一些业务。
图中纵轴均为 MIPS/VAX;横轴为 SPEC89 各基准。Performance ratio 表示性能比值,Instructions executed ratio 表示执行指令数比值,CPI ratio 表示 CPI 比值。基准名称保留原文。
回头看,RISC/CISC 之争后只有一种复杂指令集计算机(CISC)指令集存活下来,它与 PC 软件保持二进制兼容。PC 行业的芯片出货量极大,提供了足够的收入来支付额外的设计成本;Moore 定律也提供了足够的资源,使微处理器能在内部将 CISC 转换为 RISC。为在芯片上容纳这种转换而增加的流水级长度和芯片面积,会造成效率损失,但巨大的销量以及为该产品专门配置集成电路生产线的能力,弥补了这些损失。
有趣的是,Intel 也曾认为 80x86 产品线的未来并不确定。它创建 IA-64 体系结构,以支持 64 位寻址,并转向 RISC 风格的指令集。IA-64[Huck 等人,2000]在 Itanium-1 和 Itanium-2 中的实现,成败参半。虽然它在浮点应用上取得了高性能,整数性能却一直不出色。此外,Itanium 的晶体管数量多、芯片面积大,功耗也高。IA-64 指令集的复杂性,至少在某些方面与 RISC 理念相冲突,无疑也是面积和功耗效率低下的原因。
AMD 则决定只把体系结构从 32 位地址扩展到 64 位,正如 Intel 当年在 80386 中将它从 16 位地址扩展到 32 位一样。Intel 后来也效仿 AMD。最终,80x86 已有市场地位形成的巨大优势,连这份遗产的拥有者 Intel 自己也无法克服!
参考文献
Alexander, W. G., and D. B. Wortman [1975]. “Static and dynamic characteristics of XPL programs,” IEEE Computer 8:11 (November), 41–46.
Amdahl, G. M., G. A. Blaauw, and F. P. Brooks, Jr. [1964]. “Architecture of the IBM System 360,” IBM J. Research and Development 8:2 (April), 87–101.
Barton, R. S. [1961]. “A new approach to the functional design of a computer,” Proc. Western Joint Computer Conf., May 9–11, 1961, Los Angeles, Calif., 393–396.
Bell, G., R. Cady, H. McFarland, B. DeLagi, J. O’Laughlin, R. Noonan, and W. Wulf [1970]. “A new architecture for mini-computers: The DEC PDP-11,” Proc. AFIPS SJCC, May 5–7, 1970, Atlantic City, N.J., 657–675.
Bell, G., and W. D. Strecker [1998]. “Computer structures: What have we learned from the PDP-11?” in G. S. Sohi, ed., 25 Years of the International Symposia on Computer Architecture (Selected Papers), ACM, New York, 138–151.
Bhandarkar, D. P. [1995]. Alpha Architecture and Implementations, Digital Press, Newton, Mass.
Bhandarkar, D., and D. W. Clark [1991]. “Performance from architecture: Comparing a RISC and a CISC with similar hardware organizations,” Proc. Fourth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 8–11, 1991, Palo Alto, Calif., 310–319.
Bier, J. [1997]. “The evolution of DSP processors,” paper presented at University of California, Berkeley, November 14.
Boddie, J. R. [2000]. “History of DSPs,” www.lucent.com/micro/dsp/dsphist.html.
Case, R. P., and A. Padegs [1978]. “The architecture of the IBM System/370,” Communications of the ACM 21:1, 73–96.
Chow, F. C. [1983]. “A Portable Machine-Independent Global Optimizer— Design and Measurements,” Ph.D. thesis, Stanford University, Palo Alto, Calif.
Clark, D., and H. Levy [1982]. “Measurement and analysis of instruction set use in the VAX-11/780,” Proc. Ninth Annual Int’l. Symposium on Computer Architecture (ISCA), April 26–29, 1982, Austin, Tex., 9–17.
Clark, D., and W. D. Strecker [1980]. “Comments on ‘the case for the reduced instruction set computer,’” Computer Architecture News 8:6 (October), 34–38.
Crawford, J., and P. Gelsinger [1988]. Programming the 80386, Sybex Books, Alameda, Calif.
Darcy, J. D., and D. Gay [1996]. “FLECKmarks: Measuring floating point performance using a full IEEE compliant arithmetic benchmark,” CS 252 class project, University of California, Berkeley (see http://www.sonic.net/~jddarcy/Research/fleckmrk.pdf).
Digital Semiconductor. [1996]. Alpha Architecture Handbook, Version 3, Digital Press, Maynard, Mass.
Ditzel, D. R., and D. A. Patterson [1980]. “Retrospective on high-level language computer architecture,” Proc. Seventh Annual Int’l. Symposium on Computer Architecture (ISCA), May 6–8, 1980, La Baule, France, 97–104.
Emer, J. S., and D. W. Clark [1984]. “A characterization of processor performance in the VAX-11/780,” Proc. 11th Annual Int’l. Symposium on Computer Architecture (ISCA), June 5–7, 1984, Ann Arbor, Mich., 301–310.
Furber, S. B. [2000]. ARM system-on-chip architecture. Addison-Wesley, Boston, Mass.
Gagliardi, U. O. [1973]. “Report of workshop 4—software-related advances in computer hardware,” Proc. Symposium on the High Cost of Software, September 17–19, 1973, Monterey, Calif., 99–120.
Game, M., and A. Booker [1999]. “CodePack code compression for PowerPC processors,” MicroNews, 5:1.
Garner, R., A. Agarwal, F. Briggs, E. Brown, D. Hough, B. Joy, S. Kleiman, S. Muchnick, M. Namjoo, D. Patterson, J. Pendleton, and R. Tuck [1988]. “Scalable processor architecture (SPARC),” Proc. IEEE COMPCON, February 29– March 4, 1988, San Francisco, 278–283.
Hauck, E. A., and B. A. Dent [1968]. “Burroughs’ B6500/B7500 stack mechanism,” Proc. AFIPS SJCC, April 30–May 2, 1968, Atlantic City, N.J., 245–251.
Hennessy, J. [1984]. “VLSI processor architecture,” IEEE Trans. on Computers C-33:11 (December), 1221–1246.
Hennessy, J. [1985]. “VLSI RISC processors,” VLSI Systems Design 6:10 (October), 22–32.
Hennessy, J., N. Jouppi, F. Baskett, and J. Gill [1981]. “MIPS: A VLSI processor architecture,” in CMU Conference on VLSI Systems and Computations, Computer Science Press, Rockville, Md.
Hewlett-Packard. [1994]. PA-RISC 2.0 Architecture Reference Manual, 3rd ed., Hewlett-Packard, Palo Alto, Calif.
Hitachi. [1997]. SuperH RISC Engine SH7700 Series Programming Manual, Hitachi, Santa Clara, Calif.
Huck, J. et al. [2000]. “Introducing the IA-64 Architecture” IEEE Micro, 20:5, (September–October), 12–23.
IBM. [1994]. The PowerPC Architecture, Morgan Kaufmann, San Francisco.
Intel. [2001]. “Using MMX instructions to convert R GB to YUV color conversion,” cedar.intel.com/cgi-bin/ids.dll/content/content.jsp?cntKey=Legacy::irtm_AP548_9996&cntType=IDS_EDITORIAL.
Kahan, J. [1990]. “On the advantage of the 8087’s stack,” unpublished course notes, Computer Science Division, University of California, Berkeley.
Kane, G. [1986]. MIPS R2000 RISC Architecture, Prentice Hall, Englewood Cliffs, N.J.
Kane, G. [1996]. PA-RISC 2.0 Architecture, Prentice Hall, Upper Saddle River, N.J.
Kane, G., and J. Heinrich [1992]. MIPS RISC Architecture, Prentice Hall, Englewood Cliffs, N.J.
Kissell, K. D. [1997]. “MIPS16: High-density for the embedded market,” Proc. Real Time Systems ’97, June 15, 1997, Las Vegas, Nev.
Kozyrakis, C. [2000]. “Vector IRAM: A media-oriented vector processor with embedded DRAM,” paper presented at Hot Chips 12, August 13–15, 2000, Palo Alto, Calif, 13–15.
Lee, R. [1989]. “Precision architecture,” Computer 22:1 (January), 78–91.
Levy, H., and R. Eckhouse [1989]. Computer Programming and Architecture: The VAX, Digital Press, Boston.
Lindholm, T., and F. Yellin [1999]. The Java Virtual Machine Specification, 2nd ed., Addison-Wesley, Reading, Mass.
Lunde, A. [1977]. “Empirical evaluation of some features of instruction set processor architecture,” Communications of the ACM 20:3 (March), 143–152.
Magenheimer, D. J., L. Peters, K. W. Pettis, and D. Zuras [1988]. “Integer multiplication and division on the HP precision architecture,” IEEE Trans. on Computers 37:8, 980–990.
McGhan, H., and M. O’Connor [1998]. “PicoJava: A direct execution engine for Java bytecode,” Computer 31:10 (October), 22–30.
McKeeman, W. M. [1967]. “Language directed computer design,” Proc. AFIPS Fall Joint Computer Conf., November 14–16, 1967, Washington, D.C., 413–417.
Meyers, G. J. [1978]. “The evaluation of expressions in a storage-to-storage architecture,” Computer Architecture News 7:3 (October), 20–23.
Meyers, G. J. [1982]. Advances in Computer Architecture, 2nd ed., Wiley, New York.
MIPS. [1997]. MIPS16 Application Specific Extension Product Description.
Mitsubishi. [1996]. Mitsubishi 32-Bit Single Chip Microcomputer M32R Family Software Manual, Mitsubishi, Cypress, Calif.
Morse, S., B. Ravenal, S. Mazor, and W. Pohlman [1980]. “Intel microprocessors—8080 to 8086,” Computer 13:10 (October).
Moussouris, J., L. Crudele, D. Freitas, C. Hansen, E. Hudson, S. Przybylski, T. Riordan, and C. Rowen [1986]. “A CMOS RISC processor with integrated system functions,” Proc. IEEE COMPCON, March 3–6, 1986, San Francisco, 191.
Muchnick, S. S. [1988]. “Optimizing compilers for SPARC,” Sun Technology 1:3 (Summer), 64–77.
Palmer, J., and S. Morse [1984]. The 8087 Primer, John Wiley & Sons, New York, 93.
Patterson, D. [1985]. “Reduced instruction set computers,” Communications of the ACM 28:1 (January), 8–21.
Patterson, D. A., and D. R. Ditzel [1980]. “The case for the reduced instruction set computer,” Computer Architecture News 8:6 (October), 25–33.
Patterson, D. A., P. Garrison, M. Hill, D. Lioupis, C. Nyberg, T. Sippel, and K. Van Dyke [1983]. “Architecture of a VLSI instruction cache for a RISC,” 10th Annual Int’l. Conf. on Computer Architecture Conf. Proc., June 13–16, 1983, Stockholm, Sweden, 108–116.
Radin, G. [1982]. “The 801 minicomputer,” Proc. Symposium Architectural Support for Programming Languages and Operating Systems (ASPLOS), March 1–3, 1982, Palo Alto, Calif., 39–47.
Riemens, A., K. A. Vissers, R. J. Schutten, F. W. Sijstermans, G. J. Hekstra, and G. D. La Hei [1999]. “Trimedia CPU64 application domain and benchmark suite,” Proc. IEEE Int’l. Conf. on Computer Design: VLSI in Computers and Processors (ICCD’99), October 10–13, 1999, Austin, Tex., 580–585.
Ropers, A., H. W. Lollman, and J. Wellhausen [1999]. DSPstone: Texas Instruments TMS320C54x, Tech. Rep. Nr. IB 315 1999/9-ISS-Version 0.9, Aachen University of Technology, Aaachen, Germany (www.ert.rwth-aachen.de/Projekte/Tools/coal/dspstone_c54x/index.html).
Shustek, L. J. [1978]. “Analysis and Performance of Computer Instruction Sets,” Ph.D. dissertation, Stanford University, Palo Alto, Calif.
Silicon Graphics. [1996]. MIPS V Instruction Set (see http://www.sgi.com/MIPS/arch/ISA5/#MIPSV_indx).
Sites, R. L., and R. Witek, eds. [1995]. Alpha Architecture Reference Manual, 2nd ed., Digital Press, Newton, Mass.
Strauss, W. [1998]. “DSP Strategies 2002,” www.usadata.com/market_research/spr_05/spr_r127-005.htm.
Strecker, W. D. [1978]. “VAX-11/780: A virtual address extension of the PDP-11 family,” Proc. AFIPS National Computer Conf., June 5–8, 1978, Anaheim, Calif., 47, 967–980.
Sun Microsystems. [1989]. The SPARC Architectural Manual, Version 8, Part No. 800-1399-09, Sun Microsystems, Santa Clara, Calif.
Tanenbaum, A. S. [1978]. “Implications of structured programming for machine architecture,” Communications of the ACM 21:3 (March), 237–246.
Taylor, G., P. Hilfinger, J. Larus, D. Patterson, and B. Zorn [1986]. “Evaluation of the SPUR LISP architecture,” Proc. 13th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–5, 1986, Tokyo.
Texas Instruments [2000]. “History of innovation: 1980s,” www.ti.com/corp/docs/company/history/1980s.shtml.
Thornton, J. E. [1964]. “Parallel operation in Control Data 6600,” Proc. AFIPS Fall Joint Computer Conf., Part II, October 27–29, 1964, San Francisco, 26, 33–40.
Ungar, D., R. Blau, P. Foley, D. Samples, and D. Patterson [1984]. “Architecture of SOAR: Smalltalk on a RISC,” Proc. 11th Annual Int’l. Symposium on Computer Architecture (ISCA), June 5–7, 1984, Ann Arbor, Mich., 188–197.
van Eijndhoven, J. T. J., F. W. Sijstermans, K. A. Vissers, E. J. D. Pol, M. I. A. Tromp, P. Struik, R. H. J. Bloks, P. van der Wolf, A. D. Pimentel, and H. P. E. Vranken [1999]. “Trimedia CPU64 architecture,” Proc. IEEE Int’l. Conf. on Computer Design: VLSI in Computers and Processors (ICCD’99), October 10–13, 1999, Austin, Tex., 586–592.
Wakerly, J. [1989]. Microcomputer Architecture and Programming, Wiley, New York.
Waters, F. (ed.) [1986]. IBM RT Personal Computer Technology, SA 23-1057, IBM, Austin, Tex.
Weaver, D. L., and T. Germond [1994]. The SPARC Architectural Manual, Version 9, Prentice Hall, Englewood Cliffs, N.J.
Weiss, S., and J. E. Smith [1994]. Power and PowerPC, Morgan Kaufmann, San Francisco.
Wiecek, C. [1982]. “A case study of the VAX 11 instruction set usage for compiler execution,” Proc. Symposium on Architectural Support for Programming Languages and Operating Systems (ASPLOS), March 1–3, 1982, Palo Alto, Calif., 177–184.
Wulf, W. [1981]. “Compilers and computer architecture,” Computer 14:7 (July), 41–47.
M.5 流水线与指令级并行性的发展(第 3 章及附录 C、H)
早期的流水线 CPU
IBM 7030,即 Stretch,通常被认为是第一种通用流水线处理器。Stretch 接续 IBM 704,目标是比 704 快 100 倍;这一目标远远超出当时的技术水平,因而获得 Stretch 这个绰号。设计计划用四级流水线重叠取指、译码和执行,获得 1.6 倍的加速。Bloch[1959]和 Bucholtz[1962]介绍了其设计和工程权衡,包括 ALU 旁路的使用。
20 世纪 70 年代末至 80 年代初出现了一系列关于流水线的一般性论述,形成了大部分常用术语,也介绍了简单流水线采用的大部分基本技术。这些综述包括 Keller[1975]、Ramamoorthy 和 Li[1977]、Chen[1980],以及 Kogge[1981];Kogge 的整本书都围绕流水线展开。Davidson 及其同事[1971、1975]提出了流水线预约表的概念,作为设计带反馈的多周期流水线的方法,Kogge[1981]也介绍了这一方法。许多设计者在设计流水线或编写调度流水线的软件时,都使用了这些概念的某种变体。
RISC 处理器最初就把易于实现和易于流水线化作为设计目标。20 世纪 80 年代初发表的几篇早期 RISC 论文,尝试量化简化指令集所带来的性能优势。不过,最有说服力的分析,是 Bhandarkar 和 Clark 于 1991 年发表的 VAX 与 MIPS 实现比较,距第一批 RISC 论文发表已过去十年,参见图 M.1。在关于 RISC 实现优势的十年争论之后,这篇论文使最持怀疑态度的设计者也信服了 RISC 指令集体系结构的优点。
J. E. Smith 及其同事撰写了多篇论文,研究高速标量 CPU 的指令发射、异常处理和流水线深度。Kunkel 和 Smith[1986]评估了流水线开销和依赖对最优流水线深度选择的影响,还出色地讨论了锁存器设计及其对流水线的影响。Smith 和 Pleszkun[1988]评估了多种保持精确异常的技术。Weiss 和 Smith[1984]评估了多种硬件流水线调度与指令发射技术。
MIPS R4000 是最早的一批深流水线微处理器,Killian[1991]和 Heinrich[1993]对其进行了介绍。Alpha 的首个实现 21064 具有相似的指令集和整数流水线结构,但浮点单元的流水线划分更深。
动态调度的引入
1964 年,CDC 交付了第一台 CDC 6600。CDC 6600 在许多方面都独具特色。除了引入记分牌机制,它还是第一种广泛使用多个功能单元的处理器;其外围处理器也采用了多线程。设计者理解流水线与指令集设计之间的相互影响,采用简单的 load-store 指令集来促进流水线化。CDC 6600 还使用了先进的封装技术。Thornton[1964]介绍了它的流水线和 I/O 处理器体系结构,包括指令乱序执行的概念。Thornton[1970]的书从工艺技术到体系结构,对整个处理器作了出色的描述,并由 Cray 作序;遗憾的是,原文撰写时该书已绝版。CDC 6600 的 FORTRAN 编译器还具有指令调度器,见 Thorlin[1967]。
IBM 360 Model 91:一台里程碑式的计算机
IBM 360/91 引入了许多新概念,包括数据标记、寄存器重命名、动态检测内存冒险,以及通用的转发机制。Tomasulo 在 1967 年的论文中描述了他的算法。Anderson、Sparacio 和 Tomasulo[1967]介绍了处理器的其他方面,包括分支预测的使用。360/91 中的许多思想在近 25 年里淡出了实际应用,直到 20 世纪 90 年代才广泛复兴。遗憾的是,360/91 并未成功,只售出了少量机器。设计过于复杂使其上市延迟,也使 IBM 第一种带缓存的处理器 Model 85 能够在性能上超过 Model 91。
分支预测方案
J. E. Smith[1981]描述了 2 位动态硬件分支预测方案。Ditzel 和 McLellan[1987]介绍了 CRISP 的一种新型分支目标缓冲区,它实现了分支折叠。书中研究的相关预测器由 Pan、So 和 Rameh[1992]描述。Yeh 和 Patt[1992、1993]将相关性的思想推广,提出利用各分支历史的多级预测器,类似于 21264 使用的局部历史预测器。McFarling 在 1993 年的技术报告中介绍了竞赛预测方案,他称之为组合预测器。此后出现的许多分支预测论文,都是多级预测器和相关预测器思想的变体。Kaeli 和 Emma[1991]介绍了返回地址预测,Evers 等人[1998]则深入分析了多级预测器。第 3 章的数据来自 Skadron 等人[1999]。还有几种预测方案,可能在竞赛预测器之上进一步获益;Eden 和 Mudge[1998]以及 Jimenez 和 Lin[2002]描述了这些方法。
多发射处理器的发展
IBM 在多发射方面开展了先驱性工作。20 世纪 60 年代,一个名为 ACS 的项目在加利福尼亚州开展。它包含多发射概念、动态调度方案,以及沿分支两条路径取指的设计。动态调度采用备份寄存器,其机制比 Tomasulo 方案简单。项目最初旨在设计一种接续 Stretch、超越 CDC 6600/6800 的新体系结构。ACS 起步于纽约,随后迁往加利福尼亚州,后来又改为与 S/360 兼容,最终被取消。John Cocke 是该团队在思想上的主要推动者之一。团队汇集了 IBM 的资深人员和年轻贡献者,其中许多人后来在 IBM 或其他地方承担了重要职责,包括 Jack Bertram、Ed Sussenguth、Gene Amdahl、Herb Schorr、Fran Allen、Lynn Conway 和 Phil Dauber 等。编译器团队发表了许多思想,对 IBM 以外的研究产生了重大影响,但体系结构方面的思想当时并未广泛传播。关于这个重要项目,最完整的公开资料位于 www.cs.clemson.edu/~mark/acs.html,其中包括对 ACS 老成员的访谈和其他资料的线索。Sussenguth[1999]对 ACS 作了很好的概述。
早期真正进入市场的多发射处理器,大多采用 LIW 或 VLIW 设计。Charlesworth[1981]介绍了 Floating Point Systems 的 AP-120B,它是最早在一条指令中包含多个操作的宽指令处理器之一。Floating Point Systems 在编译器和手工编写的汇编语言库中都采用软件流水线,以高效利用处理器。由于它是附接处理器,可以忽略通用处理器实现多发射时的许多难题,例如虚拟内存和异常处理。
AP-120B、i860 等早期 VLIW 处理器采用过一种有趣的流水线组织方式:操作必须被“推过”功能单元,再在流水线末端“接住”结果。在这种处理器中,只有后续另一个操作按顺序从后面推动时,已有操作才会前进。而且,一条新指令指定的目的位置,属于更早发射的某条指令:新操作被推进流水线时,先前的结果就被推出。这样做的优点是,操作初次发射时无需指定结果目的位置,直到真正写结果寄存器时才指定。这种分离使硬件不必检测写后写(WAW)和读后写(WAR)冒险。缺点是代码大小会增加:如果程序依赖一个仍留在流水线中的操作,而眼下又不需要同类的其他操作,就可能必须用 no-op 将结果推出。几乎所有设计者最终都选择了能够自行排空的流水线,而不是这两种处理器的“推入—接住”方式。在自行排空的流水线中,发射指令本身指定目的位置,指令发射后无需进一步推动便能完成。代码密度的优势和代码生成的简化,看来超过了这种特殊结构带来的好处。
20 世纪 80 年代中期,一些研究项目引入了某种形式的多发射。例如,Stanford MIPS 处理器能将两个操作放在一条指令中;不过,主要出于性能原因,商用版本取消了这一能力。Fisher[1983]和 Yale 的同事提出,建造指令极宽、达到 512 位的处理器,并将这类处理器命名为 VLIW。其代码使用踪迹调度生成;Fisher[1981]最初为生成水平型微代码而开发了这种技术。Fisher 等人[1984]和 Ellis[1986]介绍了 Yale 处理器的踪迹调度实现。
虽然 IBM 取消了 ACS,20 世纪 80 年代这一领域的研究仍然活跃。ACS 取消十多年后,John Cocke 提出新的超标量处理器方案,由硬件动态决定发射;他和 Tilak Agerwala 在 80 年代中期的几次演讲中介绍了关键思想,并创造了 superscalar(超标量)一词。Cocke 将该设计命名为 America,见 Agerwala 和 Cocke[1987]。IBM Power1 体系结构,即 RS/6000 产品线,以这些思想为基础[Bakoglu 等人,1989]。
J. E. Smith[1984]及其在 Wisconsin 的同事提出了解耦方法,支持多发射和有限的动态流水线调度。这种处理器的重要特点,是利用队列保持某一类指令,例如访存指令内部的顺序,同时允许该类指令落后于或超前于另一类指令。Smith 等人[1987]介绍的 Astronautics ZS-1 体现了这种方法,用队列连接 load-store 单元与运算单元。Power2 也以类似方式使用队列。J. E. Smith[1989]还讨论了动态调度的优点,并将其与静态调度比较。
推测的概念可以追溯到最初的 360/91,它执行了一种非常有限的推测。后来处理器采用的方法,将 360/91 的动态调度技术与允许按序提交的缓冲区相结合。Smith 和 Pleszkun[1988]研究了用缓冲区保持精确中断的方法,并描述了重排序缓冲区的概念。Sohi[1990]介绍了加入重命名和动态调度的办法,使这一机制能够用于推测。Patt 及其同事很早就主张进行积极的重排序和推测;他们重点研究检查点和重启机制,并率先提出名为 HPSm 的方法,也是 Tomasulo 算法的一种扩展[Hwu 和 Patt,1986]。
Smith、Johnson 和 Horowitz[1989]使用重排序缓冲区,评估了多发射处理器中的推测技术,目的是研究非科学计算代码在推测和多发射条件下可利用的 ILP。Johnson[1990]随后在一本书中描述了推测超标量处理器的设计。他后来领导 AMD K-5 的设计;K-5 是最早的一批推测超标量处理器。
在超标量发展的同时,商业界对 VLIW 的兴趣也在增长。Multiflow 处理器[Colwell 等人,1987]以 Yale 开发的概念为基础,但作出了许多重要改进,提高其实用性。其中包括一种可控的 store 缓冲区,支持某种形式的推测。虽然 Multiflow 处理器售出超过 100 台,公司仍因多方面问题而失败:小公司引入新指令集困难重重,商用 RISC 微处理器又改变了小型机市场的经济格局,带来了强烈竞争。
与 Multiflow 大约同时,Cydrome 公司成立,目标是制造 VLIW 风格的处理器[Rau 等人,1989];它在商业上也未成功。Dehnert、Hsu 和 Bratt[1989]介绍了 Cydrome Cydra 5 的体系结构和性能。Cydra 5 采用宽指令字,提供动态寄存器重命名,以及额外的软件流水线支持。它将硬件与软件独特地结合起来,包括条件指令和寄存器轮转,旨在开发 ILP。Cydrome 比 Multiflow 处理器依赖更多硬件,主要在向量风格的代码上取得了有竞争力的性能。最终,Cydrome 遇到了与 Multiflow 类似的困难,未能获得商业成功。虽然这两家公司都未能成功,但它们培养了一批具有丰富 ILP 开发经验和先进编译技术经验的人才;其中许多人后来把这些经验和部分技术带入了新处理器。Fisher 和 Rau[1993]编辑了一部全面的论文集,涵盖这两种重要处理器的硬件与软件。
Rau 还开发了名为 polycyclic scheduling 的调度技术,它构成了大多数软件流水线方案的基础[Rau、Glaeser 和 Picard,1982]。Rau 的工作继承了 Davidson 及其同事关于为流水线处理器设计最优硬件调度器的早期研究。历史上的其他 LIW 处理器还包括 Apollo DN 10000 和 Intel i860,两者都能双发射浮点操作和整数操作。
调度的编译器技术与硬件支持
循环级并行性和依赖分析,主要由 D. Kuck 及其在 Illinois 大学的同事在 20 世纪 70 年代发展起来。他们还创造了如今常用的反依赖和输出依赖术语,并开发了几种标准的依赖检验,包括 GCD 检验和 Banerjee 检验。后者以 Uptal Banerjee 命名,有多种变体。后来,依赖分析的研究重点转向一系列精确检验,最后使用名为 Fourier–Motzkin 的线性规划算法。D. Maydan 和 W. Pugh 都证明,这种精确检验序列是一种实用方案。
在发现和调度 ILP 方面,许多早期工作与前述 VLIW 处理器的发展有关。Lam[1988]开发了软件流水线算法,并在 Warp 上评估其使用效果;Warp 是为专用应用设计的宽指令字处理器。Weiss 和 Smith[1987]比较了软件流水线与循环展开,研究它们作为流水线处理器代码调度技术的效果。Rau[1994]开发了模调度,以处理循环的软件流水线化问题,并同时处理寄存器分配。
研究者在多种背景下探索了推测代码调度的支持。几种处理器提供了忽略异常的模式,使 load 可以被更积极地调度,例如 MIPS TFP[Hsu,1994]。一些研究组还探索了更积极的推测代码调度硬件支持。例如,Smith、Horowitz 和 Lam[1992]提出名为 boosting 的概念:用硬件设施支持推测,同时提供检查和恢复机制,类似于 IA-64 和 Crusoe 的机制。Illinois 大学与 HP Laboratories 的研究者共同开发了哨兵调度思想[Mahlke 等人,1992],也类似于 Crusoe 和 IA-64 采用的“推测后检查”方法。
20 世纪 90 年代初,Illinois 大学的 Wen-Mei Hwu 及其同事开发了名为 IMPACT 的编译器框架[Chang 等人,1991],用来探索多发射体系结构与编译技术之间的相互作用。该项目产生了几个重要思想,包括超块调度[Hwu 等人,1993]、广泛利用运行剖析来指导过程内联等各种优化,以及使用特殊缓冲区实现编译器辅助的内存冲突检测[Gallagher 等人,1994];这种缓冲区类似于 ALAT 或程序控制的 store 缓冲区。他们还在 Mahlke 等人[1995]中研究了部分支持与完全支持谓词执行之间的性能权衡。
早期 RISC 处理器都采用延迟分支,这一方案受到微程序设计的启发;延迟分支机制又启发了若干关于编译时分支预测的研究。McFarling 和 Hennessy[1986]量化比较了多种编译时与运行时分支预测方案。Fisher 和 Freudenberger[1992]用相邻误预测之间的距离作为指标,评估了一系列编译时分支预测方案。Ball 和 Larus[1993]及 Calder 等人[1997]描述了利用已收集程序行为的静态预测方案。
EPIC 与 IA-64 的发展
EPIC 方法的根源,在于早期建造 LIW 和 VLIW 机器的尝试,特别是 Cydrome 和 Multiflow 的工作,也在于长期积累的编译器研究。这些公司失败之后,相关编译器工作仍在 HP、Illinois 大学及其他机构继续。由此获得的认识,使 HP 的设计者提出一种 VLIW 风格的 64 位体系结构,以接续 HP PA RISC。Intel 当时正在寻找新体系结构,以替换 x86——后来称为 IA-32——并提供 64 位能力。1995 年,两家公司建立合作关系,设计新体系结构 IA-64[Huck 等人,2000],并据此制造处理器。Itanium[Sharangpani 和 Arora,2000]是第一种这样的处理器。2002 年,Intel 推出了第二代 IA-64 设计 Itanium 2[McNairy 和 Soltis,2003;McCormick 和 Knies,2002]。
ILP 的研究及增加 ILP 的思路
一系列早期论文,包括 Tjaden 和 Flynn[1970]、Riseman 和 Foster[1972],得出结论:如果不投入极其庞大的硬件,在指令级能够获得的并行性就很少。这些论文使多指令发射的吸引力减弱了十多年。Nicolau 和 Fisher[1984]根据踪迹调度的工作发表论文,指出科学程序中存在大量潜在 ILP。
此后,可用 ILP 成为许多研究的对象。这些研究受到批评,因为它们都预设了一定程度的硬件支持和编译器技术。尽管如此,它们仍有助于建立合理预期,并理解限制因素的来源。Wall 参与了多项此类研究,包括 Jouppi 和 Wall[1989]以及 Wall[1991、1993]。早期研究被批评为过于保守,例如没有考虑推测;但其中最后一项,是截至原文所述时期最为大胆、范围最广的 ILP 研究,也是 3.10 节数据的基础。Sohi 和 Vajapeyam[1989]提供了宽指令字处理器可用并行性的测量。Smith、Johnson 和 Horowitz[1989]也用推测超标量处理器研究了 ILP 的极限。在研究时,他们认为自己规定的处理器已经是合理设计的上限。然而,后来已有和即将出现的处理器,很可能至少与它同样激进。Skadron 等人[1999]考察了一种与 2005 年最激进处理器相当的设计的性能权衡和限制,认为如果整数程序的分支预测没有显著改善,扩大窗口就没有意义。
Lam 和 Wilson[1992]研究了推测带来的限制,表明如果允许处理器沿多个方向推测,还可以获得额外收益,但这需要不止一个 PC。这类方案无法超过完美推测所能达到的性能,却有助于缩小实际预测与完美预测之间的差距。Wall 在 1993 年的研究中,对这种方法作了有限评估,最多探索 8 个分支。
超越数据流极限
文献中探索的另一种方法是值预测。值预测允许处理器根据预测的数据值进行推测。关于其用途已有多项研究。Lipasti 和 Shen 在 1996 年发表两篇论文,评估值预测的概念及其对 ILP 开发的潜在影响。Calder、Reinman 和 Tullsen[1999]探索了选择性值预测。Sodani 和 Sohi[1997]则从重用指令产生的值这一角度研究同一问题。
Moshovos 等人[1997]表明,要通过值推测获得性能收益,关键是跟踪过去的推测是否准确,据此决定何时推测。Moshovos 和 Sohi[1997]以及 Chrysos 和 Emer[1998]重点研究了内存依赖的预测,并利用这些信息消除经由内存形成的依赖。González 和 González[1998]、Babbay 和 Mendelson[1998],以及 Calder、Reinman 和 Tullsen[1999]是稍后的值预测研究。原文撰写时,这一领域十分活跃,每次会议都有新成果发表。
较新的先进微处理器
1994 年和 1995 年,各主要处理器厂商都发布了宽超标量处理器,即每周期发射三条或更多指令的处理器:Intel Pentium Pro 和 Pentium II,两者共享核心流水线体系结构[Colwell 和 Steck,1995];AMD K-5、K-6 和 Athlon;Sun UltraSPARC[Lauterbach 和 Horel,1999];Alpha 21164[Edmondson 等人,1995]和 21264[Kessler,1999];MIPS R10000、R12000[Yeager,1996];PowerPC 603、604、620[Diep、Nelson 和 Shen,1995];以及 HP 8000[Kumar,1997]。该年代后半段,即 1996—2000 年,许多产品出现了第二代,例如 Pentium III、AMD Athlon 和 Alpha 21264。第二代的发射率虽然相近,却能维持更低的 CPI,并提供高得多的时钟频率。它们都采用动态调度,且几乎普遍支持推测。实际中,实现技术、存储层次结构、设计者的水平,以及用作基准的应用类型等许多因素,共同决定哪种方法最好。
2000—2005 年,超标量处理器的发展主要体现出三个趋势:通过更深流水线获得更高时钟频率,例如 Pentium 4[Hinton 等人,2001];IBM 在 Power 4、Intel 在 Pentium 4 Extreme 中引入多线程;以及开始转向多核,包括 IBM 的 Power 4、AMD 的 Opteron[Keltcher 等人,2003],以及稍后的 Intel 产品[Douglas,2005]。
多线程与同时多线程
多线程概念可以追溯到最早的一批晶体管计算机之一 TX-2。TX-2 还因 Ivan Sutherland 在它上面创建 Sketchpad 而闻名;Sketchpad 是第一个计算机图形系统。TX-2 由 MIT Lincoln Laboratory 建造,于 1959 年投入运行。它用多个线程支持快速上下文切换,以处理 I/O 功能。Clark[1957]介绍了基本体系结构,Forgie[1957]介绍了 I/O 体系结构。CDC 6600 也使用多线程,其 I/O 处理器采用细粒度多线程,在线程间交错调度。Denelcor 设计的流水线多处理器 HEP 于 1982 年交付,利用细粒度多线程同时隐藏流水线延迟和所有处理器共享的大容量存储器的访问延迟。HEP 没有缓存,因此隐藏内存延迟至关重要。主要设计者之一 Burton Smith 在 1978 年的论文中介绍了 HEP 体系结构,Jordan[1983]发表了性能评估。TERA 扩展了多线程思想,Alverson 等人在 1992 年的论文中进行了介绍。Niagara 的多线程方法与 HEP、TERA 类似,但 Niagara 使用缓存,降低了通过线程隐藏延迟的需求。
20 世纪 80 年代末至 90 年代初,研究者探索了粗粒度多线程,也称块多线程,用来容忍延迟,尤其是多处理器环境中的延迟。Alewife 系统的 SPARCLE 处理器采用这种方案:每当发生高延迟的异常事件,例如耗时很长的缓存未命中,就切换线程。Agarwal 等人在 1993 年的论文中描述了 SPARCLE。IBM Pulsar 处理器使用了类似思想。
到 20 世纪 90 年代初,几个研究组形成了两点关键认识。首先,要获得最大的性能收益,需要细粒度多线程;粗粒度方案中的线程切换和启动开销,例如用新线程的指令重新填满流水线,会抵消很大一部分性能优势[Laudon、Gupta 和 Horowitz,1994]。其次,要有效利用大量功能单元,需要同时利用指令级并行性(ILP)和线程级并行性(TLP)。这些认识促成了几种将多线程与多发射结合的体系结构。Wolfe 和 Shen[1991]介绍了 XIMD,它对为 VLIW 处理器调度的线程进行静态交错。Hirata 等人[1992]描述了一种面向媒体的处理器方案,将静态超标量流水线与多线程支持相结合,并报告了同时利用两种并行性所获得的加速。Keckler 和 Dally[1992]则在具有多个功能单元的处理器中,将 ILP 的静态调度与线程的动态调度结合。如何在 ILP 和 TLP 之间平衡功能单元分配,以及如何调度这两种并行性,当时仍是尚未解决的问题。
20 世纪 90 年代中期,人们已经明确看到动态调度超标量处理器即将问世,几个研究组提出利用其动态调度能力,在运行中混合来自不同线程的指令。Yamamoto 等人[1994]似乎发表了最早的此类方案,不过其多线程超标量体系结构的仿真采用了过于简单的假设。紧接着,Tullsen、Eggers 和 Levy[1995]给出了第一份较为真实的仿真评估,并创造了 simultaneous multithreading(同时多线程,SMT)一词。该团队随后与产业界合作者解决了许多有关 SMT 的开放问题。例如,Tullsen 等人[1996]研究了 ILP 与 TLP 调度的挑战;Lo 等人[1997]广泛讨论了 SMT 概念并评估其性能潜力;Lo 等人[1998]评估了 SMT 处理器上的数据库性能;Tuck 和 Tullsen[2003]回顾了 Pentium 4 上的 SMT 性能。
IBM Power4 引入了多线程[Tendler 等人,2002],Power5 则采用同时多线程。Mathis 等人[2005]研究了 Power5 的 SMT 性能,Sinharoy 等人[2005]介绍了其系统体系结构。
参考文献
Agarwal, A., J. Kubiatowicz, D. Kranz, B.-H. Lim, D. Yeung, G. D’Souza, and M. Parkin [1993]. “Sparcle: An evolutionary processor design for large-scale multiprocessors,” IEEE Micro 13 (June), 48–61.
Agerwala, T., and J. Cocke [1987]. High Performance Reduced Instruction Set Processors, Tech. Rep. RC12434, IBM Thomas Watson Research Center, Yorktown Heights, N.Y.
Alverson, G., R. Alverson, D. Callahan, B. Koblenz, A. Porterfield, and B. Smith [1992]. “Exploiting heterogeneous parallelism on a multithreaded multiprocessor,” Proc. ACM/IEEE Conf. on Supercomputing, November 16–20, 1992, Minneapolis, Minn., 188–197.
Anderson, D. W., F. J. Sparacio, and R. M. Tomasulo [1967]. “The IBM 360 Model 91: Processor philosophy and instruction handling,” IBM J. Research and Development 11:1 (January), 8–24.
Austin, T. M., and G. Sohi [1992]. “Dynamic dependency analysis of ordinary programs,” Proc. 19th Annual Int’l. Symposium on Computer Architecture (ISCA), May 19–21, 1992, Gold Coast, Australia, 342–351.
Babbay, F., and A. Mendelson [1998]. “Using value prediction to increase the power of speculative execution hardware,” ACM Trans. on Computer Systems 16: 3 (August), 234–270.
Bakoglu, H. B., G. F. Grohoski, L. E. Thatcher, J. A. Kaeli, C. R. Moore, D. P. Tattle, W. E. Male, W. R. Hardell, D. A. Hicks, M. Nguyen Phu, R. K. Montoye, W. T. Glover, and S. Dhawan [1989]. “IBM second-generation RISC processor organization,” Proc. IEEE Int’l. Conf. on Computer Design, October, Rye Brook, N.Y., 138–142.
Ball, T., and J. Larus [1993]. “Branch prediction for free,” Proc. ACM SIGPLAN’93 Conference on Programming Language Design and Implementation (PLDI), June 23–25, 1993, Albuquerque, N.M., 300–313.
Bhandarkar, D., and D. W. Clark [1991]. “Performance from architecture: Comparing a RISC and a CISC with similar hardware organizations,” Proc. Fourth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 8–11, 1991, Palo Alto, Calif., 310–319.
Bhandarkar, D., and J. Ding [1997]. “Performance characterization of the Pentium Pro processor,” Proc. Third Int’l. Symposium on High Performance Computer Architecture, February 1–5, 1997, San Antonio, Tex., 288–297.
Bloch, E. [1959]. “The engineering design of the Stretch computer,” Proc. Eastern Joint Computer Conf., December 1–3, 1959, Boston, Mass., 48–59.
Bucholtz, W. [1962]. Planning a Computer System: Project Stretch, McGraw-Hill, New York.
Calder, B., D. Grunwald, M. Jones, D. Lindsay, J. Martin, M. Mozer, and B. Zorn [1997]. “Evidence-based static branch prediction using machine learning,” ACM Trans. Program. Lang. Syst. 19:1, 188–222.
Calder, B., G. Reinman, and D. M. Tullsen [1999]. “Selective value prediction,” Proc. 26th Annual Int’l. Symposium on Computer Architecture (ISCA), May 2–4, 1999, Atlanta, Ga.
Chang, P. P., S. A. Mahlke, W. Y. Chen, N. J. Warter, and W. W. Hwu [1991]. “IMPACT: An architectural framework for multiple-instruction-issue processors,” Proc. 18th Annual Int’l. Symposium on Computer Architecture (ISCA), May 27–30, 1991, Toronto, Canada, 266–275.
Charlesworth, A. E. [1981]. “An approach to scientific array processing: The architecture design of the AP-120B/FPS-164 family,” Computer 14:9 (September), 18–27.
Chen, T. C. [1980]. “Overlap and parallel processing,” in Introduction to Computer Architecture, H. Stone, ed., Science Research Associates, Chicago, 427–486.
Chrysos, G. Z., and J. S. Emer [1998]. “Memory dependence prediction using store sets,” Proc. 25th Annual Int’l. Symposium on Computer Architecture (ISCA), July 3–14, 1998, Barcelona, Spain, 142–153.
Clark, D. W. [1987]. “Pipelining and performance in the VAX 8800 processor,” Proc. Second Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 5–8, 1987, Palo Alto, Calif., 173–177.
Clark, W. A. [1957]. “The Lincoln TX-2 computer development,” Proc. Western Joint Computer Conference, February 26–28, 1957, Los Angeles, 143–145.
Colwell, R. P., and R. Steck [1995]. “A 0.6 μm BiCMOS processor with dynamic execution.” Proc. of IEEE Int’l. Symposium on Solid State Circuits (ISSCC), February 15–17, 1995, San Francisco, 176–177.
Colwell, R. P., R. P. Nix, J. J. O’Donnell, D. B. Papworth, and P. K. Rodman [1987]. “A VLIW architecture for a trace scheduling compiler,” Proc. Second Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 5–8, 1987, Palo Alto, Calif., 180–192.
Cvetanovic, Z., and R. E. Kessler [2000]. “Performance analysis of the Alpha 21264-based Compaq ES40 system,” 27th Annual Int’l. Symposium on Computer Architecture (ISCA), June 10–14, 2000, Vancouver, Canada, 192–202.
Davidson, E. S. [1971]. “The design and control of pipelined function generators,” Proc. IEEE Conf. on Systems, Networks, and Computers, January 19–21, 1971, Oaxtepec, Mexico, 19–21.
Davidson, E. S., A. T. Thomas, L. E. Shar, and J. H. Patel [1975]. “Effective control for pipelined processors,” Proc. IEEE COMPCON, February 25–27, 1975, San Francisco, 181–184.
Dehnert, J. C., P. Y.-T. Hsu, and J. P. Bratt [1989]. “Overlapped loop support on the Cydra 5,” Proc. Third Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 3–6, 1989, Boston, Mass., 26–39.
Diep, T. A., C. Nelson, and J. P. Shen [1995]. “Performance evaluation of the PowerPC 620 microarchitecture,” Proc. 22nd Annual Int’l. Symposium on Computer Architecture (ISCA), June 22–24, 1995, Santa Margherita, Italy.
Ditzel, D. R., and H. R. McLellan [1987]. “Branch folding in the CRISP microprocessor: Reducing the branch delay to zero,” Proc. 14th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–5, 1987, Pittsburgh, Penn., 2–7.
Douglas, J. [2005]. “Intel 8xx series and Paxville Xeon-MP Microprocessors,” paper presented at Hot Chips 17, August 14–16, 2005, Stanford University, Palo Alto, Calif.
Eden, A., and T. Mudge [1998]. “The YAGS branch prediction scheme,” Proc. of the 31st Annual ACM/IEEE Int’l. Symposium on Microarchitecture, November 30–December 2, 1998, Dallas, Tex., 69–80.
Edmondson, J. H., P. I. Rubinfield, R. Preston, and V. Rajagopalan [1995]. “Superscalar instruction execution in the 21164 Alpha microprocessor,” IEEE Micro 15:2, 33–43.
Ellis, J. R. [1986]. Bulldog: A Compiler for VLIW Architectures, MIT Press, Cambridge, Mass.
Emer, J. S., and D. W. Clark [1984]. “A characterization of processor performance in the VAX-11/780,” Proc. 11th Annual Int’l. Symposium on Computer Architecture (ISCA), June 5–7, 1984, Ann Arbor, Mich., 301–310.
Evers, M., S. J. Patel, R. S. Chappell, and Y. N. Patt [1998]. “An analysis of correlation and predictability: What makes two-level branch predictors work,” Proc. 25th Annual Int’l. Symposium on Computer Architecture (ISCA), July 3–14, 1998, Barcelona, Spain, 52–61.
Fisher, J. A. [1981]. “Trace scheduling: A technique for global microcode compaction,” IEEE Trans. on Computers 30:7 (July), 478–490.
Fisher, J. A. [1983]. “Very long instruction word architectures and ELI-512,” 10th Annual Int’l. Symposium on Computer Architecture (ISCA), June 5–7, 1982, Stockholm, Sweden, 140–150.
Fisher, J. A., and S. M. Freudenberger [1992]. “Predicting conditional branches from previous runs of a program,” Proc. Fifth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 12–15, 1992, Boston, 85–95.
Fisher, J. A., and B. R. Rau [1993]. Journal of Supercomputing, January (special issue).
Fisher, J. A., J. R. Ellis, J. C. Ruttenberg, and A. Nicolau [1984]. “Parallel processing: A smart compiler and a dumb processor,” Proc. SIGPLAN Conf. on Compiler Construction, June 17–22, 1984, Montreal, Canada, 11–16.
Forgie, J. W. [1957]. “The Lincoln TX-2 input-output system,” Proc. Western Joint Computer Conference, February 26–28, 1957, Los Angeles, 156–160.
Foster, C. C., and E. M. Riseman [1972]. “Percolation of code to enhance parallel dispatching and execution,” IEEE Trans. on Computers C-21:12 (December), 1411–1415.
Gallagher, D. M., W. Y. Chen, S. A. Mahlke, J. C. Gyllenhaal, and W.W. Hwu [1994]. “Dynamic memory disambiguation using the memory conflict buffer,” Proc. Sixth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 4–7, Santa Jose, Calif., 183–193.
González, J., and A. González [1998]. “Limits of instruction level parallelism with data speculation,” Proc. Vector and Parallel Processing (VECPAR) Conf., June 21–23, 1998, Porto, Portugal, 585–598.
Heinrich, J. [1993]. MIPS R4000 User’s Manual, Prentice Hall, Englewood Cliffs, N.J.
Hinton, G., D. Sager, M. Upton, D. Boggs, D. Carmean, A. Kyker, and P. Roussel [2001]. “The microarchitecture of the Pentium 4 processor,” Intel Technology Journal, February.
Hirata, H., K. Kimura, S. Nagamine, Y. Mochizuki, A. Nishimura, Y. Nakase, and T. Nishizawa [1992]. “An elementary processor architecture with simultaneous instruction issuing from multiple threads,” Proc. 19th Annual Int’l. Symposium on Computer Architecture (ISCA), May 19–21, 1992, Gold Coast, Australia, 136–145.
Hopkins, M. [2000]. “A critical look at IA-64: Massive resources, massive ILP, but can it deliver?” Microprocessor Report, February.
Hsu, P. [1994]. “Designing the TFP microprocessor,” IEEE Micro 18:2 (April), 2333.
Huck, J. et al. [2000]. “Introducing the IA-64 Architecture” IEEE Micro, 20:5 (September–October), 12–23.
Hwu, W.-M., and Y. Patt [1986]. “HPSm, a high performance restricted data flow architecture having minimum functionality,” 13th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–5, 1986, Tokyo, 297–307.
Hwu, W. W., S. A. Mahlke, W. Y. Chen, P. P. Chang, N. J. Warter, R. A. Bringmann, R. O. Ouellette, R. E. Hank, T. Kiyohara, G. E. Haab, J. G. Holm, and D. M. Lavery [1993]. “The superblock: An effective technique for VLIW and superscalar compilation,” J. Supercomputing 7:1, 2 (March), 229–248.
IBM. [1990]. “The IBM RISC System/6000 processor” (collection of papers), IBM J. Research and Development 34:1 (January).
Jimenez, D. A., and C. Lin [2002]. “Neural methods for dynamic branch prediction,” ACM Trans. Computer Sys 20:4 (November), 369–397.
Johnson, M. [1990]. Superscalar Microprocessor Design, Prentice Hall, Englewood Cliffs, N.J.
Jordan, H. F. [1983]. “Performance measurements on HEP—a pipelined MIMD computer,” Proc. 10th Annual Int’l. Symposium on Computer Architecture (ISCA), June 5–7, 1982, Stockholm, Sweden, 207–212.
Jouppi, N. P., and D. W. Wall [1989]. “Available instruction-level parallelism for superscalar and superpipelined processors,” Proc. Third Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 3–6, 1989, Boston, 272–282.
Kaeli, D. R., and P. G. Emma [1991]. “Branch history table prediction of moving target branches due to subroutine returns,” Proc. 18th Annual Int’l. Symposium on Computer Architecture (ISCA), May 27–30, 1991, Toronto, Canada, 34–42.
Keckler, S. W., and W. J. Dally [1992]. “Processor coupling: Integrating compile time and runtime scheduling for parallelism,” Proc. 19th Annual Int’l. Symposium on Computer Architecture (ISCA), May 19–21, 1992, Gold Coast, Australia, 202–213.
Keller, R. M. [1975]. “Look-ahead processors,” ACM Computing Surveys 7:4 (December), 177–195.
Keltcher, C. N., K. J. McGrath, A. Ahmed, and P. Conway [2003]. “The AMD Opteron processor for multiprocessor servers,” IEEE Micro 23:2 (March– April), 66–76.
Kessler, R. [1999]. “The Alpha 21264 microprocessor,” IEEE Micro 19:2 (March/ April) 24–36.
Killian, E. [1991]. “MIPS R4000 technical overview–64 bits/100 MHz or bust,” Hot Chips III Symposium Record, August 26–27, 1991, Stanford University, Palo Alto, Calif., 1.6–1.19.
Kogge, P. M. [1981]. The Architecture of Pipelined Computers, McGraw-Hill, New York.
Kumar, A. [1997]. “The HP PA-8000 RISC CPU,” IEEE Micro 17:2 (March/ April).
Kunkel, S. R., and J. E. Smith [1986]. “Optimal pipelining in supercomputers,” Proc. 13th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–5, 1986, Tokyo, 404–414.
Lam, M. [1988]. “Software pipelining: An effective scheduling technique for VLIW processors,” SIGPLAN Conf. on Programming Language Design and Implementation, June 22–24, 1988, Atlanta, Ga., 318–328.
Lam, M. S., and R. P. Wilson [1992]. “Limits of control flow on parallelism,” Proc. 19th Annual Int’l. Symposium on Computer Architecture (ISCA), May 19–21, 1992, Gold Coast, Australia, 46–57.
Laudon, J., A. Gupta, and M. Horowitz [1994]. “Interleaving: A multithreading technique targeting multiprocessors and workstations,” Proc. Sixth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 4–7, San Jose, Calif., 308–318.
Lauterbach, G., and T. Horel [1999]. “UltraSPARC-III: Designing third generation 64-bit performance,” IEEE Micro 19:3 (May/June).
Lipasti, M. H., and J. P. Shen [1996]. “Exceeding the dataflow limit via value prediction,” Proc. 29th Int’l. Symposium on Microarchitecture, December 2–4, 1996, Paris, France.
Lipasti, M. H., C. B. Wilkerson, and J. P. Shen [1996]. “Value locality and load value prediction,” Proc. Seventh Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 1–5, 1996, Cambridge, Mass., 138–147.
Lo, J., L. Barroso, S. Eggers, K. Gharachorloo, H. Levy, and S. Parekh [1998]. “An analysis of database workload performance on simultaneous multithreaded processors,” Proc. 25th Annual Int’l. Symposium on Computer Architecture (ISCA), July 3–14, 1998, Barcelona, Spain, 39–50.
Lo, J., S. Eggers, J. Emer, H. Levy, R. Stamm, and D. Tullsen [1997]. “Converting thread-level parallelism into instruction-level parallelism via simultaneous multithreading,” ACM Trans. on Computer Systems 15:2 (August), 322–354.
Mahlke, S. A., W. Y. Chen, W.-M. Hwu, B. R. Rau, and M. S. Schlansker [1992]. “Sentinel scheduling for VLIW and superscalar processors,” Proc. Fifth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 12–15, 1992, Boston, 238–247.
Mahlke, S. A., R. E. Hank, J. E. McCormick, D. I. August, and W. W. Hwu [1995]. “A comparison of full and partial predicated execution support for ILP processors,” Proc. 22nd Annual Int’l. Symposium on Computer Architecture (ISCA), June 22–24, 1995, Santa Margherita, Italy, 138–149.
Mathis, H. M., A. E. Mercias, J. D. McCalpin, R. J. Eickemeyer, and S. R. Kunkel [2005]. “Characterization of the multithreading (SMT) efficiency in Power5,” IBM J. of Research and Development, 49:4/5 (July/September), 555–564.
McCormick, J., and A. Knies [2002]. “A brief analysis of the SPEC CPU2000 benchmarks on the Intel Itanium 2 processor,” paper presented at Hot Chips 14, August 18–20, 2002, Stanford University, Palo Alto, Calif.
McFarling, S. [1993]. Combining Branch Predictors, WRL Technical Note TN-36, Digital Western Research Laboratory, Palo Alto, Calif.
McFarling, S., and J. Hennessy [1986]. “Reducing the cost of branches,” Proc. 13th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–5, 1986, Tokyo, 396–403.
McNairy, C., and D. Soltis [2003]. “Itanium 2 processor microarchitecture,” IEEE Micro 23:2 (March–April), 44–55.
Moshovos, A., and G. S. Sohi [1997]. “Streamlining inter-operation memory communication via data dependence prediction,” Proc. 30th Annual Int’l. Symposium on Microarchitecture, December 1–3, Research Triangle Park, N.C., 235–245.
Moshovos, A., S. Breach, T. N. Vijaykumar, and G. S. Sohi [1997]. “Dynamic speculation and synchronization of data dependences,” Proc. 24th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–4, 1997, Denver, Colo.
Nicolau, A., and J. A. Fisher [1984]. “Measuring the parallelism available for very long instruction word architectures,” IEEE Trans. on Computers C-33:11 (November), 968–976.
Pan, S.-T., K. So, and J. T. Rameh [1992]. “Improving the accuracy of dynamic branch prediction using branch correlation,” Proc. Fifth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 12–15, 1992, Boston, 76–84.
Postiff, M.A., D. A. Greene, G. S. Tyson, and T. N. Mudge [1999]. “The limits of instruction level parallelism in SPEC95 applications,” Computer Architecture News 27:1 (March), 31–40.
Ramamoorthy, C. V., and H. F. Li [1977]. “Pipeline architecture,” ACM Computing Surveys 9:1 (March), 61–102.
Rau, B. R. [1994]. “Iterative modulo scheduling: An algorithm for software pipelining loops,” Proc. 27th Annual Int’l. Symposium on Microarchitecture, November 30–December 2, 1994, San Jose, Calif., 63–74.
Rau, B. R., C. D. Glaeser, and R. L. Picard [1982]. “Efficient code generation for horizontal architectures: Compiler techniques and architectural support,” Proc. Ninth Annual Int’l. Symposium on Computer Architecture (ISCA), April 26–29, 1982, Austin, Tex., 131–139.
Rau, B. R., D. W. L. Yen, W. Yen, and R. A. Towle [1989]. “The Cydra 5 departmental supercomputer: Design philosophies, decisions, and trade-offs,” IEEE Computers 22:1 (January), 12–34.
Riseman, E. M., and C. C. Foster [1972]. “Percolation of code to enhance paralleled dispatching and execution,” IEEE Trans. on Computers C-21:12 (December), 1411–1415.
Rymarczyk, J. [1982]. “Coding guidelines for pipelined processors,” Proc. Symposium Architectural Support for Programming Languages and Operating Systems (ASPLOS), March 1–3, 1982, Palo Alto, Calif., 12–19.
Sharangpani, H., and K. Arora [2000]. “Itanium Processor Microarchitecture,” IEEE Micro, 20:5 (September–October), 24–43.
Sinharoy, B., R. N. Koala, J. M. Tendler, R. J. Eickemeyer, and J. B. Joyner [2005]. “POWER5 system microarchitecture,” IBM J. of Research and Development, 49:4–5, 505–521.
Sites, R. [1979]. Instruction Ordering for the CRAY-1 Computer, Tech. Rep. 78-CS-023, Dept. of Computer Science, University of California, San Diego.
Skadron, K., P. S. Ahuja, M. Martonosi, and D. W. Clark [1999]. “Branch prediction, instruction-window size, and cache size: Performance tradeoffs and simulation techniques,” IEEE Trans. on Computers, 48:11 (November).
Smith, A., and J. Lee [1984]. “Branch prediction strategies and branch-target buffer design,” Computer 17:1 (January), 6–22.
Smith, B. J. [1978]. “A pipelined, shared resource MIMD computer,” Proc. Int’l. Conf. on Parallel Processing (ICPP), August, Bellaire, Mich., 6–8.
Smith, J. E. [1981]. “A study of branch prediction strategies,” Proc. Eighth Annual Int’l. Symposium on Computer Architecture (ISCA), May 12–14, 1981, Minneapolis, Minn., 135–148.
Smith, J. E. [1984]. “Decoupled access/execute computer architectures,” ACM Trans. on Computer Systems 2:4 (November), 289–308.
Smith, J. E. [1989]. “Dynamic instruction scheduling and the Astronautics ZS-1,” Computer 22:7 (July), 21–35.
Smith, J. E., and A. R. Pleszkun [1988]. “Implementing precise interrupts in pipelined processors,” IEEE Trans. on Computers 37:5 (May), 562–573. (This paper is based on an earlier paper that appeared in Proc. 12th Annual Int’l. Symposium on Computer Architecture (ISCA), June 17–19, 1985, Boston, Mass.)
Smith, J. E., G. E. Dermer, B. D. Vanderwarn, S. D. Klinger, C. M. Rozewski, D. L. Fowler, K. R. Scidmore, and J. P. Laudon [1987]. “The ZS-1 central processor,” Proc. Second Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 5–8, 1987, Palo Alto, Calif., 199–204.
Smith, M. D., M. Horowitz, and M. S. Lam [1992]. “Efficient superscalar performance through boosting,” Proc. Fifth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 12–15, 1992, Boston, 248–259.
Smith, M. D., M. Johnson, and M. A. Horowitz [1989]. “Limits on multiple instruction issue,” Proc. Third Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 3–6, 1989, Boston, 290–302.
Sodani, A., and G. Sohi [1997]. “Dynamic instruction reuse,” Proc. 24th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–4, 1997, Denver, Colo.
Sohi, G. S. [1990]. “Instruction issue logic for high-performance, interruptible, multiple functional unit, pipelined computers,” IEEE Trans. on Computers 39:3 (March), 349–359.
Sohi, G. S., and S. Vajapeyam [1989]. “Tradeoffs in instruction format design for horizontal architectures,” Proc. Third Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 3–6, 1989, Boston, 15–25.
Sussenguth, E. [1999]. “IBM’s ACS-1 Machine,” IEEE Computer 22:11 (November).
Tendler, J. M., J. S. Dodson, J. S. Fields, Jr., H. Le, and B. Sinharoy [2002]. “Power4 system microarchitecture,” IBM J. of Research and Development, 46:1, 5–26.
Thorlin, J. F. [1967]. “Code generation for PIE (parallel instruction execution) computers,” Proc. Spring Joint Computer Conf., April 18–20, 1967, Atlantic City, N.J., 27.
Thornton, J. E. [1964]. “Parallel operation in the Control Data 6600,” Proc. AFIPS Fall Joint Computer Conf., Part II, October 27–29, 1964, San Francisco, 26, 33–40.
Thornton, J. E. [1970]. Design of a Computer, the Control Data 6600, Scott, Foresman, Glenview, Ill.
Tjaden, G. S., and M. J. Flynn [1970]. “Detection and parallel execution of independent instructions,” IEEE Trans. on Computers C-19:10 (October), 889–895.
Tomasulo, R. M. [1967]. “An efficient algorithm for exploiting multiple arithmetic units,” IBM J. Research and Development 11:1 (January), 25–33.
Tuck, N., and D. Tullsen [2003]. “Initial observations of the simultaneous multithreading Pentium 4 processor,” Proc. 12th Int. Conf. on Parallel Architectures and Compilation Techniques (PACT’03), September 27–October 1, New Orleans, La., 26–34.
Tullsen, D. M., S. J. Eggers, and H. M. Levy [1995]. “Simultaneous multithreading: Maximizing on-chip parallelism,” Proc. 22nd Annual Int’l. Symposium on Computer Architecture (ISCA), June 22–24, 1995, Santa Margherita, Italy, 392–403.
Tullsen, D. M., S. J. Eggers, J. S. Emer, H. M. Levy, J. L. Lo, and R. L. Stamm [1996]. “Exploiting choice: Instruction fetch and issue on an implementable simultaneous multithreading processor,” Proc. 23rd Annual Int’l. Symposium on Computer Architecture (ISCA), May 22–24, 1996, Philadelphia, Penn., 191–202.
Wall, D. W. [1991]. “Limits of instruction-level parallelism,” Proc. Fourth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 8–11, 1991, Palo Alto, Calif., 248–259.
Wall, D. W. [1993]. Limits of Instruction-Level Parallelism, Research Rep. 93/6, Western Research Laboratory, Digital Equipment Corp., Palo Alto, Calif.
Weiss, S., and J. E. Smith [1984]. “Instruction issue logic for pipelined supercomputers,” Proc. 11th Annual Int’l. Symposium on Computer Architecture (ISCA), June 5–7, 1984, Ann Arbor, Mich., 110–118.
Weiss, S., and J. E. Smith [1987]. “A study of scalar compilation techniques for pipelined supercomputers,” Proc. Second Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 5–8, 1987, Palo Alto, Calif., 105–109.
Wilson, R. P., and M. S. Lam [1995]. “Efficient context-sensitive pointer analysis for C programs,” Proc. ACM SIGPLAN’95 Conf. on Programming Language Design and Implementation, June 18–21, 1995, La Jolla, Calif., 1–12.
Wolfe, A., and J. P. Shen [1991]. “A variable instruction stream extension to the VLIW architecture,” Proc. Fourth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 8–11, 1991, Palo Alto, Calif., 2–14.
Yamamoto, W., M. J. Serrano, A. R. Talcott, R. C. Wood, and M. Nemirosky [1994]. “Performance estimation of multistreamed, superscalar processors,” Proc. 27th Annual Hawaii Int’l. Conf. on System Sciences, January 4–7, 1994, Maui, 195–204.
Yeager, K. [1996]. “The MIPS R10000 superscalar microprocessor,” IEEE Micro 16:2 (April), 28–40.
Yeh, T., and Y. N. Patt [1992]. “Alternative implementations of two-level adaptive branch prediction,” Proc. 19th Annual Int’l. Symposium on Computer Architecture (ISCA), May 19–21, 1992, Gold Coast, Australia, 124–134.
Yeh, T., and Y. N. Patt [1993]. “A comparison of dynamic branch predictors that use two levels of branch history,” Proc. 20th Annual Int’l. Symposium on Computer Architecture (ISCA), May 16–19, 1993, San Diego, Calif., 257–266.
M.6 SIMD 超级计算机、向量计算机、多媒体 SIMD 指令扩展与 GPU 的发展(第 4 章)
本节首先以或许是最声名狼藉的超级计算机 Illiac IV 为例,介绍早期 SIMD(单指令、多数据)体系结构;随后转向或许最负盛名的超级计算机 Cray-1,介绍向量体系结构。接下来讨论多媒体 SIMD 扩展。这个名称的流行,部分得益于一场以“Bunny People”为主角的广告活动:一群穿着半导体生产线洁净服的工人跳起了迪斯科。最后,我们介绍 GPU 的历史,它就没有这么多戏剧性了。
SIMD 超级计算机
然而,通用多处理器的成本非常高,因此还考虑了其他设计选择,希望在不严重降低系统能力或效率的情况下减少成本。这些选择,就是将三个主要组成部分之一重新集中起来。……将[控制单元]集中,就形成了……Illiac IV 这样的阵列处理器的基本组织结构。
——Bouknight 等人[1972]
……对 Illiac IV 来说,编程非常困难,而且这种体系结构可能并不适合我们当时尝试运行的一些应用。我的主要看法是:在 Illiac IV 上,应用与体系结构之间并没有形成很好的匹配。
——David Kuck,Illiac IV 软件设计者、并行软件的早期先驱;Andrew Goldstein 于 1991 年进行的口述史访谈,IEEE History Center,New Brunswick,New Jersey
SIMD 是最早的并行计算模型之一,可以追溯到第一台大规模多处理器 Illiac IV。这类机器不像向量体系结构那样将数据计算流水线化,而是使用一组构成阵列的功能单元,因此也可以称为阵列处理器。
SIMD 风格计算机的最早思想来自 Unger[1958]和 Slotnick、Borck、McReynolds[1962]。Slotnick 的 Solomon 设计构成了 Illiac IV 的基础;后者也许是超级计算机项目中最声名狼藉的一个。它虽然成功推动了几项后来被证明有用的技术,但作为计算机却失败了。尽管最终只建成原计划多处理器的四分之一,成本仍从 1966 年估计的 800 万美元,上升到 1972 年的 3100 万美元。按 2011 年美元价值计算,相当于从 5400 万增至 1.52 亿美元。实际性能最高只有 15 MFLOPS,而最初预测完整系统可达到 1000 MFLOPS[Hord,1982]。机器于 1972 年交付 NASA Ames Research 后,又经过三年工程改进才可使用。这些事件减缓了 SIMD 的研究,但 Danny Hillis[1985]通过拥有 65,536 个 1 位处理器的 Connection Machine,使这种体系结构重获生机。
SIMD 多处理器的基本权衡,是单个处理器的性能与处理器数量之间的权衡。20 世纪 80 年代的 SIMD 超级计算机,更重视大规模并行,而非单个处理器的性能。例如,Connection Multiprocessor 2 提供 65,536 个 1 位宽处理器,而 Illiac IV 的方案采用 64 个 64 位处理器。大规模并行 SIMD 多处理器依靠互连或通信网络,在处理单元之间交换数据。
20 世纪 80 年代,Thinking Machines 和后来的 MasPar 先后使 SIMD 模型复兴;但它随后又退出了超级计算机主流,主要有两个原因。第一,它缺乏灵活性。许多重要问题并不具备数据并行性,而且这种体系结构缩小规模后缺乏竞争力;也就是说,小规模 SIMD 多处理器的性价比往往不如其他方案。第二,SIMD 无法利用 80 年代 SISD(单指令、单数据)微处理器技术在性能和成本上的巨大优势;当时这种技术的性能每 18 个月就翻一番。SIMD 多处理器的设计者不能利用这种低成本技术,而必须为其多处理器设计定制处理器。
向量计算机
我当然不是在发明向量处理器。据我所知,今天已有三种,分别是 Illiac-IV、[CDC]Star 和 TI[ASC]。它们都是开创性的处理器。……作为先驱,一个问题就是总会犯错,而我从来、从来不想成为先驱。能够看看先驱犯过哪些错误,再做第二个,总是更好。
——Seymour Cray,1976 年在 Lawrence Livermore Laboratories 介绍 Cray-1 的公开演讲
最早的向量处理器,是 1972 年公布的 Control Data Corporation(CDC)STAR-100[Hintz 和 Tate,1972]和 Texas Instruments ASC[Watson,1972]。两者都是内存—内存向量处理器,标量单元相对较慢。STAR 的标量与向量共用运算单元,导致标量流水线极深。两种处理器的启动开销都很高,处理的向量通常有数百至数千个元素。向量处理开始优于标量处理的交叉点,可能要超过 50 个元素。看来,这两种处理器的设计没有充分重视 Amdahl 定律的作用。
Seymour Cray 在 CDC 参与了 6600 和 7600 的研制,随后创立 Cray Research,并于 1976 年推出 Cray-1[Russell,1978]。Cray-1 采用向量寄存器体系结构,显著降低了启动开销和内存带宽需求。它还高效支持非单位步长,Cray 也发明了链接技术。最重要的是,Cray-1 当时还是世界上最快的标量处理器。出色的标量与向量性能相互匹配,可能是 Cray-1 成功的最关键因素。有些客户购买它,主要就是看中其优异的标量性能。后来的许多向量处理器,都以这款最早取得商业成功的向量处理器的体系结构为基础。Baskett 和 Keller[1977]对 Cray-1 作了很好的评估。
1981 年,CDC 开始交付 CYBER 205[Lincoln,1982]。205 与 STAR 的基本体系结构相同,但各方面性能都有提升;其向量单元还可以扩展到最多四条通道,每条通道具有多个功能单元,以及每周期可传送多个字的宽 load-store 流水线。CYBER 205 的峰值性能远高于 Cray-1,但在实际程序中,差距小得多。
1983 年,Cray Research 交付了第一台 Cray X-MP[Chen,1983]。更快的时钟周期——9.5 ns,而 Cray-1 为 12.5 ns——更好的链接支持,以及多条访存流水线,使 Cray Research 保住了超级计算机领域的领先地位。改进的链接支持,使存在 RAW 依赖的向量操作能够并行执行。后来推出的 Cray-2 是全新设计,最多可配置四个处理器。其重要特点是采用 DRAM,从而在当时实现了很大的内存容量。第一台 Cray-2 配备 256M 个 64 位字的内存,比此前所有已交付 Cray 机器的内存总量还大!Cray-2 的时钟比 X-MP 快得多,流水线也深得多;但它没有链接功能,内存延迟极大,每个处理器也只有一条访存流水线。总体而言,只有在问题需要其巨大主存时,Cray-2 才比 Cray X-MP 更快。
同年,日本处理器厂商进入超级计算机市场。最先出现的是 Fujitsu VP100、VP200[Miura 和 Uchida,1983],后来又有 Hitachi S810 和 NEC SX/2[Watanabe,1987]。这些处理器的性能接近 Cray X-MP。总体而言,这三家厂商的处理器峰值性能远高于 Cray X-MP,但由于启动开销很大,典型性能常常更低。Cray X-MP 倾向于多处理器方法,先推出双处理器版本,再推出四处理器版本;相比之下,三种日本处理器强调可扩展的向量能力。
1988 年,Cray Research 推出 Cray Y-MP,它是更大、更快的 X-MP,最多允许八个处理器,周期缩短到 6 ns。满配八个处理器的 Y-MP 通常是最快的超级计算机,不过单处理器的日本超级计算机可能快于单处理器 Y-MP。1989 年末,Cray Research 分成两家公司,都以研制 90 年代初可交付的高端处理器为目标。Seymour Cray 领导分拆出的 Cray Computer Corporation,直到该公司于 1995 年倒闭。其首款处理器 Cray-3 原计划采用砷化镓实现,但公司未能开发出可靠且具有成本效益的实现技术。1996 年,Seymour Cray 在车祸中不幸去世;此前不久,他又创办了一家公司开发高性能系统,但这一次采用商用通用组件。
Cray Research 则专注于 C90:一种最多支持 16 个处理器、时钟频率为 240 MHz 的新高端系统,于 1991 年交付。1993 年,公司推出第一种高度并行的处理器系统 T3D,最多采用 2048 个 Digital Alpha 21064 微处理器。1995 年,公司宣布推出新的低端向量机 J90 和高端机器 T90。T90 与 C90 很相似,但采用三维封装和光学时钟分配,时钟频率达到约两倍,即 460 MHz。
1995 年,Cray Research 被 Silicon Graphics 收购。1998 年发布的 SV1 系统,将速度快得多的 CMOS 处理器接入 J90 的存储系统,并为每个 CPU 增加向量数据缓存,以满足提高后的内存带宽需求。2000 年,Silicon Graphics 将 Cray Research 出售给 Tera Computer,合并后的公司更名为 Cray Inc.。
日本超级计算机厂商继续改进其设计。2001 年,NEC SX/5 普遍被认为是当时最快的向量超级计算机,具有 16 条工作于 312 MHz 的通道,最多 16 个处理器共享内存。同年发布的 NEC SX/6 是第一种商用单芯片向量微处理器,将乱序四发射超标量处理器、标量指令和数据缓存,以及八通道向量单元集成在一个芯片上[Kitagawa 等人,2003]。Earth Simulator 由 640 个节点通过完整交叉开关连接而成,每个节点包含八个共享本地内存的 SX-6 向量微处理器。2004 年发布的 SX-8 将通道数减为四条,却将向量时钟频率提高到 2 GHz。标量单元以较低的 1 GHz 运行;这在向量机中很常见,因为向量单元缺少冒险,更容易采用深流水线。
2002 年,Cray Inc. 推出基于全新向量 ISA 的 X1。X1 的 SSP 处理器芯片,集成了工作于 400 MHz、带标量缓存的乱序超标量处理器,以及工作于 800 MHz 的双通道向量单元。四个 SSP 芯片组合为一个 MSP 时,峰值向量性能达到 12.8 GFLOPS,与同时代 NEC SX 机器具有竞争力。2004 年交付的增强型 X1E,将这两个频率分别提高到 565 MHz 和 1130 MHz。许多思想借鉴自 Cray T3E;T3E 是采用现成微处理器的 MIMD(多指令、多数据)计算机。X1 的新指令集具有更多寄存器,内存以本地方式分布在各处理器旁,但处于共享地址空间中。乱序标量单元与向量单元解耦,使标量单元能超前运行。当数据为利用 MSP 缓存而分块时,向量会变短,这不太适合八通道向量单元。为处理这些较短向量,每个只有两条向量通道的处理器可以执行不同的循环。
Cray X2 于 2007 年公布。考虑到市场规模,投资开发新芯片很难证明其合理性,因此它可能成为最后一种实际建造的 Cray 向量体系结构。其处理器时钟频率为 1.3 GHz,具有八条向量通道,单精度峰值性能为 42 GFLOP/s,并包含 L1 和 L2 缓存。每个节点为四路 SMP,最多配备 128 GB DRAM;整个系统最大为 8K 个节点。
NEC SX-9 于 2008 年公布,每个节点最多有 16 个处理器,每个处理器具有八条通道,运行于 3.2 GHz,双精度向量峰值性能为 102 GFLOP/s。16 处理器 SMP 可配备 1024 GB DRAM;最大系统规模为 512 个节点。
现代向量化编译器技术的基础和数据依赖的概念,由 Illinois 大学的 Kuck 及其同事[1974]建立。Padua 和 Wolfe[1986]对向量化编译器技术作了很好的概述。
多媒体 SIMD 指令扩展
一家计算机硬件公司……怎么可能与迪斯科有什么共同之处?如果看看世界上最大的微处理器公司……Intel 于 1997 年推出的一场广告活动,就会发现共同之处还真不少。
——IBS Center for Management Research,“Dancing Its Way Towards Leadership”,2002 年
翻阅历史,1957 年的 TX-2 已经采用分段 ALU 来支持当时的媒体处理,但这些思想后来淡出了视野,直到 30 年后个人计算机时代才被重新发现。桌面微处理器都要支持自身的图形显示;随着晶体管预算增加,为图形操作增加支持就成为必然。许多图形系统用 8 位表示三原色中的每一种颜色,再用 8 位表示像素的透明度。视频会议和电子游戏加入扬声器、麦克风后,也需要支持声音。音频采样要求高于 8 位的精度,但 16 位就足够。
每种微处理器都有专门支持,使字节和半字在内存中占用更少空间;但典型整数程序很少对这种宽度的数据执行算术运算,因此支持通常仅限于数据传送。Intel i860 在公司内部是以图形加速器的定位获得立项的。其设计者认识到,许多图形和音频应用会对由此类数据组成的向量执行相同操作[Atkins,1991;Kohn,1989]。1989 年 i860 的晶体管预算还无法容纳向量单元,但只要将 64 位 ALU 内的进位链分段,就能同时操作由八个 8 位、四个 16 位或两个 32 位操作数组成的短向量。这种分段 ALU 的成本很低。适合利用这种支持的应用,包括 MPEG 视频、电子游戏中的三维图形、数字摄影,以及视频会议中的音频和图像处理。
这种多媒体支持后来像病毒一样,传播到几乎所有桌面微处理器。HP 率先在取得市场成功的桌面 RISC 中加入这种支持;很快,其他厂商也都在 20 世纪 90 年代提出了各自的版本。
这些扩展最初称为子字并行或向量。Intel 市场部门用 SIMD 来描述 1996 年公布的 80x86 MMX 扩展后,SIMD 成了流行名称;其中一部分功劳,要归于成功的电视广告:迪斯科舞者穿着以半导体生产线洁净服为原型的服装。
图形处理单元
自 NVIDIA 于 2007 年 9 月推出 CUDA API、GPU 计算进入高性能计算主流以来,已经过去近三年。此后,这项技术以出人意料的强劲且稳定的速度被采用。一两年前还在开展小规模试点的许多组织,已经转向企业级部署;GPU 加速机器也已进入 TOP500 榜单,而且从第二名就开始出现。高性能计算界向来不以快速接受新事物著称,CUDA 却能得到相对迅速的采用,这是一个值得关注的信号。
人们通常认为 GPU 计算更困难,我却认为,它迄今的成功表明,其复杂程度并不超过高质量的 CPU 编程。而且,它能更清楚、更简洁地表达一大类问题中的并行性,使代码更易维护、更具可扩展性,也更适合映射到未来的众核体系结构。
——Vincent Natol,“Kudos for CUDA”,HPCwire,2010 年
三维图形流水线硬件从 20 世纪 80 年代初大型、昂贵的系统,发展为小型工作站,再发展到 90 年代中后期的 PC 加速器。期间发生了三项主要变化:
- 性能领先的图形子系统,价格从 50,000 美元降到 200 美元。
- 性能从每秒 5000 万像素提升到每秒 10 亿像素,从每秒 10 万顶点提升到每秒 1000 万顶点。
- 硬件原生能力从线框,即多边形轮廓,发展到以固定颜色平面着色的填充多边形,再到以插值颜色平滑着色的填充多边形,最终支持带纹理映射和初步多重纹理的全场景抗锯齿。
可扩展 GPU
图形系统从一开始就将可扩展性视为有吸引力的特征。工作站图形系统通过改变安装的像素处理器电路板数量,让客户选择像素处理能力。20 世纪 90 年代中期以前,PC 图形几乎没有扩展选择,只有 VGA 控制器。支持三维的加速器出现后,市场开始容纳不同档次的产品。3dfx 在 Voodoo2 中引入最初的 SLI(Scan Line Interleave,扫描线交错),支持多板扩展,并在 1998 年一度占据性能冠军位置。同样在 1998 年,NVIDIA 开始基于同一体系结构推出不同产品,包括高性能的 Riva TNT Ultra 和低成本的 Vanta。最初通过按速度分档和封装区分,后来转向独立芯片设计,例如 GeForce 2 GTS 与 GeForce 2 MX。在原文所述时期,同一代体系结构需要四到五种独立 GPU 芯片设计,才能覆盖桌面 PC 的性能和价格范围;此外,笔记本和工作站还有各自的细分市场。收购 3dfx 后,NVIDIA 于 2004 年从 GeForce 6800 开始延续多 GPU SLI 概念,以对程序员和用户透明的方式提供多 GPU 扩展能力。整个扩展范围内的功能行为一致,同一个应用无需修改,就能在该体系结构系列的任何实现上运行。
图形流水线
早期图形硬件可以配置,却不能由应用开发者编程。每一代产品都会提供渐进式改进,但开发者的需求日益复杂,要求的新功能越来越多,已无法合理地全部作为内置固定功能提供。Lindholm 等人[2001]介绍的 NVIDIA GeForce 3,迈出了通向真正通用、可编程着色器的第一步:把原本内部专用的浮点顶点引擎指令集开放给应用开发者。这与 Microsoft DirectX 8 和 OpenGL 顶点着色器扩展的发布同步。DirectX 9 时期的后续 GPU,将通用可编程性和浮点能力扩展到像素片段阶段,并允许顶点阶段访问纹理。2002 年推出的 ATI Radeon 9700,具有可通过 DirectX 9 和 OpenGL 编程的 24 位浮点像素片段处理器。GeForce FX 则加入了 32 位浮点像素处理器。这是统一不同阶段功能这一总体趋势的一部分,至少从应用程序员的角度看如此。NVIDIA 的 GeForce 6800 和 7800 系列仍分别采用不同的处理器设计,并为顶点处理和片段处理配备独立硬件。2005 年的 Xbox 360 引入了一种早期统一处理器 GPU,使顶点着色器和像素着色器能够在同一个处理器上执行。
GPGPU:过渡阶段
支持 DirectX 9 的 GPU 出现后,一些研究者注意到 GPU 原始计算性能的增长趋势,开始探索用 GPU 解决复杂并行问题。DirectX 9 GPU 的设计只针对图形 API 要求的功能;要使用其计算资源,程序员必须将问题转化为原生图形操作。例如,要同时运行许多个像素着色器实例,就必须向 GPU 提交一个三角形;如果需要矩形形状,还必须进行裁剪。着色器无法向内存执行任意散布(scatter)操作。将结果写入内存的唯一方法,是把它作为像素颜色值输出,再配置帧缓冲操作阶段,将结果写入二维帧缓冲区,或者根据需要与已有值混合。除此之外,将一轮计算结果传给下一轮的唯一方法,是把所有并行结果写入像素帧缓冲区,再把这个帧缓冲区作为纹理映射,输入下一计算阶段的像素片段着色器。在那个时期,将通用计算映射到 GPU 上十分别扭。尽管如此,勇于探索的研究者仍通过艰苦努力,展示了一些有用的应用。这个领域被称为 GPGPU,即 GPU 上的通用计算。
GPU 计算
在为 GeForce 8800 开发 Tesla 体系结构时,NVIDIA 意识到:如果程序员能够把 GPU 当作处理器来思考,它的潜在用途会广泛得多。NVIDIA 选择了一种编程方法,让程序员显式声明工作负载中的数据并行部分。为支持 DirectX 10 这一代产品的逻辑图形流水线,NVIDIA 已经开始研制高效的浮点与整数处理器,使其能够同时运行多种工作负载。该处理器的设计利用了这样一种常见情况:一组线程执行同一条代码路径。为满足编译后的 C 程序的要求,NVIDIA 加入了按整数字节地址寻址的 load 和 store 指令;还引入线程块,即协作线程数组、线程块网格,以及屏障同步,来派发和管理高度并行的计算工作,并加入原子内存操作。NVIDIA 开发了 CUDA C/C++ 编译器、库和运行时软件,使程序员易于使用新的数据并行计算模型并开发应用。
为了创建独立于厂商的 GPU 编程语言,许多公司正在为 OpenCL 开发编译器。OpenCL 具有 CUDA 的许多特征,却能运行在多得多的平台上。按原文 2011 年的情况,为 GPU 编写 CUDA 代码的性能远高于编写 OpenCL 代码。
AMD 收购第二大 GPU 厂商 ATI,预示着 GPU 计算将进一步普及。原文这一部分即将定稿时公布的 AMD Fusion 体系结构,是传统 GPU 与传统 CPU 的初步融合。NVIDIA 也宣布了 Project Denver,将 ARM 标量处理器与 NVIDIA GPU 放在同一地址空间中。等这些系统交付后,值得关注的问题包括:它们究竟集成得多紧密,以及这种集成会怎样影响数据并行应用和图形应用的性能与能耗。
参考文献
SIMD 超级计算机
Bouknight, W. J., S. A. Deneberg, D. E. McIntyre, J. M. Randall, A. H. Sameh, and D. L. Slotnick [1972]. “The Illiac IV system,” Proc. IEEE 60:4, 369–379. Also appears in D. P. Siewiorek, C. G. Bell, and A. Newell, Computer Structures: Principles and Examples, McGraw-Hill, New York, 1982, 306–316.
Hillis, W. D. [1985]. The Connection Multiprocessor, MIT Press, Cambridge, Mass.
Hord, R. M. [1982]. The Illiac-IV, The First Supercomputer, Computer Science Press, Rockville, Md.
Slotnick, D. L., W. C. Borck, and R. C. McReynolds [1962]. “The Solomon computer,” Proc. AFIPS Fall Joint Computer Conf., December 4–6, 1962, Philadelphia, Penn., 97–107.
Unger, S. H. [1958]. “A computer oriented towards spatial problems,” Proc. Institute of Radio Engineers 46:10 (October), 1744–1750.
向量体系结构
Asanovic, K. [1998]. “Vector Microprocessors,” Ph.D. thesis, Computer Science Division, University of California, Berkeley.
Baskett, F., and T. W. Keller [1977]. “An Evaluation of the Cray-1 Processor,” in High Speed Computer and Algorithm Organization, D. J. Kuck, D. H. Lawrie, and A. H. Sameh, eds., Academic Press, San Diego, Calif., 71–84.
Chen, S. [1983]. “Large-scale and high-speed multiprocessor system for scientific applications,” Proc. NATO Advanced Research Workshop on High Speed Computing, June 20–22, Julich, West Germany. Also in K. Hwang, ed., “Superprocessors: Design and applications,” IEEE, August, 59–73, 1984.
Flynn, M. J. [1966]. “Very high-speed computing systems,” Proc. IEEE 54:12 (December), 1901–1909.
Gebis, J. and Patterson, D. [2007]. “Embracing and extending 20th-century instruction set architectures,” IEEE Computer, 40:4 (April), 68–75.
Hintz, R. G., and D. P. Tate [1972]. “Control data STAR-100 processor design,” Proc. IEEE COMPCON, September 12–14, 1972, San Francisco, 1–4.
Kitagawa, K., S. Tagaya, Y. Hagihara, and Y. Kanoh [2003]. “A hardware overview of SX-6 and SX-7 supercomputer,” NEC Research and Development Journal 44:1 (January), 2–7.
Kozyrakis, C., and D. Patterson [2002]. “Vector vs. superscalar and VLIW architectures for embedded multimedia benchmarks,” Proc. 35th Annual Intl. Symposium on Microarchitecture (MICRO), November 18–22, 2002, Istanbul, Turkey.
Kuck, D., P. P. Budnik, S.-C. Chen, D. H. Lawrie, R. A. Towle, R. E. Strebendt, E. W. Davis, Jr., J. Han, P. W. Kraska, and Y. Muraoka [1974]. “Measurements of parallelism in ordinary Fortran programs,” Computer 7:1 (January), 37–46.
Lincoln, N. R. [1982]. “Technology and design trade offs in the creation of a modern supercomputer,” IEEE Trans. on Computers C-31:5 (May), 363–376.
Miura, K., and K. Uchida [1983]. “FACOM vector processing system: VP100/ 200,” Proc. NATO Advanced Research Workshop on High Speed Computing, June 20–22, Julich, West Germany. Also in K. Hwang, ed., “Superprocessors: Design and applications,” IEEE, August, 59–73, 1984.
Padua, D., and M. Wolfe [1986]. “Advanced compiler optimizations for supercomputers,” Communications of the ACM 29:12 (December), 1184–1201.
Russell, R. M. [1978]. “The Cray-1 processor system,” Communications of the ACM 21:1 (January), 63–72.
Vajapeyam, S. [1991]. “Instruction-Level Characterization of the Cray Y-MP Processor,” Ph.D. thesis, Computer Sciences Department, University of Wisconsin–Madison.
Watanabe, T. [1987]. “Architecture and performance of the NEC supercomputer SX system,” Parallel Computing 5, 247–255.
Watson, W. J. [1972]. “The TI ASC—a highly modular and flexible super processor architecture,” Proc. AFIPS Fall Joint Computer Conf., December 5–7, 1972, Anaheim, Calif., 221–228.
多媒体 SIMD
Atkins, M. [1991]. “Performance and the i860 Microprocessor,” IEEE Micro, 11: 5 (September), 24–27, 72–78.
Kohn, L., and N. Margulis [1989]. “Introducing the Intel i860 64-Bit Microprocessor,” IEEE Micro, 9:4 (July), 15–30.
GPU
Akeley, K., and T. Jermoluk [1988]. “High-performance polygon rendering,” Proc. SIGGRAPH 88, August 1–5, 1988, Atlanta, Ga., 239–46.
Hillis, W. D., and G. L. Steele [1986]. “Data parallel algorithms,” Communications of the ACM 29:12 (December), 1170–1183 (http://doi.acm.org/10.1145/7902.7903).
IEEE 754-2008 Working Group. [2006]. DRAFT Standard for Floating-Point Arithmetic, 754-2008 (https://doi.org/10.1109/IEEESTD.2008.4610935).
Lee, W. V., et al. [2010]. “Debunking the 100X GPU vs. CPU myth: an evaluation of throughput computing on CPU and GPU,” Proc. ISCA ’10, June 19–23, 2010, Saint-Malo, France.
Lindholm, E., M. J. Kligard, and H. Moreton [2001]. A user-programmable vertex engine. In SIGGRAPH ’01: Proceedings of the 28th annual conference on Computer graphics and interactive techniques, 149–158.
Moore, G. E. [1965]. “Cramming more components onto integrated circuits,” Electronics 38:8 (April 19), 114–117.
Williams, S., A. Waterman, and D. Patterson [2009]. “Roofline: An insightful visual performance model for multicore architectures,” Communications of the ACM, 52:4 (April), 65–76.
M.7 多处理器与并行处理的历史(第 5 章及附录 F、G、I)
多处理器的历史内容极为丰富。本节同时按时期和体系结构组织讨论,先介绍 SIMD 方法和 Illiac IV,再简要讨论其他早期实验性多处理器,继而回顾并行处理领域的几场重大争论。随后追溯现有多处理器的历史根源,最后介绍较新的进展。
SIMD 计算机:诱人的想法,众多的尝试,却没有持久的成功
然而,通用多处理器的成本非常高,因此还考虑了其他设计选择,希望在不严重降低系统能力或效率的情况下减少成本。这些选择,就是将三个主要组成部分之一重新集中起来。……将[控制单元]集中,就形成了……Illiac IV 这样的阵列处理器的基本组织结构。
——Bouknight 等人[1972]
SIMD 是最早的并行计算模型之一,可以追溯到第一台大规模多处理器 Illiac IV。它与后来 SIMD 多处理器的核心思想相同:利用许多功能单元,让一条指令同时操作许多数据项。
SIMD 风格计算机的最早思想来自 Unger[1958]以及 Slotnick、Borck 和 McReynolds[1962]。Slotnick 的 Solomon 设计构成了 Illiac IV 的基础;后者也许是超级计算机项目中最声名狼藉的一个。它虽然成功推动了几项后来被证明有用的技术,但作为计算机却失败了。尽管只建成原计划多处理器的四分之一,成本仍从 1966 年估计的 800 万美元,上升到 1972 年的 3100 万美元。实际性能最高只有 15 MFLOPS,而最初预测完整系统可达到 1000 MFLOPS[Hord,1982]。机器于 1972 年交付 NASA Ames Research 后,又经过三年工程改进才可使用。这些事件减缓了 SIMD 的研究,但 Danny Hillis[1985]通过拥有 65,636 个 1 位处理器的 Connection Machine,使这种体系结构重获生机。
原文数字说明: 此段原书为 65,636;M.6 节及本节后文均为 65,536。此处保留原数,注明这一处不一致。
实际 SIMD 计算机需要混合使用 SISD 与 SIMD 指令。SISD 主机负责分支、地址计算等不需要并行执行的操作。SIMD 指令广播到所有执行单元,每个单元都有自己的寄存器组。为增加灵活性,执行 SIMD 指令时可以禁用个别执行单元。此外,大规模并行 SIMD 多处理器依靠互连或通信网络,在处理单元之间交换数据。
SIMD 最适合处理 for 循环中的数组。因此,要获得大规模 SIMD 并行的机会,就必须有大量数据,也就是数据并行性。SIMD 最不擅长处理 case 语句:每个执行单元可能需要根据自身数据的不同,对数据执行不同操作。数据不符合当前分支条件的执行单元会被禁用,只有符合条件的单元继续执行。这种情况下,性能实际上降到原来的 ,其中 是分支情况数。
SIMD 多处理器的基本权衡,是单个处理器性能与处理器数量之间的权衡。后来出现的多处理器更重视大规模并行,而非单个处理器的性能。例如,Connection Multiprocessor 2 提供 65,536 个 1 位宽处理器,而 Illiac IV 有 64 个 64 位处理器。
20 世纪 80 年代,Thinking Machines 和后来的 MasPar 先后使 SIMD 模型复兴;但它作为通用多处理器体系结构,又一次沉寂下去,主要有两个原因。第一,它缺乏灵活性。许多重要问题无法利用这种多处理器,而且体系结构缩小规模后缺乏竞争力,即小规模 SIMD 多处理器的性价比往往不如其他方案。第二,SIMD 无法利用微处理器技术在性能和成本上的巨大优势。SIMD 多处理器的设计者必须制造定制处理器,而不能直接利用这种低成本技术。
虽然 SIMD 计算机已退出通用计算方案的竞争,这种体系结构仍将在专用设计中发挥作用。许多专用任务具有很强的数据并行性,只需要有限种类的功能单元。因此,设计者可以为某些操作提供专门支持,并在功能单元之间设置硬连线的互连通路。这种组织方式通常称为阵列处理器,适用于图像处理和信号处理等任务。
其他早期实验
很难确定哪一台是最早的 MIMD 多处理器。例如,令人意外的是,Eckert-Mauchly Corporation 的第一台计算机就采用重复单元来提高可用性。Holland[1959]很早就提出了使用多个处理器的论据。记录最充分的两个多处理器项目,在 20 世纪 70 年代由 Carnegie Mellon University 开展。第一个是 C.mmp[Wulf 和 Bell,1972;Wulf 和 Harbison,1978],由 16 台 PDP-11 通过交叉开关连接到 16 个存储单元。它是最早超出少数几个处理器规模的多处理器之一,采用共享内存编程模型。C.mmp 项目的研究重点大多在软件,尤其是操作系统方面。后来的 Cm*[Swan 等人,1977]是一种基于集群的多处理器,采用分布式内存和非均匀访问时间。由于没有缓存,远程访问延迟又长,数据放置至关重要。Gehringer、Siewiorek 和 Segall[1987]充分描述了这台多处理器及其应用实验。20 世纪 80 年代,微处理器大幅降低了建造多处理器的成本,这些机器中的许多思想因此被重新采用。
并行处理中的重大争论
20 世纪 60 年代中期,提高计算机运算速度的努力开始受到收益递减规律的影响,于是人们开始偏离传统组织结构。……电子电路的工作速度最终受到光速的限制……而许多电路已经工作在纳秒量级。
——Bouknight 等人[1972]
……顺序计算机的潜在计算能力,正在接近一个根本性的物理极限。这个极限就是光速……
——Angel L. DeCegama,The Technology of Parallel Processing,第 I 卷,1989 年
……今天的多处理器……随着技术逼近光速而接近困境。即使顺序处理器的各个部件能以这样的速度工作,最多也只能期待每秒几百万条指令。
——David Mitchell,The Transputer: The Time Is Now,1989 年
以上引文给出了主张放弃现有计算方式的经典论据,而 Amdahl[1967]则给出了继续专注于 IBM 360 体系结构的经典回应。关于并行执行优势的论证,甚至可以追溯到 19 世纪[Menabrea,1842]!然而,多处理器究竟能多大程度地缩短单个重要程序的执行延迟,仍在探索之中。除并行性优势与限制的争论外,人们还围绕如何建造多处理器展开了数场激烈讨论。
未来很难预测,但 Gordon Bell 于 1989 年对 1995 年作出了两项预测。我们将它们收入本书第一版时,结果还完全不明朗。下面讨论这些预测,并评估其准确性。
第一项预测是:到 1995 年,将建成能持续达到 1 TFLOPS,即一百万 MFLOPS 的计算机;它可能是具有 4K 至 32K 个节点的多计算机系统,也可能是具有数百万处理单元的 Connection Multiprocessor[Bell,1989]。为理解这一预测,不妨考察每年表彰并行计算进展的 Gordon Bell 奖,其中包括运行最快、MFLOPS 最高的实际程序。1989 年的获奖者在八处理器 Cray Y-MP 上达到 1680 MFLOPS。根据这些数字,要使最快程序在 1995 年达到 1 TFLOPS,多处理器和程序性能每年必须达到上年的 3.6 倍。直到 1999 年,Gordon Bell 奖获奖者才首次越过 1 TFLOPS 门槛:他们使用为 Livermore Laboratories 专门设计、具有 5832 个处理器的 IBM RS/6000 SST 系统,在冲击波仿真中达到 1.18 TFLOPS。这相当于性能每年达到上年的 1.93 倍,仍然十分惊人。
自 20 世纪 90 年代以来,人们认识到:即使技术上能够制造 TFLOPS 多处理器,也不能确定这种机器是否具有成本效益;例外也许只有少数高度专用、对国家安全至关重要的应用。1990 年,我们估计达到 1 TFLOPS 需要约 5000 个处理器,成本约为 1 亿美元。Livermore 的 5832 处理器 IBM 系统实际耗资 1.1 亿美元。可以预料,单个微处理器在成本与性能上的改进,会直接影响大规模多处理器的成本和性能;但一个 5000 处理器系统的成本,会高于采用相同处理器的桌面系统价格的 5000 倍。此后,人们建造了快得多的多处理器,但在原文所述的最近五年间,主要改进越来越多地来自处理器,而非并行体系结构的根本突破。
Bell 的第二项预测,涉及 1995 年交付的超级计算机中的数据流数量。Danny Hillis 认为,虽然数据流较少的超级计算机可能销量最好,最大的多处理器却会具有许多数据流,并承担大部分计算。Bell 与 Hillis 打赌:在 1995 年第四季度交付的多处理器中,采用少量数据流(不超过 100 条)的系统,其持续 MFLOPS 总量将高于采用大量数据流(至少 1000 条)的系统。赌约只涉及超级计算机,即价格超过 100 万美元、用于科学应用的多处理器。赌约将持续 MFLOPS 定义为每月执行的浮点操作数,因此机器的可用性也影响评分。
1989 年打赌时,谁会赢完全不清楚。1995 年对当时公开已知超级计算机的调查表明,全世界只有六台多处理器拥有超过 1000 条数据流,因此 Bell 明确获胜。事实上,1995 年规模小得多、采用微处理器的多处理器——不超过 20 个处理器——正在成为主流。基于 Linpack 评分的 TOP500 调查列出在用的 500 台最高性能多处理器;1995 年的结果显示,其中数量最多的竟是基于总线的共享内存多处理器!到 2005 年,各种集群或多计算机系统占据了重要位置。例如,排名前 25 的系统中,11 台为定制集群,如 IBM Blue Gene 和 Cray XT3;10 台由共享内存多处理器组成,其中既有分布式内存,也有集中式内存;其余四台是用 PC 和现成互连组成的集群。
较新的进展与发展
除了并行向量多处理器,见附录 G,以及后来 IBM Blue Gene 的设计之外,其他较新的 MIMD 计算机都使用现成微处理器构建,采用总线加逻辑集中式内存,或者互连网络加分布式内存。20 世纪 80 年代建造的一批实验性多处理器,进一步完善和扩展了构成许多现有多处理器基础的概念。
基于总线、支持缓存一致性的多处理器的发展
虽然 20 世纪 60 年代和 70 年代已经建造采用多个处理器的大型主机,多处理器直到 80 年代才取得广泛成功。Bell[1985]认为,关键在于微处理器体积较小,使内存总线能够替代互连网络硬件;同时,可移植操作系统意味着多处理器项目不再需要重新发明操作系统。Bell 在论文中定义了 multiprocessor(多处理器)和 multicomputer(多计算机系统),为构建更大规模多处理器的两条路线奠定了基础。
第一种采用监听缓存的总线式多处理器,是 Frank[1984]介绍的 Synapse N+1。Goodman[1983]发表了最早描述监听缓存的论文之一。20 世纪 80 年代末,许多商用总线式监听缓存体系结构相继出现,包括 Silicon Graphics 4D/240[Baskett、Jermoluk 和 Solomon,1988]、Encore Multimax[Wilson,1987]和 Sequent Symmetry[Lovett 和 Thakkar,1988]。80 年代中期,各种一致性协议蓬勃发展。Archibald 和 Baer[1986]提供了很好的综述与分析,以及原始论文的参考资料。图 M.2 汇总了几种监听式缓存一致性协议,并列出使用过或正在使用这些协议的多处理器。
20 世纪 90 年代初,此类系统开始通过极宽的高速总线扩大规模。例如,SGI Challenge 使用 256 位、面向分组的总线,最多支持八块处理器板、32 个处理器。随后又出现多总线和交叉开关互连,例如 Sun SPARCCenter 和 Enterprise;Charlesworth[1998]讨论了这些系统的互连体系结构。2001 年,Sun Enterprise 服务器是在用大规模对称多处理器,即超过 16 个处理器的系统的主要代表。在原文撰写时,大多数总线式机器只提供四个左右处理器;八个及以上处理器通常采用交换网络或其他设计。
| 名称 | 协议类型 | 内存写策略 | 特有性质 | 采用该协议的多处理器 |
|---|---|---|---|---|
| Write Once | 写失效 | 首次写入之后采用写回 | 文献中最早描述的监听协议 | 原表未列出 |
| Synapse N+1 | 写失效 | 写回 | 显式表示“内存为所有者”的状态 | Synapse 多处理器;最早可购得的缓存一致性多处理器 |
| Berkeley(MOESI) | 写失效 | 写回 | 带所有权的共享状态 | Berkeley SPUR;Sun Enterprise 服务器 |
| Illinois(MESI) | 写失效 | 写回 | 干净的私有状态;任何持有干净副本的缓存都能提供数据 | SGI Power 和 Challenge 系列 |
| “Firefly” | 写广播 | 私有时写回,共享时直写 | 广播时更新内存 | 当时没有在用的多处理器;SPARCCenter 2000 最接近 |
迈向大规模多处理器
构建大规模多处理器的努力,探索了两条不同路线:消息传递多计算机系统,以及可扩展共享内存多处理器。虽然此前已有许多采用网格和超立方体连接的尝试,Caltech 的 Cosmic Cube[Seitz,1985]却是最早成功将各个环节整合起来的多处理器之一。它在路由和互连技术上引入重要进展,大幅降低互连成本,有助于使多计算机系统成为可行方案。Intel iPSC 860 是由 i860 构成的超立方体系统,以这些思想为基础。后来的系统,例如 Intel Paragon,采用维数更低、单条链路能力更强的网络。Paragon 还在每个节点配备独立的 i860 作为通信控制器,不过一些用户发现,让两个 i860 同时承担计算和通信更好。Thinking Multiprocessors CM-5 使用现成微处理器和胖树互连,见附录 F;它允许用户级直接访问通信通道,显著降低了通信延迟。1995 年,这两种多处理器代表了消息传递多计算机系统的最高水平。
可扩展共享内存多处理器的早期尝试,包括 IBM RP3[Pfister 等人,1985]、NYU Ultracomputer[Elder 等人,1985;Schwartz,1980]、Illinois 大学的 Cedar 项目[Gajksi 等人,1983],以及 BBN Butterfly 和 Monarch[BBN Laboratories,1986;Rettberg 等人,1990]。这些系统都采用非均匀分布式内存模型的某种变体,因而属于分布式共享内存(DSM)多处理器,但不支持缓存一致性,使编程复杂得多。RP3 和 Ultracomputer 既探索了新的同步机制 fetch-and-operate,也研究了在网络中合并访问的想法。在上述四类多处理器中,互连网络的成本都高于处理节点,给小规模版本带来困难。Cray T3D/E 在这些思想上继续发展:它采用不提供缓存一致性的共享地址空间,同时利用多计算机领域发展出的互连技术。T3D 的评估见 Arpaci 等人[1995],T3E 的增强设计见 Scott[1996],互连技术见 Scott 和 Thorson[1996]。
通过结合多种思想,人们为共享内存模型增加了可扩展的缓存一致性。基于目录的缓存一致性技术,实际上早于监听缓存技术。最早的缓存一致性协议就采用目录,Tang[1976]对此作了介绍,IBM 3081 中也进行了实现。Censier 和 Feautrier[1978]描述了一种将标记保存在内存中的目录一致性方案。把目录与内存一起分布,以实现可扩展缓存一致性的思想,由 Agarwal 等人[1988]首次描述,并成为 Stanford DASH 多处理器的基础[Lenoski 等人,1990、1992]。DASH 是第一台能够运行的缓存一致性 DSM 多处理器。它是采用“胖节点”的 cc-NUMA 机器,每个节点是四处理器 SMP;节点互连方式类似 Wildfire,但采用更可扩展的二维网格,而不是交叉开关。
Kendall Square Research KSR-1[Burkhardt 等人,1992]是可扩展一致性共享内存的第一个商用实现。它扩展基本 DSM 方法,实现了仅缓存存储器体系结构(cache-only memory architecture,COMA),使主存也成为缓存。KSR-1 的内存块可以复制到各节点的主存中,并由硬件处理这些复制块带来的额外一致性要求。严格来说,KSR-1 并非纯粹的 COMA,因为它不迁移数据项的归属位置,而总在归属节点保留一个副本,本质上只实现了复制。研究界还提出了许多 COMA 风格的体系结构[Falsafi 和 Wood,1997;Hagersten、Landin 和 Haridi,1992;Saulsbury 等人,1995;Stenström、Joe 和 Gupta,1992],以及通过迁移减轻非均匀内存访问负担的相近方法[Chandra 等人,1994;Soundararajan 等人,1998],但没有出现后续商用实现。
Convex Exemplar 用两级体系结构实现可扩展一致性共享内存:最低层用交叉开关构建八处理器模块,再通过环形网络连接最多 32 个模块,总共 256 个处理器;评估见 Thekkath 等人[1997]。Laudon 和Lenoski[1997]介绍了 SGI Origin。它于 1996 年首次交付,主要基于最初的 Stanford DASH,但在可扩展性和易编程性方面加入了多项创新。Origin 的目录使用 16 位或 32 位位向量,每个位代表一个含两个处理器的节点。采用粗粒度位向量表示时,每个位最多代表八个节点,从而支持总共 1024 个处理器。Galles[1996]介绍了其高性能胖超立方体全局互连。Hristea、Lenoski 和 Keen[1997]全面评估了 Origin 存储系统的性能。
还有一些研究原型探索了支持或不支持多线程的可扩展一致性,包括 MIT Alewife[Agarwal 等人,1995]和 Stanford FLASH[Gibson 等人,2000;Kuskin 等人,1994]。
集群
集群很可能由 20 世纪 60 年代的用户“发明”:他们或是无法将全部工作放进一台计算机,或是需要一台备用机器,以应对主机故障[Pfister,1998]。Tandem 于 1975 年推出 16 节点集群;Digital 随后在 1984 年推出 VAX 集群。最初,它们是共享 I/O 设备的独立计算机,需要分布式操作系统协调活动。很快,计算机之间加入了通信链路;其中一个目的是允许机器分布在不同地点,以在某一站点遭遇灾难时提高可用性。用户登录集群,并不知道自己实际运行在哪台机器上。到 1993 年,DEC——后来成为 HP 的一部分——已售出超过 25,000 套集群。其他早期厂商包括 Tandem,后来同样并入 HP,以及 IBM,仍然是 IBM。原文撰写时,几乎每家公司都有集群产品。多数产品主要面向可用性,性能扩展是次要收益。
集群上的科学计算后来成为大规模并行处理器(MPP)的竞争者。Beowulf 项目于 1993 年启动,目标是满足 NASA 的需求:用不到 50,000 美元,获得一台 1 GFLOPS 计算机。1994 年,用采用 80486 的现成 PC 构建的 16 节点集群达成了这一目标[Bell 和 Gray,2001]。对这种用途的重视,催生了多种软件接口,以便提交、协调和调试大型程序,或者大量独立程序。
一些研究项目努力降低集群通信延迟,同时提高带宽。低延迟研究的一项商业成果是 VI 接口标准,后来被下文提到的 InfiniBand 采用。低延迟又被证明有助于其他应用。例如,1997 年,University of California, Berkeley 的 100 台 UltraSPARC 桌面机,通过每条链路 160 MB/s 的 Myrinet 交换机连接,创下数据库排序和破解加密消息的世界纪录:一分钟内,将原本位于磁盘上的 8.6 GB 数据排序;3.5 小时内,破解一个 40 位 DES 密钥。
这个名为 Network of Workstations 的研究项目[Anderson、Culler 和 Patterson,1995]还开发了 Inktomi 搜索引擎,并促成同名创业公司的成立。Google 效仿 Inktomi,使用桌面机集群构建搜索引擎,而非大型 SMP;后者是当时领先的 Alta Vista 搜索引擎的策略,Google 后来超过了它[Brin 和 Page,1998]。到 2011 年,几乎所有 Internet 服务都依靠集群服务数百万客户。
集群也很受科学家欢迎。一个原因是成本低,个人科学家或小团队就能拥有专用于自身程序的集群。与在超级计算中心共享 MPP 上排队相比,这种集群往往能更快得到结果;共享系统的作业队列可能长达数周。希望深入了解的读者,可以阅读 Pfister[1998]那本生动有趣的集群著作。
大规模多处理器的较新趋势
20 世纪 90 年代中后期,人们逐渐看清:超大规模并行计算市场很可能不会出现所期待的增长。缺少这种市场增长,高端并行计算市场就越来越难承担为小众市场专门设计的高度定制硬件和软件成本。这一认识引出的最重要趋势,或许就是通过集群达到最高性能。大规模多处理器大体上形成了四类:
- 利用 Myrinet 或 InfiniBand 等互连技术,将标准桌面主板集成为集群。
- 用标准微处理器组成处理单元,再以定制互连连接的多计算机系统。例如 Cray XT3,采用较早版本的 Cray 互连和简单集群结构;以及稍后将详细介绍的 IBM Blue Gene。
- 由小规模共享内存计算机组成的集群,可能还支持向量处理。Earth Simulator 属于这一类,它还拥有可在线阅读的专门期刊。
- 大规模共享内存多处理器,例如 Cray X1[Dunigan 等人,2005],以及 SGI Origin 和 Altix。SGI 系统也被组成集群,使处理器数量超过 512 个,不过不同系统之间仅支持消息传递。
其中最引人注目的是 IBM Blue Gene,因为其设计依据,与单处理器体系结构转向多核的根本原因相似。Blue Gene 起初是 IBM 内部面向蛋白质测序和折叠问题的研究项目。设计者观察到,大规模多处理器越来越受功耗问题制约,而嵌入式处理器的每瓦性能远好于高端单处理器。如果通向高性能的道路是并行性,为什么不从效率最高的基本构件出发,再增加构件数量呢?
因此,Blue Gene 采用定制芯片,其中集成嵌入式 PowerPC 微处理器:性能约为高端 PowerPC 的一半,面积和功耗却只占很小一部分。这使包括全局互连在内的更多系统功能能够集成到同一芯片上。结果是一种高效、易于大量复制的基本构件,让 Blue Gene 更高效地扩展到大得多的处理器数量。Blue Gene 的基本构件不是独立微处理器,也不是标准桌面主板,而是处理器核。这种方法无疑能提供更高效率,但市场能否承担定制设计和专用软件的成本,仍是开放问题。
原文写道:2006 年,Lawrence Livermore 一台具有 32K 个处理器、并计划于 2005 年末扩展到 65K 个处理器的 Blue Gene,其 Linpack 性能是排名第三系统的 2.6 倍;后者由 20 台各含 512 个处理器的 SGI Altix,通过 InfiniBand 互连成集群。
原文年代说明: 上段同时写有“2006 年”和“计划于 2005 年末”,存在时间表述不一致;译文保留原文的年代和数量。
Blue Gene 的前身是实验机器 QCDOD。它率先使用低功耗嵌入式微处理器,并将互连紧密集成,以降低节点成本和功耗。
同步与存储一致性模型的发展
人们为共享内存多处理器提出了多种同步原语。Mellor-Crummey 和 Scott[1991]概述了相关问题,并给出了锁、屏障等重要原语的高效实现。其详尽的参考文献还涵盖自旋锁、队列锁、屏障等领域的其他重要贡献。Lamport[1979]引入了顺序一致性概念,并定义并行程序正确执行的含义。Dubois、Scheurich 和 Briggs[1988]介绍了弱序思想,它最早于 1986 年提出。1990 年,Adve 和 Hill 对弱序给出了更完善的定义,并定义了无数据竞争的概念;在同一次会议上,Gharachorloo 及其同事[1990]引入释放一致性,并首次提供了放宽一致性模型的性能数据。较宽松的一致性模型被微处理器体系结构广泛采用,包括 Sun SPARC、Alpha 和 IA-64。Adve 和 Gharachorloo[1996]提供了一篇出色的教程,介绍存储一致性及不同模型之间的差异。
其他参考资料
Kai Li 于 1988 年在 Ivy 系统中,率先使用虚拟内存为不同机器实现共享地址空间。后续论文继续探索其硬件支持、软件机制和编程问题。Amza 等人[1996]介绍了一种建立在工作站上、使用新一致性模型的系统;Kontothanassis 等人[1997]介绍了采用远程写的软件共享内存方案;Erlichson 等人[1996]则介绍了利用共享虚拟内存,以 SMP 为节点构建大规模多处理器的方法。
有关多处理器和多计算机系统的资料几乎无穷无尽:会议、期刊论文,甚至书籍的出现速度,似乎都超过了任何一个人吸收思想的速度。毫无疑问,许多论文会无人注意,正如过去一样。大多数主要体系结构会议都会发表多处理器论文。每年举办的 Supercomputing XY 会议,XY 为年份的最后两位,汇集用户、体系结构设计者、软件开发者和厂商;其论文集以图书、CD-ROM 和在线形式出版,网址为 www.scXY.org。两种主要期刊 Journal of Parallel and Distributed Computing 和 IEEE Transactions on Parallel and Distributed Systems,刊载并行处理各方面的论文。下面的文献还列出多本专门讨论并行处理的书,其中 Culler、Singh 和 Gupta[1999]是原文所述时期最新的一项大型著作。NASA Ames Research Center 的 Eugene Miya 多年来一直收集并行处理论文的在线书目;原文撰写时已有 35,000 多条,可在 liinwww.ira.uka.de/bibliography/Parallel/Eugene/index.html 查阅。
这些文献不仅记录了如今已投入实践的概念如何被发现,也描述了许多经过探索却被发现有不足的思想,以及一些只是时机尚未成熟的思想。随着高性能计算机体系结构的未来转向多核与多处理器,我们预计,今后会有许多新方法得到探索。其中少数方法将成功解决硬件和软件问题;而在过去 40 年中,这些问题始终是利用多处理技术的关键!
参考文献
Adve, S. V., and K. Gharachorloo [1996]. “Shared memory consistency models: A tutorial,” IEEE Computer 29:12 (December), 66–76.
Adve, S. V., and M. D. Hill [1990]. “Weak ordering—a new definition,” Proc. 17th Annual Int’l. Symposium on Computer Architecture (ISCA), May 28–31, 1990, Seattle, Wash., 2–14.
Agarwal, A., R. Bianchini, D. Chaiken, K. Johnson, and D. Kranz [1995]. “The MIT Alewife machine: Architecture and performance,” 22nd Annual Int’l. Symposium on Computer Architecture (ISCA), June 22–24, 1995, Santa Margherita, Italy, 2–13.
Agarwal, A., J. L. Hennessy, R. Simoni, and M. A. Horowitz [1988]. “An evaluation of directory schemes for cache coherence,” Proc. 15th Annual Int’l. Symposium on Computer Architecture, May 30–June 2, 1988, Honolulu, Hawaii, 280–289.
Agarwal, A., J. Kubiatowicz, D. Kranz, B.-H. Lim, D. Yeung, G. D’Souza, and M. Parkin [1993]. “Sparcle: An evolutionary processor design for large-scale multiprocessors,” IEEE Micro 13 (June), 48–61.
Alles, A. [1995]. “ATM Internetworking,” White Paper (May), Cisco Systems, Inc., San Jose, Calif. (www.cisco.com/warp/public/614/12.html).
Almasi, G. S., and A. Gottlieb [1989]. Highly Parallel Computing, Benjamin/ Cummings, Redwood City, Calif.
Alverson, G., R. Alverson, D. Callahan, B. Koblenz, A. Porterfield, and B. Smith [1992]. “Exploiting heterogeneous parallelism on a multithreaded multiprocessor,” Proc. ACM/IEEE Conf. on Supercomputing, November 16–20, 1992, Minneapolis, Minn., 188–197.
Amdahl, G. M. [1967]. “Validity of the single processor approach to achieving large scale computing capabilities,” Proc. AFIPS Spring Joint Computer Conf., April 18–20, 1967, Atlantic City, N.J., 483–485.
Amza C., A. L. Cox, S. Dwarkadas, P. Keleher, H. Lu, R. Rajamony, W. Yu, and W. Zwaenepoel [1996]. “Treadmarks: Shared memory computing on networks of workstations,” IEEE Computer 29:2 (February), 18–28.
Anderson, T. E., D. E. Culler, and D. Patterson [1995]. “A case for NOW (networks of workstations),” IEEE Micro 15:1 (February), 54–64.
Ang, B., D. Chiou, D. Rosenband, M. Ehrlich, L. Rudolph, and Arvind [1998]. “StarT-Voyager: A flexible platform for exploring scalable SMP issues,” Proc. ACM/IEEE Conf. on Supercomputing, November 7–13, 1998, Orlando, FL.
Archibald, J., and J.-L. Baer [1986]. “Cache coherence protocols: Evaluation using a multiprocessor simulation model,” ACM Trans. on Computer Systems 4:4 (November), 273–298.
Arpaci, R. H., D. E. Culler, A. Krishnamurthy, S. G. Steinberg, and K. Yelick [1995]. “Empirical evaluation of the CRAY-T3D: A compiler perspective,” Proc. 22nd Annual Int’l. Symposium on Computer Architecture (ISCA), June 22–24, 1995, Santa Margherita, Italy.
Baer, J.-L., and W.-H. Wang [1988]. “On the inclusion properties for multi-level cache hierarchies,” Proc. 15th Annual Int’l. Symposium on Computer Architecture, May 30–June 2, 1988, Honolulu, Hawaii, 73–80.
Balakrishnan, H. V., N. Padmanabhan, S. Seshan, and R. H. Katz [1997]. “A comparison of mechanisms for improving TCP performance over wireless links,” IEEE/ACM Trans. on Networking 5:6 (December), 756–769.
Barroso, L. A., K. Gharachorloo, and E. Bugnion [1998]. “Memory system characterization of commercial workloads,” Proc. 25th Annual Int’l. Symposium on Computer Architecture (ISCA), July 3–14, 1998, Barcelona, Spain, 3–14.
Baskett, F., T. Jermoluk, and D. Solomon [1988]. “The 4D-MP graphics superworkstation: Computing + graphics = 40 MIPS + 40 MFLOPS and 10,000 lighted polygons per second,” Proc. IEEE COMPCON, February 29–March 4, 1988, San Francisco, 468–471.
BBN Laboratories. [1986]. Butterfly Parallel Processor Overview, Tech. Rep. 6148, BBN Laboratories, Cambridge, Mass.
Bell, C. G. [1985]. “Multis: A new class of multiprocessor computers,” Science 228 (April 26), 462–467.
Bell, C. G. [1989]. “The future of high performance computers in science and engineering,” Communications of the ACM 32:9 (September), 1091–1101.
Bell, C. G., and J. Gray [2001]. Crays, Clusters and Centers, Tech. Rep. MSR-TR-2001-76, Microsoft Research, Redmond, Wash.
Bell, C. G., and J. Gray [2002]. “What’s next in high performance computing,” CACM, 45:2 (February), 91–95.
Bouknight, W. J., S. A. Deneberg, D. E. McIntyre, J. M. Randall, A. H. Sameh, and D. L. Slotnick [1972]. “The Illiac IV system,” Proc. IEEE 60:4, 369–379. Also appears in D. P. Siewiorek, C. G. Bell, and A. Newell, Computer Structures: Principles and Examples, McGraw-Hill, New York, 1982, 306–316.
Brain, M. [2000]. Inside a Digital Cell Phone, www.howstuffworks.com/inside-cell-phone.htm.
Brewer, E. A., and B. C. Kuszmaul [1994]. “How to get good performance from the CM-5 data network,” Proc. Eighth Int’l. Parallel Processing Symposium (IPPS), April 26–29, 1994, Cancun, Mexico.
Brin, S., and L. Page [1998]. “The anatomy of a large-scale hypertextual Web search engine,” Proc. 7th Int’l. World Wide Web Conf., April 14–18, 1998, Brisbane, Queensland, Australia, 107–117.
Burkhardt III, H., S. Frank, B. Knobe, and J. Rothnie [1992]. Overview of the KSR1 Computer System, Tech. Rep. KSR-TR-9202001, Kendall Square Research, Boston.
Censier, L., and P. Feautrier [1978]. “A new solution to coherence problems in multicache systems,” IEEE Trans. on Computers C-27:12 (December), 1112–1118.
Chandra, R., S. Devine, B. Verghese, A. Gupta, and M. Rosenblum [1994]. “Scheduling and page migration for multiprocessor compute servers,” Proc. Sixth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 4–7, 1994, San Jose, Calif., 12–24.
Charlesworth, A. [1998]. “Starfire: Extending the SMP envelope,” IEEE Micro 18:1 (January/February), 39–49.
Clark, W. A. [1957]. “The Lincoln TX-2 computer development,” Proc. Western Joint Computer Conference, February 26–28, 1957, Los Angeles, 143–145.
Comer, D. [1993]. Internetworking with TCP/IP, 2nd ed., Prentice Hall, Englewood Cliffs, N.J.
Culler, D. E., J. P. Singh, and A. Gupta [1999]. Parallel Computer Architecture: A Hardware/Software Approach, Morgan Kaufmann, San Francisco.
Dally, W. J., and C. I. Seitz [1986]. “The torus routing chip,” Distributed Computing 1:4, 187–196.
Davie, B. S., L. L. Peterson, and D. Clark [1999]. Computer Networks: A Systems Approach, 2nd ed., Morgan Kaufmann, San Francisco.
Desurvire, E. [1992]. “Lightwave communications: The fifth generation,” Scientific American (International Edition) 266:1 (January), 96–103.
Dongarra, J., T. Sterling, H. Simon, and E. Strohmaier [2005]. “High-performance computing: Clusters, constellations, MPPs, and future directions,” Computing in Science & Engineering, 7:2 (March/April), 51–59.
Dubois, M., C. Scheurich, and F. Briggs [1988]. “Synchronization, coherence, and event ordering,” IEEE Computer 21:2 (February), 9–21.
Dunigan, W., K. Vetter, K. White, and P. Worley [2005]. “Performance evaluation of the Cray X1 distributed shared memory architecture,” IEEE Micro, January/ February, 30–40.
Eggers, S. [1989]. “Simulation Analysis of Data Sharing in Shared Memory Multiprocessors,” Ph.D. thesis, Computer Science Division, University of California, Berkeley.
Elder, J., A. Gottlieb, C. K. Kruskal, K. P. McAuliffe, L. Randolph, M. Snir, P. Teller, and J. Wilson [1985]. “Issues related to MIMD shared-memory computers: The NYU Ultracomputer approach,” Proc. 12th Annual Int’l. Symposium on Computer Architecture (ISCA), June 17–19, 1985, Boston, Mass., 126–135.
Erlichson, A., N. Nuckolls, G. Chesson, and J. L. Hennessy [1996]. “SoftFLASH: Analyzing the performance of clustered distributed virtual shared memory,” Proc. Seventh Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 1–5, 1996, Cambridge, Mass., 210–220.
Falsafi, B., and D. A. Wood [1997]. “Reactive NUMA: A design for unifying S-COMA and CC-NUMA,” Proc. 24th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–4, 1997, Denver, Colo., 229–240.
Flynn, M. J. [1966]. “Very high-speed computing systems,” Proc. IEEE 54:12 (December), 1901–1909.
Forgie, J. W. [1957]. “The Lincoln TX-2 input-output system,” Proc. Western Joint Computer Conference, February 26–28, 1957, Los Angeles, 156–160.
Frank, S. J. [1984]. “Tightly coupled multiprocessor systems speed memory access time,” Electronics 57:1 (January), 164–169.
Gajski, D., D. Kuck, D. Lawrie, and A. Sameh [1983]. “CEDAR—a large scale multiprocessor,” Proc. Int’l. Conf. on Parallel Processing (ICPP), August, Columbus, Ohio, 524–529.
Galles, M. [1996]. “Scalable pipelined interconnect for distributed endpoint routing: The SGI SPIDER chip,” Proc. IEEE HOT Interconnects ’96, August 15–17, 1996, Stanford University, Palo Alto, Calif.
Gehringer, E. F., D. P. Siewiorek, and Z. Segall [1987]. Parallel Processing: The Cm* Experience, Digital Press, Bedford, Mass.
Gharachorloo, K., A. Gupta, and J. L. Hennessy [1992]. “Hiding memory latency using dynamic scheduling in shared-memory multiprocessors,” Proc. 19th Annual Int’l. Symposium on Computer Architecture (ISCA), May 19–21, 1992, Gold Coast, Australia.
Gharachorloo, K., D. Lenoski, J. Laudon, P. Gibbons, A. Gupta, and J. L. Hennessy [1990]. “Memory consistency and event ordering in scalable shared-memory multiprocessors,” Proc. 17th Annual Int’l. Symposium on Computer Architecture (ISCA), May 28–31, 1990, Seattle, Wash., 15–26.
Gibson, J., R. Kunz, D. Ofelt, M. Horowitz, J. Hennessy, and M. Heinrich [2000]. “FLASH vs. (simulated) FLASH: Closing the simulation loop,” Proc. Ninth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), November 12–15, Cambridge, Mass., 49–58.
Goodman, J. R. [1983]. “Using cache memory to reduce processor memory traffic,” Proc. 10th Annual Int’l. Symposium on Computer Architecture (ISCA), June 5–7, 1982, Stockholm, Sweden, 124–131.
Goralski, W. [1997]. SONET: A Guide to Synchronous Optical Network, McGraw-Hill, New York.
Grice, C., and M. Kanellos [2000]. “Cell phone industry at crossroads: Go high or low?” CNET News (August 31), technews.netscape.com/news/0-1004-201-2518386-0.html?tag=st.ne.1002.tgif.sf.
Groe, J. B., and L. E. Larson [2000]. CDMA Mobile Radio Design, Artech House, Boston.
Hagersten E., and M. Koster [1998]. “WildFire: A scalable path for SMPs,” Proc. Fifth Int’l. Symposium on High-Performance Computer Architecture, January 9–12, 1999, Orlando, Fla.
Hagersten, E., A. Landin, and S. Haridi [1992]. “DDM—a cache-only memory architecture,” IEEE Computer 25:9 (September), 44–54.
Hill, M. D. [1998]. “Multiprocessors should support simple memory consistency models,” IEEE Computer 31:8 (August), 28–34.
Hillis, W. D. [1985]. The Connection Multiprocessor, MIT Press, Cambridge, Mass.
Hirata, H., K. Kimura, S. Nagamine, Y. Mochizuki, A. Nishimura, Y. Nakase, and T. Nishizawa [1992]. “An elementary processor architecture with simultaneous instruction issuing from multiple threads,” Proc. 19th Annual Int’l. Symposium on Computer Architecture (ISCA), May 19–21, 1992, Gold Coast, Australia, 136–145.
Hockney, R. W., and C. R. Jesshope [1988]. Parallel Computers 2: Architectures, Programming and Algorithms, Adam Hilger, Ltd., Bristol, England.
Holland, J. H. [1959]. “A universal computer capable of executing an arbitrary number of subprograms simultaneously,” Proc. East Joint Computer Conf. 16, 108–113.
Hord, R. M. [1982]. The Illiac-IV, The First Supercomputer, Computer Science Press, Rockville, Md.
Hristea, C., D. Lenoski, and J. Keen [1997]. “Measuring memory hierarchy performance of cache-coherent multiprocessors using micro benchmarks,” Proc. ACM/IEEE Conf. on Supercomputing, November 15–21, 1997, San Jose, Calif.
Hwang, K. [1993]. Advanced Computer Architecture and Parallel Programming, McGraw-Hill, New York.
IBM. [2005]. “Blue Gene,” IBM J. of Research and Development, 49:2/3 (special issue).
Infiniband Trade Association. [2001]. InfiniBand Architecture Specifications Release 1.0.a, www.infinibandta.org.
Jordan, H. F. [1983]. “Performance measurements on HEP—a pipelined MIMD computer,” Proc. 10th Annual Int’l. Symposium on Computer Architecture (ISCA), June 5–7, 1982, Stockholm, Sweden, 207–212.
Kahn, R. E. [1972]. “Resource-sharing computer communication networks,” Proc. IEEE 60:11 (November), 1397–1407.
Keckler, S. W., and W. J. Dally [1992]. “Processor coupling: Integrating compile time and runtime scheduling for parallelism,” Proc. 19th Annual Int’l. Symposium on Computer Architecture (ISCA), May 19–21, 1992, Gold Coast, Australia, 202–213.
Kontothanassis, L., G. Hunt, R. Stets, N. Hardavellas, M. Cierniak, S. Parthasarathy, W. Meira, S. Dwarkadas, and M. Scott [1997]. “VM-based shared memory on low-latency, remotememory-access networks,” Proc. 24th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–4, 1997, Denver, Colo.
Kurose, J. F., and K. W. Ross [2001]. Computer Networking: A Top-Down Approach Featuring the Internet, Addison-Wesley, Boston.
Kuskin, J., D. Ofelt, M. Heinrich, J. Heinlein, R. Simoni, K. Gharachorloo, J. Chapin, D. Nakahira, J. Baxter, M. Horowitz, A. Gupta, M. Rosenblum, and J. L. Hennessy [1994]. “The Stanford FLASH multiprocessor,” Proc. 21st Annual Int’l. Symposium on Computer Architecture (ISCA), April 18–21, 1994, Chicago.
Lamport, L. [1979]. “How to make a multiprocessor computer that correctly executes multiprocess programs,” IEEE Trans. on Computers C-28:9 (September), 241–248.
Laudon, J., A. Gupta, and M. Horowitz [1994]. “Interleaving: A multithreading technique targeting multiprocessors and workstations,” Proc. Sixth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 4–7, 1994, San Jose, Calif., 308–318.
Laudon, J., and D. Lenoski [1997]. “The SGI Origin: A ccNUMA highly scalable server,” Proc. 24th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–4, 1997, Denver, Colo., 241–251.
Lenoski, D., J. Laudon, K. Gharachorloo, A. Gupta, and J. L. Hennessy [1990]. “The Stanford DASH multiprocessor,” Proc. 17th Annual Int’l. Symposium on Computer Architecture (ISCA), May 28–31, 1990, Seattle, Wash., 148–159.
Lenoski, D., J. Laudon, K. Gharachorloo, W.-D. Weber, A. Gupta, J. L. Hennessy, M. A. Horowitz, and M. Lam [1992]. “The Stanford DASH multiprocessor,” IEEE Computer 25:3 (March), 63–79.
Li, K. [1988]. “IVY: A shared virtual memory system for parallel computing,” Proc. Int’l. Conf. on Parallel Processing (ICCP), August, The Pennsylvania State University, University Park, Penn.
Lo, J., L. Barroso, S. Eggers, K. Gharachorloo, H. Levy, and S. Parekh [1998]. “An analysis of database workload performance on simultaneous multithreaded processors,” Proc. 25th Annual Int’l. Symposium on Computer Architecture (ISCA), July 3–14, 1998, Barcelona, Spain, 39–50.
Lo, J., S. Eggers, J. Emer, H. Levy, R. Stamm, and D. Tullsen [1997]. “Converting thread-level parallelism into instruction-level parallelism via simultaneous multithreading,” ACM Trans. on Computer Systems 15:2 (August), 322–354.
Lovett, T., and S. Thakkar [1988]. “The Symmetry multiprocessor system,” Proc. Int’l. Conf. on Parallel Processing (ICCP), August, The Pennsylvania State University, University Park, Penn., 303–310.
Mellor-Crummey, J. M., and M. L. Scott [1991]. “Algorithms for scalable synchronization on shared-memory multiprocessors,” ACM Trans. on Computer Systems 9:1 (February), 21–65.
Menabrea, L. F. [1842]. “Sketch of the analytical engine invented by Charles Babbage,” Bibliothèque Universelle de Genève, 82 (October).
Metcalfe, R. M. [1993]. “Computer/network interface design: Lessons from Arpanet and Ethernet.” IEEE J. on Selected Areas in Communications 11:2 (February), 173–180.
Metcalfe, R. M., and D. R. Boggs [1976]. “Ethernet: Distributed packet switching for local computer networks,” Communications of the ACM 19:7 (July), 395–404.
Mitchell, D. [1989]. “The Transputer: The time is now,” Computer Design (RISC suppl.), 40–41.
Miya, E. N. [1985]. “Multiprocessor/distributed processing bibliography,” Computer Architecture News 13:1, 27–29.
National Research Council. [1997]. The Evolution of Untethered Communications, Computer Science and Telecommunications Board, National Academy Press, Washington, D.C.
Nikhil, R. S., G. M. Papadopoulos, and Arvind [1992]. “*T: A multithreaded massively parallel architecture,” Proc. 19th Annual Int’l. Symposium on Computer Architecture (ISCA), May 19–21, 1992, Gold Coast, Australia, 156–167.
Noordergraaf, L., and R. van der Pas [1999]. “Performance experiences on Sun’s WildFire prototype,” Proc. ACM/IEEE Conf. on Supercomputing, November 13–19, 1999, Portland, Ore.
Partridge, C. [1994]. Gigabit Networking, Addison-Wesley, Reading, Mass.
Pfister, G. F. [1998]. In Search of Clusters, 2nd ed., Prentice Hall, Upper Saddle River, N.J.
Pfister, G. F., W. C. Brantley, D. A. George, S. L. Harvey, W. J. Kleinfekder, K. P. McAuliffe, E. A. Melton, V. A. Norton, and J. Weiss [1985]. “The IBM research parallel processor prototype (RP3): Introduction and architecture,” Proc. 12th Annual Int’l. Symposium on Computer Architecture (ISCA), June 17–19, 1985, Boston, Mass., 764–771.
Reinhardt, S. K., J. R. Larus, and D. A. Wood [1994]. “Tempest and Typhoon: User-level shared memory,” Proc. 21st Annual Int’l. Symposium on Computer Architecture (ISCA), April 18–21, 1994, Chicago, 325–336.
Rettberg, R. D., W. R. Crowther, P. P. Carvey, and R. S. Towlinson [1990]. “The Monarch parallel processor hardware design,” IEEE Computer 23:4 (April), 18–30.
Rosenblum, M., S. A. Herrod, E. Witchel, and A. Gupta [1995]. “Complete computer simulation: The SimOS approach,” in IEEE Parallel and Distributed Technology (now called Concurrency) 4:3, 34–43.
Saltzer, J. H., D. P. Reed, and D. D. Clark [1984]. “End-to-end arguments in system design,” ACM Trans. on Computer Systems 2:4 (November), 277–288.
Satran, J., D. Smith, K. Meth, C. Sapuntzakis, M. Wakeley, P. Von Stamwitz, R. Haagens, E. Zeidner, L. Dalle Ore, and Y. Klein [2001]. “iSCSI,” IPS Working Group of IETF, Internet draft www.ietf.org/internet-drafts/draft-ietf-ips-iscsi-07.txt.
Saulsbury, A., T. Wilkinson, J. Carter, and A. Landin [1995]. “An argument for Simple COMA,” Proc. First IEEE Symposium on High-Performance Computer Architectures, January 22–25, 1995, Raleigh, N.C., 276–285.
Schwartz, J. T. [1980]. “Ultracomputers,” ACM Trans. on Programming Languages and Systems 4:2, 484–521.
Scott, S. L. [1996]. “Synchronization and communication in the T3E multiprocessor,” Seventh Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 1–5, 1996, Cambridge, Mass., 26–36.
Scott, S. L., and G. M. Thorson [1996]. “The Cray T3E network: Adaptive routing in a high-performance 3D torus,” Proc. IEEE HOT Interconnects ’96, August 15–17, 1996, Stanford University, Palo Alto, Calif., 14–156.
Seitz, C. L. [1985]. “The Cosmic Cube (concurrent computing),” Communications of the ACM 28:1 (January), 22–33.
Singh, J. P., J. L. Hennessy, and A. Gupta [1993]. “Scaling parallel programs for multiprocessors: Methodology and examples,” Computer 26:7 (July), 22–33.
Slotnick, D. L., W. C. Borck, and R. C. McReynolds [1962]. “The Solomon computer,” Proc. AFIPS Fall Joint Computer Conf., December 4–6, 1962, Philadelphia, Penn., 97–107.
Smith, B. J. [1978]. “A pipelined, shared resource MIMD computer,” Proc. Int’l. Conf. on Parallel Processing (ICPP), August, Bellaire, Mich., 6–8.
Soundararajan, V., M. Heinrich, B. Verghese, K. Gharachorloo, A. Gupta, and J. L. Hennessy [1998]. “Flexible use of memory for replication/migration in cache-coherent DSM multiprocessors,” Proc. 25th Annual Int’l. Symposium on Computer Architecture (ISCA), July 3–14, 1998, Barcelona, Spain, 342–355.
Spurgeon, C. [2001]. “Charles Spurgeon’s Ethernet Web site,” www.host.ots.utexas.edu/ethernet/ethernet-home.html.
Stenström, P., T. Joe, and A. Gupta [1992]. “Comparative performance evaluation of cachecoherent NUMA and COMA architectures,” Proc. 19th Annual Int’l. Symposium on Computer Architecture (ISCA), May 19–21, 1992, Gold Coast, Australia, 80–91.
Sterling, T. [2001]. Beowulf PC Cluster Computing with Windows and Beowulf PC Cluster Computing with Linux, MIT Press, Cambridge, Mass.
Stevens, W. R. [1994–1996]. TCP/IP Illustrated (three volumes), Addison-Wesley, Reading, Mass.
Stone, H. [1991]. High Performance Computers, Addison-Wesley, New York.
Swan, R. J., A. Bechtolsheim, K. W. Lai, and J. K. Ousterhout [1977]. “The implementation of the Cm* multi-microprocessor,” Proc. AFIPS National Computing Conf., June 13–16, 1977, Dallas, Tex., 645–654.
Swan, R. J., S. H. Fuller, and D. P. Siewiorek [1977]. “Cm*—a modular, multi-microprocessor,” Proc. AFIPS National Computing Conf., June 13–16, 1977, Dallas, Tex., 637–644.
Tanenbaum, A. S. [1988]. Computer Networks, 2nd ed., Prentice Hall, Englewood Cliffs, N.J.
Tang, C. K. [1976]. “Cache design in the tightly coupled multiprocessor system,” Proc. AFIPS National Computer Conf., June 7–10, 1976, New York, 749–753.
Thacker, C. P., E. M. McCreight, B. W. Lampson, R. F. Sproull, and D. R. Boggs [1982]. “Alto: A personal computer,” in D. P. Siewiorek, C. G. Bell, and A. Newell, eds., Computer Structures: Principles and Examples, McGraw-Hill, New York, 549–572.
Thekkath, R., A. P. Singh, J. P. Singh, S. John, and J. L. Hennessy [1997]. “An evaluation of a commercial CC-NUMA architecture—the CONVEX Exemplar SPP1200,” Proc. 11th Int’l. Parallel Processing Symposium (IPPS), April 1–7, 1997, Geneva, Switzerland.
Tullsen, D. M., S. J. Eggers, J. S. Emer, H. M. Levy, J. L. Lo, and R. L. Stamm [1996]. “Exploiting choice: Instruction fetch and issue on an implementable simultaneous multithreading processor,” Proc. 23rd Annual Int’l. Symposium on Computer Architecture (ISCA), May 22–24, 1996, Philadelphia, Penn., 191–202.
Tullsen, D. M., S. J. Eggers, and H. M. Levy [1995]. “Simultaneous multithreading: Maximizing on-chip parallelism,” Proc. 22nd Annual Int’l. Symposium on Computer Architecture (ISCA), June 22–24, 1995, Santa Margherita, Italy, 392–403.
Unger, S. H. [1958]. “A computer oriented towards spatial problems,” Proc. Institute of Radio Engineers 46:10 (October), 1744–1750.
Walrand, J. [1991]. Communication Networks: A First Course, Aksen Associates: Irwin, Homewood, Ill.
Wilson, A. W., Jr. [1987]. “Hierarchical cache/bus architecture for shared-memory multiprocessors,” Proc. 14th Annual Int’l. Symposium on Computer Architecture (ISCA), June 2–5, 1987, Pittsburgh, Penn., 244–252.
Wolfe, A., and J. P. Shen [1991]. “A variable instruction stream extension to the VLIW architecture.” Proc. Fourth Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), April 8–11, 1991, Palo Alto, Calif., 2–14.
Wood, D. A., and M. D. Hill [1995]. “Cost-effective parallel computing,” IEEE Computer 28:2 (February), 69–72.
Wulf, W., and C. G. Bell [1972]. “C.mmp—A multi-mini-processor,” Proc. AFIPS Fall Joint Computer Conf., December 5–7, 1972, Anaheim, Calif., 765–777.
Wulf, W., and S. P. Harbison [1978]. “Reflections in a pool of processors—an experience report on C.mmp/Hydra,” Proc. AFIPS National Computing Conf. June 5–8, 1978, Anaheim, Calif., 939–951.
Yamamoto, W., M. J. Serrano, A. R. Talcott, R. C. Wood, and M. Nemirosky [1994]. “Performance estimation of multistreamed, superscalar processors,” Proc. 27th Hawaii Int’l. Conf. on System Sciences, January 4–7, 1994, Wailea, 195–204.
M.8 集群的发展(第 6 章)
本节介绍集群的发展,它是仓库级计算机(WSC)和效用计算的基础。希望深入了解的读者,可以从 Barroso 和 Hölzle[2009],以及 James Hamilton 在 http://perspectives.mvdirona.com 上发表的博客和演讲入手。
集群:WSC 的先驱
集群很可能由 20 世纪 60 年代的用户“发明”:他们或是无法将全部工作放进一台计算机,或是需要一台备用机器,以应对主机故障[Pfister,1998]。Tandem 于 1975 年推出 16 节点集群;Digital 随后在 1984 年推出 VAX 集群。最初,它们是共享 I/O 设备的独立计算机,需要分布式操作系统协调活动。很快,计算机之间加入了通信链路;其中一个目的是允许机器分布在不同地点,以在某一站点遭遇灾难时提高可用性。用户登录集群,并不知道自己实际运行在哪台机器上。到 1993 年,DEC——后来成为 HP 的一部分——已售出超过 25,000 套集群。其他早期厂商包括 Tandem,后来同样并入 HP,以及 IBM,仍然是 IBM。原文撰写时,几乎每家公司都有集群产品。多数产品主要面向可用性,性能扩展是次要收益。
集群上的科学计算后来成为大规模并行处理器(MPP)的竞争者。Beowulf 项目于 1993 年启动,目标是满足 NASA 的需求:用不到 50,000 美元,获得一台 1 GFLOPS 计算机。1994 年,用采用 80486 的现成 PC 构建的 16 节点集群达成了这一目标[Bell 和 Gray,2001]。对这种用途的重视,催生了多种软件接口,以便提交、协调和调试大型程序,或者大量独立程序。
一些研究项目努力降低集群通信延迟,同时提高带宽。低延迟研究的一项商业成果是 VI 接口标准,后来被下文提到的 InfiniBand 采用。低延迟又被证明有助于其他应用。例如,1997 年,University of California, Berkeley 的 100 台 UltraSPARC 桌面机,通过每条链路 160 MB/s 的 Myrinet 交换机连接,创下了数据库排序和破解加密消息的世界纪录:一分钟内,将原本位于磁盘上的 8.6 GB 数据排序;3.5 小时内,破解一个 40 位 DES 密钥。
这个名为 Network of Workstations 的研究项目[Anderson、Culler 和 Patterson,1995]还开发了 Inktomi 搜索引擎,并促成同名创业公司的成立。Eric Brewer 先在 Berkeley、后在公司领导 Inktomi 工作,展示了如何用商用通用硬件构建 Internet 服务的计算基础设施。Inktomi 在 PC 服务器机架内采用标准化网络,获得了更好的可扩展性。相比之下,此前领先的搜索引擎 Alta Vista 采用大型 SMP。与集群领域的高性能计算工作相比,Inktomi 更重视数量较多的低成本节点,以及清晰的编程模型。因此,NOW 项目和 Inktomi 被视为 WSC 与云计算的基础。Google 采用与 Inktomi 类似的技术,从 Inktomi 手中接过搜索引擎的领先地位,正如 Inktomi 此前超过 Alta Vista 一样[Brin 和 Page,1998]。Google 最初的创新在搜索质量,WSC 方面的创新则晚得多。此后多年来,所有 Internet 服务都依靠集群技术服务数百万客户。
效用计算:云计算的先驱
正如正文所述,效用计算最早的形式是分时系统。虽然更小、更便宜的个人计算机出现后,分时逐渐衰落,但在原文所述的过去十年间,复兴效用计算的尝试很多,只是都未获得充分成功。Sun 于 2000 年开始以每小时 1 美元出售 Sun Cloud 的使用时间;HP 于 2001 年推出 Utility Data Center;Intel 也在 21 世纪初尝试出售内部超级计算机的使用时间。这些服务虽然已经商业化,却很少有人使用。
相关的另一个领域是网格计算,它最初旨在让科学程序跨越地理分散的计算设施运行。当时,姑且不论实现的难度,就有人质疑这个目标本身是否明智。网格计算往往要求极大的系统运行极大的程序,并用多个数据中心完成任务。然而,远距离固有的长延迟,使单个应用难以在地理分散的条件下高效运行。这一最初尝试最终促成了一些数据访问约定,但网格计算界没有形成在高性能计算领域之外也有用的 API,因此云计算与网格计算共享的代码和历史都很少。
Armbrust 等人[2009]指出,Internet 服务公司一旦解决大规模运营的问题,就会发现显著的规模经济,使成本低于较小的数据中心。Amazon 意识到,如果这种成本优势成立,就应该能够通过出售这类服务盈利。2006 年,Amazon 公布 Elastic Cloud Computing(EC2),每个实例每小时收费 0.10 美元。EC2 随后的流行,使其他 Internet 公司也开始提供云计算服务,例如 Google App Engine 和 Microsoft Azure;不过,它们提供的抽象层次高于 Amazon Web Services 的 x86 虚拟机。因此,按使用量付费的计算之所以流行,并非因为有人最近才想出这一主意,而是技术与商业模式终于相互契合,使公司能够通过提供许多人愿意使用的服务来赚钱。效用计算未来会出现许多成功模式,还是会围绕单一标准趋于统一,只有时间才能回答。这一过程一定值得关注。
集装箱
2003 年秋,许多人开始考虑用集装箱容纳服务器。Internet Archive 的创始人兼负责人 Brewster Kahle 在演讲中介绍,如何把整个档案库放进一个 40 英尺集装箱。他希望复制档案并将副本分布到世界各地,确保其长期存续,避免重蹈公元前 48 年亚历山大图书馆毁于大火的覆辙。与 Kahle 合作的人根据其 2003 年 11 月的演讲撰写了白皮书,进一步说明集装箱设计的具体形态。
同一年,Google 工程师也在研究用集装箱建造数据中心,并于 2003 年 12 月就其中一些设计提交专利申请。第一个用于数据中心的集装箱于 2005 年 1 月交付,Google 于 2007 年 10 月获得专利,并在 2009 年 4 月公开披露其使用集装箱的做法。
Sun Microsystems 的 Greg Papadopolous 和 Applied Minds 的 Danny Hillis 听过 Kahle 的演讲后,设计了名为 Sun Modular Datacenter 的产品,于 2006 年 10 月首次亮相。项目代号是 Black Box,许多人后来仍沿用这一称呼。这个半长、20 英尺的集装箱可容纳 280 台服务器。该产品的发布,加上 Microsoft 宣布正在建造能够容纳 220 个 40 英尺集装箱的数据中心,促使许多其他公司推出集装箱,以及专为安装在其中而设计的服务器。
故事迎来了令人欣慰的转折:2009 年,Internet Archive 将数据迁入 Sun Modular Datacenter。原文撰写时,埃及的新亚历山大图书馆已保存了一份 Internet Archive 副本,地点就在古代图书馆遗址附近。
参考文献
Anderson, T. E., D. E. Culler, and D. Patterson [1995]. “A case for NOW (networks of workstations),” IEEE Micro 15:1 (February), 54–64.
Apache Software Foundation. [2011]. Apache Hadoop project, http://hadoop.apache.org.
Armbrust, M., A. Fox, R. Griffith, A.D. Joseph, R. Katz, A. Konwinski, G. Lee, D. Patterson, A. Rabkin, I. Stoica, and M. Zaharia [2009]. Above the Clouds: A Berkeley View of Cloud Computing, Tech. Rep. UCB/EECS-2009-28, University of California, Berkeley (http://www.eecs.berkeley.edu/Pubs/TechRpts/2009/EECS-2009-28.html).
Barroso, L. A. [2010]. “Warehouse scale computing [keynote address],” Proc. ACM SIG-MOD, June 8–10, 2010, Indianapolis, Ind.
Barroso, L. A., and U. Hölzle [2007]. “The case for energy-proportional computing,” IEEE Computer 40:12 (December), 33–37.
Barroso, L.A., and U. Hölzle [2009]. “The datacenter as a computer: An introduction to the design of warehouse-scale machines,” in M. D. Hill, ed., Synthesis Lectures on Computer Architecture, Morgan & Claypool, San Rafael, Calif.
Barroso, L.A., Clidaras, J. and Hölzle, U., 2013. The datacenter as a computer: An introduction to the design of warehouse-scale machines. Synthesis lectures on computer architecture, 8(3), pp.1–154.
Barroso, L.A., Marty, M., Patterson, D., and Ranganathan, P. 2017. Attack of the Killer Microseconds. Communications of the ACM, 56(2).
Bell, C. G., and J. Gray [2002]. “What’s next in high performance computing,” Communications of the ACM 45:2 (February), 91–95.
Brady, J.T., 1986. A theory of productivity in the creative process. IEEE Computer Graphics and Applications, 6(5), pp.25–34.
Brin, S., and L. Page [1998]. “The anatomy of a large-scale hypertextual Web search engine,” Proc. 7th Int’l. World Wide Web Conf., April 14–18, 1998, Brisbane, Queensland, Australia, 107–117.
Carter, J., and K. Rajamani [2010]. “Designing energy-efficient servers and data centers,” IEEE Computer 43:7 (July), 76–78.
Chang, F., J. Dean, S. Ghemawat, W. C. Hsieh, D. A. Wallach, M. Burrows, T. Chandra, A. Fikes, and R. E. Gruber [2006]. “Bigtable: A distributed storage system for structured data,” in Proc. Operating Systems Design and Implementation (OSDI ’06), November 6–8, 2006, Seattle, Wash.
Chang, J., J. Meza, P. Ranganathan, C. Bash, and A. Shah [2010]. “Green server design: Beyond operational energy to sustainability,” Workshop on Power Aware Computing and Systems (HotPower ’10), October 4–6, 2010, Vancouver, British Columbia.
Clark, J., 2014 Five Numbers That Illustrate the Mind-Bending Size of Amazon’s Cloud, Bloomberg, https://www.bloomberg.com/news/2014-11-14/5-numbersthat-illustrate-the-mind-bending-size-of-amazon-s-cloud.html.
Clidaras, J., C. Johnson, and B. Felderman [2010]. Private communication.
Climate Savers Computing. [2007]. Efficiency specs, http://www.climatesaverscomputing.org/.
Clos, C., 1953. A Study of Non-Blocking Switching Networks. Bell Labs Technical Journal, 32(2), pp.406-424.
Dean, J. [2009]. “Designs, lessons and advice from building large distributed systems [keynote address],” Proc. 3rd ACM SIGOPS International Workshop on Large Scale Distributed Systems and Middleware, Co-located with the 22nd ACM Symposium on Operating Systems Principles (SOSP 2009), October 10–11, 2009, Big Sky, Mont.
Dean, J. and Barroso, L.A., 2013. The tail at scale. Communications of the ACM, 56(2), pp.74-80.
Dean, J., and S. Ghemawat [2004]. “MapReduce: Simplified data processing on large clusters.” In Proc. Operating Systems Design and Implementation (OSDI ’04), December 6–8, 2004, San Francisco, 137–150.
Dean, J., and S. Ghemawat [2008]. “MapReduce: simplified data processing on large clusters,” Communications of the ACM 51:1, 107–113.
DeCandia, G., D. Hastorun, M. Jampani, G. Kakulapati, A. Lakshman, A. Pilchin, S. Sivasubramanian, P. Vosshall, and W. Vogels [2007]. “Dynamo: Amazon’s highly available key-value store,” in Proc. 21st ACM Symposium on Operating Systems Principles, October 14–17, 2007, Stevenson, Wash.
Doherty, W.J. and Thadhani, A.J., 1982. The economic value of rapid response time. IBM Report.
Fan, X., W. Weber, and L. A. Barroso [2007]. “Power provisioning for a warehouse-sized computer,” in Proc. 34th Annual Int’l. Symposium on Computer Architecture (ISCA), June 9–13, 2007, San Diego, Calif.
A. Fikes, “Storage architecture and challenges,” in Google Faculty Summit, 2010.
Ghemawat, S., H. Gobioff, and S.-T. Leung (2003). “The Google file system,” in Proc. 19th ACM Symposium on Operating Systems Principles, October 19–22, 2003, Lake George, N.Y.
Greenberg, A., N. Jain, S. Kandula, C. Kim, P. Lahiri, D. Maltz, P. Patel, and S. Sengupta [2009]. “VL2: A scalable and flexible data center network,” in Proc. SIGCOMM, August 17–21, Barcelona, Spain.
González, A. and Day, M. April 27, 2016, “Amazon, Microsoft invest billions as computing shifts to cloud,” The Seattle Times. http://www.seattletimes.com/business/technology/amazon-microsoft-invest-billions-as-computing-shifts-to-cloud/
Hamilton, J. [2009]. “Data center networks are in my way,” Stanford Clean Slate CTO Summit, October 23, 2009, http://mvdirona.com/jrh/TalksAndPapers/JamesHamilton_CleanSlateCTO2009.pdf.
Hamilton, J. [2010]. “Cloud computing economies of scale,” Proc. AWS Workshop on Genomics & Cloud Computing, June 8, 2010, Seattle, Wash. (http://mvdirona.com/jrh/TalksAndPapers/JamesHamilton_GenomicsCloud20100608.pdf).
Hamilton, J., 2014. AWS Innovation at Scale, AWS Re-invent conference. https://www.youtube.com/watch?v=JIQETrFC_SQ
Hamilton, J., May 2015. The Return to the Cloud, http://perspectives.mvdirona.com/2015/05/the-return-to-the-cloud//
Hamilton, J., April 2017. How Many Data Centers Needed World-Wide, http://perspectives.mvdirona.com/2017/04/how-many-data-centers-needed-worldwide/
Hölzle, U. [2010]. “Brawny cores still beat wimpy cores, most of the time,” IEEE Micro, July/August.
Kanev, S., Darago, J.P., Hazelwood, K., Ranganathan, P., Moseley, T., Wei, G.Y. and Brooks, D., 2015, June. Profiling a warehouse-scale computer. ACM/IEEE 42nd Annual International Symposium on Computer Architecture (ISCA).
Lang, W., J. M. Patel, and S. Shankar [2010]. “Wimpy node clusters: What about non-wimpy workloads?” Proc. Sixth Int’l. Workshop on Data Management on New Hardware, June 7, 2010, Indianapolis, Ind.
Lim, K., P. Ranganathan, J. Chang, C. Patel, T. Mudge, and S. Reinhardt [2008]. “Understanding and designing new system architectures for emerging warehouse-computing environments,” Proc. 35th Annual Int’l. Symposium on Computer Architecture (ISCA), June 21–25, 2008, Beijing, China.
Narayanan, D., E. Thereska, A. Donnelly, S. Elnikety, and A. Rowstron [2009]. “Migrating server storage to SSDs: Analysis of trade-offs,” Proc. 4th ACM European Conf. on Computer Systems, April 1–3, 2009, Nuremberg, Germany.
Pfister, G. F. [1998]. In Search of Clusters, 2nd ed., Prentice Hall, Upper Saddle River, N.J.
Pinheiro, E., W.-D. Weber, and L. A. Barroso [2007]. “Failure trends in a large disk drive population,” Proc. 5th USENIX Conference on File and Storage Technologies (FAST ’07), February 13–16, 2007, San Jose, Calif.
Ranganathan, P., P. Leech, D. Irwin, and J. Chase [2006]. “Ensemble-level power management for dense blade servers,” Proc. 33rd Annual Int’l. Symposium on Computer Architecture (ISCA), June 17–21, 2006, Boston, Mass., 66–77.
Reddi, V. J., B. C. Lee, T. Chilimbi, and K. Vaid [2010]. “Web search using mobile cores: Quantifying and mitigating the price of efficiency,” Proc. 37th Annual Int’l. Symposium on Computer Architecture (ISCA), June 19–23, 2010, Saint-Malo, France.
Schroeder, B., and G. A. Gibson [2007]. “Understanding failures in petascale computers,” Journal of Physics: Conference Series 78, 188–198.
Schroeder, B., E. Pinheiro, and W.-D. Weber [2009]. “DRAM errors in the wild: A large-scale field study,” Proc. Eleventh Int’l. Joint Conf. on Measurement and Modeling of Computer Systems (SIGMETRICS), June 15–19, 2009, Seattle, Wash.
Schurman, E. and J. Brutlag [2009]. “The User and Business Impact of Server Delays,” Proc. Velocity: Web Performance and Operations Conf., June 22–24, 2009, San Jose, Calif.
Tezzaron Semiconductor. [2004]. “Soft Errors in Electronic Memory—A White Paper, Tezzaron Semiconductor, Naperville, Ill. (http://www.tezzaron.com/about/papers/soft_errors_1_1_secure.pdf).
Vahdat, A., M. Al-Fares, N. Farrington, R. N. Mysore, G. Porter, and S. Radhakrishnan [2010]. “Scale-out networking in the data center,” IEEE Micro July/ August 2010.
M.9 历史回顾与参考文献
体系结构设计者在尝试领域专用体系结构(DSA)时,了解体系结构历史可能会有所帮助。一些较早的思想在通用计算中未能成功,却可能非常适合 DSA。毕竟,它们很可能在某些方面做得很好:这些方面也许恰好契合你的领域;反过来,你的领域也可能不包含那些曾使它们遇到困难的特征。例如,20 世纪 60 年代的 Illiac IV[Barnes 等人,1968]和 70 年代的 FPS 120a[Charlesworth,1981]都具有二维处理单元阵列,因此可视为 TPU 和 Paintbox 的真正先驱。类似地,Multiflow[Rau 和 Fisher,1993]及 Itanium[Sharangpani 和 Arora,2000]的 VLIW 体系结构,虽然在通用计算市场未获成功,但 Paintbox 并不存在让 VLIW 难以应付的那些问题:时常突发的数据缓存未命中、难以预测的分支,或庞大的代码占用空间。
两篇综述表明,定制神经网络 ASIC 的历史至少可以追溯到 25 年前[Ienne 等人,1996;Asanović,2002]。例如,CNAPS 芯片包含由 64 个 16 位乘 8 位乘法器组成的 SIMD 阵列,多片 CNAPS 可以通过一个定序器连接起来[Hammerstrom,1990]。Synapse-1 系统以定制的脉动乘加芯片 MA-16 为基础,一次执行 16 个 16 位乘法[Ramacher 等人,1991]。系统将多个 MA-16 芯片串接起来,并使用定制硬件执行激活函数。
从 1995 年开始,研究者部署了 25 台用 T0 定制 ASIC 加速的 SPERT-II 工作站,同时承担语音识别神经网络的训练和推理[Asanović 等人,1998]。运行于 40 MHz 的 T0,为 MIPS 指令集体系结构增加了向量指令。其八通道向量单元每周期最多能够根据 8 位和 16 位输入,产生 16 个 32 位算术结果,使推理速度达到 SPARC-20 工作站的 25 倍,训练速度达到 20 倍。他们发现 16 位不足以满足训练要求,于是改用两个 16 位字,导致训练时间加倍。为克服这一缺点,他们引入包含 32 至 1000 组数据的“bunches”,即批次,减少更新权重所花的时间;结果,比使用一个字、却不采用批处理的训练还快。
我们用 Image Processing Unit(图像处理单元,IPU)来称呼 Paintbox 所代表的新兴处理器类别,但这个术语并非首次出现。我们能够找到的最早用例是 1999 年:Sony PlayStation 将它用作一块本质上是 MPEG2 解码器的芯片名称[Sony/Toshiba,1999]。2006 年,Freescale 又用 IPU 命名 i.MX31 Applications Processor 的一个组成部分,其含义更接近我们在此采用的较通用解释[Freescale as part of i.MX31 Applications Processor,2006]。
参考文献
Abadi, M., Agarwal, A., Barham, P., Brevdo, E., Chen, Z., Citro, C., Corrado, G.S., Davis, A., Dean, J., Devin, M., Ghemawat, S., 2016. Tensor-flow: large-scale machine learning on heterogeneous distributed systems. arXiv preprint arXiv:1603.04467.
Adolf, R., Rama, S., Reagen, B., Wei, G.Y., Brooks, D., 2016. Fathom: reference workloads for modern deep learning methods. In: IEEE International Symposium on Workload Characterization (IISWC).
Amodei, D., et al., 2015. Deep speech 2: end-to-end speech recognition in English and mandarin, arXiv:1512.02595.
Asanović, K., 2002. Programmable neurocomputing. In: Arbib, M.A. (Ed.), The Handbook of Brain Theory and Neural Networks, second ed. MIT Press, Cambridge, MA. ISBN: 0-262-01197-2. https://people.eecs.berkeley.edu/~krste/papers/neurocomputing.pdf.
Asanović, K., Beck, A., Johnson, J., Wawrzynek, J., Kingsbury, B., Morgan, N., 1998. Training neural networks with Spert-II. In: Sundararajan, N., Saratchandran, P. (Eds.), Parallel Architectures for Artificial Networks: Paradigms and Implementations. IEEE Computer Society Press. ISBN: 0-8186-8399-6. (Chapter 11) https://people.eecs.berkeley.edu/~krste/papers/annbook.pdf.
Bachrach, J., Vo, H., Richards, B., Lee, Y., Waterman, A., Avižienis, R., Wawrzynek, J., Asanović, K., 2012. Chisel: constructing hardware in a Scala embedded language. In: Proceedings of the 49th Annual Design Automation Conference, pp. 1216–1225.
Barnes, G.H., Brown, R.M., Kato, M., Kuck, D.J., Slotnick, D.L., Stokes, R., 1968. The ILLIAC IV computer. IEEE Trans. Comput. 100 (8), 746–757.
Bhattacharya, S., Lane, N.D., 2016. Sparsification and separation of deep learning layers for constrained resource inference on wearables. In: Proceedings of the 14th ACM Conference on Embedded Network Sensor Systems CD-ROM, pp. 176–189.
Brunhaver, J., 2014. PhD thesis. Stanford.
Canis, A., Choi, J., Aldham, M., Zhang, V., Kammoona, A., Czajkowski, T., Brown, S.D., Anderson, J.H., 2013. LegUp: an open-source high-level synthesis tool for FPGA-based processor/accelerator systems. ACM Trans. Embed. Comput. Syst. 13 (2).
Canny, J., et al., 2015. Machine learning at the limit. In: IEEE International Conference on Big Data.
Caulfield, A.M., Chung, E.S., Putnam, A., Haselman, H.A.J.F.M., Humphrey, S.H.M., Daniel, P.K.J.Y.K., Ovtcharov, L.T.M.K., Lanka, M.P.L.W.S., Burger, D.C.D., 2016. A cloud-scale acceleration architecture. In: MICRO Conference.
Charlesworth, A.E., 1981. An approach to scientific array processing: the architectural design of the AP-120B/FPS-164 family. Computer 9, 18–27.
Clark, J., October 26, 2015. Google Turning Its Lucrative Web Search Over to AI Machines. Bloomberg Technology, www.bloomberg.com.
Dally, W.J., 2002. Computer architecture is all about interconnect. In: Proceedings of the 8th International Symposium High Performance Computer Architecture.
Freescale as part of i.MX31 Applications Processor, 2006. http://cache.freescale.com/files/32bit/doc/white_paper/IMX31MULTIWP.pdf.
Galal, S., Shacham, O., Brunhaver II, J.S., Pu, J., Vassiliev, A., Horowitz, M., 2013. FPU generator for design space exploration. In: 21st IEEE Symposium on Computer Arithmetic (ARITH).
Hameed, R., Qadeer, W., Wachs, M., Azizi, O., Solomatnikov, A., Lee, B.C., Richardson, S., Kozyrakis, C., Horowitz, M., 2010. Understanding sources of inefficiency in general-purpose chips. ACM SIGARCH Comput. Architect. News 38 (3), 37–47.
Hammerstrom, D., 1990. A VLSI architecture for high-performance, low-cost, on-chip learning. In: IJCNN International Joint Conference on Neural Networks.
He, K., Zhang, X., Ren, S., Sun, J., 2016. Identity mappings in deep residual networks. Also in arXiv preprint arXiv:1603.05027.
Huang, M., Wu, D., Yu, C.H., Fang, Z., Interlandi, M., Condie, T., Cong, J., 2016. Programming and runtime support to blaze FPGA accelerator deployment at datacenter scale. In: Proceedings of the Seventh ACM Symposium on Cloud Computing. ACM, pp. 456–469.
Iandola, F., 2016. Exploring the Design Space of Deep Convolutional Neural Networks at Large Scale (Ph.D. dissertation). UC Berkeley.
Ienne, P., Cornu, T., Kuhn, G., 1996. Special-purpose digital hardware for neural networks: an architectural survey. J. VLSI Signal Process. Syst. Signal Image Video Technol. 13 (1).
Jouppi, N., 2016. Google supercharges machine learning tasks with TPU custom chip. https://cloudplatform.googleblog.com.
Jouppi, N., Young, C., Patil, N., Patterson, D., Agrawal, G., et al., 2017. Datacenter performance analysis of a matrix processing unit. In: 44th International Symposium on Computer Architecture.
Karpathy, A., et al., 2014. Large-scale video classification with convolutional neural networks. CVPR.
Krizhevsky, A., Sutskever, I., Hinton, G., 2012. Imagenet classification with deep convolutional neural networks. Adv. Neural Inf. Process. Syst.
Kung, H.T., Leiserson, C.E., 1980. Algorithms for VLSI processor arrays. Introduction to VLSI systems.
Lee, Y., Waterman, A., Cook, H., Zimmer, B., Keller, B., Puggelli, A., Kwak, J., Jevtic, R., Bailey, S., Blagojevic, M., Chiu, P.-F., Avizienis, R., Richards, B., Bachrach, J., Patterson, D., Alon, E., Nikolic, B., Asanovic, K., 2016. An agile approach to building RISC-V microprocessors. IEEE Micro 36 (2), 8–20.
Lewis-Kraus, G., 2016. The Great A.I. Awakening. New York Times Magazine.
Nielsen, M., 2016. Neural Networks and Deep Learning. http://neuralnetworksanddeeplearning.com/.
Nvidia, 2016. Tesla GPU Accelerators For Servers. http://www.nvidia.com/object/teslaservers.html.
Olofsson, A., 2011. Debunking the myth of the $100 M ASIC. EE Times. http://www.eetimes.com/author.asp?section_id=36&doc_id=1266014.
Ovtcharov, K., Ruwase, O., Kim, J.Y., Fowers, J., Strauss, K., Chung, E.S., 2015a. Accelerating deep convolutional neural networks using specialized hardware. Microsoft Research Whitepaper. https://www.microsoft.com/en-us/research/publication/accelerating-deepconvolutional-neural-networks-using-specialized-hardware/.
Ovtcharov, K., Ruwase, O., Kim, J.Y., Fowers, J., Strauss, K., Chung, E.S., 2015b. Toward accelerating deep learning at scale using specialized hardware in the datacenter. In: 2015 IEEE Hot Chips 27 Symposium.
Patterson, D., Nikolić, B., 7/25/2015, Agile Design for Hardware, Parts I, II, and III. EE Times, http://www.eetimes.com/author.asp?doc_id=1327239.
Patterson, D.A., Ditzel, D.R., 1980. The case for the reduced instruction set computer. ACM SIGARCH Comput. Architect. News 8 (6), 25–33.
Prabhakar, R., Koeplinger, D., Brown, K.J., Lee, H., De Sa, C., Kozyrakis, C., Olukotun, K., 2016. Generating configurable hardware from parallel patterns. In: Proceedings of the Twenty-First International Conference on Architectural Support for Programming Languages and Operating Systems. ACM, pp. 651–665.
Putnam, A., Caulfield, A.M., Chung, E.S., Chiou, D., Constantinides, K., Demme, J., Esmaeilzadeh, H., Fowers, J., Gopal, G.P., Gray, J., Haselman, M., Hauck, S., Heil, S., Hormati, A., Kim, J.-Y., Lanka, S., Larus, J., Peterson, E., Pope, S., Smith, A., Thong, J., Xiao, P.Y., Burger, D., 2014. A reconfigurable fabric for accelerating large-scale datacenter services. In: 41st International Symposium on Computer Architecture.
Putnam, A., Caulfield, A.M., Chung, E.S., Chiou, D., Constantinides, K., Demme, J., Esmaeilzadeh, H., Fowers, J., Gopal, G.P., Gray, J., Haselman, M., Hauck, S., Heil, S., Hormati, A., Kim, J.-Y., Lanka, S., Larus, J., Peterson, E., Pope, S., Smith, A., Thong, J., Xiao, P.Y., Burger, D., 2015. A reconfigurable fabric for accelerating large-scale datacenter services. IEEE Micro. 35 (3).
Putnam, A., Caulfield, A.M., Chung, E.S., Chiou, D., Constantinides, K., Demme, J., Esmaeilzadeh, H., Fowers, J., Gopal, G.P., Gray, J., Haselman, M., Hauck, S., Heil, S., Hormati, A., Kim, J.-Y., Lanka, S., Larus, J., Peterson, E., Pope, S., Smith, A., Thong, J., Xiao, P.Y., Burger, D., 2016. A reconfigurable fabric for accelerating large-scale datacenter services. Commun. ACM.
Qadeer, W., Hameed, R., Shacham, O., Venkatesan, P., Kozyrakis, C., Horowitz, M.A., 2015. Convolution engine: balancing efficiency & flexibility in specialized computing. Commun. ACM 58 (4).
Ragan-Kelley, J., Barnes, C., Adams, A., Paris, S., Durand, F., Amarasinghe, S., 2013. Halide: a language and compiler for optimizing parallelism, locality, and recomputation in image processing pipelines. ACM SIGPLAN Not. 48 (6), 519–530.
Ramacher, U., Beichter, J., Raab, W., Anlauf, J., Bruels, N., Hachmann, A., Wesseling, M., 1991. Design of a 1st generation neurocomputer. VLSI Design of Neural Networks. Springer, USA.
Rau, B.R., Fisher, J.A., 1993. Instruction-level parallelism. J. Supercomput. 235, Springer Science & Business Media.
Russakovsky, O., Deng, J., Su, H., Krause, J., Satheesh, S., Ma, S., Huang, Z., Karpathy, A., Khosla, A., Bernstein, M., Berg, A.C., 2015. Imagenet large scale visual recognition challenge. Int. J. Comput. Vis. 115 (3).
Sergio Guadarrama, 2015. BVLC googlenet. https://github.com/BVLC/caffe/tree/master/models/bvlc_googlenet.
Shao, Y.S., Brooks, D., 2015. Research infrastructures for hardware accelerators. Synth. Lect. Comput. Architect. 10 (4), 1–99.
Sharangpani, H., Arora, K., 2000. Itanium processor microarchitecture. IEEE Micro 20 (5), 24–43.
Silver, D., Huang, A., Maddison, C.J., Guez, A., Sifre, L., Van Den Driessche, G., Schrittwieser, J., Antonoglou, I., Panneershelvam, V., Lanctot, M., Dieleman, S., 2016. Mastering the game of Go with deep neural networks and tree search. Nature 529 (7587).
Smith, J.E., 1982. Decoupled access/execute computer architectures. In: Proceedings of the 11th International Symposium on Computer Architecture.
Sony/Toshiba, 1999. ‘Emotion Engine’ in PS2 (“IPU is basically an MPEG2 decoder…”). http://www.cpu-collection.de/?l0=co&l1=Sony&l2=Emotion+Engine, http://arstechnica.com/gadgets/2000/02/ee/3/.
Steinberg, D., 2015. Full-Chip Simulations, Keys to Success. In: Proceedings of the Synopsys Users Group (SNUG) Silicon Valley 2015.
Szegedy, C., Liu, W., Jia, Y., Sermanet, P., Reed, S., Anguelov, D., Erhan, D., Vanhoucke, V., Rabinovich, A., 2015. Going deeper with convolutions. In: Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition.
TensorFlow Tutorials, 2016. https://www.tensorflow.org/versions/r0.12/tutorials/index.html.
Tung, L., 2016. Google Translate: ‘This landmark update is our biggest single leap in 10 years’, ZDNet. http://www.zdnet.com/article/google-translate-this-landmarkupdate-is-our-biggest-single-leap-in-10years/.
Vanhoucke, V., Senior, A., Mao, M.Z., 2011. Improving the speed of neural networks on CPUs. https://static.googleusercontent.com/media/research.google.com/en//pubs/archive/37631.pdf.
Wu, Y., Schuster, M., Chen, Z., Le, Q., Norouzi, M., Macherey, W., Krikun, M., Cao, Y., Gao, Q., Macherey, K., Klingner, J., Shah, A., Johnson, M., Liu, X., Kaiser, Ł., Gouws, S., Kato, Y., Kudo, T., Kazawa, H., Stevens, K., Kurian, G., Patil, N., Wang, W., Young, C., Smith, J., Riesa, J., Rudnick, A., Vinyals, O., Corrado, G., Hughes, M., Dean, J., 2016. Google’s Neural Machine Translation System: Bridging the Gap between Human and Machine Translation. http://arxiv.org/abs/1609.08144.
M.10 磁存储、RAID 与 I/O 总线的历史(附录 D)
这里所说的海量存储,是指单个设备容量超过一百万个字母数字字符……
——Hoagland[1963]
存储 I/O 的种类和问题多种多样,因此其历史也有许多不同线索。Smotherman[1989]更深入地探讨了 I/O 的历史。本节讨论磁存储、RAID,以及 I/O 总线和控制器。希望进一步学习排队论的读者,可以阅读 Jain[1991]和 Lazowska 等人[1984]的著作。
磁存储
磁记录最初为记录声音而发明,到 1941 年,磁带已能与其他存储设备竞争。1947 年 ENIAC 的成功,推动了用磁带记录数字信息的尝试。直到 20 世纪 70 年代,卷式磁带一直主导可移动存储。80 年代,IBM 3480 盒式磁带成为事实标准,至少在大型机领域如此。它同时读取 18 条磁道,传输率为 3 MB/s,但这种半英寸磁带的容量只有 200 MB。StorageTek 在 Powder-Horn 中采用的 9840 盒式磁带,传输率为 10 MB/s,容量为 20,000 MB。它并非只沿纵向记录,而是以折返方式排列磁道,使磁头反向跟随磁道;这种技术称为蛇形记录。另一种半英寸磁带是 Digital Linear Tape;DLT7000 容量为 35,000 MB,传输率为 5 MB/s。与它竞争的是螺旋扫描,通过旋转磁头来提高记录密度。2001 年,8 mm 螺旋扫描磁带的容量为 20,000 MB,传输率约为 3 MB/s。无论密度和成本如何,磁带的顺序访问性质始终使人们渴望能够随机访问的存储设备。
1953 年,IBM 的 Reynold B. Johnson 挑选了 15 名科学家,目标是建造一种随机访问存储系统,其速度要比磁带快得多。设计目标是存储相当于 50,000 张标准 IBM 穿孔卡的信息,并在一秒内取出数据。Johnson 的磁盘驱动器设计很简单,却未经验证:磁读写传感器必须悬浮在持续旋转的盘面上方几千分之一英寸处。24 个月后,团队造出了可工作的原型,重 1 吨,占据约 300 立方英尺空间。RAMAC-350(Random Access Method of Accounting Control)采用 50 张直径 24 英寸的盘片,以每分钟 1200 转旋转,总容量 5 MB,访问时间 1 秒。
从 RAMAC 开始,IBM 一直保持磁盘行业的领先地位,其存储业务总部就设在 Johnson 团队开展工作的加利福尼亚州 San Jose。后来许多竞争磁盘厂商的领导者,都在 IBM 开始职业生涯;许多磁盘公司也位于 San Jose 附近。
RAMAC 虽然包含第一种磁盘,磁记录的一项重大突破却来自后来磁盘的气浮式读写磁头:磁头运行在高速盘面产生的空气垫上。这层空气垫既使磁头能够随盘面不平整处起伏,又让它非常接近盘面。后续进展主要来自部件质量的改善和精度的提高。2001 年,磁头与盘面间距为 2 至 3 微英寸,而 RAMAC 驱动器中为 1000 微英寸。
移动磁头磁盘很快成为主要的高速磁存储设备,但其高成本使磁带直到 20 世纪 70 年代仍被广泛采用。硬盘的下一项重要进展,是 IBM 于 1962 年开发的可换盘式硬盘驱动器;它允许多个盘组共享昂贵的驱动器电子电路,帮助磁盘取代磁带,成为首选存储介质。1962 年的 IBM 1311 面密度为每平方英寸 50,000 位,成本约为每 MB 800 美元。IBM 还在 1970 年发明了软盘驱动器,最初用于保存 IBM 370 系列的微代码。约十年后,软盘随着 PC 而普及。
磁盘的第二项重大突破,是大约 1973 年出现的 Winchester 设计。它得益于两项相互关联的变化。首先,集成电路不仅降低了 CPU 成本,也降低了磁盘控制器和控制磁臂的电子电路成本。电子电路变便宜后,不再需要由多个盘组共享,因而固定式磁盘在经济上变得可行。盘片固定并可以封装在密闭外壳内,大幅减轻了环境和控制方面的问题。密封系统使磁头能够更贴近盘面,进一步提高面密度。IBM 交付的第一种密封磁盘有两个主轴,每个主轴配备 30 MB 磁盘;“30-30”这一绰号引出了 Winchester 名称。美国流行的运动步枪 Winchester 94,也因所用弹药口径而被昵称为“30-30”。Winchester 磁盘在 20 世纪 80 年代迅速普及,到该年代中期完全取代了可换盘式磁盘。在此之前,控制磁盘的电子电路成本很高,存储介质必须能够更换。
正如附录 D 所述,DRAM 开始缩小面密度差距、似乎将赶上磁盘存储时,IBM 内部会议曾质疑磁盘驱动器的未来。磁盘设计者得出结论:要抵御 DRAM 威胁,磁盘必须每年改进 60%,而此前的历史增速只有每年 29%。关键使能技术是磁阻磁头,后来的巨磁阻磁头又使原文所述密度成为可能。由于这种竞争,从实验室创造密度纪录,到实际交付相应密度磁盘的间隔,已大幅缩短。
个人计算机创造了小尺寸(SFF)磁盘驱动器市场,因为大型机使用的 14 英寸磁盘驱动器,比 PC 本身还大。2006 年,3.5 英寸驱动器在市场上领先,而笔记本必需的 2.5 英寸驱动器销量也相当可观。iPod 或摄像机等需要更小磁盘的手持设备,能否持续保持显著销量,当时仍有待观察。例如,20 世纪 90 年代初为掌上电脑开发过 1.8 英寸驱动器,但那个市场选择了 Flash,1.8 英寸驱动器便消失了。
RAID
20 世纪 80 年代面向 PC 的小尺寸硬盘,促使 Berkeley 一个研究组提出廉价磁盘冗余阵列(Redundant Arrays of Inexpensive Disks,RAID)。该小组此前参与 RISC 研究,预期快得多的 CPU 即将出现。他们提出两个问题:随 PC 一起使用的这些小磁盘能做些什么?在 I/O 领域,怎样才能跟上快得多的处理器?他们主张用 50 个小驱动器替代一个大型机驱动器,利用许多独立磁臂获得高得多的性能。众多小驱动器甚至还能节省功耗和占地面积。缺点在于,磁盘数量多会使平均失效前时间(MTTF)大幅缩短。因此,他们独立推导出冗余磁盘和轮转奇偶校验的优点,以解决这样的问题:既利用许多小驱动器提高性能,又让可靠性达到单个大型机磁盘的水平。
解释这些思想时,他们遇到的问题是:有些研究者听说过具有某种冗余的磁盘阵列,却不明白 Berkeley 方案的不同。因此,第一篇 RAID 论文[Patterson、Gibson 和 Katz,1987]不仅论证了小尺寸磁盘阵列,也在一定程度上充当了既有磁盘阵列工作的教程和分类说明。镜像,即 RAID 1,早已用于 Tandem 等厂商销售的容错计算机。1987 年,Thinking Machines 有一种采用 32 个数据盘和七个校验盘、通过 ECC 纠错的阵列,即 RAID 2;Honeywell Bull 更早就有 RAID 2 产品。同一时期,科学计算机也采用了带单个奇偶校验盘的阵列,即 RAID 3。论文随后介绍了支持扇区访问的单奇偶校验盘方案 RAID 4,以及轮转奇偶校验方案 RAID 5。Chen 等人[1994]综述了最初的 RAID 思想、商用产品和后续发展。
Berkeley 小组当时并不知道,IBM 研制 AS/400 的工程师也提出了轮转奇偶校验,用来提高一组大型磁盘的可靠性。IBM 在 Berkeley 小组撰写论文之前,就提交了 RAID 5 的专利申请。几家公司关于 RAID 1、RAID 2、RAID 3 的专利,又早于 IBM 的 RAID 5 专利,由此引发了大量诉讼。
Berkeley 论文写于万维网出现之前,但它激发了许多工程师的想象力,复印件通过传真传遍世界。后来属于 Seagate 的一家公司中,有位工程师从朋友和客户那里收到了七份论文。EMC 原本为 IBM 计算机供应 DRAM 板,但 IBM 大约在 1988 年出台的新政策,使 EMC 几乎无法继续销售 IBM 内存板。看来,这篇 Berkeley 论文也曾摆到 EMC 高层的办公桌上,于是他们决定改为进军 IBM 磁盘存储产品主导的市场。按照论文的主张,他们用许多小驱动器与大型机驱动器竞争,并在 1990 年发布 RAID 产品。该产品用镜像,即 RAID 1,保障可靠性;EMC 的 RAID 5 产品晚得多才出现。随后一年中,Micropolis 推出 RAID 3,Compaq 推出 RAID 4,Data General、IBM 和 NCR 则推出 RAID 5 产品。
RAID 思想很快传播到其他工作站和服务器厂商。Byte 杂志一篇解释 RAID 的文章[Anderson,1990]促成了桌面 PC RAID 产品的出现,这令 Berkeley 小组颇感意外。他们关注的是在保持良好可用性的同时提高性能,但更高可用性本身就对 PC 市场很有吸引力。
另一个出乎意料之处是磁盘阵列的成本。冗余电源与风扇、磁盘热插拔能力、RAID 硬件控制器、冗余磁盘等因素,使早期磁盘阵列的价格达到所用磁盘成本的许多倍。也许正因如此,RAID 中的 inexpensive(廉价)逐渐变成 independent(独立)。原文撰写时,许多市场部门和技术作者只知道 RAID 的全称是“独立磁盘冗余阵列”。
EMC 的转型取得了成功。2006 年,EMC 成为领先的存储系统供应商,NetApp 则是领先的网络附加存储系统供应商。当年 RAID 产业规模达到 300 亿美元,非 PC 磁盘销量中超过 80% 用于 RAID。为表彰他们的贡献,Garth Gibson、Randy Katz 和 David Patterson 于 1999 年获得 IEEE Reynold B. Johnson 信息存储奖,获奖理由是“开发了廉价磁盘冗余阵列(RAID)”。
I/O 总线与控制器
无处不在的微处理器,不仅催生了 20 世纪 70 年代的个人计算机,也促成了 80 年代末至 90 年代将控制器功能移入 I/O 设备的趋势。I/O 设备继续沿着这一方向演进,将控制器集成到设备内部。这类设备称为智能设备,有些总线标准,例如 SCSI,就是专为它们而制定的。智能设备自行处理许多低级任务,并对结果排队,从而放宽时序约束。例如,许多兼容 SCSI 的磁盘驱动器在盘内设置磁道缓冲区,支持预读和连接/断开操作。因此,在一条 SCSI 设备链上,一些磁盘可以寻道,另一些可以装填磁道缓冲区,而同时有一个设备将缓冲区中的数据经 SCSI 总线传出。最初 RAMAC 的控制器采用真空管,只需将磁头移动到目标磁道,等待数据经过磁头下方,再传送数据并计算奇偶校验。SCSI 是 Small Computer Systems Interface 的缩写,它体现了这样一种做法:一家公司发明总线,并慷慨鼓励其他公司制造能接入该总线的设备。Shugart 创建了这条总线,最初称为 SASI,后来由 IEEE 标准化。
SCSI 曾有几个潜在继任者,原文所述时期领先的是 Fibre Channel Arbitrated Loop(FC-AL,光纤通道仲裁环)。SCSI 委员会持续提高总线时钟频率,赋予这一标准新的生命;SCSI 的寿命已经超过了某些被提议的继任者。随着 SCSI 串行接口“Serial Attach SCSI”和 ATA 串行接口“Serial ATA”的出现,它们还可能继续使用很久。
第一种由多家厂商支持的总线,或许是 DEC 于 1970 年推出的 PDP-11 Unibus。遗憾的是,这种开放政策,与一些公司利用专利接口建立专有总线、阻止插接兼容厂商竞争的做法形成对照。专有总线还会增加成本,减少可接入的 I/O 设备种类,因为设备必须专门为该总线设计接口。Intel 推动的 PCI 总线,代表着计算机内部 I/O 总线回归开放标准。它的直接后继是 PCI-X;InfiniBand 则在 2000 年仍处于开发中,两者都由多家公司组成的行业协会制定标准。
RAMAC 时代的机器不仅带来存储设备,也带来 I/O 中断。1954 年的 NBS DYSEAC 通常被认为是第一台将中断从检测算术异常,扩展到检测异步 I/O 事件的机器[Leiner 和 Alexander,1954]。第二年,第一台采用 DMA 的机器 IBM SAGE 投入运行。与今天的 DMA 一样,SAGE 具有地址计数器,能够在 CPU 运算的同时执行块传送。
早期 IBM 360 开创了今天 I/O 系统采用的许多思想。360 是第一种大量使用 DMA 的商用机器,并引入了由设备解释执行的 I/O 程序概念。I/O 程序链接是一项重要功能。360 引入的通道概念,对应今天的 I/O 总线。
Myer 和 Sutherland[1968]撰写了一篇经典论文,讨论 I/O 控制器中复杂性与性能的权衡。他们借用宗教中的“轮回”概念,指出自己最终陷入一个循环:不断增强 I/O 处理器的能力,直到它又需要一个更简单的协处理器。他们在附录 D 中的引文,概括了这个值得警惕的故事。
IBM 大型机中配有 I/O 处理器的 I/O 通道,可以被视为 InfiniBand 的灵感来源;InfiniBand 的 Host Channel Adapter(主机通道适配器)卡上同样配有处理器。
参考文献
Anderson, D. [2003]. “You don’t know jack about disks,” Queue 1:4 (June), 20–30.
Anderson, D., J. Dykes, and E. Riedel [2003]. “SCSI vs. ATA—more than an interface,” Proc. 2nd USENIX Conf. on File and Storage Technology (FAST ’03), March 31–April 2, 2003, San Francisco.
Anderson, M. H. [1990]. “Strength (and safety) in numbers (RAID, disk storage technology),” Byte 15:13 (December), 337–339.
Anon. et al. [1985]. A Measure of Transaction Processing Power, Tandem Tech. Rep. TR 85.2. Also appeared in Datamation, 31:7 (April), 112–118.
Bashe, C. J., W. Buchholz, G. V. Hawkins, J. L. Ingram, and N. Rochester [1981]. “The architecture of IBM’s early computers,” IBM J. Research and Development 25:5 (September), 363–375.
Bashe, C. J., L. R. Johnson, J. H. Palmer, and E. W. Pugh [1986]. IBM’s Early Computers, MIT Press, Cambridge, Mass.
Blaum, M., J. Brady, J. Bruck, and J. Menon [1994]. “EVENODD: An optimal scheme for tolerating double disk failures in RAID architectures,” Proc. 21st Annual Int’l. Symposium on Computer Architecture (ISCA), April 18–21, 1994, Chicago, 245–254.
Blaum, M., J. Brady, J. Bruck, and J. Menon [1995]. “EVENODD: An optimal scheme for tolerating double disk failures in RAID architectures,” IEEE Trans. on Computers 44:2 (February), 192–202.
Blaum, M., J. Brady, J., Bruck, J. Menon, and A. Vardy [2001]. “The EVENODD code and its generalization,” in H. Jin, T. Cortes, and R. Buyya, eds., High Performance Mass Storage and Parallel I/O: Technologies and Applications, IEEE & Wiley Press, New York, 187–208.
Blaum, M., J. Bruck, and A. Vardy [1996]. “MDS array codes with independent parity symbols,” IEEE Trans. on Information Theory, IT-42 (March), 529–542.
Brady, J. T. [1986]. “A theory of productivity in the creative process,” IEEE CG&A (May), 25–34.
Brown, A., and D. A. Patterson [2000]. “Towards maintainability, availability, and growth benchmarks: A case study of software RAID systems.” Proc. 2000 USENIX Annual Technical Conf., June 18–23, San Diego, Calif.
Bucher, I. V., and A. H. Hayes [1980]. “I/O performance measurement on Cray-1 and CDC 7000 computers,” Proc. Computer Performance Evaluation Users Group, 16th Meeting, October 20–23, 1980, Orlando, Fl., 245–254.
Chen, P. M., G. A. Gibson, R. H. Katz, and D. A. Patterson [1990]. “An evaluation of redundant arrays of inexpensive disks using an Amdahl 5890,” Proc. ACM SIGMETRICS Conf. on Measurement and Modeling of Computer Systems, May 22–25, 1990, Boulder, Colo.
Chen, P. M., and E. K. Lee [1995]. “Striping in a RAID level 5 disk array,” Proc. ACM SIGMETRICS Conf. on Measurement and Modeling of Computer Systems, May 15–19, 1995, Ottawa, Canada, 136–145.
Chen, P. M., E. K. Lee, G. A. Gibson, R. H. Katz, and D. A. Patterson [1994]. “RAID: High-performance, reliable secondary storage,” ACM Computing Surveys 26:2 (June), 145–188.
Corbett, P., B. English, A. Goel, T. Grcanac, S. Kleiman, J. Leong, and S. Sankar [2004]. “Row-diagonal parity for double disk failure correction,” Proc. 3rd USENIX Conf. on File and Storage Technology (FAST ’04), March 31–April 2, 2004, San Francisco.
Denehy, T. E., J. Bent, F. I. Popovici, A. C. Arpaci-Dusseau, and R. H. Arpaci-Dusseau [2004]. “Deconstructing storage arrays,” Proc. 11th Int’l. Conf. on Architectural Support for Programming Languages and Operating Systems (ASPLOS), October 7–13, 2004, Boston, Mass., 59–71.
Doherty, W. J., and R. P. Kelisky [1979]. “Managing VM/CMS systems for user effectiveness,” IBM Systems J. 18:1, 143–166.
Douceur, J. R., and W. J. Bolosky [1999]. “A large scale study of file-system contents,” Proc. ACM SIGMETRICS Conf. on Measurement and Modeling of Computer Systems, May 1–9, 1999, Atlanta, Ga., 59–69.
Enriquez, P. [2001]. “What happened to my dial tone? A study of FCC service disruption reports,” poster, Richard Tapia Symposium on the Celebration of Diversity in Computing, October 18–20, 2001, Houston, Tex.
Friesenborg, S. E., and R. J. Wicks [1985]. DASD Expectations: The 3380, 3380-23, and MVS/XA, Tech. Bulletin GG22-9363-02, IBM Washington Systems Center, Gaithersburg, Md.
Gibson, G. A. [1992]. Redundant Disk Arrays: Reliable, Parallel Secondary Storage, ACM Distinguished Dissertation Series, MIT Press, Cambridge, Mass.
Goldstein, S. [1987]. Storage Performance—An Eight Year Outlook, Tech. Rep. TR 03.308-1, IBM Santa Teresa Laboratory, San Jose, Calif.
Gray, J. [1990]. “A census of Tandem system availability between 1985 and 1990,” IEEE Trans. on Reliability, 39:4 (October), 409–418.
Gray, J. (ed.) [1993]. The Benchmark Handbook for Database and Transaction Processing Systems, 2nd ed., Morgan Kaufmann, San Francisco.
Gray, J., and A. Reuter [1993]. Transaction Processing: Concepts and Techniques, Morgan Kaufmann, San Francisco.
Gray, J., and D. P. Siewiorek [1991]. “High-availability computer systems.” Computer 24:9 (September), 39–48.
Gray, J., and C. van Ingen [2005]. Empirical Measurements of Disk Failure Rates and Error Rates,” MSR-TR-2005-166, Microsoft Research, Redmond, Wash.
Gurumurthi, S., A. Sivasubramaniam, and V. Natarajan [2005]. Disk Drive Roadmap from the Thermal Perspective: A Case for Dynamic Thermal Management, Proceedings of the International Symposium on Computer Architecture (ISCA), June, 38–49.
Henly, M., and B. McNutt [1989]. DASD I/O Characteristics: A Comparison of MVS to VM, Tech. Rep. TR 02.1550, IBM General Products Division, San Jose, Calif.
Hewlett-Packard. [1998]. “HP’s ‘5NINES:5MINUTES’ vision extends leadership and re-defines high availability in mission-critical environments,” February 10, www.future.enterprisecomputing.hp.com/ia64/news/5nines_vision_pr.html.
Hoagland, A. S. [1963]. Digital Magnetic Recording, Wiley, New York.
Hospodor, A. D., and A. S. Hoagland [1993]. “The changing nature of disk controllers.” Proc. IEEE 81:4 (April), 586–594.
IBM. [1982]. The Economic Value of Rapid Response Time, GE20-0752-0, IBM, White Plains, N.Y., 11–82.
Imprimis. [1989]. Imprimis Product Specification, 97209 Sabre Disk Drive IPI-2 Interface 1.2 GB, Document No. 64402302, Imprimis, Dallas, Tex.
Jain, R. [1991]. The Art of Computer Systems Performance Analysis: Techniques for Experimental Design, Measurement, Simulation, and Modeling, Wiley, New York.
Katz, R. H., D. A. Patterson, and G. A. Gibson [1989]. “Disk system architectures for high performance computing,” Proc. IEEE 77:12 (December), 1842–1858.
Kim, M. Y. [1986]. “Synchronized disk interleaving,” IEEE Trans. on Computers C-35:11 (November), 978–988.
Kuhn, D. R. [1997]. “Sources of failure in the public switched telephone network,” IEEE Computer 30:4 (April), 31–36.
Lambright, D. [2000]. “Experiences in measuring the reliability of a cache-based storage system,” Proc. of First Workshop on Industrial Experiences with Systems Software (WIESS 2000), Co-Located with the 4th Symposium on Operating Systems Design and Implementation (OSDI), October 22, 2000, San Diego, Calif.
Laprie, J.-C. [1985]. “Dependable computing and fault tolerance: Concepts and terminology,” Proc. 15th Annual Int’l. Symposium on Fault-Tolerant Computing, June 19–21, 1985, Ann Arbor, Mich., 2–11.
Lazowska, E. D., J. Zahorjan, G. S. Graham, and K. C. Sevcik [1984]. Quantitative System Performance: Computer System Analysis Using Queueing Network Models, Prentice Hall, Englewood Cliffs, N.J. (Although out of print, it is available online at www.cs.washington.edu/homes/lazowska/qsp/.)
Leiner, A. L. [1954]. “System specifications for the DYSEAC,” J. ACM 1:2 (April), 57–81.
Leiner, A. L., and S. N. Alexander [1954]. “System organization of the DYSEAC,” IRE Trans. of Electronic Computers EC-3:1 (March), 1–10.
Maberly, N. C. [1966]. Mastering Speed Reading, New American Library, New York.
Major, J. B. [1989]. “Are queuing models within the grasp of the unwashed?” Proc. Int’l. Conf. on Management and Performance Evaluation of Computer Systems, December 11–15, 1989, Reno, Nev., 831–839.
Mueller, M., L. C. Alves, W. Fischer, M. L. Fair, and I. Modi [1999]. “RAS strategy for IBM S/390 G5 and G6,” IBM J. Research and Development, 43:5–6 (September–November), 875–888.
Murphy, B., and T. Gent [1995]. “Measuring system and software reliability using an automated data collection process,” Quality and Reliability Engineering International, 11:5 (September–October), 341–353.
Myer, T. H., and I. E. Sutherland [1968]. “On the design of display processors,” Communications of the ACM, 11:6 (June), 410–414.
National Storage Industry Consortium. [1998]. “Tape Roadmap,” www.nsic.org.
Nelson, V. P. [1990]. “Fault-tolerant computing: Fundamental concepts,” Computer 23:7 (July), 19–25.
Nyberg, C. R., T. Barclay, Z. Cvetanovic, J. Gray, and D. Lomet [1994]. “AlphaSort: A RISC machine sort,” Proc. ACM SIGMOD, May 24–27, 1994, Minneapolis, Minn.
Okada, S., S. Okada, Y. Matsuda, T. Yamada, and A. Kobayashi [1999]. “System on a chip for digital still camera,” IEEE Trans. on Consumer Electronics 45:3 (August), 584–590.
Patterson, D. A., G. A. Gibson, and R. H. Katz [1987]. A Case for Redundant Arrays of Inexpensive Disks (RAID), Tech. Rep. UCB/CSD 87/391, University of California, Berkeley. Also appeared in Proc. ACM SIGMOD, June 1–3, 1988, Chicago, 109–116.
Pavan, P., R. Bez, P. Olivo, and E. Zanoni [1997]. “Flash memory cells—an overview,” Proc. IEEE 85:8 (August), 1248–1271.
Robinson, B., and L. Blount [1986]. The VM/HPO 3880-23 Performance Results, IBM Tech. Bulletin GG66-0247-00, IBM Washington Systems Center, Gaithersburg, Md.
Salem, K., and H. Garcia-Molina [1986]. “Disk striping,” Proc. 2nd Int’l. IEEE Conf. on Data Engineering, February 5–7, 1986, Washington, D.C., 249–259.
Scranton, R. A., D. A. Thompson, and D. W. Hunter [1983]. The Access Time Myth, Tech. Rep. RC 10197 (45223), IBM, Yorktown Heights, N.Y.
Seagate. [2000]. Seagate Cheetah 73 Family: ST173404LW/LWV/LC/LCV Product Manual, Vol. 1, Seagate, Scotts Valley, Calif. (www.seagate.com/support/disc/manuals/scsi/29478b.pdf).
Smotherman, M. [1989]. “A sequencing-based taxonomy of I/O systems and review of historical machines,” Computer Architecture News 17:5 (September), 5–15. Reprinted in Computer Architecture Readings, M. D. Hill, N. P. Jouppi, and G. S. Sohi, eds., Morgan Kaufmann, San Francisco, 1999, 451–461.
Talagala, N. [2000]. “Characterizing Large Storage Systems: Error Behavior and Performance Benchmarks,” Ph.D. dissertation, Computer Science Division, University of California, Berkeley.
Talagala, N., and D. Patterson [1999]. An Analysis of Error Behavior in a Large Storage System, Tech. Report UCB//CSD-99-1042, Computer Science Division, University of California, Berkeley.
Talagala, N., R. Arpaci-Dusseau, and D. Patterson [2000]. Micro-Benchmark Based Extraction of Local and Global Disk Characteristics, CSD-99-1063, Computer Science Division, University of California, Berkeley.
Talagala, N., S. Asami, D. Patterson, R. Futernick, and D. Hart [2000]. “The art of massive storage: A case study of a Web image archive,” IEEE Computer (November), 22–28.
Thadhani, A. J. [1981]. “Interactive user productivity,” IBM Systems J. 20:4, 407–423.