A.3 存储器寻址
无论采用加载—存储体系结构,还是允许任意操作数访问存储器,都必须规定如何解释存储器地址,以及如何指定这些地址。这里给出的测量大多不依赖具体计算机,但并非完全如此。有些测量会明显受到编译技术的影响。考虑到编译技术的关键作用,这些测量都使用优化编译器。
存储器地址的解释
应当如何解释一个存储器地址?换言之,给定地址和长度,会访问什么对象?本书讨论的所有指令集都按字节寻址,并提供字节(8 位)、半字(16 位)和字(32 位)访问。大多数计算机还提供双字(64 位)访问。
对于较大对象内部的字节次序,有两种约定。小端序(Little Endian)将地址为“x…x000”的字节放在双字的最低有效位置,也就是“小端”。从最高有效位置到最低有效位置,字节编号为:
大端序(Big Endian)将地址为“x…x000”的字节放在双字的最高有效位置,也就是“大端”。字节编号为:
在同一台计算机内部,字节序通常不易察觉;只有同时以不同粒度(例如既按字又按字节)访问同一存储位置的程序,才能看出差异。然而,在不同字节序的计算机之间交换数据时,它就成为问题。比较字符串时,小端序也与字的通常排列次序不一致;字符串在寄存器里会呈现为“SDRAWKCAB”,即 BACKWARDS 的倒序。
第二个存储器问题是,许多计算机要求大于一个字节的对象访问必须对齐。在字节地址 处访问大小为 字节的对象,若 ,就称该访问对齐。图 A.5 展示哪些地址上的访问是对齐或非对齐的。
为什么要在计算机中施加对齐限制?非对齐会增加硬件复杂性,因为存储器通常按字或双字的整数倍边界组织。因此,一次非对齐访存可能需要多次对齐访存才能完成。即使计算机允许非对齐访问,使用对齐访问的程序仍会执行得更快。
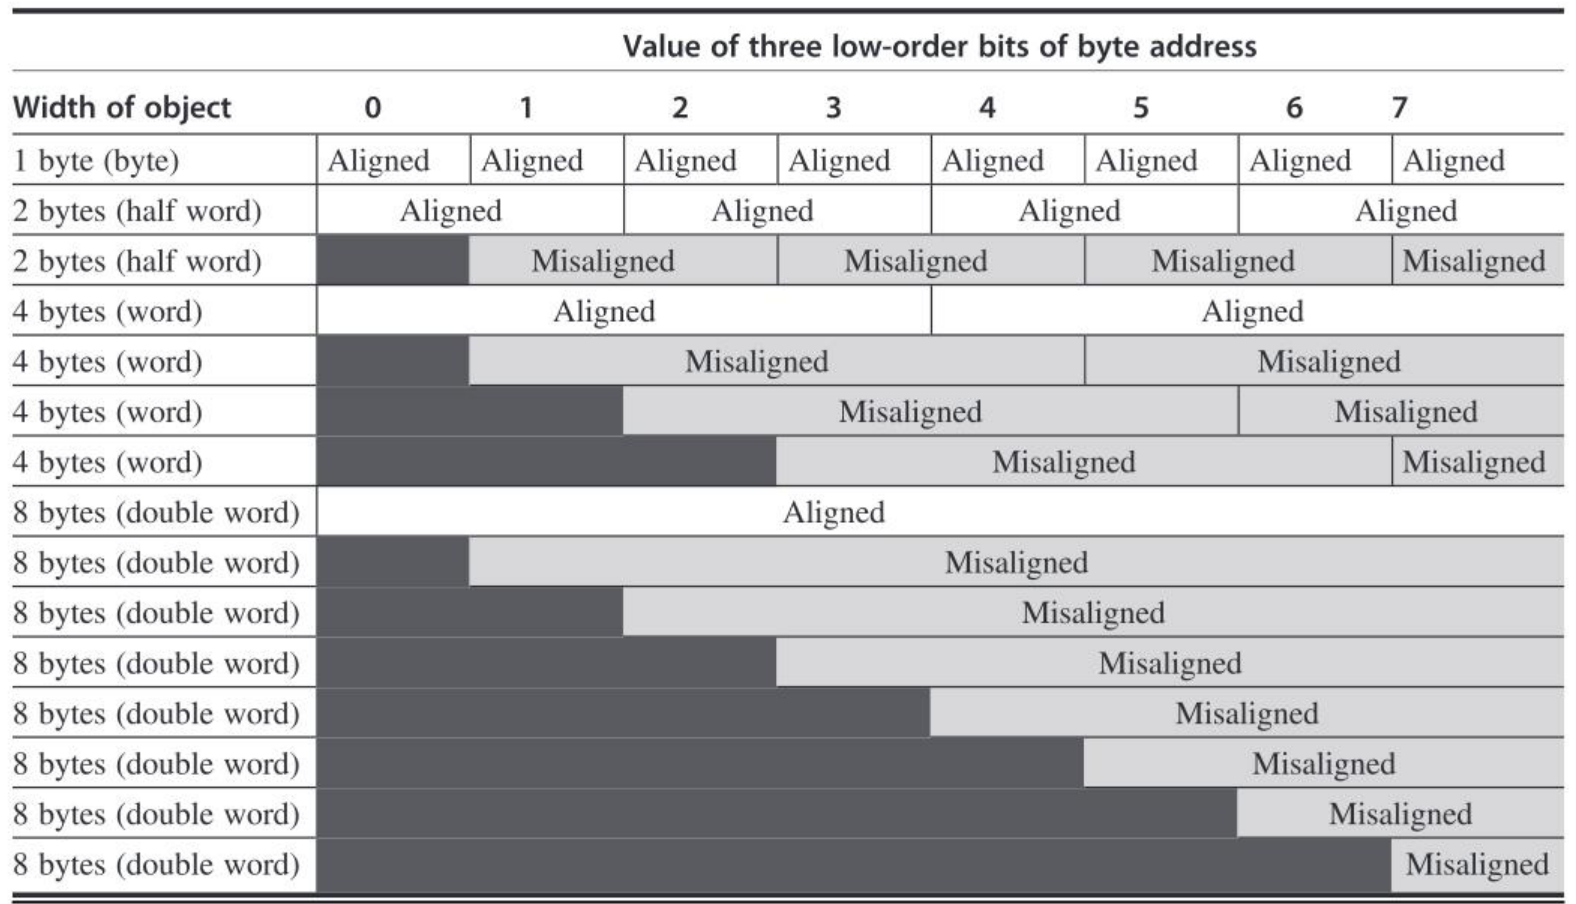
图内术语:Width of object=对象宽度;Value of three low-order bits of byte address=字节地址最低 3 位的值;Aligned=对齐;Misaligned=非对齐。byte、half word、word、double word 分别为字节、半字、字、双字。
即使数据已经对齐,支持字节、半字和字访问,也需要对齐网络,将它们在 64 位寄存器中对齐。例如,假定在图 A.5 中,从地址最低 3 位的值为 4 的位置读取一个字节,就需要右移 3 字节,将这个字节放到 64 位寄存器的适当位置。根据具体指令,计算机可能还需要对该数值进行符号扩展。存储操作比较容易:只需改变存储器中被寻址的那些字节。在某些计算机中,字节、半字或字操作不会影响寄存器的高位部分。本书讨论的计算机都允许按字节、半字和字访问存储器,但只有 IBM 360/370、Intel 80x86 和 VAX,支持对宽度小于整个寄存器的寄存器操作数执行 ALU 运算。
讨论了存储器地址的不同解释之后,接下来研究指令指定地址的方式,即寻址方式。
寻址方式
给定地址后,我们已经知道要访问存储器中的哪些字节。本小节考察体系结构如何指定待访问对象的地址。寻址方式不仅可以指定存储器位置,也可以指定常数和寄存器。使用存储器位置时,寻址方式所确定的实际地址称为有效地址。
图 A.6 列出近代计算机中出现过的全部数据寻址方式。立即数或字面量通常被视为存储器寻址方式,尽管所访问的值实际上位于指令流中;寄存器往往单独列出,因为它们通常没有存储器地址。我们将依赖程序计数器的方式单列,称为 PC 相对寻址。它主要用于在控制转移指令中指定代码地址,将在 A.6 节讨论。
| 寻址方式 | 指令示例 | 含义 | 用途 |
|---|---|---|---|
| 寄存器 | Add R4,R3 | Regs[R4] ← Regs[R4] + Regs[R3] | 值已经位于寄存器中。 |
| 立即数 | Add R4,3 | Regs[R4] ← Regs[R4] + 3 | 使用常数。 |
| 位移 | Add R4,100(R1) | Regs[R4] ← Regs[R4] + Mem[100 + Regs[R1]] | 访问局部变量;也可模拟寄存器间接寻址和直接寻址。 |
| 寄存器间接 | Add R4,(R1) | Regs[R4] ← Regs[R4] + Mem[Regs[R1]] | 通过指针或计算出的地址访问。 |
| 变址 | Add R3,(R1+R2) | Regs[R3] ← Regs[R3] + Mem[Regs[R1] + Regs[R2]] | 有时用于数组寻址:R1 为数组基址,R2 为索引偏移。 |
| 直接/绝对 | Add R1,(1001) | Regs[R1] ← Regs[R1] + Mem[1001] | 有时用于访问静态数据;地址常数可能需要较大范围。 |
| 存储器间接 | Add R1,@(R3) | Regs[R1] ← Regs[R1] + Mem[Mem[Regs[R3]]] | 若 R3 保存指针 p 的地址,则此方式得到 *p。 |
| 自动递增 | Add R1,(R2)+ | Regs[R1] ← Regs[R1] + Mem[Regs[R2]];Regs[R2] ← Regs[R2] + d | 在循环中遍历数组。R2 指向数组起点;每次访问后,按元素大小 d 递增 R2。 |
| 自动递减 | Add R1,-(R2) | Regs[R2] ← Regs[R2] - d;Regs[R1] ← Regs[R1] + Mem[Regs[R2]] | 用途与自动递增相同;自动递减/递增也可分别充当 push/pop,以实现栈。 |
| 比例变址(scaled) | Add R1,100(R2)[R3] | Regs[R1] ← Regs[R1] + Mem[100 + Regs[R2] + Regs[R3] * d] | 数组变址;有些计算机允许将其用于任何变址寻址方式。 |
图 A.6 使用寻址方式最常见的名称,尽管不同体系结构的名称可能不同。本图及全书采用 C 语言的一种扩展作为硬件描述记法。此图只有一个不属于 C 的特征:用左箭头 ← 表示赋值。我们还用数组 Mem 表示主存,用数组 Regs 表示寄存器。因此,Mem[Regs[R1]] 表示以寄存器 1(R1)内容为地址的存储单元中的内容。后面还将引入用于访问和传送不足一个字的数据的扩展。
寻址方式可以显著减少指令数,但也会增加计算机实现的复杂性,并可能提高实现这些方式的计算机的平均每条指令周期数(CPI)。因此,了解各种寻址方式的使用情况,对决定体系结构应包含哪些方式十分重要。
图 A.7 给出 VAX 体系结构上三个程序的寻址方式使用情况。本附录有少数测量采用较早的 VAX,因为它的寻址方式最丰富,对存储器寻址的限制也最少。例如,原书 A-9 页的图 A.6 展示了 VAX 支持的全部方式。不过,本附录大多数测量采用较新的寄存器—寄存器体系结构,以说明程序如何使用当代计算机的指令集。
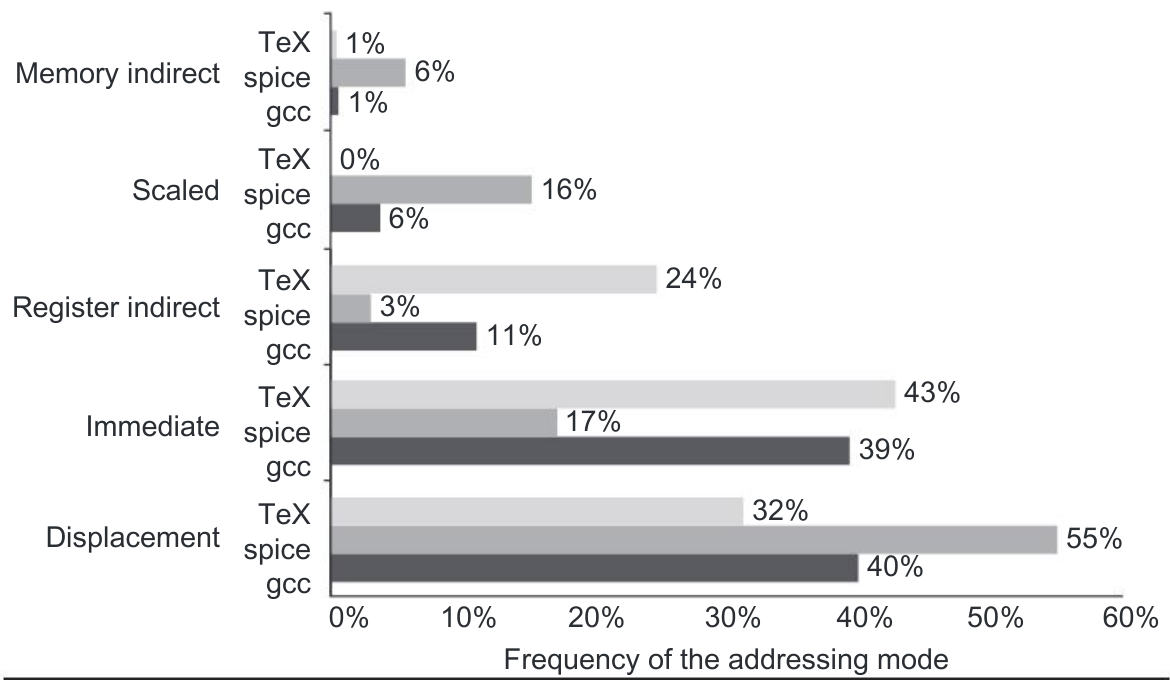
图内术语:Memory indirect=存储器间接;Scaled=比例变址;Register indirect=寄存器间接;Immediate=立即数;Displacement=位移;Frequency of the addressing mode=寻址方式使用频率。各组三条柱依次为 TeX、spice、gcc。
如图 A.7 所示,位移寻址与立即数寻址占主导地位。下面考察这两种常用方式的一些性质。
位移寻址
采用位移寻址时,首要问题是实际使用的位移范围。了解各种位移长度的使用情况,才能决定支持哪些长度。位移字段的大小直接影响指令长度,因此这一选择很重要。图 A.8 展示在加载—存储体系结构上,使用我们的基准程序测量数据访问得到的结果。分支偏移将在 A.6 节讨论。数据访问模式与分支不同,将它们混合分析意义不大;不过在实际设计中,为简化实现,往往将立即数字段设为相同宽度。
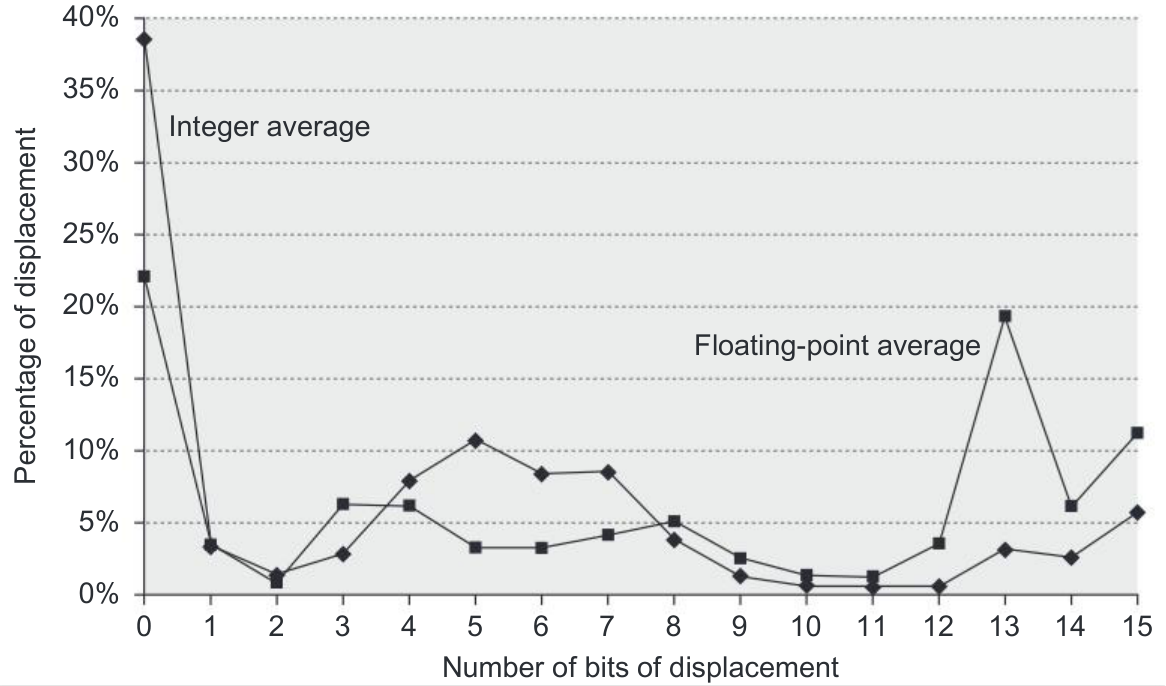
图内术语:Percentage of displacement=位移占比;Number of bits of displacement=位移位数;Integer average=整数程序平均值;Floating-point average=浮点程序平均值。
立即数或字面量寻址
立即数可用于算术运算、比较(主要供分支使用),以及需要将常数放入寄存器的传送操作。最后一种情形包括代码中直接写出的常数(通常较小),以及地址常数(通常较大)。设计立即数支持时,需要知道所有操作是否都应支持立即数,还是只需部分操作支持。图 A.9 给出指令集中一般整数、浮点操作类别的立即数使用频率。
另一项重要测量是立即数的值域。与位移一样,立即数大小会影响指令长度。图 A.10 显示,小立即数使用最多;但也会用到大立即数,很可能主要用于地址计算。
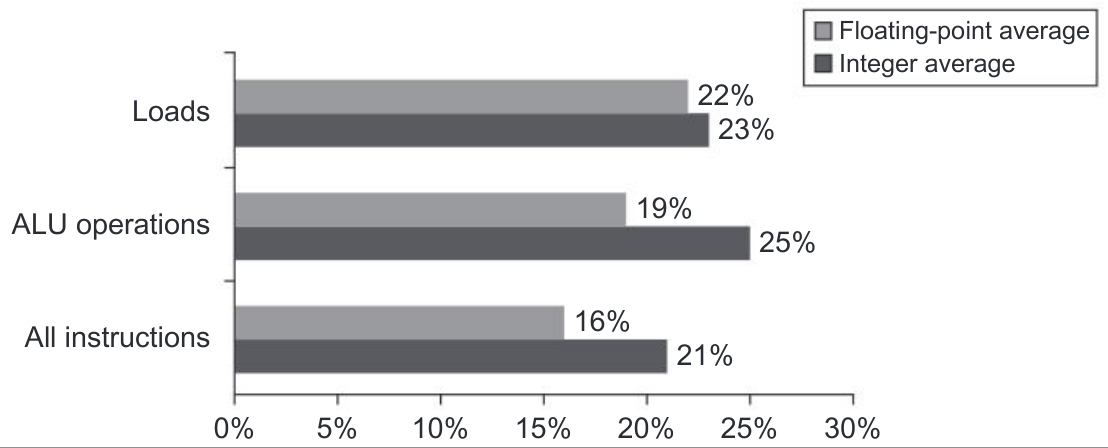
图内术语:Loads=加载;ALU operations=ALU 操作;All instructions=全部指令;Floating-point average=浮点程序平均值,Integer average=整数程序平均值。三组数值依次为浮点/整数 22%/23%、19%/25%、16%/21%。
小结:存储器寻址
首先,由于使用广泛,一种新的体系结构至少应支持位移、立即数和寄存器间接寻址。图 A.7 表明,这三种方式占测量中全部寻址方式的 75%–99%。其次,位移寻址的地址字段至少应有 12–16 位,因为图 A.8 的图注表明,这些长度能覆盖 75%–99% 的位移。最后,立即数字段至少应有 8–16 位。这一说法未得到所引用图注的支持。
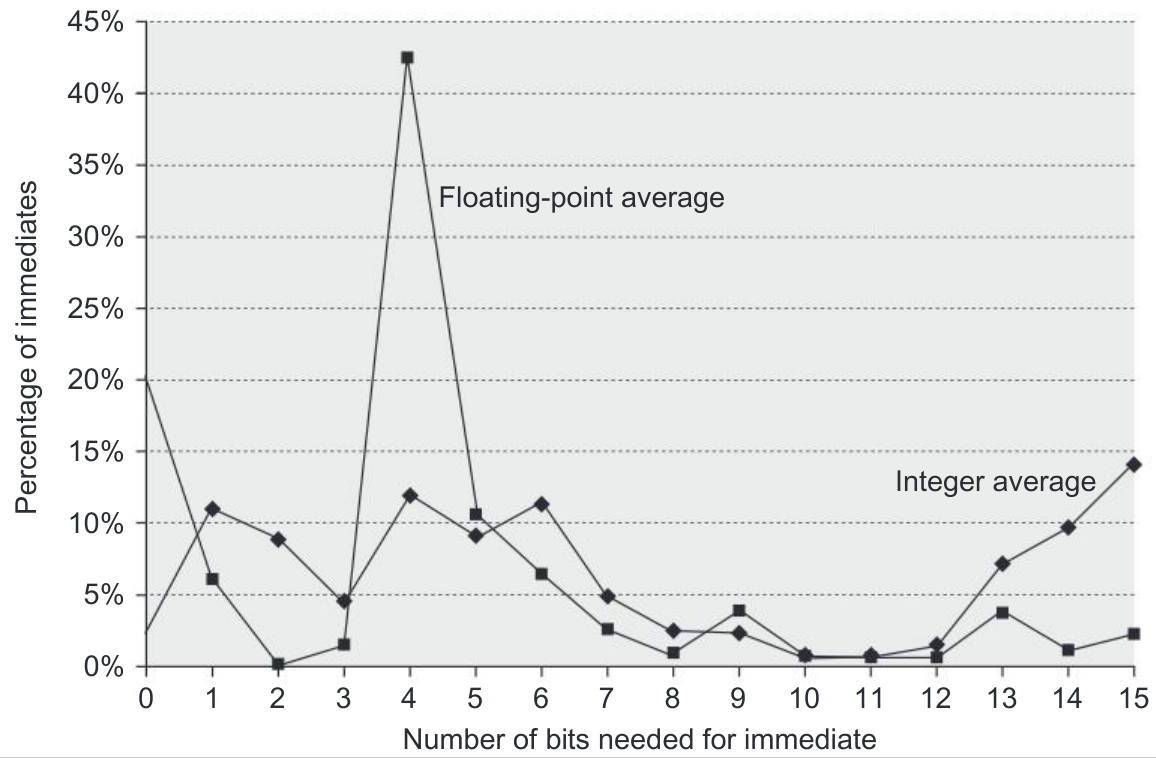
图内术语:Percentage of immediates=立即数占比;Number of bits needed for immediate=立即数所需位数;Floating-point average=浮点程序平均值;Integer average=整数程序平均值。
讨论了指令集类别并选定寄存器—寄存器体系结构,又给出数据寻址方式的建议之后,下一节将讨论数据的大小与含义。