A.8 贯穿各层的问题:编译器的作用
如今,桌面和服务器应用几乎都使用高级语言编程。这意味着,执行的大多数指令来自编译器,指令集体系结构实质上已经成为编译器的目标。在较早时期,这些应用的体系结构决策,往往是为简化汇编编程或服务某个特定计算内核而作出的。编译器会显著影响计算机性能,因此,理解当今编译技术,对于设计并高效实现指令集至关重要。
过去人们曾试图将编译技术及其对硬件性能的影响,与体系结构及其性能隔离;这与当时试图将体系结构和实现分离的想法类似。对于当今桌面编译器和计算机,这种分离基本不可能。体系结构的选择,无论好坏,都会影响所能生成的代码质量,以及为它构建优秀编译器的复杂度。
本节主要从编译器的角度讨论指令集的重要目标。先回顾当今编译器的结构,再讨论编译技术如何影响体系结构决策,以及设计者如何让编译器更容易或更难生成好代码。最后考察编译器与多媒体操作;遗憾的是,它们是编译器作者与体系结构设计者合作不佳的一个例子。
近期编译器的结构
先考察当今优化编译器的样貌。图 A.19 展示近期编译器的结构。
编译器作者的首要目标是正确性:所有有效程序都必须正确编译。第二目标通常是生成代码的执行速度。随后才是编译速度、调试支持、不同语言之间的互操作性等其他目标。编译器的各遍(pass)通常将高层、较抽象的表示,逐步变换为更低层表示,最终到达指令集。这种结构有助于管理变换的复杂性,更容易编写没有错误的编译器。
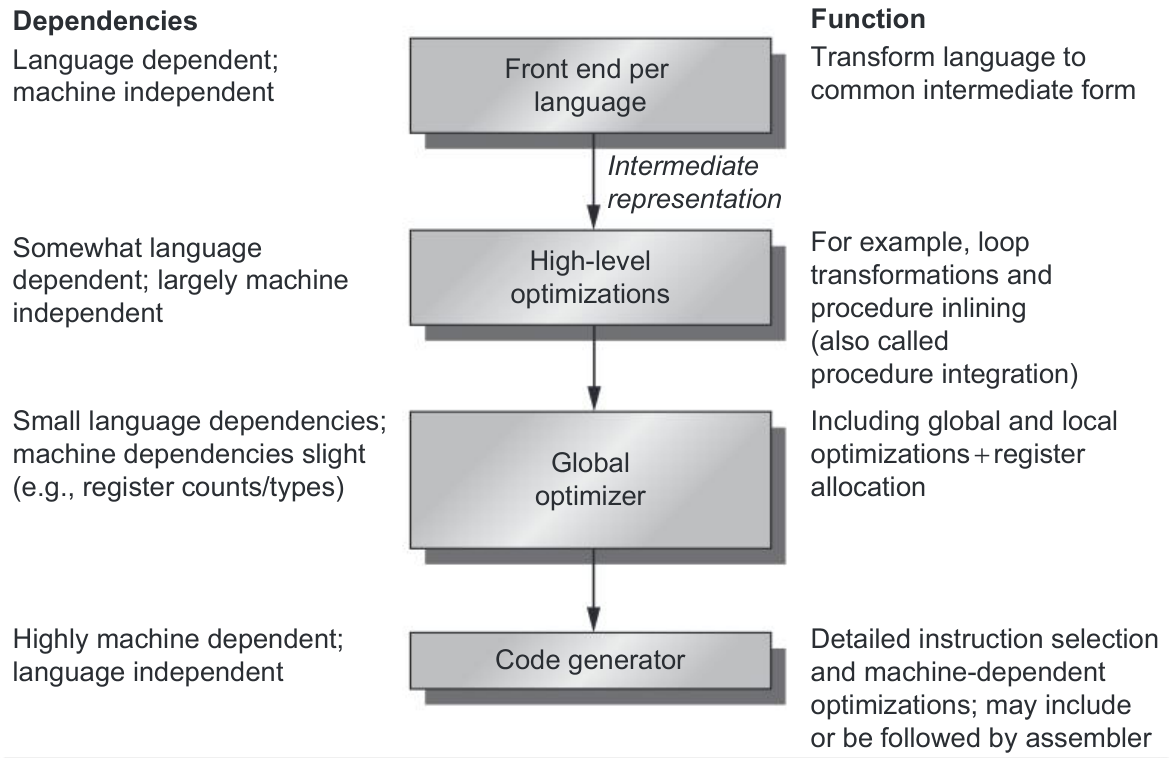
图中的处理顺序及说明如下,前端输出中间表示(Intermediate representation):
| 阶段 | 依赖关系 | 功能 |
|---|---|---|
| 每种语言的前端(Front end per language) | 依赖语言,与机器无关 | 将语言转换为通用中间形式 |
| 高层优化(High-level optimizations) | 部分依赖语言,基本与机器无关 | 例如循环变换与过程内联,也称过程集成(procedure integration) |
| 全局优化器(Global optimizer) | 对语言依赖很少,对机器依赖较小,例如寄存器数量与类型 | 全局及局部优化,加上寄存器分配 |
| 代码生成器(Code generator) | 高度依赖机器,与语言无关 | 具体指令选择与机器相关优化;可能包含汇编器,或随后运行汇编器 |
编写正确编译器的复杂度,是限制优化程度的一大因素。多遍结构虽能降低复杂性,却意味着某些变换必须先于另一些变换进行。图 A.19 表明,有些高层优化发生得很早,当时还不知道最终代码是什么样。作出这类变换后,编译器无法承受重新回顾全部步骤、甚至撤销变换的代价;无论编译时间还是复杂度,都难以接受这种反复。因此,编译器会假定后续阶段能够处理某些问题。例如,通常必须在知道被调用过程的精确大小之前,就决定将哪些调用展开为内联代码。这就是阶段顺序问题(phase-ordering problem)。
这种变换顺序如何与指令集体系结构相互影响?全局公共子表达式消除就是一个好例子。它找到两处计算同一值的表达式,将第一次计算结果保存在临时量中,随后使用这个临时值,省去第二次计算。
要使这种优化真正有价值,临时量必须分配到寄存器。否则,将其存入内存并随后重新加载的代价,可能抵消避免重复计算的收益。事实上,临时量未获分配寄存器时,这种优化有时反而使代码变慢。阶段顺序令问题更加复杂,因为寄存器分配通常在全局优化阶段接近结束、代码生成之前才进行。所以,执行这项优化时,优化器必须假定寄存器分配器会把临时量放入寄存器。
现代编译器的优化可以按变换方式分类:
- 高层优化:经常直接作用于源程序,输出再交给后续优化阶段。
- 局部优化:只在顺序执行的代码片段内部进行;编译领域称这种片段为基本块。
- 全局优化:将局部优化扩展到跨越分支的范围,并引入一组针对循环的变换。
- 寄存器分配:建立寄存器与操作数的对应关系。
- 处理器相关优化:利用特定体系结构知识进行优化。
寄存器分配
寄存器分配既能加快代码,也能使其他优化发挥作用,因此即使不是最重要的优化,也一定是最重要者之一。当今的分配算法基于图着色。基本思想是构造一张图,表示可能分配到寄存器的候选对象,再借助该图分配寄存器。粗略地说,就是使用有限种颜色,使依赖图中任意两个相邻节点都不同色;目标是将活跃变量全部分配到寄存器。一般图着色问题的耗时可能随图规模呈指数增长(NP 完全),但实践中有表现良好的启发式算法,能以接近线性的时间得到接近最优的分配。
当整数变量的全局分配至少有 16 个通用寄存器可用,最好更多,并且浮点数另有寄存器时,图着色的效果最好。寄存器太少时,启发式着色算法容易失败,图着色也就难以奏效。
优化对性能的影响
某些简单优化——局部优化和处理器相关优化——有时难以与代码生成器中的变换明确区分。图 A.20 给出典型优化的例子,最后一列表示这些变换应用于源程序的频率。
| 优化类别与名称 | 说明 | 占优化变换总次数的比例 |
|---|---|---|
| 高层优化 | 在源代码层次或接近该层次进行,与处理器无关 | |
| 过程集成 | 用过程体替换过程调用 | N.M. |
| 局部优化 | 在顺序代码内部进行 | |
| 公共子表达式消除 | 用一次计算代替两次相同计算 | 18% |
| 常量传播 | 若一个变量被赋予常量,则用该常量替换变量的各次出现 | 22% |
| 降低栈高度 | 重排表达式树,尽量减少表达式求值需要的资源 | N.M. |
| 全局优化 | 跨越分支进行 | |
| 全局公共子表达式消除 | 与局部版本相同,但允许跨越分支 | 13% |
| 复制传播 | 将被赋值为 X 的变量 A(即 A=X)的所有出现替换为 X | 11% |
| 代码移动 | 将每次迭代计算相同值的代码移出循环 | 16% |
| 归纳变量消除 | 简化或消除循环内部的数组寻址计算 | 2% |
| 处理器相关优化 | 依赖处理器知识 | |
| 强度削减 | 例如用加法和移位代替乘以常数 | N.M. |
| 流水线调度 | 重排指令,改善流水线性能 | N.M. |
| 分支偏移优化 | 选择能够到达目标的最短分支位移 | N.M. |
图 A.21 展示不同优化对两个程序执行指令数的影响。在这个例子中,优化后的程序比未优化程序少执行约 25%–90% 的指令。这说明,在提出新的指令集特性之前,必须先考察优化后的代码:设计者试图改进的指令,可能已经被编译器完全删除。
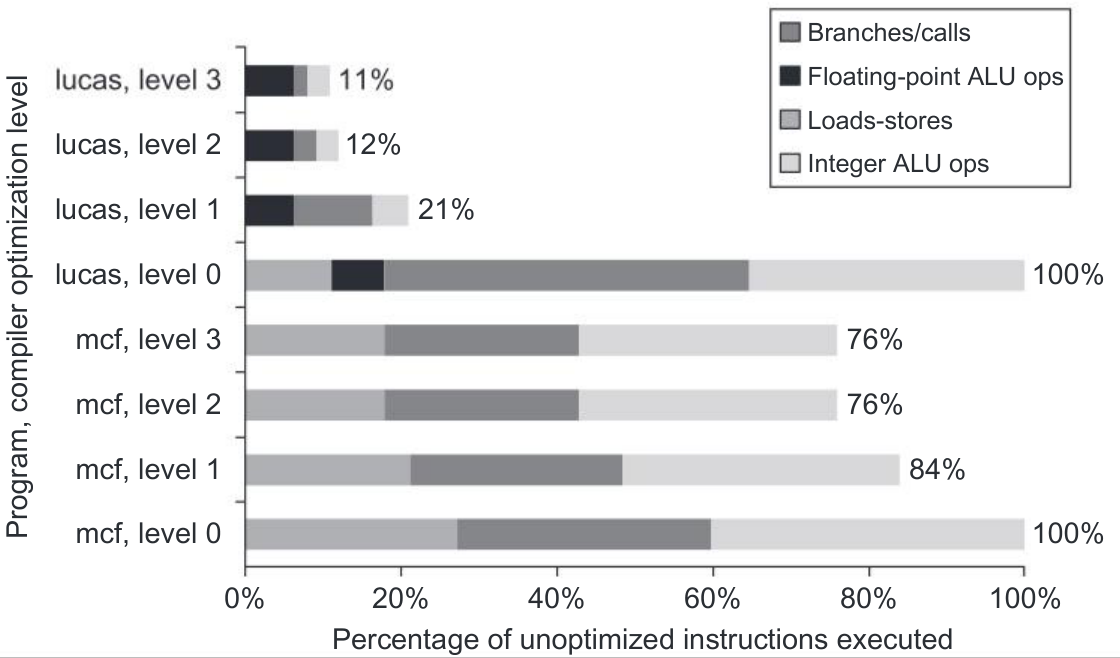
图内术语:Branches/calls=分支/调用;Floating-point ALU ops=浮点 ALU 操作;Loads-stores=加载/存储;Integer ALU ops=整数 ALU 操作。横轴为相对未优化版本的执行指令数百分比,纵轴为程序和编译优化等级。等级 0、1、2、3 下,mcf 为 100%、84%、76%、76%;lucas 为 100%、21%、12%、11%。
编译技术对体系结构决策的影响
编译器与高级语言的相互作用,会显著影响程序使用指令集的方式。有两个重要问题:变量如何分配和寻址?适当分配变量需要多少寄存器?回答这些问题,必须考察当今高级语言分配数据的三个独立区域:
- 栈用于分配局部变量,分别在过程调用和返回时增长、缩小。栈中对象以栈指针为基址寻址,主要是标量,即单个变量,而非数组。这里的栈用于保存活动记录,并不是用来求表达式值的栈,因此几乎不会逐值执行入栈、出栈。
- **全局数据区**用于分配静态声明的对象,如全局变量和常量;其中很大比例是数组或其他聚合数据结构。
- 堆用于分配不遵循栈式纪律的动态对象,通过指针访问,通常不是标量。
对栈分配对象,寄存器分配比对全局变量有效得多;对堆对象则基本无法进行,因为它们通过指针访问。某些全局变量和栈变量无法分配寄存器,是因为存在别名:可以通过多种途径引用变量地址,将其放进寄存器会破坏程序语义。对于当今编译技术,大多数堆变量实质上都有别名。
例如,下面的 & 返回变量地址,* 对指针解引用:
跨过对 *p 的赋值时,不能始终将 a 分配在寄存器中,否则生成的代码就不正确。别名会造成严重问题,因为确定指针可能指向哪些对象,往往很困难,甚至不可能。编译器必须保守;有些编译器只要发现某指针可能指向过程内某个局部变量,就不再将该过程中的任何局部变量分配到寄存器。
体系结构设计者如何帮助编译器作者
当今编译器的复杂性并不来自翻译 A=B+C 这样的简单语句。多数程序在局部都很简单,用简单翻译方法即可。复杂性来自程序规模大、全局交互复杂,也来自编译器的结构:它只能一步一步决定哪种代码序列最好。
编译器作者常遵循体系结构基本原则的一条推论:让常见情况执行得快,让少见情况执行正确。也就是说,如果知道哪些情况常见、哪些少见,并且两者的代码都容易生成,那么少见情况的代码质量可能并不特别重要,但正确性必须保证。
有些指令集特征能够帮助编译器作者。它们不是不可更改的硬性规则,而是帮助编写高效、正确编译器的指导原则。
- 保持规则性。 只要合理,指令集的三个主要组成部分——操作、数据类型、寻址方式——就应当正交。两个方面相互独立,就称它们正交。例如,对任意操作,只要能使用一种寻址方式,就能使用全部寻址方式,则操作与寻址方式正交。这种规则性可简化代码生成;当生成何种代码的决策分散在编译器两遍中时,尤其重要。一个反例是限制某类指令只能使用某些寄存器。面向专用寄存器体系结构的编译器常陷入困境:明明还有许多可用寄存器,却没有类型合适的寄存器。
- 提供基本操作,而不是完整解决方案。 与某个语言结构或计算内核函数“匹配”的专用功能,常常无法使用。对高级语言的支持尝试,可能只适用于一种语言,或者执行的工作多于、少于该语言正确高效实现所需。A.10 节给出一个失败实例。
- 简化不同方案之间的权衡。 编译器作者最困难的任务之一,是为每一段代码选择最佳指令序列。过去,指令数或总代码大小或许是好指标;但第 1 章已说明,如今已非如此。缓存与流水线使权衡变得很复杂。设计者若能帮助编译器作者理解不同代码序列的成本,就能改善代码质量。一个特别困难的例子是寄存器—存储器体系结构:变量被引用多少次之后,先把它加载进寄存器才更便宜?这一阈值很难计算,甚至同一体系结构的不同机型也可能不同。
- 提供能将编译时已知量绑定为常数的指令。 编译器作者不希望处理器在运行时解释一个编译时就已确定的值。反例是那些仍在运行时解释编译时固定值的指令。例如,VAX 过程调用指令
calls动态解释一个指明需保存哪些寄存器的掩码,而这个掩码在编译时就已固定(见 A.10 节)。
编译器对多媒体指令的支持与不足
遗憾的是,SIMD 指令设计者(见第 4 章 4.3 节)基本忽略了上述建议。这些指令往往提供完整解决方案而非基本操作,寄存器不足,数据类型也不适合既有编程语言。设计者希望用低成本方案帮助一部分用户,但通常只有少量底层图形库例程使用它们。
SIMD 指令实质上是一种优雅体系结构的简化版本,而后者拥有自己的编译技术。4.2 节说明,向量体系结构对数据向量执行操作;它最初为科学代码发明,但多媒体计算内核也常能向量化,只是向量往往较短。如 4.3 节所述,可以将 Intel MMX、SSE,PowerPC AltiVec,或 RISC-V P 扩展视作短向量计算机:MMX 的向量包含八个 8 位元素、四个 16 位元素或两个 32 位元素;AltiVec 的向量长度是其两倍。实现时,只需将较窄元素相邻地放在宽寄存器中。
这些微处理器将向量寄存器大小写入体系结构:MMX 各元素位数之和限制为 64 位,AltiVec 为 128 位。当 Intel 决定扩展到 128 位向量时,就增加了一整套新指令,称为流式 SIMD 扩展(SSE)。
向量计算机的主要优点之一,是一次加载多个元素,再将执行与数据传送重叠,从而隐藏访存延迟。向量寻址方式旨在汇集散布在存储器中的数据,紧凑排列以便高效处理,再将结果放回对应位置。
向量计算机包含带步长寻址和聚集/散布寻址(见 4.2 节),以扩大可向量化的程序范围。带步长寻址在每次访问之间跨过固定字数,因此顺序寻址常称为单位步长寻址。聚集与散布从另一个向量寄存器获取地址,可视为向量计算机的寄存器间接寻址。相较之下,这些短向量 SIMD 计算机只支持单位步长访问:一次访存从一个宽存储单元装入或存出全部元素。多媒体数据通常形成以存储器为起点和终点的数据流,因此,带步长与聚集/散布寻址对成功向量化至关重要(见 4.7 节)。
例题 比较向量计算机与 MMX,将每个像素由 3 字节表示的 RGB(红、绿、蓝)转换为 YUV(亮度、色度)。转换只需把三行 C 代码放进循环:
译注: 原页第二、三行若干项之间缺少运算符,U 行的 B 系数确为 4221。这段代码不能直接作为可编译的 C 示例使用。习题 A.8给出了带减号的数组版本,可对照阅读。
一台数据宽度为 64 位的向量计算机,可同时计算 8 个像素。支持带步长寻址的一种媒体向量计算机需要:
- 3 条向量加载,取入 RGB;
- 3 条向量乘法,处理 R;
- 6 条向量乘加,处理 G、B;
- 3 条向量移位,完成除以 32768;
- 2 条向量加法,加上 128;
- 3 条向量存储,写出 YUV。
总共 20 条指令,完成上面 C 代码中的 20 个操作,转换 8 个像素(Kozyrakis,2000)。由于一个向量可能包含 32 个 64 位元素,实际可一次转换 个像素。
相比之下,Intel 网站给出的库例程,对 8 个像素执行相同计算,需要 116 条 MMX 指令,加 6 条 80x86 指令(Intel,2001)。指令数约为六倍,是因为缺少带步长访存,必须用大量指令装入并展开 RGB 像素,再压紧并存储 YUV 像素。
向量短、长度受体系结构限制,寄存器少,再加上简单的访存方式,都使向量化编译技术更难发挥作用。因此,这些 SIMD 指令更常见于手写库,而非编译生成的代码。
小结:编译器的作用
本节给出几项建议。首先,新指令集体系结构至少应有 16 个通用寄存器,不包括独立的浮点寄存器,以简化基于图着色的寄存器分配。关于正交性的建议意味着,所有数据传送指令都应适用全部已支持的寻址方式。最后三条建议——提供基本操作而非完整方案、简化方案之间的权衡、不要在运行时绑定常数——都表明,宁可偏向简单。也就是说,设计指令集时应理解“少即是多”。遗憾的是,SIMD 扩展更像成功营销的例子,而非软硬件协同设计的杰出成果。