A.9 融会贯通:RISC-V 体系结构
本节介绍一种名为 RISC-V 的加载—存储体系结构。RISC-V 是免费许可的开放标准,与许多 RISC 体系结构相似,也建立在类似于前几节讨论的观察结果之上。(M.3 节将讨论这些体系结构如何兴起,以及流行的原因。)RISC-V 汲取了 RISC 体系结构 30 年的经验,清理了大多数出于短期考虑而加入或遗漏的设计,使其更容易实现,也更高效。RISC-V 提供 32 位和 64 位指令集,以及浮点等多种功能扩展;这些扩展均可添加到 32 位或 64 位基础指令集之上。我们讨论 64 位版本 RV64,它是 32 位版本 RV32 的超集。
回顾前面各节,对于桌面与服务器应用,我们期望指令集具备以下特点:
- A.2 节:采用通用寄存器和加载—存储体系结构。
- A.3 节:支持位移寻址(地址偏移量为 12–16 位)、立即数寻址(8–16 位)和寄存器间接寻址。
- A.4 节:支持 8、16、32、64 位整数和 64 位 IEEE 754 浮点数。
- A.5 节:支持加载、存储、加、减、寄存器间传送和移位这些简单指令,因为它们在执行的指令中占绝大多数。
- A.6 节:支持相等、不等和小于比较,以及分支(至少 8 位 PC 相对地址)、跳转、调用和返回。
- A.7 节:重视性能时采用定长指令编码,重视代码大小时采用变长编码。在某些缓存较小或只有一级缓存的低端嵌入式应用中,较大的代码可能显著影响性能。提供压缩指令集扩展的 ISA,为应对这种差异提供了办法。
- A.8 节:至少提供 16 个、最好 32 个通用寄存器;确保所有寻址方式都适用于所有数据传送指令;以精简的指令集为目标。该节没有讨论浮点程序,但它们通常使用独立的浮点寄存器。这样可以增加寄存器总数,而不增加指令格式或通用寄存器堆速度方面的困难。不过,这种折中并不满足正交性。
下面通过说明 RISC-V 如何遵循这些建议,介绍其体系结构。与先前的 RISC 一样,RISC-V 强调:
- 简单的加载—存储指令集。
- 有利于流水线效率的设计(见附录 C),包括固定的指令集编码。
- 作为编译器目标的高效率。
RISC-V 很适合作为研究体系结构的模型,不仅因为这类处理器广泛使用,也因为它容易理解。附录 C 和第 3 章还会使用这一体系结构;若干习题和编程项目也以它为基础。
RISC-V 指令集的组织
RISC-V 由三个支持 32 位或 64 位整数的基础指令集,以及可附加于某个基础指令集的多种可选扩展组成。这使 RISC-V 能覆盖广泛的应用:小到逻辑电路与存储器预算极其有限、成本可能不超过 1 美元的小型嵌入式处理器,大到完整支持浮点、向量及多处理器配置的高端处理器。图 A.22 汇总三个基础指令集、各扩展及其基本功能。本书的实例使用 RV64IMAFD,简称 RV64G。RV32G 是 64 位体系结构 RV64G 的 32 位子集。
| 基础指令集或扩展名称 | 功能 |
|---|---|
| RV32I | 32 位整数基础指令集,含 32 个寄存器。 |
| RV32E | 32 位整数基础指令集,但仅有 16 个寄存器,面向非常低端的嵌入式应用。 |
| RV64I | 64 位基础指令集;所有寄存器均为 64 位,并增加向寄存器加载和从寄存器存储 64 位数据的指令 LD、SD。 |
| M | 增加整数乘法和除法指令。 |
| A | 增加并发处理所需的原子指令;见第 5 章。 |
| F | 增加 IEEE 单精度(32 位)浮点支持,包括 32 个 32 位浮点寄存器,以及加载、存储和操作这些寄存器的指令。 |
| D | 将浮点支持扩展为 64 位双精度,使寄存器宽度变为 64 位,并增加相应的加载、存储和运算指令。 |
| Q | 进一步增加四倍精度浮点支持,即 128 位操作。 |
| L | 增加 IEEE 标准的 64 位和 128 位十进制浮点支持。 |
| C | 定义面向小存储器嵌入式应用的压缩指令集版本,为常见 RV32I 指令提供 16 位形式。 |
| V | 未来支持向量操作的扩展;见第 4 章。 |
| B | 未来支持位字段操作的扩展。 |
| T | 未来支持事务性存储器的扩展。 |
| P | 支持打包 SIMD 指令的扩展;见第 4 章。 |
| RV128I | 未来提供 128 位地址空间的基础指令集。 |
译注:本节保留原书对扩展名称与发展阶段的描述,其中“未来”等措辞反映原书文字,不能据此判断这些扩展今天的标准化状态。
RISC-V 的寄存器
RV64G 有 32 个 64 位通用寄存器(GPR),编号为 x0、x1、…、x31,也称整数寄存器。RV64G 所包含的浮点扩展 F、D 还提供 32 个浮点寄存器(FPR),编号为 f0、f1、…、f31,可保存 32 个单精度(32 位)或 32 个双精度(64 位)数。(保存一个单精度数时,FPR 的另一半不使用。)它同时提供单精度和双精度浮点操作。
x0 的值始终为 0。后面将看到,借助这个寄存器,简单指令集也能合成多种有用的操作。
少数特殊寄存器可以与通用寄存器相互传送数据。例如浮点状态寄存器,用于保存浮点运算结果的信息。此外,也有在 FPR 与 GPR 之间传送数据的指令。
RISC-V 的数据类型
整数数据类型包括 8 位字节、16 位半字、32 位字和 64 位双字;浮点类型包括 32 位单精度和 64 位双精度。之所以加入半字,是因为 C 等语言包含这种类型,而且操作系统等关注数据结构大小的程序经常使用它。如果 Unicode 得到广泛使用,半字也会更常用。
RV64G 的操作针对 64 位整数,以及 32 位或 64 位浮点数。字节、半字和字加载到通用寄存器时,通过补零或复制符号位填满 GPR 的 64 位;随后使用 64 位整数操作处理它们。
RISC-V 数据传送的寻址方式
数据寻址方式只有立即数和位移两种,字段均为 12 位。将 12 位位移字段置为 0,就能实现寄存器间接寻址;以寄存器 0 为基址寄存器,就能实现地址范围受 12 位字段限制的绝对寻址。充分利用零,便可让体系结构直接支持的两种方式产生四种实际效果。
RV64G 的存储器按字节寻址,地址宽度为 64 位,采用 Little Endian 字节编号。它是加载—存储体系结构,因此存储器与 GPR 或 FPR 之间的所有访问,都通过加载或存储完成。为支持前述类型,涉及 GPR 的访存宽度可以是字节、半字、字或双字;FPR 可以加载和存储单精度或双精度数。访存不一定要对齐,但未对齐访问可能极其缓慢。实际使用时,程序员和编译器选择未对齐访问是很不明智的。
RISC-V 指令格式
RISC-V 只有两种寻址方式,因此可以将其编码在操作码中。为便于流水线实现与译码,所有指令都是 32 位,主操作码占 7 位。图 A.23 给出四种主要指令类型的布局。格式既简单,又提供 12 位字段,用于位移寻址、立即数常量或 PC 相对分支地址。
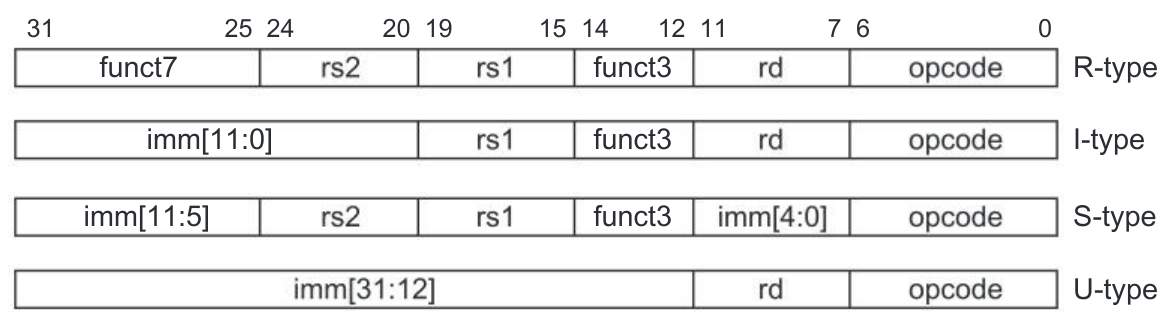
图内术语:R/I/S/U-type=R/I/S/U 型;opcode=操作码;rd=目的寄存器;rs1、rs2=第一、第二源寄存器;funct3、funct7=3 位、7 位功能字段;imm=立即数。图中保留原字段名和位编号。
图 A.24 说明各指令格式及字段用途。opcode 指定指令大类,如 ALU 指令、ALU 立即数、加载、存储、分支或跳转;funct 字段指定具体操作。例如 ALU 指令共用一个操作码,由 funct 决定加、减、与等操作。注意,一种格式可能编码多类指令:I 型同时用于 ALU 立即数指令与加载,S 型用于存储与条件分支。
| 指令格式 | 主要用途 | rd | rs1 | rs2 | 立即数 |
|---|---|---|---|---|---|
| R 型 | 寄存器—寄存器 ALU 指令 | 目的 | 第一源 | 第二源 | |
| I 型 | ALU 立即数;加载 | 目的 | 第一源;基址寄存器 | 数值;位移 | |
| S 型 | 存储;比较并分支 | 基址寄存器;第一源 | 待存储的数据源;第二源 | 位移;偏移量 | |
| U 型 | 跳转并链接;寄存器跳转并链接 | 保存返回 PC 的目的寄存器 | 寄存器跳转并链接的目标地址 | 跳转并链接的目标地址 |
RISC-V 的操作
RISC-V,更准确地说 RV64G,支持前面推荐的简单操作以及少量其他操作。指令分为四大类:加载与存储、ALU 操作、分支与跳转、浮点操作。
任意通用寄存器或浮点寄存器均可加载和存储,但加载到 x0 不产生效果。图 A.25 给出加载与存储指令实例。单精度浮点数占浮点寄存器的一半;单精度与双精度之间必须显式转换。浮点格式采用 IEEE 754(见附录 J)。图 A.28(原文标为 A-42 页)列出 RV64G 的全部指令。2
| 指令示例 | 指令名称 | 含义 |
|---|---|---|
ld x1,80(x2) | 加载双字 | |
lw x1,60(x2) | 加载字 | |
lwu x1,60(x2) | 无符号加载字 | |
lb x1,40(x3) | 加载字节 | |
lbu x1,40(x3) | 无符号加载字节 | |
lh x1,40(x3) | 加载半字 | |
flw f0,50(x3) | 加载单精度浮点数 | |
fld f0,50(x2) | 加载双精度浮点数 | |
sd x2,400(x3) | 存储双字 | |
sw x3,500(x4) | 存储字 | |
fsw f0,40(x3) | 存储单精度浮点数 | |
fsd f0,40(x3) | 存储双精度浮点数 | |
sh x3,502(x2) | 存储半字 | |
sb x2,41(x3) | 存储字节 |
为理解这些图表,需要对 A-9 页开始使用的类 C 描述语言再作几项扩充:
- 当传送数据的长度可能不明确时,在 后加下标。因此 表示传送一个 位量。 表示将 同时传送给 、。
- 下标也用于选择字段中的位。位编号从最高有效位的 0 开始,可以是单个位,例如 得到 x4 的符号位;也可以是范围,例如 得到 x3 的最低有效字节。
Mem是表示主存的数组变量,以字节地址为下标,可以传送任意字节数。- 上标表示重复某字段,例如 表示长度为 48 位的全零字段。
##表示连接两个字段,可以出现在数据传送的任一侧; 和 分别将第一个操作数左移或右移第二个操作数指定的位数。
例如,假定 x8、x10 为 32 位寄存器:
它表示:取出以寄存器 x8 的内容为地址的存储器字,将其符号扩展为 64 位,再存入 x10。3
所有 ALU 指令都是寄存器—寄存器指令。图 A.26 给出若干算术/逻辑指令实例,包括加、减、AND、OR、XOR 和移位等简单操作;这些指令还都提供使用 12 位符号扩展立即数的形式。LUI(load upper immediate,加载高位立即数)装入寄存器第 12–31 位,将立即数字段符号扩展到高 32 位,并将低 12 位清零。利用 LUI,可以用两条指令构造一个 32 位常量,也可以在数据传送时仅增加一条指令,就使用任意 32 位常量地址。
如前所述,x0 可以合成常用操作。加载常量只需使用以 x0 为源操作数的立即数加法;寄存器间传送只需使用一个源为 x0 的加法或按位或。(有时用助记符 li,即 load immediate,表示前者,用 mv 表示后者。)
| 指令示例 | 指令名称 | 含义 |
|---|---|---|
add x1,x2,x3 | 加法 | |
addi x1,x2,3 | 无符号立即数加法 | |
lui x1,42 | 加载高位立即数 | |
sll x1,x2,5 | 逻辑左移 | |
slt x1,x2,x3 | 小于则置位 | 若 ,则 ,否则 。 |
RISC-V 控制流指令
控制流由一组跳转和分支指令处理;图 A.27 给出典型实例。两条跳转指令——跳转并链接、寄存器跳转并链接——都是无条件转移,并始终将“链接地址”,即顺序上紧接跳转指令的下一条指令地址,存入 rd 字段指定的寄存器。不需要链接地址时,令 rd 为 x0,就得到通常的无条件跳转。两条指令的区别是:目标地址通过立即数字段加 PC 得到,还是通过立即数字段加寄存器内容得到。偏移量按半字单位解释,以兼容包含 16 位指令的压缩指令集 R64C。4
所有分支都有条件。条件由指令指定,允许各种算术比较:相等、大于、小于及其反条件。分支目标由 12 位有符号偏移量指定,先左移一位以得到 16 位对齐地址,再加上当前程序计数器。基于浮点寄存器内容的分支,先执行浮点比较,例如 feq.d 或 fle.d,按比较结果将整数寄存器置为 0 或 1;再执行以 x0 为一个操作数的 beq 或 bne。
细心的读者会发现,RV64G 中仅适用于 64 位的指令非常少,主要是 64 位加载与存储,以及不作符号扩展的 32、16、8 位加载形式(默认形式进行符号扩展)。为无需额外指令就能支持 32 位模运算,还有忽略 64 位寄存器高 32 位的指令变体,例如字加法、字减法 addw、subw。其余部分竟然都能直接适用。
| 指令示例 | 指令名称 | 含义 |
|---|---|---|
jal x1,offset | 跳转并链接 | |
jalr x1,x2,offset | 寄存器跳转并链接 | |
beq x3,x4,offset | 等于零则分支 | 若 ,则 。 |
bgt x3,x4,name | 不等于零则分支 | 若 ,则 。 |
RISC-V 浮点操作
浮点指令操作浮点寄存器,并指定单精度或双精度。操作包括加、减、乘、除、平方根,以及融合乘加和乘减。所有浮点指令都以字母 f 开头,后缀 d 表示双精度,s 表示单精度,例如 fadd.d、fadd.s、fmul.d、fmul.s、fmadd.d、fmadd.s。浮点比较按比较结果设置整数寄存器,与整数指令“小于则置位”和“大于则置位”类似。
除浮点加载与存储 flw、fsw、fld、fsd 外,还有不同浮点精度间的转换、整数寄存器与浮点寄存器间的数据传送 fmv,以及浮点数与整数之间的转换 fcvt;后者按需要将整数寄存器用作源或目的。
图 A.28 列出几乎全部 RV64G 指令,并概述其含义。
| 指令类型/操作码 | 指令含义 |
|---|---|
| 数据传送 | 在寄存器与存储器之间,或整数与浮点寄存器之间传送数据;唯一的存储器寻址方式是 12 位位移加 GPR 内容。 |
lb, lbu, sb | 加载字节、无符号加载字节、存储字节;与整数寄存器传送。 |
lh, lhu, sh | 加载半字、无符号加载半字、存储半字;与整数寄存器传送。 |
lw, lwu, sw | 加载字、存储字;与整数寄存器传送。 |
ld, sd | 加载双字、存储双字。 |
| 算术/逻辑 | 操作 GPR 中的数据;字形式忽略高 32 位。 |
add, addi, addw, addiw, sub, subi, subw, subiw | 加法与减法,同时提供字形式和立即数形式。 |
slt, sltu, slti, sltiu | 小于则置位,有符号、无符号以及立即数形式。 |
and, or, xor, andi, ori, xori | 与、或、异或,均有寄存器—寄存器和寄存器—立即数形式。 |
lui | 加载高位立即数:将立即数装入寄存器第 31…12 位,高 32 位设为 0。 |
auipc | 将立即数与 PC 的高 20 位相加后放入寄存器;用于构造到任意 32 位地址的分支。 |
sll, srl, sra, slli, srli, srai, sllw, slliw, srli, srliw, srai, sraiw | 移位:逻辑左移、逻辑右移和算术右移,均有立即数和字形式;字形式不改变高 32 位。 |
mul, mulw, mulh, mulhsu, mulhu, div, divw, divu, rem, remu, remw, remuw | 有符号和无符号整数乘法、除法及求余,支持用两条指令得到 64 位乘积;也有字形式。 |
| 控制 | 条件分支与跳转;采用 PC 相对寻址或寄存器寻址。 |
beq, bne, blt, bge, bltu, bgeu | 比较两个寄存器后分支:相等、不等、小于、大于或等于;有符号与无符号形式。 |
jal, jalr | 跳转并链接,地址相对于寄存器或 PC。 |
| 浮点 | 所有浮点操作均有双精度(.d)和单精度(.s)形式。 |
flw, fld, fsw, fsd | 加载、存储字(单精度)和双字(双精度)。 |
fadd, fsub, fmult, fiv, fsqrt, fmadd, fmsub, fnmadd, fnmsub, fmin, fmax, fsgn, fsgnj, fsjnx | 加、减、乘、除、平方根、乘加、乘减、负乘加、负乘减、最大值、最小值,以及替换符号位的指令。单精度操作码后加 .s,双精度后加 .d,例如 fadd.s、fadd.d。 |
feq, flt, fle | 比较两个浮点寄存器,将 0 或 1 的结果存入 GPR。 |
fmv.x.*, fmv.*.x | 在浮点寄存器与 GPR 之间传送;“*”为 s 或 d。 |
fcvt.*.l, fcvt.l.*, fcvt.*.lu, fcvt.lu.*, fcvt.*.w, fcvt.w.*, fcvt.*.wu, fcvt.wu.* | 在浮点寄存器与整数寄存器之间转换;“*”为 S 或 D,分别表示单精度、双精度。有符号、无符号,以及字、双字形式。 |
RISC-V 指令集的使用情况
为说明哪些指令经常使用,图 A.29 给出 SPECint2006 程序在 RV32G 上各指令和指令类别的出现频率。
| 程序 | 加载 | 存储 | 分支 | 跳转 | ALU 操作 |
|---|---|---|---|---|---|
| astar | 28% | 6% | 18% | 2% | 46% |
| bzip | 20% | 7% | 11% | 1% | 54% |
| gcc | 17% | 23% | 20% | 4% | 36% |
| gobmk | 21% | 12% | 14% | 2% | 50% |
| h264ref | 33% | 14% | 5% | 2% | 45% |
| hmmer | 28% | 9% | 17% | 0% | 46% |
| libquantum | 16% | 6% | 29% | 0% | 48% |
| mcf | 35% | 11% | 24% | 1% | 29% |
| omnetpp | 23% | 15% | 17% | 7% | 31% |
| perlbench | 25% | 14% | 15% | 7% | 39% |
| sjeng | 19% | 7% | 15% | 3% | 56% |
| xalancbmk | 30% | 8% | 27% | 3% | 31% |
译注:图 A.24 原表将两种跳转列于 U 型,并将寄存器跳转目标列入 rs1;原图注末句写作“S 和 J”。这些与图 A.23 的字段布局及本节随后描述并不一致。 译注:图 A.29 的 bzip 行按原表相加为 93%,与图注所称“除 omnetpp 外,其他指令均不到 1%”不一致;原图注也确实将加载与存储频率之比写为“1/5 到 3 倍”。 ↩︎
译注:图 A.28 实际位于原书 A-41 页;A-42 页为图 A.29。正文的“All”与图 A.28 的“绝大多数”表述也有差异。 ↩︎
译注:原文既假定 x8、x10 为“32 位寄存器”,又将 64 位结果写入 x10,且同一式中混用 x8 和 R8。 ↩︎
译注:压缩指令集名称在此原文写作 R64C。图 A.27 的
beq、bgt英文名称分别写成“Branch equal zero”“Branch not equal zero”,与右侧比较两个寄存器的含义不一致;示例中的name与语义栏offset也不一致。 ↩︎译注:图 A.26、A.28 的部分指令名、助记符和语义存在疑点,包括
addi的“unsigned”、sll的立即数示例、subi/subiw、重复出现的srli/srai、fmult/fiv/fsgn/fsjnx,以及 LUI 高 32 位“置零”与正文“符号扩展”的差异等。这些条目存在明显疑点,不宜把本表直接当作汇编编程规范。 ↩︎