A.10 谬误与陷阱
体系结构设计者曾反复被一些常见但错误的观念绊倒。本节考察其中几种。
陷阱:专门为高级语言结构设计“高级”指令集特性
试图把高级语言特性纳入指令集,曾促使设计者提供功能强大、灵活性很高的指令。然而,这些指令往往在常见情况下完成了多余的工作,或不能恰好满足某些语言的需要。许多尝试旨在消除 20 世纪 70 年代所谓的语义鸿沟(semantic gap)。其想法是补充指令集,让硬件达到语言层次,但新增内容可能造成 Wulf 等人(1981)所称的语义冲突(semantic clash):
……由于赋予指令过多的语义内容,计算机设计者反而使这条指令只能在有限的上下文中使用。(第 43 页)
更多时候,指令只是大材小用:对于最常见情况而言过于通用,执行了不必要的工作,因而变慢。VAX 的 CALLS 又是一个好例子。它采用被调用者保存策略,即由被调用者指定要保存哪些寄存器;但保存操作是在调用者中的调用指令里完成的。执行 CALLS 前,实参已压入栈中;它接着执行:
- 必要时对齐栈。
- 将实参数量压栈。
- 将过程调用掩码指定的寄存器压栈(见 A.8 节)。掩码保存在被调用过程的代码中,即使分别编译,被调用者也能指定调用者应保存哪些寄存器。
- 将返回地址压栈,再将栈顶和栈底指针压栈,以保存活动记录。
- 清除条件码,使陷阱使能处于已知状态。
- 将一个状态信息字和一个全零字压栈。
- 更新两个栈指针。
- 跳转到过程的第一条指令。
实际程序中的绝大多数调用不需要这样的开销。多数过程知道自己的实参数量;采用寄存器而非存储器中的栈传递参数,就能建立快得多的链接约定。而且,CALLS 强制使用两个寄存器来建立链接,许多语言却只需一个链接寄存器。许多支持过程调用和活动栈管理的尝试没有实用价值:有的与语言需求不符,有的太通用,使用代价过高。
VAX 设计者还提供了简单得多的 JSB 指令,它只将返回 PC 压栈并跳转到过程,因此快得多。然而,多数 VAX 编译器仍使用开销更大的 CALLS。将调用指令加入体系结构,是为了统一过程链接约定。其他计算机则通过编译器开发者之间的约定统一调用规范,无需承担复杂、极度通用的过程调用指令的开销。
谬误:存在一种“典型程序”
许多人希望相信,存在一个单一的“典型”程序,可以用来设计最优指令集。例如,第 1 章讨论过合成基准程序。本附录的数据清楚表明,不同程序使用指令集的方式可能差异很大。图 A.30 给出四个 SPEC2000 程序的数据传送宽度分布;仅凭这四个程序,就很难说什么才算典型。如果指令集支持某类专用应用,例如其他应用完全不使用的十进制指令,差异还会更大。
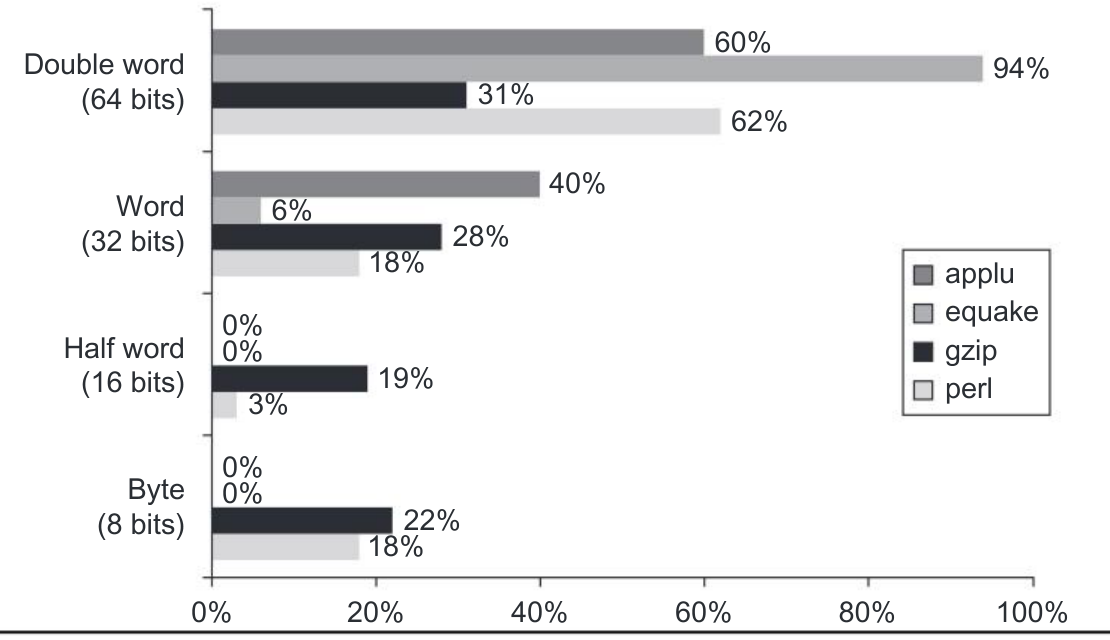
图内术语:Double word=双字(64 位);Word=字(32 位);Half word=半字(16 位);Byte=字节(8 位)。applu、equake、gzip、perl 为程序名;横轴为各宽度占数据访问的比例。
陷阱:通过指令集体系结构创新缩减代码,却不考虑编译器
图 A.31 比较四种 MIPS 编译器生成的相对代码大小。设计者努力将代码减小 30%–40%,而不同编译策略带来的变化可能远大于此。与性能优化一样,体系结构设计者应先以编译器能生成的最紧凑代码为起点,再提出节省空间的硬件创新。
| 编译器 | Apogee Software 4.1 | Green Hills Multi2000 2.0 | Algorithmics SDE4.0B | IDT/c 7.2.1 |
|---|---|---|---|---|
| 体系结构 | MIPS IV | MIPS IV | MIPS 32 | MIPS 32 |
| 处理器 | NEC VR5432 | NEC VR5000 | IDT 32334 | IDT 79RC32364 |
| 自相关计算内核 | 1.0 | 2.1 | 1.1 | 2.7 |
| 卷积编码器计算内核 | 1.0 | 1.9 | 1.2 | 2.4 |
| 定点位分配计算内核 | 1.0 | 2.0 | 1.2 | 2.3 |
| 定点复数 FFT 计算内核 | 1.0 | 1.1 | 2.7 | 1.8 |
| Viterbi GSM 解码器计算内核 | 1.0 | 1.7 | 0.8 | 1.1 |
| 五个计算内核的几何平均值 | 1.0 | 1.7 | 1.4 | 2.0 |
谬误:有缺陷的体系结构不可能成功
80x86 是一个鲜明的例子:它的指令集体系结构,大概只有创造者才会喜欢(见附录 K)。一代代 Intel 工程师试图弥补最初设计中不受欢迎的决定。例如,80x86 支持分段,其他体系结构却选择了分页;它对整数使用扩展累加器,其他处理器使用通用寄存器;它对浮点数据使用栈,而其他人早已放弃执行栈。
尽管存在这些重大问题,80x86 仍取得了巨大成功,原因有三。第一,最初的 IBM PC 选择它作为微处理器,使 80x86 的二进制兼容性极具价值。第二,Moore 定律提供了充足资源,使 80x86 微处理器能够将指令转换为内部 RISC 指令集,再执行类似 RISC 的指令。这种组合既能兼容宝贵的 PC 软件,又能取得与 RISC 处理器相当的性能。第三,PC 微处理器销量极大,Intel 很容易承担硬件转换所增加的设计成本。大批量生产还让厂商沿学习曲线不断进步,降低产品成本。
转换所需的更大的裸片面积和更高功耗,可能是嵌入式应用的负担,但在桌面市场具有极大的经济合理性。桌面市场的性价比优势也使它对服务器很有吸引力;它在服务器上的主要弱点原是 32 位地址,这已通过 64 位地址扩展解决。
谬误:能够设计出毫无缺陷的体系结构
任何体系结构设计,都要在特定软硬件技术背景下权衡取舍。技术随时间变化,当初可能正确的决定,后来会显得像错误。例如,1975 年 VAX 设计者过于重视代码大小效率,低估了五年后易于译码和流水线实现的重要性。RISC 阵营的例子是延迟分支(见附录 K):对于五级流水线,它能简单地处理流水线冒险;对于流水线更深、每周期发射多条指令的处理器,却成为难题。此外,几乎所有体系结构最终都会受到地址空间不足的限制。这也是 RISC-V 预先考虑 128 位地址可能性的原因之一,尽管数十年后才可能需要它。
一般来说,若想长期避免此类缺陷,就可能不得不牺牲短期效率。这很危险,因为一种新 ISA 在问世头几年必须努力争取生存。