B.1 引言
本附录简要复习存储层次结构,包括缓存与虚拟存储器的基本原理、性能公式和简单优化。本节先回顾以下 36 个术语:
| 英文术语 | 中文 |
|---|---|
| cache | 缓存 |
| fully associative | 全相联 |
| write allocate | 写分配 |
| virtual memory | 虚拟存储器 |
| dirty bit | 脏位 |
| unified cache | 统一缓存 |
| memory stall cycles | 存储器停顿周期数 |
| block offset | 块内偏移 |
| misses per instruction | 每条指令的未命中次数 |
| direct mapped | 直接映射 |
| write back | 写回 |
| block | 块 |
| valid bit | 有效位 |
| data cache | 数据缓存 |
| locality | 局部性 |
| block address | 块地址 |
| hit time | 命中时间 |
| address trace | 地址轨迹 |
| write through | 直写 |
| cache miss | 缓存未命中 |
| set | 组 |
| instruction cache | 指令缓存 |
| page fault | 缺页 |
| random replacement | 随机替换 |
| average memory access time | 平均存储器访问时间 |
| miss rate | 未命中率 |
| index field | 索引字段 |
| cache hit | 缓存命中 |
| n-way set associative | n 路组相联 |
| no-write allocate | 非写分配 |
| page | 页 |
| least recently used | 最近最少使用 |
| write buffer | 写缓冲区 |
| miss penalty | 未命中代价 |
| tag field | 标签字段 |
| write stall | 写停顿 |
如果觉得复习节奏太快,可以先阅读我们为经验较少的读者编写的《计算机组成与设计》第 7 章。
地址离开处理器后,遇到的存储层次结构最高层,也就是第一层,称为缓存。由于局部性原理适用于许多层次,利用局部性提高性能也已成为普遍做法,所以只要通过缓冲重用经常出现的内容,往往都称为缓存,例如文件缓存、名称缓存等。
处理器在缓存中找到所需数据项,称为缓存命中;找不到,则发生缓存未命中。此时,从主存取出包含目标字的一组固定大小的数据,称为块或行,放入缓存。时间局部性告诉我们,近期很可能再次需要这个字,因此把它放在访问快速的缓存中很有价值;空间局部性则意味着块中的其他数据也很可能很快用到。
处理一次缓存未命中所需的时间,同时取决于存储器延迟和带宽。延迟决定取回块中第一个字所需的时间,带宽决定取回其余部分的时间。缓存未命中由硬件处理,会让顺序执行处理器暂停,即停顿,直至数据可用。对于乱序执行,使用该结果的指令仍须等待,但其他指令可以在未命中期间继续执行。
类似地,程序引用的对象不必全部驻留主存。虚拟存储器允许一些对象驻留磁盘。地址空间通常划分为固定大小的块,称为页。任意时刻,每页位于主存或磁盘中。处理器引用的页面既不在缓存中,也不在主存中时,就发生缺页,整页从磁盘调入主存。 缺页耗时很长,因此由软件处理,而不是让处理器一直停顿;磁盘访问期间,处理器通常切换去执行其他任务。从较高层次看,缓存与主存之间对访问局部性的依赖,以及容量、单位位成本的相对关系,与主存和磁盘之间的关系很相似。
图 B.1 给出从高端桌面机到低端服务器,各存储层次的典型容量和访问时间范围。
| 层次 | 1 | 2 | 3 | 4 |
|---|---|---|---|---|
| 名称 | 寄存器 | 缓存 | 主存 | 磁盘存储 |
| 典型容量 | <4 KiB | 32 KiB–8 MiB | <1 TB | >1 TB |
| 实现技术 | 多端口定制 CMOS 存储器 | 片上 CMOS SRAM | CMOS DRAM | 磁盘或 FLASH |
| 访问时间(ns) | 0.1–0.2 | 0.5–10 | 30–150 | 5,000,000 |
| 带宽(MiB/s) | 1,000,000–10,000,000 | 20,000–50,000 | 10,000–30,000 | 100–1000 |
| 管理者 | 编译器 | 硬件 | 操作系统 | 操作系统 |
| 后备层次 | 缓存 | 主存 | 磁盘或 FLASH | 其他磁盘及 DVD |
缓存性能回顾
由于局部性,以及小容量存储器速度更快,存储层次结构可以显著改善性能。一种评价缓存性能的方法,是扩展第 1 章的处理器执行时间公式,加入处理器等待访存而停顿的周期数,称为存储器停顿周期数。执行时间等于处理器周期数与存储器停顿周期数之和,再乘以时钟周期时间:
这里假设 CPU 时钟周期数包含处理缓存命中的时间,并假设缓存未命中期间处理器停顿。B.2 节将重新考察这一简化假设。
存储器停顿周期数取决于未命中次数,以及每次未命中的开销,即未命中代价:
最后一种形式的优点,是各项都容易测量。我们已知道如何测量指令数 IC;对于推测执行处理器,只统计提交的指令。每条指令的访存次数也可用同样方式测量:每条指令都需要一次取指,而是否还需要数据访问,也很容易判断。
注意,未命中代价按平均值计算,这里却把它当作常量使用。未命中发生时,缓存后面的存储器可能正忙于先前的请求或刷新;处理器、总线和存储器的时钟不同,在这些时钟域接口处所需周期数也会变化。因此,用一个数表示未命中代价是一种简化。
未命中率就是缓存访问中未命中的比例,即未命中次数除以访问次数。可以用缓存模拟器测量:输入指令和数据访问的地址轨迹,模拟缓存行为,判断各次访问是否命中,再报告命中与未命中的总数。如今,许多微处理器提供统计未命中次数和访存次数的硬件,使测量更简单、更快。
上式只是近似,因为读、写的未命中率和未命中代价往往不同。可以分别按每条指令的读写次数、以周期为单位的未命中代价,以及读写未命中率来表示:
通常,我们合并读写,并求其平均未命中率与平均未命中代价,从而将完整公式简化为:
未命中率是缓存设计最重要的指标之一,但后面将看到,它不是唯一指标。
例题:缓存未命中对执行时间的影响
某计算机在所有访存均命中缓存时,每条指令周期数 CPI 为 1.0。数据访问仅有加载和存储,共占指令的 50%。若未命中代价为 50 个时钟周期、未命中率为 1%,所有指令都命中缓存时,计算机会快多少?
解答。 先计算全部命中时的执行时间:
对于实际缓存,先计算存储器停顿周期数:
其中 表示每条指令有一次取指和 0.5 次数据访问。总执行时间为:
性能之比等于执行时间之比的倒数:
因此,没有缓存未命中的计算机,速度是原来的 1.75 倍。
有些设计者喜欢用每条指令未命中次数,而非每次存储器访问的未命中率来衡量。两者关系为:
已知每条指令的平均访存次数,就能利用这个公式,在未命中率与每条指令未命中次数之间转换。例如,将上一例按访存计算的未命中率转换为每条指令未命中次数:
顺便说,每条指令未命中次数常换算成每 1000 条指令未命中次数,以便用整数而非小数表示。上面的结果也可写为每 1000 条指令未命中 30 次。
这一指标的优点是与硬件实现无关。例如,推测执行处理器取入的指令数量约为实际提交数量的两倍;若按访存次数而非指令数计算未命中率,就可能人为压低结果。缺点是它与体系结构有关:80x86 与 RISC-V 每条指令的平均访存次数可能很不相同。因此,它最受研究同一计算机系列的设计者欢迎,不过 RISC 体系结构之间的相似性,仍使一种体系结构的结果对其他体系结构有所启发。
例题:两种未命中指标的等价性
为说明两种未命中率公式等价,重新计算前一例,这次假定每 1000 条指令未命中 30 次。用指令数表示存储器停顿时间。
解答。 重新计算停顿周期数:
得到与 B-5 页相同的结果,说明两种公式等价。1
存储层次结构的四个问题
继续介绍缓存,先回答存储层次结构第一层的四个共同问题:
- 一个块可以放到上层的什么位置?——块放置。
- 如果块在上层,如何找到它?——块识别。
- 发生未命中时,应替换哪个块?——块替换。
- 写操作如何处理?——写策略。
这些问题的答案,有助于理解不同存储层次的权衡;因此,每个实例都会围绕这四个问题展开。
问题 1:块可以放入缓存的什么位置?
图 B.2 表明,块放置位置的限制,将缓存组织分成三类。
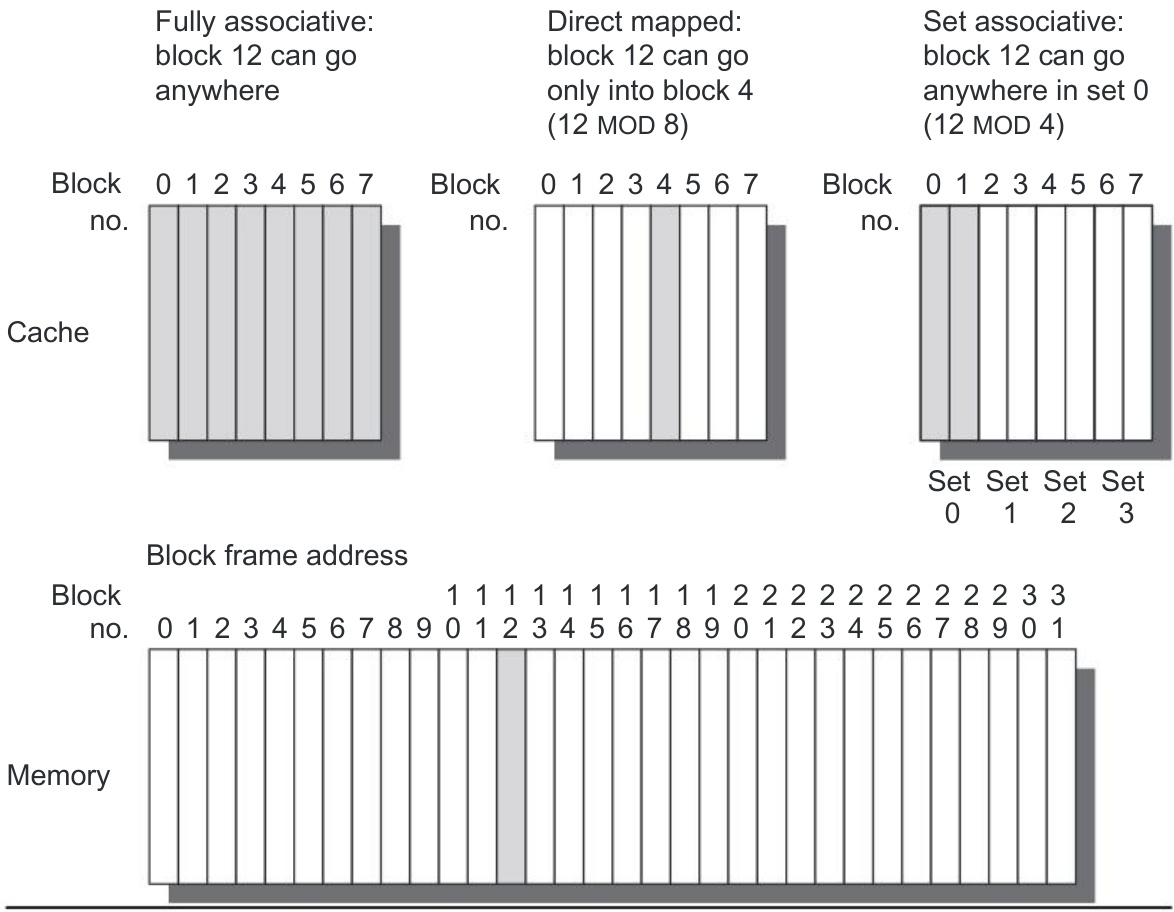
图内术语:Fully associative=全相联;Direct mapped=直接映射;Set associative=组相联;Block no.=块编号;Block frame address=块框地址;Cache=缓存;Memory=存储器;Set=组。图中三项位置说明完整译于图注。
- 每个块在缓存中只有一个可放置位置,称为直接映射。映射通常是“块地址 mod 缓存块数”。
- 块可放在缓存任意位置,称为全相联。
- 块只可放在缓存中某组限定位置,称为组相联。组是缓存内的一组块;先将块映射到一个组,再放入该组任意位置。通常通过选择地址位来确定组,即“块地址 mod 缓存组数”。每组含 个块,就称为 路组相联。
从直接映射到全相联,实际上是一系列相联度。直接映射就是一路组相联;含 个块的全相联缓存,可以称为 m 路组相联。等价地,直接映射有 个组,全相联只有一个组。
原书所述的大多数处理器缓存采用直接映射、二路或四路组相联,原因稍后说明。
问题 2:如果块在缓存中,如何找到它?
每个缓存块框都有一个地址标签,记录块地址。对于可能包含目标数据的所有缓存块,检查其标签是否与处理器给出的块地址相符。由于速度至关重要,通常会并行比较所有可能的标签。
还必须判断缓存块是否包含有效信息。最常见做法是在标签旁增加有效位,说明该表项是否包含有效地址;有效位未置位,就不能认为地址匹配。
进入下一个问题之前,先看处理器地址与缓存的关系。图 B.3 展示地址如何划分:先分为块地址与块内偏移,块框地址又可分成标签字段和索引字段。
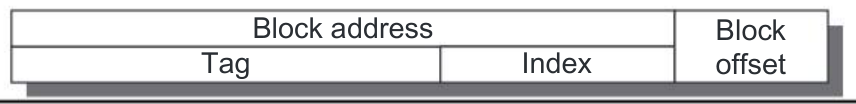
图内术语:Block address=块地址;Tag=标签;Index=索引;Block offset=块内偏移。
块内偏移选择块内所需数据,索引选择组,再比较标签以判断命中。虽然可以比较比标签更完整的地址,但没有必要:
- 不应比较偏移量,因为整个块要么存在,要么不存在;只要块存在,任何块内偏移都应匹配。
- 索引已经用来选择待检查的组,重复检查它没有意义。例如,存于组 0 的地址,其索引必为 0,否则不可能存入组 0;组 1 的索引必为 1,依此类推。缩短缓存标签存储的位宽,可以节省硬件和能耗。
缓存总容量不变时,提高相联度会增加每组块数,因而缩小索引、增大标签。也就是说,图 B.3 的标签与索引分界向右移动;最终到全相联时,索引字段消失。
问题 3:缓存未命中时替换哪个块?
未命中时,缓存控制器必须选择一个块,用所需数据替换它。直接映射的优点是简化硬件决策,实际上根本无须选择:只检查一个块框是否命中,也只能替换该块。全相联或组相联有多个候选块,主要采用三种策略:
- 随机替换:随机选择候选块,使分配均匀分布。有些系统生成伪随机块号,使行为可复现,这对硬件调试尤其有用。
- 最近最少使用(LRU):记录块的访问情况,降低淘汰即将再次使用的数据的概率。依据过去预测未来,替换最久未用的块。其依据是局部性的推论:如果最近使用过的块很可能再次使用,那么最久未用的块就是较好的淘汰候选。
- 先进先出(FIFO):由于精确确定 LRU 可能复杂,改为找出进入缓存时间最早的块,以近似 LRU。
随机替换易于硬件实现。需要跟踪的块越多,LRU 越昂贵,通常只能近似。一种常见的近似方案称为 pseudo-LRU(伪 LRU),为缓存每组维护一组位,每位对应一路;路是组相联缓存中的一个存储体,四路组相联就有四路。访问某组时,将包含目标块的那一路对应的位设为 1;如果该组所有位都为 1,就清零除最近设置那一位之外的全部位。需要替换块时,从标志位为 0 的路中选择;若候选不止一个,通常随机选择。这近似于 LRU,因为被替换的块,自上次组内所有块都被访问过之后,就没有再被访问。图 B.4 比较 LRU、随机、FIFO 的未命中情况。
| 容量 | 二路 LRU | 二路随机 | 二路 FIFO | 四路 LRU | 四路随机 | 四路 FIFO | 八路 LRU | 八路随机 | 八路 FIFO |
|---|---|---|---|---|---|---|---|---|---|
| 16 KiB | 114.1 | 117.3 | 115.5 | 111.7 | 115.1 | 113.3 | 109.0 | 111.8 | 110.4 |
| 64 KiB | 103.4 | 104.3 | 103.9 | 102.4 | 102.3 | 103.1 | 99.7 | 100.5 | 100.3 |
| 256 KiB | 92.2 | 92.1 | 92.5 | 92.1 | 92.1 | 92.5 | 92.1 | 92.1 | 92.5 |
问题 4:写操作如何处理?
处理器缓存访问以读为主:所有取指都是读,多数指令不写存储器。附录 A 的图 A.32、A.33 给出的 RISC-V 程序指令混合中,存储占 10%,加载占 26%。2 因此,写占总访存的 ,约 7%;占数据缓存访问的 ,约 28%。加速常见情况,就意味着优先优化读,尤其因为处理器传统上必须等待读完成,却不一定要等待写。尽管如此,Amdahl 定律(1.9 节)仍提醒我们,高性能设计不能忽视写速度。
幸运的是,常见情况也比较容易加速。读取和比较标签时,可以同时读取缓存块,因此只要块地址可用,读取就能开始。若命中,立即将目标部分送给处理器;若未命中,这次读取没有收益,但对桌面和服务器而言,除额外耗电外也没有损害,忽略读出的值即可。
写操作不能如此乐观。在标签检查确认命中之前,不能修改块。由于检查标签不能与写并行,写通常比读慢。另一个复杂因素是处理器还会指定写入大小,通常为 1–8 字节;只能修改块中的相应部分。读则可以放心地多读一些字节。
写策略通常是区分缓存设计的重要特征。写缓存有两种基本选择:
- 直写(write through):同时写缓存中的块和下一级存储器中的块。
- 写回(write back):只写缓存块;直到该块被替换时,才将修改后的内容写入主存。
为减少替换时的写回次数,通常加入脏位,记录块是脏的(在缓存中被修改)还是干净的(未被修改)。干净块无需在未命中替换时写回,因为下层已有相同副本。
写回和直写各有优点。写回以缓存速度完成写入,同一块被多次写,只需向下层写一次。部分写操作不必到达存储器,节省了带宽,因此写回对多处理器很有吸引力。它也减少其余存储层次及互连的使用,从而节省能耗,对嵌入式应用同样有吸引力。
直写比写回易于实现:缓存始终干净,读未命中不会像写回那样触发下层写入。它还保证下一级始终保存最新副本,简化数据一致性处理。数据一致性对多处理器和 I/O 很重要,原书在第 4 章与附录 D 讨论。多级缓存使上层采用直写更可行,因为写只需传播到下一级,不必一直到主存。
后面会看到,I/O 与多处理器提出的要求并不一致:一方面,希望处理器缓存采用写回来减少流量;另一方面,又希望采用直写,使缓存与下层存储保持一致。
直写期间,如果处理器必须等待写完成,就发生写停顿。常见优化是加入写缓冲区:数据进入缓冲区后,处理器即可继续执行,使执行与存储器更新重叠。不过稍后也会看到,即使有写缓冲区,仍可能发生写停顿。
写操作不需要先取得原数据,因此写未命中有两种选择:
- 写分配:写未命中时先分配并装入该块,再按写命中处理。这是自然的选择,写未命中的行为类似读未命中。
- **非写分配**:看似不寻常,但写未命中不改变缓存,只修改下一级存储器中的块。
因此,非写分配时,一个块要等程序尝试读取它,才会进入缓存;写分配则使只被写、不被读的块也进入缓存。
例题:写分配与非写分配
一个拥有大量表项的全相联写回缓存初始为空。依次发生以下五次访存,方括号内为地址:
分别采用非写分配和写分配时,命中、未命中各多少次?
解答。 非写分配时,地址 100 不在缓存中,写又不分配块,因此前两次写均未命中。地址 200 也不在缓存,所以读也未命中,但它把块装入缓存,随后对 200 的写命中。最后对 100 的写仍未命中。总计 4 次未命中、1 次命中。
写分配时,首次访问 100、200 未命中;之后二者均在缓存中,其余访问命中。总计 2 次未命中、3 次命中。
两种写未命中策略,都可以配合直写或写回。写回缓存通常采用写分配,希望后续对同一块的写能在缓存中完成。直写缓存通常采用非写分配,理由是后续写即使命中,仍必须传到下层,那么把块装入缓存又有何收益?
实例:Opteron 数据缓存
图 B.5 用 AMD Opteron 微处理器的数据缓存,使上述概念具体化。它保存 65,536 字节,即 64 KiB 数据;块大小为 64 字节,采用二路组相联、LRU 替换、写回,以及写未命中时写分配。
按图中四个带圈数字,跟踪一次命中。B.5 节将说明,Opteron 向缓存提供 48 位虚拟地址,同时将其转换为 40 位物理地址,用于标签比较。
Opteron 没有使用完整的 64 位虚拟地址,是因为设计者认为当时尚无人需要如此大的虚拟地址空间;较小宽度也简化映射。他们计划在后续微处理器中扩大虚拟地址。
送入缓存的物理地址分成 34 位块地址和 6 位块内偏移,因为 ,且 。块地址再分成地址标签和缓存索引;图中的步骤 1 就是这一划分。
缓存索引选择待比较的标签,以判断目标块是否在缓存中。索引宽度取决于缓存容量、块大小和相联度。Opteron 为二路组相联,其索引计算如下:
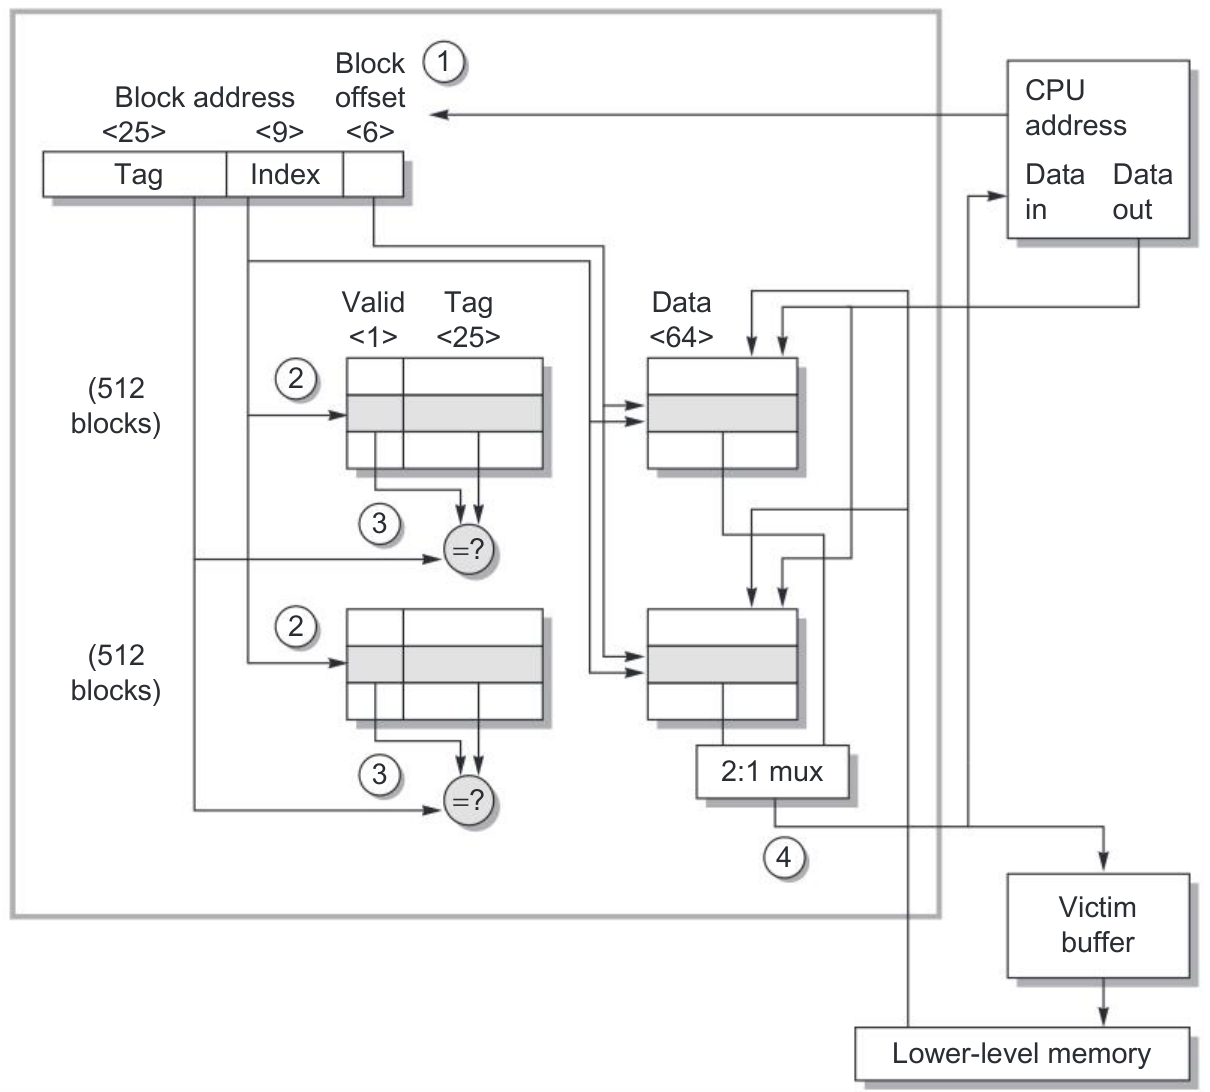
图内术语:Block address=块地址;Tag=标签(25 位);Index=索引(9 位);Block offset=块内偏移(6 位);Valid=有效位;Data=数据(64 位);512 blocks=512 块;CPU address=CPU 地址;Data in/out=输入/输出数据;2:1 mux=二选一多路选择器;Victim buffer=牺牲块缓冲区;Lower-level memory=下一级存储器。“=?” 表示相等比较。3
所以索引为 9 位,标签为 位。虽然这个索引足以选出正确的块,但 64 字节远超过处理器一次所需的数据。更合理的做法,是将缓存的数据部分组织成 8 字节宽,正好对应 64 位 Opteron 的自然字长。因此,除选择缓存块的 9 位外,还从块内偏移中取 3 位,选择正确的 8 字节。索引选择就是图中的步骤 2。
读出两个标签后,与处理器块地址中的标签部分比较,这是步骤 3。还必须检查有效位;若未置位,即使比较相等也不算命中。
假定一个标签匹配,最后用二选一多路选择器选出命中的一路,通知处理器接收正确数据。Opteron 用 2 个时钟周期完成这四步;因此,随后的 2 个周期内,若指令试图使用该加载结果,就需要等待。
与任何缓存一样,Opteron 的写处理比读复杂。待写字在缓存中时,前三步相同。由于 Opteron 乱序执行,只有指令已获准提交、标签比较又确认命中后,数据才能写入缓存。
目前讨论的是常见的命中情况。读未命中时,缓存通知处理器数据尚不可用,并从下一层读取 64 字节。块的前 8 字节延迟为 7 个时钟周期,余下部分每 8 字节需 2 个周期。由于是组相联缓存,还需选择替换块。Opteron 采用 LRU,选择最久未访问的块,所以每次访问都要更新 LRU 位。替换块需要更新数据、地址标签、有效位和 LRU 位。
由于采用写回,被替换的数据块可能已修改,不能直接丢弃。Opteron 每块维护 1 个脏位,记录它是否被写过。如果“牺牲块”已修改,就把其数据和地址送入牺牲块缓冲区;它类似其他计算机的写缓冲区,可容纳 8 个牺牲块。Opteron 在执行其他缓存操作的同时,将这些块写入下一级。缓冲区满时,缓存必须等待。
写未命中与读未命中非常相似,因为二者都会分配块。
数据缓存的工作方式已经清楚,但它不能满足处理器的全部存储需求:处理器还需要指令。虽然可以让一个缓存同时提供指令和数据,却可能形成瓶颈。例如,执行加载或存储时,流水线处理器会同时请求一个数据字和一个指令字;单个缓存就会产生结构冒险,引起停顿。简单办法是分开:一个缓存专供指令,另一个专供数据。包括 Opteron 在内,多数较新的处理器都采用分离缓存。因此,Opteron 除 64 KiB 数据缓存外,还有 64 KiB 指令缓存。
处理器知道自己发出的是指令地址还是数据地址,所以可以分别提供端口,使处理器与存储层次之间的带宽加倍。分离还允许独立优化容量、块大小和相联度,改善性能。与 Opteron 的指令、数据分离缓存相对,能够同时保存指令和数据的缓存称为统一缓存或混合缓存。
图 B.6 表明,指令缓存未命中率低于数据缓存。分离指令和数据,可以消除两者块之间的冲突,但也固定了分配给各类数据的缓存空间。哪种影响更重要?公平比较必须保持总容量相同:例如,16 KiB 指令缓存加 16 KiB 数据缓存,应与 32 KiB 统一缓存比较。计算分离缓存的平均未命中率,必须知道访问各缓存的比例。根据附录 A 的数据,指令访问比例为 ,约 74%;数据访问为 ,约 26%。缓存分离对性能的影响,不止未命中率的变化,后面会继续说明。
| 容量(KiB) | 指令缓存 | 数据缓存 | 统一缓存 |
|---|---|---|---|
| 8 | 8.16 | 44.0 | 63.0 |
| 16 | 3.82 | 40.9 | 51.0 |
| 32 | 1.36 | 38.4 | 43.3 |
| 64 | 0.61 | 36.9 | 39.4 |
| 128 | 0.30 | 35.3 | 36.2 |
| 256 | 0.02 | 32.6 | 32.9 |