B.3 六种基本缓存优化
平均存储器访问时间公式,为介绍缓存性能优化提供了框架:
因此,将六种缓存优化分为三类:
- 降低未命中率:增大块、增大缓存容量、提高相联度。
- 降低未命中代价:采用多级缓存,让读优先于写。
- 缩短命中时间:索引缓存时避免地址转换。
本节末的图 B.18(原文指 B-40 页)汇总这六种方法的实现复杂度及性能收益。
改善缓存行为的传统方法,是降低未命中率。下面介绍三种技术。为理解未命中的原因,先将其划分为三个简单类别:
- 强制未命中(compulsory miss):第一次访问某块时,它不可能已在缓存中,必须先装入;也称冷启动未命中或首次访问未命中。
- 容量未命中(capacity miss):缓存无法同时容纳程序执行所需的全部块,某块被丢弃后又要重新取回,除强制未命中外便出现容量未命中。
- 冲突未命中(conflict miss):组相联或直接映射中,如果太多块映射到同一组,一些块会被丢弃后又重新取回;这是强制、容量之外的冲突未命中,也称 collision miss。在全相联缓存中命中、在 n 路组相联中却未命中的情况,可理解为某些热门组收到超过 n 个不同块的请求。
第 5 章还加入第四个 C,即 coherence miss:多处理器为保持多个缓存一致而清除缓存内容,导致的一致性未命中。本节暂不考虑。
图 B.8 按三个 C 列出未命中的相对频率。无限容量缓存仍会发生的,是强制未命中;全相联缓存发生的,是容量未命中;从全相联降为八路、四路等相联度后新增的,是冲突未命中。图 B.9 用图形表示相同数据:上图为绝对未命中率,下图为各类占全部未命中的百分比随容量的变化。
为显示相联度的收益,按每次降低相联度所增加的未命中,将冲突未命中再分为四部分:
- 八路:从没有冲突的全相联降至八路组相联,新增的冲突未命中。
- 四路:从八路降至四路新增的冲突未命中。
- 二路:从四路降至二路新增的冲突未命中。
- **一路**:从二路降至一路,即直接映射,新增的冲突未命中。
图中可见,SPEC2000 的强制未命中率很小;许多长时间运行的程序也是如此。
明确三个 C 后,设计者可以采取什么措施?概念上最容易解决的是冲突:全相联消除所有冲突未命中。但硬件昂贵,而且可能降低处理器时钟频率(见 B-29 页例题),使总体性能下降。
对于容量未命中,除增大缓存外,办法不多。如果上层容量远小于程序需求,大量时间花在两层之间搬移数据,就称存储层次发生抖动(thrashing)。由于替换过于频繁,计算机速度接近下层存储器,甚至因未命中额外开销而更慢。
另一个方向是增大块,以减少强制未命中;但稍后会看到,大块也可能增加其他未命中。
三个 C 有助于理解原因,却也有局限:它解释平均行为,不一定能解释某一次未命中。例如,改变容量不仅改变容量未命中,也改变冲突未命中,因为更大的缓存将访问分散到更多块中;同一次访问可能随容量变化,从容量未命中变为冲突未命中。类似地,Gupta 等人(2013)指出,改变块大小除了预期的强制未命中减少,有时也会减少容量未命中。
三个 C 还忽略替换策略,因为它难以建模,通常影响也较小。但特定情况下,替换策略可能产生反常行为,例如相联度提高,未命中率反而变差,与三个 C 模型矛盾。有人建议利用地址轨迹确定存储器中的最优放置,以避免三个 C 模型中的放置未命中;这里未采用这一建议。
遗憾的是,许多降低未命中率的技术,也会增加命中时间或未命中代价。必须将降低未命中率的愿望,与加速整个系统的目标平衡。第一个例子就说明这种整体视角的重要性。
| 缓存容量(KiB) | 相联度 | 总未命中率 | 强制未命中率 | 强制占比 | 容量未命中率 | 容量占比 | 冲突未命中率 | 冲突占比 |
|---|---|---|---|---|---|---|---|---|
| 4 | 一路 | 0.098 | 0.0001 | 0.1% | 0.070 | 72% | 0.027 | 28% |
| 4 | 二路 | 0.076 | 0.0001 | 0.1% | 0.070 | 93% | 0.005 | 7% |
| 4 | 四路 | 0.071 | 0.0001 | 0.1% | 0.070 | 99% | 0.001 | 1% |
| 4 | 八路 | 0.071 | 0.0001 | 0.1% | 0.070 | 100% | 0.000 | 0% |
| 8 | 一路 | 0.068 | 0.0001 | 0.1% | 0.044 | 65% | 0.024 | 35% |
| 8 | 二路 | 0.049 | 0.0001 | 0.1% | 0.044 | 90% | 0.005 | 10% |
| 8 | 四路 | 0.044 | 0.0001 | 0.1% | 0.044 | 99% | 0.000 | 1% |
| 8 | 八路 | 0.044 | 0.0001 | 0.1% | 0.044 | 100% | 0.000 | 0% |
| 16 | 一路 | 0.049 | 0.0001 | 0.1% | 0.040 | 82% | 0.009 | 17% |
| 16 | 二路 | 0.041 | 0.0001 | 0.2% | 0.040 | 98% | 0.001 | 2% |
| 16 | 四路 | 0.041 | 0.0001 | 0.2% | 0.040 | 99% | 0.000 | 0% |
| 16 | 八路 | 0.041 | 0.0001 | 0.2% | 0.040 | 100% | 0.000 | 0% |
| 32 | 一路 | 0.042 | 0.0001 | 0.2% | 0.037 | 89% | 0.005 | 11% |
| 32 | 二路 | 0.038 | 0.0001 | 0.2% | 0.037 | 99% | 0.000 | 0% |
| 32 | 四路 | 0.037 | 0.0001 | 0.2% | 0.037 | 100% | 0.000 | 0% |
| 32 | 八路 | 0.037 | 0.0001 | 0.2% | 0.037 | 100% | 0.000 | 0% |
| 64 | 一路 | 0.037 | 0.0001 | 0.2% | 0.028 | 77% | 0.008 | 23% |
| 64 | 二路 | 0.031 | 0.0001 | 0.2% | 0.028 | 91% | 0.003 | 9% |
| 64 | 四路 | 0.030 | 0.0001 | 0.2% | 0.028 | 95% | 0.001 | 4% |
| 64 | 八路 | 0.029 | 0.0001 | 0.2% | 0.028 | 97% | 0.001 | 2% |
| 128 | 一路 | 0.021 | 0.0001 | 0.3% | 0.019 | 91% | 0.002 | 8% |
| 128 | 二路 | 0.019 | 0.0001 | 0.3% | 0.019 | 100% | 0.000 | 0% |
| 128 | 四路 | 0.019 | 0.0001 | 0.3% | 0.019 | 100% | 0.000 | 0% |
| 128 | 八路 | 0.019 | 0.0001 | 0.3% | 0.019 | 100% | 0.000 | 0% |
| 256 | 一路 | 0.013 | 0.0001 | 0.5% | 0.012 | 94% | 0.001 | 6% |
| 256 | 二路 | 0.012 | 0.0001 | 0.5% | 0.012 | 99% | 0.000 | 0% |
| 256 | 四路 | 0.012 | 0.0001 | 0.5% | 0.012 | 99% | 0.000 | 0% |
| 256 | 八路 | 0.012 | 0.0001 | 0.5% | 0.012 | 99% | 0.000 | 0% |
| 512 | 一路 | 0.008 | 0.0001 | 0.8% | 0.005 | 66% | 0.003 | 33% |
| 512 | 二路 | 0.007 | 0.0001 | 0.9% | 0.005 | 71% | 0.002 | 28% |
| 512 | 四路 | 0.006 | 0.0001 | 1.1% | 0.005 | 91% | 0.000 | 8% |
| 512 | 八路 | 0.006 | 0.0001 | 1.1% | 0.005 | 95% | 0.000 | 4% |
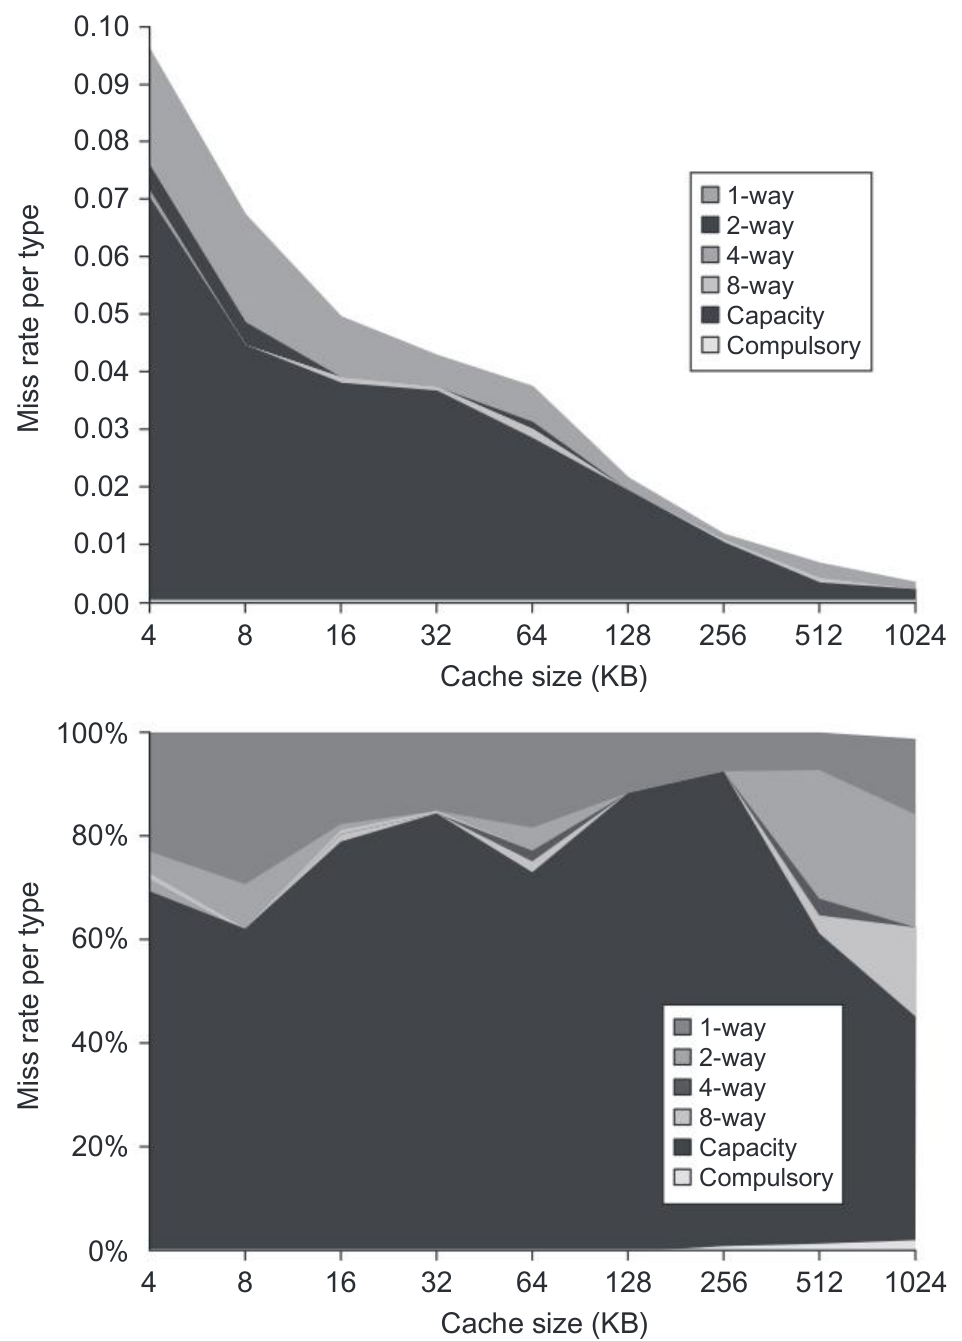
图内术语:Miss rate per type=各类未命中率;Cache size=缓存容量(图中 KB);1/2/4/8-way=分别从二路降到一路、四路降到二路、八路降到四路、全相联降到八路而增加的冲突未命中;Capacity=容量;Compulsory=强制。下图纵轴表示占全部未命中的比例。
第一种优化:增大块以降低未命中率
最简单的办法是增大块。图 B.10 展示一组程序与多种缓存容量下,块大小与未命中率的权衡。大块减少强制未命中,因为局部性既包含时间局部性,也包含空间局部性,而大块利用了后者。
同时,大块也增加未命中代价。缓存中的块数因此减少,可能增加冲突未命中;缓存较小时,甚至增加容量未命中。显然,没有理由把块增大到未命中率反而上升。即使未命中率降低,如果平均访问时间增加,也没有收益:未命中代价的上升,可能超过未命中率下降所带来的好处。
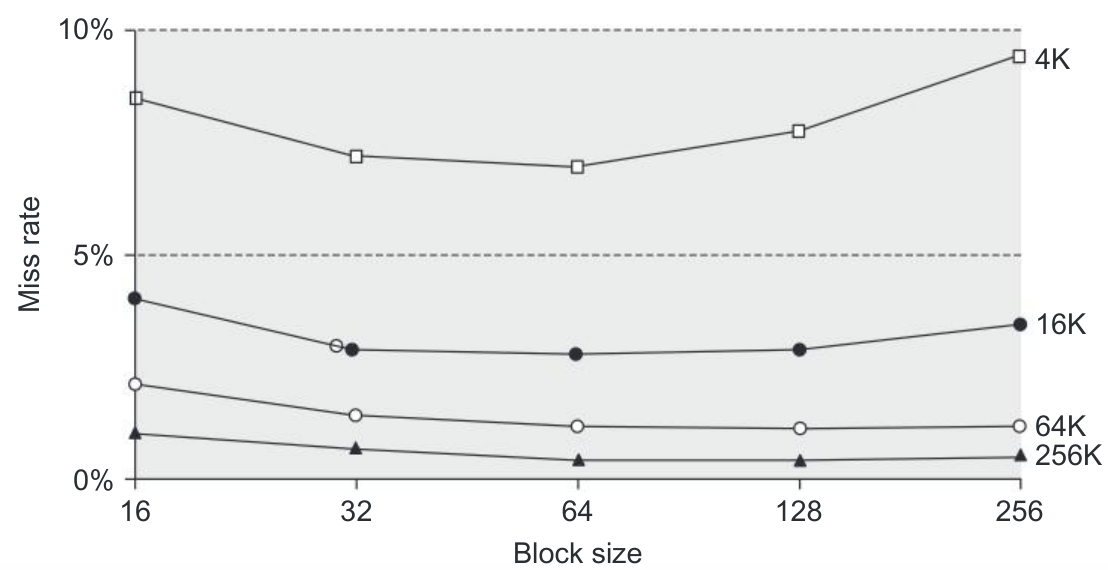
图内术语:Miss rate=未命中率;Block size=块大小(字节);4K、16K、64K、256K 为缓存容量。原图注称“五种”,图和表实际列出四种容量、五种块大小,见本节译注:1
例题:按平均访问时间选择块大小
图 B.11 给出图 B.10 的实际未命中率。假设存储系统先花 80 周期开销,此后每 2 周期提供 16 字节。因此,16 字节需 82 周期,32 字节需 84 周期,依此类推。对图 B.11 的每种缓存容量,哪种块大小使平均访问时间最短?
解答。
假设命中时间恒为 1 周期,与块大小无关,则 4 KiB 缓存采用 16 字节块时:
256 KiB 缓存采用 256 字节块时:
图 B.12 列出两种极端之间所有块大小与缓存容量的平均访问时间。粗体为同一容量下最快的选择:4 KiB 缓存选 32 字节块,较大缓存选 64 字节块。这也是原书所述处理器缓存的常用块大小。
| 块大小(字节) | 4 KiB 缓存 | 16 KiB 缓存 | 64 KiB 缓存 | 256 KiB 缓存 |
|---|---|---|---|---|
| 16 | 8.57% | 3.94% | 2.04% | 1.09% |
| 32 | 7.24% | 2.87% | 1.35% | 0.70% |
| 64 | 7.00% | 2.64% | 1.06% | 0.51% |
| 128 | 7.78% | 2.77% | 1.02% | 0.49% |
| 256 | 9.51% | 3.29% | 1.15% | 0.49% |
| 块大小(字节) | 未命中代价(周期) | 4 KiB 缓存 | 16 KiB 缓存 | 64 KiB 缓存 | 256 KiB 缓存 |
|---|---|---|---|---|---|
| 16 | 82 | 8.027 | 4.231 | 2.673 | 1.894 |
| 32 | 84 | 7.082 | 3.411 | 2.134 | 1.588 |
| 64 | 88 | 7.160 | 3.323 | 1.933 | 1.449 |
| 128 | 96 | 8.469 | 3.659 | 1.979 | 1.470 |
| 256 | 112 | 11.651 | 4.685 | 2.288 | 1.549 |
与所有这些技术一样,设计者既要降低未命中率,也要降低未命中代价。块大小取决于下层存储器的延迟与带宽。高延迟、高带宽有利于大块,因为每次未命中可以多取许多字节,而代价只略增。反过来,低延迟、低带宽有利于小块,因为大块节省不了多少时间。例如,小块未命中代价的两倍,可能接近双倍大小块的代价。小块数量更多,也可能减少冲突。图 B.10 与图 B.12 正说明了:以最小未命中率选块大小,与以最小平均访问时间选择,并不相同。
看过增大块对强制、容量未命中的正反影响,下面考察提高容量和相联度的潜力。
第二种优化:增大缓存以降低未命中率
减少图 B.8、B.9 中容量未命中的直接办法,是增加缓存容量。明显缺点是命中时间可能更长,成本和功耗更高。这种技术在片外缓存中尤其常见。
第三种优化:提高相联度以降低未命中率
图 B.8、B.9 展示提高相联度如何改善未命中率,可得两条经验。第一,对于这些容量,从减少未命中的实用效果看,八路组相联几乎相当于全相联。比较图 B.8 的八路数据与容量未命中列即可看出差异,因为后者按全相联计算。
第二条称为 2∶1 缓存经验法则:容量为 N 的直接映射缓存,其未命中率约等于容量为 N/2 的二路组相联缓存。在前面三个 C 的图中,这适用于小于 128 KiB 的缓存。
与许多例子相同,改善平均访问时间的一个方面,往往损害另一个方面。大块降低未命中率,却提高未命中代价;高相联度可能增加命中时间。因此,短时钟周期推动简单的缓存设计,而越来越高的未命中代价又鼓励提高相联度。
例题:提高相联度是否值得?
假定提高相联度使时钟周期时间变化如下:
命中时间为 1 周期。直接映射时,未命中访问一个永不未命中的 L2 缓存(见下一小节),代价为 25 周期;未命中代价不必取整为整数周期。使用图 B.8 的未命中率,以下各关系分别在哪些缓存容量下成立?
这里 AMAT 表示平均存储器访问时间。
解答。 各相联度的平均访问时间为:
各方案的未命中实际耗时相同,因此保留 25 个基准周期。例如,4 KiB 直接映射缓存为:
512 KiB 八路组相联缓存为:
译注: 以上两式保留原书结果。若直接使用式中显示的三位小数未命中率,结果分别为 3.45 和 1.67,而非 3.44 和 1.66;原书未说明是否使用了未显示的更高精度数据。图 B.13 的数值也按原表保留。
| 缓存容量(KiB) | 一路 | 二路 | 四路 | 八路 |
|---|---|---|---|---|
| 4 | 3.44 | 3.25 | 3.22 | 3.28 |
| 8 | 2.69 | 2.58 | 2.55 | 2.62 |
| 16 | 2.23 | 2.40 | 2.46 | 2.53 |
| 32 | 2.06 | 2.30 | 2.37 | 2.45 |
| 64 | 1.92 | 2.14 | 2.18 | 2.25 |
| 128 | 1.52 | 1.84 | 1.92 | 2.00 |
| 256 | 1.32 | 1.66 | 1.74 | 1.82 |
| 512 | 1.20 | 1.55 | 1.59 | 1.66 |
利用这些公式与图 B.8 的数据,就得到图 B.13。缓存不超过 8 KiB、相联度提高到四路为止,例题中的相应不等式成立;从 16 KiB 开始,高相联度增加的命中时间,超过未命中减少所节省的时间。
本例没有计入较慢时钟对程序其余部分的影响,因此还低估了直接映射的优势。
第四种优化:采用多级缓存以降低未命中代价
降低未命中次数曾是缓存研究的传统重点,但性能公式表明,降低未命中代价可能同样有效。此外,第 80 页图 2.2 表明,处理器速度的提升比 DRAM 快,未命中相对代价随时间增加。
这一性能差距让设计者面临问题:应该加快缓存,跟上处理器速度,还是增大缓存,以弥合处理器与主存间越来越大的差距?
一个答案是两者都做。在原有缓存和主存之间增加一级缓存,就简化了选择。L1 可以小到足以匹配高速处理器的时钟周期,L2 则可大到截获许多原本必须访问主存的请求,降低有效未命中代价。
增加一级的概念很直接,却使性能分析复杂化;二级缓存的某些定义也并不直观。用 L1、L2 分别表示一级和二级缓存,则:
又有:
所以:
这里,二级未命中率是在一级过滤后剩余的请求中测量的。为避免歧义,采用两个术语:
- 局部未命中率:某级缓存未命中次数,除以访问该缓存的总次数。L1 为 ,L2 为 。
- 全局未命中率:某级缓存未命中次数,除以处理器发出的全部访存次数。L1 仍为 ,L2 则为 。
L2 的局部未命中率较高,因为 L1 已经截获了最容易命中的访问。因此,全局未命中率更有用:它说明处理器发出的访存中,有多大比例最终到达主存。
此时,每条指令未命中次数的指标很有优势:无需纠结局部、全局,只要在每条指令的存储器停顿中加入 L2 影响。
例题:两级缓存的未命中率与停顿
1000 次访存中,L1 未命中 40 次,L2 未命中 20 次。各类未命中率是多少?假设 L2 到主存的未命中代价为 200 周期,L2 命中为 10 周期,L1 命中为 1 周期,每条指令访问存储器 1.5 次。平均存储器访问时间和每条指令平均停顿周期数是多少?忽略写操作影响。
解答。 L1 局部、全局未命中率均为 ;L2 局部为 ,全局为 。因此:
将 1000 次访存除以每条指令 1.5 次访存,得到约 667 条指令。因此,换算为每 1000 条指令未命中次数,需要乘以 1.5:L1 为 次,L2 为 次。假定未命中在取指和数据访问间均匀分布:
从 AMAT 中减去 L1 命中时间,再乘以每条指令平均访存次数,同样得到:
因此,多级缓存计算中,采用每条指令未命中次数,通常比采用未命中率更不容易混淆。
上述公式合并读写,并假定 L1 采用写回。若 L1 采用直写,它会将所有写操作送到 L2,而不只是未命中;也可能采用写缓冲区。
图 B.14、B.15 展示一种设计中,未命中率与相对执行时间如何随 L2 容量变化,可得两点认识。第一,只要 L2 远大于 L1,全局未命中率就与同等容量单级缓存的未命中率非常接近,因此对一级缓存的直觉与知识仍适用。第二,局部未命中率不适合评价二级缓存,因为它取决于 L1 未命中率,仅改变 L1 就能使它变化。所以应使用全局未命中率。
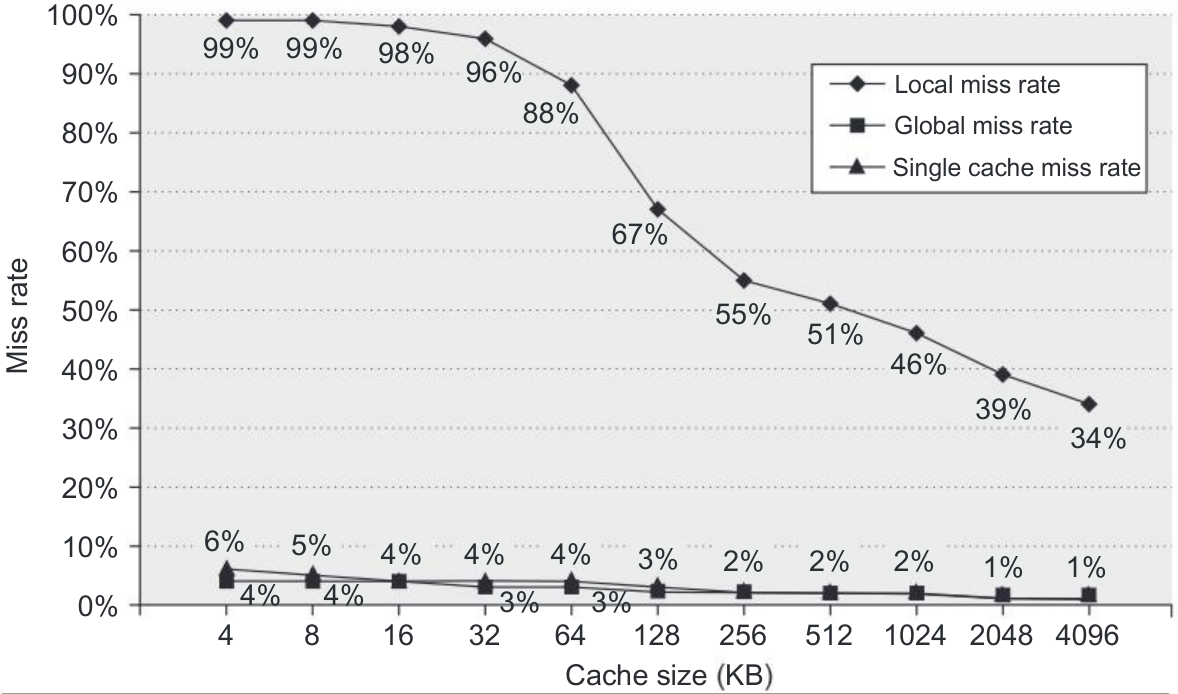
图内术语:Local miss rate=局部未命中率;Global miss rate=全局未命中率;Single cache miss rate=单级缓存未命中率;Miss rate=未命中率;Cache size=缓存容量(图中 KB)。2
明确这些定义后,再考察 L2 参数。两级最重要的差别是:L1 速度会影响处理器时钟频率,而 L2 速度只影响 L1 的未命中代价。因此,某些不适合 L1 的方案,可以用于 L2。二级缓存设计主要回答两件事:能否降低 CPI 中与平均访问时间有关的部分?成本是多少?
首先决定 L2 容量。L1 中的所有内容很可能也在 L2,所以 L2 应大得多;若仅略大,局部未命中率会很高。这一观察促使人们设计非常大的 L2,容量相当于早期计算机的主存!
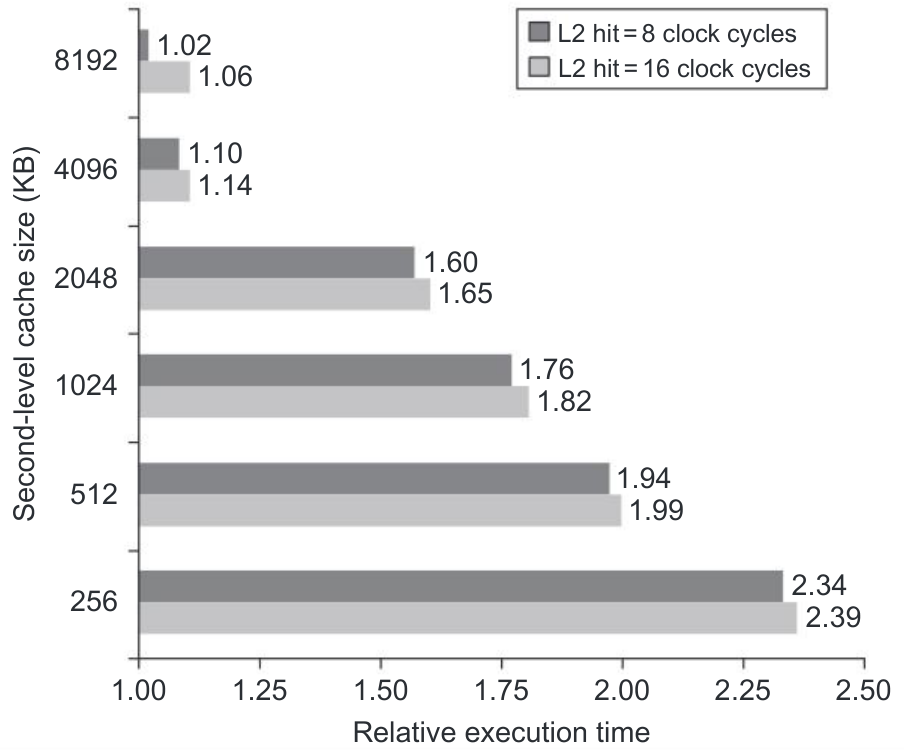
图内术语:Second-level cache size=L2 容量(KB);Relative execution time=相对执行时间;L2 hit=L2 命中,深色为 8 周期,浅色为 16 周期。
另一个问题是:组相联是否更适合 L2?
例题:L2 相联度对未命中代价的影响
已知:
- 直接映射 L2 命中时间为 10 周期。
- 二路组相联使命中时间增加 0.1 周期,变成 10.1 周期。
- 直接映射 L2 局部未命中率为 25%。
- 二路组相联 L2 局部未命中率为 20%。
- L2 未命中代价为 200 周期。
L2 相联度对未命中代价有何影响?
解答。 L2 直接映射时,L1 未命中代价为:
相联度只使命中增加 0.1 周期,因此新的 L1 未命中代价为:
实际 L2 几乎总与 L1 和处理器同步,因此命中时间必须是整数周期。若能略作优化,可缩短至 10 周期;否则向上取整至 11 周期。两种情况都优于直接映射:
因此,可以通过降低 L2 未命中率,来降低 L1 未命中代价。
还需考虑 L1 中的数据是否也在 L2。**多级包含(multilevel inclusion)**是存储层次的自然策略:L1 数据始终也在 L2。其优点是,仅检查 L2,就能判断 I/O 与缓存之间,或多处理器各缓存之间的一致性。
一个缺点是:测量可能表明,小 L1 适合小块,大 L2 适合大块。例如 Pentium 4 的 L1 块为 64 字节,L2 为 128 字节。仍可维持包含关系,但 L2 未命中时要额外工作:使 L1 中所有映射到被替换 L2 块的块失效,略微提高 L1 未命中率。为避免此问题,许多设计者让所有缓存层采用相同块大小。
但若成本只允许 L2 比 L1 略大,是否还应将很大一部分容量用于重复保存 L1?此时合理的反向策略是多级互斥(multilevel exclusion):L1 数据绝不同时存在于 L2。通常,L1 未命中时,在 L1、L2 之间交换块,而不是单纯用 L2 块替换 L1 块,从而避免浪费 L2 空间。例如 AMD Opteron 的两个 64 KiB L1 与 1 MiB L2,就遵循互斥属性。
这些问题说明,新手可能分别设计 L1 和 L2,但如果已有兼容的 L2,L1 设计会容易得多。例如,下一级若为采用多级包含关系的写回缓存,可吸收重复写入,那么 L1 采用直写的风险就小得多。
所有缓存设计的核心,都是在快速命中与减少未命中之间平衡。L2 命中次数远少于 L1,因此重点转向减少未命中;这推动更大容量,以及提高相联度、增大块等降低未命中率的技术。
第五种优化:读未命中优先于写,以降低未命中代价
这项优化在写完成之前,先服务读请求。先看写缓冲区带来的复杂性。
对于直写缓存,最重要的改进是设置适当大小的写缓冲区。但它可能保存读未命中所需位置的最新值,因此使访存复杂化。
例题:写缓冲区中的数据冒险
考虑以下代码:
假定缓存直接映射、直写,地址 512 与 1024 映射到同一缓存块;写缓冲区可容纳四个字,读未命中时不检查它。x2 的值是否总与 x3 相同?
解答。 按第 2 章术语,这是存储器中的写后读数据冒险。存储后,x3 的数据进入写缓冲区。随后加载使用相同缓存索引,因此未命中。第二次加载试图把地址 512 的值装入 x2,也未命中。如果缓冲区尚未完成向主存地址 512 的写入,就会从 512 读到旧的错误值,送入缓存,再送入 x2。没有适当措施,x3 就可能不等于 x2!3
最简单的解决办法,是让读未命中等到写缓冲区清空。另一种办法是检查缓冲区:如果没有冲突,且存储系统可用,就让读未命中继续。几乎所有桌面和服务器处理器都采用后一种,让读优先于写。
写回缓存也能减少处理器写操作的开销。假设读未命中将替换一个脏块,可以先把脏块复制到缓冲区,再读存储器,最后才写回,而不是先完成脏块写回再读。处理器很可能正在等待的读,就能更早结束。与前述情况类似,再发生读未命中时,要么等待缓冲区清空,要么检查缓冲区内各字地址是否冲突。
已有五种优化用来降低未命中率或未命中代价,现在考虑平均访问时间的最后一项:命中时间。它至关重要,因为可能影响处理器频率。许多处理器即使需要多个周期访问缓存,缓存访问时间仍限制其时钟频率。因此,快速命中的意义超出了平均访问时间公式:它能加快一切。
第六种优化:索引缓存时避免地址转换,以缩短命中时间
即使缓存很小、很简单,也必须处理从处理器虚拟地址到访存物理地址的转换。B.4 节将说明,处理器将主存视为存储层次的另一层,因此磁盘上的虚拟存储器地址必须映射到主存。
“加速常见情况”原则建议使用虚拟地址访问缓存,因为命中远比未命中常见。这称为虚拟缓存,与传统采用物理地址的物理缓存相对。但必须区分索引缓存和比较地址两个任务:索引用虚拟还是物理地址?标签比较又用哪一种?索引、标签都使用虚拟地址,可以把地址转换从命中路径中去掉。为什么不是所有缓存都这样设计?
第一是保护。页级保护通常在虚拟地址转换为物理地址时检查,而且无论如何都不能省略。一个办法是在未命中时从 TLB 复制保护信息,增加字段保存,并在每次虚拟缓存访问时检查。
第二,每次切换进程,同一虚拟地址就可能指向不同物理地址,需要清空缓存。图 B.16 展示它对未命中率的影响。一个办法是在缓存标签中加入进程标识符(PID)。由操作系统分配,只在 PID 被回收重用时才需清空;PID 可以区分缓存数据是否属于当前程序。图中也显示用 PID 避免清空所带来的改善。
第三,操作系统和用户程序可能使用两个不同虚拟地址访问同一个物理地址。这些地址称为同义地址或别名(synonyms/aliases),可能让虚拟缓存保存同一数据的两份副本;修改一份后,另一份就错误。物理缓存不会出现这一情况,因为访问首先转换到同一个物理缓存块。
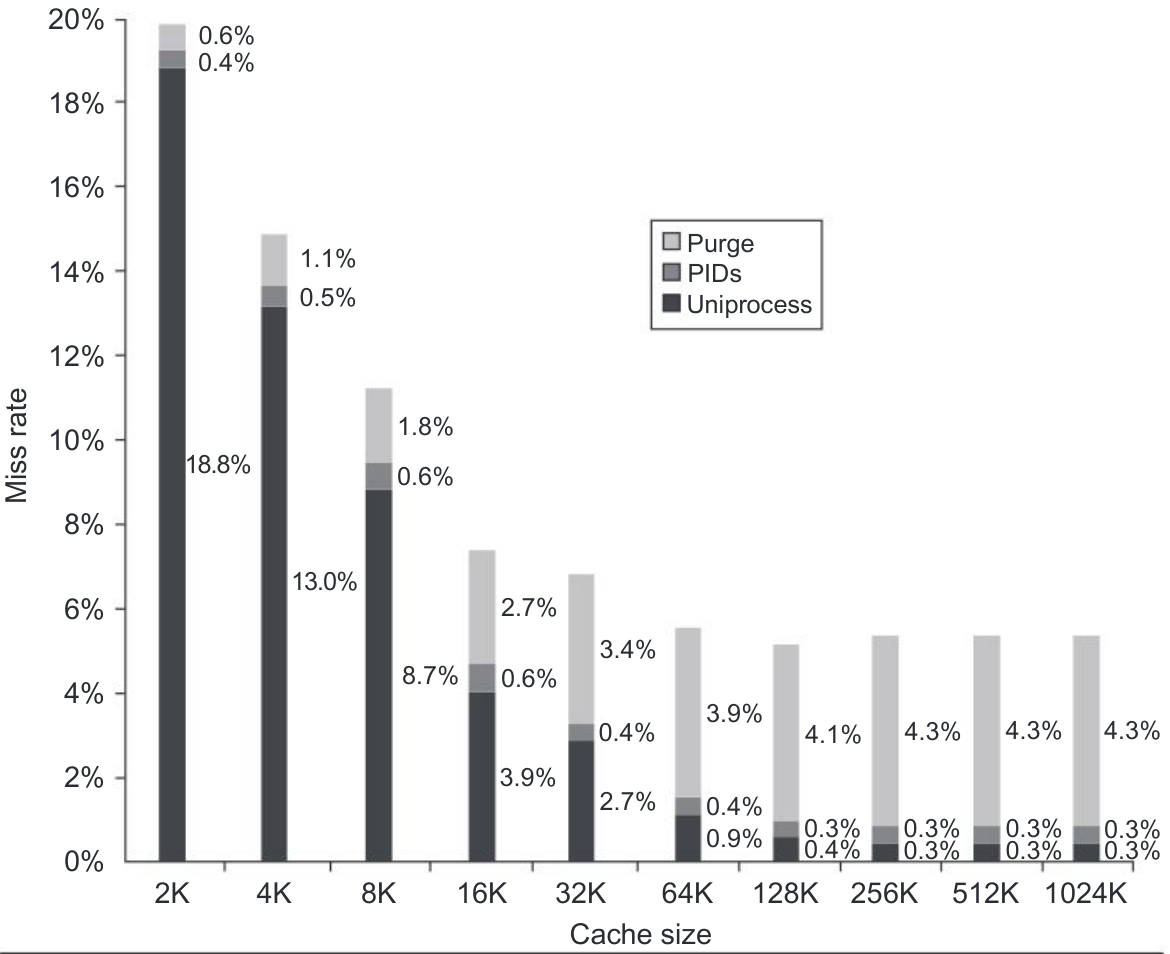
图内术语:Miss rate=未命中率;Cache size=缓存容量;Uniprocess=无进程切换的基础部分;PIDs=使用 PID 后增加的部分;Purge=清空缓存再增加的部分。柱形为堆叠,不是三种方案各自独立的未命中率。
解决同义地址的硬件方案称为 antialiasing(消除别名),保证每个物理地址在缓存中只有唯一副本。例如,AMD Opteron 指令缓存为 64 KiB、二路组相联,页为 4 KiB;组索引中有三个虚拟地址位,因此硬件必须处理对应的别名。未命中时,它检查全部八个可能位置,原文写作“四组、每组两块”,确认没有块匹配即将取入数据的物理地址。如果找到,就使其失效,保证新数据装入后物理地址唯一。4
软件可以强制别名共享某些地址位,大大简化问题。例如 Sun Microsystems 的一个较早 UNIX 版本,要求所有别名的低 18 位相同,这种限制称为页着色(page coloring)。它实际上是把组相联映射用于虚拟存储器:4 KiB()页面映射到 64()组,使虚拟地址和物理地址低 18 位一致。于是,容量不超过 字节,即 256 KiB 的直接映射缓存,不会出现同一物理块的重复副本。从缓存角度看,软件保证虚拟页地址与物理页地址低几位相同,相当于扩大了页内偏移。
最后一个问题是 I/O。I/O 通常使用物理地址,要与虚拟缓存交互,就需反向映射为虚拟地址。附录 D 将进一步讨论 I/O 对缓存的影响。
一种兼取虚拟、物理缓存优点的方案,是用页内偏移的一部分——虚拟与物理地址中相同的部分——索引缓存。按索引读缓存的同时,转换地址的虚拟部分,并用物理地址比较标签。
这样,读取可立即开始,标签比较仍用物理地址。**虚拟索引、物理标签(VIPT)**的限制,是直接映射缓存不能大于页大小。例如,B-13 页图 B.5 的数据缓存有 9 位索引、6 位块内偏移;要完全采用这个技巧,页至少需 字节,即 32 KiB。否则,一部分索引必须从虚拟地址转换。图 B.17 展示采用这一技术的缓存、TLB 和虚拟存储器组织。
提高相联度,可以在保持索引位属于地址中无需转换部分的同时,支持更大缓存。回顾索引公式:
例如,相联度与容量同时加倍,索引宽度不变。IBM 3033 是极端例子:尽管研究表明超过八路后,未命中率收益很小,它仍采用十六路组相联。这样,即使 IBM 体系结构的页面只有 4 KiB,64 KiB 缓存仍能使用无需转换的物理索引。
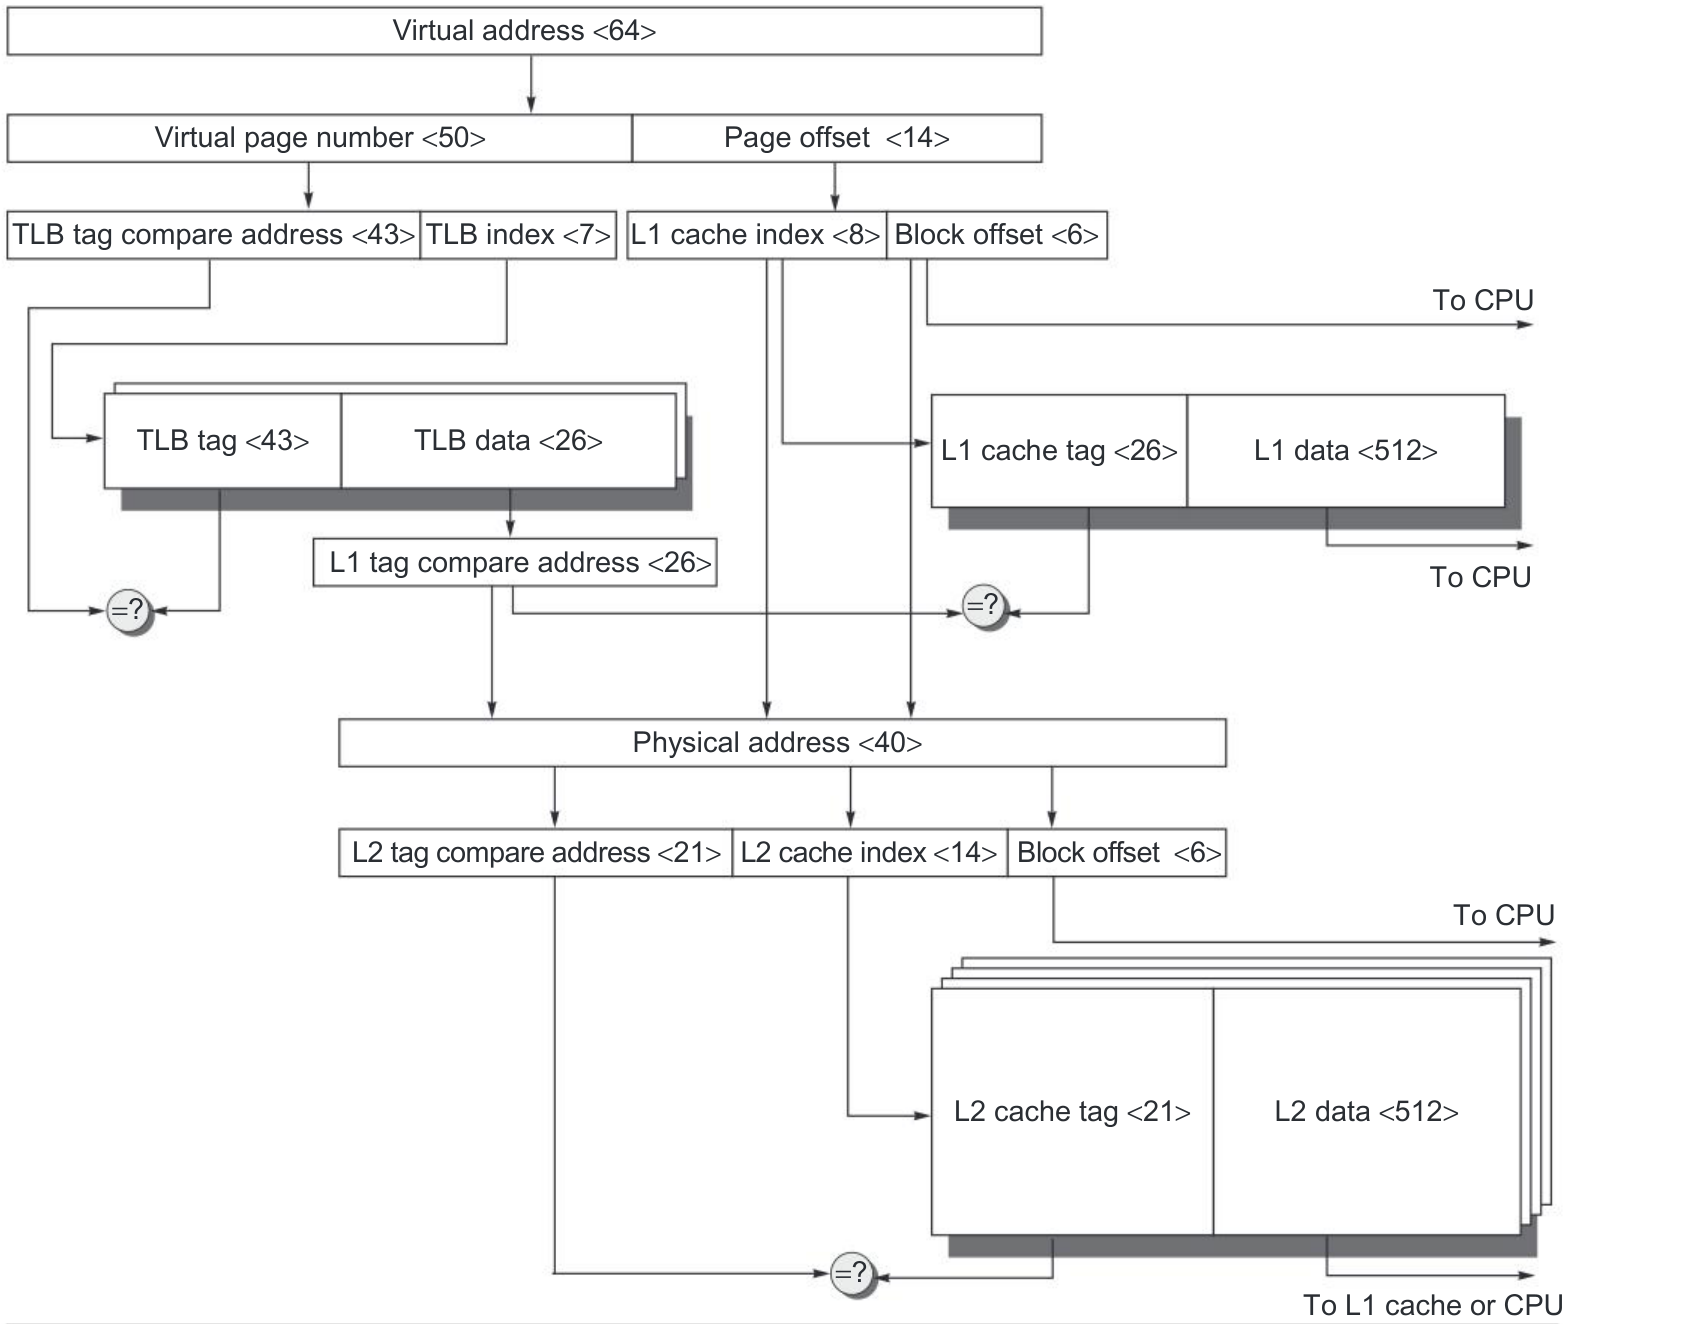
图内全部字段如下,尖括号内为原图位宽:
| 原字段 | 中文及位宽 |
|---|---|
| Virtual address | 虚拟地址,64 位 |
| Virtual page number | 虚拟页号,50 位 |
| Page offset | 页内偏移,14 位 |
| TLB tag compare address | 与 TLB 标签比较的地址,43 位 |
| TLB index | TLB 索引,7 位 |
| TLB tag / TLB data | TLB 标签 43 位/数据 26 位 |
| L1 cache index / Block offset | L1 索引 8 位/块内偏移 6 位 |
| L1 tag compare address / L1 cache tag | L1 标签比较地址/缓存标签,均 26 位 |
| L1 data | L1 数据,512 位 |
| Physical address | 物理地址,40 位 |
| L2 tag compare address / L2 cache tag | L2 标签比较地址/缓存标签,均 21 位 |
| L2 cache index / Block offset | L2 索引 14 位/块内偏移 6 位 |
| L2 data | L2 数据,512 位 |
| To CPU | 送往 CPU |
| To L1 cache or CPU | 送往 L1 或 CPU |
| =? | 相等比较 |
基本缓存优化小结
本节改善未命中率、未命中代价和命中时间的技术,通常也影响平均访问时间公式的其他项,以及存储层次的复杂度。图 B.18 汇总这些技术,并估计复杂度。“+”表示改善,“−”表示损害,空白表示无影响。没有一种优化能同时改善超过一类指标。
| 技术 | 命中时间 | 未命中代价 | 未命中率 | 硬件复杂度 | 说明 |
|---|---|---|---|---|---|
| 增大块 | − | + | 0 | 很简单;Pentium 4 的 L2 使用 128 字节块。 | |
| 增大缓存容量 | − | + | 1 | 广泛使用,尤其是 L2。 | |
| 提高相联度 | − | + | 1 | 广泛使用。 | |
| 多级缓存 | + | 2 | 硬件昂贵;L1、L2 块大小不同时更复杂;广泛使用。 | ||
| 读优先于写 | + | 1 | 广泛使用。 | ||
| 索引缓存时避免地址转换 | + | 1 | 广泛使用。 |
译注:图 B.10、B.11、B.12 的原图注均称“五种不同容量”,实际图表列出 4、16、64、256 KiB 四种容量及五种块大小。图 B.18 的页码在本节开头原文写作 B-40,实际图表位于 B-41。 ↩︎
译注:图 B.14 原图注在同一段同时出现“32 KiB 一级缓存”与“两个各 64 KiB 一级缓存”。 ↩︎
译注:原代码注释首行使用 R3,解答最后一句印作“x3x1 would not be equal to x2”。依照题干所比较的寄存器及前述操作,译文解释为 x3 与 x2,并在此保留原稿异常文字。 ↩︎
译注:原文给出三个虚拟索引位,却称检查“四组、每组两块,共八个位置”;这些数量之间存在疑点。 ↩︎
译注:图 B.17 的 L2 标签 21 位、索引 14 位、块内偏移 6 位合计为 41 位,与图示 40 位物理地址不符;字段按原图保留,未静默改数。 ↩︎