B.4 虚拟存储器
……我们设计了一种系统,使磁芯存储器与磁鼓的组合在程序员看来如同单级存储器,所需的数据传送则自动完成。
——Kilburn 等(1962)
计算机在任一时刻都运行着多个进程,每个进程都有自己的地址空间。(下一节将介绍进程。)为每个进程都配置足以覆盖其整个地址空间的存储器,代价过高,何况许多进程只会使用其中很小的一部分。因此,必须让多个进程能够共享容量较小的物理存储器。
实现这一目标的一种方式是虚拟存储器(virtual memory):把物理存储器分成若干块,再分配给不同进程。这种方法必须内含保护机制,把进程的访问限制在属于它自己的块内。多数虚拟存储器形式还可以缩短程序启动时间,因为程序开始执行前,无须把全部代码和数据都放入物理存储器。
虚拟存储器提供的保护对于今天的计算机至关重要,但共享并不是当初发明虚拟存储器的原因。早先,当程序大到物理存储器容纳不下时,程序员必须设法让它能够运行。他们把程序分成若干部分,找出不会同时使用的部分,再在执行过程中由用户程序控制这些覆盖段(overlay)的装入和卸载。程序员既要保证程序访问的物理主存不超过计算机实际拥有的容量,还要保证正确的覆盖段在正确的时刻被装入。
不难想见,这种负担降低了程序员的生产效率。
虚拟存储器正是为了把程序员从这一负担中解放出来而发明的:它自动管理主存与辅助存储器构成的两级存储层次结构。图 B.19 展示了一个含四个页面的程序从虚拟存储器到物理存储器的映射。
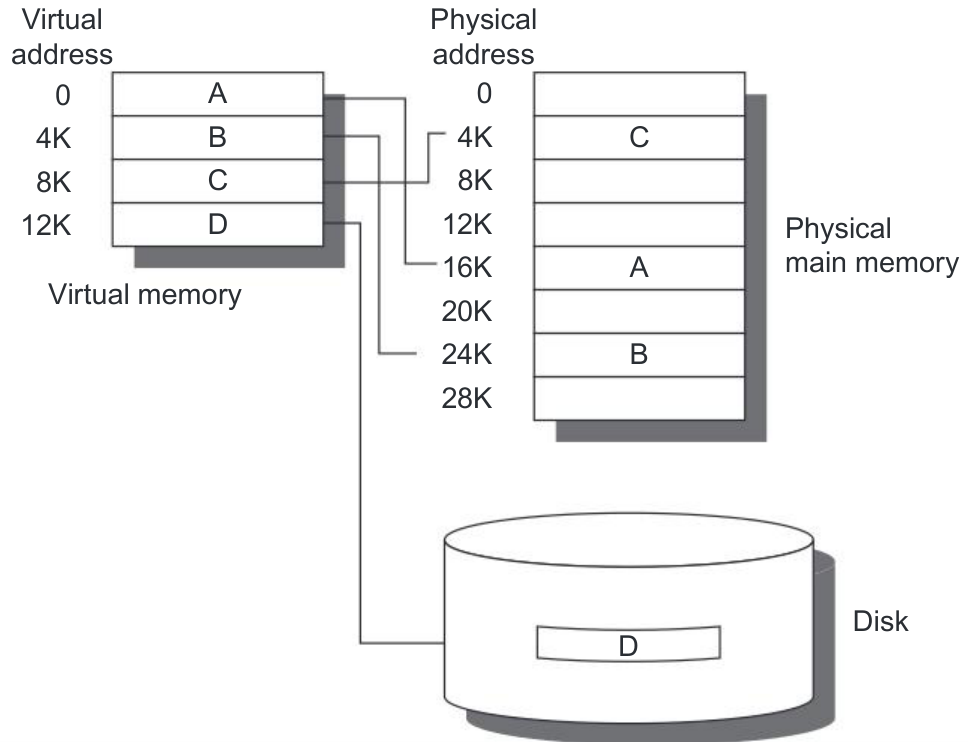
图中文字:Virtual address=虚拟地址;Virtual memory=虚拟存储器;Physical address=物理地址;Physical main memory=物理主存;Disk=磁盘。虚拟页面 A、B、C 的起始地址分别为 0、4K、8K,映射到物理地址 16K、24K、4K;起始地址为 12K 的 D 页位于磁盘。
除了共享受保护的存储空间、自动管理存储层次结构之外,虚拟存储器还简化了程序的装入运行。这个机制称为重定位(relocation),它使同一个程序可以在物理存储器的任意位置运行。只需改变映射关系,图 B.19 的程序就可以放在物理存储器或磁盘上的任意位置。(在虚拟存储器普及之前,处理器会专门为此设置重定位寄存器。)除硬件方案外,也可以用软件在每次运行程序时修改程序中的全部地址。
第 1 章介绍的若干有关缓存的一般存储层次结构概念,同样适用于虚拟存储器,只是许多术语不同:块称为页(page)或段(segment),未命中称为缺页(page fault)或地址故障(address fault)。使用虚拟存储器时,处理器产生虚拟地址(virtual address),再由软硬件协同把它转换成访问主存所用的物理地址(physical address)。这一过程称为存储器映射(memory mapping)或地址转换(address translation)。目前,虚拟存储器管理的两级存储器是 DRAM 和磁盘。图 B.20 给出了虚拟存储器相关参数的典型范围。
| 参数 | 一级缓存 | 虚拟存储器 |
|---|---|---|
| 块(页)大小 | 16–128 字节 | 4096–65,536 字节 |
| 命中时间 | 1–3 个时钟周期 | 100–200 个时钟周期 |
| 未命中代价 | 8–200 个时钟周期 | 1,000,000–10,000,000 个时钟周期 |
| 其中:访问时间 | 6–160 个时钟周期 | 800,000–8,000,000 个时钟周期 |
| 其中:传送时间 | 2–40 个时钟周期 | 200,000–2,000,000 个时钟周期 |
| 未命中率 | 0.1%–10% | 0.00001%–0.001% |
| 地址映射 | 25–45 位物理地址映射到 14–20 位缓存地址 | 32–64 位虚拟地址映射到 25–45 位物理地址 |
除了图 B.20 的数量差异,缓存与虚拟存储器还存在以下区别:
- 缓存未命中时的替换主要由硬件控制,而虚拟存储器的替换主要由操作系统控制。未命中代价越高,作出正确选择就越重要,因此可以让操作系统介入,花一些时间决定替换什么。
- 处理器的地址位数决定虚拟存储器的大小;缓存的容量则与处理器的地址位数无关。
- 辅助存储器除了充当主存的下一级后备存储器,还用于存放文件系统。事实上,文件系统占用了辅助存储器的大部分空间,而这部分通常不在地址空间中。
虚拟存储器还涵盖若干相关技术。它可以分成两类:一类使用固定大小的块,称为页;另一类使用可变大小的块,称为段。页大小通常固定为 4096–8192 字节,而段大小可以变化。不同处理器支持的最大段大小从 字节到 字节不等;最小的段为 1 字节。图 B.21 展示了两种方式如何划分代码与数据。
选择分页还是分段虚拟存储器,也会影响处理器。分页地址是单个固定大小的地址,分为页号和页内偏移,与缓存地址类似。分段地址则不能只用一个这样的地址表示:段长可变,需要用一个字表示段号,另一个字表示段内偏移,共两个字。不分段的地址空间对编译器更简单。
操作系统教材已充分讨论过这两种方法的优缺点,图 B.22 汇总了主要观点。
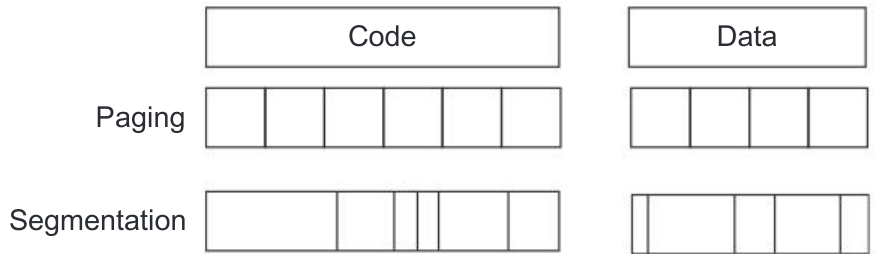
图中文字:Code=代码;Data=数据;Paging=分页;Segmentation=分段。分页把代码和数据划为等长的块;分段则按可变长度划分。
| 比较项目 | 分页 | 分段 |
|---|---|---|
| 每个地址占用的字数 | 一个 | 两个(段号与偏移) |
| 对程序员是否可见 | 对应用程序员不可见 | 可能对应用程序员可见 |
| 替换一个块 | 简单,所有块大小相同 | 困难,必须找到连续、大小适合且未使用的主存区域 |
| 存储空间利用不充分的原因 | 内部碎片,即页内未使用部分 | 外部碎片,即主存中未使用的小片空间 |
| 磁盘传输是否高效 | 是,可调整页大小以平衡访问时间和传送时间 | 不一定;小段可能只传送几个字节 |
由于替换问题(图中第三行),今天很少有计算机采用纯分段。某些计算机采用称为段页式(paged segments)的混合方法,一个段由整数个页组成。这样简化了替换,因为一个段占用的存储空间不必连续,而且整个段也不必全部驻留主存。较新的一种混合方式是提供多种页大小,较大的页是最小页大小的 的幂倍。例如,IBM 405CR 嵌入式处理器允许单个页面为 1 KiB、4 KiB()、16 KiB()、64 KiB()、256 KiB()、1024 KiB()和 4096 KiB()。
再看存储层次结构的四个问题
现在,我们可以针对虚拟存储器回答存储层次结构的四个问题了。
问题 1:块可以放在主存的什么位置?
虚拟存储器未命中需要访问旋转磁介质设备,因此未命中代价相当高。在较低未命中率和较简单的放置算法之间,操作系统设计者通常选择前者,因为未命中代价实在太高。因此,操作系统允许把块放在主存的任意位置。按照 B-8 页图 B.2 的术语,这就是全相联。
问题 2:若块已在主存中,如何找到它?
分页与分段都依赖一个以页号或段号索引的数据结构,其中存放块的物理地址。分段时,把偏移与段的物理地址相加,就得到最终物理地址;分页时,则只需把偏移拼接到物理页地址之后(见图 B.23)。
这种包含物理页地址的数据结构通常称为页表(page table)。它以虚拟页号为索引,表项数量等于虚拟地址空间中的页数。假设虚拟地址为 32 位,页面为 4 KiB,每个页表项(page table entry,PTE)占 4 字节,则页表大小为:
为了减小这个数据结构,某些计算机会对虚拟地址应用散列函数,使表的长度只需等于主存中的物理页数,这可能远小于虚拟页数。这种结构称为反向页表(inverted page table)。沿用上述示例,若物理存储器为 512 MiB,反向页表只需 1 MiB();每个表项增加的 4 字节用于保存虚拟地址。HP/Intel IA-64 同时提供传统页表与反向页表,把采用何种机制的选择留给操作系统程序员。
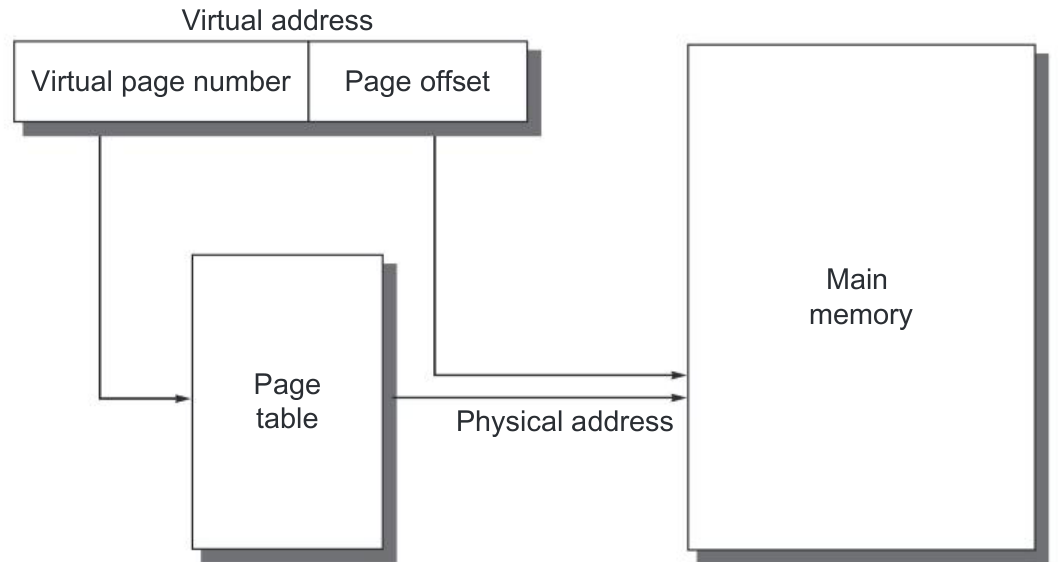
图中文字:Virtual address=虚拟地址;Virtual page number=虚拟页号;Page offset=页内偏移;Page table=页表;Physical address=物理地址;Main memory=主存。
为减少地址转换时间,计算机会设置一个专门缓存地址转换结果的缓存,称为地址转换后备缓冲器(translation lookaside buffer,TLB),也简称 translation buffer;稍后将详细介绍。
问题 3:虚拟存储器未命中时应该替换哪个块?
如前所述,操作系统最重要的原则是尽量减少缺页。遵循这一原则,几乎所有操作系统都尝试替换最近最少使用(LRU)的块:如果过去可以预示未来,那么它最不可能很快再次被使用。
为了帮助操作系统近似实现 LRU,许多处理器提供使用位(use bit)或引用位(reference bit),逻辑上每次访问页面都会将它置位。(为减少工作量,实际上只在后面介绍的地址转换缓冲器未命中时才置位。)操作系统定期清除使用位,并在稍后记录这些位,从而确定某段时间内访问过哪些页面。通过这种跟踪方式,操作系统可以选出最近最少被引用的页面之一。
问题 4:写入时会发生什么?
主存的下一级是旋转磁盘,访问一次要耗费数百万个时钟周期。由于访问时间相差悬殊,还没有人构造过这样一种虚拟存储器操作系统:处理器每执行一次 store,就从主存直写到磁盘。(请不要把这句话理解为一个可以凭“率先实现”而出名的机会!)因此,写策略始终是写回。
由于不必要地访问下一级的代价极高,虚拟存储器系统通常设有脏位(dirty bit)。只有块在从磁盘读入后被修改过,才需要写回磁盘。
快速地址转换技术
页表通常大到必须放在主存中,有时页表自身还会被分页。分页意味着:从逻辑上说,每次访存至少要花两倍时间,一次访问取得物理地址,第二次访问取得数据。如第 2 章所述,可以利用局部性避免额外的访存。把地址转换结果保存在一个专门的缓存中,访存时就很少需要额外访问一次主存来转换地址。这个专用的地址转换缓存称为 TLB,也称 TB(translation buffer)。
TLB 表项与缓存表项相似:标签包含虚拟地址的一部分,数据部分包含物理页框号、保护字段、有效位,通常还有使用位和脏位。操作系统要修改页表项中的物理页框号或保护属性时,必须确保旧表项不在 TLB 中,否则系统就无法正确工作。
这里的脏位表示对应的页面已脏,并不是说 TLB 中的地址转换结果已脏,也不是说数据缓存中某个特定块已脏。操作系统通过修改页表中的值来复位这些位,然后使对应的 TLB 表项无效。之后从页表重新装入该表项时,TLB 就会得到这些位的准确副本。
图 B.24 展示了 Opteron 数据 TLB 的组织,并标出了地址转换的每一步。该 TLB 采用全相联放置,因此转换首先把虚拟地址送到全部标签(步骤 1、2)。当然,只有标签的有效位置位,才能构成匹配。同时,硬件根据 TLB 中的保护信息检查此次访存类型是否违规(也在步骤 2)。
与缓存中的道理相同,12 位页内偏移不必包含在 TLB 中。匹配的标签把相应的物理地址送过一个等效的 40 选 1 多路选择器(步骤 3)。然后,将页内偏移与物理页框拼接,形成完整的物理地址(步骤 4);其宽度为 40 位。
地址转换很容易处在决定处理器时钟周期的关键路径上,因此 Opteron 的 L1 缓存采用虚拟地址索引、物理地址标签。
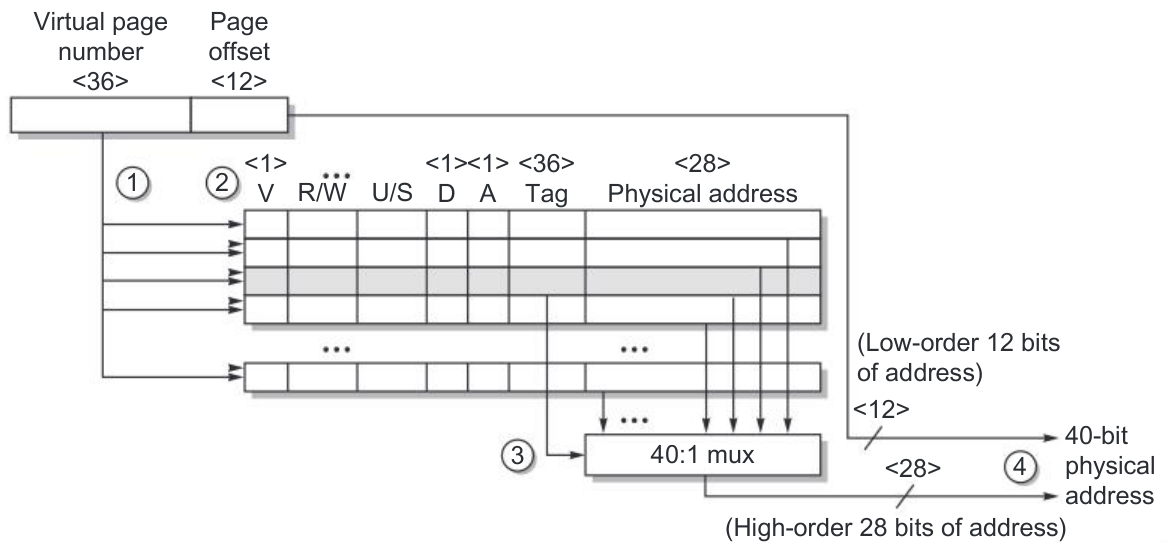
图中文字:Virtual page number=虚拟页号(36 位);Page offset=页内偏移(12 位);V=有效位;R/W=读/写;U/S=用户/系统;D=脏位;A=已访问位;Tag=标签(36 位);Physical address=物理地址字段(28 位);40:1 mux=40 选 1 多路选择器;Low-order 12 bits of address=地址低 12 位;High-order 28 bits of address=地址高 28 位;40-bit physical address=40 位物理地址。尖括号中的数字表示字段位数。
选择页大小
最明显的体系结构参数是页大小。选择页大小,需要权衡支持大页与支持小页的各种因素。以下因素支持使用大页:
- 页表大小与页大小成反比,因此增大页面可以节省用于地址映射的存储器或其他资源。
- 如 B.3 节所述,较大的页可以使容量较大的缓存仍具有较短的命中时间。
- 在辅助存储器与主存之间传送较大的页,比传送较小的页更高效;这一传送也可能经过网络。
- TLB 表项数量有限,因此页越大,能够高效映射的存储空间越多,TLB 未命中也就越少。
最后一个原因促使近年的微处理器支持多种页大小。对某些程序来说,TLB 未命中对 CPI 的影响可以和缓存未命中同样显著。
采用较小页面的主要动机是节省存储空间。当连续的虚拟存储区域大小不是页大小的整数倍时,小页可以减少浪费。页内未使用的空间称为内部碎片(internal fragmentation)。若假设每个进程有三个主要的段——代码、堆和栈——则每个进程平均浪费的空间是页大小的 1.5 倍。对于拥有数百兆字节内存、页面为 4–8 KiB 的计算机来说,这点浪费可以忽略。不过,当页面非常大时(超过 32 KiB),主存、辅助存储器以及 I/O 带宽都可能被浪费。最后还要考虑进程启动时间:许多进程很小,大页会延长启动进程所需的时间。
虚拟存储器与缓存小结
虚拟存储器、TLB、一级缓存、二级缓存都在映射虚拟和物理地址空间的一部分,很容易弄混地址的哪些位应该送到哪里。图 B.25 用一个假想示例展示了从 64 位虚拟地址到 41 位物理地址、再到两级缓存的整个过程。L1 缓存的容量和页大小同为 8 KiB,因此它采用虚拟索引、物理标签。L2 缓存为 4 MiB;两级缓存的块大小均为 64 字节。
首先,在逻辑上把 64 位虚拟地址分成虚拟页号和页内偏移。前者送往 TLB 以转换为物理地址,后者的高位送往 L1 缓存作为索引。若 TLB 命中,就把物理页号送到 L1 缓存标签处进行匹配检查。若匹配,则 L1 缓存命中,再由块内偏移选出要送给处理器的字。
若 L1 缓存未命中,则使用物理地址尝试访问 L2 缓存。物理地址的中间部分用作 4 MiB L2 缓存的索引,把读出的 L2 缓存标签与物理地址的高位部分比较。若匹配,则 L2 缓存命中——
——数据送到处理器,再由块内偏移选出所需的字。若 L2 未命中,就用物理地址从主存取得该块。
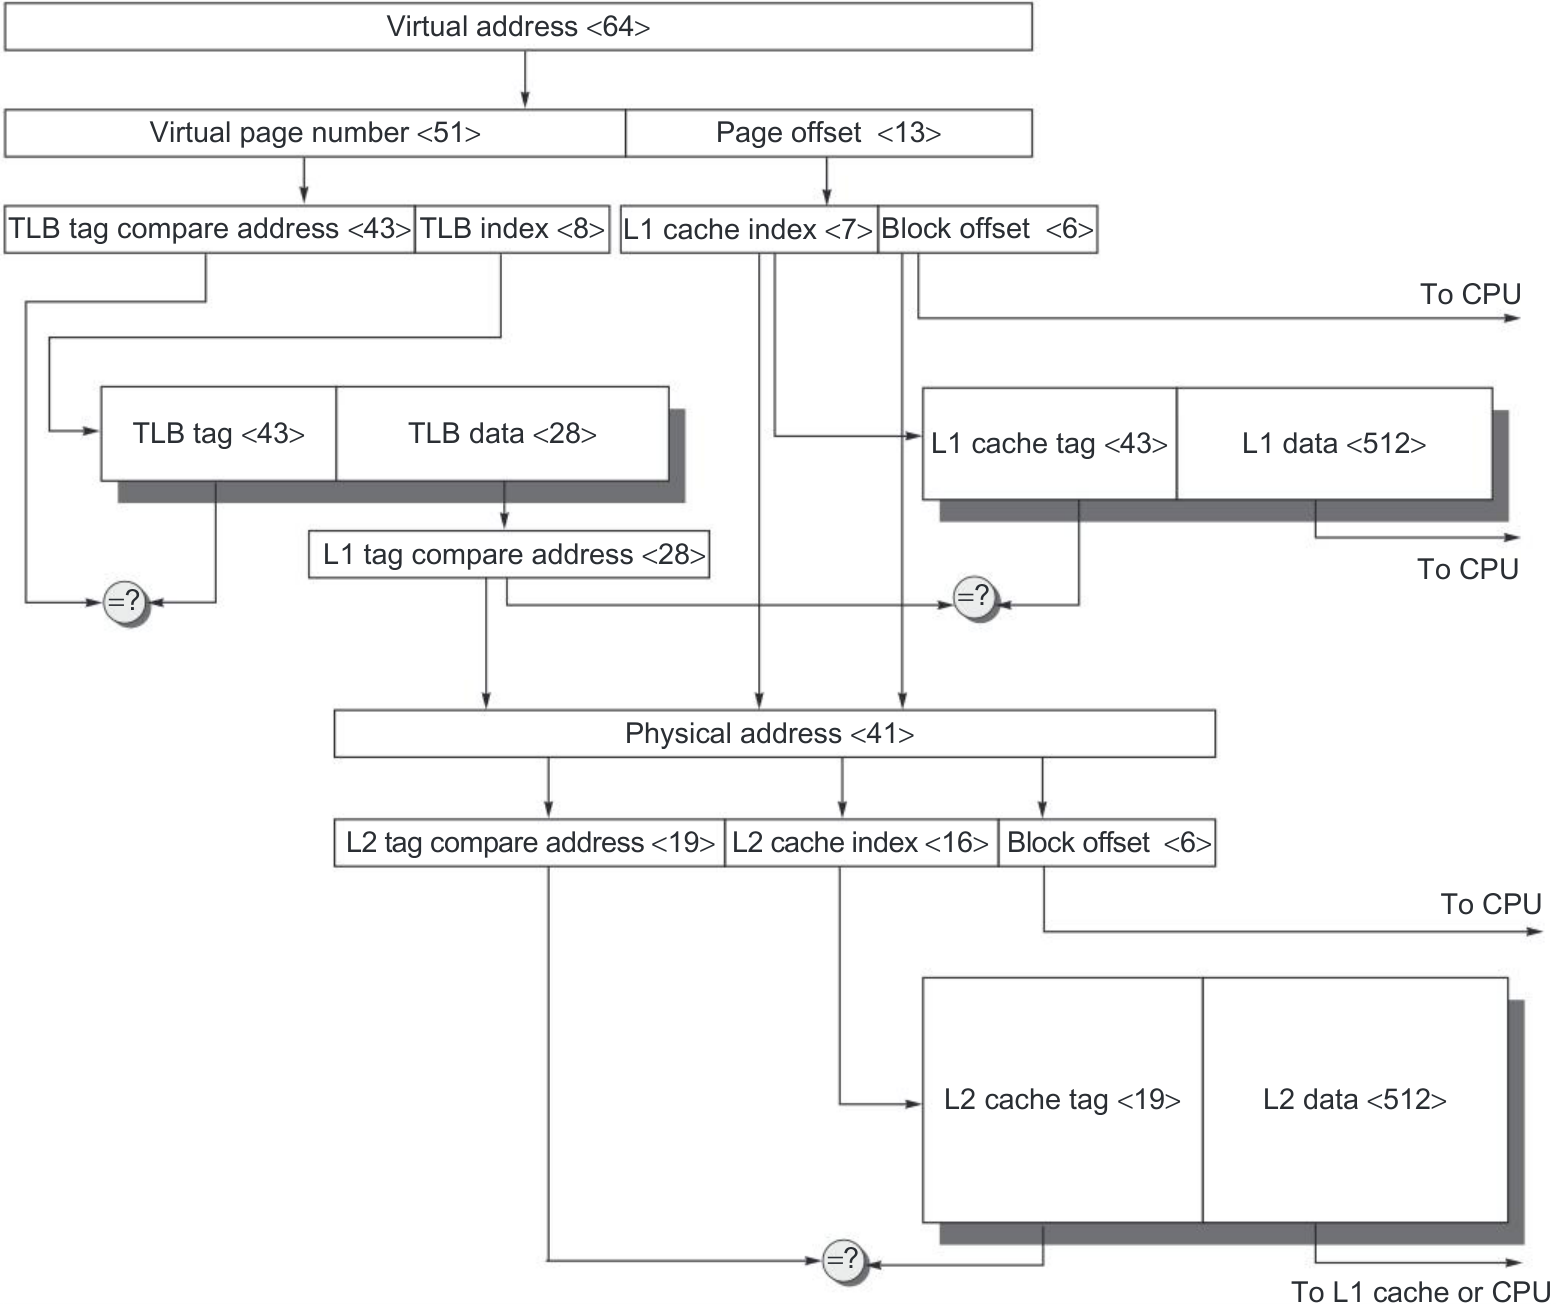
图中文字:Virtual address=虚拟地址(64 位);Virtual page number=虚拟页号(51 位);Page offset=页内偏移(13 位);TLB tag compare address=TLB 标签比较地址(43 位);TLB index=TLB 索引(8 位);L1 cache index=L1 缓存索引(7 位);Block offset=块内偏移(6 位);TLB tag=TLB 标签(43 位);TLB data=TLB 数据(28 位);L1 tag compare address=L1 标签比较地址(28 位);L1 cache tag=L1 缓存标签(原图标为 43 位);L1 data=L1 数据(512 位);Physical address=物理地址(41 位);L2 tag compare address=L2 标签比较地址(19 位);L2 cache index=L2 缓存索引(16 位);L2 cache tag=L2 缓存标签(19 位);L2 data=L2 数据(512 位);To CPU=送往 CPU;To L1 cache or CPU=送往 L1 缓存或 CPU;“=?”表示相等比较。1
这个例子虽然简单,但与实际缓存的主要差异在于复制。首先,图中只有一个 L1 缓存;若有两个 L1 缓存,图的上半部分就要复制一份。这样通常也会有两个 TLB:一组缓存与 TLB 服务指令,由 PC 驱动;另一组服务数据,由有效地址驱动。
第二处简化是所有缓存和 TLB 都采用直接映射。若某一个采用 路组相联,就需要把标签存储器、比较器和数据存储器各复制 份,并以 多路选择器连接各数据存储器,选择命中的数据。当然,如果缓存总容量不变,那么根据 B-22 页图 B.7 中的公式,缓存索引也要减少 位。
译注:原图把 L1 缓存标签标为 43 位,但同图中的 L1 标签比较地址为 28 位;按 41 位物理地址减去 13 位页内偏移也应为 28 位。图中原始标注予以保留,并在此说明不一致。 ↩︎