C.2 流水线的主要障碍:流水线冒险
有些情形会阻止指令流中的下一条指令在指定周期执行,这些情形称为冒险(hazard)。冒险会使流水线达不到理想加速比。冒险分为三类:
- 结构冒险: 硬件无法同时支持重叠执行中所有可能的指令组合,从而产生资源冲突。在现代处理器中,结构冒险主要发生在使用频率较低的专用功能单元上,例如浮点除法及其他执行时间较长的复杂指令。只要程序员和编译器开发者了解这些指令的吞吐量较低,它们就不是影响性能的主要因素。我们不再深入讨论这种不常见的情形,而把重点放在另外两类更常见的冒险上。
- 数据冒险: 一条指令依赖前一条指令的结果,而流水线中的重叠执行使这种依赖暴露出来。
- 控制冒险: 对分支及其他改变 PC 的指令进行流水线处理所产生的冒险。
冒险可能迫使流水线停顿。避免冒险常常需要让部分指令继续推进,同时延迟其他指令。在本附录讨论的流水线中,一条指令停顿时,比它更晚发射、因而在流水线中行进得更少的所有指令也必须停顿;更早发射、因而行进得更远的指令则必须继续,否则冒险永远无法消除。因此,停顿期间不再取新指令。本节将用几个例子说明停顿如何工作;它并没有听起来那么复杂。
有停顿时的流水线性能
停顿会使流水线性能低于理想值。由上一节的公式出发,可以计算实际加速比:
这里 为时钟周期。可以把流水线理解为降低 CPI,也可以理解为缩短时钟周期。通常使用 CPI 比较流水线,因此先采用前一种观点。流水线处理器的理想 CPI 几乎总是 1,所以:
忽略流水线引入的周期开销,并假定各级完全均衡,两种处理器的周期便可以相同,于是:
一种重要而简单的情形,是所有指令所需周期数都相同,并且等于流水级数,即流水线深度。此时,非流水线 CPI 等于流水线深度,因此:
若没有停顿,就得到直观结论:流水线能使性能提高到原来的流水线深度倍。
数据冒险
流水线的一个主要作用,是通过重叠执行改变指令之间的相对时序。这种重叠引入数据冒险和控制冒险。当流水线改变操作数的读写顺序,使其不同于非流水线处理器按顺序执行指令时的顺序,就会发生数据冒险。假定程序顺序中指令 先于指令 ,两者都使用寄存器 ,则可能出现三类冒险:
- 写后读(RAW): 最常见的一类。指令 读取 早于指令 写入 。若不阻止它, 就会使用错误的 值。
- 读后写(WAR): 指令 读取 晚于指令 写入 ,于是 使用了错误的值。简单五级整数流水线不可能发生 WAR,但重排指令时会出现;从原书 C-65 页开始讨论动态调度流水线时将看到这种情况。
- 写后写(WAW): 指令 写入 晚于指令 写入 ,导致后续使用的 值错误。简单五级整数流水线也不会发生这种冒险,但指令重排或执行时间不同时会发生,后文将讨论。1
第 3 章将更详细地讨论数据依赖与冒险。现在只关注 RAW。考虑以下指令的流水线执行:
add 后面的所有指令都使用它的结果。如图 C.4 所示,add 在 WB 阶段写入 x1,但 sub 在 ID 阶段就读取它,因而发生 RAW 冒险。若不采取预防措施,sub 会读到并使用错误的值。事实上,这个值甚至是不确定的:虽然看起来可以认为它总是 add 之前某条指令写入 x1 的旧值,但事实并不总是如此。如果 add 与 sub 之间发生中断,add 的 WB 会完成,此时 x1 已经是 add 的结果。显然,这种不可预测的行为不能接受。
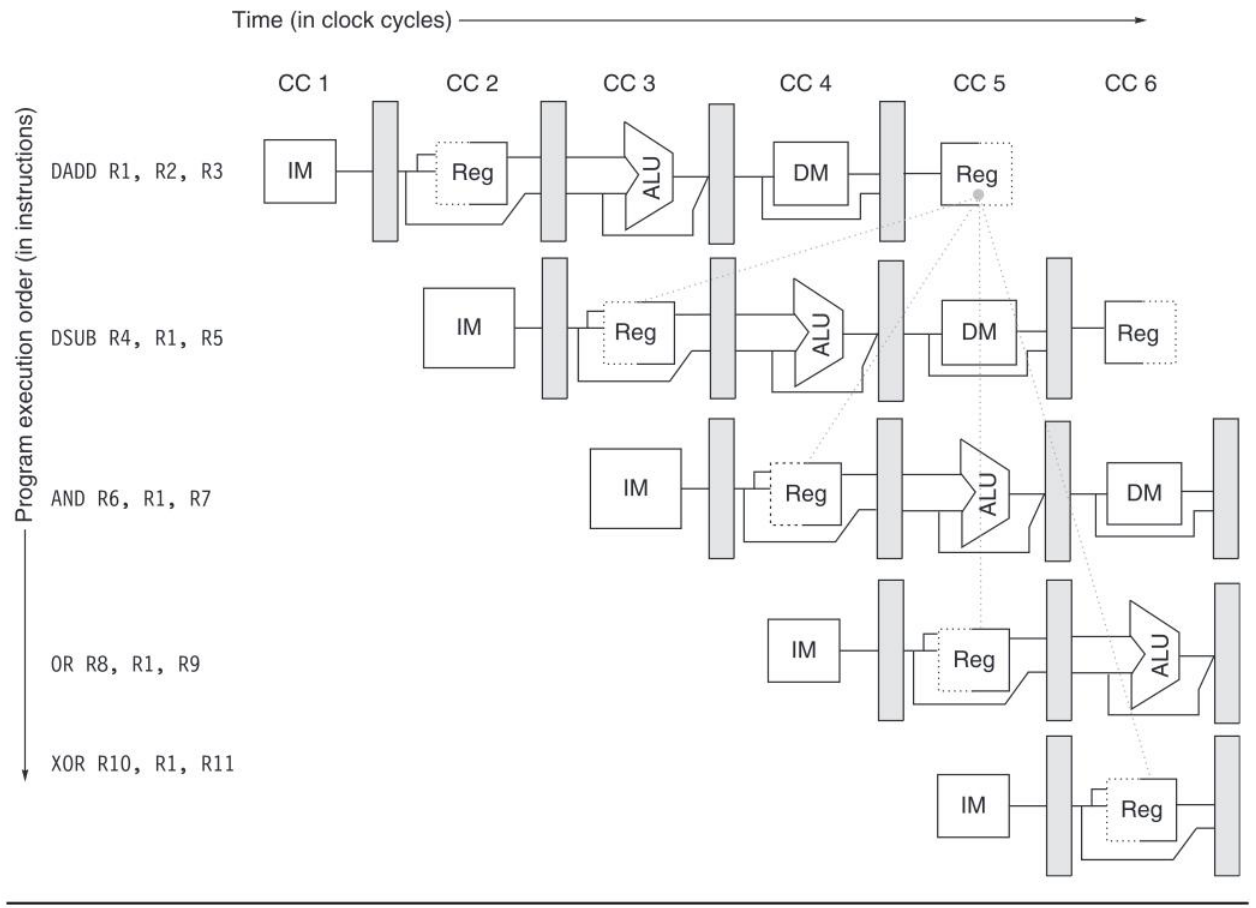
and 也可能产生 RAW 冒险。图 C.4 中 x1 的写入直到第 5 周期结束才完成,因此第 4 周期读取寄存器的 and 会取得错误结果。
xor 可以正确执行,因为它在第 6 周期读取寄存器,晚于写回。or 也不会发生冒险,因为寄存器堆在周期前半段写入、后半段读取。注意,xor 仍然依赖 add,只是不会再构成冒险;第 3 章将更深入地讨论这一点。下一小节介绍如何消除 sub 和 and 冒险导致的停顿。2
用转发尽量减少数据冒险停顿
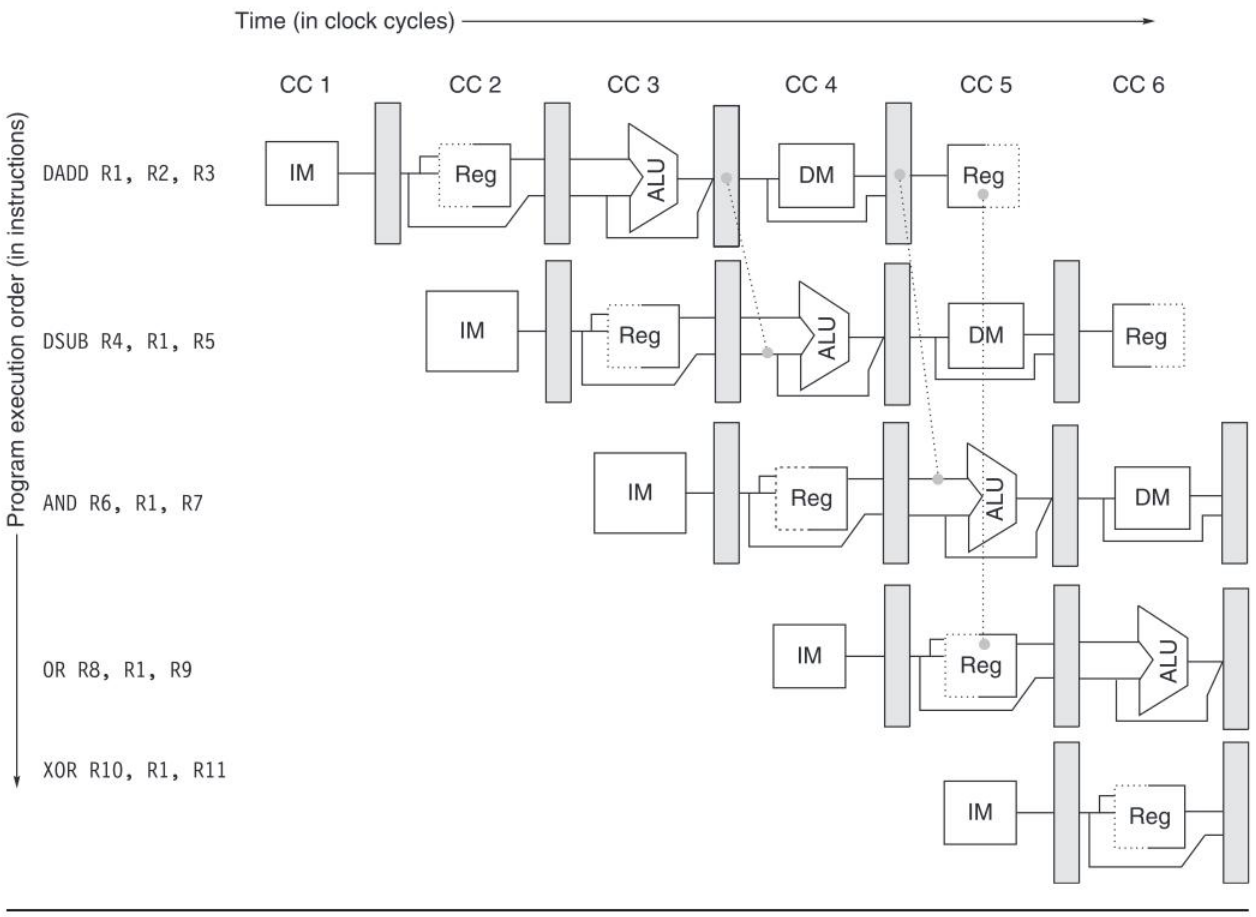
图 C.4 的问题可以用一种简单硬件技术解决,称为转发(forwarding),也称旁路(bypassing),有时称 short-circuiting。关键在于:sub 真正需要结果的时刻,晚于 add 产生结果的时刻。如果直接把结果从 add 保存它的流水线寄存器,送到 sub 需要它的位置,就能避免停顿。其工作方式如下:
- 始终把 EX/MEM 与 MEM/WB 流水线寄存器中的 ALU 结果反馈到 ALU 输入。
- 若转发硬件发现,前一条 ALU 操作写入的寄存器,正是当前 ALU 操作的源寄存器之一,控制逻辑就选择转发结果作为 ALU 输入,而不使用从寄存器堆读出的值。
注意,采用转发后,如果 sub 停顿,add 就会先完成,旁路便不会启用。两条指令之间发生中断时,也是如此。
图 C.4 的例子表明,结果不仅可能来自紧前一条指令,也可能来自早两个周期启动的指令。图 C.5 加入了旁路,并突出显示寄存器读写的时序。这段代码可以无停顿执行。
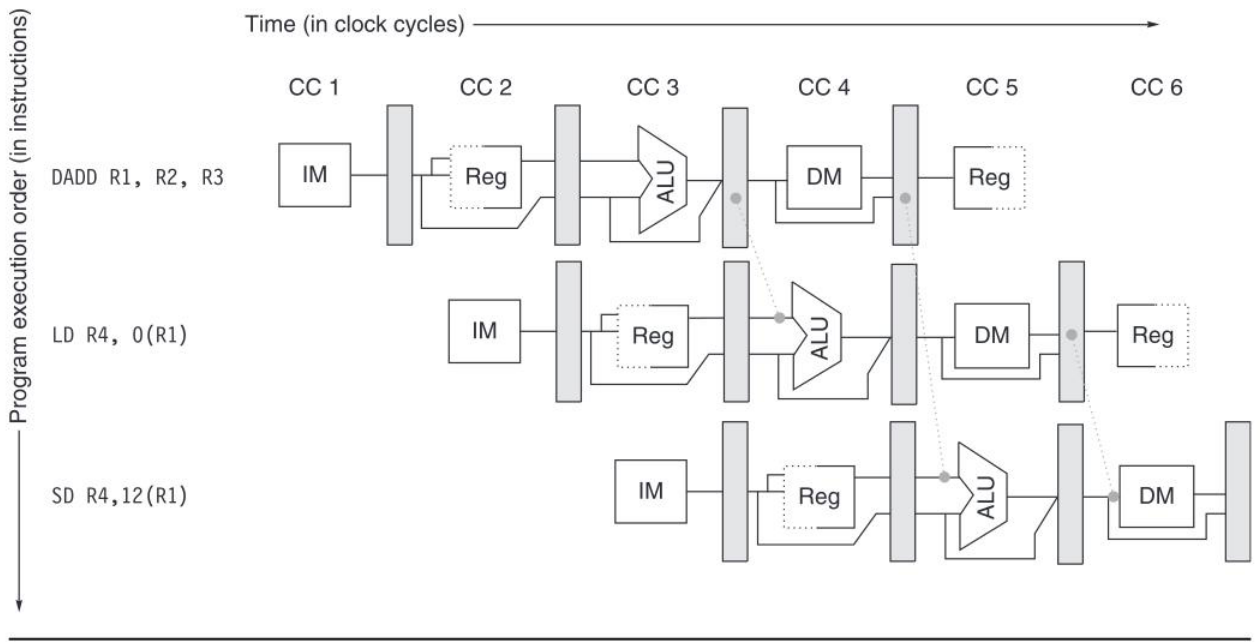
转发还可以推广为:把结果直接传给需要它的功能单元,即从一个单元输出端的流水线寄存器传到另一个单元的输入,而不只是反馈给原来的单元。例如:
要避免这段代码停顿,需要把流水线寄存器中的 ALU 输出和存储器输出,分别转发给 ALU 与数据存储器输入。图 C.6 展示了全部转发路径。
必须停顿的数据冒险
可惜,旁路无法处理所有潜在的数据冒险。考虑以下指令:
图 C.7 展示了这段代码带旁路的数据通路。它与连续两条 ALU 指令不同:ld 到第 4 周期,即 MEM 周期结束,才取得数据,而 sub 在该周期开始时就需要数据。因此,使用加载结果造成的数据冒险,无法用简单硬件完全消除。图中所需的转发路径必须逆着时间工作,而计算机设计者还没有这种本领!可以把结果从流水线寄存器直接转发给 ALU,供比加载晚两个周期启动的 and 使用;or 也没有问题,它通过寄存器堆取得值。但对 sub 来说,转发结果来得太晚:需要时是在周期开始,结果却在周期结束才到达。
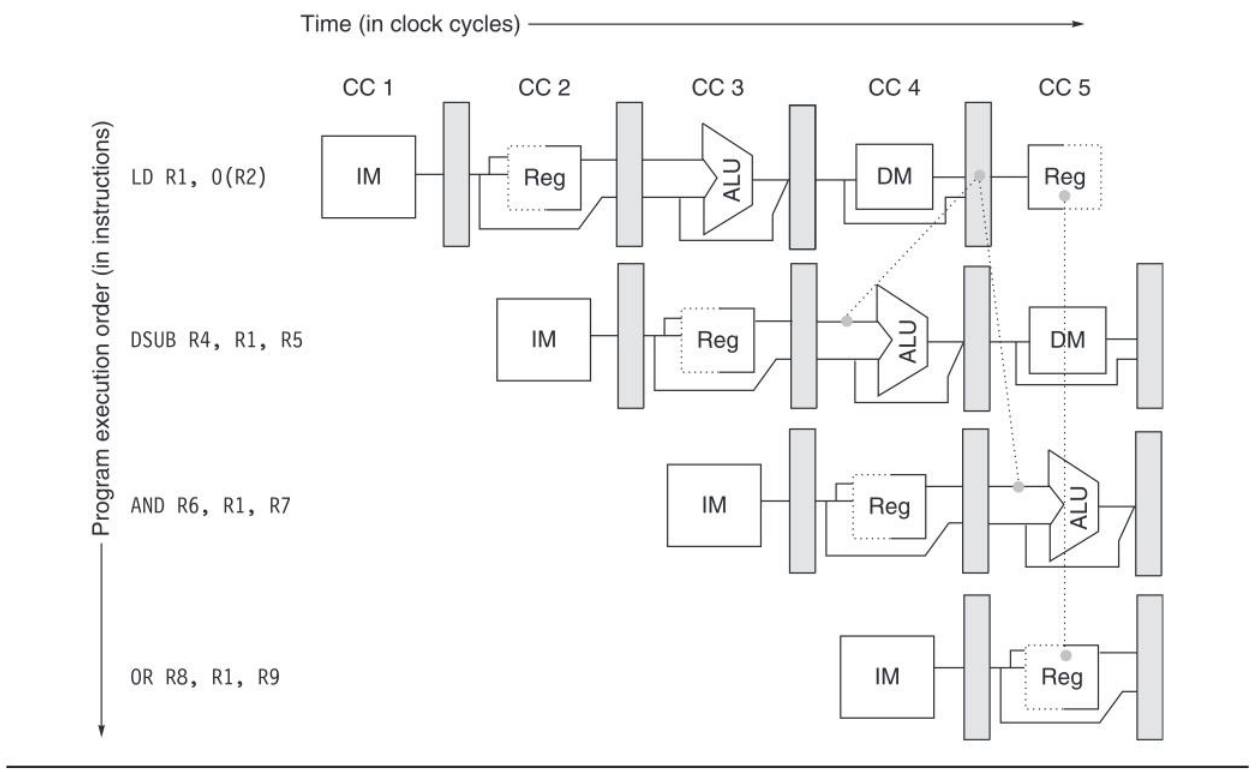
加载指令的延迟无法仅靠转发消除。需要增加称为流水线互锁(pipeline interlock)的硬件,以保证正确的执行模式。一般来说,互锁检测冒险,并使流水线停顿,直到冒险消失。在这里,它让需要使用数据的指令及其后的指令停顿,等待源指令产生数据。这会插入一个停顿,也称气泡,与处理结构冒险时相同。该指令的 CPI 增加量等于停顿长度;这里为一个周期。
图 C.8 用流水级名称展示停顿前后的时序。停顿使 sub 及其后指令都晚一个周期,因而给 and 的转发现在通过寄存器堆完成,or 则完全不再需要转发。插入气泡使整个序列的完成时间增加一个周期;第 4 周期没有新指令启动,第 6 周期没有指令完成。
| 情形/指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
无停顿:ld x1,0(x2) | IF | ID | EX | MEM | WB | ||||
sub x4,x1,x5 | IF | ID | EX | MEM | WB | ||||
and x6,x1,x7 | IF | ID | EX | MEM | WB | ||||
or x8,x1,x9 | IF | ID | EX | MEM | WB | ||||
有停顿:ld x1,0(x2) | IF | ID | EX | MEM | WB | ||||
sub x4,x1,x5 | IF | ID | 停顿 | EX | MEM | WB | |||
and x6,x1,x7 | IF | 停顿 | ID | EX | MEM | WB | |||
or x8,x1,x9 | 停顿 | IF | ID | EX | MEM | WB |
分支冒险
控制冒险对这条 RISC-V 流水线造成的性能损失,可能大于数据冒险。执行分支时,PC 可能改为当前值加 4 以外的其他值,也可能不改变顺序流。分支把 PC 改为目标地址,称为跳转(taken);顺序执行下一条指令,则称为不跳转(not taken 或 untaken)。若指令 是跳转分支,通常要在 ID 结束、地址计算与比较完成后,才能修改 PC。
图 C.9 所示的最简单处理方法,是在 ID 译码时发现分支后,重新取分支的后继指令。第一次 IF 实际上是停顿,因为它没有完成有效工作。若分支不跳转,已取出的指令本来就是正确的,这次重复 IF 就没有必要。稍后将利用这一点提出几种方案。
每次分支停顿一周期,随分支频率不同,会造成 10%~30% 的性能损失,下面研究如何减少这种损失。
降低流水线的分支代价
处理分支延迟所致停顿的方法很多。先讨论四种简单的编译时方案。它们都是静态方案:每条分支在整个执行期间采取的处理方式固定。软件可以利用对硬件方案和分支行为的了解,尽量减少分支代价。随后讨论按程序行为动态预测分支的硬件方案;第 3 章还会介绍更强大的动态分支预测技术。
最简单的方法,是冻结或冲刷流水线:保持或删除分支后的所有指令,直到知道分支目标。其主要吸引力在于软硬件都简单,前面的图 C.9 就采用这种方法。它的分支代价固定,软件无法降低。
| 情形/指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| 分支指令 | IF | ID | EX | MEM | WB | ||||
| 分支后继 | IF | IF | ID | EX | MEM | WB | |||
| 分支后继+1 | IF | ID | EX | MEM | |||||
| 分支后继+2 | IF | ID | EX |
性能更好、复杂度只略高的方案,是把每个分支都当作不跳转,硬件像没有分支一样继续运行。但在确定分支结果前,必须小心避免修改处理器状态。复杂性来自判断指令何时可能修改状态,以及如何撤销修改。
在简单五级流水线中,预测不跳转方案像对待普通指令一样,继续取分支后的指令;流水线看起来没有任何异常。如果实际跳转,就把已取指令转为空操作,并从目标地址重新取指。图 C.10 展示了两种情况。
另一种方案是把所有分支都预测为跳转。一旦译码并算出目标地址,就开始从目标取指、执行。当实际跳转时,这会节省一周期,因为 ID 结束就已知道目标地址,比 ALU 阶段确定分支条件早一周期。无论预测跳转还是不跳转,编译器都可以通过组织代码,让最常走的路径符合硬件选择,以改善性能。3
第四种方案称为延迟分支,曾广泛用于早期 RISC 处理器。延迟为一条指令时,执行顺序为:
| 情形/指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| 不跳转:分支 | IF | ID | EX | MEM | WB | ||||
| 指令 i+1 | IF | ID | EX | MEM | WB | ||||
| 指令 i+2 | IF | ID | EX | MEM | WB | ||||
| 指令 i+3 | IF | ID | EX | MEM | WB | ||||
| 指令 i+4 | IF | ID | EX | MEM | WB | ||||
| 跳转:分支 | IF | ID | EX | MEM | WB | ||||
| 指令 i+1 | IF | 空闲 | 空闲 | 空闲 | 空闲 | ||||
| 分支目标 | IF | ID | EX | MEM | WB | ||||
| 目标+1 | IF | ID | EX | MEM | WB | ||||
| 目标+2 | IF | ID | EX | MEM | WB |
顺序后继指令位于分支延迟槽中,无论分支是否跳转都要执行。图 C.11 给出了五级流水线的相应行为。虽然延迟可以超过一条指令,但实际采用延迟分支的处理器几乎都只有一个指令延迟;若流水线潜在分支代价更长,则使用其他技术。编译器的任务是让延迟槽中的后继指令既合法又有用。
在硬件预测过于昂贵的年代,延迟分支对短而简单的流水线很有用,但它会使采用动态分支预测的实现变得复杂。因此,RISC-V 合理地没有采用延迟分支。
各种分支方案的性能
各方案的实际性能如何?假定理想 CPI 为 1,计入分支代价后:
又因为:
所以:
无条件分支和条件分支都可以贡献分支频率与分支代价,但条件分支更常见,因此占主导。
| 情形/指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| 不跳转:分支 | IF | ID | EX | MEM | WB | ||||
| 延迟槽指令(i+1) | IF | ID | EX | MEM | WB | ||||
| 指令 i+2 | IF | ID | EX | MEM | WB | ||||
| 指令 i+3 | IF | ID | EX | MEM | WB | ||||
| 指令 i+4 | IF | ID | EX | MEM | WB | ||||
| 跳转:分支 | IF | ID | EX | MEM | WB | ||||
| 延迟槽指令(i+1) | IF | ID | EX | MEM | WB | ||||
| 分支目标 | IF | ID | EX | MEM | WB | ||||
| 目标+1 | IF | ID | EX | MEM | WB | ||||
| 目标+2 | IF | ID | EX | MEM | WB |
例题 对更深的流水线,例如 MIPS R4000 及后来的 RISC 处理器,在不存在条件比较寄存器停顿的前提下,至少经过三个流水级才能知道分支目标,再过一个周期才能确定分支条件。这种三级延迟下,三种最简单预测方案的分支代价如图 C.12 所示。假定下列频率,求分支对 CPI 的实际增加量:
| 分支类型 | 频率 |
|---|---|
| 无条件分支 | 4% |
| 条件分支,不跳转 | 6% |
| 条件分支,跳转 | 10% |
解答 将各类分支的相对频率乘以对应代价,就得到 CPI 增量,结果见图 C.13。
| 分支方案 | 无条件分支代价 | 条件分支不跳转代价 | 条件分支跳转代价 |
|---|---|---|---|
| 冲刷流水线 | 2 | 3 | 3 |
| 预测跳转 | 2 | 3 | 2 |
| 预测不跳转 | 2 | 0 | 3 |
| 分支方案/频率 | 无条件分支 | 不跳转的条件分支 | 跳转的条件分支 | 全部分支 |
|---|---|---|---|---|
| 事件频率 | 4% | 6% | 10% | 20% |
| 停顿流水线 | 0.08 | 0.18 | 0.30 | 0.56 |
| 预测跳转 | 0.08 | 0.18 | 0.20 | 0.46 |
| 预测不跳转 | 0.08 | 0.00 | 0.30 | 0.38 |
更长的延迟显著放大了方案之间的差异。如果基础 CPI 为 1,分支是唯一停顿来源,那么理想流水线的性能为采用停顿方案的 1.56 倍。在相同假设下,预测不跳转方案的性能为停顿方案的 1.13 倍。
用预测降低分支成本
流水线越深,分支的潜在代价越大,仅靠延迟分支之类的方法就不够了,必须采用更积极的预测。方案分两类:利用编译时信息的低成本静态方法,以及根据程序行为动态预测的方法。下面分别讨论。
静态分支预测
改善编译时预测的一个重要方法,是利用此前运行采集的性能剖析信息(profile)。它之所以有效,是因为分支行为常呈双峰分布:单条分支通常明显倾向于跳转或不跳转。图 C.14 展示了这种策略的效果。图中采集 profile 与评测使用相同输入;其他研究表明,即使改变输入、使用另一次运行的 profile,预测准确率也只发生很小变化。
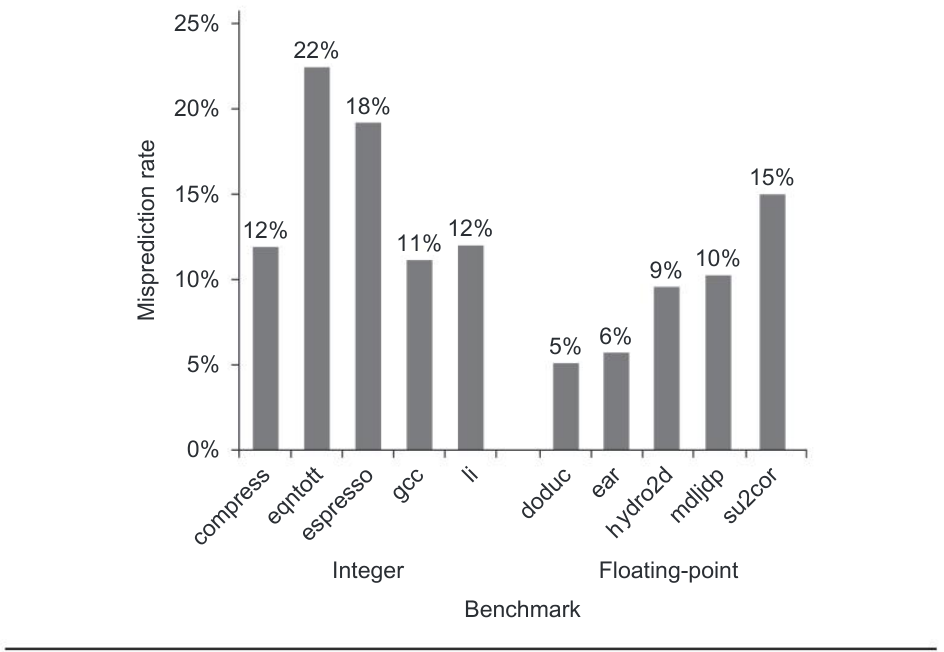
任何分支预测方案的效果,都取决于准确率和条件分支频率;SPEC 的条件分支频率为 3%~24%。整数程序不仅失误率较高,分支频率通常也更高,这是静态预测的主要限制。下一小节介绍近年来大多数处理器使用的动态预测器。
动态分支预测与分支预测缓冲器
最简单的动态方案是分支预测缓冲器,也称分支历史表。它是由分支指令地址的低位索引的小型存储器,其中一位记录分支最近是否跳转。这种最简单的缓冲器没有标记,只有当分支延迟长于计算可能目标 PC 所需的时间时,才能帮助缩短分支延迟。
采用这种缓冲器时,我们实际上并不知道预测是否对应当前分支:该条目可能由另一条地址低位相同的分支写入。但这无关紧要。预测只是一个暂且当作正确的提示,硬件沿预测方向取指;如果错误,就翻转预测位并写回。
它实际上相当于一个每次访问都命中的缓存。其效果既取决于条目有多大概率确实对应当前分支,也取决于对应时的预测准确率。分析性能之前,先对预测方案做一个虽小却重要的改进。
简单的 1 位方案有一个缺点:即使某分支几乎总是跳转,一次不跳转也可能导致连续两次预测错误,而非一次,因为第一次失误会翻转预测位。
常用的改进是 2 位预测方案:必须连续失误两次,才改变预测方向。图 C.15 给出了相应有限状态机。
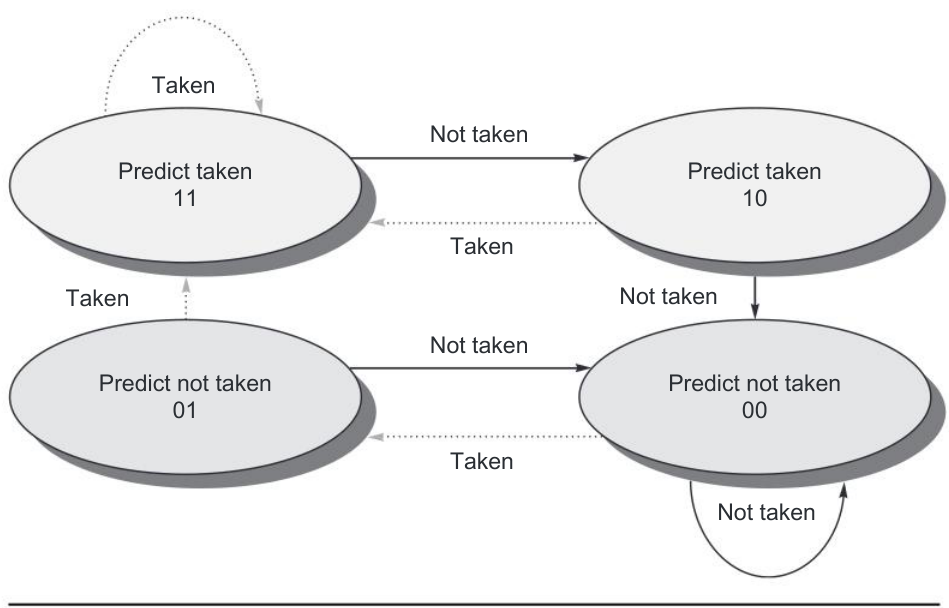
图 C.15(续) 2 位方案是更一般的预测缓冲器每项使用一个 位饱和计数器方案的特例。计数器取值范围为 到 ;值不小于最大值的一半时,预测跳转,否则预测不跳转。研究表明,2 位预测器与更一般的 位方案效果几乎相同,所以大多数系统使用 2 位预测器。
译注: 原图的两条跨状态转移为
10 → 00(不跳转)和01 → 11(跳转),并非每次严格加一或减一的相邻饱和计数器转移。
分支预测缓冲器可以实现为小型专用“缓存”,在 IF 阶段用指令地址访问;也可以把两位附在每个指令缓存块中,与指令一起取出。如果译码发现是分支,并预测跳转,那么目标 PC 一旦确定,就从目标取指;否则继续顺序取指和执行。图 C.15 表明,若预测错误,就改变预测位。
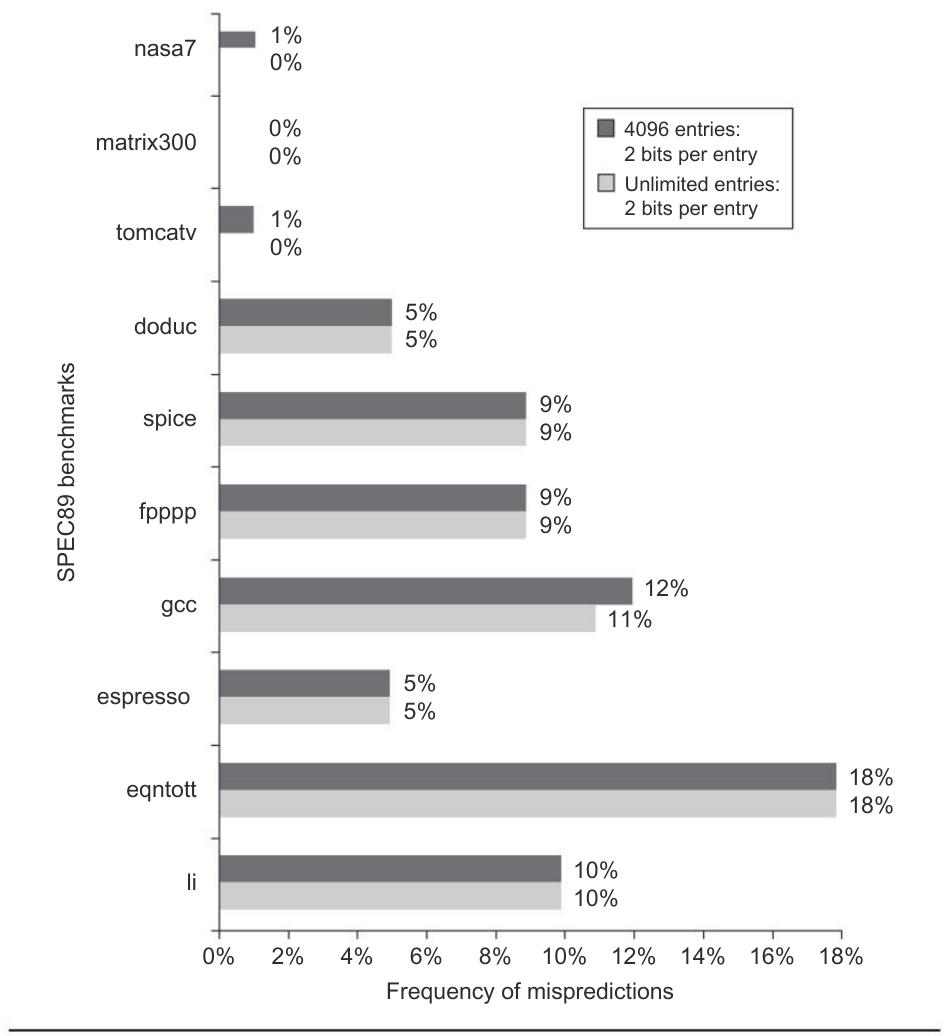
在真实应用上,每项两位的缓冲器能达到怎样的准确率?图 C.16 表明,4096 项缓冲器在 SPEC89 中的准确率从超过 99% 到 82% 不等,即失误率为 1%~18%。这样的 4K 项缓冲器在 2017 年已经算小,扩大容量还能略有改善。
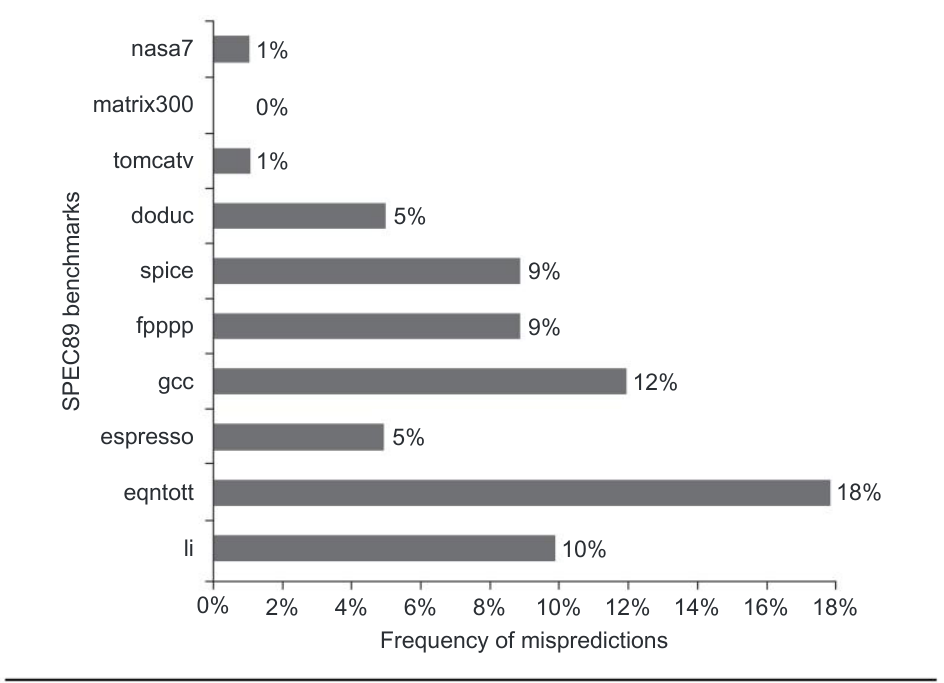
随着我们尝试开发更多 ILP,预测准确率变得至关重要。图 C.16 表明,通常具有更高分支频率的整数程序,预测准确率反而低于循环密集的科学计算程序。有两条改进途径:增大缓冲器,以及提高每次预测所用方法的准确率。但图 C.17 表明,至少对 SPEC 这类基准,4K 项与无限容量缓冲器的表现已经相当接近,缓冲器命中率并非主要限制。正如前面所说,只增加每个预测器的位数而不改变结构,效果也很小。我们需要提高每个预测器本身的准确率,第 3 章将介绍这一方向。