C.3 如何实现流水线?
进一步讨论基本流水线之前,先复习 RISC-V 的一种简单非流水线实现。
RISC-V 的一种简单实现
本节沿用 C.1 节的方式,先介绍简单的非流水线实现,再介绍流水线实现;但这次具体针对 RISC-V 体系结构。
我们关注一个整数子集,包括字加载与存储、相等条件分支和整数 ALU 操作;后文再加入基本浮点操作。虽然只讨论子集,基本原理可以扩展到全部指令,例如加入存储需要额外处理立即数字段。起初对分支采用较保守的实现,本节末尾再说明更积极的实现。
每条 RISC-V 指令最多可在 5 个周期内完成:
1. 取指周期(IF)
操作: 输出 PC,从存储器取指,放入指令寄存器 IR;PC 加 4,得到下一条顺序指令的地址。IR 保存后续周期仍需使用的指令,NPC 则保存下一个顺序 PC。
2. 指令译码/寄存器读取周期(ID)
操作: 译码并访问寄存器堆,读取 rs1、rs2 指定的寄存器。通用寄存器的输出保存到临时寄存器 A、B,供后续周期使用。IR 的低 16 位也进行符号扩展,存入临时寄存器 Imm,供下一周期使用。1
由于这些字段在 RISC-V 指令中的位置固定,译码和读寄存器可并行进行。加载与 ALU 立即数指令的立即数字段位置相同,因此本周期也计算符号扩展后的立即数,以备下周期使用。存储指令的立即数字段分成两部分,需要单独进行符号扩展。
3. 执行/有效地址计算周期(EX)
ALU 对上一周期准备的操作数执行操作,按指令类型分为四种。
访存:
操作: ALU 将两个操作数相加,形成有效地址,结果保存到 ALUOutput。
寄存器—寄存器 ALU 指令:
操作: ALU 对 A、B 执行功能码指定的操作;功能码由 func3 和 func7 字段组合而成。结果保存到临时寄存器 ALUOutput。
寄存器—立即数 ALU 指令:
操作: ALU 对 A、Imm 执行操作码指定的运算,结果保存到 ALUOutput。
分支:
操作: Imm 中符号扩展后的立即数左移两位,形成字偏移,再与 NPC 相加,计算分支目标。由于这里只考虑相等条件分支,比较上一周期读出的 A 与 B,以确定是否跳转。
RISC-V 的加载—存储体系结构允许将有效地址计算与执行放在同一周期,因为没有指令需要同时计算数据地址、计算指令目标地址并对数据运算。这里未包含的其他整数指令是各种跳转,它们与分支类似。
4. 存储器访问/分支完成周期(MEM)
所有指令都更新 PC:PC ← NPC;。
访存:
操作: 按需访问存储器。加载把返回数据放入 LMD(load memory data,加载存储器数据)寄存器;存储把 B 写入存储器。两者均使用上一周期算出、保存在 ALUOutput 中的地址。
分支:
操作: 若分支跳转,用 ALUOutput 中的目标地址替换 PC。
5. 写回周期(WB)
寄存器—寄存器或寄存器—立即数 ALU 指令:
加载指令:
操作: 把来自存储系统(LMD)或 ALU(ALUOutput)的结果,写入 rd 指定的寄存器。
图 C.18 展示指令在数据通路中的流动。每个周期结束时,本周期算出且以后仍需使用的值——无论供当前指令还是下一条指令使用——都要写入存储部件。这些部件可以是内存、通用寄存器、PC 或临时寄存器,如 LMD、Imm、A、B、IR、NPC、ALUOutput、Cond。临时寄存器在同一条指令的不同周期之间保存值,其他存储部件则属于可见状态,在相继执行的指令之间保存值。
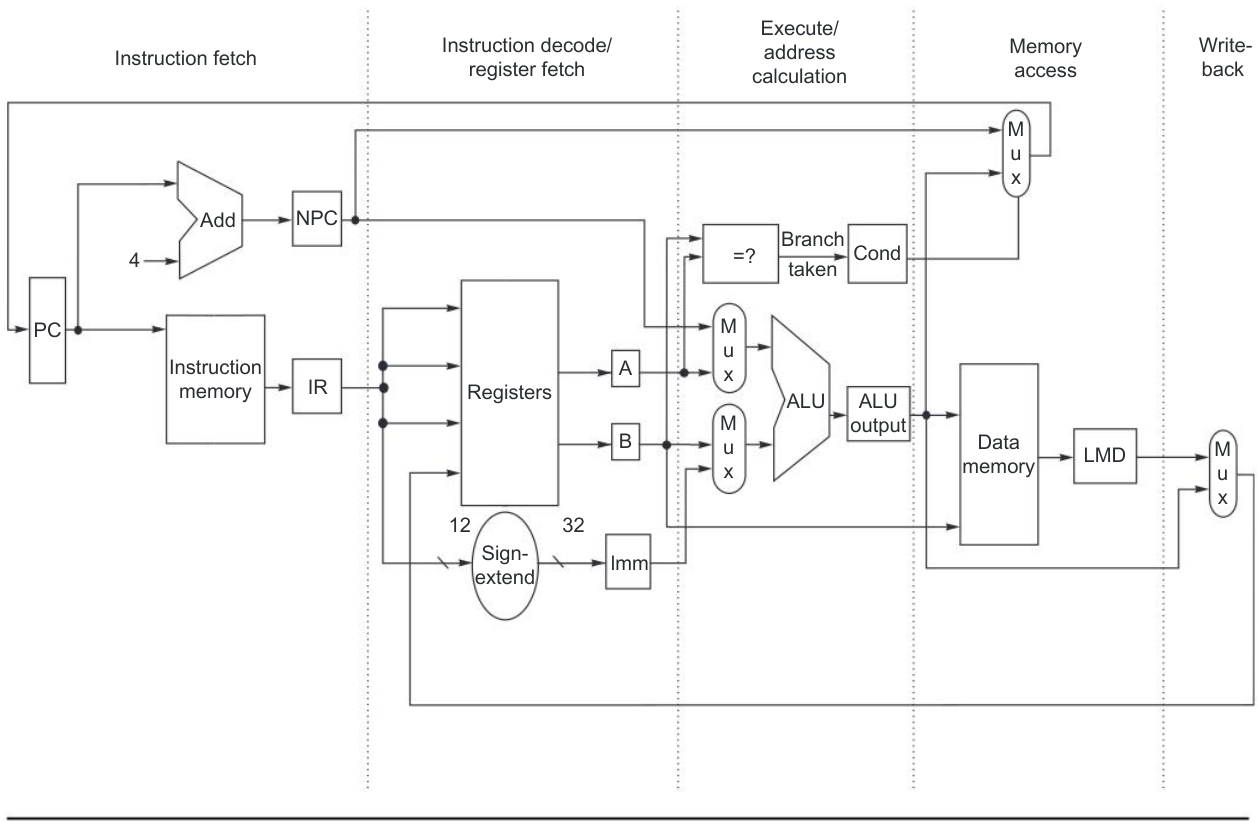
图内术语:Instruction fetch=取指;Instruction decode/register fetch=译码/读取寄存器;Execute/address calculation=执行/地址计算;Memory access=访存;Write-back=写回;Instruction/Data memory=指令/数据存储器;Registers=寄存器堆;Sign-extend=符号扩展;Mux=多路选择器;Add=加法器;Branch taken=分支跳转;ALU output=ALU 输出。A、B、IR、NPC、Imm、Cond、LMD 为正文定义的临时寄存器。
如今处理器都采用流水线,但这种多周期实现,大致反映了早期多数处理器的实现方式。按上述五周期结构,用简单有限状态机即可实现控制;更复杂的处理器可以采用微码控制。无论哪一种,指令执行步骤都决定控制结构。
这个多周期实现有些硬件冗余可以消除。例如,递增 PC 与计算有效地址/执行 ALU 操作各用了一个 ALU。它们不在同一周期使用,因此可以增加多路选择器,共享一个 ALU。类似地,指令和数据访问发生在不同周期,也可放入同一存储器。
这里不优化这种简单实现,而保留图 C.18 的设计,因为它更适合作为流水线实现的基础。
RISC-V 的基本流水线
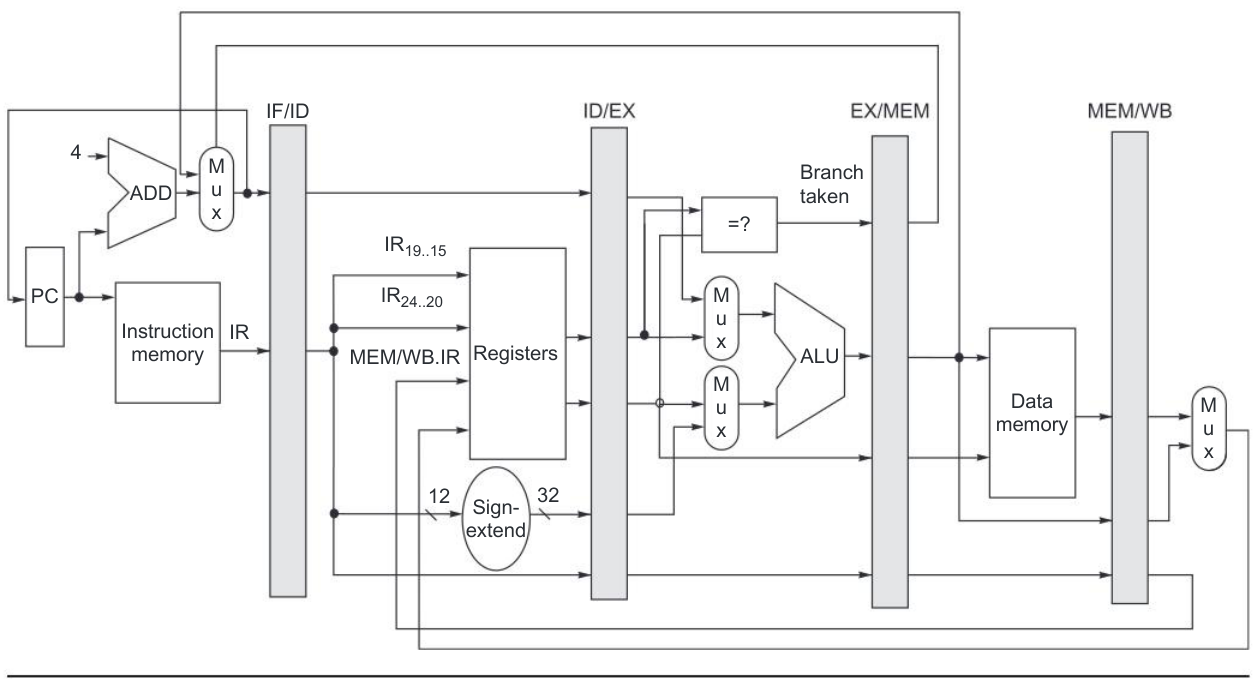
与前面一样,每周期启动一条新指令,就能在几乎不改动的情况下,将图 C.18 流水线化。每个级在每个周期都活跃,所以一级内的全部操作必须在一周期内完成,各种操作的组合也必须能够同时发生。此外,级间传递的值必须保存到寄存器。图 C.19 在每对相邻级之间加入合适的寄存器,称为流水线寄存器或流水线锁存器,按所连接的级命名。图中特别清楚地展示了穿过这些寄存器的连接。
原先为单条指令在各周期间临时保存值的寄存器,现都归入流水线寄存器。IR 是 IF/ID 的一部分;用于提供寄存器名称的字段已单独标出。流水线寄存器既传数据也传控制。以后还需使用的值,必须存入这些寄存器,并逐级复制,直到不再需要。若仍使用原先非流水线数据通路的临时寄存器,值可能尚未用完就被覆盖。例如,加载或 ALU 操作写回时,目的寄存器字段来自 MEM/WB,而不是 IF/ID。我们要写的是当前加载或 ALU 指令指定的寄存器,而不是此刻正从 IF 进入 ID 的另一条指令指定的寄存器。目的字段因此逐级复制,直到 WB 使用。
任一时刻,一条指令只活跃于一个流水级,所以为它执行的操作都位于一对流水线寄存器之间。也可以按指令类型,逐级考察必须发生的操作,图 C.20 就采用这一视角。字段名称反映数据从一级流向下一级的过程。前两级的操作与当前指令类型无关;它们必须如此,因为到 ID 结束才完成译码。
IF 的活动取决于 EX/MEM 中的指令是否为跳转分支。如果是,IF 结束时把 EX/MEM 中的分支目标写入 PC;否则写入递增后的 PC。前面说过,分支的这一作用会引入复杂性,后续几节将处理它。源寄存器采用固定位置编码,是能够在 ID 读取寄存器的关键。
控制这条简单流水线,只需决定图 C.19 中四个多路选择器的设置。ALU 阶段的两个选择器根据 ID/EX 的 IR 字段所指示的指令类型设置:上方输入取决于是否为分支,下方输入取决于是否为寄存器—寄存器 ALU 操作。IF 中的选择器在递增 PC 与 EX/MEM.ALUOutput(分支目标)间选择,受 EX/MEM.cond 控制。第四个选择器按 WB 指令是加载还是 ALU 操作,选择写回值。
| 级 | 任意指令的操作 | ALU 指令 | 加载指令(原表栏名) | 分支指令 |
|---|---|---|---|---|
| IF | IF/ID.IR ← Mem[PC];IF/ID.NPC, PC ← (if ((EX/MEM.opcode == branch) & EX/MEM.cond) {EX/MEM.ALUOutput} else {PC+4}); | |||
| ID | ID/EX.A ← Regs[IF/ID.IR[rs1]];ID/EX.B ← Regs[IF/ID.IR[rs2]];ID/EX.NPC ← IF/ID.NPC;ID/EX.IR ← IF/ID.IR;ID/EX.Imm ← sign-extend(IF/ID.IR[immediate field]); | |||
| EX | EX/MEM.IR ← ID/EX.IR;EX/MEM.ALUOutput ← ID/EX.A func ID/EX.B;或 EX/MEM.ALUOutput ← ID/EX.A op ID/EX.Imm; | EX/MEM.IR ← ID/EX.IR;EX/MEM.ALUOutput ← ID/EX.A + ID/EX.Imm;EX/MEM.B ← ID/EX.B; | EX/MEM.ALUOutput ← ID/EX.NPC + (ID/EX.Imm << 2);EX/MEM.cond ← (ID/EX.A == ID/EX.B); | |
| MEM | MEM/WB.IR ← EX/MEM.IR;MEM/WB.ALUOutput ← EX/MEM.ALUOutput; | MEM/WB.IR ← EX/MEM.IR;MEM/WB.LMD ← Mem[EX/MEM.ALUOutput];或 Mem[EX/MEM.ALUOutput] ← EX/MEM.B; | ||
| WB | Regs[MEM/WB.IR[rd]] ← MEM/WB.ALUOutput; | 仅加载:Regs[MEM/WB.IR[rd]] ← MEM/WB.LMD; |
图 C.20(续) IF 除取指和计算新 PC 外,也把递增 PC 保存到 PC 和流水线寄存器 NPC,以便以后计算分支目标;与图 C.19 相同,IF 中 PC 有两个可能来源。ID 读取寄存器,对 IR 的 12 位立即数字段符号扩展,并传递 IR 与 NPC。EX 执行 ALU 运算或地址计算,传递 IR,以及存储指令所需的 B;若分支跳转,则置 cond=1。MEM 访问存储器、必要时写 PC,并传递最后一级需要的值。WB 用 ALU 输出或加载值更新寄存器。为简化表达,整个 IR 都逐级传递,尽管实际所需字段会越来越少。
译注: 原表“Load instruction”栏也包含存储操作;EX 栏第一行原印为
EX/MEM.IR to ID/EX.IR,这里按其他栏的同类赋值格式明确箭头。图注又写“MEM 阶段必要时写 PC”,与本节及图 C.19 把 PC 写入移至 IF 的说明不一致。
除四个已画出的选择器外,还需要一个图 C.19 未画出的选择器;从 ALU 指令的 WB 操作可看出原因。原文称目的寄存器字段随指令类型不同而处在两个位置:寄存器—寄存器 ALU 指令一类,ALU 立即数或加载另一类。所以,对写寄存器的指令,还需要从 MEM/WB 的 IR 中选择正确的目的字段。此处字段布局问题见前面的译注:
RISC-V 流水线的控制实现
让指令从 ID 进入 EX 的过程通常称为指令发射;完成这一步,就称已发射。对 RISC-V 整数流水线,所有数据冒险都能在 ID 检查;若有冒险,则在发射前停顿。也可以在 ID 确定所需转发,并设好控制。尽早检测互锁会简化硬件,因为除非整个处理器都停顿,否则不必暂停一条已经更新处理器状态的指令。
另一种方法是在使用操作数的周期开始时检测冒险或转发;本流水线对应 EX 和 MEM。为了展示两种方法的区别,下面在 ID 检测源指令为加载的 RAW 冒险,即加载互锁,而在 EX 决定 ALU 输入转发。图 C.21 列出必须处理的各种情况。
先实现加载互锁。如果存在加载引起的 RAW 冒险,那么需要加载结果的指令处于 ID 时,加载处于 EX。用一个小表就能列出全部危险情形,并直接转成硬件。图 C.22 在使用结果的指令处于 ID 时,检测全部加载互锁。
检测到冒险后,控制单元必须插入停顿,阻止 IF 和 ID 中的指令继续推进。所有控制信息都在流水线寄存器中;只要保留指令本身就足够,因为控制可由它导出。因而只需把 ID/EX 中的控制部分清零,使之成为空操作,例如不做任何事的 add x0,x0,x0。同时,让 IF/ID 的内容保持不变,保存被阻塞的指令。更复杂的冒险也可用相同思路:比较一组流水线寄存器来检测冒险,插入空操作以防错误执行。
转发逻辑的实现类似,但要考虑更多情形。关键是流水线寄存器同时含有待转发数据和源/目的寄存器字段。从逻辑上说,转发都是从 ALU 或数据存储器输出,送往 ALU 输入、数据存储器输入或零值检测单元。因此,比较 EX/MEM、MEM/WB 中 IR 的目的寄存器,与 ID/EX、EX/MEM 中 IR 的源寄存器,就能实现转发。
| 情形 | 代码示例(从上到下执行) | 处理 |
|---|---|---|
| 无依赖 | ld x1,45(x2)add x5,x6,x7sub x8,x6,x7or x9,x6,x7 | 后面紧接的三条指令都不依赖 x1,因此不可能有冒险。 |
| 依赖必须停顿 | ld x1,45(x2)add x5,x1,x7sub x8,x6,x7or x9,x6,x7 | 比较器发现 add 使用 x1,在 add 进入 EX 前将它及其后的 sub、or 停顿。 |
| 通过转发克服依赖 | ld x1,45(x2)add x5,x6,x7sub x8,x1,x7or x9,x6,x7 | 比较器发现 sub 使用 x1,把加载结果及时转发到 ALU,使 sub 能开始 EX。 |
| 有依赖,但访问次序正确 | ld x1,45(x2)add x5,x6,x7sub x8,x6,x7or x9,x1,x7 | 无需处理:加载在周期前半段写 x1,or 在 ID 后半段读 x1。 |
ID/EX 的操作码字段(原表记为 ID/EX.IR0..5) | IF/ID 的操作码字段(原表记为 IF/ID.IR0..6) | 匹配的操作数字段 |
|---|---|---|
| 加载 | 寄存器—寄存器 ALU、加载、存储、ALU 立即数或分支 | ID/EX.IR[rd] == IF/ID.IR[rs1] |
| 加载 | 寄存器—寄存器 ALU 或分支 | ID/EX.IR[rd] == IF/ID.IR[rs2] |
译注: 图 C.22 两列表头的操作码位范围分别为
0..5和0..6,原表即如此,这里不统一成同一范围。
图 C.23 列出转发目标为当前 EX 指令的 ALU 输入时,所需比较及可能的转发。
| 源指令所在流水线寄存器 | 源指令操作码 | 目的指令所在流水线寄存器 | 目的指令操作码 | 转发目标 | 比较条件:相等则转发 |
|---|---|---|---|---|---|
| EX/MEM | 寄存器—寄存器 ALU、ALU 立即数 | ID/EX | 寄存器—寄存器 ALU、ALU 立即数、加载、存储、分支 | 上方 ALU 输入 | EX/MEM.IR[rd] == ID/EX.IR[rs1] |
| EX/MEM | 寄存器—寄存器 ALU、ALU 立即数 | ID/EX | 寄存器—寄存器 ALU | 下方 ALU 输入 | EX/MEM.IR[rd] == ID/EX.IR[rs2] |
| MEM/WB | 寄存器—寄存器 ALU、ALU 立即数、加载 | ID/EX | 寄存器—寄存器 ALU、ALU 立即数、加载、存储、分支 | 上方 ALU 输入 | MEM/WB.IR[rd] == ID/EX.IR[rs1] |
| MEM/WB | 寄存器—寄存器 ALU、ALU 立即数、加载 | ID/EX | 寄存器—寄存器 ALU | 下方 ALU 输入 | MEM/WB.IR[rd] == ID/EX.IR[rs2] |
图 C.23(续) 原图注说,判断是否转发需要 10 次独立比较。EX 中目的指令的流水线寄存器是 ID/EX;源值来自 EX/MEM 或 MEM/WB 的 ALUOutput,或 MEM/WB 的 LMD。这里的逻辑尚未处理多条指令写同一寄存器的情况。例如:
必须保证 sub 使用 addi 而非 add 的结果。只需增加条件:对同一个输入,只有 EX/MEM 转发未启用时,才允许 MEM/WB 转发。addi 结果位于 EX/MEM,因此会优先于 MEM/WB 中的 add 结果被选择。
译注: 表内列出四行寄存器相等比较,但图注仍写“10 次独立比较”,未解释其计数口径。原图注把图 C.24 的页码写成 C.36,实际为 C-37。
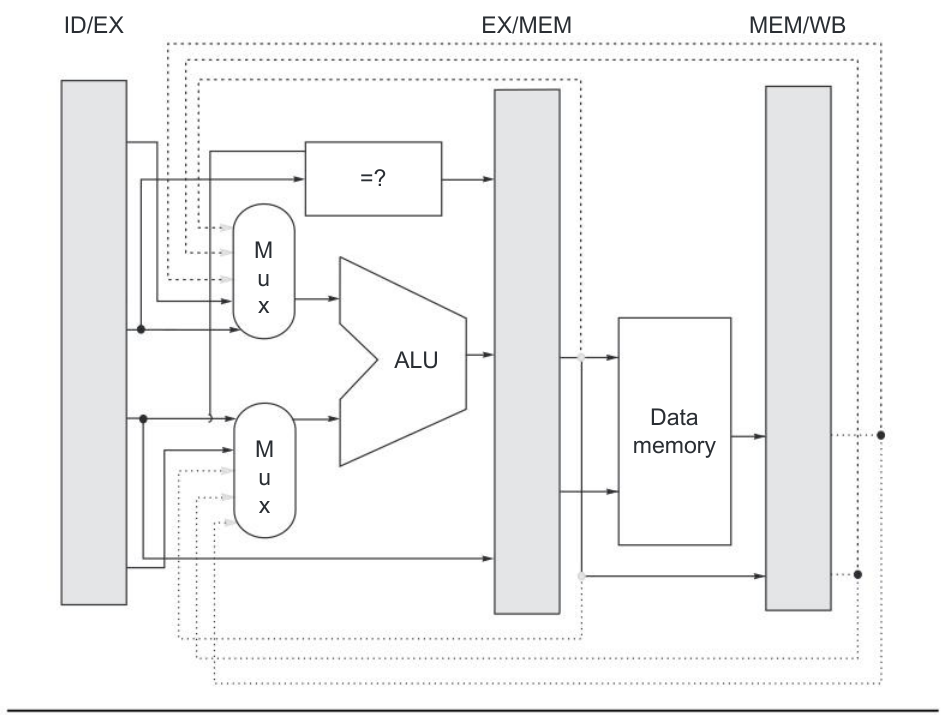
除判断何时启用转发的比较器与组合逻辑外,还必须扩展 ALU 输入多路选择器,增加来自相关流水线寄存器的连接。图 C.24 展示了新增选择器和连接后的相关数据通路。
RISC-V 的冒险检测与转发硬件比较简单;扩展到浮点后,情况会复杂一些。在此之前,先处理分支。
在流水线中处理分支
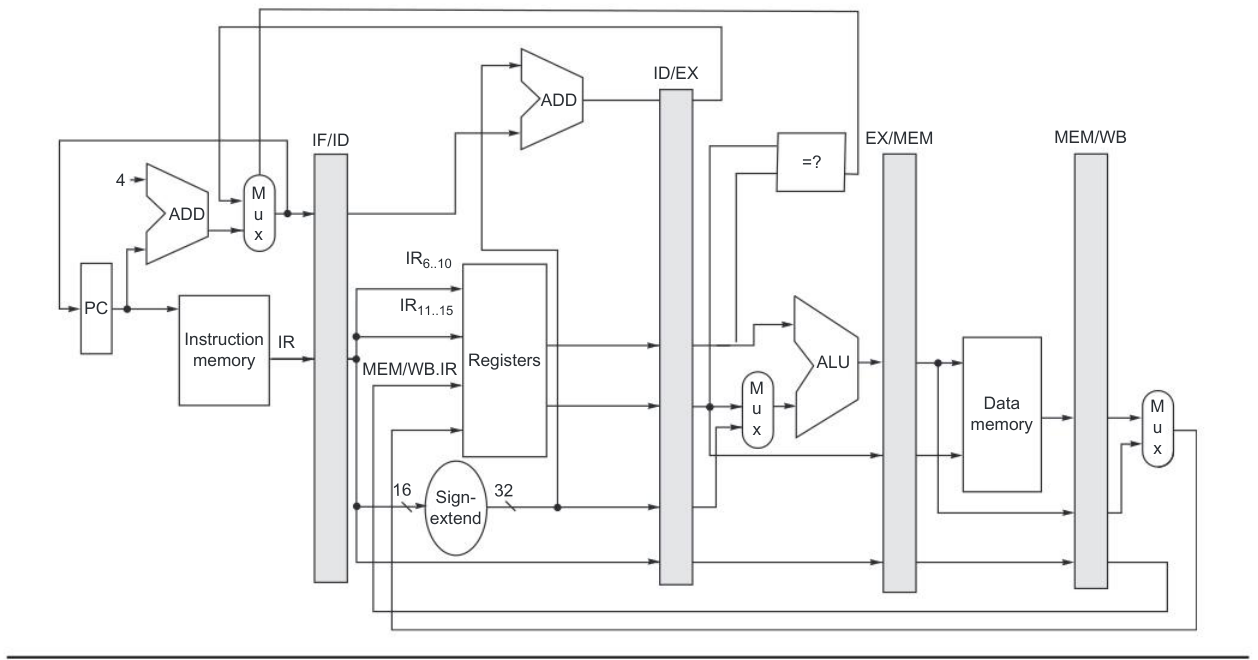
RISC-V 的条件分支比较两个寄存器值,这里假定比较在 EX 中借助 ALU 完成。还要计算分支目标。分支条件判断与下一 PC 的确定决定分支代价,因此希望在 EX 结束前,算出两种可能 PC 并选出正确值。可以增加一个独立加法器,在 ID 计算目标。由于指令尚未完成译码,会把每条指令都暂当分支,计算可能目标。这可能比在 EX 同时算目标和判断条件更快,但会多用一点能量。
图 C.25 将加法器放在 ID、条件判断放在 EX,只对流水线结构做了小改动。这条流水线的分支代价为两个周期。某些早期 RISC,例如 MIPS,限制分支条件的形式,使比较可以在 ID 完成,将延迟降至一个周期。不过,若 ALU 指令写某寄存器,紧接着的分支就根据它判断,会发生数据冒险;若判断放在 EX,则没有这一问题。
流水线越来越深,分支延迟随之增加,使动态预测成为必要。例如,把译码与读寄存器分成两个级,分支延迟很可能至少再增加一周期。若不处理,分支延迟就转化为实际代价。许多实现复杂指令集的旧处理器,其分支延迟为 4 周期或更多;大型深流水线处理器的分支代价常达 6 或 7 周期。设计激进的高端超标量处理器,例如第 3 章讨论的 Intel i7,甚至可能达到 10~15 周期。总的来说,流水线越深,以周期计的分支代价越大,准确预测就越关键。
译注: 本节原文混用了字段布局。此处写“低 16 位”,图 C.18、C.19 及 C.20 图注却写 12 位;分支伪代码采用
NPC + (Imm << 2);后文还说目的寄存器随指令类别处于两个位置,图 C.25 使用IR6..10、IR11..15。这些与本书第 1 章给出的 RISC-V 固定字段并不一致,疑有旧版示例遗留。原页存储赋值行的箭头未印出,此处根据紧随其后的文字说明补明写入方向。 ↩︎