C.5 扩展 RISC-V 整数流水线以处理多周期操作
现在来考察如何扩展 RISC-V 流水线,使其支持浮点运算。本节重点介绍基本方法和设计选择,最后给出 RISC-V 浮点流水线的若干性能测量结果。
要求所有 RISC-V 浮点操作都在一个、甚至两个时钟周期内完成,并不现实。这样做意味着必须接受很低的时钟频率,或者在浮点单元中使用极大量的逻辑电路,或者两者兼有。因此,我们允许浮点流水线中的操作具有更长的延迟。可以把浮点指令想象成沿用整数指令的流水线,但有两点重要改变。第一,EX 周期可以重复多次,直到操作完成;不同操作的重复次数可以不同。第二,可以设置多个浮点功能单元。如果待发射的指令会在所需功能单元上引起结构冒险,或者引起数据冒险,就必须停顿。
本节假定 RISC-V 实现有四个独立的功能单元:
- 主整数单元,处理加载、存储、整数 ALU 操作和分支。
- 浮点与整数乘法器。
- 浮点加法器,处理浮点加法、减法和转换。
- 浮点与整数除法器。
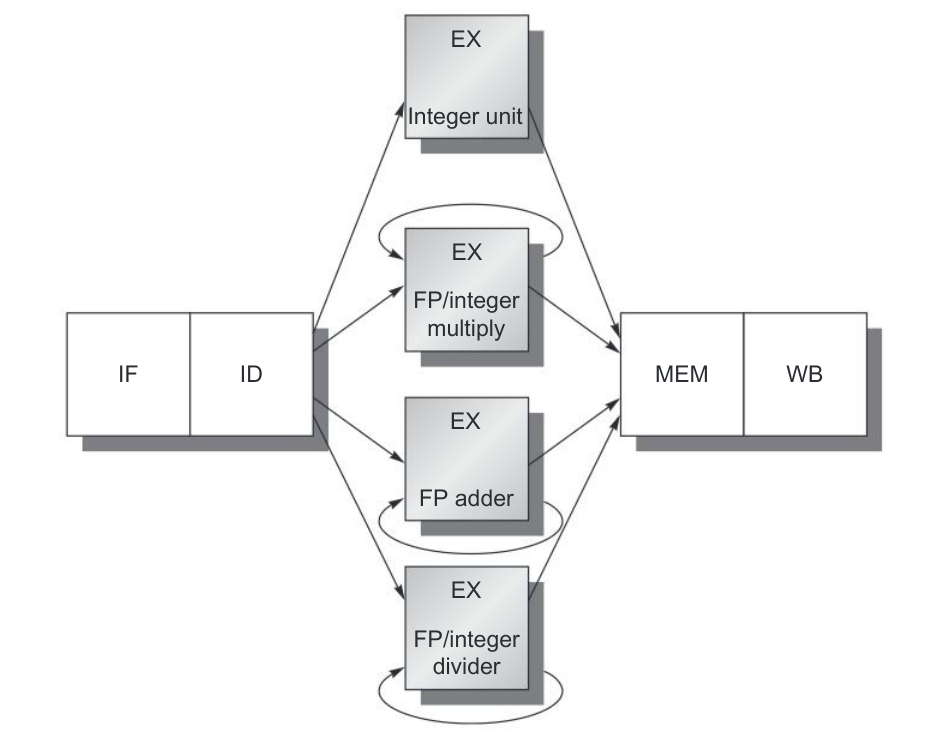
如果还假定这些功能单元的执行阶段不采用流水线,得到的结构如图 C.28。由于 EX 没有流水线化,使用同一功能单元的下一条指令必须等前一条离开 EX,才能发射。而且,如果一条指令不能进入 EX,其后面的整条流水线都要停顿。
实际电路中,中间结果大概不会像图 C.28 暗示的那样,在 EX 单元周围循环;EX 阶段只是需要多个时钟周期。我们可以推广图中的浮点流水线结构,使某些阶段流水线化,并允许多个操作同时进行。描述这种流水线时,既要定义功能单元的延迟,也要定义启动间隔(initiation interval,又称 repeat interval)。延迟仍按前文定义:产生结果的指令与使用该结果的指令之间,需要间隔的周期数。启动间隔则是连续发射两项同类操作之间,至少必须经过的周期数。以下采用图 C.29 所列的延迟和启动间隔。
| 功能单元 | 延迟 | 启动间隔 |
|---|---|---|
| 整数 ALU | 0 | 1 |
| 数据存储器(整数和浮点加载) | 1 | 1 |
| 浮点加法器 | 3 | 1 |
| 浮点乘法器(也执行整数乘法) | 6 | 1 |
| 浮点除法器(也执行整数除法) | 24 | 25 |
按这个定义,整数 ALU 操作的延迟是 0,因为其结果可在下一周期使用;加载的延迟是 1,因为其结果必须间隔一周期后才能使用。多数操作在 EX 开始时取用操作数,因此,延迟通常等于从 EX 之后到结果产生位置之间的阶段数:例如,ALU 操作是零级,加载是一级。主要例外是存储:它晚一个周期才取用待写入存储器的值。因此,向存储指令提供待存储数据时,产生该数据的操作与存储指令之间所需的间隔少一个周期;基址寄存器则没有这种减免。流水线延迟实质上等于执行流水线深度减一;执行深度是从 EX 到产生结果的阶段所包含的阶段数。因此,上例中浮点加法有四级,浮点乘法有七级。为了提高时钟频率,设计者需要减少每级的逻辑层数,这使复杂操作所需的流水级数增加。
所以,提高时钟频率的代价是操作延迟增大。
图 C.29 的示例流水线允许同时有四项尚未完成的浮点加法、七项浮点/整数乘法,以及一项浮点除法。把图 C.28 扩展后,就得到图 C.30 的画法。图 C.30 通过增加由流水线寄存器隔开的阶段来实现相应的启动间隔。各功能单元彼此独立,因此采用不同的阶段名称。对于除法单元这样需要多个时钟周期的阶段,图中进一步分格,以表示其延迟。这些小格并非完整的流水级,所以其中只能有一项活动操作。也可以使用本附录前面常用的时序图来表示这一结构;图 C.31 给出了一组相互独立的浮点运算和浮点加载、存储操作。浮点操作的延迟更长,自然会提高 RAW 冒险及相应停顿的发生频率,本节稍后将讨论这一点。
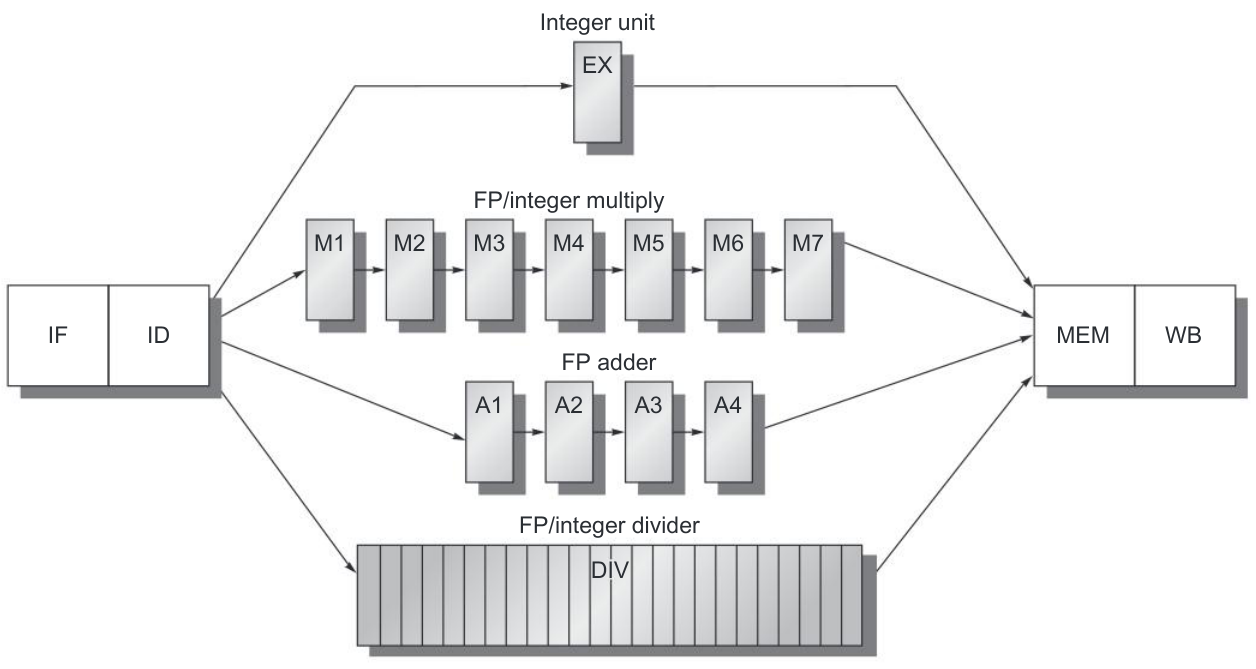
译注:图 C.29 将除法的延迟和启动间隔分别列为 24 和 25,而图 C.30 的原图注称除法需 24 周期完成。按本节的延迟定义,两处存在一周期的差别。
图 C.30 的结构需要增加流水线寄存器,例如 A1/A2、A2/A3 和 A3/A4,并修改相应连线。ID/EX 寄存器必须扩展,使 ID 能连接到 EX、DIV、M1 和 A1;可分别用 ID/EX、ID/DIV、ID/M1 或 ID/A1 表示其中连接到相应下一阶段的部分。
ID 与后续各阶段之间的流水线寄存器,在逻辑上可以视为相互独立,实际也可以实现为独立寄存器。每个流水级同时只容纳一项操作,因此控制信息可以与该级入口的寄存器关联。
| 指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|
fmul.d | IF | ID | M1 | M2 | M3 | M4 | M5 | M6 | M7 | MEM | WB |
fadd.d | IF | ID | A1 | A2 | A3 | A4 | MEM | WB | |||
fadd.d(原图如此) | IF | ID | EX | MEM | WB | ||||||
fsd | IF | ID | EX | MEM | WB |
延迟较长的流水线中的冒险与转发
对于图 C.30 这样的流水线,冒险检测与转发有几个不同于前面的方面:
- 除法单元没有完全流水线化,因此可能出现结构冒险,需要检测并暂停指令发射。
- 指令运行时间不同,同一周期要求进行的寄存器写入可能多于一次。
- 指令不再按顺序到达 WB,因此可能出现 WAW 冒险。不过,寄存器读取始终在 ID 中完成,所以不会出现 WAR 冒险。
- 指令完成顺序可能与发射顺序不同,从而给异常处理带来问题;下一小节将讨论。
- 操作延迟变长,RAW 冒险造成的停顿更频繁。
延迟变长导致的停顿增加,与整数流水线中的情况本质相同。在讨论浮点流水线带来的新问题及其解决方法之前,先看 RAW 冒险的潜在影响。图 C.32 给出一段典型浮点代码及其停顿。本节末尾还将考察这条浮点流水线在所选 SPEC 子集上的性能。
再看上述第 2、3 项与写操作有关的问题。若浮点寄存器堆只有一个写端口,一连串浮点运算,以及浮点加载与浮点运算的组合,都可能争用它。考虑图 C.33 的时序:在周期 11,三条指令同时到达 WB,都要写寄存器堆。
| 指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 | 13 | 14 | 15 | 16 | 17 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
fld f4,0(x2) | IF | ID | EX | MEM | WB | ||||||||||||
fmul.d f0,f4,f6 | IF | ID | 停顿 | M1 | M2 | M3 | M4 | M5 | M6 | M7 | MEM | WB | |||||
fadd.d f2,f0,f8 | IF | 停顿 | ID | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | A1 | A2 | A3 | A4 | MEM | WB | ||
fsd f2,0(x2) | IF | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | ID | EX | 停顿 | 停顿 | 停顿 | MEM |
| 指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 |
|---|---|---|---|---|---|---|---|---|---|---|---|
fmul.d f0,f4,f6 | IF | ID | M1 | M2 | M3 | M4 | M5 | M6 | M7 | MEM | WB |
… | IF | ID | EX | MEM | WB | ||||||
… | IF | ID | EX | MEM | WB | ||||||
fadd.d f2,f4,f6 | IF | ID | A1 | A2 | A3 | A4 | MEM | WB | |||
… | IF | ID | EX | MEM | WB | ||||||
… | IF | ID | EX | MEM | WB | ||||||
fld f2,0(x2) | IF | ID | EX | MEM | WB |
只有一个写端口时,处理器必须让指令依次完成。这是一个结构冒险。增加写端口可以解决它,但这种做法未必合算,因为额外端口很少用得上:稳态所需的最大写端口数只是一个。因此,我们选择把写端口访问作为结构冒险来检测和约束。
实现这种互锁有两种方法。第一种是在 ID 中跟踪写端口的使用,像处理其他结构冒险一样,在发射前暂停指令。可以用一个移位寄存器,记录已发射指令将在何时使用寄存器堆。若 ID 中的指令与已发射指令需要在同一时间写寄存器堆,就让 ID 中的指令停顿一周期。
每个时钟周期,把这个预约寄存器移位一位。其优点是保留了“所有互锁检测和停顿插入都在 ID 中进行”的性质,代价是增加移位寄存器和写冲突检测逻辑。本节以下均采用这一方案。
另一种方案是在发生冲突的指令试图进入 MEM 或 WB 时才暂停它。延迟到这一位置检测,可以选择暂停冲突双方中的任一条。一个简单但有时并非最优的启发式规则是:优先让延迟最长的单元通过,因为它最可能已经因 RAW 冒险而使其他指令等待。这一方案的优点是到 MEM 或 WB 入口才需检测,冲突在那里很容易看出;缺点是停顿现在可能来自两个位置,使控制更加复杂。注意,在 MEM 之前停顿,会占住 EX、A4 或 M7,并可能让停顿向流水线上游传播;在 WB 前停顿,则会堵住 MEM。
另一个问题是 WAW 冒险。以图 C.33 为例,假如后面的加载指令提前一周期发射,并以 f2 为目的寄存器,它会比前面的浮点加法早一周期写入 f2,因而造成 WAW 冒险。这个冒险仅在前一条运算的结果从未被任何指令使用、随后就被覆盖时发生。如果在这两次写入之间有一条使用 f2 的指令,就必须因 RAW 冒险而停顿,后面的写入也无法在前一条运算完成前发射。可以说,在这条流水线上,WAW 冒险只会在执行了一条没有用处的指令时出现;但仍必须检测它,确保最终留在 f2 中的是程序顺序中后一条指令的结果。C.8 节将说明,合理代码中有时也会出现这种序列。
译注:原书这一段及下一段多处把本应区分的指令都排作
fadd.d,同时又明确提到“加载指令”,使描述自相矛盾。上、下两段依据图 C.33 的指令次序和时序,用“前面的浮点运算”与“后面的加载指令”区分其角色;此处并未把原书的排印混乱当作新的一种冒险。
处理 WAW 冒险有两种可能。第一,延迟加载指令的发射,直到前面的浮点加法进入 MEM。第二,检测到冒险后取消前一条浮点加法的结果,修改控制,使其不写回;这样后面的指令可以立即发射。由于此类冒险很少见,任选较易实现的一种即可。在两种方案中,都可在后面的指令处于 ID、准备发射时检测冒险;暂停后面的指令,或把前面的结果写入变为空操作,都不难。难处在于判断后面的指令可能先完成,这需要知道流水线长度和前一条指令的当前位置。幸而“两次写入之间没有读取”的序列极少出现,可以采用简单办法:只要 ID 中的指令要写的寄存器也是某条已发射指令的目的寄存器,就不让它进入 EX。C.7 节将介绍如何借助额外硬件消除这种停顿。现在先把浮点流水线的冒险检测和发射逻辑串起来。
检测冒险时,既要考虑浮点指令之间,也要考虑浮点与整数指令之间。除浮点加载、存储以及浮点—整数寄存器传送之外,浮点和整数寄存器互不相干。整数指令操作整数寄存器,浮点运算操作自己的寄存器。因此,检测两类指令之间的冒险,只需考虑浮点加载、存储和寄存器传送。这种控制简化是分开设置整数、浮点寄存器堆的另一项优点。主要优点是:不增大任一寄存器堆就能使寄存器总数翻倍,也不增加任一寄存器堆的端口数就能提高带宽。主要缺点除了需要额外的寄存器堆,还包括偶尔在两组寄存器间传送数据的少量开销。
假定流水线在 ID 中完成全部冒险检测,那么发射前须进行三项检查:
- 检查结构冒险。 等待所需功能单元空闲——本流水线只有除法需要这样检查——并确保需要写回时寄存器写端口可用。
- 检查 RAW 数据冒险。 等待源寄存器不再列为某个流水线寄存器中尚未完成的目的寄存器,除非结果能在本指令需要时及时提供。这里需要若干项检查,取决于产生数据的指令何时给出结果,以及使用数据的指令何时需要结果。例如,ID 中的浮点运算若以
f2为源寄存器,则 ID/A1、A1/A2、A2/A3 中都不能把f2列为目的寄存器,因为这些浮点加法在 ID 中的指令需要结果时尚未完成。ID/A1 是 ID 输出寄存器中送往 A1 的部分。除法的情况稍复杂:若希望把除法的最后几个周期也与后续指令重叠,就必须专门处理即将完成的除法。实际设计可能放弃这一优化,以简化发射条件。 - 检查 WAW 数据冒险。 检查 A1 到 A4、D、M1 到 M7 中是否有指令与本指令写同一目的寄存器;若有,就暂停 ID 中指令的发射。
多周期浮点操作使冒险检测更复杂,但概念仍与 RISC-V 整数流水线相同;转发逻辑也是如此。可以比较 EX/MEM、A4/MEM、M7/MEM、D/MEM、MEM/WB 中的目的寄存器,是否等于浮点指令的某个源寄存器;若相同,就使相应输入多路选择器选取转发的数据。习题将要求你具体写出 RAW、WAW 冒险检测及转发逻辑。
多周期浮点操作也给异常机制带来问题,下面接着讨论。
保持精确异常
长时间运行的指令还会造成另一个问题,可用下面的代码说明:
这段代码看似简单,没有依赖关系。但先发射的指令可能比后发射的更晚完成。在这里,fadd.d 和 fsub.d 都可能在 fdiv.d 之前完成。这称为乱序完成(out-of-order completion),在包含长时间操作的流水线中很常见,参见 C.7 节。
既然冒险检测会保证指令间依赖关系不被破坏,乱序完成为什么还是问题?假设 fadd.d 已完成、fdiv.d 尚未完成时,fsub.d 触发浮点算术异常。结果就是我们希望避免的非精确异常。看起来似乎可以像整数流水线那样,让浮点流水线排空,但异常可能出现在无法这样处理的位置。例如,若加法完成后,fdiv.d 才决定触发浮点算术异常,硬件层面就无法形成精确异常。实际上,fadd.d 已覆盖自己的一个操作数,即使有软件帮助,也不能恢复到 fdiv.d 之前的状态。
问题的根源是完成次序与发射次序不同。处理乱序完成有四种方法。
第一种是忽略这一问题,接受非精确异常。20 世纪 60 年代和 70 年代初采用过这种方式;原书回顾的此前十五年中,某些超级计算机仍这样做:禁止某些类别的异常,或由硬件在不停止流水线的情况下处理它们。对当代多数处理器,这种办法很难采用,因为虚拟内存和 IEEE 浮点标准等功能实际上要求软硬件配合提供精确异常。前面提过,一些处理器采用两种执行模式解决它:一种速度快但异常可能不精确;另一种较慢但精确。较慢的模式可以由模式开关实现,也可以插入显式检查浮点异常的指令。两种做法都会严格限制浮点流水线中允许的重叠和重排,使得实际上一次只有一条浮点指令在执行。DEC Alpha 21064、21164,IBM Power1、Power2,以及 MIPS R8000 都采用过这种方案。
第二种是先缓冲一项操作的结果,直到所有更早发射的操作都完成。有些处理器确实采用这种办法;但若各操作运行时间相差很大,需要缓冲的结果数也可能很大,代价便会增加。而且,为了在等待长指令期间继续发射,必须从结果队列提供旁路,这需要大量比较器和很大的多路选择器。
这一基本方法有两种可行变体。其一是 CYBER 180/990 使用的 history file,它保存寄存器的旧值。发生异常,且必须回退到某条已乱序完成的指令之前时,可以从 history file 恢复原值。VAX 等处理器也用相似技术处理自动递增、自动递减寻址。另一种是 Smith 和 Pleszkun 于 1988 年提出的 future file,它保存寄存器的新值;更早的指令全部完成后,再用它更新主寄存器堆。这样发生异常时,主寄存器堆就包含被中断状态的精确值。第 3 章还将介绍支持推测执行所需的另一种方法;所谓推测执行,是指在尚不知道先前分支结果时就执行后续指令。
第三种是允许异常在一定程度上不精确,但保存足够信息,让陷阱处理例程重新构造精确的异常次序。这意味着要知道流水线中有哪些操作,以及它们各自的 PC。处理异常后,由软件完成位于“最晚一条已完成指令”之前的所有未完成指令,然后重新开始。考虑以下最坏情况:
- 指令 1:一条长时间运行、最终导致执行中断的指令。
- 指令 2 到指令 :一系列尚未完成的指令。
- 指令 :一条已经完成的指令。
给定流水线中所有指令的 PC 以及异常返回 PC,软件就能找到指令 1 和指令 的状态。指令 已完成,因此应当从指令 重新开始。处理异常后,软件必须模拟指令 1 到指令 的执行,随后从异常返回,并在指令 处恢复。陷阱处理程序要正确执行这些指令,复杂度很高;这是该方案的主要困难。
对于类似 RISC-V 的简单流水线,可以做一项重要简化:若指令 2 到指令 都是整数指令,那么既然指令 已完成,指令 2 到指令 必然也已完成;因此,只需处理浮点操作。为使方案可实现,可以限制同时重叠执行的浮点指令数。例如,如果只允许两条指令重叠,就只需要软件完成触发中断的那一条。
当浮点流水线很深,或浮点功能单元较多时,这种限制可能降低潜在吞吐率。一些 SPARC 实现用这一方案来允许浮点操作与整数操作重叠。
第四种是混合方案:只有在能够确定所有更早的指令都将完成而不会引发异常时,才继续发射后续指令。这样一来,发生异常时,触发异常的指令之后没有指令已经完成,而之前的指令都能完成。为了维持精确异常,有时必须暂停处理器。浮点功能单元必须在 EX 早期判断是否可能发生异常,在这里的 RISC-V 流水线中是最初三个时钟周期之内,从而阻止后续指令完成。MIPS R2000/3000、R4000 和 Intel Pentium 采用这种办法;附录 J 还将进一步讨论。
简单 RISC-V 浮点流水线的性能
图 C.30 的流水线可能因除法单元而发生结构停顿,也可能因 RAW 冒险而停顿;WAW 冒险也存在,但实际很少发生。图 C.34 按各类浮点操作的每次执行,给出停顿周期数。例如,每个浮点基准程序的第一根柱表示每次浮点加、减或转换导致的结果等待周期数。正如预期,每项操作的停顿周期数大致随浮点操作延迟变化,为功能单元延迟的 46% 到 59%。
图 C.35 则给出五个 SPECfp 基准程序中整数和浮点停顿的完整分解。图中有四类:浮点结果停顿、浮点比较停顿、加载与分支延迟,以及浮点结构停顿。实际未计入分支延迟停顿;若分支延迟只有一周期,并采用一个哪怕不很强的分支预测器,这部分就很小。每条指令的总停顿周期数在 0.65 到 1.21 之间。
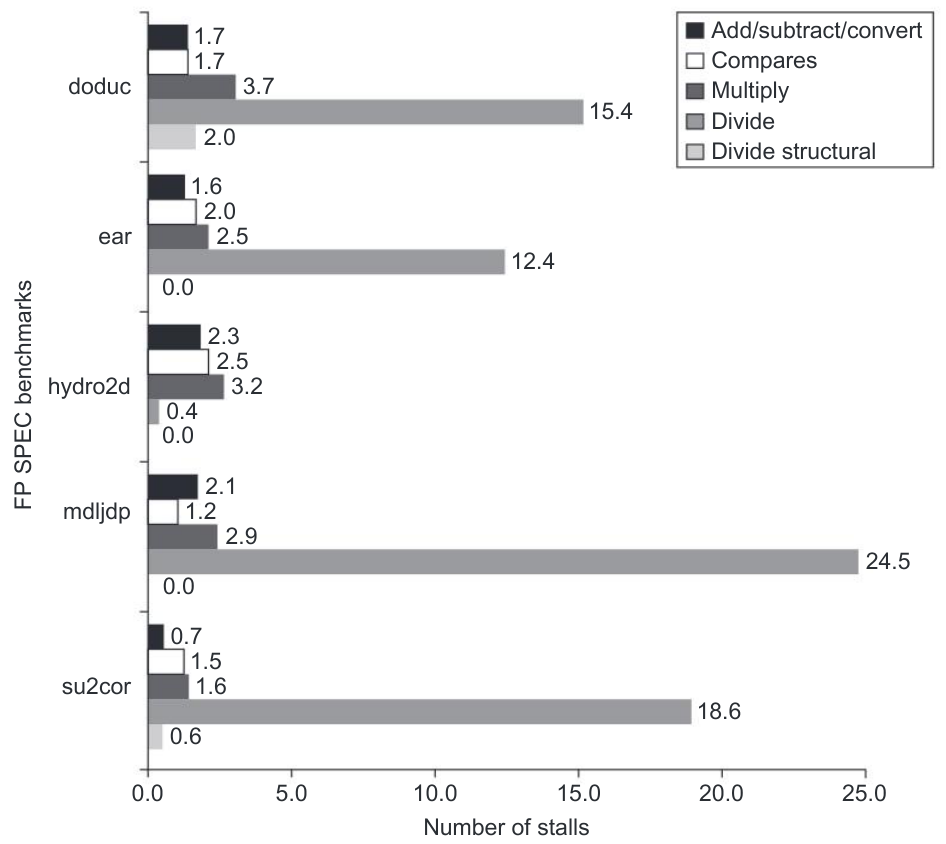
| 基准程序 | 加/减/转换 | 比较 | 乘法 | 除法 | 除法结构停顿 |
|---|---|---|---|---|---|
| doduc | 1.7 | 1.7 | 3.7 | 15.4 | 2.0 |
| ear | 1.6 | 2.0 | 2.5 | 12.4 | 0.0 |
| hydro2d | 2.3 | 2.5 | 3.2 | 0.4 | 0.0 |
| mdljdp | 2.1 | 1.2 | 2.9 | 24.5 | 0.0 |
| su2cor | 0.7 | 1.5 | 1.6 | 18.6 | 0.6 |
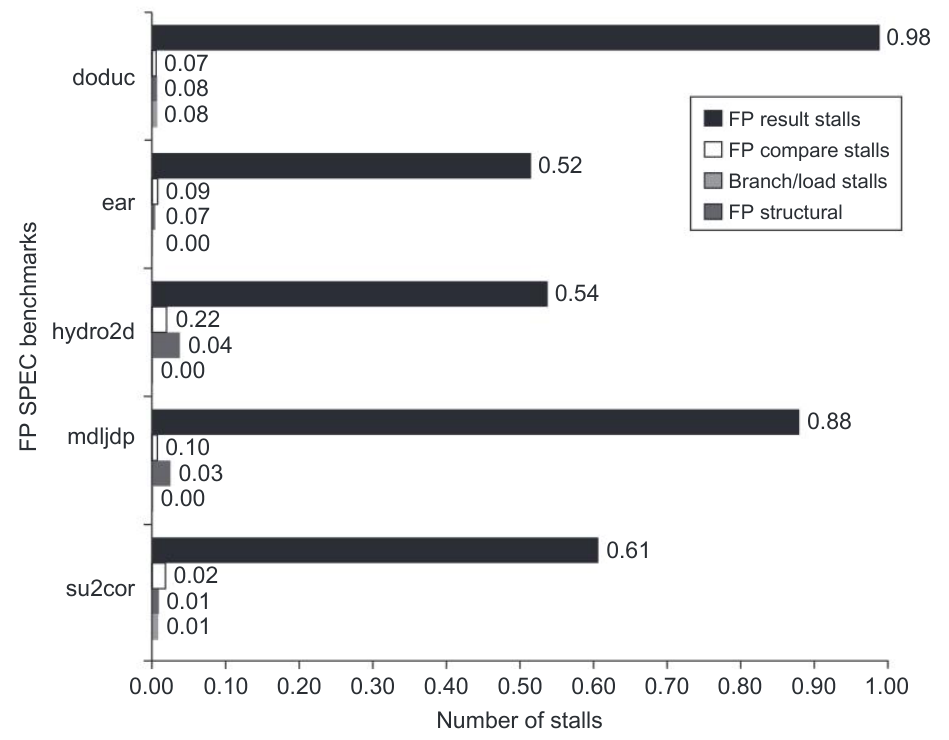
| 基准程序 | 浮点结果停顿 | 浮点比较停顿 | 分支/加载停顿(原图标签) | 浮点结构停顿 |
|---|---|---|---|---|
| doduc | 0.98 | 0.07 | 0.08 | 0.08 |
| ear | 0.52 | 0.09 | 0.07 | 0.00 |
| hydro2d | 0.54 | 0.22 | 0.04 | 0.00 |
| mdljdp | 0.88 | 0.10 | 0.03 | 0.00 |
| su2cor | 0.61 | 0.02 | 0.01 | 0.01 |