C.6 融会贯通:MIPS R4000 流水线
本节考察 MIPS R4000 处理器家族(包括 4400)的流水线结构与性能。MIPS 体系结构与 RISC-V 非常相似,只在少数指令上不同,例如 MIPS ISA 中的延迟分支。R4000 实现 MIPS64,但整数和浮点程序都采用比前述五级设计更深的流水线。它把五级整数流水线拆成八级,以获得更高的时钟频率。由于缓存访问的时间尤为关键,新增的阶段来自对存储器访问过程的拆分。这种较深的流水线有时称为超流水线(superpipelining)。
图 C.36 用抽象数据通路表示八级流水线结构,图 C.37 则表示连续指令在其中的重叠。虽然指令存储器和数据存储器访问都占多个周期,但它们完全流水线化,所以仍可每周期启动一条新指令。实际上,在缓存命中检测完成以前,流水线就已经使用了数据;第 3 章会更详细地讨论其实现。
各级的功能如下:
- IF: 取指的前半部分。此时实际完成 PC 选择,并启动指令缓存访问。
- IS: 取指的后半部分,完成指令缓存访问。
- RF: 指令译码、读取寄存器、检查冒险,以及检测指令缓存是否命中。
- EX: 执行,包括有效地址计算、ALU 操作,以及分支目标计算与条件判断。
- DF: 取数据,即数据缓存访问的前半部分。
- DS: 取数据的后半部分,完成数据缓存访问。
- TC: 检查标签,判断数据缓存访问是否命中。
- WB: 加载指令和寄存器—寄存器操作写回。
除了显著增加所需转发通路,这条延迟更长的流水线也增加了加载和分支的延迟。图 C.37 显示,加载延迟为两周期,因为数据在 DS 结束时可用。图 C.38 用简略时序表示了加载之后立即使用结果的情况,也说明:加载结果需要转发给比加载晚三或四周期的使用者。
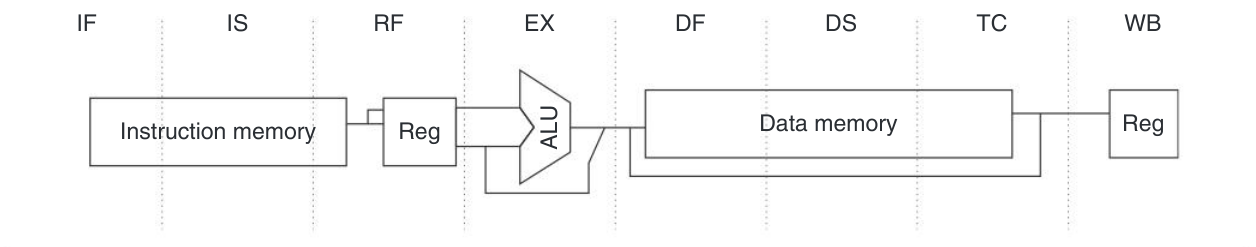
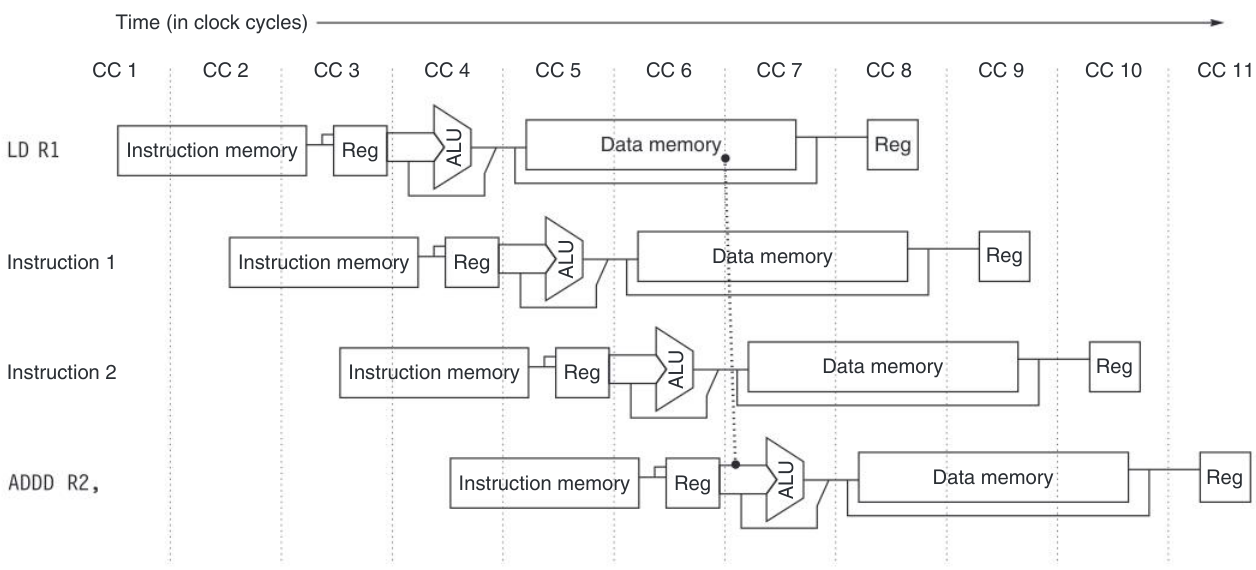
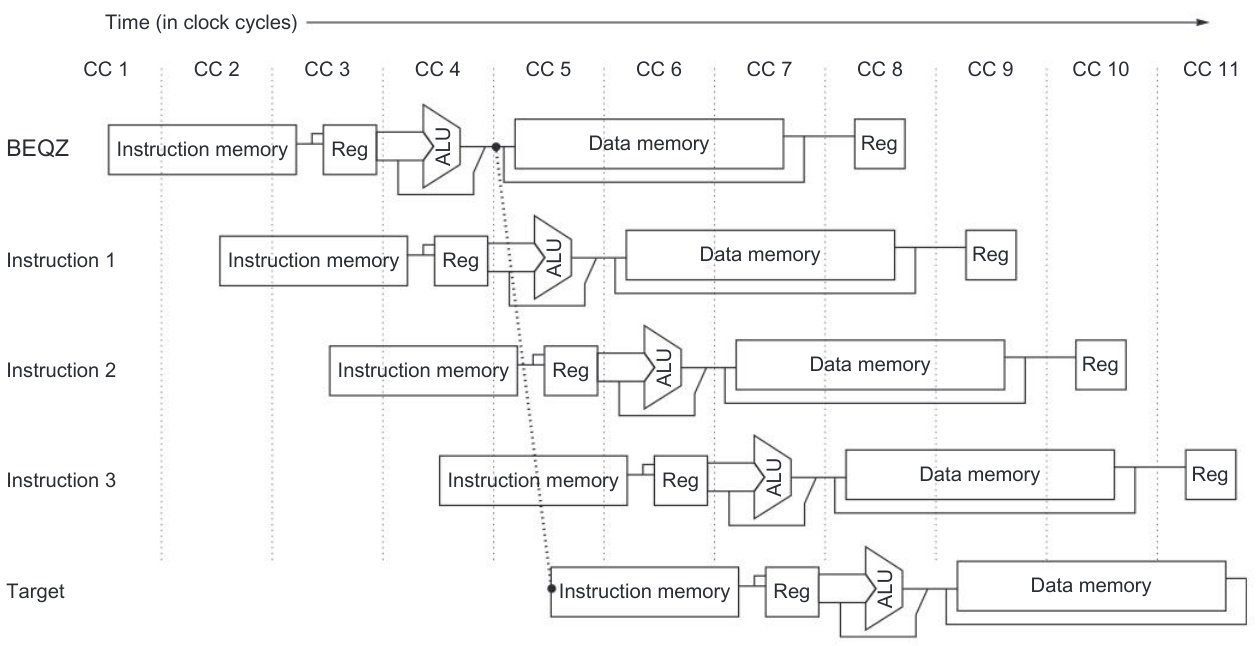
图 C.39 中,分支条件在 EX 阶段判断,因此基本分支延迟为三周期。MIPS 体系结构有一个周期的延迟分支槽;R4000 对剩余两周期采用预测不跳转策略。如图 C.40,不跳转的分支只有一个周期的延迟槽;跳转的分支则在延迟槽之后还有两个空闲周期。指令集中提供了前面介绍的 branch-likely 指令,有助于填充分支延迟槽。流水线互锁既负责落实分支跳转时的两周期停顿代价,也负责因使用加载结果而引起的数据冒险停顿。
R4000 之后的所有 MIPS 处理器实现都使用了动态分支预测。
| 指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
ld x1,… | IF | IS | RF | EX | DF | DS | TC | WB | |
add x2,x1,… | IF | IS | RF | 停顿 | 停顿 | EX | DF | DS | |
sub x3,x1,… | IF | IS | 停顿 | 停顿 | RF | EX | DF | ||
or x4,x1,… | IF | 停顿 | 停顿 | IS | RF | EX |
较深流水线不仅增加加载和分支停顿,也增加 ALU 操作所需的转发层数。在五级 RISC-V 流水线中,两条寄存器—寄存器 ALU 指令之间可以从 ALU/MEM 或 MEM/WB 转发;在 R4000 中,ALU 旁路有四个可能的来源:EX/DF、DF/DS、DS/TC 和 TC/WB。
| 情形与指令 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 |
|---|---|---|---|---|---|---|---|---|---|
| 跳转:分支指令 | IF | IS | RF | EX | DF | DS | TC | WB | |
| 延迟槽 | IF | IS | RF | EX | DF | DS | TC | WB | |
| 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | ||
| 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | 停顿 | |||
| 分支目标 | IF | IS | RF | EX | DF | ||||
| 不跳转:分支指令 | IF | IS | RF | EX | DF | DS | TC | WB | |
| 延迟槽 | IF | IS | RF | EX | DF | DS | TC | WB | |
| 分支后第 2 条指令 | IF | IS | RF | EX | DF | DS | TC | ||
| 分支后第 3 条指令 | IF | IS | RF | EX | DF | DS |
浮点流水线
R4000 的浮点部件包含浮点除法器、乘法器和加法器三个功能单元。乘法或除法的最后一步也会使用加法器逻辑。双精度浮点运算的时间从取负的两周期,到平方根的 112 周期不等;各单元的启动频率也不同。可以把浮点部件看作由图 C.41 所列的八种阶段组成;它们按不同次序组合,执行各种浮点操作。
每种阶段只有一份硬件,不同指令可能按不同次序使用某级零次或多次。图 C.42 给出最常见双精度浮点操作的延迟、启动间隔及所用阶段。
根据图 C.42,可以判断一串相互独立但类型不同的浮点操作能否无停顿地发射。如果时序会导致共享流水级冲突,就需要停顿。图 C.43–C.46 给出四种常见的双指令序列:乘法后接加法、加法后接乘法、除法后接加法,以及加法后接除法。各图列出第二条指令所有值得考察的起始位置,以及在该位置能够发射还是必须停顿。当然,也可能同时有三条活动指令,那样停顿的可能性更大,图也更复杂。
| 阶段 | 功能单元 | 说明 |
|---|---|---|
| A | 浮点加法器 | 尾数相加 |
| D | 浮点除法器 | 除法流水级 |
| E | 浮点乘法器 | 异常检测 |
| M | 浮点乘法器 | 乘法器第一阶段 |
| N | 浮点乘法器 | 乘法器第二阶段 |
| R | 浮点加法器 | 舍入 |
| S | 浮点加法器 | 操作数移位 |
| U | — | 拆解浮点数的编码 |
| 浮点指令 | 延迟 | 启动间隔 | 流水阶段(按使用次序) |
|---|---|---|---|
| 加法、减法 | 4 | 3 | U, S+A, A+R, R+S |
| 乘法 | 8 | 4 | U, E+M, M, M, M, N, N+A, R |
| 除法 | 36 | 35 | U, A, R, D²⁸, D+A, D+R, D+A, D+R, A, R |
| 平方根 | 112 | 111 | U, E, (A+R)¹⁰⁸, A, R |
| 取负 | 2 | 1 | U, S |
| 绝对值 | 2 | 1 | U, S |
| 浮点比较 | 3 | 2 | U, A, R |
| 操作 | 发射/停顿 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 乘法 | 发射 | U | E+M | M | M | M | N | N+A | R | |||||
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | |||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | |||||||||
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 加法 | 发射 | U | S+A | A+R | R+S |
| 操作 | 发射/停顿 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 乘法 | 发射 | U | E+M | M | M | M | N | N+A | R | |||||
| 乘法 | 发射 | U | M | M | M | M | N | N+A | R |
| 操作 | 发射/停顿 | 25 | 26 | 27 | 28 | 29 | 30 | 31 | 32 | 33 | 34 | 35 | 36 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 除法 | 周期 0 已发射… | D | D | D | D | D | D+A | D+R | D+A | D+R | A | R | |
| 加法 | 发射 | U | S+A | A+R | R+S | ||||||||
| 加法 | 发射 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 停顿 | U | S+A | A+R | R+S | ||||||||
| 加法 | 发射 | U | S+A | A+R | |||||||||
| 加法 | 发射 | U | S+A | ||||||||||
| 加法 | 发射 | U |
| 操作 | 发射/停顿 | 0 | 1 | 2 | 3 | 4 | 5 | 6 | 7 | 8 | 9 | 10 | 11 | 12 |
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 加法 | 发射 | U | S+A | A+R | R+S | |||||||||
| 除法 | 停顿 | U | A | R | D | D | D | D | D | D | D | D | D | |
| 除法 | 发射 | U | A | R | D | D | D | D | D | D | D | D | ||
| 除法 | 发射 | U | A | R | D | D | D | D | D | D | D |
译注:图 C.44 最后一行在 U 后仅标 M,未标通常的 E+M,译表照录。图 C.45 原图注称周期 28 开始的加法要等到周期 36,但表内周期 34 和 35 的起始位置已标为可发射;两处不一致,均予保留。
R4000 流水线的性能
下面考察 SPEC92 基准在 R4000 流水线上运行时的停顿。流水线停顿或效率损失主要有四个来源:
- 加载停顿: 在加载之后一或两周期内使用结果而引起的延迟。
- 分支停顿: 每个跳转分支造成两周期停顿,再加上未填满或被取消的分支延迟槽。R4000 实现的 MIPS 指令集支持在编译时预测分支的指令;实际行为与预测不符时,取消延迟槽中的指令。这有助于填充分支延迟槽。
- 浮点结果停顿: 因浮点操作数的 RAW 冒险而停顿。
- 浮点结构停顿: 浮点流水线中的功能单元冲突限制了发射,从而造成延迟。
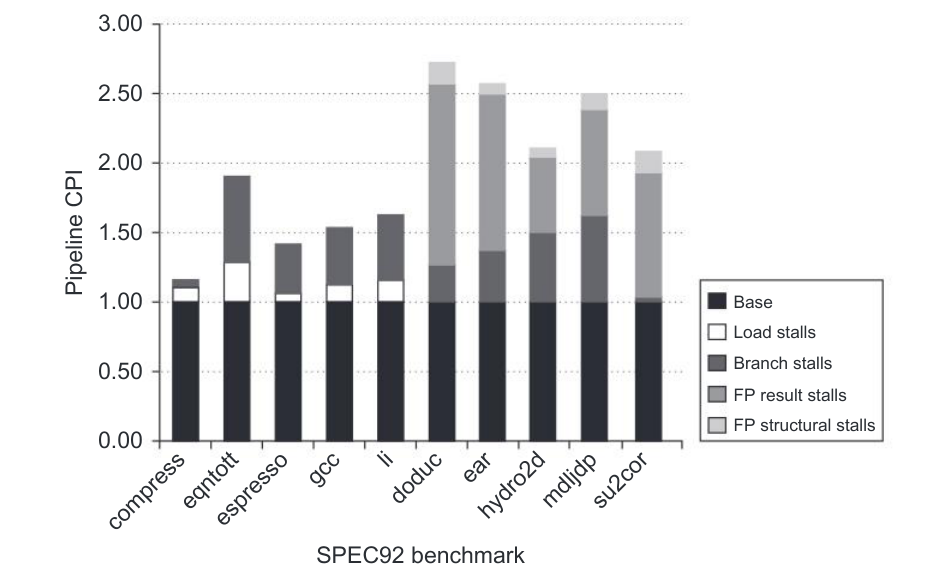
图 C.47 给出 10 个 SPEC92 基准在 R4000 流水线上的 CPI 分解,图 C.48 以表格给出同一组数据。
这两图显示了加深流水线的代价。R4000 的分支延迟远长于经典五级流水线,显著增加了分支耗费的周期;分支较频繁的整数程序尤为明显。这也是后来的中等深度到深流水线处理器几乎都使用动态分支预测器的原因;原书这里以 8–16 级作为典型深度。
浮点程序有一个有趣现象:浮点功能单元的延迟造成的结果停顿,多于结构冒险造成的停顿。后者既来自启动间隔限制,也来自不同浮点指令之间的功能单元冲突。因此,应先着力降低浮点操作延迟,再考虑进一步流水线化或复制功能单元。当然,降低延迟可能增加结构停顿,因为许多潜在结构停顿原先被数据冒险遮住了。
| 基准程序 | 流水线 CPI | 加载停顿 | 分支停顿 | 浮点结果停顿 | 浮点结构停顿 |
|---|---|---|---|---|---|
| Compress | 1.20 | 0.14 | 0.06 | 0.00 | 0.00 |
| Eqntott | 1.88 | 0.27 | 0.61 | 0.00 | 0.00 |
| Espresso | 1.42 | 0.07 | 0.35 | 0.00 | 0.00 |
| Gcc | 1.56 | 0.13 | 0.43 | 0.00 | 0.00 |
| Li | 1.64 | 0.18 | 0.46 | 0.00 | 0.00 |
| 整数平均值 | 1.54 | 0.16 | 0.38 | 0.00 | 0.00 |
| Doduc | 2.84 | 0.01 | 0.22 | 1.39 | 0.22 |
| Mdljdp2 | 2.66 | 0.01 | 0.31 | 1.20 | 0.15 |
| Ear | 2.17 | 0.00 | 0.46 | 0.59 | 0.12 |
| Hydro2d | 2.53 | 0.00 | 0.62 | 0.75 | 0.17 |
| Su2cor | 2.18 | 0.02 | 0.07 | 0.84 | 0.26 |
| 浮点平均值 | 2.48 | 0.01 | 0.33 | 0.95 | 0.18 |
| 总体平均值 | 2.00 | 0.10 | 0.36 | 0.46 | 0.09 |