D.2 磁盘存储进阶
磁盘行业历来着力提高容量。容量进步通常用面密度的提高来表示,单位是每平方英寸的位数:
到约 1988 年为止,面密度每年提高 29%,即每三年翻倍。此后到约 1996 年,年增长率增至 60%,每三年提高到四倍,与 DRAM 的传统增长率相当。从 1997 年到约 2003 年,年增长率升至 100%,每年翻倍。当促成这轮复兴的创新潜力基本释放之后,近年的增长率回落至约 30%。2011 年,商用产品的最高密度为每平方英寸 4000 亿位。每 GB 成本下降的速度至少与面密度增长一样快,其中小直径磁盘的贡献更大。1983 至 2011 年间,每 GB 成本改善了近 100 万倍。
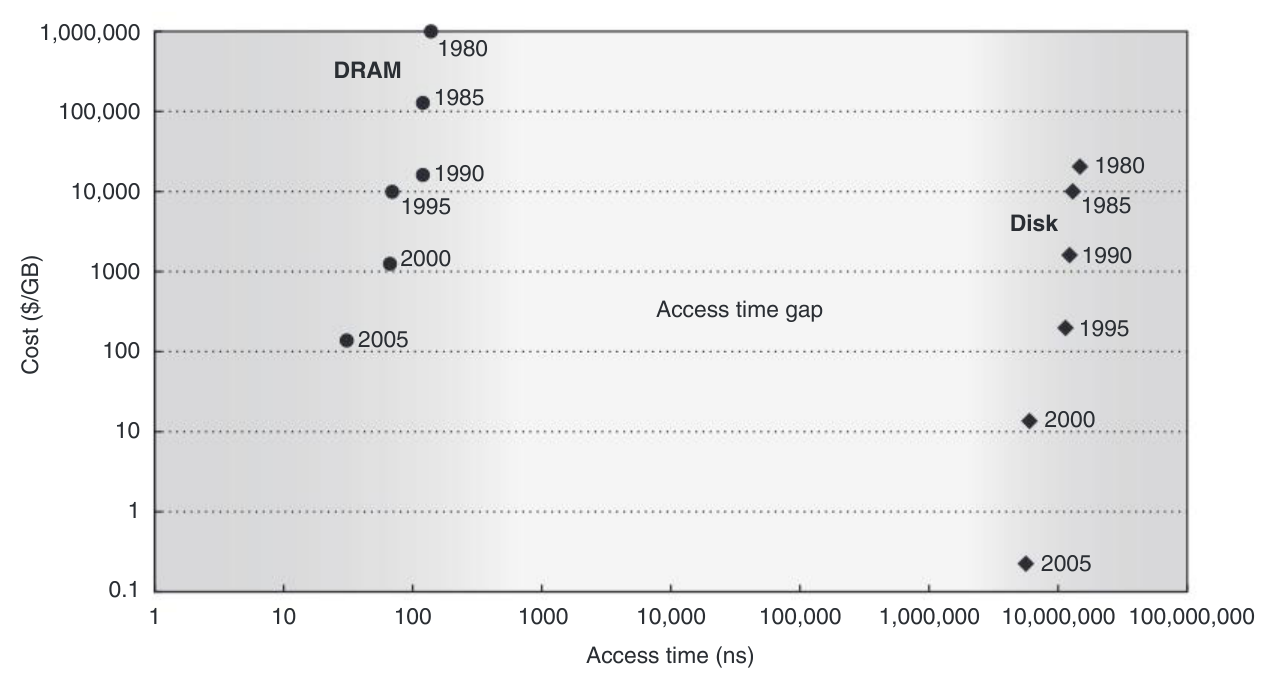
磁盘在辅助存储领域的主导地位曾多次受到挑战。图 D.1 展示了一个原因:磁盘与 DRAM 之间著名的访问时间鸿沟。DRAM 延迟约为磁盘的十万分之一,但代价是每 GB 成本为磁盘的 30–150 倍。
带宽差距更复杂。例如,2011 年一种高速磁盘容量为 600 GB,介质传输速率为 200 MB/s,售价约 $400。同年一个售价约 $200、容量为 4 GB 的 DRAM 模块能以 16,000 MB/s 传输(见第 2 章),带宽约为该磁盘的 80 倍。但按每 GB 容量计算,DRAM 的带宽高 6000 倍;按每美元计算,则高 160 倍。
**译注:**原页确写 6000 倍;按同段给出的带宽和容量,,应为 12,000 倍。80 倍的总带宽比和 160 倍的每美元带宽比则与所列条件一致。
许多人曾试图发明一种比 DRAM 便宜、比磁盘快的技术来填补鸿沟,但迄今均未成功。挑战者始终未能在恰当时机推出产品。等新产品上市时,DRAM 与磁盘已如前述预测那样取得进展,成本随之下降,挑战者的产品立刻就过时了。
最接近成功的挑战者是闪存。这种半导体存储器与磁盘一样非易失,带宽也相近,但延迟低 100–1000 倍。2011 年,闪存每 GB 价格为 DRAM 的 1/15–1/20。它在手机中很流行,因为可以采用小得多的容量,而且比磁盘节能,尽管每 GB 成本比磁盘高 15–25 倍。与磁盘和 DRAM 不同,闪存位会磨损,典型写入次数上限约为 100 万次,因此当时在桌面计算机和服务器中尚不普及。
磁盘在可预见的未来仍有生命力,但传统的扇区—磁道—柱面模型已不再适用。该模型假定相邻块位于同一磁道;同一柱面的块因无需寻道而访问更快;某些磁道彼此比另一些更近。
首先,磁盘内加入微处理器后,开始提供 ATA、SCSI 等更高层的智能接口。为加快顺序传输,这些接口把磁盘组织得更像磁带,而不是随机访问设备。逻辑块沿单个盘面按蛇形次序排列,尽可能连续覆盖以相同位密度记录的所有扇区。(磁盘会改变记录密度,因为外磁道的数据块旋转得快得多,电子电路难以跟上;降低线密度可简化任务。)因此,顺序块可能处于不同磁道。后文图 D.22将说明,处理现代磁盘时假定传统扇区—磁道模型是一个谬误。
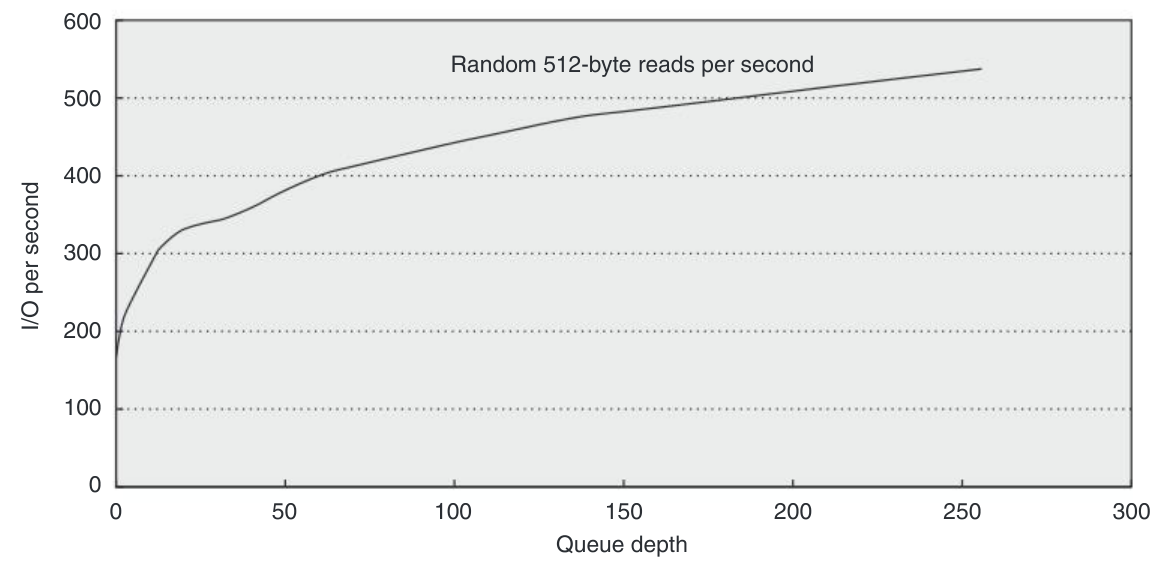
其次,微处理器进入磁盘不久,磁盘就加入缓冲区,在计算机准备接收之前暂存数据;后来又加入缓存,以免再次执行读访问。此外,还出现了命令队列,允许磁盘在保持正确行为的前提下决定命令执行顺序,尽可能提高性能。图 D.2 表明,队列深度达到 50 时,较好的调度可使随机 I/O 的每秒操作数翻倍。虽然实际系统不太可能在队列中积压 256 个命令,但这能使每秒 I/O 数达到原来的三倍。有了缓冲、缓存与乱序访问,要准确建模真实磁盘性能,就远比扇区—磁道—柱面模型复杂。
最后,盘片数从过去的 12 张减少为如今的 4 张,甚至 1 张。因此,单个柱面容纳的数据占比大幅减少,柱面也不再像过去那样重要。
磁盘功耗
与处理器一样,磁盘功耗也日益受到重视。2011 年典型 ATA 磁盘在空闲、读写、寻道时的功耗可能分别为 9 W、11 W、13 W。旋转更小的质量效率更高,因此小直径磁盘可以节能。下式说明转速与盘片大小对电机功耗的重要影响[Gurumurthi 等 2005]:
因此,更小的盘片、更低转速、更少盘片,都有助于降低电机功耗;而电机占了磁盘功耗的大部分。
图 D.3 列出 2011 年两种 3.5 英寸磁盘的规格。串行 ATA(SATA)追求大容量与低廉的每 GB 成本,因此 2000 GB 磁盘每 GB 不到 $0.05。它们采用外形尺寸允许的最宽盘片,装四到五张;转速为 5900 RPM,寻道也相对慢,以支持更高面密度并降低功耗。相应的 Serial Attach SCSI(SAS)磁盘追求性能,转速达 15,000 RPM,寻道快得多。为了高速旋转,它使用较低面密度;为了省电,盘片明显窄于外形尺寸。这些因素使 SAS 容量降到 600 GB。
SATA 每 GB 成本约有五倍优势;反过来,SAS 在每单位 IOPS 或每单位 MB/s 的成本上约有五倍优势。尽管盘片更小且数量少得多,SAS 因转速与寻道快得多,功耗仍是 SATA 的两倍。
| 接口 | 容量(GB) | 价格 | 盘片数 | RPM | 直径(英寸) | 平均寻道(ms) | 功耗(W) | I/O/s | 磁盘带宽(MB/s) | 缓冲带宽(MB/s) | 缓冲大小(MB) | MTTF(小时) |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| SATA | 2000 | $85 | 4 | 5900 | 3.7 | 16 | 12 | 47 | 45–95 | 300 | 32 | 0.6 M |
| SAS | 600 | $400 | 4 | 15,000 | 2.6 | 3–4 | 16 | 285 | 122–204 | 750 | 16 | 1.6 M |
**译注:**原图注确写“512 KB 扇区”。正文关于盘片数、功耗及成本倍数的描述,与表中四张/四张、12 W/16 W 和价格/容量数据并不一致。
磁盘阵列进阶
磁盘阵列同时改善存储系统的可信赖性与性能。一个理由是:采用更多磁盘、因而更多磁臂,可以比少量大磁盘提供更高的潜在吞吐量。把数据分散在多个磁盘上称为条带化(striping);当数据文件足够大时,它自动把访问分散到多个磁盘。(阵列提高吞吐量,但未必改善延迟。)如第 1 章所见,缺点是设备越多,可信赖性越低: 个设备的可靠性通常只有单设备的 。
**译注:**这里的 应理解为特定模型下的平均失效前时间(MTTF)之比:各设备寿命独立且服从相同指数分布,任何一个设备失效都会使系统失效。若“可靠性”指给定时间内无失效的概率,则系统可靠性为单设备可靠性的 次方,不能直接除以 。
若单盘可靠性相同,磁盘阵列发生故障的次数会多于少量大容量磁盘;但可通过添加冗余磁盘容错,提高可信赖性。一个磁盘失效后,丢失的信息由冗余信息重建。危险仅在于平均修复时间 MTTR 内又有磁盘失效。磁盘的平均失效前时间 MTTF 达数十年,而 MTTR 以小时计,所以冗余能使多磁盘系统测得的可靠性远高于单盘。
这种冗余磁盘阵列称为 RAID,最初是 redundant array of inexpensive disks(廉价磁盘冗余阵列)的缩写;有人更愿意用 independent(独立)解释 I。故障恢复能力,加上以 MB/s 或 I/O/s 衡量的高吞吐量,使 RAID 很有吸引力。再结合小直径磁盘体积小、功耗低的优势,RAID 现已主导大型存储系统。
图 D.4 概括了五种标准 RAID 级别,列出每级为八个用户数据磁盘配备的冗余/校验盘数量,以及优缺点。标准级别已有充分文献,因此这里仅作简要回顾,再深入讨论高级组织。
- **RAID 0:**没有冗余,有时也叫 JBOD,即 just a bunch of disks(只是一组磁盘),尽管数据可能跨磁盘条带化。通常列出这一级,是为了给其他级别的成本、性能、可信赖性提供比较基准。
- **RAID 1:**也叫镜像(mirroring)或影子复制(shadowing),每份数据保留两个副本。它最简单、出现最早,但成本也最高。有些控制器允许镜像盘独立处理读取,以优化读性能;代价可能是镜像写入完成得更慢。
- **RAID 2:**来自将内存式纠错码 ECC 应用于磁盘的思路。最初 RAID 论文发表时有这样的阵列产品,因而将它纳入;此后其他 RAID 组织更具吸引力,便没有了这类产品。
| RAID 级别 | 组织 | 可容忍失效数;八个数据盘的校验空间开销 | 优点 | 缺点 | 厂商/产品 |
|---|---|---|---|---|---|
| 0 | 无冗余条带化 | 0 个;0 个校验盘 | 无空间开销 | 无保护 | 广泛使用 |
| 1 | 镜像 | 1 个;8 个校验盘 | 无需奇偶校验计算;恢复快;小写入比更高 RAID 级别快;读取快 | 校验存储开销最高 | EMC、HP(Tandem)、IBM |
| 2 | 内存式 ECC | 1 个;4 个校验盘 | 不依赖失效磁盘自行诊断 | 约 Log 2 的校验存储开销 | 未使用 |
| 3 | 位交错奇偶校验 | 1 个;1 个校验盘 | 校验开销低;大读/写带宽高 | 不支持小规模随机读写 | Storage Concepts |
| 4 | 块交错奇偶校验 | 1 个;1 个校验盘 | 校验开销低;小读带宽更高 | 校验盘是小写入的瓶颈 | Network Appliance |
| 5 | 块交错分布式奇偶校验 | 1 个;1 个校验盘 | 校验开销低;小读写带宽更高 | 小写入需要 4 次磁盘访问 | 广泛使用 |
| 6 | 行—对角线奇偶校验、EVEN-ODD | 2 个;2 个校验盘 | 可抵御两盘失效 | 小写入需要 6 次磁盘访问;校验开销翻倍 | Network Appliance |
- **RAID 3:**高层磁盘接口知道磁盘健康状况,因此很容易确定哪块盘失效。设计者发现,只需额外一盘保存各数据盘信息的奇偶校验,就能恢复单盘失效。数据组成条带,每条带含 个数据块和一个校验块。失效时,只要从有效校验信息中“减去”完好数据块,剩下的就是缺失数据;无论坏的是数据盘还是校验盘,都适用。RAID 3 假定读写数据跨越所有磁盘,适合大量数据读写。
- **RAID 4:**许多应用以小访问为主。由于扇区自带错误检查,允许每盘独立读就能安全提高每秒读取次数。乍看之下,写入仍会很慢,因为必须读取所有磁盘以计算奇偶校验。另一种只涉及两个磁盘的方法能提高写入速率:先读即将覆盖的旧数据,在写新数据之前算出哪些位会改变;再读校验盘的旧校验值,根据变化更新校验,然后写回。这样的“小写入”仍比小读慢,需要四次磁盘访问,但比每次写入都读取所有盘更快。RAID 4 与 RAID 3 一样,校验盘开销低;除了小读写,它的大读写速度也能与 RAID 3 相同,但控制更复杂。
- **RAID 5:**RAID 4 的小写入有个性能缺陷:都要读写同一校验盘,造成瓶颈。RAID 5 把校验信息分散到阵列所有磁盘,消除这个瓶颈。各条带的校验块轮换所在磁盘,使校验均匀分布。控制器在写某个块时,须计算哪块盘存放相应校验,不过这可以很简单。RAID 5 与 RAID 3、4 一样,校验盘开销低;既有 RAID 3 的大读写能力,又有 RAID 4 的小读能力,小写带宽则比 RAID 4 更高。不过,它也需要经典 RAID 级别中最复杂的控制器。
简要回顾经典 RAID 之后,来看 RAID 问世后逐渐流行的两类组织。
RAID 10 与 01,即 1+0 与 0+1
RAID 文献并不总会讨论 RAID 1 的镜像如何与条带化结合。假设需要存放四个磁盘容量的数据,有八个物理盘可用。可以先把盘分成四对,每对组成 RAID 1,再跨四对条带化;也可以先分成两个四盘组,各组成 RAID 0,再向两个 RAID 0 组镜像写入。前者称为 RAID 1+0 或 RAID 10,即“条带化的镜像”;后者称为 RAID 0+1 或 RAID 01,即“镜像的条带”。
RAID 6:超越单盘失效
RAID 1–5 中基于奇偶校验的方案,能够抵御一个可自行识别的失效;但如果操作员在故障期间不慎更换了错误的磁盘,阵列就同时出现两个失效,造成数据丢失。另一个问题是磁盘带宽增长慢于容量,因此 RAID 中磁盘的 MTTR 越来越大,第二次失效的概率随之上升。例如,在没有干扰的情况下,顺序读完一个 500 GB SATA 磁盘可能要三小时。受损 RAID 往往还必须继续提供数据服务,重建可能被大幅拉长,进一步增加 MTTR。除了时间增长,重建时读取更多数据,也更容易遭遇不可纠正的介质错误,造成数据丢失。阵列盘数增加,以及采用比 SCSI 更慢、更大的 ATA 磁盘,也让人担忧同时发生多个失效。
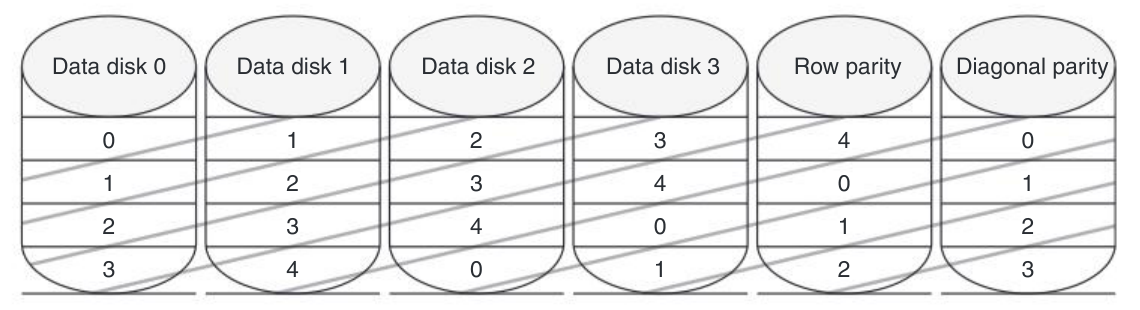
因此,多年来人们越来越重视抵御不止一个失效。例如,Network Appliance(NetApp)最初构建 RAID 4 文件服务器。双盘失效逐渐威胁客户数据后,它提出更强健的行—对角线奇偶校验(row-diagonal parity),也称 RAID-DP[Corbett 等 2004]。与标准 RAID 一样,它逐条带计算奇偶校验并保存冗余信息。为保护双盘失效,每条带增加两个校验块。假设共有 个磁盘,其中 个存数据。图 D.5 采用 。
行校验盘与 RAID 4 相同,保存本条带其他四个数据块的偶校验。对角线校验盘的每个块保存同一对角线上各块的偶校验。注意,每条对角线都会漏掉一个磁盘,例如对角线 0 不覆盖磁盘 1。因此,只需 条对角线就能保护 个磁盘,图 D.5 的校验盘只存对角线 0–3。
假设图 D.5 中数据盘 1、3 同时失效,看看这个方案如何工作。第一行缺少这两个盘的数据块,无法按标准 RAID 用行校验恢复;但对角线 0 只缺磁盘 3 的一个块,所以能够恢复。这样,先用对角线校验恢复失效盘四块中的一块。每条对角线各漏掉不同磁盘,因而有两条只缺一个块。本例为对角线 0、2;接着从对角线 2 恢复失效磁盘 1 的块。恢复这些块之后,就能用标准 RAID 4 的条带 0、2 再恢复两块,进而恢复更多对角线。持续这一过程,直到两块失效磁盘全部重建。
IBM 研究者更早提出的 EVEN-ODD 与行—对角线校验相似,但正常运行和恢复的计算量稍大[Blaum 1995]。后来的论文展示了如何扩展 EVEN-ODD,以抵御三个失效[Blaum、Bruck 和 Vardy 1996;Blaum 等 2001]。