D.3 故障与失效的定义及真实案例
人们也许能接受计算机偶尔崩溃、所有程序必须重启,却坚持要求信息永不丢失。因此,存储的首要原则是:无论发生什么,都必须记住信息。
第 1 章介绍了可信赖性基础,本节进一步给出失效的标准定义与实例。
首先,要澄清术语混淆。fault、error、failure 常被混用,但在可信赖性文献中含义不同。例如,编程失误属于故障、错误还是失效?讨论设计时刻与程序运行时刻,结论是否不同?如果运行时未触发该失误,它还算故障/错误/失效吗?再如,α 粒子击中 DRAM 单元,但数值没改变,属于什么?如果数值改变了,但未访问该位呢?如果内存纠错后向 CPU 返回了正确值,又是否发生了故障/错误/失效?这些问题足以说明,必须有精确定义才能有效讨论。
为避免含混,本节采用 Laprie[1985]及 Gray 和 Siewiorek[1991]的术语,它们得到 IFIP 第 10.4 工作组与 IEEE Computer Society 容错技术委员会认可。把系统当作一个模块讨论,而术语可递归应用于子模块。先看可信赖性(dependability)的定义:
计算机系统的可信赖性,是其所提供服务具备的一种品质,使人有充分理由信赖该服务。系统提供的服务,是与其用户交互的其他系统所感知到的实际行为。每个模块也都有理想的规定行为;服务规范是对预期行为达成一致的描述。实际行为偏离规定行为时,就发生了系统失效(failure)。失效源于该模块的缺陷,即错误(error);错误的原因则是故障(fault)。
故障发生后产生潜在错误,错误被激活后成为有效错误;当错误真正影响所提供的服务时,便发生失效。从错误出现到因此发生失效之间的时间,称为错误潜伏期(error latency)。因此,错误是故障在系统内部的表现,失效则是错误在服务层面的表现。[第 3 页]
回到前面的例子。编程失误是故障,其后果是软件中的错误或潜在错误。激活后,它成为有效错误;当有效错误产生错误数据并影响所提供的服务时,就发生失效。
α 粒子击中 DRAM 可视为故障。如果改变内存内容,就产生错误;在读取受影响的内存字之前,错误一直潜伏。如果被激活的字错误影响服务,就发生失效。如果 ECC 纠正了错误,则不会失效。
操作员的失误是故障,由此改变的数据是错误;错误在激活前保持潜伏,后续过程相同。
概括起来,三者关系如下:
- 一个故障产生一个或多个潜在错误。
- 错误有三项性质:①潜在错误一旦激活,就成为有效错误;②错误可能在潜在与有效状态之间反复切换;③有效错误常从一个组件传播到另一个,形成新错误。因此,组件中的有效错误,或由其原有潜在错误激活而来,或由该组件内或其他地方的错误传播而来。
- 当错误影响所提供的服务时,组件发生失效。
- 这些性质可以递归应用于系统中的任何组件。
Gray 和 Siewiorek 按成因将故障分为四类:
- **硬件故障:**设备失效,例如 α 粒子击中存储单元。
- **设计故障:**软件设计中的故障较常见,硬件设计中的较少见。
- **操作故障:**运行、维护人员的失误。
- **环境故障:**火灾、洪水、地震、断电和蓄意破坏。
按持续时间,故障又分为瞬态、间歇性和永久性[Nelson 1990]。瞬态故障只存在有限时间,不会复发;间歇性故障使系统在有故障与无故障运行之间反复;永久性故障不会随时间自行消失。
明确区别之后,来看真实案例。实际错误率很少公开,一是学术界很少有足够多硬件可供测量;二是工业界研究人员通常不获准公开失效信息,以免公司在市场竞争中处于不利地位。下面是少数例外。
Berkeley 的 Tertiary Disk
加利福尼亚大学的 Tertiary Disk 项目于 2000 年为旧金山美术博物馆建立艺术图像服务器,数据库包含超过 70,000 件艺术品的高质量图像[Talagala 等 2000]。数据放在一个由 20 台 PC 组成、通过交换式以太网连接的集群上,共有 368 个磁盘,占据七个七英尺高的机架。
图 D.6 列出各组件的失效率。建设之前,设计者预计 SCSI 数据盘最不可靠,因为它们既是机械部件,数量又多;其次是数量较少的 IDE 磁盘,再次是电源和集成电路。他们认为电缆等无源器件几乎不会失效。
| 组件 | 系统内总数 | 失效总数 | 失效比例 |
|---|---|---|---|
| SCSI 控制器 | 44 | 1 | 2.3% |
| SCSI 电缆 | 39 | 1 | 2.6% |
| SCSI 磁盘 | 368 | 7 | 1.9% |
| IDE/ATA 磁盘 | 24 | 6 | 25.0% |
| 磁盘机箱——背板 | 46 | 13 | 28.3% |
| 磁盘机箱——电源 | 92 | 3 | 3.3% |
| 以太网控制器 | 20 | 1 | 5.0% |
| 以太网交换机 | 2 | 1 | 50.0% |
| 以太网电缆 | 42 | 1 | 2.3% |
| CPU/主板 | 20 | 0 | 0% |
图 D.6 打破了一些预想。设计者遵从厂商建议,让磁盘机箱减振并保持良好散热,数据盘因而非常可靠。相比之下,放置 IDE/ATA 磁盘的 PC 机箱没有同等环境控制。(这些磁盘不存数据,而是存放用于启动 PC 的应用与操作系统。)表中 SCSI 背板、SCSI 电缆及以太网电缆的可靠性,竟然并不比数据盘更高!
Tertiary Disk 是具有大量冗余组件的大系统,能够承受这些不同失效。组件连接与镜像放置经过安排,使任何单点失效都不能令某幅图像不可用。最初看似过度设计,后来证明至关重要。
这段经历也说明了瞬态故障与硬故障的差别。图 D.6 的几乎所有失效,最初都表现为瞬态故障。操作员需要判断组件表现是否差到必须替换,还是可以继续使用。团队实际上没有用“失效”一词,而借用了处理问题员工的说法,由操作员决定是否“解雇”问题组件。
Tandem
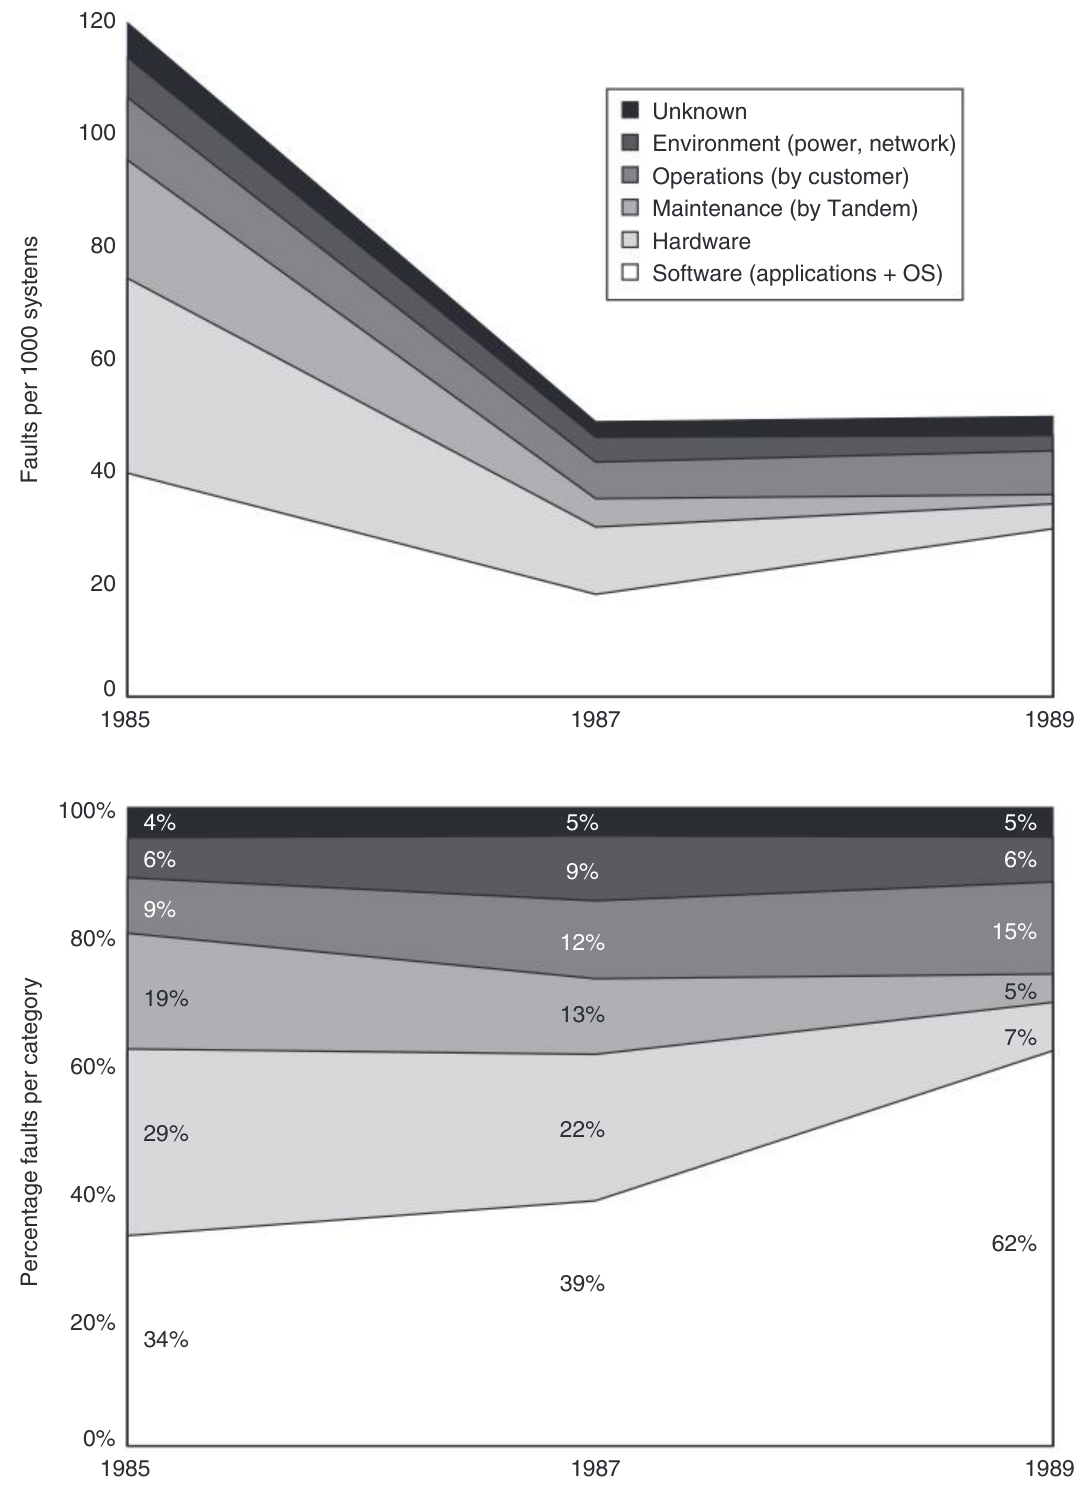
第二个案例来自工业界。Gray[1990]收集了 Tandem Computers 的故障资料;Tandem 是容错计算先驱之一,系统主要用于数据库。图 D.7 展示 1985–1989 年导致系统失效的故障,分别给出每系统绝对故障数和分类比例。数据表明,硬件与维护可靠性明显改善。1985 年的磁盘需要 Tandem 每年维护,后来改用无需计划维护的磁盘。系统中芯片、连接器数量减少,加上软件能够容忍硬件故障,到 1989 年硬件只占失效的 7%。而且,即便归因于硬件,真正原因也常是设备内嵌的软件,即固件。1989 年已报告停机的首要原因是软件,占 62%,其次是系统操作,占 15%。
这种统计的局限,是只反映被报告的问题。例如,断电引起的环境失效被视为本地问题,不会上报 Tandem。操作故障的数据很难收集,因为操作员要报告自己的失误,可能影响主管评价,进而影响工作稳定和加薪。Gray 认为环境与操作故障均存在漏报。他得出的结论是:要提高可用性,必须改进软件质量及软件容错,简化操作,并容忍操作故障。
关于操作员在可信赖性中作用的其他研究
Tertiary Disk 与 Tandem 都侧重存储。若想更准确衡量人在失效中的作用,需要考察存储以外的系统。Murphy 和 Gent[1995]试图改进操作故障数据:让系统在每次启动时自动询问操作员重启原因。他们把同一故障引起的连续崩溃归为操作故障,也计入直接导致崩溃的操作,例如错误参数、不当配置、不正确的应用安装。他们仍认为操作员错误存在漏报,但数据比 Gray 依赖操作员填表、再逐级上报管理部门的方法准确。VAX 系统中硬件/操作系统导致的失效,占比从 1985 年的 70% 降到 1993 年的 28%;同期操作员导致的失效从 15% 升到 52%。他们预计,系统管理将成为未来可信赖性的主要挑战。
最后一组数据来自政府。美国联邦通信委员会 FCC 要求,电话公司出现影响至少 30,000 人或持续 30 分钟的中断时,必须提交说明。详细报告由调查人员确定原因,而非设备操作员,因此没有前述自行报告的问题。Kuhn[1997]研究了 1992–1994 年的中断原因,Enriquez[2001]追踪了 2001 年上半年。虽然多年间网络过载引起的失效显著减少,但人为原因造成的用户中断分钟数占比,从约三分之一增至三分之二。
这些及其他案例说明,当时大型系统失效的首要原因,是操作员故障。芯片和连接器数量减少,降低了硬件故障;内存 ECC、RAID 等容错技术也改善了硬件可信赖性。至少有些操作系统会在加入新功能前考虑可靠性影响,所以到 2011 年,失效大多发生在其他环节。
虽然失效可能由操作员引发,但维护与升级流程如此容易出错,本身就暴露了系统技术水平的不足。多数存储厂商当时表示,客户在存储整个生命周期中的管理支出,远高于购买成本。因此,未来可信赖存储的挑战,是容忍操作员故障,或者通过简化管理工作来避免故障。注意,RAID 6 即使遇到操作员误换一块好盘,也能保持系统存续。
至此,我们介绍了存储的根基——可信赖性,给出了定义、案例和改进方法。下一站是性能。