D.4 I/O 性能、可靠性度量与基准测试
I/O 性能有些指标,在其他设计中找不到对应物。一项是多样性:哪些 I/O 设备能接入计算机?另一项是容量:能连接多少个 I/O 设备?
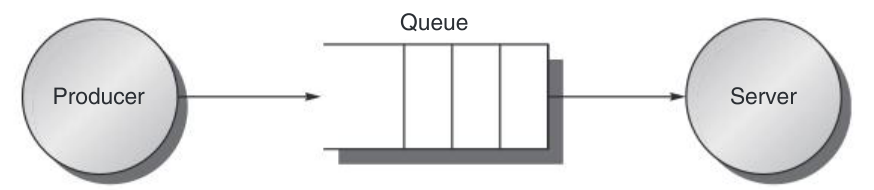
除了这些独有指标,传统的响应时间、吞吐量同样适用于 I/O。I/O 吞吐量有时称为 I/O 带宽,响应时间也称延迟。下面两图说明二者如何权衡。图 D.8 是简单的生产者—服务者模型:生产者创建任务并放入缓冲区,服务者从先进先出缓冲区取出任务并执行。
响应时间从任务进入缓冲区开始,到服务者完成任务为止。吞吐量是在一段时间内平均完成的任务数。要尽可能提高吞吐量,服务者就不能空闲,缓冲区也不能空;但响应时间包括缓冲区中的等待,所以空缓冲区有利于缩短响应时间。
另一项 I/O 性能指标是它对处理器执行的干扰。数据传输可能妨碍另一进程运行,处理中断也有开销。这里关心的是:一个进程会因另一个进程的 I/O 而多花多少时间?
吞吐量与响应时间
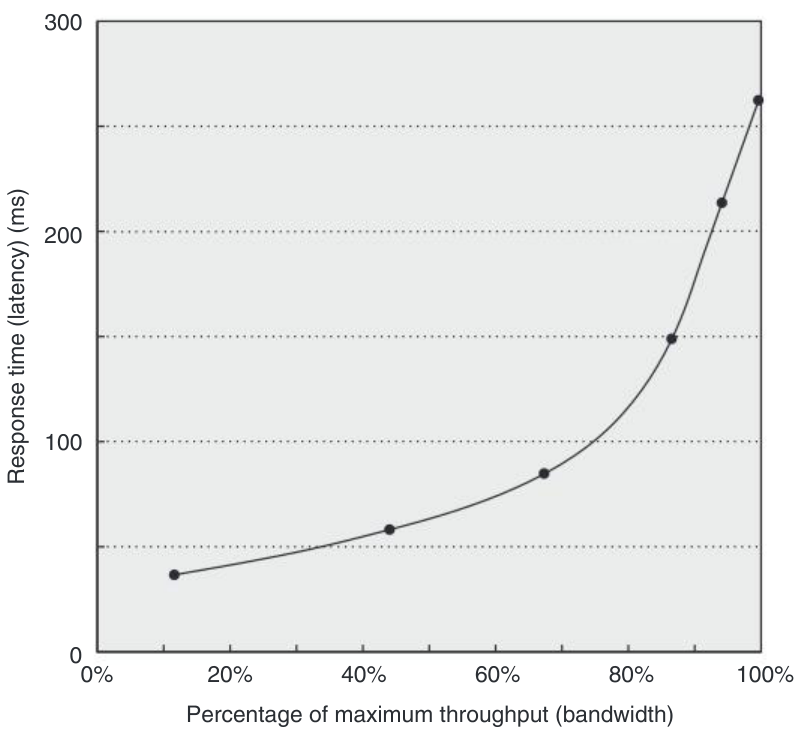
图 D.9 描绘典型 I/O 系统的吞吐量和响应时间。曲线拐弯区域意味着:略增吞吐量,响应时间就显著变长;反之,略微缩短响应时间,就会使吞吐量大幅下降。
体系结构设计者怎样平衡冲突?如果计算机需要与人交互,图 D.10 提供了答案。人与计算机的一次交互,即事务,可分为三部分:
- **输入时间:**用户输入命令的时间。
- **系统响应时间:**从用户提交命令到完整响应显示出来的时间。
- **思考时间:**从收到响应,到开始输入下一条命令的时间。
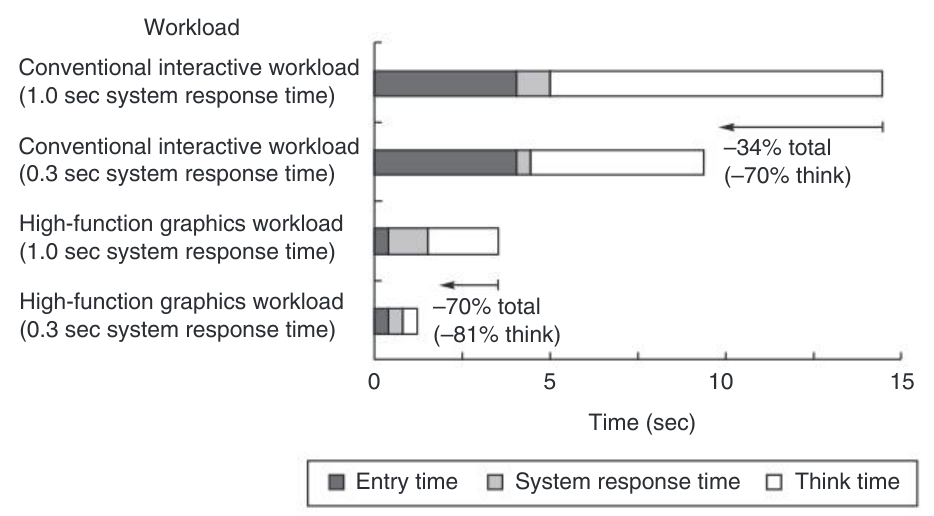
三者之和称为事务时间。多项研究报告,用户生产率与事务时间成反比。图 D.10 表明,系统响应缩短 0.7 秒,传统事务却节省 4.9 秒,即 34%;图形事务节省 2.0 秒,即 70%。看似不可思议,却符合人的特性:响应越快,思考所需时间越少。尽管该研究已有 20 年,处理器也快了 1000 倍,响应时间仍常远超一秒。例如,桌面 PC 启动应用时会有大量磁盘 I/O,点击网页链接时会有网络延迟。
为反映响应时间对生产率的重要性,I/O 基准也权衡吞吐量和响应时间。图 D.11 列出三种基准的响应时间边界:在 90% 响应时间低于限定值,或平均响应时间低于限定值的条件下,报告最大吞吐量。下面详述这些基准。
| I/O 基准 | 响应时间限制 | 吞吐量指标 |
|---|---|---|
| TPC-C:复杂查询 OLTP | 至少 90% 的事务满足限制;多数事务类型为 5 秒 | 每分钟新订单事务数 |
| TPC-W:事务型 Web 基准 | 至少 90% 的 Web 交互满足限制;多数交互类型为 3 秒 | 每秒 Web 交互数 |
| SPECsfs97 | 平均响应时间 ≤40 ms | 每秒 NFS 操作数 |
事务处理基准
事务处理(TP,在线事务处理则为 OLTP)主要关注 I/O 速率,即每秒磁盘访问次数,而非以每秒字节数衡量的数据速率。TP 通常涉及许多终端对大量共享信息的修改,并保证失效时行为仍正确。例如,顾客从 ATM 取款时银行计算机失效,事务系统必须保证:若钱已到手,账户就扣款;若钱没到手,账户保持不变。航空订票和银行都是传统用户。
如第 1 章所述,TP 社群的两打成员合力制定行业基准,为免触怒各自法律部门,匿名发表了报告[Anon. 等 1985]。这促成了 Transaction Processing Council(事务处理委员会,TPC),其成立后陆续制定了八项基准,概括于图 D.12。
以 TPC-C 为例。它用数据库模拟批发供应商的订单录入环境,包括订单录入与交付、付款记录、订单状态查询、仓库库存监控。它并发运行五种复杂度不同的事务,数据库有九张表,记录和客户规模可以扩展。指标为每分钟事务数 tpmC,以及包含硬件、软件、三年维护支持的系统价格。原书指向第 1 章第 42 页图 1.17,列举 TPC-C 性能及性价比最好的系统。
TPC 最先引入了以下不同寻常的特点,其中有些直到当时仍只有 TPC 采用:
- **结果包括价格。**提交结果必须列出硬件、软件和维护合同成本,因此既能比较性能,也能比较性价比。
- **数据集通常随吞吐量扩大。**基准力求模拟真实系统:需求增加时,存储数据量也一起增长。例如,让每分钟数千人只访问几百个银行账户,并不合理。
- **结果要审计。**提交前须经认证 TPC 审计员批准,以规则保证公平。结果可以受到质疑,争议提交 TPC 解决。
| 基准 | 数据大小(GB) | 性能指标 | 首次结果日期 |
|---|---|---|---|
| A:借记/贷记(已退役) | 0.1–10 | 每秒事务数 | 1990 年 7 月 |
| B:批量借记/贷记(已退役) | 0.1–10 | 每秒事务数 | 1991 年 7 月 |
| C:复杂查询 OLTP | 100–3000,最小为 0.07×TPM | 每分钟新订单事务数(TPM) | 1992 年 9 月 |
| D:决策支持(已退役) | 100、300、1000 | 每小时查询数 | 1995 年 12 月 |
| H:即席决策支持 | 100、300、1000 | 每小时查询数 | 1999 年 10 月 |
| R:业务报表决策支持(已退役) | 1000 | 每小时查询数 | 1999 年 8 月 |
| W:事务型 Web 基准 | 约 50、500 | 每秒 Web 交互数 | 2000 年 7 月 |
| App:应用服务器与 Web 服务基准 | 约 2500 | 每秒 Web 服务交互数(SIPS) | 2005 年 6 月 |
- **用吞吐量衡量性能,但约束响应时间。**例如 TPC-C 要求 90% 的新订单事务响应少于五秒。
- **由独立机构维护。**TPC 会费支持包含首席运营机构在内的管理体系,负责解决争议、邮寄投票批准基准变更、举行董事会会议等。
SPEC 系统级文件、邮件与 Web 服务器基准
SPEC 最著名的是处理器性能基准,但也开发了文件、邮件与 Web 服务器基准。
七家公司共同制定综合基准 SFS,评估运行 Sun Microsystems 网络文件服务 NFS 的系统。后来升级为 SFS 3.0,也称 SPEC SFS97_R1,支持 NFS 第 3 版、在 UDP 之外增加 TCP 传输,并采用更真实的操作组合。通过对 NFS 系统的测量,构成读、写和文件操作的综合混合。SFS 提供默认参数,以便比较。例如,一半写操作使用完整的 8 KB 块,另一半使用 1、2、4 KB 的部分块;读操作则为 85% 完整块、15% 部分块。
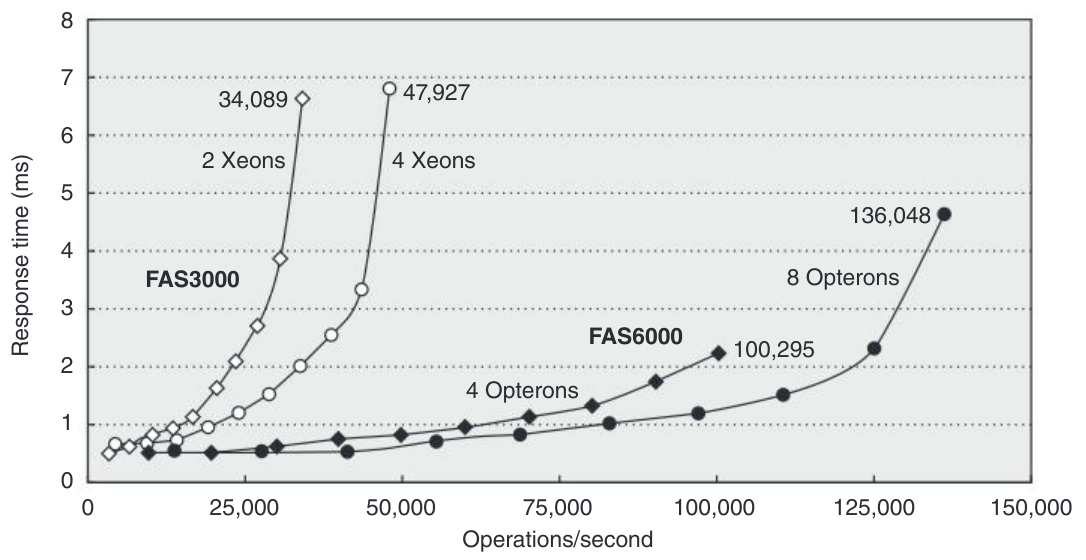
与 TPC-C 一样,SFS 按报告吞吐量扩大数据量:每增加 100 NFS 操作/s,容量必须增加 1 GB。它也限制平均响应时间,上限为 40 ms。图 D.13 给出两个 NetApp 系统的响应时间—吞吐量曲线。遗憾的是,SFS 不像 TPC 那样对不同价格配置作归一化。
SPECMail 用于评估 Internet 服务商的邮件服务器。SPECMail2001 基于 SMTP 和 POP3,在用户数从一万扩展到一百万时,测量吞吐量和响应时间。
SPECWeb 评估万维网服务器,衡量同时进行的用户会话数。SPECWeb2005 模拟 Web 服务商访问场景,由服务器托管多个组织的主页,包含三类负载:银行(HTTPS)、电子商务(HTTP 与 HTTPS)、支持(HTTP)。
可信赖性基准的例子
TPC-C 确实包含可信赖性要求:被测系统必须能应对单磁盘失效,所以实际提交者都在存储系统中采用某种 RAID。
更近一些的研究关注容错的实际效果。Brown 和 Patterson[2000]建议:向系统注入故障,观察服务质量指标随时间变化,以测量可用性。对于 Web 服务器,显然应测性能——每秒完成请求数,以及容错程度——存储子系统、网络连接拓扑等能容忍的故障数。
最初实验注入单个故障,例如磁盘扇区写错误,再通过服务质量记录系统行为。实验比较 Linux、Solaris、Windows 2000 Server 的软件 RAID;用 SPECWeb99 提供负载并测性能。为注入故障,将 RAID 卷中一块 SCSI 盘替换成模拟盘:一台运行相应软件的 PC,通过 SCSI 控制器在总线上表现为磁盘。模拟器支持注入多种瞬态故障,如可纠正读错误,以及永久故障,如写入时的介质失效。
图 D.14 展示各系统遇到不同故障的行为。上排左侧为 Linux,右侧为 Solaris。RAID 在重建完成前若再失去一盘,就可能丢数据,因此重建时间 MTTR 越长,可用性越低。但重建越快,从应用夺取的 I/O 资源越多,应用性能越差。策略必须在重建期间牺牲性能,与延长脆弱窗口、降低预测 MTTF 之间取舍。
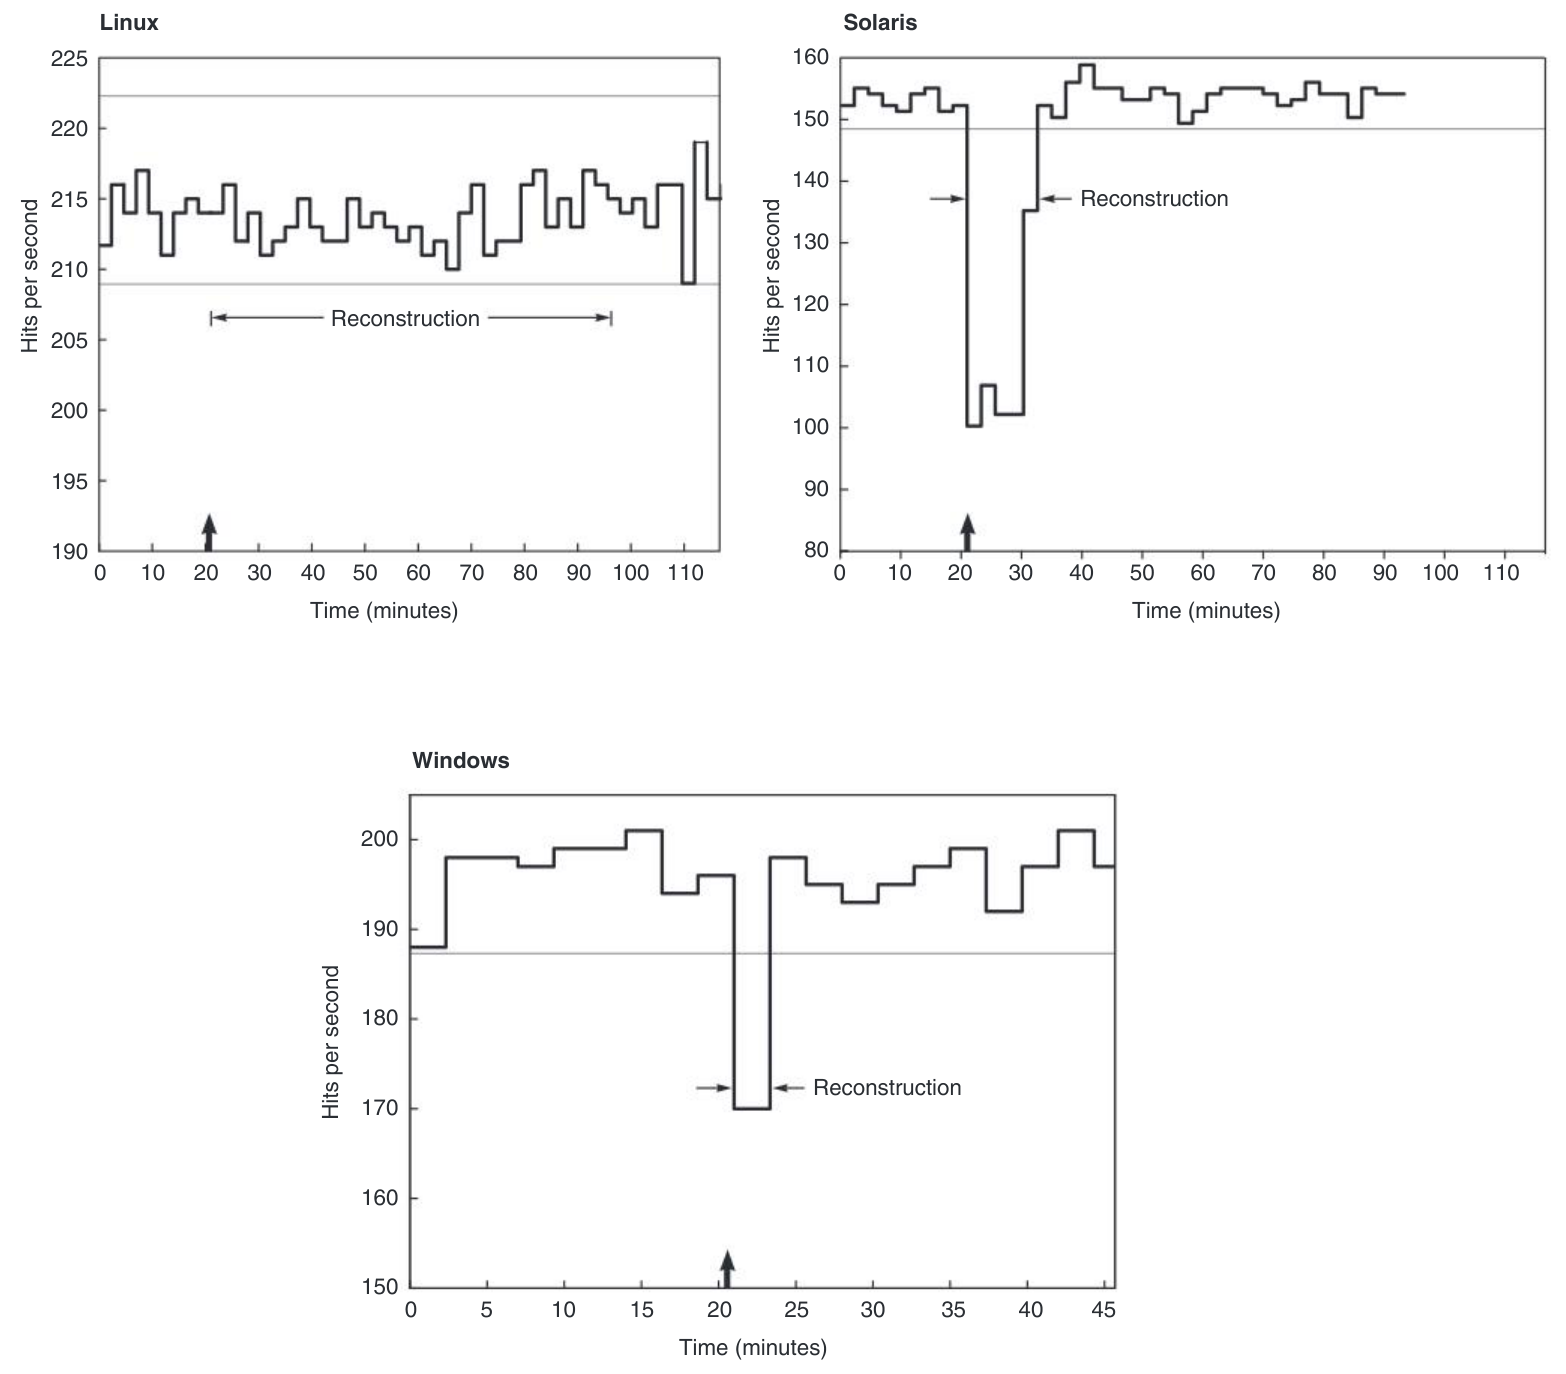
**译注:**原图注把置信区间解释成单次性能观测值的概率区间,这并不严谨。通常的 99% 置信区间描述重复抽样构造的区间对待估参数的覆盖率,不能直接解释为未来观测值有 99% 概率落入该区间。
虽然这些系统除源代码外,都没有文档说明重建策略,仅一次故障注入就足以揭示差异。Linux 与 Solaris 在活动磁盘因故障停用后,会自动向热备盘重建 RAID 卷;Windows 虽支持重建,却必须手动启动。所以,没有人工介入时,Windows 在第一次失效后仍暴露于第二次失效,脆弱窗口扩大。不过,一旦得到指令,它修复得很快。
实验还揭示了自动备用盘使用、重建速率、瞬态错误等可用性策略,同样没有系统为这些策略提供文档。
对于瞬态故障,Linux 软件 RAID 与 Solaris、Windows 恰好相反。Linux 非常保守:第一次错误出现,就宁愿可控地停用磁盘,也不等着判断是否瞬态。Solaris 和 Windows 更宽容,忽略多数瞬态故障,预期它们不会复发。因此,后两者对瞬态故障的耐受力显著强于 Linux。它们仍会记录瞬态故障,确保即使不采取动作也有错误报告。面对永久故障,各系统表现相似。