D.5 排队论入门
设计处理器时,可以用第 1 章 CPI 公式作简单的粗算,也可以付出更大代价,进行完整模拟以提高准确性。I/O 系统同样可以用最好情况分析粗算;完整模拟能更准确预测性能,但工作量也大得多。
I/O 设计还可借助一种数学工具:它比最好情况分析稍费力,却准确得多;又比完整模拟省事得多。I/O 事件具有概率性,I/O 资源又是共享的,因此可以用一些简单定理计算整个系统的响应时间与吞吐量。这就是排队论(queuing theory)。该领域已有许多专著和课程,本节只作初步介绍;即便如此,也有助于设计更好的 I/O 系统。
先把 I/O 系统看成图 D.15 的黑箱。处理器发出 I/O 请求,请求到达设备;设备满足请求后,请求便“离开”。
通常关心系统长期运行的稳态,而非启动过程。如果要研究非稳态,虽然可以借助 Markov 链,但除少数情况外,所得方程只能通过模拟求解。本节旨在介绍比粗算稍难、比模拟简单的方法,因此不涉及这些分析;详情可参见附录 M 所列文献。
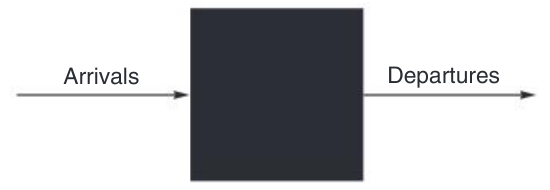 图 D.15 把 I/O 系统视为黑箱,可得到简单而重要的观察:稳态时,进入和离开的任务数必须相等。这种流量平衡是稳态的必要条件,但并不充分。若观察或测量足够长时间,平均等待时间也趋于稳定,就说系统达到稳态。Arrivals 为到达,Departures 为离开。
本节因此假定:系统处理多个相互独立的 I/O 请求,并处于平衡,输入率必须等于输出率;任务持续到来,其供应不依赖等待服务的时间。现实中许多系统,如 TPC-C,任务消费速率还由内存容量等其他特性决定。
由此得到 Little 定律,它关联系统平均任务数、新任务平均到达率与平均完成时间:
系统平均任务数=到达率×平均响应时间.只要黑箱内部不创建或销毁任务,该定律适用于任何平衡系统。到达率与响应时间必须采用相同时间单位,单位不一致是常见错误来源。
试着推导它。观察系统 Timeobserve 分钟,记录每个任务的服务经历并累加。期间完成 Numbertasks 个任务,各任务在系统内停留时间之和为 Timeaccumulated。任务在时间上可能重叠,原文据此写出 Timeaccumulated≥Timeobserved。于是:
系统平均任务数平均响应时间到达率=TimeobserveTimeaccumulated,=NumbertasksTimeaccumulated,=TimeobserveNumbertasks.**译注:**任务时间“可能重叠”并不能保证累计时间总大于观察时间;若系统长时间空闲,上述不等式未必成立。这不影响后面由三个比值建立的 Little 定律关系;有限观察窗口还须妥善处理边界任务。
用代数分解第一式:
TimeobserveTimeaccumulated=NumbertasksTimeaccumulated×TimeobserveNumbertasks.**译注:**原页两分式之间印为“∞”;根据两侧等式与紧接着的文字,该处应为乘号,以上明确按乘法排出。
代入三个定义并交换右侧两项顺序,便得到 Little 定律:系统平均任务数=到达率×平均响应时间。这个简单等式的作用远超直觉,后面会看到。
打开黑箱,就得到图 D.16。任务积压等待服务的区域称为队列或等待队列,执行请求的设备称为服务者(server)。直到本节最后两页之前,都先假设只有一个服务者。
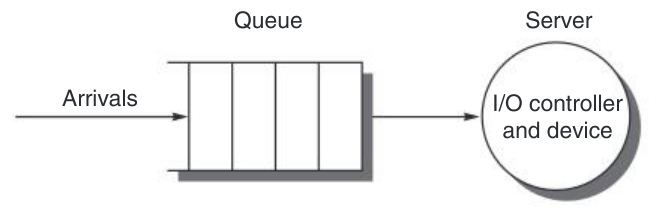 图 D.16 本节的单服务者模型。I/O 请求由服务者完成时即“离开”。Arrivals 为到达,Queue 为队列,Server 为服务者,其内部为 I/O 控制器与设备。
结合 Little 定律与以下定义,可得到几个有用等式:
- Timeserver:任务平均服务时间。平均服务率为其倒数 1/Timeserver,许多排队论教材用 μ 表示。
- Timequeue:任务在队列中的平均时间。
- Timesystem:任务在系统中的平均时间,即响应时间,是前两者之和。
- 到达率:每秒平均到达任务数,通常用 λ 表示。
- Lengthserver:平均正在接受服务的任务数。
- Lengthqueue:平均队列长度。
- Lengthsystem:系统平均任务数,是前两者之和。
这些定义澄清一个常见混淆:问的是开始服务前要排队多久,还是任务完成总共要多久?后者才是响应时间,两者关系为:
Timesystem=Timequeue+Timeserver.由 Little 定律,平均接受服务任务数是到达率乘以平均服务时间。原文接着说,服务者利用率是“平均接受服务任务数除以服务率”。单服务者的服务率是 1/Timeserver,随后给出的利用率(此时也等于每服务者平均任务数)公式为:
服务者利用率=到达率×Timeserver.**译注:**上述引号内文字与量纲不一致。这里正确的比例是“到达率÷服务率”,即紧接着的公式;不是平均任务数除以服务率。
利用率必须在 0 与 1 之间,否则到达任务多于能够服务的任务,违背平衡假设。这其实也是 Little 定律的另一种写法。利用率也称流量强度(traffic intensity),通常记为 ρ。
例题:单盘利用率
一个单磁盘 I/O 系统平均每秒收到 50 个请求,磁盘平均每个请求服务 10 ms,利用率是多少?
**解答。**将 10 ms 写成 0.01 s:
ρ=50/s×0.01s=0.50.因此利用率为 0.5。
队列向服务者交付任务的规则称为排队规则(queue discipline)。最简单、最常见的是先进先出 FIFO。假设 FIFO,队列等待时间可表示为:
Timequeue=Lengthqueue×Timeserver+新任务到达时,若服务者忙碌,完成当前任务所需的平均时间项.也就是排在前面的任务数乘平均服务时间,再加上到达时正在服务的任务还要占用多久。(到达过程还有一个限制,将在后文说明。)
最后一项不像初看那样简单。新任务可以在任何时刻到达,无法知道现有任务已服务多久。但虽然请求是随机事件,只要知道事件的分布,仍能预测性能。
随机变量的 Poisson 分布
要估计最后一项,先了解随机变量分布。若变量以给定概率取某个给定集合中的值,它就是随机变量:不能确知下一个值,却可能知道各个值的概率。
I/O 请求可用随机变量建模,因为操作系统通常在多个进程间切换,而进程各自产生独立请求。磁盘寻道与旋转延迟同样具有概率性,因此服务时间也用随机变量建模。
对离散取值,可用直方图刻画分布:把最小值到最大值分成称为桶的子区间,再用柱形表示每桶数量。它适合 I/O 请求数等离散量。对于等待时间等连续量,可以画覆盖全范围的曲线,或者用非常小的时间单位划出大量桶,以精确估计。例如,虽然磁盘服务时间连续,仍可每 10 μs 一个区间绘制直方图。
为求前式最后一项,必须刻画这个随机变量;平均时间和某种方差度量就够了。平均值采用加权算术平均时间。测得第 i 类任务出现 ni 次,其频率为:
fi=∑i=1nnini.于是:
Tˉ=f1T1+f2T2+⋯+fnTn,其中 Ti 为第 i 类任务时间,fi 为出现频率。为描述均值附近的变化,通常用标准差;这里使用标准差的平方,即方差,以便刻画概率分布:
Variance=(f1T12+f2T22+⋯+fnTn2)−Tˉ2.计算方差时必须注意单位。100 ms 平方后是 10,000 平方毫秒,这个单位很不直观;无量纲度量更方便。因此使用变异系数的平方,记为 C2:
C2=Tˉ2Variance.由此得到变异系数 C:
C=TˉVariance=Tˉ标准差.为了预测性能,需要数学上易于处理的随机事件分布。最常用的是指数分布,其 C=1。
这里用一个常数刻画围绕平均值的变化。原文称,C 不随时间变化,反映了事件历史不影响当前事件发生概率的性质。这种“健忘”称为无记忆性(memoryless),是这些模型用于预测的重要假设。否则,就必须考虑请求相互之间的精确到达时刻,数学处理会复杂得多。
原文将最广泛使用的一种“指数分布”称为 Poisson 分布,以数学家 Siméon Poisson 命名。它描述给定时间区间内的随机事件,有若干便利的数学性质,其概率质量函数为:
P(k)=k!e−aak,a=事件速率×经过时间.若到达间隔服从指数分布,且采用前述到达率作为事件速率,则到达计数形成 Poisson 过程;时间区间 t 内的到达数服从参数 a=λt 的 Poisson 分布。如前文所述,前面的等待时间关系还要求到达过程为 Poisson 过程(原文此处把该关系称为 Timeserver 的等式)。
译注:Poisson 分布是离散计数分布,并非指数分布;Poisson 过程的到达间隔才服从指数分布。C 恒定也不足以推出无记忆性。下面 C 描述的是服务时间分布,指数服务时间满足 C=1,不能把这个结论直接套给 Poisson 计数。
现在可回答新任务还需等待正在服务的任务多久,即平均剩余服务时间;仍假设 Poisson 到达:
平均剩余服务时间=21×算术平均服务时间×(1+C2).虽然不推导,可用直觉理解:若服务时间并不随机,全部等于平均值,标准差为零,C=0,平均剩余时间正好是平均服务时间的一半。如果服务时间随机,原文称“且为 Poisson”,则 C=1,剩余时间等于加权平均服务时间;此处应按前述译注理解为指数服务时间。
例题:推导平均排队时间
利用上面的定义和公式,以平均服务时间和利用率表示平均排队时间。
**解答。**新任务前面的 Lengthqueue 个任务都必须先完成,每个平均耗时 Timeserver。若服务者正忙,还要等待平均剩余服务时间;忙碌概率就是利用率 ρ。因此:
Timequeue=LengthqueueTimeserver+ρ×平均剩余服务时间.代入剩余时间公式,以及由 Little 定律得到的 Lengthqueue=λTimequeue:
Timequeue=ρ[21Timeserver(1+C2)]+(λTimequeue)Timeserver.本节采用指数服务时间,因此 C2=1:
Timequeue=ρTimeserver+(λTimequeue)Timeserver.整理末项,用 λTimeserver=ρ 代换:
Timequeue=ρTimeserver+(λTimeserver)Timequeue=ρTimeserver+ρTimequeue.移项、化简:
Timequeue−ρTimequeueTimequeue(1−ρ)Timequeue=ρTimeserver,=ρTimeserver,=Timeserver1−ρρ.黑箱内部组件同样处于平衡,所以也可应用 Little 定律:
Lengthqueue=λTimequeue.代入排队时间公式:
Lengthqueue=λTimeserver1−ρρ.因为 λTimeserver=ρ,所以:
Lengthqueue=ρ1−ρρ=1−ρρ2.这样就建立了队列任务数与利用率的关系。
例题:平均排队请求数
对于前面例题中利用率为 0.5 的系统,队列平均有多少 I/O 请求?
解答。
Lengthqueue=1−0.50.52=0.500.25=0.5.平均有 0.5 个请求排队。
这些等式来自应用数学中的排队论,用于预测此类随机变量的行为。真实系统过于复杂,难以精确分析,所以排队论最适合只需近似答案的情况。
排队论严格区分过去事件与未来事件:过去可用简单算术汇总测量,未来则须用更复杂数学预测。计算机系统常用过去预测未来,例如第 2 章的最近最少使用替换策略;因此测量与预测分布的区别常被淡化。我们先以测量验证分布类型,再依赖该分布推断。
回顾模型假设:
- 系统处于平衡。
- 连续请求之间的时间,即到达间隔,服从指数分布。
- 请求源数量无限。这是无限总体模型;若到达率随系统内已有任务数变化,则使用有限总体模型。
- 服务者完成上一任务后,能立即开始下一任务。
- 队列长度无限,采用 FIFO,因此排在前面的任务都必须完成。
- 只有一个服务者。
这样的队列称为 M/M/1:
- 第一个 M:请求到达间隔服从指数分布,C2=1。M 来自定义和分析无记忆过程的数学家 A. A. Markov。
- 第二个 M:服务时间服从指数分布,C2=1,同样代表 Markov。
- 1:单服务者。
M/M/1 简单而广泛使用。排队示例常假设指数分布,有一个充分理由、一个尚可理由、一个不佳理由。充分理由是原文所说的许多任意分布叠加后表现为指数分布;计算机行为常由多个组件交互形成,因此指数到达间隔往往适合建模。尚可的理由是:变异程度不明确时,选择中等变异的 C=1,比假定几乎无变异 C≈0 或很大变异的大 C 更稳妥。不佳的理由则只是数学简单。
译注:“任意分布叠加成为指数分布”不能按字面作为一般定理;常见近似指许多相互独立、各自相对稀疏的到达流汇合,可近似为 Poisson 到达,其间隔近似指数分布。
下面实际运用排队论。
例题:旧磁盘的响应时间
处理器每秒发送 40 个磁盘 I/O,请求满足指数分布假设,旧磁盘平均服务时间为 20 ms。求:①平均利用率;②平均排队时间;③包含排队与服务的平均响应时间。
**解答。**每秒平均到达 40 个任务,服务时间 20 ms=0.02 s,所以:
ρ=λTimeserver=40×0.02=0.8.服务时间服从指数分布,可使用简式:
TimequeueTimesystem=20ms×1−0.80.8=20×0.20.8ms=20×4ms=80ms,=80+20=100ms.平均有 80% 的时间花在排队上!
例题:换用更快磁盘
换新磁盘,服务时间降到 10 ms,重新计算。
解答。
ρ=40×0.01=0.4,Timequeue=10ms×1−0.40.4=10×0.60.4ms=10×32ms≈6.7ms.平均响应时间为 10+6.7=16.7 ms。服务速度只提高两倍,响应却快了六倍。
多服务者模型
到目前为止,假设服务者只有一个,例如一块磁盘。实际系统常有多盘,可采用图 D.17 的多个服务者,这在排队论中称 M/M/m。
用 Nservers 表示服务者数,对应公式如下。前两个很简单:
Utilization=NserversλTimeserver,Lengthqueue=λTimequeue.排队时间为:
Timequeue=TimeserverNservers(1−Utilization)Ptasks≥Nservers.它与 M/M/1 公式相似,但将单服务者利用率换为“新任务必须排队、不能立即服务”的概率,并将等待时间除以服务者数。
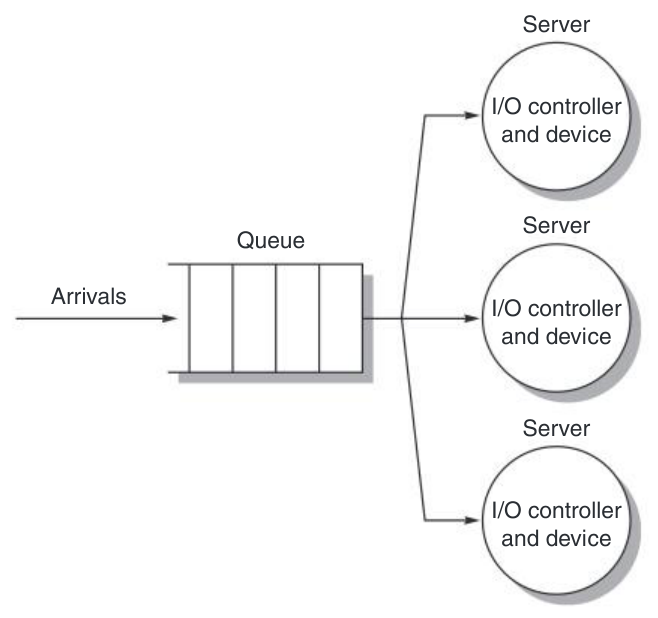 图 D.17 M/M/m 多服务者模型。到达请求进入一个公共队列,随后分配给多个服务者;每个服务者由 I/O 控制器与设备组成。Arrivals、Queue、Server 分别为到达、队列、服务者。
遗憾的是,多服务者时排队概率复杂得多。首先,系统没有任务的概率是:
P0=[1+Nservers!(1−Utilization)(NserversUtilization)Nservers+n=1∑Nservers−1n!(NserversUtilization)n]−1.随后,原书将“任务数至少等于服务者数”的概率印为:
Ptasks≥Nservers∣原式=Nservers!(1−Utilization)NserversUtilizationNserversP0.**译注:**原页分子漏了括号和对 Nservers 的相应乘方。与前式和下一页数值代入一致的关系应为:
>Ptasks≥Nservers>=Nservers!(1−Utilization)(NserversUtilization)NserversP0.>
当 Nservers=1 时,概率退化为利用率,便回到 M/M/1 公式。来看例题。
例题:增加第二块慢磁盘
不换快盘,而增加另一块慢盘并复制数据,让任何一盘都能服务读取。假设全部请求都是读,使用 M/M/m 重新回答前面的问题。
**解答。**两盘平均利用率为:
Utilization=240×0.02=0.4.先计算零任务概率(原文此处写“队列中无任务”,但公式 P0 指整个系统无任务):
P0=[1+2!(1−Utilization)(2Utilization)2+n=1∑1n!(2Utilization)n]−1=[1+2(1−0.4)(2×0.4)2+2×0.4]−1=[1+1.20.640+0.800]−1=[1+0.533+0.800]−1=2.333−1.再计算必须排队的概率。原书第一行沿用分子 2Utilization2 的排印错误,但下一行实际按 (2×0.4)2 计算;以下显式按正确括号保持其数值推导:
Ptasks≥2=2!(1−Utilization)(2Utilization)2P0=2(1−0.4)(2×0.4)2×2.333−1=1.20.640×2.333−1=2.3330.533=0.229.最后,排队时间为:
Timequeue=TimeserverNservers(1−Utilization)Ptasks≥Nservers=0.020×2(1−0.4)0.229=0.020×1.20.229=0.020×0.190=0.0038s.平均响应时间为 20+3.8=23.8 ms。对这个工作负载,两盘将排队等待时间缩短到单慢盘的 1/21,比单快盘也缩短 1.75 倍。不过,单快盘系统的平均服务时间——原文如此称呼此处的响应时间——仍比双慢盘快 1.4 倍,因为单盘服务本身快两倍。
若能把 M/M/m 推广到多队列、多服务者,就更接近现实。可惜这些模型难以求解和使用,本节不再展开。