附录 D 案例研究与习题
作者:Andrea C. Arpaci-Dusseau 与 Remzi H. Arpaci-Dusseau。
案例研究 1:剖析单个磁盘
本案例涉及:性能特征、微基准测试。
存储系统内部通常隐藏在一个简单接口之后:线性块数组。所有存储系统采用公共接口有许多好处:操作系统无需修改便能使用任何存储系统,后者则可以在接口背后自由创新。例如,单盘可按最佳性能的方式,将内部〈扇区、磁道、盘面〉几何映射到线性数组;多盘 RAID 也可把任意数量磁盘的块映射成同样的数组。但固定接口也有缺点,尤其是操作系统不知道底层精确块布局时,无法进行某些性能、可靠性、安全性优化。
本案例探索如何用软件揭示块接口背后的结构。基本思想是给系统做“指纹识别”:运行定义明确的负载,测量不同请求耗时,就能推断出数量惊人的底层细节。
Berkeley 的 Nisha Talagala 等提出 Skippy,用于识别单盘参数。关键是连续寻址到地址差线性增加的扇区,即差值依次增加 1、2、3……,以分离旋转影响。算法在盘上跳跃,每次写入前把跳跃距离增加一个扇区,输出每次写入的距离与时间。使用原始设备接口,避开文件系统优化。SECTOR_SIZE 等于磁盘一次能读取的最小数据量,例如 512 字节。详见 Talagala 和 Patterson[1999]。
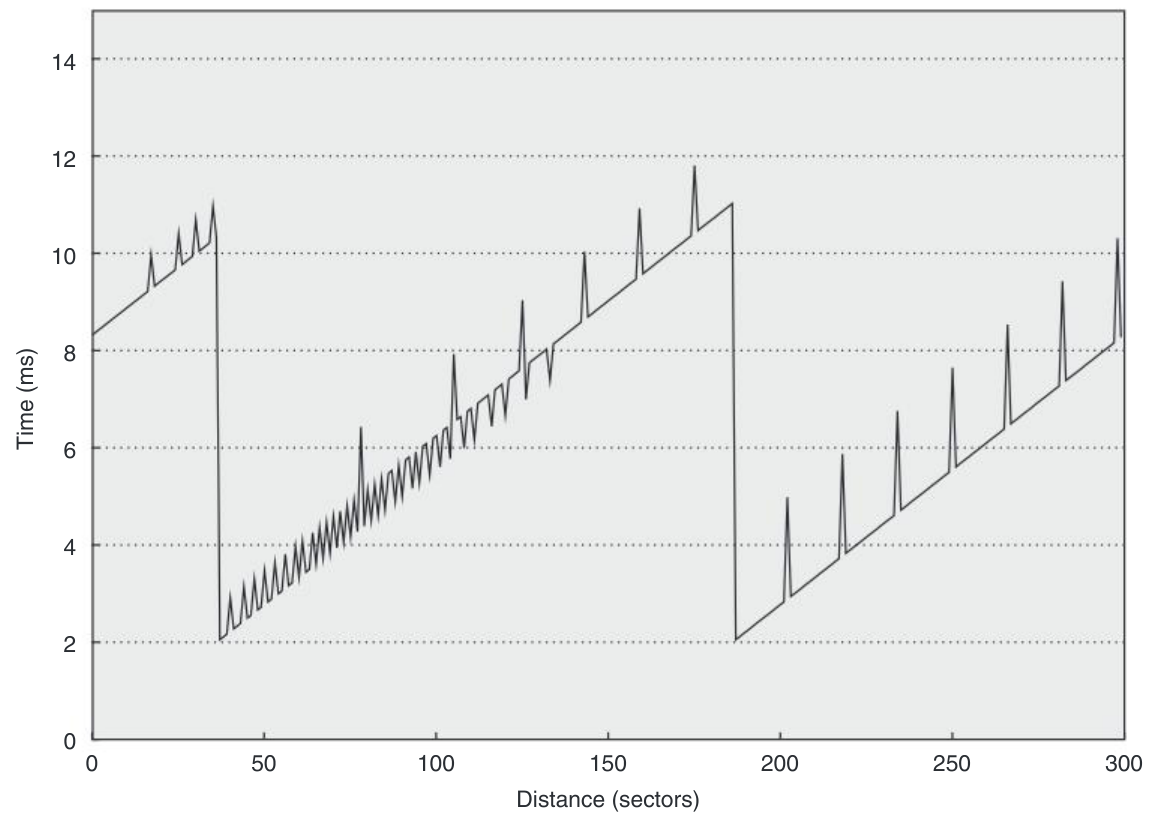
把写入耗时画成寻道距离的函数,可推断最小传输时间(无寻道、无旋转延迟)、磁头切换时间、柱面切换时间、旋转延迟和磁头数。典型图形有四条斜率相同、截距不同的线。最高与最低两条对应不同旋转延迟,但没有柱面或磁头切换开销;两者之差揭示旋转延迟。次低线对应磁头切换加上逐渐增加的旋转延迟;第三条线对应柱面切换加旋转延迟。
习题 D.1
[10/10/10/10/10]〈D.2〉图 D.25 是在模拟磁盘 Disk Alpha 上运行 Skippy 的结果。
a. [10]〈D.2〉最小传输时间是多少?
b. [10]〈D.2〉旋转延迟是多少?
c. [10]〈D.2〉磁头切换时间是多少?
d. [10]〈D.2〉柱面切换时间是多少?
e. [10]〈D.2〉磁头数量是多少?
习题 D.2
[25]〈D.2〉近似画出在 Disk Beta 上运行 Skippy 的图形。该盘参数:最小传输时间 2.0 ms,旋转延迟 6.0 ms,磁头切换 1.0 ms,柱面切换 1.5 ms,四个磁头,每磁道 100 个扇区。
习题 D.3
[10/10/10/10/10/10/10]〈D.2〉在自行选择的磁盘上实现并运行 Skippy。
a. [10]〈D.2〉画出结果,并报告厂商与型号。
b. [10]〈D.2〉最小传输时间是多少?
c. [10]〈D.2〉旋转延迟是多少?
d. [10]〈D.2〉磁头切换时间是多少?
e. [10]〈D.2〉柱面切换时间是多少?
f. [10]〈D.2〉磁头数量是多少?
g. [10]〈D.2〉真实磁盘的结果与模拟磁盘相比,是否存在定性差异?
案例研究 2:剖析磁盘阵列
本案例涉及:性能特征、微基准测试。
Wisconsin 大学 Timothy Denehy 等的 Shear 算法[Denehy 等 2004]用于识别 RAID 参数。基本思路是生成请求负载并计时,观察哪些请求组合更慢,从而推断哪些块位于同一磁盘。
这里定义几个 RAID 属性。数据以 block(块) 为单位分配;块是文件系统向存储系统读写的最小单位,因此文件系统和识别软件知道其大小。chunk 是单盘内连续分配的一组块。stripe(条带) 是跨越 个数据盘、每盘一个 chunk 的集合。pattern(重复模式) 是最短的数据块序列,使模式中偏移 始终位于同一个磁盘 。
习题 D.4
[20/20]〈D.2〉下面代码识别 pattern 大小,使用原始设备以避开文件系统优化。所有 Shear 算法的关键是随机请求,避免触发 RAID 或单盘预取、缓存。基本做法是在 RAID 内以固定间隔 访问 个随机块,测量每一间隔对应的完成时间。下面保留原代码结构,非 C 语句按伪代码翻译。
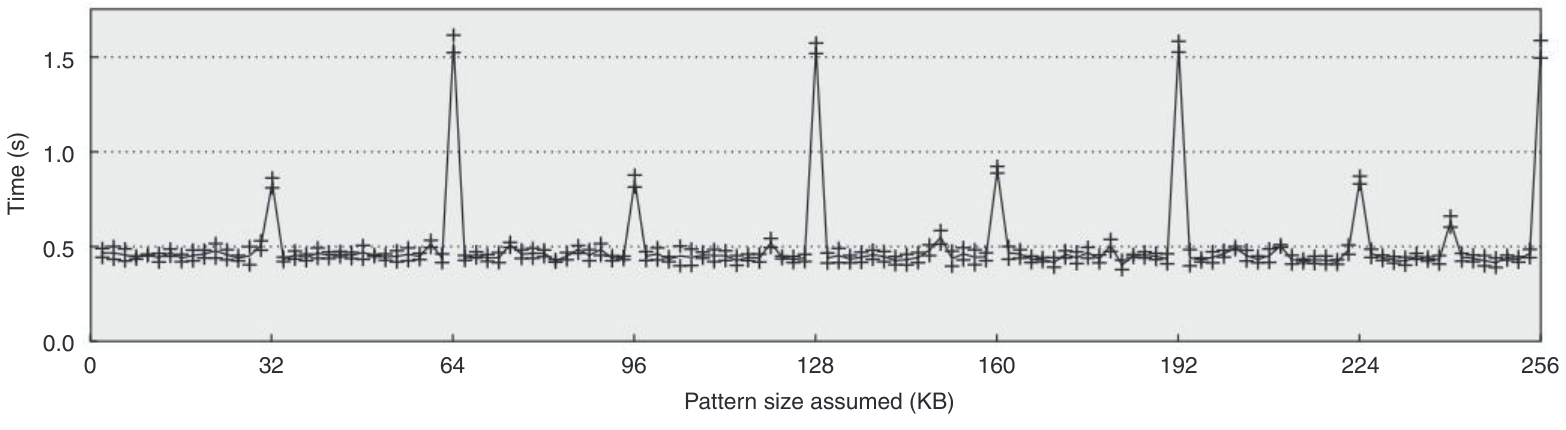
把 个请求的测量时间画成 的函数,会看到所有请求落在同一盘时最慢;因此,最高耗时对应的 就是 RAID 的 pattern 大小。
a. [20]〈D.2〉图 D.26 是未知 RAID 的测量结果。其 pattern 多大?0.4、0.8、1.6 秒各对应什么?如果是 RAID 0,有多少盘?chunk 多大?
b. [20]〈D.2〉画出以下系统运行该段 Shear 代码的结果:,磁盘随机读 5 ms,RAID 0,四盘,chunk 为 8 KB。
习题 D.5
[20/20]〈D.2〉下面代码识别 chunk 大小。随机选择 个 pattern,但始终从受控偏移 、 读取。
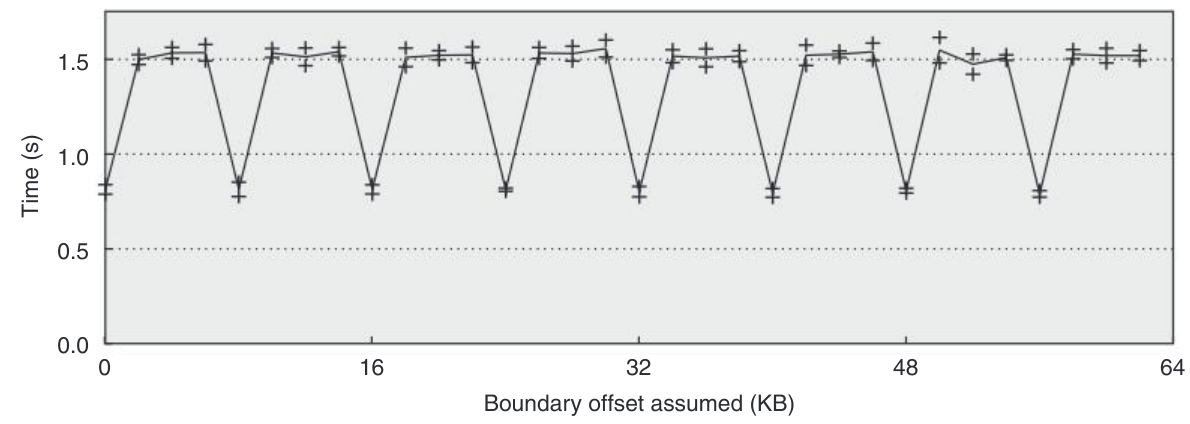
将时间画成 的函数,requestA、requestB 落在不同盘时耗时最低;因此,低耗时对应的 是 RAID 不同盘的 chunk 边界。
a. [20]〈D.2〉图 D.27 是未知 RAID 的结果。chunk 多大?0.75、1.5 秒在该系统中分别对应什么?
b. [20]〈D.2〉画出以下系统的结果:,随机读 5 ms,RAID 0,八盘,chunk 为 12 KB。
习题 D.6
[10/10/10/10]〈D.2〉最后,用下面代码确定 chunk 如何分布到磁盘。随机选择 个 pattern,穷举模式内 chunk 的所有两两组合,并一起读取。
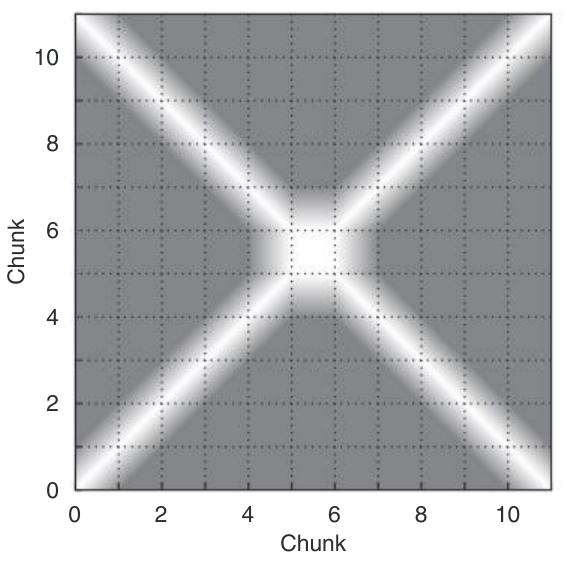
运行后,把测量时间表示为 的函数。最简单的画法,是以二者为坐标建立二维表,用灰度表示时间:深色较快、浅色较慢。因此,浅色意味着两个偏移落在同一盘。
图 D.28 对应一个已知 pattern 为 384 KB、chunk 为 32 KB 的系统。
a. [20]〈D.2〉一个 pattern 有多少 chunk?
b. [20]〈D.2〉哪些 chunk 看起来位于同一盘?
c. [20]〈D.2〉系统看起来有多少盘?
d. [20]〈D.2〉画出块跨盘分配的可能布局。
**译注:**本题总标题的难度为四个 10,四个小问却各标 20。
习题 D.7
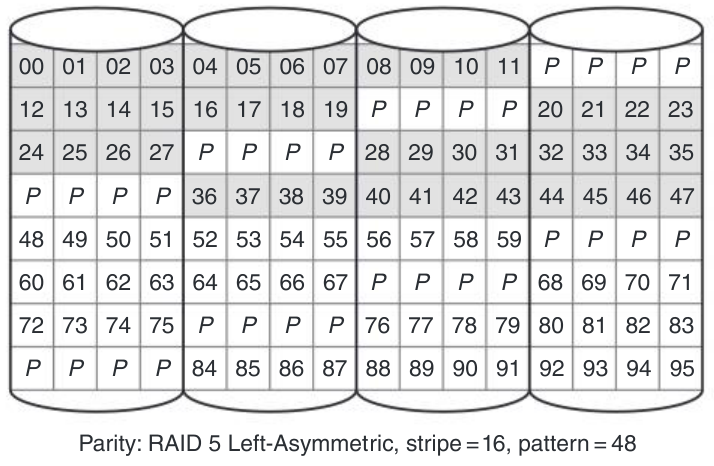
[20]〈D.2〉画出图 D.29 系统运行布局算法后的图形。系统有四盘,每个 chunk 为四个 4 KB 块,即 16 KB,采用 RAID 5 Left-Asymmetric(左非对称)布局。
案例研究 3:RAID 重建
本案例涉及:RAID 系统、RAID 重建、平均失效前时间 MTTF、平均数据丢失前时间 MTDL、performability、双重失效。
RAID 保证单盘失效不丢数据,关键职责之一就是恢复失效盘的数据,这称为重建。本案例分别考虑可容忍单盘失效的 RAID,以及可容忍双盘失效的 RAID-DP。
重建通常有两种方式。离线重建把全部资源用于恢复,不服务应用请求;在线重建边恢复边处理请求,通常将恢复带宽限制在总带宽的一部分。
重建方式影响可靠性和 performability。RAID 5 若在第一盘恢复前又坏第二盘,就丢数据,所以重建时间 MTTR 越长,可靠性或 MTDL 越低。Performability 试图结合性能和可用性,定义为某状态下的性能乘以该状态概率。阵列状态可以是无故障正常运行、单盘失效重建、多盘失效停机。
本组习题假定 RAID 有六盘和足够热备盘;每盘采用原书称为图 D.3 中的 37 GB SCSI 磁盘,峰值顺序读 142 MB/s、写 85 MB/s。连接到总传输能力 320 MB/s 的 Ultra320 SCSI 总线。磁盘独立失效,忽略其他故障;XOR 与内存复制开销忽略。在线重建最多使用 RAID 总计 10 MB/s 带宽。
**译注:**本版图 D.3 列的是 600 GB SAS,并无这里所称的 37 GB SCSI。题内给出的容量、读写速率和总线参数原样保留;若需要未给出的旧磁盘参数,例如 MTTF,不能把该交叉引用当作已补齐条件。
习题 D.8
[10]〈D.2〉六盘 RAID 4,画出块跨盘分布的简单示意图。
习题 D.9
[10]〈D.2,D.4〉单盘失效时 RAID 4 开始重建。预计经过多久需要重建一次?
习题 D.10
[10/10/10]〈D.2,D.4〉假定重建在时刻 开始。
a. [10]〈D.2,D.4〉重建需要哪些读写操作?
b. [10]〈D.2,D.4〉离线重建何时完成?
c. [10]〈D.2,D.4〉在线重建何时完成?
习题 D.11
[10/10/10/10]〈D.2,D.4〉研究 MTDL。RAID 4 只有在第一失效盘修复前发生第二盘失效,才丢数据。
a. [10]〈D.2,D.4〉离线重建期间再次失效的概率是多少?
b. [10]〈D.2,D.4〉根据这一概率,离线重建的 MTDL 是多少?
c. [10]〈D.2,D.4〉在线重建期间再次失效的概率是多少?
d. [10]〈D.2,D.4〉根据这一概率,在线重建的 MTDL 是多少?
习题 D.12
[10]〈D.2,D.4〉RAID 4 离线重建的 performability 是多少?以 IOPS 衡量,假设负载为均匀分布到阵列磁盘的随机只读请求。
习题 D.13
[10]〈D.2,D.4〉在线重建的 performability 是多少?假定在线修复期间 IOPS 降至峰值的 70%。在线和离线哪种更好?
习题 D.14
[10]〈D.2,D.4〉RAID 6 容忍最多两个同时失效。假定六盘 RAID-DP 基于 RAID 4,,如图 D.5。若数据盘 0、3 失效,如何重建?列出计算前四条带缺失块的步骤。
案例研究 4:预测 RAID 性能
本案例涉及:RAID 级别、排队论、工作负载影响、磁盘布局影响。
本案例用简单排队论预测 I/O 性能,考察配置与负载如何影响服务时间、利用率、平均响应时间。
配置对性能影响很大。不同 RAID 级别可用不同队列模型表示。例如, 盘 RAID 0,若请求适当分散,可建模为 个独立 M/M/1。RAID 1 则依赖负载:读可发给任一镜像,写须送达两盘,因此双盘只读用 M/M/2,只写用 M/M/1。 盘 RAID 4 也依赖负载:读到特定数据盘,写都须更新校验盘,后者成为瓶颈。所以只读时可建模为 个独立系统,只写时为一个 M/M/1。
块布局也很重要。40 GB 单盘若随机访问整个 40 GB,布局影响不大;若只访问一半,即 20 GB,就可把数据紧凑放在连续的 20 GB 磁道,而非均匀铺满 40 GB,以缩短寻道。
本题故意采用简化模型:小随机请求的平均定位与传输时间,是寻道距离的线性函数。40 GB 磁盘服务时间为 5 ms×空间利用率。全盘使用时是 5 ms,只用前 20 GB 则为 2.5 ms。
整个案例中,处理器每秒发出 167 个小随机请求,满足指数分布假设;请求等于块大小,为 8 KB;每盘 40 GB。无论配置如何,工作负载共访问 40 GB 数据,应尽可能高效地在各盘分配。
习题 D.15
[10/10/10/10/10]〈D.5〉先假定只有一个 40 GB 磁盘。
a. [10]〈D.5〉平均服务时间是多少?
b. [10]〈D.5〉平均利用率是多少?
c. [10]〈D.5〉每请求平均等待磁盘多久?
d. [10]〈D.5〉平均排队请求数是多少?
e. [10]〈D.5〉平均响应时间是多少?
习题 D.16
[10/10/10/10/10/10]〈D.2,D.5〉改用两块 40 GB 盘组成 RAID 0,按 8 KB 块均匀条带化,无冗余。
a. [10]〈D.2,D.5〉40 GB 如何跨盘分配?总计随机访问 40 GB 时,每请求的预期服务时间是多少?
b. [10]〈D.2,D.5〉如何用排队论建模?
c. [10]〈D.2,D.5〉每盘平均利用率是多少?
d. [10]〈D.2,D.5〉每请求平均等待多久?
e. [10]〈D.2,D.5〉每队列平均请求数是多少?
f. [10]〈D.2,D.5〉平均响应时间是多少?
习题 D.17
[20/20/20/20/20]〈D.2,D.5〉改为两块 40 GB 盘组成 RAID 1,将数据镜像;用排队论建模只读负载。
a. [20]〈D.2,D.5〉40 GB 如何分配?总计随机访问 40 GB 时,每请求的预期服务时间是多少?
b. [20]〈D.2,D.5〉如何建模?
c. [20]〈D.2,D.5〉每盘平均利用率是多少?
d. [20]〈D.2,D.5〉每请求平均等待多久?
e. [20]〈D.2,D.5〉平均响应时间是多少?
习题 D.18
[10/10]〈D.2,D.5〉将 RAID 1 的只读负载换成只写。
a. [10]〈D.2,D.5〉说明如何用排队论建模系统与负载。
b. [10]〈D.2,D.5〉平均利用率、等待时间、响应时间分别是多少?
案例研究 5:I/O 子系统设计
本案例涉及:RAID 系统、平均失效前时间 MTTF、性能与可靠性权衡。
在给定预算下设计 I/O 子系统,满足最低容量,优化性能、可靠性或两者。只要预算允许,磁盘和控制器数量不限。可用部件如下:
- 10,000 MIPS CPU,$1000,MTTF 为 1,000,000 小时。
- 1000 MB/s I/O 总线,可容纳 20 条 Ultra320 SCSI 总线及其控制器。
- Ultra320 SCSI 总线,每条 320 MB/s,最多 15 盘,也称 SCSI string;电缆 MTTF 为 1,000,000 小时。
- Ultra320 SCSI 控制器,50,000 IOPS,$250,MTTF 为 500,000 小时。
- 机箱 $2000,可为最多八盘供电、散热;机箱 MTTF 为 1,000,000 小时,风扇和电源各为 200,000 小时。
- 图 D.3 所述 SCSI 磁盘。
- 替换任何失效组件都需要 24 小时。
负载假设:操作系统每磁盘 I/O 执行 70,000 条 CPU 指令;有许多并发随机 I/O,平均大小 16 KB。所有方案都必须满足:预算 $28,000,容量至少 1 TB。
习题 D.19
[10]〈D.2〉先只优化容量与性能,不考虑可靠性,特别关注 IOPS。讨论什么 RAID 级别和块大小能获得最佳性能。
习题 D.20
[20/20/20/20]〈D.2,D.4,D.7〉在预算与容量约束下,怎样配置 SCSI 磁盘、控制器、机箱才能性能最佳?
a. [20]〈D.2,D.4,D.7〉预计能提供多少 IOPS?
b. [20]〈D.2,D.4,D.7〉系统成本是多少?
c. [20]〈D.2,D.4,D.7〉容量是多少?
d. [20]〈D.2,D.4,D.7〉MTTF 是多少?
习题 D.21
[10]〈D.2,D.4,D.7〉重设计为 RAID 10 或 RAID 01,以优化可靠性。不仅要容忍盘坏,还要容忍控制器、电缆、电源、风扇失效;具体而言,任一单组件失效,不能同时阻断一对副本的访问。画出 RAID 10、RAID 01 的跨盘块布局。此环境中哪种更合适?
习题 D.22
[20/20/20/20/20]〈D.2,D.4,D.7〉在容量和预算限制内,只优化 RAID 10 或 RAID 01 的可靠性。给出配置。
a. [20]〈D.2,D.4,D.7〉组件整体 MTTF 是多少?
b. [20]〈D.2,D.4,D.7〉系统 MTDL 是多少?
c. [20]〈D.2,D.4,D.7〉可用容量是多少?
d. [20]〈D.2,D.4,D.7〉系统成本是多少?
e. [20]〈D.2,D.4,D.7〉只写负载预计有多少 IOPS?
习题 D.23
[10]〈D.2,D.4,D.7〉若有同价但容量翻倍的磁盘,仍然只优化可靠性,会怎样改变配置?为什么?
案例研究 6:悄然损坏的位
本案例涉及:磁盘局部失效、失效分析、性能分析、奇偶校验保护、校验和。
你的任务是避免 bit rot,即文件中的位或块随时间损坏。归档场景尤其重要:数据写一次,可能多年后才访问;如果不额外保护,文件的位或块可能因介质错误、其他 I/O 故障而逐渐改变或不可访问。
应对 bit rot 需要两部分:检测与恢复。高效检测可为文件每块保存校验和。校验和函数输入一个可能很长的数据串,输出固定长度的校验串。利用的性质是:数据变了,计算出的校验和也极可能改变。
检测之后,恢复需要冗余。例如镜像保存多个块副本;奇偶校验保存额外信息,通常比镜像节省空间。本案例分析这些技术在不同场景中的有效性,并编写代码保护一组文件的数据完整性。
习题 D.24
[20/20/20]〈D.2〉D.24–D.27 使用简单奇偶校验:为文件系统每个文件计算一个校验块,并为文件的每个 4 KB 块使用原文所称的 20 字节 MD5 校验和。
**译注:**原页确为“20-byte MD5”,而 MD5 输出为 128 位,即 16 字节;后面的 D.27 也明确写 128 位。
先考察空间开销。Douceur 和 Bolosky[1999]发现,PC 文件大小分布如下:
| 文件大小 | ≤1 KB | 2 KB | 4 KB | 8 KB | 16 KB | 32 KB | 64 KB | 128 KB | 256 KB | 512 KB | ≥1 MB |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 比例 | 26.6% | 11.0% | 11.2% | 10.9% | 9.5% | 8.5% | 7.1% | 5.1% | 3.7% | 2.4% | 4.0% |
研究还发现文件系统通常约半满。假定有一个 37 GB 卷,约半满且符合该分布,回答:
a. [20]〈D.2〉用校验和检测单个错误,需要在盘上额外保存多少信息?分别给出字节数、占卷容量比例。
b. [20]〈D.2〉若既检测又纠正单个错误,额外信息是多少?同样给出字节数和容量比例。
c. [20]〈D.2〉根据这个分布,用来计算校验和的块过大、过小,还是恰好合适?
习题 D.25
[10/10]〈D.2,D.3〉数据保护的一大问题是错误检测。可采用惰性检测:等文件被访问才检查数据。问题是,不常访问的文件会慢慢损坏,等终于访问时,错误多到无法纠正。主动方法是 disk scrubbing:周期性扫描全部数据,主动发现错误。
a. [10]〈D.2,D.3〉假定位翻转独立,每 GB 数据每月发生一次。使用原文所称的“同一个半满的 20 GB 卷”,以及图 D.3 的 SCSI 盘,寻道 4 ms、传输约 100 MB/s,应多久扫描一次文件、检查并修复完整性?
b. [10]〈D.2,D.3〉位翻转速率达到多少时,不可能继续维持完整性?仍用 20 GB 卷和该 SCSI 盘。
**译注:**本题从前题 37 GB 改称“同一个 20 GB 卷”,且所引旧 SCSI 规格不完全对应本版图 D.3;各题明确给定的值分别保留。
习题 D.26
[10/10/10/10]〈D.2,D.4〉额外保护也有性能成本,下面研究这一方案的开销。
a. [10]〈D.2,D.4〉顺序写入一个 40 MB 文件,然后一次性写入实现保护方案所需的额外信息。方案产生多少写流量?给出总字节数及占总流量的比例。
b. [10]〈D.2,D.4〉改为像更新数据库表一样随机更新文件:连续执行 4 KB 随机写,每次都更新盘上保护信息。共写 10,000 次,方案产生多少 I/O 流量?给出总字节数及占总流量比例。
c. [10]〈D.2,D.4〉假定保护信息始终放在磁盘另一独立区域,远离被保护文件;每个文件 A 的所有校验和存在另一文件 Achecksums。每次读取都要检查校验和,因此会有开销。顺序读取 10,000 个 4 KB 块,平均寻道 4 ms,传输 100 MB/s(如图 D.3 的 SCSI 盘);读取文件及其校验和需要多久?增加校验和带来的时间代价是多少?
d. [10]〈D.2,D.4〉仍按 c 问分开放置保护信息,但改为从远大于 10,000 块的文件随机读取 10,000 个 4 KB 块,每次仍检查校验和。同样磁盘条件下,读取要多久?额外时间代价是多少?
习题 D.27
[40]〈D.2,D.3,D.4〉将理论付诸实践,开发用户级文件防损坏工具。编写一组简单工具,检测并修复数据完整性。第一个用于建立校验和与奇偶校验,命名为 build:
build 将文件 filename 所需校验和与冗余信息,存到同目录的 .filename.cp,以便查找。
第二个用于检查并尽可能修复损坏文件,命名为 repair:
它读取相应 .cp,验证保存的校验和是否与重新计算的一致。只有一个块不匹配时,用冗余重建正确数据并修复文件;若至少两个块损坏,只报告文件已无法修复。为测试系统,原书提供名为 corrupt 的破坏工具:
它只是用随机噪声填满指定块。校验和采用 MD5,对输入串输出 128 位“指纹”。原书给出一个简单实现地址:
奇偶校验通过 XOR 计算。C 中两个 BLOCKSIZE 块的计算如下:
案例研究 7:把数据排好序
本案例涉及:基准测试、性能分析、性价比分析、开销摊销、平衡系统。
数据库领域长期用基准比较系统。本题研究 Anon. 等[1985]引入的一项基准(见第 1 章):外排序,即磁盘到磁盘的排序。
它很有意思。首先,排序同时考验磁盘、内存、处理器。其次,要达到最高性能,需要深入了解 CPU 缓存、操作系统、I/O 子系统。最后,它又足够简单,学生也能实现,见后文。
视数据量而定,排序可以一趟或多趟完成。若内存能容纳全部数据,读入、排序、写回即可,称为“一趟排序”。内存不足则需多趟。有多种方法;简单做法是逐块排序输入并写回,留下“输入文件大小/内存大小”个有序临时文件,再归并为最终输出,即“两趟排序”。若第二趟还不能同时归并全部流,这种不常见情形还需更多趟。
本案例分析排序在不同场景的有效性和性价比,并自行实现外排序,在真实硬件上测量。
习题 D.28
[20/20/20]〈D.4〉先不限制花费,配置完成排序耗时最短的系统。要取得峰值带宽,所有数据路径都必须够快。
为简化,假定内存中键排序的时间与 CPU 速率及内存带宽线性相关:例如 1 MIPS、内存带宽 1 MB/s 的机器,排序 1 MB 记录需一秒。另假定 I/O 阶段经过仔细编写,能达到顺序带宽。内存装不下全部数据时,当然需要两趟。
I/O 可能有额外内存复制。例如 read() 先将磁盘数据读入系统缓冲,再复制到用户缓冲,因此 I/O 时内存带宽也会成为问题。
再假定读、排序、写完全不重叠:读盘时只读盘;排序时只用 CPU 与内存;写盘时只写盘。
任务是配置系统,以峰值性能排序 1 GB,即约一千万条 100 字节记录。按下表选择 CPU、内存、I/O 互连、磁盘。
| 部件 | 等级 | 性能/带宽 | 价格 |
|---|---|---|---|
| CPU | 慢 | 1 GIPS | $200 |
| CPU | 标准 | 2 GIPS | $1000 |
| CPU | 快 | 4 GIPS | $2000 |
| I/O 互连 | 慢 | 80 MB/s | $50 |
| I/O 互连 | 标准 | 160 MB/s | $100 |
| I/O 互连 | 快 | 320 MB/s | $400 |
| 内存 | 慢 | 512 MB/s | $100/GB |
| 内存 | 标准 | 1 GB/s | $200/GB |
| 内存 | 快 | 2 GB/s | $500/GB |
| 磁盘 | 慢 | 30 MB/s | $70 |
| 磁盘 | 标准 | 60 MB/s | $120 |
| 磁盘 | 快 | 110 MB/s | $300 |
注意:购买单处理器系统,最多两条 I/O 互连;内存容量与磁盘数自行决定,每互连的盘数视为无限。
a. [20]〈D.4〉总成本多少?按 CPU、内存容量、磁盘数、I/O 总线分别列出。
b. [20]〈D.4〉排序 1 GB 记录需要多久?分别列出磁盘读、磁盘写与排序时间。
c. [20]〈D.4〉瓶颈在哪里?
习题 D.29
[25/25/25]〈D.4〉再看性价比。买高性能机器容易,买高性价比机器难。
PennySort 比赛(research.microsoft.com/barc/SortBenchmark/)就是例子:用一美分尽可能多地排序记录。假定系统可用三年,即 94,608,000 秒,用这个时间除以机器总价(美分),得到一美分的时间预算。
本题略简化:预算不超过 $2000,能构建的最快排序机器是什么?使用 D.28 相同硬件表。(提示:可以编写小程序,枚举所有配置。)
a. [25]〈D.4〉总成本多少?按 CPU、内存容量、磁盘数、I/O 总线分别列出。
b. [25]〈D.4〉这一配置的读、写、排序时间各是多少?
c. [25]〈D.4〉瓶颈在哪里?
习题 D.30
[20/20/20]〈D.4,D.6〉良好磁盘性能常依赖开销摊销:既然必须付出某项开销,付出之后就尽量多做有用工作,以降低它的影响。这个思想广泛适用于计算机系统。磁盘中,每次传输前要寻道、旋转;传更多数据,就能摊薄昂贵的定位开销。
本题关注两趟排序的第二趟。假设开始时盘上有 个有序段(run),每段大小均能放进主存。从每段读取一个 chunk,归并为最终有序输出。每次读一个段都要寻道和旋转,因为上次很可能读的是另一段。
a. [20]〈D.4,D.6〉磁盘带宽 100 MB/s,平均寻道 7 ms,转速 10,000 RPM。每次从一个段读 1 MB,共 100 段,每段 1 GB;最终输出以 1 GB 大块写入。若 I/O 是主要且唯一成本,归并阶段多久完成?
b. [20]〈D.4,D.6〉将每次读取从 1 MB 改为 10 MB,第二趟总时间如何变化?
c. [20]〈D.4,D.6〉两种情况都以最大化磁盘效率为目标。效率定义为传输数据时间占全部磁盘访问时间的比例。各自效率是多少?
习题 D.31
[40]〈D.2,D.4,D.6〉自行编写外排序。原书提供数据生成工具 generate:
它创建名为 filename、大小为 size MB 的文件。原文称,文件由“100 字节的键,带有 10 字节的记录(需要排序的部分)”构成。
译注:原页把 key 与 record 的大小/名称倒置;结合 D.28、以及本题末尾“100 字节记录”,通常应理解为100 字节记录,其中 10 字节是排序键。
另有 check 检查输入是否有序:
基本一趟排序就是读取、排序、写出。不过有许多优化:重叠读取与排序,将键和记录其余部分分离以改善缓存、加快排序,重叠排序与写入,等等。
一个重要规则是数据最初必须在磁盘上,而不在文件系统缓存中。最容易保证的方法是卸载再重新挂载文件系统。
目标之一:打破 Datamation 排序纪录。原书所述纪录为一百万条 100 字节记录用时 0.44 秒,由 32 台机器集群取得。如果足够精心,配几块磁盘的单台 PC 也可能超过它。