E.2 信号处理与嵌入式应用:数字信号处理器
数字信号处理器(digital signal processor,DSP)是针对数字信号处理算法优化的专用处理器。这些算法中的大多数,从时域滤波(例如无限长冲激响应和有限长冲激响应滤波)、卷积,到各种变换(例如快速傅里叶变换、离散余弦变换),乃至前向纠错(forward error correction,FEC)编码,都以同一种运算为核心:乘累加。例如,离散傅里叶变换的形式为:
其中
离散余弦变换常被用来替代它,因为离散余弦变换不需要复数运算。这两种变换都以乘积求和为核心。为了加速这一运算,DSP 通常提供执行乘累加(multiply-accumulate,MAC)的专用硬件。指令 MAC A,B,C 的语义为 A = A + B * C。在某些情况下,这一运算的性能如此重要,以至于为应用选择 DSP 时,只依据它的 MAC 运算吞吐量作决定。
DSP 经常使用定点运算。如果把整数的小数点看作位于最低有效位的右侧,那么这里所说的定点数,其二进制小数点就在符号位的右侧。因此,这种定点数据表示的是介于 −1 和 +1 之间的小数。
例题
有以下三个简单的 16 位二进制位串:
如果将它们解释为二进制补码整数,分别代表什么值?如果解释为定点数呢?
解答
数的表示方法告诉我们,二进制小数点左边第 位的位权为 ,右边第 位的位权为 。先假设这三个二进制位串是整数。此时小数点位于最右侧,所以它们分别表示 、 和 ,即 16384、2048 和 18440。
定点表示把二进制小数点放在符号位右侧,因此三个二进制位串分别表示 、 和 。相应分数为 、 和 ,近似小数值分别为 0.50000、0.06250 和 0.56274。另一种求法是:对于 位二进制补码定点数,用其整数表示值除以 ,也会得到相同结果:
可以把定点运算看成一种低成本浮点运算。它不在每个字中保存指数,也没有自动对齐和规格化操作数的硬件,而是依靠 DSP 程序员把指数保存在单独的变量中,并将每次结果适当地左移或右移,使其与该指数变量保持一致。由于一个指数变量往往由一组定点变量共享,这种运算方式也称为块浮点(blocked floating point),即一块变量共用同一个指数。
为了支持这类手工安排的计算,DSP 通常提供一些较宽的寄存器,以防舍入误差;这与浮点单元内部使用额外保护位类似。图 E.2 概览了四代 DSP,列出了数据宽度和累加寄存器宽度。注意,DSP 体系结构设计者并不要求字长必须是 2 的幂。图 E.3 列出了 TI TMS320C55 DSP 的数据操作数大小。
| 代次 | 年份 | 代表性 DSP | 数据宽度 | 累加器宽度 |
|---|---|---|---|---|
| 1 | 1982 | TI TMS32010 | 16 位 | 32 位 |
| 2 | 1987 | Motorola DSP56001 | 24 位 | 56 位 |
| 3 | 1995 | Motorola DSP56301 | 24 位 | 56 位 |
| 4 | 1998 | TI TMS320C6201 | 16 位 | 40 位 |
图 E.2 四代 DSP 的数据宽度,以及用于减少舍入误差的寄存器宽度。
| 数据大小 | 运算中的内存操作数占比 | 数据传送中的内存操作数占比 |
|---|---|---|
| 16 位 | 89.3% | 89.0% |
| 32 位 | 10.7% | 11.0% |
图 E.3 TMS320C55 DSP 的数据操作数大小。 大约 90% 的操作数是 16 位。该 DSP 有两个 40 位累加器。与许多 DSP 一样,它没有浮点运算,所以这些数据都是定点整数。
除了 MAC 运算,DSP 往往还提供加速通信算法中某些部分的运算。一类重要算法围绕前向纠错码的编码与译码展开。这类编码在数字比特流中加入额外信息,以抵御传输错误。原书将码率为 的编码描述为:每 个信息位对应 个校验位。例如,码率为 1/2 的编码,每 2 位中包含 1 个信息位。这类码常称为网格码(trellis code),因为一种常见的编码流程图看起来像花园中的格架。Viterbi 提出了网格码的一种常用译码算法。该算法通过一系列比较和选择操作,恢复传输比特的真实值。因此,DSP 往往提供比较—选择运算,以支持 FEC 码的 Viterbi 译码。
译注: 原文确实将 写作“校验位”数,与紧接的 1/2 码率例子不一致。通常码率 表示每 个编码输出位包含 个信息位,即冗余位为 。
为了更好地说明 DSP,下面详细考察 Texas Instruments(德州仪器)的两类 DSP。TMS320C55 系列面向由电池供电的嵌入式应用。TMS VelociTI 320C6x 系列则是一组强大的八发射 VLIW 处理器,面向更广泛、对功耗可能不那么敏感的应用。
TI 320C55
TI 320C55 体系结构位于 DSP 产品范围的一端。C55 针对低功耗嵌入式应用进行优化,总体体系结构如图 E.4 所示。其核心是一个七级流水线 CPU,各级概述如下:
- 取指级:从内存读取程序数据,送入指令缓冲队列。
- 译码级:对指令译码,将任务派发给其他主要功能单元。
- 地址级:计算数据访问地址,以及程序执行不连续时的分支地址。
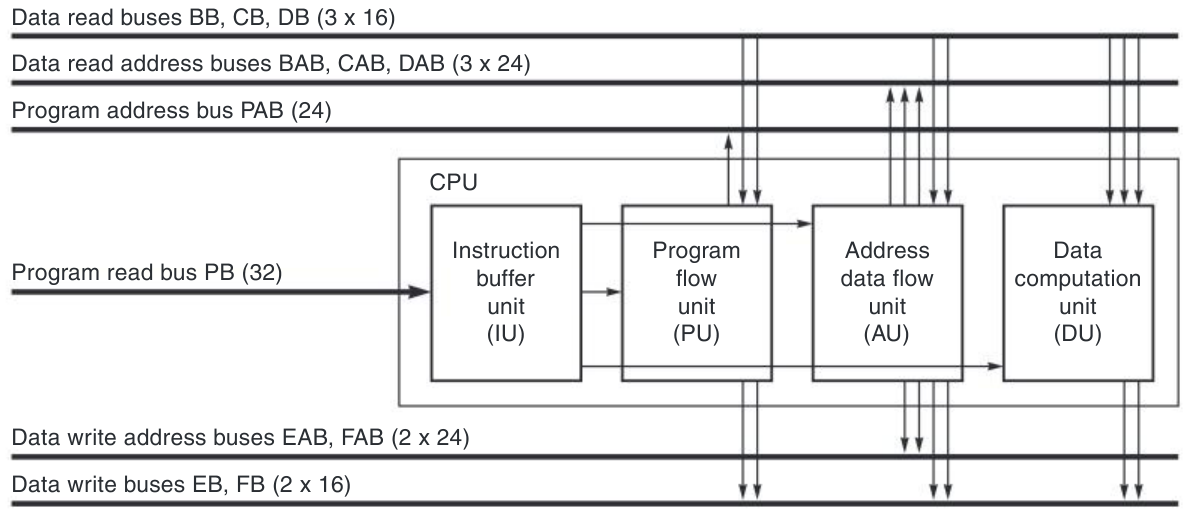
图 E.4 TMS320C55 DSP 的体系结构。 C55 是七级流水线处理器,具有一些独特的指令执行设施。(Texas Instruments 提供。)图中的 IU、PU、AU、DU 分别为指令缓冲单元、程序流单元、地址数据流单元和数据计算单元。数据读总线 BB、CB、DB 各为 16 位,对应的读地址总线 BAB、CAB、DAB 各为 24 位;数据写总线 EB、FB 各为 16 位,写地址总线 EAB、FAB 各为 24 位。程序地址总线 PAB 为 24 位,程序读总线 PB 为 32 位。
- 访问 1/访问 2 级:将数据读地址送往内存。
- 读级:通过 B、C、D 总线传送操作数数据。
- 执行级:在 A 单元和 D 单元执行运算,并通过 E、F 总线执行写操作。
C55 的流水线会检测流水线冒险,在出现读后写(WAR)和写后读(RAW)冒险时停顿。
C55 确实配有 24 KB 指令缓存,但可以配置以适应不同工作负载。它可以配置成两路组相联、直接映射,或称为“ramset”的模式。最后一种模式用于支持硬实时应用:在该模式下,缓存中的块不能被替换。
C55 还具备先进的电源管理功能。它通过软件可编程的“空闲域”(idle domain)实现动态电源管理。芯片上的电路块被划分到这些空闲域中,每个域都可以正常运行,也可以进入低功耗空闲状态。程序员可访问的空闲控制寄存器(Idle Control Register,ICR)决定下次执行 IDLE 指令时,哪些域将进入空闲状态。这六个域分别是 CPU、直接内存访问(DMA)、外设、时钟发生器、指令缓存,以及外部内存接口。某个域进入空闲状态后,该域的功能就不可用。不过,在外设域中,每个外设都有一个 Idle Enable 位,用来控制该外设是否响应空闲状态的变化。因此,可以分别配置每个外设,使其在外设域进入空闲状态时一同空闲,或继续保持活动。
作为 DSP,C55 的核心特征是其 MAC 单元。C55 有两个 MAC 单元,每个由一个 17 位乘 17 位的乘法器与一个 40 位专用加法器组成。每个 MAC 单元在一个周期内完成其工作;因此,在流水线充分运行时,C55 每周期可以执行两次 MAC。这种能力对于高效执行信号处理应用至关重要。C55 还有一个比较、选择和存储单元(compare, select, and store unit,CSSU),用于 Viterbi 译码器的加法/比较部分。
TI 320C6x
与 C55 DSP 系列形成鲜明对照的,是高端 Texas Instruments VelociTI 320C6x 处理器系列。C6x 更接近传统的超长指令字(VLIW)处理器,它力图利用许多信号处理算法中丰富的指令级并行性(ILP)。在嵌入式领域采用 VLIW 来开发 ILP 的厂商,并非只有 Texas Instruments;其他 VLIW DSP 厂商还包括 Ceva、StarCore、Philips/TriMedia 和 STMicroelectronics。为什么这些厂商倾向于 VLIW,而不是超标量?在嵌入式领域,代码兼容性没有那么突出,因此,可以针对最新一代处理器手工调优新应用,也可以重新编译。超标量在桌面领域表现出色的另一个原因,是编译器无法在编译时预测内存延迟。
而在嵌入式领域,内存延迟往往更容易预测。事实上,硬实时约束要求内存延迟能够静态预测。当然,在这种环境和约束下,超标量也能表现良好,但用于动态调度指令的额外硬件,既消耗宝贵的芯片面积,也增加功耗。因此,VLIW 自然成为高性能嵌入式处理器的一种选择。
C6x 系列不同成员采用不同的流水线深度。例如,C64x 的流水线有 11 级。最前面的 4 级执行取指,随后 2 级执行指令译码,最后 4 级执行指令。C64x 的总体体系结构如图 E.5 所示。
译注: 原文列出的 4+2+4 合计为 10 级,与同段“11 级”不一致。
C6x 系列的执行级分为两个部分:左侧或称“1”侧,右侧或称“2”侧。L1 和 L2 单元执行逻辑及算术运算;D 单元执行其中一部分逻辑和算术运算,还负责内存访问,即 load 和 store。两个 M 单元执行乘法及相关运算,例如移位。最后,S 单元执行比较、分支以及某些 SIMD 运算;下一小节将详细解释 SIMD。每一侧都有自己的寄存器堆,包含 32 个 32 位寄存器:1 侧为 A 寄存器堆,2 侧为 B 寄存器堆。一侧可以访问另一侧的寄存器,但代价是多花 1 个周期。例如,在 1 侧执行的指令可以访问 B5,不过因此会增加 1 个周期的执行时间。
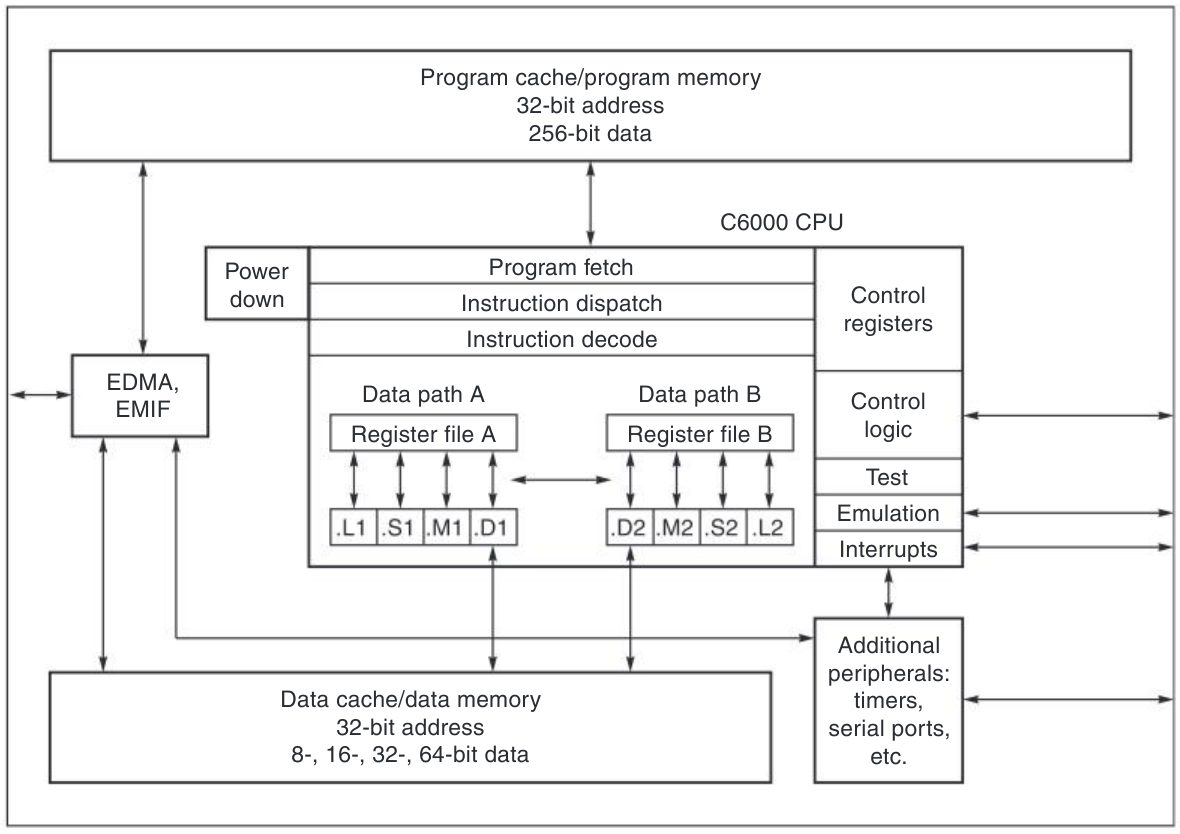
图 E.5 TMS320C64x DSP 系列的体系结构。 C6x 是八发射的传统 VLIW 处理器。(Texas Instruments 提供。)上方为程序缓存/程序内存,地址宽度 32 位、数据宽度 256 位;下方为数据缓存/数据内存,地址宽度 32 位,数据可为 8、16、32 或 64 位。CPU 包含程序取指、指令派发、指令译码、数据通路 A/B 及各自的寄存器堆,还包括低功耗控制(Power down)、控制寄存器、控制逻辑、测试、仿真和中断支持;其他外设包括定时器、串行端口等。EDMA 和 EMIF 保留原图接口标识。
传统 VLIW 的代码大小表现很差,这与嵌入式系统的需求相悖。但 C6x 系列通过一种“压缩”指令的方法,使 VLIW 代码达到与等价 RISC(精简指令集计算机)代码相同的密度。为此,取指以图 E.6 所示的“指令包”为单位进行。每条指令都有一个 p 位,用来指定指令属于当前 VLIW 字还是下一个 VLIW 字,具体含义见图注。这样,VLIW 编码就不再需要用 NOP 填充。
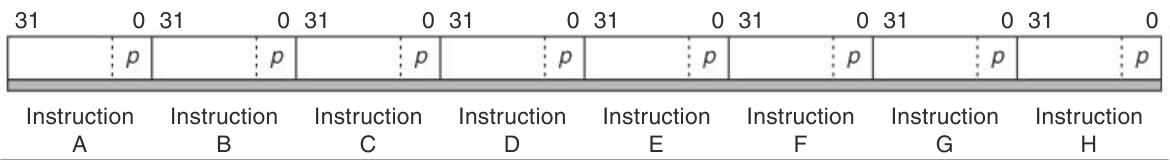
图 E.6 TMS320C6x DSP 系列的指令包。 p 位决定下一条指令是否开始一个新的 VLIW 字。如果指令 的 p 位为 1,那么指令 与指令 并行执行,即在同一周期执行。如果指令 的 p 位为 0,那么指令 在指令 之后的周期执行。(Texas Instruments 提供。)图中 A–H 为八条 32 位指令,位号为 31 至 0。
软件流水线是 VLIW 实现高性能的重要技术,但它要求循环每次迭代的调度都与其他迭代相同。条件分支指令会破坏这一模式,因此 C6x 系列提供了通过谓词执行(predication)来有条件执行指令的方法。在谓词执行中,指令先完成其工作,但执行结束时会检查另一个寄存器,例如 A1。如果 A1 为零,指令就不写入结果;如果 A1 非零,指令正常完成。这样,就可以把简单的 if-then 和 if-then-else 结构转换为直线代码,以便进行软件流水线调度。
媒体扩展
在 DSP 与微控制器之间,还有一种折中方式:媒体扩展。这些扩展以相对较低的成本,向微控制器体系结构加入类似 DSP 的能力。由于媒体处理的效果由人的感官判断,多媒体运算的数据通常远窄于现代桌面和服务器处理器的 64 位数据字。例如,图形浮点运算通常使用单精度而非双精度,而且所需精度往往低于 IEEE 754 的要求。在处理 32 位、16 位甚至 8 位整数时,与其闲置 64 位算术逻辑单元(ALU)的能力,不如用多媒体指令同时操作多个较窄的数据项。因此,在 64 位 ALU 上对 16 位数据执行一次分段加法(partitioned add),就能在单个时钟周期内完成 4 次 16 位加法。额外的硬件成本只是阻断 ALU 四个 16 位分段之间的进位。这类指令例如可以用于像素的图形运算,通常称为单指令多数据(SIMD)指令或向量指令。
大多数图形多媒体应用使用 32 位浮点运算。一些计算机把单精度浮点运算的峰值性能提高一倍,方法是让一条指令同时启动两次 32 位运算,操作数并排放在一个双精度寄存器中。两个分段必须彼此隔离,避免一个半部的运算影响另一个半部。这种浮点运算称为成对单精度运算(paired single operation),例如可用于顶点的图形变换。这种性能翻倍通常通过将浮点单元数量加倍来实现,因此比仅仅阻断整数加法器中的进位更加昂贵。
图 E.7 概括了当时几种计算机中的 SIMD 多媒体指令。
| 指令类别 | Alpha MAX | HP PA-RISC MAX2 | Intel Pentium MMX | PowerPC AltiVec | SPARC VIS |
|---|---|---|---|---|---|
| 加/减 | — | 4H | 8B、4H、2W | 16B、8H、4W | 4H、2W |
| 饱和加/减 | — | 4H | 8B、4H | 16B、8H、4W | — |
| 乘法 | — | — | 4H | 16B、8H | — |
| 比较 | 8B(≥) | — | 8B、4H、2W(=、>) | 16B、8H、4W(=、>、≥、<、≤) | 4H、2W(=、≠、>、≤) |
| 右移/左移 | — | 4H | 4H、2W | 16B、8H、4W | — |
| 算术右移 | — | 4H | — | 16B、8H、4W | — |
| 乘加 | — | — | — | 8H | — |
| 移位并加法(饱和) | — | 4H | — | — | — |
| AND/OR/XOR | 8B、4H、2W | 8B、4H、2W | 8B、4H、2W | 16B、8H、4W | 8B、4H、2W |
| 绝对差 | 8B | — | — | 16B、8H、4W | 8B |
| 最大值/最小值 | 8B、4W | — | — | 16B、8H、4W | — |
| 打包(2n 位 → n 位) | 2W → 2B;4H → 4B | 2*4H → 8B | 4H → 4B;2W → 2H | 4W → 4B;8H → 8B | 2W → 2H;2W → 2B;4H → 4B |
| 解包/合并 | 2B → 2W;4B → 4H | — | 2B → 2W;4B → 4H | 4B → 4W;8B → 8H | 4B → 4H;2*4B → 8B |
| 置换/重排 | — | 4H | — | 16B、8H、4W | — |
图 E.7 桌面处理器的多媒体支持概览。 五种体系结构的支持方式多种多样,共同点很少。所有运算的宽度都是固定的,在 64 位或 128 位 ALU 上执行多个较窄的运算。B 表示字节(8 位),H 表示半字(16 位),W 表示字(32 位);因此,8B 表示一条指令操作 8 个字节。AltiVec 按 128 位 ALU 计,其余按 64 位计。打包和解包中的 2*2W 表示两个操作数,每个操作数含两个字。本表对完整多媒体体系结构作了简化,省略了很多细节。例如,HP MAX2 包含计算平均值的指令,SPARC VIS 包含将寄存器设置为常数的指令。本表也未列出 AltiVec、MAX 和 VIS 的内存对齐操作。表中“—”对应原表空白单元格。
DSP 也提供图 E.7 前三行中的运算,不过会稍微改变它们的语义。首先,由于 DSP 经常用于实时应用,算术溢出不能触发异常,否则可能错过一个事件;因此,无论输入是什么,运算结果都会被使用。为了适应这种不容延误的环境,DSP 体系结构使用饱和运算:如果结果太大而无法表示,就根据结果的符号,将其设置为相应方向上可表示的极限值。原文接着对比二进制补码运算:“可以把一个较小的正数加到一个较大的正数上。”
译注: 这一对比句没有给出相加之后的结果。从饱和运算的上下文看,这里应当讨论补码溢出时结果可能变成负数;此说明仅用于提示缺失的论意,不作为作者原文的补译。