F.2 互连两个设备
本节介绍理解两个联网设备之间如何通信所必需的基本概念,包括接收方可能尚未准备好处理发送方发来的数据,以及传输中可能发生错误等情况。为便于理解,此时可以将黑盒网络看作理想网络,其行为相当于两个设备之间的简单专用链路。图 F.3 展示了这种情况:单向连线从设备 A 通向设备 B,反方向也有一条;每个端节点都包含一个保存数据的缓冲区。不论网络多么复杂、是否采用专用链路,每个端节点设备都需要与网络连接,向网络注入信息并从网络接收信息。我们先介绍端节点为发起和完成通信所必须执行的基本功能,再讨论网络介质以及网络为实现通信所必须执行的基本功能。之后给出一个简单的性能模型,并通过若干例子说明关键网络参数的影响。
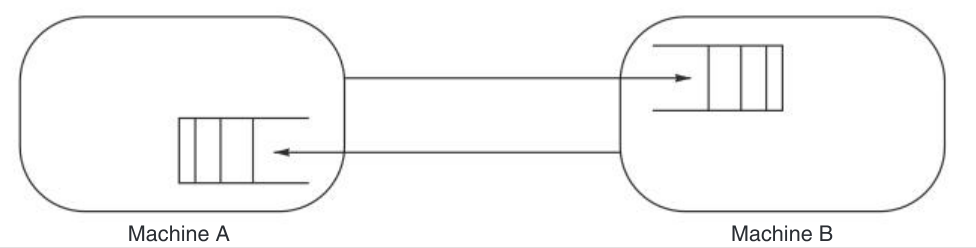
网络接口的功能:构造与处理消息
假设希望两个联网设备互相读取对方存储器中的一个字。发送或接收的信息单位称为消息(message)。为了取得所需数据,两个设备首先必须构造并发送一种消息,即包含该数据在另一设备中地址的请求。这个地址,即存储器或操作数的位置,使接收方能够确定到哪里寻找被请求的信息。处理请求后,每个设备再构造并发送另一种消息,即包含数据的应答。地址与数据信息通常称为消息的有效载荷(payload)。
除了有效载荷,每条消息还包含一些控制位,供网络投递消息以及接收方处理消息使用。最常见的控制位用于区分消息类型,例如请求、应答、请求确认和应答确认,以及使网络能够将信息正确传送到目的地。根据这些附加控制位相对于有效载荷的位置,它们编码在消息的首部和/或尾部中。图 F.4 给出了图 F.3 所示简单专用链路网络的一种消息格式。这个例子只有一个字的有效载荷,但某些互连网络中的一条消息可以包含数千个字。
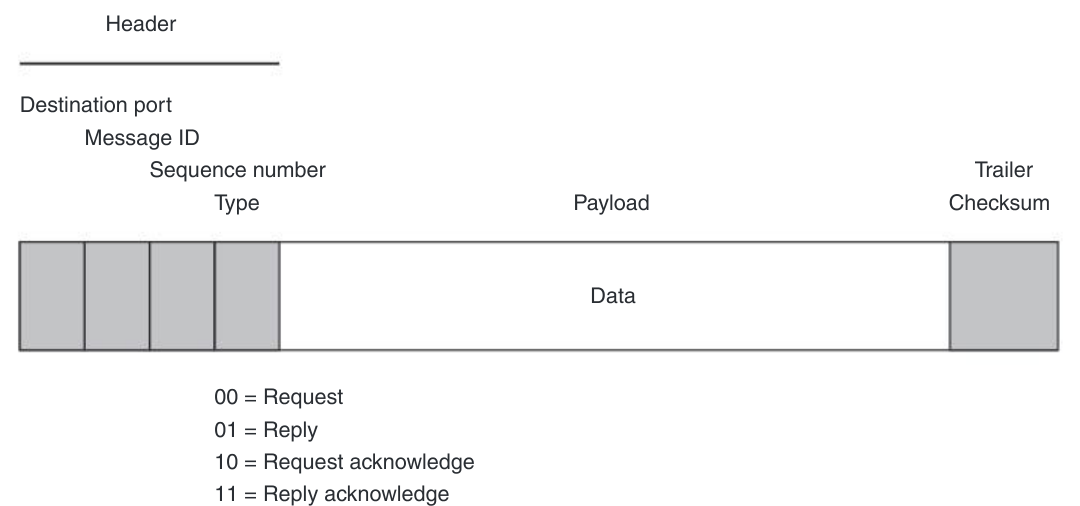
图内字段:Destination port=目的端口;Message ID=消息 ID;Sequence number=序号;Data=数据;Checksum=校验和。Type=类型,其中 00 为请求、01 为应答、10 为请求确认、11 为应答确认;Header、Payload、Trailer 分别表示首部、有效载荷与尾部。
消息在通过网络传输之前,必须先构造出来;从网络收到消息之后,也必须进行处理。这些操作以及下文介绍的其他功能,由端节点中的网络接口负责,网络接口也称通道适配器。除了用于向网络发送消息、从网络接收消息的直接存储器访问(DMA)引擎与链路驱动器,还可以使用专用存储器或寄存器来缓冲收发消息。根据网络所属领域和设计要求,网络接口硬件可以仅由通信设备自身构成,如 OCN 和某些 SAN;也可以是一块独立接口卡,集成多个嵌入式处理器、多个 DMA 引擎以及数千兆字节 RAM,如许多 SAN 以及大多数 LAN 和 WAN。
除硬件外,网络接口也可包含软件或固件,以执行所需操作。即使是图 F.3 的简单例子,也可能调用消息传递软件,将请求和应答转换为带有适当首部的消息。这样,用户应用就不必关心消息的构造和处理,因为这些任务可以在较低层次自动完成。应用程序通常与操作系统或运行时系统协作,发送和接收消息。由于每个设备上的多个进程很可能共享网络,操作系统不能让发给一个进程的消息被另一个进程接收。因此,消息传递软件必须包含区分进程的保护机制。一种做法是在首部中增加发送进程与目标接收进程都知道的端口号。
除了构造和处理消息,端节点还必须完成其他功能,才能在设备之间建立通信。虽然硬件支持可以减少工作量,其中有些工作也可以用软件完成。例如,大多数网络都规定一次可以传输的信息上限,即最大传输单元,以便合理确定网络缓冲区的大小。超过最大传输单元的消息会被划分为较小的单位,称为分组(packet)或数据报(datagram),再通过网络传送。目的端节点在将数据交付应用之前,会把这些分组重新组装为消息。通过在分组首部中加入消息 ID 字段,可以区分属于同一条消息的分组与其他分组。如果分组乱序到达目的地,就在重组消息时重新排序;通常为此在分组首部设置另一个包含序号的字段。
端节点为发起并完成网络通信所遵循的一系列步骤,称为通信协议。发送和接收通常遵循彼此对称、顺序相反的步骤。通信协议由软件与硬件共同实现,以加快执行速度。例如,许多网络接口卡具有硬件定时器,以及将消息拆分为分组、重新组装消息、计算循环冗余校验(CRC)校验和、处理虚拟存储器地址等硬件支持。
一些网络接口还包含额外硬件,将协议处理从主机计算机卸载出去,例如 LAN 和 WAN 中使用的 TCP 卸载引擎。但对于 SAN 这类低延迟互连网络,即使使用消息传递接口(MPI)等较轻量的通信协议,这也可能仍然不够。通过绕过操作系统(OS),还能进一步提高通信性能。实现方法可以是直接在网络接口存储器中分配消息缓冲区,使应用直接读写这些缓冲区,从而避免额外的存储器到存储器复制。相应协议称为零复制协议或用户级通信协议。在初始化时调用 OS 分配缓冲区,并由硬件阻止未经授权的存储器访问,仍然能够保持保护机制。
一般而言,端节点通过网络发送消息时,需要执行以下部分或全部步骤:
- 应用执行系统调用,将待发送数据复制到操作系统或网络接口缓冲区;必要时将消息拆分成分组,并构造分组首部与尾部。
- 计算校验和,将其写入分组首部或尾部。
- 启动定时器,由网络接口硬件发送分组。
消息接收按相反顺序进行:
步骤 3: 网络接口硬件接收分组,放入自身缓冲区或操作系统缓冲区。
步骤 2: 对每个分组计算校验和。如果与发送方的校验和匹配,接收方就向分组发送方返回确认;否则丢弃该分组,并假定发送方会在相应定时器超时后重新发送。
步骤 1: 全部分组通过检查后,系统重新组装消息,将数据复制到用户地址空间,并通知相应应用。
发送方还必须对分组确认作出响应:
- 收到确认时,释放缓冲区中相应分组的副本。
- 如果尚未收到确认就发生超时,则重新发送分组,并重新启动定时器。
正如网络端节点通过协议支持通信一样,网络内部的物理层、数据链路层与网络层也使用协议,主要负责分组传输、流量控制、错误处理及下面介绍的其他功能。
网络的基本结构与功能:介质与物理形式、分组传输、流量控制和错误处理
分组在源端准备好发送之后,由网络接口中的专用硬件注入网络。硬件包含收发器电路,以驱动电气或光学的物理网络介质。介质类型与物理形式,主要取决于应在多大互连距离上维持某种信号速率,例如传输速度。在芯片或多芯片模块内的厘米或更短距离上,通常可以利用中上层铜金属互连,使每条线达到数 Gbps 的信号速率。印制在电路板、中板与背板上的十几层或更多层铜走线,可以在约 1 m 距离上支持 Gbps 级差分对信号速率。Category 5E 非屏蔽双绞铜线可在 100 m 距离上实现 0.25 Gbps 的传输速度;同轴铜缆可在千米距离上提供 10 Mbps。在这些导体线路中,通常可以在一定限度内,以缩短距离换取更高传输速度。光学介质则能在千米距离上实现更高速度:多模光纤可在几千米距离上支持 100 Mbps,更昂贵的单模光纤可在数千米距离上支持 Gbps 级传输。波分复用还能使光纤带宽提高数倍,倍数等于所用波长的数量。
驱动网络链路的硬件还可能包含编码器,将信号编码为适合给定传输距离的非二进制形式。编码技术可以采用多个电压电平、冗余、数据与控制的轮换(例如 4b5b 编码),以及/或者保证单位时间内的最少信号跳变次数,以便接收方恢复时钟。接收端对信号解码,并将分组存入对应缓冲区。所有这些操作都在网络物理层完成,其细节超出了本附录的范围;幸运的是,我们无需深入这些细节。从数据链路层及更高层看,物理层可以视为一条没有分级的长线性流水线,信号以波的形式在网络传输介质中传播。上述各项功能通常统称为分组传输。
除了传输分组,网络硬件和软件还在数据链路层与网络层协议中共同负责可靠投递。这包括两项责任:(1)防止发送方发送分组的速率超过接收方的处理速率;(2)确保分组在传输过程中既不损坏,也不丢失。第一项责任有两种实现方式:接收方缓冲区满时丢弃分组,之后通知发送方重传;或者在缓冲区满时通知发送方停止发送,待缓冲区有空间容纳更多分组时再恢复。后一种策略通常称为流量控制。
除了发送方与接收方之间简单的握手,还有几种常用且值得关注的流量控制技术。较流行的是 Xon/Xoff(也称 Stop & Go)和基于 credit 的流量控制。Xon/Xoff 在缓冲区占用率达到高水位时,通知发送方停止发送;降至低水位时,通知发送方恢复发送。两者之间保留一定滞回区间,以减少通知数量。这些“停止”和“继续”信号可以通过附加控制线发送,也可以编码在控制分组中。
基于 credit 的流量控制通常在发送方设置一个 credit 计数器,初始 credit 数等于接收方的缓冲区条目数。每发送一个分组,发送方就将计数器减一。接收方从缓冲区中取走一个分组后,以控制分组的形式返还一个 credit;发送方收到它后将计数器加一。这些方法本质上都是在接收方达到低水位,或发送方用完 credit 时,限制发送端注入分组,从而控制流入网络的分组数量。
译注: 上一段原文写作“接收方达到低水位”。结合前文 Xon/Xoff 的占用率定义,停止发送对应高占用率,低水位对应恢复发送。
Xon/Xoff 通常产生的控制流量远少于基于 credit 的流量控制,因为只有跨过高、低占用率水位时才发送通知。另一方面,基于 credit 的流量控制所需缓冲区不足 Xon/Xoff 的一半。Xon/Xoff 的缓冲区必须足够大,以保证“停止”信号到达发送方之前不会溢出;而基于 credit 的流量控制不会发生这种溢出,因为发送方会在 credit 耗尽时停止传输。对这两种方法而言,只有缓冲区大小与通信距离相适应,才能充分利用链路带宽。
下面用一个覆盖不同互连网络领域的简单例子,比较这两种流量控制技术的缓冲需求。
例题:流量控制所需的缓冲容量
假设一个专用链路网络连接两个设备,每条链路每个方向的原始数据带宽都是 8 Gbps。为了充分利用网络带宽,一个设备持续向另一个设备发送大小为 100 字节(包括首部)的分组。若只考虑链路传播延迟,在互连距离分别为 1 cm、1 m、100 m 和 10 km 时,基于 credit 的流量控制最少需要多少 credit 和缓冲空间?与 Xon/Xoff 相比,所需的最小缓冲空间有何差别?
解答 起初接收缓冲区为空,发送方的 credit 数等于缓冲区容量。每发送一个分组,发送方消耗一个 credit。为了使发送方能持续以网络速率发送分组,第一个返还的 credit 必须在 credit 耗尽之前到达发送方。收到第一个 credit 后,发送方会以发送分组的相同速率持续收到 credit。这里仅考虑链路上的传播延迟,不考虑其他延迟和开销,因此假定发送方和接收方的处理时间为零。从开始发送第一个分组,到第一个 credit 返回发送方,所需时间等于分组到接收方、再由 credit 返回发送方的往返传播延迟。该时间必须小于或等于分组发送时间与初始 credit 数的乘积:
光速约为 300,000 km/s。假定在导体中可以达到其 66%,则每个距离所需的最小 credit 数满足:
每个 credit 对应一个能容纳一个分组的缓冲条目。因此,在 1 cm 和 1 m 距离上,每个设备所需的最少 credit 数及缓冲空间均为 1 个分组;在 100 m 距离上为 10 个分组;在 10 km 距离上为 1000 个分组。
对于 Xon/Xoff,上述最小缓冲容量分别对应高水位到缓冲区顶部,以及低水位到缓冲区底部的空间。为了减少通知,还需要在高、低水位之间增加滞回区间。因此,Xon/Xoff 所需的最小缓冲空间是基于 credit 的流量控制的两倍以上。
实现流量控制的网络不需要丢弃分组,有时称为无损网络;会丢弃分组的网络则有时称为有损网络。这种分组处理方式上的单一差异,会强烈限制其他相关网络问题可采用的解决方案,包括分组路由、拥塞、死锁和可靠性;本附录后面将讨论这些问题。它对性能的影响也很大:丢弃的分组需要重传,因而占用更多链路带宽,并承受额外延迟。这些行为与性能差异,最终限制了某些方案适用的互连网络领域。例如,较短距离上传输分组的大多数网络,如 OCN 和 SAN,倾向于实现流量控制;较长距离上的网络,如 LAN 和 WAN,则倾向于允许丢弃分组。在较短距离上,流控信息传回发送方的延迟可以忽略,而在较长距离上则不能。通常运行的应用种类,也会影响有损或无损网络的选择。例如,丢弃 Web 浏览器等互联网客户端发出的分组,只影响对应用户观察到的延迟;但如果丢弃的是并行应用中某个进程发送的分组,而该分组延迟位于关键路径上,就可能显著延长整个应用的执行时间。
第二项责任,即确保分组在传输中既不损坏也不丢失,可以通过检测并恢复传输错误的机制实现。如图 F.4 所示,在分组格式中加入校验和或其他检错字段,便可使接收方检测错误。这些冗余信息在发送时计算,在接收时核验。分组通过检查后,接收方以控制分组的形式发送确认。注意,这种确认控制分组也可以同时携带流量控制信息,例如一个 credit 或停止信号,从而减少控制分组开销。前面已经说明,最常见的错误恢复方式,是用定时器记录每个分组的发送时间;如果确认到达之前定时器已经超时,就认定分组丢失或传输有误,并重新发送。
网络内部及端节点之间的通信协议,还必须处理分组传输、流量控制和可靠性之外的许多问题。例如,两个设备若来自不同制造商,可能采用不同的字内字节顺序,即大端或小端字节序;协议就必须在投递过程中将每个字的字节顺序反转。协议还必须防范一种情况:先前延迟的分组重新继续传输,从而产生重复分组。根据系统要求,协议可能需要使操作流水化,以提高性能。最后,在连接两个以上设备时,协议可能还要处理网络拥塞,避免性能下降;F.7 节将进一步介绍。
性能刻画:延迟与有效带宽
介绍了两个设备间收发消息的基本步骤之后,现在可以讨论性能了。先看传输单个分组的延迟,再看在分组粒度上将多个分组的网络传输流水化时,所能达到的有效带宽,也称吞吐量。
图 F.5 展示了单个分组延迟的基本组成部分。随着后面逐渐揭示网络“黑盒”的内部结构,一些延迟分量还会进一步细分。图中的时间参数适用于许多互连网络领域:芯片内部、电路板上的芯片之间、机箱中的电路板之间、计算机中的机箱之间、集群中的计算机之间、集群之间,等等。具体数值可能变化,但延迟的组成部分相同。
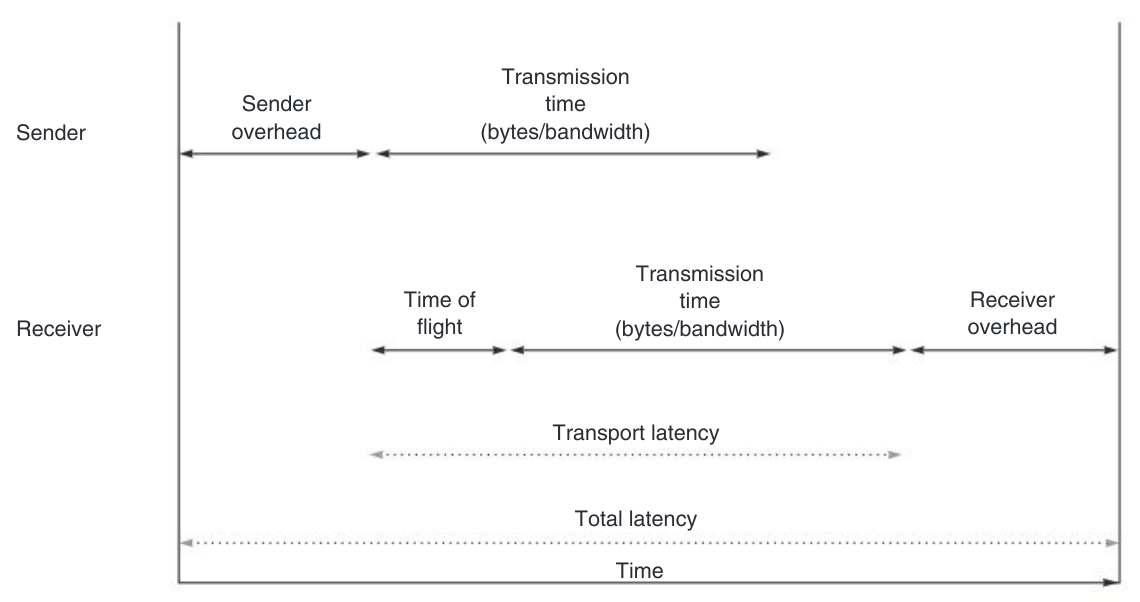
图内术语:Sender/Receiver=发送方/接收方;Sender overhead/Receiver overhead=发送开销/接收开销;Transmission time=传输时间,等于字节数除以带宽;Time of flight=飞行时间;Transport latency=传送延迟;Total latency=总延迟;Time=时间。
下面这些术语经常被宽泛使用,容易造成混淆,因此在这里给出较精确的定义。
- 带宽(bandwidth):严格地说,传输介质的带宽是一个频率范围;在这个范围内,该介质引入的单位长度衰减低于某个阈值。它必须与传输速度区分,后者是单位时间通过介质传输的信息量。例如,20 世纪 90 年代末,调制解调器通过编码更多电压电平,使每个信号周期承载更多位,在固定带宽下提高了传输速度;这里的固定带宽,是电话线路话音信道提供的 3 kHz 带宽。不过,为了与更广泛使用的含义一致,本附录用“带宽”表示信息能够传输的最高速率,其中的信息包括分组首部、有效载荷与尾部。单位通常为 bit/s,有时也使用 byte/s。带宽一词也用于表示介质,即网络链路的实测速率。聚合带宽是网络提供的总数据带宽;有效带宽或吞吐量,是聚合带宽中网络实际交付给应用的部分。
- 飞行时间(time of flight):分组的第一位到达接收方所需的时间,包括链路传播延迟,以及网络内其他硬件(如链路中继器和网络交换机)引起的延迟。其单位可以是 WAN 中的毫秒、LAN 中的微秒、SAN 中的纳秒,以及 OCN 中的皮秒。
- 传输时间(transmission time):分组通过网络所需的时间,不包括飞行时间。一种测量方法,是求分组第一位与最后一位到达接收方的时刻之差。按定义,传输时间等于分组大小除以网络链路的数据带宽。这里假定没有其他分组竞争带宽,即网络为零负载或无负载状态。
- 传送延迟(transport latency):飞行时间与传输时间之和,即分组停留在互连网络内的时间。换一种表述,就是从分组第一位注入网络,到最后一位到达接收方的时间;它不包括发送方准备分组的开销,以及接收方收到分组后进行处理的开销。
- 发送开销(sending overhead):端节点准备一个分组,以便注入网络所需的时间;这里指分组,而不是消息,包括硬件和软件两部分。在这整个时间内端节点都处于忙碌状态,所以称为开销。端节点一旦空闲,此后的延迟便计入传送延迟。假定开销由一个常数项,以及一个依赖分组大小的可变项组成。常数项包括存储器分配、分组首部准备、DMA 设备设置等;可变项主要来自缓冲区之间的复制,对极短分组通常可以忽略。
- 接收开销(receiving overhead):端节点处理到达分组所需的时间,也包括硬件和软件两部分。同样假定它由常数项和依赖分组大小的可变项构成。一般而言,接收开销大于发送开销。例如,接收方可能需要支付中断处理成本,也可能必须将分组重新排序并组装成消息。
一个分组的总延迟可以写成:
下面看看,从 OCN 到 SAN、LAN 再到 WAN,传送延迟的各分量以及发送和接收开销的重要性如何变化。
例题:不同网络领域中的总延迟
假定一个专用链路网络连接 OCN、SAN、LAN 或 WAN 中的两个设备,每条链路每个方向的数据带宽都是 8 Gbps,希望在设备间传送大小为 100 字节(包括首部)的分组。端节点的每分组发送开销为 ,接收开销为 ;其中 OCN、SAN、LAN、WAN 的 分别为 0 μs、0.3 μs、3 μs、30 μs,这些是相应网络类型的典型值。假定飞行时间仅包括链路传播延迟,不包括交换或其他延迟,请计算在互连距离分别为 0.5 cm、5 m、5000 m、5000 km 时,从一个设备向另一个设备发送分组的总延迟。
解答 利用上面的表达式,以及前一个例题给出的导体传播延迟计算方式,代入各网络参数即可求得总分组延迟。对于 OCN:
将所有项换算成纳秒,OCN 的总延迟为:
代入 SAN 的相应数值:
代入 LAN 的相应数值:
代入 WAN 的相应数值:
长距离情况下,飞行时间占总延迟的比例增大,且传输错误更容易发生;因此,WAN 和 LAN 采用更复杂、更耗时的通信协议,使发送与接收开销增大。标准化的需要也是原因之一。此外,从几十个、几百个、几千个到数万个设备,不同互连网络领域中典型应用对协议提出的要求,也会增加复杂性。后面讨论连接两个以上设备时,还会考察这一问题。
上述例子表明,对 WAN 和某些 LAN 而言,飞行时间中的传播延迟极大,其他延迟分量,包括发送与接收开销,实际上都可以忽略。但 SAN 和 OCN 并非如此:与开销和传输延迟相比,传播延迟很小。请记住,这个例子只考虑了信号在链路中的传播,忽略了交换机及网络中其他硬件造成的飞行时间。在不拥塞的 WAN 和 LAN 中,交换机延迟通常远小于端节点开销和链路传播延迟;但对多处理器 SAN 和多核 OCN 而言,不一定如此,后面将会看到这一点。
到目前为止,我们只考察了单个分组的传送,并计算其端到端总延迟。为了计算两个联网设备的有效带宽,需要考察它们之间连续传送的分组流。必须记住,对给定成本与功耗目标进行优化的网络,除了要尽量缩短分组延迟,还要在尽可能短的时间内传送尽可能多的可用信息;衡量这一点的指标就是网络交付的有效带宽。
对于不必等到应答就能发送下一分组的应用,发送方可以将后续分组的发送开销,与先前分组的传送延迟和接收开销重叠。这本质上是将网络上的分组传输流水化,也称链路流水化。幸运的是,正如本书前面各章所述,许多应用领域都允许多个应用,或同一应用的多个线程并发通信,例如 Web 服务器并发处理数千个客户端请求,或流媒体传送。因此,设备能够连续发送分组流,而不必等待确认或应答。此外,长消息在传送前通常会拆分成最大大小的分组,在这种情况下,也会连续向网络注入多个分组。若无法实现这种重叠,就必须等到前一分组被确认之后才能发送后一分组,性能会显著下降。
对流水化传送的分组进行确认也很直接:只需在源端保留所有已发送但尚未确认分组的副本,并跟踪返回确认与缓冲分组之间的对应关系。发送方收到相应确认后,便将分组从缓冲区移除。确认中包含该分组的消息 ID 和序号,就能建立这种对应关系。此外,每个缓冲分组必须关联一个独立定时器,以便超时后重传。
网络分组传送的流水化,与处理器内部计算的流水化有很多相似之处,但也存在差别,例如不需要任何级间锁存器。信息只是以连续信号波的形式在网络链路上传播。因此,可以将网络看成具有所需任意级数的逻辑流水线,使飞行时间不影响可实现的有效带宽。前一分组传输结束后,可以立即开始下一分组的传输,从而将当前分组的发送开销,与先前分组的传送延迟及接收延迟重叠。
如果发送开销小于传输时间,分组便能背靠背地连续传输;持续发送时,有效带宽趋近于原始链路带宽。反之,如果发送开销大于传输时间,注入点的有效带宽就会远低于原始链路带宽。对于每条持续向网络注入分组流的链路,其链路注入带宽 为:
还必须考虑接收方无法以分组到达速率消耗分组的情况。如果接收开销大于发送开销,接收方处理到达分组的速度不够快,就会出现这种现象。此时,网络每条接收链路的链路接收带宽 小于链路注入带宽,其表达式为:
两个设备通过专用链路通信时,一个设备发送的全部分组都由另一个设备接收。如果接收方无法足够快地处理分组,其缓冲区就会填满,流量控制将限制发送方的传输。由于这种情况来自网络外部的原因,这里不作进一步讨论。另外,如果接收开销大于发送开销,接收缓冲区同样会填满,流量控制也会限制发送方的传输。在这种情况下,从平均效果看,流量控制相当于用接收开销替代发送开销。
假定网络理想地表现为两条方向相反、以满链路带宽运行的专用链路,这与迄今为止对网络的黑盒认识一致,则有效带宽等于“注入带宽的两倍”和“接收带宽的两倍”中的较小者。乘以二,是因为两个设备各有一条注入链路。由此得到:
其中,。结合传输时间的表达式,可以看出:当传输时间大于开销时,网络交付的有效带宽就等于聚合网络带宽。因此,只要网络行为理想,即为基于 credit 和 Xon/Xoff 的流量控制提供足够的 credit 与缓冲区,就能充分利用网络,而与飞行时间以及分组传播距离无关。
这个分析假定发送方与接收方的网络接口一次只能处理一个分组。如果可以并行处理多个分组,例如 IBM Federation 网络接口的做法,那么这些分组的开销就能重叠,使有效带宽按重叠倍数提高,直到达到传输时间规定的上限。
下面利用前述表达式,考察分组大小、传输时间和开销对 OCN、SAN、LAN、WAN 中链路注入带宽、链路接收带宽及有效带宽的影响。
例题:分组大小与有效带宽
与上一例相同,假定专用链路网络连接 OCN、SAN、LAN 或 WAN 中的两个设备,每条链路每个方向的数据带宽为 8 Gbps。对于 4 字节(一个 32 位字)到 1500 字节(以太网最大传输单元)的分组,绘制各类网络中有效带宽随分组大小变化的曲线。端节点的每分组发送与接收开销仍分别为 和 ;OCN、SAN、LAN、WAN 的 分别为 0 μs、0.3 μs、3 μs 和 30 μs。什么因素限制了有效带宽?分组大小达到多少时,有效带宽与聚合网络带宽的差距不超过 10%?
解答 图 F.6 利用上述简单表达式和参数,绘出了四种网络领域中有效带宽随分组大小变化的曲线。对 OCN 而言,在所有分组大小下,传输时间都大于发送或接收开销,因而能够充分利用 16 Gbps 的聚合带宽,即将注入链路(或接收链路)带宽乘以二,以计入两个设备。
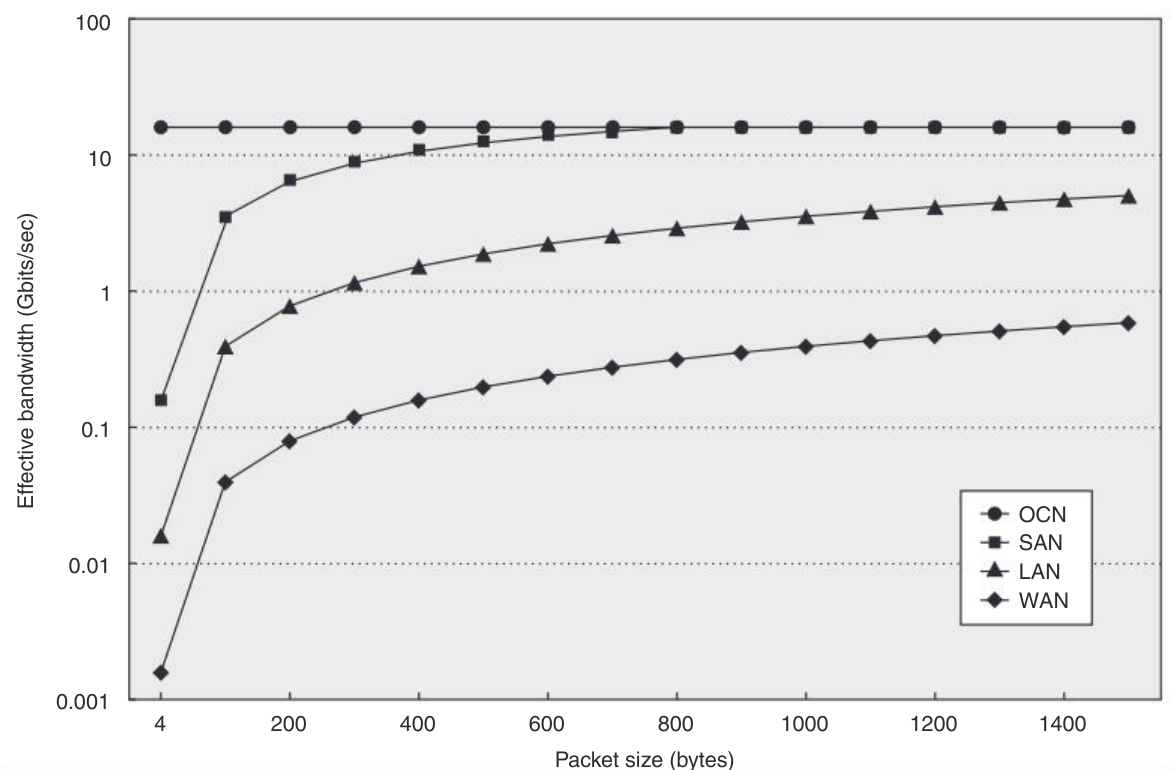
图内横轴为分组大小(bytes),纵轴为有效带宽(Gbit/s);四条曲线分别对应 OCN、SAN、LAN、WAN。
对 SAN 而言,当分组小于约 800 字节时,开销,具体说是接收开销,大于传输时间;因此,要利用至少 90% 的聚合带宽,分组必须达到 655 字节或更大。对于 LAN 和 WAN,在本例所有分组大小下,开销都远大于传输时间,因此大多数链路带宽未被利用。
译注: 原图、原解答中的约 800 字节和 655 字节按原书保留。若严格代入题干给定的 SAN 参数,接收开销为 ns,传输时间为 ns( 为分组字节数);两者相等时约为 421.1 字节,达到 90% 带宽所需约为 377.0 字节。因此,题干参数与图、解答的阈值并不一致,不应把原图阈值当作该组参数的精确计算结果。
这个例子说明,要使网络交付的有效带宽最大化,降低相对于分组传输时间的发送与接收开销十分重要。
上述分析表明,可以通过检查分组经过的路径、确定瓶颈位置,给有效带宽求出一个上界。我们可以将这个思路扩展到网络接口之外:把整个端到端网络看作一条管道,并找出其中最窄的部分。需要关注三处:全部网络注入链路的聚合及其网络注入带宽 ;全部网络接收链路的聚合及其网络接收带宽 ;以及全部网络链路的聚合及其网络带宽 。随着后面逐步揭示网络黑盒的内部结构,将给出这些带宽的表达式。
到目前为止,我们假定只互连两个设备时,黑盒网络表现理想,网络带宽等于聚合原始网络带宽。实际上,网络带宽可能远低于聚合带宽,下面各节将说明这一点。一般而言,网络端到端交付给应用的有效带宽,受上述三个潜在瓶颈区域中最小值的限制:
后面随着对互连网络了解加深,并考察互连两个以上设备的一般情况,还会进一步扩展这个表达式。
本附录的一些小节将介绍相应概念在高端商用产品中的具体实现。图 F.7 列出了几种商用计算机;它们都曾在其发展历程的某个时刻,成为同类中全球性能最高的系统之一。虽然这些系统能够互连两个以上设备,但同样实现了仅互连两个设备所必需的基本功能。本节讨论的问题不仅适用于这些系统中的 SAN,也适用于从 OCN 到 WAN 的其他互连领域。
| 公司 | 系统[网络名称] | 推出年份 | 最大计算节点数[每节点 CPU 数] | 最大配置占地 | 分组最大大小[首部](字节) | 每节点注入[接收]带宽(MB/s) | 最小发送/接收开销 | 最大铜缆长度;流控;检错 |
|---|---|---|---|---|---|---|---|---|
| Intel | ASCI Red Paragon | 2001 | 4510[×2] | 2500 ft² | 1984[4] | 400[400] | 数 μs | 握手;CRC+奇偶校验 |
| IBM | ASCI White SP Power3[Colony] | 2001 | 512[×16] | 10,000 ft² | 1024[6] | 500[500] | 约 3 μs | 25 m;基于 credit;CRC |
| Intel | Thunder Itanium2 Tiger4[QsNet II] | 2004 | 1024[×4] | 120 m² | 2048[14] | 928[928] | 0.240 μs | 13 m;基于 credit;链路与目的端 CRC |
| Cray | XT3[SeaStar] | 2004 | 30,508[×1] | 263.8 m² | 80[16] | 3200[3200] | 数 μs | 7 m;基于 credit;CRC |
| Cray | X1E | 2004 | 1024[×1] | 27 m² | 32[16] | 1600[1600] | 0(直接 LD、ST 访问) | 5 m;基于 credit;CRC |
| IBM | ASC Purple pSeries 575[Federation] | 2005 | >1280[×8] | 6720 ft² | 2048[7] | 2000[2000] | 约 1 μs,最多并行处理 4 个分组 | 25 m;基于 credit;CRC |
| IBM | Blue Gene/L eServer Sol.[Torus Net.] | 2005 | 65,536[×2] | 2500 ft²(每 1K 节点机架为 0.9 × 0.9 × 1.9 m³) | 256[8] | 612.5[1050] | 约 3 μs(2300 周期) | 8.6 m;基于 credit;CRC(首部/分组) |