F.4 网络拓扑
当设备数量较少时,一个交换机就足以在交换介质网络中将它们连接起来。然而,交换机的端口数受现有超大规模集成电路(VLSI)技术、成本、功耗等因素限制。当所需网络端口数超过单个交换机支持的端口数时,就需要由互连交换机组成的交换结构。为了具备必要的完全可达性,即连通性,网络交换结构必须提供从任意端节点设备到其他任意设备的路径。无论是接入交换结构的连接,还是交换结构内部交换机之间的连接,都采用点到点链路,而非共享链路;也就是说,链路两端各只有一个交换机或一个端节点设备。由交换机、链路、端节点设备等全部部件构成的互连结构,称为网络拓扑。
文献中描述过的网络拓扑很难统计,但在商业系统中实际使用的,大约不超过十几种。20 世纪 70 年代至 80 年代初,研究者不断尝试提出新拓扑,以减少分组必须经过的交换机数量,即跳数。20 世纪 90 年代,随着流水化传输和交换技术的引入,跳数的重要性有所降低。不过,拓扑今天仍然重要,尤其对 OCN 和 SAN 而言,因为拓扑与其他影响性能的网络设计参数之间存在微妙联系;在端节点极多时,例如 Blue Gene/L 超级计算机的 64K 个节点,或延迟极其关键时,例如多核处理器芯片,这一点尤为突出。拓扑也极大地影响网络的实现成本。
并行超级计算机 SAN 的拓扑最引人注目,也最富想象力;为简化路由、封装和扩展,它们通常采用规则结构。LAN 和 WAN 的拓扑则往往更加随意或因地制宜,主要受长距离连接、跨不同通信子网连接等困难影响。基于交换机的 OCN 拓扑出现较晚,但正迅速普及。本节介绍商用产品中较流行的拓扑,并简要讨论其优点、缺点和约束。
集中式交换网络
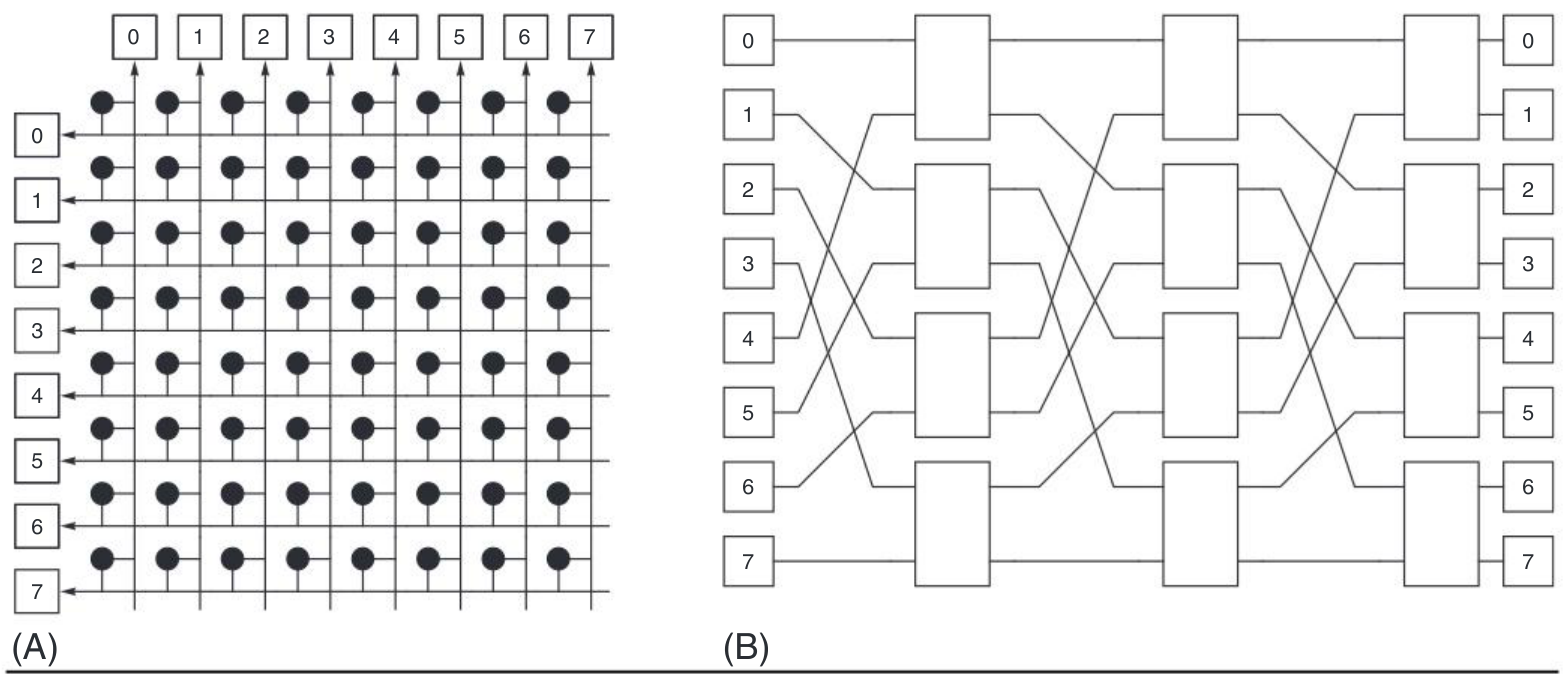
如前所述,当交换机端口数不小于设备数时,单个交换机就能互连这些设备。这种简单网络通常称为交叉开关(crossbar)或交叉开关交换机。图 F.11(a) 表明,交叉开关内部交叉点开关的复杂度,随端口数按平方增长。因此,当设备规模超出实现技术所能支持的范围时,需要成本更低的方案。
解决交叉开关扩展问题的一种常见方法,是把一个大交叉开关拆成多级小交换机,再按一定方式互连,使任何源端只需通过交换结构一次,就能到达任何目的端。按这种方式组织的拓扑,通常称为多级互连网络(multistage interconnection network,MIN)或多级交换结构,其复杂度一般按 增长。MIN 最初于 20 世纪 50 年代为电话交换提出,后来用于构建并行超级计算机、对称多处理器、多计算机集群和 IP 路由器交换结构的通信骨干。
MIN 级间的互连模式是一种或多种置换,可以用一组数学函数表示,每级对应一个函数。图 F.11(b) 展示了著名的 Omega 拓扑:每级采用完美洗牌置换(perfect-shuffle permutation)作为互连模式,后接交换开关,形成每级的 perfect-shuffle exchange。在这个例子中,八个输入/输出端口通过三级 交换机互连。可以很容易看出,任意输入端口经过这三级一次,就能到达任意输出端口。一般而言,使用 交换机时,具有 个输入/输出端口的 MIN 至少需要 级,每级含 个交换机,总计 个交换机。
尽管具有内部结构,MIN 整体上仍可视为集中式交换结构,端节点设备连接在网络外围,因此称为集中式交换网络。换一个角度,MIN 通过一组交换机来互连节点,而其中一些交换机可能没有直接连接任何节点,因此它还有另一个常见名称:间接网络。
例题:交叉开关与 MIN 的成本
计算使用单个交叉开关互连 4096 个节点,相对于使用由 、 和 交换机构成的 MIN 的成本。分别比较单向链路与交换机的相对成本。对 交换机,假定交换机成本随输入端口数,或等价地输出端口数 ,按平方增长。
解答 使用单个交叉开关时,网络交换机成本与 成正比。单向链路成本为 8192,计入了端节点到交叉开关,以及交叉开关返回端节点的全部链路。使用 交换机构成 MIN 时,每个交换机成本与 成正比,但总共有 个交换机。此外,交换机输出方向共有 级单向链路,每级 条,再加上从端节点接入 MIN 的 条链路。因此,交叉开关相对于各 MIN 的成本为:
译注: 交换机成本前三项的 170、170、85 为原书给出的近似整数;对应比值分别约为 170.67、170.67、85.33。原式仍保留等号和原数值。
在所有情况下,单个交叉开关的交换机成本都远高于 MIN。使用尺寸最小、数量最多的交换机构成 MIN,可以获得最显著的成本下降;有趣的是, 与 交换机组成的 MIN,其相对交换机成本相同。交叉开关的链路成本低于 MIN,但差距在所有情况下都不到一个数量级。还必须记住,端节点链路与交换机间链路在长度和封装要求上不同,因此单位成本通常也不同。尽管链路成本较低,交叉开关的总体相对成本仍然较高。
MIN 降低交换机成本的代价是性能:网络链路上更容易发生竞争,从而降低性能。不同源端到不同目的端的路径同时共享一条或多条链路,就会出现分组在网络中阻塞的竞争。竞争程度取决于通信流量行为。例如,在图 F.11(b) 的 Omega 网络中,从端口 0 发往端口 1 的分组,会在第一级交换机处等待从端口 4 发往端口 0 的分组。在交叉开关中,到不同目的端的路径不共享链路,因此不会出现这种阻塞;所以交叉开关是无阻塞的。当然,如果两个节点同时发往同一个目的端,即使是交叉开关,也会在接收链路处发生阻塞。正如上一节末尾所述,性能分析中用平均接收因子 来计入这种影响。
为了减少 MIN 的阻塞,需要增加交换机数量,或使用更大的交换机,为每对源端与目的端提供替代路径。第一种常见方案,是至少再增加 级交换机,使其结构与原拓扑形成镜像。得到的网络具有可重排无阻塞性:它允许为新出现的源端—目的端设备对建立不冲突的路径。但跳数也大致增加一倍,而且可能需要通过某种集中控制,重新安排现有通信设备对的路径。
第二种方案不再增加交换级数,而是在前后两级交换机之间使用更大的中间级交换机;如有需要,中间级交换机本身也可用多级结构实现。中间级提供足够多的替代路径,使第一级与最后一级之间能够建立互不冲突的路径。最著名的例子是无阻塞的 Clos 网络。可以对三级 Clos 拓扑中的中间级交换机递归应用多路径性质,将所有交换机逐步缩小至 ,前提是第一和最后一级一开始也使用这种尺寸。最终得到具有 级的 Beneš 拓扑,它是可重排无阻塞的。图 F.12(a) 同时说明这两种拓扑:除第一和最后一级之外的全部交换机,共同递归地构成 Clos 网络的中间级交换机。
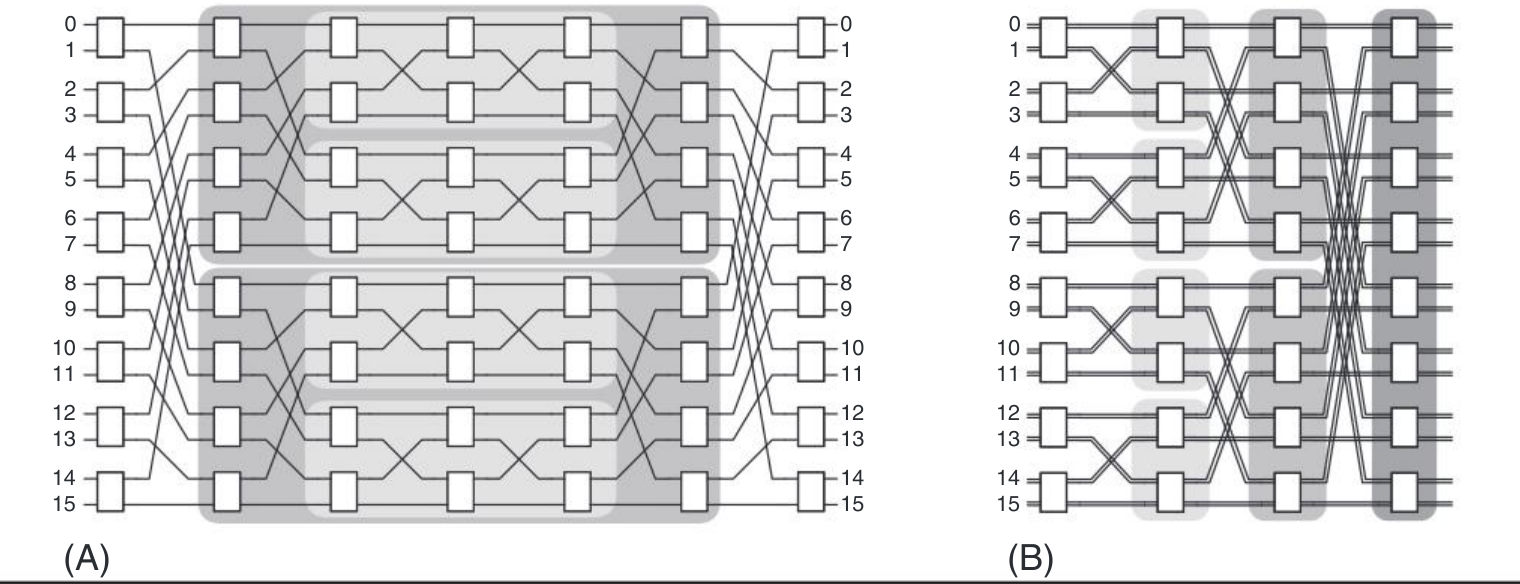
迄今讨论的 MIN 使用单向网络链路,但只需折叠 Clos、Beneš 等对称网络,就很容易得到双向形式。重叠的单向链路沿相反方向运行,构成双向链路;重叠的交换机则合并成一个端口数翻倍的交换机,即 交换机。图 F.12(b) 展示了这种折叠 Beneš 拓扑,但端节点连接在原网络最内侧的交换级。网络另一侧仍有空闲端口,可供以后扩展规模。这类网络称为双向多级互连网络。
这种网络具有许多有用性质,包括模块化,以及利用通信局部性的能力,使分组不必经过全部网络级。规则结构还降低了路由复杂度;多路径特性则有助于将流量更均匀地分散到网络资源上,并容忍故障。
另一种构造具有可重排无阻塞性质的双向 MIN 的方法,是形成一棵平衡树,端节点设备位于叶子,交换机位于树的内部顶点。每一层都必须提供足够链路,使总链路带宽在各层保持不变。此外,除根之外,每个顶点的交换机端口数通常按 增长,其中 是树层数。可以在每个顶点使用总计 个交换机实现,每个交换机有 个输入端口和 个输出端口,或者说 个双向端口,即 个输入/输出端口。这种拓扑称为胖树网络。
由于每个方向只使用 个双向端口中的一半,所以每级需要 个交换机,胖树总共需要 个交换机。根级不需要向上的链路,因此该级交换机数量可以减半,总交换机数减少 。图 F.12(b) 给出了采用 交换机的胖树;可以看到,它与折叠 Beneš 网络相同。
对多数采用 MIN 的商用系统而言,在很宽的规模范围内,胖树都是首选拓扑。多计算机集群中的大多数 SAN,以及许多最强大超级计算机中的 SAN,均基于胖树。Myrinet、Mellanox 和 Quadrics 提供的商用通信子系统也由胖树构建。
分布式交换网络
如上所述,交换介质网络为设计独立于通信设备的通信子系统,提供了十分灵活的框架。但某些情况下,将端节点设备与使其通信的网络资源更紧密地集成起来会更合适。与其把交换结构集中在外部子系统中,不如将交换机分布到各个端节点上;这些端节点于是成为网络节点,或简称节点,整个网络称为分布式交换网络。每个交换机直接连接一个或多个端节点设备,组成一个网络节点。这些节点直接与其他节点相连,不必间接通过某个外部交换机,因此这种网络也常称为直接网络。
分布式与集中式交换网络的拓扑形式很不相同:前者的端节点分布在整个交换结构区域,而不是仅连接在外围的一条或两条边上。这使系统中的交换机数量等于总节点数。一种很直接的连接方式,是为每个节点与其他任意节点之间都设置专用链路。这样的全连接拓扑提供最佳连通性,实际上就是完全连通,但成本高于交叉开关,下面的例子说明了这一点。
例题:全连接网络与交叉开关的成本
计算用全连接拓扑互连 个节点,相对于用交叉开关拓扑的成本。分别考虑单向链路与交换机的相对成本。假定 交换机成本随单向端口数按平方增长,而 交换机成本只按线性增长。
解答 交叉开关拓扑需要一个 交换机,所以交换机成本与 成正比。链路成本为 ,包括从端节点到集中式交叉开关的单向链路及反向链路。
在全连接拓扑中,每个节点采用两组 交换机,也可以将它们合并成一组,以直接与所有其他节点双向连接。因此, 个节点的总交换机成本与 成正比。每个节点的端设备与本地交换机之间,需要两条方向相反的单向链路;此外,本地交换机还需要 条单向链路,通向其他端节点上的交换机。总单向链路数因此为 。全连接拓扑相对于交叉开关的成本为:
随着互连设备数增加,全连接拓扑的交换机成本接近交叉开关的两倍;两者都很高,即按平方增长。此外,全连接拓扑的相对链路成本始终更高,且随节点数线性增长。再次提醒,端节点链路与交换机间链路在长度和封装方式上不同,直接网络尤其如此,因此对应成本通常也不同。尽管成本更高,全连接拓扑相对于交叉开关并无额外性能收益,因为二者都无阻塞。所以实践中通常使用交叉开关网络,而非全连接网络。
成本更低的一种替代方案,是按环形拓扑将节点依次直接连接,如图 F.13 所示。对于双向环,每个节点只使用一个 交换机和两条与相邻节点共享的双向网络链路,总计 个交换机、 条双向网络链路。这个线性成本没有计入节点内部所需的 条注入/接收双向链路。
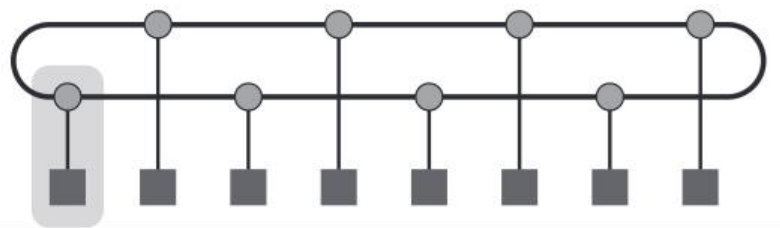
与共享介质网络不同,环允许多次传输同时进行:第一个节点可以发给第二个,同时第二个发给第三个,依此类推。不过,逻辑上不相邻的节点对之间没有专用链路,分组到达目的地之前必须经过中间节点,传送延迟因此增加。在双向环中,分组可以沿任一方向传输,通常选择通向目的地的最短路径。此时平均需要经过 次网络交换机跳转;若再计入源节点的本地交换机,总交换机跳数还要加一。沿途也可能因为其他分组同时请求相同资源而阻塞。
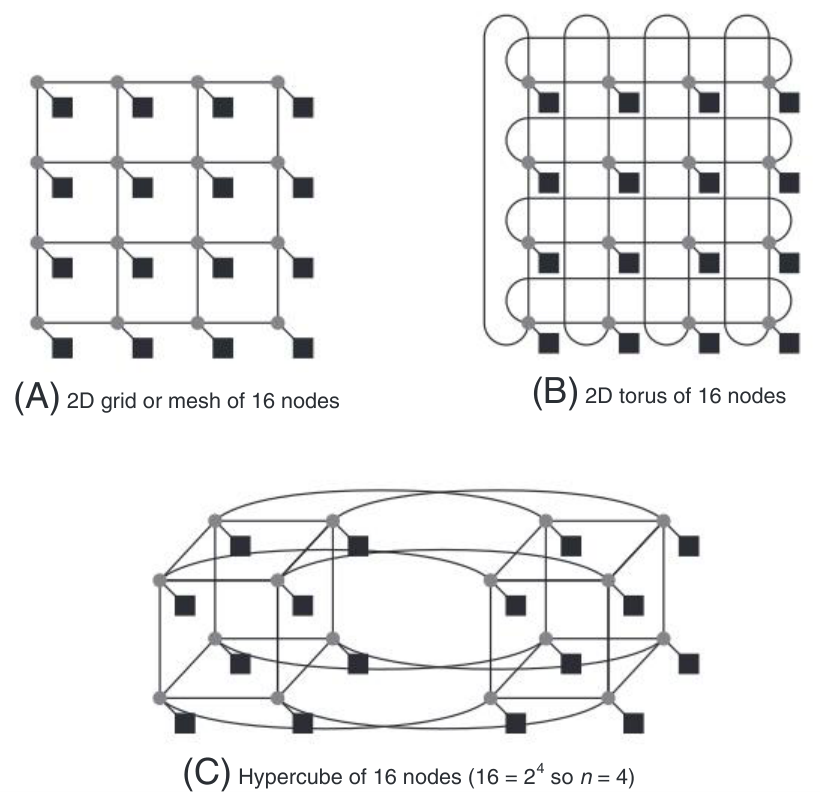
全连接网络与环形网络,构成分布式交换拓扑的两个极端;对于给定的成本与性能要求,两者之间还有许多值得考虑的方案。一般而言,理想的交换介质拓扑,其成本应接近环形网络,而性能应接近全连接网络。图 F.14 展示了三种常见直接网络拓扑,广泛用于不同成本与性能定位的系统。它们都将节点沿多个维度排列,并按可用数学方式描述的规则模式互连。
在 mesh(网格)拓扑中,每个维度上的节点组成线性阵列;在 torus(环面)拓扑中,每个维度上的节点组成一个环。两者都支持与相邻节点直接通信,旨在相对于单一环形网络减少分组跳数;这是通过增加维度、提高连通性实现的,商用系统通常不超过三维。超立方体或 n-cube 则是 mesh 的特例,每个维度只连接两个节点,因此必须有足够维度来连接系统的全部 个节点,即 。超立方体的连通性优于 mesh 和 torus,代价是链路数和每节点端口数较多,导致更高的链路和交换机成本。
例题:torus 与胖树的成本
计算使用 torus 拓扑互连 个设备,相对于使用胖树拓扑的成本。分别考虑双向链路与交换机的相对成本,假定交换机成本随双向端口数按平方增长。给出交换机规模相近时的近似表达式。
解答 使用 交换机时,胖树需要 台交换机;这里假定最后一级即根节点,与其他各级的交换机数量相同。每台交换机有 个双向端口,即 个输入端口和 个输出端口;交换机成本随端口数按平方增长,所以网络交换机总成本与 成正比。链路成本为 ,因为 级中的每一级都需要 条双向链路,其中包括设备与胖树之间的链路。torus 的交换机数量与节点数相同,每台交换机有 个双向端口,其中包括连接通信设备的端口, 是维数。
因此,torus 的交换机总成本为 。每个节点需要 条双向链路,分别用于 个不同维度及其端节点设备连接。不过,各维度上的链路由两个节点共享,因此全部 个节点的双向链路总数为 。torus 相对于胖树的成本为:
当交换机规模相近时,,因而:
交换机端口数,也称交换机度数,较小时,torus 的成本较低,维数较低时尤其如此。对于较大的 ,这一特性特别有用。另一方面,如果使用较大的交换机,或者 torus 维数较多,那么胖树成本更低,也更可取。例如,互连 256 个节点、采用 交换机时,胖树的交换机与链路成本均为 torus 的四倍;它平均而言较少的网络争用,补偿了这部分额外成本。使用 交换机时,例如同样互连 256 个节点,胖树与 torus 的成本相当。交换机规模继续增大,torus 会因每个节点都包含交换机而比胖树更昂贵。让每台交换机连接多个端节点设备,可以摊薄这一成本,这种做法称为 bristling。
图 F.14 的拓扑有一个有趣的共同点:网络链路规则地分布在若干个正交维度上。实际上,它们都是更大一类直接网络拓扑 k-ary n-cube 的特例,其中 表示 个维度中的每一维所互连的节点数。这些拓扑的对称性和规则性简化了网络实现,即封装,以及分组路由:分组沿某一维移动时,不会改变其他维度上到达目的地还需经过的跳数。下一节将看到,简单的路由算法很容易利用这种拓扑性质。
与间接网络一样,直接网络中并发请求同一路径或其部分路径的分组,也可能相互阻塞;全连接网络是唯一的例外。间接网络可以通过增大交换机来减少级数和交换机跳数,同样,直接网络可以通过增大交换机度数、增加拓扑维数来减少跳数。
对于规模和交换机成本给定的系统,似乎总应尽量增加维数,但事实并非总是如此。大多数电子系统是在三维物理世界中,使用集成电路芯片、印制电路板、背板等平面二维封装技术构建的。三维以内的直接网络,无论系统规模如何,都能在三维空间中用相对较短的链路实现。维数更高时,导线或光纤会越来越长。链路长度随系统规模增加的现象也见于 MIN,包括胖树:它们要么所有级都需要较长链路,要么随着级数增多而需要越来越长的链路。F.2 节第一个例题已经表明,采用流量控制的缓冲区,其大小与链路长度成正比,因而需要更多芯片面积。这也是 2005 年计算节点数最多的超级计算机 IBM Blue Gene/L,采用三维 torus 进行处理器间通信的原因之一。胖树需要长得多的链路,会使 64K 节点系统更难实现。这突出表明,必须正确选择满足系统要求的网络拓扑。
除了链路长度,实现拓扑所带来的其他约束也会限制其扩展程度,包括可用引脚数和能够实现的二分带宽。引脚数是芯片、印制电路板以及背板或机箱连接器带宽的一项局部限制。在将处理器核与交换机集成于同一芯片或多芯片模块的直接网络中,引脚带宽既用于访问主存,也用于实现节点链路。有限的引脚数因此可能迫使设计减少交换机端口数,或者减少每条链路的位线数。在间接网络中,交换机与处理器核分开实现,大多数引脚因而可以专门用于通信。但交换机组合成板卡时,对于给定拓扑,板上交换结构所有输入、输出链路的总需求,不能超过板卡连接器的可用引脚数。
二分带宽是一项更全局的限制,反映给定实现或封装技术能够达到的互连密度和带宽。互连密度与时钟频率彼此相关:导线排列得越密,串扰与寄生电容越大,通常就必须降低时钟频率。例如,片上网络的线密度和频率受到可用金属层及其间距限制;印制电路板则受到铜线密度限制。网络拓扑要能够实现,就不能超出实现技术所能提供的二分带宽。迄今实现的大多数网络,受到的引脚限制比二分带宽限制更强,近年来转向刀片式系统后尤其如此。不过,二分带宽对性能仍有重大影响。
对于给定拓扑,计算二分带宽 的方法是:把网络分为大致相等的两部分,每部分含一半节点,再将穿过这条假想分界线的链路带宽相加。对于不对称拓扑,二分带宽取所有将网络等分的方案中带宽最小者。全连接网络的二分带宽与 条单向链路或 条双向链路成正比,其中 为节点数。总线的二分带宽,就是那一条共享半双工链路的带宽。其他拓扑的数值位于这两个极端之间。通常以网络注入和接收的二分带宽为参照:对于分别有 条注入、接收链路的网络,该值为 。凡能提供这一二分带宽的网络拓扑,都称为具有全二分带宽。
图 F.15 汇总了本节讨论的几种拓扑在互连 64 个节点时,需要的交换机与链路数、交换机规模、节点之间最大与平均交换机跳数,以及用链路数表示的二分带宽。
| 评价项目 | 总线 | 环 | 二维 mesh | 二维 torus | 超立方体 | 胖树 | 全连接 |
|---|---|---|---|---|---|---|---|
| 性能 | |||||||
| 二分带宽,按链路数计 | 1 | 2 | 8 | 16 | 32 | 32 | 1024 |
| 最大跳数(平均跳数) | 1(1) | 32(16) | 14(7) | 8(4) | 6(3) | 11(9) | 1(1) |
| 成本 | |||||||
| 每台交换机的输入/输出端口数 | 不适用 | 3 | 5 | 5 | 7 | 4 | 64 |
| 交换机数 | 不适用 | 64 | 64 | 64 | 64 | 192 | 64 |
| 网络链路数 | 1 | 64 | 112 | 128 | 192 | 320 | 2016 |
| 链路总数 | 1 | 128 | 176 | 192 | 256 | 384 | 2080 |
拓扑对网络性能的影响
交换网络拓扑要求分组经过一跳或多跳才能到达目的地,每一跳都是分组穿过一台交换机及其相应链路的过程。有意思的是,可以把每台交换机及其链路,建模为上一节所说的、连接两个以上设备的黑盒网络;这里的“设备”是指端节点或其他交换机。区别仅在于,穿过交换机时没有发送与接收开销,而路由、交换与仲裁延迟不再是累计值,而是各台交换机自身的延迟。
因此,若分组到达目的地平均需要经过 跳,则 ,其中 、、 分别为单台交换机的路由、仲裁和交换延迟。假设网络在每一跳都以分组为单位划分流水级,下一节将重新审视这一假设,那么传输延迟也会相应地随跳数倍增。再作一个简化假设:到第一台交换机或第一级交换机的全部注入链路,以及从各交换机引出的全部链路,包括接收链路,长度和延迟都大致相等。于是,网络中的总传播延迟 ,等于单条链路的传播延迟 乘以 ;这里在跳数之外加一,是为计入注入链路。由此,网络平均分组延迟在最佳情况下的下界,即无争用时的延迟为:
再次强调,前述表达式假定交换机能以分组为单位对分组传输进行流水化。
沿用前面的方法,找到端到端网络管道最窄的部分,就可以估计有效带宽在最佳情况下的上界。只考虑管道内部的网络部分,网络带宽由拓扑的阻塞特性决定。要实现无阻塞,就必须为每个源—目的节点对提供许多备选路径,这会使网络总带宽远高于网络注入或接收的总带宽,成本相当高。由于这种方案通常昂贵得难以接受,多数网络都允许不同程度的阻塞,从而降低拓扑所提供总带宽的利用率。原文接着指出:“这同样有代价,但并非性能方面的代价。”
译注:原文为 “This, too, is costly but not in terms of performance.”,其否定词与前文关于阻塞降低带宽利用率的论述不一致。
网络阻塞程度取决于拓扑和流量分布。假定拓扑的二分带宽 能够实现,通常确实如此,就可以用它作为衡量网络最大阻塞程度的一个固定指标。理想情况下,不论流量如何变化,网络都能达到全二分带宽,瓶颈于是转移到注入或接收链路。然而,目的地位于另一半网络的分组必然穿过二分链路,因此这些链路可能成为瓶颈,使网络带宽低于全二分带宽。幸运的是,并非所有流量都必须跨越网络二分面,因而拓扑提供的总带宽可以得到更充分利用。此外,二分链路更多的拓扑,到达目的地的备选路径也更多,通常阻塞更少,总带宽利用率因而更高。若只有一部分流量必须跨越二分面,用二分流量比例 表示,,那么二分面处的网络管道,实际等效地加宽为原来的 倍。这里假定流量分布使二分链路的平均负载,至少与其他网络链路一样高。这给出了可实现网络带宽 的上限:
相应地,考虑网络拓扑后,有效带宽表达式变为:
必须注意, 高度依赖应用程序产生的流量模式,需要通过测量或详细流量分析得到。
例题:NEWS 最近邻通信
科学计算程序中常见的一种通信模式,是二维数组的最近邻元素沿指定方向通信。有时称之为 NEWS 通信,即 north、east、west、south,分别代表北、东、西、南四个方向。将一个 数组的元素,一一映射到采用下列拓扑互连的 64 个端节点设备上:总线、环、二维 mesh、二维 torus、超立方体、全连接和胖树。假定分组可以使用拓扑提供的任意最短路径,在最佳情况下,每个节点分别向北侧与东侧邻居发送一条消息,需要多长时间?对应的有效带宽是多少?忽略没有北侧或东侧邻居的元素。为简化分析,假设所有网络中每跳的分组传送时间均为一个单位,即每跳的 、、、 与分组传输时间之和为 1;注入链路延迟也包含在这一单位时间内,发送和接收开销为零。
解答 这种通信模式总共需要发送 个分组,即向北和向东两个通信阶段各 56 个。分组经过的跳数取决于拓扑。源与目的之间是一对一通信,因此 。注入和接收带宽将有效带宽限制在最多 64 个带宽单位,尽管这种通信模式只需要 56 个带宽单位。该上限还可能受到可实现网络带宽的进一步限制,后者由二分带宽与跨越二分面的流量比例 决定,两者都依赖拓扑。各类情况如下。
- 总线。 数组元素如何映射到节点,对总线没有影响,因为所有节点间的距离都同为一跳。但这 112 次传输必须依次进行,总共需要 112 个时间单位。二分带宽为 1,,所以有效带宽仅为 1 个单位。
- 环。 假定数组第一行映射到节点 0–7,第二行映射到节点 8–15,依此类推。所有节点同时向东侧邻居发送,即由节点 发往节点 ,只需要一个时间单位。在这种映射下,每个节点与北侧邻居恰好相隔八跳,因此需要八个时间单位,所有节点也并行进行。通信总时间为九个时间单位。假定使用双向环,二分带宽为两条双向链路,小于全二分带宽的 32 条双向链路。向东通信时,最坏情况下也只有 56 个分组中的两个跨越二分面,因而二分链路不会成为瓶颈。向北通信时,56 个分组中有八个必须跨越这两条链路,故 ,网络带宽为 个单位。有效带宽同样被限制在 22.4 个单位,低于这种通信模式所需带宽的一半。
- 二维 mesh。 64 个节点排成八行八列,与 NEWS 通信完全匹配。所有节点先同时向北侧邻居发送,再同时向东侧邻居发送,总共只需两个时间单位。二分带宽为八条双向链路,虽低于全二分带宽,但最近邻通信模式与拓扑完美匹配,仍能达到最大有效带宽。向东通信时,最坏情况下有 56 个分组中的八个跨越二分面,没有超过二分带宽;向北通信没有分组跨越同一二分面。因此 ,网络带宽为 个单位。有效带宽由通信模式限制为 56 个单位,而不是受 mesh 网络限制。
- 二维 torus。 这种通信模式没有使用 torus 的回绕链路,所以映射及性能与 mesh 相同。
- 超立方体。 假定一行中的元素映射到构成整个超立方体的八个三维子立方体中的相同位置,使连续的行元素落在仅相隔一跳的节点上。北侧邻居同样可以映射到正交维度中相隔一跳的节点。因此这种通信模式只需两个时间单位。超立方体提供 32 条链路的全二分带宽,但 112 个分组中至多只有八个需要跨越二分面。所以有效带宽仅由通信模式限制为 56 个单位,不受超立方体网络限制。
- 全连接。 无论如何映射,节点间距离都同为一跳。如果注入和接收链路能同时发送、接收两个分组,那么向北和向东并行传输只需一个时间单位。实际并非如此,所以需要两个时间单位。有效带宽由通信模式限制为 56 个单位,1024 条二分链路中的大部分因此未能充分利用。
- 胖树。 假定采用与环相同的元素映射,交换机有八个双向端口。每个八节点组通过三级双向网络互连,共八组,因此同时向东侧邻居通信至多需要三跳,即三个时间单位。每个节点的北侧邻居位于相邻的八节点组,需要五跳,即五个时间单位。胖树上的总时间因此为八个单位。胖树提供全二分带宽,所以即使最坏情况下有一半流量跨越二分面,只要持续注入分组,仍能达到 56 个单位的有效带宽;这一限制来自通信模式,而非胖树网络。
不能从上述例题得出错误结论,以为 mesh 与 torus、超立方体、胖树等二分带宽更高的网络同样好。为简化分析,例题采用了若干有利于低二分带宽网络的假设。实际中,分组通常大于链路宽度,占用链路的时间远不止一个网络周期。许多通信模式也不能这样整齐地映射到二维 mesh,通常更具全局性且更不规则。这些因素共同增加了低二分带宽网络中分组阻塞的机会,导致延迟升高、有效带宽下降。
为了进一步将拓扑讨论与实际系统联系起来,图 F.16 列出了商用高性能计算机所用拓扑的若干属性。
| 公司 | 系统[网络]名称 | 最大节点数[× CPU 数] | 基本网络拓扑 | 节点注入[接收]带宽,MB/s | 每条链路每方向的数据位数 | 原始单方向网络链路带宽,MB/s | 原始网络二分带宽,双向,GB/s |
|---|---|---|---|---|---|---|---|
| Intel | ASCI Red Paragon | 4816[×2] | 二维 mesh,64×64 | 400[400] | 16 位 | 400 | 51.2 |
| IBM | ASCI White SP Power3[Colony] | 512[×16] | 使用 8 端口双向交换机的双向 MIN,通常为胖树或 Omega | 500[500] | 8 位,另加 1 个控制位 | 500 | 256 |
| Intel | Thunder Itanium2 Tiger4[QsNet II] | 1024[×4] | 使用 8 端口双向交换机的胖树 | 928[928] | 8 位,另加 2 个用于 4b/5b 编码的控制位 | 1333 | 1365 |
| Cray | XT3[SeaStar] | 30,508[×1] | 三维 torus,40×32×24 | 3200[3200] | 12 位 | 3800 | 5836.8 |
| Cray | X1E | 1024[×1] | 每台交换机连接 4 个端设备的二维 torus,约 23×11,带 express 链路 | 1600[1600] | 16 位 | 1600 | 51.2 |
| IBM | ASC Purple pSeries 575[Federation] | >1280[×8] | 使用 8 端口双向交换机的双向 MIN,通常为胖树或 Omega | 2000[2000] | 8 位,另加 2 个用于新型 5b/6b 编码方案的控制位 | 2000 | 2560 |
| IBM | Blue Gene/L eServer Sol.[Torus Net.] | 65,536[×2] | 三维 torus,32×32×64 | 612.5[1050] | 1 位,串行传输 | 175 | 358.4 |