F.5 网络路由、仲裁与交换
在交换介质网络中,无论采用何种拓扑,分组所经路径上的每台交换机都要执行路由、仲裁和交换。文献提出了许多实现这些功能的有趣技术。本节重点介绍商业系统针对较常见拓扑所采用的一组代表性方法,并说明其性能影响。
路由
路由算法规定每个分组允许使用哪条或哪些网络路径。理想情况下,算法为所有分组提供最短路径,同时将流量负载均匀分散到各条网络链路,以尽量减少争用。但为了保证无论流量行为如何,所有分组都能送达,拓扑提供的某些路径可能必须禁用。例如,如果允许分组从源节点出发后,无限制地经过非最短路径上的跳转,分组就可能永远到不了目的地,这种情况称为活锁。同样,如果一组分组沿某些路径,永远阻塞在网络中,只等待被同组其他分组占有的链路或相关缓冲区等资源,也会使分组无法送达,这称为死锁。死锁源于网络资源有限,因此网络流量越大、可用资源越少,死锁发生概率越高。要让网络正常工作,路由算法必须防止这种异常;它有多种形式,例如路由死锁、请求—应答即协议死锁,以及故障引起的重配置死锁等。同时,为使网络性能尽可能高,路由算法还必须高效:最佳情况下,应让分组能选择拓扑提供的所有路径。
防止活锁最简单的方法,是只允许源到目的节点之间的最短路径;也可以略放宽限制,只允许有限次非最短路径跳转。最严格的方式还有一个好处,即消耗的网络带宽最少,但若最短路径发生争用或故障,分组就不能改走其他非最短路径。
死锁更难防止。实践中常用两种策略:避免与恢复。在死锁避免中,路由算法只允许分组沿那些能使网络全局状态保持无死锁的路径传输。常见方法是在一组资源间建立次序;该资源集是支持网络完全可达性所需的最小集合。按某种全序或偏序向分组授予这些资源,就能防止这些资源形成循环依赖。这样,无论分组处于网络何处,都始终可以获得一条逃逸路径,避免进入死锁状态。在死锁恢复中,资源授予不以避免死锁为前提;由于死锁可能发生,系统采用某种机制检测其存在的可能性。一旦检测到,就从死锁资源集中移走一个或多个分组,可以丢弃分组以回退,也可以将分组转移到专门的死锁恢复资源上,使其继续前进。释放的资源随后分配给其他需要它们的分组,从而解除死锁。
先考察用于分布式交换网络的路由算法。图 F.17(a) 展示了二维 mesh 某区域中,众多可能的分组死锁配置之一。只允许分组使用按照某种全序依次穿过各维度的最短路径,就可以避免所有这类死锁及活锁。也就是说,只有分组到达目的地已不再需要使用此前各维度的任何链路,路由算法才允许它使用当前维度的链路。图 F.17(b) 给出了按 XY 维序穿过网络的例子。所有分组必须遵循相同的维度顺序,且只有在某一维度中不再需要链路时,才可离开该维度。这一著名算法称为维序路由(dimension-order routing,DOR),在超立方体中称为 e-cube 路由。许多采用分布式交换网络及片上网络的商业系统都使用它。由于它对给定源—目的节点对总是提供同一条路径,所以属于确定性路由算法。
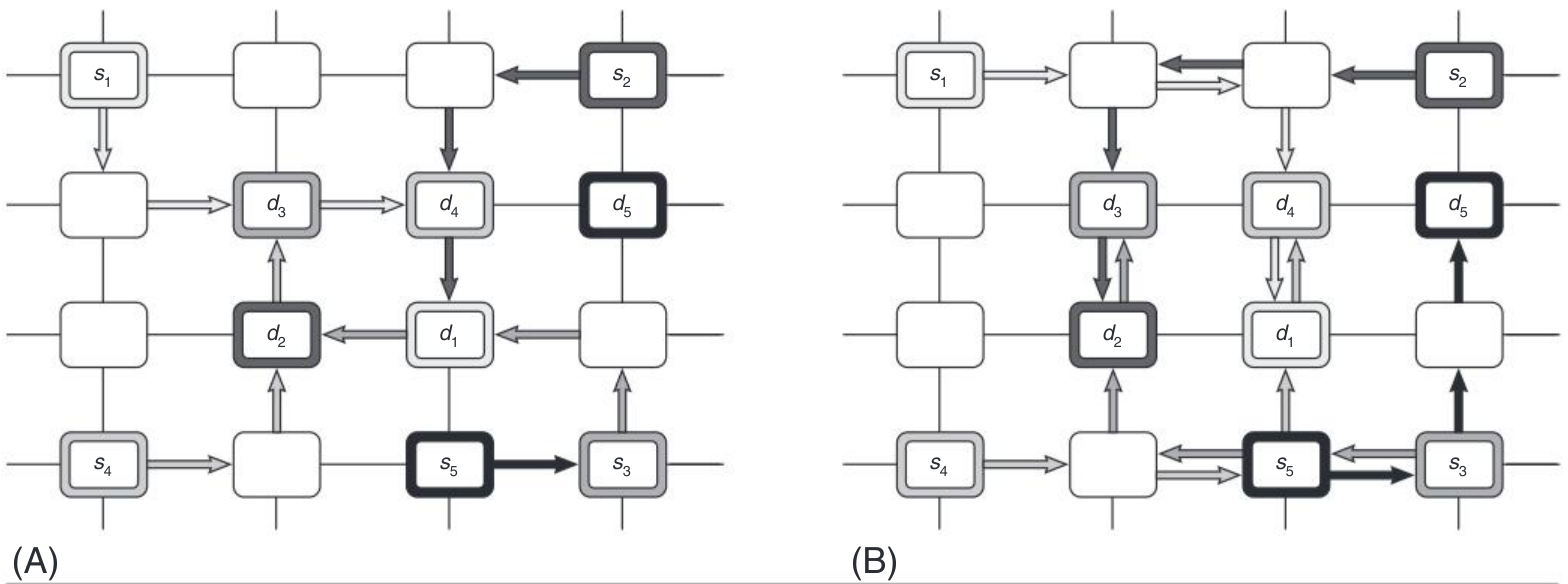
在支持网络完全可达性所必需的某个最小资源集上,按维度顺序传输,可以避免 mesh 和超立方体中的死锁。但是,对于带有回绕链路的分布式交换拓扑,例如环和 torus,如果要将资源用到全部容量,还必须在各维度内部的某个最小资源集上建立全序。另一种办法,是要求各维度中始终保留一些空闲资源,即 bubble(空泡),使占用量低于全部容量,从而避免死锁。为保证完全可达性,可以复制物理链路,也可以复制每条链路对应的逻辑缓冲区,分别形成物理通道或虚拟通道,再在这些通道上排序。避免死锁不需要给全部网络资源排序,只需对支持完全可达性的某个最小资源集,即某个逃逸资源集排序。基于这一技术,即 Duato 协议,可以定义这样的路由算法:除了逃逸资源集以外,还允许给定源—目的节点对使用拓扑提供的备选路径。算法必须从允许的路径中选一条,最好选择最高效者。根据当前网络流量状态调整路径,可以更充分利用网络总带宽并减少争用。这种能力称为自适应路由,许多商业系统都采用它。
例题:维序路由消除了多少种转向
在 维 mesh 中,维序路由排除了多少种可能的维间转向?在维持连通且无死锁的前提下,实际最少需要排除多少种转向?以二维 mesh 说明。
解答 维序路由恰好排除一半可能的维间转向。很容易证明,从任意较低次序维度转到较高次序维度都是允许的,反向则不允许。例如,图 F.17 二维 mesh 的八种可能转向中,允许 、、、;正负号表示沿某维移动的方向。不允许的四种转向是 、、、。排除这些转向,既能防止任何形式的环形成,从而避免死锁,又能保持网络连通;代价是完全不能进行自适应路由。
Turn Model 路由算法证明,要防止环形成且保持连通,最少只需排除四分之一的可能转向,但必须选对转向集合。只有某些特定集合能同时满足两个要求。若选错了,即使排除四分之一的转向,其余允许转向的组合仍可能模拟已被排除的转向,从而形成环与死锁,或者使网络不连通。例如,对二维 mesh,只需排除两个最终朝西的转向,即 和 ,同时要求需要向西移动的分组一开始就先向西走,便能维持连通。二维 mesh 除了这种 west-first(向西优先)路由,还可以采用 negative-first(负方向优先)路由和 north-last(最后向北)路由。与 DOR 相比,这些算法多允许的四分之一转向,提供了部分路由自适应能力,所以它们属于自适应路由算法。
集中式交换网络也可通过限定资源使用的全序或偏序,定义无死锁路由算法。在胖树中,可以沿从输入叶级向上到根、再向下到输出叶级的路径,为资源建立全序。路由算法允许分组按递增偏序使用资源:先沿树向上,到达源和目的节点的某个最近公共祖先(least common ancestor,LCA),再沿树向下直到目的地。对于给定目的节点,存在多个最近公共祖先,所以向上阶段有多条备选路径,算法因此具有自适应性。不过,从一个最近公共祖先向下到目的地,胖树拓扑只提供一条确定路径。这种自路由性质也见于许多 MIN,很容易利用:只需对目的节点地址作移位,就能得到各级交换机应选的输出端口。
更一般地,无论直接或间接网络,都可以将一棵树映射到任意拓扑上,并通过赋予方向,允许使用同一树层级节点之间的链路:“up”表示朝根节点移动,“down”表示远离根节点移动。这样就能在任意拓扑上定义通用的 up/down 路由**,让分组沿零条或多条 up 链路,再沿零条或多条 down 链路到达目的地;路径选择也可以自适应。up/down 次序防止形成环,从而避免死锁。自配置交换 LAN Autonet 以及早期 Myrinet SAN 都使用过这种技术。
实际路由算法由两部分共同实现:源节点写入分组头的路由信息,以及交换机内的路由控制机制。对于源路由,完整路径由源节点预先计算,可能通过查表得到,并写入分组头。这通常包括预定源—目的路径上各台交换机应使用的一个或多个输出端口;分组经过交换机时,路由控制机制可逐步剥除这些信息。头部还可以增加一个位字段,说明是否允许自适应路由,即能否任选所列输出端口之一。对于分布式路由,路由信息通常就是目的地址。沿途各交换机的路由控制机制利用它,通过有限状态机计算或查阅本地路由表,即转发表,决定下一个输出端口。源路由相比分布式路由,简化了交换机内的路由控制机制,但每个分组头都需要更多路由位,增大了头部开销。
仲裁
仲裁算法决定分组何时可以使用它所请求的网络路径。理想情况下,仲裁器尽量将空闲网络资源与请求它们的分组匹配起来。在交换机层面,仲裁器尽量将空闲输出端口,与位于输入端口并请求相应输出端口的分组匹配。当无法同时满足所有请求时,交换机仲裁器应公平分配输出端口,解决冲突,防止分组因始终得不到请求资源而饥饿。如果采用 serve-longest-queue(优先服务最长队列,SLQ),短队列中的分组就可能饥饿。对同一优先级的分组,简单的轮询(round-robin,RR)或基于等待时间的策略,既足够公平,也容易实现。
仲裁可以分布进行,以避免集中式瓶颈。简单的方法有请求和授权两个阶段。假定每个输入端口都有队列存放到达的分组,每个输出端口都有采用轮询策略的本地仲裁器。图 F.18(a) 展示了四端口交换机的一组可能请求。在请求阶段,各输入端口队首分组,向它所需输出端口的仲裁器发送一个请求。各输出端口仲裁器独立仲裁所收到的请求,只选中一个。在授权阶段,每个仲裁器的一个请求者获得所请求的输出端口。如图所示,不同输入端口的两个分组若请求同一输出端口,就只有一个获得授权。因此,即使所有输入队列都有待发送分组,某些输出端口的带宽仍会闲置。
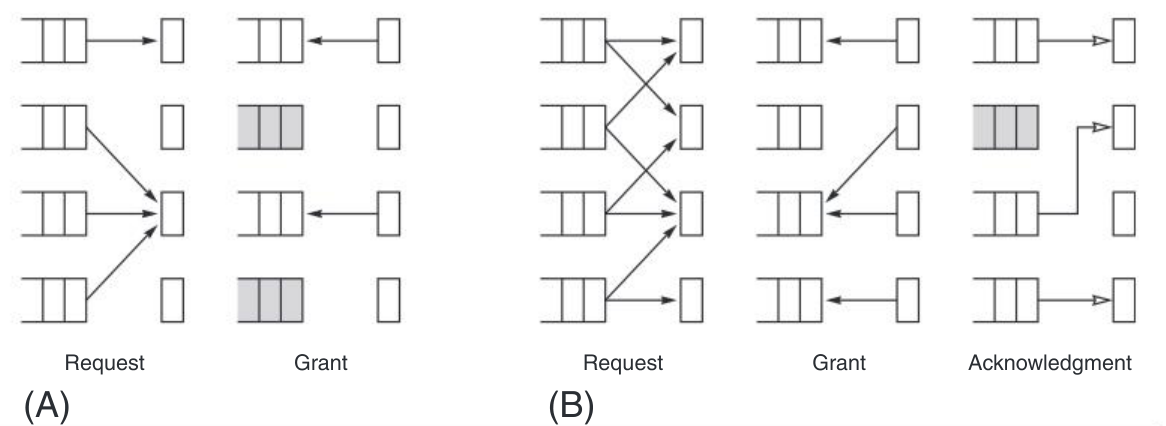
可以改进简单的两阶段方法,让每个输入端口同时提交多个请求;这些请求可能来自不同虚拟通道,也可能对应多个自适应路由选项,并发往不同输出端口仲裁器。每个输入端口提交多个请求,能提高匹配概率。此时仲裁需要三个阶段:请求、授权和确认。图 F.18(b) 中,每个输入端口的分组最多可以提交两个请求。请求阶段与两阶段仲裁相同:请求发往输出端口仲裁器,后者从收到的请求中选一个。授权阶段也相同:选中的请求获得授权。但一个输入端口可能提交多个请求,所以也可能收到多个授权,必须再用轮询等仲裁策略选一个,并在确认阶段通知相应输出端口仲裁器。
如图 F.18(b) 所示,一个输入端口虽然提交了多个请求,也可能一个授权都没得到,而某些被请求的端口仍空闲。因此,进行第二轮仲裁可以提高匹配概率。这一轮只提交尚未匹配的输入、输出端口之间的请求。允许每个输入端口提出多个请求的迭代仲裁器,可以提高交换机输出端口以及网络链路带宽的利用率,代价是仲裁器更复杂、仲裁延迟更大;如果仲裁位于关键路径上,还可能延长路由器时钟周期。
交换
交换技术规定如何在网络中建立连接。理想情况下,从时间与空间两方面考虑,网络资源之间的连接应恰在资源准备好、且确实需要使用之时才建立或“接通”,并且只维持实际需要的时间。这样,不同流量既能高效共享可用带宽,也能实现低延迟。在路由算法允许、仲裁算法授权的拓扑路径上,每一跳的连接可以采用三种基本方式建立:分组到达前,用电路交换建立;整个分组到达后,用存储转发分组交换建立;或者只接收部分分组后,用 cut-through 分组交换建立,接收单位不小于分组头。
电路交换预先建立电路,为整个源—目的路径上的分组传输分配网络带宽。可以在路径每一跳设置流水级,使分组沿电路流水传输,称为流水化电路交换。一个或多个分组只需进行一次路由、仲裁与交换,因此分组头不需要路由位,降低了延迟和开销。如果设备间持续在同一已建立电路上传输信息,这种方式可能很高效。但带宽从共享资源池中预先划走,无论源节点是否需要使用都已占定,因此电路交换也可能极不高效,严重浪费带宽。
更常见的情况是间歇发送分组;此时分组交换能让网络带宽得到更有效的共享和利用。它主要分为存储转发与 cut-through 两类,两者都能以分组大小或更小的信息单位复用链路带宽,让不同来源分组更好地共享带宽。不过,更细粒度的共享也增加了交换开销:每个分组都要进行路由、仲裁和交换,每个分组都需要路由位,采用流量控制时还需要流控位。
存储转发分组交换先在接收交换机完整存下分组,再按源—目的路径依次转发到下一跳。分组在每台交换机都完整存下后才继续发送,因此链路完全解耦,即使各链路带宽差异很大,也能充分利用各自带宽。这一点对 WAN 很重要,代价则是分组延迟。原文指出,总路由、仲裁与交换延迟随跳数成倍累积;F.4 节已经在该假设下分析过性能。
cut-through 分组交换在接收交换机暂存下分组头,或分组头之后等量的载荷时,就可以建立连接,让分组以流水方式“穿过”交换机;无须等到其余部分到达,便可接通已获授权的资源。原文将这描述为:路由、仲裁和交换延迟与跳数的关系由乘法变为加法,从而减少总分组延迟。cut-through 有两种形式,主要区别是流量控制所作用的信息单位大小,以及由此决定的交换机缓冲需求。虚拟 cut-through 交换按分组实施流量控制;虫孔交换则按流控单元,即 flit,实施流量控制。flit 小于最大分组,通常至少与分组头一样大。虫孔交换机只须能存储分组的一小部分,所以阻塞的分组可能横跨多台交换机。这会阻塞需要使用相同链路的其他分组,使网络过早饱和、有效带宽降低;除非在交换机内部使用某种集中缓冲区存放这些分组,这称为带缓冲的虫孔交换。现有工艺可以在芯片上实现较大缓冲区,所以虚拟 cut-through 更常见;但对于力求节省芯片资源的 OCN,虫孔交换仍可能更合适。
允许多个分组通过 flit 级时分复用,同时共享一条物理链路的带宽,可以缓解虫孔交换引起的过早饱和。这要求物理链路两端都配备一组虚拟通道,即前面提到的逻辑缓冲区,并将分组交换到这些通道中。此前已说明,虚拟通道可以将物理链路带宽与已缓冲分组解耦,以避免死锁。这里的复用则使某个分组即使与前方已阻塞分组共享部分链路,它的 flit 仍能获得带宽并继续前进。这又提高了网络带宽利用率,进而降低平均分组延迟。
对网络性能的影响
路由、仲裁与交换可以减少分组争用延迟,从而影响有负载网络的分组延迟。在没有争用的空载网络中,路由和仲裁算法除了决定这些功能在交换机中的实现延迟外,不会影响分组延迟;交换芯片从输入引脚到输出引脚的延迟,通常为几十纳秒。上一节给出的最佳情况分组延迟表达式,只有交换方式改变时才需要调整。前面假定采用存储转发,因此源节点和全部 跳都要付出整个分组的传输延迟。cut-through 则以分组头而非整个分组为粒度,在路径各条网络链路上流水传输,减少了这一延迟分量。分组延迟下界为:
译注:式中的 和 对应前文的单台交换机仲裁与交换延迟 、;Packet 与 Header 分别表示分组和分组头的大小。 原文此前关于“乘法变为加法”的措辞容易引起误解:对照 F.4 节的存储转发公式,改变的是分组传输项,由 变为 ;各交换机的路由、仲裁和交换延迟仍按跳数累加。
有效带宽取决于路由、仲裁与交换能让带宽得到多高效的利用。路由算法可将有负载网络中的流量分布得更均匀,提高拓扑总带宽,特别是二分链路带宽的利用率。仲裁算法可尽量增加接受分组的输出端口数,同样提高带宽利用率。交换技术则可提高分组间资源共享程度,进一步提高利用率。这些因素通过效率因子 ,,共同影响网络带宽:
除仿真外,很难用其他手段计算或量化 。不过,有了这个参数,就可用下式估计有效带宽的最佳情况上界,同时计入路由、仲裁和交换的影响:
也取决于网络对应用流量的适应程度。例如,如果源—目的节点对之间持续发送大量分组流,电路交换的 可能高于 cut-through;若分组间歇发送,情况则可能相反。
例题:确定性路由与自适应路由的性能
对一个互连 4096 个节点的三维 torus,绘制延迟和吞吐量随施加负载变化的曲线,比较确定性路由和自适应路由;同时比较其中最好与最差网络的效率。假定采用虚拟 cut-through、三阶段仲裁及虚拟通道,分别考察两个和四个虚拟通道的情况。假定其中一个虚拟通道按维序采用 bubble 流量控制,以避免死锁;其他虚拟通道则按维序使用,用于确定性路由,或者沿最短路径使用,用于自适应路由,方式与 IBM Blue Gene/L torus 网络相同。
解答 路由算法的行为取决于多个网络设计参数,参数间又有复杂依赖,因此很难解析计算其性能。设计人员通常使用周期精确仿真器评估。一种评估设计决策的方法,是在一系列网络负载下运行多组仿真,每次只修改一个感兴趣的设计参数,其他参数保持不变。这类评估经常使用合成流量,因为它能让网络稳定在某个工作点,便于细致分析行为。这里采用这一方法;也可以使用轨迹驱动或执行驱动仿真。
图 F.19 展示了典型的互连网络性能曲线。左图对两种路由算法及各自两个、四个虚拟通道的情况,画出平均分组延迟,以网络周期计,随施加负载即流量生成率的变化;右图同样画出吞吐量即流量交付率的变化。施加负载除以网络节点数进行归一化,单位为字节/周期/节点。仿真假定流量均匀分布,分组为 256 字节,flit 为 1 字节。每跳的路由、仲裁与交换延迟之和为一个网络周期,每条链路的飞行时间为十个周期。链路带宽为每周期 1 字节,因此结果不依赖网络时钟频率。
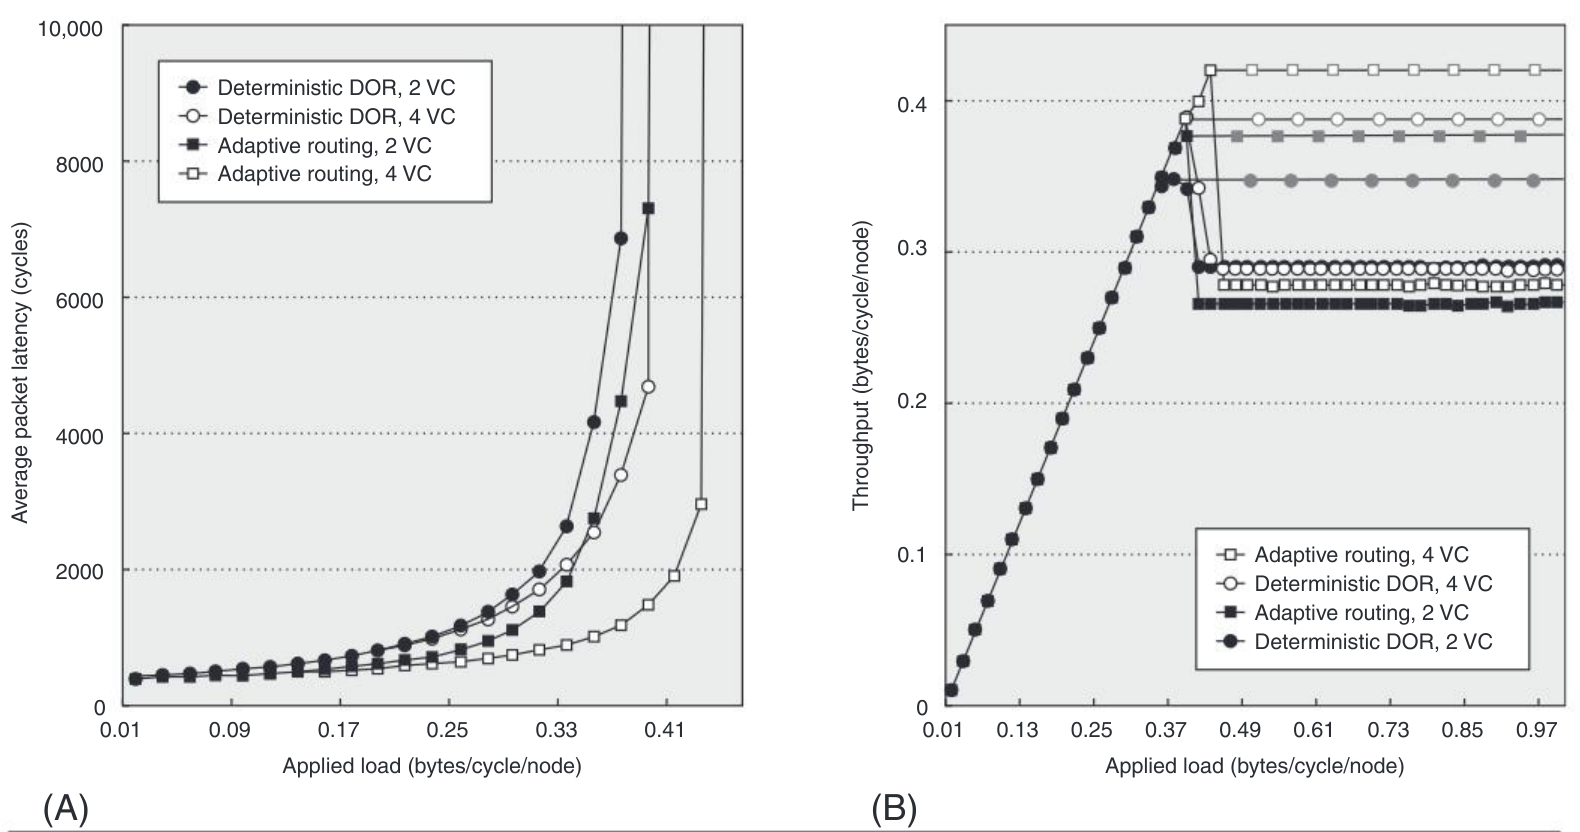
各条曲线具有相似形状,但数值不同。延迟曲线都从前述公式预测的空载延迟开始,然后随流量及资源争用增加而缓慢上升。施加负载更大时,延迟呈指数增长,网络接近饱和,无法吸收全部施加负载,导致分组在源节点排队等待注入。仿真中队列会随时间持续增长,延迟趋于无穷;实际中,队列达到容量上限后,会迫使应用停止生成更多分组,或者应用等待未完成分组的确认和响应,自行限制生成速率。不过,自适应路由为拥塞资源上的分组提供备选路径,所以延迟增长更慢。
同样的原因使自适应路由在虚拟通道数相同时,能达到比确定性路由更高的峰值吞吐量。未饱和时,吞吐量随施加负载近似线性增长;网络达到饱和后,交付流量的速率便跟不上生成速率。因此,饱和点表示最大可达即“峰值”吞吐量,不会高于前述有效带宽公式的预测值。饱和后,全网络发生大量队头阻塞,F.6 节将进一步说明,吞吐量往往下降,正如高峰时段车辆反而走得更慢。这一吞吐量区域很重要:它表明,如果没有有效采用 F.7 节将简述的拥塞管理技术,路由算法会造成多大的性能下降。本例中,以饱和后的持续吞吐量衡量,自适应路由的性能下降比确定性路由更大。
对于两种算法,四个虚拟通道比两个通道更能让分组越过前方阻塞分组,因而提高峰值吞吐量。四虚拟通道自适应路由的峰值吞吐量为 0.43 字节/周期/节点,接近效率为 100%,即 ,时的最大值 0.5。这里假定注入和接收带宽足够高,使网络二分面成为瓶颈。此时,网络带宽就是 100% 乘以二分带宽,再除以跨越二分面的流量比例 。二分面将 torus 分成大小相等的两半,对于均匀流量,只有一半注入流量的目的节点在另一半,所以 。4096 节点三维 torus 的二分带宽,为 条单向链路乘以每条链路每周期 1 字节的带宽。再像归一化网络带宽一样除以节点数,得到二分带宽 0.25 字节/周期/节点;除以 ,即得理想最大网络带宽 0.5 字节/周期/节点。
将测得的峰值吞吐量除以理想吞吐量,就能得到仿真网络的效率因子。完全自适应路由加四虚拟通道的效率为 ,确定性路由加两个虚拟通道则为 。二者相差 12 个百分点;如果进一步改进路由、仲裁、交换及虚拟通道设计,还可能获得另外 14 个百分点的效率提升。
为把这部分讨论放到实际系统中观察,图 F.20 列出商用高性能计算机 SAN 使用的技术。这些问题不仅适用于图中的 SAN,也适用于从 OCN 到 WAN 的其他互连领域。
| 公司 | 系统[网络] | 最大节点数[× CPU 数] | 基本拓扑 | 交换机排队/缓冲 | 路由算法 | 交换机仲裁 | 网络交换技术 |
|---|---|---|---|---|---|---|---|
| Intel | ASCI Red Paragon | 4510[×2] | 二维 mesh,64×64 | 输入缓冲,1 flit | 分布式维序路由 | 两阶段 RR,分布在交换机各处 | 虫孔交换,无虚拟通道 |
| IBM | ASCI White SP Power3[Colony] | 512[×16] | 8 端口双向交换机组成的双向 MIN,通常为胖树或 Omega | 输入和中央缓冲,输出排队,8 倍加速 | 基于源的 LCA 自适应最短路径路由,以及基于表的多播路由 | 两阶段 RR;集中式,同时在输出处为旁路路径设置分布式仲裁 | 带缓冲的虫孔交换,多播采用虚拟 cut-through;无虚拟通道 |
| Intel | Thunder Itanium2 Tiger4[QsNet II] | 1024[×4] | 8 端口双向交换机组成的胖树 | 输入缓冲 | 基于源的 LCA 自适应最短路径路由 | 两阶段 RR、优先级与 aging,分布在输出端口 | 虫孔交换,两个虚拟通道 |
| Cray | XT3[SeaStar] | 30,508[×1] | 三维 torus,40×32×24 | 输入缓冲,输出暂存 | 分布式、基于表的维序路由 | 两阶段 RR,分布在输出端口 | 虚拟 cut-through,四个虚拟通道 |
| Cray | X1E | 1024[×1] | 每交换机连接 4 个端设备的二维 torus,约 23×11,带 express 链路 | 输入缓冲,虚拟输出排队 | 分布式、基于表的维序路由 | 两阶段 wavefront,全局流水化仲裁器 | 虚拟 cut-through,四个虚拟通道 |
| IBM | ASC Purple pSeries 575[Federation] | >1280[×8] | 8 端口双向交换机组成的双向 MIN,通常为胖树或 Omega | 输入和中央缓冲,输出排队,8 倍加速 | 源路由与分布式、基于表的 LCA 自适应最短路径及多播路由 | 两阶段 RR;集中式,同时在输出处为旁路路径设置分布式仲裁 | 带缓冲的虫孔交换,多播采用虚拟 cut-through;八个虚拟通道 |
| IBM | Blue Gene/L eServer Solution[Torus Net.] | 65,536[×2] | 三维 torus,32×32×64 | 输入、输出缓冲 | 分布式自适应路由,带 bubble 逃逸虚拟通道 | 两阶段 SLQ,分布在输入、输出处 | 虚拟 cut-through,四个虚拟通道 |