F.6 交换机微体系结构
网络交换机实现交换介质网络的路由、仲裁与交换功能,也实现缓冲区管理机制;对于无损网络,还实现相应的流量控制。某些网络的交换机还承担部分网络管理功能,在启动或发生故障时探索、配置和重新配置网络拓扑。本节通过一种基本交换机微体系结构,以及适合前述不同路由、仲裁和交换技术的多种方案,揭示交换机的内部结构。
基本交换机微体系结构
交换机内部数据通路提供输入与输出端口之间的连接。虽然可以采用共享总线或多端口中央存储器,但当所需总带宽较高时,前者能力不足,后者则过于昂贵。多数高性能交换机采用内部交叉开关,实现无阻塞连接,允许多个输入—输出端口对并发连接。阻塞分组可由先进先出(FIFO)或循环队列缓冲;为获得较大容量和灵活性,可以在静态 RAM 中实现为动态可分配多队列(dynamically allocatable multi-queues,DAMQ)。这些队列可放在输入端口,形成输入缓冲交换机;放在输出端口,形成输出缓冲交换机;集中放在内部,形成中央缓冲交换机;或输入、输出两侧都设置,形成输入—输出缓冲交换机。图 F.21 为后一种结构的框图。
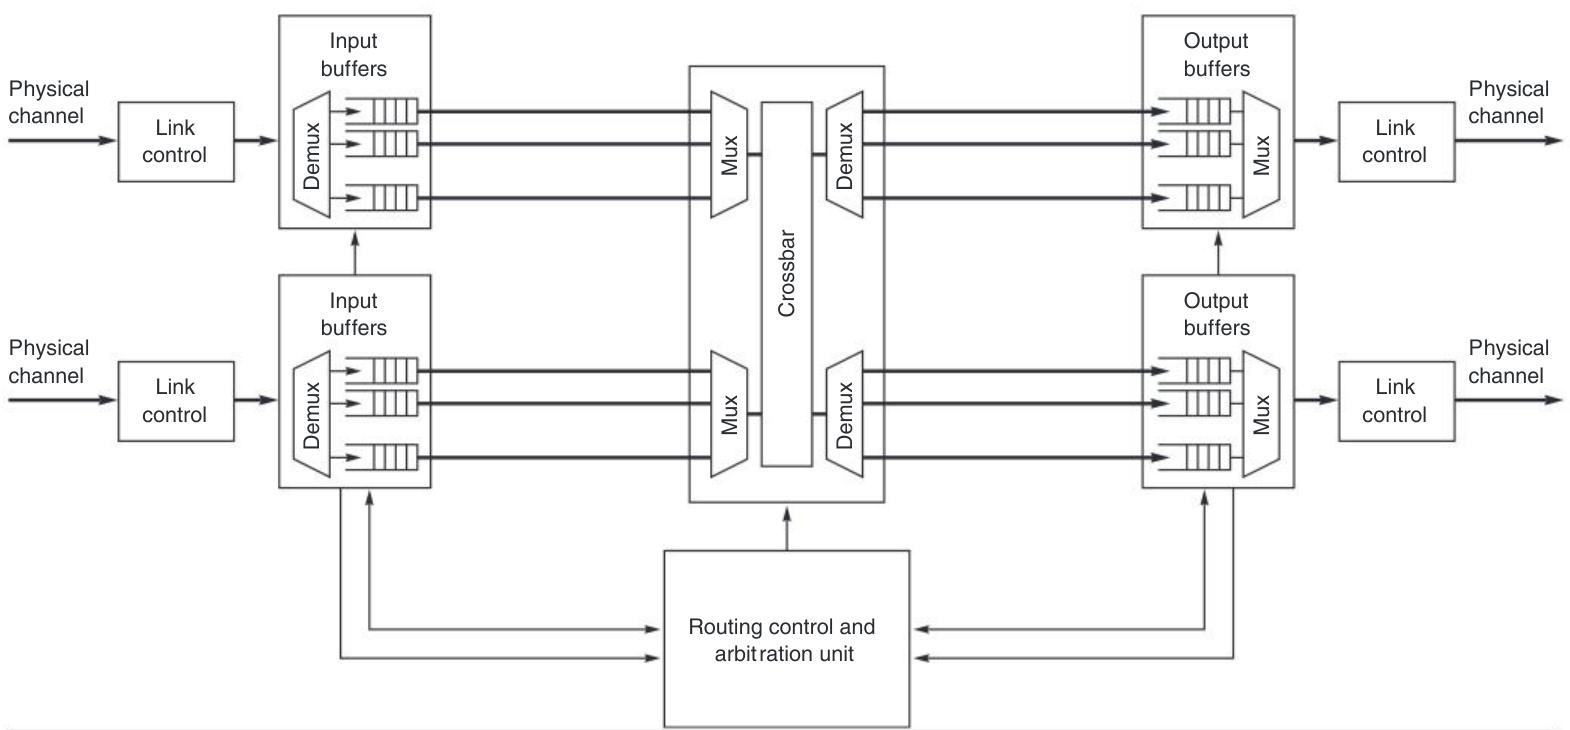
路由可以用路由控制单元中的有限状态机或转发表实现。使用有限状态机时,状态机处理分组头提供的路由信息,按路由算法确定可用输出端口;自适应路由可能给出多个端口。头部中的部分路由信息在使用后,通常由路由控制单元剥除或修改,以简化下一跳处理。使用转发表时,头部路由信息作为地址,访问包含路由算法所允许输出端口的表项。网络开始运行时,必须先把转发表加载到交换机中。还存在混合方案:将转发表缩减为一小组路由位,与一个小型逻辑模块结合。路由控制单元据这些位判断允许的路径,并决定分组应走的输出端口。其目标是构建灵活而紧凑的路由控制单元,避免大型转发表浪费面积和功耗,从而适用于 OCN。路由控制单元通常是集中资源,也可以在每个输入端口复制一份,避免形成瓶颈。每个分组只进行一次路由,而分组通常足够大,需要多个周期才能穿过交换机,因此集中路由控制单元很少成为瓶颈。图 F.21 假定使用集中式路由控制。
如上一节所述,当两个或更多分组同时请求同一输出端口时,需要仲裁。交换机仲裁可集中或分布实现:前者把全部请求和状态信息送到中央仲裁单元;后者将仲裁器分布在交换机各处,通常位于输入或输出端口。一个分组可能多次参与仲裁,每个输入端口还可能关联多个队列,使需处理的仲裁请求增加。因此,许多实现采用分层仲裁:先在各输入端口本地,从该端口对应的分组与队列中选出一个请求;再全局仲裁各输入端口仲裁器选出的请求。图 F.21 假定采用集中式仲裁单元。
图 F.21 基本结构的工作过程如下。分组开始到达输入端口时,链路控制器解码输入信号并生成位序列;如果外部链路宽度与内部数据通路不同,还可能反串行化数据,以适配内部宽度。它同时从分组头或链路控制信号中提取信息,确定分组应存入哪个队列。接收并缓冲分组的同时,或者根据交换技术在完整缓冲后,将头部送往路由单元。路由单元向仲裁单元提出一个或多个输出端口请求。如果端口空闲且有足够空间容纳整个分组或一个 flit,具体取决于交换方式,仲裁就可成功。若实现带虚拟通道的虫孔交换,每个 flit 的传输还可能需要额外仲裁和分配步骤。资源分配后,如果前面没有其他分组且链路空闲,分组便穿过内部交叉开关,进入相应输出缓冲区和链路。链路控制器实现的链路级流量控制,防止链路另一端相邻交换机的输入队列溢出。如果采用虚拟通道交换,多个分组可以按 flit 在链路上时分复用。各输入、输出端口独立工作,因此没有争用时,多个到达分组可以并发处理。
缓冲区组织
如前所述,队列可以位于输入侧、输出侧或两侧。输出缓冲交换机的优点是完全消除队头阻塞(head-of-line blocking,HOL)。当一个队列中缓冲了两个或多个分组,队首分组阻塞,从而挡住后面的分组,而后者若位于队首本来可以前进,这就称为队头阻塞。输出缓冲交换机不会发生这种情况,因为同一队列的所有分组状态相同,都需要同一输出端口。但所有输入端口可能同时收到发往同一输出端口的分组。由于输入侧没有缓冲区,输出缓冲区必须能同时存下全部这些到达分组。这要求内部交换速度加速 倍,即输出队列写入带宽为链路带宽的 倍, 为端口数。这往往太昂贵,因此无损网络很少单独采用这种方案。由于同时收到许多发往同一输出端口分组的概率通常较小,采用输出缓冲交换机的商用系统,往往只提供适度内部加速,罕见的缓冲区溢出则通过丢包处理。
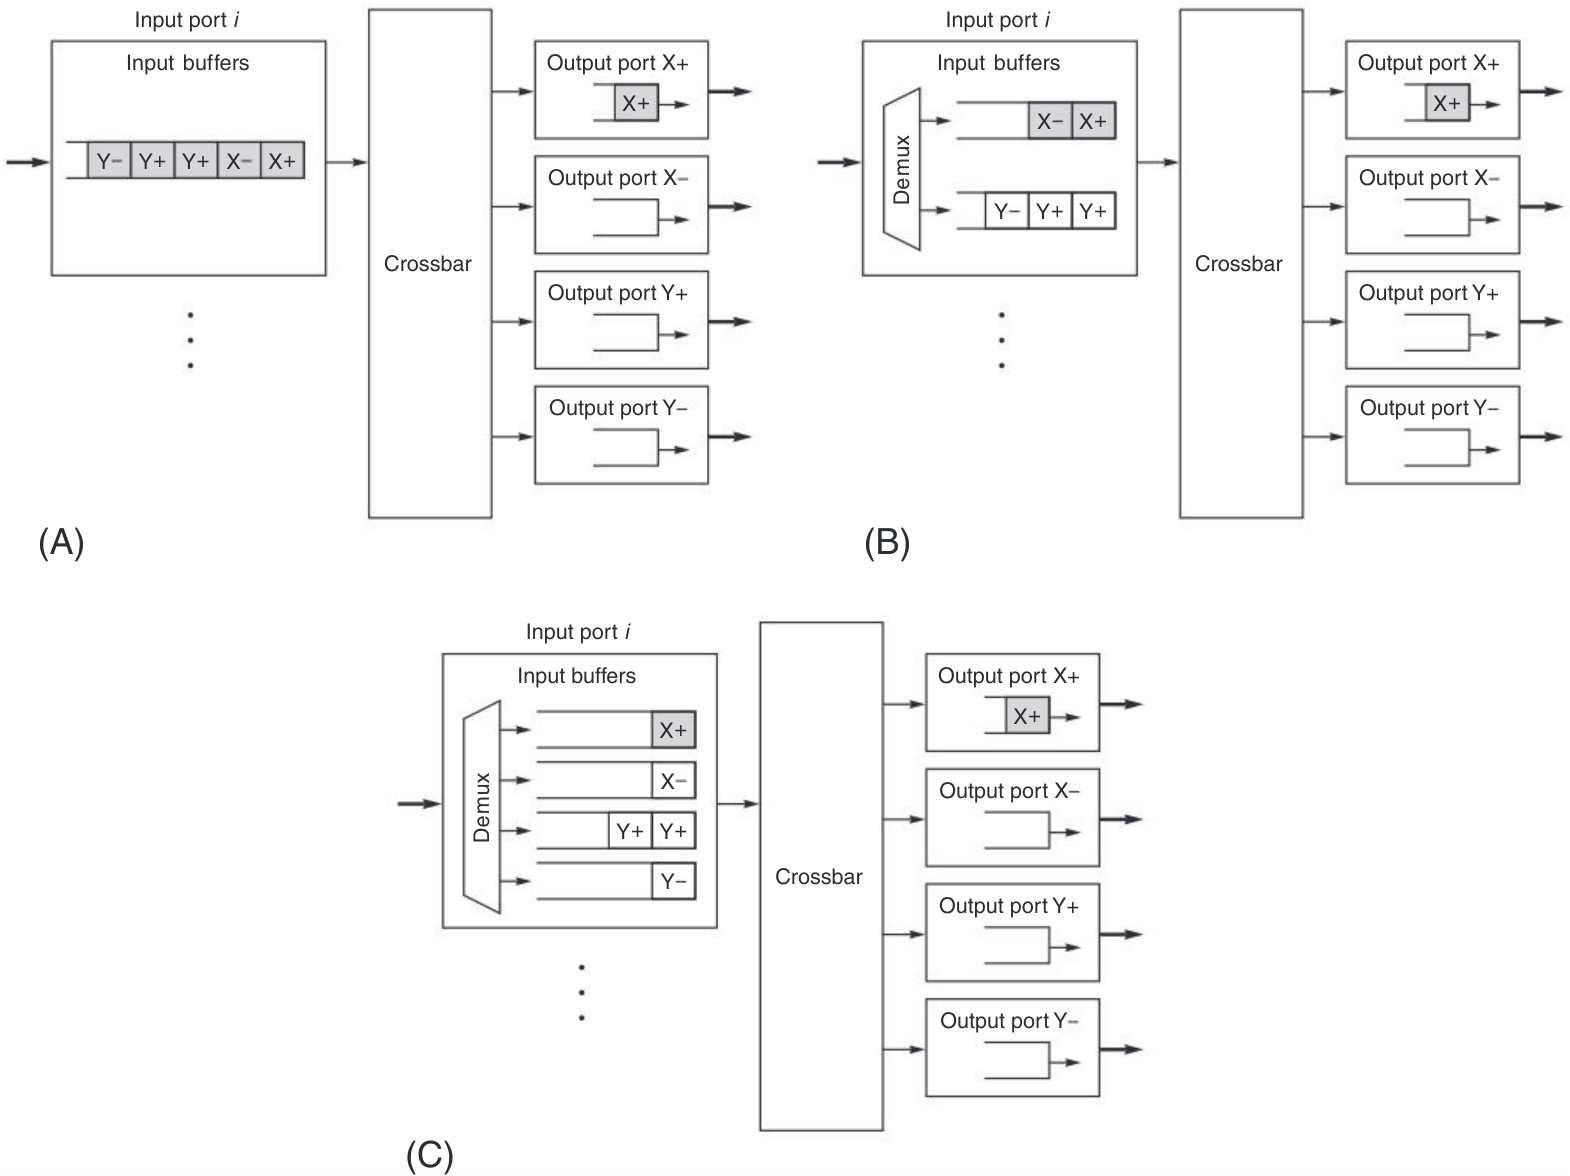
输入缓冲交换机无须内部加速就能接收分组,但输入队列可能发生 HOL 阻塞,如图 F.22(a)。即使分组目的地均匀分布,输出端口利用率也可能因此低于 60%。图 F.22(b) 表明,虚拟通道,图中为两个,可以缓解但不能消除 HOL 阻塞。更有效的办法是将输入队列组织为图 F.22(c) 的虚拟输出队列(virtual output queues,VOQ):每个输入端口都设置与输出端口数相同的队列,分别缓冲发往不同输出端口的分组。这一技术广泛用于 ATM 交换机和 IP 路由器。主要缺点是成本与可扩展性:VOQ 数量随端口数按平方增长。而且,虽然它消除了单台交换机内部的 HOL 阻塞,却没有解决端到端网络层面的 HOL 阻塞。当然,也可以支持网络级 VOQ,即在每个交换机输入端口,设置与整个网络输出端口总数相同的队列,但这极其昂贵。另一种办法是只动态分配一部分队列,将发往拥塞目的地的分组单独存储或缓存。
输入—输出联合缓冲交换机,在输出侧有足够空间时尽量减少 HOL 阻塞,同时由于输入侧也有缓冲,尽量降低所需内部加速倍数。它还将内部交叉开关传输与外部链路传输解耦。这对于采用虚拟通道、在链路上按 flit 时分复用的 cut-through 实现尤其有用。许多商用设计都采用输入—输出缓冲交换机。
路由算法的实现
必须区分路由算法与其实现。算法描述分组穿过网络的转发规则,影响分组延迟和网络吞吐量;实现则影响分组到达节点后的处理延迟、所需芯片面积及路由计算功耗。研究者提出了多种预先计算路由,或隐藏路由计算延迟的方法。但在不明显削弱路由灵活性的前提下,减少面积和功耗,得到的关注少得多。这两方面如今都非常重要,OCN 尤其如此。许多现有设计通过采用相对简单的路由算法应对这些问题,但随着工艺继续缩放,制造缺陷、工艺波动等问题增加,未来很可能需要更复杂的算法,下面将作简述。
如前所述,按计算发生的位置,可区分源路由与分布式路由。源路由将实现复杂度移到端节点:路径需要存入表中,按目的端节点标识符选择分组路径。分布式路由则将复杂度移入交换机,在分组路径的每一跳都选择输出端口。分布式路由有两种基本实现。第一种,用逻辑模块为特定拓扑实现固定算法;最常见的是维序路由,按既定顺序消除各维度上的位移。另一种使用转发表,每个表项编码到某个目的地应使用的输出端口,所以最坏情况下,表项数须与目的节点数相同。
两者各有利弊。基于逻辑的路由计算延迟很短,面积通常很小,功耗低,但必须针对特定拓扑设计,因而受该拓扑限制。基于表的分布式路由相当灵活,能支持任意拓扑和路由算法,只需按所用算法填写适当表项;例如 up*/down* 算法可定义在任意不规则拓扑上。缺点是面积和功耗开销不可忽视,可扩展性也成问题:最坏情况下,一个具有 个端节点及交换机的系统,需要 张表,每表 项,成本按平方增长。
哪种方案更合适取决于网络领域。SAN 常见基于表的方案,InfiniBand 就是如此;OCN 等环境则因面积和功耗而尽量避免查表,适合采用基于逻辑的实现。这也构成 OCN 设计者面临的挑战:器件不断微缩,带来更多制造缺陷、更高的瞬态或永久故障率、明显工艺波动,即晶体管行为偏离设计规格,还需要不同的时钟和电压域,并面临严格的功率与能量预算。这些挑战都要求网络支持异构性。故障部件、关闭供电的交换机和链路,以及因性能波动不可接受而禁用的部件,会在网络中形成不同且可能不规则的区域。因此,同构设计可能最终形成异构系统。在这种背景下,高效实现足够灵活、能应对新挑战的路由算法非常重要。
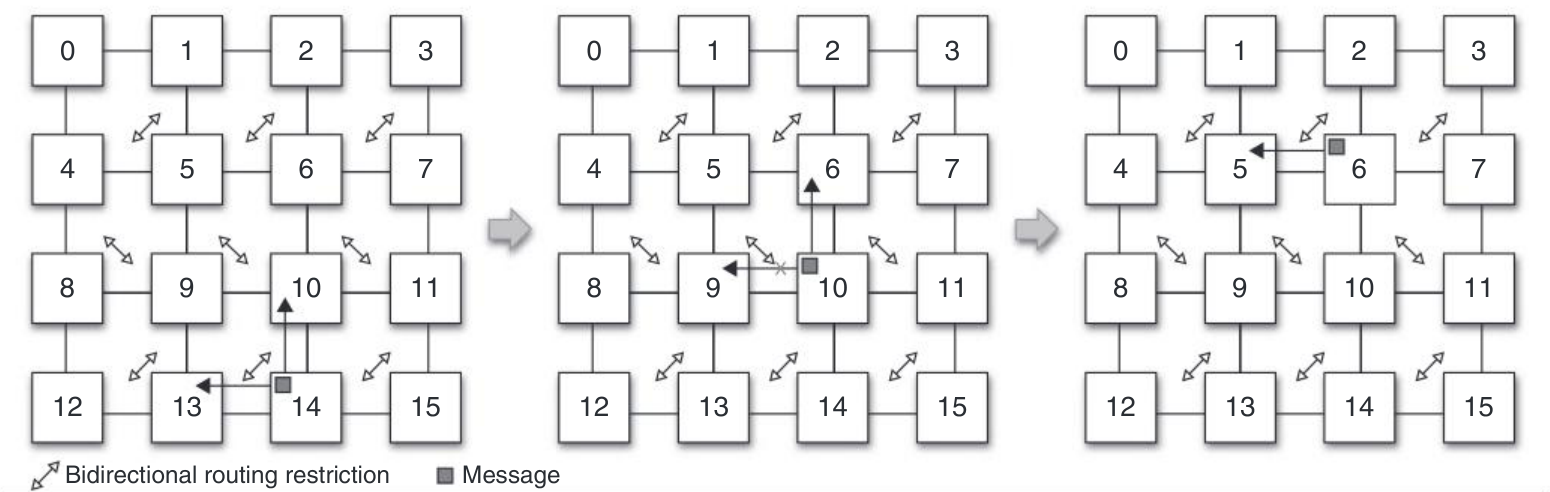
一种著名方法是区间路由(interval routing)[Leeuwen 1987],为每个输出端口定义一段目的地址范围;它具有一定灵活性,又比传统查表方案紧凑得多。虽然灵活性仍不足,却提供了解决新挑战的线索。较新的 Logic-Based Distributed Routing(LBDR,基于逻辑的分布式路由),在逻辑实现的高效与表实现的灵活之间,提供了一种可行折中。它以规则二维 mesh 为参照,但允许制造缺陷、故障及其他异常改变拓扑,从中派生出不规则网络。故障、禁用或断电部件破坏规则性后,维序路由已不能使用。为支持此类拓扑,LBDR 在每台交换机定义一组配置位:四个连接位,每端口一个,指出与拓扑中相邻交换机的连接情况;例如可以用它们禁用通向故障部件的输出端口。此外还有八个路由位,每输出端口两个,规定可用路由选项。这些路由位根据待实现算法计算,在加电时设置。基本含义是:某路由位置位,就表示分组可以通过关联输出端口离开,并允许在下一台交换机进行某种转向。LBDR 在这方面类似区间路由,不过它定义的是几何区域,而非目的地址范围。图 F.23 给出在不规则拓扑上,用 LBDR 实现一种与拓扑无关的算法的例子,并列出计算出的配置位。
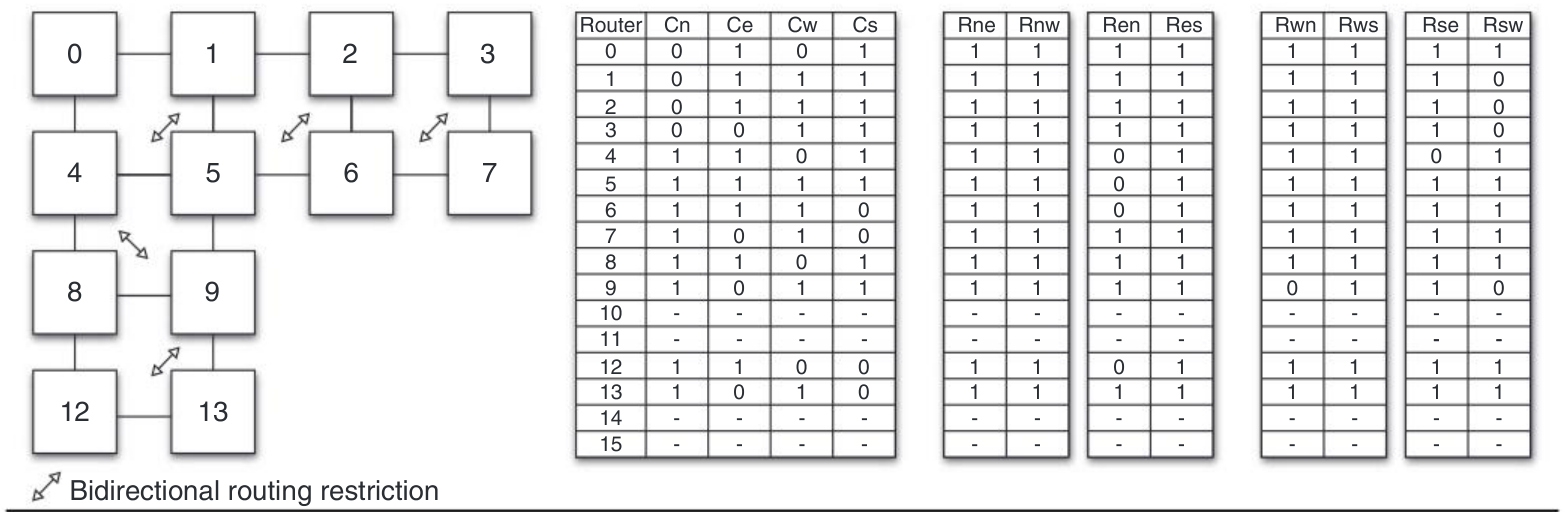
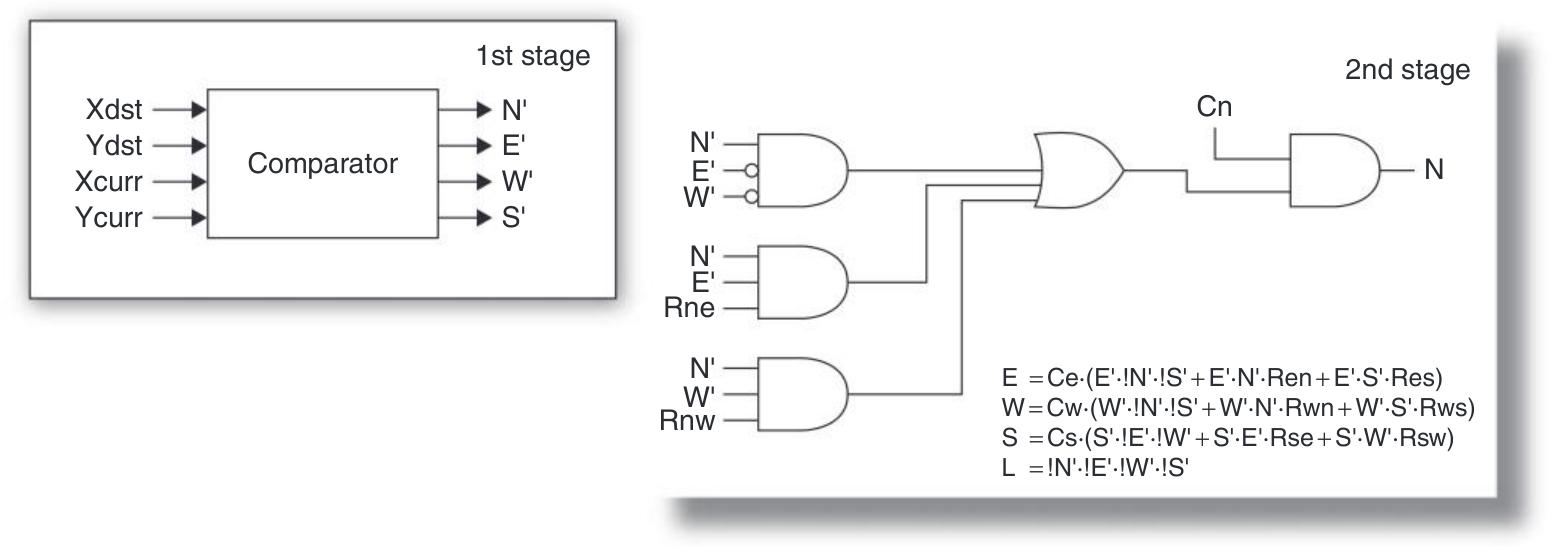
连接位与路由位配合一小组逻辑门,实现路由算法。LBDR 以初始拓扑,即二维 mesh 为参照,根据当前路由器坐标、目的路由器坐标和配置位作决定。图 F.24 展示所需逻辑,图 F.25 展示如何在各路由器中使用配置位,将分组从源送到目的地。可以看到,交换机 10 禁用了西向端口,以落实路由限制。
LBDR 提供了一种高效实现 OCN 路由的方法。最近,它已扩展为支持非最短路径、集合通信操作与流量隔离。所有这些改进都仅使用少量配置位,保持了紧凑而高效的实现。LBDR 及其扩展的详细介绍,以及当时 OCN 的研究进展,见 Flich[2010]。
交换机微体系结构的流水化
对交换机微体系结构进行流水化,可以提高性能。交换机流水处理分组,与向量处理器流水执行指令有相似之处。在向量流水线中,一条指令规定对流水处理的全部向量元素执行何种操作;类似地,交换机中的一个分组头,规定如何处理该分组在内部数据通路上传输的全部物理传输单元,即 phit,这些单元以流水方式处理。不同输入端口的分组彼此独立,还能并行处理,就像多个独立指令或指令线程可以并行执行一样。
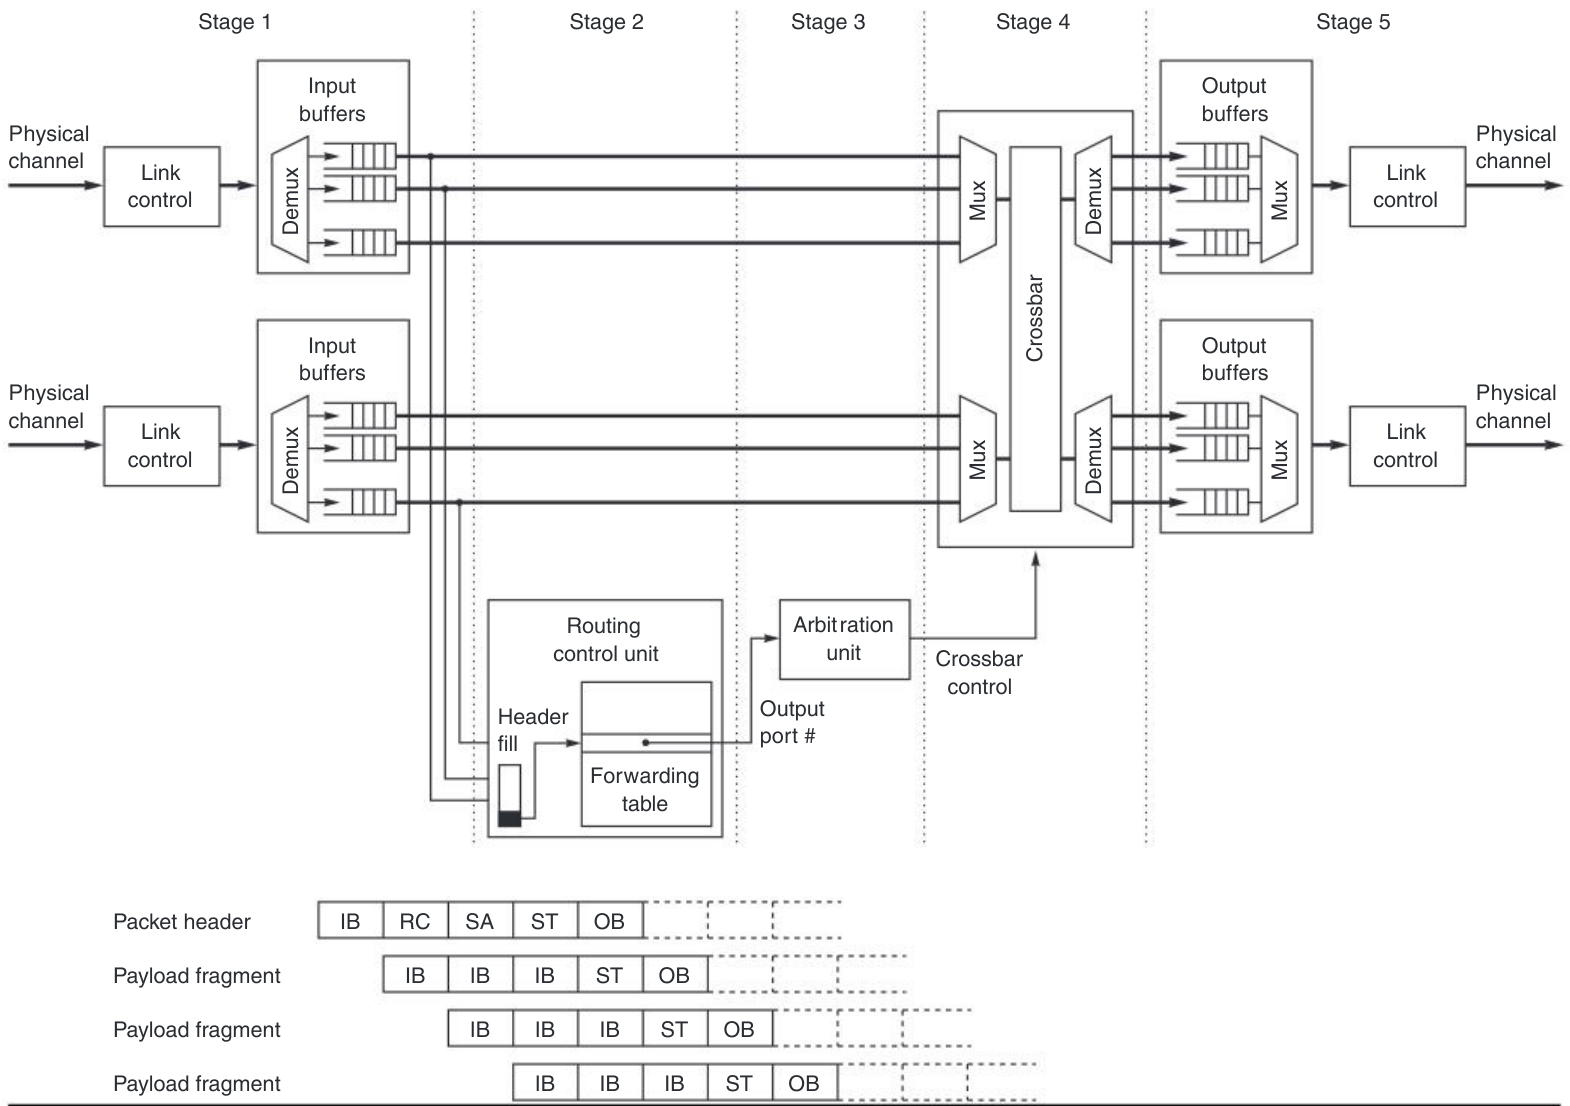
分析交换机内部基本功能,并将其组织成多个阶段,就能实现流水化。图 F.26 是图 F.21 基本结构的一种五级流水组织,假定采用 cut-through,并用转发表实现路由。第一级接收分组头后,第二级利用目的地址等路由信息,查找转发表中允许的路由选项。与此同时,第一级继续接收分组的其他部分并存入输入队列。第三级进行仲裁,第四级配置交叉开关,将获准输出端口分配给分组;第五级将分组头存入输出缓冲区,准备沿外部链路发送。注意,第二和第三级只供分组头使用;一旦内部数据通路建立,载荷和尾部只使用数据流经的三个阶段。
虚拟通道交换机通常还需要一级进行虚拟通道分配,而且每个 flit 穿过交叉开关之前都需要仲裁。路由和仲裁算法若较复杂,这些操作还可能占用多个时钟周期。
其他交换机微体系结构改进
如前所述,有时会提高交换机内部速度,以提升输出端口利用率。通常通过提高时钟频率、增大内部数据通路宽度即 phit 大小,或两者结合来实现。另一种办法,是为每个输入端口的队列组到输出端口设置多条并行数据通路,例如增加交叉开关的输入端口数。如果每个输入端口实现多个物理队列,就可以为每个输入队列设置一个独立的交叉开关端口。例如 IBM Blue Gene/L 为每个交换机输入端口实现了两个交叉开关访问端口与两个读取端口。
输入、输出间并行数据通路的另一种实现方式,是把缓冲区移到交叉开关的交叉点。这通常称为带缓冲交叉开关(buffered crossbar switch)。它为每个输入端口到不同输出端口提供独立通路,使一个输入端口可以同时向 个不同输出端口发送最多 个分组。为各输入—输出端口对提供独立交叉点存储器,可消除单台交换机内的 HOL 阻塞;仲裁也比其他结构简单得多。每个输出端口只能从自身对应、与其他输出端口互不重叠的一组交叉点存储器接收分组,因此每个输出端口可以使用完全独立且十分简单的仲裁器。
如果不是成本太高,带缓冲交叉开关将是理想结构。交叉点存储器数量随端口数按平方增长,相比基本结构显著提高成本并降低可扩展性。此外,每个交叉点存储器都必须足够大,才能高效实现链路级流量控制。为降低成本,多数设计者选择输入缓冲或输入—输出联合缓冲,再辅以前述某些增强机制。