F.8 互连网络实例
为了进一步使前述概念具体化,本节从本附录讨论的四类互连领域中选取五个实例。OCN、LAN、WAN 各一个,SAN 两个,分别为系统区域网络和系统/存储区域网络。前两个是高性能系统的专有网络,后三个是商用系统广泛使用的网络标准。
片上网络:Intel Single-Chip Cloud Computer
随着晶体管集成度按 Moore 定律持续提高,处理器设计者迫切需要应对横跨芯片的片内连线延迟,以及深亚微米工艺缩放带来的其他问题。多核微体系结构因简单、模块化,并能开发超越单核激进流水化和多指令/多数据发射所能实现的并行性,而日益普及。不论处理器是单核还是多核,对片内通信带宽的要求都越来越高,更不用说片间带宽。这激发了人们对 OCN 的广泛兴趣,希望高效支持指令、寄存器操作数、内存与 I/O 数据在核内、核间以及片内、片外的通信。这里重点介绍 Intel Single-chip Cloud Computer(SCC) 原型中的片上网络。
SCC 是具有 48 个 Intel IA-32 核的芯片多处理器原型。图 F.28 显示,其核分布在 二维 mesh 上,网络连接 24 个 tile、四个片上存储器控制器、一个电压调节控制器(VRC)以及一个外部系统接口控制器(SIF)。每个 tile 内两个核连接一台路由器。四个存储器控制器位于 mesh 两侧边缘,每侧两个,VRC 和 SIF 位于底边。
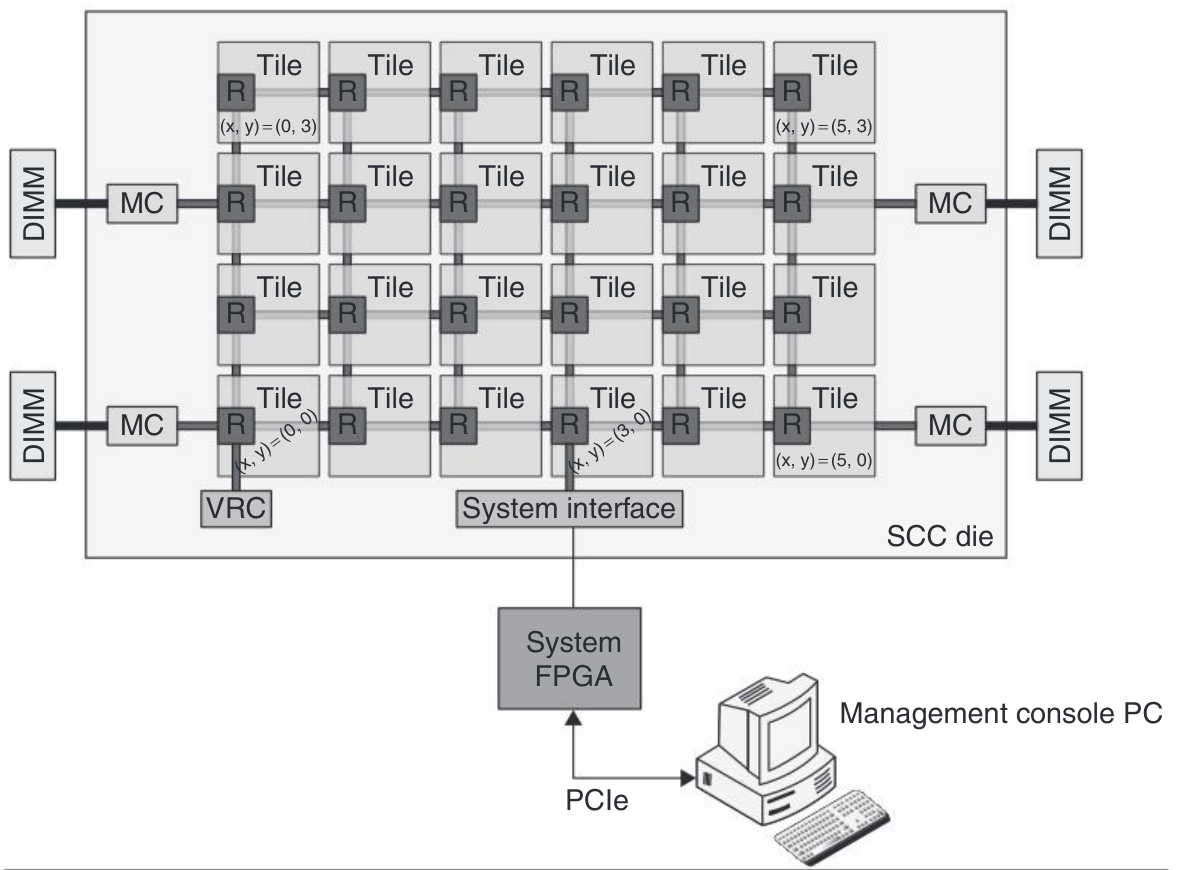
每个存储器控制器可寻址两个 DDR3 DIMM,每个 DIMM 最多 8 GB,因此总容量最多 64 GB。VRC 允许任一核或系统接口调节六个预定义区域中任一区域的电压;原文将每区描述为两个双 tile 区。时钟还能以更细粒度调节,每个 tile 有自己的运行频率。关闭区域或降低其运行水平,可大幅节能。应用因此能完全控制各核的功耗状态,并可通过 API 设定各区电压与频率。SIF 用于从芯片外部与网络通信。
每个 tile 包含两个基于 P54C 的 IA 处理器核,各配有 16 KB L1 数据 缓存、16 KB 指令 缓存,以及 256 KB L2 缓存 和控制器;还包含五端口路由器、仅供测试的流量发生器、处理所有消息传递请求的 mesh 接口单元(MIU)、内存查找表(配有配置寄存器,用于将核的物理地址映射到系统的扩展内存映射)、消息传递缓冲区,以及用于时钟生成和跨异步边界同步的电路。
就 OCN 而言,MIU 负责核与网络之间的接口,包括大消息的分组化与重组、命令转换、地址解码与查找、链路级流控、credit 管理,以及按轮询进行仲裁。系统采用基于 credit的流控及虚拟 cut-through,因此长消息必须拆成分组。路由器按二维 mesh 连接,原文在此描述各路由器具有自己的电源和时钟源。路由器间链路为 16 字节数据加 2 字节边带,频率 2 GHz。包含链路穿越在内的空载延迟为四个周期。八个虚拟通道中,六个用于性能,两个用于处理协议级死锁。消息级仲裁采用 wrapped wave-front 仲裁器。路由为 XY 维序算法,每台路由器都预计算输出端口。
除了 tile 的电压、频率区域之外,由路由器和链路构成的网络自身只有一个独立区域。因此,全部网络部件使用相同电源、运行于相同速度;路由器与 tile 之间需要异步时钟域转换。
译注:原页先称路由器“each on its own power supply and clock source”,随后又明确称全部网络部件使用同一电源和速度。此处分别保留两个陈述,未擅自消除其表述差异。
SCC 的一个特色,是核间通信采用基于消息的协议,而不是硬件 缓存 一致存储器。每台路由器都有消息传递缓冲区,并提供 API 对 MPI 结构进行完全控制;缓存 一致性可以由软件实现。
相比 Teraflops 处理器,SCC 路由器对二维片上互连作了显著改进。它面向多处理器互连中更宽的数据通路,并针对该宽度进一步优化延迟、面积和功耗。目标频率从前代 Teraflops 的 5 GHz 降到 2 GHz,但互连体系结构性能更高。
| 机构与处理器[网络] | 年份 | 网络端口数[核/tile+其他端口] | 基本拓扑 | 每链路每方向数据位数 | 链路带宽[链路时钟] | 路由;仲裁;交换 | 芯片金属层数;流控;虚拟通道 |
|---|---|---|---|---|---|---|---|
| MIT Raw[General Dynamic Network] | 2002 | 16[16 个 tile] | 二维 mesh,4×4 | 32 位 | 0.9 GB/s[225 MHz,与处理器同频] | XY DOR,带请求—应答死锁恢复;RR;虫孔 | 6 层;基于 credit;无虚拟通道 |
| IBM Power5 | 2004 | 7[2 个 PE 核+5 个其他端口] | 交叉开关 | 取指 256 位;存储 64 位;装入 256 位 | [1.9 GHz,与处理器同频] | 最短路径;无阻塞;电路交换 | 7 层;握手;无虚拟通道 |
| U.T. Austin TRIP Edge[Operand Network] | 2005 | 25[25 个执行单元 tile] | 二维 mesh,5×5 | 110 位 | 5.86 GB/s[533 MHz,时钟按 80% 缩放] | YX DOR;分布式 RR;虫孔 | 7 层;on/off 流控;无虚拟通道 |
| U.T. Austin TRIP Edge[On-Chip Network] | 2005 | 40[16 个 L2 tile+24 个网络接口 tile] | 二维 mesh,10×4 | 128 位 | 6.8 GB/s[533 MHz,时钟按 80% 缩放] | YX DOR;分布式 RR;虚拟 cut-through(VCT) | 7 层;基于 credit;4 个虚拟通道 |
| Sony、IBM、Toshiba Cell BE[Element Interconnect Bus] | 2005 | 12[1 个 PPE、8 个 SPE+3 个内存及 I/O 接口端口] | 环,共 4 个,每方向 2 个 | 128 位数据,另加 16 位标签 | 25.6 GB/s[1.6 GHz,为处理器频率一半] | 最短路径;集中式树形 RR;流水化电路交换 | 8 层;基于 credit;无虚拟通道 |
| Sun UltraSPARC T1 | 2005 | 最多 13[8 个 PE 核+4 个 L2 存储体+1 个共享 I/O] | 交叉开关 | 8 个核与 4 个 L2 存储体 均为 128 位 | 19.2 GB/s[1.2 GHz,与处理器同频] | 最短路径;基于等待时间仲裁;VCT | 9 层;握手;无虚拟通道 |
系统区域网络:IBM Blue Gene/L 三维 torus
据 www.top500.org,IBM Blue Gene/L 是 2005 年全球规模最大、性能最高的计算机系统。它有 65,536 个双处理器计算节点、1024 个 I/O 节点,峰值性能 360 TFLOPS,占地约 2500 平方英尺。每节点两个处理器可都用于计算,并在 virtual mode 下各自处理通信协议;也可一个负责计算,另一个负责网络接口处理。分组从 32 字节到最大 256 字节不等,头部占 8 字节,包含路由、虚拟通道、链路级流控、大小等信息,以及保护头部的 1 字节 CRC。另有 3 字节用于分组级 CRC,1 字节作为有效指示。
主互连是专有的 三维 torus SAN,连接全部 64K 节点。每个节点交换机通过六条双向 350 MB/s 链路连接相邻节点;两个本地处理器的注入带宽为 612.5 MB/s,接收带宽为 1050 MB/s。网络接收带宽等于全部交换机端口的入站带宽,避免接收链路成为瓶颈;较高的接收带宽使目的节点可以同时吸收多个分组。
两个节点组成一块 计算卡;16 块计算卡加 2 块 I/O 卡组成 节点板;16 块节点板组成 midplane;两个 midplane 构成一个 1024 节点机架,物理尺寸为 米。链路最长 8.6 米,因此只需相对少量缓冲,就能高效实施链路级流控。为降低延迟,系统采用虚拟 cut-through,在输入、输出端口分布仲裁,并在前一台交换机用有限状态机预先计算当前交换机的路径,使部分路由延迟移出关键路径。为提高有效带宽,采用双读取端口的输入缓冲交换机、四虚拟通道虚拟 cut-through,以及基于 bubble 流控的完全自适应无死锁路由。
如此规模的网络,容错至关重要。链路采用相对较低的 700 MHz 时钟,与处理器同频,双沿传输,即每方向每条位串行链路支持 1.4 Gbit/s 或 175 MB/s,以降低故障率;但故障仍会发生。故障时,包含故障的 midplane 节点板被关闭并旁路,隔离故障,计算从最后一个检查点恢复。每个 midplane 配备独立的旁路交换板,作为 torus 节点板之外的附加部件。旁路板可配置为连接对应 midplane 节点板的链路,或连接下一旁路板,从而有效移除对应的一组节点板。虽有某些维度的处理节点数减少,机器仍保留其拓扑结构和路由算法。
屏障同步、广播/多播和归约等集合通信,在三维 torus 上效果不佳,因为它们可能用流量淹没网络。为此,系统另外使用两套每链路带宽更高的树形网络,高效实现集合与合并操作。除高效同步及广播/多播外,硬件还高效支持某些算术归约,例如对每节点提供的一个值求总和或最大值。除了 torus 和两套树网,Blue Gene/L 还实现用于 I/O 的千兆以太网,以及带宽更低的控制系统快速以太网,支持并行 I/O、配置、调试和维护。
系统/存储区域网络:InfiniBand
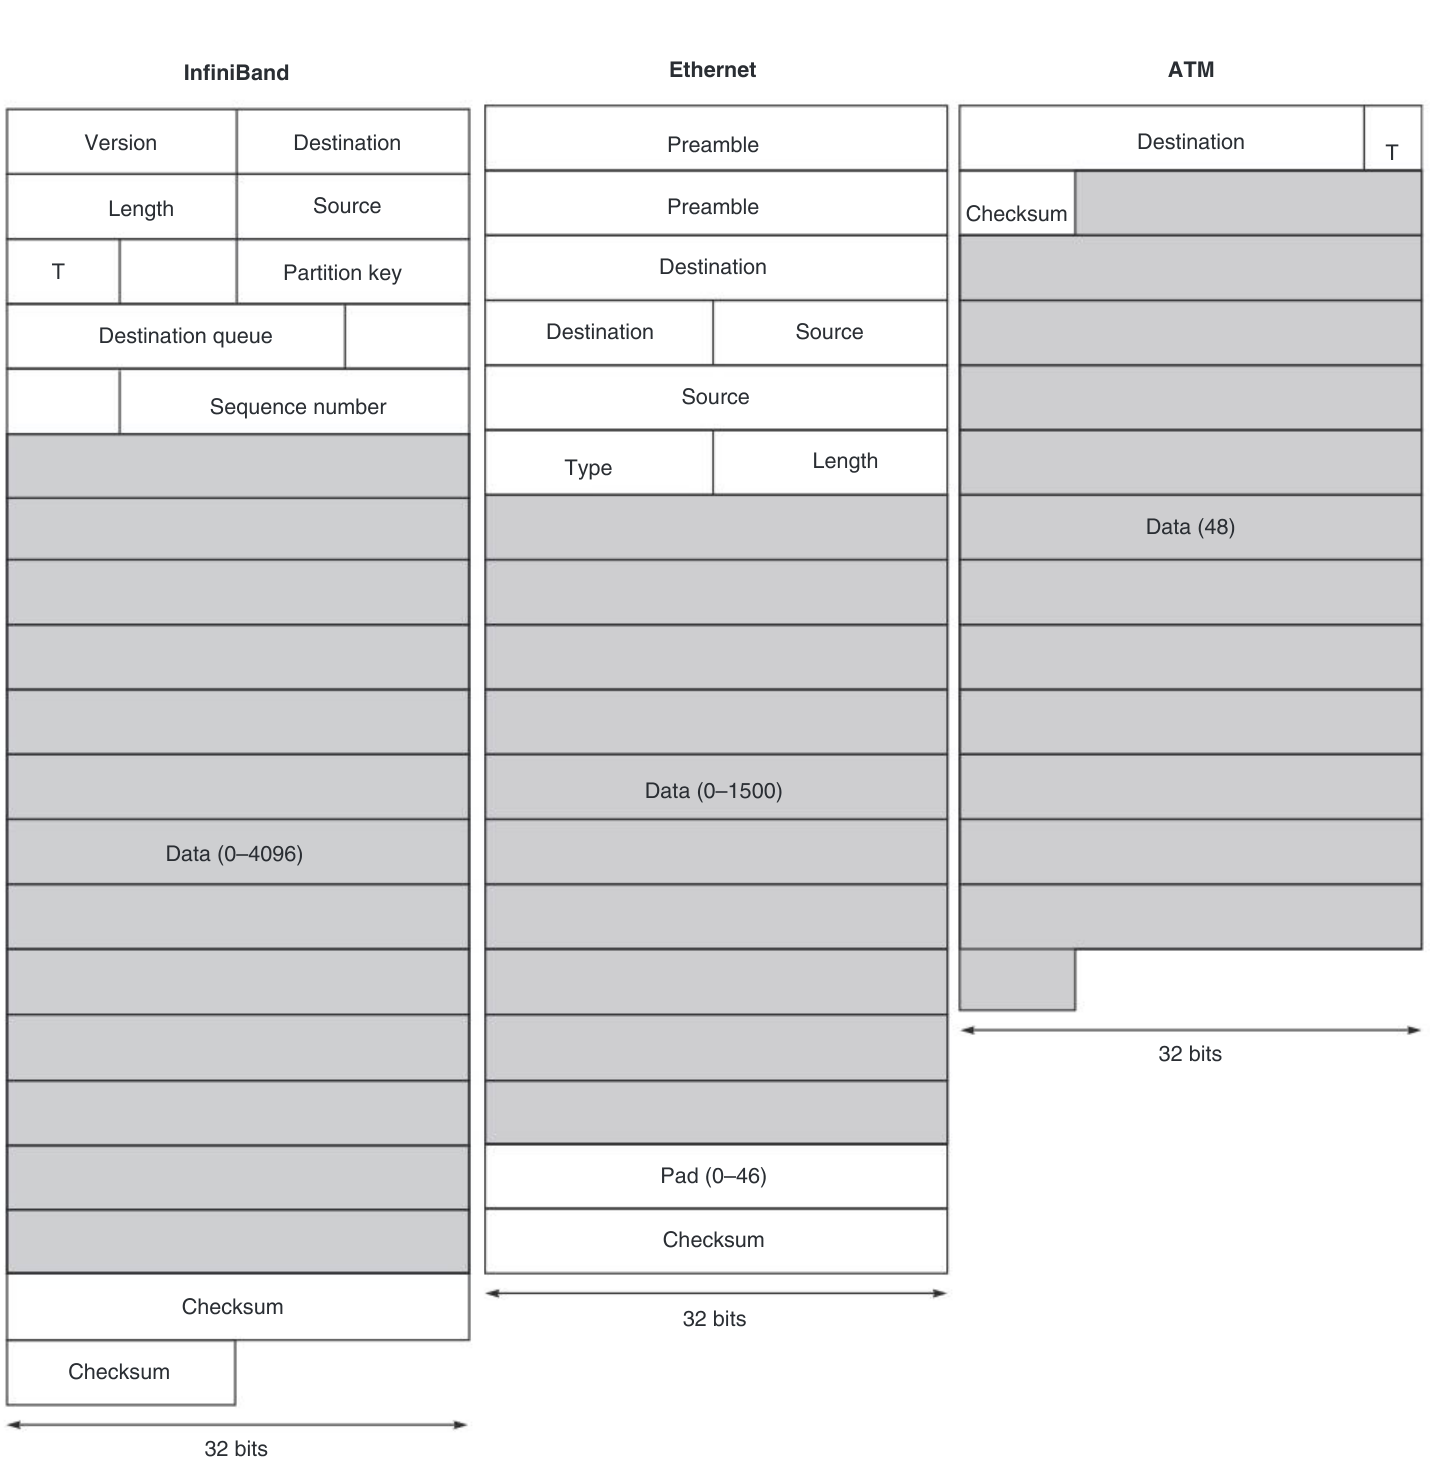
InfiniBand 是 InfiniBand Trade Association 成员公司联盟在 2000 年 10 月制定的行业事实网络标准。它既可作为处理器间通信的系统区域网络,也可作为服务器 I/O 的存储区域网络。它是基于交换机的互连,供应商与用户可灵活选择拓扑、路由及仲裁方法。它支持 300 米距离,每链路每方向 2–120 Gbit/s 数据速率;采用 cut-through、16 个虚拟通道与服务等级、基于 credit的链路级流控、加权轮询公平调度,以及可编程转发表。还包含通信子网管理、端到端路径建立、虚拟目的地命名等提高可靠性和可用性的功能。图 F.30 将其分组格式与 LAN、WAN 的另外两项标准并列;图 F.31 则与科研及商用高性能系统中广泛使用的两种专有 SAN 比较。
InfiniBand 提供两种基本用户级通信机制:发送/接收及远程 DMA(RDMA)。发送/接收要求接收者在发送者发数据前,显式提交接收缓冲区,即在通道适配器网络接口中分配空间。RDMA 则允许发送者直接将数据远程 DMA 到接收设备内存。例如,在连接 3.4 GHz Intel Xeon 主机的 Mellanox MHEA28-XT 通道适配器上测量,名义分组大小为 4 字节时,发送/接收机制的发送和接收开销分别为 0.946 μs、1.423 μs,RDMA 则分别为 0.910 μs、0.323 μs。
| 网络[供应商] | 2005 年前十名超级计算机集群中的应用 | 节点数 | 基本拓扑 | 原始双向链路带宽 | 路由算法 | 仲裁技术 | 交换技术;流控 |
|---|---|---|---|---|---|---|---|
| InfiniBand[Mellanox、Voltair] | SGI Altrix、Dell PowerEdge Thunderbird | 超过数百万,GUID 地址空间为 2¹²⁸,类似 IPv6 | 完全可配置,任意拓扑 | 4–240 Gbit/s | 任意,表驱动,通常为 up*/down* | 加权 RR 公平调度,两级优先级 | cut-through;16 个虚拟通道,其中 15 个传数据;基于 credit |
| Myrinet-2000[Myricom] | 西班牙 Barcelona Supercomputer Center | 8192 | 16 端口双向交换机组成的双向 MIN,Clos 网络 | 4 Gbit/s | 基于源的 dispersive 自适应最短路由 | RR | cut-through,无虚拟通道;Xon/Xoff |
| QsNet II[Quadrics] | Intel Thunder Itanium2 Tiger4 | 超过数万个 | 8 端口双向交换机组成的胖树 | 21.3 Gbit/s | 基于源的 LCA 自适应最短路径 | 两阶段 RR、优先级、aging,分布在输出端口 | 虫孔,两个虚拟通道;基于 credit |
F.2 节已经说明,分组大小对充分利用带宽十分重要。自然会问,消息本来的大小是什么样?图 F.32(a) 展示商用流体动力学仿真应用 Fluent 的消息大小,数据采自俄亥俄州立大学 Network-Based Computer Laboratory 的 InfiniBand 网络。一条曲线累计发送消息数,另一条累计数据字节数。这里的消息是 MPI 信息单位,网络传输时还会分成 InfiniBand 最大传输单位,即分组。最大消息超过 512 KB,但约 90% 小于 512 字节;2 KB 消息对应约 50% 的传输字节。NAS Parallel Benchmark 的 Integer Sort 内核也测得约 75% 的消息小于 512 字节,图未列出。许多应用发送的小消息远多于大消息,尤其因为请求和确认比数据响应、块写入更加频繁。
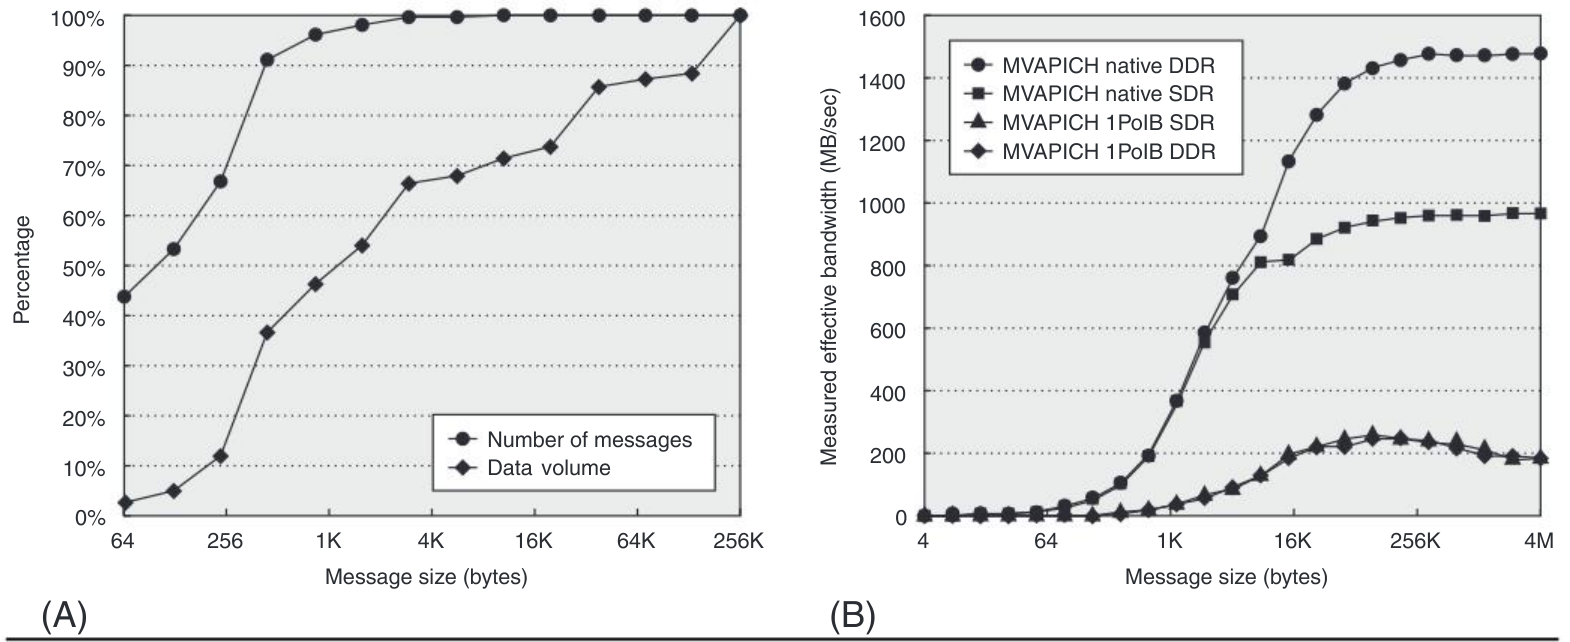
InfiniBand 允许将协议处理从主机卸载到网卡控制器,降低处理开销。图 F.32(b) 用广泛使用的 InfiniBand MPI 实现 MVAPICH,展示卸载及绕过操作系统的收益。图按两种模式、两种网络速度绘制有效带宽。IPoIB 模式由主机操作系统 IP 层处理 InfiniBand 通信,不绕过 OS;另一模式让 MVAPICH 直接运行在 Mellanox 原生接口 VAPI 上,将传输协议处理卸载到通道适配器硬件,绕过 OS。图包括 10 Gbit/s 单倍数据率(SDR)与 20 Gbit/s 双倍数据率(DDR)网络。结果清楚表明,协议卸载和 OS bypass 显著降低发送、接收开销,使有效带宽接近线速。
以太网:局域网
以太网作为 LAN 极其成功,从 1978 年提出、原文称当时几乎处处可见的 10 Mbit/s 标准,到较新的、预计会广泛采用的 10 Gbit/s 标准。多类计算机都将以太网作为标准通信接口。IEEE 802.3 以太网是按目的地址路由分组的分组交换网络。最早为同轴电缆设计,后来主要使用 Cat5e 铜缆,长距离和高带宽采用光纤。原文还提到其无线版本 802.11,以说明这一技术体系的普及。
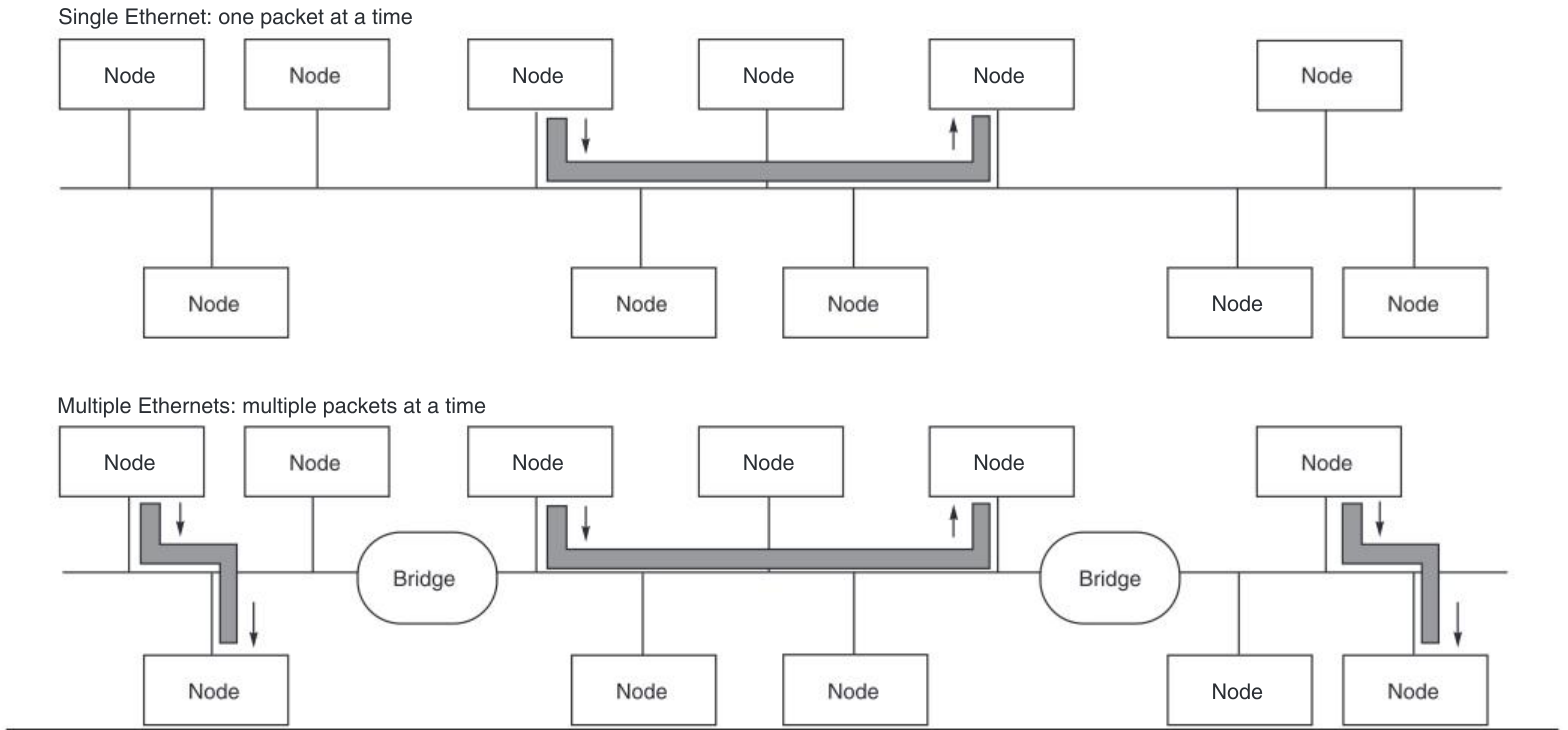
在 20 年间,计算机相比 1978 年快了数千倍,共享介质以太网却保持不变。于是,在更快、更高带宽网络出现前,工程师不得不寻找过渡办法。一种办法是以多个以太网连接机器,再用互联设备连接这些以太网,需要时将流量从一个转到另一个。各以太网由此能并行工作,提高整个计算机集合的总互连带宽;这些设备实际上提供了类似前述点到点网络交换机的功能。
图 F.33 展示潜在并行性。根据转发方式及所连网络类型,这些设备名称不同:
- 网桥。 连接各 LAN,按分组地址将流量从一侧转到另一侧。工作于以太网协议层,通常比下面的路由器更简单、便宜。按下一节 OSI 模型,见图 F.36,它工作于第二层,即数据链路层。
- 路由器或网关。 将 LAN 接到 WAN,或连接不同 WAN,并处理不兼容的编址。通常比网桥慢,工作于 OSI 第三层即网络层。WAN 路由器将网络划为较小、分离的子网,简化管理并提高安全性。
另一类互联设备是集线器,但它仅把多个网段扩展成一个 LAN,任一时刻仍只有一条消息能传输,所以无助于性能。它工作于 OSI 第一层即物理层。由于这些设备并非最初以太网标准规划的一部分,后来补入的性质增加了 LAN 维护难度和成本。
截至 2011 年,以太网链路有 10、100、10,000、100,000 Mbit/s 等速率。10 和 100 Mbit/s 以太网允许多设备共享介质,1000 Mbit/s 及以上则依靠点到点链路和交换机。交换机通常采用某种存储转发。
原文从以太网最早实现谈起,指出其没有真正的流量控制。最初它用载波侦听和指数退避,见 F-23 页,仲裁共享介质。有些交换机尝试利用这一接口补入自己的流控版本;原文称流量控制不是以太网标准的一部分。
广域网:ATM
异步传输模式(Asynchronous Transfer Mode,ATM)是电信行业制定的广域网标准。20 世纪 90 年代,它曾尝试在 LAN 领域与以太网竞争,后来退回其 WAN 优势领域。
这一电信标准内建可扩展带宽,从 155 Mbit/s 起,以四倍递增至 620 Mbit/s、2480 Mbit/s,依此类推。作为 WAN,它采用单模或多模光纤。虽然也是交换介质,ATM 与前述实例不同,依赖虚连接通信;它用虚拟通道进行路由,在同一网络段复用不同连接,避免传统基于连接网络的低效。面向 WAN 也促使它采用存储转发。如图 F.30,它与其他协议不同,使用载荷 48 字节的小型固定分组;并采用基于 credit的流控,而 IP 路由器不实施这种流控。
虚连接和小分组的原因在于服务质量。电信行业关心语音流量,因此既重视带宽,也重视可预测性。建立虚连接比分组无连接网络的变化更小,并简化存储转发。固定小分组还更容易实现快速路由器和交换机。为此,ATM 甚至提出自己的协议栈,与 TCP/IP 竞争。令人意外的是,交换机虽简单,ATM 协议族却庞大复杂。最初的梦想是从 LAN 到 WAN 无缝衔接,摆脱当时各式路由器拼凑的局面;这个梦想后来已从鼓舞人心的愿景,变成令人怀念的往事。