F.10 互连网络中贯穿各层的问题
本节讨论其他章节涉及的五个主题。互连网络从根本上影响这些主题,而它们也反过来影响互连网络。
针对密度优化与针对 SPEC 优化的处理器
世界各地的人都在访问网站,服务器究竟放在哪里并不太重要。因此,许多服务器放在托管机房,按预留和使用的网络带宽、占用空间以及耗电量收费。过去,桌面微处理器通常在能散掉热量的前提下尽量追求速度,很少顾及封装及周边芯片尺寸。直到 2006 年,Intel 和 AMD 某些桌面微处理器功耗仍高达 130 瓦!机房占地效率也很少被重视。这些优先取舍使电力成为托管机房的主要成本,处理器密度受到功耗与散热能力限制,互连的功耗也包括在内。
随着便携计算机普及,2005 年笔记本销量首次超过台式机,其功耗和散热需求较低,因而有机会用这类技术实现密度高得多的计算。例如,2006 年 Intel Pentium M 的功耗为 25 瓦,但许多应用的性能已接近桌面微处理器。因此,每瓦性能或每立方英尺性能,可能取代每处理器性能,成为重要评价指标。关键是许多应用已经采用大型集群,所以用例如 256 个节能处理器替换 64 个高耗电处理器,可能既更便宜,又保持软件兼容。这使功耗与性能都高效的互连设计更加重要。
Google 集群就是从少量“更热”处理器转向大量“更凉”处理器的典型例子。每机架采用最多 80 个 1 GHz Intel Pentium III,而非高耗电的高端处理器。其他例子包括基于移动处理器、机架单元刀片宽 1 英寸高 7 英寸的刀片服务器。HP ProLiant BL10e G2 支持最多 20 个 1 GHz 超低电压 Pentium M,配 400 MHz 前端总线、1 MB L2 缓存 及最多 1 GB 内存。Fujitsu Primergy BX300 支持最多 20 个 1.4 或 1.6 GHz Pentium M,每处理器有 512 MB 内存,可扩至 4 GB。
智能交换机与智能接口卡
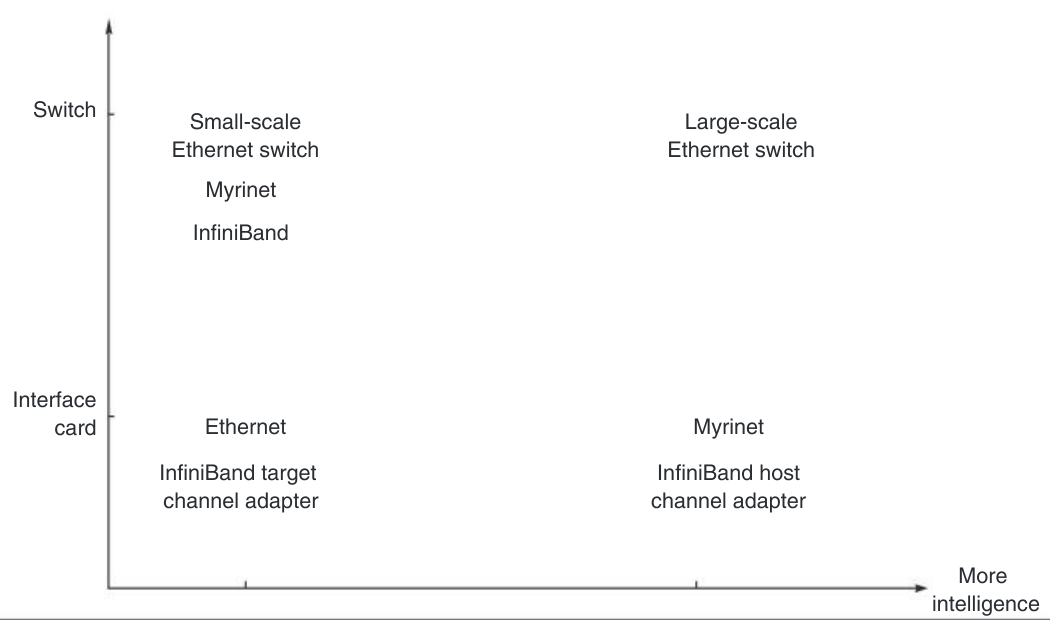
图 F.39 展示网络中智能放在哪里的权衡:一般是在更智能的网络接口与更智能的交换机之间选择。一方更智能,另一方通常就能更简单、更便宜。以太网接口便宜,因而成为多数桌面机和服务器的标准部件。对规模较小、不需要大型交换机复杂转发表与生成树协议的用户,也有低成本交换机可选。
Myrinet 采取相反思路。其交换机很简单,除流控和仲裁外,只提取分组头第一个字节,直接选择输出端口,不实现路由表。智能放在网络接口卡 NIC 中,NIC 负责高效通信支持,以及网络配置和重配置的分布式协议。
InfiniBand 采用混合方案:对磁盘等要求较低的设备,提供便宜而简单的目标通道适配器(TCA),希望它能直接集成进某些 I/O 设备;对主机则提供更昂贵、更强大的主机通道适配器(HCA)。交换机实现路由表。
保护与用户访问网络
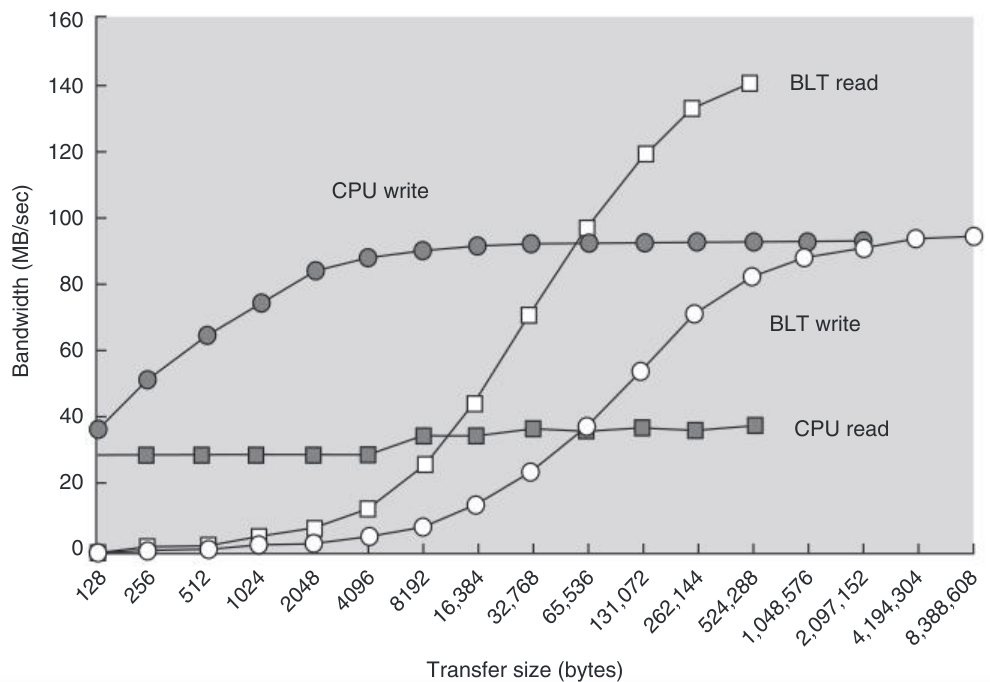
一项挑战是:在常见情况下不调用操作系统,同时保证安全通信。Cray Research T3D 超级计算机提供了有趣案例。它与较新的 Cray X1E 一样支持全局地址空间,load/store 可以跨网络访问内存;每次访问都经 TLB 检查,因此有保护保障。为了传送较大对象,硬件又增加块传输引擎(BLT)。但使用 BLT 前必须调用操作系统,检查整个访问范围,确认不会违反保护要求。
图 F.40 比较不同对象大小下的读写带宽。很大的读取,例如 512 KB,BLT 达到最高 140 MB/s;但 8 KB 及以下,简单 load 性能更高。写入时两者都达到 90 MB/s 峰值,可能是受内存总线限制。但 BLT 要到传输 2 MB 时才追上简单 store;更小传输用 store 更快。显然,若 BLT 在常见情况下能避免调用操作系统,就会更有用。
高效访问存储层次与高效访问网络
SPECint、SPECfp 等传统处理器评测,鼓励把存储层次与处理器紧密集成,因为存储层次的效率直接转化为处理器性能。因此,微处理器把多级 缓存 及写缓冲放到片上。然而,这些基准不奖励良好的互连接口,许多机器访问网络时都必须等整个存储层次走完:写操作缓慢穿过已满的写缓冲,读操作先经历一级、二级、甚至三级 缓存 未命中,才到达互连。因此,新系统访问互连的延迟可能比旧机器更高。
比较三款过去的机器:40 MHz SPARCstation-2、无外部 缓存 的 50 MHz SPARCstation-20、有外部 缓存 的 50 MHz SPARCstation-20。按 SPECint95,其性能依次提高;但访问 I/O 总线 S-bus 的时间也依次增至 200、500、1000 ns。SPARCstation-2 最快,因为内存和 I/O 共用一条总线,且只有一级 缓存。SPARCstation-20 访问必须先经过内存总线 M-bus,再到 I/O 总线,增加 300 ns;有二级 缓存 的机器在访问 I/O 总线前,还要再付出 500 ns。
面向计算优化的处理器与接收开销
如果没有卸载,接收消息往往涉及中断,必须清空并重新启动处理器流水线。前面已经提到,读取网络状态及从接口接收数据,通常只能以 缓存 未命中的速度完成。如果微处理器进一步提高超标量程度和时钟频率,每次接收消息所错过的指令发射机会,可能增加到不可接受的程度。