G.4 提高向量性能
本节将在第 4 章的基础上,更深入地介绍提高向量处理器性能的技术。
深入探讨向量链接
早期的向量链接实现类似转发,但这会限制链接中源指令和目的指令的执行时序。较新的实现采用灵活链接(flexible chaining):只要不产生结构冒险,一条向量指令基本上可以与任何其他正在执行的向量指令链接。灵活链接要求不同向量指令同时访问同一个向量寄存器。可以通过增加读写端口实现,也可以像存储系统那样,把向量寄存器堆组织为交错存储体。本附录余下部分都假定采用这种链接方式。
即使两个操作互相依赖,链接仍允许它们在向量的不同元素上并行推进。因此,可以将它们调度到同一编队,减少所需的 chime 数。对前述指令序列,即使操作之间有依赖,仍可达到每周期持续执行两次浮点运算的速率(忽略启动时间),也就是一个 chime!整个序列的运行时间变为:
图 G.8 给出向量长度为 64 时,这两条向量指令采用链接和不采用链接的时序。该编队只需一个 chime;但由于使用链接,实际编队执行时间中仍会显现启动开销。图中链接执行共需 77 个时钟周期,即每个结果 1.2 个周期。其间完成 128 次浮点运算,所以达到每时钟周期 1.7 次浮点运算。不采用链接时需要 141 个周期,即每时钟周期 0.9 次浮点运算。
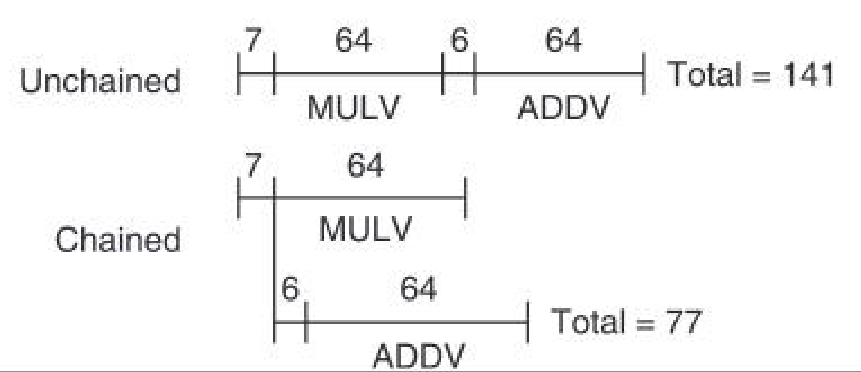
图内术语:Unchained=不链接;Chained=链接;Total=总周期数。原图分别给出 141 与 77 个周期。
虽然链接能将两条有依赖的指令放入同一编队,减少执行时间中的 chime 部分,却不能消除启动开销。要准确估计运行时间,就必须同时计算编队内部和编队之间的启动时间。采用链接时,一个序列的 chime 数取决于处理器中不同向量功能单元的数量,以及应用对它们的需求。尤其要注意,任何编队都不能包含结构冒险。例如,在 VMIPS 这样只有一个向量加载—存储单元的处理器上,含两条向量访存指令的序列至少需要两个编队,也就是两个 chime。
链接如此重要,以至于每种现代向量处理器都支持灵活链接。
深入探讨稀疏矩阵
第 4 章介绍了让稀疏矩阵程序以向量方式执行的技术。先简要回顾一下:稀疏矩阵中的向量元素通常以某种紧凑形式保存,再通过间接寻址访问。对于一种简化的稀疏表示,代码可能如下:
这段代码对数组 A、C 执行稀疏向量求和,使用索引向量 K、M 指定 A、C 中的非零元素。A 和 C 必须有相同数量的非零元素,即各有 个。另一种常见的稀疏矩阵表示,用位向量标记哪些元素存在,再用一个稠密向量保存非零元素。同一程序中往往会同时使用两种表示。许多程序都会遇到稀疏矩阵;具体实现方式很多,取决于程序采用的数据结构。
简单的向量化编译器不能自动向量化上述代码,因为它不知道 K 中各元素的值互不相同,因而也不知道不存在依赖。程序员需要通过编译指示,告诉编译器可以按向量方式执行该循环。
更先进的向量化编译器,可以插入运行时数据依赖检查,不依赖程序员注释便自动完成向量化。检查采用高级加载地址表(ALAT)的向量化软件实现;ALAT 硬件是附录 H 所述 Itanium 处理器的一项机制。这里用软件哈希表替代相联 ALAT 硬件,检测同一次 strip-mining 迭代中的两个元素访问是否指向同一地址。若未发现依赖,该次迭代就可以按最大向量长度完成;若检测到依赖,则将向量长度调小,使所有依赖约束都不被违反,剩余元素留给下一次 strip-mining 迭代。这个方案确实会增加相当多的软件开销,但在通常没有依赖的情况下,这些额外操作大多也能向量化。因此,循环仍远快于标量代码,不过比程序员提供编译指示时慢得多。
许多较新的超级计算机都具有散布—聚集功能。这些操作实现更复杂,也更容易遇到存储体冲突,因此通常比固定步长访问慢;但它们仍远快于可能采用的另一种实现,即标量循环。矩阵的稀疏性特征若有变化,就必须重新计算索引向量。许多处理器提供快速计算索引向量的支持。VMIPS 的 CVI(create vector index,创建向量索引)指令,根据给定步长 生成索引向量,其元素为 。有些处理器提供生成压缩索引向量的指令,只生成对应于掩码寄存器中 1 所在位置的条目;另一些向量体系结构则提供压缩向量的方法。在 VMIPS 中,我们把 CVI 定义为始终依据向量掩码生成压缩索引向量。掩码全为 1 时,就生成普通索引向量。
索引加载—存储与 CVI 指令,还提供了另一种支持条件向量执行的方法。先回顾第 4 章的代码:
下面的向量指令序列使用 CVI 实现这个循环:
译注: 原书在这里给出的高级语言代码是 DAXPY:
Y(i)=a*X(i)+Y(i);紧接着的汇编却按A(i)≠0筛选元素,并计算A(i)=A(i)-B(i),两段代码并不对应。下文条件的比较符号在原页中排印异常;前面的SNEVS.D注释和后文“非零”共同表明其含义为A(i)≠0。
散布—聚集实现是否优于条件执行实现,取决于条件成立的频率与各操作的开销。忽略链接时,原版本的运行时间为 。第二个版本采用索引加载与存储,假设每周期处理一个元素,则运行时间为 ,其中 是条件成立的元素比例,即 A(i)≠0 的比例。假定 、 大致相当,或远小于 ,即可求出第二种方法何时更好:
希望 ,因此:
也就是说,非零元素不足四分之一时,第二种方法更快。许多情况下,实际执行条件内操作的频率远低于这个比例。如果索引向量可以重用,或者 if 内向量语句的数量增多,散布—聚集方法的优势还会显著扩大。