G.7 现代向量超级计算机:Cray X1
Cray X1 于 2002 年推出,与 NEC SX/8 一起代表了当时现代向量超级计算机的先进水平。X1 的系统体系结构支持数千个强大的向量处理器共享同一个全局存储器空间。
图 G.11 展示了 Cray X1 独特的处理器体系结构。一个大型多流处理器(Multi-Streaming Processor,MSP)由四个单流处理器(Single-Streaming Processor,SSP)组合而成。每个 SSP 都是一颗单芯片向量处理器,包含一个标量单元、标量缓存和一个双通道向量单元。标量单元是一颗双发射、乱序执行的超标量处理器,具有 16 KB 指令缓存和 16 KB 标量直写数据缓存;两者均为两路组相联,缓存行大小为 32 字节。向量单元包含向量寄存器堆、三个算术单元和一个加载—存储单元。与超标量指令发射机制相比,向量功能单元更容易采用深流水线,因此向量单元的运行频率为 800 MHz,而标量部分为 400 MHz。每条向量通道每周期都能执行一次 64 位浮点加法和一次 64 位浮点乘法,使每个 MSP 的峰值性能达到 12.8 GFLOPS。
早期 Cray 的 ISA 可以追溯到 1976 年的 Cray-1,分别为地址、标量和向量提供八个寄存器。X1 的 ISA 则从头重新设计,吸收了近 30 年编译器与微体系结构研究的经验。它具有 64 个 64 位标量地址寄存器、64 个 64 位标量数据寄存器、32 个每元素 64 位的向量数据寄存器,以及八个每元素 1 位的向量掩码寄存器。寄存器数量大幅增加,使编译器能够将更多程序变量映射到寄存器中,减少访存流量;也有利于代码的静态调度,提高运行时指令执行的重叠程度。早期 Cray 使用紧凑的变长指令集,而 X1 的 ISA 采用定长指令,以简化超标量取指和译码。
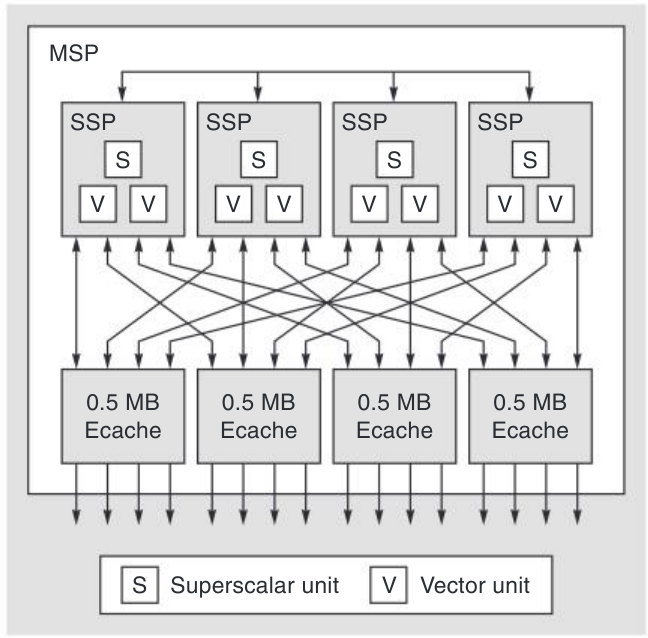
图内术语:MSP=多流处理器;SSP=单流处理器;Superscalar unit=超标量单元;Vector unit=向量单元;Ecache=外部缓存,每片为 0.5 MB。
四颗 SSP 芯片与四颗缓存芯片一起封装在一个多芯片模块中;后者构成四个 SSP 共享的 2 MB 外部缓存(Ecache)。Ecache 为两路组相联,缓存行大小为 32 字节,采用写回策略。它可以缓存向量,从而减少具有时间局部性的代码所产生的访存流量。ISA 还提供不在缓存中分配空间的向量加载、存储指令变体,避免已知局部性很差的数据污染 Ecache。Ecache 的带宽足以在每个 800 MHz 时钟周期,为每条通道提供一个 64 位字,即每个 MSP 超过 50 GB/s。
X1 封装层次的下一级如图 G.12 所示:四个 MSP、16 颗存储器控制器芯片和 DRAM 放在同一块印制电路板上,构成一个 X1 节点。每颗存储器控制器芯片有八个独立的 Rambus DRAM 通道,每通道提供 1.6 GB/s 存储器带宽。节点共有 128 个存储器通道,主存总带宽超过 200 GB/s。
一个 X1 系统最多可包含 1024 个节点,即 4096 个 MSP 或 16,384 个 SSP;节点间通过带宽极高的全局网络连接。网络连接经由存储器控制器芯片实现,任一处理器都可以使用加载、存储指令直接访问系统内的全部存储器。与基于集群的系统所采用的消息传递协议相比,这提供了快得多的全局通信。在如此多的高带宽共享内存节点之间维护缓存一致性,是一项挑战。X1 的做法是限制每个 Ecache 只能缓存本地节点 DRAM 中的数据。存储器控制器采用目录方案,维护节点内四个 Ecache 之间的一致性。远程节点访问某个存储位置时,可以获得其最新值;远程存储操作则先使本地 Ecache 中的相应副本失效,再更新存储器。不过,远程节点不能缓存这些本地存储位置的数据。
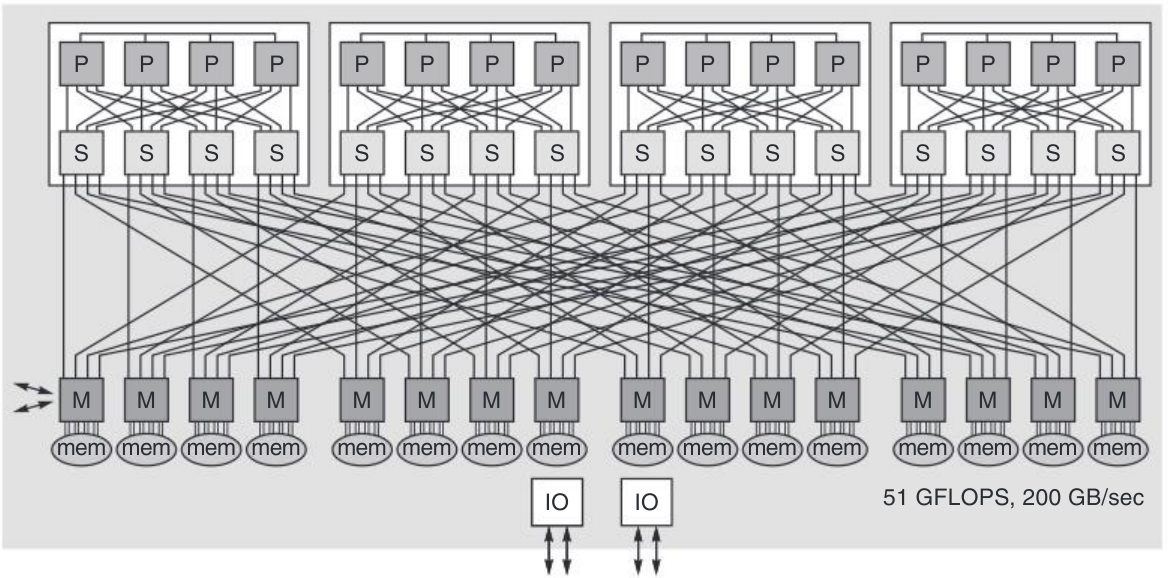
图内术语:mem=存储器;IO=输入/输出;51 GFLOPS 表示每秒 510 亿次浮点运算,200 GB/sec 表示每秒 200 GB。P、S、M 沿用原图模块缩写;原图注没有分别展开其名称,此处不推造定义。
面对长延迟的缓存未命中和全局通信,向量加载、存储尤其有用,因为相对简单的向量硬件便能生成并跟踪大量尚未完成的访存请求。当时的超标量微处理器仅支持 8~16 个尚未完成的缓存未命中,而每个 MSP 处理器最多可以支持 2048 个未完成访存请求,即每个 SSP 512 个。为作弥补,超标量微处理器逐渐采用更大的缓存行——128 字节及以上——以便每次未命中都取回更多数据;但在对大型数据集进行非单位步长访问时,这会造成大量带宽浪费。X1 在各处都采用较短的 32 字节缓存行来减少浪费,并依靠支持大量相互独立的缓存未命中来维持存储器带宽。这样的延迟容忍能力,加上面向非单位步长访问的巨大存储器带宽,解释了为何某些代码在向量机上的执行速度远高于超标量微处理器。
多流处理器
Cray 首先在 SV1 中引入 Multi-Streaming 概念,随后在 X1 中作了大幅增强。MSP 内的四个 SSP 共享 Ecache,硬件支持这四个 SSP 之间的屏障同步。每个 X1 SSP 具有一个双通道向量单元和 32 个向量寄存器,每个寄存器容纳 64 个元素。对于如何使用一个 MSP 中的 SSP,编译器有多种选择。
最简单的方式,是把四个双通道 SSP 组合起来,模拟一个八通道向量处理器。X1 为节点内的 SSP 提供高效的屏障同步原语,编译器负责生成 MSP 代码。例如,对于一个遍历 1000 个元素、可以向量化的内循环,编译器将第 0~249 次迭代分配给 SSP0,第 250~499 次分配给 SSP1,第 500~749 次分配给 SSP2,第 750~999 次分配给 SSP3。各 SSP 可以独立处理自己的迭代,但进入下一组嵌套循环之前,必须与其他 SSP 同步。
如果内循环的迭代次数不多,八通道 MSP 的效率就会很低:每个 SSP 只能处理少量元素,启动时间和同步开销将主导执行时间。另一种用法是由编译器在外循环层面进行并行化,让各 SSP 处理不同的内循环。例如,下面的嵌套循环将矩阵的上三角部分乘以一个常数:
考虑 MAX_ROWS 和 MAX_COLS 均为 100 的情况。随着外循环迭代,内循环的向量长度从 100 逐步减至 1。即使第一次执行内循环,其长度也远低于八通道 MSP 的最大向量长度 256,因此代码效率较低。编译器也可以把整个内循环分配给单个 SSP。例如,SSP0 处理第 0、4、8 等行,SSP1 处理第 1、5、9 等行。这样,各 SSP 所看到的向量都会更长。这种方式实际上把标量开销也并行化了,利用了各 SSP 内独立的标量单元。
大多数应用代码采用 MSP,但如果向量并行性有限而线程级并行性丰富,也可以将代码编译为把所有 SSP 都用作独立处理器的形式。
Cray X1E
2004 年,Cray 宣布对最初的 X1 设计进行升级。X1E 采用较新的制造工艺,能在一颗芯片上放置两个 SSP,因而成为第一款多核向量微处理器。每个物理节点现在包含八个 MSP,但组织成两个各含四个 MSP 的逻辑节点,以保持与 X1 相同的编程模型。此外,标量和向量时钟频率分别从 400 MHz、800 MHz 提升到 565 MHz、1130 MHz,峰值性能提高至 18 GFLOPS。