H.6 Intel IA-64 体系结构与 Itanium 处理器
本节概述 Intel IA-64 体系结构,以及它在 Itanium 处理器中的实现。原书将其视为最先进的 VLIW 风格处理器。
Intel IA-64 指令集体系结构
IA-64 是 RISC 风格的寄存器—寄存器指令集,但包含许多新颖特性,支持编译器开发 ILP。这里着重介绍 IA-64 ISA 的独特之处;其中多数已经在本附录讨论过,包括谓词化、由编译器检测并行性,以及存储器访问推测。
发布 IA-64 时,HP 和 Intel 引入 EPIC(Explicitly Parallel Instruction Computer,显式并行指令计算机)一词,以区别于早期 VLIW 和其他 RISC 体系结构。VLIW 与 EPIC 共享许多特性,但 EPIC 还加入了若干扩展,主要分为两类:
- 更灵活地表示指令间并行性,并提供更灵活的指令格式。 VLIW 依赖固定格式,要求一条宽指令内的所有操作都能并行执行,格式也非常僵硬。EPIC 则显式标示可能存在的指令依赖,并采用多种指令格式。与僵硬的 VLIW 方法相比,EPIC 能更灵活地表达并行性,也能减少不灵活指令格式通常带来的代码膨胀。
- 提供更全面的软件推测支持。 早期 VLIW 方案在这方面的支持很有限。
此外,IA-64 还包含寄存器窗口、可轮转的浮点寄存器(FPR)栈等多种提升性能的特性。
IA-64 寄存器模型
IA-64 的寄存器状态包括:
- 128 个 64 位通用寄存器;稍后会看到,它们实际为 65 位宽。
- 128 个 82 位浮点寄存器,比标准 80 位 IEEE 格式多两位指数。
- 64 个 1 位谓词寄存器。
- 8 个用于间接分支的 64 位分支寄存器。
- 用于系统控制、存储映射、性能计数器,以及与操作系统通信的其他寄存器。
整数寄存器采用寄存器栈机制来加速过程调用,类似 Berkeley RISC-I 中提出、后来用于 SPARC 的机制。0–31 号寄存器始终可访问,并以 0–31 编址;32–128 号寄存器用作寄存器栈,每个过程分配 0–96 个寄存器。1 硬件通过寄存器重命名,为被调用过程创建新的栈帧;一个称为当前帧指针(CFM)的特殊寄存器,指向该过程使用的寄存器集合。栈帧分为局部区和输出区:局部区存放局部数据,输出区向被调用过程传递值。alloc 指令指定这两个区域的大小。只有整数寄存器支持寄存器栈。
发生过程调用时,更新 CFM,使被调用过程的 R32 指向输出区的第一个寄存器。原文在此将输出区也称为“被调用过程”的输出区;随后说明,这样就能把调用者的参数传入被调用者可寻址的寄存器。2 被调用者执行 alloc,分配所需的局部寄存器和用于进一步调用其他过程、传递参数的输出寄存器。
局部寄存器包含调用者的输出寄存器。专用加载和存储指令负责保存及恢复寄存器栈;称为寄存器栈引擎的专用硬件处理栈溢出。
除整数寄存器外,还有浮点、谓词和分支寄存器。浮点寄存器保存浮点数据,分支寄存器保存间接分支的目标地址。谓词寄存器保存控制谓词指令执行的谓词;稍后详述这一机制。
整数和浮点寄存器都为 32–128 号寄存器支持轮转。1 寄存器轮转旨在简化软件流水线循环的寄存器分配,这是 H.3 节讨论过的难题。结合谓词化,还可以避免循环展开,以及独立的序言、尾声代码。这能减少软件流水线引起的代码膨胀,并使它适用于迭代次数较少的循环;在传统方法中,这类循环的额外开销往往抵消许多收益。
指令格式与显式并行支持
IA-64 的设计目标,是获得 VLIW 方法的主要优势——一条指令内操作的隐式并行性,以及操作字段的固定格式——同时保有比通常 VLIW 更大的灵活性。它依赖编译器检测 ILP,把指令调度到并行指令槽;同时增加格式灵活性,并允许编译器标明一条指令不能与其后继指令并行执行。
IA-64 用两个不同概念,兼顾隐式并行性与易于译码。把指令放入指令组(instruction group)来表达隐式并行;用包含三条指令的 bundle 实现多条指令的固定打包格式。先定义指令组。
指令组是一段连续指令序列,其中没有寄存器数据依赖,只有少数例外。只要硬件资源足够,而且保持经由存储器产生的依赖,组内所有指令都可以并行执行。组的长度没有固定限制,但编译器必须显式标出组间边界,即在属于不同组的两条指令之间插入 stop 标记。要解释 stop 如何表示,必须先说明指令怎样放进 bundle。
IA-64 将指令编码为 128 位 bundle。每个 bundle 包含一个 5 位模板字段和三条各 41 位的指令。严格说,这些 41 位单元不能单独算作指令,必须结合模板字段才能解释;有时称之为 syllable。为简便,这里仍称“指令”。为简化译码与发射,模板字段规定 bundle 中每条指令所需的执行单元类型。图 H.6 给出五种槽类型、可容纳的指令类别和例子。
| 执行单元槽 | 指令类型 | 指令说明 | 指令示例 |
|---|---|---|---|
| I-unit | A | 整数 ALU | 加、减、AND、OR、比较 |
| I-unit | I | 非 ALU 整数操作 | 整数和多媒体移位、位测试、传送 |
| M-unit | A | 整数 ALU | 加、减、AND、OR、比较 |
| M-unit | M | 存储器访问 | 整数/浮点寄存器的加载和存储 |
| F-unit | F | 浮点 | 浮点指令 |
| B-unit | B | 分支 | 条件分支、调用、循环分支 |
| L + X | L + X | 扩展 | 扩展立即数、stop 和空操作 |
每个 bundle 的 5 位模板字段,同时描述与该 bundle 关联的 stop,以及其中各条指令需要的执行单元类型。图 H.7 列出模板能编码的格式和 stop 位置。它只能表示所有可能的指令类型与 stop 组合中的一个子集。下面用例子说明。
例题 将数组递增循环 x[i] = x[i] + s 展开七次,并把指令放入 bundle。先忽略流水线延迟,以最小化 bundle 数量;再调度代码,以最小化停顿。假设每周期执行一个 bundle,任何停顿都使整个 bundle 停顿;采用图 3.2 的流水线延迟。为简便,使用 MIPS 助记符。
| 模板值 | 槽 0 | 槽 1 | 槽 2 | stop 位置 |
|---|---|---|---|---|
| 0 | M | I | I | 无 |
| 1 | M | I | I | 槽 2 后 |
| 2 | M | I | I | 槽 1 后 |
| 3 | M | I | I | 槽 1 后、槽 2 后 |
| 4 | M | L | X | 无 |
| 5 | M | L | X | 槽 2 后 |
| 8 | M | M | I | 无 |
| 9 | M | M | I | 槽 2 后 |
| 10 | M | M | I | 槽 0 后 |
| 11 | M | M | I | 槽 0 后、槽 2 后 |
| 12 | M | F | I | 无 |
| 13 | M | F | I | 槽 2 后 |
| 14 | M | M | F | 无 |
| 15 | M | M | F | 槽 2 后 |
| 16 | M | I | B | 无 |
| 17 | M | I | B | 槽 2 后 |
| 18 | M | B | B | 无 |
| 19 | M | B | B | 槽 2 后 |
| 22 | B | B | B | 无 |
| 23 | B | B | B | 槽 2 后 |
| 24 | M | M | B | 无 |
| 25 | M | M | B | 槽 2 后 |
| 28 | M | F | B | 无 |
| 29 | M | F | B | 槽 2 后 |
解答 两个版本见图 H.8。这里的延迟虽与 Itanium 不同,但最常见的 MMF bundle 在 Itanium 中必须独立发射,与本例假定一致。
(a) 使 bundle 数量最少。 每周期至多执行一个 bundle;“末尾 stop”表示槽 2 之后的组边界。
| bundle 模板 | 槽 0 | 槽 1 | 槽 2 | 末尾 stop | 执行周期 |
|---|---|---|---|---|---|
| 9: M M I | L.D F0,0(R1) | L.D F6,-8(R1) | 是 | 1 | |
| 14: M M F | L.D F10,-16(R1) | L.D F14,-24(R1) | ADD.D F4,F0,F2 | 否 | 3 |
| 15: M M F | L.D F18,-32(R1) | L.D F22,-40(R1) | ADD.D F8,F6,F2 | 是 | 4 |
| 15: M M F | L.D F26,-48(R1) | S.D F4,0(R1) | ADD.D F12,F10,F2 | 是 | 6 |
| 15: M M F | S.D F8,-8(R1) | S.D F12,-16(R1) | ADD.D F16,F14,F2 | 是 | 9 |
| 15: M M F | S.D F16,-24(R1) | ADD.D F20,F18,F2 | 是 | 12 | |
| 15: M M F | S.D F20,-32(R1) | ADD.D F24,F22,F2 | 是 | 15 | |
| 15: M M F | S.D F24,-40(R1) | ADD.D F28,F26,F2 | 是 | 18 | |
| 16: M I B | S.D F28,-48(R1) | DADDUI R1,R1,#-56 | BNE R1,R2,Loop | 否 | 21 |
(b) 假定每周期执行一个 bundle,使周期数最少。
| bundle 模板 | 槽 0 | 槽 1 | 槽 2 | 末尾 stop | 执行周期 |
|---|---|---|---|---|---|
| 8: M M I | L.D F0,0(R1) | L.D F6,-8(R1) | 否 | 1 | |
| 9: M M I | L.D F10,-16(R1) | L.D F14,-24(R1) | 是 | 2 | |
| 14: M M F | L.D F18,-32(R1) | L.D F22,-40(R1) | ADD.D F4,F0,F2 | 否 | 3 |
| 14: M M F | L.D F26,-48(R1) | ADD.D F8,F6,F2 | 否 | 4 | |
| 15: M M F | ADD.D F12,F10,F2 | 是 | 5 | ||
| 14: M M F | S.D F4,0(R1) | ADD.D F16,F14,F2 | 否 | 6 | |
| 14: M M F | S.D F8,-8(R1) | ADD.D F20,F18,F2 | 否 | 7 | |
| 15: M M F | S.D F12,-16(R1) | ADD.D F24,F22,F2 | 是 | 8 | |
| 14: M M F | S.D F16,-24(R1) | ADD.D F28,F26,F2 | 否 | 9 | |
| 9: M M I | S.D F20,-32(R1) | S.D F24,-40(R1) | 是 | 11 | |
| 16: M I B | S.D F28,-48(R1) | DADDUI R1,R1,#-56 | BNE R1,R2,Loop | 否 | 12 |
译注:图 H.8 图注把整数加法简称为 DADD,表中实际助记符是 DADDUI。
指令集基础
介绍推测专用支持之前,先简述主要指令编码,并概览五类主要指令 A、I、M、F、B。每条 IA-64 指令长 41 位,高 4 位与 bundle 中指定执行单元槽的位共同构成主操作码。也就是说,4 位操作码在不同执行槽类别中复用,可以把操作码理解为这 4 位加 M、F、I、B 或 L + X 标识。每条指令的低 6 位指定保护该指令的谓词寄存器,下一小节将讨论。
图 H.9 汇总除多媒体指令外的大多数主要格式,并列出各格式编码的指令示例。
| 指令类型 | 该类格式数 | 代表指令 | 额外操作码位 | GPR/FPR 数 | 立即数字段 | 其他/说明 |
|---|---|---|---|---|---|---|
| A | 8 | 加、减、AND、OR | 9 | 3 | 0 位 | |
| A | 左移并相加 | 7 | 3 | 0 位 | 2 位移位计数 | |
| A | ALU 立即数操作 | 9 | 2 | 8 位 | ||
| A | 立即数加法 | 3 | 2 | 14 位 | ||
| A | 立即数加法 | 0 | 2 | 22 位 | ||
| A | 比较 | 4 | 2 | 0 位 | 2 个谓词目的寄存器 | |
| A | 立即数比较 | 3 | 1 | 8 位 | 2 个谓词目的寄存器 | |
| I | 29 | 可变移位量的右移/左移 | 9 | 3 | 0 位 | 许多多媒体指令使用此格式 |
| I | 位测试 | 6 | 3 | 6 位字段指定符 | 2 个谓词目的寄存器 | |
| I | 传送到 BR | 6 | 1 | 9 位分支预测 | 分支寄存器指定符 | |
| M | 46 | 整数/浮点加载、存储及缓存行预取 | 10 | 2 | 0 位 | 推测/非推测 |
| M | 整数/浮点加载、存储、缓存行预取,并按立即数后递增 | 9 | 2 | 8 位 | 推测/非推测 | |
| M | 整数/浮点加载、预取,并按寄存器值后递增 | 10 | 3 | 推测/非推测 | ||
| M | 整数/浮点推测检查 | 3 | 1 | 两字段合计 21 位 | ||
| B | 9 | PC 相对分支、计数分支 | 7 | 0 | 21 位 | |
| B | PC 相对调用 | 4 | 0 | 21 位 | 1 个分支寄存器 | |
| F | 15 | 浮点算术 | 2 | 4 | ||
| F | 浮点比较 | 2 | 2 | 2 个 6 位谓词寄存器字段 | ||
| L + X | 4 | 长立即数传送 | 2 | 1 | 64 位 |
译注:表中保留源书的字段数和空白,包括“22 位立即数、2 个 GPR/FPR”一行;按前文通常的寄存器字段宽度直接相加会出现位数疑点,不能仅凭本表推导准确的机器码布局。
谓词化与推测支持
IA-64 提供全面的谓词化支持:几乎每条指令都可以带谓词。谓词寄存器的编号放在指令字段的低 6 位。由于支持范围很广,if 转换和代码移动的开销,比只支持有限条件指令时更低。完全谓词化带来的一个结果是:条件分支不过是一条带保护谓词的分支!
谓词寄存器通过比较或测试指令设置。比较指令指定十种比较测试之一,以及两个目的谓词寄存器。这两个寄存器可以分别写入比较结果(0 或 1)及其反值,也可以写入组合两个测试的某种逻辑函数,例如 AND,以及其反值。这种能力允许一条指令完成多个比较。
IA-64 分别支持两类推测:控制推测负责推迟推测指令的异常;存储器访问推测支持加载指令的推测执行。
推迟异常采用与 poison 位等价的机制。通用寄存器上的位称为 NaT(Not a Thing);多出的这一位使 GPR 实际宽度达到 65 位。浮点寄存器则使用特殊值 NaTVal(Not a Thing Value),以零有效数和超出 IEEE 范围的指数编码。只有推测加载会生成这些值,但所有不影响存储器的指令,都会把 NaT 或 NaTVal 传播到结果寄存器。加载有推测和非推测两种;后者只能立即触发异常,不能推迟。浮点异常不通过这套机制处理,而用浮点状态寄存器记录。
推迟的异常可以通过两种方式解决。第一,如果非推测指令,例如存储,将 NaT 或 NaTVal 作为源操作数,就立即触发不可恢复的异常。第二,可以用 chk.s 检测 NaT 或 NaTVal,并跳转到编译器安排的恢复例程,从推测操作中恢复。这种恢复方式对存储器访问推测更有意义。
如果带有 NaT 或 NaTVal 的内容不能存储,操作系统就无法保存处理器状态。因此,IA-64 提供特殊的寄存器保存与恢复指令:它们不会因 NaT 或 NaTVal 而引发异常,同时会保存和恢复 NaT 位。
IA-64 对存储器访问推测的支持,采用 advanced load,即提前加载:把加载推测性地移到它可能依赖的存储之前。用 ld.a 执行提前加载时,会在称为 ALAT 的特殊表中创建一项,同时记录加载的目的寄存器和访问地址。每条存储执行时,都对有效 ALAT 项进行相联查找;若发现相同地址,就将该项标为无效。
在任何非推测指令,例如存储,使用提前加载的结果或由该结果派生的值之前,必须显式检查。检查指定提前加载的目的寄存器。如果对应 ALAT 项仍有效,推测就合法,检查只需清除该项。若检查失败,则取决于检查形式:ld.c 直接在此处重新从存储器加载数据,适用于只提前加载本身的情况;另一种 chk.a 指定修复例程地址,用于重新执行加载,以及依赖加载值的其他推测代码。
Itanium 2 处理器
Itanium 2 是 IA-64 的第二代实现。第一代 Itanium 1 于 2001 年推出,时钟频率为 800 MHz。原书记载 Itanium 2 于 2003 年首次交付,2005 年最高频率达到 1.6 GHz。两者很相似,流水线结构有一些差异,存储层次结构的差异则更大。Itanium 2 的速度约为 Itanium 1 的四倍,来自频率翻倍、更积极的存储层次结构、增加功能单元以提高指令吞吐量、更完善的旁路、缩短流水线以减少部分停顿,以及更加成熟的编译器系统。
在两代 Itanium 之间大致相同的时间跨度里,Pentium 性能提高到原来的三倍多。相比已经成熟的 IA-32 实现,Itanium 的体系结构和软件系统都较新,因此更大的改进幅度是合理的。
Itanium 2 每周期可取指和发射两个 bundle,至多六条指令。它采用全片上的三级存储层次结构。第一级指令和数据缓存分离,各为 16 KB;浮点数据不放入一级缓存。第二、三级为统一缓存,容量分别为 256 KB 和 3–9 MB。
功能单元与指令发射
Itanium 2 有 11 个功能单元:两个 I-unit、四个 M-unit(两个加载、两个存储)、三个 B-unit、两个 F-unit。所有功能单元都采用流水线。图 H.10 给出典型指令的延迟。此外,结果从一个单元旁路到另一个单元,通常至少增加一个周期。
| 指令 | 延迟 |
|---|---|
| 整数加载 | 1 |
| 浮点加载 | 5–9 |
| 正确预测为跳转的分支 | 0–3 |
| 预测错误的分支 | 6 |
| 整数 ALU 操作 | 0 |
| 浮点算术 | 4 |
Itanium 2 每周期从两个 bundle 发射至多六条指令。最坏情况下,如果某个 bundle 在发射时被拆开,硬件可能只看到四条指令:第一个 bundle 剩一条,第二个有三条。指令依据 bundle 位分配到功能单元;这种分配不因其中出现空操作或谓词为假的指令而改变。此外,如果下一条待发射指令需要的单元已被占用,使发射受阻,相应 bundle 就会被拆开。即使只剩一条指令,拆开的 bundle 仍占据两个 bundle 槽中的一个。
Itanium 2 的八级流水线分为四个主要部分:
- 前端:IPG、Rotate。 每周期向预取缓冲区取至多 32 字节,即两个 bundle。缓冲区最多容纳八个 bundle,共 24 条指令。分支预测使用类似第 3 章所述的多级自适应预测器。
- 指令分发:EXP、REN。 将至多六条指令分发到 11 个功能单元,并实现寄存器轮转和寄存器栈所需的重命名。
- 操作数分发:REG。 访问寄存器堆、进行寄存器旁路、访问并更新寄存器记分牌,以及检查谓词依赖。记分牌判断各条指令何时能继续,使 bundle 中某一条指令因缓存未命中等不可预测事件而停顿时,不必让整个 bundle 停顿。图 H.8 已说明,除非精心调度,整包停顿会导致较差性能。
- 执行:EXE、DET、WRB。 通过 ALU 和加载—存储单元执行指令,检测异常并设置 NaT,退役指令并写回。
Itanium 1 和 Itanium 2 都具有许多通常与第 3 章动态调度流水线联系在一起的机制:动态分支预测、寄存器重命名、记分牌、执行前用于指令对齐和重命名等的多个流水级,以及执行后用于异常检测的多个流水级。虽然这些机制一般比先进动态调度超标量处理器中的对应机制简单,但总体看来,更依赖编译器技术的 Itanium,似乎与第 3 章那些动态调度处理器一样复杂!
既然主要依靠编译时技术寻找并行性,为何还要加入这些特性?原因主要有两个。第一,动态技术有时确实好得多,省去它们会严重损害性能;动态分支预测就是例子。
第二,高性能离不开缓存,而缓存不可避免地产生未命中。未命中难以预测,在当时处理器上耗时也很长。早期 VLIW 处理器发生缓存未命中时,整个处理器会冻结,保持编译器最初规定的同步并行关系。现代处理器的未命中代价可达数十到数百周期,这种方法完全不现实。允许部分指令继续而另一些停顿,就需要引入某种动态调度,这里采用记分牌。若停顿很长,反依赖还会阻碍等待期间的进展。
因此,Itanium 实现也引入寄存器重命名。
Itanium 2 的性能
图 H.11 比较 1.5 GHz Itanium 2 与 Pentium 4、AMD Athlon、IBM Power5 在五个 SPECint 和五个 SPECfp 基准上的性能。就完整 SPEC 浮点套件而言,Itanium 2 略慢于 Power5,比 AMD Athlon 或 Pentium 4 快约 35%。在 SPECint 上,Itanium 2 比 Power5 快 15%,而 AMD Athlon 和 Pentium 4 又都比 Itanium 2 快约 15%。Itanium 2 与 Power5 的功耗和裸片面积都大得多。事实上,Power5 包含两个处理器,普通 SPEC 测试时只启用其中一个,但其晶体管数仍不到 Itanium 的一半。如果移除 Power5 的一个处理器来缩小面积、晶体管数和功耗,那么 Itanium 将明显成为规模最大、功耗最高的处理器。
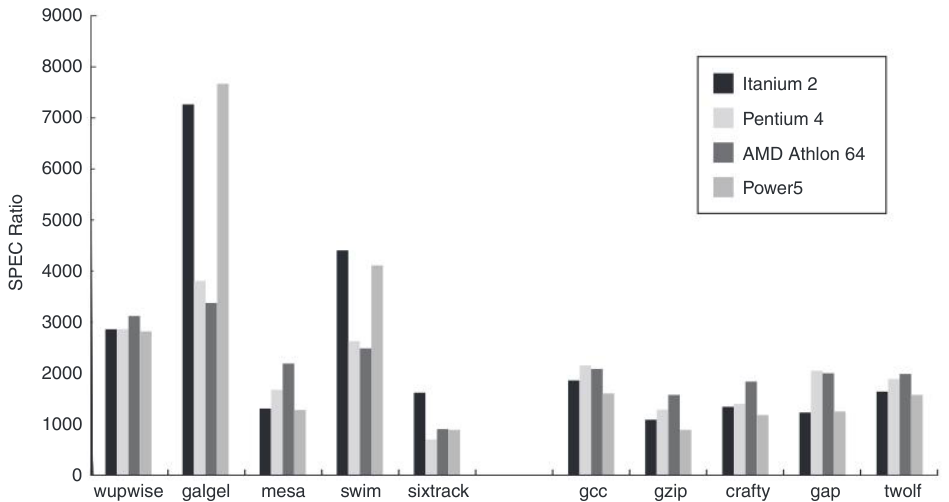
图内纵轴 SPEC Ratio 为 SPEC 性能比;横轴依次为 wupwise、galgel、mesa、swim、sixtrack、gcc、gzip、crafty、gap、twolf;图例保留处理器名称。