I.5 科学应用在共享内存多处理器上的性能
本节讨论 I.3 节的科学应用在对称共享内存多处理器和分布式共享内存多处理器上的性能。
科学工作负载在对称共享内存多处理器上的性能
我们使用下列问题规模,评估四个科学应用在对称共享内存多处理器上的性能:
- Barnes–Hut: 16K 个物体,运行六个时间步;精度控制参数设为 1.0,这是典型且符合实际的取值。
- FFT: 一百万个复数数据点。
- LU: 矩阵,采用 的块。
- Ocean: 网格,使用典型误差容限。
考察处理器数、缓存容量和块大小变化时的未命中率,我们将总未命中率分为一致性未命中和普通单处理器未命中。后者包括容量未命中、冲突未命中和强制未命中。这里将其统称为容量未命中,因为容量是这些基准程序中的主要原因。测量中,即使没有其他处理器共享一个缓存块,任何将它从共享状态升级为独占状态所需的写未命中,也计为一致性未命中。这对应一种不区分私有块和共享块的协议。
图 I.8 显示固定问题规模、将处理器数量从 1 增加到 16 时,四个应用的数据未命中率。处理器增多使缓存总量增大,通常会降低容量未命中率;另一方面,更多处理器通常带来更多通信,使一致性未命中率上升。这两种效应的强弱因应用而异。
在 FFT 中,容量未命中率从接近 7% 降到略高于 5%,一致性未命中率则从约 1% 增至约 2.7%,因此总未命中率大致不变。Ocean 呈现多种因素的共同影响,其中一些与网格划分,以及网格边界如何映射到缓存块有关。典型二维网格程序中,通信引起的未命中与各网格分区的边界成正比,而容量未命中与网格面积成正比。因此,固定总问题规模、增加缓存总量,对容量未命中率的影响更大,至少在每个子网格都能装入单个处理器缓存之前如此。从一个处理器增加到两个时,未命中率显著跳升,原因在于多个网格映射到缓存的方式引起冲突。这种冲突存在于直接映射和两路组相联缓存中,相联度更高时逐渐消失。对基于数组、尤其是同时使用多个网格的应用,这类冲突并不少见。Barnes 和 LU 中,处理器数增加对未命中率影响不大,有时略升,有时略降。
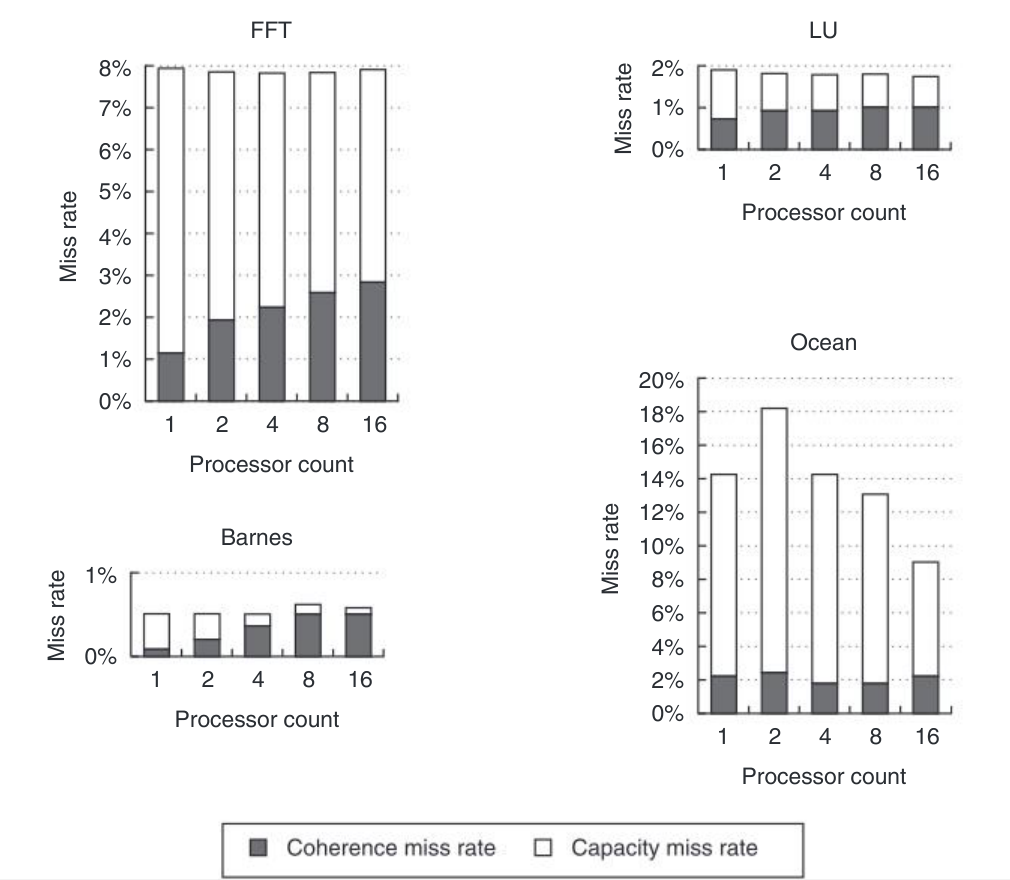
这些基准的强制未命中都很少,已计入容量未命中。大部分未命中来自对潜在共享数据的访问,但未命中率较高的 FFT 和 Ocean 中,容量未命中而非一致性未命中占主要部分。只要数据分配在用于共享数据的地址空间区域,就属于“潜在共享”。除 Ocean 外,这些数据都被大量共享;Ocean 虽然把整个网格视为潜在共享对象,实际共享的却只有子网格边界。固定问题规模下,处理器增加会改变边界,因而网格中实际共享的部分也随之变化。
Ocean 从一个处理器增加到两个时,容量未命中率的异常上升来自子网格访问冲突。除 Ocean 外,固定规模问题使用更多处理器时,一致性事务造成的缓存未命中比例都上升。Ocean 最初的一致性未命中会随处理器增加而下降,因为其中有大量对“潜在共享但实际未共享”数据取得写所有权的未命中;在约 16 个处理器时,子网格开始装入总缓存,这种效应减弱。单处理器数据也包括写升级未命中:在该协议中,数据即使实际未共享,只要处于共享状态也会发生这种未命中。所有运行都采用 64 KB、两路组相联、32 字节块的缓存。各图纵轴刻度不同,以便清楚展示各基准的行为。图中灰色为一致性未命中,白色为容量未命中;Miss rate 为未命中率,Processor count 为处理器数量。
增大缓存通常有利于性能,因为它减少了代价高昂的缓存未命中。图 I.9 展示固定 16 个处理器、增加缓存容量时,未命中率及其一致性、单处理器容量两部分如何变化。有两种效应可能使缓存增大后未命中率不下降,或下降得不如预期快:应用固有的通信,以及未命中率的平台区间。
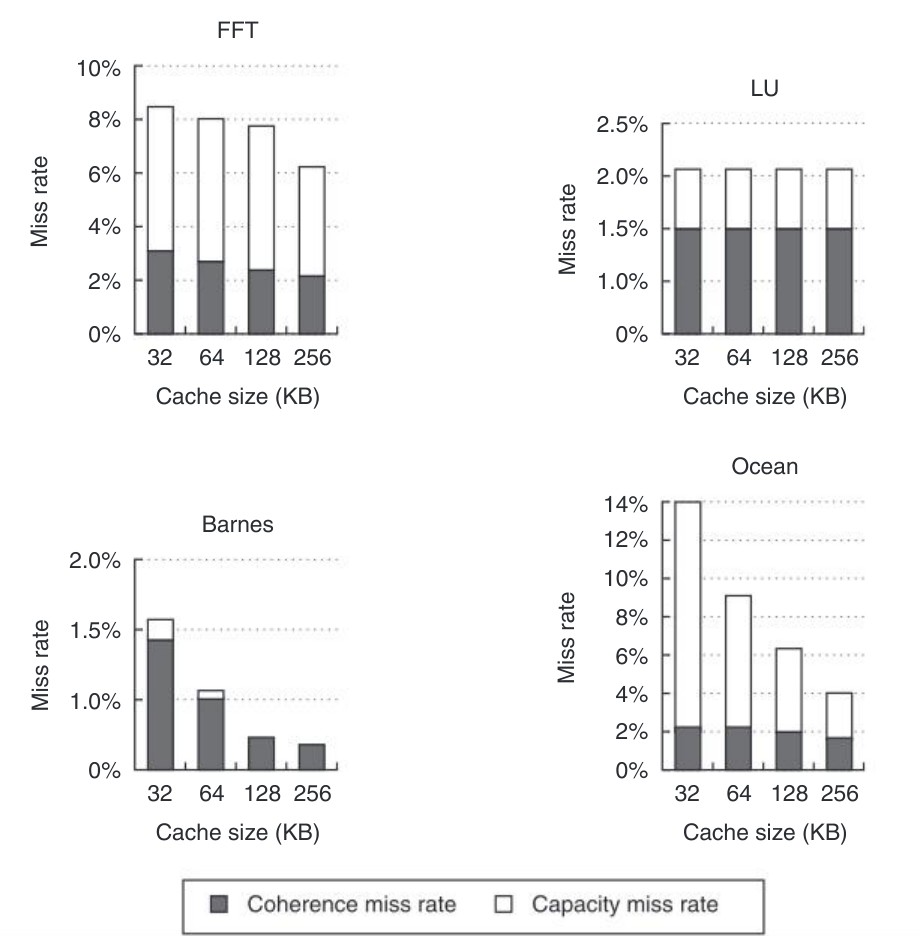
图中 Cache size 为缓存容量,单位 KB;灰色为一致性未命中率,白色为容量未命中率。
固有通信带来一定频率的一致性未命中,增加缓存容量不会显著影响它。因此,固定问题规模下不断增大缓存,最终会由一致性未命中率限制总体未命中率的进一步下降。Barnes 最明显:一致性未命中几乎成为全部未命中。
另一个次要效应,是容量未命中率会暂时停留在某个平台:此时部分数据已经驻留缓存,但数据集的另一重要部分仍放不进去,略微增大缓存也无济于事。LU 中,约 4 KB 的很小缓存就能容纳内层循环使用的两个 块;此后,下一次明显改善要等到两个矩阵都装入缓存,即缓存总量达到 4–8 MB 时。这有时称为工作集效应。FFT 在缓存容量为 32–128 KB 时也部分表现出这一效应,容量未命中率只降低 0.3 个百分点。超过这一范围后,一个主要数据结构开始驻留缓存,容量未命中率下降加快。这种平台区间常见于有规则地处理大型数组的程序。
增加块大小是改变缓存未命中率的另一种办法。在单处理器中,较大缓存往往适合较大块。但多处理器中还出现两个新效应:共享数据的空间局部性降低,以及伪共享可能使未命中率上升。若干研究表明,共享数据的空间局部性低于非共享数据。局部性较差意味着,在块中全部内容被访问之前,该块被替换的可能性更高,因此获取大块对共享数据的收益不如单处理器明显。同样,增大基本块大小,也会增加伪共享的潜在频率,使未命中率上升。
图 I.10 展示 16 个处理器、64 KB 缓存条件下,增加缓存块大小后的未命中率。最有意思的是 Barnes:未命中率先降后升,上升来自一致性未命中增加,很可能由伪共享引起。其他基准中,块越大,总未命中率越低。Ocean 和 LU 中,块大小增加对一致性未命中与容量未命中的影响大致相同。FFT 中,一致性未命中率实际下降得比容量未命中率更快,这是因为它的通信组织得非常高效。对于优化较少的程序,预计会有更多伪共享,共享数据空间局部性也更差,从而更接近 Barnes 的行为。
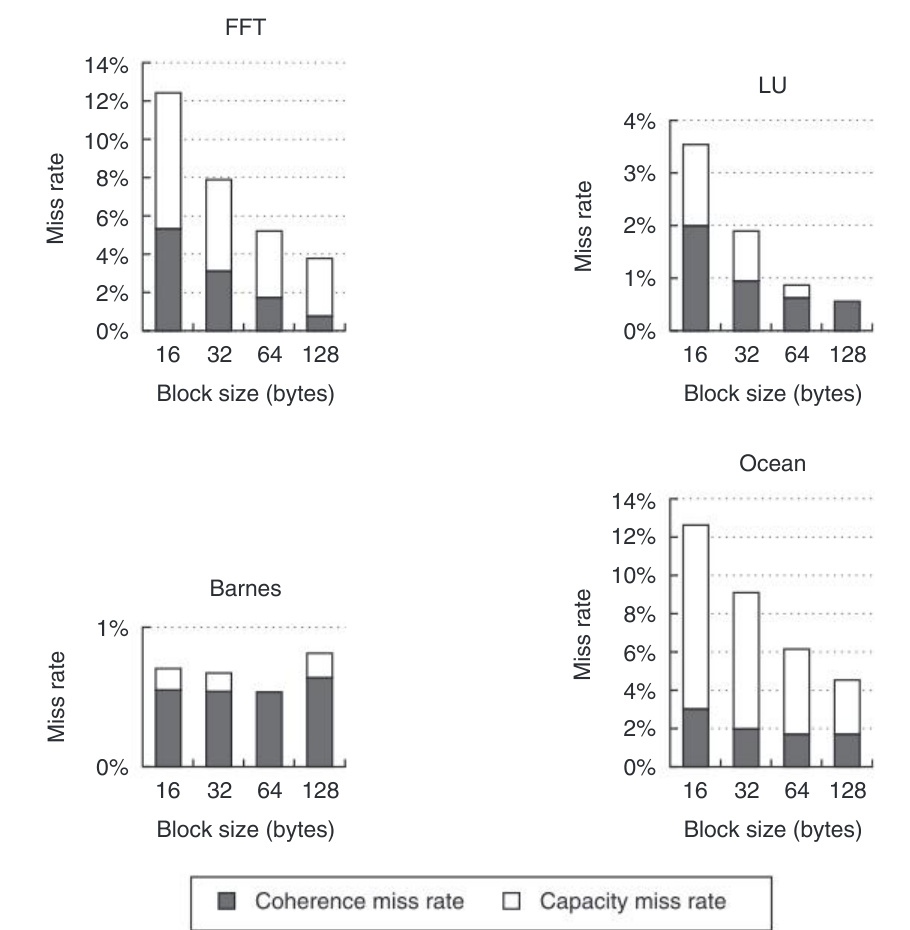
图中 Block size 为块大小,单位字节;灰色为一致性未命中率,白色为容量未命中率。图注概括总体趋势,Barnes 的例外见正文。
更长的块使未命中率下降,似乎意味着总应选择更长的块;然而,总线式多处理器的瓶颈往往是有限的存储器与总线带宽。块越大,每次未命中在总线上传输的字节数就越多。图 I.11 显示块增大后的总线流量增长;高未命中率程序、尤其 Ocean 最严重。流量增长会同时增加未命中代价和总线争用,实际可能使性能下降。
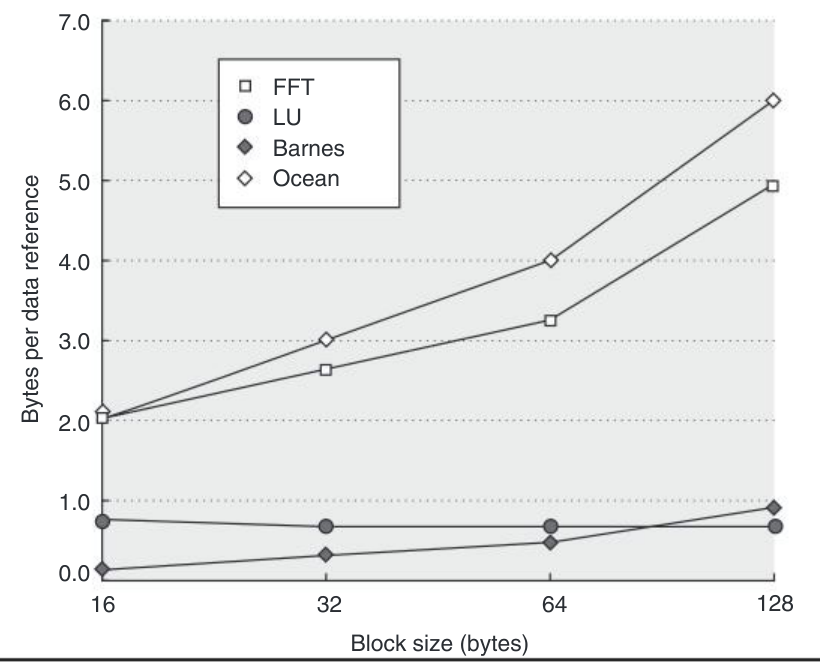
记住,这里的协议将所有权或升级未命中按普通未命中处理,略微增加了大缓存块的代价;在 Ocean 和 FFT 中,这一简化造成的流量都不到总流量的 10%。纵轴 Bytes per data reference 表示每次数据访问的字节数,横轴为块大小,单位字节。
科学工作负载在分布式存储器多处理器上的性能
目录式多处理器的性能也受许多与总线式多处理器相同的因素影响,例如缓存容量、处理器数和块大小;此外,还取决于未命中在存储层次结构中不同位置的分布。请求数据项的位置同时取决于最初的分配和共享模式。我们先看科学与工程工作负载的基本缓存性能,再分析不同未命中类型的影响。
由于这台多处理器规模更大、延迟也高于前面的监听式多处理器,我们从稍大的 128 KB 缓存和 64 字节块开始分析。
在分布式存储器体系结构中,内存请求在本地和远程之间的分布是性能关键,因为它既影响全局带宽消耗,也影响请求延迟。因此,本部分各图将缓存未命中分为本地和远程请求。阅读时应记住:这些应用的大部分远程未命中是一致性未命中,但容量未命中也可能发生在远程;对数据分布不佳的应用,这种远程容量未命中可能很多。
图 I.12 表明,在上述缓存容量下,处理器数变化对未命中率影响不大,Ocean 是例外:64 个处理器时其未命中率上升。这有两个原因:网格变小后,缓存映射冲突增加,使本地未命中上升;一致性未命中也增加,而它们都是远程未命中。
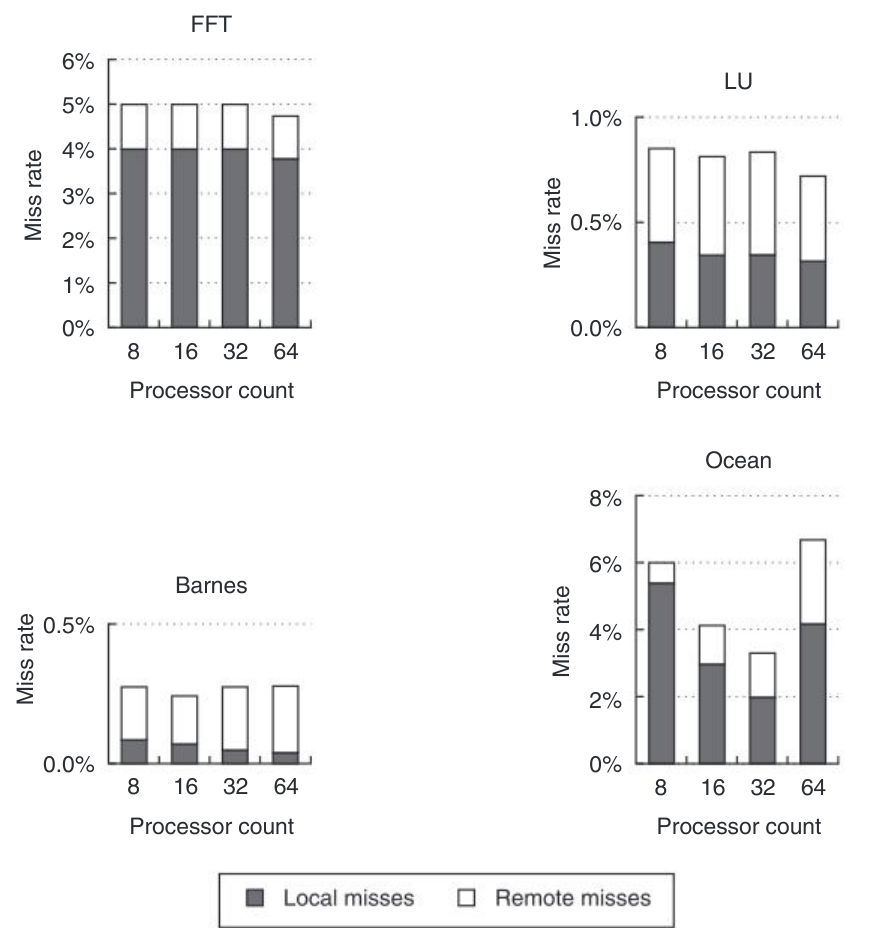
Ocean 的本地未命中率从 8 个处理器时的 5%,降到 32 个处理器时的 2%,再升到 64 个处理器时的 4%;主要由通信驱动的远程未命中率则从 1% 单调升至 2.5%。各图纵轴刻度不同,以呈现细节。所有运行均采用 128 KB、两路组相联、64 字节块的缓存。灰色为本地未命中,白色为远程未命中。
远程未命中包括所有需要与另一节点通信的未命中,无论是取数据还是发送失效请求。尤其是,本图及本部分其他数据把写升级未命中也计入远程未命中:数据在本地存储器中已经是最新的,但其他节点仍缓存着它,所以必须发送失效消息。这些失效确实产生远程流量,但是否延迟写入,取决于存储一致性模型。
图 I.13 展示固定 64 个处理器、64 字节块时,缓存增大对未命中率的影响。下降幅度大体符合预期,但由于一致性未命中很少降低或完全不降低,远程未命中的下降通常慢于本地未命中。到所示最大容量 512 KB 时,远程未命中率已不小于本地未命中率。更大的缓存会强化这一趋势。
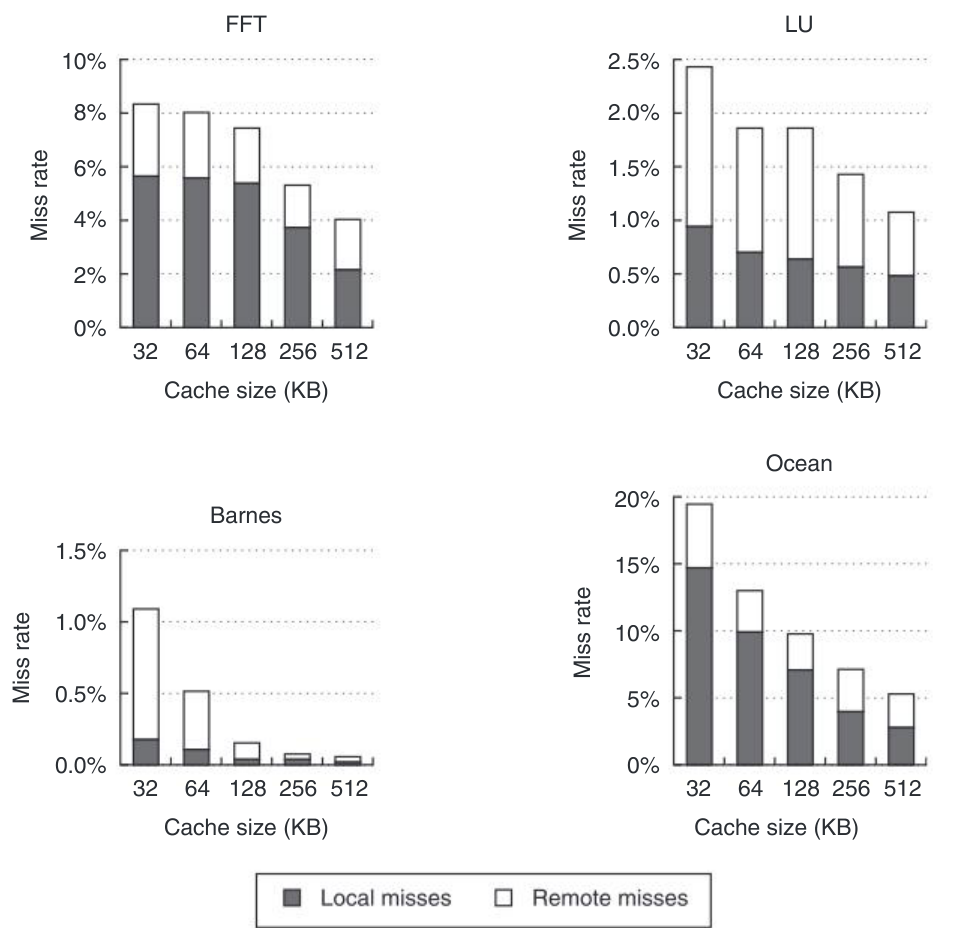
原图注指出,在所有情况下,本地未命中率降幅都大于远程未命中率降幅。前文所述 FFT 的未命中率平台在缓存超过 128 KB 后结束。运行使用 64 个处理器和 64 字节缓存块。横轴为缓存容量,单位 KB;灰色为本地未命中,白色为远程未命中。
译注: 图注的“所有情况下”与图中 Barnes 的柱状数据并不完全一致:Barnes 的远程部分下降更明显。
图 I.14 考察改变块大小的影响。这些应用空间局部性良好,因此即使块已经很大,进一步增大仍能降低未命中率,只是最大块的性能收益较小。而且,大部分改善来自本地未命中的减少。
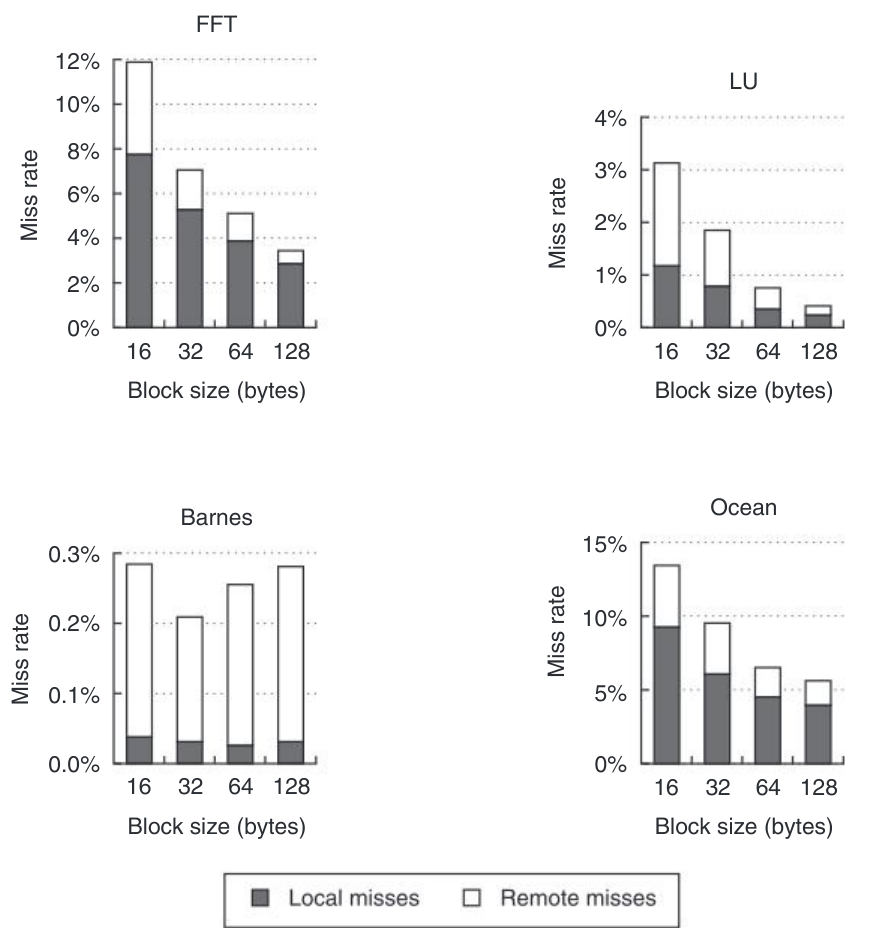
灰色为本地未命中,白色为远程未命中;横轴块大小以字节计。
图 I.15 没有直接画内存总流量,而是给出每次数据访问所需字节数随块大小的变化,并分解为本地与全局带宽需求。在总线系统中,把各处理器需求相加即可得到总线与存储器带宽总需求。对于可扩展互连,则可用图 I.15 的数据计算每节点所需全局带宽,并估计对分带宽,如下例所示。
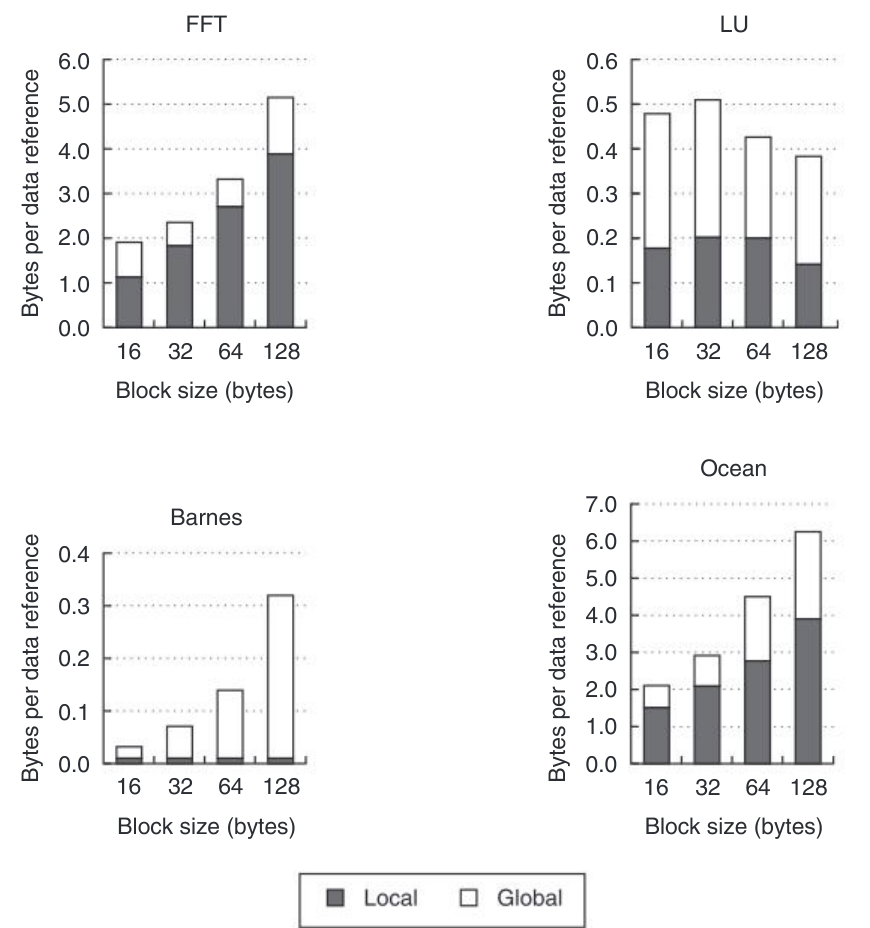
横轴为块大小,单位字节;纵轴为每次数据访问的字节数。灰色 Local 表示本地部分,白色 Global 表示全局部分。原图 LU 并非单调上升,图注描述的是总体趋势。
例题 假设有 64 个处理器,频率为 1 GHz,每个处理器每时钟周期持续发出一次访存。块大小为 64 字节时,远程未命中率为 0.7%。求 FFT 的每节点带宽和估计的对分带宽。假设处理器不因远程访存请求而停顿,例如全部远程数据都已预取时可能如此。这些带宽需求与各种互连技术相比如何?
原书指出,FFT 采用全到全通信,因此对分带宽等于处理器数乘以每节点带宽,约为 。64 处理器的 SGI Origin 3000 的对分带宽约为 50 GB/s,当时没有标准网络技术能接近这一水平。
解答 每节点带宽就是每次访问传输的数据字节数乘以访问速率:
该速率略高于 Cray T3E 使用块预取时硬件可持续的传输速率,低于 SGI Origin 3000 每两个处理器 1.6 GB/s 的速率。FFT 的每节点需求超过当时最快标准网络可持续带宽的五倍。
译注: 原式中速率写成
1 GB/sec,量纲与“每秒十亿次访问”的题设不符;这里用显式的次数、字节单位表达同一计算,结果仍为 448 MB/s。原书的 28.7 GB/s 是把所有节点注入带宽直接相加的估计,没有另列跨越二分截面的流量比例或单向/双向口径,不能把该乘法当成对分带宽的一般定义。原文将对分带宽说明排在 Answer 标记之前。
前例考察带宽需求;并行程序的另一个关键问题是远程内存访问时间,也就是延迟。为理解这一点,考虑一个简单的目录式多处理器。图 I.16 给出模型参数:本地存储器访问的首字时间为 85 个处理器周期;本地存储器通路宽 16 字节,网络互连宽 4 字节。模型忽略争用;除采用全到全通信的 FFT 可能例外,这对所考察并行基准的影响应该不太严重。但其他工作负载中,争用可能显著影响性能。
| 特征 | ≤16 个处理器:处理器时钟周期 | 17–64 个处理器:处理器时钟周期 |
|---|---|---|
| 缓存命中 | 1 | 1 |
| 缓存未命中,由本地存储器提供 | 85 | 85 |
| 缓存未命中,由远程归属目录提供 | 125 | 150 |
| 缓存未命中,访问远程缓存数据(三跳未命中) | 140 | 170 |
最后一种情况称为三跳未命中,因为必须询问归属目录和远程缓存,代价更高。这个简单模型没有计入失效时间,但包含了互连时间随规模增加的部分因素。远程延迟以 SGI Origin 3000 为依据;原书将其称为 2001 年最快的可扩展互连系统,并假定处理器频率为 500 MHz。
图 I.17 在图 I.16 参数下,给出每次内存访问的平均周期代价;这里只计算各类访问本身的延迟。每根柱子分别列出缓存命中、本地未命中、远程未命中和三跳远程未命中的贡献。代价同时受未命中与升级的总频率,以及未命中在哪个位置得到服务的分布影响。除 Ocean 外,处理器数增加时远程访存代价相当稳定。Ocean 在 64 个处理器时未命中率的上升,已在图 I.12 中清楚显示;未命中率上升,自然应使访存耗时增加。
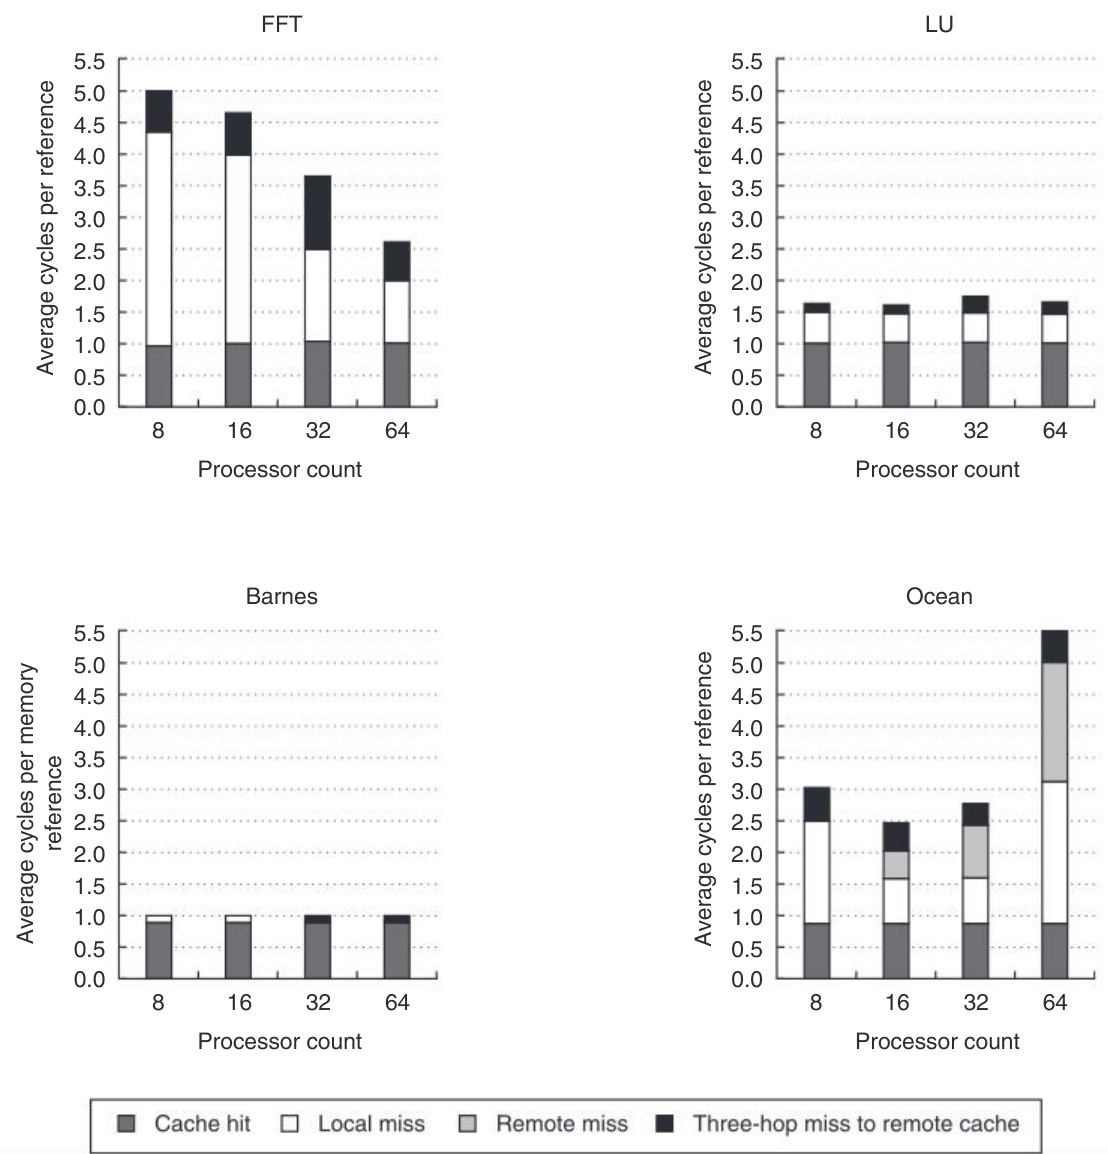
图中给出各基准在 8、16、32、64 个处理器上的访存代价,即第 2 章所称平均存储器访问时间;假设数据缓存为 512 KB、两路组相联、64 字节块。代价由四种访问组成,各类代价见图 I.16。Barnes 和 LU 未命中率低,所以总访问时间低。FFT 的较高代价由较高的本地未命中率(1%–4%)及明显的三跳未命中率(1%)决定。随着总缓存增加,本地未命中率从 4% 降至 1%,带来 FFT 的改善。Ocean 的访存代价变化最大,64 个处理器时总成本也最高,主要来自较高的本地未命中率,平均为 1.6%。从 8 增至 16 个处理器时,网格更容易装入各自缓存,访存代价下降;到 64 个处理器时,数据集太小,难以良好映射,本地未命中与一致性未命中都上升,如图 I.12 所示。
图中横轴为处理器数量,纵轴为每次访存平均周期数;图例依次为缓存命中、本地未命中、远程未命中、到远程缓存的三跳未命中。
图 I.17 展示的访存代价,是这些基准中主要的多处理器成本;但完整性能模型还应计入存储系统争用,以及同步延迟造成的损失。