I.8 定制集群方案:Blue Gene/L
Blue Gene/L(BG/L)是一种可扩展的消息传递超级计算机。按每瓦计算能力衡量,其设计提供了前所未有的计算密度。由于注重能效,BG/L 的每立方英尺吞吐量也达到了当时无与伦比的水平。高计算密度、性价比高的节点,以及对可靠性、可用性和可维护性(RAS)的广泛支持,使 BG/L 能高效扩展到极大的处理器规模。
BG/L 采用分布式存储和消息传递,却与常见的集群计算机颇为不同。后者往往面向吞吐量,处理器、互连,有时连封装和系统组织都采用通用商品技术。BG/L 则使用专门定制的处理节点:其中包含两个处理器、缓存和互连逻辑;处理器源自嵌入式市场中低功耗、较低时钟频率的 PowerPC 440。加入 SDRAM 芯片后,就构成完整的计算节点;这些 SDRAM 是 BG/L 设计中唯一的通用商品半导体器件。
原书描述,BG/L 最多包含 64 K 个节点,组织成 32 个机架,每架在约 50 立方英尺的空间中容纳 1 K 个节点。每个机架包含两块双面板,每板 512 个节点。由于板内和机架内密度很高,85% 的互连都位于单个机架内部,大幅减少了机架间连接的复杂性与延迟。节点的低功耗和高密度又使机架十分紧凑,从而显著提高效率:机架内连接所需的互连网络逻辑,集成在构成每个节点的单颗计算芯片中。
译注: 原书同段的“64 K 个节点”与“32 架、每架 1 K 节点”不相符;后者合计为 32 K 节点。
附录 F 讨论了 BG/L 的主要互连网络,即三维 torus。它还有四种网络:连接指定 I/O 节点的千兆以太网、用于测试的 JTAG 网络、屏障网络,以及全局集体通信网络。屏障网络包含四条独立通道,可在所有处理器之间执行全局 OR 或全局 AND,延迟小于 1.5 μs。全局集体通信网络把所有处理器连接成树,用于全局操作;它直接支持多种整数归约,无须处理器介入,使大规模归约比典型超级计算机快 10–100 倍。该网络还能高效地广播单个值。集体通信网络与 torus 的支持逻辑,都集成在每个处理节点的核心芯片中。
Blue Gene/L 计算节点
每个 BG/L 节点由一颗处理芯片和若干 SDRAM 芯片组成。图 I.18 中的处理芯片包含以下部分:
- 两个 PowerPC 440 CPU。 原书将每个 CPU 描述为双发射超标量处理器,采用七级流水线,具备推测式乱序发射能力,时钟频率为适中而节能的 700 MHz。每个 CPU 有独立的 32 KB 指令缓存和 32 KB 数据缓存,采用非阻塞设计,最多支持四个尚未完成的未命中请求;缓存一致性必须由软件保证。每个 CPU 还包含一对浮点协处理器,每个协处理器都有自己的浮点寄存器组,每周期能发射一次乘加操作。它们支持专用 SIMD 指令集能力,其中包括利用寄存器对和 128 位操作数完成复数运算。
- 各自独立的全相联 L2 缓存。 每个 L2 容纳 2 KB 数据,块大小为 128 字节,实质上充当预取缓冲区。L2 控制器识别流式数据访问,也负责从 L3 或主存预取。其延迟很低,为 11 个周期;原书给出的带宽为每周期 5 字节,并称 L2 预取缓冲区能够向 L1 缓存提供 5.5 GB/s。
- 采用嵌入式 DRAM 实现的 4 MB L3 缓存。 每个 L2 缓冲区都通过总线连接 L3,总线从 L3 提供 11 GB/s 带宽。
- 支持 256–512 MB DDR DRAM 的存储器总线。 它向 L3 缓存提供 5.5 GB/s 的主存带宽。考虑到每个节点有两个处理器、每个处理器又有两个浮点单元,这个内存容量似乎偏小。按 Amdahl 的经验规则,即每 1 MIPS 配备 1 MB 内存,再假定性能达到峰值的 25%,每节点内存应约为现有容量的 2.7 倍。不过,对于浮点运算密集型应用,计算需求相对于内存容量通常呈超线性增长,所以每节点最高 512 MB 的配置可能是合理的。
- 五种互连网络的支持逻辑。
译注: 原书所列“每周期 5 字节”与 700 MHz、5.5 GB/s 并不一致:按前两项相乘为 3.5 GB/s。原图也标示 5.5 GB/s。CPU 发射方式等描述同样按本节原述保留。
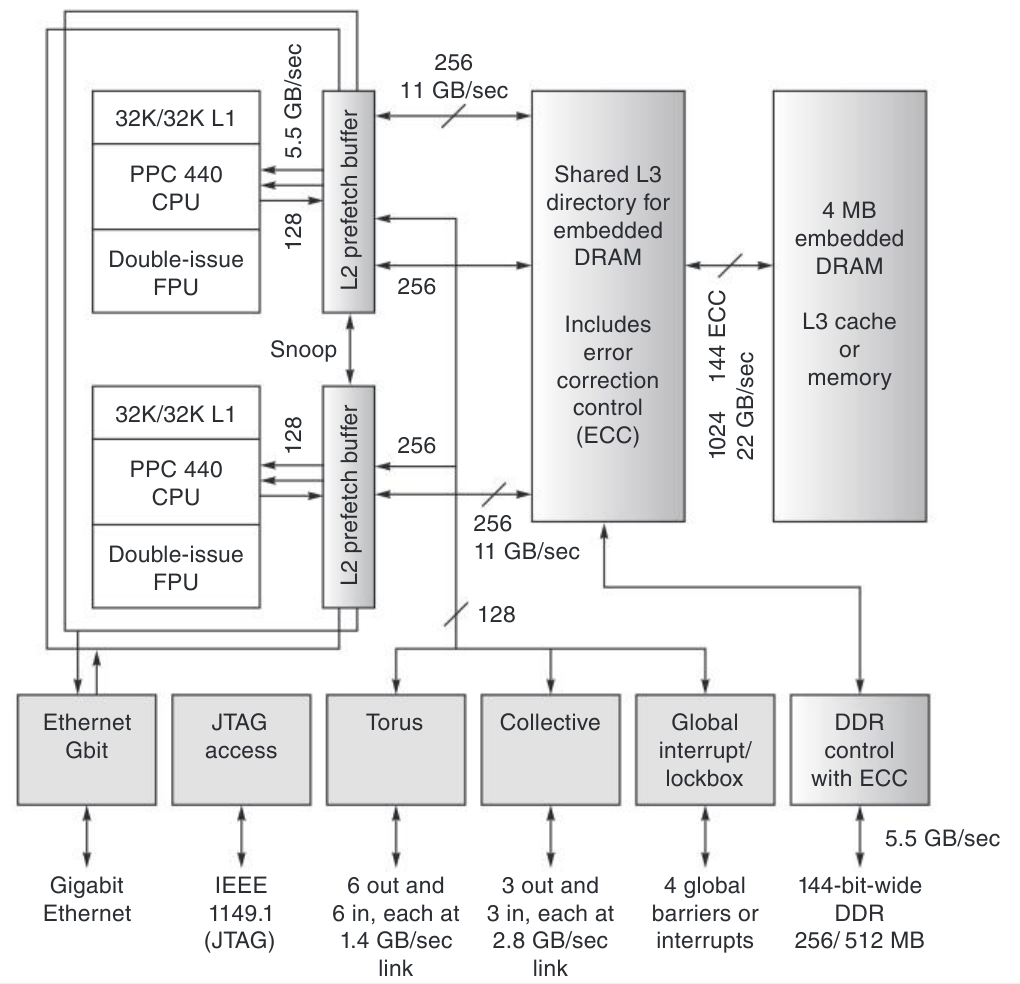
图中两个 CPU 各有 32 KB/32 KB 的 L1 缓存和双发射浮点单元;L2 prefetch buffer 为 L2 预取缓冲区,Snoop 为监听通路。中间是带 ECC 纠错控制的嵌入式 DRAM 共享 L3 目录,右侧为可用作 L3 缓存或存储器的 4 MB 嵌入式 DRAM。连线标出 128、256、1024 位等宽度,以及 5.5、11、22 GB/s 的带宽。底部接口从左到右依次为千兆以太网、IEEE 1149.1 JTAG、torus、集体通信、全局中断/lockbox、带 ECC 的 DDR 控制器。原图将 torus 标为六条出链路和六条入链路、每条 1.4 GB/s;集体通信为三出三入、每条 2.8 GB/s;全局网络支持四个全局屏障或中断;DDR 为含 ECC 的 144 位宽、256/512 MB,带宽 5.5 GB/s。这些链路单位照原图保留。
BG/L 把 DRAM 以外的全部逻辑放入单颗芯片,提高密度、降低功耗与成本,使处理节点可以极其紧凑地排列。这种密度又使互连网络兼具低延迟、高带宽和较高性价比。两者结合,得到了一种能够经济有效地扩展的超级计算机:对于超大规模多处理器,与其他方案相比,每瓦 GFLOPS 提高了一个数量级,每美元 GFLOPS 也显著改善。
例如,具有 64 K 节点的 BG/L 峰值性能为 360 TFLOPS,功耗约 1.4 MW。若使用原书所称能效最高的高端浮点处理器 Power5+ 达到同样的 360 TFLOPS 峰值,约需 23,500 个处理器——其双处理器配置以 1.9 GHz 运行,每周期最多执行 8 次浮点运算。仅处理器本身,不包括外部缓存、DRAM 和互连,功耗就约为 2.9 MW,约是整套 BG/L 的两倍。同样,BG/L 节点芯片面积较小,外部只需 DRAM 芯片,因此与基于高端多处理器构建的节点相比,成本也显著降低。图 I.19 展示了 64 K 节点 BG/L 的照片。这个拥有 128 K 处理器的系统,总占地规模与早期 16 K 处理器的多处理器系统相当。
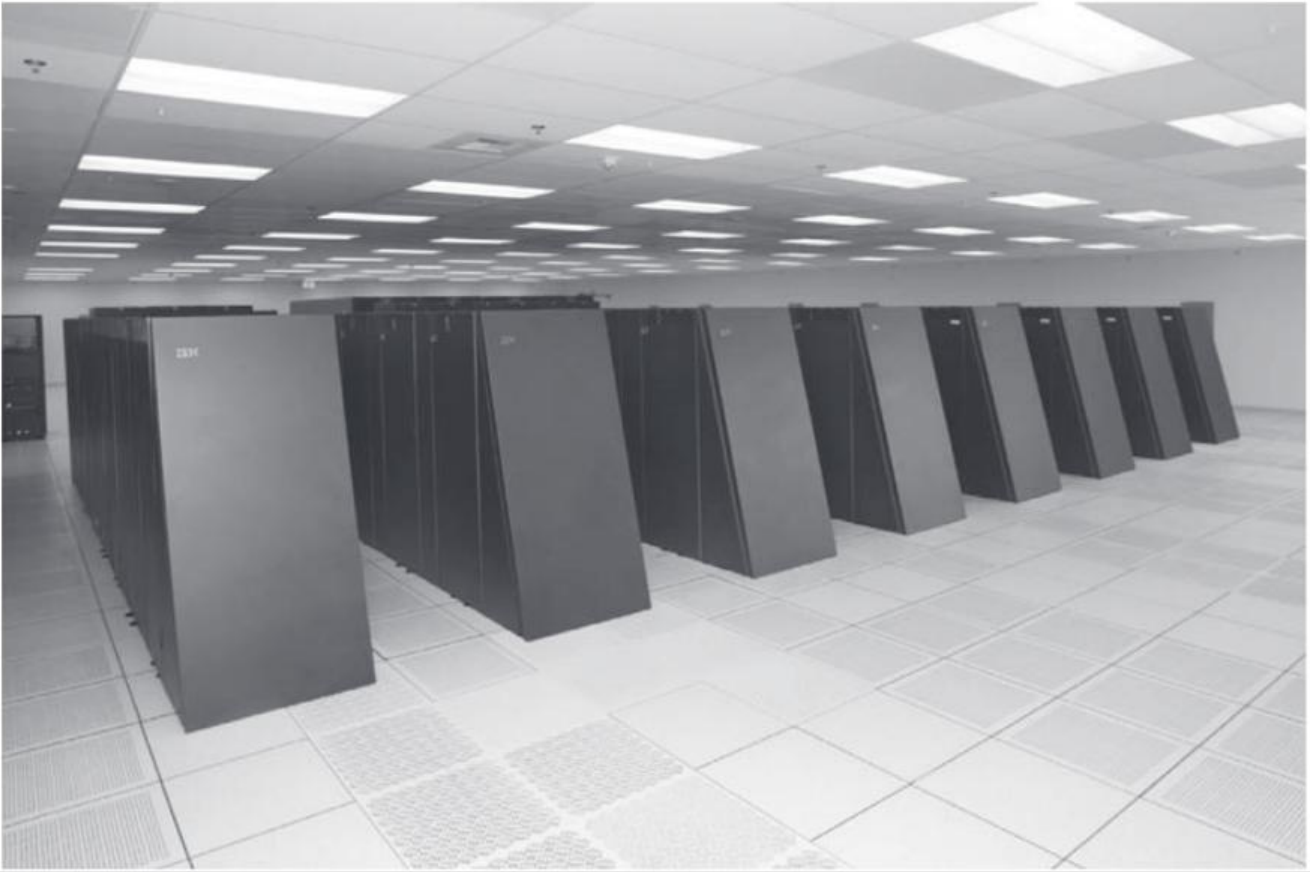
译注: 图 I.19 原图注写的是“64 K 处理器”,而同页正文写“64 K 节点、128 K 处理器”。两种口径有冲突。