J.8 加速整数加法 前一节表明,浮点运算需要很多步骤,但最终都归结为整数运算。因此,加速整数运算也能加速浮点运算。
整数加法最简单,也最重要。即使程序不显式计算数值,递增程序计数器和计算地址也需要加法。尽管加法简单,高速实现却没有唯一最佳方法。下面讨论三种实际采用的技术:先行进位、跳跃进位和选择进位。
先行进位 n n n i i i
s i = a i b ˉ i c ˉ i + a ˉ i b i c ˉ i + a ˉ i b ˉ i c i + a i b i c i . (J.8.1)
s_i=a_i\bar b_i\bar c_i+\bar a_i b_i\bar c_i+\bar a_i\bar b_i c_i+a_i b_i c_i.\tag{J.8.1}
s i = a i b ˉ i c ˉ i + a ˉ i b i c ˉ i + a ˉ i b ˉ i c i + a i b i c i . ( J.8.1 ) c i c_i c i i i i i − 1 i-1 i − 1 a i , b i a_i,b_i a i , b i c i c_i c i c i c_i c i
c i = g i − 1 + p i − 1 c i − 1 , g i − 1 = a i − 1 b i − 1 , p i − 1 = a i − 1 + b i − 1 . (J.8.2)
c_i=g_{i-1}+p_{i-1}c_{i-1},\qquad
g_{i-1}=a_{i-1}b_{i-1},\qquad
p_{i-1}=a_{i-1}+b_{i-1}.\tag{J.8.2}
c i = g i − 1 + p i − 1 c i − 1 , g i − 1 = a i − 1 b i − 1 , p i − 1 = a i − 1 + b i − 1 . ( J.8.2 ) 这里 g 代表 generate(生成):若 g i − 1 g_{i-1} g i − 1 c i c_i c i p i − 1 p_{i-1} p i − 1 c i − 1 c_{i-1} c i − 1 c i c_i c i c i c_i c i c i − 1 , c i − 2 , … c_{i-1},c_{i-2},\ldots c i − 1 , c i − 2 , …
c i = g i − 1 + p i − 1 g i − 2 + p i − 1 p i − 2 g i − 3 + ⋯ + p i − 1 p i − 2 ⋯ p 1 g 0 + p i − 1 p i − 2 ⋯ p 1 p 0 c 0 . (J.8.3)
c_i=g_{i-1}+p_{i-1}g_{i-2}+p_{i-1}p_{i-2}g_{i-3}+\cdots
+p_{i-1}p_{i-2}\cdots p_1g_0
+p_{i-1}p_{i-2}\cdots p_1p_0c_0.\tag{J.8.3}
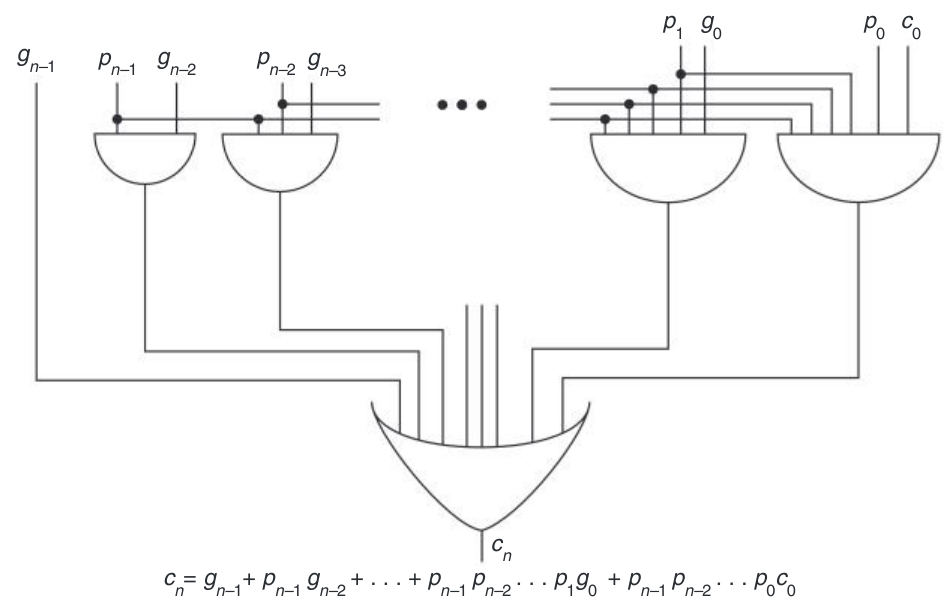
c i = g i − 1 + p i − 1 g i − 2 + p i − 1 p i − 2 g i − 3 + ⋯ + p i − 1 p i − 2 ⋯ p 1 g 0 + p i − 1 p i − 2 ⋯ p 1 p 0 c 0 . ( J.8.3 ) 采用该式计算进位的加法器称为先行进位加法器 (carry-lookahead adder,CLA)。先用一级逻辑生成 p、g,再用两级生成进位,最后两级生成和,共五级,比行波进位的 2 n 2n 2 n
图 J.14 计算 n 位加法器最终进位 cn 的纯先行进位电路。各项的逻辑关系与式 J.8.3 相同。 遗憾的是,从式 J.8.3 或图 J.14 可以看出,n n n n + 1 n+1 n + 1 p n − 1 p_{n-1} p n − 1 n n n n n n
不过,可以逐步生成 p、g,构造约 log 2 n \log_2n log 2 n
c 1 = g 0 + c 0 p 0 .
c_1=g_0+c_0p_0.
c 1 = g 0 + c 0 p 0 . 即第 0 位自己生成进位,或把输入进位传播出去,就会产生 c 1 c_1 c 1
c 2 = G 01 + P 01 c 0 , G 01 = g 1 + p 1 g 0 , P 01 = p 1 p 0 .
c_2=G_{01}+P_{01}c_0,
\qquad G_{01}=g_1+p_1g_0,\qquad P_{01}=p_1p_0.
c 2 = G 01 + P 01 c 0 , G 01 = g 1 + p 1 g 0 , P 01 = p 1 p 0 . G 01 G_{01} G 01 P 01 P_{01} P 01 i < j , j + 1 < k i<j,j+1<k i < j , j + 1 < k
c k + 1 = G i k + P i k c i . (J.8.4)
c_{k+1}=G_{ik}+P_{ik}c_i.\tag{J.8.4}
c k + 1 = G ik + P ik c i . ( J.8.4 ) G i k = G j + 1 , k + P j + 1 , k G i j . (J.8.5)
G_{ik}=G_{j+1,k}+P_{j+1,k}G_{ij}.\tag{J.8.5}
G ik = G j + 1 , k + P j + 1 , k G ij . ( J.8.5 ) P i k = P i j P j + 1 , k . (J.8.6)
P_{ik}=P_{ij}P_{j+1,k}.\tag{J.8.6}
P ik = P ij P j + 1 , k . ( J.8.6 ) 式 J.8.5 表示:第 i 到 k 位的整个块生成进位,当且仅当高半块 ( j + 1 , k ) (j+1,k) ( j + 1 , k ) ( i , j ) (i,j) ( i , j ) G i i = g i , P i i = p i G_{ii}=g_i,P_{ii}=p_i G ii = g i , P ii = p i i ≤ j < k i\le j<k i ≤ j < k
例题 用 p、g 表示 P 03 , G 03 P_{03},G_{03} P 03 , G 03
解答 由式 J.8.6,
P 03 = P 01 P 23 = P 00 P 11 P 22 P 33 = p 0 p 1 p 2 p 3 .
P_{03}=P_{01}P_{23}=P_{00}P_{11}P_{22}P_{33}=p_0p_1p_2p_3.
P 03 = P 01 P 23 = P 00 P 11 P 22 P 33 = p 0 p 1 p 2 p 3 . 由式 J.8.5,
G 03 = G 23 + P 23 G 01 = ( G 33 + P 33 G 22 ) + ( P 22 P 33 ) ( G 11 + P 11 G 00 ) = g 3 + p 3 g 2 + p 3 p 2 g 1 + p 3 p 2 p 1 g 0 .
\begin{aligned}
G_{03}&=G_{23}+P_{23}G_{01}\\
&=(G_{33}+P_{33}G_{22})+(P_{22}P_{33})(G_{11}+P_{11}G_{00})\\
&=g_3+p_3g_2+p_3p_2g_1+p_3p_2p_1g_0.
\end{aligned}
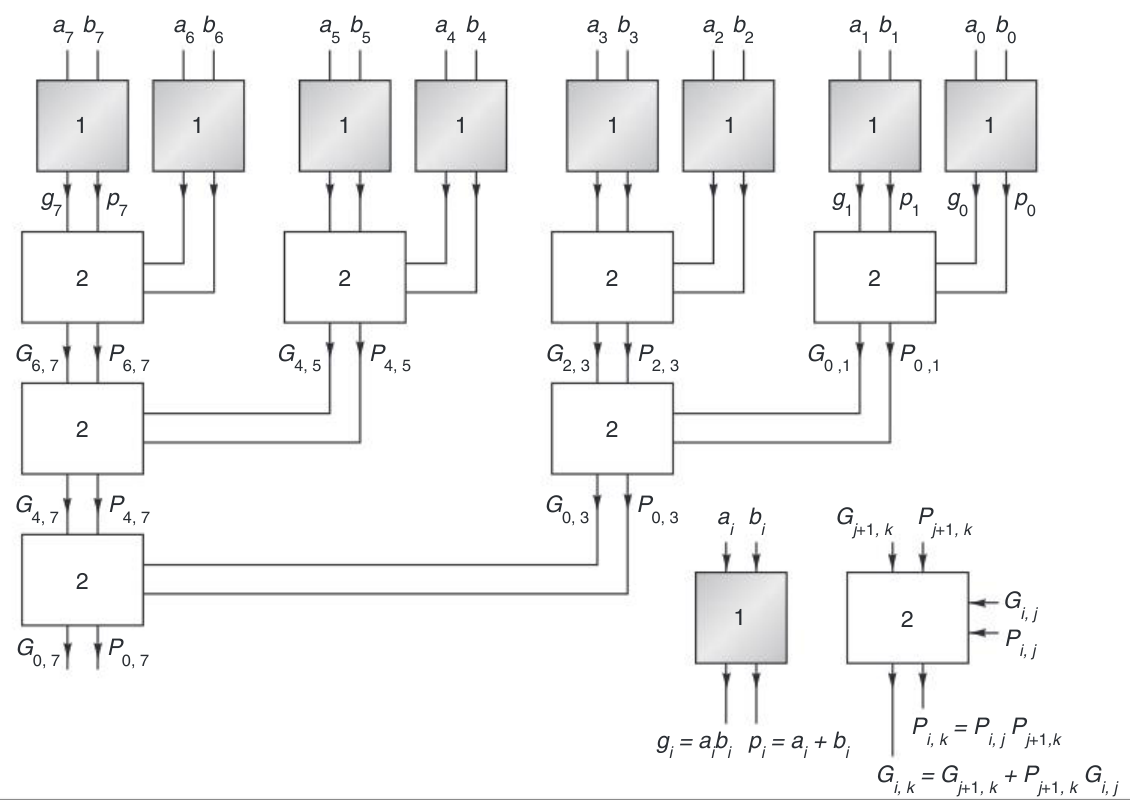
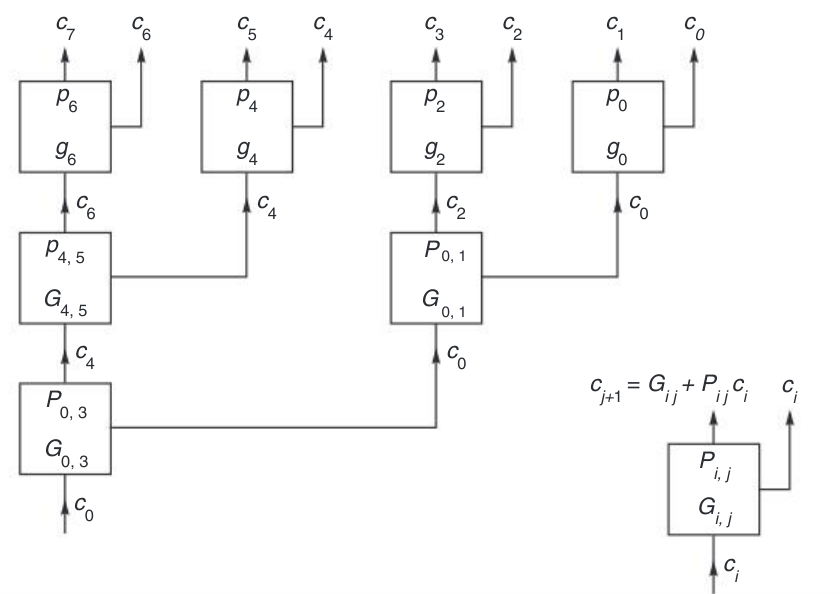
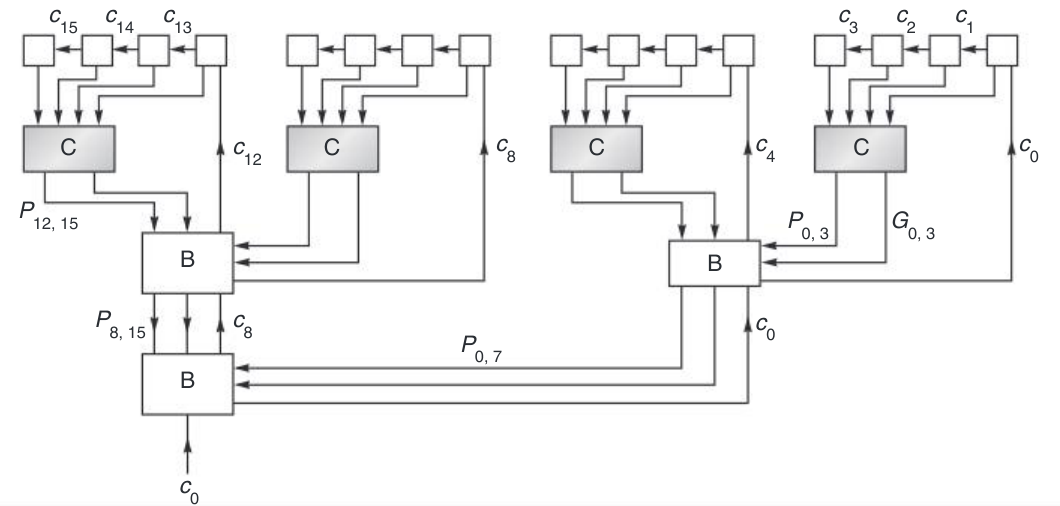
G 03 = G 23 + P 23 G 01 = ( G 33 + P 33 G 22 ) + ( P 22 P 33 ) ( G 11 + P 11 G 00 ) = g 3 + p 3 g 2 + p 3 p 2 g 1 + p 3 p 2 p 1 g 0 . 有了这些准备,就可设计实用 CLA。第一部分用式 J.8.5、J.8.6,从各位的 p、g 生成各种分组 P、G;第二部分用式 J.8.4 生成全部进位。第一部分见图 J.15:输入 a 7 ⋯ a 0 , b 7 ⋯ b 0 a_7\cdots a_0,b_7\cdots b_0 a 7 ⋯ a 0 , b 7 ⋯ b 0
图 J.15 先行进位树的第一部分。信号自上而下流动,计算不同范围的 P 和 G。类型 1 单元计算 gi=aibi、pi=ai+bi;类型 2 单元按式 J.8.5、J.8.6 合并相邻分组。 类型 2 单元按二叉树连接,生成各组 P、G。第二部分见图 J.16:从树底输入 c 0 c_0 c 0 c 0 c_0 c 0 c 8 c_8 c 8
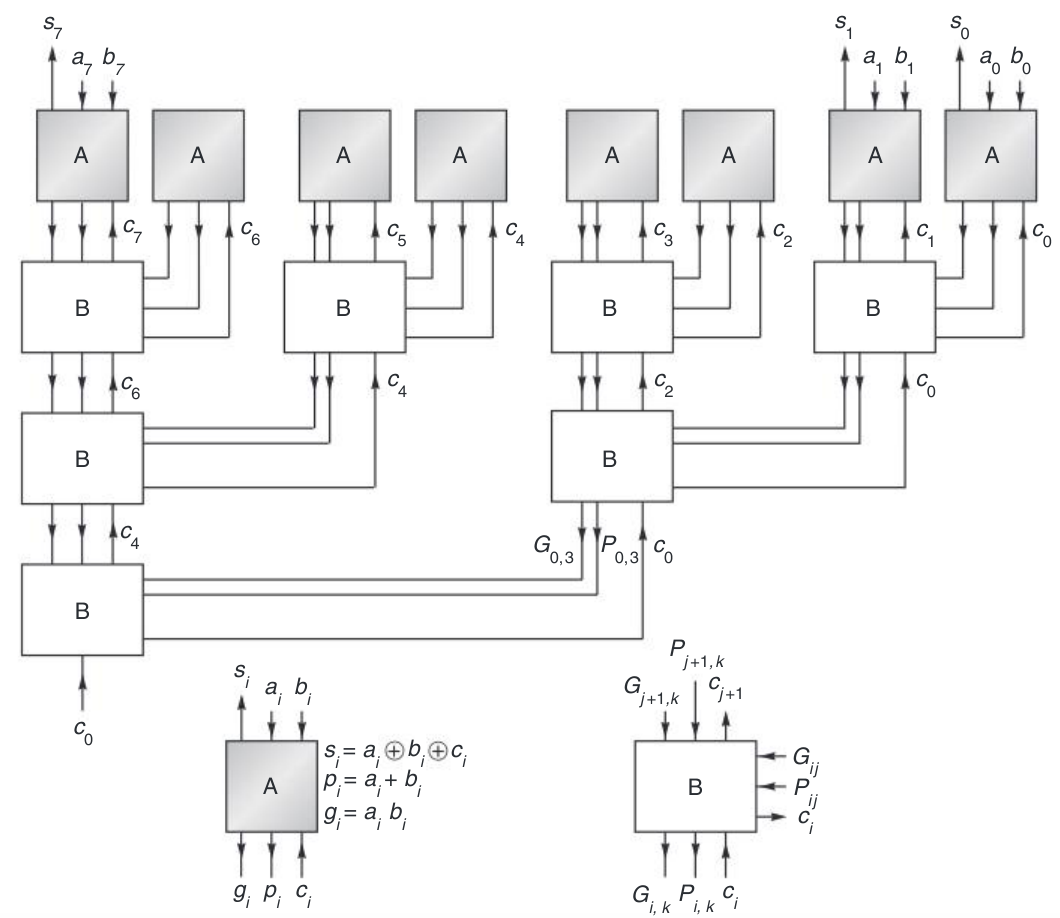
图 J.16 先行进位树的第二部分。信号自下而上流动,与 P、G 结合形成进位;每个单元使用 cj+1=Gij+Pijci。 CLA 的信号约经过 log 2 n \log_2n log 2 n 2 n 2n 2 n n n n n log n n\log n n log n
还可按工艺作调整。例如,把每个树节点的输入从两个增为三个,树高便从 log 2 n \log_2n log 2 n log 3 n \log_3n log 3 n
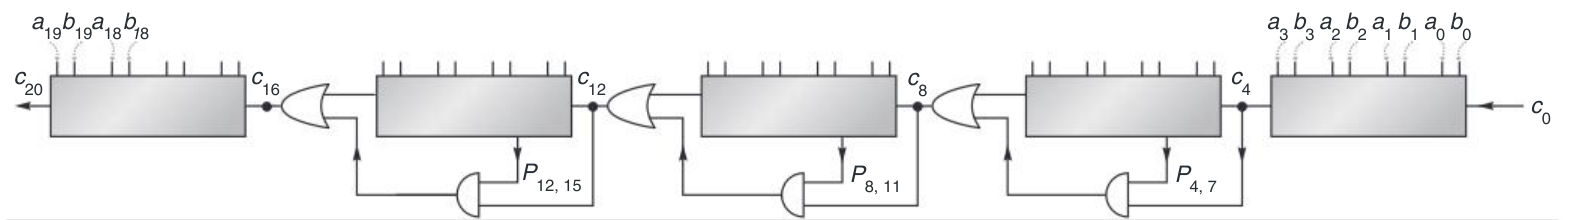
图 J.17 完整先行进位树加法器,由图 J.15、J.16 合并而成。加数从顶部进入,在底部与 c0 结合,再向上传播计算各个和位。A 单元除生成 pi、gi 外,还计算 si=ai XOR bi XOR ci;B 单元合并分组信号并分配进位。 跳跃进位加法器 跳跃进位加法器 (carry-skip adder)的速度和成本都介于行波进位与先行进位之间。它不简称 CSA,因为 CSA 已用于 carry-save adder。其思路来自 P、G 的方程,例如
P 03 = p 0 p 1 p 2 p 3 , G 03 = g 3 + p 3 g 2 + p 3 p 2 g 1 + p 3 p 2 p 1 g 0 .
P_{03}=p_0p_1p_2p_3,\qquad
G_{03}=g_3+p_3g_2+p_3p_2g_1+p_3p_2p_1g_0.
P 03 = p 0 p 1 p 2 p 3 , G 03 = g 3 + p 3 g 2 + p 3 p 2 g 1 + p 3 p 2 p 1 g 0 . P 比 G 简单得多,因此跳跃进位加法器只计算 P,见图 J.18。
图 J.18 跳跃进位加法器。总位数 n=20,每块宽度 k=4。 进位在所有块内同时开始逐位传播。某块若自身生成进位,即使该块的输入进位尚未确定,输出进位也会为真。若每次加法开始时把各块输入进位置 0,就不会产生伪进位,因此可以把各块的进位输出当作 G 信号。最低块的进位一旦产生,不仅送往下一块,还与下一块的 P 通过 AND 门结合。如果两者都为真,进位就跳过 第二块,直接进入第三块,依此类推。只有各块进位输入能在每次运算开始时方便清零,例如利用 CMOS 预充电,这种设计才实用。
图 J.19 CLA 与行波进位的组合。在顶行每四个方框组成的组内,进位逐位传播。 分析速度时,假设穿过两级逻辑耗时一个单位,则进位穿过 k 位块耗时 k,跳过一个块耗时 1。最长路径从第 0 位生成进位开始:穿过首块用 k,跳过中间块用 n / k − 2 n/k-2 n / k − 2 4 + ( 20 / 4 − 2 ) + 4 = 11 4+(20/4-2)+4=11 4 + ( 20/4 − 2 ) + 4 = 11
还有更好的分组。若从低到高采用 2、5、6、5、2 位的五个块,时间降为 9。可见,把内部块做得较大有利于加速;变块宽的思想有时也适用于其他加法器。由于仍有大量行波传播,这种加法器最适合行波传播快的工艺。
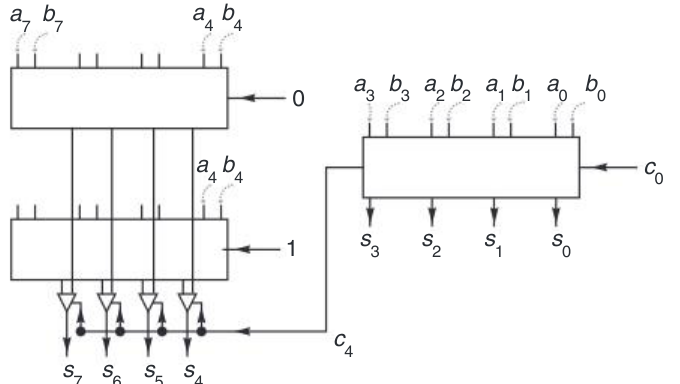
选择进位加法器 选择进位加法器 (carry-select adder)并行计算两次,一次假设输入进位为 0,一次假设为 1。真正的输入进位确定后,只需选择预先算好的正确结果。图 J.20 将 8 位分成两半,用低半部分进位选择高半部分和位。如果各块内部使用线性时间的行波进位,它以增加 50% 成本换取约两倍速度。但 c 4 c_4 c 4
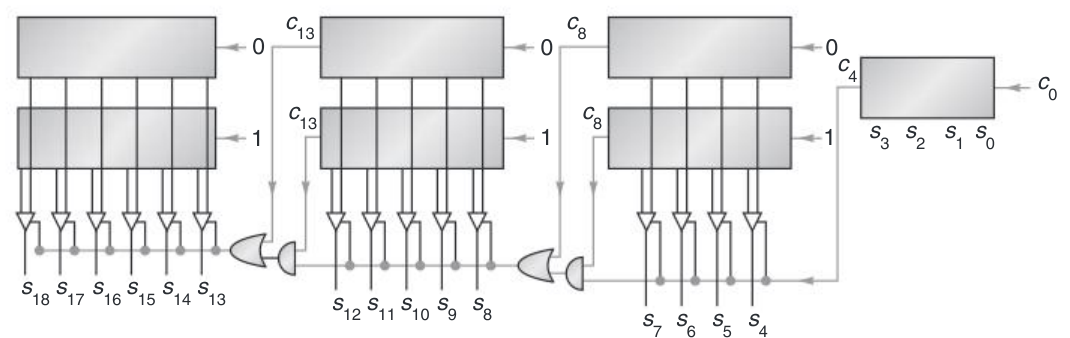
图 J.20 简单的选择进位加法器。计算低 4 位之和的同时,高 4 位并行计算两遍:分别假设 c4=0 和 c4=1。 还可从两块增至四块以继续加速,如图 J.21。若 k 位块相加需 k 个时间单位,而由两个进位输出产生多路选择控制需 1 个时间单位,那么最佳分组应沿高位方向逐块增加一位,如图所示。因此,与跳跃进位类似,最佳设计采用可变块宽。
图 J.21 选择进位加法器。最右块的进位输出一旦确定,就用于选择其余和位。 图 J.22 四类加法器的渐近时间与空间需求。
图 J.22 总结了本节。跳跃进位、选择进位的时间来自恰当的块宽选择;跳跃进位的推导见习题 J.26。不要把这些方法看成互斥选项,而应把它们看成构造加法器的模块。适用性高度依赖工艺:信号能驱动很多多路选择器时,选择进位很好;每次运算开始时能方便清零时,跳跃进位很有吸引力。
渐近性质有助于理解,却不宜过分依赖,因为它只在 n 极大时才占主导。加法器的 n 是精度位数,而双精度与 20 年前一样,仍约 53 位。计算机越快,计算过程往往越长、舍入误差更多,确实会要求更高精度,但这种增长随时间发生得很慢。