J.9 加速整数乘法与除法
J.2 节的乘除法算法较慢,每周期只产生一位,尽管这里的周期可能只是 CPU 指令周期的一部分。本节讨论提高乘除法性能的各种技术,包括 Pentium 芯片使用的除法算法。
跳过连续零位
跳过连续零位(shifting over zeros)如今用得不多,但很有启发性。它的特点是执行时间依赖操作数。它未能比逐位算法快很多,而且可变执行时间不利于流水线、与 CPU 同步和编译器优化,因此较少采用。乘法中的思路是增加逻辑,检测图 J.2(a) 中 A 的最低位是否为 0。
若为 0,就跳过加法,直接移位,这便是名称的由来。
除法呢?不恢复余数法每步都执行一次 ALU 加法或减法,似乎无从省略。但可以换个角度:计算 ,就是从 a 中减去若干倍 b,再记录减了多少次。每一步的余数都必须容纳于图 J.2(b) 的 P 中。如果余数是很小的正数,通常会减 b,但也可以仅移位,等下一步再减。只要余数足够小,最高位为 0,移位后仍容纳得下,就不会丢信息;不过,需要改变记录减法次数的方式。
这类方法通常称为 SRT 除法,以独立提出类似算法的 Sweeney、Robertson、Tocher 命名。主要额外复杂性在于:不像普通不恢复余数法,每步的商位不能立即由本步结束时 P 的符号确定。
具体算法如下。以 n 位 a 除以 n 位 b,将它们分别装入 A、B,P 初始为 0。
SRT 除法
- 若 B 的 n 位表示有 k 个前导 0,把所有寄存器左移 k 位。
- 对 ,依次执行:
- (a) 若 P 的最高三位相同,令 ,将 (P,A) 左移一位。
- (b) 若最高三位不全相同且 P 为负,令 ,也记作 ,将 (P,A) 左移一位,再加 B。
- (c) 其余情况,令 ,将 (P,A) 左移一位,再减 B。
- 若最终余数为负,加 B 修正余数,并把商减 1。最后,余数右移 k 位,撤销初始缩放。
译注:原算法第 3 步写“从 减 1”,但本节按生成顺序编号, 是首个商位。图 J.23、J.35 都明确对完整商减 1;正文据此说明,不把它误作从最高商位减 1。
图 J.23 给出例子。虽然讨论的是整数除法,为解释算法,可把二进制小数点想象在数值最高位之前,把 看成 。分子分母同时缩放,商不变。(P,A) 保存补码余数。例如 P=11110、A=0 时,余数为 。记余数值为 r,则 。
| P | A(含已生成的商数字) | 步骤 |
|---|---|---|
00000 | 1000 | 除以 ,B=0011 |
00010 | 0000 | 步骤 1:B 有两个前导 0,全部左移两位,B=1100 |
00100 | 0000 | 步骤 2.1:P 最高三位相同,情况 (a),,移位 |
01000 | 0001 | 步骤 2.2:最高位不全相同且 P 非负,情况 (c),,移位 |
11100 | 0001 | 减 B,即加 10100 |
11000 | 0010 | 步骤 2.3:最高三位相同,情况 (a),,移位 |
10000 | 步骤 2.4:最高位不全相同且 P 为负,情况 (b),,移位 | |
11100 | 加 B=01100 | |
01000 | 步骤 3:余数为负,加 01100 恢复,商减 1 | |
00010 | 0010 | 余数右移两位,得 ;商 |
算法先将 b 规格化到 。ALU 决策规则是:若 ,即 P 最高三位相同,只左移得到 2r;若 ,由于已排除前一条件,此时 ,左移后加 b,得 ;若 ,则从 2r 减 b。利用 ,容易验证余数始终满足 。普通不恢复余数法只有 ,P 需 n+1 位;SRT 的范围更紧,可省去 P、b 和加法器的最高一位,检测最高三位相同也随之变成检测最高两位。
实际实现还可在每次 ALU 操作后,把 P 一次左移到满足 或 。若移 k 位,就一次生成 k 个零商位。因此,SRT 有时也被描述为把余数保持在 的规格化形式。
SRT 的本步商位取决于本步选择的操作,而操作取决于上一步结果;不恢复余数法的本步商位,则取决于本步结果。因此,最终余数为负时,SRT 还要调整商,不恢复余数法不用。更关键的是,SRT 允许商数字为 。图 J.23 为了示意把商放在 A 的空闲低位,但一位不能容纳 −1、0、1 三种值,实际不能如此实现。最后还要通过完整加法器转成普通补码。一种常见方法是用两个寄存器分别累计正商位、负商位,最后相减。
由于同一个数可用 −1、0、1 数字写成多种形式,这称为冗余商表示。SRT 与普通不恢复余数法的区别可归纳为:
- ALU 决策:后者依据 P 的符号,SRT 依据 P 的最高两位。
- 最终商:后者由各步 P 的符号直接得到;SRT 有 1、0、−1 三种数字,需要完整 n 位加法器转换。
- 速度:操作数导致较多零商位时,SRT 更快。
这个简单 SRT 版本通常还不够快,不太实用;本节稍后会介绍实用变体。
用一个加法器加速乘法
跳零技术用得不多,下面介绍广泛采用的方法。乘法加速可分为使用一个加法器和使用多个加法器两类,先看前者。
由于进位传播,实际不能用两级逻辑完成普通加法。用图 J.17 的单元相加两个 64 位数,生成 P、G 要穿过七个单元,生成进位再穿过七个,至少 28 级逻辑。图 J.2 的简单乘法器每一步都要经过它。
保留进位加法器(carry-save adder,CSA)能显著减少每步工作量。它只是 n 个彼此独立的全加器,图 J.24 给出使用它的乘法器。每个“+”圆圈是单比特全加器,方框是寄存器的一位。每次加法产生和位、进位,分别存入 P 的两部分。各位独立,只需两级逻辑,远少于 28 级。
操作时,先将 P 的和位与进位全部清零,执行第一步 ALU 运算;若用 Booth 重编码,可能是减法。然后把 P 的最低和位移入 A,并移动 A。P 的高 n−1 位不必真的移位,因为下一周期它们的和位会送入低一位的加法器。
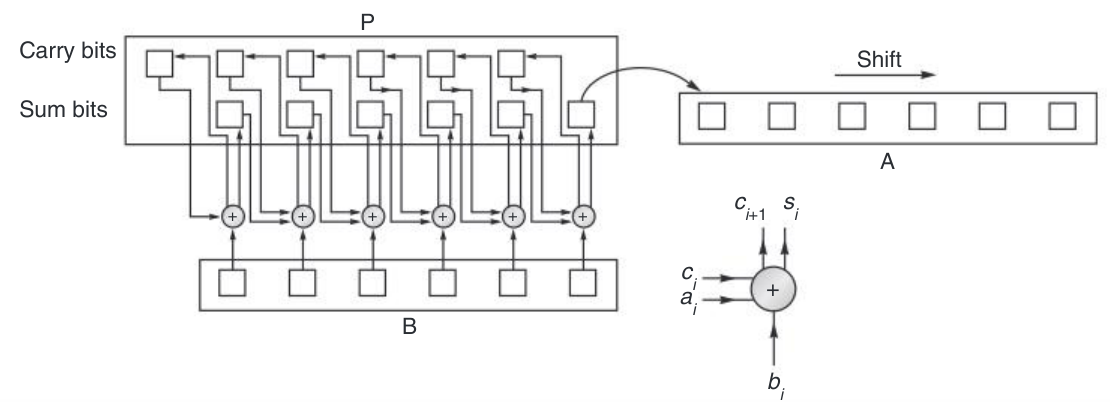
图中 Carry bits 为进位,Sum bits 为和位,Shift 为右移。因为各单元独立、不传播进位,每步加法都快得多。
CSA 有两个缺点。第一,保存进位需再增加一份 P 寄存器,硬件更多。第二,最后一步后,乘积的高位字仍需普通加法器把和与进位合并;可把 P 的输出送入本来执行加法指令的加法器。用两个寄存器表示 P,有多种可能组合,属于冗余表示,因此这种乘法也称冗余乘法。不是 CSA 的普通加法器称为进位传播加法器(carry-propagate adder,CPA),可采用行波、先行进位等方式。
不增加加法器的另一种办法,是每步查看 A 的低 k 位,而不只一位,称为高基数乘法。例如 k=2:低两位为 00 加 0,01 加 B,10 则把 b 左移一位再加;11 看似要计算 ,却可用高基数 Booth 重编码避免。把 A 看成四进制数:出现数字 3 时,改为 ,并给高一位加 1 补偿。它与普通 Booth 一样,对正负整数都有效。
图 J.25 给出基 4 Booth 的规则。第 i 步,A 的低两位为 ,再结合刚移出的 ,选择向 P 加多少倍 b。图 J.26 给出例子。这种方法也称 overlapping triplets(重叠三位组),因为每步查看三位,而普通 Booth 查看两位。
| A 的第 位 | A 的第 位 | 刚移出的第 位 | 加入的倍数 |
|---|---|---|---|
| 0 | 0 | 0 | 0 |
| 0 | 0 | 1 | +b |
| 0 | 1 | 0 | +b |
| 0 | 1 | 1 | +2b |
| 1 | 0 | 0 | −2b |
| 1 | 0 | 1 | −b |
| 1 | 1 | 0 | −b |
| 1 | 1 | 1 | 0 |
| P | A | L | 操作 |
|---|---|---|---|
00000 | 1001 | 0 | 乘 ,B=1011 |
11011 | 1001 | 0 | A 低位为 01,L=0,加 B,即加 11011 |
11110 | 1110 | 0 | 右移两位,左侧补 1 |
01000 | 1110 | 0 | A 低位为 10,L=0,加 −2b,即加 01010 |
00010 | 0011 | 1 | 右移两位;乘积 |
除控制逻辑更复杂外,重叠三位组还要求 P 多一位,以容纳 ±2b。也可以采用基 8 或更高基数,但此时需要 3B 这样的加数。基 8 乘法器通常在乘法开始时预先计算一次 3B,后续复用。
用多个加法器加速乘法
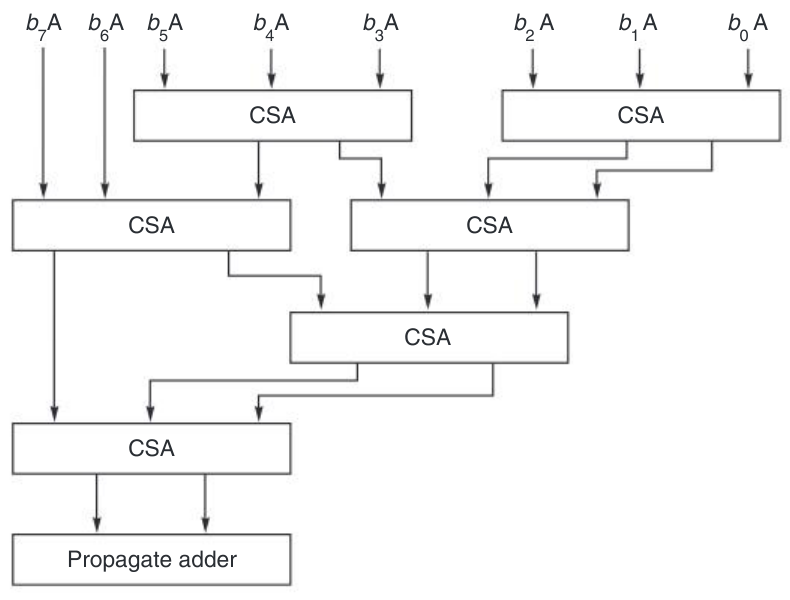
若面积允许设置多个加法器,还能继续加速。图 J.27 是两个 5 位数相乘的简单阵列乘法器,使用三个 CSA 和一个 CPA。(a) 是本节采用的框图形式,(b) 展示所有输入,(c) 展示加法器及其连接;(c) 的每一行对应 (a) 的一个方框。
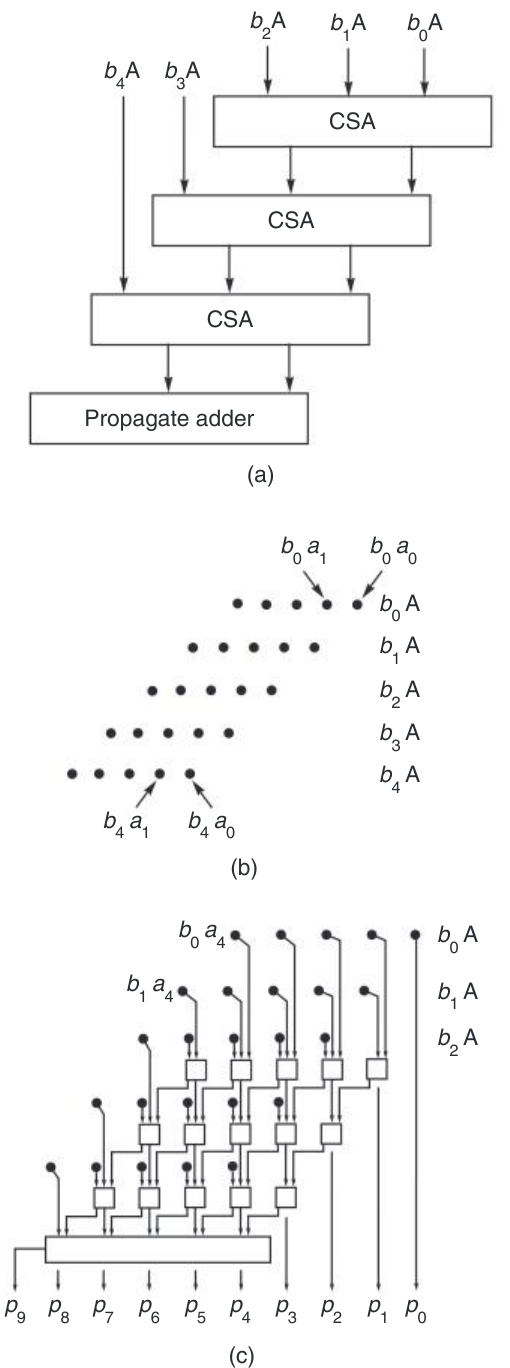
图中 CSA 为保留进位加法器,Propagate adder 为进位传播加法器。为使相同位权处于同一列,图形被“扭转”了;实际版图更可能排成方形。
它的加法次数与图 J.24 相同,所以延迟与单个 CSA 的方案没有巨大差异;但阵列能够流水化,提高总吞吐率。阵列处理器有时采用如此细的流水线,J.10 节讨论的单芯片浮点加速器却都没有这样做。
流水线的一般讨论见附录 C,乘法器中的应用见 Kogge [1981]。
若芯片分给算术的面积容纳不下完整双精度阵列,可采用图 J.28 的两遍方案。第一遍“处理掉”B 的五位,结果反馈到阵列顶部,与接下来的三个部分积相加;第二遍结果再送入 CPA。但这样会失去流水化能力。
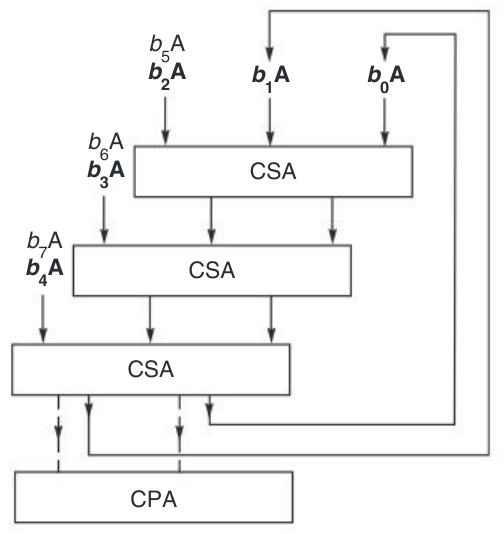
阵列与便宜得多的图 J.2、J.24 方案加法次数相同,为何仍流行?首先,阵列是组合电路,信号直接流过、无需逐级时钟锁存,延迟小于重复使用单个加法器。图 J.28 的两遍方案通常仍有时钟,但穿过 k 级阵列的周期,可以小于单级方案时钟的 k 倍。其次,阵列方便进一步加速。例如图 J.29 让两次加法并行,每条流仅穿过约一半的加法器,所以速度接近图 J.27 的两倍。这种奇偶阵列乘法器因结构规则,很适合 VLSI。
还可利用异步逻辑。图 J.2 需要时钟,原因之一是防止加法器输出尚未稳定,就反馈回输入。若图 J.28 的阵列足够长,信号从顶部到底部的时间不短于第一个加法器稳定所需时间,可能完全不用时钟。
Williams 等 [1987] 讨论过这种设计,不过针对的是除法器。
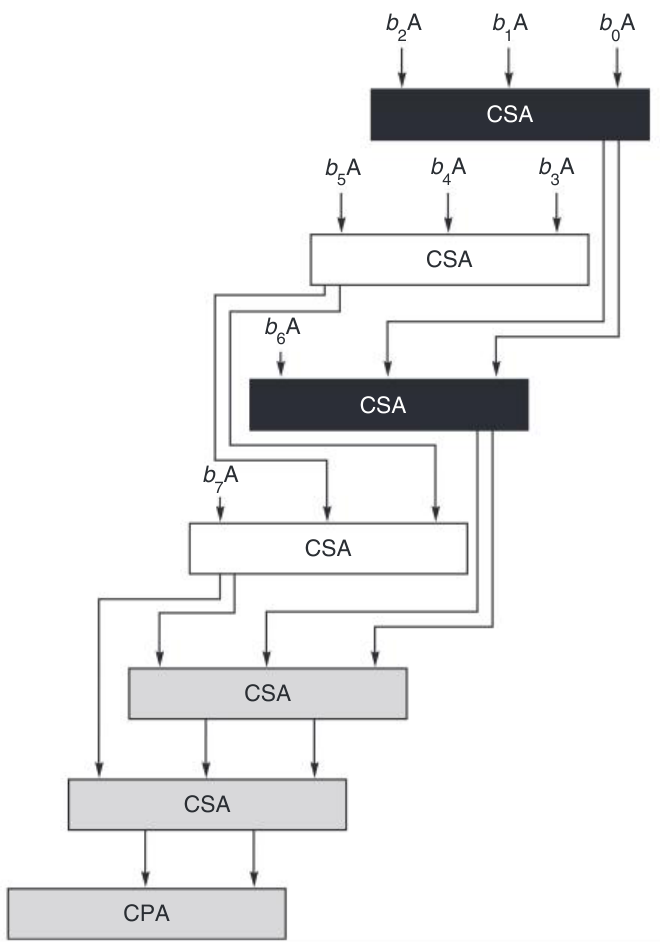
以上方法的乘法时间仍为 ,使用树可降为 。最简单的树先将 两两相加,使加数从 n 降为 n/2,再降为 n/4,约 log n 步后得到总和。但普通全加器是 (3,2) 器件,三个输入压成两个,不是两压一,不能直接套用二叉树。使用全加器的 Wallace 树见图 J.30。在用中规模集成器件构建算术单元的年代,它是高速乘法器的首选。VLSI 中却有版图问题:展开所有加法器和连线后,它不像图 J.27 那样规则。因此,VLSI 设计者常采用其他 log n 设计,例如下面的二叉树乘法器。
要在二叉树中相加,需有将两个数字合成一个和数字的 (2,1) 加法器。普通二进制受进位影响,做不到,但换一种表示就可能做到。
采用前面解释 Booth 时使用的带符号数字表示(signed-digit representation):每位可为 1、、0。代价有二:每个数字需两位二进制编码;相加规则较复杂,要检查 与 。虽然需要回看两位,但普通二进制的进位可能需要回看任意多位。
先按图 J.31 计算每位的和 、进位 ,再计算 。表的设计保证最终这一步不再生成进位。
| 当前数字之和 | 更低一位数字 x、y 的条件 | 输出 |
|---|---|---|
| 任意 | ||
| 任意 | ||
| 任意 | ||
| 任意 | ||
| 原页列为 的左侧条件组 | 且 | |
| 同上 | 其他 | |
| 原页列为 的右侧条件组 | 且 | 原页为 |
| 同上 | 其他 |
译注:两组条件式的输入都印成 ,且右组第一输出印成 。按数值恒等式及紧随其后的例题,左组输入应为 ,右组第一输出应为 。也就是:当前和为 +1 时,下位 x、y 均非负则取 ,否则取 ;当前和为 −1 时,下位均非负则取 ,否则取 。
例题 带符号数字 与 的和是什么?
解答 最低位 ,中间位 ,最高位 ,因此
这样就有了 (2,1) 加法器,可直接构成二叉树:第一步并行计算 、 等。
下一步再把这些结果两两相加,依此类推。最后仍需 CPA,把带符号数字转为补码,但所有 CSA 乘法器本来也需要这一步。
Wallace 树和带符号数字树的时间都是 log n。前者门数少、版图较难;后者规则,却需每位两比特和更复杂的加法逻辑。各种乘法技术也能组合,例如 Booth 重编码结合阵列:把图 J.27 中单个 换成两位一组的部分积,并用 Booth 避免计算 3b。
用一个加法器加速除法
一个加法器加速乘法的方法有 CSA 与高基数两种,但把它们用于不恢复余数除法有困难。如果图 J.2(b) 改为 CSA,P 就变成和、进位两个寄存器,如图 J.24。每周期末尚未求出两者之和,所以 P 的符号未知,而选择下一步 ALU 操作和商数字都需要它。
高基数也有商选择问题。纸笔除法需要猜商;二进制只有两个候选,可先猜再按 P 的符号修正。高基数有多个候选,似乎必须计算 b 的所有倍数,与 P 比较,选择会很复杂。
采用冗余商表示,就能同时解决这两类问题。允许 −1、0、1 后,往往有多个合法商数字。前面的 SRT 尽量选择 0,以省去 ALU 运算;保留进位除法则利用这种自由度:余数以和、进位分存,虽不知道精确值,仍可能选出合法商位。
图 J.32 横轴为第 i 步余数 ,三条线分别表示选择 后的 。只要 满足 ,就可以选该 q。右半图给出允许范围,可以相互重叠。
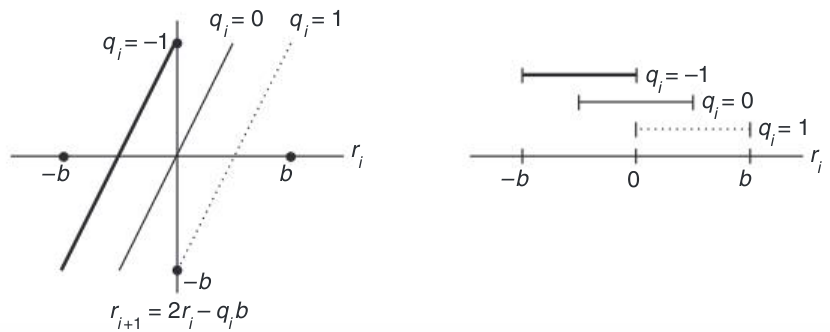
不必精确知道 r,只需知道它落在足够小的区间内,且整个区间包含于某一条允许范围即可。实现时,把保留进位表示的高几位送入 CPA 求出近似 r,再结合除数 b,通常查表选择 q。高基数除法也可这样做,无论是否使用 CSA,都能以 P 的高位索引商选择表。
设计高速 SRT 除法器的关键,是决定要检查 P、B 的多少位。例如,基 4、商数字为 −2、−1、0、1、2,使用 CPA,需要多少位?分两步考虑。普通基 2 不恢复余数法中, 保证 P 不溢出;但基 4 每步计算 ,若 接近 b,4r 就接近 4b,最大商数字 2 也无法把它拉回 ,余数可能无限增大。改为限制 ,就容易验证它始终有界。
确定范围后,可画图 J.33。例如 时可选 q=1,即 。假设检查 P 的最高 5 位,含符号,和 b 的最高 4 位,不含始终非负的符号。若 P 为 00011xxx…、b 为 1001xxx…,把小数点放在各数值字段左侧,则截断信息只能说明 r 处于 到 ,b 处于 到 。因此,r/b 可低至 ,要求 q=1;也可高至 ,要求 q=2。可见 5 位 P 与 4 位 b 不足以选择。
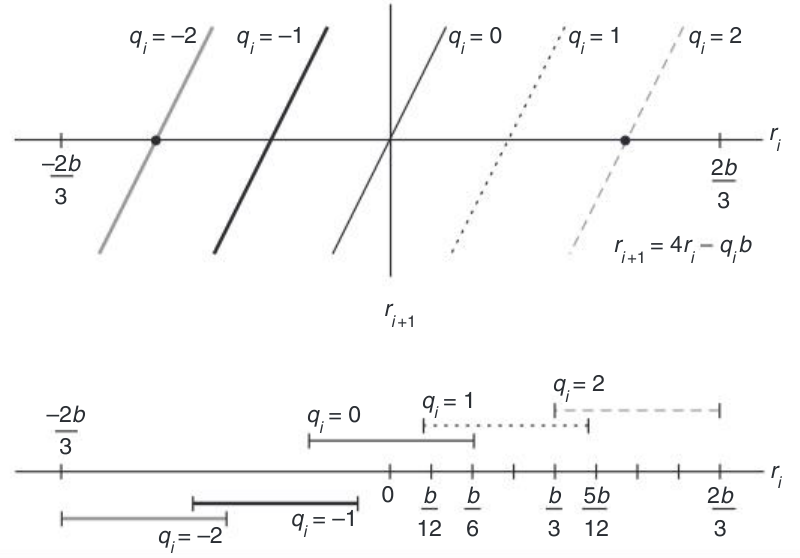
检查 P 的 6 位与 b 的 4 位就足够,可编写简单程序遍历验证,结果见图 J.34。
例题 用 8 位寄存器和基 4 SRT 算法计算 149/5。
解答 沿用前面的 SRT 算法,但把步骤 2 的商选择改为查图 J.34,详见图 J.35。
Pentium 采用与此类似的基 4 SRT 算法,但使用 CSA,习题 J.34(c)、J.35 进一步探讨。原文这里的习题编号与本附录的题目编排不完全一致:保留进位形式的 SRT 除法见习题 J.33(c),Pentium 缺陷见习题 J.34;J.35 则讨论高基数方法对余数分步指令的影响。尽管这里例子简单,所有 SRT 分析的步骤都相同:先确定 范围,再画 对 图,确定商选择范围,最后写程序检查需要多少位;有时也能解析求出位数。
实际实现还有许多细节。例如商表很规则,编码为 PLA 通常比 ROM 便宜。更多讨论见 Burgess 与 Williams [1995]。
| b 的高 4 位(十进制) | q=−2 时 P 范围 | q=−1 时 P 范围 | q=0 时 P 范围 | q=1 时 P 范围 | q=2 时 P 范围 |
|---|---|---|---|---|---|
| 8 | −12…−7 | −6…−3 | −2…1 | 2…5 | 6…11 |
| 9 | −14…−8 | −7…−3 | −3…2 | 2…6 | 7…13 |
| 10 | −15…−9 | −8…−3 | −3…2 | 2…7 | 8…14 |
| 11 | −16…−9 | −9…−3 | −3…2 | 2…8 | 8…15 |
| 12 | −18…−10 | −10…−4 | −4…3 | 3…9 | 9…17 |
| 13 | −19…−11 | −10…−4 | −4…3 | 3…9 | 10…18 |
| 14 | −20…−11 | −11…−4 | −4…3 | 3…10 | 10…19 |
| 15 | −22…−12 | −12…−4 | −5…4 | 3…11 | 11…21 |
| P | A 与商数字(示意) | 操作 |
|---|---|---|
000000000 | 10010101 | 149 除以 5,B=00000101 |
000010010 | 10100000 | 步骤 1:B 有 5 个前导 0,左移 5 位后 B=10100000,查 b=10 的分组 |
001001010 | 1000000 | 步骤 2.1:P 高六位为 2,左移两位;可选 q=0 或 1,取 |
100101010 | 000002 | 步骤 2.2:P 高六位为 9,左移两位, |
111101010 | 000002 | 减 2b,即加 011000000 |
110101000 | 00020 | 步骤 2.3:高位为 −3,左移两位;可选 0 或 −1,取 |
010100000 | 步骤 2.4:高位为 −11,左移两位, | |
111100000 | 加 2b=101000000 | |
010000000 | 步骤 3:余数为负,加 b=010100000 恢复,商减 1 |