J.10 融会贯通
本节比较 Weitek 3364、MIPS R3010 与 Texas Instruments 8847,见图 J.36、J.37。这是很合适的一组对象:三者都在单芯片上实现 IEEE 标准的加、减、乘、除,都于 1988 年推出。
它们的时钟周期都在 40 ns 左右,算法却很不相同。Weitek 设计详见 Birman 等 [1990],MIPS 的较简略介绍见 Rowen、Johnson 与 Ries [1988],TI 的细节见 Darley 等 [1989]。
三者都可以并行进行加法与乘法,都不实现扩展精度,也不提供 remainder-step。J.6 节指出,若有该指令,软件实现 IEEE 余数很方便。设计者可能认为,最有影响力的用户运行的是不能依赖扩展精度的可移植程序,因此不提供它;但扩展精度确实能使数学库更快、更简单。
| 特性 | MIPS R3010 | Weitek 3364 | TI 8847 |
|---|---|---|---|
| 时钟周期(ns) | 40 | 50 | 30 |
| 面积(mil²) | 114,857 | 147,600 | 156,180 |
| 晶体管数 | 75,000 | 165,000 | 180,000 |
| 引脚数 | 84 | 168 | 207 |
| 功耗(W) | 3.5 | 1.5 | 1.5 |
| 每次加法周期数 | 2 | 2 | 2 |
| 每次乘法周期数 | 5 | 2 | 3 |
| 每次除法周期数 | 19 | 17 | 11 |
| 每次平方根周期数 | — | 30 | 14 |
晶体管越多,通常所需周期越少。不过,比较每次运算的周期数要小心:MIPS 数字来自完整 R3000/R3010 系统;Weitek 与 TI 数字来自独立芯片,在完整系统中通常会更大。
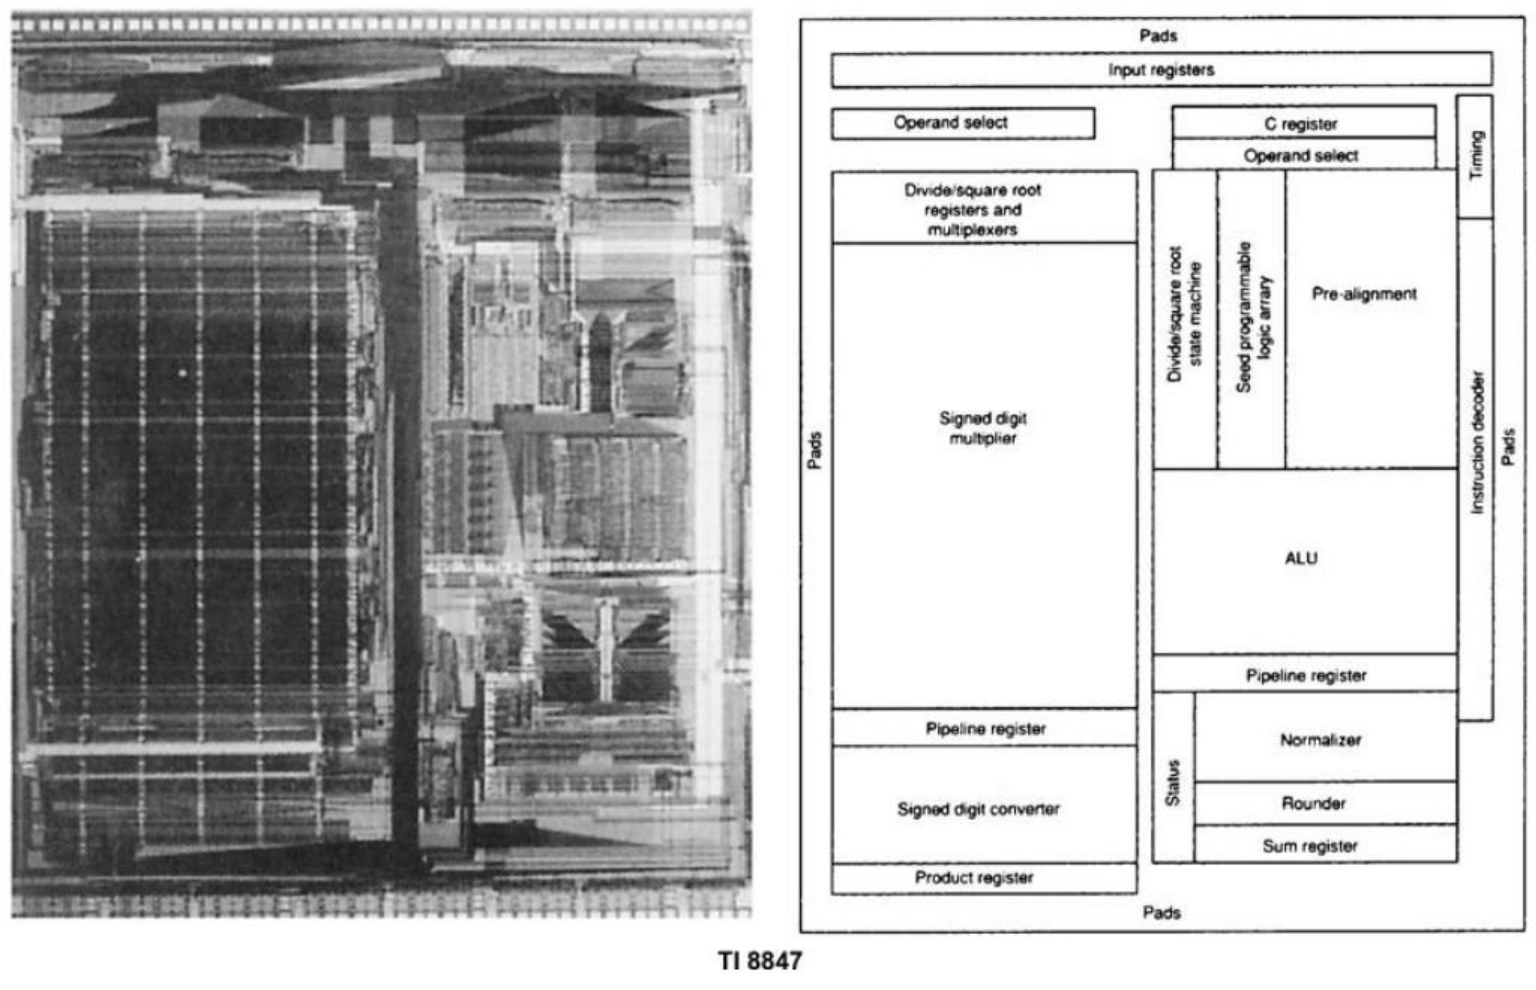
TI 8847 图内标注如下:
| 原标注 | 中文 |
|---|---|
| Pads | 焊盘 |
| Input registers | 输入寄存器 |
| Operand select | 操作数选择 |
| C register | C 寄存器 |
| Divide/square root registers and multiplexers | 除法/平方根寄存器与多路选择器 |
| Signed digit multiplier | 带符号数字乘法器 |
| Divide/square root state machine | 除法/平方根状态机 |
| Seed programmable logic array | 初值可编程逻辑阵列 |
| Pre-alignment | 预对阶 |
| Timing | 时序 |
| Instruction decoder | 指令译码器 |
| ALU | 算术逻辑单元 |
| Pipeline register | 流水线寄存器 |
| Signed digit converter | 带符号数字转换器 |
| Product register | 乘积寄存器 |
| Status | 状态 |
| Normalizer | 规格化单元 |
| Rounder | 舍入单元 |
| Sum register | 和寄存器 |
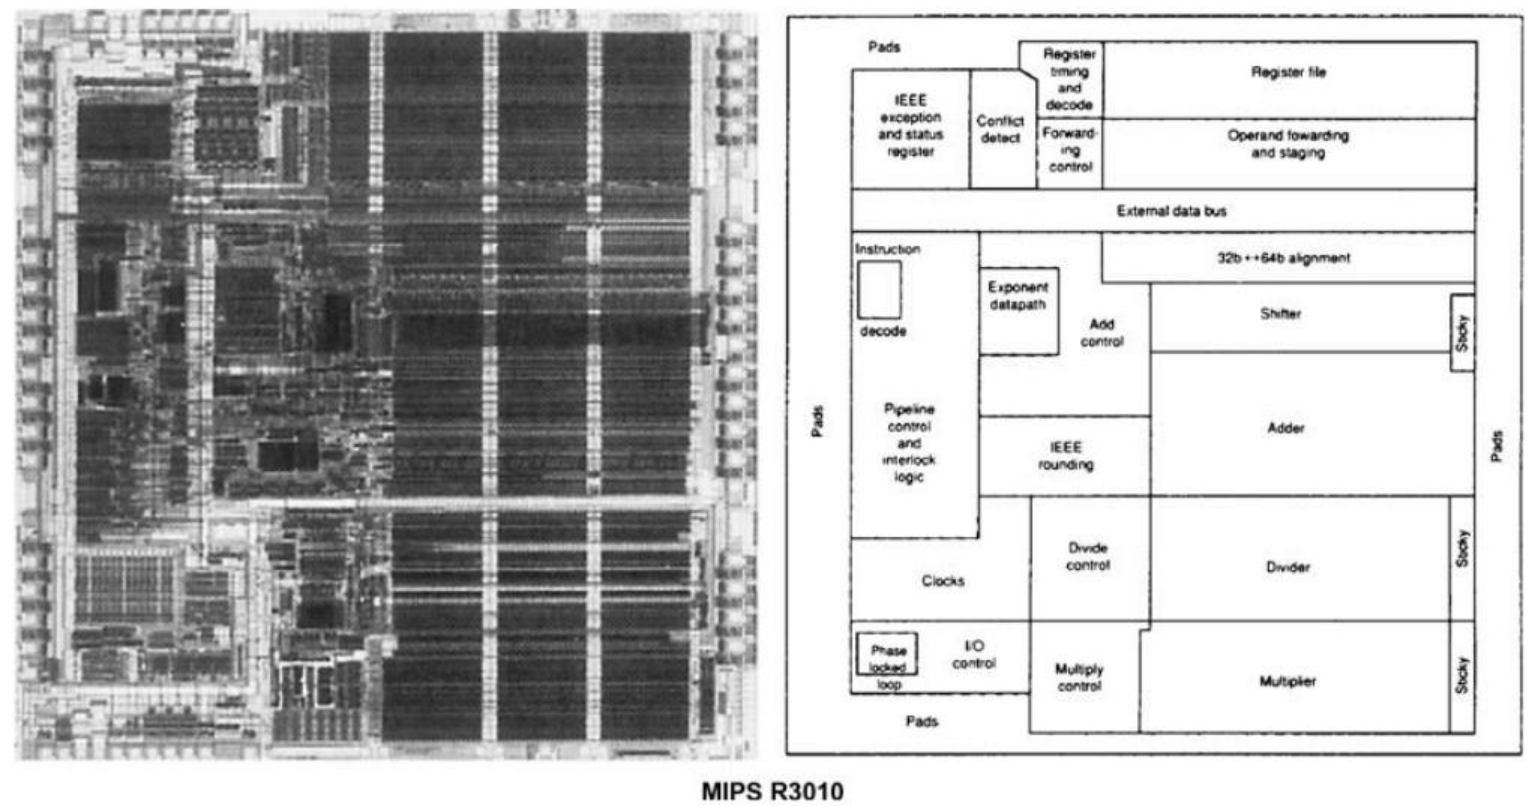
MIPS R3010 图内标注如下:
| 原标注 | 中文 |
|---|---|
| Pads | 焊盘 |
| IEEE exception and status register | IEEE 异常与状态寄存器 |
| Conflict detect | 冲突检测 |
| Register timing and decode | 寄存器时序与译码 |
| Register file | 寄存器文件 |
| Forwarding control | 转发控制 |
| Operand forwarding and staging | 操作数转发与分级暂存 |
| External data bus | 外部数据总线 |
| Instruction decode | 指令译码 |
| 32b ↔ 64b alignment | 32 位与 64 位对齐 |
| Exponent datapath | 指数数据通路 |
| Add control | 加法控制 |
| Shifter | 移位器 |
| Sticky | sticky 位逻辑 |
| Pipeline control and interlock logic | 流水线控制与互锁逻辑 |
| IEEE rounding | IEEE 舍入 |
| Adder | 加法器 |
| Clocks | 时钟 |
| Divide control / Divider | 除法控制/除法器 |
| Phase locked loop | 锁相环 |
| I/O control | I/O 控制 |
| Multiply control / Multiplier | 乘法控制/乘法器 |
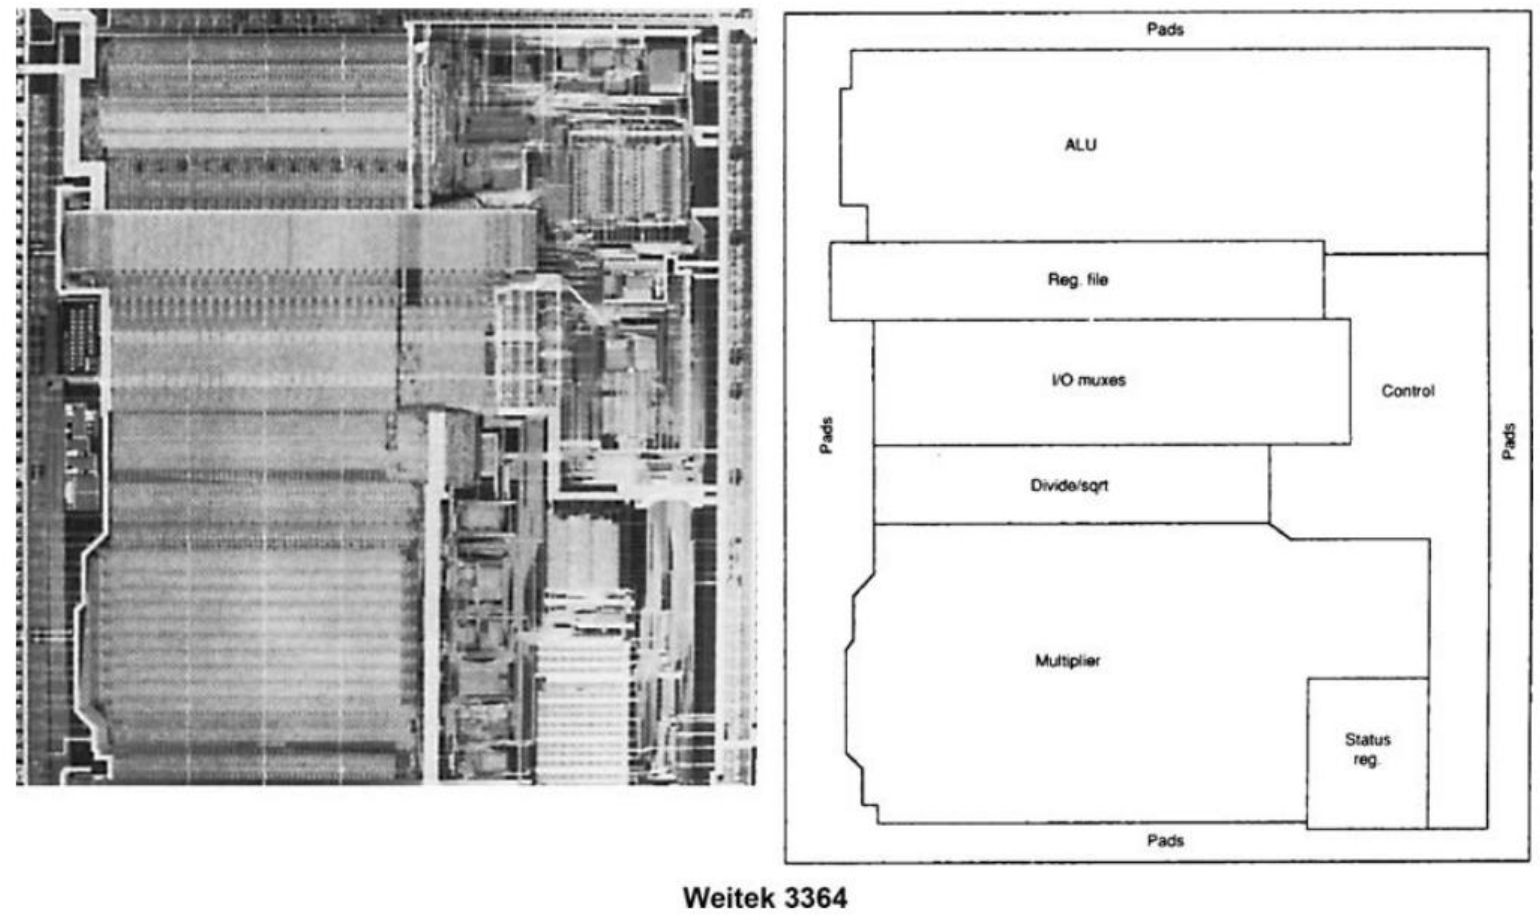
Weitek 图中 Pads 为焊盘,ALU 为算术逻辑单元,Reg. file 为寄存器文件,I/O muxes 为 I/O 多路选择器,Control 为控制,Divide/sqrt 为除法/平方根单元,Multiplier 为乘法器,Status reg. 为状态寄存器。
MIPS 的晶体管最少,也只有它既无流水化运算,也无硬件平方根。乘法与加法还不是完全独立的,因为共用最终舍入的 CPA 与舍入逻辑。
R3010 的加法混合使用行波、CLA 与选择进位:先按图 J.20 分成两半,各半内部采用图 J.19 那样的行波与 CLA 混合结构,再进一步改变块宽,而不是每块固定 4 位。乘法器介于图 J.2 与 J.27 之间:阵列恰好足够大,使输出无需时钟即可反馈;同时采用基 4 Booth 和图 J.29 的奇偶技术。它与 Weitek 一样,可以并行乘除,TI 则不行。除法采用商数字 −2、−1、0、1、2 的基 4 SRT,与 Taylor [1985] 的设计相似。双精度除法约比乘法慢四倍。
R3010 表明,采用 乘法器时,SRT 除法器可以足够快,维持合理的乘除速度比。
Weitek 3364 有独立加、乘、除单元,也采用基 4 SRT,但加法和乘法都流水化。加法三级为:(1) 比较指数,(2) 加法后移位或移位后加法,(3) 最终舍入。第 1、3 级各半周期,所以三级流水线总延迟仍为两周期。乘法采用图 J.28 式阵列,但使用基 8 Booth,需要预先算 3b。三级分别是:(1) 算 3b,(2) 通过阵列,(3) 最终进位传播加法与舍入。单精度通过阵列一次,双精度两次,总延迟也为两周期。
Weitek 的加法器是图 J.18 跳跃进位的变体。 是多个项的 AND,但它通过逐级传播计算,每一级做一次 AND。因此,块内进位向左传播时,下一块的 向右传播,块宽选择成两股信号同时到达。3364 还支持与除法共用硬件的平方根。其双精度乘、除周期比为 2:17,差距较大,是因为乘法用基 8、除法用基 4;R3010 的乘除则采用相同基数。
TI 8847 最突出的特点,是用 J.6 节的 Goldschmidt 迭代作除法。它使乘除周期比改善为 3:11,但两者无法并行。加法为两级流水线:第一级比较指数、移动小数部分并相加,第二级规格化和舍入。乘法使用带符号数字加法器的二叉树,分三级:第一遍穿过阵列,处理一半位;第二遍处理另一半;第三级把带符号数字转换为补码。只有一套阵列,因此每隔一个周期才能启动一次乘法。不过,放慢时钟后,可在一个周期内穿过阵列两遍,从而每周期启动一次乘法。8847 加法器采用选择进位而非 CLA。如 J.6 节所述,为确保除法正确舍入,TI 内部保留 60 位精度。
这三款芯片展示了相似约束下的不同取舍。最有趣的是算法多样性:加法各不相同,乘法也各不相同;Booth 重编码是三者共同采用的技术。