K.2 桌面、服务器及嵌入式计算机的 RISC 体系结构概览
引言
本节介绍两组精简指令集计算机(RISC)体系结构。第一组面向桌面、服务器和个人移动设备(PMD):
- Advanced RISC Machines 的 ARMv8,即 64 位 ISA AArch64。
- MIPS64 第 6 版,即原书讨论的最新 64 位 ISA。
- Power 3.0,合并了早期 IBM Power 和 PowerPC 体系结构。
- RISC-V,具体采用 64 位扩展 RV64G。
- SPARCv9,即 64 位 ISA。
如图 K.1 所示,这些体系结构相当相似。
| 项目 | ARMv8 | MIPS64 R6 | Power v3.0 | RV64G | SPARCv9 |
|---|---|---|---|---|---|
| 基础 ISA 最初年代 | 1986 | 1986 | 1990 | 2016 | 1987 |
| 本版 ISA 年代 | 2011 | 2014 | 2013 | 2016 | 2008 |
| 指令长度(位) | 32 | 32 | 32 | 32 | 32 |
| 地址空间:大小、模型 | 64 位,平坦 | 64 位,平坦 | 64 位,平坦 | 64 位,平坦 | 64 位,平坦 |
| 数据对齐 | 优先对齐 | 优先对齐 | 可不对齐 | 优先对齐 | 对齐 |
| 数据寻址方式数 | 8,含比例变址及前/后递增 | 1,另有 1 种仅用于浮点 | 4 | 1 | 2 |
| 整数寄存器:数量、模型、宽度 | 31 个 64 位 GPR,加栈指针 | 31 个 64 位 GPR | 31 个 64 位 GPR | 31 个 64 位 GPR | 31 个 64 位 GPR |
| 独立浮点寄存器 | 32 × 32 位或 32 × 64 位 | 32 × 32 位或 32 × 64 位 | 32 × 32 位或 32 × 64 位 | 32 × 32 位或 32 × 64 位 | 32 × 32 位或 32 × 64 位 |
| 浮点格式 | IEEE 754 单/双精度 | IEEE 754 单/双精度 | IEEE 754 单/双精度 | IEEE 754 单/双精度 | IEEE 754 单/双精度 |
历史上还有两款重要 RISC 处理器,与上述体系结构近乎相同。Digital Equipment Corporation 在 1992–2004 年制造的 DEC Alpha,与 MIPS64 几乎一致。HP 约从 1986 年到 2005 年生产 PA-RISC,之后由 Itanium 取代。PA-RISC 与 Power ISA 最接近;后者来自 IBM Power,而 IBM Power 又继承自 IBM 801。
第二组是面向较低端应用的嵌入式 RISC:
- Advanced RISC Machines 的 Thumb-2:包含 16 位和 32 位指令的 32 位指令集,兼有 ARMv7、ARMv8 的特性。
- microMIPS64:包含 16 位指令的 MIPS64 版本。
- RISC-V 压缩扩展 RV64GC:在 RV64G 上增加一组 16 位指令。
RV64GC 和 microMIPS64 都有对应的 32 位版本,即 RV32GC、microMIPS32。
由于基础 32 位或 64 位桌面、服务器体系结构的比较会讨论各 ISA 的差异,这里对嵌入式体系结构主要关注 16 位指令。
| 项目 | microMIPS64 | RV64GC | Thumb-2 |
|---|---|---|---|
| 发布年份 | 2009 | 2016 | 2003 |
| 指令长度(位) | 16/32 | 16/32 | 16/32 |
| 地址空间:大小、模型 | 32/64 位,平坦 | 32/64 位,平坦 | 32 位,平坦 |
| 数据对齐 | 对齐 | 优先对齐 | 对齐 |
| 数据寻址方式数 | 2 | 1 | 6 |
| 整数寄存器:数量、模型、宽度 | 31 个 64 位 GPR | 31 个 64 位 GPR | 15 个 32 位 GPR |
| 大多数 16 位指令可访问的整数寄存器 | 8 个 GPR + SP + GP + RA;GPR 为 0、2–7、17,或 2–7、16、17 | 8 个 GPR + SP;GPR 为 8–15 | 8 个 GPR + SP,宽 32 位 |
图 K.2 表明,这些嵌入式体系结构也很相似。三者的 16 位指令都是 32 位指令的简化版本,通常只允许使用有限的寄存器。基本思想是用 16 位版本替换常见的 32 位指令,从而缩小代码。RV32GC 或 Thumb-2 加入 16 位指令后,代码大小约为仅使用对应 32 位 ISA——RV32G 或 ARMv7——时的 0.73 倍。
三者的重要区别在基础 32 位 ISA 的结构。RV64GC 的 32 位指令与 RV64G 完全相同,因为 RISC-V 从一开始就考虑了 16 位选项,分支和跳转目标按 16 位边界指定。microMIPS64 基于 MIPS64,只作一项改变:分支和跳转偏移量按 16 位而不是 32 位对齐解释。它还使用了 MIPS64 为用户自定义指令扩展保留的编码空间;这些扩展不属于基础 ISA。
Thumb-2 稍有不同。其 32 位指令大多是 ARMv7 的子集,但不包含一些在 ARMv8 中被删除的特性,例如大多数指令的条件执行,以及把 PC 当作 GPR 写入。Thumb-2 还包含数十条在 ARMv8 引入的指令,具体为位字段操作、额外系统指令和同步支持。因此,Thumb-2 的 32 位指令构成一个独特的 ISA。
较早的 MIPS16 和 Thumb 采用独立模式:通过过程调用,转入只使用 16 位指令的代码段。其 16 位指令集并不完整,只面向对代码大小敏感的用户程序。
这些说明还受到一个复杂因素影响:较早的 RISC 经多年不断扩展。因此,本节选择描述原书所述时期的最新版本:桌面、服务器和 PMD 使用 ARMv8/AArch64、MIPS64 R6、Power v3.0、RV64G、SPARC v9;嵌入式部分描述 microMIPS64、RV64GC 和 Thumb-2 的 16 位子集。
讨论寻址方式和指令格式后,按五步概览指令:
- 附录 A 描述的 RV64G 核心中已有的指令。
- RV64G 或 RV64GC 没有、但至少另外两种体系结构具有的指令,按功能组织,例如扩展整数算术。
- ARM、MIPS、Power 或 SPARC 独有的指令组,按功能组织。
- 桌面、服务器、PMD RISC 的多媒体扩展。
- 嵌入式 RISC 的数字信号处理扩展。
本节覆盖这些体系结构的大多数指令,但并非每一条;Power 和 ARM 尤其如此,因为其指令很多。
寻址方式与指令格式
图 K.3 给出桌面、服务器、PMD 体系结构的数据寻址方式。除 ARM 外,它们都有一个寄存器,在参与地址计算时始终取零;因此,位移寻址以寄存器 0 为基址,就能合成范围有限的绝对寻址。PowerPC 的该寄存器可以被 ALU 操作修改,但用于地址计算时仍按零处理。同样,将位移设为零,就能合成寄存器间接寻址。简化的寻址方式是 RISC 的特征之一。
| 寻址方式 | ARMv8 | MIPS64 R6 | Power v3.0 | RV64G | SPARCv9 |
|---|---|---|---|---|---|
| 寄存器 + 偏移量:位移/基址 | B,H,W,D | B,H,W,D | B,H,W,D | B,H,W,D | B,H,W,D |
| 寄存器 + 寄存器:变址 | B,H,W,D | B,H,W,D | B,H,W,D | ||
| 寄存器 + 按比例缩放的寄存器:比例变址 | B,H,W,D | W,D | |||
| 寄存器 + 寄存器 + 偏移量 | B,H,W,D | ||||
| 寄存器 + 偏移量,并将寄存器更新为有效地址:带更新的基址寻址 | B,H,W,D | B,H,W,D | |||
| 使用寄存器原值寻址,再将寄存器更新为寄存器 + 偏移量:带更新的寄存器寻址 | B,H,W,D | ||||
| 寄存器 + 寄存器,并将寄存器更新为有效地址:带更新的变址寻址 | B,H,W,D | B,H,W,D | |||
| PC 相对:PC + 位移 | W,D | W,D |
如图 K.4 所示,嵌入式体系结构限制了 16 位指令可访问的寄存器;大多数指令通常只能访问八个寄存器,少数特殊指令能访问其他寄存器。图 K.5 给出其 16 位指令模式的数据寻址方式。这些加载和存储版本既限制了地址计算可用的寄存器,也大幅缩短了位移立即数字段。
| 寄存器指定方式 | microMIPS64 | RV64GC | Thumb-2 |
|---|---|---|---|
| 3 位编码 | 2–7、16、17 | 8–15 | 0–7 |
| 栈指针寄存器 | 29 | 2 | 0(用于加载/存储时) |
| 全局指针寄存器 | 28 | ||
| 返回地址寄存器 | 31 | 1 | 14 |
| 使用特殊寄存器 | 栈指针或全局指针;5 位偏移量 | 栈指针;5 位偏移量 | 栈指针;8 位偏移量 |
| 寻址方式 | microMIPS64 | RV64GC | Thumb-2 |
|---|---|---|---|
| 寄存器 + 偏移量:位移/基址 | 4 位偏移量,八个寄存器之一 | 5 位偏移量,八个寄存器之一 | 5 位偏移量,八个寄存器之一 |
| PC 相对数据 | 仅字;8 位偏移量 | ||
| 使用特殊寄存器 | 栈指针或全局指针;5 位偏移量 | 栈指针;5 位偏移量 | 栈指针;8 位偏移量 |
译注:图 K.4 的 microMIPS64 全局指针为 28,图 K.5 图注却写 30;Thumb-2 栈指针在图 K.4 写作 0,图 K.5 图注写作 r31,又与图 K.2 所述寄存器规模不协调。这些都是原页可见的源书差异。
代码引用通常采用 PC 相对方式,同时支持寄存器间接跳转,用于过程返回、case 语句和经指针调用函数。桌面 RISC 的 PC 相对分支地址经常先左移两位再与 PC 相加,以扩大分支范围;这是因为指令均为 32 位,且必须在存储器中按 32 位字对齐。嵌入式体系结构和带压缩扩展的 RISC-V 包含 16 位指令,出于类似原因,PC 相对地址通常左移一位。
图 K.6 展示桌面、服务器、PMD RISC 最重要的指令格式。每种 ISA 使用四种主要格式,通常覆盖 90%–98% 的指令。寄存器—寄存器格式用于相应 ALU 指令;ALU 立即数格式用于带立即数的 ALU 指令,也用于加载与存储;分支格式用于条件分支;跳转/调用格式用于无条件分支和过程调用。
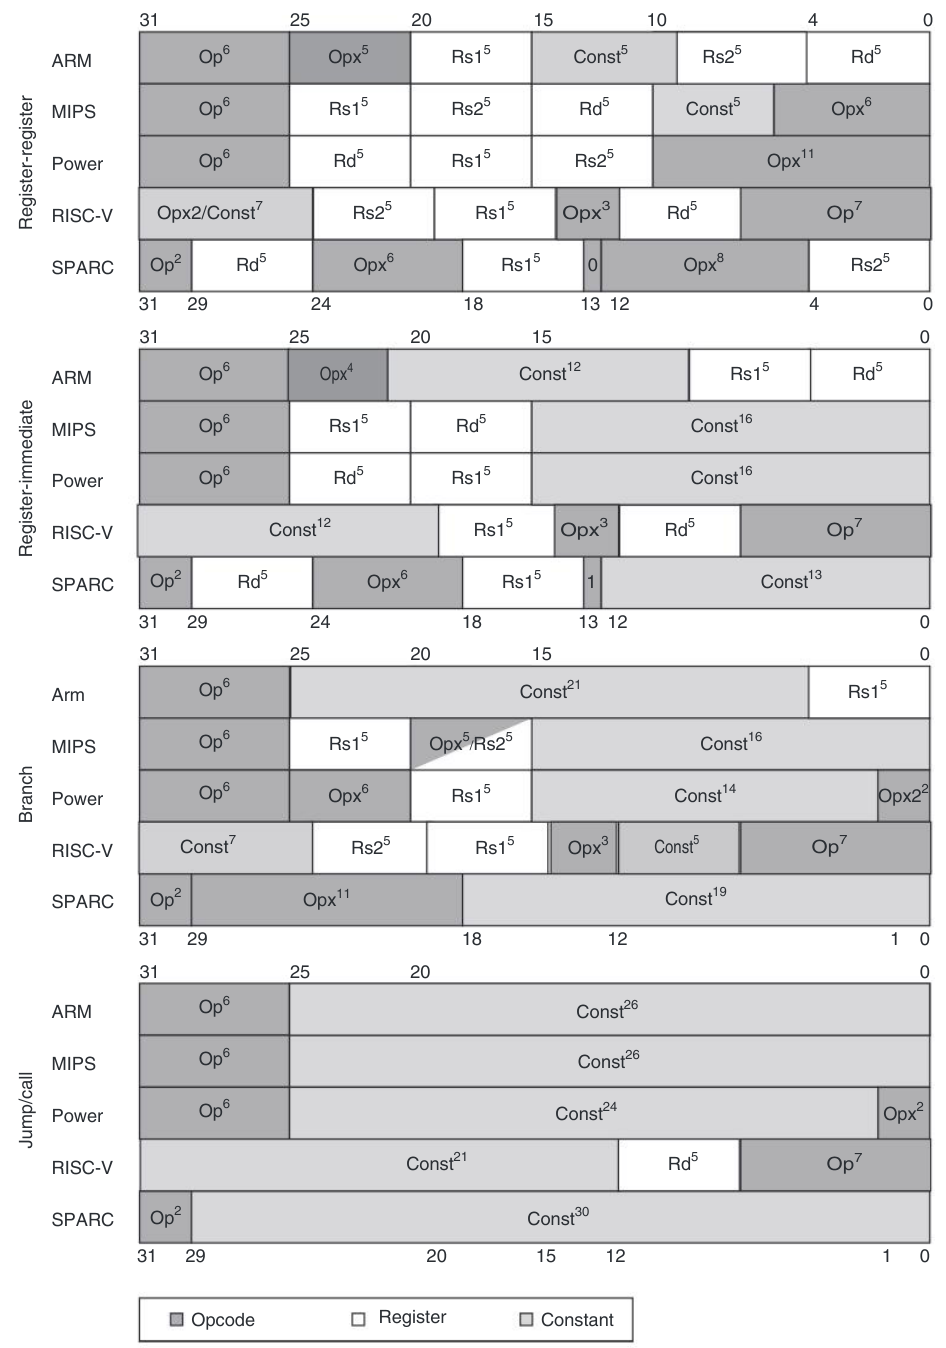
图内术语:Register-register=寄存器—寄存器;Register-immediate=寄存器—立即数;Branch=分支;Jump/call=跳转/调用;Opcode=操作码;Register=寄存器;Constant=常数。
译注:原图 RISC-V 跳转行的常数字段标为 21,加上 Rd 的 5 位和 Op 的 7 位会得出 33 位;原图保留这一标注。RISC-V 的分支、存储格式对立即数字段的解释也并非完全相同,下一图继续区分 SB 等变体。
图 K.6 省略了一些较少使用的格式,图 K.7 将其汇总。
| 体系结构 | 额外格式数 | 格式功能与用途 |
|---|---|---|
| ARMv8 | 至少 10 种,另有许多小变体;右列列出主要形式 | 带 13 位立即数字段的逻辑立即数操作 |
| ARMv8 | 常量移位量的移位,16 位操作码 | |
| ARMv8 | 16 位立即数格式 | |
| ARMv8 | 独占访问操作,三个寄存器字段 | |
| ARMv8 | 寄存器分支,较长操作码 | |
| ARMv8 | 带寻址方式位的加载/存储 | |
| MIPS64 | 1 | 一组 PC 相对加载/存储,使用寄存器—立即数格式,但立即数为 18 位,因为另一源操作数是 PC |
| Power | 9,不含小变体和向量扩展 | DQ 模式:使用 ALU 立即数形式,将位移的四位用于其他功能 |
| Power | DS 模式:使用 ALU 立即数形式,将位移的两位用于其他功能 | |
| Power | DX 格式:类似寄存器—立即数,以 PC 取代一个源寄存器 | |
| Power | MD、MDS 格式:类似寄存器—寄存器,用于移位和循环移位 | |
| Power | X、XS 及若干小变体:用于变址寻址、移位和多种扩展功能 | |
| Power | Z22、Z23 格式:操作浮点数 | |
| RV64 | 2 | SB 格式:分支格式的变体,对立即数作不同解释 |
| RV64 | UJ 格式:跳转/调用格式的变体,对立即数作不同解释 | |
| SPARC | 3 | 另一种条件分支格式,多三位位移,总共 22 位而不是 19 位,但没有预测提示 |
| SPARC | 22 位立即数格式,用于加载寄存器高半部 | |
| SPARC | 基于寄存器与零比较的条件分支格式 |
与基础 32 位体系结构不同,microMIPS64、RV64GC、Thumb-2 的 16 位扩展着重最小化代码。因此,虽然指令少得多,格式反而更多:microMIPS64、RV64GC 分别有八种和七种主要格式,Thumb-2 有十五种。图 K.8 显示,它们具有不同数量的寄存器操作数(0–3 个)、不同大小的立即数字段,甚至不同宽度的寄存器指定符。大多数指令只访问少量寄存器,较少的指令才可访问全部 32 个寄存器。
| 体系结构 | 操作码位数:主/扩展 | 寄存器指定符:个数 × 位宽 | 立即数字段位数 | 典型指令 |
|---|---|---|---|---|
| microMIPS64 | 6 | 无 | 10 | 跳转 |
| microMIPS64 | 6 | 1 × 5 | 5 | 寄存器—寄存器操作,32 个寄存器;以 SP 为基址的加载,目的寄存器不限 |
| microMIPS64 | 6 | 1 × 3 | 7 | 等于/不等于零的分支;以 GP 为基址的加载 |
| microMIPS64 | 6:4 | 2 × 3 | 寄存器—寄存器,rd/rs1 与 rs2;八个寄存器 | |
| microMIPS64 | 6:1 | 2 × 3 | 3 | 寄存器—寄存器立即数,rd/rs1 与 rs2;八个寄存器 |
| microMIPS64 | 6 | 2 × 3 | 4 | 加载和存储;八个寄存器 |
| microMIPS64 | 6:4 | 2 × 3 | 寄存器—寄存器,rd 与 rs1;八个寄存器 | |
| microMIPS64 | 6 | 2 × 5 | 寄存器—寄存器;32 个寄存器 | |
| RV64GC | 2:3 | 11 | 跳转 | |
| RV64GC | 2:3 | 1 × 3 | 7 | 分支 |
| RV64GC | 2:3 | 1 × 3 | 8 | 立即数操作,一个源寄存器 |
| RV64GC | 2:3 | 1 × 5 | 6 | 以 SP 为基址的存储 |
| RV64GC | 2:3 | 1 × 5 | 6 | ALU 立即数,以及以 SP 为基址的加载 |
| RV64GC | 2:4 | 2 × 5 | 寄存器—寄存器操作 | |
| RV64GC | 2:3 | 2 × 3 | 5 | 使用八个寄存器的加载和存储 |
| Thumb-2 | 3:2 | 2 × 3 | 5 | 移位、传送、字/字节加载和存储 |
| Thumb-2 | 3:2 | 1 × 3 | 8 | 立即数加、减、传送、比较 |
| Thumb-2 | 4:1 | 1 × 3 | 8 | 以 SP 为基址的加载/存储,对 SP 或 PC 做加法,多寄存器加载/存储 |
| Thumb-2 | 4:3 | 3 × 3 | 寄存器变址加载 | |
| Thumb-2 | 4:4 | 8 | 条件分支、系统指令 | |
| Thumb-2 | 4:12 | 杂项:22 条指令、12 种格式,包括比较零并分支、寄存器压栈/出栈、调整栈指针、字节反转、IF-THEN | ||
| Thumb-2 | 5 | 1 × 3 | 8 | PC 相对加载 |
| Thumb-2 | 5 | 11 | 无条件分支 | |
| Thumb-2 | 6:1 | 3 × 3 | 加/减 | |
| Thumb-2 | 6:3 | 1 × 4、1 × 3 | 特殊数据处理 | |
| Thumb-2 | 6:4 | 2 × 3 | 逻辑数据处理 | |
| Thumb-2 | 6:6 | 1 × 4 | 分支并切换指令集:ARM 与 Thumb |
指令
各体系结构的相似性,让我们能够同时介绍它们,先从与 RISC-V 64 位 ISA 等价的操作开始。
RV64G 核心指令
RV64G 几乎每条指令,都能在其他体系结构中找到对应操作,如图 K.9–K.19 所示;RISC-V 指令定义见 A.9 节。分为四类:数据传送(图 K.9)、算术和逻辑(图 K.10)、控制(图 K.11、K.12)、浮点(图 K.13)。
若一条 RV64G 核心指令在其他体系结构中需要短指令序列合成,图 K.9–K.13 用分号分隔该序列。为避免混淆,本附录总将目的寄存器写在最左边,不受各体系结构通常记法的影响。
| 数据传送指令 | ARMv8(R-I) | MIPS64(R-I) | Power(R-I、R-R) | RV64G(R-I) | SPARC(R-I、R-R) |
|---|---|---|---|---|---|
| 有/无符号字节加载 | LDR_B | LB_ | LBZ; EXTSB | LB_ | LD_B |
| 有/无符号半字加载 | LDR_H | LH_ | LHA/LHZ | LH_ | LD_H |
| 字加载 | LDRSW/LDR | LW_ | LW_ | LW_ | LD_W |
| 双字加载 | LDRX | LD | LD | LD | LDD |
| 单/双精度浮点寄存器加载 | LD_ | L_C1 | LF_ | FL_ | LD_F |
| 字节存储 | STB | SB | STB | SB | STB |
| 半字存储 | STW | SH | STH | STH | STH |
| 字存储 | STL | SW | STW | SW | ST |
| 双字存储 | STX | SD | SD | SD | STD |
| 单/双精度浮点存储 | ST_ | S_C1 | STF_ | FS_ | ST_F |
| 加载保留 | LDEXB, LDEXH, LDEXW, LDEXD | LL, LLD | lwarx, ldarx | LR | |
| 条件存储 | STEXB, STEXH, STEXW, STEXD | SC, SCD | stwcx, stdcx | SC | |
| 读/写特殊寄存器 | MF_, MT_ | MF, MT_ | M_SPR | csrr_, csrr_i | RD__, WR__ |
| 整数寄存器传送到浮点寄存器 | ITOFS | MFC1/DMFC1 | STW; LDFS | STW; FLDWX | ST; LDF |
| 浮点寄存器传送到整数寄存器 | FTTOIS | MTC1/DMTC1 | STFS; LW | FSTWX; LDW | STF; LD |
| 数据/指令流同步 | DSB, ISB | SYNC, SYNCI | SYNC, ISYNC | Fence, Fence.i | MEMBAR, FLUSH |
| 原子操作 | LDWAT, LDDAT, STWAT, STDAT | LLWP, LLDP, SCWP, SCDP | AMOSWAP.W/D, AMOADD.W/D, AMOAND.W/D, AMOXOR.W/D, AMOOR.W/D, AMOMIN_.W/D, AMOMAX_.W/D | CASA, SWAP, LDSTUB |
译注:图 K.9 的助记符按原表保留,包括 RV64G 栏的 STH、FLDWX、FSTWX、LDW,以及 MIPS 两行寄存器传送的名称与方向。这张跨体系结构概要表含版本混用和疑似笔误,不能将每个单元格直接作为可汇编代码。R-I、R-R 分别指寄存器—立即数和寄存器—寄存器格式。
比较与条件分支
每种体系结构都必须提供比较和条件分支。尽管它们有诸多相似之处,具体方法却各不相同。图 K.11 汇总控制指令,图 K.12 说明条件分支的处理。
SPARC 使用程序状态字中传统的四个条件码位:负、零、进位、溢出。任意算术或逻辑指令都可设置它们;与早期体系结构不同,每条指令是否设置条件码是可选的,显式选项可以减少流水线实现的问题。条件码既可作为操作的副作用设置,也可通过以 r0 为目的寄存器的减法来合成显式比较。条件分支检查条件码,判断各种无符号及有符号关系。浮点使用独立条件码编码 IEEE 754 条件,需要浮点比较指令。
SPARC 第 9 版从四方面扩展分支:为 64 位操作增加独立条件码;增加直接检查寄存器是否等于、不等于、小于、小于等于、大于等于或小于等于零的分支;增加三组浮点条件码;在分支指令中编码静态分支预测。1
Power 也采用四个条件码:小于、大于、等于和汇总溢出,但有八组副本。这使不同指令可使用不同条件码而不冲突,相当于多出八个 4 位寄存器。比较可以写入任意一组,条件分支也可读取任意一组。整数指令的选项位产生这样的效果:仿佛整数操作后面跟着一次与零比较,并设置第一组条件“寄存器”。
浮点指令也可选择设置第二组。PowerPC 允许对这八组条件码寄存器执行逻辑运算 CRAND、CROR、CRXOR、CRNAND、CRNOR、CREQV,让一个分支检测更复杂条件。Power 还包含分支计数寄存器,测试时自动递减,并可参与分支条件;另有专用指令用于读写条件寄存器。
RISC-V 与 MIPS 最相似。RISC-V 将完整的算术比较与分支结合;MIPS 也使用比较并分支,但比较限于相等以及与零比较。这种限制简化了分支判断,因为判断条件无需 ALU 操作,代价是有时必须先使用“小于则置位”指令 SLT、SLTI、SLTU、SLTIU:比较两个操作数,若前者小于后者,将目的寄存器置 1,否则置 0。更多细节见图 K.12。RISC-V 浮点比较将整数寄存器置为 0 或 1,再据此条件分支。MIPS 也使用独立浮点比较,把浮点寄存器置为 0 或 1,然后由浮点条件分支测试。
ARM 类似 SPARC,可选择设置传统四条件码。CMP 相减并据差设置条件码;CMN(compare negative)相加并据和设置条件码。TST 对两个操作数做 AND,设置除溢出以外的条件码;TEQ 用 XOR 设置前三个条件码。ARM 条件分支也根据条件码判断各类无符号及有符号关系。ARMv8 增加位测试指令,以及与零比较并分支。ARM 浮点比较设置整数条件码,由 B.cond 使用。
图 K.13 表明,五种体系结构的浮点支持也很相似。
| 算术/逻辑指令(各列均有 R-R、R-I 格式) | ARMv8 | MIPS64 | Power v3 | RISC-V | SPARC v9 |
|---|---|---|---|---|---|
| 字加法、立即数加法 | ADD, ADDI | ADDU, ADDUI | ADD, ADDI | ADDW, ADDWI | ADD |
| 双字加法 | ADDX | DADDU, DADDUI | ADD, ADDI | ADD, ADDI | ADD |
| 减法 | SUB, SUBI | SUBU, SUBI | SUBF | SUBW, SUBWI | SUB |
| 双字减法 | SUBX | DSUBU, DSUBUI | SUBF | SUB, SUBI | SUB |
| 乘法 | MUL, SMUL | MUL, MULU, DMUL, DMULU | MULLW, MULLI | MUL, MULU, MULW, MULWU | MULX |
| 除法 | MULX, SMULX | DIV, DIVU, DDIV, DDIVU | DIVW | DIV, DIVU, DIVW, DIVWU | DIVX |
| 余数 | MOD, MODU, DMOD, DMODU | MODSW, MODUW | REM, REMU, REMW, REMWU | ||
| AND | AND, ANDI | AND, ANDI | AND, ANDI | AND, ANDI | AND |
| OR | OR, ORI | OR, ORI | OR, ORI | OR, ORI | OR |
| XOR | XOR, XORI | XOR, XORI | XOR, XORI | XOR, XORI | XOR |
| 加载第 31–16 位 | MOV | LUI | ADDIS | ADDIS | SETHI (Bfmt.) |
| 加载 PC 高位 | ADR | ADDIUPC | ADDPCIS | AUIPC | |
| 逻辑左移:字/双字,立即数/可变移位量 | LSL | SLLV, SLL | RLWINM | SLL, SLLI, SLLW, SLLWI | SLL |
| 逻辑右移:字/双字,立即数/可变移位量 | RSL | SRLV, SRL | RLWINM 32-i | SRL, SRLI, SRLW, SRLWI | SRL |
| 算术右移:字/双字,立即数/可变移位量 | RSA | SRAV, SRA | SRAW | SRA, SRAI, SRAW, SRAWI | SRA |
| 比较 | CMP | SLT/U, SLTI/U | CMP(I)CLR | SLT/U, SLTI/U | SUBcc r0,... |
译注:图 K.10 原表存在多处助记符疑点,例如 ARM“除法”栏写 MULX, SMULX,RISC-V 栏写 ADDIS、SUBI、MULU 等,且部分 W/I 后缀顺序与附录 A 的写法不同。
| 控制指令 | ARMv8 | MIPS64 | PowerPC | RISC-V | SPARC v9 |
|---|---|---|---|---|---|
| 整数比较后分支 | B.cond, CBZ, CBNZ | BEQ, BNE, B_Z(<、>、≤、≥);或 S***; BEZ | BC | BEQ, BNE, BLT, BGE, BLTU, BGEU | BR_Z, BPcc(<、>、≤、≥、=、≠) |
| 浮点比较后分支 | B.cond | BC1T, BC1F | BC | BEZ, BNZ | FBPfcc(<、>、≤、≥、= 等) |
| 跳转、寄存器跳转 | B, BR | J, JR | B, BCLR, BCCTR | JAL, JALR,目的为 x0 | BA, JMPL r0,... |
| 调用、寄存器调用 | BL, BLR | JAL, JALR | BL, BLA, BCLRL, BCCTRL | JAL, JALR | CALL, JMPL |
| 陷阱 | SVC, HVC, SMC | BREAK | TW, TWI | ECALL | Ticc, SIR |
| 中断返回 | ERET | JR; ERET | RFI | EBREAK | DONE, RETRY, RETURN |
译注:原图把 EBREAK 放在 RISC-V“中断返回”行,存在明显功能分类疑点;保留原表,不应据此把断点指令用于中断返回。
| 条件分支特性 | ARMv8 | MIPS64 | PowerPC | RISC-V | SPARC v9 |
|---|---|---|---|---|---|
| 条件码位数:整数、浮点 | 16,即 8 加其反值 | 无 | 两者均 8 × 4 | 无 | 整数 2 × 4,浮点 4 × 2 |
| 基本比较指令数:整数、浮点 | 整数 1,浮点 1 | 整数 1,浮点 1 | 整数 4,浮点 2 | 整数 2,浮点 3 | 浮点 1 |
| 基本分支指令数:整数、浮点 | 1 | 整数 2,浮点 1 | 两者共 1 | 整数 4,也用于浮点结果 | 整数 3,浮点 1 |
| 寄存器与寄存器/常数比较并分支 | — | =、≠ | — | =、≠、≥、< | — |
| 寄存器与零比较并分支 | — | =、≠、<、≤、>、≥ | — | =、≠、<、≤、>、≥ | =、≠、<、≤、>、≥ |
译注:图 K.12 的 ARMv8 条件码数量写作“16(8 加反值)”,与正文所述四个条件码位不一致;其“与零比较并分支”行也与图 K.11 的 CBZ、CBNZ 不一致。原表数字与空缺均保留。
| 浮点指令(均为 R-R 格式) | ARMv8 | MIPS64 | PowerPC | RISC-V | SPARC v9 |
|---|---|---|---|---|---|
| 单/双精度加 | FADD | ADD.* | FADD* | FADD.* | FADD* |
| 单/双精度减 | FSUB | SUB.* | FSUB* | FSUB.* | FSUB* |
| 单/双精度乘 | FMUL | MUL.* | FMUL* | FMUL.* | FMUL* |
| 单/双精度除 | FDIV | DIV.* | FDIV* | FDIV.* | FDIV* |
| 单/双精度平方根 | FSQRT | SQRT.* | FSQRT* | FSQRT.* | FSQRT* |
| 单/双精度乘加、负乘加 | FMADD, FNMADD | MADD.*, NMAD.* | FMADD*, FNMADD* | FMADD.*, FNMADD.* | |
| 单/双精度乘减、负乘减 | FMSUB, FNMSUB | MSUB.*, NMSUB.* | FMSUB*, FNMSUB* | FMSUB.*, FNMSUB.* | |
| 将单/双精度符号或反符号复制到另一浮点寄存器 | FMOV, FNEG | FMOV.*, FNEG.* | FMOV*, FNEG* | FSGNJ.*, FSGNJN.* | FMOV*, FNEG* |
| 用符号位的 XOR 替换符号位,单/双精度 | FABS | FABS.* | FABS* | FSGNJX.* | FABS* |
| 单/双精度最大/最小 | FMAX, FMIN | MAX.*, MIN.* | FMAX.*, FMIN.* | ||
| 单/双精度浮点值分类 | CLASS.* | FCLASS.* | |||
| 比较 | FCMP | CMP.* | FCMP* | FCMP.* | FCMP* |
| 单/双精度浮点之间,或与有/无符号单字/双字整数之间的带舍入转换 | FCVT | CVT, CEIL, FLOOR | FCVT | F*TO* |
RV64GC 的核心 16 位指令
图 K.14–K.17 汇总 microMIPS64、RV64GC、Thumb-2 的数据传送、ALU 和控制指令。因为它们都基于完整体系结构的 32 位或 64 位版本,这里只关注 16 位指令实现的功能。浮点是可选项,因此不纳入这组比较。
| 数据传送指令 | microMIPS64:rs1;rs2/dst;偏移位数 | RV64GC:rs1;rs2/dst;偏移位数 | Thumb-2:rs1;rs2/dst;偏移位数 |
|---|---|---|---|
| 字加载 | 8;8;4 | 8;8;5 | 8;8;5 |
| 双字加载 | 8;8;5 | ||
| 以栈指针为基址的字加载 | 1;32;5 | 1;32;6 | 1;3;8 |
| 以栈指针为基址的双字加载 | 1;32;6 | ||
| 字存储 | 8;8;4 | 8;8;5 | 8;8;5 |
| 双字存储 | 8;8;5 | ||
| 以栈指针为基址的字存储 | 1;32;5 | 1;32;6 | 1;3;8 |
| 以栈指针为基址的双字存储 | 1;32;6 |
译注:Thumb-2 两处 1;3;8 均为原表数字,未将 3 擅改为其他寄存器数量。
| ALU 指令/功能 | microMIPS64 | RV64GC | Thumb-2 |
|---|---|---|---|
| 加载立即数 | 8;7 | 32;6 | 8;8 |
| 加载高位立即数 | 32;6 | ||
| 立即数加法 | 32;4 | 32;6 | 8;8;3 |
| 32 位字立即数加法并符号扩展 | 32;6 | ||
| 栈指针加立即数 | 1;9 | 1;6,增加立即数的 16 倍 | 1;7 |
| 栈指针加立即数,结果存入寄存器 | 1;8;6 | 1;8;6,增加立即数的 4 倍 | |
| 逻辑左/右移 | 8;8;3,末项为移位量 | 8;6,末项为移位量 | 8;8;5,末项为移位量 |
| 算术右移 | 8;6,末项为移位量 | 8;8;5,末项为移位量 | |
| AND 立即数 | 8;8;4 | 8;6 | 8;8 |
| 传送 | 32;32 | 32;32 | 16;16 |
| 加法 | 8;8;8 | 32;32 | 8;8;8 或 16;16 |
| AND、OR、XOR | 8;8 | 8;8 | 8;8 |
| 减法 | 8;8;8 | 8;8 | 8;8;8 |
| 32 位字加/减并符号扩展 | 8;8 |
| 控制操作 | microMIPS64 | RV64GC | Thumb-2 |
|---|---|---|---|
| 无条件分支 | 10 位偏移量 | 11 位偏移量 | 11 位偏移量 |
| 无条件分支并链接 | 11 位偏移量 | 11 位偏移量 | |
| 无条件寄存器分支,带/不带链接 | 任意 32 个寄存器之一 | 任意 32 个寄存器之一 | |
| 寄存器与零比较,等于/不等于时分支 | 八个寄存器;7 位偏移量 | 八个寄存器;8 位偏移量 | 无,但见图注 |
RV64G 之外的共同扩展
图 K.15–K.18 列出图 K.9–K.13 未包含的指令,仍按数据传送、ALU 和控制等类别组织。2 唯一显著的浮点扩展是倒数指令,MIPS64 和 Power 都支持。某条指令只有出现在不止一种标准体系结构中,才列入这些表。
回顾 K-6 页的图 K.3,各指令集支持的寻址方式比 RV64G 丰富。采用额外方式的加载和存储未列入图 K.17,但实际上也构成额外数据传送指令:ARM 有 64 条,Power3 有 12 条,MIPS64、SPARCv9 各有四条。
| 功能 | 定义 | ARMv8 | MIPS64 | PowerPC | SPARC v9 |
|---|---|---|---|---|---|
| 多寄存器加载/存储 | 加载或存储至少两个寄存器 | 加载寄存器对、存储寄存器对 | 多寄存器加载/存储,至多 31 个寄存器 | ||
| 缓存操作与预取 | 修改缓存行状态或预取 | Prefetch | CACHE、PREFETCH | Prefetch | Prefetch |
| 名称 | 定义 | ARMv8 | MIPS64 | PowerPC | SPARC v9 |
|---|---|---|---|---|---|
| 延迟分支 | 带/不带撤销的延迟分支 | BEQ, BNE, BGTZ, BLEZ, BCxEQZ, BCxNEZ | BPcc,A; FPBcc,A | ||
| 条件陷阱 | 条件为真时触发陷阱 | TEQ, TNE, TGE, TLT, TGEU, TLTU | TW, TD, TWI, TDI | Tcc |
现代处理器使用动态分支预测来加速分支,见 3.3 节。许多体系结构早期支持延迟分支,后续版本将其删除或基本淘汰,通常提供非延迟版本作为首选条件分支。
SPARC 的“撤销”分支优化了延迟分支:只有分支跳转时才执行延迟槽指令,否则撤销它。因此,可以安全地把分支目标指令复制进延迟槽,因为它只在跳转时执行。限制是目标不能又是一条分支,且编译时必须知道目标。SPARC 还提供非延迟跳转,因为设置 annul 位的无条件分支不执行下一条指令。
与完整 ISA 之间的差异相比,三种嵌入式 ISA 的 16 位子集,除了前面图中列出的立即数字段、SP 和其他寄存器使用等区别外,基本没有显著差异。
共同点已经介绍完,下面转向独有特性。先讲桌面/服务器 RISC,按描述独特特性所需篇幅由短到长排列,再讲嵌入式 RISC。
MIPS64 R6 独有的指令
MIPS 指令集经历六代。第 1–4 代主要增加指令;Release 6 删除许多旧指令,同时增加非延迟分支和非对齐数据访问支持。图 K.19 汇总其独有指令。
| 指令类别 | 指令名称 | 功能 |
|---|---|---|
| ALU | Byte align | 从一对寄存器提取由若干字节组成的字或双字,用于非对齐字节复制 |
| ALU | Align Immediate to PC | 将 PC 的高 16 位与左移 16 位的立即数相加,结果放入寄存器,用于形成 PC 相对地址 |
| ALU | Bit swap | 反转寄存器中每个字节内的位顺序 |
| ALU | No-op and link | 将 PC+8 写入寄存器 |
| ALU | Logical NOR | 对两个寄存器计算 NOR |
| 控制转移 | Branch and Link conditional | 寄存器与零比较,条件为真则分支;将返回地址放入链接寄存器 |
| 控制转移 | Jump indexed、Jump and link indexed | 偏移量与寄存器相加形成新 PC,可带或不带链接地址 |
SPARC v9 独有的指令
SPARC 有几项独特特性。下面先介绍其中的主要特性,再用一张表汇总这些特性及其他较小差异。
寄存器窗口
SPARC 最主要的独特特性是寄存器窗口(register windows),它通过优化过程调用来减少寄存器与存储器之间的数据传送。处理器有多组寄存器,每次过程调用分配一组新寄存器。这样做原本可能限制过程调用的深度,但把这些寄存器组作为循环缓冲区使用即可避免这一限制。成本与性能曲线的拐点似乎在 6–8 组;调用栈更深的程序需要把寄存器内容保存到存储器,并在需要时恢复。
SPARC 可以有 2–32 个窗口,全局变量、局部变量、传入参数和传出参数通常各用 8 个寄存器。
每个窗口有 16 个不与其他窗口共用的寄存器,因此 SPARC 实现的物理寄存器数最少可以是 40 个,最多可以是 520 个;迄今大多数实现有 128–136 个。SPARC 没有把窗口切换绑定到调用和返回指令,而是提供独立的 SAVE 与 RESTORE 指令。SAVE 通过指向下一组寄存器来“保存”调用者的窗口,同时执行一次加法。巧妙之处在于,加法的源寄存器来自调用者窗口,目的寄存器却属于被调用者窗口。SPARC 编译器通常用这条指令改变栈指针,为新栈帧中的局部变量分配空间。RESTORE 与 SAVE 相反:恢复调用者窗口,同时执行加法;源寄存器来自被调用者窗口,目的寄存器属于调用者窗口。这样便自动释放栈帧。编译器还可以用它生成被调用过程的最终返回值。
寄存器窗口的风险是,寄存器数量增加可能降低时钟频率。不过,早期实现并未出现这种情况。自 1987 年起,带寄存器窗口的 SPARC 体系结构和不带寄存器窗口的 MIPS R2000 体系结构,都采用过多种工艺实现。在若干代产品中,同等工艺的 SPARC 实现并未比 MIPS 的时钟频率低,这可能是因为这些实现中,缓存访问时间比寄存器访问时间更具决定性。多发射需要多得多的寄存器端口;加上寄存器重命名或重排序缓冲区之后,寄存器窗口的代价变得更大。寄存器窗口是最早的 Berkeley RISC 设计的特性,SPARC 正是受这些设计启发而采用它。在本书所述时期仍在使用的其他主要体系结构中,只有 Tensilica 也采用寄存器窗口;RISC-V ISA 没有纳入这一特性。
快速陷阱
SPARC v9 提供了加快陷阱处理的支持。它把单级陷阱扩展到至少四级,使寄存器窗口上溢和下溢的陷阱处理程序也能被中断。增加这些级别后,处理程序就不必在代码中显式检查缺页或栈指针未对齐的情况,因此可以执行得更快。体系结构增加两条指令来从这种多级处理程序返回:RETRY 会重新执行被中断的指令,DONE 则不会。为支持用户级陷阱,RETURN 指令可以在非特权模式下从陷阱返回。
对 LISP 和 Smalltalk 的支持
剩下最主要的算术特性是带标记的加法和减法。SPARC 的设计者花了相当多时间研究 LISP、Smalltalk 等语言,这影响了前面已经讨论的若干 SPARC 特性:寄存器窗口、条件陷阱指令、使用 32 位指令地址的调用,以及多字算术运算,参见 Taylor 等人 [1986] 和 Ungar 等人 [1984]。体系结构为带标记的数据类型提供少量支持,可以进行加法、减法,进而进行比较。最低两位用于标识操作数是否为整数,整数编码为 00。因此,只要任一操作数没有标为整数,或者结果过大,TADDcc 和 TSUBcc 就会设置溢出位。随后的条件分支或陷阱指令决定下一步怎么处理。如果操作数不是整数,软件就恢复操作数、检查其类型,并根据类型调用正确的运算。未对齐存储器访问陷阱也可以用于带标记数据,因为用标记错误的指针进行加载可能属于非法访问。图 K.20 展示这两种标记支持。
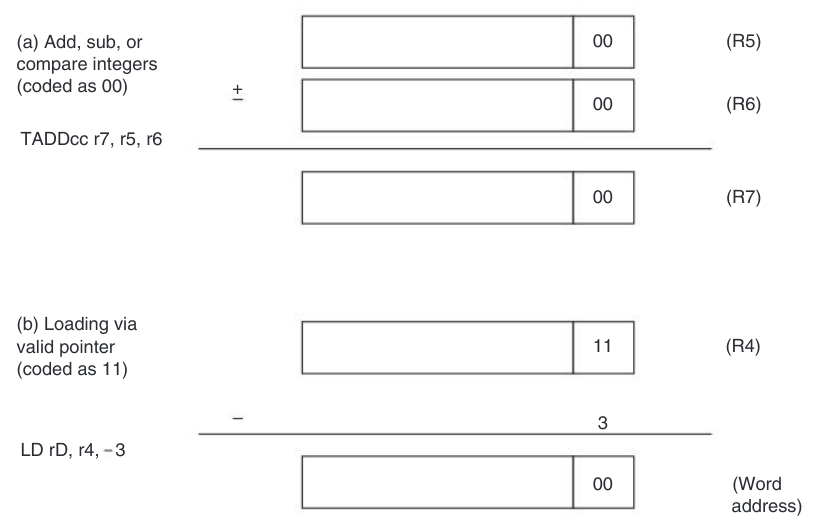
图中整数标记为 00,有效指针标记为 11;Word address 表示字地址。示例指令分别为 TADDcc r7, r5, r6 和 LD rD, r4, −3。
图 K.21 汇总上面介绍的额外指令及其他若干指令。
| 指令类别 | 指令名称 | 功能 |
|---|---|---|
| 数据传送 | SAVE, RESTORE | 保存或恢复寄存器窗口 |
| 数据传送 | Nonfaulting load | 加载指令的一种变体,地址异常不会引发故障,允许对加载进行推测执行 |
| ALU | Tagged add、Tagged subtract,带陷阱和不带陷阱两种形式 | 执行带标记加/减法,设置条件码,并可选择触发陷阱 |
| 控制转移 | Retry, Return, Done | 支持陷阱处理 |
| 浮点 | FMOVcc | 根据整数或浮点条件码,在浮点寄存器之间进行条件传送 |
ARM 独有的指令
较早的 ARM 体系结构版本 ARM v6 和 v7 具有许多不同寻常的特性,包括所有指令都能条件执行,以及把 PC 当作通用寄存器。这些特性在 ARMv8 中被移除,32 位和 64 位 ISA 都是如此。不过,至少从指令集规模来看,它仍保留了相当大的复杂性。如第 K-6 页的图 K.3 所示,ARM 的寻址方式最多,包含表中列出的全部方式。要记住,这些寻址方式使它比 RVG 多出数十条加载/存储指令,即使后面的表格没有逐一列出。第 K-8 页的图 K.6 还表明,ARMv8 的指令格式数量远远最多,既反映了指令种类的多样性,也反映了寻址方式的差异,其中某些寻址方式适用于一些加载/存储指令,却不适用于另一些。
大多数 ARMv8 ALU 指令允许在完成运算之前先对第二个操作数移位。这扩大了立即数的取值范围,但可移位的操作数不限于立即数。可选操作包括逻辑左移、逻辑右移、算术右移和循环右移。此外,与 Power3 一样,大多数 ALU 指令可以选择是否设置条件标志。图 K.22 列出了额外的指令,但没有枚举所有变体,例如选择设置条件标志的形式;详见图注。
尽管所有指令都能条件执行这一特性已被取消,ARMv8 除前面提到的条件传送和条件置位之外,仍提供多种条件指令。
| 指令类别 | 指令名称 | 功能 |
|---|---|---|
| 数据传送 | Load/Store Non-temporal pair | 加载/存储一对寄存器,并指示不要缓存这些数据;只支持基址加按比例缩放偏移量寻址 |
| ALU | Add Extended word/double word | 对第二个寄存器操作数左移并扩展后,把两个寄存器相加 |
| ALU | Add with shift;add immediate with shift | 先对第二个操作数移位,再相加 |
| ALU | Address of page | 根据 PC 计算页地址,类似 ADDUIPC;原书称其与 ARMv8 的 ADR 相同 |
| ALU | AND、OR、XOR、XOR NOT shifted register | 对一个寄存器和一个经过移位的寄存器进行逻辑运算 |
| ALU | Bit field clear shifted | 对操作数移位、取反,再与另一个操作数相与 |
| ALU | Conditional compare、immediate、negative、negative immediate | 条件为真时,把条件标志设置为比较结果;否则保持条件标志不变 |
| ALU | Conditional increment、invert、negate | 根据条件,将目的寄存器设为源寄存器加一、按位取反或取负的结果 |
| ALU | CRC | 计算 CRC 校验和,支持字节、字、半字和双字 |
| ALU | Multiply add、subtract | 整数乘加或乘减 |
| ALU | Multiply negate | 将两个整数的乘积取负,支持字和双字 |
| ALU | Move immediate or inverse | 用立即数替换寄存器中的 16 位,立即数可能先经过移位 |
| ALU | Reverse bit order | 反转寄存器中的位顺序 |
| ALU | Signed bit field move | 传送有符号位字段,向左作符号扩展,向右补零 |
| ALU | Unsigned divide、multiply、multiply negate、multiply-add、multiply-sub | 基本指令的无符号版本 |
| 控制转移 | CBNZ, CBZ | 与零比较并按不等/相等条件分支,同时指示这不是调用或返回 |
| 控制转移 | TBNZ, TBZ | 测试寄存器中的某一位不等于/等于零,并据此分支 |
译注:
Address of page一行把页地址计算与ADR混为一谈;条件比较一行“否则保持条件标志不变”的描述也不宜直接当作指令手册的精确定义。
Power3 独有的指令
Power3 源于 IBM 多代商用 RISC 计算机——IBM RT/PC、IBM Power1 和 IBM Power2——以及主要由 IBM、Motorola 开展的 PowerPC 开发工作。下面先介绍分支寄存器和循环分支支持,随后图 K.23 列出只有 Power3 提供的其他指令。
分支寄存器:链接寄存器与计数寄存器
Power3 不占用 32 个通用寄存器之一来保存过程调用的返回地址,而是把地址放入专用的链接寄存器。许多过程在返回前不会调用其他过程,因此并非总要把链接寄存器的值另存起来。把返回地址放在专用寄存器中还能加快返回跳转,因为硬件处理这种跳转时不必经过寄存器读取流水级。
类似地,Power3 还有一个计数寄存器,用于执行固定次数迭代的 for 循环。使用专用寄存器后,分支硬件可以快速判断基于计数寄存器的分支是否可能跳转,因为在执行周期的早期就能知道该寄存器的值。分支指令测试计数寄存器的值时,会自动将它减一。
计数寄存器和链接寄存器本来就位于控制分支的硬件附近;而分支预测的问题之一,是在流水线中尽早得到目标地址,见附录 C。因此,Power 的设计者决定让这两个寄存器再承担一种用途:任意一个都可保存条件分支的目标地址。于是,PowerPC 在基本条件分支之外增加了从这两个寄存器取目标地址的指令 BCLR 和 BCCTR。图 K.23 列出所增加的数十条指令;此外还应注意,它为十进制浮点数提供了丰富的功能。
| 指令类别 | 指令名称 | 功能 |
|---|---|---|
| 数据传送 | LHBRX, LWBRX, LDBRX | 加载半字/字/双字,同时反转字节顺序 |
| 数据传送 | SHBRX, SWBRX, SDBRX | 存储半字/字/双字,同时反转字节顺序 |
| 数据传送 | LDQ, STQ | 在存储器与一对寄存器之间加载/存储四字 |
| ALU | DRAN | 在寄存器中生成随机数 |
| ALU | CMPB | 比较寄存器中的各个字节,并逐字节设置另一个寄存器 |
| ALU | CMPRB | 将字节 与另外两个字节 、 比较,并设置条件,指示是否满足 |
| ALU | CRAND, CRNAND, CROR, CRNOR, CRXOR, CREQV, CORC, CRANDC | 对条件寄存器进行逻辑运算 |
| ALU | ZCMPEQB | 将字节 与另一个寄存器中的 8 个字节比较,并设置条件,指示 是否等于其中任意一个 |
| ALU | EXTSWSL | 对字作符号扩展并左移 |
| ALU | POPCNTB, POPCNTW, POPCNTD | 分别统计每个字节、每个字或一个双字中 1 的个数;字节/字的统计结果放入对应的另一字节/字 |
| ALU | PRTYD, PRTYW | 计算字或双字中各字节的奇偶校验 |
| ALU | BPERMD | 置换双字中的位,生成一个经置换的字节 |
| ALU | CDTBCD, CDCBCD, ADDGCS | 转换为/转换自二进制编码十进制数(BCD),或对两个 BCD 值进行运算 |
| 控制转移 | BA, BCA | 无条件或有条件地分支到绝对地址 |
| 控制转移 | BCCTR, BCCTRL | 有条件地分支到计数寄存器中的地址,不带/带链接 |
| 控制转移 | BCTSAR, BCTARL | 有条件地分支到分支目标地址寄存器中的地址,不带/带链接 |
| 控制转移 | CLRBHRB, MFBHRBE | 操作分支历史滚动缓冲区 |
| 浮点 | FRSQRTE | 估算平方根的倒数 |
| 浮点 | FTDIV, FTSQRT | 检查除零或对负数求平方根的情况 |
| 浮点 | FSEL | 将寄存器与零比较,从两个操作数中选择一个传送 |
| 浮点 | Decimal floating point operations | 一组共 48 条指令,支持十进制浮点运算 |
译注: 本表助记符依原页保留,包括
DRAN、CORC、ZCMPEQB、BCTSAR等可疑拼写。原表FTSQRT功能写作 “square of negative number”,结合该行的平方根指令名译为“对负数求平方根”;并未把这些源书拼写视为已校正的汇编语法。
桌面/服务器 RISC 的多媒体扩展指令
对多媒体和图形操作的支持经历了若干阶段,起点是 1996 年出现的 Intel MMX、MIPS MDMX 和 SPARC VIS。正如 4.3 节所述——这里假定读者已读过该节——这些扩展把一个寄存器视为多个相互独立的短整数,每个为 8 位或 16 位,并对寄存器内的全部元素并行执行算术和逻辑运算。这些最初的 SIMD 扩展有时称为打包 SIMD(packed SIMD)。2000 年以后,它们通过加宽寄存器、将这些寄存器部分或全部与通用寄存器或浮点寄存器分离,以及增加并行浮点运算支持,得到进一步发展。RISC-V 为这类打包 SIMD 指令预留了扩展,但设计者目前选择把重点放在真正的向量扩展上。向量扩展 RV64V 是一种向量体系结构;正如 4.3 节指出的,真正的向量指令集通用得多,通常能够用向量运算完成 SIMD 扩展所处理的操作。
图 K.24 展示 ARM、MIPS、Power 和 SPARC 的 SIMD 扩展的基本结构。注意这些 SIMD“向量寄存器”的组织方式不同:复用浮点寄存器、扩展浮点寄存器,或增加额外寄存器。其他重要区别还包括:是否同时支持浮点数和整数,是否支持 128 位整数,以及整数和逻辑运算是否允许把立即数字段用作操作数。SIMD 寄存器与存储器之间的数据传送使用标准加载和存储指令,同时增加特殊扩展来处理不足一个完整 SIMD 寄存器的数据。SPARC VIS 是最早用于图形的 ISA 扩展之一,能力要有限得多:算术运算只包含加、减、乘,没有浮点支持,针对位元素操作的指令也很有限。图 K.24 包含它,但后面不再详述。
| 项目 | ARMv8 | MIPS64 R6 | Power v3.0 | SPARC v9 |
|---|---|---|---|---|
| ISA 扩展名称 | Advanced SIMD | MIPS64 SIMD Architecture | Vector Facility | VIS |
| 当前版本年份 | 2011 | 2012 | 2015 | 1995 |
| 向量寄存器:数量 × 位数 | 32 × 128 | 32 × 128 | 32 × 128 | 32 × 64 |
| 复用 GP/FP 寄存器还是独立寄存器组 | 扩展 FP 寄存器,宽度加倍 | 扩展 FP 寄存器,宽度加倍 | 独立 | 与 FP 寄存器相同 |
| 整数位数 | 8、16、32、64 | 8、16、32、64 | 8、16、32、64、128 | 8、16、32 |
| 浮点位数 | 32、64 | 32、64 | 32 | |
| 整数与逻辑运算的立即数 | 算术 5 位;逻辑 8 位 |
图 K.25 展示这些 SIMD 扩展中的算术指令,只列出至少两种扩展都具有的指令。MIPS SIMD 还有许多其他指令,Power 3 的 Vector-Scalar Extension 也是如此,这里不作介绍。其中一种常见、但通用微处理器通常不具备的功能是饱和运算。饱和意味着,计算溢出时把结果设为最大正数或最小负数,而不像补码算术那样进行模运算。这类饱和运算常见于数字信号处理器,见下一小节,对于滤波程序很有用。另一种常见扩展是在单个寄存器内部累积数值的指令,点积以及最大值/最小值指令就是典型例子。
| 指令类别 | ARM Advanced SIMD | MIPS SIMD | Power Vector Facility |
|---|---|---|---|
| 加/减 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 饱和加/减 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 差的绝对值 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 相邻元素加/减,成对操作 | 16B、8H、4W | 16B、8H、4W | 16B、8H、4W、2D |
| 平均值 | 16B、8H、4W、2D | 16B、8H、4W、2D、Q | |
| 点积加、点积减 | 16B、8H、4W | 16B、8H、4W | 16B、8H、4W、2D |
| 有符号/无符号除法 | 16B、8H、4W | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 有符号/无符号乘法 | 16B、8H、4W | 16B、8H、4W | 16B、8H、4W、2D |
| 乘加、乘减 | 16B、8H、4W | 16B、8H、4W | 16B、8H、4W、2D |
| 有符号/无符号最大值 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 有符号/无符号最小值 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 有符号/无符号取模 | 16B、8H、4W、2D | 16B、8H、4W、2D、Q | |
| 相等比较 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 小于/小于等于比较,有符号/无符号 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
除算术指令外,最常见的增加内容是逻辑和按位操作,以及对 SIMD 寄存器内元素进行各种置换与打包的指令。图 K.26 汇总了这些扩展。最后,三种扩展都支持 SIMD 浮点操作,如图 K.27 所示。
| 指令类别 | ARM Advanced SIMD | MIPS SIMD | Power Vector Facility |
|---|---|---|---|
| 右移/左移,逻辑/算术 | 16B、8H、4W、2D | 16B、8H、4W、2D、Q | 16B、8H、4W、2D、Q |
| 统计前导零或尾随零 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| AND/OR/XOR | Q | Q | Q |
| 位插入与提取 | 16B、8H、4W、2D | 16B、8H、4W、2D | 16B、8H、4W、2D、Q |
| 统计 1 的个数 | 16B、8H、4W、2D | 16B、8H、4W、2D、Q | |
| 交织偶数/奇数、左侧/右侧元素 | 16B、8H、4W、2D | 6B、8H、4W、2D | |
| 打包偶数/奇数元素 | 16B、8H、4W、2D | 6B、8H、4W、2D | |
| Shuffle | 16B、8H、4W、2D | 16B、8H、4W、2D | |
| SPLAT | 16B、8H、4W、2D | 16B、8H、4W、2D |
译注: Power 列中两处
6B与同列其他行的16B不一致。
| 指令类别 | ARM Advanced SIMD | MIPS SIMD | Power Vector Facility |
|---|---|---|---|
| 浮点加、减、乘、除 | 4W、2D | 4W、2D | 4W、2D |
| 浮点乘加/乘减 | 4W、2D | 4W、2D | 4W、2D |
| 浮点最大值/最小值 | 4W、2D | 4W、2D | 4W、2D |
| 浮点平方根与平方根的倒数 | 4W、2D | 4W、2D | 4W、2D |
| 浮点比较 | 4W、2D | 4W、2D | 4W、2D |
| 浮点数与整数相互转换 | 4W、2D | 4W、2D | 4W、2D |
译注: 图 K.24 对 Power Vector Facility 只列 32 位浮点数,而本表又列出
2D。图 K.25–K.27 是原书的概括性比较,不宜当作完整的 ISA 支持清单。
嵌入式 RISC 的数字信号处理扩展指令
Thumb2 和 microMIPS32 都提供 DSP(数字信号处理)及多媒体操作指令。在 Thumb2 中,这些属于核心指令集;在 microMIPS32 中,它们属于 DSP 扩展。这些扩展编码为 32 位指令,其功能范围小于 MIPS64 或 ARMv8(AArch64)的 SIMD/向量扩展所提供的多媒体和图形支持。与后者那些更全面的扩展一样,Thumb2 和 microMIPS32 也采用打包 SIMD,但使用现有整数寄存器,仅作少量扩充来支持宽累加器,而且只操作整数数据。RISC-V 已规定,P 扩展将使用浮点寄存器支持打包整数 SIMD。
不过在本书出版时,该规范尚未完成。
DSP 操作经常包括线性代数函数和卷积等运算,其中间结果需要比输入更大的表示范围。Thumb2 用一组基于成对整数寄存器、产生 64 位结果的操作来处理这一问题。microMIPS32 DSP 有 4 个 64 位累加器寄存器,其中包括原本用于整数乘除的 Hi-Lo 寄存器。两种体系结构都对字节、半字和字提供并行算术,类似于 ARMv8 和 MIPS64 的多媒体扩展。此外,MIPS DSP 扩展还处理 DSP 运算大量使用的定点小数数据。这类数据有一个符号位,其余位表示小数部分。
其取值范围用十进制近似表示为 −1.0 到 0.9999。MIPS DSP 支持 Q15 和 Q31 两种定点小数格式,分别包含 1 个符号位以及 15 位或 31 位小数。
图 K.28 使用图 K.25 相同的记法列出共同操作。应记住,基本的 32 位指令集还提供其他功能,包括基本算术、逻辑和位操作。
| 功能 | Thumb-2 | microMIPS32 DSP |
|---|---|---|
| 加/减 | 4B、2H | 4B、2Q15 |
| 饱和加/减 | 4B、2H | 4B、2Q15、Q31 |
交换后加/减:交换 rt 中两个半字,对第一个半字作加法、第二个作减法;可选择饱和 | 2H | |
| 加法规约,即对各值求和 | 4B | |
| 绝对值 | 2Q15、Q31 | |
| 降低/提高数值精度 | 2B、Q15、2Q15、Q31 | |
| 左/右移,逻辑/算术,可选择饱和 | 4B、2H | |
| 乘法 | 2H | 2B、2H、2Q15 |
| 乘加/乘减,在 MIPS 中写入 GPR 或累加器 | 2H | 2Q15 |
| 复数乘法步骤:两次乘法加一次加/减法 | 2H | 2Q15 |
| 乘法并累加,通过加法或减法累积 | 2H | Q15、Q31 |
| 位复制 | B、H | |
比较 =、<、<=,设置条件字段 | 4B、2H | |
| Pick:根据条件位,从两个操作数中选择字节或半字 | 4B、2H | |
| Pack:从每个操作数中选择一个半字进行打包 | H | |
| Extract:提取 | Q63 | |
| 与累加器之间传送 | DW |
结束语
本节概述了 8 种 RISC 体系结构的寻址方式、指令格式和几乎全部指令。虽然后半部分着重讨论差异,但如果它们没有如此多的相似之处,就不可能在这么少的篇幅内介绍 8 种体系结构。事实上,我们估计,无论哪一种体系结构,所执行指令中超过 90% 都能在图 K.9–K.13 中找到。为了与这种一致性对照,图 K.29 用类似图 K.1 的格式,汇总了 20 世纪 70 年代的四种体系结构。
这些体系结构无法用同样的方式在一节中统一介绍,因此后面三节分别讨论 80x86、VAX 和 IBM 360/370。在计算史上,从来没有出现过像 20 世纪 80 年代 RISC 思想兴起后这样,对计算机体系结构达成如此广泛共识的时期。
| 项目 | IBM 360/370 | Intel 8086 | Motorola 68000 | DEC VAX |
|---|---|---|---|---|
| 发布年份 | 1964/1970 | 1978 | 1980 | 1977 |
| 指令长度,位 | 16、32、48 | 8、16、24、32、40、48 | 16、32、48、64、80 | 8、16、24、32、…、432 |
| 寻址:位数与模型 | 24 位,平坦/31 位,平坦 | 4+16 位,分段 | 24 位,平坦 | 32 位,平坦 |
| 数据须对齐? | 360 是,370 否 | 否 | 按 16 位边界对齐 | 否 |
| 数据寻址方式数 | 2/3 | 5 | 9 | =14 |
| 保护 | 页 | 无 | 可选 | 页 |
| 页大小 | 2 KB、4 KB | — | 0.25–32 KB | 0.5 KB |
| I/O | 专用操作码 | 专用操作码 | 存储器映射 | 存储器映射 |
| 整数寄存器:数量、模型、位数 | 16 个 GPR × 32 位 | 8 个专用数据寄存器 × 16 位 | 8 个数据寄存器及 8 个地址寄存器 × 32 位 | 15 个 GPR × 32 位 |
| 独立浮点寄存器 | 4 × 64 位 | 可选:8 × 80 位 | 可选:8 × 80 位 | 0 |
| 浮点格式 | IBM,十六进制浮点 | IEEE 754 单精度、双精度、扩展精度 | IEEE 754 单精度、双精度、扩展精度 | DEC |