K.3 Intel 80x86
引言
MIPS 出自一位体系结构设计者的构想。体系结构的各个部分配合得很协调,整体也能简明地描述出来。80x86 则不然:它是几个相互独立的团队在 20 多年里逐步演化的产物;在原有指令集上添加新特性,就像不断往已经塞满的旅行包里再塞衣服。下面是 80x86 的重要里程碑。
- 1978 年:Intel 发布 8086 体系结构。它是当时取得成功的 8 位微处理器 Intel 8080 的扩展,在汇编语言层面与其兼容。8086 是 16 位体系结构,内部寄存器均为 16 位。
8080 是直接明了的累加器机器,8086 则增加了一些寄存器。由于几乎每个寄存器都有专用用途,8086 介于累加器机器与通用寄存器机器之间,可以恰当地称为扩展累加器机器。
- 1980 年:Intel 发布 8087 浮点协处理器。它在 8086 基础上增加约 60 条浮点指令。设计者没有采用扩展累加器,而是选择栈与寄存器的混合形式,实质上是一种扩展栈体系结构:在完整的栈指令集之外,补充有限的一组寄存器—存储器指令。
- 1982 年:80286 扩展了 8086 体系结构,把地址空间扩大到 24 位,建立了精细复杂的存储器映射与保护模型,并增加少量指令,以补全指令集和操作保护模型。由于不加修改地运行 8086 程序十分重要,80286 提供实地址模式,使机器表现得就像一台 8086。
- 1985 年:80386 把 80286 体系结构扩展到 32 位。除了 32 位寄存器和 32 位地址空间之外,80386 还增加了新的寻址方式和操作,使它几乎成为通用寄存器机器。除分段寻址外,80386 还增加了分页支持,见第 2 章。与 80286 一样,80386 也有一种模式,可以不加修改地执行 8086 程序。
这段历史说明了兼容性这副“金手铐”对 80x86 的影响:每一步演进时,已有软件基础都太重要,不能冒险用大幅度体系结构变化去破坏它。幸运的是,后来的 80486(1989 年)、Pentium(原书列 1992 年)和 P6(1995 年)以提高性能为目标,对用户可见的指令集只增加了四条指令:三条用于辅助多处理器处理,另一条是条件传送指令。1
从 1997 年起,Intel 增加了数百条指令,在一个时钟周期内对多个较窄的数据类型进行操作,以支持多媒体,见附录 A。这些 SIMD 或向量指令主要用于手工编写的库或驱动程序,编译器很少生成它们。第一个扩展称为 MMX,于 1997 年出现。它包含 57 条指令,可在 64 位寄存器中打包和解包多个字节、16 位字或 32 位双字,并对这些窄数据项并行执行移位、逻辑和整数算术。它既支持饱和算术,也支持非饱和算术。MMX 使用构成浮点栈的那些寄存器,因此没有增加操作系统需要保存的新状态。
1999 年,Intel 在 Pentium III 中又增加 70 条指令,称为 SSE。主要变化是增加 8 个独立寄存器,把宽度加倍到 128 位,并增加单精度浮点数据类型,因此可以并行执行四个 32 位浮点操作。
为改善存储器性能,SSE 增加了缓存预取指令,以及绕过缓存、直接写入存储器的流式存储指令。
2001 年,Intel 又增加 144 条指令,称为 SSE2。新增数据类型是双精度浮点数,允许同时执行两个 64 位浮点操作。这 144 条指令几乎全部是已有 MMX 和 SSE 指令的变体,用于并行处理 64 位数据。这一变化不仅支持多媒体操作,还给编译器提供了独特栈体系结构之外的另一种浮点操作目标。编译器可以像在 RISC 机器上一样,把 8 个 SSE 寄存器当作浮点寄存器。Pentium 4 是第一款纳入 SSE2 指令的微处理器,这一变化提高了它的性能。发布时,1.5 GHz Pentium 4 的 SPECint2000(base)性能是 1 GHz Pentium III 的 1.24 倍,而 SPECfp2000(base)性能则达到 1.88 倍。
2003 年,这次由 Intel 之外的一家公司扩展 IA-32 体系结构。AMD 宣布一组体系结构扩展,把地址空间从 32 位扩展到 64 位。类似于 1985 年 80386 从 16 位到 32 位地址空间的过渡,AMD64 把所有寄存器加宽到 64 位;它还把寄存器数量增加到 16 个,并提供 16 个 128 位寄存器以支持 XMM——原书称其为 AMD 对 SSE2 的回应。其主要变化并非扩展指令集,而是增加一种称为长模式(long mode)的新模式,重新定义全部 IA-32 指令在 64 位地址下的执行方式。为了寻址更多寄存器,它为指令增加一个新前缀。AMD64 仍保留与标准 Intel 指令集向后兼容的 32 位模式,因此与 HP/Intel Itanium 相比,向 64 位寻址的过渡更加平滑。后来 Intel 效仿 AMD,作出几乎相同的改动,使大多数软件无需修改就能在 80x86 的两种 64 位地址版本上运行。
无论从设计美感上如何评价 80x86,都应记住,世界上这一体系结构家族的实例数量超过任何其他服务器或桌面处理器。不过,它曲折的身世确实造就了一种难以解释、也难以令人喜爱的体系结构。
下面先介绍寄存器和寻址方式,再讨论整数操作、浮点操作,最后分析指令编码。
80x86 寄存器与数据寻址方式
指令集的演化可以从 80x86 的寄存器中看出来,见图 K.30。原有寄存器用黑色表示,80386 的扩展用浅色表示,后续图也采用这一配色。80386 基本上把除段寄存器以外的全部 16 位寄存器扩展到 32 位,并在名称前加 E 表示 32 位版本。算术、逻辑和数据传送指令采用双操作数形式,允许图 K.31 所示的组合。
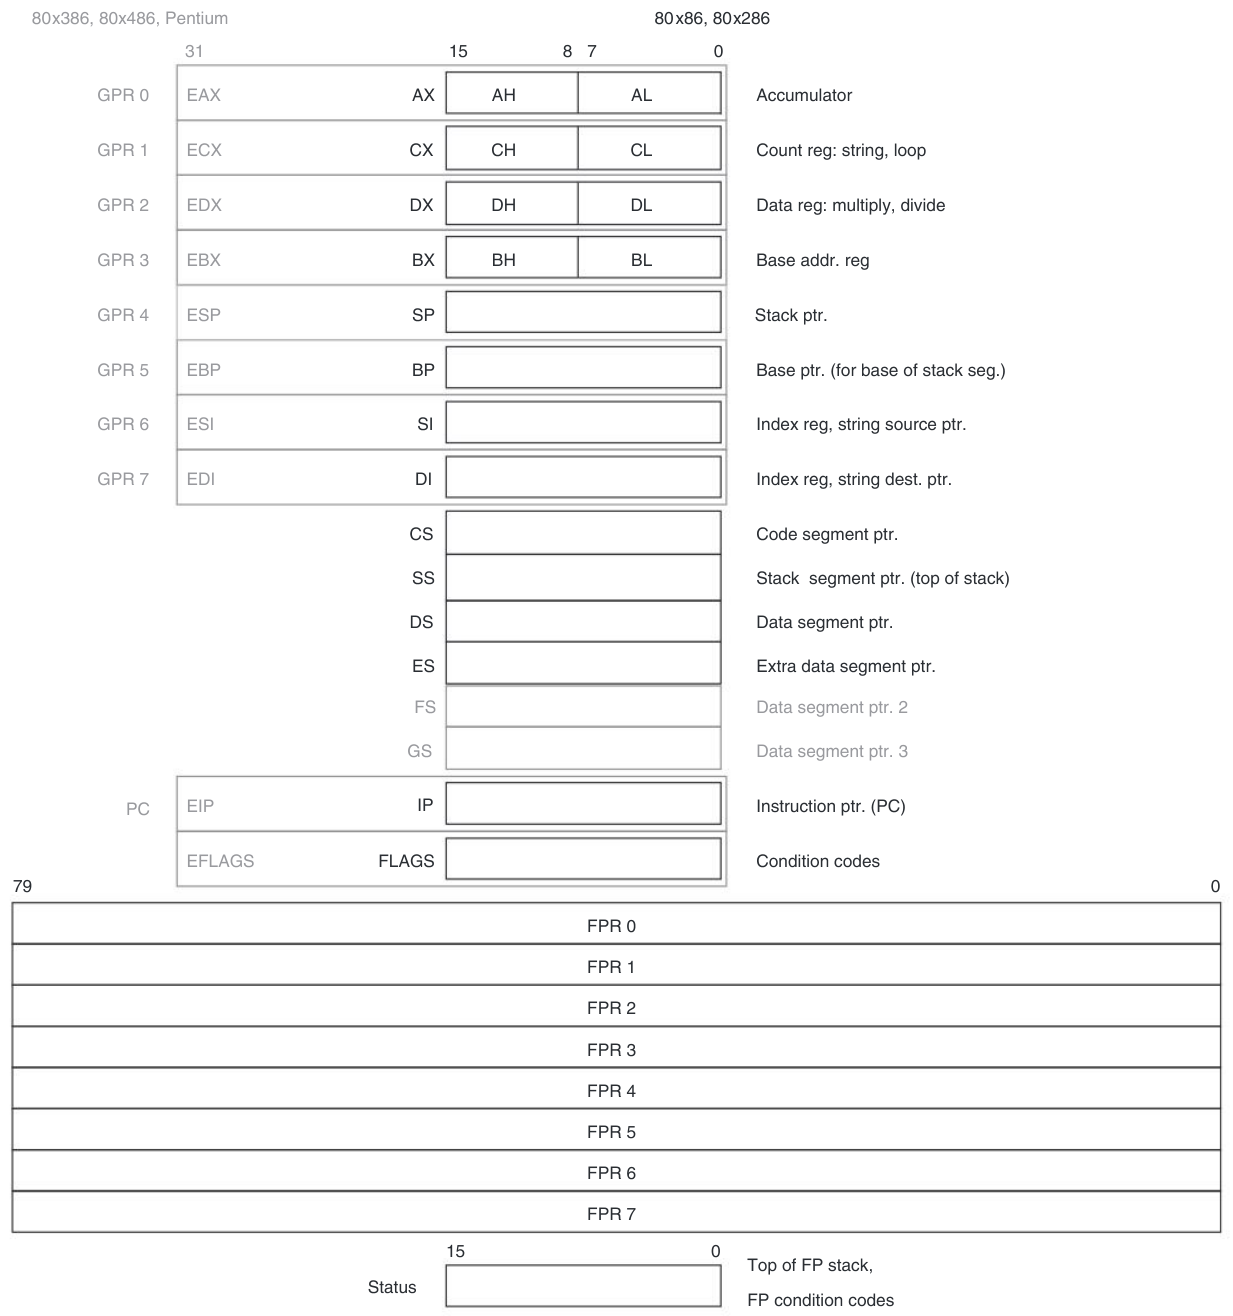
图中各寄存器用途为:EAX 累加器;EBX 基址寄存器;ECX 字符串/循环计数;EDX 乘除法数据寄存器;ESI 变址寄存器、字符串源指针;EDI 变址寄存器、字符串目的指针;EBP 基址指针,用于栈段基部;ESP 栈指针;EIP 指令指针,即 PC;EFLAGS 条件码。段寄存器 CS、SS、DS、ES、FS、GS 分别表示代码段、栈段、数据段、附加数据段及另两个数据段指针。浮点 Status 保存浮点栈顶位置和浮点条件码。
| 同时作源与目的的操作数类型 | 第二个源操作数类型 |
|---|---|
| 寄存器 | 寄存器 |
| 寄存器 | 立即数 |
| 寄存器 | 存储器 |
| 存储器 | 寄存器 |
| 存储器 | 立即数 |
解释寻址方式时,必须分清讨论的是 8086、80286 使用的 16 位模式,还是 80386 及后继处理器具有的 32 位模式。所支持的七种数据存储器寻址方式是:
- 绝对寻址。
- 寄存器间接寻址。
- 基址寻址。
- 变址寻址。
- 带位移量的基址变址寻址。
- 基址加比例变址寻址。
- 带位移量的基址加比例变址寻址。
在 32 位模式中,位移量可以是 8 位或 32 位;在 16 位模式中,可以是 8 位或 16 位。如果把地址长度的不同也分别算作一种寻址方式,总计有 11 种。
虽然存储器操作数可以使用任一种寻址方式,但每种方式可使用哪些寄存器受到限制。后面的“80x86 指令编码”小节列出全部限制;原书此处所引第 K-11 页与本附录实际位置不符。下面先说明基本的寄存器选项。
- 绝对寻址:根据模式使用 16 位或 32 位位移量。
- 寄存器间接寻址:16 位模式使用
BX、SI、DI;32 位模式使用EAX、ECX、EDX、EBX、ESI、EDI。 - 带 8 位或 16/32 位位移量的基址寻址:16 位模式使用
BP、BX、SI、DI;32 位模式使用EAX、ECX、EDX、EBX、ESI、EDI。位移量为 8 位,或者与地址模式同宽,即 16 位或 32 位。Intel 把这同一种寻址方式分成基址和变址两个名称,但两者实质相同,因此本书将其合并。本书所谓“变址寻址”另有所指,见下一项。 - 变址寻址:地址是两个寄存器之和,允许的组合为
BX+SI、BX+DI、BP+SI、BP+DI。
8086 将其称为基址变址寻址。32 位模式用另一种寻址方式达到相同效果。
带 8 位或 16 位位移量的基址变址寻址:地址是位移量与两个寄存器内容之和,寄存器限制与变址寻址相同。
基址加比例变址寻址:本方式及下一种方式在 80386 中加入,只能用于 32 位模式。地址计算为
Scale为 0、1、2 或 3;变址寄存器可以是除ESP之外的任意一个 32 位通用寄存器,基址寄存器可以是八个 32 位通用寄存器中的任何一个。带 8 位或 32 位位移量的基址加比例变址寻址:地址是位移量与上一种比例变址方式所算地址之和,寄存器限制相同。
80x86 采用小端(Little Endian)寻址。
理想情况下,80x86 逻辑地址与物理地址的讨论可留给第 2 章,但分段地址空间使我们无法略去这些信息。图 K.32 展示历代 80x86 机器的存储器映射选项;第 2 章更详细地讨论分段保护机制。
显然,无论使用哪种寻址方式,汇编程序员都必须说明某个地址应使用哪个段寄存器。为节省指令空间,处理器根据所用的地址寄存器自动选择段寄存器。规则很简单:指令引用 IP 使用代码段寄存器 CS;栈引用 BP 或 SP 使用栈段寄存器 SS;其他寄存器默认使用数据段寄存器 DS。下一小节说明如何覆盖这些默认选择。
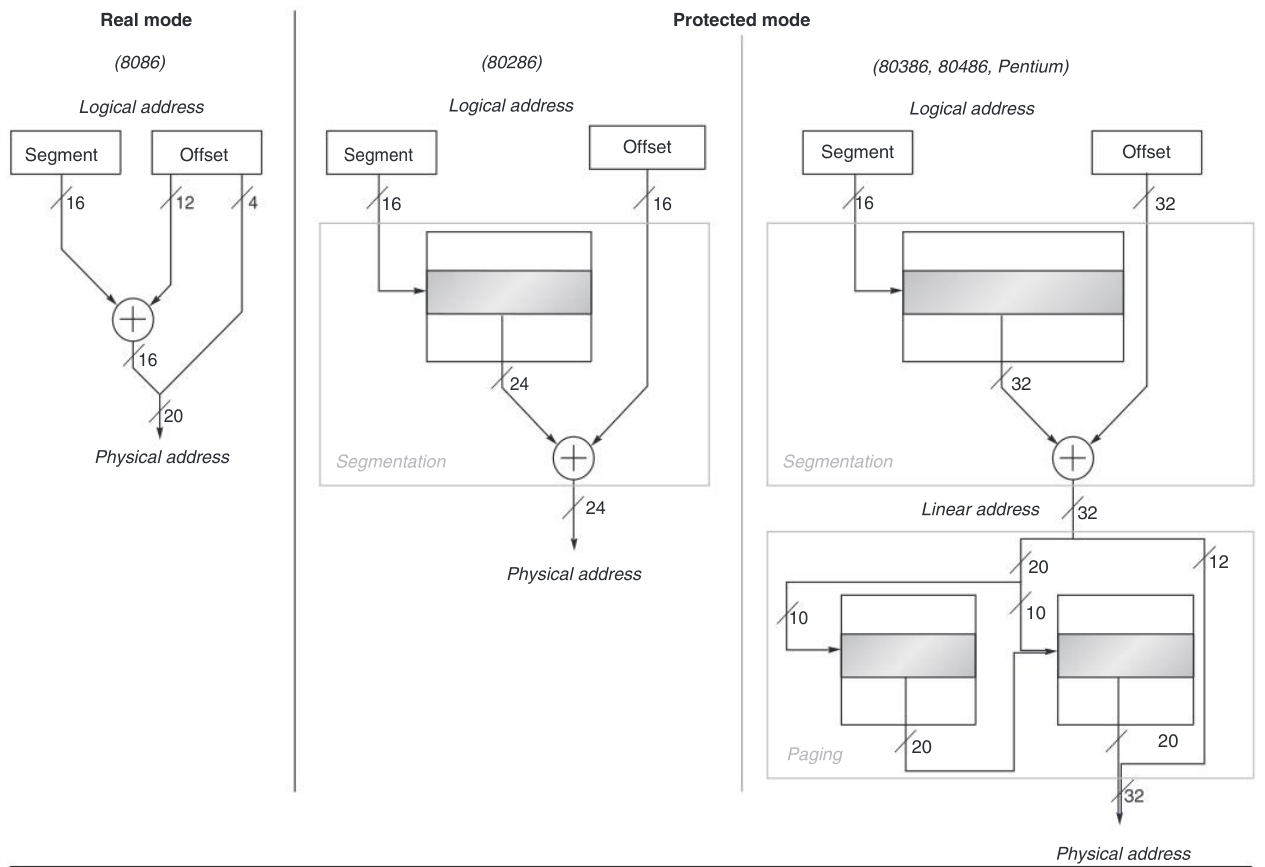
图中 Real mode/Protected mode 为实模式/保护模式;Logical address、Linear address、Physical address 分别为逻辑地址、线性地址和物理地址;Segment 为段,Offset 为偏移量;Segmentation 和 Paging 分别为分段、分页。
80x86 整数操作
8086 支持 8 位字节和 16 位字(word)两种数据类型。数据类型的区分既适用于寄存器操作,也适用于存储器访问。80386 增加了 32 位地址与数据,后者称为双字(double word)。几乎每种操作都能处理 8 位数据以及另一种更长的数据;较长者由模式决定,为 16 位或 32 位。
显然,有些程序需要操作全部三种长度的数据。因此,80x86 的设计者提供了一种方便的方法,在不显著增加代码大小的情况下指定各个版本。他们认为,大多数程序会以 16 位或 32 位数据中的一种为主,所以可以设置一种默认的较长数据长度。代码段寄存器中的一个位决定该默认长度。若要覆盖默认值,就在指令前附加一个 8 位前缀,告诉机器这条指令使用另一种较长长度。
前缀办法借鉴自 8086;后者允许使用多个前缀改变指令行为。最初的三种前缀分别用于覆盖默认段寄存器、锁住总线以实现信号量操作(见第 5 章),以及重复执行后一条指令直到 CX 减至零。
最后一种前缀原本是为配合字节传送指令,以便传送可变数量的字节。80386 还增加了覆盖默认地址长度的前缀。
80x86 整数操作可分为四大类:
- 数据移动,包括传送、入栈和出栈。
- 算术与逻辑,包括逻辑运算、测试、移位,以及整数和十进制算术运算。
- 控制流,包括条件分支、无条件跳转、调用和返回。
- 字符串指令,包括字符串传送和比较。
图 K.33 给出若干典型 80x86 指令及其功能。
| 指令 | 功能 |
|---|---|
JE name | 若 equal(CC),则 IP ← name;原表给出范围 IP−128 ≤ name ≤ IP+128 |
JMP name | IP ← name |
CALLF name, seg | SP ← SP−2; M[SS:SP] ← IP+5; SP ← SP−2; M[SS:SP] ← CS; IP ← name; CS ← seg |
MOVW BX,[DI+45] | BX ←₁₆ M[DS:DI+45] |
PUSH SI | SP ← SP−2; M[SS:SP] ← SI |
POP DI | DI ← M[SS:SP]; SP ← SP+2 |
ADD AX,#6765 | AX ← AX+6765 |
SHL BX,1 | BX ← BX₁…₁₅ ## 0,将原字段与末尾零拼接 |
TEST DX,#42 | 按 DX & 42 的结果设置条件码标志 |
MOVSB | M[ES:DI] ←₈ M[DS:SI]; DI ← DI+1; SI ← SI+1 |
译注: 表中的
JE边界、CALLF入栈次序和MOVSB的递增方向均按原表保留,是原书的简化或可疑表述;不可据此代替对完整指令语义的核查。SR:X图注公式描述的是实模式地址形成。
数据传送、算术和逻辑指令总体上并无特别之处,只是算术与逻辑操作允许目的位置既可以是寄存器,也可以是存储器单元。
控制流指令必须能够寻址另一个段中的目标。因此,控制流指令分两种:段内转移为“近”(near),段间转移为“远”(far)。远跳转必须是无条件跳转;在 16 位模式中,操作码后跟两个 16 位量,一个作为指令指针,另一个装入 CS,成为新的代码段。在 32 位模式中,第一个字段扩展到 32 位,以匹配 32 位程序计数器 EIP。
调用和返回采用类似方式:远调用把返回指令指针与返回段压栈,然后同时装入指令指针和代码段;远返回则把二者从栈中弹出。程序员或编译器编写者必须确保同一过程始终使用相配的调用与返回类型:近返回不能与远调用配合,反之亦然。
字符串指令来自 80x86 的 8080 血统,在大多数程序中并不经常执行。
图 K.34 列出部分整数指令,许多指令同时具有字节和字两种形式。
| 类别 | 指令 | 含义 |
|---|---|---|
| 控制:条件与无条件分支 | JNZ, JZ | 条件成立时跳至 IP 加 8 位偏移量;JNE 是 JNZ 的别名,JE 是 JZ 的别名 |
| 控制 | JMP, JMPF | 无条件跳转;8 位或 16 位偏移量,有段内近跳转和段间远跳转版本 |
| 控制 | CALL, CALLF | 子程序调用;16 位偏移量,返回地址压栈,有近、远两种版本 |
| 控制 | RET, RETF | 从栈中弹出返回地址并跳转,有近、远两种版本 |
| 控制 | LOOP | 循环分支:CX 减一;若 CX ≠ 0,则跳至 IP 加 8 位位移量 |
| 数据传送:寄存器间或寄存器与存储器之间 | MOV | 在两个寄存器间,或寄存器与存储器间传送 |
| 数据传送 | PUSH | 将源操作数压栈 |
| 数据传送 | POP | 将栈顶操作数弹出到寄存器 |
| 数据传送 | LES | 从存储器装入 ES 和一个通用寄存器 |
| 算术/逻辑:使用数据寄存器与存储器 | ADD | 源操作数加到目的操作数,寄存器—存储器格式 |
| 算术/逻辑 | SUB | 从目的操作数中减去源操作数,寄存器—存储器格式 |
| 算术/逻辑 | CMP | 比较源与目的操作数,寄存器—存储器格式 |
| 算术/逻辑 | SHL | 左移 |
| 算术/逻辑 | SHR | 逻辑右移 |
| 算术/逻辑 | RCR | 通过进位位循环右移 |
| 算术/逻辑 | CBW | 把 AL 中的字节转换为 AX 中的字 |
| 算术/逻辑 | TEST | 源与目的操作数作逻辑 AND,并设置标志 |
| 算术/逻辑 | INC | 目的操作数加一,寄存器—存储器格式 |
| 算术/逻辑 | DEC | 目的操作数减一,寄存器—存储器格式 |
| 算术/逻辑 | OR | 逻辑 OR,寄存器—存储器格式 |
| 算术/逻辑 | XOR | 异或,寄存器—存储器格式 |
| 字符串:长度由重复前缀给出 | MOVS | 从源字符串复制到目的字符串,可以重复 |
| 字符串 | LODS | 将字符串的一个字节或字装入 A 寄存器 |
80x86 浮点操作
Intel 为浮点指令采用栈体系结构:加载把数压栈,运算从栈顶的两个元素中取得操作数,存储可以把元素弹出,正如附录 A 的栈机器示例所示。2
Intel 又补充了一些指令和寻址方式,使这种体系结构具备寄存器—存储器模型的部分优点。除从栈顶两个元素取得操作数之外,一个操作数也可以在存储器中,或位于栈顶以下七个寄存器之一。
不过,这种混合方式仍是一种受限的寄存器—存储器模型:加载总是把数据放到栈顶,并调整栈顶指针;存储则只能把栈顶内容写入存储器。3 Intel 用 ST 表示栈顶,用 ST(i) 表示栈顶以下第 个寄存器。
这一体系结构的新颖之处是,操作数在寄存器栈中的宽度大于它在存储器中的宽度,而且全部运算都按这种较宽的内部精度进行。加载时,数值自动转换为内部的 80 位格式;存储时,再转换回相应长度。存储器中的浮点数据可以是 32 位单精度或 64 位双精度,Intel 称之为 real。寄存器—存储器版本的指令先把存储器操作数转换为 Intel 80 位格式,再进行运算。整数加载和存储的数据传送指令还会自动在 16/32 位整数与实数之间转换。
80x86 浮点操作可分为四大类:
- 数据移动,包括加载、加载常量和存储。
- 算术,包括加、减、乘、除、平方根和绝对值。
- 比较,包括把结果传给整数 CPU 以便进行分支的指令。
- 超越函数指令,包括正弦、余弦、对数和求幂。
图 K.35 给出约 60 种浮点操作中的一部分。花括号 {} 表示基本操作的可选变体:{I} 表示有整数版本,{P} 表示运算后从栈中弹出一个操作数,{R} 表示交换该运算中操作数的次序。
| 数据传送 | 算术 | 比较 | 超越函数 |
|---|---|---|---|
F{I}LD mem/ST(i) | F{I}ADD{P} mem/ST(i) | F{I}COM{P}{P} | FPATAN |
F{I}ST{P} mem/ST(i) | F{I}SUB{R}{P} mem/ST(i) | F{I}UCOM{P}{P} | F2XM1 |
FLDPI | F{I}MUL{P} mem/ST(i) | FSTSW AX/mem | FCOS |
FLD1 | F{I}DIV{R}{P} mem/ST(i) | FPTAN | |
FLDZ | FSQRT | FPREM | |
FABS | FSIN | ||
FRNDINT | FYL2X |
并非所有组合都存在。因此,记法
代表 80x86 实际提供的以下指令:
整数减法指令没有弹栈或反向弹栈版本。
如果再计入操作数形式,组合会更多。忽略整数和弹栈变体,浮点加法有以下选项:
| 指令形式 | 操作数与结果 |
|---|---|
FADD | 两个操作数都在栈内,结果替换栈顶 |
FADD ST(i) | 一个源操作数为栈顶以下第 个寄存器,结果替换栈顶 |
FADD ST(i),ST | 一个源操作数为栈顶,结果替换栈顶以下第 个寄存器 |
FADD mem32 | 一个源操作数为存储器中的 32 位单元,结果替换栈顶 |
FADD mem64 | 一个源操作数为存储器中的 64 位单元,结果替换栈顶 |
如前所述,SSE2 提供了 IEEE 浮点寄存器模型。
80x86 指令编码
最棘手的部分留到最后:8086 的指令编码很复杂,有许多不同格式。没有操作数时,指令可以短至 1 字节;包含 16 位立即数并采用 16 位位移寻址时,可长至 6 字节。前缀还会使 8086 指令超出这些直观长度。
80386 的新增内容进一步扩大了指令长度,如图 K.36 所示。位移量和立即数字段都可以长达 32 位;还可能有两个新增前缀;操作码可长达 16 位;比例变址方式说明符再增加 8 位。原书据此称,80386 指令的最大可能长度为 17 字节。4
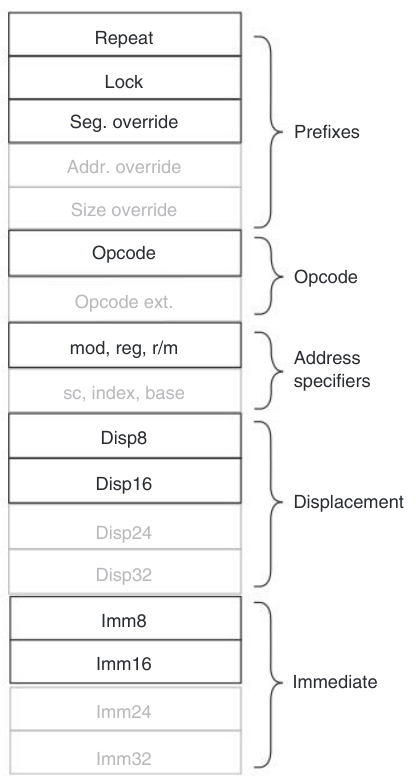
图中从上到下为:前缀 Prefixes,依次包括重复 Repeat、锁定 Lock、段覆盖 Seg. override、地址长度覆盖 Addr. override 和操作数长度覆盖 Size override;操作码 Opcode 与扩展 Opcode ext.;地址说明符 mod, reg, r/m 及 sc, index, base;位移量 Displacement;立即数 Immediate。Disp8 到 Disp32、Imm8 到 Imm32 分别表示这些字段的各个字节。
图 K.37 展示图 K.33 中若干示例指令的格式。操作码字节通常含有一位,用于指示操作数宽度是一个字节,还是由当前模式决定的较长长度,即 16 位或 32 位。某些指令的操作码还可以包含寻址方式和寄存器;许多形式为 register ← register op immediate 的指令就是如此。
其他指令使用一个 postbyte,即额外的操作码字节,图 K.36 中记为 mod, reg, r/m,其中包含寻址方式信息。
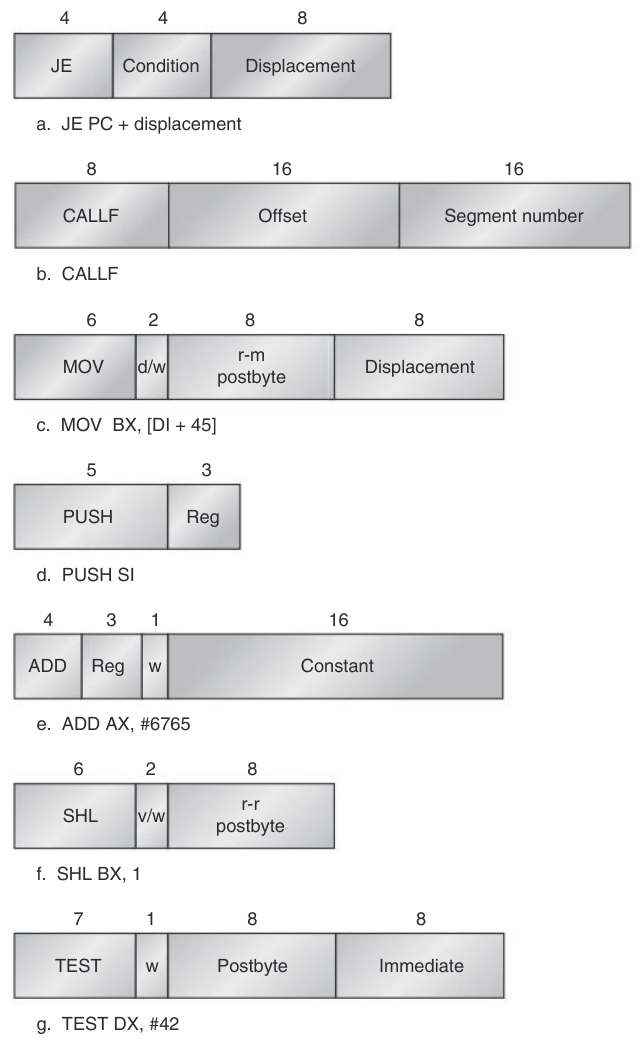
图中示例依次为:(a)JE PC + displacement;(b)远调用 CALLF,含偏移量 Offset 和段号 Segment number;(c)MOV BX,[DI+45];(d)PUSH SI;(e)ADD AX,#6765;(f)SHL BX,1;(g)TEST DX,#42。Condition 为条件,Displacement 为位移量,Constant/Immediate 为常量/立即数,Reg 为寄存器字段,r-m/r-r postbyte 为寄存器—存储器/寄存器—寄存器形式的 postbyte。
许多访问存储器的指令都使用这个 postbyte。基址加比例变址方式再使用第二个 postbyte,图 K.36 中记为 sc, index, base。
浮点指令编码在 8086 的 escape 操作码和 postbyte 地址说明符中。访问存储器的操作预留两位,决定操作数是 32/64 位实数,还是 16/32 位整数。在不访问存储器的版本中,同样两位用来决定运算后是否弹栈,以及结果写入栈顶还是栈顶以下的寄存器。
遗憾的是,在 80x86 中,寄存器限制无法与寻址方式的编码分开说明。因此,图 K.38 和 K.39 列出了 16 位、32 位模式下两个 postbyte 地址说明符的编码。
图 K.38 分为寄存器字段和地址字段两部分。以下按原表列出,包括原表自身的不一致。
reg | w=0 | w=1,16 位模式 | w=1,32 位模式 |
|---|---|---|---|
| 0 | AL | AX | EAX |
| 1 | CL | CX | ECX |
| 2 | DL | DX | EDX |
| 3 | BL | BX | EBX |
| 4 | AH | SP | ESP |
| 5 | CH | BP | EBP |
| 6 | DH | SI | ESI |
| 7 | BH | DI | EDI |
r/m | mod=0,16 位 | mod=0,32 位 | mod=1,16 位 | mod=1,32 位 | mod=2,16 位 | mod=2,32 位 | mod=3 |
|---|---|---|---|---|---|---|---|
| 0 | BX+SI | EAX | BX+SI+disp8 | EAX+disp8 | BX+SI+disp16 | EAX+disp32 | 同 reg 编码 |
| 1 | BX+DI | ECX | BX+DI+disp8 | ECX+disp8 | BX+DI+disp16 | ECX+disp32 | 同 reg 编码 |
| 2 | BP+SI | EDX | BP+SI+disp8 | EDX+disp8 | BP+SI+disp16 | EDX+disp32 | 同 reg 编码 |
| 3 | BP+SI | EBX | BP+SI+disp8 | EBX+disp8 | BP+SI+disp16 | EBX+disp32 | 同 reg 编码 |
| 4 | SI | (sib) | SI+disp16 | (sib)+disp8 | SI+disp8 | (sib)+disp32 | 同 reg 编码 |
| 5 | DI | disp32 | DI+disp8 | EBP+disp8 | DI+disp16 | EBP+disp32 | 同 reg 编码 |
| 6 | disp16 | ESI | BP+disp8 | ESI+disp8 | BP+disp16 | ESI+disp32 | 同 reg 编码 |
| 7 | BX | EDI | BX+disp8 | EDI+disp8 | BX+disp16 | EDI+disp32 | 同 reg 编码 |
译注: 原图的
r/m=3、16 位模式写成BP+SI,与前文列出的第四种组合BP+DI不一致;r/m=4的 16 位mod=1、mod=2两格,又分别写成SI+disp16、SI+disp8,与图注规则相反。
| 编码 | Index,变址寄存器 | Base,基址寄存器/值 |
|---|---|---|
| 0 | EAX | EAX |
| 1 | ECX | ECX |
| 2 | EDX | EDX |
| 3 | EBX | EBX |
| 4 | 无变址寄存器 | ESP |
| 5 | EBP | mod=0 时为 disp32;mod≠0 时为 EBP |
| 6 | ESI | ESI |
| 7 | EDI | EDI |
译注: 图注第二个 EBP 例子没有给出
Base字段,条件并不完整。保留原书条件,不能将其视为足以唯一确定地址方式的编码。
融会贯通:指令集使用情况的测量
本节给出 80x86 的详细测量,再与相同程序在 MIPS 上的测量比较。
为便于比较动态指令集测量结果,我们使用 SPEC92 的一个程序子集。80x86 数据于 1994 年取得,使用 Sun Solaris FORTRAN 和 C 编译器 V2.0,并在 32 位模式下执行。这些编译器的质量与 MIPS 所用编译器相当。
应记住,测量结果取决于所选基准程序与编译器技术。虽然我们认为本节测量能够较合理地反映这些体系结构的使用情况,其他程序的行为仍可能与这里任何一个基准不同,不同编译器也可能产生不同结果。实际研究指令集时,体系结构设计者应使用大得多的基准集合,尽量覆盖广泛的应用,并考虑操作系统及其对指令集的使用。这里测量的单用户基准,不一定具有与操作系统相同的行为。
我们先单独评价 80x86 的特性,再将指令数与 DLX 比较。5
80x86 操作数寻址测量
先看寻址方式。图 K.40 展示 80x86 操作数类型的分布。这里统计的是操作的“第二个”操作数,例如
只计为一个存储器操作数。若把第一个操作数的类型也计入,寄存器使用比例会增加到约 1.5 倍。
| 操作数类型 | 整数程序平均 | 浮点程序平均 |
|---|---|---|
| 寄存器 | 45% | 22% |
| 立即数 | 16% | 6% |
| 存储器 | 39% | 72% |
图 K.41 按各自寻址方式划分 80x86 的存储器操作数。最出人意料的可能是 80386 新增寻址方式很常用,即图中最后四行,约占全部存储器访问的一半。另一个意外是直接寻址也很常见。在大多数其他机器上,等价的直接寻址方式很少使用。可能因为 80x86 的分段地址空间使地址相对于段寄存器中的基址,直接寻址因此更有用。
| 寻址方式 | 整数程序平均 | 浮点程序平均 |
|---|---|---|
| 寄存器间接 | 13% | 3% |
| 基址 + 8 位位移量 | 31% | 15% |
| 基址 + 32 位位移量 | 9% | 25% |
| 变址 | 0% | 0% |
| 基址变址 + 8 位位移量 | 0% | 0% |
| 基址变址 + 32 位位移量 | 0% | 1% |
| 基址 + 比例变址 | 22% | 7% |
| 基址 + 比例变址 + 8 位位移量 | 0% | 8% |
| 基址 + 比例变址 + 32 位位移量 | 4% | 4% |
| 32 位直接寻址 | 20% | 37% |
这些寻址方式在很大程度上决定 Intel 指令的大小。图 K.42 展示指令长度分布。整数程序平均每条指令为 2.8 字节,标准差 1.5;浮点程序平均为 4.1 字节,标准差 1.9。长度差异部分来自寻址方式差异:整数程序更多采用较短的寄存器间接和 8 位位移量寻址。
浮点程序则更常使用 80386 新增、带较长的 32 位位移量的寻址方式。
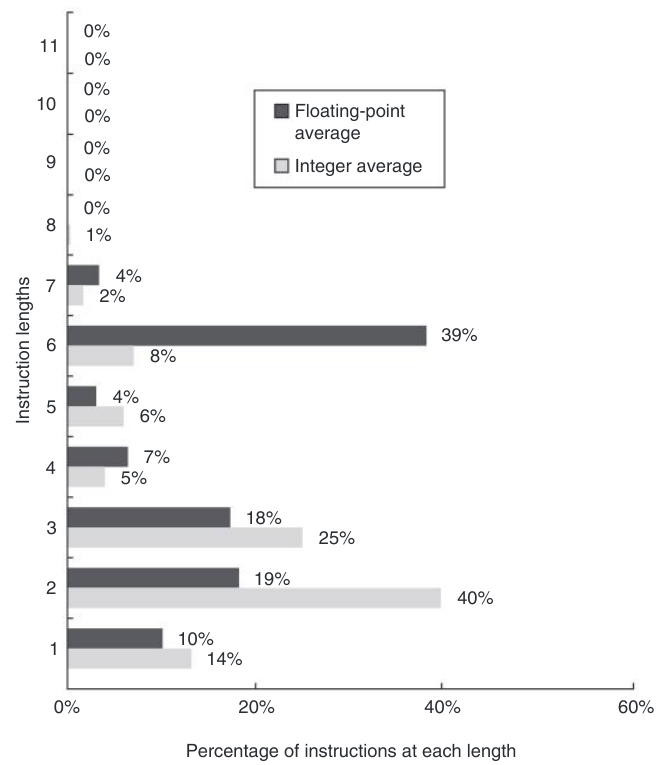
图中长度 1–11 字节对应的浮点/整数平均百分比分别为:10/14、19/40、18/25、7/5、4/6、39/8、4/2、0/1、0/0、0/0、0/0。原图各项按所示精度取整,不重新归一化。
浮点指令兼具栈和寄存器两方面特征,实际如何使用呢?图 K.43 表明,至少本次测量所用的编译器很少遵循纯栈执行模型。原书建议参见 L.3 节了解这一现象的历史原因。6
最后,图 K.44 和 K.45 给出十个 SPEC92 程序的指令混合。
| 操作数形式 | doduc | ear | hydro2d | mdljdp2 | su2cor | 浮点平均 |
|---|---|---|---|---|---|---|
栈,第二操作数为 ST(1) | 1.1% | 0.0% | 0.0% | 0.2% | 0.6% | 0.4% |
寄存器,第二操作数为 ST(i), | 17.3% | 63.4% | 14.2% | 7.1% | 30.7% | 26.5% |
| 存储器 | 81.6% | 36.6% | 85.8% | 92.7% | 68.7% | 73.1% |
| 指令 | doduc | ear | hydro2d | mdljdp2 | su2cor | 浮点平均 |
|---|---|---|---|---|---|---|
| 加载 | 8.9% | 6.5% | 18.0% | 27.6% | 27.6% | 20% |
| 存储 | 12.4% | 3.1% | 11.5% | 7.8% | 7.8% | 8% |
| 加法 | 5.4% | 6.6% | 14.6% | 8.8% | 8.8% | 10% |
| 减法 | 1.0% | 2.4% | 3.3% | 2.4% | 2.4% | 3% |
| 乘法 | 0% | |||||
| 除法 | 0% | |||||
| 比较 | 1.8% | 5.1% | 0.8% | 1.0% | 1.0% | 2% |
| 寄存器间传送 | 3.2% | 0.1% | 1.8% | 2.3% | 2.3% | 2% |
| 加载立即数 | 0.4% | 1.5% | 0% | |||
| 条件分支 | 5.4% | 8.2% | 5.1% | 2.7% | 2.7% | 5% |
| 无条件分支 | 0.8% | 0.4% | 1.3% | 0.3% | 0.3% | 1% |
| 调用 | 0.5% | 1.6% | 0.1% | 0.1% | 0% | |
| 返回、间接跳转 | 0.5% | 1.6% | 0.1% | 0.1% | 0% | |
| 移位 | 1.1% | 4.5% | 2.5% | 2.5% | 2% | |
| AND | 0.8% | 0.8% | 0.7% | 1.3% | 1.3% | 1% |
| OR | 0.1% | 0.1% | 0.1% | 0% | ||
| 其他,XOR、NOT 等 | 0% | |||||
| 浮点加载 | 14.1% | 22.5% | 9.1% | 12.6% | 12.6% | 14% |
| 浮点存储 | 8.6% | 11.4% | 4.1% | 6.6% | 6.6% | 7% |
| 浮点加法 | 5.8% | 6.1% | 1.4% | 6.6% | 6.6% | 5% |
| 浮点减法 | 2.2% | 2.7% | 3.1% | 2.9% | 2.9% | 3% |
| 浮点乘法 | 8.9% | 8.0% | 4.1% | 12.0% | 12.0% | 9% |
| 浮点除法 | 2.1% | 0.8% | 0.2% | 0.2% | 0% | |
| 浮点比较 | 9.4% | 6.9% | 10.8% | 0.5% | 0.5% | 5% |
| 浮点寄存器间传送 | 2.5% | 0.8% | 0.3% | 0.8% | 0.8% | 1% |
| 其他浮点,绝对值、平方根等 | 3.9% | 3.8% | 4.1% | 0.8% | 0.8% | 2% |
| 指令 | compress | eqntott | espresso | gcc(cc1) | li | 整数平均 |
|---|---|---|---|---|---|---|
| 加载 | 20.8% | 18.5% | 21.9% | 24.9% | 23.3% | 22% |
| 存储 | 13.8% | 3.2% | 8.3% | 16.6% | 18.7% | 12% |
| 加法 | 10.3% | 8.8% | 8.15% | 7.6% | 6.1% | 8% |
| 减法 | 7.0% | 10.6% | 3.5% | 2.9% | 3.6% | 5% |
| 乘法 | 0.1% | 0% | ||||
| 除法 | 0% | |||||
| 比较 | 8.2% | 27.7% | 15.3% | 13.5% | 7.7% | 16% |
| 寄存器间传送 | 7.9% | 0.6% | 5.0% | 4.2% | 7.8% | 4% |
| 加载立即数 | 0.5% | 0.2% | 0.6% | 0.4% | 0% | |
| 条件分支 | 15.5% | 28.6% | 18.9% | 17.4% | 15.4% | 20% |
| 无条件分支 | 1.2% | 0.2% | 0.9% | 2.2% | 2.2% | 1% |
| 调用 | 0.5% | 0.4% | 0.7% | 1.5% | 3.2% | 1% |
| 返回、间接跳转 | 0.5% | 0.4% | 0.7% | 1.5% | 3.2% | 1% |
| 移位 | 3.8% | 2.5% | 1.7% | 1% | ||
| AND | 8.4% | 1.0% | 8.7% | 4.5% | 8.4% | 6% |
| OR | 0.6% | 2.7% | 0.4% | 0.4% | 1% | |
| 其他,XOR、NOT 等 | 0.9% | 2.2% | 0.1% | 1% | ||
| 浮点加载 | 0% | |||||
| 浮点存储 | 0% | |||||
| 浮点加法 | 0% | |||||
| 浮点减法 | 0% | |||||
| 浮点乘法 | 0% | |||||
| 浮点除法 | 0% | |||||
| 浮点比较 | 0% | |||||
| 浮点寄存器间传送 | 0% | |||||
| 其他浮点,绝对值、平方根等 | 0% |
译注: 两张指令混合表均保留原页空格、数值和平均值,不把空格擅自填成零。图 K.44 的
mdljdp2与su2cor两列逐项相同,且部分“平均”不等于所列五项的简单平均;图 K.45 的espresso加法项确为8.15%。
操作数量的比较测量
图 K.46 和 K.47 列出十个程序在 80x86 上执行的指令数,以及相对于 DLX 的执行指令数比值。小于 1.0 意味着 80x86 执行的指令更少。许多整数程序的指令数与 DLX 惊人地接近,因为人们原本会预期,DLX 这样的加载—存储体系结构所执行的指令数应多于 80x86 这样的寄存器—存储器体系结构。
浮点程序在 80x86 上的指令数总是更多,可能因为它没有普通的浮点寄存器模型,而采用栈体系结构。
另一个问题是 80x86 与 DLX 的总数据流量:80x86 可在运算中直接指定存储器操作数,DLX 则只能通过加载和存储访问存储器。图 K.46 和 K.47 也列出这十个程序的数据读、数据写及数据读—修改—写。下部各行给出每类访问相对于 DLX 的总次数比值,其中一次读—修改—写同时计为一次读和一次写。对于浮点程序,80x86 的数据访问次数约为 DLX 的 2–4 倍。
对于整数程序,约为 1.25 倍。最后,图 K.48 给出 80x86 和 DLX 各类别指令的比例。
| 测量项目 | compress | eqntott | espresso | gcc(cc1) | li | 整数平均 |
|---|---|---|---|---|---|---|
| 80x86 执行指令数,百万条 | 2226 | 1203 | 2216 | 3770 | 5020 | |
| 执行指令数/DLX | 0.61 | 1.74 | 0.85 | 0.96 | 0.98 | 1.03 |
| 80x86 数据读,百万次 | 589 | 229 | 622 | 1079 | 1459 | |
| 80x86 数据写,百万次 | 311 | 39 | 191 | 661 | 981 | |
| 80x86 数据读—修改—写,百万次 | 26 | 1 | 129 | 48 | 48 | |
| 80x86 数据读总数,百万次 | 615 | 230 | 751 | 1127 | 1507 | |
| 数据读/DLX | 0.85 | 1.09 | 1.38 | 1.25 | 0.94 | 1.10 |
| 80x86 数据写总数,百万次 | 338 | 40 | 319 | 709 | 1029 | |
| 数据写/DLX | 1.67 | 9.26 | 2.39 | 1.25 | 1.20 | 3.15 |
| 80x86 数据访问总数,百万次 | 953 | 269 | 1070 | 1836 | 2536 | |
| 数据访问/DLX | 1.03 | 1.25 | 1.58 | 1.25 | 1.03 | 1.23 |
| 测量项目 | doduc | ear | hydro2d | mdljdp2 | su2cor | 浮点平均 |
|---|---|---|---|---|---|---|
| 80x86 执行指令数,百万条 | 1223 | 15,220 | 13,342 | 6197 | 6197 | |
| 执行指令数/DLX | 1.19 | 1.19 | 2.53 | 2.09 | 1.62 | 1.73 |
| 80x86 数据读,百万次 | 515 | 6007 | 5501 | 3696 | 3643 | |
| 80x86 数据写,百万次 | 260 | 2205 | 2085 | 892 | 892 | |
| 80x86 数据读—修改—写,百万次 | 1 | 0 | 189 | 124 | 124 | |
| 80x86 数据读总数,百万次 | 517 | 6007 | 5690 | 3820 | 3767 | |
| 数据读/DLX | 2.04 | 2.36 | 4.48 | 4.77 | 3.91 | 3.51 |
| 80x86 数据写总数,百万次 | 261 | 2205 | 2274 | 1015 | 1015 | |
| 数据写/DLX | 3.68 | 33.25 | 38.74 | 16.74 | 9.35 | 20.35 |
| 80x86 数据访问总数,百万次 | 778 | 8212 | 7965 | 4835 | 4782 | |
| 数据访问/DLX | 2.40 | 3.14 | 5.99 | 5.73 | 4.47 | 4.35 |
译注: 原表以百万次显示并取整,部分合计与所列分项相加相差 1–2。正文的“2–4 倍”也是原文概括,与图 K.47 某些超过 4 的比值并不完全吻合。
| 类别 | 整数平均:x86 | 整数平均:DLX | 浮点平均:x86 | 浮点平均:DLX |
|---|---|---|---|---|
| 全部数据传送 | 34% | 36% | 28% | 2% |
| 全部整数算术 | 34% | 31% | 16% | 12% |
| 全部控制 | 24% | 20% | 6% | 10% |
| 全部逻辑 | 8% | 13% | 3% | 2% |
| 全部浮点数据传送 | 0% | 0% | 22% | 33% |
| 全部浮点算术 | 0% | 0% | 25% | 41% |
结束语
美在观者眼中。
——古老谚语
正如前面所见,Intel 的体系结构词典里找不到“正交”这个词。要完全弄清哪些寄存器、哪些寻址方式可用,必须查看所有寻址方式的编码,有时甚至还得查看指令编码。
有人认为,80x86 指令集的不优雅不可避免,是任何体系结构大获成功都必须付出的代价。我们不赞同这种看法。显然,任何成功的体系结构都无法抛弃以前实现中增加的特性;随着时间推移,有些特性也可能显得不再理想。但 80x86 的别扭从核心的 8086 指令集就已开始,8087、80286、80386 在体系结构上不一致的扩展又加重了它。
IBM 360/370 是一个反例,它比 80x86 古老得多,在大型机市场的统治地位也正如 80x86 在 PC 市场一样。毫无疑问,因为基础更好、扩展更一致,在首次实现 30 多年之后,这套指令集仍比 80x86 更合乎情理。
无论好坏,Intel 比竞争对手那些更优雅的体系结构早数年推出了 16 位微处理器,这一先发优势促使 IBM PC 选择了 8086 作为 CPU。7 它在风格上的不足由数量弥补;从合适的角度看,80x86 也很美。
80x86 的可取之处是,其体系结构组成部分并不太难实现。自 1978 年起,Intel 迅速提高整数程序性能,已经证明了这一点。对这种体系结构而言,实现很高的浮点性能是更大的挑战。
原文在这里写 Pentium 于 1992 年。 ↩︎
原文引用“第 A-4 页图 A.31”,图号与页码不相符;译文指向附录 A 的栈机器示例,并保留原始引用疑点。 ↩︎
原文在这里写“递增栈顶指针”(incrementing the top of stack pointer);译文用“调整”描述加载的栈行为,避免将抽象栈位置与物理寄存器索引的增减方向混同。此处原文没有说明物理寄存器的编号方向。 ↩︎
这里的 17 字节是原文把各字段最大长度相加所得的说法,不应直接理解为 x86 有效指令的体系结构长度上限。 ↩︎
本小节开头称比较对象为 MIPS,随后正文和图表均称 DLX。 ↩︎
附录 L 未收录。 ↩︎
原文写 IBM PC 选用 8086。它把体系结构家族与具体芯片的关系作了简化,不应据此判定原始 IBM PC 的具体 CPU 型号。 ↩︎