# K.4 VAX 体系结构
> VAX:产业史上最成功的小型机设计……VAX 很可能是 hacker 最喜爱的机器……
> 尤以规模庞大、方便汇编程序员使用的指令集著称;但在 RISC 革命之后,这一优势变成了负担。
>
> ——Eric Raymond,《The New Hacker’s Dictionary》,1991 年
## 引言
为加深读者对指令集体系结构的理解,我们选 VAX 作为复杂指令集计算机(CISC)的代表,因为它与 MIPS 截然不同,却仍容易理解。了解这两种差异如此显著的风格后,我们相信读者能够自行学习其他指令集。
设计 VAX 时,流行的思想是让指令集接近编程语言,从而简化编译器。例如,编程语言有循环,指令集就应有循环指令。VAX 体系结构设计者 William Strecker 曾在《VAX-11/780—A Virtual Address Extension to the PDP-11 Family》(AFIPS,National Computer Conference 会议录,1978 年)中说:
> VAX-11 指令集的一个主要目标,是让编译器生成有效率的代码。四项决定帮助实现了这一目标:1)以非常规整、一致的方式处理运算符……2)避免加入编译器不大可能生成的指令……3)为常用运算符提供多种形式……4)用单条指令替代常见指令序列……例如过程调用、多路分支、循环控制和数组下标计算。
要记住,20 世纪 70 年代中期的 DRAM 容量不足本书所说“今天”DRAM 的千分之一,因此代码占用空间也至关重要。另一项流行思想便是尽量减小代码大小,而像 MIPS 这样的定长指令集并不强调这一点。例如,即使地址很小,MIPS 的地址字段也总是占 16 位;VAX 指令的字节数则可以变化,因此地址字段几乎不会浪费空间。
专门介绍 VAX 的书已有整部著作,本附录的这部分内容不可能穷尽一切。因此,下面只描述其中一些寻址方式和指令。为了展示 VAX 指令的实际使用,后面还给出两个 C 过程的 VAX 汇编代码。总体上,我们会将这些指令与读者已经熟悉的 MIPS 代码对照。
VAX 和 MIPS 的不同目标,导致了差别很大的体系结构。VAX 追求简单的编译器和高代码密度,因此采用强大的寻址方式、强大的指令和紧凑高效的指令编码。MIPS 的目标是通过流水线获得高性能、易于硬件实现,并与高度优化的编译器相配合。
这些目标促使 MIPS 采用简单指令、简单寻址方式、定长指令格式和较多寄存器。
## VAX 操作数与寻址方式
VAX 是 32 位体系结构,地址和寄存器均为 32 位。但它还支持图 K.49 所示的许多其他数据长度与类型。遗憾的是,VAX 用“word”指 16 位量;而本书通常用“字”指 32 位量。图 K.49 给出 MIPS 与 VAX 数据类型名称的对应。阅读 VAX 指令时必须小心,因为指令采用的是 VAX 自己的数据类型名称。
| 位数 | 数据类型 | MIPS 名称 | VAX 名称 |
| --- | --- | --- | --- |
| 8 | 整数 | Byte,字节 | Byte,字节 |
| 16 | 整数 | Half word,半字 | Word,字 |
| 32 | 整数 | Word,字 | Long word,长字 |
| 32 | 浮点 | Single precision,单精度 | `F_floating` |
| 64 | 整数 | Double word,双字 | Quad word,四字 |
| 64 | 浮点 | Double precision,双精度 | `D_floating` 或 `G_floating` |
| \(8n\) | 字符串 | Character,字符 | Character,字符 |
{#fig-K.49 .wide .expand num="K.49" caption="VAX 数据类型的长度和名称。VAX 类型名称首字母 b、w、l、f、q、d、g、c 常用于构成指令名。例如传送指令有 movb、movw、movl、movf、movq、movd、movg 和 movc3。每条指令传送的数据类型由 mov 后的字母指定。"}
VAX 提供 16 个 32 位寄存器。VAX 汇编器用 `r0`、`r1`、……、`r15` 表示,我们也采用这种记法。不幸的是,其中四个实际上已经被指令集体系结构指定了用途。例如,`r14` 是栈指针 `sp`,`r15` 是程序计数器 `pc`。因此,`r15` 不能作通用寄存器,而使用 `r14` 也很困难,因为它会干扰操作栈的指令。另外两个专用寄存器是作为参数指针 `ap` 的 `r12` 和作为帧指针 `fp` 的 `r13`,后面会说明其用途。与 MIPS 一样,VAX 汇编器既接受寄存器编号,也接受寄存器名称。
VAX 的寻址方式包括附录 A 讨论的全部 MIPS 寻址方式:寄存器、位移量、立即数和 PC 相对寻址。而且,这些方式都既可用于跳转地址,也可用于数据地址。
但寻址方式还不止这些。为减小代码大小,VAX 的位移量寻址支持 8 位、16 位、32 位三种地址长度,分别称为字节位移量、字位移量和长字位移量寻址。因此,地址可以尽可能短,也能按需要足够长。大地址不必拆分,因而不需要 MIPS `lui` 那样的等价指令,见第 A-37 页图 A.24。[^vax-page-refs]
这仍未囊括全部 VAX 寻址方式。几种方式还有 deferred 选项,意味着所寻址的对象只是实际对象的地址,必须再访问一次存储器才能取得操作数。其他机器通常称其为间接寻址。因此,还可以选择寄存器间接、自动递增间接,以及字节/字/长字位移量间接寻址。例如,按 VAX 汇编器记法,`r1` 表示操作数是寄存器 1,`(r1)` 表示操作数是 `r1` 所指的存储器单元。
还有一种变址寻址,它自动把变址操作数的值转换为相应的字节地址增量,再与地址的其余部分相加。对于一个 32 位字,在把下标加到基址前,需要先乘以 4。某些计算机把变址寻址称为比例寻址,它在地址计算过程中自动将 4 字节数据的下标乘以 4。
为处理如此丰富的寻址选择,VAX 把寻址方式的说明与操作本身的说明分离。操作码规定操作和操作数个数,每个操作数另有自己的寻址方式说明符。图 K.50 列出其名称、汇编语法、示例、含义与长度。
| 寻址方式 | 语法 | 示例 | 含义 | 地址说明符长度,字节 |
| --- | --- | --- | --- | --- |
| 字面量 Literal | `#value` | `#−1` | −1 | 1,原表称 6 位有符号值 |
| 立即数 | `#value` | `#100` | 100 | 1 + 立即数长度 |
| 寄存器 | `rn` | `r3` | `r3` | 1 |
| 寄存器间接 | `(rn)` | `(r3)` | `Memory[r3]` | 1 |
| 字节/字/长字位移量 | `displacement(rn)` | `100(r3)` | `Memory[r3+100]` | 1 + 位移量长度 |
| 字节/字/长字位移量间接 | `@displacement(rn)` | `@100(r3)` | `Memory[Memory[r3+100]]` | 1 + 位移量长度 |
| 变址,比例寻址 | `base mode[rx]` | `(r3)[r4]` | `Memory[r3+r4×d]`,`d` 为数据字节数 | 1 + 基础寻址方式长度 |
| 自动递增 | `(rn)+` | `(r3)+` | `Memory[r3]; r3=r3+d` | 1 |
| 自动递减 | `−(rn)` | `−(r3)` | `r3=r3−d; Memory[r3]` | 1 |
| 自动递增间接 | `@(rn)+` | `@(r3)+` | `Memory[Memory[r3]]; r3=r3+d` | 1 |
{#fig-K.50 .wide .expand num="K.50" caption="VAX 操作数说明符的定义与长度。每种寻址方式长度为 1 字节,加上所需位移量或立即数字段的长度。字面量方式使用专门的 2 位标记,余下 6 位编码常数;常数太大时,必须使用立即数寻址。立即数操作数长度由操作码指定的数据类型长度决定,不由立即数的值决定。最后四种方式中的 d 表示数据字节数,32 位加法的 d=4。"}
> **译注:** 原图把 Literal 标成“6 位有符号值”,并以 `#−1` 为例;自动递增间接一行又用数据长度 `d` 表示地址寄存器的步长。这两处不应直接当作完整的 VAX 编码规则。
这种寻址风格意味着,操作本身不必知道操作数来自哪里:一条 VAX 加法指令的三个操作数可以全在寄存器、全在存储器,也可以任意混合。
### 例题
下面这条指令有多长?
```asm
addl3 r1,737(r2),(r3)[r4]
```
`addl3` 表示有三个操作数的 32 位加法指令。假设 VAX 操作码长度为 1 字节。
### 解答
第一个操作数说明符 `r1` 指定寄存器寻址,占 1 字节。第二个 `737(r2)` 指定位移量寻址,分两部分:首字节指明字位移量寻址方式和基址寄存器 `r2`,随后是 2 字节位移量 737。第三个 `(r3)[r4]` 也有两部分:一个字节指定寄存器间接寻址 `(r3)`,另一个字节指定变址寄存器及变址寻址 `[r4]`。因此总长度为
$$1+(1)+(1+2)+(1+1)=7\text{ 字节}.$$
本示例把 VAX 的目的操作数放左边,源操作数放右边,与本书展示 MIPS 代码的方式相同。VAX 汇编器实际要求相反顺序;为减少混淆,本书在两种机器的示例中都将目的放在左侧。显然,左右安排是人为约定,唯一要求是保持一致。
### 补充说明
由于 PC 是 VAX 寻址方式可选择的 16 个寄存器之一,22 种寻址方式中的四种实际上由其他方式合成。分别选择 PC 作为寄存器时:立即数寻址实质是自动递增,PC 相对寻址实质是位移量寻址,绝对寻址实质是自动递增间接,相对间接寻址则是位移量间接。
## VAX 指令编码
操作与寻址方式相互独立,因此 VAX 的指令编码与 MIPS 很不相同。
VAX 指令以一个字节的操作码开头,包含操作及操作数个数。操作数跟在操作码之后。每个操作数都以一个字节的地址说明符开头,说明其寻址方式。对于寄存器寻址这样的简单方式,这一个字节同时指定方式与寄存器号,见图 K.50 最右列。其他情况下,首字节之后还可能有多个字节,给出余下的地址信息。
以先前例题中的加法指令为例,看看它的编码:
```asm
addl3 r1,737(r2),(r3)[r4]
```
假设指令从地址 201 开始。图 K.51 展示其编码。注意,操作数在存储器中的顺序与上面的汇编表示相反。执行 VAX 指令首先要取得源操作数,因此先存放源操作数很合理。对于 MIPS 这样的定长指令,顺序并不重要,因为在一个 32 位字中很容易找到源和目的操作数。
地址 201 的第一个字节是操作码。地址 202 的下一个字节是使用 `r4` 的变址方式说明符。与许多其他说明符一样,高 4 位给出方式,低 4 位给出该方式所用寄存器。由于 `addl3` 操作 4 字节数据,`r4` 将乘以 4,再加到随后指定的地址上;本例后续是使用 `r3` 的寄存器间接寻址。因此,202、203 两个字节共同定义汇编表示中的第三个操作数。
地址 204 的下一字节说明使用 `r2` 作基址的字位移量寻址。该说明符告诉 VAX,随后地址 205、206 的两个字节包含需要加到 `r2` 上的 16 位地址量。
最后一个字节给出目的操作数,选择使用 `r1` 的寄存器寻址。
| 字节地址 | 每个字节的内容 | 机器码,十六进制 |
| --- | --- | --- |
| 201 | `addl3` 操作码 | `c1` |
| 202 | `[r4]` 的变址方式说明符 | `44` |
| 203 | `(r3)` 的寄存器间接方式说明符 | `63` |
| 204 | 以 `r2` 为基址的字位移量说明符 | `c2` |
| 205 | 16 位常数 737 的低字节 | `e1` |
| 206 | 16 位常数 737 的高字节 | `02` |
| 207 | `r1` 的寄存器方式说明符 | `51` |
{#fig-K.51 .wide .expand num="K.51" caption="VAX 指令 addl3 r1,737(r2),(r3)[r4] 的编码,假定起始地址为 201。最右列给出实际 VAX 十六进制编码,供感兴趣的读者查看。16 位十进制常数 737 占两个字节。"}
寻址方式如此多变,意味着同一种 VAX 操作可以具有许多长度;例如,整数加法可以是 3–19 字节。VAX 实现必须先译码第一个操作数,才能找到第二个,因此实现者很容易选择用一个时钟周期译码一个操作数。这样,即使采用简单地址,这种复杂的指令集也可能导致更高的每条指令时钟周期数。
## VAX 操作
与其设计思想一致,VAX 不仅寻址方式很多,操作也很多。下面简要介绍一些,以展示这台机器的特点。
由于寻址方式很强,VAX 传送指令能够完成其他机器上的多种操作。它可在任意两个可寻址位置之间传送数据,因此加载、存储、寄存器间传送、存储器间传送都是其特例。把图 K.49 中类型的首字母 `b`、`w`、`l`、`f`、`q`、`d`、`g`、`c` 接在 `mov` 后面,就决定数据长度。有一种特殊的传送称为“传送地址”,传送操作数的 32 位地址,而不是数据,其名称为 `mova`。
MIPS 的算术操作在 VAX 中也有,但有两大差异。第一,数据类型直接附在名称后面。因而 `addb`、`addw`、`addl` 分别操作存储器或寄存器中的 8 位、16 位、32 位数据;MIPS 只有一种操作完整 32 位寄存器的 `add`。第二,为减小代码大小,加法指令会指明不同操作数的个数;MIPS 则始终指定三个,即使有一个是重复的。例如 MIPS 指令
```asm
add $1, $1, $2
```
和其他 MIPS 指令一样占 32 位;而 VAX 指令
```asm
addl2 r1, r2
```
将 `r1` 同时用作源与目的,只占 24 位:操作码 8 位,两个寄存器说明符各 8 位。
### 操作数量
现在可以说明 VAX 指令名的构成:
```text
(操作)(数据类型)(2 或 3)
```
`add` 适用于 byte、word、long、float、double 数据类型,且各有两个或三个不同操作数的版本,因此 VAX 提供以下全部指令:
```text
addb2 addw2 addl2 addf2 addd2
addb3 addw3 addl3 addf3 addd3
```
如果计入全部寻址方式,但不区分寄存器号和立即数数值,并仅考虑 byte、word、long 三种整数类型,VAX 的整数加法就有 30,000 多种版本;MIPS 只有四种!
VAX 指令数量大的另一个原因,是它提供了可以替代指令序列、或用更少字节表示单个操作的指令。下面给出四例,`*` 表示数据类型。
| VAX 操作 | 示例 | 含义 |
| --- | --- | --- |
| `clr*` | `clrl r3` | `r3=0` |
| `inc*` | `incl r3` | `r3=r3+1` |
| `dec*` | `decl r3` | `r3=r3−1` |
| `push*` | `pushl r3` | `sp=sp−4; Memory[sp]=r3` |
最后一行的入栈指令,与对栈指针使用自动递减寻址的传送指令完全相同:
```asm
movl -(sp), r3
```
`pushl` 的优点是简短:由于 `sp` 隐含指定,它少占 1 字节。
### 分支、跳转和过程调用
VAX 分支指令与算术指令相关,因为分支依赖条件码。条件码是操作的副作用,表示结果为正、负、零,或是否溢出。大多数指令根据结果设置条件码;分支之类没有结果的指令则不设置。VAX 的条件码是 `N`(负)、`Z`(零)、`V`(溢出)和 `C`(进位)。另有比较指令 `cmp*`,专门为后续分支设置条件码。
VAX 分支指令覆盖所有条件。常用者有 `beql`(=)、`bneq`(≠)、`blss`(<)、`bleq`(≤)、`bgtr`(>)、`bgeq`(≥),功能与名称相符。无条件分支则根据 PC 相对偏移量长度命名:`brb`(branch byte)使用 8 位位移量,`brw`(branch word)使用 16 位位移量。
这里讨论的最后一大类是过程调用与返回。与 MIPS 不同,这些复杂指令可能需要数十个时钟周期。后面两个小节会展示其工作方式,但先要解释 `calls`、`ret` 操作的几个栈相关指针。栈指针 `sp` 与 MIPS 一样,指向栈顶;参数指针 `ap` 指向存储器中传给过程的实参或参数列表的起点;帧指针 `fp` 指向存储器中该过程局部变量区域,即栈帧的基部。VAX 调用和返回指令操作这些指针,使栈在跨过程调用时保持正确状态。
它们也为访问存储器操作数提供方便的基址寄存器。如后面将看到的,调用和返回还保存与恢复通用寄存器和程序计数器。图 K.52 再列出一些 VAX 指令。
| 指令类别 | 示例 | 含义 |
| --- | --- | --- |
| 数据传送:字节、半字、字、双字;`*` 为类型 | `mov*` | 在两个操作数之间传送 |
| 数据传送 | `movzb*` | 字节零扩展为半字或字后传送 |
| 数据传送 | `mova*` | 传送操作数的 32 位地址,末尾表示数据类型 |
| 数据传送 | `push*` | 将操作数压栈 |
| 算术/逻辑:整数或逻辑字节、16 位半字、32 位字 | `add*_` | 两操作数或三操作数加法 |
| 算术/逻辑 | `cmp*` | 比较并设置条件码 |
| 算术/逻辑 | `tst*` | 与零比较并设置条件码 |
| 算术/逻辑 | `ash*` | 算术移位 |
| 算术/逻辑 | `clr*` | 清零 |
| 算术/逻辑 | `cvtb*` | 将字节符号扩展到指定数据类型的长度 |
| 控制:条件与无条件分支 | `beql, bneq` | 相等时分支、不等时分支 |
| 控制 | `bleq, bgeq` | 小于等于时分支、大于等于时分支 |
| 控制 | `brb, brw` | 采用 8 位或 16 位地址量的无条件分支 |
| 控制 | `jmp` | 可用任意寻址方式指定目标的跳转 |
| 控制 | `aobleq` | 操作数加一;若结果 ≤ 第二操作数,则分支 |
| 控制 | `case_` | 根据 case 选择值跳转 |
| 过程:调用/返回 | `calls` | 参数位于栈上的过程调用,见下文“更长的例子:sort” |
| 过程 | `callg` | 使用 FORTRAN 风格参数列表的过程调用 |
| 过程 | `jsb` | 跳至子程序并保存返回地址,类似 MIPS `jal` |
| 过程 | `ret` | 从过程调用返回 |
| 浮点:D、F、G、H 格式 | `addd_` | D 格式双精度浮点加法 |
| 浮点 | `subd_` | D 格式双精度浮点减法 |
| 浮点 | `mulf_` | F 格式单精度浮点乘法 |
| 浮点 | `polyf` | 使用 F 格式系数表计算多项式 |
| 其他:特殊操作 | `crc` | 计算循环冗余校验 |
| 其他 | `insque` | 将队列项插入队列 |
{#fig-K.52 .wide .expand num="K.52" caption="VAX 指令类别与示例。星号表示 b、w、l、d、f、g、h、q 等多种数据类型;如 addd_ 中的下划线表示两操作数 addd2 和三操作数 addd3 两种形式。"}
## 融会贯通的例子:swap
为展示 VAX 汇编编程,我们翻译两个 C 过程 `swap` 和 `sort`。图 K.53 重列 `swap` 的 C 代码;下一小节讨论 `sort`。
我们按汇编编程的三个一般步骤描述 `swap`:
1. 为程序变量分配寄存器。
2. 生成过程主体代码。
3. 在过程调用前后保持寄存器内容。
这些过程的 VAX 代码以 VMS C 编译器开启优化后生成的代码为基础。
| C 代码 |
| --- |
| `swap(int v[], int k)`
`{`
` int temp;`
` temp = v[k];`
` v[k] = v[k + 1];`
` v[k + 1] = temp;`
`}` |
{#fig-K.53 .wide .expand num="K.53" caption="交换存储器中两个位置内容的 C 过程。下一小节的排序示例会使用它。"}
### 为 swap 分配寄存器
与 MIPS 不同,VAX 参数通常分配在存储器中,因此这一步更恰当地说应是“变量分配”。VAX 标准参数传递约定使用栈。两个参数 `v[]` 和 `k` 可通过参数指针 `ap` 访问:`4(ap)` 对应 `v[]`,`8(ap)` 对应 `k`。要记住,按字节寻址时,相邻 4 字节字的地址相差 4。另一个变量只有 `temp`,把它分配给 `r3`。
### swap 过程主体代码
`swap` 剩下的 C 代码为:
```c
temp = v[k];
v[k] = v[k + 1];
v[k + 1] = temp;
```
因为程序多次使用 `v[]` 和 `k`,为提高运行速度,VAX 编译器先把两个参数都移入寄存器:
```asm
movl r2, 4(ap) ; r2 = v[]
movl r1, 8(ap) ; r1 = k
```
这里遵循 VAX 用分号开始注释的约定。MIPS 的注释符号 `#`,在 VAX 汇编中表示常数操作数。
VAX 有变址寻址,可以直接使用下标 `k`,不必先换算成字节地址。因此代码很直接:
```asm
movl r3, (r2)[r1] ; r3(temp)= v[k]
addl3 r0, #1,8(ap) ; r0 = k + 1
movl (r2)[r1],(r2)[r0] ; v[k] = v[r0],即 v[k + 1]
movl (r2)[r0],r3 ; v[k + 1] = r3,即 temp
```
MIPS 的关键代码基本上是两次加载加两次存储;VAX 则是一次存储器到寄存器传送、一次存储器到存储器传送和一次寄存器到存储器传送。`addl3` 还体现了 VAX 寻址方式的灵活性:它把常数 1 加到存储器操作数上,再把结果放入寄存器。
至此,已经分配好存储位置,并写出执行过程操作的代码。剩下的只是跨越 `swap` 调用保持寄存器内容的代码。
### 在 swap 调用前后保持寄存器
VAX 提供一对保存、恢复寄存器的指令 `calls` 和 `ret`。本例展示它们的工作方式。
VAX C 编译器采用一种由被调用者决定保存内容的约定。检查上面代码可知,`r0`、`r1`、`r2`、`r3` 的值必须保存,才能稍后恢复。`calls` 预期在过程起始处看到一个 16 位掩码,用来决定保存哪些寄存器:若第 \(i\) 位为 1,就把寄存器 \(i\) 压栈。此外,`calls` 还把这个掩码压栈,使返回指令 `ret` 能恢复正确的寄存器。因此,保存动作由调用者执行的 `calls` 完成,而被调用者通过调用掩码决定保存哪些内容。
`calls` 的一个操作数给出传递的参数个数,以便调整栈相关的参数指针 `ap`、帧指针 `fp` 和栈指针 `sp`。当然,它还保存程序计数器,使过程能够返回。
因此,为 `swap` 保存这四个寄存器,只需在过程开始处增加掩码,让调用者的 `calls` 完成全部工作:
```asm
.word ^m ; 设置掩码的第 0、1、2、3 位
```
这条汇编伪指令要求汇编器放入一个 16 位常数,将适当的位设为 1,以保存 `r0` 到 `r3`。
返回指令撤销 `calls` 所做的工作。结束时,`ret` 根据当前帧指针设置栈指针,从而弹出 `calls` 压入的所有内容。在此过程中,它恢复 `calls` 保存的寄存器,包括掩码指定的寄存器以及旧的 `fp`、`ap`、`pc`。
为完成 `swap`,只需再加一条指令:
```asm
ret ; 恢复寄存器并返回
```
### 完整的 swap 过程
现在可以组合整个过程。图 K.54 标出每一段代码的用途,左列为 MIPS,右列为 VAX。
| 代码部分 | MIPS | VAX |
| --- | --- | --- |
| 保存寄存器 | `swap: addi $29,$29,-12`
`sw $2,0($29)`
`sw $15,4($29)`
`sw $16,8($29)` | `swap: .word ^m` |
| 过程主体 | `muli $2,$5,4`
`add $2,$4,$2`
`lw $15,0($2)`
`lw $16,4($2)`
`sw $16,0($2)`
`sw $15,4($2)` | `movl r2,4(a)`
`movl r1,8(a)`
`movl r3,(r2)[r1]`
`addl3 r0,#1,8(ap)`
`movl (r2)[r1],(r2)[r0]`
`movl (r2)[r0],r3` |
| 恢复寄存器 | `lw $2,0($29)`
`lw $15,4($29)`
`lw $16,8($29)`
`addi $29,$29,12` | |
| 过程返回 | `jr $31` | `ret` |
{#fig-K.54 .wide .expand num="K.54" caption="图 K.53 的 swap 过程的 MIPS 与 VAX 汇编代码对照。"}
> **译注:** 原图前两条 VAX 传送写为 `4(a)`、`8(a)`,而前文写为 `4(ap)`、`8(ap)`;图中保留原样,按上下文实际指参数指针 `ap`。图内 MIPS 部分按可见指令计为 15 行,下一段原文却称 17 行;这里不擅自补两条指令。
这个例子展示了 VAX 比例变址寻址与复杂调用、返回指令在减少代码行数方面的优势。原文称,17 行 MIPS 汇编代码变成了 8 行 VAX 汇编代码。它也说明,在存储器中传递参数会增加存储器访问。
要记住,执行指令数不等于性能;后面的相关谬误会说明这一点。
VAX 软件约定把 `r0`、`r1` 视为不跨过程调用保存的临时寄存器;但原文接着说,VMS C 编译器“确实把”这两个寄存器纳入保存掩码。[^vax-mask] 此外,编译器本应在 `addl3` 中使用 `r1`,而不是 `8(ap)`。这样的例子总会激起计算机体系结构设计者自己编写编译器的冲动!
## 更长的例子:sort
下面介绍较长的 `sort` 过程。图 K.55 是它的 C 版本。仍分几步讨论,最后与 MIPS 代码并排比较。
| C 代码 |
| --- |
| `sort(int v[], int n)`
`{`
` int i, j;`
` for (i = 0; i < n; i = i + 1) {`
` for (j = i - 1; j >= 0 && v[j] > v[j + 1]; j = j - 1) {`
` swap(v,j);`
` }`
` }`
`}` |
{#fig-K.55 .wide .expand num="K.55" caption="对数组 v 排序的 C 过程;原书将其称为冒泡排序。"}
> **译注:** 保留原程序与“冒泡排序”这一原图称谓;从逐个插入并向前交换的循环结构看,它也容易被归为通过相邻交换实现的插入式排序。这里不改写算法以迁就名称。图 K.53、K.55 保留原书未显式声明返回类型的历史 C 写法。
### 为 sort 分配寄存器
参数 `v`、`n` 分别位于栈中的 `4(ap)`、`8(ap)`。两个局部变量分配给寄存器:`i` 用 `r6`,`j` 用 `r4`。由于代码频繁引用两个参数,VMS C 编译器在进入过程时把参数的地址复制到寄存器:
```asm
moval r7,8(ap) ; 将 n 的地址移入 r7
moval r5,4(ap) ; 将 v 的地址移入 r5
```
把操作数的值而非地址放入寄存器,似乎更有用;但这里我们仍服从 VMS C 编译器的决定。
显然,编译器不能确信 `v` 和 `n` 在存储器中不会重叠。
### sort 过程主体代码
主体由两个嵌套 `for` 循环和一次带参数的 `swap` 调用组成。下面从外到内展开。
### 外层循环
首先翻译第一个 `for`:
```c
for (i = 0; i < n; i = i + 1) {
```
C 的 `for` 语句有初始化、循环测试和迭代递增三部分。第一部分把 `i` 初始化为零,只需一条指令:
```asm
clrl r6 ; i = 0
```
最后一部分给 `i` 加一,也只需一条:
```asm
incl r6 ; i = i + 1
```
若 `i < n` 为假就应退出,换言之,`i >= n` 时退出。测试需要两条指令:
```asm
for1tst: cmpl r6,(r7) ; 比较 r6 与 Memory[r7],即 i 与 n
bgeq exit1 ; 若 r6 >= Memory[r7],即 i >= n,转到 exit1
```
`cmpl` 设置条件码,供条件分支 `bgeq` 使用。循环末尾只需跳回测试处:
```asm
brb for1tst ; 转到外层循环测试
exit1:
```
因此,第一个 `for` 的框架是:
```asm
clrl r6 ; i = 0
for1tst: cmpl r6,(r7) ; 比较 i 与 n
bgeq exit1 ; 若 i >= n,转到 exit1
... ; 第一个 for 循环的主体
incl r6 ; i = i + 1
brb for1tst ; 转到外层循环测试
exit1:
```
### 内层循环
第二个 `for` 为:
```c
for (j = i - 1; j >= 0 && v[j] > v[j + 1]; j = j - 1) {
```
初始化同样只需一条指令:
```asm
subl3 r4,r6,#1 ; j = i - 1
```
`j` 减一也只需一条:
```asm
decl r4 ; j = j - 1
```
循环测试有两部分。只要任一条件不成立就退出,因此第一项失败,即 `j < 0` 时,必须直接离开循环:
```asm
for2tst: blss exit2 ; 若 r4 < 0,即 j < 0,转到 exit2
```
注意,这里没有显式比较。这是条件码的一项好处:前一条指令的副作用已经设置条件。这个分支会跳过第二项条件测试。
若 `v[j] > v[j+1]` 为假,即 `v[j] <= v[j+1]`,第二项测试也退出。先加载 `v`,并把 `j+1` 放入寄存器:
```asm
movl r3,(r5) ; r3 = Memory[r5],即 v
addl3 r2,r4,#1 ; r2 = r4 + 1,即 j + 1
```
第一条指令用寄存器间接寻址取得 `r5` 指向的操作数。
变址寻址再次使我们能直接使用下标,无需换算成字节地址,所以测试 `v[j] <= v[j+1]` 的两条指令为:
```asm
cmpl (r3)[r4],(r3)[r2] ; 比较 v[r4] 与 v[r2],即 v[j] 与 v[j+1]
bleq exit2 ; 若 v[j] <= v[j+1],转到 exit2
```
循环末尾跳回完整测试的起点:
```asm
brb for2tst ; 跳到内层循环测试
```
组合后,第二个 `for` 为:
```asm
subl3 r4,r6,#1 ; j = i - 1
for2tst: blss exit2 ; 若 r4 < 0,即 j < 0,退出
movl r3,(r5) ; r3 = Memory[r5],即 v
addl3 r2,r4,#1 ; r2 = j + 1
cmpl (r3)[r4],(r3)[r2] ; 比较 v[j] 与 v[j+1]
bleq exit2 ; 若 v[j] <= v[j+1],退出
... ; 第二个 for 循环的主体
decl r4 ; j = j - 1
brb for2tst ; 跳到内层循环测试
exit2:
```
> **译注:** `bleq` 的比较条件为 `v[j] ≤ v[j+1]`。
注意,循环顶部的 `blss` 测试的是根据 `r4`,即 `j` 的新值设置的条件码。这些条件码可能由进入循环之前的 `subl3` 设置,也可能由循环末尾的 `decl` 设置。
### 过程调用
下一步是内层 `for` 的主体:
```c
swap(v,j);
```
调用 `swap` 很简单:
```asm
calls #2,swap
```
常数 2 表示压入栈中的参数个数。
### 传递参数
C 编译器通过栈传递变量,因此用下面两条指令向 `swap` 传参:
```asm
pushl (r5) ; swap 的第一个参数是 v
pushl r4 ; swap 的第二个参数是 j
```
第一条使用寄存器间接寻址取得操作数。
> **译注:** 这两条 `pushl` 的先后顺序,与前面把 `4(ap)`、`8(ap)` 分别解释为 `v`、`k` 的参数布局存在顺序上的不一致。
### 在 sort 调用前后保持寄存器
剩下的代码是按被调用者保存约定保存、恢复寄存器。该过程使用 `r2` 到 `r7`,因此增加对应位置为 1 的掩码:
```asm
.word ^m ; 设置寄存器 2–7 的掩码
```
由于 `ret` 会撤销全部相关操作,只需把它接到过程末尾。
### 完整的 sort 过程
图 K.56 将全部部分组合起来。为便于阅读,仍按用途划分代码块,并将 MIPS 与 VAX 并列。这个例子中,11 行 C 语言 `sort` 变成 44 行 MIPS 汇编和 20 行 VAX 汇编。VAX 最大的优势是寄存器保存、恢复以及变址寻址。
| 代码部分 | MIPS | VAX |
| --- | --- | --- |
| 保存寄存器 | `sort: addi $29,$29,-36`
`sw $15,0($29)`
`sw $16,4($29)`
`sw $17,8($29)`
`sw $18,12($29)`
`sw $19,16($29)`
`sw $20,20($29)`
`sw $24,24($29)`
`sw $25,28($29)`
`sw $31,32($29)` | `sort: .word ^m` |
| 主体:移动参数 | `move $18,$4`
`move $20,$5` | `moval r7,8(ap)`
`moval r5,4(ap)` |
| 外层循环 | `add $19,$0,$0`
`for1tst: slt $8,$19,$20`
`beq $8,$0,exit1` | `clrl r6`
`for1tst: cmpl r6,(r7)`
`bgeq exit1` |
| 内层循环 | `addi $17,$19,-1`
`for2tst: slti $8,$17,0`
`bne $8,$0,exit2`
`muli $15,$17,4`
`add $16,$18,$15`
`lw $24,0($16)`
`lw $25,4($16)`
`slt $8,$25,$24`
`beq $8,$0,exit2` | `subl3 r4,r6,#1`
`for2tst: blss exit2`
`movl r3,(r5)`
`addl3 r2,r4,#1`
`cmpl (r3)[r4],(r3)[r2]`
`bleq exit2` |
| 传参和调用 | `move $4,$18`
`move $5,$17`
`jal swap` | `pushl (r5)`
`pushl r4`
`calls #2,swap` |
| 内层循环末尾 | `addi $17,$17,-1`
`j for2tst` | `decl r4`
`brb for2tst` |
| 外层循环末尾 | `exit2: addi $19,$19,1`
`j for1tst` | `exit2: incl r6`
`brb for1tst` |
| 恢复寄存器 | `exit1: lw $15,0($29)`
`lw $16,4($29)`
`lw $17,8($29)`
`lw $18,12($29)`
`lw $19,16($29)`
`lw $20,20($29)`
`lw $24,24($29)`
`lw $25,28($29)`
`lw $31,32($29)`
`addi $29,$29,36` | |
| 过程返回 | `jr $31` | `exit1: ret` |
{#fig-K.56 .wide .expand num="K.56" caption="图 K.55 中 sort 过程的 MIPS32 与 VAX 汇编版本。"}
## 谬误与陷阱
> 简化的能力,就是去除不必要之物,让必要之物得以表达。
>
> ——Hans Hoffman,《Search for the Real》,1967 年
### 谬误:可以设计出毫无缺陷的体系结构
所有体系结构设计都涉及在特定硬件与软件技术背景下作出取舍。这些技术很可能随时间改变,曾经正确的决定,后来也可能显得像错误。例如,1975 年的 VAX 设计者过分强调代码大小效率,却低估了十年后易于译码和流水线化的重要性。而且,几乎所有体系结构最终都会遭遇地址空间不足。不过,若要长期避免这些问题,往往就得牺牲体系结构的短期效率。
### 谬误:有缺陷的体系结构不可能成功
文献经常批评 IBM 360:分支不是 PC 相对的,位移量寻址的地址字段也太小。然而,这台机器取得了巨大成功,因为它正确解决了几个新问题。第一,它有很大的地址空间;第二,按字节寻址且善于处理字节;第三,它是一台通用寄存器机器;最后,它足够简单,能在很广的性能与成本范围内高效实现。
Intel 8086 是更鲜明的例子。按本段写作时的范围,8086 是仍广泛存在的体系结构中唯一不真正属于通用寄存器机器的一种。此外,分段地址空间给程序员和编译器编写者都造成了重大问题。尽管如此,由于被 IBM PC 选用,8086 体系结构获得了巨大成功。
### 谬误:执行指令更少的体系结构更快
VAX 设计者对 VAX 与 MIPS 作了量化比较,选用组织结构相近的 VAX 8700 和 MIPS M2000。图 K.57 展示执行指令数之比,以及按时钟周期衡量的性能之比。MIPS 执行的指令约为 VAX 的两倍,但 MIPS M2000 的性能却接近 VAX 8700 的三倍。
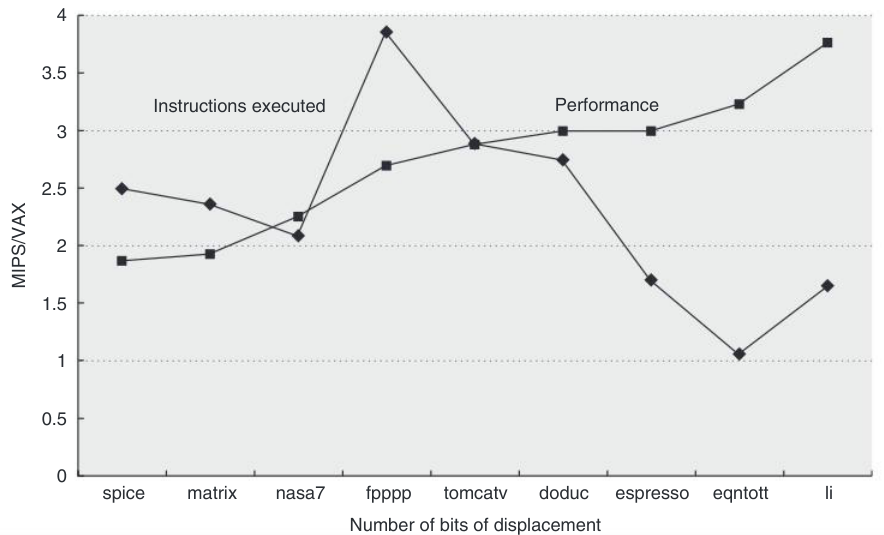
{#fig-K.57 .wide .expand num="K.57" caption="使用 SPEC89 程序比较 MIPS M2000 与 VAX 8700 的执行指令数比和以时钟周期衡量的性能比。平均而言,MIPS 执行的指令略多于 VAX 的两倍,但 VAX 的 CPI 几乎是 MIPS 的六倍,因此 MIPS 有接近三倍的性能优势。数据依据 D. Bhandarkar、D. Clark 的 Performance from Architecture: Comparing a RISC and CISC with Similar Hardware Organization,第四届体系结构对编程语言与操作系统支持研讨会(ASPLOS IV)会议录,1991 年。"}
纵轴为 MIPS/VAX 比值,图例 `Instructions executed` 为执行指令数,`Performance` 为性能。横轴列出 `spice`、`matrix`、`nasa7`、`fpppp`、`tomcatv`、`doduc`、`espresso`、`eqntott`、`li`。原图横轴标题却误写为“位移量的位数(Number of bits of displacement)”,这里保留图像并指出其与所列程序名称不相符。
## 结束语
> PDP-11 体系结构的虚拟地址扩展(Virtual Address eXtension)……提供约 4.3 GB 的虚拟地址空间;即使考虑存储器技术的迅速进步,这也应足以满足相当遥远的未来。
>
> ——William Strecker,《VAX-11/780—A Virtual Address Extension to the PDP-11 Family》,AFIPS,National Computer Conference 会议录,1978 年
我们已经看到,指令集既可在访问操作数的方式上差异巨大,也可在一条指令能够完成的操作上差异巨大。图 K.58 比较两个程序在这两种体系结构上的指令使用情况;即使体系结构很不相同,各类指令的使用行为也可能相似。
VAX 是其时代的产物,它强调代码密度、复杂操作与复杂寻址方式;这与本书这里强调的易于译码、简单操作、简单寻址方式和流水线性能相冲突。
VAX 累计售出超过 600,000 台,经历了非常成功的发展历程。1991 年,DEC 开始从 VAX 转向 Alpha。
| 程序 | 机器 | 分支 | 算术/逻辑 | 数据传送 | 浮点 | 合计 |
| --- | --- | --- | --- | --- | --- | --- |
| gcc | VAX | 30% | 40% | 19% | | 89% |
| gcc | MIPS | 24% | 35% | 27% | | 86% |
| spice | VAX | 18% | 23% | 15% | 23% | 79% |
| spice | MIPS | 4% | 29% | 35% | 15% | 83% |
{#fig-K.58 .wide .expand num="K.58" caption="两个程序在 VAX 和 MIPS 上的指令分布频率。"}
正交性是 VAX 体系结构的关键:操作码独立于寻址方式,寻址方式又独立于数据类型,甚至独立于不同操作数的个数。因此,一旦计入数据类型、操作数个数和寻址方式,几百种操作就扩展为数十万种指令。
[^vax-page-refs]: 本节沿用原书的图号引用。源书有多处过时或错置的页码:`lui` 引用写第 A-37 页图 A.24;编码例题指向第 K-24 页,实际例题在 K-54 页;图 K.52、K.56 指 `sort` 在 K-33 页,实际位于 K-62 页之后;图 K.54 指图 K.53 在 K-30 页,实际为 K-60 页;相关谬误引用 K-38 页,实际为 K-67 页。译文以本节题名、图号为导航,不杜撰缺页。
[^vax-mask]: 原文此句确为“does include”,与前半句“不保存临时寄存器”的约定相冲突,但与示例掩码包含 r0、r1 一致。