1.1 引言
自第一台通用电子计算机诞生以来,在大约 75 年的时间里,计算机技术取得了令人难以置信的进步。如今,800 美元就能买到一部手机,其性能足以媲美 2000 年耗资逾 1 亿美元购置的世界最快计算机。这种飞速进步既源于制造计算机的技术不断发展,也源于计算机设计上的创新。
从历史上看,技术进步的步伐一直相当稳定,而计算机体系结构改进带来的进步却远没有那么均匀。在电子计算机问世后的最初 25 年里,这两股力量都作出了重要贡献,使性能每年提高约 25%。20 世纪 70 年代末,微处理器开始出现。微处理器能够充分受益于集成电路技术的发展,使性能的年增长率进一步提高到约 35%。
这一增长速度,加上微处理器批量生产带来的成本优势,使计算机产业中采用微处理器的比例不断上升。此外,计算机市场上的两项重大变化,使新的体系结构比以往更容易取得商业成功。第一,汇编语言编程几乎退出了主流,因而对目标代码兼容性的需求随之降低。第二,UNIX 及其仿制系统 Linux 等标准化、不依赖特定厂商的操作系统出现,降低了推出新体系结构的成本和风险。
这些变化使人们得以在 20 世纪 80 年代初成功开发出一批指令更简单的新体系结构,即精简指令集计算机(Reduced Instruction Set Computer,RISC)体系结构。基于 RISC 的计算机将设计者的注意力引向两项关键的性能技术:一是挖掘指令级并行性(instruction-level parallelism,ILP),最初通过流水线,后来通过多指令发射来实现;二是使用缓存,最初采用简单形式,后来逐步采用更精巧的组成方式与优化技术。
RISC 计算机抬高了性能门槛,迫使既有体系结构要么跟上,要么退出。Digital Equipment 的 Vax 未能跟上,最终被 RISC 体系结构取代。Intel 则迎难而上,主要做法是在内部把 80x86 指令转换为类似 RISC 的指令,从而得以采用许多最早由 RISC 设计开创的创新。到 20 世纪 90 年代末,随着晶体管数量激增,转换较为复杂的 80x86 体系结构所需的硬件开销变得微不足道。而在手机等低端应用中,80x86 指令转换在功耗和硅片面积上带来的额外成本,则推动了 RISC 体系结构 ARM 成为主流。
图 1.1 表明,体系结构与组成方面的改进相结合,使性能连续 17 年保持了超过 50% 的年增长率,这在计算机产业中前所未有。
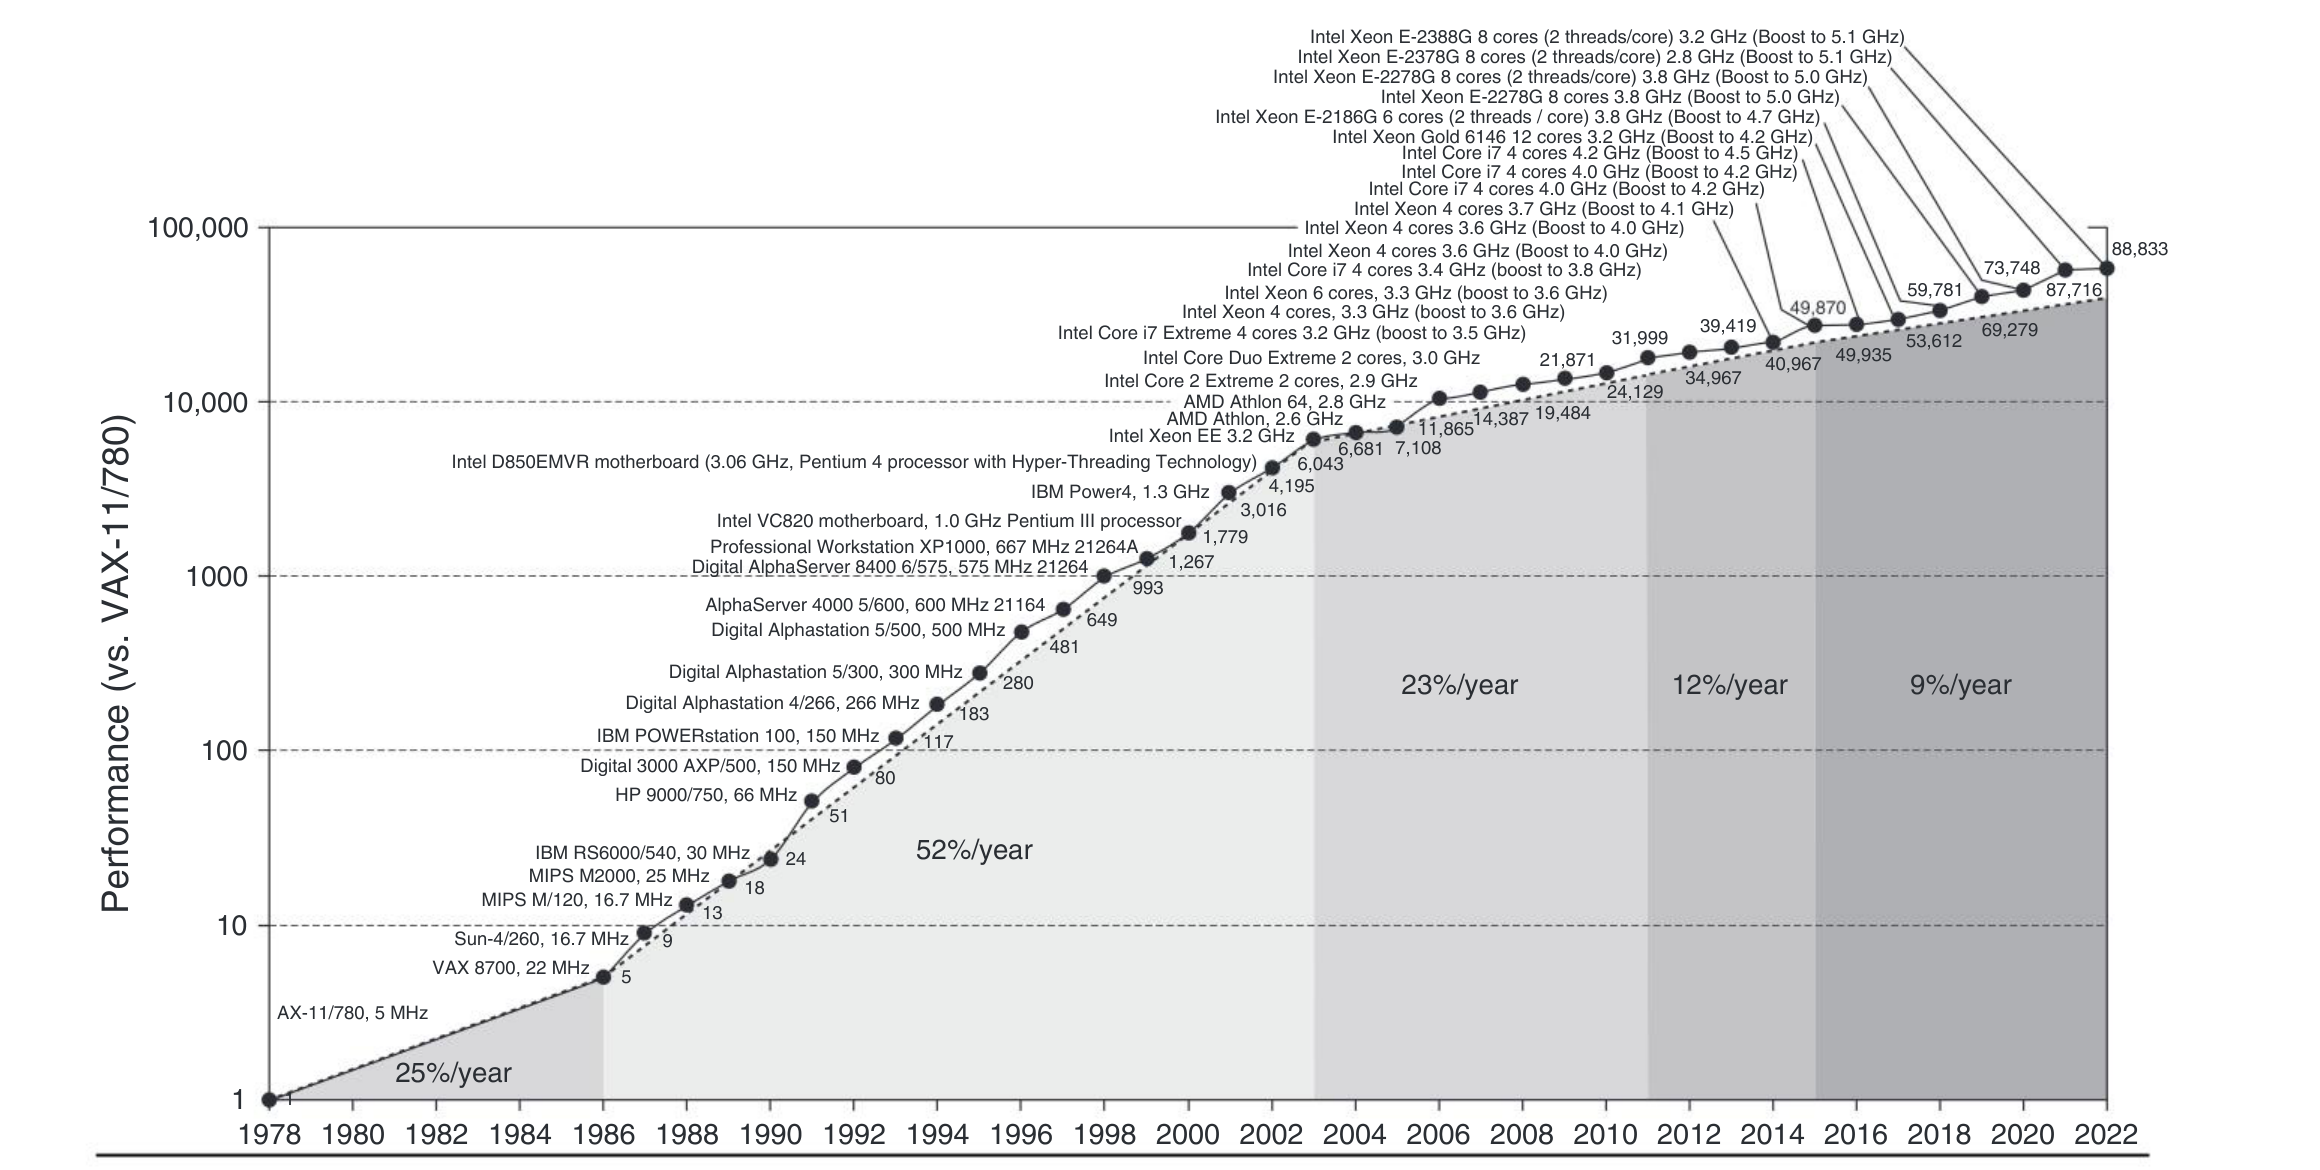
本图以 VAX-11/780 为基准,绘出了由 SPEC 整数基准测试的 base 配置测得的程序性能(原文指向 1.8 节1)。20 世纪 80 年代中期以前,处理器性能的增长主要由技术进步驱动,平均每年约 25%,即每 3.5 年翻一番。从 1986 年开始,年增长率提高到约 52%,即每 2 年翻一番。这既得益于 RISC 体系结构所代表的更先进的体系结构与组成思想,也得益于转向使用微处理器作为 CPU 的基本构件。到 2003 年,这种增长使实际性能达到持续按 25% 年增长率发展时所能达到性能的 25 倍。如果假设半导体技术改进本身每年能带来 35% 的增长,那么实际性能仍是这一水平的 7.5 倍。
2003 年,Dennard 缩放规律失效带来的功耗限制,以及可利用的指令级并行性的限制,使单处理器性能的年增长率降至 23%,并一直持续到 2011 年,相当于每 3.5 年翻一番。这些结果仅涉及单芯片系统,通常每片至多 8 个核心,每个核心支持 1 或 2 个硬件线程。自 2007 年起,最快的 SPECintbase 测试成绩都启用了自动并行化,因此更难据此衡量单处理器的速度。2011–2015 年,年增长率不足 12%,即每 6 年翻一番;部分原因在于 Amdahl 定律对并行加速的限制。2015 年以来,随着 Moore 定律放缓,年增长率降至 9%,即每 8 年翻一番。面向浮点运算的性能也呈现出同样的趋势,但在图中的各个阴影区间,年增长率通常要高出 1–2 个百分点。1989–2017 年间,SPEC 先后发布了六个版本,因此跨时期的性能是通过换算系数估算的;这些系数根据同时具有前后两代 SPEC 评分的计算机计算而得。
图内用语:Performance (vs. VAX-11/780) 为“相对于 VAX-11/780 的性能”,year 为“年”,cores 为“核心”,threads/core 为“每核心线程数”,Boost to 为“最高加速频率”。处理器型号与频率保留原文。
20 世纪这种惊人的增长速度带来了四方面影响。首先,它显著提升了计算机用户能够获得的计算能力。对于许多应用,性能最高的微处理器已经超过了不到 20 年前的超级计算机。
其次,性价比的大幅提高催生了新的计算机类别。随着微处理器的普及,个人计算机和工作站在 20 世纪 80 年代出现。过去 15 年又见证了智能手机和平板电脑的兴起,许多人已经用它们代替 PC,作为主要的计算平台。这些移动客户端设备越来越多地通过互联网访问容纳 50,000 台服务器的数据中心,而这些数据中心正被当作一台庞大的计算机来设计。带有无线连接的嵌入式计算机统称为物联网(Internet of Things,IoT)设备,如今每年的出货量已超过 100 亿台,预计还将大幅增长。
第三,Moore 定律所预示的半导体制造工艺进步,使基于微处理器的计算机在整个计算机设计领域占据了主导地位。传统上采用现成逻辑器件或门阵列构建的小型机,被采用微处理器构建的服务器取代。如今,即便是大型机和高性能超级计算机,也都是由微处理器组成的系统。
上述硬件创新带来了一场计算机设计的复兴,既强调体系结构创新,也强调充分利用技术进步。增长不断累积,到 2003 年,高性能微处理器的速度已经是单靠技术进步——包括电路设计的改进——所能达到水平的 7.5 倍;两者的年复合增长率分别为 52% 和 35%。
这场硬件复兴带来的第四项影响落在了软件开发上。自 1978 年以来约 90,000 倍的性能提升(见图 1.1),使现代程序员能够以一部分性能换取开发效率。与 C 和 C++ 这类注重性能的语言相比,如今更多程序采用 Java 这样的托管编程语言编写。此外,开发效率更高的 JavaScript、Python 等脚本语言,以及 AngularJS、Django 等编程框架,也越来越受欢迎。为了保持开发效率,同时尽量缩小性能差距,配备即时编译器和采用基于执行轨迹编译的解释器,正在取代过去传统的编译器与链接器。软件的交付方式也在变化:通过互联网使用的软件即服务(Software as a Service,SaaS),正在取代需要安装并运行在本地计算机上的盒装软件。
应用本身的性质同样在变化。语音、声音、图像和视频日益重要,而可预测的响应时间对用户体验也至关重要。Google Translate 就是一个令人振奋的例子。使用这款应用时,你可以举起手机,把摄像头对准一个物体;图像会通过无线互联网发送到仓库级计算机(warehouse-scale computer,WSC),由后者识别照片中的文字,并将其译成你的母语。你也可以对着它说话,让它用另一种语言输出语音翻译。它支持 133 种语言的文本翻译、37 种语言的照片翻译,以及对话模式下 32 种语言的语音翻译。
遗憾的是,图 1.1 同样表明,通用处理器快速提升的这场历时 17 年的硬件复兴已经结束。根本原因在于,半导体工艺中延续了数十年的两个特征,如今都不再成立。
1974 年,Robert Dennard 注意到,即使随着晶体管尺寸缩小而增加晶体管数量,给定面积硅片上的功率密度仍可保持不变。更令人惊叹的是,晶体管能够在运行得更快的同时消耗更少的功率。这种 Dennard 缩放规律在 2004 年前后失效了,因为电流与电压已经无法在保持集成电路可信赖性的同时继续下降。
这一变化迫使微处理器产业采用多个高效处理器或核心,来代替单个效率较低的处理器。事实上,Intel 在 2004 年取消了高性能单处理器项目,转而与其他厂商一道宣布,今后提升性能的途径是让每个芯片包含多个处理器,而不是一味加快单个处理器。这一里程碑标志着历史性的转变:从单纯依靠本书前三版重点讨论的 ILP,转向第四版着重介绍、第五版进一步扩充的数据级并行性(data-level parallelism,DLP)和线程级并行性(thread-level parallelism,TLP)。第五版还加入了 WSC 和请求级并行性(request-level parallelism,RLP),本版又扩展了这部分内容。编译器与硬件能够相互配合,在程序员不必关注的情况下隐式挖掘 ILP;相比之下,DLP、TLP 和 RLP 都是显式并行,需要重构应用,才能利用这种并行性。有时这很容易,但在许多情况下,它给程序员带来了重大的新负担。
Amdahl 定律(1.10 节)规定了每个芯片上能够有效利用的核心数量的实际上限。如果一项任务有 10% 必须串行执行,那么无论在芯片上放置多少核心,并行带来的最大加速比都只有 10。
最近发生变化的第二项观察是 Moore 定律。1965 年,Gordon Moore 作出了著名的预测:每个芯片上的晶体管数量每年翻一番;1975 年,他将这一周期修正为每 2 年。这个预测成立了约 50 年,如今却不再适用。例如,在本书 2010 年的版本中,Intel 最新的微处理器含有 1,170,000,000 个晶体管。如果 Moore 定律继续成立,那么我们本可预期 2022 年的微处理器含有 105,900,000,000 个晶体管。然而,Apple M2 微处理器只有 20,000,000,000 个晶体管,与 Moore 定律的预测相差约 5 倍。2
以下因素共同作用:
- Moore 定律放缓,Dennard 缩放规律失效,晶体管自身的改进幅度不再显著;
- 微处理器的功耗预算没有增加;
- 单个高功耗处理器被多个节能处理器取代;
- Amdahl 定律限制了多处理器能够带来的加速。
这些因素使处理器性能的提高速度放缓:如今每 8 年才翻一番,不再像 1986–2003 年那样每 1.5 年翻一番(见图 1.1)。3
要显著改善能耗、性能和成本这三者的综合表现,剩下的唯一途径就是专用化。未来的微处理器将包含若干领域专用核心,每种核心只擅长某一类计算,但在这类计算上的表现会远胜于通用核心。第 7 章介绍领域专用体系结构。2023 年 ChatGPT 的发布,极大地加速了专门面向 AI 领域的加速器部署,覆盖了从 IoT 设备到 WSC 的各类系统。
本书关注同步数字计算机,过去 75 年来,正是它们推动了计算机产业的发展。随着改进速度开始放缓,一些研究者正在探索尚未产生显著商业影响的替代方案,例如模拟计算、生物计算、量子计算、神经形态计算以及异步计算。由于这些不同设计何时能够、乃至究竟能否在经济上变得可行,仍不明确,我们的主题依然是同步数字硬件。
本书讨论过去一个世纪里促成惊人增长速度的体系结构思想及相应的编译器改进,也讨论这一局面发生剧变的原因,以及面向 21 世纪的体系结构、编译器和解释器所面临的挑战与初见前景的探索。贯穿全书的核心,是计算机设计与分析的定量方法:以对程序的实证观察、实验和仿真作为工具。本书体现的正是这种计算机设计风格与方法。本章的任务,是为后续章节和附录奠定定量分析的基础。
我们撰写本书,不仅是为了说明这种设计方法,也希望激励你为这一进步作出贡献。我们相信,正如这种方法过去适用于隐式并行的计算机,它也将适用于未来的计算机。