1.4 技术发展趋势
一种 ISA 要获得长久成功,就必须在设计时考虑如何适应计算机技术的快速变化。毕竟,成功的新 ISA 可能沿用数十年:例如,IBM 大型机的核心体系结构已经使用了 60 年。体系结构设计者必须为技术变化预作规划,以延长成功计算机设计的生命期。
要规划计算机的演进,设计者就必须了解实现技术的迅速变化。以下五类发展迅猛的技术,对现代计算机的实现至关重要:
集成电路逻辑技术。 历史上,晶体管密度每年增长约 35%,略多于四年就能增至四倍。裸片面积的增长较慢,也较难预测,年增幅为 10%–20%。两者结合,使芯片上晶体管数量的传统年增长率达到约 40%–55%,即每 18–24 个月翻一番。如前所述,这一趋势称为 Moore 定律。器件速度的提升较慢,我们将在后面讨论。令人震惊的是,Moore 定律正在放缓。每个芯片上的器件数量仍在增加,但增长速度正在下降。与 Moore 定律盛行的年代不同,我们预计,每出现一代新工艺,晶体管数量翻番所需的时间都会进一步延长,见 1.12 节的图 1.24。
半导体 DRAM(动态随机存取存储器)。 这项技术是主存的基础,第 2 章将详细讨论。过去,DRAM 容量每三年增至四倍,如今增长速度已大幅下降。8 Gbit DRAM 于 2014 年开始出货,16 Gbit DRAM 却直到 2019 年才出货。下一步是在 2023 年推出 24 Gbit 产品,这是 DRAM 容量首次不再是 2 的幂。再下一目标是 32 Gbit DRAM。这意味着,DRAM 容量从 8 Gbit 增至 32 Gbit、达到原来的四倍,至少需要十年。未来的增长还面临重大挑战(Kim, 2005)。第 2 章提到了几种试图取代 DRAM 的技术,但现在越来越清楚的是,DRAM 不大可能被替代。
半导体 Flash(电可擦除可编程只读存储器)。 这种非易失性半导体存储器是个人移动设备(PMD)的标准存储装置;随着应用迅速普及,其容量也在快速增长。在服务器市场,2024 年基于 Flash 的固态硬盘(SSD)已占磁盘销售的一半以上。近年来,单个 Flash 芯片的容量每年增长约 50%–60%,大约每三年翻一番。1 目前,Flash 每比特的成本约为 DRAM 的 1/8–1/10。第 2 章将介绍 Flash。未来的容量增长仍将沿第三维度展开:在晶圆加工过程中增加更多层,同时缩小存储单元的尺寸。
磁盘技术。 1990 年以前,磁盘存储密度每年提高约 30%,三年翻一番;此后年增幅提高到 60%,并于 1996 年达到 100%。
2004–2011 年间,年增幅下降到约 40%,即每两年翻一番。过去十年,磁盘的进步速度已放缓至每年不到 5%,翻番需要 15–20 年。增加磁盘容量的一种办法是在面密度不变的情况下增加盘片,但厚度为 1 英寸的 3.5 英寸规格硬盘中,已经装有十张盘片。如今,硬盘每比特的成本约为 Flash 的 1/3–1/5,为 DRAM 的 1/100–1/200。未来可能需要增加封装厚度来容纳更多盘片,这又可能减少单位体积内能够容纳的硬盘数量。这项技术是服务器和仓库级存储的核心;附录 D 将详细讨论其发展趋势。
网络技术。 网络性能既取决于交换设备的性能,也取决于传输系统的性能。附录 F 将讨论网络的发展趋势。
这些技术共同塑造了计算机设计。随着速度和技术的改进,一个设计的生命期可能达到 3–7 年。工程师往往面向下一代技术开展设计,因为他们知道,等产品开始大批量出货时,再下一代技术可能已经具有更好的性价比,或者具备性能优势。
技术通常在持续进步,但当它跨越某个门槛、使一种新能力成为可能时,其影响可能表现为离散的跃升。例如,20 世纪 80 年代初,MOS 技术已能在单个芯片上容纳 25,000–50,000 个晶体管,于是单芯片 32 位微处理器成为可能。到 80 年代末,一级缓存可以集成到芯片上;此后的进步又使二级乃至三级缓存得以集成。消除了处理器内部以及处理器与各级缓存之间的跨芯片传输,就可能显著改善性价比和能效。技术发展到一定程度之前,这种设计根本无法实现。这样的技术门槛并不罕见,而且会对各种设计决策产生重大影响。
性能趋势:带宽的进步快于延迟
如 1.8 节将要讨论的,带宽或吞吐量是单位时间内完成的工作总量,例如磁盘传输的 MB/s;延迟或响应时间则是一个事件从开始到完成所需的时间,例如一次磁盘访问的毫秒数。2 图 1.9 绘出了微处理器、内存、网络和磁盘各个技术里程碑相对于起点的带宽与延迟改善倍数。图 1.10 对这些实例与里程碑给出了更详细的说明。
性能是微处理器和网络最主要的差异化因素,因此它们的进步最大:带宽提高了 45,000–80,000 倍,延迟改善了 50–90 倍。对于内存和磁盘,容量通常比性能更重要,因此容量的增长更大;不过,它们 450–4000 倍的带宽提升,仍然远大于 5–9 倍的延迟改善。
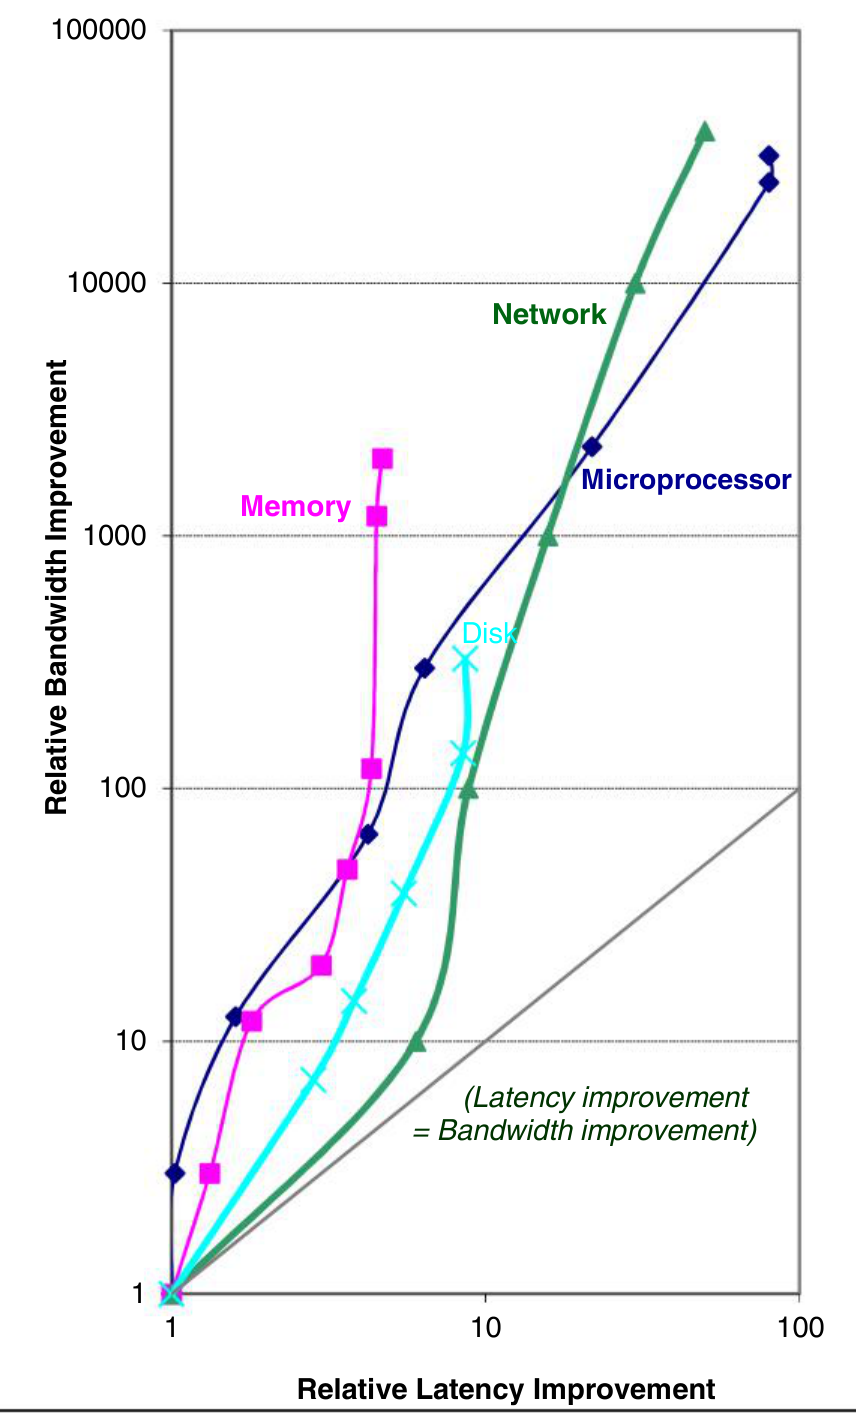
图 1.9(续)。 延迟改善了 5–64 倍,带宽则提高了约 450–80,000 倍。自上一版以来的五年中,各项技术的带宽增幅为 14%–100%,延迟却没有改善。事实上,磁盘和微处理器的延迟还增大了。对磁盘来说,2016 年那款容量为 0.6 TB、转速为 15,000 RPM 的硬盘仍然可以买到,不过我们认为,选用容量为 20 TB、转速为 7200 RPM 的硬盘更有意义,尽管它的延迟更长。2021 年 SPEC2017 性能最高的微处理器,标准时钟频率只有 2.8 GHz,低于 2016 年微处理器的 4.0 GHz,但其 Turbo 频率为 5.1 GHz,高于后者的 4.2 GHz。较低的标准时钟频率意味着更长的延迟。还应注意,图中采用的网络标准预计要到 2026 年才能完成,因此网络部分的结果略显乐观。根据 Patterson, D., 2004. “Latency lags bandwidth.” Commun. ACM 47 (10), 71–75 更新。
图内术语:Relative Bandwidth Improvement=相对带宽改善倍数;Relative Latency Improvement=相对延迟改善倍数;Microprocessor=微处理器;Memory=内存;Network=网络;Disk=磁盘。灰色对角线表示“延迟改善倍数=带宽改善倍数”。
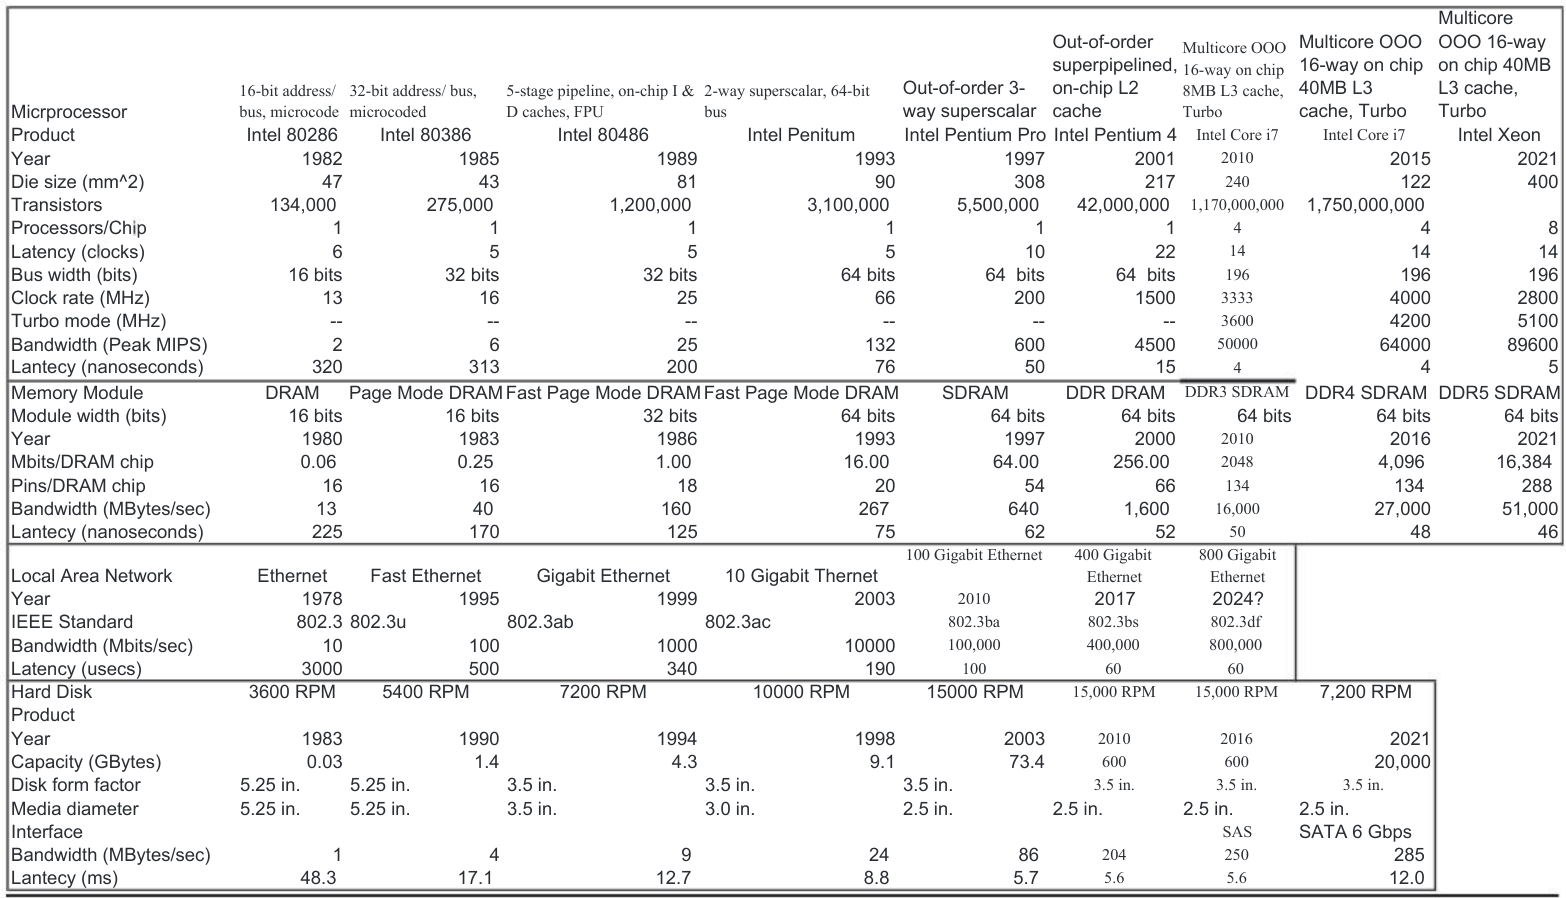
图 1.10(续)。 微处理器的里程碑覆盖了数代 IA-32 处理器:从采用 16 位总线、微码实现的 80286,发展到采用 64 位总线、多核、乱序执行、超流水线以及三级片上缓存的 Xeon。内存模块从 16 位宽的普通 DRAM,发展到 64 位宽的第五代双倍数据率同步 DRAM。以太网从 10 Mbit/s,发展到约 2026 年的 800 Gbit/s。磁盘的里程碑以转速为依据:到 2016 年,转速从 3600 RPM 提高到 15,000 RPM,2021 年又回到 7200 RPM。各例中的带宽均为最佳情况带宽,延迟则是假定不存在争用时执行一次简单操作所需的时间。根据 Patterson, D., 2004. “Latency lags bandwidth.” Commun. ACM 47 (10), 71–75 更新。
图中的四组数据如下。原表的空白单元格仍留空;“—”对应原表的双连字符。
图 1.10:微处理器
| 指标 | Intel 80286 | Intel 80386 | Intel 80486 | Intel Pentium | Intel Pentium Pro | Intel Pentium 4 | Intel Core i7 | Intel Core i7 | Intel Xeon |
|---|---|---|---|---|---|---|---|---|---|
| 特征 | 16 位地址/总线,微码 | 32 位地址/总线,微码 | 5 级流水线,片上指令/数据缓存,FPU | 双发射超标量,64 位总线 | 乱序三发射超标量 | 乱序超流水线,片上 L2 缓存 | 多核乱序,片上 16 路,8 MB L3 缓存,Turbo | 多核乱序,片上 16 路,40 MB L3 缓存,Turbo | 多核乱序,片上 16 路,40 MB L3 缓存,Turbo |
| 年份 | 1982 | 1985 | 1989 | 1993 | 1997 | 2001 | 2010 | 2015 | 2021 |
| 裸片面积(mm²) | 47 | 43 | 81 | 90 | 308 | 217 | 240 | 122 | 400 |
| 晶体管数 | 134,000 | 275,000 | 1,200,000 | 3,100,000 | 5,500,000 | 42,000,000 | 1,170,000,000 | 1,750,000,000 | |
| 每芯片处理器数 | 1 | 1 | 1 | 1 | 1 | 1 | 4 | 4 | 8 |
| 延迟(时钟周期) | 6 | 5 | 5 | 5 | 10 | 22 | 14 | 14 | 14 |
| 总线宽度(bit) | 16 | 32 | 32 | 64 | 64 | 64 | 196 | 196 | 196 |
| 时钟频率(MHz) | 13 | 16 | 25 | 66 | 200 | 1500 | 3333 | 4000 | 2800 |
| Turbo 频率(MHz) | — | — | — | — | — | — | 3600 | 4200 | 5100 |
| 带宽(峰值 MIPS) | 2 | 6 | 25 | 132 | 600 | 4500 | 50,000 | 64,000 | 89,600 |
| 延迟(ns) | 320 | 313 | 200 | 76 | 50 | 15 | 4 | 4 | 5 |
图 1.10:内存模块
| 指标 | DRAM | Page Mode DRAM | Fast Page Mode DRAM | Fast Page Mode DRAM | SDRAM | DDR DRAM | DDR3 SDRAM | DDR4 SDRAM | DDR5 SDRAM |
|---|---|---|---|---|---|---|---|---|---|
| 模块宽度(bit) | 16 | 16 | 32 | 64 | 64 | 64 | 64 | 64 | 64 |
| 年份 | 1980 | 1983 | 1986 | 1993 | 1997 | 2000 | 2010 | 2016 | 2021 |
| 每颗 DRAM 容量(Mbit) | 0.06 | 0.25 | 1.00 | 16.00 | 64.00 | 256.00 | 2048 | 4096 | 16,384 |
| 每颗 DRAM 引脚数 | 16 | 16 | 18 | 20 | 54 | 66 | 134 | 134 | 288 |
| 带宽(MB/s) | 13 | 40 | 160 | 267 | 640 | 1600 | 16,000 | 27,000 | 51,000 |
| 延迟(ns) | 225 | 170 | 125 | 75 | 62 | 52 | 50 | 48 | 46 |
Page Mode DRAM 为页模式 DRAM,Fast Page Mode DRAM 为快速页模式 DRAM。
图 1.10:局域网
| 指标 | Ethernet | Fast Ethernet | Gigabit Ethernet | 10 Gigabit Ethernet | 100 Gigabit Ethernet | 400 Gigabit Ethernet | 800 Gigabit Ethernet |
|---|---|---|---|---|---|---|---|
| 年份 | 1978 | 1995 | 1999 | 2003 | 2010 | 2017 | 2024? |
| IEEE 标准 | 802.3 | 802.3u | 802.3ab | 802.3ac | 802.3ba | 802.3bs | 802.3df |
| 带宽(Mbit/s) | 10 | 100 | 1000 | 10,000 | 100,000 | 400,000 | 800,000 |
| 延迟(μs) | 3000 | 500 | 340 | 190 | 100 | 60 | 60 |
Ethernet=以太网;Fast Ethernet=快速以太网;Gigabit Ethernet=千兆以太网,其余名称分别表示 10、100、400 和 800 Gbit/s 以太网。
图 1.10:硬盘
| 指标 | 3600 RPM | 5400 RPM | 7200 RPM | 10,000 RPM | 15,000 RPM | 15,000 RPM | 15,000 RPM | 7200 RPM |
|---|---|---|---|---|---|---|---|---|
| 产品 | ||||||||
| 年份 | 1983 | 1990 | 1994 | 1998 | 2003 | 2010 | 2016 | 2021 |
| 容量(GB) | 0.03 | 1.4 | 4.3 | 9.1 | 73.4 | 600 | 600 | 20,000 |
| 硬盘规格 | 5.25 英寸 | 5.25 英寸 | 3.5 英寸 | 3.5 英寸 | 3.5 英寸 | 3.5 英寸 | 3.5 英寸 | 3.5 英寸 |
| 盘片直径 | 5.25 英寸 | 5.25 英寸 | 3.5 英寸 | 3.0 英寸 | 2.5 英寸 | 2.5 英寸 | 2.5 英寸 | 2.5 英寸 |
| 接口 | SAS | SATA 6 Gbit/s | ||||||
| 带宽(MB/s) | 1 | 4 | 9 | 24 | 86 | 204 | 250 | 285 |
| 延迟(ms) | 48.3 | 17.1 | 12.7 | 8.8 | 5.7 | 5.6 | 5.6 | 12.0 |
译注(图 1.10): 原表中三列总线宽度均印为 196 bit,800 Gbit/s 以太网年份印为“2024?”,而图注与图 1.9 说明写“约 2026 年”;此处照录,没有自行统一。正文中的改善倍数与图注也不完全一致。
显然,在这些技术领域中,带宽的进步一直快于延迟,而且这种趋势很可能继续。计算机设计者应据此作出规划。
晶体管性能与连线的缩放
集成电路工艺通常以特征尺寸来描述,即晶体管或连线在 x 或 y 方向上的最小尺寸。特征尺寸从 1971 年的 10 μm,缩小到了 2022 年的 0.007 μm。事实上,我们已经换用了新的单位,因此 2022 年的量产工艺称为“7 nm”,而 3 nm 芯片也正在推进。Intel 宣布了 1.8 nm 芯片的计划,并将其重新命名为 18 Å(埃),为进一步缩小几何尺寸作铺垫。
每平方毫米硅片上能够容纳的晶体管数量,取决于一个晶体管的表面积。因此,随着特征尺寸线性缩小,晶体管密度按平方关系增加。
晶体管性能的提升却更复杂。特征尺寸缩小时,器件在水平方向的面积按平方关系缩小,在垂直方向上也会缩小。垂直尺寸的缩小要求降低工作电压,以保证晶体管正常工作并维持可靠性。这些缩放因素共同作用,使晶体管性能与工艺特征尺寸之间形成复杂关系。过去,作为一阶近似,可以认为晶体管性能会随特征尺寸的缩小而线性提高。
晶体管数量按平方关系增加,性能却只线性提高:这既是计算机体系结构设计者面临的挑战,也是他们施展才华的机会!在微处理器发展的早期,密度更快增长所带来的空间,被用于迅速从 4 位扩展到 8 位、16 位、32 位和 64 位。近些年来,密度提升则使一个芯片内集成多个处理器、更宽的 SIMD 单元,以及第 2–5 章介绍的推测执行与缓存创新成为可能。
晶体管的性能通常会随特征尺寸缩小而改善,集成电路中的连线却并非如此。具体而言,连线的信号延迟与其电阻和电容的乘积成正比。特征尺寸缩小时,连线当然会变短,但单位长度的电阻和电容特性会变差。这里的关系很复杂,因为电阻和电容都取决于工艺细节、连线的几何形状、连线负载,甚至与其他结构的相邻关系。工艺偶尔也会取得改进,例如引入铜互连,从而使连线延迟获得一次性改善。
不过,总体而言,相比晶体管性能,连线延迟随工艺缩放而改善的程度很有限,给设计者带来了额外挑战。除了功耗限制之外,连线延迟已经成为大规模集成电路的主要设计障碍,而且往往比晶体管的开关延迟更关键。信号在线路上传播的延迟占据了越来越大的时钟周期份额;但如今,功耗的影响甚至超过了连线延迟。