1.6 成本趋势
虽然某些计算机设计,特别是超级计算机,对成本的重视程度相对较低,但成本敏感型设计的重要性却在不断上升。事实上,过去四十年,利用技术进步降低成本、同时提高性能,一直是计算机产业的一条主线。
教科书常常忽略“性价比”中的成本这一半:一方面,成本不断变化,会使书中的内容过时;另一方面,成本问题相当复杂,而且各个细分市场的情况不同。然而,要在成本敏感的设计中明智地决定是否加入某项新功能,体系结构设计者就必须理解成本及其影响因素。试想一下,建筑师如果对钢梁和混凝土的价格一无所知,要怎样设计摩天大楼?
本节讨论影响计算机成本的主要因素,以及这些因素如何随时间变化。
时间、产量与商品化的影响
即使基本实现技术没有显著进步,制造出来的计算机部件,其成本也会随时间降低。推动这一变化的基本原理是学习曲线(learning curve):制造成本会随时间下降。衡量学习曲线的最佳方式,是观察**良率(yield)**的变化。
良率指制成器件中通过测试的比例。无论是芯片、电路板还是系统,良率翻一番,成本就能减半。
要预测产品整个生命期内的成本,就必须理解学习曲线如何提高良率。一个例子是,长期以来,DRAM 每 GB 的价格一直在下降。除了供不应求或供过于求的时期,DRAM 的定价通常与成本密切相关,因此两者走势基本一致。
微处理器的价格也会随时间下降,但它们不像 DRAM 那么标准化,所以价格与成本的关系更复杂。竞争激烈时,价格往往紧随成本变化,不过微处理器厂商大概很少会亏本销售。
产量是决定成本的第二个关键因素。增加产量会从几个方面影响成本。首先,它缩短了走过学习曲线所需的时间,而这一过程在一定程度上与制造的系统或芯片数量有关。其次,提高产量能够提升采购和制造效率,从而降低成本。作为经验法则,一些设计者估计,产量每翻一番,成本就会降低约 10%。此外,产量增加还减少了每台计算机需要分摊的开发费用,使成本与售价能够更加接近,同时仍有利润可赚。
**标准化商品(commodities)**是由多家厂商大量销售、彼此基本相同的产品。食品杂货店货架上的产品几乎都属于这一类,标准 DRAM、Flash、显示器和键盘也是如此。过去四十年,个人计算机产业中的很大一部分已经成为标准化商品业务,专注于制造通常运行 Microsoft Windows 的台式机和笔记本电脑。
由于许多厂商销售的产品几乎完全相同,这类市场的竞争非常激烈。竞争当然会压缩成本与售价之间的差距,但它也会降低成本。原因在于,标准化商品市场既有足够的规模,也有清晰的产品定义,使多家供应商能够竞争生产同一类产品所需的部件。部件供应商之间的竞争,加上它们能够实现的规模效益,共同降低了整体产品成本。这种竞争使计算机产业的低端市场能够提供优于其他细分市场的价格性能比,也推动了低端市场更快增长,只是利润极为有限——这与其他标准化商品行业一样。
集成电路的成本
一本计算机体系结构书,为什么要专门讨论集成电路成本?在竞争日趋激烈的计算机市场中,磁盘、Flash、DRAM 等标准部件在任何系统成本中都占据了相当比例;而在不同计算机之间存在差异的那部分成本里,集成电路所占的比重正在上升,尤其是在产量大、对成本敏感的细分市场。
事实上,由于 PMD 依赖片上系统(system on a chip,SoC),集成电路成本占据了 PMD 成本的很大一部分。因此,要理解当今计算机的成本,设计者就必须理解芯片的成本。
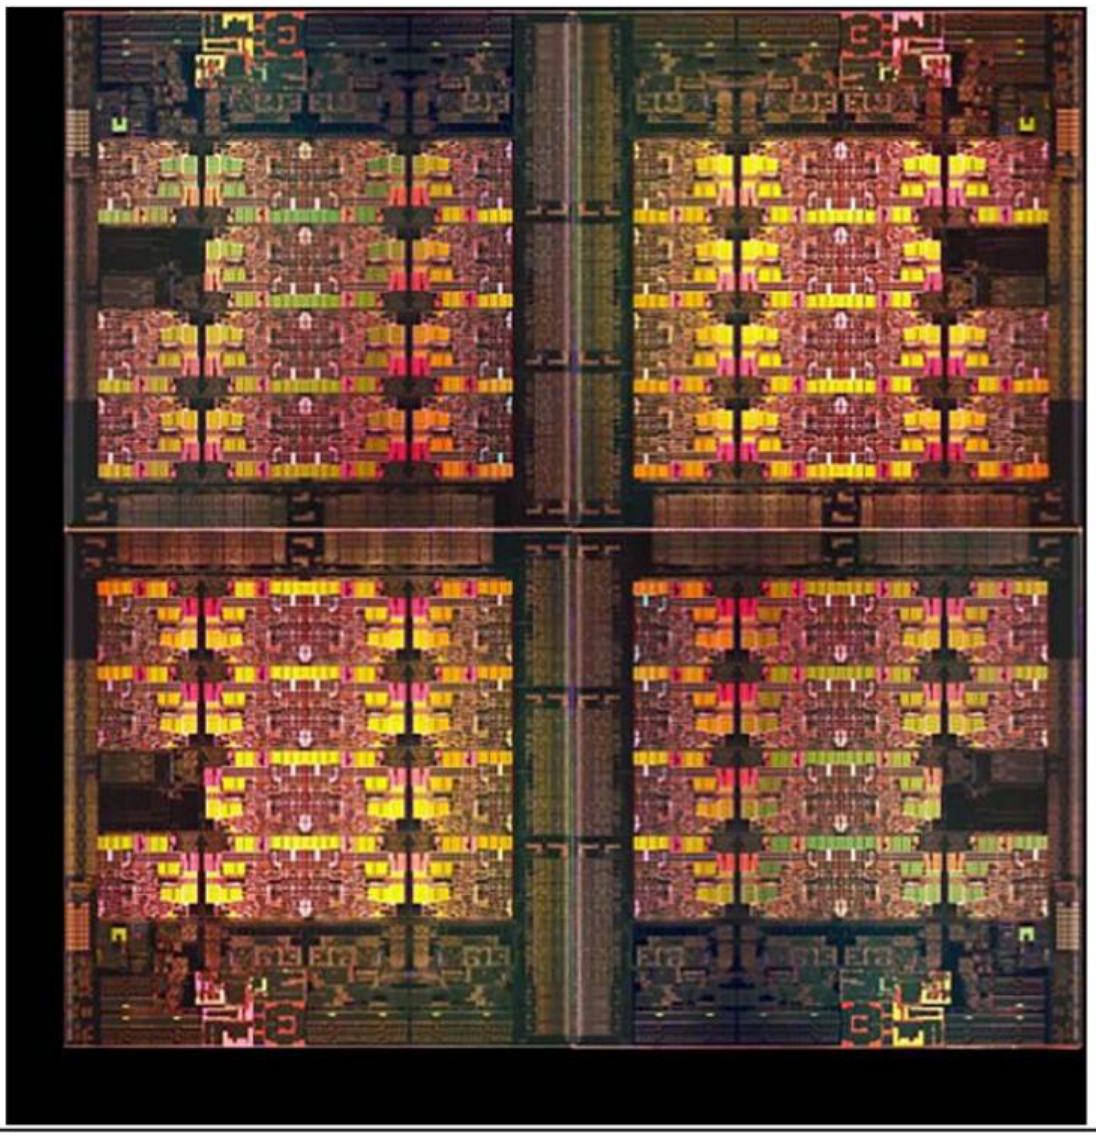
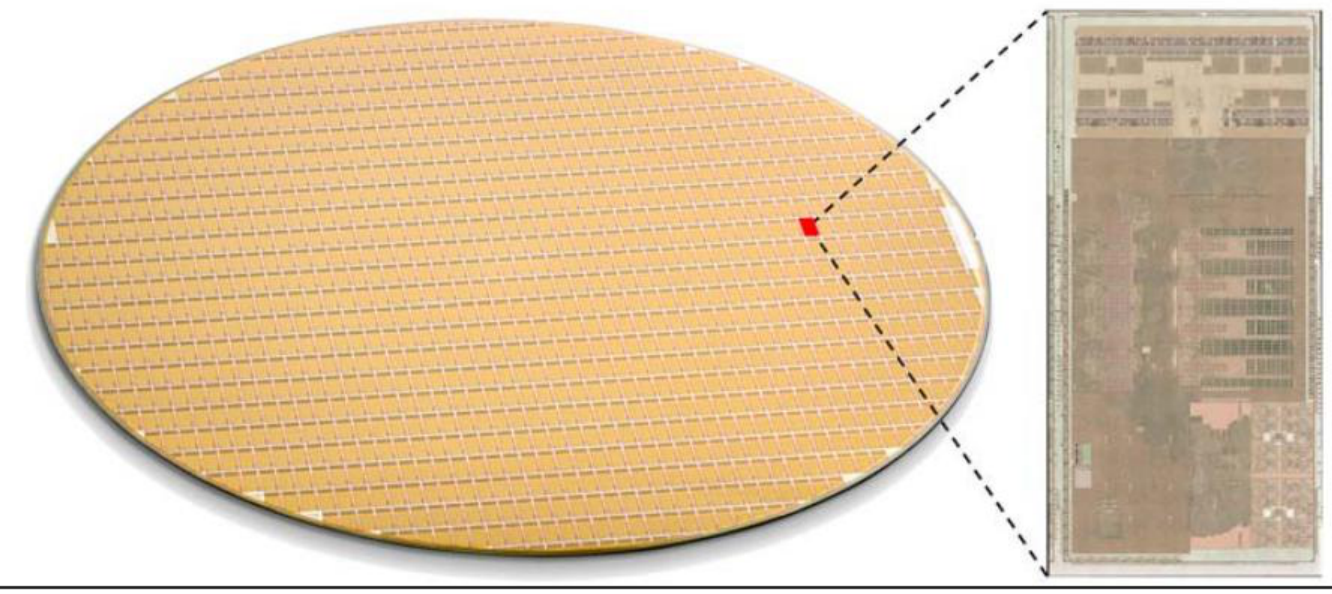
虽然集成电路成本已经呈指数级下降,但硅器件制造的基本过程没有改变:晶圆(wafer)仍然需要测试、切割成裸片(die),再进行封装,见图 1.14–1.16。因此,封装后集成电路的成本为:
本节重点讨论裸片成本,在末尾简要总结测试与封装方面的关键问题。
要预测每片晶圆能够得到多少颗合格芯片,首先要知道一片晶圆能容纳多少颗裸片,然后再预测其中能够正常工作的比例。这样就很容易估算成本:
这个芯片成本公式的第一项,最值得关注的特点是它对裸片尺寸十分敏感,下面就来说明。
每片晶圆的裸片数,大致等于晶圆面积除以裸片面积。更准确的估计为:
第一项是晶圆面积 与裸片面积之比。第二项修正了“方块装进圆盘”的问题,也就是圆形晶圆边缘的矩形裸片无法完整容纳的情况。用晶圆周长 除以正方形裸片的对角线长度,就近似得到沿边缘分布的裸片数量。
例:每片晶圆的裸片数
问题。 对于直径为 300 mm(30 cm)的晶圆,分别求边长为 1.5 cm 和 1.0 cm 的裸片,每片晶圆可以容纳多少颗。
解答。 当裸片面积为 2.25 cm² 时:
大裸片的面积是小裸片的 2.25 倍,因此每片晶圆能容纳的小裸片数大约也是大裸片数的 2.25 倍,实际比值为 :
然而,上式给出的只是每片晶圆能够容纳的最大裸片数。关键问题是:其中合格裸片的比例,也就是裸片良率,是多少?一个简单的集成电路良率模型,假定缺陷在晶圆上随机分布,且良率与制造工艺的复杂程度成反比,可得到:
这个 Bose–Einstein 公式是根据多条生产线的良率建立的经验模型(Sydow, 2006),至今仍然适用。晶圆良率反映整片晶圆报废的情况;这种晶圆上的各个裸片都不必再测试。为简化讨论,我们假定晶圆良率为 100%。单位面积缺陷数用来衡量随机制造缺陷。
2022 年,7 nm 和 5 nm 工艺的典型数值都是每平方英寸 0.075 个缺陷,换算为公制约为每平方厘米 0.012 个缺陷。最后,参数 称为工艺复杂度因子,用于衡量制造难度。2022 年的 7 nm 工艺中,;5 nm 工艺中,。
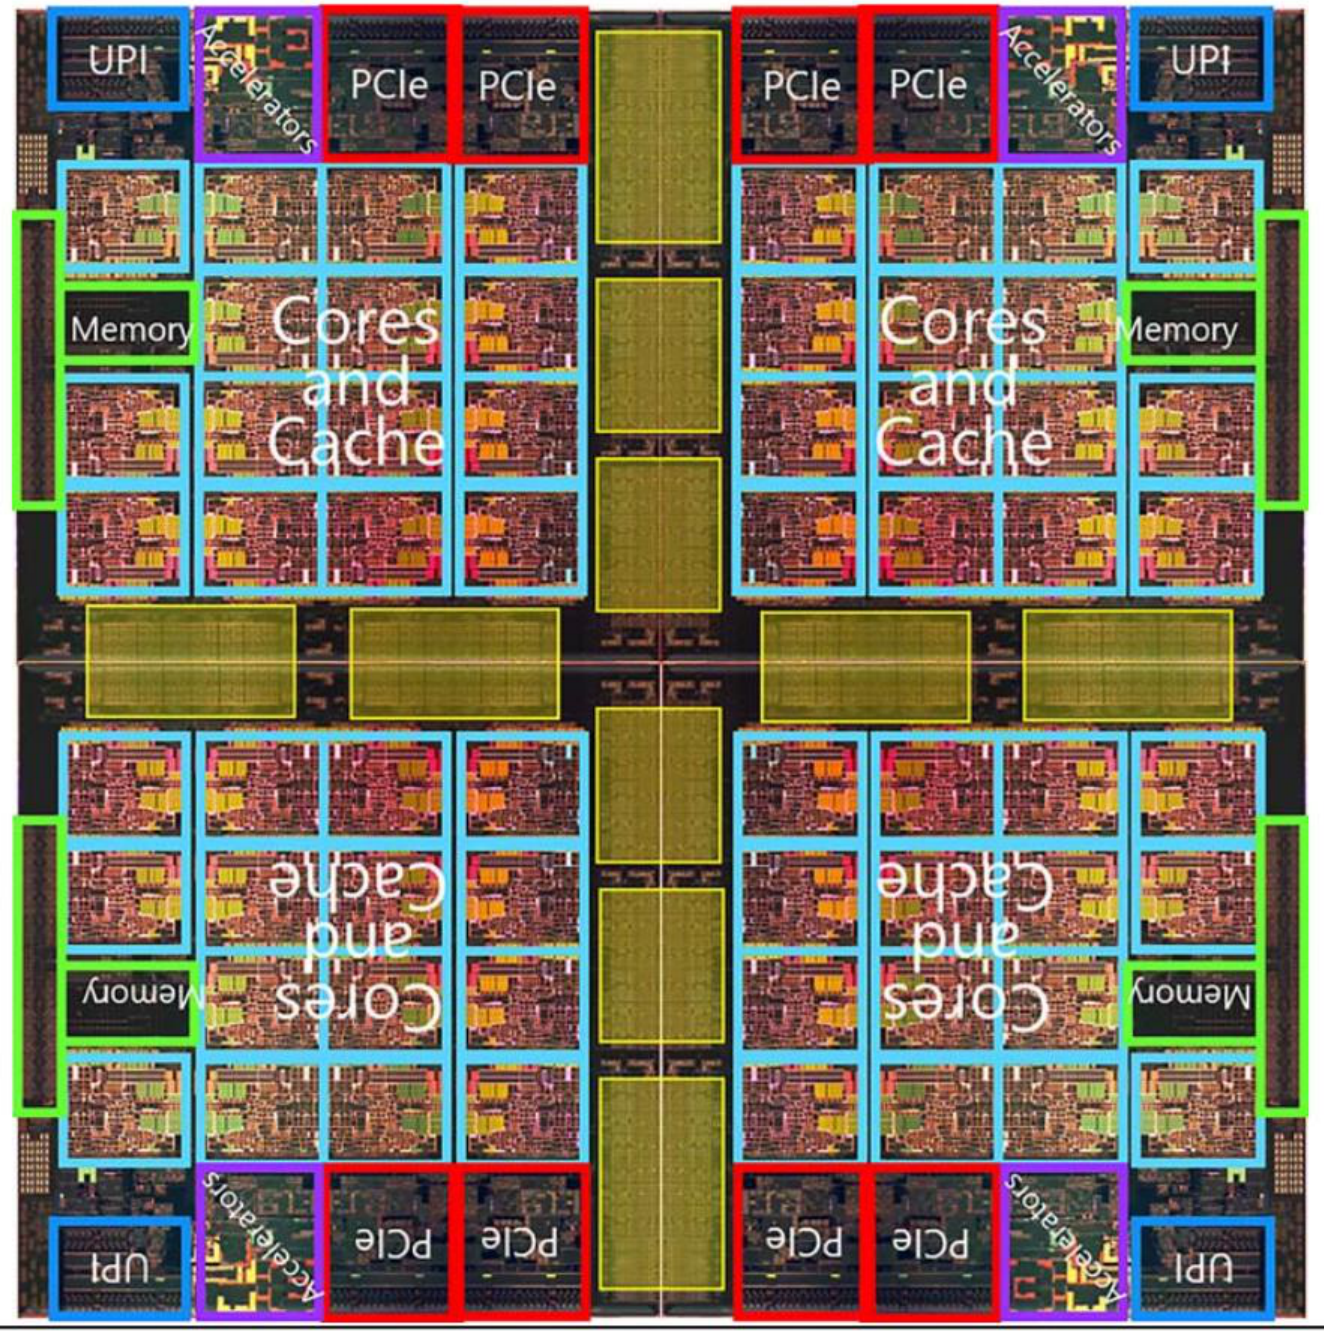
图 1.15(续)。 UPI(Ultra Path Interconnect)是 Intel 在处理器插槽之间使用的点对点互连。PCIe(Peripheral Component Interconnect Express)是连接 GPU、网络接口和存储设备的标准高速串行扩展总线。Memory 区域是 DDR5 DRAM 的内存控制器。Accelerators 区域包含对 Advance Matrix Extension(AMX)和 Advance Vector Extension(AVX)的硬件支持,还包含用于加速密码运算及数据压缩/解压缩的引擎 QuickAssist Technology,以及名副其实的 Data Streaming Accelerator(DSA,数据流加速器)。Sapphire Rapids 还有与高带宽内存共同封装的版本;HBM 接口也位于 Accelerator 区域。
图内其余术语:Cores and Cache=核心与缓存;Memory=内存控制器区域;Accelerators=加速器。
例:裸片良率
问题。 假定缺陷密度为每 cm² 0.012 个、,求边长分别为 1.5 cm 和 1.0 cm 的裸片的良率。
解答。 两种裸片的总面积分别为 2.25 cm² 和 1.00 cm²。对于较大的裸片,原书给出的良率计算为:
对于较小的裸片,原书给出的计算为:
最终关心的是每片晶圆上的合格裸片数。大裸片只有 40% 合格,小裸片则约有三分之二合格。小裸片的面积略小于大裸片的一半,每片晶圆的合格裸片数却大约是其四倍。
译注: 两式左端在原页中都写作 Die yield,但右端乘以了每片晶圆裸片数,因此实际计算的是“合格裸片数”,不是良率。原书算术结果也与其参数不完全一致:按原式重算,两种良率分别约为 0.3936 和 0.6587,合格裸片数分别约为 106.27 和 421.56,而非 109 和 427。
许多微处理器的裸片面积在 1.00–2.25 cm² 之间,但低端嵌入式 32 位处理器有时只有 0.05 cm²;用于廉价 IoT 设备嵌入式控制的处理器,往往还不到 0.01 cm²;高端服务器和 GPU 芯片则可达到 8 cm²。芯片能够重复制作的最大尺寸称为 reticle limit,即光刻设备在一次掩模曝光步骤中能够覆盖的面积,约为 8.5 cm²。
DRAM 和 SRAM 等标准化商品面临巨大价格压力,设计者因此引入冗余来提高良率。多年来,DRAM 普遍加入一些冗余存储单元,以容忍一定数量的缺陷。对于微处理器内部用作缓存的大型 SRAM 阵列,设计者也采用了类似技术。出于同样原因,GPU 在约 100 个片上处理器中会配置 4 个冗余处理器。显然,冗余单元可以显著提高良率。
2022 年,一片直径为 300 mm(12 英寸)的晶圆,采用 7 nm 工艺加工的成本约为 10,000 美元,采用 5 nm 工艺则约为 16,000 美元。假定加工后晶圆的成本为 16,000 美元,1.00 cm² 裸片的成本约为 35 美元,而 2.25 cm² 裸片的成本约为 135 美元。1
对于芯片成本,计算机设计者应记住什么?制造工艺决定晶圆成本、晶圆良率和单位面积缺陷数,因此设计者能控制的是裸片面积和冗余。原文接着指出:实际上,由于单位面积的缺陷数很小,每片晶圆的合格裸片数,以及由此得到的每颗裸片成本,大致随裸片面积的平方增长。2 设计者通过决定哪些功能放到裸片上、哪些不放,以及 I/O 引脚的数量,影响裸片尺寸,进而影响成本。从环境角度看,一片晶圆所对应的隐含碳成本,不取决于它最终产出多少颗合格裸片;因此,提高每片晶圆的合格裸片产出,是降低每颗裸片隐含碳成本的一种好办法。3
在得到可以装进计算机的部件之前,裸片必须先接受测试,以区分合格与不合格产品,再进行封装,并在封装后再次测试。这些测试显著增加了从流片到获得可用芯片的时间,也增加了芯片制造成本。
前面的分析主要讨论制造一颗可用裸片的可变成本,这适用于大批量集成电路。不过,对于低产量产品——少于一百万颗——有一项极其重要的固定成本,会显著影响集成电路的成本,那就是一整套掩模的成本。集成电路工艺的每个步骤都需要单独的掩模。因此,对于金属层数多达十层的现代高密度制造工艺,7 nm 的掩模成本约为 1000 万美元,5 nm 则约为 2000 万美元。
图 1.17 展示了商用芯片开发总成本的组成,以及这些成本在近期工艺节点上显著上升的情况。这些费用统称为非重复性工程费用(nonrecurring engineering,NRE),也就是新产品开发的一次性成本。
好消息是,半导体公司提供 shuttle runs,可以大幅降低微型测试芯片的成本。它们把许多个小设计放进同一个裸片,以分摊掩模费用;之后再切分成更小的部分,交给各个项目。因此,在 2022 年,TSMC 以 12,000 美元的价格,就能提供 80–100 颗未经测试、采用 28 nm 工艺、尺寸为 1 mm × 1 mm 的裸片。这些裸片虽然很小,却能为体系结构设计者提供数百万个晶体管的试验空间。例如,这样一颗裸片能够容纳数个 RISC-V 处理器。
shuttle runs 有利于原型制作和调试,但无法解决几万到几十万颗产品的小批量生产问题。由于掩模成本可能继续上涨,一种新的方法正逐渐受到重视,下面就来讨论。
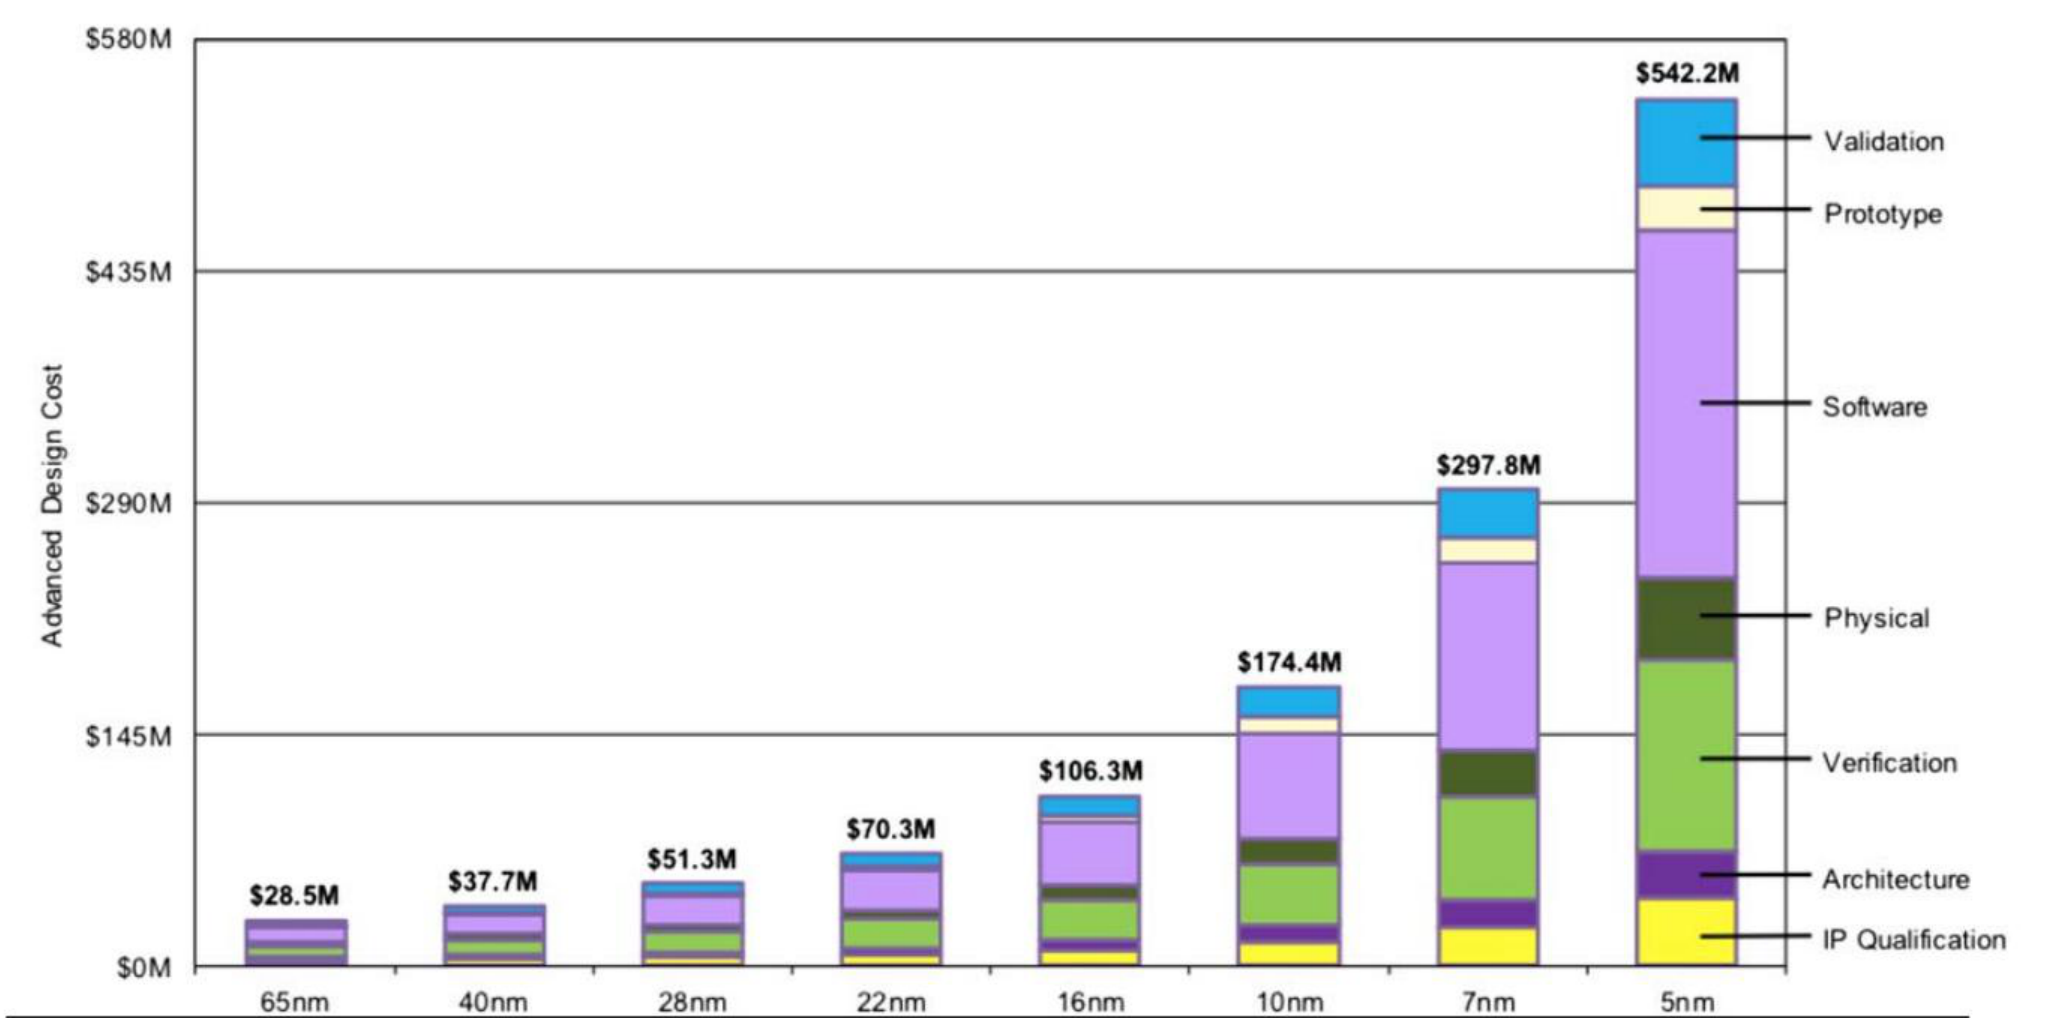
图 1.17(续)。 从图例下方向上看,各项含义如下:IP Qualification 是验证芯片所获授权 IP 模块的费用;Architecture 是芯片的逻辑设计;Verification 是检查芯片是否符合设计规格;Physical 是芯片版图的物理设计;Software 是该设计特有的底层软件,包括驱动程序、固件和诊断程序,这些软件必须为该芯片移植或重新优化;Prototype 包括评估芯片所需的电路板和软件;Validation 的层次高于 Verification,它检查软硬件系统是否满足用户最终应用的实际需求。掩模成本包含在物理设计中。5 nm 节点的数据是预测值,其他节点则依据实际经验。图源:Joel Hruska,2018 年 6 月 22 日,“As Chip Design Costs Skyrocket, 3nm Process Node Is in Jeopardy”。
图内纵轴 Advanced Design Cost 为先进芯片设计成本,M 表示百万美元。总额如下;各色分项未给出精确数字,不能从柱形高度补造数据。
| 工艺节点(nm) | NRE 总费用(百万美元) |
|---|---|
| 65 | 28.5 |
| 40 | 37.7 |
| 28 | 51.3 |
| 22 | 70.3 |
| 16 | 106.3 |
| 10 | 174.4 |
| 7 | 297.8 |
| 5 | 542.2(预测) |
Chiplet
本书前几版记录了向更小几何尺寸发展所需的费用。在第 6 版中,我们列出的 28 nm 工艺、300 mm 晶圆加工成本为 4000–5000 美元,与第 5 版所列 90 nm 晶圆的价格相近。
如今,5 nm 晶圆的成本为 16,000 美元,约为原来的四倍。第 6 版中,28 nm 工艺的掩模费用为 150 万美元,同样与第 5 版中 90 nm 工艺的费用相近;到了 5 nm,费用升至 2000 万美元,约增长到原来的 13 倍。AMD 发现,从 45 nm 到 5 nm,一颗面积为 250 mm² 的合格裸片,其成本升至原来的五倍(Naffziger, 2021)。
不断上涨的掩模成本,对高产量芯片,例如产量超过一千万颗的产品,影响相对较小;但对产量低于一百万颗的芯片,则形成了显著的成本下限。如第 7 章将要讨论的,通用处理器无法像专用处理器那样显著提高性价比,于是产业开始制造种类更多、各自产量较低的芯片,而不是把产量集中到少数几种芯片上。体系结构走向专用化的趋势,与半导体经济性更偏好超大规模生产的趋势发生了冲突。
此外,虽然最新、也更昂贵的工艺仍能改善逻辑门,芯片中的其他部件却未能同步进步,见图 1.13。单位连线长度的能耗改善得慢得多,SRAM 密度的增长也比过去缓慢。比较 65 nm 和 3 nm 工艺,图 1.18 表明,每 mm² 的 SRAM 容量约只有理想缩放所预期密度的 1/20;较早的工艺世代曾经能够达到那种理想缩放。模拟电路的缩放也在放缓,这意味着 7 nm 之后,I/O 的进步会很缓慢。
由于技术发展趋势与体系结构发展趋势方向相反,一种解决办法就是 chiplet,即用于组成同一封装系统的小型裸片。多个较小的裸片,其中一些可以采用较老、成本更低的工艺节点,被集成到一个封装中,取代 Moore 定律所展现的传统路径:不断制造更大的单一裸片。
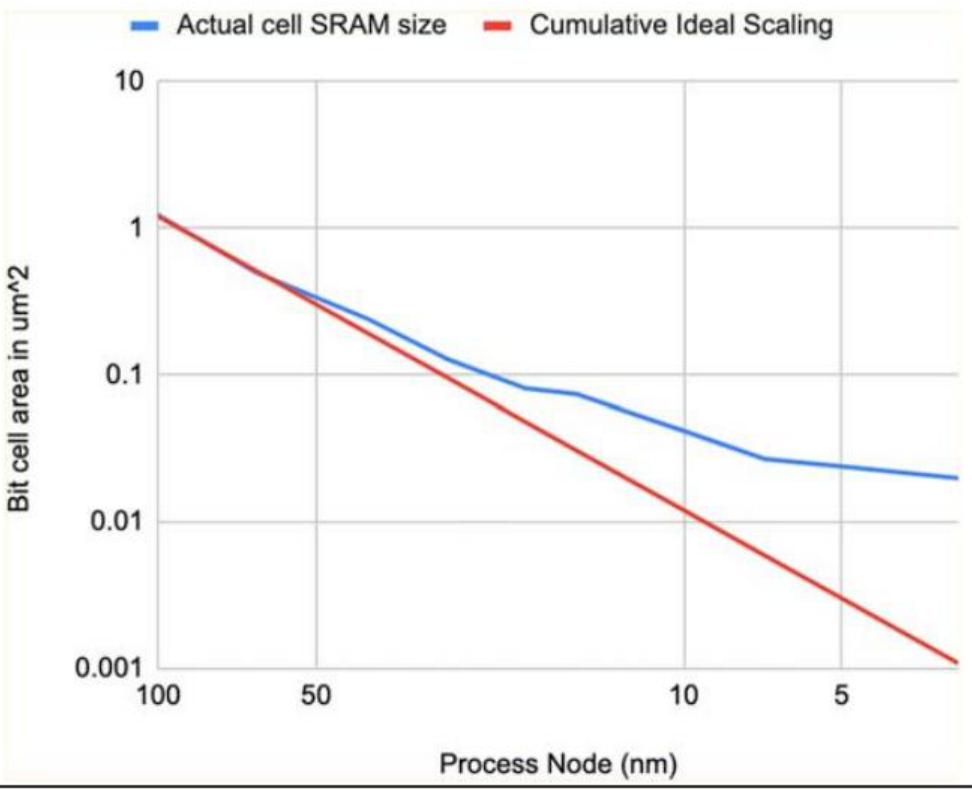
图内术语:Actual cell SRAM size=实际 SRAM 单元尺寸;Cumulative Ideal Scaling=累积理想缩放;Bit cell area in μm²=位单元面积(μm²);Process Node (nm)=工艺节点(nm)。
这种新型封装方案也带来了新的挑战:
- 芯片设计更复杂,因为必须把一个完整的逻辑设计划分成多个较小的独立部分。
- 需要新的 chiplet 间通信通路。与片上通信相比,这些通路更长,功耗或延迟更高,带宽也更低。
- 某些功能在单个大裸片中只需实现一次,拆成 chiplet 后则可能要在每个 chiplet 上重复实现。
尽管如此,相比单个大芯片的设计,合理选择 chiplet 仍然能够降低成本,并增加有效硅片总面积。
例如,最初的 AMD EPYC CPU 使用四个 14 nm chiplet(Naffziger, 2021)。AMD 估算,如果采用 14 nm 工艺制造一颗完整的 32 核芯片,需要 777 mm²。采用 chiplet 后,每个面积为 213 mm²,四个总共需要 mm²,比前者多约 10%。但将良率考虑在内,AMD 预计,采用 chiplet 可以获得约 1.7 倍的成本优势。此外,chiplet 还让 AMD 能够利用同一种设计,同时提供 16 核和 32 核产品。
对于第二代 EPYC Rome CPU,AMD 发现 I/O 在 7 nm 工艺下改善不大,因此,更合理的做法是把这些功能集中到一个采用较便宜工艺制造的 I/O chiplet 中:12 nm 工艺、面积 416 mm²;与此同时,采用 7 nm 工艺的 8 核 chiplet 可以缩小到 74 mm²。chiplet 再次使 AMD 能够基于一种设计,提供 16、24、48 和 64 核等多种产品。在与单片定制设计的比较中,AMD 估计,16–48 核设计的成本会高出约 1.8–2 倍;但 64 核设计根本无法制造,因为它的面积将超过 1000 mm²,越过掩模的 reticle limit。4 chiplet 之间的通信,确实比同一个大芯片内部通信更耗电;不过,这只占整个系统功耗的一小部分,可以纳入系统设计的统筹考虑。
AMD、Intel、NVIDIA 以及许多其他公司,已经在使用为特定产品设计的专用 chiplet。除了这些定制产品,如果 chiplet 能够标准化、在多条产品线之间复用,整个行业就有望受益:产量能够提高,每颗产品分摊的掩模成本也会降低。熟悉芯片历史的人会知道,Texas Instruments 的 TTL Data Book 及其 74xx 系列芯片,就是成功建立通用构件标准的例子;它们出现在 20 世纪 70 年代 Moore 定律的小规模集成阶段。今天,有许多工作正在尝试启动一个通用 chiplet 产业。一旦成功,定制硬件设计的成本和开发时间就可能大幅下降。不过,到目前为止,这更多还是一个理论上很有吸引力的可能性,尚不能说很有把握会实现。
为避免在系统讨论中混淆芯片与 chiplet,后续章节将用 **socket(插槽)**指代一个 CPU,无论它是单个大芯片,还是由多个 chiplet 组成的封装。
成本与价格
随着计算机走向商品化,产品制造成本与售价之间的差额不断缩小。这部分差额需要支付公司的研发(R&D)、市场推广、销售、制造设备维护、房屋租赁、融资成本、税前利润和税款。许多工程师会惊讶地发现,多数公司的研发开支只占收入的 4%–12%:标准化 PC 业务约为 4%,高端服务器业务约为 12%,而所有工程工作都要由这笔研发预算来承担。
制造成本与运行成本
在本书前四版中,“成本”指制造计算机的成本,“价格”指购买计算机的价格。仓库级计算机(WSC)出现后,一个系统内包含数万台服务器,除了购买费用,运行计算机的费用也变得非常可观。经济学把这两类费用分别称为资本性支出(CAPEX)和运营支出(OPEX)。
如第 6 章所示,如果假定 IT 设备的使用寿命较短,只有 3–4 年,那么服务器和网络设备摊销后的购置价格,约占 WSC 每月运行总成本的一半。总拥有成本(TCO)就是 CAPEX 加上 3–4 倍的 OPEX。5 每月运营成本中,约 40% 用于电力,以及配电、IT 设备散热基础设施的摊销;尽管这些基础设施的摊销年限已经长达 10–15 年。因此,要降低 WSC 的运营成本,计算机体系结构设计者必须高效利用能源。还要注意,随着 Moore 定律放缓,一些公司已经开始把 IT 设备的使用寿命延长到 6–8 年。
译注: 此处 35 美元和 135 美元均照录原文。即使用上一例原书给出的 427 和 109 颗合格裸片,16,000 美元分别相除也约为 37.47 和 146.79 美元;按上一例公式重新计算,则约为 37.95 和 150.56 美元。因此,不能把原文报价与前述参数视为完全一致的计算结果。 ↩︎
译注: 原文确实把“每片晶圆的合格裸片数”和“每颗裸片成本”一起说成随面积平方增长。按本节给出的公式,面积增大时,前者减少,后者增加;两者不能同向增长。这里明确保留并指出源文的问题。 ↩︎
译注: 原页在此印为“the number of ideas on a wafer”。根据同段上下文,应指晶圆上的 dies(裸片);译文按此语境译出,并在这里注明原文拼写问题。 ↩︎
译注: 原文写“Compared to single custom designs”,随后说成本“1.8× to 2× higher”,比较方向表述不清,与本段强调 chiplet 成本优势的上下文也有歧义。 ↩︎
译注: 原文紧接“每月成本”后写“TCO is then CAPEX plus 3–4 times OPEX”,没有在该句交代 OPEX 的时间口径。3–4 年寿命下使用这一关系,需要将 OPEX 理解为年度运营支出;不能把前面的月度 OPEX 直接乘以 3–4。 ↩︎