1.9 性能的测量、报告与汇总
当我们说一台计算机比另一台更快时,究竟指什么?手机用户可能认为,程序运行所需的时间越短,计算机就越快;而 Amazon.com 的管理员可能认为,每小时完成的事务越多,计算机就越快。手机用户希望缩短响应时间(response time),即从一项活动开始到结束所经历的时间,也称执行时间。云数据中心的运营者则希望提高吞吐量(throughput),即给定时间内完成的工作总量。
比较不同设计方案时,我们经常需要说明两台计算机的性能关系,设它们分别为 X 和 Y。本书中,“X 比 Y 快”是指:对于给定任务,X 的响应时间或执行时间比 Y 短。
具体而言,“X 的速度是 Y 的 倍”表示:
由于执行时间是性能的倒数,下面的关系成立:
“X 的吞吐量是 Y 的 1.3 倍”则表示:在单位时间内,计算机 X 完成的任务数是 Y 的 1.3 倍。
遗憾的是,比较计算机性能时,人们采用的指标并不总是时间。我们的立场是:真实程序的执行时间,是唯一始终一致而可靠的性能度量。无论是提出其他指标来代替时间,还是用其他测量对象来代替真实程序,最终都曾导致误导性的宣传,甚至导致计算机设计上的错误。
即使是执行时间,也会因为计入的内容不同而有不同的定义。最直观的定义称为墙钟时间(wall-clock time)、响应时间或经过时间(elapsed time):它是完成一项任务所经历的全部延迟,包括存储设备访问、内存访问、I/O 活动、操作系统开销等一切时间。在多道程序环境下,处理器等待 I/O 时会转而执行另一个程序,因此未必会使某一个程序的经过时间最短。为了描述这种情况,我们需要另一个术语。CPU 时间专门区分了这一点:它是处理器实际进行计算的时间,不包括等待 I/O 或运行其他程序的时间。(显然,用户感受到的响应时间是程序的经过时间,而不是 CPU 时间。)
经常运行同一组程序的用户,是评估新计算机的理想人选。他们只需比较自身工作负载的执行时间,就能评价新系统。这里的工作负载,是指用户在计算机上运行的程序和操作系统命令的组合。不过,很少有人拥有这样的便利条件。大多数人不得不依靠其他方法,往往还要依靠其他评估者,来评价计算机,并寄望于这些方法能够预测自己使用新机器时的性能。一种方法是运行基准测试程序:许多公司用这类程序来确定其计算机的相对性能。
基准测试
测量性能时,最好的基准测试是真实应用,例如 1.1 节提到的 Google Translate。尝试用远比真实应用简单的程序来衡量性能,曾引发种种问题。
这类程序包括:
- 核心片段(kernels):真实应用中小而关键的部分。
- 玩具程序(toy programs):来自编程入门作业、从头到尾大约只有 100 行的程序,例如 Quicksort。
- 合成基准测试(synthetic benchmarks):为模仿真实应用的特征与行为而人为构造的程序,例如 Dhrystone。
如今,这三种做法都已失去公信力,通常是因为编译器开发者与体系结构设计者可以联手优化这些替代程序,使计算机在它们上面显得比运行真实应用时更快。令本书作者遗憾的是,Dhrystone 这个合成程序,至今仍是嵌入式处理器领域最常被引用的基准测试之一!我们曾以为,所有计算机体系结构设计者都已经承认,用合成基准测试表征性能是一种站不住脚的做法,因此在本书第 4 版中删掉了对这一谬误的讨论。
另一个问题是基准测试的运行条件。过去,提升基准测试性能的一种办法,是使用专门针对该测试的编译器选项。这些选项往往会触发某些变换,而这些变换对许多程序来说并不合法,或者会降低其他程序的性能。为限制这种做法、提高结果的意义,基准测试制定者通常要求:对于同一种语言(例如 C++ 或 C)编写的全部程序,厂商必须使用同一个编译器和同一组编译选项。其目的,是尽量降低“benchmarketing”的影响,即围绕基准成绩进行营销式优化(见 1.11 节)。1
除了编译器选项,还要决定是否允许修改源代码。对此有三种不同做法:
- 不允许对源代码作任何修改。
- 允许修改源代码,但实际上几乎不可能这样做。例如,数据库基准测试依赖标准数据库程序,其代码规模达数千万行。数据库公司极不可能仅为提升某一台计算机的性能而修改这些程序。
- 允许修改源代码,只要修改后的版本产生相同的结果。
基准测试设计者在决定是否允许修改源代码时,面临的关键问题是:这些修改是否符合实际使用方式,能否为用户提供有价值的信息;还是仅仅削弱了基准测试预测真实性能的准确性。第 7 章将看到,领域专用体系结构的设计者在为定义明确的任务开发处理器时,通常采用第三种做法。
为了避免把过多希望寄托在单一测试上,人们常把多个基准应用组合成基准测试套件(benchmark suite),用来衡量处理器运行不同应用时的性能。
当然,套件的质量取决于组成它的各项基准测试。不过,套件的一个重要优点是:其他基准测试的存在,能够减轻某一个测试的缺陷所造成的影响。基准测试套件的目标,是刻画两台计算机真实的相对性能,尤其是客户可能运行、却不在套件中的那些程序的相对性能。
建立标准化基准应用套件的尝试中,最成功的组织之一是 SPEC(Standard Performance Evaluation Corporation)。它源于 20 世纪 80 年代末为工作站和服务器提供更好基准测试的努力。当时,越来越流行的 Dhrystone 基准测试准确性欠佳,这也是促成 SPEC 的原因之一。计算机行业不断发展,对基准测试套件的需求也随之变化;如今 SPEC 已提供覆盖多种应用类别的测试。全部 SPEC 基准测试套件及其报告结果,都可以在 SPEC 网站 找到。
虽然下面许多小节主要讨论 SPEC 基准测试,但针对运行 Windows 的 PC,也开发了不少其他基准测试,例如 Geekbench。
一个值得警惕的例子是 Electronic Design News Embedded Microprocessor Benchmark Consortium 的基准测试,简称 EEMBC,发音与“embassy”相同。这套测试包含 41 个核心片段,用于预测不同嵌入式应用的性能,包括汽车与工业、消费类产品、网络、办公自动化和电信应用。EEMBC 同时报告未经修改的性能和“full fury”性能;后者几乎允许采取任何手段。部分因为这些测试使用小型核心片段,又部分因为其结果报告方式,EEMBC 的成绩并未被广泛引用。正因为它没有取得成功,那个它原本打算取代的 Dhrystone,遗憾地仍被沿用。EEMBC 于 2009 年推出 CoreMark:这是一个由四个核心片段组成的单一合成程序,如今它被引用的频率已经与 Dhrystone 相当。近期的 Embench 项目(Patterson et al., 2025)受到 SPEC 启发,旨在为嵌入式计算提供免费、开放的基准测试套件,取代 Dhrystone 和 CoreMark,成为标准的嵌入式基准测试(见 Embench 网站)。
桌面基准测试
桌面基准测试大致分为两类:处理器密集型和图形密集型,尽管许多图形基准测试也会给处理器带来繁重负载。SPEC 最初建立的是一套关注处理器性能的测试,起初称为 SPEC89。经过 SPEC92、SPEC95、SPEC2000 和 SPEC2006,它发展到了第六代 SPEC CPU2017。SPEC CPU2017 包含 10 个整数基准测试(CPU2017 Integer Speed)和 17 个浮点基准测试(CPU2017 Floating Point Speed)。2 图 1.19 描述了这一代 SPEC CPU 基准测试及其沿革。
对于前面讨论的编译器选项问题,SPEC 的解决方法是同时提供 base 和 peak 两种结果。base 要求同一种语言的所有基准程序使用相同的编译器选项,peak 则允许程序员为每项基准测试选择尽可能好的选项。
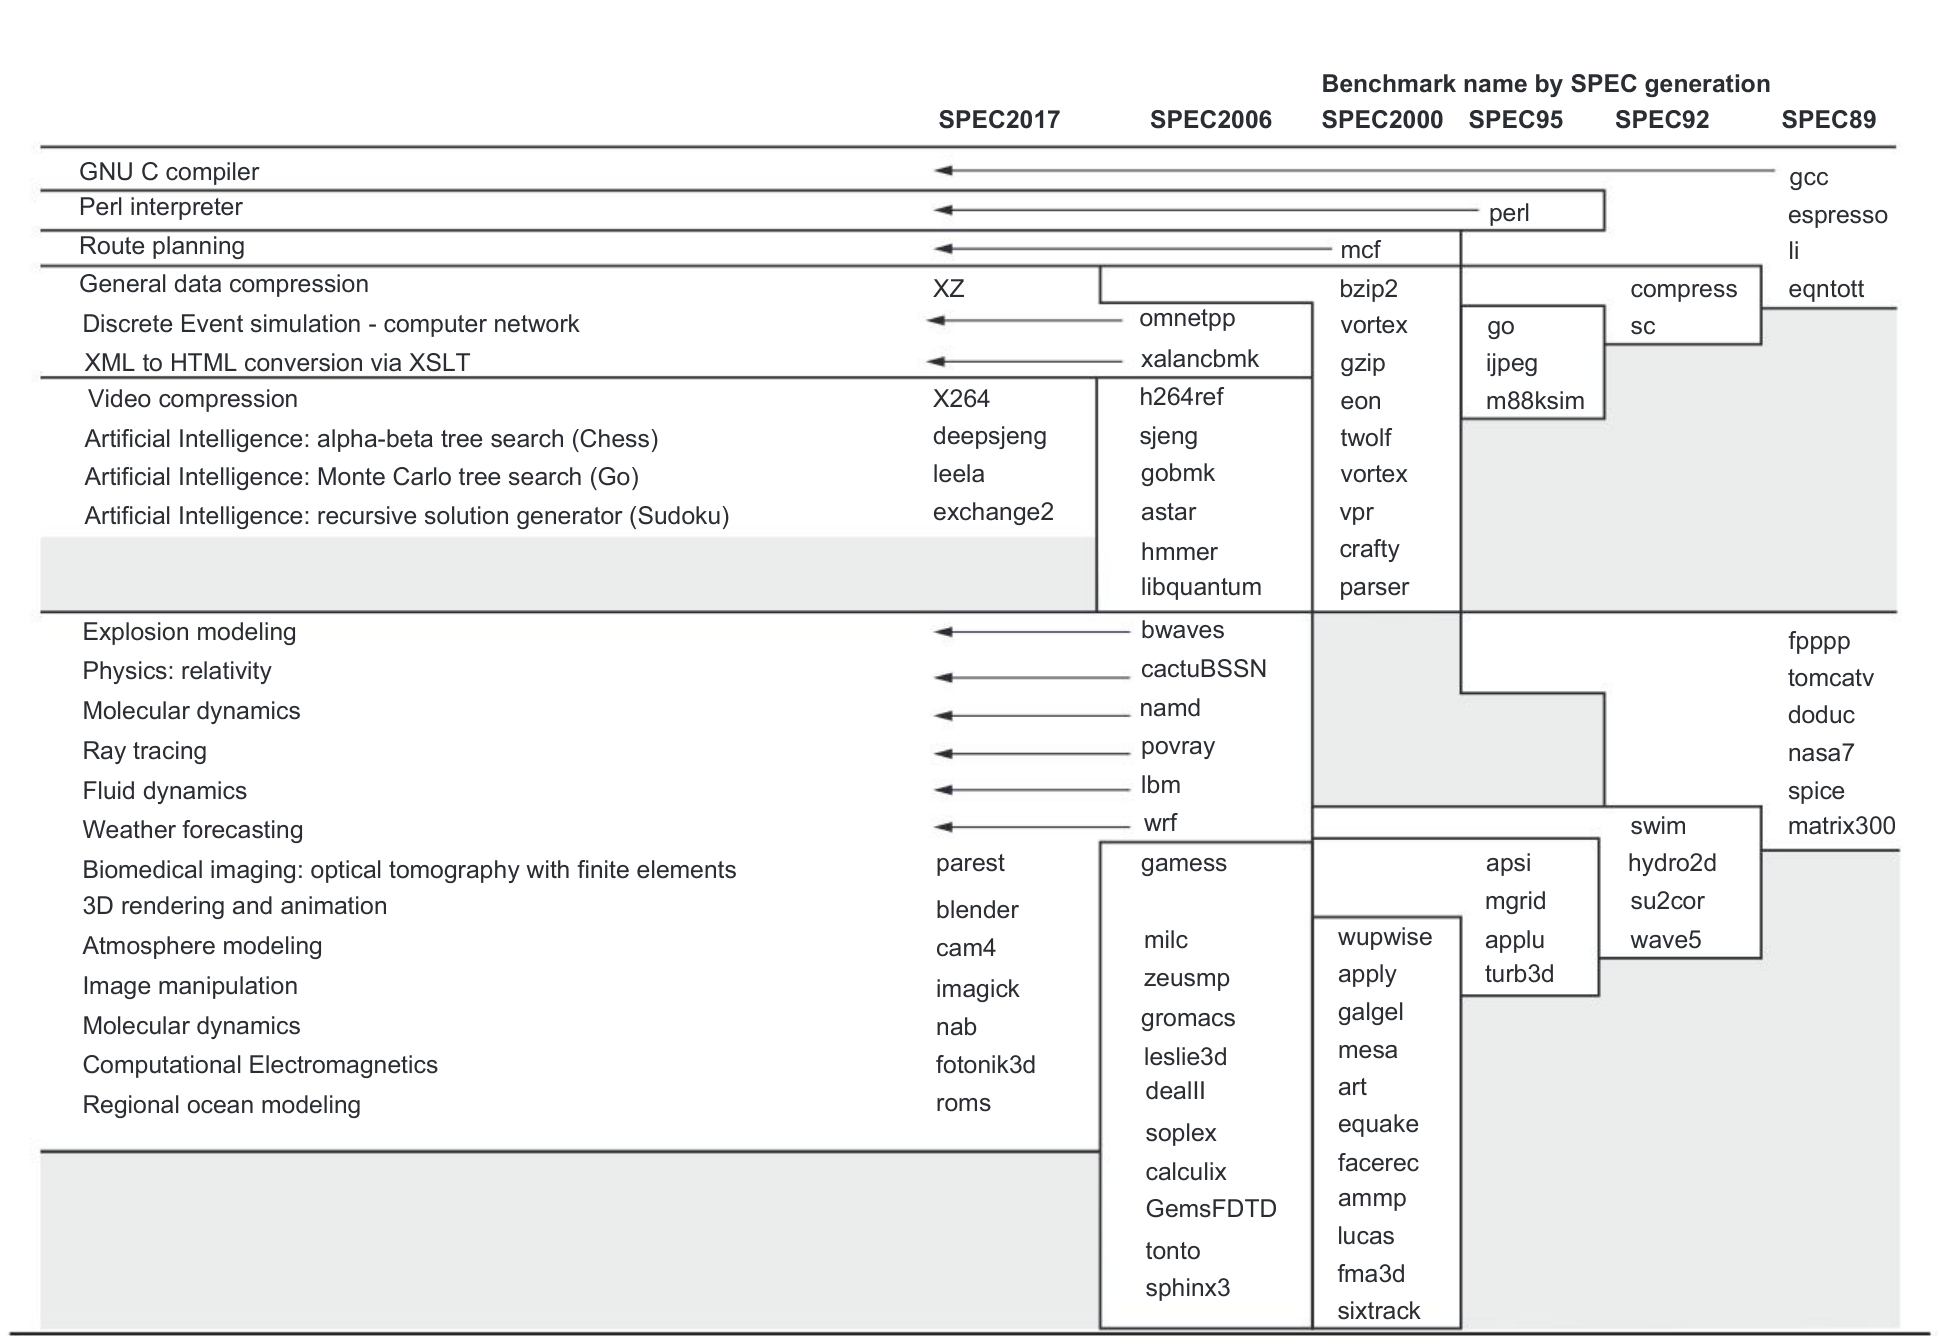
图 1.19 SPEC2017 程序及 SPEC 基准测试随时间的演变。分界线上方为整数程序,下方为浮点程序。SPEC2017 的 10 个整数程序中,5 个用 C 编写,4 个用 C++ 编写,1 个用 Fortran 编写。浮点程序中,3 个用 Fortran 编写,2 个用 C++ 编写,2 个用 C 编写,6 个混合使用 C、C++ 和 Fortran。图中列出了 1989、1992、1995、2000、2006 和 2017 年各版中的全部 82 个程序,其中 gcc 资历最老。只有 3 个整数程序和 3 个浮点程序历经了三代或更多代。虽然少数程序会从一代保留到下一代,但程序版本会变化,输入或测试规模也往往会扩大,以延长运行时间,避免测量受到扰动,或避免执行时间被 CPU 时间以外的某个因素主导。左侧的基准用途说明仅适用于 SPEC2017,并不适用于早期版本。不同代 SPEC 中处于同一行的程序通常没有关系;例如,fpppp 并不像 bwaves 那样是计算流体动力学(CFD)程序。
图内“Benchmark name by SPEC generation”意为“各代 SPEC 的基准程序名称”;程序名保留原标识符。图左侧用途说明译如下:
| SPEC2017 程序 | 用途 |
|---|---|
| gcc | GNU C 编译器 |
| perlbench | Perl 解释器 |
| mcf | 路径规划 |
| XZ | 通用数据压缩 |
| omnetpp | 计算机网络的离散事件仿真 |
| xalancbmk | 通过 XSLT 将 XML 转换为 HTML |
| X264 | 视频压缩 |
| deepsjeng | 人工智能:alpha-beta 树搜索(国际象棋) |
| leela | 人工智能:Monte Carlo 树搜索(围棋) |
| exchange2 | 人工智能:递归解生成器(数独) |
| bwaves | 爆炸建模 |
| cactuBSSN | 物理:相对论 |
| namd | 分子动力学 |
| povray | 光线追踪 |
| lbm | 流体动力学 |
| wrf | 天气预报 |
| parest | 生物医学成像:基于有限元的光学层析成像 |
| blender | 三维渲染与动画 |
| cam4 | 大气建模 |
| imagick | 图像处理 |
| nab | 分子动力学 |
| fotonik3d | 计算电磁学 |
| roms | 区域海洋建模 |
SPEC 基准测试采用真实程序,并作适当修改,以提高可移植性、尽量降低 I/O 对性能的影响。整数测试涵盖 C 编译器的一部分、围棋程序以及视频压缩等任务;浮点测试包括分子动力学、图像处理和天气预报。SPEC CPU 套件适合测试桌面系统和服务器的处理器性能。本书后面会多次使用这些程序的数据。不过,这些程序与现代编程语言及运行环境、与 1.1 节介绍的 Google Translate 应用,都相距甚远。其中三分之一的程序至少有一部分是用 Fortran 编写的!它们甚至采用静态链接,而大多数真实程序采用动态链接。遗憾的是,SPEC2017 中的应用或许确实是真实程序,却难以令人振奋。SPECINT2017 和 SPECFP2017 能否反映 21 世纪计算领域令人激动的发展,并不清楚。
1.11 节将介绍 SPEC CPU 套件开发过程中出现的问题,以及维持一套有用、具有预测能力的基准测试套件所面临的挑战。1
SPEC CPU2017 面向处理器性能,但 SPEC 还提供许多其他基准测试。图 1.20 列出了 2023 年仍在使用的 17 项 SPEC 基准测试。3
服务器基准测试
正如服务器具有多种功能,服务器基准测试也有多种类型。最简单的一种,或许是面向处理器吞吐量的测试。SPEC CPU2017 利用 SPEC CPU 程序构造了一种简单的吞吐量测试:同时运行每个 SPEC CPU 程序的多个副本,通常副本数与处理器数相同,再将 CPU 时间转换为处理速率,分别称为 SPEC CPU2017 Integer Rates 和 CPU2017 Floating Point Rates,以此衡量多处理器的处理速率。如果某次测量运行了 8 个副本,而用时只有参考机器的一半,那么该项测试的 SPECrate 就是 16。这类测试衡量的是 1.2 节所说的请求级并行性(RLP)。为了衡量线程级并行性(TLP),SPEC 还提供了它所称的高性能计算基准测试,围绕 OpenMP、MPI(Message Passing Interface,消息传递接口),以及 GPU 等加速器展开(见图 1.20)。
除 SPECrate 外,多数服务器应用和基准测试都有大量 I/O 活动,来源是存储访问或网络通信。这包括文件服务器、Web 服务器,以及数据库与事务处理(TP)系统的测试。SPEC 提供文件服务器基准测试 SPECstorage,也提供 Java 服务器基准测试。(附录 D 详细讨论若干文件与 I/O 系统基准测试。)SPEC VIRT_SC 2013 和 SPECvirt Datacenter 2021 评估虚拟化数据中心服务器的端到端性能。SPEC 还有一个衡量功耗的测试,将在 1.11 节讨论。
事务处理基准测试衡量系统处理事务的能力;这些事务由数据库访问和更新组成。航空订票系统和银行 ATM 系统是典型而简单的事务处理实例;更复杂的系统还涉及复杂数据库与决策。
| 类别 | 名称 | 衡量的性能 |
|---|---|---|
| 云 | Cloud_IaaS 2018 | 云端 NoSQL 数据库事务,以及使用 map/reduce 的 K-Means 聚类 |
| CPU | CPU2017 | 计算密集型整数与浮点工作负载 |
| 图形与工作站性能 | SPECviewperf® 2020 | 运行 OpenGL 和 Direct X 的系统的三维图形性能 |
| 图形与工作站性能 | SPECworkstation 3.1 | Windows 工作站运行专业应用时的性能 |
| 图形与工作站性能 | SPECapcSM for Maya® 2017 | 运行专有应用 Autodesk 3ds Max 2017 时的三维图形性能 |
| 图形与工作站性能 | SPECapcSM for PTC Creo 3.0 | 运行专有应用 PTC Creo 3.0 时的三维图形性能 |
| 图形与工作站性能 | SPECapcSM for Siemens NX 9.0 and 10.0 | 运行专有应用 Siemens NX 9.0 或 10.0 时的三维图形性能 |
| 图形与工作站性能 | SPECapcSM for SolidWorks 2021 | 运行专有 CAD/CAM 应用 SolidWorks 2021 的系统的三维图形性能 |
| 高性能计算 | SPEC ACCEL | 加速器与主机 CPU 运行使用 OpenCL 和 OpenACC 的并行应用时的性能 |
| 高性能计算 | SPEChpc 2021 | 四组规模递增的 HPC 应用或小型应用套件,覆盖单节点至数百节点 |
| 高性能计算 | SPEC MPI 2007 | 集群和对称多处理器(SMP)上运行的 MPI 并行、浮点、计算密集型程序 |
| 高性能计算 | SPEC OMP 2012 | 采用 OpenMP 的并行应用 |
| Java 客户端/服务器 | SPECjbb2015 | Java 服务器 |
| Java 客户端/服务器 | SPECjEnterprise 2018 Web Profile | Java EE Web Profile V7 或更高版本的应用服务器、数据库及其支撑基础设施 |
| Java 客户端/服务器 | SPECJEnterprise 2010 | Java EE Web Profile V5 或更高版本的应用服务器、数据库及其支撑基础设施 |
| Java 客户端/服务器 | SPECjvm 2008 | Java 运行时环境中的真实应用,以及侧重 Java 核心功能的基准测试 |
| 功耗 | SPECpower_ssj2008 | 运行 SPECjbb2015 的主流服务器级计算机的功耗。其他一些 SPEC 套件也测量功耗:ACCEL、CPU 2017、OMP、2012 和 VIRT_SC 2013 |
| 存储 | SPECstorage Solution 2020 | 文件服务器的吞吐量与响应时间 |
| 虚拟化 | SPEC VIRT_SC 2013 | 用于虚拟化服务器整合的数据中心服务器 |
| 虚拟化 | SPECvirt Datacenter 2021 | 数据中心多主机虚拟化环境的第三代基准测试 |
图 1.20 截至 2022 年仍在使用的 SPEC 基准测试。3
20 世纪 80 年代中期,一批关注此问题的工程师成立了独立于厂商的 Transaction Processing Council(TPC),试图为事务处理建立真实而公平的基准测试。其测试说明见 TPC 网站。
第一个 TPC 基准测试 TPC-A 于 1985 年发布,后来被多种不同的测试取代和增强。TPC-C 最初建立于 1992 年,模拟复杂的查询环境。TPC-H 模拟临时性的决策支持:查询彼此独立,无法利用对过去查询的了解来优化未来查询。TPC-DI 则面向数据集成(DI)这一新任务,它也称 ETL,即 Extract、Transform、Load(提取、转换、加载),是数据仓库的重要组成部分。TPC-DS 是决策支持基准测试。TPC-E 是一种在线事务处理(OLTP)工作负载,模拟证券经纪公司的客户账户。
面对传统关系数据库与“NoSQL”存储方案之间的争论,TPCx-HS 衡量的是使用 Hadoop 文件系统、运行 MapReduce 程序的系统;TPC-DS 则衡量使用关系数据库或 Hadoop 系统的决策支持系统。TPC-VMS 和 TPCx-V 衡量虚拟化系统的数据库性能;TPC-Energy 为现有全部 TPC 测试增加能耗指标。近年来,TPC 还把测试扩展到了物联网与人工智能领域。
所有 TPC 基准测试都用每秒事务数衡量性能。此外,它们还规定响应时间要求,因此只有满足响应时间限制时,测得的吞吐量才有效。为了模拟真实系统,更高的事务处理速率也要对应更大的系统规模,包括更多用户和更大的事务数据库。最后,还必须报告测试系统的成本,以便准确比较性价比。TPC 修改了其定价政策,让全部 TPC 测试遵循统一规范,并允许核实 TPC 公布的价格。
报告性能结果
报告性能测量结果时,首要原则应当是可复现性:列出另一位实验者重现结果所需的一切信息。SPEC 报告要求详细说明计算机和编译器选项,并同时公开基线结果与优化结果。除了硬件、软件以及基线调优参数的描述外,SPEC 报告还包括实际执行时间,同时以表格和图形呈现。TPC 报告更加完整,因为它还必须包含基准测试审计结果和成本信息。由于厂商既竞争性能,也竞争性价比,这些报告是了解计算系统真实成本的极佳资料。
汇总性能结果
在实际计算机设计中,必须使用一组被认为与目标有关的基准测试,对大量设计选择的相对收益进行定量评估。同样,消费者选择计算机时,也可能依赖基准测试的性能测量结果;理想情况下,这些测试应当类似于用户自己的应用。在这两种情形中,拥有一整套基准测试的测量结果都很有帮助:既可以使重要应用的性能与套件中的某一个或若干测试相对应,也可以了解性能的变化范围。最理想的情况是,这套测试能够构成应用空间中一个具有统计有效性的样本。不过,这需要的测试数量远多于通常的套件,还需要随机抽样,而几乎没有基准测试套件这样做。
一旦选定通过基准测试套件来衡量性能,我们就希望用一个数概括整套测试的结果。一种简单办法,是比较套件内各程序执行时间的算术平均值。另一种办法,是为每项基准测试赋予权重,再用加权算术平均值概括性能。选择权重的一种思路,是使所有程序在某台参考计算机上的加权执行时间相等;但这样会使结果偏向该参考计算机的性能特征。
我们也可以不选择权重,而是把执行时间相对于参考计算机进行归一化:用参考计算机的执行时间除以被评估计算机的执行时间,得到一个与性能成正比的比值。SPEC 采用这一方法,并将所得比值称为 SPECRatio。它有一项非常有用的性质,恰好契合本书衡量计算机性能的方法:比较性能之比。例如,假设某项基准测试上,计算机 A 的 SPECRatio 是 B 的 1.25 倍,那么:
注意,参考计算机的执行时间被约掉了。因此,像本书一贯采用的那样通过比值进行比较时,参考计算机的选择与结果无关。图 1.21 给出了一个例子。
由于 SPECRatio 是比值,而不是绝对执行时间,必须使用几何平均值来计算平均值。(SPECRatio 没有单位,因此对 SPECRatio 作算术比较没有意义。)4 其计算公式如下。
| 基准程序 | Sun UltraSPARC-IV+ 时间(秒) | AMD EPYC 7763 时间(秒) | AMD SPEC CPU2017 Ratio | Intel Xeon Platinum 8380 时间(秒) | Intel SPEC CPU2017 Ratio | AMD/Intel 时间之比 | Intel/AMD SPEC 比值之比 |
|---|---|---|---|---|---|---|---|
| perlbench | 1,774 | 257 | 6.90 | 253 | 7.01 | 1.02 | 1.02 |
| gcc | 3,976 | 310 | 12.83 | 371 | 10.72 | 0.84 | 0.84 |
| mcf | 4,721 | 236 | 20.00 | 240 | 19.67 | 0.98 | 0.98 |
| omnetpp | 1,630 | 199 | 8.19 | 138 | 11.81 | 1.44 | 1.44 |
| xalancbmk | 1,417 | 103 | 13.76 | 108 | 13.12 | 0.95 | 0.95 |
| x264 | 1,763 | 107 | 16.48 | 105 | 16.79 | 1.02 | 1.02 |
| deepsjeng | 1,432 | 231 | 6.20 | 248 | 5.77 | 0.93 | 0.93 |
| leela | 1,703 | 310 | 5.49 | 362 | 4.70 | 0.86 | 0.86 |
| exchange2 | 2,939 | 131 | 22.44 | 156 | 18.84 | 0.84 | 0.84 |
| xz | 6,182 | 253 | 24.43 | 255 | 24.24 | 0.99 | 0.99 |
| 几何平均值 | — | — | 11.99 | — | 11.69 | 0.98 | 0.98 |
图 1.21 SPEC CPU2017 参考计算机 Sun UltraSPARC-IV+ 的 Integer Speed 执行时间(秒),以及 AMD EPYC 7763 和 Intel Xeon Platinum 8380 的执行时间与 SPECRatio。最后两列分别给出执行时间之比与 SPEC 比值之比。该图表明,比较相对性能时,参考计算机无关紧要:执行时间之比与 SPEC 比值之比相同;几何平均值之比 ,也等于各项比值的几何平均值 0.98。5
对于 SPEC, 就是程序 的 SPECRatio。使用几何平均值可以保证两项重要性质:
- 比值的几何平均值,等于几何平均值之比。
- 几何平均值之比,等于性能比值的几何平均值;这意味着参考计算机的选择无关紧要。
因此,使用几何平均值有充分理由,尤其是在通过性能比值进行比较时。
例:几何平均值与参考计算机
证明:几何平均值之比等于性能比值的几何平均值,而且 SPECRatio 所采用的参考计算机不影响结果。
解: 假设有两台计算机 A 和 B,并分别测得一组 SPECRatio。
也就是说,A 与 B 的 SPECRatio 几何平均值之比,等于套件内全部基准测试上 A 相对 B 的性能比值的几何平均值。图 1.21 用 SPEC2017 的实例验证了这一点。
译注:原文两处均指向 1.11 节;本版实际集中讨论 benchmarketing 与基准测试失效问题的是 1.12 节。 ↩︎ ↩︎
译注:正文写“17 个浮点基准测试”,图 1.19 的语言分类则合计为 13 个,图中 SPEC2017 浮点项也列出 13 个。这里分别保留原文数字,未把其中一处静默改成另一处。 ↩︎
译注:原文正文写“2023 年、17 项”,图题写“截至 2022 年”,实际表格列出 20 项。表中 Maya 名称对应 Autodesk 3ds Max 描述,功耗行把“OMP, 2012”分开列出,也均按原表保留。 ↩︎ ↩︎
译注:“无单位,所以不能作算术比较”是原文的论断;无量纲本身并不排除算术运算。本节真正证明的是,几何平均值具备所需的比值关系,使相对比较不依赖参考计算机的选择。 ↩︎
译注:原表的“AMD/Intel times”列头另标有“seconds”,但这一列实际是执行时间之比,秒在相除时已约掉,因此译表按无量纲比值呈现;原列头的单位问题在此保留记录。 ↩︎