1.12 谬误与陷阱
本书每章都有“谬误与陷阱”这一节,目的是解释一些广泛流传、却应当避免的错误认识。我们把这类误解称为谬误(fallacies),讨论时会尽量给出反例。我们还会介绍陷阱(pitfalls),即很容易犯的错误。陷阱往往源于把仅在特定条件下成立的原则过度推广。本节旨在帮助你在设计计算机时避免这些错误。本章涉及的主题中,不乏错误认识和容易重蹈的覆辙。
陷阱:所有指数增长规律都会放缓
最先失效的是 Dennard 缩放规律。Dennard 在 1974 年观察到,电压和电流应当与晶体管的线性尺寸成正比。由于动态功耗与 成正比,这意味着随着 CMOS 工艺缩小,电路可以在保持功耗不变的同时,使用更多晶体管并运行于更高频率。30 年后,Dennard 缩放规律失效了:阈值电压和漏电流为每个晶体管的功耗设定了一个无法随尺寸继续缩减的下限。因此,现代芯片受到功率约束,频率提升也基本停滞,利用更高晶体管密度的代价越来越高。
接下来放缓的是硬盘。虽然磁盘领域没有一条对应的定律,但在过去 30 年里,决定磁盘容量的最大面密度曾以每年 30% 到 100% 的速度提高。过去十年中,这一增速却不足每年 5%。单盘容量的增长,主要依靠增加一块硬盘中的盘片数量。
再接下来,是久负盛名的 Moore 定律。每颗芯片的晶体管数每隔 1 到 2 年翻一番,已经不是近年的现实。例如,2014 年推出的 DRAM 芯片包含 80 亿个晶体管,直到 2019 年,包含 160 亿个晶体管的 DRAM 芯片才实现量产;按照 Moore 定律,那时本应至少达到 640 亿个晶体管。
图 1.24 展示了 Intel 自 1999 年以来对新工艺节点的估计。从 180 nm 到 22 nm,节点演进一直保持两年一代;到 14 nm 时延长为三年,下一个节点所需时间更长。
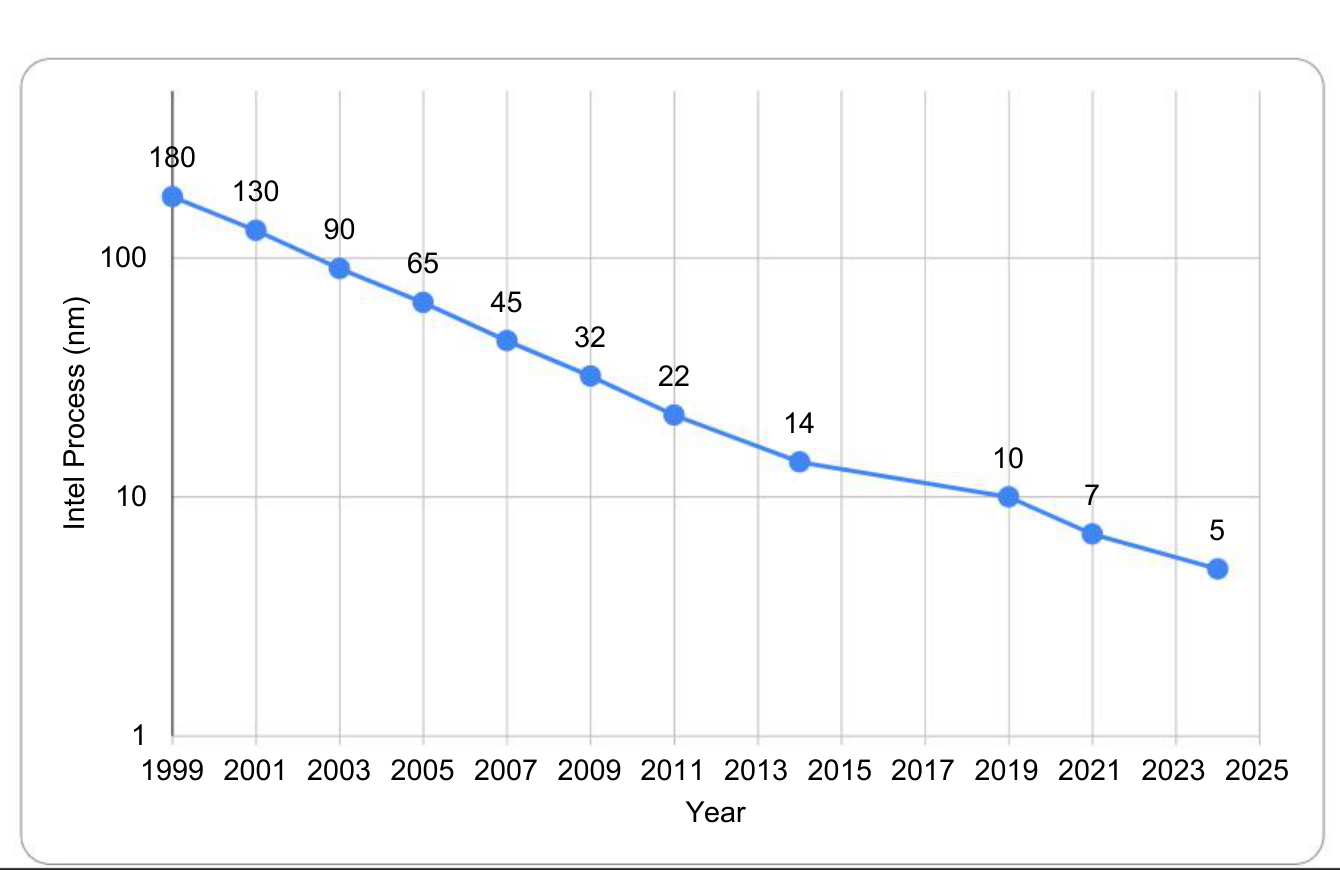
图 1.24 Moore 定律的放缓。图中给出了 Intel 新半导体工艺出现的时间,工艺节点以 nm 表示,纵轴采用对数刻度。注意,自 2011 年以来,新工艺节点之间的间隔由此前约两年延长为约三至五年。来源:WikiChip 的 Intel 工艺资料。
图内标注:Intel Process (nm) 为 Intel 工艺节点(nm),Year 为年份。
图 1.25 展示了微处理器与 DRAM 的带宽增长随时间的变化,这两者都受到 Dennard 缩放规律和 Moore 定律失效的影响;图中还列出了网络与磁盘的变化。曲线逐渐弯折,清楚地反映出技术进步正在放缓。自 1980 年前后以来,微处理器和网络的带宽改善幅度,是内存带宽改善幅度的十倍以上;而内存的改善幅度,又接近磁盘带宽改善幅度的十倍。
陷阱:工艺线宽已不再对应晶体管的实测宽度
直到 2005 年前后,以纳米表示的工艺数字仍对应芯片内部一个真实的物理尺寸。后来,传统平面晶体管在 20 nm 下表现不佳,因此转向在相同几何尺度下采用 FinFET 晶体管。为了表示这种新的 FinFET 晶体管更好,出于营销考虑,人们把它重新标成“16 nm 工艺”,尽管它仍处在相同的工艺尺度。一旦节点数字不再对应某个测量值,命名也就失去了约束。TSMC 7 nm 工艺的金属线间距为 40 nm,而 Intel 10 nm 工艺为 36 nm,因此 Intel 的 10 nm 可能做出比 TSMC 7 nm 更小的芯片。既然这些数字如今已经成为营销名称,就很难预测所谓“5 nm”及更小节点究竟能带来什么收益;而且,仍在制造最先进逻辑芯片的三家公司——Intel、Samsung 和 TSMC——采用的命名也可能不一致。
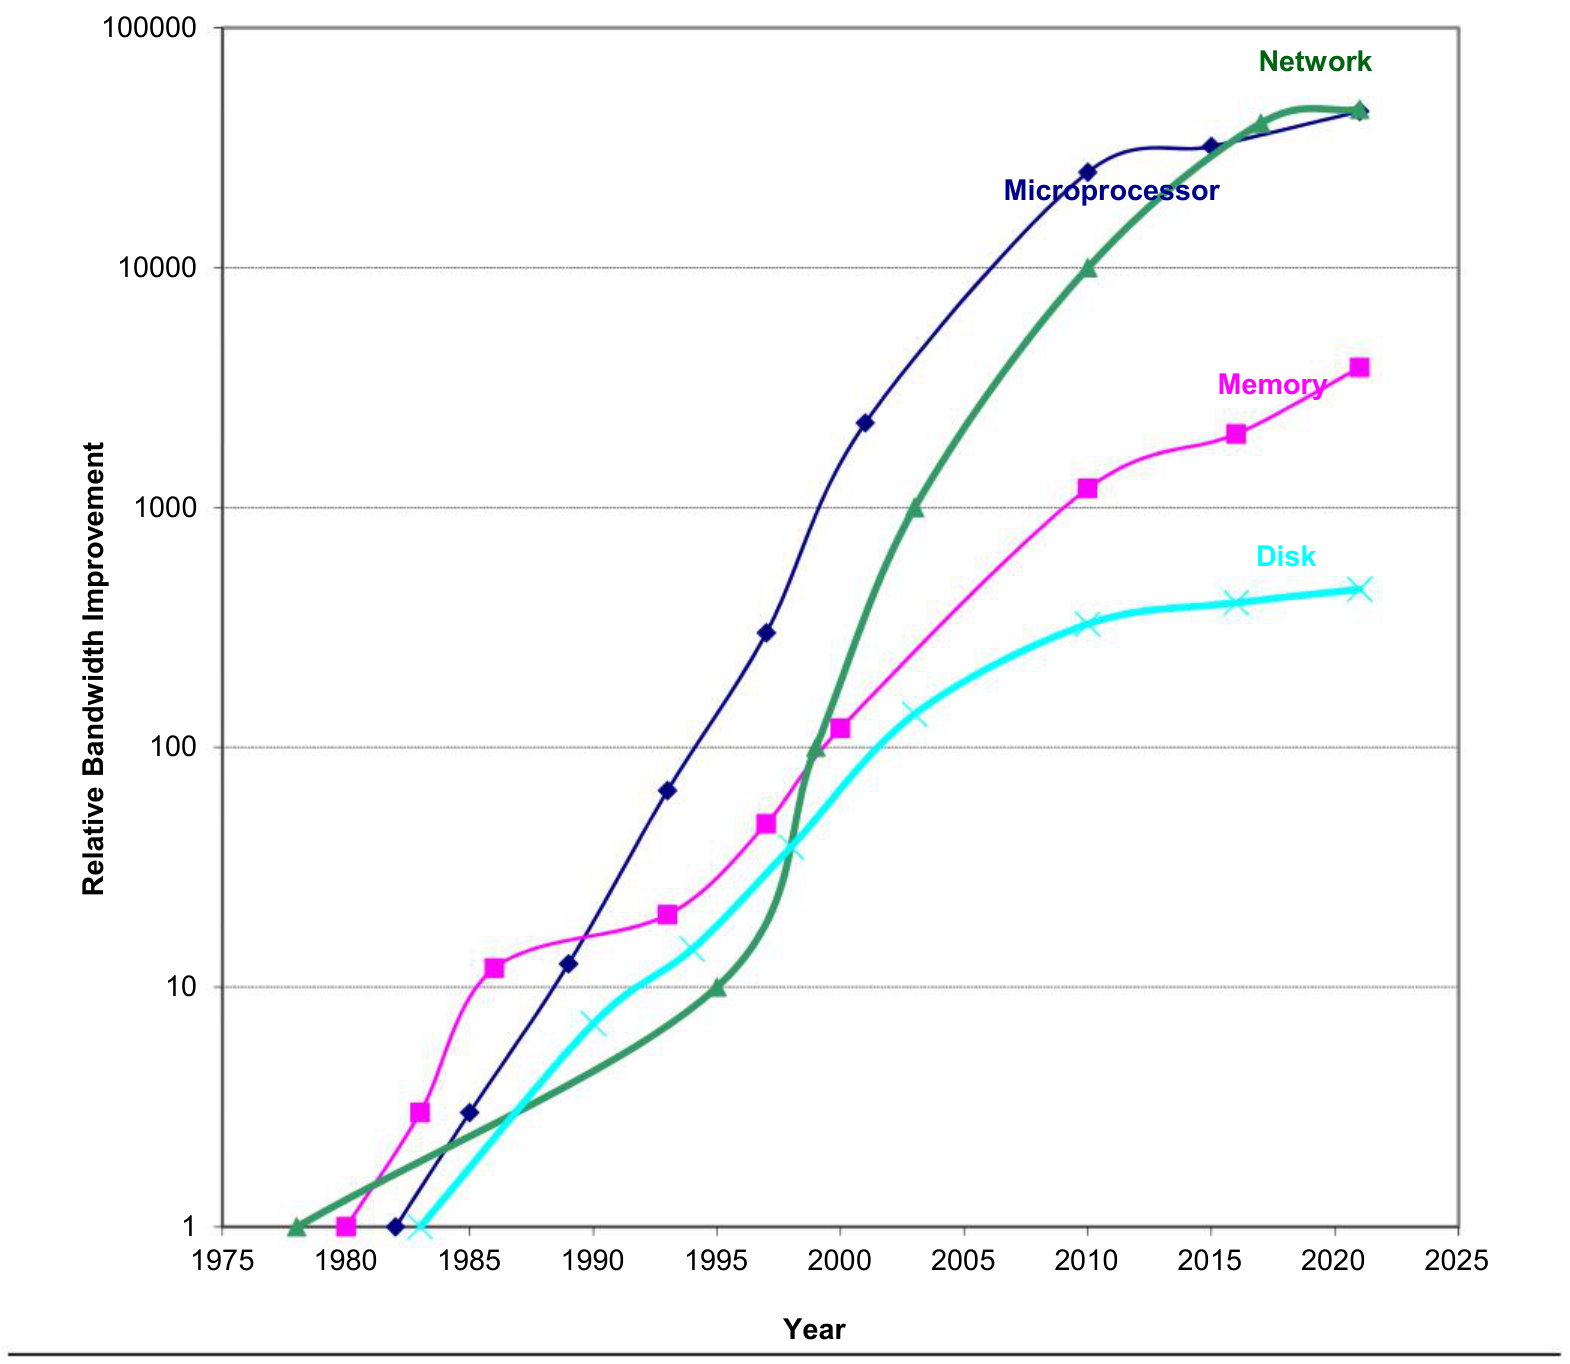
图 1.25 微处理器、网络、内存与磁盘的相对带宽随时间的变化,数据来自图 1.10。注意,在 2021 年,网络和微处理器与内存之间的带宽改善幅度相差约十倍,而内存与磁盘之间又相差近十倍。
图内标注:Relative Bandwidth Improvement 为相对带宽改善倍数,Year 为年份;Microprocessor、Memory、Network 和 Disk 分别为微处理器、内存、网络和磁盘。
谬误:多处理器是万能解药
2005 年前后转向在单颗芯片上放置多个处理器,并不是因为出现了某种突破,使并行编程骤然简单起来,或使多核计算机容易构建。发生这种转变,是因为指令级并行性的限制和功耗墙让人别无选择。一颗芯片上有多个处理器,并不保证功耗更低;设计一颗功耗更高的多核芯片,完全办得到。其潜力只在于:可以用多个较低频、较高效的核心,取代一个高频却低效的核心,从而继续提升性能。
第 4、5 章将看到,提高性能如今已经成了程序员的责任。程序员靠在 La-Z-Boy 躺椅上,什么也不做,只等硬件设计者让程序越来越快的时代,已经正式结束了。如果希望程序每一代都运行得更快,程序员就必须让程序具有更多并行性。
广为流传的那个版本的 Moore 定律——每一代技术都会带来更高性能——如今已有一部分要靠程序员来实现。
陷阱:栽在令人心碎的 Amdahl 定律上
几乎每位实际从事计算机设计的体系结构工程师都知道 Amdahl 定律。即便如此,我们差不多都曾在没有先测量某项功能的原有使用比例时,就花费巨大精力去优化它。直到整体加速效果令人失望,才想起本来应当先测量,再投入那么多精力改进!
陷阱:单点失效
1.10 节使用 Amdahl 定律进行的可靠性改善计算表明,系统的可信赖性受制于最薄弱的一环。 即使像前面的例子那样,把电源做得再可靠,单个风扇仍会限制磁盘子系统的可靠性。由 Amdahl 定律得出的这一认识,形成了容错系统的一条经验准则:应确保每个部件都有冗余,使任何单个部件的失效都不至于使整个系统停机。第 6 章将说明,软件层如何避免仓库级计算机(WSC)内部的单点失效。
谬误:提高性能的硬件改进也会提高能效,最差也不会增加能耗
Esmaeilzadeh et al.(2011)在一颗 2.67 GHz Intel Core i7 上,仅使用一个核心运行 SPEC2006,并启用 Turbo 模式(见 1.5 节)。时钟频率提高到 2.94 GHz,即原来的 1.10 倍后,性能提高到 1.07 倍,但 i7 消耗的焦耳数达到原来的 1.37 倍,瓦时数更达到 1.47 倍!1 也许正是这种低能效,使工程师在运行图 1.23 中两台服务器的 SPECpower 测试时关闭了 Turbo 模式。
谬误:基准测试永远有效
有许多因素影响基准测试预测真实性能的能力,其中一些会随时间变化。一个重要因素,是测试能否抵御“benchmark engineering”或“benchmarketing”——为了基准成绩而进行的专门优化。一旦某项基准测试标准化并广受采用,就会产生巨大压力,促使人们通过有针对性的优化,或对运行规则作激进解读,来提升成绩。
短小的核心片段,或执行时间集中在少量代码上的程序,尤其容易受到这种影响。
例如,尽管初衷很好,最初的 SPEC89 套件中还是包含了一个名为 matrix300 的小型核心片段,它由八种不同的 矩阵乘法组成。其中 99% 的执行时间花在同一行代码上(见 SPEC, 1989)。IBM 编译器对这个内层循环进行优化后,性能相对于前一版编译器提高到了九倍!它使用的是一种很好的技术,称为分块(blocking),第 2、4 章会讨论。但这项测试测到的是编译器调优效果,当然不能很好地反映整体性能,也不能代表这项优化通常能带来的收益。
如果忽视历史,就可能重蹈覆辙。SPEC Cint2006 整整十年没有更新,给了编译器开发者充足时间,针对这套测试不断打磨优化器。在一款 Intel 微处理器上,除了 libquantum,其他 SPEC Cint2006 测试的比值都落在 22 到 78 之间;libquantum 却快了 7,300 倍!这一“奇迹”来自 Intel 编译器的优化:它自动将代码并行化到所有核心上,还利用位打包(bit packing)来优化内存,把多个取值范围较窄的整数紧密打包,以节省内存空间,进而节省内存带宽。
为了说明基准测试的寿命之短,图 1.19 列出了历代 SPEC 中全部 82 个程序的状况;gcc 是 SPEC89 中唯一留存下来的程序。 令人吃惊的是,SPEC2000 及更早版本中的程序,约有 70% 在下一版中就被移除了。
谬误:磁盘的标称 MTTF 为 1,200,000 小时,接近 140 年,所以磁盘几乎不会失效
磁盘厂商当下的营销方式可能误导用户。如此高的 MTTF 是怎样算出来的?在早期测试中,厂商会把数千块磁盘放在一个房间里,运行几个月,然后统计失效数量。MTTF 等于这些磁盘累计工作小时数,除以失效磁盘数。
问题之一是,这个数值远远超过一块磁盘的使用寿命,而磁盘寿命通常按 5 年、即 43,800 小时估计。为使如此大的 MTTF 有所解释,厂商认为其模型对应如下使用方式:用户买入一块磁盘,此后每隔 5 年,也就是磁盘的计划使用寿命,就换一块。其含义是,如果许多客户以及他们的曾孙后代在今后一个世纪里一直这样做,那么平均更换 27 次、也就是约 140 年后,才会遇到一次失效。
更有用的指标是失效磁盘所占的比例,或年失效率(见 1.7 节)。假设有 1,000 块 MTTF 为 1,000,000 小时的磁盘,每天使用 24 小时。如果把失效磁盘换成可靠性特征相同的新盘,那么一年 8,760 小时内,失效磁盘的数量为:
换句话说,每年约有 0.9% 的磁盘失效,或在 5 年寿命中累计约 4.5%。2
而且,这些很高的标称数字,还假定温度和振动处于限定范围内。一旦超出范围,就不能再作同样保证。对真实使用环境中的磁盘进行的一项调查(Gray and van Ingen, 2005)发现,每年有 3% 到 7% 的磁盘失效,对应的 MTTF 约为 125,000–300,000 小时。一项规模更大的研究发现,磁盘年失效率为 2% 到 10%(Pinheiro et al., 2007)。因此,实际环境中的 MTTF,约比厂商标称值差 2 到 10 倍。
谬误:峰值性能能够反映实测性能
关于峰值性能,唯一普遍成立的定义是:“计算机保证不会超过的性能水平。”图 1.26 展示了四个程序在四种多处理器系统上的实测性能占峰值性能的比例,范围从 5% 到 58%。由于差距很大,而且会因基准程序不同而显著变化,峰值性能通常无助于预测实际性能。
陷阱:检测故障可能降低可用性
这个看似矛盾的陷阱,是因为计算机硬件中有相当多的状态,并非始终对正确运行至关重要。例如,分支预测器发生错误并不致命,可能只是性能受损。
在积极挖掘 ILP 的处理器中,并非所有操作都是程序正确执行所必需的。Mukherjee et al.(2003)发现,对于 SPEC2000 基准测试,可能处在关键路径上的操作不到 30%。
程序也存在同样现象。如果一个寄存器中的值已经“死亡”(dead),也就是程序会在下一次读取之前先写入新值,那么这个寄存器中的错误就无关紧要。如果在这样的寄存器中发现瞬态故障,就让程序崩溃,只会无谓地降低可用性。
Oracle 旗下 Sun Microsystems 部门曾在 2000 年遭遇这一问题:Sun E3000 到 Sun E10000 系统的 L2 缓存有奇偶校验,却没有纠错功能。构建缓存所用的 SRAM 存在间歇性故障,奇偶校验能够发现它们。如果缓存中的数据未被修改,处理器只需重新从缓存中读取数据。3 但设计者没有用纠错码(ECC)保护缓存,因此遇到脏数据错误时,操作系统别无选择,只能报告错误并使程序崩溃。现场工程师检查时,超过 90% 的案例都查不出问题。
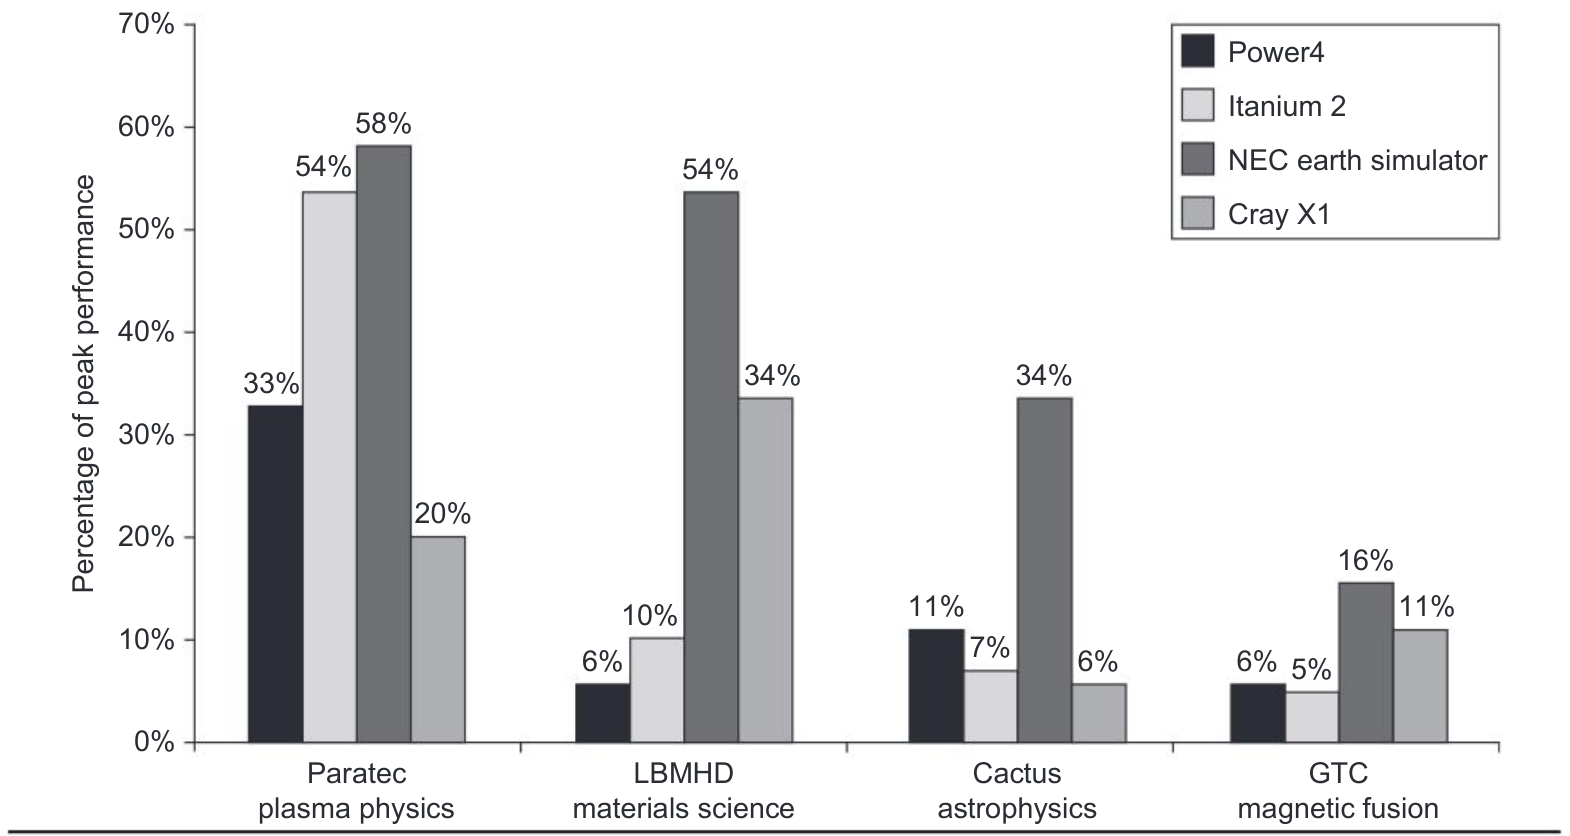
图 1.26 四个程序在四种多处理器系统上、规模扩展到 64 个处理器时,实测性能占峰值性能的比例。Earth Simulator 与 X1 是向量处理器(见第 4 章及附录 G)。它们不仅实现了更高的峰值性能比例,而且峰值性能本身最高,时钟频率却最低。除 Paratec 外,Power4 与 Itanium 2 系统的实测性能约为各自峰值的 5% 到 10%。4
图内标注:Percentage of peak performance 为占峰值性能的百分比。四个程序依次为 Paratec(等离子体物理)、LBMHD(材料科学)、Cactus(天体物理)和 GTC(磁约束聚变)。每组柱从左到右分别是 Power4、Itanium 2、NEC Earth Simulator、Cray X1。
原图来源:Oliker, L., Canning, A., Carter, J., Shalf, J., Ethier, S., 2004. Scientific computations on modern parallel vector systems. In Proceedings of the ACM/IEEE Conference on Supercomputing, November 6–12, 2004, Pittsburgh, PA, p. 10.
为降低这类错误的发生频率,Sun 修改了 Solaris 操作系统,安排一个进程主动把脏数据写回内存,以“清洗”(scrub)缓存。由于处理器芯片没有足够的引脚来增加 ECC,对脏数据而言,唯一可行的硬件方案是复制外部缓存,并用未发生奇偶校验错误的副本纠正错误。
陷阱就在于:检测到了故障,却没有提供纠正机制。这些工程师此后大概不会再设计外部缓存不带 ECC 的计算机了。
陷阱:高估计算技术对碳排放的影响
全球气候变化如此重要,考虑信息技术在其中的作用,当然不可或缺。但我们必须把数字算对,才能确保处理的是最重要的问题,也才能维护建议的可信度。讽刺的是,错误的计算有时反而更有新闻价值,从而吸引大量注意。即便后续发表的材料予以纠正,也往往得不到同样关注,那些错误的“似是而非的事实”便会在互联网上自行流传。
“Brandolini 定律”以幽默的方式概括了这种讽刺:驳斥错误信息所需的精力,是制造错误信息所需精力的十倍。
Koomey 和 Masanet 总结了估算排放时常见的四种错误(Koomey and Masanet, 2021):
- 忽视、误解,或错误描述关键参数随时间的变化。
- 认为计算活动的短期变化,必然立即引起用电量的同比例变化。
- 信息技术发展极快,哪怕预测未来几年也高度不确定,却仍试图作长期预测。
- 仅凭信息技术生态中某一部分的趋势,就得出适用于整体的结论。
以下三个例子说明了这些陷阱:
- 2010 到 2018 年间,云数据中心的工作负载增长到了原来的 26 倍,估算用电量增长到了 5 倍。有人据此预测云计算会带来严重后果。但尽管云发展迅速,全球所有数据中心的实际能耗增长却不到 10%。两种观察之所以可以同时成立,是因为在这段时期,大量计算从效率相对较低的本地数据中心,转移到了效率高得多的云数据中心(Masanet et al., 2020)。这一错误估计,正是犯了上面的第四种错误。
- 报纸曾声称:“观看 30 分钟 Netflix 产生的排放[1.6 kg CO₂e],相当于驾车近 4 英里。”更准确的估计是 36 克 CO₂e,约为前者的四十五分之一(Kamiya, 2020)。这一高估,主要源于第一种错误:忽视关键参数的变化。
- 报纸曾报道:“训练一个深度神经网络模型的排放,是一辆汽车全生命周期排放的五倍[284,019 kg]。”实际数字只有 2.4 kg CO₂e,约为前者的十二万分之一(Patterson et al., 2022)。第 7 章的“谬误与陷阱”会解释这一错误高估是如何产生的,主要原因仍是上述四种错误中的第一种。