2.1 引言
计算机先驱们正确地预见到,程序员会希望拥有无限多的高速存储器。满足这一愿望的一种经济办法,就是利用局部性以及不同存储技术在性价比上的权衡,构建存储层次结构。第 1 章介绍的局部性原理指出,大多数程序并不会均匀地访问所有代码或数据。局部性既体现在时间上,即时间局部性,也体现在空间上,即空间局部性。再结合这样一条准则——在实现技术和功率预算既定时,规模更小的硬件可以做得更快——便形成了由不同速度、不同容量的存储器组成的层次结构。图 2.1 展示了几种多级存储层次结构,以及典型的容量和访问速度。随着 Flash 和下一代存储技术在每比特成本上不断缩小与磁盘的差距,这些技术很可能会越来越多地取代磁盘,成为辅助存储。图 2.1 表明,它们已经用于许多个人计算机,并越来越多地用于服务器,因为它们在性能、功耗和密度方面具有显著优势。
高速存储器更昂贵,因此,存储层次结构分成若干级:每一级都比离处理器更远的下一级容量更小、速度更快、每字节价格更高。目标是让整个存储系统的每字节成本接近最便宜的一级,而速度接近最快的一级。在大多数情况下,但并非所有情况下,下一级所含的数据是相邻上一级数据的超集。这称为包含性(inclusion property)。对于缓存,这一性质通常由主存维持;对于虚拟内存,则通常由磁盘或 Flash 等辅助存储维持。
随着处理器性能提高,存储层次结构的重要性也在增加。图 2.2 将单核性能的变化与主存访问时间的历史改进情况进行了比较。处理器曲线表示单个核心平均每秒发出的内存请求数的增长,也就是两次访存间隔的倒数;存储器曲线表示每秒 DRAM 访问次数的增长,也就是 DRAM 访问延迟的倒数,假设只有一颗 DRAM 和一个存储体。实际情况更加复杂:处理器请求速率并不均匀,处理器往往包含多个核心,而存储系统通常有多个 DRAM 存储体和通道。尽管访问时间的差距多年来大幅扩大,但单个处理器的性能已难以显著提高,因此,处理器与 DRAM 之间差距扩大的速度也有所放缓。
高端处理器具有多个核心,其带宽需求因而高于单核。虽然近年来单核带宽的增长放慢,但随着核心数增加,CPU 的内存需求与 DRAM 带宽之间的差距仍在扩大。Intel Core i9 12900 这样的现代高端桌面处理器,每个核心在每个时钟周期内可以产生四次数据访存。
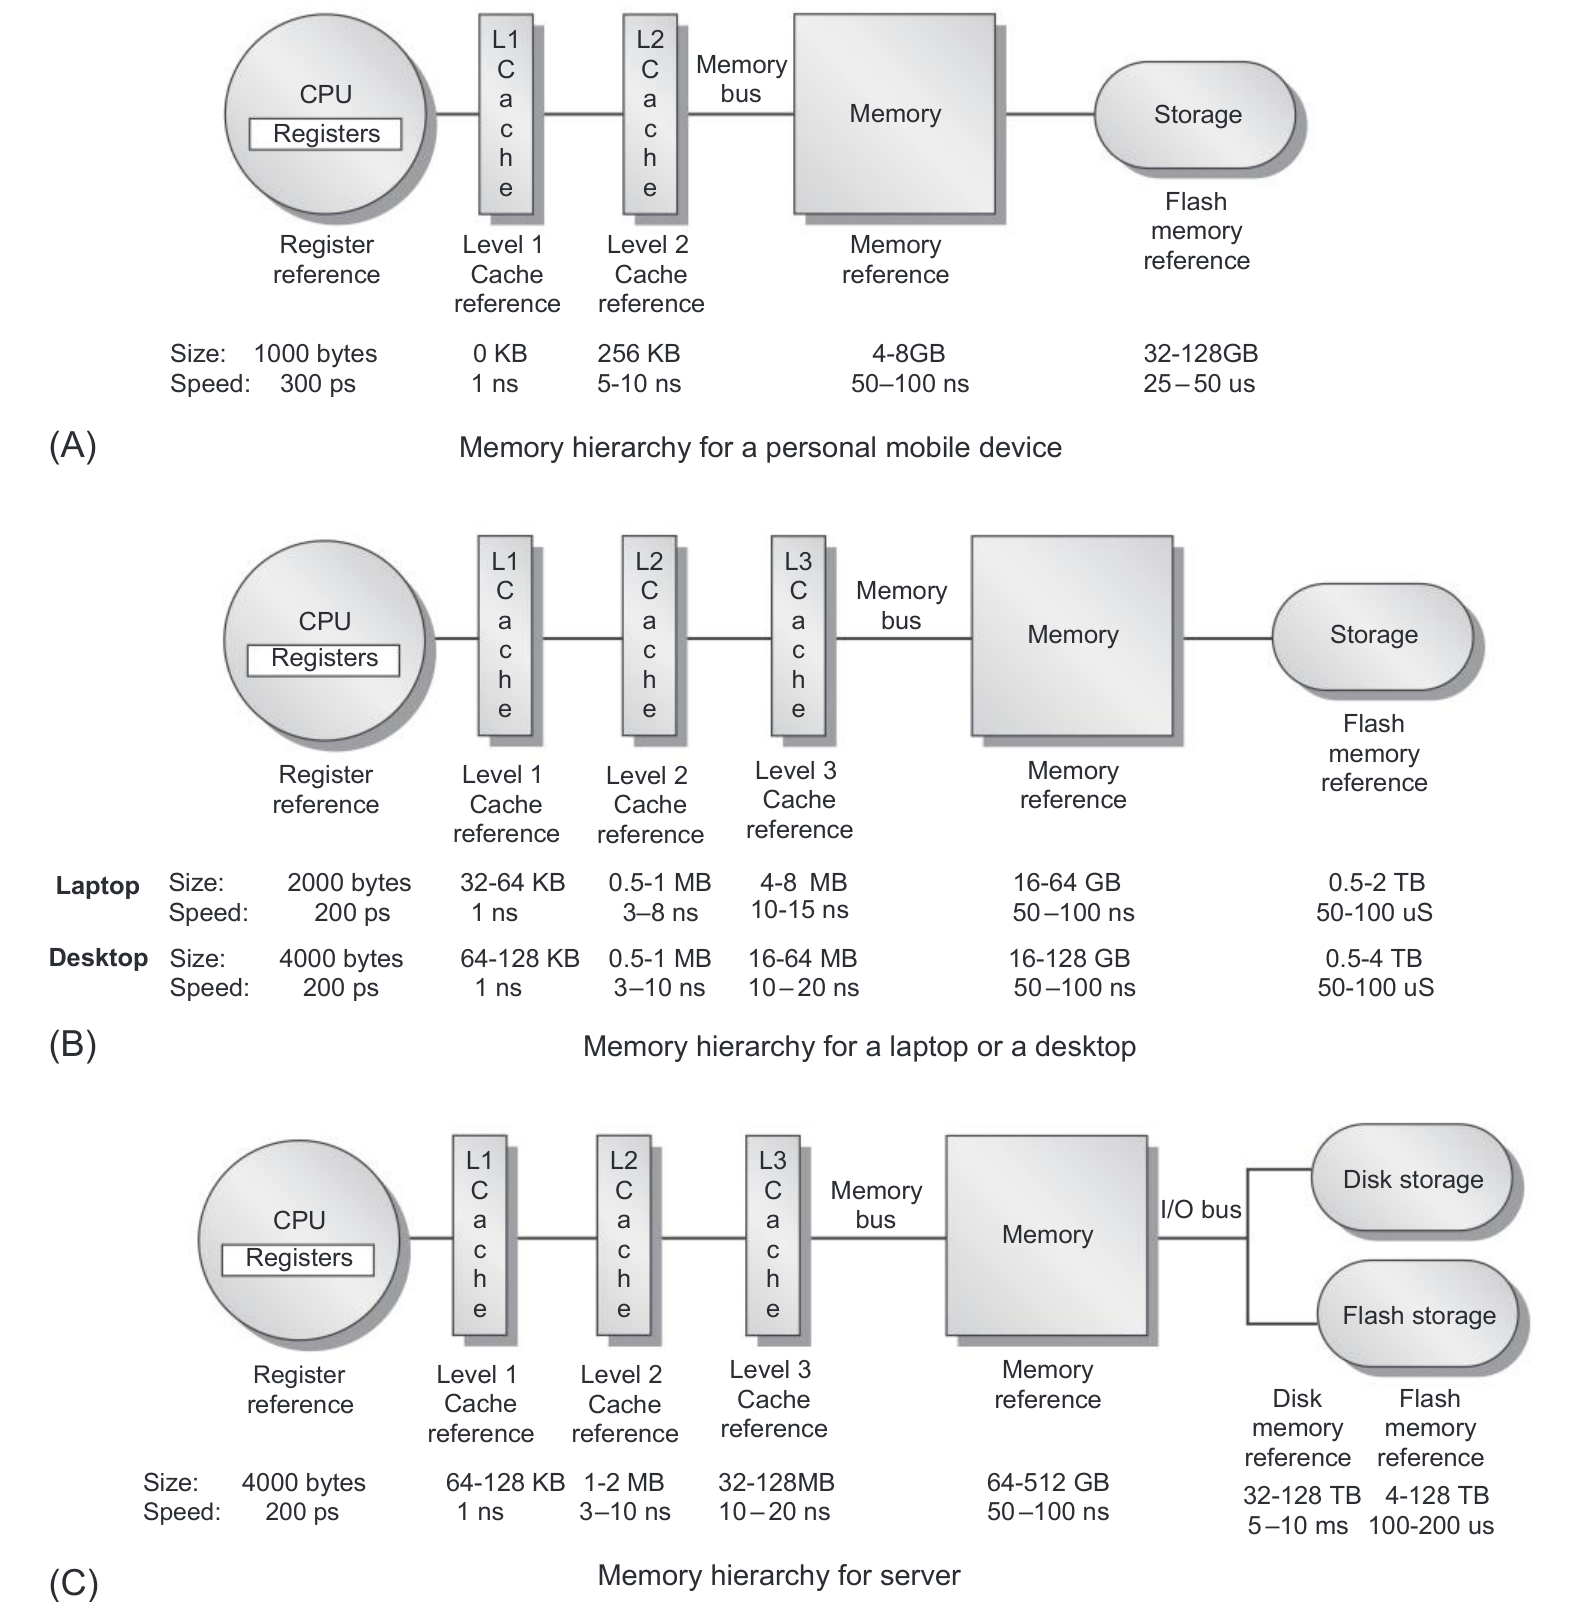
图 2.1(续)。 离处理器越远,下一级存储器就越慢、容量越大。注意,对于磁盘,时间单位从皮秒变为毫秒,相差 倍;容量单位从数千字节变为数十 TB,相差 倍。如果把仓库级计算机也纳入,而不仅仅考虑服务器,容量尺度还会增加三到六个数量级。PMD 完全采用由 Flash 构成的固态硬盘(SSD),笔记本和台式机也大量使用 SSD。许多台式机的主要存储系统是 SSD,而扩容和备份主要使用硬盘(HDD)。同样,许多服务器混合使用 SSD 与 HDD。HDD 正越来越多地主要用于备份和归档。
图内术语:Registers=寄存器;L1/L2/L3 Cache=一级/二级/三级缓存;Memory=主存;Storage=存储设备;Memory bus=内存总线;I/O bus=I/O 总线;Disk storage=磁盘存储;Flash storage=Flash 存储;reference=访问;Size=容量;Speed=访问时间;Laptop=笔记本;Desktop=台式机。ps、ns、μs、ms 分别为皮秒、纳秒、微秒和毫秒。图中各级容量及时间照录原图。
译注(图 2.1): PMD 的 L1 容量在原页中确实印为“0 KB”。
对于八个核心、平均时钟频率为 3 GHz 的 i9,数据访存峰值可达每秒 1920 亿次,每次 128 bit;此外,取指需求峰值约为每秒 480 亿次,每次同样为 128 bit。总需求带宽峰值达到惊人的 3840 GiB/s!1 实现如此高的带宽,靠的是缓存的多端口设计和流水线化;采用三级缓存,其中每个核心私有前两级,共享 L3;以及在第一级分别设置指令缓存和数据缓存。相比之下,采用两个内存通道的单总线 DDR5 主存,其峰值带宽仅为需求带宽的 2%,即 56 GiB/s。HBM 的访问时间更短、带宽更高,见 2.2 节和 2.3 节。
传统上,存储层次结构设计者主要优化平均访存时间,它由缓存访问时间、未命中率和未命中开销决定。近来,功耗也成为主要考虑因素。高端微处理器可能拥有 60 MiB 甚至更多的片上缓存,多芯片插槽中的缓存容量则可能达到 1 GiB。大型二级或三级缓存在不工作时会因漏电消耗相当多的功率,称为静态功耗;执行读写时还会消耗工作功率,称为动态功耗,见 2.3 节。PMD 处理器面临的问题更加突出,因为其中 CPU 的设计不那么激进,功率预算可能只有前者的 1/20–1/50。
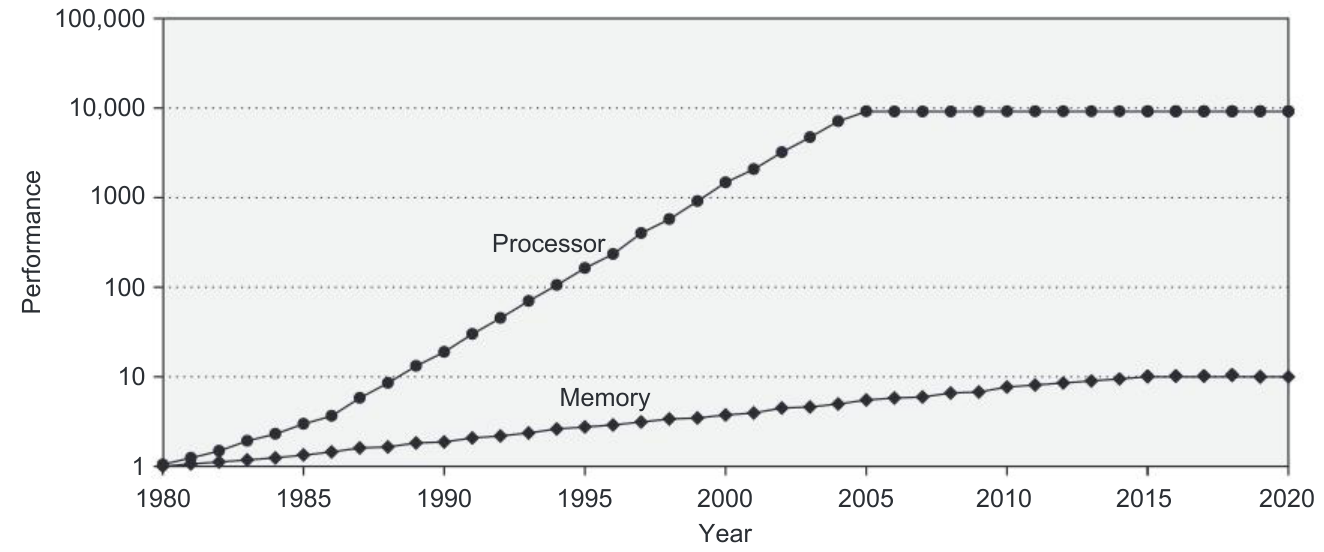
图 2.2(续)。 2017 年年中,AMD、Intel 和 NVIDIA 都宣布了采用不同版本 HBM(高带宽内存)技术的芯片组,图中未包含该技术。要表现处理器与 DRAM 性能差距的规模,纵轴必须使用对数坐标。存储器的基准是 1980 年的 64 KiB DRAM;到 2015 年为止,按延迟衡量的性能每年提高到前一年的 1.07 倍,见图 2.4,过去五年则基本没有改善。 处理器曲线假设:1986 年以前,每年提高到前一年的 1.25 倍;此后到 2000 年,每年为 1.52 倍;2000–2005 年为 1.20 倍;2005–2015 年,按每核心计的处理器性能只有小幅改善。可以看到,2010 年以前,DRAM 访问时间的改进缓慢但持续;2010 年以后,与早期相比,访问时间的改进幅度减小了,不过带宽仍在持续提高。更多信息见第 1 章图 1.1。
图内术语:Performance=性能;Processor=处理器;Memory=存储器;Year=年份。
在这些情况下,缓存可能占总功耗的 25%–50%。因此,设计者必须同时权衡性能与功耗,本章也将同时讨论这两个方面。
存储层次结构基础:简要回顾
处理器与存储器之间的性能差距不断扩大,重要性日益提高,存储层次结构的基础知识因而已经进入计算机体系结构的本科课程,甚至进入操作系统和编译原理课程。因此,我们先简要回顾缓存及其工作方式;本章的大部分内容则介绍更先进的创新技术,以应对处理器与存储器之间的性能差距。
当缓存中找不到某个字时,必须从层次结构的下一级——可能是另一层缓存,也可能是主存——取回这个字并放入缓存,然后才能继续执行。为了提高效率,一次搬移多个字,组成一个块(block),也称行(line);而且,由于空间局部性,这些字很可能很快就会用到。每个缓存块都包含一个标签(tag),用于指明它对应哪个内存地址。
一项关键设计决策是:块或行可以放在缓存的什么位置。最常用的方案是组相联(set associative),其中,一个组由缓存中的若干块组成。先把块映射到一个组,再将它放在该组中的任意位置。查找时,先根据块地址找到对应的组,再搜索这个组,通常是并行搜索,以找到所需的块。组由数据地址按下式选择:
如果一组有 个块,这种放置方式就称为 路组相联。相联度的两个极端各有专名。**直接映射缓存(direct-mapped cache)**每组只有一个块,因此一个块总是放在同一个位置;**全相联缓存(fully associative cache)**只有一个组,因此一个块可以放在任何位置。
只读数据很容易缓存,因为缓存与内存中的副本完全相同。写操作则更复杂,例如,如何保持两个副本一致?主要有两种策略。直写(write-through)缓存既更新缓存中的数据项,也将写操作传递下去,更新主存。写回(write-back)缓存只更新缓存中的副本;当其中的块即将被替换时,再将其复制回内存。两种策略都可以使用写缓冲区(write buffer):数据一旦进入缓冲区,缓存即可继续工作,无须等待写入内存的全部延迟。如果写缓冲区中已有其他修改过的块,就可以检查地址,判断新数据的地址是否与某个有效条目的地址匹配;若匹配,就将新数据并入该条目。这种优化称为写合并(write merging),Intel Core i7 等许多处理器都采用它。它对直写缓存更有帮助,因为写回缓存通常一次写回整个块。注意,I/O 设备寄存器往往也映射到物理地址空间。
这些 I/O 地址不能允许写合并,因为彼此独立的 I/O 寄存器不一定像内存中的字数组那样工作。例如,每个 I/O 寄存器可能都要求单独提供地址和数据字,而不能使用一个地址写入多个字。通常通过给页面设置属性,要求缓存采用不进行合并的直写方式,以满足这些带有副作用的访问要求。
衡量不同缓存组织收益的一项指标是未命中率(miss rate),即缓存访问中未命中的比例,也就是未命中次数除以访问总次数。
为了深入理解高未命中率的原因,进而改进缓存设计,三个 C 模型将未命中分成三类:
- 强制性未命中(compulsory miss):第一次访问某个块时,它不可能已经位于缓存中,因而必须把它取入缓存。即使缓存容量无限大,这类未命中仍然会发生。
- 容量未命中(capacity miss):如果缓存容纳不下程序执行期间所需的全部块,就会因块被丢弃后又重新取入,而在强制性未命中之外产生容量未命中。
- 冲突未命中(conflict miss):如果块放置策略不是全相联,就可能有多个块映射到同一组。在对这些块的访问交错发生时,某个块可能被丢弃后又重新取入,从而在强制性和容量未命中之外产生冲突未命中。
第 24 页的图 B.8 按三个 C 给出了各类缓存未命中的相对频率。2 如附录 B 所述,三个 C 模型是概念模型,它揭示的规律通常成立,但并不是解释每一次具体访问行为的决定性模型。
第 3 章和第 5 章将说明,多线程和多核给缓存增加了复杂性:它们既可能增加容量未命中,也带来第四个 C,即一致性未命中(coherency miss)。在多处理器中,为使多个缓存保持一致,缓存的刷新操作会引发这类未命中。第 5 章将讨论这些问题。
不过,未命中率可能由于多种原因产生误导。因此,一些设计者更愿意衡量每条指令的未命中次数,而不是每次访存的未命中次数,也就是未命中率。两者的关系为:
这项指标常写成每 1000 条指令的未命中次数,以便用整数而不是分数表示。
两种指标都没有计入一次未命中的代价。更好的指标是平均访存时间:
其中,命中时间是在缓存中命中所需的时间;未命中开销是从内存取回并替换缓存块所需的时间,即一次未命中的代价。平均访存时间仍然是间接性能指标;它虽优于未命中率,却不能取代执行时间。第 3 章将介绍,采用推测执行的处理器可以在未命中期间执行其他指令,从而降低实际承担的未命中开销。多线程也能让处理器容忍未命中,而不必被迫闲置,第 3 章会介绍这一技术。我们很快就会看到,要利用这些容忍延迟的技术,缓存就必须能够在处理尚未完成的未命中时,继续为其他请求提供服务。
如果这些内容对你而言是新的,或上述回顾过于简略,请参阅附录 B。它更详细地介绍了同样的基础知识,还给出了真实计算机中的缓存实例及其效果的定量评估。
附录 B 的 B.3 节介绍了六项基本缓存优化,这里简要回顾。附录还用定量实例说明了收益;这里也简要讨论这些取舍对功耗的影响。
增大块以降低未命中率。 最简单的办法是利用空间局部性,增加块大小。较大的块可以减少强制性未命中,但也会增加未命中开销。由于标签数量减少,静态功耗可能略有降低。较大的块也可能增加容量或冲突未命中,尤其是小缓存。选择合适的块大小需要复杂的权衡,取决于缓存容量和未命中开销。
增大缓存以降低未命中率。 减少容量未命中最直接的办法,就是增加缓存容量。缺点是命中时间可能变长,成本和功耗也更高。较大的缓存会同时增加静态和动态功耗。
提高相联度以降低未命中率。 提高相联度显然可以减少冲突未命中,但可能以更长的命中时间为代价。稍后还会看到,相联度也可能增加功耗。
采用多级缓存以降低未命中开销。 一项困难的选择是:让缓存命中足够快,以跟上处理器的高时钟频率,还是让缓存足够大,以缩小处理器访问与主存访问之间的差距?在原有缓存和内存之间再加一级缓存,可以简化这一选择。一级缓存可以足够小,以适应较短的时钟周期;二级或三级缓存则可以足够大,截获许多本来会访问主存的请求。二级缓存更重视减少未命中,因此通常采用更大的块、更大的容量和更高的相联度。多级缓存也比一个合并成整体的大缓存更节能。若 L1、L2 分别表示一级和二级缓存,则平均访存时间可改写为:
如今,从低端 PMD 到高端服务器多核处理器,所有处理器都采用多级缓存,通常有两级或三级。不同层级的设计取舍可能不同,因为需要优化的可能是命中时间,也可能是未命中时间。例如,L1 命中时间至关重要,但**末级缓存(last-level cache,LLC)**的命中时间略有增加,性能通常不那么敏感;LLC 一般是 L2 或 L3。而且,LLC 的未命中开销通常大于 L1。因此,在 L1 中代价过高的优化,在 LLC 中可能是合理的。
让读未命中优先于写,以降低未命中开销。 写缓冲区很适合实现这一优化。不过,它也会引起数据冒险:读未命中所需地址的最新值可能仍在写缓冲区中,即通过内存形成了写后读(RAW)冒险。一种解决办法是在读未命中时检查写缓冲区;如果没有冲突,而且存储系统可用,就让读请求先于写请求发出,以减少未命中开销。大多数处理器都让读优先于写。这一选择对功耗影响很小。
在缓存索引过程中避免地址转换,以缩短命中时间。 缓存必须处理从处理器虚拟地址到访存物理地址的转换;虚拟内存见 2.4 节和 B.4 节。一种常用优化是利用页内偏移来索引缓存,因为这部分在虚拟地址和物理地址中完全相同,详见附录 B 第 B.36 页。这种**虚拟索引、物理标签(virtual index/physical tag)方法会使系统更复杂,并且/或者限制 L1 缓存的容量与结构;但将转换后备缓冲区(translation lookaside buffer,TLB)**访问移出关键路径,收益超过了这些缺点。提高 L1 相联度也能避免这一问题,因为这样会减少缓存索引所需的位数。近期的 Intel 和 ARM 处理器采用了这种办法。
注意,以上六项优化都有潜在缺点,可能使平均访存时间反而增加。
本章其余部分假定读者已熟悉上述内容以及附录 B 的细节。在“融会贯通”一节中,我们将考察两种微处理器的存储层次结构:一种是用于高端台式机或小型服务器的 Intel Core i9 12900,另一种是用于 PMD 的 Arm Cortex-53,它是若干平板电脑和智能手机所用处理器的基础。3 在每一类中,处理器的预定用途不同,具体设计方法也有明显差异。
虽然 i9 比 Intel 面向移动设备的处理器拥有更多核心、更大缓存,但它们的体系结构相近。面向小型服务器的 i9 系列,以及面向较大型服务器的 Intel Xeon,通常会运行许多并发进程,而且往往服务于不同用户。因此,内存带宽变得更重要,这些处理器会提供更大的缓存和更积极的存储系统设计来提高带宽。
相比之下,PMD 只服务一个用户,操作系统通常较小,多任务较少,即同时运行的应用较少,应用也更简单。PMD 必须同时考虑性能与能耗,因为能耗决定续航时间。在深入讨论更先进的缓存组织与优化之前,需要先了解各种存储技术及其演进方式。