2.2 存储技术与优化
……真正让计算机站稳脚跟的一项发展,是可靠存储器的发明,也就是磁芯存储器。……它成本合理,工作可靠;正因为可靠,才得以逐步扩大容量。(第 209 页)
——Maurice Wilkes,Memoirs of a Computer Pioneer(1985)
本节介绍存储层次结构采用的技术,特别是用于构建缓存和主存的技术,包括 SRAM(静态随机存取存储器,用于缓存)、DRAM(动态随机存取存储器,用于主存)以及 Flash(用于非易失性存储)。最后一种技术用于替代硬盘,不过它基于半导体技术,因而也适合在本节介绍。
缓存未命中时,需要尽快从主存搬移数据,这要求内存具有很高的带宽,原文称高带宽内存(HBM)。可以把组成主存的许多 DRAM 芯片组织成多个存储体(bank)和 rank,或者加宽内存总线,也可以同时采用这两种方法来实现这一带宽。rank 是共同响应同一内存命令的一组 DRAM 芯片。
为了让存储系统跟上现代处理器的带宽需求,创新开始进入 DRAM 芯片内部。本节将介绍芯片内部的存储技术;在讨论各种技术与方案之前,先说明一些术语。**访问时间(access time)**是从发出读请求到所需的字到达之间的时间。注意,Flash 和 DRAM 都支持突发传输,传完整个块所需的时间可能比取得块的第一部分更长。
自 1975 年以来,几乎所有计算机都采用 DRAM 作为主存、SRAM 作为缓存,并把一至三级缓存与 CPU 集成在同一处理器芯片上。如今,所有 PMD 和笔记本,以及大多数台式机,都使用 Flash 而非磁盘;许多服务器则结合使用两者。
SRAM 技术
SRAM 的首字母 S 表示 static,即“静态”。DRAM 电路的动态特性要求读出数据后再将其写回,但只有下一次请求需要访问同一个存储体时,才会看到这一延迟。
SRAM 通常每比特使用六个晶体管,避免读取时扰动所存信息。在待机模式下,SRAM 只需很小的功率就能保持电荷。
早期,大多数桌面和服务器系统都使用独立 SRAM 芯片作为一级、二级或三级缓存。如今,这三级缓存都已集成到处理器芯片上。高端服务器采用 chiplet 时,可以有多达 60 个核心和 100 MiB 以上的缓存;采用堆叠裸片时,则可以超过 100 个核心,缓存达到 1 GB 以上。这类系统通常为每颗处理器芯片配置 256–512 GiB DRAM。大型片上三级缓存的访问时间通常是二级缓存的四至八倍;即便如此,L3 访问时间通常仍不超过 DRAM 的五分之一。
片上缓存 SRAM 的组织宽度通常与缓存块大小一致,标签与各块并列存放,因此可以在一个周期内读出或写入整个块。未命中后把取回的数据写入缓存,或将必须逐出的块写回时,这一能力尤其有用。如果不计组相联缓存的命中检测与选择,缓存访问时间与其中的块数成正比;能耗则同时取决于比特总数和块数:前者影响漏电引起的静态功耗,后者影响访问时的动态功耗。为提高带宽、改善访问时间并降低功耗,许多多级缓存采用分存储体组织,2.3 节将讨论这一主题。
DRAM 技术
早期 DRAM 容量不断增大时,封装必须引出全部必要的地址线,其成本成了问题。解决办法是复用地址线,将地址引脚数减半。图 2.3 给出了 DRAM 的基本组织。先在**行地址选通信号(row access strobe,RAS)期间发送一半地址,再在列地址选通信号(column access strobe,CAS)**期间发送另一半。这些名称来自芯片的内部组织:存储器组成一个矩形阵列,用行和列寻址。
DRAM 的另一个要求来自首字母 D 所表示的 dynamic,即“动态”。为了让每颗芯片容纳更多比特,原文描述为:DRAM 每比特只使用一个晶体管,它实际上起着电容器的作用。1 这带来两方面影响。首先,检测电荷的感测线必须先预充电,把电平设在逻辑 0 和 1 的“中间”,从而让单元中少量的电荷足以使感测放大器判定 0 或 1。读取时,一行数据被放入行缓冲区(row buffer),CAS 信号再选择其中一部分,从 DRAM 读出。由于读出一行会破坏其中的信息,当不再需要该行时,必须将它写回。写回可与其他操作重叠,但在早期 DRAM 中,这意味着再次读取新行之前所需的周期时间,会大于读出一行并访问其中一部分所需的时间。
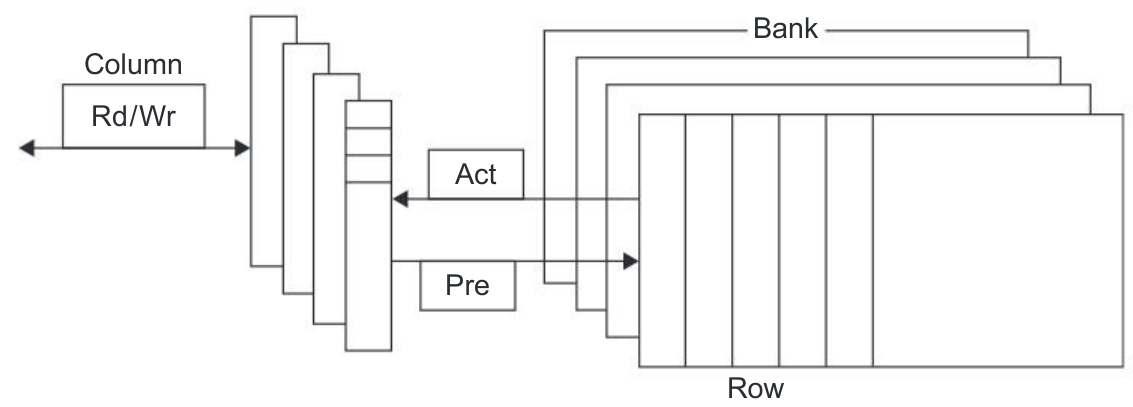
图 2.3(续)。 每个存储体由一系列行组成。发送 Act(Activate,激活)命令,会打开一个存储体及其中一行,并将该行装入行缓冲区。随后,可以连续提供列地址,按 DRAM 的接口宽度传输数据,DDR4 通常为 4、8 或 16 bit;也可以指定块传输及起始地址。Precharge(Pre,预充电)命令关闭该存储体和行,为下一次访问做好准备。每条命令以及块传输都与时钟同步,参见下面关于 SDRAM 的讨论。根据最初的信号名称,行信号和列信号有时仍分别称为 RAS 和 CAS。
图内术语:Bank=存储体;Row=行;Column=列;Rd/Wr=读/写;Act=激活;Pre=预充电。
此外,在没有读写操作的情况下,单元中的电荷会逐渐泄漏。为避免信息丢失,必须定期**刷新(refresh)**每个比特。幸运的是,只需读出一行再写回,就能同时刷新该行的全部比特。因此,存储系统中的每颗 DRAM 都必须在一定时间窗口内,例如 64 ms,访问每一行。DRAM 控制器和芯片内部都含有定期刷新的硬件。
这一要求意味着,存储系统有时会因向所有芯片发送刷新信号而暂时不可用。一次行刷新需要行激活和预充电,同时把该行写回;因为不必选择列,所需时间大约是取得一个数据项的 2/3,而 DRAM 的每一行都要执行一次。DRAM 的存储阵列在概念上是正方形,因此刷新步骤数通常是 DRAM 容量的平方根。设计者力求将刷新时间控制在总时间的 5% 以下。到目前为止,我们把主存描述得像瑞士列车一样,总能准时交付数据。实际上,SDRAM 的控制器通常位于处理器芯片上,会尽量避免打开新行,并尽可能采用块传输,以优化访问;刷新又增加了一个不可预测的因素。
Amdahl 提出过一条经验法则:内存容量应随处理器速度线性增长,才能维持系统平衡。因此,1000 MIPS 的处理器应配备 1000 MiB 内存。处理器设计者依靠 DRAM 来满足这一需求。过去,他们预期容量每三年增至四倍,或每年增长 55%。不幸的是,DRAM 性能增长慢得多,主要因为行访问时间的缩短幅度较小;它取决于功率限制、单个存储单元的储电能力,以及由此决定的单元大小等因素。深入讨论这些性能趋势之前,需要先介绍 20 世纪 90 年代中期以来 DRAM 的主要变化。
改善 DRAM 芯片内部的性能:SDRAM
很早的 DRAM 就有缓冲区,允许对同一行进行多次列访问,而不必重新访问行;不过,它们采用异步接口,因此每次列访问和传输,都要承担与控制器同步的开销。20 世纪 90 年代中期,设计者在 DRAM 接口中增加时钟信号,使重复传输免于这一开销,由此形成了同步 DRAM(synchronous DRAM,SDRAM)。除减少开销外,SDRAM 还能增加突发传输模式,无须指定新的列地址,就能连续传输多次。例如,把 DRAM 设为突发模式后,无须发送任何新地址,即可连续进行八次或更多的 16 bit 传输。突发传输的引入,使随机访问流与连续数据块访问之间的带宽出现显著差距。
随着 DRAM 密度增加,为取得更高带宽,DRAM 的接口也变得更宽。最初采用 4 bit 传输模式;到 2024 年,DDR DRAM 提供 4、8、16 或 32 bit 总线。21 世纪初又引入了双倍数据率(double data rate,DDR),使 DRAM 能在内存时钟的上升沿和下降沿都传输数据,从而将峰值数据率翻倍。
最后,SDRAM 引入多个存储体,以便管理功耗、改善访问时间,并允许对不同存储体进行交错和重叠访问。不同存储体的访问可以彼此重叠,每个存储体都有独立行缓冲区,因此不同存储体可以同时打开多行。把一颗 DRAM 划分为多个存储体,相当于在地址中新增一部分;此时地址由存储体号、行地址和列地址组成。当地址指定某个存储体中的新行时,必须打开这一行,产生额外延迟。现代内存控制接口完全负责存储体和行缓冲区的管理;如果后续访问指定了已经打开的行,就只需发送列地址,快速完成访问。
开始新访问时,DRAM 控制器先发送存储体号和行号;SDRAM 中称为 Activate,过去称为 RAS,即行选择。该命令打开一行,并将整行读入缓冲区。随后发送列地址,SDRAM 就根据请求类型,传输一个数据项,或执行突发传输。在访问新行之前,必须对存储体预充电。如果下一行仍在同一个存储体中,预充电延迟就会显现;如果位于另一个存储体,则关闭原行及预充电可以与新行的访问重叠。SDRAM 中,每一种命令周期都占整数个时钟周期。
1980–1995 年,DRAM 按 Moore 定律缩放,容量每 18 个月翻一番,即每三年增至四倍。20 世纪 90 年代中期至 2010 年,容量增长放慢,约每 26 个月翻番。再下一次翻番用了六年,即 2010–2016 年,而随后一次直到 2024 年年底才实现!图 2.4 给出了几代 DDR SDRAM 的容量与访问时间。从 DDR1 到 DDR3,访问时间约缩短至原来的三分之一,改善速度约合每年 7%。DDR4 和 DDR5 相比 DDR3 改善了功耗与带宽,但访问延迟相近。
DDR 是一系列标准,如图 2.4 所示。DDR2 将电压从 DDR1 的 2.5 V 降至 1.8 V,以降低功耗,同时提供 266、333 和 400 MHz 的更高时钟频率。DDR3 将电压降至 1.5 V,最高时钟频率为 800 MHz。DDR4 原预计 2014 年推出,实际于 2016 年年初大批量出货;它将电压降至 1.2 V,预计最高时钟频率为 1600 MHz。DDR5 使用 1.1 V 电压,直到 2022 年才达到量产规模;DDR6 看来要到 2025 年才会出现。
随着 DDR 引入,由于访问时间难以改善,存储器设计者越来越关注带宽。更宽的 DRAM、突发传输和 DDR 都推动了内存带宽的快速增长。DRAM 通常以小型电路板的形式出售,称为双列直插式内存模块(dual inline memory module,DIMM),包含 4–16 颗 DRAM 芯片。在桌面和服务器系统中,通常组织为 8 字节宽,另加 ECC。容易令人混淆的是,DDR SDRAM 组成 DIMM 后,名称按 DIMM 峰值带宽标注。例如,PC3200 的名称来自 字节,即 3200 MiB/s,其中装有 DDR SDRAM 芯片。2 芯片本身又按每秒比特数而不是时钟频率命名,使混淆进一步加重;因此,200 MHz 的 DDR 芯片称为 DDR400。图 2.5 展示了 I/O 时钟频率、每颗芯片每秒传输次数、芯片带宽、芯片名称、DIMM 带宽和 DIMM 名称之间的关系。
| 量产年份 | 芯片容量 | DRAM 类型 | 无须预充电:RAS 时间(ns) | 无须预充电:CAS 时间(ns) | 无须预充电:总时间(ns) | 需要预充电:总时间(ns) |
|---|---|---|---|---|---|---|
| 2000 | 256 Mbit | DDR1 | 21 | 21 | 42 | 63 |
| 2002 | 512 Mbit | DDR1 | 15 | 15 | 30 | 45 |
| 2004 | 1 Gbit | DDR2 | 15 | 15 | 30 | 45 |
| 2006 | 2 Gbit | DDR2 | 10 | 10 | 20 | 30 |
| 2010 | 4 Gbit | DDR3 | 13 | 13 | 26 | 39 |
| 2016 | 8 Gbit | DDR4 | 13 | 13 | 26 | 39 |
| 2021 | 8 Gbit | DDR5 | 13 | 13 | 26 | 39 |
图 2.4(续)。 访问时间针对随机地址处的一个字,假定必须打开新行。如果该行位于另一个存储体,假定该存储体已预充电;如果行尚未打开,则需要预充电,访问时间更长。随着存储体数量增加,隐藏预充电时间的能力也增强了。DDR4 原预计 2014 年推出,但直到 2016 年年初才开始量产。DDR5 最初容量与 DDR4 相同,但到 2024 年,每芯片密度已达到后者的四倍。
| 标准 | I/O 时钟频率(MHz) | 每秒百万次传输 | DRAM 名称 | 每 DIMM 带宽(MiB/s) | DIMM 名称 |
|---|---|---|---|---|---|
| DDR1 | 133 | 266 | DDR266 | 2128 | PC2100 |
| DDR1 | 150 | 300 | DDR300 | 2400 | PC2400 |
| DDR1 | 200 | 400 | DDR400 | 3200 | PC3200 |
| DDR2 | 266 | 533 | DDR2-533 | 4264 | PC4300 |
| DDR2 | 333 | 667 | DDR2-667 | 5336 | PC5300 |
| DDR2 | 400 | 800 | DDR2-800 | 6400 | PC6400 |
| DDR3 | 533 | 1066 | DDR3-1066 | 8528 | PC8500 |
| DDR3 | 666 | 1333 | DDR3-1333 | 10,664 | PC10700 |
| DDR3 | 800 | 1600 | DDR3-1600 | 12,800 | PC12800 |
| DDR4 | 1333 | 2666 | DDR4-2666 | 21,300 | PC21300 |
| DDR5 | 2400 | 4800 | DD5-4800 | 38,400 | PC38400 |
图 2.5(续)。 注意各列的数值关系:第三列为第二列的两倍;第四列把第三列的数字用于 DRAM 芯片名称;第五列为第三列的八倍,DIMM 名称则采用该数字的舍入值。DDR5 在 2022 年首次得到较大规模的应用。
译注(图 2.5): 原表最后一行的 DRAM 名称确实为“DD5-4800”,不是文本提取漏字;此处照录。21,300 等数值和 MiB/s 单位也按原表保留。
降低 SDRAM 功耗
动态存储芯片的功耗包括读写时的动态功耗,以及静态或待机功耗,两者都取决于工作电压。DDR5 SDRAM 的工作电压降到 1.1 V,较 DDR4 略有改善,较 DDR3 则约降低 25%。增加存储体也降低了功耗,因为一次只需读取一个存储体中的一行。
此外,所有近代 SDRAM 都支持低功耗模式(power-down mode),通过通知 DRAM 忽略时钟进入该模式。除内部自动刷新之外,SDRAM 的其他功能都被禁用;若不保留刷新,低功耗状态一旦持续超过刷新间隔,内存内容就会丢失。图 2.6 展示了 2 GB DDR3 SDRAM 在三种状态下的功耗。从低功耗模式恢复的确切延迟因芯片而异,典型值为 200 个 SDRAM 时钟周期。另有面向便携设备的低功耗 DDR,即 LPDDR1–5。它们供电电压更低、时钟更快,但每个通道允许连接的芯片更少,且芯片直接连接 CPU,而不是放在 DIMM 上。
图形数据 RAM,即 GDRAM(GDDR1–6),基于 SDRAM,但接口更宽、时钟更快,因此带宽为其 2–5 倍。较高时钟频率限制了每个通道可连接的 GDRAM 数量,并要求像 LPDDR 一样直接连接。到 2024 年,GDRAM 正被采用 HBM 的新设计取代,下一部分将介绍 HBM。
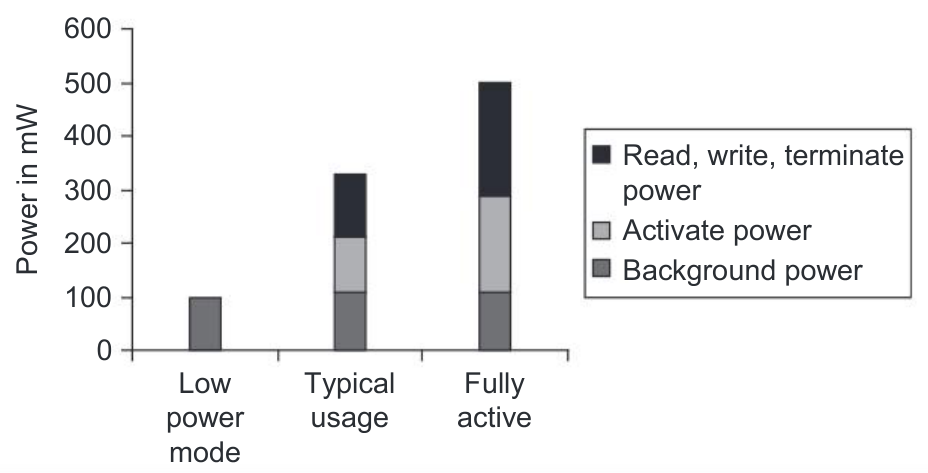
图 2.6(续)。 典型模式中,DRAM 有 30% 的时间执行读操作,15% 执行写操作;读写都假设采用八次传输组成的突发。数据基于 Micron 的 1.5 V、2 GB DDR3-1066。DDR4 和 DDR5 也能按类似比例节省功耗,而且由于工作电压较低,功耗还降低了 30%–40%。近期 DDR5 DRAM 可以在 DIMM 层面管理功耗,并提供更深的关闭模式,以进一步节能。
图内术语:Power in mW=功耗,单位 mW;Low power mode=低功耗模式;Typical usage=典型使用;Fully active=完全活动;Background power=背景功耗;Activate power=激活功耗;Read, write, terminate power=读、写及终端匹配功耗。
这些改进降低了 DRAM 功耗,但无论访问时间还是功耗,片外访问的代价仍占主导。例如,图 2.1 中,片外 DRAM 的访问时间是小型 L1 的 50–100 倍,是大型 L3 的 5–10 倍。能耗的比例也类似:片外 DRAM 访问约为小型 L1 的 100 倍、大型 L3 的 10–20 倍。片外访问较长的延迟和较高的能耗,共同推动了大型 LLC 的使用,以及改善其性能的各种技术。
封装创新:堆叠或嵌入式 DRAM、SRAM
DRAM 最近的一项创新来自封装,而非电路:把多颗 DRAM 堆叠起来,与处理器放在同一封装中。“嵌入式 DRAM”一词也可指把 DRAM 直接放到处理器芯片上的设计。将二者共同封装,缩短了 DRAM 与处理器之间的传输延迟,因而降低访问延迟;还可以采用更多、更快的连接,提高带宽。这种技术称为高带宽内存(high bandwidth memory,HBM)。
主要做法是通过带有互连的基板,即中介层(interposer),将 DRAM 堆叠在 CPU 旁边,并装入同一封装。假定 CPU 有多个内存通道,可以在四边各放一组,共四组,每组最多堆叠八颗 DRAM。采用专用 SDRAM 和四组堆叠,这样一个封装可包含 32 GiB 内存,数据传输率可达 4 TB/s。
因为芯片必须专为堆叠制造,早期用途大多集中于高端服务器、GPU 和领域专用体系结构(DSA)。图 2.7 展示了中介层方案,以及将芯片直接堆叠在处理器之上的另一种结构。图中的 3D 结构面临散热和电气噪声方面的挑战;到目前为止,垂直堆叠的唯一用途,是将用作 L3 的 SRAM 放在处理器之上。
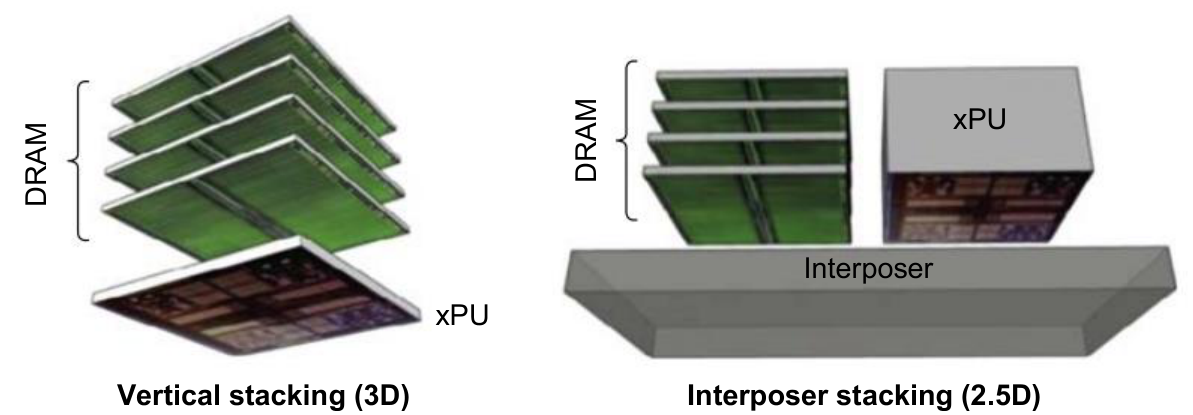
图 2.7(续)。 2.5D 形式已经广泛采用,可容纳最多四组堆叠,每组八颗 DRAM。AMD Genoa 芯片组目前采用 3D 堆叠,在每个裸片上堆叠一颗 SRAM,使一个 96 核 chiplet 上可以支持最多 1 GB 的 L3 缓存。3
图内术语:Vertical stacking (3D)=垂直堆叠(3D);Interposer stacking (2.5D)=中介层堆叠(2.5D);Interposer=中介层;xPU 为原图对处理器的泛称。
对于一些应用,封装内部可能容纳足够的 DRAM,满足全部需求。例如,一种作为专用集群节点的 NVIDIA GPU 正在采用 HBM 开发,而对于高端应用,HBM 很可能成为 GDDR5 的后继技术。有时可以直接将 HBM 用作主存,尽管成本限制和散热问题目前仍使它不适合某些嵌入式应用。下一节将讨论将 HBM 用作额外一级缓存,或额外主存单元的可能性。
Flash 存储器
Flash 是 EEPROM(电可擦除可编程只读存储器)的一种,通常只读,但可以擦除。另一项关键性质是,无须供电也能保持内容。这里着重介绍 NAND Flash:其密度高于 NOR Flash,更适合大容量非易失性存储;缺点是访问按顺序进行,写入也较慢,下面将说明。
Flash 在 PMD 和大多数台式机中作为辅助存储使用,与磁盘在服务器中的作用相同。此外,多数 PMD 的 DRAM 容量有限,因此 Flash 也可能充当存储层次中的一级;它承担这一角色的程度,远高于主存容量可能大 10–100 倍的台式机或服务器。
Flash 的体系结构和性质与标准 DRAM 大不相同,最重要的区别如下。
- Flash 按顺序读取,且一次读取整页;页大小可能为 512 字节、2 KiB 或 4 KiB。NAND Flash 访问随机地址的首字节时延迟较长,约 25 μs,但可以约 40 MiB/s 的速度提供页内其余数据。相比之下,DDR5 SDRAM 取得首字节约需 40 ns,随后可按 5 GiB/s 传输该行剩余数据。传输 2 KiB 时,NAND Flash 约需 75 μs,而 DDR SDRAM 不到 450 ns,即 Flash 的传输耗时超过 DDR SDRAM 的 150 倍。不过,读取 2 KiB 数据时,Flash 的速度仍是磁盘的 300–500 倍。由此可见,Flash 不适合取代 DRAM 作为主存,但由于每比特成本已经接近磁盘,尤其在较小容量下,已在许多系统中取代磁盘。
- Flash 必须先擦除才能覆写,flash 这个名称就来自这种“闪速”擦除过程;而且擦除以块为单位,不能单独擦除一个字节或字。因此,写入时必须凑齐整个块,或全部提供新数据,或把待写数据与块内其余内容合并。Flash 的写入速度约为 SDRAM 的 1/1500,但约为磁盘的 8–15 倍。
- Flash 是非易失性的,即断电仍能保存内容;不执行读写时,功耗显著较低,在待机模式下不到一半,完全不活动时可降为零。
- Flash 中任一块的写入次数有限,通常至少为 100,000 次。通过把写入均匀分布到整个存储器的各个块,系统可以尽量延长寿命。这种技术称为磨损均衡,原文称 write leveling,由 Flash 控制器负责。
- 高密度 NAND Flash 比 SDRAM 便宜,但比磁盘贵:Flash 约为每 GiB 0.12–0.20 美元,SDRAM 为每 GiB 5–10 美元,磁盘为每 GiB 0.02–0.05 美元。过去五年,Flash 成本下降的速度几乎是磁盘的两倍。
与 DRAM 类似,Flash 芯片也包含冗余块,使存在少量缺陷的芯片仍能使用;块重映射由芯片内部处理。Flash 控制器负责页面传输、页面缓存和磨损均衡。
高密度 Flash 的快速进步,对低功耗 PMD 和笔记本的发展至关重要;它也显著改变了台式机和大型服务器,前者越来越多地使用 SSD,后者则往往结合磁盘与 Flash 存储。
相变存储技术
**相变存储器(phase-change memory,PCM)**几十年来一直是活跃的研究领域。它通常利用微小的加热元件,使块体衬底在晶态与非晶态之间转换;这两种状态的电阻特性不同。衬底上覆盖着二维网络,每个比特对应其中一个交叉点。读取时检测某个 x 点和 y 点之间的电阻,因而原文也称其为 memristor(忆阻器);写入时施加电流,改变材料的相态。由于不需要晶体管等有源器件,理论上应能比 NAND Flash 获得更低成本和更高密度。
2017 年,Micron 和 Intel 开始交付基于这一技术的 Xpoint 存储芯片。相比 Flash,PCM 有两个主要优势:随机写性能更好,因为不需要擦除步骤;写入寿命也可能更长。读取延迟则略好于 Flash。由于“谬误与陷阱”一节将讨论的原因,PCM 未能形成发展势头,至少目前已经基本被搁置。
提高存储系统的可信赖性
大型缓存和主存显著增加了制造阶段以及运行期间发生错误的可能性。由于电路本身改变而产生、并且可以重复出现的错误,称为硬错误(hard error)或永久性故障(permanent fault)。它们既可能在制造阶段出现,也可能因运行期间的电路变化而产生,例如 Flash 单元在大量写入后失效。所有 DRAM、Flash 以及大多数 SRAM 在制造时都配有备用行,通过编程,用备用行替换缺陷行,便可容忍少量制造缺陷。运行期间只改变单元内容、没有改变电路本身的错误,则称为软错误(soft error)或瞬态故障(transient fault)。如果没有某种错误检测手段,它们就会成为第 1 章讨论的静默数据错误。
这类动态错误可以用奇偶校验位检测,也可以用**纠错码(error-correcting code,ECC)**检测并纠正。指令缓存只读,因此奇偶校验便足够;大型数据缓存和主存则使用 ECC,同时提供检测和纠错能力。奇偶校验只需增加一个比特,就能检测一串比特中的单比特错误。原文指出,多比特错误会逃过奇偶校验,成为静默错误,因此每个校验位所保护的比特数必须受到限制。4 典型比例为每 8 个数据比特配 1 个校验位。每 64 个数据比特增加 8 个冗余比特的 ECC,可以检测双比特错误并纠正单比特错误。ECC 在 DDR5 中成为标准配置。
在超大规模系统中,多比特错误乃至整颗存储芯片失效的概率都不可忽视。IBM 为此引入 Chipkill,IBM 服务器和 Google 集群等许多超大规模系统都采用了它;Intel 将自己的版本称为 SDDC。其思路与磁盘 RAID 类似:分散存放数据和 ECC 信息,即使一整颗芯片失效,也能利用其余芯片重构丢失的数据。
按 IBM 的一项分析,假设一台服务器有 10,000 个处理器,每个处理器配备 4 GiB 内存,则三年运行期间不可恢复错误的发生情况如下:
- **仅用奇偶校验:**约 90,000 次,平均每 17 分钟出现一次不可恢复或未检出的失效。
- **仅用 ECC:**约 3500 次,平均每 7.5 小时出现一次未检出或不可恢复的失效。
- **采用 Chipkill:**平均每两个月出现一次未检出或不可恢复的失效。
还可以换个角度:要达到上述 Chipkill 系统同样的错误率,最多能够保护多少台各有 4 GiB 内存的服务器?对于奇偶校验,即使只有一个处理器的服务器,其不可恢复错误率也高于由 10,000 台服务器组成、受 Chipkill 保护的系统。对于 ECC,由 17 台服务器组成的系统,其失效率约等于由 10,000 台服务器组成的 Chipkill 系统。5 因此,对于含 50,000–100,000 台服务器的仓库级计算机,Chipkill 是必需的,见第 6 章 6.8 节。
译注: 原文将单个晶体管描述为“实际上充当电容器”,此处按原文呈现。常见 DRAM 单元由访问晶体管和储存电荷的电容组成,不宜把这一简化表述理解为两者在结构上是同一个器件。 ↩︎
译注: 原文及图 2.5 使用 MiB/s;按 MHz 的十进制定义, 字节/秒为 3200 MB/s,而非 3200 MiB/s。 ↩︎
译注: 图 2.7 原注确实写“on a 96-core chiplet”。 ↩︎
译注: 原文将多比特错误概括为无法被奇偶校验检测。更准确地说,同一校验范围内,偶数个比特翻转会保持奇偶性而漏检;奇数个比特翻转仍可检测。 ↩︎
译注: 原文先讨论 10,000 个处理器的服务器,随后改用 10,000 台服务器进行比较,并给出 17 台 ECC 服务器。该换算口径未说明;仅按前文三年 3500 次与每两个月一次线性换算,也不能得到 17。 ↩︎