2.3 存储层次结构的十项高级性能优化
前面的平均访存时间公式,给出了缓存优化的三个指标:命中时间、未命中率和未命中开销。考虑到近期发展趋势,再加上缓存带宽与功耗。按照这些指标,可以把本节研究的十项高级存储系统优化分为五类:
- 缩短命中时间并降低功耗。 小缓存可以同时缩短命中时间、降低功耗,但代价是命中率下降。多个存储体也能缩短命中时间、降低功耗,尤其适用于较大的 L2、L3 缓存。
- 提高缓存带宽。 包括流水线化 L1、多存储体缓存和非阻塞缓存。它们对功耗的影响各不相同。如果存储系统能支持多个尚未完成的未命中,它们还可能降低未命中开销。
- 降低未命中开销。 包括关键字优先和写缓冲区合并,对功耗影响很小。采用多个存储体和 HBM,也可以缩短从内存访问一个块的延迟,从而降低未命中开销;无论访问单个块,还是并行访问多个块,都能受益。
- 降低未命中率。 包括编译器优化与相联度调整。显然,编译时取得的改进也有助于降低功耗。组相联会略微增加命中时间,但能降低未命中率;优化组相联缓存的替换策略,也可能减少未命中。
- 通过并行性降低未命中开销或未命中率。 包括硬件预取和编译器预取。它们通常会增加功耗,主要原因是预取的数据有一部分最终没有使用。
总体而言,随着我们依次讨论这些优化,硬件复杂度会逐渐增加。其中若干优化还需要先进的编译器技术,一项则依赖 HBM。最后将用图 2.17 汇总这十项技术的实现复杂度与性能收益。 有些技术较为直接,介绍会简短一些;另一些则需要更详细的说明。
第一项优化:采用虚拟索引和组相联的流水线化 L1 缓存
将 L1 流水线化,可以在延迟略有增加的代价下提高时钟频率。例如,20 世纪 90 年代中期,Intel Pentium 的指令缓存访问需要一个时钟周期;从 90 年代中期到 2000 年的 Pentium Pro 至 Pentium III,需要两个周期;2000 年面世的 Pentium 4,以及当前的 Intel i7 和 i9,则需要四个周期。指令缓存流水线化,实际上增加了流水线级数,使分支预测错误的代价更高。类似地,数据缓存流水线化,会增加从发出加载指令到使用数据之间的周期数,见第 3 章。如今,所有处理器都对 L1 进行了某种程度的流水线化,最简单的做法也是分开访问与命中检测;许多高速处理器的缓存流水线则有三级以上。
缓存流水线化后,组相联更容易实现,几乎不增加命中时间,甚至没有额外代价,因此可以提高 L1 命中率。较高相联度还可以避免虚拟索引缓存中的别名问题。
典型的缓存访问流水线可以把访问与命中检测分成四步:
- 译码地址,得到用于选择缓存字线的地址。
- 访问指令缓存或数据缓存的 SRAM。
- 将组内各条目的标签与 TLB 给出的物理标签比较,判断命中或未命中;命中时确定组内的对应条目。
- 通过多路选择器选出正确的缓存块,将所需的字与块内被访问的部分对齐,并传给 CPU。
在制造芯片之前,可以用 CAD 工具评估命中时间和功耗。CACTI 能估计 CMOS 微处理器中不同缓存结构的访问时间与能耗,其结果与更详细的 CAD 工具相比,误差在 10% 以内。给定最小特征尺寸后,CACTI 根据缓存容量、相联度、读写端口数量及其他更复杂的参数估算命中时间。图 2.8 给出了改变容量和相联度的估算结果。当然,这些估计既依赖工艺,也依赖缓存规模,因此必须使 CACTI 与所用工艺仔细匹配;图 2.8 展示的是某一工艺下的相对取舍。
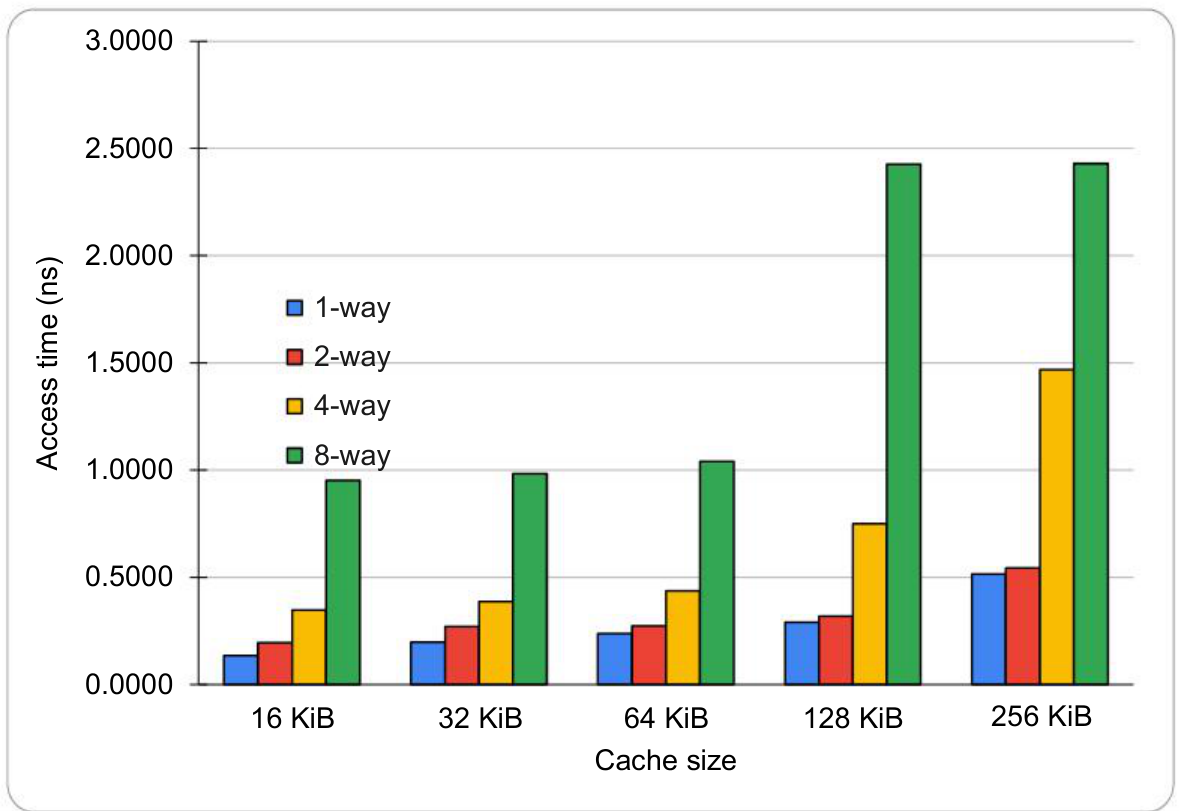
图 2.8(续)。 数据来自一个新的 CACTI 模型,模拟采用 14 nm、0.8 V 工艺、基于 FIN-FET 的 SRAM,详见 Ravipati et al.(2022)。假定单存储体、64 字节块。缓存布局假设,以及互连延迟与标签检查、多路选择代价之间的复杂取舍,使估算访问时间较高,八路组相联尤其如此;互连延迟也会随路数变化。用于连接缓存块的 H 树布局,可能进一步提高高相联度的估算访问时间,因为需要连接到 H 树的块更多。
图内术语:Access time (ns)=访问时间(ns);Cache size=缓存容量;1-way/2-way/4-way/8-way=一路/两路/四路/八路。
例:相联度与平均访存时间
问题。 利用附录 B 的图 B.8 和图 2.8,判断 32 KiB 四路组相联 L1 的访存时间,是否短于同容量的两路组相联 L1。假设访问 L2 的未命中开销,是较快 L1 访问时间的 15 倍;忽略 L2 之后的未命中。哪一种平均访存时间更短?
解答。 令两路组相联缓存的访问时间为 1,则原书给出的两路缓存计算为:
四路缓存的访问时间是两路的 1.4 倍。原书将未命中开销对应的时间写为 ,为简单起见取 10,于是:
显然,更高的相联度看起来不划算;不过,现代处理器的缓存访问通常是流水线化的,因此对时钟周期的确切影响很难判断,较高的相联度可能并不影响周期时间。如果还存在其他缓存优化,这一权衡会更加复杂。
译注: 应为 1.57,而非 1.38; 约为 10.714,而非 10.1。此外,第二式把以两路命中时间计的 1.4,与按另一时间单位缩放的未命中开销相加,单位不统一。若统一采用两路命中时间为单位,并沿用题设 15 的实际未命中开销,四路结果为 。
选择缓存容量和相联度时,还要考虑能耗,如图 2.9 所示。从两路增加到四路,能耗会变为原来的 1.1–1.7 倍,具体取决于缓存容量。
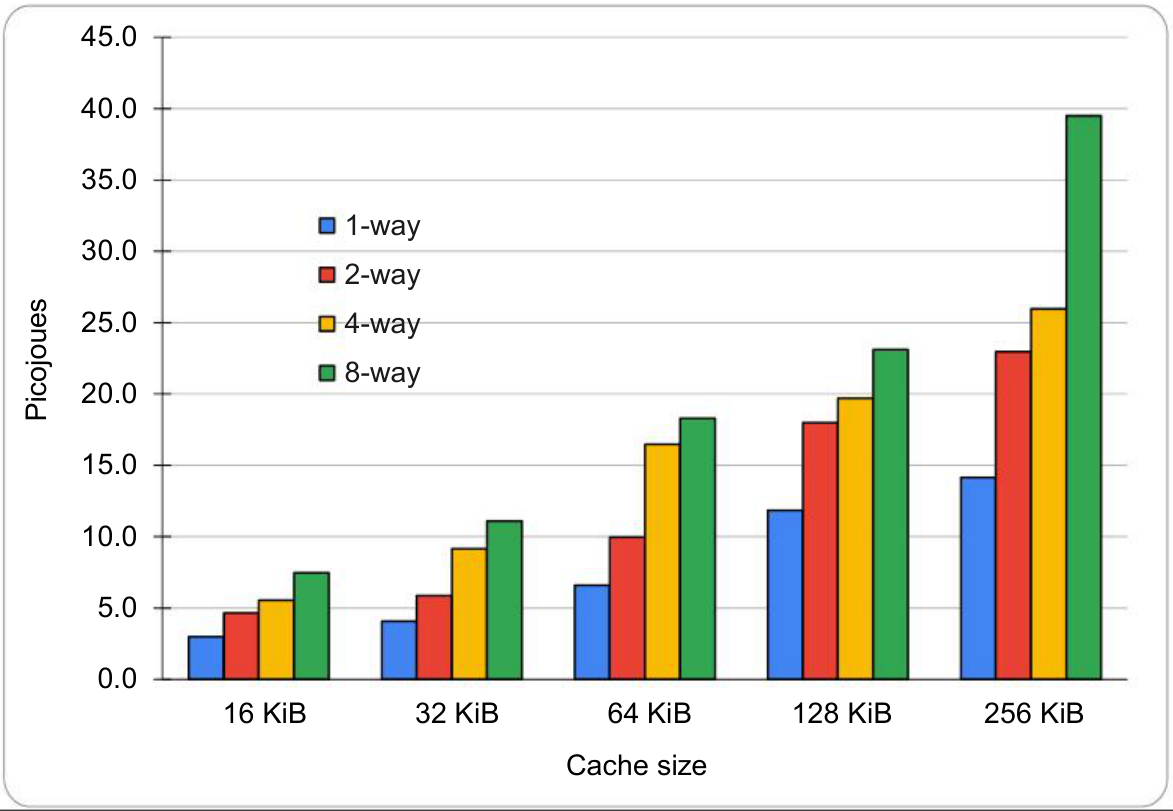
图 2.9(续)。 与前图一样,采用相同工艺参数的 CACTI 建模,见 Ravipati et al.(2022)。八路组相联的代价很大,因为必须并行读出八个标签及其对应数据。类似前图,用于布局缓存块的 H 树,可能增加高相联度所需能量的估计值。
图内术语:Picojoules=皮焦耳(原图拼为 Picojoues);Cache size=缓存容量;各路数含义同图 2.8。
能耗日益重要,设计者开始着力减少缓存访问所需能量。除相联度外,另一项关键因素是缓存中的块数,因为它决定了被访问的“行”数。保持总容量不变而增大块,可以减少行数,但可能增加未命中率,尤其是较小的 L1。
**路预测(way prediction)**试图在利用相联度的同时,保持直接映射缓存的命中速度。缓存保留额外比特,预测下一次访问的路,即组内的块。这样就能提前设置多路选择器,选出所需块,并在同一周期内并行读取数据和进行一次标签比较。若未命中,下一周期再检查其余块是否匹配。模拟表明,两路组相联的预测准确率超过 90%,四路组相联超过 80%;指令缓存通常比数据缓存预测得更准。对两路组相联缓存而言,只要路预测能让命中至少快 10%,就能缩短平均访存时间,而达到这一点很可能并不困难。路预测最早用于 20 世纪 90 年代中期的 MIPS R10000,后来广泛用于两路组相联处理器,也用于若干采用四路组相联的 ARM 处理器。对极高速处理器,可能难以实现只停顿一个周期的机制,而这恰恰是控制预测错误代价的关键。
另一种取得部分组相联优势的方法是牺牲缓存(victim cache),即用一个小缓存保存最近逐出的少数缓存行。Jouppi(1990)表明,八个条目的小型牺牲缓存,可以显著降低小型直接映射 L1 的未命中率。如今 L1、L2 更大,提高 L1 相联度并采用预取,效果已超过牺牲缓存。后面将看到,一些近期处理器实际上将 LLC 用作牺牲缓存。
第二项优化:采用多个存储体和端口,提高 L1 数据缓存带宽
处理器每周期能执行的指令数不断增加,设计者也必须增加数据缓存每周期能够接收的加载和存储操作数。早期多发射处理器每周期可以执行一次加载和一次存储;近期处理器则能执行两次加载和两次存储。这要求数据缓存每周期接收四次访问!如 2.5 节所述,指令缓存则利用空间局部性和分支预测,通过前瞻和预取跟上取指需求。
给寄存器堆增加多个读写端口是合理的,但在更大的缓存存储阵列中代价更高。因此,多数设计者选择多个存储体,可能再配上数量有限的多端口。
分存储体最初用于改善主存性能,如今既用于 DRAM 芯片内部,也用于缓存。Intel Core i7 的 L1 数据缓存有四个存储体,以支持每周期最多两次访存;i9 则采用双端口和八个存储体,以应对每周期四次访存的峰值。
显然,访问能够自然分散到不同存储体时,效果最好,因此地址到存储体的映射会影响存储系统行为。一种简单而有效的办法是将连续块地址依次分配到各存储体,称为顺序交错(sequential interleaving)。例如,有四个存储体时,块地址模 4 为 0 的块全部属于存储体 0,模 4 为 1 的属于存储体 1,依此类推。图 2.10 展示了这种组织。
| 存储体 0 的块地址 | 存储体 1 的块地址 | 存储体 2 的块地址 | 存储体 3 的块地址 |
|---|---|---|---|
| 0 | 1 | 2 | 3 |
| 4 | 5 | 6 | 7 |
| 8 | 9 | 10 | 11 |
| 12 | 13 | 14 | 15 |
起初你可能认为,即使分了存储体,数据缓存访问仍会发生大量冲突;但有几个因素会减少冲突。首先,其他流水线停顿和缓存未命中会干扰执行,处理器很少能够持续每周期四次访存。其次,即使四次访问同时到达,数据局部性也使其中两次或更多很可能访问同一个块,从而合并为一次缓存访问。
例:存储体冲突概率
问题。 假设有八个存储体和四次访问,访问同一块的请求数分别为一个、两个或三个,求发生冲突的概率。
解答。 如果四次访问分别指向不同的块,那么八个存储体中不发生冲突的概率,就是第 2、3、4 次访问都不落入先前请求已使用存储体的概率:
如果其中两次访问指向同一块,另外两次各自指向不同的块,则这一概率为:
原文接着指出,如果只有两个存储体被访问,冲突概率降至 12.5%(7/8)。存储体发生冲突时,其中一个请求延后处理,其余请求继续执行。
译注: 前两式给出的是“无冲突”概率,41% 和 66% 为舍入值。最后一句原文确实把冲突概率 12.5% 括注为 7/8;其中 7/8=87.5% 是无冲突概率,冲突概率应为 1/8。
当然,任何一个没有四次访存同时就绪的周期,冲突概率也会降低。双端口同样可以在不必处理冲突的情况下增加带宽。四个存储体均采用双端口时,冲突概率会低很多,因为同一存储体至少收到三个请求才会冲突。
双端口总会增加访问时间,而多个存储体的影响还取决于相联度和缓存容量等因素。提高 L1 带宽的这些方案,在访问时间上有何差异?图 2.11 展示了 CACTI 对 1、2、4 个存储体,分别配备 1、2、4 个端口时的估算。
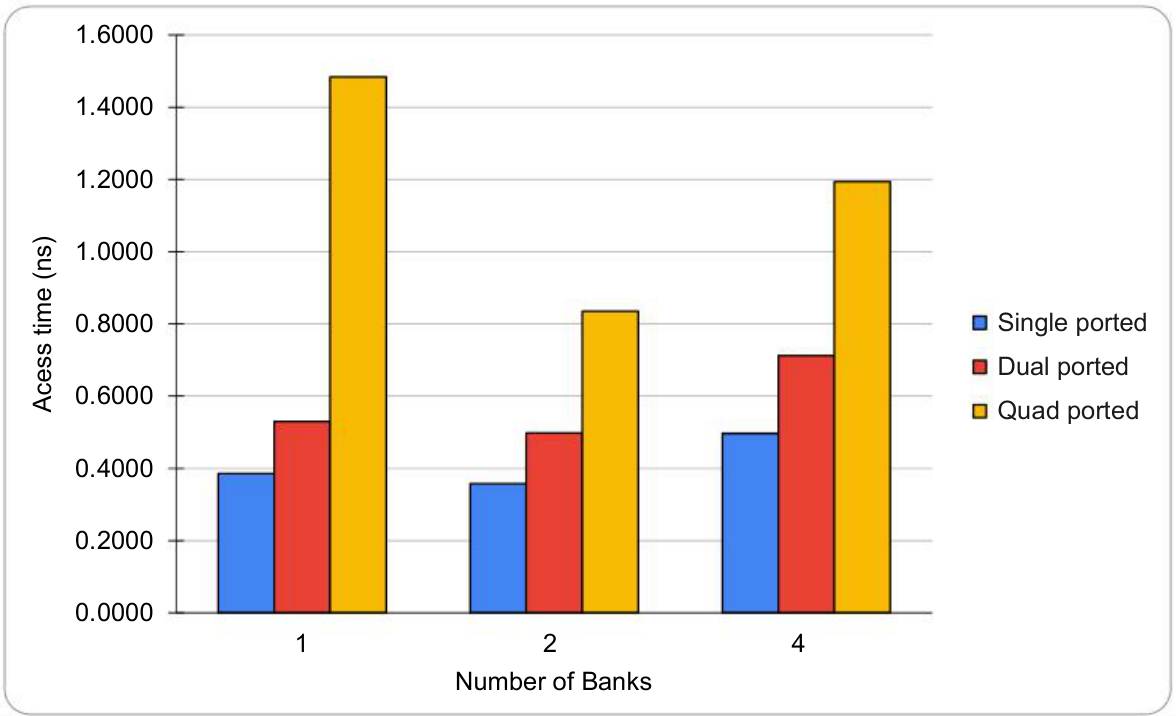
图内术语:Access time (ns)=访问时间(ns);Number of Banks=存储体数量;Single ported=单端口;Dual ported=双端口;Quad ported=四端口。
例:比较多存储体和多端口
问题。 为简单起见,假设只要发生冲突,就让缓存访问增加 1 ns,即使有四次冲突也一样。使用图 2.11 的数据,假定四次访问同时到达,以下哪种设计的访问时间最短?
- 四个单端口存储体;
- 两个双端口存储体,每个存储体都有双端口;
- 四端口。
解答。 先考虑单端口,冲突概率为:
对于双端口,原文给出的冲突概率为 37.5%,并指出,有兴趣的读者可以检查全部 16 种请求组合,其中只有 6 种会有三个请求命中同一个存储体。因此:
最后,四端口方案只有一个存储体,访问时间为 1.5 ns。按照这些参数及冲突代价,两个双端口存储体的方案最佳。
译注: 双端口段给出的数值为 37.5%、6/16 和 0.875 ns。若四个独立请求等概率映射到两个存储体,发生冲突的是分布为 3+1、1+3、4+0、0+4 的 10 种组合,概率为 62.5%;6/16 则是 2+2、没有冲突的情况。按题设计算,双端口平均时间应为 1.125 ns。单端口式的准确概率为 90.625%,原文作近似。修正概率后,双端口、双存储体仍是三者中较快的方案。
第三项优化:用更好的替换策略降低未命中率
直接映射缓存的替换策略很简单,因为每个块只能去一个位置。相联度提高后,未命中时必须决定替换组内哪个条目。选择得当可以降低未命中率,尤其是相联度较高时,因为可选的块更多。不过,这需要为每个缓存块维护额外状态。L1 的访问占用率很高,很难承担这样的工作,因此常采用随机替换或简单近似。L2、L3 访问占用率较低,未命中开销较高,因此优化替换策略更有意义。
事实上,确实存在最优策略,称为 Belady 的 MIN 策略:替换下一次使用时间最遥远的块。遗憾的是,正如 Yogi Barra 曾说过的:“预测很难,尤其是预测未来。”尽管如此,MIN 既为替换策略设计提供了思考方式,也提供了衡量实际算法的基准。另一种常被提出的方案是 LRU(Least Recently Used,最近最少使用),替换上一次使用时间最久远的块。精确 LRU 很难实现,因为必须维护组内所有块的先后次序。
因此,实际采用更新更简单的伪 LRU或近似 LRU。一种简单方案是 NRU(Not Recently Used,最近未使用):组内每个条目保留一位,表示该块最近未被使用;每次访问相应条目时,就把这一位清零。未命中时,从 NRU 位为 1 的块中选一个替换;随后除新换入的块外,将所有 NRU 位设为 1。
如果组内多个块的 NRU 位为 1,原文解释为这些块要么全都在近期被访问过,要么全都未被近期访问过,就在组内随机选一个替换。NRU 很容易实现,因为请求匹配到组之后,只需写入一位。它曾用于若干早期 Intel 处理器的 L2 和 LLC,也常用于 L1。
另一种低成本 LRU 近似,是把 NRU 推广为每块多个比特组成的计数器,试图预测哪个块将在最遥远的未来才被再次使用。例如,每块使用一个 2 bit 饱和计数器,原文称为 recently referenced prediction counter。缓存命中时,将该块计数器置零;未命中时,如果有块的计数器值为 3,就替换该块,并把计数器设为 2。数值 2 表示该块可能很快再次使用,也可能不会。如果没有计数器为 3,就把组内所有计数器递增,直到至少一个达到 3,再替换那个块。这一方案的关键,是区分只使用一次的流式访问与反复使用同一块的访问。
Jaleel et al.(2010)模拟了多种引用预测替换策略,包括 NRU、LRU 和上述 2 bit 方案。对于 2 MB、16 路 L2,大致相当于 Intel i7 单个核心的配置,NRU 性能比 LRU 低约 1%,而 2 bit 预测方案高约 5%。在四核、8 MB LLC 的多程序环境中,2 bit 方案的改善为 7%;原因可能是多程序活动使 LLC 中一次性访问更多,而 2 bit 方案比 1 bit 方案更善于处理这种流式访问。还可以推广到 bit 计数器;随着 增加,原文指出,该方案会接近真正的 LRU。像 2 bit 方案那样对计数器赋予不同权重,可以优先保留那些在一次未命中之后至少又命中过一次的块,因为它们较不可能是只访问一次的流式数据。
还有许多更复杂的替换策略,试图比基于 LRU 的方法作出更好的选择,本质上是在模拟工作集行为,类似操作系统对虚拟内存的处理。一些研究取得了显著改善;如果能以足够低的开销实现,并继续优于这些加权近似 LRU 策略,它们可能成为未来 LLC 的候选方案。
第四项优化:采用多存储体 L2、L3,降低功耗与延迟并增加带宽
L1 数据缓存使用多个存储体,主要是为了增加加载/存储带宽;它们也能为非阻塞未命中提供更高的回填带宽,稍后将介绍这一优化。在更大的 L2、L3 中,多个存储体可以像 DRAM 那样降低功耗、缩短延迟,并增加响应非阻塞 L1 或 L2 未命中的带宽。Intel Core i9 的 L2 有八个存储体。
Arm Cortex 处理器则使用过 1–4 个存储体的 L2。Intel 多核处理器将 LLC 分布在各核心之间,因此存储体数量随核心数增加。
第五项优化:用非阻塞缓存提高缓存带宽
对于允许乱序执行的流水线计算机,第 3 章将介绍,数据缓存未命中时,处理器不一定必须停顿。例如,在等待缺失数据返回期间,处理器仍可以从指令缓存继续取指。非阻塞缓存(nonblocking cache),也称 lockup-free cache,允许数据缓存在一次未命中尚未完成时继续服务命中请求,从而扩大这一办法的收益。这种 hit under miss 优化,使处理器在未命中期间仍能做有用的工作,而不必完全停顿,因此降低了实际未命中开销。更精细也更复杂的办法,是让多个未命中相互重叠,进一步降低开销,称为 hit under multiple miss 或 miss under miss。后者只有在存储系统能服务多个未命中时才有益。近期 Intel、AMD 等高性能处理器通常同时支持二者;许多低端处理器则只在 L2 提供有限的非阻塞支持。
Farkas 和 Jouppi(1994)为考察非阻塞缓存降低未命中开销的效果,假设 8 KiB 缓存、14 周期未命中开销,这与 20 世纪 90 年代初相符。他们发现,允许一次未命中期间继续处理命中,可以使 SPECINT92 的实际未命中开销下降 20%,SPECFP92 下降 30%。Li et al.(2011)更新了这项研究,采用多级缓存、更符合当时情况的未命中开销,以及规模更大、要求更高的 SPECCPU2006。研究模型基于 Intel i7 的一个核心,峰值每周期可以产生两次数据访存。图 2.12 显示了原文所称“在一次未命中期间允许 1、2 和 64 次命中”时,数据缓存访问延迟的下降,图注给出了更多存储系统细节。1 与早期研究相比,缓存变大并新增 L3,减少了收益:SPECINT2006 平均延迟下降约 9%,SPECFP2006 约 12.5%。
非阻塞缓存未命中并不一定使处理器停顿,因此,很难单独判断某次未命中的影响,也很难计算平均访存时间。实际未命中开销不是各次未命中时间之和,而是处理器停顿期间不能与其他工作重叠的时间。收益取决于多个未命中存在时的开销、访存模式,以及处理器在未命中尚未完成时能执行多少条指令。
一般来说,乱序处理器能隐藏 L1 数据缓存未命中、但 L2 命中时的大部分开销;对于更低层级的缓存未命中,则很难隐藏其大部分开销。
决定支持多少个尚未完成的未命中,要考虑多项因素:
- 未命中访问流的时间和空间局部性,它们决定一次未命中是否会向更低一级缓存或内存发起新访问;
- 响应请求的缓存或内存的带宽;
- 如果处理器在未命中时间最长的末级缓存允许更多未完成请求,则更高层级至少也必须支持同样多,因为未命中从最高一级缓存开始;
- 存储系统的延迟。
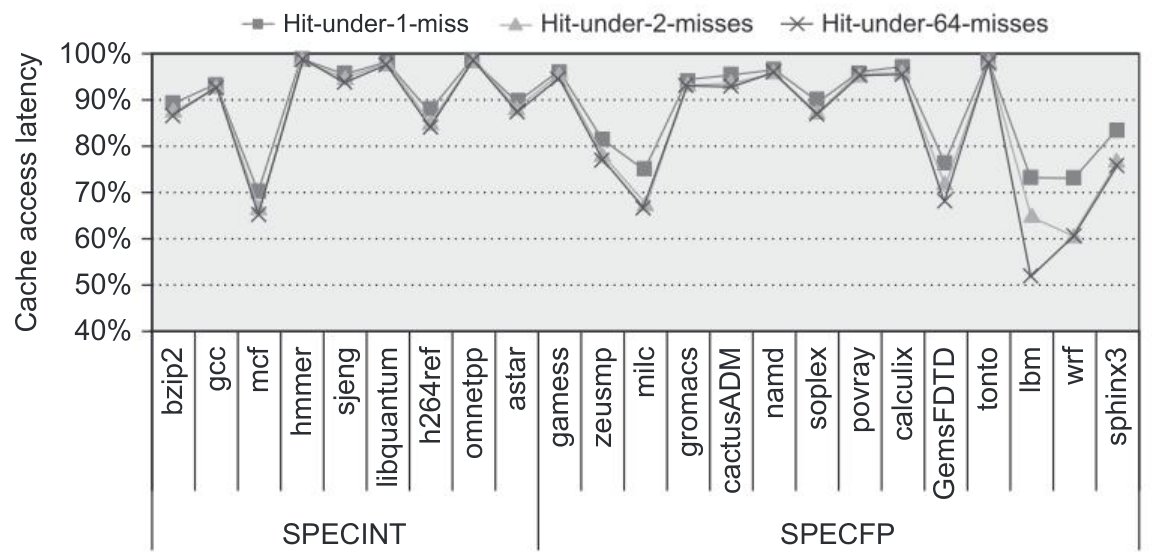
图 2.12(续)。 模拟的数据存储系统基于 Intel i7:32 KiB L1,访问延迟四周期;与指令共享的 256 KiB L2,延迟十周期;2 MiB L3,延迟 36 周期。三级均为八路组相联,块大小 64 字节。按原图注,允许一次命中,使整数程序未命中开销降低 9%、浮点程序降低 12.5%;允许第二次,则分别改善至 10% 和 16%;允许 64 次,额外收益很小。
图内术语:Cache access latency=缓存访问延迟;Hit-under-1-miss、Hit-under-2-misses、Hit-under-64-misses 分别表示存在 1、2、64 个未完成未命中时仍可继续命中。程序名称保持原标识符。
译注: 原图注把右侧 SPECFP 数量写为 9,但图中右侧实际列出 14 个名称。正文和图注的“命中次数”说法,也与图例按“未完成未命中数”区分三种方案的表达不一致。
以下简化例子说明关键思想。
例:需要支持多少个未完成未命中
问题。 主存访问时间为 36 ns,存储系统持续传输率可达 16 GiB/s,块大小为 64 字节。假设请求流足以维持峰值带宽,且访问从不冲突,需要支持的最大未完成未命中数是多少?如果某次访问与前四次之一发生冲突的概率为 50%,且必须等到前一个访问完成后才能执行,估算最大未完成请求数。为简单起见,忽略两次未命中之间的时间。
解答。 第一种情况下,假设能保持峰值带宽,原书将每秒可支持的访问数写为:
每次访问耗时 36 ns,因此可支持:
如果冲突概率大于零,就需要更多未完成请求,因为冲突请求暂时无法开始处理;存储系统需要的是更多独立请求,而不是更少!近似地,可以假定一半访存暂时不必发到内存,因此必须支持两倍的未完成请求,即 18 个。
译注: 原页的第一式确实将指数 9 放在整个括号之外。其给出的 2.5 亿次/秒,对应的是 ,并非 。题设写 GiB/s,计算却采用十进制的 字节;若严格按 GiB 换算,乘以 36 ns 后约为 9.664 个。
Li、Chen、Brockman 和 Jouppi 的研究发现,整数程序在原文所称“一次”情况下,CPI 下降约 7%,64 次时约下降 12.7%;浮点程序分别下降 12.7% 和 17.8%。这些下降幅度与图 2.12 的数据缓存访问延迟变化很接近。
非阻塞缓存的实现
非阻塞缓存虽然能提高性能,却不易实现。首先面临两类挑战:仲裁命中与未命中的竞争,以及跟踪尚未完成的未命中,以确定加载或存储何时可以继续。
先看第一个问题。阻塞缓存未命中会使处理器停顿,未命中处理完成前,不再出现新的缓存访问;非阻塞缓存中,命中却可能与从下一层返回的未命中数据相冲突。几乎所有近期处理器都允许多个未完成未命中,因此不同未命中的返回也可能冲突。必须解决这些冲突,通常先让命中优先于未命中,再为彼此冲突的未命中确定处理次序。
第二个问题来自对多个未完成未命中的跟踪。阻塞缓存最多只有一个未完成请求,所以始终知道返回的是哪一个;非阻塞缓存很少如此。乍看之下,似乎可以假设按序返回,用简单队列把返回数据与等待最久的请求匹配。但 L1 未命中可能在 L2 命中,也可能在 L2 未命中;若 L2 也非阻塞,返回 L1 的顺序就不一定与原来的发出顺序相同。具有非均匀缓存访问时间,即 NUCA,的多核及其他多处理器系统,也会带来这一复杂性。
未命中数据返回时,处理器必须知道是哪条加载或存储指令引起的,才能让它继续;还必须知道数据应放到缓存哪里,以及该块标签的值。近期处理器通常把这些信息保存在一组**未命中状态处理寄存器(Miss Status Handling Registers,MSHR)**中。如果允许 个未完成未命中,就设置 个 MSHR。
每个 MSHR 记录数据应放入缓存的位置、相应标签位的值,以及引发未命中的加载或存储指令信息;下一章会介绍如何跟踪这些指令。因此,未命中时先分配一个 MSHR,填入相关信息,并用它的索引给内存请求加上标识。存储系统返回数据时携带该标识,缓存据此将数据和标签写入正确的块,并“通知”引发未命中的指令:数据已就绪,可以继续执行。非阻塞缓存显然需要额外逻辑,因而有能耗代价;但很难准确评估,因为它也可能缩短停顿和执行时间,从而降低能耗。
除了上述问题,多处理器存储系统无论位于单芯片还是多芯片,还必须解决与缓存一致性和存储一致性有关的复杂实现问题。而且,缓存未命中不再是原子操作:请求与响应分开,多个请求之间可以交错,因此也可能出现死锁。第 5 章将再次讨论,在线附录 I 的 I.7 节会作更详细的介绍。
第六项优化:关键字优先与提前重启,降低未命中开销
这项技术基于一个观察:处理器通常一次只需要块内的一个字。策略就是“不必耐心等完”:不等整个块装入,就发送所需字并恢复处理器执行。具体有两种方法:
- 关键字优先(critical word first):先向内存请求缺失的那个字,一到达就送给处理器;处理器继续执行,同时填充块内其余字。
- 提前重启(early restart):按正常次序取字,但所需字一到达,就送给处理器,让它继续执行。
一般只有缓存块较大时收益才明显。注意,在填充块内其余部分的同时,缓存通常仍会服务对其他块的访问。
不过,空间局部性使下一次访问很可能指向同一块的其余部分。与非阻塞缓存一样,未命中开销并不好算。关键字优先方案中,如果又出现第二次请求,其实际开销就是从请求发出到第二部分数据到达之间、无法与其他工作重叠的时间。两项技术的收益取决于块大小,以及再次访问尚未取回部分的可能性。
例如,在采用这两项技术的 i7 6700 上运行 SPECint2006 时,对仍有未完成未命中的块,平均会产生不止一次访问:平均 1.23 次,范围为 0.5–3.0。2.6 节将更详细地研究先进存储层次结构的性能。
第七项优化:通过编译器优化降低未命中率
到目前为止,所讨论的技术都需要改变硬件。下面的方法却无须改变硬件,就能降低未命中率。
这种“魔法”来自软件优化——硬件设计者最喜欢的解决办法!处理器与主存之间日益扩大的性能差距,促使编译器开发者仔细研究存储层次结构,寻找编译时优化的机会。研究同样分为改善指令未命中与改善数据未命中两类。下面介绍的优化,许多现代编译器都已采用。
循环交换
有些程序的嵌套循环按非连续顺序访存。只需交换循环嵌套次序,就能按数据存放顺序访问。假设数组无法完全放入缓存,这种方法通过改善空间局部性来减少未命中:在一个缓存块被丢弃前,尽可能多地使用其中的数据。例如,二维数组 x 的大小为 [5000,100],使 x[i,j] 与 x[i,j+1] 相邻存放;因为数组按行排列,这称为行优先(row major)。以下前后两段代码展示了如何优化访问:
原代码按 100 个字的步长跳跃访问;修改后则先访问完一个缓存块内的全部字,再转向下一个块。它在不改变执行指令数的情况下改善了缓存性能。
分块
**分块(blocking)**通过改善时间局部性减少未命中。这里仍涉及多个数组,其中有的按行访问,有的按列访问;每次循环迭代都会同时使用行和列,因此无论将数组按行优先还是列优先存放,都不能解决问题。这种相互正交的访问方式意味着,即便做过循环交换,仍有很大优化空间。
分块算法不处理完整行或完整列,而是处理子矩阵,即二维块,目的是在缓存中的数据被替换前尽可能多地使用它们。以下矩阵乘法代码说明了优化动机:
最内侧的两个循环会读遍 z 的全部 个元素,反复读取 y 同一行的 N 个元素,并写入 x 一行中的 N 个元素。图 2.13 展示了三个数组的访问状态:深色表示近期访问,浅色表示较早访问,白色表示尚未访问。
容量未命中的数量显然取决于 N 和缓存容量。如果能容纳全部三个 矩阵,只要没有缓存冲突,就没有问题。如果能容纳一个 矩阵和长度为 N 的一行,那么至少 y 的第 i 行与整个 z 可以保留在缓存中。容量再小一些,原文指出 x 与 z 都可能发生未命中。最坏情况下, 次运算需要访问 个内存字。
为保证正在访问的元素能放入缓存,将代码改为对 子矩阵计算。最内侧两个循环不再跨越 x 和 z 的完整长度,而以 B 为范围分段处理。B 称为分块因子(blocking factor)。假设 x 已初始化为零:
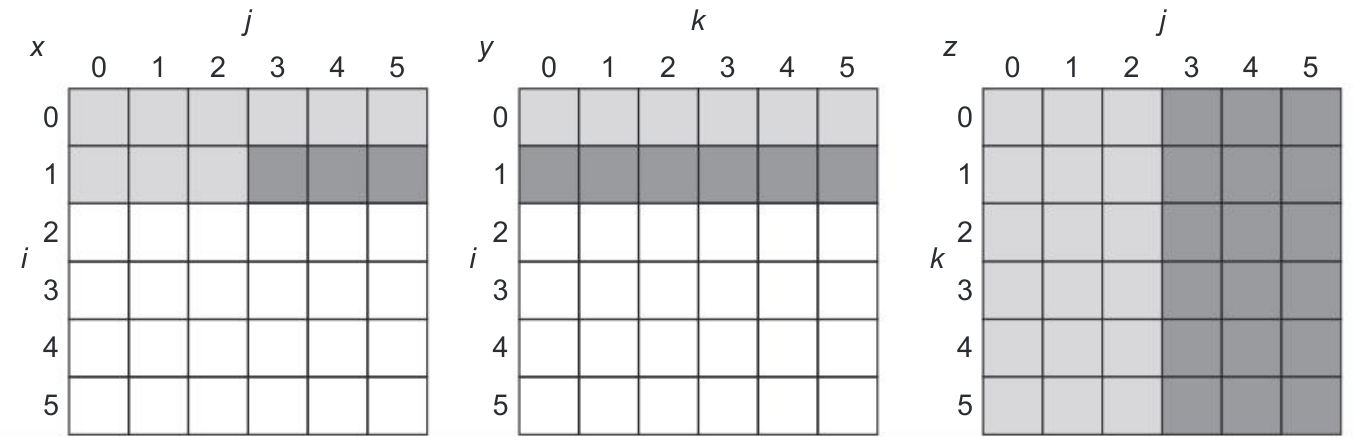
图 2.13(续)。 颜色深浅表示距访问发生的时间:白色表示尚未访问,浅色表示较早访问,深色表示较近访问。反复读取 y 和 z 的元素,用于计算 x 的新元素。图中沿相应行或列标出用于访问数组的变量 i、j、k。
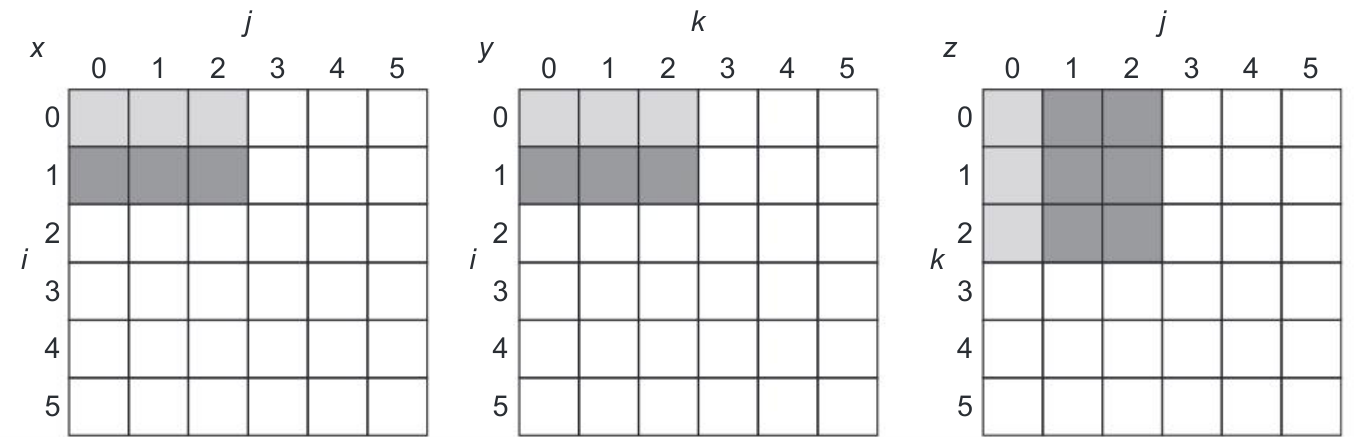
图 2.14 展示了分块后的访问。只考虑容量未命中,访问内存字的总数为 ,相当于将访问量约降至原来的 。因此,分块结合利用了空间和时间局部性:y 受益于空间局部性,z 受益于时间局部性。这里采用正方形块 ,也可以用矩形块;如果矩阵不是正方形,这样做就是必要的。
我们关注的是减少缓存未命中,但分块还可以帮助寄存器分配。选择足够小的块,使其能够放入寄存器,即可尽量减少程序的加载和存储操作。
第 4 章 4.8 节将说明,对于以矩阵为主要数据结构的应用,要在采用缓存的处理器上取得良好性能,缓存分块不可或缺。
第八项优化:用硬件预取指令和数据,降低未命中开销或未命中率
非阻塞缓存使程序执行与内存访问重叠,从而有效降低未命中开销。另一种办法是在处理器提出请求前,提前**预取(prefetch)**所需内容。指令和数据都可以预取,既可以直接送入缓存,也可以送入一个访问速度快于主存的外部缓冲区。
指令预取常由缓存之外的硬件完成。通常,处理器在发生未命中时取回两个块:所请求的块及其后紧邻的块。所请求的块返回后放入指令缓存,预取的块则放入指令流缓冲区(instruction stream buffer)。如果请求的块已经在指令流缓冲区中,就取消原来的缓存请求,从流缓冲区读出该块,并发出下一次预取请求。
数据访问也可以采用类似方法(Jouppi,1990)。Palacharla 和 Kessler(1994)研究了一组科学计算程序,考察了能够处理指令或数据的多个流缓冲区。他们发现,对于配备两个 64 KiB 四路组相联缓存、分别存放指令和数据的处理器,8 个流缓冲区能够捕获全部未命中的 50%~70%。
Intel Core i7 和 i9 都支持向 L1 和 L2 进行硬件预取,最常见的预取操作是访问下一条缓存行。如果应用的 L1 和 L2 未命中率很低,预取就难以带来很大改善。即便 L1 或 L2 未命中率较高,也必须谨慎使用预取,因为“错误”的预取可能替换掉有用的缓存块,并且会消耗缓存或内存带宽。Xeon Skylake-SP 的硬件预取与 Sapphire Rapids 非常相似,包含 4 种数据预取器:L1 数据缓存单元预取器(Data cache unit prefetcher,DCUI)、L1 数据缓存指令指针步长预取器(Data cache instruction pointer stride prefetcher,DCUP)、L2 数据缓存空间预取器(Data cache spatial prefetcher,L2A)和 L2 数据缓存流预取器(Data cache streamer,L2P)。在 SPECCPU2017 中内存访问较密集的基准测试里,L2P 最为重要,贡献了 CPI 改善的 70%。注意,L2 预取器可以从 L3 或内存取数据,并将结果直接放入 L2;如果数据来自内存,则不会同时放入 L3。
图 2.15 给出了多核 Xeon 处理器 Skylake-SP 开启硬件预取后,一部分 SPECCPU2017 程序的总体性能改善,以 CPI 的下降衡量。不同程序的结果差异很大:有两个基准测试的性能略有下降,5 个的改善约为 10% 或更少,还有两个的性能提高到原来的两倍以上。图中还给出了 L3 的 MPKI(Misses Per K Instructions,每千条指令的未命中次数)下降情况,它与 CPI 的下降高度相关。
预取不计入未命中次数。因此,当 L2P 向 L2 缓存预取时,既可以消除原本会在 L3 命中的 L2 未命中,也可以消除原本会在 L3 未命中的 L2 未命中。由于 L3 未命中的耗时大约是 L2 未命中的 4 倍,大部分性能改善来自 L3 未命中的减少,如图 2.15 所示。
如果取消预取,被消除的 L3 未命中中会有许多、甚至全部重新出现。不过,预取机制并不完美,也可能引起额外的未命中。比较开启和关闭预取时 L3 所请求的数据流量,就能看出这一点。开启预取后,L3 缓存请求的数据量比关闭时增加了 19%。在少数情形下,例如 bwaves 和 lbm,预取器似乎非常准确,L3 流量的增幅不足 1%。预取效果良好时,对功耗的影响可以忽略,甚至略有益处;如果预取数据没有被使用,或有用的数据被挤出缓存,预取就会显著增加功耗。
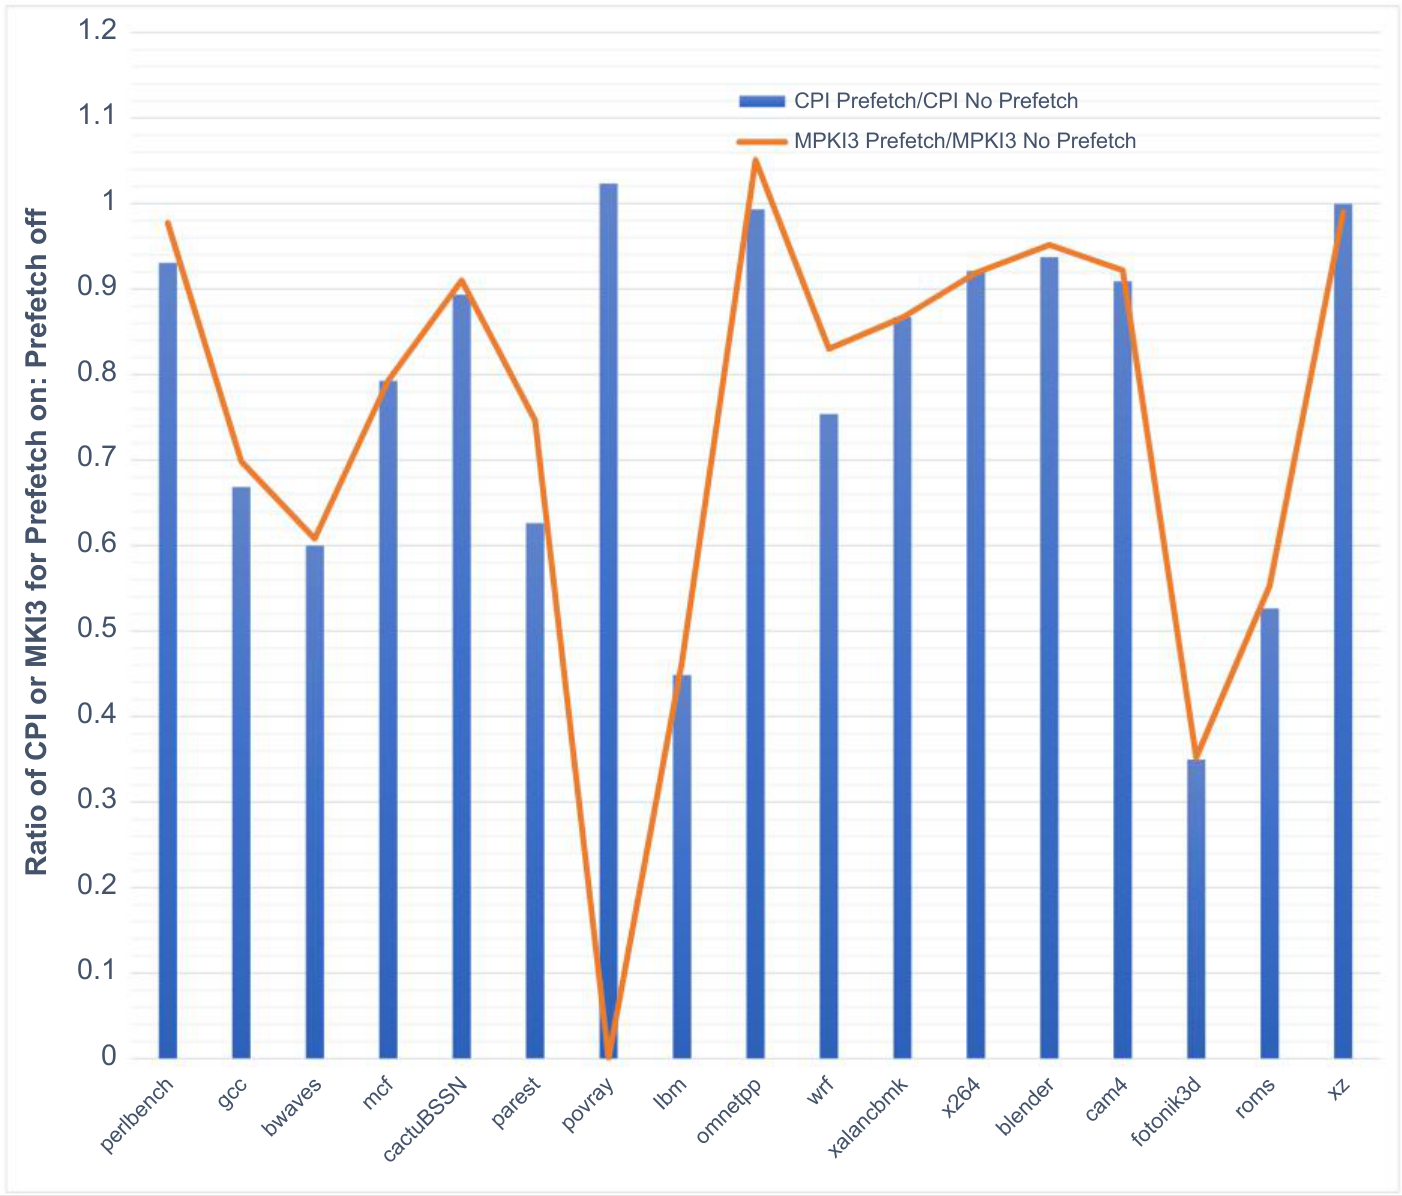
图 2.15(续)。 如果某个基准测试有多个输入,采集的数据来自其中内存访问最密集的输入。除 povray 外,CPI 的改善与 MKPI3 的下降非常接近;povray 的 MKPI3 接近 0,因此它的全部收益来自将数据从 L3 预取到 L2。L2P 不仅总体效果最好,而且在改善最大的 7 个基准测试中,贡献了 90% 的收益。数据来自 Navarro-Torres 等人(2019)。图中蓝色柱与橙色折线分别表示“开启预取时的 CPI / 关闭预取时的 CPI”和“开启预取时的 MPKI3 / 关闭预取时的 MPKI3”;纵轴为相应比值。
译注: 原图图例使用 MPKI3,图注却写作 MKPI3,纵轴还写作 MKI3,均指 L3 的每千条指令未命中次数。图注说有 15 个基准测试,图中实际列出了 17 个名称。
第九项优化:由编译器控制预取,降低未命中开销或未命中率
硬件预取之外的另一种办法,是由编译器插入预取指令,在处理器需要数据之前发出请求。预取分为两类:
- 寄存器预取(register prefetch):将值加载到寄存器中。
- 缓存预取(cache prefetch):只将数据加载到缓存中,不加载到寄存器中。
两者都可以采用会引发异常或不会引发异常的形式(faulting 或 nonfaulting);也就是说,地址出现虚拟地址错误或违反保护规则时,可以引发异常,也可以不引发异常。不会引发异常的预取如果遇到原本应产生异常的情形,就退化为空操作,这正是我们所希望的行为。
最有效的预取对程序在“语义上不可见”:不改变寄存器和内存的内容,也不会引起虚拟内存异常。今天的大多数处理器都提供不会引发异常的缓存预取。本节假定采用这种预取,也称为 nonbinding prefetch。
只有处理器在预取数据时能够继续执行,预取才有意义;也就是说,缓存不能停顿,而应在等待预取数据返回时继续提供指令和数据。正如你可能已经想到的,这类计算机的数据缓存通常是非阻塞的。
与硬件控制的预取一样,目标是使程序执行与数据预取重叠。循环很适合做预取优化,因此是重点。如果未命中开销较小,编译器只需将循环展开一两次,再将预取与执行调度在一起。如果未命中开销较大,就采用软件流水线(见附录 H),或者将循环展开多次,为未来的迭代预取数据。
不过,发射预取指令本身会带来指令开销,因此编译器必须确保这些开销不超过收益。通过把注意力集中于很可能发生缓存未命中的访问,程序既可以避免不必要的预取,又能显著改善平均内存访问时间。
例题:识别并预取可能未命中的数据
对于以下代码,判断哪些访问可能引发数据缓存未命中,然后插入预取指令以减少未命中,最后计算所执行的预取指令数及预取所避免的未命中次数。假设有一个容量为 8 KiB、块大小为 16 字节的直接映射数据缓存,采用写回和写分配策略。a 和 b 是双精度浮点数组,每个元素占 8 字节;a 有 3 行、100 列,b 有 101 行、3 列。程序开始时,两数组都不在缓存中。
解答。 编译器首先确定哪些访问可能引起缓存未命中,否则就会浪费时间,为本来能够命中的数据发射预取指令。a 的元素按照它们在内存中的存放顺序写入,因此 a 能受益于空间局部性:j 为偶数时未命中,为奇数时命中。a 有 3 行、100 列,因此这些访问将产生 次未命中。
b 的访问顺序与存放顺序不同,因此不能受益于空间局部性。不过,b 可以在两个层面受益于时间局部性:每次 i 的迭代都会访问相同元素,而每次 j 的迭代又会使用上一次迭代用过的 b 值。忽略可能发生的冲突未命中,b 的未命中发生于 i=0 时的 b[j + 1][0] 访问,以及 j=0 时对 b[j][0] 的第一次访问。i=0 时 j 从 0 变化到 99,因此 b 的访问产生 次未命中。
这样,循环对 a 产生约 150 次数据缓存未命中,对 b 产生 101 次,共 251 次。
为简化优化,我们不考虑预取循环最开始访问的元素。这些元素可能已经在缓存中;否则,就为 a 或 b 的前几个元素付出未命中开销。我们也不考虑抑制循环末尾越过 a 末端(a[i][100] 至 a[i][106])以及 b 末端(b[101][0] 至 b[107][0])的预取。如果预取可能引发异常,就不能如此处理。假设未命中开销很大,至少需要提前 7 次迭代开始预取;换句话说,假定预取直到第 8 次迭代才开始带来收益。下面列出加入预取后的代码,原书以加下划线的方式标示修改。
修改后的代码预取了 a[i][7] 至 a[i][99],以及 b[7][0] 至 b[100][0],将未获预取覆盖的未命中减少为:
- 第一个循环中,元素
b[0][0]、b[1][0]、……、b[6][0]产生 7 次未命中。 - 第一个循环中,元素
a[0][0]、a[0][1]、……、a[0][6]产生 4 次()未命中;空间局部性使每个 16 字节缓存块只发生一次未命中。 - 第二个循环中,元素
a[1][0]、a[1][1]、……、a[1][6]产生 4 次()未命中。 - 第二个循环中,元素
a[2][0]、a[2][1]、……、a[2][6]产生 4 次()未命中。
合计为 19 次未获预取覆盖的未命中。避免 232 次缓存未命中的代价是执行 400 条预取指令,这很可能是值得的。
例题:计算预取节省的时间
计算前例节省的时间。忽略指令缓存未命中,并假定数据缓存没有冲突未命中或容量未命中。假定预取可以彼此重叠,也可以与缓存未命中重叠,因而能够以最大内存带宽传输数据。忽略缓存未命中时,各循环的关键执行时间如下:原循环每次迭代用 7 个时钟周期,第一个预取循环每次用 9 个时钟周期,第二个预取循环每次用 8 个时钟周期,其中包含外层 for 循环的开销。一次未命中用 100 个时钟周期。
解答。 原来的双重循环共执行 次乘法。每次迭代用 7 个时钟周期,因此不计缓存未命中时为 个时钟周期。缓存未命中再增加 个时钟周期,总计 27,200 个时钟周期。
第一个预取循环迭代 100 次,每次 9 个时钟周期,共 900 个时钟周期;再加上缓存未命中的 个时钟周期,总计 2000 个时钟周期。第二个循环执行 次,每次 8 个时钟周期,共 1600 个时钟周期;加上缓存未命中的 个时钟周期,总计 2400 个时钟周期。
由前例可知,两个循环总共执行 个时钟周期,期间执行 400 条预取指令。如果预取能够与其余执行过程完全重叠,那么预取版本的加速比就是 ,约为 6.2。
虽然数组优化容易理解,现代程序却更常使用指针。Luk 和 Mowry(1999)证明,编译器预取有时也可以扩展到指针。在 10 个使用递归数据结构的程序中,访问节点时预取所有指针,使其中一半程序的性能提高了 4%~31%;其余程序的性能变化则仍在原性能的 2% 以内。关键既在于预取的数据是否已经位于缓存中,也在于预取是否足够早,能够使数据在需要时及时到达。
许多处理器支持缓存预取指令;高端处理器,例如 Intel Core i7 和 i9,通常还会在硬件中进行某种形式的自动预取。
第十项优化:用多条内存总线和多个内存模块提高带宽
桌面高性能处理器,例如 Intel i9 和 AMD Ryzen,服务器处理器,例如 Intel Xeon 和 IBM Power 系列,以及面向图形或深度学习的领域专用处理器,往往利用多个内存通道来增加可用内存带宽。多个通道允许独立访问,因此还能避免一次访问阻塞另一次访问,有效降低未命中开销。
有了多条内存总线,就可以考虑设计两种总线结构不同的内存通道,将 SDRAM 和 HBM 组合使用。这种搭配可以利用 HBM 的速度和带宽优势——HBM 的信号传输约定不同于普通 SDRAM——同时又不必将内存总容量限制在少数几个 HBM 堆叠所能提供的规模。以这种方式使用不同类型的内存,会形成 NUMA(原文展开为 NonUniform Memory Architecture,非均匀内存体系结构);要利用这一能力,就需要将关键数据放入更快的 HBM 内存。对于领域专用处理器,这通常由软件控制,并且往往需要领域专用语言来指导软件分配数据,以及在不同内存之间搬移数据(见第 7 章)。
除了显式管理 NUMA,也可以将 HBM 用作缓存;最新的 Intel 和 AMD 处理器也支持这种方式。
HBM 缓存实际上相当于新增的 L4 或末级缓存(LLC),其容量可以达到最大片上 L3 缓存的 10 倍或更多。不过,如此大的 DRAM 缓存带来一个问题:标签放在哪里?答案取决于标签数量。假设块大小为 64 字节,那么 1 GiB 的 L4 缓存需要 96 MiB 标签——大致相当于一个大型多核处理器全部缓存所使用的 SRAM 容量!增大块可以减少标签数量,但过大的块也可能提高未命中率,尤其是冲突未命中和一致性未命中(原文为 consistency misses)。
如果把 LLC 的标签放在 HBM 中,而不是片上,就可以采用更小的块和更多的标签。乍看之下,这似乎行不通,因为每次访问 L4 都需要两次 DRAM 访问:一次读标签,一次读数据。Loh 和 Hill(2011)提出了一个巧妙方案,本书称为 L-H 方案:将标签与数据放在 HBM SDRAM 的同一行中。虽然打开一行,以及随后关闭它,要花费较长时间,但访问该行另一部分的 CAS 延迟,约为访问新行耗时的三分之一。因此,可以先访问块的标签部分;若命中,再通过一次列访问选出正确的字。
Qureshi 和 Loh(2012)提出了一种称为 Alloy Cache 的改进,以缩短命中时间。它将标签和数据组合在一起,并采用直接映射结构。这样就可以直接索引 HBM 缓存,以突发传输同时读出标签和数据,将 LLC 的访问时间缩短为一个 HBM 周期。
与 L-H 方案相比,Alloy Cache 的命中时间缩短至不足一半,代价是未命中率增加到原来的 1.1~1.2 倍。
遗憾的是,两种方案在未命中时都需要两次完整的 DRAM 访问:先读出标签,再访问速度更慢的主存。图 2.16 给出了按 SPECRate 方式运行 10 个内存密集型 SPECCPU2006 基准测试时获得的加速比。Alloy Cache 增加了一个小型未命中预测器,尝试在预测会未命中时跳过最初的 HBM 访问。有了这一改进,Alloy Cache 的性能超过了 L-H 方案,甚至超过了并不实际可行的 SRAM 标签方案:预测器访问速度快,预测效果又好,因此能够更快判断未命中,降低未命中开销。Alloy Cache 的性能接近 Ideal 情形,也就是未命中预测完全准确、命中时间最短的 LLC。
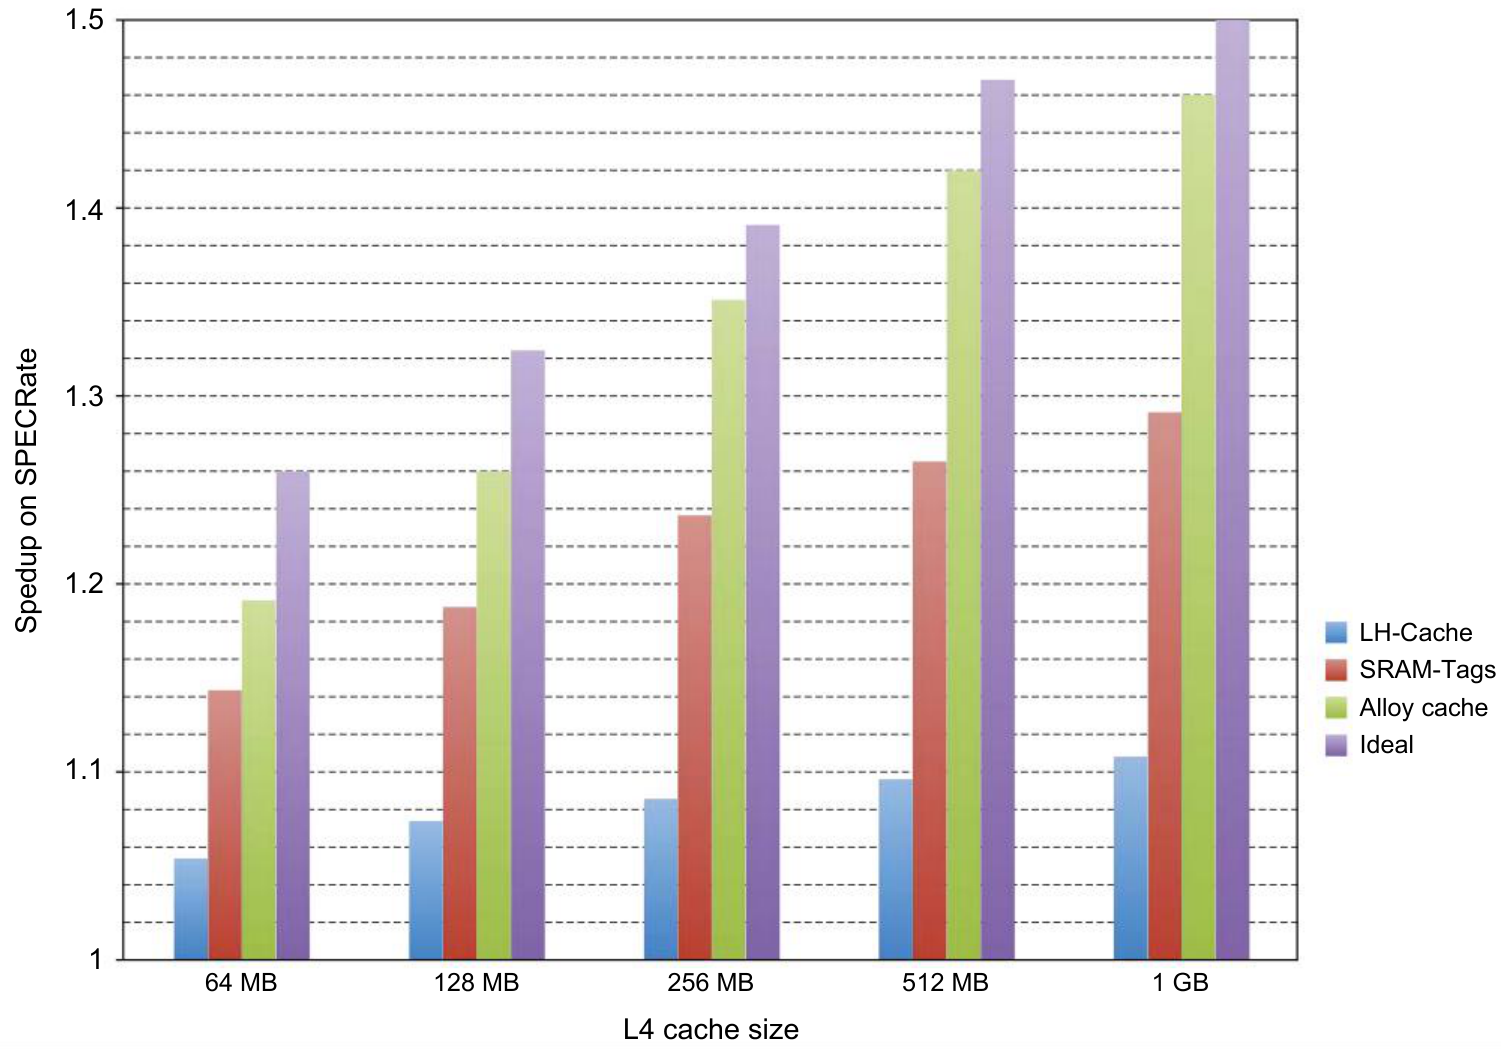
图 2.16(续)。 加速比为 1 表示 L4 LLC 未带来改善;如果 L4 完美无缺且访问不耗时,则能够达到加速比 2。测试使用内存访问最密集的 10 个 SPECCPI2006 基准测试,每个运行 8 次,并采用相应的未命中预测机制。Ideal 假定 LLC 只需访问和传输所请求的 64 字节块,且 LLC 的预测完全准确,即所有未命中都能以零成本预先获知。图中横轴为 L4 缓存容量,纵轴为 SPECRate 加速比;LH-Cache、SRAM-Tags、Alloy cache、Ideal 分别对应上述四种方案。
译注: 图 2.16 的原图注写作 SPECCPI2006,而前面的正文写作 SPECCPU2006。
HBM 很可能广泛用于多种不同配置:既可以作为某些高性能专用系统的全部内存,也可以作为多内存总线设计中的一部分内存,还可以充当 LLC 缓存。
存储层次结构优化小结
改善命中时间、带宽、未命中开销和未命中率的技术,通常也会影响平均内存访问时间公式中的其他部分,以及存储层次结构的复杂程度。图 2.17 汇总了这些技术,并估计了它们对复杂度的影响。
| 技术 | 命中时间 | 带宽 | 未命中开销 | 未命中率 | 功耗 | 硬件成本/复杂度 | 说明 |
|---|---|---|---|---|---|---|---|
| 小而简单的缓存 | + | − | + | 0 | 很简单;广泛使用 | ||
| 路预测缓存 | + | + | 1 | Pentium 4 使用 | |||
| 流水线化与多存储体缓存 | − | + | 1 | 广泛使用 | |||
| 非阻塞缓存 | + | + | 3 | 广泛使用 | |||
| 关键字优先与提前重启 | + | 2 | 广泛使用 | ||||
| 合并写缓冲区 | + | 1 | 在直写缓存中广泛使用 | ||||
| 降低缓存未命中的编译器技术 | + | 0 | 软件实现有挑战,但许多编译器能处理常见线性代数计算 | ||||
| 硬件预取指令和数据 | + | + | − | 指令:2;数据:3 | 大多数处理器提供预取指令;现代高端处理器还在硬件中自动预取 | ||
| 编译器控制的预取 | + | + | 3 | 需要非阻塞缓存;可能增加指令开销;许多 CPU 使用 | |||
| 用 HBM 增加一级缓存 | +/− | − | + | + | 3 | 依赖新的封装技术;效果高度依赖命中率的改善 |
图 2.17(续)。 一种技术通常只改善一个因素;但如果足够早地预取,就能减少未命中,否则也可以降低未命中开销。+表示改善该因素,−表示使该因素变差,空白表示没有影响。复杂度是主观评价,0 表示最容易,3 表示较有挑战。
表中的+表示该技术改善相应因素,−表示使相应因素变差,空白表示没有影响。一般来说,没有哪一种技术能改善一个以上的类别。
译注: 原文正文与图注在此使用“1、2、64 次命中”的说法,但图例为 Hit-under-1-miss、Hit-under-2-misses、Hit-under-64-misses。数字在图例中修饰未完成未命中数量,详见图后说明。 ↩︎