2.6 融会贯通:ARM Cortex-A53 与 Intel Core i9 12900 的存储层次结构
本节介绍 ARM Cortex-A53(以下简称 A53)和 Intel Core i9 12900(以下简称 i9)的存储层次结构,并通过一组单线程基准测试,展示各组成部分的性能。先考察存储系统较简单的 Cortex-A53,再更详细地分析 i9,逐步追踪一次内存访问。本节假定读者熟悉采用虚拟地址索引的两级缓存层次结构。附录 B 详细解释了这种存储系统的基本组成;如果对此还不熟悉,强烈建议先回顾附录 B 的 Opteron 示例。
理解了 Opteron 的组成之后,下面对结构相似的 A53 系统的简要说明就容易掌握了。
ARM Cortex-A53
Cortex-A53 是一种可配置的核,支持同时包含 32 位和 64 位模式的 ARMv8A ISA。它以 IP(intellectual property,知识产权)核的形式交付。在嵌入式系统、PMD 及相关市场中,IP 核是主要的技术交付形式;数十亿颗 ARM、MIPS 和 RISC-V 处理器就是基于这些 IP 核制造的。注意,IP 核与 Intel i7 或 AMD Athlon 多核处理器中的“核”不是同一概念。IP 核本身也可以是多核结构,它的设计目标是与其他逻辑集成,包括专用处理器(如视频编码器或解码器)、I/O 接口和内存接口,然后制造出针对特定应用优化的处理器;从这个意义上说,它是芯片的核心。例如,Cortex-A53 IP 核用于多种平板电脑和智能手机,其设计高度重视能效,这是电池供电 PMD 的关键指标。A53 核非常普及,可以在一个芯片上配置多个核,用于高端 PMD;这里的讨论聚焦于单核。
IP 核通常分为两种。**硬核(hard core)**针对某个半导体厂商优化,是一个通过外部接口与其他部分连接的黑盒;这些接口仍位于芯片内部。硬核通常只允许参数化配置核外的逻辑,例如 L2 缓存容量,IP 核本身不能修改。**软核(soft core)**通常以使用标准逻辑单元库的形式交付,可以面向不同半导体厂商进行编译,也可以修改。不过,现代 IP 核十分复杂,大幅修改仍然很困难。通常,硬核具有更高的性能和更小的裸片面积,而软核能够移植到其他厂商的工艺,并且更容易修改。
Cortex-A53 每个时钟周期可以发射两条指令,时钟频率最高为 1.3 GHz。它支持两级 TLB 和两级缓存;图 2.18 汇总了存储层次结构。发生未命中时,先返回关键字;其余未命中处理尚未结束,处理器便可以继续执行。系统最多支持 4 个存储体。当数据缓存容量为 32 KiB、页大小为 4 KiB 时,每个物理页可能映射到两个不同的缓存地址,因为缓存索引占 7 位,块内偏移占 6 位,两者之和比页内偏移多 1 位。附录 B 的 B.3 节介绍了如何在未命中时通过硬件检测避免这类别名。图 2.19 展示 32 位虚拟地址如何索引 TLB 和缓存,正文假定一级缓存为 32 KiB、二级缓存为 1 MiB、页大小为 16 KiB。
| 结构 | 容量 | 组成 | 典型未命中开销(时钟周期) |
|---|---|---|---|
| 指令 MicroTLB | 10 项 | 全相联 | 2 |
| 数据 MicroTLB | 10 项 | 全相联 | 2 |
| L2 统一 TLB | 512 项 | 四路组相联 | 20 |
| L1 指令缓存 | 8~64 KiB | 两路组相联;64 字节块 | 13 |
| L1 数据缓存 | 8~64 KiB | 两路组相联;64 字节块 | 13 |
| L2 统一缓存 | 128 KiB~2 MiB | 16 路组相联;LRU | 124 |
图 2.18(续)。 页映射缓存(page map cache)记录一组虚拟页对应的物理页位置,以降低 L2 TLB 未命中开销。L1 缓存采用虚拟地址索引、物理地址标签;L1 数据缓存和 L2 均采用写回策略,默认在写入时分配。所有缓存的替换策略都是近似 LRU。如果 MicroTLB 和 L1 同时未命中,到 L2 的未命中开销会更高。L2 到主存的总线宽度为 64~128 位,较窄的总线带来的未命中开销更大。
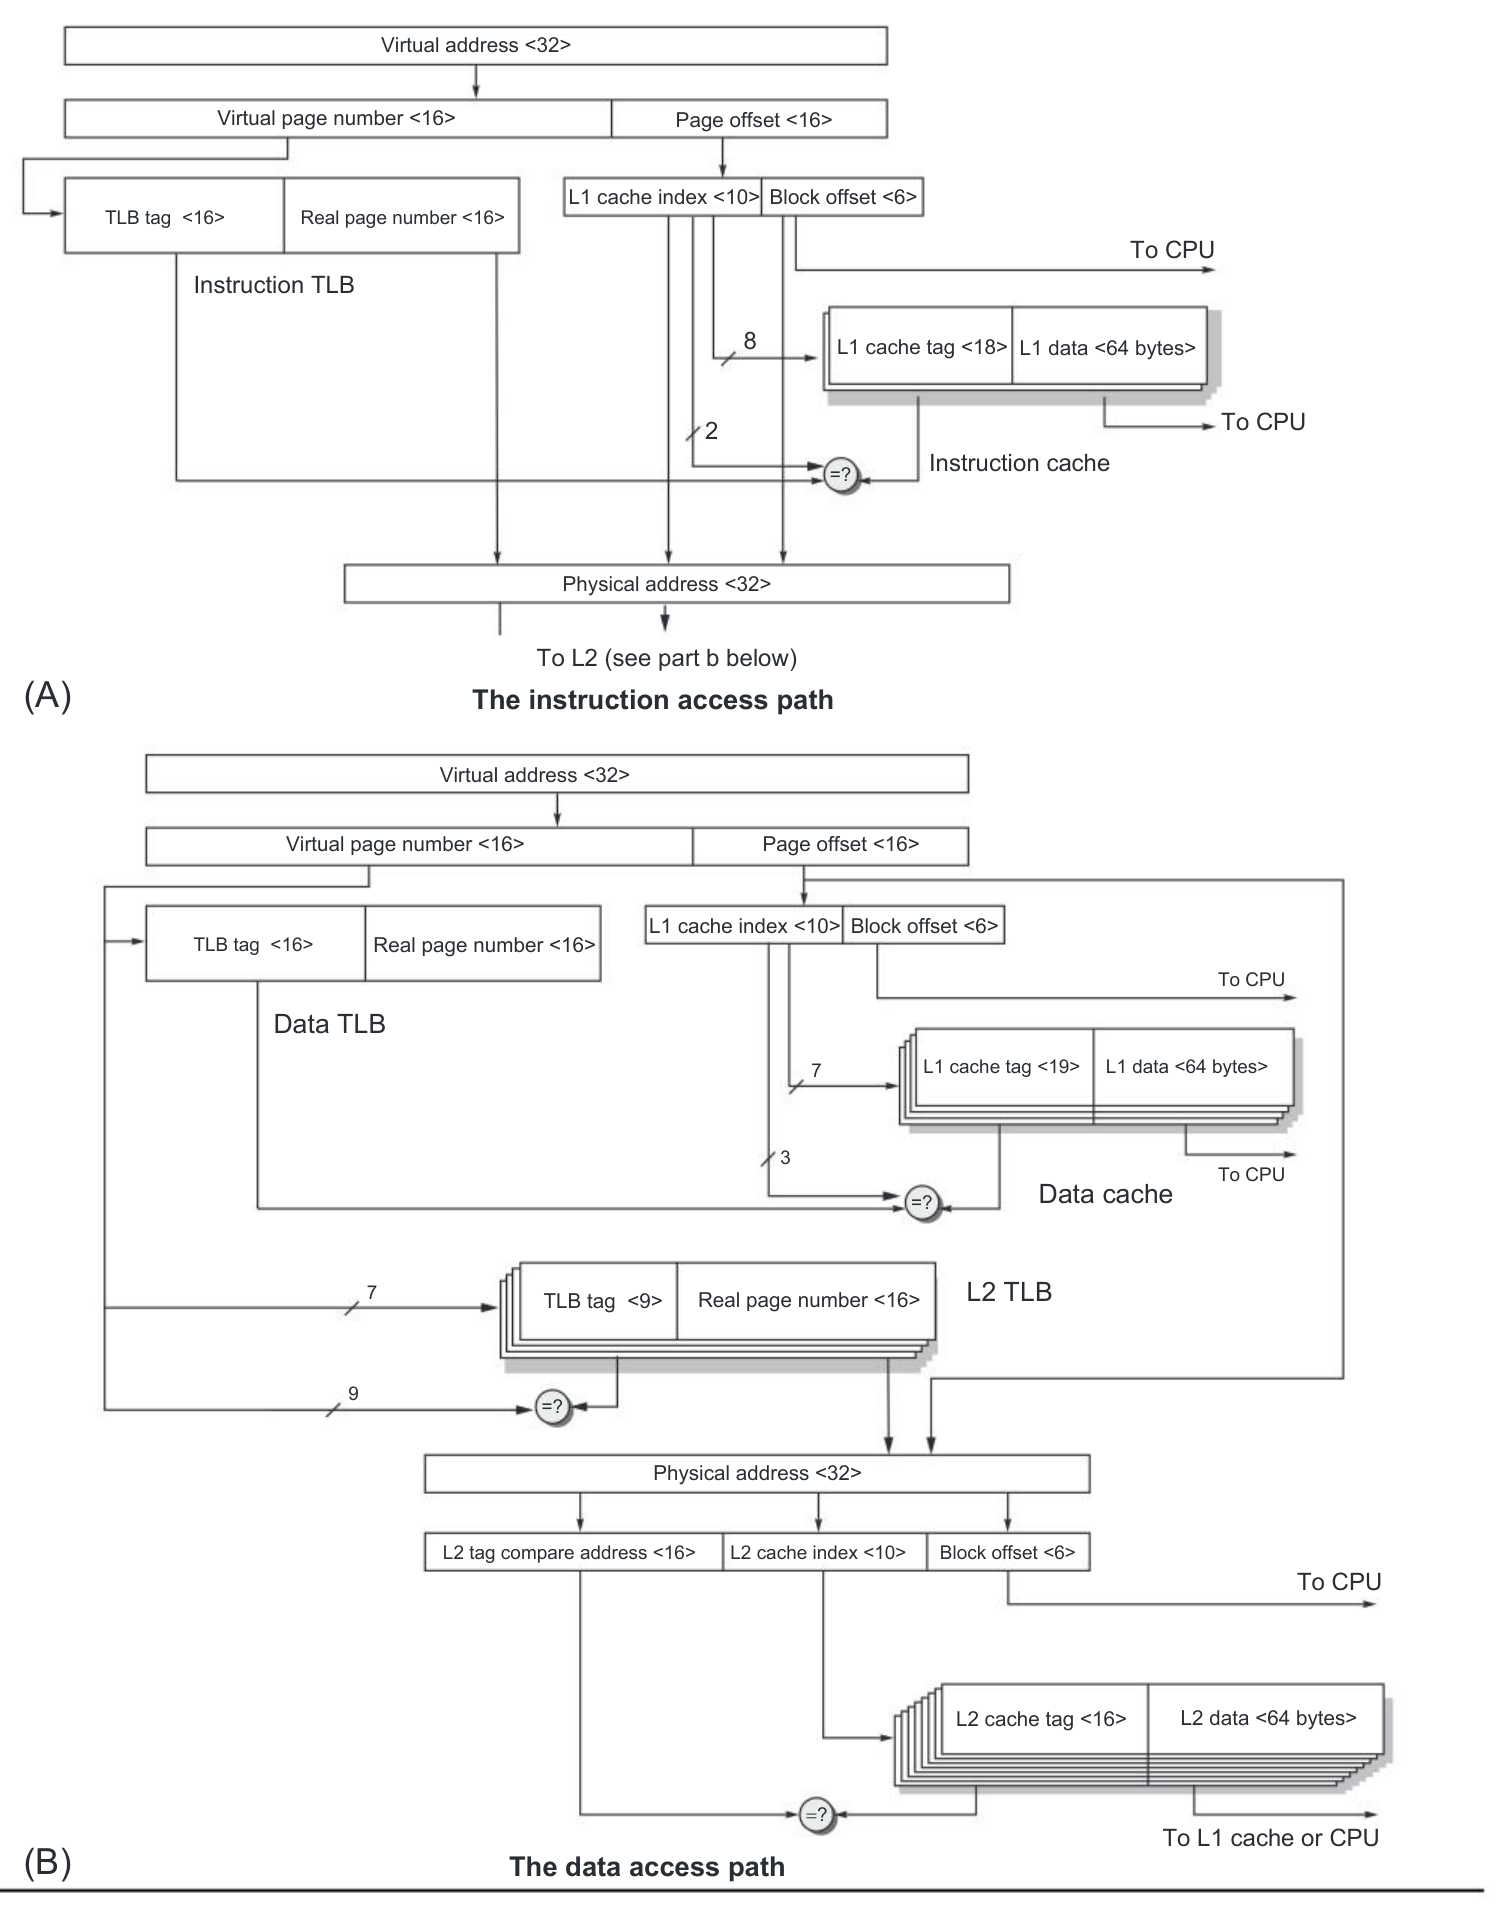
图 2.19(续)。 上半部分 A 为指令访问,下半部分 B 为数据访问,包括 L2。指令 TLB 和数据 TLB 都是全相联结构,各有 10 项;本图示例使用 64 KiB 页面。L1 指令缓存为两路组相联,块大小 64 字节,容量 32 KiB;L1 数据缓存容量 32 KiB,四路组相联,块大小 64 字节。L2 TLB 有 512 项,四路组相联。L2 缓存为 16 路组相联,块大小 64 字节,容量范围原图注写作 128 cKiB~2 MiB;图中画出的是 1 MiB L2。图中省略了缓存和 TLB 的有效位及保护位。
图内术语对照:Virtual address=虚拟地址;Physical address=物理地址;Virtual page number=虚拟页号;Real page number=物理页号;Page offset=页内偏移;Block offset=块内偏移;cache index=缓存索引;cache tag=缓存标签;L2 tag compare address=用于 L2 标签比较的地址;Instruction/Data TLB=指令/数据 TLB;Instruction/Data cache=指令/数据缓存;To CPU=送往 CPU;To L2=送往 L2;To L1 cache or CPU=送往 L1 缓存或 CPU。尖括号中的数字表示位数,标有 bytes 的数据字段表示字节数;“=?”为相等比较。
译注: 原正文写页大小为 16 KiB,图 2.19 的图注和图内 16 位页内偏移对应的却是 64 KiB。图 2.18 把 L1 数据缓存列为两路组相联,图 2.19 则写四路;图中 7 位索引与 6 位块内偏移,也与 32 KiB、四路组相联数据缓存相符。原图注中的“cKiB”并非常规容量单位。
Cortex-A53 存储层次结构的性能
原文对 Cortex-A8 的存储层次结构进行测量,配置为 32 KiB 一级缓存和 1 MiB L2 缓存,运行 SPECInt2006 基准测试。1
这些 SPECInt2006 程序的指令缓存未命中率很低,即使只看 L1 也是如此:大多数接近零,全部低于 1%。这可能是因为 SPECCPU 程序偏重计算,而两路组相联缓存又消除了大多数冲突未命中。
图 2.20 给出了数据缓存结果,其 L1 和 L2 未命中率都不可忽视。L1 未命中率从 0.5% 到 37.3%,相差约 75 倍,中位数为 2.4%。L2 全局未命中率从 0.05% 到 9.0%,相差 180 倍,中位数为 0.3%。素有“缓存克星”之称的 MCF 达到了上限,并显著影响均值。请记住,L2 全局未命中率远低于 L2 局部未命中率;例如,单独考察 L2 时,未命中率的中位数为 15.1%,而全局未命中率的中位数只有 0.3%。
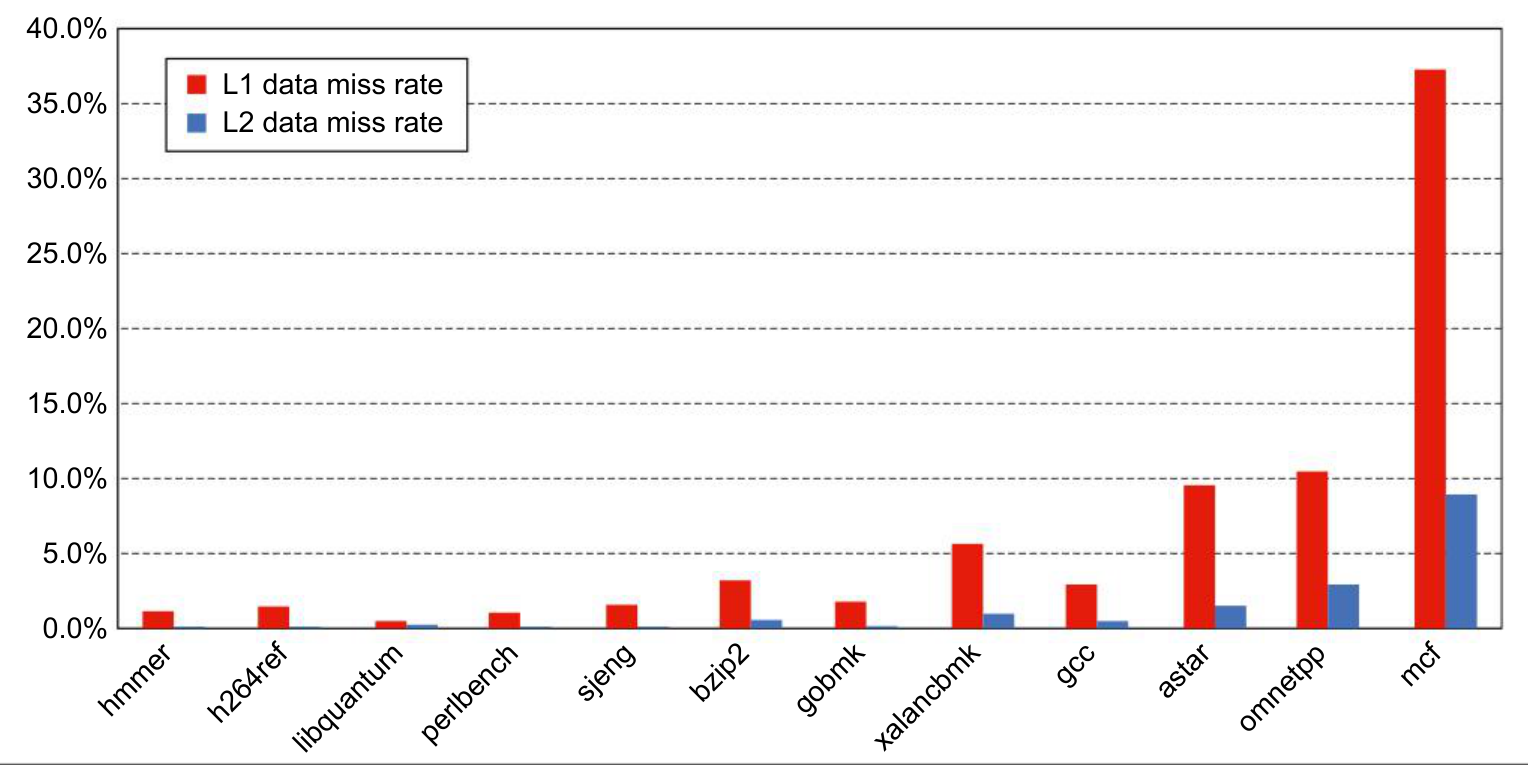
图 2.20(续)。 内存占用较大的应用,往往在 L1 和 L2 中都有较高的未命中率。注意,L2 的指标是以全部访问为分母的全局未命中率,包括在 L1 命中的访问。MCF 素有“缓存克星”之称。红柱表示 L1 数据未命中率,蓝柱表示 L2 数据全局未命中率。
使用这些未命中开销
采用图 2.18 中的未命中开销,可以得到图 2.21 所示的每次数据访问平均开销。虽然 L1 的未命中率约为 L2 的 7 倍,但 L2 的未命中开销是 L1 的 9.5 倍,因此对于给存储系统带来较大压力的基准测试,L2 未命中的影响略占上风。下一章将考察缓存未命中对总体 CPI 的影响。
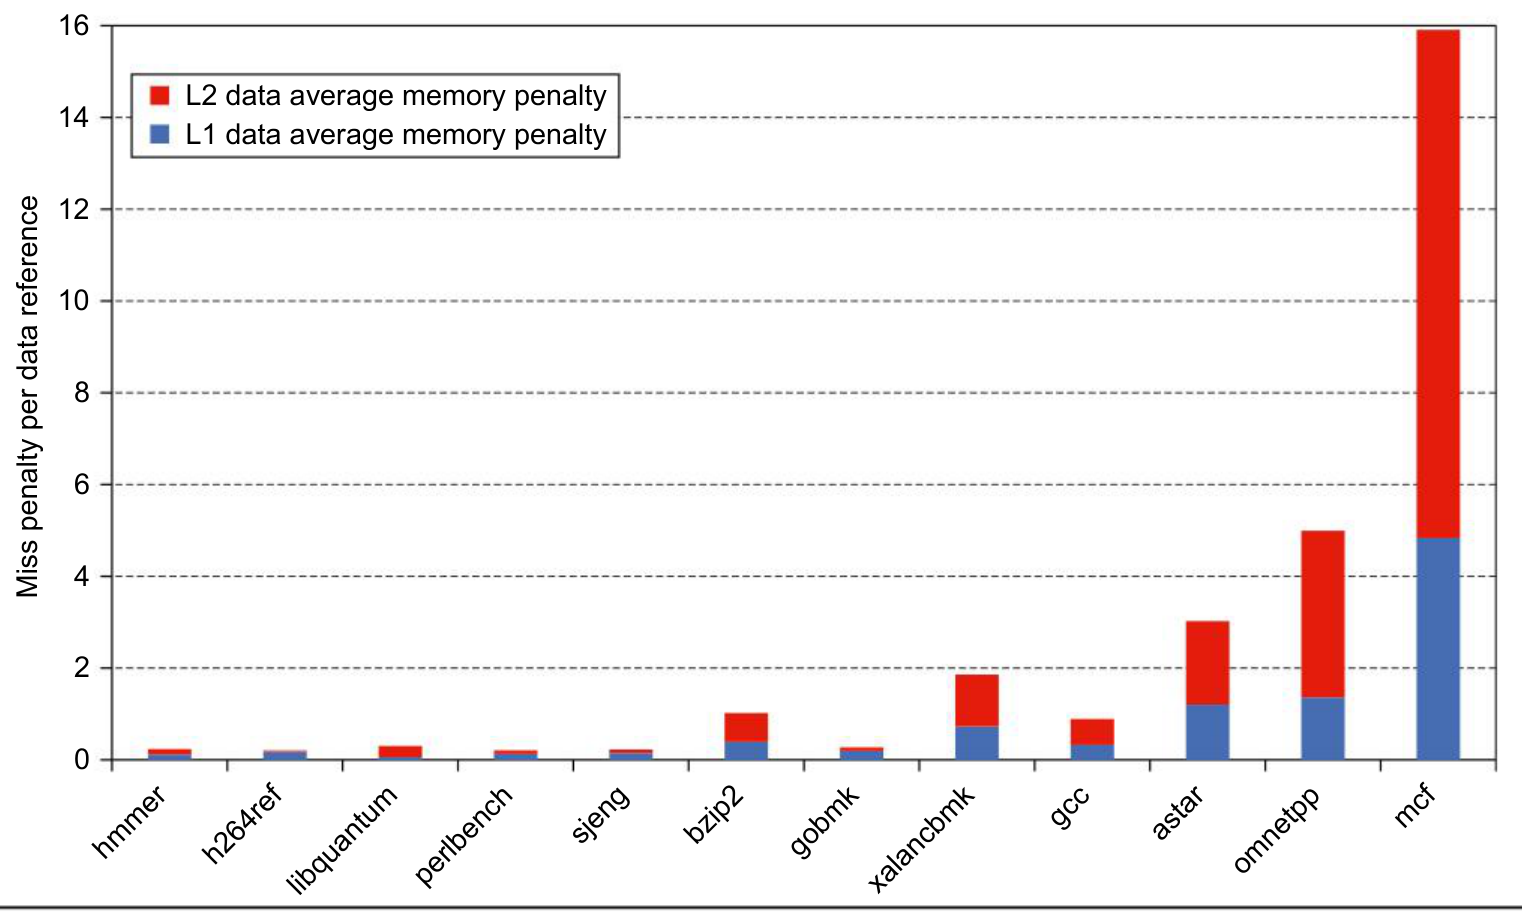
图 2.21(续)。 尽管 L1 未命中率明显较高,但 L2 未命中开销超过 L1 的 5 倍,因此 L2 未命中仍可能产生显著影响。纵轴为每次数据访问的未命中开销;蓝色为 L1 数据平均内存开销,红色为 L2 数据平均内存开销。
Intel Core i9
i9 支持 x86-64 ISA,也就是 80x86 体系结构的 64 位扩展。采用 Alder Lake 微体系结构的 i9 12900 属于 big.little 设计,组合了两类核:8 个性能核(P-core)和 8 个能效核(E-core)。P 核时钟频率更高,并支持多线程(见第 3 章)。本章从单个 P 核的角度,讨论存储系统的设计与性能。
i9 的流水线和多线程性能将在第 3 章探讨,多处理器性能将在第 5 章考察。
i9 的每个核采用多发射、动态调度的 16 级流水线,每个时钟周期最多执行 4 条 80x86 指令;第 3 章将详细介绍。在 2024 年,最快的 i9 在 Turbo Boost 模式下,单个 P 核的时钟频率达到 5.1 GHz。当然,i9 不能让多个 P 核同时在 Turbo Boost 模式下工作而不发生过热。
i9 支持两个内存通道,每个通道连接各自的一组 DIMM,并可采用 DDR4 或 DDR5 并行传输。使用 DDR5-4800 时,最大内存带宽为 77 GB/s。
i9 使用 48 位虚拟地址和 36 位物理地址,原文据此给出的最大物理内存为 36 GiB。2 内存管理采用两级 TLB,见附录 B 的 B.4 节;图 2.22 汇总了相关参数。
| 特性 | 指令 TLB | 数据 DLB(原表列名) | 二级 TLB |
|---|---|---|---|
| 表项数 | 256 项,4 KiB 页面;32 项,2/4 MiB 页面 | 96 项,4 KiB 页面;32 项,2/4 MiB 页面;8 项,1 GiB 页面 | 2048 项,用于 4 KiB、2 MiB 和 1 GiB 页面 |
| 相联度 | 8 路 | 6 路、4 路、8 路 | 16 路 |
| 替换策略 | 伪 LRU | 伪 LRU | 伪 LRU |
| 访问延迟 | 1 个周期 | 1 个周期 | 8 个周期 |
| 未命中 | 8 个周期 | 8 个周期 | 访问页表需数十至数百个周期 |
图 2.22(续)。 一级 TLB 支持标准 4 KiB 页大小,并为其他页大小设置独立 TLB。数据 TLB 还包含分别用于加载和存储的小型 TLB。i9 可以用硬件页表遍历器并行处理 4 个 L2 TLB 未命中。关于多级 TLB、多种页大小支持以及硬件 TLB 未命中处理器的进一步讨论,请参阅在线附录 L。
译注: 原表将数据 TLB 列名拼为 Data DLB;表内参数及图注仍在讨论数据 TLB。
图 2.23 汇总了 i9 的三级缓存层次结构。一级缓存采用虚拟地址索引和物理地址标签,见附录 B 的 B.3 节;L2 和 L3 采用物理地址索引。与早期 Skylake 微体系结构相比,最新的高端处理器选择显著增大 L2,达到原来的 2~4 倍,而 L3 容量的增幅较小。这样一来,全部 L2 的总容量与 L3 总容量更为接近,因此设计者决定让 L3 采用**非包含式(noninclusive)**结构。某些版本的 i9 将支持采用 HBM 封装的四级缓存。
| 特性 | L1 指令缓存 | L1 数据缓存 | L2 | L2(原表末列) |
|---|---|---|---|---|
| 容量 | 32 KiB | 48 KiB;双端口;8 个存储体 | 每核 1.25 MiB | 所有核共享 30 MiB;非包含式 |
| 相联度 | 8 路 | 6 路 | 10 路 | 15 路 |
| 访问延迟 | 4 个周期 | 5 个周期 | 15 个周期 | 50 个周期 |
| 替换策略 | 伪 LRU | 伪 LRU | 加权 n 位 LRU | 加权 n 位 LRU |
图 2.23(续)。 三级缓存都采用写回和 64 字节块。L1 和 L2 为每核私有,L3 则由芯片上的各核共享。L3 在物理上分布为靠近各核的多个存储体,以简单的散列函数将地址分配到 L3 存储体。三级缓存都是非阻塞的,允许多个未完成写请求。L1 使用合并写缓冲区;如果写入时相应缓存行不在 L1,就将数据暂存其中,即 L1 写未命中不会分配缓存行。L3 是非包含式的,这使全部 L2 与 L3 合起来能够容纳的数据量超过 L3 容量;包含式 L3 则做不到这一点。非包含性对缓存一致性的影响将在第 5 章讨论。替换策略采用伪 LRU 与近似 LRU 的变体:L1 使用单个位,即一种 NRU 形式;L2 和 L3 使用多位方案。
译注: 原表最后两列均写作 L2;根据本表图注以及紧邻正文,最后一列实际讨论 L3。译表保留原列名,并明确指出这一差异。
图 2.24 标出了访问存储层次结构的各个步骤,假定页大小为 4 KiB。首先,将 PC 送到指令缓存。指令缓存索引的计算为:
因此需要 6 位索引。指令地址中的页号部分为 位,送到指令 TLB(步骤 1);与此同时,虚拟地址的 12 位页内偏移送到指令缓存(步骤 2)。注意,八路组相联的指令缓存恰好需要 12 位缓存地址:6 位索引,加上 64 字节块所需的 6 位块内偏移,因此不可能出现别名。
早期 i7 的指令缓存采用四路组相联,一个虚拟地址所对应的块可能出现在缓存中的两个位置,因为相应物理地址在这一位上可能为 0,也可能为 1。对于指令,这并不构成问题:即使同一条指令出现在缓存的两个位置,两个版本也必然相同。如果允许数据以这种方式重复存在,也就是出现别名,那么修改页映射时就必须检查缓存;不过,页映射修改并不频繁。只需采用一种很简单的**页着色(page coloring)**办法,见附录 B 的 B.3 节,就能消除这类别名的可能性:把偶数页号的虚拟页映射到偶数页号的物理页,奇数页同理。这样,虚拟页号与物理页号的最低位始终一致,便不会产生别名。
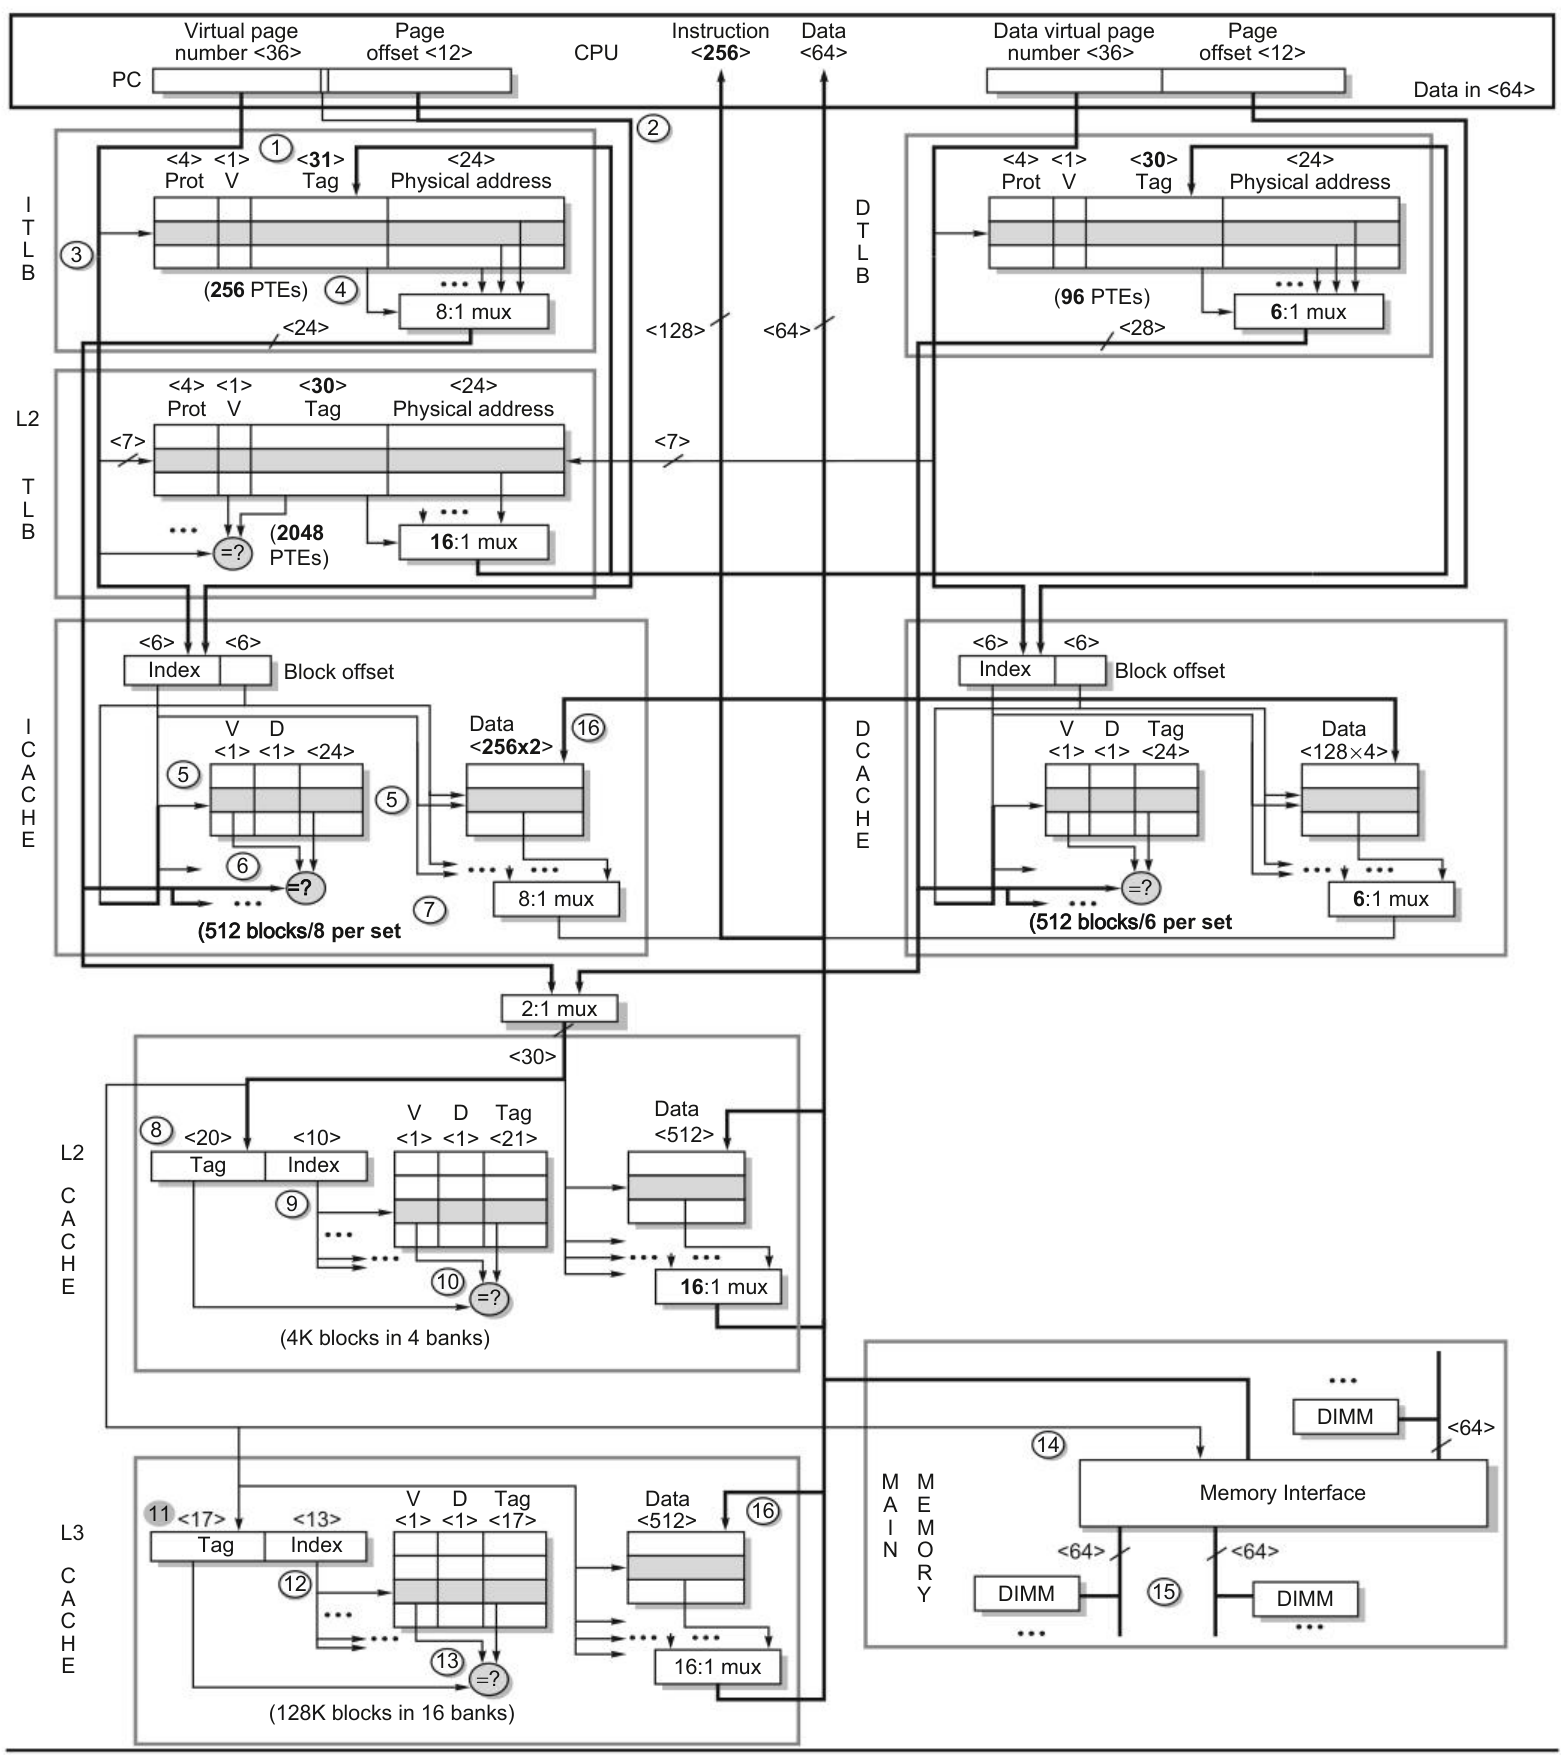
图 2.24(续)。 图中只画出读取操作,以及用于 4 KiB 页面的一级 TLB。写入过程类似,但由于 L1 缓存不采用写分配,写未命中只需将数据放入写缓冲区。系统包含多个数据 TLB,指令和数据 TLB 还都支持大页面。
图内术语对照:Virtual page number/Data virtual page number=虚拟页号/数据虚拟页号;Page offset=页内偏移;Physical address=物理地址;Tag=标签;Index=索引;Block offset=块内偏移;Prot=保护字段;V=有效位;D=脏位;PTEs=页表项;mux=多路选择器;Instruction=指令;Data/Data in=数据/写入数据;I/D CACHE=指令/数据缓存;I/D TLB=指令/数据 TLB;MAIN MEMORY=主存;Memory Interface=内存接口;blocks per set=每组的块数;banks=存储体。圆圈中的数字对应正文的访问步骤,尖括号中的数字表示位数。
译注: 本图多处标注与相邻正文及图 2.23 的参数不一致。例如,L2 在图内使用 16∶1 选择器、10 位索引,并标有“4 个存储体中 4K 个块”,而正文使用 10 路、11 位索引和 1.25 MiB;L3 图内写“16 个存储体中 128K 个块”,使用 16∶1 选择器和 13 位索引,而正文采用 8 个存储体、15 路、12 位索引、30 MiB。图内还有标签位宽和数据缓存块数的不一致。这些原图参数按原样保留,不能将图与正文视作一套完全一致的实现参数。
访问指令 TLB,寻找与地址匹配的有效 PTE(步骤 3 和 4)。TLB 除了转换地址,还检查 PTE 的保护要求,判断本次访问是否因违反访问权限而应引发异常。
指令 TLB 未命中时,先访问 L2 TLB,也称 STLB。它包含 2048 个用于 4 KiB 页面的 PTE,采用 16 路组相联结构。从 L2 TLB 装入 L1 TLB 需要 8 个时钟周期,加上最初访问 L1 TLB 的一个周期,共形成 9 个周期的未命中开销。如果 L2 TLB 也未命中,则由硬件算法遍历页表,更新 TLB 表项。在线附录 L 的 L.5 和 L.6 节介绍了页表遍历器与页结构缓存。
最坏情况下,页面不在内存中,需要操作系统从辅助存储器读入。处理一次缺页期间,处理器原本能够执行数百万条指令,因此只要有其他进程等待运行,操作系统就会换入另一个进程。如果没有 TLB 异常,则继续访问指令缓存。
地址的索引字段送往指令缓存全部 8 个存储体(步骤 5)。指令缓存标签为 位,即物理地址减去 6 位索引和 6 位块内偏移。原文随后将“四个标签和有效位”与指令 TLB 提供的物理页框进行比较(步骤 6)。i9 每次取指需要 32 字节,因此再从 6 位块内偏移中取 1 位,选择所需的 32 字节。原文据此写道:“6+1,也就是 87 位”,用于选择并向处理器发送 32 字节指令。3 L1 缓存采用流水线结构,命中延迟为 4 个时钟周期(步骤 7);未命中则访问二级缓存。
前文提到,指令缓存采用虚拟地址寻址和物理地址标签。二级缓存采用物理地址寻址,因此将 TLB 输出的物理页地址与页内偏移组合,构成访问 L2 的地址。L2 索引为:
因此,30 位块地址,即 36 位物理地址减去 6 位块内偏移,分为 19 位标签和 11 位索引(步骤 8)。索引和标签再次送到该核的 L2 缓存(步骤 9),并行进行比较。如果某一项匹配且有效(步骤 10),经过最初 15 个周期的延迟后,按每时钟周期 8 字节的速率,顺序返回整个块。
如果 L2 未命中,就访问 L3。对于包含 8 个 P 核和 8 个 E 核的 i9-12900,L3 总容量为 30 MiB,分成 8 个存储体。通过散列减少冲突,从散列结果中取 3 位选择存储体,而且只访问该存储体。每个存储体内的索引大小为:
12 位索引(步骤 11)送往选中 L3 存储体的全部 15 路(步骤 12)。L3 标签为 位,与 TLB 给出的物理地址进行比较(步骤 13)。如果命中,经过最初 50 个周期的延迟后,按每周期 16 字节的速率返回整个块,并将其同时放入 L1 和 L2。如果 L3 未命中,就发起内存访问。
i9 有两个独立内存通道;Xeon 服务器处理器则更多。这些通道可以连接 HBM 内存或标准 DIMM。由主存处理的未命中,其总延迟约等于判断 L3 未命中所需的 50 个处理器周期,加上取得关键指令的 DRAM 延迟。对于单存储体 DDR5-4800 SDRAM 和 4.0 GHz CPU,首批 16 字节的 DRAM 延迟约为 40 ns,即 160 个时钟周期,总未命中开销约为 200 个时钟周期。内存控制器以每个 I/O 总线时钟周期 32 字节的速率,填充 64 字节缓存块的其余部分,这还需 2.5 ns,即 10 个时钟周期。发生未命中时,所缺的块写入 L2 和 L1,不插入 L3;请记住,LLC 是非包含式的。
LLC 的主要作用是保存从 L2 淘汰的块。忽略多个核之间的共享,L2 和 L3 将保存不同的块,因此它们能缓存的数据总量等于两者容量之和,而不只是 L3 的容量。L2 和 L3 都采用写回,所以任何一次未命中都可能分别触发旧块向 L3 或内存写回。i9 配备合并写缓冲区,在下一级缓存未用于读取时,写回脏缓存行。未命中时还会检查写缓冲区;如果所需缓存行就在缓冲区内,便直接从中满足此次未命中。
现在假设指令是存储而不是加载。存储发射时,同样先查找数据缓存。未命中会使块进入写缓冲区,因为 L1 在写未命中时不分配块。命中时,也不会立即更新 L1 或 L2,而要等到确定这条存储指令不再具有推测性之后才更新。在此期间,存储操作保留在加载—存储队列中;这个队列属于处理器的乱序控制机制。
i9 还支持从存储层次结构的下一级向 L1 和 L2 预取。它的预取器与前文考察过性能的 i7 预取器相似。
i9 存储系统的性能
我们使用 SPECINT2017 基准测试,即 SPECINTRate,评价 i9 缓存结构的性能。i9 流水线使用独立取指单元、推测执行、指令预取和数据预取,结构复杂,因而难以与更简单处理器的缓存性能直接比较。如前所述,使用预取的处理器可以独立于程序实际执行的内存访问,另外产生缓存访问。由实际指令访问或数据访问所触发的缓存访问,有时称为按需访问(demand access),以区别于预取访问。按需访问既可能来自推测取指,也可能来自推测数据访问。
其中一些访问随后会被取消;第 3 章详细介绍推测执行与指令完成确认(instruction graduation)。推测执行处理器产生的未命中次数,至少与顺序执行、非推测处理器一样多,通常还会更多。由于这些复杂因素,单谈未命中率的意义已经不大。我们改用如今常见的每千条指令未命中次数(misses per kilo instructions,MPKI):分子为未命中次数,分母为已提交指令数,再按每千条指令计量。不同层级都可以给出 MPKI,因此有 MPKID1,即一级数据缓存指标,以及原文所写的 MKPI2 和 MKPI3,分别表示 L2 和 L3 的未命中次数。4
按需未命中之外,指令和数据预取也会产生实际发生的未命中。如果预取器非常有效,取消预取便会产生其他未命中。发出预取并出现一次“预取未命中”,只要能避免稍后发生的按需未命中,就可能让处理器运行得更快。i9 P 核的预取器是 Skylake 预取器的扩展;前文硬件预取一节中讨论过其性能。
i9 的取指单元尝试每周期取回 32 字节,因此每周期会取多条指令,这使指令缓存未命中率的比较更复杂。实际上,访问会读出整个 64 字节缓存行,随后的 32 字节取指不需要再次访问缓存,所以只按 64 字节块统计未命中。对于 SPECintRate 程序,32 KiB、八路组相联的指令缓存能实现非常低的指令未命中率。为简便起见,如果将未命中率定义为 64 字节块的未命中次数除以完成的指令数,那么除了 XALANCBMK,所有基准测试都低于 1%。由于一个 64 字节块通常包含 16~20 条指令,按每条指令衡量的有效未命中率还会低得多,具体取决于指令流的空间局部性。
图 2.25 展示了 SPECCPUINT2017 基准测试的 L1 数据缓存、L2 和 L3 的 MPKI。注意,有 4 个基准测试的 L1 数据缓存未命中相当多,每千条指令超过 20 次;前面已提到,Skylake 的 L1 预取器效果并不突出。同样这 4 个基准测试,即使使用容量达 1.25 MiB 的大 L2,L2 未命中仍达到每千条指令 10 次或更多。
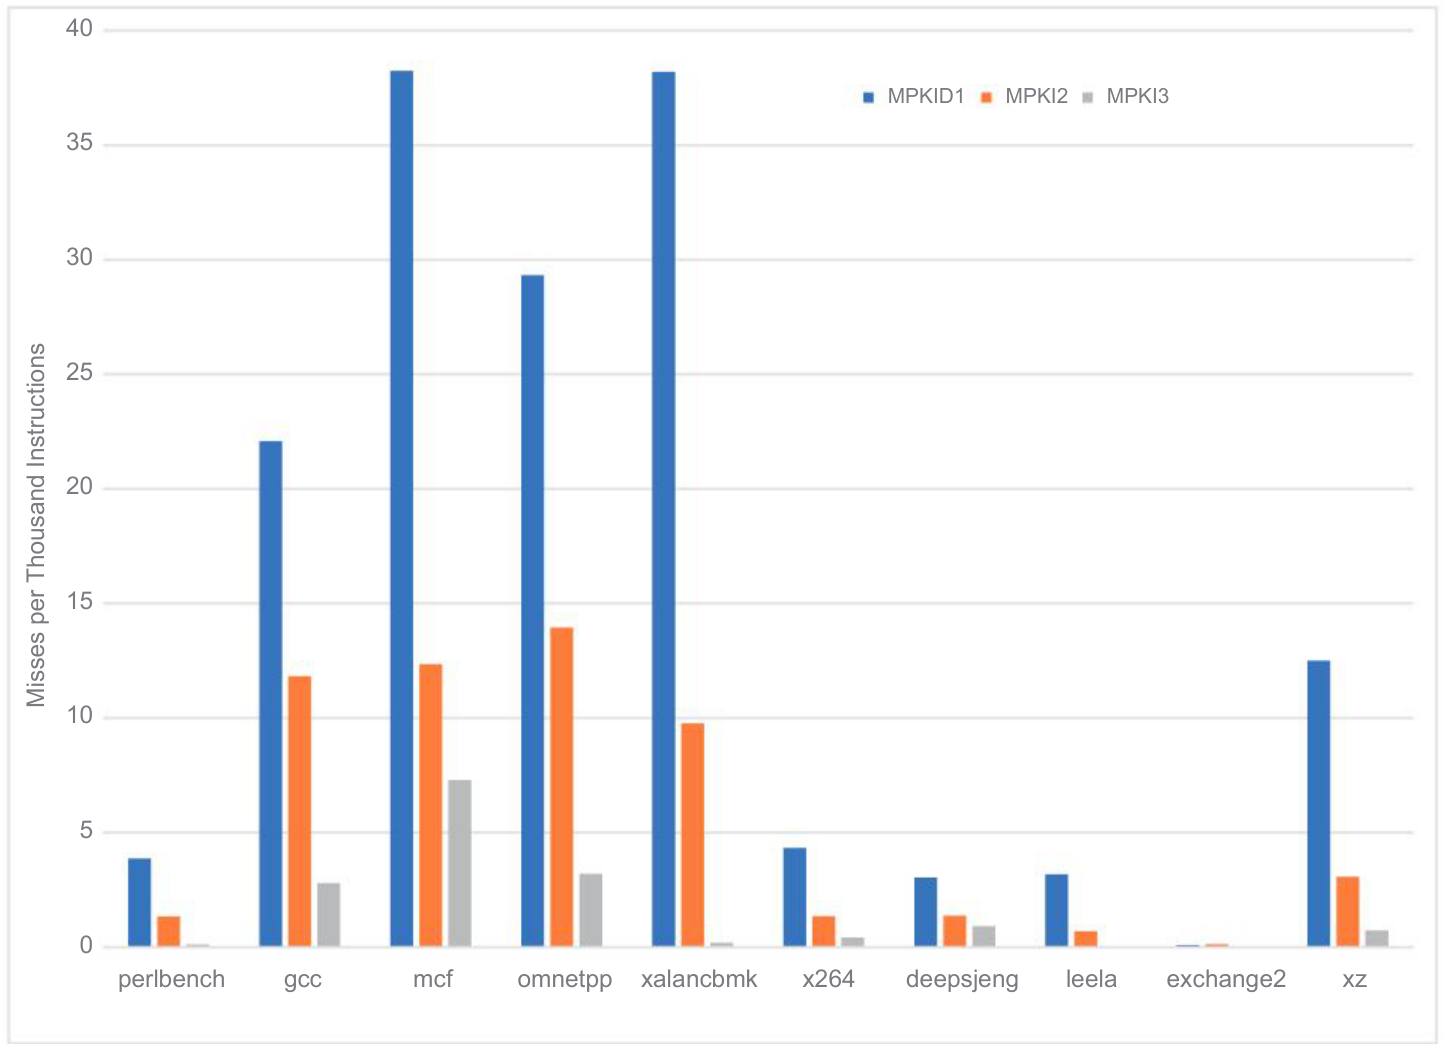
图 2.25(续)。 L2 和 L3 也处理 L1 指令缓存未命中,但只有很少一部分会越过 L2。预取已开启,正如前文所示,它显著减少了原本会由 L2 引起的 L3 按需未命中。图中纵轴为每千条指令的未命中次数;MPKID1、MPKI2、MPKI3 分别对应 L1 数据缓存、L2 和 L3。
图 2.25 没有反映未命中的潜在影响。当然,在采用非阻塞缓存和乱序执行的处理器中,要准确测量这一影响几乎不可能:相互重叠的未命中代价较低,而处理器尤其可能在较短的 L1 未命中期间继续忙于其他工作。为了粗略估计 L1、L2 和 L3 未命中的潜在影响,图 2.26 将各级 MPKI 乘以一次未命中访问下一级所需的平均延迟。这并非对实际代价的测量,而是用来提示不同层级未命中的潜在重要程度。
MCF 是众所周知的“缓存克星”,其 L3 未命中很显著。对于其他内存密集型基准测试,L1、L2 和 L3 未命中的影响相对均衡。回想前文对 i7 预取的讨论,一些 SPEC 浮点基准测试的缓存未命中率同样很高。
下一章将考察 i9 的 CPI 与缓存未命中的关系,以及其他流水线因素的影响。
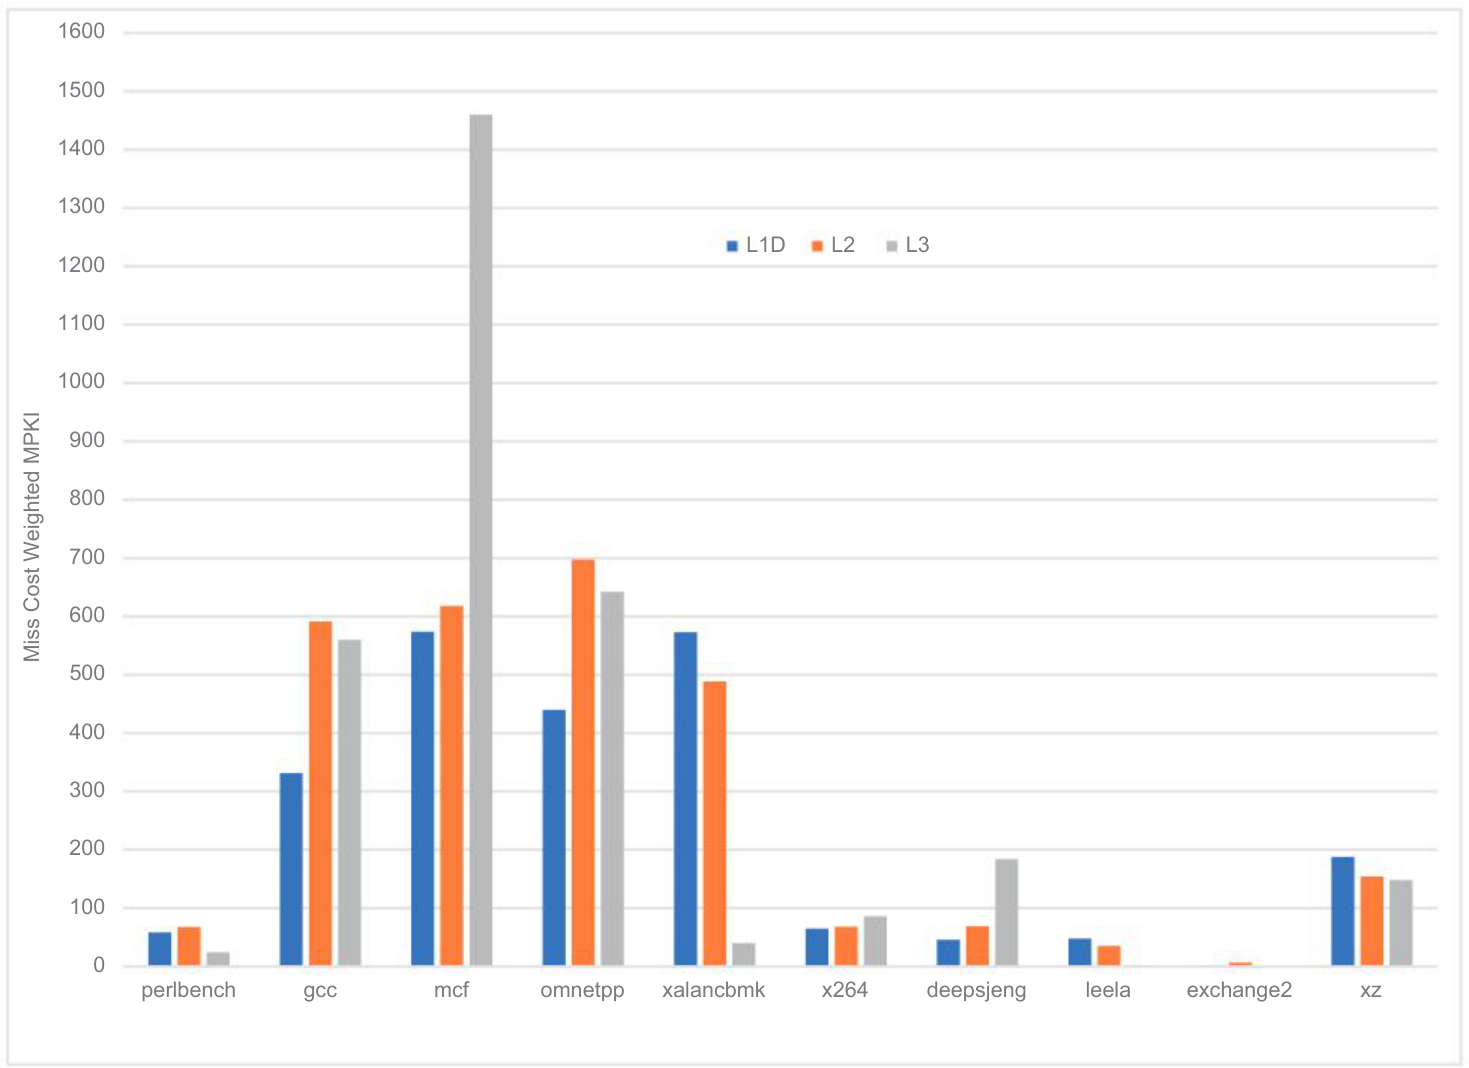
图 2.26(续)。 权重使用平均未命中开销,既忽略争用,也忽略未命中与指令执行重叠的可能性。纵轴为按未命中代价加权后的 MPKI,三组柱分别对应 L1D、L2 和 L3。