2.7 谬误与陷阱
存储层次结构在计算机体系结构的各个领域中,最天然地适合定量研究,似乎应该较少受到谬误与陷阱的影响。然而,本节受限的并不是无话可说,而是篇幅不足!
谬误:根据一个程序预测另一个程序的缓存性能
图 2.27 展示了 SPEC2000 基准测试套件中 3 个程序的指令和数据未命中率随缓存容量的变化。对于 4096 KiB 缓存,不同程序每千条指令的数据未命中次数分别为 9、2 或 90;对于 4 KiB 缓存,每千条指令的指令未命中次数分别为 55、19 或 0.0004。
数据库等商业程序即使使用较大的二级缓存,未命中率仍会很高,而 SPECCPU 程序通常不是这样。显然,将一个程序的缓存性能推而广之,用来判断另一个程序,并不明智。正如原文引用的图 2.23 所提醒的那样,差异可能非常大;甚至对整数密集型与浮点密集型程序相对未命中率的预测也可能出错,mcf 与 sphnix3 就提醒了我们这一点。1
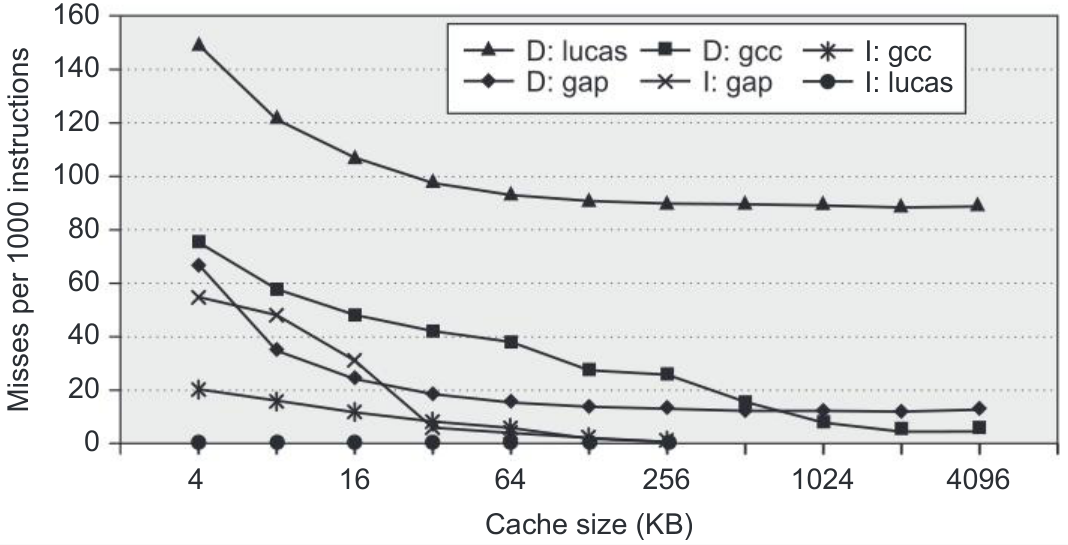
图 2.27(续)。 gcc 的指令未命中次数是 lucas 的 30,000~40,000 倍;反过来,lucas 的数据未命中次数是 gcc 的 2~60 倍。gap、gcc 和 lucas 都来自 SPEC2000 基准测试套件。图例中 I 表示指令未命中,D 表示数据未命中;纵轴为每 1000 条指令的未命中次数,横轴为缓存容量,原图横轴单位标作 KB。
陷阱:模拟足够多的指令,才能准确测量存储层次结构的性能
这里实际有三个陷阱。其一,试图用很短的访存轨迹预测大缓存的性能。其二,程序的局部性行为并非在整个执行过程中始终不变。其三,局部性还可能随输入而改变。
图 2.28 展示了同一个 SPEC2000 程序在 5 种输入下,每千条指令的累计平均指令未命中次数。对于这些输入,前 19 亿条指令的平均未命中率,与后续执行期间的平均未命中率相差很大。
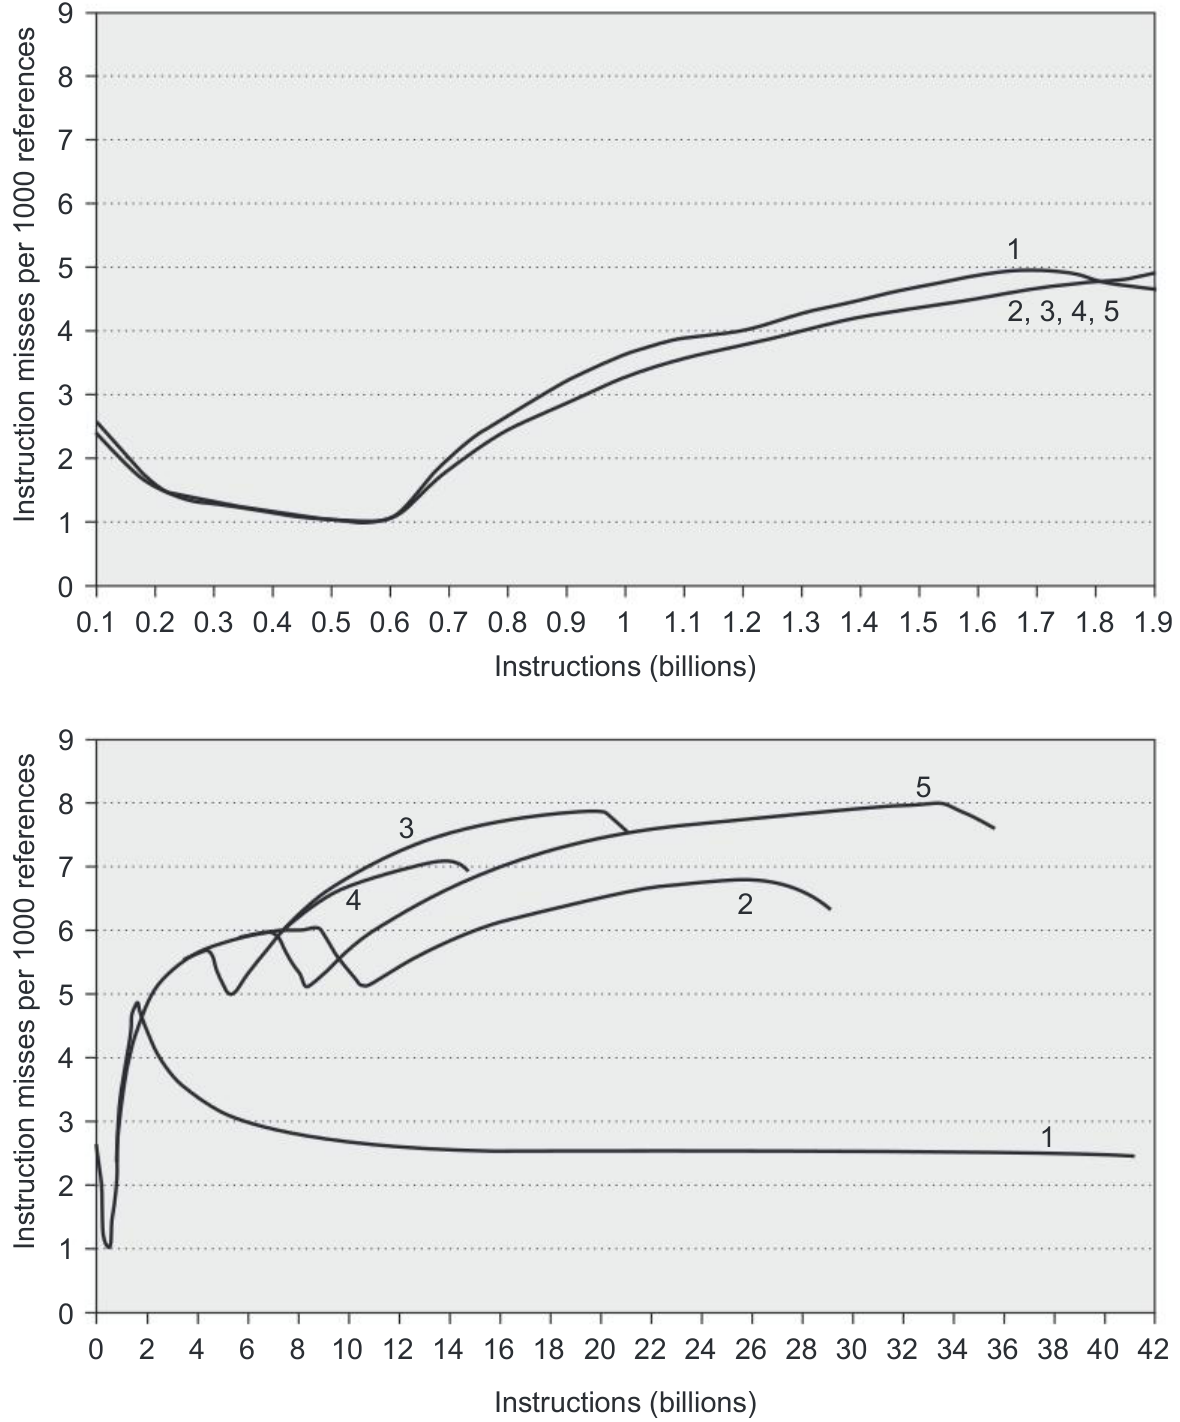
图 2.28(续)。 在前 19 亿条指令中,未命中次数的变化较小,5 种输入之间的差别也不大。运行至程序结束后,才能看出未命中次数如何随运行过程变化,又如何依赖输入。上图给出前 19 亿条指令的累计平均值:5 种输入都从每 1000 次访问约 2.5 次未命中开始,到约 4.7 次结束。下图展示运行至结束的累计平均值,所需指令数随输入不同,在 160 亿到 410 亿之间。前 19 亿条指令之后,每 1000 次访问的未命中次数随输入不同,在 2.4 到 7.9 之间变化。模拟对象是 Alpha 处理器,指令和数据分别使用 64 KiB、两路组相联、LRU 替换的 L1 缓存,另有一个统一的 1 MiB 直接映射 L2 缓存。图中 1~5 标识五种输入,横轴单位为十亿条指令,纵轴为每 1000 次访问的指令未命中次数。
陷阱:带缓存的系统未能提供足够高的内存带宽
缓存有助于降低平均内存访问延迟,但对于必须访问主存的应用,却不一定能提供较高内存带宽。体系结构设计者必须为这类应用在缓存之后配置高带宽内存(HBM)。第 4 章和第 5 章将再次讨论这一陷阱。
陷阱:引入一种“介于”两种现有技术之间,却在速度或价格上没有明确优势的存储技术
人们曾尝试引入新的存储技术,要么取代现有技术,要么填补两种现有技术之间的空白,例如 DRAM 与磁盘之间。多数尝试都失败了,因为新技术没有提供显著而持久的优势。有时,新技术每位成本更低,却慢得多;有时速度更快,却更昂贵。相变存储器,即 Micron 和 Intel 所称的 Xpoint,似乎是最近遇到这一陷阱的技术;更早还有电荷耦合器件、磁泡存储器和光盘等许多例子。
相比之下,Flash 是唯一取得重大成功的例子。Flash 获胜的原因在于:它不易失,速度又远快于磁盘,尤其是在读取方面;而且随着时间推移,每位成本的差距也大幅缩小。到 2022 年,除了大规模归档存储,Flash 已在很大程度上取代硬盘。
译注: 此处原文引用图 2.23,但该图是 i9 缓存参数表,并非程序间未命中率比较图;基准测试名称也确实拼作 sphnix3。 ↩︎