案例与习题
作者:Rajeev Balasubramonian、Norman P. Jouppi、Naveen Muralimanohar 和 Sheng Li。
案例一:用高级技术优化缓存性能
本案例涉及的概念:
- 非阻塞缓存
- 面向缓存的编译器优化
- 软件和硬件预取
- 计算缓存性能对更复杂处理器的影响
矩阵转置就是交换矩阵的行与列。下面这段简单的 C 循环展示了转置操作:
习题 2.1
[10/15/15/12/20]〈2.3〉 假设输入和输出矩阵都按行优先顺序存放,即同一行中相邻的元素占据连续的内存地址。现在要在一个处理器上执行 256×256 双精度矩阵转置。该处理器的 L1 数据缓存容量为 16 KB,采用全相联结构,因此不必考虑缓存冲突;替换策略为最近最少使用(LRU),块大小为 64 字节。请记住,一个双精度值占 8 字节。
假设 L1 未命中或预取需要 16 个周期,并且总会在 L2 命中;L2 每 2 个处理器周期能够处理一个请求。若数据位于 L1 中,前述内层循环每次迭代需要 4 个周期。缓存对写未命中采用写分配和写时取入(fetch-on-write)策略。再作一个不现实的假设:写回脏缓存块需要 0 个周期。
上述简单实现对输出矩阵的访问顺序并不理想;但是,应用循环交换优化,又会使输入矩阵的访问顺序不理想。因此,仅靠循环交换不足以改善性能,必须采用分块。
a. [10]〈2.3〉 要从分块执行中获益,缓存至少需要多大?
b. [15]〈2.3〉 在上述最小容量缓存中,分块版本与未分块版本的未命中次数相比如何?
c. [15]〈2.3〉 编写矩阵转置代码,以 B 为块大小参数,使用 B×B 的块。
d. [12]〈2.3〉 要使性能不受两个数组在内存中所处位置的影响,L1 至少需要多高的相联度?
e. [20]〈2.3〉 在计算机上试运行分块和未分块的 256×256 矩阵转置。根据你对该计算机存储系统的了解,实际结果与预期有多接近?如有可能,解释其中差异。
习题 2.2
[10]〈2.3〉 假设你正在为前述未分块矩阵转置代码设计硬件预取器。最简单的硬件预取器只在发生未命中之后预取顺序相邻的缓存块。更复杂的“非单位步长”硬件预取器能够分析未命中访问流,检测非单位步长并据此预取。
相比之下,软件预取判断非单位步长,与判断单位步长同样容易。例如,可以使用 __builtin_prefetch() 函数在 C 代码中插入软件预取。假设预取直接写入缓存,而且不存在“污染”,即不会覆盖那些必须比预取数据更早使用的数据。采用非单位步长预取器时,为获得最佳性能,在内层循环的稳定执行阶段,任一时刻必须有多少个尚未完成的预取?
习题 2.3
[15/20]〈2.3〉 使用软件预取时,既要让预取足够及时,赶得上数据使用,又要尽量减少未完成的预取数量,以免超出微体系结构的能力,并尽量减少缓存污染。不同处理器具有不同的能力和限制,使这个问题更加复杂。
a. [15]〈2.3〉 编写一个带软件预取的分块矩阵转置版本。
b. [20]〈2.3〉 估计并比较分块与未分块矩阵转置在使用和不使用软件预取时的性能。
案例二:融会贯通——高度并行的存储系统
本案例涉及的概念:
- 贯穿各层的问题:存储层次结构设计
- 现代处理器中的存储层次结构参数
图 2.29 的程序可用来评价存储系统的行为。关键在于准确计时,再让程序以不同步长访问内存,从而触及存储层次结构的不同层级。图中给出了 C 代码。
第一部分是一个过程,利用标准工具准确测量用户 CPU 时间;在某些系统上,可能需要修改此过程。第二部分是一组嵌套循环,以不同步长和缓存容量读写内存。为了准确测量缓存时间,代码会反复执行多次。第三部分仅测量嵌套循环的开销,以便从总测量时间中扣除,得到访问本身的耗时。结果按 .csv 文件格式输出,方便导入电子表格。
根据待回答的问题以及被测系统的内存容量,可能需要调整 CACHE_MAX。以单用户模式运行,或者至少在没有其他活动应用的情况下运行,结果会更加稳定。注意,这段代码在现代计算机上可能需要数分钟才能完成。图 2.29 的代码源于 University of California, Berkeley 的 Andrea Dusseau 编写的程序,并以 Saavedra-Barrera(1992)中的详细说明为基础。
图 2.29 用于评价存储系统的 C 程序
图 2.29(续)。
译注: 代码按原书保留,仅翻译注释并整理缩进。正文说测量“用户 CPU 时间”,但
get_seconds()实际调用的是time();正文提到的CACHE_MAX在代码中名为ARRAY_MAX。此外,label()的形参类型为int,原书输出格式却使用%ld,两者类型不匹配。原文并未针对这些差异给出修订版本;这里不静默修改程序。
这段程序后来经过修改,以修复在较新计算机上遇到的一些问题。兼容 Linux 和 Microsoft Visual C++ 的版本,可在原书提供的代码页面找到。
前面的程序假定程序地址与物理地址保持对应关系;对于少数采用虚拟地址缓存的计算机,这一假定成立。通常,重启之后不久,虚拟地址往往还与物理地址保持这种对应关系,因此可能需要重启计算机,才能在结果中得到平滑的曲线。
回答以下问题时,假设存储层次结构所有组成部分的容量都是 2 的幂。假设页面大小远大于二级缓存块大小,如果存在二级缓存的话;并且二级缓存块大小不小于一级缓存块大小。
习题 2.4
[12/12/12/10/12]〈2.6〉 图 2.30 绘出了程序的一组示例输出;原文称横轴列出被访问数组的大小。根据图中的程序结果,回答以下问题。
a. [12]〈2.6〉 二级缓存的总容量和块大小分别是多少?
b. [12]〈2.6〉 二级缓存的未命中开销是多少?
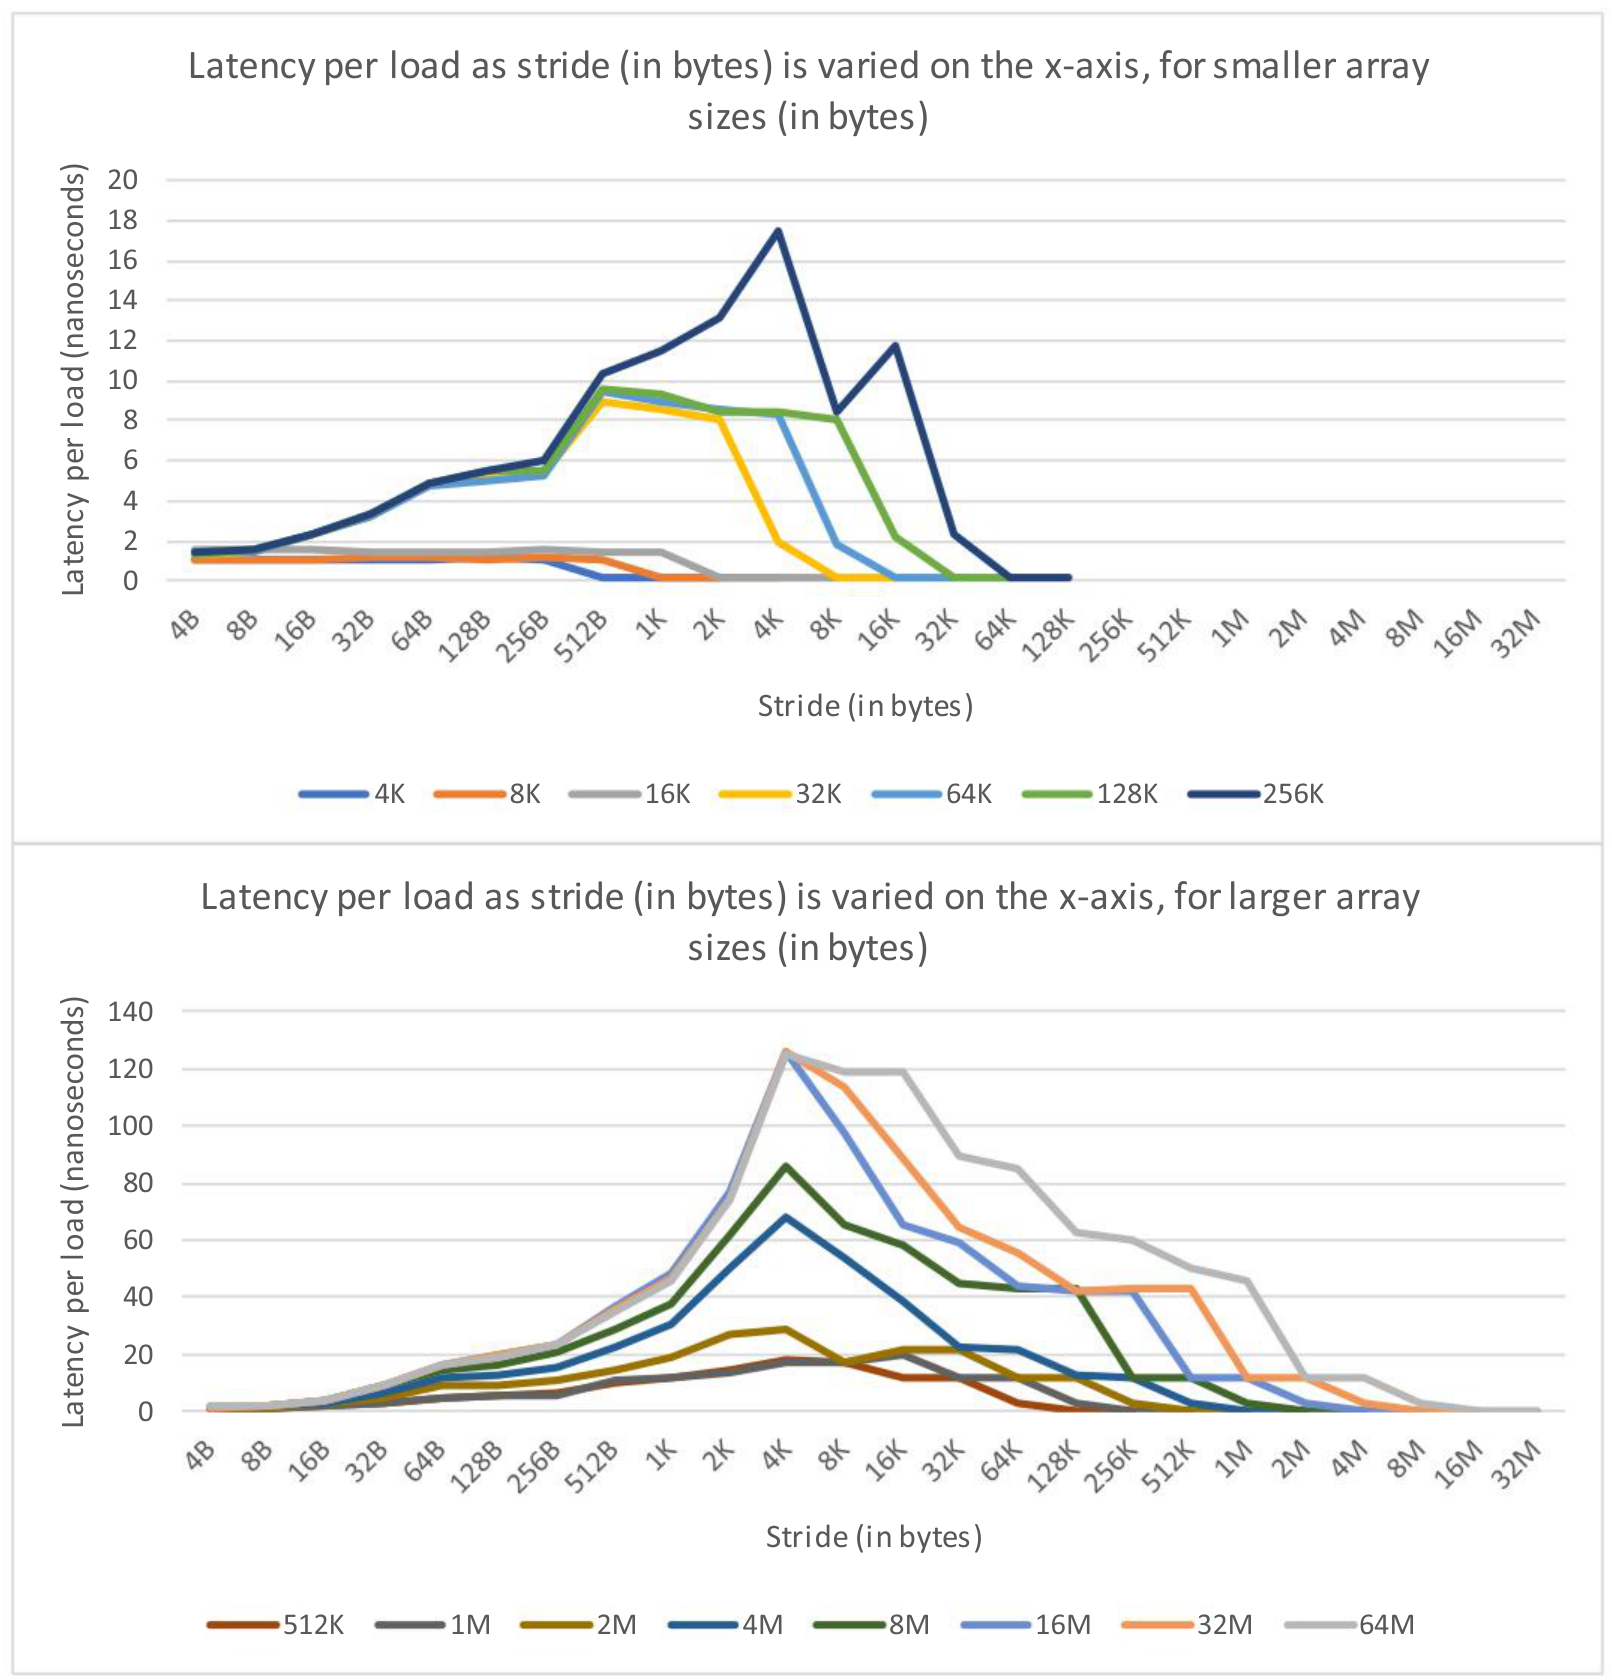
图内文字对照:上图是较小数组、下图是较大数组在不同步长下的单次加载延迟;横轴 Stride (in bytes)=步长,单位为字节;纵轴 Latency per load (nanoseconds)=每次加载的延迟,单位为纳秒。图例中的数值表示数组大小,单位为字节;上图为 4K、8K、16K、32K、64K、128K、256K,下图为 512K、1M、2M、4M、8M、16M、32M、64M。
译注: 题干写横轴为数组大小,但原图横轴明确标为访问步长,数组大小由不同曲线的图例区分。原图按原样保留。
c. [12]〈2.6〉 二级缓存的相联度是多少?
d. [10]〈2.6〉 主存容量是多少?
e. [12]〈2.6〉 若页大小为 4 KB,换页时间是多少?
习题 2.5
[12/15/15/20]〈2.6〉 如有必要,修改图 2.29 的代码,测量下列系统特性。绘制实验结果,以耗时为纵轴、内存访问步长为横轴;两个坐标轴都采用对数刻度,并为每种缓存容量绘制一条曲线。
a. [12]〈2.6〉 系统页大小是多少?
b. [15]〈2.6〉 TLB 有多少个表项?
c. [15]〈2.6〉 TLB 的未命中开销是多少?
d. [20]〈2.6〉 TLB 的相联度是多少?
习题 2.6
[20/20]〈2.6〉 在多处理器存储系统中,单个处理器可能无法使存储层次结构的较低层级达到饱和,但多个处理器协同工作应当能够做到。修改图 2.29 的代码,同时运行多个副本。你能否确定:
a. [20]〈2.6〉 计算机系统中有多少个实际处理器,又有多少个系统所见的处理器只是额外的多线程执行上下文?
b. [20]〈2.6〉 系统有多少个内存控制器?
习题 2.7
[20]〈2.6〉 能否想出一种通过程序测试指令缓存某些特性的方法?提示: 一段代码经编译后,可能产生大量不容易从源代码看出的指令。尽量使用 ISA 中长度已知的简单算术指令。
案例三:研究不同存储系统组成的影响
本案例涉及的概念:
- DDR3/DDR4 存储系统
- rank、存储体和行缓冲区对性能与功耗的影响
- DRAM 时序参数
- DRAM 调度策略
处理器芯片通常支持若干 DDR3 或 DDR4 内存通道。本案例只考察一个通道,探索改变若干参数如何影响其性能与功耗。回顾一下,一个通道可以连接一个或多个 DIMM,每个 DIMM 支持一个或多个 rank。rank 是协同工作的一组 DRAM 芯片,共同处理内存控制器发出的一条命令。
例如,一个 rank 可以由 16 颗 DRAM 芯片组成,每颗芯片在通道时钟的每个边沿处理 4 位输入或输出。这种芯片称为 x4(by four)芯片。一个 rank 也可以由 8 颗 x8 芯片或 4 颗 x16 芯片组成。注意,每种组合都能处理 64 位内存通道上传送的数据。rank 内部又分为 8 个(DDR3)或 16 个(DDR4)存储体。每个存储体都有一个行缓冲区,用来保存最近从该存储体读出的行。下面给出从一个存储体读取数据时,典型的内存命令序列。
(i) 内存控制器发出 **Precharge(预充电)**命令,使存储体准备好访问新行。经过 时间,预充电完成。
(ii) 然后发出 **Activate(激活)**命令,从存储体中读出所需行。经过 时间,激活完成,该行可视为已进入行缓冲区。
(iii) 接下来可以发出列读命令(column-read),即 CAS,将行缓冲区的指定部分送到内存通道。经过 CL 时间,突发数据的首个 64 位被送上内存通道。一次突发通常包含 8 次 64 位传输,在 4 个内存时钟周期的上升沿和下降沿完成;这段时间称为传输时间。
(iv) 如果接下来要访问该存储体中另一行的数据,也就是行缓冲区未命中,内存控制器就重复步骤 (i)~(iii)。这里暂且假定,CL 时间一过,就能发出步骤 (i) 的 Precharge 命令;有些情形还需要额外延迟,这里忽略。如果访问的是同一行中的另一个数据块,也就是行缓冲区命中,则只需再发出一个 CAS 命令。连续两个 CAS 命令至少必须相隔 4 个周期,确保第一次数据传输结束后,第二次才开始。
注意,内存控制器可以在相邻周期向不同存储体发命令,从而并行执行许多内存读写,不必闲等某个存储体的 、 和 CL 结束。以下各题假设 ,内存通道频率为 1 GHz,即传输时间为 4 ns。
习题 2.8
[10]〈2.2〉 行缓冲区未命中时,内存控制器经历的读取延迟是多少?
习题 2.9
[10]〈2.2〉 行缓冲区命中时,内存控制器经历的延迟是多少?
习题 2.10
[10]〈2.2〉 如果内存通道只支持一个存储体,而且内存访问主要表现为行缓冲区未命中,内存通道的利用率是多少?
习题 2.11
[15]〈2.2〉 假设行缓冲区未命中率为 100%,为了实现 100% 的内存通道利用率,通道至少需要支持多少个存储体?
习题 2.12
[10]〈2.2〉 假设行缓冲区未命中率为 50%,为了实现 100% 的内存通道利用率,通道至少需要支持多少个存储体?
习题 2.13
[15]〈2.2〉 假设正在执行一个含 4 个线程的应用,各线程都没有空间局部性,即行缓冲区未命中率为 100%。每隔 200 ns,4 个线程会同时各向内存控制器队列插入一个读操作。如果内存通道只支持一个存储体,平均内存访问延迟是多少?如果支持 4 个存储体,又是多少?
习题 2.14
[10]〈2.2〉 从以上问题中,你认识到了增加存储体数量有哪些收益和不利之处?
习题 2.15
[20]〈2.2〉 现在转而考察内存功耗。从原书提供的Micron 功耗计算器页面下载一份计算器。
该页面提供面向不同 DDR 技术的电子表格,这里只分析 DDR3。表格预先配置了 Micron 制造的多种 DRAM 芯片,可估计其功耗。在“DDR3 Config”工作表中,选择一颗 x8 DDR3 2 Gb DRAM 芯片,速度等级为 -093,预充电退出模式为 Fast。然后到“System Config”工作表,将工作负载设置为:页命中率,即行缓冲区命中率,50%;读数据总线利用率 45%;写数据总线利用率 25%;其他参数保持默认。
点击“Summary”工作表,查看这些芯片参数与工作负载条件下,单颗 DRAM 芯片的功耗构成。Micron 会随技术进展定期更新这些表格。2024 年夏季的版本显示,DRAM 芯片消耗 229 mW,其中 Activate 操作 45 mW、CAS 操作 145 mW、背景功耗 39 mW。
接着再次点击“System Config”,修改读写流量与行缓冲区命中率,观察功耗构成如何变化。例如,若通道利用率为 35%,其中读取占 25%、写入占 10%,功耗会下降多少?若将行缓冲区命中率提高到 80%,又会下降多少?
习题 2.16
[20]〈2.2〉 默认配置中,一个 rank 由 8 颗 x8、2 Gb DRAM 芯片组成。也可以使用 16 颗 x4 芯片,或 4 颗 x16 芯片。单颗 DRAM 的容量也可以选择 1 Gb、2 Gb 或 4 Gb。这些选项都在 Micron 功耗计算器的“DDR3 Config”工作表中。列出各种 rank 组成方式的总功耗。对于给定容量的 rank,哪种组成方式最省电?
习题 2.17
[20]〈2.2〉 考虑 DDR 存储系统中的两种内存控制器。正如前文所述,一种采用开页策略(open-page policy),另一种采用关页策略(close-page policy)。
采用开页策略时,如果某个存储体没有待处理请求,就保持行缓冲区打开,期待未来发生行缓冲区命中。采用关页策略时,如果没有待处理请求,就发出预充电命令,使存储体准备好未来访问另一行;这样做是预期空间局部性有限。两种策略在有待处理请求时,都优先选择行缓冲区命中的请求;如果没有能命中的请求,就按先来先服务顺序处理。
下表列出发往一个存储体的一串块读取请求,以所访问的 DRAM 行(X、Y、Z)以及进入内存控制器队列的周期表示。请写出内存控制器发出每条命令的周期。假设 Precharge、Activate 和 Column-Read 都需要 10 个周期。第一个请求在第 20 周期到达时,存储体已经完成预充电。
| 内存事务 | 入队周期 | 开页策略下的命令序列 | 关页策略下的命令序列 |
|---|---|---|---|
| 读 X | 20 | ||
| 读 X | 35 | ||
| 读 X | 90 | ||
| 读 Y | 95 | ||
| 读 X | 100 | ||
| 读 X | 160 |
习题
若干习题需要使用缓存模拟器。功能最强、公开可用的模拟器是 CACTI 7.0,但它使用较旧的 32 nm 工艺。这不会从根本上影响习题,尽管结果不会与更新的 SRAM 和 DRAM 工艺相符。原书提供了 CACTI 7.0 的 GitHub 地址。如果希望使用更新的 14 nm 工艺探索这些问题,可以尝试 FT-CACTI,它将 CACTI 7.0 的模型更新到较新的工艺。原书还提供了 FT-CACTI 的 GitHub 地址。1
习题 2.18
[12/12/15]〈2.3〉 以下问题使用 CACTI 7.0 或 FT-CACTI,研究小而简单的缓存所带来的影响。
a. [12]〈2.3〉 比较容量为 64 KB、块大小为 64 字节、只有一个存储体的缓存的访问时间。两路和四路组相联缓存的访问时间,相对于直接映射结构分别是多少?
b. [12]〈2.3〉 比较采用 64 字节块、单存储体、四路组相联缓存的访问时间。相对于 16 KB 缓存,32 KB 和 64 KB 缓存的访问时间分别是多少?
c. [15]〈2.3〉 对于 64 KB 缓存,在 1~8 路中找出平均内存访问时间最短的相联度。已知某工作负载套件的每条指令未命中次数如下:直接映射为 0.00664,两路组相联为 0.00366,四路组相联为 0.000987,八路组相联为 0.000266。总体而言,每条指令有 0.3 次数据访问。假定所有模型的缓存未命中都需要 10 ns。将命中时间换算为周期数时,采用 CACTI 输出的周期时间;它对应缓存流水线中不出现气泡时能够达到的最高工作频率。
习题 2.19
[15]〈2.3〉 你受命为一种新微处理器研究多存储体 L1 数据缓存与流水线化 L1 数据缓存的相对性能。假设缓存为 64 KB、两路组相联,块大小为 64 字节。流水线化版本需要 4 个流水级,才能完成访问、命中检测和组选择。多存储体版本由两个 32 KB、两路组相联存储体组成。使用 CACTI 或 FT-CACTI,假定采用其所支持的最佳条件。比较流水线化设计与多存储体设计的面积,以及每次访问所需的总动态读取能耗。指出哪种面积更小、哪种功耗更高,并解释可能的原因。
译注: 本题原文的 “assume the best supported” 未进一步说明“最佳”所指的具体参数或配置。
习题 2.20
[12/15]〈2.3〉 考虑在 L2 缓存未命中时采用关键字优先和提前重启。假设 L2 容量为 2 MB,块大小为 64 字节,回填通路宽 16 字节。每 4 个处理器周期可以向 L2 写入 16 字节;从内存控制器收到首个 16 字节块需要 120 个周期,随后主存每再传来一个 16 字节块需要 16 个周期。数据可以通过旁路直接送入 L2 的读端口。忽略将未命中请求传给 L2,以及将所请求数据传给 L1 的周期数。
a. [12]〈2.3〉 采用和不采用关键字优先与提前重启时,处理一次 L2 缓存未命中各需多少个周期?
b. [15]〈2.3〉 你认为关键字优先和提前重启,对 L1 还是 L2 更重要?哪些因素会影响两者的相对重要性?
习题 2.21
[12/12]〈2.3〉 你正在直写 L1 缓存与写回 L2 缓存之间设计一个写缓冲区。L2 写数据总线宽 16 B,每 4 个处理器周期能够对一个独立缓存地址执行一次写入。
a. [12]〈2.3〉 每个写缓冲区表项应当有多少字节宽?
b. [15]〈2.3〉 假设通过执行 64 位存储指令将内存清零,其他所有指令都可以与存储指令并行发射,而且相应块已在 L2 中。在稳定执行阶段,采用合并写缓冲区,相比不合并的写缓冲区,预期能获得多大加速比?
c. [15]〈2.3〉 对于采用阻塞缓存和非阻塞缓存的系统,可能发生的 L1 未命中,会怎样影响所需写缓冲区表项的数量?
译注: 本题题头的难度标记原为
[12/12],但实际有 a、b、c 三个小问,分别标为[12]、[15]、[15]。
习题 2.22
[20]〈2.1,2.2,2.3〉 缓存起到过滤器的作用。例如,一个程序每执行 1000 条指令,平均可能有 20 次内存访问的局部性过低,以至于无法由 2 MB 缓存满足。这时称该 2 MB 缓存的 MPKI,即每千条指令未命中次数,为 20;无论它前面有哪些更小的缓存,这个数值大体都成立。
假设缓存容量/延迟/MPKI 分别为:32 KB/1/100、128 KB/2/80、512 KB/4/50、2 MB/8/40,以及 8 MB/16/10。假设访问片外内存系统平均需要 200 个周期。对下面各缓存配置,计算访问缓存层次结构所花的平均时间。对于层级过浅或过深的缓存结构,你观察到了哪些不利之处?
a. 32 KB L1;8 MB L2;片外内存。
b. 32 KB L1;512 KB L2;8 MB L3;片外内存。
c. 32 KB L1;128 KB L2;2 MB L3;8 MB L4;片外内存。
习题 2.23
[15]〈2.1,2.2,2.3〉 考虑一个由程序 A 和 B 共享的 16 MB、16 路组相联 L3 缓存。缓存中有一种机制,监测每个程序的缓存未命中率,并为每个程序分配 1~15 路,以减少总的缓存未命中次数。假设为程序 A 分配 1 MB 时,MPKI 为 100;每增加 1 MB,MPKI 减少 1。为程序 B 分配 1 MB 时,MPKI 为 50;每增加 1 MB,MPKI 减少 2。应如何向 A 和 B 分配缓存路数,才能获得最佳效果?
习题 2.24
[20]〈2.1,2.6〉 你正在设计一台 PMD,并针对低能耗进行优化。处理器核连同一个 16 KB 的 L1 数据缓存,只要没有休眠,就消耗 1 W。对于给定任务,如果 L1 命中率达到 100%,处理器核的平均 CPI 为 1,即 1000 个周期执行 1000 条指令。每增加一个用于访问 L2 或更低层级的周期,处理器核便增加一个停顿周期。根据以下规格,哪一种 L2 容量能让该 PMD,包括处理器核、L1、L2 和内存,在执行这个任务时消耗最少能量?
a. 处理器核频率为 1 GHz,L1 的 MPKI 为 100。
b. 256 KB L2 的延迟为 10 个周期,MPKI 为 20,背景功耗为 0.2 W,每次 L2 访问消耗 0.5 nJ。
c. 1 MB L2 的延迟为 20 个周期,MPKI 为 10,背景功耗为 0.8 W,每次 L2 访问消耗 0.7 nJ。
d. 内存系统的平均延迟为 100 个周期,背景功耗为 0.5 W,每次内存访问消耗 35 nJ。
习题 2.25
[20]〈2.2〉 遵循 DDR 标准的存储系统,在内存时钟的每个边沿传输 64 位数据。为了容忍每次传输中的单个位损坏,无论它来自随机软错误,还是某个 DRAM 引脚或连线的硬错误,可靠存储系统会为每次 64 位数据传输附加 8 位编码。通常采用 Hamming 码,实现单错纠正、双错检测(SECDED)。
但是,有些硬件基础设施需要更高的可靠性。例如,它们可能要求即使整颗 DRAM 芯片及其全部输出位都失效,仍能保证纠错,这种能力称为 Chipkill。你能否设计一个简单的存储系统,在一颗 DRAM 芯片失效时仍能提供正确数据?提供这种更高可靠性有哪些代价?你或许不是编码理论专家,但很可能熟悉 RAID 存储实现中采用的奇偶校验和循环冗余校验(CRC)。
习题 2.26
[20]〈2.4〉 本章以共享缓存访问和 prime–probe 为主要例子介绍了侧信道。请列举存储层次结构中的其他几种侧信道,说明攻击者可能如何利用它们,以及处理器体系结构设计者可以如何防御这些攻击。
习题 2.27
[20]〈2.3〉 考虑以下三种四路组相联 L2 缓存设计。
(i) 并行访问标签和数据: 标签查找耗时 4 个周期、能耗 20 pJ,与耗时 20 个周期、能耗 1000 pJ 的数据阵列访问并行进行。
(ii) 串行访问标签和数据: 先进行耗时 4 个周期、能耗 20 pJ 的标签查找,再访问单独一路的数据阵列,后者耗时 20 个周期、能耗 250 pJ。
(iii) 带路预测的标签和数据访问: 先访问路预测器,耗时 1 个周期、能耗 5 pJ;随后并行访问预测路的标签和数据,分别耗时 4 和 20 个周期,能耗分别为 5 pJ 和 250 pJ。如果路预测错误,再并行访问其余三路的标签和数据,标签与数据查找分别耗时 4 和 20 个周期,能耗分别为 15 pJ 和 750 pJ。
假设路预测准确率为 80%,分别按性能和能耗对这三种设计排序。
习题 2.28
[20]〈2.3〉 本章介绍了使用大容量 L4 DRAM 缓存的可能性,并最终讨论了 Alloy Cache 设计。为了减轻 DRAM 访问的高代价,Alloy Cache 采用直接映射结构。通常认为,直接映射缓存可能具有较高的冲突未命中率。你认为这会成为 Alloy Cache 的问题吗?如果会,可以如何缓解?进一步讨论在 Alloy Cache 中使用较大数据块的利弊。例如,采用 4 KB 数据块会有哪些影响?
习题 2.29
[20]〈2.3〉 考虑一种基准 Alloy Cache 设计:访问标签需要 30 个周期,之后再花 4 个周期接收数据。如果标签访问发现未命中,就发起一次平均耗时 100 个周期的内存访问。由于确认 Alloy Cache 未命中耗时很长,设计中引入一个耗时 1 个周期的命中/未命中预测器,与 Alloy Cache 访问并行工作。若预测命中,操作序列与基准设计完全一样;若预测未命中,就在查找 Alloy Cache 的同时发起内存访问。
计算这两种设计从 Alloy Cache 开始、包括后续层级在内的平均访问延迟。假设预测器的表现如下,所有百分比都以全部访问为分母:(i) 对 80% 的访问正确预测为命中;(ii) 对 5% 的访问正确预测为未命中;(iii) 对 5% 的访问错误地预测为命中;(iv) 对 10% 的访问错误地预测为未命中。
习题 2.30
[10/10]〈2.1,2.2,2.3〉 一个组中的各路,可以看作按优先级从高到低排列的列表。每次访问该组,都可以重新排列列表,改变块的优先级。从这一角度看,缓存管理策略可分解为三个子策略:插入(Insertion)、提升(Promotion)和淘汰选择(Victim Selection)。插入规定新取回的块放在优先级列表的什么位置;提升规定每次访问某块,即缓存命中时,如何调整它在列表中的位置;淘汰选择规定发生未命中时,移除列表中的哪一项,为新块腾出空间。
a. 能否用插入、提升和淘汰选择三个子策略描述 LRU 缓存策略?
b. 能否提出其他具有竞争力、值得进一步探索的插入与提升策略?
习题 2.31
[15]〈2.1,2.3〉 处理器运行多个程序时,末级缓存通常由所有程序共享。这会引起相互干扰:一个程序的行为与缓存占用,会影响其他程序可用的缓存。
首先,这带来了服务质量(QoS)问题:干扰使程序获得的资源更少、性能更低,无法达到例如云服务运营者所承诺的水平。其次,这还涉及隐私:程序可以利用侧信道攻击,根据自己受到的干扰,推断其他程序的内存访问模式。可以为末级缓存增加哪些策略,使一个程序的行为不受其他共享缓存程序的影响?
习题 2.32
[15]〈2.3〉 容量达数 MB 的大 L3 缓存,可能需要数十个周期才能访问,因为信号必须经过很长的连线。例如,访问一个 16 MB L3 可能需要 20 个周期。可以不把整个 16 MB 缓存组织成每次访问都耗时 20 个周期的结构,而将它组织为由较小缓存存储体构成的阵列。有些存储体离处理器核较近,有些则较远。
这形成了非均匀缓存访问(NonUniform Cache Access,NUCA):其中 2 MB 可能只需 8 个周期,再往外的 2 MB 需要 10 个周期,依此类推,直到最后 2 MB 需要 22 个周期。你可以引入哪些新策略,使 NUCA 缓存的性能达到最大?
习题 2.33
[10/10/10]〈2.2〉 考虑一台桌面系统,其处理器连接到容量为 2 GB、带纠错码(ECC)的 DRAM。假设只有一个 72 位宽的内存通道,其中 64 位用于数据、8 位用于 ECC。
a. [10]〈2.2〉 如果采用 1 Gb DRAM 芯片,DIMM 上需要多少颗 DRAM?如果 DIMM 的每个数据引脚只连接一颗 DRAM,那么每颗 DRAM 必须有多少个数据 I/O?
b. [10]〈2.2〉 为支持 32 B 的 L2 缓存块,需要多大的突发长度?
c. [10]〈2.2〉 从已激活页面读取数据时,不计 ECC 开销,计算 DDR2-667 和 DDR2-533 DIMM 的峰值带宽。
习题 2.34
[20]〈2.3〉 在末级缓存中准确跟踪 LRU 信息,主要面临哪些挑战?
习题 2.35
[20]〈2.3〉 晶体管在电源和地之间会持续存在一定漏电流。处理器内部的能耗分为两类:晶体管切换时产生电流所消耗的动态能耗,以及每个晶体管在每个周期都存在漏电流所产生的漏电能耗。动态能耗取决于切换活动,漏电能耗则取决于晶体管数量。现代微处理器超过一半的面积由缓存占据,因此缓存是总漏电能耗的主要来源。
一种降低漏电能耗的办法,是通过电源门控切断晶体管供电,使其不再漏电。但有一个问题:如果切断缓存块中晶体管的供电,该块中保存的数据就会丢失。注意,假如某缓存块每周期消耗 X 单位的漏电能量,那么从内存取回该块就需要消耗 1000X 单位的动态能量。请利用上述技术,为末级缓存设计一种机制,在尽量少影响性能的同时,显著降低系统总能耗。
习题 2.36
[12]〈2.2〉 你正在配置一台服务器,它使用 16 核、3 GHz 的片上多处理器(CMP)。假设 L2 未命中回填不会被延迟,处理器执行某工作负载时的总体 CPI 为 2.0。L2 缓存行大小为 32 字节,系统使用 DDR4-2666 DIMM。若带宽需求有时达到平均值的两倍,应提供多少个独立内存通道,才能使系统不受内存带宽限制?该工作负载平均每 1000 条指令发生 6.67 次 L2 未命中。
习题 2.37
[15]〈2.2〉 考虑一个有 4 个内存通道的处理器。连续的内存块应放在同一存储体中,还是应分散到不同通道上的不同存储体?
习题 2.38
[15]〈2.2〉 计算机空闲时,可以让它待机,此时 DRAM 仍保持活动;也可以让它休眠。假设休眠只需将 DRAM 的内容复制到 Flash 等非易失介质。若向 Flash 读取或写入一个 64 字节缓存行需要 2.56 J,而 DRAM 对应操作需要 0.5 nJ,DRAM 的空闲功耗为 1.6 W,对应 8 GB 容量,那么系统至少空闲多久,休眠才有利?假设主存容量为 8 GB。
译注: 原页所印 Flash 能耗确为
2.56 J,并非文本提取丢失前缀后的结果。这个数值与题中 DRAM 的 0.5 nJ 相差极大。
习题 2.39
[15]〈2.2,2.7〉 正如 2.7 节所讨论的,Intel i7 处理器有一个积极的预取器。设计一个极其积极的预取器,可能带来哪些不利影响?2