3.4 利用高级分支预测降低分支代价
程序必须通过频繁出现的分支来维持控制依赖,因此分支预测对于开发 ILP 至关重要。附录 C 讨论了简单的分支预测器:它们或者依赖编译时信息,或者仅根据一条分支自身已观察到的动态行为进行预测。随着流水线加深、每周期发射数增加,在途指令越来越多,更准确的分支预测也越来越重要。本节研究提高动态预测准确率的硬件技术,既包括方向预测(跳转或不跳转),也包括目标预测。本节大量使用 C.2 节介绍的简单 2 位预测器,因此读者必须先理解其工作原理,再继续阅读。
相关分支预测器
附录 C 的 2 位预测方案,只使用某一条分支的近期行为来预测它的未来行为。如果除了目标分支自身之外,还考察其他分支的近期行为,可能进一步提高准确率。考虑早期 SPEC 基准测试套件中 eqntott 的一小段代码,该程序的分支预测表现特别差:
假设 aa 和 bb 分别分配到 x1 和 x2,通常会生成以下 RISC-V 代码:
将这些分支分别标为 b1、b2 和 b3。关键观察在于:b3 的行为与 b1、b2 的行为相关。显然,如果 b1 和 b2 都不跳转,即两个条件都为真,aa 与 bb 都被赋值为 0,那么 b3 就会跳转,因为 aa 与 bb 显然相等。仅根据一条分支自身的行为来预测其结果,永远无法捕捉这种关系。
利用其他分支行为进行预测的预测器,称为相关预测器(correlating predictor)或两级预测器(two-level predictor)。现有相关预测器加入最近几条分支的行为信息,决定如何预测某条给定分支。例如, 预测器根据上一条分支的行为,从两个 2 位分支预测器中选择一个,预测当前分支。一般而言, 预测器根据最近 条分支的行为,从 个分支预测器中选择一个,每个预测器都是针对单条分支的 位预测器。
这种相关预测器的吸引力在于:只增加很少的硬件,就能取得比普通 2 位方案更高的预测准确率。
硬件之所以简单,来自一个简单观察:最近 条分支的全局历史可以保存在一个 位移位寄存器中,每一位记录相应分支是跳转(T)还是不跳转(NT)。将分支指令地址(PC)的低位与这 位全局历史拼接,就能索引分支预测缓冲区。例如,一个共有 64 个条目的 缓冲区,可以把分支字地址的低 4 位,与表示最近两条已执行分支行为的 2 位全局历史组合,形成 6 位索引,访问 64 个计数器。通过拼接或简单散列函数组合局部与全局信息,便能用结果索引预测表,而且预测速度与标准 2 位预测器一样快,稍后就会看到。
相关分支预测器比标准 2 位方案好多少?为了公平比较,必须让两者使用相同数量的状态位。 预测器的位数为:
没有全局历史的 2 位预测器,就是 预测器。
例题 有 4K 个条目的 分支预测器占多少位?使用相同位数的 预测器包含多少条目?
解答 4K 条目预测器包含:
若 预测器的预测缓冲区共占 8K 位,由分支选择的条目有多少?已知:
因此,由分支选择的预测条目数为 1K。
图 3.5 比较了前述 4K 条目的 预测器与 1K 条目的 预测器的错误预测率。可以看到,这种相关预测器不仅胜过状态位总数相同的简单 2 位预测器,而且常常胜过条目数量不受限制的 2 位预测器。
最著名的相关预测器,也许是 McFarling 的 gshare。gshare 将分支地址与最近条件分支的结果进行异或(XOR),形成索引;这实际上相当于对分支地址与分支历史作散列,再用散列结果索引由 2 位计数器组成的预测数组,如图 3.6。作为一种简单预测器,gshare 的效果相当好,经常成为比较更复杂预测器时的基线。将局部分支信息与全局分支历史结合的预测器,也称为 alloyed predictor 或混合预测器(hybrid predictor)。
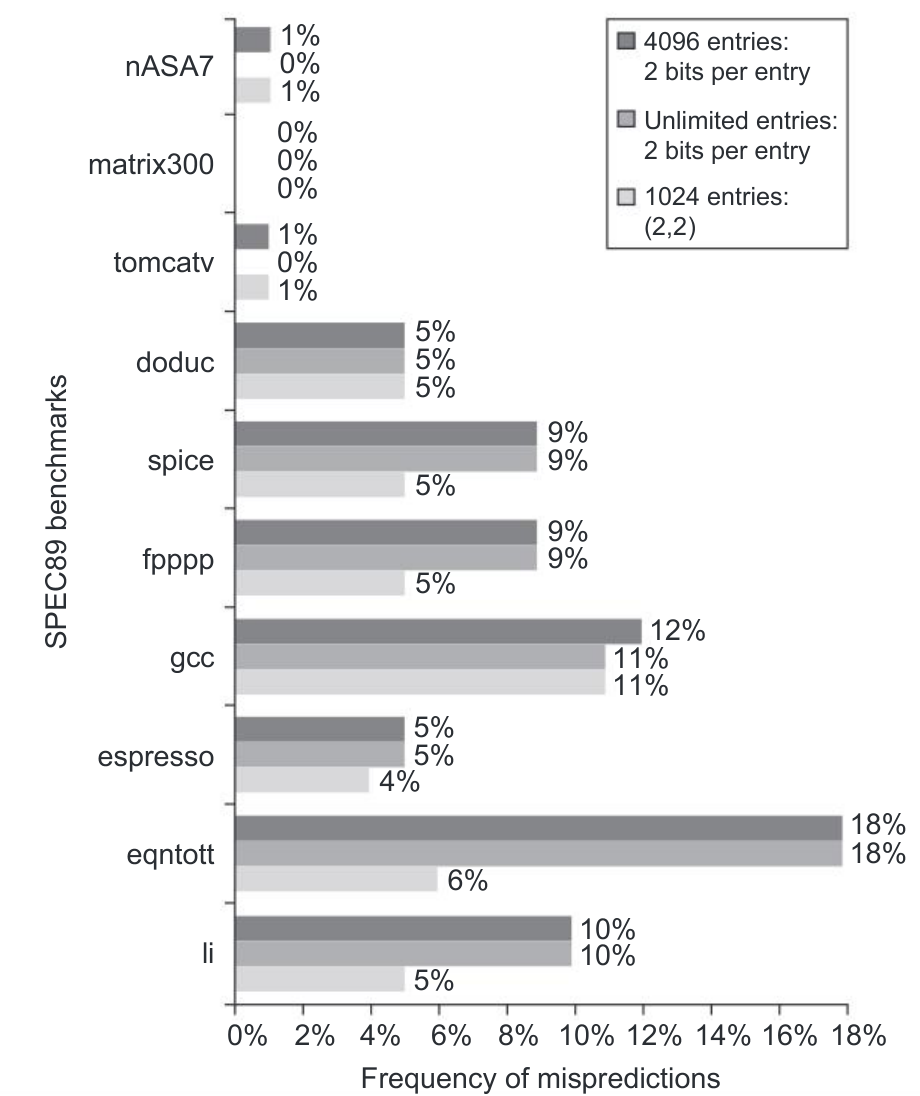
图 3.5 2 位预测器的比较。首先是一个 4096 位的非相关预测器,其次是条目数无限的非相关 2 位预测器,最后是具有 2 位全局历史、共 1024 个条目的 2 位预测器。1 虽然数据来自较老版本的 SPEC,但较新的 SPEC 基准也会表现出类似的准确率差异。
图中纵轴为 SPEC89 基准程序,名称保留英文;横轴为错误预测频率。三组柱依次表示:4096 个条目、每条目 2 位;无限条目、每条目 2 位;1024 个条目的 预测器。
竞争预测器:自适应地组合局部与全局预测器
相关分支预测的主要动机,是标准 2 位预测器只使用局部信息,因此在某些重要分支上预测不佳;加入全局历史可以弥补这个不足。竞争预测器(tournament predictor)更进一步,使用多个预测器,通常是一个全局预测器和一个局部预测器,并通过选择器在两者之间选择,如图 3.7。全局预测器用最近的分支历史进行索引,局部预测器用分支地址进行索引。竞争预测器是混合预测器或 alloyed predictor 的另一种形式。
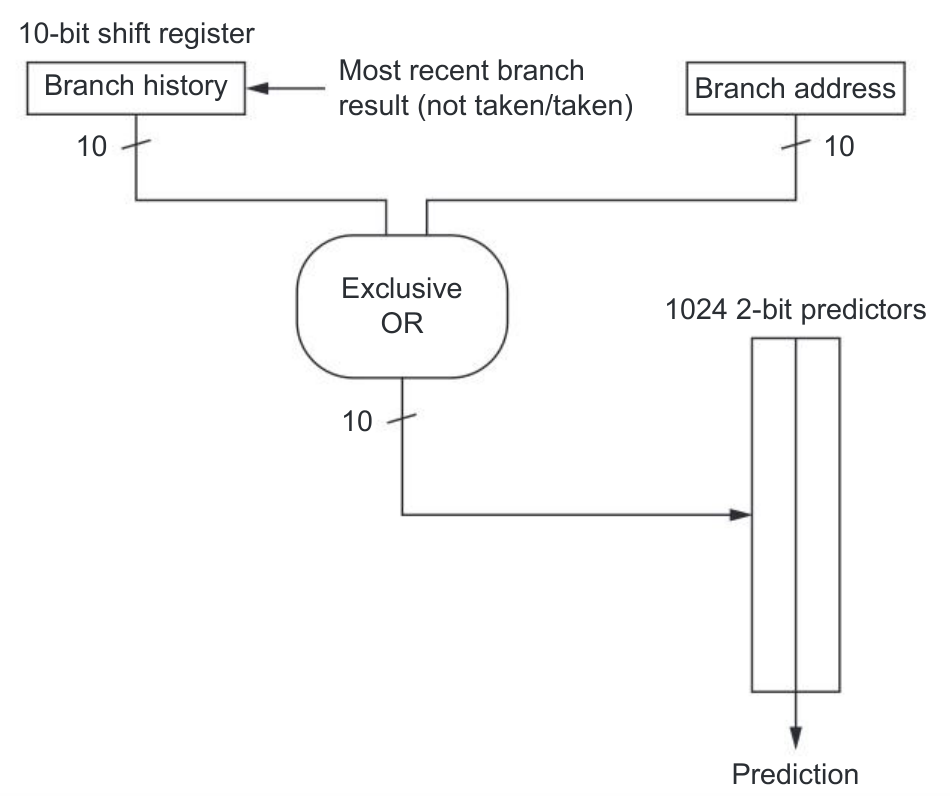
图 3.6 一个含 1024 个条目的 gshare 预测器,每个条目都是标准的 2 位预测器。图中 Branch history 为分支历史,保存在 10 位移位寄存器(10-bit shift register)中;Most recent branch result (not taken/taken) 为最近分支的结果(不跳转/跳转);Branch address 为分支地址;Exclusive OR 为异或;1024 2-bit predictors 为 1024 个 2 位预测器;Prediction 为预测结果。各条标为 10 的连线表示 10 位。
竞争预测器在中等规模(8K~32K 位)时能够取得更高准确率,也能有效利用规模很大的预测状态。现有竞争预测器为每条分支使用一个 2 位饱和计数器,根据近期哪一种预测器更有效——局部、全局,甚至随时间变化的混合——在两个预测器之间进行选择。与简单的 2 位预测器一样,饱和计数器需要两次错误预测,才会改变首选预测器。
竞争预测器的优势,是能为特定分支选择合适的预测器;这一点对于整数基准尤为关键。典型竞争预测器在 SPEC 整数基准中,有接近 40% 的时间选择全局预测器;在 SPEC 浮点基准中,这一比例则不足 15%。除率先采用这种技术的 Alpha 处理器外,多款 AMD 处理器也曾采用竞争式预测器。
图 3.8 使用 SPEC89,比照三种预测器在不同位数下的表现:局部 2 位预测器、相关预测器和竞争预测器。局部预测器最先达到极限;相关预测器明显改善;竞争预测器则略胜一筹。对于更新版本的 SPEC,结果也会类似,只是要到稍大的预测器规模才达到渐近行为。
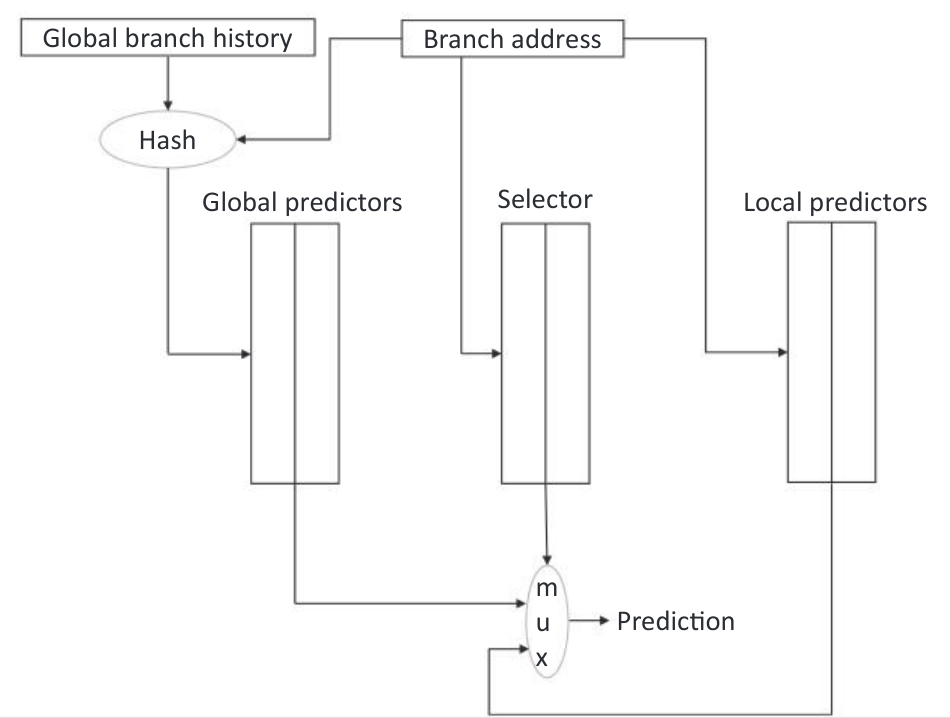
图 3.7 竞争预测器使用分支地址索引一组 2 位选择计数器,在局部与全局预测器之间选择。本图中,选择器表的索引就是当前分支地址。另外两张表也都是 2 位预测器,分别由全局历史和分支地址索引。选择器的行为类似 2 位预测器:当连续出现两次错误预测时,改变相应分支地址的首选预测器。用于索引选择器表和局部预测表的分支地址位数,与用于索引全局预测表的全局分支历史长度相同。注意,错误预测的处理有些复杂,因为既要修改选择器表,又要修改全局或局部预测器。
图中 Global branch history 为全局分支历史;Branch address 为分支地址;Hash 为散列;Global predictors 为全局预测器;Selector 为选择器;Local predictors 为局部预测器;mux 为多路选择器;Prediction 为预测结果。
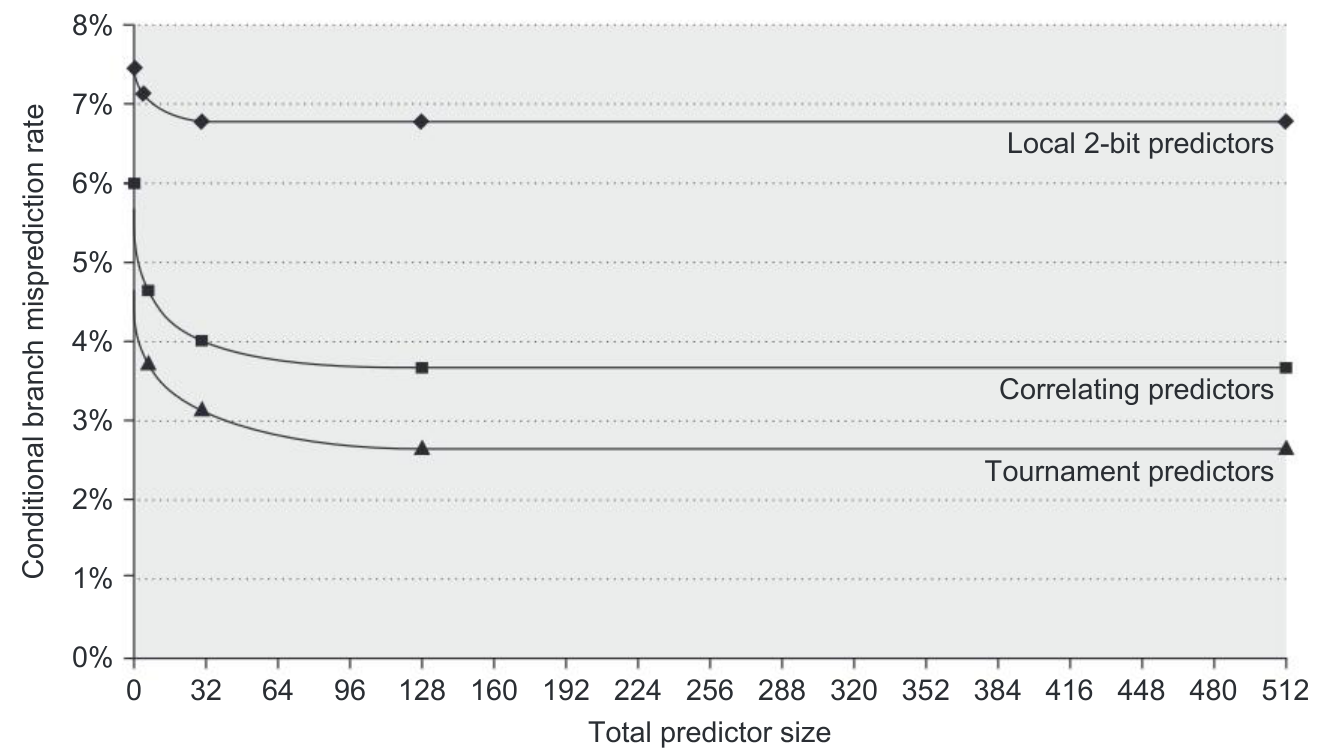
图 3.8 SPEC89 上三种预测器的错误预测率与预测器大小(千位)的关系。三种预测器分别是:局部 2 位预测器;在图中每个容量点,都对全局与局部信息的使用方式作最优组织的相关预测器;竞争预测器。虽然数据来自较老版本的 SPEC,但更新的 SPEC 基准表现出类似行为,只是可能要到稍大的预测器规模才收敛至渐近极限。横轴 Total predictor size 为预测器总大小;纵轴 Conditional branch misprediction rate 为条件分支错误预测率。三条曲线自上而下分别为局部 2 位、相关、竞争预测器。
图 3.8 所评估的局部预测器,本身也是两级预测器。第一级是局部历史表,包含 1024 个 10 位条目;每个条目对应最近 10 次分支结果。如果分支连续跳转 10 次或以上,局部历史表的相应条目便全为 1;如果跳转与不跳转交替出现,历史条目就是交替的 0 和 1。这 10 位历史使预测器能够发现并预测长度不超过 10 次分支的模式。局部历史表选中的条目,再用于索引一个包含 1K 个 3 位饱和计数器的表,由其提供局部预测。这个组合总共使用 29K 位,能够实现很高的分支预测准确率,同时比准确率相同的单级表占用更少的位。2 两级局部预测器对迭代次数较少的循环尤其有效。对于一个迭代 3 次的循环,局部历史可以识别连续三次跳转(TTT)的情况,并训练一个 2 位或 3 位饱和计数器,预测下一次分支不跳转。因此,经常执行、迭代次数较少的循环,可以达到 100% 的预测准确率。
带标签的混合预测器
维护局部和全局历史的预测器,其主要不足在于难以确定合适的历史长度。历史太短,就可能无法捕捉某些重复模式。例如,4 位局部历史无法准确捕捉一个迭代 5 次的循环。历史太长,则需要更长的训练时间才能准确捕捉模式,因为会用到饱和计数器表中的更多条目。例如,如果对上面的 eqntott 代码使用 3 位全局历史,就需要训练两个饱和计数器,才能正确预测 B1、B2、B3 之间的相关关系;这两个计数器分别对应全局历史 NNN 和 TNN。准确捕捉一种模式所需的计数器越多,就越容易遇到别名冲突(aliasing):散列碰撞导致多条分支使用同一个计数器跟踪历史。如果共享计数器的分支结果相反,而且经常交错执行,别名冲突就会造成破坏性干扰。
截至 2022 年,表现最好的分支预测方案通过组合多个预测器来应对这些不足,并跟踪某个预测是否可能属于当前分支。其中一类重要预测器,大体基于一种名为 PPM(prediction by partial matching,部分匹配预测)的统计压缩算法。PPM(见 Jiménez and Lin, 2001)与分支预测算法一样,试图根据历史预测未来行为。我们称这类分支预测器为带标签的混合预测器(tagged hybrid predictor,见 Seznec and Michaud, 2006);它使用一系列全局预测器,以不同长度的历史进行索引。
例如,图 3.9 中一个由五个组件构成的带标签混合预测器,包含五张预测表:。其中,访问 时,对 PC 与最近 条分支的历史进行散列;历史保存在移位寄存器 中,与 gshare 相同。用不同长度的历史分别索引独立预测器,是第一个关键区别。第二个关键区别,是在 至 中使用标签,减少别名冲突。标签可以很短,因为不要求百分之百匹配:4~8 位的小标签,看来就已能获得大部分收益。只有标签与分支地址及全局历史的散列结果匹配时,才使用 的预测。注意,与缓存不同,分支预测器的标签只用来降低别名冲突的概率,并不用于保证正确性。短标签仍有小概率发生别名冲突,但这只影响预测准确率,不影响正确性。 中每个预测器都可以采用标准 2 位计数器。实际中,需要三次错误预测才改变预测结果的 3 位计数器,比 2 位计数器略好。
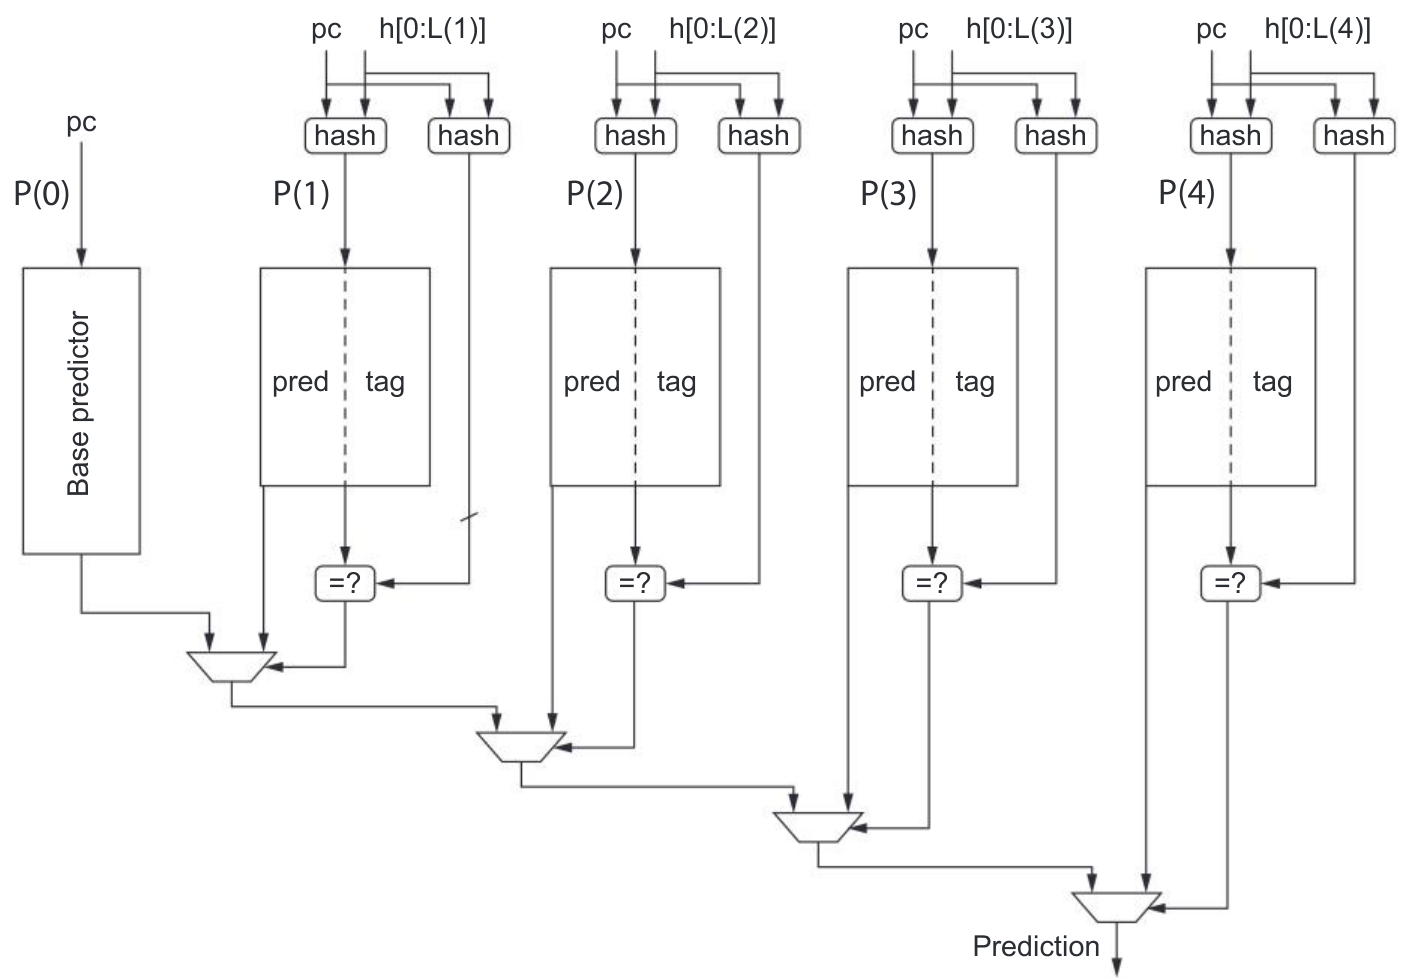
图 3.9 含五个组件的带标签混合预测器,具有五张独立的预测表。索引由分支地址与长度为 0~4 的近期分支历史片段散列而成,图中历史记作 h。散列可以像 gshare 一样简单,采用异或即可。每个预测器是 2 位预测器,也可能是 3 位预测器。标签通常为 4~8 位。最终选择标签匹配、且所用历史最长的那个预测。图中 Base predictor 为基础预测器;pc 为程序计数器;hash 为散列;pred 为预测值;tag 为标签;=? 表示是否相等的比较;Prediction 为最终预测;h[0:L(i)] 表示第 组使用的历史片段。3
对给定分支,选择使用最长历史、同时标签匹配的预测器。 没有标签,因此总会匹配;如果 至 均不匹配,它就提供默认预测。这种带标签混合方案还在每个按历史索引的预测条目中加入一个 2 位的 use 字段。该字段指示这个预测最近是否被使用,因而是否可能更准确;可以定期重置所有条目的 use 字段,清理陈旧预测。实现此类预测器还有许多细节,尤其是错误预测的处理。寻找最优预测器的搜索空间也很大,因为预测器数量、索引所用的具体历史,以及每个预测器的大小,都可以变化。
带标签混合预测器,有时称为 TAGE(TAgged GEometic)预测器,以及更早的基于 PPM 的预测器,曾赢得近期国际分支预测竞赛。它们使用中等容量的存储(32~64 KiB),就能胜过 gshare 与竞争预测器;而且这类预测器似乎还能够有效利用更大的预测缓存,进一步提高准确率。
大容量预测器的另一个问题是如何初始化。可以随机初始化,但随后需要相当长的执行时间,才能让预测器充满有用的预测。有些预测器,包括许多较新的设计,带有有效位,指示条目是否已被设置,还是仍处于“未使用”状态。对于未使用条目,可以用某种方法初始化,而不是使用随机预测。例如,某些指令集提供一个位,指示相应分支预期会跳转还是不跳转。在动态分支预测出现之前,这些提示位就是预测本身;在近期处理器中,它们可用来设置初始预测。也可以根据分支方向设置:向前跳转的分支初始化为不跳转,向后跳转的分支很可能是循环分支,初始化为跳转。对于运行时间较短的程序以及预测器较大的处理器,初始设置会对预测性能产生可以测量的影响。
图 3.10 显示,带标签混合预测器明显胜过 gshare,尤其是在 SPECint 和服务器应用等较难预测的程序上。图中用每千条指令的错误预测次数衡量性能。假设分支频率为 20%~25%,对于多媒体基准,gshare 每条分支的错误预测率为 2.7%~3.4%,带标签混合预测器为 1.8%~2.2%,即错误预测约减少三分之一。与 gshare 相比,带标签混合预测器实现更复杂,而且需要检查多个标签、选择预测结果,速度可能略慢。不过,对于流水线很深、分支错误预测代价很高的处理器,准确率提高的收益超过了这些不利影响。因此,许多高端处理器设计者选择在最新实现中加入带标签混合预测器。
此外,采用多级和多流水级设计,也为绕开分支预测器在速度、大小与复杂度之间的取舍提供了途径。
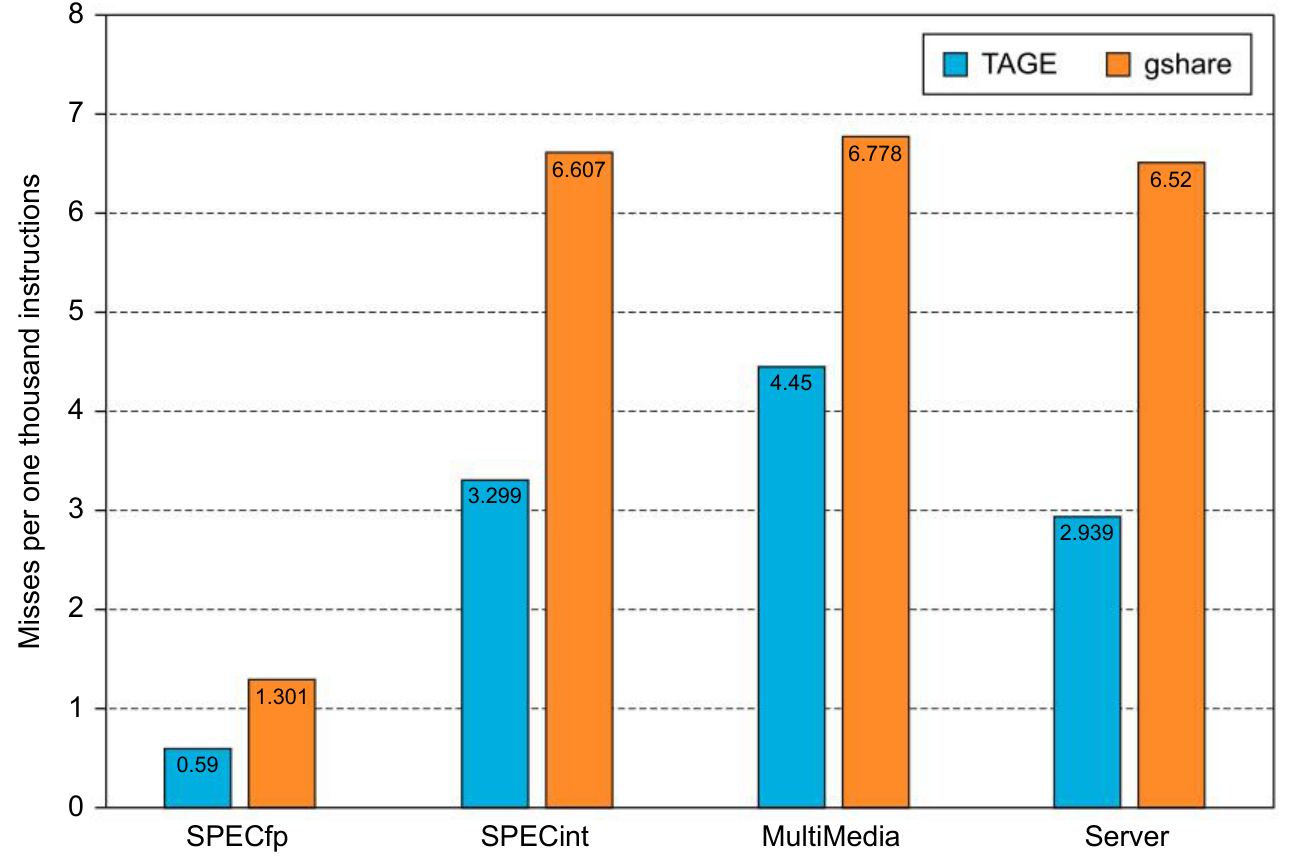
图 3.10 带标签混合预测器与 gshare 的错误预测率比较,以每执行 1000 条指令发生的错误预测次数衡量。两者使用的总位数相同,但带标签混合预测器将部分存储用于标签,gshare 则没有标签。基准包括 SPECfp、SPECint 的执行轨迹,以及一系列多媒体和服务器基准;后两类更接近 SPECint 的行为。蓝色为 TAGE,橙色为 gshare;纵轴为每千条指令的错误预测次数,横轴 MultiMedia 与 Server 分别为多媒体与服务器应用。
Intel 处理器分支预测器的演变
深流水线与每周期多发射相结合,使超标量处理器同时拥有许多在途指令;近期设计中可达数百条。因此,分支预测十分关键,也是 Intel 不断改进的领域。或许正因为它对性能如此重要,Intel 一向严格保密其分支预测器的细节。即使对于 2008 年推出的 Core i7 920 这样的老处理器,公开的信息也很有限。这里简要介绍已知情况,并比较采用 Nehalem 微体系结构的 Core i7 920,与 2016 年发布、采用 Skylake 微体系结构的 Intel Core i7 6700 中的预测器性能。
Core i7 920 使用两级预测器。第一级较小,目的是满足每个时钟周期预测一条分支的时间约束;第二级较大,作为后备。每一级都组合三种预测器:(1)附录 C 介绍的简单 2 位预测器,前面的竞争预测器也使用了它;(2)刚刚介绍过的全局历史预测器;(3)循环退出预测器。对于检测为循环分支的分支,循环退出预测器使用计数器,准确预测它会跳转多少次,也就是循环迭代次数。与竞争预测器一样,它跟踪三种预测的准确性,为每条分支选择最佳预测。除了这个多级主预测器,还用独立单元预测间接分支的目标地址,用栈预测返回地址。
关于 Core i7 6700 预测器的已知信息更少,但有充分理由相信 Intel 使用了带标签混合预测器。其优点之一,是同时具备早期 i7 中三个第二级预测器的功能。采用不同历史长度的带标签混合预测器,涵盖了循环退出预测器、局部历史预测器和全局历史预测器的功能。返回地址仍由单独的预测器处理。
与其他场合一样,推测执行使预测器评估面临一些困难:一次错误预测,很容易导致另一条分支被取入,并再次预测错误。为简化分析,我们考察错误预测次数占成功完成的分支数的比例;成功完成的分支,是那些并非由错误推测产生的分支。图 3.11 给出了这些数据。
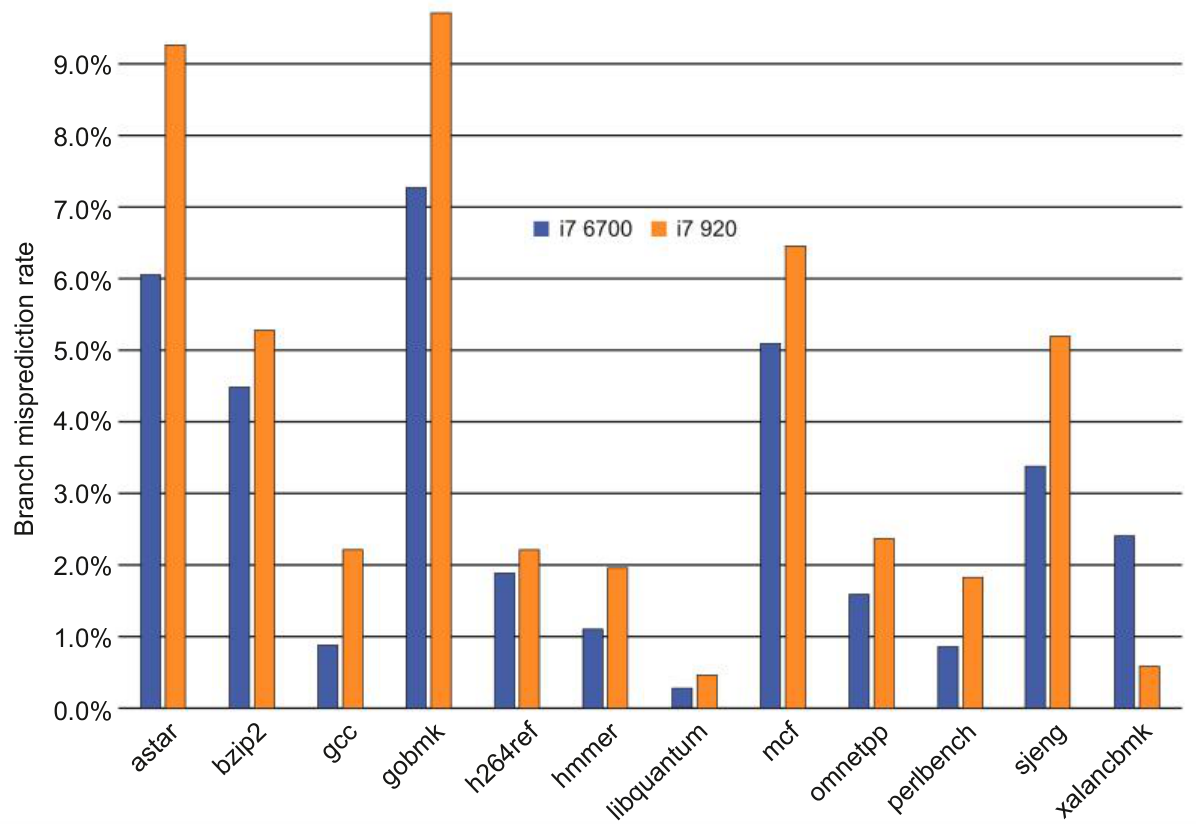
图 3.11 Intel Core i7 920 与 6700 上整数 SPEC CPU2006 基准的错误预测率。错误预测率按“已完成且预测错误的分支数/全部已完成分支数”计算。这可能在一定程度上低估错误预测率,因为如果一次分支错误预测又导致另一条本不该执行的分支被错误预测,这里只计为一次错误预测。平均而言,i7 920 的分支错误预测频率是 i7 6700 的 1.3 倍。纵轴为分支错误预测率;横轴为原始基准程序名;蓝色代表 i7 6700,橙色代表 i7 920。
这些数据对应 SPEC CPUint2006 基准。它们比 SPEC89 或 SPEC2000 大得多,因此即使采用更强大的预测器组合,错误预测率仍高于图 3.8。分支错误预测会导致无效推测执行,因此造成工作浪费,本章后面会进一步讨论。
分支目标缓冲区
到目前为止,所介绍的分支预测器能推测当前取指 PC 是否指向一条会跳转或不会跳转的分支。如果尚未译码的指令是一条预测为跳转的分支,还必须预测分支目标地址,才能重定向取指,并实现零分支代价。这通过分支目标缓冲区(branch-target buffer,BTB)或分支目标缓存完成。它是一种缓存,保存预测的分支后下一条指令地址。图 3.12 展示了一个 BTB。每个条目包含预测目标,以及一个标签,保存该条目对应分支的 PC。标签使处理器在 BTB 冲突时,避免误用另一条分支的目标地址,否则会降低性能。BTB 条目还包含有效位、分支类型,以及用于实现替换策略的若干位。
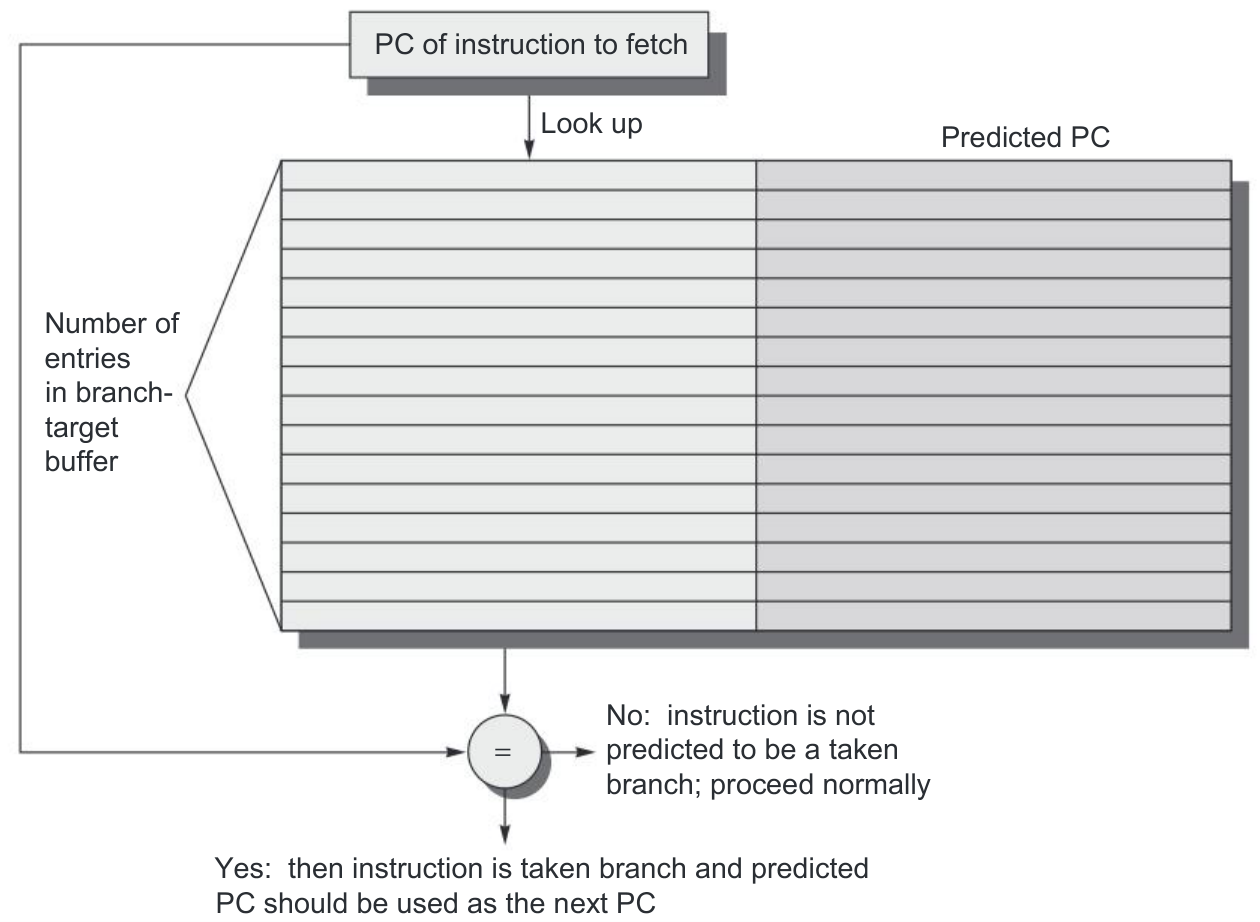
图 3.12 分支目标缓冲区。将正在取入的指令的 PC,与第一列保存的一组指令地址比较;这些地址是已知分支的地址。如果 PC 与某个条目匹配,那么正在取入的指令就是一条跳转分支,第二个字段“预测 PC”保存分支之后下一 PC 的预测值,立即从这个地址开始取指。第三个字段是可选的,可以用于保存额外的预测状态位。
图中文字:PC of instruction to fetch 为待取指令的 PC;Look up 为查找;Predicted PC 为预测 PC;Number of entries in branch-target buffer 为分支目标缓冲区的条目数。比较结果为否时:预测该指令不是一条跳转分支,按正常方式继续;为是时:该指令是一条跳转分支,将预测 PC 作为下一 PC。
访问 BTB 与访问分支预测器并行进行。若预测分支不跳转,就忽略 BTB 查找结果。若预测跳转,且 BTB 条目标签与所取指令的 PC 匹配,即 BTB 命中,就在后续周期使用预测 PC。若预测跳转,但 BTB 未命中,处理器就必须暂停取指,直到当前指令被取入、译码并计算出目标地址。频繁执行且跳转的分支目标会被放入 BTB,替换近期没有使用,或如今经常不跳转的分支目标。BTB 只需保存预测为跳转的分支,因为不跳转的分支只需取顺序的下一条指令,就像它不是分支一样。
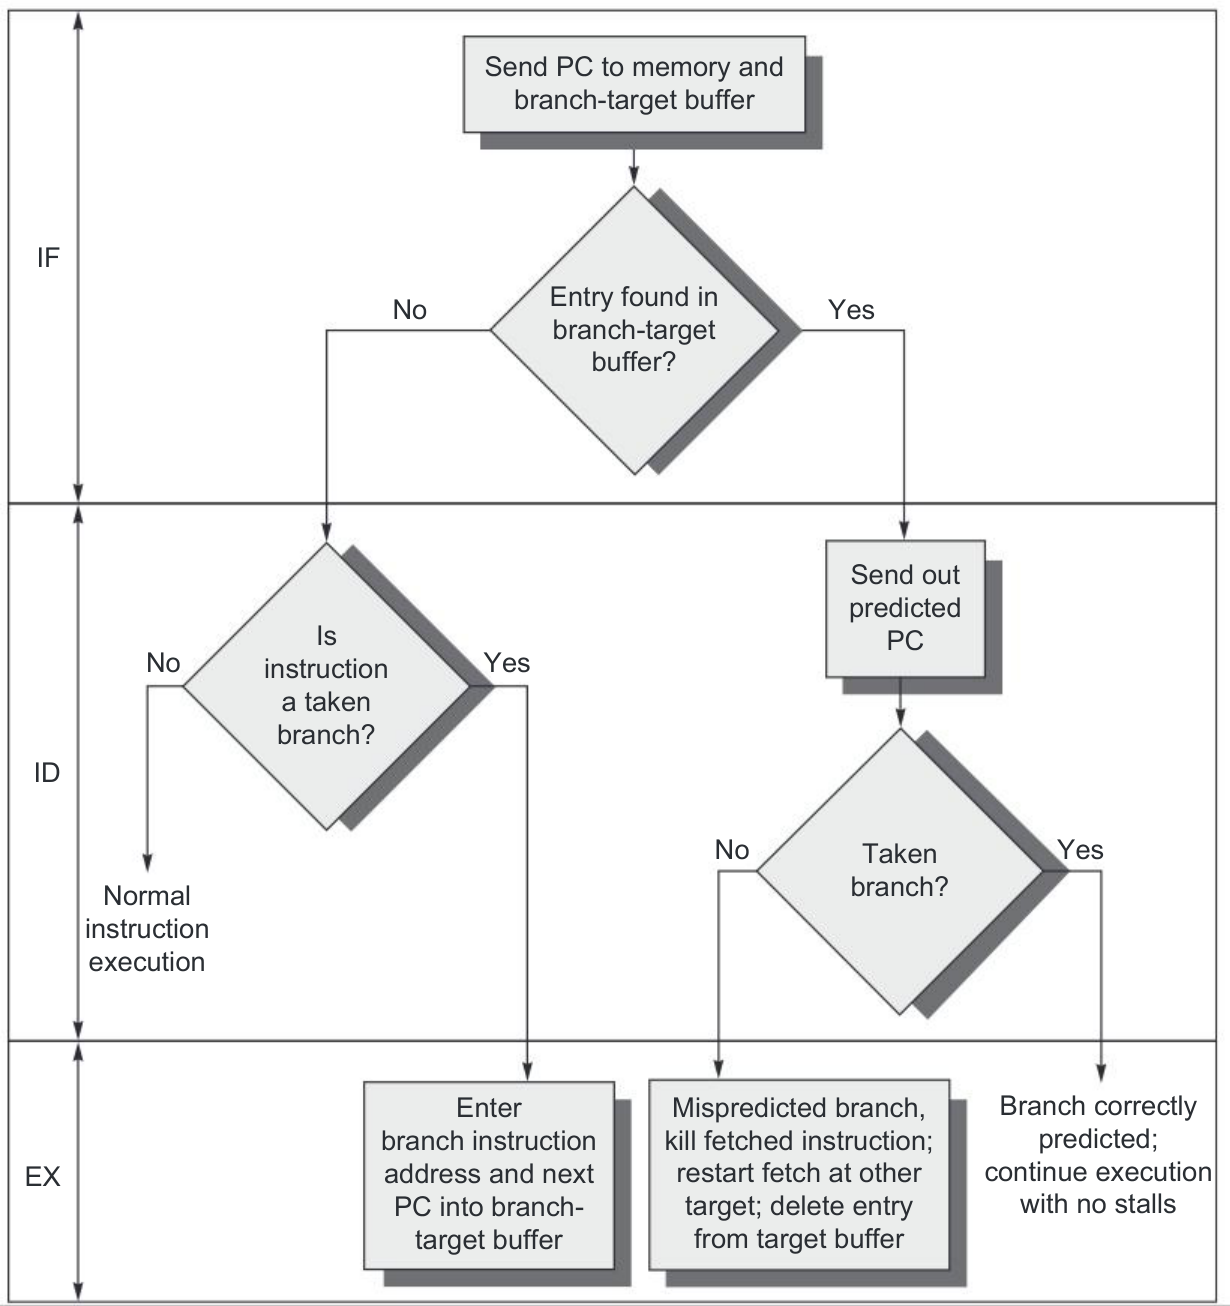
图 3.13 使用分支目标缓冲区处理一条指令所涉及的步骤。图中的 IF、ID、EX 分别表示取指、译码、执行阶段。
图内流程完整译文如下:IF 阶段将 PC 发送到存储器和分支目标缓冲区,然后判断“是否在分支目标缓冲区中找到条目”。若否,ID 阶段判断“该指令是否为跳转分支”;若不是,则正常执行指令;若是,则在 EX 阶段把分支指令地址与下一 PC 写入分支目标缓冲区。若 IF 阶段找到了条目,ID 阶段发出预测 PC,并判断“分支是否跳转”;若否,则为错误预测,撤销已取指令,从另一目标重新取指,并从目标缓冲区删除该条目;若是,则分支预测正确,无停顿地继续执行。Yes、No 分别为是、否。
BTB 对跳转分支的命中率对性能至关重要,可以借助类似第 2 章缓存优化的方法提高。采用相联 BTB,可以减少冲突未命中;采用多级 BTB 结构,可以缓解命中时间与容量未命中之间的权衡。对于从取指到算出有效目标需要 5~10 个周期的处理器流水线,多级 BTB 尤其有用。
图 3.13 展示简单五级流水线使用 BTB 的步骤。可以看到,对一条实际跳转的分支,如果方向预测正确,而且在缓冲区中找到分支目标条目,就没有分支延迟;否则,至少有两个时钟周期的代价。
要评估 BTB 的效果,首先必须确定所有可能情形的代价。图 3.14 列出简单五级流水线的这些信息。
| 指令是否在缓冲区中 | 预测 | 实际分支行为 | 代价(周期) |
|---|---|---|---|
| 是 | 跳转 | 跳转 | 0 |
| 是 | 跳转 | 不跳转 | 2 |
| 否 | 跳转 | 2 | |
| 否 | 不跳转 | 0 |
图 3.14 假设缓冲区只保存跳转分支,表中列出分支是否在缓冲区内、实际是否跳转的所有可能组合及其代价。如果预测完全正确,且在目标缓冲区中找到分支,则没有分支代价。如果预测不正确,需要 1 个时钟周期用正确信息更新缓冲区,这期间无法取指;若需要重新取入该分支之后的正确指令,则再花 1 个周期。如果未找到分支而实际跳转,则有 2 个周期的代价,期间更新缓冲区。
例题 使用图 3.14 中各类错误预测的代价周期数,计算分支目标缓冲区的总分支代价。假设:
- 对缓冲区中的指令,预测准确率为 90%。
- 对预测跳转的分支,缓冲区命中率为 90%。
解答 考察两种事件的概率:预测跳转而实际不跳转;实际跳转但在缓冲区中未找到。两者代价均为 2 个周期。
随着流水线加长、分支延迟增大,动态分支预测带来的改善也会增加;更好的预测器还能进一步扩大性能优势。现代高性能处理器的分支错误预测延迟约为 15 个时钟周期,准确预测显然至关重要!
BTB 的一种变体,是保存一条或多条目标指令,以替代预测目标地址,或者两者同时保存。这有两个潜在优点。第一,允许 BTB 的访问时间长于连续两次取指之间的间隔,从而可能采用更大或多级的 BTB。第二,缓存实际目标指令,可以实施称为分支折叠(branch folding)的优化。分支折叠可使无条件分支只需 0 个周期,有时条件分支也能达到 0 周期。稍后会看到,Cortex A-53 使用单条目的分支目标缓存,保存预测目标处的指令。
考虑一个保存预测路径指令的 BTB,当前用一条无条件分支的地址访问它。无条件分支唯一的作用是改变 PC。因此,当 BTB 命中,且指示该分支为无条件分支时,流水线可以直接用 BTB 中的指令,替换指令缓存返回的那条无条件分支。如果处理器每周期发射多条指令,缓冲区也必须提供多条指令,才能获得最大收益。有些情况下,还可能消除条件分支的代价。
专用分支预测器:预测过程返回、间接跳转与循环分支
通过推测执行增加并行机会时,会遇到预测间接跳转的挑战,即跳转目标地址在运行时变化。高级语言程序会为间接过程调用,例如 C++ 虚函数调用、select 或 case 语句,以及 FORTRAN 的计算转移 goto,生成此类跳转。不过,许多间接跳转只是过程返回。例如,在 SPEC95 基准中,过程返回平均占所有分支的 15% 以上,并占间接跳转的绝大多数。对于 C++ 和 Java 等面向对象语言,过程返回更加频繁,因此优先研究过程返回是合理的。
虽然 BTB 可以预测过程返回,但如果一个过程从多个调用点被调用,而且同一调用点的调用在时间上并不集中,这种方法的准确率可能很低。例如,在 SPEC CPU95 中,一个激进的分支预测器对这类返回分支的准确率不足 60%。为解决这一问题,大多数处理器使用一个按栈方式工作的、小型返回地址缓冲区。这种返回地址栈(return address stack,RAS)缓存最近的返回地址:调用时压入返回地址,返回时弹出一个地址。如果该缓存足够大,即容量达到最大调用深度,就能完美预测返回。图 3.15 给出了若干 SPEC CPU95 基准在返回缓冲区包含 0~16 个条目时的表现。近期所有高性能超标量处理器都实现了 RAS。
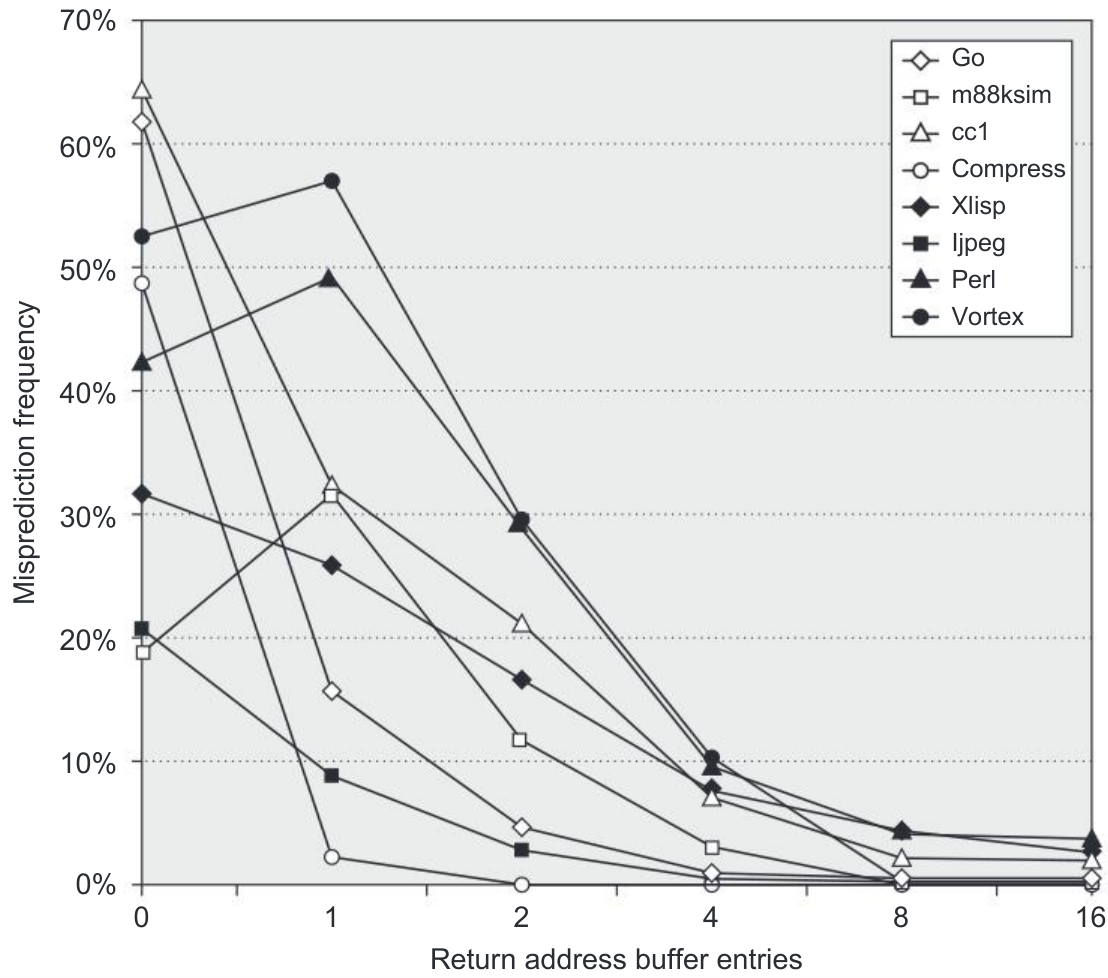
图 3.15 按栈方式工作的返回地址缓冲区,在若干 SPEC CPU95 基准上的预测准确率。准确率指正确预测的返回地址所占比例。4 0 条目表示使用标准分支预测。除少数例外,调用深度通常不大,因此中等容量的缓冲区就能取得良好效果。数据来自 Skadron et al.(1999),使用修复机制,防止缓存的返回地址遭到破坏。图中纵轴 Misprediction frequency 实际为错误预测频率;横轴 Return address buffer entries 为返回地址缓冲区条目数;Go、m88ksim、cc1、Compress、Xlisp、Ijpeg、Perl、Vortex 为原基准程序名。
各种函数调用与控制转移也会产生间接跳转。预测这类分支的目标,不像过程返回那么简单。有些处理器为所有间接跳转增加专用预测器,另一些则依赖分支目标缓冲区。
gshare 之类的简单预测器,对许多条件分支预测得很好,但并没有针对循环分支、特别是长时间运行的循环作专门设计。如前所述,Intel Core i7 920(Skylake 微体系结构)使用了专用循环分支预测器。5 随着带标签混合预测器出现,而它们对循环分支也同样擅长预测,一些近期设计者选择把资源投入更大的带标签混合预测器,而不再设置独立的循环分支预测器。
集成取指单元
为满足多发射处理器的需求,近年来许多设计者将集成取指单元实现为独立、自主工作的单元,为流水线其余部分提供指令;这种组织通常称为解耦前端(decoupled front-end)。这实际上承认了:面对多发射的复杂性,已不能再把取指看作简单的单个流水级。因此,近期设计采用集成取指单元,将以下功能结合起来:
- 集成分支预测:分支预测器成为取指单元的一部分,持续预测分支,驱动取指流水线。分支预测器与 BTB 处理每个取指指令束中的多条分支。
- 指令预取:为了每周期提供多条指令,取指单元很可能需要提前获取指令。该单元自主管理指令预取,并将其与分支预测结合;有关预取技术,见第 2 章。
- 指令存储访问与缓冲:每周期取多条指令会遇到各种复杂问题,例如可能需要访问多个缓存行。取指单元封装这些复杂性,尝试通过预取隐藏跨缓存块的代价。它还提供缓冲,实质上作为按需供应单元,在发射级需要时,提供所需数量的指令。
如今几乎所有高端处理器都采用独立取指单元,并通过保存待处理指令的缓冲区,与流水线其余部分连接。
译注:原图注明确写作“4096 bits”,但图例和前文均为“4096 entries”,每条目 2 位,即 8192 位。 ↩︎
译注:原文写“总共 29K 位”。按本段明确列出的 1024×10 位历史表与 1024×3 位计数器表,相加为 13K 位;原文未说明其余 16K 位的来源。 ↩︎
译注:原正文称第 个预测器使用最近 条分支,图注称历史长度为 0~4,而图中标的是 至 。这些是源文自身的不同表述;图与文字均保留,未将图中 擅自改为 。原文 TAGE 展开词拼作“TAgged GEometic”,此处亦保留。 ↩︎
译注:原图注称“预测准确率”,但纵轴明确为“错误预测频率”,两者互为补数。读图时应以纵轴所示错误预测率理解数值。 ↩︎
译注:本处原文确写 Core i7 920(Skylake);但本节前文将 i7 920 归为 Nehalem、i7 6700 归为 Skylake。 ↩︎