3.5 利用寄存器重命名克服名依赖
寄存器重命名使超标量处理器能够利用大量物理寄存器,消除名依赖带来的 WAR 和 WAW 冒险风险。我们先通过一种可能的实现,详细考察重命名如何工作,再讨论其他实现方案的取舍。为简化说明,这里讨论整数寄存器重命名所需的硬件;浮点寄存器也使用类似结构。
图 3.16 展示采用统一寄存器堆(unified register file,URF)进行寄存器重命名所需的硬件结构。该寄存器堆实现大量物理寄存器,图中为 p0~p127,既保存 32 个体系结构可见寄存器的值,也保存尚未提交指令的临时值。两个硬件结构负责管理这些物理寄存器。重命名映射表标明:指令作为输入操作数指定的体系结构寄存器,当前对应哪一个物理寄存器编号,即 。当指令在处理器前端发射时,读取并更新这张表。因此,表中的映射具有推测性,因为其中一些指令以后可能因错误推测或异常而被撤销。体系结构映射表则根据已经提交的指令,记录每个体系结构寄存器对应的物理寄存器编号。体系结构映射表在流水线后端更新,用于异常与错误预测恢复。
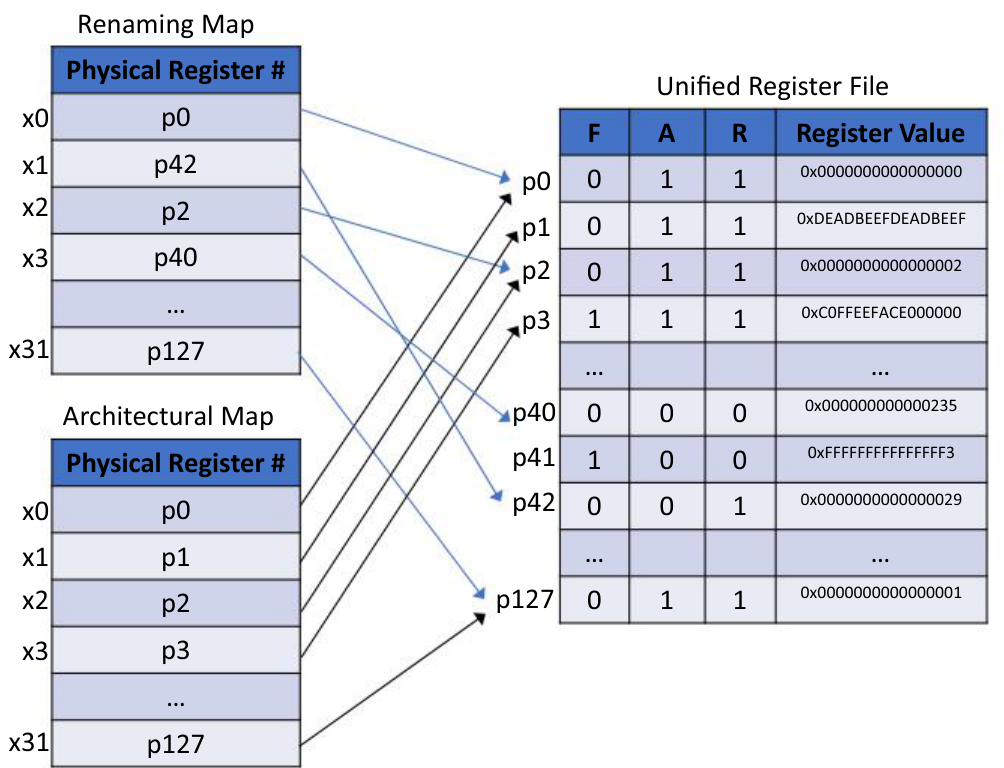
图 3.16 采用统一寄存器堆(URF)的寄存器重命名硬件结构。每个 URF 条目的三个元数据位,分别表示物理寄存器是否空闲(F)、是否处于体系结构状态(A)、是否就绪(R)。如图所示,p0~p3 处于体系结构状态。p40 与 p42 分别处于已占用但未就绪、已占用且就绪状态,它们的值由尚未完成提交的指令产生。p41 空闲。1
图中文字:Renaming Map 为重命名映射表;Architectural Map 为体系结构映射表;Physical Register # 为物理寄存器编号;Unified Register File 为统一寄存器堆;Register Value 为寄存器值。图中箭头保留原映射关系,十六进制值为原示例数据。
图 3.17 描述物理寄存器可能处于的四种状态:空闲、已占用但未就绪、已占用且就绪、体系结构状态。空闲表示该物理寄存器未被使用,可以分配给新指令。两种已占用状态表示它已被一条尚未完成提交的指令分配。未就绪表示该指令尚未执行完成,后续依赖指令还不能使用这个值;就绪表示产生该值的指令已执行完成,但尚未提交,因此寄存器值已经可用。体系结构状态表示它保存的是一条已执行完成并已提交指令的结果;体系结构映射表的一个条目会指向它。体系结构寄存器总是就绪的。复位时,前 32 个物理寄存器处于体系结构状态,其余为空闲。图 3.16 用三个元数据位(Free、Architectural、Ready)编码每个物理寄存器的状态,编码如下:空闲 ;已占用但未就绪 ;已占用且就绪 ;体系结构状态 。
重命名的大部分工作在指令译码之后的发射阶段完成。不过,随着指令经过各执行阶段,物理寄存器也会发生状态转换。
- 发射(顺序):指令发射时,在重命名映射表中查找输入操作数。表给出当前保存该指令所读体系结构寄存器最新值的物理寄存器地址。物理寄存器编号及其状态,随后送往动态调度硬件(见 3.5 节)。2 同时,指令为输出寄存器 的新值分配一个新的物理寄存器 ,将重命名映射表中的 条目更新为 ,并把新分配物理寄存器设为已占用但未就绪。注意,存储、分支等指令不产生新的寄存器值,所以不分配物理寄存器。
- 派发(乱序):当保存指令输入操作数的所有物理寄存器,都处于体系结构状态或已占用且就绪状态时,该指令就绪,可以派发执行。3.5 节将介绍跟踪输入操作数状态的调度硬件。2 指令输出所用物理寄存器 的状态保持不变,仍为已占用但未就绪。
- 完成(乱序):功能单元完成指令执行后,将新值存入已分配的物理寄存器 ,把其状态改为已占用且就绪。依赖该指令的其他指令现在可以使用此值。
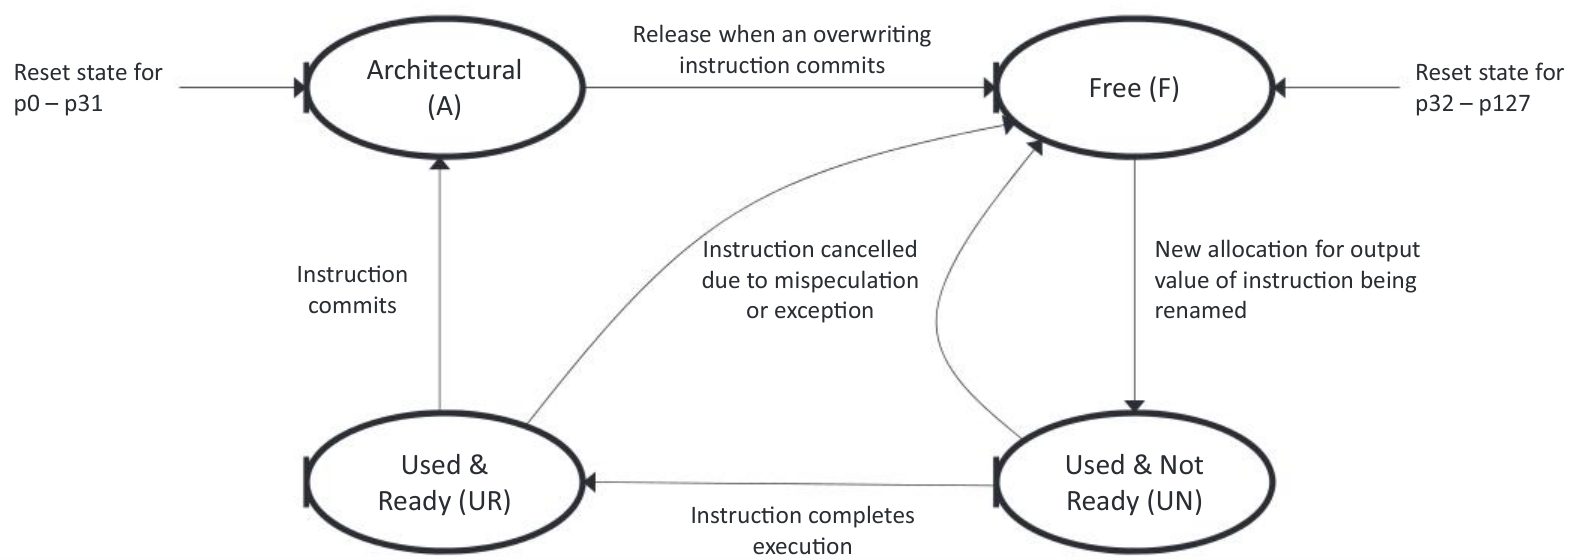
图 3.17 物理寄存器的生命周期。除一个转换外,所有状态转换都由分配该寄存器的指令在执行过程中触发。从体系结构状态转为空闲状态,则发生于一条后续指令提交时;这条后续指令为同一个体系结构寄存器使用了另一个物理寄存器。
图中四个状态分别是 Architectural(A,体系结构状态)、Free(F,空闲)、Used & Not Ready(UN,已占用但未就绪)、Used & Ready(UR,已占用且就绪)。复位时,p0~p31 进入 A,p32~p127 进入 F。为正在重命名的指令输出分配寄存器时,F→UN;指令执行完成时,UN→UR;指令提交时,UR→A;覆盖它的后续指令提交时,A→F;指令因错误推测或异常而撤销时,UN 或 UR→F。
- 提交(顺序):指令到达 ROB 头部,而且没有产生异常或错误预测时,就把结果提交到体系结构状态。物理寄存器 转为体系结构状态,同时更新体系结构映射表中 的条目。如果此前为 ,则改为 ,并将 设为空闲。由于覆盖它的指令刚刚提交, 中的值不可能再被需要。
- 恢复(顺序):如果 ROB 中最老的指令关联异常或错误预测,就必须撤销所有尚未提交的指令,恢复精确的体系结构状态,如同从未部分处理过这些指令。对重命名状态而言,只需两个快速步骤:首先,将所有处于两种已占用状态的物理寄存器标为空闲;其次,丢弃重命名映射表的当前状态,通过一次批量复制,将其初始化为体系结构映射表的状态。
超标量处理器在单个时钟周期内,对一个指令束中的所有指令重命名,因此重命名逻辑很复杂。第一项要求是映射表必须具有多个端口。如果处理器每周期派发 条指令,重命名映射表就必须支持 个读端口,查询全部输入操作数的当前映射,还需要 个写端口,更新全部输出操作数的映射。如果处理器每周期提交 条指令,体系结构映射表就需要 个写端口完成相应更新。物理寄存器的三个元数据位也必须支持每周期多次访问。由于它们以位掩码实现,为并行更新提供多个端口的成本较低。
每周期对多条指令重命名的第二项要求,是重命名逻辑必须检测并遵守指令束内部的数据依赖。如果依赖不在指令束内部,就利用重命名映射表,确定保存或将要保存所需结果的物理寄存器。如果一条指令依赖同一指令束中较早的指令,就应把较早指令所分配的物理寄存器作为输入操作数。通过下面这个给整数数组所有元素加 1 的循环,来看一个例子:
图 3.18 展示处理器如何以每周期 5 条指令的速度,对该循环两次迭代中的指令重命名。每个指令束含 5 条指令。第一个周期为结果分配三个物理寄存器:ld 用 p51 重命名 x2,第一条 addi 用 p52 重命名 x2,第二条 addi 用 p53 重命名 x1。周期结束时,映射表中 x2 的映射来自两条写入指令中较新的那一条,即 p52。指令束内部还存在三处数据依赖。第一处是 ld 产生 x2,后续 addi 使用它。addi 会忽略重命名表为 x2 返回的 p40,改用 ld 同时分配的 p51。重命名逻辑以类似方式,处理 sd 与 addi 之间关于 x2 的真依赖,以及 bne 与 addi 之间关于 x1 的真依赖。第二个周期,它同样处理第二次迭代的指令束,为这些指令产生的新值分配新的物理寄存器 p61、p62、p63。
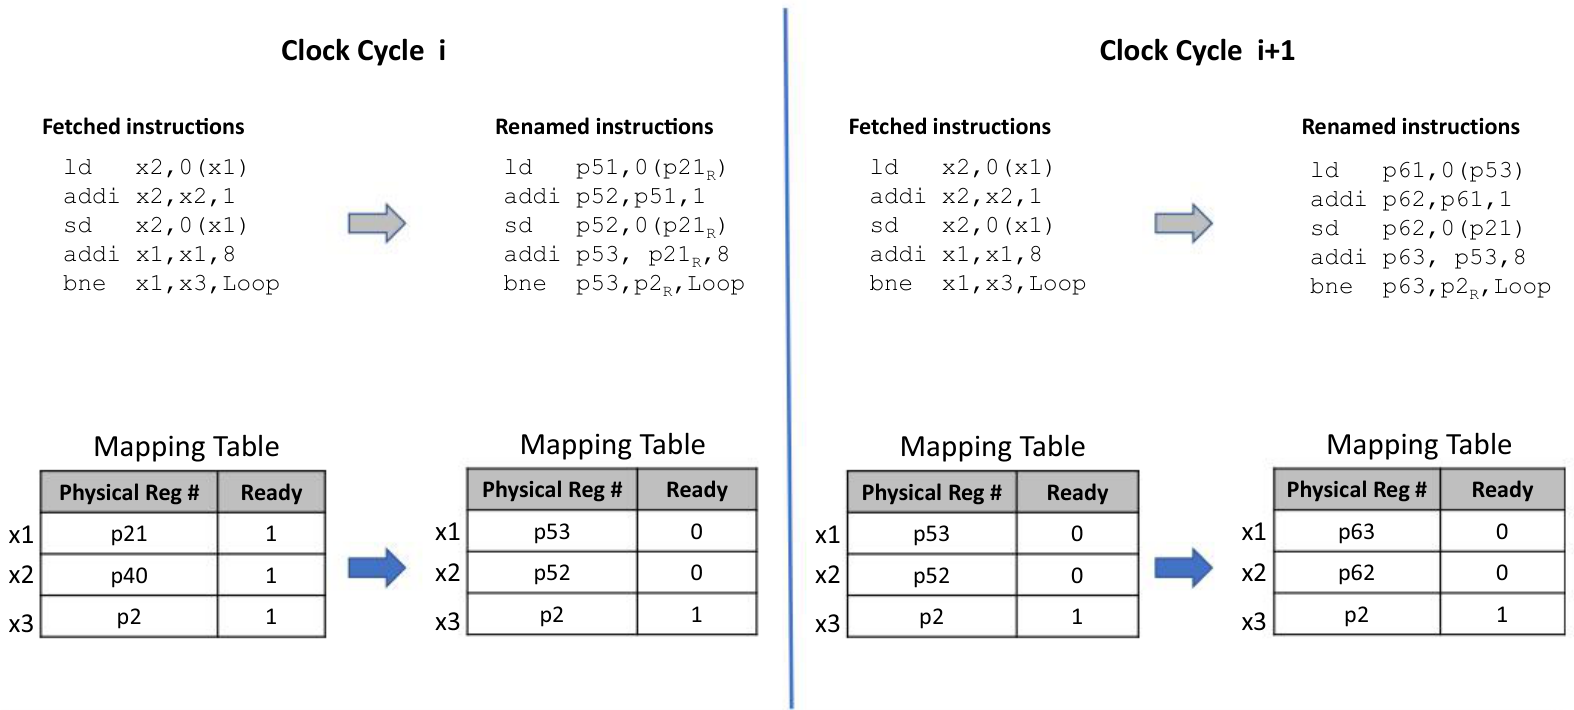
图 3.18 以每周期 5 条指令的速度,对循环的两次迭代进行寄存器重命名。为简洁起见,图中只显示映射表的三个相关条目,以及每个条目所指物理寄存器的就绪位。一个指令束中的 5 条指令并行重命名,但必须遵守束内数据依赖。例如,bne 对前面的 addi 存在关于 x1 的数据依赖。重命名级输出交给动态调度使用;为辅助调度,已就绪的物理寄存器以下标 R 标记。3
图中文字:Clock Cycle i/i+1 为时钟周期 /;Fetched instructions 为已取指令;Renamed instructions 为重命名后的指令;Mapping Table 为映射表;Physical Reg # 为物理寄存器编号;Ready 为就绪位。第一个周期映射从 x1→p21、x2→p40、x3→p2(均就绪),变为 x1→p53、x2→p52(未就绪)、x3→p2(就绪);第二个周期进一步变为 x1→p63、x2→p62(未就绪)、x3→p2(就绪)。
另一项复杂性来自判断何时能安全地释放物理寄存器。一个用于体系结构寄存器 的物理寄存器 ,只有在后续覆盖指令为 分配了新的物理寄存器,而且所有仍等待调度的指令都不再需要读取 后,才能释放。此外,还必须确保在覆盖指令提交之前,没有指令会引发异常。因此,多数处理器选择延后到覆盖指令提交时才释放物理寄存器,以更长的占用时间换取实现简单。
寄存器重命名的其他实现
寄存器重命名还可以采用多种其他实现。
不设体系结构映射表。 使用 URF 时,可以只保留重命名映射表。发生错误预测或异常后,按以下方法恢复精确寄存器状态:派发时,每条指令在用新分配的物理寄存器编号 覆盖目标映射之前,先读取并在 ROB 中记录旧映射 。如果指令提交,就丢弃旧映射;如果发生异常或错误预测,就从较新指令向较老指令反向遍历 ROB,将每个条目中的旧映射依次恢复到重命名映射表。缺点是恢复延迟与 ROB 大小成正比。
分离物理寄存器与体系结构寄存器。 不采用具有 128 个物理位置的 URF,而是实现两个寄存器堆:一个体系结构寄存器堆 ARF,含 32 个条目 x0~x31;另一个重命名寄存器堆 RRF,保存临时重命名寄存器。指令派发时分配 RRF 寄存器,完成时更新其值;提交时,将新输出值从 RRF 的物理寄存器复制到 ARF 的体系结构寄存器,并更新重命名表以反映这一变化。异常或错误预测恢复很快,只需将所有 RRF 寄存器标为空闲,并重新初始化重命名映射表,使其指向 ARF。实际上,还可以把 ARF 与重命名映射表合并为一个 32 条目的结构:每个 ARF 条目包含指向 RRF 的指针,指明最新一条尚未提交、将覆盖该体系结构寄存器的指令所分配的物理寄存器。不再需要单独的体系结构映射表。
把重命名寄存器放入 ROB。 如果按上述方式分离体系结构寄存器与重命名寄存器,就可以把重命名寄存器集成进 ROB。每个 ROB 条目提供保存一个寄存器值的空间,将指令输出缓冲到提交时;提交时再从 ROB 复制到 ARF。若发生异常或错误预测,这个临时缓冲区与 ROB 条目一并释放。缺点是,它会让本来就具有多个端口的 ROB 更复杂。
把重命名表放入 ROB。 某些设计更进一步,把映射表也集成进 ROB。派发时,新指令必须在 ROB 中搜索:对于自己要读取的每个体系结构寄存器,找出最新的一条可能写入它的指令。如果找到匹配的 ROB 条目,那么当值就绪时,就由该条目向新指令提供输入值;否则,从体系结构寄存器堆读取。这种方式消除了读取输入操作数的两步过程,即先访问重命名映射表,再访问寄存器堆。但它要求 ROB 每周期针对多条指令、多个输入操作数进行相联搜索。搜索还必须优先选择较新的指令,也就是距离 ROB 头部最远的指令。