3.6 利用动态调度克服数据冒险
动态调度使超标量处理器能够在指令的数据依赖一旦解除后立即执行它,不受程序顺序限制,从而开发 ILP。当存在缓存未命中或其他长延迟操作时,动态调度也不可或缺,否则这些操作会造成长时间的流水线停顿。本书前几版首先介绍 Tomasulo 动态执行算法:它开发于 1967 年,实现在 IBM 360/91 大型机的浮点单元中。本版则直接介绍现代动态调度实现,它们建立在分支预测、推测执行与寄存器重命名之上。
动态调度的基本思想
动态调度包含两个步骤。首先,硬件必须跟踪每条待执行指令的数据依赖状态,确定它何时就绪,这称为指令唤醒(instruction wakeup)。其次,硬件必须从就绪指令中选择一部分,启动其执行,这称为指令派发(instruction dispatch)。尽管指令会乱序派发和执行,ROB 仍能保证从错误推测中恢复,并在指令产生异常时恢复精确状态。
指令唤醒与派发,可以由集中式硬件调度器,也称统一调度器,实现;也可以采用一组分布式的小型调度结构。近期 Intel 处理器,例如 Skylake 和 Golden Cove,对整数与浮点指令采用集中式方案;近期 AMD 处理器,例如 Milan 和 Genoa,则采用分布式方案。我们先介绍集中式调度器,再讨论分布式设计的取舍。在研究文献中,集中式调度器有时也称指令窗口、指令缓冲区或指令队列,尽管它并不按先进先出的方式工作。
图 3.19 上半部分给出集中式调度器各条目的字段,下半部分给出整体结构。每个条目都有 busy 字段,表示是否被一条尚未调度的指令占用。接下来的三个字段,在指令开始执行时使用:操作码、目标物理寄存器、待更新的 ROB 条目。之后,条目跟踪两个输入寄存器 和 的状态:执行该指令是否需要它们(Vj、Vk),将提供值的物理寄存器编号(Regj、Regk),以及值是否就绪(Rj、Rk)。最后一个字段指示整条指令是否就绪;当全部有效输入寄存器都就绪时,设置该字段。如果输入物理寄存器在发射时已就绪,或者功能单元通知调度器,写入它的指令已经完成,那么该输入就已就绪。功能单元通过广播总线,每周期通知调度器已完成指令所写入的物理寄存器。
每个调度器条目都带有比较器,持续把两个输入物理寄存器编号 Regj、Regk,与功能单元刚刚更新的物理寄存器编号比较。一旦匹配,就把相应的一个或两个寄存器标为就绪,即设置 Rj 和/或 Rk 为真。
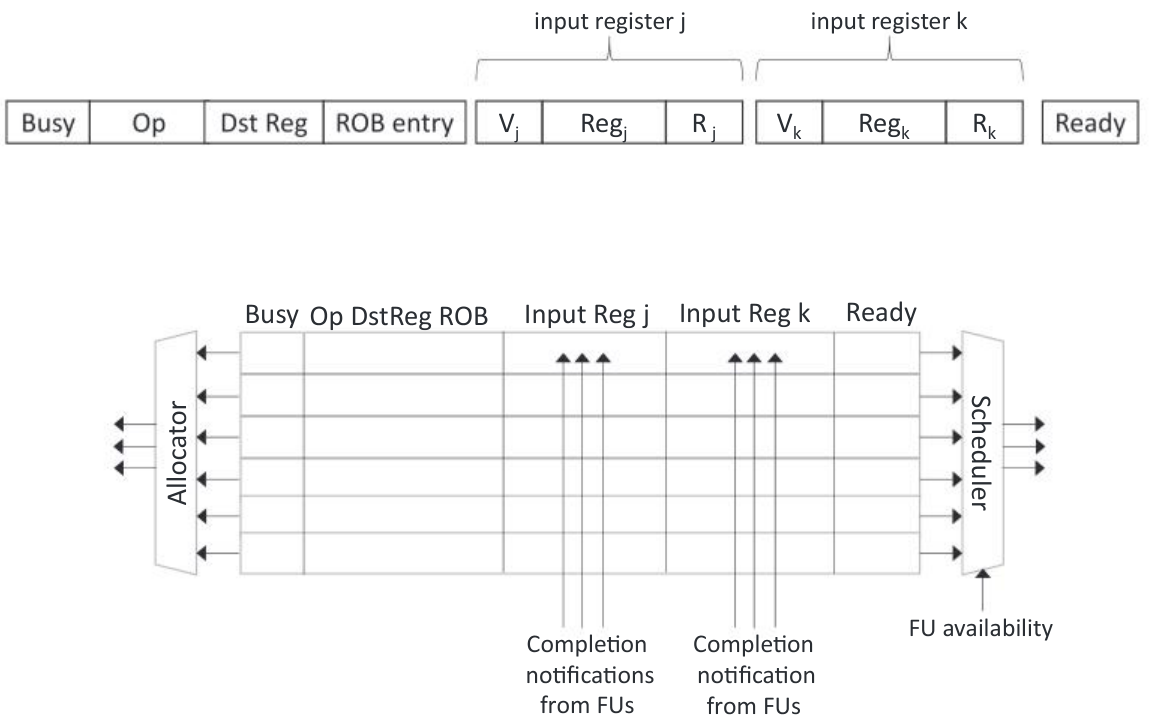
图 3.19 集中式指令调度器的条目格式(上)与结构(下)。图中 Busy 为占用位,Op 为操作码,Dst Reg 为目标寄存器,ROB entry 为 ROB 条目,input register j/k 为输入寄存器 ,Ready 为就绪位。Allocator 为分配器,Scheduler 为调度器,FU availability 为功能单元可用情况,Completion notifications from FUs 为来自功能单元的完成通知。V、Reg、R 各字段含义见正文。
图 3.20 展示 ROB 的组成。每个条目跟踪一条指令:执行是否完成(Ready),是否产生寄存器输出(DestV),写入的体系结构寄存器与物理寄存器编号(Dst AReg、PReg),指令地址(PC),以及指令是否引起错误预测或异常的编码信息,包括错误预测或异常的类型。ROB 使用头、尾指针,按循环缓冲区管理。
图 3.21 是处理器执行引擎与后端的框图,包括指令窗口和 ROB。实线表示数据值或地址的传递,虚线表示指令、控制信号和通知的传递。图中也给出了加载/存储单元的基本结构,3.7 节将予以讨论。
下面回顾指令重命名之后的执行步骤。
1. 发射(顺序):所有指令都分配一个 ROB 条目。算术、逻辑与分支操作还分配调度器条目。加载、存储操作送入加载/存储队列,进行内存地址消歧与调度(见 3.7 节)。如果 ROB、硬件调度器或加载/存储队列已满,就使前端停顿,直到有空位。
| Ready:就绪 | Dst V:目标有效 | Dst AReg:目标体系结构寄存器 | Dst PReg:目标物理寄存器 | PC | 异常/错误预测信息 | 指针 |
|---|---|---|---|---|---|---|
| 0 | 0 | – | – | 0xff…204 | ROB 尾 | |
| 0 | 1 | x2 | p21 | 0xff…200 | ||
| 1 | 1 | x5 | p52 | 0xff…012 | ||
| 1 | 1 | x5 | p51 | 0xff…008 | ||
| 0 | 1 | x4 | p41 | 0xff…004 | ROB 头 |
图 3.20 重排序缓冲区(ROB)的结构。头、尾指针将条目作为循环缓冲区管理。表中未列出的上下方空行,表示原图中的空闲条目;Ready 列接收来自功能单元的完成信号,异常/错误预测信息列接收来自功能单元的异常与错误预测信号。
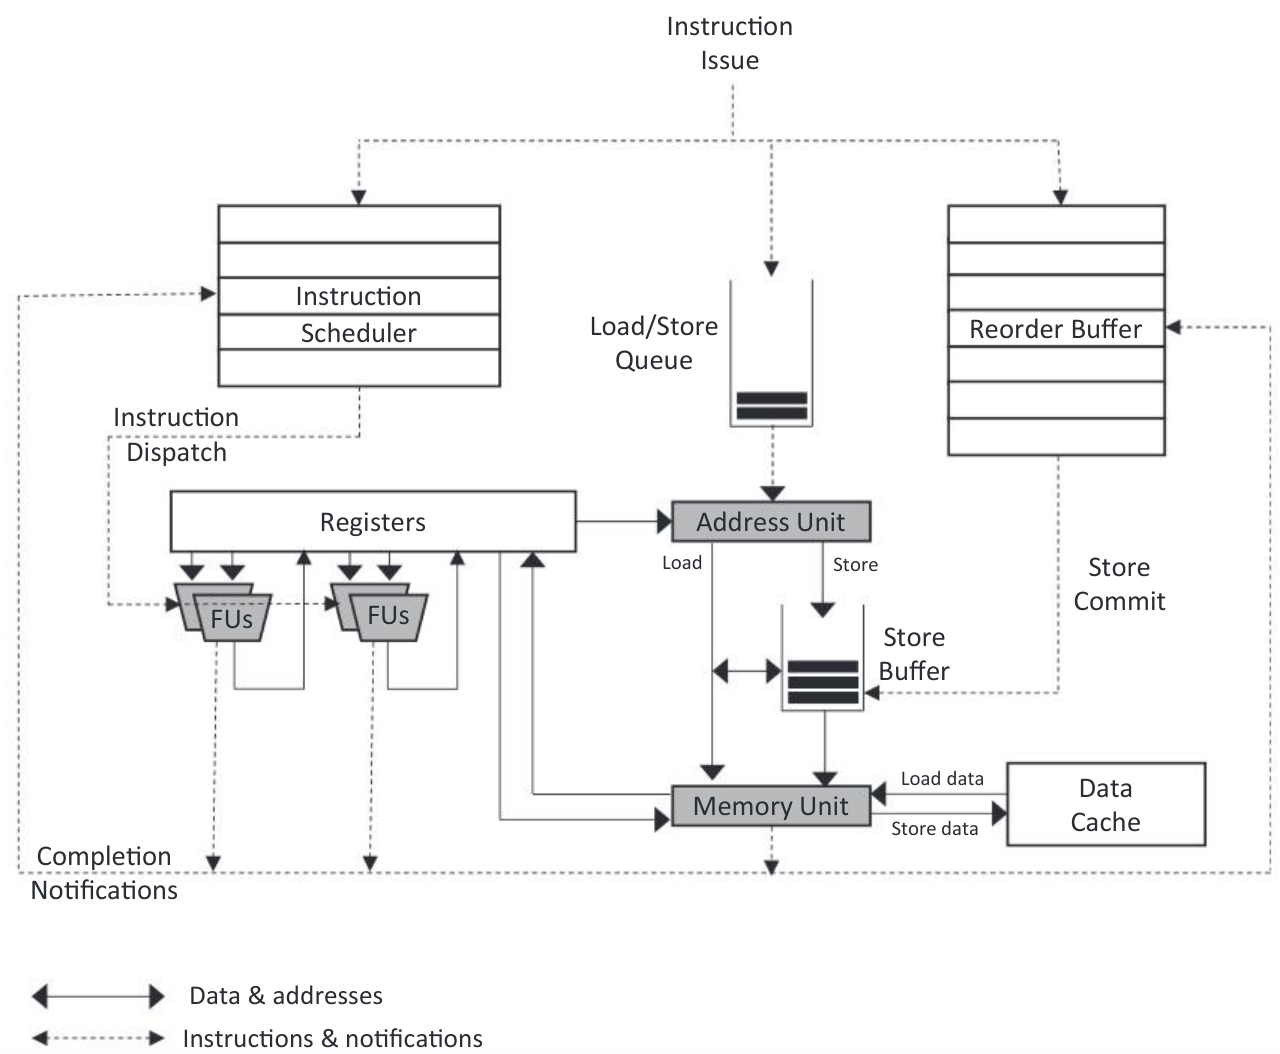
图 3.21 动态调度超标量处理器执行引擎与后端的基本结构,其中 ROB 用于推测恢复。指令由前端发射到 ROB 和指令调度器。调度器跟踪输入操作数的就绪状态,判断每条指令的数据冒险何时解除,再将其发送到功能单元(加、减、乘、除等),或内存单元(加载、存储)。指令执行完成时,更新其物理寄存器的值,并通知指令调度器,使依赖指令就绪,同时通知 ROB。
图中文字:Instruction Issue 为指令发射;Instruction Scheduler 为指令调度器;Instruction Dispatch 为指令派发;Reorder Buffer 为重排序缓冲区;Load/Store Queue 为加载/存储队列;Registers 为寄存器;FUs 为功能单元;Address Unit 为地址单元;Store Buffer 为存储缓冲区;Store Commit 为存储提交;Memory Unit 为内存单元;Data Cache 为数据缓存;Load/Store 为加载/存储;Load data/Store data 为加载数据/存储数据;Completion Notifications 为完成通知。实线 Data & addresses 为数据与地址,虚线 Instructions & notifications 为指令与通知。
2. 派发(乱序):每个周期,调度器从就绪指令中选择一部分执行。选择电路考虑可用功能单元的数量和类型,以及就绪指令的类型和年龄。由于指令必须按顺序提交,优先调度最老的就绪指令更好。被选中的指令从指令窗口移除,送到匹配的功能单元。对于流水线化的功能单元,每周期可发出一条指令。
3. 完成(乱序):功能单元先从 URF 读取输入数据,再执行送来的指令。算术操作完成后,将结果写回目标物理寄存器,同时向 ROB 和调度器发出完成通知。ROB 用通知把相应指令标为就绪,并记录可能检测到的异常或错误预测。调度器得到目标物理寄存器已就绪的通知后,进行指令唤醒:每个条目将目标寄存器编号与自己的输入寄存器编号比较,确定其中一个或两个输入是否刚刚就绪。如果某条目的两个输入寄存器现在都已就绪,该指令也就就绪,可以参与调度。
4. 提交或恢复(顺序):当指令到达 ROB 头部,且已经执行完成、没有产生异常时,可以提交。此外,分支指令不能预测错误,加载指令也不能在内存消歧中涉及错误推测。对于多数指令,提交就是更新目标寄存器的体系结构映射,并将指令从 ROB 移除。存储提交也类似,但还要通知存储缓冲区,现在可以安全地更新内存。如果导致错误推测的分支或加载,或产生异常的指令到达 ROB 头部,就清空 ROB 及整个处理器流水线,再从正确 PC 重新执行:正确的分支目标、加载指令地址,或异常处理程序的 PC。
上述四个步骤,每个都每周期处理多条指令。例如,一条流水线可以设计成每周期发射 4 条、派发 6 条、提交 4 条指令。派发宽度大于发射与提交宽度,是常见做法。只要功能单元足够,这就能在关键依赖解除后快速处理指令。例如,一条同时发生 L1 和 L2 缓存未命中的加载,可能使许多依赖指令在调度器中等待;当加载完成时,更宽的派发能力可以迅速处理这些积压指令。
动态调度示例
例题 假设一个动态调度超标量处理器有三个功能单元,分别执行浮点加载/存储、浮点加/减、浮点乘/除。功能单元延迟如图 3.2 所示:加法 2 周期,乘法 6 周期,除法 12 周期。1 下面是重命名后的代码,注释中给出原始代码;pf6 表示浮点物理寄存器,p2 表示整数物理寄存器。当 fmul.d 即将提交时,指令窗口、ROB 与浮点物理寄存器分别处于什么状态?
解答 图 3.22 给出 ROB、调度器和浮点物理寄存器的状态。注意,虽然 fsub.d 已执行完成,但必须等 fmul.d 提交后才能提交。fadd.d 可以先于 fdiv.d 执行并完成,因为 f6 已被重命名,避免了 WAR 冒险。浮点乘/除单元刚刚变为空闲,因此 fdiv.d 将在下一周期开始执行。
这个例子展示了采用动态调度与 ROB 的超标量处理器的关键特征:最早尚未完成的指令 fmul.d 之后,没有任何指令可以提交。因此,可以保持精确异常模型。
例如,如果 fmul.d 引发浮点异常,只需等它到达 ROB 头部,再触发异常,并清除 ROB 中其他尚未提交的指令。由于指令按顺序提交,异常便是精确的。相反,如果指令一完成就提交结果,那么 fsub.d 和 fadd.d 都可能在 fmul.d 触发异常之前完成;它们的目标寄存器 f8 和 f6 会被覆盖,这时中断就是不精确的。
重排序缓冲区:
| 条目 | 占用 | 指令 | 状态 | 就绪 | 目标 |
|---|---|---|---|---|---|
| 1 | 否 | fld pf6,0(p2) | 已提交 | 是 | pf6 (f6) |
| 2 | 否 | fld pf2,0(p3) | 已提交 | 是 | pf2 (f2) |
| 3 | 是 | fmul.d pf0,pf2,pf4 | 已完成 | 是 | pf0 (f0) |
| 4 | 是 | fsub.d pf8,pf2,pf6 | 已完成 | 是 | pf8 (f8) |
| 5 | 是 | fdiv.d pf10,pf0,pf6 | 已派发 | 否 | pf0 (f10) |
| 6 | 是 | fadd.d pf16,pf8,pf2 | 已完成 | 是 | pf16 (f6) |
指令调度器:
| 条目 | 占用 | Op | Dst | ROB | Vj | Regj | Rj | Vj(原表第二组) | Regj(原表第二组) | Rj(原表第二组) | 就绪 |
|---|---|---|---|---|---|---|---|---|---|---|---|
| 1 | 否 | fld | pf6 | 1 | – | – | – | – | – | – | 否 |
| 2 | 否 | fld | pf2 | 2 | – | – | – | – | – | – | 否 |
| 3 | 否 | fmul.d | pf0 | 3 | – | – | – | – | – | – | 否 |
| 4 | 否 | fsub.d | pf8 | 4 | – | – | – | – | – | – | 否 |
| 5 | 是 | fdiv.d | Pf0 | 5 | 是 | pf0 | 是 | 是 | Pf6 | 否 | 是 |
| 6 | 否 | fadd.d | pf16 | 6 | – | – | – | – | – | – | 否 |
浮点重命名寄存器:
| 寄存器 | 状态 | 值 |
|---|---|---|
pf0 | 已占用/就绪 | Mem[p3]+X |
pf2 | 体系结构状态 | Mem[p3] |
pf4 | 体系结构状态 | X |
pf6 | 体系结构状态 | Mem[p2] |
pf8 | 已占用/就绪 | Mem[p3]-Mem[p2] |
pf10 | 已占用/未就绪 | Y |
pf12 | 已占用/就绪 | 2*Mem[p3]-Mem[p2] |
图 3.22 当 fmul.d 即将提交时,只有两条 fld 已提交,虽然其他若干指令已经执行完成。fmul.d 位于 ROB 头部,两条 fld 仅为帮助理解而保留在图中。fsub.d 和 fadd.d 必须等 fmul.d 提交后才能提交,但其结果已经可用,其他指令可以把它们作为源操作数。fdiv.d 使用 fmul.d 刚刚算出的 pf0 值,现在已就绪,可以派发到执行单元;调度器即将选择它执行。ROB 中的状态、占用和指令字段仅为说明而显示。图中未画出加载/存储队列条目,但这些条目保持有序。2
有些用户和体系结构设计者认为,高性能处理器可以接受不精确的浮点异常,因为程序很可能就此终止;附录 J 进一步讨论这个问题。其他异常,例如缺页,如果不精确就难以处理得多,因为异常处理完成后,程序必须能够透明地恢复执行。
使用 ROB 实现指令顺序提交,除了提供精确异常,也能支持推测执行,如下例所示。
例题 考虑下列循环:
假设已经预测分支跳转,并已将循环中的全部指令派发了两次。再假设第一次迭代的 fld 与 fmul.d已提交,其余指令都已派发并完成执行。通常,存储会在 ROB 中等待有效地址操作数(本例为 x1)和待存数据(本例为 f4)计算完成。由于这里只考虑浮点流水线,假设存储指令发射时,其有效地址已经算出。此时重排序缓冲区与物理寄存器的状态如何?
解答 图 3.23 给出了重排序缓冲区,以及整数和浮点物理寄存器的状态。
重排序缓冲区:
| 条目 | 占用 | 指令 | 状态 | 就绪 | 目标 |
|---|---|---|---|---|---|
| 1 | 否 | fld f0,0(x1) | 已提交 | 是 | pf10 (f0) |
| 2 | 否 | fmul.d f4,f0,f2 | 已提交 | 是 | pf14 (f4) |
| 3 | 是 | fsd f4,0(x1) | 已完成 | 是 | – |
| 4 | 是 | addi x1,x1,-8 | 已完成 | 是 | p11 (x1) |
| 5 | 是 | bne x1,x2,Loop | 已完成 | 是 | – |
| 6 | 是 | fld f0,0(x1) | 已完成 | 是 | pf20 (f0) |
| 7 | 是 | fmul.d f4,f0,f2 | 已完成 | 是 | pf24 (f4) |
| 8 | 是 | fsd f4,0(x1) | 已完成 | 是 | – |
| 9 | 是 | addi x1,x1,-8 | 已完成 | 是 | p21 (x1) |
| 10 | 是 | bne x1,x2,Loop | 已完成 | 是 | – |
浮点物理寄存器:
| 寄存器 | 状态 | 值 |
|---|---|---|
pf0 | 空闲 | X |
pf2 | 体系结构状态 | Y |
pf4 | 空闲 | Z |
pf10 | 已占用/就绪 | Mem[A] |
pf14 | 已占用/就绪 | Mem[A]+Y |
pf20 | 已占用/就绪 | Mem[A-8] |
pf24 | 已占用/就绪 | Mem[A-8]+Y |
整数物理寄存器:
| 寄存器 | 状态 | 值 |
|---|---|---|
p1 | 体系结构状态 | A |
p2 | 体系结构状态 | B |
p11 | 已占用/就绪 | A-8 |
p21 | 已占用/就绪 | A-16 |
图 3.23 只有 fld 与 fmul.d 已提交,其他指令虽然都完成执行,却尚未提交。因此没有占用的指令调度器条目,图中也未显示它们。其余指令将尽快提交。前两个重排序缓冲区条目已经为空,此处仍列出,以保持示例完整。3
由于待存值尚未写入内存,而且旧寄存器值会在物理寄存器中保留到指令提交,处理器在发现分支预测错误时,可以撤销推测行为。假设图 3.23 的 bne 第一次实际上不跳转。该分支之前的指令到达 ROB 头部时照常提交;分支到达头部时,清空 ROB,从体系结构映射表恢复重命名映射表,再从正确分支目标开始取指。
许多采用推测执行的处理器,一旦发现分支预测错误,就尽早恢复。这需要清除该分支之后所有指令的 ROB 条目,同时允许 ROB 中分支之前的指令继续执行。在从正确后继指令重新启动之前,恢复正确的重命名状态要更困难。
通常的做法是在分支发射时,为整个重命名映射表保存一个检查点。如果后来发现分支预测错误,就恢复相应检查点。用于保存重命名状态检查点的硬件数量,限制了流水线中可以同时存在的待决分支数。在推测执行处理器中,一次错误预测通常影响很大,因此性能对分支预测更敏感。分支处理的各个方面——预测准确率、错误预测检测延迟、恢复时间——都变得更重要。
异常处理会推迟到指令准备提交时才真正触发。如果指令执行时产生异常,就在 ROB 中记录它。如果后来发现,比这条指令更老的某条分支预测错误,那么清空 ROB 时,该异常会与指令一起被丢弃。如果指令到达 ROB 头部,就知道它已不再是推测执行,确实应该触发异常。也可以尝试在异常一出现、且所有更早的分支均已确定后,立即处理异常;但与分支错误预测相比,这样处理异常更具挑战,而且异常发生频率较低,因此也没那么关键。
动态调度的细节
图 3.24 给出指令执行的各步骤、进入步骤必须满足的条件,以及所采取的动作。图中采用直到提交时才处理分支错误预测的方案。存储只有到达 ROB 头部才更新内存,确保只有在指令不再具有推测性之后,才改变内存。图 3.24 对存储作了一项重要简化,实际实现不必如此:它要求存储在两个输入寄存器值都就绪之后才计算地址。实际上,待存储的值只需要在存储即将提交、更新内存之前可用即可。
图 3.24 某些步骤的速度,对乱序处理器性能至关重要。例如,两条简单算术指令存在数据依赖,一条加法后面跟着一条减法。在附录 C 的简单五级流水线中,利用转发逻辑,它们可以在相邻周期执行,没有任何停顿。而在本节介绍的超标量处理器中,加法执行完成后,减法执行之前必须经过以下步骤:(1)更新减法的调度器条目,标明它已经就绪,即唤醒;(2)调度器选择减法执行,即发射;(3)从 URF 读取减法的输入寄存器值。如果每步都占一个完整周期,这两条指令的执行就会相隔三个周期,意味着必须有更多 ILP 才能使功能单元保持忙碌。许多处理器先把唤醒与调度合并到同一周期,以降低依赖指令间的执行延迟。因为完成通知可以在周期较早阶段发出,与加法执行并行进行,所以能够这样做。
这种技术可以推广到任何固定延迟指令:提前发出完成通知,抵消依赖指令唤醒与调度的延迟。此外,可以在派发时读取已经就绪的物理寄存器,并将其值保存在指令调度器中,从而避免以后从 URF 读取输入的额外延迟。加法结果可以通过额外的转发路径,在功能单元之间直接传递。这些优化虽然可行,能够缩短流水线并降低 CPI,却也增加了复杂度,使其与处理器时钟周期时间之间形成取舍。
图 3.24 的表格以下按“条件表+对应动作”重排,代码标识符与源文伪代码保持一致。4
| 当前步骤 | 等待条件 | 对应动作 |
|---|---|---|
| 所有指令的发射 | ROB 条目 b 可用,并且:加载/存储的 LSQ 条目 ls 可用,或其他指令的 SCHED 条目 w 可用 | A |
| 非加载/存储指令的发射 | B | |
| 加载指令的发射 | C | |
| 存储指令的发射 | D | |
| 指令派发 | SCHED[w].Ready | 选择指令,送往功能单元 |
| 非加载/存储指令的执行 | 指令已派发 | E |
| 加载/存储第 1 步 | LSQ[ls].Ready,且是最老的加载/存储指令 | F |
| 加载第 2 步 | 所有较早存储均访问不同地址 | G |
| 存储第 2 步 | 存储已提交 | H |
| 通知指令完成 | 执行结束 | I |
| 提交 | 指令位于 ROB 头部(条目 h),且 ROB[h].Ready=Yes | J |
A.所有指令的发射
B.非加载/存储指令的发射
C.加载指令的发射
D.存储指令的发射
E.非加载/存储指令的执行
F.加载/存储第 1 步
G.加载第 2 步
H.存储第 2 步
I.通知指令完成
J.提交
上段保留原伪代码关键词:clear 为清空,reset 为重置,fetch branch dest 为从分支目标取指,raise exception 为触发异常,notify LSQ 为通知加载/存储队列。原页在 ArchMap[a]=p;} 后结束,没有给出最外层 else 的闭合大括号;此处不补造。
图 3.24 指令执行的步骤及每一步的要求。对于正在发射的指令,rd 为目标寄存器,rs 与 rt 为源寄存器,w 为分配的指令调度器条目,b 为分配的 ROB 条目,h 为 ROB 头部条目。SCHED 是指令调度器数据结构,ROB 是重排序缓冲区数据结构,URF 是统一寄存器堆数据结构,LSQ 是加载/存储单元数据结构。RenamingMap 与 ArchMap 分别是重命名映射表与体系结构映射表。
减轻集中式指令调度器日益增长的复杂度,一种常见方法是采用分布式方案。一个极端设计是:为每个功能单元配一个仅有 4~10 个条目的调度器。发射时,每条指令分配到特定功能单元的调度器,由其跟踪指令何时就绪。这类分布式调度器通常称为保留站(reservation station)。对于唤醒和派发,一个 10 条目的小保留站,比一个超过 100 条目的集中式调度器简单、快速得多。例如,从 10 条指令中选择最老的就绪指令,比从 100 条中选择更快;每周期为本地功能单元选择 1 条指令,也比集中式调度器选择 4~8 条更容易。在大型调度器中,判断指令年龄最简单的方式,是依据条目位置。这要求部分指令派发后,压紧其余条目,使较老指令位于底部,留给新发射指令的空条目位于顶部。小型保留站则可以直接比较编码指令年龄的标签,而不依赖位置;即使采用压紧,处理 10 个条目也比 100 个容易。分布式保留站的缺点是条目利用率可能不均。如果程序的指令组合偏离设计者确定各结构大小时假定的常见组合,一个功能单元的保留站可能已满,另一个却为空。保留站满会使指令发射停顿。集中式调度器则能把任意条目用于发往任意功能单元的指令。
近期 AMD 处理器采用混合设计。例如,Milan 流水线的分布式设计具有 4 个整数调度器与 2 个浮点调度器。每个整数调度器可容纳任意整数指令、向任意整数功能单元派发;浮点调度器对浮点指令与功能单元也一样。因此,它们避免了为每个功能单元单独设置保留站造成的利用不足。六个分布式调度结构中的每一个,都比集中式调度器小,每周期需要派发的指令也更少。额外的复杂性在于,4 个整数调度器与 2 个浮点调度器必须分别协调,避免向同一个功能单元派发指令。由于可压紧保留站的大小与时钟频率之间存在取舍,一些近期处理器采用带年龄矩阵(age matrix)的非压紧保留站。年龄矩阵不提供完整的指令全序,但对于 路调度器,保证可以派发最老指令,以及其他任意 条指令。
译注:原文将本例延迟称为“图 3.2 所示”,但图 3.2 没有列出乘法 6 周期、除法 12 周期,且其中的延迟定义是两条指令之间需插入的周期数。本例按其明确给出的 2、6、12 保留,不把引用视为一致的延迟定义。 ↩︎
译注:原表存在多处不一致:(1)除法目标写
pf0 (f10),与代码pf10、原指令目标f0相反;调度器 Dst 也写Pf0。(2)除法在 ROB 中写“已派发”,但仍占用调度器,图注称即将派发;第二个输入Pf6的就绪位为“否”,整条指令却为“是”,而寄存器表的pf6已处于体系结构状态。(3)浮点寄存器最后一列写pf12,代码与 ROB 则为pf16。(4)pf0的乘法结果写成Mem[p3]+X,而非由所示乘法得到的积。(5)调度器第二组输入表头重复Vj/Regj/Rj,没有写成 k。这些冲突不能作为正确的调度规则。 ↩︎译注:原表把已提交指令对应的
pf10、pf14仍标为“已占用/就绪”,与 3.5 节规定的体系结构状态不符;fmul.d的两个结果写为Mem[A]+Y、Mem[A-8]+Y,使用的是加号。原值保留,不据此替换成推断的乘法结果。 ↩︎译注:原表伪代码存在标识符与逻辑不一致。包括:加载/存储行混用
ls与w,仍写SCHED[w].ROB;Readuy拼写;完成通知中ROB.Exception缺条目索引、SCHED[w]=Ready/LSQ[ls]=Ready未指明字段;加载就绪检查使用 Rj 而前面为地址输入设置 Rk;存储写内存读取 Regk,但前面把待存值放在 Regj;提交部分分支嵌套与最外层大括号不完整。译校只标明可从本表直接发现的不一致,不代作者设计另一套算法。 ↩︎