3.7 利用动态消歧克服内存依赖
上一节着重讨论存在寄存器数据依赖时的动态调度。现在考察经由内存的数据依赖,也就是加载与存储通过内存位置产生的依赖。这类依赖的检测与管理要困难得多。输入、输出寄存器名称完整编码在指令中,可以在流水线较早阶段检查依赖;内存地址却不是如此。加载和存储必须经过地址生成单元处理后,才能确定有效内存地址。此外,如果与较早的算术或加载指令之间存在寄存器依赖,而那些指令还在修改指针值,地址计算也可能停顿。
一种简单但缓慢的办法,是按程序顺序执行所有加载和存储。最老的内存访问指令先等待寄存器数据依赖解除,再计算地址,将其发送给缓存层次结构。遗憾的是,这会严重损害多发射处理器的性能,因为在存储提交之前,不能允许它覆盖缓存中的数据。即使用了分支预测和寄存器重命名,后续循环迭代的加载,也无法在当前迭代的存储提交之前访问数据缓存。采用这种方法,就无法跨循环迭代开发 ILP。
图 3.21 暗示了一种性能更好的方法,称为加载旁路(load bypassing)。一旦数据依赖允许,加载与存储便计算有效地址,但存储在提交前不送往缓存层次结构。加载则可以绕过较早的存储,前提是没有数据依赖:所有较早存储都已算出有效地址,而且都不同于该加载的有效地址。加载旁路要求存储缓冲区条目具有比较器,以便快速比较加载地址与所有待处理存储的地址。即使较早的存储还未提交,这项优化也能让后续迭代的加载提前访问缓存,隐藏未命中的延迟,并解除后续算术指令对加载的依赖。
另一项优化是存储转发(store forwarding)。如果地址比较表明加载依赖某条较早的存储,就允许加载直接从该存储的输入物理寄存器获取数据,无需访问存储层次结构。与多于两条指令之间的寄存器依赖类似,加载必须从它所依赖的、最新的那条存储获取数据。存储转发对 x86 处理器十分重要。体系结构寄存器数量少,只有 8 个整数寄存器,迫使编译器经常把变量从寄存器溢出到内存,几条指令后又重新加载。因此,超标量 x86 处理器常常重叠执行多对溢出(存储)与恢复(加载)指令。存储转发加速这些依赖加载,也加速其后的依赖指令。
推测性内存消歧
只有当所有地址都已知、可以检查依赖时,才允许加载绕过较早存储,这一要求仍然严重限制性能。
因此出现了推测性内存消歧:允许加载绕过尚未算出内存地址的较早存储,推测两者没有依赖。当缺失的存储地址变为可用时,再实际检查依赖。如果推测有误,就必须重新执行加载,以及所有已经使用其结果的依赖指令。由于在复杂流水线中选择性重执行很困难,常用恢复机制与分支错误预测或异常类似,清空加载指令之后的整个流水线。
多项研究定量表明,简单地一律推测不存在内存依赖,可能还不如完全不推测(Moshovos et al., 1997;Chrysos and Emer, 1998)。因此,近期所有乱序处理器都实现了有选择的推测性内存消歧。与分支预测学习模式类似,处理器学习哪些加载很可能依赖待处理存储。如果较早存储还没有算出地址,就不允许这些加载提前执行。当没有其他信息时,处理器可以先简单地推测不存在内存依赖,从而学习循环中加载和存储的模式。如果后来发现内存依赖,就把涉及该依赖的加载与存储的 PC 保存到硬件结构中。该加载再次执行时,查询这些结构,辅助判断它是否可能依赖某条尚未算出地址的待处理存储。
下面详细介绍 Chrysos 与 Emer 于 1998 年提出的 store sets(存储集合)方案,作为有选择的推测性内存消歧的一个设计例子。该方案侧重记录最近参与过内存依赖错误推测的加载与存储,能够简洁表示一条加载可能依赖一组存储,或一组加载可能依赖一条存储。图 3.25 给出所需的两个硬件结构。存储集合 ID 表(store set ID table,SSIT)跟踪最近参与内存依赖错误推测的加载、存储所属的存储集合 ID。SSIT 用加载与存储 PC 的若干位索引,初始时全部条目无效。集合 ID 是一个短整数,例如 0~63。最近取入存储表(last fetched store table,LFST)跟踪每个集合中最近取入的存储指令地址,即 PC。
硬件发现一次内存依赖错误推测时,分配一个存储集合标识符,将它写入相关加载与存储的 SSIT 条目。如果其中一条已经属于某个集合,即 SSIT 有效,就沿用它现有的集合 ID;如果两条分别属于不同集合,就合并这两个集合。存储派发时,查找自身的 SSIT 条目;若有效,就把自己的指令地址 PC 记入该集合的 LFST 条目。存储算出地址后,重置该 LFST 条目。加载算出地址、准备派发到存储层次结构时,检查这两个结构。如果它的 SSIT 有效,而且相应LFST 条目指向一条尚未算出地址的待处理存储,就不允许加载继续。其他情况下,即 SSIT 条目无效,或有效 SSIT 条目指向空的 LFST 条目,都允许加载推测性地先于尚无地址的较早存储发出。SSIT 无效,说明该加载近期没有参与依赖错误推测;SSIT 有效而 LFST 为空,则说明这条加载可能依赖的所有存储,都已经算出地址。
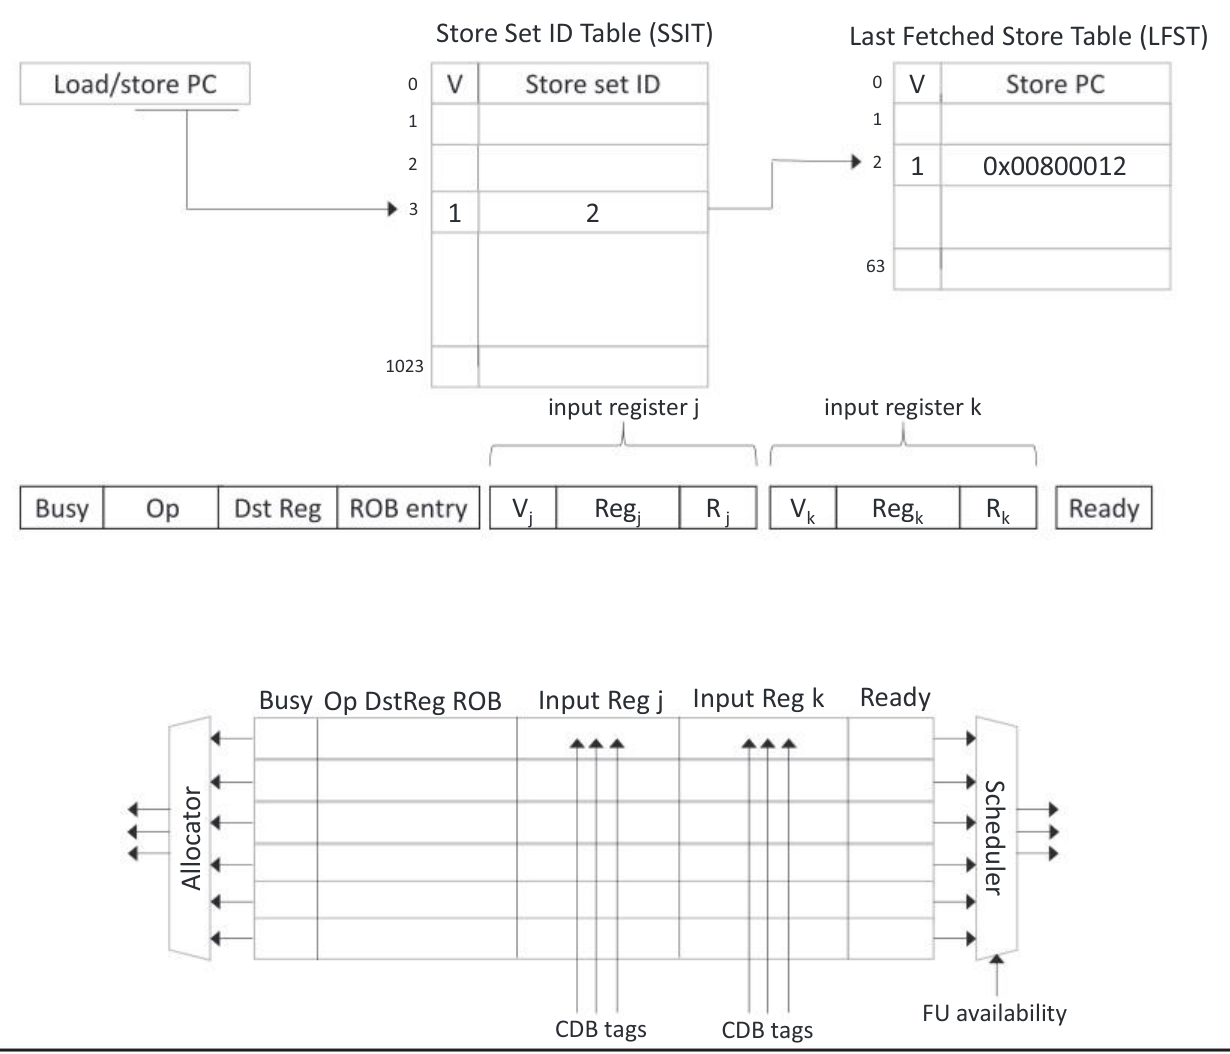
图 3.25 store sets 方案用于有选择的推测性内存消歧所需的硬件(Chrysos and Emer, 1998)。原论文建议 SSIT 包含 1K~4K 个条目,LFST 包含 64~128 个条目。根据处理器其余部分的实现方式,LFST 条目可以保存最近取入存储的指令地址 PC、ROB 条目编号,或加载/存储队列条目编号。
图中文字对照:Load/store PC 为加载/存储指令的 PC;Store Set ID Table 为存储集合 ID 表;Last Fetched Store Table 为最近取入存储表;V 为有效位;Store set ID 为存储集合 ID;Store PC 为存储指令 PC。示例中 SSIT 条目 3 有效、集合 ID 为 2,指向 LFST 条目 2,其有效位为 1,存储 PC 为 0x00800012。原图还列出调度器条目与结构:Busy 为占用,Op 为操作码,Dst Reg 为目标寄存器,ROB entry 为 ROB 条目,input register j/k 为输入寄存器 j/k,Ready 为就绪,Allocator 为分配器,Scheduler 为调度器,FU availability 为功能单元可用情况,CDB tags 为公共数据总线标签。
存储集合方案逐步捕捉那些曾导致依赖错误推测的加载、存储指令集合。它的准确率受若干因素限制。第一,不同加载和存储可能映射到同一个 SSIT 条目,造成不必要的集合合并。第二,如果某对加载/存储很少发生依赖错误推测,不在这些结构中跟踪它们,可能反而性能更好。最后,存储集合只能随时间增长,使处理器对加载旁路越来越保守。
一种简单的应对方法,是每隔几百万条指令就重置这两个结构,让硬件重新发现推测时最关键、最应保留的依赖。
第 5 章讨论存储一致性时会看到,多处理器系统给加载与存储施加更多顺序约束,即使内存地址已经确定也如此。有些情况下,连加载之间的重排都会出错。推测性内存消歧使处理器在这些约束之下仍能保持高性能。硬件可以学习哪些重排会违反存储一致性,只有在不太可能违反时,才通过重排内存访问来提高性能。
推测性内存消歧是值预测(value prediction)的一种简单、受限形式。值预测试图预测一条指令将产生的值。如果足够准确,它就可能消除数据流限制,实现更高的 ILP。过去 20 年,虽然许多研究者发表了数十篇有关值预测的论文,但迄今其效果还没有吸引力到足以促成商用处理器采用通用值预测。